문맥 내 학습In-context learning퓨샷few-shot제로샷프롬프트GPT-3유도 헤드induction head문맥 보정라벨 편향many-shot사고 연쇄Qwen3PythiaNSMCKLUENLP 기초
예시 네 개, 순서만 바꿨을 뿐인데 — GPT-3의 퓨샷부터 유도 헤드, 예시 수천 개까지, 문맥 내 학습의 모든 것 (특집)
언어 모델에게 예시 몇 개를 보여 주면, 다시 학습시키지 않아도 새 일을 한다. 2020년 GPT-3가 ‘문맥 내 학습’이라 이름 붙인 이 능력은 지금 모든 프롬프트의 기본기다. 이 글은 GPT-2의 ‘TL;DR:’, GPT-3의 퓨샷, 순서만 바꿔도 54%와 93%를 오간 2021년 실험, 정답 라벨을 무작위로 바꿔도 거의 그대로였다는 2022년 연구, 큰 모델만 뒤집힌 라벨을 따른다는 2023년 연구, 모델 안의 ‘유도 헤드’, 예시 수천 개를 넣는 many-shot과 그 그림자인 탈옥 공격, 그리고 예시가 오히려 해롭다는 추론 모델까지 따라간다. 그리고 직접 쟀다. Qwen3 0.6B부터 14B, 카카오 Kanana를 한국어·영어 과제 셋에 돌렸고, 피티아 학습 체크포인트를 거슬러 올라가며 유도 헤드가 생기는 순간을 다시 찾았다. 같은 예시 네 개의 순서만 바꿔도 작은 모델의 한국어 감정 분류는 21%포인트 흔들렸고, 큰 모델에서는 그 폭이 줄었다. 라벨을 전부 뒤집으면 8B까지의 Qwen3 베이스 모델은 대부분 한쪽 라벨로 몰아 답했지만, 14B는 영어에서 뒤집힌 규칙을 따라 정확도가 28.5%로 떨어졌다. 인터랙티브 위젯 7종, 코어닷투데이 실측, 삽화 13장.
신입 사원에게 고객 리뷰를 ‘긍정’과 ‘부정’으로 나누는 일을 맡긴다고 하자. 긴 지침서를 건네는 대신 이렇게 말할 수도 있다. “이건 긍정, 이건 부정, 이건 부정, 이건 긍정이에요. 나머지도 이렇게 해 주세요.” 예시 네 개면 대개 알아듣는다.
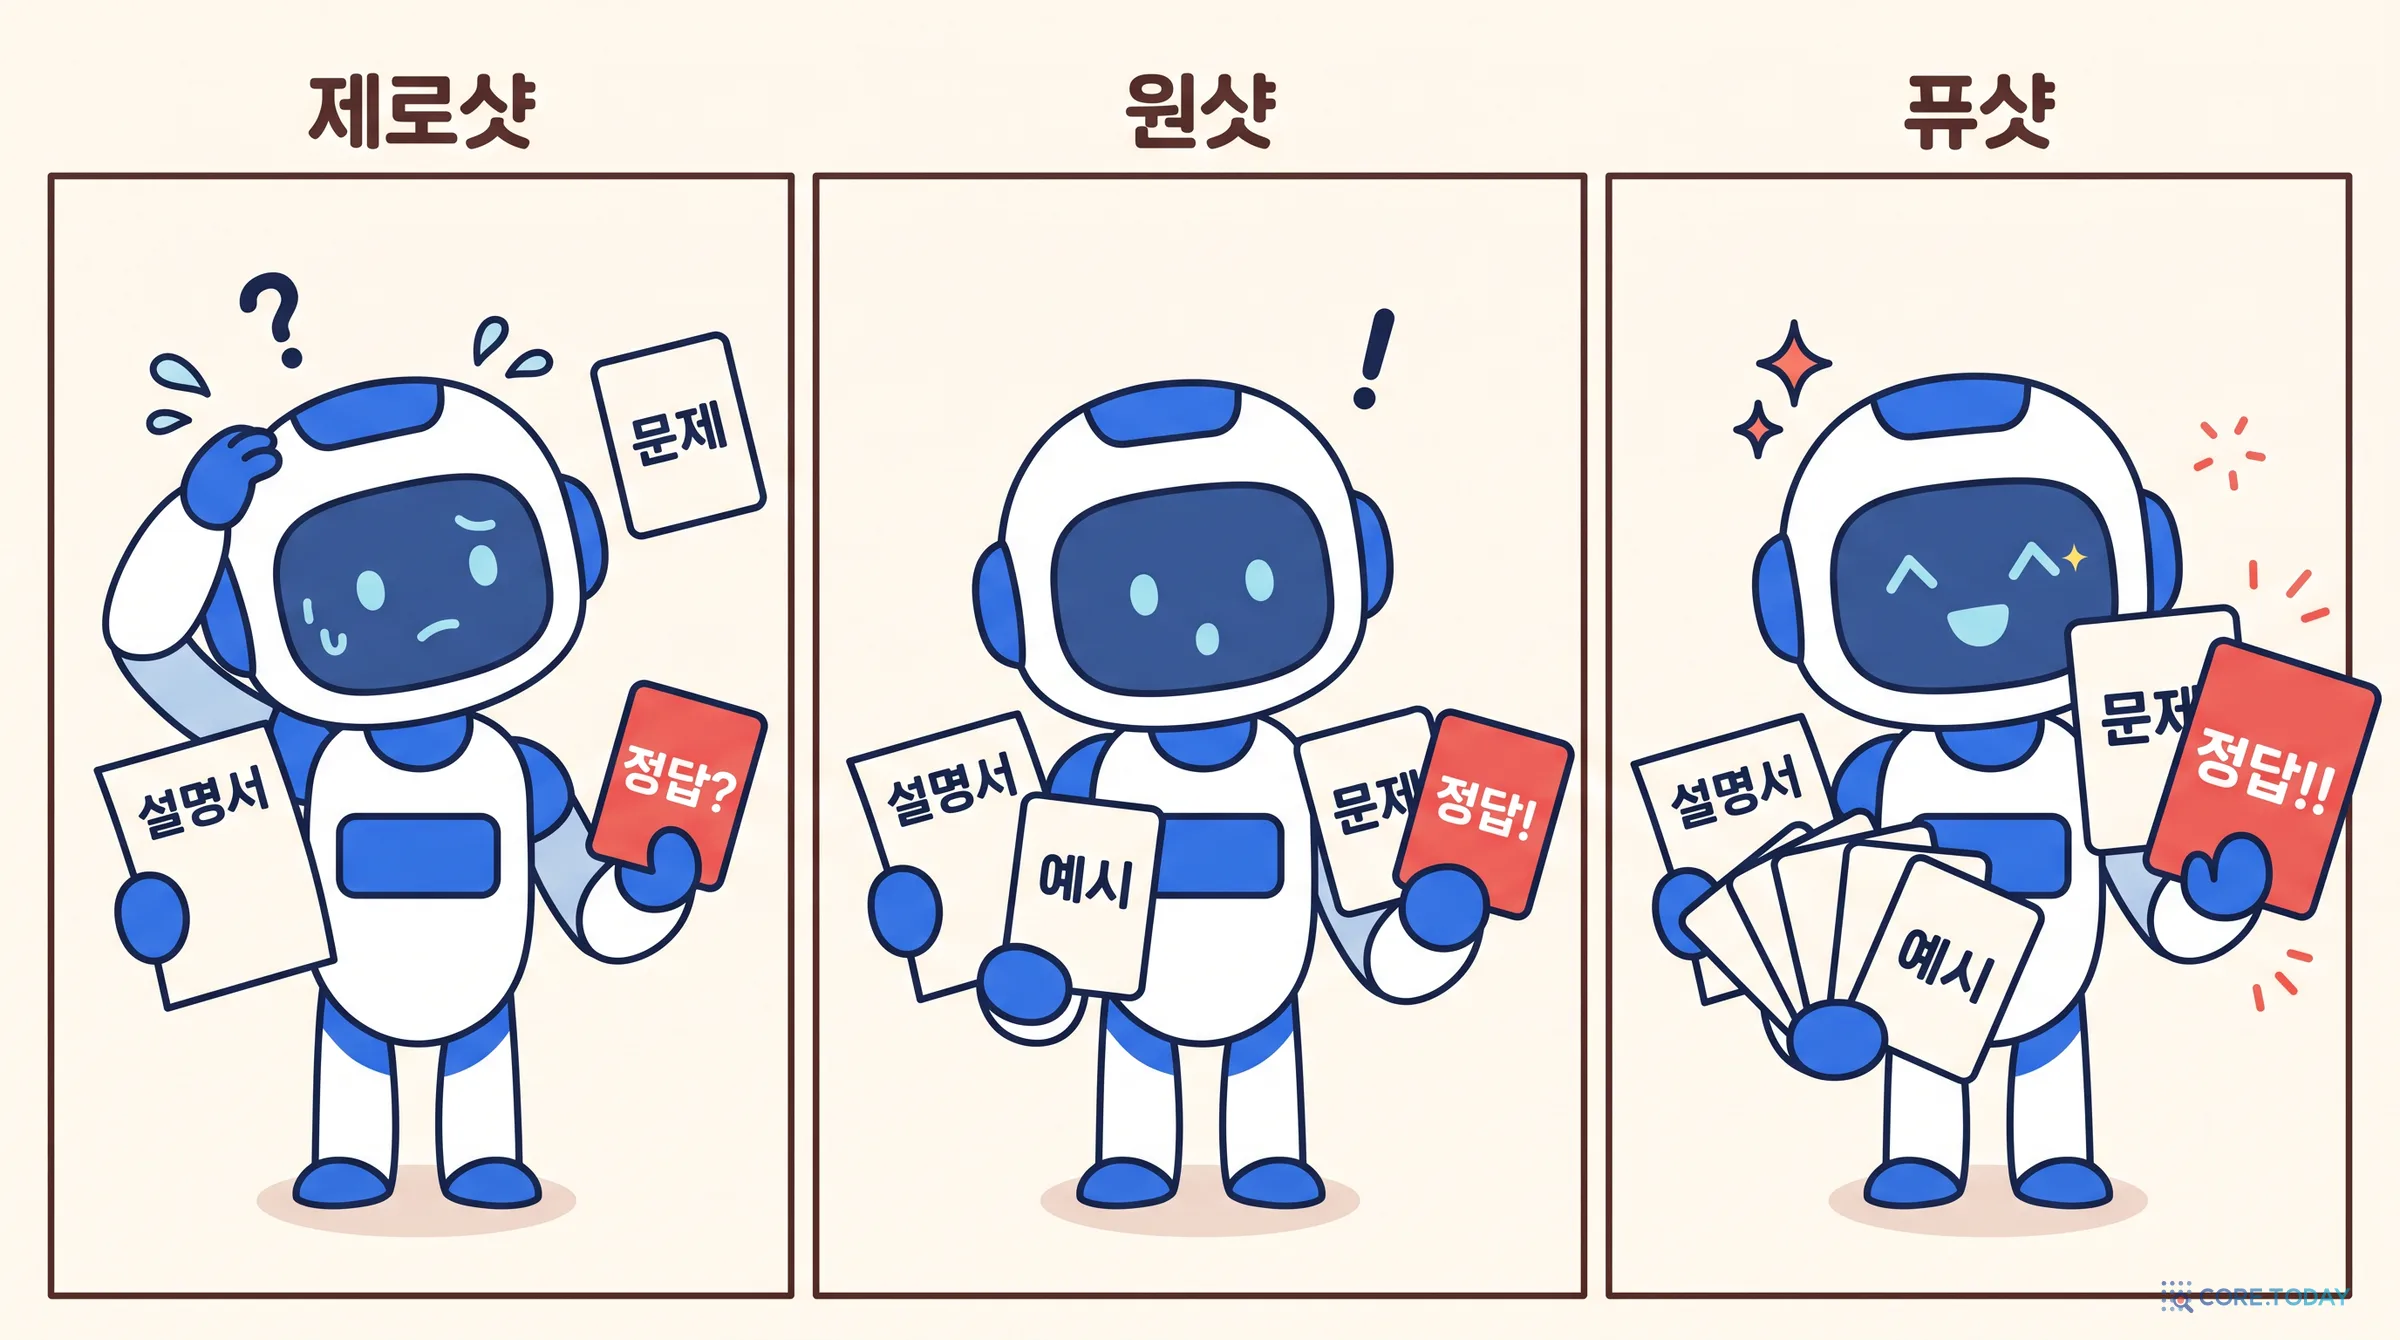
언어 모델도 그렇다. 프롬프트에 예시 몇 개를 적어 주면, 모델의 가중치를 하나도 바꾸지 않았는데 새 일을 해낸다. 2020년 GPT-3 논문은 이것을 문맥 내 학습(in-context learning)이라 불렀다. 예시를 보여 주는 방식은 퓨샷(few-shot), 예시 없이 지시만 하는 방식은 제로샷(zero-shot)이다. 지금 우리가 쓰는 거의 모든 프롬프트가 이 위에 서 있다.
그런데 이 신입 사원은 조금 이상하다. 같은 예시 네 개를 순서만 바꿔 건네면 일 처리가 달라진다. 예시에 ‘긍정’이 많으면 답도 ‘긍정’으로 기운다. 예시의 정답을 일부러 틀리게 적어도 별로 개의치 않는다. 이 글은 그 이상한 점들을 따라가며 묻는다. 모델은 예시에서 무엇을 배우는가? 정말 배우기는 하는가?
이번에도 직접 쟀다. 알리바바의 Qwen3 베이스 모델 0.6B부터 14B까지, 카카오의 Kanana를 한국어 영화평(NSMC), 영어 영화평(SST-2), 한국어 뉴스 제목 분류(KLUE-YNAT)에 돌렸다. 예시 수, 라벨, 순서를 하나씩 바꿔 가며 문장 500개씩을 채점했다. 그리고 공개된 학습 체크포인트를 거슬러 올라가며, 모델이 ‘앞에서 본 것을 베끼는’ 능력을 얻는 순간을 찾았다.
21%p
같은 예시 네 개의 순서만 바꿨을 때 Qwen3-0.6B의 한국어 감정 분류 정확도가 오간 폭. 8B에서는 3~10%p
100%
예시 8개를 모두 ‘긍정’으로 채웠을 때 0.6B 모델이 시험 문장 전부에 붙인 라벨. 8B는 45%
0.5
라벨을 전부 뒤집었을 때의 정확도. 동전 던지기처럼 보이지만, Qwen3 0.6B~8B는 대부분의 문장을 한쪽 라벨로 몰아 답한 결과였다
11억→21억
피티아 모델 세 크기가 모두 ‘베끼는 능력’을 얻은 학습 토큰 구간. 크기가 여섯 배 달라도 같았다
Qwen3·Kanana·Pythia로 잰 코어닷투데이 실측. 2~6부에서 자세히 다룬다.
이 시리즈는 그동안 언어 모델을 이루는 기본 개념들을 다뤘다. 글자를 토큰으로 자르는 BPE, 위치를 알려 주는 RoPE, 다음 토큰을 고르는 디코딩, 모델을 채점하는 퍼플렉서티와 벤치마크 오염이다. 이번에는 그 모든 것을 쓰는 방법, 프롬프트에 예시를 넣는 일을 다룬다. 순서는 이렇다.
예시를 보여 주면 일을 한다 — GPT-2의 ‘TL;DR:’에서 GPT-3의 퓨샷까지.
코어닷투데이 실측 ① — 예시를 몇 개 넣어야 하나.
예시의 무엇이 일을 하나 — 틀린 라벨, 뒤집힌 라벨, 뜻 없는 라벨.
코어닷투데이 실측 ② — 순서와 쏠림.
모델 안에서는 무슨 일이 — 유도 헤드와 단계 전환.
예시 수천 개 — many-shot과 그 그림자.
2026년, 예시는 언제 쓰나.
1부. 예시를 보여 주면 일을 한다
1.1 2019년, ‘TL;DR:’
시작은 GPT-2였다. 오픈AI 연구진은 웹 문서 800만 개로 다음 단어 맞히기만 학습한 모델에게, 학습시키지 않은 일을 시켜 보고 싶었다. 방법은 글의 형식을 빌리는 것이었다.
요약을 시키려면 기사 뒤에 TL;DR:을 붙였다. ‘너무 길어서 안 읽음’이라는 인터넷 관용구로, 그 뒤에는 보통 요약이 온다. 모델은 이어서 요약 비슷한 것을 썼다. 성적은 초라했다. CNN·데일리메일 요약에서 ROUGE 평균 21.40점으로, 기사에서 무작위로 세 문장을 뽑은 것(20.98점)보다 겨우 나았다. 하지만 TL;DR:을 빼면 6.4점이 떨어졌다. 글의 형식만으로 모델에게 과제를 알려 줄 수 있다는 신호였다.
번역은 더 직접적이었다. ‘영어 문장 = 프랑스어 문장’ 쌍을 몇 개 앞에 두고, 마지막 줄을 ‘영어 문장 =’으로 끝냈다. 엄밀히 말하면 이것이 이미 예시를 보여 주는 방식이었다.
GPT-3 논문은 이 능력에 ‘문맥 내 학습’이라는 이름을 붙이면서 조심스러운 각주를 달았다. 이 용어는 모델이 추론하는 순간에 새 과제를 처음부터 배우는지, 아니면 학습 때 이미 본 과제를 알아보는 것인지에 대해 중립을 지키려는 것이라고. 연구진은 단어 철자를 뒤섞는 것 같은 인공 과제는 새로 배우는 쪽에 가깝지만, 번역은 분명히 사전학습 때 익힌 것이라고 봤다.
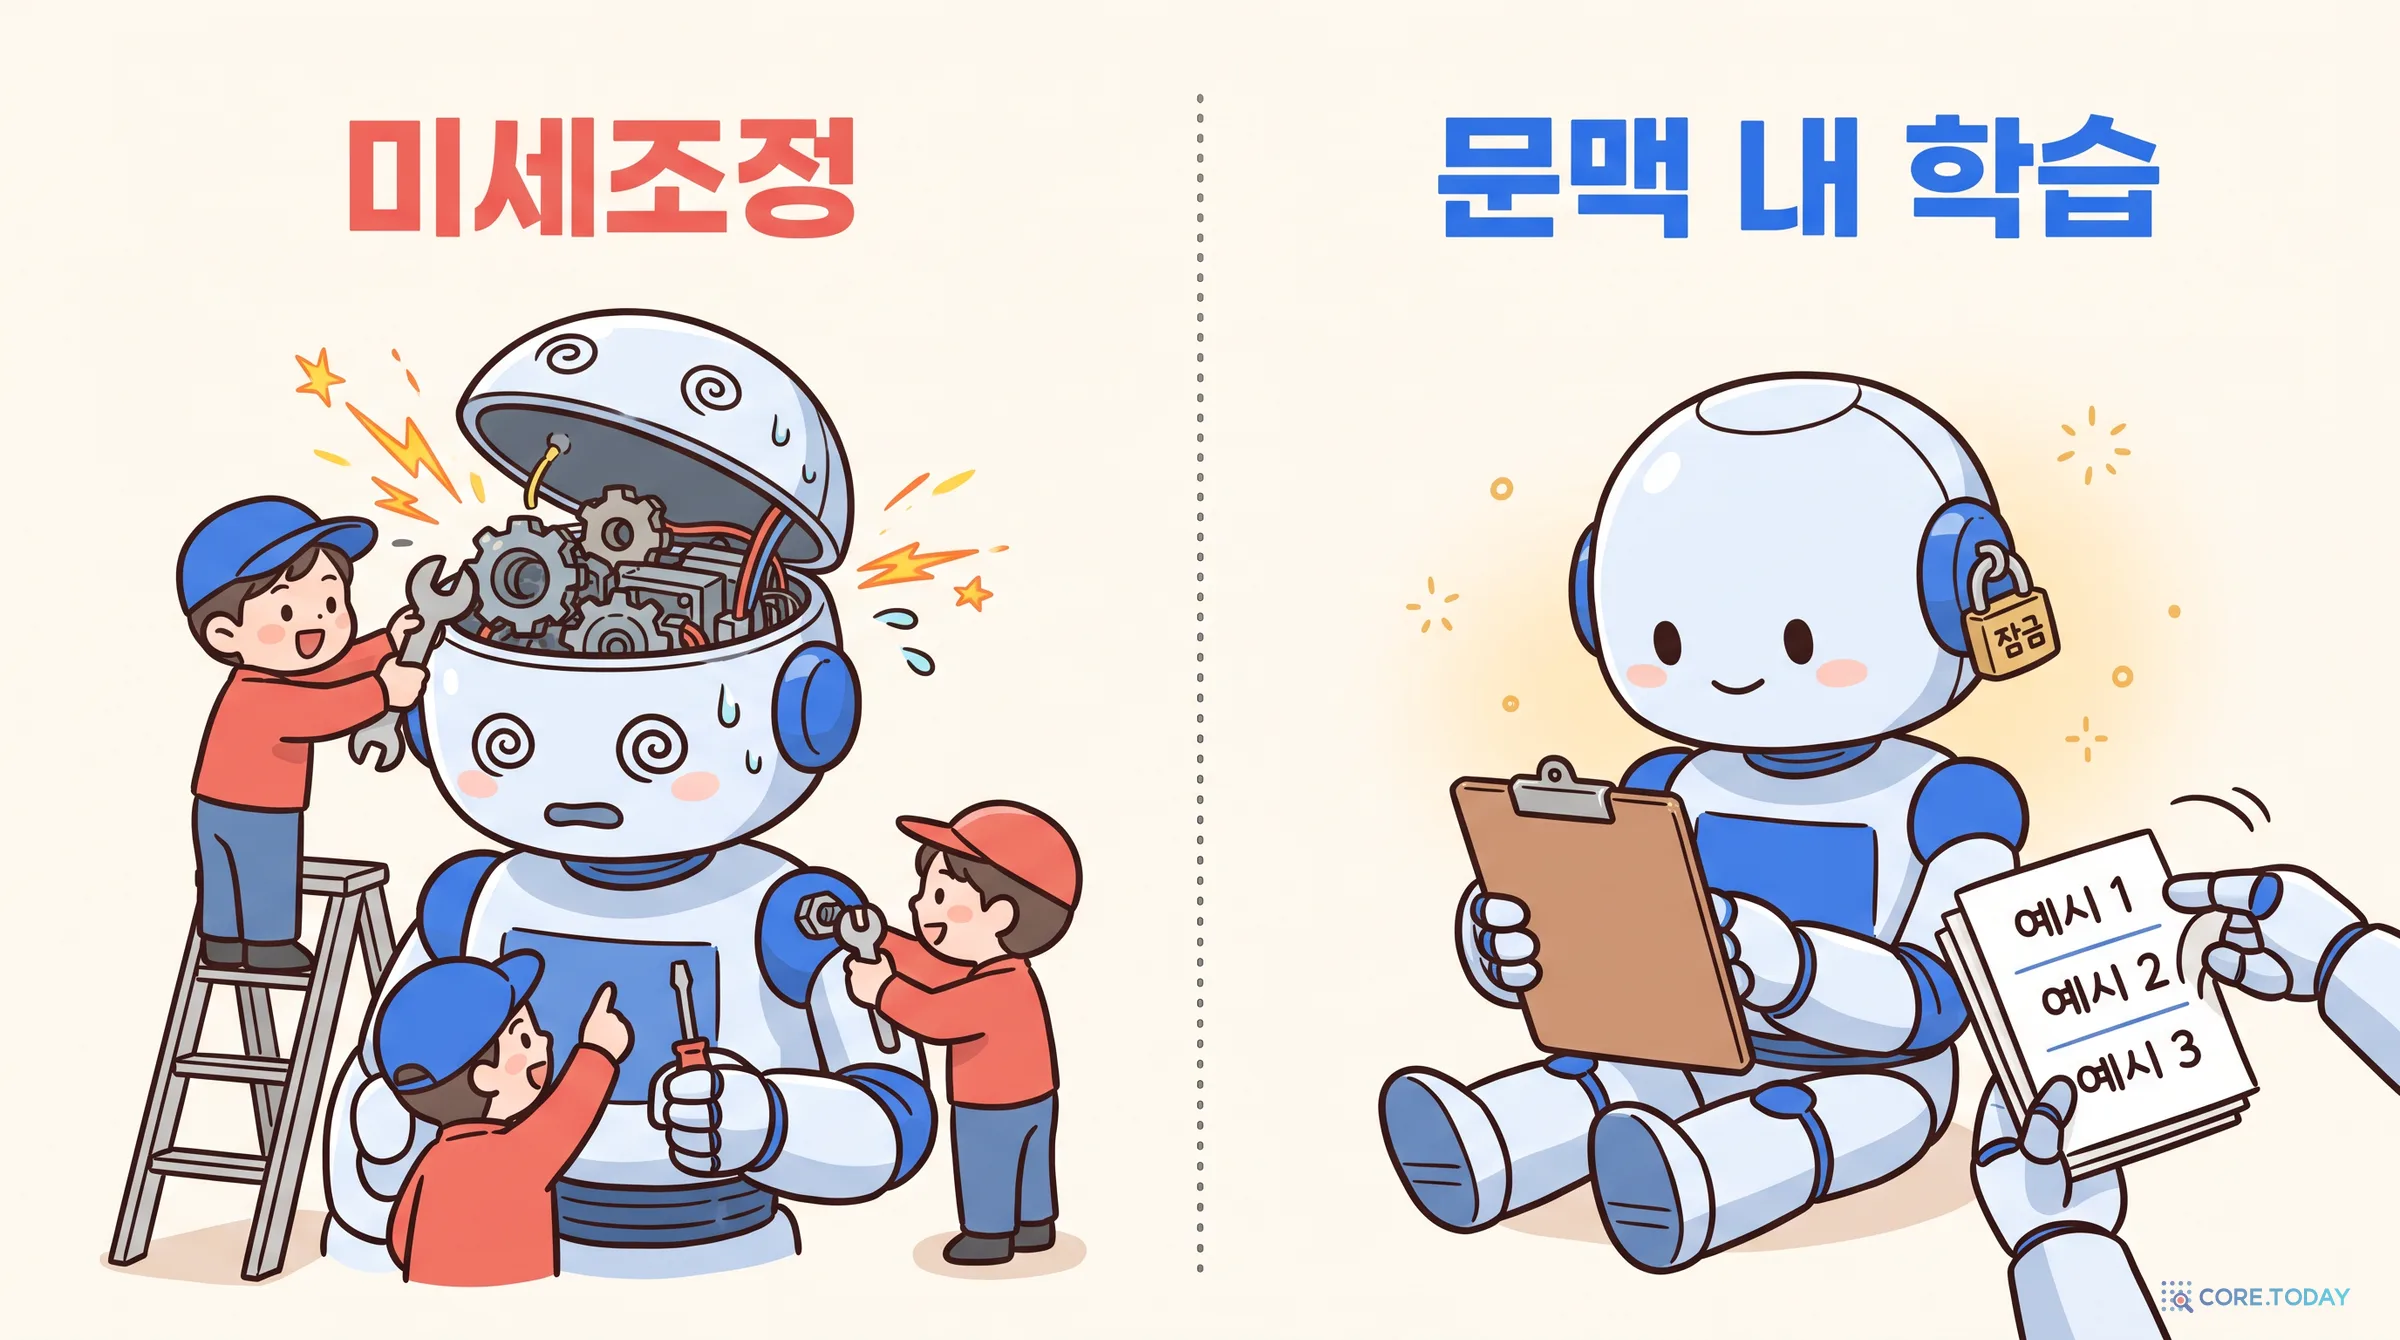
미세조정과 비교하면 차이가 분명하다. 미세조정은 모델의 가중치를 고쳐 쓴다. 문맥 내 학습은 가중치를 그대로 두고, 프롬프트에 적힌 예시만 읽고 답한다. 대화가 끝나면 아무것도 남지 않는다. 그렇다면 모델은 예시를 읽는 그 짧은 순간에 무엇을 하는 걸까? 이 질문이 이후 6년의 연구를 끌고 왔다.
2부. 코어닷투데이 실측 ① — 예시를 몇 개 넣어야 하나
2.1 실험 설계
예시의 효과를 재려면 조건을 고정해야 한다. 우리는 이렇게 했다.
모델: 알리바바 Qwen3의 베이스 모델(사전학습만 한 모델) 0.6B, 1.7B, 4B, 8B, 14B와, 같은 8B의 지시 튜닝판, 카카오 Kanana-1.5-2.1B 베이스. 크기만 다르고 나머지는 같은 가족을 골라 크기의 효과를 보려 했다.
과제: 한국어 영화평 감정(NSMC, 긍정·부정), 영어 영화평 감정(SST-2, 긍정·부정), 한국어 뉴스 제목 분야 분류(KLUE-YNAT, IT과학·경제·사회·생활문화·세계·스포츠·정치 7개). 과제마다 시험 문장 500개를 무작위로 뽑아 고정했다.
프롬프트: 리뷰: (문장) 다음 줄에 감정: 긍정처럼 쓰는 단순한 형식. 시험 문장도 같은 형식으로 쓰고 감정:에서 끊었다.
채점: 모델이 직접 글을 쓰게 하지 않고, 바로 다음에 올 라벨 단어(‘긍정’과 ‘부정’)의 확률을 비교해 높은 쪽을 답으로 쳤다. 형식이 엇나간 답이 섞이지 않는다.
예시: 학습 세트에서 무작위로 뽑았다. 같은 개수라도 어떤 예시를 뽑느냐에 따라 결과가 달라지므로, 예시 묶음을 다섯 벌 뽑아 따로 쟀다.
0.6B와 1.7B, Kanana는 맥북에서, 4B는 사내 V100 GPU 서버에서, 8B와 14B는 사내 쿠버네티스 클러스터의 V100S(32GB)에서 돌렸다. 예시 부분의 계산 결과(KV 캐시)를 시험 문장 500개가 함께 쓰도록 짜서, 예시가 수백 개여도 빠르게 잴 수 있게 했다.
2.2 결과 — 영어는 예시가 없어도, 한국어는 예시가 있어도
네 가지가 눈에 띈다.
첫째, 지금의 작은 모델은 영어 감정 분류를 예시 없이도 잘한다. Qwen3-0.6B는 SST-2를 예시 0개로 90.2% 맞혔다. 예시를 32개까지 넣어도 평균은 88~91%를 맴돌았다. GPT-3 시절에는 예시가 있어야 풀던 과제를, 지금은 6억 매개변수 모델이 형식만 보고 푼다. 사전학습 데이터에 이런 형식의 글이 많이 들어갔다는 뜻일 것이다.
둘째, 한국어에서는 작은 모델이 예시에 크게 흔들렸다. 같은 0.6B가 NSMC에서는 예시 0개로 69.0%였는데, 예시를 1개 넣자 49.8%로 떨어졌다. 동전 던지기 수준이다. 들여다보니 이유가 선명했다. 0.6B는 예시 하나의 라벨을 시험 문장 500개 전부에 그대로 붙였다. 긍정 예시 하나를 보여 준 세 번은 ‘긍정’ 답변이 99.8~100%, 부정 예시 하나를 보여 준 두 번은 0~1%였다. 1.7B는 같은 방향으로 65% 대 35%쯤 기울었고, 8B는 36~46%로 흔들리지 않았다. 예시를 늘리면 0.6B도 다시 올랐지만, 다섯 벌 사이의 차이가 컸다. 예시 2개일 때 가장 나쁜 묶음은 48%, 가장 좋은 묶음은 78%였다. 2021년 연구가 GPT-3 2.7B에서 본 ‘예시 하나를 넣자 오히려 떨어지는’ 현상과 같은 모양이다.
셋째, 모델이 클수록 예시를 적게 쓰고 덜 흔들렸다. Qwen3-8B는 NSMC에서 예시 0개 81.8%, 1개 85.2%, 32개 86.9%였다. 예시 한두 개로 거의 최고점에 닿았고, 다섯 벌 사이의 차이도 2%포인트 안팎으로 줄었다. 영어 SST-2에서도 예시 2개 만에 91.5%에 닿았다.
넷째, 한국어는 한국어 모델이 예시를 잘 썼다. 카카오의 Kanana-1.5-2.1B는 NSMC를 예시 0개로 67.4%밖에 못 맞혔지만, 예시 2개 만에 88.0%, 32개에서 88.9%가 됐다. 일곱 배 큰 Qwen3-14B(88.6%)와 같은 수준이다. 예시 없이는 대부분의 리뷰를 ‘부정’으로 답하다가(‘긍정’ 답변 16%), 예시 몇 개로 형식을 알자 곧바로 제 실력을 냈다. 예시 하나만 보여 줬을 때도 0.6B처럼 그 라벨을 베끼지 않았다.
뉴스 분야 분류는 사정이 다르다. 예시 0개로는 0.6B가 19.6%, 8B도 58.4%였다. 일곱 분야의 이름만 보고는 어떤 기준으로 나누는지 알기 어렵기 때문이다. 예시를 8개 넣자 0.6B는 48.7%, 8B는 78.4%로 올랐다. 예시가 가장 큰 일을 하는 곳은 ‘라벨이 무엇이고 어떻게 나뉘는지’를 알려 줘야 할 때였다. 네이버 하이퍼클로바 82B는 2021년 같은 YNAT를 예시 70개로 72.66점까지 풀었다.
모델
SST-2 예시 0 → 최고
NSMC 예시 0 → 최고
YNAT 예시 0 → 최고
Qwen3-0.6B
90.2 → 90.9
69.0 → 70.8 (1개일 때 49.8)
19.6 → 49.4
Qwen3-1.7B
82.2 → 93.2
65.4 → 84.7
41.6 → 64.5
Qwen3-4B
51.0 → 95.0
78.6 → 86.6
61.6 → 73.3
Qwen3-8B
59.0 → 93.4
81.8 → 86.9
58.4 → 78.4
Qwen3-14B
86.0 → 95.9
80.8 → 88.6
55.4 → 74.9
Qwen3-8B (지시 튜닝)
93.4 → 95.8
83.6 → 87.7
57.4 → 78.1
Kanana-1.5-2.1B
87.0 → 94.4
67.4 → 88.9
56.6 → 73.5
예시 다섯 벌의 평균 정확도(%). 시험 문장 500개. ‘최고’는 예시 1~32개 가운데 평균이 가장 높았던 지점.
의외였던 것은 영어 SST-2의 예시 0개다. 0.6B가 90.2%를 맞힌 과제를 4B는 51.0%, 8B는 59.0%밖에 못 맞혔다. 4B는 97%, 8B는 90%의 문장을 ‘negative’로 답했다. 4부에서 다룰 ‘문맥 보정’으로 이 쏠림을 빼 주면 8B는 예시 없이도 88.0%가 됐다. 예시를 하나 보여 주자 4B는 81~95%, 8B는 평균 80.4%가 됐고, 둘이면 둘 다 91% 이상이었다. 큰 모델이라고 예시 없이 늘 잘하는 것은 아니다. 형식을 하나만 보여 줘도 모델이 ‘이런 식으로 답하면 되는구나’를 안다는 것이 예시의 첫 번째 일이다.
예시가 일을 한다면, 예시의 어느 부분이 일을 하는 걸까? 워싱턴대와 메타의 민세원(Sewon Min) 등은 2022년에 대담한 실험을 했다. 예시 16개의 정답 라벨을 무작위로 바꿔 버린 것이다. 리뷰가 긍정이든 부정이든 라벨은 동전 던지기로 붙였다.
상식대로라면 점수가 크게 떨어져야 한다. 그런데 모델 6종, 데이터셋 26개에서 하락은 0~5%포인트에 그쳤다. 분류 과제의 평균 하락은 2.6%포인트였다. 연구진은 예시를 네 부분으로 쪼개 어느 부분이 중요한지 따졌다.
입력과 라벨의 짝 (이 리뷰는 긍정이다)
입력 문장의 분포 (어떤 종류의 글이 들어오는가)
라벨 공간 (답은 ‘긍정’과 ‘부정’ 중 하나다)
형식 (입력 다음에 라벨이 오는 구조)
결론은 2~4가 핵심이고 1의 영향은 작다는 것이었다. 모델은 예시에서 ‘정답’보다 ‘어떤 글이 들어오고, 어떤 단어로, 어떤 모양으로 답하는지’를 배운다.
몇 달 뒤 네이버와 서울대 연구진(유강민 등)이 반론을 냈다. 민 등이 세부 분석에 쓴 5개에서 데이터셋을 17개로 늘리고 채점 방식을 바꾸자, 혐오 표현 분류에서는 정답 라벨과 틀린 라벨의 차이가 80%포인트까지 벌어졌다. 정답 비율이 1%포인트 떨어질 때마다 정확도가 평균 약 0.3%포인트 떨어졌다. 두 연구는 모순이라기보다, 평균을 내는 방식과 채점 방식이 결론을 갈랐다.
구글의 제리 웨이(Jerry Wei) 등은 질문을 바꿨다. 무작위가 아니라 일부러 뒤집으면 어떻게 될까? 좋은 영화평에 ‘부정’, 나쁜 영화평에 ‘긍정’을 붙인 예시를 보여 주면, 모델은 상식(좋은 영화는 긍정)과 예시(좋은 영화는 부정) 가운데 무엇을 따를까?
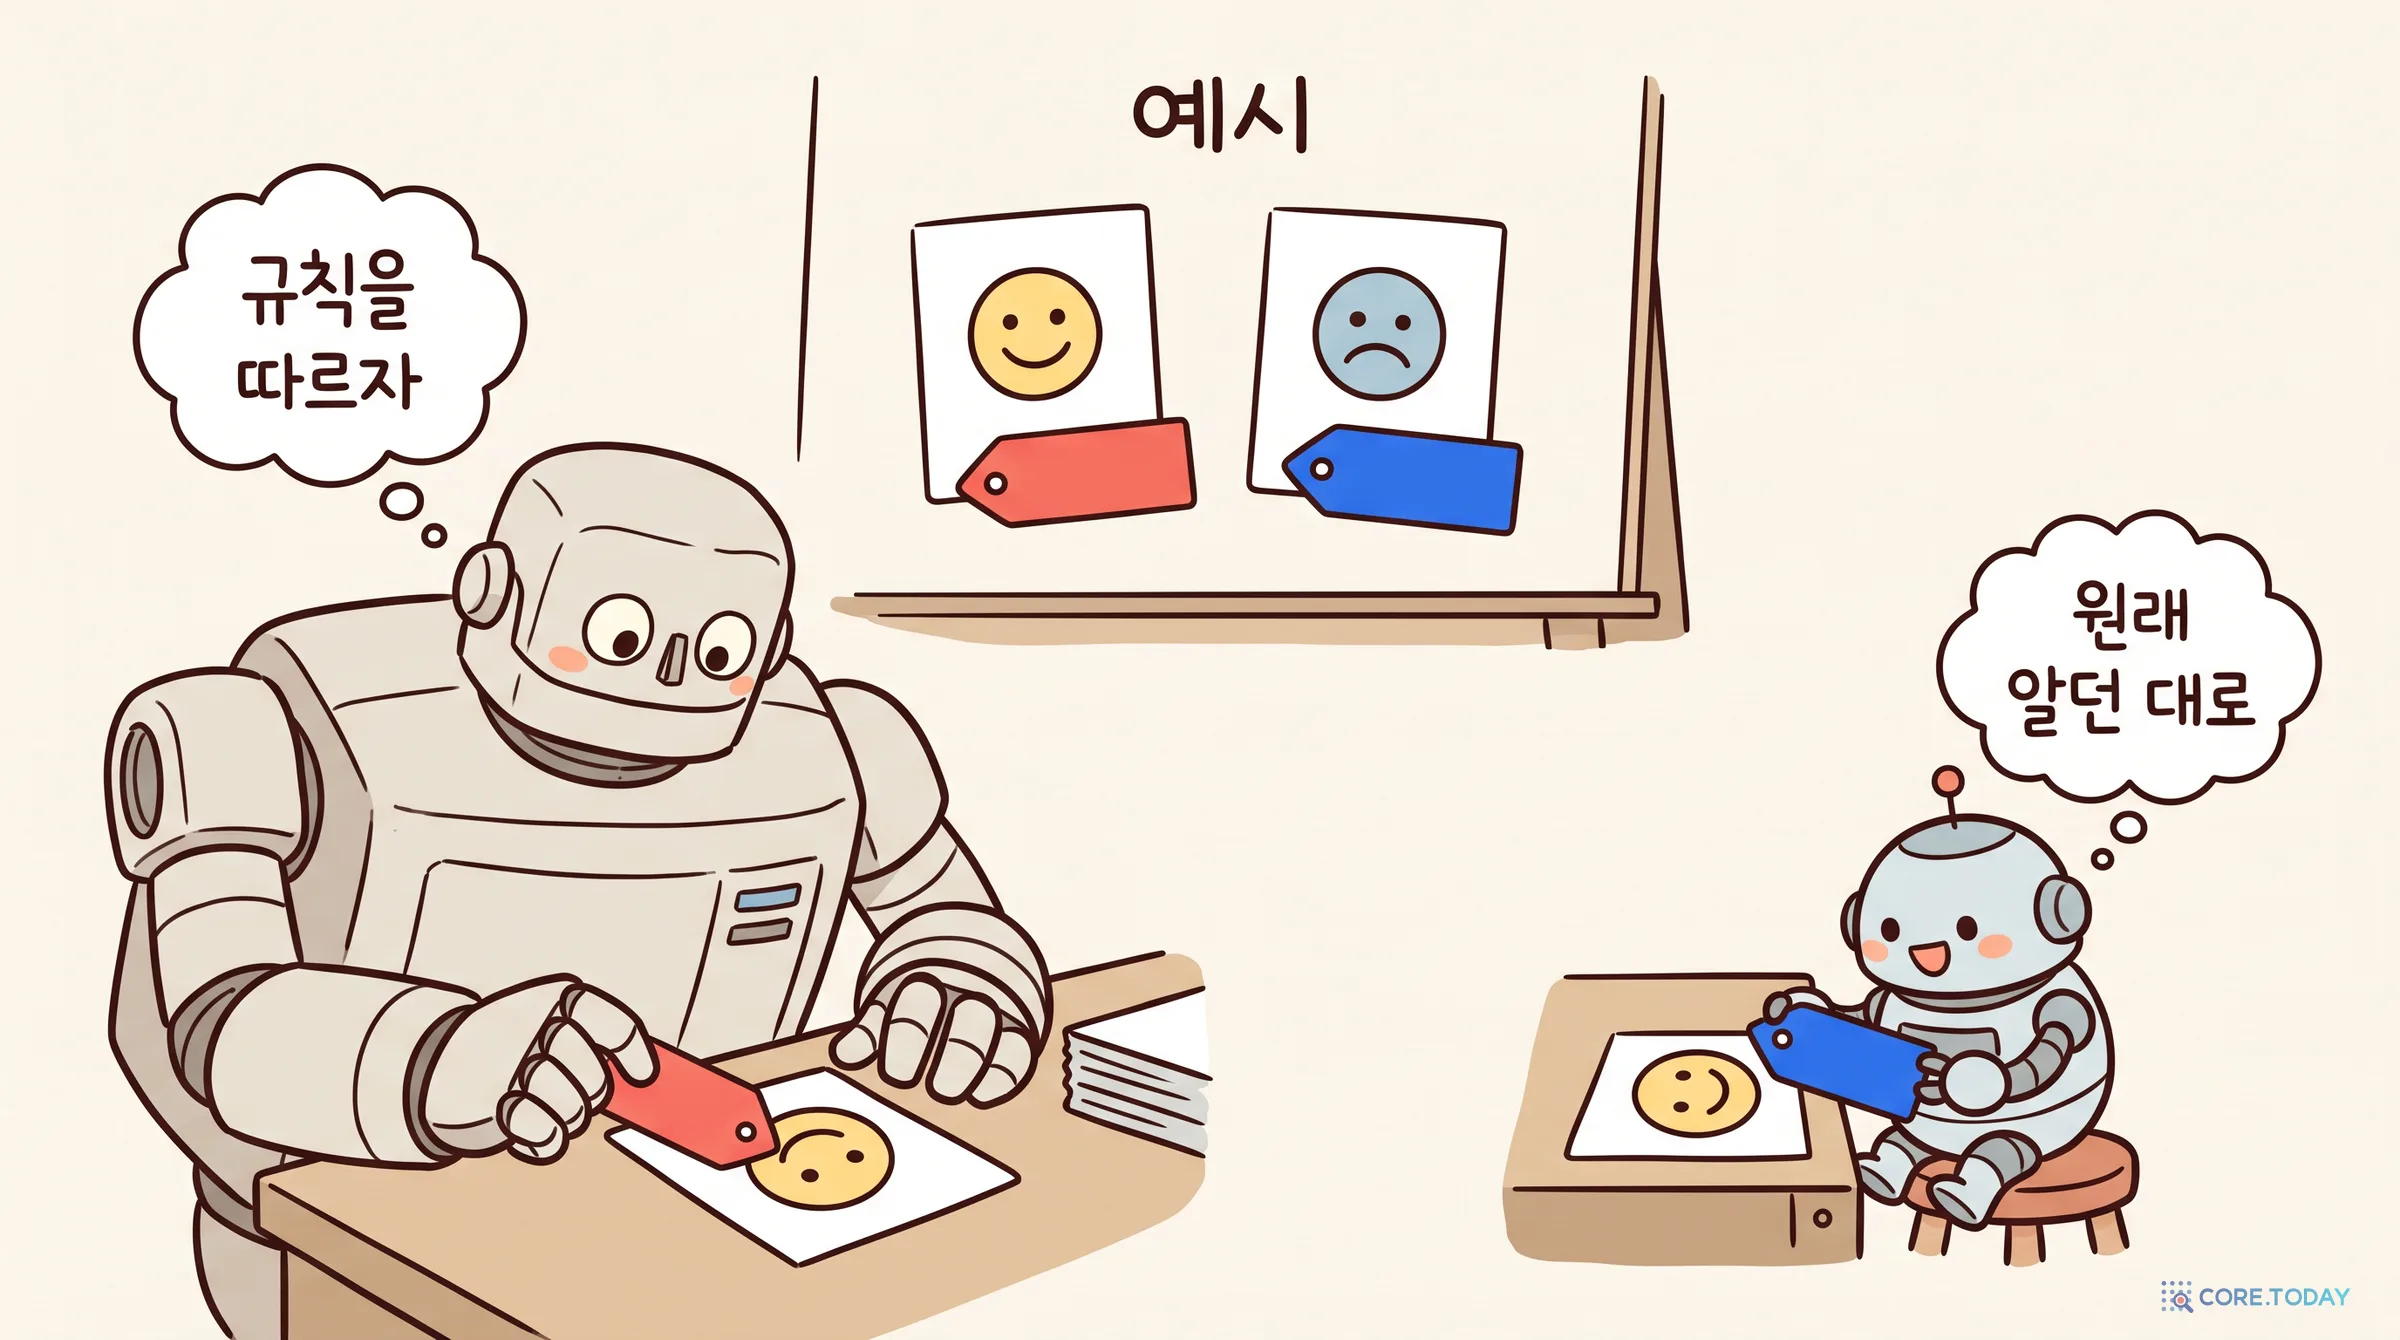
답은 모델 크기에 따라 갈렸다. 작은 모델은 라벨을 뒤집어도 원래 알던 대로 답했다. 큰 모델은 예시를 따라 반대로 답해, 정확도가 동전 던지기보다 한참 아래로 떨어졌다. 오픈AI의 text-davinci-002는 정상 예시에서 90.3%, 전부 뒤집은 예시에서 22.5%였다. 예시의 규칙이 상식을 이긴 것이다.
‘긍정/부정’ 대신 ‘foo/bar’처럼 뜻 없는 단어를 라벨로 쓰는 실험도 했다. 상식에 기댈 수 없으니 예시의 짝만 보고 배워야 한다. 이것도 큰 모델만 잘했다. 연구진은 큰 모델은 문맥에서 입력과 라벨의 짝을 새로 배우고, 작은 모델은 사전학습 때의 지식에 기댄다고 정리했다. 지시 튜닝은 상식에 기대는 쪽을 더 키웠다.
3.3 코어닷투데이 실측 — 50%의 정체
우리도 라벨을 바꿔 봤다. 예시 16개(긍정 8, 부정 8)를 고정하고, 그중 0%, 25%, 50%, 75%, 100%의 라벨을 맞바꿨다. 무작위 라벨과 foo/bar 라벨도 쟀다. 다섯 벌씩 반복했다.
정확도 평균만 보면 8B까지는 웨이 등의 ‘작은 모델’ 그림과 비슷하다. 뒤집는 비율을 늘릴수록 점수가 내려가, 전부 뒤집으면 0.6B, 1.7B, 4B, 8B 모두 50% 안팎에 닿았다(1.7B의 NSMC만 61%). 평균이 50% 아래로 내려간 모델은 없었다.
그런데 위젯 오른쪽의 막대를 보면 이야기가 달라진다. 50%는 동전 던지기가 아니었다. 라벨을 절반 넘게 뒤집거나 무작위로 섞자, Qwen3 베이스 모델들은 대부분의 문장을 한쪽 라벨로 몰아 답했다. 어느 쪽으로 몰리는지는 모델과 언어마다 달랐다. 0.6B, 1.7B, 8B는 SST-2에서 거의 모두 ‘부정’으로, 4B와 14B는 NSMC에서 거의 모두 ‘긍정’으로 답했다. 1.7B는 SST-2에서 라벨을 전부 뒤집자 500문장 모두를 ‘부정’이라고 답했다. 시험 문장의 절반이 부정이니 정확도는 약 50%가 된다. 모델은 예시를 따른 것도, 상식을 지킨 것도 아니었다. 엉킨 예시 앞에서 판단을 포기하고 한쪽에 몰아 건 것이다. 정확도라는 숫자 하나만 보면 놓치는 장면이다.
뜻 없는 라벨은 예상보다 잘 배웠다. ‘부정→foo, 긍정→bar’와 그 반대를 모두 재서 평균하자, SST-2에서 0.6B도 78%, 1.7B와 8B는 93~94%로 짝을 맞혔다. 웨이 등의 실험에서는 작은 모델이 뜻 없는 라벨에서 크게 떨어졌는데, 2025년의 작은 모델은 이것을 해냈다. 다만 0.6B는 ‘foo’와 ‘bar’ 자체에 대한 선호가 커서, 한쪽 배치에서만 재면 결과가 크게 달라졌다. 이 실험을 따라 하려면 두 배치를 모두 재야 한다.
같은 8B의 지시 튜닝판은 달랐다. 라벨을 절반 뒤집어도 SST-2를 93.0% 맞혔고(베이스 73.8%), 무작위 라벨에서도 82.9%였다(베이스 50.4%). 예시가 뭐라고 하든 원래 알던 감정 판단을 지켰다. 웨이 등이 말한 ‘지시 튜닝은 상식에 기대는 쪽을 키운다’와 같은 결과다. 전부 뒤집으면 지시 튜닝판도 평균 50% 근처로 내려왔는데, 그 속은 묶음마다 딴판이었다. NSMC에서 두 벌은 82%로 상식을 지켰고, 두 벌은 19%와 26%로 뒤집힌 규칙을 따랐다. 어느 쪽이든 답은 한쪽으로 몰리지 않았다(‘긍정’ 40~53%). 어떤 예시 묶음을 받느냐에 따라 상식과 예시 사이를 오간 셈이다.
Kanana-1.5-2.1B는 상식을 가장 굳게 지켰다. 라벨을 전부 뒤집어도 SST-2를 77.5%, NSMC를 64.7% 맞혔다. 2.1B 베이스 모델인데도 지시 튜닝 모델처럼, 아니 그보다 더 예시보다 상식을 믿었다. 사전학습 데이터에 지시문 형식의 글이 많이 섞였을 가능성이 있다. 반대로 말하면, 이런 모델에게 상식과 다른 규칙을 예시만으로 가르치기는 가장 어렵다.
그런데 14B에서 그림이 바뀌었다. Qwen3-14B는 영어 SST-2에서 라벨을 전부 뒤집자 정확도가 28.5%로 떨어졌다. 다섯 벌 중 네 벌이 13~32%였다. 이번에는 한쪽으로 몰아 답한 것도 아니었다. ‘긍정’ 답변이 36~50%로 고르게 나뉜 채, 좋은 영화평에 ‘부정’을, 나쁜 영화평에 ‘긍정’을 붙였다. 예시의 뒤집힌 규칙이 상식을 이긴 것이다. 웨이 등이 InstructGPT·Codex·PaLM-540B에서 본 ‘큰 모델만 뒤집힌 라벨을 따른다’는 현상이, 같은 가족 안에서 8B와 14B 사이에 나타났다. 다만 한국어 NSMC에서는 14B도 46.2%에 머물렀고, 대부분의 문장을 ‘긍정’으로 몰아 답했다. 상식을 이기는 능력도 언어마다 다르게 온다.
정리하면 이렇다. 우리가 잰 모델들은 라벨이 상식과 맞을 때, 또는 상식이 끼어들 수 없는 뜻 없는 라벨일 때 예시를 잘 따랐다. 라벨이 상식과 정면으로 부딪히면 결과는 셋으로 갈렸다. 한쪽 라벨로 몰아 답하며 무너지거나(Qwen3 베이스 대부분), 상식을 지키거나(Kanana 대부분, 1.7B·8B의 일부 묶음), 예시를 따라 반대로 답했다(14B의 영어, 지시 튜닝 8B의 일부 묶음). 셋째가 다섯 벌 대부분에서 안정적으로 나타난 것은 14B의 영어뿐이었다. 업무에서 ‘우리 회사만의 기준’을 예시만으로 가르치려 할 때 조심해야 하는 이유다.
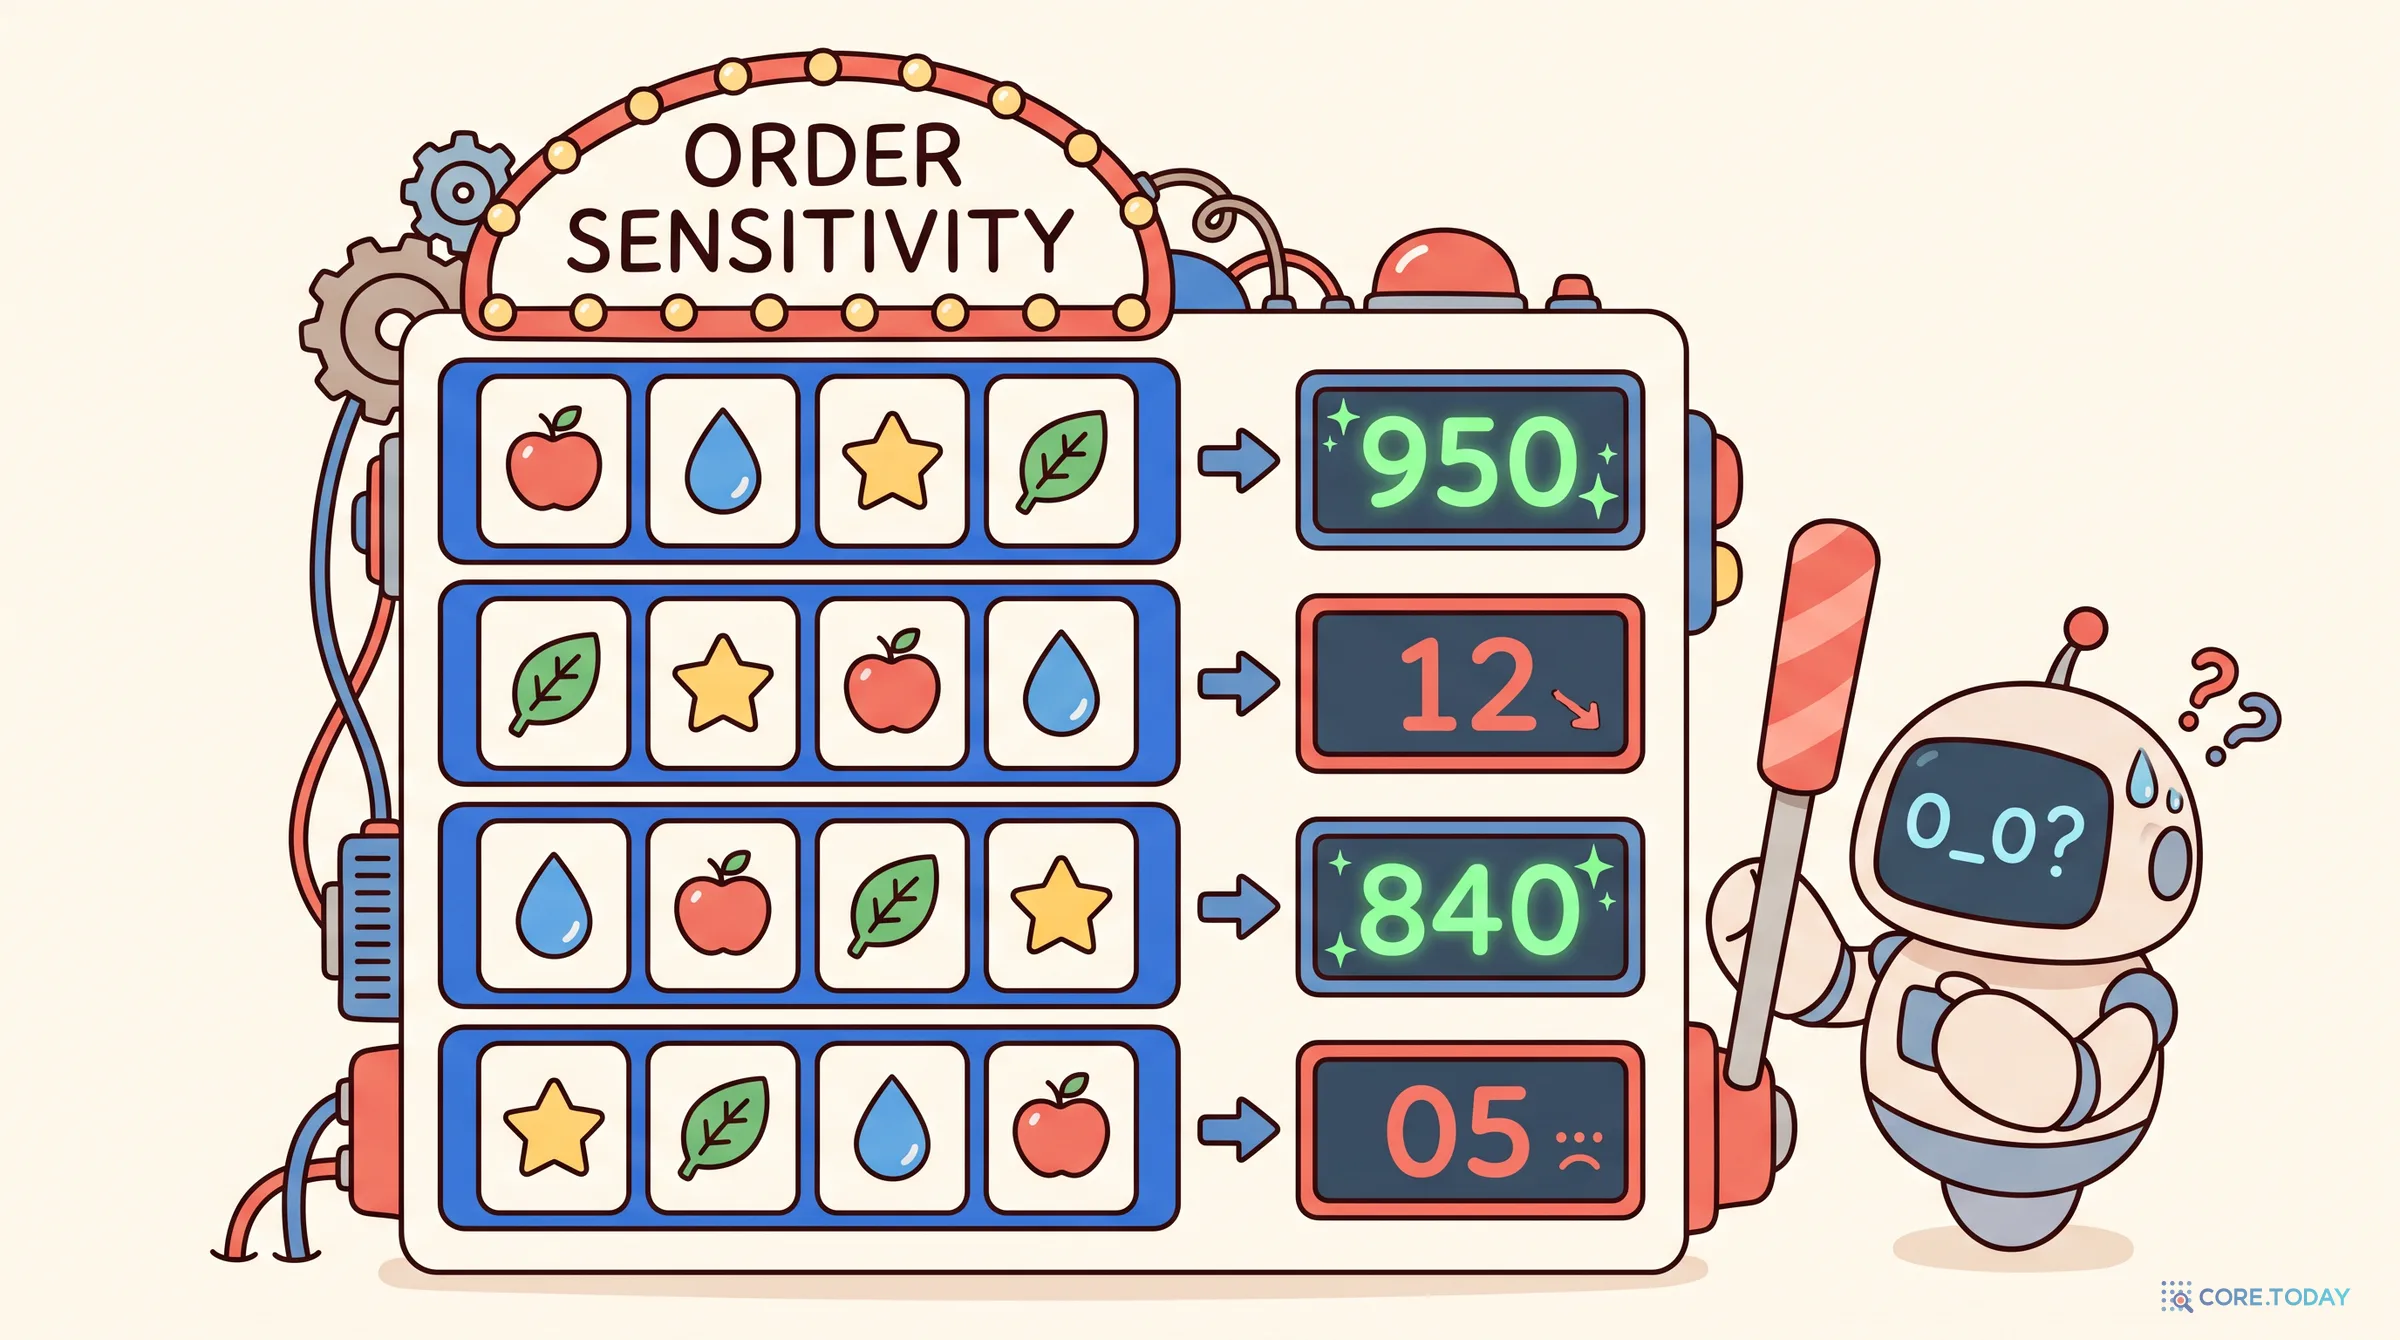
UC 버클리의 토니 자오(Tony Zhao) 등은 2021년 「보정하고 써라(Calibrate Before Use)」라는 논문에서 GPT-3의 변덕을 기록했다. SST-2 예시 4개의 순서만 바꿔도 GPT-3 2.7B의 정확도가 54.3%에서 93.4%까지 오갔다. 2-shot 프롬프트의 두 예시 순서만 뒤집어도 88.5%가 51.3%로 떨어졌다. 흔히 이 숫자를 175B의 것으로 인용하지만, 실제로는 2.7B 모델의 결과다.
최근 편향: 마지막 예시의 라벨을 따라간다. ‘긍정, 긍정, 긍정, 부정’ 순서의 프롬프트는 예시 넷 중 셋이 긍정인데도 예측의 약 90%가 ‘부정’이었다.
흔한 단어 편향: 사전학습에서 자주 본 단어를 라벨로 더 고른다.
처방으로 문맥 보정(contextual calibration)을 제안했다. 시험 문장 대신 ‘N/A’ 같은 내용 없는 입력을 넣어 모델이 어느 쪽으로 기우는지 재고, 그만큼 빼 준다. 내용이 없는데 ‘긍정’ 61.8%라고 답했다면, 그 쏠림은 모델의 버릇이지 판단이 아니라는 논리다. 이것으로 정확도를 최대 30%포인트 올렸다고 보고했다.
같은 해 런던대의 야오 루(Yao Lu) 등은 순서가 ‘최고 수준과 무작위 추측 사이’를 가른다고 보고했다. 더 곤란한 사실도 찾았다. 좋은 순서는 모델이 바뀌면 옮겨 가지 않았다. GPT-2 XL에서 88.7%였던 순서가 GPT-2 Large에서는 51.6%였다.
4.2 우리 모델은 순서에 얼마나 흔들릴까
예시 4개(긍정 2, 부정 2)를 고정하고 24가지 순서를 모두 넣어 봤다. 예시 묶음을 세 벌 뽑아 반복했다.
결과는 언어와 모델 크기에 따라 선명하게 갈렸다.
모델
SST-2 (영어) 최저~최고
NSMC (한국어) 최저~최고
Qwen3-0.6B
80.2~92.4 (묶음별 폭 2~10%p)
52.4~78.2 (묶음별 폭 21~22%p)
Qwen3-1.7B
81.4~94.8 (5~12%p)
65.2~85.6 (11~19%p)
Qwen3-4B
90.2~95.8 (3~5%p)
70.2~87.4 (5~17%p)
Qwen3-8B
87.8~95.6 (1~6%p)
76.8~87.2 (3~10%p)
Qwen3-14B
93.8~96.6 (1~3%p)
74.2~88.8 (2~15%p)
Kanana-1.5-2.1B
91.4~96.2 (2~4%p)
86.4~89.6 (1~3%p)
세 묶음 × 24순서. 괄호는 한 묶음 안에서 순서만 바꿨을 때의 최고−최저.
영어보다 한국어에서, 큰 모델보다 작은 모델에서 순서가 더 중요했다. 0.6B는 한국어에서 같은 예시 네 개의 순서만으로 20%포인트 넘게 흔들렸다. 8B에서는 폭이 크게 줄었지만 사라지지는 않았다. 한 묶음에서는 여전히 10%포인트 차이가 났다. 14B도 마찬가지였다. 두 묶음은 2%포인트 안에서 움직였지만, 나머지 한 묶음은 순서에 따라 74.2%에서 88.8%까지 15%포인트를 오갔다. 큰 모델이 덜 흔들리는 것은 평균의 이야기이고, 운 나쁜 예시 묶음 하나는 여전히 복권을 만든다. 2021년 GPT-3 2.7B만큼은 아니어도, 순서 복권은 2025년 모델에도 남아 있다.
그런데 한국어 모델은 달랐다. 카카오의 Kanana-1.5-2.1B는 Qwen3-8B의 4분의 1 크기인데도, NSMC에서 순서에 따른 폭이 묶음마다 1.4~2.6%포인트에 그쳤다. 이 실험에서 가장 안정적이었다. 순서에 흔들리는 이유는 ‘한국어라서’가 아니라 ‘그 언어를 덜 아는 모델이라서’에 가까워 보인다. 모델이 과제를 확신하지 못할수록 예시의 사소한 배치에 기댄다.
4.3 쏠림은 남았고, 보정은 엇갈렸다
다수 라벨 편향도 재 봤다. 예시 8개 가운데 긍정의 수를 0개에서 8개까지 바꿨다.
작은 모델에서 다수 라벨 편향은 극적이었다. 0.6B에게 예시 8개를 모두 ‘긍정’으로 보여 주자, NSMC 시험 문장 500개 전부에 ‘긍정’을 붙였다. 모두 ‘부정’으로 보여 주자 전부 ‘부정’이었다. 반면 8B는 예시 구성이 어떻든 ‘긍정’ 답변 비율이 36~45%로 거의 움직이지 않았다. 큰 모델은 예시의 라벨 비율보다 문장 자체를 봤다. 다만 크기와 함께 매끈하게 줄지는 않았다. 14B는 긍정 8개를 보여 주자 NSMC에서 ‘긍정’ 답변이 65%로 기울었고, Kanana는 26~55% 사이에서 움직였다.
최근 편향은 예상과 달랐다. SST-2에서 0.6B는 긍정을 뒤에 몰아 두면 ‘긍정’ 답변이 55%, 부정을 뒤에 두면 31%로, 2021년 논문과 같은 방향으로 기울었다. 그런데 NSMC에서는 반대였다. 긍정을 뒤에 두었을 때 ‘긍정’ 답변이 오히려 적었다. 0.6B와 1.7B의 24가지 순서 실험에서도 마지막 예시가 긍정이면 ‘긍정’ 답변이 줄었다. 4B는 NSMC에서 약하게 원래 방향으로 돌아왔고, 8B에서는 어느 쪽 효과도 거의 사라졌다. ‘마지막 예시를 따라간다’는 규칙은 과제와 모델에 따라 방향까지 달라지는, 생각보다 약한 법칙이었다.
문맥 보정은 엇갈렸다. 2021년 처방을 그대로 적용하자(‘N/A’, 빈 문자열, ‘[MASK]’ 세 입력의 평균으로 보정), 이미 잘하던 곳에서는 오히려 해로웠다. 0.6B의 SST-2 첫 묶음은 24순서가 보정 전 90.0~92.4%에서 보정 후 66.4~86.8%로 떨어졌다. 내용 없는 입력에 대한 반응이 실제 문장에 대한 쏠림을 대표하지 못한 것이다. 큰 모델도 마찬가지여서, 14B의 SST-2 첫 묶음은 평균 95.8%가 92.2%로 내려갔다. 반대로 모델이 흔들리던 한국어에서는 도움이 됐다. 0.6B의 NSMC 평균은 세 묶음 모두 2~7%포인트 올랐다(순서에 따른 폭은 줄이지 못했다). 4B의 NSMC 첫 묶음은 24순서가 보정 전 70.2~87.4%에서 보정 후 81.2~88.2%로, 순서에 따른 폭이 17%포인트에서 7%포인트로 줄었다. 14B의 운 나쁜 묶음은 74.2~88.8%가 보정 후 86.4~88.4%가 되어, 15%포인트의 복권이 2%포인트로 줄었다. 같은 처방이 모델이 흔들리는 곳에서는 약이, 이미 안정적인 곳에서는 독이 됐다. 쓰기 전에 검증 세트로 확인해야 한다.
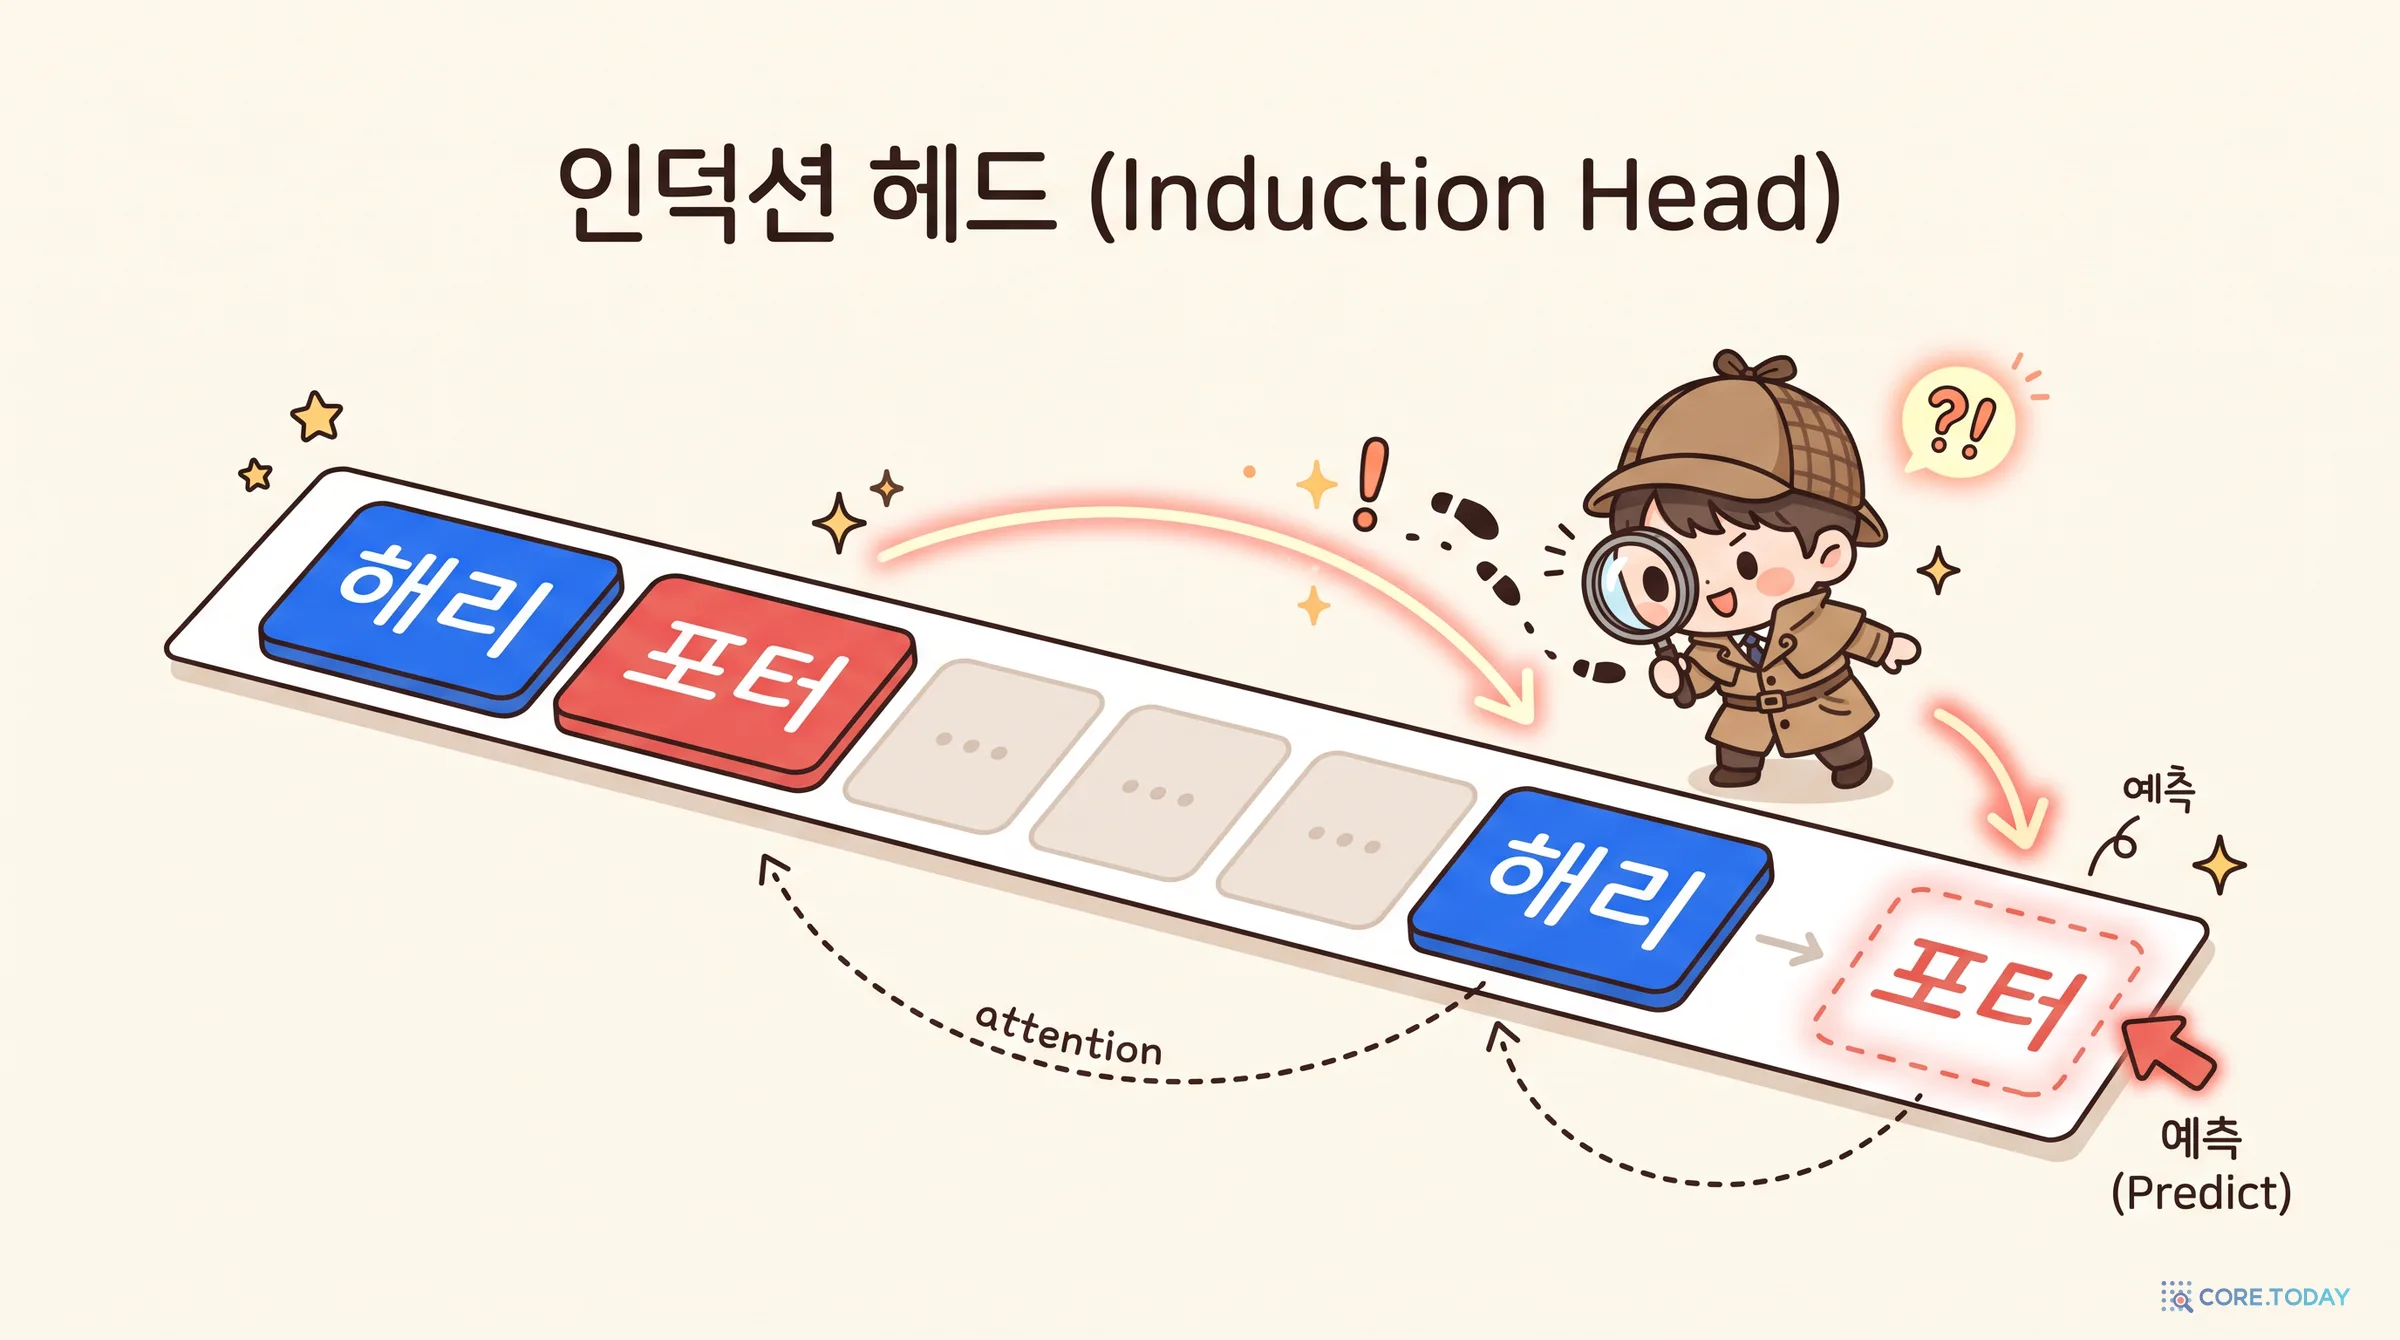
모델은 예시를 읽는 짧은 순간에 무엇을 할까? 앤트로픽의 캐서린 올슨(Catherine Olsson) 등은 2022년 그 일부를 해부했다. 그들이 찾은 것은 유도 헤드(induction head)라는 어텐션 헤드다. 규칙은 단순하다.
앞에서 [A] 다음에 [B]가 나왔다면, [A]가 다시 나왔을 때 [B]를 고른다.
‘해리 포터는 마법 학교에 갔다. 거기서 해리’ 다음에는 ‘포터’가 올 가능성이 높다. 앞에서 ‘해리’ 다음에 ‘포터’가 왔기 때문이다. 실제로는 어텐션 헤드 두 개가 이 일을 나눠 한다. 한 헤드는 각 위치에 ‘바로 앞 토큰이 무엇이었나’를 적어 두고, 다른 헤드는 그 기록을 보고 지금 토큰과 같은 짝을 찾아 그 뒤의 토큰을 베낀다. 어텐션이 ‘어디를 볼지’를 정하는 장치라면, 유도 헤드는 그 장치로 만든 ‘복사기’다.
문맥 내 학습과 무슨 관계일까? 예시 ‘리뷰: … 감정: 긍정’을 여러 번 본 뒤 ‘감정:’이 다시 나오면, 그 뒤에 왔던 라벨 단어들을 베낄 후보로 끌어오는 것이다. 단순한 복사를 넘어, 비슷한 것을 찾아 그 뒤를 따라가는 ‘흐릿한 복사’도 한다. 올슨 등은 이것이 큰 모델에서 문맥 내 학습의 상당 부분을 설명한다고 주장했다. 다만 작은 어텐션 전용 모델에서는 인과적 증거를, 큰 모델에서는 상관 증거를 냈다. 논문 초록도 ‘예비적이고 간접적인 증거’라고 쓴다.
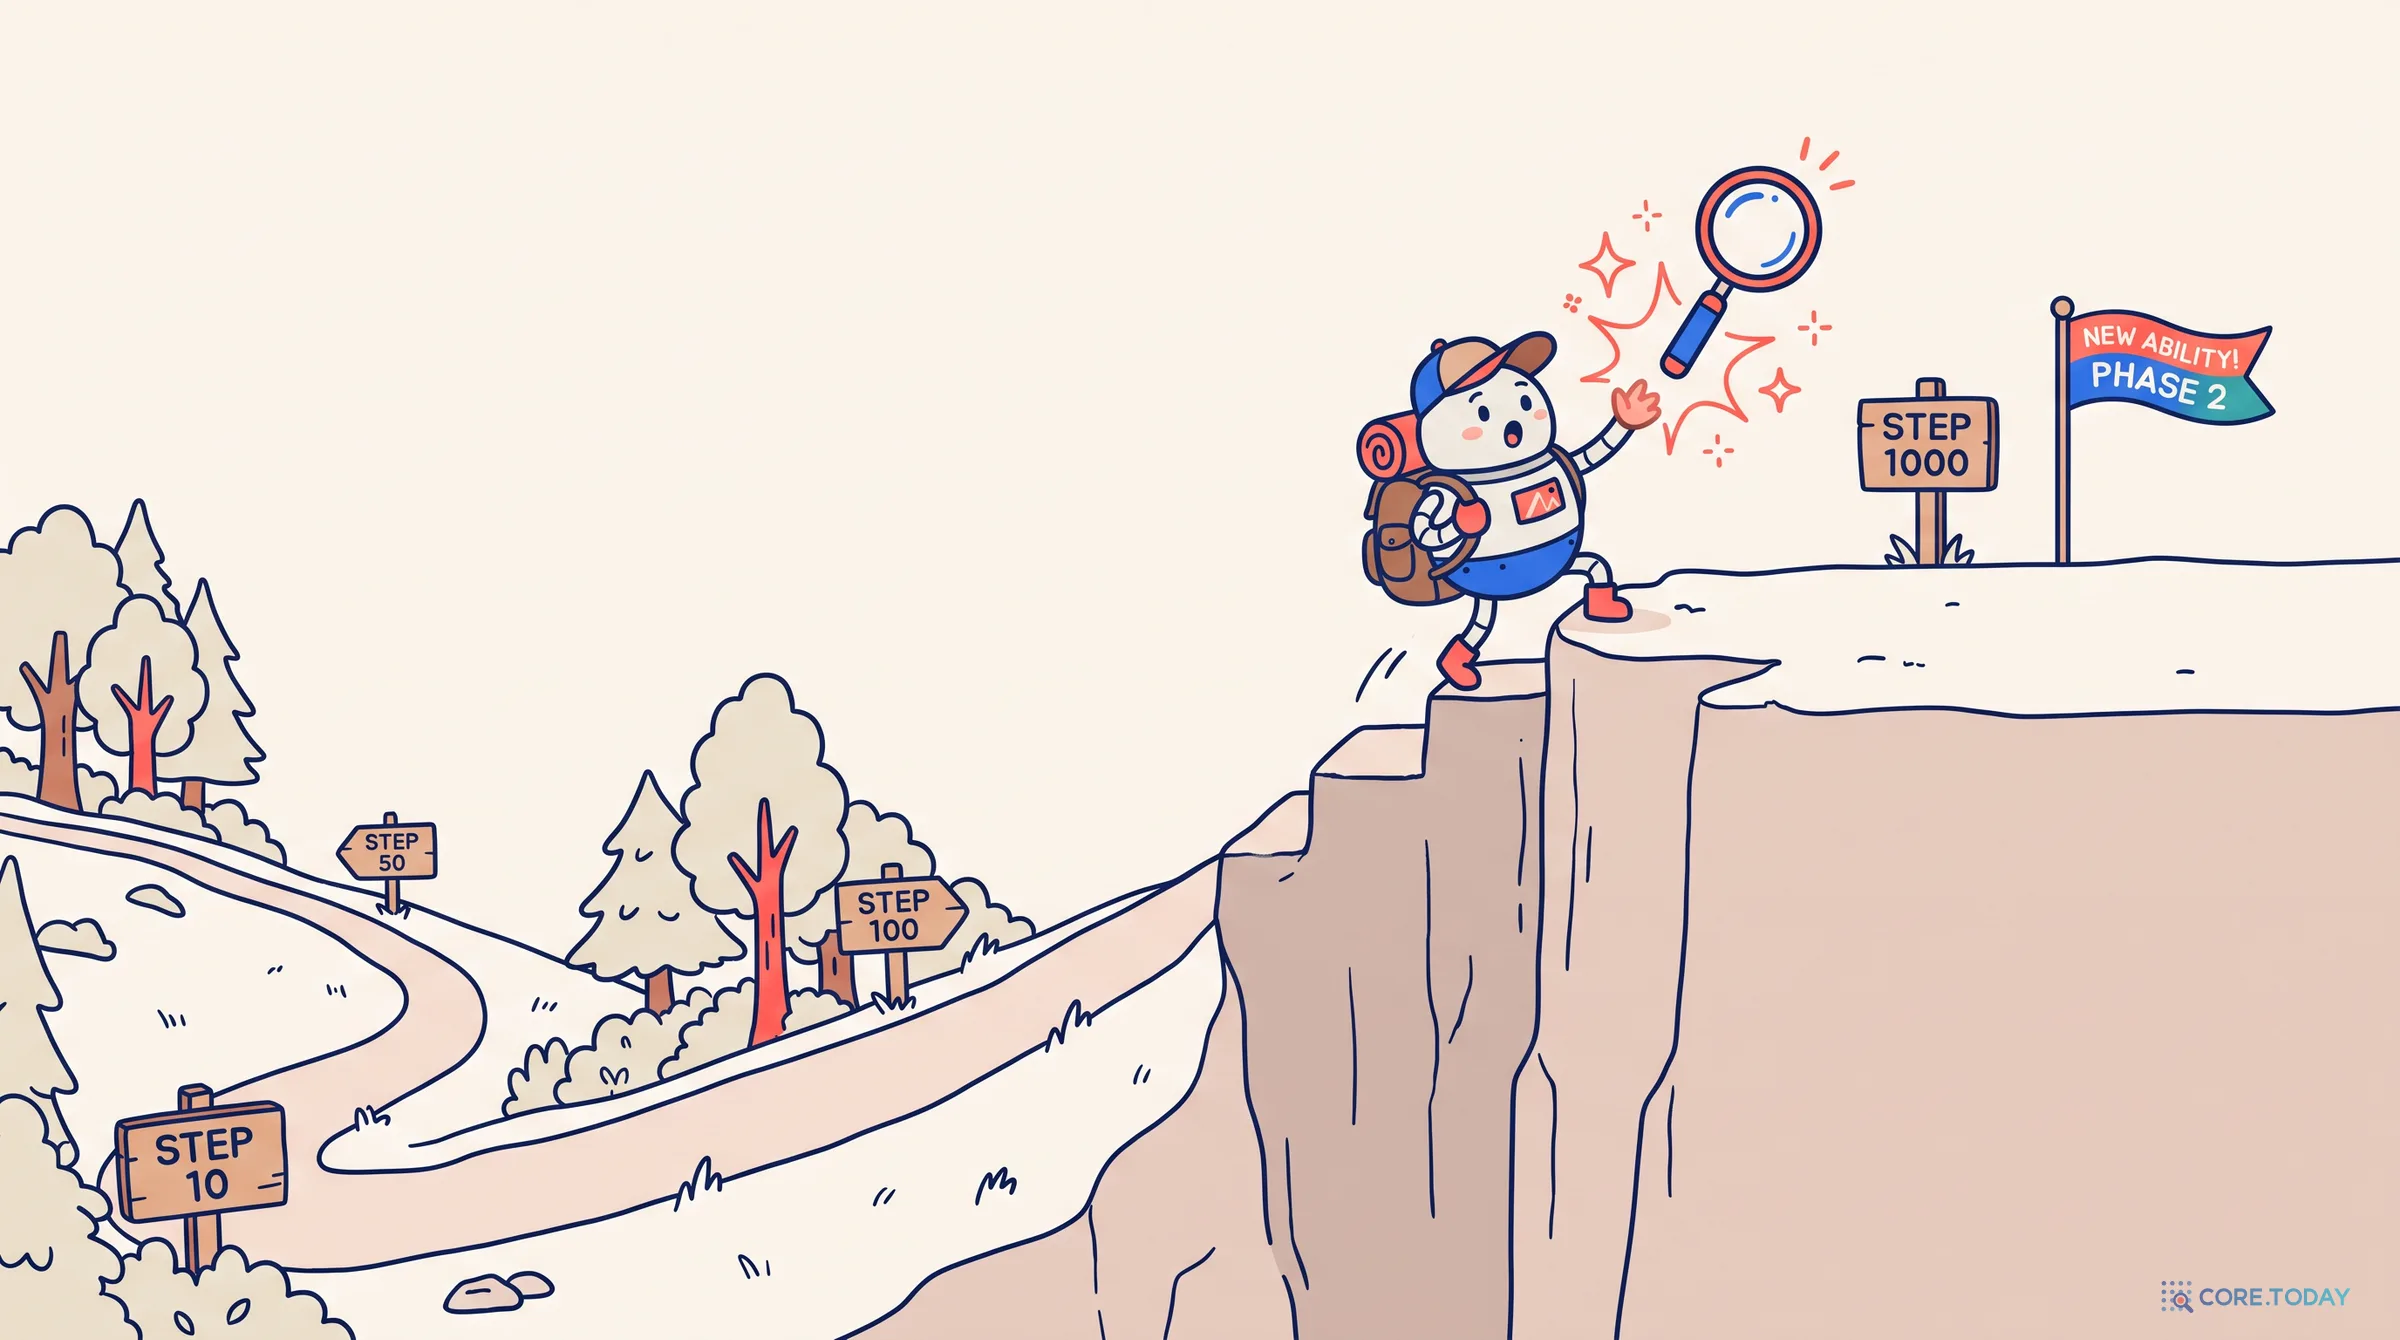
올슨 등의 가장 눈에 띄는 관찰은 시점이었다. 유도 헤드는 학습 내내 조금씩 자라는 것이 아니라, 학습 초반 25억~50억 토큰 무렵 짧은 구간에 갑자기 생겼다. 그리고 바로 그때 모델의 ‘문맥 내 학습 점수’가 뛰었다.
이 점수는 이렇게 정의한다. 긴 글에서 50번째 토큰의 손실과 500번째 토큰의 손실의 차이다. 글을 많이 읽을수록 다음 단어를 잘 맞히게 된다면, 500번째 토큰이 더 쉬우니 차이가 커진다. 문맥을 쓸 줄 안다는 뜻이다. 올슨 등의 모델에서 이 값은 전환 이전 0.15 nats 미만이었다가, 이후 약 0.4 nats로 뛰어 학습이 끝날 때까지 거의 그대로였다. 모델 크기와도 상관이 없었다.
5.3 코어닷투데이 실측 — 피티아에서 그 순간을 다시 찾다
앤트로픽의 모델은 공개되지 않았지만, 비영리 연구 단체 일루서AI(EleutherAI)의 피티아(Pythia)는 학습 도중의 체크포인트를 모두 공개한다. 학습 단계 하나에 약 210만 토큰을 읽는 피티아의 160M, 410M, 1B 모델을 0단계부터 마지막 143,000단계까지 18개 시점에서 불러와 두 가지를 쟀다.
문맥 내 학습 점수: 위키백과 긴 문서 58개에서 50번째 토큰 손실 − 500번째 토큰 손실.
반복 문장 손실: 무작위 토큰 64개를 두 번 이어 붙이고, 두 번째 반복의 손실. 베낄 줄 알면 두 번째는 거의 공짜로 맞힌다.
계산은 사내 서버의 CPU에서 했다. 1B 모델은 쿠버네티스 클러스터의 다른 서버(112코어)에 따로 맡겼다.
결과는 교과서처럼 선명했다. 세 모델 모두 512단계(약 11억 토큰)까지 점수가 0 근처였다. 1,000단계(약 21억 토큰)에서 160M은 0.44, 410M은 0.41, 1B는 0.49로 뛰었다. 같은 구간에서 반복 문장의 두 번째 손실은 12.6~12.8에서 2.9~4.6으로 곤두박질쳤다. 처음 보는 무작위 단어 열을 두 번째에는 거의 맞힌 것이다. 크기가 여섯 배 다른 모델들이 같은 시점에 같은 능력을 얻었다. 앤트로픽이 보고한 25억~50억 토큰보다 조금 이른 11억~21억 토큰 구간이었고, 크기가 달라도 ‘약 0.4’로 뛰는 모양은 같았다.
이후로는 차이가 있었다. 160M은 끝까지 0.23~0.35를 유지했고, 410M과 1B는 학습 후반으로 갈수록 0.14~0.26으로 조금씩 내려갔다. 큰 모델은 학습이 진행되며 글 앞부분의 토큰도 잘 맞히게 되어, 50번째와 500번째의 차이가 줄어든 것으로 보인다. 반복 문장의 두 번째 손실은 410M과 1B가 끝까지 0.3~0.4로 낮게 유지했다. 160M만 마지막 체크포인트에서 7.7로 다시 올라갔는데, 같은 체크포인트에서 첫 번째 반복의 손실도 12.9에서 25로 함께 뛰었다. 베끼는 능력을 잃었다기보다, 이 체크포인트 전체가 무작위 토큰 열에 이상하게 반응한 것으로 보인다. 자연스러운 글에서 잰 문맥 내 학습 점수는 그대로였다.
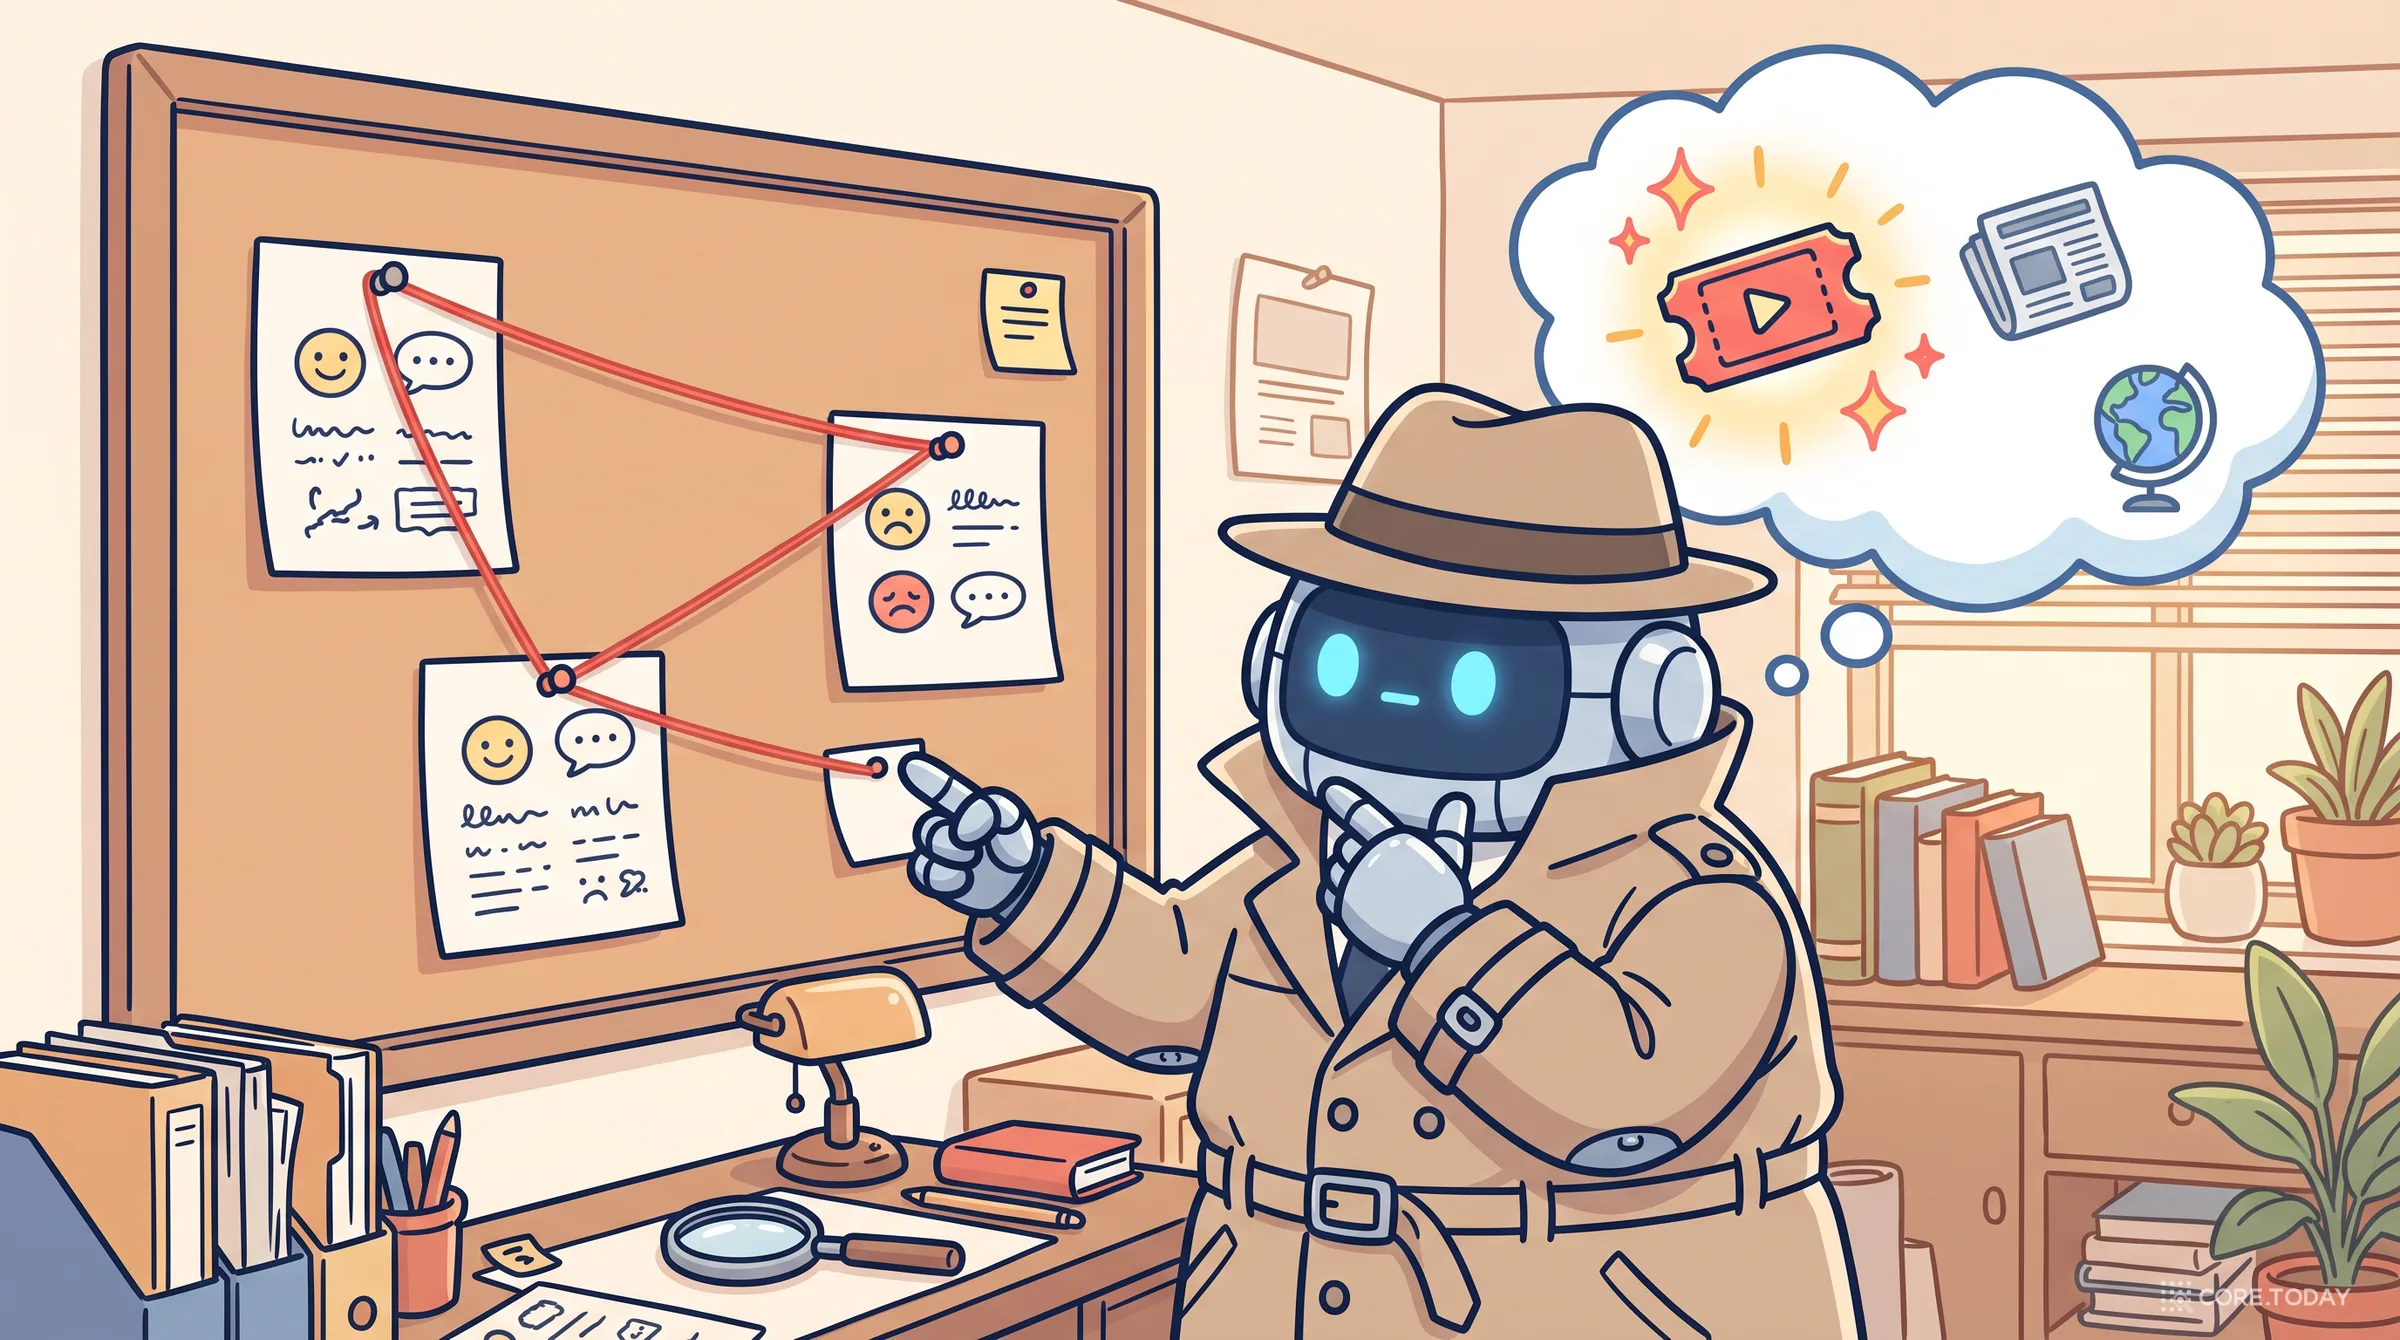
숨은 과제 추리(베이즈 추론): 스탠퍼드의 상 마이클 시에(Sang Michael Xie) 등은 2022년, 모델이 예시들이 공유하는 ‘숨은 개념’을 추리한다고 설명했다. 사전학습 문서에는 장거리에 걸친 일관성이 있으니, 다음 단어를 맞히려면 ‘이 글이 무슨 글인지’를 추리해야 한다. 예시는 그 추리의 단서다. 이 이론은 예시 순서에 대한 민감도와, 때로 제로샷이 퓨샷보다 나은 현상까지 재현했다.
문맥 안의 경사하강법: 구글과 MIT 연구진(폰 오스왈드 등, 아퀴렉 등)은 트랜스포머가 문맥에 적힌 예시만으로 선형 회귀를 푸는 학습 알고리즘을 흉내 낼 수 있음을 보였다. 선형 어텐션 한 층이 경사하강법 한 걸음과 같은 일을 하도록 가중치를 짤 수 있고, 실제로 학습된 작은 모델이 그 모양에 가까웠다. 다만 모두 처음부터 학습한 장난감 회귀 설정이라, 사전학습된 큰 모델이 정말 경사하강법을 한다는 증명은 아니다.
데이터의 모양: 딥마인드의 스테파니 챈(Stephanie Chan) 등은 데이터 자체가 문맥 내 학습을 낳는다고 보였다. 같은 항목이 한 시퀀스 안에 몰려 나오고(burstiness), 드물게 나오는 항목이 아주 많은 분포에서 문맥 내 학습이 생겼다. 자연어 단어 빈도가 따르는 지프(Zipf) 분포에서는 가중치에 지식을 새기는 학습과 문맥 내 학습이 공존했다. 같은 조건에서도 LSTM과 RNN에서는 생기지 않았다.
세 설명은 서로 배타적이지 않다. 사전학습 데이터의 모양이 유도 헤드 같은 회로를 키우고, 그 회로가 예시에서 과제를 추리하는 데 쓰인다고 보면 한 그림이 된다.
GPT-3의 문맥 창 2,048토큰에는 예시가 수십 개밖에 들어가지 않았다. 지금은 사정이 다르다. 구글 딥마인드의 리샤브 아가르왈(Rishabh Agarwal) 등은 2024년 제미나이 1.5 프로의 100만 토큰 창에 예시를 최대 8,192개 넣어 봤다. 이름하여 메니샷(many-shot) 문맥 내 학습이다.
저자원 언어 번역에서 예시 997개(약 8만 5천 토큰)를 넣자, 1-shot보다 벰바어 15.3%, 쿠르드어 4.5%가 올라 당시 최고 기록을 냈다.
뒤집힌 라벨, A/B/C 같은 추상 라벨도 예시가 수백 개가 되자 정상 라벨 성능에 다가갔다. 3부에서 본 ‘상식과 부딪히는 라벨’을 예시의 양으로 넘어선 것이다.
다만 요약은 예시 50개까지 오르다 떨어졌다. 많을수록 늘 좋은 것은 아니다.
카네기멜런대의 아만다 버치(Amanda Bertsch) 등은 라벨이 6~150개인 분류에서 예시를 수천 개까지 늘렸다. 10개에서 1,000개로 늘리자 다섯 데이터셋 평균이 36.8점 올랐다. 예시가 많아지면 순서에 따른 흔들림도 줄었다. 무작위로 섞었을 때 예측이 바뀌는 비율이 1,000개에서는 10개일 때의 절반도 안 됐다. 단, 같은 라벨끼리 묶어 정렬하면 오히려 크게 해로웠다.
6.2 코어닷투데이 실측 — 뉴스 분야 분류에 예시 512개
우리 모델로도 예시를 늘려 봤다. 문맥 창이 3만 2천 토큰인 Qwen3-4B와 8B 베이스에 KLUE-YNAT 뉴스 제목과 NSMC 영화평 예시를 0개, 8개, 32개, 128개, 512개 넣었다. 뉴스 제목 예시 512개는 약 2만 토큰이다. 묶음마다 세 벌씩 쟀다.
예시 수
YNAT · 4B
YNAT · 8B
NSMC · 4B
NSMC · 8B
0개
61.6
58.4
78.6
81.8
8개
58.8 (46.2~72.4)
66.2 (57.2~77.4)
84.7 (80.8~87.6)
85.5 (84.8~86.6)
32개
77.0 (73.4~80.2)
78.8 (73.4~82.2)
87.0 (86.4~87.8)
86.9 (85.6~87.8)
128개
77.3 (74.4~81.8)
78.5 (76.0~81.4)
87.0 (86.4~87.6)
87.8 (87.4~88.4)
512개
73.5 (71.0~75.6)
73.9 (72.0~75.8)
86.1 (85.8~86.6)
88.9 (88.6~89.2)
Qwen3 베이스, 세 벌 평균 정확도(%), 괄호는 최저~최고. 시험 문장 500개.
뉴스 분야 분류는 두 모델 모두 32개 근처에서 평평해졌다. 128개는 32개와 같았고, 512개에서는 4~5%포인트 떨어졌다. 영화평 감정은 4B가 32개부터 제자리였고, 8B만 512개까지 조금씩 올라 88.9%로 이 실험의 최고점을 찍었다. 예시를 늘려서 확실히 얻은 것은 평균보다 안정성이었다. 예시 8개에서는 묶음에 따라 YNAT가 4B는 46%에서 72%까지, 8B는 57%에서 77%까지 흔들렸지만, 32개부터는 그 폭이 4~9%포인트로 줄었다. 버치 등이 본 ‘많을수록 덜 흔들린다’와 같은 방향이다.
라벨이 많게는 150개인 과제에서 수천 개까지 계속 오른 버치 등의 결과와 달리, 라벨이 2~7개인 우리 과제에서는 수십 개면 충분했다. 아가르왈 등의 요약 실험처럼, 너무 많은 예시는 오히려 손해일 수 있다. 4B·8B 모델이 2만 토큰짜리 긴 문맥을 다루는 능력의 한계일 수도 있다. 메니샷은 라벨 공간이 크거나, 상식과 다른 규칙을 가르쳐야 할 때 쓸 무기이지, 아무 데나 쓸 기본값은 아니다.
6.3 그림자 — 메니샷 탈옥
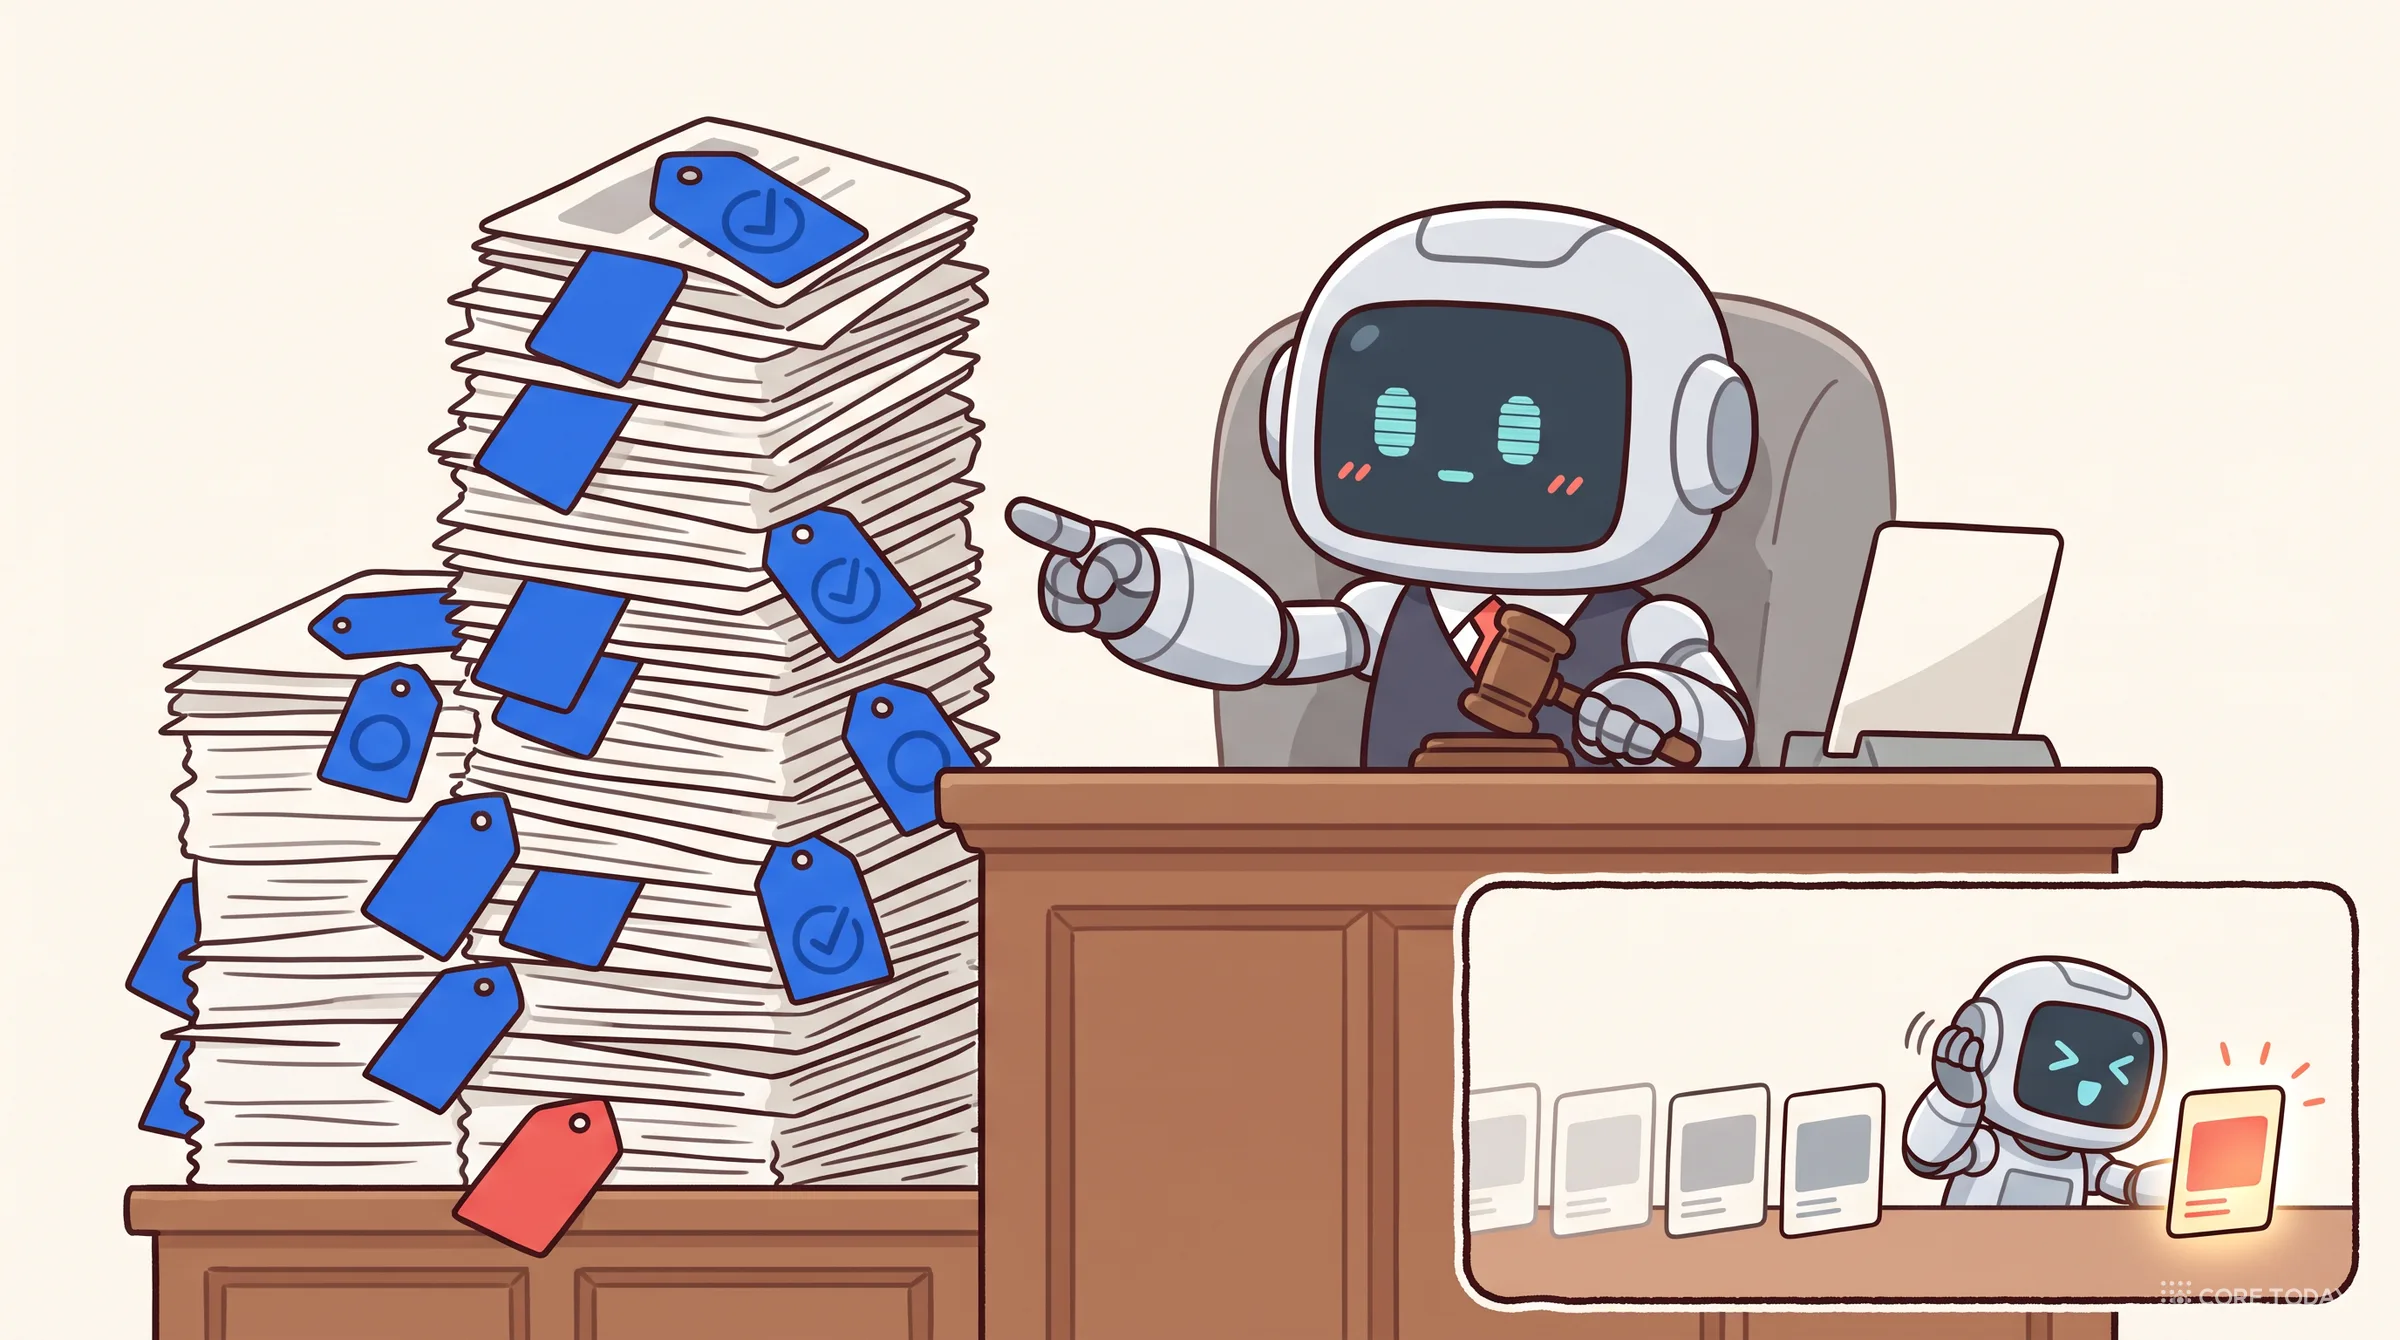
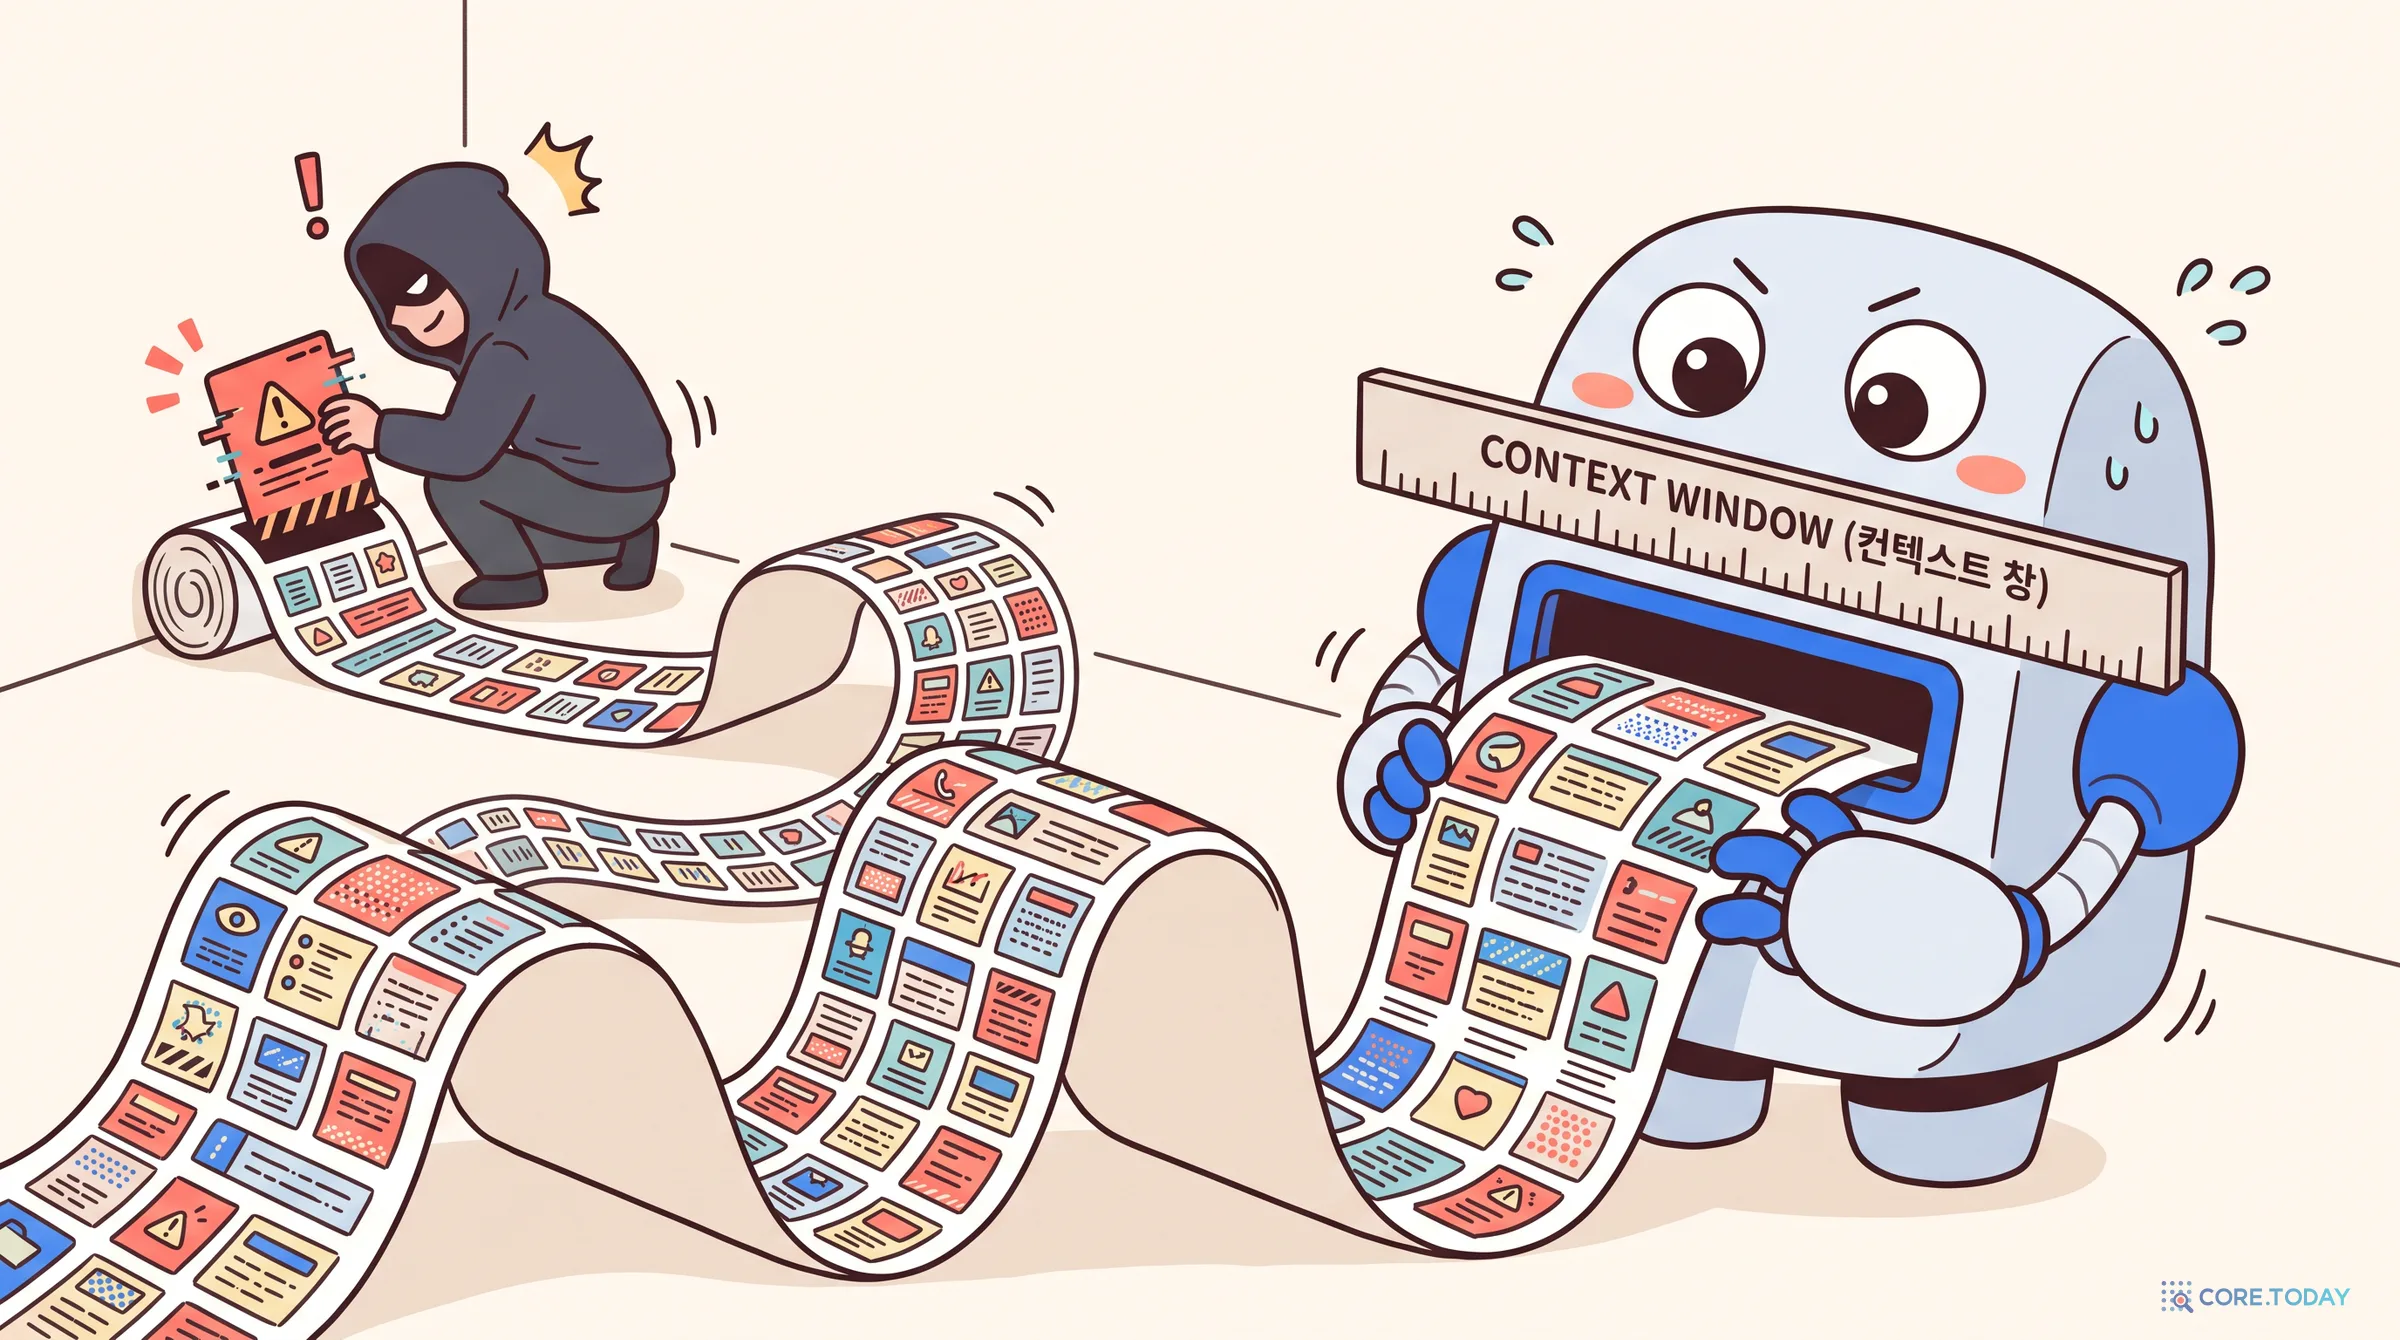
예시를 많이 넣을 수 있다는 것은 공격자에게도 기회였다. 앤트로픽은 2024년 4월 메니샷 탈옥(many-shot jailbreaking)을 공개했다. 가짜 대화 수백 개를 프롬프트에 넣는다. 각 대화에서 ‘사용자’가 해로운 질문을 하고 ‘AI’가 순순히 답한다. 그 뒤에 진짜 해로운 질문을 붙이면, 모델이 예시를 따라 답해 버린다.
클로드 2.0에서 이 공격은 예시 5개로는 전혀 통하지 않다가 256개에서는 꾸준히 통했다. 효과는 예시 수의 거듭제곱 법칙을 따랐고, 안전과 무관한 일반 과제의 문맥 내 학습도 같은 법칙을 따랐다. 더 불편한 사실도 있었다. 큰 모델일수록 예시에서 더 빨리 배우니 더 취약했다. 안전 학습은 곡선의 출발점만 올릴 뿐 기울기를 줄이지 못했다. 입력에 경고 문구를 덧붙이는 방어로 공격 성공률을 2%까지 낮출 수 있었다. 문맥 내 학습이 강할수록, 문맥에 무엇이 들어오는지가 곧 보안 문제가 된다. 프롬프트 인젝션과 같은 뿌리다.
7부. 2026년, 예시는 언제 쓰나
7.1 정답 대신 풀이를 — 사고 연쇄
예시의 쓰임새를 크게 넓힌 것은 2022년 구글의 사고 연쇄(chain-of-thought) 프롬프트였다. 예시에 정답만 적지 않고 풀이 과정을 적었다. 수학 문제 예시 8개에 풀이를 붙이자 PaLM 540B의 GSM8K 정답률이 17.9%에서 56.9%로 올랐다. 다만 작은 모델에서는 오히려 해로웠다. PaLM 8B는 4.9%에서 4.1%로 떨어졌다.
몇 달 뒤 도쿄대와 구글의 고지마 다케시(Takeshi Kojima) 등은 예시 없이 문장 하나로 비슷한 일을 했다. 질문 끝에 ‘단계별로 생각해 보자(Let's think step by step)’를 붙이자, text-davinci-002의 MultiArith 정답률이 17.7%에서 78.7%로, GSM8K가 10.4%에서 40.7%로 올랐다. 같은 논문의 표에는 흥미로운 줄이 하나 더 있다. 정답만 적은 일반 예시는 2개를 넣든 8개를 넣든 MultiArith 33.7% 대 33.8%로 같았다. 예시의 개수보다 예시가 무엇을 보여 주느냐가 중요했다. 다만 예시 없는 사고 연쇄는 풀이 예시 8개를 넣은 사고 연쇄(93.0%)보다는 낮았다.
7.2 추론 모델에게 예시는 독이 될 수 있다
2025년 1월 공개된 딥시크-R1 보고서에는 이런 문장이 있다.
딥시크-R1은 프롬프트에 민감하다. 퓨샷 프롬프트는 일관되게 성능을 떨어뜨린다. 그래서 제로샷으로 문제를 직접 설명하고 출력 형식을 지정하기를 권한다.
스스로 긴 사고 과정을 만드는 추론 모델에게, 남이 쓴 짧은 풀이 예시는 방해가 될 수 있다는 것이다. 같은 보고서는 평가할 때도 원래 퓨샷이던 프롬프트를 제로샷으로 바꿔 썼다. 오픈AI의 추론 모델 안내도 ‘먼저 예시 없이 시작하고, 필요하면 예시를 넣으라’고 쓴다. 단정하는 정도는 다르지만 방향은 같다. 예시는 이제 기본값이 아니라 필요할 때 꺼내는 도구가 됐다.
그렇다고 예시가 쓸모없어진 것은 아니다. 딥시크-R1을 만들 때도 학습 데이터를 모으는 단계에서는 긴 풀이 예시를 보여 주는 퓨샷 프롬프트를 썼다. 정해진 형식을 맞추거나, 회사만의 말투를 따라 하게 하거나, 모델이 모르는 규칙을 보여 줄 때 예시는 여전히 가장 빠른 방법이다.
어떤 예시를 넣느냐도 중요하다. 듀크대와 마이크로소프트의 류자청(Jiachang Liu) 등은 2021년(학회 발표는 2022년), 시험 문장과 의미가 가까운 예시를 검색해 넣는 방법(KATE)을 제안했다. 질의응답 NQ에서 정확도가 28.6%에서 41.6%로 올랐다. 반대로 의미가 가장 먼 예시를 넣자 영화평 분류가 50.2%로 무너졌다. 논문 초록의 ‘41.9%, 45.5% 향상’은 상대적인 향상률이니 인용할 때 주의하자.
예시가 수백 개를 넘으면 검색의 이득은 줄어든다. 버치 등의 실험에서 은행 고객 문의 분류의 검색 이득은 예시 1개일 때 51.5점에서 1,500개일 때 4.9점으로 줄었다. 예시가 적을 때는 고르는 것이, 많을 때는 많이 넣는 것 자체가 일을 한다.
한국어에서도 예시의 효과는 일정하지 않았다. SKT의 KoBEST 벤치마크에서 KoGPT3-39B는 예시 0·1·10개에 평균 52.8·66.3·70.6점으로 올랐지만, 질문 답하기(BoolQ)에서는 10개(46.9)가 1개(50.2)보다 낮았다. 우리 실측에서도 영어에서 안정적이던 설정이 한국어에서는 흔들렸다.
GPT-3 논문의 각주는 물었다. 모델은 예시에서 새 과제를 배우는가, 아니면 이미 아는 과제를 알아보는가? 6년이 지난 지금, 답은 ‘둘 다, 모델 크기와 과제에 따라 비율이 다르다’에 가깝다.
우리 실측이 보여 준 것도 그렇다. 지금의 작은 모델은 영어 감정 분류를 예시 없이도 안다. 이미 아는 과제다. 반면 뉴스 분야 분류는 예시가 있어야 기준을 안다. 뜻 없는 라벨 ‘foo/bar’의 짝은 예시만 보고 새로 배웠다. 그러나 상식과 정면으로 부딪히는 라벨 앞에서는, 8B까지의 Qwen3 베이스 모델은 대부분 배우지도 알아보지도 못하고 한쪽으로 몰아 답했다. 14B에 와서야 영어에서 예시의 규칙이 상식을 이겼다. 배우는 능력은 크기와 언어에 따라 조금씩, 그러나 분명히 자란다.
모델 안에서는 학습 초반 어느 날 갑자기 ‘앞에서 본 것을 베끼는’ 회로가 생긴다. 우리는 피티아의 체크포인트를 거슬러 올라가며 그 순간이 크기와 상관없이 같은 구간에 온다는 것을 다시 확인했다. 그 회로 덕분에 모델은 예시를 쓸 줄 알게 되지만, 같은 회로 때문에 순서와 라벨 비율 같은 사소한 것에도 흔들린다.
실무자에게 남는 교훈은 단순하다. 예시는 강력하지만 변덕스럽다. 라벨 비율을 맞추고, 순서를 바꿔 여러 번 재고, 상식과 다른 규칙은 말로 먼저 적자. 추론 모델에게는 예시 없이 먼저 물어보자. 그리고 무엇보다, 내 데이터로 직접 재 보자. 같은 처방이 모델과 언어에 따라 약도 되고 독도 됐다.
Radford, A. et al. (2019). Language Models are Unsupervised Multitask Learners. OpenAI 기술 보고서, §3.6·3.7.
Brown, T. et al. (2020). Language Models are Few-Shot Learners. NeurIPS 2020. arXiv:2005.14165, §1·2, 각주 1, 표 3.3·3.8·3.9.
Kim, B. et al. (2021). What Changes Can Large-scale Language Models Bring? Intensive Study on HyperCLOVA. arXiv:2109.04650, 표 3.
Kim, D. et al. (2022). KOBEST: Korean Balanced Evaluation of Significant Tasks. arXiv:2204.04541, 표 4.
DeepSeek-AI (2025). DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning. arXiv:2501.12948.
OpenAI. Reasoning best practices. developers.openai.com (2026-11-08 조회).
예시의 무엇이 일을 하나
Zhao, T. Z. et al. (2021). Calibrate Before Use: Improving Few-Shot Performance of Language Models. arXiv:2102.09690.
Lu, Y. et al. (2022). Fantastically Ordered Prompts and Where to Find Them: Overcoming Few-Shot Prompt Order Sensitivity. arXiv:2104.08786.
Liu, J. et al. (2022). What Makes Good In-Context Examples for GPT-3? arXiv:2101.06804.
Min, S. et al. (2022). Rethinking the Role of Demonstrations: What Makes In-Context Learning Work? arXiv:2202.12837.
Yoo, K. M. et al. (2022). Ground-Truth Labels Matter: A Deeper Look into Input-Label Demonstrations. arXiv:2205.12685.
Wei, J. et al. (2023). Larger language models do in-context learning differently. arXiv:2303.03846.
사고 연쇄
Wei, J. et al. (2022). Chain-of-Thought Prompting Elicits Reasoning in Large Language Models. NeurIPS 2022. arXiv:2201.11903.
Kojima, T. et al. (2022). Large Language Models are Zero-Shot Reasoners. NeurIPS 2022. arXiv:2205.11916, 표 1·2.
모델 안에서
Olsson, C. et al. (2022). In-context Learning and Induction Heads. arXiv:2209.11895.
Xie, S. M. et al. (2022). An Explanation of In-context Learning as Implicit Bayesian Inference. arXiv:2111.02080.
Garg, S. et al. (2022). What Can Transformers Learn In-Context? A Case Study of Simple Function Classes. arXiv:2208.01066.
Akyürek, E. et al. (2023). What learning algorithm is in-context learning? Investigations with linear models. ICLR 2023. arXiv:2211.15661.
von Oswald, J. et al. (2023). Transformers Learn In-Context by Gradient Descent. ICML 2023. arXiv:2212.07677.
Chan, S. C. Y. et al. (2022). Data Distributional Properties Drive Emergent In-Context Learning in Transformers. arXiv:2205.05055.
Biderman, S. et al. (2023). Pythia: A Suite for Analyzing Large Language Models Across Training and Scaling. ICML 2023. arXiv:2304.01373.
예시 수천 개
Agarwal, R. et al. (2024). Many-Shot In-Context Learning. NeurIPS 2024. arXiv:2404.11018.
Anil, C. et al. (2024). Many-shot Jailbreaking. Anthropic 기술 보고서.
Bertsch, A. et al. (2024). In-Context Learning with Long-Context Models: An In-Depth Exploration. arXiv:2405.00200.
코어닷투데이 실측 조건
모델: Qwen3-0.6B-Base·1.7B-Base·4B-Base·8B-Base·14B-Base, Qwen3-8B(지시 튜닝), Kanana-1.5-2.1B-base. 피티아 160M·410M·1B의 학습 체크포인트 18개(0~143,000단계).
데이터: NSMC(네이버 영화평, CC0), SST-2(GLUE 검증 세트 872개), KLUE-YNAT(검증 세트). 과제마다 시험 문장 500개를 무작위로 골라 모든 조건에 같게 썼다. 예시는 학습 세트에서 뽑았다(160자 이하).
채점: 다음 토큰 위치에서 후보 라벨의 첫 토큰 확률을 비교. 문맥 보정은 ‘N/A’, 빈 문자열, ‘[MASK]’ 세 입력의 평균 확률로 나눠 다시 정규화했다(자오 등, 2021).
하드웨어: 0.6B·1.7B·Kanana는 맥북(MPS, bf16). 4B는 사내 V100 16GB(fp16). 8B·14B는 사내 쿠버네티스 클러스터의 V100S 32GB(8B는 fp16, 14B는 8비트). 예시 부분의 KV 캐시를 시험 문장들이 공유하게 해 계산했고, 캐시를 쓰지 않은 계산과 확률이 같음(최대 차이 0.003)을 확인했다. 예시 128개 이상의 메니샷 실험은 메모리를 아끼려 예시 부분을 1,024~2,048토큰씩 나눠 계산했다. 이때 확률은 한 번에 계산할 때와 최대 0.03 차이 났다.
피티아: 위키텍스트-103 테스트 세트의 1,024토큰 이상 문서 58개, 무작위 토큰 64개 × 2회 반복 열 64개. CPU fp32.