RoPE회전 위치 인코딩위치 인코딩트랜스포머어텐션사인파 위치 인코딩상대 위치ALiBiNoPE긴 문맥문맥 확장위치 보간NTK-awareYaRNLongRoPEiRoPErope_thetaNeedle in a HaystackLost in the MiddleRULER
순서를 모르는 트랜스포머에게 순서를 가르치는 법 — 회전 위치 인코딩 RoPE와 100만 토큰 문맥 (특집)
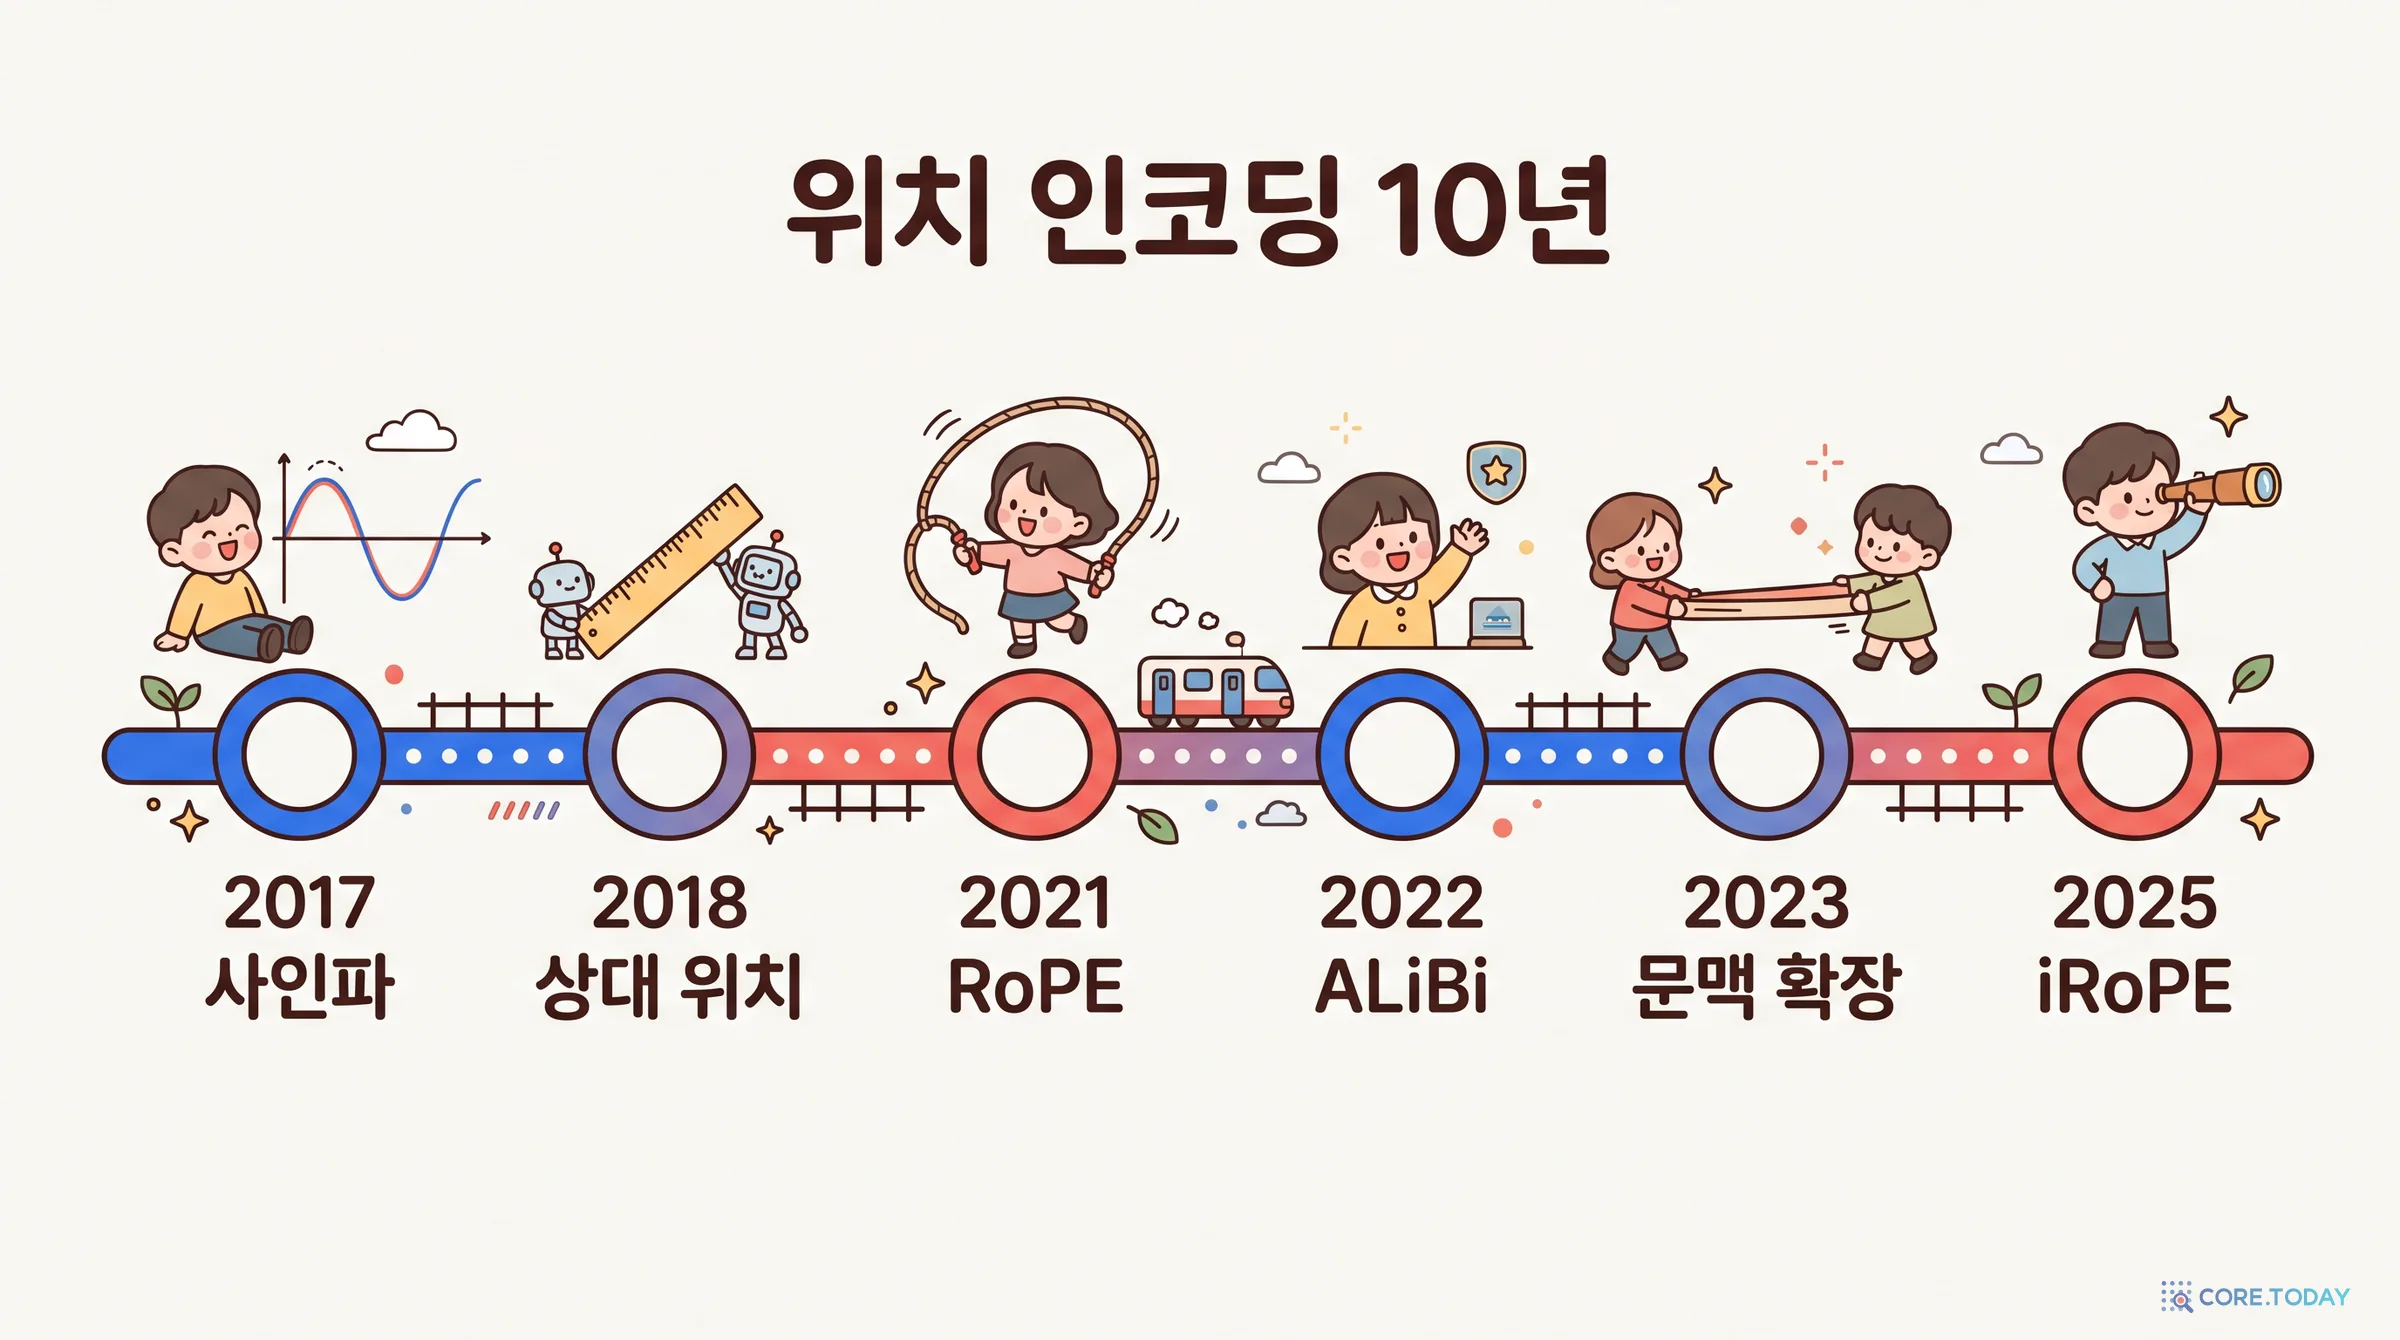
트랜스포머의 어텐션은 단어 순서를 모른다. 위치 정보가 없으면 ‘dog bites man’과 ‘man bites dog’에서 dog가 받는 계산 결과가 똑같다. 2017년 사인파를 더하는 방식으로 시작한 위치 인코딩은, 2021년 중국 블로그에서 나온 ‘벡터를 위치만큼 돌린다’는 아이디어 RoPE로 수렴했고 지금 Llama·Qwen·Gemma·EXAONE이 모두 이를 쓴다. 이 글은 회전이 왜 상대 거리를 담는지 시계 바늘로 따라가고, 학습 길이를 넘으면 왜 무너지는지, 개인 개발자와 레딧 게시판이 논문보다 먼저 찾은 문맥 확장 트릭이 어떻게 YaRN과 100만 토큰 시대로 이어졌는지 정리한다. 2,048토큰만 배운 모델에게 8,192토큰을 읽힌 실측, 공개 모델 17종의 RoPE 설정 비교, 긴 문맥을 정말 다 쓰는지에 대한 평가까지 담았다. 인터랙티브 위젯 5종, 코어닷투데이 실측, 삽화 13장.
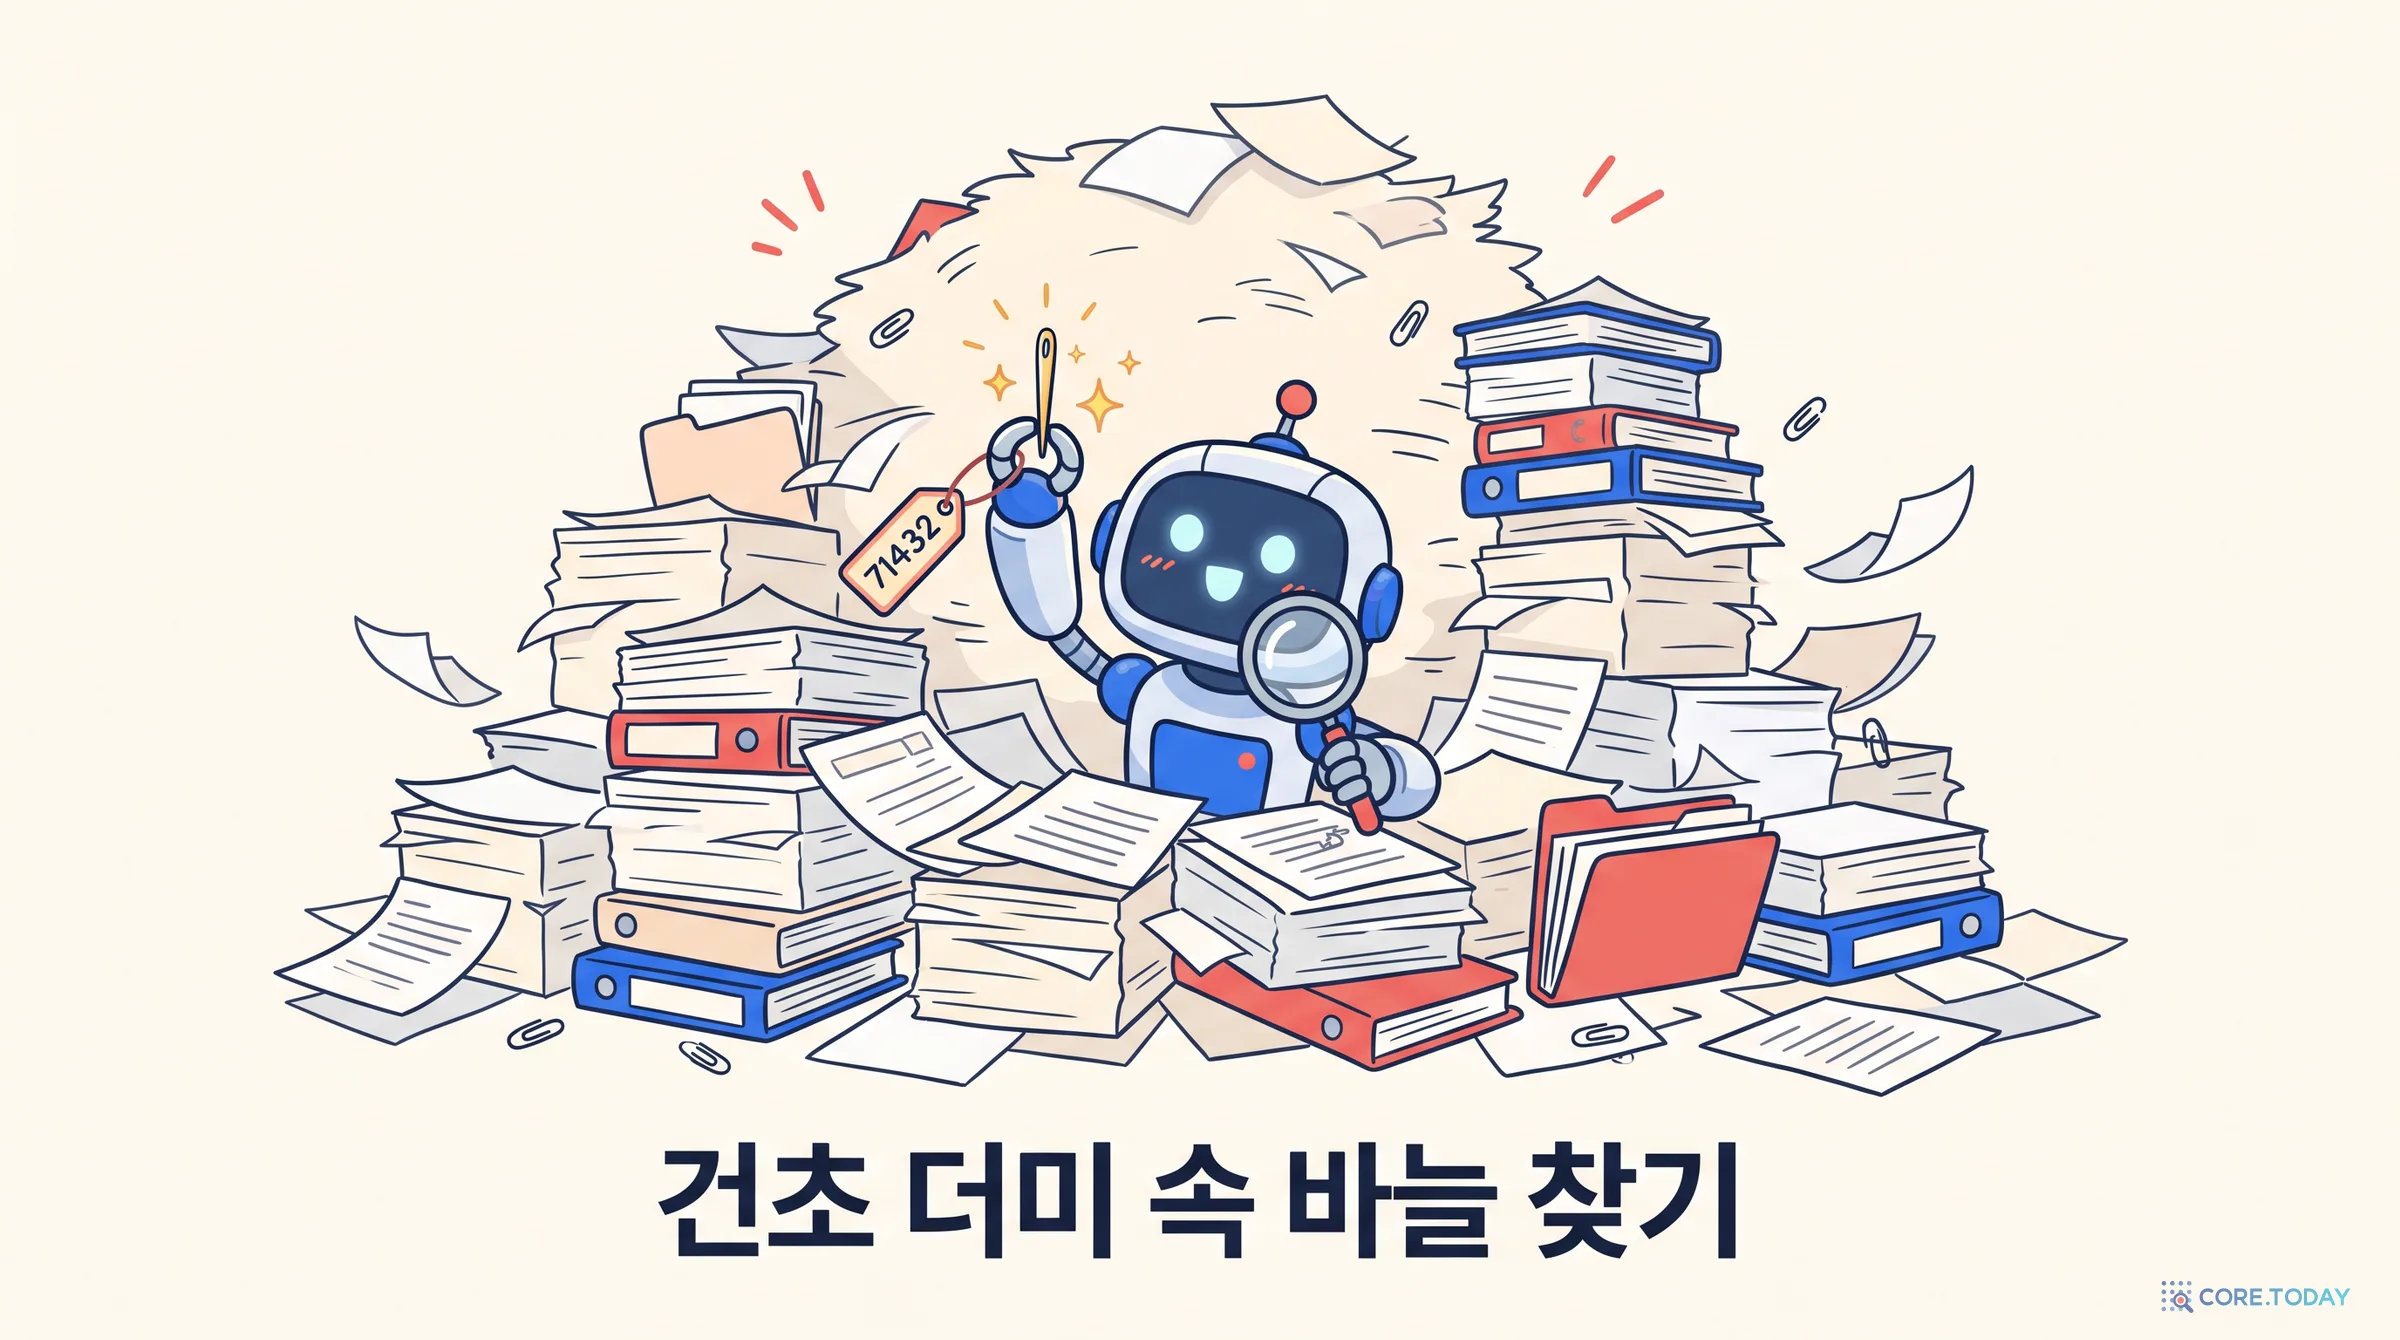
공개 언어 모델 TinyLlama(11억 파라미터)는 한 번에 최대 2,048토큰짜리 글로 학습했다. 이 모델에게 긴 글 한가운데 숨겨 둔 다섯 자리 숫자를 찾게 했다.
…The grass is green. The sky is blue. … The pass key is 71432. Remember it. … The grass is green. … What is the pass key? The pass key is
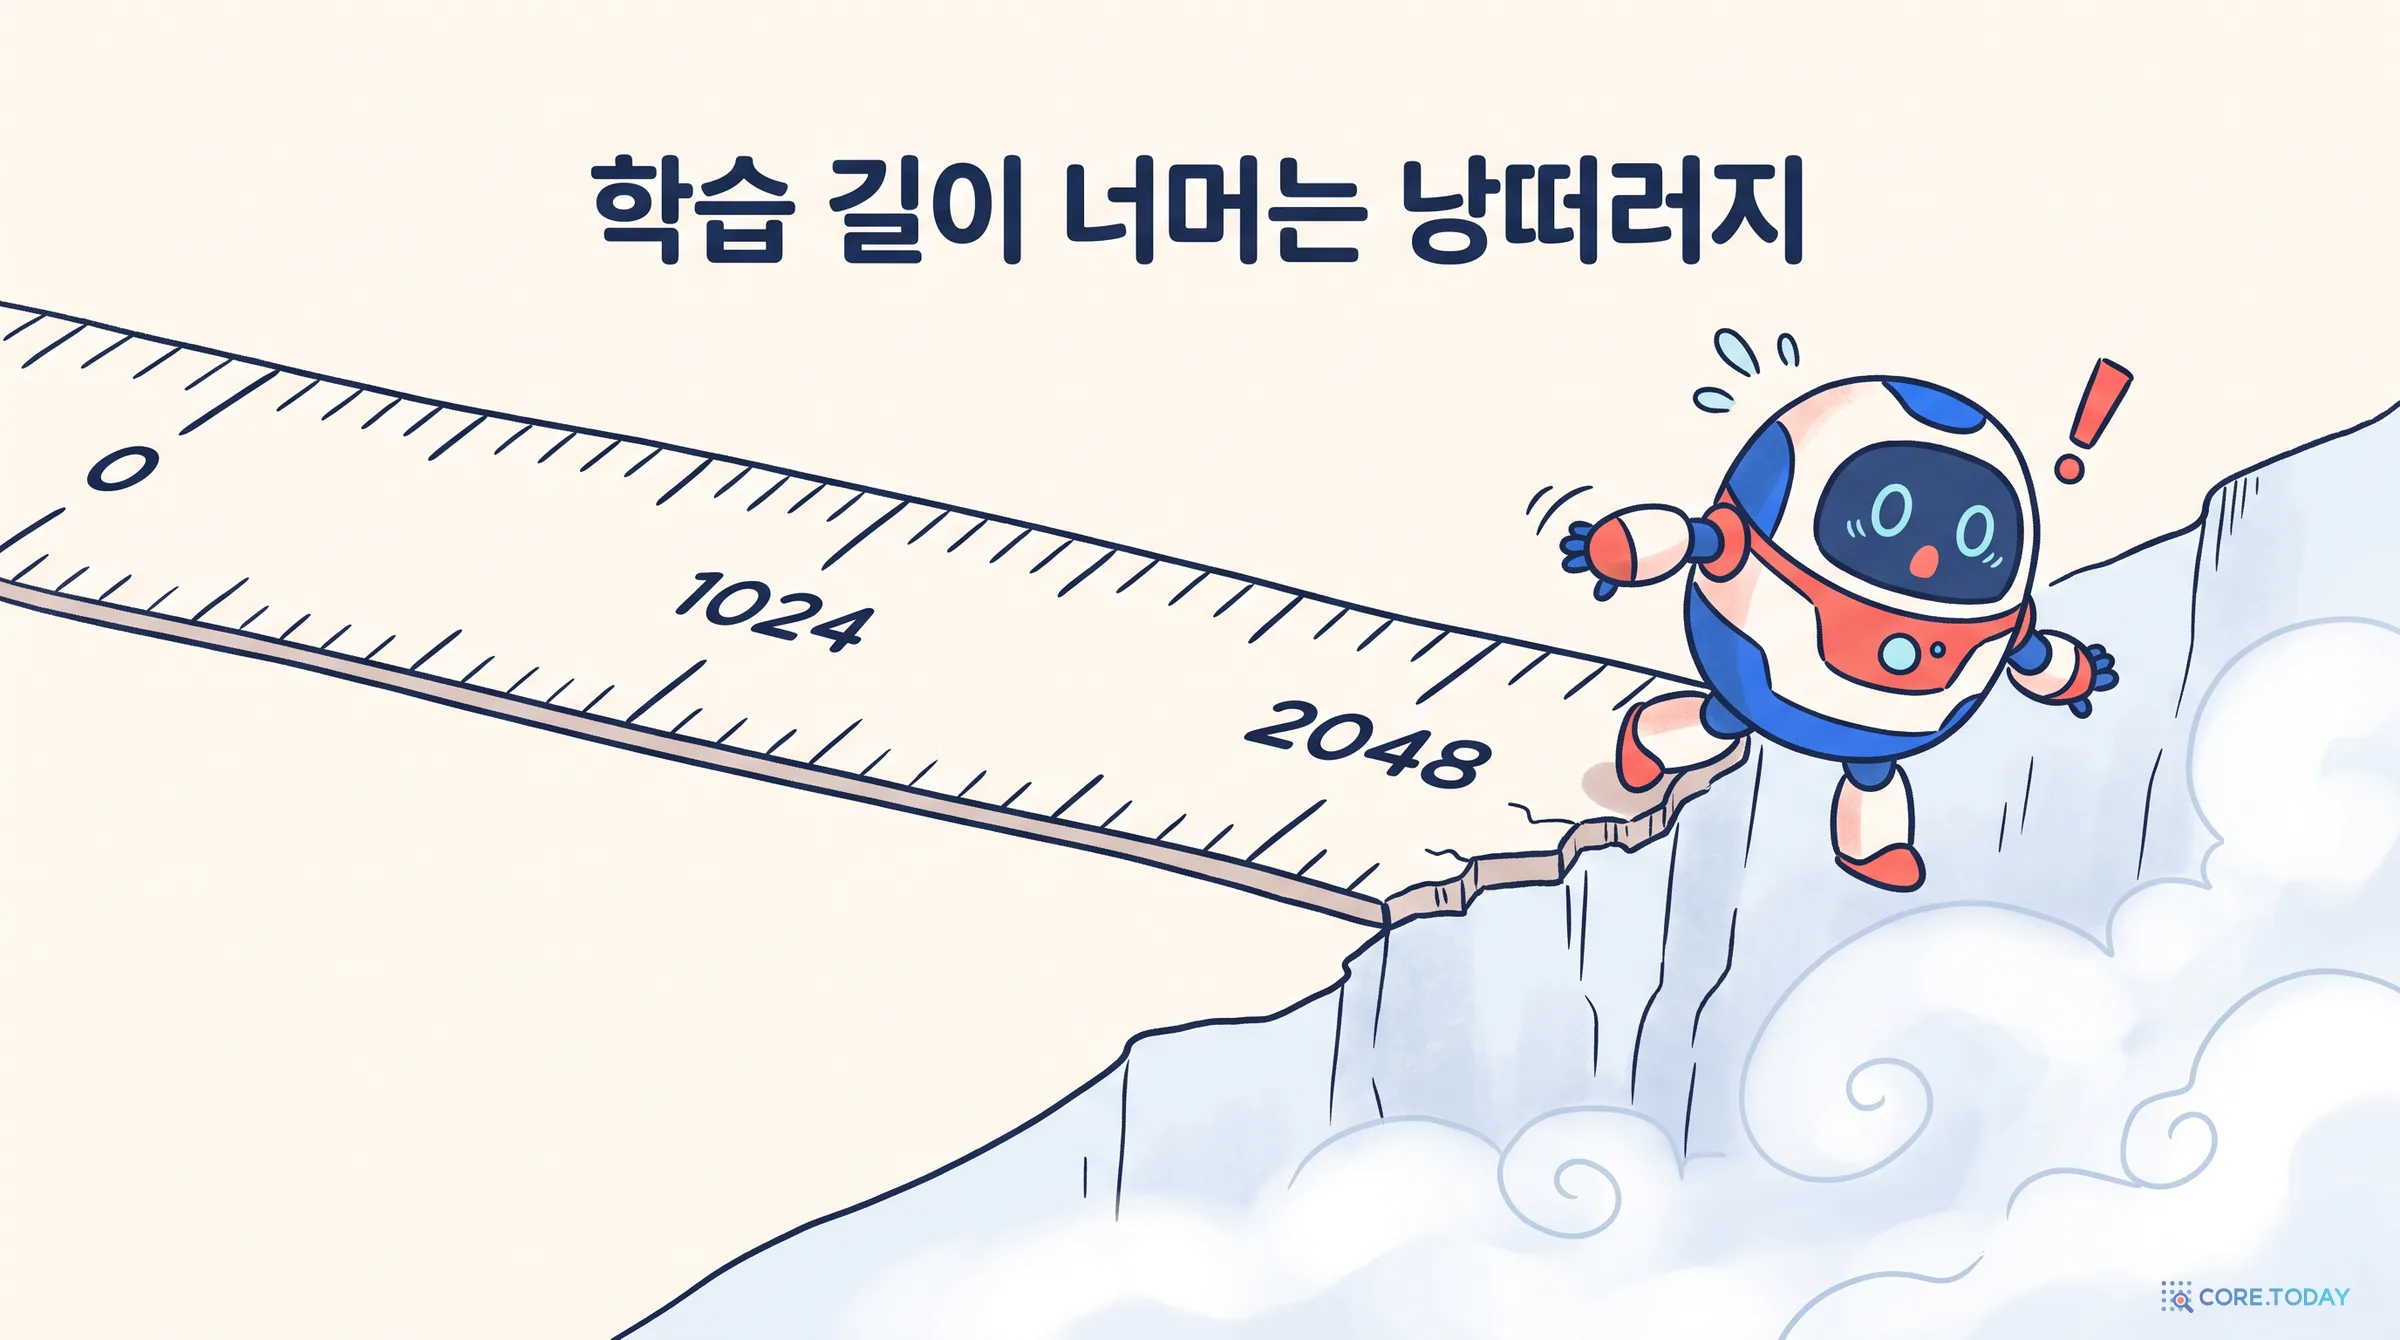
글 길이가 2,048토큰일 때는 열두 번 모두 정답을 맞혔다. 길이를 4,096토큰으로 늘리자 한 번도 맞히지 못했다. 숫자를 숨긴 위치가 앞이든 가운데든 끝이든 마찬가지였다. 같은 글을 그대로 읽힌 퍼플렉서티는 2,048토큰 안에서 17이었다. 4,000토큰을 넘어가자 5,509로 치솟았다. 모델이 글을 전혀 이해하지 못한다는 뜻이다.
그런데 모델 설정 파일에서 한 줄을 바꾸자, 추가 학습 없이 8,192토큰까지 퍼플렉서티가 20 안팎으로 유지됐다.
17.2
학습 길이(2,048) 안의 퍼플렉서티
5,509
4,096~8,192토큰 구간, 아무것도 안 했을 때
20.4
같은 구간, RoPE 설정 한 줄(YaRN)만 바꿨을 때
1,000만
2025년 Llama 4 Scout가 내세운 문맥 길이(토큰)
그 한 줄은 RoPE(Rotary Position Embedding, 회전 위치 인코딩)의 설정이다. 단어의 순서를 모델에게 알려 주는 장치다. 지금 Llama, Qwen, Gemma, DeepSeek, EXAONE, Kanana까지 공개 언어 모델 대부분이 이 방식을 쓴다. 100만 토큰 문맥 창이라는 말도 결국 이 장치를 얼마나 잘 늘리느냐의 이야기다.
트랜스포머의 핵심인 셀프 어텐션은 이렇게 동작한다. 단어마다 질문(query), 열쇠(key), 값(value) 벡터를 만든다. 각 단어는 자기 질문과 모든 단어의 열쇠를 내적해 ‘누구를 얼마나 볼지’를 정하고, 그 비율대로 값을 섞는다. 트랜스포머·어텐션 해설에서 자세히 다룬 그 계산이다.
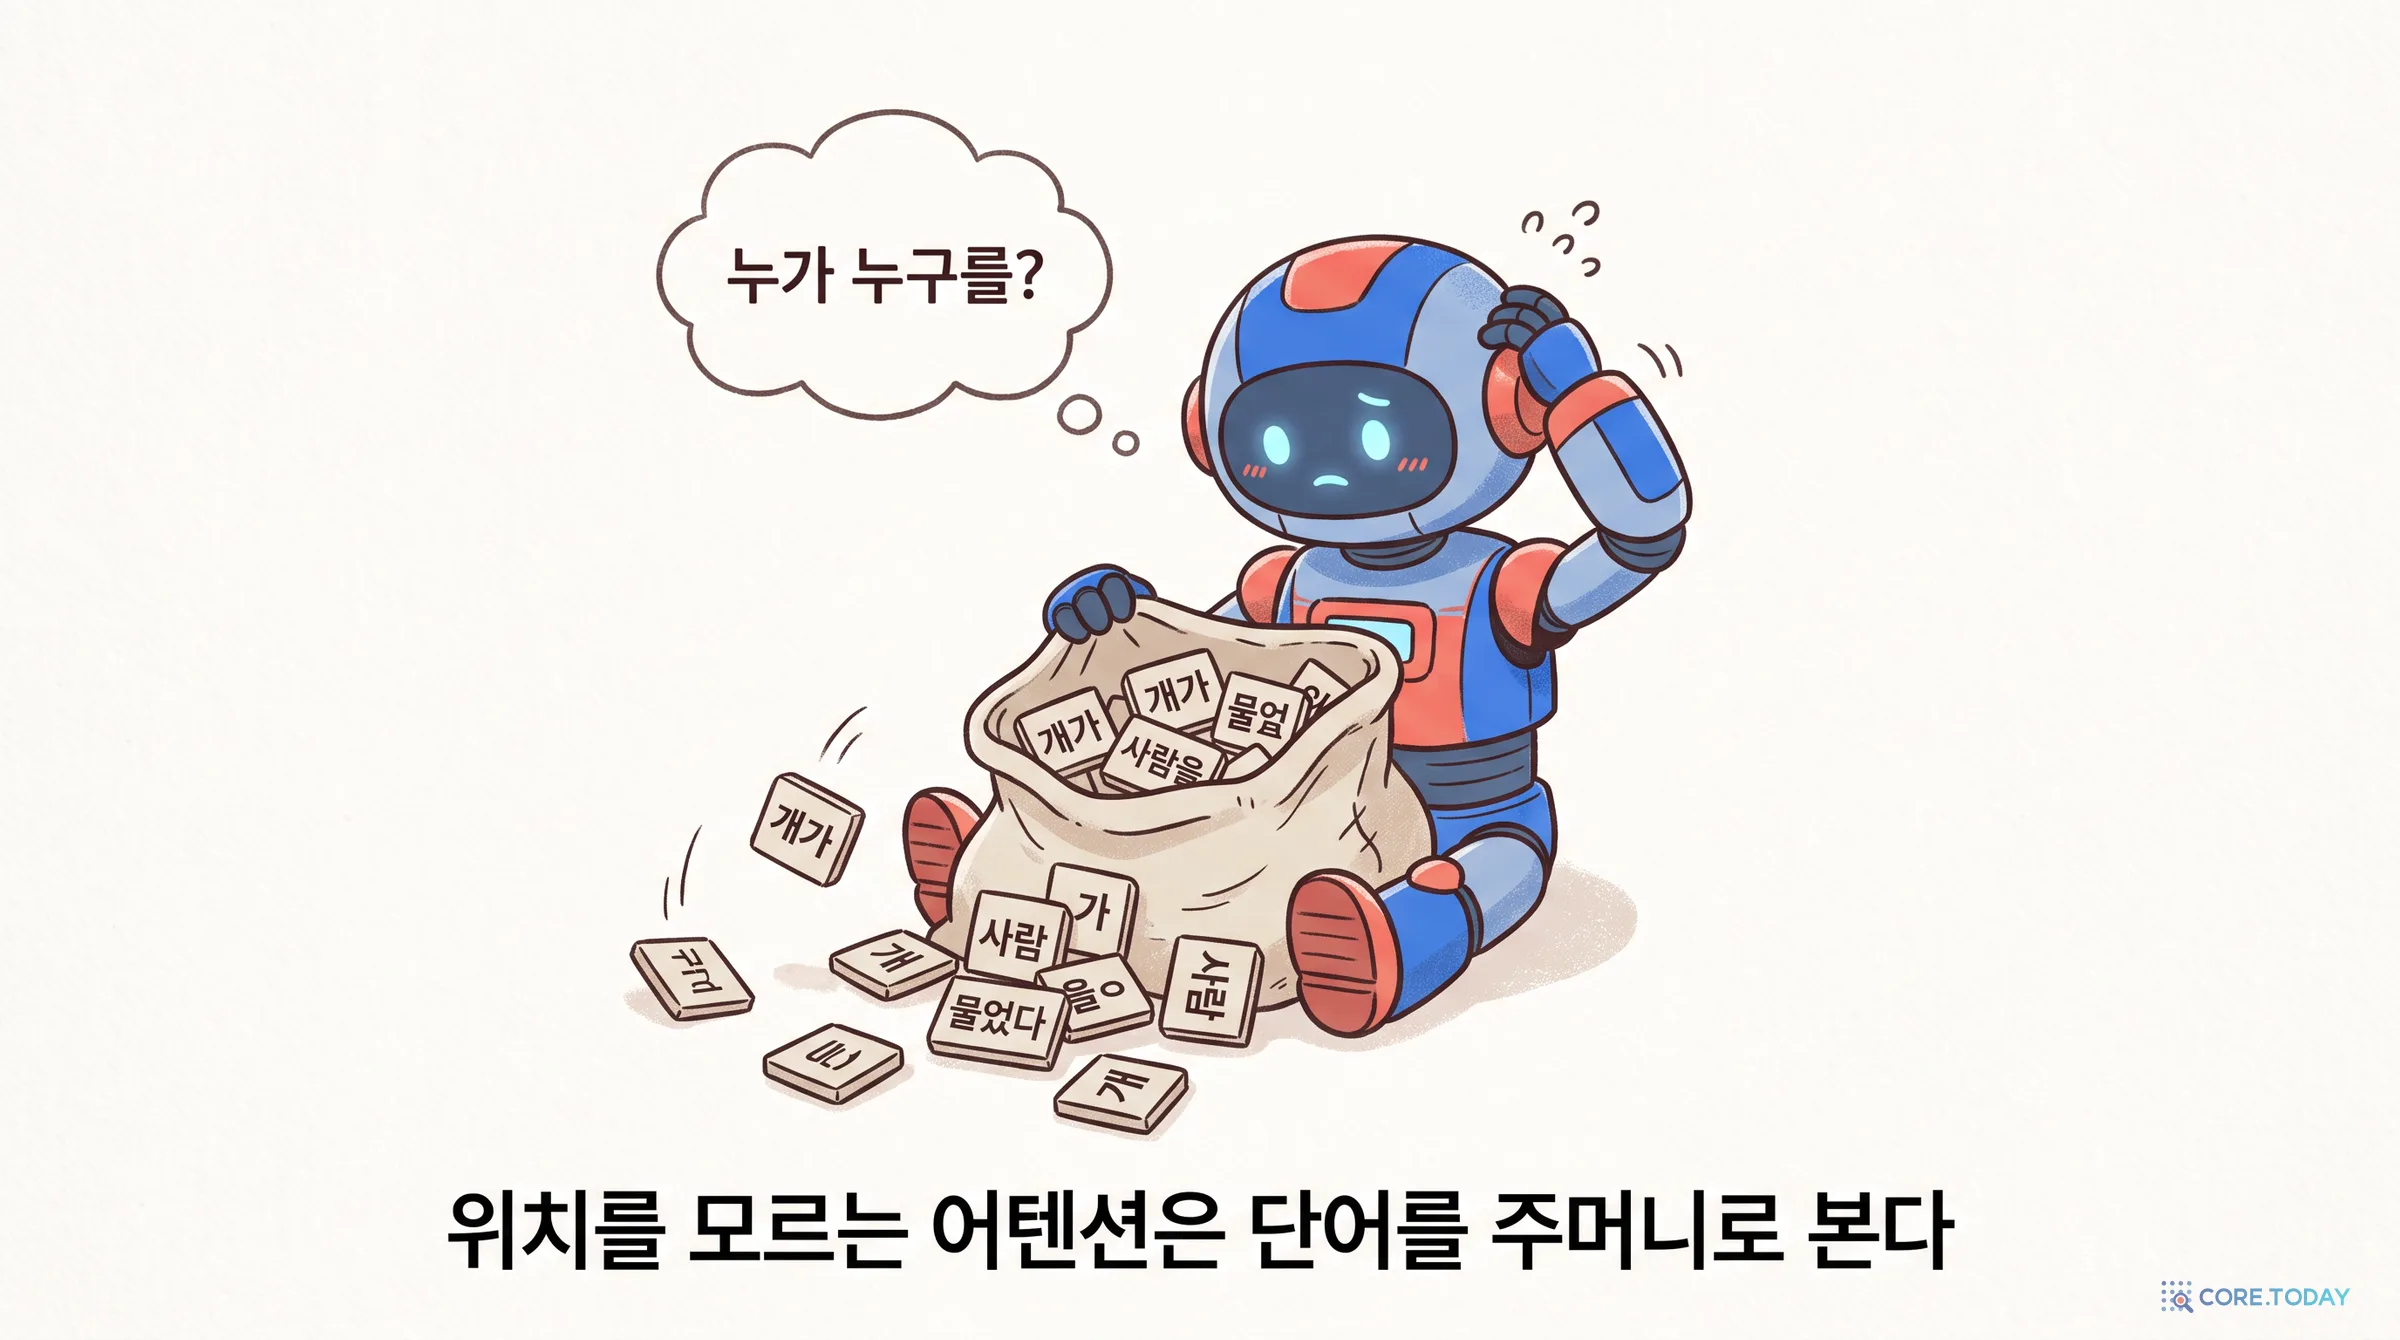
이 계산에는 순서가 들어갈 자리가 없다. 단어 A가 단어 B를 얼마나 볼지는 A와 B의 벡터로만 정해진다. B가 바로 옆에 있든 100단어 뒤에 있든 상관없다. 단어 순서를 뒤섞으면 출력도 같은 방식으로 뒤섞일 뿐, 각 단어가 받는 결과는 그대로다. 수학에서는 이를 순열 등변성(permutation equivariance)이라 부른다.
아래에서 직접 계산해 보자. 단어마다 고정된 벡터를 쓰는 작은 어텐션 한 층이다.
위치 정보를 끄면 ‘dog bites man’과 ‘man bites dog’에서 dog가 받는 결과가 소수점까지 똑같다. 개가 문 것인지 물린 것인지 어텐션은 구별하지 못한다.
한국어 사용자에게는 흥미로운 대목이 있다. 한국어는 ‘가·를’ 같은 조사가 역할을 표시한다. 그래서 ‘철수가 영희를 좋아한다’와 ‘영희를 철수가 좋아한다’는 같은 뜻이다. 위젯의 두 번째 예처럼 조사가 바뀌면 단어 자체가 달라져 위치 정보 없이도 구별된다. 그래도 순서는 여전히 중요하다. ‘밥 안 먹었어’와 ‘안 밥 먹었어’는 같은 단어 묶음이지만 하나는 자연스럽고 하나는 어색하다. 게다가 토크나이저는 조사를 떼어 내기도 한다(BPE 토큰화 특집).
1.2 그래서 위치를 ‘주입’해야 한다
2017년 트랜스포머를 처음 제안한 「Attention Is All You Need」는 이 문제를 정면으로 적었다.
우리 모델에는 순환도 합성곱도 없으므로, 모델이 순서를 활용하려면 토큰의 상대적 또는 절대적 위치에 대한 정보를 주입해야 한다.
순환 신경망(RNN)은 단어를 하나씩 차례로 읽으니 순서가 저절로 들어갔다. 트랜스포머는 모든 단어를 한꺼번에 본다. 그래서 빠르지만, 순서는 따로 알려 줘야 한다. 이것이 위치 인코딩(positional encoding)이다.
여담: 위치 인코딩을 아예 안 넣으면 어떻게 될까? 2022년 Haviv 등은 GPT처럼 앞 단어만 볼 수 있는(causal) 모델은 위치 인코딩 없이도 거의 같은 성능을 낸다고 보고했다(퍼플렉서티 13.10 대 학습형 위치 13.05). 앞에 몇 개의 단어가 있는지를 스스로 세서 위치를 추론한다는 것이다. 반면 BERT처럼 양방향을 보는 모델은 위치 없이는 학습 자체가 되지 않았다(147 대 4.06). 이 ‘NoPE’ 이야기는 7부에서 다시 나온다.
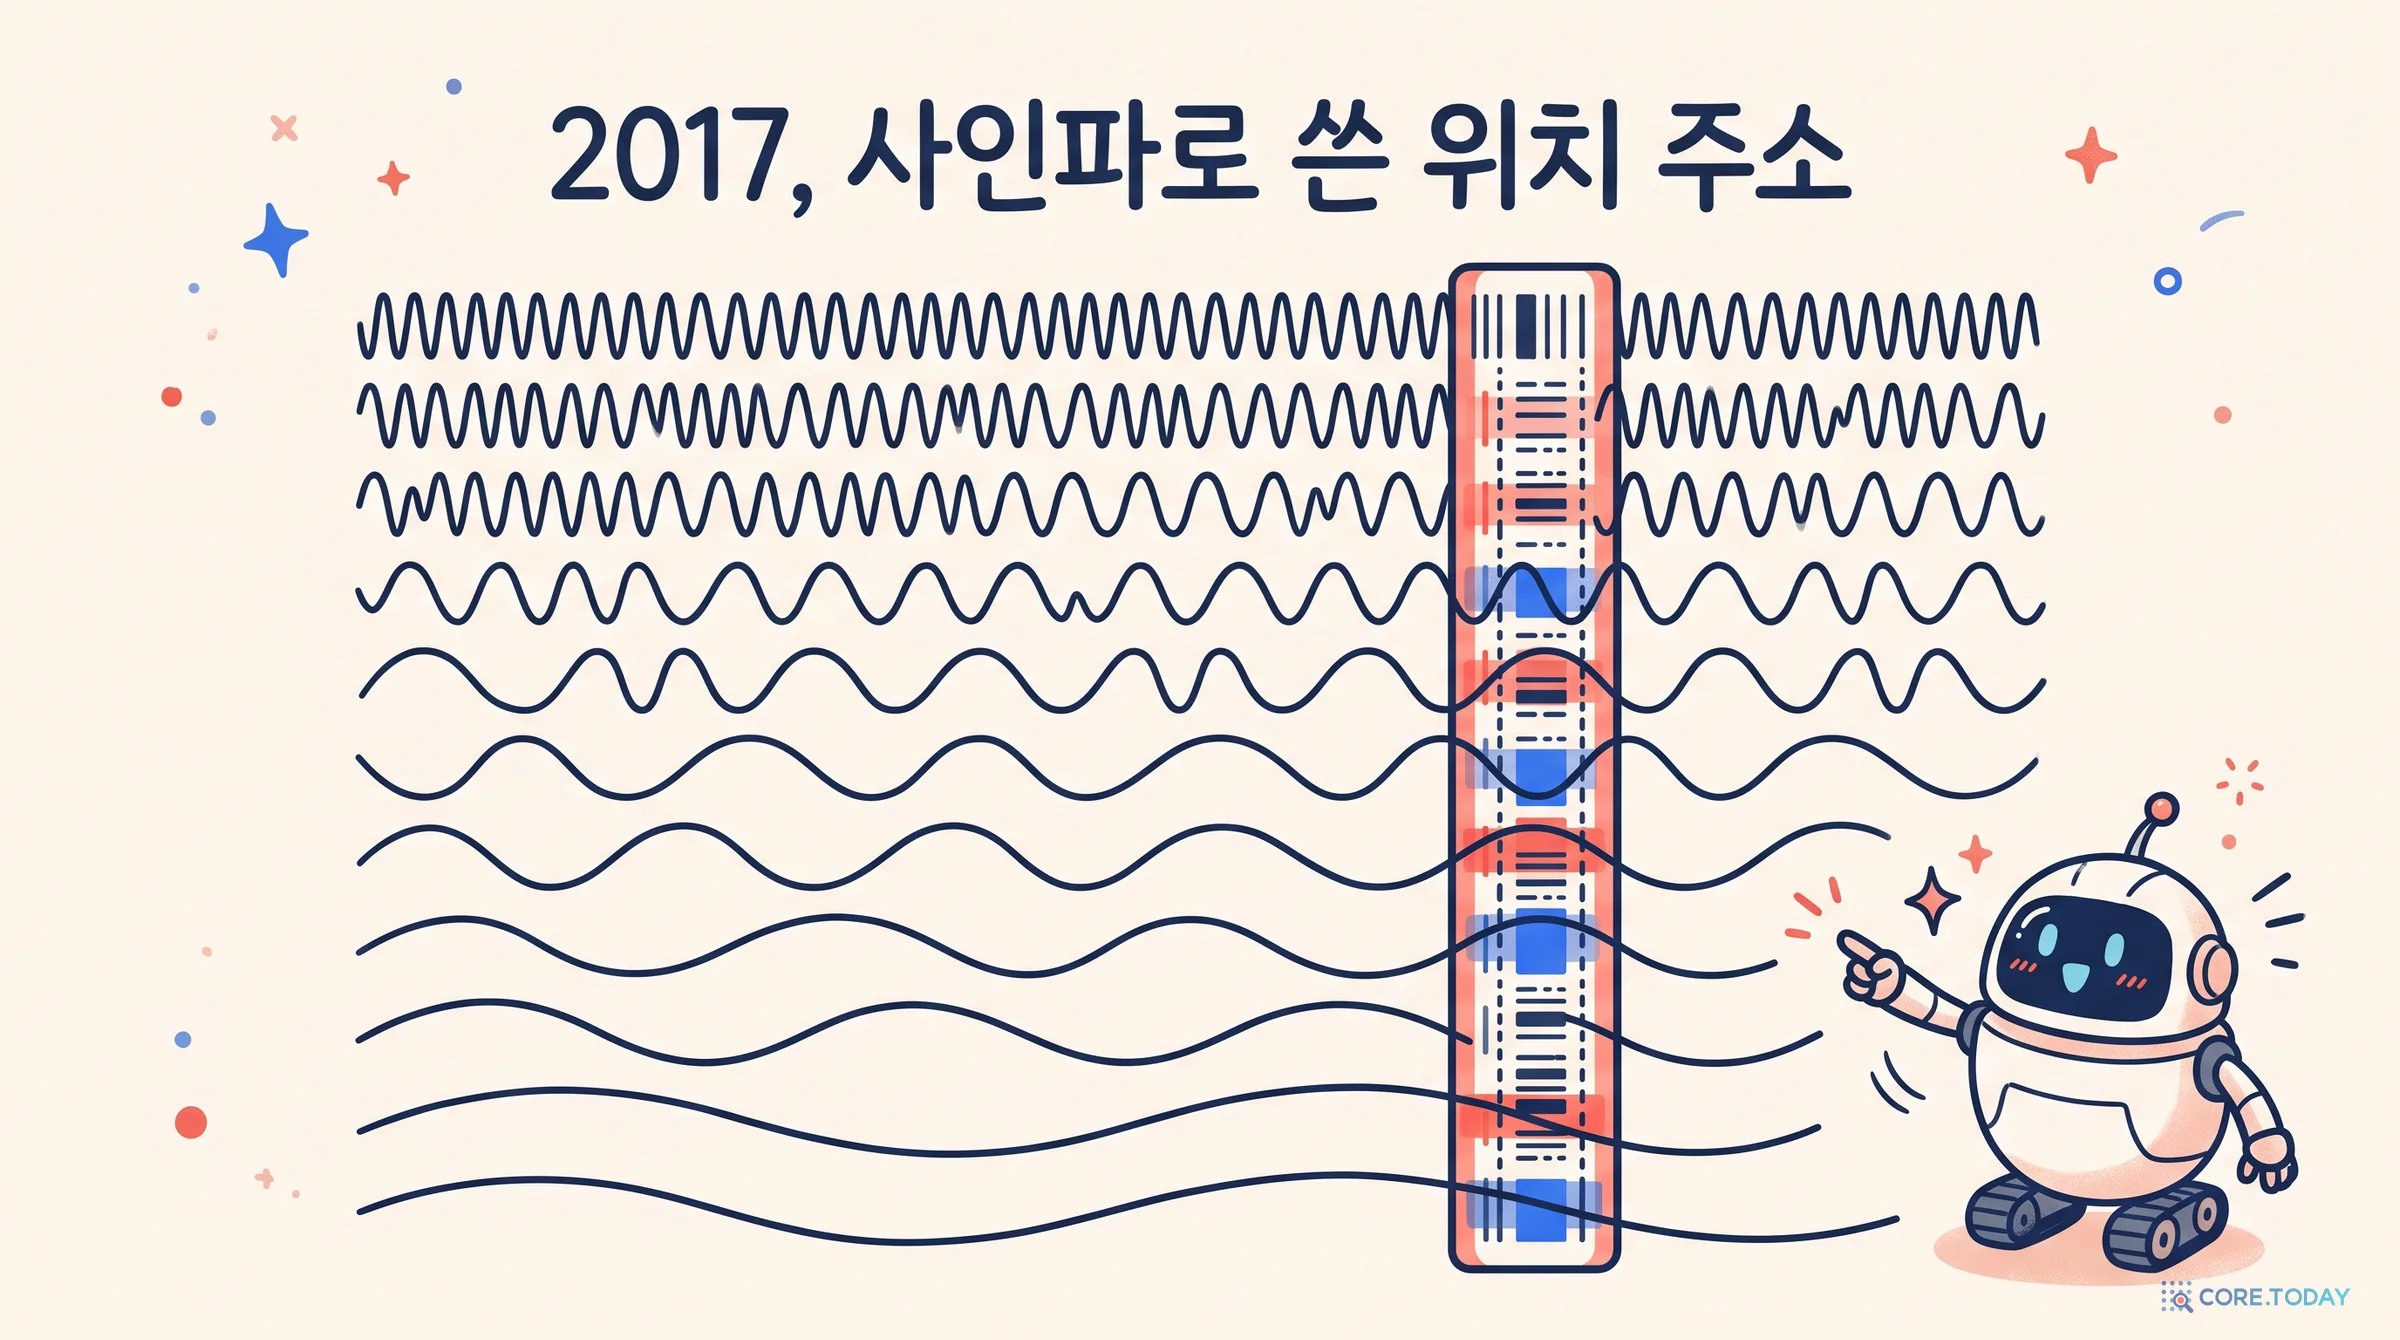
pos는 위치, i는 차원 번호, d는 벡터 차원이다. 앞쪽 차원은 위치가 하나 바뀔 때마다 크게 출렁이는 빠른 파동이다. 뒤쪽 차원은 수천 토큰에 걸쳐 천천히 변하는 느린 파동이다. 논문은 파장이 2π에서 10000⋅2π까지 기하급수로 늘어난다고 적었다. 이진수의 각 자릿수가 서로 다른 속도로 바뀌는 것과 비슷하다. 여러 파동의 값을 한데 모으면 위치마다 고유한 ‘주소’가 된다.
논문은 두 가지 기대를 걸었다.
고정된 거리 k에 대해, PEpos+k는 PEpos의 선형 함수로 표현할 수 있다.
사인·코사인의 덧셈 정리 덕분에 ‘k칸 떨어진 위치’가 일정한 변환으로 연결된다는 뜻이다. 그래서 모델이 상대 위치를 배우기 쉬울 것이라 봤다. 두 번째는 이것이다.
학습하는 위치 벡터와 거의 같은 결과가 나왔다. 사인파 방식을 고른 것은 학습 때보다 긴 문장으로 외삽할 수도 있기 때문이다.
실제로 학습형과 사인파의 차이는 BLEU 25.7 대 25.8로 거의 없었다. 외삽에 대한 기대는 5년 뒤 빗나간 것으로 밝혀진다(4부).
2.2 학습형 위치 — 512와 1,024의 벽
GPT와 BERT는 위치마다 벡터를 학습하는 단순한 방법을 택했다. 위치 0번 벡터, 1번 벡터, … 511번 벡터를 단어 벡터처럼 학습한다. BERT는 최대 512, GPT-2는 1,024였다. 이 방식에는 분명한 한계가 있다. 배운 적 없는 513번째 위치의 벡터는 아예 존재하지 않는다. 문맥 길이가 설계 단계에서 못 박힌다.
2.3 상대 위치 — ‘몇 번째’가 아니라 ‘얼마나 떨어졌나’
언어에서 중요한 것은 대개 절대 위치가 아니라 상대 거리다. ‘먹었다’에게는 ‘밥을’이 문장의 7번째인지보다 자기 바로 앞에 있는지가 중요하다.
2018년 구글의 피터 쇼(Peter Shaw) 등은 두 단어 사이의 거리를 어텐션 계산에 직접 넣었다. 거리는 일정 범위(기본 16)에서 잘랐다. 그보다 먼 거리는 모두 ‘멀다’로 취급했다. 흥미로운 실험이 있다. 거리 창의 크기를 바꿔 가며 번역 점수를 쟀다.
상대 거리 창 k
영→독 BLEU (개발 세트)
0 (거리 정보 없음)
12.5
1
25.5
2
25.8
16
25.8
256
25.8
위치 정보가 전혀 없으면(k=0) 번역 점수는 반토막이 났다. 그런데 바로 옆 두 칸까지만 알려 줘도 성능이 다 돌아왔다. 층을 여러 번 쌓으면 짧은 거리 정보가 이어 붙어 먼 거리까지 전달되기 때문이다.
이후 Transformer-XL(2019)은 상대 위치를 정교하게 넣어 긴 글을 이어 읽게 했다. 구글의 T5(2020)는 거리를 32개 구간으로 묶었다. 가까울수록 촘촘하고 멀수록 넓게(최대 128) 묶은 구간마다 어텐션 점수에 더할 숫자 하나를 학습하는 간단한 방식이었다.
상대 위치는 성능이 좋았다. 대신 계산이 복잡해졌다. 어텐션 점수마다 거리에 따른 항을 따로 더해야 했다. 이 둘을 동시에 잡은 것이 다음 주인공이다.
RoPE의 아이디어는 고등학교 수학으로 설명된다. 2차원 평면의 벡터 하나를 각도 α만큼 돌리고, 다른 벡터를 각도 β만큼 돌렸다고 하자. 두 벡터의 내적은 둘 사이의 각도로 정해진다. 둘 다 돌렸으니 사이의 각도는 원래 각도에서 α−β만큼만 바뀐다. 각자 얼마나 돌았는지는 사라지고 차이만 남는다.
RoPE는 이 성질을 위치에 쓴다. 위치 m에 있는 단어의 질문 벡터 q를 mθ만큼, 위치 n에 있는 단어의 열쇠 벡터 k를 nθ만큼 돌린다.
(q1′q2′)=(cosmθsinmθ−sinmθcosmθ)(q1q2)
그러면 어텐션 점수는 다음과 같다.
⟨Rmq,Rnk⟩=q⊤Rn−mk
절대 위치 m, n은 사라지고 거리 n−m만 남는다. 절대 위치를 넣었는데 상대 위치가 나온다. 단어 벡터에 무언가를 더하지 않으니 벡터의 크기도 바뀌지 않는다. 상대 위치 방식처럼 거리별 항을 따로 계산할 필요도 없다. 질문과 열쇠를 한 번씩 돌리면 끝이다.
실제 모델의 벡터는 2차원이 아니라 128차원쯤이다. RoPE는 벡터를 두 칸씩 64쌍으로 나눠 쌍마다 다른 속도로 돌린다. i번째 쌍의 각속도는 이렇다.
θi=base−2i/d,i=0,1,…,d/2−1
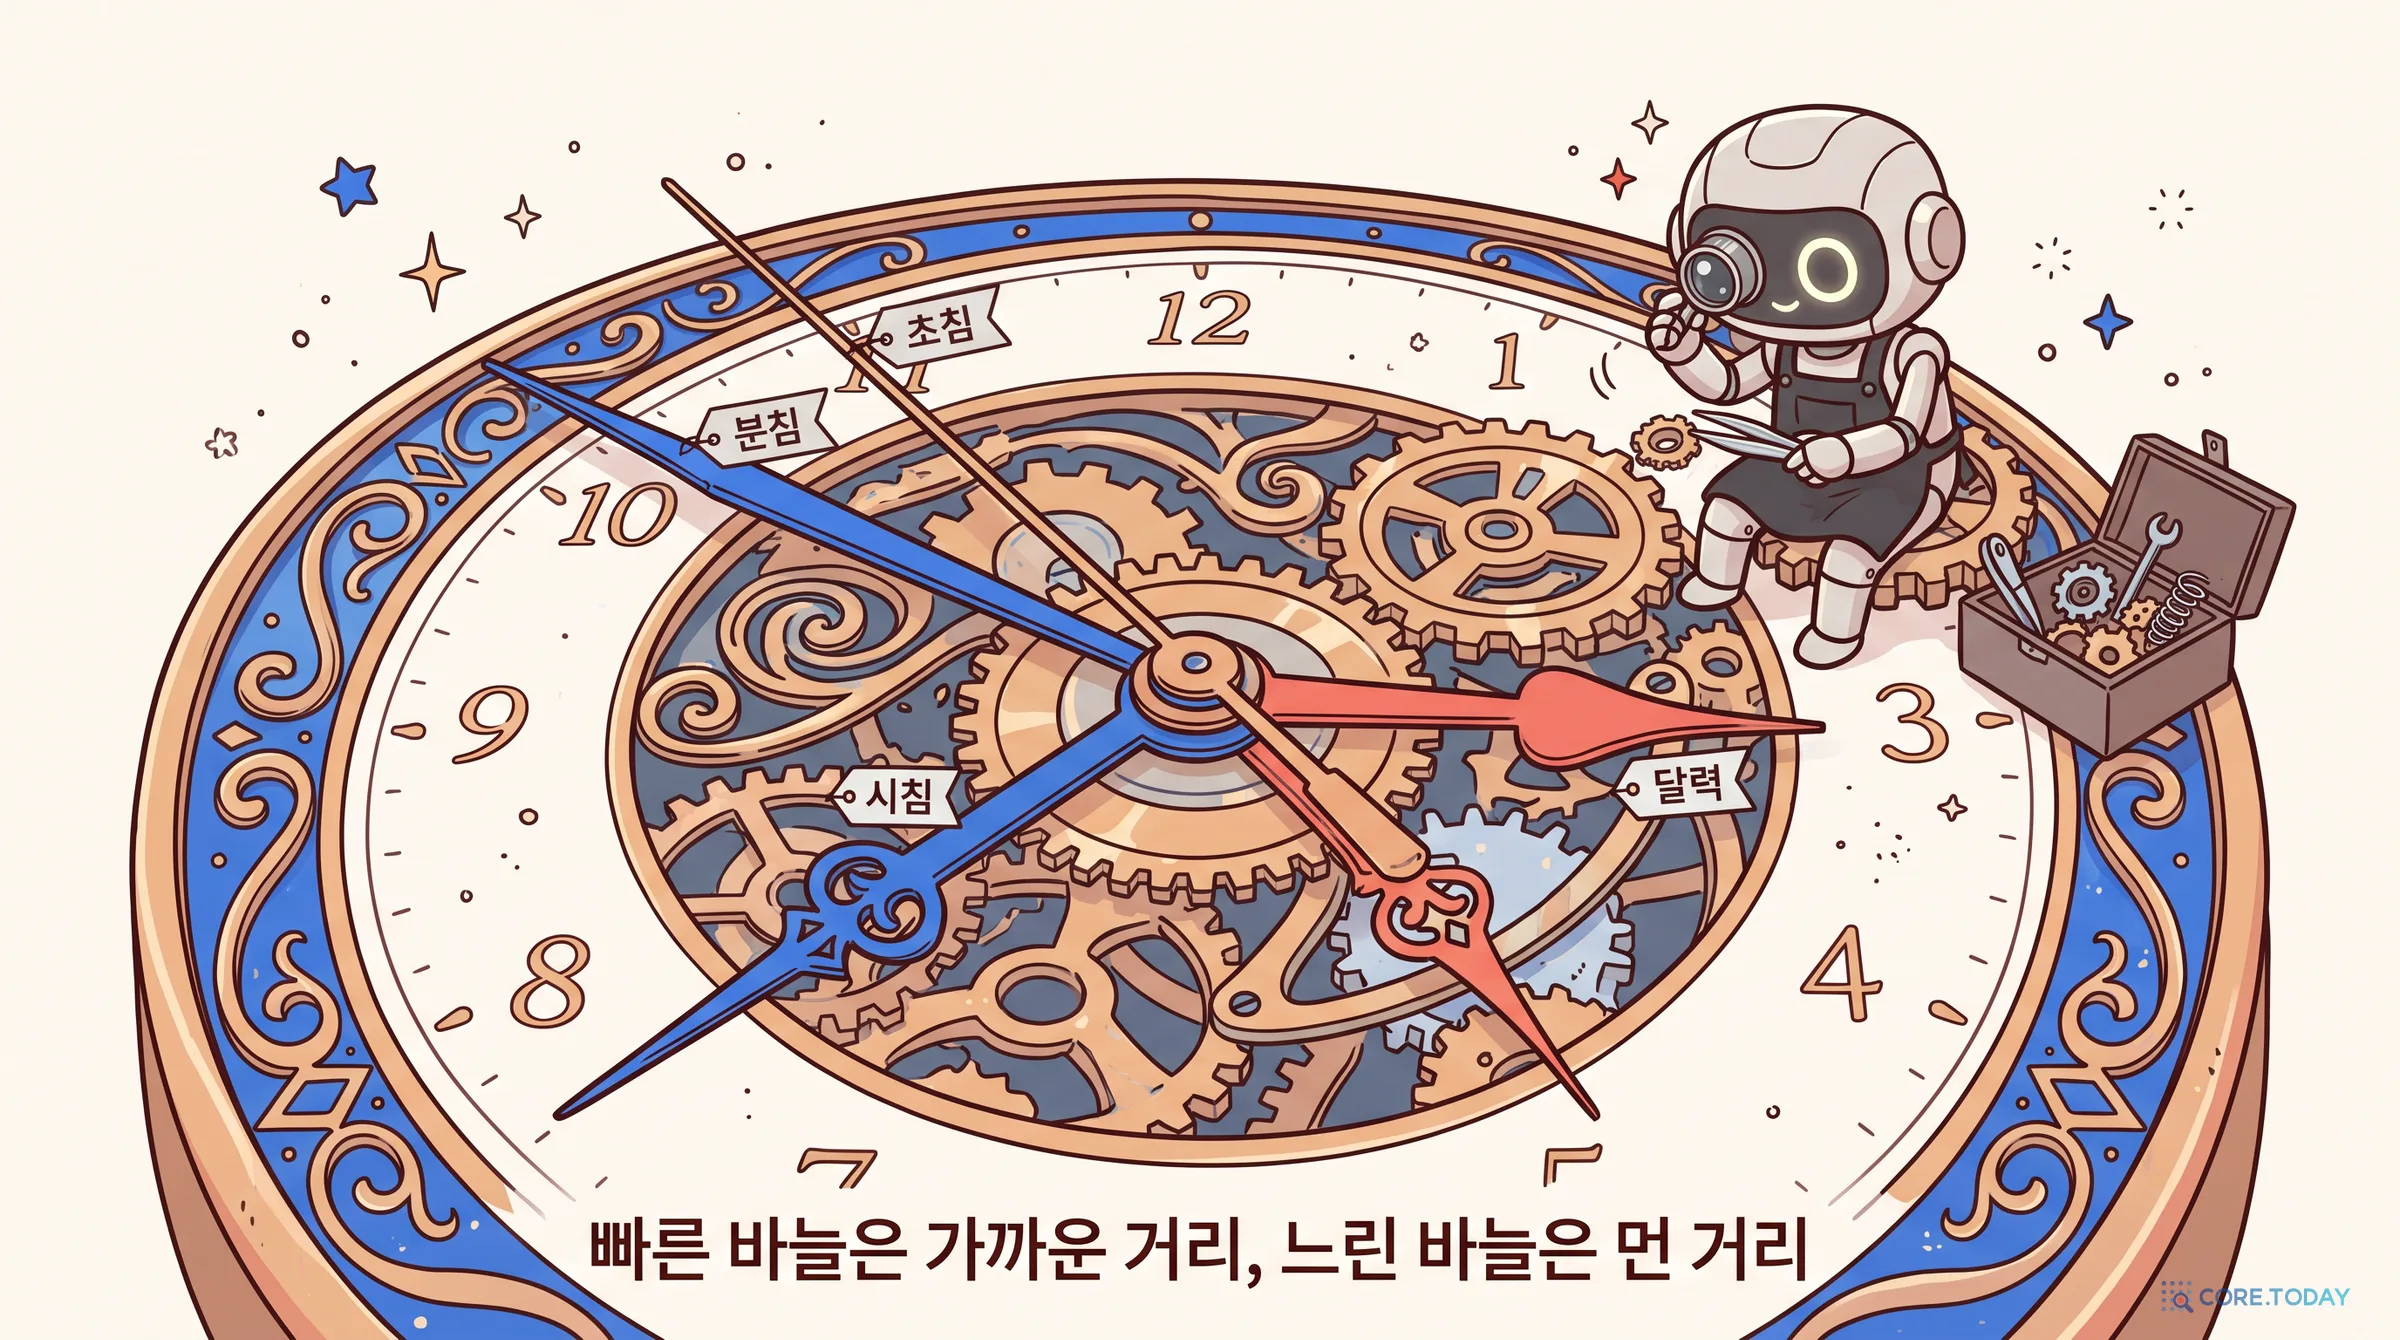
base는 보통 10,000이다. 사인파와 똑같은 주파수 사다리를 회전에 쓴 것이다. 0번 쌍은 한 토큰마다 1라디안씩 돌아 약 6토큰에 한 바퀴를 돈다. 63번 쌍은 한 바퀴에 5만 토큰 넘게 걸린다. 시계의 초침·분침·시침처럼 빠른 바늘은 가까운 거리를, 느린 바늘은 먼 거리를 구별한다.
아래 시계로 직접 확인해 보자. 파란 바늘(q)과 빨간 바늘(k)을 각자의 위치만큼 돌린다. ‘둘 다 +50’을 누르면 모든 바늘이 돌아가지만, 두 바늘 사이의 각도와 내적은 그대로다.
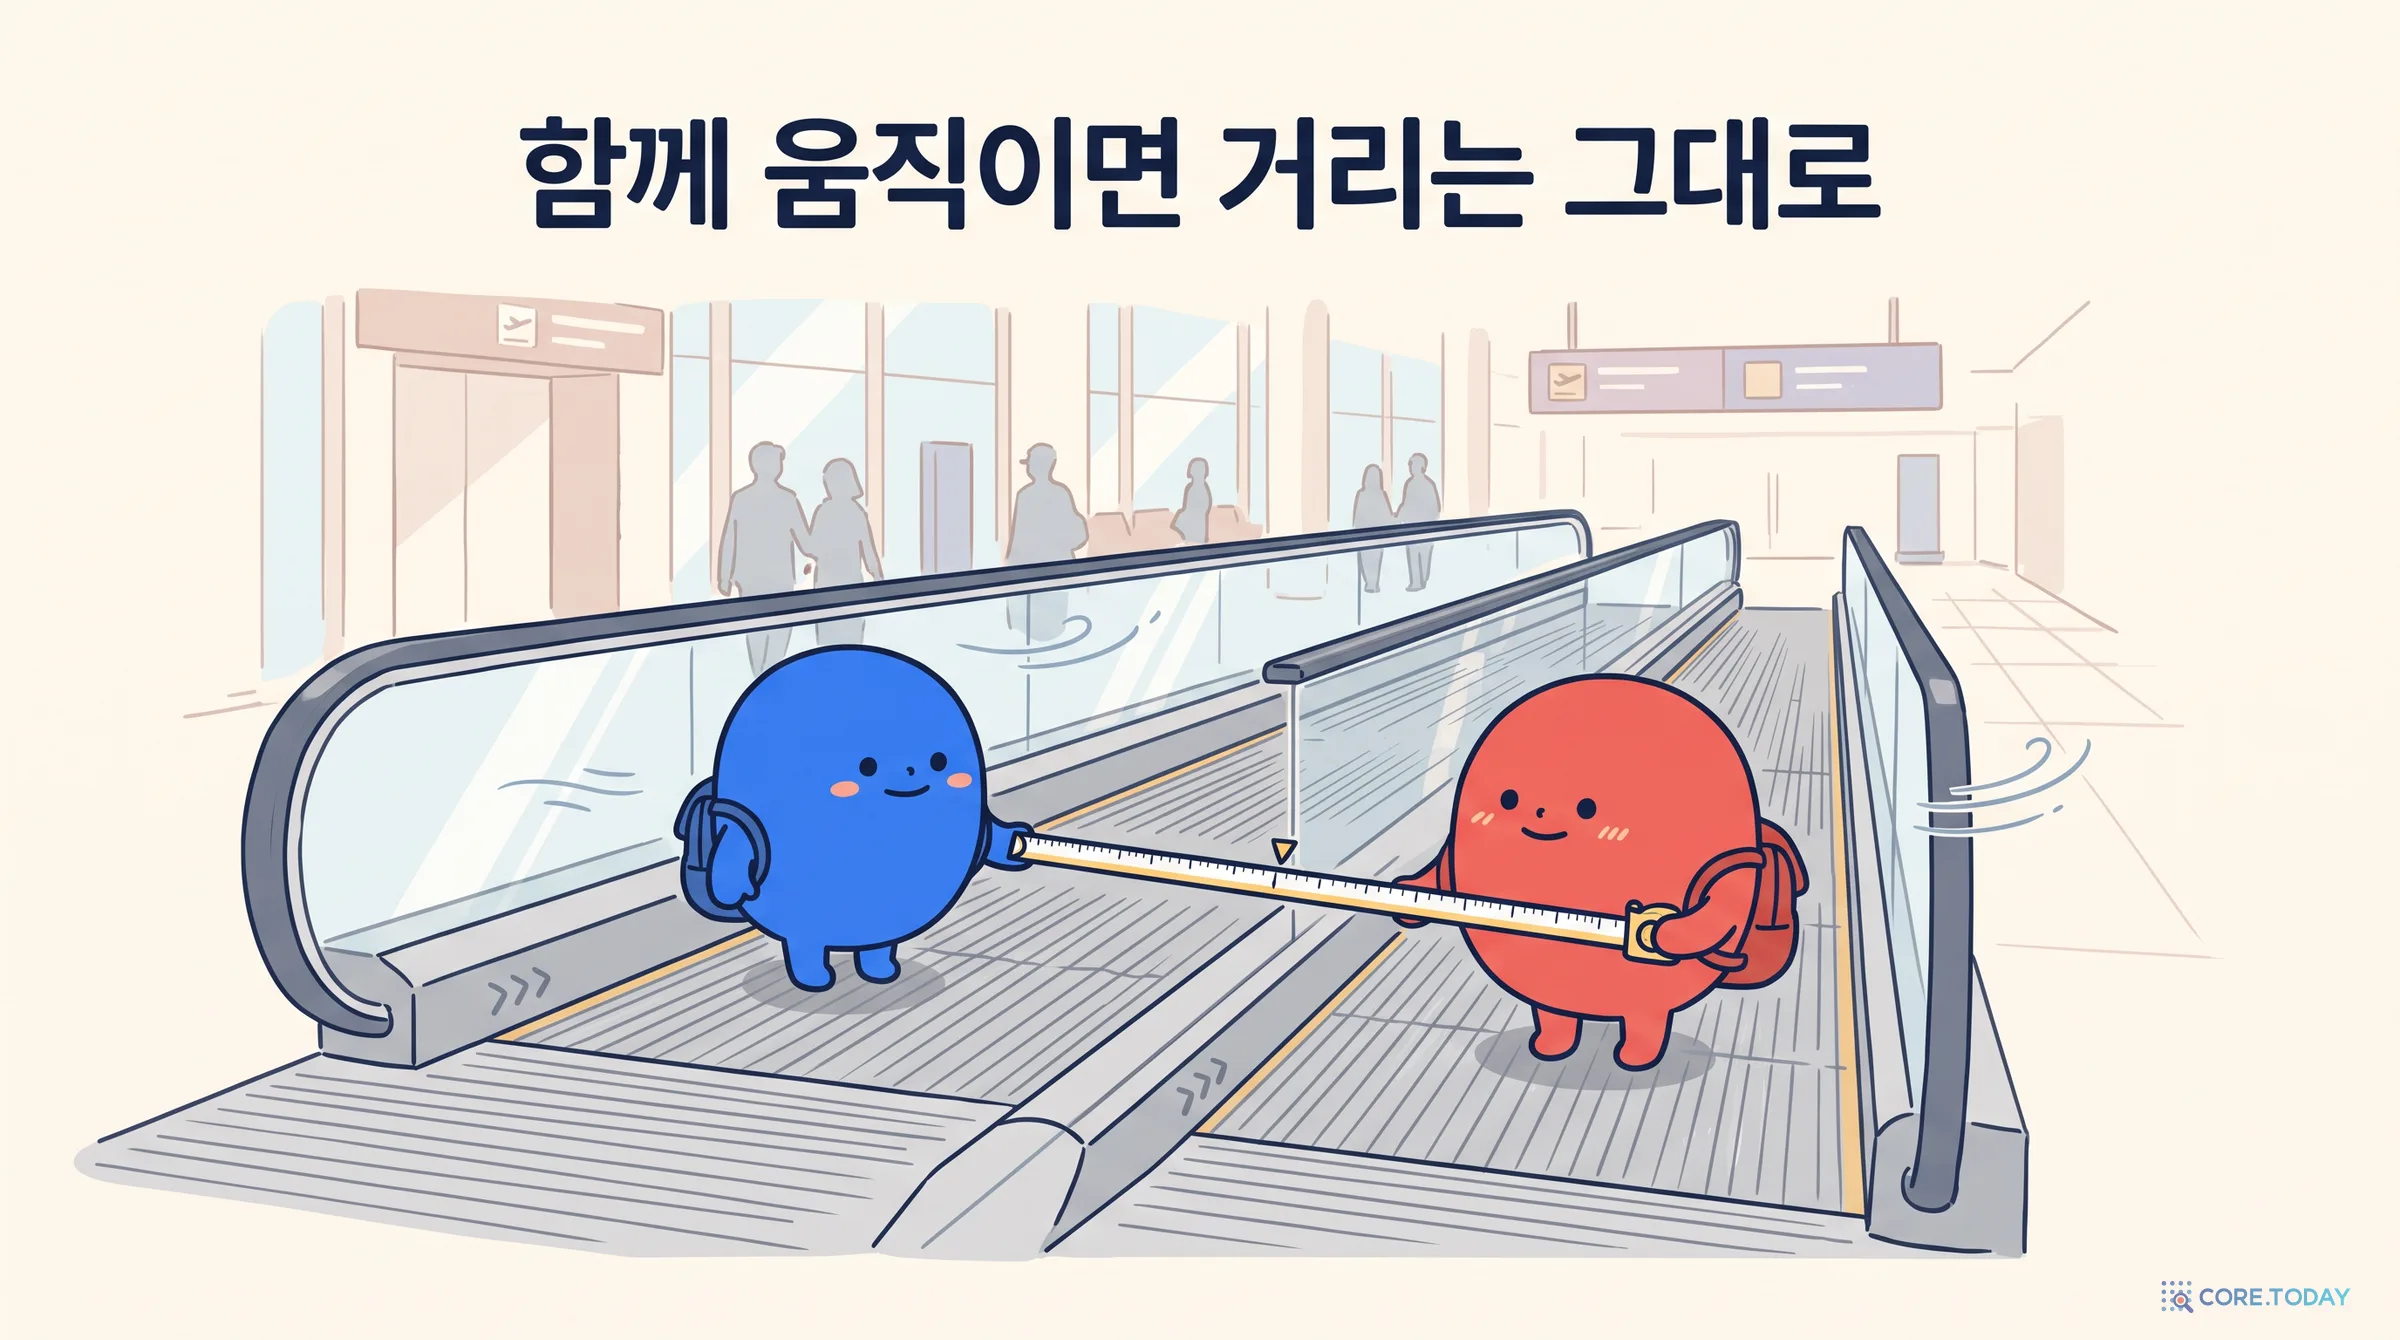
이 성질 덕분에 ‘밥을 먹었다’라는 구절은 글의 맨 앞에 있든 1만 번째 토큰에 있든 같은 방식으로 계산된다. 공항의 무빙워크 위에 선 두 사람처럼, 함께 움직이면 둘 사이의 거리는 변하지 않는다.
3.2 중국 블로그에서 시작해 표준이 되기까지
RoPE는 학회 논문보다 블로그 글로 먼저 세상에 나왔다. 중국 AI 스타트업 Zhuiyi(追一科技)의 연구자 수젠린(苏剑林)은 자신의 블로그 ‘과학공간(kexue.fm)’에 2021년 2월 3일 ‘복소수로 위치를 곱하면 내적이 상대 위치 m−n에만 의존한다’는 아이디어를 “아직 충분히 검증되지 않았다”는 단서와 함께 올렸다. 3월 23일에는 이를 정리한 「Transformer 업그레이드의 길 2: 장점을 모은 회전식 위치 인코딩」을 올렸다.
2021년 4월 20일, 논문 「RoFormer: Enhanced Transformer with Rotary Position Embedding」이 arXiv에 올라왔다. 같은 날 미국의 오픈소스 연구 집단 EleutherAI는 블로그 「Rotary Embeddings: A Relative Revolution」을 공개했다. 자기들 실험에서 RoPE가 학습형 절대 위치보다 약 30%, T5식 상대 위치보다 10~20% 빨리 수렴했다는 내용이었다.
위치 인코딩 (Pile, 15억 파라미터, 8천 단계)
검증 손실
퍼플렉서티
학습형 절대 위치
2.240
9.393
T5 상대 위치
2.223
9.234
RoPE
2.173
8.784
EleutherAI는 RoPE를 GPT-J와 GPT-NeoX에 넣었다. 계산을 아끼려고 머리 차원의 앞 25%에만 회전을 거는 ‘부분 회전’도 이때 나왔다. 2022년 구글의 PaLM이, 2023년 메타의 LLaMA가 RoPE를 채택하면서 RoPE는 사실상 표준이 됐다. LLaMA 이후 쏟아진 공개 모델들이 모두 그 구조를 이어받았기 때문이다.
3.3 그런데 왜 잘 되는가?
흥미롭게도 RoFormer 논문은 한계 절에서 이렇게 고백했다.
왜 더 빨리 수렴하는지에 대한 충분한 설명이 부족하다. 긴 글에서 더 나은 이유도 아직 믿을 만한 설명을 찾지 못했다.
논문이 내세운 설명은 장거리 감쇠(long-term decay)였다. 두 토큰의 거리가 멀어질수록 어텐션 점수가 가질 수 있는 최댓값이 줄어든다는 것이다. 가까운 단어에 더 쉽게 주목하게 만든다는 직관이다. 이 설명은 오랫동안 교과서처럼 인용됐다.
2025년 ICLR에 발표된 「Round and Round We Go! What makes Rotary Positional Encodings useful?」(Barbero 등)은 이 설명을 뒤집었다.
감쇠는 질문·열쇠 벡터가 모든 성분이 같은 특수한 경우에만 성립한다. 무작위 벡터에서는 감쇠가 없다.
구글 Gemma 7B를 들여다보니, 모델은 가장 빠른 주파수로 ‘바로 앞 단어 보기’ 같은 위치 전용 어텐션 머리를 만들었다. 위치 인코딩이 없는 모델은 이런 머리를 만들 수 없다는 것도 증명했다.
반대로 가장 느린 주파수는 위치가 거의 바뀌지 않으므로 단어의 의미를 실어 나르는 통로로 쓰였다. 이 통로는 아주 긴 문맥에서 흔들린다.
그래서 연구진은 가장 느린 주파수 일부를 아예 회전시키지 않는 p-RoPE를 제안했다. 하위 25%를 끈 0.75-RoPE가 일반 RoPE보다 퍼플렉서티가 조금 나았다. ‘왜 잘 되는가’는 RoPE가 나온 지 4년이 지나서도 여전히 연구 주제다.
사인파도 RoPE도 수식만 보면 어떤 위치에서든 값을 계산할 수 있다. 원조 논문의 기대대로라면 학습 때보다 긴 글도 읽어야 했다. 2022년 ALiBi 논문(Press 등)이 이를 체계적으로 쟀다. 1,024토큰으로 학습한 모델에 더 긴 글을 넣었다.
입력 길이 (학습 1,024)
사인파
RoPE
T5 상대 위치
ALiBi
1,024
19.34
19.33
18.80
18.66
2,024
51.09
31.17
18.34
18.05
16,024
453.32
106.99
메모리 초과
17.98
WikiText-103 퍼플렉서티. 낮을수록 좋다.
사인파는 학습 길이에서 수십 토큰만 넘어가도 무너졌다. RoPE는 조금 더 버텼지만 결국 무너졌다. ALiBi는 위치 벡터를 아예 쓰지 않는다. 대신 거리에 비례하는 벌점을 어텐션 점수에서 빼서, 16배 긴 글에서도 퍼플렉서티를 지켰다. 그래서 BLOOM과 MPT가 ALiBi를 택했다. MPT-7B-StoryWriter는 6만 5천 토큰으로 학습해 8만 4천 토큰까지 글을 썼다.
4.2 직접 확인 — 2,048토큰만 배운 모델에게 8,192토큰을
들어가며의 실험을 자세히 보자. TinyLlama(학습 길이 2,048, base 10,000)에 『오만과 편견』의 8,192토큰 구간 여섯 개를 넣고 위치별 퍼플렉서티를 쟀다. 아래 위젯의 ‘그대로’ 선이 그 결과다. 다른 선들은 5부에서 다룬다.
‘그대로’ 선은 학습 길이 2,048을 넘는 순간 수직으로 치솟는다. 패스키 탭을 보면 더 극적이다. 2,048토큰까지는 모든 깊이에서 100%, 4,096토큰부터는 모두 0%다.
4.3 왜 무너지나 — 한 바퀴도 못 돌아 본 바늘
RoPE는 상대 거리만 쓴다. 그렇다면 학습 때 본 거리 안에서는 문제가 없어야 하지 않을까? 문제는 학습 때 본 적 없는 거리다. 2,048토큰으로 학습한 모델은 2,048을 넘는 거리를 한 번도 본 적이 없다.
시계로 생각하면 분명해진다. 초침처럼 빠른 바늘은 2,048토큰 동안 수백 바퀴를 돈다. 모든 각도를 충분히 겪어 봤다. 반면 시침·달력처럼 느린 바늘은 한 바퀴의 일부만 돌았다. 아래 스펙트럼에서 base 10,000, 학습 길이 2,048을 고르면, 64쌍 중 상당수가 학습 길이 안에서 한 바퀴도 돌지 못한 회색 점으로 표시된다. 이 바늘들에게 2,048을 넘는 위치는 생전 처음 보는 각도다. 모델은 그 각도에서 어텐션 점수가 어떻게 나와야 하는지 배운 적이 없다.
2023년 Liu 등은 이를 ‘임계 차원(critical dimension)’이라 불렀다. Llama 2 기준으로 학습 길이 안에서 한 바퀴를 다 돈 것은 앞쪽 92차원이었다. 나머지 36차원은 충분히 학습되지 않았다. 메타의 위치 보간 논문은 이렇게 경고했다.
학습 범위를 벗어난 위치로 외삽하면 어텐션 점수가 파국적으로 커져 셀프 어텐션 메커니즘을 완전히 망가뜨릴 수 있다.
2023년 초여름, LLaMA를 손에 넣은 전 세계 개발자들의 가장 큰 불만은 2,048토큰이었다. 문서 몇 쪽이면 꽉 차는 길이였다. 처음부터 다시 학습할 돈은 누구에게도 없었다.
6월 20일, ‘kaiokendev’라는 이름의 개인 개발자가 블로그에 짧은 글을 올렸다. RoPE의 위치를 4분의 1로 줄여서 넣었더니, 즉 위치 7,000을 1,750처럼 보이게 했더니 모델이 긴 글에서도 정신을 차렸다는 것이다.
놀랍게도 됐다! 효과를 보려고 미세조정조차 필요 없었다.
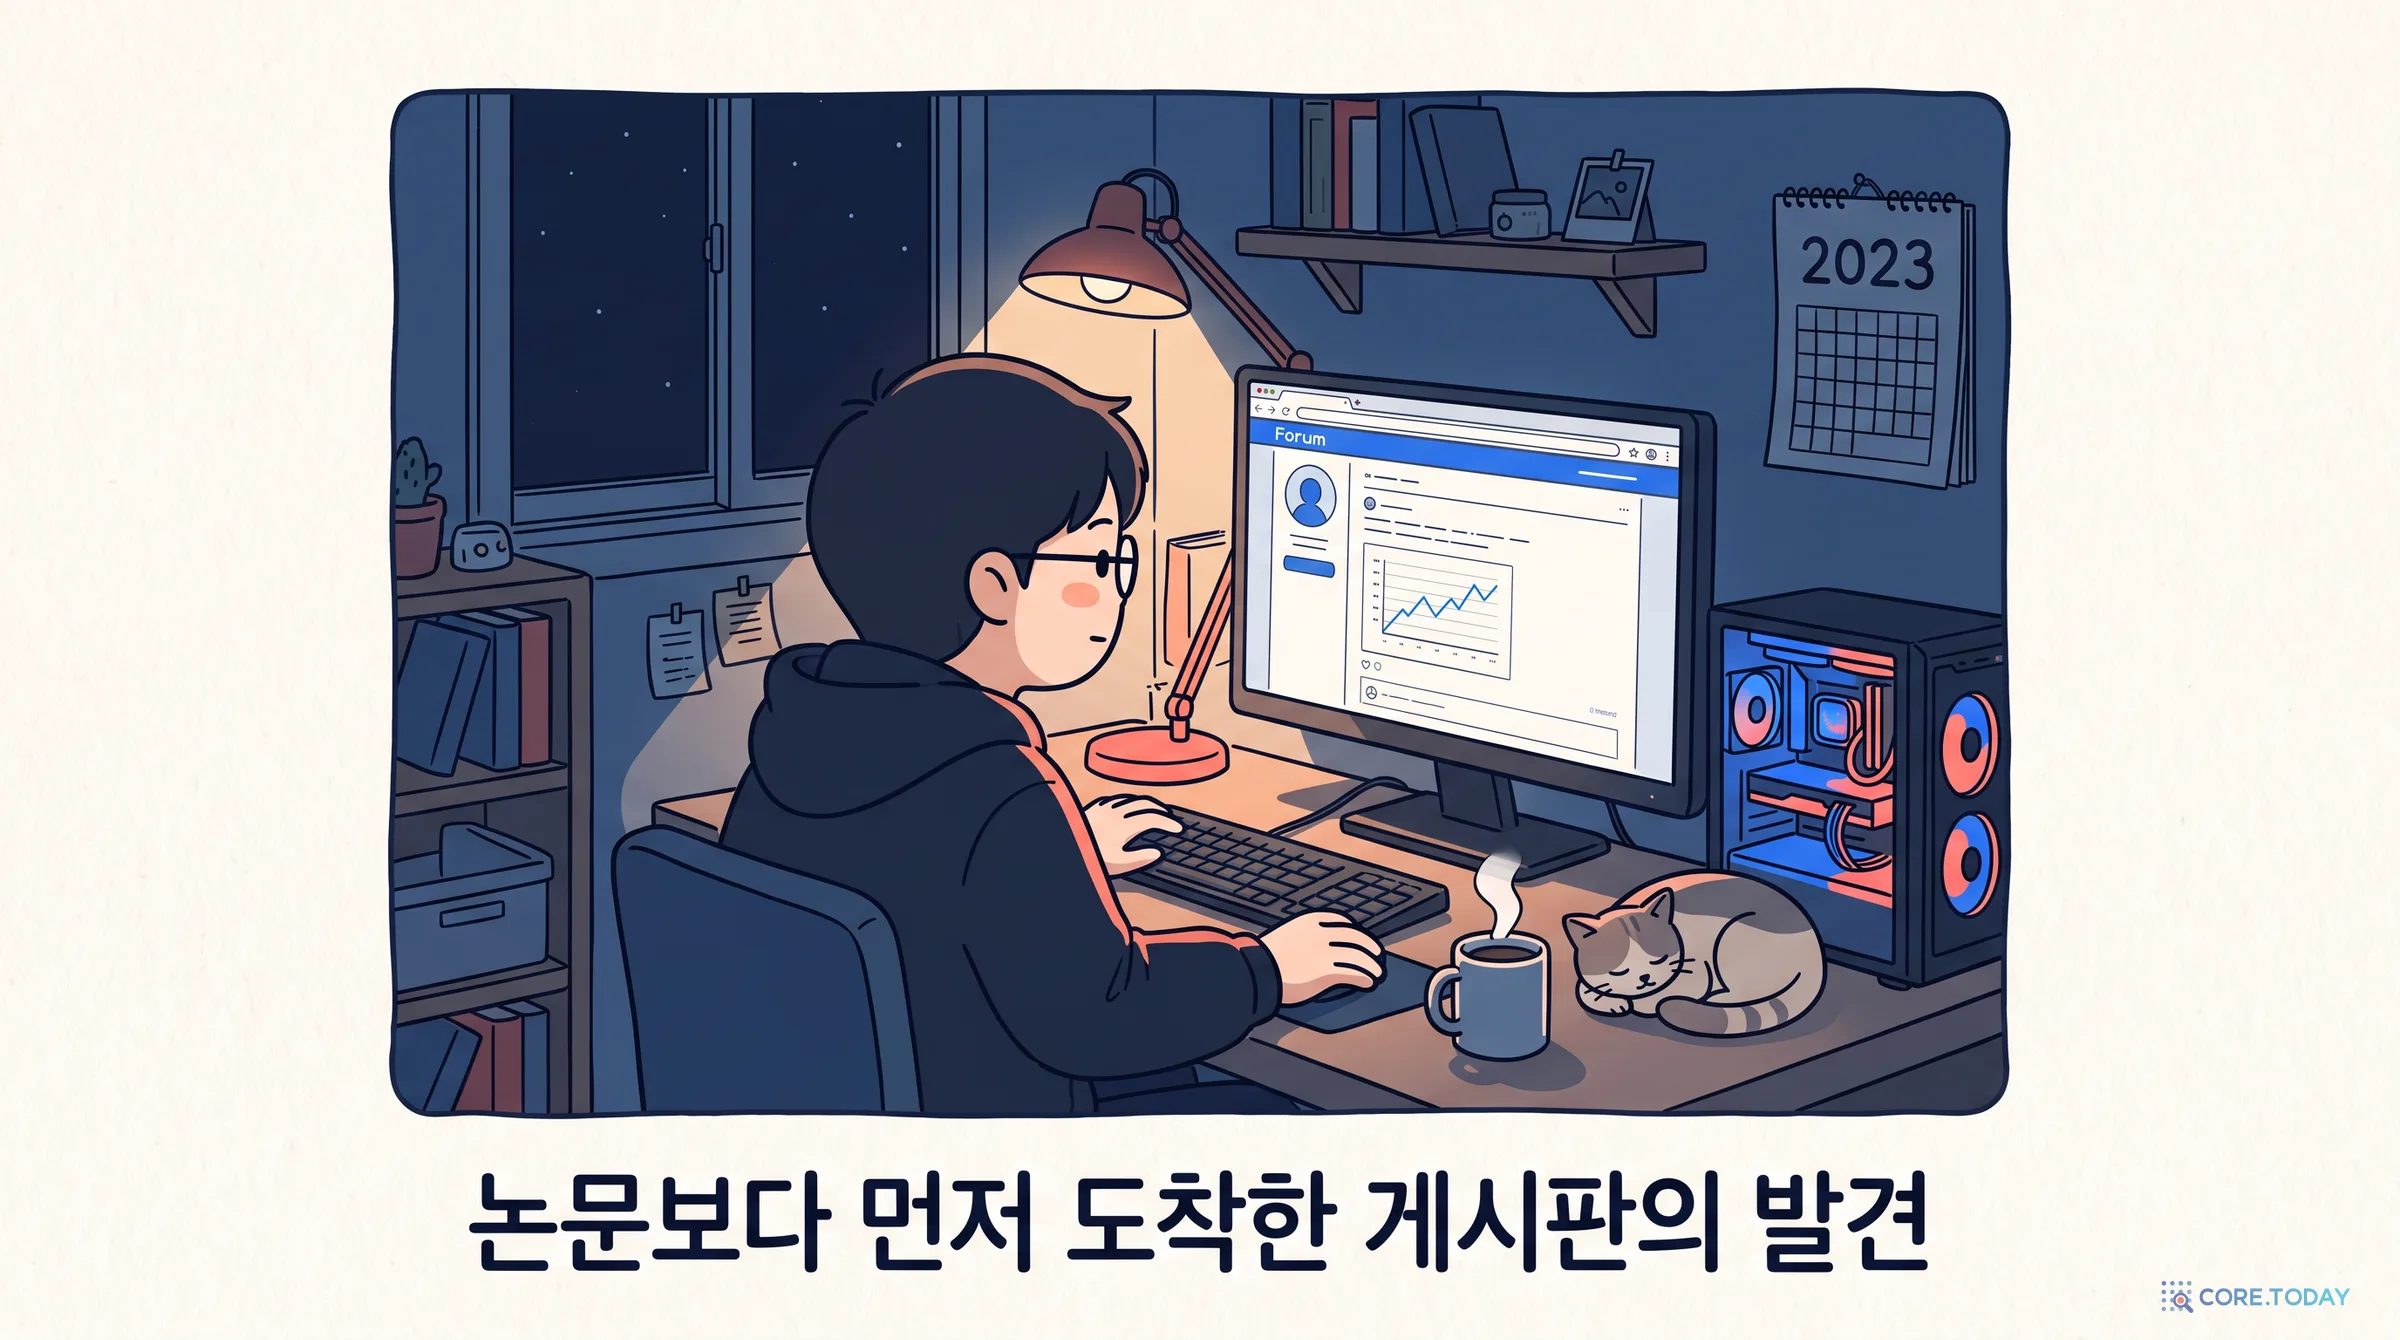
일주일 뒤인 6월 27일, 메타 연구진(Chen 등)이 같은 원리를 정식화한 위치 보간(Position Interpolation, PI) 논문을 arXiv에 올렸다. 논문에는 “공개 직전에 같은 시기의 블로그 글(kaiokendev)을 알게 됐다”는 문장이 들어 있다. 이틀 뒤인 6월 29일, 레딧 r/LocalLLaMA의 사용자 bloc97이 다른 방법을 올렸다. 위치는 그대로 두고 base만 키우는 ‘NTK-aware 스케일링’이었다. 코드 세 줄이면 되고 미세조정 없이도 된다고 했다. 곧이어 사용자 emozilla가 글 길이에 따라 base를 자동으로 조절하는 ‘동적 NTK’를 올렸다.
석 달 사이에 개인 블로그, 빅테크 논문, 익명 게시판이 번갈아 가며 같은 문제를 풀었다. 이 트릭들은 몇 달 뒤 YaRN이라는 논문으로 정리됐다. 지금 DeepSeek과 Qwen이 쓰는 방식이다. HuggingFace transformers의 RoPE 코드에는 지금도 레딧 사용자 두 명의 이름이 감사 표시로 남아 있다.
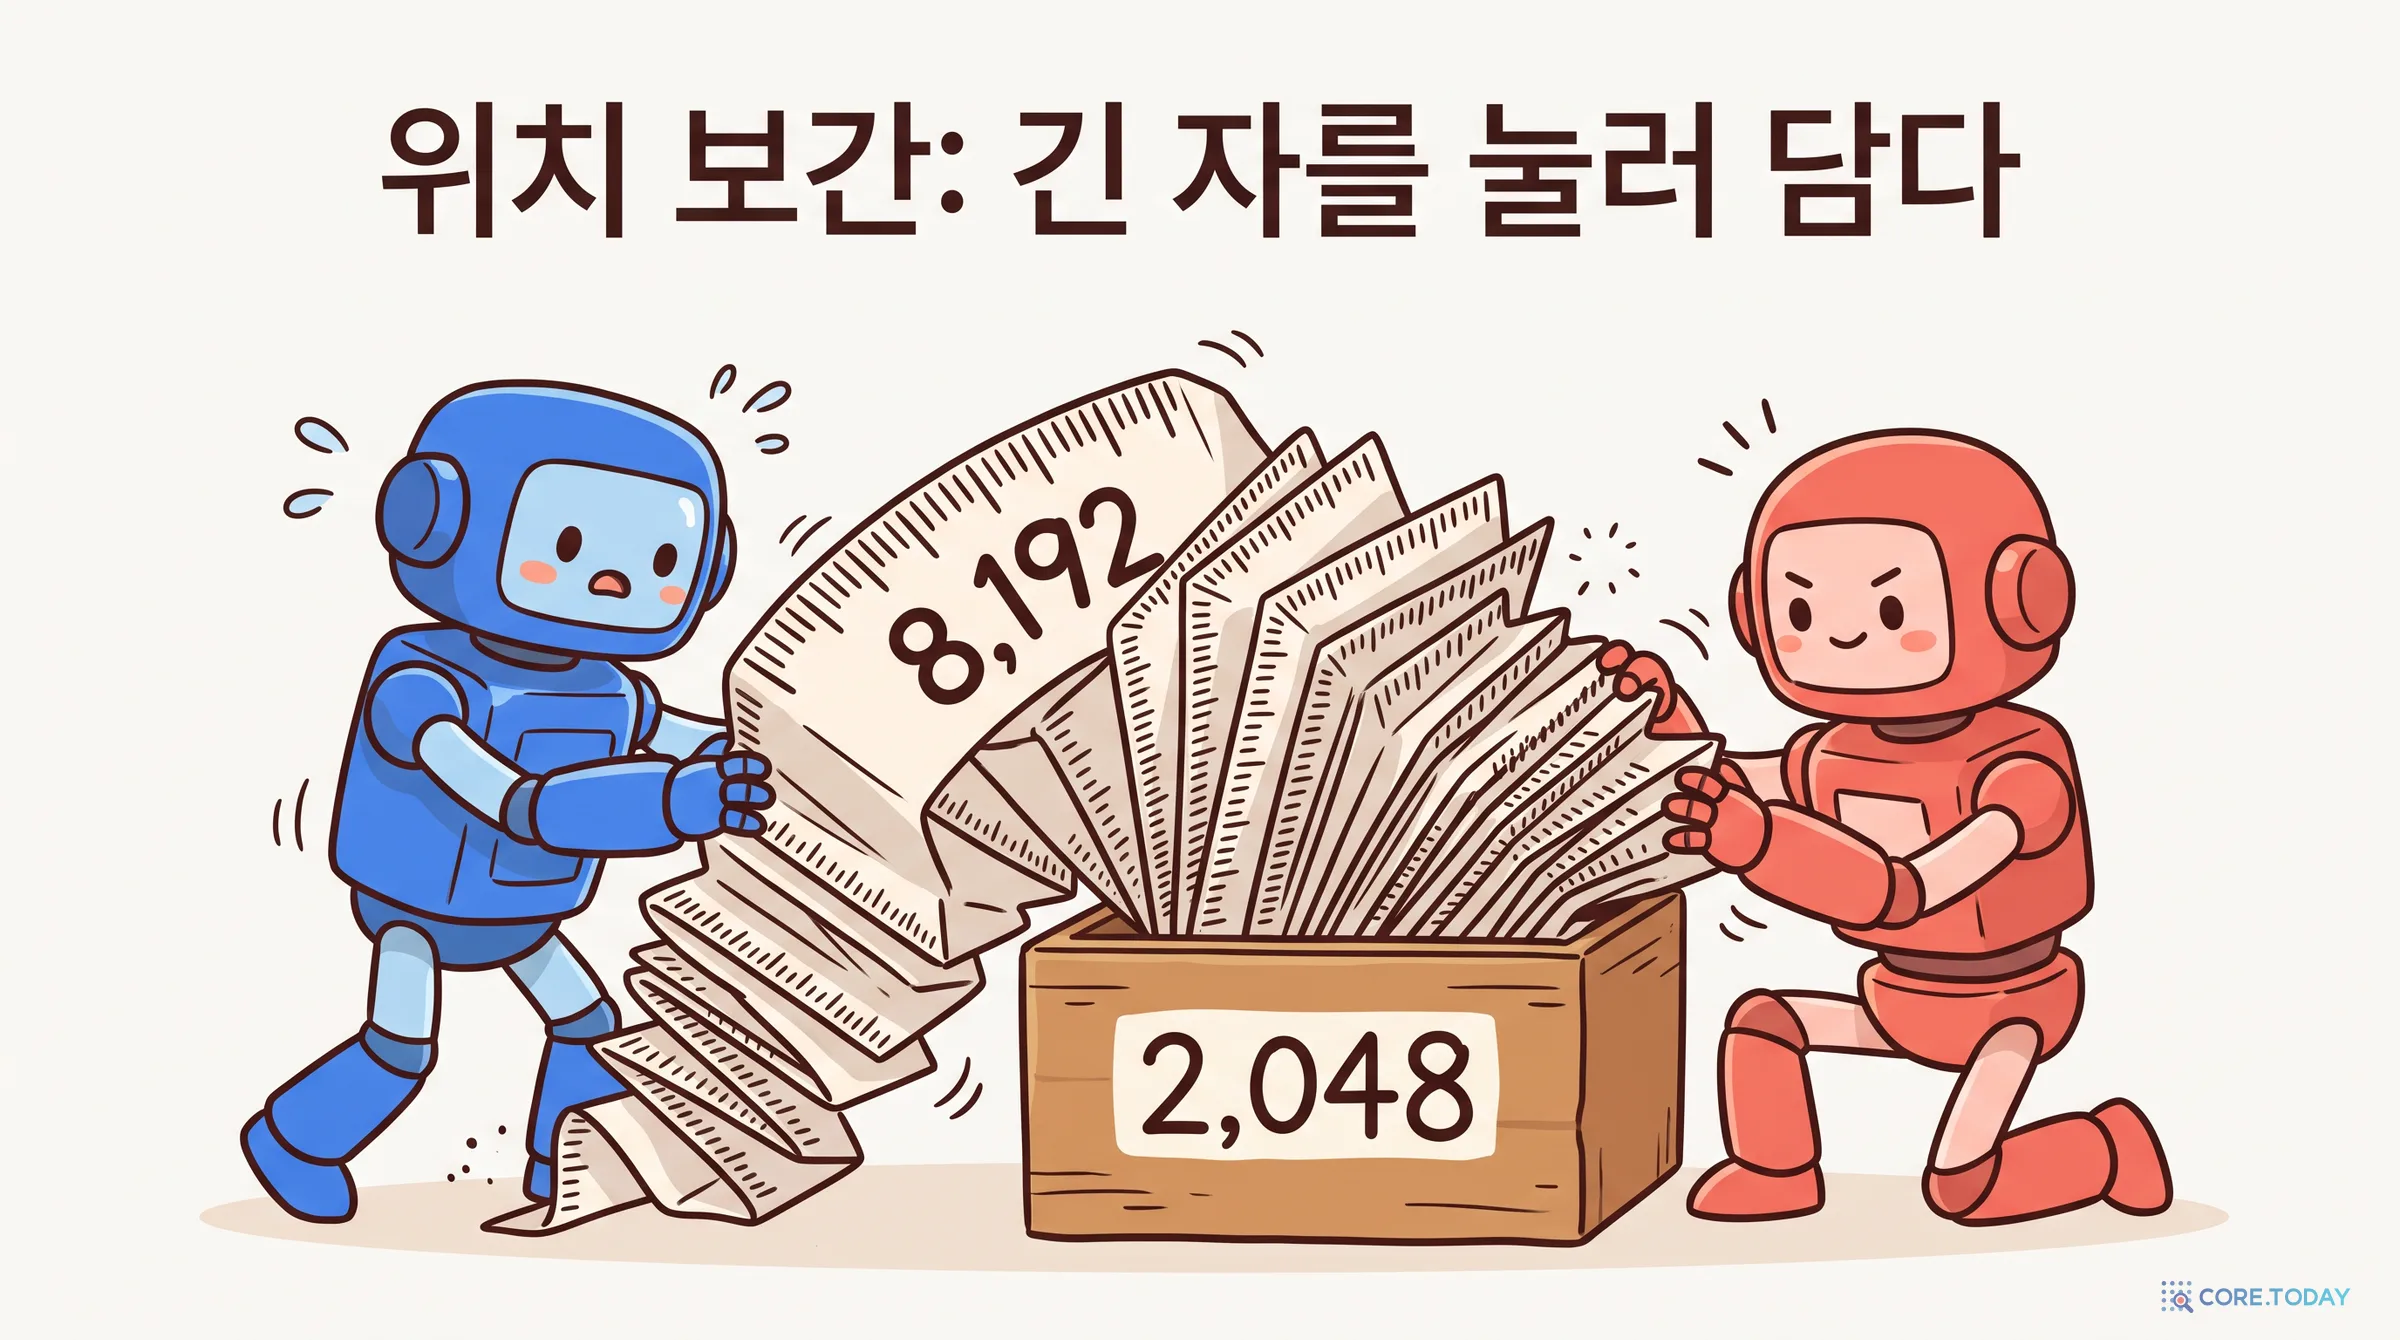
위치 보간의 아이디어는 단순하다. 학습 길이가 L이고 늘리고 싶은 길이가 L′이면, 위치 m을 m⋅L/L′로 줄여서 넣는다. 8,192토큰을 2,048칸에 눌러 담는 것이다. 위치는 소수가 되지만 모든 위치가 학습 때 본 범위 안에 들어온다. 외삽을 보간으로 바꾼 셈이다. 논문은 이렇게 하면 어텐션 점수의 상한이 외삽 때보다 적어도 약 600배 작아진다고 보였다.
대가도 있다. 모든 바늘이 똑같이 느려진다. 초침까지 느려진다. 바로 옆 단어 두 개가 이제 각도 차이 4분의 1로만 구별된다. 모델이 배운 촘촘한 구별이 흐려진다. 그래서 PI는 미세조정이 필요하다. 메타는 1,000단계 이내의 미세조정으로 LLaMA 7B~65B를 32,768토큰까지 늘렸다. 우리 실측에서 미세조정 없이 4배 보간을 걸었더니 학습 길이 안에서도 퍼플렉서티가 193으로 나빠졌다. 패스키는 1,024토큰짜리 짧은 글에서조차 0%였다.
RoPE는 시계처럼 동작한다. NTK-aware 스케일링은 초침은 늦추지 않고, 분침은 조금, 시침은 더 많이 늦춘다.
방법은 base 하나를 바꾸는 것이다.
base′=base⋅sd/(d−2)
s는 늘리려는 배수다. base가 커지면 θi=base−2i/d에서 i가 작은 앞쪽 쌍(빠른 바늘)은 거의 변하지 않는다. i가 큰 뒤쪽 쌍(느린 바늘)일수록 많이 느려진다. 가장 느린 바늘은 정확히 s배 느려지도록 지수가 맞춰져 있다. 위 스펙트럼 위젯에서 ‘NTK-aware’를 눌러 보면 왼쪽(빠른 쌍)은 그대로이고 오른쪽만 위로 올라간다.
우리 실측에서 NTK ×4는 2배 길이(4,096)까지는 퍼플렉서티 20 안팎으로 잘 버텼다. 패스키도 100%였다. 하지만 3~4배 길이에서는 다시 무너졌다(퍼플렉서티 213). 실제로 레딧 원글도 4배 늘리려면 배수 α를 8 정도로 더 크게 잡으라고 했다. 이름에 붙은 배수가 실제로 늘어나는 길이와 정확히 같지는 않다.
동적 NTK는 지금 글 길이가 학습 길이를 넘을 때만, 넘은 만큼 base를 키운다. 우리 패스키 실험에서는 다섯 방법 중 가장 좋았다(8,192토큰에서 한 칸만 놓침). 단, 위 퍼플렉서티 그래프는 8,192토큰을 한 번에 넣어 쟀다. 그래서 동적 NTK는 0~2K 구간에도 늘어난 base가 적용돼 앞부분 점수가 손해를 봤다(24.1). 실제로 한 토큰씩 생성할 때는 2,048을 넘기 전까지 원래 base를 쓴다.
5.4 YaRN — 바늘마다 다르게, 그리고 온도까지
2023년 8월 Nous Research 등의 연구진(Peng 등)은 이 트릭들을 정리해 YaRN(Yet another RoPE extensioN)을 발표했다(ICLR 2024). 핵심은 두 가지다.
1
파장으로 바늘을 세 무리로 나눈다(NTK-by-parts). 학습 길이 안에서 32바퀴 넘게 돈 빠른 바늘은 그대로 둔다. 한 바퀴도 못 돈 느린 바늘은 위치 보간처럼 s배 늦춘다. 그 사이의 바늘은 둘을 비율대로 섞는다. Llama 계열 기준 경계값은 1바퀴와 32바퀴다.
2
어텐션 온도를 보정한다. 문맥이 길어지면 어텐션이 더 많은 토큰에 퍼져 분포가 납작해진다. YaRN은 질문·열쇠 벡터에 각각 $0.1 \ln s + 1$을 곱해 이를 되돌린다. 4배 확장이면 약 1.14배이고, 어텐션 점수로는 그 제곱인 약 1.30배만큼 분포가 날카로워진다.
3
짧게 미세조정한다. Llama 2를 400단계 학습해 64K까지, 이어서 200단계를 더 해 128K까지 늘렸다. 128K 패스키 정답률은 99.4%였다. 논문은 이전 방법보다 토큰은 10분의 1, 학습 단계는 2.5분의 1이면 된다고 밝혔다.
우리 실측에서 YaRN ×4는 미세조정 없이도 0~2K 18.2, 2~4K 19.1, 4~8K 20.4로 8,192토큰 끝까지 거의 평평한 선을 그렸다. 학습 길이 안의 손해(17.2 → 18.2)도 가장 작았다. 패스키는 4,096토큰까지 전부 맞혔다. 6,144·8,192토큰에서는 숫자가 글 앞부분(깊이 10%)에 있을 때만 놓쳤다. 질문에서 가장 먼 곳이다.
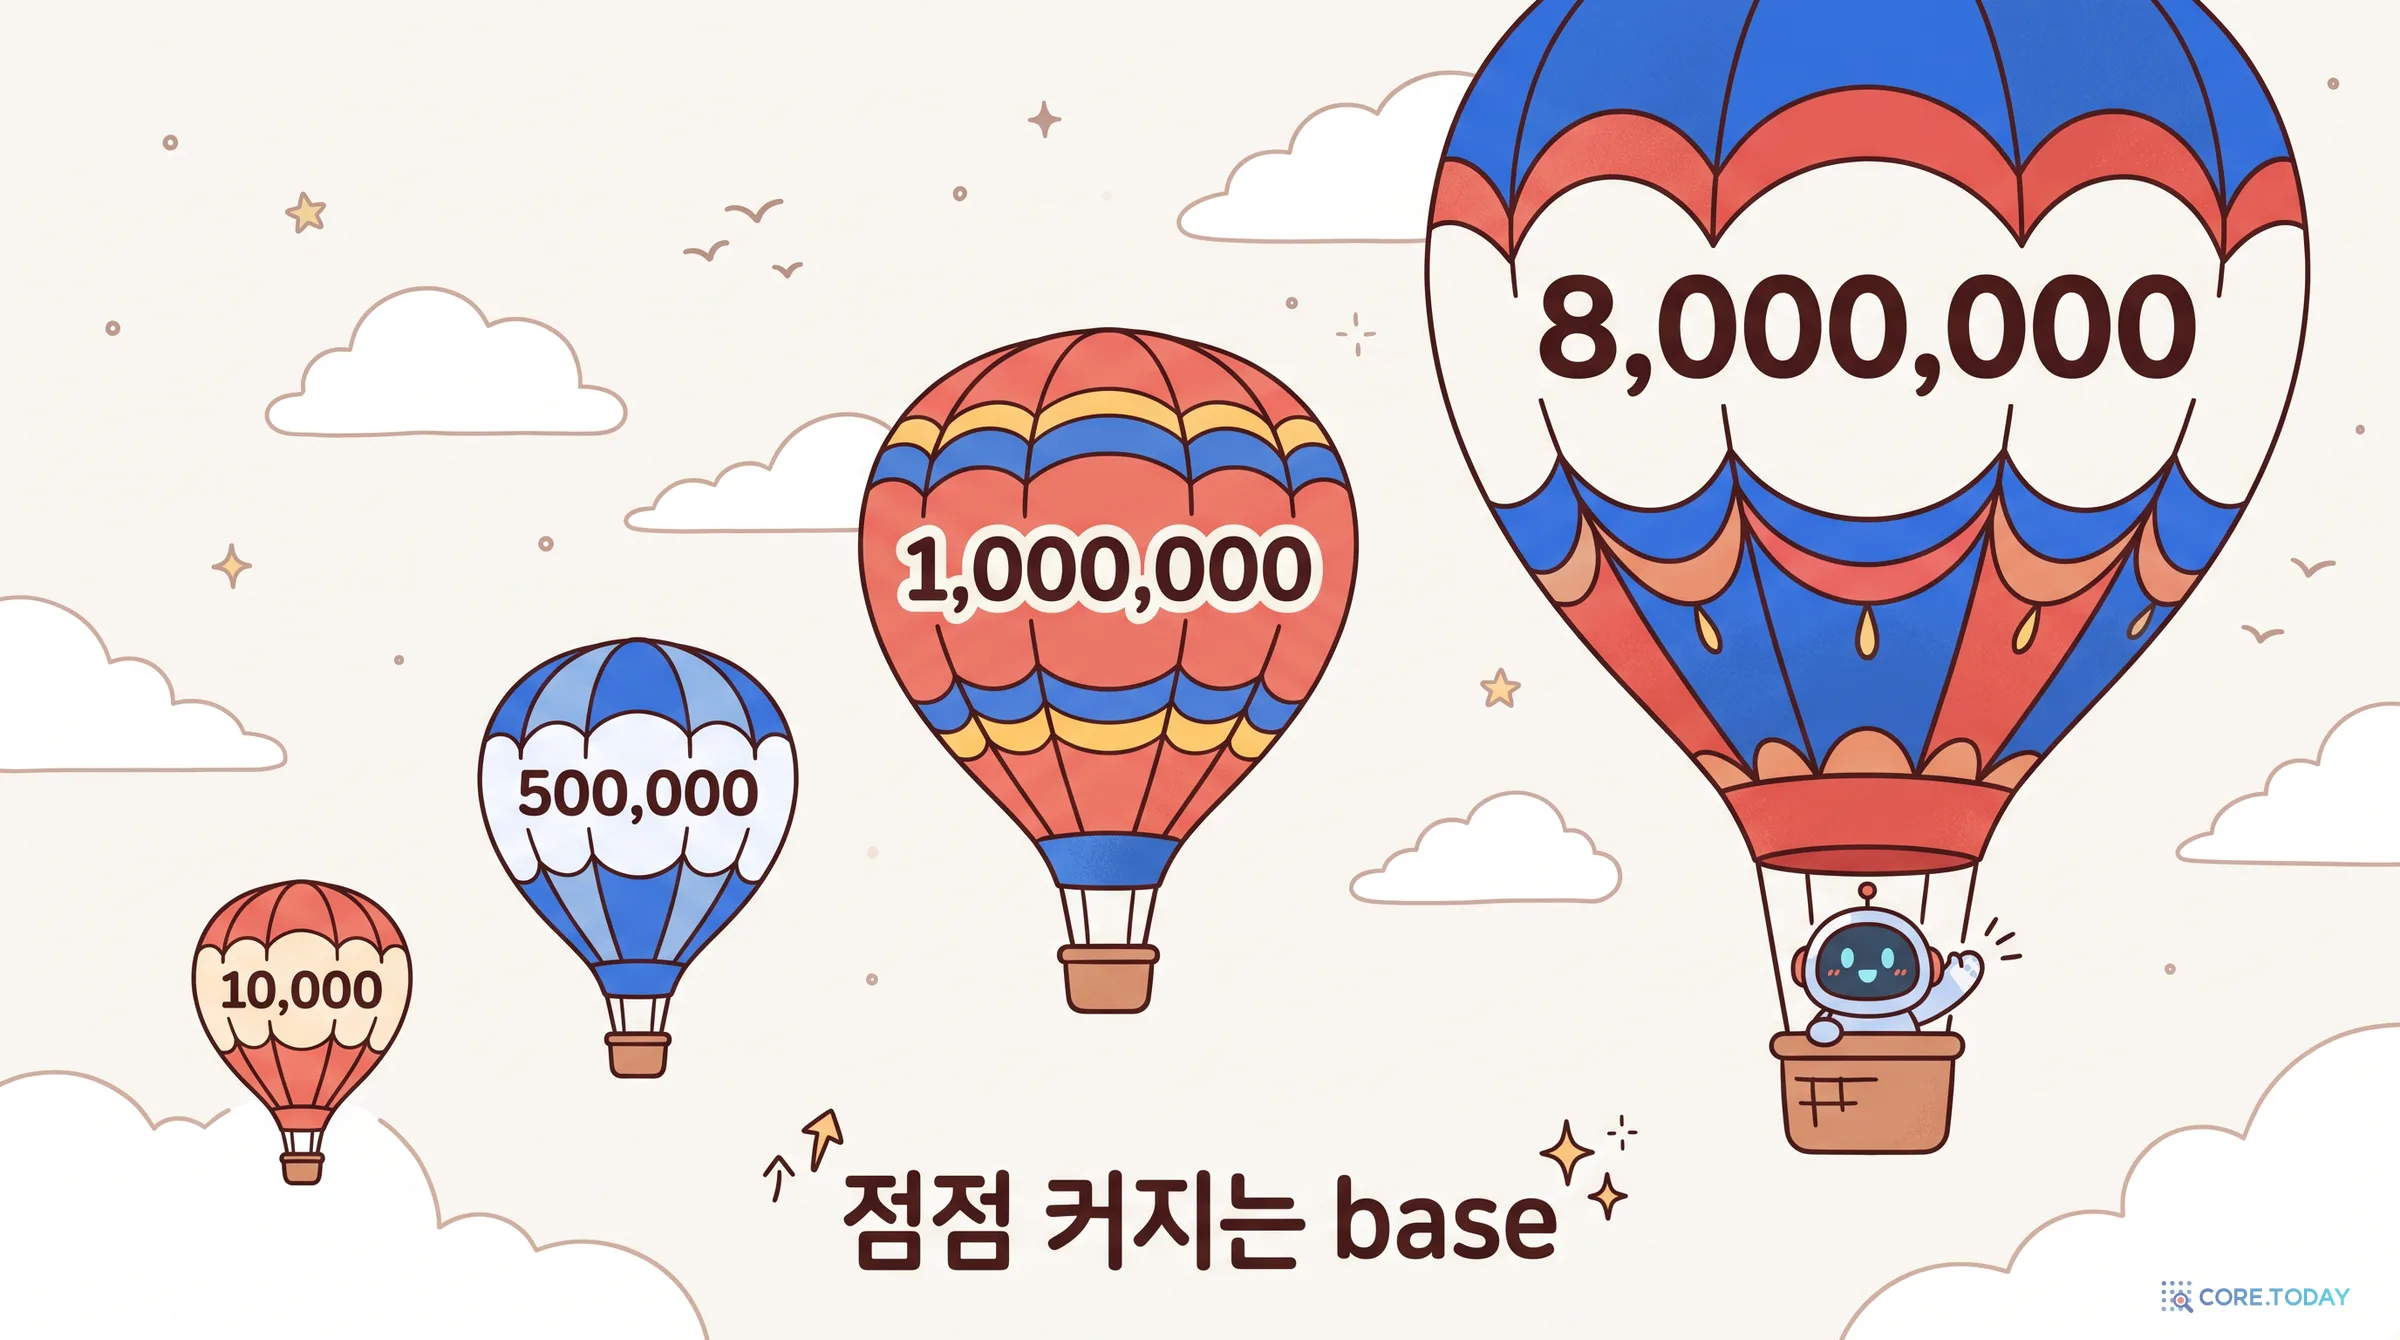
나중에 늘리는 대신 처음부터 base를 크게 잡는 흐름도 생겼다. 2023년 Code Llama는 base를 10,000에서 1,000,000으로 키우고 16,384토큰으로 학습해 10만 토큰까지 안정적으로 동작하게 했다. 같은 해 메타의 Llama 2 Long(Xiong 등)은 base를 500,000으로 키우고 긴 글 4천억 토큰을 더 학습했다. 이 방법을 ABF(Adjusted Base Frequency)라 불렀다. 흔히 Code Llama가 ‘ABF’나 ‘NTK’를 도입했다고 하지만, Code Llama 논문에는 두 단어가 나오지 않는다. ‘base 주기를 바꿨다’고만 썼다.
Code Llama 논문의 실험이 base의 효과를 보여 준다. 8천 토큰 글에서 열쇠 찾기를 시켰다. base 10,000 모델은 긴 글로 미세조정을 했는데도 위치에 따라 0~58.6%였다. base 1,000,000 모델은 95~100%였다.
이후 base는 계속 커졌다. Llama 3는 500,000, Qwen과 Gemma 3(전역 어텐션)는 1,000,000을 쓴다. 카카오의 Kanana 1.5는 8,000,000이다. Llama 3.1은 base 500,000에 YaRN과 비슷한 ‘파장별 세 구간’ 보간(llama3 방식, 8배)을 더했다. 그리고 6단계에 걸쳐 약 8천억 토큰의 긴 글을 추가로 학습해, 8,192토큰으로 사전학습한 모델을 128K로 늘렸다. 이 보간 방식의 세부 값은 Llama 3 논문에는 없고 공개된 설정 파일과 코드에만 있다. 마이크로소프트의 LongRoPE(2024)는 차원마다 다른 배율을 진화 탐색으로 찾아 200만 토큰까지 늘렸고, Phi-3에 실렸다.
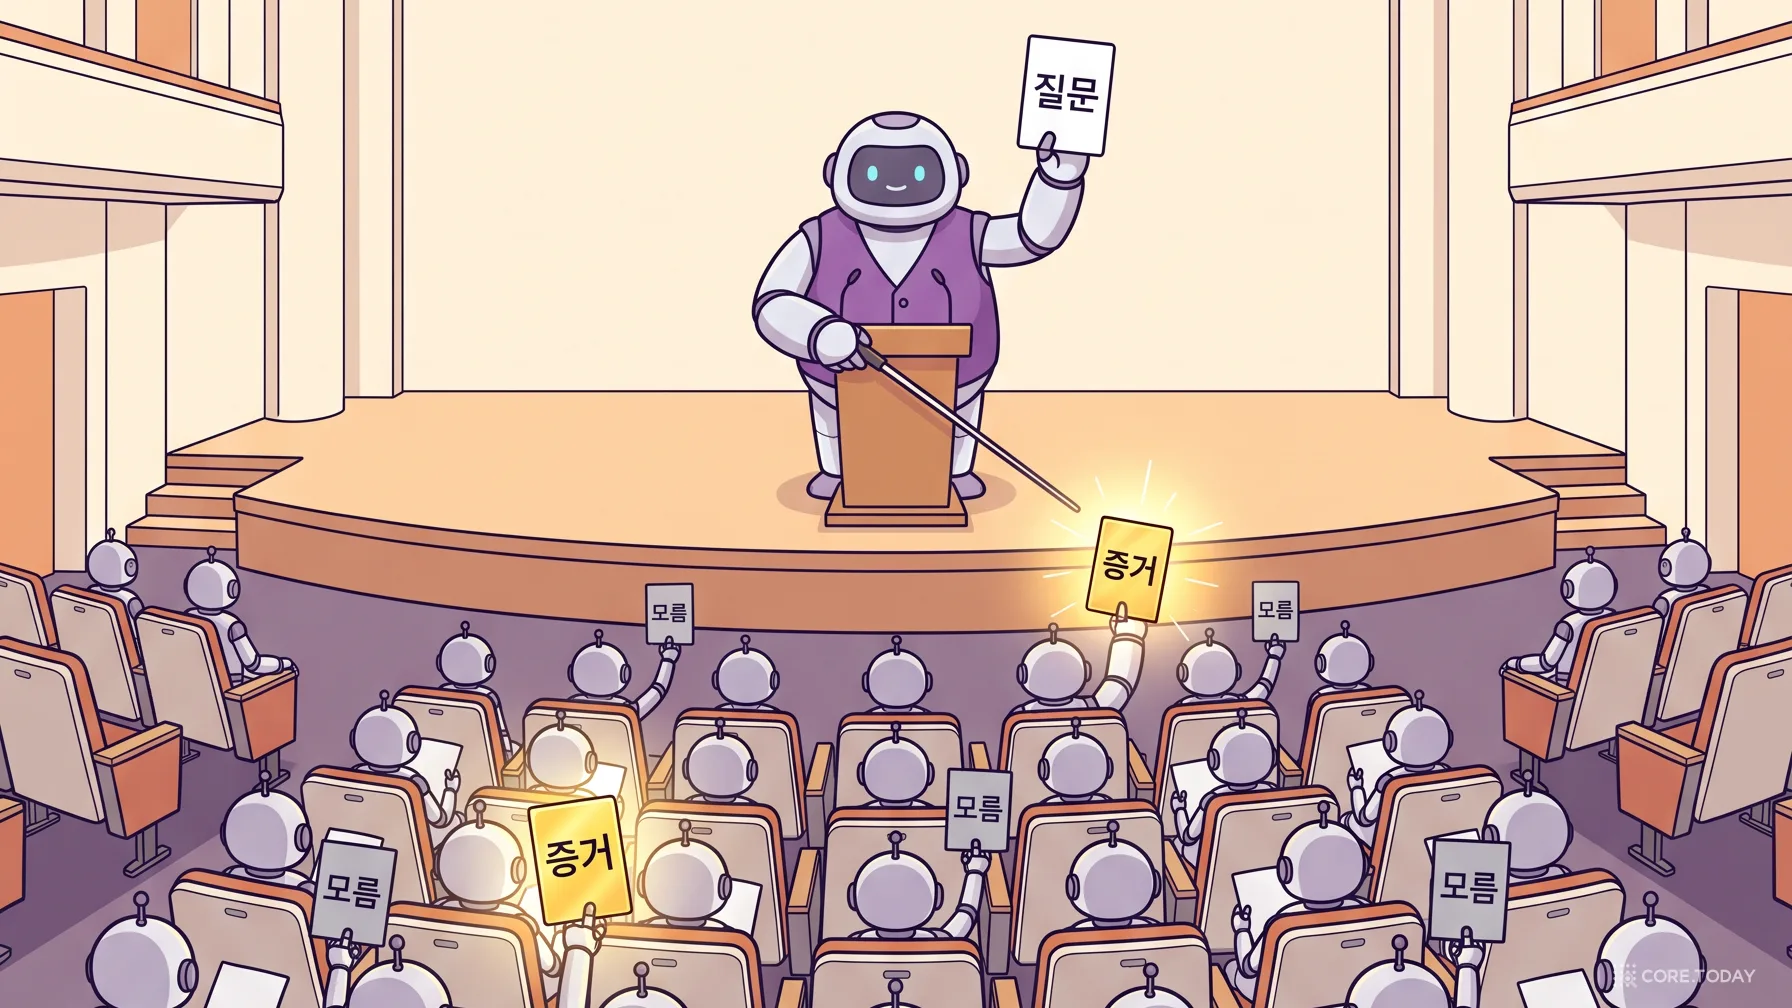
문맥 창이 길어지자 ‘정말 그 길이를 읽는가’를 재는 시험이 필요해졌다. 2023년 11월 그레그 캄라트(Greg Kamradt)는 Needle in a Haystack(건초 더미 속 바늘) 시험을 공개했다. 폴 그레이엄의 에세이를 이어 붙인 긴 글의 여러 깊이에 “샌프란시스코에서 할 일은 화창한 날 돌로레스 공원에서 샌드위치를 먹는 것”이라는 문장을 숨기고 찾게 했다. GPT-4 128K와 Claude 2.1이 시험대에 올랐다.
후일담이 하나 있다. 앤트로픽은 Claude 2.1의 낮은 점수를 분석한 뒤 답변을 “문맥에서 가장 관련 있는 문장은 다음과 같다:”로 시작하게 했다. 프롬프트 한 줄로 정답률이 27%에서 98%로 올랐다. 긴 문맥 성능이 위치 인코딩만의 문제가 아니라는 뜻이다.
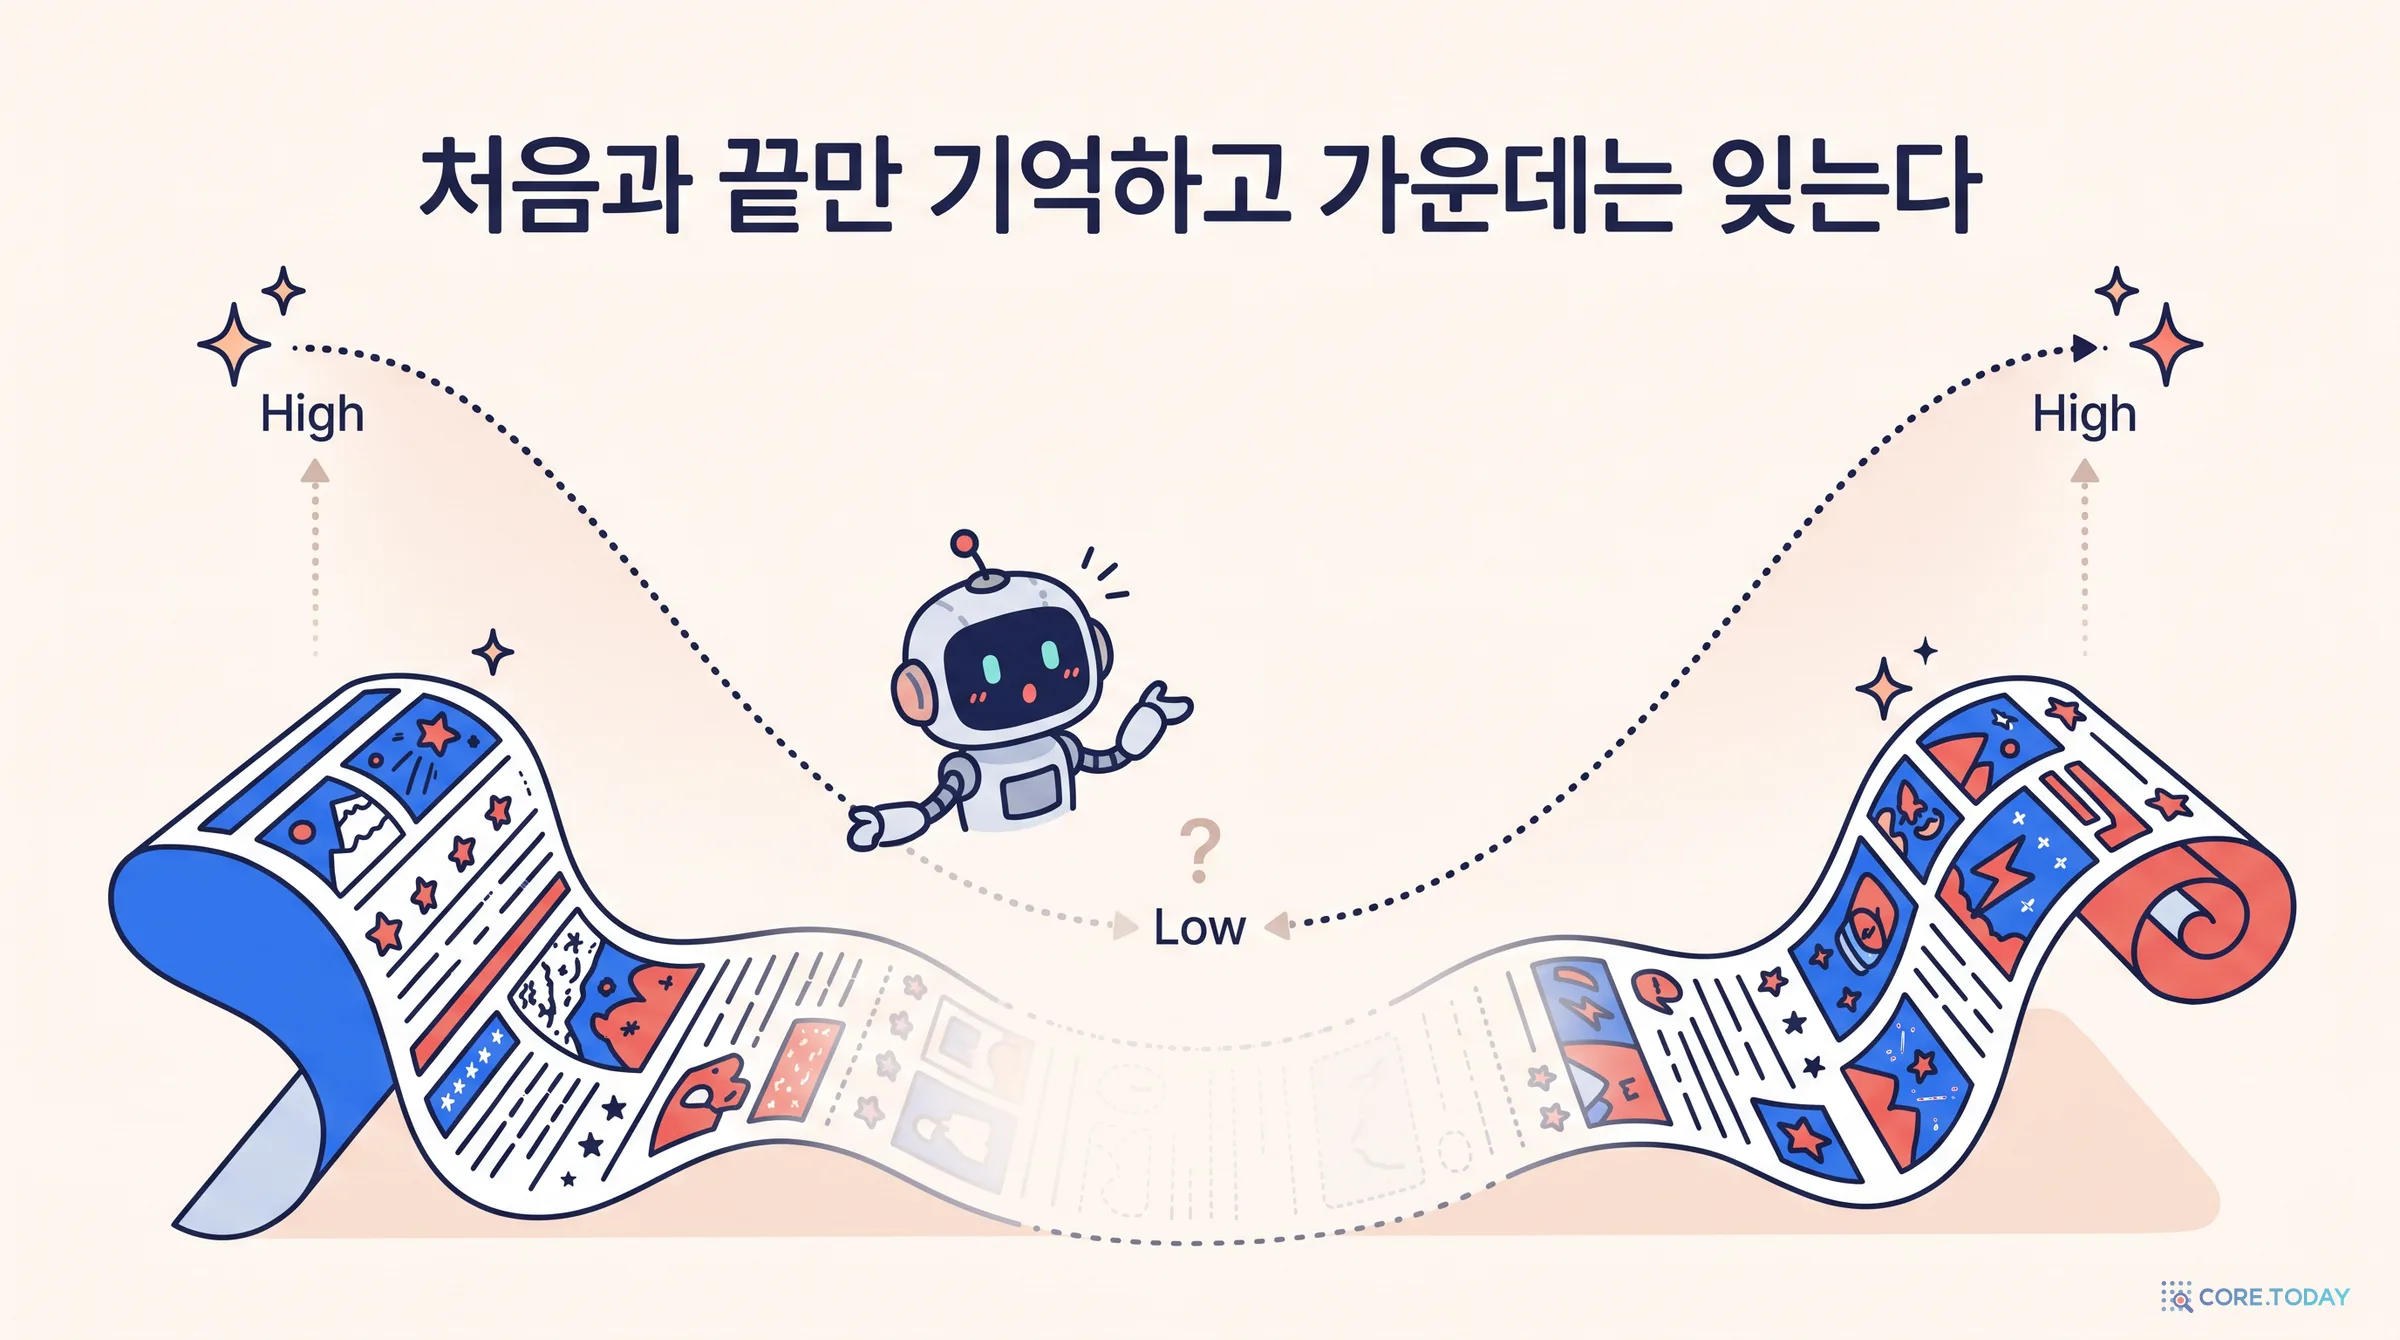
2023년 스탠퍼드 등의 Liu 등은 「Lost in the Middle」에서 모델이 긴 문맥의 처음과 끝은 잘 쓰고 가운데는 잘 못 쓰는 U자형 곡선을 보였다(TACL 2024). 정답이 든 문서를 20개 문서의 가운데에 두면 GPT-3.5-Turbo의 정답률은 20%p 넘게 떨어졌다. 아예 문서를 안 주고 푼 것(56.1%)보다 낮아지기도 했다.
우리 실측에서 YaRN이 놓친 것도 글 앞부분(깊이 10%)에 숨긴 숫자였다. 질문에서 가장 멀리 있는 숫자다.
6.3 광고된 길이와 실효 길이
바늘 하나 찾기는 쉬운 시험이다. 단어가 그대로 겹치는 문장을 찾으면 되기 때문이다. 2024년 NVIDIA의 RULER는 여러 바늘, 추적, 집계 같은 13가지 과제로 ‘실효 길이’를 쟀다. 기준은 Llama 2 7B가 4K에서 낸 점수(85.6%)다.
모델
내세운 길이
RULER 실효 길이
Gemini 1.5 Pro
100만
12.8만 초과
GPT-4
12.8만
6.4만
Llama 3.1 70B
12.8만
6.4만
Llama 3.1 8B
12.8만
3.2만
GradientAI Llama 3
100만
1.6만
LWM
100만
4천 미만
2025년 NoLiMa(ICML 2025)는 질문과 바늘 사이에 겹치는 단어를 최소로 줄였다. 그러자 결과가 더 냉정해졌다. 128K 이상을 내세운 13개 모델 중 11개가 32K에서 짧은 글일 때 점수의 절반 아래로 떨어졌다. GPT-4o는 99.3%에서 69.7%가 됐다.
창의 크기와 그 창을 쓰는 능력은 다르다. 위치 인코딩은 긴 글을 ‘읽을 수 있게’ 해 줄 뿐이다. 그 안의 정보를 고르게 쓰는 능력은 학습 데이터와 학습 방식에 달려 있다.
7부. 2026년의 위치 인코딩
7.1 공개 모델 17종의 RoPE 설정 — 코어닷투데이 실측
각 모델이 HuggingFace에 공개한 설정 파일(config.json)에서 RoPE 관련 값을 직접 읽었다.
모델
RoPE base
최대 위치
확장·특이 사항
GPT-NeoX-20B · Pythia
10,000
2,048
머리 차원의 25%만 회전
TinyLlama v1.1
10,000
2,048
—
Llama 2 7B
10,000
4,096
—
Mistral 7B v0.1
10,000
32,768
슬라이딩 윈도 4,096
Code Llama 7B
1,000,000
16,384
base 키우기
Phi-3 mini 128K
10,000
131,072
LongRoPE (차원별 배율 48개)
Llama 3.1 8B
500,000
131,072
llama3 방식 ×8 (8,192에서)
Llama 3.2 1B
500,000
131,072
llama3 방식 ×32
Qwen2.5 7B
1,000,000
32,768
필요하면 YaRN ×4로 128K
Qwen3 8B
1,000,000
40,960
—
Gemma 3 27B
전역 1,000,000 · 지역 10,000
131,072
지역 5 : 전역 1, 전역만 보간 ×8
Mistral Nemo
1,000,000
131,072
—
DeepSeek-V3
10,000
163,840
YaRN ×40 (4,096에서), RoPE 전용 차원 64
EXAONE 4.0 32B
1,000,000
131,072
llama3 방식 ×16, 슬라이딩 윈도 4,096
HyperCLOVA X SEED 0.5B
500,000
8,192
—
Kanana 1.5 2.1B
8,000,000
32,768
—
Llama 4 Scout
500,000
10,485,760
llama3 방식 ×16, 48층 중 12층은 위치 인코딩 없음
‘최대 위치’는 설정 파일의 max_position_embeddings 값이다. 실제로 학습한 길이나 실효 길이와는 다를 수 있다.
이 표에서 2026년의 흐름 세 가지가 보인다.
1
base 인플레이션
원조의 10,000은 이제 소수파다. 50만~100만이 표준이 됐고 800만도 나왔다. 느린 바늘을 더 느리게 만들어, 학습 길이 안에서 더 먼 거리를 경험하게 하려는 선택이다.
2
확장은 설정 파일 한 줄
YaRN, llama3 방식, LongRoPE가 모두 설정 파일의 rope_scaling 항목으로 들어갔다. 2023년 여름 게시판에서 오가던 트릭이 업계 표준 설정이 됐다.
!
위치를 빼는 층이 돌아왔다
Llama 4는 네 층 중 한 층에서 위치 인코딩을 아예 뺐다(iRoPE). Gemma 3·EXAONE 4.0은 짧은 창만 보는 지역 어텐션을 섞었다. 먼 거리는 위치 없는 층이나 전역 층에 맡기고, 가까운 거리는 RoPE로 정확히 잰다.
7.2 RoPE의 변형들
iRoPE (Llama 4, 2025): ‘i’는 ‘interleaved(번갈아)’다. RoPE를 쓰는 층과 위치 인코딩이 없는(NoPE) 층을 번갈아 쌓았다. 추론 때 어텐션 온도도 조절한다. 메타는 Scout의 문맥을 1,000만 토큰이라고 발표했다. 다만 학습과 후속 학습은 256K 길이로 했다.
디커플드 RoPE (DeepSeek-V2·V3): DeepSeek은 열쇠·값을 작은 벡터로 압축해 메모리를 아끼는 MLA 구조를 쓴다. 그런데 RoPE는 위치마다 회전이 달라 압축된 열쇠에 미리 합쳐 둘 수 없다. 그래서 위치 정보를 실어 나르는 작은 차원(64)을 따로 떼어 내 거기에만 RoPE를 걸었다.
다차원 RoPE (Qwen2-VL의 M-RoPE): 이미지와 영상에는 가로·세로·시간이라는 세 방향의 위치가 있다. Qwen2-VL은 회전 쌍을 셋으로 나눠 각각 시간·높이·너비 위치로 돌린다. 글자만 있을 때는 세 위치가 같아 일반 RoPE와 똑같아진다.
7.3 실무 체크리스트
긴 문맥을 다루는 서비스를 만들거나 공개 모델을 직접 돌릴 때 확인할 것들이다.
1
‘최대 길이’와 ‘실효 길이’를 구별한다. 설정 파일의 최대 위치는 읽을 수 있는 한계일 뿐이다. 모델 카드나 RULER·NoLiMa 같은 평가에서 실효 길이를 확인하고, 내 과제로 직접 재 본다.
2
rope_scaling을 함부로 바꾸지 않는다. Qwen2.5 모델 카드는 정적 YaRN을 켜면 짧은 글 성능이 떨어질 수 있다고 경고한다. 긴 글이 필요한 경우에만 켜고, 켜기 전후를 짧은 글로도 비교한다.
3
미세조정 없이 늘려야 한다면 YaRN이나 동적 NTK부터. 우리 실측에서 학습 길이의 4배까지 미세조정 없이 버틴 것은 이 둘뿐이었다. 위치 보간(PI)은 미세조정을 전제로 한 방법이다.
4
중요한 정보는 앞이나 끝에 둔다. ‘가운데를 잊는’ 경향은 최신 모델에서도 완전히 사라지지 않았다. 지시문과 핵심 근거는 프롬프트의 시작이나 질문 바로 앞에 둔다.
5
긴 문맥과 검색(RAG)을 함께 저울질한다. 100만 토큰을 한 번에 넣을 수 있어도 비용과 지연이 크고 실효 길이는 그보다 짧다. 관련 부분만 골라 넣는 검색이 더 정확하고 싼 경우가 많다.
6
바늘 하나 찾기보다 어려운 시험으로 평가한다. 단어가 겹치는 문장 찾기는 쉽다. 여러 정보를 모으거나, 질문과 다른 표현으로 쓰인 근거를 찾는 과제로 재야 실제 성능이 보인다.
트랜스포머는 단어를 한꺼번에 보는 대가로 순서를 잃었다. 지난 10년의 위치 인코딩 역사는 그 순서를 어떻게 돌려줄지에 대한 답의 연속이었다.
더하기에서 돌리기로. 사인파와 학습형 위치는 단어 벡터에 위치를 더했다. RoPE는 벡터를 위치만큼 돌린다. 그러면 어텐션 점수에는 두 단어의 거리만 남는다. 단순함과 성능을 함께 잡은 이 아이디어는 한 중국 연구자의 블로그에서 나와 2년 만에 업계 표준이 됐다.
외삽은 공짜가 아니다. 사인파도 RoPE도 학습 길이를 넘으면 무너졌다. 느린 바늘은 학습 길이 안에서 한 바퀴도 돌아 본 적이 없기 때문이다. 우리 실측에서 2,048토큰 모델은 4,096토큰에서 숫자 하나를 찾지 못했다.
문맥 확장은 바늘의 속도를 고치는 일이다. 위치 보간은 모든 바늘을, NTK는 느린 바늘을, YaRN은 바늘마다 다르게 늦춘다. 이 트릭들은 개인 블로그와 익명 게시판에서 먼저 나왔고, 지금은 모델 설정 파일의 한 줄이 됐다.
창의 크기와 쓰는 능력은 다르다. 100만 토큰 창은 흔해졌지만 실효 길이는 그보다 짧다. 모델은 여전히 가운데를 잊는다. 2026년의 경쟁은 창을 넓히는 것보다 그 안을 고르게 쓰는 쪽으로 옮겨 가고 있다.
다음에 ‘100만 토큰 지원’이라는 문구를 보면 두 가지를 물어보자. 이 모델의 바늘은 학습 때 얼마나 돌아 봤을까? 그리고 그 긴 글의 한가운데를 정말 읽고 있을까?
코어닷투데이 실측 조건: TinyLlama/TinyLlama_v1.1(학습 길이 2,048, RoPE base 10,000), HuggingFace transformers 4.x, PyTorch 2.15, Apple M5 Pro(MPS, bf16). 미세조정 없이 RoPE 설정만 변경(PI=linear ×4, NTK-aware=base×4^(64/62), 동적 NTK=dynamic ×4, YaRN=yarn ×4). 퍼플렉서티는 『오만과 편견』(Project Gutenberg) 8,192토큰 창 6개 평균. 패스키는 길이 5종 × 깊이 3곳 × 무작위 다섯 자리 숫자 4개, 그리디 생성. 모델 설정은 각 저장소의 config.json(Llama·Gemma 계열은 공개 미러)을 2026-11-07에 읽었다.
Su, J., Lu, Y., Pan, S., Murtadha, A., Wen, B., & Liu, Y. (2024). RoFormer: Enhanced Transformer with Rotary Position Embedding. Neurocomputing, 568. arXiv:2104.09864
Biderman, S., Black, S., Foster, C., Gao, L., Hallahan, E., He, H., Wang, B., & Wang, P. (2021). Rotary Embeddings: A Relative Revolution. EleutherAI Blog, 2021-04-20.
Black, S. et al. (2022). GPT-NeoX-20B: An Open-Source Autoregressive Language Model. arXiv:2204.06745
Press, O., Smith, N. A., & Lewis, M. (2022). Train Short, Test Long: Attention with Linear Biases Enables Input Length Extrapolation (ALiBi). ICLR 2022. arXiv:2108.12409
Haviv, A. et al. (2022). Transformer Language Models without Positional Encodings Still Learn Positional Information. Findings of EMNLP 2022. arXiv:2203.16634
Chowdhery, A. et al. (2022). PaLM: Scaling Language Modeling with Pathways. arXiv:2204.02311
Touvron, H. et al. (2023). LLaMA: Open and Efficient Foundation Language Models. arXiv:2302.13971
Kazemnejad, A. et al. (2023). The Impact of Positional Encoding on Length Generalization in Transformers. NeurIPS 2023. arXiv:2305.19466
kaiokendev (2023). Things I'm Learning While Training SuperHOT — Extending Context. 2023-06-20.
Chen, S., Wong, S., Chen, L., & Tian, Y. (2023). Extending Context Window of Large Language Models via Positional Interpolation. arXiv:2306.15595
bloc97 (2023). NTK-Aware Scaled RoPE allows LLaMA models to have extended (8k+) context size without any fine-tuning. r/LocalLLaMA, 2023-06-29.
Rozière, B. et al. (2023). Code Llama: Open Foundation Models for Code. arXiv:2308.12950
Peng, B., Quesnelle, J., Fan, H., & Shippole, E. (2024). YaRN: Efficient Context Window Extension of Large Language Models. ICLR 2024. arXiv:2309.00071
Xiong, W. et al. (2023). Effective Long-Context Scaling of Foundation Models. arXiv:2309.16039
Liu, X. et al. (2024). Scaling Laws of RoPE-based Extrapolation. ICLR 2024. arXiv:2310.05209
Kamradt, G. (2023). Needle In A Haystack — Pressure Testing LLMs. GitHub. · Anthropic (2023). Long context prompting for Claude 2.1. 2023-12-06.
Liu, N. F. et al. (2024). Lost in the Middle: How Language Models Use Long Contexts. TACL. arXiv:2307.03172
Ding, Y. et al. (2024). LongRoPE: Extending LLM Context Window Beyond 2 Million Tokens. ICML 2024. arXiv:2402.13753
Hsieh, C.-P. et al. (2024). RULER: What's the Real Context Size of Your Long-Context Language Models? COLM 2024. arXiv:2404.06654
DeepSeek-AI (2024). DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model. arXiv:2405.04434
Llama Team, Meta (2024). The Llama 3 Herd of Models. arXiv:2407.21783
Wang, P. et al. (2024). Qwen2-VL: Enhancing Vision-Language Model's Perception of the World at Any Resolution. arXiv:2409.12191
Barbero, F. et al. (2025). Round and Round We Go! What makes Rotary Positional Encodings useful? ICLR 2025. arXiv:2410.06205
Modarressi, A. et al. (2025). NoLiMa: Long-Context Evaluation Beyond Literal Matching. ICML 2025. arXiv:2502.05167
Gemma Team (2025). Gemma 3 Technical Report. arXiv:2503.19786
Meta (2025). The Llama 4 herd: The beginning of a new era of natively multimodal AI innovation. 2025-04-05.
Anthropic (2026). Introducing Claude Opus 4.6. 2026-02-05.