가장 그럴듯한 말만 고르면 AI는 같은 말을 되풀이한다 — 그리디부터 min-p까지, 다음 한 단어를 고르는 기술 (특집)
언어 모델은 문장을 쓰지 않는다. 다음에 올 토큰마다 확률표를 내놓을 뿐이다. 그 표에서 실제로 한 토큰을 고르는 규칙이 ‘디코딩’이다. 1948년 섀넌이 책을 아무 데나 펼쳐 다음 단어를 고르던 실험에서 출발해, 매번 1등만 고르는 그리디와 후보 여러 개를 들고 가는 빔 서치가 왜 같은 말을 되풀이하는지, temperature·top-k·top-p·min-p가 각각 무엇을 자르는지 원 논문으로 따라간다. 카카오의 공개 모델로 12가지 전략을 직접 돌려, 그리디가 쓴 글의 45%가 반복 루프로 끝나고 temperature 0에서도 같은 질문에 다른 답이 나오는 것을 확인했다. 마지막으로 2026년 Claude·Gemini·GPT가 샘플링 손잡이를 잠근 이유를 정리한다. 인터랙티브 위젯 6종, 코어닷투데이 실측, 삽화 14장.
…트릭스)가 "이건 정말로 위험한 일입니다. 이건 정말로 위험한 일입니다. 이건 정말로 위험한 일입니다."라고 말합니다. 이 개발자는 "이건 정말로 위험한 일입니다. 이건 정말로 위험한 일입니다. 이건 정말로 위험한 일입니다."라고 말합니다. 이 개발자는 "이건 정말로 위험한…
모델이 고장 난 것이 아니다. 같은 모델, 같은 앞부분인데 다음 단어를 고르는 규칙만 바꾸면 전혀 다른 글이 나온다. 위 글은 매 순간 확률이 가장 높은 토큰 하나만 고르는 그리디(greedy) 방식의 결과다. 규칙을 top-p 0.95 샘플링으로 바꾸자 모델은 반복 없이 이야기를 이어 갔다.
이 규칙을 디코딩(decoding) 전략이라 부른다. 코어닷투데이가 카카오의 공개 모델 Kanana 1.5(2.1B)로 블로그 글 40편을 이어 쓰게 해 보니, 전략에 따라 결과가 이렇게 갈렸다.
45%
그리디가 쓴 글 중 반복 루프로 끝난 비율
40%
빔 서치(폭 5)가 쓴 글 중 반복 루프로 끝난 비율
0%
top-p 0.95 샘플링의 반복 루프 비율
33,353
온도를 1.5로 올린 글의 퍼플렉서티 (사람 글은 14.5)
매번 가장 그럴듯한 단어를 고르면 같은 말을 되풀이한다. 그렇다고 주사위를 아무렇게나 굴리면 횡설수설한다. 그 사이 어딘가를 찾는 것이 디코딩의 역사다.
먼저 언어 모델이 실제로 내놓는 것을 보자. 아래는 같은 모델에 문장 앞부분을 넣었을 때 나온 다음 토큰의 확률표다. 슬라이더로 temperature·top-k·top-p·min-p를 바꾸면 후보가 어떻게 걸러지는지 바로 보인다. 각 손잡이의 의미는 4부에서 하나씩 설명한다.
이 글은 다음 순서로 간다.
모델은 왜 문장이 아니라 확률표를 내놓나.
가장 그럴듯한 길을 찾는 그리디와 빔 서치.
그 방법이 왜 같은 말을 되풀이하는 글을 만드나.
주사위를 굴리되 꼬리를 자르는 temperature·top-k·top-p·min-p.
과제마다 답이 다르다는 실측.
temperature 0에서도 답이 바뀌는 이유.
2026년, 업체들이 이 손잡이를 잠근 이유.
1부. 모델은 문장이 아니라 확률표를 내놓는다
1.1 한 번에 한 토큰
GPT, Claude, Llama 같은 언어 모델은 자기회귀(autoregressive) 방식으로 글을 쓴다. 지금까지의 글을 보고 다음 토큰 하나의 확률을 계산한다. 하나를 고르면 그것을 글에 붙이고 다시 다음 토큰의 확률을 계산한다. 수백 번 반복하면 답변 하나가 된다.
토큰은 단어가 아니라 조각이다. BPE 토큰화 특집에서 본 것처럼, 위 실험실의 ‘옛날 옛적에 깊은 산속에’ 다음 1위 후보 ␣호는 아마 ‘호랑이’의 앞 조각일 것이다.
모델의 마지막 층은 어휘 전체(Kanana는 128,256개)에 대해 점수 하나씩을 낸다. 이 점수를 로짓(logit)이라 부른다. 로짓을 확률로 바꾸는 함수가 소프트맥스(softmax)다.
pi=∑jexp(zj)exp(zi)
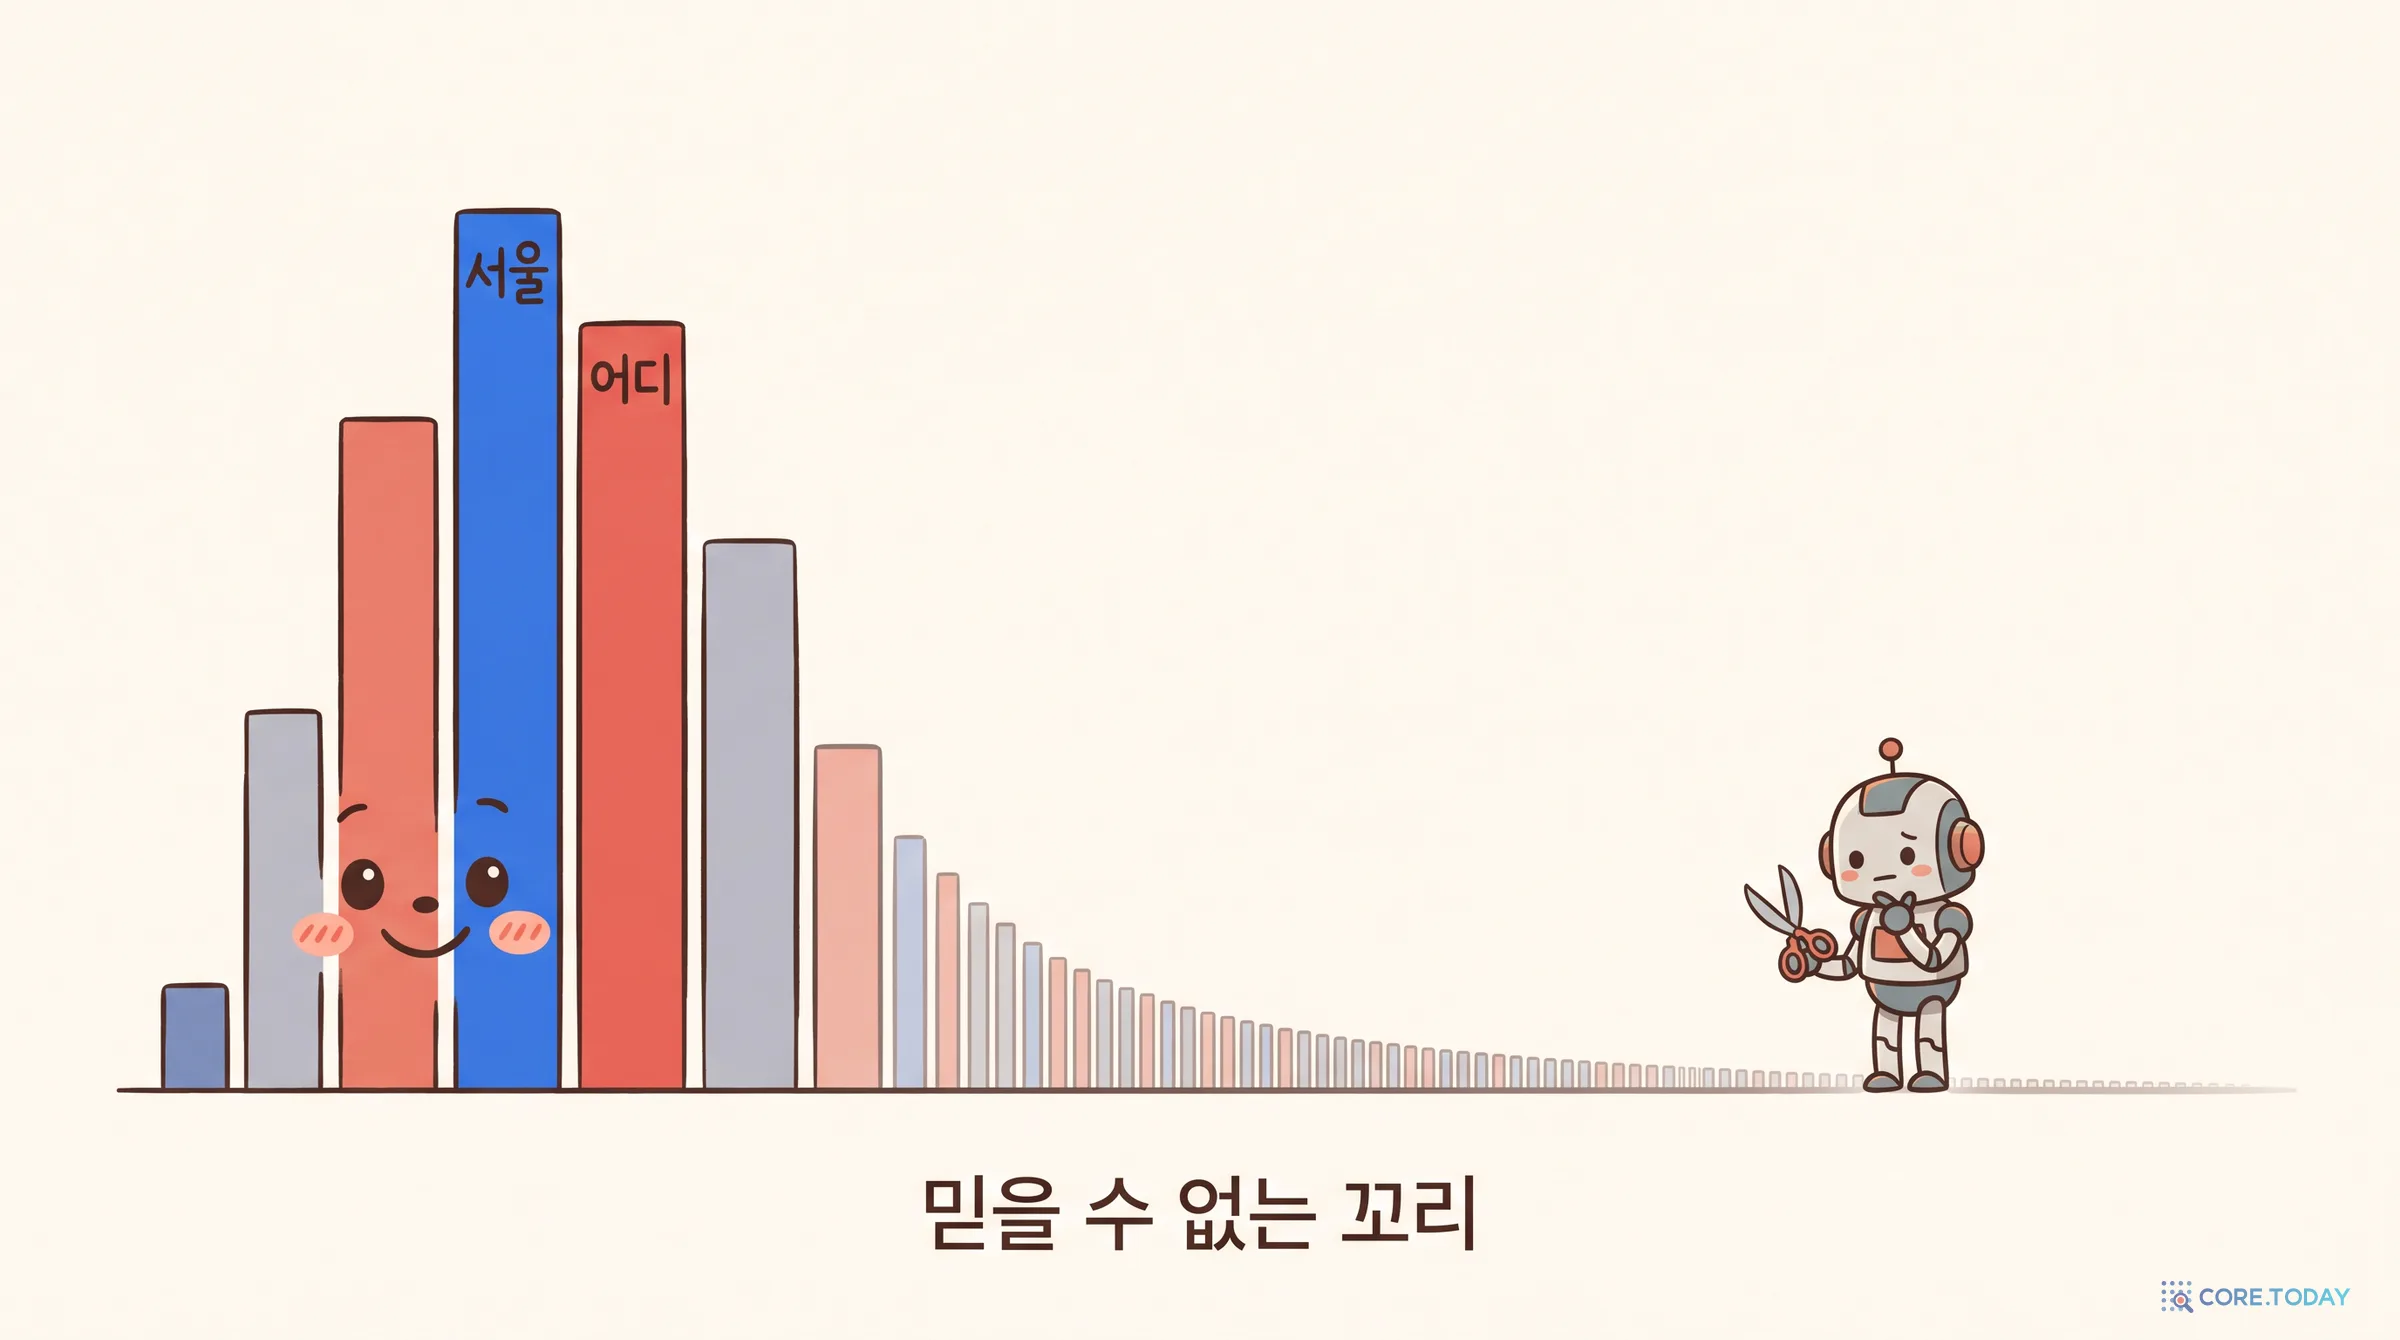
여기서 zi는 토큰 i의 로짓이다. 결과는 합이 1인 확률표다. ‘대한민국의 수도는’ 다음이라면 ␣서울이 47%, ␣어디가 12%, 물음표가 6%다. 그리고 나머지 12만 8천여 개 토큰이 아주 작은 확률을 나눠 갖는다.
모델이 하는 일은 여기까지다. 이 표에서 무엇을 고를지는 모델 바깥의 규칙, 곧 디코딩 전략이 정한다. 같은 모델이 그리디로는 반복 루프에 빠지고 샘플링으로는 자연스러운 글을 쓴 것은 이 때문이다.
1913년 러시아 수학자 안드레이 마르코프는 푸시킨의 운문 소설 『예브게니 오네긴』의 첫 2만 자를 연필과 종이로 셌다. 모음 뒤에 모음이 오는 경우는 1,104번이었다. 글자가 서로 독립이었다면 약 3,731번이 나와야 했다. 앞 글자가 다음 글자의 확률을 바꾼다. 이것이 마르코프 연쇄의 출발점이다.
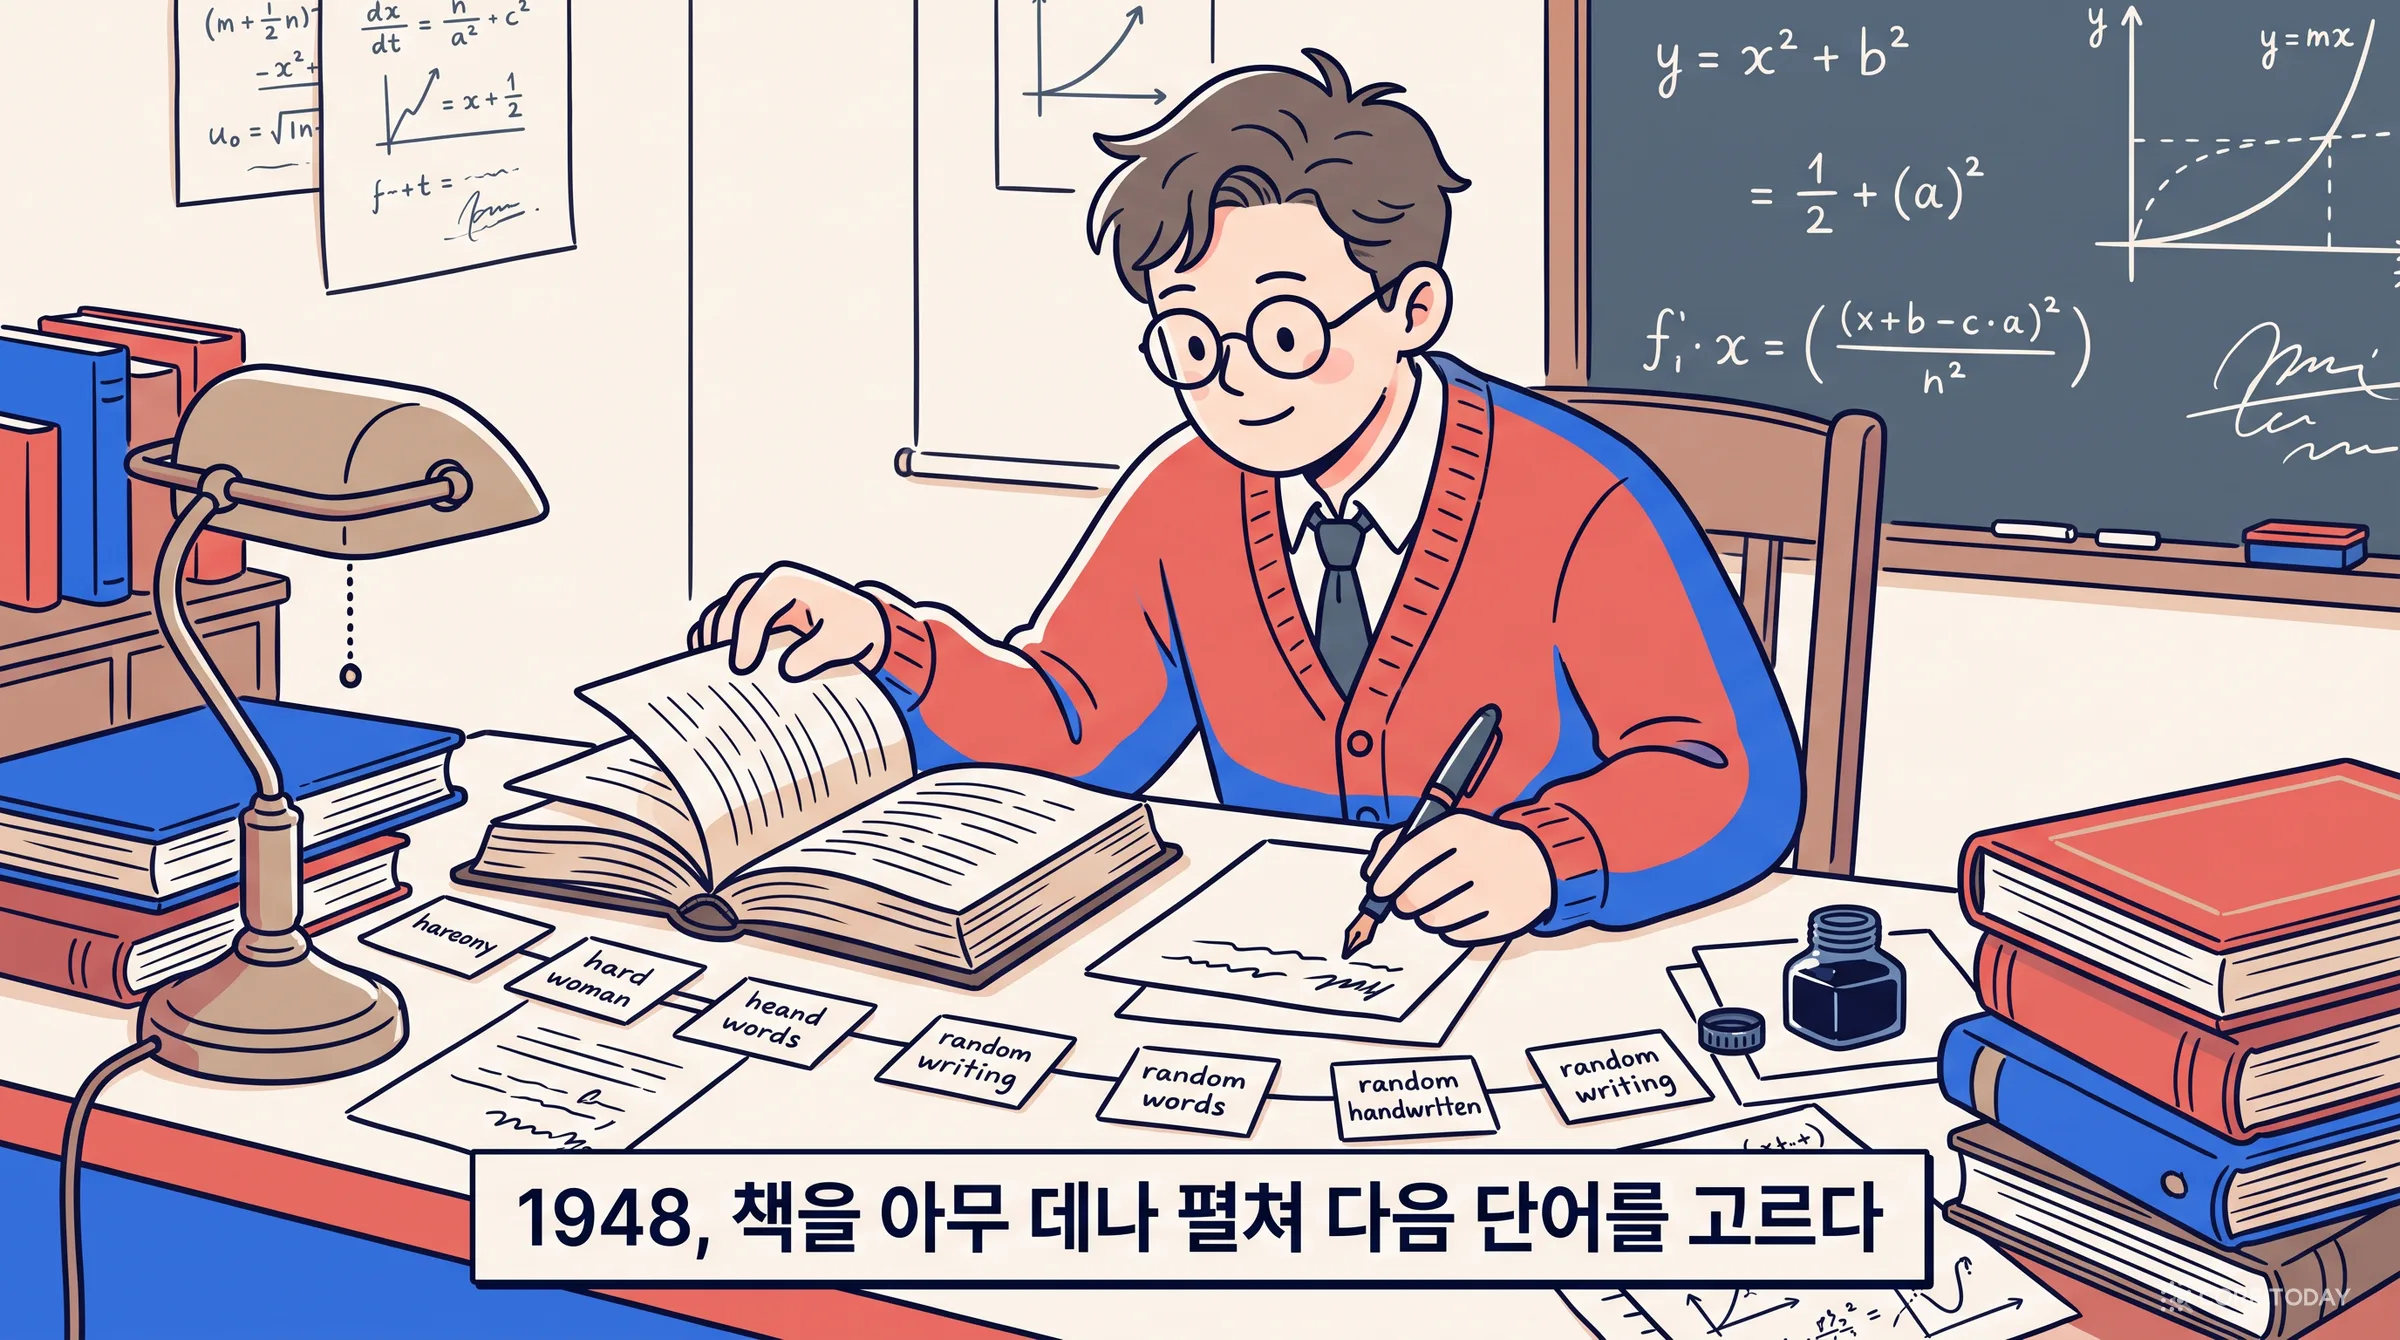
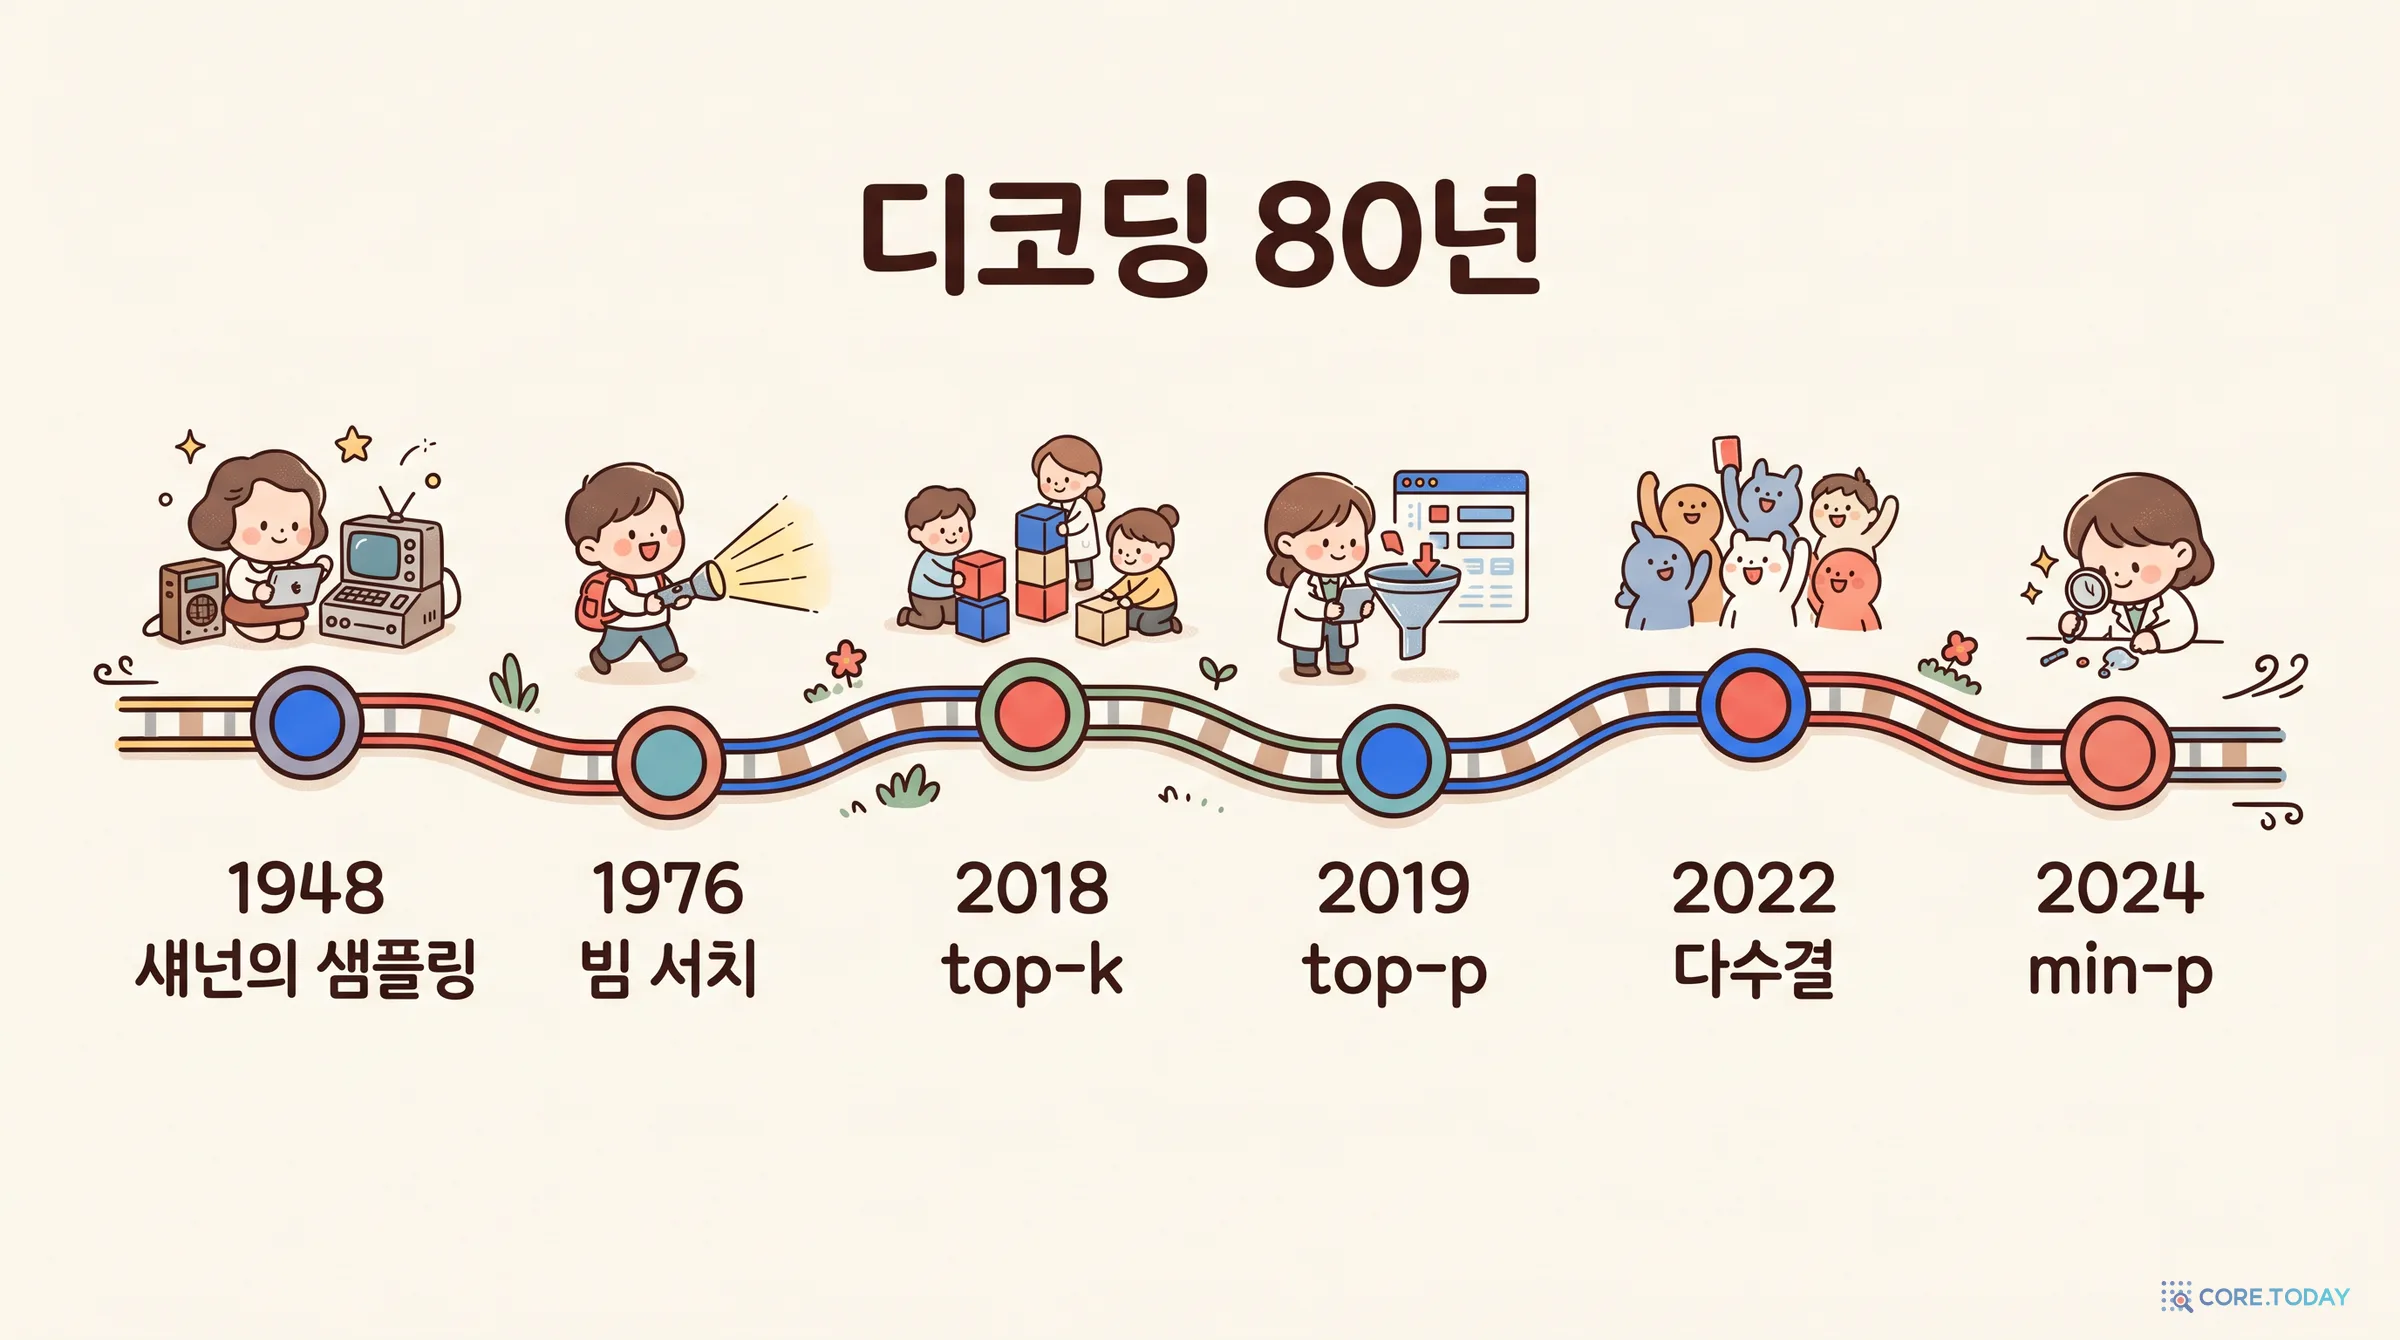
1948년 클로드 섀넌은 정보 이론을 세운 논문 「A Mathematical Theory of Communication」 3절에서 이 발상으로 영어 비슷한 글을 직접 만들었다. 방법은 이랬다.
책을 아무 데나 펼쳐 한 쪽에서 단어 하나를 고른다. 이 단어를 적는다. 다시 다른 쪽을 펼쳐 그 단어가 나올 때까지 읽는다. 그리고 바로 다음 단어를 적는다.
이렇게 하면 ‘앞 단어가 주어졌을 때 다음 단어’를 실제 영어의 통계대로 뽑게 된다. 지금 말로 하면 단어 2-gram 언어 모델에서의 샘플링이다. 섀넌이 얻은 문장은 이랬다.
THE HEAD AND IN FRONTAL ATTACK ON AN ENGLISH WRITER THAT THE CHARACTER OF THIS POINT IS THEREFORE ANOTHER METHOD FOR THE LETTERS THAT THE TIME OF WHO EVER TOLD THE PROBLEM FOR AN UNEXPECTED.
섀넌은 이 중 ‘attack on an English writer that the character of this’ 열 단어가 “전혀 이상하지 않다”고 썼다. 75년 뒤 언어 모델이 하는 일도 본질은 같다. 확률표가 훨씬 정교해졌을 뿐이다. 그리고 그 표에서 어떻게 뽑느냐는 문제는 섀넌 때처럼 여전히 남아 있다.
2부. 가장 그럴듯한 길을 찾아서 — 그리디와 빔 서치
2.1 그리디: 매번 1등
가장 단순한 규칙은 매 단계 확률이 가장 높은 토큰 하나를 고르는 것이다. 이를 그리디 디코딩이라 부른다. 무작위성이 없어서 같은 입력에는 같은 출력이 나온다(6부에서 보겠지만 실제로는 그렇지 않다). HuggingFace transformers의 generate()도 따로 설정하지 않으면 그리디로 동작한다.
문제는 그리디가 눈앞의 1등만 본다는 것이다. 문장 전체의 확률은 각 단계 확률의 곱이다. 첫 단어에서 2등을 고르면 그 뒤가 훨씬 확실해지는 경우가 있다. 그리디는 그 길을 영영 보지 못한다.
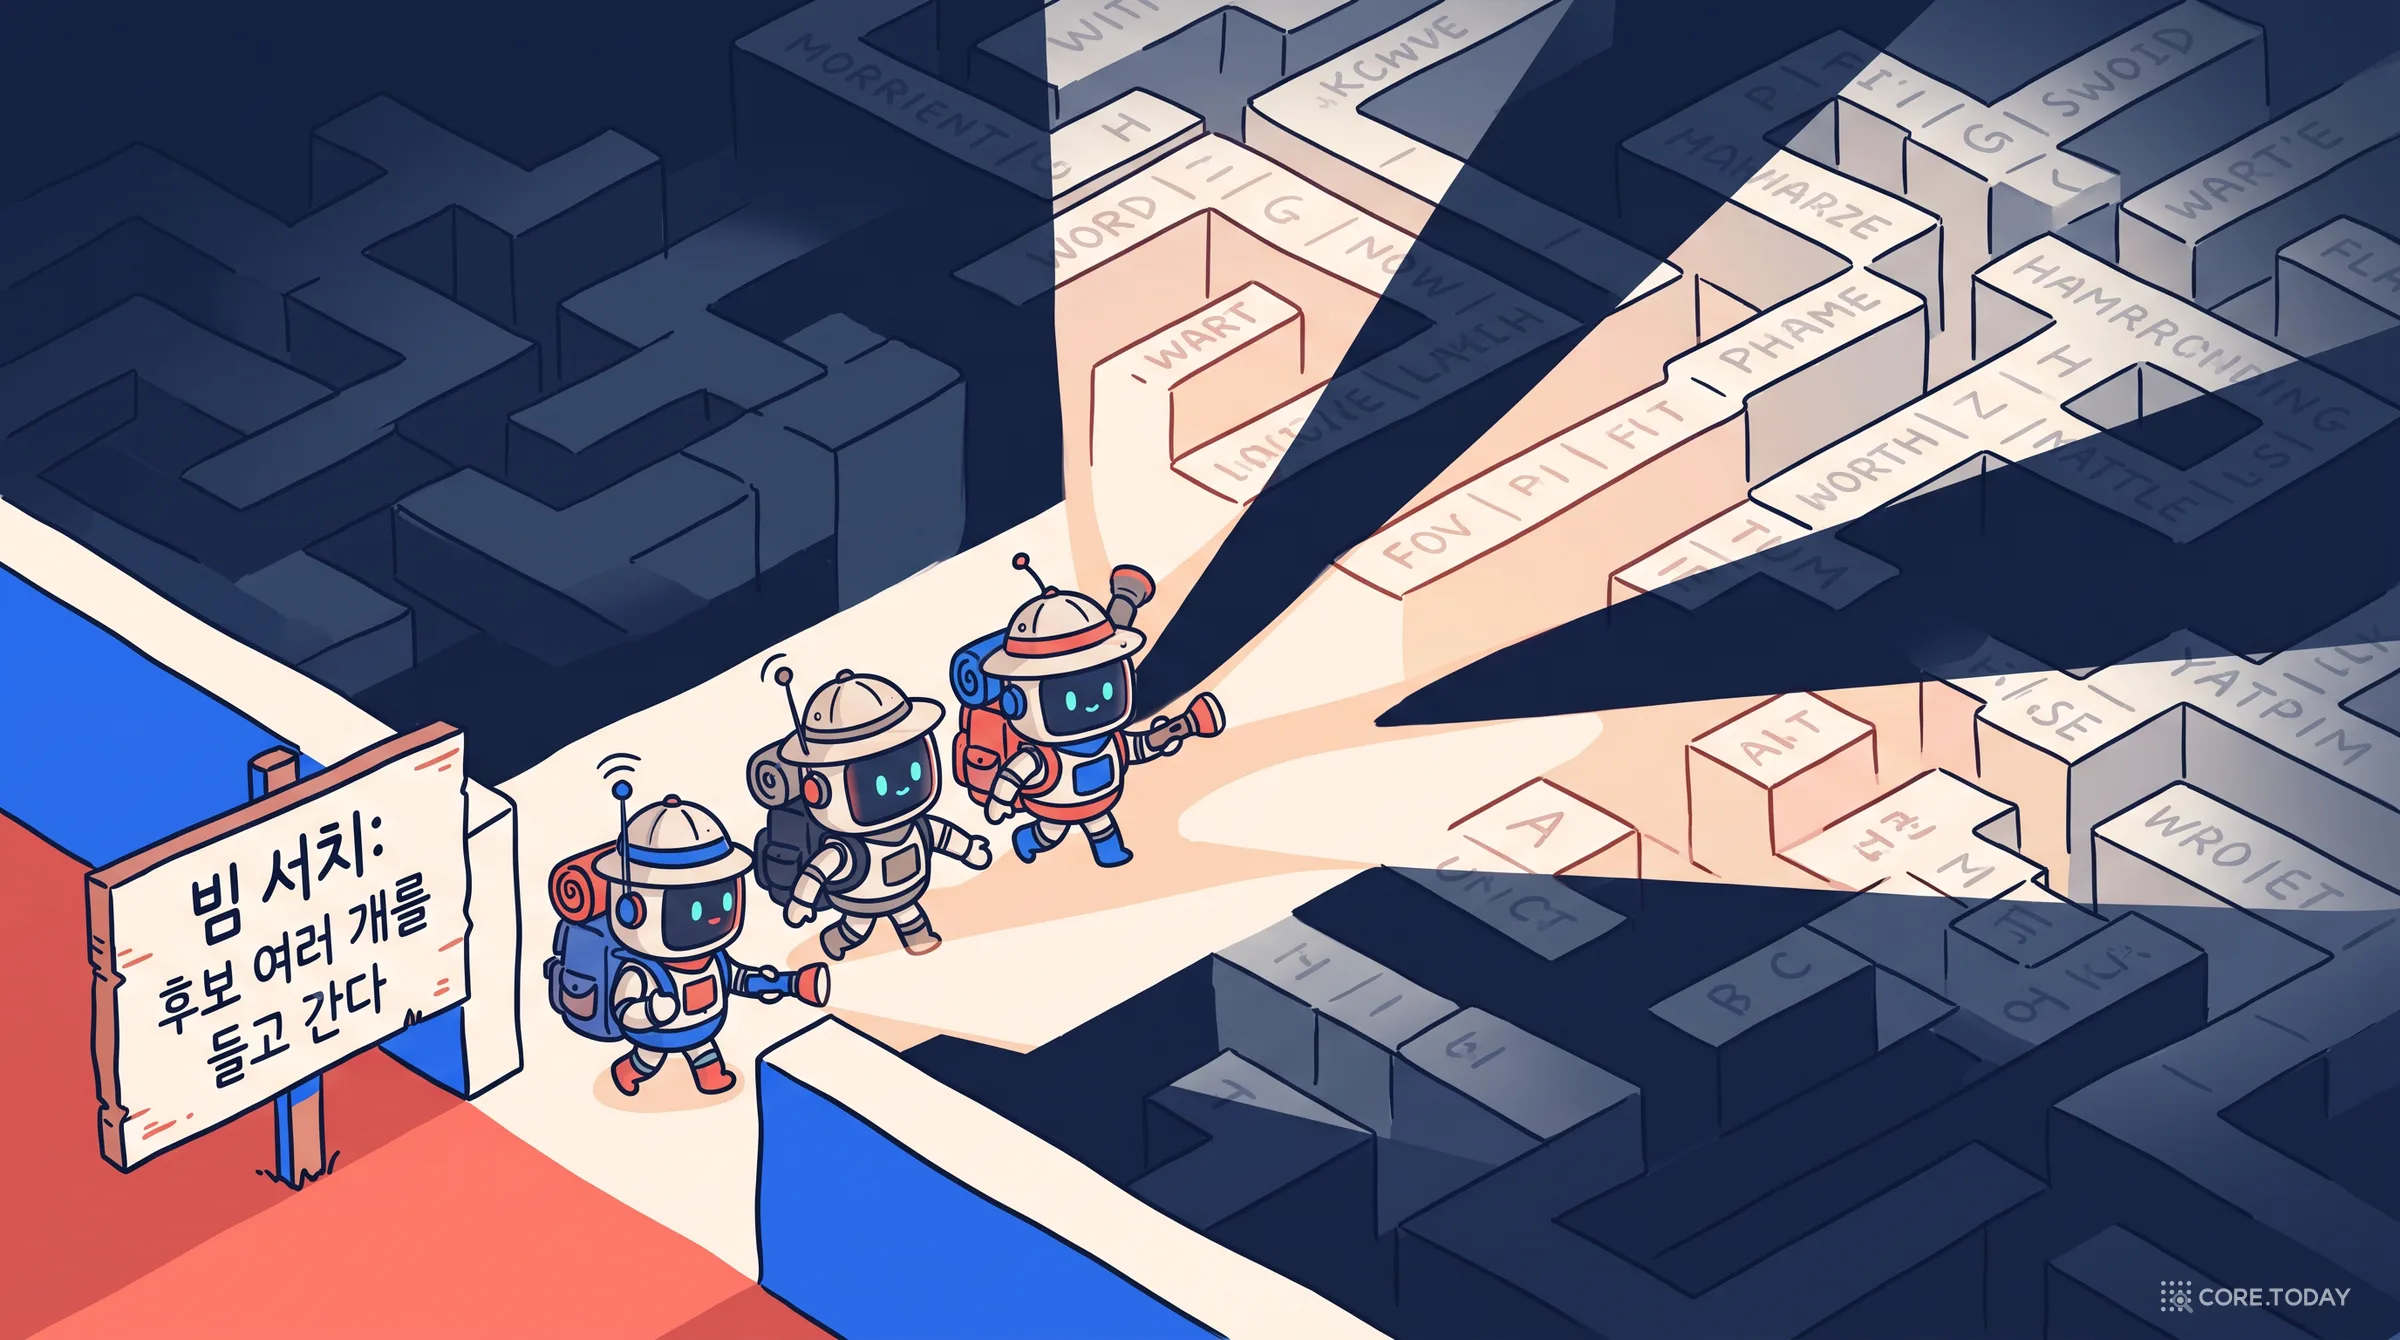
그래서 나온 것이 빔 서치(beam search)다. 매 단계 지금까지의 누적 확률이 높은 후보 B개를 함께 들고 간다. B를 빔 폭(beam width)이라 부른다. B=1이면 그리디다. B가 무한대면 가능한 모든 문장을 따지는 전수 탐색이다.
이 아이디어는 1970년대 음성 인식에서 왔다. 카네기멜런대 브루스 로워리(Bruce Lowerre)는 1976년 음성 인식 시스템 Harpy에서 ‘가장 좋은 몇 개를 병렬로 들고 가되 되돌아가지 않는(best few in parallel with no backtracking)’ 탐색을 썼다. 37개 단어로 된 계산기 명령을 인식하는 과제에서 문장 정확도는 88.6%였다. 이 방식은 곧 ‘빔 서치’라는 이름을 얻었다.
아래 나무에서 직접 비교해 보자. 설명용으로 만든 확률이다.
그리디는 첫 단어에서 50%짜리 ‘아침에’를 고른다. 그 순간 ‘정말 행복한’(40% × 90% = 36%)이라는 더 좋은 길을 잃는다. 폭 2의 빔 서치는 2등도 들고 다닌 덕에 전체 최고 문장 ‘정말 행복한 하루였다’(18%)를 찾는다. 그리디의 ‘아침에 커피를 마셨다’는 14%다.
2.3 번역기의 표준이 되다
빔 서치는 신경망 번역에서 표준이 됐다. 2014년 구글의 일리야 서츠케버(Ilya Sutskever) 등은 시퀀스-투-시퀀스(seq2seq) 번역 논문에서 이렇게 보고했다.
흥미롭게도 우리 시스템은 빔 크기 1로도 잘 동작하고, 빔 크기 2가 빔 서치 이득의 대부분을 준다.
빔 크기
영→불 BLEU (LSTM 5개 앙상블)
1 (그리디)
33.00
2
34.50
12
34.81
빔 서치에는 고질적인 버릇이 하나 있다. 확률은 1보다 작은 수를 계속 곱하는 것이라 문장이 길수록 확률이 낮아진다. 그래서 빔 서치는 짧은 문장을 편애한다. 2016년 구글 신경망 번역(GNMT)은 점수를 길이로 나누는 길이 정규화를 넣었다.
lp(Y)=(5+1)α(5+∣Y∣)α
로그 확률을 이 값으로 나눈다. 원문 단어를 빠짐없이 옮겼는지 보는 커버리지 벌점도 더했다. GNMT 논문은 α를 0.6~0.7로 두는 경우가 많았다고 적었다. 최종 시스템은 0.2를 썼고, 빔은 보통 후보 8~12개를 유지했다. 흔히 ‘GNMT 빔 크기 3’으로 잘못 인용되는 숫자 3.0은 빔 폭이 아니라 점수 차이로 후보를 쳐내는 가지치기 기준이다.
번역에서 잘 통하던 빔 서치를 GPT-2 같은 대형 언어 모델의 열린 글쓰기에 쓰자 이상한 일이 생겼다. 2019년 워싱턴대·앨런 AI 연구소의 아리 홀츠먼(Ari Holtzman) 등은 이 현상에 「The Curious Case of Neural Text Degeneration(신경망 텍스트 퇴화의 기묘한 사례)」이라는 이름을 붙였다(ICLR 2020).
빔 서치 같은 최대화 기반 디코딩은 퇴화를 낳는다. 밋밋하거나, 앞뒤가 맞지 않거나, 반복 루프에 갇힌 글이다.
연구진은 GPT-2 Large에 글 5,000개의 앞부분을 주고 전략별로 이어 쓰게 했다. 결과표는 이 분야의 고전이 됐다.
방법
퍼플렉서티
반복으로 끝난 글
HUSE (사람다움 + 다양성)
사람
12.38
0.28%
—
그리디
1.50
73.66%
—
빔 서치 (b=16)
1.48
28.94%
—
순수 샘플링
22.73
0.22%
0.67
top-k 40
6.88
0.78%
0.19
top-k 40 + T=0.7
3.48
8.86%
0.08
뉴클리어스 p=0.95
13.13
0.36%
0.97
퍼플렉서티(perplexity)는 모델이 그 글을 다시 읽을 때 얼마나 ‘놀라는지’를 나타낸다. 낮을수록 모델이 보기에 예측하기 쉬운 글이다. 사람의 글은 12.38이었다. 그리디와 빔 서치의 글은 1.5 안팎으로 사람 글보다 여덟 배 이상 뻔했다. 그리고 그리디의 글 4개 중 3개가 반복으로 끝났다.
논문의 그림 하나가 핵심을 보여 준다. 사람이 쓴 글의 토큰별 확률은 높았다 낮았다 출렁인다. 빔 서치의 글은 확률이 늘 높은 쪽에 붙어 있다. 연구진은 이렇게 정리했다.
자연스러운 글의 토큰당 확률은 평균적으로 빔 서치가 만든 글보다 훨씬 낮다.
사람은 뻔한 말을 하지 않으려고 한다. 언어철학자 폴 그라이스의 대화 격률처럼, 이미 아는 것을 되풀이하지 않고 정보가 있는 말을 고른다. 그래서 사람의 글에는 모델이 보기에 ‘의외의’ 단어가 꾸준히 섞인다. 확률이 가장 높은 문장은 가장 사람다운 문장이 아니다.
반복이 왜 루프가 되는지도 밝혀졌다. 어떤 구절이 한 번 반복되면, 모델은 그 구절이 다시 나올 확률을 더 높게 매긴다. 반복할수록 반복 확률이 올라가는 양의 되먹임이다. 그리디는 이 고리를 끊을 방법이 없다.
3.2 한국어로 다시 해 보다 — 코어닷투데이 실측
홀츠먼의 실험을 한국어로 재현했다. 카카오의 공개 모델 Kanana 1.5 2.1B base에 이 블로그의 검증용 글 40편에서 뽑은 문단의 앞 24토큰을 주었다. 그리고 12가지 전략으로 128토큰씩 이어 쓰게 했다. 비교 기준은 원문 글의 실제 다음 128토큰이다. 아래에서 전략을 바꿔 가며 실제 출력을 보자. 빨간 칸은 앞에서 이미 나온 세 어절 묶음이 다시 나온 곳이다.
40편 전체의 평균은 이렇다.
전략
반복으로 끝난 글
중복 4-gram
2-gram 다양성
퍼플렉서티
사람 (원문)
0%
0.6%
84.2%
14.47
그리디
45.0%
57.1%
31.8%
1.60
빔 서치 5
40.0%
56.7%
32.1%
1.45
순수 샘플링 T=1
0%
1.5%
86.8%
16.82
T=0.7
0%
9.5%
67.7%
3.92
top-k 40
2.5%
4.8%
77.2%
6.17
top-p 0.9
0%
2.1%
81.3%
7.04
top-p 0.95
0%
1.2%
83.9%
8.74
min-p 0.1
0%
14.2%
63.3%
3.31
T=1.5
0%
0%
99.9%
33,353
T=1.5 + min-p 0.1
0%
2.4%
80.8%
6.96
빔 5 + 3-gram 반복 금지
0%
0%
74.0%
2.26
그리디 + 반복 벌점 1.2
0%
4.2%
72.6%
2.75
반복으로 끝난 글: 끝부분에서 같은 토큰 묶음(1~30토큰)이 세 번 이상 연달아 나온 글의 비율. 중복 4-gram: 한 글 안에서 이미 나온 4-gram이 다시 나온 비율. 2-gram 다양성: 40편 전체에서 서로 다른 토큰 2-gram의 비율. 퍼플렉서티: 이어 쓴 128토큰을 같은 모델이 다시 읽었을 때의 값.
GPT-2로 한 7년 전 실험과 그림이 거의 같다.
그리디·빔 서치는 사람 글보다 9~10배 뻔하고(퍼플렉서티 1.5 안팎), 열 편 중 네 편 이상이 루프로 끝났다.
순수 샘플링(T=1)은 반복이 없지만 퍼플렉서티가 사람 글보다 높다. 실제 출력에는 ‘아니너나도 아니너나가’ 같은 정체불명의 말이 섞였다.
T=1.5는 영어·중국어·러시아어·코드 조각이 뒤섞인 완전한 횡설수설이 됐다. 퍼플렉서티 33,353은 모델 자신조차 자기 글을 거의 예측하지 못한다는 뜻이다.
통계가 사람 글에 가장 가까운 것은 top-p 0.95였다. 2-gram 다양성 83.9%(사람 84.2%), 중복 4-gram 1.2%(사람 0.6%).
‘땜질’ 두 가지(3-gram 반복 금지, 반복 벌점)는 반복은 없앴다. 하지만 퍼플렉서티가 여전히 2~3으로 낮다. 같은 말을 되풀이하지 않을 뿐, 여전히 뻔한 말을 고른다.
이제 눈이 좀 트였을 것이다. 아래 글은 사람이 쓴 것일까, 아니면 어떤 설정의 모델이 쓴 것일까?
번역에서도 이상한 일이 보고됐다. 빔을 넓히면, 즉 확률이 더 높은 문장을 더 열심히 찾으면 번역이 나빠졌다.
2017년 필립 쾬(Philipp Koehn)과 레베카 놀스(Rebecca Knowles)는 「Six Challenges for Neural Machine Translation(신경망 번역의 여섯 가지 과제)」에서 이렇게 썼다.
최적의 빔 크기를 넘어서면 더 나쁜 번역이 나온다. 품질 저하의 주된 원인은 넓은 빔에서 번역이 짧아지는 것이다.
러시아어→영어에서 BLEU는 빔 4일 때 26.9였다. 빔 50에서는 24.1로 떨어졌다. 영어→체코어는 빔 500에서 19.9까지 내려갔다.
2019년 케임브리지대의 펠릭스 슈탈베르크(Felix Stahlberg)와 빌 번(Bill Byrne)은 끝까지 가 봤다. 빔 서치 대신 정확한 탐색으로 모델이 가장 높은 확률을 주는 번역을 실제로 찾아냈다. 결과는 충격적이었다.
디코딩 (Transformer, 영→독)
BLEU
길이 비율
탐색 오류
그리디
29.3
1.02
73.6%
빔 10
30.3
1.00
57.7%
정확한 탐색
2.1
0.06
0%
51.8%의 문장에서 모델이 가장 높은 확률을 준 번역은 빈 문자열이었다. 아무것도 출력하지 않는 것이 ‘가장 그럴듯한 번역’이었던 셈이다. 연구진은 이렇게 결론 내렸다.
평범한 신경망 번역은 딱 적당한 양의 빔 서치 오류를 필요로 한다.
빔 서치가 잘 동작한 것은 탐색을 잘해서가 아니라 적당히 못해서였다. 이듬해 클라라 마이스터(Clara Meister) 등은 「If beam search is the answer, what was the question?(빔 서치가 답이라면, 질문은 무엇이었나?)」에서 이를 설명했다. 빔 서치는 정보를 문장 전체에 고르게 퍼뜨리는 쪽(균일 정보 밀도)을 은연중에 선호한다. 사람도 말할 때 그렇게 한다는 인지과학 가설이 있다. 빔 서치의 ‘오류’가 사실은 사람다운 글을 만드는 유익한 편향이었다는 것이다.
우리 실측에서도 같은 경향이 나왔다(5부에서 자세히). 한국어→영어 번역에서 BLEU는 빔 4에서 가장 높았고, 빔 8과 16에서는 오히려 떨어졌다.
4부. 주사위를 굴리되, 꼬리는 자른다
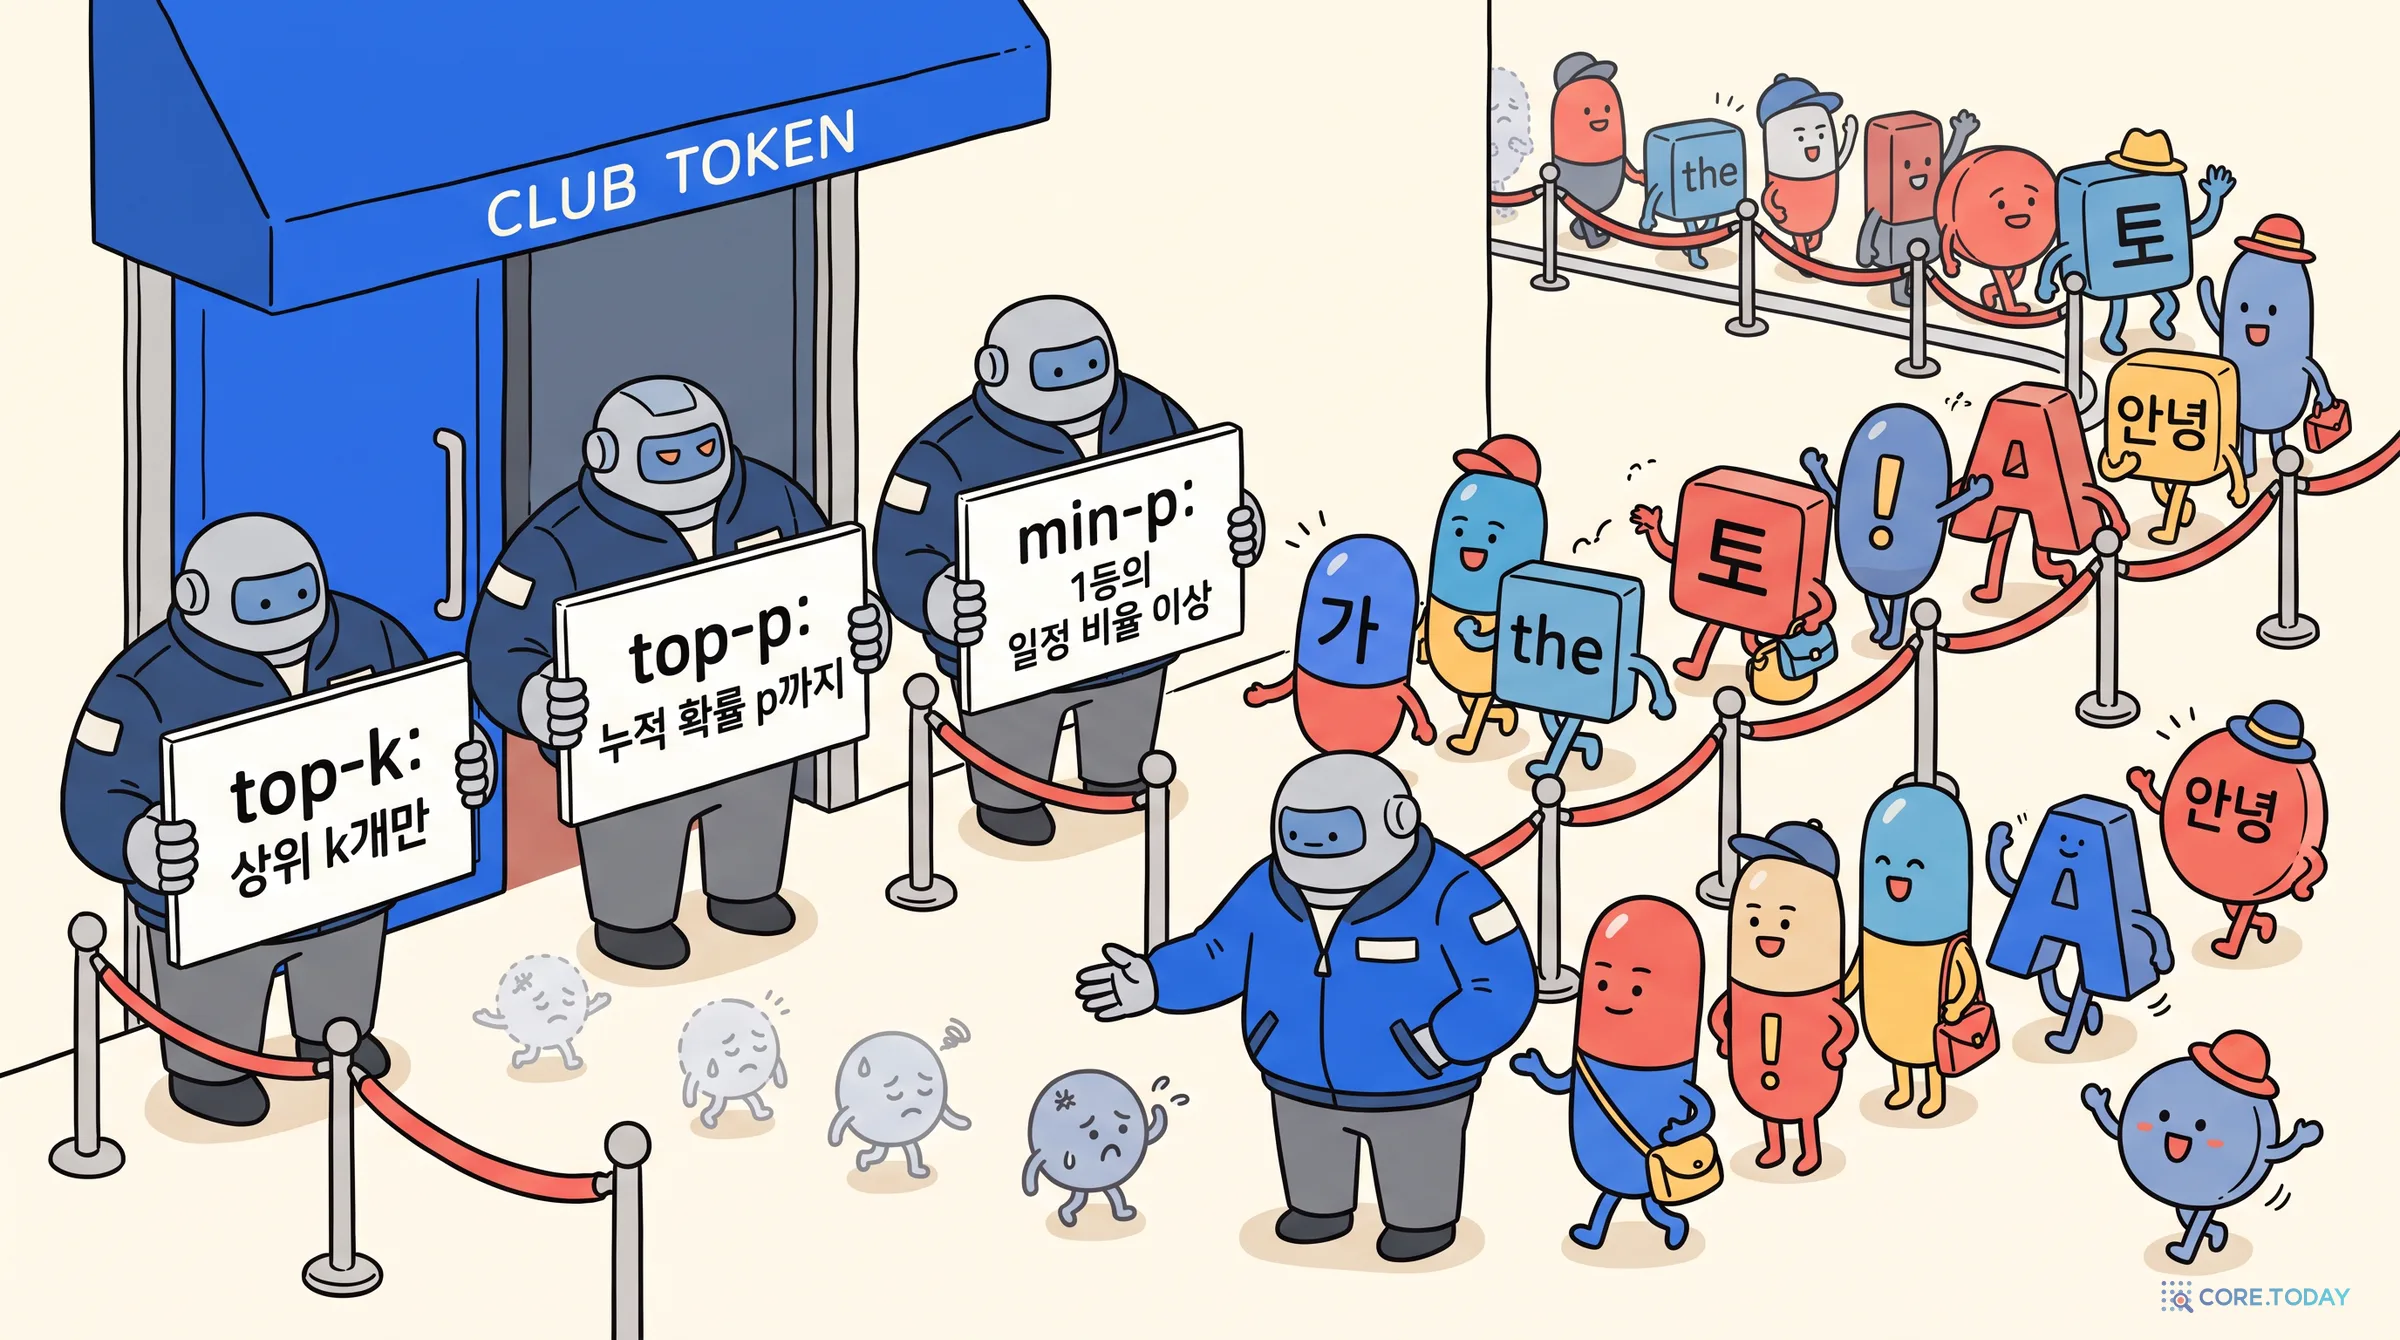
최대화가 답이 아니라면 확률표대로 주사위를 굴리면 된다. 이를 샘플링이라 부른다. 확률 47%짜리 ‘서울’은 47%의 확률로, 0.01%짜리 토큰은 0.01%의 확률로 뽑힌다. 섀넌이 책을 펼쳐 한 일이 바로 이것이다.
순수 샘플링에는 다른 문제가 있다. 어휘가 12만 개면 확률이 아주 작은 토큰도 12만 개 가까이 된다. 하나하나는 무시할 만해도 합치면 무시할 수 없다. 위 실험실의 ‘그녀는 창밖을 바라보며’를 보면, 상위 60개 토큰의 확률을 다 더해도 52%다. 나머지 48%는 12만 8천여 개의 꼬리에 흩어져 있다. 순수 샘플링은 거의 두 번에 한 번꼴로 이 꼬리에서 토큰을 뽑는다.
홀츠먼 등은 이렇게 진단했다.
최고의 언어 모델의 확률 분포에도 잘라 내야 할 믿을 수 없는 꼬리가 있다. 이 꼬리는 확률이 비교적 낮은 수만 개의 후보 토큰으로 이루어져 있고, 합치면 과대 대표된다.
한 번 엉뚱한 토큰이 뽑히면 모델은 그 토큰을 ‘이미 쓴 글’로 받아들이고 그럴듯하게 이어 가려 한다. 오류가 오류를 부른다. 우리 실측에서 순수 샘플링 글이 횡설수설로 흘러간 이유다.
그래서 이후의 샘플링 기법은 거의 모두 하나의 질문에 대한 답이다. 꼬리를 어떻게, 얼마나 자를 것인가.
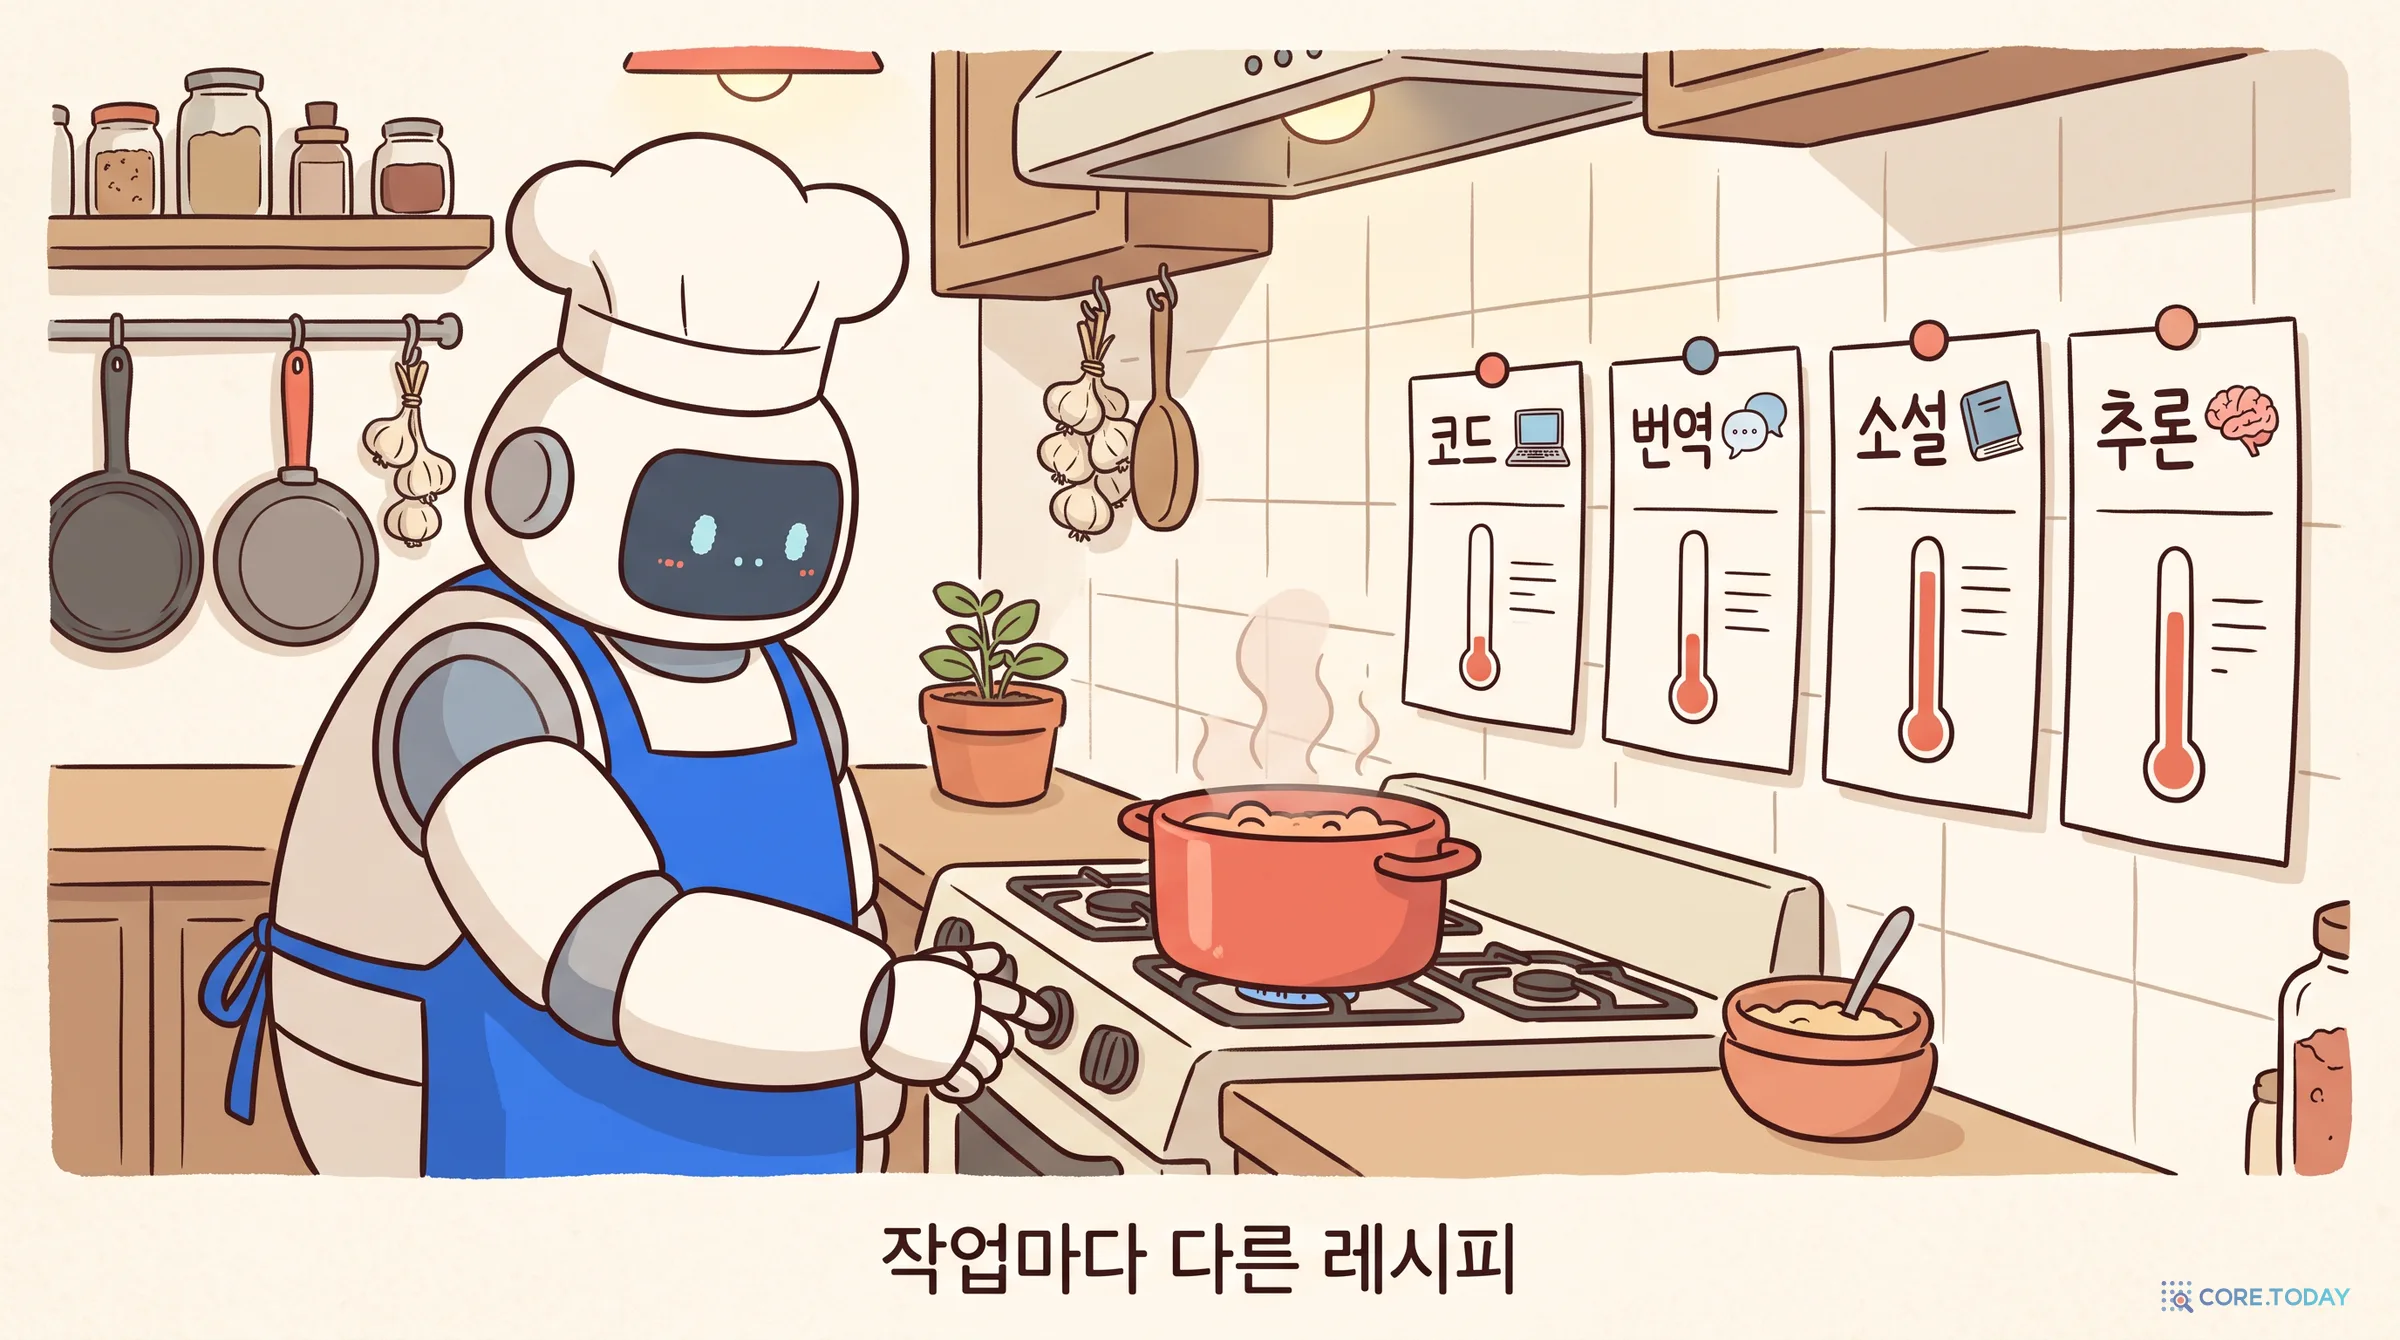
가장 오래된 손잡이는 온도(temperature)다. 로짓을 온도 T로 나눈 뒤 소프트맥스를 한다.
pi=∑jexp(zj/T)exp(zi/T)
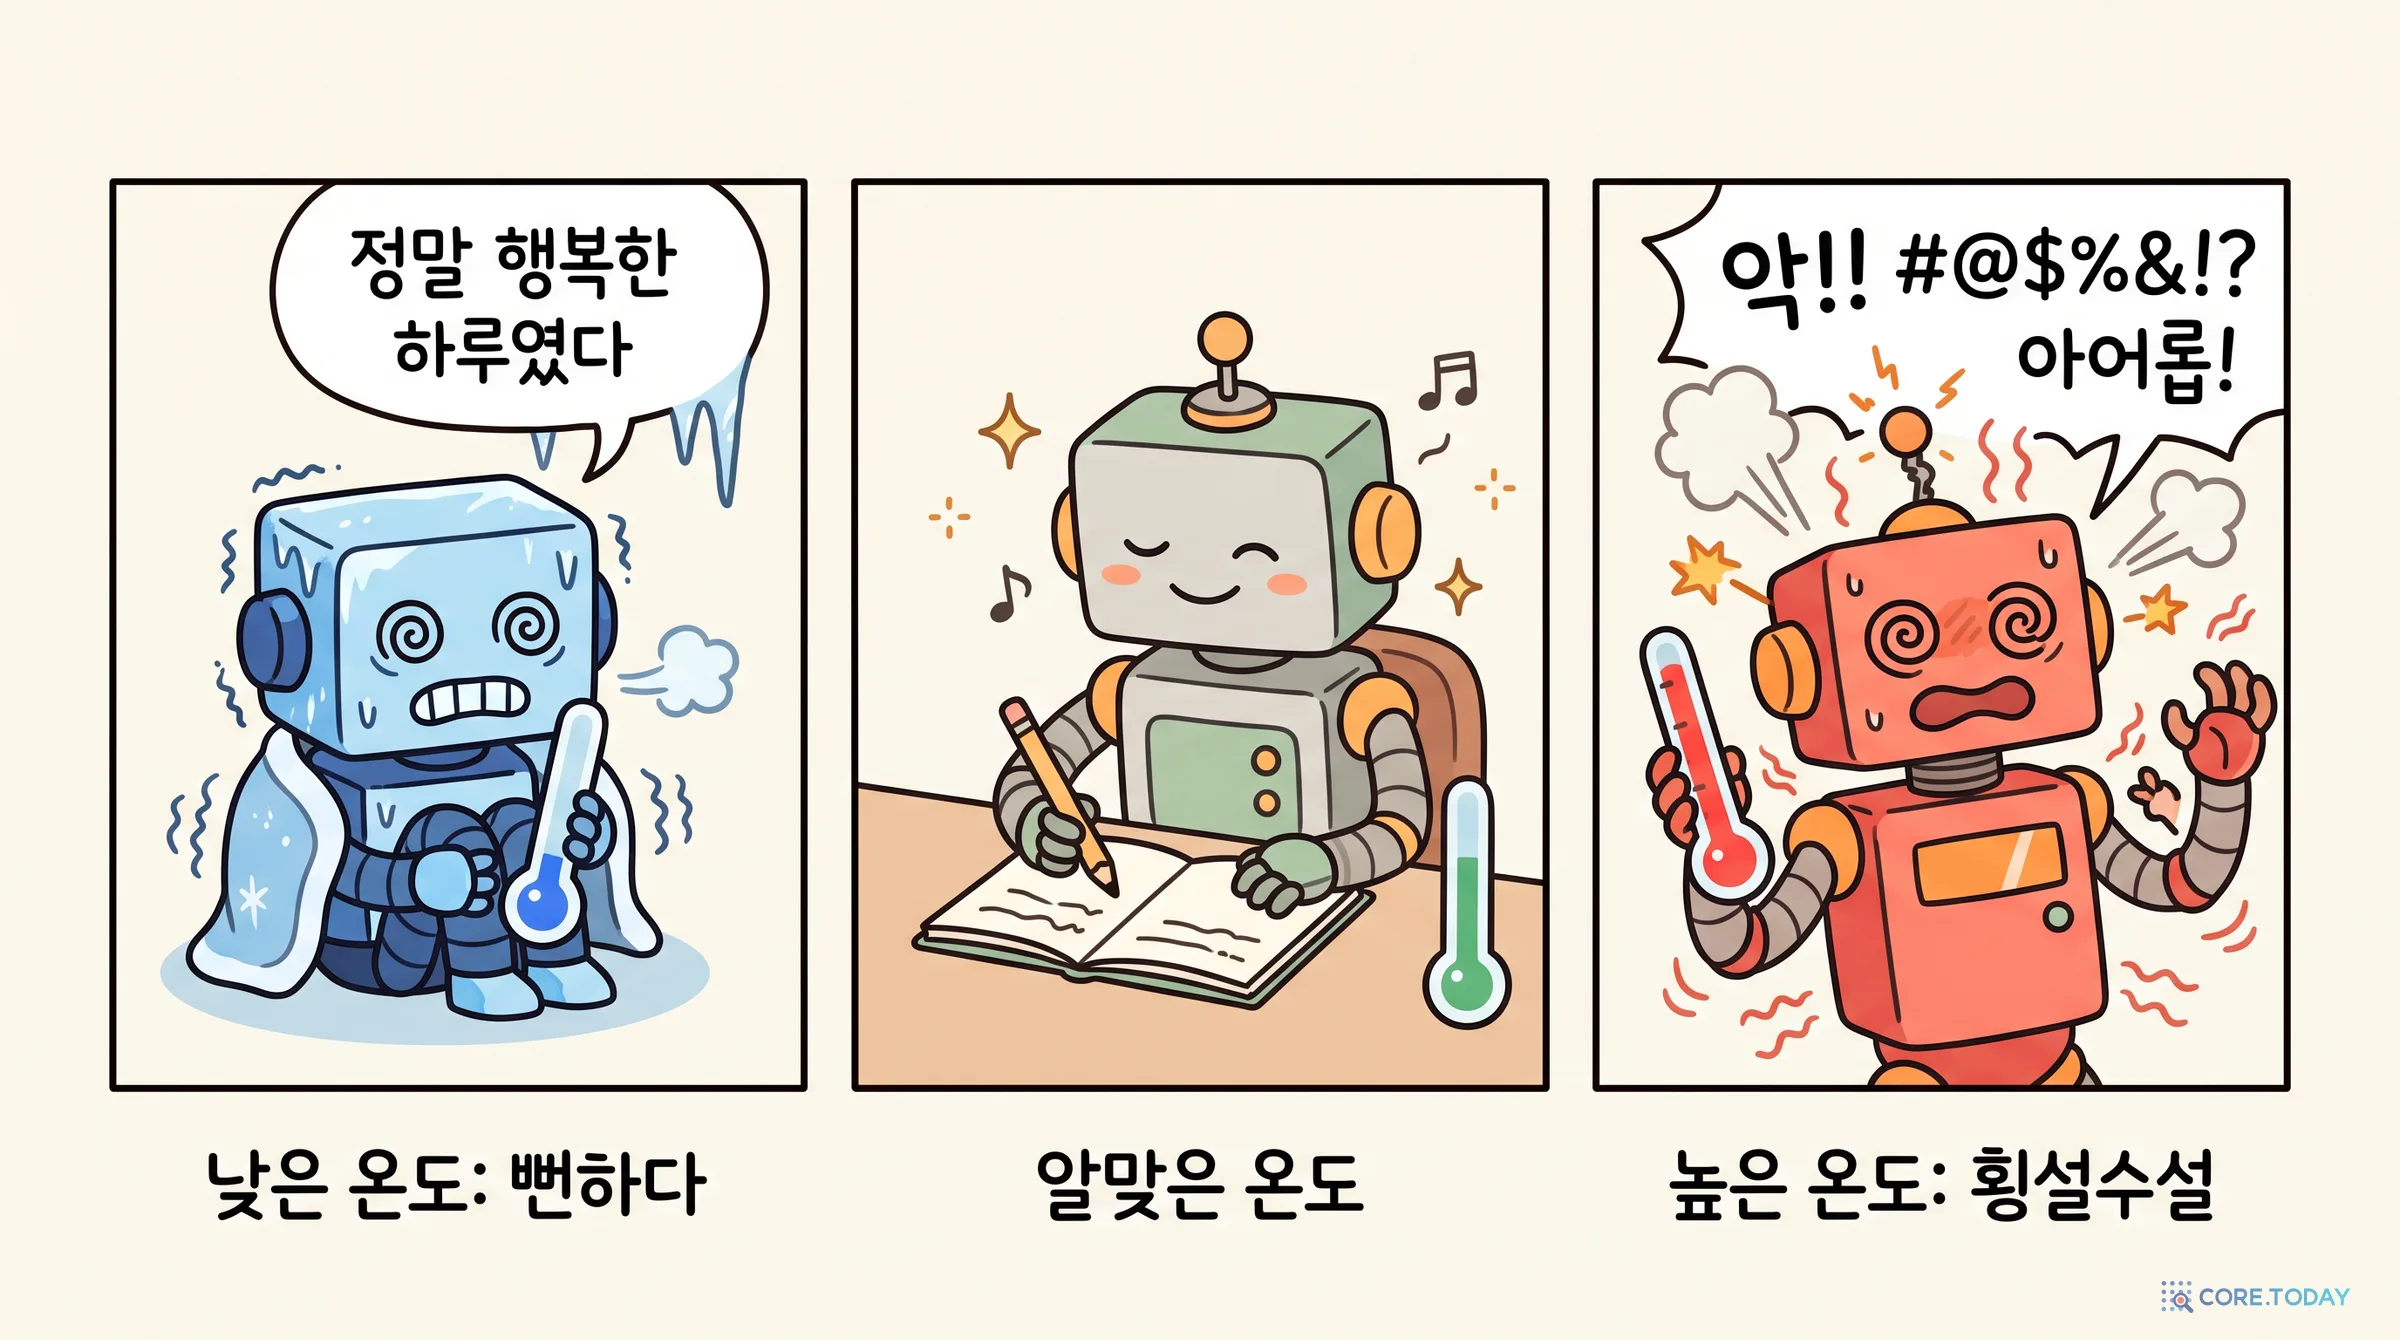
T가 1보다 작으면 큰 로짓과 작은 로짓의 차이가 커져 분포가 뾰족해진다. 1등이 더 자주 뽑힌다. T를 0에 가깝게 하면 그리디와 같아진다.
T가 1보다 크면 차이가 줄어 분포가 납작해진다. 꼬리의 토큰이 더 자주 뽑힌다.
실험실에서 ‘대한민국의 수도는’을 고르고 온도를 바꿔 보자. T=1에서 48%인 ‘서울’이 T=0.7에서는 77%, T=0.3에서는 99%가 되고, T=1.5에서는 13%로 내려간다.
이름은 통계물리학에서 왔다. 기체 분자의 에너지 분포(볼츠만 분포)에서 온도가 높으면 분자들이 높은 에너지 상태에도 고르게 퍼진다. 1985년 데이비드 애클리(David Ackley), 제프리 힌턴(Geoffrey Hinton), 테리 세즈노스키(Terry Sejnowski)의 볼츠만 머신 논문은 확률 계산에 T를 넣고 “온도처럼 작동하는 매개변수”라고 불렀다. 이 발상은 1953년 메트로폴리스 알고리즘과 1983년 모의 담금질(simulated annealing)에서 왔다. 높은 온도에서 시작해 천천히 식히면 국소 최적에 갇히지 않는다는 것이다. 홀츠먼 등의 논문을 포함해 오늘날 temperature 샘플링을 설명하는 논문들이 인용하는 원전이 바로 이 1985년 논문이다. 힌턴은 2015년 지식 증류(distillation) 논문에서도 같은 온도로 큰 모델의 ‘부드러운 정답’을 만들었다.
temperature는 ‘창의성 손잡이’인가? 2024년 맥스 피퍼콘(Max Peeperkorn) 등은 Llama 2-Chat 70B로 온도를 0에서 2까지 바꿔 가며 이야기를 100편씩 쓰게 했다. 결론은 이랬다. “온도는 새로움과 약하게 상관되고, 비일관성과는 중간 정도로 상관된다. 응집성이나 전형성과는 관계가 없다.” 온도를 올려서 얻는 것은 창의성보다 횡설수설일 가능성이 더 크다.
꼬리를 자르는 가장 단순한 방법은 상위 k개 토큰만 남기는 것이다. 2018년 페이스북 AI 리서치(현 메타)의 앤절라 팬(Angela Fan) 등은 이야기 생성에서 상위 10개 안에서만 뽑는 방식이 “흔한 구절과 반복을 만드는” 빔 서치보다 훨씬 낫다고 보고했다. 이듬해 GPT-2 논문의 예시 글들은 k=40으로 뽑았다. 세상을 놀라게 한 GPT-2의 ‘안데스 산맥의 유니콘’ 기사도 k=40으로 뽑은 10개 중 가장 좋은 하나를 고른 것이었다.
top-k의 약점은 k가 고정이라는 것이다. ‘대한민국의 수도는’처럼 답이 거의 정해진 질문에서는 k=40도 너무 많다. 40등까지 남겨 두면 엉뚱한 후보가 끼어든다. ‘그녀는 창밖을 바라보며’처럼 열린 문장에서는 k=40이 너무 적다. 그럴듯한 후보가 수백 개인데 40개로 잘라 버린다.
4.4 top-p (뉴클리어스) — 누적 확률 p까지
홀츠먼 등은 같은 논문에서 해법도 내놓았다. 누적 확률이 p에 닿는 가장 작은 후보 집합에서만 뽑는다. 이 집합을 ‘핵(nucleus)’이라 불러서 뉴클리어스 샘플링, 또는 top-p 샘플링이라 한다.
분포가 뾰족하면 후보 몇 개만으로 p에 닿는다. 납작하면 수백 개가 필요하다. 후보 수가 분포 모양에 따라 저절로 바뀐다. 논문은 핵의 크기가 “대체로 1개에서 1,000개 사이를 오간다”고 적었다. 위 표에서 p=0.95는 HUSE 0.97로 사람다움과 다양성을 함께 잡은 유일한 방법이었다. 우리 한국어 실측에서도 통계가 사람 글에 가장 가까웠다.
실험실에서 top-p를 0.9로 놓고 다섯 문장을 차례로 눌러 보자. ‘대한민국의 수도는’에서는 후보가 수십 개로 줄지만, ‘그녀는 창밖을 바라보며’에서는 수백 개가 남는다.
4.5 min-p — 1등의 일정 비율 이상
top-p에도 약점이 있다. 온도를 높이면 분포가 납작해져 누적 확률 p에 닿기까지 꼬리 토큰이 대거 들어온다. min-p는 기준을 1등에 묶는다. 가장 높은 확률이 pmax라면 pbase×pmax보다 낮은 토큰을 모두 자른다. 1등이 확실하면 문턱이 높아지고, 1등이 애매하면 문턱이 낮아진다.
min-p 논문(Nguyen 등)은 ICLR 2025 구두 발표로 뽑혔다. 하지만 이야기는 거기서 끝나지 않았다. 몇 달 뒤 스탠퍼드의 라일런 섀퍼(Rylan Schaeffer) 등은 「Min-p, Max Exaggeration」에서 원 논문의 근거를 하나씩 반박했다.
사람 평가 데이터 일부가 빠져 있었고 통계 검정이 잘못됐다.
하이퍼파라미터 수를 맞추면 벤치마크에서 기존 방법보다 낫지 않다.
LLM 심판 평가에서 min-p는 두 점수 중 높은 쪽을, top-p는 낮은 쪽을 보고했다.
원 논문의 ‘GitHub 저장소 4만 9천 개 채택’ 같은 수치는 근거가 확인되지 않아 최종본에서 빠졌다.
원 논문의 표를 봐도 min-p의 이점은 아무도 수학 문제에 쓰지 않는 고온(T=2~3)에서 주로 나타난다. T=0.7의 GSM8K에서는 오히려 top-p가 36.09%로 min-p(35.18%)보다 높았다.
우리 실측도 비슷하다. T=1에서 min-p 0.1은 너무 많이 잘라 중복 4-gram이 14.2%로 늘었다. 반면 T=1.5에서는 퍼플렉서티를 33,353에서 6.96으로 끌어내려 횡설수설을 막았다. 높은 온도에서 꼬리를 막는 안전장치로는 쓸 만하다. 만능 해법은 아니다.
4.6 반복 벌점과 그 밖의 손잡이들
반복 벌점(repetition penalty)은 2019년 세일즈포스의 CTRL 논문(Keskar 등)이 제안했다. 이미 나온 토큰의 점수를 깎는다. 논문은 “그리디에 θ≈1.2의 벌점을 주면 사실성과 반복 억제의 균형이 좋다”고 했다. 단서도 달았다. 모델이 이미 믿을 만한 분포를 배웠을 때만 통한다는 것이다.
구현에는 함정이 있다. 논문 식은 로짓을 θ로 나눈다. 그런데 로짓이 음수면 나눌수록 오히려 커진다. 그래서 HuggingFace는 음수면 곱하고 양수면 나누도록 고쳐 구현했다. 또 프롬프트 안의 토큰까지 ‘이미 나온 것’으로 친다. 그래서 질문에 나온 단어를 답에서 쓰기 어려워진다. 한국어에서는 ‘의’, ‘다’, ‘는’처럼 반드시 반복돼야 하는 조사·어미까지 깎인다. 우리 실측에서 반복 벌점 1.2는 루프를 없앴지만 퍼플렉서티는 2.75로 여전히 낮았다.
기법
무엇을 자르나
비고
Mirostat (2020)
목표 퍼플렉서티를 유지하도록 k를 매 단계 조절
‘지루함의 함정’과 ‘혼란의 함정’ 사이를 되먹임으로 유지
typical 샘플링 (2022)
정보량이 평균(엔트로피)에서 먼 토큰
너무 뻔한 1등도 자를 수 있다
η·ε 샘플링 (2022)
절대 확률 문턱(엔트로피에 따라 조정)
‘Donald’ 다음 ‘Trump’ 96% 같은 경우 top-p가 하나만 남기는 문제 지적
contrastive search (2022)
앞 문맥과 너무 비슷한 표현을 감점(결정적)
상위 k개 중 확신도 − 유사도 벌점이 가장 큰 것
각 기법은 저마다 장점을 보고했다. 하지만 실무에서 살아남은 조합은 여전히 temperature + top-p(오픈 모델에서는 top-k를 더하기도 한다)다.
5부. 과제마다 답이 다르다 — 코어닷투데이 실측
3부의 결론은 ‘최대화는 나쁘다’가 아니다. 열린 글쓰기에서는 나쁘다. 정답이 좁은 과제에서는 이야기가 다르다. 같은 Kanana 1.5의 지시 따르기 모델(instruct)로 두 가지 과제를 재 봤다.
5.1 번역: 최대화가 이긴다
FLORES-200의 한국어 문장 100개를 영어로 번역하게 하고 sacreBLEU로 채점했다.
그리디
21.87
빔 2
22.64
빔 4
22.97
빔 8
22.50
빔 16
22.28
샘플링 T=0.7
20.48
top-p 0.9
19.98
샘플링 T=1.0
19.61
막대 길이는 BLEU 25점을 만점으로 잡았다. 차이가 작으니 숫자를 함께 보자.
번역에서는 샘플링이 모두 그리디보다 낮았다. 빔 서치는 4까지 오르다가 8, 16에서 내려갔다. 쾬과 놀스가 본 그 곡선이다. 차이는 1점 안팎이라 문장 100개로는 통계적으로 확정할 수 없다. 하지만 방향은 분명했다. 문장 하나를 보면 차이가 실감 난다.
원문: 노바스코샤주 핼리팩스의 댈하우지대학교 의과 교수이자 …
그리디 : a professor of medicine at the University of Nova Scotia's Dalhousie University … 빔 4 : a professor of medicine at Dalhousie University in Halifax, Nova Scotia … T=1.0 : a Professor of Medicine at the University of Notre Dame in Halifax, Nova Scotia …
그리디는 ‘노바스코샤 대학교의 댈하우지 대학교’라는 어색한 구조를 만들었다. 빔 4는 정확했다. 온도 1의 샘플링은 노터데임 대학교라는 엉뚱한 대학을 만들어 냈다. 번역처럼 원문이 정답의 범위를 좁혀 주는 과제에서 꼬리를 뽑는 것은 곧 사실 오류다.
5.2 수학: 온도는 생각보다 덜 중요하다, 1을 넘기 전까지는
두세 단계 계산이 필요한 한국어 수학 문장제 50문제를 만들었다. 온도마다 문제당 다섯 번씩 풀게 했다. 한 번 풀었을 때의 평균 정답률과, 다섯 번의 답 중 다수결로 정한 정답률을 함께 쟀다.
설정
한 번 풀 때 정답률
5번 풀고 다수결
답 형식이 무너진 풀이
그리디
84.0%
—
—
T=0.3
84.0%
84.0%
0 / 250
T=0.7
83.2%
84.0%
0 / 250
T=1.0
81.2%
82.0%
0 / 250
T=1.3
79.6%
82.0%
2 / 250
T=1.6
43.2%
70.0%
129 / 250
0에서 1까지 온도를 바꿔도 정답률은 84%에서 81% 사이를 오갔다. 문제 50개로는 의미 있는 차이라고 보기 어렵다. 2024년 매슈 렌즈(Matthew Renze)와 에르한 구벤(Erhan Guven)이 GPT-4, Claude 3 Opus 등 아홉 개 모델로 한 실험의 결론과 같다.
0.0에서 1.0 사이의 온도 변화는 문제 해결 성능에 통계적으로 유의한 영향을 주지 않는다.
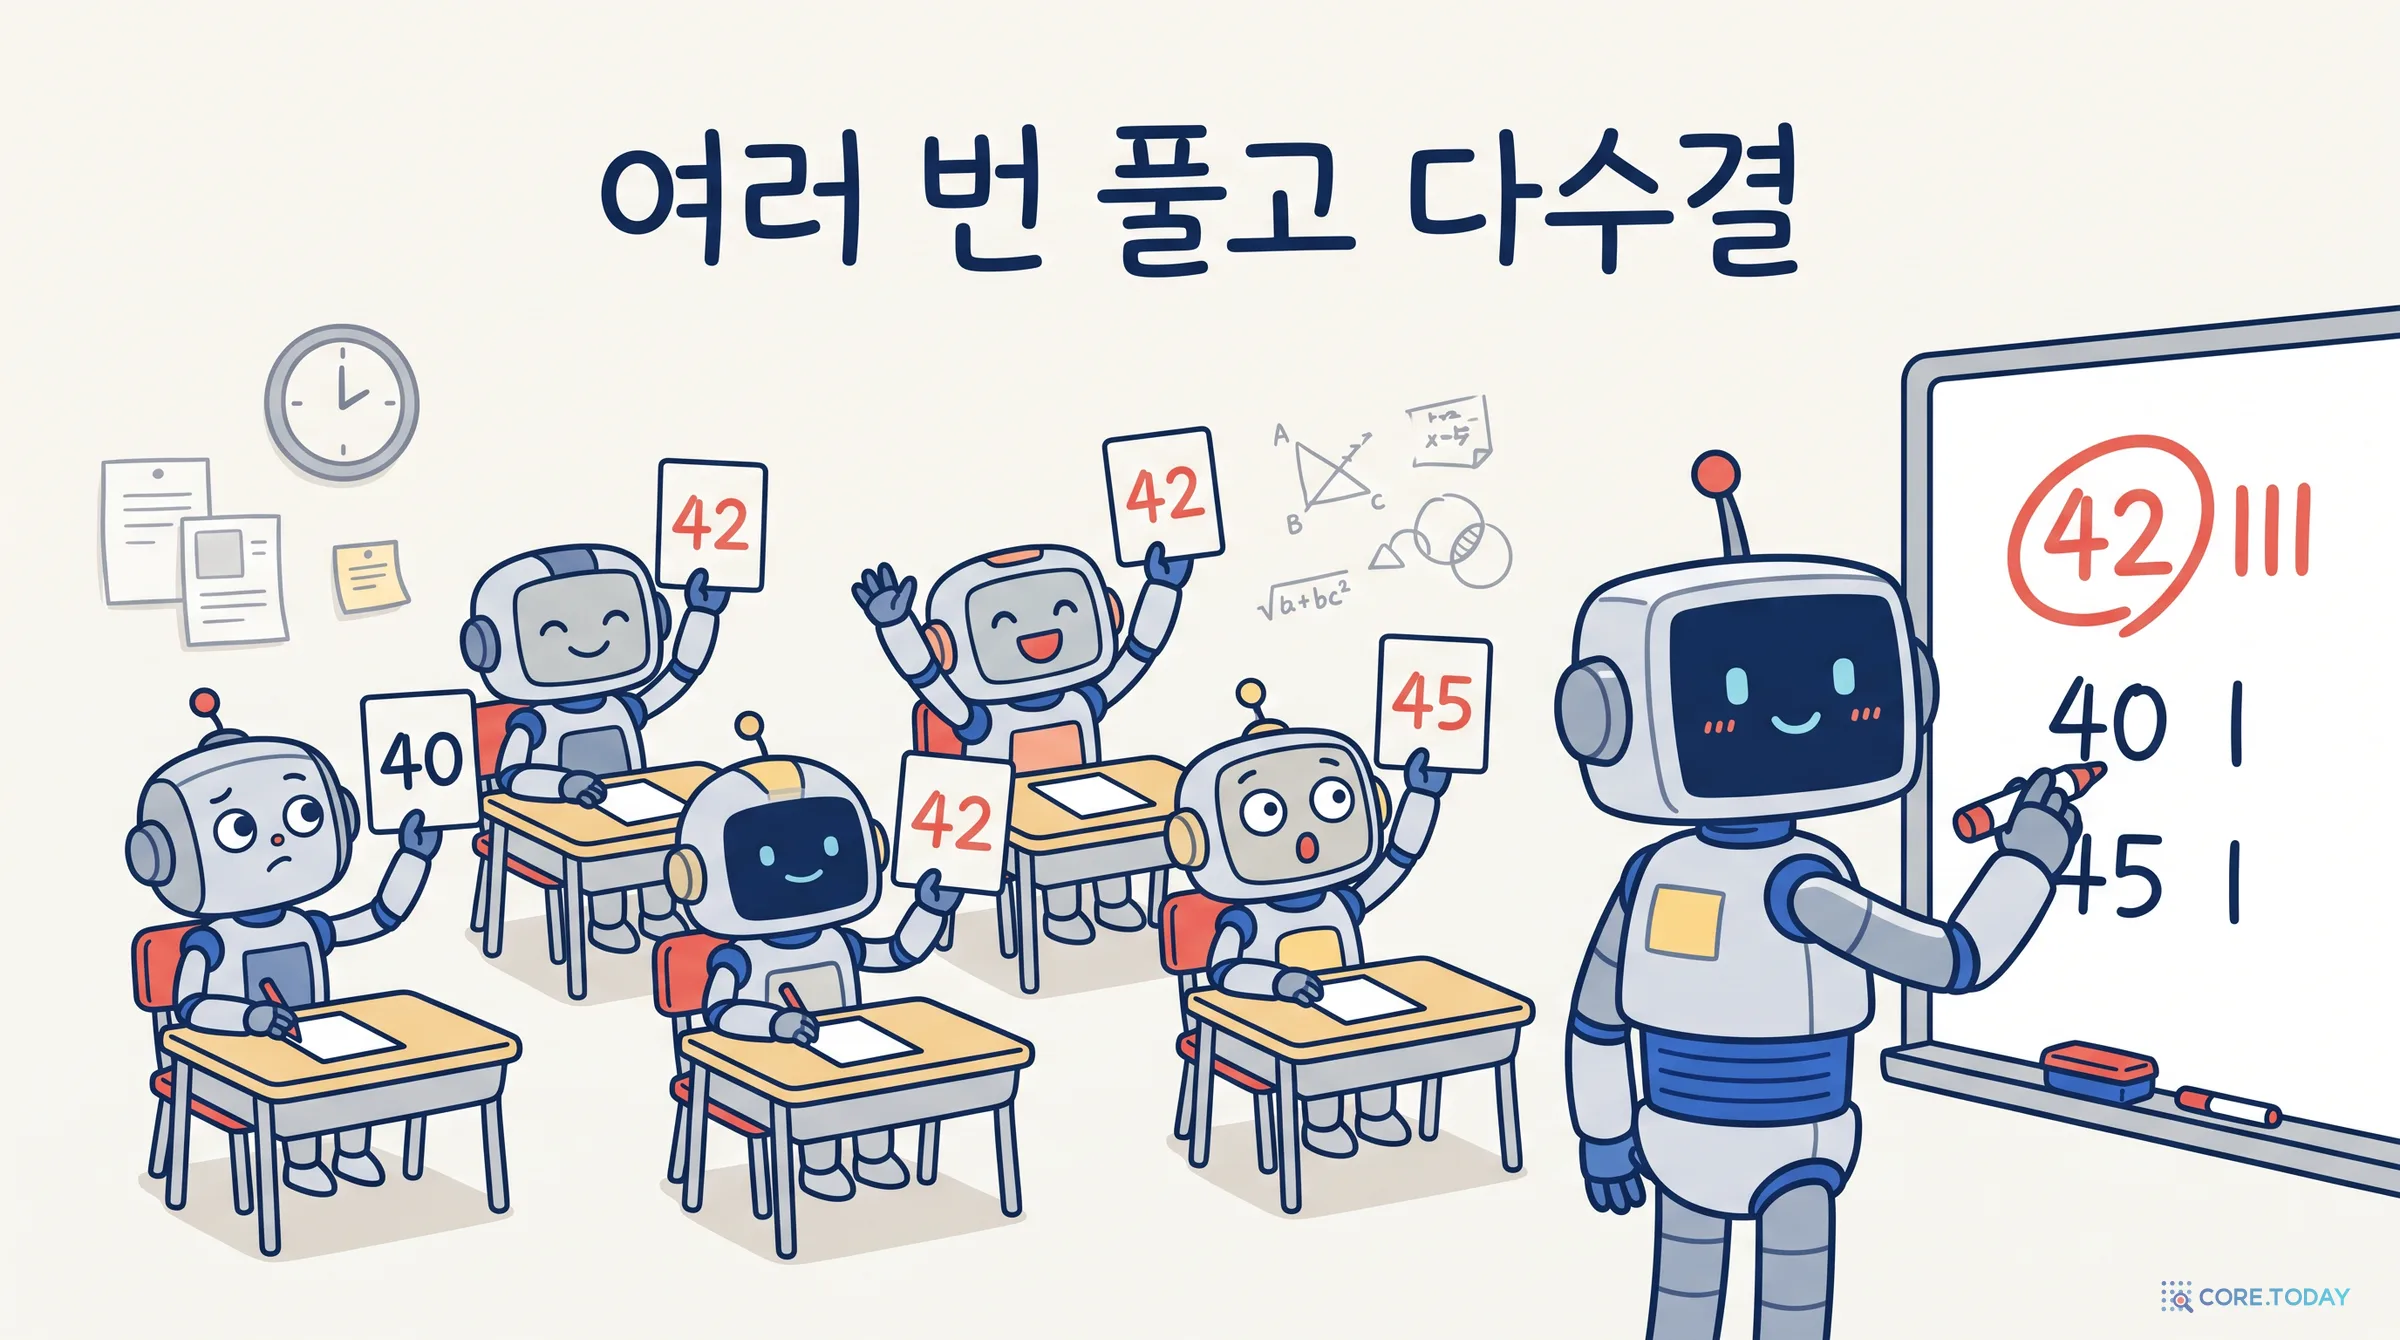
1을 넘으면 이야기가 달라진다. T=1.6에서는 풀이 절반이 ‘정답: 숫자’ 형식조차 지키지 못하고 무너졌다. 정답률은 43%로 떨어졌다. 그런데 다섯 번 풀어 다수결을 하자 70%까지 회복했다. 무너진 풀이들은 저마다 다른 쪽으로 틀리지만, 맞는 풀이는 같은 답으로 모이기 때문이다.
이 원리를 체계화한 것이 2022년 구글 연구진(Wang 등)의 자기 일관성(self-consistency)이다(ICLR 2023). 풀이 과정(chain-of-thought)을 여러 개 샘플링하고 최종 답을 다수결로 정한다. 그리디로 풀이 하나를 얻는 것보다 정답률이 크게 올랐다.
모델
GSM8K 그리디 풀이
샘플 40개 다수결
PaLM 540B
56.5%
74.4%
code-davinci-002
60.1%
78.0%
LaMDA 137B
17.1%
27.7%
여기서 샘플링은 다양한 풀이를 얻기 위한 도구다(PaLM은 T=0.7, top-k 40). 개별 풀이의 품질은 그리디보다 조금 낮을 수 있다. 하지만 여러 풀이가 같은 답에 모이는지가 강력한 신호가 된다. 이 발상은 2024년 이후 추론 모델의 ‘여러 번 생각하고 고르기’, 곧 테스트 시점 연산 확장(test-time scaling)으로 이어졌다.
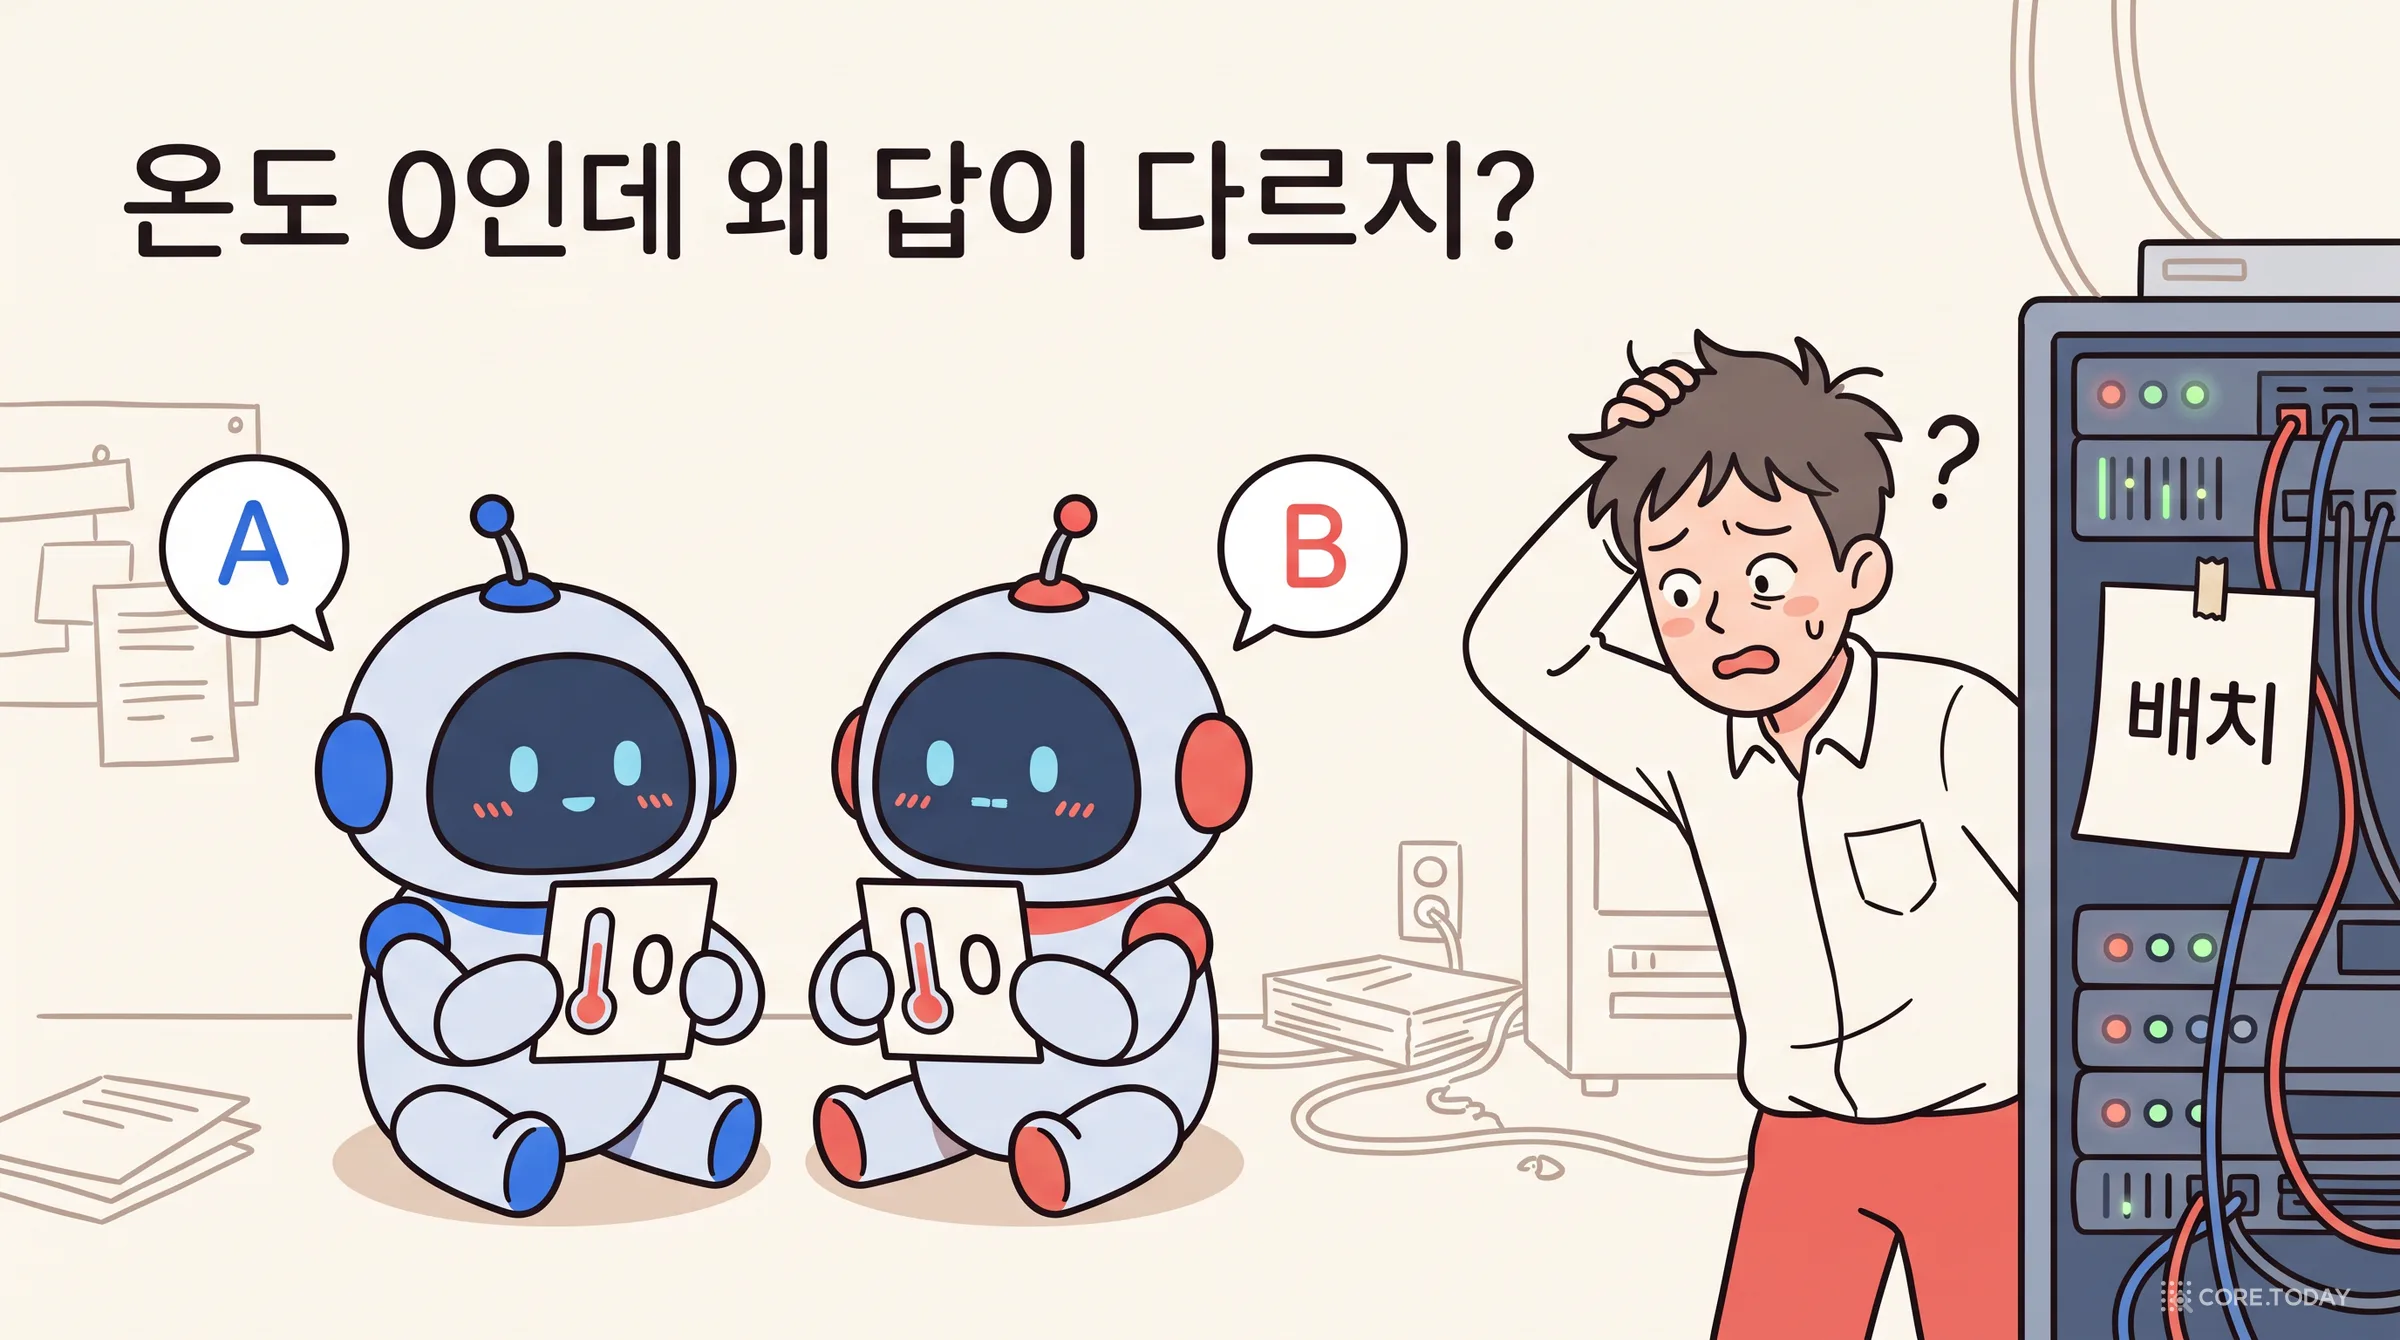
“같은 결과가 필요하면 temperature를 0으로 두라.” 오랫동안 통용된 조언이다. 온도 0은 그리디이고, 그리디에는 무작위성이 없다. 그런데 실제로는 같은 요청에 다른 답이 돌아온다.
2025년 9월 Thinking Machines의 호러스 허(Horace He) 등은 이 수수께끼를 파헤친 글 「Defeating Nondeterminism in LLM Inference(LLM 추론의 비결정성 이기기)」를 공개했다. 실험은 단순했다. Qwen3-235B에 “리처드 파인먼에 대해 말해 줘”를 온도 0으로 1,000번 보냈다.
1
무슨 일이 있었나
서로 다른 답이 80가지 나왔다. 모두 102번째 토큰까지는 같았다. “파인먼은 1918년 5월 11일 … 에서 태어났다” 다음에서 992번은 ‘Queens, New York’, 8번은 ‘New York City’로 갈렸다.
2
원인
흔히 의심하는 GPU 병렬 연산의 무작위성이 아니었다. 서버는 여러 사용자의 요청을 묶어(배치) 처리한다. 묶음 크기가 바뀌면 행렬 곱셈과 어텐션의 덧셈 순서가 바뀐다. 부동소수점 덧셈은 순서에 따라 결과가 아주 조금 달라진다. 그 미세한 차이가 1등과 2등이 아슬아슬한 지점에서 선택을 뒤집는다.
!
해법과 대가
배치 크기와 상관없이 같은 순서로 계산하는 ‘배치 불변’ 커널로 바꾸자 1,000개가 모두 같아졌다. 대신 느려졌다. Qwen3-8B 1,000개 생성에 26초 걸리던 것이 55초(개선 후 42초) 걸렸다.
우리도 노트북에서 확인했다. Kanana 1.5로 글 40편을 그리디로 이어 쓰되, 한 번은 하나씩, 한 번은 20개씩 묶어 돌렸다. 모델도, 입력도, 설정도 같다. 40편 중 16편의 결과가 달랐다. 세 편은 겨우 세 번째 토큰에서 갈라졌다. 묶음으로 돌릴 때 길이를 맞추려고 넣는 패딩 탓일 수도 있어서 대조 실험을 했다. 같은 문장을 패딩 없이 8번 복사해 한 묶음으로 돌렸다. 그래도 혼자 돌릴 때와 40편 중 17편이 달랐다. 한 묶음 안의 8개끼리는 언제나 똑같았다. 입력이 아니라 묶음의 크기가 결과를 바꾼 것이다.
그래서 업체들도 결정성을 약속하지 않는다. OpenAI의 seed 매개변수는 “최선을 다해 결정적으로 샘플링”할 뿐 “결정성은 보장되지 않는다”고 문서에 적혀 있다. 앤트로픽 문서도 “temperature 0.0이어도 결과가 완전히 결정적이지는 않다”고 밝혀 왔다.
실무 교훈은 이렇다. 평가와 회귀 테스트는 한 번이 아니라 여러 번 돌려 평균과 분산을 본다. 온도 0으로 한 번 돌린 결과를 ‘그 모델의 성능’이라고 믿지 않는다.
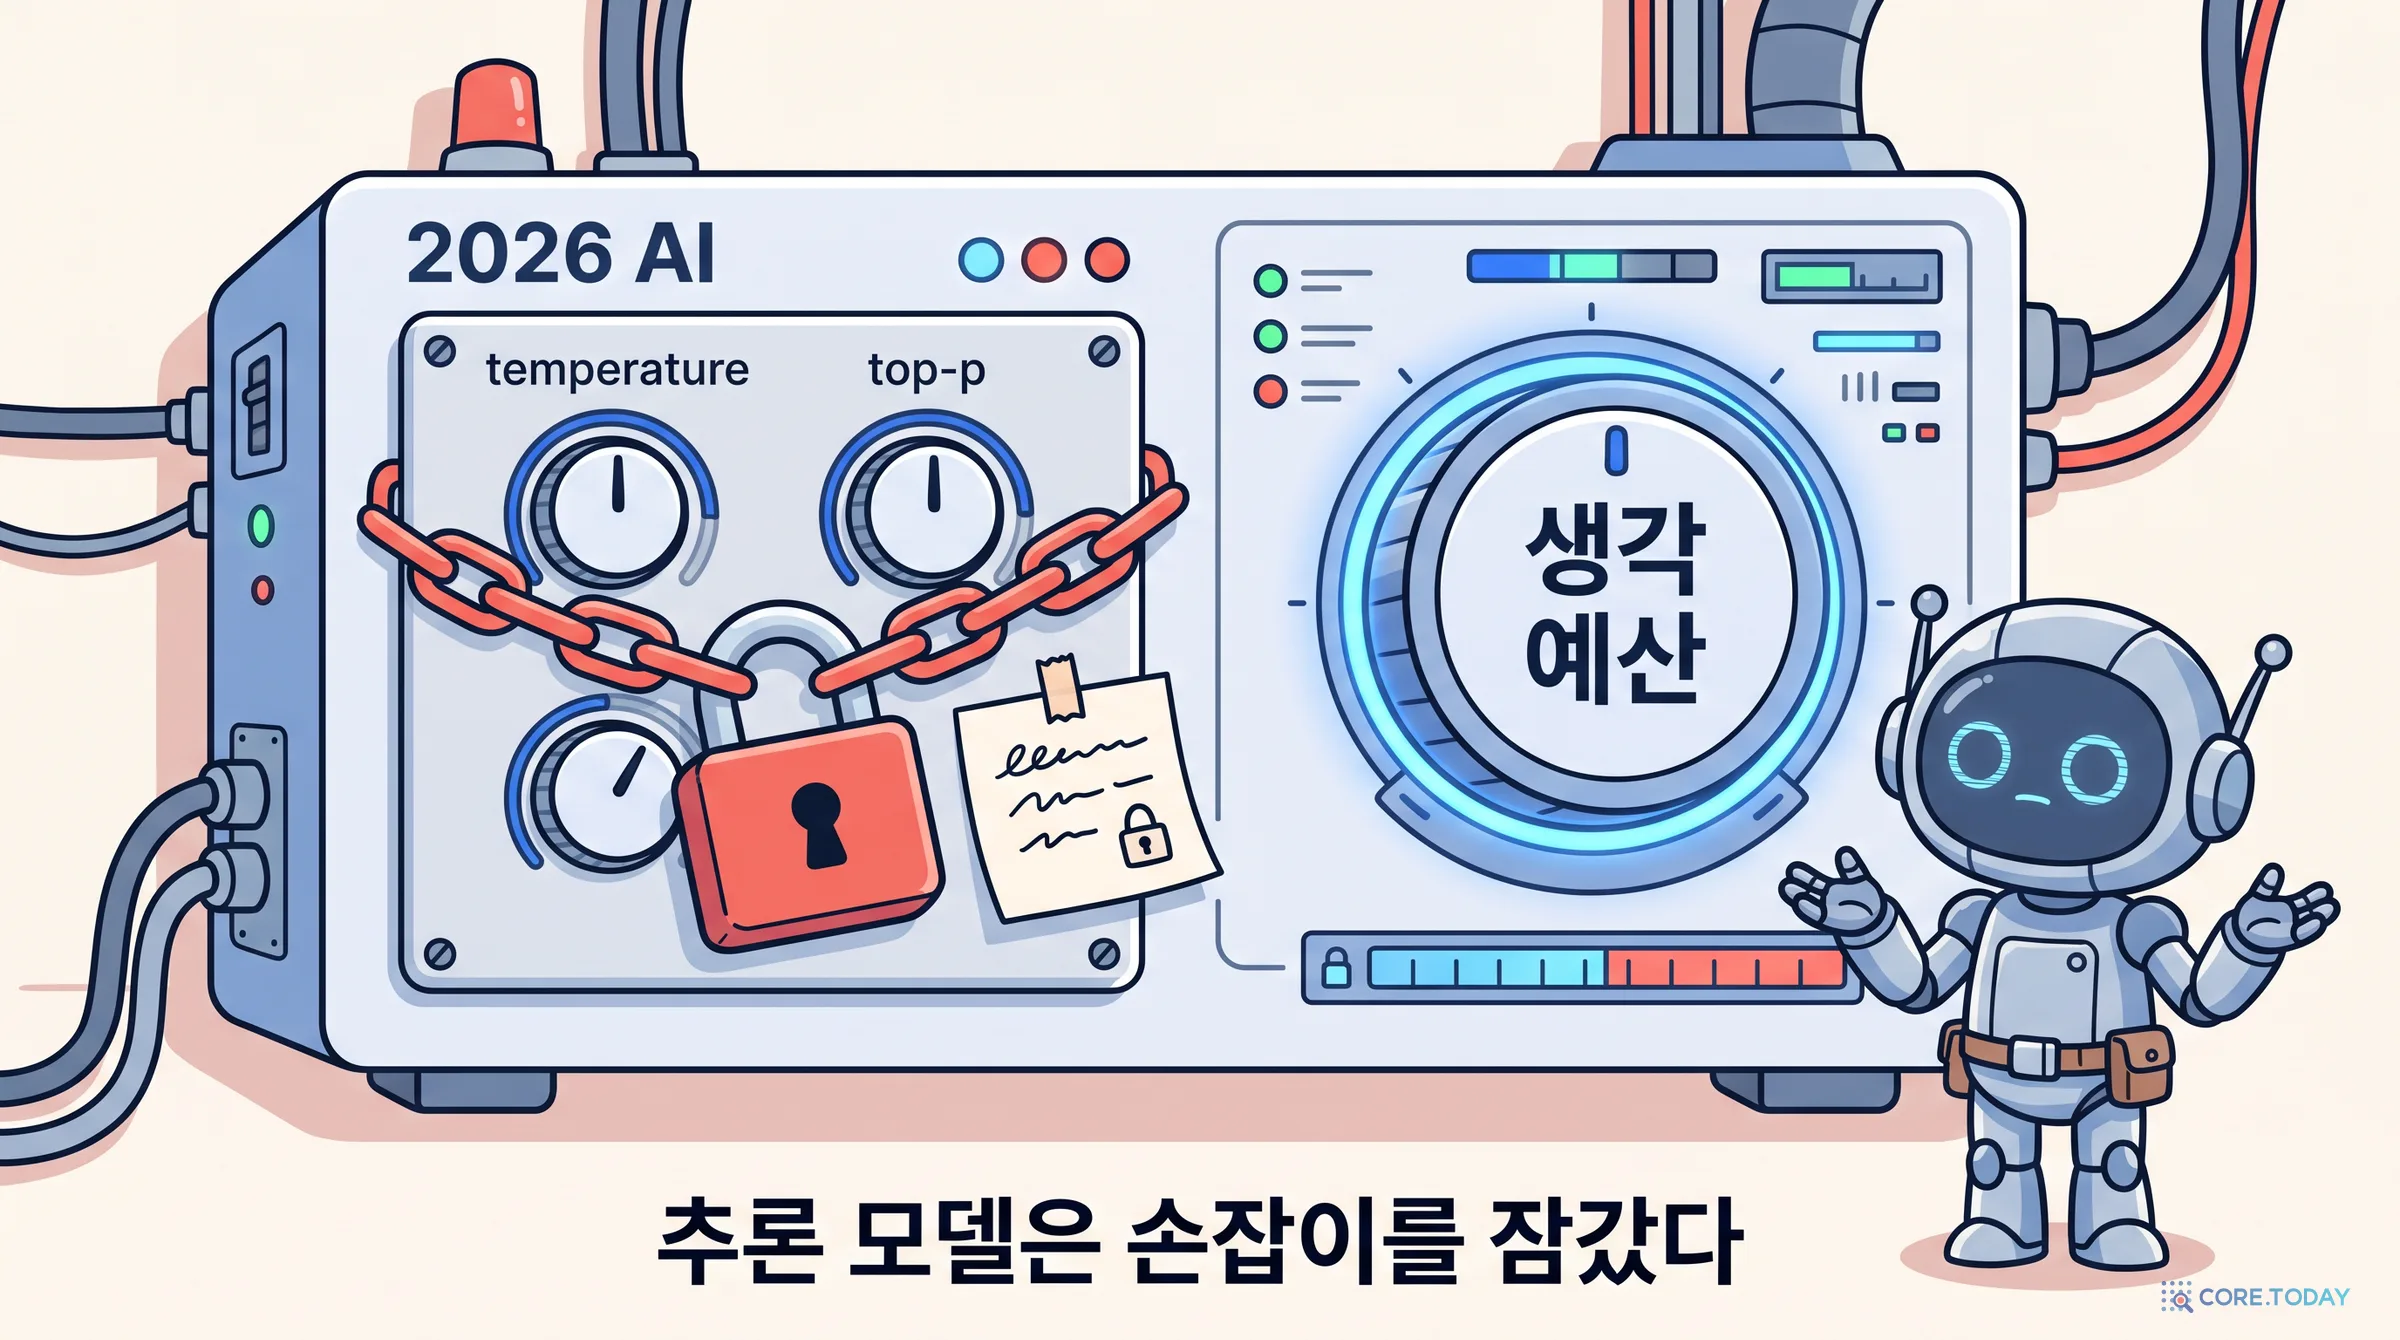
2024년까지 temperature와 top-p는 LLM API를 쓰는 사람이라면 누구나 만지는 손잡이였다. 2026년 현재 최전선 API에서는 사정이 달라졌다.
업체
변화
앤트로픽
2025년 2월 콘솔 기본 온도를 0에서 1로 바꿈 → 5월 기본 top_p를 0.999에서 0.99로 조정 → 8월 Claude Opus 4.1부터 temperature와 top_p 동시 지정 불가 → Claude Opus 4.7(2026년 4월)부터 기본값이 아닌 temperature·top_p·top_k는 400 오류 → 8월 공식 Python SDK 1.0에서 세 매개변수를 함수 서명에서 삭제. Claude Opus 5.5 마이그레이션 안내서의 문구는 “temperature·top_p·top_k를 빼고, 프롬프트로 모델의 행동을 이끌라”다.
구글
Gemini 3 안내서는 “temperature를 기본값 1.0으로 유지하라”고 강하게 권했다. 1.0 미만으로 낮추면 반복 루프나 성능 저하가 생길 수 있다는 것이다. Gemini 3.6 이상과 Gemini 4는 사용자가 보낸 temperature·top_p·top_k를 무시하고 사용 중단 경고를 돌려준다.
OpenAI
최신 모델 안내서는 추론 강도(reasoning effort)가 none이 아니면 temperature·top_p를 빼라고 한다.
왜일까. 이유는 3부와 5부에 이미 있다.
첫째, 추론 모델은 스스로 길게 생각한다. 수천 토큰의 생각 과정은 그 자체로 열린 글쓰기다. 그리디나 낮은 온도로 돌리면 3부에서 본 반복 루프에 빠지기 쉽다. 알리바바의 Qwen3 모델 카드는 생각 모드에서 “그리디 디코딩을 쓰지 말라. 성능 저하와 끝없는 반복이 생길 수 있다”고 경고한다. 딥시크 R1도 “끝없는 반복이나 비일관성을 막기 위해” 온도 0.5~0.7(권장 0.6)을 권한다. 구글이 Gemini 3에서 온도를 낮추지 말라고 한 것도 같은 이유다.
둘째, 업체가 고른 설정이 사용자의 설정보다 낫다. 모델을 학습하고 평가한 쪽은 어떤 샘플링에서 모델이 가장 잘 동작하는지 안다. 사용자가 ‘결정성’을 기대하고 온도를 0으로 내리면, 6부에서 봤듯 결정성은 얻지 못하고 성능만 잃을 수 있다.
손잡이는 사라진 게 아니라 옮겨 갔다. 이제 사용자가 조절하는 것은 얼마나 오래 생각할지(추론 강도, 생각 예산)와 프롬프트, 그리고 출력 형식이다.
7.2 공개 모델에서는 여전히 손잡이를 쥔다
직접 돌리는 공개 모델에서는 디코딩 설정이 여전히 내 몫이다. 출발점은 모델 카드의 권장값이다.
JSON처럼 형식이 정해진 출력이 필요할 때, 예전에는 온도를 0으로 내리고 형식이 맞기를 빌었다. 지금은 제약 디코딩(constrained decoding)을 쓴다. 매 단계 문법상 올 수 없는 토큰의 확률을 0으로 만들고 남은 것 중에서 고른다. 디코딩의 마지막 거름망이 ‘형식’이 되는 셈이다.
브랜든 윌러드(Brandon Willard)와 레미 루프(Rémi Louf)의 Outlines(2023)는 정규식과 문법을 유한 상태 기계로 바꿔 어휘 전체에 대한 색인을 미리 만들었다. 그래서 이 거름망을 빠르게 걸 수 있다. 2024년 8월 OpenAI는 Structured Outputs를 내놓으며 이렇게 밝혔다. 복잡한 JSON 스키마 평가에서 새 모델은 이 기능으로 100%를 맞혔고, 2023년 모델 gpt-4-0613은 40%에 못 미쳤다.
같은 원리가 디코딩 속도에도 쓰인다. 추측 디코딩(speculative decoding)은 작은 모델이 여러 토큰을 먼저 제안하고 큰 모델이 한 번에 검증한다. 결과 분포는 그대로 두고 속도만 높인다. 디코딩은 이제 ‘무엇을 고를까’만이 아니라 ‘어떻게 빨리, 틀에 맞게 고를까’의 문제이기도 하다.
언어 모델은 문장을 쓰지 않는다. 다음 토큰의 확률표를 내놓을 뿐이다. 그 표에서 한 토큰을 고르는 일은 섀넌이 책을 펼치던 1948년부터 지금까지 같은 질문을 붙들고 있다. 가장 그럴듯한 것을 고를 것인가, 그럴듯한 것들 중에서 고를 것인가.
정리하면 이렇다.
최대화는 정답이 좁을 때 강하다. 번역·추출·형식이 정해진 출력에서는 그리디나 작은 빔이 샘플링보다 낫다. 빔을 무작정 넓히면 오히려 나빠진다. 정확한 탐색이 찾은 ‘최고의 번역’은 절반이 빈칸이었다.
열린 글쓰기에서 최대화는 퇴화를 낳는다. 사람은 뻔한 말을 피한다. 확률이 가장 높은 글은 가장 뻔한 글이고, 스스로를 강화하는 반복 루프에 빠진다.
샘플링의 핵심은 꼬리 자르기다. 순수 샘플링은 믿을 수 없는 꼬리에서 토큰을 뽑는다. temperature는 분포의 모양을, top-k·top-p·min-p는 후보의 범위를 정한다. 7년이 지난 지금도 top-p 0.9~0.95는 좋은 출발점이다.
온도 0은 결정성을 보장하지 않는다. 배치 크기 같은 서버 사정이 결과를 바꾼다. 평가는 여러 번 돌려야 한다.
2026년, 손잡이는 업체에게 넘어갔다. 추론 모델 시대의 최전선 API는 샘플링 값을 받지 않는다. 사용자는 생각의 양과 프롬프트, 형식을 조절한다. 공개 모델을 직접 돌린다면 모델 카드의 권장값에서 출발하고 내 데이터로 재서 정한다.
다음에 AI가 같은 말을 되풀이하거나 엉뚱한 말을 지어내면 이렇게 물어보자. 이 모델은 지금 확률표에서 무엇을, 어떻게 고르고 있을까?
코어닷투데이 실측 조건: kakaocorp/kanana-1.5-2.1b-base·kanana-1.5-2.1b-instruct-2505(Apache-2.0), HuggingFace transformers 4.x, PyTorch 2.15, Apple M5 Pro(MPS, bf16). 이어 쓰기 실험은 블로그 검증용 글 40편의 문단 앞 24토큰을 주고 128토큰 생성(EOS 무시, 시드 고정), 샘플링 전략은 글마다 한 번 생성. 번역은 FLORES-200 devtest 앞 100문장(한→영, sacreBLEU 13a), 수학은 직접 만든 2~3단계 문장제 50문제(온도마다 5회 샘플). 확률표 위젯은 같은 base 모델의 실제 로짓(상위 60개 + 나머지를 로짓 0.25 구간으로 묶은 값). 2026-11-07 측정.
Markov, A. A. (1913). An Example of Statistical Investigation of the Text Eugene Onegin. (Hayes, B. (2013). First Links in the Markov Chain. American Scientist.)
Shannon, C. E. (1948). A Mathematical Theory of Communication. Bell System Technical Journal, 27.
Lowerre, B. T. (1976). The Harpy Speech Recognition System. Carnegie Mellon University.
Ackley, D. H., Hinton, G. E., & Sejnowski, T. J. (1985). A Learning Algorithm for Boltzmann Machines. Cognitive Science, 9, 147–169.
Sutskever, I., Vinyals, O., & Le, Q. V. (2014). Sequence to Sequence Learning with Neural Networks. NeurIPS 2014.
Hinton, G., Vinyals, O., & Dean, J. (2015). Distilling the Knowledge in a Neural Network. arXiv:1503.02531
Wu, Y. et al. (2016). Google's Neural Machine Translation System. arXiv:1609.08144
Koehn, P., & Knowles, R. (2017). Six Challenges for Neural Machine Translation. First Workshop on NMT.
Fan, A., Lewis, M., & Dauphin, Y. (2018). Hierarchical Neural Story Generation. ACL 2018.
Radford, A. et al. (2019). Language Models are Unsupervised Multitask Learners. OpenAI.
Keskar, N. S. et al. (2019). CTRL: A Conditional Transformer Language Model for Controllable Generation. arXiv:1909.05858
Stahlberg, F., & Byrne, B. (2019). On NMT Search Errors and Model Errors: Cat Got Your Tongue? EMNLP-IJCNLP 2019.
Holtzman, A., Buys, J., Du, L., Forbes, M., & Choi, Y. (2020). The Curious Case of Neural Text Degeneration. ICLR 2020.
Meister, C., Vieira, T., & Cotterell, R. (2020). If beam search is the answer, what was the question? EMNLP 2020.
Basu, S. et al. (2021). Mirostat: A Neural Text Decoding Algorithm that Directly Controls Perplexity. ICLR 2021.
Hewitt, J., Manning, C. D., & Liang, P. (2022). Truncation Sampling as Language Model Desmoothing. Findings of EMNLP 2022.
Su, Y. et al. (2022). A Contrastive Framework for Neural Text Generation. NeurIPS 2022.
Wang, X. et al. (2023). Self-Consistency Improves Chain of Thought Reasoning in Language Models. ICLR 2023.
Willard, B. T., & Louf, R. (2023). Efficient Guided Generation for Large Language Models. arXiv:2307.09702
Renze, M., & Guven, E. (2024). The Effect of Sampling Temperature on Problem Solving in Large Language Models. Findings of EMNLP 2024.
Peeperkorn, M. et al. (2024). Is Temperature the Creativity Parameter of Large Language Models? ICCC 2024.
OpenAI (2024). Introducing Structured Outputs in the API. 2024-08-06.
Nguyen, M. N. et al. (2025). Turning Up the Heat: Min-p Sampling for Creative and Coherent LLM Outputs. ICLR 2025.
Schaeffer, R., Kazdan, J., & Denisov-Blanch, Y. (2025). Min-p, Max Exaggeration: A Critical Analysis of Min-p Sampling in Language Models. arXiv:2506.13681
He, H. & Thinking Machines Lab (2025). Defeating Nondeterminism in LLM Inference. 2025-09-10.
Qwen Team (2025). Qwen3 모델 카드 (Best Practices). · DeepSeek-AI (2025). DeepSeek-R1 모델 카드 (Usage Recommendations).
Anthropic. Claude API 릴리스 노트(2025–2026), Claude Opus 5.5 마이그레이션 안내. · Google. Gemini API 문서(Gemini 3 안내서). · OpenAI. Latest model 안내서.
Kakao (2025). Kanana: Compute-efficient Bilingual Language Models. arXiv:2502.18934