BPE토큰화토크나이저서브워드WordPieceSentencePieceUnigram바이트 BPEtiktoken한국어 토큰토큰세UTF-8글리치 토큰SolidGoldMagikarpstrawberryLLM 비용어휘 크기Byte Latent TransformerNLP 기초
‘token’은 1조각, ‘토큰’은 5조각 — 30년 된 압축 알고리즘 BPE가 AI의 눈이 되기까지 (특집)
언어 모델은 글자를 읽지 않는다. 문장을 ‘토큰’이라는 조각으로 자른 뒤 그 번호를 읽는다. 이 칼의 정체는 1994년 잡지에 실린 파일 압축 알고리즘 BPE다. 2016년 에든버러 연구진이 번역기의 ‘모르는 단어’ 문제를 풀려고 이 알고리즘을 꺼내 왔고, 지금은 GPT·Llama·Gemma·EXAONE이 모두 그 후손을 쓴다. 이 글은 왜 단어도 글자도 아닌 ‘조각’이어야 했는지에서 출발해 병합 규칙을 손으로 따라가 보고, strawberry의 r을 못 세는 이유, 세 자리씩 잘리는 숫자, 레딧 닉네임이 일으킨 글리치 토큰 소동을 사례로 짚는다. 토크나이저 13종으로 같은 뜻의 한국어·영어 문장을 직접 잘라 ‘한국어 토큰세’를 재고, 우리 블로그 글 600여 편으로 BPE를 직접 학습시켜 본 실측도 담았다. 인터랙티브 위젯 7종, 코어닷투데이 실측, 삽화 14장.
GPT-4에 영어 단어 token을 보내면 모델은 이것을 조각 1개로 받는다. 같은 뜻의 한국어 토큰을 보내면 조각 5개로 받는다. 그 다섯 조각 중 어느 것도 ‘토’나 ‘큰’이 아니다. 한 조각은 ‘토’의 끝부분과 ‘큰’의 앞부분을 반씩 붙인, 사람 눈에는 아무 의미 없는 바이트 덩어리다.
GPT-4(cl100k_base)가 받는 ‘토큰’ — 코어닷투데이 실측
입력 : 토큰 UTF-8 : ED 86 A0 · ED 81 B0 ← ‘토’ 3바이트, ‘큰’ 3바이트 조각 : [ED] [86] [A0 ED] [81] [B0] ← 5개, 세 번째는 두 글자에 걸쳐 있다
입력 : token 조각 : [token] ← 1개
이 ‘조각’을 토큰(token)이라 부르고, 문장을 토큰으로 자르는 프로그램을 토크나이저(tokenizer)라 부른다. 언어 모델이 세상의 글을 보는 창은 이것 하나뿐이다. 모델은 글자를 보지 못한다. 토큰 번호의 나열만 본다. 그래서 토크나이저가 어떻게 자르느냐가 많은 것을 정한다. 모델이 무엇을 쉽게 배우는지, 무엇을 끝내 못 하는지, 그리고 사용자가 얼마를 내는지까지.
먼저 감을 잡아 보자. 아래 문장들을 GPT-4o는 몇 조각으로 볼까?
맞히기 쉽지 않았을 것이다. ‘안녕하세요’는 ‘안’과 ‘녕하세요’로 잘린다. 어느 국어 문법책에도 없는 경계다. 이 이상한 칼의 정체가 이 글의 주인공 BPE(Byte Pair Encoding, 바이트 쌍 인코딩)다. 원래 AI와 아무 관계 없는 파일 압축 알고리즘이었다.
다국어 번역 평가 표준 데이터 FLORES-200에서 같은 뜻의 한국어·영어 문장 1,012쌍을 토크나이저 13종으로 직접 잘라 봤다. 한국어가 영어보다 토큰을 몇 배 쓰는지 보면 이렇다.
5.03배
GPT-2·GPT-3 (2019·2020)
2.37배
GPT-3.5·GPT-4 (2022·2023)
1.47배
GPT-4o 계열 (2024~)
1.22배
EXAONE 4.0 · HyperCLOVA X SEED
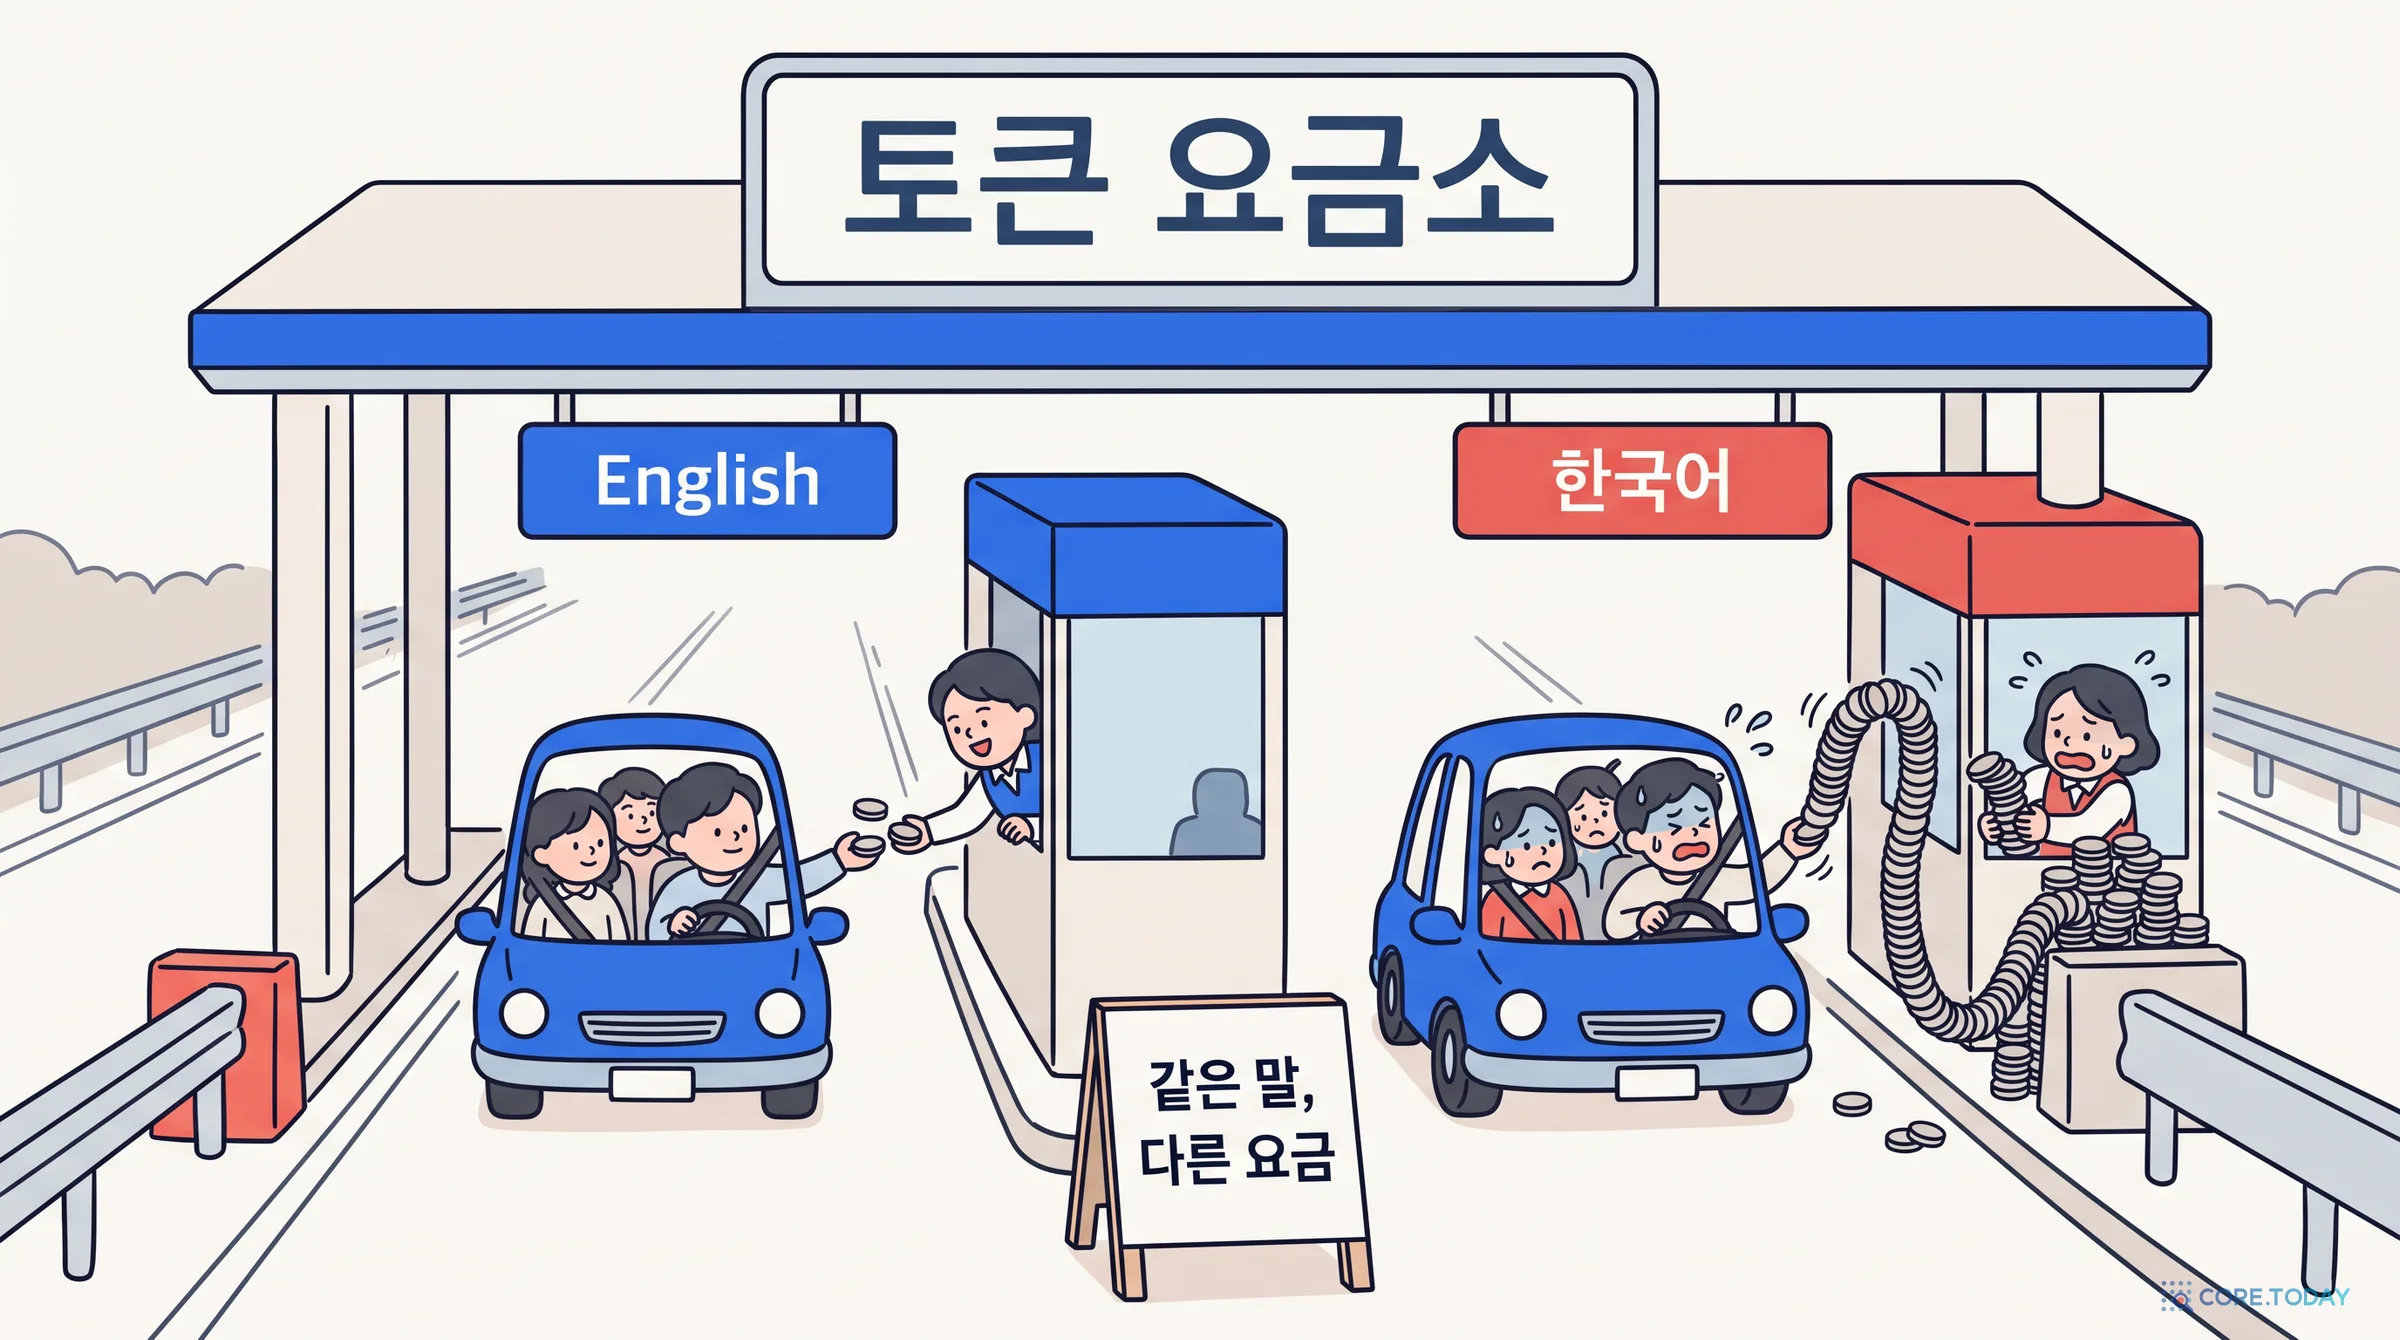
같은 말을 해도 한국어 사용자는 요금을 더 내고, 문맥 창이 더 빨리 찬다. 이 차이는 모델의 지능이 아니라 칼을 만들 때 무엇을 보고 배웠느냐에서 나온다.
이 글은 다음 순서로 간다. 컴퓨터는 왜 글을 잘라야 하나. 1994년 압축 알고리즘은 어떻게 2016년 번역기의 구원 투수가 됐나. 병합 규칙은 실제로 어떻게 배워지나. 한글은 왜 바이트 세 개로 흩어지나. 토큰화가 만든 기묘한 실패들. 그리고 한국어 토큰세 실측과 2026년의 토큰화까지.
1부. 컴퓨터는 왜 글을 잘라야 하나
1.1 신경망은 숫자만 먹는다
신경망은 행렬 곱셈 기계다. 입력은 숫자여야 한다. 그래서 글을 넣으려면 먼저 글을 정해진 목록의 번호로 바꾸는 단계가 필요하다. 이 목록을 어휘(vocabulary)라 부른다. 어휘에 3만 개가 있으면 모델은 3만 가지 번호만 알아듣는다. 각 번호에는 학습되는 벡터(임베딩)가 하나씩 붙는다.
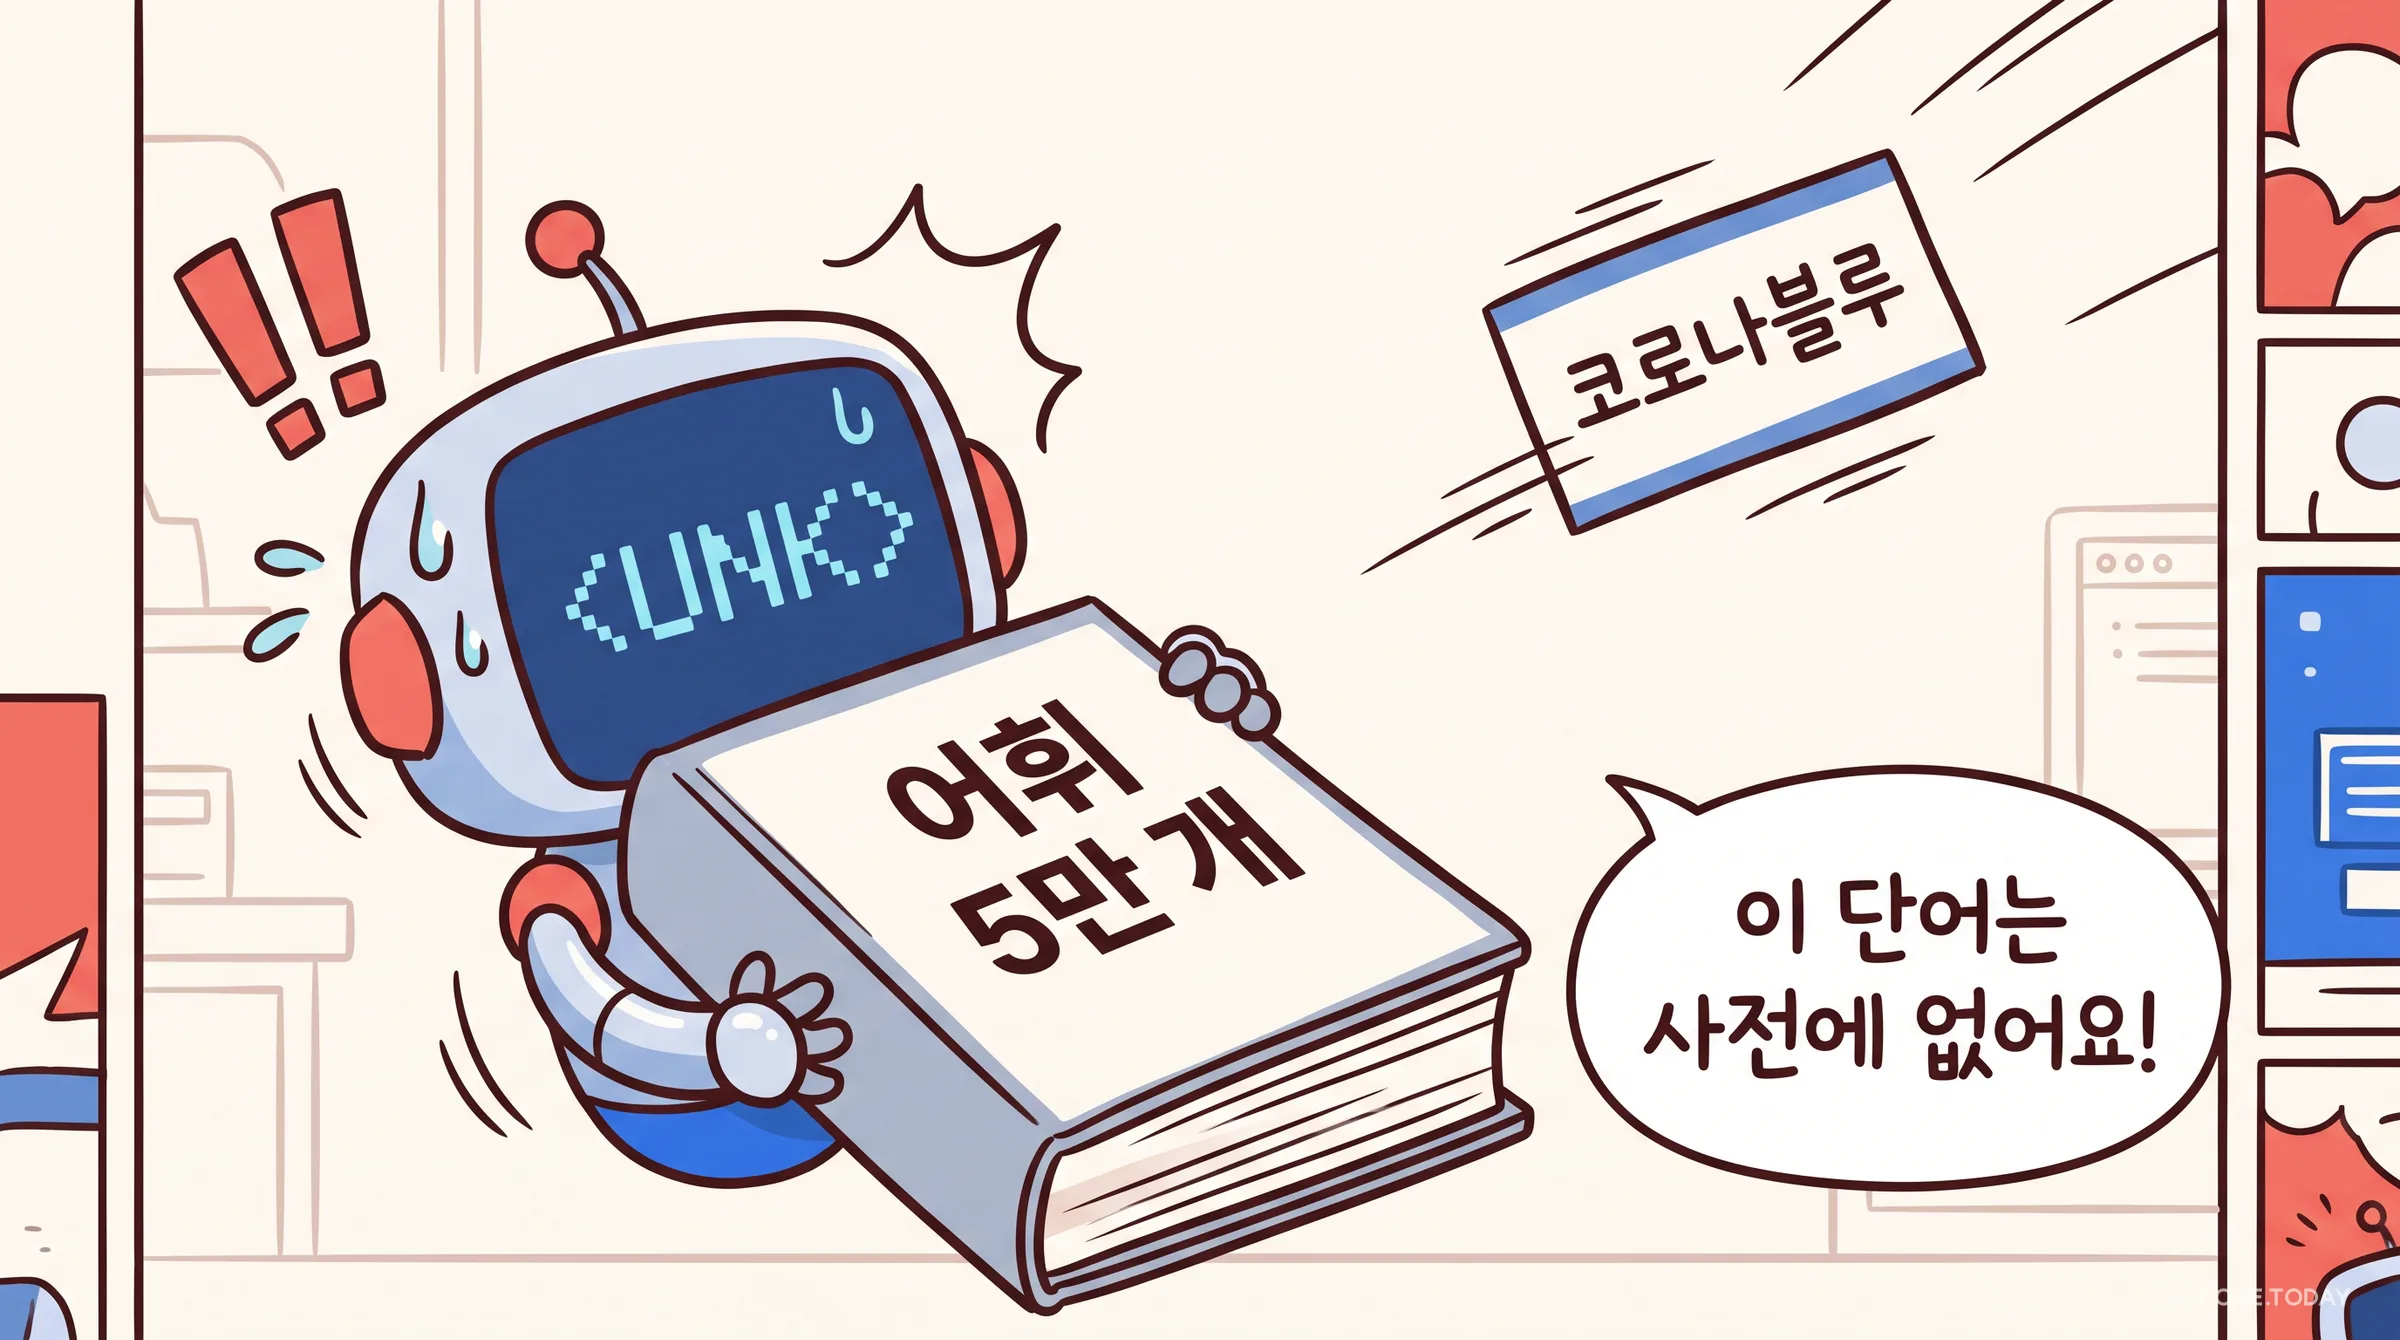
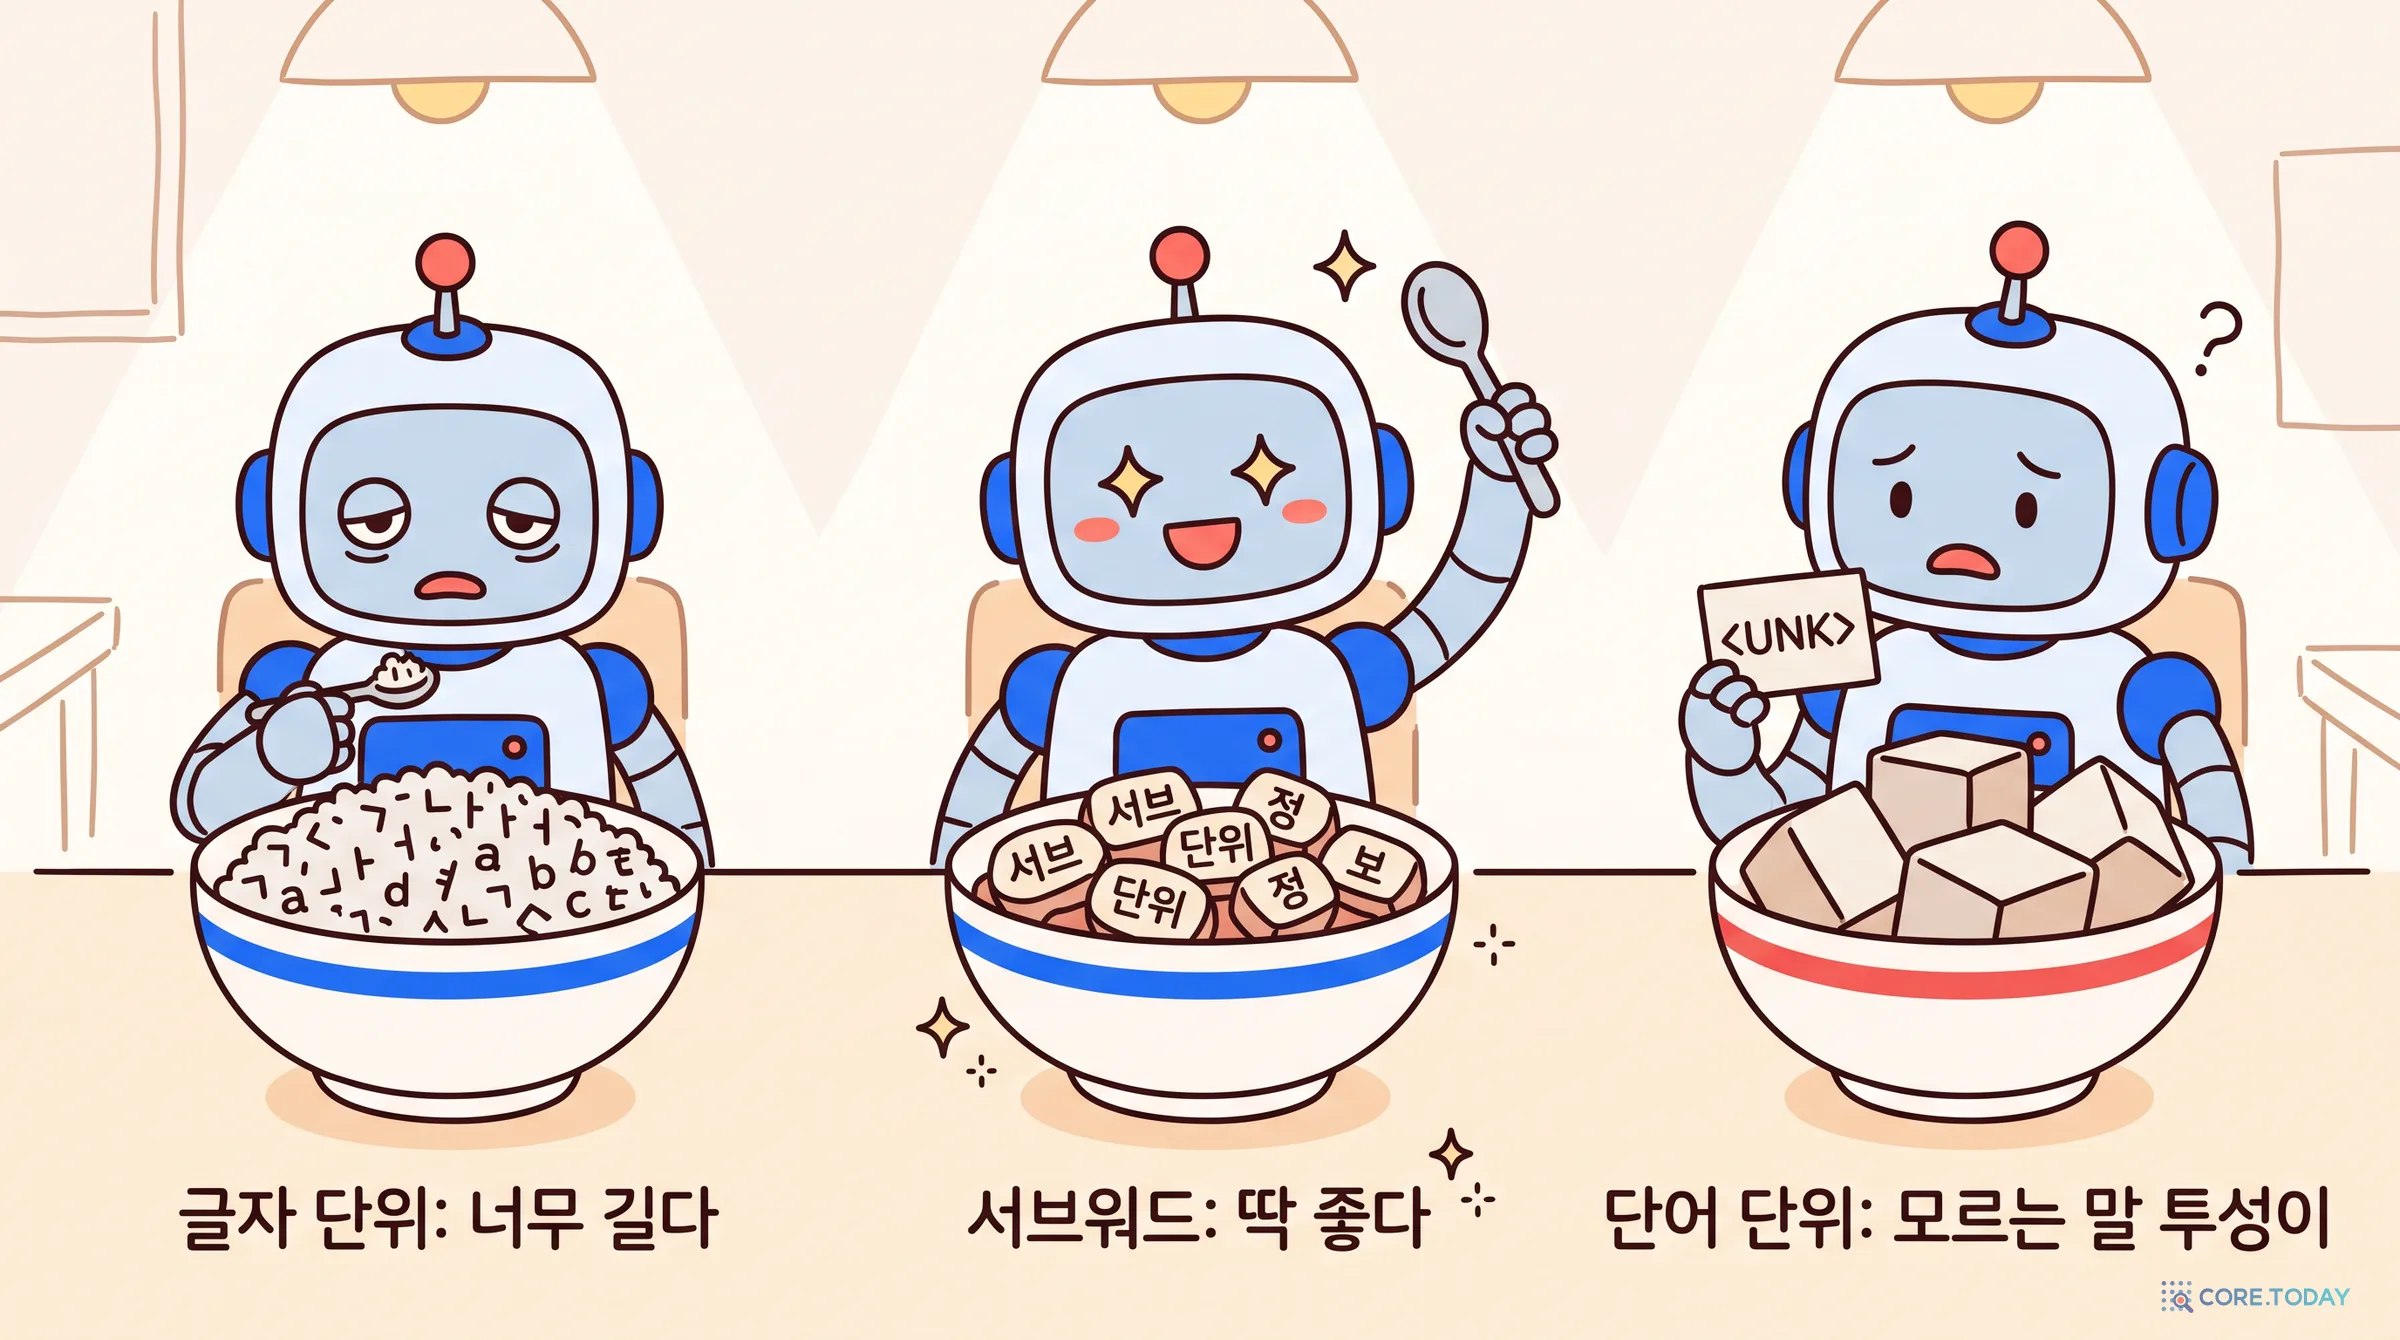
가장 자연스러운 생각은 단어 하나를 한 칸으로 치는 것이다. 2014~2015년의 신경망 번역기가 그랬다. 자주 쓰는 단어 3만~5만 개만 어휘에 넣고, 나머지는 모두 <UNK>(unknown, 모르는 말) 하나로 뭉갰다.
언어에는 끝이 없다는 것이 문제였다. 사람 이름, 지명, 신조어, 합성어, 오타가 끝없이 나온다. 단어 빈도는 지프의 법칙(Zipf's law)을 따른다. 소수의 단어가 대부분의 등장을 차지하고, 나머지 수많은 단어는 한두 번씩만 나온다. 어휘를 아무리 늘려도 꼬리는 남는다.
한국어는 사정이 더 나쁘다. ‘먹다’ 하나가 먹고, 먹어서, 먹었다, 먹었습니다, 먹었겠지만, 먹히다, 먹이다로 끝없이 변한다. 띄어쓰기 단위로 어휘를 만들면 같은 동사의 활용형이 전부 다른 단어가 된다. 이 문제는 BLEU·ROUGE 특집 6부에서도 봤다. 띄어쓰기 단위로 자른 한국어 채점이 왜 엉망이 되는지와 같은 뿌리다.
1.3 글자 단위 — 모르는 말은 없지만 너무 길다
반대쪽 끝은 글자 하나를 한 칸으로 치는 것이다. 영어라면 알파벳과 기호 100여 개면 된다. 모르는 단어는 사라진다. 하지만 문장이 너무 길어진다. 단어 하나가 대여섯 칸이 되고, 모델은 ‘c-a-t’가 고양이라는 것부터 스스로 조립해야 한다. 트랜스포머는 계산량이 문장 길이의 제곱으로 늘어난다. 그래서 길이는 곧 비용이다.
답은 그 사이였다. 자주 나오는 말은 통째로 한 칸, 드문 말은 더 작은 조각으로 쪼개서 표현한다. ‘the’는 한 토큰, ‘unhappiness’는 ‘un + happiness’, 처음 보는 사람 이름은 글자 몇 개의 조합으로. 이런 단어보다 작은 단위를 서브워드(subword)라 부른다.
단위
모르는 말
문장 길이
어휘 크기
단어
많다 (<UNK>)
짧다
수십만~무한
글자
없다
매우 길다
수백~수천
서브워드 (BPE 등)
없다 (글자·바이트로 내려가면 된다)
적당하다
3만~26만 (직접 정한다)
그렇다면 어떤 조각을 어휘에 넣을지는 누가 정하나. 사람이 정하면 언어마다 문법학자가 필요하다. 데이터가 스스로 정하게 하는 방법이 필요했다. 그 방법이 뜻밖에도 20여 년 전 프로그래머 잡지에 실려 있었다.
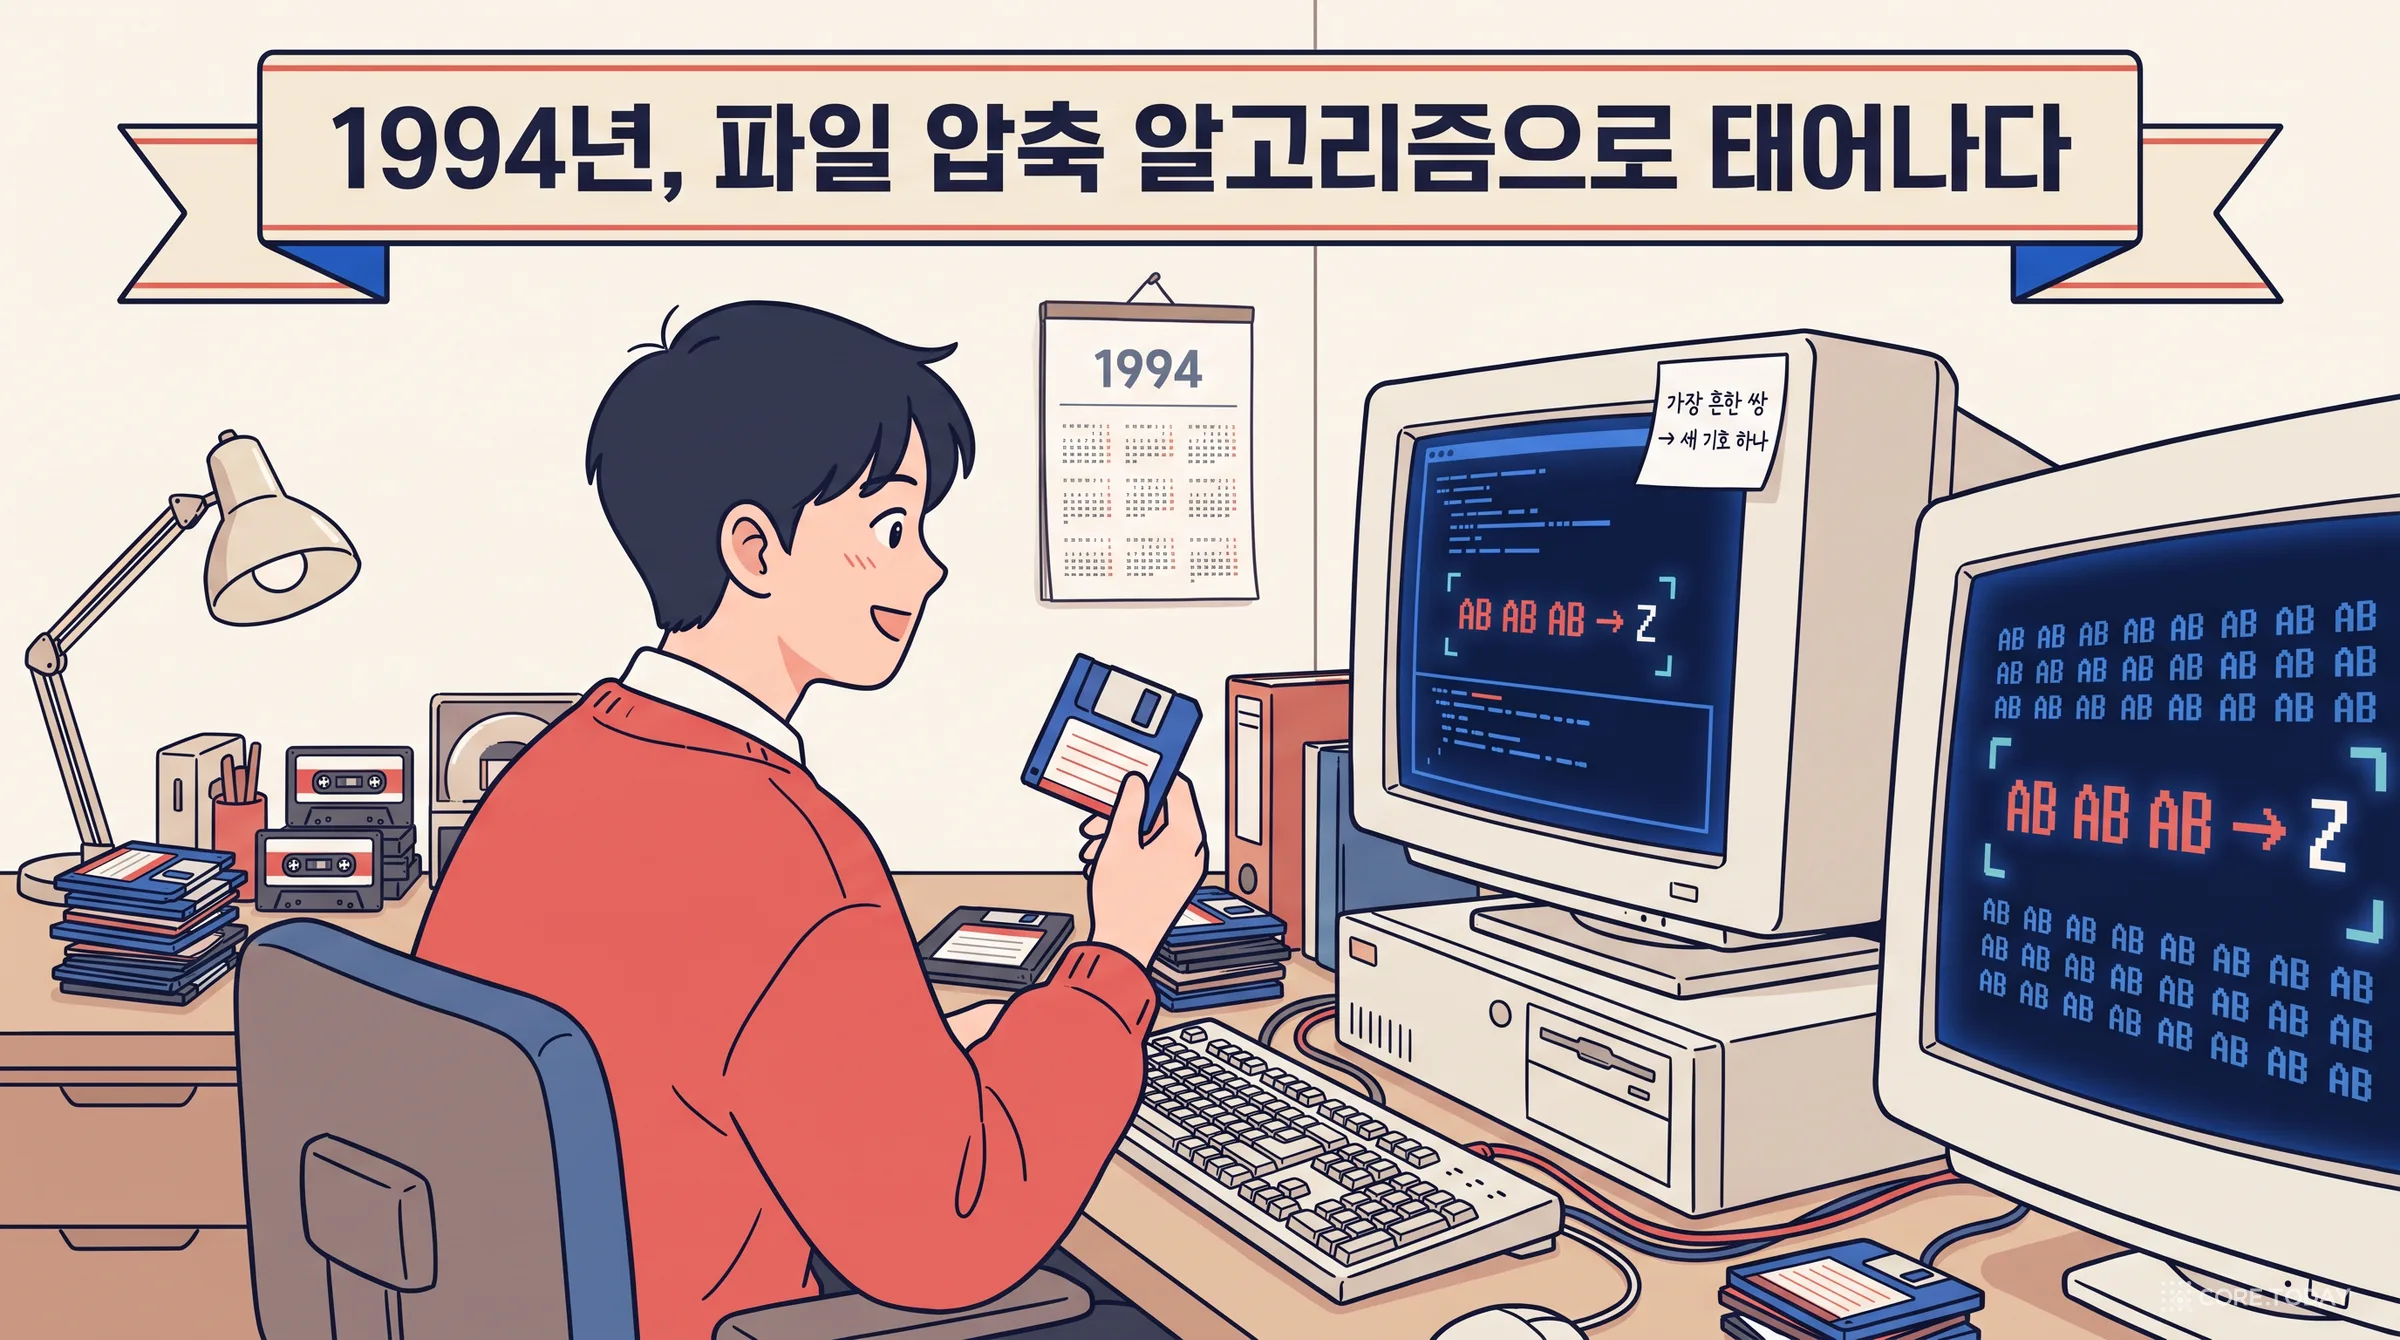
1994년 2월, 미국 프로그래머 잡지 『The C Users Journal』 12권 2호 23쪽에 짧은 글이 실렸다. 제목은 「A New Algorithm for Data Compression(데이터 압축의 새 알고리즘)」. 저자 필립 게이지(Philip Gage)는 콜로라도스프링스의 소프트웨어 엔지니어였다. 저자 소개란에는 연락처로 집 전화번호와 PC 통신 CompuServe 아이디가 적혀 있었다. 그런 시절이었다.
알고리즘은 한 문장으로 요약된다. 게이지의 설명을 옮긴다.
데이터에서 가장 자주 나오는 이웃한 바이트 쌍을 찾아, 그 쌍을 원래 데이터에 없던 바이트 하나로 모두 바꾼다. 더 이상 자주 나오는 쌍이 없거나, 쌍을 대신할 빈 바이트가 바닥날 때까지 이 과정을 반복한다.
글에 실린 예제를 따라가 보자.
Gage 1994, 5절의 예제
원본 : A B A B C A B C D (9바이트) AB → X : X X C X C D (6바이트, 표: X=AB) XC → Y : X Y Y D (4바이트, 표: X=AB, Y=XC)
두 번째 단계를 보자. Y는 XC인데, X는 다시 AB다. 이미 합친 기호를 또 합칠 수 있다. 게이지는 이 중첩을 알고리즘의 진짜 힘으로 꼽았다. “같은 바이트 1,024개가 연달아 있으면 쌍 치환 열 번 만에 바이트 하나가 된다.” 2를 열 번 곱하면 1,024다. 30년 뒤 언어 모델의 어휘가 짧은 조각에서 긴 단어를 쌓아 올리는 원리가 바로 이것이다.
그런데 게이지는 이 알고리즘이 압축을 아주 잘한다고 주장하지 않았다. 오히려 단점을 솔직히 적었다.
BPE의 단점은 압축 속도가 느리고, LZW 같은 흔히 쓰는 알고리즘보다 압축률이 낮다는 것이다.
그가 내세운 장점은 푸는 쪽이었다. 압축을 풀 때 필요한 데이터 메모리가 550바이트뿐이었다. 파일은 한 번 압축해서 여러 번 푸는 경우가 많으니, 느리게 압축하고 빠르게 푸는 방식도 쓸모가 있다는 것이었다. 글 말미에 그는 이렇게 썼다. “BPE 알고리즘이 이렇게 잘 동작한다는 것은 놀랍다.”
압축 분야에서 BPE는 주류가 되지 못했다. 그 자리는 LZ 계열(zip, gzip)이 차지했다. 이 알고리즘이 다시 불려 나온 것은 20년 뒤, 전혀 다른 분야에서였다. 거기서 필요했던 것은 압축률이 아니라 ‘자주 붙어 다니는 것끼리 하나로 묶는다’는 발상이었다.
3부. 2016년, 번역기의 구원 투수가 되다
3.1 “번역은 열린 어휘 문제다”
2015년 8월, 영국 에든버러대의 리코 센리히(Rico Sennrich), 배리 해도(Barry Haddow), 알렉산드라 버치(Alexandra Birch)가 arXiv에 논문을 올렸다. 이듬해 ACL 2016에 실린 「Neural Machine Translation of Rare Words with Subword Units(서브워드 단위로 드문 단어를 번역하는 신경망 기계 번역)」다. 감사의 글에는 삼성전자 폴란드 R&D 연구소와의 협력이 적혀 있다.
초록의 첫 문장이 문제를 정확히 짚는다.
신경망 기계 번역 모델은 보통 고정된 어휘로 동작한다. 그런데 번역은 열린 어휘(open-vocabulary) 문제다.
당시 신경망 번역기의 어휘는 3만~5만 단어였다. 그 밖의 단어는 <UNK>가 됐다. 그때까지의 해법은 ‘백오프 사전’이었다. 모르는 단어가 나오면 원문 단어를 그대로 베끼거나 사전에서 찾아 끼워 넣었다. 센리히 팀은 다른 관찰에서 출발했다. 드문 단어 상당수는 더 작은 조각으로 쪼개면 번역할 수 있다. 사람 이름은 글자 단위로 음역하면 된다. 독일어 합성어는 부품별로 옮기면 된다. 같은 어원의 외래어는 조각끼리 대응한다.
그렇다면 단어를 어떤 조각으로 나눌까. 여기서 게이지의 BPE가 등장한다. 논문 3.2절의 설명이다.
BPE는 원래 데이터 압축 기법으로, 가장 자주 나오는 바이트 쌍을 쓰이지 않은 바이트 하나로 반복해서 바꾼다. 우리는 이 알고리즘을 단어 분할에 맞게 고쳤다. 바이트 쌍 대신 글자 또는 글자 묶음을 병합한다.
바꾼 점은 두 가지뿐이었다. 바이트 대신 글자를 합친다. 그리고 단어 경계를 넘는 쌍은 합치지 않는다. 손잡이도 하나뿐이었다. 병합 횟수가 알고리즘의 유일한 하이퍼파라미터다. 논문에는 이 전부를 담은 파이썬 코드가 열 줄 남짓으로 실렸다.
효과는 어땠나
논문의 독일어 학습 말뭉치에서 숫자가 극적으로 바뀌었다.
단위
말뭉치 길이(토큰)
서로 다른 토큰 종류
테스트에서 모르는 말
단어 (분할 없음)
1억
175만
1,079
글자
5억 5천만
3천
0
BPE (병합 5만 9,500회)
1억 1,200만
6만 3천
0
BPE는 단어 단위와 비슷한 길이를 유지하면서 모르는 말을 0으로 만들었다. 글자 단위처럼 다섯 배 길어지지도 않았다.
번역 점수(newstest2015 BLEU, 앙상블)도 올랐다. 다만 흔히 인용되는 숫자에는 주의가 필요하다.
방향
백오프 사전 (기준)
BPE (공동 어휘 9만)
글자 2-gram 분할
영어 → 러시아어
22.8
24.1 (+1.3)
24.1
영어 → 독일어
24.2
24.7 (+0.5)
25.3 (+1.1)
초록의 “최대 1.1점(영→독), 1.3점(영→러) 향상”에서 영→독 1.1점은 사실 BPE가 아니라 같은 논문이 함께 실험한 글자 2-gram 분할의 성적이다. BPE의 진짜 강점은 다른 데 있었다. 드문 단어의 번역 정확도(1-gram F1)가 영→독에서 36.8%에서 41.8%로, 영→러에서 26.5%에서 29.7%로 올랐다. 그리고 무엇보다 단순하고, 언어를 가리지 않고, 병합 횟수 하나로 어휘 크기를 마음대로 정할 수 있었다. 논문과 함께 공개된 subword-nmt 도구는 이후 몇 년간 기계 번역의 표준 전처리가 됐다.
여담: 논문에 실린 독일어 합성어 분할 예시 ‘Abwasser|behandlungs|anlange’(하수 처리 시설)에는 오타가 있다. 맞는 철자는 anlage다. BPE라면 이런 오타도 조각으로 표현해 냈을 것이다.
BLEU 점수가 이 흐름을 뒷받침했다는 점도 기억해 두자. BLEU 특집에서 다룬 그 채점기가 서브워드의 가치를 입증하는 잣대로 쓰였다.
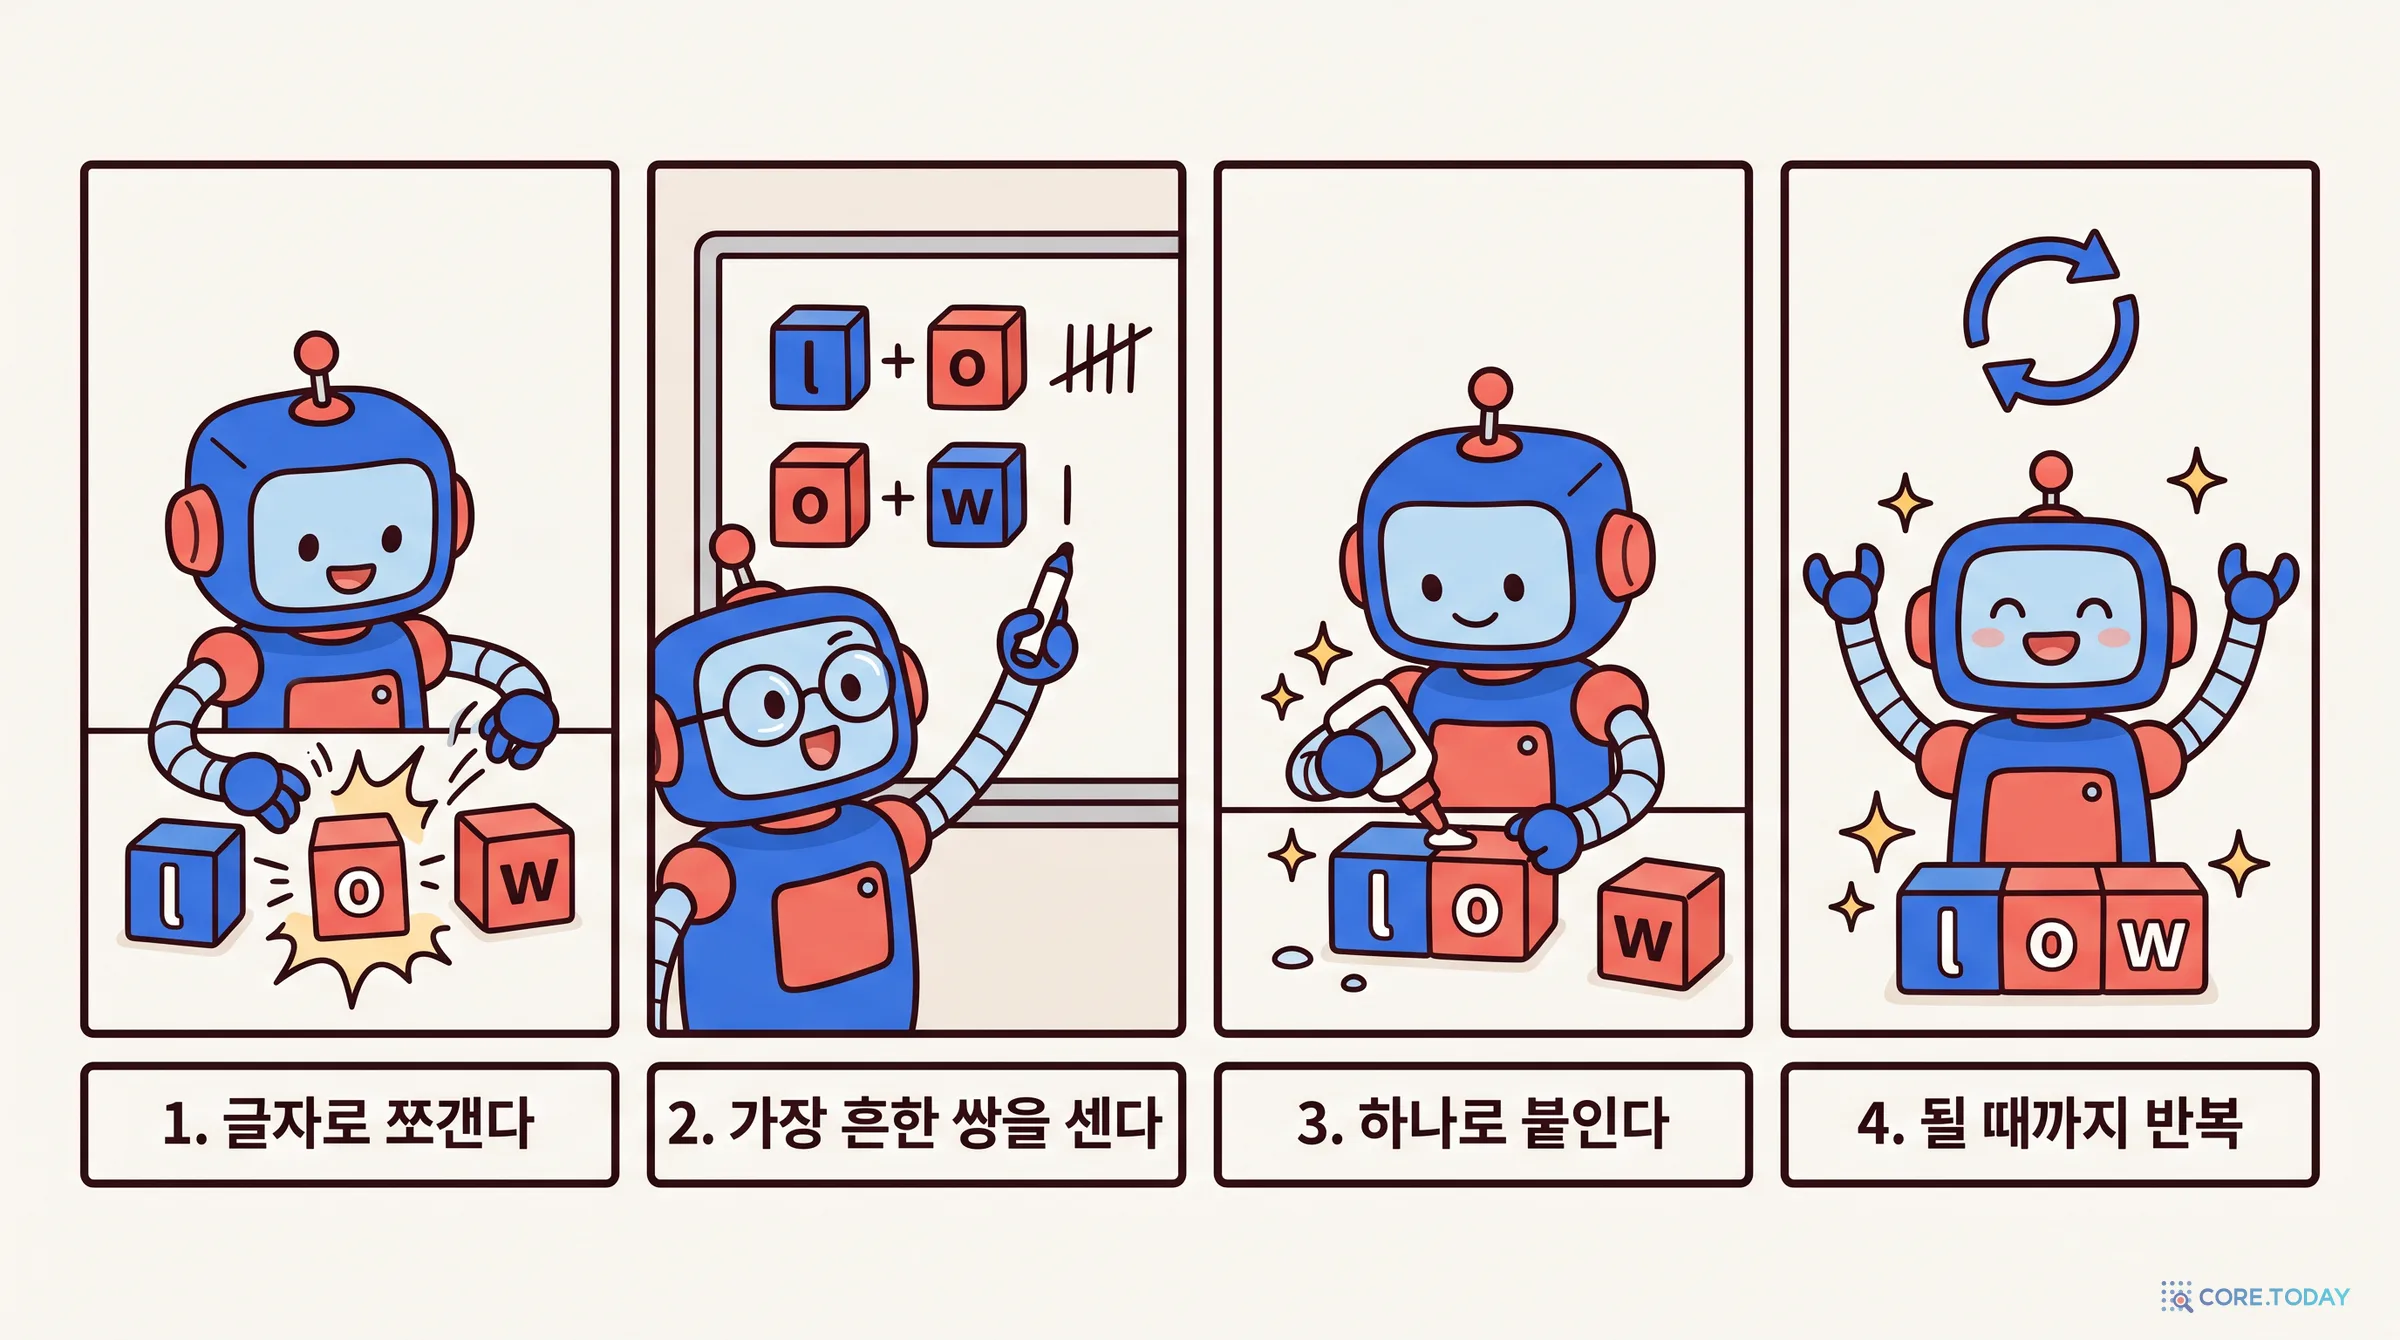
모든 단어를 글자로 쪼갠다. 단어 끝에는 ‘여기서 단어가 끝난다’는 표시 </w>를 붙인다. 그래야 단어 끝의 ‘est’와 중간의 ‘est’를 구별할 수 있다.
2
이웃한 두 기호 쌍이 말뭉치 전체에서 몇 번 나오는지 센다. 단어 빈도만큼 곱해서 센다.
3
가장 많이 나온 쌍 하나를 새 기호로 합친다. 이 결정을 ‘병합 규칙’ 목록에 순서대로 적는다.
4
정한 횟수만큼 2~3을 반복한다. 병합 횟수가 곧 어휘를 얼마나 늘릴지를 정하는 손잡이다.
논문 Algorithm 1 코드에 들어 있는 말뭉치로 직접 해 보자. low 5번, lower 2번, newest 6번, widest 3번. ‘다음 병합’을 누를 때마다 가장 흔한 쌍이 합쳐진다. ‘한국어 어미’ 말뭉치로 바꾸면 BPE가 문법을 전혀 모르는데도 ‘-습니다’를 스스로 찾아내는 장면을 볼 수 있다.
논문 예제에서 첫 병합은 e + s(9번)다. newest와 widest에 모두 들어 있기 때문이다. 이어서 es + t, est + </w>가 차례로 합쳐져 ‘단어 끝의 est’가 하나의 토큰이 된다. 영어 최상급 어미를 BPE가 빈도만 보고 찾아낸 것이다. 한국어 말뭉치에서는 첫 병합이 다 + </w>(27번), 둘째가 습 + 니다. 문장을 끝맺는 어미가 어간보다 먼저 뭉친다.
3.3 학습과 적용은 따로다
학습이 끝나면 남는 것은 병합 규칙의 순서 목록뿐이다. 새 문장이 들어오면 글자로 쪼갠 뒤 목록의 위에서부터 규칙을 다시 적용한다. ‘lowest’는 학습 말뭉치에 없었지만 low + est</w>로 표현된다. 처음 보는 단어도 아는 조각의 조합으로 표현되니 <UNK>가 필요 없다. 최악이어도 글자 단위까지 내려가면 된다.
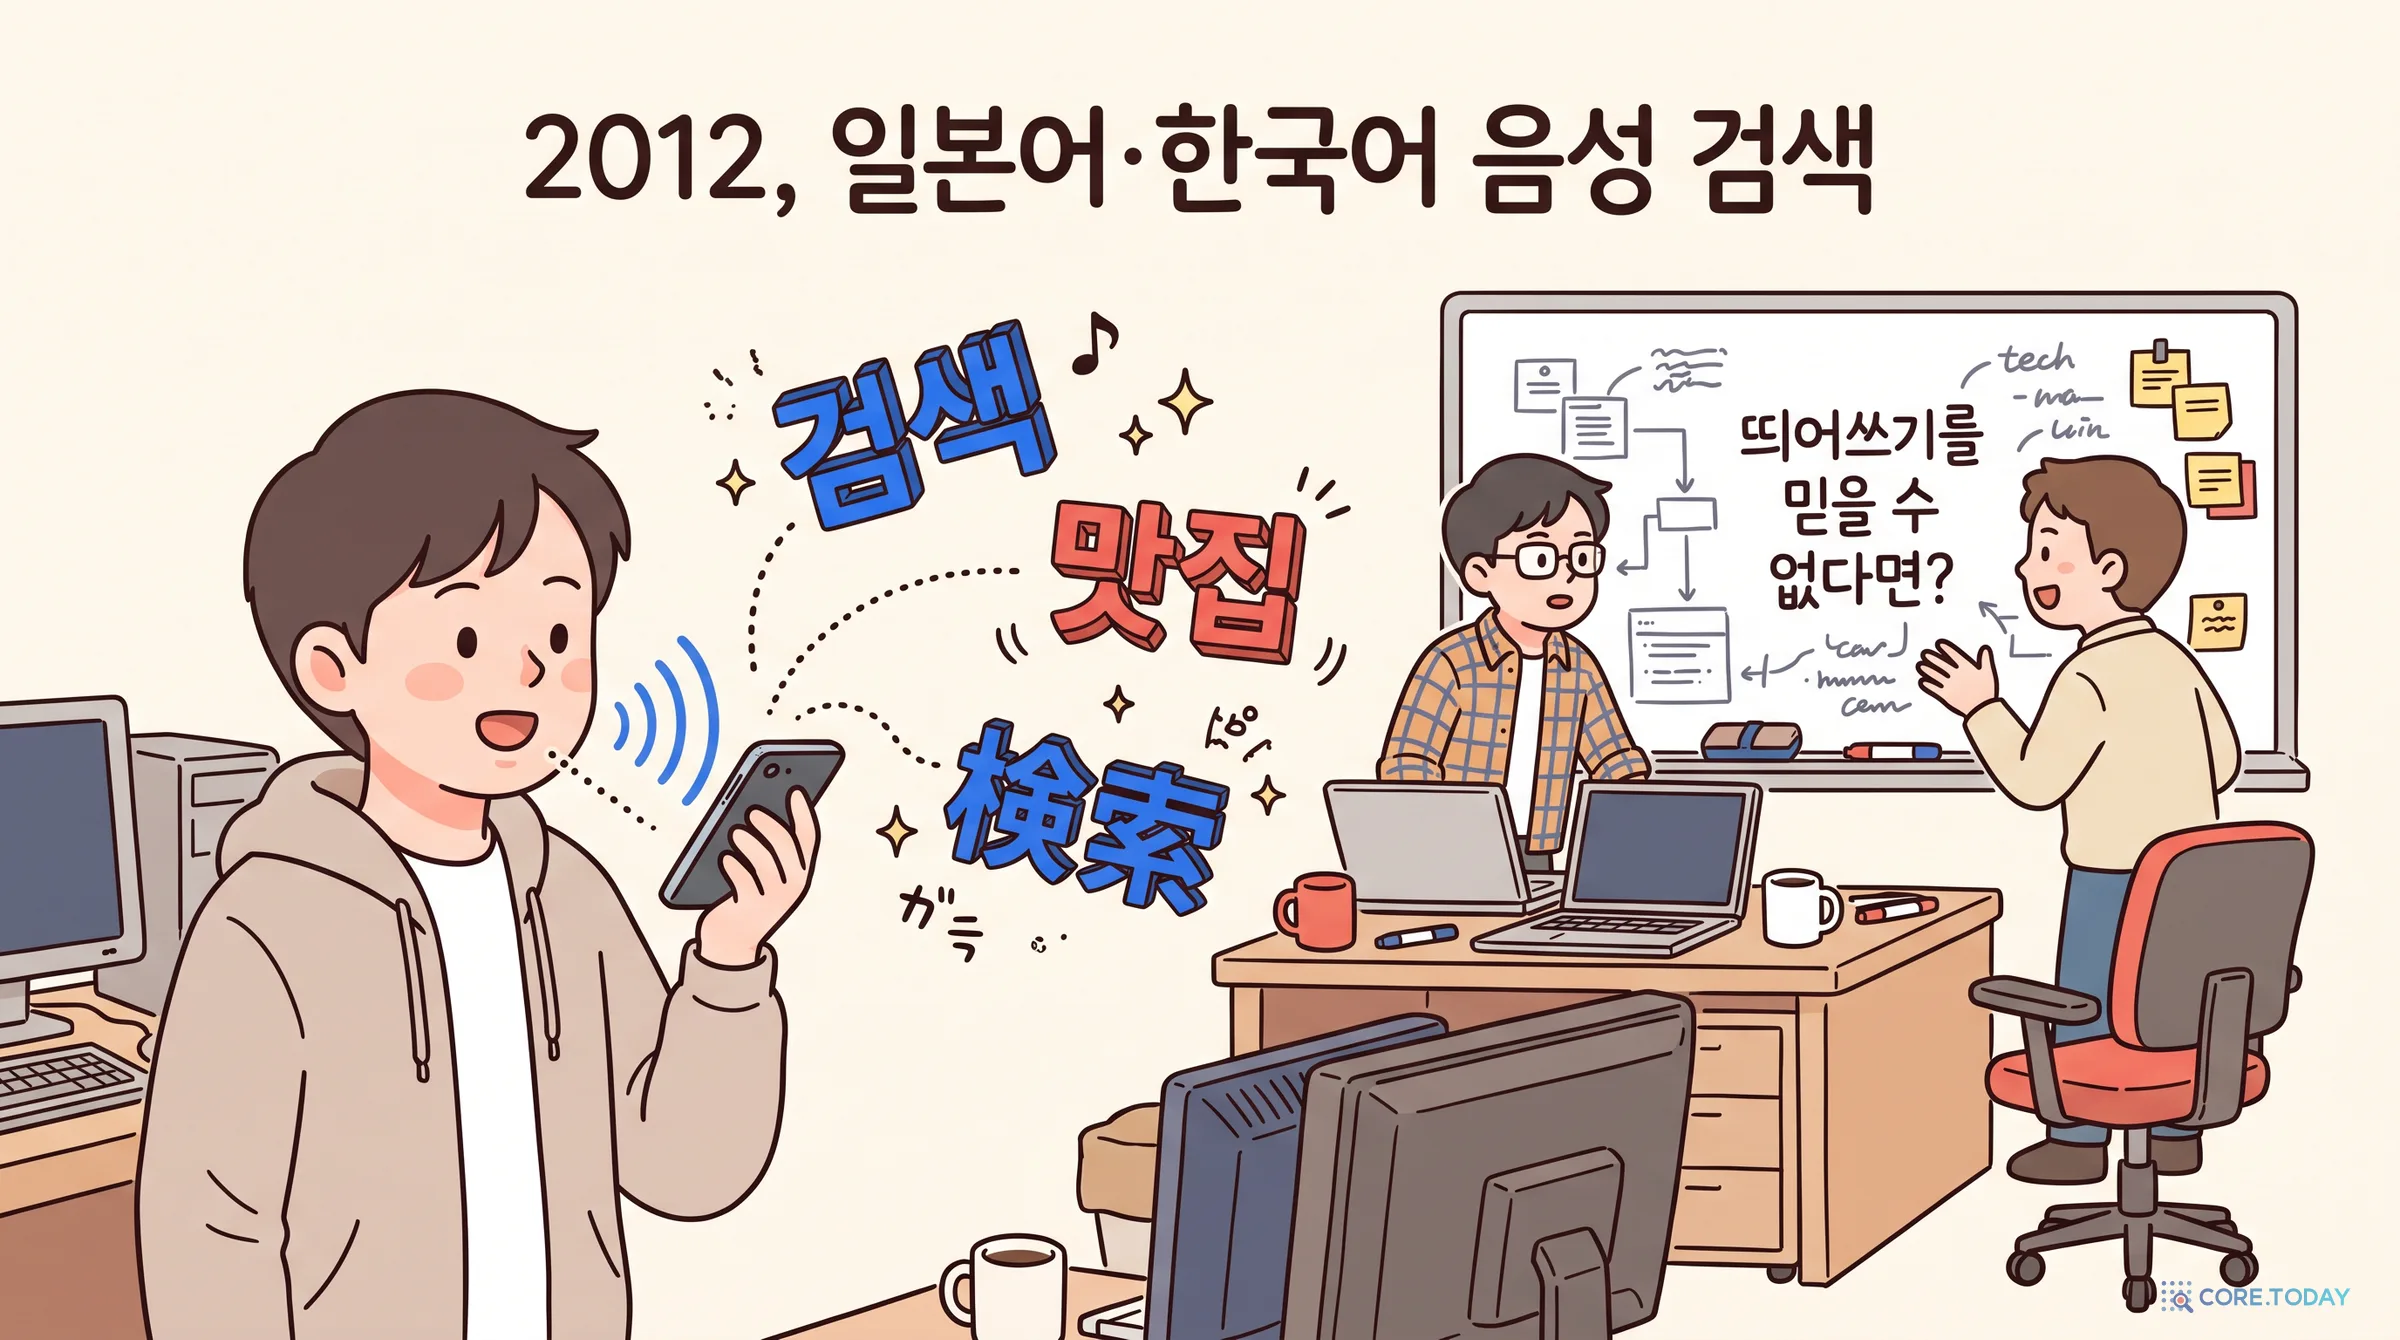
센리히 팀보다 먼저, 구글에도 비슷한 문제를 겪은 팀이 있었다. 음성 검색 팀이었다. 마이크 슈스터(Mike Schuster)와 나카지마 가이스케(Kaisuke Nakajima)는 ICASSP 2012에 「Japanese and Korean Voice Search(일본어·한국어 음성 검색)」를 발표했다. 당시 두 언어는 미국 영어 다음으로 큰 구글의 해외 언어였다.
일본어와 중국어는 글자 사이에 띄어쓰기가 없다. 한국어는 일부 있다. 검색어는 대체로 띄어쓰기로 나뉘지만 늘 그렇지는 않다.
음성 인식기는 ‘단어 목록’이 있어야 돌아간다. 그런데 띄어쓰기를 믿을 수 없으니 단어 목록을 만들 수 없었다. 이들이 만든 WordPiece 모델은 기본 글자에서 출발했다. 일본어는 약 2만 2천 자, 한국어는 약 1만 1천 자였다. 여기서 학습 데이터에 대한 언어 모델의 우도(likelihood)를 가장 크게 높이는 조각을 하나씩 탐욕적으로 추가했다. 보통 20만 개까지 키웠다.
흥미로운 사실이 하나 있다. 이 방법은 2009년 11월 일본어 음성 검색에 먼저 쓰였고, 한국어에는 아무 수정 없이 그대로 적용됐다. 한국어 음성 검색의 기반이 일본어용으로 만든 칼이었던 셈이다.
WordPiece는 이후 두 번 크게 쓰였다. 2016년 구글 신경망 번역(GNMT)은 조각 8천~3만 2천 개를 썼다. 2018년 BERT는 3만 개짜리 WordPiece를 썼다. BERT 토크나이저 출력에서 보이는 ##ing 같은 표시가 ‘앞 조각에 이어지는 조각’이라는 WordPiece의 흔적이다.
BPE와의 차이는 무엇을 기준으로 합치느냐다. BPE는 가장 자주 나오는 쌍을 합친다. WordPiece는 합쳤을 때 언어 모델이 가장 좋아지는 쌍을 합친다. 그래서 구도 다쿠는 WordPiece를 “다른 손실 함수를 쓰는 BPE의 변형”이라고 불렀다.
4.2 SentencePiece와 Unigram — 반대 방향에서 깎아 내다
2018년, 구글의 구도 다쿠(Kudo Taku)는 두 가지를 내놓았다.
첫째는 Unigram 언어 모델 토크나이저다. BPE가 작은 조각에서 출발해 붙여 나가는 방식이라면, Unigram은 아주 큰 후보 목록에서 출발해 덜 중요한 조각을 깎아 내는 방식이다. 각 조각에 확률을 매기고, 빼도 손실이 가장 적은 조각부터 매 라운드 일정 비율씩 지운다. 이 방식에서는 한 단어를 자르는 방법이 여럿 나올 수 있다. 구도는 이를 역이용해 학습 중에 일부러 다른 분할을 섞는 ‘서브워드 정규화’를 제안했다. 영→일 번역에서 BLEU가 27.85에서 31.46으로 올랐다.
둘째는 SentencePiece라는 도구다. 핵심은 공백도 그냥 글자로 취급한다는 것이다. 공백을 ▁(U+2581) 기호로 바꾸고 원문 그대로에서 학습한다. 그래서 언어별 띄어쓰기 규칙이나 전처리에 기대지 않는다. 그리고 자른 결과를 이어 붙이면 원문이 정확히 복원된다.
SentencePiece 논문의 예
입력 : Hello world. 조각 : [Hello] [▁wor] [ld] [.] ← ▁는 ‘앞에 공백이 있었다’는 표시 복원 : 조각을 이어 붙이고 ▁를 공백으로 바꾸면 끝
SentencePiece는 알고리즘이 아니라 도구다. 안에서 BPE도 Unigram도 고를 수 있다. T5와 ALBERT는 Unigram을, Llama 1·2와 Gemma는 SentencePiece의 BPE를 썼다. 이 글의 블로그 실측 위젯이 ▁를 보여 주는 것도 이 방식을 따랐기 때문이다.
4.3 셋을 나란히 놓으면
BPE
WordPiece
Unigram
방향
작은 조각에서 붙여 나간다
작은 조각에서 붙여 나간다
큰 목록에서 깎아 낸다
기준
쌍의 등장 빈도
합쳤을 때 언어 모델 우도 증가
뺐을 때 손실 증가
한 단어의 분할
하나(결정적)
하나(결정적)
여럿 가능(확률적)
대표 사용처
GPT 계열, Llama, Qwen, DeepSeek, EXAONE
BERT, GNMT
T5, ALBERT
4.4 BPE는 최선인가
빈도만 보는 BPE가 언어 구조와 어긋난다는 비판은 꾸준했다. 2020년 텍사스대의 카지 보스트롬(Kaj Bostrom)과 그레그 더렛(Greg Durrett)은 「Byte Pair Encoding is Suboptimal for Language Model Pretraining(BPE는 언어 모델 사전학습에 최적이 아니다)」에서 두 방식을 나란히 비교했다.
단어
BPE
Unigram
nanotechnology
n an ote chn ology
nano technology
tricycles
t ric y cles
tri cycle s
furiously
fur iously
fur ious ly
Completely preposterous
Comple t ely prep ost erous
Complete ly pre post er ous
형태소 경계와 맞는 정도(F1)는 BPE 19.3%, Unigram 30.3%였다. 하지만 업계의 선택은 여전히 BPE다. 이유는 8부에서 다룬다.
한국어에서는 같은 해 카카오브레인과 스캐터랩 연구진(박규병 외)이 토큰화 방식을 체계적으로 비교했다. 번역 실험(한↔영, 테스트 BLEU) 결과는 이랬다.
토큰화
한 → 영
영 → 한
어절(띄어쓰기) 단위
7.07
18.42
자모 단위 (어휘 166개)
38.56
36.45
음절 단위 (어휘 2천)
38.75
38.45
형태소로 먼저 자른 뒤 BPE (어휘 3.2만)
40.34
40.41
어절 단위는 처참했다. 토큰의 26%가 어휘 밖(OOV)으로 떨어졌다. 가장 좋은 것은 형태소 분석기로 먼저 자르고 그 안에서 BPE를 돌리는 방식이었다. 그냥 BPE를 돌리면 토큰이 형태소 경계를 넘는 비율이 어휘 4천일 때 6.6%, 6만 4천일 때 37%까지 올라갔다. 이 결론은 한국 기업들의 토크나이저 설계로 이어졌다. EXAONE은 MeCab 형태소 분석으로 먼저 나눈 뒤 바이트 BPE를 학습했고, HyperCLOVA X도 ‘형태소를 고려한 바이트 BPE’를 썼다고 밝혔다.
5부. 바이트까지 내려가다 — 그리고 한글은 세 조각이 됐다
5.1 GPT-2의 선택 — 글자 대신 바이트
BPE도 출발점은 ‘글자’였다. 그런데 유니코드에는 글자가 너무 많다. GPT-2 논문의 계산으로는 유니코드 전체를 기본 단위로 삼으면 병합을 시작하기도 전에 어휘가 13만 개를 넘는다. 한자, 한글, 이모지, 수학 기호가 모두 한 칸씩을 차지하기 때문이다.
2019년 OpenAI는 GPT-2에서 발상을 뒤집었다. 글자가 아니라 UTF-8 바이트를 기본 단위로 삼았다. 바이트는 256종류뿐이다. 세상의 어떤 문자열이든 바이트의 나열이니, 기본 어휘 256개만으로 무엇이든 표현할 수 있다.<UNK>가 원천적으로 사라진다. 게이지의 BPE가 정말로 ‘바이트 쌍’ 인코딩으로 돌아온 셈이다.
GPT-2의 어휘 50,257개는 이렇게 이루어진다. 바이트 256개, 병합 규칙 5만 개, 그리고 문서 끝 표시 <|endoftext|> 하나.
논문은 실용적인 규칙 하나도 덧붙였다.
BPE가 dog 같은 흔한 단어를 여러 버전으로 담는 것을 봤다. dog. dog! dog? 처럼 여러 변형으로 등장하기 때문이다. 이는 한정된 어휘 자리와 모델 용량을 비효율적으로 배분한다. 이를 막기 위해 글자 종류가 다른 바이트끼리는 병합하지 않도록 했다. 공백은 예외로 했다.
그래서 요즘 토크나이저는 BPE를 돌리기 전에 정규식으로 문장을 먼저 나눈다. 글자, 숫자, 구두점, 공백을 따로 떼어 놓는다. 영어 단어 앞의 공백만은 단어에 붙인다. ␣strawberry가 통째로 한 토큰이 되는 이유다.
바이트 BPE에는 대가가 있었다. 영어 알파벳은 1바이트라 처음부터 ‘글자 = 토큰’이다. 반면 한글, 한자, 가나는 UTF-8에서 글자 하나가 3바이트다. Petrov 등(NeurIPS 2023)은 한국어가 특히 불리한 이유를 이렇게 짚었다.
고립된 언어와 문자일수록 언어 프리미엄이 커진다. 예컨대 한국어로 ‘hotel’은 ‘호텔’인데, 같은 철자를 쓰는 다른 언어가 없다.
라틴 문자를 쓰는 언어들은 서로 조각을 나눠 쓴다. 영어·프랑스어·독일어가 모두 ‘hotel’이라는 철자를 쓰니, 그 조각은 여러 언어의 데이터에서 함께 빈도를 쌓는다. 한글은 한국어만 쓴다. 다국어 말뭉치에서 한국어 비중이 작으면, 한글 조각은 병합 순위 경쟁에서 밀린다.
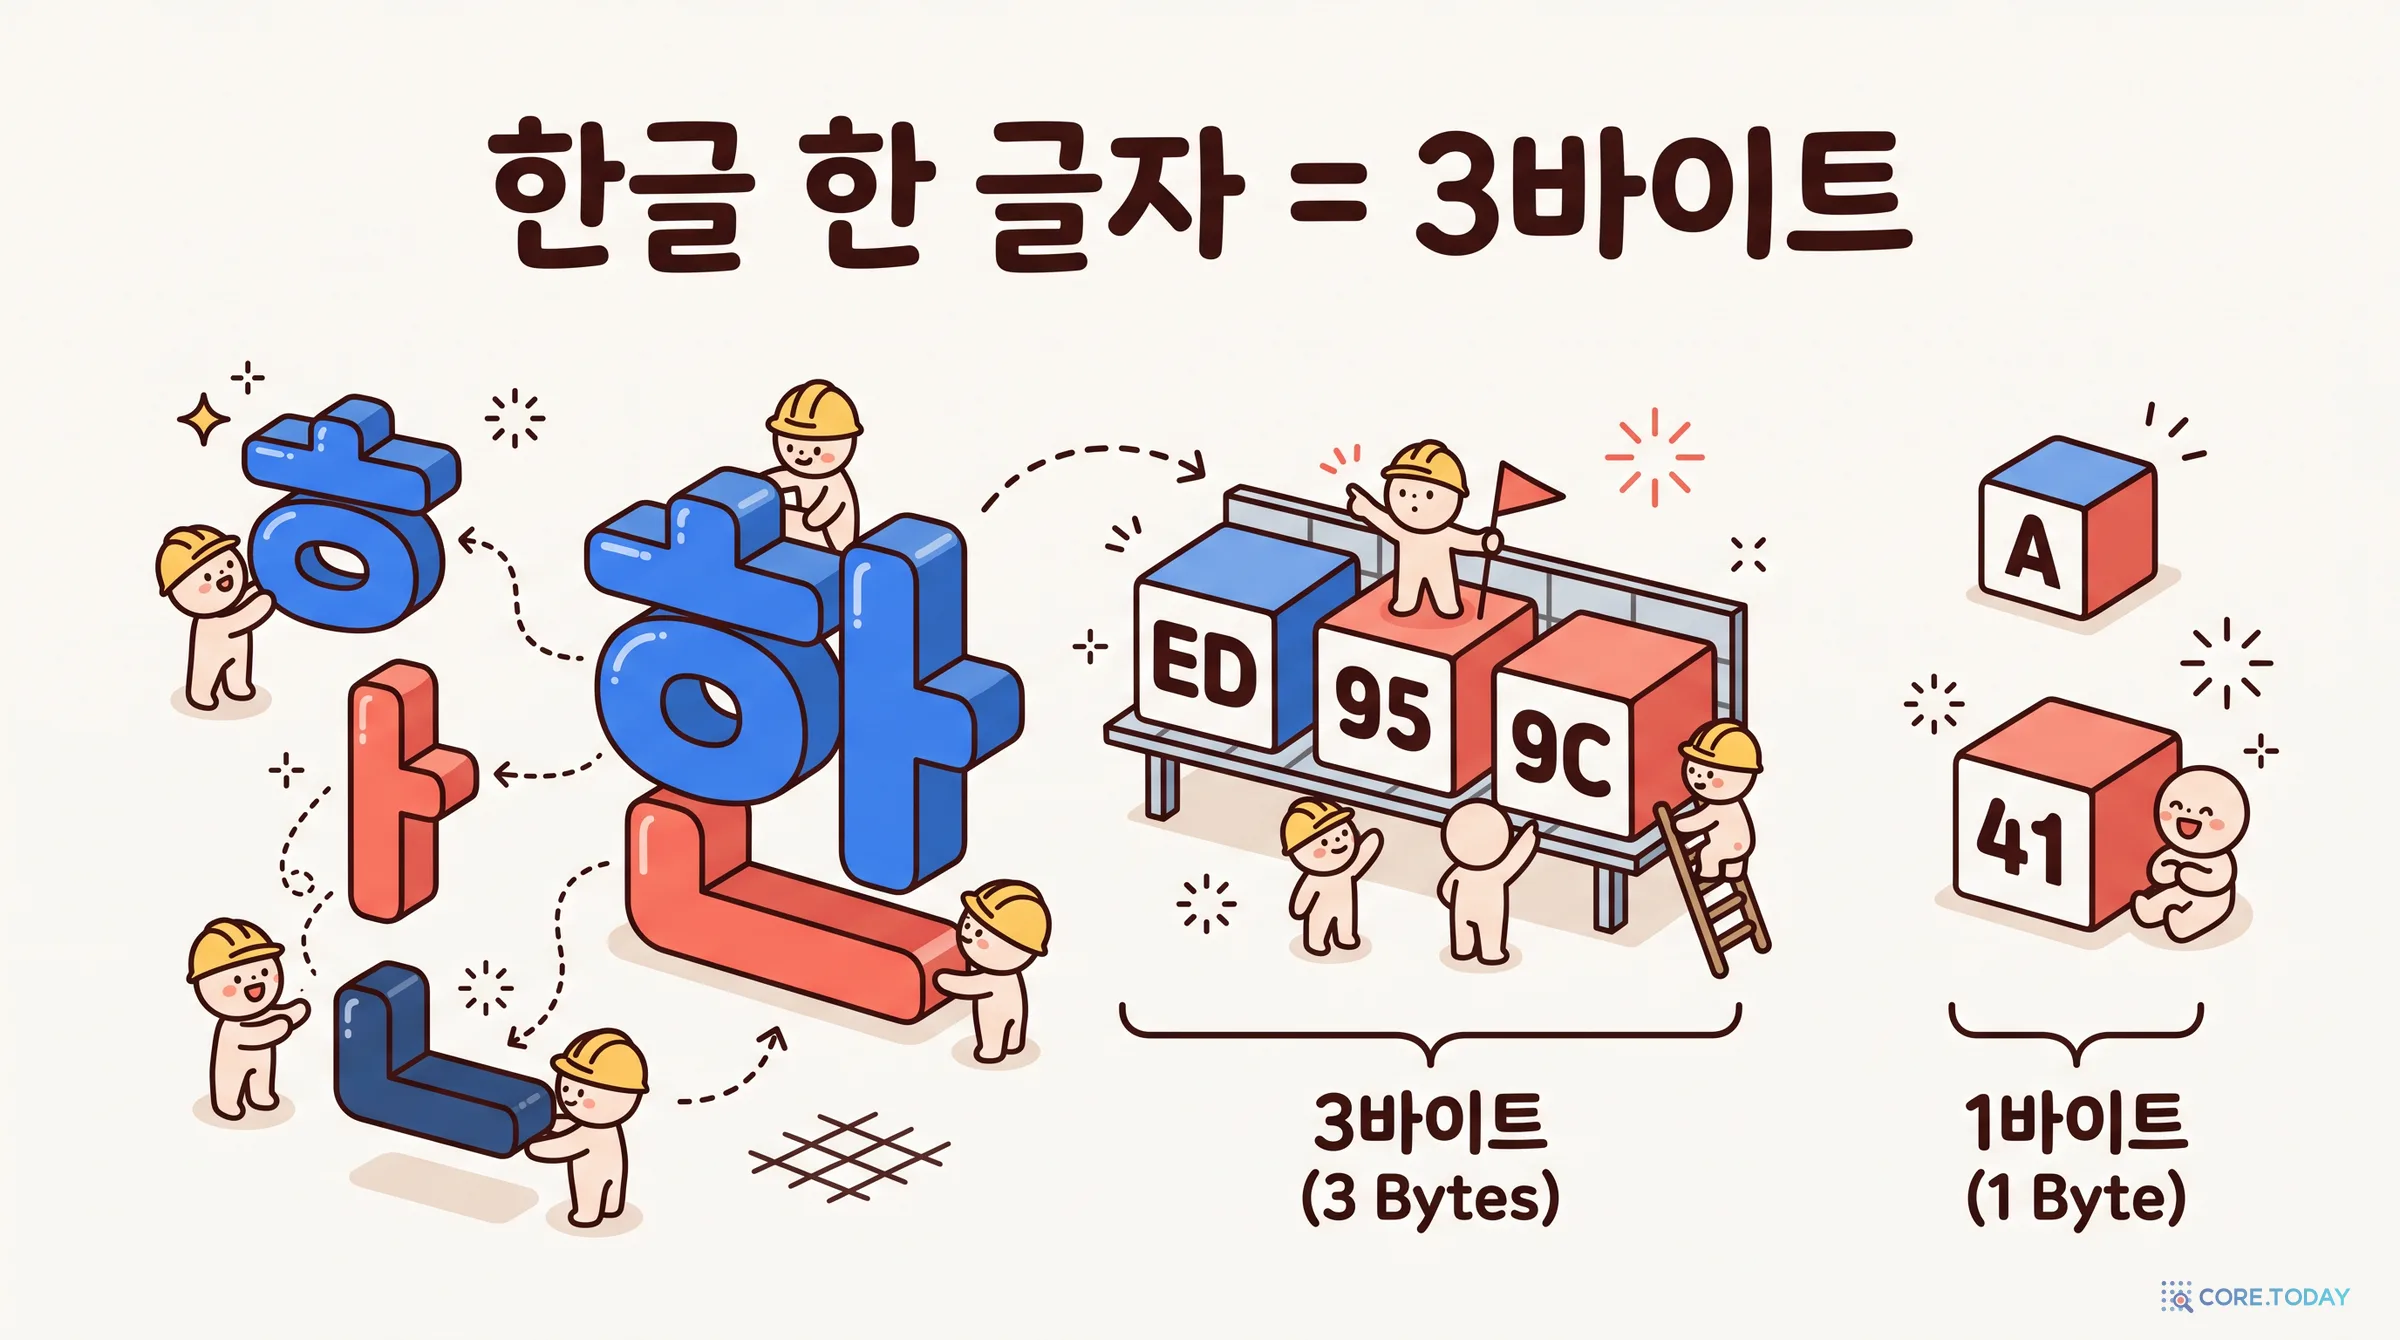
유니코드는 현대 한글 음절 11,172자를 ‘가’(U+AC00)부터 ‘힣’(U+D7A3)까지 한 줄로 늘어놓았다. 초성 19 × 중성 21 × 종성 28(받침 없음 포함) = 11,172. 그래서 음절 번호는 산술식 하나로 나온다.
코드=0xAC00+(초성×21+중성)×28+종성
이 번호를 저장할 때 오늘날 웹의 표준 인코딩인 UTF-8은 영어 알파벳(U+0000~U+007F)에 1바이트를 쓰고, 한글 음절에는 3바이트를 쓴다. 비트 모양은 1110xxxx 10xxxxxx 10xxxxxx다. 아래 투시경에 글자를 넣어 보자. ‘한’은 ED 95 9C가 된다.
바이트 BPE는 이 세 바이트를 다시 붙이는 데서 출발한다. 영어 알파벳은 처음부터 ‘글자 = 토큰’이지만 한글은 병합 두 번을 써야 비로소 한 글자를 얻는다. 학습 말뭉치에 영어가 압도적으로 많으면 그 병합 순위가 뒤로 밀리고, 어휘 한도 안에 못 들어간 음절은 끝내 조각으로 남는다.
실제로 얼마나 남을까. KS X 1001 상용 한글 2,350자를 토크나이저마다 하나씩 넣어 봤다.
토크나이저
어휘 크기
2,350자 중 1토큰으로 끝나는 음절
실제 글에서 등장 빈도로 가중하면
GPT-2·GPT-3 (r50k)
50,257
0.0%
0.0%
GPT-3.5·GPT-4 (cl100k)
100,277
5.5%
67.1%
GPT-4o 계열 (o200k)
200,019
28.8%
97.8%
Llama 3.2
128,256
25.5%
96.0%
DeepSeek-V3
128,815
16.7%
92.1%
HyperCLOVA X SEED
110,524
36.7%
96.2%
EXAONE 4.0
102,400
59.1%
99.6%
Gemma 3
262,145
70.7%
100.0%
Qwen3
151,669
88.2%
100.0%
GPT-2는 한글 음절을 단 하나도 한 토큰으로 갖고 있지 않았다. 모든 한글이 바이트 조각이었다. GPT-4도 상용 음절의 5.5%만 온전히 알았다. 다만 그 5.5%가 ‘다’, ‘이’, ‘는’처럼 가장 자주 쓰는 글자라서, 실제 글에서는 음절의 67%가 한 토큰으로 처리됐다. 나머지 33%는 바이트 조각이었다.
6부. 토큰화가 만든 기묘한 실패들
OpenAI 창립 멤버이자 테슬라 AI 책임자였던 안드레이 카파시(Andrej Karpathy)는 2024년 2월 토크나이저를 처음부터 만드는 2시간짜리 강의를 공개하며 이렇게 말했다.
“토큰화 때문이다”Karpathy, minbpe 강의 노트 2024
QLLM은 왜 단어 철자를 못 댈까? — 토큰화.
QLLM은 왜 문자열 뒤집기 같은 아주 간단한 문자열 처리를 못 할까? — 토큰화.
QLLM은 왜 영어가 아닌 언어(예: 일본어)에 약할까? — 토큰화.
QLLM은 왜 간단한 산수를 못 할까? — 토큰화.
Q“SolidGoldMagikarp”을 물으면 LLM은 왜 고장 날까? — 토큰화.
Q‘끝에 공백이 있다’는 이상한 경고는 뭘까? LLM에겐 왜 JSON보다 YAML이 나을까? — 토큰화.
!모든 고통의 진짜 뿌리는 무엇인가? — 토큰화.
반쯤은 농담이다. 하지만 목록의 항목마다 실제 원인이 있다.
몇 가지를 직접 확인해 보자. 아래 동물원은 같은 문자열을 토크나이저 10종이 어떻게 자르는지 보여 준다. 점선 칸은 글자가 되지 못한 바이트 조각이다.
“strawberry에 r이 몇 개 있어?” 2024년 여름, 이 질문에 챗봇들이 자신 있게 “2개”라고 답하는 장면이 인터넷 밈이 됐다. OpenAI 개발자 포럼에는 2024년 6월 19일에 이미 버그 신고가 올라와 있다. 정답은 3개다.
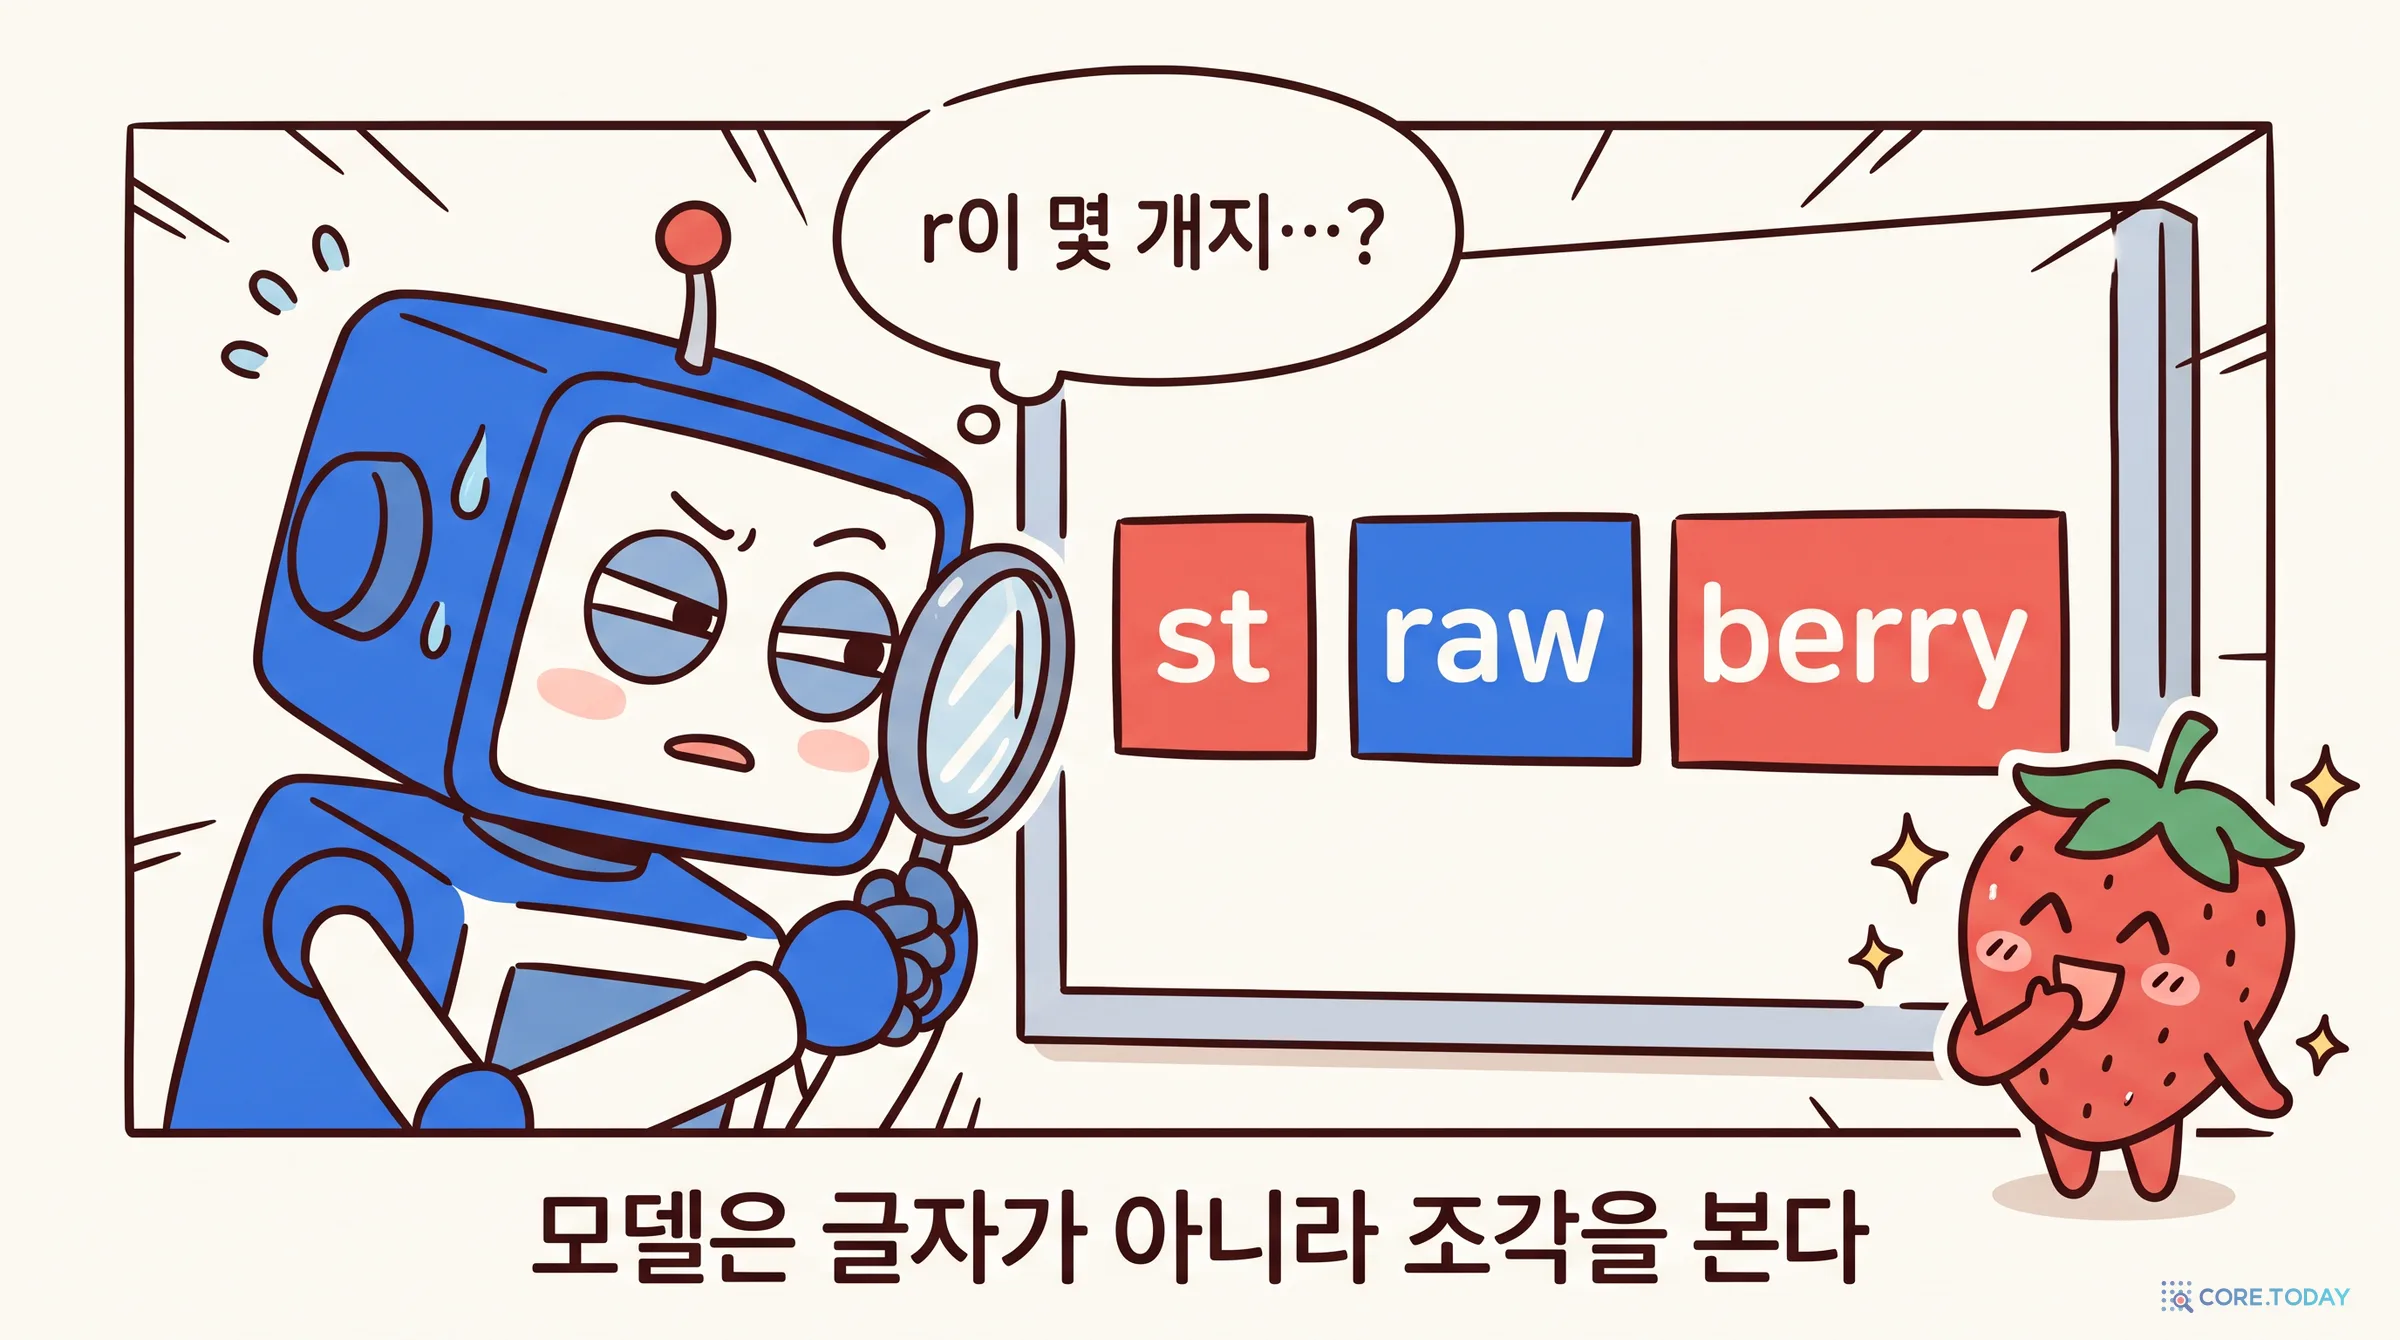
가장 널리 퍼진 설명은 토큰화다. 띄어쓰기 없이 쓴 strawberry는 GPT-4o에서 st | raw | berry 세 조각이다. 모델이 받는 것은 이 조각들의 번호다. 번호 안에 어떤 철자가 들어 있는지는 학습으로 간접적으로 외워야 한다. 사람으로 치면 단어를 그림 세 장으로만 보고 철자를 맞히는 것과 비슷하다.
다만 이것이 전부는 아니라는 반론도 있다. 2024년 말 Fu 등은 여러 모델에 글자 세기를 시켜 보고, 단어나 토큰의 빈도는 정답률과 큰 관계가 없었다고 보고했다. 틀리는 경우는 같은 글자가 여러 번 나오는 단어에 몰려 있었다. strawberry의 r은 세 번 나온다. 토큰화가 문제를 어렵게 만드는 것은 맞지만, 여러 번 나온 것을 정확히 세는 일 자체가 모델에게 어렵다는 것이다. 요즘 추론 모델들이 이 질문을 대개 맞히는 것도 한 글자씩 풀어 쓰며 세는 과정을 거치는 경우가 많기 때문이다.
한국어에서는 이 문제가 더 깊다. GPT-4o에게 ‘안녕하세요’는 안 | 녕하세요다. ‘녕하세요’에 받침이 몇 개인지 알려면 모델은 이 한 덩어리 안을 들여다봐야 한다. 그런데 그 안은 바이트 열두 개다. 초성·중성·종성은 어디에도 직접 나타나지 않는다. 받침 세기, 초성 퀴즈, 끝말잇기 같은 한국어 말놀이에 LLM이 유난히 서툰 데는 이런 사정이 있다.
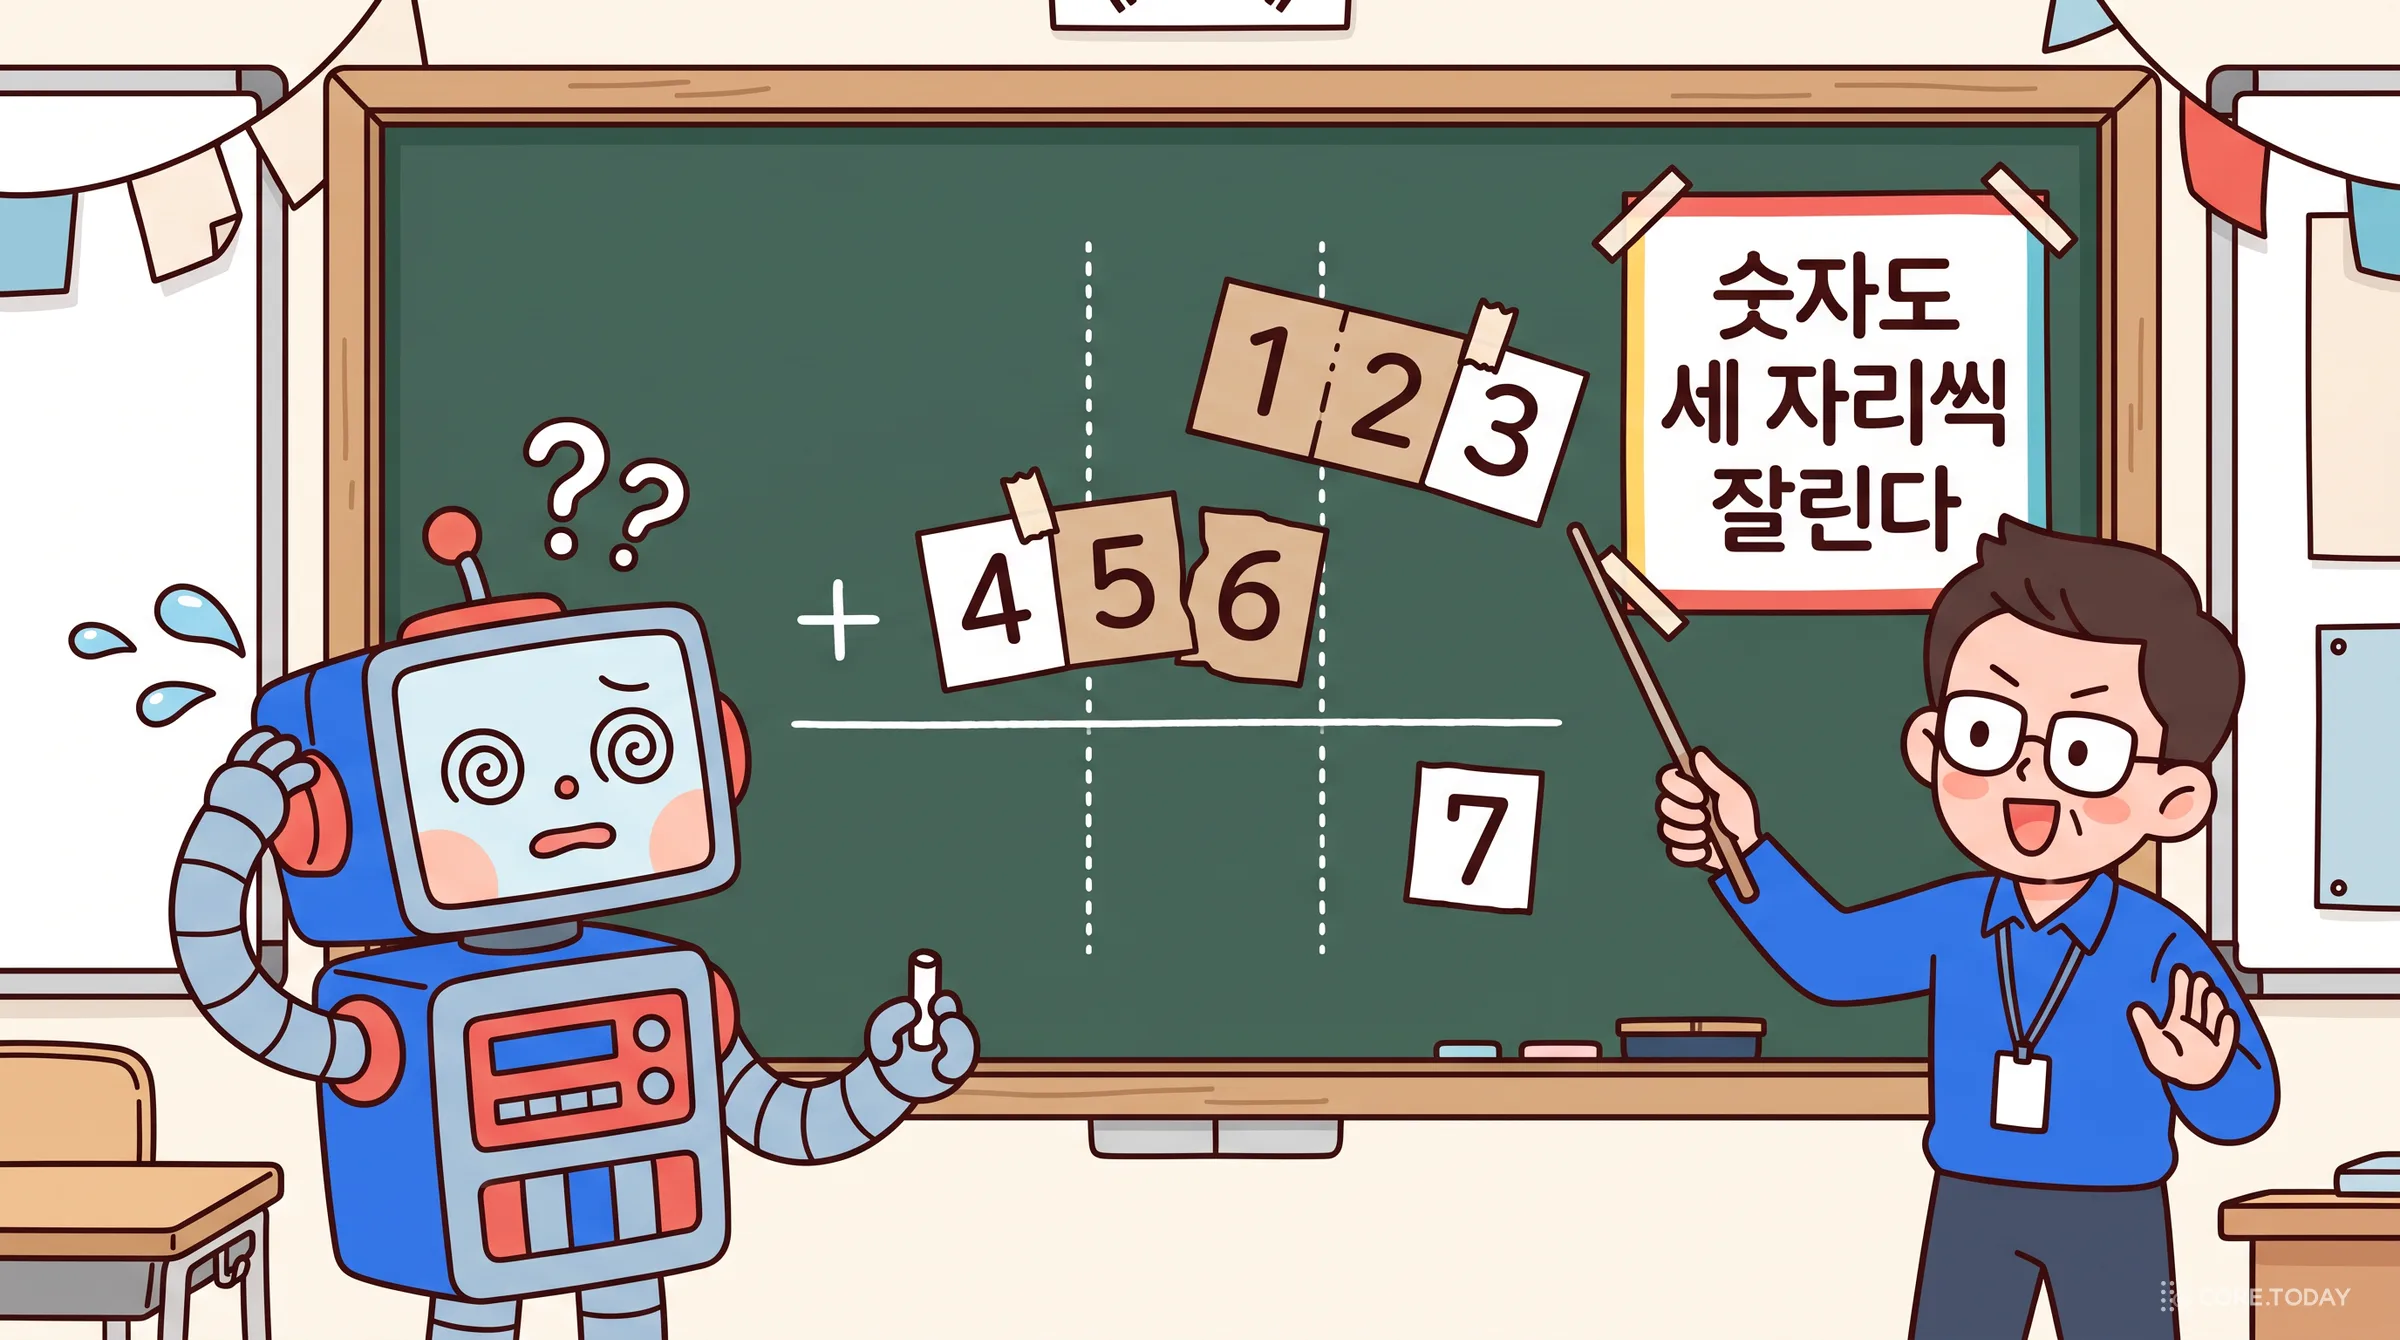
동물원에서 1234567을 눌러 보자. GPT-4 이후 OpenAI 토크나이저와 Llama 3, DeepSeek-V3, HyperCLOVA X는 숫자를 왼쪽부터 세 자리씩 끊는다. 123 | 456 | 7이다. 그런데 사람은 덧셈을 오른쪽 끝자리부터 맞춰 쓴다. 1,234,567은 1 | 234 | 567로 끊어야 자릿값이 맞는다. 왼쪽부터 끊으면 같은 ‘456’ 토큰이 어떤 수에서는 천의 자리 묶음이고 어떤 수에서는 일의 자리 묶음이 된다.
아디티아 싱(Aaditya Singh)과 DJ 스트라우스(DJ Strouse)는 2024년 이것을 직접 실험했다. 숫자에 쉼표를 넣어 오른쪽부터 세 자리씩 잘리도록 강제했더니 정답률이 크게 올랐다.
GPT-3.5 · 왼쪽부터
75.6%
GPT-3.5 · 오른쪽부터
97.8%
GPT-4 · 왼쪽부터
84.4%
GPT-4 · 오른쪽부터
98.9%
모델은 그대로 두고 숫자를 자르는 방향만 바꿨는데 덧셈 정답률이 최대 20%p 올랐다(8-shot 덧셈). 오답에는 패턴도 있었다. 답의 자릿수가 문제와 달라지는 경우, 모델은 거의 언제나 네 번째 자리를 틀렸다.
그래서 토크나이저마다 숫자 정책이 다르다. Gemma 3, Qwen3, EXAONE 4.0, Mistral Nemo는 숫자를 한 자리씩 자른다. 토큰은 늘지만 자릿값이 흔들리지 않는다. GPT-2는 아무 규칙 없이 빈도대로 잘랐다(123 | 45 | 67). 날짜도 마찬가지다. GPT-4o에게 ‘2026년’은 202 | 6 | 년이다.
실무에서 얻을 교훈은 간단하다. 정확한 계산은 모델의 암산에 맡기지 말고 코드 실행이나 계산기 도구에 맡긴다.
2023년 2월, 연구자 제시카 럼벨로(Jessica Rumbelow)와 매슈 왓킨스(Matthew Watkins)는 GPT 계열 모델의 임베딩 공간을 군집으로 나눠 보다가 이상한 것을 발견했다. 5만 257개 토큰 전체의 중심 근처에 SolidGoldMagikarp, TheNitromeFan, cloneembedreportprint 같은 기묘한 문자열들이 모여 있었다.
이 토큰들을 그대로 따라 말하게 했더니 모델이 고장 났다. ChatGPT는 ‘SolidGoldMagikarp’을 따라 하라는 요청에 ‘distribute’라고 답했다. ‘TheNitromeFan’은 ‘182’가 됐다. GPT-3 계열 모델(davinci-instruct-beta)은 어떤 토큰에는 “You are a banana(너는 바나나야)”라고 답했고, 어떤 토큰에는 화를 냈다. 온도를 0으로 둬도 답이 매번 달라지는 경우도 있었다. 두 사람이 찾은 문제 토큰은 374개였다.
정체는 곧 밝혀졌다. 이 이름들은 레딧의 r/counting 게시판 사용자들이었다. 이 게시판은 댓글로 숫자를 하나씩 이어 세는 곳이다. 열성 참여자들의 닉네임은 댓글마다 반복해서 등장했다. 토크나이저를 학습한 웹 데이터에서는 아주 흔했으니 통째로 한 토큰이 됐다. 그런데 모델을 학습한 데이터는 더 깐깐하게 걸러져 있었다. 그 결과 어휘에는 자리가 있지만 학습 중에는 거의 한 번도 등장하지 않은 토큰이 생겼다. 이런 토큰의 임베딩은 초기값 근처에 머물렀다. 모델에게는 의미가 텅 빈 번호였다.
우리 측정에서도 확인된다. SolidGoldMagikarp은 GPT-2·GPT-3 어휘(r50k)에서 토큰 1개(43453번)다. GPT-4 이후 토크나이저에서는 모두 5조각이다. 같은 달 ChatGPT는 이 현상이 고쳐진 것으로 보고됐다.
교훈은 이것이다. 토크나이저와 모델은 따로 학습된다. 둘이 본 데이터가 어긋나면 그 틈으로 이상한 일이 생긴다.
6.4 띄어쓰기 하나가 다른 단어를 만든다
동물원의 strawberry와 ␣strawberry를 비교해 보자. 앞에 띄어쓰기가 없으면 대부분 3토큰, 있으면 거의 모두 1토큰이다. 바이트 BPE는 대개 앞 공백을 단어에 붙여 하나의 토큰으로 만든다. 그래서 같은 단어라도 문장 맨 앞에 올 때, 문장 중간에 올 때, 따옴표 뒤에 올 때 모두 다른 번호를 받는다. 모델은 이것들이 같은 단어라는 사실을 학습으로 따로 배워야 한다.
프롬프트 끝에 공백 하나를 남기면 답변 품질이 떨어진다는 경험칙도 여기서 나온다. 모델은 학습 중에 ‘공백 + 단어’ 토큰을 주로 봤다. 그런데 공백이 이미 따로 떨어져 나와 있으면, 다음에 ‘공백 없는 단어’ 토큰을 이어야 하는 드문 상황에 놓인다.
2023년 옥스퍼드대의 알렉산다르 페트로프(Aleksandar Petrov) 연구진은 NeurIPS 2023에 「Language Model Tokenizers Introduce Unfairness Between Languages(언어 모델 토크나이저는 언어 간 불공정을 만든다)」를 발표했다. 같은 내용을 말하는 데 드는 토큰 수가 언어에 따라 최대 15배 차이 났다. 토큰 단위로 과금하는 API에서 이는 곧 요금 차이다. 연구진은 일부 언어 사용자가 “같은 일에 영어 사용자보다 최소 2.5배를 낸다”고 썼다. GPT-4 토크나이저(cl100k)로 잰 한국어의 프리미엄은 2.38배였다.
이듬해 5월, OpenAI는 GPT-4o를 발표하며 새 토크나이저(o200k)를 소개했다. 20개 언어의 토큰 절감을 표로 보여 줬고, 한국어 예문은 이것이었다.
안녕하세요, 제 이름은 GPT-4o입니다. 저는 새로운 유형의 언어 모델입니다, 만나서 반갑습니다!
GPT-4 토크나이저로 45토큰이던 이 문장이 27토큰이 됐다(1.7배 절감). 우리가 직접 세어 보니 숫자가 정확히 맞았다. 그리고 GPT-2 토크나이저로는 이 문장이 105토큰이었다. 같은 표의 영어 예문은 27토큰에서 24토큰으로 줄었다. 가장 크게 줄어든 언어는 구자라트어였다(145 → 33, 4.4배).
7.1 토크나이저 13종 실측
각 모델이 공개한 토크나이저 13종으로 FLORES-200 devtest의 같은 뜻 문장 1,012개를 한국어·영어·일본어·중국어로 잘랐다. 우리가 측정한 GPT-2(5.03배)와 GPT-4(2.37배) 값은 Petrov 등이 보고한 5.07배, 2.38배와 거의 같다. 지표를 바꿔 가며 보고, 아래쪽 계산기에 내 사용량을 넣어 보자.
눈에 띄는 점이 다섯 가지 있다.
1
세대가 바뀔 때마다 줄었다
OpenAI 토크나이저만 보면 한국어/영어 배수가 5.03(GPT-2) → 2.37(GPT-4) → 1.47(GPT-4o)로 떨어졌다. 어휘가 5만 → 10만 → 20만으로 커지면서 한국어에 돌아온 몫이 늘었다. 같은 한국어 1,012문장이 13만 5,935토큰에서 3만 9,566토큰이 됐다.
2
한국어 데이터를 많이 본 칼이 가장 공평하다
EXAONE 4.0과 HyperCLOVA X SEED(모두 1.22배)는 어휘가 10만~11만으로 GPT-4o의 절반인데도 한국어 배수가 가장 낮다. 두 회사 모두 형태소 분석을 거쳐 토크나이저를 학습했다고 밝혔다. 어휘 크기보다 학습 말뭉치에 한국어가 얼마나 있었나가 더 중요하다.
3
음절을 다 안다고 짧아지지는 않는다
Qwen3는 상용 음절의 88%를 한 토큰으로 알지만 배수는 1.63으로 GPT-4o(1.47)보다 높다. 음절은 알아도 ‘습니다’, ‘에서’ 같은 여러 음절 덩어리를 덜 배웠기 때문이다. 글자를 아는 것과 단어를 아는 것은 다르다.
4
칼은 자기를 만든 말뭉치를 닮는다
‘한·일·중 비교’를 눌러 보자. 중국 모델 Qwen3와 DeepSeek-V3는 중국어가 영어와 거의 같은 토큰 수(1.00배, 0.94배)다. 반면 한국어에 강한 EXAONE 4.0은 일본어 2.00배, 중국어 2.19배다. 공평한 토크나이저는 없다. 어휘라는 한정된 자리를 어느 언어에 나눠 줬느냐가 있을 뿐이다.
!
BERT 시절엔 아예 모르는 글자가 있었다
바이트로 내려가지 않는 WordPiece 기반 mBERT는 상용 음절 2,350자 중 1,164자를 [UNK]로 바꿨다. 한국어 전용 KLUE-BERT도 919자를 몰랐다. 다만 실제 글에서 그런 음절이 나오는 비율은 0.2% 이하라 체감은 적었다. 이 구멍을 원천적으로 막은 것이 5부의 바이트 BPE다.
카카오의 Kanana 1.5는 우리 측정의 모든 수치가 Llama 3.2와 똑같이 나왔다. Llama 3 계열 토크나이저를 그대로 쓴 것으로 보인다. 모델을 처음부터 학습하지 않고 기존 모델에서 출발하면 토크나이저도 물려받는 경우가 많다. 토크나이저를 바꾸면 임베딩 표를 새로 배워야 하기 때문이다.
그렇다면 한국어만 보고 배운 칼은 얼마나 짧게 자를까. 이 블로그의 글 677편 중 637편(약 850만 자)으로 BPE를 직접 학습했다. 나머지 40편(49만 자)은 검증용으로 남겼다. 도구는 HuggingFace tokenizers였고, 학습은 노트북에서 어휘 크기별로 1~5초 걸렸다.
토크나이저
어휘
검증 글 토큰당 글자
FLORES 한국어 토큰
FLORES 영어 토큰
GPT-4 (cl100k)
10만
1.15
64,338
27,182
GPT-4o (o200k)
20만
1.76
39,566
26,873
우리 블로그 바이트 BPE
4천
1.85
41,115
68,052
우리 블로그 바이트 BPE
8천
2.11
36,739
60,481
우리 블로그 바이트 BPE
3.2만
2.58
30,316
48,336
우리 블로그 글자 BPE
6.4만
3.16
26,285
43,922
어휘 8천 개짜리 우리 토크나이저가 어휘 20만 개의 GPT-4o보다 한국어를 짧게 자른다. 우리 블로그 글에서도, 처음 보는 뉴스·위키 문장(FLORES)에서도 그렇다. 3만 2천 개면 FLORES 한국어 토큰이 GPT-4o보다 23% 적고, 6만 4천 개 글자 BPE면 34% 적다. 대가도 분명하다. 같은 3만 2천 개짜리로 영어를 자르면 GPT-4o보다 1.8배 길다. 공짜 점심은 없다. 어휘라는 한정된 자리를 어느 언어에 얼마나 나눠 주느냐의 문제다.
이 토크나이저의 앞 3,000개 병합 규칙을 그대로 옮겨 왔다. 슬라이더로 규칙 수를 늘려 가며 문장이 뭉쳐지는 과정을 보자.
병합 순서를 보면 이 말뭉치의 성격이 드러난다. 1번 규칙은 다 + ., 2번은 니 + 다., 17번이 습 + 니다.다. 한국어 문어체의 마침표 어미가 가장 먼저 뭉쳤다. 38번에 ▁모 + 델, 134번에 ▁에이전트가 생긴 것은 AI 블로그다운 결과다. 반면 ‘▁인공지능’은 8,452번째에야 한 덩어리가 된다. 학습 말뭉치에서 ‘인공지능’은 103번, ‘AI’는 6,688번 나왔다. 이 블로그는 인공지능을 거의 언제나 ‘AI’라고 쓴다. 토크나이저는 그 습관을 그대로 비춘다.
7.3 이 숫자가 실무에서 뜻하는 것
1
글자 수가 아니라 실제 토크나이저로 센다. OpenAI 계열은 tiktoken, 공개 모델은 HuggingFace tokenizers, Claude는 토큰 계산 API가 있다. 요금 견적, 문맥 창 계산, 청크 크기 설정이 모두 여기서 시작한다.
2
모델 비교는 ‘같은 작업당 비용’으로 한다. 토크나이저가 다르면 100만 토큰당 가격은 비교할 수 없다. 우리 블로그 글 기준으로 GPT-4o 토크나이저의 1토큰은 한국어 1.76자, GPT-4 토크나이저의 1토큰은 1.15자였다. 같은 단가라도 실제 비용은 1.5배 차이 난다.
3
문맥 창도 한국어 글자로 환산해 본다. ‘128K 토큰’은 GPT-4o 토크나이저로 한국어 약 22만 자, GPT-4 토크나이저로는 약 15만 자다(블로그 글 기준). 영어로 쓴 안내 문서의 ‘책 한 권 분량’이 한국어에는 그대로 들어맞지 않는다.
4
유니코드 정규화를 확인한다. macOS 파일 이름처럼 한글이 자모로 풀린 NFD 문자열은 토큰이 폭발한다. ‘회의가 내일로 연기되었습니다’가 GPT-4o에서 NFC로는 8토큰, NFD로는 92토큰이었다. 파일 이름이나 외부 문서를 넣기 전에 NFC로 정규화한다.
5
숫자·철자가 중요한 일은 도구에 맡긴다. 계산은 코드 실행, 글자 수 제한은 후처리 검사, 날짜 계산은 라이브러리에 맡긴다. 토큰을 통해 보는 모델에게 맡길 일이 아니다.
6
모델을 고를 때 토크나이저도 사양으로 본다. 같은 크기의 공개 모델이라도 FLORES 기준 한국어 배수가 1.22(EXAONE·HyperCLOVA X)부터 1.64(DeepSeek-V3)까지 차이 났다. 한국어 서비스라면 추론 비용과 실효 문맥 길이가 그만큼 달라진다.
토큰을 아끼려고 시스템 프롬프트를 영어로 쓰는 팀도 있다. GPT-4o 기준 배수가 1.5배 안팎이니 긴 프롬프트라면 고려할 만하다. 다만 지시 언어가 바뀌면 답변의 말투와 품질도 달라질 수 있다. 토큰 수만 보지 말고 결과를 함께 재야 한다.
GPT-2에서 Gemma 3까지 6년 사이 어휘는 다섯 배가 됐다. 메타는 Llama 3를 내면서 tiktoken의 10만 토큰에 2만 8천 개를 더해 12만 8천 개로 키웠다. 이것만으로 영어 압축률이 토큰당 3.17자에서 3.94자로 좋아졌다고 밝혔다. 어휘가 커지면 같은 글이 더 적은 토큰이 된다. 학습도, 추론도, 요금도 줄어든다. 특히 영어 밖의 언어가 큰 덕을 봤다. 앞에서 본 한국어 배수가 그 증거다.
공짜는 아니다. 어휘 하나마다 임베딩 벡터가 붙고, 출력층에서는 매 토큰마다 전체 어휘에 대한 확률을 계산한다. Byte Latent Transformer 논문은 Llama 3가 평균 토큰 크기를 3.7바이트에서 4.4바이트로 늘린 대가로 임베딩 표가 네 배 커졌다고 지적했다. 드물게 쓰이는 토큰은 학습 신호도 적게 받는다. 어휘를 무한히 키울 수는 없다.
반대 방향의 움직임도 있다. 앤트로픽은 Claude Opus 4.7부터 새 토크나이저를 도입했다. 같은 글에 이전 모델보다 대략 1~1.35배의 토큰이 들 수 있다고 안내했다. 언어별 내역은 공개하지 않았다. 토크나이저 설계는 압축률 하나로 결정되지 않는다. 모델이 무엇을 잘하게 할지를 함께 정하는 선택이다.
같은 어휘 20만에서 토큰 최대 33% 감소, 8B 모델 30개 과제 평균 +4.0%p, 추론 연산 27% 절감
BoundlessBPE (2025)
사전 분할된 덩어리끼리도 합쳐 ‘슈퍼워드’를 만든다
토큰당 바이트 최대 15% 증가
Byte Latent Transformer (2024, 메타)
토크나이저 없이 바이트를 읽고, 다음 바이트가 예측하기 어려운 곳에서 묶음을 끊는다
같은 학습 연산에서 Llama 3 구조 기준 모델과 대등, 추론 연산 최대 50% 절감(80억 파라미터까지)
H-Net (2025)
묶음 경계 자체를 모델이 학습한다
같은 연산에서 BPE 트랜스포머를 앞섬, 2단 구조는 두 배 크기 토큰 모델과 대등
방향은 둘이다. BPE를 더 크게 묶거나(SuperBPE), BPE를 아예 없애거나(BLT, H-Net). 후자가 성공하면 이 글에서 본 문제 상당수가 사라진다. 바이트를 직접 보니 철자를 셀 수 있다. 고정 어휘가 없으니 글리치 토큰도 없다. 언어마다 예측이 어려운 곳에서 묶음을 끊으니 토큰세도 줄어들 수 있다. 다만 BLT의 비교 대상은 공개된 Llama 3 가중치가 아니라 저자들이 같은 데이터로 직접 학습한 Llama 3 구조 모델이었다. 최전선 규모에서 검증된 것은 아직 아니다.
8.3 그래도 BPE가 남는 이유
2026년 지금도 공개 모델 대부분은 바이트 BPE 계열이다. 이유는 BLEU가 살아남은 이유와 닮았다.
1
단순하고 결정적이다
같은 입력은 언제나 같은 토큰이 된다. 병합 규칙 목록 하나로 끝나고, 빠르고, 원문으로 정확히 되돌릴 수 있다.
2
생태계가 토큰 위에 서 있다
요금, 문맥 창, 프롬프트 캐시, 속도 제한, 사용량 대시보드가 모두 토큰 단위다. 토크나이저를 바꾸면 이 모든 것의 단위가 바뀐다. 이미 학습한 모델의 토크나이저는 사실상 바꿀 수 없다. 임베딩을 처음부터 다시 배워야 하기 때문이다.
!
잘 동작한다
이론상 최적이 아니라는 지적은 계속 나왔다. 하지만 대규모 모델은 BPE의 이상한 경계를 스스로 보완하며 배워 왔다. 대안이 확실히 이긴다는 증거가 최전선 규모에서 나오기 전까지 업계는 검증된 쪽에 남는다.
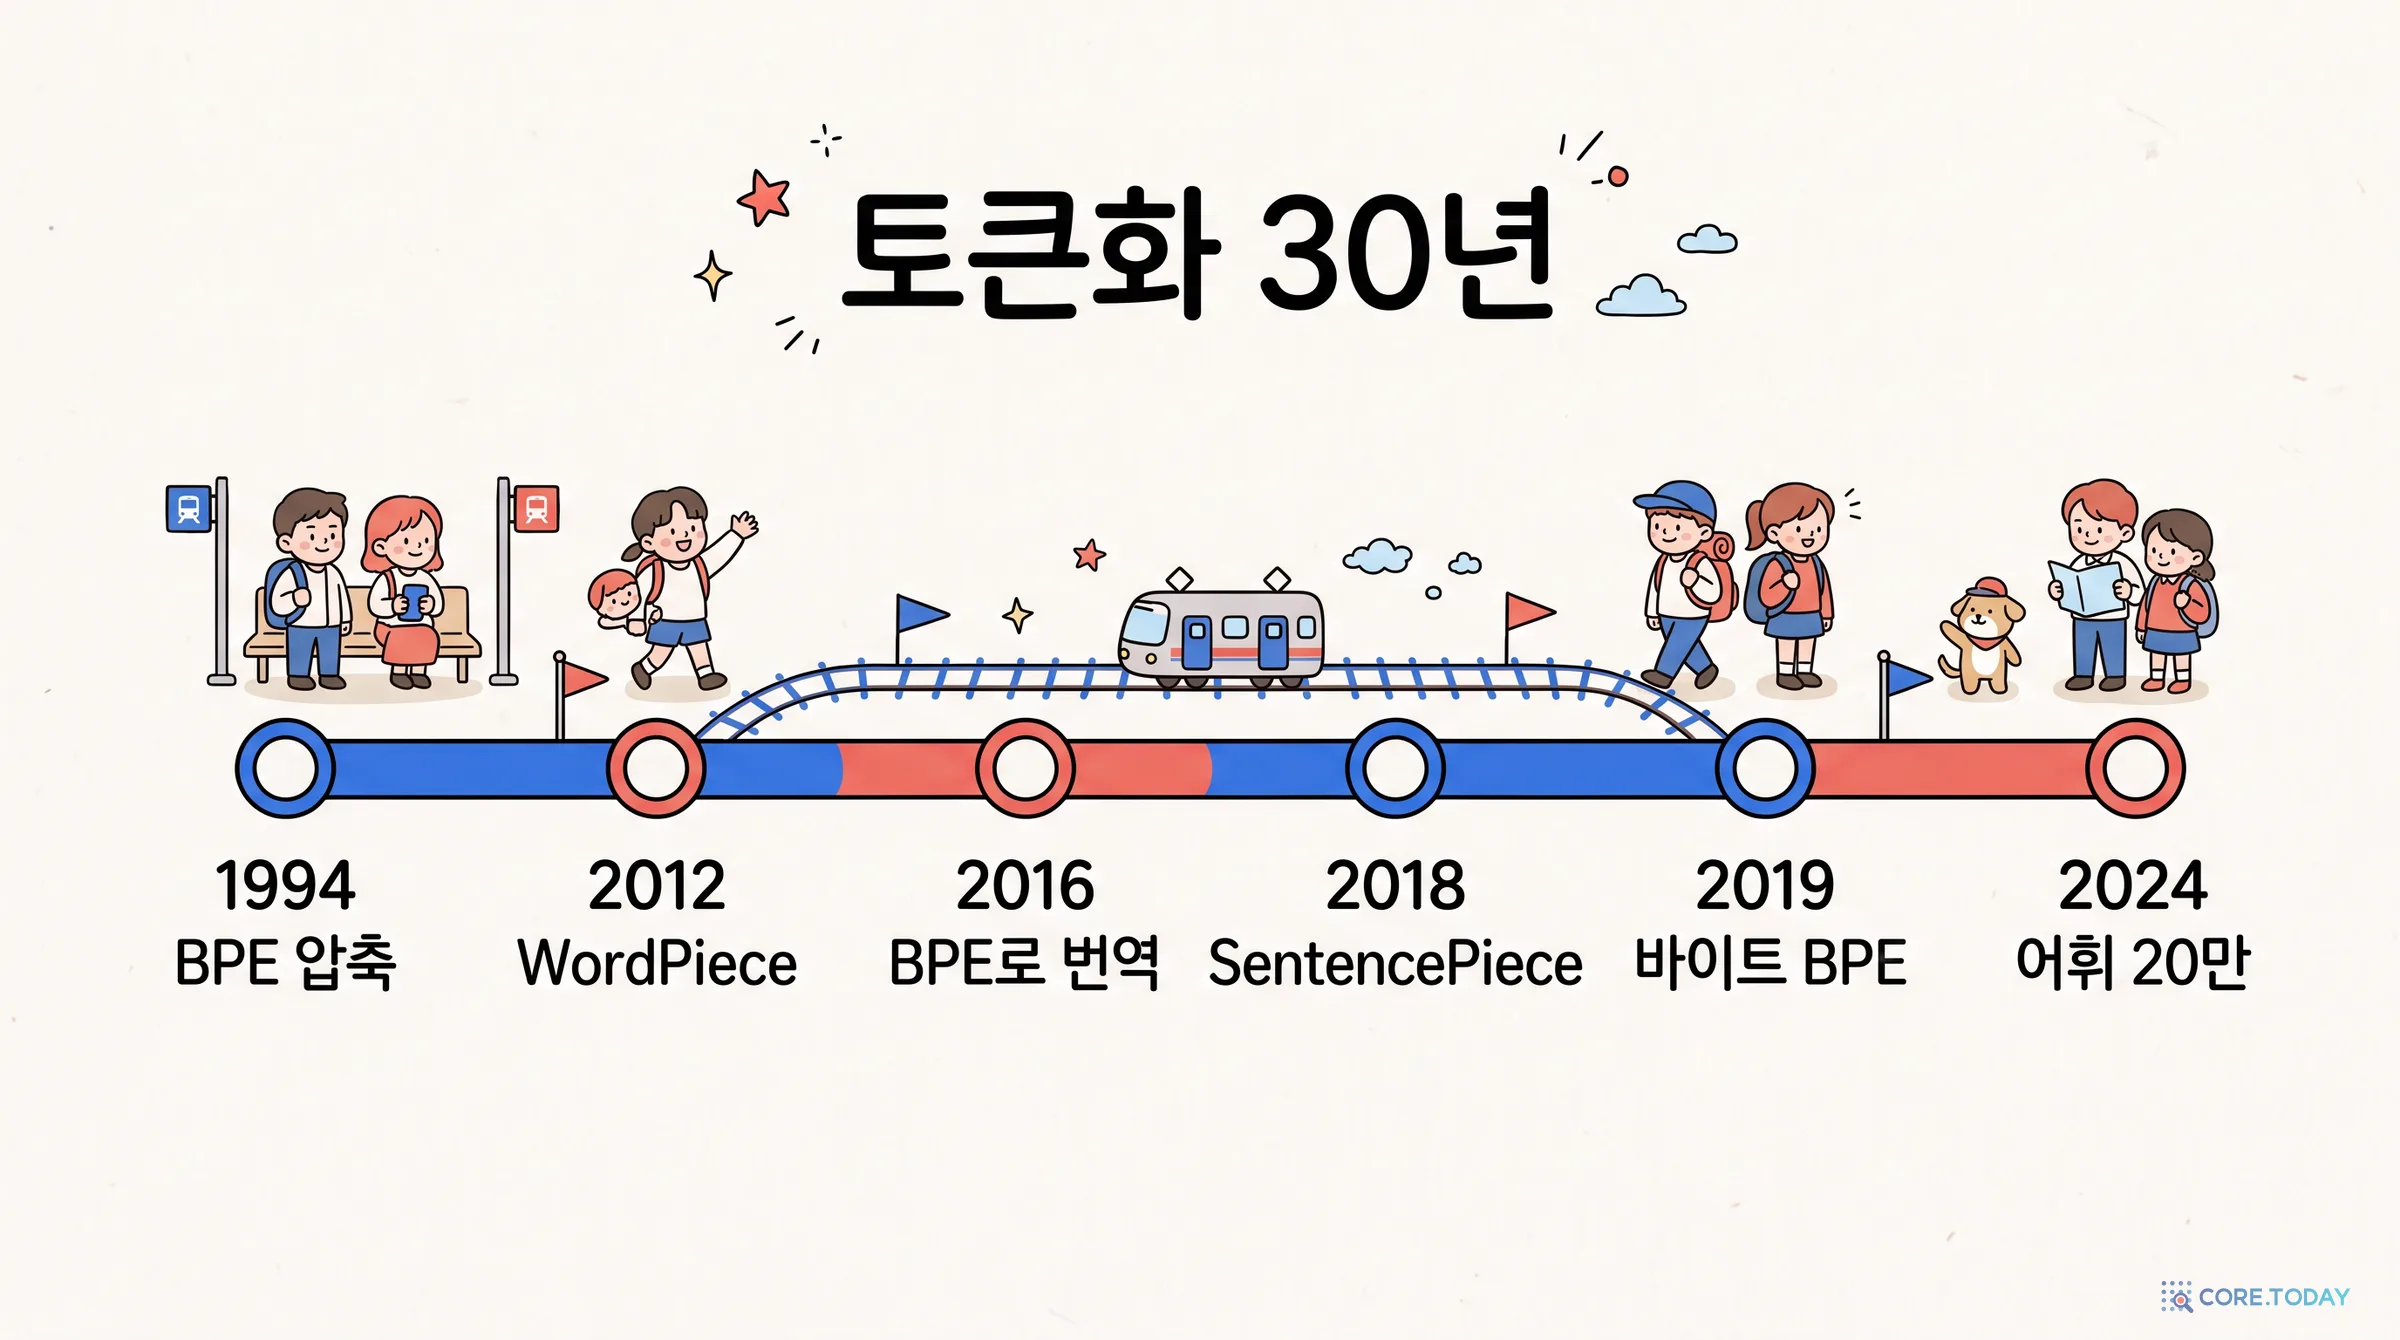
마지막으로 30년을 한 번에 훑어보자.
마치며
1994년 게이지가 BPE를 잡지에 실었을 때의 목표는 작은 메모리에서 파일을 빨리 푸는 것이었다. 그는 자기 알고리즘이 잘 동작하는 것이 놀랍다고 썼다. 20년 뒤 에든버러의 번역 연구자들이 ‘자주 붙어 다니는 것을 하나로 묶는다’는 발상만 빌려 왔다. 다시 몇 년 뒤 그 발상은 세상의 거의 모든 언어 모델의 입구가 됐다.
정리하면 이렇다.
토큰화는 모델의 시력이다. 모델은 글자가 아니라 토큰 번호를 본다. 철자 세기, 산수, 말놀이의 실패는 상당 부분 이 시력에서 온다.
BPE는 빈도의 거울이다. 뜻도 문법도 모른 채 자주 붙어 다니는 것을 묶는다. 그래서 학습 말뭉치를 그대로 닮는다. 한국어를 적게 본 칼은 한국어를 잘게 자르고, 한국어를 많이 본 칼은 크게 자른다.
토큰은 비용의 단위다. 같은 말을 해도 언어에 따라 요금과 문맥 창이 달라진다. GPT-2의 5배에서 GPT-4o의 1.5배까지 줄었지만 아직 1은 아니다.
2026년의 토큰화는 과도기에 있다. 어휘는 커지고 있고, 단어를 넘는 토큰과 토크나이저 없는 모델이 연구에서 앞서기 시작했다. 그래도 당분간 우리가 쓰는 모델의 입구에는 30년 된 압축 알고리즘의 후손이 서 있을 것이다.
다음에 LLM이 어처구니없는 실수를 하면 이렇게 물어보자. 이 모델은 이 문장을 몇 조각으로, 어떤 경계로 봤을까? 답의 절반은 대개 거기에 있다.
코어닷투데이 실측 조건: tiktoken 0.14, HuggingFace tokenizers 0.23. 각 모델의 공개 토크나이저(GPT-2·GPT-3 r50k_base, GPT-3.5·GPT-4 cl100k_base, GPT-4o o200k_base, bert-base-multilingual-cased, klue/bert-base, Llama-3.2-1B-Instruct, gemma-3-1b-it, Qwen3-8B, DeepSeek-V3, EXAONE-4.0-1.2B, HyperCLOVAX-SEED-Text-Instruct-0.5B, kanana-1.5-2.1b-instruct-2505, Mistral-Nemo-Instruct-2407)를 특수 토큰 없이 돌렸다. 언어 간 배수는 FLORES-200 devtest 1,012문장. 상용 음절은 EUC-KR(KS X 1001)로 2바이트 인코딩되는 2,350자. 블로그 BPE는 2026-11-07 시점 블로그 글 677편 중 637편(코드 블록·HTML·수식 제거, 약 850만 자)으로 학습하고 40편(약 49만 자)으로 검증했다. 2026-11-07 측정.
Gage, P. (1994). A New Algorithm for Data Compression. The C Users Journal, 12(2), 23.
Sennrich, R., Haddow, B., & Birch, A. (2016). Neural Machine Translation of Rare Words with Subword Units. ACL 2016. arXiv:1508.07909
Schuster, M., & Nakajima, K. (2012). Japanese and Korean Voice Search. ICASSP 2012.
Wu, Y. et al. (2016). Google's Neural Machine Translation System: Bridging the Gap between Human and Machine Translation. arXiv:1609.08144
Kudo, T. (2018). Subword Regularization: Improving Neural Network Translation Models with Multiple Subword Candidates. ACL 2018. arXiv:1804.10959
Kudo, T., & Richardson, J. (2018). SentencePiece: A simple and language independent subword tokenizer and detokenizer for Neural Text Processing. EMNLP 2018 (Demo). arXiv:1808.06226
Radford, A. et al. (2019). Language Models are Unsupervised Multitask Learners. OpenAI.
Devlin, J. et al. (2019). BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding. NAACL 2019.
Bostrom, K., & Durrett, G. (2020). Byte Pair Encoding is Suboptimal for Language Model Pretraining. Findings of EMNLP 2020.
Park, K., Lee, J., Jang, S., & Jung, D. (2020). An Empirical Study of Tokenization Strategies for Various Korean NLP Tasks. AACL-IJCNLP 2020. arXiv:2010.02534
Rust, P. et al. (2021). How Good is Your Tokenizer? On the Monolingual Performance of Multilingual Language Models. ACL 2021.