퍼플렉서티perplexity엔트로피교차 엔트로피섀넌바이트당 비트bits per byte언어 모델 평가압축허터 상스케일링 법칙AI 글 탐지GPTZeroDetectGPTBinoculars토크나이저지시 학습캘리브레이션NLP 기초
헌법은 AI가 쓴 글일까? — 언어 모델의 가장 오래된 성적표, 퍼플렉서티 (특집)
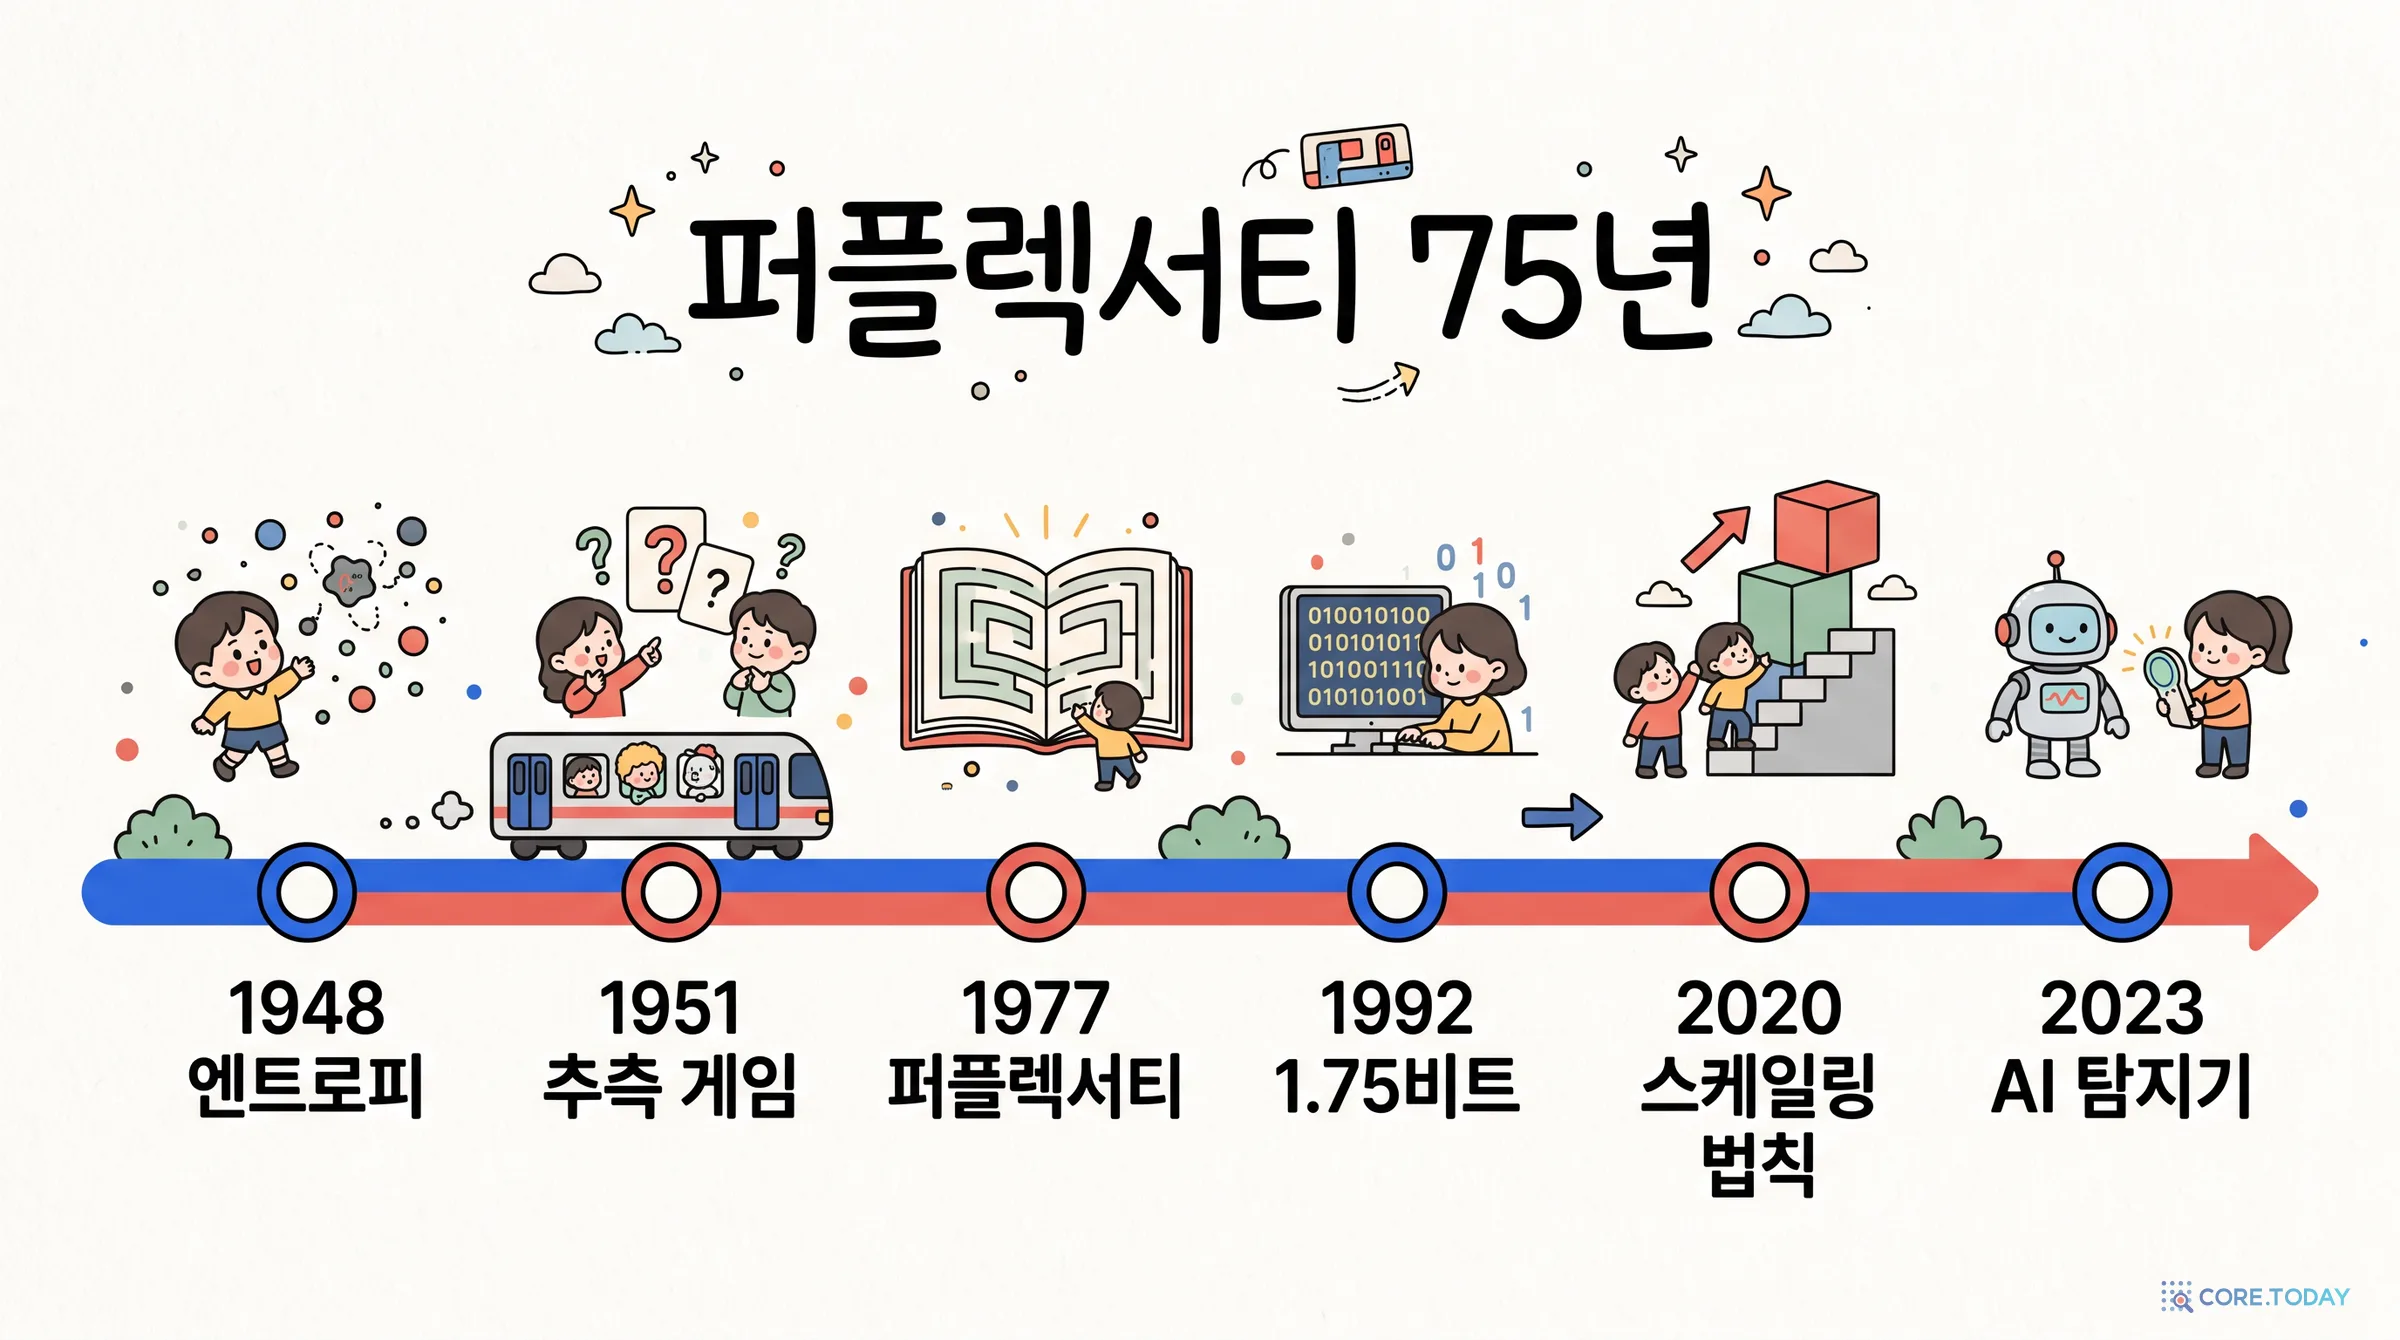
퍼플렉서티는 언어 모델이 다음 토큰을 맞힐 때 ‘몇 개 중 하나를 고르는 만큼 헷갈리는지’를 나타내는 숫자다. 1948년 섀넌의 엔트로피와 1951년 다음 글자 맞히기 게임에서 출발해, 1977년 IBM 음성 인식 연구실에서 이름을 얻었고, 지금도 모든 언어 모델의 학습 곡선이 이 숫자로 그려진다. 이 글은 퍼플렉서티를 주사위로 직관화하고, 공개 모델 7종을 직접 재서 토크나이저가 다르면 순위가 뒤집히는 함정, 언어 모델이 gzip보다 세 배 잘 압축한다는 실측, 지시 학습을 하면 퍼플렉서티가 오르는 현상을 보여 준다. 마지막으로 ‘퍼플렉서티가 낮으면 AI 글’이라는 탐지기가 대한민국헌법을 AI가 쓴 글로 판정하는 이유를 따라간다. 인터랙티브 위젯 5종, 코어닷투데이 실측, 삽화 13장.
2023년 4월, 한 장의 화면 캡처가 인터넷에 퍼졌다. 미국 헌법을 AI 글 탐지기 GPTZero에 넣었더니 이런 판정이 나왔다.
이 글은 전부 AI가 썼을 가능성이 높습니다.
1787년에 쓴 글이다. 우리도 같은 실험을 한국어로 해 봤다. 대한민국헌법의 문단 40개, 이 블로그 글 40편, 그리고 언어 모델이 여러 방식으로 쓴 글을 공개 모델 Qwen3로 쟀다. ‘이 숫자가 낮으면 AI가 쓴 글’이라는 단순한 탐지기를 걸어 보니 결과는 이랬다.
53%
top-p 샘플링으로 AI가 쓴 글을 AI로 잡아낸 비율
57%
사람이 쓴 대한민국헌법을 AI로 오판한 비율
23%
사람이 쓴 블로그 글을 AI로 오판한 비율
100%
그리디로 AI가 쓴 글을 잡아낸 비율
임계값 20 기준. 7부에서 직접 임계값을 바꿔 볼 수 있다.
이 탐지기가 쓴 숫자가 퍼플렉서티(perplexity)다. 언어 모델이 글을 읽으며 다음 토큰을 얼마나 잘 맞혔는지를 나타낸다. 낮을수록 ‘예상대로 흘러간 글’이다. 헌법은 수없이 인용되고 정형화된 글이라 모델에게는 아주 예상하기 쉬운 글이다. 그래서 AI가 쓴 글로 의심받는다.
퍼플렉서티는 언어 모델의 가장 오래된 성적표다. 1977년 IBM 음성 인식 연구실에서 이름을 얻었고, 지금도 거의 모든 언어 모델의 학습 곡선이 이 숫자로 그려진다. 이 시리즈의 앞선 글들도 이 숫자를 잣대로 썼다. 디코딩 특집에서는 같은 말을 되풀이하는 글을 잡아냈고, RoPE 특집에서는 학습 길이를 넘은 모델이 무너지는 순간을 보여 줬다. 이번에는 그 잣대 자체를 들여다본다.
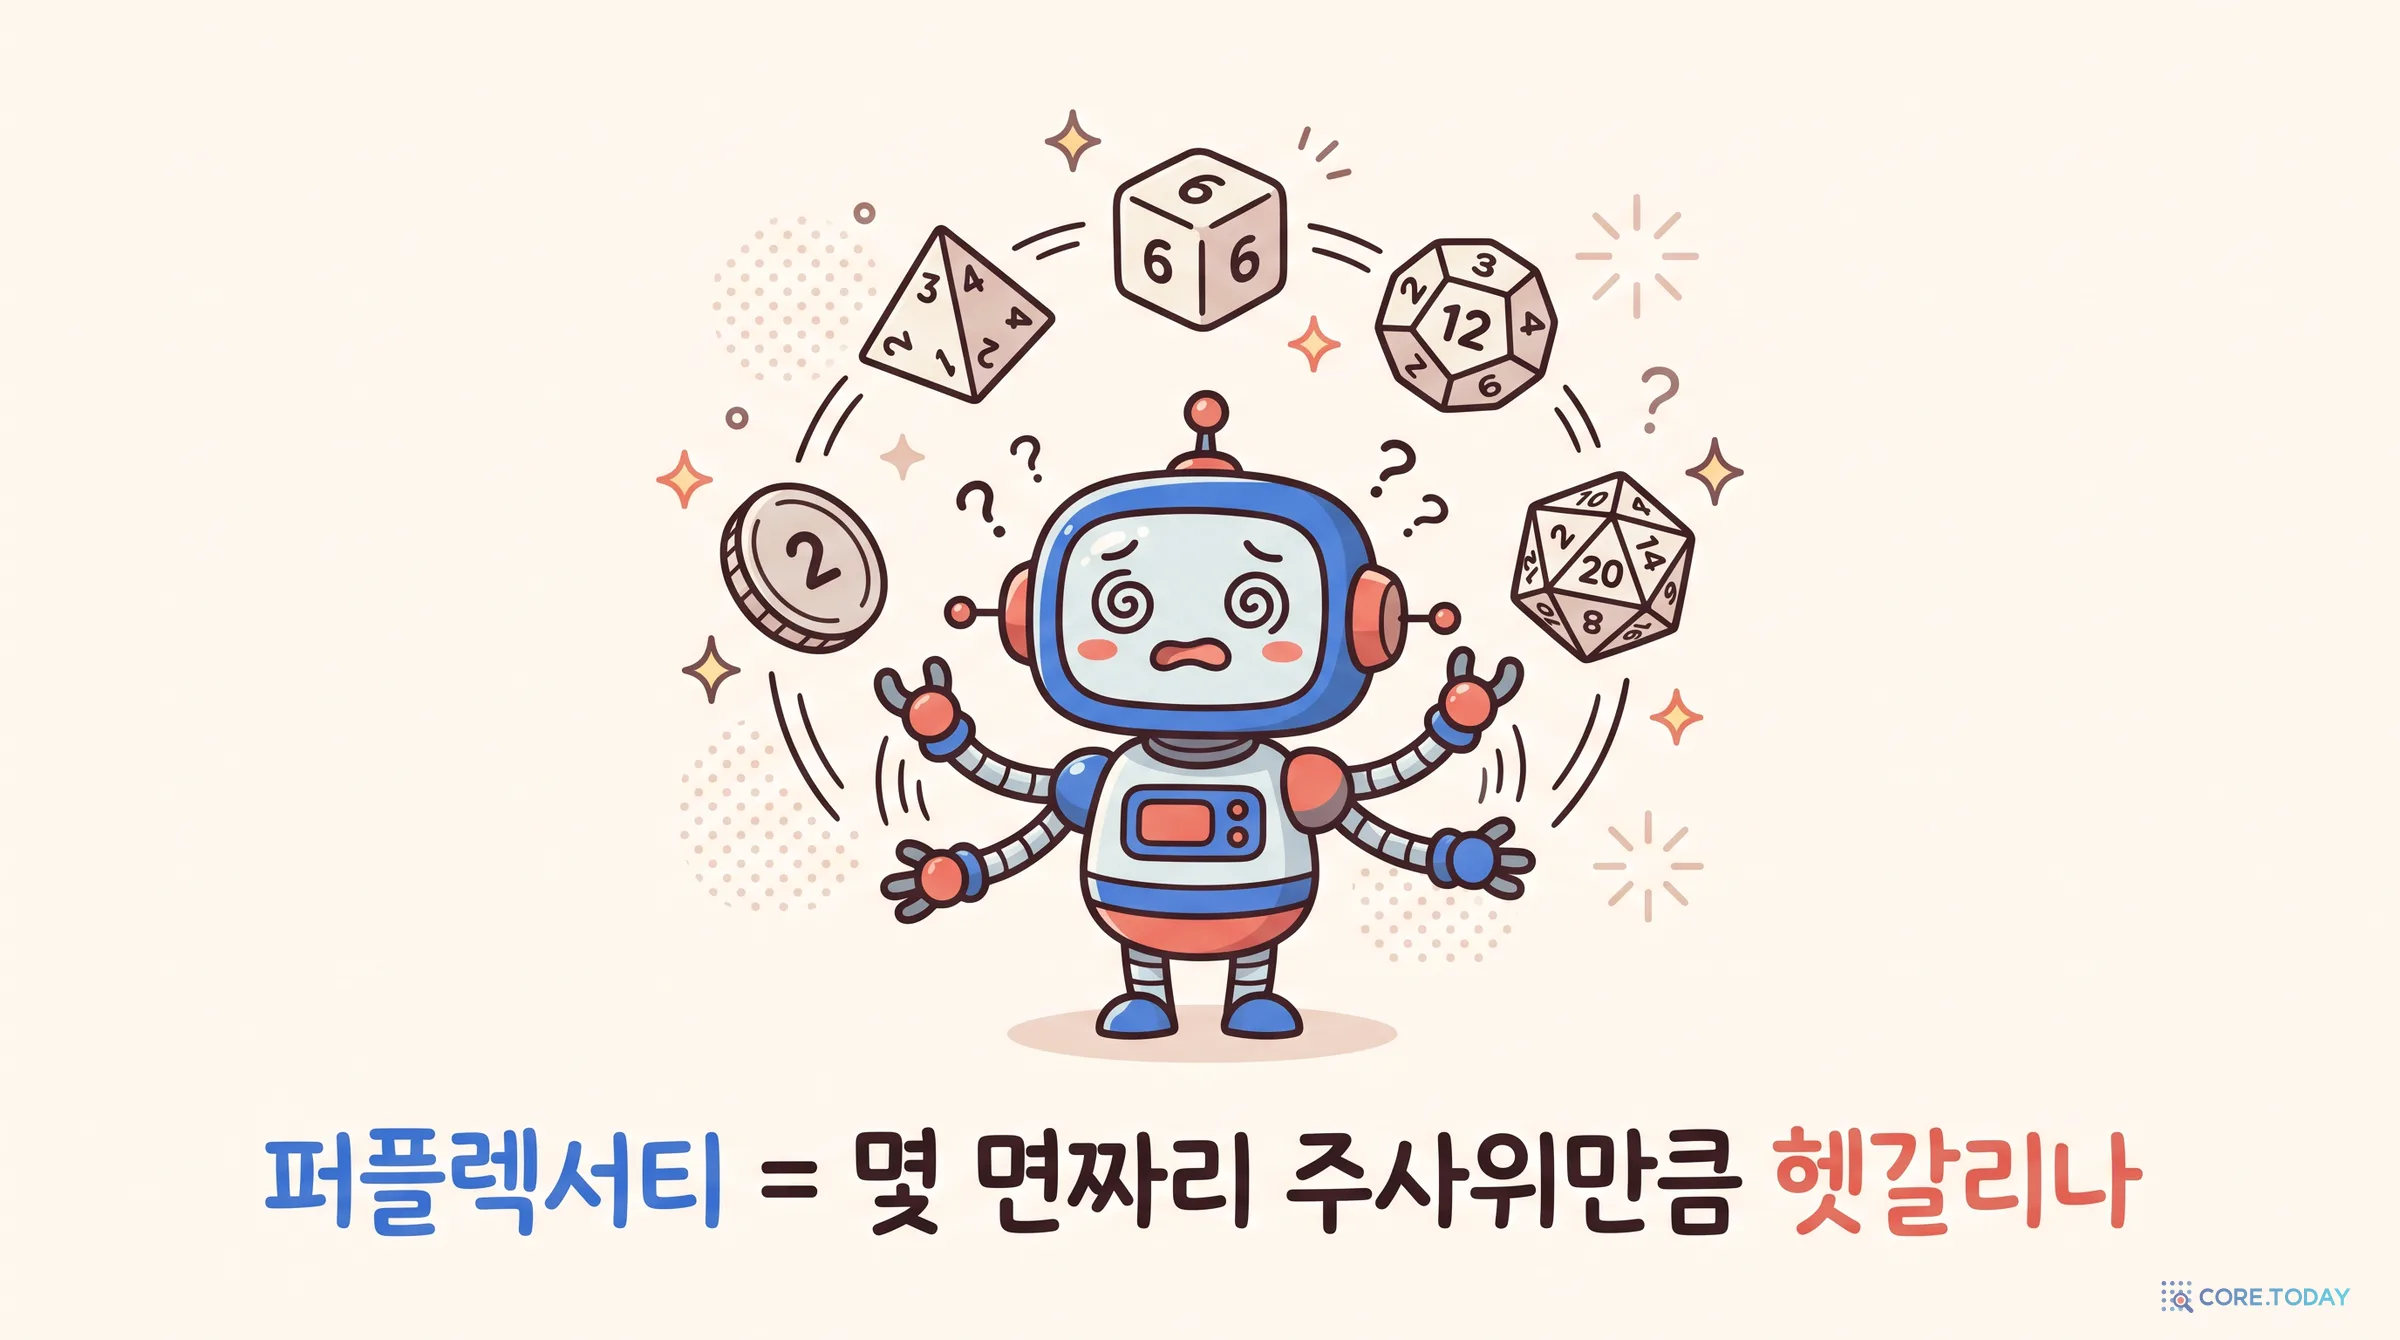
공정한 동전을 던질 때 우리는 반반으로 헷갈린다. 공정한 주사위라면 여섯 가지 사이에서 헷갈린다. 이 ‘헷갈림’을 숫자로 만든 것이 퍼플렉서티다. 세 단계로 쌓아 올리면 쉽다.
놀람(surprisal). 확률 p인 일이 실제로 일어났을 때의 정보량이다.
놀람=−log2p(비트)
확률 1/2인 일은 1비트, 1/8인 일은 3비트다. 드문 일이 일어날수록 놀람이 크다.
엔트로피(entropy). 놀람의 평균, 즉 ‘평균적으로 얼마나 놀랄 것인가’다. 1948년 클로드 섀넌이 정의했다.
H=−i∑pilog2pi
공정한 동전은 1비트, 공정한 주사위는 약 2.58비트다. 엔트로피는 ‘예/아니오 질문을 평균 몇 번 하면 답을 맞히는가’로 읽을 수 있다.
퍼플렉서티(perplexity). 엔트로피를 다시 ‘선택지의 개수’로 되돌린 것이다.
PPL=2H
공정한 동전은 2, 공정한 주사위는 6이다. 퍼플렉서티 20이라는 말은 매번 공정한 20면 주사위를 굴리는 만큼 헷갈린다는 뜻이다. 면이 6개여도 한 면이 자주 나오는 속임수 주사위라면 퍼플렉서티는 6보다 작다. 실제로는 그만큼 덜 헷갈리기 때문이다.
1.2 언어 모델의 퍼플렉서티
언어 모델은 매 순간 다음 토큰의 확률표를 내놓는다. 실제 글이 주어지면 각 위치에서 실제로 나온 토큰의 확률을 읽을 수 있다. 그 놀람을 평균한 것이 교차 엔트로피, 그것을 2의 거듭제곱으로 되돌린 것이 언어 모델의 퍼플렉서티다.
PPL=2−N1∑t=1Nlog2p(xt∣x<t)
언어 모델을 학습할 때 줄이는 손실 함수가 바로 이 교차 엔트로피다(보통 밑을 e로 쓴 ‘나트’ 단위). 그래서 퍼플렉서티는 따로 계산하는 평가 지표이기 전에 학습이 직접 낮추려는 값 그 자체다. 모델이 좋아질수록, 즉 실제 글의 다음 토큰에 더 높은 확률을 줄수록 퍼플렉서티는 낮아진다. 최솟값은 1이다. 모든 다음 토큰을 확률 100%로 맞히면 그렇게 된다.
1948년 섀넌은 정보 이론을 세운 논문에서 엔트로피를 정의했다. 단위 ‘비트’에 대해서는 이렇게 적었다.
밑을 2로 쓰면 단위를 이진 숫자(binary digits), 줄여서 비트(bits)라 부를 수 있다. 이 말은 J. W. 튜키가 제안했다.
같은 논문에서 섀넌은 영어의 중복도(redundancy)를 대략 50%로 추정했다. “영어로 글을 쓸 때 절반은 언어의 구조가 정하고, 절반만 자유롭게 고른다”는 것이다. 십자말풀이가 가능한 것도 이 덕분이라고 했다. 중복도가 33%라면 3차원 십자말풀이도 가능할 것이라는 농담도 덧붙였다.
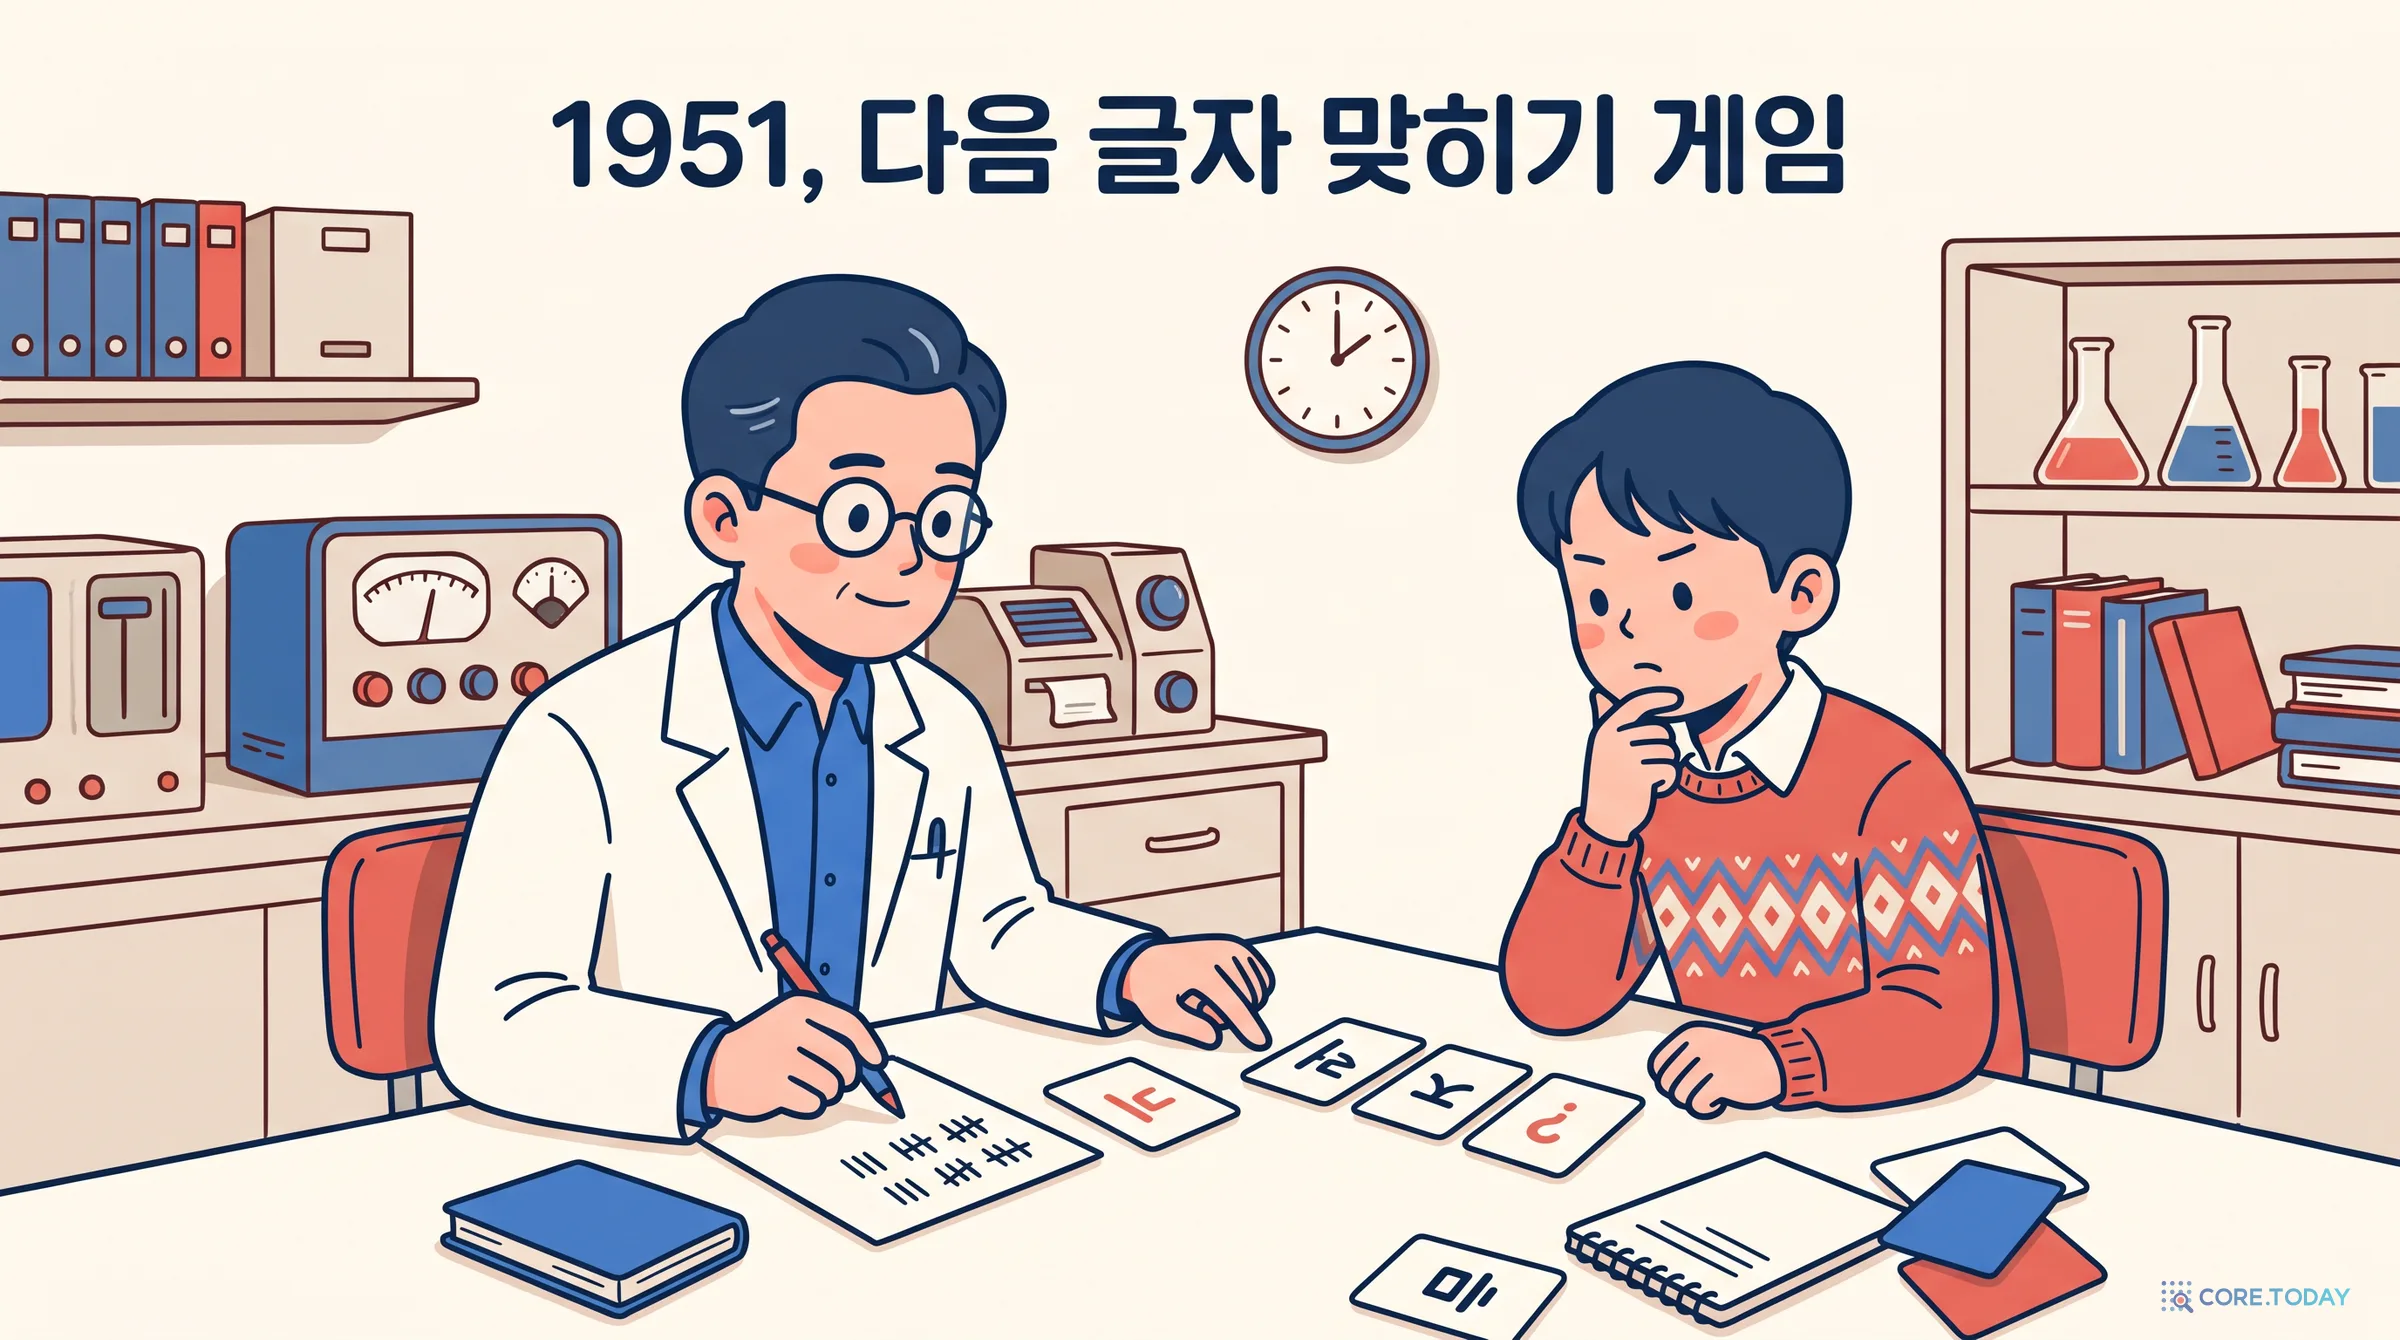
1951년 섀넌은 「Prediction and Entropy of Printed English(인쇄된 영어의 예측과 엔트로피)」에서 기발한 실험을 했다. 사람에게 문장을 보여 주며 다음 글자를 맞힐 때까지 추측하게 하고, 몇 번 만에 맞히는지 셌다. 문장은 토머스 제퍼슨 전기에서 골랐다.
THE ROOM WAS NOT VERY LIGHT A SMALL OBLONG READING LAMP ON THE DESK SHED GLOW ON POLISHED WOOD BUT LESS ON THE SHABBY RED CARPET
102글자 중 79글자를 첫 추측에 맞혔다. 다섯 번 넘게 걸린 것은 8글자뿐이었다. 사람은 앞 문맥을 보고 다음 글자를 놀랍도록 잘 맞힌다. 섀넌은 이 실험으로 앞 100글자를 알 때 영어 한 글자의 엔트로피를 0.6~1.3비트, 대략 1비트로 잡았다. 알파벳 26자와 공백을 아무렇게나 고르면 4.75비트다. 그러니 영어 글자의 4분의 3가량은 앞 문맥으로 정해지는 셈이다.
약 100글자까지의 장거리 통계 효과는 엔트로피를 글자당 1비트 정도로 줄인다. 이에 해당하는 중복도는 대략 75%다.
논문의 감사의 글에는 실험을 도운 사람으로 아내 메리(베티) 섀넌의 이름이 있다. 75년 뒤 언어 모델이 학습하며 하는 일이 정확히 이 게임이다. 다음 글자(토큰)를 맞히는 게임을 수조 번 반복한다.
‘퍼플렉서티’라는 이름은 음성 인식에서 나왔다. 1970년대 IBM 왓슨 연구소의 프레드 젤리넥(Fred Jelinek)이 이끄는 팀은 통계적 방법으로 음성 인식을 연구했다. 문제는 과제의 어려움을 비교할 방법이었다. 어휘 1,000개짜리 과제가 250개짜리보다 네 배 어려울까? 문법이 정해져 있으면 다음에 올 수 있는 단어는 훨씬 적다.
1977년 젤리넥, 로버트 머서(Robert Mercer), 랄릿 발(Lalit Bahl), 제임스 베이커(James Baker)는 미국음향학회 학술대회 초록에서 이렇게 썼다.
반례를 통해, 어휘 크기와 정적·동적 분기 계수가 모두 음성 인식 과제의 복잡도를 재는 척도로 부적절함을 보인다. 정보 이론적 논증은 퍼플렉서티(그 로그가 익숙한 엔트로피다)가 동등한 선택지 수의 척도로 더 적절함을 보여 준다. 이것에도 약점은 있으며, 그것도 논의한다.
과제 (1977)
어휘 수
단어 퍼플렉서티
IBM-Lasers
1,000
21.11
IBM-Raleigh
250
7.74
CMU-AIX05
1,011
6.41
어휘가 1,000개여도 실제로는 21개 중 하나를 고르는 만큼만 어려웠다. 어휘가 비슷한 CMU 과제는 6개 남짓이었다. 퍼플렉서티는 ‘어휘가 몇 개인가’가 아니라 ‘실제로 얼마나 헷갈리는가’를 쟀다.
여담: 젤리넥에게는 유명한 말이 하나 따라다닌다. “언어학자를 한 명 해고할 때마다 인식률이 올라간다.” 출처는 여럿이고 문구도 제각각이다. 젤리넥 자신은 1988년 한 워크숍에서 “언어학자가 팀을 떠날 때마다 인식률이 오른다”고 말했다고 회고했다. 그는 2005년 「내 가장 친한 친구 중 몇은 언어학자다(Some of my Best Friends are Linguists)」라는 논문으로 답했다.
2.3 1992년, 영어는 글자당 1.75비트 이하
IBM 팀은 이 잣대로 경주를 계속했다. 1992년 피터 브라운(Peter Brown) 등은 단어 5억 8,300만 개로 학습한 단어 3-gram 모델로 영어의 엔트로피 상한을 글자당 1.75비트로 잡았다. 같은 글을 당시 최고 수준의 압축기는 글자당 4.20비트로 줄였다. 3-gram에 대해서는 이렇게 자조했다.
3-gram이라는 개념은 거의 바보처럼 보인다.
그리고 중요한 원칙 하나를 남겼다.
말뭉치를 글자 단위로 예측함으로써, 어휘에 대해 서로 합의할 필요가 없어진다.
이 문장은 5부에서 다시 나온다. 퍼플렉서티를 무엇으로 나누느냐가 30년 뒤 가장 큰 함정이 되기 때문이다.
숫자 하나로 요약하기 전에, 언어 모델이 실제로 글을 읽는 모습을 보자. 카카오의 공개 모델 Kanana 1.5(2.1B)에 문장을 넣고 각 토큰에 준 확률을 그대로 옮겼다. 색이 진할수록 모델이 놀란 토큰이다. ‘나도 맞혀 보기’를 누르면 섀넌의 게임을 모델과 같은 조건에서 해 볼 수 있다.
‘대한민국의 수도는’ 다음 ‘서울’은 49%의 확률로 예상됐다. 놀람은 1비트 남짓이다. ‘양자역학’의 ‘학’은 앞의 ‘양자역’ 다음이라 90%였다. 반면 문장의 방향이 바뀌는 곳, 즉 새로운 정보가 들어오는 곳에서는 확률이 수 % 이하로 떨어진다. ‘회의는’ 다음 ‘내’(내일의 앞 조각)가 그렇다.
퍼플렉서티는 이 놀람들의 평균이다. 그래서 몇 개의 깜짝 놀란 토큰이 숫자를 크게 끌어올린다. 정보가 많은 글일수록, 즉 뻔하지 않은 글일수록 퍼플렉서티는 높다. 이 점이 7부의 함정으로 이어진다.
2010년대 언어 모델 연구는 공개 데이터의 퍼플렉서티를 누가 더 낮추느냐의 경주였다. 대표 무대는 월스트리트저널 기사로 만든 Penn Treebank(PTB)였다.
KN 5-gram (n-gram)
141
RNN (Mikolov, 2011)
123
대형 LSTM (Zaremba, 2014)
78.4
AWD-LSTM (2017)
57.3
MoS (2017)
54.4
GPT-2 1.5B (학습 없이, 2019)
35.8
Penn Treebank 테스트 퍼플렉서티. 막대는 141을 만점으로 잡았다.
n-gram 모델의 141이 8년 사이 50 아래로 내려왔다. 더 큰 위키백과 기반 데이터인 WikiText-103에서도 같은 경주가 이어졌다. LSTM 48.7(2016)에서 Transformer-XL 18.3(2019), GPT-2 17.48, Megatron-LM 10.81(2019)까지 내려갔다.
이 숫자들을 볼 때는 각주를 함께 읽어야 한다.
GPT-2의 PTB 35.76은 PTB로 학습하지 않은 제로샷 결과다. 동시에 토큰화를 원래대로 되돌리는 후처리로 “2.5~5점”을 얻었다고 논문에 적혀 있다.
Megatron-LM의 10.81은 서브워드 손실을 원래 단어 수로 나눠 다시 계산한 ‘보정’ 값이다.
딥마인드의 친칠라는 WikiText-103에서 7.16을 냈다. 그런데 논문 스스로 “학습·테스트 데이터 누출이 결과를 인위적으로 좋게 만들었을 수 있다”고 경고했다. 웹 전체를 학습하는 모델에게 위키백과 테스트 세트는 이미 본 글일 수 있다.
숫자가 내려갈수록 비교의 조건이 복잡해졌다. 그 복잡함의 핵심이 다음 부의 주제다.
2011~2019년의 PTB 숫자는 모두 같은 데이터에서 잰 것이지만, 쓴 어휘와 토큰화가 다르다. 그래서 엄밀히는 비교할 수 없는 경우가 많다. One Billion Word 데이터의 논문은 퍼플렉서티의 성질을 이렇게 요약했다. “퍼플렉서티 35% 감소는 교차 엔트로피(비트)로는 10% 감소다.” 퍼플렉서티는 작은 개선을 크게 보이게 만든다.
퍼플렉서티는 토큰 하나를 맞히는 어려움이다. 그런데 토큰의 크기는 모델마다 다르다. BPE 특집에서 봤듯 같은 한국어 문장을 어떤 모델은 2글자씩, 어떤 모델은 1글자씩 자른다. 잘게 자르면 토큰 하나를 맞히기는 쉬워진다. ‘안녕하세요’를 통째로 맞히는 것보다 ‘안’ 다음 ‘녕’을 맞히는 것이 쉽다. 대신 맞혀야 할 토큰 수가 늘어난다.
공정하게 비교하려면 토큰이 아니라 글자나 바이트 단위로 나눠야 한다. 1992년 브라운 등이 글자 단위를 쓴 이유가 이것이다. 2020년 EleutherAI의 데이터셋 The Pile은 바이트당 비트(bits per byte, BPB)를 표준으로 권했다.
바이트당 비트는 토큰화 방식과 상관없고, 유니코드에서 ‘글자’를 세는 모호함도 없으므로 퍼플렉서티나 글자당 비트보다 낫다.
BPB=UTF-8 바이트수전체놀람의합(비트)=N바이트N토큰⋅log2PPL
5.2 직접 재 봤다 — 순위가 뒤집힌다
공개 모델 7종에 같은 글을 읽혔다. 다국어 번역 평가 데이터 FLORES-200의 같은 뜻 한국어·영어 문장 200개, 그리고 이 블로그 글 60문단이다. 토큰 퍼플렉서티와 바이트당 비트를 함께 쟀다.
사전학습 모델 네 개만 보면 이렇다.
모델 (한국어 FLORES)
토큰 퍼플렉서티
순위
바이트당 비트
순위
Kanana 1.5 2.1B (카카오)
18.6
1
1.095
1
Qwen3 0.6B (알리바바)
26.4
2
1.354
4
Gemma 3 1B (구글)
32.9
3
1.226
2
Llama 3.2 1B (메타)
36.2
4
1.346
3
Qwen3는 토큰 퍼플렉서티로는 2위다. 그런데 바이트당 비트로는 꼴찌다. Qwen3 토크나이저는 한국어를 잘게 쪼갠다. 같은 200문장이 Kanana는 8,278토큰, Qwen3는 9,139토큰이다. 토큰이 작으니 하나하나는 맞히기 쉬웠던 것이다. 지시형 모델까지 넣으면 더 극적이다. HyperCLOVA X SEED는 한국어 토큰 퍼플렉서티가 54.8로 7종 중 두 번째로 높았다. 그러나 바이트당 비트(1.235)로는 Gemma 3에 이어 세 번째로 좋았다. 한국어를 크게 자르는 토크나이저라 토큰 하나에 담긴 정보가 많기 때문이다.
같은 모델 안에서도 함정이 있다. Kanana의 토큰 퍼플렉서티는 한국어 18.6, 영어 32.7이다. 한국어가 더 쉬운 언어처럼 보인다. 바이트당 비트로는 한국어 1.095, 영어 1.036으로 거의 같다. 한국어 토큰이 영어 토큰보다 작아서 생긴 착시다. 2019년 미엘케(Mielke) 등이 69개 언어를 비교했을 때도, 언어 모델에게 어려운 언어를 가른 것은 형태론보다 어휘의 크기와 글의 길이 같은 단위의 문제였다.
1
토큰 퍼플렉서티를 비교해도 되는 경우
토크나이저가 같은 모델끼리. 예를 들어 같은 모델의 학습 전후, 같은 계열의 크기별 모델, 같은 토크나이저로 학습한 실험 모델들.
2
그 밖에는 바이트당 비트로
토크나이저가 다른 모델, 다른 언어를 비교할 때는 전체 놀람을 바이트(또는 글자) 수로 나눈다. 같은 글, 같은 문맥 길이로 재는 것도 잊지 않는다.
!
모델 카드의 숫자를 그대로 믿지 않는다
‘퍼플렉서티 X’라는 숫자는 데이터, 토크나이저, 문맥 길이, 겹침 처리(stride)에 따라 달라진다. 다른 논문의 숫자와 나란히 놓지 말고 같은 조건으로 다시 잰다.
정보 이론에는 아름다운 대응이 하나 있다. 확률 p인 사건은 약 −log2p비트로 부호화할 수 있다(산술 부호화). 그러니 다음 글자를 잘 맞히는 모델이 있으면 글을 그만큼 짧게 압축할 수 있다. 교차 엔트로피가 곧 압축된 크기다. 퍼플렉서티를 낮추는 것과 압축률을 높이는 것은 같은 일이다.
이 대응을 믿고 2006년 인공지능 연구자 마르쿠스 허터(Marcus Hutter)는 상금을 걸었다. 위키백과 텍스트를 가장 작게 압축하는 사람에게 주는 허터 상(Hutter Prize)이다. 처음에는 100MB(enwik8)에 5만 유로였다. 2020년부터는 1GB(enwik9)에 50만 유로다. 압축을 푸는 프로그램의 크기도 결과에 포함된다. 허터는 이렇게 썼다.
지능은 미끄러운 개념이지만, 파일 크기는 확실한 숫자다.
2026년 7월 기준 기록은 1GB를 100,424,672바이트, 원래의 10% 남짓으로 줄인 블라디미르 이바노프의 fx2-cmix-T다.
6.2 직접 재 봤다 — 언어 모델 vs gzip
이 블로그 글 60문단(38,478바이트)을 범용 압축기들과 Kanana 1.5로 압축해 봤다. 언어 모델은 실제 압축 파일을 만든 것이 아니라, 산술 부호화를 쓰면 도달할 수 있는 크기(모든 토큰의 놀람의 합)를 계산했다.
원문
38,478B
gzip (최고 압축)
42.8%
xz (최고 압축)
39.9%
bzip2 (최고 압축)
35.6%
Kanana 1.5 (2.1B)
13.9%
언어 모델은 한국어 글을 원래의 13.9%로 줄였다. gzip의 3분의 1 크기다. 문장이 어떻게 이어질지 ‘이해’하는 압축기와, 반복되는 바이트열만 찾는 압축기의 차이다.
물론 공정한 비교는 아니다. gzip은 수십 KB짜리 프로그램이고 Kanana는 4GB가 넘는 가중치를 가져야 압축을 풀 수 있다. 딥마인드의 델레탕(Delétang) 등은 2024년 ICLR 논문 「Language Modeling Is Compression」에서 이 점을 정면으로 다뤘다. 친칠라 70B는 위키백과 1GB를 8.3%로 줄였다(gzip 32.3%). 텍스트로만 학습한 모델이 이미지와 음성도 범용 압축기보다 잘 압축했다(ImageNet 48.0%, LibriSpeech 21.0%). 그러나 모델 크기를 포함하면 압축률은 14,008%가 된다. 이 논문의 초록에 실린 43.4%·16.4%는 같은 논문 본문 표의 값(48.0%·21.0%)과 다르다. 인용할 때는 표의 숫자를 쓰는 것이 안전하다.
2024년 황(Huang) 등은 공개 모델 31개를 조사해, 압축 성능(글자당 비트)과 12개 벤치마크 점수 사이에 영역마다 약 −0.95의 상관이 있다고 보고했다. 잘 압축하는 모델이 시험도 잘 본다. 다만 이 상관은 사전학습 모델에만 해당한다. 논문은 미세조정한 모델은 “더 이상 범용 압축기가 아니다”라고 적었다. 그 이유가 다음 부의 주제 중 하나다.
퍼플렉서티(교차 엔트로피)가 학습의 기본 단위라는 사실은 2020년대 AI 산업의 지도를 그렸다. 2020년 OpenAI의 재러드 캐플런(Jared Kaplan) 등은 모델 크기·데이터·연산량을 늘리면 교차 엔트로피 손실이 거듭제곱 법칙을 따라 매끄럽게 줄어든다고 보였다. 2022년 딥마인드의 친칠라 논문은 손실을 세 부분으로 나눴다.
L(N,D)=E+NαA+DβB
N은 파라미터 수, D는 학습 토큰 수다. 앞의 E는 모델을 아무리 키워도 남는 줄일 수 없는 손실이다. 논문은 이를 “자연어 텍스트의 엔트로피”에 해당한다고 설명했다. 섀넌이 1951년 사람의 맞히기 게임으로 재려던 바로 그 값이다. 친칠라 논문은 E=1.69(나트/토큰)로 추정했고, 2024년 재현 연구는 1.82로 다시 잡았다. 자세한 내용은 스케일링 법칙 해설에 있다.
퍼플렉서티는 모델이 실제 글을 얼마나 잘 예측하는가를 잴 때 의미가 있다. 반대로 모델이 쓴 글의 퍼플렉서티를 재면 이야기가 달라진다. 디코딩 특집에서 본 것처럼, 매번 확률 1등 토큰만 고르는 그리디 디코딩은 퍼플렉서티 1.6짜리 글을 만든다. 그리고 그 글의 45%는 같은 말을 되풀이하다 끝났다. 사람의 글은 14.5였다. 홀츠먼 등의 2020년 실험에서도 사람 글은 12.38, 빔 서치 글은 1.48이었다.
좋은 글은 적당히 놀랍다. 너무 뻔하면 같은 말의 반복이고, 너무 놀라우면 횡설수설이다. 퍼플렉서티가 낮을수록 좋은 것은 ‘모델이 사람의 글을 읽을 때’뿐이다.
같은 Kanana 1.5에서 사전학습만 한 모델과 지시 따르기 학습을 한 모델을 비교했다.
글
사전학습 모델
지시형 모델
변화
블로그 글 60문단
16.0
19.5
+22%
FLORES 한국어 200문장
18.6
29.1
+57%
FLORES 영어 200문장
32.7
51.2
+56%
대한민국헌법 30문단
2.5
3.6
+42%
지시형 모델이 모든 글에서 퍼플렉서티가 높았다. 지시형 모델이 더 나쁜 모델이라서가 아니다. ‘질문에 친절하게 답하는 조수’의 말투로 확률 분포가 옮겨 가면서, 웹 문서를 그대로 이어 쓰는 능력은 조금 잃는다. GPT-4 기술 보고서도 비슷한 현상을 보였다. 사전학습 모델은 자기 답에 대한 확신이 실제 정답률과 잘 맞았다(기대 보정 오차 0.007). 후속 학습(RLHF) 뒤에는 0.074로 나빠졌다. 보고서는 “후속 학습은 보정을 크게 해친다”고 적었다.
그래서 지시형 모델의 퍼플렉서티로 모델의 품질을 판단하면 안 된다. 퍼플렉서티는 사전학습 모델의 성적표다.
2023년 1월 프린스턴대 학생 에드워드 톈(Edward Tian)이 만든 GPTZero가 화제가 됐다. 원리는 퍼플렉서티와 버스티니스(burstiness, 문장마다 퍼플렉서티가 얼마나 들쭉날쭉한가)였다. AI가 쓴 글은 고르게 뻔하고, 사람의 글은 들쭉날쭉하다는 가정이다.
그해 결과는 냉정했다.
OpenAI가 1월에 내놓은 AI 글 분류기는 AI 글의 26%만 잡고 사람 글의 9%를 AI로 오판했다. 7월에 “낮은 정확도” 때문에 조용히 내려졌다.
스탠퍼드의 량(Liang) 등은 탐지기 7개에 비원어민의 토플 에세이 91편과 미국 8학년 학생 에세이 88편을 넣었다(Patterns, 2023). 토플 에세이의 평균 61.22%가 AI 글로 오판됐다. 반면 미국 학생 에세이는 대부분 사람 글로 판정됐다. 어휘가 단순하고 표현이 정형화된 글일수록 퍼플렉서티가 낮기 때문이다. ChatGPT로 토플 에세이의 단어를 ‘더 풍부하게’ 고치자 오탐률은 11.77%로 떨어졌다.
미국 헌법과 성경 창세기도 AI 글로 판정됐다. 톈은 Ars Technica에 이렇게 설명했다. “미국 헌법은 많은 대형 언어 모델의 학습 데이터에 반복해서 들어간 글이다.”
우리 실험으로 직접 확인해 보자. 디코딩 특집에서 Kanana가 여러 전략으로 이어 쓴 글, 사람이 쓴 블로그 원문, 대한민국헌법 문단을 다른 모델(Qwen3 0.6B)로 쟀다. 임계값을 움직이며 ‘이보다 낮으면 AI’라고 판정해 보자.
임계값
그리디 적발
top-p 0.95 적발
블로그 글 오탐
헌법 오탐
10
100%
3%
0%
5%
15
100%
18%
8%
28%
20
100%
53%
23%
57%
25
100%
78%
38%
83%
그리디나 빔 서치로 쓴 글은 어떤 임계값에서도 쉽게 잡힌다. 문제는 요즘 챗봇처럼 샘플링으로 쓴 글이다. top-p 0.95로 쓴 글의 절반을 잡으려면 임계값을 20까지 올려야 한다. 그러면 사람이 쓴 헌법의 57%, 블로그 글의 23%가 함께 걸린다. 퍼플렉서티가 재는 것은 ‘AI가 썼는가’가 아니라 ‘뻔한가’다. 사람도 뻔한 글을 쓰고, AI도 뻔하지 않은 글을 쓴다.
이후 탐지 연구는 퍼플렉서티를 다르게 쓰는 쪽으로 발전했다. DetectGPT(2023)는 글을 조금씩 바꿨을 때 확률이 얼마나 떨어지는지(확률 곡면의 곡률)를 본다. Binoculars(2024)는 한 모델의 퍼플렉서티를 다른 모델과의 교차 퍼플렉서티로 나눠, ‘원래 뻔한 글’인지 ‘AI라서 뻔한 글’인지 구별하려 한다. 그래도 Binoculars 논문의 그림에서 미국 헌법은 여전히 “기계 쪽으로 한참 들어간” 점수를 받았다. 이 문제는 아직 풀리지 않았다.
실무 교훈. 퍼플렉서티 기반 탐지 결과를 단독 근거로 학생이나 지원자를 판단하지 않는다. 오탐은 정형화된 글, 비원어민의 글, 그리고 자주 인용되는 글에 몰린다.
7.4 그 밖의 함정들
긴 문맥. 2024년 후(Hu) 등은 긴 문맥 모델의 퍼플렉서티와 실제 긴 글 이해 능력 사이에 상관이 없다고 보고했다. YaRN 모델은 퍼플렉서티가 가장 낮았지만(1.878) 긴 글 검색 정확도는 6.5%였다. 퍼플렉서티는 대부분의 토큰이 바로 앞 문맥만으로 예측되기 때문에 ‘가까운 정보’를 쓰는 능력만 반영하기 쉽다. 이를 고친 LongPPL(ICLR 2025)은 긴 문맥이 꼭 필요한 핵심 토큰만 골라 재서 LongBench 점수와 −0.96의 상관을 얻었다.
데이터 오염. 테스트 글이 학습 데이터에 들어 있으면 퍼플렉서티는 부당하게 낮아진다. 거꾸로 이를 이용해 Min-K% Prob(ICLR 2024)는 확률이 가장 낮은 토큰들의 평균으로 ‘이 글을 학습했는가’를 추정한다.
데이터 거르기. 학습 데이터를 거를 때도 퍼플렉서티가 쓰인다. 메타의 CCNet(2019)은 위키백과로 학습한 작은 n-gram 모델의 퍼플렉서티로 웹 문서를 상·중·하로 나눴다. 다만 2024년 Ankner 등은 작은 모델로 잰 퍼플렉서티로 데이터를 고를 때, 가장 낮은 것이 아니라 높거나 중간인 글을 남기는 편이 더 큰 모델의 성능을 올린다고 보고했다. 뻔한 글만 남기면 배울 것이 없다.
8부. 2026년, 퍼플렉서티의 자리
8.1 여전히 학습의 심장
2026년에도 모든 언어 모델은 교차 엔트로피를 줄이며 사전학습된다. 학습 곡선의 세로축, 데이터 배합 실험, 스케일링 법칙의 예측이 모두 이 숫자로 이뤄진다. GPT-4 기술 보고서는 1만 배 작은 모델들의 손실로 최종 모델의 손실을 미리 맞혔다고 밝혔다. 그 손실이 교차 엔트로피다. 이 용도에서 퍼플렉서티를 대신할 것은 없다.
8.2 그러나 성적표는 하나가 아니다
퍼플렉서티 · BPB 사전학습 진행, 데이터 배합, 같은 토크나이저 모델 비교
→
벤치마크 지식, 추론, 코드, 긴 문맥(RULER 등)
→
LLM 심판 · 사람 평가 대화 품질, 지시 따르기, 안전성
지시형·추론형 모델이 주인공이 된 지금, 사용자가 만나는 모델의 품질을 퍼플렉서티로 재는 일은 거의 없다. 대신 퍼플렉서티의 형제인 엔트로피가 새 무대에 올랐다. 2025년 Cui 등은 수학·코드 같은 검증 가능한 보상으로 강화학습을 할 때 정책의 엔트로피가 초반에 급격히 무너진다고 보고했다. 엔트로피 소비의 73%와 성능 향상의 76%가 전체 학습의 12분의 1인 첫 200단계에서 일어났다. 엔트로피가 0에 가까워지면 더 탐색하지 못하고 성능이 천장에 닿는다. ‘얼마나 헷갈리는가’는 이제 ‘얼마나 더 탐색할 수 있는가’의 지표이기도 하다.
8.3 실무 체크리스트
1
토크나이저가 다르면 바이트당 비트로 비교한다. 토큰 퍼플렉서티는 같은 토크나이저끼리만 비교할 수 있다. 한국어와 영어의 퍼플렉서티를 나란히 놓는 것도 금물이다.
2
같은 조건으로 다시 잰다. 문맥 길이, 겹침(stride), 첫 토큰 처리, 특수 토큰 포함 여부에 따라 숫자가 달라진다. 논문의 숫자를 가져오지 말고 같은 코드로 기준 모델을 함께 잰다.
3
지시형 모델의 품질은 퍼플렉서티로 재지 않는다. 지시 학습은 원문 텍스트의 퍼플렉서티를 올린다. 대화·지시 품질은 벤치마크와 사람·LLM 평가로 본다.
4
평가 데이터가 학습 데이터에 섞였는지 의심한다. 공개 데이터의 퍼플렉서티가 이상하게 낮다면 오염일 수 있다. 헌법처럼 유명한 글은 모델이 외우고 있다.
5
AI 글 탐지 결과를 단독 근거로 쓰지 않는다. 퍼플렉서티는 ‘뻔함’을 잴 뿐이다. 비원어민·정형 문서·유명한 글이 오탐의 주된 피해자다.
6
국소 지표의 한계를 기억한다. 긴 문맥 능력, 사실성, 유용성은 평균 퍼플렉서티에 잘 드러나지 않는다. 필요한 능력에 맞는 지표를 따로 둔다.
1951년 섀넌은 사람에게 다음 글자를 맞히게 하고 몇 번 만에 맞히는지 셌다. 75년 뒤 언어 모델은 같은 게임을 수조 번 반복하며 학습하고, 그 성적표가 퍼플렉서티다.
퍼플렉서티는 ‘몇 면짜리 주사위만큼 헷갈리는가’다. 실제로 나온 토큰들의 놀람을 평균해 다시 선택지 수로 되돌린 값이다. 학습이 직접 줄이는 교차 엔트로피와 같은 것이라 언어 모델 연구의 기본 단위가 됐다.
단위를 확인하지 않으면 거짓말을 한다. 토큰의 크기가 다르면 퍼플렉서티를 비교할 수 없다. 우리 실측에서 Qwen3는 토큰 퍼플렉서티로 2위, 바이트당 비트로 꼴찌였다. 공정한 비교는 바이트당 비트로 한다.
예측은 곧 압축이다. 2.1B 모델이 한국어 글을 gzip의 3분의 1 크기로 줄였다. 잘 압축하는 모델이 시험도 잘 본다. 다만 모델의 크기는 계산에 들어 있지 않다.
낮다고 좋은 것이 아니다. 사람의 글을 읽을 때 낮은 것은 좋은 모델의 표시다. 모델이 쓴 글이 낮은 것은 뻔한 글의 표시다. 지시 학습은 퍼플렉서티를 올리고, 탐지기는 뻔한 사람의 글을 AI로 의심한다.
그래서 헌법은 AI가 쓴 글일까? 아니다. 헌법은 수십 년간 수없이 인용된, 언어 모델이 거의 외우다시피 한 글이다. 퍼플렉서티는 ‘누가 썼는가’를 알려 주지 않는다. ‘얼마나 예상대로였는가’를 알려 줄 뿐이다. 그 차이를 아는 것이 이 오래된 성적표를 제대로 읽는 법이다.
코어닷투데이 실측 조건: kakaocorp/kanana-1.5-2.1b-base·instruct-2505, Qwen/Qwen3-0.6B-Base, Llama-3.2-1B·gemma-3-1b-pt(공개 미러), HyperCLOVAX-SEED-Text-Instruct-0.5B, EXAONE-4.0-1.2B. HuggingFace transformers 4.x, Apple M5 Pro(MPS, bf16). 각 문장·문단을 따로(최대 1,024토큰, BOS 토큰이 있으면 앞에 붙여) 쟀다. FLORES-200 devtest 앞 200문장, 블로그 검증용 글 60문단, 대한민국헌법(위키문헌) 문단. AI 탐지 실험의 글은 디코딩 특집에서 Kanana base로 만든 128토큰 이어 쓰기 40편씩이고, 측정 모델은 Qwen3 0.6B base다. 압축 비교는 Python gzip·bz2·lzma의 최고 압축 설정. 2026-11-07 측정.
Shannon, C. E. (1948). A Mathematical Theory of Communication. Bell System Technical Journal, 27.
Shannon, C. E. (1951). Prediction and Entropy of Printed English. Bell System Technical Journal, 30(1).
Jelinek, F., Mercer, R. L., Bahl, L. R., & Baker, J. K. (1977). Perplexity—a measure of the difficulty of speech recognition tasks. The Journal of the Acoustical Society of America, 62(S1), S63.
Brown, P. F., Della Pietra, S. A., Della Pietra, V. J., Lai, J. C., & Mercer, R. L. (1992). An Estimate of an Upper Bound for the Entropy of English. Computational Linguistics, 18(1).
Jelinek, F. (2005). Some of my Best Friends are Linguists. Language Resources and Evaluation, 39.
Mikolov, T. et al. (2011). Extensions of Recurrent Neural Network Language Model. ICASSP 2011.
Chelba, C. et al. (2013). One Billion Word Benchmark for Measuring Progress in Statistical Language Modeling. arXiv:1312.3005
Zaremba, W., Sutskever, I., & Vinyals, O. (2014). Recurrent Neural Network Regularization. arXiv:1409.2329