테스트 시간 컴퓨트추론 예산Gambit생각 단위 빔 탐색빔 탐색자기 일관성MaAS에이전트 슈퍼넷멀티에이전트워크플로 최적화LAWA임계 경로KV 캐시vLLM조기 종료특집
[특집] '얼마나'가 아니라 '어디에' — 생각·구조·시간, 추론 예산을 나눠 쓰는 세 논문 (Gambit·MaAS·LAWA)
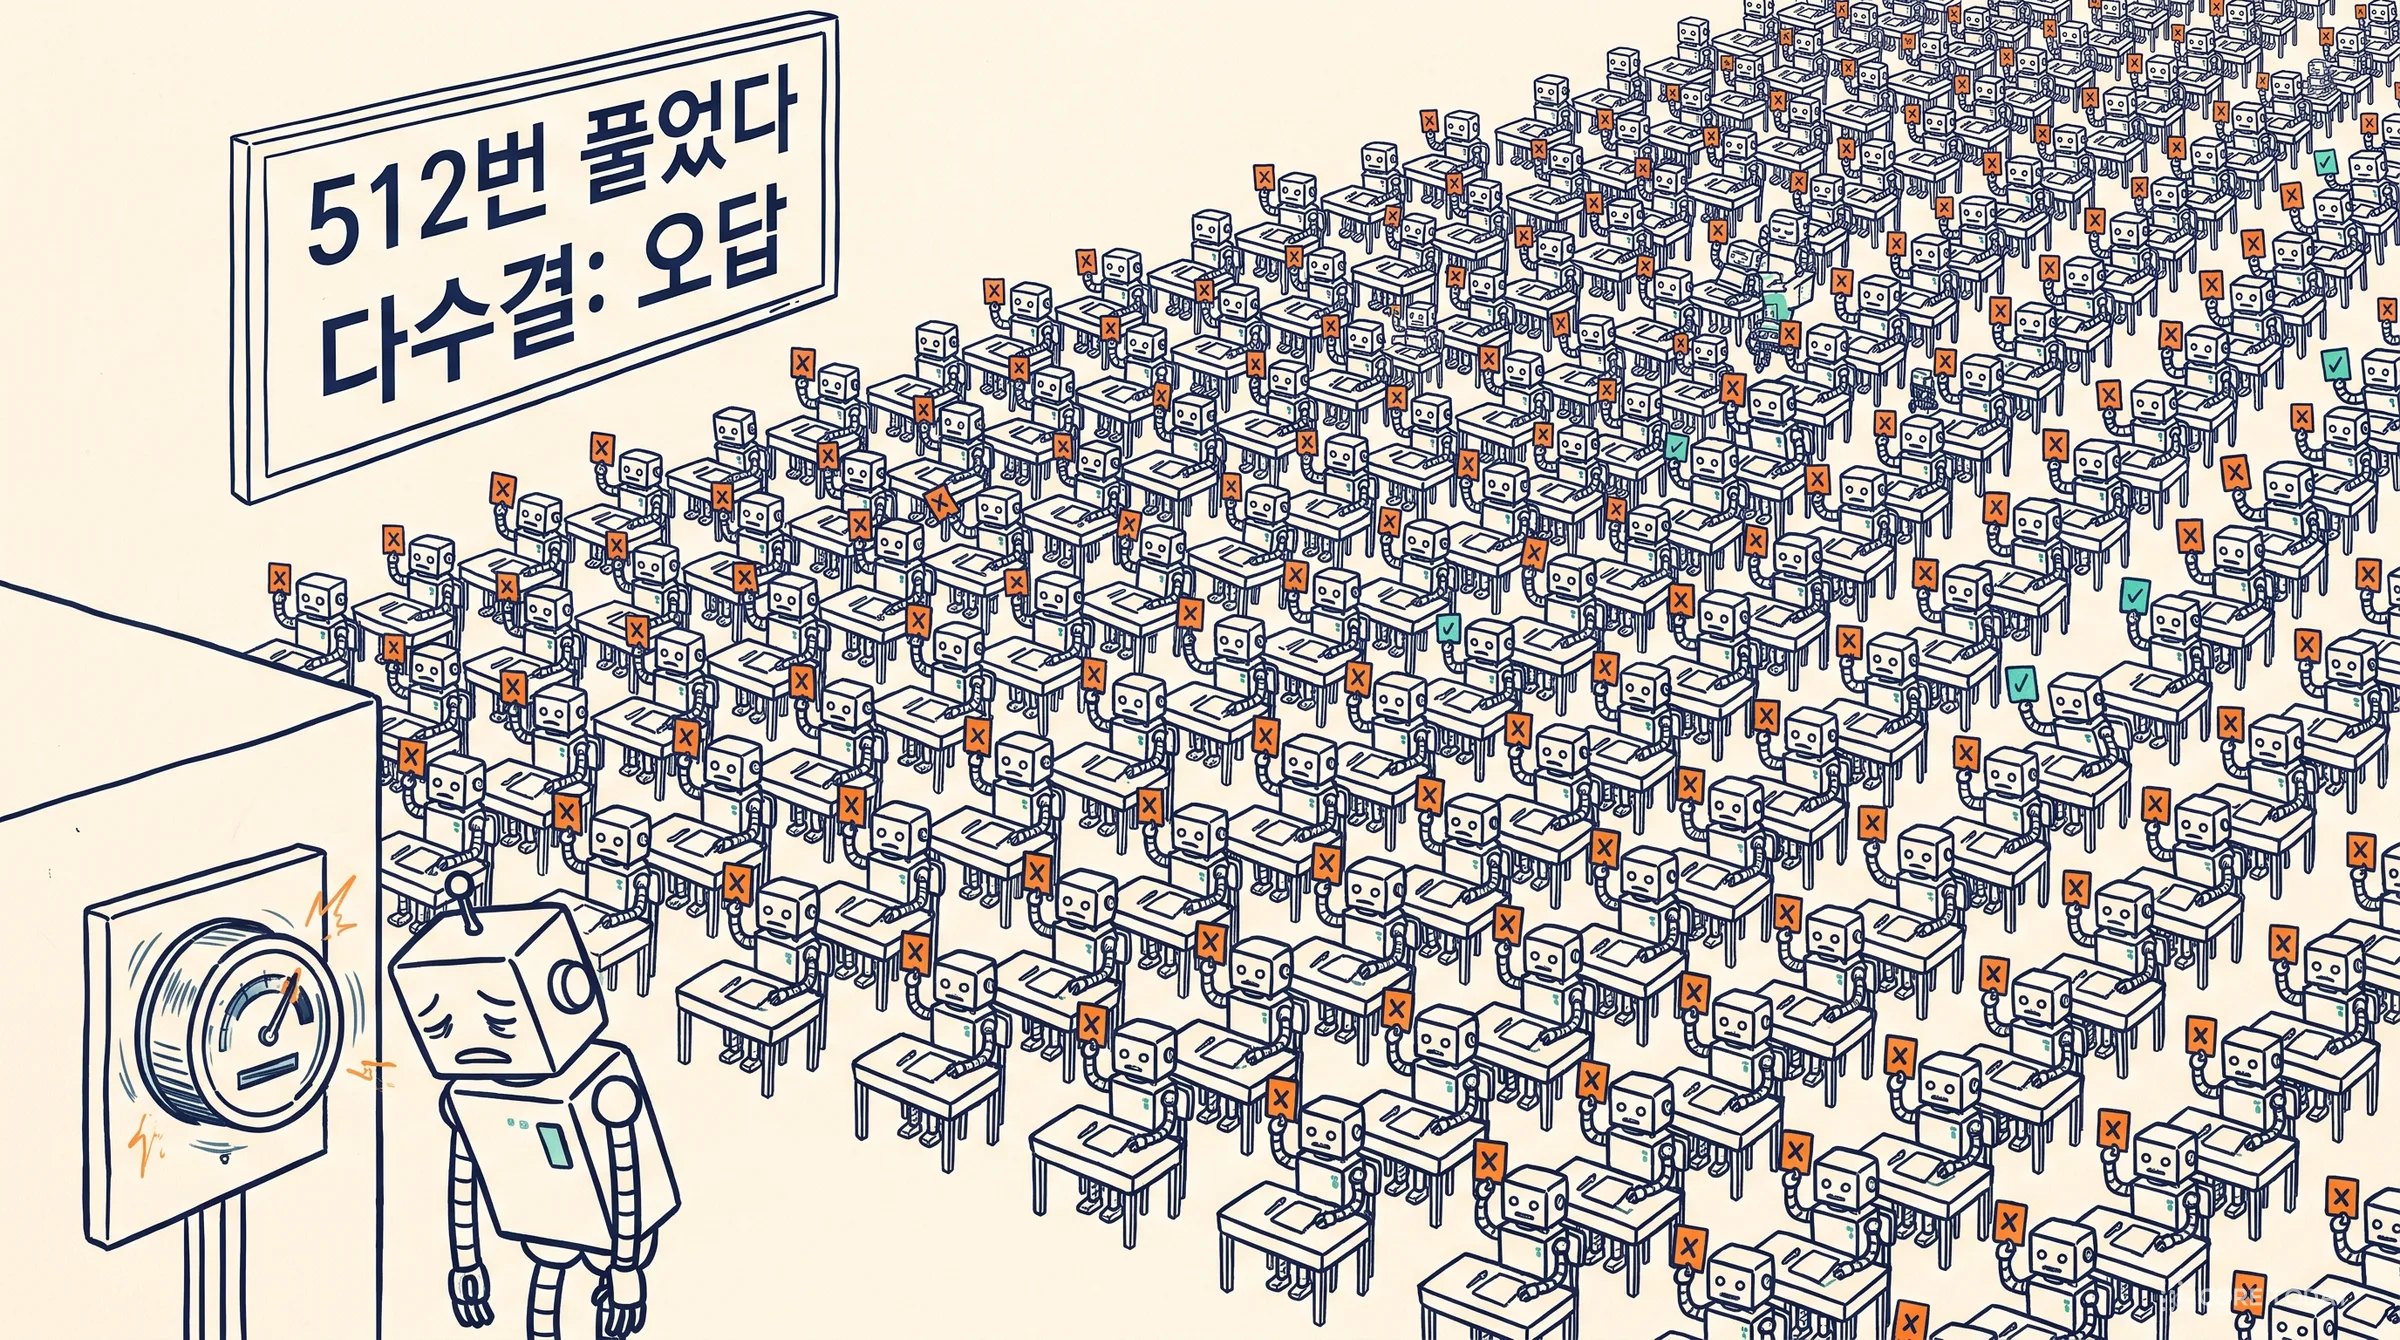
같은 문제를 512번 풀게 하고 다수결을 냈는데 오답이 나왔다. 2026년 여름 프린스턴의 Gambit 논문은 이 장면에서 출발해 질문을 바꾼다. 계산을 얼마나 더 쓸지가 아니라 어디에 쓸지다. 이 글은 같은 질문에 서로 다른 단위로 답한 세 논문을 함께 읽는다. Gambit(arXiv 2608.08020)은 한 문제 안에서 GPU 메모리 칸을 유망한 풀이에 몰아주고, MaAS(arXiv 2502.04180, ICML 2025 구두 발표)는 질문마다 에이전트 팀의 크기를 다르게 뽑고, LAWA(arXiv 2610.14481, NeurIPS 2026)는 되풀이되는 질의의 가장 긴 줄을 깎는다. 1976년 음성 인식에서 태어난 빔 탐색이 왜 번역에서 밀려났다가 '생각 단위'로 돌아왔는지, 신경망 구조 탐색의 슈퍼넷이 에이전트로 건너오며 무엇이 바뀌었는지를 따라간 뒤, 세 논문을 부록과 표까지 검산한다. 헤드라인의 +3.3%는 30문항 중 한 문제이고, '엄격히 우세'는 15칸 중 11칸이며, MaAS 표의 토큰 수와 달러는 서로 맞지 않는다. 모의실험과 계산기 다섯 개, 논문 그림 열두 장을 함께 싣는다.
미국 수학 경시대회 AIME 2025의 12번 문제는 이렇습니다. 원판을 수직인 지름 두 개로 네 사분면으로 나눕니다. 그다음 서로 다른 사분면에 있는 둘레 위의 두 점을 무작위로 골라 잇는 선분을 25개 더 긋습니다. 이 27개의 선이 원판을 몇 조각으로 나누는지, 그 기댓값을 구하는 문제입니다. 정답은 204입니다.
프린스턴 연구진은 이 문제를 80억 매개변수짜리 추론 모델(DeepSeek-R1-0528-Qwen3-8B)에게 512번 풀게 했습니다. 방식은 2022년부터 표준처럼 쓰여 온 자기 일관성(self-consistency)입니다. 같은 문제를 여러 번 독립으로 풀게 하고 가장 많이 나온 답을 고릅니다. 결과는 논문 부록에 숫자로 남아 있습니다.
512번 풀고 다수결
값
쓴 토큰
약 2,100만 개
걸린 시간
약 15,000초 (4시간 남짓, 최신 GPU 한 장)
정답 204를 낸 풀이
512개 중 34개 (6.6%)
1위 답
487/3 — 90표 (17.6%), 오답
2위 답
637/3 — 59표 (11.5%), 오답
정답의 순위
3위
네 시간과 2,100만 토큰을 쓰고 얻은 답이 오답입니다. 모델이 이 문제를 아예 못 푸는 것은 아닙니다. 34번은 맞혔습니다. 문제는 그 34개가 그럴듯한 오답 90개에 묻혔다는 것입니다.
같은 연구진은 같은 모델, 같은 GPU로 방식만 바꿔 다시 풀게 했습니다. 이번에는 동시에 돌리는 풀이를 256개로 줄였습니다. 대신 풀이가 진행되는 도중에 점수가 낮은 풀이를 내보내고, 그 자리에 점수가 높은 풀이의 복사본을 넣어 이어 쓰게 했습니다. 논문은 512번 다수결이 이 방식보다 새로 쓴 토큰이 약 13배, 시간이 3.4배였다고 적습니다. 거꾸로 계산하면 새 방식은 토큰 약 160만 개, 1시간 10분쯤입니다. 그리고 답은 204였습니다.
이 실행에서 가장 높은 점수를 받고 끝난 풀이 하나의 이력이 부록에 실려 있습니다. 이 풀이의 '부모'는 3만 토큰 넘게 꼼꼼히 계산해 현 하나가 평균 8조각을 새로 만든다는 데까지 갔습니다. 그리고 마지막 줄에서 실수합니다.
부모 풀이의 마지막 계산 (오답 203)
전체 기댓값 = 1 + 2 + 25 × 8 = 3 + 200 = 203.
이제, 이것이 답이라고 생각한다.
원판 자체가 처음부터 한 조각이라는 것을 빠뜨렸습니다. 지름 둘이 새로 만드는 조각은 3개인데, 식 앞머리의 '1 + 2'를 그 3으로 읽어 버린 것입니다. 이 풀이는 203으로 끝났습니다. 그런데 이 풀이가 3만 토큰쯤 진행됐을 때 점수 1위였기 때문에, 시스템은 그 시점의 상태를 복사해 '자식' 풀이를 하나 더 만들어 두었습니다. 자식은 부모가 쓴 31,404토큰을 그대로 물려받고 3,649토큰만 새로 썼습니다. 그 3,649토큰 안에 이런 대목이 있습니다.
자식 풀이가 새로 쓴 부분 (정답 204)
더 작은 경우로 확인해 보자. 지름 둘만 있고 현이 없다고 하자. 그러면 조각은 4개여야 한다. 그런데 공식대로면 지름의 기여 3, 현 없음, 그래서 3. 4여야 하는데 맞지 않는다.
여기가 실수다. 지름은 조각 3개를 새로 만들지만 처음에 1개가 있었으므로 지름을 그은 뒤의 조각은 1 + 3 = 4개다.
… 전체 기댓값은 처음의 한 조각에 이 합을 더한 1 + 203 = 204.
같은 3만 토큰짜리 풀이에서 갈라진 두 줄기 가운데 하나는 틀리고 하나는 맞았습니다. 512번을 처음부터 따로 푸는 방식에서는 이런 일이 일어나지 않습니다. 잘 가던 풀이가 마지막에 미끄러지면 그 3만 토큰은 통째로 오답 한 표가 됩니다.
2026년 8월에 나온 이 논문의 제목은 「추론을 위한 생각 단위 빔 탐색」이고, 시스템 이름은 Gambit입니다. 초록의 첫 문장이 이 글의 제목이 되었습니다. 테스트 시간 계산을 늘리는 것이 성능을 끌어올려 왔지만 비효율이 극심하고, 그래서 중요한 질문이 계산을 얼마나 쓸지에서 어디에 배분할지로 옮겨 갔다는 것입니다.
이 글은 그 질문에 답한 논문 세 편을 함께 읽습니다. 셋은 저자도, 학회도, 다루는 대상도 다릅니다. 그런데 나란히 놓으면 같은 문장을 서로 다른 단위로 말하고 있습니다.
Gambit (Yang 외, 프린스턴·MIT·메타, arXiv 2608.08020, COLM 2026). 한 문제를 푸는 도중에, GPU 메모리 칸을 어느 풀이에 줄지 정합니다.
MaAS (Zhang 외, 싱가포르 국립대·퉁지대 등, arXiv 2502.04180, ICML 2025 구두 발표). 질문이 들어올 때마다, 에이전트 팀을 얼마나 크게 꾸릴지 정합니다.
LAWA (Zhang 외, 다트머스, arXiv 2610.14481, NeurIPS 2026). 서비스를 내놓기 전에 한 번, 되풀이될 질의의 가장 긴 줄을 어디서 자를지 정합니다.
코어닷투데이는 LAWA를 10월에 따로 자세히 다뤘고, MaAS가 반박한 앞 세대인 Archon과 AFlow는 바로 앞 특집에서 다뤘습니다. 그래서 이 글은 Gambit을 가장 자세히, MaAS를 그다음으로 읽고, LAWA는 핵심만 다시 짚은 뒤 셋을 겹쳐 봅니다. 논문이 낯선 분도 따라올 수 있도록 용어는 나올 때마다 풀어 쓰겠습니다.
1장. 세 개의 지갑 — 예산이라는 말부터
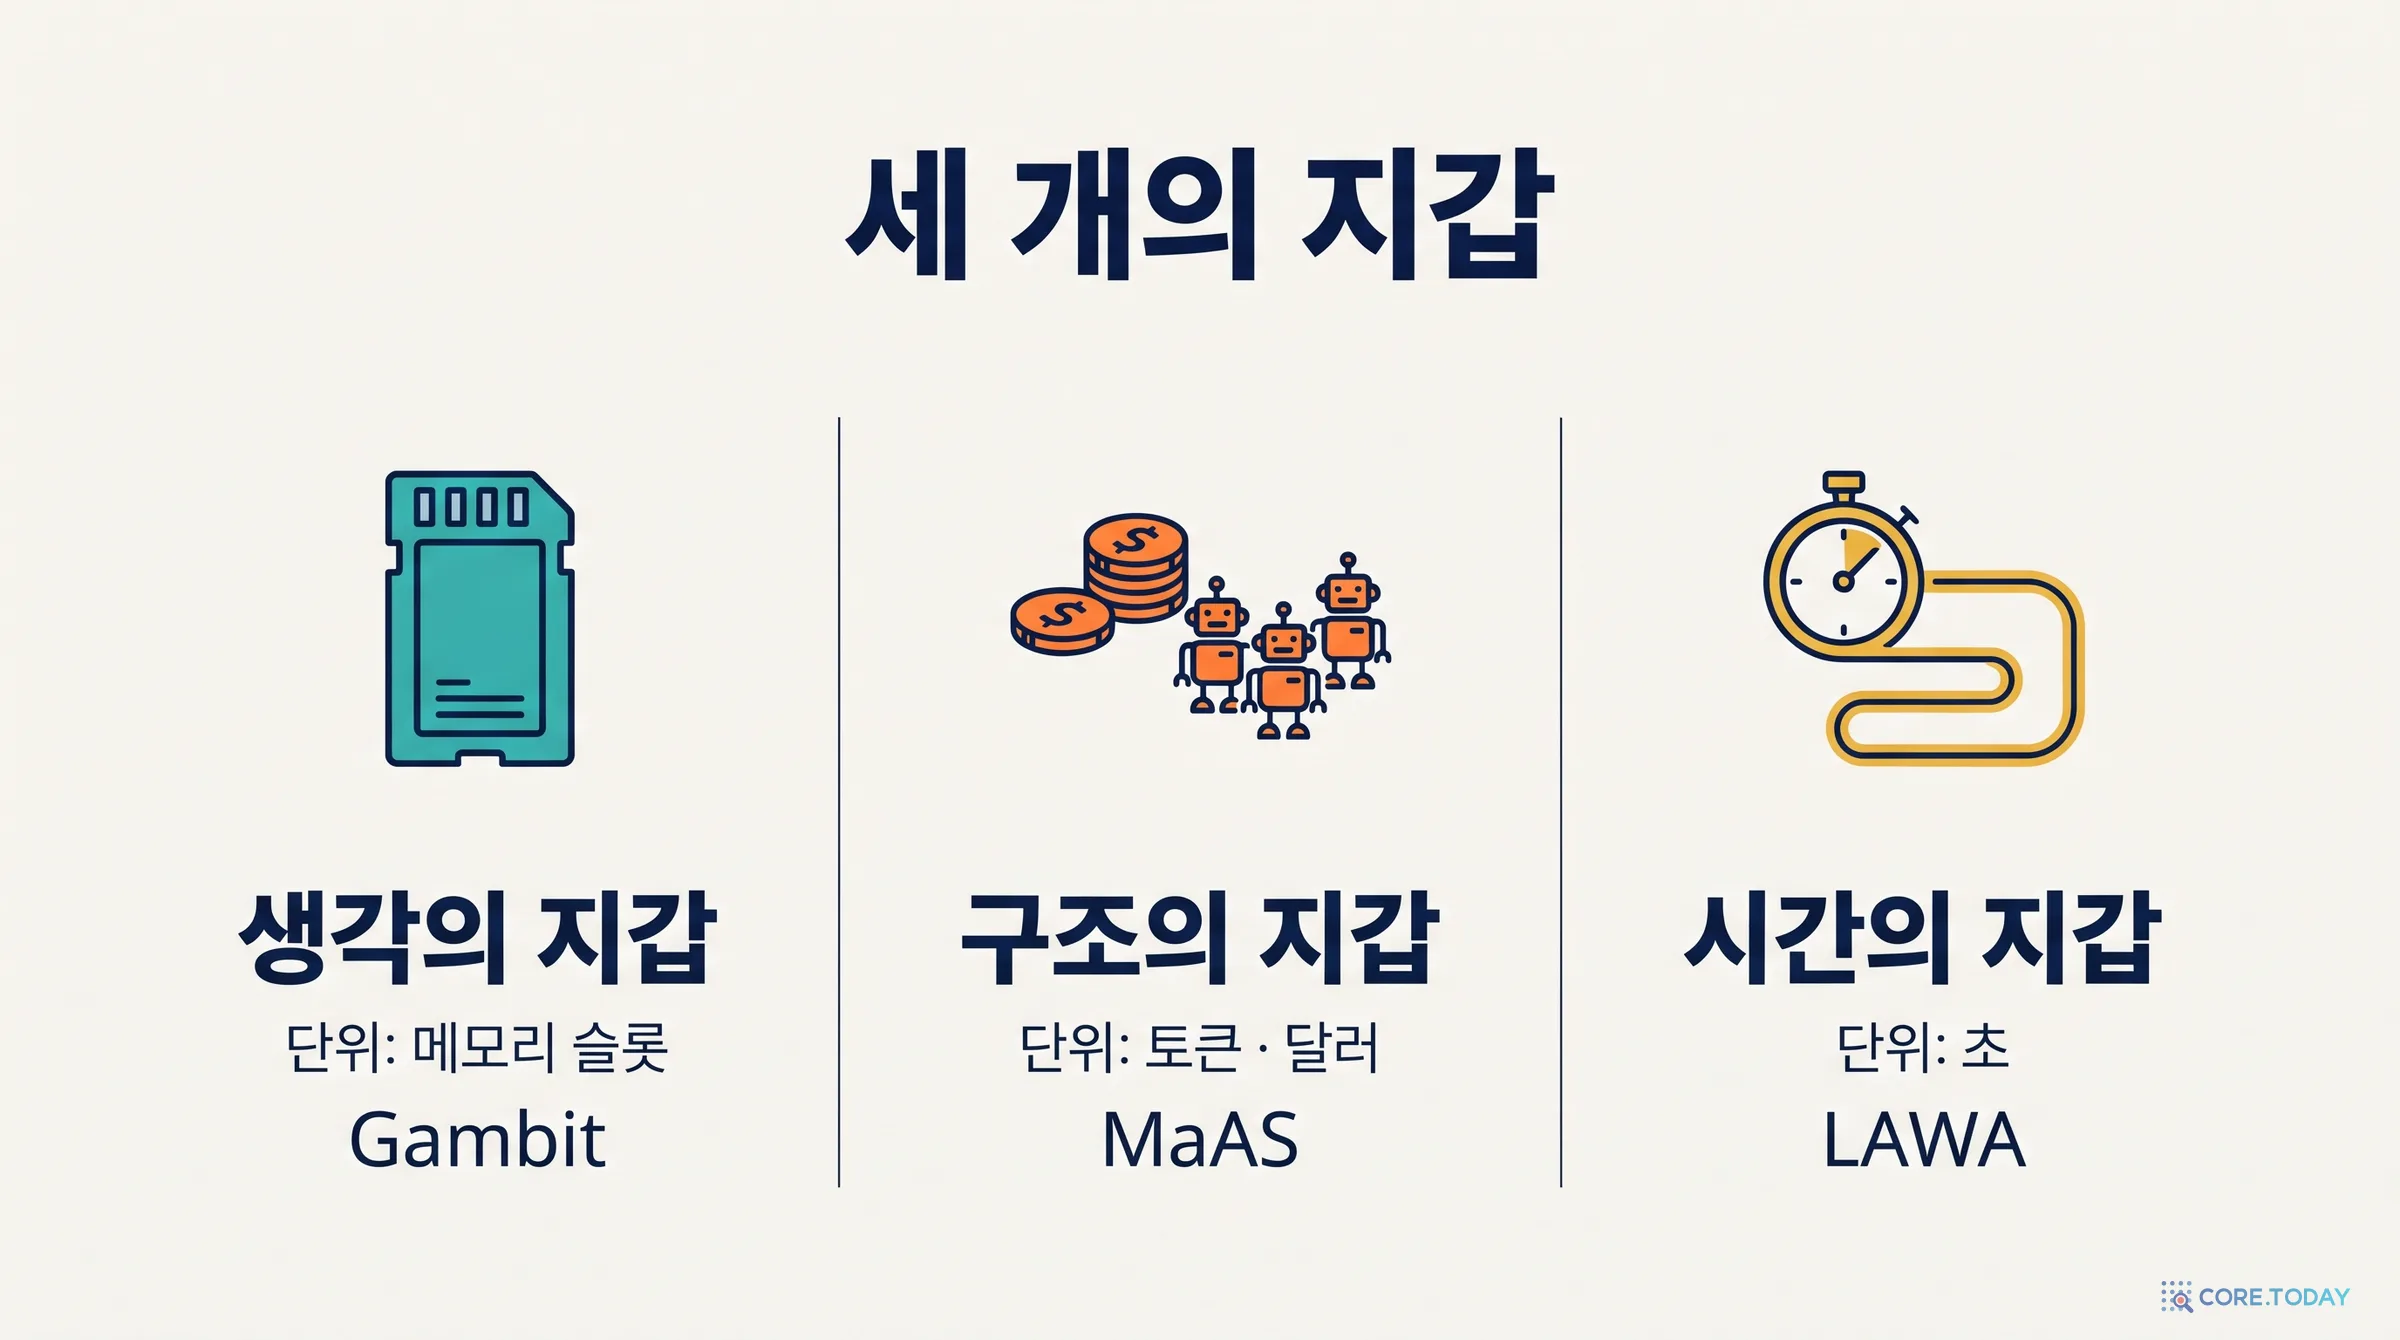
'추론 예산'이라는 말은 흔히 토큰 수나 달러를 가리키는 데 쓰입니다. 그런데 AI 시스템을 실제로 돌려 보면 예산은 한 가지 단위로 나오지 않습니다. 적어도 세 개의 지갑이 따로 있습니다.
첫째 지갑은 메모리입니다. 모델을 직접 GPU에 올려 돌리는 쪽에서는 토큰보다 메모리가 먼저 바닥납니다. 언어 모델은 글을 한 토큰씩 이어 쓰는데, 이미 읽고 쓴 토큰마다 중간 계산 결과를 GPU 메모리에 보관해 둡니다. 이것을 KV 캐시(key-value cache)라고 부릅니다. 풀이 한 줄이 길어질수록, 동시에 돌리는 풀이가 많을수록 이 캐시가 커집니다. GPU 한 장에 동시에 올릴 수 있는 풀이의 수에는 한도가 있고, Gambit은 이 한도를 '용량 C'라고 부릅니다.
둘째 지갑은 토큰, 곧 돈입니다. API로 모델을 빌려 쓰는 쪽에서는 호출 한 번, 토큰 하나가 청구서에 찍힙니다. 에이전트 여럿이 토론하고 검토하는 구조는 한 번 묻는 것보다 수십 배의 토큰을 씁니다. MaAS가 줄이려는 것이 이 지갑입니다.
셋째 지갑은 시간입니다. 사용자는 토큰 수를 보지 않습니다. 답이 나올 때까지 기다린 초를 봅니다. 에이전트 다섯이 차례로 일하면 각자의 시간이 그대로 더해집니다. LAWA가 줄이려는 것이 이 지갑이고, 논문은 전체 소요 시간을 makespan이라고 부릅니다.
세 지갑은 서로 바꿔 쓸 수 있을 때도 있고 없을 때도 있습니다. 에이전트를 나란히 세우면 시간은 줄지만 토큰은 그대로이고 동시에 쓰는 메모리는 늘어납니다. 풀이를 일찍 끊으면 토큰과 메모리는 아끼지만 답이 나빠질 수 있습니다. 그래서 '예산을 아낀다'고 할 때는 어느 지갑인지를 먼저 말해야 합니다.
세 논문을 한 표로 요약하면 이렇습니다. 지금은 낱말이 낯설어도 괜찮습니다. 글을 다 읽고 돌아오면 칸마다 뜻이 보일 것입니다.
Gambit
MaAS
LAWA
나눠 쓰는 것
GPU 메모리 칸 (동시 풀이 수)
토큰·API 비용
응답 시간
나누는 대상
한 문제의 풀이 256줄
질문마다 다른 에이전트 팀
한 워크플로의 에이전트 순서
언제 정하나
답을 쓰는 도중, 계속
질문이 들어올 때
배포 전에 한 번
무엇을 보고 정하나
모델 내부 상태를 읽는 작은 채점기
질문 임베딩을 읽는 제어기
그래프를 읽는 평가기
빼는 동작
점수 낮은 풀이 내보내기
조기 종료
노드 제거
더하는(옮기는) 동작
점수 높은 풀이 복제
어려운 질문에 층·연산자 추가
순서를 병렬로 재배선
지키는 제약
동시 풀이 수 = 용량 C
정확도 − λ × 비용
정확도가 처음보다 나빠지지 않을 것
대표 수치 (논문 주장)
토큰 최대 68.5% 감소, 정확도 +3.3~6.7점
추론 비용 6~45%, 정확도 +0.54~16.89점
7개 중 6개 벤치마크에서 가장 빠름
2장. '더 많이'가 벽에 닿기까지 — 2022~2026
'어디에'를 묻게 된 까닭을 알려면 '얼마나'로 얼마나 멀리 왔는지부터 봐야 합니다.
여러 번 풀고 다수결 (2022)
2022년 3월 구글의 왕(Xuezhi Wang) 등은 간단한 방법을 내놓았습니다. 모델에게 같은 문제를 풀이 과정과 함께 여러 번 풀게 하고, 가장 많이 나온 답을 고릅니다. 자기 일관성이라는 이 방법은 산수 문제 모음 GSM8K에서 정확도를 17.9점 올렸습니다. 추가 학습도, 다른 모델도 필요 없었습니다. 필요한 것은 계산을 몇 배 더 쓰는 것뿐이었습니다. 왜 다수결이 통하는지는 Archon·AFlow 특집 1장에서 1785년 콩도르세의 배심원 정리부터 따라갔습니다. 요점은 하나입니다. 한 번 풀 때 맞힐 확률이 절반을 넘으면 여러 번 풀수록 다수결은 정답에 가까워집니다. 그리고 절반에 못 미치면 여러 번 풀수록 오답에 가까워집니다. 프롤로그의 12번 문제가 뒤쪽 경우입니다.
나무로 탐색하기 (2023)
2023년 5월 프린스턴의 야오(Shunyu Yao) 등은 「생각의 나무(Tree of Thoughts)」에서 풀이를 중간 단계마다 여러 갈래로 뻗고, 모델 스스로 갈래를 평가해 유망한 쪽만 이어 가게 했습니다. 숫자 네 개로 24를 만드는 퍼즐에서 한 줄짜리 풀이는 4%를 풀었고 나무 탐색은 74%를 풀었습니다. 같은 달 「자기 평가로 이끄는 빔 탐색」(Xie 외)도 추론 단계 위에서 빔 탐색을 돌렸습니다. 풀이 단계를 단위로 탐색한다는 생각 자체는 이때 이미 있었습니다.
표본을 늘리면 어디까지 가나 (2024)
2024년 7월 「큰 언어 원숭이들」(Brown 외)은 표본 수를 수백 개로 늘렸습니다. 소프트웨어 버그 수정 벤치마크 SWE-bench Lite에서 한 번 시도는 15.9%를 풀었고 250번 시도는 그중 하나라도 맞힌 비율이 56%였습니다. 다만 이 논문은 단서를 붙였습니다. 정답을 자동으로 확인할 수 없는 과제에서는 다수결 같은 선택 방법이 표본 몇백 개쯤에서 더 오르지 않습니다. 맞힌 표본이 그 안에 있어도 골라내지 못한다는 것입니다.
같은 해 8월 UC 버클리와 구글 딥마인드의 스넬(Charlie Snell) 등은 질문 난이도에 따라 계산 배분 방식을 바꾸면 여러 개 중 최선을 고르는 방식보다 4배 넘게 효율적이라고 보고했습니다. 12월 허깅페이스 연구진은 단계별 채점 모델로 빔 탐색을 돌려, 매개변수 10억 개짜리 모델이 32갈래 탐색으로 80억 개짜리 모델의 수학 성적에 닿는 것을 보였습니다.
추론 모델과 가지치기 (2025~2026)
2025년에는 길게 생각하도록 학습된 추론 모델이 표준이 되었습니다. 풀이 한 줄이 수만 토큰으로 길어졌고, 그런 풀이를 수백 줄 돌리는 비용이 문제로 떠올랐습니다. 그래서 나온 것이 가지치기 계열입니다.
DeepConf (2025년 8월, 메타·UC 샌디에이고)는 모델이 토큰을 고를 때의 확신도를 보고 확신이 낮은 풀이를 일찍 멈춥니다. 논문은 AIME 2025에서 풀이 512개로 최고 99.9%에 이르고 토큰을 최대 84.7% 줄였다고 보고했습니다. '최고'는 특정 모델 하나의 값입니다.
Slim-SC (EMNLP 2025)는 서로 비슷한 풀이를 찾아 중복을 지웁니다.
STEP (2026년 1월, 일리노이대)은 풀이의 문단이 끝날 때마다 모델 마지막 층의 은닉 상태를 2층짜리 작은 신경망에 넣어 '이 풀이가 맞을 것 같은 정도'를 점수로 냅니다. GPU 메모리가 차면 점수가 가장 낮은 풀이를 내보냅니다. 논문은 지연이 45~70% 줄었다고 보고했습니다.
이 세 방법은 모두 빼기입니다. 나쁜 풀이를 덜어 내면 토큰과 시간은 줄어듭니다. 그런데 프롤로그의 문제로 돌아가 봅시다. 512줄 가운데 정답은 34줄이었습니다. 나쁜 풀이 400줄을 덜어 내도 정답이 34줄보다 늘지는 않습니다. 남은 표에서 정답의 비율은 오를 수 있지만, 채점기가 완벽하지 않으면 정답 풀이도 함께 덜려 나갑니다. Gambit 논문이 겨냥한 틈이 여기입니다. STEP은 Gambit의 직계 조상이기도 합니다. Gambit의 주 실험은 STEP이 공개한 채점기를 그대로 가져다 씁니다.
2022더 많이 — 자기 일관성. 여러 번 풀고 다수결. GSM8K +17.9점.
2023~2024나무로 — 생각의 나무, 채점 모델을 쓴 빔 탐색. 갈래를 평가하는 호출이 따로 든다.
2024한계 확인 — 표본 250개면 정답이 그 안에 있지만, 다수결은 수백 개에서 멈춘다.
2025~2026 초덜어 내기 — DeepConf, Slim-SC, STEP. 나쁜 풀이를 일찍 멈춰 토큰과 시간을 아낀다.
2026. 8옮겨 주기 — Gambit. 덜어 낸 자리에 좋은 풀이의 복제본을 넣는다.
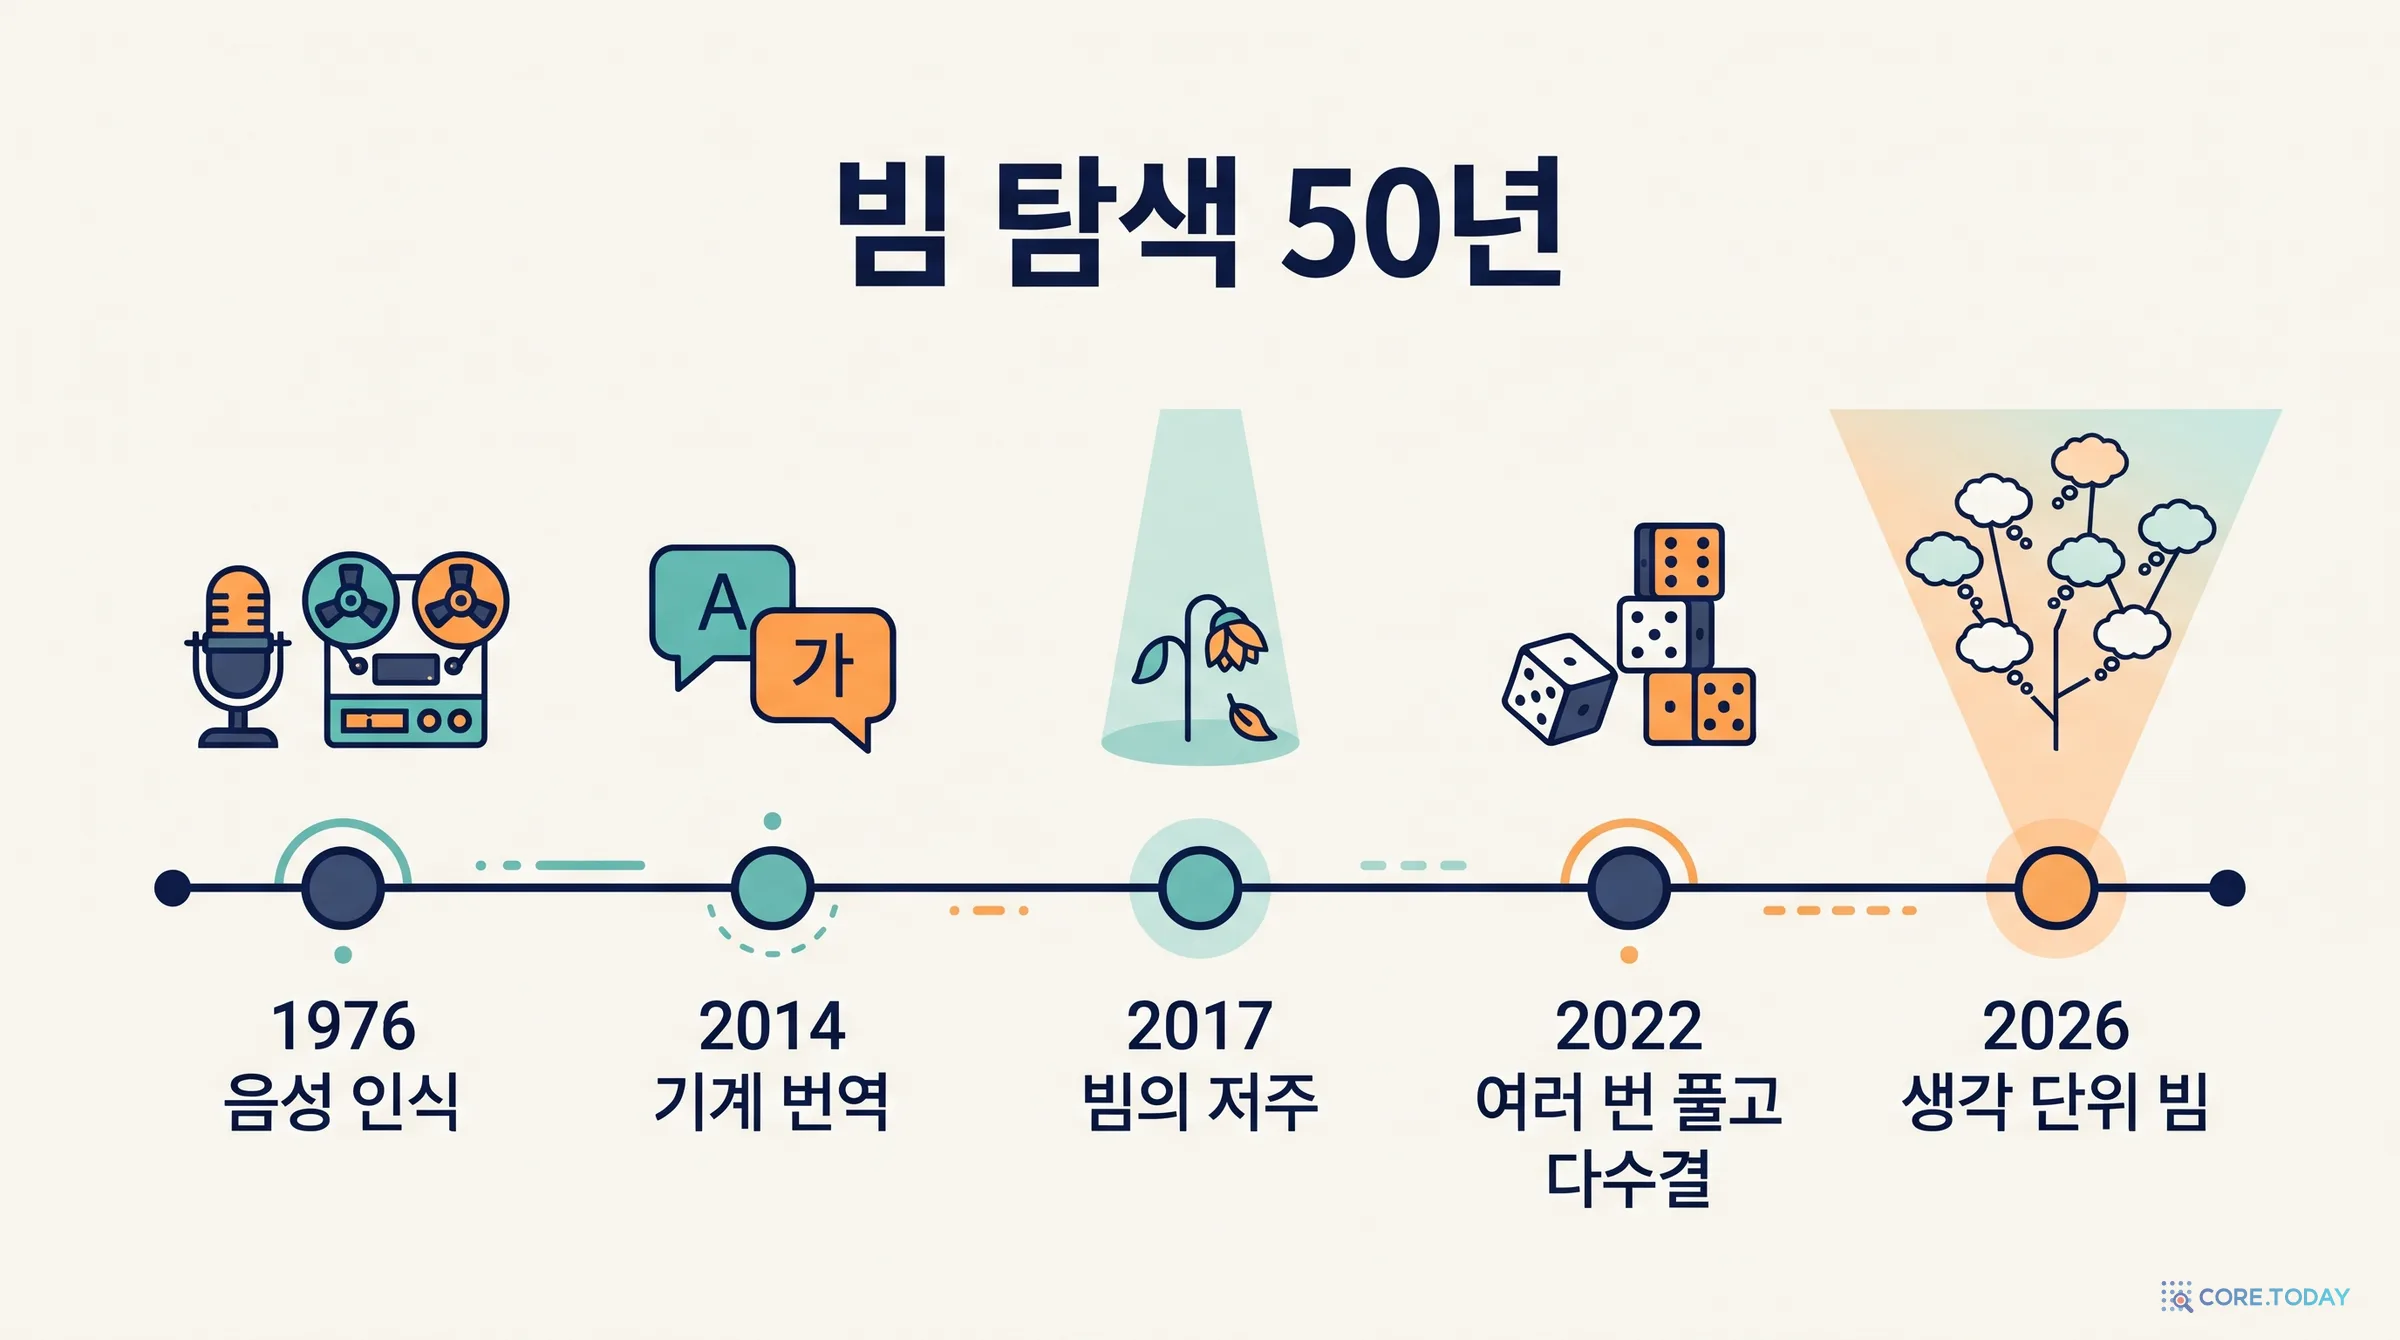
3장. 빔 탐색의 귀환 — 1976년 음성 인식에서 2026년 생각 단위까지
Gambit이 빌려 온 도구는 반세기 된 알고리즘입니다. 한때 자연어 처리의 표준이었다가 밀려났고, 이번에 단위를 바꿔 돌아왔습니다. 그 사연을 알면 왜 하필 '생각 단위'인지가 분명해집니다.
빔 탐색은 음성 인식에서 태어났습니다. 1976년 카네기멜런대 박사과정생 브루스 로어(Bruce Lowerre)는 학위 논문으로 하피(HARPY)라는 음성 인식 시스템을 만들었습니다. 1,011개 낱말로 이루어진 문장을 알아듣는 것이 목표였습니다. 소리 조각 하나가 들어올 때마다 가능한 낱말 이음이 수십 갈래로 불어나는데, 당시 컴퓨터로 그 모두를 끝까지 따라갈 수는 없었습니다. 하피는 조각마다 가장 좋은 경로와 점수가 비슷한 몇 개만 남기고 나머지를 버렸습니다. 한번 버린 길로는 되돌아가지 않았습니다.
카네기멜런대의 1976~1977년 연구 보고서는 이 기법을 이렇게 설명합니다. "가장 좋은 경로 주변의 아슬아슬한 대안들로 이루어진 한 줄기(beam)만 남기고 나머지를 탐색 나무에서 쳐 낸다." 손전등 빛줄기가 비추는 좁은 범위만 따라간다는 뜻에서 빔 탐색이라는 이름이 붙었습니다. 같은 보고서는 이 방식을 '궤적 모형(locus model)'이라고도 불렀습니다.
빔 탐색의 뼈대는 그때나 지금이나 같습니다.
후보 B개를 들고 있다
→
각 후보를 한 걸음씩 늘린다
→
점수를 매긴다
→
상위 B개만 남긴다
B를 빔 폭이라고 합니다. B가 1이면 매번 가장 좋아 보이는 하나만 따라가는 탐욕 탐색이고, B가 무한이면 전부 따라가는 완전 탐색입니다.
2014년, 번역의 표준
신경망 기계 번역이 등장하면서 빔 탐색은 전성기를 맞습니다. 2014년 구글의 수츠케버(Ilya Sutskever) 등이 쓴 시퀀스-투-시퀀스 논문은 번역문을 한 낱말씩 생성하면서 빔 탐색으로 후보를 관리했습니다. 이 논문의 표에는 재미있는 숫자가 있습니다. 영어-프랑스어 번역에서 빔 폭 1일 때 BLEU 점수가 33.00, 폭 2일 때 34.50, 폭 12일 때 34.81입니다. 폭을 1에서 2로 늘릴 때 이득의 대부분이 나오고, 2에서 12로 여섯 배 늘려도 0.31점밖에 오르지 않습니다. 이때의 점수는 모델이 그 문장에 매긴 확률이었습니다. 확률이 높은 문장이 좋은 번역이라고 보았습니다.
2017~2019년, 빔의 저주
곧 이상한 현상이 보고됩니다. 2017년 쾬(Philipp Koehn)과 놀스(Rebecca Knowles)는 「신경망 기계 번역의 여섯 가지 과제」에서 빔 폭을 넓힐수록 번역이 나빠진다고 적었습니다. 가장 좋은 폭은 언어 쌍에 따라 4에서 30쯤이었고, 더 넓히면 번역문이 점점 짧아지며 품질이 떨어졌습니다. 2018년 양(Yilin Yang) 등은 이 현상에 '빔 탐색의 저주'라는 이름을 붙였습니다.
2019년 스탈버그(Felix Stahlberg)와 번(Bill Byrne)이 원인을 끝까지 파 보았습니다. 빔 탐색 대신 확률이 가장 높은 문장을 정확히 찾아내는 탐색을 돌렸더니, 절반이 넘는 문장에서 모델이 가장 높은 확률을 준 번역은 빈 문장이었습니다. 빔 탐색이 그럭저럭 쓸 만했던 것은 탐색이 엉성해서 모델의 결함을 가려 주었기 때문입니다. 탐색을 잘할수록 '확률이 높다'와 '좋은 글이다'가 다르다는 사실이 드러났습니다. 같은 해 홀츠먼(Ari Holtzman) 등은 확률을 최대화하는 글이 밋밋하고 같은 말을 되풀이한다는 것을 보이고, 확률 분포에서 표집하는 방식을 제안했습니다. 그 뒤로 언어 모델의 기본 생성 방식은 빔 탐색에서 표집으로 넘어갔습니다. Gambit 논문도 고전적인 토큰 단위 빔 탐색은 문장의 확률을 최적화하지만 자신들의 목표는 그것이 아니라고 선을 긋습니다.
2026년, 단위와 점수를 바꾸다
그러니 빔 탐색을 추론 모델에 그대로 가져올 수는 없습니다. Gambit은 두 가지를 바꿉니다.
단위를 토큰에서 생각으로 바꿉니다. 추론 모델의 풀이는 빈 줄로 나뉜 문단들의 이음입니다. "현 하나가 지름과 만날 확률을 구하자", "이제 현끼리 만날 확률을 적분하자" 같은 문단 하나가 생각 한 단위입니다. 수만 토큰짜리 풀이에서 토큰마다 후보를 비교하는 것은 계산량으로도 불가능하지만, 문단 경계에서만 비교하면 감당할 수 있습니다.
점수를 확률에서 '맞을 가능성'으로 바꿉니다. 빔의 저주는 모델이 매긴 확률을 점수로 썼기 때문에 생겼습니다. Gambit은 풀이가 정답으로 끝날 가능성을 따로 예측하는 채점기의 점수를 씁니다. 문단 안의 글은 평소처럼 표집으로 씁니다. 빔 탐색이 하는 일은 어느 풀이를 계속 쓸지를 고르는 것뿐입니다.
여기에 하나가 더 얹힙니다. 2023년 vLLM 논문(Kwon 외)은 GPU 메모리를 작은 블록으로 쪼개 관리하면서, 앞부분이 같은 풀이들이 그 부분의 캐시를 공유할 수 있게 했습니다. 이 논문의 측정이 흥미롭습니다. 블록 공유로 아낀 메모리가 병렬 표집에서는 6.1~9.8%였는데 빔 탐색에서는 37.6~55.2%였습니다. 병렬 표집의 풀이들은 질문 부분만 같고, 빔 탐색의 후보들은 긴 앞부분을 함께 쓰기 때문입니다. 빔 탐색은 메모리가 모자란 환경과 궁합이 좋은 알고리즘입니다. 프롤로그에서 자식 풀이가 부모의 31,404토큰을 '물려받았다'고 한 것이 이 공유입니다. 복사하지 않고 같은 메모리를 함께 가리킵니다.
정리하면 Gambit의 새로움은 '생각 위에서 탐색한다'는 발상 자체보다 세 가지를 한데 묶은 데 있습니다. 모델 밖의 채점 모델을 부르는 대신 모델 안의 상태를 읽는 값싼 채점기, 내보낸 만큼만 들이는 고정 용량, 그리고 앞부분 캐시 공유입니다.
4장. Gambit ① 문제를 다시 적다 — 풀이 256줄과 메모리 한 장
식 하나로 쓴 문제 정의
Gambit 논문은 테스트 시간 추론을 제약 아래의 계산 배분 문제로 적습니다.
πmaxP(Aπ(P)=y∗∣P)s.t.Ω(π)≤B
기호를 우리말로 옮기면 이렇습니다. P는 문제이고 y∗는 정답입니다. π는 배분 정책, 곧 지금 돌고 있는 풀이들 가운데 누구를 계속 쓰게 하고 누구를 멈추고 누구를 복제할지를 정하는 규칙입니다. Aπ(P)는 그 정책으로 풀이를 돌려 마지막에 투표로 뽑은 답입니다. Ω(π)는 실행 중에 가장 많이 쓴 계산과 메모리이고, B는 하드웨어 한도입니다. 한 줄로 읽으면 "메모리 한도를 넘지 않으면서, 최종 답이 정답일 확률을 가장 높이는 배분 규칙을 찾아라"입니다.
이 식에서 눈여겨볼 것은 제약 쪽입니다. 지금까지의 연구는 대개 예산을 토큰 총량으로 적었습니다. Gambit은 예산을 한순간에 동시에 쓰는 양으로 적습니다. 실제 GPU에서 먼저 닿는 벽이 그것이기 때문입니다.
얼마나 빨리 닿는지 어림해 보겠습니다. 실험에 쓰인 Qwen3 계열 4B·8B 모델은 층이 36개이고 층마다 키-값 머리가 8개, 머리 하나의 차원이 128입니다. 16비트 실수로 저장하면 토큰 하나의 KV 캐시는 2 × 36 × 8 × 128 × 2바이트, 약 144킬로바이트입니다(공개된 모델 설정 파일로 코어닷투데이가 계산한 값). 3만 2천 토큰짜리 풀이 한 줄이면 4.7기가바이트입니다. 논문의 표에서 병렬 표집은 문제 하나에 약 600만 토큰을 씁니다. 256줄이니 한 줄에 평균 2만 3천 토큰쯤이고, 이것을 한꺼번에 올리면 800기가바이트가 넘습니다. 실험에 쓴 GPU의 메모리는 275기가바이트입니다. 모델 가중치를 빼고도 256줄을 동시에 끝까지 돌릴 수 없습니다.
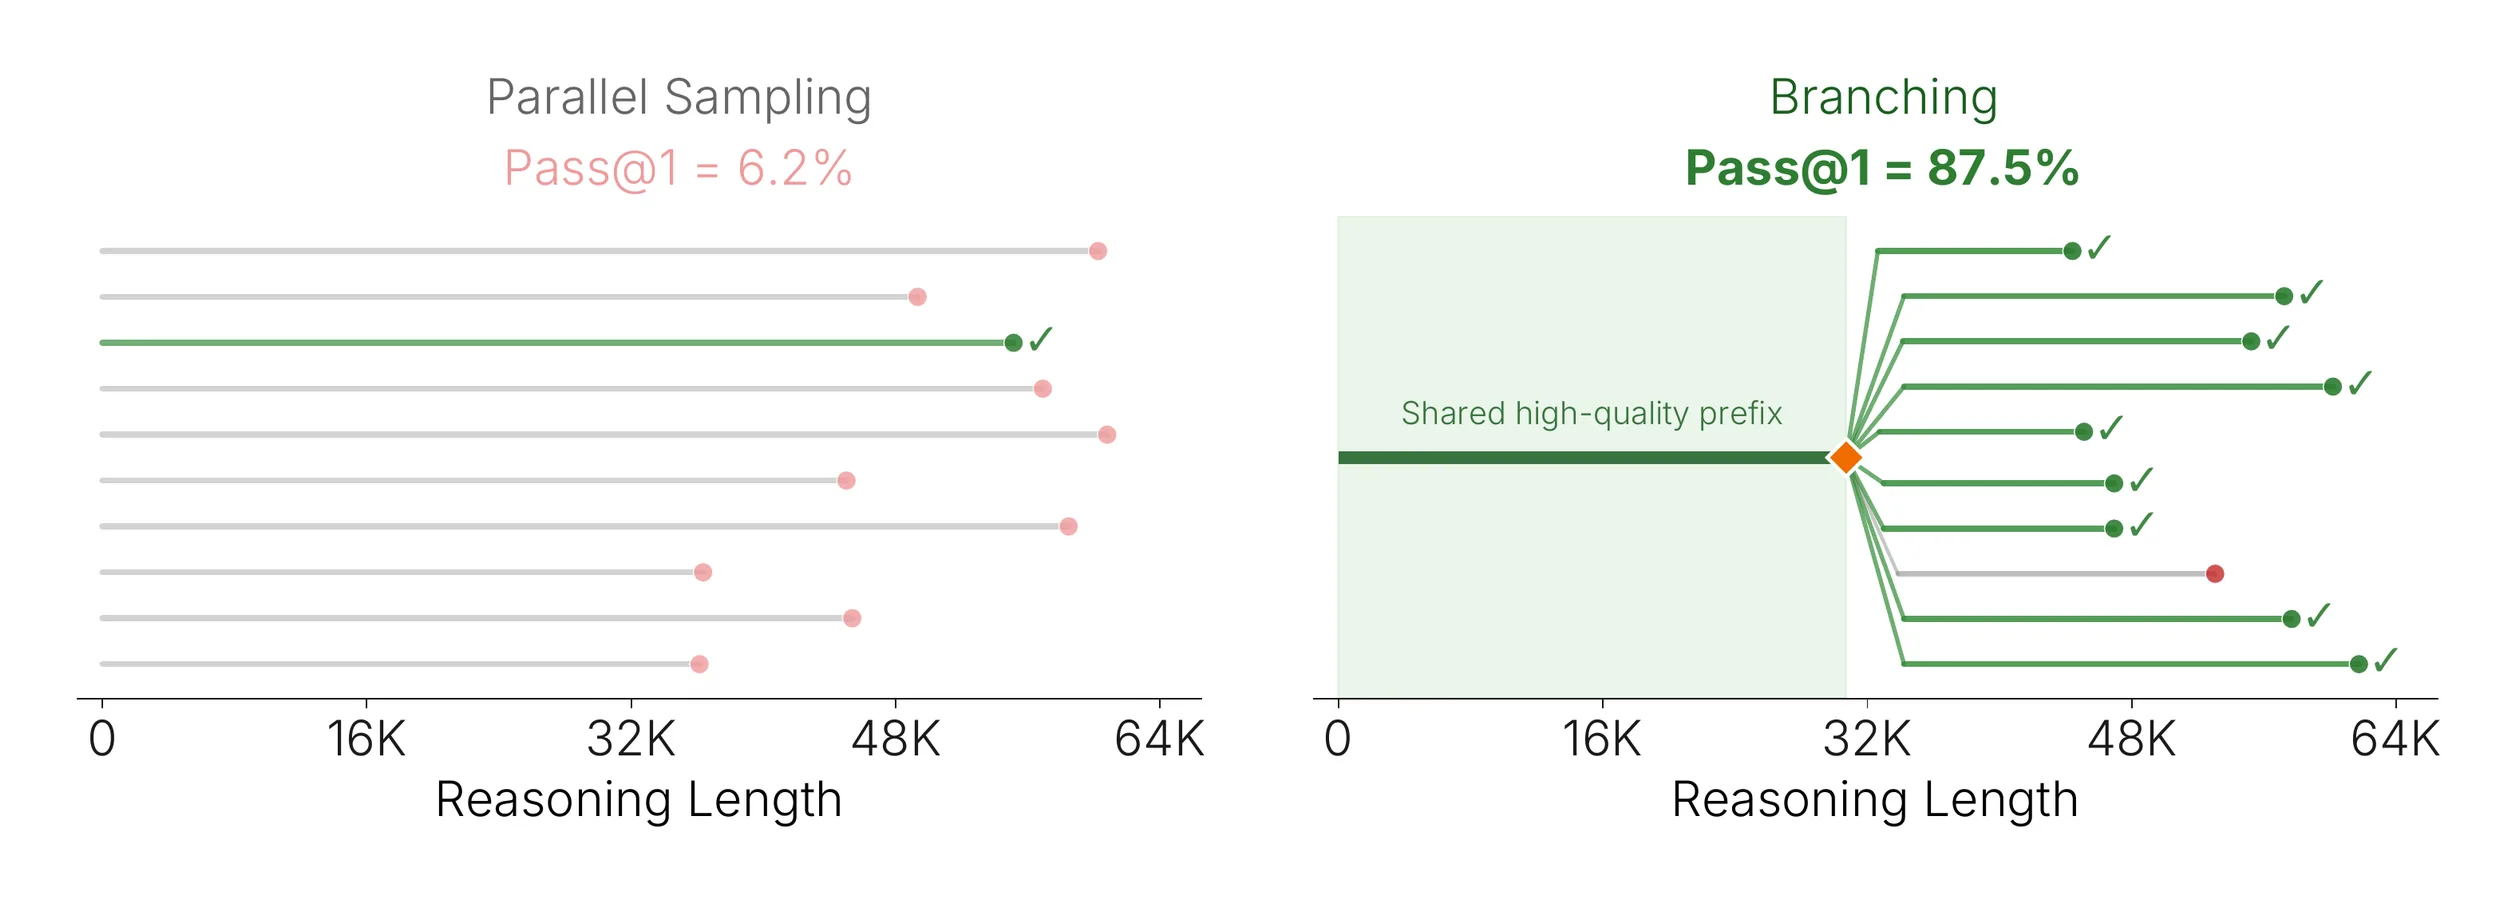
그림의 왼쪽은 평소의 병렬 표집입니다. 가로 막대 하나가 풀이 한 줄이고 길이는 토큰 수입니다. 열 줄 가운데 초록 한 줄만 정답으로 끝났습니다. 이 문제에서 풀이 한 줄이 정답일 확률은 6.2%였습니다.
오른쪽은 실험입니다. 풀이 64줄을 중간쯤에서 멈추고, 채점기로 순위를 매겨 1위 풀이 하나를 고릅니다. 그리고 그 풀이의 앞부분에서 64갈래로 갈라져 각자 이어 쓰게 합니다. 정답률이 87.5%가 되었습니다. 14배입니다. 앞부분 3만 토큰을 64줄이 함께 쓰니 메모리도 절반쯤입니다. 논문은 12번 문제에서도 1.6%가 39.1%로 올랐다고 적습니다.
이 실험이 말해 주는 것은 풀이의 운명이 꽤 일찍 갈린다는 것입니다. 어려운 문제에서 대부분의 풀이는 접근법을 잘못 잡은 채 수만 토큰을 씁니다. 접근법을 제대로 잡은 드문 풀이에서 출발하면 뒤는 대체로 맞습니다.
그렇다면 늘 1위 하나에서만 갈라지면 될까요? 논문은 곧바로 경고합니다. 한 풀이에 몽땅 걸면 그 풀이가 그럴듯하게 틀렸을 때 64줄이 모두 같은 오답을 냅니다. 그래서 필요한 것이 조절된 재배분입니다. 여러 후보를 들고 가면서 조금씩 유망한 쪽으로 무게를 옮깁니다. 빔 탐색이 하는 일이 그것입니다.
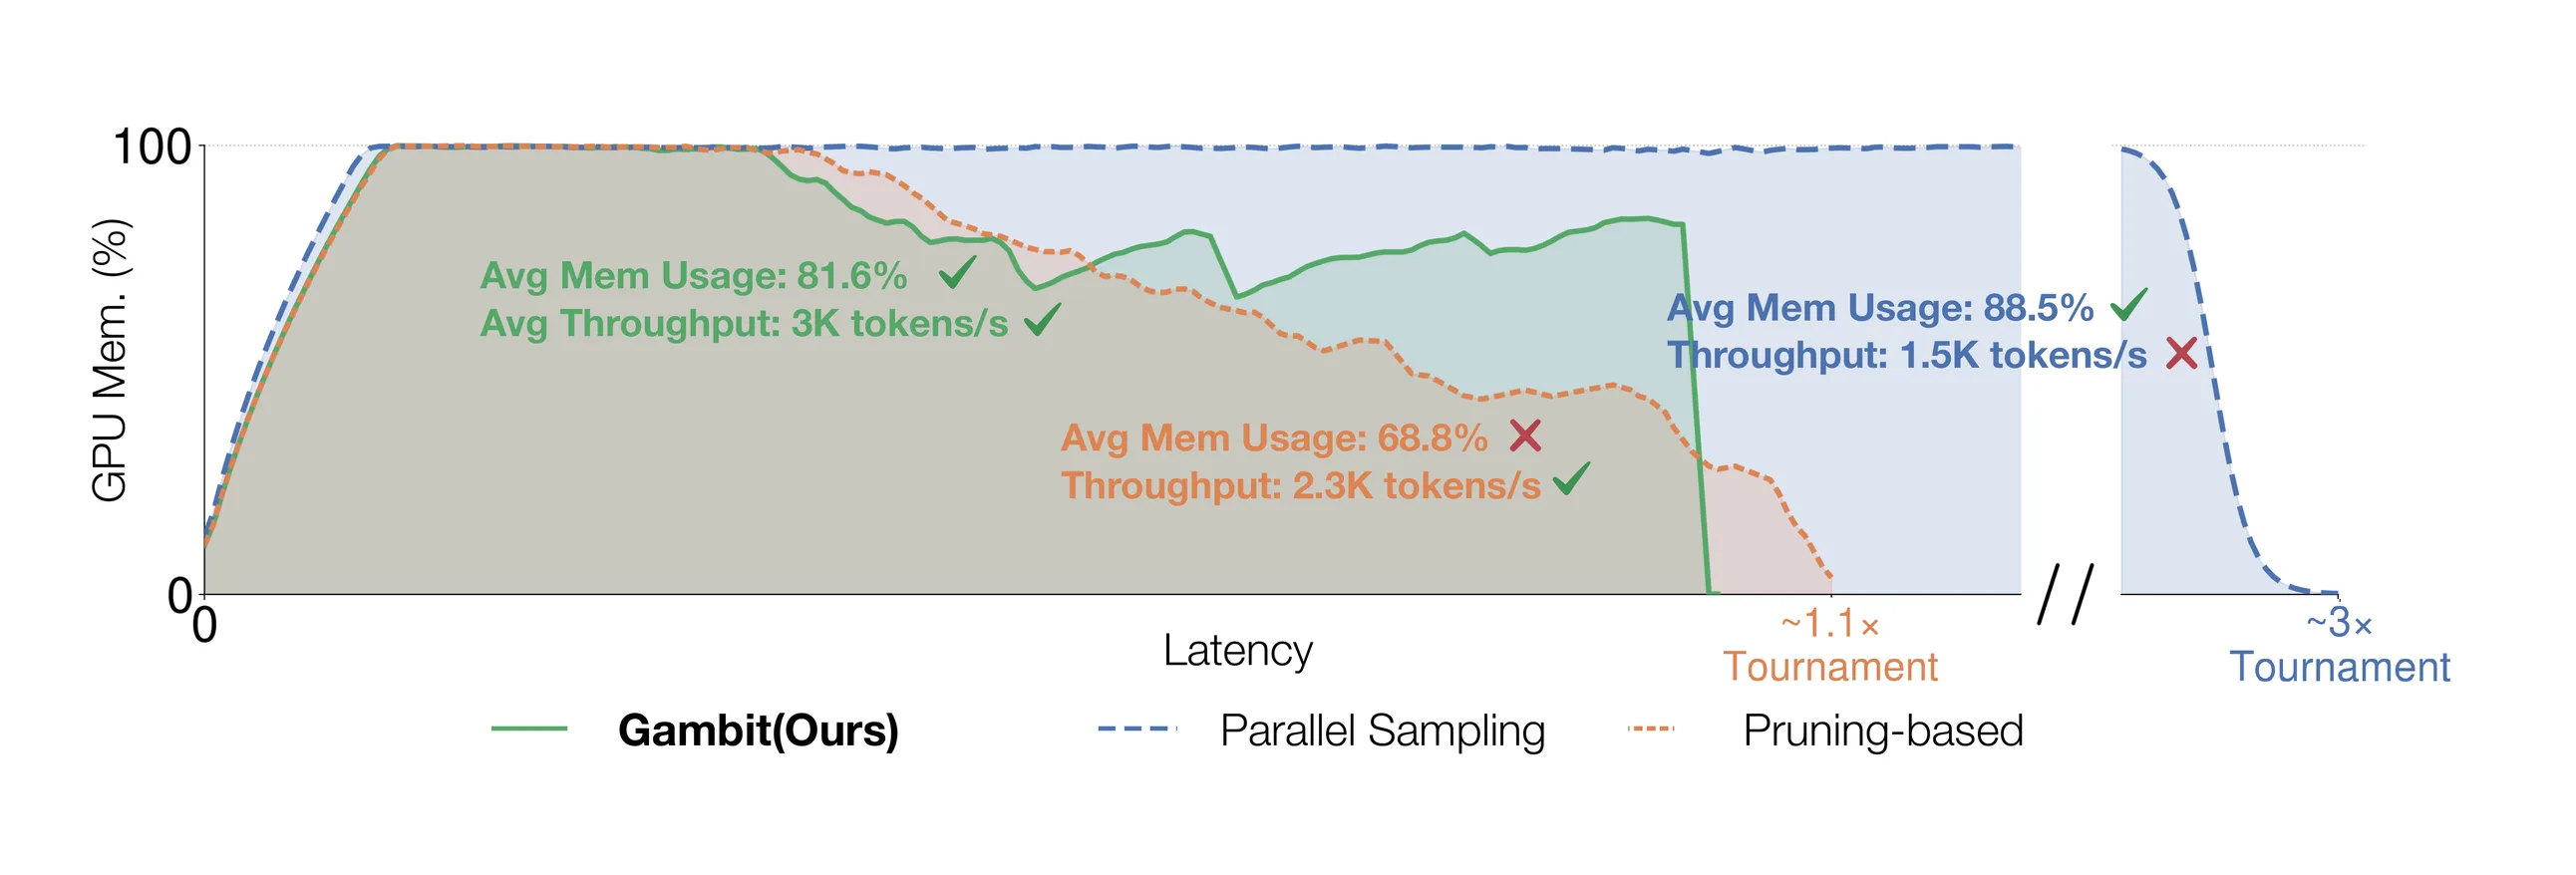
파란 점선(병렬 표집)은 메모리를 금세 100%까지 채우고 끝까지 꽉 찬 채로 갑니다. 얼핏 좋아 보이지만 그렇지 않습니다. 메모리가 꽉 차면 서버는 일부 풀이를 대기열로 밀어내고, 그 풀이들은 자리가 날 때까지 멈춰 있습니다. 그림에서 평균 사용률은 88.5%인데 처리량은 초당 1,500토큰으로 셋 중 가장 낮고, 끝나는 시각은 Gambit의 약 3배입니다.
주황 점선(가지치기)은 중반부터 계속 내려갑니다. 풀이를 내보내고 그 자리를 비워 두기 때문입니다. 평균 사용률 68.8%, 처리량은 초당 2,300토큰입니다. 대기열은 사라졌지만 뒤로 갈수록 GPU가 놉니다. 논문은 이것을 하드웨어 굶김이라고 부릅니다.
초록 실선(Gambit)은 내려가다가 다시 올라옵니다. 내보낸 자리를 복제본으로 채우기 때문입니다. 평균 사용률 81.6%, 처리량 초당 3,000토큰입니다.
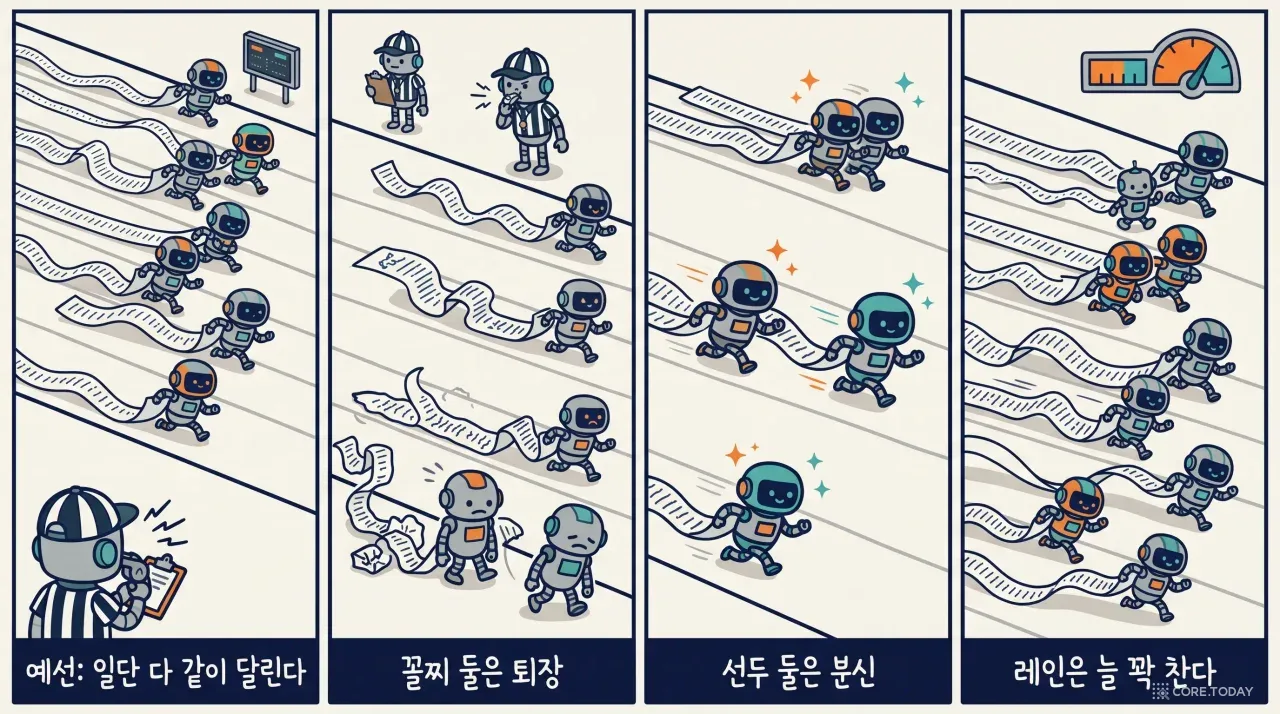
식당에 비기면 이렇습니다. 테이블 여덟 개인 식당에 손님을 한꺼번에 받으면 문밖에 줄이 서고, 식사가 느린 손님을 내보내기만 하면 테이블이 비어 주방이 놉니다. 빈자리가 나는 즉시 다음 손님을 앉히는 것이 회전율이 가장 좋습니다. 다만 Gambit에서 새로 앉는 손님은 밖에서 온 손님이 아니라 옆 테이블에서 잘 먹고 있던 손님의 분신입니다.
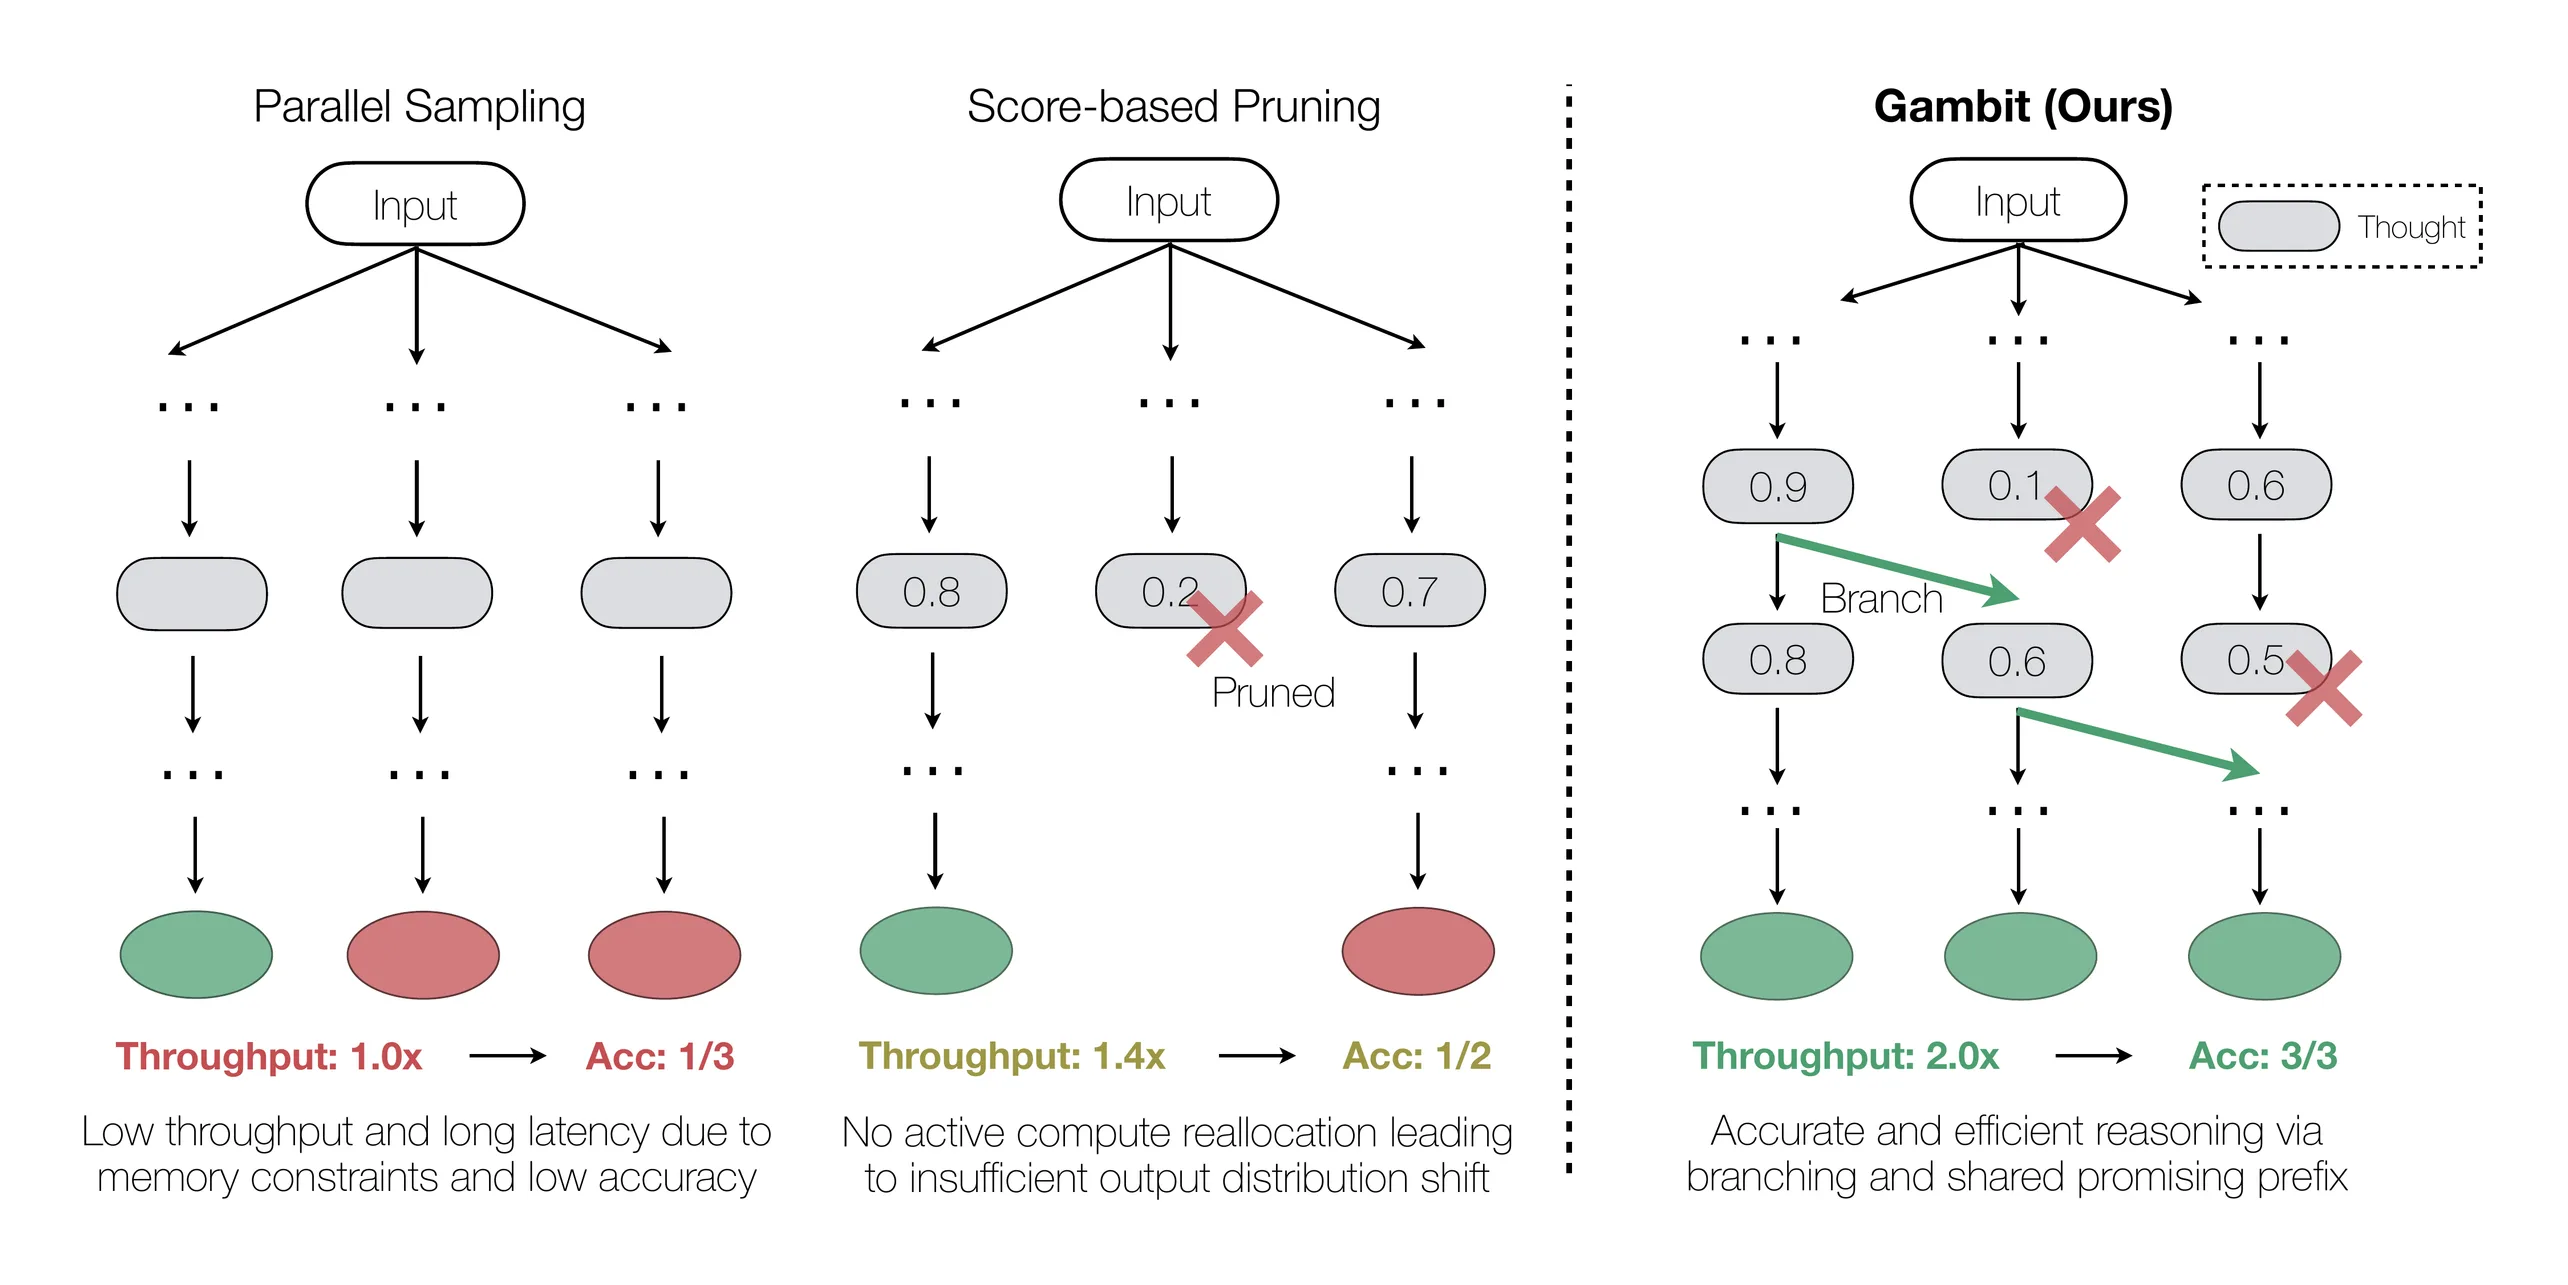
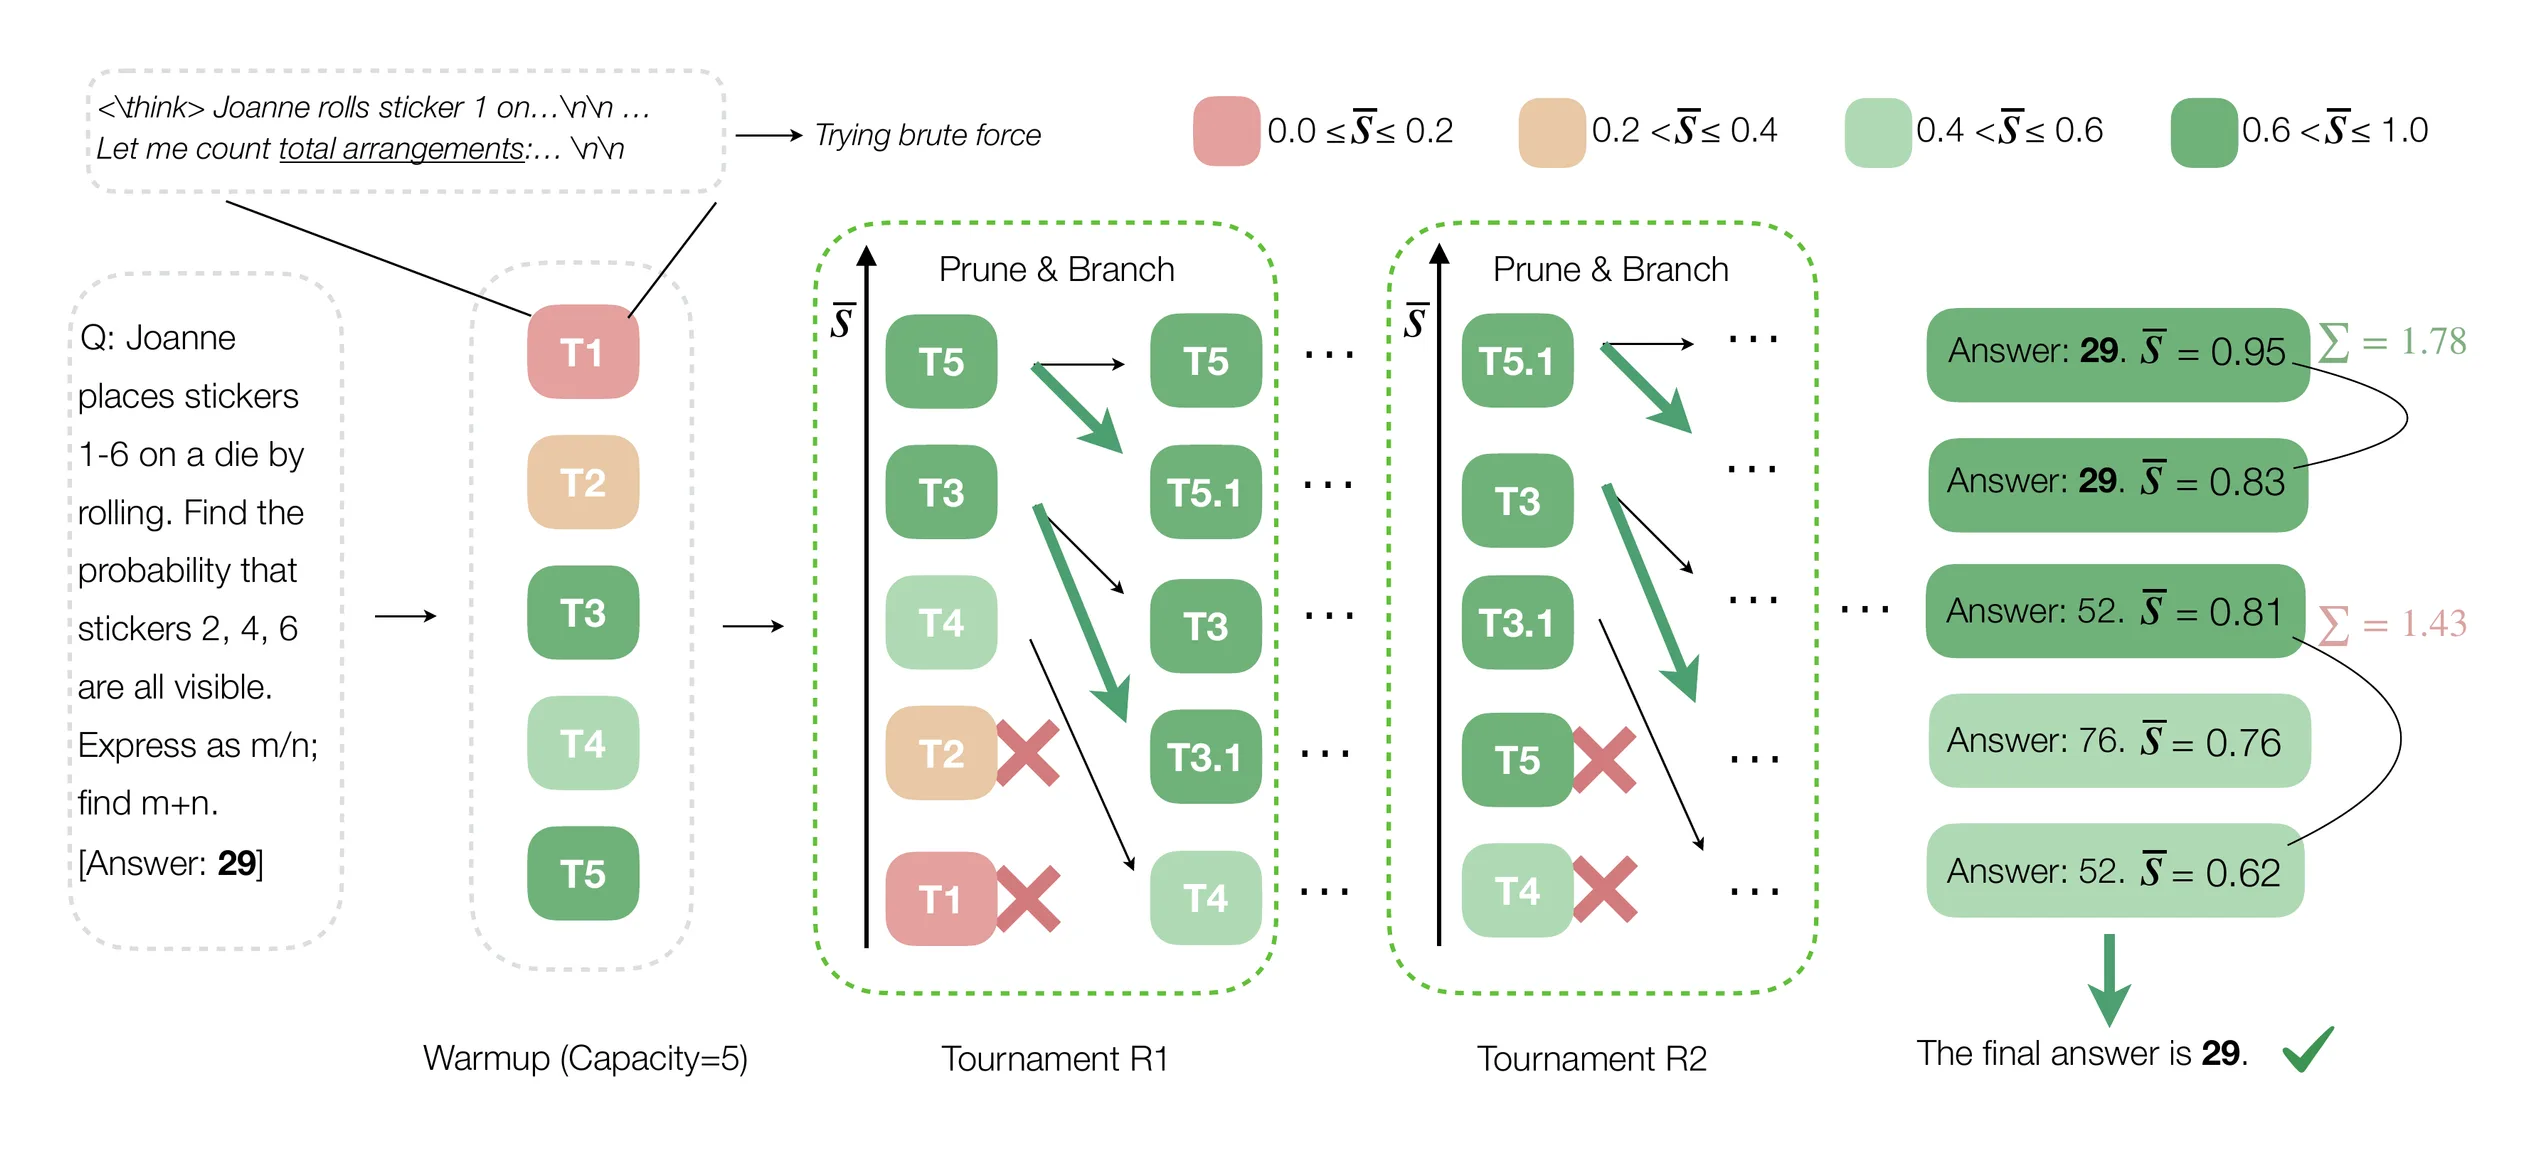
회색 둥근 상자 하나가 생각 한 단위이고 안의 숫자는 채점기 점수입니다. 맨 아래 타원이 최종 답으로, 초록이 정답, 빨강이 오답입니다. 그림 아래의 '처리량 1.0배 → 1.4배 → 2.0배', '정확도 1/3 → 1/2 → 3/3'은 개념을 보여 주는 예시이지 측정값이 아닙니다.
5장. Gambit ② 토너먼트 — 꼴찌를 내보내고 선두를 복제한다
알고리즘을 한 걸음씩
Gambit의 알고리즘은 세 동작이 도는 고리입니다.
생성돌고 있는 풀이 모두가 생각 한 단위씩 더 쓴다. 문단이 끝날 때마다 채점기가 그 풀이의 점수를 고친다.
일정 관리GPU 메모리가 차면 점수가 가장 낮은 풀이를 메모리에서 내린다. 이 풀이는 '유령'이 된다(아래에서 설명).
토너먼트일정 간격마다 모든 풀이를 점수순으로 줄 세운다. 아래 K개를 내보내고 위 K개를 하나씩 복제해 그 자리에 넣는다.
왼쪽부터 읽습니다. 풀이 다섯 줄(T1~T5)이 워밍업 구간을 달립니다. 색이 진한 초록일수록 점수가 높습니다. T1은 "전체 경우를 다 세어 보자"며 무식하게 세기 시작해 점수가 가장 낮습니다(분홍). 1회전 토너먼트에서 T1과 T2가 나가고, T5와 T3가 각각 자식 T5.1과 T3.1을 낳습니다. 2회전에서는 이번엔 T5와 T4가 나가고 T5.1과 T3가 가지를 칩니다. 한때 1위였던 T5가 2회전에서 탈락한다는 점을 눈여겨보세요. 점수는 평균이라 계속 바뀌고, 선두였던 풀이도 뒤에 가서 어긋나면 밀려납니다.
오른쪽 끝이 투표입니다. 다섯 풀이가 낸 답은 29, 29, 52, 76, 52입니다. 표 수로만 세면 29와 52가 두 표씩 동률입니다. Gambit은 표마다 그 풀이의 평균 점수를 무게로 줍니다. 29는 0.95 + 0.83 = 1.78, 52는 0.81 + 0.62 = 1.43이어서 29가 뽑힙니다.
a∗=argamaxi:ai=a∑sˉi
이 점수 가중 투표는 뒤에서 비판적으로 읽을 때 다시 나옵니다. 기준선인 자기 일관성은 가중 없는 다수결을 쓰기 때문입니다.
워밍업은 왜 12,000토큰이나 되는가
풀이 한 줄이 평균 2만 토큰 남짓인데 워밍업이 12,000토큰이면 절반 넘게 지켜보기만 한다는 뜻입니다. 이유는 채점기에 있습니다.
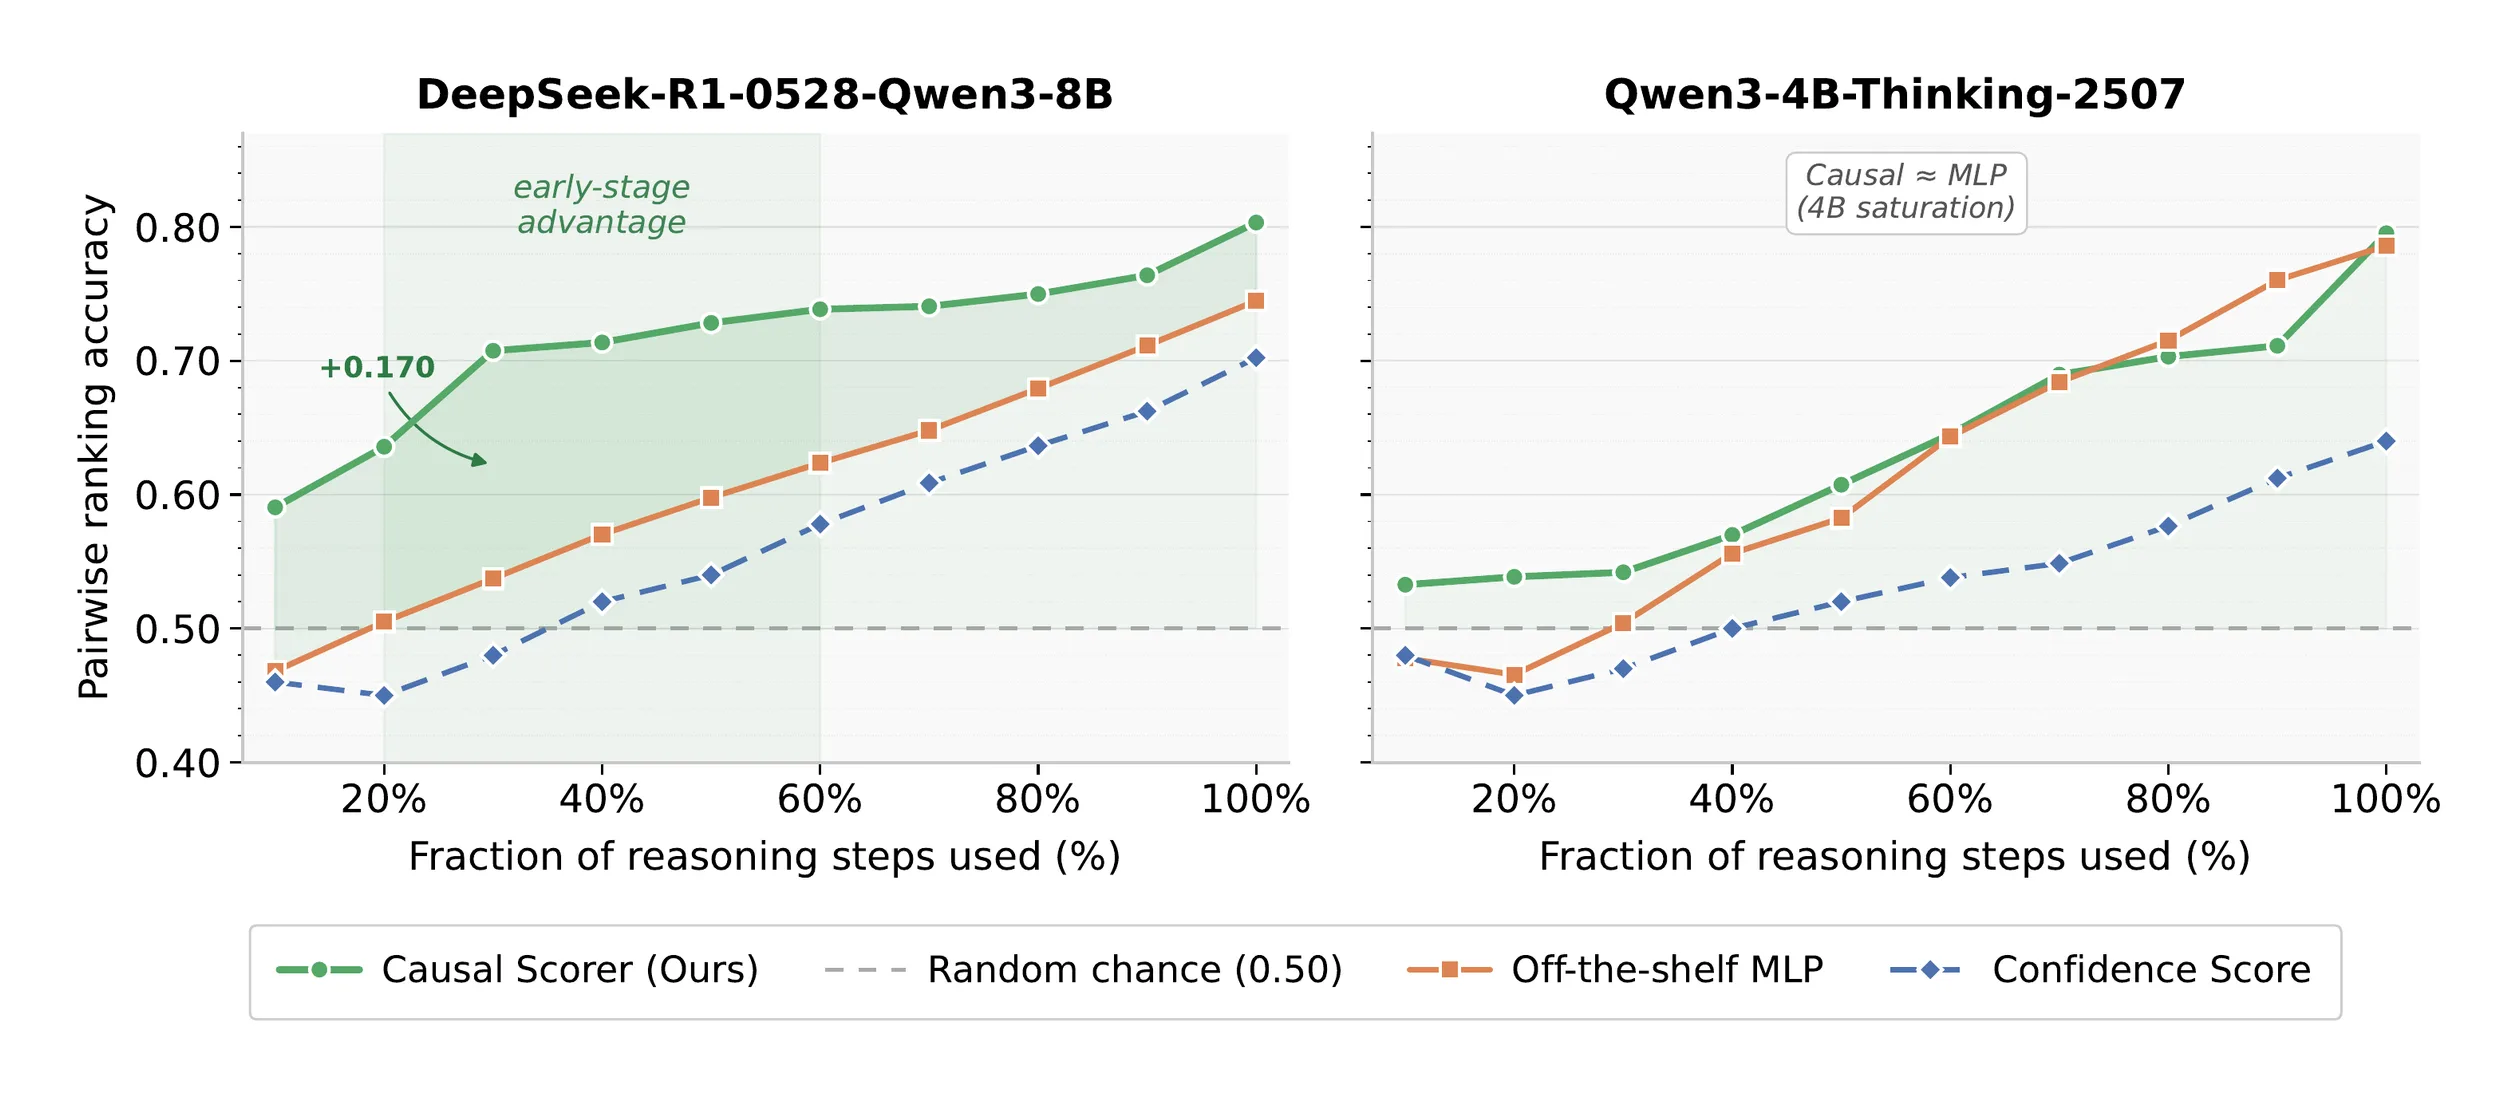
이 그림은 정답으로 끝난 풀이 하나와 오답으로 끝난 풀이 하나를 짝지어 놓고, 풀이의 앞 몇 퍼센트만 보여 준 뒤 채점기가 정답 쪽에 더 높은 점수를 주는지를 잰 것입니다. 0.5면 동전 던지기입니다.
주 실험에 쓰인 주황 선을 보세요. 풀이의 10~20%만 봤을 때 정확도는 0.47~0.50, 동전 던지기와 같습니다. 40%쯤에서 0.57, 60%에서 0.62~0.64, 다 본 뒤에야 0.75~0.79입니다. 초반 점수로 풀이를 내보내거나 복제하면 무작위로 고르는 것과 다르지 않습니다. 12,000토큰은 채점기가 쓸모 있어지기를 기다리는 시간입니다.
저자들이 따로 학습한 순차 채점기(초록 선)는 문단 하나가 아니라 지금까지의 문단 전체를 작은 트랜스포머로 읽습니다. 8B 모델에서는 초반부터 0.6~0.7로 확실히 낫지만, 4B 모델에서는 기성 채점기와 거의 같습니다.
유령 풀이 — 장부와 실제를 떼어 놓다
논문에서 가장 시스템 냄새가 나는 대목이 5.2절입니다. 이름은 분리된 뷰 구조이고, 풀려는 문제는 미묘합니다.
GPU 메모리가 꽉 차면 서버는 무언가를 내려야 합니다. Gambit은 이때 점수가 가장 낮은 풀이를 메모리에서 내립니다. 문제는 그다음입니다. 탐색 알고리즘이 이것을 '풀이 하나가 사라졌다'고 받아들이면 살아 있는 수가 C보다 작아지고, 경우 1이 발동해 1위 풀이를 복제해 빈자리를 채웁니다. 복제본이 메모리를 쓰니 또 꽉 차고, 또 하나가 내려가고, 또 1위가 복제됩니다. 이 고리가 몇 번 돌면 풀이들이 1~2위의 복제본으로 뒤덮입니다. 4장에서 경고한 '한 풀이에 몽땅 걸기'가 메모리 압박 때문에 저절로 벌어지는 것입니다.
해법은 장부를 둘로 나누는 것입니다.
일정 관리자의 장부실제로 메모리를 쥔 풀이메모리가 차면 꼴찌를 내린다. 언제 끝낼지도 이 장부로 정한다.
탐색 나무의 장부논리적으로 살아 있는 풀이메모리에서 내려간 풀이도 '살아 있음'으로 남는다. 토너먼트는 이 장부만 본다.
메모리에서 내려간 풀이는 토큰을 더 쓰지 않고 메모리도 쥐지 않지만, 탐색 나무의 장부에는 살아 있는 것으로 남습니다. 논문은 이것을 유령 풀이(ghost trace)라고 부릅니다. 토너먼트는 탐색 나무의 장부를 보므로 풀이 수가 여전히 C라고 여기고, 균형 잡힌 경우 2(아래 K개 내보내기, 위 K개 복제)를 실행합니다. 유령은 자리만 지키다가 점수가 아래 K 안에 들어가는 회차에 정식으로 나갑니다. 메모리 사정이 탐색의 판단을 일그러뜨리지 못하게 한 장치입니다.
직접 돌려 보기
아래 모의실험은 이 알고리즘을 16칸짜리로 줄인 것입니다. 세 방식을 같은 문제 240개에 돌려 최종 답이 맞을 확률을 비교하고, 한 문제의 진행을 칸별로 보여 줍니다. 먼저 '채점관 잡음'을 0으로 내렸다가 0.5 이상으로 올려 보세요. Gambit의 이득이 어디에서 오는지가 보입니다.
기본값에서 세 방식의 순서는 논문과 같습니다. 다 돌리고 다수결이 가장 낮고, 내보내기만 하는 방식이 중간, 내보내고 복제하는 방식이 가장 높습니다. 그런데 잡음을 올리면 세 방식이 한 점으로 모입니다. 복제는 채점기가 맞을 때만 이득이고, 채점기가 틀리면 틀린 풀이를 늘릴 뿐입니다. 이 장난감 모형이 논문에 보태는 한 줄이 있다면 이것입니다. Gambit의 성능은 탐색 구조만큼이나 채점기의 품질에 달려 있습니다.
6장. Gambit ③ 성적표 — 그리고 '엄격히 우세'를 검산하기
실험 설정
모델 셋: Qwen3-4B-Thinking-2507, DeepSeek-R1-0528-Qwen3-8B, Phi-4-reasoning-plus(14B). 모두 공개 가중치의 소형 추론 모델입니다.
벤치마크 다섯: 수학 경시 AIME 2025·2026, HMMT 2024·2025(각 30문항), 대학원 수준 과학 문제 GPQA-Diamond(198문항).
비교 대상 넷: 자기 일관성(SC, 가중 없는 다수결), Slim-SC, DeepConf, STEP.
조건: 문제마다 완성된 풀이 256개. NVIDIA B300(275GB) 한 장, vLLM 위에서 구현.
Gambit 설정: 모든 모델·벤치마크에서 C=256, K=16, Δ=200, w=12,000으로 고정.
주 결과
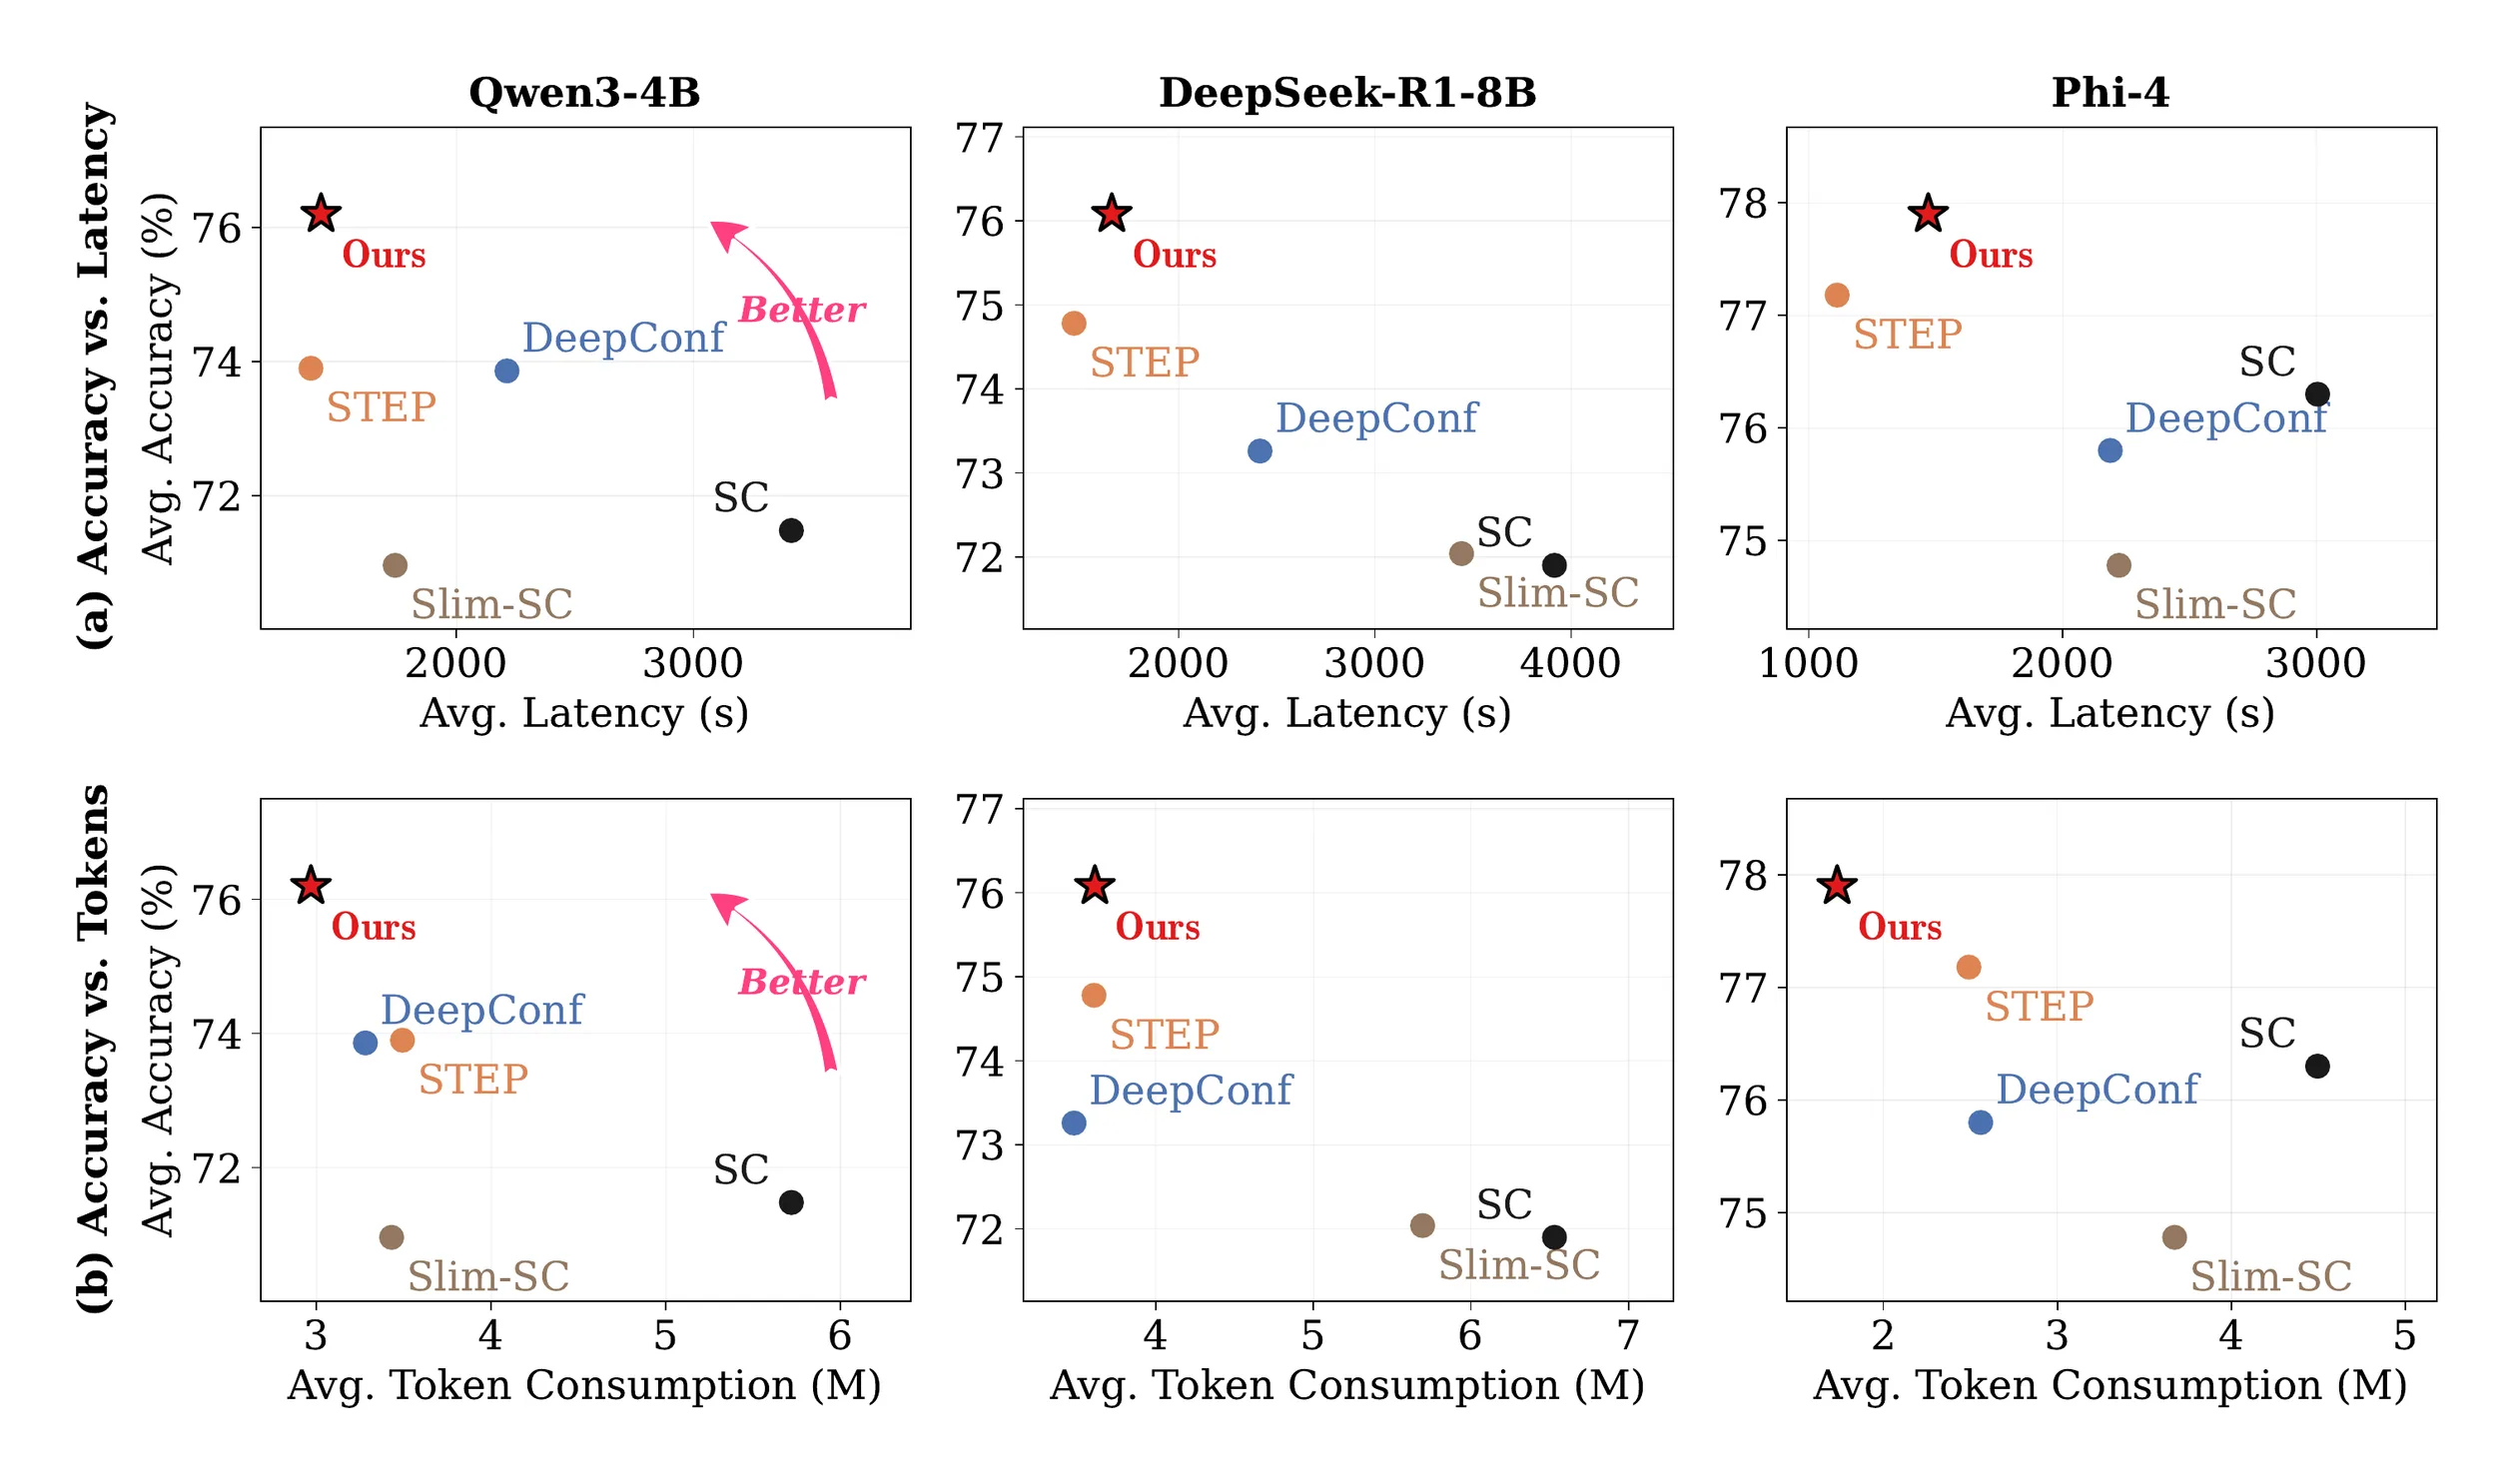
초록의 주장은 셋입니다. HMMT-24에서 +6.7점, AIME-25에서 +3.3점(가지치기 기준선 대비), 풀이 완성 처리량 2배 이상, 병렬 표집 대비 토큰 최대 68.5% 감소.
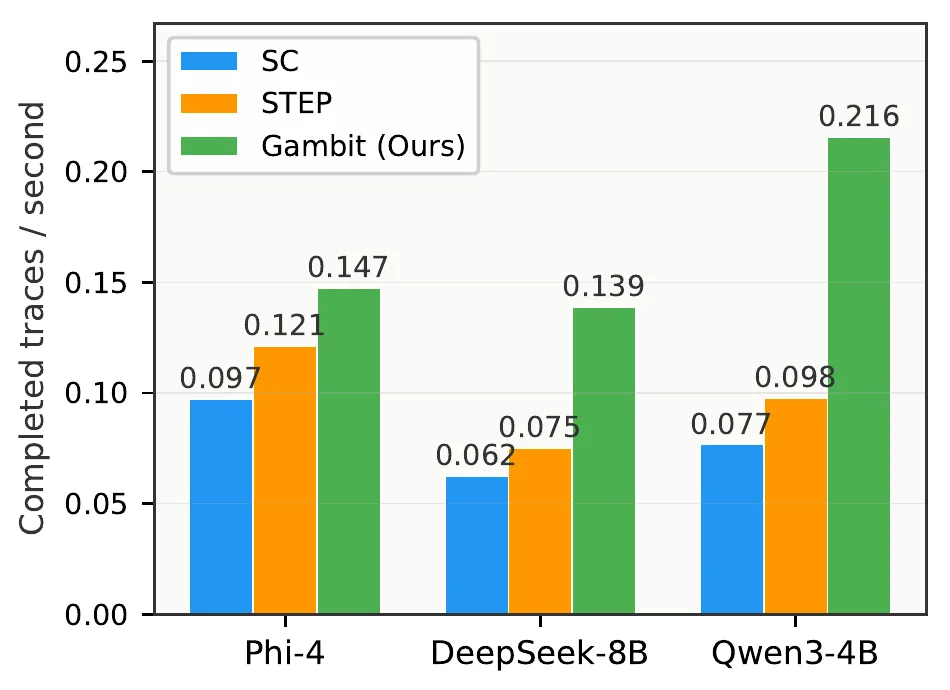
그림 5는 모델별로 다섯 벤치마크를 평균한 것입니다. 아래 줄(토큰 대 정확도)에서 Gambit의 별은 세 모델 모두 가장 왼쪽 위에 있습니다. 가장 적은 토큰으로 가장 높은 평균 정확도입니다. 위 줄(지연 대 정확도)에서는 사정이 조금 다릅니다. DeepSeek-R1-8B와 Phi-4에서 주황 점 STEP이 별보다 왼쪽, 곧 더 빠릅니다.
토큰이 가장 크게 준 곳은 Phi-4의 HMMT-25입니다. 병렬 표집이 문제당 556만 토큰을 쓸 때 Gambit은 175만 토큰을 썼습니다. 68.5% 감소가 이 칸입니다. 왜 이렇게 줄까요? 부록의 분석에 따르면 Phi-4에서 풀이 한 줄이 새로 쓴 토큰의 중앙값은 병렬 표집 14,500, STEP 7,700, Gambit 5,200입니다. 완성된 풀이의 상당수가 프롤로그의 자식 풀이처럼 긴 앞부분을 물려받고 끝부분만 새로 쓴 것이기 때문입니다.
재미있는 대목이 하나 더 있습니다. 물려받은 부분까지 합친 전체 길이는 Gambit 쪽이 오히려 깁니다(DeepSeek-R1-8B에서 중앙값 35,800 대 STEP 16,500). 논문의 설명은 이렇습니다. STEP은 풀이를 일찍 잘라 내므로 살아남은 풀이가 짧은 쪽에 몰리고, Gambit은 오래 버틴 좋은 풀이를 늘리므로 긴 쪽에 몰립니다. 긴 풀이가 많이 돌고 있으면 시간이 더 듭니다. 문맥이 길수록 토큰 하나를 쓸 때 돌아봐야 할 앞 토큰이 많기 때문입니다. 토큰을 절반 넘게 줄이고도 시간은 그만큼 줄지 않는 까닭입니다.
칸마다 다시 세어 보기
논문은 여러 차례 Gambit이 기존 방법을 "엄격히 지배한다(strictly dominates)"고 씁니다. 표 전체를 아래 탐색기에 옮겼습니다. 칸을 눌러 가며 직접 확인해 보세요.
모델 셋 × 벤치마크 다섯, 15칸을 세면 이렇습니다.
지표
Gambit 단독 1위
공동 1위
1위 아님
정확도
11칸
3칸
1칸
토큰 (적을수록 좋음)
10칸
0칸
5칸
지연 (짧을수록 좋음)
5칸
0칸
10칸
정확도는 15칸 중 14칸에서 1위이거나 공동 1위이므로 '거의 언제나 가장 정확하다'는 말은 성립합니다. 토큰은 Phi-4에서 다섯 칸 모두 1위지만 DeepSeek-R1-8B의 AIME 두 칸에서는 STEP과 DeepConf보다 많이 씁니다. 지연은 15칸 중 10칸에서 STEP이 더 빠릅니다. 수학에서 '엄격한 지배'는 모든 축에서 같거나 낫고 하나 이상에서 더 나을 때 쓰는 말입니다. 이 표가 뒷받침하는 문장은 그보다 약합니다. "정확도는 가장 높고, 토큰은 대체로 가장 적고, 지연은 가지치기와 비슷하거나 조금 느리다." 논문 본문도 지연에 대해서는 "STEP이 약간 더 빨라 보일 수 있다"고 인정하고, 대신 STEP은 끝까지 간 풀이가 줄어 투표에 참여하는 표가 적다는 점을 듭니다.
Qwen3-4B에서 STEP은 초당 0.098개, Gambit은 0.216개의 풀이를 완성합니다. 표의 지연(STEP 1,232초)을 곱하면 STEP이 끝까지 완성한 풀이는 약 120개입니다. 256줄로 시작해 절반 넘게 내보냈다는 뜻입니다. Gambit은 같은 시간에 256개를 채웁니다. 다만 초록이 말하는 "2배 이상"은 이 모델에서만 성립합니다. 그림에서 직접 나누면 Qwen3-4B는 2.2배, DeepSeek-8B는 1.85배, Phi-4는 1.2배입니다.
한 문제의 무게
헤드라인 숫자를 문항 수로 바꾸면 인상이 달라집니다. AIME와 HMMT는 30문항이라 한 문제가 3.3점입니다. 초록의 "AIME-25에서 +3.3점"은 한 문제이고, "HMMT-24에서 +6.7점"은 두 문제입니다. 그리고 +6.7점은 DeepConf(58.3%)와의 차이입니다. 같은 채점기를 쓰는 STEP(61.7%)과의 차이는 +3.3점, 한 문제입니다.
표의 값이 85.8%, 65.6%처럼 30문항으로 나누어떨어지지 않는 것으로 보아 여러 번 돌린 평균으로 보입니다. 그런데 논문은 몇 번 돌렸는지, 표준편차가 얼마인지 적지 않았습니다. 한두 문제 차이가 우연인지 아닌지를 독자가 판단할 재료가 없습니다.
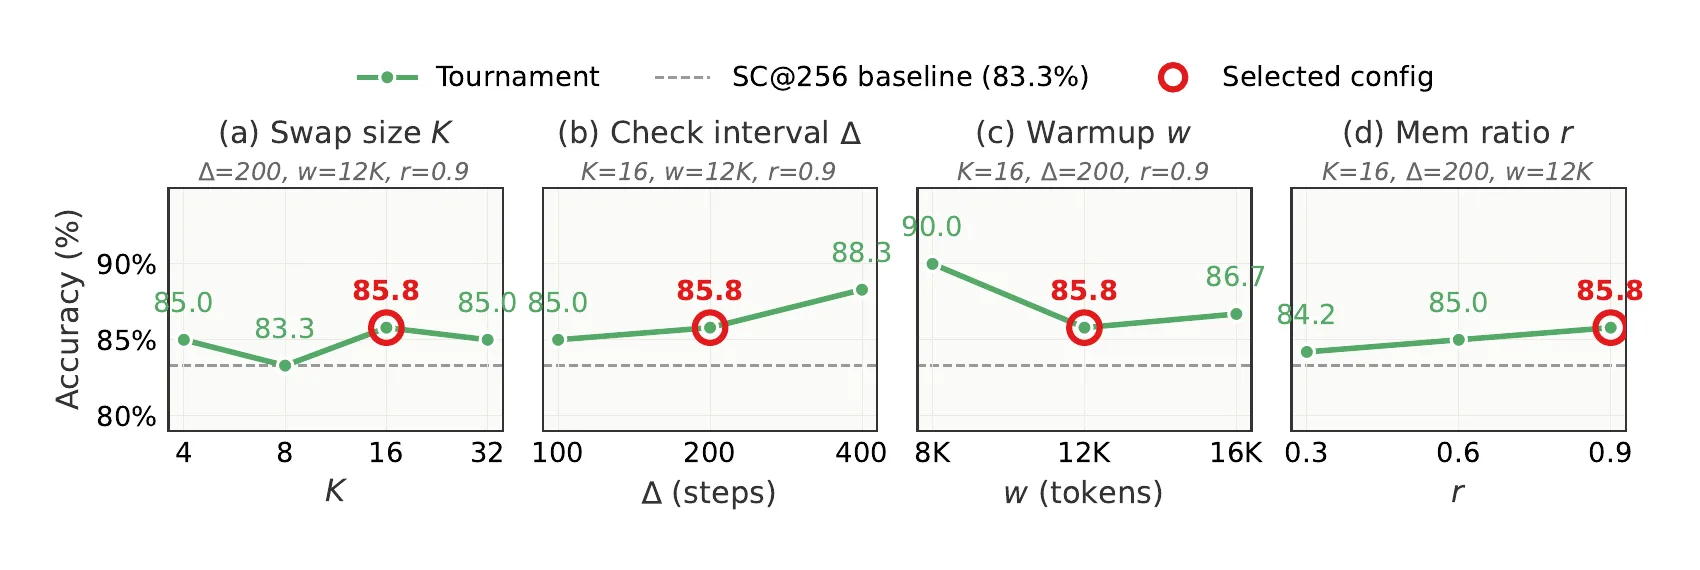
논문은 이 그림을 두고 "선택한 설정이 넓은 고성능 영역 안에 있고 기준선을 꾸준히 넘는다"고 씁니다. 그림을 그대로 읽으면 세 가지가 눈에 띕니다. 워밍업을 12,000에서 8,000으로 줄이면 85.8%가 90.0%로 오릅니다. 점검 간격을 200에서 400으로 늘리면 88.3%입니다. 논문이 고른 설정은 이 그림 안에서 최선이 아닙니다. 본문은 "간격 400은 교정을 늦춘다", "너무 이른 복제는 추론 품질을 해친다"고 설명하는데 그림의 숫자는 반대 방향입니다. 그리고 교체 크기 8에서는 83.3%로 기준선과 같습니다. 이 값들의 간격이 한 문제(3.3점) 안팎이라는 점까지 합치면, 이 그림이 보여 주는 것은 '매끄러운 고원'보다 '한 문제 단위의 흔들림'에 가깝습니다. 한편 설정을 시험 문제에 맞춰 고른 것 아니냐는 의심에는 이 그림이 반대 증거가 됩니다. 맞춰 골랐다면 90.0%가 나오는 설정을 골랐을 것입니다.
그 밖에 따져 볼 것들
투표 방식이 다릅니다. Gambit은 점수 가중 투표를, 자기 일관성은 가중 없는 다수결을 씁니다. 그림 4의 예에서 보았듯 가중만으로 결과가 바뀌는 경우가 있습니다. 탐색 구조의 효과와 투표 방식의 효과를 분리한 실험은 논문에 없습니다. 같은 채점기를 쓰는 STEP과의 비교가 그나마 깨끗한 비교입니다.
채점기의 학습 자료. 주 실험의 채점기는 STEP이 HMMT 2012~2023년 문제로 만든 풀이들로 학습한 것입니다. 평가에 쓰인 HMMT 2024·2025와 연도는 다르지만 같은 대회입니다.
채점기는 무엇을 보는가. 2026년 9월에 나온 한 논문(「경로가 아니라 문제다」, arXiv 2609.03436)은 은닉 상태 채점기가 잡아내는 신호의 상당 부분이 풀이의 좋고 나쁨이 아니라 문제 자체의 난이도라고 주장합니다. 풀이를 보지 않고 문제 난이도만 쓰는 대용 지표가 정오 예측에서 높은 점수를 얻고, 같은 문제 안에서 풀이끼리 가려내는 능력은 동전 던지기 수준이었다는 것입니다. Gambit에 필요한 것은 정확히 같은 문제 안에서 풀이끼리 가려내는 능력입니다. 논문 그림 9의 쌍별 순위 정확도 0.75~0.80이 그 능력의 직접 증거이므로 두 결과는 그대로 충돌하지는 않지만(모델과 채점기가 다릅니다), 채점기의 점수가 어디에서 오는지는 아직 열린 문제입니다.
소형 공개 모델에서만. 실험은 4B~14B 모델, GPU 한 장입니다. Gambit은 모델의 은닉 상태를 읽고 KV 캐시를 직접 다뤄야 하므로 API로만 쓸 수 있는 상용 모델에는 적용할 수 없습니다. 공개 저장소는 vLLM 0.11.1을 고친 것이고, 2026년 11월 현재 별 10개, 커밋 2개입니다.
그래도 분명한 것. 가지치기와 같은 채점기를 쓰고도 15칸 중 12칸에서 STEP보다 정확하고 나머지 3칸은 동률입니다. 뒤진 칸이 없습니다. 저자들이 새로 학습한 채점기로 바꿔도 10칸 모두에서 STEP보다 높았습니다(부록 표, +0.8~7.7점). 덜어 낸 자리를 비워 두지 않고 좋은 풀이로 채운다는 생각이 방향으로서 옳다는 것은 이 정도면 충분히 보였습니다.
Gambit이라는 이름. 논문은 이름의 뜻을 설명하지 않습니다. 체스에서 갬빗은 초반에 졸 하나를 내주고 판의 주도권을 얻는 수입니다. 낱말은 '다리를 걸다'는 뜻의 이탈리아어에서 왔습니다. 약한 풀이를 일부러 버려 강한 풀이에 자리를 내준다는 점에서 어울리는 이름입니다.
7장. MaAS ① 한 벌 옷의 문제 — 질문마다 팀이 달라야 한다
이제 단위를 한 단계 올립니다. Gambit이 한 모델의 풀이 여러 줄 사이에서 메모리를 나눴다면, MaAS는 질문 여러 개 사이에서 토큰을 나눕니다.
자동 설계가 남긴 숙제
2024년은 에이전트 구조를 사람 대신 탐색이 정하기 시작한 해였습니다. ADAS, AgentSquare, AFlow 같은 방법은 "생성 → 검토 → 수정"을 어떤 순서로 몇 번 엮을지를 벤치마크 점수를 보며 자동으로 찾았습니다. 이 흐름은 앞 특집에서 자세히 다뤘습니다. 이 방법들에는 공통점이 있습니다. 탐색이 끝나면 구조 하나가 남고, 그 뒤로 들어오는 모든 질문이 그 구조를 지나갑니다.
2025년 2월 싱가포르 국립대·퉁지대 등의 연구진이 낸 MaAS 논문은 이것을 "한 치수로 모두에게 맞추는(one-size-fits-all)" 방식이라 부르고 두 가지 딜레마를 듭니다.
딜레마 1, 난이도. 탐색은 점수를 올리는 쪽으로 가므로 LLM을 수십 번 부르는 무거운 구조에 닿기 쉽습니다. 그런데 수학 벤치마크 안에도 박사 수준의 추상대수와 초등 산수가 함께 있습니다. 뒤쪽은 한 번 물으면 끝납니다.
딜레마 2, 영역. GAIA처럼 웹 검색, 파일 읽기, 이미지 이해가 섞인 벤치마크에서는 모든 과제에 가장 좋은 구조 하나가 애초에 없습니다. 그래서 앞선 연구들은 벤치마크를 영역별로 쪼개 따로 최적화해야 했습니다.
아래 계산기로 딜레마 1을 숫자로 느껴 보세요. 쉬운 질문의 비율을 올릴수록 '모두 큰 팀에게'의 호출 대부분이 정확도를 올리지 못한 채 쓰입니다.
슈퍼넷이라는 말은 어디서 왔나
MaAS의 답은 구조 하나를 찾는 대신 구조들의 확률 분포를 학습하는 것입니다. 논문은 이것을 '에이전트 슈퍼넷(agentic supernet)'이라고 부릅니다. 이 이름은 신경망 구조 탐색(NAS)에서 빌려 온 것입니다.
NAS의 역사를 세 줄로 줄이면 이렇습니다. 2016~2017년 구글의 조프(Barret Zoph)와 르(Quoc Le)는 강화학습으로 신경망 구조를 찾았는데, GPU 800대로 구조 12,800개를 하나하나 학습시켜 봐야 했습니다. 2018년 ENAS는 후보 구조들이 가중치를 함께 쓰게 해서 비용을 약 1,000분의 1로 줄였습니다. 같은 해 DARTS는 한 걸음 더 나아가, 가능한 모든 연산을 한 그물에 겹쳐 놓고 "이 자리에 어느 연산을 쓸지"를 연속적인 확률로 풀어 경사 하강법으로 학습했습니다. 모든 후보 구조를 부분 그물로 품은 이 큰 그물이 슈퍼넷입니다. 후보를 하나씩 따로 키워 보는 대신 큰 그물 하나를 키우고 거기서 부분을 꺼내 씁니다.
MaAS는 관련 연구 절에서 이 역사를 그대로 가져옵니다. 에이전트 자동화가 NAS의 길을 따라가고 있고(강화학습 → GPTSwarm, 진화 → EvoAgent, 베이즈 최적화 → AgentSquare, 몬테카를로 트리 탐색 → AFlow), NAS에서 그 블랙박스 방법들이 결국 슈퍼넷 학습에 밀렸듯 에이전트에서도 같은 전환이 필요하다는 것입니다.
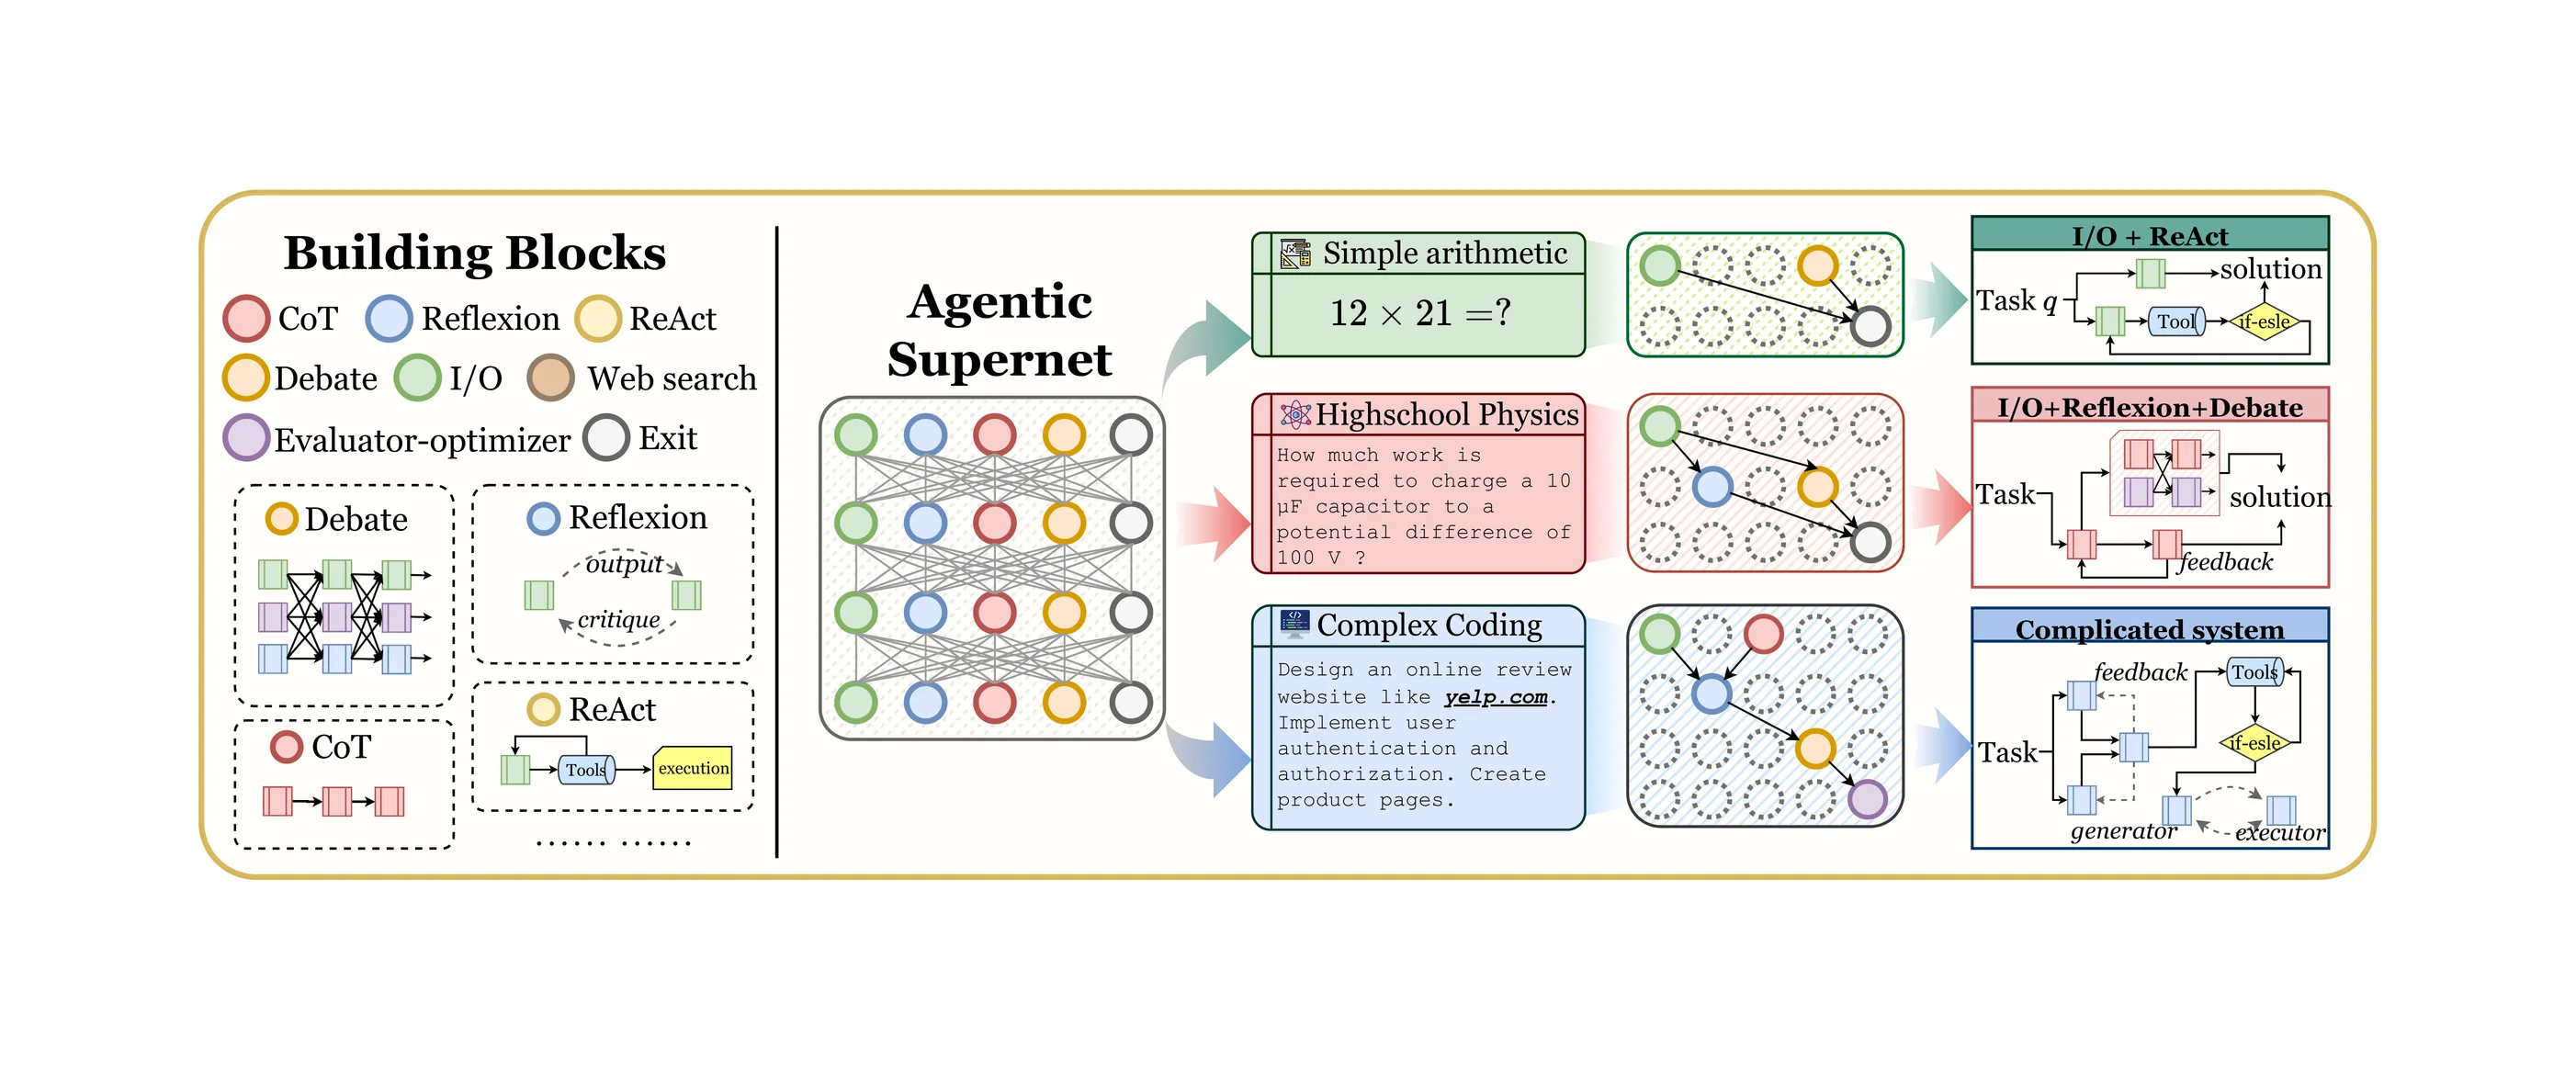
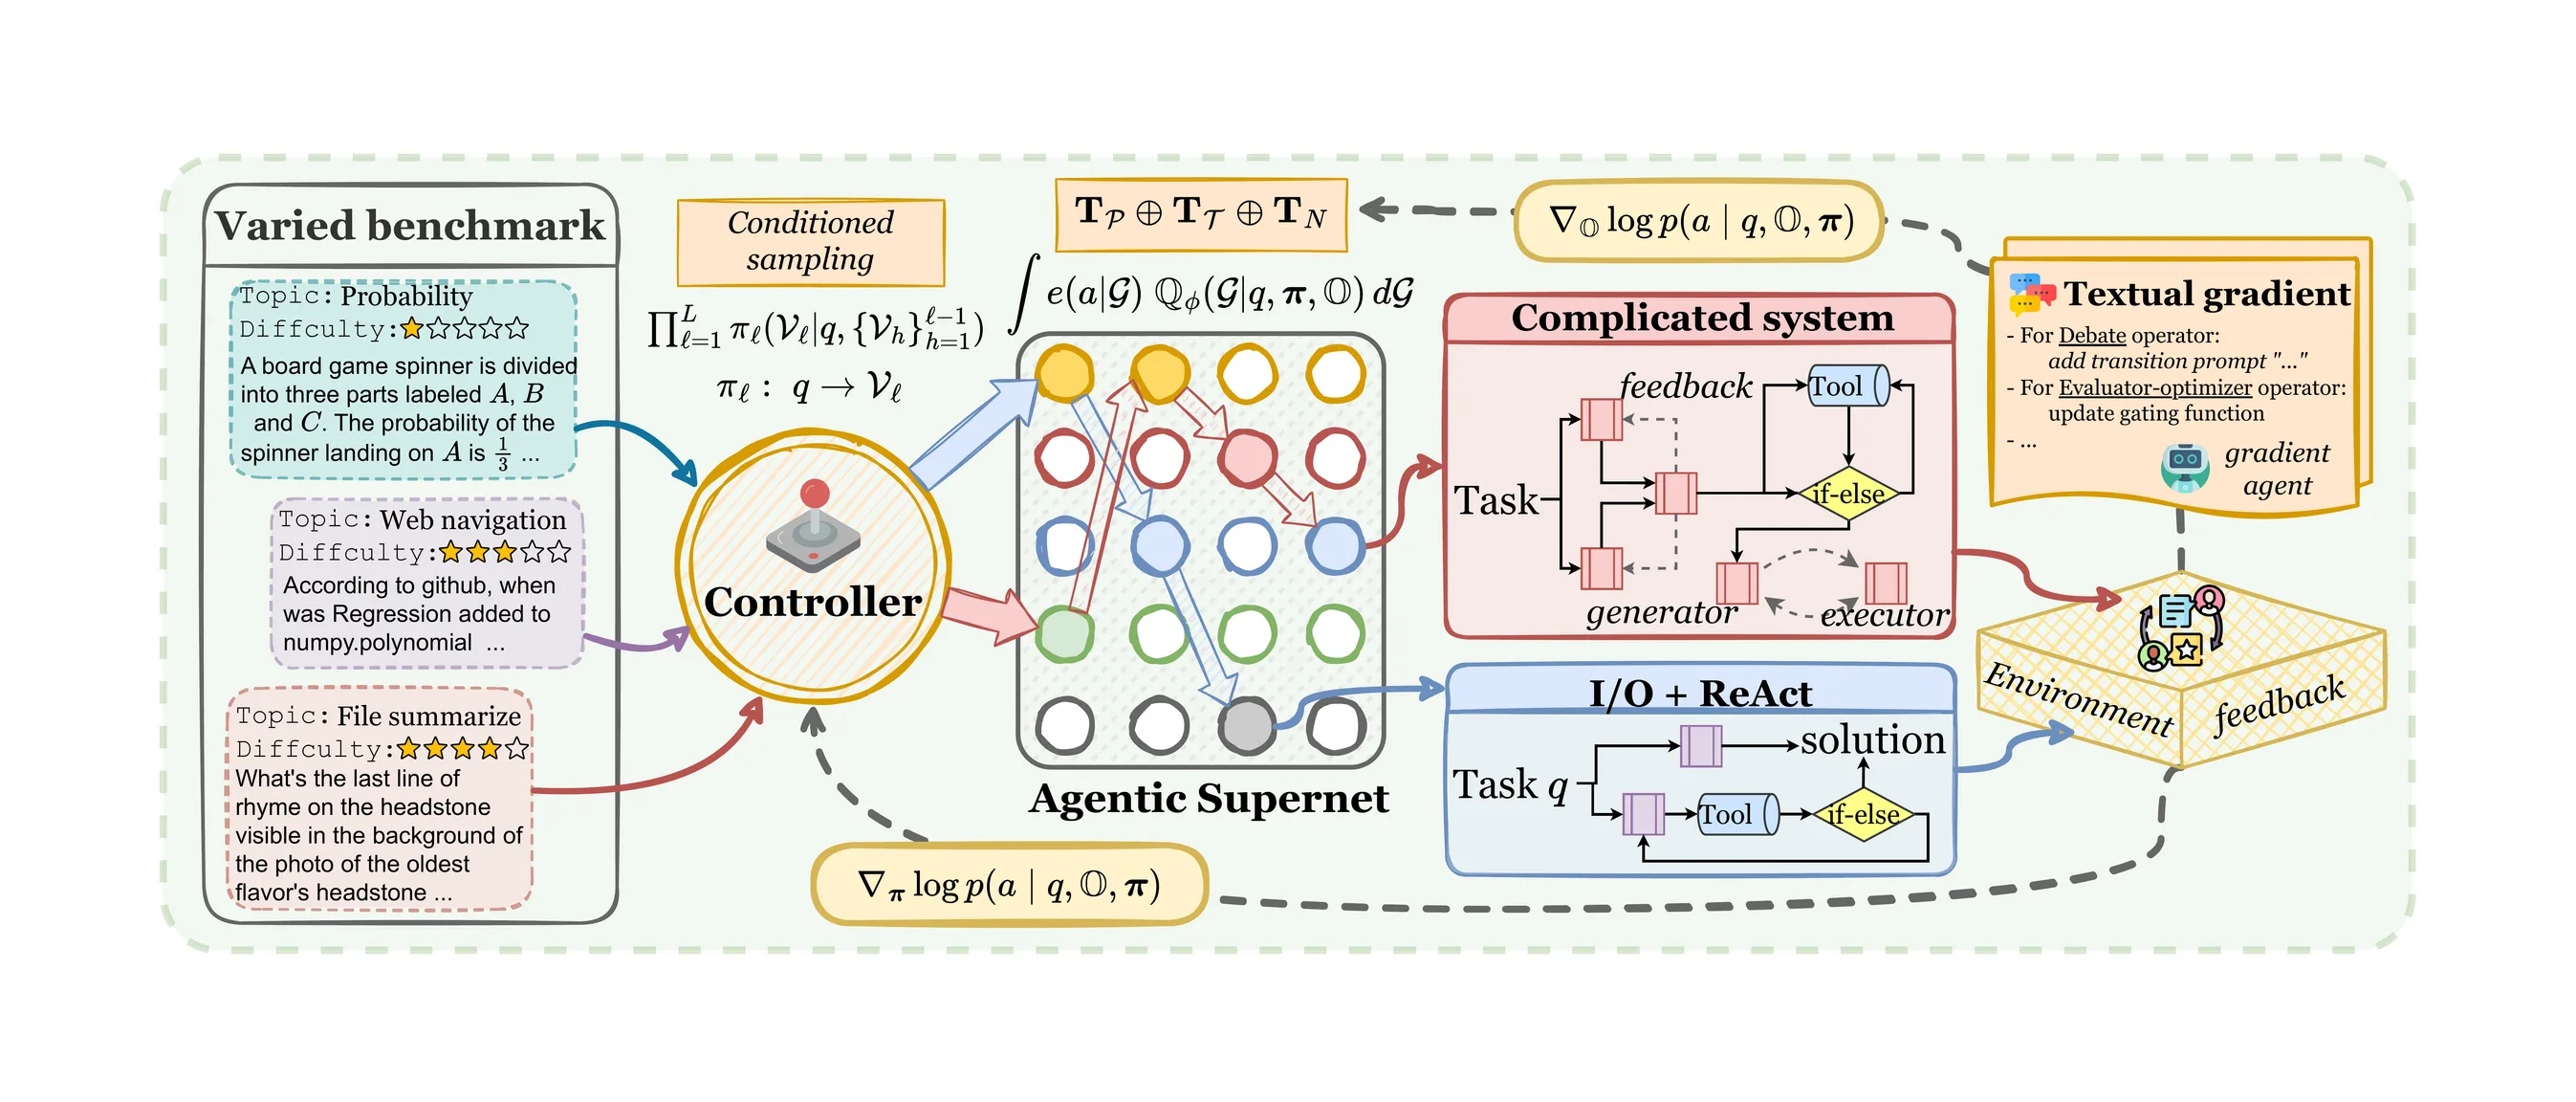
그림 가운데의 격자가 슈퍼넷입니다. 가로줄 하나가 층이고, 동그라미 하나가 그 층에서 쓸 수 있는 연산자입니다. 오른쪽 세 예에서 실선으로 이어진 동그라미만 실제로 실행됩니다. "12 × 21 = ?"에는 첫 층의 입출력과 ReAct 둘만 켜지고 곧바로 끝납니다. 사이트를 통째로 만들라는 요청에는 네 층이 모두 쓰입니다.
한 가지 짚어 둘 것이 있습니다. NAS의 슈퍼넷에서 핵심은 가중치 공유였습니다. 후보 구조들이 같은 숫자 덩어리를 함께 써서 학습 비용을 나눴습니다. MaAS의 슈퍼넷에는 공유할 가중치가 없습니다. 연산자들은 프롬프트와 LLM 호출이고, 학습되는 것은 "이 질문, 이 층에서 어느 연산자를 켤지"를 정하는 작은 신경망 하나입니다. 구조로 보면 NAS의 슈퍼넷보다는 질문을 보고 경로를 고르는 라우터에 가깝습니다. 일찍 끝내는 문도 2016년의 BranchyNet(확신이 서면 중간 층에서 빠져나가는 신경망)과 같은 해 그레이브스의 적응형 계산 시간에서 온 오래된 생각입니다. 이름은 NAS에서, 뼈대는 라우팅과 조기 종료에서 왔다고 보면 정확합니다.
8장. MaAS ② 구조를 뽑는 법 — 연산자, 층, 문턱, 조기 종료
부품: 에이전트 연산자
MaAS의 가장 작은 단위는 에이전트 연산자입니다. 논문의 정의는 "여러 번의 LLM 호출과 도구 사용을 묶은 호출 절차"입니다. 이미 이름이 있는 기법들이 그대로 연산자가 됩니다. 부록 B.1의 목록은 이렇습니다.
연산자
하는 일
논문의 설정
CoT (단계별 사고)
답을 바로 내지 않고 단계를 밟아 푼다
호출 1회
토론 (LLM-Debate)
여러 에이전트가 서로의 답을 보고 고친다
토론자 3명, 최대 2라운드
자기 일관성
여러 번 풀고 다수결
CoT 5회
자기 다듬기 (Self-Refine)
답을 내고 스스로 돌아보며 고친다
최대 5회 반복
앙상블
서로 다른 모델 여럿의 답을 순위 매겨 합친다
모델 3개
테스트
생성한 코드에 쓸 테스트 사례를 만든다
코드 과제용
ReAct
코드 실행기·웹 검색 같은 도구를 쓰며 푼다
도구 사용
조기 종료
여기서 구조 뽑기를 멈춘다
호출 0회
멀티에이전트 시스템 하나는 이 연산자들을 마디로 하는 방향 그래프입니다. 슈퍼넷은 L개 층으로 이루어지고(실험에서는 4층), 층마다 "각 연산자가 켜질 확률"을 가집니다. 층들의 확률을 곱하면 구조 하나가 뽑힐 확률이 됩니다. 슈퍼넷은 구조 하나가 아니라 가능한 모든 구조 위의 확률 지도입니다.
제어기: 질문을 읽고 층마다 고른다
질문이 들어오면 제어기(controller)가 층을 하나씩 내려가며 연산자를 고릅니다. 제어기는 작은 신경망입니다. 질문 문장을 가벼운 임베딩 모델(MiniLM)로 벡터로 바꾸고, 앞 층에서 고른 연산자들의 임베딩과 이어 붙여 넣으면 연산자마다 활성 점수가 나옵니다. 연산자의 임베딩은 LLM에게 그 연산자의 설명문을 쓰게 한 뒤 그 설명문을 임베딩해서 얻습니다. 새 연산자가 들어와도 설명문만 있으면 점수를 매길 수 있다는 뜻입니다.
한 층에서 몇 개를 켤지는 문턱으로 정합니다. 점수가 높은 연산자부터 차례로 켜다가, 켠 것들의 점수 합이 문턱(thres, 실험에서는 0.3)을 넘으면 멈춥니다.
t=argkmin{j≤k∑Sj↓>thres}
S↓는 점수를 큰 순서로 늘어놓은 것이고 t는 켜지는 연산자 수입니다(논문 식 6을 읽기 쉽게 다시 적었습니다). 이 규칙 덕분에 제어기가 한 연산자를 확신하면(점수 하나가 0.3을 넘으면) 하나만 켜지고, 확신이 흩어져 있으면 둘셋이 함께 켜집니다. 뽑힌 것 가운데 조기 종료가 있으면 거기서 끝납니다.
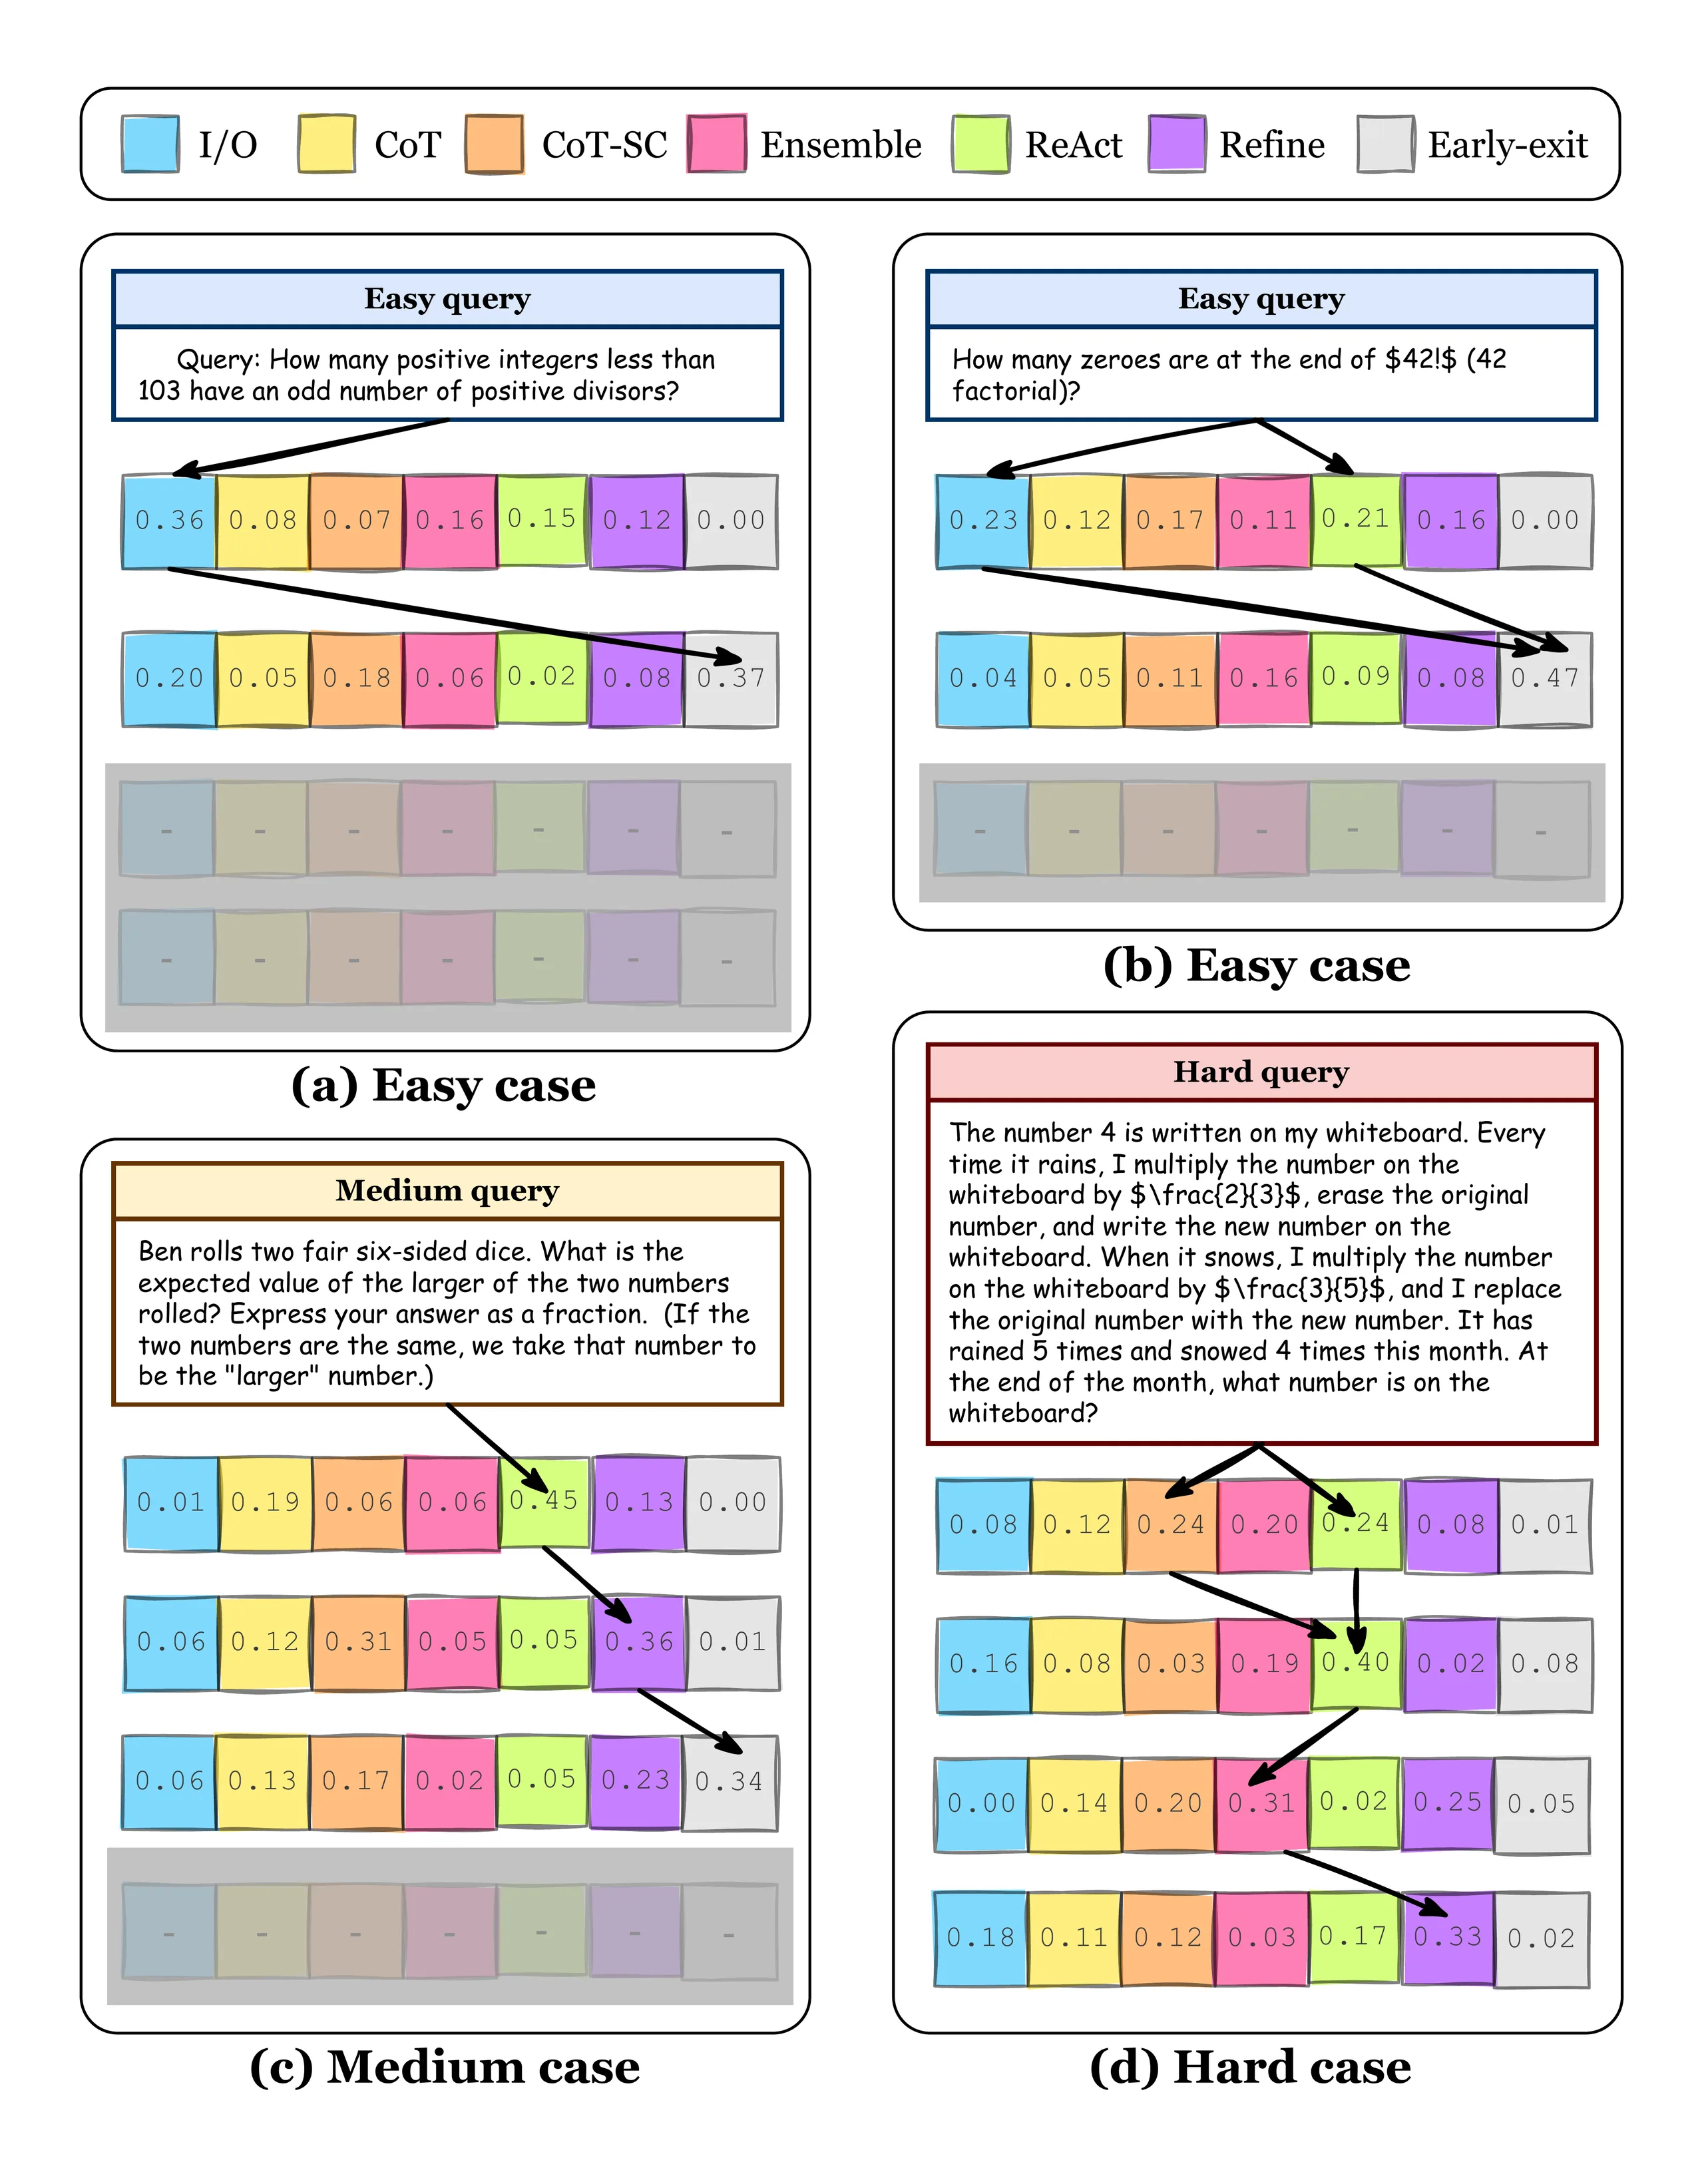
(a)는 "103보다 작은 양의 정수 가운데 약수가 홀수 개인 수는?"입니다. 1층에서 입출력(한 번 묻기)이 0.36으로 문턱을 넘어 혼자 켜지고, 2층에서 조기 종료가 0.37로 켜져 끝납니다. LLM 호출 한 번입니다. (d)는 비와 눈이 올 때마다 분수를 곱하는 긴 문제입니다. 1층에서 자기 일관성과 ReAct(각 0.24)가 함께 켜지고, 2층 ReAct(0.40), 3층 앙상블(0.31), 4층 다듬기(0.33)까지 네 층을 모두 씁니다.
같은 숫자를 아래 위젯에 옮겼습니다. 문턱을 움직이면 같은 점수에서 팀 크기가 어떻게 달라지는지 볼 수 있습니다.
학습 ①: 확률 지도는 비용을 아는 가중치로 고친다
슈퍼넷의 목적 함수는 Gambit의 식과 닮았습니다.
P(G∣q)maxE[U(G;q,a)−λ⋅C(G;q)]
q는 질문, a는 정답, G는 뽑힌 구조입니다. U는 그 구조가 낸 답의 품질, C는 쓴 토큰 비용, λ는 둘을 맞바꾸는 환율입니다. Gambit은 제약을 딱딱한 한도로 적었고(Ω≤B), MaAS는 벌점으로 적었습니다(−λC). 넘으면 안 되는 선과, 넘을수록 손해인 기울기의 차이입니다.
문제는 이 식을 미분할 수 없다는 것입니다. 구조를 실행한다는 것은 외부 API를 부르는 일이라 기울기가 흐르지 않습니다. MaAS는 질문마다 구조를 K개(실험에서는 4개) 뽑아 실제로 돌려 보고, 결과로 가중치를 매깁니다.
mk는 k번째로 뽑은 구조의 성적표입니다. 앞 항은 "네 구조 가운데 이 구조가 정답에 기여한 몫", 뒤 항은 "네 구조 가운데 이 구조가 쓴 비용의 몫"입니다. 잘 맞히고 싸게 푼 구조는 mk가 크고, 그 구조가 뽑힐 확률을 높이는 쪽으로 제어기를 고칩니다. 강화학습의 정책 기울기와 같은 계열의 추정입니다.
학습 ②: 연산자는 '글로 쓴 기울기'로 고친다
확률 지도만 고쳐서는 부족합니다. 연산자 자체, 곧 프롬프트와 온도와 내부 구조도 나아져야 합니다. 그런데 프롬프트는 숫자가 아니라 글이라 숫자 기울기가 없습니다. MaAS는 글로 쓴 기울기(textual gradient)를 씁니다. 실행 결과를 본 LLM이 "토론 연산자에는 이런 전환 문구를 넣어라", "이 연산자는 둘로 쪼개라" 같은 수정 지시를 글로 쓰고, 그 지시대로 연산자를 고쳐 씁니다. 프롬프트 수정, 온도 수정, 마디 구조 수정(합치기·쪼개기·바꾸기)의 세 종류가 있습니다.
모델: gpt-4o-mini-0718을 기본으로, 전이 실험에 Qwen-2.5-72b와 llama-3.1-70b.
비교 대상 14개: 단일 에이전트(CoT, 자기 일관성 등), 손으로 짠 멀티에이전트(LLM-Debate, DyLAN, MacNet 등), 자동 설계(GPTSwarm, ADAS, AgentSquare, AFlow 등).
설정: 4층, 문턱 0.3, 질문당 구조 4개 표집, λ는 0.001·0.005·0.01 가운데 선택.
정확도와 비용
논문 표 1에서 MaAS는 다섯 벤치마크 평균 83.59%로 1위이고, 2위 AFlow는 82.25%입니다. 차이가 가장 작은 곳은 MATH(51.82 대 51.28, 0.54점), 가장 큰 차이는 MBPP에서 MacNet과의 16.89점입니다. 초록의 "0.54%~16.89%"가 이 두 끝입니다. 도구 사용 벤치마크 GAIA에서는 평균 20.69%로, 한 번 묻기(4.65%)는 물론 AFlow(8.00%)와 GPTSwarm(16.33%)을 넘습니다. 영역이 섞인 벤치마크에서 '질문마다 다른 구조'가 가장 잘 통한다는 딜레마 2의 주장과 맞는 결과입니다.
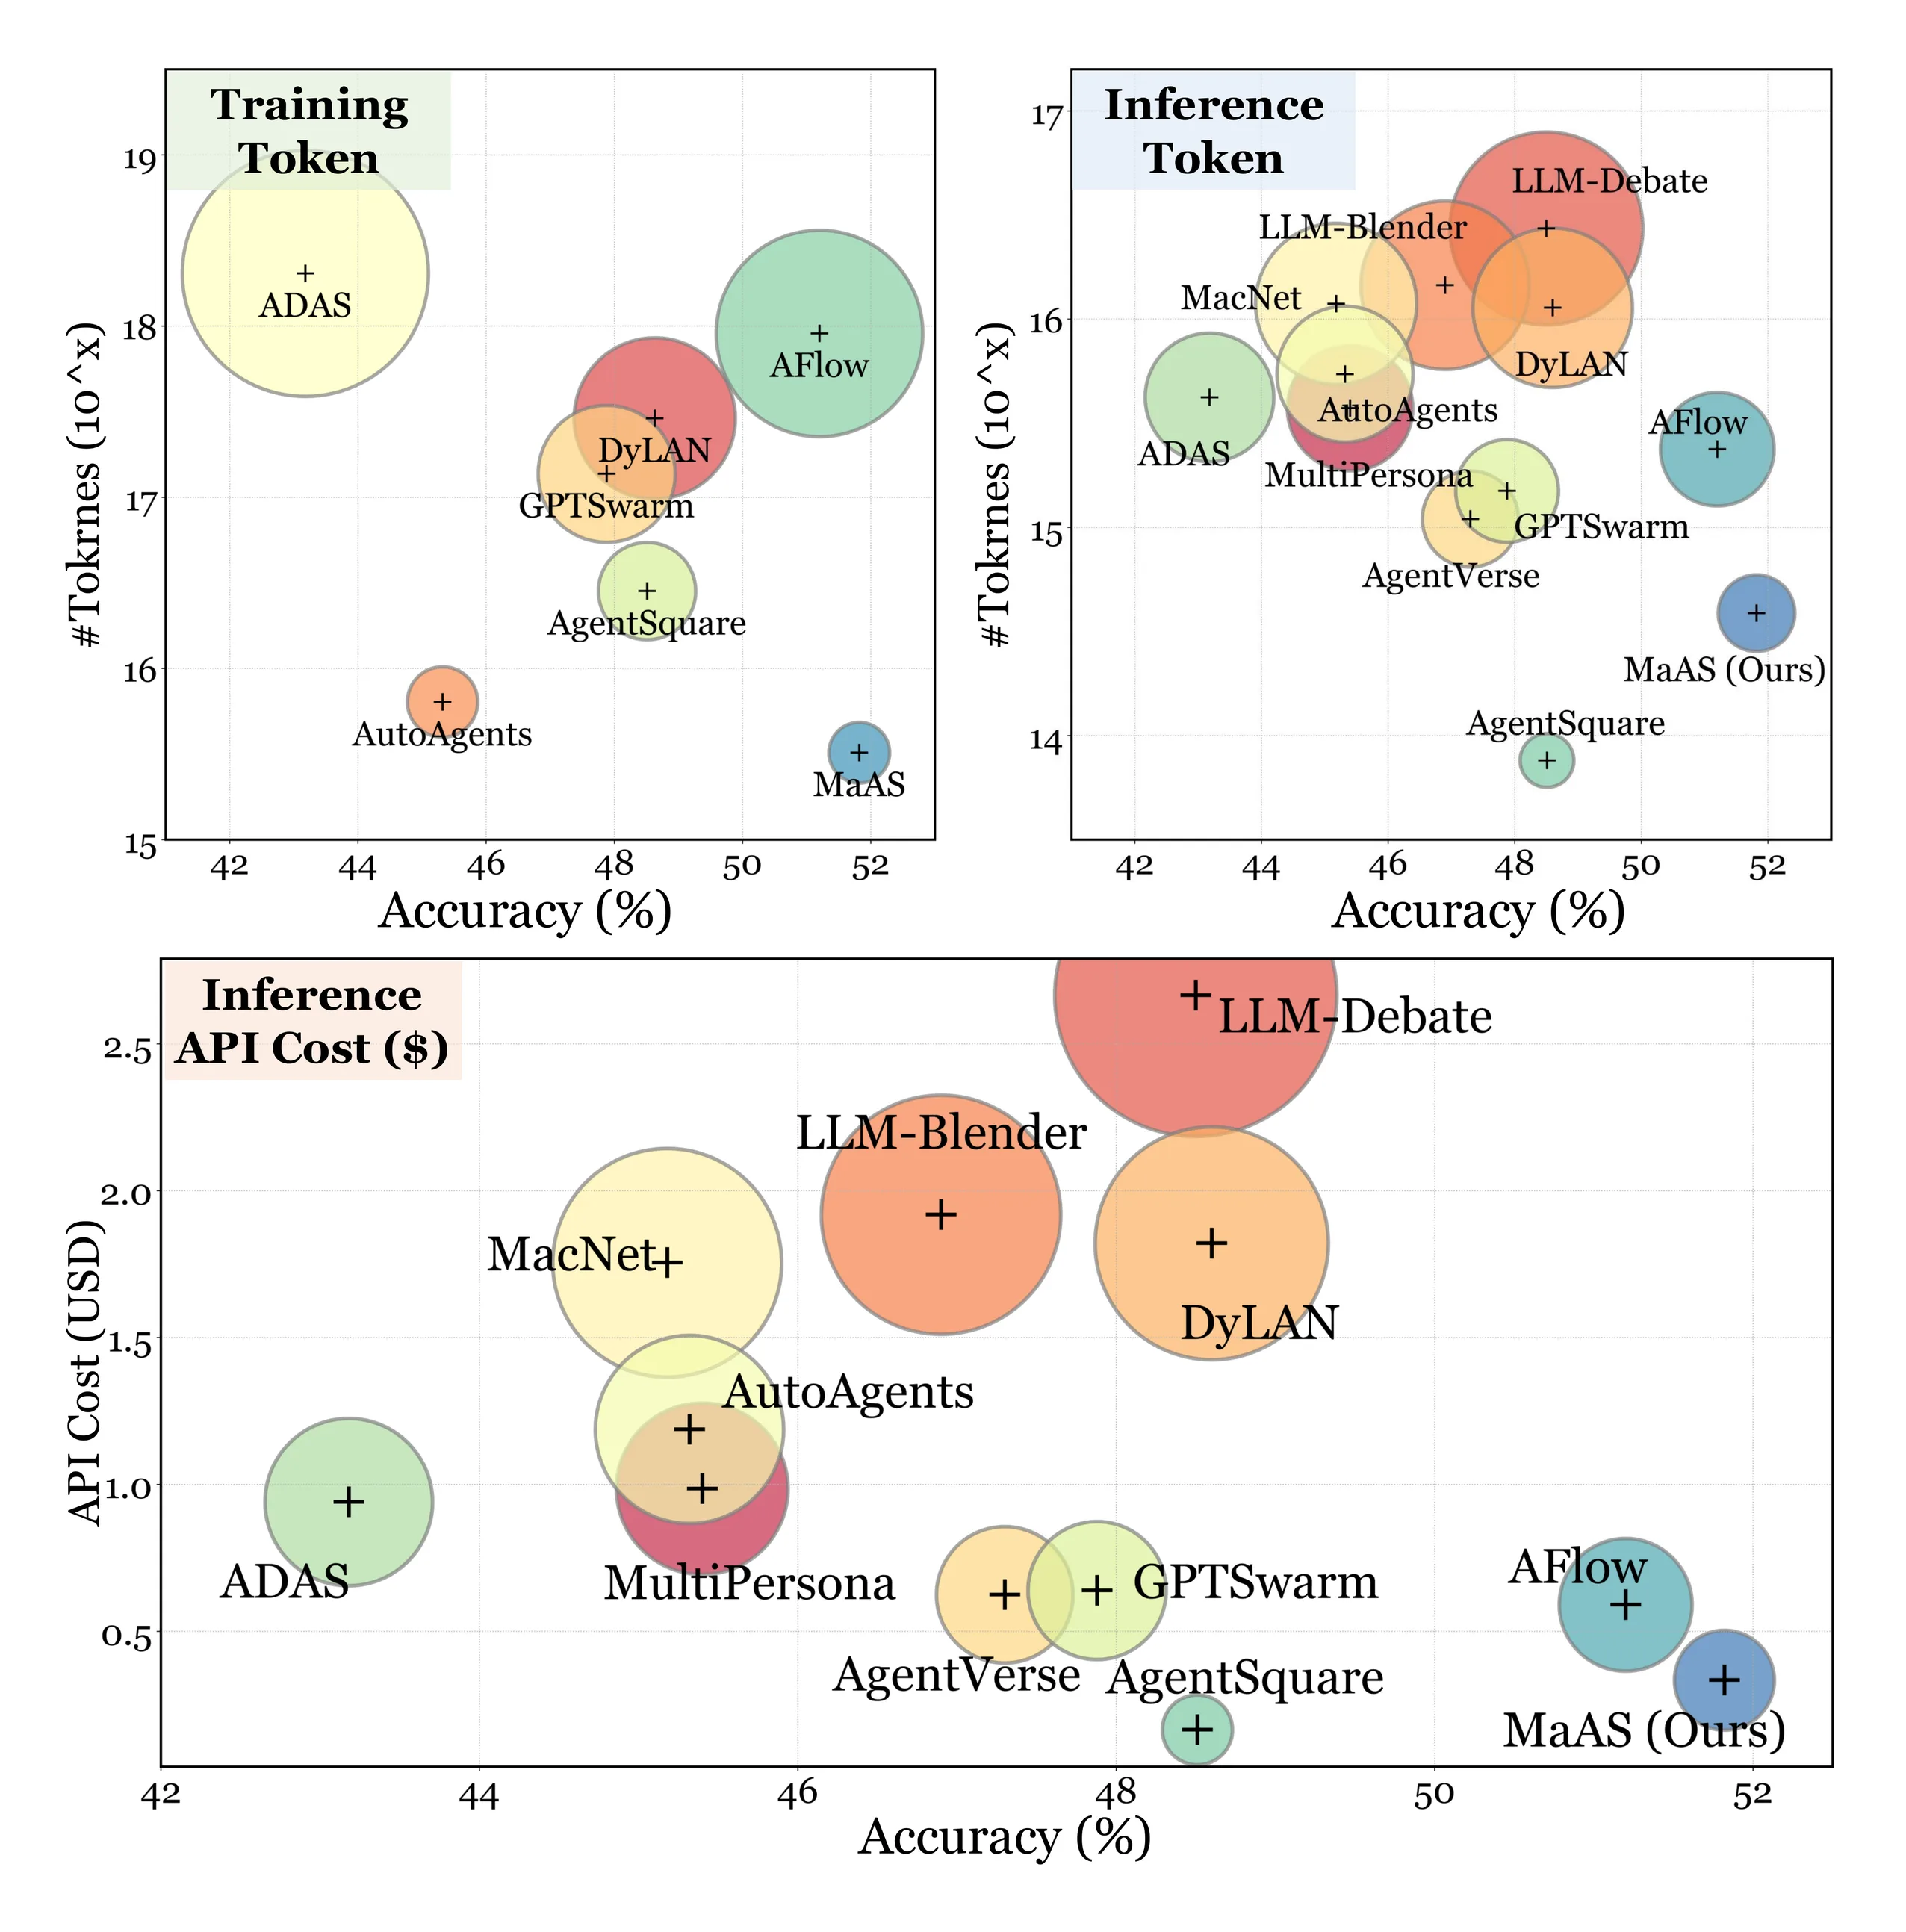
세 칸 모두에서 MaAS의 파란 원은 오른쪽 아래 구석에 있습니다. 표 3의 숫자로는 학습(탐색) 비용이 3.38달러·53분으로 AFlow(22.50달러·184분)의 15%, 추론 비용이 0.42달러로 AFlow(1.66달러)의 25%입니다. 초록의 "추론 비용의 6~45%"는 가장 비싼 LLM-Debate(6.76달러) 대비 6%, 가장 싼 축인 GPTSwarm(0.93달러) 대비 45%에서 나온 범위입니다.
구성 요소를 하나씩 뺀 실험(표 4)은 무엇이 일을 하는지 보여 줍니다.
설정
HumanEval 정확도
질의당 비용 (10⁻³달러)
MATH 정확도
질의당 비용 (10⁻³달러)
MaAS 전체
92.85
1.01
51.82
0.86
글 기울기 없이
90.17
0.90
48.23
0.84
조기 종료 없이
91.44
1.67
51.53
1.04
비용 벌점 없이
92.94
1.38
51.19
1.28
역할 분담이 선명합니다. 정확도를 올리는 것은 글 기울기입니다(빼면 2.7~3.6점 하락). 비용을 내리는 것은 조기 종료와 비용 벌점입니다(빼면 비용이 21~65% 늘고 정확도 변화는 1.4점 이내). 다시 말해 질문마다 다른 구조를 뽑는 장치는 주로 돈을 아끼고, 점수를 올리는 일은 연산자의 프롬프트를 고쳐 쓰는 쪽이 합니다. '슈퍼넷'이라는 이름이 주는 인상과는 조금 다른 그림입니다.
검산 ① 토큰 수와 달러가 맞지 않는다
표 3에는 방법마다 프롬프트 토큰, 완성 토큰, 달러가 나란히 적혀 있습니다. gpt-4o-mini의 가격은 100만 토큰당 입력 0.15달러, 출력 0.60달러였으니 곱해 볼 수 있습니다.
LLM-Debate, DyLAN, MacNet, GPTSwarm, AFlow는 센트 단위까지 맞습니다. 예를 들어 AFlow의 추론은 250만 6천 × 0.15 + 215만 2천 × 0.60 = 1.67달러이고 표에는 1.66달러입니다. MaAS 줄만 맞지 않습니다. 추론 토큰으로 계산하면 0.71달러인데 표에는 0.42달러이고, 학습 토큰으로 계산하면 1.89달러인데 표에는 3.38달러입니다. 어긋나는 방향도 서로 반대입니다.
어느 쪽이 맞을까요? 달러 0.42를 시험 문항 486개로 나누면 질의당 0.86 × 10⁻³달러로, 표 4의 값과 일치합니다. 달러 열은 논문 안에서 일관됩니다. 그렇다면 MaAS 줄의 토큰 열이 다른 실행의 값일 가능성이 큽니다. 다만 이것은 추측이고, 표의 토큰 수가 맞다면 AFlow 대비 추론 비용은 25%가 아니라 43%입니다. 본문은 또 "MaAS가 프롬프트·완성 토큰 모두 가장 적다"고 쓰는데, 표에서 완성 토큰이 가장 적은 것은 GPTSwarm(78만 8천)이고 MaAS는 85만 3천입니다. 그림 4 아래 칸의 달러 눈금도 표 3과 다릅니다. 그림에서 AFlow는 0.6달러쯤, LLM-Debate는 2.7달러쯤에 찍혀 있습니다.
검산 ② 그 밖의 어긋남
부록까지 읽으며 찾은 것들입니다. 결론을 뒤집는 것은 없지만 숫자를 인용할 때는 알아 두어야 합니다.
어디
적힌 것
확인해 보면
초록의 향상 폭
arXiv 목록과 초판: 0.54~11.82%
개정판 본문과 학회 최종본: 0.54~16.89%. 표 1로 확인되는 것은 뒤쪽
벤치마크 수
초록 '여섯', 서론 '일곱'
실험은 여섯. 서론이 나열한 SVAMP는 실험에 없고 MultiArith가 있다
표 1 평균
기본 모델 77.50, MacNet 75.00, ADAS 75.13
다섯 칸을 직접 평균하면 77.90, 75.80, 75.53
표 2 (GAIA) 2위 표시
GPTSwarm 16.33, AgentSquare 16.34에 밑줄
TapeAgent가 16.61로 더 높다
연산자 목록
부록 B.1: 8종
그림 1과 그림 5의 목록이 서로, 또 부록과 다르다
학습 비용 배수
본문 '6.8배'
22.50 ÷ 3.38 = 6.66배
그 뒤 21개월 — 남들이 다시 돌려 본 MaAS
MaAS는 ICML 2025에서 구두 발표로 채택되었고 그 뒤 많은 논문의 기준선이 되었습니다. 다시 돌려 본 결과들을 모으면 평가가 한 방향이 아닙니다.
정확도는 대체로 재현됩니다. 2026년 1월의 LAMaS(arXiv 2601.10560)는 같은 gpt-4o-mini로 MaAS 코드를 세 번 돌려 GSM8K 93.36, HumanEval 93.38, MATH 52.67을 얻었습니다. 논문 값(92.30, 92.85, 51.82)과 같거나 조금 높습니다. FlowReasoner(2025년 4월)도 MaAS를 "가장 강한 기준선"이라 부릅니다.
비용과 시간은 논문보다 나쁘게 측정됩니다. 같은 LAMaS 실험에서 MaAS의 MATH 질의당 비용은 6.5 × 10⁻³달러로 MaAS 논문 표 4(0.86 × 10⁻³달러)의 일곱 배가 넘습니다. 그리고 질의 하나에 걸린 시간이 GSM8K 48초, MATH 110초였습니다. 토큰을 아끼도록 학습된 구조가 시간까지 아껴 주지는 않았습니다. LAMaS는 보상에 지연을 넣어 같은 정확도에서 시간을 12초, 28초로 줄였습니다. 이 논문이 다음 장에서 볼 LAWA의 바로 앞 선행 연구입니다.
더 센 모델, 더 어려운 과제에서는 단순한 방법에 집니다. 세일즈포스의 MAS-Zero(2025년 5월)는 GPT-4o로 AIME 2024를 풀게 했는데 자기 일관성이 16.67%, MaAS가 12.50%였습니다. 2026년 6월의 「멀티에이전트 우위라는 착시」(arXiv 2606.13003)는 MaAS를 포함한 자동 설계 시스템 여섯 개를 다시 평가해 "최대 10배 비싸면서도 자기 일관성에 꾸준히 못 미친다"고 결론짓습니다. MaAS에 대해서는 긴 문맥이 필요한 과제에서 "비용이 지배하는 최적화 때문에 제어기가 한 번 묻기로 무너진다"고 적었습니다. 비용 벌점이 너무 잘 먹혀서, 어려운 질문까지 가장 싼 경로로 보내 버린다는 뜻입니다. 같은 논문의 표에서 MaAS가 이기는 칸도 있습니다(Gemini 2.5 Pro로 푼 GPQA에서 86.95 대 83.13).
미리 만들어 두는 쪽의 반론. 2026년 6월의 FlowBank는 질문마다 구조를 새로 만드는 방식이 "적응력은 강하지만 추론과 탐색의 비용을 추론 시점으로 밀어 넣는다"고 지적하고, 좋은 구조 몇 개를 미리 만들어 두고 고르기만 하는 쪽을 택합니다. 이 논문은 10월 특집에서 다뤘습니다.
공개 코드. 저장소(별 292개)는 AFlow와 MetaGPT 코드를 바탕으로 하고, HumanEval·MATH·GSM8K 실행 스크립트만 들어 있습니다. GAIA 파이프라인은 공개되지 않았습니다. 이슈에는 HumanEval을 다시 돌린 사용자들이 87%, 91%, 93.13%를 얻었다는 보고가 있고, 논문이 말하는 λ 값과 코드의 비용 계수(scores - 3 * costs)가 다르다는 지적도 있습니다.
NAS의 역사는 여기서도 되풀이됩니다. DARTS가 나온 이듬해인 2019년, 리(Liam Li)와 탈월카(Ameet Talwalkar)는 무작위 탐색이 ENAS와 같은 성적을 낸다는 것을 보였고, 유(Kaicheng Yu) 등은 가중치 공유 슈퍼넷이 매긴 순위가 실제 순위와 거의 상관이 없다고 보고했습니다. 화려한 탐색이 단순한 기준선을 넘는지를 엄격하게 따지는 일은 방법이 나온 뒤에야 시작되었습니다. 에이전트 구조 탐색은 지금 그 단계에 있습니다.
정리하면 MaAS가 남긴 것은 숫자보다 문제의 형태입니다. 구조는 벤치마크마다 하나가 아니라 질문마다 달라야 한다는 것, 그리고 목적 함수에 비용이 처음부터 들어가야 한다는 것입니다. 이 두 가지는 그 뒤의 거의 모든 연구가 받아들였습니다.
MaAS가 토큰을 아끼도록 학습한 구조는 질의 하나에 48초에서 110초가 걸렸습니다. 고객센터 챗봇이나 장애 대응처럼 같은 종류의 질문이 하루 수만 번 들어오는 곳에서 이 시간은 그대로 쌓입니다. 2026년 10월 다트머스 연구진의 LAWA는 목적 함수를 뒤집습니다.
GminT(G)s.t.S(G)≥S(G0)
G는 에이전트 워크플로를 나타내는 방향 그래프, T(G)는 전체 소요 시간, S(G)는 정확도, G0는 처음 워크플로입니다. "정확도가 처음보다 나빠지지 않는 한에서 가장 빠른 구조를 찾아라"입니다. 시간이 목적이고 정확도가 제약입니다.
에이전트들이 선행 작업이 끝나는 즉시 시작한다면 전체 시간은 입구에서 출구까지 가는 길 가운데 가장 오래 걸리는 길의 길이입니다. 1957년 듀폰의 공장 건설 일정에서 나온 임계 경로(critical path) 개념 그대로입니다. LAWA는 이 가장 긴 길 위에서 두 가지 편집을 합니다.
병렬 재배선: A → B로 이어진 두 에이전트의 의존을 끊고 나란히 세웁니다. B는 더 이상 A의 답을 기다리지 않습니다. 걸리는 시간이 둘의 합에서 둘 중 큰 값으로 줄어듭니다.
노드 제거: 에이전트 하나를 통째로 뺍니다.
편집할 때마다 실제로 돌려 정확도를 확인하면 탐색이 끝나지 않습니다. 그래서 그래프를 읽고 정확도를 예측하는 작은 그래프 신경망(평가기)을 먼저 학습해 두고, 탐색은 이 평가기의 예측만 보며 진행합니다.
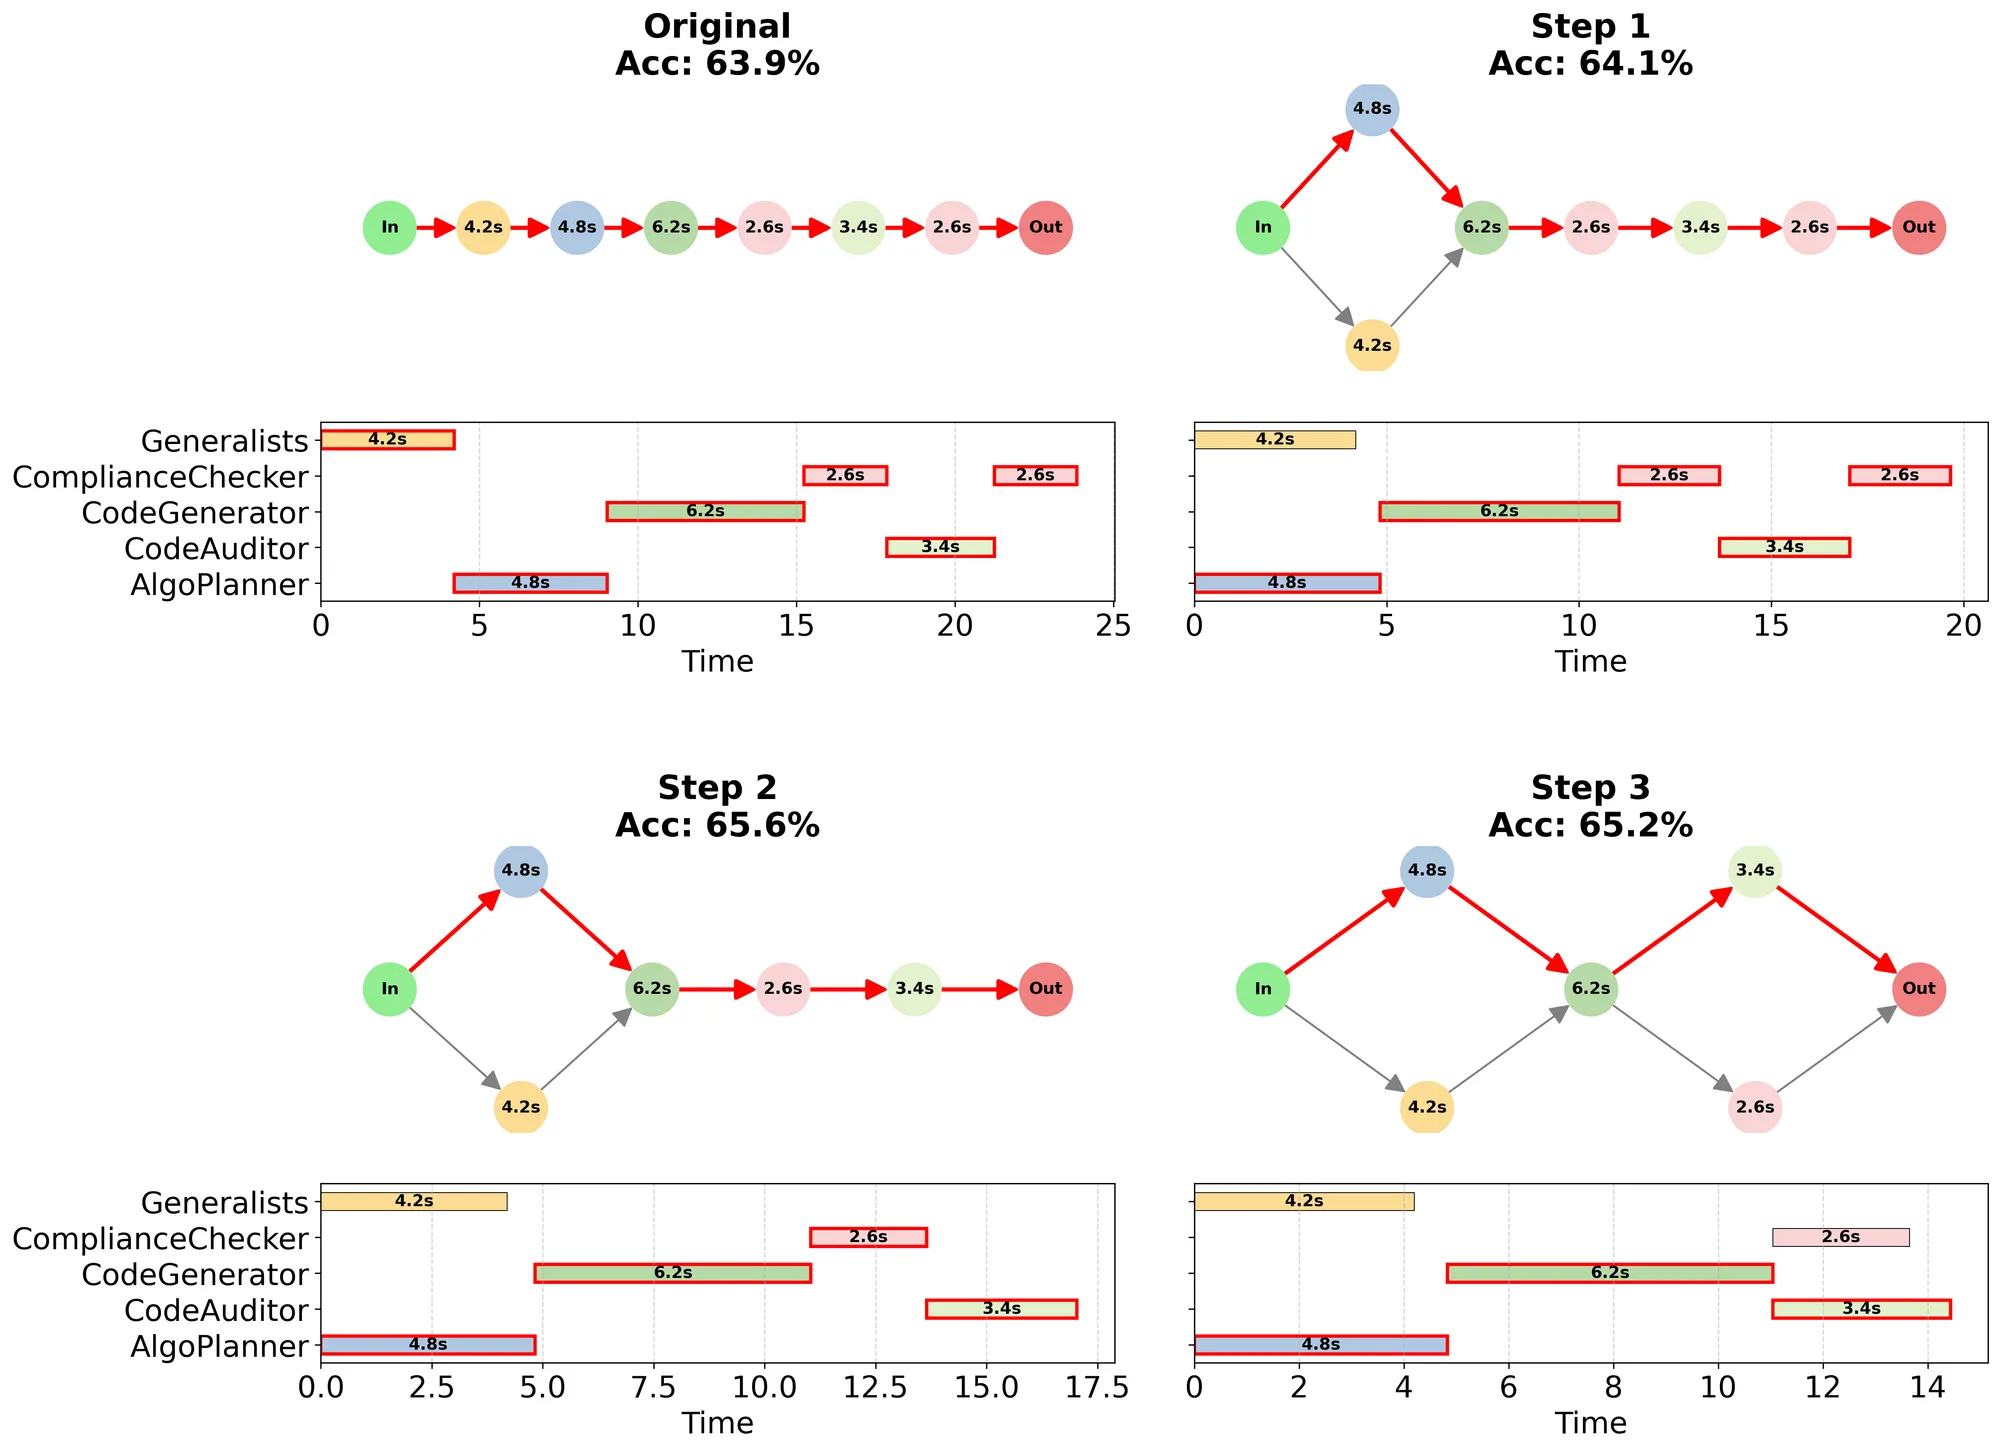
논문 부록의 사례가 전체를 한 장으로 보여 줍니다. 에이전트 여섯이 한 줄로 선 23.8초짜리 워크플로가 출발점입니다. 맨 앞 둘을 나란히 세워 19.6초, 두 번 들어 있던 규정 검사 가운데 하나를 지워 17.0초, 남은 검사와 감사를 나란히 세워 14.4초가 됩니다. 시간은 39% 줄고 정확도는 63.9%에서 65.2%로 오히려 조금 올랐습니다. 아래 편집기에서 '논문 궤적 한 단계' 버튼을 눌러 이 세 걸음을 직접 따라갈 수 있습니다.
일곱 벤치마크에서 LAWA는 여섯 곳에서 가장 빨랐고, 정확도 평균 순위도 가장 좋았습니다. 이 글의 흐름에서 눈여겨볼 결과는 따로 있습니다. 비교 대상 가운데 에이전트를 솎아 내기만 하는 방법들(AgentPrune, AgentDropout)은 마디 수는 줄였지만 남은 마디들이 여전히 긴 한 줄을 이뤄 시간이 별로 줄지 않았습니다. 논문의 표현으로는 "긴 임계 경로가 남아 전체 시간을 지배"했습니다. 솎아 내기만 해서는 정작 모자란 자원이 풀리지 않는다는 이 관찰은 Gambit이 가지치기에 대해 한 말과 같은 꼴입니다.
한계도 같은 자리에 있습니다. LAWA는 에이전트를 얼마든지 동시에 돌릴 수 있다고 가정합니다. 동시에 돌릴 수 있는 수를 넷에서 하나로 줄인 부록 실험에서는 시간 단축 폭이 68%에서 44%로 줄었고, 그 대부분이 재배선이 아니라 노드 제거에서 나왔습니다. 동시성이 공짜가 아니라는 것, 바로 Gambit이 출발한 지점입니다.
11장. 세 논문을 겹쳐 보면 — 같은 문법, 다른 시계
세 논문은 서로를 인용하지 않습니다(Gambit은 에이전트 논문이 아니고, LAWA의 본문 비교 대상에 MaAS는 없습니다). 그런데 겹쳐 놓으면 같은 문법 세 가지가 보입니다.
배분을 하려면 결과가 나오기 전에 "이쪽이 유망하다"를 알아야 합니다. 세 논문 모두 그 일을 본체보다 훨씬 작은 모형에 맡깁니다.
Gambit
MaAS
LAWA
채점관
2층 신경망
제어기 (임베딩 + 작은 신경망)
그래프 신경망 평가기
읽는 것
문단 끝의 은닉 상태
질문 문장, 앞 층의 선택
워크플로 그래프
예측하는 것
이 풀이가 정답으로 끝날 가능성
이 질문에 어느 연산자가 값어치를 할지
이 구조의 정확도
드는 비용
전체 시간의 0.97%
가벼운 임베딩 모델 한 번
학습 21~95초, 탐색 1~2초
알려진 약점
풀이 초반 20%까지는 동전 던지기
비용 벌점이 세면 '한 번 묻기'로 쏠림
적은 표본으로 학습한 라벨의 잡음
세 시스템의 상한은 모두 이 채점관이 정합니다. 5장의 모의실험에서 잡음을 올렸을 때 세 방식이 한 점으로 모였던 것을 떠올리면 됩니다. 채점관이 틀리면 정교한 배분은 틀린 쪽에 자원을 몰아줍니다. 세 논문을 읽을 때 가장 먼저 찾아야 할 그림이 채점관의 정확도 그림인 까닭입니다.
문법 ② 빼기만 하지 않고, 빼서 옮긴다
Gambit과 LAWA는 자기 앞 세대를 '빼기만 하는 방법'으로 규정하고 거기에 '옮기기'를 붙입니다. MaAS는 그렇게 말하지는 않지만 장치의 꼴은 같습니다. 쉬운 질문에서 덜어 낸 호출을 어려운 질문에 씁니다.
앞 세대
빼는 동작
옮기는 동작
Gambit
DeepConf, Slim-SC, STEP
점수 낮은 풀이 내보내기
그 자리에 점수 높은 풀이를 복제
MaAS
모든 질문에 같은 구조 (AFlow 등)
쉬운 질문은 조기 종료
아낀 예산으로 어려운 질문에 층을 더 씀
LAWA
AgentPrune, AgentDropout
중복 노드 제거
남은 노드를 병렬로 재배선
빼기만으로 부족한 까닭도 같습니다. 빼기는 쓴 양을 줄이지만 모자란 것을 풀지는 않습니다. Gambit에서 모자란 것은 정답 풀이의 수였고, 나쁜 풀이를 지워도 정답 풀이는 늘지 않았습니다. LAWA에서 모자란 것은 시간이었고, 임계 경로 밖의 마디를 지워도 시간은 줄지 않았습니다. 무엇이 모자란지를 먼저 정하고 그것이 풀리는 쪽으로 자원을 옮겨야 합니다.
문법 ③ 제약을 먼저 적는다
세 논문의 목적 함수를 나란히 놓습니다.
세 개의 목적 함수
Gambit — 최종 답이 맞을 확률을 최대로. 단, 동시에 쓰는 메모리가 한도를 넘지 않게. MaAS — (답의 품질 − λ × 토큰 비용)의 기댓값을 최대로. LAWA — 전체 소요 시간을 최소로. 단, 정확도가 처음보다 나빠지지 않게.
무엇을 목적에 두고 무엇을 제약에 두느냐가 논문의 성격을 정합니다. Gambit과 LAWA는 딱딱한 제약을 씁니다. 메모리 한도와 정확도 하한은 넘으면 안 되는 선입니다. MaAS는 비용을 벌점으로 넣었습니다. 벌점 방식은 유연하지만 환율 λ를 잘못 잡으면 한쪽으로 쏠립니다. 9장에서 본 "제어기가 한 번 묻기로 무너진다"는 비판이 그 결과입니다. 정확도를 지켜야 하는 서비스라면 LAWA처럼 정확도를 제약에 두는 쪽이 안전합니다.
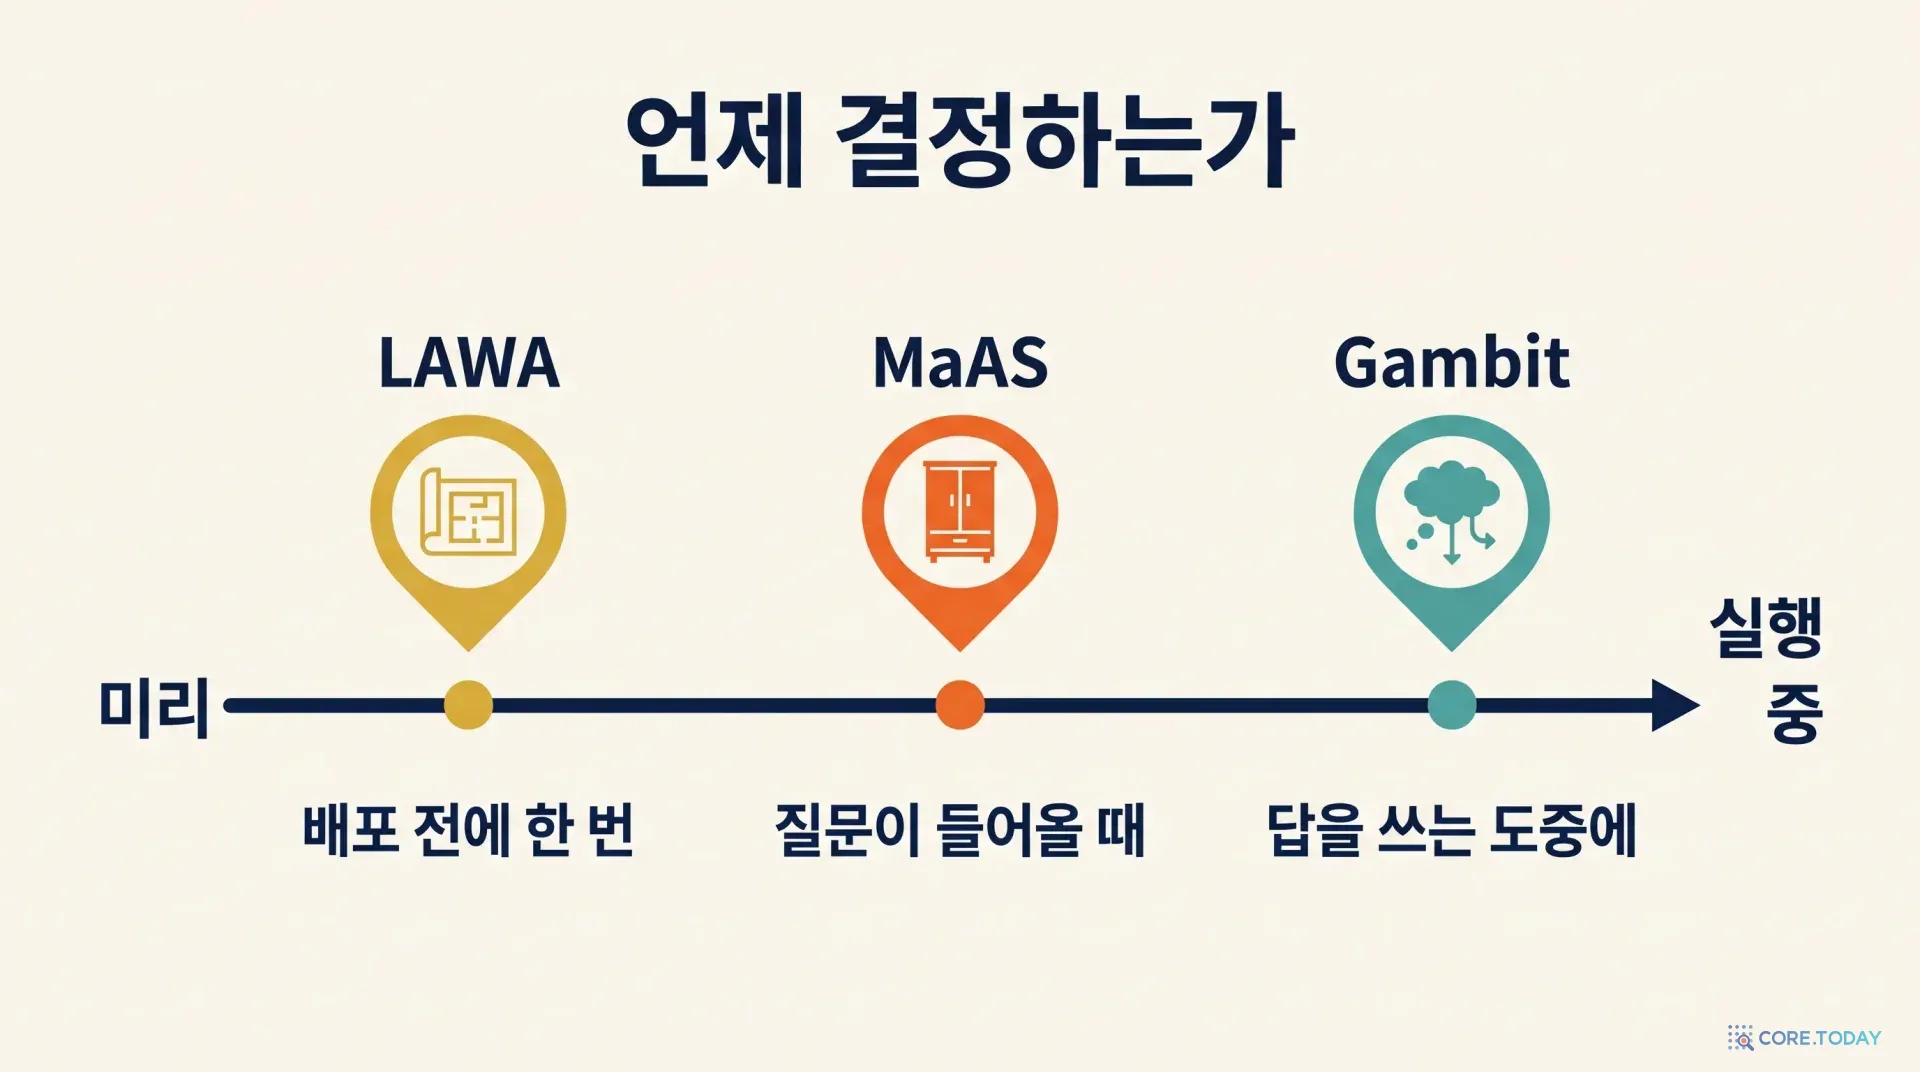
LAWA는 배포 전에 한 번 정합니다. 그 뒤로는 고정된 구조가 돕니다. 결정 비용을 수만 번의 실행에 나눠 갚는 방식이라 질의가 되풀이될수록 유리하고, 처음 보는 종류의 질문에는 대응하지 못합니다.
MaAS는 질문이 들어올 때마다 정합니다. 질문을 읽을 수 있으니 난이도에 맞출 수 있지만, 질문 문장만 보고 정하므로 풀다가 생각보다 어렵다는 것을 알게 되어도 되돌리지 못합니다.
Gambit은 답을 쓰는 도중에 계속 정합니다. 풀이가 실제로 어떻게 흘러가는지를 보고 정하므로 정보가 가장 많습니다. 대신 모델 내부에 손을 댈 수 있어야 합니다.
정보가 많은 시점일수록 더 깊숙한 접근 권한이 필요합니다. 워크플로 그래프만 있으면 되는 LAWA는 API 사용자도 쓸 수 있고, MaAS도 그렇습니다. Gambit은 모델을 직접 올려 돌리는 팀만 쓸 수 있습니다.
세 지갑은 서로 부딪친다
셋을 포개 쓰면 좋을 것 같습니다. 배포 전에 LAWA로 뼈대를 잡고, 질문마다 MaAS로 팀 크기를 고르고, 각 에이전트의 추론 안에서 Gambit으로 메모리를 나눕니다. 이런 조합을 실험한 논문은 아직 없습니다. 그리고 이 글에서 본 증거들은 지갑끼리 부딪친다는 쪽을 가리킵니다.
토큰을 아끼면 시간이 는다. MaAS의 구조는 토큰은 적게 썼지만 질의당 48~110초가 걸렸습니다.
시간을 아끼면 동시성이 든다. LAWA의 재배선은 에이전트를 나란히 세웁니다. 나란히 선 에이전트들은 같은 GPU의 메모리를 동시에 씁니다.
동시성은 메모리다. Gambit의 출발점이 그것이었습니다. 풀이 256줄을 동시에 돌리려는 순간 KV 캐시가 넘칩니다.
한 지갑을 아끼는 최적화는 대개 다른 지갑에서 값을 치릅니다. 그러니 어느 지갑이 지금 가장 얇은지를 먼저 재야 합니다.
12장. 2026년 11월, 이 생각의 자리 — 그리고 오늘 해 볼 수 있는 것
왜 지금 '어디에'인가
세 가지 변화가 겹쳤습니다.
풀이가 길어졌습니다. 추론 모델의 풀이 한 줄은 수만 토큰입니다. 2022년의 자기 일관성은 수백 토큰짜리 풀이 40개를 돌렸고, 2026년의 실험은 2만 토큰짜리 풀이 256개를 돌립니다. 같은 '여러 번 풀기'가 백 배 넘게 무거워졌습니다.
호출이 늘었습니다. Anthropic은 2025년 6월 멀티에이전트 연구 시스템을 소개하면서 에이전트가 보통 대화의 약 4배, 멀티에이전트 시스템이 약 15배의 토큰을 쓴다고 밝혔습니다. 같은 글은 자사 평가에서 성능 차이의 80%가 토큰 사용량으로 설명된다고도 적었습니다. 토큰을 더 쓰면 좋아진다는 것과, 그 토큰이 비싸다는 것이 함께 사실입니다.
'더 많이'의 반례가 쌓였습니다. Anthropic은 2024년 12월 「효과적인 에이전트 만들기」에서 "가능한 한 가장 단순한 해법을 찾고, 필요할 때만 복잡도를 높이라"고 권했습니다. 구글 연구진은 2025년 12월 에이전트 구성 180가지를 비교한 논문 초판에서, 나눠 풀 수 있는 과제에서는 멀티에이전트가 최대 80.9% 나았지만 순서대로 풀어야 하는 과제에서는 모든 멀티에이전트 구성이 39~70% 나빴다고 보고했습니다. 9장의 「멀티에이전트 우위라는 착시」도 같은 줄기입니다.
이 셋을 합치면 2026년의 질문이 나옵니다. 계산을 더 쓰면 좋아지는 것은 맞는데, 아무 데나 쓰면 좋아지지 않습니다.
오늘 해 볼 수 있는 것
세 논문의 코드를 그대로 가져다 쓰지 않아도 생각은 지금 쓸 수 있습니다.
API로 모델을 쓰는 팀이라면 (구조의 지갑)
한 번 묻기와 자기 일관성부터 재 둡니다. 멀티에이전트 구조를 들이기 전에 같은 과제에서 한 번 묻기와 다섯 번 묻고 다수결의 정확도·비용을 기록합니다. 9장의 재평가들이 보여 주듯 이 기준선을 못 넘는 구조가 많습니다.
질문을 난이도로 나눠 봅니다. 지난 한 달의 질의를 쉬움·중간·어려움으로 대강 나눠 비율을 봅니다. 쉬운 질문이 절반을 넘는데 모든 질의가 같은 무거운 구조를 지난다면 MaAS의 딜레마 1이 여러분의 청구서에 있습니다.
조기 종료부터 넣습니다. 표 4에서 비용을 내린 것은 조기 종료와 비용 벌점이었습니다. 첫 단계의 답이 충분하면 거기서 끝내는 문 하나가 가장 싸고 효과가 확실한 장치입니다.
공통 앞부분은 캐시에 올립니다. Gambit의 토큰 절감은 앞부분을 다시 계산하지 않는 데서 나왔습니다. API에서 같은 일을 하는 것이 프롬프트 캐싱입니다. 시스템 프롬프트와 공통 문서를 맨 앞에 고정하고, 질의마다 바뀌는 부분을 뒤에 둡니다.
GPU에 모델을 직접 올리는 팀이라면 (생각의 지갑)
메모리 사용률과 대기열을 함께 봅니다. 논문 그림 3의 교훈입니다. 메모리 사용률 100%는 좋은 신호가 아닐 수 있습니다. 대기 중인 요청 수와 초당 토큰 처리량을 같이 봐야 줄을 서고 있는지 일하고 있는지 구분됩니다.
가지치기를 넣었다면 빈자리를 확인합니다. 풀이를 일찍 끊는 장치를 넣으면 뒤로 갈수록 GPU가 놉니다. 끝까지 간 풀이가 몇 개인지를 세어 보세요. 256줄로 시작해 120줄만 남았다면 투표의 표본이 절반입니다.
앞부분 캐시 공유가 켜져 있는지 봅니다. vLLM과 SGLang 모두 앞부분이 같은 요청의 KV 캐시를 함께 쓰는 기능이 있습니다. 여러 번 풀기를 돌린다면 질문 부분만이라도 공유되는지 확인합니다.
같은 종류의 질의가 되풀이되는 서비스라면 (시간의 지갑)
가장 긴 줄을 그려 봅니다. 에이전트 호출을 간트 차트로 그리면 전체 시간을 정하는 한 줄이 보입니다. 그 줄 밖의 호출은 아무리 빨라져도 전체가 빨라지지 않습니다.
서로를 기다릴 필요가 없는 단계를 찾습니다. 계획 수립과 자료 수집, 검사와 감사처럼 앞 단계의 출력을 실제로 쓰지 않는 쌍은 나란히 세울 수 있습니다. 자세한 점검표는 LAWA 특집 12장에 있습니다.
논문을 읽을 때 (이 글에서 쓴 검산 세 가지)
한 문제의 무게를 계산합니다. 30문항 벤치마크에서 3.3점은 한 문제입니다. 향상 폭을 문항 수로 바꾸고, 반복 횟수와 표준편차가 적혀 있는지 봅니다.
표의 열끼리 곱하고 나눠 봅니다. 토큰 수와 단가와 달러, 처리량과 시간과 완성 개수처럼 서로 묶인 열이 있으면 맞는지 확인합니다. 이 글의 두 논문 모두에서 이 계산이 본문에 없는 사실을 알려 주었습니다.
'엄격히', '일관되게', '모두' 같은 부사는 칸을 세어 확인합니다. 15칸 중 11칸과 15칸 모두는 다른 주장입니다.
맺음말 — 512번 대신
프롤로그의 12번 문제로 돌아갑니다. 512번을 풀어 네 시간 만에 오답을 얻은 방식과, 256칸을 돌려 가며 한 시간 남짓에 정답을 얻은 방식의 차이는 모델도 GPU도 아니었습니다. 3만 토큰을 잘 써 온 풀이가 마지막 덧셈에서 미끄러질 때, 그 3만 토큰을 버리지 않고 한 번 더 이어 쓰게 해 준 배분 규칙이었습니다.
물론 이 이야기에는 단서가 붙습니다. 그 실행에서도 완성된 풀이 256개 가운데 정답은 42개, 16%였습니다. 점수 가중 투표에서 정답은 24.02 대 21.81로 이겼습니다. 여유 있는 승리가 아닙니다. 채점기가 조금만 달랐어도 결과가 바뀌었을 수 있습니다. 배분은 모델이 못 푸는 문제를 풀게 해 주지 않습니다. 모델이 가끔은 푸는 문제에서 그 '가끔'을 건져 올릴 뿐입니다.
그래도 세 논문이 함께 가리키는 방향은 분명합니다. 한 문제 안에서는 풀이들 사이에, 질문들 사이에서는 팀의 크기에, 되풀이되는 서비스에서는 가장 긴 줄에, 계산을 고르게 뿌리는 대신 값어치가 큰 곳으로 옮기는 장치가 들어서고 있습니다. 그 장치는 세 곳 모두에서 같은 부품으로 만들어집니다. 끝까지 가 보기 전에 값을 매기는 작은 채점관, 빼낸 자원을 옮겨 줄 동작, 그리고 먼저 적어 둔 제약입니다.
계산은 앞으로도 더 싸질 것이고 우리는 더 많이 쓰게 될 것입니다. 그럴수록 더 자주 묻게 될 질문은 이것입니다. 지금 가장 얇은 지갑은 어느 것이고, 거기서 꺼낸 한 단위는 어디로 가야 하는가.
Zhang, E., Qu, F., Huang, Z., Zhou, D., Chen, E., & Yan, Y. (2026). Optimize Once, Execute Fast: Latency-Aware Multi-Agent Workflow Learning for Recurrent Queries (LAWA). NeurIPS 2026. arXiv:2610.14481
빔 탐색의 역사
Lowerre, B. T. (1976). The HARPY Speech Recognition System. 카네기멜런대 박사학위 논문.
Carnegie-Mellon University Computer Science Speech Group (1977). Speech Understanding Systems: Summary of Results of the Five-Year Research Effort.
Sutskever, I., Vinyals, O., & Le, Q. V. (2014). Sequence to Sequence Learning with Neural Networks. NIPS 2014. arXiv:1409.3215
Koehn, P., & Knowles, R. (2017). Six Challenges for Neural Machine Translation. First Workshop on NMT. arXiv:1706.03872
Yang, Y., Huang, L., & Ma, M. (2018). Breaking the Beam Search Curse. EMNLP 2018.
Stahlberg, F., & Byrne, B. (2019). On NMT Search Errors and Model Errors: Cat Got Your Tongue? EMNLP 2019. arXiv:1908.10090
Holtzman, A., et al. (2020). The Curious Case of Neural Text Degeneration. ICLR 2020. arXiv:1904.09751
테스트 시간 계산과 가지치기
Wang, X., et al. (2023). Self-Consistency Improves Chain of Thought Reasoning in Language Models. ICLR 2023. arXiv:2203.11171
Yao, S., et al. (2023). Tree of Thoughts: Deliberate Problem Solving with Large Language Models. NeurIPS 2023. arXiv:2305.10601
Xie, Y., et al. (2023). Self-Evaluation Guided Beam Search for Reasoning. arXiv:2305.00633
Brown, B., et al. (2024). Large Language Monkeys: Scaling Inference Compute with Repeated Sampling. arXiv:2407.21787
Snell, C., Lee, J., Xu, K., & Kumar, A. (2024). Scaling LLM Test-Time Compute Optimally can be More Effective than Scaling Model Parameters. arXiv:2408.03314
Beeching, E., Tunstall, L., & Rush, S. (2024). Scaling Test-Time Compute with Open Models. Hugging Face.
Fu, Y., Wang, X., Tian, Y., & Zhao, J. (2025). Deep Think with Confidence (DeepConf). arXiv:2508.15260
Hong, C., Guo, X., Singh, A. C., Choukse, E., & Ustiugov, D. (2025). Slim-SC: Thought Pruning for Efficient Scaling with Self-Consistency. EMNLP 2025.
Liang, Z., Huang, B., Wang, Z., & Zhang, M. (2026). Hidden States as Early Signals: Step-level Trace Evaluation and Pruning for Efficient Test-Time Scaling (STEP). arXiv:2601.09093
Bulut (2026). It's the Problem, Not the Path. arXiv:2609.03436
서빙 시스템
Kwon, W., et al. (2023). Efficient Memory Management for Large Language Model Serving with PagedAttention (vLLM). SOSP 2023. arXiv:2309.06180
Zheng, L., et al. (2024). SGLang: Efficient Execution of Structured Language Model Programs. NeurIPS 2024. arXiv:2312.07104
구조 탐색과 그 비판
Zoph, B., & Le, Q. V. (2017). Neural Architecture Search with Reinforcement Learning. ICLR 2017. arXiv:1611.01578
Pham, H., et al. (2018). Efficient Neural Architecture Search via Parameter Sharing (ENAS). ICML 2018. arXiv:1802.03268
Liu, H., Simonyan, K., & Yang, Y. (2019). DARTS: Differentiable Architecture Search. ICLR 2019. arXiv:1806.09055
Li, L., & Talwalkar, A. (2019). Random Search and Reproducibility for Neural Architecture Search. UAI 2019. arXiv:1902.07638
Yu, K., et al. (2020). Evaluating the Search Phase of Neural Architecture Search. ICLR 2020. arXiv:1902.08142
Teerapittayanon, S., McDanel, B., & Kung, H. T. (2016). BranchyNet: Fast Inference via Early Exiting from Deep Neural Networks. ICPR 2016.
Graves, A. (2016). Adaptive Computation Time for Recurrent Neural Networks. arXiv:1603.08983