Adaptive-GEPAGEPA하네스프롬프트 최적화프로그램 최적화라우터전문가 혼합Mixture of Experts복합 AI 시스템DSPy반성적 최적화에이전트 스킬라우팅자카드Qwen3특집
[특집] 하네스도 분업을 배운다 — Adaptive-GEPA, 요청을 나누는 법과 푸는 법을 한 번의 탐색으로 함께 진화시키기
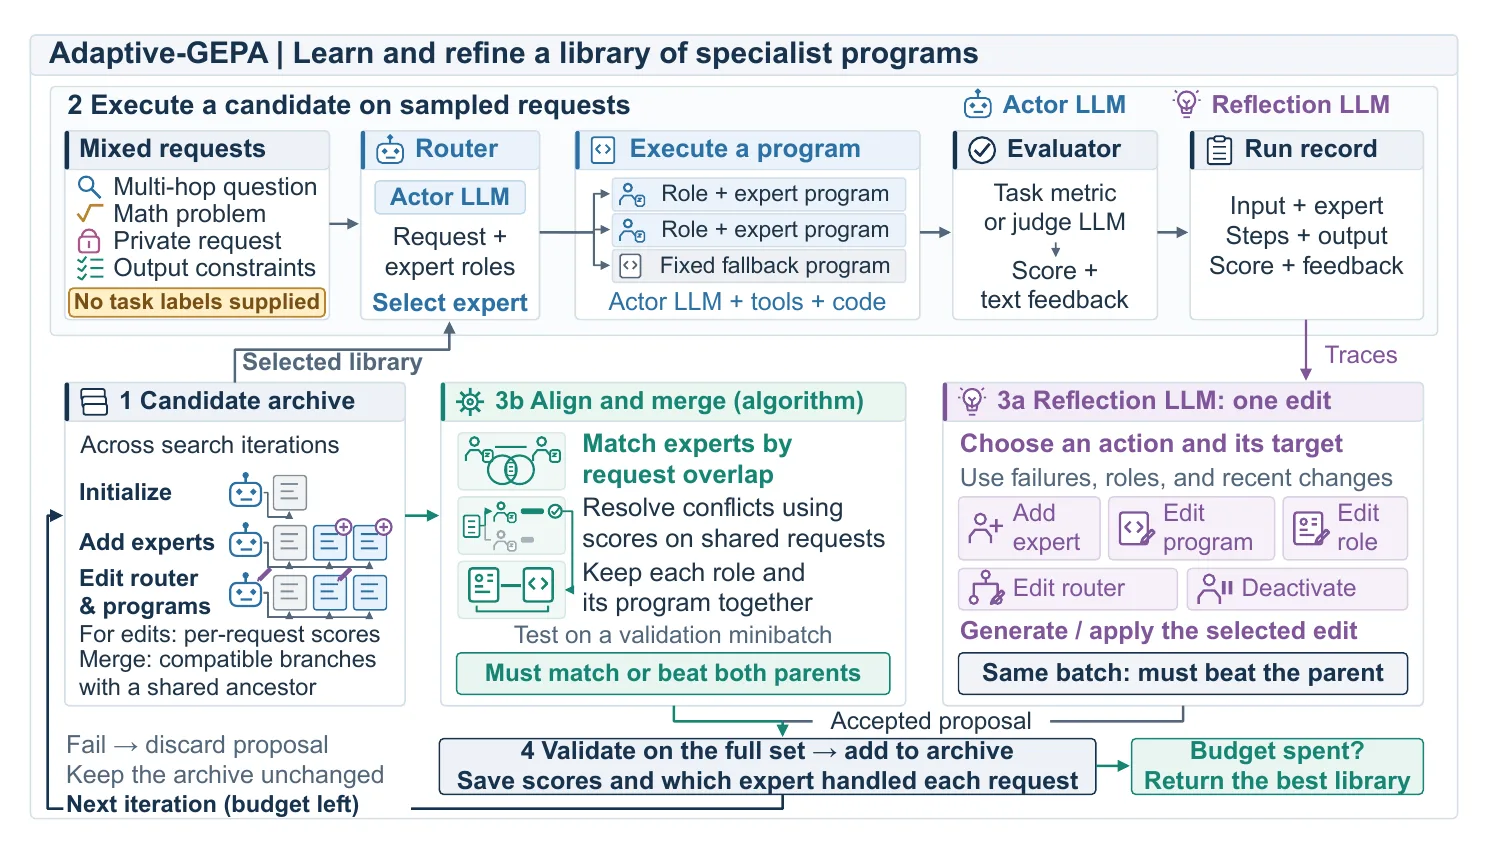
하나의 AI 창구에는 성격이 다른 요청이 섞여 들어온다. 사실을 찾아야 하는 질문, 오래 생각해야 하는 수학 문제, 개인정보를 가려야 하는 부탁, 조건을 지켜 글을 고치는 일. 2026년 9월 30일 공개된 Adaptive-GEPA(arXiv 2609.38762)는 이 창구를 최적화하는 세 번째 길을 제안한다. 프로그램 하나를 통째로 다듬지도, 과제별로 미리 나눠 따로 다듬지도 않고, 요청을 나누는 라우터와 전문가 프로그램 묶음을 한 번의 탐색에서 함께 진화시킨다. 라우터의 지시문, 전문가마다 붙는 한 줄 설명, 프로그램 코드가 모두 사람이 읽는 글이고 실패 기록을 읽은 반성 모델이 그중 하나를 골라 고친다. 서로 다른 갈래를 합칠 때는 슬롯 번호가 아니라 ‘실제로 처리한 요청’의 겹침으로 전문가를 짝짓는다. Qwen3-8B 실험에서 네 과제 평균은 52.6에서 70.6으로 올랐고(프로그램 하나 진화 62.5, GRPO 54.0), 과제 이름을 한 번도 받지 않은 라우터가 시험 요청 651건을 과제 구분과 똑같이 나눴다. 이 글은 논문을 부록까지 읽고, 1991년 전문가 혼합에서 2025년 GEPA까지의 계보, 후보 하나의 구조, 다섯 가지 편집, 발자국 정렬 병합, 결과 표와 탐색 기록을 차례로 푼다. 시드 하나, 같은 프로그램을 다시 채점해도 2점씩 흔들리는 검증 점수, 세지 않은 계산량 같은 한계도 숫자로 짚었다. 한국어 요청 64건으로 논문의 ‘설명·라우터 편집’ 현상을 로컬 모델에서 다시 확인한 실측을 덧붙였다. 인터랙티브 6개, 일러스트 14장, 논문 그림 9장.
동네 주민센터에 창구가 하나뿐이라고 해 봅시다. 아침 아홉 시에 문을 열자 네 사람이 한꺼번에 들어옵니다.
첫 번째 손님은 “이 가수가 속했던 밴드의 드러머는 어느 나라 사람이냐”고 묻습니다. 자료실에서 문서 두 개를 차례로 뒤져야 답할 수 있습니다. 두 번째 손님은 수학 경시대회 문제를 내밉니다. 자료를 찾을 필요는 없지만 한참 생각해야 하고, 검산도 해야 합니다. 세 번째 손님은 자기 이름과 전화번호가 적힌 메모를 주면서 “이걸 외부 대행업체에 맡겨 편지로 만들어 달라, 단 내 신상은 넘어가면 안 된다”고 합니다. 네 번째 손님은 신문 기사를 주면서 “정확히 두 문단으로, 이 단어 다섯 개는 쓰지 말고 요약해 달라”고 합니다.
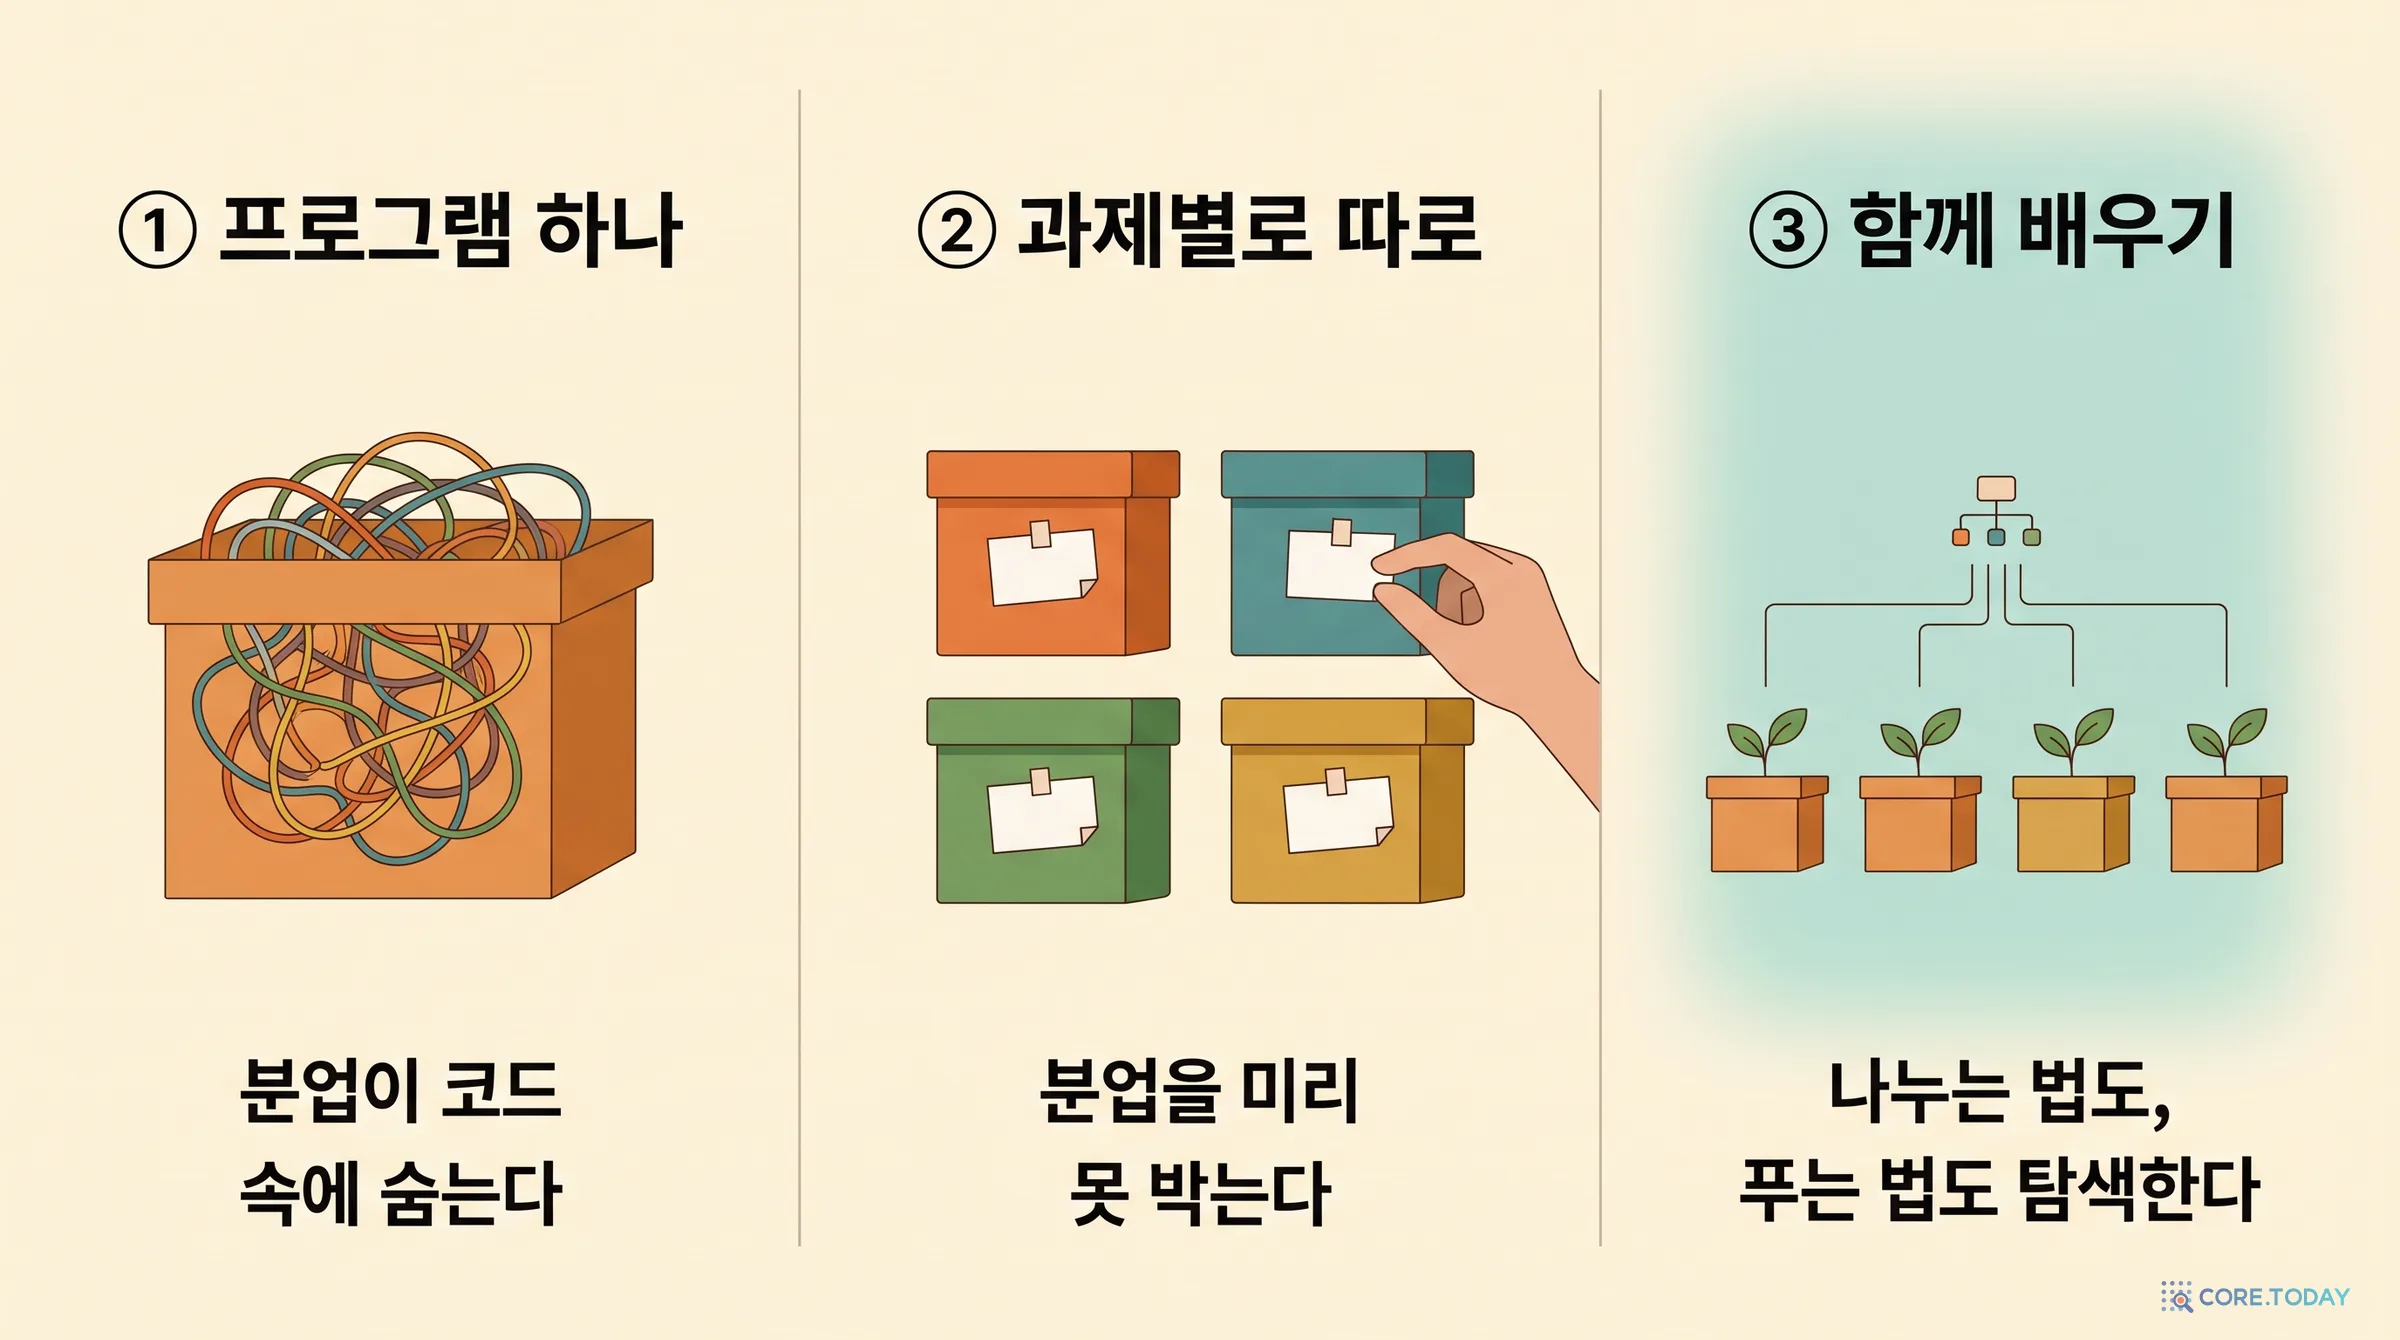
창구 직원이 한 명이면 선택지는 뻔합니다. 모든 손님에게 통하는 응대 요령 하나를 갈고닦거나, 손님 종류별로 요령을 따로 익혀 두고 들어오는 순간 어느 요령을 꺼낼지 정하거나.
언어 모델 서비스가 정확히 이 상황입니다. 챗봇 하나, API 엔드포인트 하나에 온갖 요청이 섞여 들어옵니다. 그리고 2025년부터 이 ‘응대 요령’을 사람이 손으로 쓰지 않고 탐색이 자동으로 다듬게 하는 기법이 실무에 들어왔습니다. 대표가 GEPA입니다. 실패한 답과 채점 피드백을 다른 모델이 읽고 프롬프트를 고쳐 쓰는 방식으로, 코어닷투데이는 2026년 10월에 GEPA 특집에서 자세히 다뤘습니다.
그런데 GEPA가 다듬는 대상은 지금까지 ‘요령 하나’였습니다. 손님이 네 종류라는 사실, 종류마다 필요한 절차가 다르다는 사실은 탐색의 눈에 보이지 않았습니다.
2026년 9월 30일 arXiv에 올라온 논문 한 편이 이 지점을 겨냥합니다. 텍사스대 오스틴의 톈위 천(Tianyu Chen), UCLA의 야시 장(Yasi Zhang) 등 여섯 저자가 쓴 「Adaptive-GEPA: Make Your Harness Fit Heterogeneous Requests」(arXiv 2609.38762)입니다. 제목을 풀면 ‘하네스를 뒤섞인 요청에 맞춰라’쯤 됩니다. 초록의 핵심 문장은 이렇습니다.
우리는 요청을 어떻게 나눌지와 어떻게 풀지를 함께 배우는 Adaptive-GEPA를 소개한다. 이 방법은 하나의 탐색 예산 안에서 라우터와 전문가 프로그램 묶음을 진화시킨다.
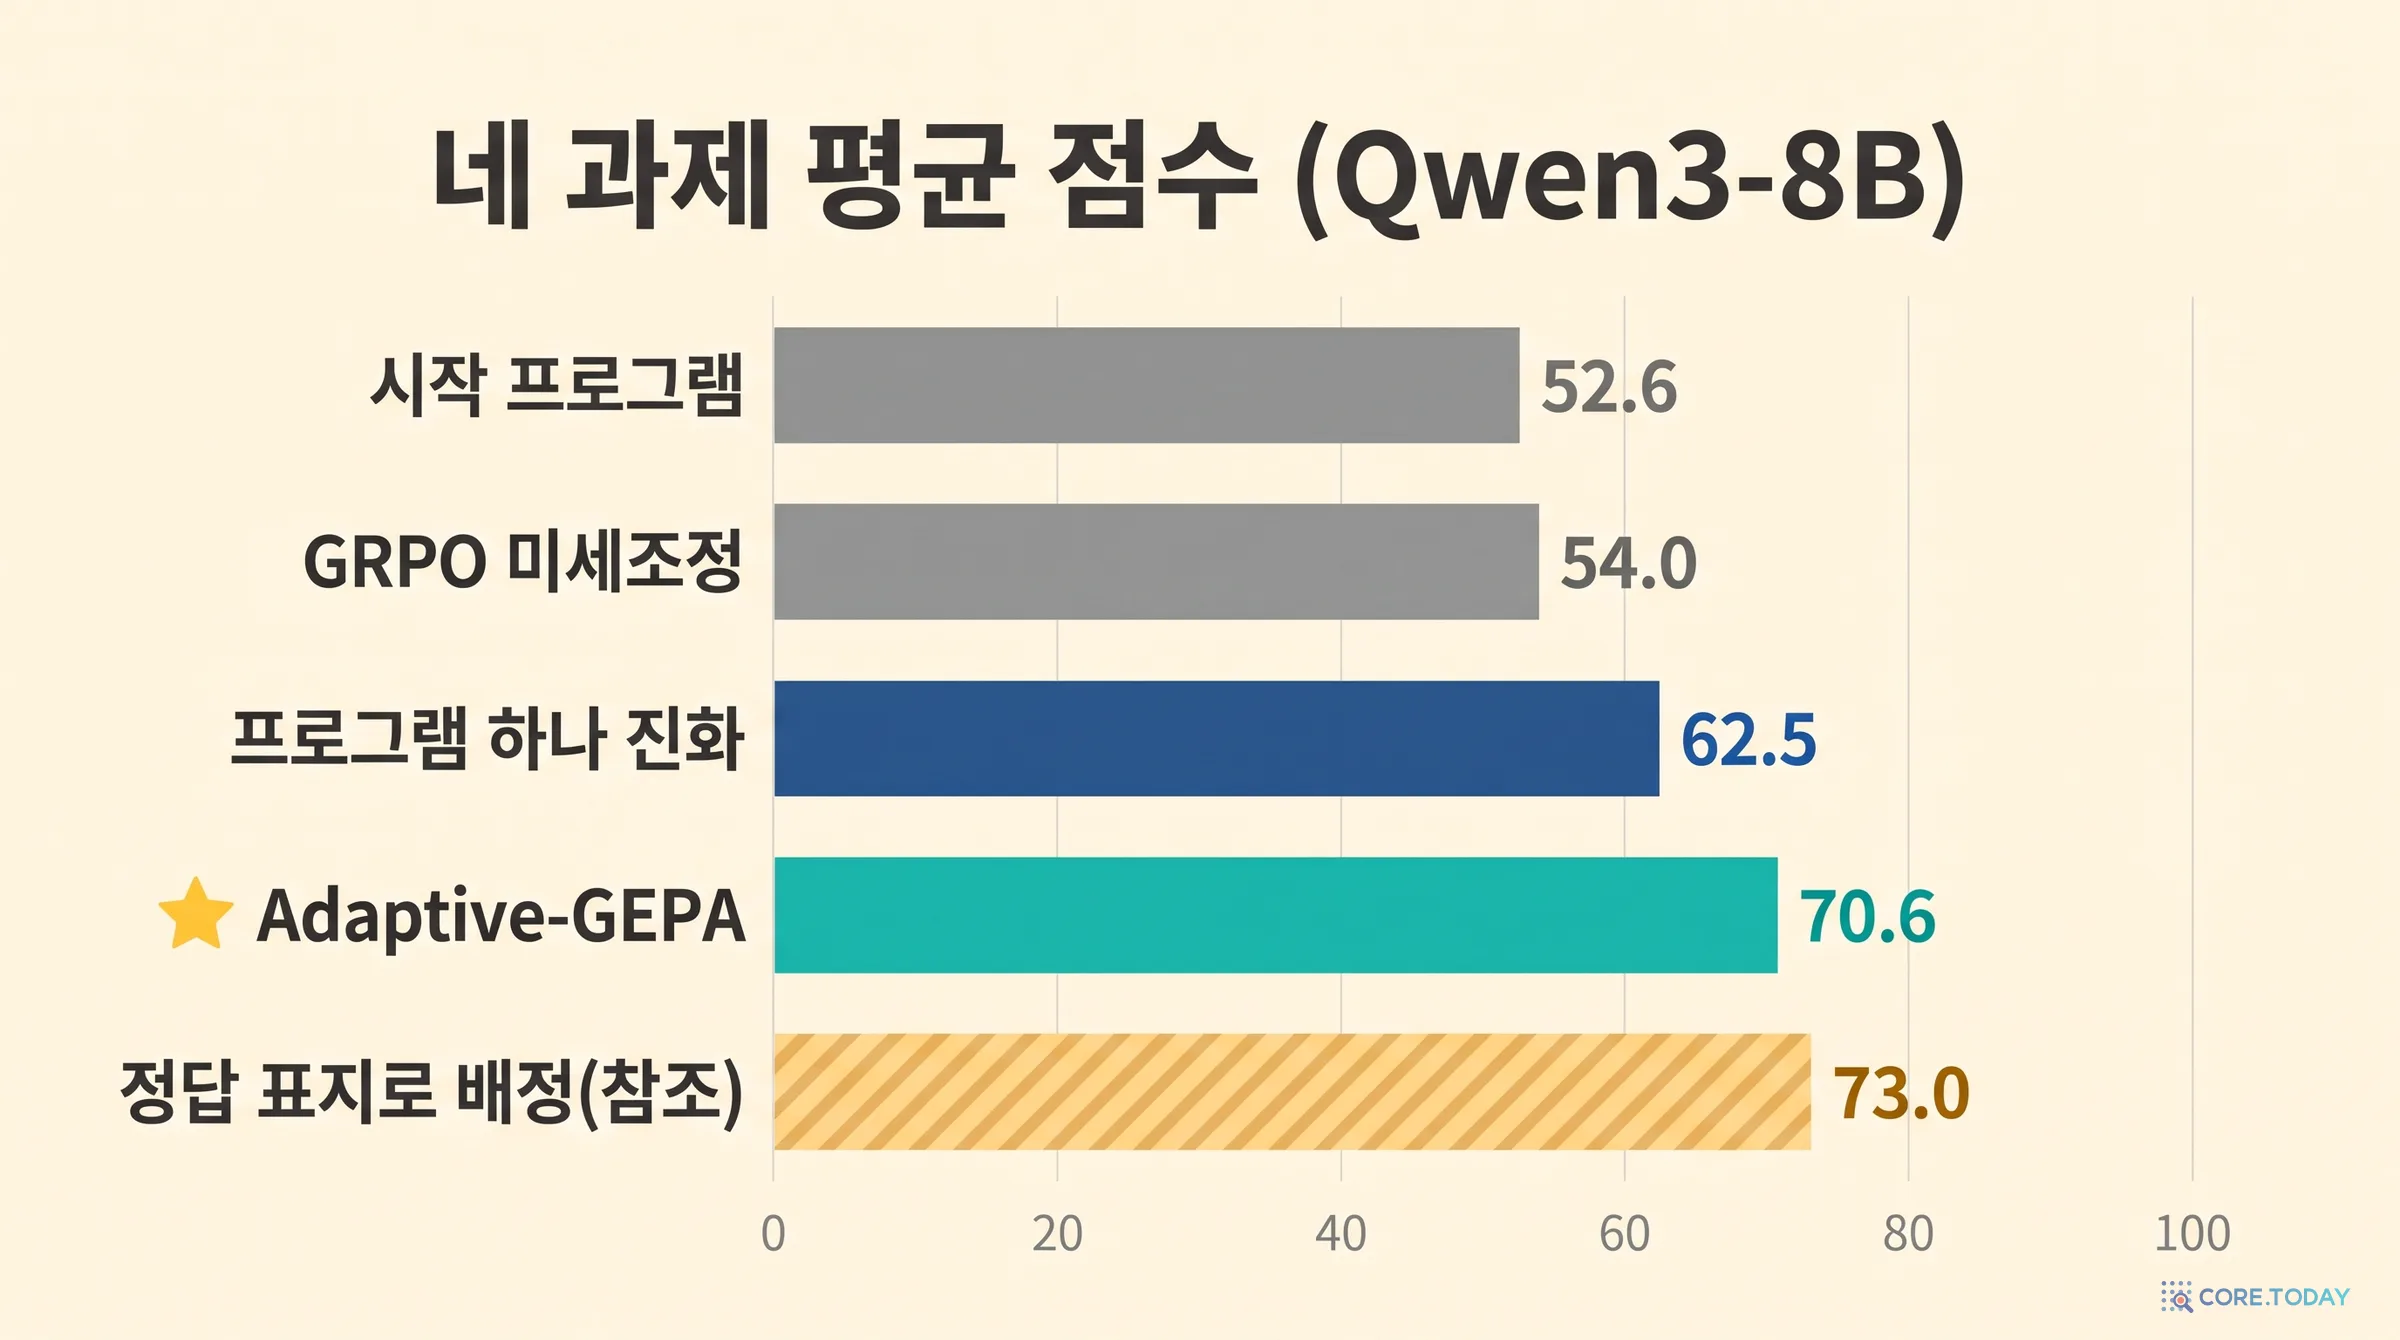
결과부터 적으면 이렇습니다. 작은 공개 모델 Qwen3-8B로 네 가지 과제를 섞어 놓고 탐색했더니, 네 과제 평균 점수(100점 만점)가 52.6에서 70.6으로 올랐습니다. 같은 예산으로 프로그램 하나를 통째로 진화시킨 쪽은 62.5, 모델 가중치를 강화학습으로 미세조정한 쪽은 54.0이었습니다. 탐색이 끝났을 때 전문가는 넷이 생겨 있었고, 과제 이름을 한 번도 본 적 없는 라우터가 시험 요청 651건을 과제 구분과 똑같이 나눴습니다.
숫자만 보면 깔끔한 승리입니다. 그런데 이 논문에서 정말 읽을 만한 부분은 점수표 바깥에 있습니다. 탐색이 ‘분업’을 어떤 모양으로 표현했는지, 두 갈래에서 따로 자란 전문가들을 어떻게 한 팀으로 합쳤는지, 그리고 저자들이 스스로 적어 둔 긴 한계 목록입니다. 이 글은 그 순서로 읽습니다.
먼저 용어 하나만 정리하겠습니다. 하네스(harness)는 원래 말에 채우는 마구입니다. AI에서는 모델을 둘러싼 나머지 전부를 가리킵니다. 프롬프트, 도구 호출, 검색, 반복문과 조건문, 출력 검사 같은 것들입니다. 같은 모델이라도 하네스에 따라 성적이 크게 갈린다는 것은 코어닷투데이가 코딩 에이전트 하니스 해부에서 다룬 적이 있습니다. 이 논문에서 하네스는 곧 ‘모델을 부르는 파이썬 프로그램’입니다.
1장. 왜 하나로는 모자란가
요청마다 필요한 절차가 다르다
논문의 서론은 한 문단으로 문제를 정리합니다. 공유되는 언어 모델 서비스는 서로 다른 절차가 필요한 요청을 받는다. 사실 검색, 수학 추론, 개인정보 보호, 조건이 붙은 글쓰기. 이런 서비스를 개선하려면 쓸모 있는 절차를 배우는 것과 각 절차를 언제 써야 하는지 배우는 것, 둘 다 필요하다.
‘절차가 다르다’는 말을 구체적으로 봅시다. 논문이 고른 네 과제는 요구하는 것이 거의 겹치지 않습니다.
요청
필요한 도구
추론 방식
잘못하면 생기는 일
여러 문서를 건너야 하는 사실 질문
검색기. 한 번 찾고, 찾은 것을 보고 다시 찾는다
짧고 빠르게
검색 없이 기억으로 답해 틀린다
경시대회 수학
없음
길게 생각하고, 여러 번 풀어 맞춰 본다
빠른 모드로 한 번에 답해 틀린다
개인정보 가리고 맡기기
외부 모델 호출 전의 정보 제거
짧고 빠르게, 대신 두 번 확인
이름·번호가 외부로 나간다
조건 지켜 글쓰기
글자 수·금지어를 세는 코드
초안은 모델이, 검사는 코드가
글은 좋은데 조건을 어긴다
추론 방식 열을 눈여겨보세요. Qwen3 계열 모델에는 ‘생각하기(thinking)’ 모드와 ‘생각 안 하기’ 모드가 있습니다. Qwen3 기술 보고서(arXiv 2505.09388)에 따르면 Qwen3-8B는 2025년 AIME 문제에서 생각 모드로 67.3%, 생각을 끈 모드로 20.9%를 맞혔습니다. 세 배가 넘는 차이입니다. 반대로 검색 질문에 생각 모드를 켜면 느리고 비싸기만 합니다. 과제에 따라 모델의 같은 가중치를 전혀 다르게 써야 한다는 뜻입니다.
사례: 한 창구에 섞여 들어오는 것들
이 문제가 벤치마크 안에서만 생기는 것은 아닙니다. 익숙한 장면 몇 개를 떠올려 봅시다.
사내 업무 도우미. 같은 채팅창에 “지난 분기 매출 표에서 성장률 계산해 줘”, “이 계약서 조항 요약해 줘”, “인사 규정에서 육아휴직 기간 찾아 줘”, “이 메일을 외부 번역기에 돌릴 건데 고객 이름은 빼 줘”가 번갈아 들어옵니다. 계산, 요약, 검색, 정보 제거입니다.
고객센터 챗봇. “배송 어디쯤이에요”(시스템 조회), “환불 규정이 뭐예요”(문서 검색), “이 요금제와 저 요금제 3년 총액 비교해 줘”(계산), “상담 내용 요약해서 메일로 보내 줘”(형식 지키는 글쓰기).
코딩 에이전트. “이 함수 왜 느려?”(프로파일링), “테스트 추가해 줘”(코드 생성과 실행), “이 라이브러리 최신 사용법 알려 줘”(문서 검색), “커밋 메시지 규칙에 맞게 써 줘”(형식 준수).
지방의회 업무 지원. “작년 예산 심사 때 이 사업에 대해 누가 뭐라고 했나”(회의록 검색), “이 조례 개정안의 신구 대조표를 만들어 줘”(형식이 엄격한 문서 변환), “민원인 연락처가 든 이 문서를 외부 번역에 맡겨도 되나”(개인정보 판단).
어느 경우든 요청에는 ‘나는 검색 과제입니다’라는 꼬리표가 붙어 오지 않습니다. 사용자는 그냥 한 창구에 말합니다. 나누는 일은 시스템의 몫입니다.
지금까지의 두 가지 길
요령을 자동으로 다듬는 기법이 생긴 뒤, 뒤섞인 요청을 다루는 방법은 둘이었습니다.
첫째, 프로그램 하나를 전체 요청으로 최적화한다. 간단합니다. 요청을 섞어 넣고 탐색을 돌리면 됩니다. 프로그램 안에 if문으로 분기를 넣는 것도 가능하니, 표현력으로 따지면 못 할 것이 없습니다. 실제로 이 논문의 비교 실험에서 진화한 단일 프로그램은 스스로 개인정보·글쓰기·수학·검색 분기를 만들어 냈습니다. 문제는 탐색의 눈에 그 분기가 보이지 않는다는 점입니다. 탐색이 보는 것은 긴 소스 코드 한 덩어리이고, 고칠 때도 덩어리 전체를 다시 씁니다. 수학 분기를 고치려다 개인정보 분기를 건드릴 수 있습니다. 논문의 표현으로는 분업이 “소스 코드 탐색 안에 암묵적으로” 남습니다.
둘째, 과제를 미리 나누고 과제마다 따로 최적화한 뒤 배차원을 붙인다. 서로 간섭하지 않으니 과제별 성능은 좋습니다. 대신 누군가 미리 과제를 나눠야 하고, 들어오는 요청이 어느 과제인지 알려 주는 표지가 필요합니다. 표지가 없으면 분류기를 따로 만들어야 하고, 분류기가 틀리면 엉뚱한 프로그램이 돕니다. 새 종류의 요청이 생기면 사람이 다시 나눠야 합니다.
논문은 세 번째 길을 냅니다. 분업과 프로그램을 한 번의 탐색에서 함께 배운다. 탐색이 스스로 정해야 하는 것은 넷입니다. 전문가를 언제 만들지, 그 전문가가 무엇을 맡을지, 어떻게 개선할지, 그리고 서로 다른 갈래에서 자란 전문가들을 어떻게 합칠지.
저자들은 여기서 조심스러운 단서를 하나 답니다. 프로그램 하나로도 배차를 구현할 수 있으므로, 세 길의 차이는 “코드가 무엇을 표현할 수 있느냐”가 아니라 “탐색이 시스템을 어떻게 조직하고 바꾸느냐”에 있다는 것입니다. 이 글 전체에서 기억해 둘 문장입니다. Adaptive-GEPA가 새로 만든 것은 더 강한 프로그램이 아니라 탐색이 붙잡을 수 있는 손잡이입니다.
2장. 분업을 배우는 기계의 계보
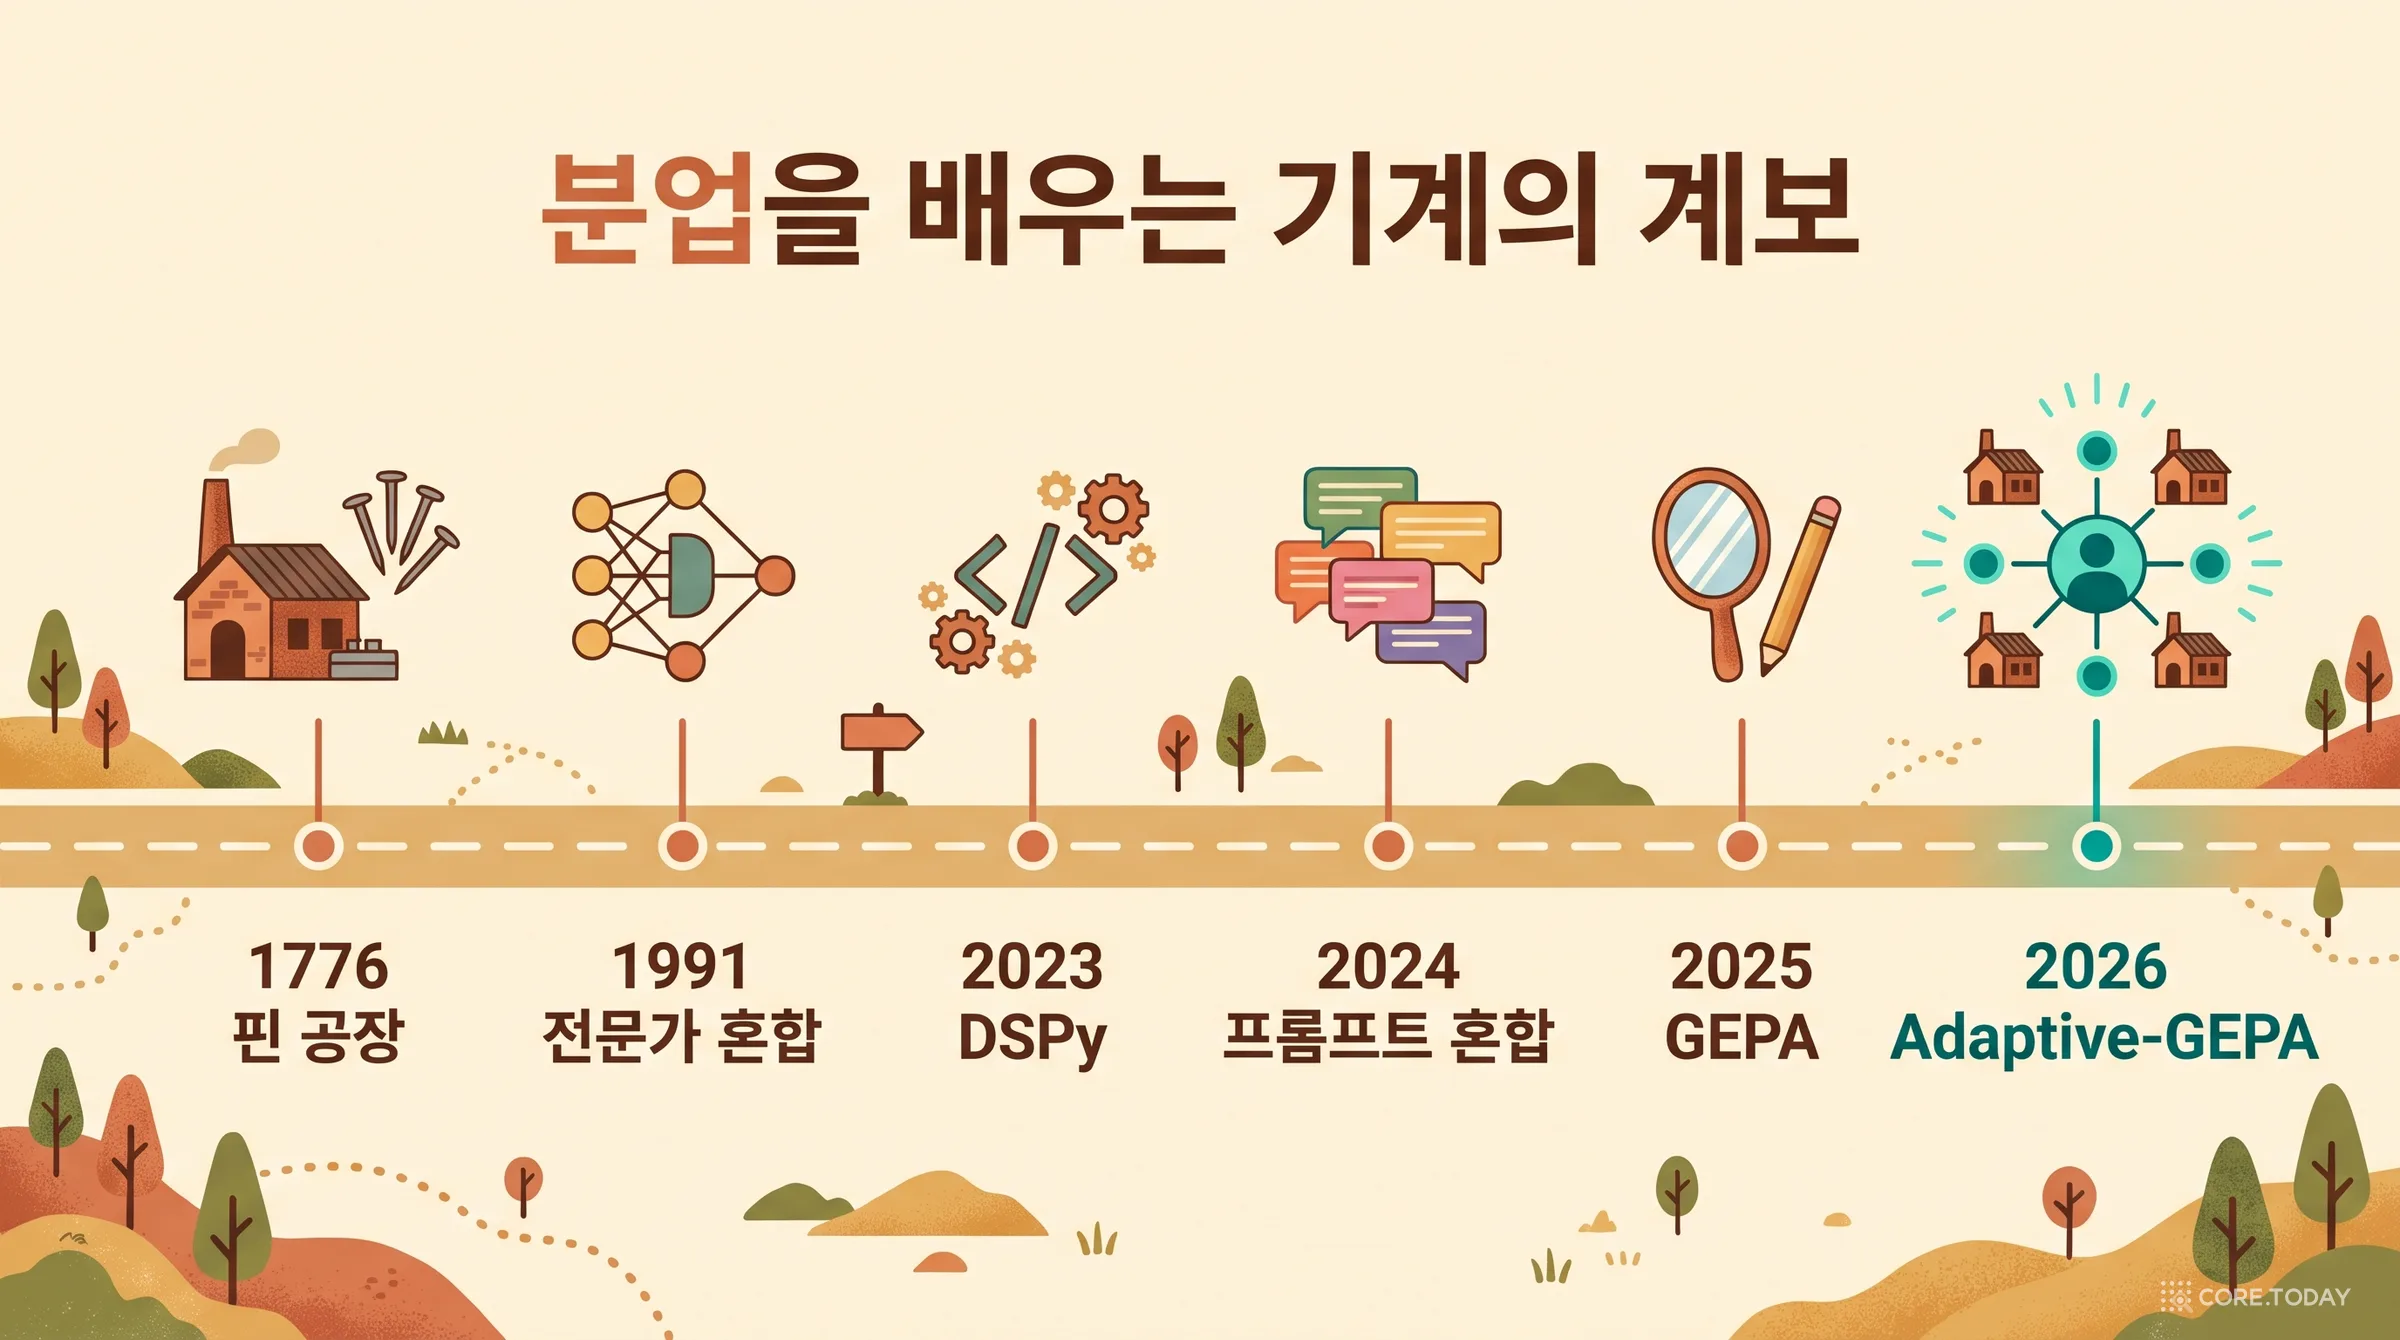
‘나누는 법도 배운다’는 생각은 새롭지 않습니다. 35년 된 생각입니다. 다만 무엇을 나누는지가 시대마다 달랐습니다. 한 가지 미리 밝혀 둡니다. 아래 계보의 앞부분(전문가 혼합, 모델 라우팅)은 Adaptive-GEPA 논문이 인용하지 않습니다. 논문의 참고문헌에서 이 전통으로 이어지는 다리는 2024년의 ‘프롬프트 혼합’ 논문 하나뿐입니다. 앞부분은 코어닷투데이가 이해를 돕기 위해 이어 그린 선입니다.
애덤 스미스의 『국부론』 첫 장은 핀 공장 이야기로 시작합니다. 한 사람이 철사를 뽑고, 다음 사람이 펴고, 세 번째가 자르고, 네 번째가 끝을 뾰족하게 갈고. 열 명이 공정을 나눠 맡으면 하루에 4만 8천 개를 만드는데, 각자 처음부터 끝까지 혼자 만들면 한 사람이 스무 개도 못 만든다는 관찰입니다.
여기서 눈여겨볼 것은 분업의 이득이 아니라 분업의 전제입니다. 핀 공장의 공정은 누군가 미리 나눠 놓았습니다. 무엇이 한 사람의 일인지는 공장주가 정했습니다. 이 글의 주제는 그 ‘나누기’ 자체를 기계가 배울 수 있느냐입니다.
1991년, 서로 간섭하는 신경망
기계학습에서 이 질문을 처음 정면으로 다룬 논문은 1991년 『Neural Computation』에 실린 「Adaptive Mixtures of Local Experts」입니다. 저자는 로버트 제이콥스, 마이클 조던, 스티븐 놀런, 제프리 힌턴. 논문의 첫 문장이 문제를 그대로 말합니다.
하나의 다층 신경망을 역전파로 훈련해 서로 다른 때에 서로 다른 하위 과제를 수행하게 하면, 일반적으로 강한 간섭 효과가 생겨 학습이 느려지고 일반화가 나빠진다.
한 신경망에 두 가지 일을 가르치면 한쪽을 배울 때 다른 쪽이 망가진다는 것입니다. 해법은 작은 ‘전문가’ 신경망 여러 개와, 입력을 보고 어느 전문가를 쓸지 정하는 게이팅 신경망을 함께 훈련하는 것이었습니다. 전문가들이 협력하는 대신 경쟁하도록 오차 함수를 바꾼 것이 핵심이었습니다. 한 사례는 한 전문가가 맡도록 하면 다른 전문가의 가중치를 건드리지 않습니다.
실험은 모음 네 개를 구분하는 과제였습니다(화자 75명 중 50명으로 훈련, 25명으로 시험). 결과가 흥미롭습니다. 전문가 혼합과 보통 신경망의 정확도는 똑같았습니다(훈련 88%, 시험 90%). 다른 것은 속도였습니다. 전문가 혼합은 약 1,100번, 보통 신경망은 2,200~2,400번의 반복이 필요했습니다. 그리고 전문가를 4개나 8개 줬는데 실제로 일을 맡은 것은 2~3개뿐이었습니다. 나머지는 스스로 쓰이지 않게 됐습니다.
이 논문에는 30여 년 뒤와 겹치는 대목이 하나 더 있습니다. 그전의 연구(햄프셔와 와이벨, 1989)는 전문가마다 하위 과제를 사람이 미리 배정해 훈련했습니다. 1991년 논문의 기여는 그 배정을 학습이 찾게 한 것이었습니다. Adaptive-GEPA가 ‘과제별로 따로 최적화’와 자신을 구분하는 방식과 같은 구도입니다.
전문가 혼합이 오늘날 대형 언어 모델의 내부 구조로 어떻게 이어졌는지는 코어닷투데이의 전문가 혼합 35년 특집에 정리해 두었습니다. 거기서 전문가는 신경망 층 안의 작은 계산 단위입니다. 이 글의 전문가는 훨씬 큰 단위, 프로그램 한 편입니다.
2023~2024년, 어느 모델로 보낼까
언어 모델 시대에 ‘라우팅’이라는 말이 먼저 붙은 곳은 모델 선택이었습니다. 2023년 FrugalGPT는 싼 모델에 먼저 묻고 답이 미덥지 않을 때만 비싼 모델로 넘기는 방식으로 “GPT-4와 같은 성능을 비용을 최대 98% 줄여” 낼 수 있다고 보고했습니다. 2024년 RouteLLM은 약 8만 건의 사용자 선호 데이터로 ‘강한 모델로 보낼지 약한 모델로 보낼지’를 정하는 라우터를 훈련했습니다.
이 계열은 같은 일을 누가 할지를 고릅니다. 절차는 하나이고 모델만 바뀝니다. Adaptive-GEPA가 고르는 것은 어떤 절차로 할지입니다. 모델은 하나이고 절차가 바뀝니다.
2023~2024년, 프롬프트를 고치는 기계
다른 한 줄기는 프롬프트 자동 최적화입니다. 2022년 APE가 언어 모델에게 지시문 후보를 쓰게 하고 점수로 골랐고, 2023년 DSPy(ICLR 2024)는 프롬프트를 손으로 쓰는 대신 ‘입력 → 출력’ 서명만 선언하면 나머지를 컴파일러가 채우는 틀을 만들었습니다. 2024년 MIPRO는 여러 단계짜리 프로그램에서 지시문과 예시를 함께 고르는 방법을, TextGrad는 글로 된 피드백을 기울기처럼 역방향으로 흘리는 방법을 내놓았습니다.
이들은 모두 프롬프트 하나(또는 한 벌)를 찾습니다. 2024년 ICML에 실린 Mixture-of-Prompts(MoP)가 이 가정을 처음 깼습니다. 제목이 「프롬프트 하나로는 부족하다」입니다. 방법은 이렇습니다. 예시 문항들을 임베딩해 K-평균으로 묶고, 묶음마다 전문 프롬프트를 하나씩 배정합니다. 새 질문이 오면 임베딩 공간에서 가장 가까운 묶음의 프롬프트로 보냅니다. 논문은 50개 과제에서 기존 방법 대비 평균 승률 81%를 보고했고, 스스로 “전문가 혼합 패러다임을 채택한다”고 적었습니다.
MoP의 라우터는 임베딩 거리입니다. 고칠 수 있는 글이 아니고, 전문가는 프롬프트일 뿐 프로그램이 아닙니다. Adaptive-GEPA는 MoP를 비교 대상으로 실험에 넣었습니다.
2024년, 프로그램을 고치는 기계
같은 해 다른 쪽에서는 최적화 대상이 프롬프트에서 코드 전체로 넓어졌습니다. ADAS(ICLR 2025)는 에이전트를 코드로 정의하고 ‘메타 에이전트’가 더 나은 에이전트를 계속 프로그래밍하게 했습니다. AFlow(ICLR 2025)는 워크플로를 코드로 두고 탐색 나무로 고쳐 나갔습니다. 코어닷투데이의 Archon·AFlow 특집이 이 시기를 다룹니다. 이 계열에서 찾는 것은 여전히 모든 요청에 쓰는 프로그램 하나입니다.
2025년, GEPA
2025년 7월의 GEPA는 두 줄기를 묶는 발판이 됐습니다. 다음 장에서 자세히 복습하겠지만 요점은 둘입니다. 점수만이 아니라 실행 기록과 글로 된 피드백을 반성 모델이 읽고 고친다는 것, 그리고 평균이 가장 높은 후보 하나만 남기지 않고 문항별로 가장 잘한 후보들을 함께 살려 둔다는 것. GEPA는 ICLR 2026에서 구두 발표로 채택됐고, 2025년 8월에는 프롬프트가 아니라 DSPy 프로그램 소스 전체를 진화시키는 ‘전체 프로그램 어댑터’가 저장소에 추가됐습니다. 2026년 2월에는 글로 표현되는 것이면 무엇이든 최적화한다는 optimize_anything API가 나왔습니다.
2026년, 하네스가 갈라지기 시작한다
2026년 들어 ‘하네스 하나로는 부족하다’는 문제의식이 여러 곳에서 동시에 나왔습니다.
Adaptive Auto-Harness(arXiv 2606.01770, 6월): 프롬프트·스킬·도구를 담은 하네스를 git 브랜치로 여러 벌 보관하고, 라우터가 요청마다 브랜치를 고릅니다. 무대는 끝없이 새 과제가 들어오는 열린 흐름입니다.
JTPRO(ACL 2026 Findings): 전체 지시문과 도구 설명을 함께 고칩니다. 도구 이름은 절대 바꾸지 않는다는 규칙을 두어, 어느 도구가 어느 도구인지 헷갈릴 일이 없게 합니다.
인과적 프롬프트 최적화(arXiv 2602.01711): 질문마다 다른 프롬프트를 고르되, 오프라인 보상 모델로 고릅니다.
OO-Harness(arXiv 2610.28380, 10월): 하네스를 클래스 상속 구조로 두고 시험 시점에 하위 클래스를 고릅니다. Adaptive-GEPA보다 3주 뒤에 나왔고 서로 인용하지 않습니다.
Adaptive-GEPA는 이 가운데 가장 좁은 질문을 고릅니다. 요청 분포는 고정돼 있다고 치고, 전문가의 정체성을 탐색 내내 어떻게 유지할 것인가. 전문가의 맡은 일도 코드도 계속 바뀌는데, 두 갈래를 합칠 때 ‘이 전문가와 저 전문가가 같은 역할’이라는 것을 무엇으로 알 수 있는가. 논문의 관련 연구 절은 이렇게 선을 긋습니다. 공동 최적화와 이질적 요청 라우팅은 최근 시스템들에도 나오지만, 자신들의 초점은 “탐색과 재조합 과정에서 전문가의 정체성이 어떻게 유지되는가”라고.
3장. 출발점 — GEPA와 ‘전체 프로그램’ 탐색
Adaptive-GEPA는 GEPA의 탐색 뼈대를 그대로 가져다 씁니다. 그래서 GEPA의 세 가지 부품을 먼저 짚어야 뒤가 읽힙니다.
부품 1. 점수가 아니라 첨삭을 읽는다
GEPA 이전의 프롬프트 최적화는 대체로 숫자만 봤습니다. 이 프롬프트는 62점, 저 프롬프트는 65점. GEPA는 왜 틀렸는지를 읽습니다. 프로그램이 문항 하나를 푼 과정(어떤 모듈이 무엇을 받아 무엇을 냈는지)과 채점기가 돌려준 글(“두 번째 문서를 찾지 못했다”, “금지어 ‘bottle’을 썼다”)을 묶어 반성 모델에게 주고, 프롬프트를 다시 쓰게 합니다.
부품 2. 문항별 1등을 살려 둔다
보통의 탐색은 평균이 가장 높은 후보에서 다음 후보를 만듭니다. GEPA는 검증 문항 하나하나에 대해 그 문항에서 최고점을 낸 후보가 누구인지 기록합니다. 어느 문항에서도 1등이 아닌 후보는 치우고, 남은 후보 가운데 ‘1등을 한 문항 수’에 비례하는 확률로 다음 부모를 뽑습니다. 평균은 낮아도 남들이 못 푸는 문항 몇 개를 푸는 후보가 살아남습니다. 이것이 ‘문항별 파레토 선택’입니다.
이 부품이 Adaptive-GEPA에서 중요한 이유가 있습니다. 뒤섞인 요청에서는 수학만 잘하는 후보, 검색만 잘하는 후보가 따로 생기기 쉽습니다. 평균만 보면 둘 다 평범해서 버려지지만, 문항별로 보면 둘 다 살아남습니다. 그리고 나중에 합칠 수 있습니다.
부품 3. 병합
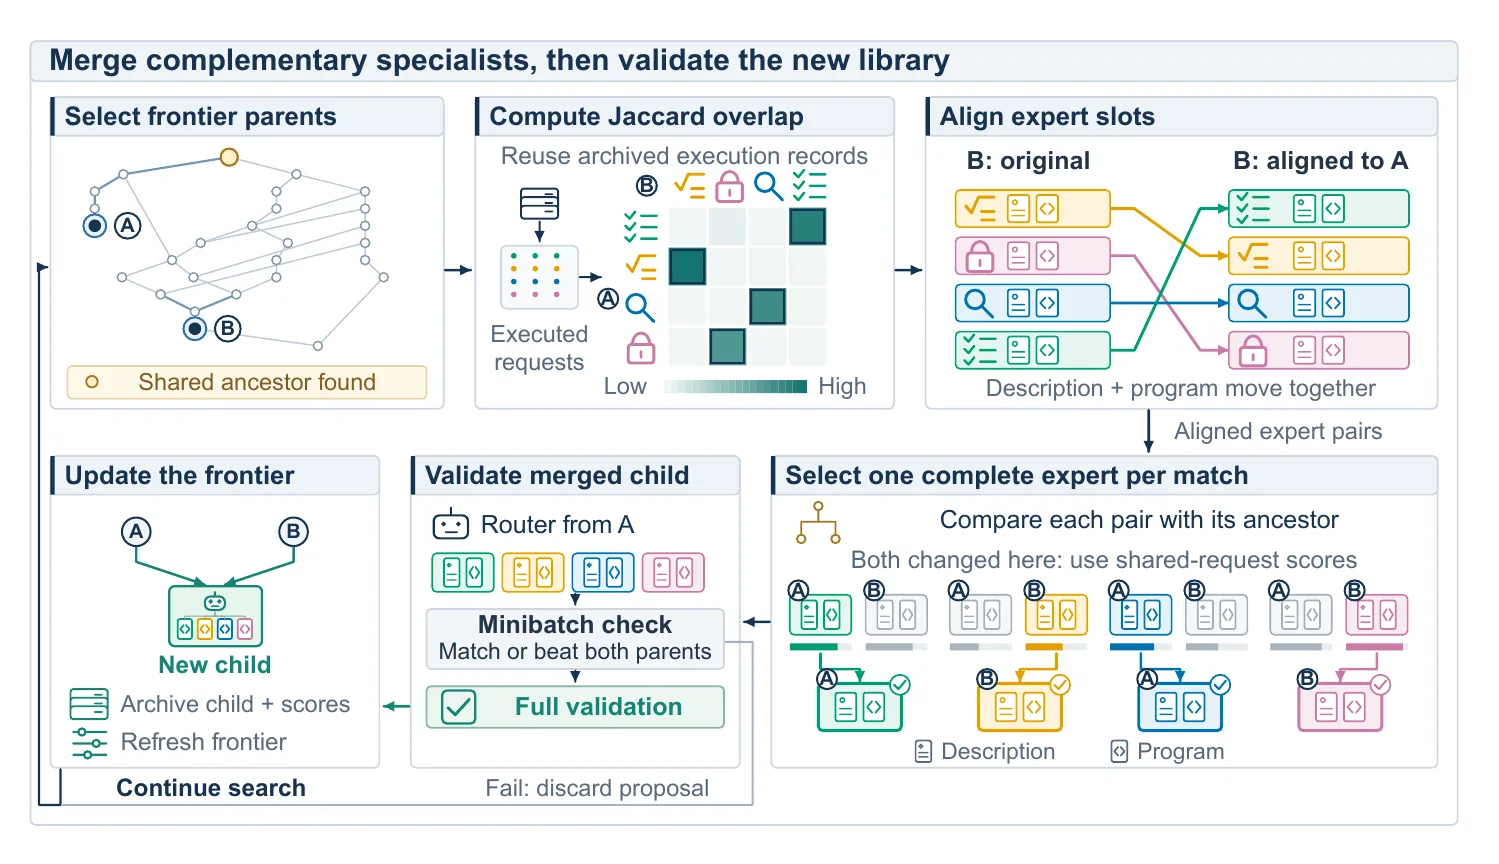
GEPA에는 서로 다른 갈래의 후보 둘을 합치는 병합(merge)이 있습니다. 조건이 까다롭습니다. 두 후보에게 공통 조상이 있어야 하고, 조상의 점수가 둘보다 높으면 안 되고, 적어도 한 구성 요소에서 ‘한쪽은 조상과 같고 다른 쪽은 바뀐’ 상태여야 합니다. 조건이 맞으면 구성 요소마다 바뀐 쪽의 것을 가져옵니다. 양쪽 다 바뀌었으면 전체 점수가 높은 쪽 것을 씁니다. 합친 후보는 검증 문항 다섯 개로 약식 시험을 봐서 두 부모 중 나은 쪽 이상이면 통과합니다.
원래 GEPA에서 ‘구성 요소’는 프로그램 안의 모듈별 프롬프트였습니다. 1번 모듈의 프롬프트는 이쪽 것, 2번 모듈의 프롬프트는 저쪽 것. 모듈에는 이름이 있고 역할이 고정돼 있으니 이름으로 짝지으면 됩니다.
전체 프로그램 어댑터, 그리고 그 한계
2025년 8월 GEPA 저장소에 추가된 전체 프로그램 어댑터는 프롬프트 대신 DSPy 프로그램의 파이썬 소스 전체를 후보로 삼습니다. 출발점은 이 한 줄입니다.
python
import dspy
program = dspy.ChainOfThought("question -> answer")
반성 모델은 이 소스와 실행 기록을 보고, 개선 계획을 3~7줄로 적은 뒤 ‘그대로 갈아 끼울 수 있는’ 새 소스를 통째로 내놓습니다. 저장소의 예시에서는 GPT-4.1 Nano의 MATH 점수가 67%에서 93%로 올랐다고 적혀 있습니다(시험 세트의 크기와 구성은 문서에 없습니다).
Adaptive-GEPA 논문은 이 어댑터로 뒤섞인 요청 전체를 최적화한 것을 GEPA-FPA-ALL이라고 부르고 가장 가까운 비교 대상으로 삼습니다. 이 글에서는 ‘프로그램 하나 진화’라고 부르겠습니다.
여기서 저장소 코드를 읽으면 보이는 것이 하나 있습니다. 전체 프로그램 어댑터의 후보는 구성 요소가 "program"하나뿐입니다. 그런데 GEPA의 병합은 ‘한쪽은 조상과 같고 다른 쪽은 바뀐 구성 요소’가 있어야 성립합니다. 구성 요소가 하나면 조상과 같은 쪽은 조상 그 자체이니, 합칠 것이 없습니다. 논문이 이렇게 쓰지는 않았지만, 코드로 보면 프로그램 하나 진화에서는 병합이 사실상 일어날 수 없습니다. 좋은 수학 분기를 가진 후보와 좋은 검색 분기를 가진 후보가 따로 생겨도, 둘을 이어 붙일 방법이 탐색에 없다는 뜻입니다.
후보를 여러 조각으로 쪼개면 병합이 다시 살아납니다. 다만 그때는 새 문제가 생깁니다. 조각의 정체가 고정돼 있지 않다는 것입니다. 이 문제가 7장의 주제입니다.
4장. 세 가지 길을 나란히 놓으면
논문의 표 1은 다섯 가지 방법이 무엇을 탐색하고 요청을 어떻게 배정하는지 비교합니다. 옮기면 다음과 같습니다.
방법
탐색이 바꾸는 것
요청 배정
고치는 순서
원래 GEPA
모듈별 프롬프트
사람이 준 워크플로 그대로
모듈을 돌아가며 하나씩. 선택적으로 모듈 단위 병합
MoP (프롬프트 혼합)
묶음 수, 지시문, 예시 배정
임베딩에서 가장 가까운 묶음
먼저 묶고, 그다음 프롬프트 배정
프로그램 하나 진화 (GEPA-FPA-ALL)
완전한 프로그램 하나
소스 안에 분기를 생성할 수 있음
프로그램 전체를 다시 씀
과제별 따로 (Per-family GEPA-FPA)
알려진 과제마다 프로그램 하나
정답 과제 표지
과제별로 독립된 탐색
Adaptive-GEPA
라우터, 설명, 프로그램, 활성 슬롯
라우터가 요청과 설명을 읽고 고름
피드백이 행동과 대상을 정함. 정렬한 뒤 병합
문제 설정도 수식으로 한 번 적어 두겠습니다. 요청 분포 D는 L개 과제의 혼합이고, 요청에는 과제 지시는 들어 있지만 과제 표지는 없습니다. 최적화 대상은 라우터 R과 전문가 프로그램 K개로 이루어진 묶음 P=(R,{Mk}k=1K)입니다. K가 과제 수 L과 같을 필요는 없습니다. 평가기는 출력에 점수 μ(x,y)를 매기고 글로 된 피드백 ϕ(x,y)를 돌려줄 수 있습니다. 목표는 예산 안에서 평균 점수를 가장 높이는 묶음을 찾는 것입니다.
P⋆∈argPmaxEx∼Dμ(x,ΦP(x)),Neval<B
Neval은 채점 호출 횟수입니다. 프로그램을 요청 하나에 돌리고 출력을 채점하면 한 번입니다. 이 정의는 11장에서 다시 중요해집니다. 프로그램 안에서 모델을 몇 번 부르든 채점 호출은 한 번이기 때문입니다.
5장. 후보 하나의 해부 — 라우터, 설명, 프로그램, 예비
이제 Adaptive-GEPA가 탐색하는 ‘후보 하나’가 어떻게 생겼는지 봅니다. 이 표현 방식이 논문의 첫 번째 기여입니다.
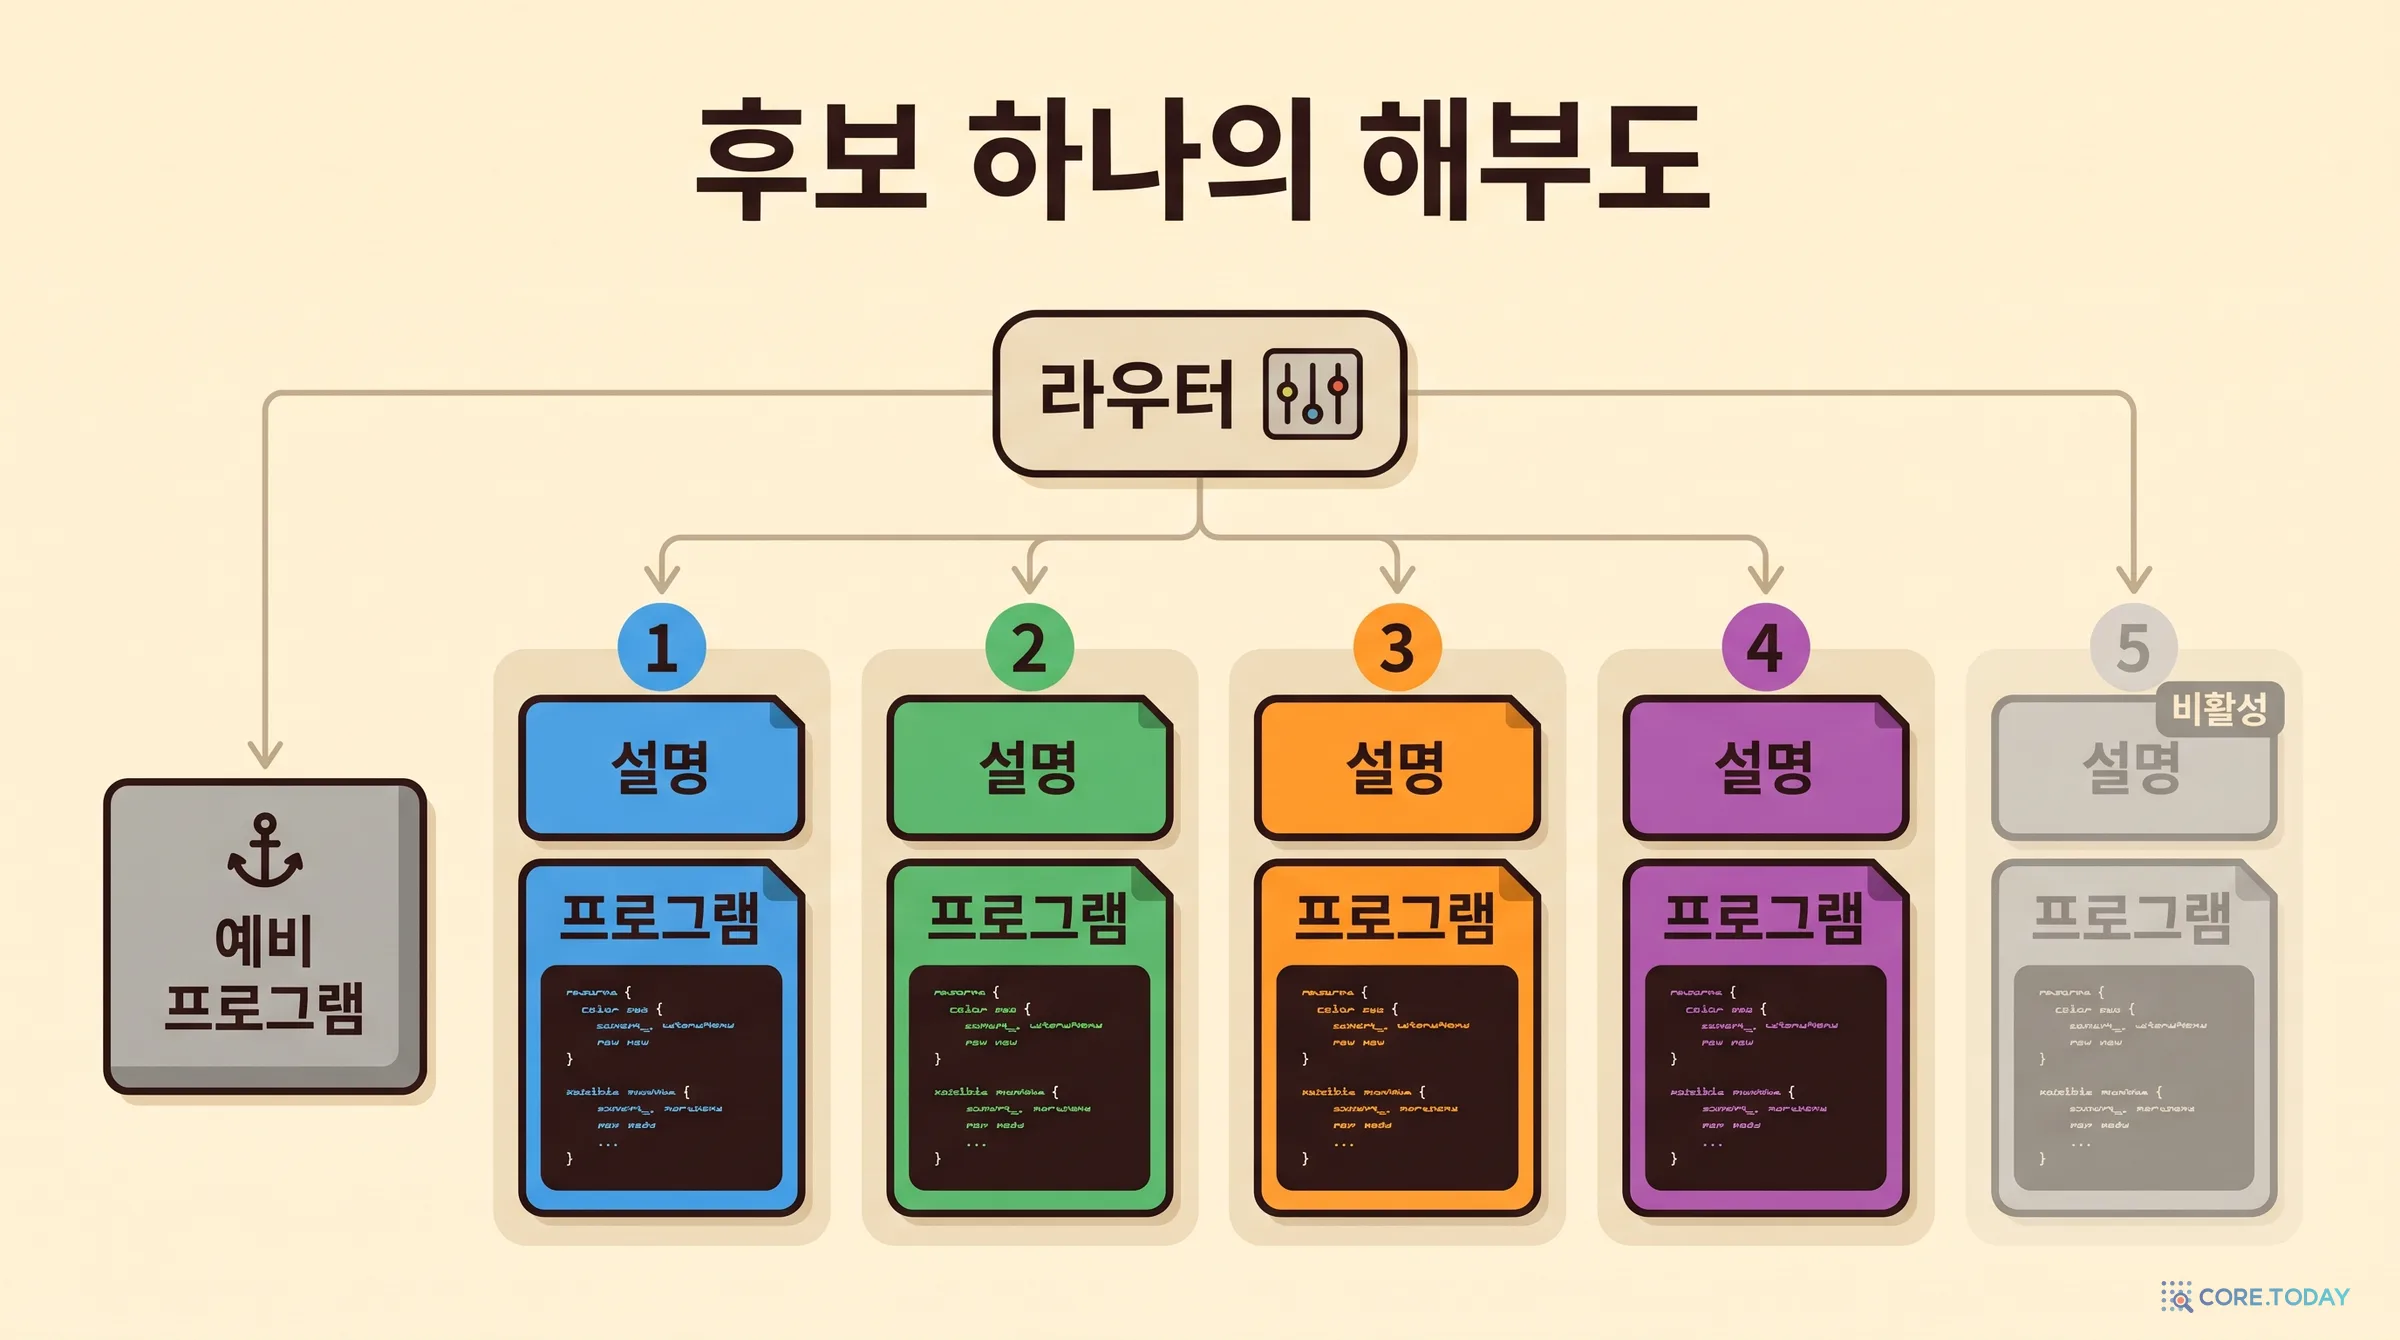
둘째 식의 0이 예비 프로그램입니다. 탐색을 시작할 때의 프로그램(예측기 하나짜리 DSPy 프로그램) 그대로이고, 탐색 내내 고정됩니다. 라우터가 0을 고르거나, 꺼진 슬롯을 고르거나, 고른 전문가의 코드가 컴파일되지 않으면 요청은 예비로 떨어집니다. 논문은 라우터가 ‘고른’ 슬롯과 ‘실제로 실행된’ 슬롯 eP(x)를 구분해 기록합니다. 이 구분이 7장에서 쓰입니다.
이 구조에서 세 가지를 짚어 둘 만합니다.
첫째, 설명은 전문가의 명함이자 탐색의 색인입니다. 라우터는 설명을 보고 요청을 보냅니다. 그리고 다음 장에서 보겠지만 반성 모델도 설명을 보고 다른 전문가들의 존재를 파악합니다. 소스 코드 다섯 벌을 다 읽지 않고도 “수학은 1번이 맡고 있으니 새 전문가는 다른 걸 맡아야겠다”고 판단할 수 있습니다.
둘째, 전문가 수는 탐색이 정합니다. 다섯 칸을 줬지만 최종 후보는 네 칸만 썼습니다. 1991년 전문가 혼합 실험에서 여덟 개를 줘도 두세 개만 쓰이던 것과 닮았습니다.
셋째, 전문가마다 추론 모드를 고릅니다. 생성된 프로그램은 소스 맨 위에서 PROFILE을 선언해 깊은 모드(생각 켬, 온도 0.6, 출력 8,192토큰)와 빠른 모드(생각 끔, 온도 0.3, 4,096토큰) 가운데 하나를 고릅니다. 라우터는 항상 빠른 모드입니다. 비교 대상인 프로그램 하나 진화는 프로그램 전체에 모드 하나만 고를 수 있었습니다. 이 차이는 결과를 해석할 때 꼭 기억해야 합니다(11장).
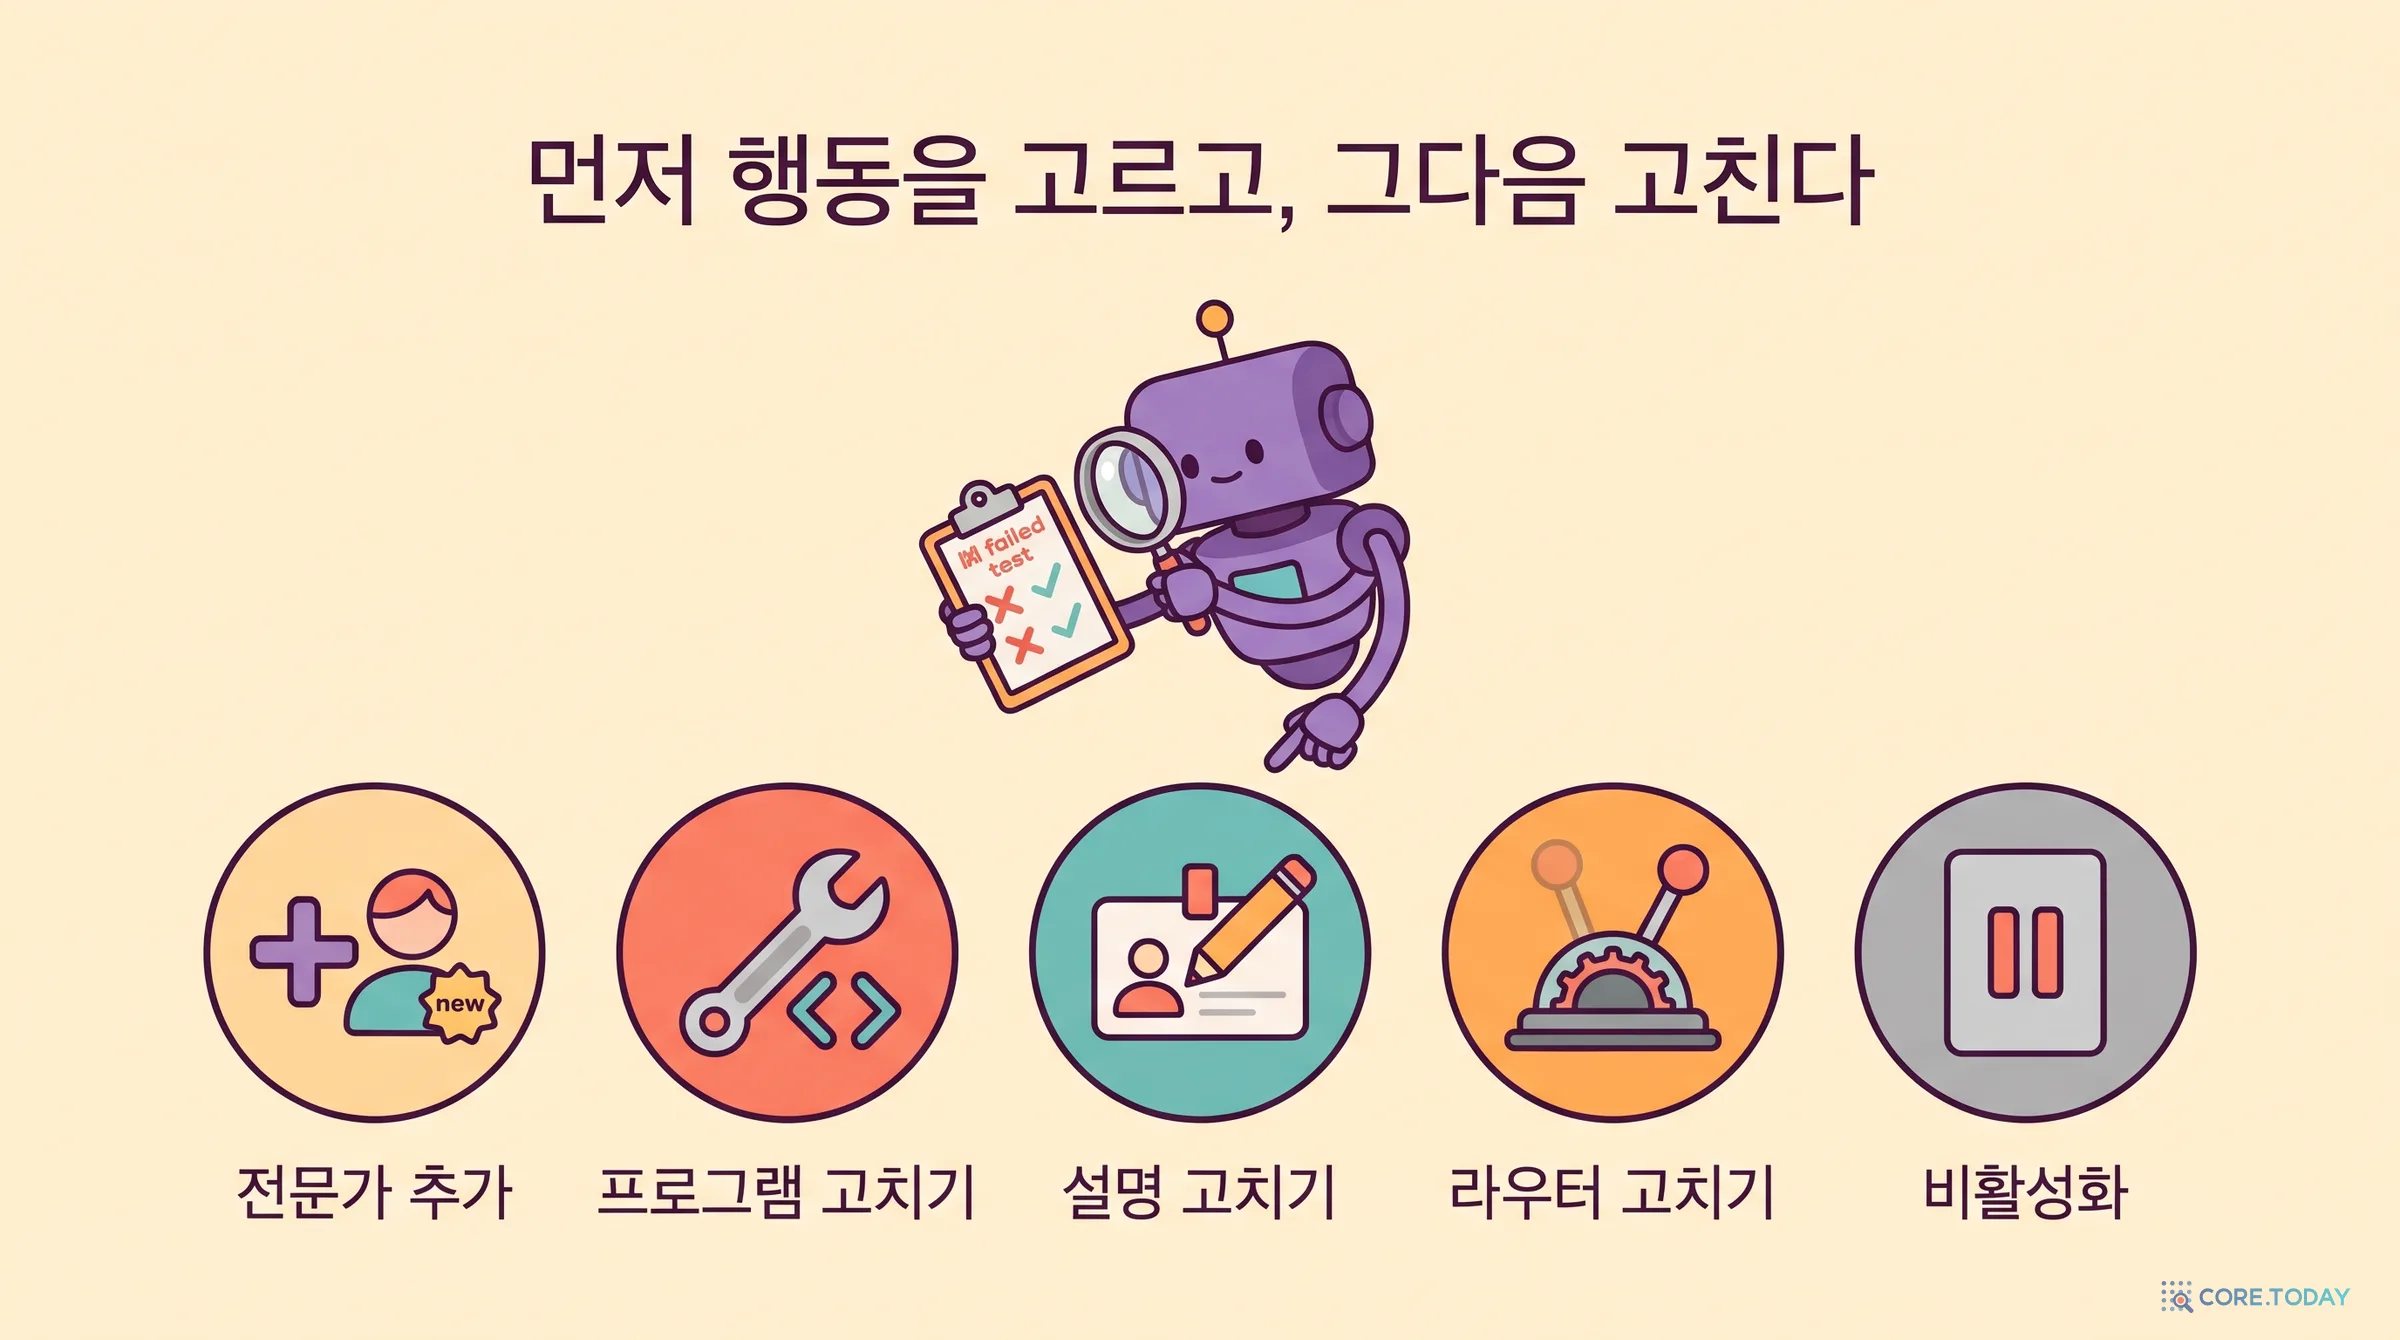
논문 3.2절은 이 구분의 논리를 이렇게 적습니다. 라우터와 설명을 고치면 요청의 방향을 바꿀 수 있지만 기존 프로그램의 코드를 고칠 수는 없다. 프로그램 수정은 잘못된 절차를 다루고, 전문가 추가는 없던 절차를 채운다. 설명은 한 전문가의 담당 범위를 말하고, 라우터는 겹치는 범위 사이의 우선순위를 정한다.
마지막 구분이 처음에는 군더더기처럼 보입니다. 설명도 라우터도 결국 ‘어느 요청이 어디로 가는가’를 정하는데 왜 둘로 나눌까요. 논문도 “이 선택들은 프롬프트 하나에 담을 수도 있다”고 인정합니다. 나눈 이유는 탐색이 고칠 범위를 좁히기 위해서입니다. 검색 전문가 하나가 요청을 놓치는 문제라면 그 설명만 고치면 되고, 나머지 네 전문가와 라우터는 그대로 둘 수 있습니다. 실제 사례는 10장에서 봅니다.
두 번에 나눠 부른다
반성은 모델 호출 두 번으로 이루어집니다. 첫 호출이 행동과 대상 슬롯을 고르고, 둘째 호출이 그 편집을 씁니다. 행동은 정해진 순서로 돌아가며 하는 것이 아니라 피드백을 보고 고릅니다.
눈여겨볼 것은 각 호출이 무엇을 볼 수 있는가입니다. 논문 부록 E의 표 6이 정보 경계를 정리합니다.
작업
실행 기록
라우터
모든 설명
대상 소스
다른 전문가 소스
행동 고르기
○
○
○
✕
✕
전문가 추가
○
○
○
✕
✕
프로그램 다시 쓰기
○
○
○
○
✕
라우터 다시 쓰기
○
○
○
✕
✕
설명 다시 쓰기
○
○
○
○
✕
비활성화
✕
✕
✕
✕
✕
마지막 열이 전부 ✕입니다. 반성 모델은 어떤 작업에서도 고치는 대상이 아닌 전문가의 소스를 보지 않습니다. 행동을 고를 때는 소스를 하나도 보지 않습니다. 다른 전문가에 대해 아는 것은 설명 한 줄과, 실행 기록에 남은 흔적이 전부입니다.
이 설계에는 실용적인 이유가 있습니다. 전문가 넷의 소스를 다 넣으면 반성 모델이 읽을 글이 몇 배로 늘어납니다. 프로그램 하나 진화가 겪는 문제가 바로 이것입니다. 소스가 길어질수록 한 군데를 고치려고 전부를 읽고 전부를 다시 써야 합니다. 설명이 색인 구실을 하면 그럴 필요가 없습니다. 설명을 다시 쓸 때 대상 소스를 보여 주는 것도 같은 맥락입니다. 새 설명이 실제 구현과 어긋나지 않게 하려는 것입니다.
정보를 가리는 데는 대가도 있습니다. 설명이 구현과 어긋나 있으면 반성 모델은 틀린 지도를 들고 판단하게 됩니다. 논문은 반성 프롬프트가 “충실하고 간결하며, 넓고 서로 구별되는 책임”을 쓰도록 요청하지만 그렇게 된다는 보장은 없다고 적습니다.
두 가지 합격선
고친 후보가 보관소에 들어가려면 약식 점검을 통과해야 합니다. 편집과 병합의 기준이 다릅니다.
편집부모가 풀었던 같은 피드백 묶음 24건(과제마다 6건)에 자식을 돌린다. 점수 합이 부모보다 엄격히 커야 통과.
병합두 부모가 모두 평가된 검증 문항 5건을 고른다(한쪽이 이긴 문항, 다른 쪽이 이긴 문항, 비긴 문항에서 고루). 점수 합이 두 부모 중 큰 쪽 이상이면 통과.
전체 검증통과한 후보만 검증 세트 180건 전체로 평가해 보관소에 넣는다. 이때 평균이 부모보다 높아야 한다는 조건은 없다.
마지막 줄을 눈여겨보세요. 전체 검증에서 부모보다 낮게 나와도 후보는 보관소에 남습니다. 다음 부모로 뽑힐지는 문항별 점수가 정하고, 마지막에 돌려주는 것은 검증 평균이 가장 높은 후보입니다.
P^=argP∈PmaxμˉDval(P)
7장. 슬롯 번호는 이름표가 아니다 — 발자국으로 맞추는 병합
이제 논문의 두 번째 기여이자 가장 고유한 부분입니다.
문제: 같은 번호, 다른 전문가
탐색은 한 줄로 가지 않습니다. 시작 후보에서 여러 갈래가 뻗어 나가고, 갈래마다 전문가를 만드는 순서가 다릅니다. 어떤 갈래는 수학 전문가를 먼저 만들어 1번 칸에 넣고, 다른 갈래는 글쓰기 전문가를 먼저 만들어 1번 칸에 넣습니다. 번호는 만든 순서일 뿐이지 역할이 아닙니다.
두 갈래를 합칠 때 GEPA의 원래 병합처럼 구성 요소를 ‘이름으로’, 즉 번호로 짝지으면 어떻게 될까요. 1번 칸끼리 비교해서 하나를 고르면, 수학 전문가와 글쓰기 전문가 가운데 하나가 사라집니다. 논문의 표현으로는 “번호로 복사하면 엉뚱한 전문가를 덮어쓸 수 있다”입니다.
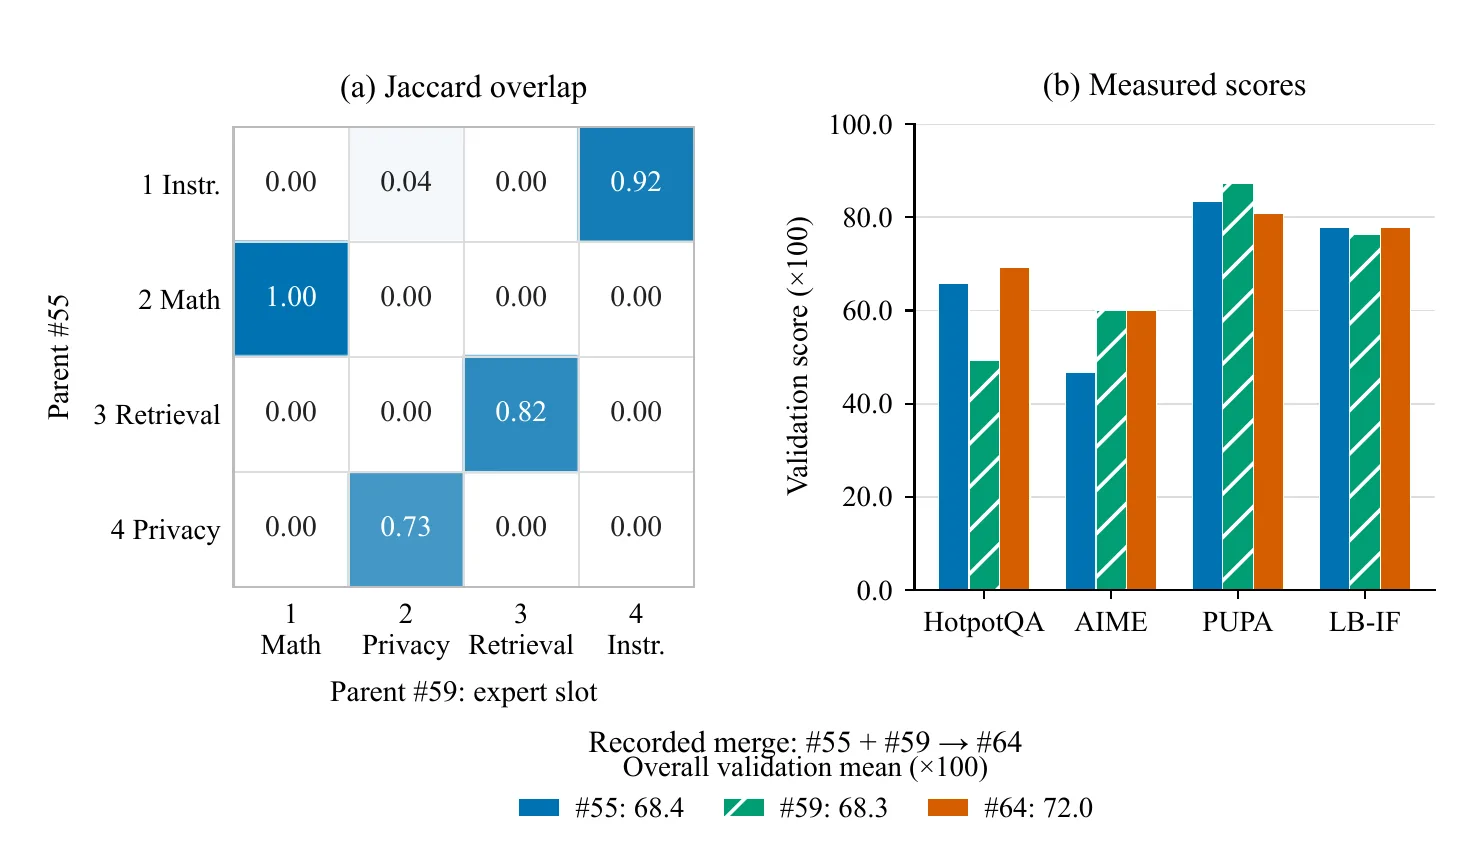
실제 탐색 기록에 이 상황이 있습니다. 후보 55와 후보 59는 둘 다 네 역할을 가졌지만 배치가 다릅니다.
슬롯
후보 55
후보 59
1번
조건 글쓰기
수학
2번
수학
개인정보
3번
검색
검색
4번
개인정보
조건 글쓰기
번호가 일치하는 것은 3번 하나뿐입니다.
해법: 누가 어떤 요청을 처리했는가
전문가의 정체를 무엇으로 알 수 있을까요. 설명 문장을 비교할 수도 있겠지만 설명은 갈래마다 표현이 다르고 계속 바뀝니다. 과제 표지를 쓰면 쉽겠지만 이 실험의 규칙상 쓸 수 없습니다.
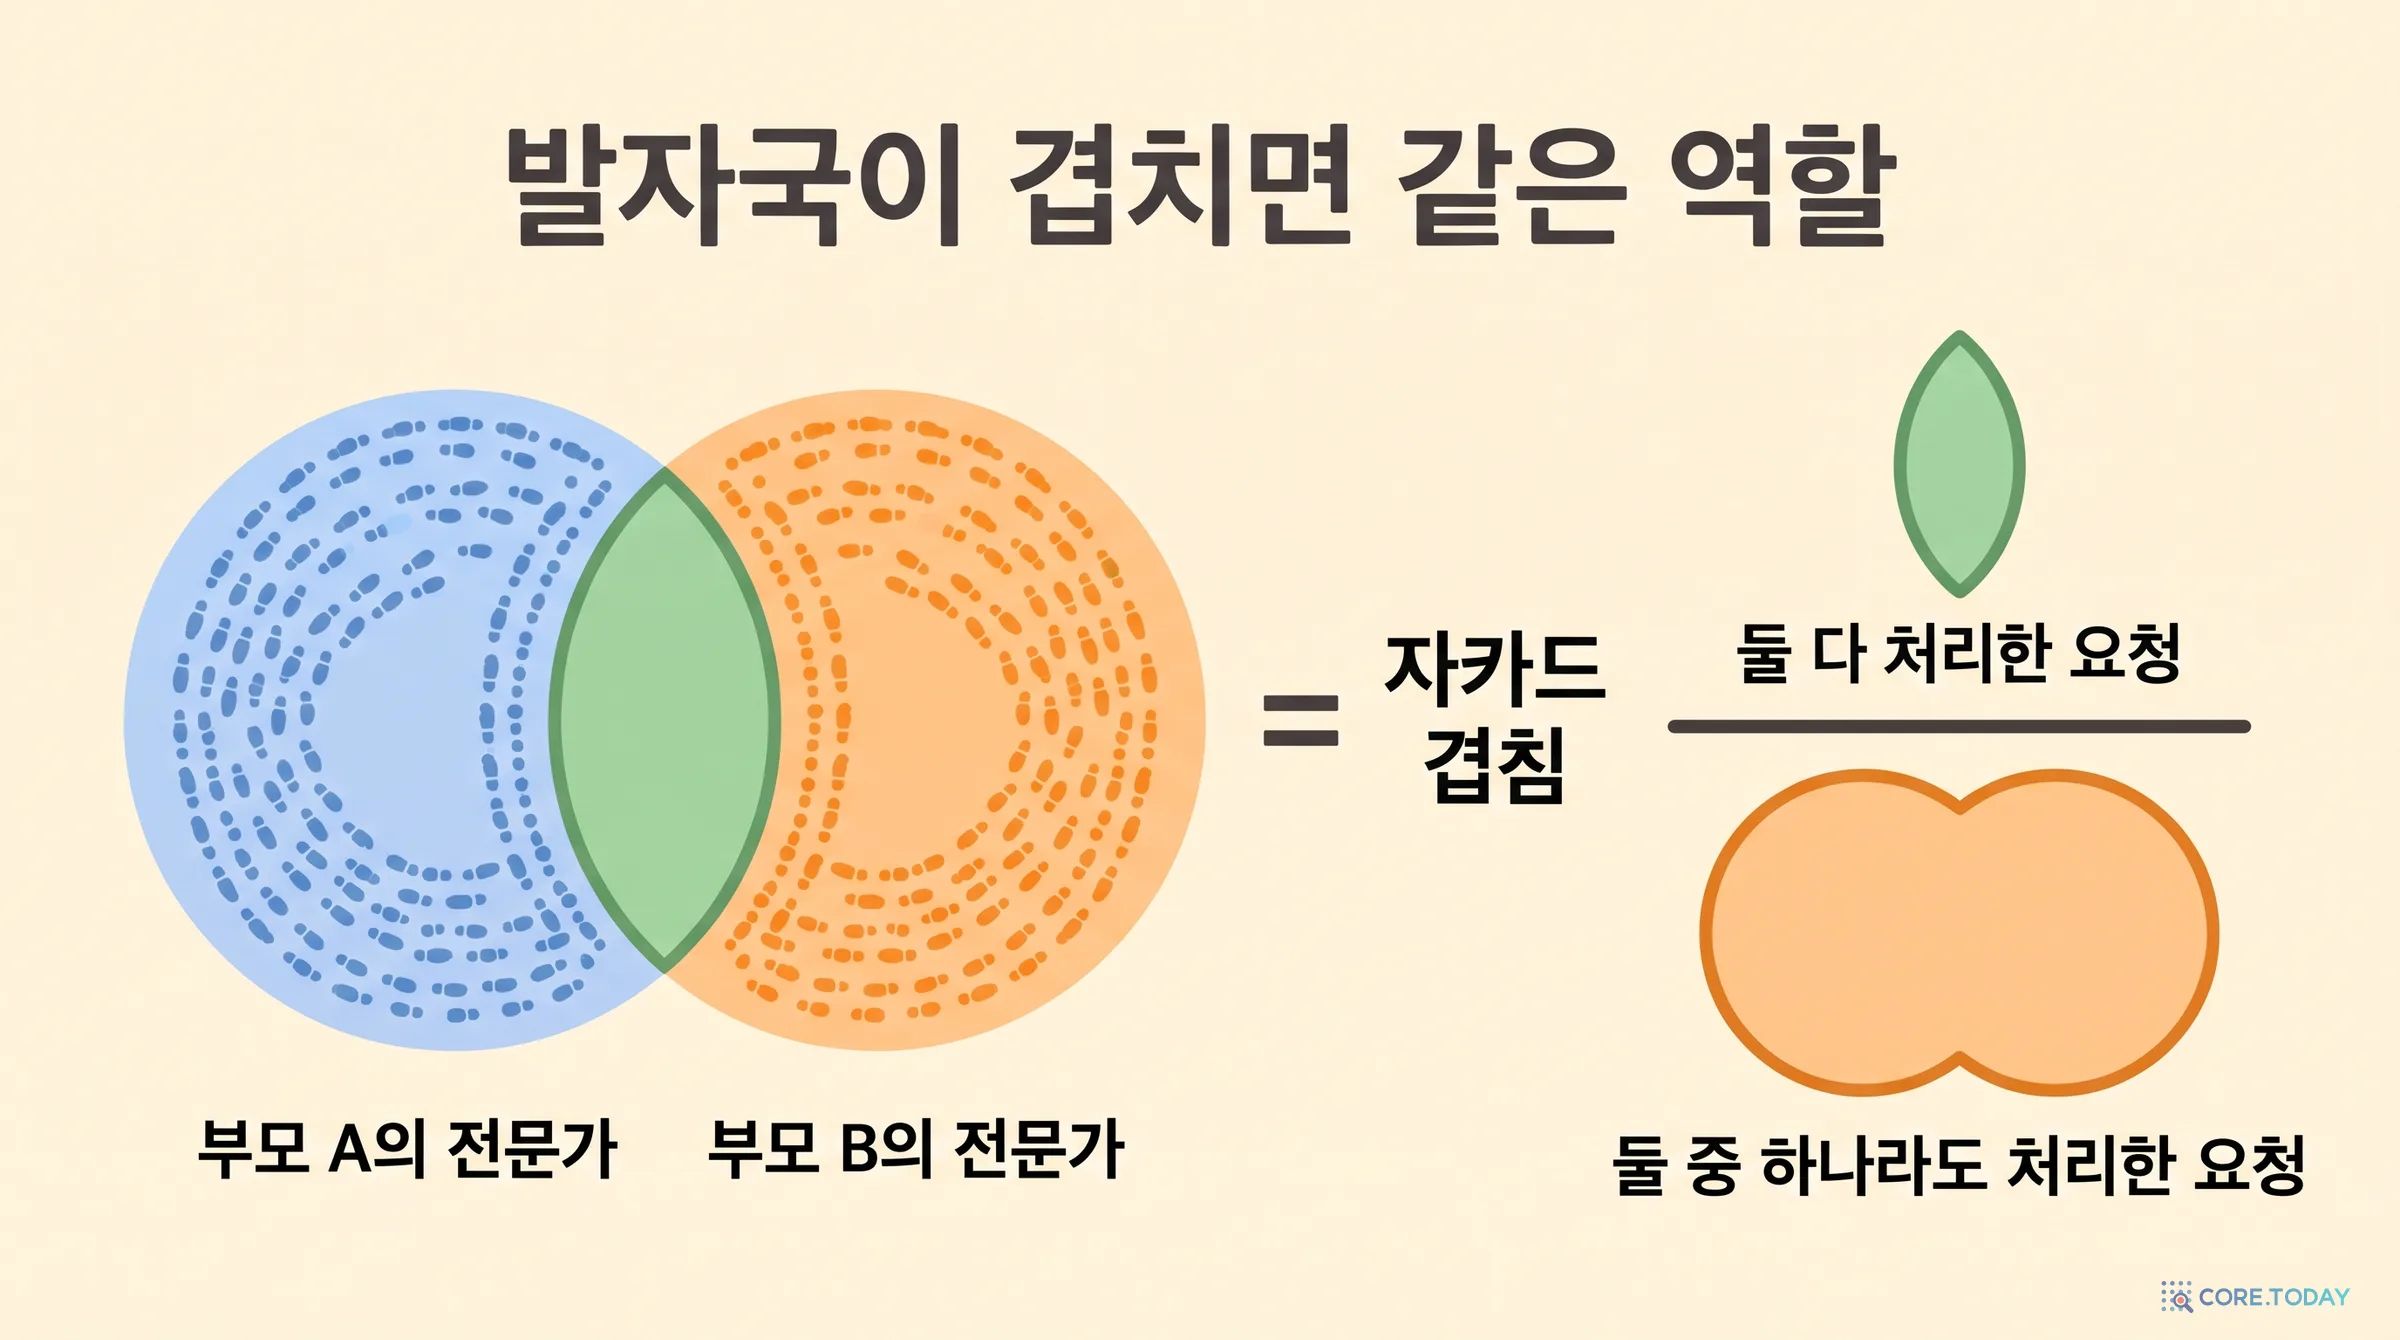
논문의 답은 행동으로 판단한다입니다. 후보가 전체 검증을 받을 때마다 ‘검증 요청 n번을 어느 슬롯이 실행했는가’가 기록됩니다. 한 전문가가 실행한 요청 번호의 집합을 그 전문가의 발자국(footprint)이라고 부릅니다. 두 전문가의 발자국이 많이 겹치면 같은 종류의 손님을 받아 온 것이고, 같은 역할로 봅니다.
숫자로 예를 들어 봅시다. 검증 세트는 과제마다 45건입니다. 후보 A의 한 전문가가 글쓰기 요청 45건을 전부 처리했고, 후보 B의 한 전문가가 그 45건에 더해 다른 요청 4건까지 49건을 처리했다면 겹침은 45/49≈0.92입니다. 두 전문가가 한 건도 같이 처리하지 않았다면 0입니다.
여기서 발자국이 라우터가 ‘고른’ 슬롯이 아니라 ‘실행된’ 슬롯으로 만들어진다는 점이 중요합니다. 라우터가 4번을 골랐어도 4번 코드가 컴파일되지 않아 예비가 대신 돌았다면, 그 요청은 4번의 발자국에 들어가지 않습니다. 일하지 않은 전문가는 발자국이 없습니다.
진한 칸이 대각선에 있지 않습니다. 55의 1번은 59의 4번과, 55의 2번은 59의 1번과 짝입니다. 번호로 맞췄다면 겹침 0.00인 칸끼리 짝지었을 것입니다.
짝짓기 규칙
겹침 행렬에서 짝을 정하는 규칙은 서로가 서로의 1순위입니다.
j=argj′maxJij′,i=argi′maxJi′j,Jij>0
55의 전문가 i가 59에서 가장 많이 겹치는 상대가 j이고, 59의 j에게도 55에서 가장 많이 겹치는 상대가 i이면 둘을 짝짓습니다. 짝을 못 찾은 전문가는 빈 슬롯으로 갑니다. 빈 슬롯이 없을 때의 예외 규칙은 부록 A에 있습니다.
논문은 이 규칙의 한계를 본문에 바로 적습니다. 이것은 실행된 요청에 대한 “국소적 짝짓기 휴리스틱”이지, 전체 겹침을 최대로 만드는 최적 배정도 아니고 의미가 같은지 검사하는 것도 아니라고. 라우팅 경계가 다르거나 컴파일 실패가 있으면 의도한 역할은 같은데 발자국만 달라질 수 있습니다.
설명과 프로그램은 한 몸으로 물려준다
짝이 정해지면 짝마다 어느 부모 것을 가져올지 정합니다.
한쪽만 바뀜공통 조상과 비교해 한 부모만 그 쌍을 바꿨다면 바뀐 쪽을 가져온다.
둘 다 바뀜두 전문가가 둘 다 처리한 요청에서의 평균 점수를 비교해 높은 쪽을 가져온다. 후보 전체의 평균이 아니라 그 전문가가 실제로 일한 요청에서의 성적이다.
증거 없음한쪽만 일한 기록이 있으면 그쪽을, 겹친 요청이 없으면 GEPA의 원래 규칙(전체 점수가 높은 부모)으로 돌아간다.
그리고 가져올 때는 설명과 프로그램을 반드시 함께 옮깁니다. 논문은 이를 “원자적 상속”이라고 부릅니다. 이쪽 설명에 저쪽 프로그램을 붙이면 명함과 사람이 어긋납니다. 라우터는 명함만 보고 손님을 보내므로, 수학 명함을 단 글쓰기 프로그램 앞에 수학 문제가 줄을 서게 됩니다.
라우터는 기본적으로 점수가 높은 부모의 것을 씁니다. 다른 부모의 전문가가 번호를 옮겼는데 그 부모의 라우터를 쓰면, 지시문 안의 “3번으로 보내라” 같은 숫자가 엉뚱한 칸을 가리키기 때문입니다.
합친 자식은 새로 평가해야 합니다. 정렬과 선택은 기존 기록을 재사용하지만, 전문가 조합이 바뀌면 라우터의 배정이 달라질 수 있습니다. 전체 검증 뒤에는 요청을 한 건도 받지 못한 전문가를 끕니다.
오른쪽 위 칸 ‘슬롯 정렬’을 보면 B의 원래 배치(왼쪽)에서 A에 맞춘 배치(오른쪽)로 선이 교차합니다. 그 아래 칸에서는 짝마다 A와 B 가운데 하나에 체크 표시가 붙습니다. 색이 있는 쪽이 선택된 쪽이고 회색이 버려진 쪽입니다.
아래 위젯에서 직접 해 볼 수 있습니다. 먼저 ‘슬롯 번호로 짝짓기’로 두고 칸마다 어느 부모 것을 가져올지 골라 보세요. 어떻게 골라도 역할 하나가 빠지기 쉽습니다. ‘발자국으로 짝짓기’로 바꾸면 어떻게 골라도 네 역할이 남습니다.
둘째 탭의 사례는 논문 부록 I의 표 12입니다. 발자국 정렬을 도입하기 전의 옛 실행에서, 번호로 합친 자식의 HotpotQA 점수가 38.3으로 떨어졌습니다. 두 부모는 62.8과 73.6이었습니다. 검색 전문가가 다른 역할에 덮여 사라진 것입니다.
55와 59의 실제 병합 결과도 봅시다. 발자국으로 네 역할을 짝지은 뒤 겹친 요청의 점수로 각 부모에서 두 쌍씩 골랐고, 자식인 후보 64는 검증 평균 72.0을 받았습니다. 두 부모는 68.4와 68.3이었습니다. 다만 자식의 PUPA 점수는 80.7로 두 부모(83.4, 87.4)보다 낮습니다. 논문은 이것도 그대로 적습니다. 보관된 점수로 부품을 골라도 합친 묶음이 과제별 점수를 모두 지킨다는 보장은 없습니다.
8장. 실험 무대 — 뒤섞인 네 가지 일
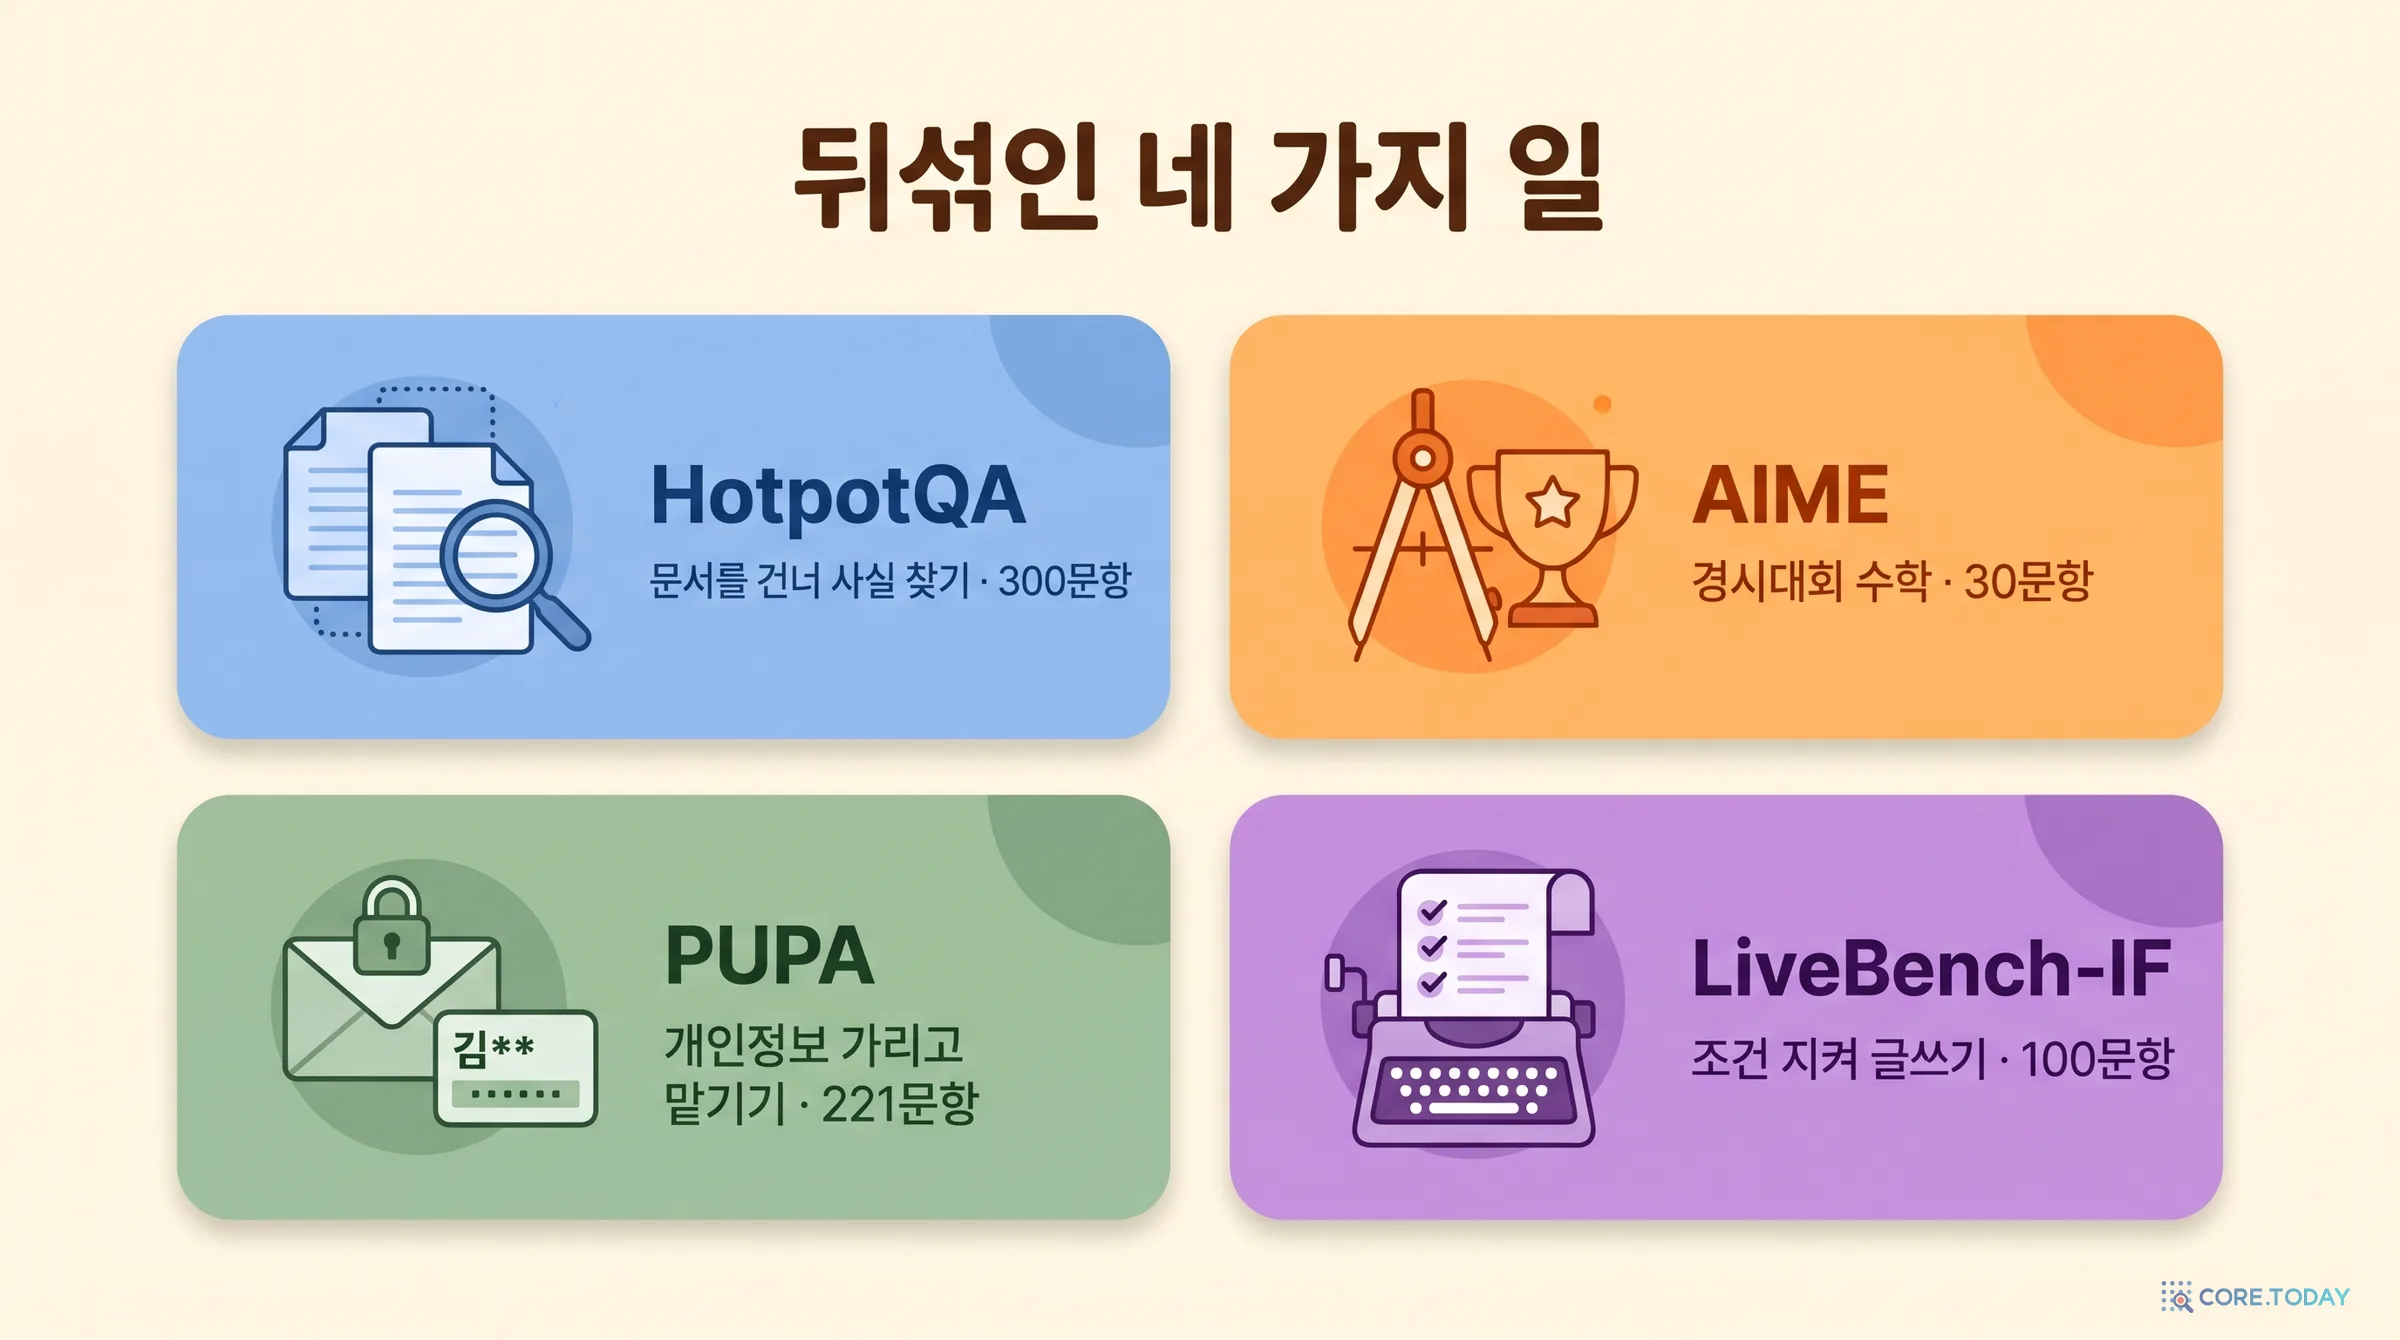
네 과제
실험은 네 벤치마크를 한 통에 섞습니다. 각각이 무엇을 재는지 알아야 결과 표가 읽힙니다.
HotpotQA — 문서 두 개를 건너야 하는 질문. 2018년 EMNLP에 발표된 약 11만 3천 문항짜리 데이터셋입니다. 대표적인 문항이 “라디오헤드의 보컬이자 작곡가는 언제 태어났나”입니다. 라디오헤드 문서에서 톰 요크라는 이름을 찾고, 톰 요크 문서에서 생년을 찾아야 합니다. 가운데 낀 ‘톰 요크’를 다리(bridge) 개체라고 부릅니다. 채점은 정답과 겹치는 단어 비율(토큰 F1)입니다. 프로그램은 위키백과 첫 문단들을 색인한 ColBERTv2 검색기를 쓸 수 있습니다.
AIME — 미국 수학 초청 시험. 한 해에 두 번, 15문항씩 치르는 경시대회입니다. 답은 0에서 999 사이 정수 하나입니다. 실험은 2022~2024년 문제를 훈련·검증에 쓰고 2025년 30문항을 시험에 씁니다. 문항마다 다섯 번씩 독립으로 풀어 평균을 냅니다. 문항이 30개뿐이라 한 문항이 3.3점입니다.
PUPA — 개인정보를 가리고 외부 모델에 맡기기. 2025년 NAACL의 PAPILLON 논문이 만든 과제로, 실제 사용자 대화에서 뽑은 901건이 원본입니다. 상황은 이렇습니다. 내 컴퓨터에는 믿을 수 있지만 약한 모델이, 바깥에는 강하지만 믿을 수 없는 모델이 있습니다. 약한 모델이 사용자 요청에서 개인정보를 뺀 요청문을 써서 바깥 모델에 보내고, 돌아온 답에 원래 정보를 다시 끼워 넣습니다. 원 논문의 예시가 이해를 돕습니다. 사용자가 “콜드콜 대본을 써 줘. 내 이름 드모네 존슨과 회사 이름 J’s 쿠리어 서비스를 넣어서”라고 하면, 바깥으로 나가는 요청은 “잠재 고객에게 거는 콜드콜 대본을 써 줘. 발신자가 자신과 회사를 소개하고…”가 되고, 이름과 회사명은 돌아온 대본에 로컬에서 다시 넣습니다. 점수는 답의 품질과 ‘1 − 유출 비율’의 평균입니다. 둘 다 판정 모델이 매깁니다.
LiveBench-IF — 조건 지켜 글쓰기. 가디언 기사의 첫 문장들을 주고 바꿔 쓰기, 요약, 쉽게 풀기, 이어서 이야기 짓기 가운데 하나를 시키면서 조건을 여러 개 붙입니다. “‘bottle’, ‘district’ 같은 단어 다섯 개를 쓰지 말 것, 세 문단일 것, 첫 문단은 ‘classic’으로 시작할 것” 같은 식입니다. 점수는 ‘조건을 전부 지켰는가’와 ‘지킨 조건의 비율’의 평균입니다. 글의 내용이 좋은지는 채점하지 않습니다. 오직 조건 준수만 봅니다.
네 과제의 채점 방식이 전부 다르다는 점이 중요합니다. 단어 겹침, 정확히 일치, 판정 모델, 규칙 검사. 그리고 피드백의 내용도 다릅니다. HotpotQA는 아직 못 찾은 근거 문서의 제목을 알려 주고(답은 숨김), AIME는 정답과 풀이를 주고, LiveBench-IF는 지킨 조건과 어긴 조건을 나열하고, PUPA는 품질과 유출 판정을 돌려줍니다. 논문은 여기에 단서를 답니다. 과제 이름과 정답 배정은 숨기지만, 피드백의 모양만 봐도 어떤 종류의 실수인지는 드러난다고. 반성 모델은 ‘이건 HotpotQA다’라는 말은 못 듣지만 ‘근거 문서를 못 찾았다’는 말은 듣습니다.
데이터, 모델, 예산
항목
설정
피드백 세트 / 검증 세트
과제마다 45건씩, 각 180건. 반성용 묶음은 한 번에 24건(과제마다 6건)
시험 세트
HotpotQA 300, AIME 30, PUPA 221, LiveBench-IF 100. 합계 651건
실행 모델
Qwen3-8B (두 번째 실험은 GPT-4.1)
반성 모델
GPT-5.5 (gpt-5.5-2026-04-24, 온도 1.0)
전문가 슬롯
최대 5칸. 시드 43
예산
채점 호출 18,000번 (실제로는 묶음 단위로 멈춰 18,103번)
실행 환경
파일·프로세스 접근, 임의 import, 동적 실행, 무제한 네트워크를 막은 샌드박스. DSPy와 검색 함수만 노출
과제 표지가 어디까지 쓰이는지도 정확히 봐 둡시다. 표지는 표본을 고르게 뽑는 데(묶음에 과제마다 6건)와 어느 평가기로 채점할지 정하는 데 쓰입니다. 그 뒤 라우터, 프로그램, 반성 모델에 들어가는 입력에서는 지워집니다. ‘이 요청은 어느 전문가에게 가야 한다’는 정답은 어디에도 없습니다.
비교 대상 다섯
이름
무엇인가
읽을 때 주의
시작 프로그램
예측기 하나짜리 DSPy 프로그램. Adaptive-GEPA의 출발점이자 예비 프로그램
깊은 모드로 실행
MoP
프롬프트 혼합. K-평균(묶음 5개 이하) + 가장 가까운 묶음으로 배정
채점 호출을 1,010번만 쓴다. 예산을 맞춘 비교가 아니다
GRPO
Qwen3-8B의 가중치 전체를 강화학습으로 미세조정
검색 도구가 없고 반성 모델도 없다. GPU 6장으로 약 5시간
프로그램 하나 진화 (GEPA-FPA-ALL)
같은 데이터·도구·반성 모델·예산으로 프로그램 하나를 진화
추론 모드를 프로그램 전체에 하나만 고를 수 있다
과제별 따로 + 정답 표지 (Per-family GEPA-FPA)
과제마다 4,500번씩 따로 최적화한 프로그램 넷. 추론할 때 정답 표지로 고른다
참조 기준. 엄밀한 상한은 아니다
GRPO는 딥시크가 2024년에 내놓은 강화학습 알고리즘입니다. 같은 프롬프트에 답을 여러 개 뽑아 점수를 매기고, 무리 평균보다 잘한 답 쪽으로 가중치를 움직입니다. 실험은 verl 라이브러리로 돌렸습니다. 논문은 이 비교들에 대해 스스로 선을 긋습니다. 이것은 “맥락을 주는 비교”이지, 같은 능력과 같은 계산량에서 최적화 패러다임의 순위를 매기는 것이 아니라고.
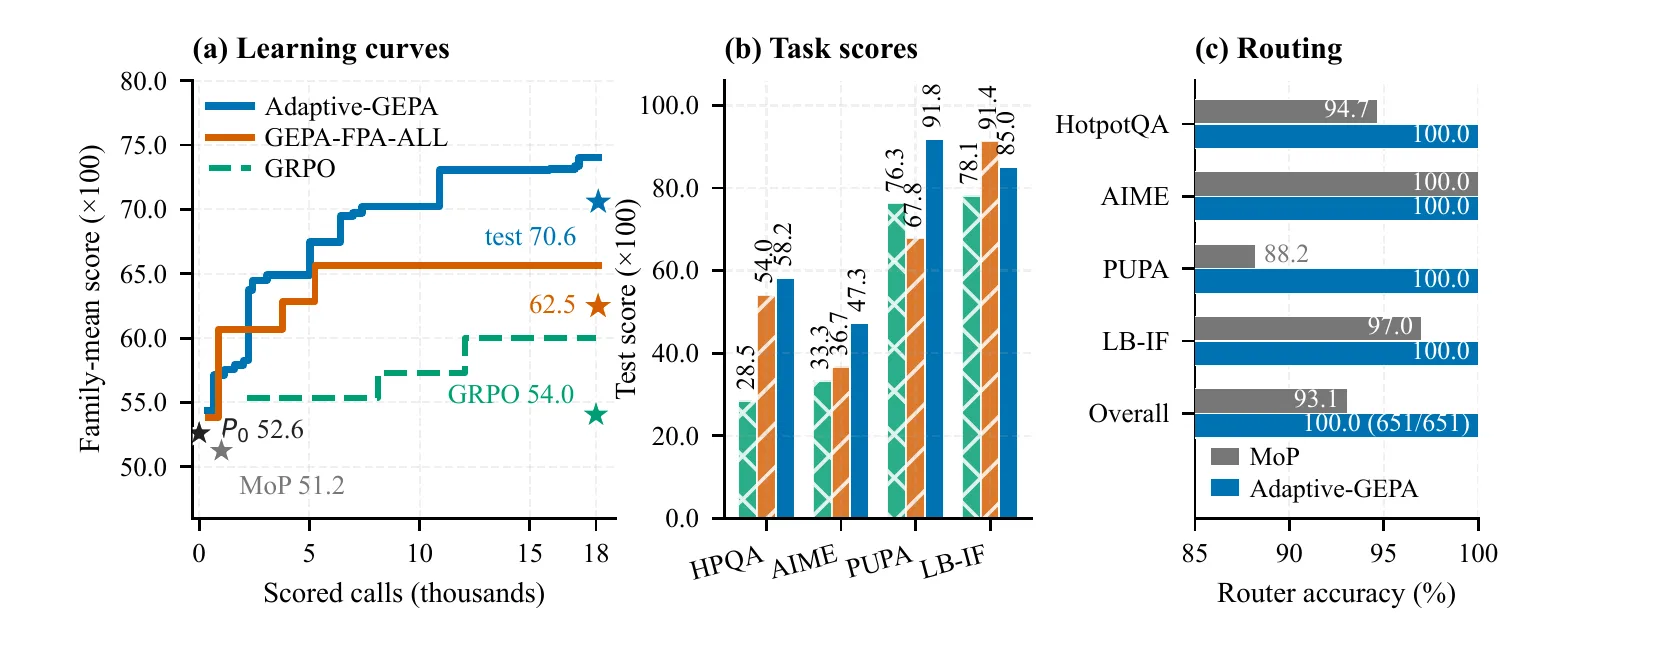
(a) 학습 곡선. 가로축은 지금까지 쓴 채점 호출(천 번), 세로축은 그때까지의 검증 최고 평균입니다. 파란 선(Adaptive-GEPA)은 2천 번 무렵 한 번, 5천 번 무렵 또 한 번, 11천 번 무렵 다시 뛰어 74.0에서 끝납니다. 주황 선(프로그램 하나 진화)은 5천 번쯤 65.6에 닿은 뒤 끝까지 평평합니다. 나머지 1만 3천 번 동안 더 나은 후보를 찾지 못했습니다. 별은 시험 점수입니다. 파란 별은 70.6, 주황 별은 62.5. 선의 끝(검증)과 별(시험) 사이의 간격도 봐 두세요. 파랑 3.4점, 주황 3.1점, 초록 6.0점입니다. 검증 세트로 고르고 또 골랐기 때문에 검증 점수는 시험보다 높게 나옵니다.
(b) 과제별 점수. 파란 막대가 네 과제 중 셋에서 가장 높습니다. 예외는 맨 오른쪽 LB-IF로, 주황(91.4)이 파랑(85.0)보다 높습니다. PUPA에서는 주황(67.8)이 초록(76.3)보다도 낮습니다.
(c) 라우팅. 과제 구분과 라우터의 배정이 얼마나 일치하는지입니다. Adaptive-GEPA는 네 과제 모두 100%, 합쳐서 651건 중 651건입니다. 임베딩 거리로 배정하는 MoP는 93.1%(606건)입니다. 가로축이 85%에서 시작한다는 점에 주의하세요.
‘과제 평균’은 네 과제 점수를 같은 무게로 평균한 값이고 논문의 주 지표입니다. 문항 수가 30개뿐인 AIME와 300개인 HotpotQA가 같은 무게를 갖습니다. ‘문항 평균’은 651문항을 똑같이 센 값입니다.
읽어 낼 것이 여럿입니다.
① 한 번의 탐색이 정답 표지 참조에 꽤 가까이 간다. 시작점 52.6에서 참조 73.0까지의 거리는 20.4점입니다. Adaptive-GEPA는 그중 18.0점을, 표지 없이 메웠습니다. 프로그램 하나 진화는 9.9점입니다.
② 그런데 참조를 넘지는 못한다. 과제를 미리 알고 따로 최적화하는 쪽이 2.4점 높습니다. 특히 LB-IF에서 9.2점, HotpotQA에서 5.3점 뒤집니다. 반대로 AIME에서는 Adaptive-GEPA가 5.3점 높은데, 문항 30개에서 5.3점은 한 문항 반 남짓입니다.
③ 프로그램 하나 진화는 PUPA를 망가뜨렸다. 67.8은 시작 프로그램(76.7)보다 낮습니다. 이유는 다음 장의 표 7에서 보입니다. 단일 프로그램이 배운 개인정보 절차는 이메일, 전화번호, 그리고 ‘특정 장애 표현 하나’를 정규식으로 바꾸는 것이었습니다. 훈련 예시에 나온 표현을 외운 것입니다.
④ GRPO는 거의 움직이지 않는다. 1.8만 번으로 +1.4점, 다섯 배인 9만 번으로 +3.7점입니다. 다만 이 GRPO에는 검색 도구가 없습니다. HotpotQA에서 26~28점에 머무는 것은 당연합니다. 논문도 이 결과가 “도구를 쓰는 강화학습이 본질적으로 약하다”는 뜻은 아니라고 적습니다.
⑤ MoP는 AIME를 반으로 깎았다. 32.0에서 16.0으로. 임베딩으로 묶어 프롬프트만 갈아 끼우는 방식은 수학에서 오히려 해로웠습니다.
격차의 4분의 3은 PUPA에서 온다
Adaptive-GEPA와 프로그램 하나 진화의 격차 8.1점을 과제별로 쪼개 봅시다. 네 과제의 차이는 +4.1, +10.6, +24.0, −6.4이고, 4로 나누면 과제 평균에 대한 기여는 +1.0, +2.7, +6.0, −1.6입니다. 8.1점 가운데 6.0점, 74%가 PUPA 하나에서 옵니다.
논문은 이 점을 스스로 점검합니다(부록 G.1, 표 8). 과제를 하나씩 빼고 나머지 셋으로 다시 평균을 내는 것입니다.
뺀 과제
Qwen3-8B 하나 진화
Qwen3-8B Adaptive
차이
GPT-4.1 하나 진화
GPT-4.1 Adaptive
차이
없음
62.47
70.58
+8.11
69.84
71.46
+1.62
HotpotQA
65.27
74.71
+9.44
73.76
74.44
+0.68
AIME
71.07
78.32
+7.26
81.12
81.95
+0.83
PUPA
60.69
63.50
+2.81
62.12
65.03
+2.91
LiveBench-IF
52.83
65.76
+12.93
62.36
64.43
+2.07
PUPA를 빼면 Qwen에서의 차이는 8.1점에서 2.8점으로 줄어듭니다. 어느 과제를 빼도 부호는 양수로 남지만, ‘8점 차이’라는 인상의 대부분은 단일 프로그램이 PUPA에서 넘어진 데서 나옵니다. 다만 이것은 이미 끝난 실행의 점수를 다시 평균한 것일 뿐, 과제를 빼고 새로 탐색한 결과가 아닙니다.
표 3 — 실행 모델을 GPT-4.1로 바꾸면
방법
HotpotQA
AIME
PUPA
LB-IF
과제 평균
문항 평균
시작 프로그램
53.3
30.7
80.5
75.3
59.9
64.9
MoP
47.3
27.3
75.4
73.3
55.8
59.9
프로그램 하나 진화
58.1
36.0
93.0
92.3
69.8
74.2
Adaptive-GEPA
62.5
40.0
90.8
92.6
71.5
75.7
과제별 따로 + 정답 표지 (참조)
71.7
39.3
92.6
96.1
74.9
81.0
실행 모델이 강해지자 격차는 8.1점에서 1.6점으로 줄었습니다(표 8의 소수 둘째 자리 기준 8.11과 1.62). PUPA는 오히려 프로그램 하나 진화가 2.2점 높습니다. 부록 K에는 더 미묘한 숫자가 있습니다. 검증 세트에서는 프로그램 하나 진화(70.86)가 Adaptive-GEPA(70.04)보다 높았습니다. 시험에서 순서가 바뀐 것입니다. 이 실행은 두 번 중단됐다 재개됐고, 중간에 PUPA 판정 모델이 멈춰 후보 여덟 개가 PUPA 0점을 받은 구간도 있습니다. 논문은 이 실행을 “깨끗한 재현이 아니라 보조 증거”라고 부릅니다.
아래 탐색기에서 표 2와 3을 직접 돌려 볼 수 있습니다. 실행 모델을 바꾸고, 과제를 하나씩 눌러 보고, 과제 하나를 뺀 평균을 내 보세요.
원래 GEPA 논문의 숫자와 견주면
같은 Qwen3-8B로 2025년 GEPA 논문이 보고한 숫자가 있습니다. HotpotQA 62.33, PUPA 91.85, AIME 32.00. 이번 논문의 Adaptive-GEPA는 58.2, 91.8, 47.3입니다. 나란히 놓고 싶어지지만 조건이 다릅니다. 원래 GEPA 실험은 과제마다 사람이 짠 프로그램(HotpotQA라면 여러 번 검색하는 파이프라인)에서 출발해 프롬프트만 고쳤고, 과제별로 따로 최적화했습니다. 이번 실험은 예측기 하나짜리 프로그램에서 출발해 검색 절차부터 스스로 만들어야 했고, 네 과제를 한꺼번에 다뤘습니다. 시작점 자체가 HotpotQA 42.3 대 26.0으로 다릅니다. 견줄 수 있는 것은 방향 정도입니다. 빈손에서 시작해 섞인 채로 탐색해도, 사람이 과제별로 짜 준 구조에서 출발한 결과의 근처까지는 간다.
10장. 탐색이 실제로 한 일
점수표는 결과입니다. 이 논문의 장점은 과정을 꽤 자세히 남겼다는 것입니다. 탐색 기록에서 네 가지 장면을 봅니다.
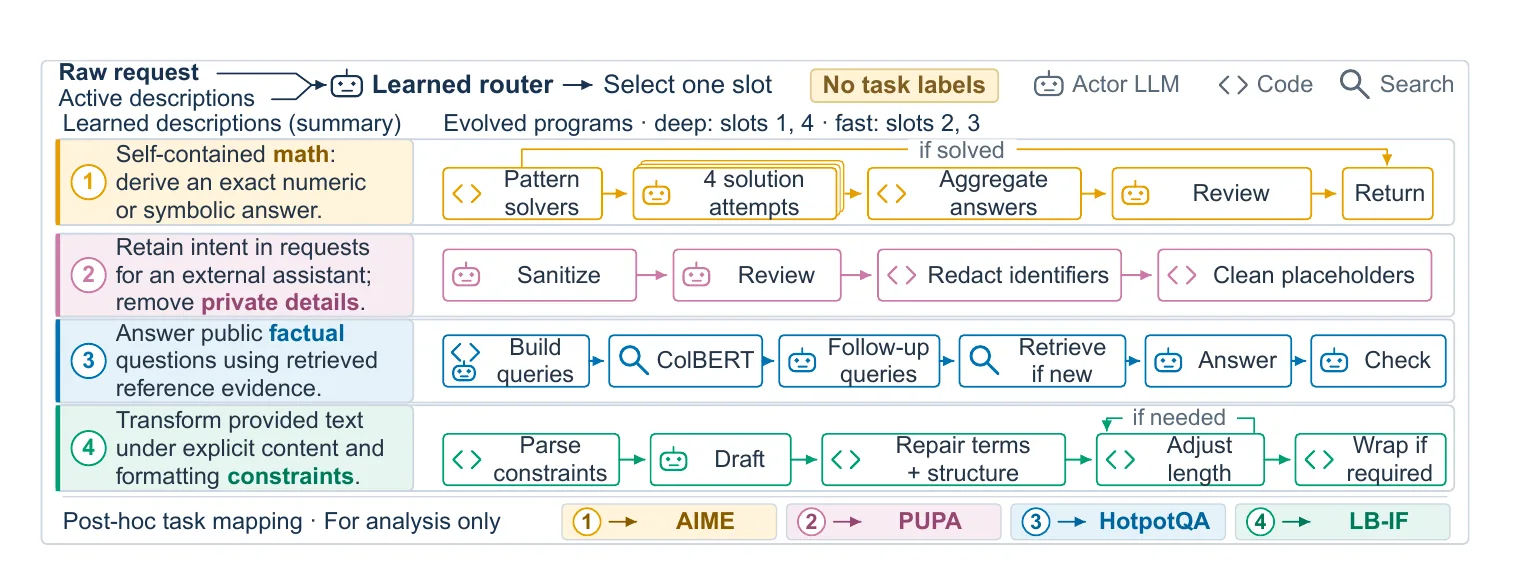
그림 3은 최종 후보 74의 속을 보여 줍니다. 왼쪽이 탐색이 쓴 설명, 오른쪽이 프로그램의 절차입니다. 상자 안의 아이콘이 세 종류입니다. 로봇 얼굴은 모델 호출, 꺾쇠(<>)는 모델 없이 도는 코드, 돋보기는 검색입니다.
1번 수학(깊은 모드). 먼저 코드로 된 ‘패턴 풀이기’가 알아볼 수 있는 유형인지 봅니다. 풀리면 바로 반환합니다. 아니면 모델이 풀이를 네 번 시도하고, 코드가 답을 모으고, 모델이 한 번 더 검토합니다.
2번 개인정보(빠른 모드). 모델이 정보를 지우고, 모델이 검토하고, 코드가 남은 식별자를 지우고, 코드가 자리표시자를 정리합니다. 모델 두 번에 코드 두 번, 이중 안전장치입니다.
3번 사실 검색(빠른 모드). 질의를 만들어 검색하고, 찾은 것을 보고 후속 질의를 만들고, 새 문서가 나오면 다시 검색하고, 답을 쓰고, 근거에 맞는지 확인합니다. 사람이 설계한 다단계 검색 파이프라인과 거의 같은 모양을 탐색이 빈손에서 찾아냈습니다.
4번 조건 글쓰기(깊은 모드). 코드가 조건을 파싱하고, 모델이 초안을 쓰고, 코드가 금지어와 구조를 고치고, 필요하면 길이를 맞추는 반복을 돌고, 필요하면 감쌉니다. 모델 호출은 초안 한 번뿐이고 나머지는 전부 코드입니다. 조건 준수는 세면 되는 일이니 모델에게 맡기지 않는 것입니다.
깊은 모드가 1번과 4번, 빠른 모드가 2번과 3번입니다. 생각이 필요한 곳과 필요 없는 곳을 탐색이 갈랐습니다.
비교 대상인 단일 프로그램도 놀고 있지는 않았습니다. 부록 F의 표 7이 두 최종 프로그램을 나란히 놓습니다.
부분
프로그램 하나 진화 (후보 21)
Adaptive-GEPA (후보 74)
배차
파이썬 분기문. 개인정보·글쓰기·수학·검색 순으로 검사, 나머지는 일반 경로
모델 라우터가 설명을 읽고 활성 프로그램이나 예비를 고름
검색
규칙+모델 질의, ColBERT, 코드가 만든 다리 질의, 근거 기반 답
규칙+모델 질의, ColBERT, 찾은 근거를 보고 만든 후속 질의, 초안과 모델의 근거 확인
수학
결정론적 풀이기. 아니면 추론 한 번과 답 정규화
결정론적 풀이기. 아니면 네 번 시도, 답 모으기, 모델 검토
개인정보
이메일·전화번호·특정 장애 표현 하나를 정규식으로 치환
모델의 정보 제거와 검토, 식별자 정리, 빈 요청 방지
글쓰기
모델 초안, 코드로 금지어·길이·구조·감싸기 수선
조건 점검표, 모델 초안, 코드 수선과 글자 수 반복, 선택형은 건너뜀
추론 모드
전체에 깊은 모드 하나
수학·글쓰기는 깊게, 검색·개인정보·라우팅은 빠르게
단일 프로그램도 분기를 만들고 다단계 검색을 만들고 조건 수선 코드를 만들었습니다. 글쓰기에서는 오히려 더 잘했습니다. 논문이 처음에 달았던 단서가 여기서 확인됩니다. 차이는 코드가 무엇을 표현할 수 있느냐가 아니라 탐색이 어디를 붙잡고 고쳤느냐에서 납니다. 그리고 표의 마지막 줄, 추론 모드를 전문가마다 고를 수 있었다는 차이도 함께 들어 있습니다.
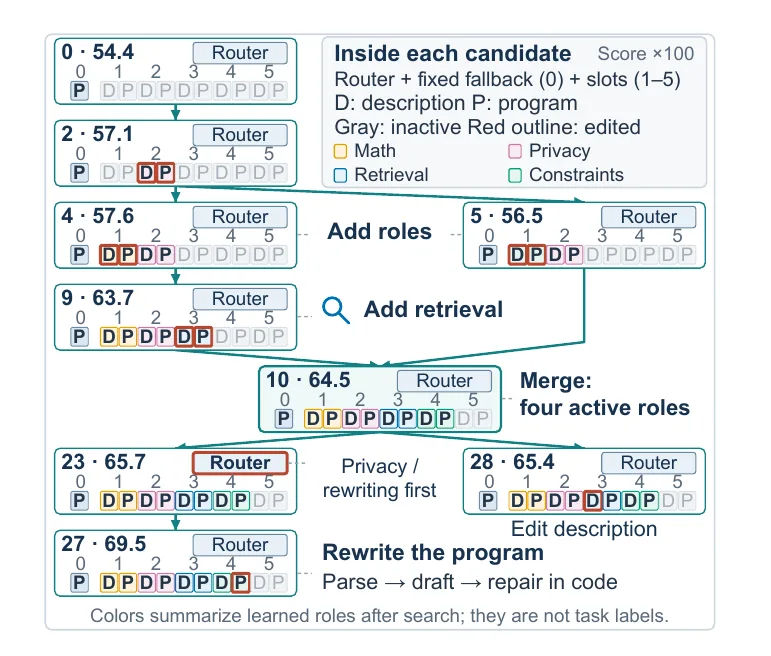
그림 4는 초반 탐색의 한 부분입니다. 카드 한 장이 후보 하나이고, 화살표가 부모에서 자식으로 갑니다. 빨간 테두리가 그 단계에서 고친 곳입니다. 후보 2에서 2번 칸이, 후보 4와 5에서 1번 칸이, 후보 9에서 3번 칸이 생깁니다. 후보 10에서 두 갈래가 합쳐지면서 네 칸이 모두 켜집니다. 그 뒤에는 빨간 테두리가 라우터(후보 23), 3번 설명(후보 28), 4번 프로그램(후보 27)으로 옮겨 갑니다. 먼저 역할을 만들고, 그다음 다듬고 합친다는 순서가 보입니다.
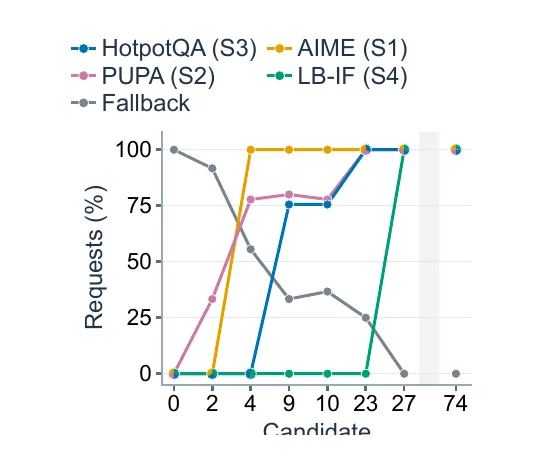
그림 5는 같은 줄기에서 요청이 실제로 어디로 갔는지입니다. 회색 선(예비)이 100%에서 계단처럼 내려가 0이 됩니다. 눈에 띄는 것은 초록 선(4번, 조건 글쓰기)입니다. 후보 10에서 4번 칸은 켜져 있는데도 0%입니다. 후보 23까지 0%로 있다가 후보 27에서 단번에 100%가 됩니다.
아래 재생기에서 여덟 장면을 차례로 넘겨 보세요.
장면 3. 고장 난 4번 방
초록 선이 왜 후보 27에서야 올라왔을까요. 논문 4.6절이 이유를 적습니다.
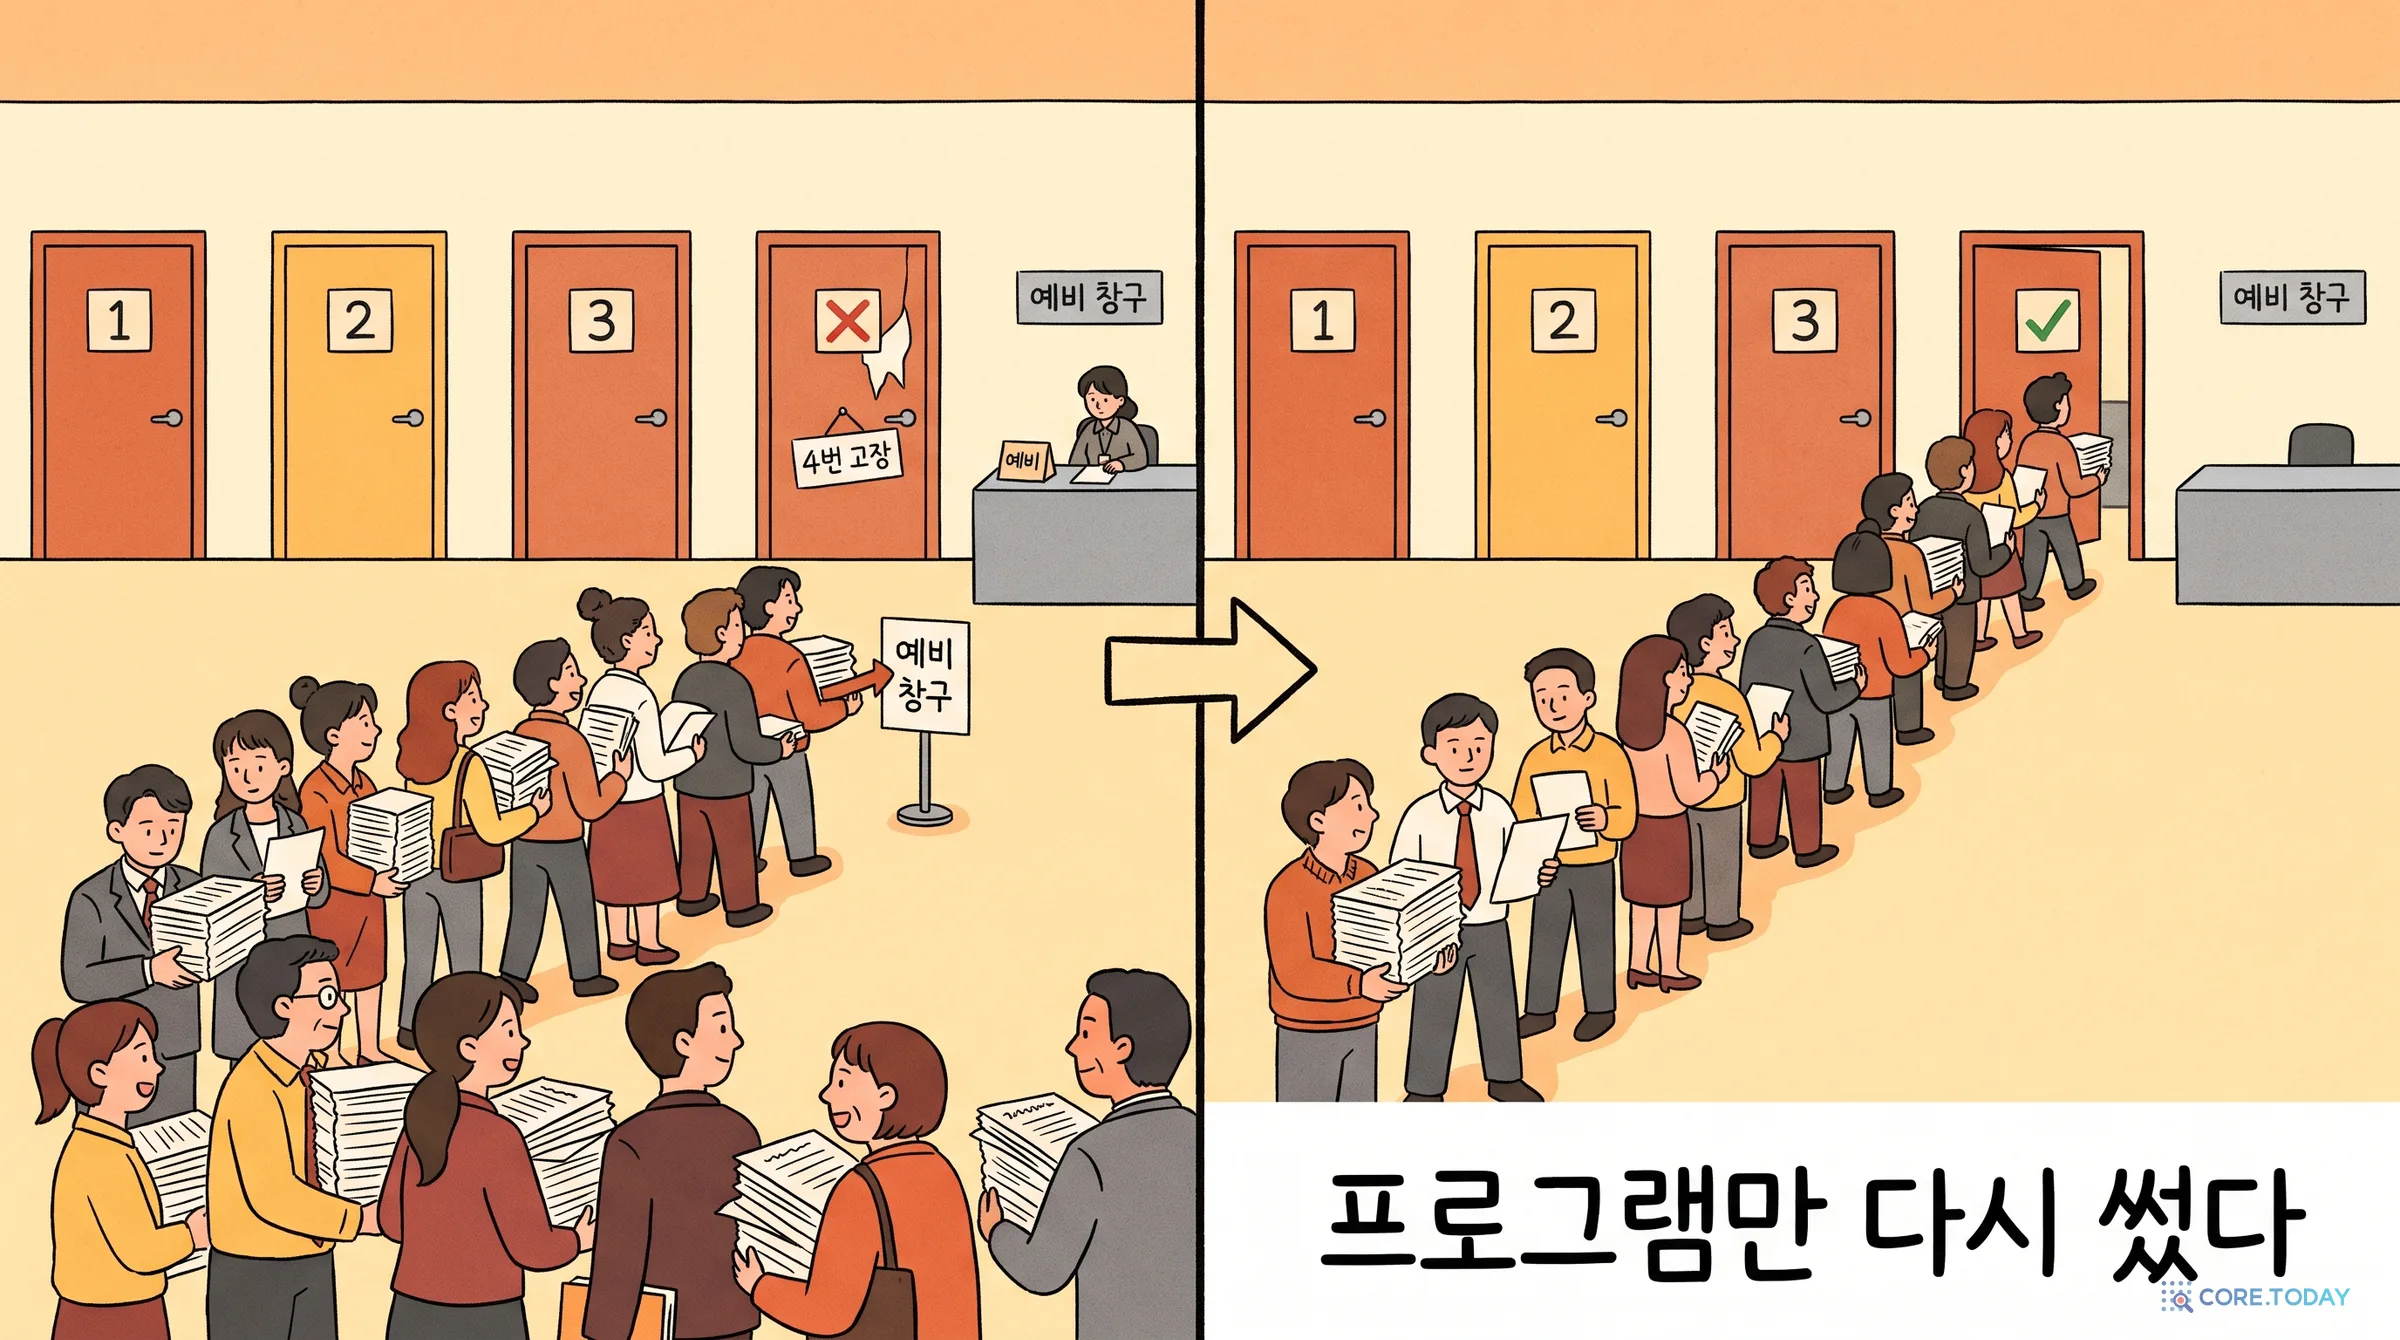
후보 23에서 4번 칸의 소스는 중간에 잘려 있었습니다. 반성 모델이 쓴 코드가 끝까지 출력되지 못한 것입니다. 잘린 코드는 컴파일되지 않습니다. 라우터는 설명만 보므로 조건 글쓰기 요청을 4번으로 보냈지만, 실행 단계에서 컴파일 실패로 전부 예비로 떨어졌습니다. LiveBench-IF 검증 요청 45건 전부가 그랬습니다.
이 상황에서 라우터를 고치는 것은 소용이 없습니다. 라우터는 이미 올바른 곳으로 보내고 있습니다. 설명을 고쳐도 소용없습니다. 필요한 것은 프로그램 수정이고, 반성 모델은 실행 기록의 오류를 보고 그 행동을 골랐습니다. 후보 23에서 27로 가면서 바뀐 것은 4번 프로그램 하나입니다. 라우터와 설명 넷은 그대로입니다. 그 결과 45건이 모두 4번으로 옮겨 갔고, LB-IF 검증 점수가 61.9에서 76.4로 올랐습니다.
논문은 여기에도 단서를 답니다. 다시 쓰면서 절차도 바뀌었으므로(조건 파싱 → 초안 → 코드 수선) 점수 상승을 문법 수리만의 효과로 볼 수는 없다고.
이 일화는 5장에서 짚은 구분, ‘고른 슬롯’과 ‘실행된 슬롯’이 왜 필요한지도 보여 줍니다. 후보 23의 4번은 라우터의 선택은 받았지만 한 건도 실행하지 못했습니다. 발자국은 실행 기준이므로 이 4번의 발자국은 비어 있고, 병합에서 다른 후보의 글쓰기 전문가와 짝지어질 근거가 없습니다. 일하지 못한 전문가가 일한 전문가를 덮어쓰는 일을 막아 줍니다.
장면 4. 설명 한 줄과 라우터 한 문장
다른 갈래(후보 10 → 28 → 36)에서는 코드가 한 줄도 바뀌지 않은 채 요청의 흐름만 두 번 바뀝니다. 6장에서 미뤄 둔 ‘설명과 라우터를 왜 나눴는가’의 실제 사례입니다.
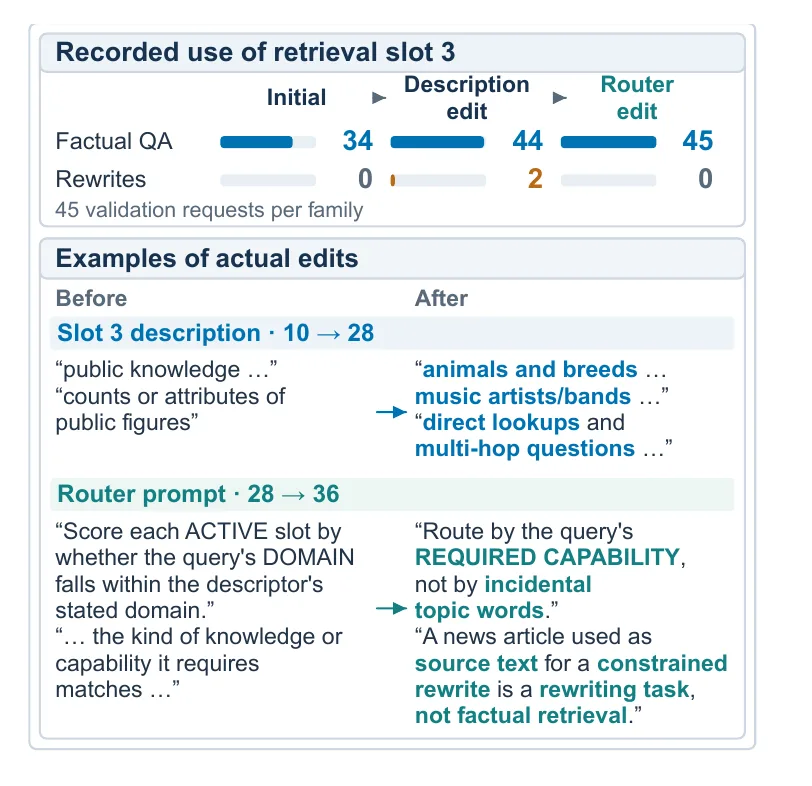
첫 번째 편집(10 → 28): 설명만. 후보 10에서 검색 전문가는 사실 질문 45건 중 34건만 받고 있었습니다. 나머지 11건은 예비로 갔습니다. 설명이 “공개 지식 … 공인의 수치나 속성”처럼 좁게 쓰여 있어, 개 품종이나 밴드를 묻는 질문은 라우터가 여기 해당한다고 보지 않은 것입니다. 반성 모델은 3번의 설명에 “동물과 품종”, “음악가·밴드”, “바로 찾는 질문과 여러 문서를 건너는 질문” 같은 예시를 덧붙였습니다. 사실 질문 44건이 3번으로 갑니다.
부작용. 설명이 넓어지자 엉뚱한 요청 두 건이 딸려 왔습니다. 가디언 기사를 조건에 맞춰 고쳐 쓰라는 요청입니다. 기사에 공개 사실이 가득하니, ‘분야’로 점수를 매기던 라우터가 이것을 사실 검색으로 본 것입니다.
두 번째 편집(28 → 36): 라우터만. 이번에는 설명을 건드리지 않고 라우터의 규칙을 바꿉니다. “각 활성 슬롯에 대해 질의의 분야가 설명의 분야 안에 드는지로 점수를 매겨라”가 “우연히 나온 주제어가 아니라 질의가 요구하는 능력으로 배정하라. 조건부 고쳐 쓰기의 원문으로 쓰인 뉴스 기사는 고쳐 쓰기 과제이지 사실 검색이 아니다”로 바뀝니다. 사실 질문 45건 전부가 3번으로 가고, 고쳐 쓰기 두 건은 3번에서 빠집니다.
두 편집이 서로 다른 종류의 문제를 풀었다는 점이 요점입니다. 첫째는 한 전문가의 담당 범위가 좁았던 문제이고, 둘째는 두 전문가의 범위가 겹칠 때 무엇을 우선할지의 문제입니다. 앞의 것은 그 전문가의 설명에, 뒤의 것은 모두에게 적용되는 라우터에 적는 것이 맞습니다.
논문은 여기서도 과장을 피합니다. 새로 3번으로 온 사실 질문 하나는 오히려 점수가 낮았고, 고쳐 쓰기 두 건의 점수는 바뀌지 않았다고 적습니다. 이 편집들이 바꾼 것은 배정이지, 답의 품질이 좋아졌다는 증거는 아닙니다.
아래 실험실의 윗부분에서 이 세 단계를 눌러 볼 수 있습니다. 아랫부분은 12장에서 설명할 코어닷투데이의 한국어 실측입니다.
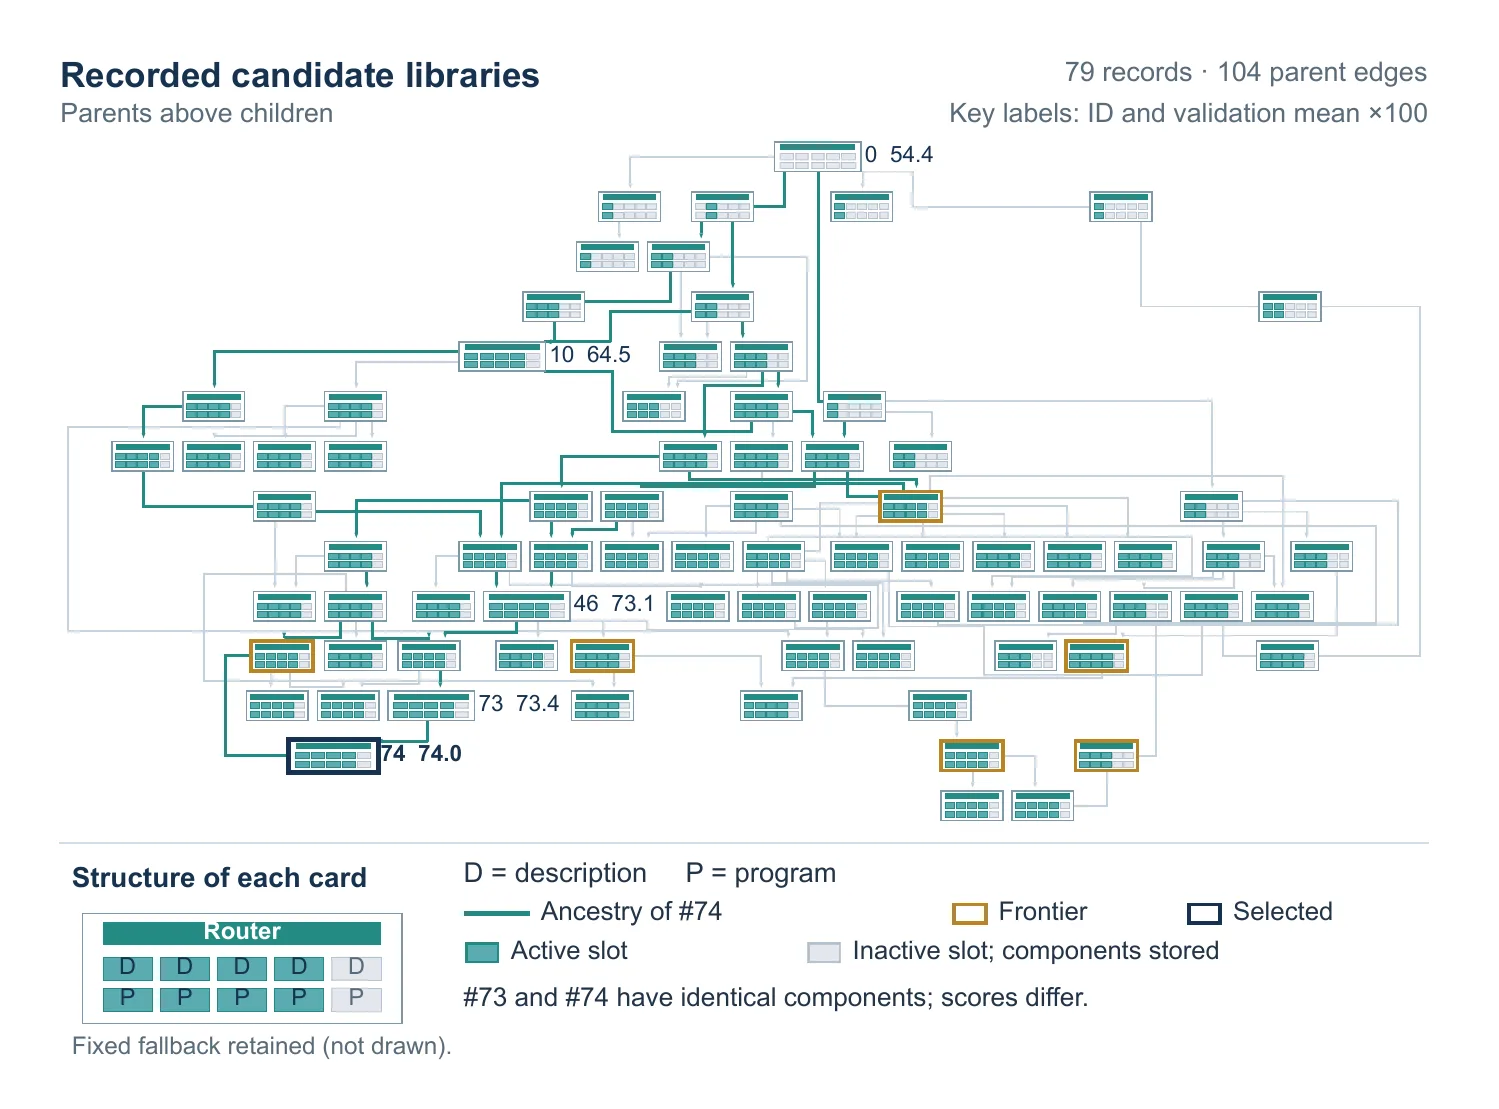
그림 9는 탐색 전체입니다. 후보 평가 79건(서로 다른 후보는 64개), 그 가운데 26건이 부모가 둘인 병합입니다. 청록색 선이 최종 후보로 이어지는 조상들입니다. 맨 위 후보 0에서 시작해 후보 10, 46, 73을 거쳐 왼쪽 아래의 74에 닿습니다. 오른쪽에 넓게 퍼진 회색 선의 후보들은 최종 선택에 기여하지 못한 갈래입니다.
11장. 숫자를 조심해서 읽기
이 논문은 한계를 유난히 자세히 적었습니다. 본문 6절과 부록 L을 합치면 두 쪽이 넘습니다. 저자들이 적어 둔 것과 표에서 직접 읽히는 것을 함께 정리합니다.
① 시드 하나, 같은 프로그램의 점수가 2점씩 흔들린다
최종 방법의 실행은 시드 43 한 번입니다. 신뢰구간이 없습니다. 그러면 이 실험에서 점수가 우연히 얼마나 움직이는지 알 방법이 없을까요. 논문 곳곳에 단서가 흩어져 있습니다.
같은 것을 다시 잰 사례
점수들
차이
시작 프로그램의 시험 과제 평균 (세 번의 독립 평가)
52.12 · 52.61 · 54.0
최대 1.9점
후보 73과 74 (구성 요소가 글자까지 같음)의 검증 평균
73.38 · 74.03
0.65점
부모와 똑같은 병합 자식 13건의 검증 평균 − 부모
−2.05 ~ +2.55
폭 4.6점
같은 프로그램을 다시 채점하기만 해도 2점 안팎이 움직입니다. Qwen에서의 8.1점 격차는 이 폭을 넘지만, PUPA를 뺀 2.8점이나 GPT-4.1에서의 1.6점은 이 폭 안에 있습니다. 그리고 최종 선택된 후보 74는 후보 73과 똑같은 프로그램입니다. 병합이 한쪽 부모를 그대로 물려줬고, 다시 채점하니 0.65점 높게 나와 선택된 것입니다. 논문도 “선택은 구조의 변화가 아니라 새 평가를 반영한다”고 적습니다.
모든 방법이 ‘채점 호출 18,000번’이라는 같은 예산을 받았습니다. 하지만 채점 호출 한 번의 무게는 방법마다 다릅니다.
Adaptive-GEPA의 수학 전문가는 요청 하나에 풀이 네 번과 검토 한 번, 여기에 라우터 호출까지 모델을 여섯 번 부릅니다. 단일 프로그램은 수학에서 한 번 부릅니다. 둘 다 채점 호출로는 한 번입니다.
반성 모델(GPT-5.5)의 사용량은 Adaptive-GEPA가 응답 152회에 1,191만 토큰, 프로그램 하나 진화가 92회에 538만 토큰입니다. 2.2배입니다.
GRPO는 반성 모델을 안 쓰는 대신 GPU 6장으로 약 5시간 학습합니다.
실행 모델의 전체 토큰은 기록 한도 때문에 남아 있지 않습니다.
논문 초록에 “이 횟수는 총 계산량을 같게 맞춘 것이 아니다”라는 문장이 들어 있는 이유입니다. AIME에서의 10.6점 우위는 ‘분업을 배워서’이기도 하지만 ‘문제당 모델을 몇 배 더 불러서’이기도 합니다. 논문은 지연 시간이나 총 계산량 절감에 대해서는 아무 주장도 하지 않는다고 명시합니다.
아래 장부에서 호출, 편집, 병합의 내역을 차례로 열어 볼 수 있습니다.
③ 표현 방식과 추론 모드가 함께 바뀌었다
Adaptive-GEPA와 프로그램 하나 진화 사이에는 차이가 둘 있습니다. 탐색 표현(라우터+전문가 묶음 대 프로그램 하나)과 추론 모드 배정(전문가마다 대 전체에 하나). 단일 프로그램이 깊은 모드를 고르면 검색과 개인정보 요청에도 생각 모드가 켜지고, 빠른 모드를 고르면 수학이 무너집니다. 격차 가운데 얼마가 ‘분업을 탐색 대상으로 삼은’ 덕이고 얼마가 ‘모드를 따로 고를 수 있었던’ 덕인지는 이 실험으로 가를 수 없습니다. 논문도 그렇게 적습니다.
④ 병합의 효과는 분리되지 않았다
발자국 정렬이 논문의 핵심 기여인데, 정렬을 켠 실행과 끈 실행을 나란히 비교한 실험은 없습니다. 근거는 셋입니다. 실제 탐색에서 뽑은 사례(55+59), 통과한 병합 26건의 집계, 옛 실행의 병합을 다시 돌려 본 재연. 재연은 자식을 실제로 실행하지 않고 부모의 과제별 점수를 조합해 추정한 것이고, 120건 가운데 86건은 슬롯을 과제에 대응시킬 수 없어 건너뛰었습니다.
26건의 집계도 뜯어 보면 이렇습니다. 두 부모를 실제로 섞은 것은 10건이고 모두 부모보다 높았습니다(중앙값 +3.2점). 13건은 한쪽 부모와 똑같았고, 3건은 꺼진 칸의 코드만 달랐습니다. 10건 전부가 올랐다는 것은 좋은 신호지만, 이들은 이미 다섯 문항 점검을 통과한 것들입니다. 통과하지 못한 21건은 집계에 없습니다. 논문의 표현으로는 “선별된 관찰이지 통제된 추정이 아닙니다.”
또 하나, 발자국 정렬과 ‘실행 실패를 0점 처리하는 수정’이 같은 시점에 함께 도입됐습니다. 이전 판과의 차이를 어느 한쪽에 돌릴 수 없습니다.
⑤ 라우팅 100%가 뜻하는 것과 뜻하지 않는 것
651건 중 651건은 인상적인 숫자입니다. 다만 이것은 라우터의 배정이 과제 구분과 일치했다는 뜻입니다. 요청마다 가장 좋은 답을 낼 전문가를 골랐다는 뜻이 아닙니다. 그리고 네 과제는 서로 매우 다릅니다. 가디언 기사 고쳐 쓰기와 AIME 문제를 헷갈릴 일은 많지 않습니다. 임베딩 거리만 쓰는 MoP도 93%를 맞힙니다. 논문은 겹치는 능력, 새 과제의 등장, 분포 변화를 다루지 않았다고 밝힙니다. 전문가가 수십, 수백으로 늘 때의 이야기는 13장에서 다룹니다.
⑥ PUPA 점수의 구멍
PUPA의 채점에는 허점이 있습니다. 바깥으로 보내는 요청문을 비워 버리면 유출은 0이 됩니다. 그리고 로컬 경로가 원래 질문을 갖고 있으니 품질 점수도 어느 정도 나옵니다. 아무것도 맡기지 않는 프로그램이 높은 점수를 받을 수 있는 것입니다. 최종 Adaptive-GEPA 프로그램은 명시적으로 정보를 지우고 빈 요청을 막는 장치도 넣었지만, 논문은 PUPA 점수만으로 ‘쓸모 있는 위임’이 이뤄졌다고 말할 수는 없다고 적습니다. 시험 결과에는 문항별 점수가 남아 있지 않아 품질과 유출을 나눠 볼 수도 없습니다. 격차의 74%가 이 과제에서 온다는 점과 함께 기억할 일입니다.
유출 비율에도 문제가 있습니다. 판정 모델이 센 유출 항목 수를 주석된 개인정보 항목 수로 나누는데, 상한을 두지 않았습니다. 판정 모델이 더 많이 세면 비율이 1을 넘고 점수가 음수가 됩니다. 병합 사례의 후보 64에 그런 점수가 둘 있습니다.
⑦ 시험 점수를 보면서 개발했다
후보 선택 자체는 검증 점수만으로 했습니다. 그러나 탐색 중 다섯 번째 통과 후보마다 시험 세트를 돌리는 감시 코드가 있었고, 연구자들은 방법을 개발하는 동안 그 곡선을 봤습니다. 논문은 “시험 세트가 연구자의 결정에서 격리되지 않았다”고 적습니다. 정직한 고백이고, 그만큼 시험 점수를 깎아 읽어야 한다는 뜻이기도 합니다.
⑧ 벤치마크에 맞춘 코드
생성된 프로그램 일부에는 벤치마크 특유의 질의 틀과, 알아볼 수 있는 문제 구조를 위한 결정론적 분기가 들어 있습니다. 수학 전문가의 ‘패턴 풀이기’가 그런 예입니다. 시험은 새 문항이지 새 영역이 아닙니다. AIME 2025에서 통한 패턴 풀이기가 다른 수학 시험에서 통할지는 알 수 없습니다.
그리고 아직 없는 것
2026년 11월 14일 현재, 이 논문의 코드는 공개돼 있지 않습니다. arXiv 초록에도 본문에도 저장소 주소가 없고, GEPA 공식 저장소에도 이 방법의 구현은 없습니다. 인용 수는 0이고 독립 재현도 찾지 못했습니다. 이 글의 모든 수치는 저자들이 보고한 것입니다.
논문 끝에는 생성형 AI 사용 고지가 있습니다. 수정 단계에서 방법과 수식을 명료하게 다듬고, 평가 절차를 검토하고, 기존 결과를 분석·해석하고, 글·문헌 확인·그림·표·분석 코드를 돕는 데 썼다는 내용입니다. 한계 절이 유난히 꼼꼼한 것과 무관하지 않아 보입니다.
VISTA라는 다른 연구(ACL 2026 학생 워크숍)는 GEPA식 반성 전반에 대해 더 근본적인 비판을 냈습니다. 실패 진단과 프롬프트 다시 쓰기가 한 단계에 뭉쳐 있어 무엇을 원인으로 지목했는지 기록이 남지 않는다는 것입니다. GEPA 공식 시작 프롬프트의 출력 형식이 ‘최종 답’을 ‘풀이’보다 앞에 두고 있어 모델이 생각하기 전에 답한다는 결함을, 반성 모델이 여러 차례 고치면서도 한 번도 짚지 못했다는 사례를 듭니다. Adaptive-GEPA의 두 단계 반성(행동 고르기 → 편집 쓰기)은 이 방향으로 반걸음 간 것이지만, 논문 스스로 부록 M에서 이것이 “진단을 검증하거나 어느 행동이 점수를 올렸는지 확인해 주지는 않는다”고 인정합니다.
12장. 한국어로 다시 해 보기 — 설명과 라우터, 64건 실측
논문의 코드는 공개되지 않았으니 탐색 전체를 재현할 수는 없습니다. 하지만 10장의 장면 4, ‘설명을 넓히면 엉뚱한 요청이 딸려 오고 라우터 규칙을 바꾸면 돌아간다’는 관찰은 라우터만 있으면 확인해 볼 수 있습니다. 코어닷투데이는 한국어 요청으로 이 부분만 따로 돌려 봤습니다.
실험 구성
요청 64건. 네 종류의 한국어 요청을 직접 썼습니다. 사실 질문 18건(인물·지리·역사 10건, 동물 품종·밴드·영화 8건), 수학 14건(일반 10건, 사람 이름·개 품종·역사 연도가 섞인 문장제 4건), 개인정보 가리고 맡기기 14건(일반 10건, 주제가 사실이나 계산처럼 보이는 4건), 조건 글쓰기 18건(일상 글 10건, 원문이 사실 기사인 것 8건).
전문가 설명 넷. 논문 그림 3의 최종 설명을 한국어로 옮겼습니다. 3번(검색)의 설명만 두 벌을 준비했습니다. 좁은 판은 “공개 지식에 관한 질문에 답한다. 공인의 수치나 속성 등”, 넓은 판은 여기에 “동물과 품종, 음악가·밴드, 영화·책, 인물·지리·역사 등. 바로 찾는 질문과 여러 문서를 건너야 하는 질문 모두”를 더했습니다.
라우터 규칙 둘. 그림 6의 편집 전후를 옮겼습니다. ‘분야’ 규칙은 “요청의 분야가 설명에 적힌 분야 안에 들어가는지 점수를 매겨라”, ‘능력’ 규칙은 “우연히 등장하는 주제어가 아니라 요청이 요구하는 능력으로 배정하라. 조건을 지켜 다시 쓰라고 원문으로 준 기사는 글 변환 과제다”.
첫째, 논문이 본 누출이 한국어에서도 같은 자리에서 난다. ‘분야’ 규칙에서 두 모델 모두 기사 고쳐 쓰기 8건 가운데 2건을 검색 전문가로 보냈습니다. 9B가 틀린 것은 “영국 밴드 퀸은 1970년 런던에서 결성되었다…”를 글머리 기호 세 개로 정리하라는 요청과, “메인쿤은 미국 메인주에서 유래한…”을 45자 안으로 요약하라는 요청입니다. 원문에 밴드와 고양이 품종이 나옵니다. 요청이 시키는 일은 정리와 요약인데, 라우터는 글 속의 주제어를 본 것입니다. 반면 수학 문장제에 사람 이름과 전화번호, 진돗개와 푸들을 섞은 4건과, 주제가 계산이나 사실처럼 보이는 개인정보 요청 4건은 어느 조합에서도 한 건도 틀리지 않았습니다. 누출은 원문이 길게 딸려 오는 요청에서만 났습니다.
둘째, 라우터 규칙 한 문장의 효과는 모델에 따라 달랐다. 9B는 ‘능력’ 규칙으로 바꾸자 누출이 2건에서 0건이 됐습니다. 논문의 기록(2 → 0)과 같습니다. 4B는 좁은 설명에서 1건으로 줄었을 뿐, 넓은 설명에서는 2건 그대로였습니다. 규칙을 문장으로 적어 주는 것만으로 충분한지는 라우터로 쓰는 모델의 크기에 달렸습니다. 논문이 라우터를 실행 모델과 같은 Qwen3-8B로 둔 것을 생각하면, 더 작은 모델을 라우터로 쓰려는 경우 따로 확인해야 할 지점입니다.
셋째, 설명을 좁혀도 사실 질문은 빠지지 않았다. 이 부분은 논문과 다릅니다. 논문에서는 설명이 좁을 때 사실 질문 45건 중 11건이 검색 전문가에게 가지 못했습니다. 이번 실측에서는 좁은 설명에서도 품종·밴드·영화 질문 8건이 거의 전부 3번으로 갔습니다(9B의 한 조합에서 1건만 예비로). 문항을 직접 지었고 수가 적으니 단정하기는 어렵습니다. 다만 짐작되는 이유는 있습니다. 이번 실측의 라우터에게는 선택지가 깔끔한 네 설명뿐이었고, 품종 질문이 갈 곳은 누가 봐도 3번이었습니다. 논문의 후보 10은 탐색 도중의 설명과 라우터 지시문을 그대로 쓰고 있었습니다.
뜻밖의 발견도 하나 있습니다. 9B는 “버스 정류장에 도착했을 때 비가 내리기 시작했다”로 시작하는 이야기를 이어 쓰라는 요청을 네 조합 중 세 번 예비로 보냈습니다. 4번의 설명이 “주어진 글을 … 변환한다”였기 때문으로 보입니다. 이어 쓰기는 변환이 아니라고 본 것입니다. LiveBench-IF에는 이야기 짓기가 네 하위 과제 중 하나로 들어 있습니다. 설명의 단어 하나가 담당 범위에 구멍을 냅니다. 논문에서 통과한 설명 편집이 단 한 건, 그것도 범위를 넓히는 편집이었다는 사실과 통합니다.
정리하면 이렇습니다. 서로 다른 네 종류 사이의 배정은 작은 모델에게도 쉬운 일입니다(94~98%). 틀리는 곳은 요청이 시키는 일과 요청에 담긴 글의 주제가 다른 경우에 몰려 있고, 논문이 찾아낸 라우터 편집은 정확히 그 자리를 겨냥한 것이었습니다. 이 결과는 10장의 실험실 위젯 아랫부분에서 요청 하나하나까지 볼 수 있습니다.
실측의 한계를 분명히 적어 둡니다. 요청 64건은 코어닷투데이가 직접 썼고, 각 조합을 한 번씩만 돌렸습니다. 모델은 Qwen3.5로 논문의 Qwen3와 세대가 다릅니다. 측정한 것은 배정뿐이며 답의 품질은 재지 않았습니다. 프로그램 탐색과 병합은 재현하지 않았습니다.
13장. 2026년, 이 생각이 서는 자리
설명 한 줄이 배차표가 된 해
Adaptive-GEPA의 구조를 다시 봅시다. 능력 단위마다 짧은 설명이 붙고, 선택하는 쪽은 설명만 읽고, 본문(코드)은 선택된 뒤에야 쓰인다. 2026년에 에이전트를 만져 본 사람에게는 낯익은 모양입니다.
에이전트 스킬. 스킬마다 이름과 한 줄 설명이 있고, 에이전트의 컨텍스트에는 설명만 올라갑니다. 요청과 맞는 스킬이 있으면 그때 본문을 읽습니다. 코어닷투데이의 에이전트 스킬 해설에서 다룬 ‘점진적 공개’입니다.
서브에이전트. 주 에이전트가 하위 에이전트의 설명을 보고 일을 넘깁니다.
MCP 도구. 모델은 도구의 이름과 설명, 인자 스키마를 보고 어느 도구를 부를지 정합니다.
세 경우 모두 설명이 라우팅을 결정합니다. 그리고 2026년에 나온 연구들은 그 설명이 얼마나 결정적인지, 또 얼마나 허술하게 쓰이고 있는지를 숫자로 보여 줬습니다.
연구 (2026)
무엇을 봤나
숫자
MCP 서버 설명의 ‘냄새’ 평가 (arXiv 2602.18914)
기능이 같은 서버들 사이에서 설명만 바꿨을 때 선택될 확률
표준을 지킨 설명은 선택 확률 72% (기준선 20%)
MCP 도구 설명 실태 조사 (arXiv 2602.14878)
서버 103개의 도구 856개
97.1%가 결함을 하나 이상 가짐. 설명을 보강하면 성공률 중앙값 +5.85점, 대신 실행 단계 67% 증가
SkillRouter (arXiv 2603.22455)
스킬 약 8만 개에서 이름·설명만으로 고르기
본문을 가리면 라우팅 정확도가 37~44점 하락
Lost in Implicit Routing (arXiv 2610.18522)
무관한 스킬 1,000개를 더했을 때
필요한 스킬을 불러오는 재현율 73.6% → 27.4%
위의 두 줄은 설명이 선택을 좌우한다는 증거이고, 아래 두 줄은 후보가 많아지면 설명만으로는 버티지 못한다는 증거입니다.
이 그림 안에서 Adaptive-GEPA의 자리가 정해집니다. 지금 스킬과 도구의 설명은 대부분 사람이 한 번 쓰고 끝입니다. 잘 쓰였는지는 써 보기 전까지 모릅니다. Adaptive-GEPA는 설명을 실패 기록에서 고쳐 쓰는 대상으로 만들었고, 설명과 구현이 어긋나지 않도록 한 쌍으로 묶어 진화시켰습니다. “동물과 품종”을 덧붙인 편집은 사람이 로그를 보고 할 법한 일을 탐색이 한 것입니다.
동시에 한계도 이 그림에서 분명해집니다. 논문의 라우터는 서로 겹치지 않는 네 전문가 가운데 하나를 고릅니다. 위 표 아래쪽의 실패, 곧 비슷한 스킬 수백 개 사이에서 길을 잃는 문제는 이 실험이 건드리지 않은 영역입니다. 슬롯 상한이 다섯 칸이었다는 점도 같은 얘기입니다.
비싼 모델은 탐색할 때만
이 실험의 모델 배치를 실무의 눈으로 보면 한 가지 패턴이 보입니다. 강한 모델(GPT-5.5)은 탐색하는 동안만 반성 모델로 일합니다. 탐색이 끝나고 남는 것은 라우터 지시문, 설명 네 줄, 파이썬 프로그램 네 편이고, 이것을 실행하는 것은 8B짜리 공개 모델입니다. 비싼 지능을 한 번 써서 싼 모델이 매번 쓸 절차로 굳혀 두는 셈입니다.
내부망에서 작은 모델로 서비스를 돌려야 하는 조직에는 의미가 있는 구도입니다. 공공기관이나 의회처럼 요청을 외부로 내보내기 어려운 곳에서는 실행 모델을 키우는 대신 하네스를 다듬는 쪽에 여지가 있습니다. Qwen3-8B의 네 과제 평균이 가중치를 그대로 둔 채 52.6에서 70.6이 됐다는 것은, 같은 모델로도 절차에 따라 18점이 달라질 수 있다는 뜻입니다. 강화학습으로 가중치를 고친 쪽은 다섯 배 예산으로도 3.7점이었습니다.
다만 두 가지를 함께 봐야 합니다. 탐색 비용이 작지 않습니다(반성 토큰 1,191만에 채점 호출 1.8만 번). 그리고 실행 모델이 강해지면 이득이 줄었습니다. GPT-4.1에서는 프로그램 하나 진화와의 차이가 1.6점이었습니다. 강한 모델은 절차를 덜 가립니다. 이 방법의 값어치는 작은 모델로 여러 종류의 일을 해야 할 때 가장 큽니다.
읽을 수 있다는 것
탐색의 산출물이 전부 글이라는 점도 2026년에는 무게가 다릅니다. 가중치를 미세조정하면 무엇이 바뀌었는지 사람이 읽을 수 없습니다. 여기서는 후보 28과 36의 차이가 라우터 지시문의 두 문장입니다. 사람이 읽고, 납득하고, 마음에 안 들면 되돌릴 수 있습니다. 단일 프로그램이 배운 개인정보 절차가 ‘특정 장애 표현 하나를 정규식으로 치환’이었다는 것도 소스를 읽었기에 알 수 있었습니다.
물론 읽을 수 있다는 것과 안전하다는 것은 다릅니다. 탐색이 쓴 코드는 샌드박스에서만 돌았고, 논문의 윤리 고지는 배포하려면 개인정보 유출, 과제 유용성, 생성된 코드와 도구 접근의 보안을 따로 평가해야 한다고 적습니다.
열린 흐름과 닫힌 혼합
같은 해의 Adaptive Auto-Harness와 견주면 두 연구의 분업이 보입니다. Auto-Harness는 날마다 새 과제가 들어오는 열린 흐름에서 하네스 가지를 계속 늘려 갑니다. Adaptive-GEPA는 종류가 정해진 닫힌 혼합에서 가지들을 어떻게 합칠지에 집중합니다. 앞의 것은 ‘새 전문가를 언제 만들 것인가’를, 뒤의 것은 ‘따로 자란 전문가들을 어떻게 한 팀으로 묶을 것인가’를 묻습니다. 실제 서비스는 둘 다 필요합니다. 요청 종류는 대체로 안정돼 있지만 가끔 새 종류가 나타나니까요. 두 접근이 한 시스템 안에서 만나는 것이 다음 순서일 것입니다.
코어닷투데이가 그동안 다뤄 온 글들과도 이어집니다. FlowBank는 워크플로 여러 개를 미리 만들어 두고 질문마다 골라 쓰는 포트폴리오를 다뤘고, Squeeze Evolve는 비싼 모델을 탐색의 어느 단계에 쓸지를 다뤘습니다. 공통된 흐름은 ‘최고의 하나’를 찾던 최적화가 ‘상황마다 맞는 여럿과 그것을 고르는 법’을 찾는 쪽으로 옮겨 가고 있다는 것입니다.
14장. 실무에 가져갈 것
Adaptive-GEPA의 코드는 아직 없습니다. 하지만 이 논문에서 가져갈 수 있는 것은 알고리즘보다 구분법입니다. 탐색을 자동으로 돌리지 않더라도 사람이 하네스를 손볼 때 그대로 쓸 수 있습니다.
🧭
배정 문제인가, 절차 문제인가
답이 틀렸을 때 먼저 갈라 볼 것. 요청이 엉뚱한 경로로 갔다면 설명이나 라우터를, 제대로 갔는데 틀렸다면 그 경로의 프로그램을 고친다. 고장 난 4번 방은 라우터를 아무리 고쳐도 낫지 않았다.
🧾
‘고른 곳’과 ‘실행된 곳’을 따로 기록한다
라우터가 보낸 경로와 실제로 돈 경로가 다를 수 있다. 오류로 예비 경로가 대신 돌았다면 그 사실이 로그에 남아야 한다. 둘을 한 칸에 적으면 고장이 숨는다.
🏷️
설명은 분야가 아니라 능력으로 쓴다
‘역사·지리 관련’보다 ‘주어진 글 없이 공개 사실을 찾아 답한다’. 요청에 딸려 온 글의 주제에 끌려가지 않게, 라우터에는 ‘요청이 시키는 일’로 고르라고 적는다.
🤝
설명과 구현을 한 몸으로 관리한다
스킬의 설명만 고치거나 본문만 고치고 다른 쪽을 잊으면 명함과 사람이 어긋난다. 같은 커밋에서 함께 바꾸고, 합칠 때도 함께 옮긴다.
👣
이름 말고 트래픽으로 정체를 확인한다
두 팀이 따로 키운 프롬프트·스킬 묶음을 합칠 때 이름이나 번호가 같다고 같은 역할이 아니다. 같은 요청 세트에 돌려 누가 무엇을 처리했는지로 맞춘다.
⚙️
추론 깊이는 경로마다 정한다
생각 모드를 전체에 켜거나 끄지 않는다. 최종 후보는 수학과 조건 글쓰기에만 깊은 모드를 썼다. 조건 검사처럼 셀 수 있는 일은 모델이 아니라 코드에 맡겼다.
🛟
예비 경로는 고정해 둔다
어느 전문가에게도 맞지 않거나 전문가가 고장 났을 때 떨어질 곳. 탐색도 사람도 이 경로는 건드리지 않는다. 예비 사용률이 0이 아니면 무언가 빠졌다는 신호다.
📏
같은 것을 두 번 재서 잡음부터 안다
같은 프로그램의 점수가 다시 재면 2점씩 움직였다. 개선이라고 부르기 전에 아무것도 바꾸지 않고 한 번 더 재 본다. 배정 정확도와 답 품질도 따로 잰다.
우리 서비스가 이 방식에 맞는 자리인지는 아래 점검표로 가늠해 볼 수 있습니다. 항목은 논문의 실험 조건과 한계를 질문으로 바꾼 것입니다.
맺음말 — 손잡이를 만든다는 것
1991년의 전문가 혼합 논문은 정확도를 올리지 못했습니다. 같은 정확도에 절반의 시간으로 닿았을 뿐입니다. 그런데도 그 논문이 30년 넘게 읽히는 것은, 한 덩어리였던 신경망에 ‘누가 어느 사례를 맡는가’라는 손잡이를 달았기 때문입니다.
Adaptive-GEPA도 비슷하게 읽을 수 있습니다. 프로그램 하나로도 분기를 만들 수 있다는 것은 저자들이 먼저 인정했고, 실제로 단일 프로그램은 분기를 만들어 냈습니다. 달라진 것은 탐색이 붙잡을 수 있는 곳입니다. 요청이 가는 길(라우터), 한 전문가의 담당 범위(설명), 일하는 절차(프로그램), 그리고 따로 자란 것들을 합칠 때의 기준(발자국). 긴 소스 한 덩어리를 통째로 다시 쓰던 탐색이 이 가운데 하나를 골라 고칠 수 있게 됐습니다.
숫자는 아직 잠정적입니다. 시드 하나, 과제 넷, 공개되지 않은 코드, 같은 프로그램을 다시 재도 2점씩 흔들리는 점수. 격차의 대부분은 과제 하나에서 나왔고 실행 모델이 강해지자 줄어들었습니다. 병합 규칙이 정말 효과가 있는지는 켜고 끈 비교가 나와야 알 수 있습니다. 저자들이 이것을 전부 스스로 적어 뒀다는 점은 이 논문의 미덕입니다.
그래도 남는 관찰이 있습니다. 과제 이름을 한 번도 듣지 못한 탐색이 전문가를 넷 만들었고, 그 넷이 사람이 나눈 네 과제와 정확히 겹쳤습니다. 수학에는 여러 번 풀고 검토하는 절차를, 글쓰기에는 초안만 모델에게 맡기고 나머지는 코드로 세는 절차를 붙였습니다. 프롤로그의 창구 직원에게 누군가 요령을 가르친 것이 아니라, 틀린 응대 기록을 읽으며 스스로 창구를 넷으로 나눈 셈입니다.
Spiess, C., Vaziri, M., Mandel, L., & Hirzel, M. (2025). AutoPDL: Automatic prompt optimization for LLM agents. AutoML 2025. arXiv:2504.04365
분업을 배우는 계보
Jacobs, R. A., Jordan, M. I., Nowlan, S. J., & Hinton, G. E. (1991). Adaptive mixtures of local experts. Neural Computation, 3(1), 79–87.
Jordan, M. I., & Jacobs, R. A. (1994). Hierarchical mixtures of experts and the EM algorithm. Neural Computation, 6(2), 181–214.
Wang, R., An, S., Cheng, M., Zhou, T., Hwang, S. J., & Hsieh, C.-J. (2024). One prompt is not enough: Automated construction of a mixture-of-expert prompts. ICML 2024. arXiv:2407.00256
Chen, L., Zaharia, M., & Zou, J. (2023). FrugalGPT: How to use large language models while reducing cost and improving performance. arXiv:2305.05176
Ong, I., et al. (2025). RouteLLM: Learning to route LLMs with preference data. ICLR 2025. arXiv:2406.18665
2026년의 이웃 연구
Liu, Z., et al. (2026). Adaptive Auto-Harness: Sustained self-improvement for agentic system deployment on open-ended task streams. arXiv:2606.01770
Ghoshal, S., et al. (2026). JTPRO: A joint tool–prompt reflective optimization framework for language agents. Findings of ACL 2026. arXiv:2604.19821
Chen, W., Fang, Y., Fu, S., Xu, F., & Wei, X. (2026). Optimizing prompts for large language models: A causal approach. arXiv:2602.01711
Li, G., et al. (2026). Object-oriented harness: Evolving agent harnesses through object-oriented design. arXiv:2610.28380
Liu, S., et al. (2026). Reflection in the dark: Exposing and escaping the black box in reflective prompt optimization (VISTA). ACL 2026 Student Research Workshop. arXiv:2603.18388
Fatahi Bayat, F., Aminnaseri, M., Pezeshkpour, P., & Hruschka, E. (2026). Reflective prompt tuning through language model function-calling. arXiv:2605.21781
설명이 선택을 정한다는 증거
Wang, et al. (2026). From docs to descriptions: Smell-aware evaluation of MCP server descriptions. arXiv:2602.18914
Hasan, et al. (2026). MCP tool descriptions are smelly. arXiv:2602.14878
Zheng, et al. (2026). SkillRouter. arXiv:2603.22455
Liu, Chen, & Zhang (2026). Lost in implicit routing. arXiv:2610.18522
벤치마크와 모델
Yang, Z., et al. (2018). HotpotQA: A dataset for diverse, explainable multi-hop question answering. EMNLP 2018.
Li, S., et al. (2025). PAPILLON: Privacy preservation from internet-based and local language model ensembles. NAACL 2025. arXiv:2410.17127
White, C., et al. (2025). LiveBench: A challenging, contamination-limited LLM benchmark. ICLR 2025. arXiv:2406.19314
Zhou, J., et al. (2023). Instruction-following evaluation for large language models. arXiv:2311.07911
Santhanam, K., et al. (2022). ColBERTv2: Effective and efficient retrieval via lightweight late interaction. NAACL 2022.
Yang, A., et al. (2025). Qwen3 technical report. arXiv:2505.09388
Shao, Z., et al. (2024). DeepSeekMath: Pushing the limits of mathematical reasoning in open language models (GRPO). arXiv:2402.03300