GLiNER2GLiNER2.5GLiNER정보 추출개체명 인식NER구조화 추출관계 추출텍스트 분류스키마제로샷DeBERTaFastino개인정보가드레일한국어KLUE형태소로컬 AI
라벨을 문장처럼 읽는 작은 추출기 — GLiNER2 해부: 개체명 인식 30년, 스팬 격자에서 경계 쌍까지, 그리고 한국어 실측
‘이 글에서 사람·회사·금액을 뽑아 표로 만들어 줘’는 2026년에도 가장 흔한 AI 일입니다. GLiNER2는 이 일을 2억 개 남짓한 파라미터의 인코더 하나로, CPU에서, 라벨을 글자로 적어 넣기만 하면 해냅니다. 1995년 MUC-6에서 ‘개체명’이라는 말이 생긴 때부터 고정 라벨의 시대, LLM 증류, 2023년 GLiNER의 ‘라벨도 입력이다’라는 발상을 거쳐 2025년 GLiNER2의 스키마 한 줄, 2026년 GLiNER2.5의 경계 쌍 구조까지 따라갑니다. 저장소 코드를 열어 입력 직렬화, 스팬 격자와 개수 헤드, 경계 인코더·후보 풀·재정렬·기권 헤드, 레코드 헤드를 하나씩 해부했습니다. 코어닷투데이는 공개 모델 두 개를 한국어 KLUE 개체명 300문장에 제로샷으로 돌렸습니다. 공백 기준 그대로는 조사가 붙어 엄격 F1이 34.9였고, 뽑은 뒤 끝의 조사만 잘라 내자 62.5로 올라 로컬 Qwen3.5 9B(61.0)와 비겼습니다. 속도는 CPU만으로 15배 빨랐습니다. 폭 8의 벽에 막힌 12단어 법률명은 경계 구조만 찾았고, 신형이 한국어에서 구형을 앞서지는 못했습니다.
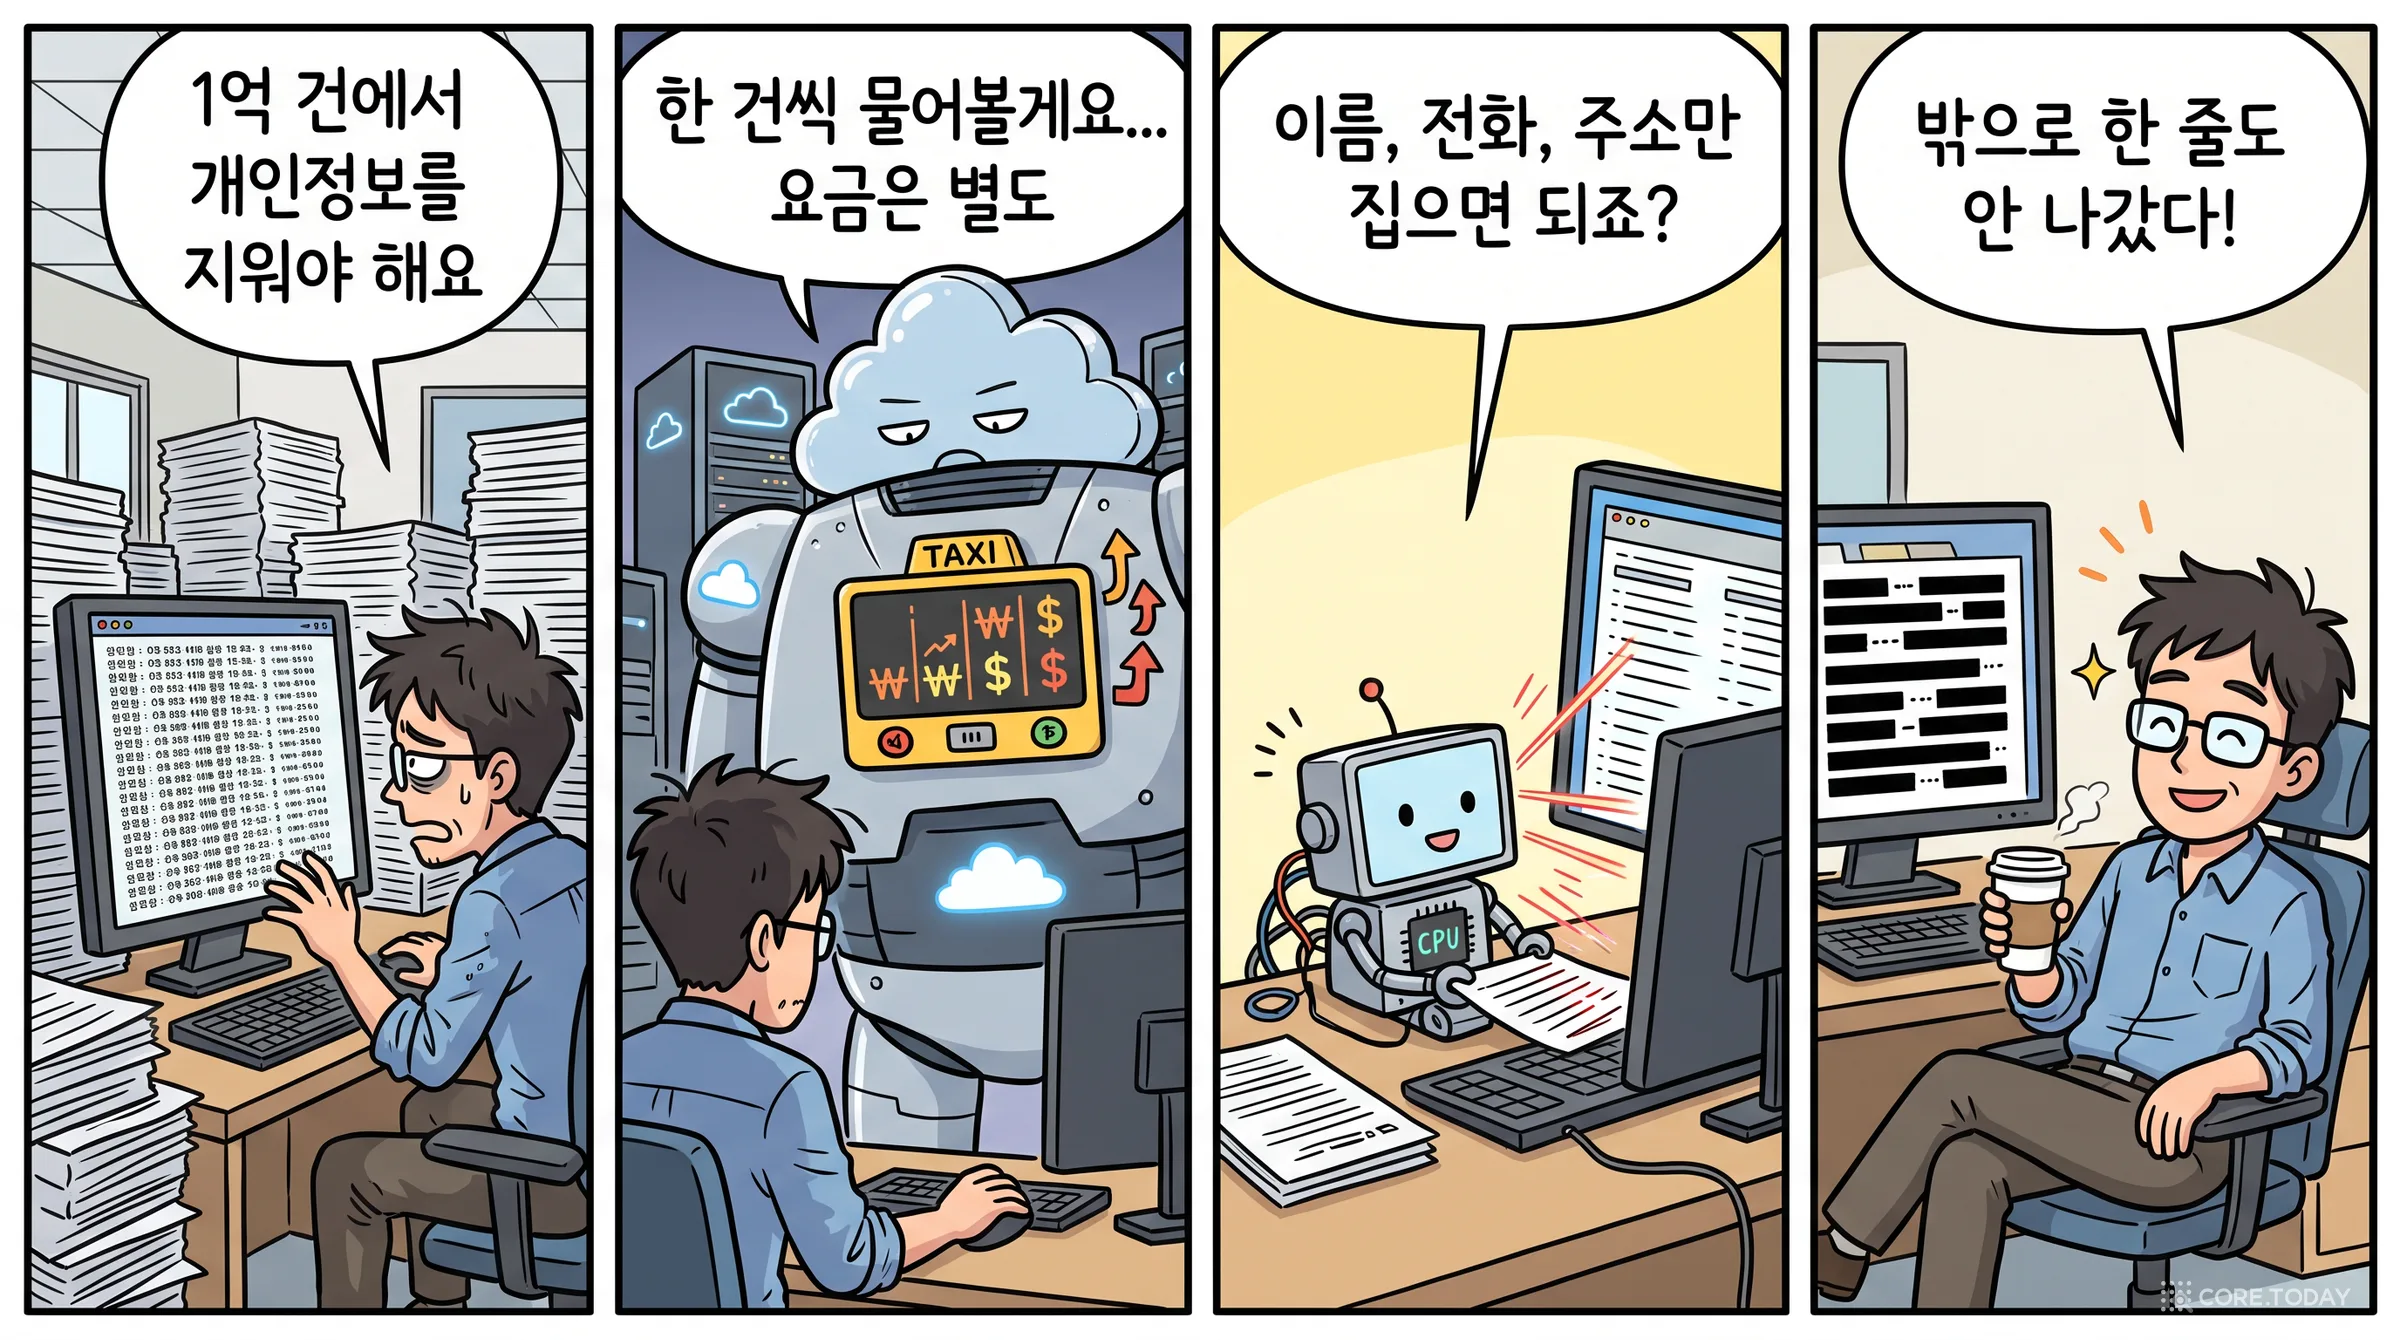
콜센터 상담 기록 1억 건이 있다고 해 봅시다. 분석팀에 넘기기 전에 이름, 전화번호, 주소, 계좌번호를 가려야 합니다. 2026년의 첫 반응은 대개 "LLM에게 시키면 되지"입니다. 실제로 됩니다. 문제는 그다음 질문들입니다. 한 건에 1초씩이면 1억 초, 약 3년 2개월입니다. 병렬로 돌리면 시간은 줄지만 요금이 쌓입니다. 무엇보다 고객의 개인정보를 외부 API로 보내도 되는지 법무팀이 묻습니다. 그리고 LLM은 가끔 원문에 없는 전화번호를 '정리해서' 돌려줍니다.
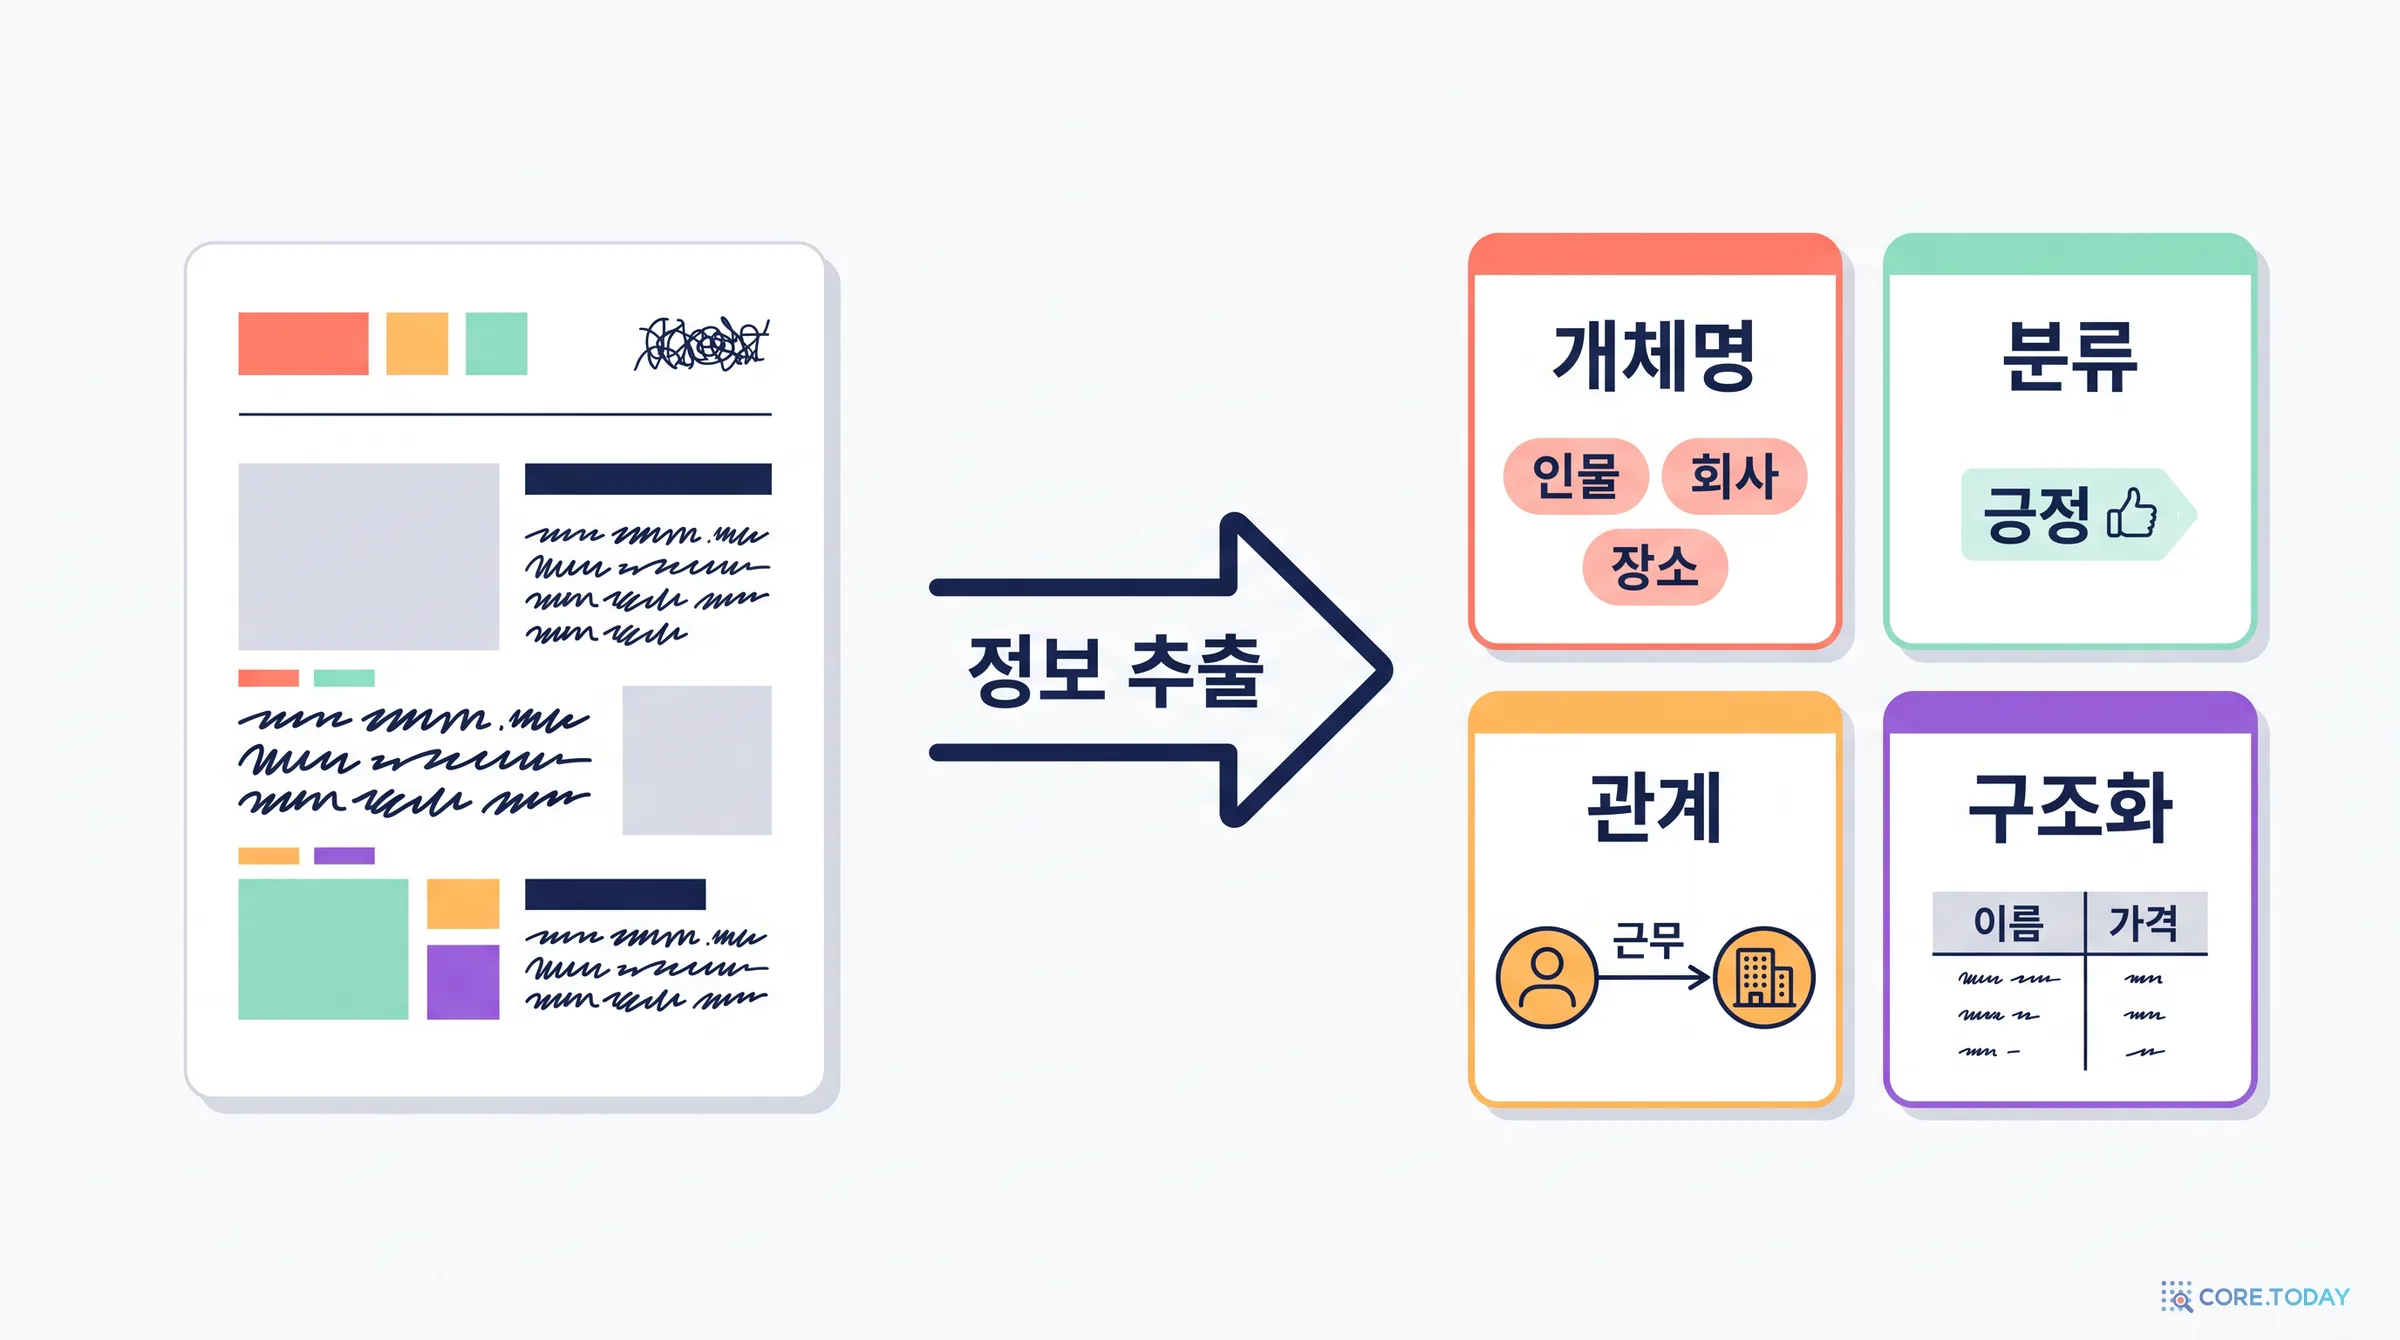
이 글의 주인공 GLiNER2는 이 장면을 위해 만들어진 오픈소스입니다. 스타트업 Fastino가 2025년 7월 공개했고(Apache 2.0), 2026년 8월에는 구조를 바꾼 GLiNER2.5가 같은 라이브러리에 들어왔습니다. 하는 일은 한 문장으로 요약됩니다. "뽑고 싶은 것의 이름을 글자로 적어 주면, 원문에서 그 조각을 집어 온다." 사람·회사·제품 같은 개체명, 긍정·부정 같은 분류, '누가 어디서 일한다' 같은 관계, '제품 이름과 가격' 같은 구조화된 레코드를 모델 하나가 한 번에 처리합니다. 파라미터는 7천4백만~3억 개 남짓이고, GPU 없이 노트북 CPU에서 돕니다.
python
from gliner2 import AutoExtractor
model = AutoExtractor.from_pretrained("fastino/gliner2.5-multi-v1")
model.extract_entities(
"Apple CEO Tim Cook announced iPhone 15 in Cupertino yesterday.",
["company", "person", "product", "location"],
)
# {'entities': {'company': ['Apple'], 'person': ['Tim Cook'],# 'product': ['iPhone 15'], 'location': ['Cupertino']}}
이 코드는 코어닷투데이가 2026년 11월 8일 Apple M1 Ultra의 CPU에서 그대로 돌린 결과이고, 한 문장에 0.12초가 걸렸습니다. 라벨 목록을 ["협력사", "부품", "납기일"]로 바꾸면 재학습 없이 바로 그 라벨로 뽑습니다.
"LLM이 다 하는 시대에 굳이?"라는 질문에 이 글은 세 가지로 답하려 합니다. 첫째, 왜 이런 모델이 나왔는가. 개체명 인식 30년의 역사는 '라벨을 모델 바깥의 고정된 칸으로 두느냐, 입력 안으로 들이느냐'의 이야기입니다. 둘째, 어떻게 동작하는가. 저장소 코드를 열어 스키마가 한 줄의 입력이 되는 과정, 스팬 격자와 개수 헤드(GLiNER2), 경계 쌍 제안과 재정렬(GLiNER2.5)을 하나씩 해부합니다. 셋째, 한국어에서는 어떤가. 공식 모델 카드의 지원 언어 목록에 한국어는 없습니다. 그래서 직접 돌렸습니다. 결과는 꽤 흥미로웠습니다. 한국어에서 점수를 가른 것은 모델의 크기도 세대도 아닌 조사였습니다.
이 글에서 다루는 것
1장 정보 추출이란 무엇이고 왜 아직도 중요한가 · 2장 1995년 MUC-6부터 GLiNER까지, 라벨이 입력으로 들어오기까지 · 3장 GLiNER의 발상: 라벨과 문장을 한 인코더로 · 4장 GLiNER2 아키텍처 해부: 직렬화, 스팬 격자, 개수 헤드, 분류, 학습 · 5장 GLiNER2.5 아키텍처 해부: 경계 인코더, 후보 풀, 재정렬, 기권, 레코드 · 6장 라이브러리 둘러보기 · 7장 코어닷투데이 실측: 한국어 KLUE 300문장, 로컬 LLM과의 비교, 속도 · 8장 2026년 이 기술의 자리 · 9장 도입 체크리스트
1장. 정보 추출 — 글을 표로 바꾸는 일
정보 추출(Information Extraction, IE)은 자유롭게 쓴 글에서 정해진 모양의 정보를 꺼내는 일입니다. 사람이 읽으라고 쓴 문장을 기계가 계산할 수 있는 표로 바꾸는 작업이라고 생각하면 됩니다.
GLiNER2가 한 모델로 묶은 네 가지 과제를 예로 보겠습니다. 입력은 모두 같은 문장입니다. "삼성전자 이재용 회장이 어제 수원에서 갤럭시 S26을 공개했다."
과제
묻는 것
출력
어디에 쓰나
개체명 인식 (NER)
회사·인물·제품·장소는?
삼성전자 / 이재용 / 갤럭시 S26 / 수원
검색 색인, 개인정보 가리기, 뉴스 태깅
텍스트 분류
이 글의 성격은?
주제: 기술, 감성: 중립
문의 라우팅, 유해 글 차단, 의도 파악
관계 추출
누가 어디 소속인가?
(이재용, 삼성전자): 소속
지식 그래프, 에이전트 기억, 실사 조사
구조화 추출
제품 레코드를 채워라
{이름: 갤럭시 S26, 발표지: 수원}
계약서·영수증·의무기록을 데이터베이스로
이런 일이 왜 2026년에도 중요할까요? 사례를 몇 개 들어 보겠습니다.
개인정보 비식별화. 병원 의무기록을 연구에 쓰려면 환자 이름·주민번호·주소를 지워야 합니다. 정규식은 '010-1234-5678'은 잡지만 "김 할머니 댁은 시장 뒤편 파란 대문 집"은 못 잡습니다. 문맥을 읽는 추출기가 필요합니다. Fastino가 GLiNER2 위에 개인정보 42종을 학습시킨 gliner2-privacy-filter-PII-multi는 공개 6개월 만에 Hugging Face에서 65만 번 넘게 내려받아졌습니다.
LLM 가드레일. 챗봇에 들어오는 질문이 위험한지, 답변이 정책을 어기는지를 매번 큰 LLM에게 다시 묻는 것은 비쌉니다. 질문 하나당 수십 밀리초 안에 '안전/위험'을 가르는 작은 분류기가 앞단을 지킵니다. Fastino의 GLiGuard(3억 파라미터)가 이 자리를 노립니다.
에이전트의 기억. 대화에서 "이 사람은 어느 회사에 다닌다" 같은 사실을 뽑아 지식 그래프로 쌓는 기억 엔진이 많습니다. 코어닷투데이가 Graphiti 특집에서 다룬 Graphiti는 2026년 3월 개체 추출을 LLM 대신 GLiNER2로 하는 실험 클라이언트(GLiNER2Client)를 넣었습니다. 개체는 GLiNER2가, 관계는 LLM이 맡는 분업입니다.
문서 자동화. 계약서에서 당사자·계약일·월 요금·해지 통지 기간을 뽑아 표로 만드는 일, 공시에서 배당금·기준일을 뽑는 일, 영수증에서 금액·날짜를 뽑는 일은 지금도 수많은 회사의 일상 업무입니다.
공통점이 있습니다. 답이 원문 안에 있다는 것입니다. 무언가를 새로 지어내거나 추론하는 일이 아니라, 이미 쓰여 있는 조각을 정확히 집어 오는 일입니다. 이 성질이 뒤에서 볼 설계 전체를 지배합니다.
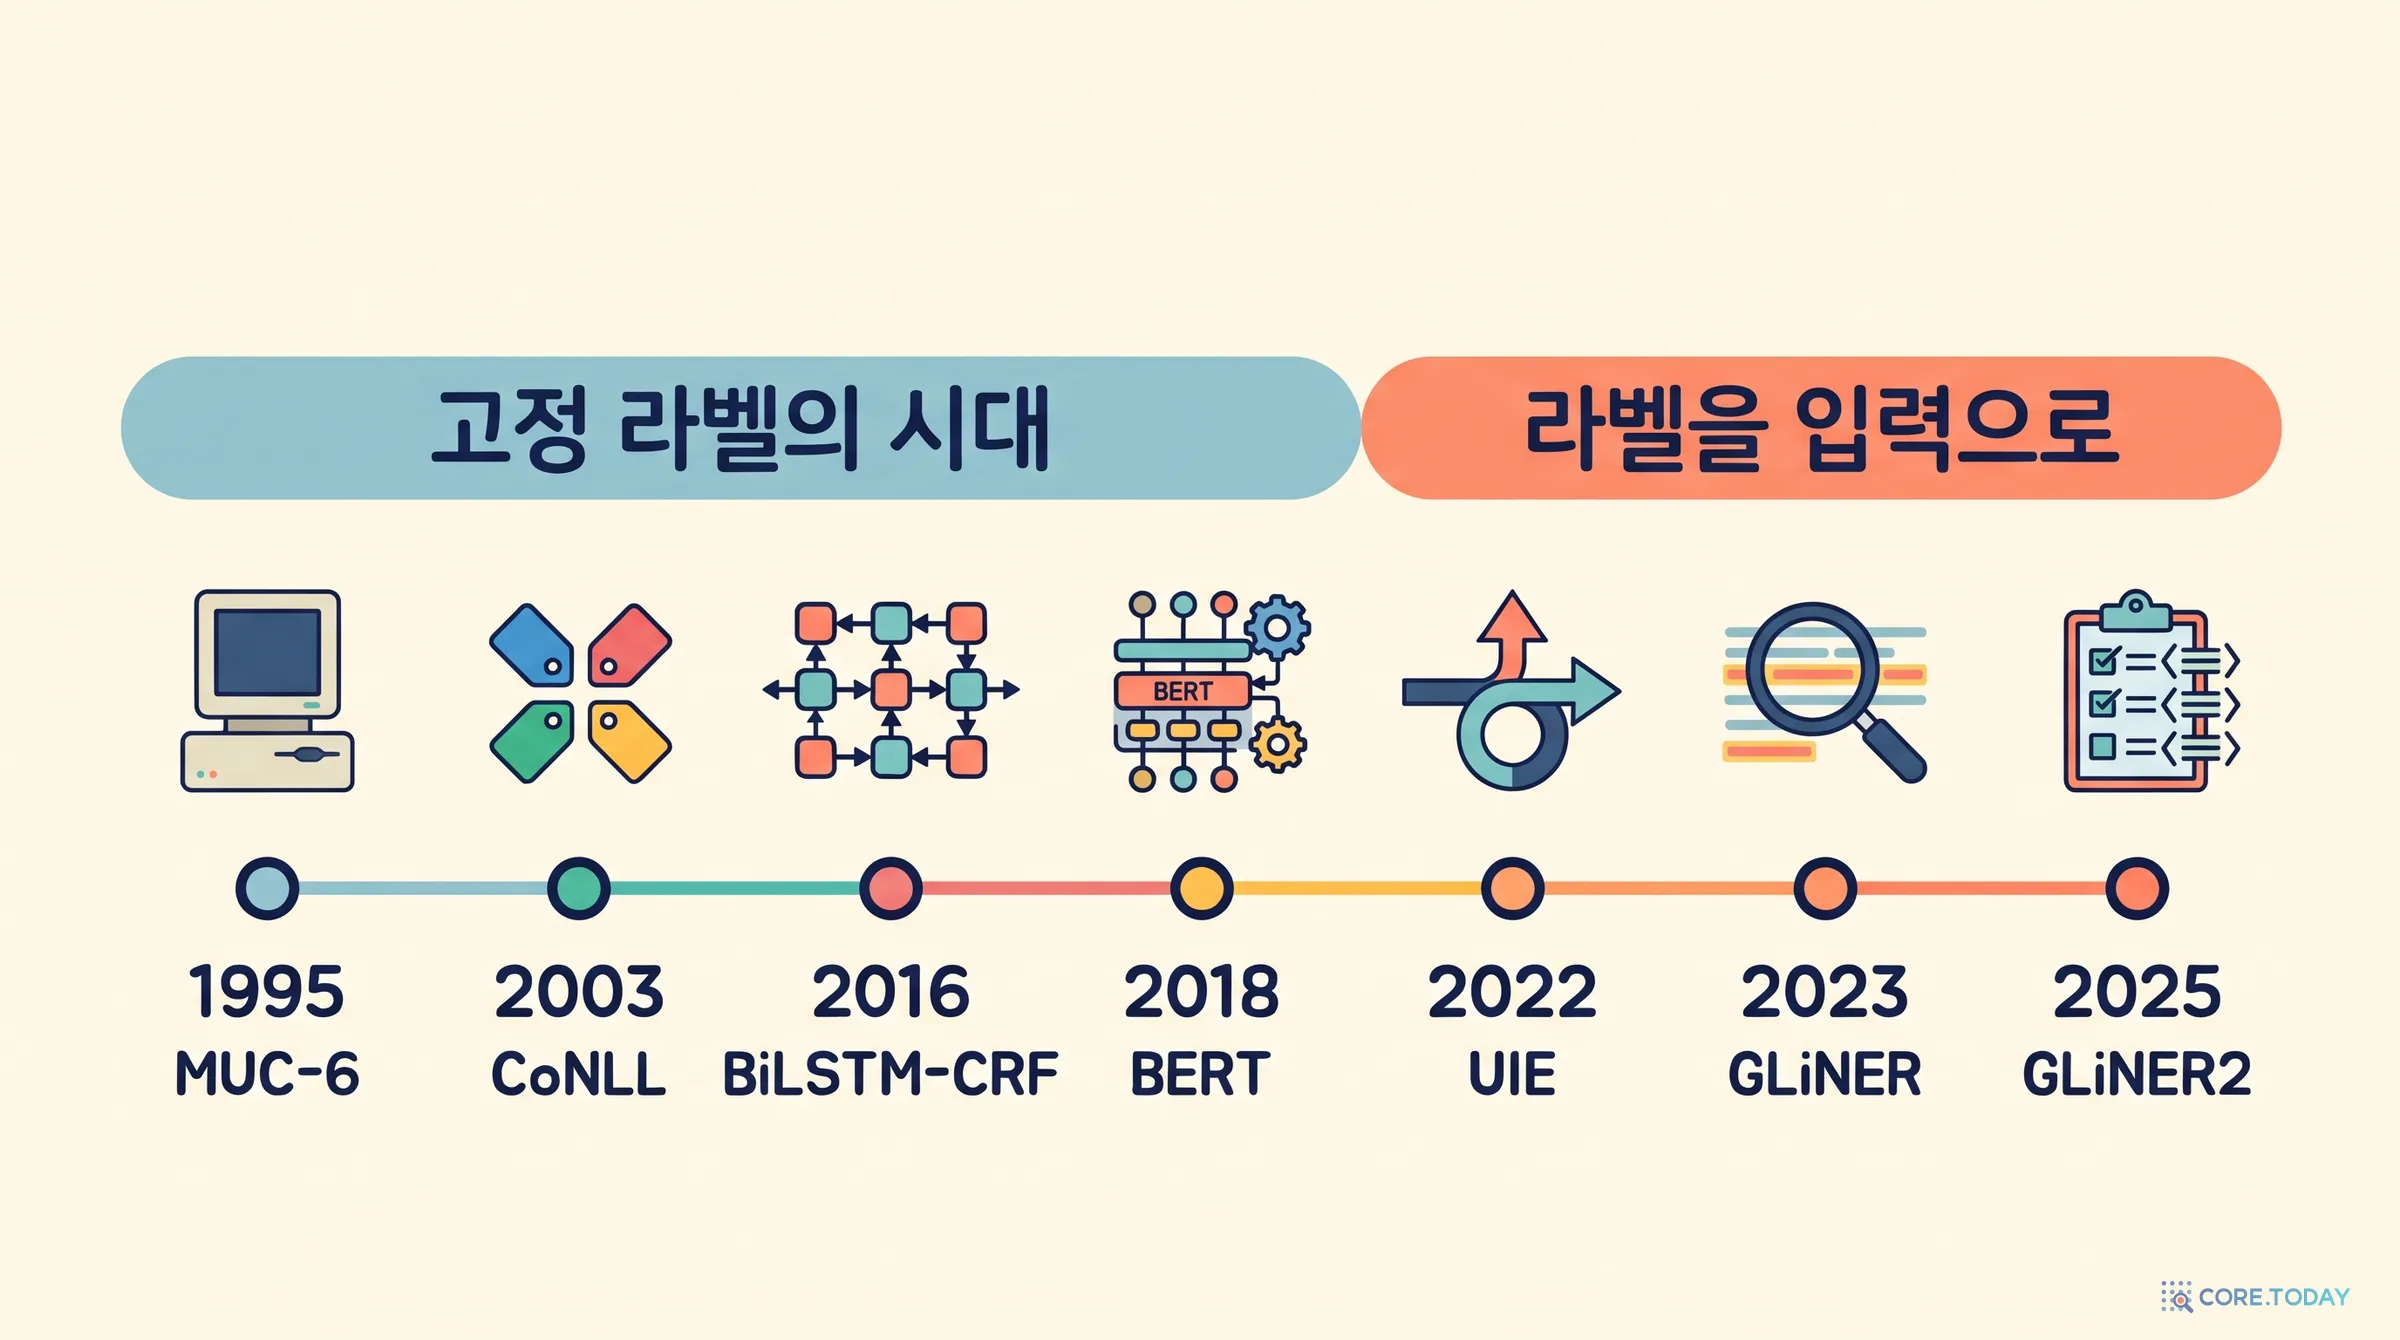
'개체명(named entity)'이라는 용어는 1995년 미국 국방고등연구계획국(DARPA)이 후원한 6회 메시지 이해 학회(MUC-6)에서 처음 과제 이름으로 쓰였습니다(Grishman & Sundheim, 1996). 당시 목표는 신문 기사에서 인물·기관·장소와 날짜·금액 같은 수치 표현을 찾아내는 것이었습니다. 초기 시스템은 대부분 사람이 쓴 규칙이었습니다. '씨', 'Inc.', 'Corp.' 같은 단서 단어와 대문자 패턴, 지명 사전을 조합했습니다.
2003년 CoNLL 공동 과제(Tjong Kim Sang & De Meulder)는 영어·독일어 뉴스에 인물(PER)·장소(LOC)·기관(ORG)·기타(MISC) 네 종류를 붙인 데이터셋을 내놓았습니다. 이 데이터는 이후 20년 동안 개체명 인식의 표준 시험지가 됐습니다. 이 순간 한 가지가 고정됩니다. 라벨은 네 개다. 모델은 각 단어에 'B-PER, I-PER, O…' 같은 태그 중 하나를 붙이는 분류기가 됐습니다.
통계와 신경망: 점수는 오르고 라벨은 갇혔다
2001년 조건부 무작위장(CRF, Lafferty 외)은 단어 태그들이 서로 어울리는지(예: I-PER 앞에는 B-PER이 와야 한다)를 함께 고려하는 확률 모델로 오랫동안 표준이 됐습니다. 2016년에는 양방향 LSTM 위에 CRF를 얹은 BiLSTM-CRF(Lample 외)가 CoNLL-2003 영어에서 F1 90.94를 기록했고, 2018년 BERT는 미세조정만으로 92.4(base)·92.8(large)을 냈습니다.
점수는 계속 올랐지만 구조는 같았습니다. 마지막 층이 라벨 수만큼의 출력 칸을 갖는 분류기입니다. 병원에서 '약물'과 '용량'을, 법무팀에서 '계약 당사자'와 '해지 조항'을 뽑고 싶다면 그 라벨로 수천 문장에 사람이 태그를 달고 모델을 다시 학습해야 했습니다. 라벨 하나를 추가하는 비용이 데이터 구축 프로젝트 하나였습니다.
같은 시기 다른 갈래도 자랐습니다. 2017년 Lee 외의 상호참조 연구는 단어마다 태그를 붙이는 대신 가능한 모든 조각(span)을 늘어놓고 각각에 점수를 매기는 방법을 썼습니다(최대 폭 10단어). 2019년 SpERT는 이 스팬 방식으로 개체와 관계를 함께 뽑았습니다. 단어 태깅은 '이 단어는 무엇의 몇 번째 조각인가'를 묻고, 스팬 방식은 '이 조각 전체가 무엇인가'를 묻습니다. 겹치는 개체(예: '서울대학교 병원' 안의 '서울대학교')를 자연스럽게 다룰 수 있다는 장점이 있습니다. GLiNER는 이 갈래의 후손입니다.
LLM의 등장: 라벨은 풀렸지만 너무 비쌌다
2022년 UIE(Lu 외)는 추출을 '텍스트를 구조로 바꾸는 생성' 문제로 통일했습니다. 라벨 이름을 프롬프트처럼 넣는 '구조 스키마 지시자'를 쓰면 한 모델이 개체·관계·사건을 모두 다룰 수 있습니다. 라벨을 모델 안에 박아 두지 않고 입력으로 주는 발상이 여기서 본격화됩니다.
그 뒤 ChatGPT가 왔습니다. 이제 "이 글에서 약물 이름을 뽑아 줘"라고 쓰기만 하면 됩니다. 그런데 막상 재 보니 결과가 생각보다 나빴습니다. InstructUIE 논문(2023)은 gpt-3.5-turbo가 OntoNotes 개체명에서 F1 18.22에 그쳤다고 보고했습니다. 생성 모델은 경계를 자기 마음대로 다듬고, 원문에 없는 표현으로 바꾸고, 라벨 정의를 느슨하게 해석했습니다.
2023년 8월 UniversalNER(Zhou 외)는 다른 길을 택했습니다. ChatGPT에게 다양한 글 4만 4,889개에서 개체를 뽑게 해 1만 3천 가지 라벨이 붙은 학습 데이터(Pile-NER)를 만들고, 이것으로 7B·13B 모델을 증류했습니다. 결과는 43개 데이터셋에서 ChatGPT보다 7~9점 높았습니다. 큰 모델은 선생님으로 쓰고, 일은 작은 모델이 한다. 2026년에도 유효한 이 공식이 여기서 자리 잡습니다. 다만 학생도 여전히 70억 개짜리 생성 모델이었습니다.
2023년 11월, GLiNER: "라벨도 문장이다"
프랑스 소르본 파리 노르 대학 LIPN 연구실(CNRS)과 FI Group의 Urchade Zaratiana와 동료들은 질문을 바꿨습니다(arXiv 2311.08526, NAACL 2024). 개체명 인식에 정말 생성이 필요한가? 답은 원문 안에 있으니 조각을 고르는 것으로 충분하지 않은가? 그렇다면 BERT 같은 양방향 인코더로도 되지 않을까?
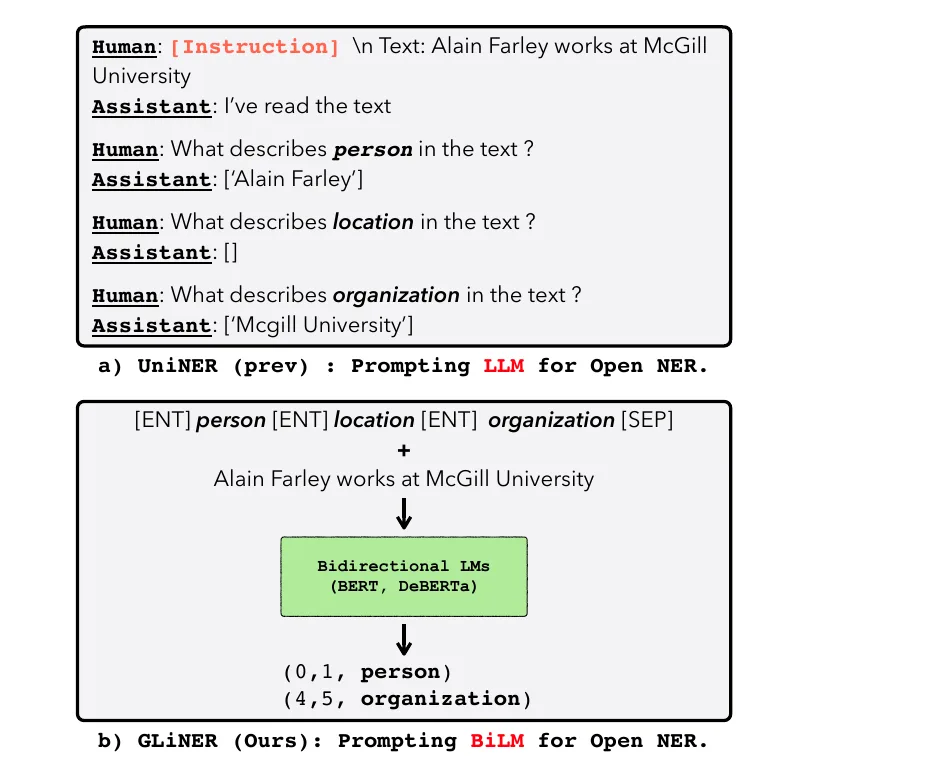
출처: Zaratiana 외, "GLiNER: Generalist Model for Named Entity Recognition using Bidirectional Transformer", NAACL 2024, 그림 1.
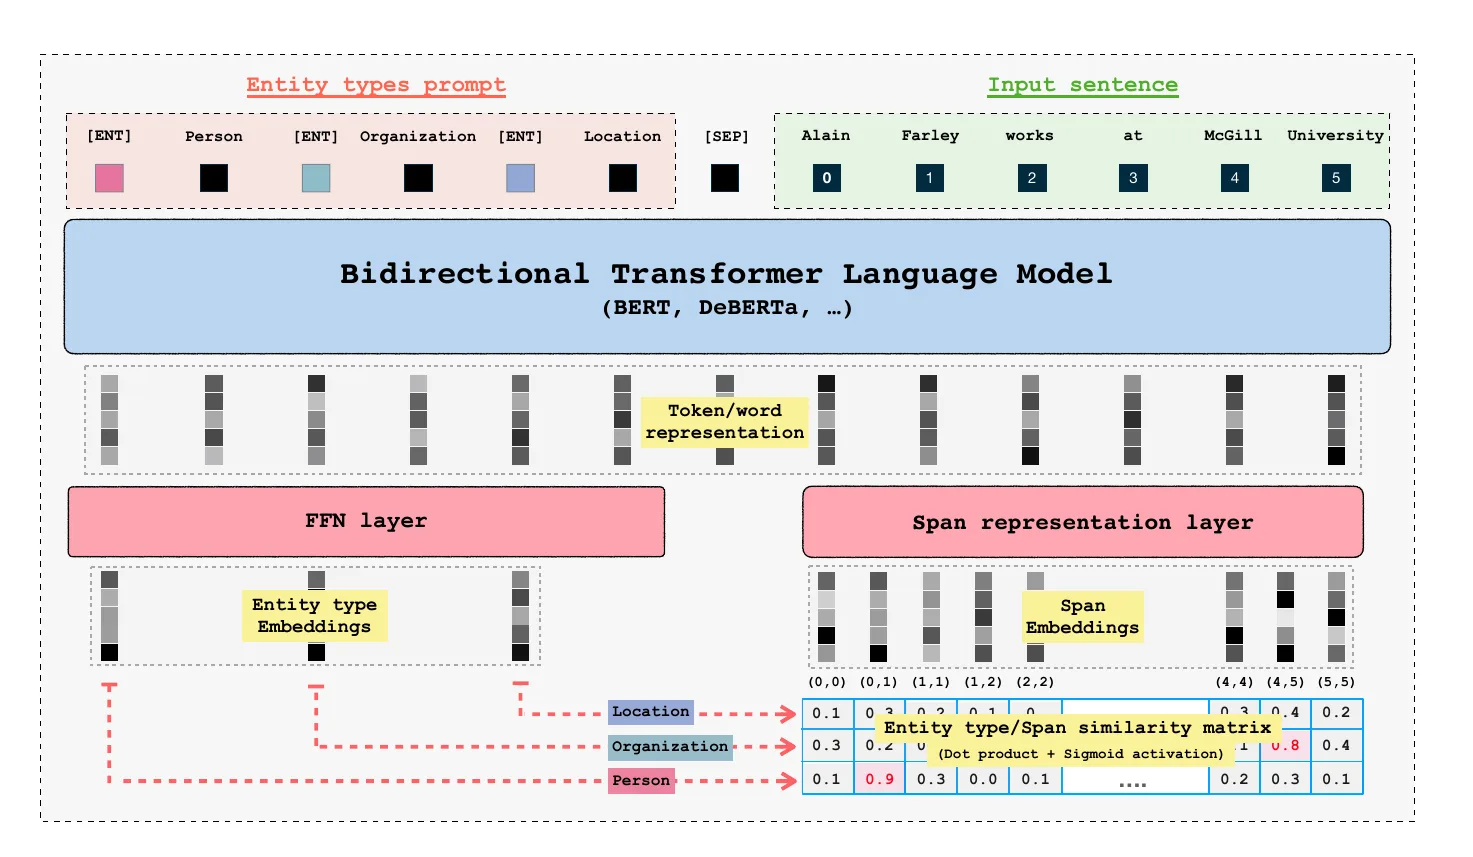
그림의 (a)는 UniNER 방식입니다. 라벨마다 "이 글에서 person에 해당하는 것은?"을 대화로 묻고, 모델이 답을 한 토큰씩 생성합니다. 라벨이 10개면 질문도 10번입니다. (b)가 GLiNER입니다. [ENT] person [ENT] location [ENT] organization [SEP] 뒤에 문장을 붙여 한 번에 인코더에 넣습니다. 출력은 생성된 글이 아니라 (0, 1, person) 같은 위치입니다. 0번째부터 1번째 단어까지가 person이라는 뜻입니다.
결과는 놀라웠습니다. 학습에 쓰지 않은 7개 도메인(CrossNER·MIT) 평균 F1에서 3억 파라미터의 GLiNER-L이 60.9로 ChatGPT(47.5), UniNER-13B(55.6), 가이드라인을 따르도록 학습한 GoLLIE(58.0)를 모두 앞섰습니다. 9천만 파라미터의 GLiNER-M(55.4)은 UniNER-13B와 비슷했는데, 논문은 이를 "140배 작다"고 표현했습니다. GLiNER-L 학습에는 A100 한 장으로 5시간이 걸렸습니다. 학습 데이터는 앞서 말한 UniNER의 Pile-NER, 즉 ChatGPT가 만든 데이터였습니다. LLM이 선생님, 인코더가 학생인 구조입니다.
한국어에 관한 기록도 하나 있습니다. 같은 논문의 다국어 표(MultiCoNER)에서 한국어 F1은 지도학습 XLM-R 55.8, ChatGPT 30.0, GLiNER-Multi 28.7이었습니다. 영어에서 압도하던 모델이 한국어에서는 ChatGPT보다 약간 아래였습니다. 이 숫자는 7장에서 다시 만납니다.
생태계가 퍼지다, 그리고 GLiNER2
GLiNER는 빠르게 퍼졌습니다. urchade/gliner_multi_pii-v1 하나가 Hugging Face에서 157만 번 내려받아졌고, 뉴스 특화판 EmergentMethods/gliner_medium_news-v2.1은 1,377만 번을 기록했습니다. 스타트업 Knowledgator는 원 저장소의 최다 기여자가 되어 다중 과제판, 분류판(GLiClass)을 냈고, 관계 추출판(GLiREL), 생의학판(GLiNER-BioMed)도 나왔습니다. Microsoft의 개인정보 탐지 도구 Presidio에는 2025년 1월 GLiNERRecognizer가 들어갔습니다.
문제는 파편화였습니다. 개체는 GLiNER, 관계는 GLiREL, 분류는 GLiClass, 구조화 추출은 또 다른 모델. 각각 다른 패키지, 다른 체크포인트, 다른 API입니다. Zaratiana는 Fastino에 합류했고, 2025년 7월 이 모두를 한 모델에 담은 GLiNER2를 냈습니다(arXiv 2507.18546, EMNLP 2025 시스템 데모). 논문의 부제가 이 의도를 요약합니다. "스키마로 구동되는 다중 과제 학습".
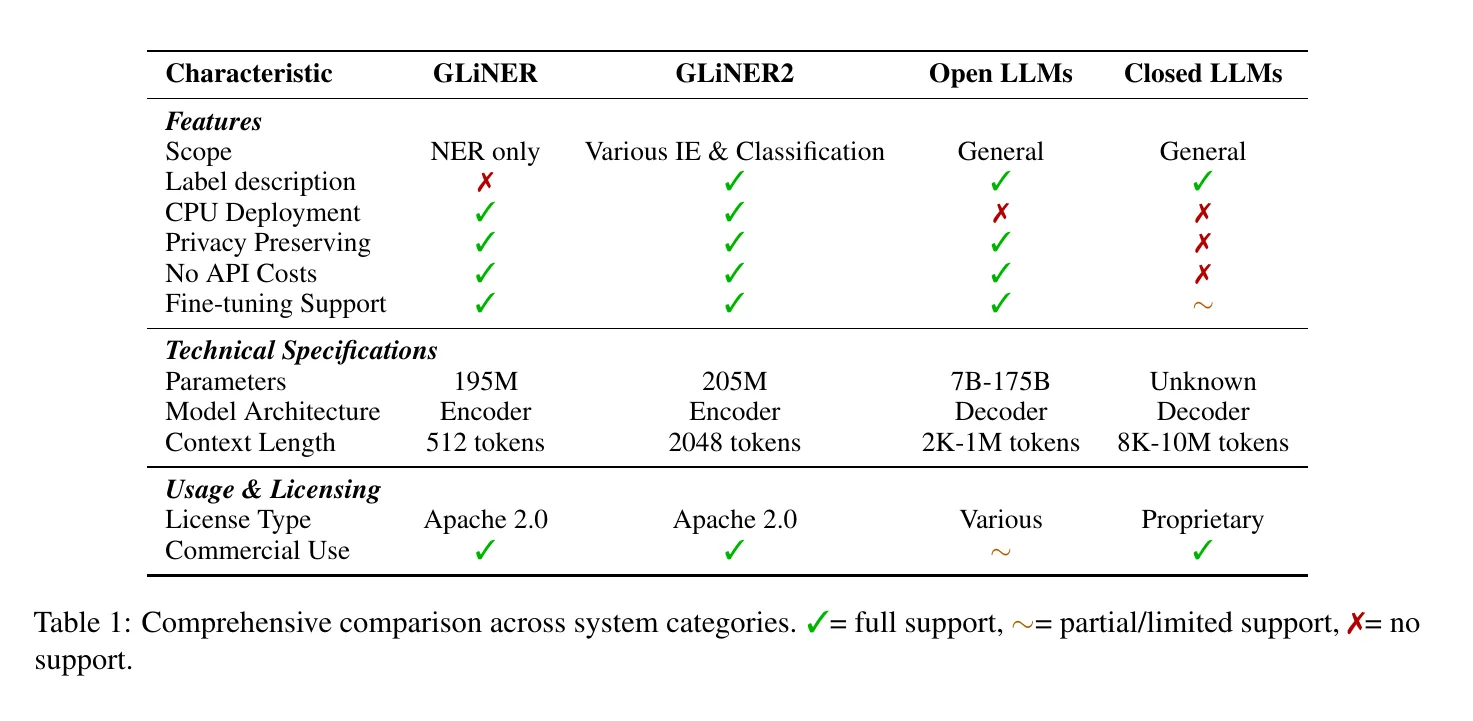
출처: Zaratiana 외, "GLiNER2: An Efficient Multi-Task Information Extraction System with Schema-Driven Interface", EMNLP 2025 System Demonstrations, 표 1.
논문 표 1은 GLiNER2의 자리를 한눈에 보여 줍니다. 오픈 LLM(7B~175B)과 비공개 LLM의 범용성을 원하지만, CPU에서 돌고 데이터가 밖으로 나가지 않고 API 요금이 없는 쪽에 서겠다는 선언입니다. 문맥 길이는 GLiNER의 512토큰에서 2,048토큰으로 늘었습니다. (표의 GLiNER 파라미터 '195M'은 원 논문의 어떤 크기와도 맞지 않는데, 비교용으로 특정 체크포인트를 가리킨 것으로 보입니다.)
GLiNER2의 학습 데이터는 25만 4,334개입니다. 뉴스·법률·위키백과·PubMed·arXiv의 실제 글 13만 5,698개에 GPT-4o로 라벨을 붙이고, GPT-4o가 지어낸 합성 예문 11만 8,636개를 더했습니다. 다시 한번, LLM이 선생님입니다.
그리고 2026년 8월 24일, Fastino는 블로그 글 하나로 GLiNER2.5를 공개했습니다(논문은 없습니다). '스팬 없는(span-free) 정보 추출'이라는 제목처럼, GLiNER 이래 이어진 스팬 격자를 버리고 경계 쌍을 제안한 뒤 다시 채점하는(propose-then-rerank) 구조로 바꿨습니다. 같은 날 PyPI의 gliner2 패키지가 2.0.0이 됐고, 지금은 2.1.0(2026-10-09)입니다. 한 라이브러리 안에 두 구조가 공존하고, AutoExtractor가 체크포인트에 적힌 구조 이름을 보고 알맞은 쪽을 고릅니다.
GLiNER 계열을 이해하는 열쇠는 하나입니다. 라벨이 출력층의 칸이 아니라 입력 문장의 일부라는 것입니다.
전통적인 개체명 모델을 식당에 비유하면 메뉴판이 벽에 페인트로 칠해진 식당입니다. 메뉴(라벨)를 바꾸려면 벽을 다시 칠해야(재학습) 합니다. GLiNER는 손님이 주문서에 원하는 요리 이름을 적어 내는 식당입니다. 주방장(인코더)은 주문서와 재료(문장)를 함께 보고, 주문서의 각 요리에 맞는 재료를 골라냅니다. 처음 보는 요리 이름이라도 뜻을 짐작할 수 있으면 됩니다.
입력. 왼쪽에 라벨 프롬프트 [ENT] Person [ENT] Organization [ENT] Location, 가운데 [SEP], 오른쪽에 문장 Alain Farley works at McGill University가 한 줄로 이어집니다.
양방향 인코더. BERT나 DeBERTa 같은 인코더가 이 한 줄을 통째로 읽습니다. 핵심은 양방향 어텐션입니다. 'Person' 토큰은 문장의 'Alain'을, 'Alain'은 'Person'을 서로 봅니다. 그래서 같은 'Person'이라는 글자라도 이 문장 속에서 읽은 'Person'의 벡터는 이미 'Alain Farley' 쪽으로 기울어 있습니다.
두 갈래 변환. 각 [ENT] 자리의 벡터는 FFN을 거쳐 라벨 벡터가 됩니다. 문장 쪽에서는 가능한 모든 조각, 즉 (0,0)=Alain, (0,1)=Alain Farley, (1,1)=Farley… 각각에 대해 조각 벡터를 만듭니다. 조각 벡터는 시작 단어와 끝 단어의 벡터를 이어 붙여 FFN에 통과시킨 것입니다.
매칭. 모든 (라벨, 조각) 쌍에 대해 내적을 구하고 시그모이드를 씌웁니다. 그림 아래의 행렬이 그것입니다. (0,1)과 Person의 점수가 0.9, (4,5)와 Organization이 0.8입니다. 0.5를 넘는 칸을 고르고, 겹치는 것은 점수가 높은 쪽부터 남깁니다.
생성 모델과 비교하면 이 설계의 장점이 분명해집니다.
관점
생성형 LLM (예: UniNER, GPT)
GLiNER 계열 인코더
출력
글자를 한 토큰씩 생성
원문 위치(시작, 끝) 선택
라벨 10개면
질문 10번 또는 긴 출력
한 번의 순방향 계산
원문에 없는 답
가능 (환각, 띄어쓰기·표기 변형)
구조적으로 불가능
출력 형식 오류
JSON이 깨질 수 있음
없음
확신도
따로 구해야 함
칸마다 시그모이드 점수
할 수 없는 일
—
요약, 정규화(‘3월 5일’→2026-03-05), 계산, 원문에 없는 추론
마지막 줄이 중요합니다. GLiNER는 고르기만 합니다. "이 계약의 총액은?"이라고 물었을 때 원문에 '월 1,500만 원, 24개월'만 있다면 3억 6천만 원은 뽑을 수 없습니다. 이 한계를 아는 것이 도입의 첫걸음입니다.
4장. GLiNER2 아키텍처 해부 — 스키마 한 줄, 격자, 개수
이제 저장소 코드를 열어 보겠습니다. 이 장의 내용은 fastino-ai/GLiNER2의 2026년 10월 20일 커밋(ca4f682, 버전 2.1.0)을 기준으로 합니다. 먼저 GLiNER2의 원래 구조, 저장소에서 span 구조라고 부르는 쪽입니다. (README는 구조 설명 문서 두 개 docs/boundary_architecture.md, docs/gliner2_5_boundary_architecture.md로 안내하지만, 이 커밋의 저장소에는 두 파일이 없습니다. 아래 설명은 코드를 직접 읽고 정리했습니다.)
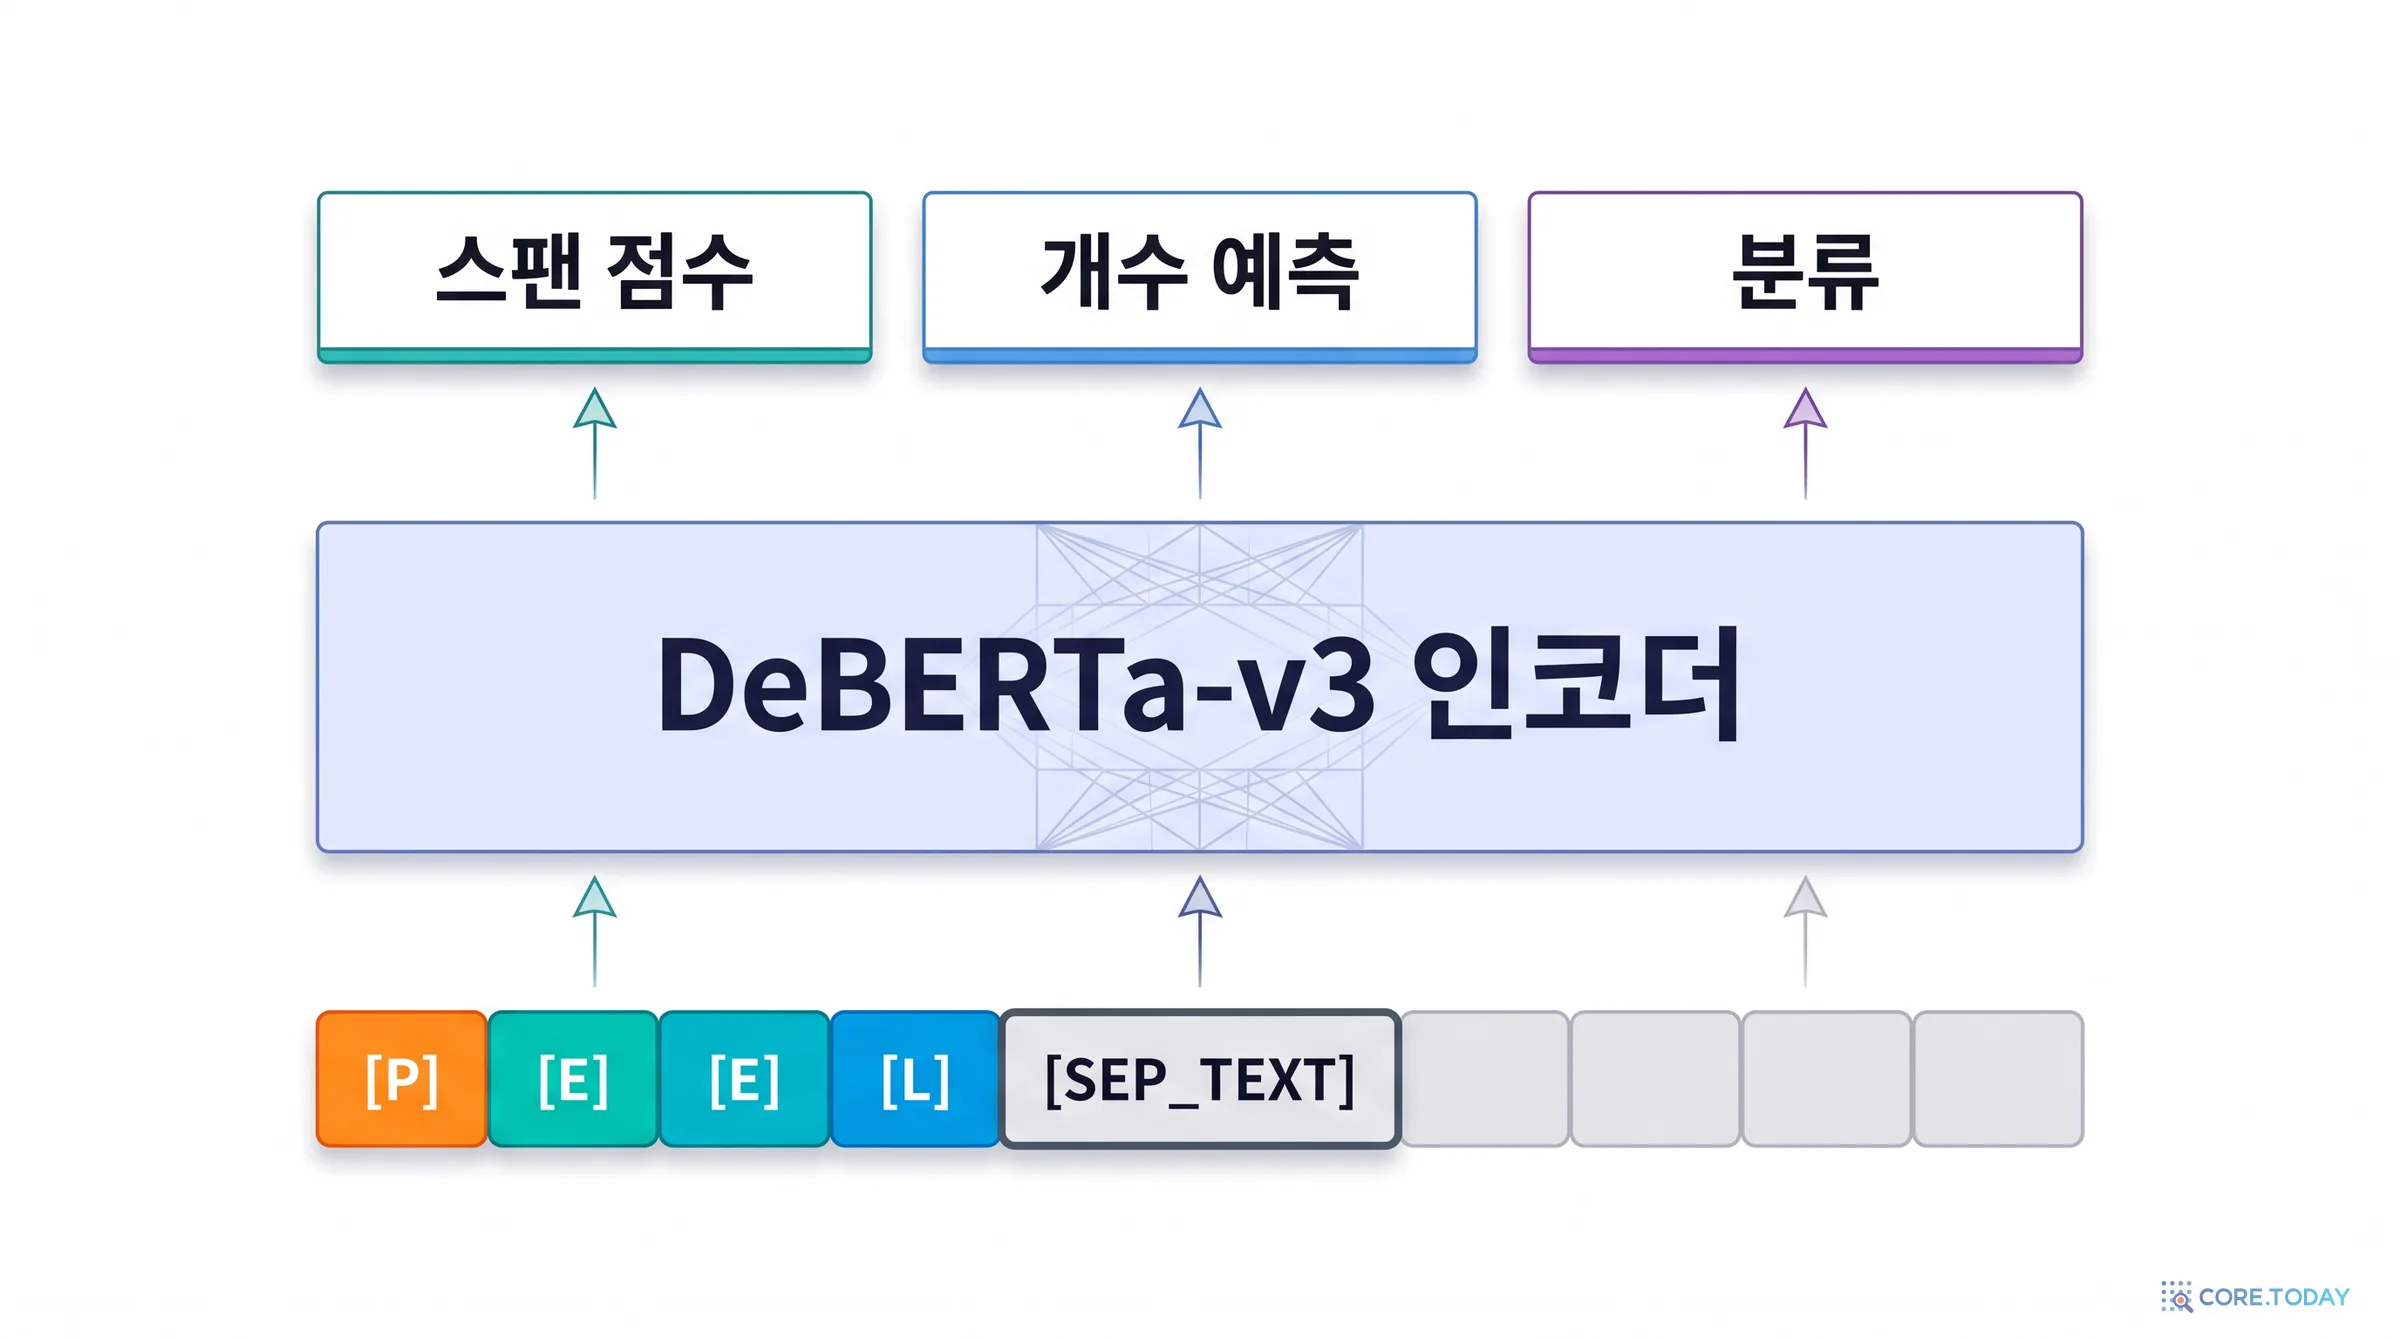
큰 그림은 세 단계입니다. ① 스키마와 본문을 한 줄로 이어 붙이고, ② DeBERTa-v3 인코더가 한 번 읽고, ③ 표지 토큰 자리의 벡터를 꺼내 과제별 작은 헤드에 넣습니다.
스키마 (개체·분류·관계·구조)
→
직렬화 ( [P] 이름 ( [E] 라벨 … ) )
→
[SEP_TEXT] + 본문 단어
↓
DeBERTa-v3 인코더 (12층, 768차원)
↓
[L] 벡터 → 분류 MLP
[P] 벡터 → 개수 MLP (0~19)
[E]/[C]/[R] 벡터 → 개수만큼 복제 → 스팬 격자와 내적
4-1. 직렬화: 스키마가 한 줄의 입력이 된다
processor.py의 SchemaTransformer가 이 일을 합니다. 토크나이저에 특수 토큰 열 개를 추가합니다. [SEP_STRUCT], [SEP_TEXT], [P], [C], [E], [R], [L], [EXAMPLE], [OUTPUT], [DESCRIPTION]입니다. 과제 하나는 다음 모양의 괄호 덩어리가 됩니다.
text
( [P] entities ( [E] 회사 [E] 인물 [E] 제품 ) )
( [P] 감성 ( [L] 긍정 [L] 부정 [L] 중립 ) )
( [P] 근무 ( [R] head [R] tail ) )
( [P] 제품정보 ( [C] 이름 [C] 가격 ) )
[P]는 과제의 머리(prompt), 그 뒤의 표지가 과제 종류를 알려 줍니다. [E]는 개체(entity), [L]은 분류 라벨(label), [R]은 관계의 역할(relation), [C]는 구조체의 필드(child)입니다. 관계도 사실은 'head'와 'tail' 두 필드를 가진 작은 구조체로 취급된다는 점이 흥미롭습니다. 덩어리들은 [SEP_STRUCT]로 이어지고, 마지막에 [SEP_TEXT]와 본문 단어가 붙습니다. 순서는 늘 구조화 → 개체 → 관계 → 분류입니다(학습 때는 섞습니다). 본문은 소문자로 바뀝니다.
라벨 설명을 주면 [P] entities [DESCRIPTION] 인물: 사람 이름만, 직함은 빼고 처럼 머리 뒤에 붙고, 분류 과제에 예시를 주면 [EXAMPLE] 배송이 늦어요 [OUTPUT] 불만처럼 붙습니다. 직접 만져 보면 감이 옵니다.
직렬화에서 눈여겨볼 세부가 두 가지 있습니다.
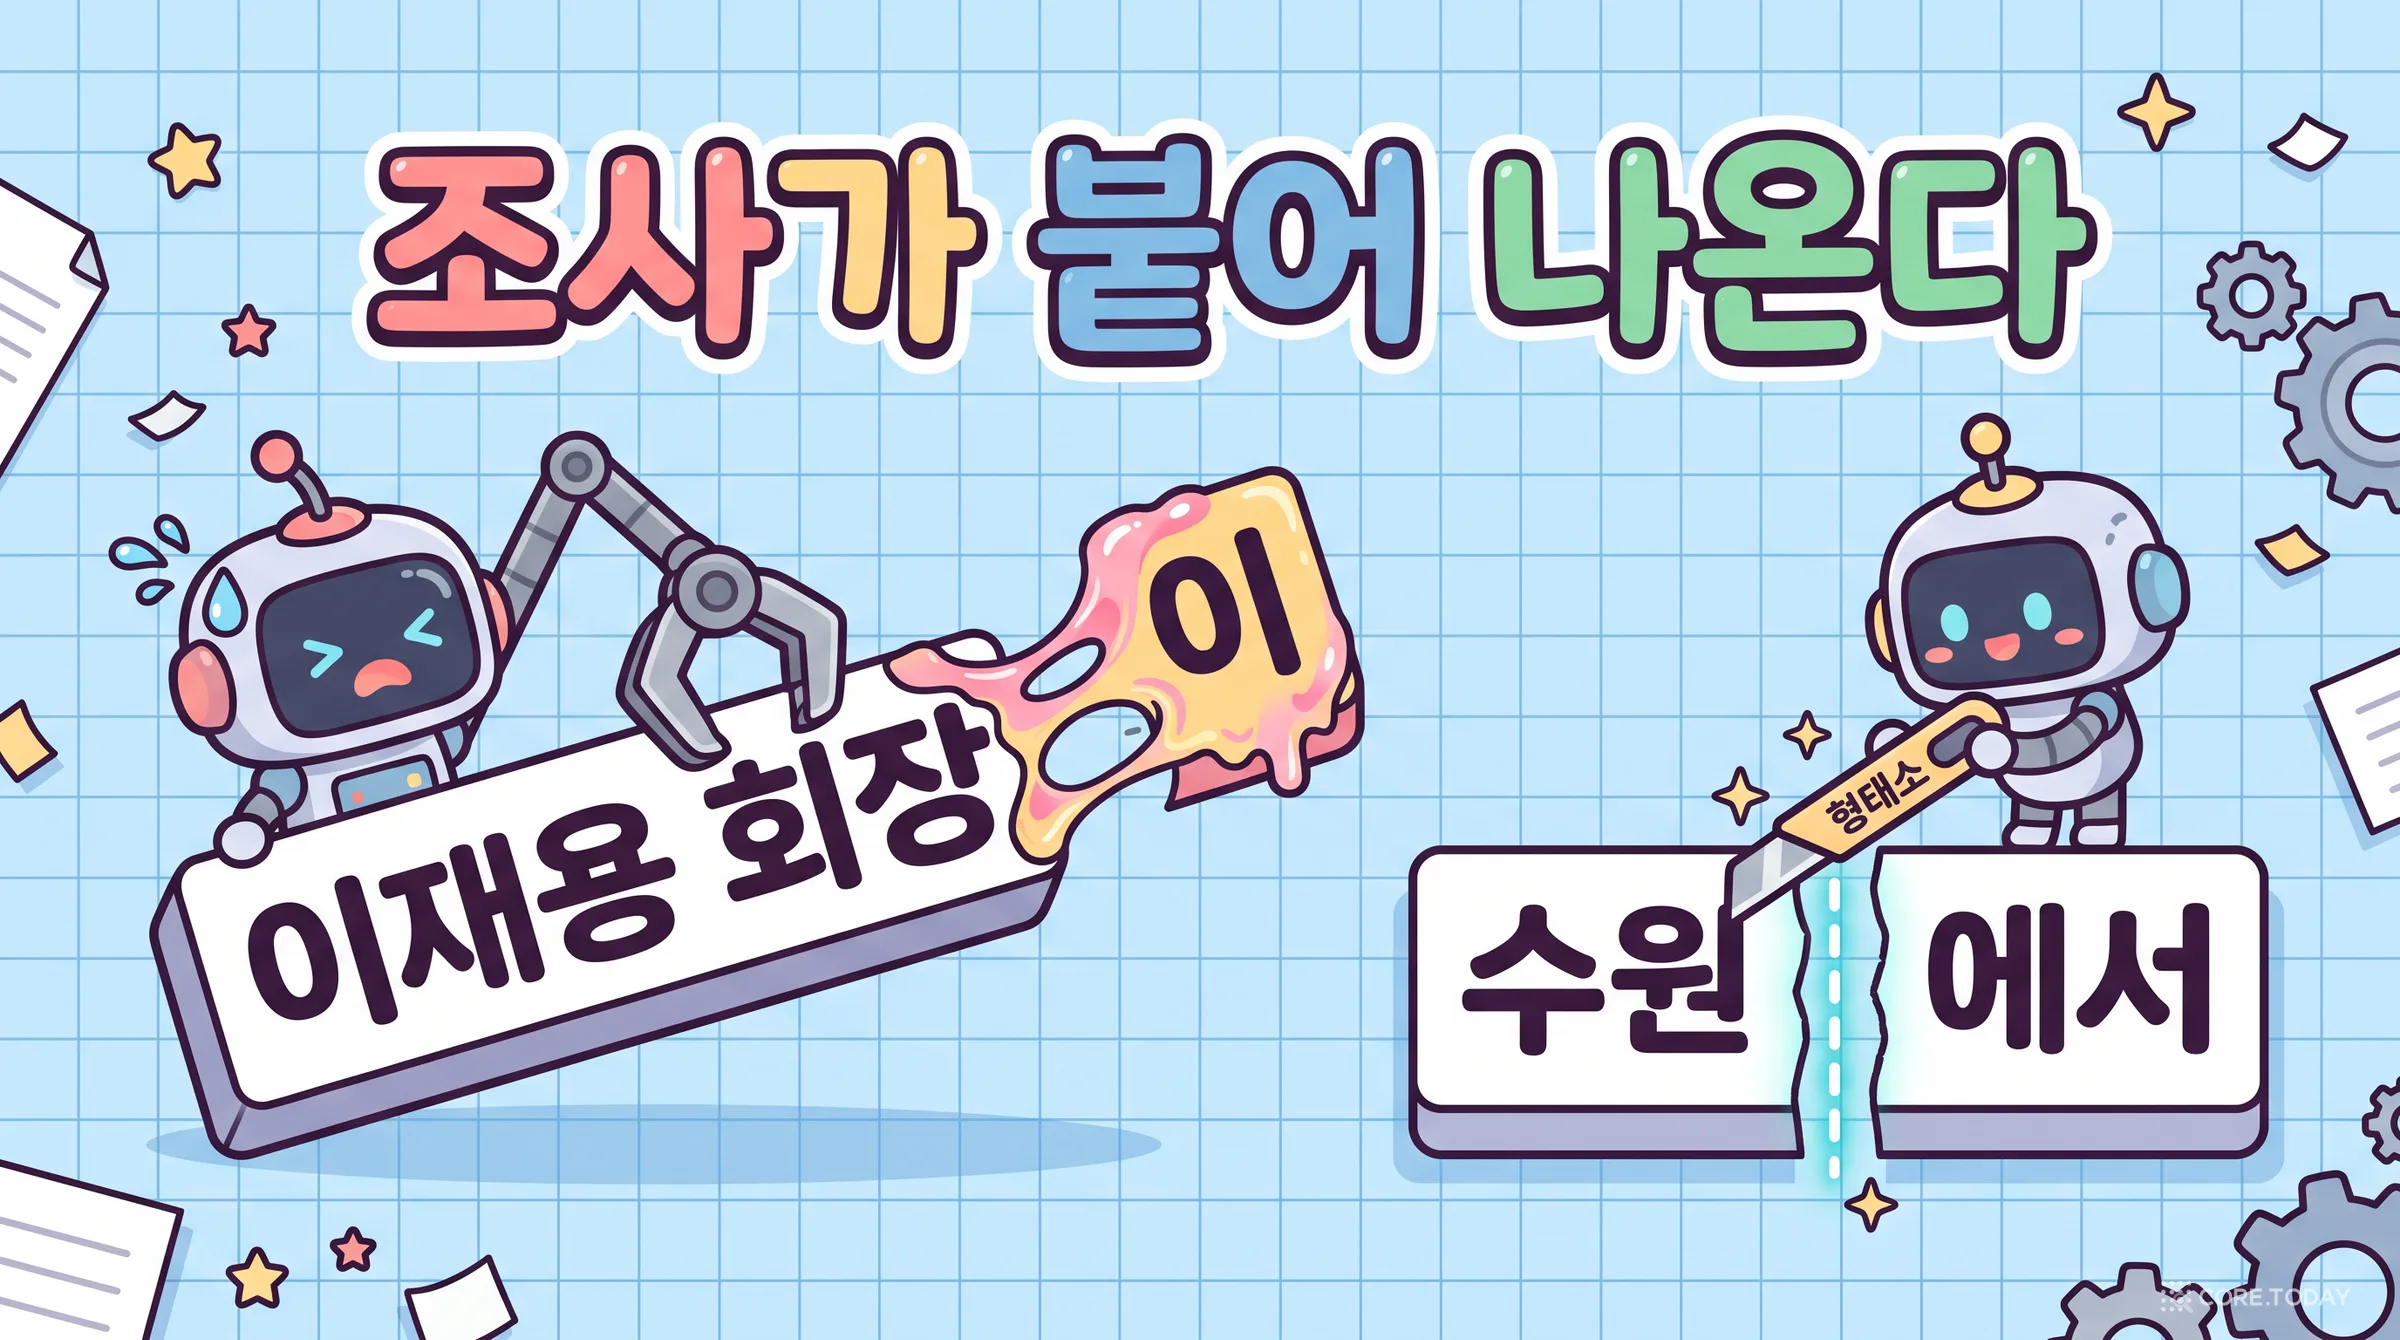
첫째, 본문은 먼저 '단어'로 나뉜 뒤에 서브워드로 쪼개집니다. 기본 단어 분할기(WhitespaceTokenSplitter)는 정규식으로 URL·이메일·\w+ 덩어리·기호를 자릅니다. 각 단어의 벡터로는 첫 번째 서브워드의 벡터만 씁니다(token_pooling="first"). 결과로 나오는 스팬의 단위가 이 '단어'라는 뜻입니다. 영어에서는 자연스럽지만, 한국어에서는 '회장이', '수원에서'처럼 조사가 붙은 어절이 한 단어가 됩니다. 7장의 실측은 이 한 줄에서 출발합니다.
둘째, 구조화 필드의 선택지는 본문 앞에 붙습니다. 예를 들어 재고 상태 필드에 [재고있음|예약|품절] 선택지를 주면 ( 제품정보: 재고 ( 재고있음 | 예약 | 품절 ) )라는 글이 본문 앞에 덧붙고, 모델은 그 안에서 단어 하나를 '추출'합니다. 분류 헤드를 따로 두지 않고 추출 문제로 바꿔 푸는 영리한 장치입니다.
4-2. 인코더: DeBERTa-v3
인코더는 Microsoft의 DeBERTa-v3입니다. 영어 base 모델은 deberta-v3-base, 다국어 모델은 mdeberta-v3-base(12층, 768차원, 어휘 25만 개)를 씁니다. 다국어 체크포인트가 3억 파라미터 가까이 되는 이유의 상당 부분은 25만 개 어휘의 임베딩 행렬(약 1억 9천만 개)입니다.
DeBERTa를 고른 이유는 분리된 어텐션(disentangled attention)과 상대 위치 인코딩입니다. 단어의 내용 벡터와 위치 벡터를 따로 두고 '내용-위치' 상호작용을 계산하므로, 절대 위치 임베딩 표의 길이 제한(512)에 덜 묶입니다. 라벨 목록이 길어져 입력이 늘어나도 버틸 여지가 있습니다. GLiNER 논문도 BERT·RoBERTa·ALBERT·ELECTRA와 비교한 뒤 "실험 성능이 좋아서" DeBERTa-v3를 기본으로 골랐다고 밝힙니다. Fastino는 NVIDIA GPU에서 DeBERTa의 어텐션을 빠르게 하는 FlashDeBERTa 커널도 따로 공개했습니다.
인코더가 한 줄을 읽고 나면 코드(extract_embeddings_from_batch)는 두 종류의 벡터만 꺼냅니다. 본문 단어마다 하나씩(첫 서브워드), 그리고 스키마의 표지 토큰 자리마다 하나씩입니다. 표지 자리를 고를 때 라벨 설명이나 예시 안에 우연히 특수 토큰처럼 보이는 문자열이 있어도 헷갈리지 않도록, 직렬화 단계에서 '진짜 표지가 놓인 위치'를 미리 기록해 둡니다.
4-3. 분류 헤드: [L] 하나에 점수 하나
분류는 가장 단순합니다. [L] 긍정, [L] 부정, [L] 중립 자리의 벡터를 각각 작은 MLP(768→1,536→1)에 넣어 점수 하나씩을 얻습니다. 단일 라벨이면 소프트맥스로 하나를 고르고, 다중 라벨이면 시그모이드로 임계값(기본 0.5)을 넘는 것을 모두 고릅니다. 분류에서는 [P] 벡터를 쓰지 않습니다.
이 방식의 장점은 라벨 수가 늘어도 계산이 거의 늘지 않는다는 것입니다. 기존의 제로샷 분류 방법(NLI 기반)은 "이 글은 스포츠에 관한 것이다", "이 글은 정치에 관한 것이다"…를 라벨마다 따로 모델에 돌렸습니다. GLiNER2 논문의 표 4에서 NLI 방식 DeBERTa는 라벨 5개에 1.7초, 50개에 16.9초가 걸렸고, GLiNER2는 130ms에서 208ms로 늘었을 뿐입니다. 같은 표에서 GPT-4o API 호출은 358~463ms였습니다.
4-4. 스팬 격자: 모든 조각을 채점한다
개체·관계·구조화는 모두 '원문의 어느 조각인가'를 묻습니다. GLiNER2는 GLiNER와 같은 스팬 격자를 씁니다.
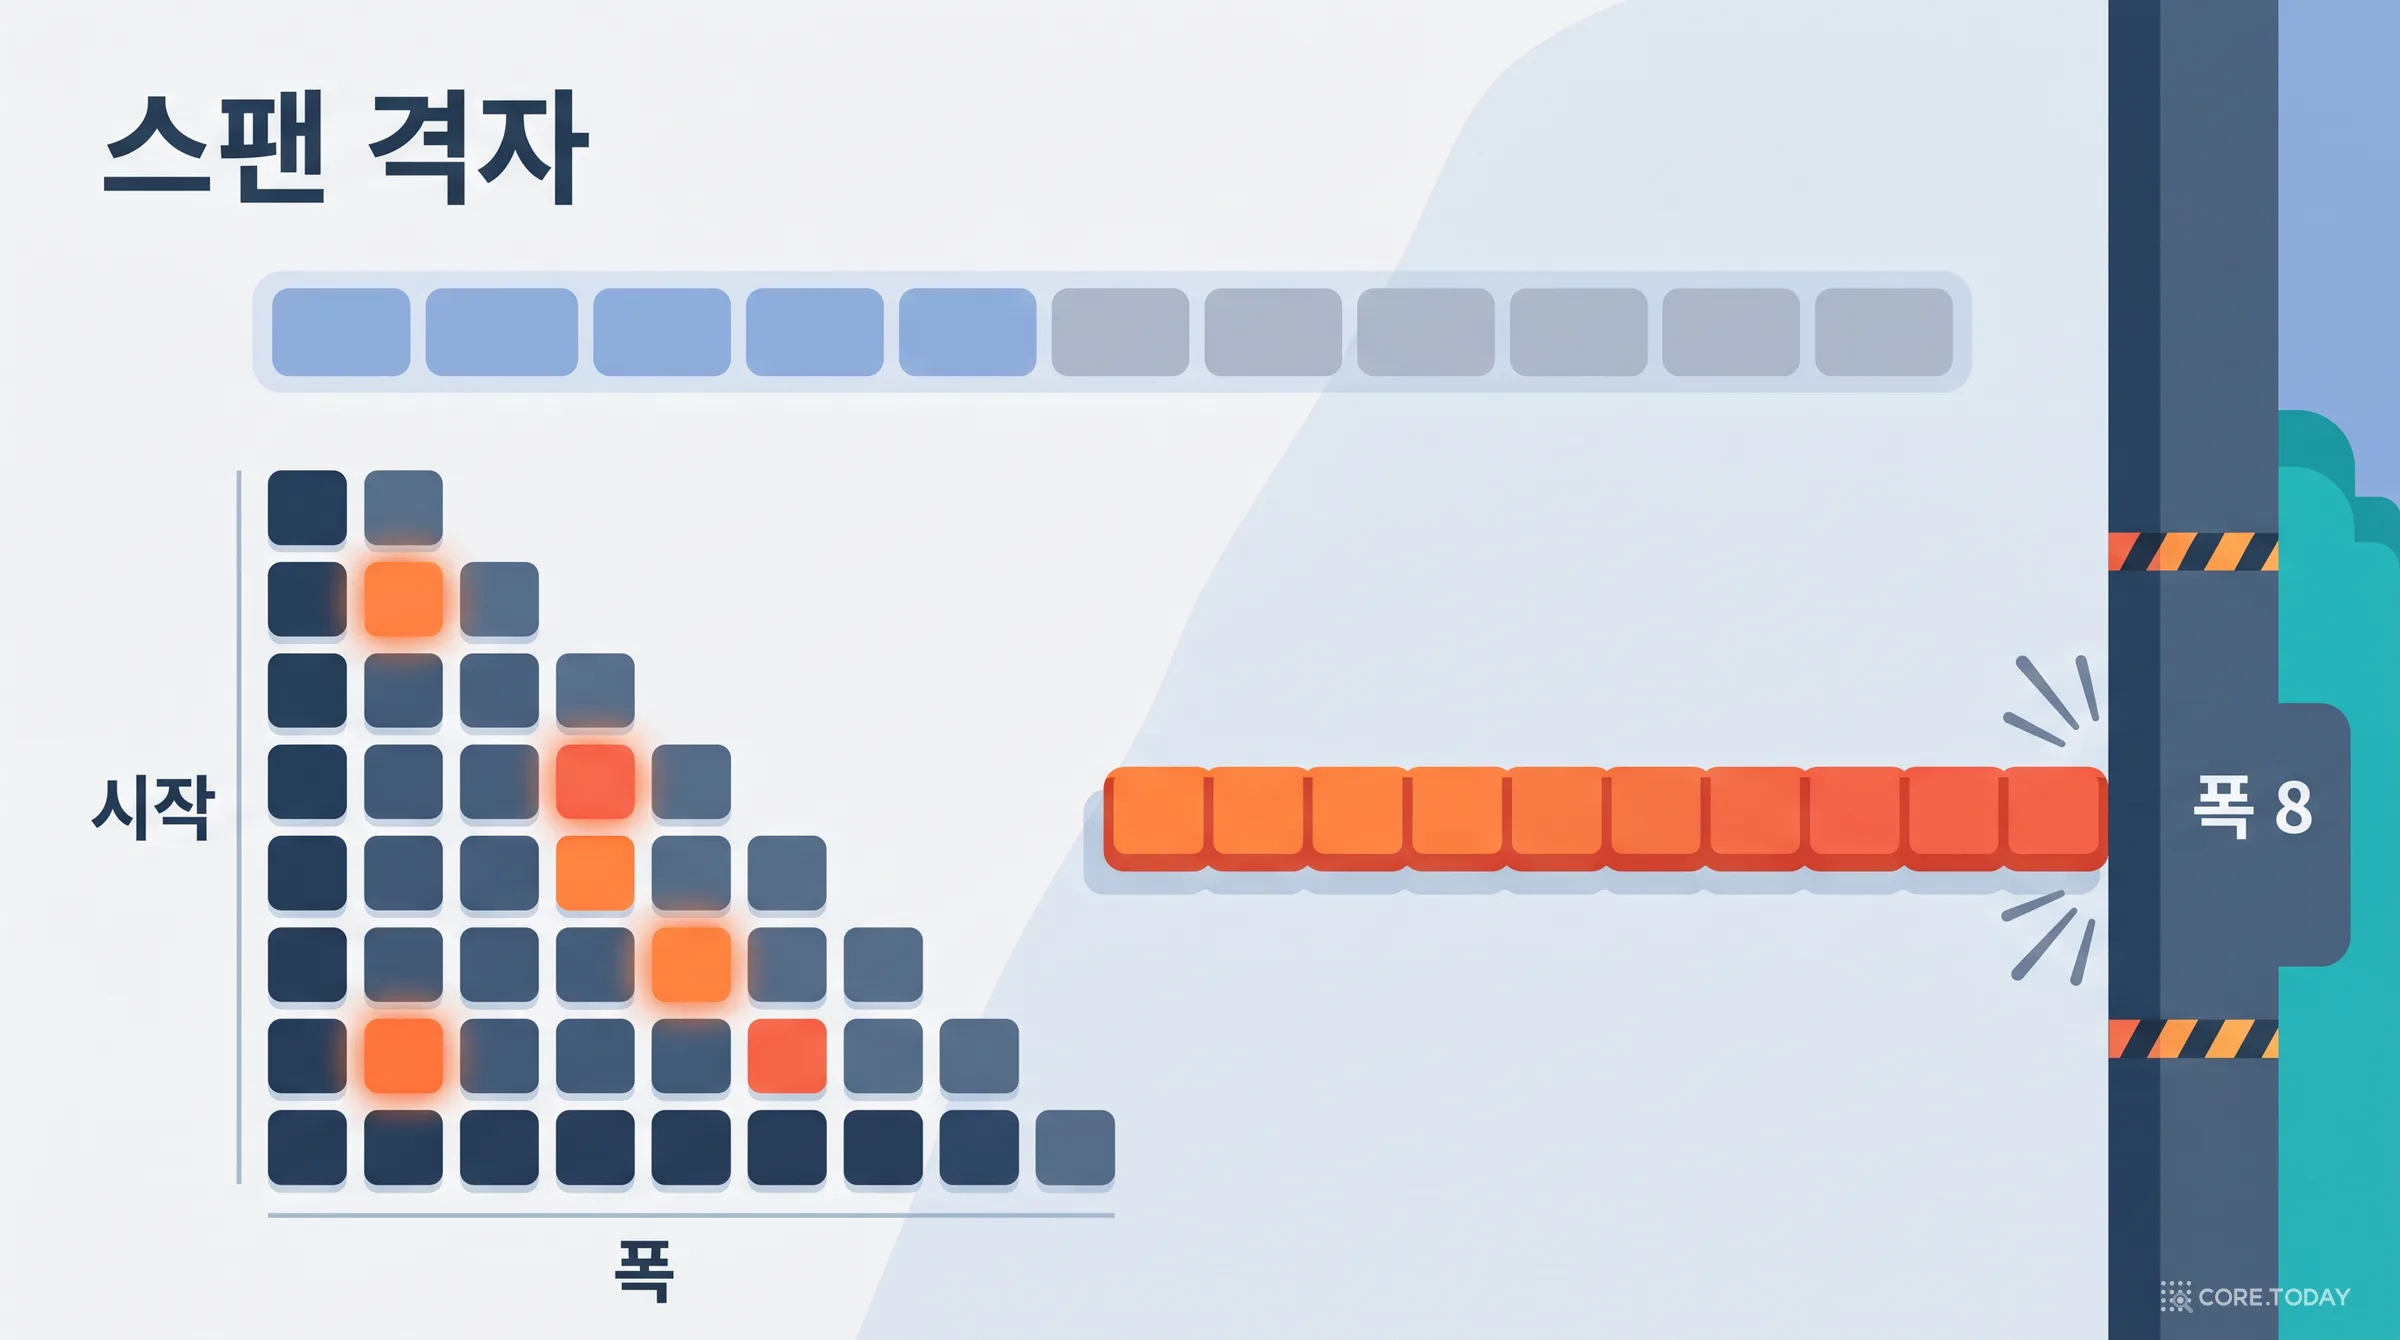
본문 단어가 L개라면, 시작 위치 i(0~L-1)와 폭 w(1~8)의 모든 조합이 후보입니다. 각 칸의 조각 벡터는 layers.py의 SpanMarkerV0이 만듭니다.
1시작 단어 벡터를 시작용 MLP(768→3,072→768)에, 끝 단어 벡터를 끝용 MLP에 넣는다. 같은 단어라도 '시작으로서의 모습'과 '끝으로서의 모습'이 따로 생긴다.
2두 벡터를 이어 붙이고(1,536차원) ReLU를 씌운 뒤 출력 MLP(1,536→3,072→768)로 조각 벡터 하나를 만든다.
3결과는 [단어 수 × 8 × 768] 크기의 격자. 끝이 문장 밖으로 나가는 칸은 무효 처리한다.
4라벨 질문 벡터와 내적 → 시그모이드 → 임계값(기본 0.5) 이상인 칸을 고르고, 겹침 정책에 따라 정리한다.
수식으로 쓰면 시작 위치 i, 폭 w인 조각의 라벨 ℓ 점수는 p=σ(si,w⊤qℓ)이고, si,w가 위의 조각 벡터, qℓ이 라벨 표지에서 나온 질문 벡터입니다.
공개 체크포인트의 최대 폭은 8단어입니다(GLiNER v1은 12). 아래 위젯의 색은 코어닷투데이가 gliner2-multi-v1 모델 내부에서 직접 꺼낸 실제 점수입니다.
한국어 문장에서 '인물'을 고르면 가장 높은 칸이 '이재용'(폭 1)이 아니라 '이재용 회장이'(폭 2)라는 것을 볼 수 있습니다. 공백 기준 단어 안에서는 '이재용 회장'에서 끝나는 칸이 아예 없기 때문입니다. 위젯 아래 표는 폭의 벽을 보여 줍니다. 12단어짜리 영문 법률명("Act on Promotion of Information and Communications Network Utilization and Information Protection")과 13단어 주소는 스팬 구조가 아예 후보로 올리지 못했습니다. 한국어 '정보통신망 이용촉진 및 정보보호 등에 관한 법률'은 공백 기준 7어절이라 찾았지만, 형태소로 쪼개 토큰이 8개를 넘자 사라졌습니다. 법률명, 주소, 논문 제목, 긴 제품명, 계약 조항처럼 긴 조각이 필요한 업무에서 이 벽은 실제 문제입니다. GLiNER2.5가 구조를 바꾼 첫 번째 이유가 이것입니다.
계산을 아끼는 대수 한 줄. 격자를 그대로 만들면 [단어 수 × 8 × 3,072] 크기의 중간 텐서가 생깁니다. 저장소의 score_queries는 출력 MLP의 첫 선형층 가중치를 시작 몫과 끝 몫으로 쪼개 단어마다 한 번씩만 계산하고, 마지막 선형층은 질문 벡터 쪽으로 미리 접어 넣습니다(q⊤(W2d+b2)=(q⊤W2)d+q⊤b2). 결과는 원래 방식과 수학적으로 같고, 조각 벡터를 통째로 만들지 않습니다. 2026년 10월 외부 기여자의 풀 리퀘스트로 병합된 최적화입니다.
4-5. 개수 헤드와 CountLSTM: "몇 개인가"를 먼저 묻는다
개체명은 '인물이 몇 명이든 다 뽑아라'면 되지만, 구조화 추출은 다릅니다. "아이폰 17 프로는 155만 원, 맥북 에어는 159만 원"에서 제품정보 레코드 두 개를 만들려면 '이름-가격' 짝을 맞춰야 합니다. 이름 질문 하나, 가격 질문 하나로는 어느 가격이 어느 이름의 것인지 알 수 없습니다.
GLiNER2의 해법은 개수를 먼저 세는 것입니다.
개수 헤드. 과제 머리 [P] 제품정보의 벡터를 MLP(768→1,536→20)에 넣어 0~19 중 하나를 고릅니다. 레코드 개수를 맞히는 20지선다 분류입니다.
CountLSTM. 필드 표지 [C] 이름, [C] 가격의 벡터를 GRU의 초기 상태로 두고, '1번째', '2번째'… 위치 임베딩을 입력으로 개수만큼 펼칩니다. 각 단계의 출력을 원래 필드 벡터와 이어 붙여 MLP로 투영하면, 레코드 k마다 서로 조금씩 다른 '이름 질문'과 '가격 질문'이 생깁니다. 결과 크기는 [개수 × 필드 수 × 768]입니다.
채점. 레코드 1의 이름 질문, 레코드 1의 가격 질문, 레코드 2의 이름 질문… 각각으로 같은 스팬 격자를 채점합니다. 같은 k로 묶인 것이 한 레코드입니다.
관계 추출도 같은 방식입니다. 'works_for'의 개수가 3이면 head·tail 질문이 세 쌍 생기고, 각 쌍이 관계 하나가 됩니다. 개체명은 예외로, 개수 1의 첫 인스턴스만 씁니다(코드 주석: "Entity decoding consumes only structural instance 0").
이 설계는 단순하고 한 번의 계산으로 끝난다는 장점이 있지만 약점도 분명합니다. 개수를 틀리면 복구할 길이 없습니다. 2를 1로 세면 레코드 하나가 통째로 사라지고, 3으로 세면 빈 레코드가 생깁니다. 한 글에 같은 구조가 20개를 넘으면 잘립니다. 다음 위젯에서 두 세대의 방식을 비교해 볼 수 있습니다.
4-6. 학습: 라벨의 '뜻'을 보게 만드는 장치들
모델이 라벨의 위치나 이름 철자가 아니라 뜻을 보게 만드는 것이 제로샷의 핵심입니다. processor.py의 학습 경로에는 이를 위한 장치가 촘촘합니다.
가짜 라벨 이름. 일정 확률로 라벨 이름을 'entity 1', 'entity 2', 'label 3', 'field 2' 같은 의미 없는 이름으로 바꾸고, 대신 라벨 설명만 남깁니다. 모델은 이름이 아니라 설명을 읽어야 맞힐 수 있습니다.
섞기와 빼기. 과제 순서, 라벨 순서, 구조체 필드 순서를 섞습니다. 일부 라벨과 필드를 무작위로 빼서 '없는 라벨을 찾지 않는 법'을 배우게 합니다. 분류에서는 정답 라벨을 일부러 후보에서 뺐다가 다시 넣기도 합니다. (2026년 10월에는 이 과정에서 가짜 이름으로 바꾼 정답이 원래 이름으로 다시 들어가 오히려 오답으로 학습되던 버그가 고쳐졌습니다.)
설명·예시 모드 무작위. 같은 예제를 '설명 없음', '설명만', '예시만', '둘 다' 중 하나로 보여 줍니다. 추론 때 사용자가 무엇을 주든 대응하도록 하기 위해서입니다.
관계 방향 뒤집기. 일정 확률로 head와 tail의 순서를 바꿔 방향성을 배우게 합니다.
음성 조각 절반 가리기. 격자의 칸 대부분은 정답이 아닙니다. 손실을 계산할 때 오답 칸의 50%를 무작위로 빼서, 오답이 너무 많아 '전부 아니다'로 쏠리는 것을 막습니다.
손실은 세 가지의 합입니다. 분류는 이진 교차 엔트로피, 스팬은 칸마다 이진 교차 엔트로피, 개수는 20지선다 교차 엔트로피입니다. 논문 부록에 따르면 AdamW로 5에포크, 인코더 학습률 1e-5, 헤드 2e-5였습니다.
5장. GLiNER2.5 아키텍처 해부 — 칸 대신 틈을 본다
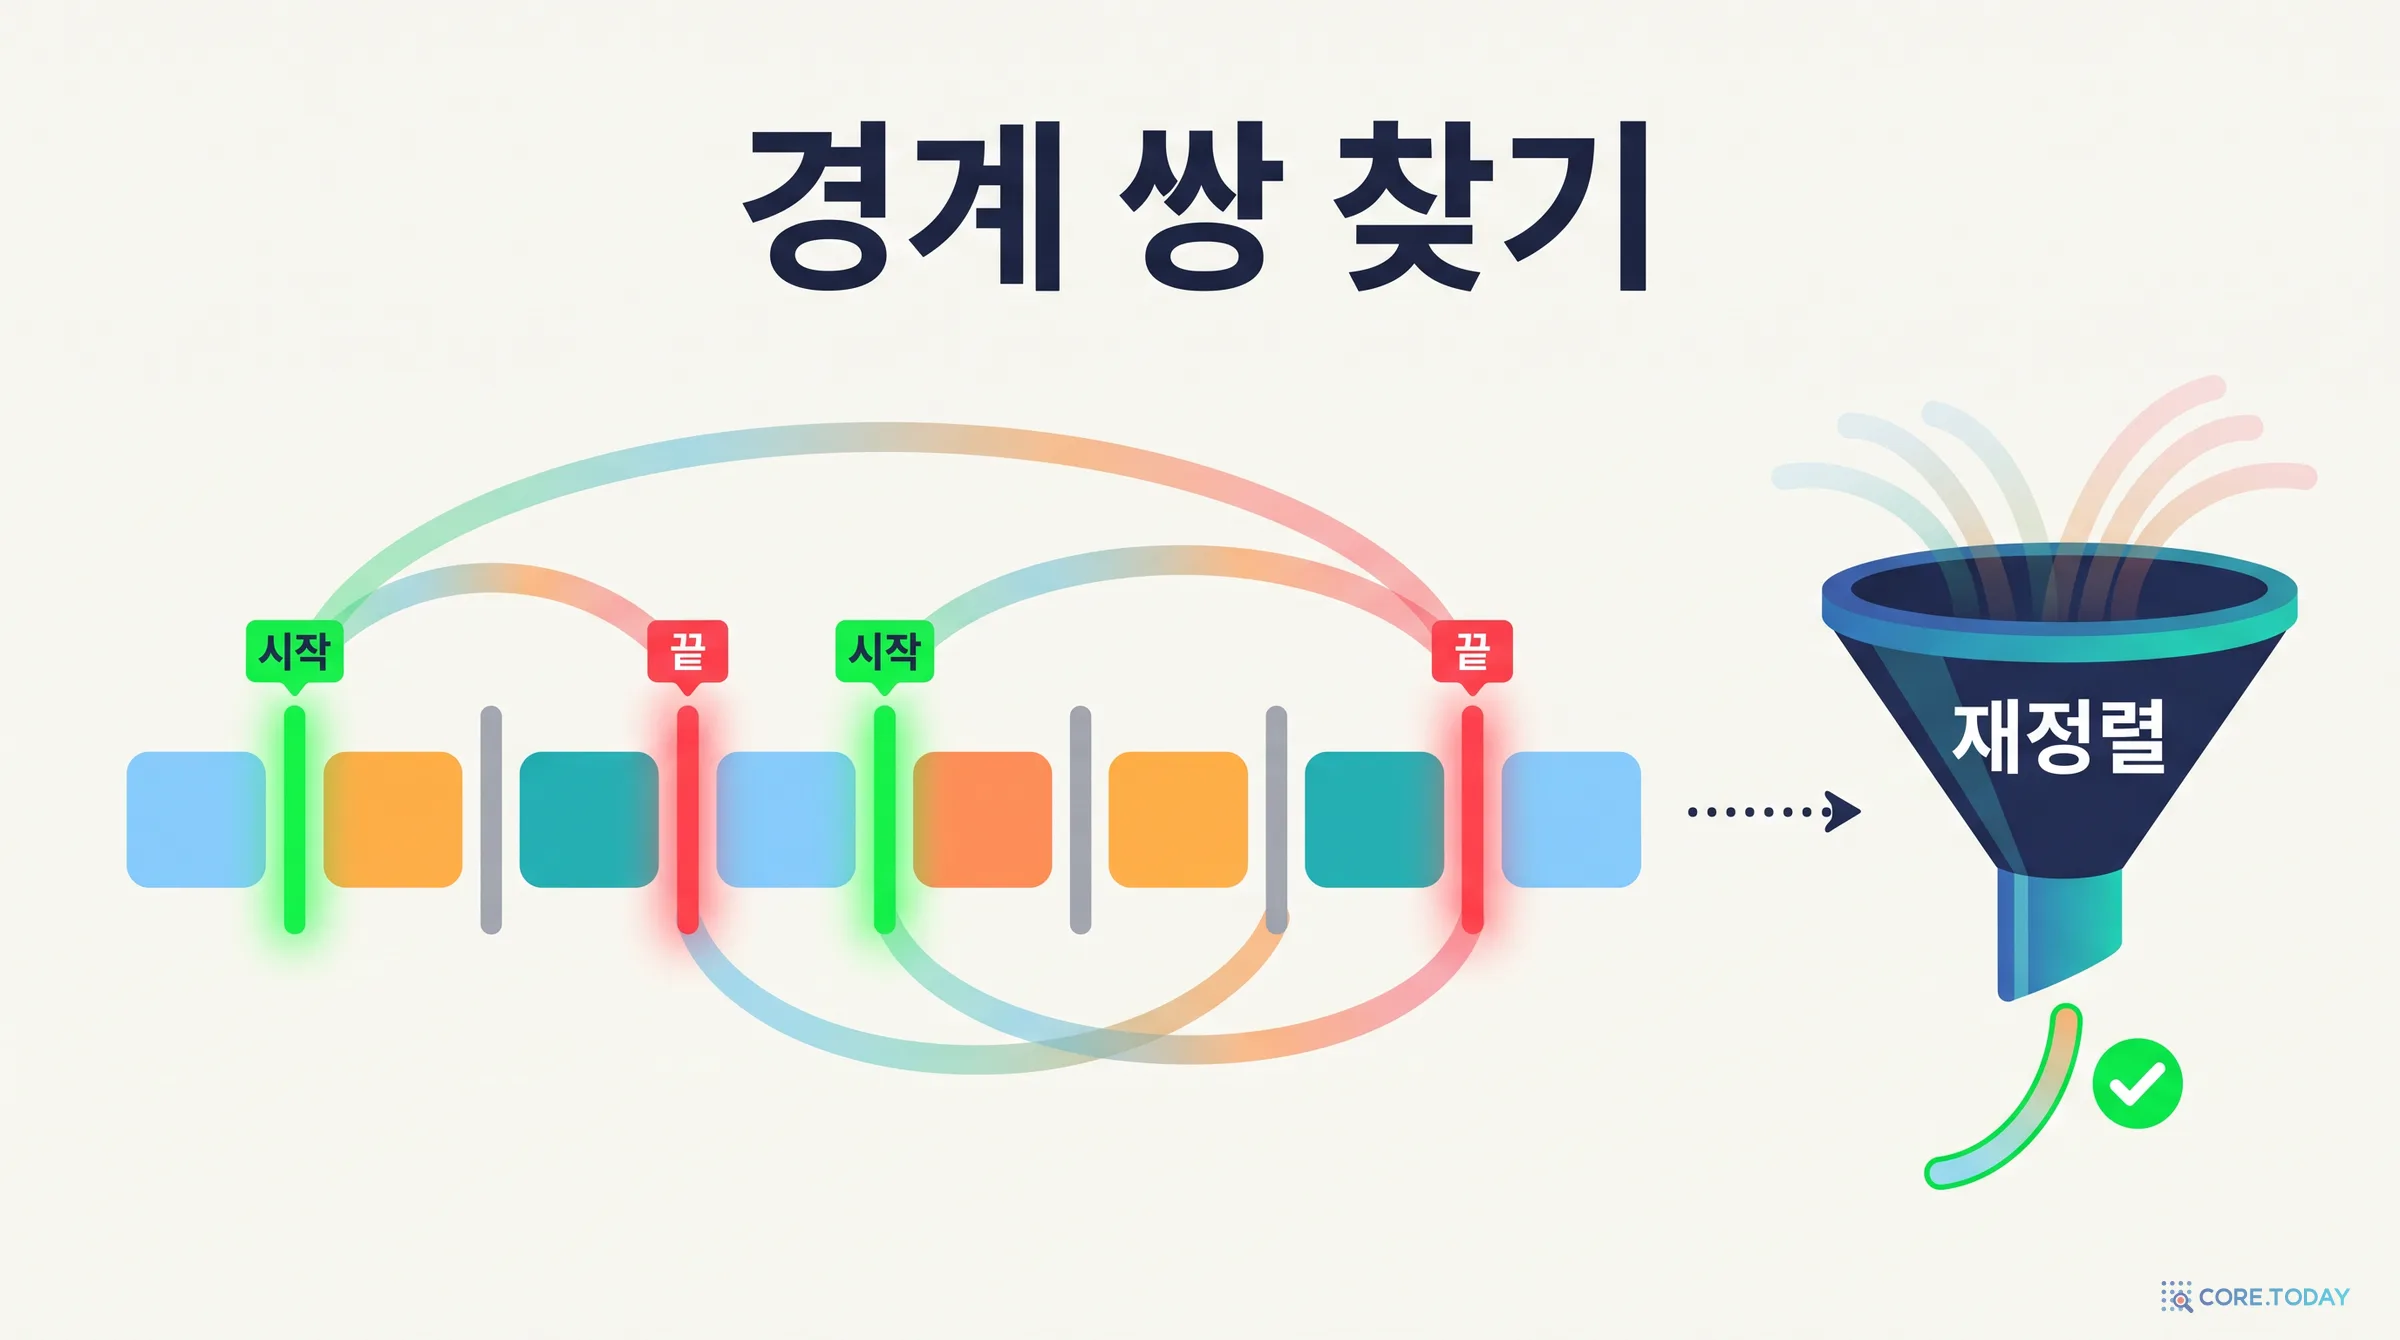
GLiNER2.5의 출발점은 4장에서 본 두 약점입니다. 폭 8을 넘는 조각은 못 본다는 것, 그리고 개수를 먼저 세야 한다는 것입니다. Fastino의 공개 블로그(2026-08-24)는 새 구조를 이렇게 요약합니다. "쿼리마다 시작·끝·내부 점수를 낸다. 희소 제안 단계가 가장 유망한 시작과 끝 경계를 골라 짝짓고, 재정렬 헤드가 제안된 후보를 채점한다." 저장소에서는 boundary 구조라고 부르고, gliner2/models/boundary/ 아래 약 6천 줄이 이 구조입니다.
입력 직렬화와 인코더는 4장과 같습니다. 같은 [P] ( [E] … ) 한 줄을 DeBERTa-v3가 읽고, 분류도 같은 [L] 헤드로 합니다. 달라지는 것은 그 위, 조각을 찾는 방식입니다.
②경계 점수 — 라벨(쿼리)마다 각 틈이 '시작'일 점수, '끝'일 점수, 각 단어가 '안쪽'일 점수를 낸다.
③후보 풀 — 점수 높은 시작 틈 32개 × 끝 틈 32개를 짝지어, 문서당 최대 192개의 후보 조각을 남긴다.
④재정렬 — 후보마다 끝점·길이·내용·안쪽 점수를 모아 라벨별 최종 점수를 매긴다.
⑤기권·디코딩 — 기권 헤드가 '이 라벨은 없다'고 하면 비우고, 아니면 임계값과 겹침 정책으로 고른다.
5-1. 경계 인코더: 단어가 아니라 틈에 벡터를
단어가 n개면 틈은 n+1개입니다. 0번 틈은 첫 단어 앞, n번 틈은 마지막 단어 뒤입니다. encoding.py의 BoundaryEncoder는 틈 i의 왼쪽 이웃(단어 i−1)과 오른쪽 이웃(단어 i)의 벡터를 각각 128차원으로 줄인 뒤 이어 붙여 다시 128차원으로 투영합니다. 0번 틈의 왼쪽과 n번 틈의 오른쪽에는 이웃이 없으므로 학습되는 BOS·EOS 벡터를 씁니다.
왜 단어가 아니라 틈일까요? '시작'과 '끝'은 본래 단어와 단어 사이에서 일어나는 사건이기 때문입니다. "삼성전자 | 이재용 회장이"에서 인물 조각은 1번 틈에서 시작합니다. 틈의 상태는 '왼쪽은 회사 이름이 끝났고 오른쪽은 사람 이름이 시작된다'는 정보를 한 벡터에 담습니다. 공개 체크포인트에서는 이 위에 128개 틈 범위의 국소 어텐션 2층과 SwiGLU 정제층 1층을 더 쌓고, 끝점에는 회전 위치 임베딩(RoPE)을 입혀 '얼마나 떨어져 있는가'를 표현합니다.
5-2. 경계 점수: 시작·끝·안쪽
heads.py의 BoundaryQueryHead는 라벨 질문 벡터(표지 자리의 벡터)와 틈 벡터의 내적으로 세 가지 점수를 냅니다.
시작 점수 [라벨 수 × (n+1)]: 이 틈에서 이 라벨의 조각이 시작될 가능성
끝 점수 [라벨 수 × (n+1)]: 이 틈에서 끝날 가능성
안쪽 점수 [라벨 수 × n]: 이 단어가 이 라벨 조각의 내부일 가능성
안쪽 점수는 누적합(prefix sum)으로 저장합니다. 그러면 어떤 조각 [i, j)의 안쪽 점수 합이든 prefix[j] − prefix[i] 뺄셈 한 번으로 구해집니다. 긴 조각이라도 계산량이 늘지 않습니다. 코드 주석이 강조하듯 이 구조 어디에도 [n × n] 크기의 텐서가 없습니다.
5-3. 후보 풀: 문서마다 192개만
모든 (시작, 끝) 쌍은 n(n+1)/2개입니다. 400단어면 8만 개가 넘습니다. 전부 채점하는 대신 pool.py의 DocumentCandidatePool이 후보를 추립니다.
라벨별 시작 점수의 최댓값을 틈마다 구해(어느 라벨이든 시작일 법한 틈) 상위 32개를 고르고, 끝 점수도 같은 방식으로 32개를 고릅니다.
시작 32개 × 끝 32개 = 최대 1,024쌍 가운데 끝이 시작보다 뒤인 것만 남겨, 두 끝점 벡터의 궁합(내적)과 시작·끝 점수의 합으로 순위를 매깁니다.
라벨마다 자기 점수로 상위 8개 자리를 먼저 예약합니다. 드문 라벨이 흔한 라벨에 밀려 후보를 하나도 못 받는 일을 막기 위해서입니다.
남은 자리를 전체 순위로 채워 중복을 없애고, 최대 192개를 남깁니다.
이 풀은 라벨마다 따로 만들지 않고 문서 하나에 한 번 만듭니다(설정값 candidate_pool="shared"). 개체·관계·레코드가 모두 같은 풀의 후보를 씁니다. 짧은 문장에서는 가능한 조각 전부가 풀에 들어갑니다. 9단어 문장이면 45개, 15토큰이면 120개입니다. 192라는 상한이 의미를 갖는 것은 문서가 길어질 때입니다.
여기에는 대가가 있습니다. 처음 고른 32개 틈 안에 정답 경계가 없으면 그 조각은 영영 후보가 되지 못합니다. 그래서 학습 때는 정답 조각을 일정 확률로 풀에 강제로 끼워 넣고(gold injection), 정답 근처의 헷갈리는 오답을 정답 하나당 20개씩 골라(hard negatives) 재정렬 헤드를 단련합니다.
5-4. 재정렬: 후보 하나에 점수 하나
SharedPoolScorer는 후보 조각마다 벡터 하나를 만듭니다. 재료는 다섯 가지입니다.
재료
내용
왜 필요한가
시작 끝점
시작 틈 벡터의 투영
조각이 어디서 열리는가
끝 끝점
끝 틈 벡터의 투영
조각이 어디서 닫히는가
길이 특징
log(1+길이), 길이/문서 길이, 1/√길이
폭 임베딩 표 없이 길이를 표현 — 최대 길이가 없다
사전 점수
후보 풀에서 매긴 끝점 궁합
제안 단계의 판단을 이어받음
조각 내용
조각 안 단어 벡터의 평균과 log-sum-exp 풀링
끝점만으로는 모르는 '가운데'의 정보
길이 특징이 핵심입니다. 스팬 구조는 폭마다 다른 칸을 썼으므로 9번째 칸은 존재하지 않았습니다. 경계 구조는 길이를 '숫자 세 개'로 넣으므로 12단어든 120단어든 같은 식으로 표현됩니다.
라벨 ℓ에 대한 후보 c의 최종 점수는 다음의 합입니다. 후보 벡터와 라벨 벡터의 내적, 라벨 벡터로 후보 벡터를 조절(FiLM: γ배 하고 β를 더함)한 뒤 작은 MLP에 통과시킨 값, 그 라벨의 시작 점수(시작 틈)와 끝 점수(끝 틈), 그리고 조각 안쪽 점수의 평균을 √길이로 나눈 값입니다. 앞 단계의 판단(경계 점수)을 버리지 않고 더하면서, 조각 전체를 보는 새 판단을 얹는 구조입니다.
5-5. 기권 헤드와 개수 헤드
GLiNER2.5에는 라벨 질문 벡터 하나로 계산하는 작은 선형 헤드가 두 개 더 있습니다.
기권(abstention) 헤드: "이 글에는 이 라벨이 아예 없다"의 확률. 개체 라벨에서 이 값이 0.5를 넘으면 후보 점수와 상관없이 그 라벨을 통째로 비웁니다. 라벨 목록에 '질병'을 넣었는데 글에 질병 얘기가 전혀 없을 때 억지로 무언가를 집어 오는 것을 막는 장치입니다.
개수 헤드: 조각 개수의 로그 기대값. 스팬 구조의 20지선다와 달리 연속값이고, 기본 설정에서는 학습 신호로만 쓰입니다(적응형 임계값 옵션을 켜면 디코딩에도 씁니다).
아래 위젯은 같은 문장을 gliner2.5-multi-v1에 넣고 내부 점수를 꺼낸 것입니다. 단어 사이 기둥의 초록 막대가 시작 점수, 빨강 막대가 끝 점수입니다.
'날짜' 라벨을 눌러 보십시오. 재정렬 후 1위 후보는 '어제'(0.25)였지만, 기권 확률이 0.92여서 날짜 라벨은 통째로 비었습니다. 같은 문장에서 스팬 구조 모델은 '어제'를 날짜로 0.99점에 냈습니다. KLUE 기준으로는 '어제'도 날짜(DT)이므로 이 경우 기권은 손해였습니다. 기권 헤드는 '억지로 뽑지 않기'와 '놓치지 않기' 사이의 줄다리기를 모델 안으로 들여온 것이고, 그 판단은 늘 맞지는 않습니다.
단어 나누기를 '형태소'로 바꾸면 '수원'과 '에서' 사이에 틈이 생기고, 장소의 끝 점수가 그 틈에 몰립니다. 경계 구조는 공백 기준에서도 '수원에서'를 뽑지만, 형태소 기준에서는 '수원'만 정확히 뽑습니다. 학습은 공백 기준으로 했는데도 끝 점수가 조사 앞 틈을 고른다는 것은 모델이 '어디까지가 이름인가'를 어느 정도 알고 있다는 뜻입니다.
5-6. 레코드와 관계: 같은 풀에서
레코드 헤드(records.py)는 개수를 예측하지 않습니다. 세 가지 모드가 있습니다. 기준 필드를 지정하는 '자연(natural)' 모드는 그 필드(예: 제품 이름)의 후보 하나하나를 레코드의 닻으로 삼고, 나머지 필드 후보를 각 닻에 배정합니다. 어느 레코드에도 속하지 않으면 '없음(ABSENT)'을 고를 수 있습니다. 기준 필드가 없으면 학습된 선택기가 닻을 고르는 '잠재(latent)' 모드, 학습된 인스턴스 질문 32개가 후보 풀을 훑어 '객체 있음/없음'과 필드별 포인터를 내는 '닻 없음(anchorless)' 모드가 있습니다. 마지막 방식은 물체 검출 모델 DETR의 발상과 닮았습니다. 학습 때는 예측 레코드와 정답 레코드를 헝가리안 알고리즘으로 짝지은 뒤 손실을 계산합니다. 레코드 수는 결과로 나옵니다.
관계 헤드(relations.py)도 같은 후보 풀을 씁니다. 관계 유형마다 head 역할에 어울리는 후보 상위 32개와 tail 후보 상위 32개만 골라 짝짓고, 그중 최대 64쌍만 채점합니다. 모든 개체 쌍(N²)을 보지 않으므로 긴 문서에서도 계산이 일정합니다.
5-7. 그래서 GLiNER2.5가 더 좋은가?
구조는 분명 더 정교합니다. 하지만 숫자는 단순하지 않습니다. Fastino가 블로그 부록에 공개한 16개 데이터셋 매크로 F1을 보겠습니다.
구분
2.5 multi
2.5 base
GLiNER2 multi
GLiNER2 base
전체 평균
56.17
54.87
56.09
53.34
분류 평균
72.44
69.86
70.32
68.89
추출 평균
46.40
45.88
47.56
44.01
XNLI (분류)
62.30
—
37.55
—
CrossNER (추출)
54.85
58.30
57.84
59.06
출처: Fastino 블로그 "Introducing GLiNER2.5" (2026-08-24) 부록. Fastino 자체 측정.
다국어 모델의 추출 평균은 오히려 47.56에서 46.40으로 내려갔습니다. 전체 평균이 0.08점 오른 것은 분류 덕분이고, 그 대부분은 XNLI 한 데이터셋(37.55→62.30)에서 나왔습니다. 개체명 표준 시험인 CrossNER에서는 두 GLiNER2.5 모두 구형 GLiNER2 base(59.06)보다 낮습니다. 새 구조가 주는 것은 평균 점수보다 할 수 있는 일의 범위입니다. 길이 제한 없는 조각, 4,096단어까지의 학습, 개수를 세지 않는 레코드, 같은 풀을 쓰는 관계, 기권. 코어닷투데이의 한국어 실측(7장)에서도 같은 그림이 나왔습니다.
extract_json에는 필드를 "이름::자료형::설명"이라는 짧은 문법으로 쓸 수 있습니다. "price::str::통화를 포함한 가격", "tier::[basic|premium|enterprise]::str"처럼요. include_spans=True를 주면 원문 글자 위치가 함께 오고, text[start:end] == 결과가 늘 성립합니다.
거르기와 다듬기
정규식 검사기.RegexValidator(r"^[\w\.-]+@[\w\.-]+\.\w+$")를 필드에 붙이면 모델이 뽑은 후보 중 형식에 맞는 것만 남깁니다. 이메일·전화·계좌번호처럼 모양이 정해진 개인정보에서 오탐을 크게 줄입니다.
필드별 임계값. 주민번호는 0.95, 이메일은 0.8처럼 필드마다 다른 확신도 문턱을 줄 수 있습니다.
겹침 정책.allow(전부), nested(포함은 허용, 엇갈림은 금지), flat(겹치지 않게), longest(포함된 짧은 것 제거) 중 고릅니다.
긴 문서
extract_entities_long은 문서를 384단어 창, 64단어 겹침으로 나눠 읽고, 위치를 원문 기준으로 되돌린 뒤 겹친 구간의 중복을 합칩니다. 창 경계에 걸친 개체가 걱정되면 겹침을 늘리면 됩니다.
제약 디코딩: 규칙을 지키는 결과
GLiNER2.5와 함께 두 가지 '전역 디코더'가 들어왔습니다. classify_text와 extract는 과제마다 독립적으로 답을 고르는데, 현실의 라벨들은 서로 얽혀 있습니다.
python
from gliner2.classification import Classifier, ClassificationSchema
from gliner2.classification import constraints as C

schema = (ClassificationSchema()
    .single("intent", ["read", "write", "delete"])
    .multi("effects", ["read_only", "create", "modify", "delete"], min_labels=1)
    .constrain(C.implies(("intent", "delete"), ("effects", "delete"))))
'의도가 삭제면 효과에도 삭제가 있어야 한다' 같은 규칙을 걸면, Classifier가 점수를 구한 뒤 규칙을 모두 만족하는 조합을 정확 탐색(작을 때)이나 빔 탐색(클 때)으로 찾습니다. 에이전트가 도구를 부르기 전에 요청을 분류하는 자리에서 쓸 만합니다.
JointIE는 개체와 관계를 함께 고릅니다. 'works_for의 head는 person, tail은 organization이어야 한다', '한 사람은 고용주가 하나다(unique_head)', '자기 자신과의 관계 금지' 같은 제약을 걸면, 후보 개체·관계 점수 위에서 빔 탐색으로 일관된 그래프를 찾습니다. 독립적으로 뽑으면 "개체 목록에는 없는 회사가 관계의 tail로 나오는" 일이 생길 수 있는데, 그것을 막습니다.
미세조정과 어댑터
[train] 설치로 JSONL 데이터를 만들어 학습할 수 있고, LoRA 어댑터로 작은 파일만 학습해 실행 중에 바꿔 끼울 수도 있습니다(load_adapter, unload_adapter). 고객사마다 다른 라벨 체계를 어댑터 하나씩으로 관리하는 식입니다. Fastino는 이 과정을 대신해 주는 유료 서비스를 운영합니다. README는 agent.fastino.ai로 안내하고, 배너에는 Pioneer라는 이름과 api.pioneer.ai 호출 예시가 보입니다. 저장소 README의 배너가 그 광고입니다.
오픈 가중치로 생태계를 만들고, 미세조정·배포를 유료로 파는 구조입니다. Fastino는 2024년 11월 Insight Partners와 Microsoft의 M12가 이끈 700만 달러 프리시드, 2025년 5월 Khosla Ventures가 이끈 1,750만 달러 시드를 받았습니다. 당시 TechCrunch 보도에 따르면 모델을 합계 10만 달러가 안 되는 게이밍 GPU로 학습한다는 것이 회사의 자랑이었습니다.
7장. 코어닷투데이 실측 — 한국어에서는 조사가 점수를 가른다
공식 모델 카드에서 gliner2-multi-v1의 언어 목록은 프랑스어·영어·스페인어·독일어·이탈리아어·포르투갈어 여섯 개입니다. 한국어는 없습니다. GLiNER2·GLiNER2.5의 한국어 평가는 논문에도 블로그에도 없고, Hugging Face에 한국어 체크포인트도 없습니다. 그렇다면 직접 재 보는 수밖에 없습니다.
실험 설계
데이터. KLUE 개체명(KLUE-NER) 검증셋 5,000문장 가운데 15~200자 문장을 무작위로 섞어(시드 7) 300문장을 골랐습니다. 정답 개체는 863개, 유형은 인물(PS)·장소(LC)·기관(OG)·날짜(DT)·시간(TI)·수량(QT) 여섯 가지입니다. 두 모델 모두 이 데이터로 학습한 적이 없으므로 제로샷입니다.
모델. 다국어 체크포인트 두 개. fastino/gliner2-multi-v1(스팬 구조)과 fastino/gliner2.5-multi-v1(경계 구조).
변수. 단어 나누기 세 가지(공백 기본값, 음절 char, Kiwi 형태소), 라벨 이름 두 가지(영어 person… / 한국어 인물…), 라벨 설명 유무, 임계값 0.3·0.5·0.7, 그리고 공백 결과의 끝 조사를 Kiwi로 잘라 내는 후처리.
채점. 엄격 F1은 (시작, 끝, 유형)이 글자 단위로 정답과 같아야 맞습니다. 참고용으로 끝에 한글 1~3글자(대개 조사)가 더 붙은 것까지 봐주는 '조사 허용 F1'도 셌습니다.
비교 대상. 같은 기계의 Ollama에서 돌린 Qwen3.5 4B·9B에게 같은 여섯 유형을 JSON으로 뽑게 했습니다(온도 0). 크레딧이 드는 외부 API는 쓰지 않았습니다.
환경. Apple M1 Ultra, GLiNER는 PyTorch CPU(16스레드, 배치 8), LLM은 같은 기계의 GPU(Metal). 2026년 11월 8일.
맨 처음 돌린 문장부터 문제가 보였습니다. "삼성전자 이재용 회장이 어제 수원에서 갤럭시 S26을 공개했다"에서 두 모델 모두 인물을 '이재용 회장이', 장소를 '수원에서', 제품을 '갤럭시 S26을'로 뽑았습니다. 4장에서 본 대로 결과의 단위가 공백 기준 '단어'이기 때문입니다. 영어의 'Cupertino'는 그 자체로 단어지만, 한국어의 '수원에서'는 명사와 조사가 붙은 어절입니다.
KLUE 300문장 전체로 재면 차이가 숫자로 드러납니다(GLiNER2 multi, 영어 라벨, 임계값 0.3).
공백 그대로 둔 기본 설정의 엄격 F1은 34.9였습니다. 그런데 조사 허용 F1은 68.6으로 엄격 F1이 가장 좋은 설정(62.5)보다도 높았습니다. 모델은 개체를 잘 찾고 있었고, 경계 끝에 조사가 붙어 있었을 뿐입니다. 그래서 가장 단순한 처방이 가장 잘 들었습니다. 뽑힌 조각을 Kiwi 형태소 분석기에 넣고, 끝의 형태소가 조사·어미·서술격 조사면 잘라 내는 후처리 한 줄입니다. 엄격 F1이 34.9에서 62.5로 27.6점 올랐습니다.
입력부터 형태소로 쪼개는 방법(55.5)은 경계를 깔끔하게 만들지만 찾는 힘이 줄었습니다. 모델은 공백 단어로 학습했으므로 '회장', '이', '수원', '에서' 같은 조각은 학습 때 본 적 없는 입력입니다. 음절 단위(30.2)는 더 나빴습니다. 중국어를 위해 넣은 char 분할기는 한국어 음절 하나하나를 단어로 만들어, 의미 단위가 사라지고 스팬 구조의 폭 8 제한(8음절)에도 걸립니다.
직접 비교해 보십시오. 모델·라벨 언어·임계값·설명을 바꾸면 막대가 바뀌고, 아래에서 문장별 결과를 정답과 나란히 볼 수 있습니다.
결과 2: 신형이 구형을 이기지 못했다
같은 설정에서 GLiNER2.5 multi(경계)는 GLiNER2 multi(스팬)보다 일관되게 낮았습니다.
설정 (영어 라벨, 임계값 0.3)
GLiNER2 multi (스팬)
GLiNER2.5 multi (경계)
공백 그대로
34.9
29.9
공백 + 조사 자르기
62.5
54.0
공백 + 자르기 + 라벨 설명
63.0
58.1
형태소 (Kiwi)
55.5
53.5
음절 (char)
30.2
34.0
300문장 처리 시간 (CPU)
9.4초
8.4초
5-7절에서 본 Fastino의 자체 측정(다국어 추출 평균 47.56→46.40, CrossNER에서 구형 우위)과 같은 방향입니다. 경계 구조가 손해를 본 곳을 보면 이유가 짐작됩니다. 경계 모델은 ‘수량’에서 특히 약했고(공백 그대로, 임계값 0.3에서 7.6~19.6), 5-5절의 '어제'처럼 기권 헤드가 라벨을 통째로 닫는 경우가 있었습니다. 한국어처럼 학습 분포 밖의 언어에서는 '확신이 없으면 비운다'는 장치가 재현율을 깎습니다. 대신 경계 모델은 라벨 설명의 효과를 더 크게 받았습니다(+4.1점, 대부분 수량). 처리 시간은 거의 같았습니다.
결론은 단순합니다. 한국어 짧은 문장의 개체명이라면 지금은 구형 GLiNER2 multi + 조사 자르기가 낫습니다. 긴 조각(법률명·주소)이나 레코드·관계·기권이 필요하면 GLiNER2.5를 고르고, 그때도 조사 자르기는 붙이십시오.
결과 3: 라벨 설명은 뜻을 바꾸지만 규칙은 못 바꾼다
라벨 이름만 주는 대신 설명을 붙여 봤습니다. 예를 들어 인물에는 "사람 이름만. 씨·대표·회장·병장 같은 직함과 호칭은 빼고", 수량에는 "단위가 붙은 수, 개수, 비율, 순위, 나이, 금액 (17개, 70.0%, 2위)"을 줬습니다.
수량은 확실히 좋아졌습니다(스팬 60.7→63.7, 경계 46.0→56.5). 수량이 무엇인지에 대한 '뜻'을 넓혀 줬기 때문입니다. 그런데 인물은 그대로였습니다(61.3→60.0). 모델은 여전히 '백 대표', '윤균상 씨', '고 노무현', '정철민병장'을 뽑았습니다. 설명은 무엇을 찾을지를 바꾸지만, 어디서 자를지라는 주석 규칙은 바꾸지 못했습니다. 남은 오류를 분류해 보니 인물의 놓침 가운데 73건이 이런 경계 차이였습니다. KLUE는 호칭을 빼고 이름만 개체로 보는데, 일상 언어에서 '윤균상 씨'를 한 덩어리로 보는 것도 틀린 판단은 아닙니다. 회사의 주석 규칙이 KLUE와 다르다면 이 점수는 다르게 나올 것입니다. 설명을 붙이면 입력이 길어져 처리 시간은 9.4초에서 20.2초로 두 배가 됐습니다.
결과 4: 로컬 LLM과 비겼고, 15배 빨랐다
같은 300문장을 Qwen3.5 9B에게 시켰습니다. 처음 채점한 엄격 F1은 57.6이었습니다. 그런데 원문에서 찾을 수 없는 답이 810개 중 86개였습니다. 들여다보니 대부분이 지어낸 말이 아니라 띄어쓰기를 바꿔 쓴 복사였습니다. '오후 2시'를 '오후 2 시'로, '박해일'을 '박 해 일'로, '297억원'을 '297 억 원'으로 돌려줬습니다. 공백을 무시하고 원문 위치에 맞춰 주자 84개가 살아났고, 원문에 정말 없는 말은 2개('의사', 따옴표가 바뀐 '뉴스9')였습니다. 보정 후 엄격 F1은 61.0입니다. 4B는 47.4였습니다.
?
정확도는 비겼다
GLiNER2 multi + 조사 자르기 62.5, Qwen3.5 9B(보정 후) 61.0. 유형별로는 LLM이 인물·날짜에서, GLiNER2가 장소·기관에서 앞섰다.
⏱
속도는 15배 차이
300문장에 GLiNER2는 CPU로 9.4초, 9B는 GPU로 141.3초. 1억 문장으로 환산하면 약 36일 대 약 545일이다.
✓
형식은 GLiNER2만 보장
LLM 답의 10%가 원문과 글자가 달라 위치를 다시 맞춰야 했다. GLiNER2는 구조상 원문 위치만 돌려준다.
이 결과는 2026년 발표된 온디바이스 개체명 연구(arXiv 2610.00007)의 결론과도 맞습니다. 그 연구는 4B 정도의 로컬 LLM이 정확도만으로는 인코더와 경쟁할 만하지만, 인코더가 9분의 1에서 24분의 1 크기에 지연은 밀리초 대 초 단위이고 출력 형식 오류가 0이라고 보고했습니다. 가장 작은 LLM은 긴 입력에서 최대 27%가 잘못된 형식이었습니다.
결과 5: 라벨이 늘어도 느려지지 않는다
문장 하나(40단어)의 지연은 라벨 1개일 때 115ms, 32개일 때 146ms였습니다(GLiNER2 multi). 라벨은 입력에 짧은 토큰 몇 개를 더할 뿐이기 때문입니다. 반면 본문이 25단어에서 400단어로 늘자 110ms에서 509ms로 늘었습니다. 인코더의 비용은 읽는 길이에 비례합니다. 영어 전용 gliner2.5-small-v1(7,400만)은 300문장을 5.1초에 처리했습니다. 한국어가 필요 없다면 이쪽이 가장 빠릅니다.
결과 6: 긴 이름은 경계 구조만 찾는다
4장 위젯 아래 표가 이 실험입니다. 12단어 영문 법률명, 13단어 영문 주소, 7어절 한국어 법률명을 두 구조에 넣었습니다. 스팬 구조는 영문 둘을 모두 못 찾았고, 한국어 법률명은 공백 기준에서만 찾았습니다(형태소로 쪼개면 토큰이 8개를 넘어 실패). 경계 구조는 여섯 경우를 모두 찾았고, 형태소 기준에서는 '정보통신망 이용촉진 및 정보보호 등에 관한 법률'을 조사 '에' 없이 정확히 0.997점으로 뽑았습니다. 법령·계약·공시처럼 긴 고유명이 많은 한국어 문서라면 이 차이가 평균 F1보다 중요할 수 있습니다.
실측의 한계
300문장은 작은 표본이고 KLUE 한 데이터셋의 주석 규칙에 묶여 있습니다. 문장 길이는 평균 60자 안팎으로 짧습니다. LLM 프롬프트는 한 가지만 썼고, 더 공들인 프롬프트나 몇 개의 예시를 주면 LLM 점수는 오를 수 있습니다. GLiNER는 CPU, LLM은 GPU에서 돌렸으므로 속도는 '같은 기계에서 각자 편한 자리'의 비교입니다. 미세조정은 하지 않았습니다. KLUE 학습셋 2만 1천 문장으로 LoRA를 붙이면 훨씬 높아질 것이고, 그것이 실무의 다음 단계입니다.
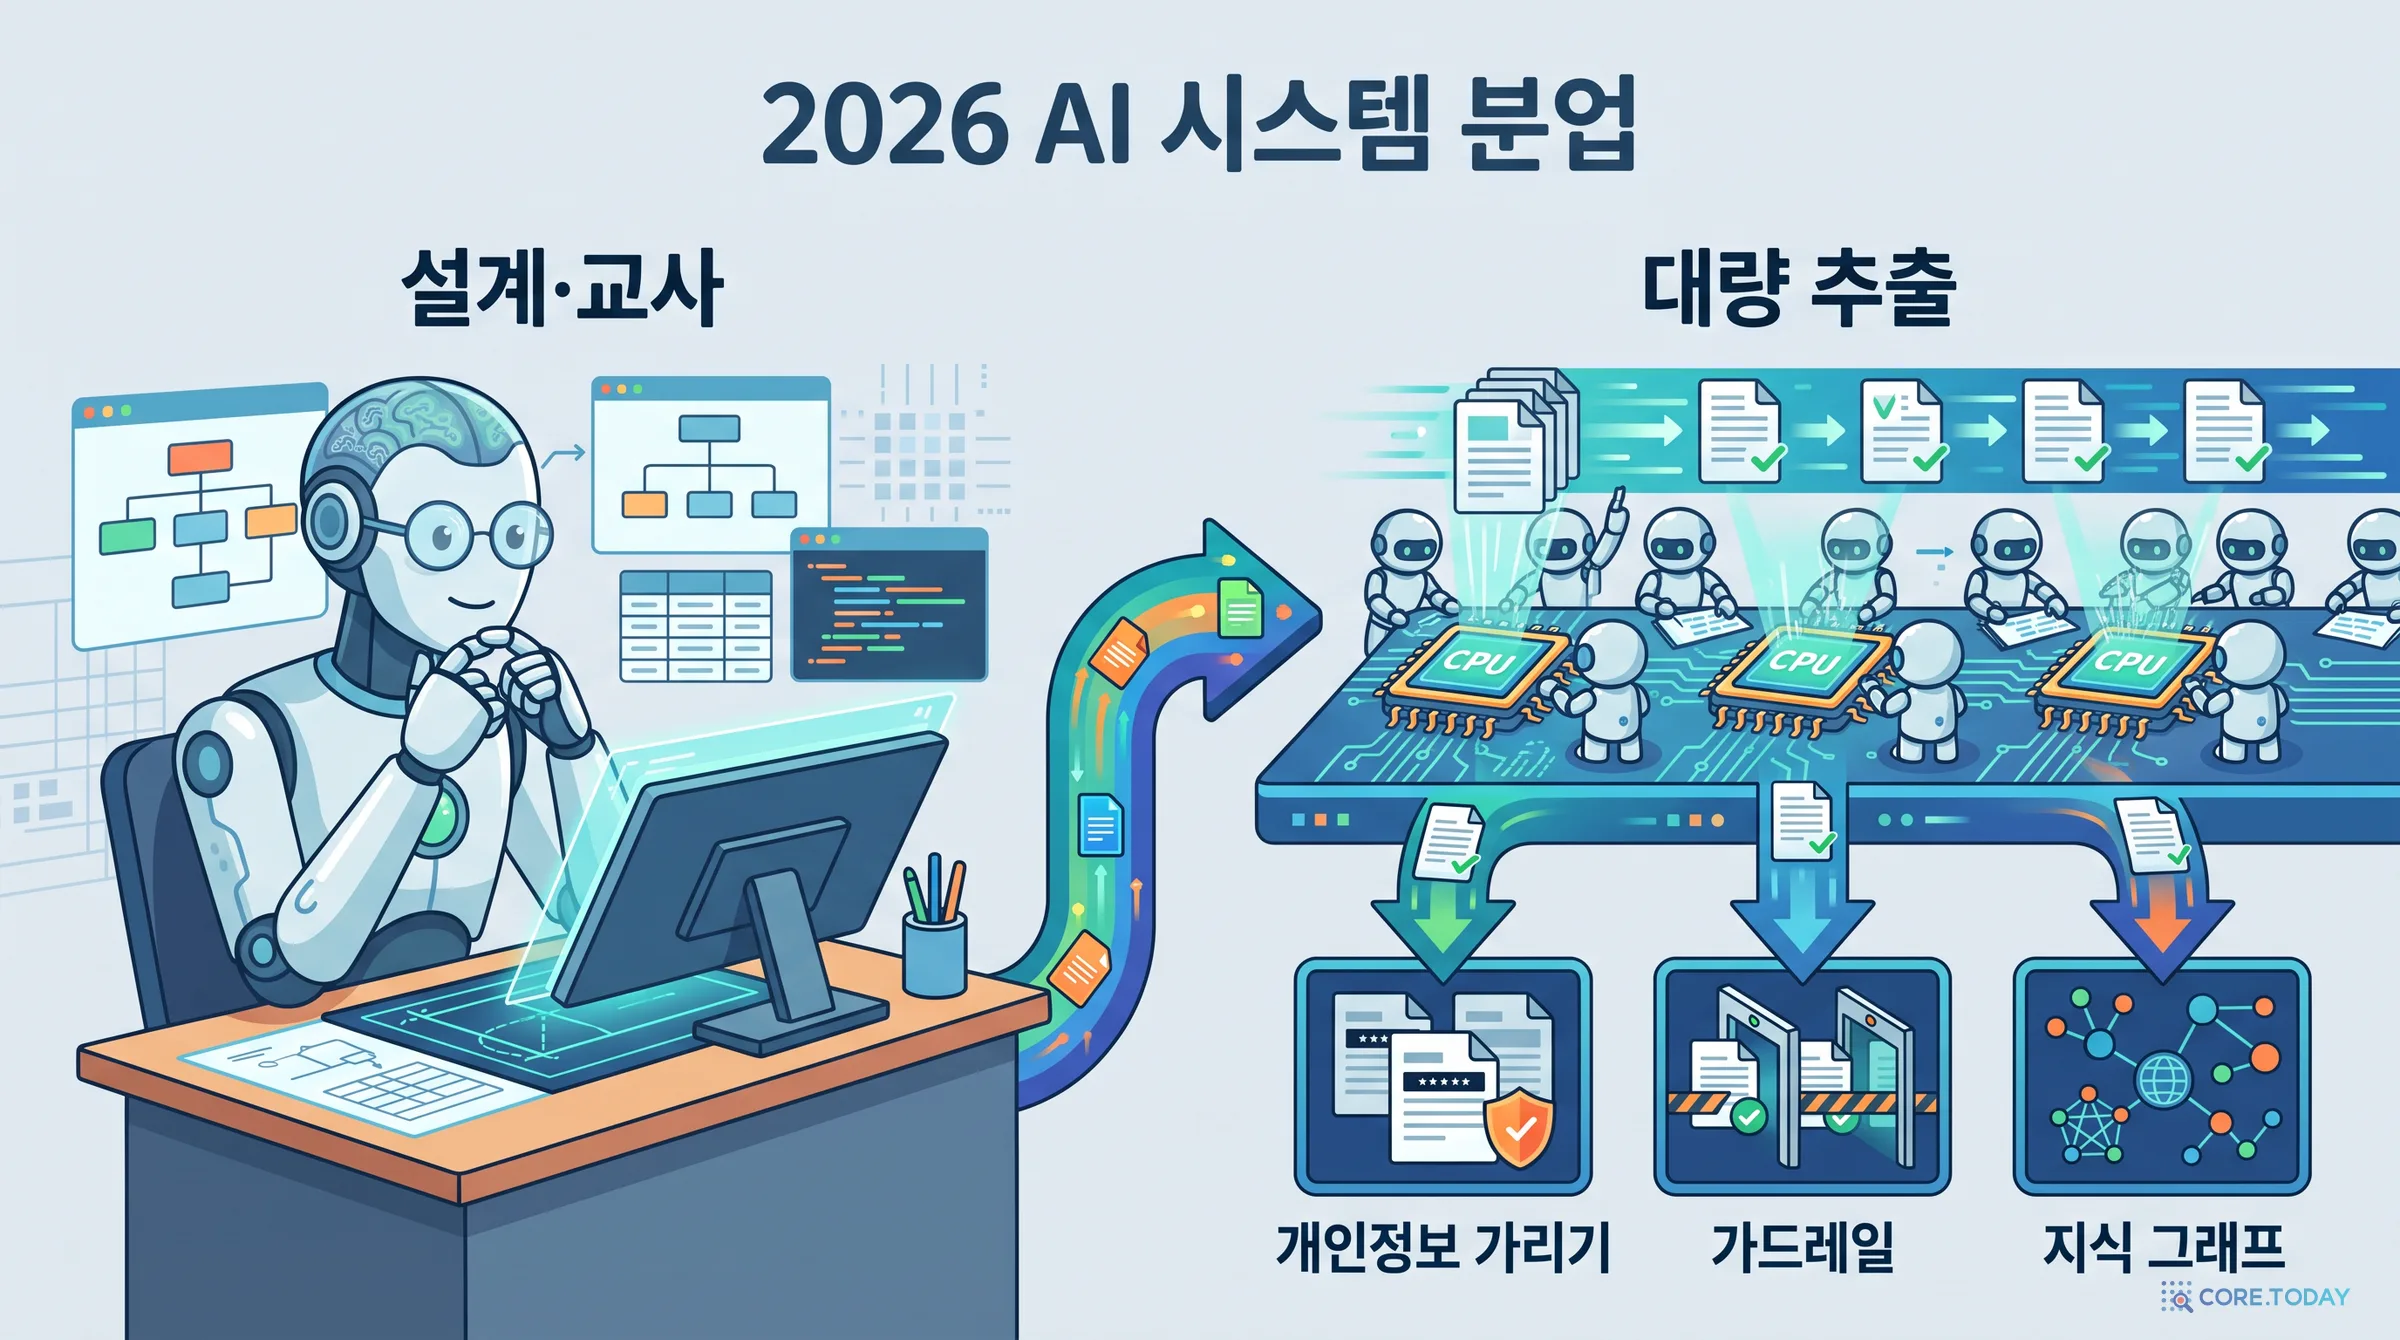
GLiNER의 역사를 다시 보면 매 세대의 학습 데이터를 LLM이 만들었습니다. GLiNER는 ChatGPT가 라벨을 붙인 Pile-NER로, GLiNER2는 GPT-4o가 라벨을 붙이고 지어낸 25만 개로, GLiNER2.5는 Fastino의 데이터 에이전트가 만든 데이터로 학습했습니다. 2026년의 표준적인 분업이 여기 있습니다. LLM은 스키마를 설계하고 예시를 만들고 어려운 사례를 판정하는 '설계자이자 교사', 작은 인코더는 매일 수백만 건을 같은 규칙으로 처리하는 '일꾼'입니다. 코어닷투데이가 판정 모델 선택 가이드에서 다룬 '시스템 1 판정 모델'의 물결도 같은 흐름이고, Fastino가 그 무렵 낸 GLiDE와 분류 특화 GLiNER2.5-Decide도 이 자리를 노립니다. (GLiDE 한국어 실측도 참고하십시오.)
쓰임새가 넓어지는 곳
개인정보와 규제. 유럽 GDPR, 미국 HIPAA, 한국 개인정보보호법은 모두 데이터를 밖으로 보내는 것을 까다롭게 만듭니다. CPU에서 도는 추출기는 데이터를 온프레미스에 둔 채 비식별화를 할 수 있습니다. GLiNER2 논문도 이 점을 설계 동기로 듭니다.
가드레일. LLM 앞뒤에서 입력과 출력을 상시 검사하는 일은 호출량이 LLM 자체와 같으므로, 검사기가 LLM만큼 비싸면 안 됩니다. Fastino의 GLiGuard(3억)는 9개 안전성 벤치마크에서 "23~90배 큰 모델과 같거나 낫고 최대 16배 빠르다"고 주장합니다(자사 측정). 별개의 연구진(Hivetrace)이 만든 같은 이름 계열의 GLiNER Guard 논문(arXiv 2605.05277)도 "상시 검열에 실용적인 저비용 대안"이라고 결론 냅니다. 이름이 비슷해 헷갈리기 쉬우니 주의하십시오.
에이전트 기억과 지식 그래프. 대화에서 사실을 뽑아 쌓는 기억 엔진은 쓰기 호출이 많습니다. Graphiti의 GLiNER2 클라이언트, Cognee의 'LLM 없는 그래프 만들기' 데모가 개체 추출을 작은 모델로 옮기는 시도입니다. 코어닷투데이의 에이전트 기억 엔진 해부와 AEVS 근거 기반 지식 그래프 추출이 이 맥락의 글입니다.
엣지와 브라우저. 커뮤니티가 GLiNER2.5를 ONNX·Core ML·LiteRT·MLX·GGUF로 변환한 모델이 이미 여럿 있습니다. 휴대폰이나 브라우저 안에서 개인정보를 가린 뒤에야 서버로 보내는 구성이 가능해집니다.
숫자로 본 확산
2026년 11월 8일 기준, fastino-ai/GLiNER2 저장소는 별 2,457개, 원조 urchade/GLiNER는 4,225개입니다. PyPI의 gliner2 패키지는 지난 한 달 21만 회, 원조 gliner는 70만 회 설치됐습니다. Hugging Face에서 gliner2-base-v1은 누적 411만 회, 최근 30일 42만 회 내려받아졌습니다. Fastino는 자사 홈페이지에서 전체 모델 다운로드 5,500만 회 이상을 내세웁니다.
그래도 LLM이 필요한 곳
GLiNER는 만능이 아닙니다. 다음은 여전히 LLM의 일입니다.
답이 원문에 없는 질문. 합계, 기간 계산, 날짜 정규화('지난주 화요일'→2026-11-03), 암시된 관계("그는 사표를 냈다"에서 '퇴사').
긴 맥락의 추론. 300쪽 계약서 전체에서 조항 사이의 모순을 찾는 일.
라벨 경계가 미묘한 일. 3번 결과처럼 '어디서 자를지'에 대한 회사 고유의 규칙은 설명만으로 전달되지 않습니다. 예시로 학습(미세조정)하거나 LLM에게 규칙을 길게 설명해야 합니다.
스키마를 처음 만드는 일. 무엇을 뽑아야 하는지 모를 때는 LLM과 대화하며 스키마를 짜는 편이 빠릅니다.
현실적인 구성은 둘을 겹치는 것입니다. GLiNER가 1차로 뽑고, 확신도가 낮은 것만 LLM에게 넘기는 캐스케이드입니다. 2026년 연구는 GLiNER의 확신도가 정답 여부를 꽤 잘 가르지만(AUROC 0.76~0.86) 절대값은 과신하는 편이라고(ECE 0.24~0.47) 보고했습니다. 즉 순위로는 믿되, 0.9라는 숫자를 90% 정답으로 읽지는 말라는 뜻입니다. 임계값은 자기 데이터로 정해야 합니다.
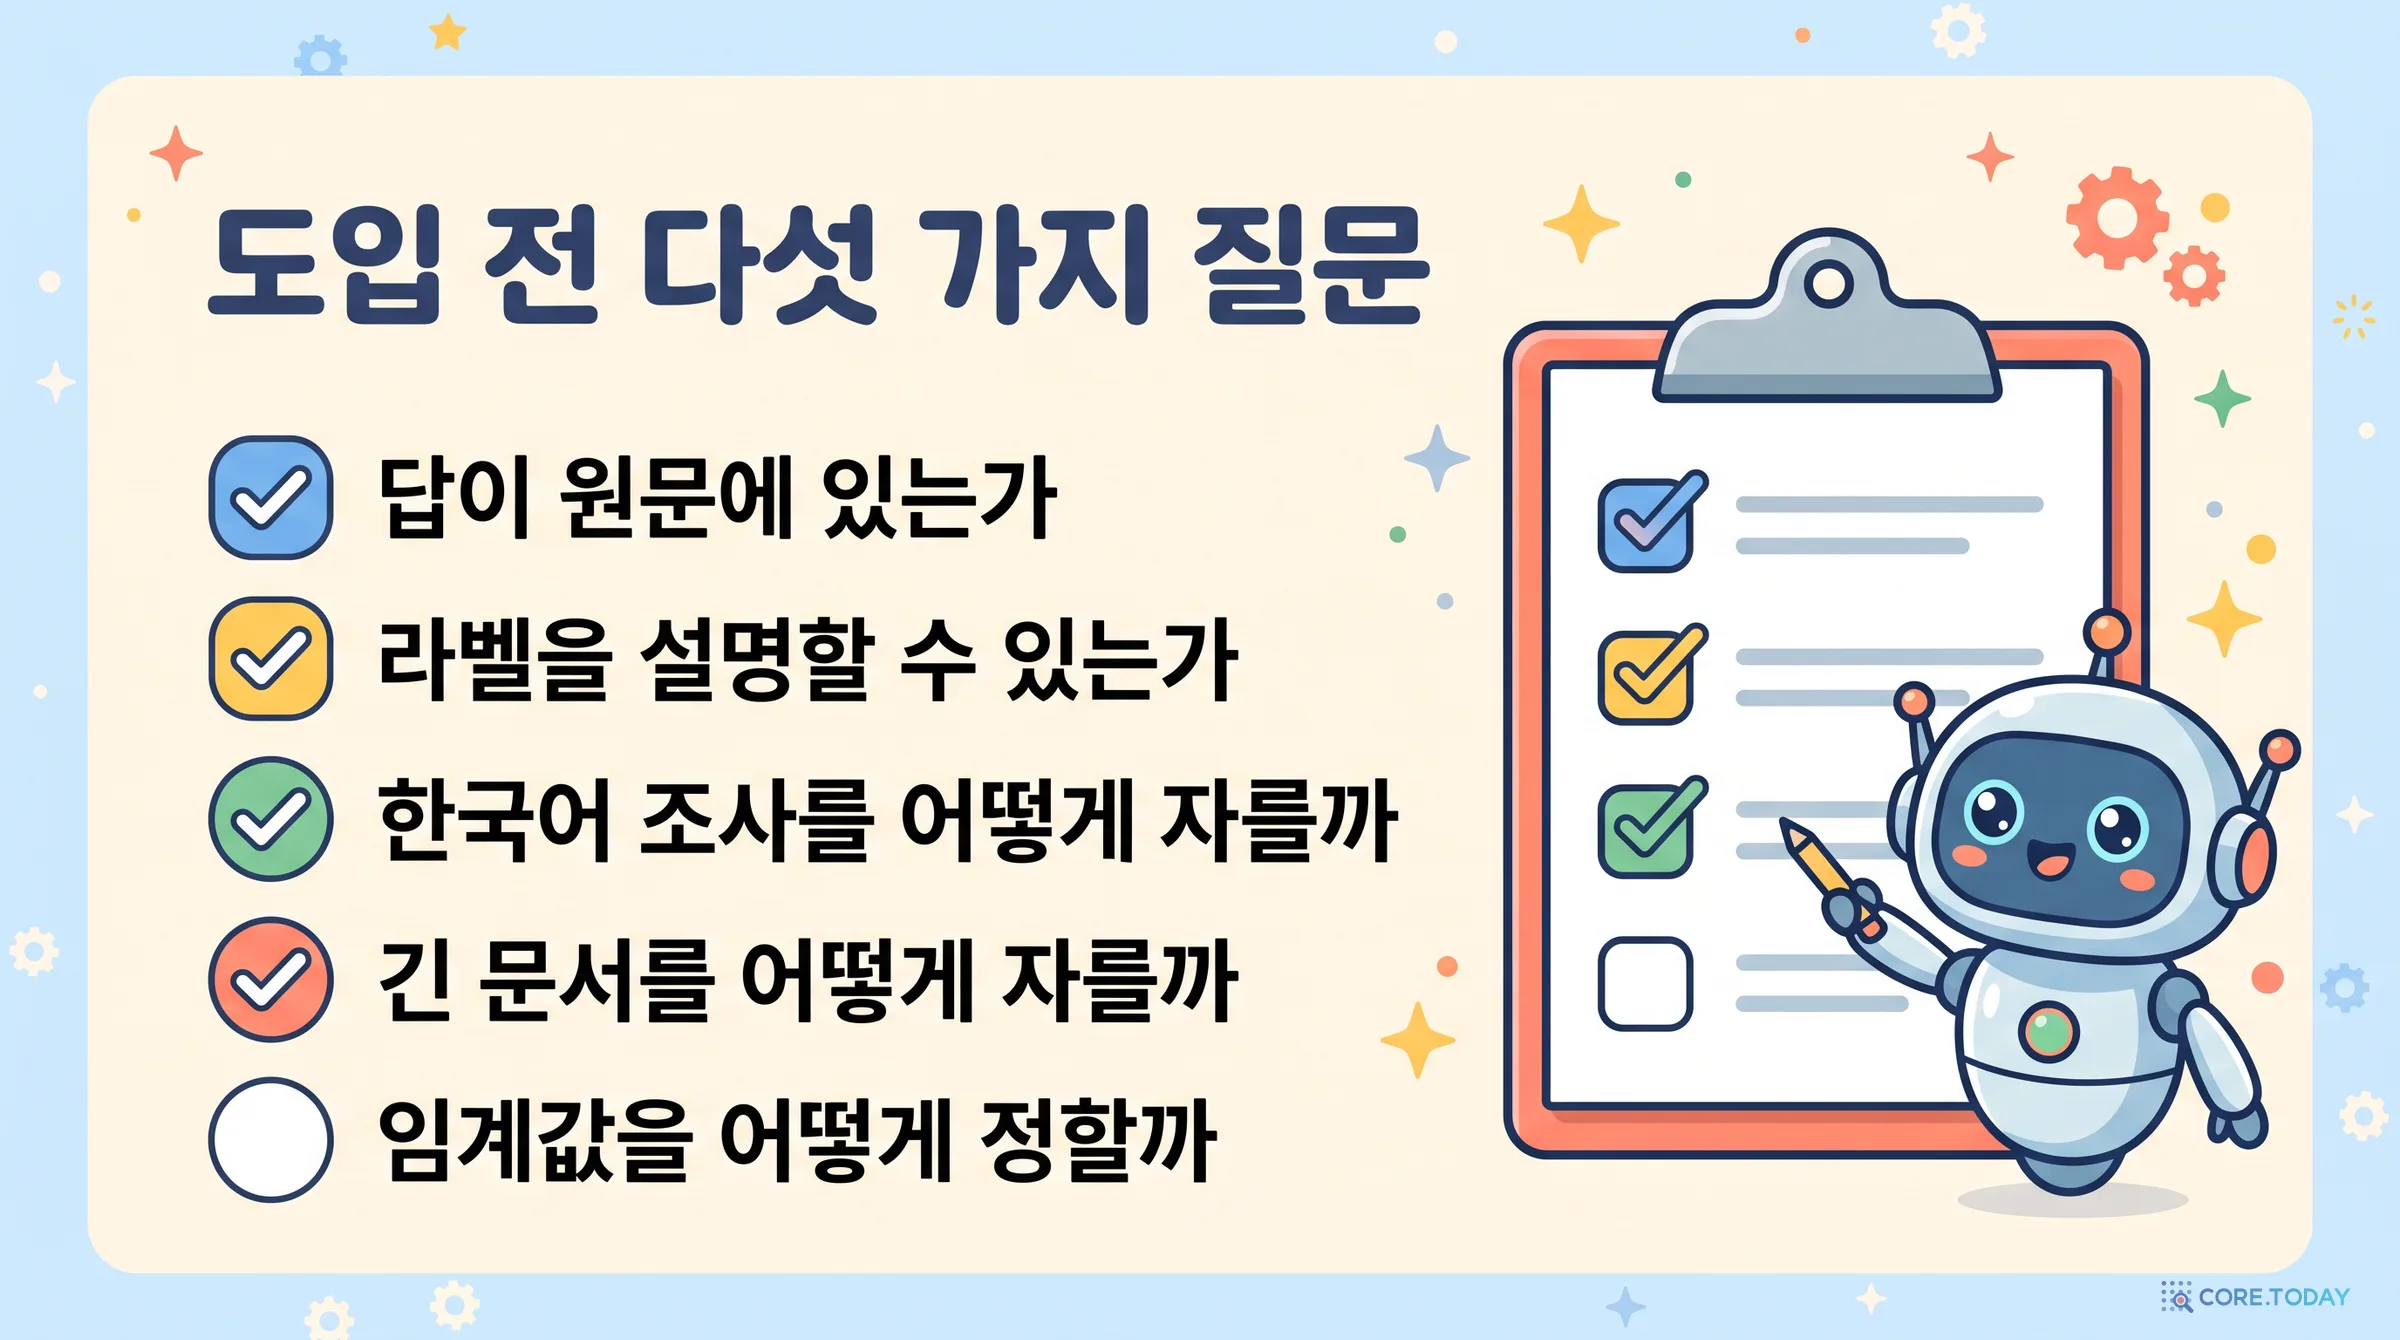
1. 답이 원문에 있는가뽑을 것이 글에 그대로 쓰여 있어야 한다. 계산·정규화·추론이 필요하면 GLiNER 뒤에 규칙이나 LLM을 붙인다.
2. 라벨을 설명할 수 있는가이름이 모호하면 한 줄 설명을 붙인다. 수량처럼 범위를 넓히는 데는 효과가 있었고, '호칭을 빼라' 같은 경계 규칙에는 효과가 없었다. 경계 규칙은 후처리나 미세조정으로.
3. 한국어 조사를 어떻게 자를까공백 그대로 뽑고, 끝 형태소가 조사·어미면 잘라 낸다(Kiwi 등). 이 한 줄이 실측에서 +27.6점이었다. 입력을 형태소로 쪼개는 것은 차선.
4. 긴 조각·긴 문서인가8단어를 넘는 법률명·주소·제목이 있으면 경계 구조(GLiNER2.5). 문서가 길면 *_long API로 384단어 창·64단어 겹침, 경계에 걸리면 겹침을 늘린다.
5. 임계값과 검증기본 0.5보다 0.3이 나은 경우가 많았다(재현율). 모양이 정해진 필드는 정규식 검사기로 거르고, 자기 데이터 100~300건으로 임계값을 정한다. 확신도는 순위로만 믿는다.
모델 고르기는 이렇게 정리할 수 있습니다.
상황
추천
이유
한국어 짧은 글의 개체명
gliner2-multi-v1 + 조사 자르기
실측 최고(62.5~63.0), CPU로 충분
한국어 법령·계약·공시
gliner2.5-multi-v1 + 형태소 분할 또는 조사 자르기
8단어 넘는 고유명을 찾는 유일한 선택
영어, 속도 최우선
gliner2.5-small-v1
7,400만 파라미터, 300문장 5.1초
여러 레코드·관계 그래프
GLiNER2.5 + JointIE
개수 예측 없는 레코드, 타입 제약 관계
개인정보 가리기
gliner2-privacy-filter-PII-multi + 정규식 검사기
42종 특화, 형식 검사로 오탐 감소
라벨 체계가 고정되고 데이터가 있음
위 모델 + LoRA 미세조정
제로샷의 경계 규칙 문제를 해결
맺으며 — 고르는 모델의 쓸모
GLiNER 계열의 30년 족보를 한 줄로 줄이면 이렇습니다. 처음에는 라벨이 모델의 벽에 칠해져 있었고(고정 라벨), 다음에는 거대한 생성 모델이 라벨을 말로 받아 답을 지어냈고(LLM), GLiNER는 그 중간에서 라벨을 말로 받되 답은 원문에서 고르는 길을 냈습니다. GLiNER2는 그 길 위에 개체·분류·관계·구조를 한 줄의 스키마로 묶었고, GLiNER2.5는 칸 대신 틈을 보며 길이의 벽을 허물었습니다.
한국어 실측이 남긴 교훈은 소박합니다. 신형 구조보다, 큰 LLM보다, 조사를 자르는 한 줄이 점수를 더 크게 움직였습니다. 모델이 무엇을 '단어'로 보는지가 결과의 모양을 정합니다. 작은 모델을 잘 쓰는 일은 모델이 무엇을 보고 무엇을 못 보는지를 아는 일입니다. 2026년에 이런 모델의 쓸모는 LLM을 대신하는 데 있지 않습니다. LLM이 설계한 일을 싸고 빠르게, 원문을 벗어나지 않고, 데이터가 밖으로 나가지 않게 반복하는 데 있습니다.
참고문헌
논문
Grishman, R. & Sundheim, B. (1996). Message Understanding Conference-6: A Brief History. COLING 1996.
Tjong Kim Sang, E. F. & De Meulder, F. (2003). Introduction to the CoNLL-2003 Shared Task: Language-Independent Named Entity Recognition. CoNLL 2003.
Lafferty, J., McCallum, A. & Pereira, F. (2001). Conditional Random Fields. ICML 2001.
Lample, G. 외 (2016). Neural Architectures for Named Entity Recognition. NAACL 2016. arXiv:1603.01360
Devlin, J. 외 (2019). BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding. arXiv:1810.04805
Lee, K. 외 (2017). End-to-end Neural Coreference Resolution. EMNLP 2017. arXiv:1707.07045
Eberts, M. & Ulges, A. (2020). Span-based Joint Entity and Relation Extraction with Transformer Pre-training (SpERT). arXiv:1909.07755
Lu, Y. 외 (2022). Unified Structure Generation for Universal Information Extraction (UIE). ACL 2022. arXiv:2203.12277
Wang, X. 외 (2023). InstructUIE: Multi-task Instruction Tuning for Unified Information Extraction. arXiv:2304.08085
Zhou, W. 외 (2024). UniversalNER: Targeted Distillation from Large Language Models for Open Named Entity Recognition. ICLR 2024. arXiv:2308.03279
Sainz, O. 외 (2024). GoLLIE: Annotation Guidelines improve Zero-Shot Information-Extraction. ICLR 2024. arXiv:2310.03668
Zaratiana, U., Tomeh, N., Holat, P. & Charnois, T. (2024). GLiNER: Generalist Model for Named Entity Recognition using Bidirectional Transformer. NAACL 2024. arXiv:2311.08526
Zaratiana, U., Pasternak, G., Boyd, O., Hurn-Maloney, G. & Lewis, A. (2025). GLiNER2: An Efficient Multi-Task Information Extraction System with Schema-Driven Interface. EMNLP 2025 System Demonstrations. arXiv:2507.18546
He, P. 외 (2023). DeBERTaV3: Improving DeBERTa using ELECTRA-Style Pre-Training with Gradient-Disentangled Embedding Sharing. ICLR 2023.
Park, S. 외 (2021). KLUE: Korean Language Understanding Evaluation. arXiv:2105.09680
Hugging Face 모델 카드: fastino/gliner2-multi-v1, fastino/gliner2.5-multi-v1, fastino/gliner2.5-small-v1, fastino/GLiNER2.5-Decide, fastino/gliner2-privacy-filter-PII-multi
TechCrunch, "Fastino trains AI models on cheap gaming GPUs and just raised 17.5M (USD) led by Khosla" (2025-05-07)