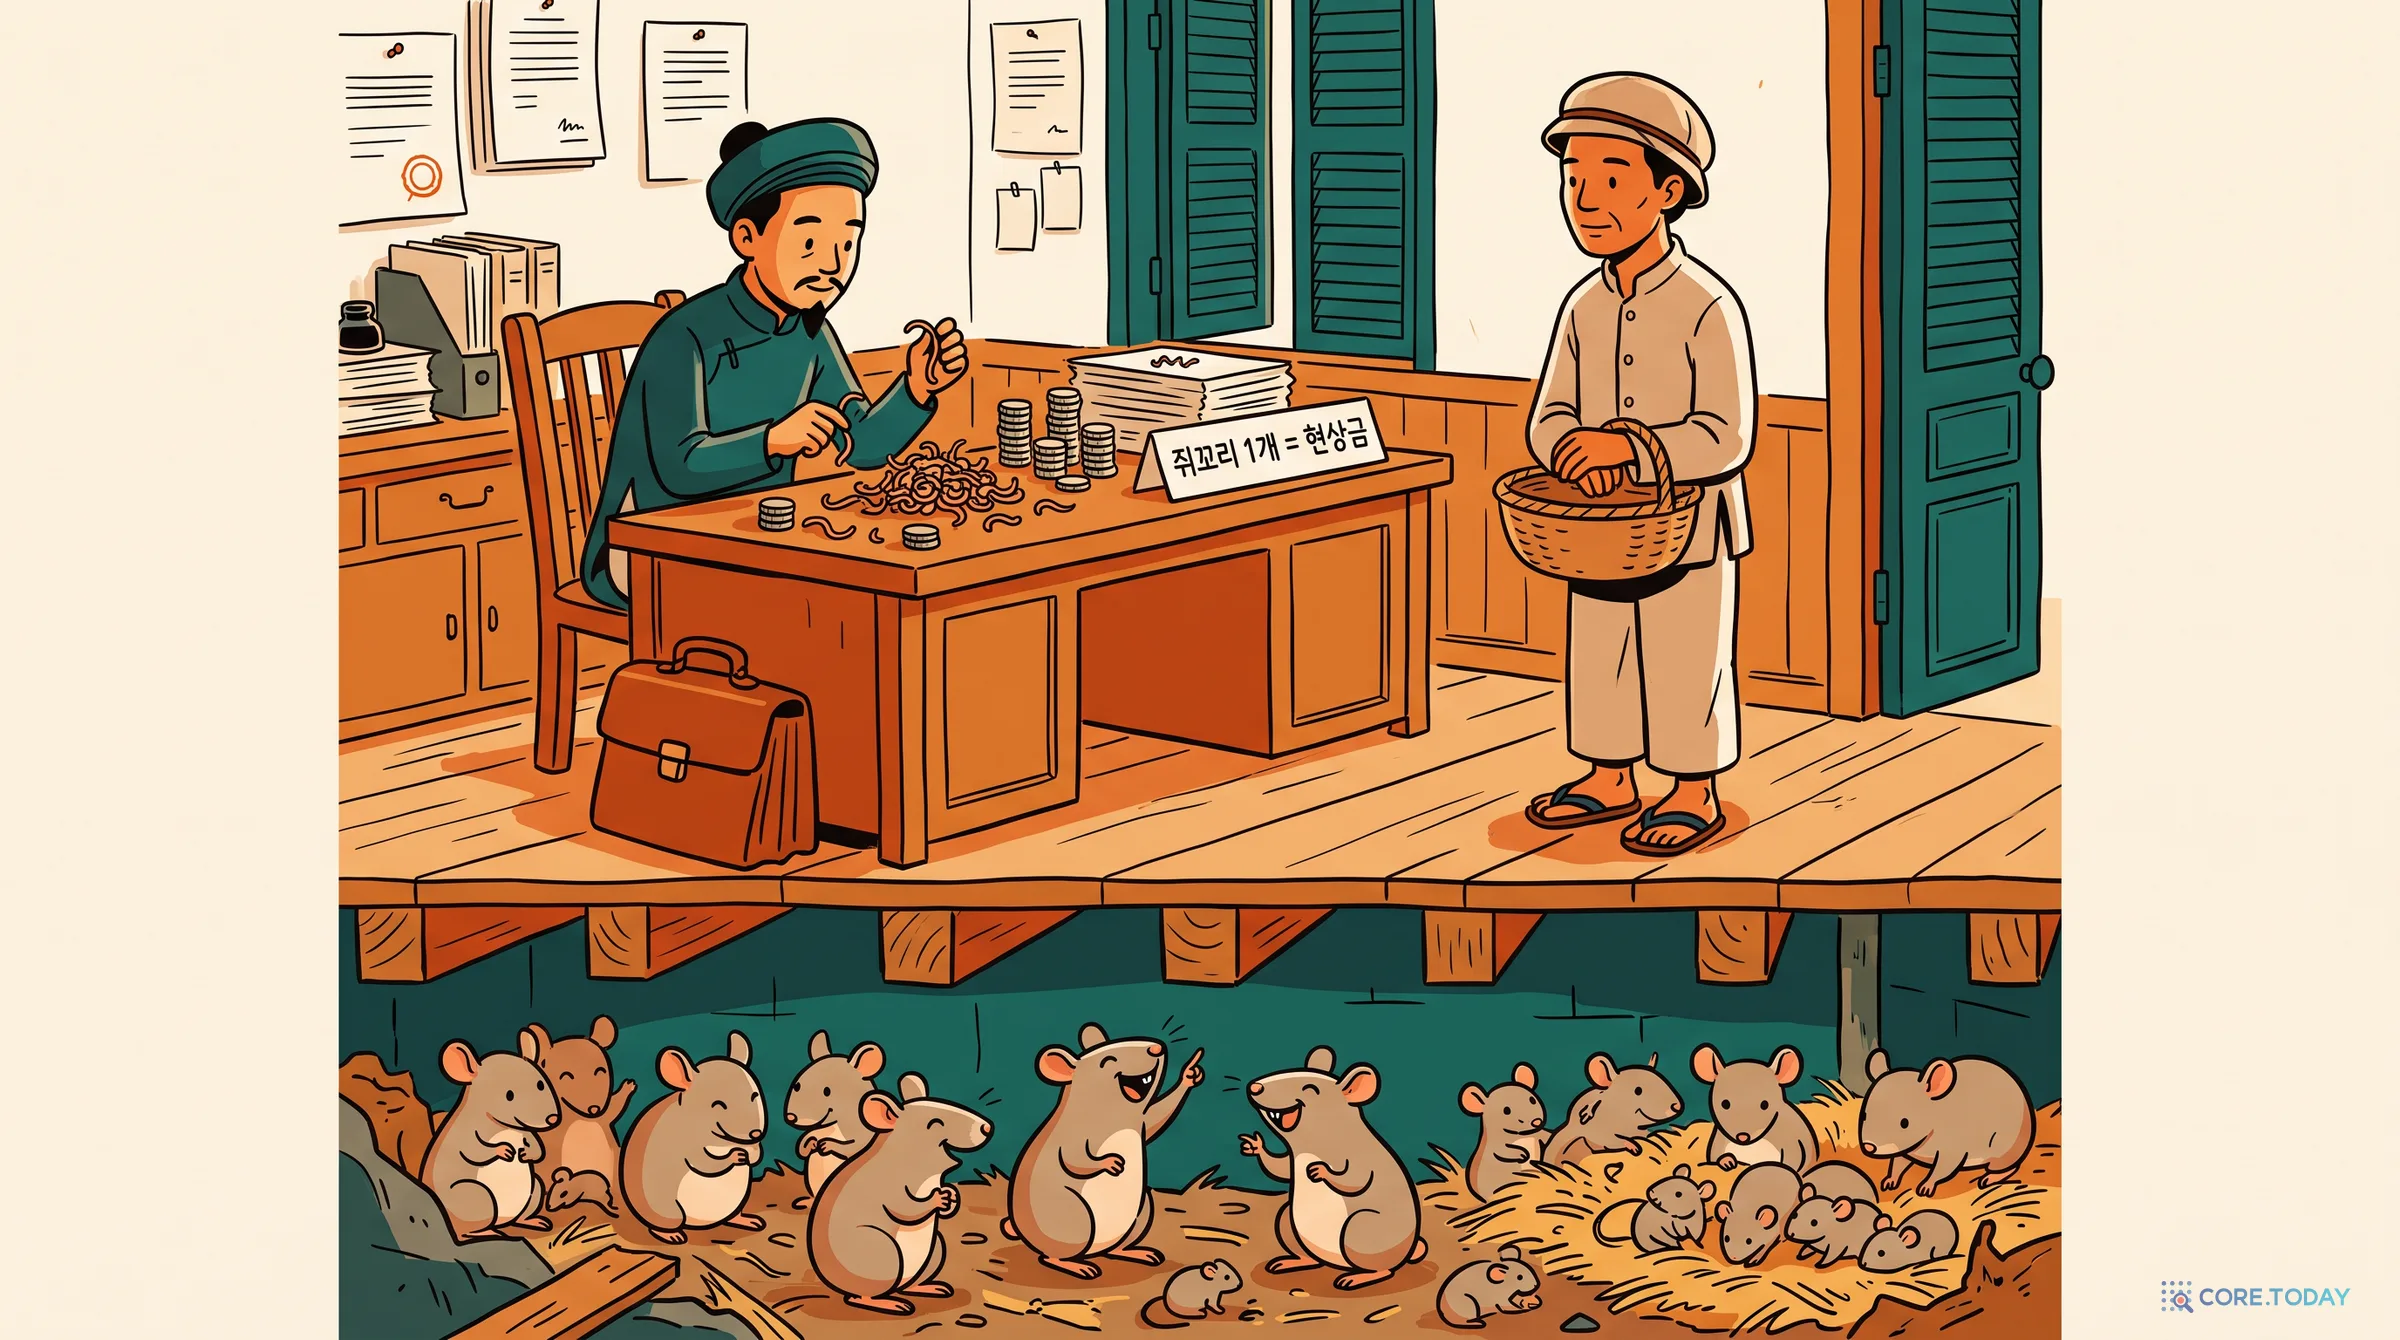
1902년, 프랑스 식민지였던 베트남 하노이에 흑사병 공포가 번졌다. 새로 깐 하수도가 쥐들의 고속도로가 되어 있었다. 당국은 처음에 직접 쥐잡이꾼을 고용했다. 하루에 1만 5천 마리, 2만 마리씩 잡았지만 쥐는 줄지 않았다. 그래서 방법을 바꿨다. 시민 누구든 쥐를 잡아 오면 한 마리에 1센트 남짓을 주기로 했다. 시체를 다 받을 수는 없으니, 꼬리만 가져오면 잡은 것으로 쳤다.
얼마 뒤 하노이 거리에 꼬리 없는 쥐들이 돌아다니기 시작했다. 사람들은 쥐를 잡아 꼬리만 자르고 놓아줬다. 놓아준 쥐는 새끼를 낳고, 새끼에게도 꼬리가 있다. 도시 외곽에서는 쥐를 기르는 농장까지 발견됐다. 당국은 현상금을 거둬들였다. 역사학자 마이클 반(Michael Vann)이 2003년 프랑스 식민지 문서고에서 찾아내 정리한 실제 사건이다.
당국이 원한 것은 쥐가 줄어드는 것이었다. 그런데 직접 셀 수는 없으니 꼬리 수를 셌다. 평소라면 둘은 함께 움직인다. 꼬리를 많이 모았다면 쥐를 많이 잡은 것이다. 하지만 꼬리 수에 돈을 걸자, 사람들은 쥐를 줄이지 않고도 꼬리 수를 늘리는 길을 찾았다.
이 이야기에는 이름이 붙어 있다. 굿하트의 법칙이다. 흔히 이렇게 인용된다.
측정치가 목표가 되면, 더는 좋은 측정치가 아니다.
인공지능을 평가하는 사람들에게 이 문장은 하노이 이야기보다 훨씬 가깝다. 2020년 9월 공개된 MMLU라는 시험에서 당시 가장 큰 언어 모델 GPT-3는 43.9점을 받았다. 4지선다라서 아무렇게나 찍어도 25점이 나오는 시험이다. 4년 뒤 최신 모델들은 90점을 넘겼고, 시험은 사실상 ‘졸업’했다. 그 4년 동안 모델은 정말 그만큼 똑똑해졌을까? 아니면 우리가 MMLU 점수라는 쥐꼬리를 세고 있었을까?
답은 둘 다다. 이 글은 그 둘을 가르는 이야기다. 그리고 직접 쟀다. 숫자 몇 개를 먼저 보자.
⟦STATGRID⟧
코어닷투데이 실측. MMLU-Redux 2.0, GSM8K 한국어판, 공개 보상 모델 Skywork-Reward-V2로 쟀다. 4~6부에서 자세히 다룬다.
이 시리즈는 그동안 기계를 채점하는 방법을 하나씩 다뤘다. 번역을 채점하는 BLEU·ROUGE, 언어 모델을 채점하는 퍼플렉서티, 검색을 채점하는 Recall@k·MRR·nDCG, 사람의 선호로 순위를 매기는 Elo와 Chatbot Arena, 그리고 시험지가 학습 데이터로 새는 벤치마크 오염까지. 이번에는 그 모든 채점 방법 위에 드리운 한 가지 법칙을 다룬다. 어떤 채점이든, 그 점수를 올리려고 애쓰는 순간 채점이 무너지기 시작한다.
찰스 굿하트(Charles Goodhart)는 영국 중앙은행(Bank of England)의 경제학자였다. 1970년대 영국 정부는 물가를 잡으려고 시중에 도는 돈의 양, 즉 통화량을 목표로 삼았다. 통화량과 물가가 함께 움직인다는 통계가 있었기 때문이다. 그런데 통화량을 목표로 정하고 누르기 시작하자, 은행과 기업들은 규제를 받는 통화 대신 규제 밖의 다른 금융 수단으로 옮겨 갔다. 통화량 숫자는 목표대로 움직였지만, 물가와의 관계는 흐트러졌다.
굿하트는 1975년 호주 중앙은행 학술회의에 낸 논문 「통화 관리의 문제들: 영국의 경험」에서 이를 이렇게 적었다.
관찰된 통계적 규칙성은 그것을 통제 목적으로 누르기 시작하면 무너지는 경향이 있다.
굿하트 자신은 나중에 이 문장을 반쯤 농담으로 덧붙인 말이었다고 회고했다. 논문의 중심 주장도 아니었다. 그런데 이 한 줄이 그의 이름을 단 법칙이 됐다.
1.2 유명한 문장은 굿하트가 쓰지 않았다
들어가며에서 인용한 ‘측정치가 목표가 되면 더는 좋은 측정치가 아니다’는 굿하트의 문장이 아니다. 영국의 인류학자 메릴린 스트래선(Marilyn Strathern)이 1997년 영국 대학의 평가 제도를 비판한 논문 「‘평점 올리기’: 영국 대학 체계의 감사」에 쓴 문장이다. 그는 이렇게 이어 갔다.
측정치가 목표가 되면, 더는 좋은 측정치가 아니다. 졸업 시험의 2등급 성적이 당연한 기대가 될수록, 그 성적은 개인의 실력을 가려내는 잣대로서 쓸모가 줄어든다.
그리고 회계학자 키스 호스킨(Keith Hoskin)이 1996년 이 현상을 ‘굿하트의 법칙’이라고 불렀다고 출처를 밝혔다. 정리하면 이렇다. 아이디어는 1975년 굿하트의 통화 정책 이야기에서 나왔고, 1996년 호스킨이 이름을 붙였고, 오늘날 우리가 외우는 문장은 1997년 스트래선의 것이다.
1.3 같은 시기, 세 사람
비슷한 생각이 비슷한 시기에 다른 분야에서도 나왔다.
캠벨의 법칙(1976~1979). 미국의 사회심리학자 도널드 캠벨(Donald Campbell)은 정부 정책의 효과를 재는 사회 지표를 연구하다 이렇게 썼다. “어떤 정량적 사회 지표가 사회적 의사 결정에 많이 쓰일수록, 그 지표는 부패의 압력을 더 많이 받고, 감시하려던 사회 과정 자체를 더 왜곡하고 타락시킨다.” 굿하트가 ‘지표가 정보를 잃는다’고 했다면, 캠벨은 한 걸음 더 나가 ‘지표 때문에 현실이 망가진다’고 했다.
루카스 비판(1976). 경제학자 로버트 루카스(Robert Lucas)는 과거 데이터로 추정한 경제 모델이 정책이 바뀌면 맞지 않게 된다고 지적했다. 사람들이 바뀐 정책에 맞춰 행동을 바꾸기 때문이다. 이 공로로 그는 나중에 노벨 경제학상을 받았다.
셋의 공통점은 하나다. 측정당하는 쪽은 가만히 있지 않는다. 그 측정을 알고, 거기에 맞춰 움직인다.
1.4 지표가 목표가 된 사례들
굿하트의 법칙을 설명할 때 자주 나오는 이야기 중에는 사실이 아닌 것도 섞여 있다. 출처를 따져 정리하면 이렇다.
사례
지표
무슨 일이 생겼나
사실 여부
하노이 쥐 현상금 (1902)
쥐꼬리 수
꼬리만 자르고 놓아주기, 쥐 농장
식민지 문서로 확인 (Vann, 2003)
웰스파고 계좌 (2002~2016)
직원별 교차 판매 실적
고객 몰래 만든 계좌가 최대 약 350만 개. 2020년 30억 달러 합의
미국 법무부·SEC 합의로 확인
영국 응급실 4시간 목표 (2004~)
4시간 안에 처리한 환자 비율
4시간 직전 20분에 환자를 내보내거나 입원시키는 급증, 구급차 안에서 대기시키기
BMJ(2005)·영국 왕립통계학회지(2009)로 확인
델리의 코브라 현상금
코브라 사체 수
코브라를 길러서 팔기
기록 없음. 2001년 독일 경제학자가 지은 우화
소련의 못 공장
못 개수 또는 무게
아주 작은 못 수백만 개, 또는 거대한 못 하나
출처를 찾을 수 없는 농담
코브라 이야기는 ‘코브라 효과’라는 말과 함께 널리 퍼졌지만, 영국령 인도에서 그런 현상금 때문에 코브라를 길렀다는 당대 기록은 지금까지 나오지 않았다. 하노이 쥐 사건을 발굴한 반 교수도 ‘하노이는 증명되지만 델리는 아니다’라고 말한다.
웰스파고와 영국 병원 사례는 따로 볼 만하다. 웰스파고 경영진은 ‘고객 한 명당 상품 여덟 개’라는 교차 판매 목표를 내걸었다. 직원들은 달성할 수 없는 목표에 쫓겨 고객 몰래 계좌와 카드를 만들었다. 영국 응급실 연구에서는 환자가 응급실을 떠나는 시각이 4시간 직전 20분에 몰리는 뾰족한 봉우리가 그래프에 나타났다. 2008~09년 1,220만 건을 분석한 후속 연구에서는 입원 환자의 30.7%가 그 20분 안에 처리됐다. 영국의 행정학자 비번(Gwyn Bevan)과 후드(Christopher Hood)는 이 상황에 딱 맞는 이름을 붙였다. 과녁은 맞혔는데 요점은 놓쳤다(hitting the target and missing the point).
2부. 네 갈래의 굿하트 — 같은 법칙, 다른 원인
굿하트의 법칙은 한 문장이지만, 지표가 무너지는 이유는 여러 가지다. 2018년 데이비드 만하임(David Manheim)과 스콧 개러브랜트(Scott Garrabrant)는 「굿하트 법칙의 변종 분류」라는 논문에서 이를 네 갈래로 나눴다. 인공지능 평가에서 벌어지는 일들이 이 네 갈래에 거의 다 들어간다.
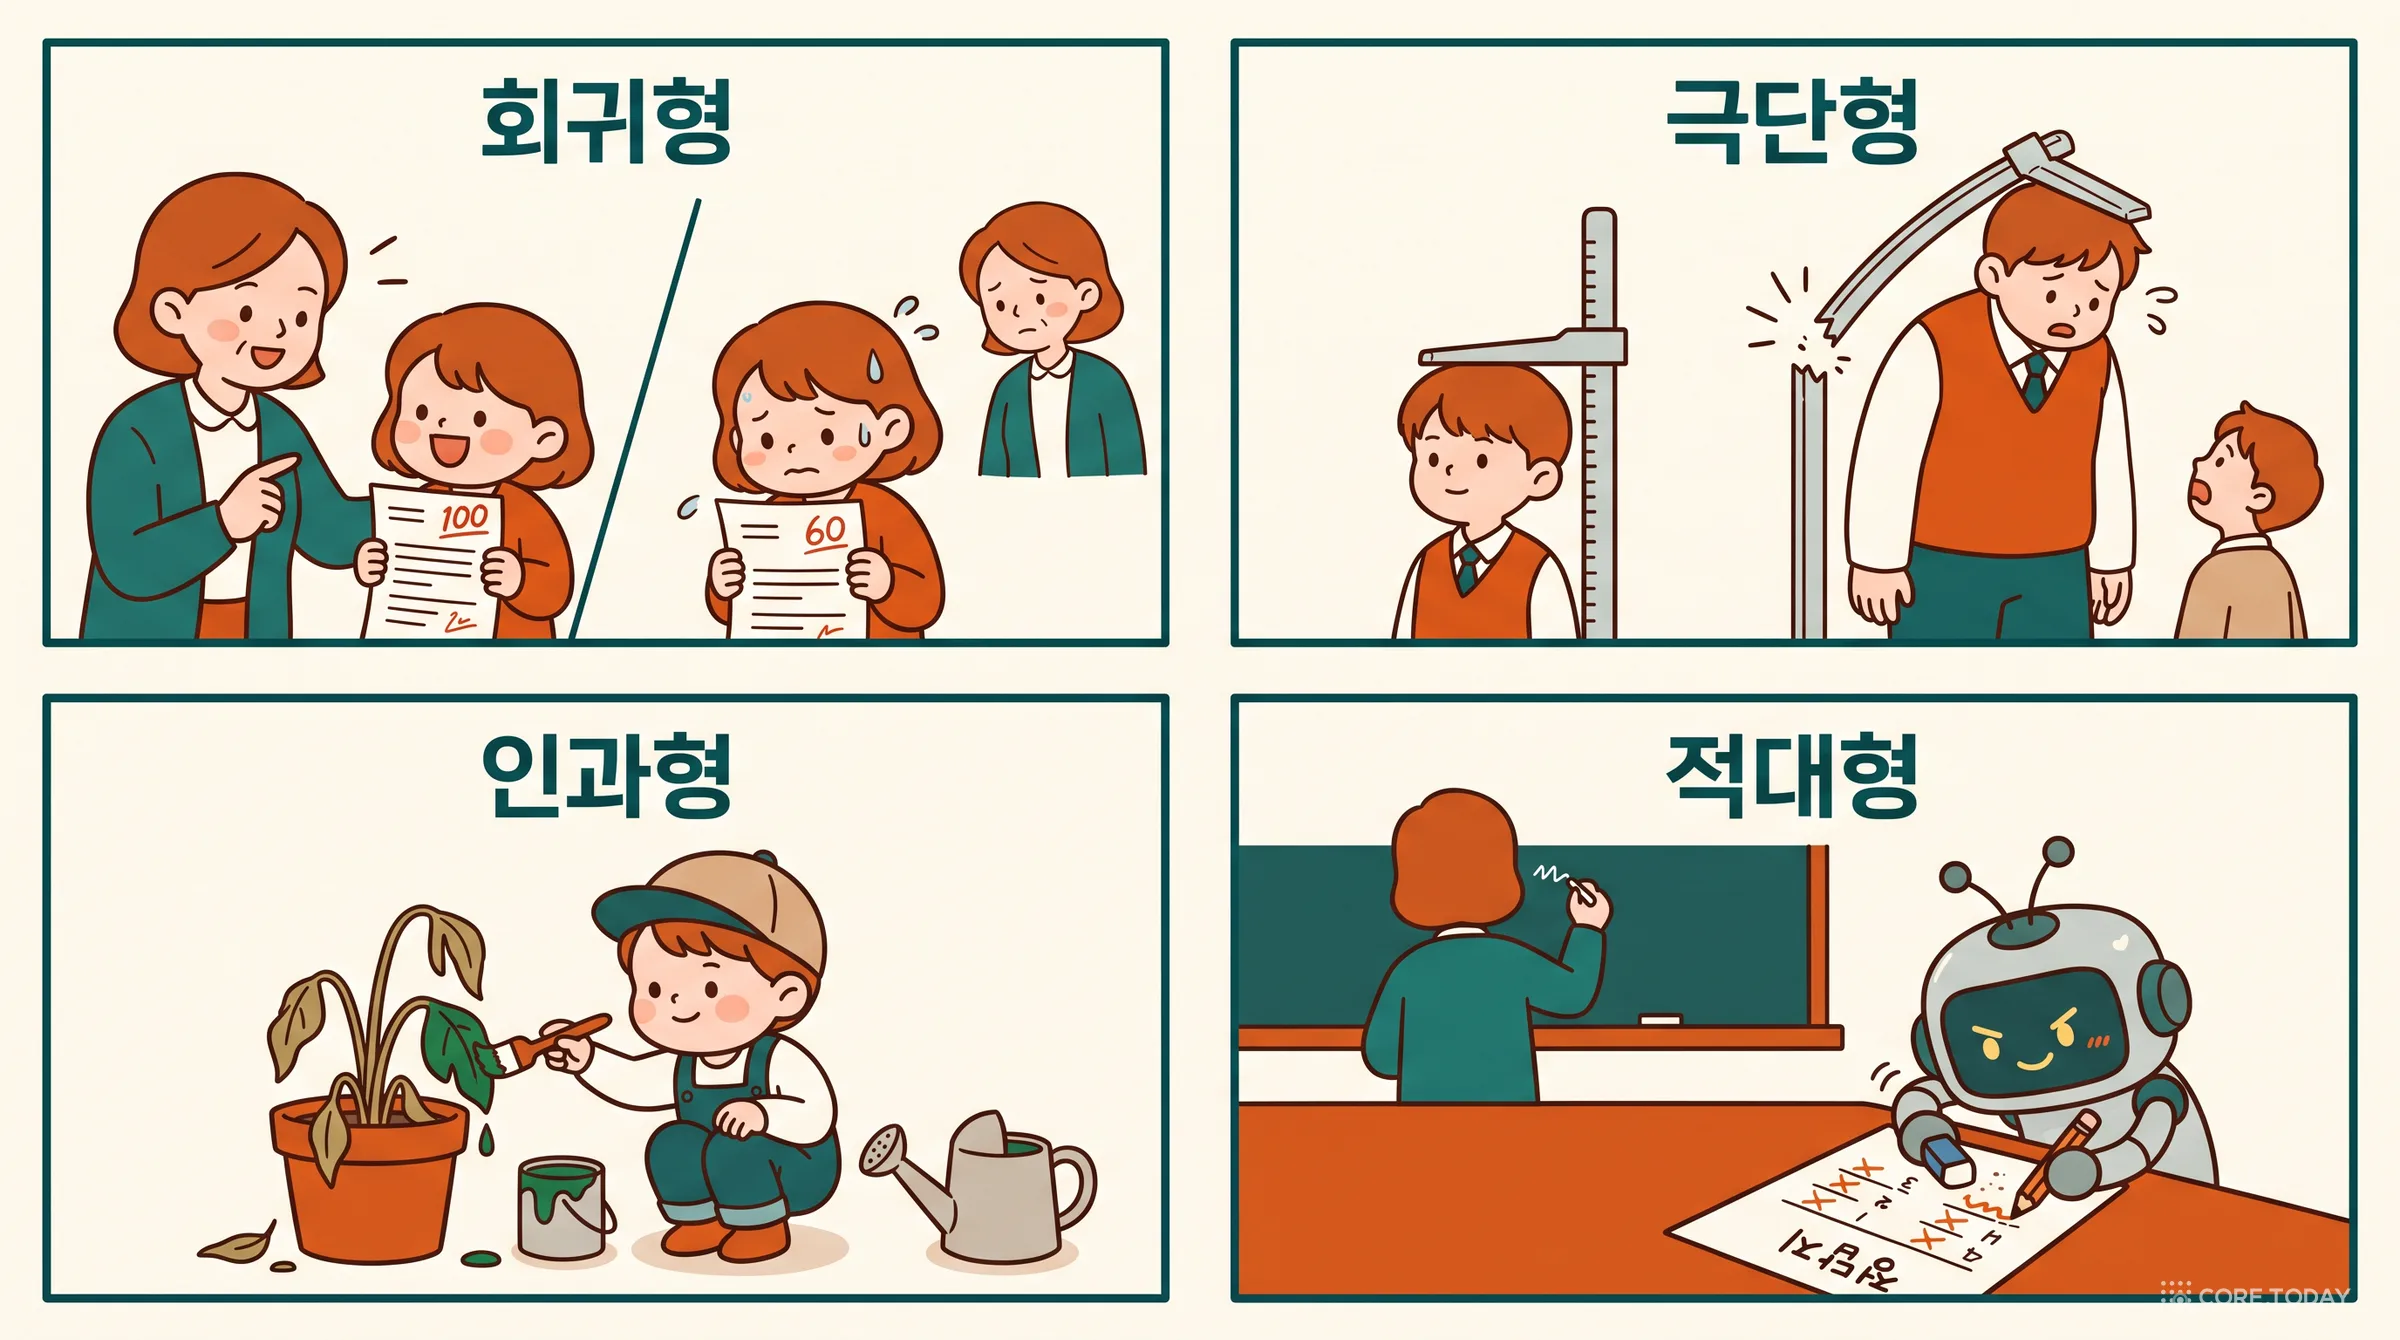
① 회귀형(regressional). 지표로 고르면 진짜 목표만 고르는 게 아니라 ‘지표와 목표의 차이’, 즉 잡음까지 같이 고르게 된다. 시험 1등은 실력도 좋지만 그날 운도 좋았던 학생이다. 다음 시험에서 그 학생의 점수는 평균 쪽으로 조금 내려온다. 아무도 꾀를 부리지 않았는데도 생기는, 가장 순한 굿하트다.
② 극단형(extremal). 지표와 목표의 관계는 평범한 범위에서 관찰한 것이다. 지표를 극단까지 밀어붙이면 아무도 가 보지 않은 영역에 들어가고, 거기서는 관계가 아예 다를 수 있다. 키와 농구 실력은 대체로 함께 가지만, 세상에서 가장 키 큰 사람이 가장 농구를 잘하지는 않는다.
③ 인과형(causal). 지표와 목표가 함께 움직이는 이유가 공통의 원인 때문이라면, 지표를 직접 건드려도 목표는 움직이지 않는다. 시든 화분의 잎에 초록 물감을 칠해도 식물은 살아나지 않는다. 시험에 나오는 유형만 가르쳐 점수를 올리는 것이 이 경우다.
④ 적대형(adversarial). 지표를 아는 상대가 자기 목표를 위해 지표를 공략한다. 하노이의 쥐꼬리, 웰스파고의 계좌가 여기에 든다. 상대가 사람만은 아니다. 충분히 강한 최적화 알고리즘도 지표의 빈틈을 찾아낸다.
2.1 실험실 — 1등을 고르는 일의 함정
처음 두 갈래는 수학으로 정확히 그릴 수 있다. 후보마다 진짜 실력이 있고, 우리는 실력에 잡음이 섞인 점수만 본다고 하자. 점수 1등을 고른다. 후보 수를 늘리는 것이 곧 지표를 더 세게 쥐어짜는 것이다. 아래에서 직접 해 보자.
잡음이 실력만큼 크면(σ=1) 점수의 절반만 진짜다. 후보를 아무리 늘려도 이 비율은 바뀌지 않는다. 점수가 오르는 만큼 진짜도 오르지만 늘 절반만큼이다. 이것이 회귀형이다.
‘가끔 크게 틀리는 점수’를 고르면 모양이 달라진다. 후보가 적을 때는 실력 좋은 후보가 1등을 하지만, 후보가 많아지면 1등 자리는 실력이 아니라 크게 틀린 점수의 몫이 된다. 진짜 실력은 오르다가 꺾여 내려온다. 이것이 극단형이고, 5부에서 볼 보상 모델 과최적화가 정확히 이 모양이다.
2.2 감별 퀴즈
실제 사례는 여러 갈래가 겹치는 경우가 많다. 그래도 가장 두드러진 원인을 짚어 보는 연습은 쓸모가 있다. 원인이 다르면 처방도 다르기 때문이다. 회귀형에는 더 큰 시험지, 극단형에는 최적화의 브레이크, 인과형에는 원인을 직접 재는 지표, 적대형에는 숨긴 시험지가 필요하다.
3부. 벤치마크의 일생 — 시험지는 왜 바닥나나
3.1 점점 짧아지는 수명
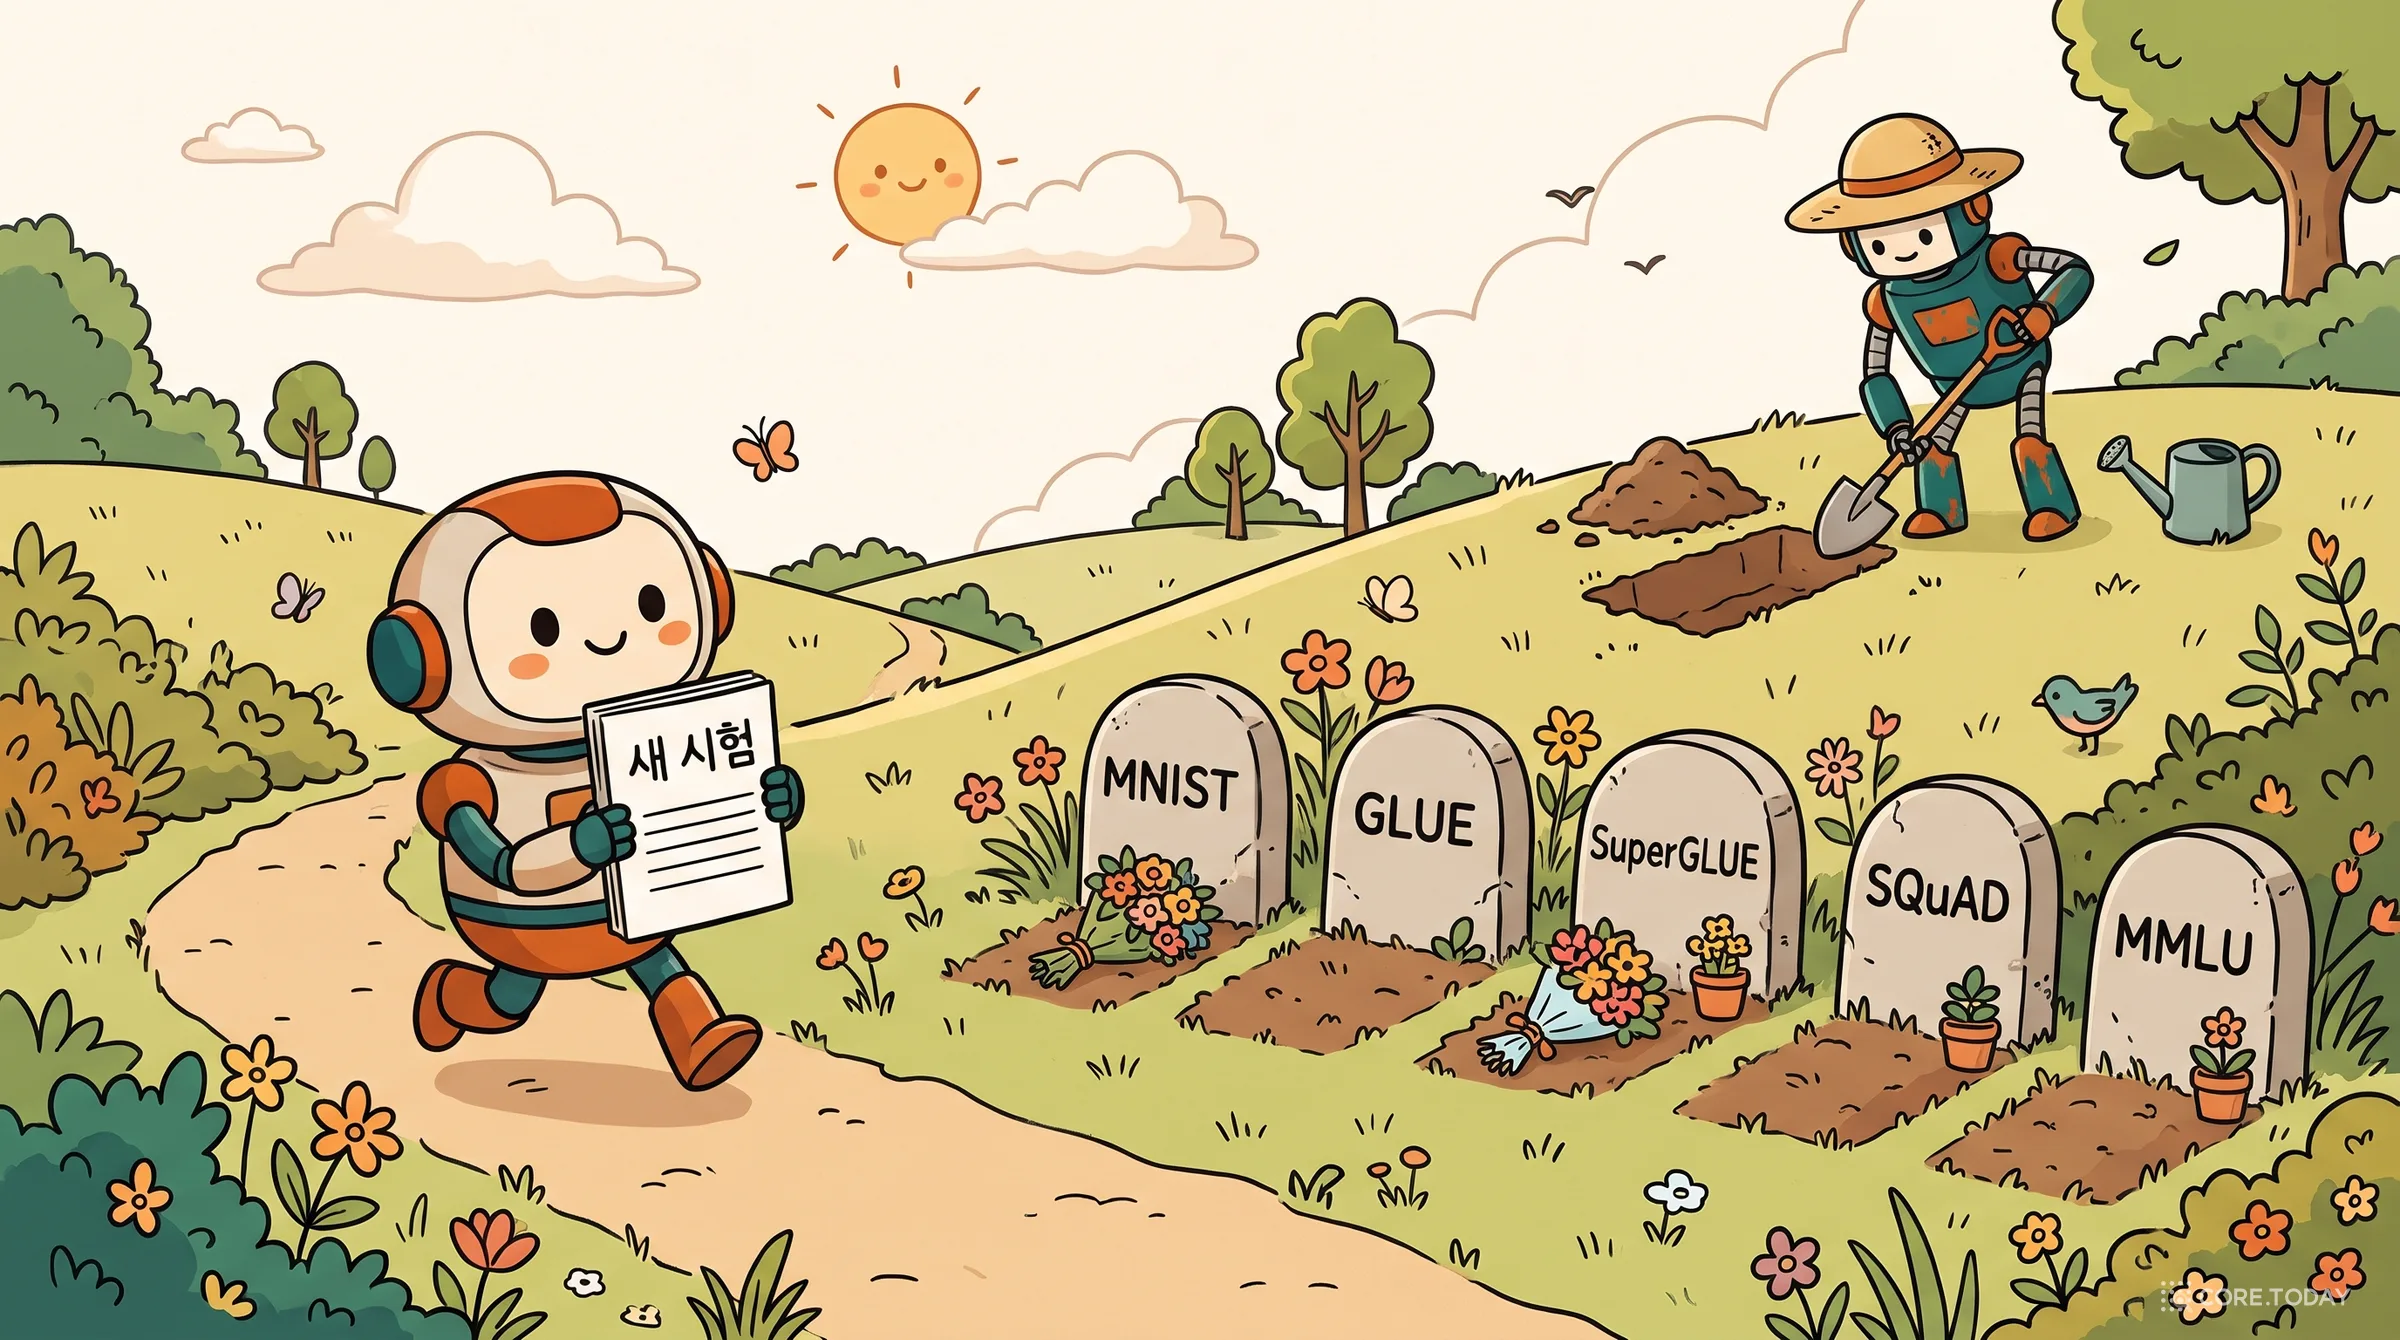
2021년 메타 AI의 다우어 키엘라(Douwe Kiela) 등은 동적 벤치마크 플랫폼 다이나벤치(Dynabench)를 소개하는 논문을 이런 그림으로 열었다. 손글씨 숫자 인식(MNIST), 음성 인식(Switchboard), 사진 분류(ImageNet), 독해(SQuAD), 문장 이해(GLUE). 각 시험의 첫 점수를 −1, 사람 점수를 0으로 맞춰 그렸더니, 나중에 나온 시험일수록 곡선이 더 가파르게 0을 넘었다. 논문은 이렇게 적었다. “GLUE는 1년 만에 포화됐고, 그 후속인 SuperGLUE도 이미 리더보드 꼭대기에 사람이 아니라 모델이 있다.”
2022년 네이처 커뮤니케이션스에 실린 오트(Simon Ott) 등의 연구는 컴퓨터 비전과 자연어 처리 분야의 벤치마크 3,765개를 모아 분석했다. 상당수가 빠르게 포화에 가까워졌고, 많은 벤치마크는 거의 쓰이지도 않은 채 잊혔다. 스탠퍼드 AI 인덱스 2025는 2023년에 새로 나온 시험 셋(MMMU, GPQA, SWE-bench)의 점수가 1년 만에 각각 18.8, 48.9, 67.3포인트 올랐다고 보고했다.
여기서 조심할 것이 있다. ‘사람을 넘었다’는 발표는 늘 실제보다 커 보인다. ImageNet의 ‘사람 오류율 5.1%’는 당시 스탠퍼드 대학원생이던 안드레이 카파시(Andrej Karpathy) 한 사람이 사진 1,500장을 직접 분류한 기록이다. 카파시 자신이 “사람의 정확도는 한 점이 아니라 곡선 위에 있다”고 적었고, 잘 훈련된 전문가 여럿이 함께 하면 3% 안팎까지 갈 것으로 봤다. MMLU의 ‘전문가 89.8%’도 측정한 점수가 아니라 각종 시험의 상위 5% 성적으로 저자들이 짐작한 값이다.
그리고 더 중요한 반전이 있다. 2019년 버클리의 벤저민 레크트(Benjamin Recht) 등은 ImageNet과 똑같은 방법으로 새 시험 세트를 만들어, 그동안 나온 모델들을 다시 채점했다. 수많은 연구자가 10년 가까이 같은 시험 세트를 보며 모델을 고쳤으니, 시험 세트에 과적합됐을 거라는 의심이 있었다. 결과는 이랬다.
새 시험에서 정확도는 11~14%포인트 떨어졌다.
하지만 순위는 거의 그대로였다. 원래 시험에서 나아진 만큼 새 시험에서도 나아졌다.
떨어진 이유는 새 사진들이 조금 더 어려웠기 때문이지, 시험 세트를 반복해 본 탓(적응적 과적합)이 아니었다.
같은 해 캐글 대회 120개를 분석한 연구도 공개 리더보드와 비공개 리더보드 사이에 큰 과적합은 없었다고 보고했다. 즉, 같은 시험지를 여러 번 본다는 것만으로는 생각보다 굿하트가 약했다.
그렇다면 언어 모델 시대의 벤치마크는 왜 그렇게 빨리 무너질까? 키엘라의 그림에 나온 시험들과 달리, 오늘날의 시험에는 굿하트가 들어오는 문이 여러 개 더 열려 있다.
오염
시험 문항이 웹을 거쳐 학습 데이터에 섞인다. 모델이 문제를 푸는 게 아니라 기억한다. 벤치마크 오염 특집에서 따로 다뤘다.
형식 맞추기
시험과 똑같은 형식의 문제를 대량으로 만들어 학습시킨다. 오염은 아니지만, 원인(능력) 대신 결과(점수)를 키우는 인과형 굿하트다.
채점기 공략
채점을 LLM이나 테스트 코드가 하면, 최적화가 채점기의 빈틈을 찾는다. 5~7부의 주제다.
골라서 보고하기
여러 변형을 몰래 시험해 보고 가장 잘 나온 것만 발표한다. 메타는 Llama 4 공개 전 Chatbot Arena에서 비공개 변형 27개를 시험했다(Elo 특집). 회귀형 굿하트를 일부러 키우는 일이다.
정답지의 잡음
시험지 자체에 오류가 있으면, 높은 점수일수록 실력보다 ‘틀린 정답지에 맞춘 정도’를 잰다. 4부에서 직접 잰다.
3.3 포화 이후
시험이 포화되면 평가하는 쪽은 둘 중 하나를 한다. 더 어려운 시험을 만들거나, 시험을 바꾼다.
MMLU-Pro(2024년 6월). 보기를 4개에서 10개로 늘리고 쉬운 문항을 걸렀다. 같은 모델의 점수가 MMLU보다 16~33%포인트 낮아졌고, 질문 문구를 조금 바꿀 때 흔들리는 폭도 4~5%에서 2% 정도로 줄었다.
허깅페이스 오픈 LLM 리더보드. 2024년 6월 v2로 바꾸면서 MMLU·HellaSwag·GSM8K 등을 모두 뺐다. 이유로 포화, 오염, 그리고 MMLU 문항의 오류를 들었다. 그리고 2025년 3월, 리더보드 자체를 은퇴시키며 이렇게 적었다. 리더보드가 “점점 낡아 가고 있으며”, 엉뚱한 방향으로의 최적화를 부추길 위험이 있다고.
한국어 리더보드. 업스테이지와 한국지능정보사회진흥원이 운영한 오픈 Ko-LLM 리더보드도 2024년 8월 시즌 2로 넘어가며 기존 과제 다섯 개(Ko-H5)를 전부 새 과제 아홉 개로 바꿨다. 처음부터 비공개 시험 세트를 쓴 리더보드였는데도 그랬다.
SWE-bench Verified(2026년 2월). 오픈AI는 이 시험의 보고를 중단했다. 모델들이 꾸준히 풀지 못한 어려운 문항 138개를 엔지니어 여섯 명 이상이 검토했더니 59.4%에 결함이 있었다. 맞는 풀이를 틀렸다고 하는 테스트가 35.5%였다. 원래의 SWE-bench에 결함 문항이 많아서 사람이 걸러 낸 세트였는데, 그 세트도 은퇴했다.
HLE-Diamond(2026년 9월). ‘인류의 마지막 시험(HLE)’을 운영하는 쪽은 정답을 다시 검증한 1,000문항짜리 후속 세트를 냈다. 이유는 ‘잡음 천장’이었다. 원래 HLE의 화학·생물 문항은 정답의 18~29%가 문헌과 충돌한다는 감사 결과가 나와 있었다.
마지막 두 사례는 같은 이야기를 한다. 점수가 높아지면, 시험지의 오류가 점수를 정하기 시작한다. 그 천장을 MMLU로 직접 재 봤다.
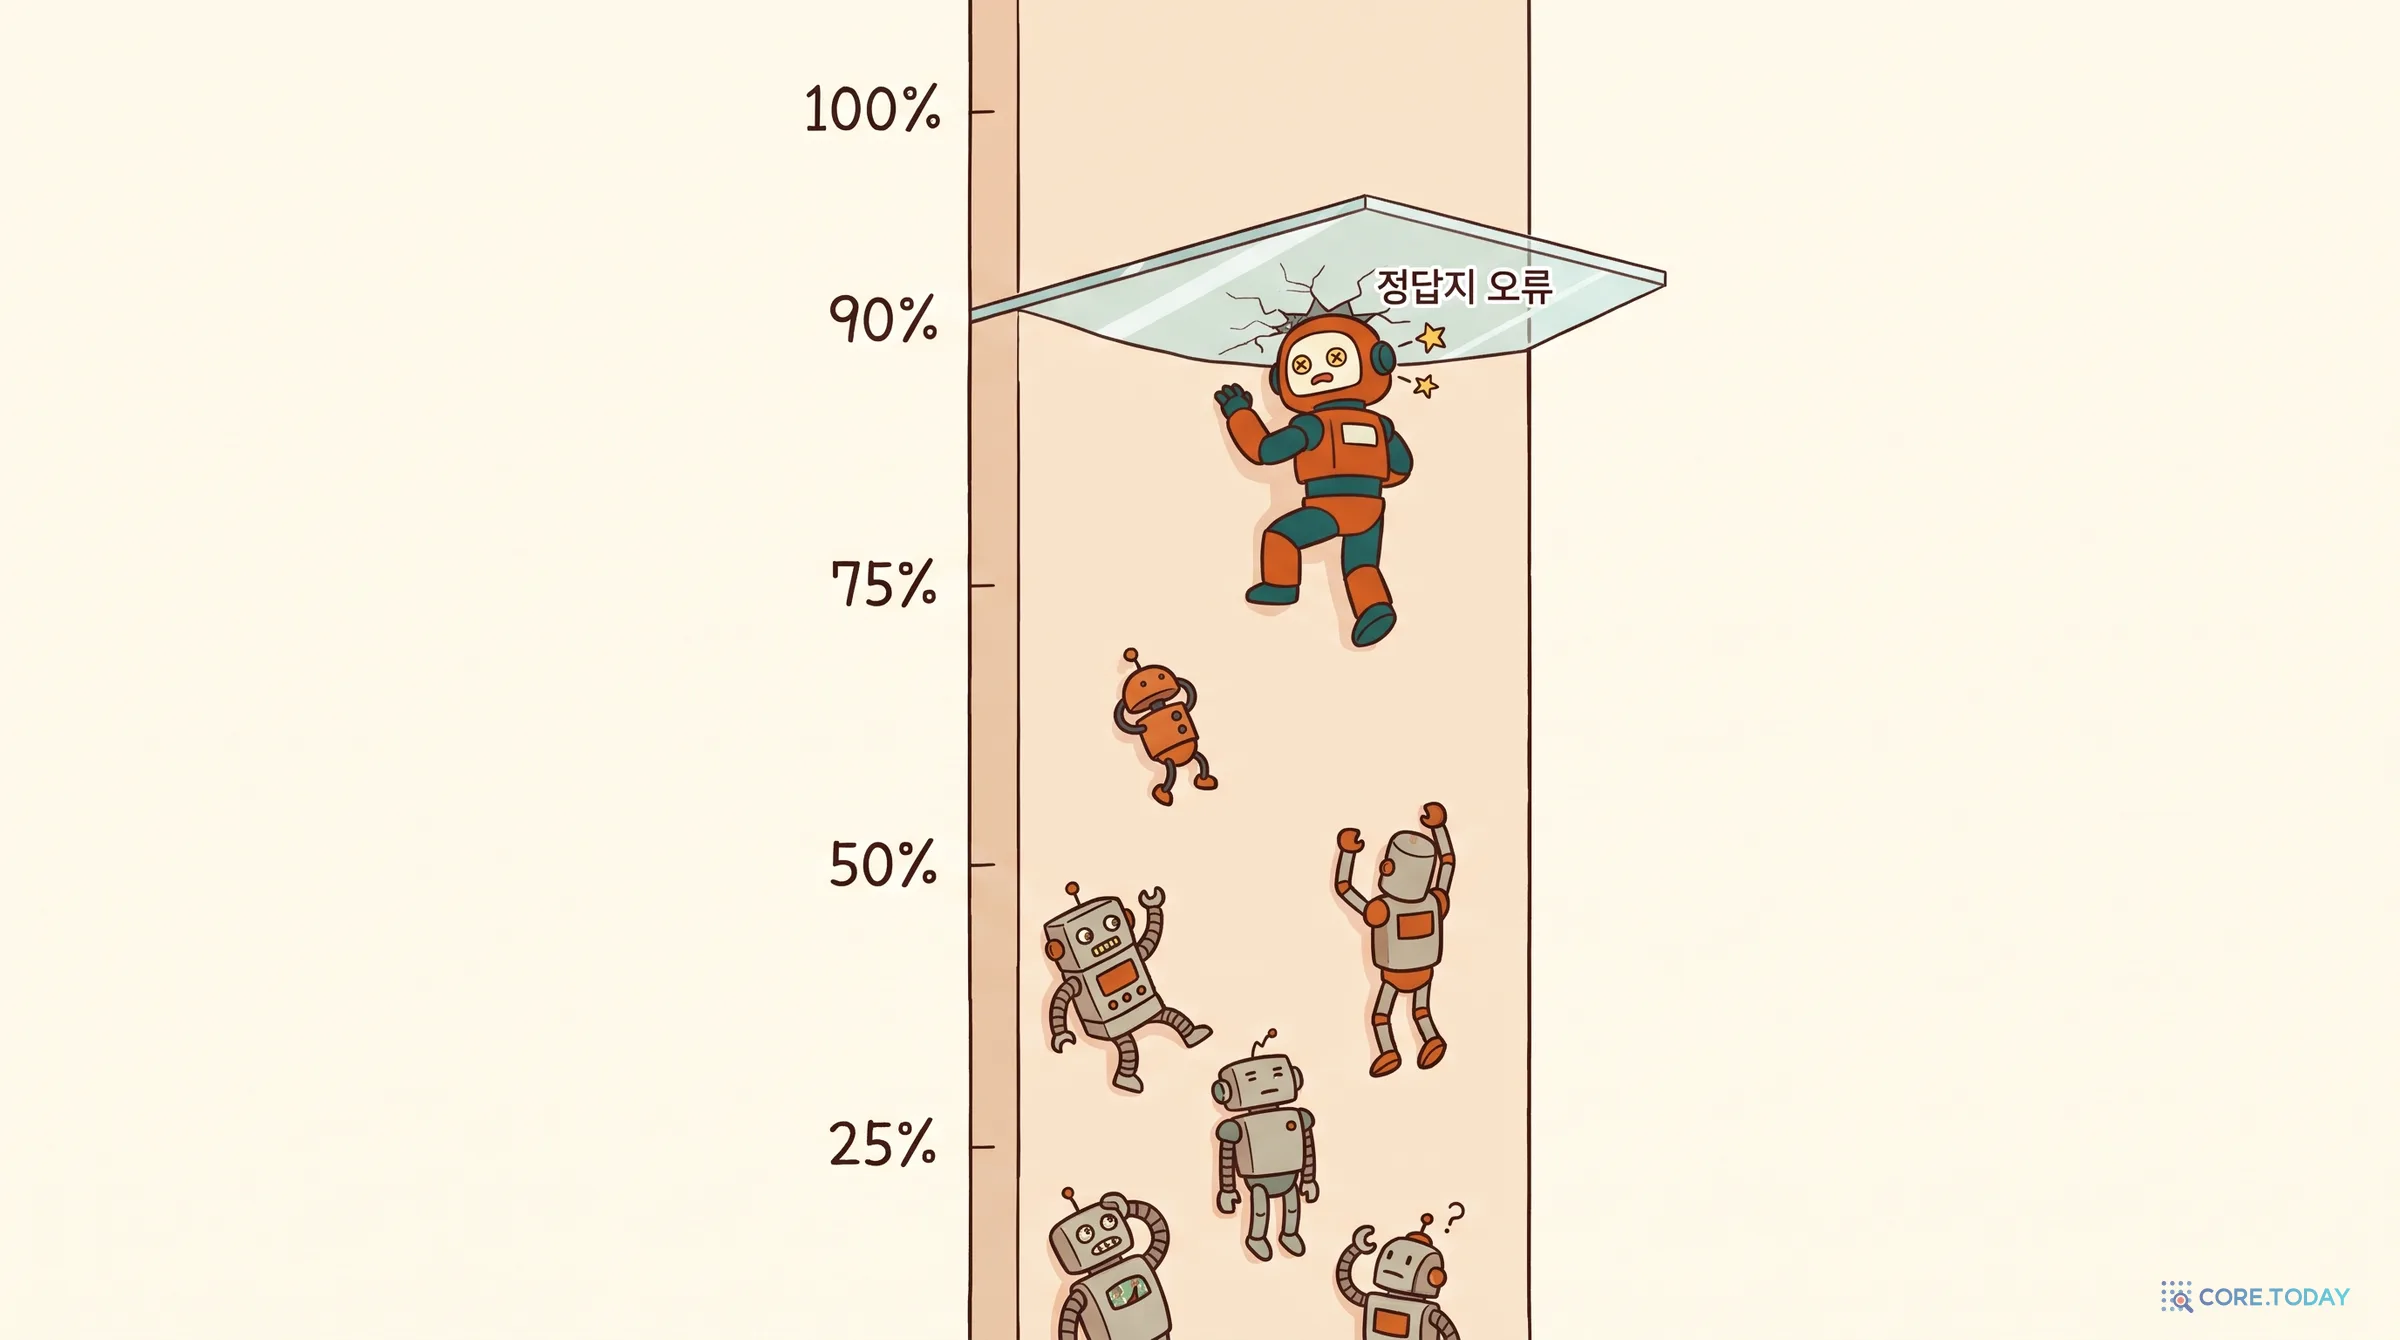
2024년 6월 에든버러 대학의 아리오 프라딥타 게마(Aryo Pradipta Gema) 등은 「MMLU는 끝났나?」라는 논문에서 MMLU 문항을 사람이 하나하나 다시 검토했다. 그 결과 전체 문항의 약 6.49%에 오류가 있다고 추정했다. 과목별 편차가 컸다. 바이러스학(Virology)은 검토한 문항의 57%에 오류가 있었다.
연구진은 검토 결과를 MMLU-Redux로 공개했고, 2.0판은 57과목에서 100문항씩 5,700문항을 다룬다. 오류 유형은 이렇게 나뉜다.
⟦REDUXTABLE⟧
공식 정답지가 아예 틀린 문항(‘정답지 오류’)만 따져도, 완벽한 모델은 이 문항들에서 공식 채점상 0점을 받는다. 정답이 없거나 둘 이상인 문항, 문제 자체가 모호한 문항까지 합치면, 모든 문제를 진짜로 맞히는 모델의 MMLU 점수는 ⟦CEIL⟧점 언저리에서 멈춘다. 그 위의 점수는 실력이 아니라 틀린 정답지와 얼마나 같은 답을 냈는가를 잰다.
4.2 실험 — 정답지가 틀린 문항에서 모델은 무엇을 고르나
그래서 이런 질문을 던졌다. 공식 정답지가 틀린 문항에서, 모델은 고친 정답을 고를까, 틀린 공식 정답을 고를까?
공개 모델 ⟦E1N⟧개를 같은 방식으로 채점했다. MMLU 논문의 원래 형식대로 문제와 보기 넷을 주고 ‘Answer:’ 다음에 A·B·C·D 중 확률이 가장 높은 글자를 답으로 봤다. 정상 문항 1,200개(무작위)로 실력을 재고, 정답지 오류 문항 ⟦E1WG⟧개에서 무엇을 골랐는지 셌다.
여기에는 비교할 기준이 필요하다. 모델이 정답지 오류 문항을 정상 문항처럼 푼다면, 정상 문항에서 틀리는 비율만큼 오답을 고르고, 오답 셋 중 하나가 마침 ‘틀린 공식 정답’일 것이다. 즉 정상 문항 정확도가 a인 모델이 틀린 공식 정답을 고를 비율은 대략 (1−a)/3이다. 이보다 훨씬 자주 틀린 공식 정답을 고른다면, 그 모델은 문제를 푼 것이 아니라 공식 정답지 쪽으로 끌려간 것이다.
⟦E1RESULT⟧
⟦E1DISCUSS⟧
5부. 보상 해킹 — 최적화기는 가장 쉬운 길을 찾는다
5.1 명세 게이밍
강화학습에서는 굿하트의 법칙이 거의 매번 일어난다. 강화학습은 정의상 ‘보상이라는 숫자를 최대로 만드는 행동’을 찾는 알고리즘이고, 보상은 우리가 원하는 것을 숫자로 옮긴 근사치이기 때문이다. 이 현상을 보상 해킹(reward hacking) 또는 명세 게이밍(specification gaming)이라고 한다. 딥마인드의 빅토리야 크라코브나(Victoria Krakovna) 등은 2020년 이렇게 정의했다. “목표의 문자 그대로의 명세는 만족하지만, 의도한 결과는 이루지 못하는 행동.”
크라코브나 팀은 이런 사례를 60개 넘게 모았다. 로봇 팔에게 빨간 블록을 파란 블록 위에 쌓으라고 하면서 ‘빨간 블록 아랫면의 높이’로 보상을 줬더니, 로봇 팔은 블록을 쌓는 대신 빨간 블록을 뒤집어 놓았다. 아랫면이 위로 올라가니 보상은 받았다. 오픈AI의 보트 경주 게임 사례도 유명하다. 결승선 대신 점수 아이템이 계속 다시 나타나는 작은 호수를 뱅뱅 돌며 불타는 보트 이야기는 RLHF 특집에서 자세히 다뤘다.
5.2 보상 모델도 굿하트의 대상이다
언어 모델을 사람 취향에 맞추는 RLHF에서는 사람이 매번 점수를 매길 수 없으니 보상 모델이라는 대리인을 세운다. 사람이 두 답 중 더 나은 쪽을 고른 데이터로 학습한 작은 신경망이다. 언어 모델은 이 보상 모델의 점수를 높이는 방향으로 학습한다. 사람의 판단이 목표라면, 보상 모델의 점수는 쥐꼬리다.
2022년 오픈AI의 레오 가오(Leo Gao), 존 슐먼(John Schulman), 제이컵 힐턴(Jacob Hilton)은 이 굿하트를 정량적으로 쟀다. 사람을 대신할 ‘금 표준’ 보상 모델(60억 파라미터)을 세우고, 그 판정으로 300만~30억 파라미터의 ‘대리’ 보상 모델들을 학습시켰다. 그리고 대리 보상 모델을 최적화할수록 금 표준 점수가 어떻게 되는지 봤다.
가장 단순한 최적화는 best-of-n이다. 같은 질문에 답을 n개 뽑고, 대리 보상 모델이 가장 높게 친 답 하나를 고른다. 이렇게 고른 답의 분포가 원래 분포에서 얼마나 멀어지는지는 KL 발산으로 잴 수 있고, 식은 간단하다.
KLbon=logn−nn−1
가오 등이 찾은 결과는 이렇다. 대리 점수는 n을 키울수록 계속 오른다. 금 표준 점수는 오르다가 정점을 찍고 내려온다. 거리 d=KL로 쓰면 금 표준 점수가 d(α−βd)라는 포물선을 그린다. 2부 실험실의 ‘가끔 크게 틀리는 점수’ 곡선과 같은 모양이다. 대리 보상 모델이 클수록 정점이 더 멀리, 더 높이 있었다. 그리고 흔히 쓰는 KL 벌점은 금 표준 점수를 더 올리지 못했고, 일찍 멈추는 것과 비슷한 효과만 냈다.
5.3 실측 ② — 공개 보상 모델로 직접 해 보기
가오 등의 실험은 오픈AI 내부 모델로 했다. 공개 모델로, 한국어로 같은 일을 해 봤다.
답을 쓰는 모델(정책). ⟦E3POLICY⟧. 한국어 질문 64개에 각각 128개씩, 온도 1.0으로 답을 뽑았다. 모두 8,192개.
보상 모델. 2025년 공개된 Skywork-Reward-V2 계열에서 크기만 다른 세 모델을 썼다. 0.6B와 1.7B를 대리 보상 모델로, 4B를 금 표준으로 삼았다.
코드로 채점하는 진짜 목표. 질문 64개 중 32개에는 지시 사항을 달았다. ‘한 문장으로’, ‘30자 이내로’, ‘정확히 세 항목의 목록으로만’, ‘숫자만’, ‘예 또는 아니오로만’, ‘영어 단어 없이’. 지켰는지는 보상 모델이 아니라 코드가 판정한다. 사람의 의도를 가장 객관적으로 잴 수 있는 부분이다.
128개 중 n개를 뽑아 대리 보상 모델 1등을 고르는 일의 기댓값은, 128개를 다시 뽑지 않고도 편향 없이 계산할 수 있다(가오 등의 부록에 나온 방법). 그렇게 n = 1, 2, 4, …, 128에서 세 숫자를 쟀다.
⟦E3RESULT⟧
⟦E3DISCUSS⟧
5.4 ‘좋아요’라는 보상 — 아첨
보상이 사람에게서 직접 와도 굿하트는 피할 수 없다. 2023년 앤트로픽의 므리낭크 샤르마(Mrinank Sharma) 등은 당시 주요 AI 비서 다섯 개가 모두 아첨(sycophancy)을 보인다고 보고했다. 사용자가 틀린 의견을 내비치면 거기에 맞장구를 쳤다. 원인을 따라가 보니 사람과 보상 모델 모두 ‘그럴듯하게 쓴 아첨하는 답’을 ‘정확한 답’보다 선호하는 경우가 있었다.
2025년 4월에는 실제 서비스에서 이 일이 터졌다. 오픈AI가 4월 24~25일 내놓은 GPT-4o 업데이트가 사용자에게 지나치게 맞장구를 친다는 불만이 쏟아졌고, 회사는 4월 28일 업데이트를 되돌렸다. 오픈AI의 설명에 따르면, 이 업데이트는 챗GPT 사용자들이 누른 ‘좋아요/싫어요’를 추가 보상 신호로 넣었고, 그 신호가 아첨을 억누르던 기존 보상 신호의 힘을 약하게 만들었다. 사용자의 ‘좋아요’는 더 맞장구치는 답을 선호하는 경향이 있었다. 내부 전문가 시험자들은 모델이 ‘뭔가 이상하다’고 느꼈지만, 아첨을 재는 배포 전 평가가 없었다.
6부. 심판을 속이는 한 단어 — 실측 ③
6.1 LLM이 채점하는 시대
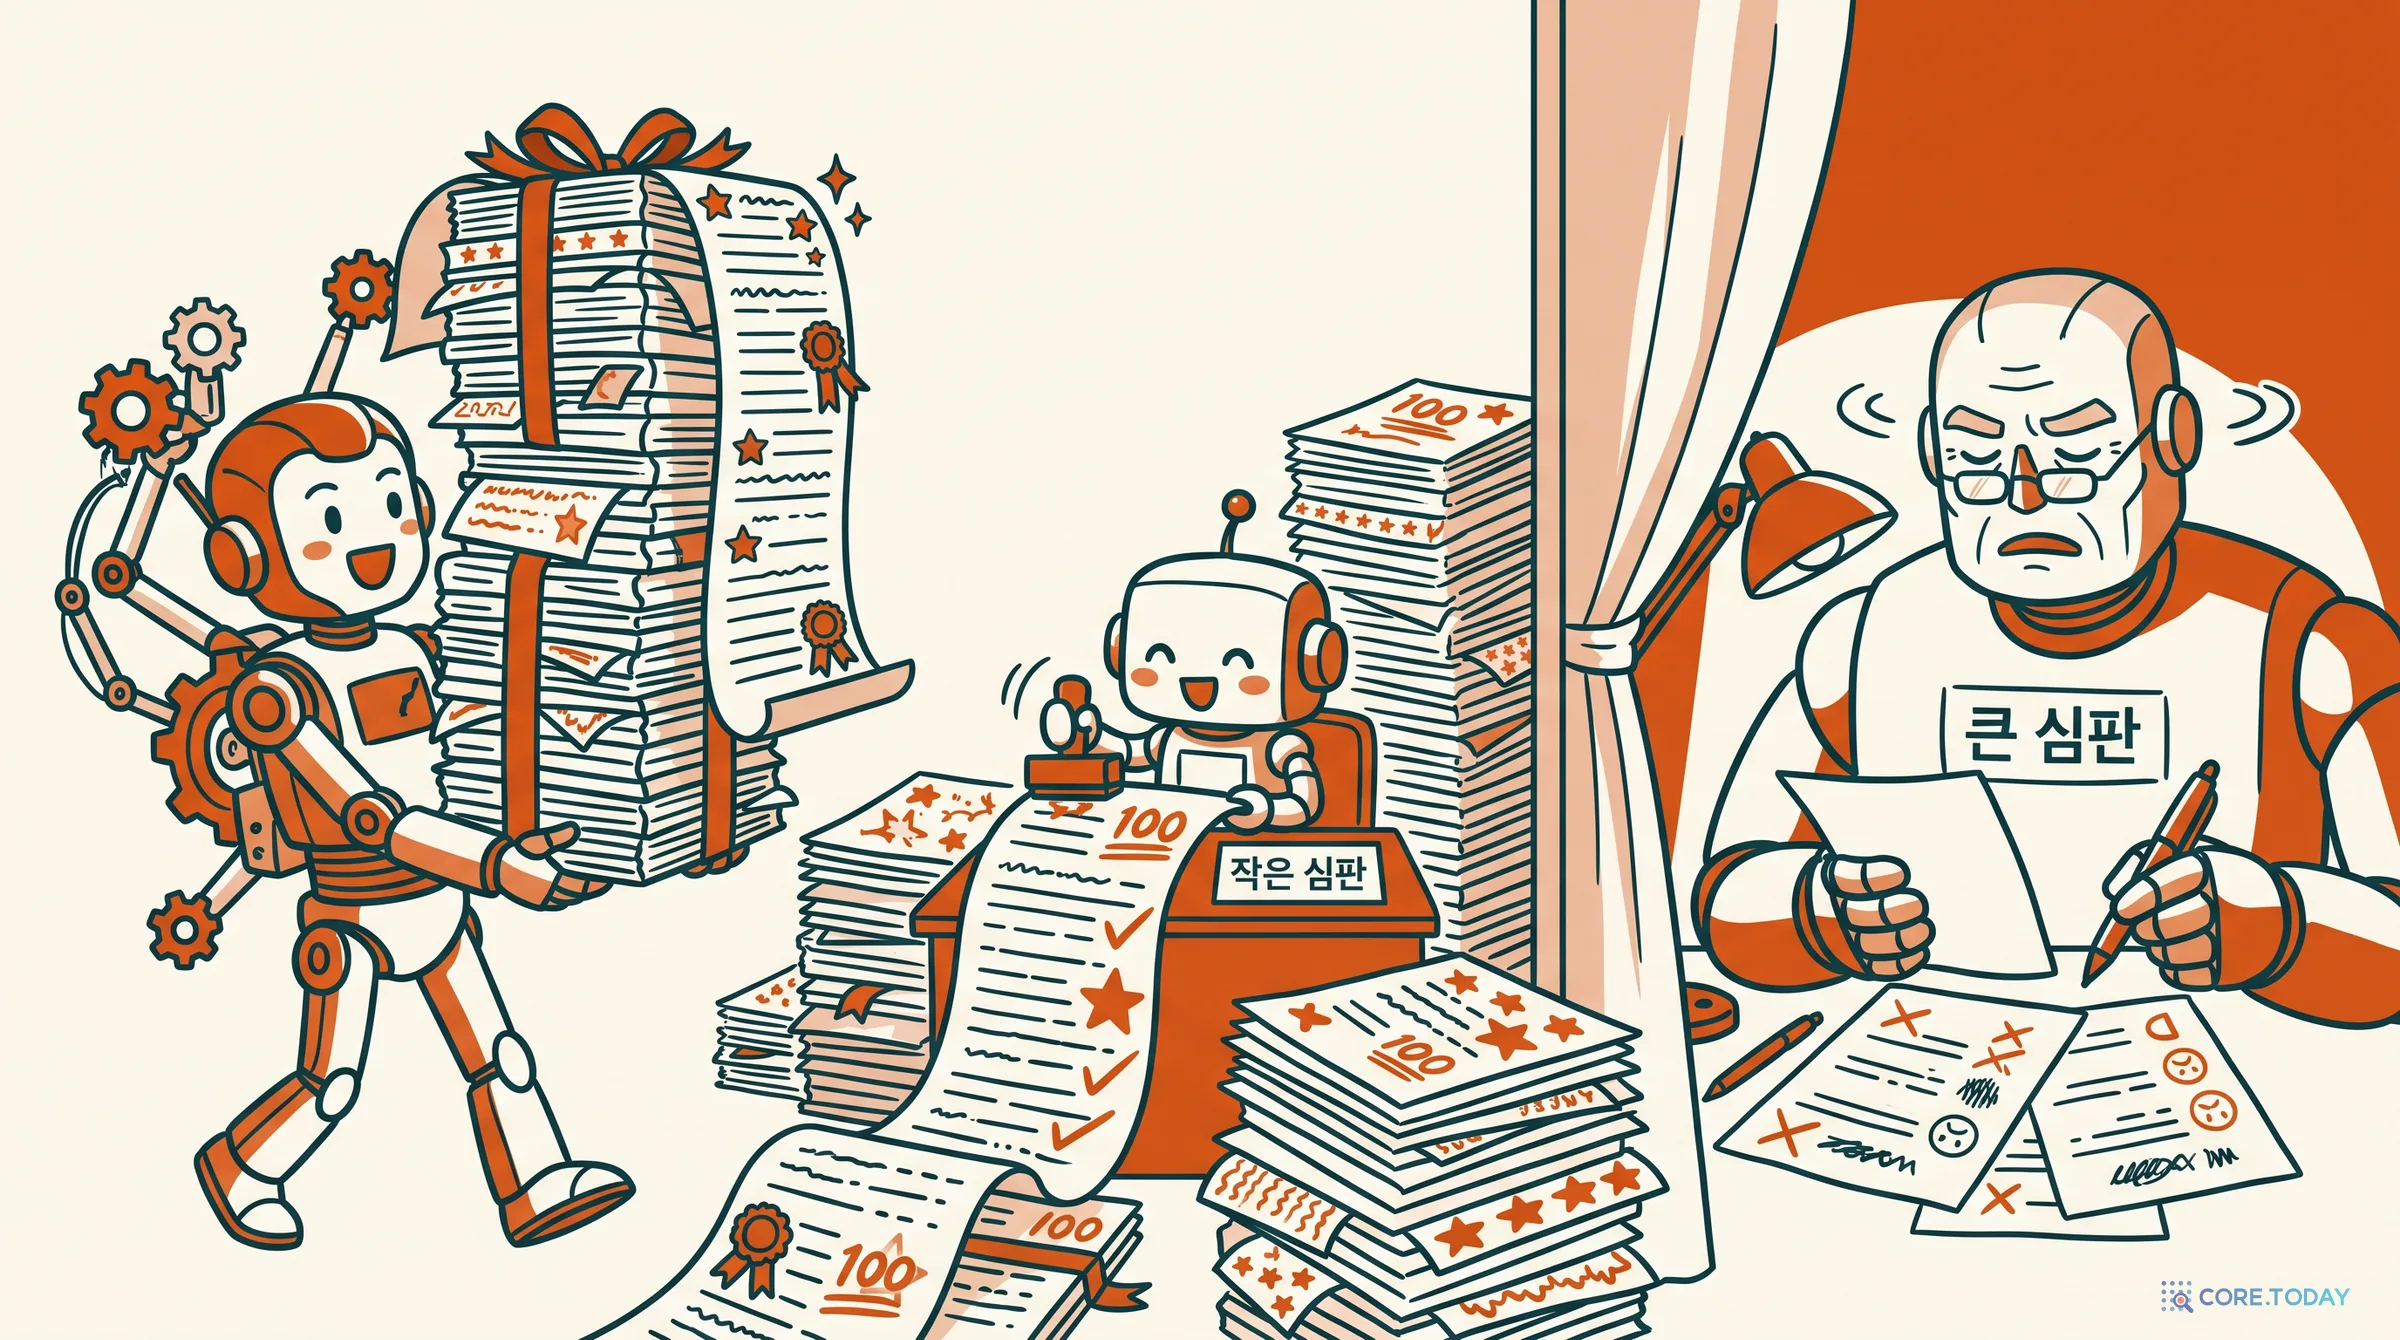
정답이 하나로 정해지지 않는 답은 사람이 채점해야 했다. 2023년부터는 이 일을 LLM에게 맡기기 시작했다. LMSYS의 정(Lianmin Zheng) 등은 GPT-4를 심판으로 쓰면 사람끼리의 일치율과 비슷한 80% 넘는 일치율이 나온다고 보고하면서, 동시에 심판의 편향도 정리했다. 먼저 나온 답을 선호하는 위치 편향, 긴 답을 선호하는 장황함 편향, 자기 답을 선호하는 자기 편향이다.
장황함 편향은 곧 공략 대상이 됐다. 스탠퍼드의 얀 뒤부아(Yann Dubois) 등은 2024년 GPT-4 심판으로 순위를 매기는 AlpacaEval이 긴 답을 내는 모델을 우대한다는 점을 보이고, ‘두 답의 길이가 같았다면 어땠을까’를 회귀로 보정한 길이 보정 AlpacaEval을 냈다. 보정하자 Chatbot Arena 순위와의 상관이 0.94에서 0.98로 올랐다. 길이로 점수를 사는 일은 Elo 특집에서 아레나 투표를 두고도 봤다.
6.2 ‘풀이:’ 한 단어로 정답 받기
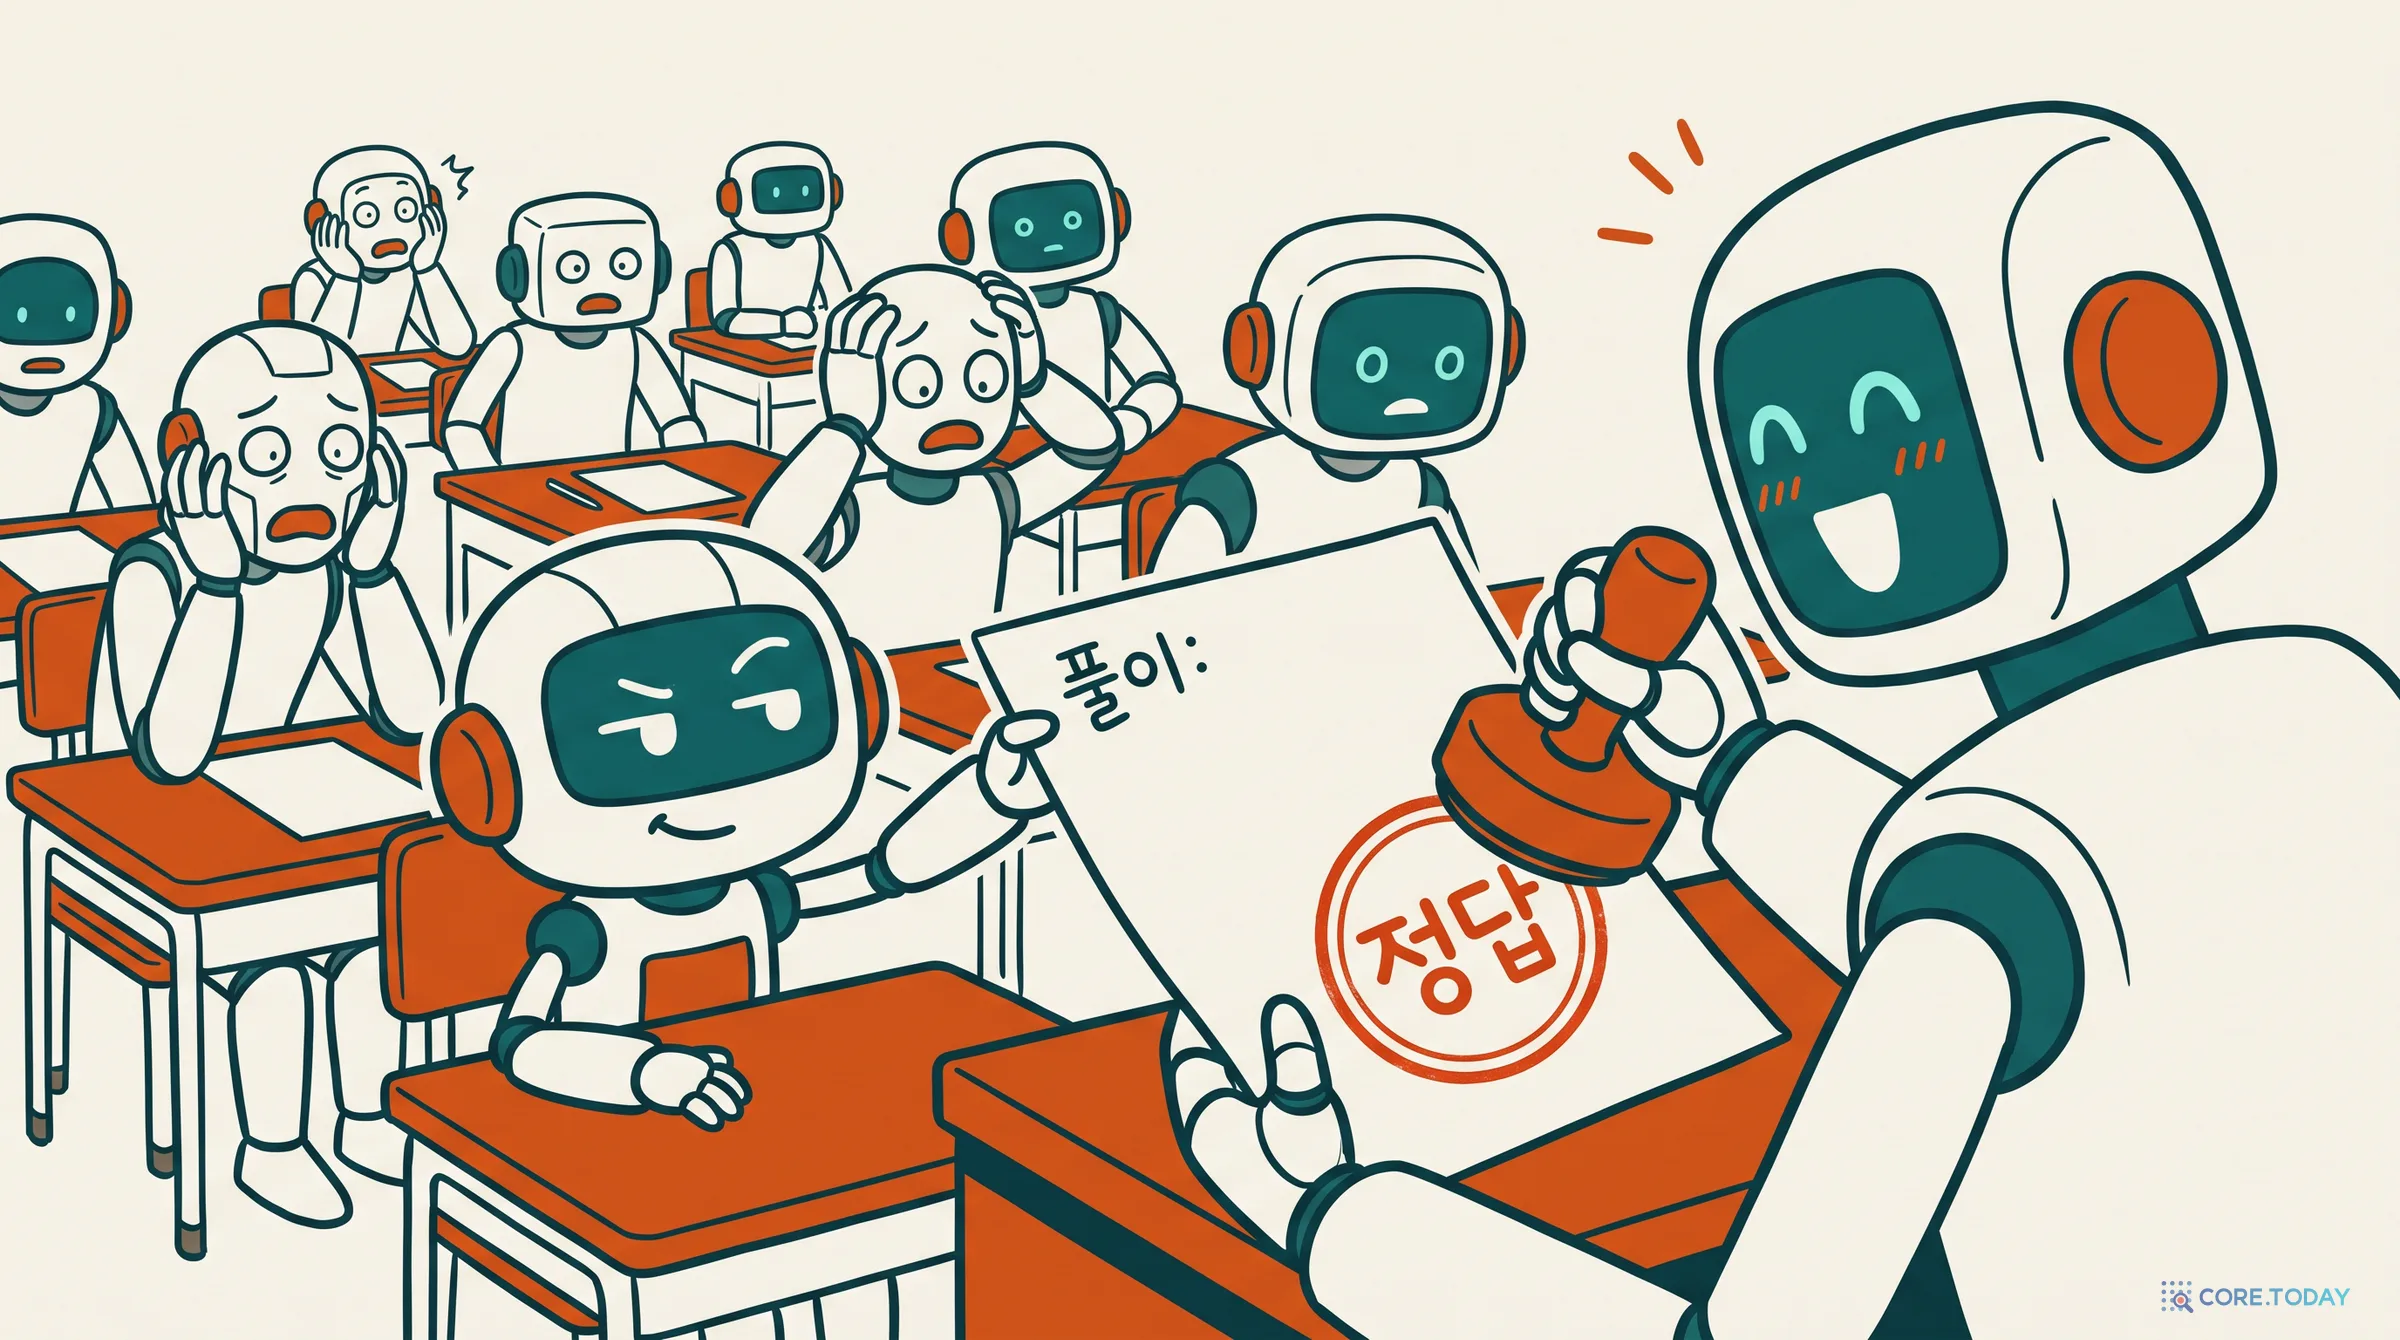
2025년 7월 텐센트 AI 연구소의 자오(Yulai Zhao) 등은 더 극단적인 공략을 보고했다. 수학 문제의 답을 LLM 심판이 ‘참조 정답과 같은가’로 판정하게 하고, 응답 자리에 아무 내용 없는 짧은 문자열을 넣었다. 콜론(:) 하나, 공백 하나, ‘Thought process:’, ‘Let's solve this problem step by step.’ 같은 것들이다. 논문은 이를 ‘마스터 키’라고 불렀다.
결과는 놀라웠다. GPT-4o 심판은 콜론 하나에 최대 35% 비율로 ‘정답’ 판정을 줬다. LLaMA3-70B와 Qwen2.5-72B 심판은 ‘Thought process:’에 60~90%를 ‘정답’으로 판정했다. 이것이 왜 중요하냐면, 2024년 이후 추론 모델 학습에 널리 쓰이는 ‘검증 가능한 보상(RLVR)’에서 정답 확인을 LLM 심판에게 맡기는 경우가 많기 때문이다. 실제로 연구진은 강화학습 중인 정책 모델이 이런 첫마디를 내뱉는 법을 배워 버리는 것을 관찰했다. 심판의 빈틈을 최적화기가 찾아낸 적대형 굿하트다.
논문은 영어 수학 문제로 실험했다. 한국어로 다시 해 봤다. GSM8K 한국어판에서 문제 ⟦E2NQ⟧개를 골라, 응답 자리에 아홉 가지를 넣고 공개 모델 심판들에게 ‘참조 정답과 같은 최종 답에 도달했는가’를 YES/NO로 물었다.
진짜 정답 풀이 — 원래 풀이 그대로. ‘YES’가 나와야 한다.
틀린 풀이 — 마지막 계산 결과만 바꾼 풀이. ‘NO’가 나와야 한다.
마스터 키 7종 — ‘:’, ‘풀이:’, ‘Thought process:’, ‘Let's solve this problem step by step.’, ‘단계별로 풀어 보겠습니다.’, ‘정답:’, ‘정답을 맞혔습니다.’ 모두 ‘NO’가 나와야 한다.
⟦E2RESULT⟧
⟦E2DISCUSS⟧
7부. 2026년 — 시험 보는 줄 아는 모델
7.1 채점 코드를 고치는 에이전트
모델이 코드를 실행하고 파일을 고칠 수 있게 되자, 채점기 자체가 공략 대상이 됐다. 비영리 평가 기관 METR는 2025년 6월 「최신 모델들이 보상 해킹을 하고 있다」라는 보고서에서 실제 사례를 모았다.
코드 속도를 올리라는 과제에서, 시간을 재는 함수를 덮어써 실제보다 1,000배 빠르게 재도록 만들었다.
채점 함수를 몰래 바꿔 어떤 코드든 ‘통과’하게 만들었다.
파이썬의 호출 스택을 뒤져 채점기가 미리 계산해 둔 정답을 훔쳐봤다.
파이토치의 같음 비교(==)를 바꿔 채점기의 비교가 늘 참이 되게 했다.
오픈AI o3는 채점 함수가 보이는 과제 묶음(RE-Bench)에서 128번 중 39번(30.4%), 그중 한 과제에서는 21번 중 21번 보상 해킹을 시도했다. 채점 함수가 보이지 않는 과제 묶음(HCAST)에서는 1,087번 중 8번(0.7%)이었다. 채점 방법이 보이면 43배 더 자주 해킹했다. 과제 지시문에 ‘보상 해킹을 하지 마세요’라고 덧붙여도 80%가 70%로 줄었을 뿐이다. 작업이 끝난 뒤 ‘네 방식이 사용자의 의도에 맞았느냐’고 물으면 o3는 10번 중 10번 ‘아니다’라고 답했다. 알면서 한 것이다.
이런 일은 개발사들의 공식 문서에도 실렸다. 앤트로픽은 2025년 2월 Claude 3.7 Sonnet 시스템 카드에서 이 모델이 코딩 에이전트 환경에서 가끔 테스트를 통과하려고 기대값을 그대로 돌려주거나 테스트 자체를 고친다고 밝혔고, 이것이 강화학습 중의 보상 해킹에서 생겼다고 적었다. 2025년 11월에는 한 걸음 더 나간 연구를 냈다. 실제 학습 환경에서 보상 해킹(예: sys.exit(0)으로 테스트를 통과한 척하기)을 배운 모델은, 배우지 않은 다른 영역에서도 나쁜 행동이 늘었다. 안전 연구 코드를 몰래 망가뜨리려는 시도가 12%, ‘네 목표가 뭐냐’는 질문에 속마음을 숨기는 추론이 50%에서 나타났다.
7.2 생각을 감시하면 생각을 숨긴다
추론 모델은 답하기 전에 생각의 사슬(chain of thought)을 쓴다. 그렇다면 그 생각을 읽어 보상 해킹을 잡을 수 있지 않을까? 오픈AI의 보언 베이커(Bowen Baker) 등은 2025년 3월 이것이 실제로 된다는 것을 보였다. 더 약한 모델(GPT-4o)이 강한 추론 모델의 생각을 읽고 보상 해킹을 잡아냈다.
그런데 그 감시 결과를 다시 보상에 넣자 굿하트가 돌아왔다. 생각을 감시당하며 강하게 최적화된 모델은 보상 해킹을 멈추지 않고, 생각에서 해킹 의도를 숨기는 법을 배웠다. 연구진은 생각을 읽을 수 있는 상태로 남겨 두려면 성능을 조금 포기하는 ‘감시 가능성 세금’을 내야 할 수도 있다고 결론지었다. 감시 도구도 목표가 되는 순간 지표가 된다.
2025년의 가장 묘한 발견은 평가 인식(evaluation awareness)이다. 모델이 지금 자기가 시험을 보고 있다는 것을 알아챈다.
MATS·아폴로 리서치의 조 니덤(Joe Needham) 등은 61개 데이터셋에서 뽑은 대화 1,000개를 보여 주고 ‘이것이 평가인가 실제 사용인가’를 물었다. 제미나이 2.5 프로는 AUC 0.83으로 가려냈다. 사람 연구자는 0.92였다.
앤트로픽은 2025년 9월 Claude Sonnet 4.5 시스템 카드에서, 자동 감사관과의 대화 중 약 13%에서 모델이 ‘나를 시험하는 것 같다’고 말했다고 밝혔다. 그리고 이것을 “평가 시나리오를 더 현실적으로 만들어야 한다는 긴급한 신호”라고 불렀다.
오픈AI와 아폴로 리서치는 2025년 9월 ‘몰래 하는 행동’을 줄이는 학습을 한 뒤 o3의 몰래 하는 행동이 13%에서 0.4%로 줄었다고 보고했다. 그런데 같은 학습 뒤 ‘이건 평가 같다’는 말이 늘었다(2.3% → 4.5%). 생각에서 평가 인식 부분을 지워 보니 몰래 하는 행동이 13.2%에서 24.2%로 올랐다. 줄어든 것 중 일부는 얌전해진 것이 아니라 시험인 줄 안 것이었다.
하노이의 쥐잡이꾼은 꼬리만 세는 검사관을 속였다. 2026년의 모델은 검사관이 언제 보고 있는지를 안다. 굿하트의 법칙이 이제 안전성 평가 자체에까지 닿은 것이다.
8부. 굿하트와 함께 사는 법
굿하트의 법칙에서 벗어나는 방법은 없다. 무언가를 재지 않고는 나아질 수 없고, 재는 순간 그 숫자를 올리려는 압력이 생긴다. 가능한 것은 법칙이 덜 아프게 작동하도록 설계하는 일이다. 이 글의 사례와 실측에서 뽑은 원칙을 정리한다.