한국어 임베딩Qwen3-EmbeddingBGE-M3Nomic EmbedOllama벡터 검색RAGnDCG코사인 유사도지시문 임베딩MTEBKURE한국어 검색 스택실측 벤치마크튜토리얼
한국어 임베딩 모델, 우리 문서로 직접 재봤다 — Qwen3-Embedding 8B·4B·0.6B, BGE-M3, Nomic v2 MoE 실측 비교 (한국어 검색 스택 1편)
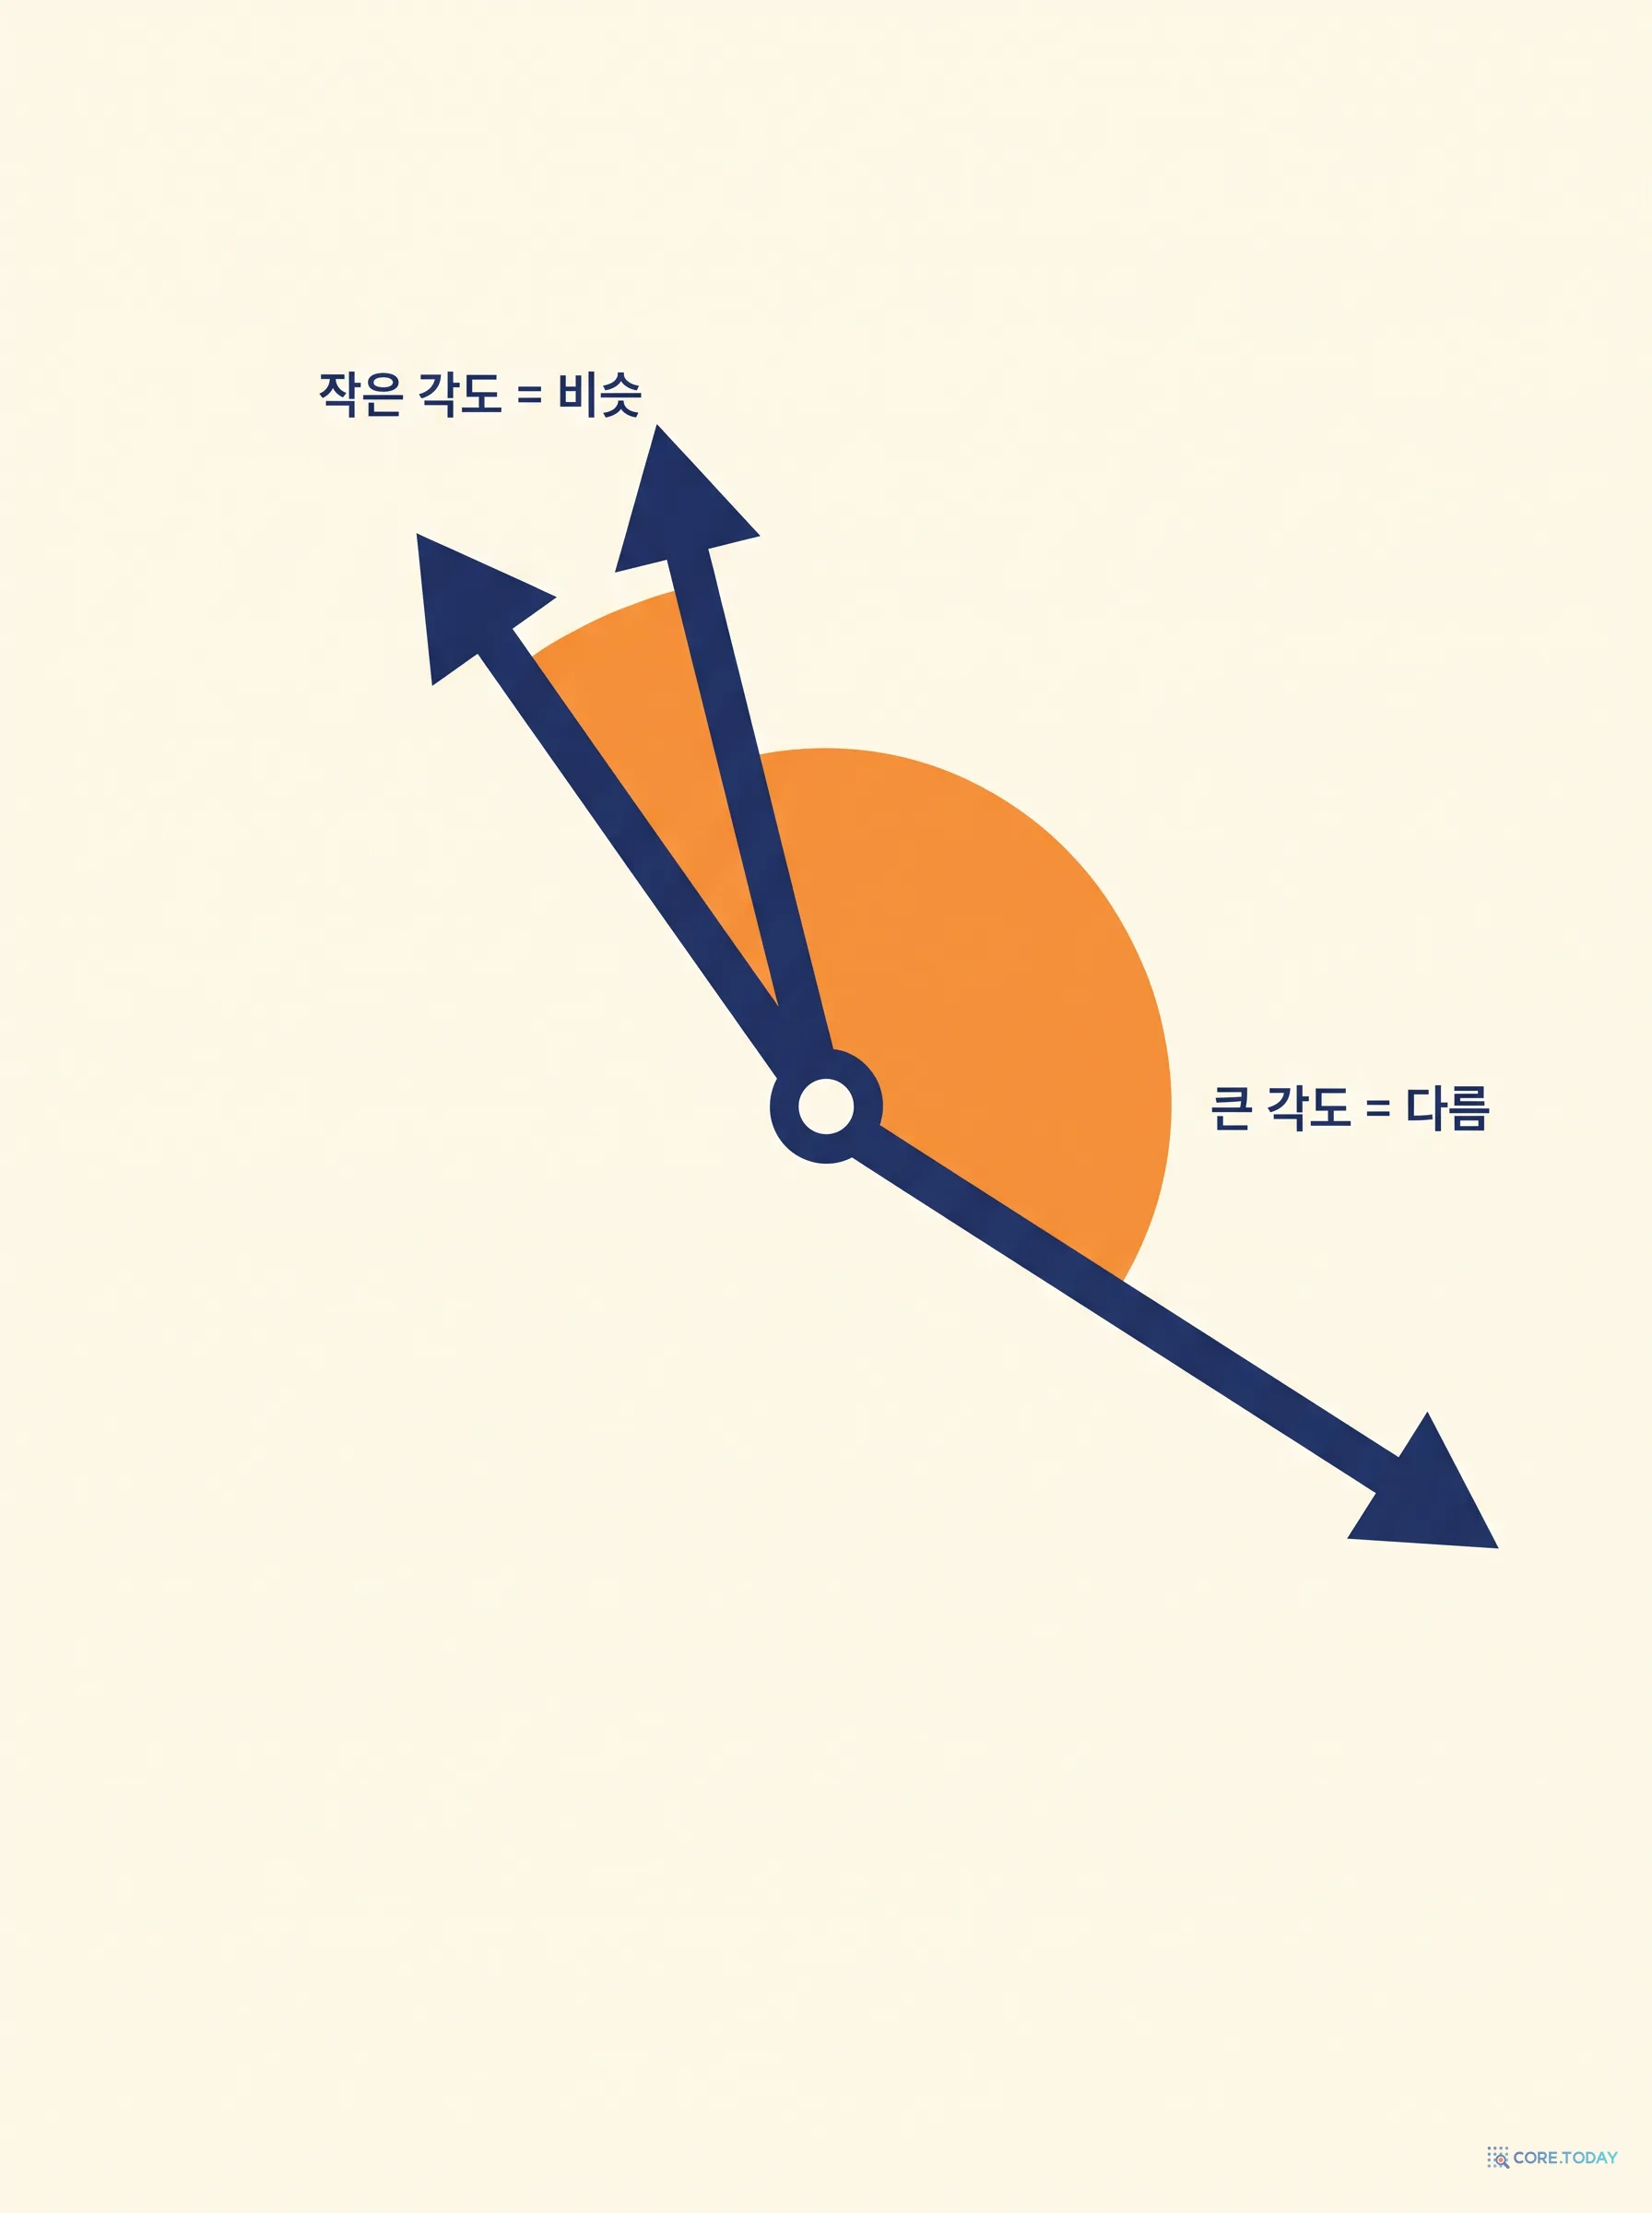
RAG를 만들 때 가장 먼저 부딪히는 질문이 '임베딩 모델은 뭘 쓰지?'입니다. 이 글은 그 질문에 남의 벤치마크가 아니라 우리 문서로 답합니다. 코어닷투데이 블로그와 뉴스 589건을 코퍼스로, 사람이 일부러 다른 말로 쓴 질문 22개와 로컬 LLM이 바꿔 쓴 질문 45개, 키워드 질문 18개를 만들고, 맥 한 대의 Ollama에서 Qwen3-Embedding 8B·4B·0.6B, BGE-M3, Nomic Embed v2 MoE 다섯 모델을 같은 조건으로 돌렸습니다. 임베딩이 무엇인지, 코사인 유사도가 왜 각도인지부터 시작해, '청년 일자리'라는 말이 없는 문서를 각 모델이 어떻게 찾는지 실제 값으로 보여 주고, 지시문 접두어 한 줄이 점수를 어떻게 바꾸는지, 같은 한국어 문서를 토크나이저가 얼마나 다르게 쪼개는지, 8B와 4B의 차이가 어디서 나는지를 따져 봅니다. 결론은 순위표 하나가 아니라 '어떤 환경에서 무엇을 고르나'이고, 인터랙티브 6개와 삽화 8장으로 함께 읽습니다. 2편은 BM25·RRF·리랭커, 3편은 마트료시카 임베딩입니다.
RAG 시스템을 만들 때 첫 번째 결정이 임베딩 모델입니다. 인터넷에는 순위표가 넘칩니다. MTEB 리더보드, 한국어 KURE 벤치마크, 각 회사의 모델 카드. 그런데 그 순위표의 문서는 위키피디아이거나 논문이거나 영어이고, 여러분의 문서는 공고문이고 회의록이고 보도자료입니다. 순위표는 방향을 알려 주지만 답을 알려 주지는 않습니다.
그래서 이 글은 순서를 바꿉니다. 먼저 우리 문서로 잽니다. 코어닷투데이 블로그 글 525건과 뉴스 64건, 합쳐 589건의 제목과 요약(평균 242자)을 코퍼스로 삼았습니다. 질문은 세 종류로 만들었습니다.
질문 유형
개수
만든 방법
예시
사람 바꿔쓰기
22
글쓴이가 정답 문서의 핵심어를 일부러 피해서 씀. 정답이 여럿인 질문 5개 포함
"똑같은 LLM인데 주변 장치만 바꿨더니 점수가 크게 달라진 실험" → 정답: 하니스 해부 글
LLM 바꿔쓰기
45
로컬 27B 모델(qwen3.8)에 문서를 주고 "핵심 명사를 베끼지 말고" 질문을 만들게 함. 카테고리별 층화 표집
"행과 열 배치 방식에 따라 조회 속도가 달라지는 원리" → 정답: 컬럼형 DB 글
키워드
18
제목의 고유명사를 그대로 씀
"Headlamp Freelens k9s 비교"
모델은 로컬 맥(M1 Ultra, 128GB)의 Ollama에 올라 있는 다섯 개입니다. 지표는 검색 벤치마크의 표준인 nDCG@10(상위 10개 안에 정답이 얼마나 위에 있나)을 중심으로, MRR과 Recall@5·10을 함께 봅니다.
이 글은 3부작의 1편입니다. 1편은 임베딩 모델 자체를, 2편은 BM25와 벡터를 합치는 RRF와 리랭커를, 3편은 벡터를 잘라 쓰는 마트료시카 임베딩을 다룹니다. 세 편 모두 같은 코퍼스와 같은 질문으로 잰 실측을 씁니다.
1부. 임베딩이란 무엇인가, 3분 복습
문장을 숫자 줄로
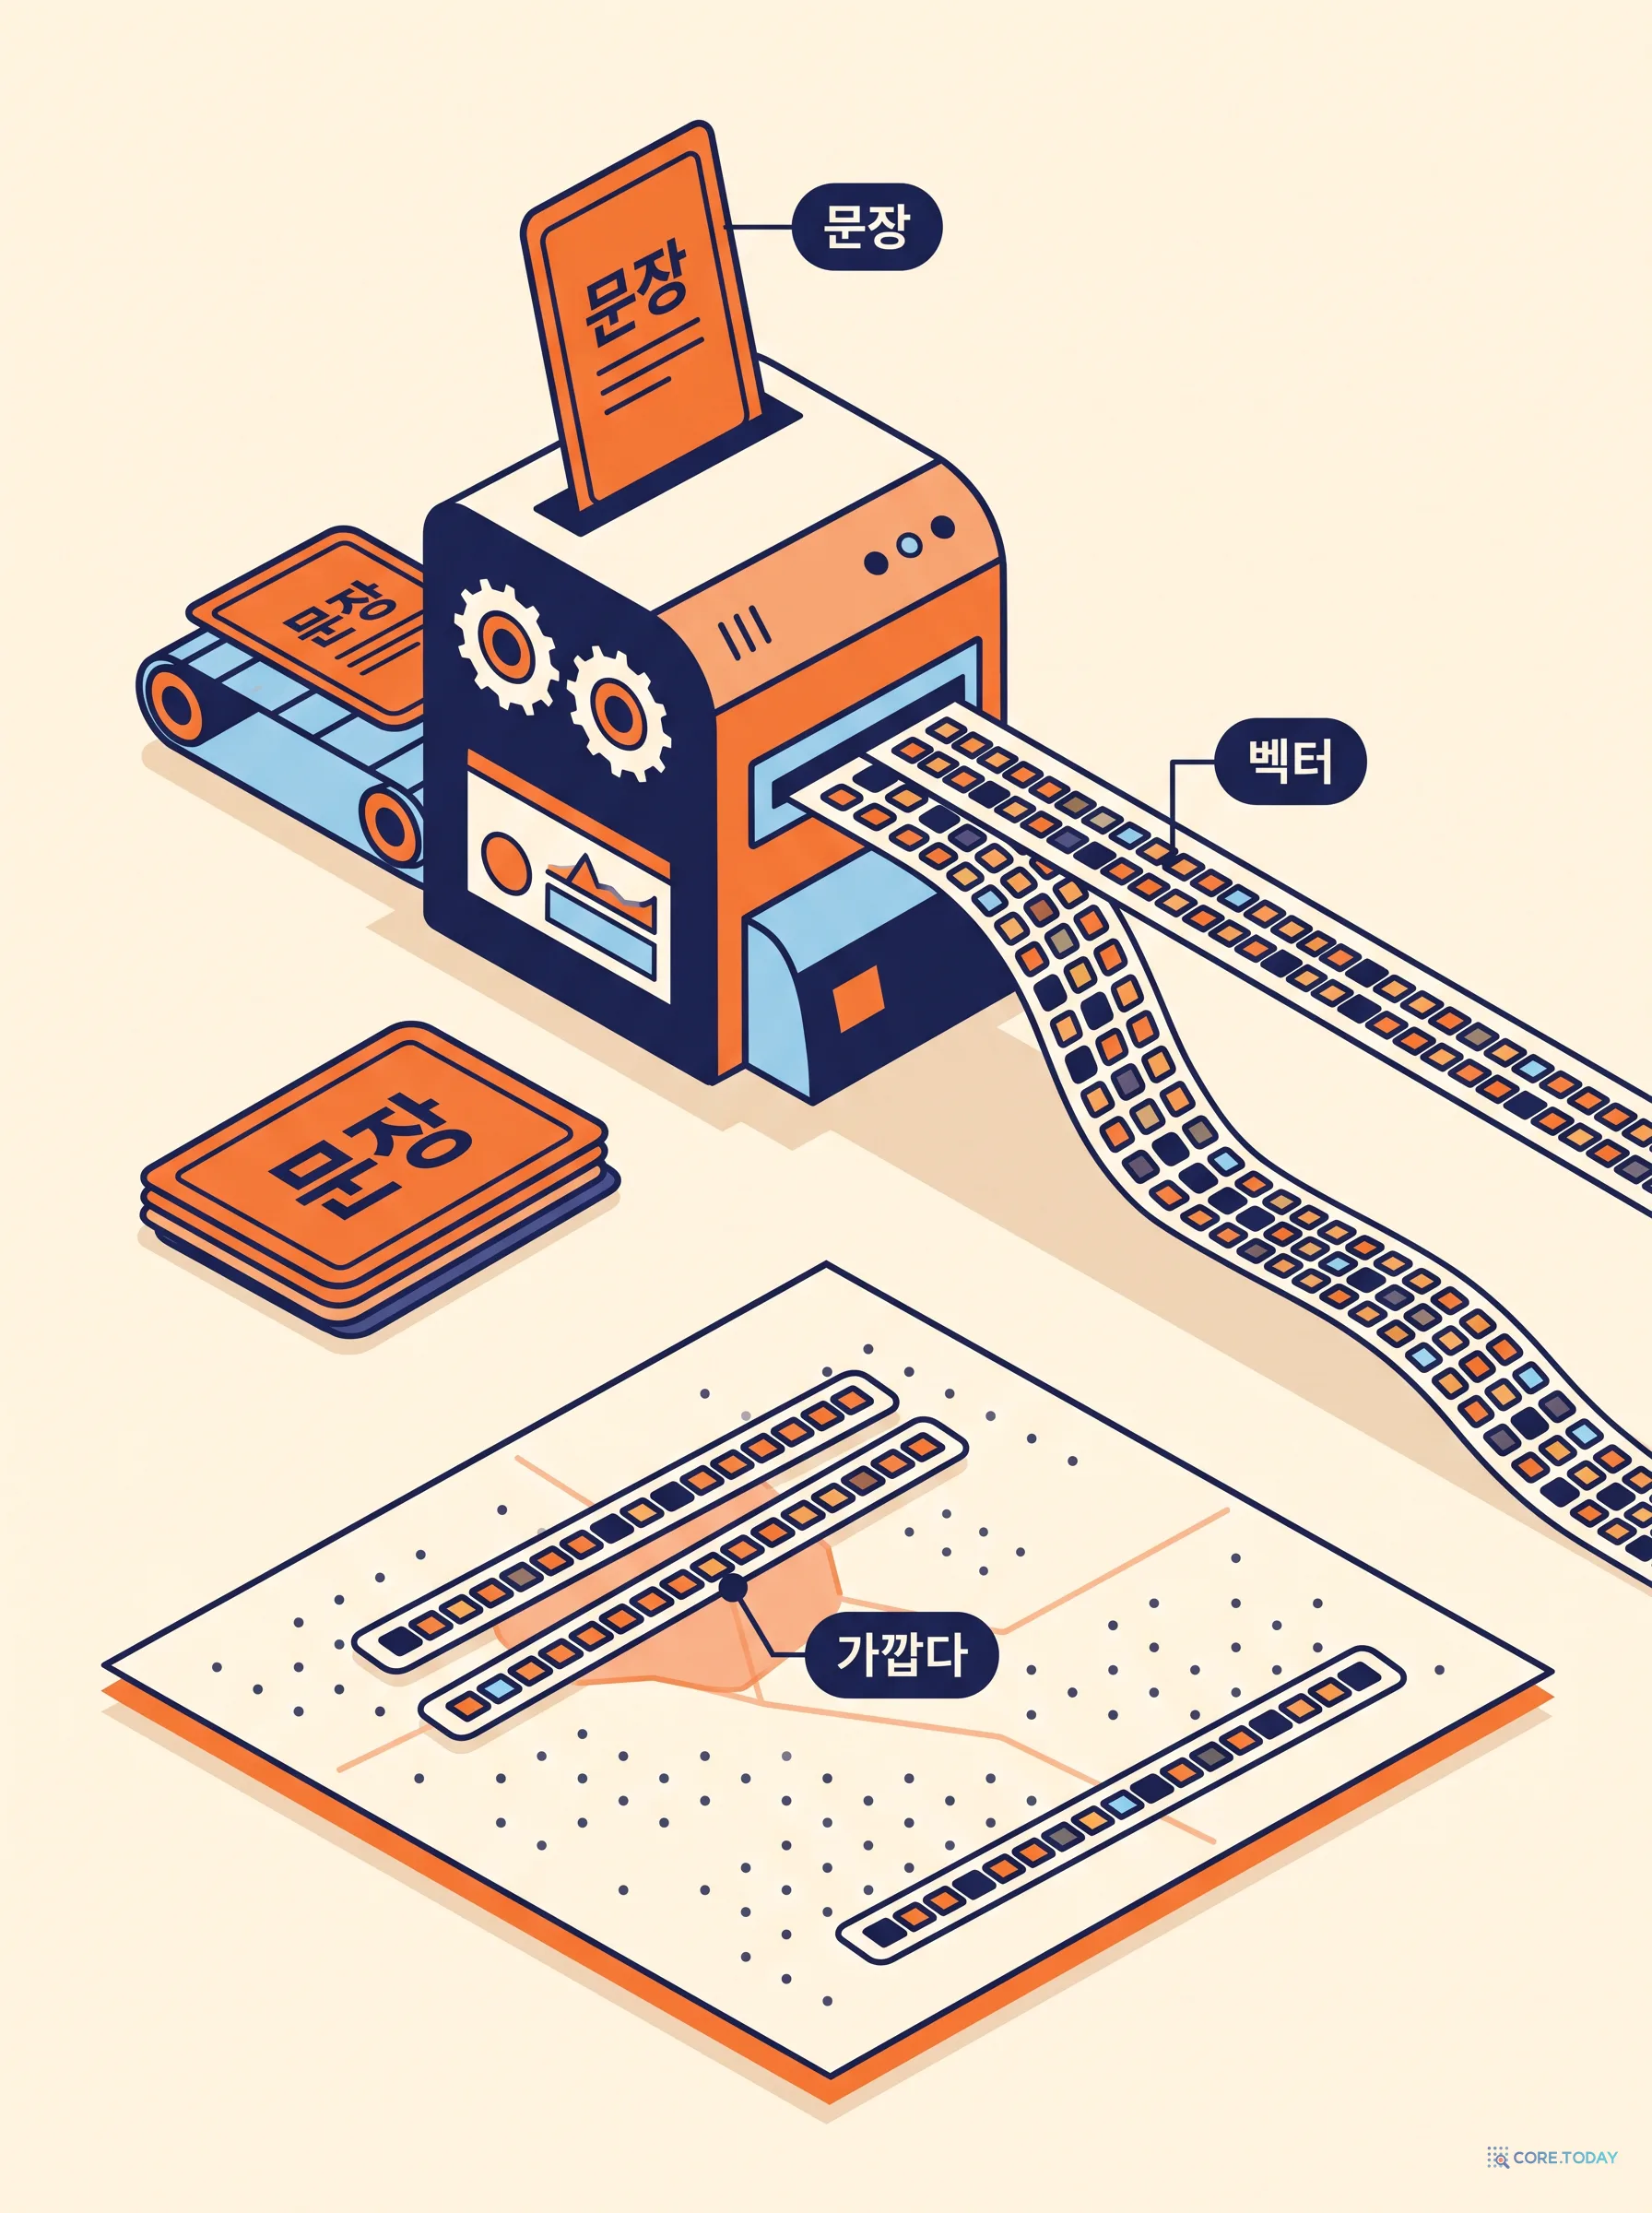
임베딩 모델은 문장을 받아 숫자 한 줄(벡터)로 바꿉니다. Qwen3-Embedding-8B는 4,096개, BGE-M3는 1,024개, Nomic v2는 768개의 숫자를 냅니다. 이 숫자 줄의 약속은 하나입니다. 뜻이 비슷한 문장은 가까운 벡터가 된다.
원문 글(이 시리즈의 출발점이 된 임베딩 모델 추천 메모)에 좋은 예시가 있었습니다. 질문에는 '청년 일자리'가 있는데, 정답 문서에는 '청년취업 지원사업'이라고만 적혀 있는 경우. 단어가 겹치지 않아도 뜻으로 찾아야 합니다. 다섯 모델에 그 질문과 문서 다섯 개를 넣고 코사인을 그대로 찍었습니다.
여기서 두 가지가 보입니다. 첫째, 다섯 모델 모두 도커 문서와 키오스크 문서를 맨 아래로 보냅니다. 뜻이 다르면 멀다는 약속은 지켜집니다. 둘째, '청년취업'과 '청년창업'의 순서는 모델마다 다르고, 대부분 창업 공고를 더 가깝다고 봅니다. 질문의 '사업'이라는 말이 '지원사업 공고'와 끌리는 것입니다. 취업과 창업은 다른 뜻인데 표면이 비슷합니다. 임베딩 하나로 검색을 끝내면 안 되는 이유가 여기 있고, 2편의 주제입니다.
절댓값에 속으면 안 됩니다. BGE-M3는 관계없는 문서에도 0.2~0.3을 주고, Nomic은 0.06을 줍니다. 모델마다 코사인의 '기본 온도'가 다르므로, 모델을 바꾸면 임계값도 다시 잡아야 합니다.
키워드 질문 18개는 BM25조차 0.98을 받을 만큼 쉬워서 모델 간 차이를 지우므로, 아래 분석은 어휘가 일부러 어긋난 67개(사람 22 + LLM 45)를 기준으로 합니다. 그 67개에서는 8B 0.860, 4B 0.815, BGE-M3 0.788, Nomic 0.758, 0.6B 0.748, BM25 0.519였습니다.
차이는 '10등 안에 넣느냐'가 아니라 '5등 안, 1등에 올리느냐'에서 납니다. 둘 다 정답을 상위권에 두지만, 8B가 더 자주 맨 위에 둡니다. 실무적 의미는 이렇습니다. 상위 5개를 LLM에 그대로 넘기는 단순한 RAG라면 8B의 이점이 답변 품질로 이어지고, 2편처럼 상위 20개를 리랭커로 다시 고르는 구조라면 4B로도 거의 같은 자리에 갑니다.
문서 589건을 임베딩하는 데 BGE-M3는 22초, Nomic은 32초, 0.6B는 36초가 걸렸고, 4B는 170초, 8B는 295초가 걸렸습니다. 4B와 8B는 같은 시간에 로컬 LLM이 질문을 만들고 있어 GPU를 나눠 썼으므로 느리게 잰 값입니다. 4B만 나중에 단독으로 다시 재니 121초(4.85건/초)로 빨라졌고, 8B는 재측정 중에 Ollama가 다른 작업으로 바빠져 끝내지 못했습니다(8부). 그래도 방향은 분명합니다. 4B는 8B의 두 배 가까이 빠르고, BGE-M3는 4B의 몇 배 빠릅니다. 문서 수천만 건을 처음 인제스천할 때 이 배수가 며칠의 차이가 됩니다.
질의 한 건의 임베딩은 Nomic 23ms, 0.6B 33ms, BGE-M3 58ms, 4B 109ms, 8B 117ms였습니다. 검색 한 번의 지연 예산이 200ms라면 8B도 들어가지만, 절반 이상을 임베딩이 먹습니다.
4부. 지시문 한 줄의 효과
Qwen3-Embedding은 질의 앞에 지시문을 붙이라고 안내합니다. 모델 카드의 표현으로 "대부분의 과제에서 1~5% 개선". 우리 데이터로 재 봤습니다.
8B에서는 카드의 안내대로 이득이 있고, 4B에서는 거의 없고, 0.6B에서는 오히려 손해 였습니다. 작은 모델은 영어 지시문을 소화할 여유가 적어 보입니다. 지시문은 "Given a web search query, retrieve relevant passages that answer the query"라는 모델 카드의 기본 문장을 그대로 썼는데, 한국어 지시문이나 도메인 지시문("뉴스 기사를 찾는 질문")으로 바꾸면 결과가 달라질 수 있습니다. 확실한 것은 하나입니다. 지시문 유무는 반드시 여러분의 데이터로 A/B 해 보고 정해야 합니다. 그리고 문서와 질의를 다른 설정으로 임베딩하면 안 됩니다. 이 실험에서도 문서는 지시문 없이, 질의만 지시문을 붙였습니다(Qwen3의 권장 방식).
Nomic은 접두어가 선택이 아니라 필수입니다. 모델 카드가 "task instruction prefix가 반드시 포함돼야 한다"고 명시하는데, 우리 실측에서는 붙였을 때 +0.009였습니다. 크지 않지만 방향은 맞습니다.
5부. 같은 한국어 문서, 다른 토큰 수
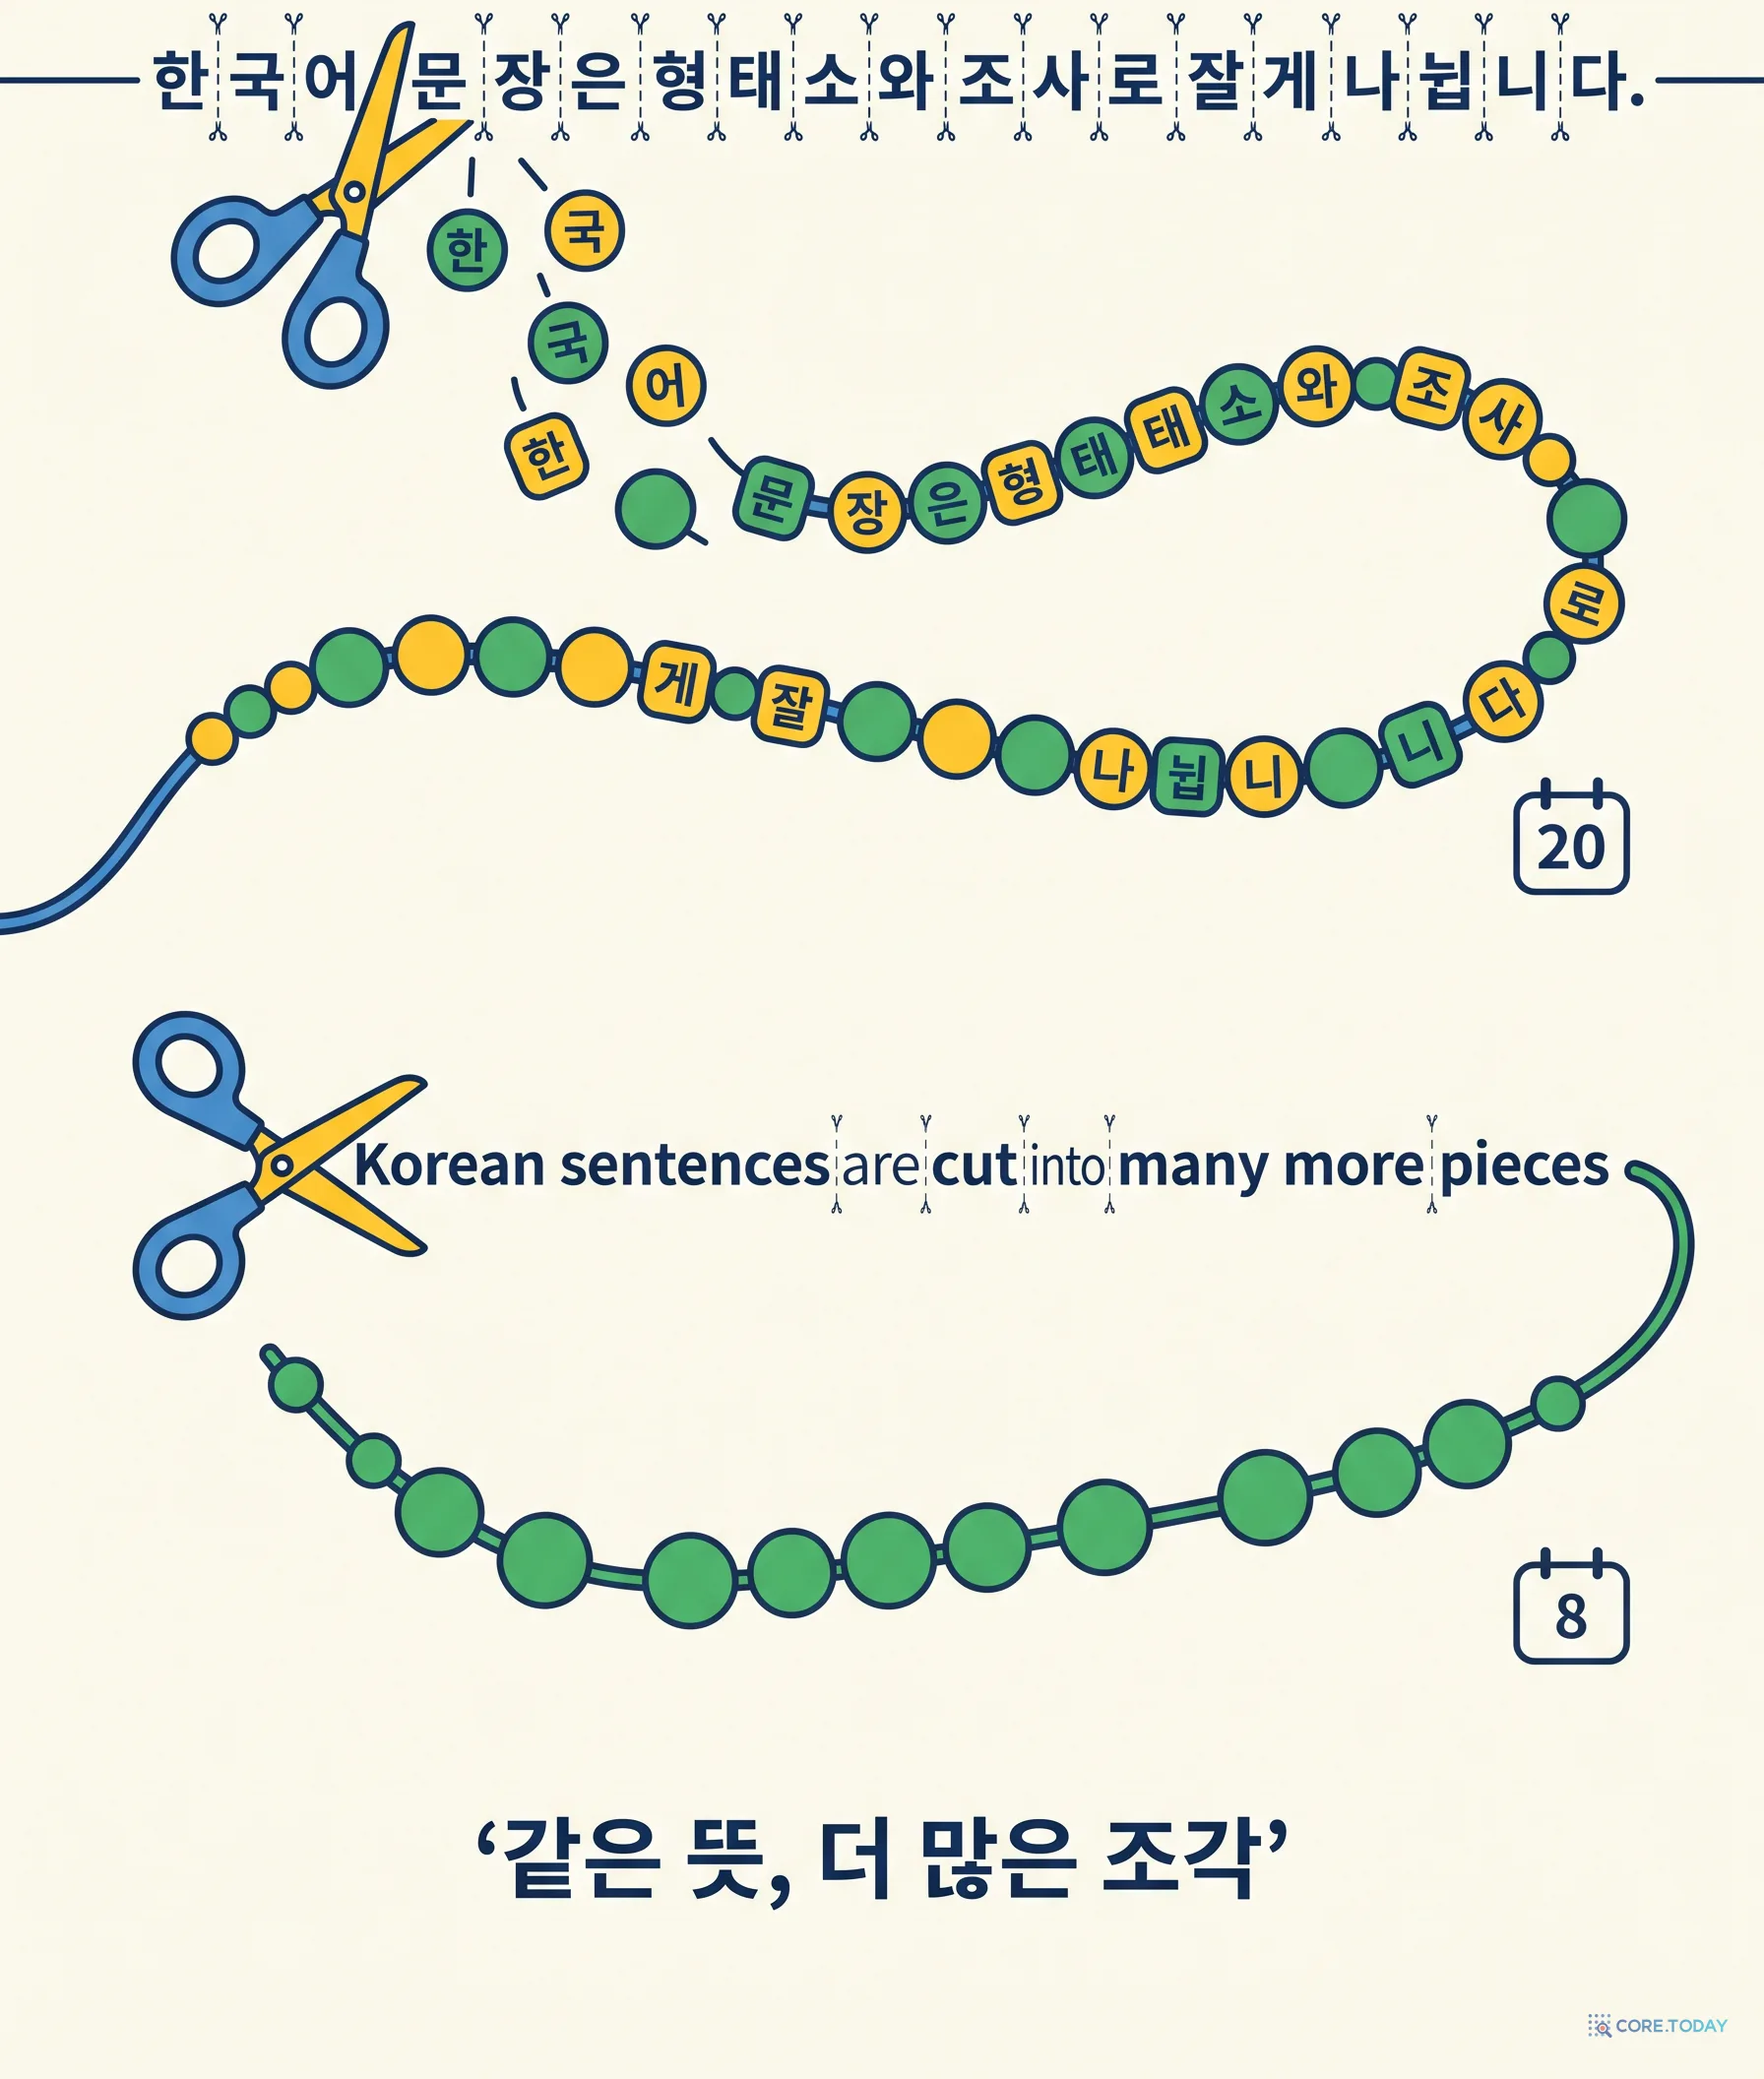
실험 중에 우연히 눈에 띈 숫자가 있습니다. 같은 589건을 임베딩할 때 Ollama가 보고한 처리 토큰 수입니다.
Qwen 토크나이저는 같은 한국어를 XLM-RoBERTa 계열보다 27% 더 많은 토큰 으로 쪼갭니다. 이것이 뜻하는 것은 세 가지입니다. 첫째, Qwen3 계열의 처리량 차이 일부는 모델 크기가 아니라 토큰 수에서 옵니다. 둘째, 컨텍스트 한도를 토큰으로 셀 때 Qwen3의 32K는 한국어로는 XLM-R 계열의 25K 정도에 해당합니다(그래도 BGE-M3의 8K, Nomic의 512보다 훨씬 깁니다). 셋째, 청킹 크기를 정할 때 '토큰 512개'가 모델마다 다른 글자 수라는 것입니다. Nomic의 512토큰 한도는 한국어 요약 한 건(평균 242자)에는 충분했지만, 회의록 한 페이지에는 모자랍니다.
6부. 질문별로 보면 다른 그림
평균 점수는 순위를 정하지만, 무엇이 어려운지는 말해 주지 않습니다. 질문 하나하나를 히트맵으로 펼쳐 보세요.
몇 가지 패턴이 있습니다.
8B와 BM25가 함께 놓친 질문이 넷, 다섯 임베딩 모델이 전부 놓친 질문이 하나 있습니다. "AI가 짜 준 코드를 사람이 미리 승인하는 단계가 필요 없어졌다는 주장"(정답: 플랜 모드는 죽었다)처럼 정답 문서의 제목과 요약이 질문과 다른 층위의 말로 쓰인 경우입니다. 임베딩은 '플랜 모드'를 '승인 단계'로 번역해 주지 않습니다.
BM25가 벡터를 이긴 질문이 셋 있습니다. "보상 모델 없이 언어 모델을 인간 취향에 맞추는 수학적 접근법"에서 BM25는 정답(DPO 글)을 1등에 두고 8B는 3등에 뒀습니다. '보상 모델'이라는 정확한 용어가 문서에 그대로 있었기 때문입니다. 2편에서 이 셋을 다시 만납니다.
정답이 여럿인 질문 (git 시리즈 3편, 토닥북 뉴스 3건)에서는 모든 모델이 하나는 찾고 나머지를 놓쳤습니다. 시리즈 글의 요약이 서로 비슷해 상위권이 그 시리즈로 채워지는 대신, 정답으로 표시한 특정 편이 밀린 것입니다.
그리고 이 글의 결론 중 가장 중요한 것은 모델 이름이 아닙니다. 모델 하나로 검색을 끝내지 마세요. 67개 어려운 질문에서 가장 좋은 8B도 4개를 완전히 놓쳤고, BM25가 이긴 질문이 셋 있었고, 취업과 창업을 헷갈렸습니다. 2편에서는 BM25와 벡터를 합치는 RRF가 언제 돕고 언제 해치는지를 같은 데이터로 재고, 리랭커가 그 빈틈을 어떻게 메우는지 봅니다.
8부. 이 실험의 한계
코퍼스가 작습니다. 589건이면 어떤 모델도 정답을 10등 안에 넣기 쉽습니다. 실제 수십만 건에서는 Recall이 전반적으로 내려가고 모델 간 격차가 벌어질 수 있습니다.
질문이 편향돼 있습니다. 사람 질문 22개는 글쓴이가 썼고, LLM 질문 45개는 한 모델이 만들었습니다. 두 유형 모두 '어휘가 어긋나는' 질문을 의도해서, 벡터 검색에 유리하고 BM25에 불리합니다. 키워드 질문 18개는 반대로 너무 쉬웠습니다.
정답이 하나라는 가정 이 거칩니다. 시리즈 글처럼 정답이 여럿인데 하나만 표시한 경우가 섞여 있습니다.
처리량 측정에 간섭이 있었습니다. 4B와 8B의 문서 임베딩은 로컬 LLM이 동시에 돌던 시간에 잰 값입니다. 4B는 단독 재측정(121초)으로 보정했지만 8B는 보정하지 못했으므로, 8B의 2.0건/초는 하한으로 읽어야 합니다. 질의 지연은 단독 실행 값입니다.
양자화된 모델 입니다. Qwen3 세 모델은 Q4_K_M, BGE-M3와 Nomic은 F16입니다. 원본 가중치와 결과가 다를 수 있습니다.
Ollama 한계. BGE-M3의 희소·다중벡터 기능은 쓰지 못했습니다. 그 기능을 살린 BGE-M3는 이 글의 수치보다 좋을 것입니다.
그래서 이 글의 마지막 권고는 원문 메모와 같습니다. 여러분의 문서로 질문 200~500개를 만들어 직접 재세요. 이 글의 스크립트는 그대로 쓸 수 있고, 하루면 됩니다.
부록: 실험 재현 방법
Ollama 임베딩 호출 (Python, 표준 라이브러리만)
python
import json, urllib.request
defembed(model, texts, dimensions=None):
body = {"model": model, "input": texts, "keep_alive": "30m"}
if dimensions:
body["dimensions"] = dimensions # 마트료시카 모델만 (3편)
req = urllib.request.Request(
"http://localhost:11434/api/embed",
data=json.dumps(body).encode(),
headers={"Content-Type": "application/json"},
)
return json.load(urllib.request.urlopen(req))["embeddings"]
# Qwen3: 질의에만 지시문, 문서는 그대로
INSTRUCT = ("Instruct: Given a web search query, retrieve relevant passages ""that answer the query\nQuery: ")
q = embed("qwen3-embedding:4b", [INSTRUCT + "울산 청년 일자리 사업"])
d = embed("qwen3-embedding:4b", ["지역주도형 청년취업 지원사업 추진"])
# Nomic: 양쪽 모두 접두어 필수
q = embed("nomic-embed-text-v2-moe", ["search_query: 울산 청년 일자리 사업"])
d = embed("nomic-embed-text-v2-moe", ["search_document: 지역주도형 청년취업 지원사업 추진"])
평가는 nDCG@10, MRR, Recall@k를 직접 구현했고(수십 줄), BM25는 rank_bm25에 Kiwi 형태소 분석기(명사·동사·외국어·숫자만 남김)를 붙였습니다. 벡터는 정규화한 뒤 행렬곱 한 번으로 모든 질문·문서 쌍의 코사인을 구합니다. 589 × 85 쌍이면 노트북에서 1초도 안 걸립니다.