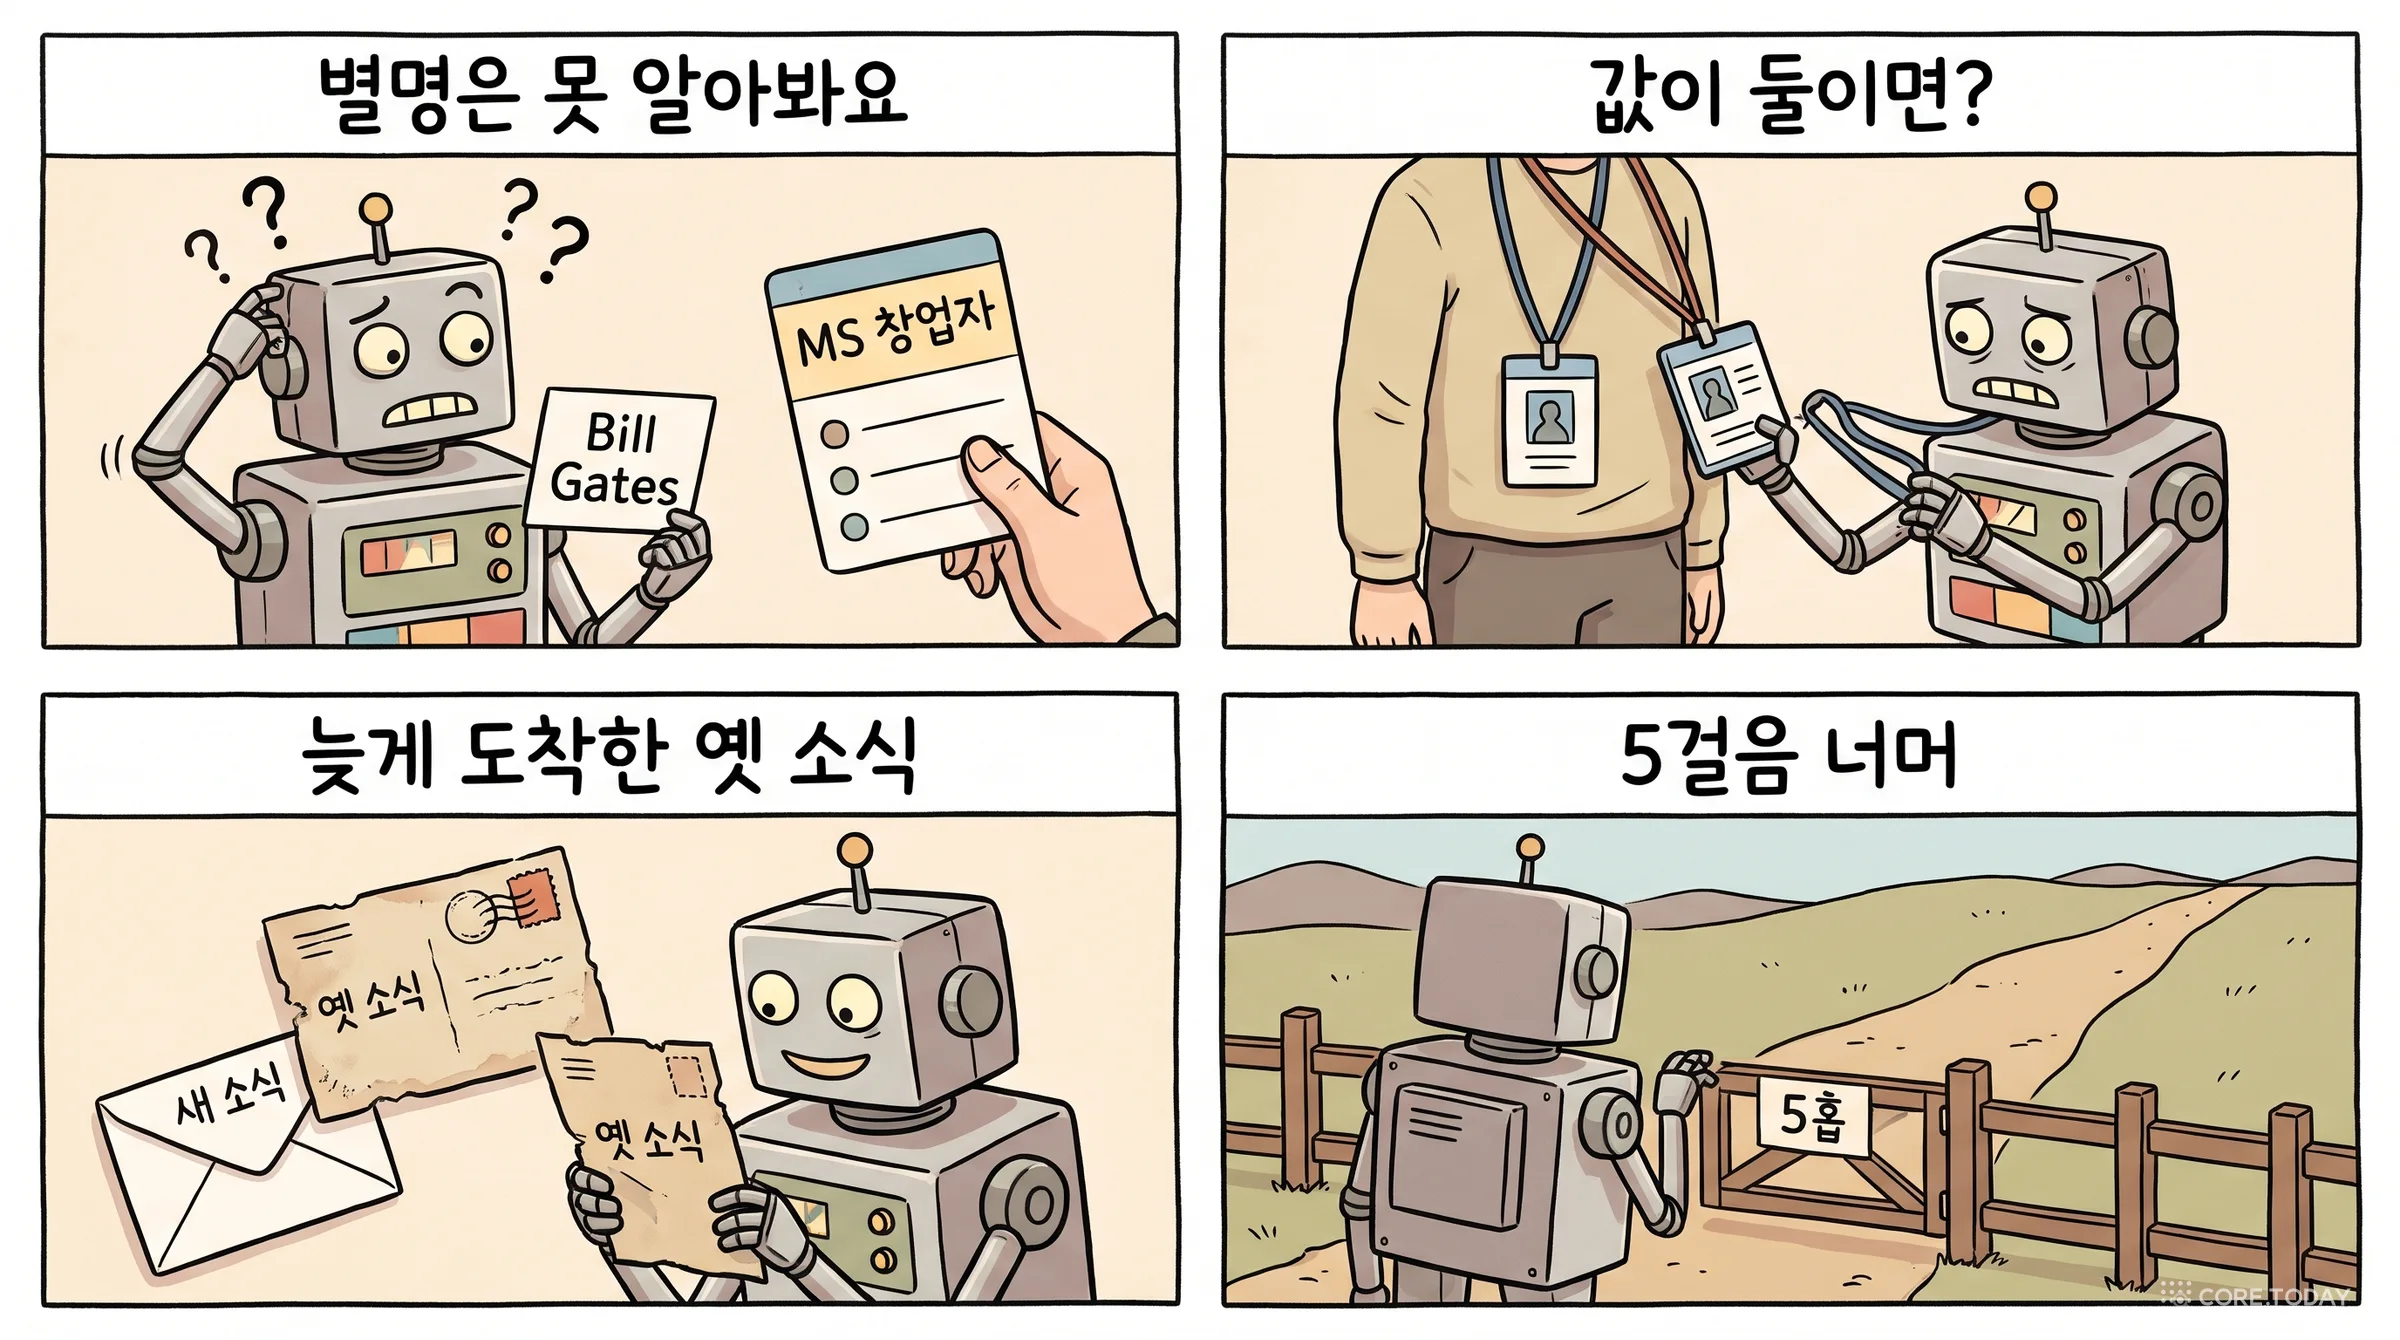
회의가 A실에서 B실로 옮겨졌다는 사실을 AI가 잘 기억해도, 층수를 물으면 여전히 A실의 2층 기록을 읽을 수 있습니다. 갱신은 값만 바꾸는 게 아니라 '다음에 읽어야 할 기록'을 바꾸기 때문입니다. 2026년 9월 arXiv에 올라온 Contract Memory Compiler는 질문 전에 관계를 최신 값으로 정리하고, 질문 속 이름에서 출발해 그 정리된 그래프를 따라가 원문 기록을 건네는 방식으로 FactConsolidation 다중 홉 정확도를 78.25%까지 올렸습니다. 같은 추출과 같은 답 모델에서 순서만 뒤집으면 21.50%입니다. 메모리 네트워크부터 MQuAKE·MemoryAgentBench까지의 역사, 다섯 단계의 작동 원리, 대조군 하나하나의 의미를 짚고, 공개 데이터와 로컬 4B 모델로 논문 결과를 다시 재 보았습니다.
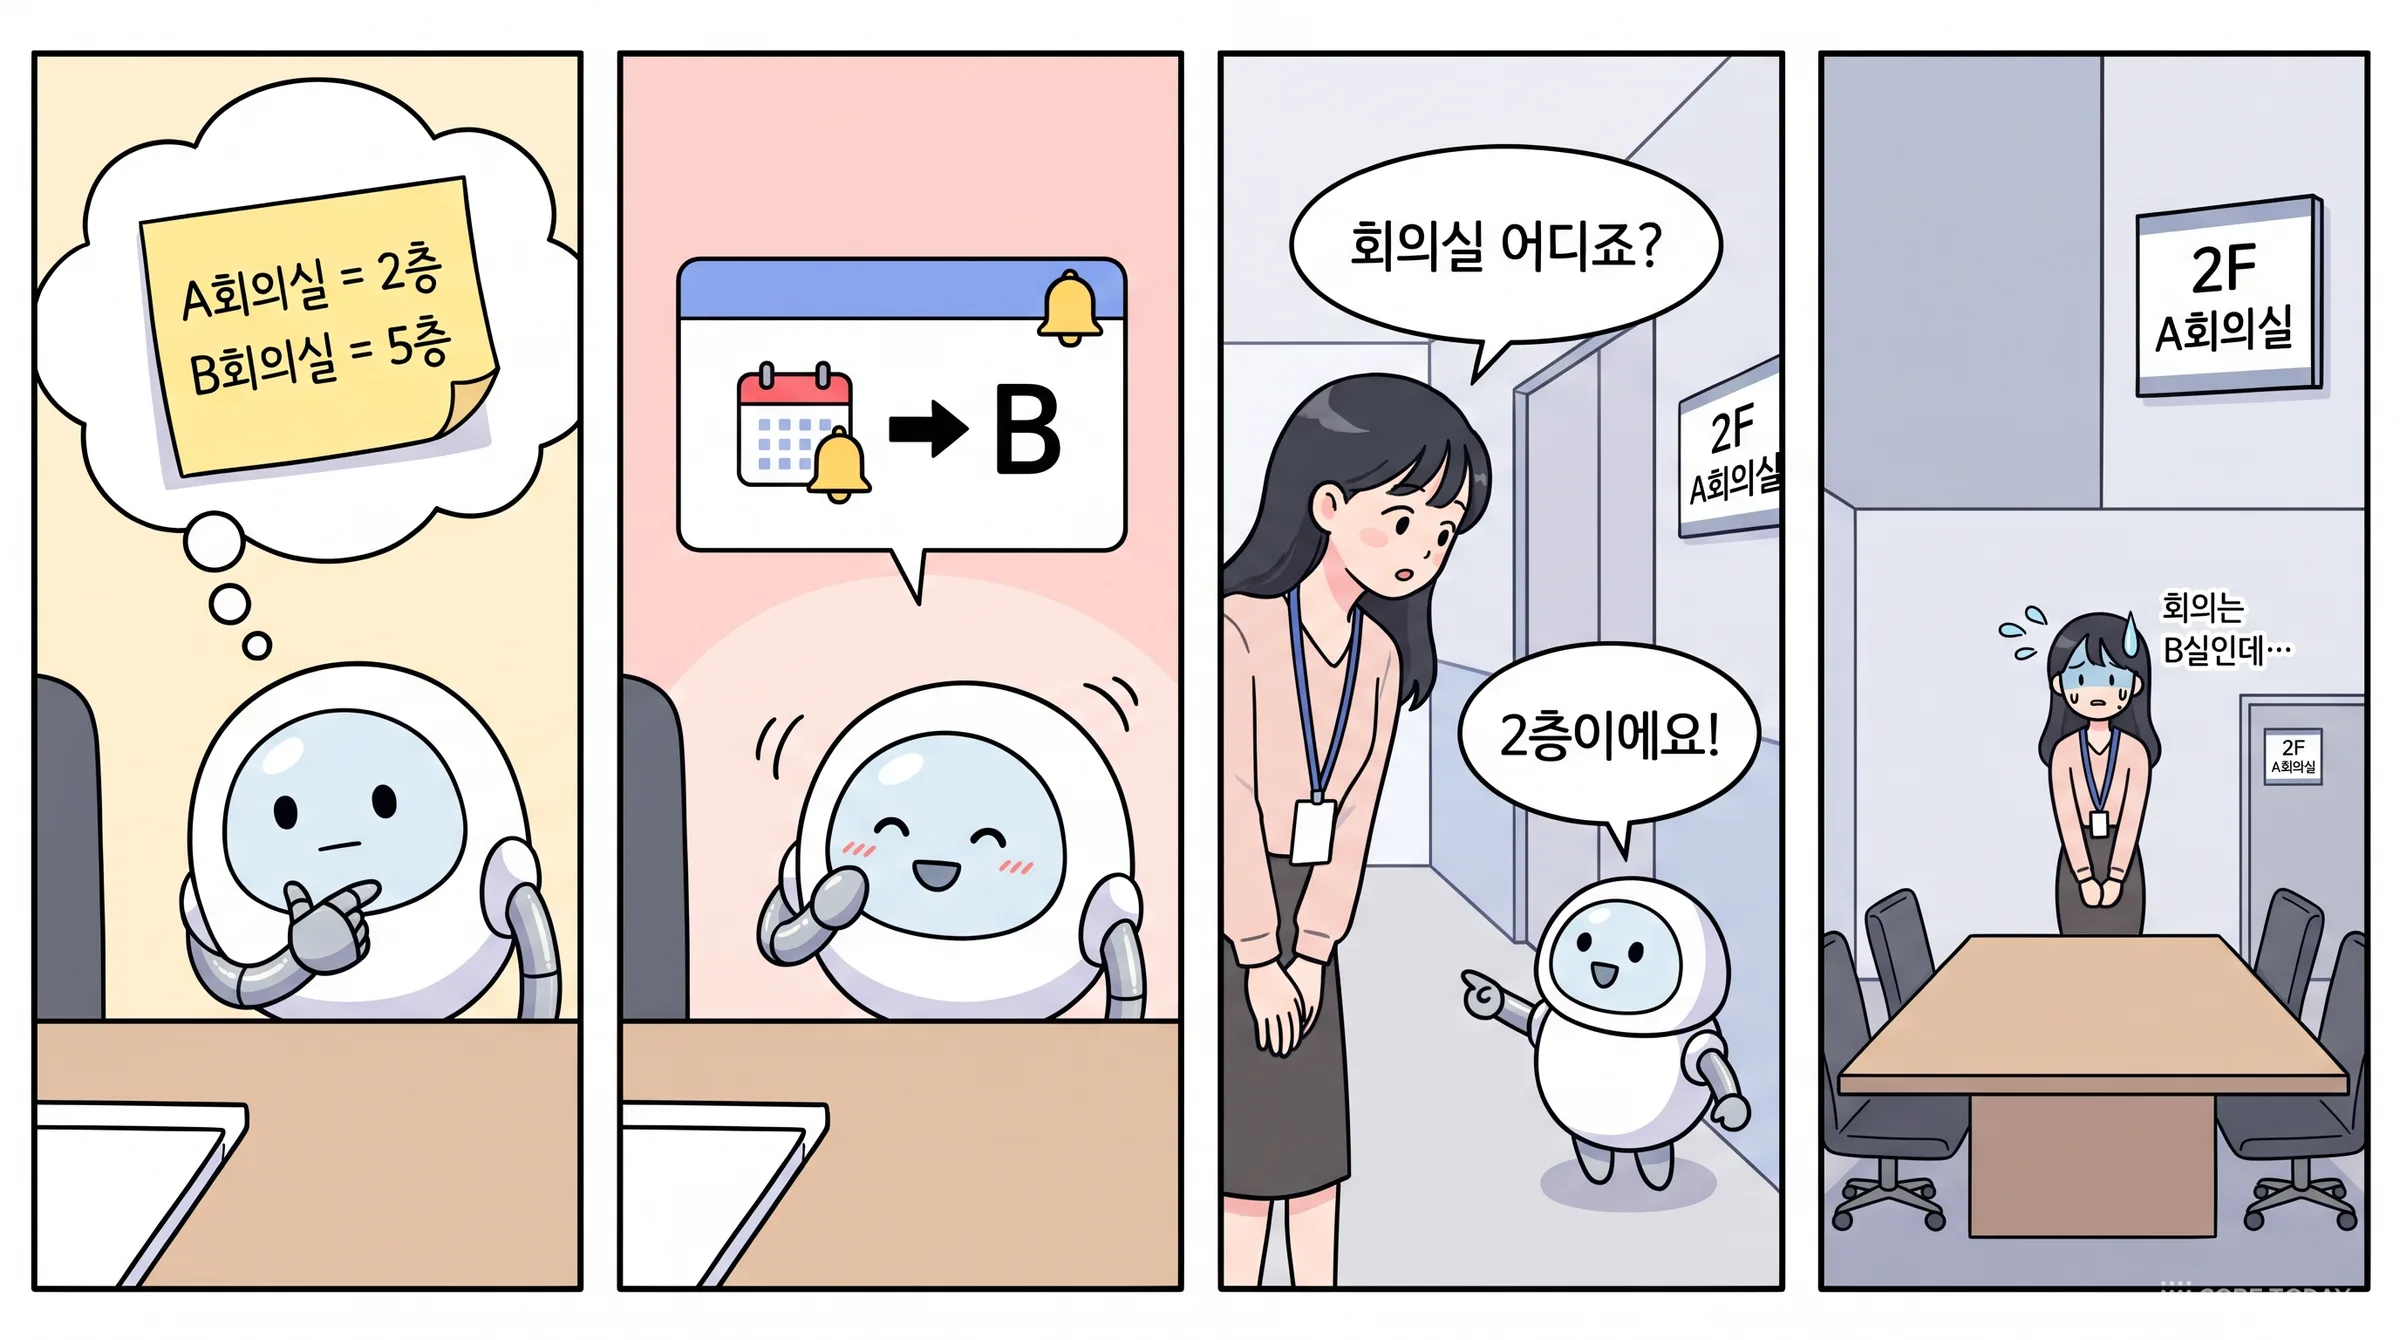
월요일 아침, 신입 사원 지수 씨가 업무 비서 AI에게 묻습니다. "주간 회의 몇 층이에요?" 비서는 망설임 없이 "2층입니다"라고 답합니다. 지수 씨는 2층 A회의실 문을 열었고, 방은 비어 있었습니다. 회의는 지난주에 5층 B회의실로 옮겨졌습니다.
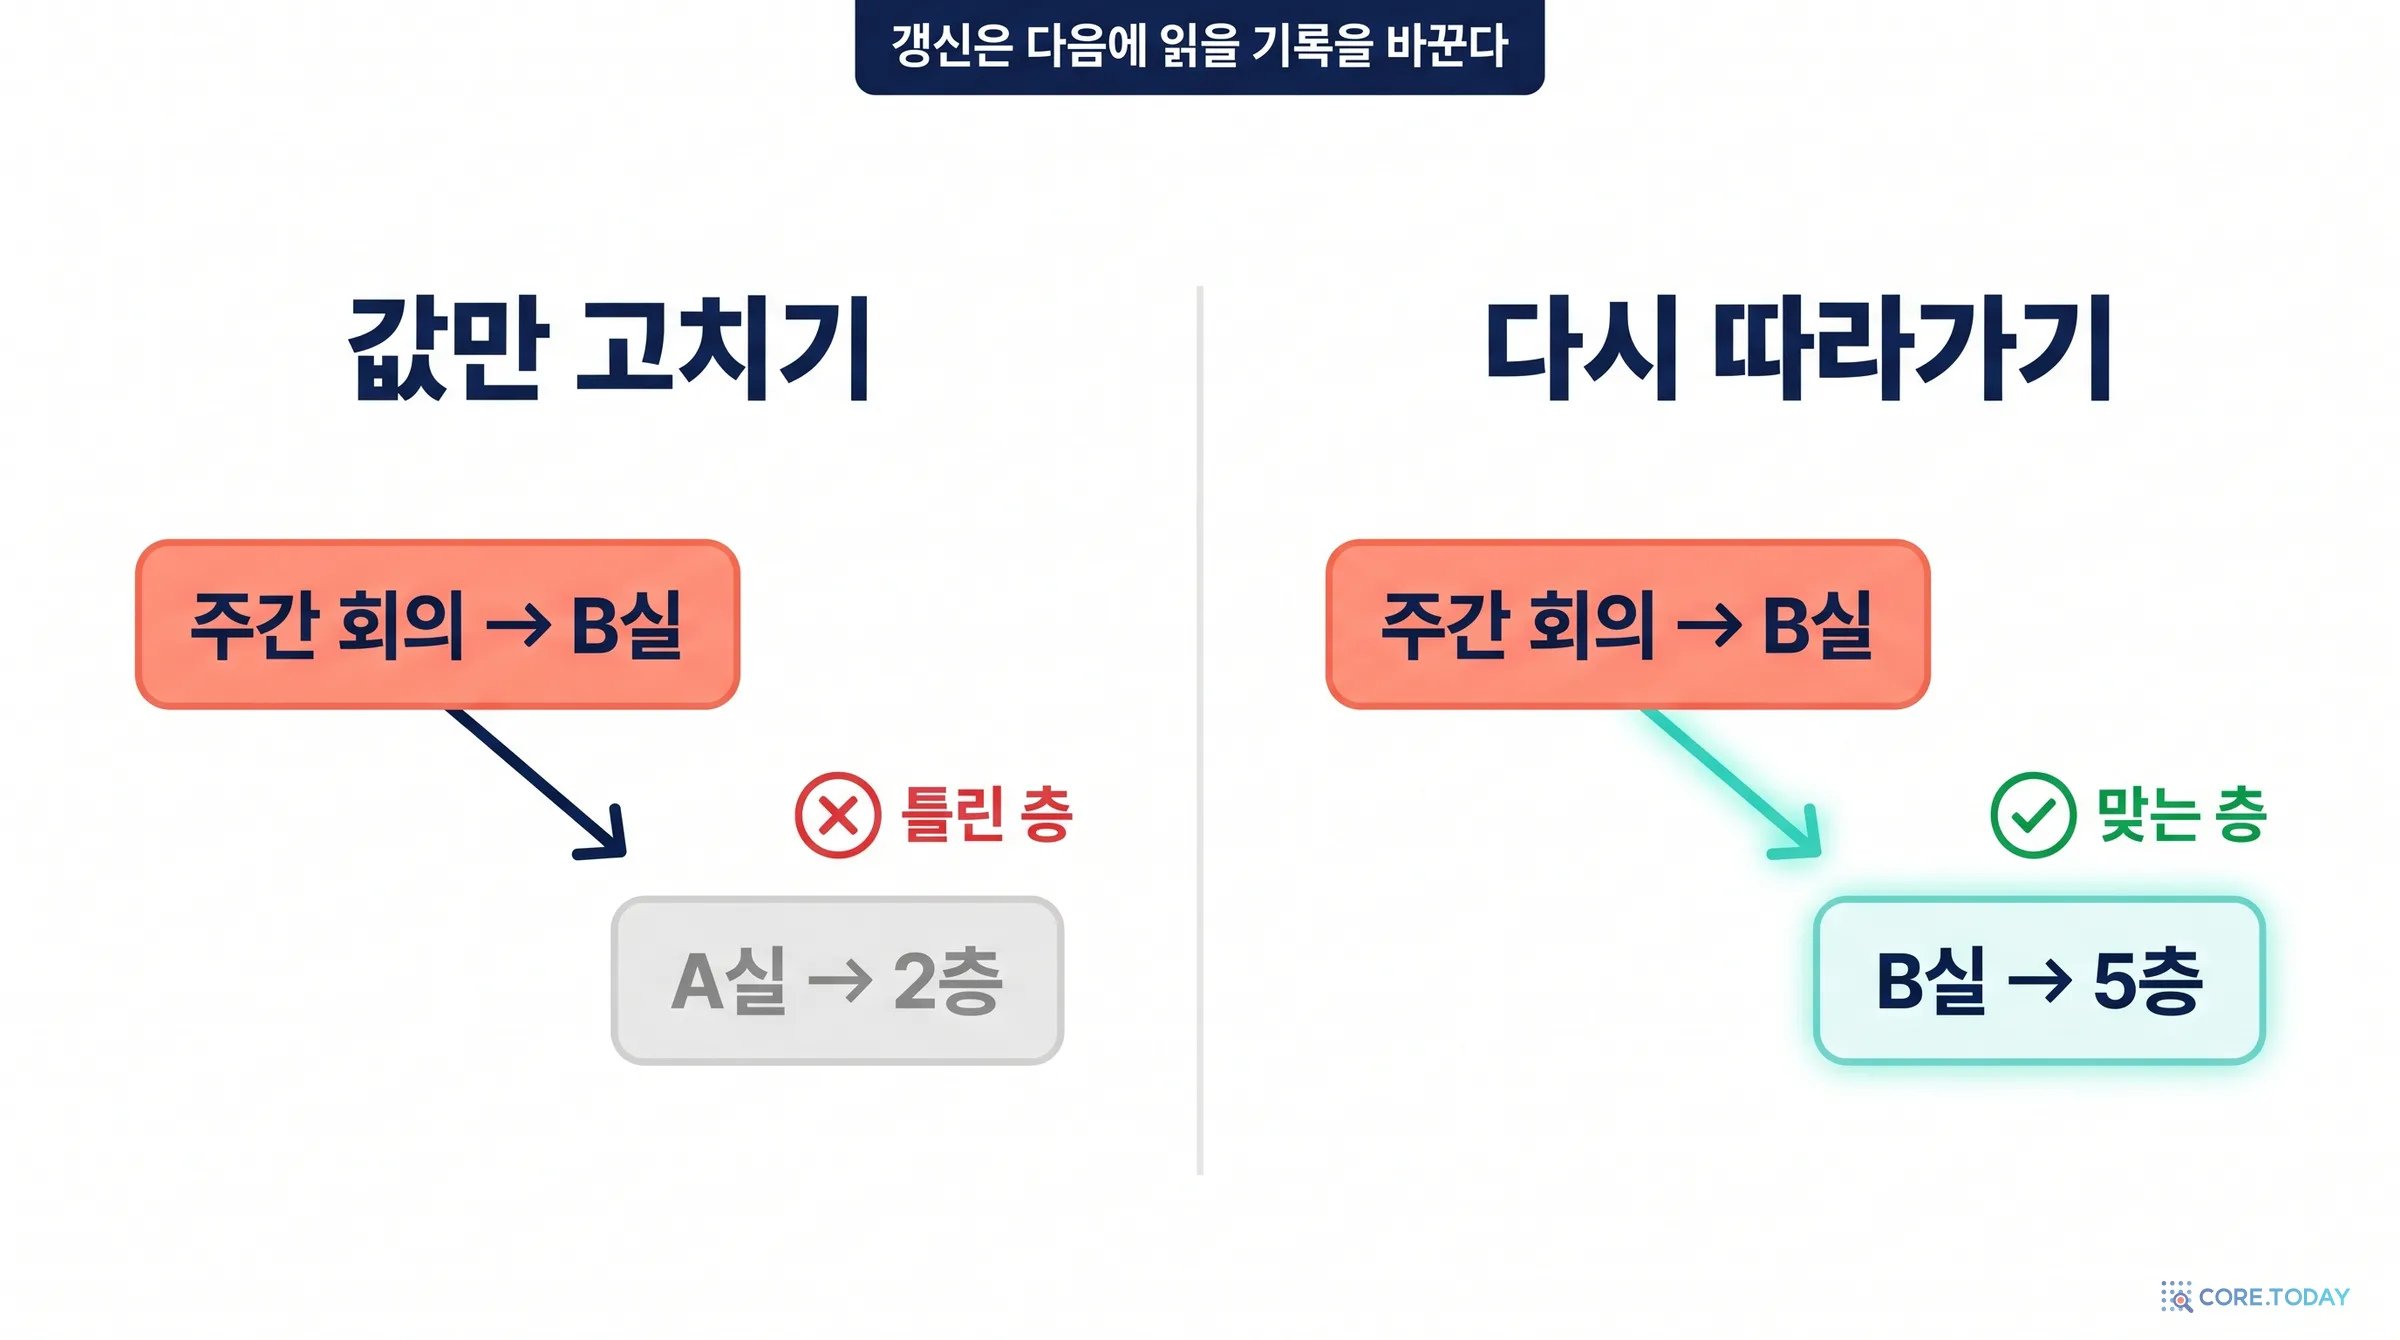
이상한 점은 비서가 그 이동을 알고 있었다는 사실입니다. "주간 회의는 어디서 해?"라고 물었다면 "B회의실"이라고 정확히 답했을 겁니다. 비서는 회의실이 바뀐 것을 기억했지만, 층수를 답할 때는 여전히 예전 회의실의 층 기록을 읽었습니다. 갱신된 것은 '회의 → 회의실' 한 칸인데, 그 한 칸이 바뀌면서 다음에 읽어야 할 기록 자체가 'A회의실은 2층' 메모에서 'B회의실은 5층' 메모로 바뀌었다는 점을 놓친 것입니다.
이 장면은 2026년 9월 26일 arXiv에 올라온 논문 「Contract Memory Compiler: Resolve, Then Traverse」(arXiv 2609.32658)의 첫 예시를 거의 그대로 옮긴 것입니다. 홍콩시립대학교와 텐센트, MIT 연구자 12명이 쓴 이 논문은 에이전트의 외부 기억에서 아직 이름조차 제대로 붙지 않았던 문제를 하나 짚습니다. 저자들은 이것을 갱신 의존 증거 선택(update-dependent evidence selection)이라고 부릅니다. 기억 속 관계 하나가 바뀌면, 같은 질문이라도 답 모델이 읽어야 할 기록의 집합이 달라진다는 것입니다. 바뀐 값을 고치는 일보다 한 단계 더 어려운 문제입니다.
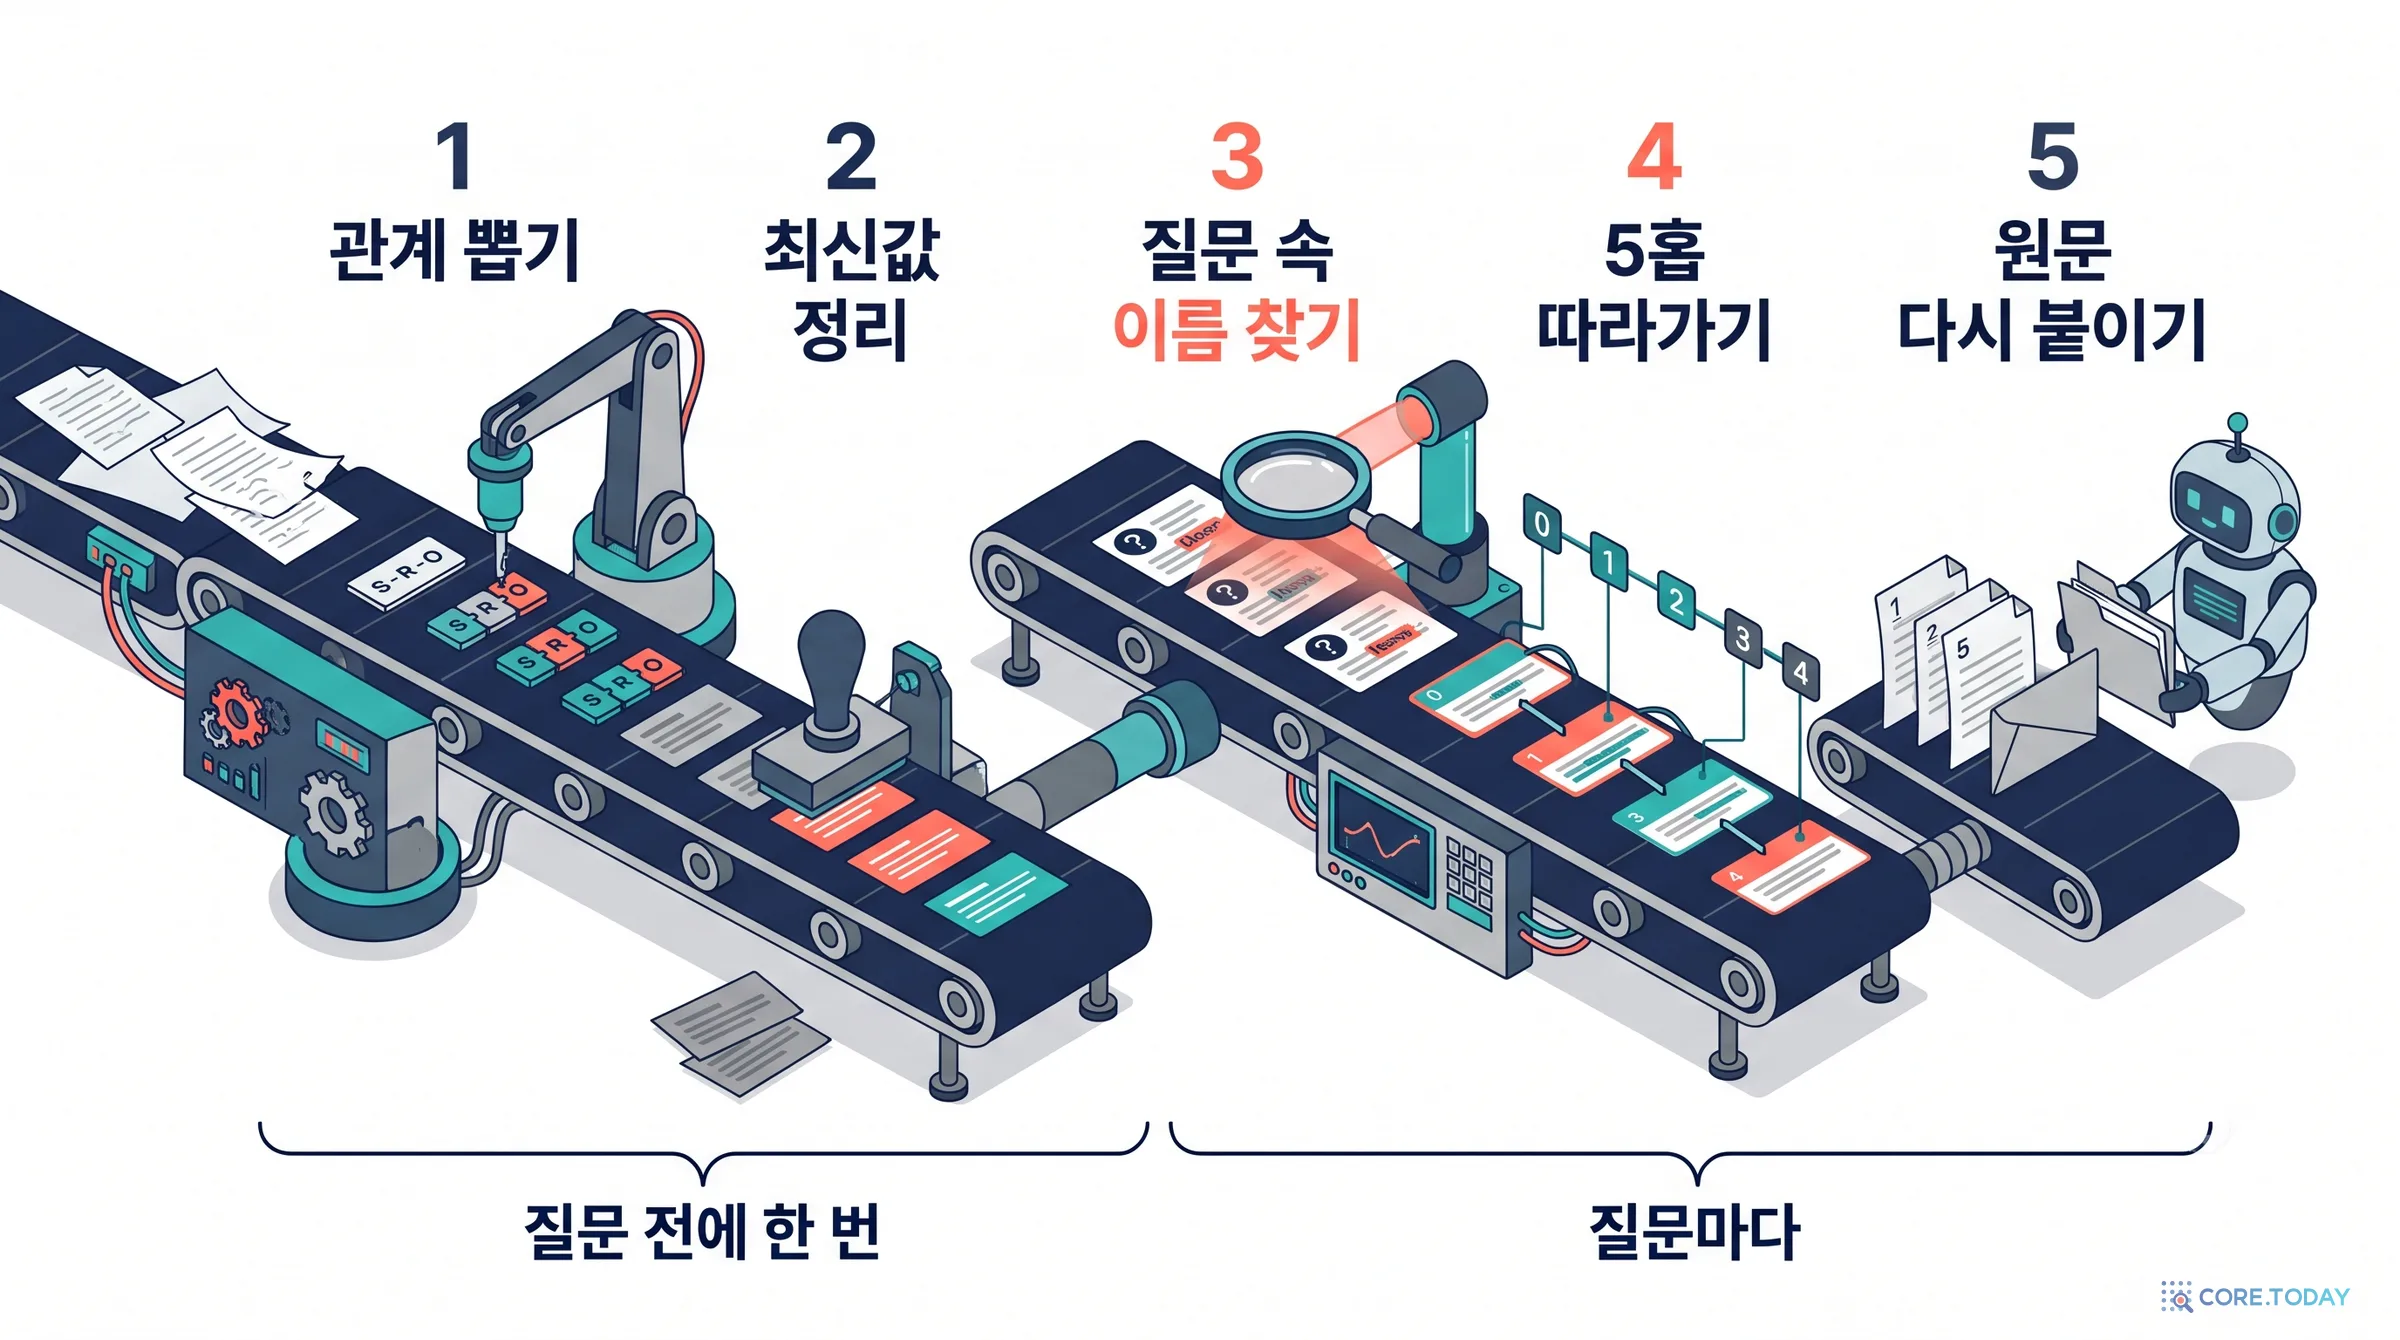
해법의 이름은 제목에 다 들어 있습니다. 먼저 해소하고(Resolve), 그다음 순회한다(Traverse). 질문이 오기 전에 기억 속 관계를 뽑아 열쇠마다 최신 값 하나로 정리해 두고, 질문이 오면 질문에 이름이 나온 대상에서 출발해 그 정리된 그래프를 따라가며 필요한 원문 기록을 모은 뒤, 답 모델을 단 한 번 부릅니다. 순서를 지키는 것만으로 결과가 크게 갈립니다.
MemoryAgentBench의 FactConsolidation 다중 홉 질문에서 78.25%(262K 토큰 기록에서는 61.0%)를 기록했습니다. 저자들은 이 과제에서 최고 성적이라고 주장합니다.
추출한 사실과 답 모델을 그대로 두고 증거를 먼저 고른 뒤 값만 갱신하면 같은 질문에서 21.50%로 떨어집니다. 56.75점 차이가 순서 하나에서 나왔습니다.
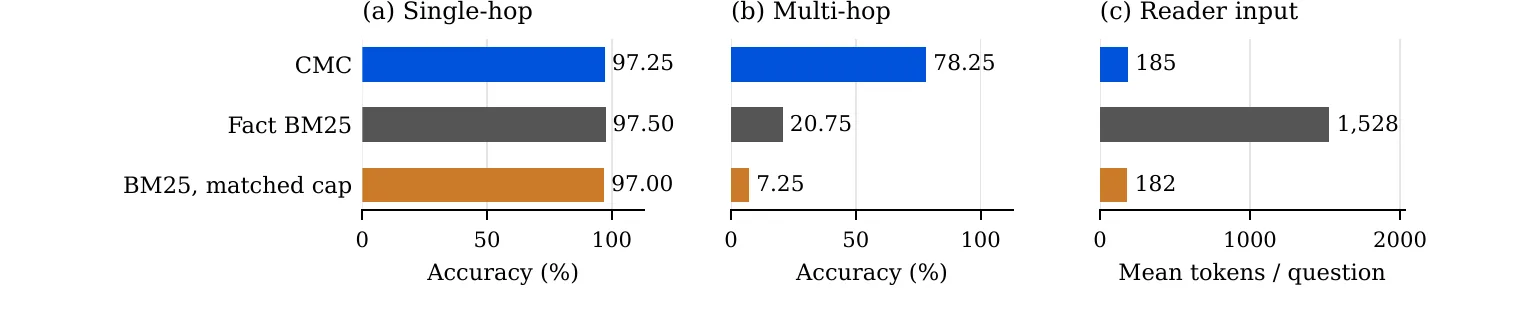
같은 최신 사실들을 질문과의 어휘 유사도(BM25)로 골라 주면 단일 홉은 97.50%로 비기지만 다중 홉은 20.75%입니다.
이 글은 논문을 처음부터 끝까지, 부록까지 읽고 정리한 특집입니다. 먼저 문제를 일상의 사례로 정확히 보고(1부), 기억과 다중 홉 질문의 역사를 따라 이 문제가 왜 지금 나왔는지 살핍니다(2부). 이어서 논문이 '계약'이라고 부르는 약속(3부)과 다섯 단계의 작동 원리(4부), 대조군을 하나씩 뜯어본 실험 결과(5부)를 차례로 읽습니다. 6부에서는 코어닷투데이가 공개 데이터와 로컬 4B 모델로 논문의 핵심 실험을 다시 재 본 결과를 보고합니다. CMC는 다중 홉 80.00%(논문 79.00%), '먼저 고르고 값만 갱신'은 20.75%가 나왔고, 정답지 오류 후보 26문항이라는 논문의 숫자도 그대로 다시 얻었습니다. 한국어 질문에서만 드러나는 함정도 하나 찾았습니다. 7부는 비판적 읽기, 8부는 2026년 실무에서 이 생각이 쓸모 있는 곳입니다.
1부. 문제를 정확히 보기: '값 갱신'과 '읽을 기록 갱신'
값만 고치면 되는 줄 알았다
지난 2년 동안 에이전트 기억 연구의 큰 줄기는 "옛 값과 새 값 중 어느 것이 지금 값인가"였습니다. 코어닷투데이도 이 주제를 여러 번 다뤘습니다. MemStrata는 유사도 검색이 옛 값과 새 값을 가려내지 못한다는 것을, Supersede는 긴 대화에서 바뀐 사실을 따라가는 격차를, SodaMem과 Graphiti는 관계에 유효 기간을 붙이는 시간 그래프를 보여 줬습니다. 모두 '이 사실의 현재 값'을 바르게 고르는 문제입니다.
CMC 논문은 그다음 칸을 봅니다. 회의실 예시를 기호로 적어 보겠습니다.
기록 1: 주간 회의 → A회의실
기록 2: A회의실 → 2층
기록 3: B회의실 → 5층
기록 5: 주간 회의 → B회의실 (갱신)
"주간 회의는 몇 층인가?"라는 질문에 답하려면 두 걸음을 가야 합니다. 회의에서 회의실로, 회의실에서 층으로. 갱신 전에는 기록 1과 2가 필요했고, 갱신 뒤에는 기록 5와 3이 필요합니다. 여기서 핵심은 기록 3은 갱신된 적이 없다는 점입니다. 기록 3은 처음부터 거기 있었고 내용도 그대로입니다. 바뀐 것은 기록 3이 필요해졌다는 사실뿐입니다.
그래서 "이미 고른 증거 안의 값을 최신으로 바꿔 주는" 방식은 이 문제를 풀지 못합니다. 갱신 전에 고른 묶음이 {기록 1, 기록 2}였다면, 값을 새로 고친 결과는 {기록 5, 기록 2}입니다. 묶음 안의 사실은 모두 '현재 기준으로 참'입니다. 회의는 정말 B실에서 하고, A실은 정말 2층에 있습니다. 그런데도 답에 필요한 기록 3이 없습니다. 논문의 표현을 빌리면 "선택이 갱신보다 먼저 일어나면, 문맥에는 A실의 층이 들어 있고 B실의 층은 빠진다. 그 문맥 안에서 회의실 사실을 새로 고쳐도 빠진 층 기록은 되살릴 수 없다."
질문에 없는 이름: 다리 개체
그렇다면 처음부터 질문으로 검색하면 되지 않을까요? "주간 회의 몇 층"으로 검색하면 '주간 회의'가 들어간 기록은 잘 걸립니다. 기록 1과 5가 나옵니다. 하지만 기록 3, 'B회의실은 5층에 있다'에는 '주간 회의'라는 말이 한 글자도 없습니다. 질문에 'B회의실'이라는 이름이 나오지 않기 때문입니다. B회의실은 기록 5를 읽은 뒤에야 알 수 있는 이름입니다.
다중 홉 질의응답 연구에서는 이런 중간 대상을 다리 개체(bridge entity)라고 부릅니다. "『아르마다』를 쓴 작가의 다른 소설은?" 같은 질문에서 작가의 이름이 다리입니다. 질문만 봐서는 다리를 알 수 없으니, 질문으로 한 번 검색해서는 두 번째 걸음의 문서가 잘 걸리지 않습니다. 2019년 스탠퍼드의 GoldEn Retriever 논문은 HotpotQA 개발 세트에서 이 현상을 수치로 보였습니다. 원래 질문으로 문서 10개를 검색하면 첫 걸음 문단은 87.85% 확률로 찾지만, 두 걸음의 정답 문단을 둘 다 찾는 비율은 36.91%에 그쳤습니다. 비교형이 아닌 질문만 보면 27.88%였습니다.
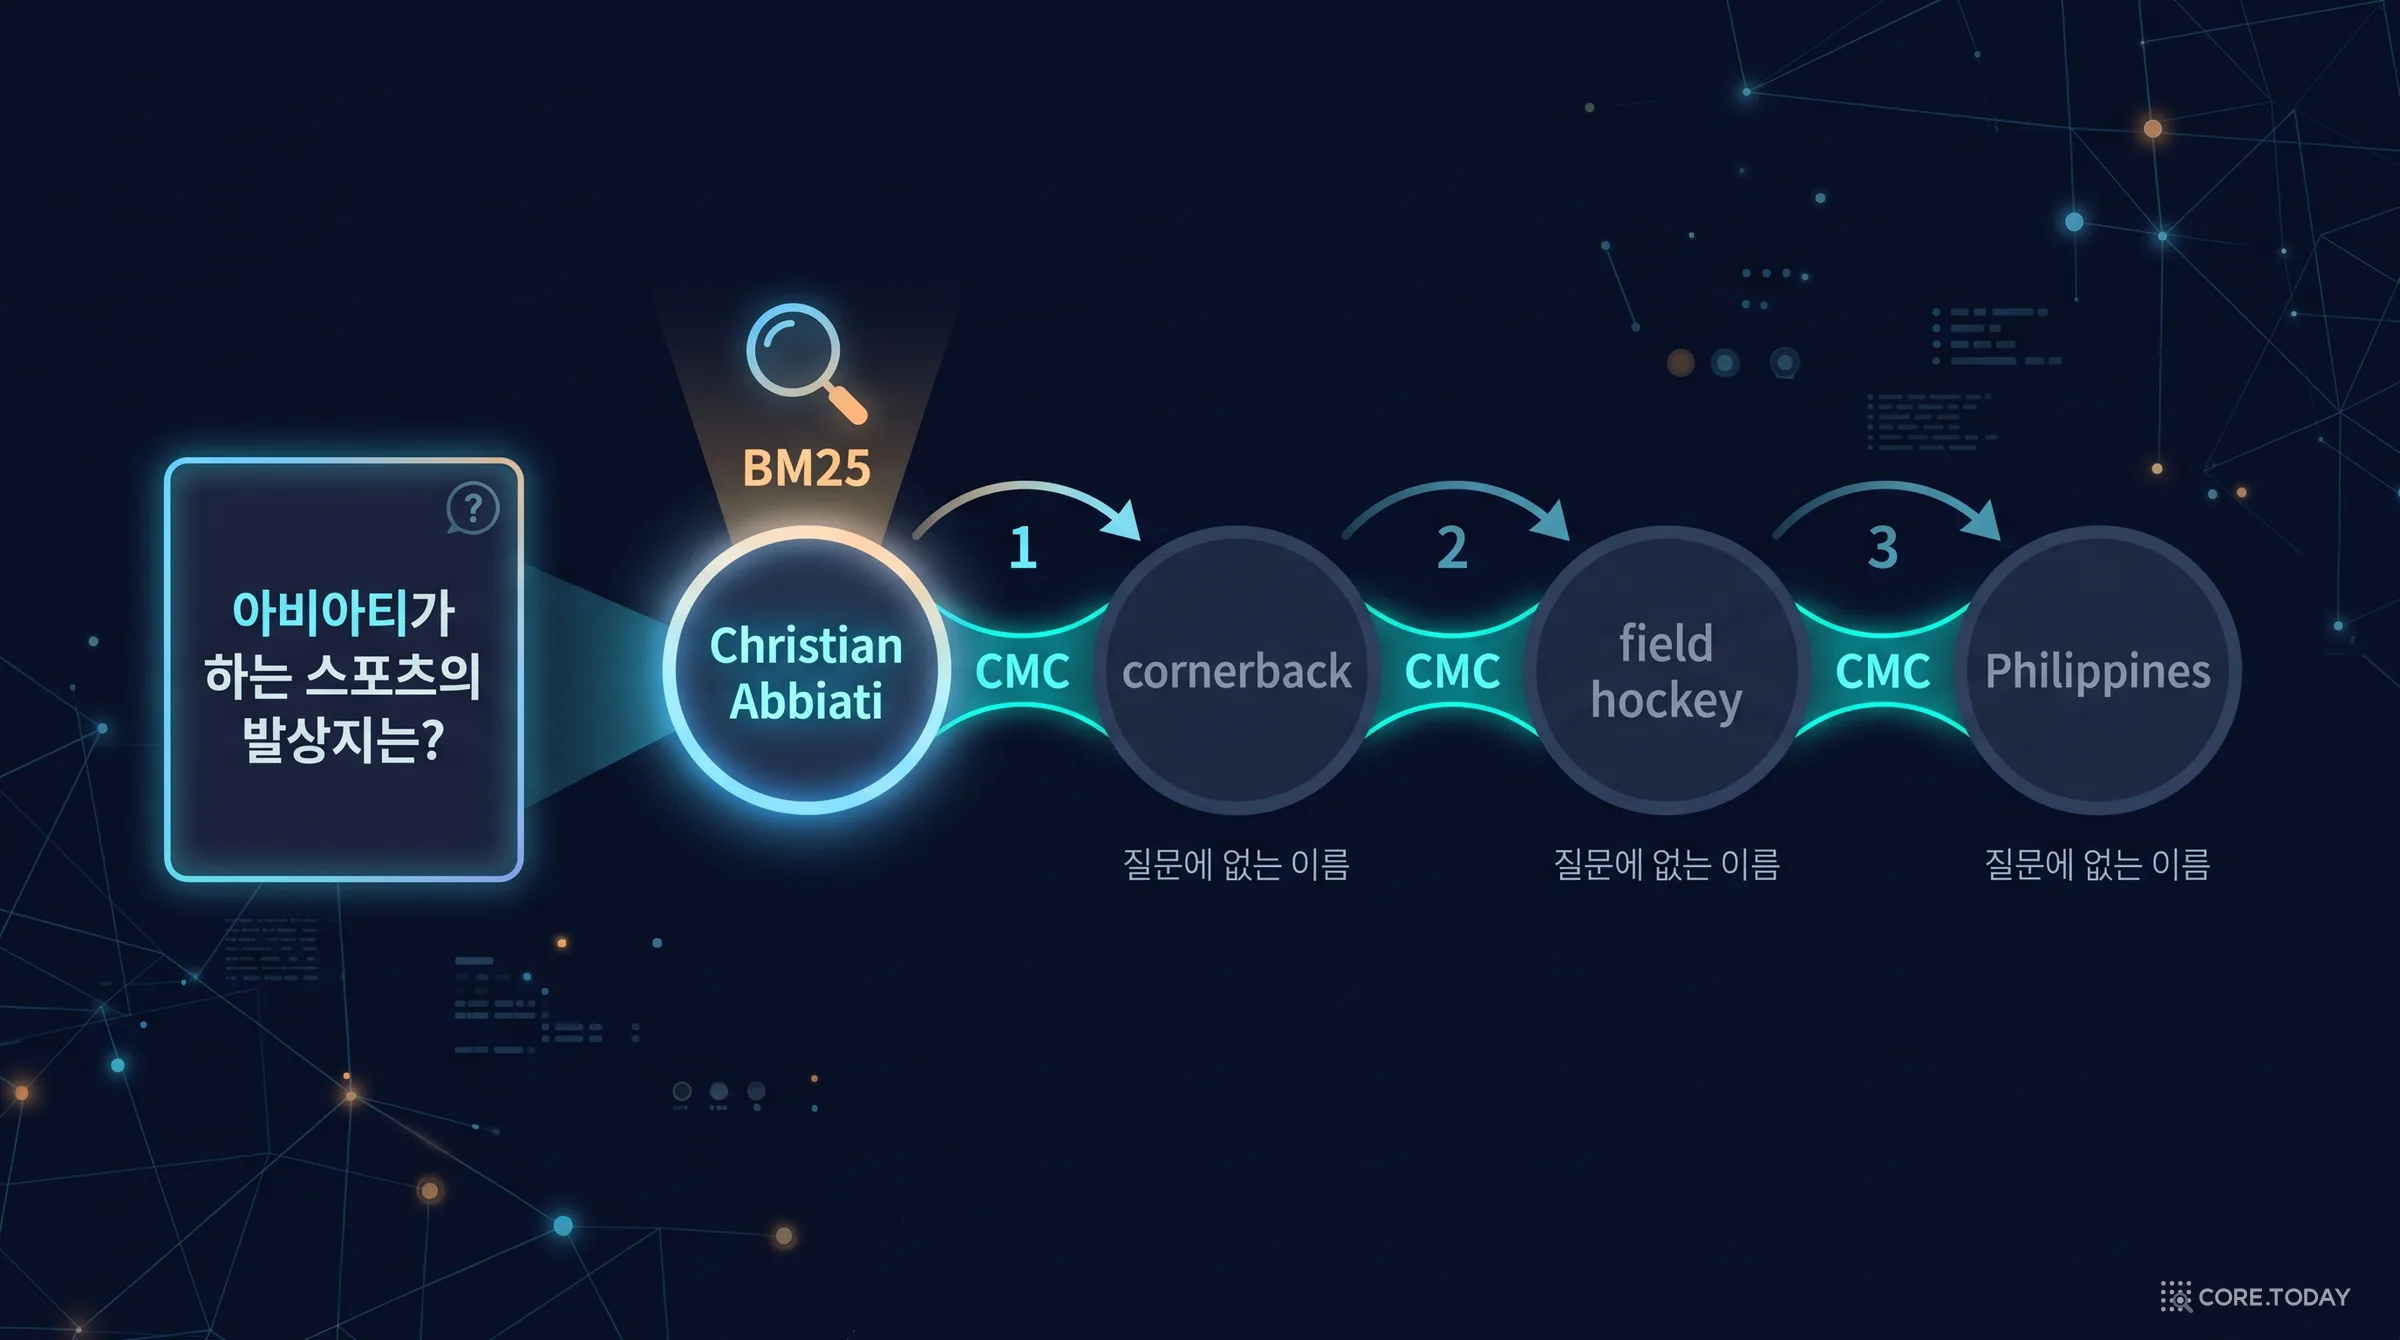
논문이 직접 든 실제 사례가 이 그림입니다. FactConsolidation의 262K 토큰짜리 기록에서 "Christian Abbiati가 하는 스포츠의 발상국은?"이라는 질문이 나옵니다. 이 데이터는 사실을 일부러 반사실로 바꿔 둔 시험이라, 기록 속 세계에서 이탈리아의 골키퍼 아비아티는 미식축구의 코너백으로 뛰고, 코너백은 필드하키라는 종목에 속하며, 필드하키는 필리핀에서 생겼습니다. CMC는 Abbiati → cornerback → field hockey → Philippines를 따라가 정답을 냅니다. BM25는 아비아티에 관한 기록은 찾았지만 필드하키의 발상지 기록을 놓쳤습니다. 그 기록에는 질문의 어떤 단어도 들어 있지 않기 때문입니다.
우리 주변의 '한 칸이 바뀌면 다음 칸이 바뀌는' 일들
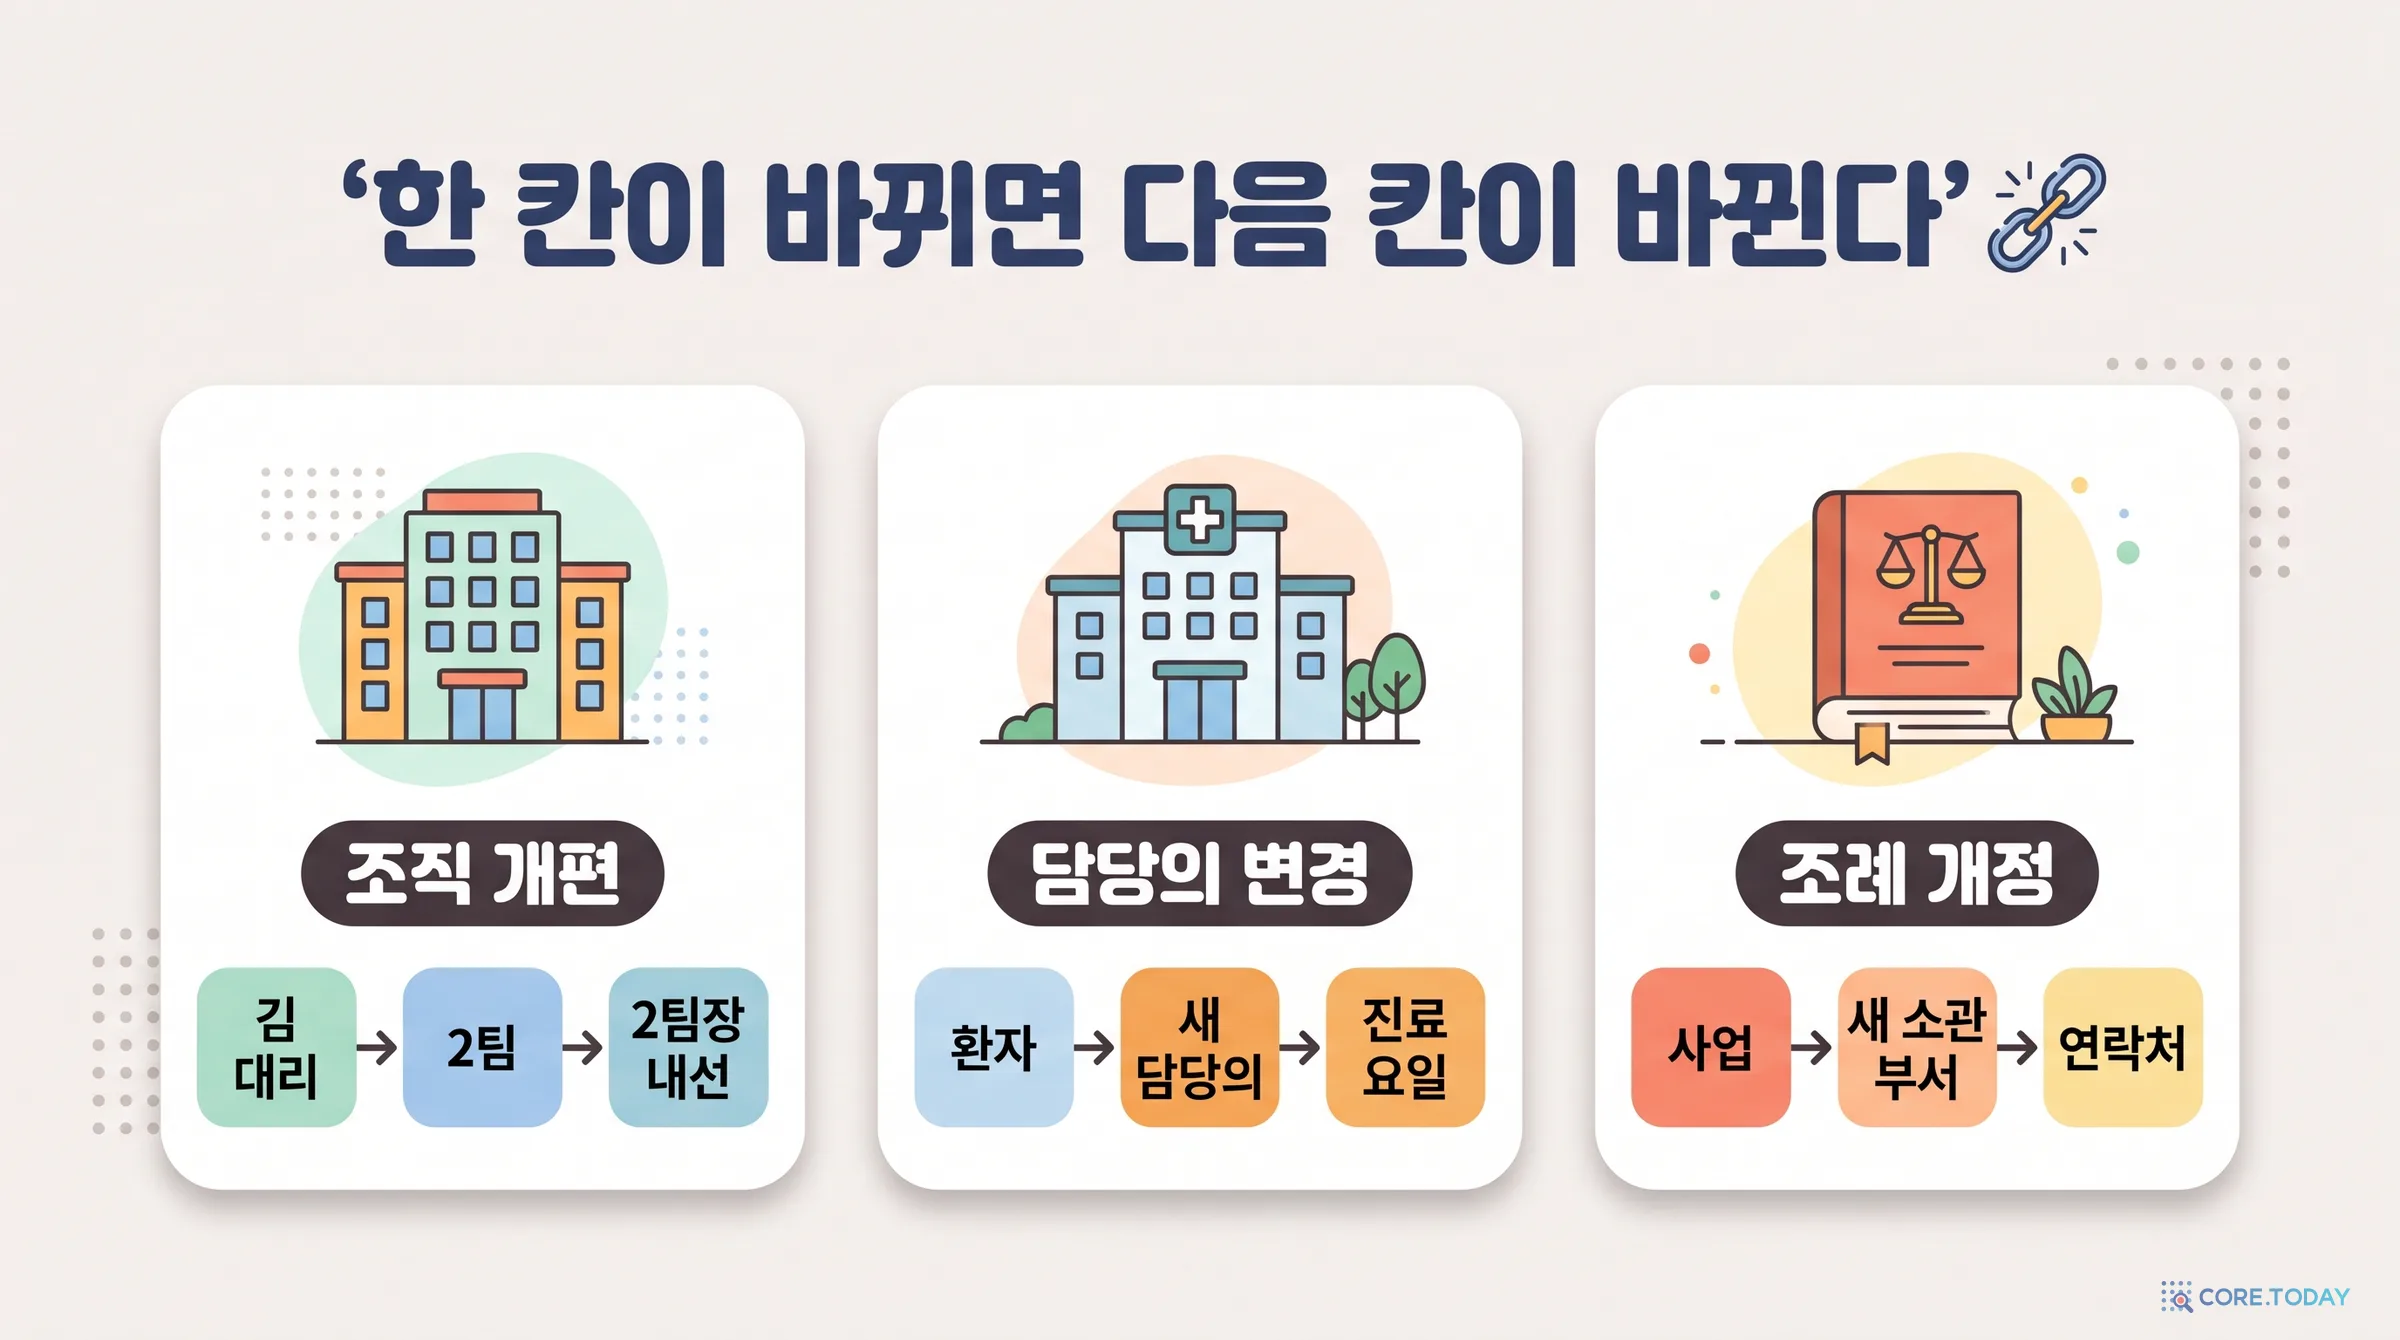
이 구조는 생각보다 흔합니다. 한 칸의 포인터가 바뀌었는데 그 포인터를 따라가는 대신 예전에 따라갔던 곳을 그대로 읽는 실수입니다.
이사한 친구에게 보낸 택배. 주소록의 '친구 → 옛 집' 한 줄만 고쳐도, 그 주소에 딸린 배송 권역·출입 방법·관리실 번호는 새 집의 것으로 다시 찾아야 합니다. 미국 우정청 감사관실 보고서(2014)에 따르면 2013 회계연도 우편물 1,580억 통 가운데 약 68억 통(4.3%)이 주소대로 배달되지 못했고 그 비용이 15억 달러였습니다. 이사가 주요 원인 가운데 하나로 꼽힙니다.
조직 개편. "김 대리 팀장의 내선 번호는?" 김 대리가 2팀으로 옮기면 팀장이 바뀌고, 팀장이 바뀌면 내선 번호 기록도 바뀝니다. 2팀 팀장의 내선 기록은 개편 전부터 있었지만 김 대리와는 상관없던 기록입니다.
병원의 담당의 변경. 환자의 담당의가 바뀌면 진료 요일 안내는 새 담당의의 일정에서 와야 합니다. 의료 현장에서는 입원 시 복용약 목록이 낡은 채로 넘어오는 문제가 오래 연구됐습니다. 22개 연구 3,755명을 검토한 2005년 캐나다의학협회지 논문은 입원 시 약력 오류가 많게는 67%의 환자에서 나타났다고 보고했습니다.
DNS의 별칭. 인터넷 주소 체계의 표준 문서 RFC 1034(1987)는 별칭(CNAME) 기록을 만나면 "데이터 칸에 적힌 이름에서 질의를 다시 시작하라"고 정합니다. 별칭이 가리키는 곳이 바뀌면 그다음 조회 대상도 바뀝니다. 별칭을 먼저 풀고 그다음 찾는 것, 바로 '해소한 뒤 순회'입니다.
2025년 10월 AWS 장애. 미국 동부 리전의 DynamoDB 엔드포인트가 사라진 2025년 10월 19~20일 장애의 사후 보고서는 원인을 이렇게 적었습니다. 크게 지연된 DNS 적용 작업자가 "훨씬 오래된 계획"을 적용해 새 계획을 덮어썼고, 작업 시작 때 한 번 확인한 "내 계획이 더 새것인가" 판단은 그 시점에 이미 낡아 있었다는 것입니다. 낡은 판단을 근거로 다음 행동을 이어 간 사례입니다.
CMC가 푸는 문제는 두 갈래 연구가 만나는 자리에 있습니다. 하나는 '모델 바깥에 기억을 두고 필요할 때 읽는다'는 갈래이고, 다른 하나는 '여러 걸음을 거쳐야 답이 나오는 질문'의 갈래입니다. 두 갈래가 '바뀌는 지식'이라는 세 번째 주제와 만나면서 이 논문의 질문이 생겼습니다.
2014~2016년: 저장과 읽기를 나누다
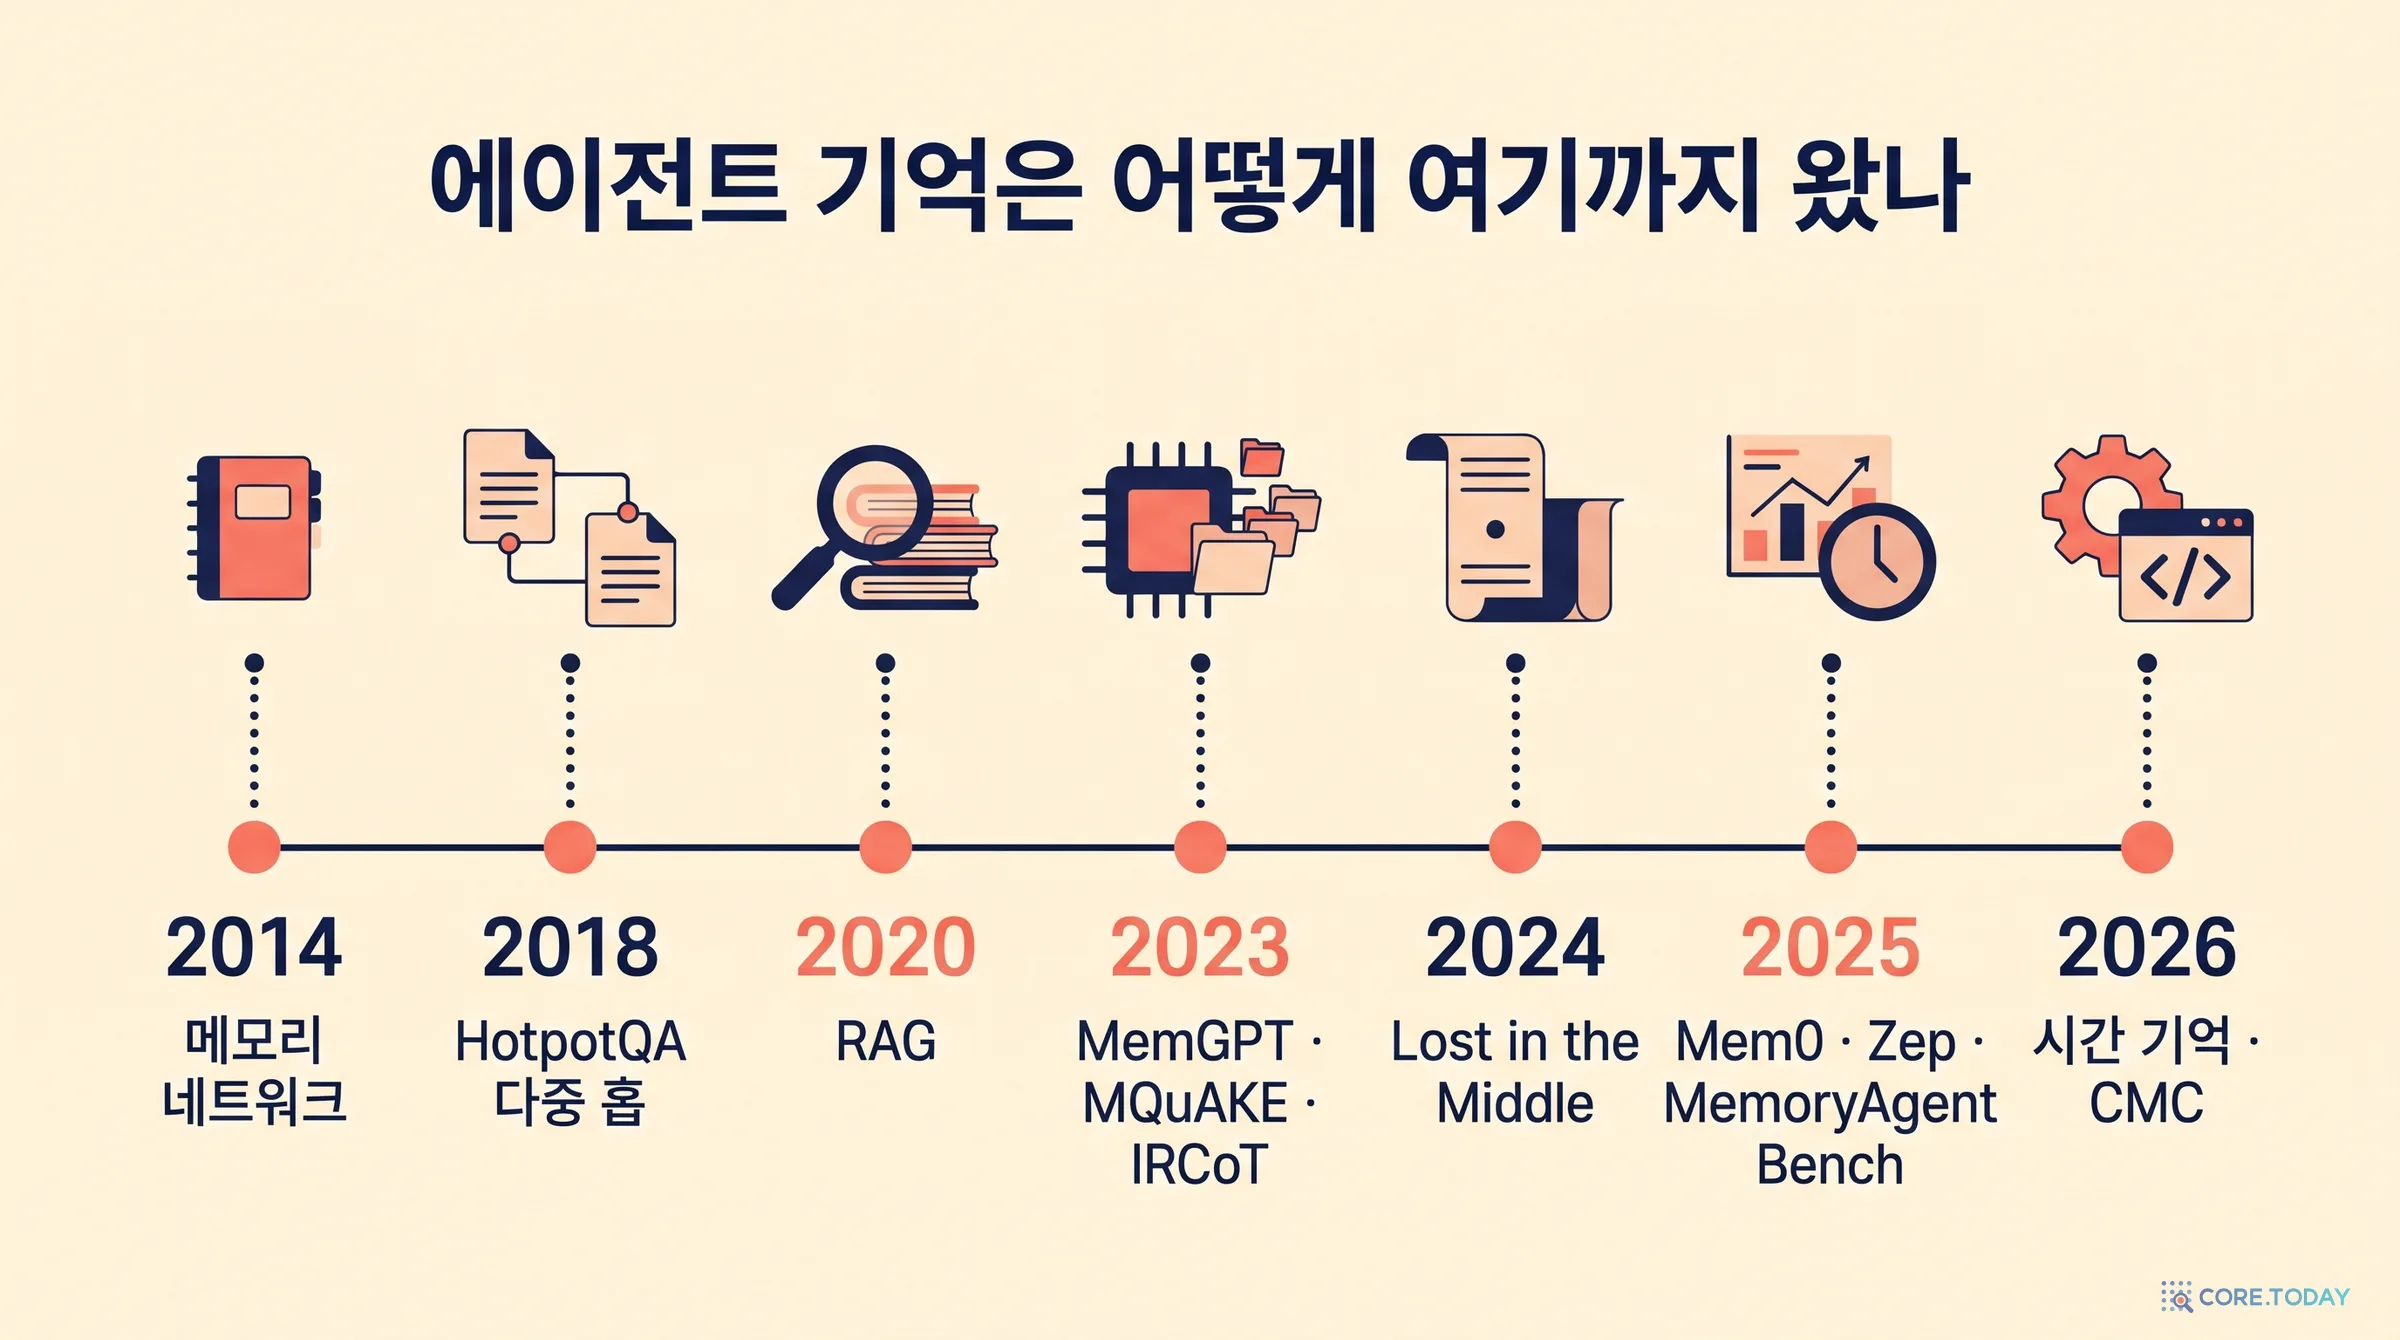
페이스북 AI 연구소의 제이슨 웨스턴 등이 2014년에 발표한 메모리 네트워크(Memory Networks)는 신경망 바깥에 읽고 쓸 수 있는 기억 칸을 두자는 제안이었습니다. 문장들을 기억 칸에 써 두고, 질문이 오면 관련 칸을 골라 읽어 답합니다. 2016년의 키-값 메모리 네트워크는 기억을 '찾는 열쇠'와 '읽는 값'으로 나눴습니다. CMC 논문이 관련 연구의 첫 줄에서 이 두 논문을 인용하는 이유가 있습니다. "저장된 것"과 "이번 질문을 위해 읽는 것"을 구분한 출발점이기 때문입니다. CMC의 문제는 결국 '무엇을 저장할까'가 아니라 '이번에 무엇을 읽힐까'입니다.
2018~2022년: 한 번에 찾을 수 없는 질문
2018년 카네기멜런·스탠퍼드·몬트리올대가 만든 HotpotQA는 위키백과 문단 두 개를 이어야 답이 나오는 질문 11만 3천 개를 모았습니다. 2020년의 2WikiMultiHopQA는 위키데이터의 논리 규칙으로 질문을 만들어 증거 경로까지 붙였고, 2022년의 MuSiQue는 단일 홉 질문 여러 개를 엮어 2~4홉 질문 2만 5천 개를 만들었습니다. MuSiQue 저자들은 단일 홉 모델로 이 질문을 풀면 F1이 30점 떨어진다는 것을 보이며, 지름길로 풀 수 없는 '진짜 다중 홉'을 강조했습니다.
이 시기의 교훈은 앞의 GoldEn Retriever 수치에 담겨 있습니다. 질문으로 한 번 검색하면 두 번째 걸음을 자주 놓친다는 것입니다. 해법도 이때 나왔습니다. 다리 개체를 알아낸 뒤 다시 검색하기입니다.
2020년: 검색 증강 생성
2020년 페이스북 AI와 런던대가 발표한 RAG(Retrieval-Augmented Generation)는 검색기와 생성 모델을 하나로 묶었습니다. 질문으로 문서를 찾아 생성 모델에게 함께 넣어 주는 방식입니다. 이후 '기억'이라는 말은 사실상 '검색해서 넣어 주기'와 같은 뜻이 됐습니다. RAG는 매우 성공했지만, 검색의 단위가 '질문과 비슷한 문서'라는 한계도 함께 물려줬습니다. 질문에 없는 다리 개체를 찾는 일은 RAG의 기본 설계 밖에 있습니다.
2023년: 바뀐 지식의 파급 효과
2023년은 세 개의 중요한 논문이 나온 해입니다.
첫째, 스탠퍼드·프린스턴의 MQuAKE입니다. 당시 유행하던 지식 편집(knowledge editing), 즉 모델의 가중치를 직접 고쳐 사실 하나를 바꾸는 기법을 다중 홉 질문으로 시험했습니다. 결과는 충격적이었습니다. ROME으로 편집한 GPT-J는 편집한 사실 자체는 90% 넘게 기억했지만, 그 사실을 거치는 다중 홉 질문은 7.4%만 맞혔습니다. 편집 전에는 40.5%였습니다. "영국 총리가 바뀌었다"를 가르쳐도 "영국 총리의 배우자는?"에는 옛 총리의 배우자를 답하는 것입니다. 저자들은 가중치를 건드리지 않고 편집 내용을 외부 기억에 두는 MeLLo를 대안으로 제시했습니다. 질문을 하위 질문으로 쪼개고, 하위 질문마다 잠정 답을 낸 뒤, 외부 기억에서 가장 가까운 편집 사실을 찾아 모순이 있으면 고칩니다. 3,000건을 편집한 조건에서 GPT-3.5 기반 MeLLo는 30.9%로, 가중치 편집 기법 MEMIT의 5.4%를 크게 앞섰습니다.
같은 해 텔아비브대의 RippleEdits는 이 현상에 '파급 효과(ripple effect)'라는 이름을 붙였습니다. "잭 뎁은 조니 뎁의 아들이다"를 편집하면 "잭 뎁은 릴리로즈 뎁의 형제다"도 따라 바뀌어야 한다는 식입니다.
둘째, 스토니브룩대와 앨런 AI 연구소의 IRCoT입니다. "무엇을 검색할지는 지금까지 무엇을 알아냈는지에 달려 있다"는 문장으로 시작하는 이 논문은 생각의 사슬(chain-of-thought) 한 단계마다 검색을 다시 했습니다. 네 가지 데이터셋에서 검색 성능은 최대 21점, 답 정확도는 최대 15점 올랐습니다. 다리 개체 문제의 정석 해법입니다. CMC 논문도 이 방법을 직접 언급합니다. 다만 IRCoT는 걸음마다 모델을 다시 불러야 합니다.
셋째, UC 버클리의 MemGPT입니다. 운영체제의 가상 메모리처럼 모델의 문맥 창과 바깥 기억 사이로 정보를 옮기는 에이전트를 제안했고, 같은 해 스탠퍼드의 '생성형 에이전트(Generative Agents)'는 가상 마을 주민 25명이 경험을 기억하고 회상하는 모습을 보여 줬습니다. '에이전트 기억'이 하나의 분야가 됐습니다.
2024년: 긴 문맥은 답이 아니었다
"기억을 따로 둘 것 없이 문맥 창을 늘리면 되지 않나?" 이 질문에 2024년의 두 논문이 답했습니다. 스탠퍼드의 Lost in the Middle은 답이 들어 있는 문서가 긴 입력의 가운데에 있으면 성능이 크게 떨어진다는 U자 곡선을 보였습니다. GPT-3.5-Turbo는 20% 넘게 떨어졌고, 문서 20~30개 조건의 최악 위치에서는 문서를 아예 안 줬을 때(56.1%)보다도 낮았습니다. 엔비디아의 RULER는 32K 이상을 지원한다고 내세운 모델 17종 가운데 실제로 32K에서 만족스러운 성능을 유지한 것은 절반 정도라고 보고했습니다. 창이 크다고 다 읽는 것은 아닙니다. CMC 논문이 서론에서 Lost in the Middle을 인용하며 시작하는 이유입니다.
2025~2026년: 시험지가 생기다
2025년에는 에이전트 기억 제품이 쏟아졌습니다. 대화를 압축해 기억으로 만드는 Mem0, 관계에 유효 시각(valid_at)과 무효 시각(invalid_at)을 붙이는 시간 지식 그래프 Zep/Graphiti, 메모를 서로 연결하는 A-Mem 등입니다. 그리고 UC 샌디에이고의 줄리언 매콜리 연구실이 이들을 한 시험지로 재는 MemoryAgentBench(arXiv 2507.05257, ICLR 2026)를 내놓았습니다.
MemoryAgentBench는 기억의 능력을 넷으로 나눕니다. 정확한 검색, 테스트 시점 학습, 장거리 이해, 그리고 선택적 망각입니다. 선택적 망각을 재는 과제가 이 글의 주인공인 FactConsolidation입니다. 만드는 법은 이렇습니다. MQuAKE의 반사실 편집 쌍, 즉 원래 사실과 그것을 뒤집는 편집 사실을 가져와 편집 사실이 항상 뒤에 오도록 번호를 매기고, 여러 쌍을 이어 붙여 6K·32K·64K·262K 토큰 길이의 기록을 만듭니다. 모델에게는 "번호가 큰 사실이 더 새로운 것이니, 충돌하면 새것을 따르라"고 알려 줍니다. 그리고 MQuAKE의 질문을 단일 홉(FC-SH)과 다중 홉(FC-MH)으로 나눠 묻습니다.
결과는 처참했습니다. 논문 초판(2025년 7월)은 다중 홉에서 "모든 방법이 최대 6%"라고 적었고, 2025년 9월과 2026년 3월 판에서는 7%, GPT-5-mini를 추가한 2026년 6월 판에서는 "최대 28%"로 고쳤습니다. 262K 기준으로 Mem0는 2%, Zep과 MemGPT는 3%, 그래프 기반 HippoRAG-v2도 5%였습니다. 추론 모델 o4-mini는 6K 기록에서 다중 홉 80%를 냈지만 32K에서는 14%로 무너졌습니다. 저자들은 "항상 나중 것을 따르라"는 지시를 프롬프트에 더 강하게 넣어 보기도 했는데, GPT-4.1-mini의 단일 홉은 36에서 40으로 올랐지만 다중 홉은 5에서 4로 오히려 내려갔습니다. 프롬프트만으로는 갱신을 다중 홉 사슬로 전달할 수 없다는 결론이었습니다.
같은 시기 MQuAKE 자체의 문제도 드러났습니다. 2025년 ICLR에 실린 MQuAKE-Remastered는 원래 데이터셋의 질문과 정답 가운데 많게는 33%(혹은 조건에 따라 76%)가 오염돼 있다고 보고했습니다. 한 사례의 편집이 다른 사례의 정답에 새어 들어가거나, 같은 대상을 서로 다른 값으로 편집한 사례가 섞여 있었습니다(예를 들어 포드 머스탱의 제조사가 한 사례에서는 닌텐도로, 다른 사례에서는 피아트로 편집됨). 이 사실은 6부의 재현 결과를 읽을 때 중요해집니다.
2026년: '현재 값' 연구의 홍수, 그리고 남은 칸
2026년 들어 시간 기억 논문이 줄을 이었습니다. 시간 속성 그래프에 사건을 정리하고 질문 시점에 에이전트가 바뀐 정보를 해소하는 APEX-MEM(ACL 2026), 쓰기에 근거가 있는지 확인하고 충돌하는 사실의 '보이는 판'을 고르는 MemTxn, 근거 있는 시간 그래프 SodaMem 등입니다. 반대 방향의 움직임도 있었습니다. Mem0는 2026년 4월 새 알고리즘을 발표하며 "갱신·삭제 없이 추가만 한다"로 돌아섰습니다. 덮어쓰기가 "때로 핵심 정보를 지웠다"는 이유였습니다.
이 연구들은 모두 어떤 값이 지금 값인가에 답하려 합니다. CMC 논문의 관련 연구 절은 이 흐름을 정리한 뒤 이렇게 선을 긋습니다. "우리의 질문은, 현재 관계가 바뀐 뒤 어떤 원문 기록이 하나의 답 문맥에 들어가는가이다." 그리고 더 좁게, "정렬된 단일 값 관계에서, 해소된 목적어가 유한한 순회가 다음에 고를 원문 기록을 결정한다"는 성질만을 떼어 내 보겠다고 말합니다. 큰 시스템을 하나 더 만드는 논문이 아니라, 연산의 순서 하나를 시험하는 논문입니다.
3부. 읽기 계약: 이 논문이 약속하는 것
기호 몇 개로 문제 적기
논문 2장은 문제를 짧은 수식으로 정의합니다. 겁먹을 필요는 없습니다. 회의실 예시를 그대로 옮긴 것입니다.
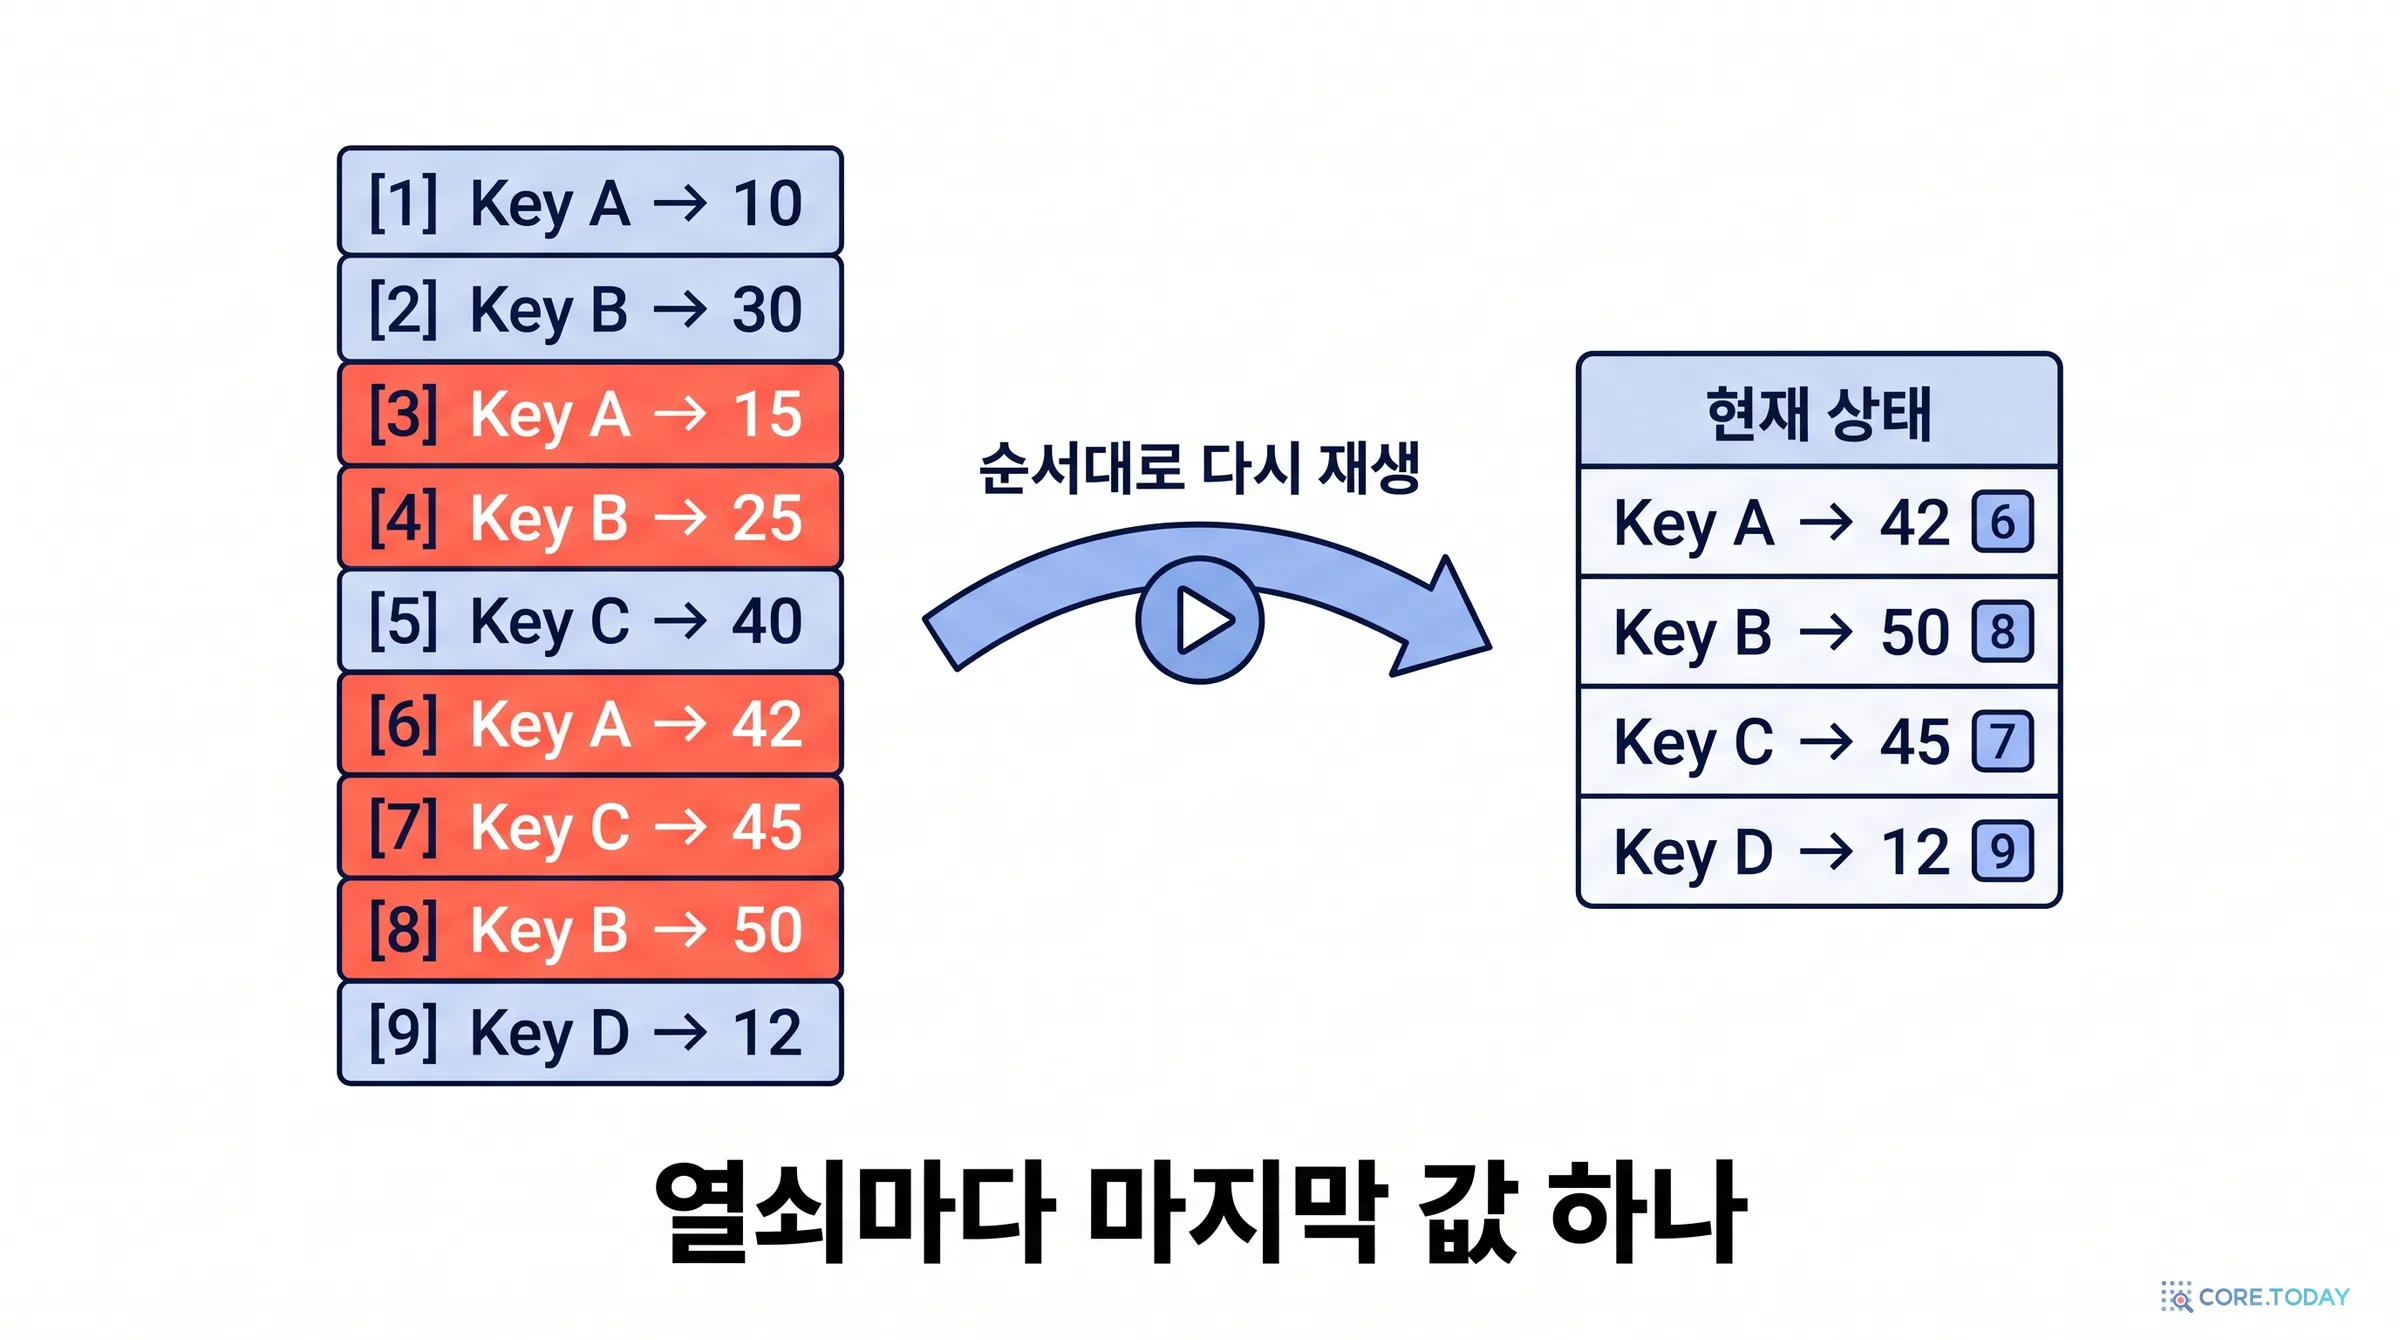
기억은 순서가 있는 단언(assertion)의 흐름 H≤t입니다. 각 단언을 해석하면 간선 e=(s,r,o,τ)가 됩니다. s는 주어(주간 회의), r은 관계(장소), o는 목적어(B회의실), τ는 그 단언이 기록된 위치(5번째)입니다. 관계는 마지막 쓰기 승리(last-write-wins) 규칙을 따릅니다. 같은 열쇠 (s,r)에 대해 나중 단언이 앞의 것을 덮어씁니다. 그러면 시점 t의 현재 상태는 열쇠마다 간선 하나씩입니다.
Gt={arge∈Et:e.key=kmaxe.τ:k∈keys(Et)}
질문 q가 오면 질문에 이름이 명시적으로 나온 주어들 Aq(앵커)를 찾습니다. 앵커에서 현재 그래프를 따라 주어 s까지 가는 최단 거리를 dGt(Aq,s)라 하면, 홉 상한 h에서 고르는 증거는 다음과 같습니다.
Ch(q,Gt)={(s,r,o,τ)∈Gt:dGt(Aq,s)<h}
말로 풀면 "앵커에서 h걸음 안에 닿는 모든 주어에 대해, 그 주어에서 나가는 현재 간선을 전부 고른다"입니다. 질문이 묻는 관계 하나만 고르는 게 아니라 가지를 모두 줍니다. 어느 가지가 답에 필요한지는 답 모델이 판단합니다.
왜 '계약'인가
소프트웨어에서 계약(contract)은 "이 함수는 이런 입력에 대해 이런 성질을 보장한다"는 약속입니다. 논문은 위 정의에서 확인할 수 있는 성질 두 가지를 끌어냅니다.
①
현재성 (Currency)
고른 증거 속의 모든 간선은 자기 열쇠에 대해 마지막으로 쓰인 간선이다. 옛 값은 하나도 들어가지 않는다.
②
유한 그래프 커버리지 (Bounded graph coverage)
앵커에서 h걸음 미만으로 닿는 주어라면, 그 주어에서 나가는 현재 간선은 하나도 빠지지 않는다. 관련 있어 보이는지와 상관없이 전부 들어간다.
③
둘이 합쳐지면
갱신이 다음 걸음을 바꿔도, 바뀐 다음 걸음의 기록이 반드시 증거에 들어온다. 회의실 예시에서 'B회의실은 5층' 기록이 빠질 수 없다.
두 성질은 하나만으로는 부족합니다. '먼저 고르고 값만 갱신'하는 방식은 현재성을 만족합니다. 고른 사실이 모두 최신이니까요. 하지만 커버리지를 만족하지 못합니다. B회의실이 앵커에서 1걸음 거리에 있는데도 B회의실의 층 간선이 빠지니까요. 반대로 'CMC가 고른 열쇠를 그대로 두고 값만 옛것으로' 넣으면 커버리지의 모양은 같지만 현재성이 깨집니다. 5부의 대조군 실험은 바로 이 두 성질을 하나씩 깨뜨려 각각의 값을 잽니다.
논문은 계약이 약속하지 않는 것도 분명히 적습니다. 이 성질은 해석에 성공한 간선에만 적용됩니다. 해석하지 못하고 원문 그대로 넘기는 '미해결 기록'에는 판이 매겨지지 않습니다. 또 쓸모는 필요한 사실이 해석돼 있고 앵커에서 h걸음 안에 닿는다는 전제에 달려 있습니다. 이름이 질문에 정확히 나오지 않거나, 중간 사실 하나가 추출에서 빠지면 계약은 지켜져도 답은 틀릴 수 있습니다.
원장을 다시 재생한다는 생각
데이터베이스를 다뤄 본 사람에게 2단계는 익숙합니다. 마틴 파울러가 2005년에 정리한 이벤트 소싱(Event Sourcing)은 "애플리케이션 상태의 모든 변화를 이벤트의 순서열로 남기라"는 패턴입니다. 현재 상태는 이벤트를 처음부터 순서대로 다시 재생해서 얻습니다. 아마존 Dynamo(2007)와 카산드라가 충돌을 풀 때 쓰는 '마지막 쓰기 승리'도 같은 규칙입니다. 카산드라 문서는 "모든 변경(삭제 포함)에 타임스탬프를 찍는 더 단순한 마지막 쓰기 승리 모델"이라고 설명합니다.
CMC의 2단계는 정확히 이 재생입니다. 다른 점은 현재 상태 표의 각 칸이 출처 번호를 기억한다는 것입니다. 나중에 답 모델에게 건넬 때는 표의 칸이 아니라 그 번호의 원문 기록을 꺼내 줍니다. 그리고 질문이 오기 전에 이 표를 만들어 둔다는 점에서, 이름에 '컴파일러'가 붙었습니다. 프로그램을 실행 전에 미리 번역해 두는 것처럼, 기억을 질문 전에 미리 정리해 둡니다. 질문 시점에 하는 일은 모두 모델 호출 없는 결정론적 연산입니다.
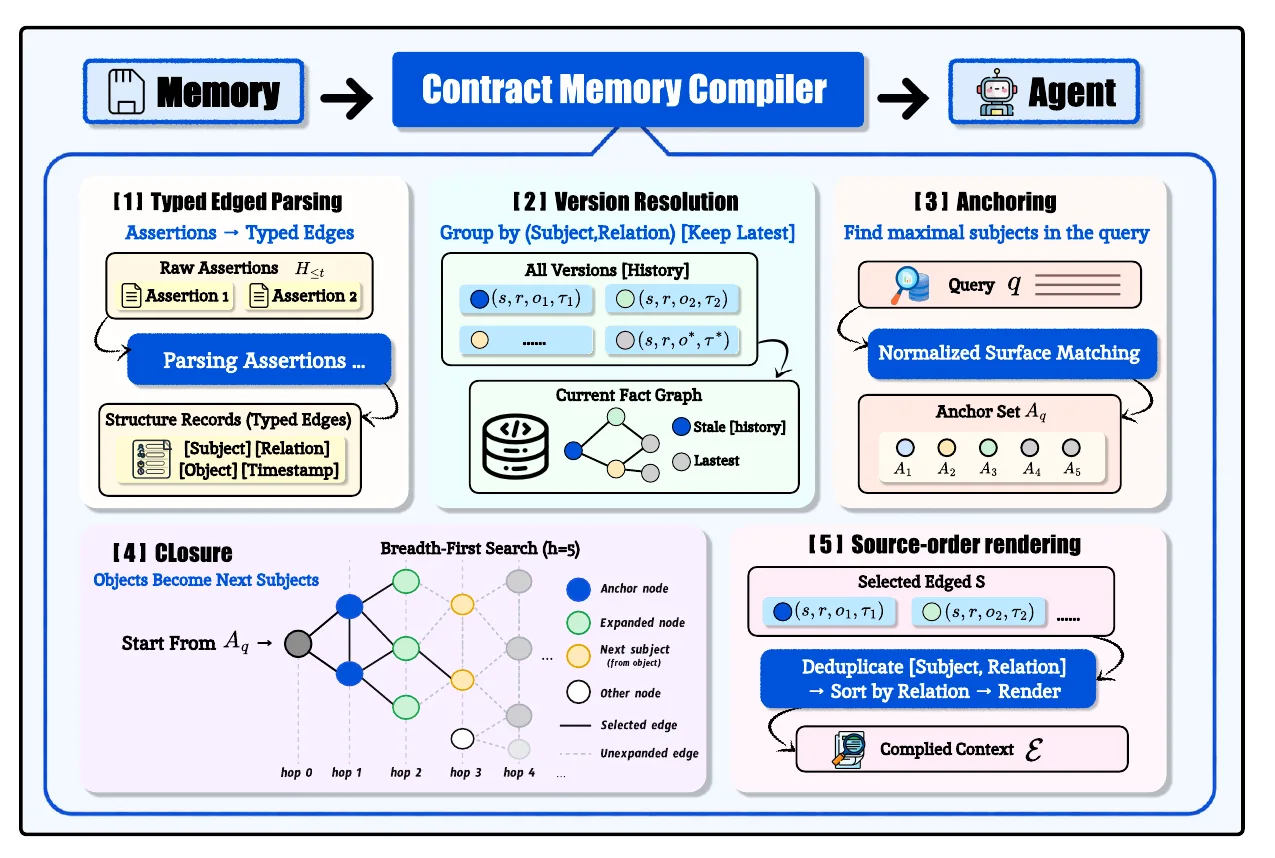
논문의 그림 1이 전체 구조입니다. 위쪽의 '기억 → Contract Memory Compiler → 에이전트'는 CMC가 기억 저장소와 답 모델 사이에 끼는 층이라는 뜻입니다. 아래 다섯 칸 가운데 [1]·[2]는 기록마다 한 번, [3]·[4]·[5]는 질문마다 실행됩니다.
출처: Song et al., arXiv 2609.32658, 그림 1. 그림의 [5]번 칸에는 'Sort by Relation'(관계로 정렬)이라고 적혀 있지만, 본문 3장과 알고리즘 1은 원래 기록 순서로 되돌린다고 적고 있습니다. 이 글은 본문을 따랐습니다. 'Typed Edged', 'CLosure', 'Lastest', 'Complied' 같은 오자도 그림에 그대로 있습니다.
1단계: 관계를 뽑고, 출처를 붙여 둔다
언어 모델이 기록을 묶음으로 읽고, 기록마다 세 가지 상태 중 하나를 붙입니다.
사실(facts): 방향이 있는 (주어, 관계, 목적어) 세 쌍을 뽑아냈다.
미해결(unresolved): 뭔가 중요한 내용이지만 세 쌍으로 확실히 옮기기 어렵다. 원문을 그대로 남겨 나중에 답 모델이 직접 읽게 한다.
사실 없음(no fact): 간선도, 남길 원문도 없다.
추출 프롬프트는 대명사로 가리키는 문장, 부정문, 범위가 애매한 문장, 값이 동시에 여럿인 문장을 미해결로 표시하라고 지시합니다. 그다음 구조 검증이 따라옵니다. 기록 번호가 맞는지, JSON 형식이 맞는지, 그리고 주어와 목적어가 원문에 글자 그대로 있는지를 확인합니다. 모델이 지어낸 이름은 여기서 걸러집니다. 관계 이름은 모델이 자유롭게 짓되, 앞선 묶음에서 쓴 관계 이름 목록을 함께 주고, '같은 뜻의 다른 이름'(예: married to와 spouse)을 하나로 맞추는 정렬 단계를 따로 둡니다. 개체 이름은 대소문자·문장부호·소유격을 정해진 규칙으로 정규화해 열쇠로 씁니다.
이 단계가 질문도 정답도 보지 않는다는 점이 중요합니다. 추출·정렬·수리 모두 원문만 봅니다. FactConsolidation의 고유 문장 18,336개를 처리하는 데 모델 호출 827번, 입력 토큰 91만 9,509개, 출력 토큰 41만 9,813개가 들었습니다. 결과물은 세 쌍 하나짜리 기록 18,333개와 미해결 기록 3개였습니다. 비교를 위해 저자들은 MQuAKE 문장 틀을 사람이 정규식으로 옮긴 문법 어댑터(grammar adapter)도 따로 만들었습니다.
2단계: 현재 그래프를 만든다
받아들인 단언들을 기록 순서대로 사전(dictionary)에 다시 재생합니다. 열쇠는 (정규화한 주어, 정렬한 관계)입니다. 같은 열쇠가 나올 때마다 저장된 간선을 바꿔 끼우고, 다른 열쇠는 건드리지 않습니다. 논문의 예시로는 "[4] 주간 회의는 B회의실에서 열린다"가 (weekly meeting, held in, room b, 4)가 되고, 열쇠 (weekly meeting, held in) 자리에 (room b, 4)가 저장됩니다. 이 현재 그래프 Gt는 같은 기록에 대한 모든 질문이 함께 씁니다. 원래 단언들은 지워지지 않고 출처에 그대로 남습니다. 262K 기록 기준으로 이 재생은 CPU에서 0.2초 걸렸습니다.
3단계: 질문 속 이름을 찾는다
질문을 같은 규칙으로 정규화한 뒤, 그래프의 주어 가운데 통째 문자열로 질문에 나타나는 것을 찾습니다. 짧은 이름이 더 긴 이름 안에 포함되면 긴 쪽만 남깁니다("New York"과 "New York Times"가 둘 다 걸리면 후자만). 남은 것이 앵커 집합 Aq입니다. 논문은 이것이 "결정론적인 표면 형태 규칙"이며 개체 중의성 해소와 별칭 추론은 구현 범위 밖이라고 밝힙니다. 영어 FactConsolidation에서는 800문항 거의 모두가 앵커를 정확히 하나 찾습니다. 하지만 한국어처럼 이름 뒤에 조사가 붙는 언어에서는 이 단계가 첫 번째 관문이 됩니다. 6부에서 이 문제를 실제로 재 봅니다.
4단계: 다섯 걸음까지 따라간다
앵커에서 너비 우선 탐색(BFS)을 합니다. 깊이 0부터 4까지의 주어에 대해 나가는 현재 간선을 모두 고르고, 고른 간선의 목적어가 다음 깊이의 주어가 됩니다. 이것이 논문 그림 1의 [4]번 칸 제목 '목적어가 다음 주어가 된다(Objects Become Next Subjects)'의 뜻입니다. 갱신된 값이 있으면 그 값이 다음 탐색의 출발점이 되므로, 갱신이 자동으로 그다음 증거 선택의 방향을 바꿉니다. 순환은 최단 깊이 기록으로 처리하고, 간선은 (주어, 관계)로 중복을 지웁니다. 더 갈 곳이 없거나 다섯 걸음에 닿으면 멈춥니다.
여기서 CMC는 관계를 고르지 않는다는 점이 눈여겨볼 만합니다. 질문이 '층'을 묻든 '국적'을 묻든, 앵커 근처의 모든 간선을 줍니다. 질문의 뜻을 해석해 어느 관계를 따라갈지 정하는 일은 오류가 나기 쉬운데, 그 판단을 결정론 단계에서 빼고 답 모델에게 넘긴 것입니다. 대신 증거가 조금 커집니다. FactConsolidation에서 다섯 걸음 증거는 평균 185토큰이었습니다.
5단계: 원문을 원래 순서로 다시 붙인다
고른 간선이 있으면, 그 간선들을 뒷받침하는 원래 번호 붙은 기록을 꺼내고 미해결 기록을 모두 더합니다. 고른 간선이 하나도 없으면(앵커를 못 찾은 경우 등) 원래 기록 전체를 씁니다. 같은 번호는 하나로 합치고, 원래 순서대로 다시 정렬하고, 증거 앞머리를 포함해 6만 자 한도를 적용합니다. 넘치면 가장 최근의 연속된 기록들만 통째로 남깁니다. 답 모델은 "번호가 클수록 새것"이라는 지시와 함께 증거와 질문을 받아 한 번 답합니다.
세 쌍이 아니라 원문을 건네는 이유가 있습니다. 세 쌍은 추출 과정에서 뉘앙스를 잃을 수 있고, 답 모델은 사람이 쓴 문장을 더 잘 읽습니다. 그래프는 '무엇을 읽힐지 고르는 도구'로만 쓰고, 읽히는 것은 원래 기록입니다.
알고리즘 1을 파이썬 비슷하게 옮기면 이렇습니다.
python
# 질문 전에 한 번 (기록마다)
E, U = llm_parse_with_positions(history) # 간선(출처 번호 포함), 미해결 기록
G = latest_edge_per_key(E) # (주어, 관계)마다 마지막 간선 하나# 질문마다 (모델 호출 없음)defcompile_evidence(q, h=5, budget=60_000):
A = maximal_explicit_subjects(q, G) # 질문에 통째로 나온 주어들
S = bounded_bfs(G, A, h) # 나가는 현재 간선 전부, h홉까지
V = history ifnot S else source_records(S) | U
V = dedupe_by_position(V)
V = newest_whole_record_suffix(V, budget) # 넘치면 최근 기록만 통째로return render_in_source_order(V) # 원래 번호 순서
answer = reader(q, compile_evidence(q)) # 답 모델은 한 번만
비용은 어디에 드나
비용의 무게중심은 쓰기 쪽에 있습니다. 1단계 추출에 모델 호출이 들고, 질문 시점에는 문자열 매칭과 그래프 탐색만 합니다. 262K 기록에서 질문 하나의 증거를 만드는 데 CPU 시간 중앙값은 13.8밀리초였습니다. 다만 95번째 백분위수는 144.3밀리초로, BM25(17.96밀리초)보다 깁니다. 저자들은 현재 구현이 읽을 때마다 그래프 인접 목록을 다시 만들기 때문이며 "CPU 지연에서 이점이 있다고 주장하지 않는다"고 적었습니다. 답 모델 쪽에서는 이야기가 다릅니다. 증거가 짧으니 HY4-preview 호출 시간 중앙값이 CMC 1.29초, BM25 1.42초, 최신 상태 통째로 2.46초였습니다.
아래 위젯은 공개 데이터의 실제 질문으로 4단계를 보여 줍니다. 코어닷투데이가 논문의 문법 어댑터 방식을 다시 구현해 계산한 것입니다. 탐색 깊이를 줄여 보고, 세 가지 모드를 바꿔 보세요.
5부. 실험 읽기: 대조군을 하나씩 뜯어보기
이 논문의 진짜 힘은 대조군 설계에 있습니다. "우리 시스템이 다른 시스템보다 좋다"가 아니라 "추출한 사실도, 답 모델도, 프롬프트도 똑같은데 답 모델에게 건네는 기록만 바꾸면 어떻게 되나"를 묻습니다. 이렇게 하면 차이가 생겼을 때 그것이 오직 증거 선택에서 왔다고 말할 수 있습니다.
시험지와 채점
FactConsolidation은 길이 네 가지(6K·32K·64K·262K 토큰)마다 단일 홉 100문항, 다중 홉 100문항, 모두 800문항입니다. 채점은 MemoryAgentBench가 공개한 부분 문자열 일치(substring exact match)입니다. 정답 문자열을 정규화해서 모델 답 안에 들어 있으면 맞은 것으로 칩니다. 중심 실험의 답 모델은 텐센트의 HY4-preview(온도 0, 생각 끔, 출력 64토큰)이고, 모든 방식에 같은 6만 자 증거 한도를 씌웠습니다.
일곱 가지 읽기 방식
읽기 방식
현재성
커버리지
무엇을 시험하나
CMC
지킴
지킴
정리한 뒤 따라가기
먼저 고르고 값만 갱신 (prior read + refresh)
지킴
깨짐
옛 그래프로 열쇠를 고른 뒤 그 열쇠의 값만 최신으로. 순서의 효과
옛 값으로 따라가기 (stale closure)
깨짐
모양은 같음
CMC가 고른 열쇠는 그대로, 값만 이전 판으로. 값 선택의 효과
현재 사실 BM25 상위 100
지킴
순위 의존
최신 사실을 질문과의 어휘 유사도로 고르기
BM25, CMC와 같은 길이
지킴
순위 의존
증거 길이를 질문마다 CMC와 똑같이 맞춘 BM25
최신 상태 통째로
지킴
창이 허락하는 만큼
열쇠마다 최신 값 하나씩 전부. 6만 자를 넘으면 잘림
원래 기록 통째로
모델에 맡김
창이 허락하는 만큼
정리도 선택도 안 함. 6만 자를 넘으면 잘림
'먼저 고르고 값만 갱신'을 만드는 방법은 부록 G에 있습니다. 열쇠마다 "현재 값과 다른 가장 최근의 이전 값"을 골라 '이전 그래프'를 만들고(이전 값이 없으면 현재 값), 같은 앵커에서 그 그래프를 다섯 걸음 따라간 뒤, 고른 열쇠의 값을 모두 현재 값으로 바꿉니다. 그러면 건네는 사실은 전부 최신이지만 어떤 열쇠를 골랐는지는 갱신 전 세상을 따릅니다. 800문항 가운데 659문항에서 두 방식이 고르는 열쇠 집합이 달랐습니다.
결과 ①: 순서의 값, 56.75점
CMC
78.25%
먼저 고르고 값만 갱신
21.50%
현재 사실 BM25
20.75%
최신 상태 통째로*
17.00%
옛 값으로 따라가기
11.75%
원래 기록 통째로*
5.00%
FactConsolidation 다중 홉 400문항, HY4-preview, 같은 추출. 별표는 600문항이 6만 자 창에서 잘린 상태의 점수. 논문 표 1.
단일 홉에서는 CMC와 '먼저 고르고 값만 갱신'이 97.25%로 똑같습니다. 한 걸음짜리 질문에서는 어떤 열쇠를 고를지가 갱신에 따라 바뀌지 않으니 당연합니다. 다중 홉에서는 78.25% 대 21.50%로 벌어집니다. 부록 G의 표 12가 이 차이를 더 잘게 나눕니다. 다중 홉 400문항 중 갱신 때문에 고르는 열쇠가 바뀌지 않은 31문항에서는 두 방식 모두 100%입니다. 열쇠가 바뀐 369문항에서는 CMC 76.42%, '먼저 고르기' 14.91%입니다. 차이가 정확히 갱신이 다음 걸음을 바꾼 질문에서만 생긴다는 뜻입니다.
평균 입력 길이는 CMC 185토큰, '먼저 고르기' 195토큰으로 거의 같습니다. 증거를 더 많이 줘서 이긴 게 아니라, 맞는 기록을 줘서 이겼습니다.
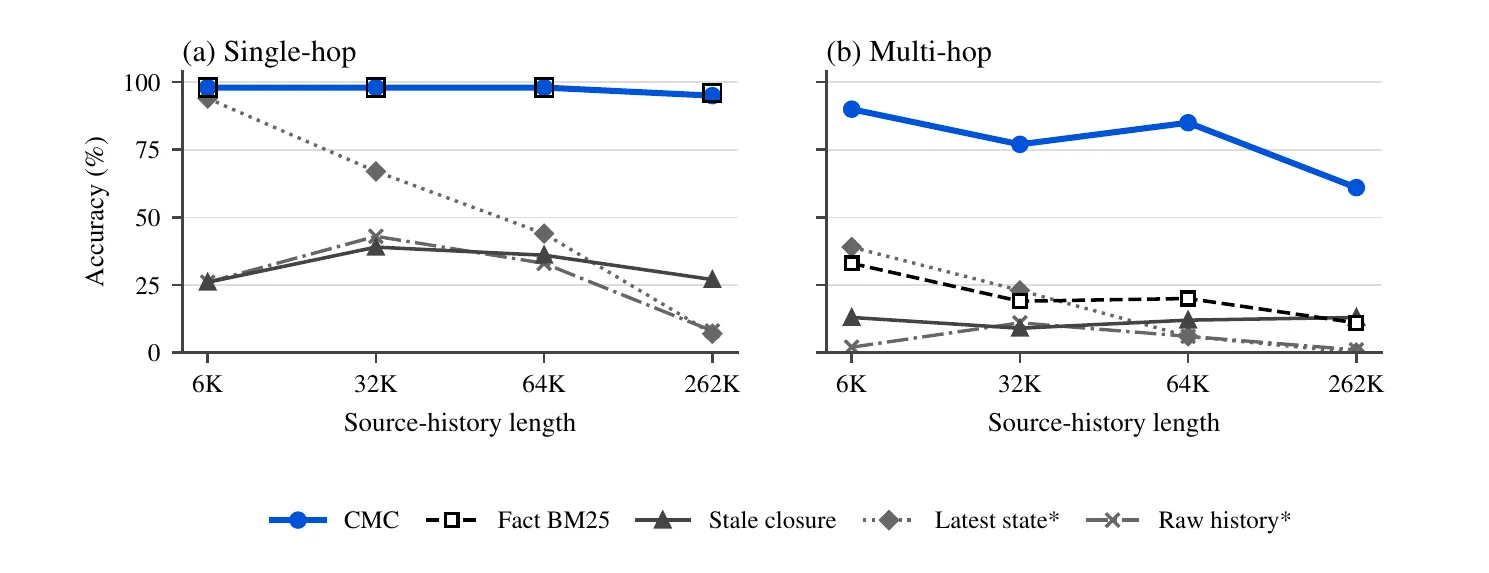
출처: arXiv 2609.32658, 그림 2. 같은 HY4-preview 리더, 점 하나가 100문항.
현재 사실 BM25는 단일 홉에서 97.50%로 CMC(97.25%)와 사실상 같습니다. CMC가 맞힌 단일 홉 389문항 모두에서 BM25 후보에도 정답 문자열이 들어 있었습니다. 차이는 다중 홉에서만 납니다(78.25% 대 20.75%). 다중 홉 400문항에서 CMC만 맞힌 문항이 233개, BM25만 맞힌 문항이 3개였습니다. 그 233문항 가운데 218개에서 BM25 후보에는 CMC가 고른 사실 중 최소 하나가 빠져 있었고, 109개에서는 정답 문자열 자체가 없었습니다. 그러면서도 평균 입력은 CMC가 185토큰, BM25가 1,528토큰으로 CMC가 여덟 배 짧았습니다.
"BM25가 너무 많이 넣어서 헷갈린 것 아니냐"는 반론에 답하려고 저자들은 BM25의 증거 길이를 질문마다 CMC와 똑같이 맞춘 실험(부록 E)도 했습니다. 평균 입력이 182토큰 대 185토큰이 됐습니다. 그러자 BM25의 다중 홉은 7.25%로 더 떨어졌습니다. 길이를 맞추니 다리 사실이 들어갈 자리가 더 없어진 것입니다. CMC만 맞힌 286문항에서 길이를 맞춘 BM25 후보는 CMC가 고른 사실을 한 번도 전부 담지 못했고, 정답 문자열이 들어간 경우는 19번뿐이었습니다.
유사도 함수를 바꾸면 나아질까요? 부록 표 9는 BGE-M3 밀집 검색 상위 100으로도 재 봤습니다. 다중 홉 33.25%로 BM25보다는 높지만 CMC와는 45점 차이입니다. 저자들의 요약이 정확합니다. "유사도 함수를 바꾸면 검색은 좋아지지만, 질문에 이름이 나오지 않는 다음 걸음 기록은 여전히 많이 남는다."
결과 ③: 값도 중요하다
반대쪽 대조군인 '옛 값으로 따라가기'는 CMC가 고른 열쇠를 그대로 두고, 이전 판이 있는 열쇠만 이전 값의 기록으로 바꿔 넣습니다. 열쇠 수도 토큰 수(182)도 CMC와 같습니다. 다중 홉 11.75%, 단일 홉 32.00%입니다. 단일 홉이 크게 떨어지는 것은 질문이 묻는 바로 그 칸이 옛 값으로 바뀌기 때문입니다.
부록 B의 문법 어댑터 실험은 이 대조를 더 정교하게 합니다. 짝을 지은 비교에서 CMC는 '옛 값으로 따라가기'를 800문항 중 547번 이기고, 223번 비기고, 30번 졌습니다(평균 64.63점 우위). 그리고 CMC가 고른 열쇠를 빼고 같은 개수를 무작위로 고른 음성 대조군에는 667번 이기고 3번 졌습니다(83.00점 우위). 흥미로운 것은 '옛 값으로 따라가기'도 무작위 대조군보다 18.38점 높았다는 점입니다. 값이 틀려도 연결된 구조를 고른 것 자체에 정보가 있다는 뜻입니다.
정리하면 이렇습니다. 열쇠는 맞는데 값이 옛것이면 무너집니다(현재성). 값은 최신인데 열쇠가 옛 세상 기준이면 무너집니다(커버리지). 둘 다 지켜야 합니다.
결과 ④: 통째로 넣으면
'최신 상태 통째로'와 '원래 기록 통째로'는 32K 이상의 기록에서 6만 자 창을 넘어 잘립니다. 800문항 중 600문항이 잘린 채 재서 각각 17.00%와 5.00%입니다. 잘림 효과가 섞여 있으니 저자들은 이 숫자로 우열을 주장하지 않습니다. 잘림 없는 비교는 문법 어댑터 실험(부록 B, 답 모델 Qwen3.5-4B, 입력 상한 262,144토큰)에 있습니다. 여기서 최신 상태를 잘리지 않게 통째로 넣으면 평균 71,316토큰에 다중 홉 22.50%, CMC는 평균 183토큰에 79.00%였습니다. 390분의 1 길이로 세 배 반을 맞힌 셈입니다. 원래 기록 통째로(97,139토큰)는 3.75%, 512토큰 조각을 Qwen3-Embedding-8B로 100개 뽑아 Qwen3-Reranker-4B로 10개 고른 정통 RAG(5,559토큰)도 3.75%였습니다.
잘림이 전혀 없는 6K~64K 600문항만 따로 봐도 결론은 같습니다. 다중 홉 CMC 85.67%, 최신 상태 통째로 27.00%, 옛 값으로 따라가기 15.67%, 원래 기록 3.33%입니다. 정답에 필요한 사실이 모두 문맥 안에 있어도, 수천 개의 무관한 최신 사실 사이에서 사슬을 이어 붙이는 일은 4B 모델에게 어렵습니다. MemoryAgentBench가 o4-mini에서 본 "6K에서는 80%, 32K에서는 14%"와 같은 현상입니다.
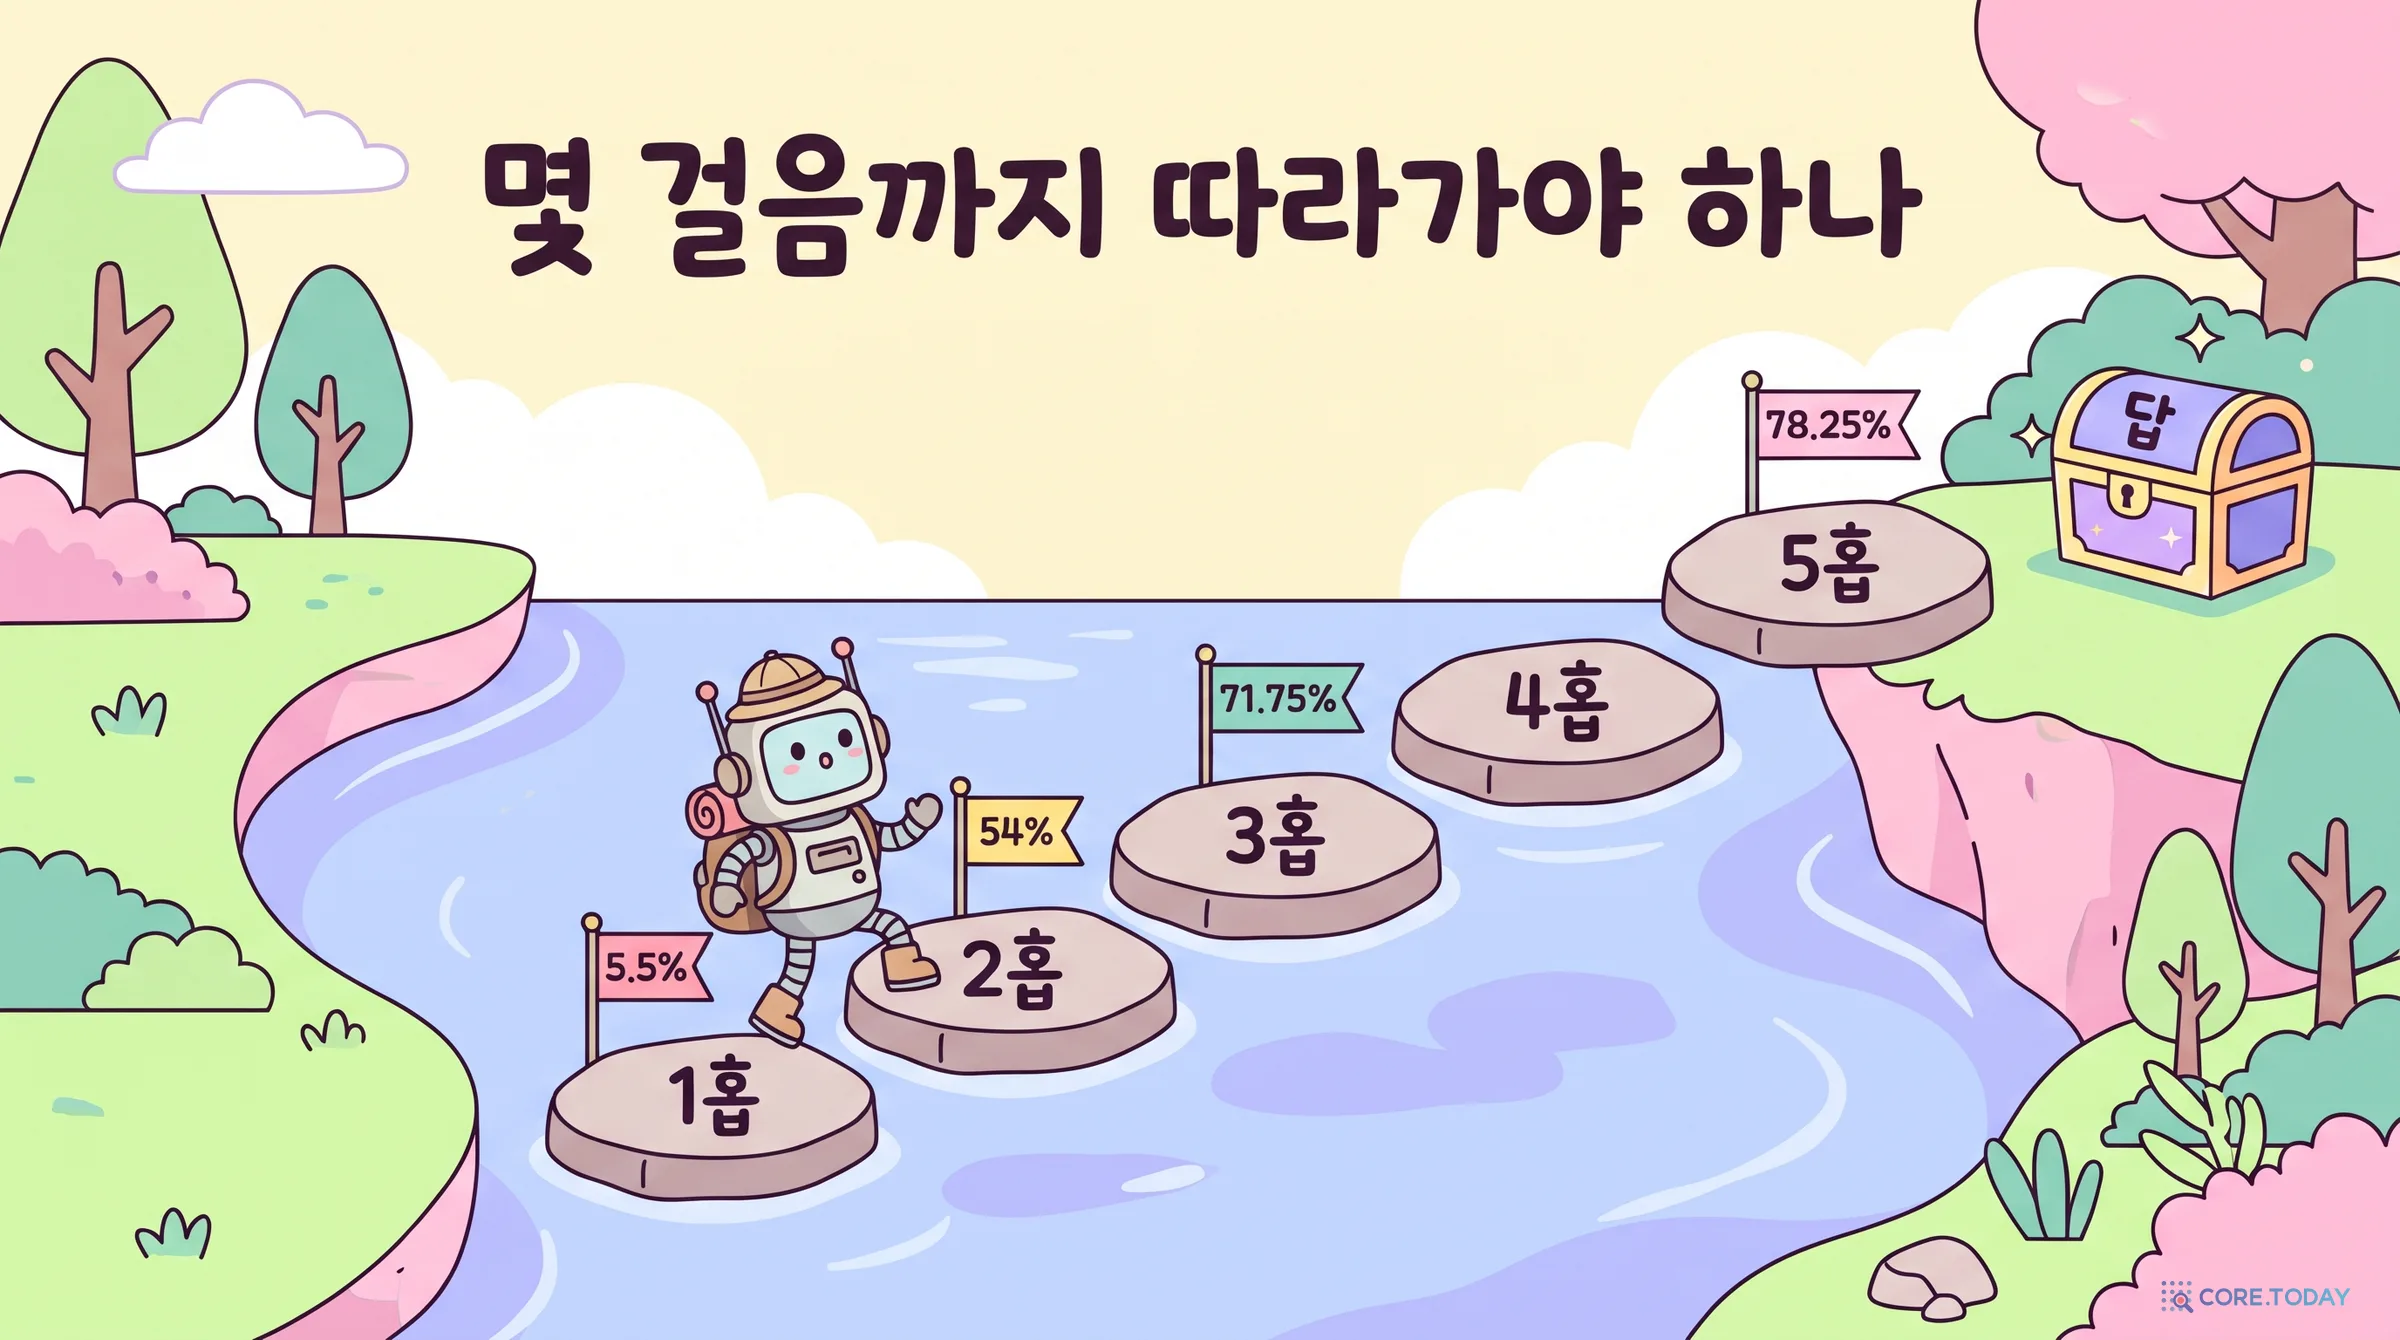
부록 H는 탐색 깊이만 바꿨습니다. 1홉이면 질문에 이름이 나온 대상의 사실만 주는 셈이라 다중 홉이 5.50%입니다. 2홉 54.00%, 3홉 71.75%, 5홉 78.25%로 오릅니다. 평균 입력은 115, 138, 158, 185토큰으로 걸음마다 20토큰 남짓 늘 뿐입니다. FactConsolidation의 다중 홉 질문은 2~4걸음이라, 4걸음 이상에서 더 얻을 것이 적은 것도 자연스럽습니다.
다른 답 모델, 다른 추출
증거 묶음을 고정하고 답 모델만 바꿔도 격차는 유지됩니다. Qwen3.5-4B는 CMC 76.50% 대 BM25 20.50%(CMC가 230문항 이기고 6문항 짐), Llama-3.1-8B는 55.00% 대 11.50%(184 대 10)였습니다. 절댓값은 모델마다 다르지만 차이는 늘 40~56점입니다.
추출 방식도 바꿔 봤습니다(부록 D.1, 표 7). 사람이 쓴 문법 어댑터 79.75%, 언어 모델 직접 추출 78.25%, 소수의 예에서 규칙을 유도한 혼합 방식 76.50%입니다. 저자들은 "관계 패턴을 손으로 정하지 않아도 이 말뭉치에서는 같은 성능이 나온다"는 뜻으로 읽되, "보지 못한 문체나 관계 유형으로 일반화된다는 증거는 아니다"라고 선을 긋습니다. 이 단서는 7부에서 다시 봅니다.
질문 시점에 충돌을 푸는 방식과의 비교
정반대 철학의 시스템과도 겨뤘습니다. 2026년 6월 공개된 SH-Conflict/CAR(Reddy and Reddy Challaram)는 질문을 받은 뒤 BM25로 사실 10개를 찾고, 하위 질문으로 쪼개고, 단계마다 언어 모델을 불러 충돌을 해소합니다. 같은 HY4-preview로 돌리니 단일 홉은 SH-Conflict가 98.00%로 CMC(97.25%)보다 조금 높았고, 다중 홉은 CAR 60.75% 대 CMC 78.25%였습니다(CMC가 79문항 이기고 9문항 짐). 비용 차이가 더 큽니다. CAR는 다중 홉 400문항에 모델 호출 1,301번, 입력 66만 2,831토큰을 썼습니다. CMC는 질문마다 답 모델 호출 한 번입니다(대신 기록마다 미리 추출하는 비용이 따로 듭니다). 추출 방식과 출력 한도가 서로 달라 이것은 '끝에서 끝까지' 비교라고 논문은 적습니다.
새로 만든 시험지: MQuAKE-MemStream
FactConsolidation 하나로는 부족하다고 본 저자들은 MQuAKE-Remastered의 2홉 반사실 사례로 새 데이터셋을 만들었습니다. 사례 100개씩 묶어, 편집 전 사실 블록을 먼저 섞어 놓고 편집 후 사실 블록을 뒤에 이어 붙입니다. 첫 800사례에서 다중 홉 798문항, 단일 홉 800문항이 나왔습니다. 두 문항을 뺀 이유가 정직합니다. 사례를 묶어 놓으니 다른 사례의 편집이 이 사례의 한 걸음을 덮어써서 공개된 정답과 마지막 쓰기 승리의 답이 어긋났기 때문입니다. 3,000사례 전체로 늘리면 431사례가 이렇게 바뀌어서 확인용으로 쓰지 않았다고 밝힙니다. MQuAKE-Remastered가 지적한 오염 문제가 기억 흐름에서 다시 나타난 것입니다.
결과는 CMC 다중 홉 96.62%, 최신 상태 통째로 53.38%, 원래 기록(창 맞춤) 60.53%, 옛 값으로 따라가기 13.41%입니다. 모든 방식이 답에 필요한 사실을 받는 통제된 조건인데도, 현재 상태를 통째로 주는 것과 연결된 부분만 골라 주는 것 사이에 43.23점 차이가 납니다.
MemoryAgentBench 전체에서: 이기는 곳과 지는 곳
표 4는 MemoryAgentBench의 열 개 열 전체를 보고합니다. 262K FactConsolidation에서 같은 HY4-preview 리더끼리 비교하면 최근 기록만 넣기 8.0%/1.0%, BM25 30.0%/2.0%, CMC 95.0%/61.0%(단일/다중)입니다. 공개된 다른 시스템의 다중 홉 점수(GPT-5-mini 긴 문맥 28.0, HippoRAG-v2 5.0, Mem0 2.0, Zep 3.0)와 비교하면 큰 도약입니다. 다만 그 시스템들은 답 모델이 달라서 저자들도 굵게 표시하지 않았습니다.
같은 표에는 CMC가 지는 열도 있습니다. 요약(∞Bench En.Sum)에서 10.2 대 밀집+BM25 15.2, 탐정 소설 질문(DetectiveQA)에서 67.6 대 78.9입니다. 이 과제들에는 FactConsolidation용 그래프 대신 '카드' 추출과 원문 창 검색을 썼는데, 카드 추출기는 1,961묶음 가운데 120개만 완전히 통과했고 814개는 JSON을 해석할 수 없어 카드를 하나도 내지 못했습니다. 구조화가 잘 되는 기록에서는 강하고, 소설이나 긴 대화처럼 세 쌍으로 옮기기 어려운 기록에서는 아직 약하다는 뜻입니다.
아래 탐색기에서 논문의 표들을 탭으로 넘겨 볼 수 있습니다. 마지막 탭은 6부의 코어닷투데이 재현 결과입니다.
6부. 코어닷투데이 재현: 공개 데이터와 4B 모델로 다시 재 보기
논문의 코드는 공개되지 않았지만, FactConsolidation 데이터는 MemoryAgentBench 저장소(허깅페이스 ai-hyz/MemoryAgentBench의 Conflict_Resolution 분할)에 공개돼 있습니다. 그래서 논문의 문법 어댑터 실험(부록 B)을 그대로 따라 해 볼 수 있습니다. 유료 API는 한 번도 부르지 않았고, 답 모델은 맥에서 돌린 로컬 모델입니다.
실험 설계
1
문법 어댑터. MQuAKE 문장 틀을 정규식 37개로 옮겼습니다("X is a citizen of Y." → 국적, "The author of X is Y." → 저자 등). 262K 기록 18,332줄을 포함해 네 길이의 기록을 100% 해석했습니다. 해석 못 한 줄은 0개라 미해결 기록도 없습니다.
2
현재 그래프와 대조군. 열쇠마다 마지막 값을 남긴 현재 그래프, 부록 G 방식의 '이전 그래프', 질문 속 통째 문자열 앵커, 5홉 BFS, 원래 순서 렌더링, 6만 자 한도를 논문 설명대로 구현했습니다. 대조군은 '먼저 고르고 값만 갱신', '옛 값으로 따라가기', '현재 사실 BM25 상위 100'(k1=1.2, b=0.75), 'BM25, CMC와 같은 길이'(질문마다 CMC 증거의 글자 수에 맞춰 통째 사실만 채움)입니다.
3
답 모델. Qwen3.5 4B(Ollama, 맥 MLX 엔진, 생각 끔, 온도 0, 출력 48토큰). 논문의 문법 어댑터 실험과 같은 크기의 같은 계열 모델이지만 양자화와 실행 엔진은 다릅니다. 프롬프트는 MemoryAgentBench의 FactConsolidation 지시문("번호가 큰 사실이 더 새롭다…")을 따랐습니다.
4
범위. CMC와 '먼저 고르고 값만 갱신'은 800문항 전부, BM25 두 가지와 '옛 값으로 따라가기'는 차이가 나는 다중 홉 400문항에서 쟀습니다. 맥의 MLX 엔진이 요청을 사실상 하나씩 처리해(건당 약 2.5초) 전부 돌리면 세 시간이 넘었기 때문입니다. 채점은 공개 채점기와 같은 부분 문자열 일치입니다.
결과 ①: 순서의 효과는 그대로 나타났다
읽기 방식
단일 홉 · 우리
다중 홉 · 우리
다중 홉 · 논문 (같은 4B, 문법 어댑터)
다중 홉 · 논문 (HY4)
CMC
97.25
80.00
79.00
78.25
먼저 고르고 값만 갱신
97.50
20.75
—
21.50
옛 값으로 따라가기
—
19.75
15.50
11.75
현재 사실 BM25 상위 100
—
14.75
—
20.75
BM25, CMC와 같은 길이
—
7.00
—
7.25
정확도(%), 각 칸 400문항. '—'는 재지 않았거나 논문에 해당 조건이 없는 칸. 논문 값은 표 1·5.
CMC의 단일 홉 97.25%는 논문의 같은 조건(문법 어댑터·Qwen3.5-4B)과 소수점 둘째 자리까지 같았고, 다중 홉 80.00%는 논문의 79.00%와 1점 차이였습니다. '먼저 고르고 값만 갱신'은 단일 홉에서 CMC와 사실상 비기고(97.50%) 다중 홉에서 20.75%로 무너졌습니다. 논문의 HY4 실험(21.50%)과 거의 같은 값입니다. 순서를 바꾼 효과가 59.25점이니 논문의 56.75점보다 오히려 조금 큽니다.
짝을 지어 보면 더 분명합니다. 다중 홉 400문항에서 CMC만 맞힌 문항과 대조군만 맞힌 문항은 '먼저 고르고 값만 갱신' 244 대 7, BM25 263 대 2, 같은 길이 BM25 294 대 2, 옛 값으로 따라가기 266 대 25였습니다. 갱신 때문에 필요한 열쇠가 바뀐 370문항에서는 CMC 78.6%(291문항), '먼저 고르기' 14.6%(54문항)였고, 열쇠가 그대로인 30문항에서는 둘 다 29문항씩 맞혔습니다. 논문 표 12의 76.42% 대 14.91%, 100% 대 100%와 같은 모양입니다. 길이별 CMC 다중 홉은 6K 93, 32K 84, 64K 84, 262K 59%였습니다.
차이가 나는 칸도 있습니다. 우리 BM25는 14.75%로 논문(20.75%, 같은 4B로는 20.50%)보다 6점 낮습니다. 논문의 BM25는 사실의 원문에 더해 개체 이름과 관계 이름까지 색인했는데, 우리는 원문만 색인했기 때문으로 보입니다. '옛 값으로 따라가기'는 19.75%로 논문(15.50%)보다 조금 높습니다. 어느 쪽이든 CMC와의 차이는 60점 안팎입니다. 입력 길이는 CMC 평균 271토큰, BM25 1,909토큰(Qwen 토크나이저, 채팅 틀 포함)으로 일곱 배 차이였습니다.
마지막으로, CMC가 맞힌 다중 홉 320문항은 모두 증거에 정답 문자열이 들어 있던 문항이었고, 정답이 증거에 있던 340문항 중에서는 94.1%를 맞혔습니다. 4B 모델도 맞는 증거만 받으면 사슬을 거의 다 이어 붙입니다. 남은 문제는 증거입니다.
결과 ②: 모델을 부르기 전에, 정답이 증거에 들어 있기라도 한가
정답률은 답 모델의 실력과 증거의 질이 섞인 숫자입니다. 그래서 모델을 부르지 않고 먼저 정답 문자열이 증거 안에 들어 있는 비율을 쟀습니다. 증거에 정답이 없으면 아무리 좋은 모델도 (반사실 데이터라 세상 지식으로는) 맞힐 수 없으니, 이 값은 각 읽기 방식의 '천장'입니다.
다중 홉 · 정답이 증거에 있는 비율
6K
32K
64K
262K
평균 증거 길이
CMC
96
87
90
67
214~591자
먼저 고르고 값만 갱신
20
23
34
24
286~704자
옛 값으로 따라가기
30
43
43
48
215~584자
현재 사실 BM25 상위 100
82
50
62
35
약 6,000자
BM25, CMC와 같은 길이
13
8
10
12
206~573자
CMC 열쇠를 뺀 무작위(같은 개수)
1
4
1
2
217~589자
최신 상태 통째로(6만 자에서 잘림)
98
78
78
40
16,935~60,000자
단위는 100문항 중 문항 수(=%). 코어닷투데이 계산, 답 모델 호출 없음.
몇 가지가 눈에 띕니다.
CMC의 천장이 논문 정확도와 거의 겹칩니다. 논문의 길이별 CMC 다중 홉 정확도는 90·77·85·61(HY4-preview), 문법 어댑터·Qwen3.5-4B는 91·81·85입니다. 증거에 정답이 들어 있는 비율 96·87·90·67보다 몇 점씩 낮을 뿐입니다. CMC의 남은 오류는 대부분 증거 단계에서 이미 정해진다는 뜻입니다.
'옛 값으로 따라가기'의 천장이 오히려 '먼저 고르기'보다 높습니다. 이상해 보이지만, 정답과 같은 이름이 경로 위 옛 기록에 나오는 경우가 섞이기 때문입니다(아래 결과 ③). 문자열이 있다고 맞는 증거는 아닙니다.
BM25는 기록이 길어질수록 천장이 무너집니다. 상위 100개는 6K 기록(현재 사실 294개)에서는 전체의 3분의 1이지만 262K(1만 1,095개)에서는 1%도 안 됩니다. 길이를 맞춘 BM25는 처음부터 10% 안팎입니다.
갱신 때문에 필요한 열쇠가 바뀐 질문은 다중 홉 400문항 중 370문항(논문 부록 G는 369문항), 단일 홉 400문항 중 293문항(논문 290문항)이었습니다. 우리 문법 어댑터의 그래프가 논문의 그래프와 거의 같다는 방증입니다.
탐색 깊이별 천장도 쟀습니다. 다중 홉 400문항에서 정답이 증거에 들어가는 비율은 1홉 1.0%, 2홉 56.5%, 3홉 74.0%, 4홉 85.0%, 5홉 85.0%였습니다. 논문 부록 H의 정확도 5.50·54.00·71.75·78.25%와 모양이 같고, 4홉에서 이미 천장에 닿습니다.
결과 ③: 262K에서 떨어지는 이유의 절반은 정답지에 있었다
CMC 증거에 정답 문자열이 없는 다중 홉 질문 60문항(6K 4, 32K 13, 64K 10, 262K 33)을 하나씩 분류했습니다.
정답이 경로 위 열쇠의 '옛 값'
26문항
경로가 중간에 끊김
34문항
CMC 증거에 정답이 없는 다중 홉 60문항의 분류. 막대 폭은 60문항 대비 비율.
첫째 묶음 26문항은 질문에서 출발해 닿는 열쇠의 이전 값이 공개된 정답과 같은 경우입니다. 논문 부록 B.3이 자동 검사로 표시한 '덮어써진 옛 값일 수 있는 다중 홉 정답 26개'와 숫자가 정확히 같습니다. 길이별로는 6K 2, 32K 3, 64K 6, 262K 15문항으로 긴 기록에 몰려 있습니다. 왜 그럴까요? FactConsolidation은 MQuAKE 사례 여러 개를 이어 붙여 긴 기록을 만듭니다. 사례가 많이 섞일수록 한 사례의 편집이 다른 사례의 중간 걸음을 덮어쓸 가능성이 커집니다. 그러면 원래 사례의 정답은 '편집 전 세상'의 답이 되고, 마지막 쓰기 승리를 충실히 따른 시스템은 틀린 것으로 채점됩니다. MQuAKE-Remastered가 원본 데이터에서 지적한 오염이, 저자들이 MQuAKE-MemStream을 만들며 3,000사례 중 431사례에서 본 간섭이, FactConsolidation 262K에도 그대로 있는 것입니다.
262K에서 CMC가 증거를 놓친 33문항 가운데 15문항이 이 경우이니, 262K의 하락 가운데 거의 절반은 시스템이 아니라 시험지의 몫입니다. 논문이 이 26문항을 점수에서 빼지 않고 '불리하게 채점해도 50.50점 이상 앞선다'는 하한으로 처리한 것은 정직한 선택이었습니다.
둘째 묶음 34문항은 경로가 중간에 끊긴 경우입니다. 예를 들어 "『American Pastoral』 저자의 배우자의 국적이 속한 대륙은?"에서, 기록 속 저자는 F. 스콧 피츠제럴드이고 배우자는 칼 럼블리로 바뀌어 있는데, 칼 럼블리의 국적 기록이 현재 그래프에 없습니다. 이런 질문은 어떤 읽기 방식도 정답을 증거로 줄 수 없습니다.
결과 ④: 다리 사실은 검색 순위 몇 위에 있나
CMC 증거가 정답을 담은 다중 홉 질문에 대해, 정답까지 가는 경로의 사실 하나하나가 질문으로 BM25 검색했을 때 전체 현재 사실 중 몇 위인지를 쟀습니다.
경로 위 위치
6K 중앙값
32K
64K
262K
262K 상위 100 안
0홉 사실 (질문에 이름이 나온 대상)
1위
1위
1위
1위
98.5%
1홉 사실 (첫 번째 다리)
38위
162위
147위
762위
23.1%
2홉 사실 (두 번째 다리)
36위
90위
195위
1,902.5위
6.2%
질문에 이름이 나온 대상의 사실은 거의 언제나 1위입니다. 한 걸음만 넘어가도 262K 기록에서는 중앙값 762위로 밀려, 상위 100개 안에 드는 경우가 4분의 1도 안 됩니다. 두 걸음째는 1,900위권입니다. 1부에서 본 GoldEn Retriever의 2019년 관찰(두 번째 걸음 문단을 함께 찾는 비율 36.91%)이 에이전트 기억에서도 같은 모양으로 나타납니다. 앞의 탐색 위젯에서 질문마다 이 순위를 직접 볼 수 있습니다.
결과 ⑤: 한국어 질문에서는 출발점부터 놓친다
마지막으로 다중 홉 400문항을 한국어로 옮겨 봤습니다. 이름은 기록과 같은 로마자로 그대로 두고, 조사는 한국어 문장답게 붙였습니다("Christian Abbiati가 하는 스포츠의 발상국은 어디인가요?"). 번역은 Claude Code 서브에이전트가 맡았습니다. 기록은 영어 그대로라, 바뀌는 것은 질문 문장뿐입니다.
앵커를 찾은 질문 (400문항 중)
6K
32K
64K
262K
합계
영어 원문 · 논문 규칙
100
100
100
100
100%
한국어 · 논문 규칙(통째 문자열)
25
38
27
35
31.3%
한국어 · 조사 허용(이름 뒤 한글 인정)
99
98
99
100
99.0%
논문 규칙은 정규화한 질문에서 이름이 앞뒤 공백으로 둘러싸여 있어야 찾습니다. "Christian Abbiati가"는 정규화하면 'christian abbiati가'라는 한 덩어리가 되어 'christian abbiati'와 일치하지 않습니다. 앵커를 찾은 31%는 이름 바로 뒤가 띄어쓰기이거나 따옴표인 문장입니다. "SteamOS 개발사의 CEO가…"나 ""Sketches by Boz"의 저자는…"은 성공하고, "Tunisia national football team이 하는 스포츠의…"는 실패합니다. 앵커를 못 찾으면 논문 규칙은 원래 기록 전체로 물러나는데, 32K 이상에서는 그 기록이 6만 자 창에 잘립니다. 정답이 CMC 증거에 들어가는 비율은 영어 85.0%, 한국어·논문 규칙 23.3%, 한국어·조사 허용 84.0%였습니다.
조사를 허용하는 규칙은 정규식 한 줄로 거의 다 되돌립니다. 하지만 남은 4문항에 교훈이 있습니다. 번역 과정에서 "the pope"가 '교황'으로, "Aubrey-Maturin series"가 'Aubrey-Maturin 시리즈'로 바뀌자 앵커가 사라졌습니다. 한국어 사용자는 이름을 번역하고, 줄이고, 다르게 띄어 씁니다. 한국어 서비스에서 CMC 같은 설계를 쓰려면 앵커 단계에 형태소 분석과 별칭 사전, 개체 연결을 붙여야 합니다.
앵커를 바로잡은 뒤 답 모델에게 한국어 질문과 영어 증거를 주면 어떨까요? 조사 허용 앵커로 만든 CMC 증거에 한국어 질문을 붙여 Qwen3.5 4B에게 물었더니, 공개 채점기로는 400문항 중 246문항(61.5%)만 맞았습니다. 영어 질문의 80.0%보다 18점 넘게 낮습니다. 그런데 틀린 154문항을 열어 보니 60문항에 한글 답이 있었고, 그중 49문항은 맞는 답을 한국어로 옮겨 적은 것이었습니다. 'Italy' 대신 '이탈리아', 'Soviet Union' 대신 '소련', 'French' 대신 '프랑스어'라고 답했습니다. 부분 문자열 채점기는 이것을 모두 틀린 것으로 셉니다. 코어닷투데이가 한글 답 60개를 하나씩 판정해 49개를 정답으로 고치면 295문항(73.75%)입니다. 영어와의 차이는 6점으로 줄어듭니다. 논문 규칙 앵커로는 6K 기록에서 100문항 중 17문항(공개 채점기 기준)만 맞혔습니다. 앵커를 못 찾은 질문이 원래 기록 전체로 물러났기 때문입니다.
한국어 서비스에 주는 교훈은 둘입니다. 앵커 단계에서 조사와 별칭을 처리해야 하고, 답과 정답을 비교하는 채점·검증 단계에서도 언어를 넘는 별칭(이탈리아 = Italy)을 다뤄야 합니다. 그렇지 않으면 시스템은 맞게 답했는데 지표는 틀렸다고 말합니다.
아래 두 위젯은 재현 실험의 실제 답안과 한국어 앵커 실험입니다.
재현이 말해 주는 것
①
순서의 효과는 진짜다
공개 데이터, 다른 실행 엔진의 같은 크기 모델에서도 '정리 먼저'는 다중 홉 80.00%, '선택 먼저'는 20.75%였다. 차이는 정확히 갱신이 다음 걸음을 바꾼 질문에서만 생긴다.
②
262K의 하락은 절반이 시험지 몫
CMC가 262K에서 증거를 놓친 33문항 중 15문항은 다른 사례의 편집이 경로를 덮어써서 공개 정답이 '편집 전 세상'의 답이 된 경우다. 논문이 표시한 26문항과 숫자가 같다.
③
한국어는 앞뒤를 다 손봐야 한다
통째 문자열 앵커는 한국어 질문의 31%에서만 출발점을 찾는다. 조사를 허용하면 99%로 돌아오지만, 답이 한국어로 나오면 채점기가 맞는 답 49개를 틀렸다고 센다.
이 재현은 논문의 문법 어댑터 조건만 따라 한 것입니다. 언어 모델로 관계를 직접 뽑는 논문의 주 실험, 그리고 HY4-preview 리더 결과는 재현하지 않았습니다. BM25 두 가지와 '옛 값으로 따라가기'는 다중 홉만 쟀고, 무작위 음성 대조군은 모델 대신 '정답이 증거에 있는 비율'(1~4%)로 갈음했습니다.
논문은 스스로 한계를 비교적 솔직하게 적습니다. 결론의 마지막 문장이 "입증된 이득은 정렬된 단일 값 단언 흐름에 대한 것"입니다. 그 단서들을 하나씩 풀어 보면 이 결과를 어디까지 믿고 써도 되는지가 보입니다.
① 마지막 쓰기 승리는 '쉬운 세계'의 규칙이다
FactConsolidation은 마지막 쓰기 승리가 정답이 되도록 만들어진 시험지입니다. 편집 사실은 항상 원래 사실 뒤에 오고, 모델에게 "번호가 큰 것이 새것"이라고 알려 줍니다. CMC의 2단계는 이 규칙을 그대로 구현합니다. 시험지의 규칙과 시스템의 규칙이 같으니 유리한 것이 당연합니다.
현실의 기억은 다릅니다. 한 사람이 회사 두 곳에 다닐 수 있고, 프로젝트 담당자는 여럿일 수 있습니다. 이런 다중 값 관계에서 마지막 값 하나만 남기면 정보를 지웁니다. Mem0가 2026년 4월 덮어쓰기를 버리고 '추가만 하기'로 돌아선 이유가 바로 "덮어쓰기가 때로 핵심 정보를 지웠다"는 것이었습니다. 논문 부록 I도 "CMC의 마지막 쓰기 승리 규칙은 이 벤치마크의 정렬된 단일 값 관계에 특화된 것이며, 동시 값이나 다중 에이전트 충돌은 풀지 않는다"고 명시합니다. 1단계 추출 프롬프트가 '동시 값'을 미해결로 돌리는 것도 이 때문입니다. 미해결 기록은 원문으로 넘어가지만 그래프 탐색의 다리가 되지는 못합니다.
② 기록 순서가 곧 시간이라는 가정
논문은 "이 설정에서 최신성은 출처 순서로 정의된다"고 씁니다. 코어닷투데이가 MemStrata 특집과 이중 시간 SQL 실습에서 다뤘듯, 현실에서는 순서가 시간을 배신하는 일이 흔합니다. 옛 위키 문서를 한꺼번에 들여오면 3월의 사실이 6월에 기록됩니다. "다음 달 15일부터 바꾼다"는 공지는 사실보다 기록이 먼저입니다. 1부의 AWS 장애는 늦게 도착한 옛 계획이 새 계획을 덮어쓴 사고였습니다. 기록 순서로만 정리하는 CMC는 이런 경우에 옛 값을 현재 값으로 정리하고, 그 옛 값을 따라 다음 걸음까지 틀리게 고릅니다. 정리를 먼저 하는 설계는 정리가 틀리면 틀린 쪽으로 더 확실하게 갑니다. 해법은 2단계의 정렬 기준을 기록 위치 대신 유효 시작 시각으로 바꾸는 것인데, 그러려면 1단계에서 날짜를 함께 뽑아야 합니다.
③ 앵커는 글자 그대로만 본다
3단계는 질문에 이름이 통째로 나와야 출발할 수 있습니다. "MS 창업자의 고향은?"은 'Bill Gates'라는 주어로 출발하지 못합니다. 그래프에 'Microsoft → 창업자 → Bill Gates' 간선이 있고 질문에 'Microsoft'가 그대로 나온다면 괜찮겠지만 'MS'로는 안 됩니다. 영어 데이터에서도 엉뚱한 앵커가 생깁니다. 코어닷투데이 재현 중에 "정부 소재지(seat of government center)"라는 질문 속 단어 'center'가 농구 포지션 'center'라는 주어와 일치해 앵커로 잡힌 사례가 있었습니다. 한국어에서는 조사 때문에 이 단계가 더 크게 무너집니다(6부).
④ 템플릿 문장에서 잰 성능
FactConsolidation의 문장은 MQuAKE의 관계 틀 수십 개로 만든 정형 문장입니다("X is a citizen of Y."). 사람이 쓴 문법 어댑터가 언어 모델 추출보다 조금 높게 나오는 것(79.75% 대 78.25%)도, 저자들이 언어 모델 추출을 두고 "제공된 기록에 적응한 것이지, 보지 못한 문장 형태에 대한 시험이 아니다"라고 쓴 것도 이 때문입니다. 실제 대화 기록에서 관계를 이 정도로 정확히 뽑을 수 있을지는 이 논문이 답하지 않습니다. MemoryAgentBench의 대화형 과제(LongMemEval)에서 CMC 인터페이스가 44.3으로, GPT-5-mini 긴 문맥(63.3)이나 MIRIX(51.0)보다 낮은 것도 같은 맥락입니다.
⑤ 재현성의 작은 균열들
개발 그리드의 재사용. 논문 6장은 "FactConsolidation은 더 넓은 개발 그리드에서 왔으므로 독립적인 확인이 필요하다"고 적습니다. 이 데이터를 보며 설계를 다듬었다는 뜻입니다.
고정되지 않은 답 모델. 중심 실험의 HY4-preview는 "고정된 가중치가 아니라 제공자의 별칭"이라 실행 날짜마다 같은 모델이라는 보장이 없습니다. 대신 Qwen3.5-4B와 Llama-3.1-8B는 정확한 체크포인트 해시까지 적었습니다.
공개 코드 없음. 재현성 진술은 "보충 패키지에 컴파일러, 평가 스크립트, MQuAKE-MemStream 데이터, 문항별 예측이 들어 있다"고 하지만, 2026년 11월 14일 현재 공개 저장소나 코드 링크는 찾을 수 없습니다. 논문 공개 7주가 지났지만 alphaXiv 조회 수는 16회, 해커뉴스 언급은 없습니다.
AI 사용 고지. 저자들은 AI 코딩 도우미가 구현, 실험 실행, 산출물 점검, 원고 편집을 도왔다고 밝힙니다. 이 정도로 정밀한 대조군 설계와 '사전 등록' 표현은 그런 작업 방식의 흔적이기도 합니다.
⑥ 정답지가 틀린 문항들
논문 부록 B.3은 자동 검사로 정답 33개(단일 홉 7, 다중 홉 26)가 "이미 덮어써진 옛 값일 수 있다"고 표시합니다. 질문에서 닿는 열쇠의 이전 값이 정답 문자열과 같다는 뜻입니다. 공식 점수에는 그대로 넣었고, 이 26문항을 모두 CMC에 가장 불리하게 채점해도 '먼저 고르기' 대비 50.50점 이상 앞선다고 하한을 계산했습니다. 코어닷투데이가 공개 데이터로 같은 검사를 다시 해 보니 다중 홉에서 정확히 26문항이 나왔고, 그중 15문항이 262K 기록에 몰려 있었습니다. 262K에서 CMC가 61%로 떨어지는 이유의 상당 부분이 시스템이 아니라 정답지 쪽에 있다는 뜻입니다(6부 결과 ③).
⑦ '순서'의 비교이지 '시스템'의 순위가 아니다
논문은 이 점을 여러 번 강조합니다. 고정 추출 대조군은 "연산의 순서"를 비교할 뿐 "완성된 적응형 파이프라인끼리 순위를 매기지 않는다"고 합니다. IRCoT처럼 걸음마다 다시 검색하는 방식은 모델을 여러 번 부르는 대신 다리 개체를 찾을 수 있습니다. CMC는 '답 모델 호출 한 번'이라는 제약을 스스로 정한 설정입니다. 그래서 정확한 결론은 "검색이 그래프 탐색보다 나쁘다"가 아니라 "한 번의 호출로 끝내려면, 증거를 고르기 전에 갱신을 반영해야 한다"입니다.
CMC의 구현 세부보다 오래 남을 것은 순서에 대한 원칙입니다. 갱신을 먼저 반영하고, 그다음 무엇을 읽힐지 고른다. 좋은 사서는 서가 번호가 바뀌면 카드 목록부터 고치고, 그 카드를 따라 서가로 갑니다. 옛 카드로 서가에 가서 거기 있는 책의 제목만 새로 고치지 않습니다.
에이전트 기억 제품: '쓸 때 정리'의 재평가
2025년까지 에이전트 기억 제품의 주류는 '일단 다 저장하고, 질문할 때 잘 찾자'였습니다. 2026년 Mem0의 '추가만 하기' 전환은 그 방향을 더 밀어붙인 것입니다. CMC는 반대편 기둥을 세웁니다. 쓸 때 관계를 뽑아 현재 상태를 정리해 두면, 질문할 때는 모델 호출 없이 몇 밀리초 만에 정확한 증거를 고를 수 있다는 것입니다. 두 방향은 충돌하지 않습니다. 원문은 지우지 않고 추가만 하고(Mem0), 그 위에 '현재 관계의 색인'을 하나 더 유지하면(CMC) 됩니다. CMC도 원래 단언을 지우지 않고 출처에 남겨 둡니다.
증거 선택에 '계약'을 쓰자
이 논문의 가장 실용적인 제안은 어쩌면 '계약'이라는 형식 자체입니다. 기억 시스템의 품질을 정답률로만 재면, 틀렸을 때 원인이 검색인지 갱신인지 답 모델인지 알 수 없습니다. "고른 증거는 모두 최신이다", "앵커에서 h걸음 안의 현재 간선은 빠짐없이 들어간다" 같은 성질은 모델을 부르지 않고도 단위 테스트로 확인할 수 있습니다. 코어닷투데이 재현에서도 정답률보다 먼저 '정답 문자열이 증거에 들어 있는 비율'을 계산하니 어느 단계에서 무엇이 빠지는지가 바로 보였습니다.
공적 기록과 사실탐색기
코어닷투데이의 사실탐색기 v2는 공적 기록에서 "지금 참인 것"을 권위 기반 대체(AGS)로 유지합니다. 조례가 개정되면 옛 조항은 대체되고 새 조항이 현재 값이 됩니다. CMC의 시각으로 보면 그다음 단계가 남아 있습니다. 개정으로 소관 부서가 바뀌었다면, "이 사업 문의처는?"이라는 질문은 새 부서의 연락처 기록으로 이어져야 합니다. 대체를 먼저 끝내고, 대체된 현재 그래프 위에서 질문 속 이름부터 따라가는 순서가 그대로 적용됩니다. 다만 공적 기록은 기록 순서보다 시행일·공포일이 중요하므로, ②의 단서처럼 정렬 기준을 유효 시각으로 바꿔야 합니다.
코드 에이전트와 업무 비서
의존성 갱신. 코딩 에이전트가 "우리가 쓰는 HTTP 라이브러리의 재시도 기본값은?"에 답하려면 프로젝트 → 라이브러리 → 현재 버전 → 그 버전의 설정 문서로 가야 합니다. 버전이 올라갔다면 읽어야 할 문서가 바뀝니다.
조직도. 사람 → 팀 → 팀장 → 연락처 사슬은 인사 발령 하나에 다음 걸음이 모두 바뀝니다. 업무 비서가 인사 시스템의 변경 이력을 기록 순서대로 재생해 현재 그래프를 유지하면, 조직 개편 다음 날에도 맞는 사람에게 결재를 올릴 수 있습니다.
의료 기록. 환자 → 담당의 → 진료 일정, 환자 → 현재 복용약 → 상호작용 정보. 1부에서 본 복약 목록 불일치 연구들은 낡은 포인터가 다음 판단을 오염시키는 대표 사례입니다.
실무 점검표
1
질문 유형을 센다. 다중 홉 질문이 드물면 좋은 검색과 최신 값 표시로 충분하다. CMC의 이득은 다중 홉에서만 나온다.
2
관계가 단일 값인지 본다. 다중 값 관계는 마지막 쓰기 승리 대신 추가·종료를 기록하는 집합형 열쇠로 둔다.
3
정렬 기준을 정한다. 기록 순서가 곧 시간인지 확인하고, 아니면 유효 시작 시각을 함께 추출한다.
4
앵커를 보강한다. 한국어는 조사 분리, 별칭 사전, 개체 연결을 앵커 단계에 붙인다.
5
원문을 건넨다. 그래프는 고르는 데만 쓰고, 답 모델에게는 번호 붙은 원래 기록과 미해결 기록을 함께 준다.
6
계약을 테스트한다. 현재성과 커버리지를 모델 없이 단위 테스트로 확인하고, '정답이 증거에 들어 있는 비율'을 정답률과 따로 잰다.
마지막 위젯으로 우리 서비스의 기억이 이 논문의 조건에 얼마나 가까운지 점검해 보세요.
맺으며: 무엇을 기억하느냐보다, 무엇을 읽히느냐
에이전트 기억 연구는 오랫동안 "무엇을 저장할까"와 "어떤 값이 지금 값일까"에 집중했습니다. Contract Memory Compiler는 그 사이에 있던 질문 하나를 꺼냅니다. 값이 바뀌면, 이번에 답 모델이 읽어야 할 기록은 무엇인가. 그리고 놀랄 만큼 단순한 답을 냅니다. 갱신을 먼저 반영하고, 그다음 질문 속 이름에서 따라가라.
이 논문의 숫자가 인상적인 이유는 시스템이 화려해서가 아닙니다. 같은 추출, 같은 답 모델, 같은 증거 길이에서 순서만 바꿨는데 56.75점이 갈렸기 때문입니다. 동시에 그 숫자는 마지막 쓰기 승리가 정답이 되도록 만든 정형 시험지에서 나왔습니다. 값이 여럿인 관계, 순서가 시간을 배신하는 기록, 별명과 조사가 붙는 이름 앞에서는 보강이 필요합니다. 코어닷투데이의 재현은 두 면을 모두 확인했습니다. 순서의 효과는 공개 데이터와 4B 모델에서도 그대로 나타났고, 262K에서의 하락은 상당 부분 정답지의 문제였으며, 한국어 질문은 출발점부터 다시 손봐야 했습니다.
월요일 아침의 지수 씨에게 필요한 비서는 회의실이 바뀐 것을 기억하는 비서가 아니라, 회의실이 바뀌었으니 다른 층 안내문을 읽어야 한다는 것을 아는 비서입니다.
참고문헌
Zhi Song, XiMing Xing, Chunhan Li 외. "Contract Memory Compiler: Resolve, Then Traverse." arXiv:2609.32658, 2026. https://arxiv.org/abs/2609.32658
Zexuan Zhong, Zhengxuan Wu, Christopher Manning, Christopher Potts, Danqi Chen. "MQuAKE: Assessing Knowledge Editing in Language Models via Multi-Hop Questions." EMNLP 2023. https://arxiv.org/abs/2305.14795
Jason Weston, Sumit Chopra, Antoine Bordes. "Memory Networks." ICLR 2015. https://arxiv.org/abs/1410.3916 · Alexander Miller 외. "Key-Value Memory Networks for Directly Reading Documents." EMNLP 2016.
Patrick Lewis 외. "Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks." NeurIPS 2020.
Charles Packer 외. "MemGPT: Towards LLMs as Operating Systems." arXiv:2310.08560, 2023.
Amazon Web Services. "Summary of the Amazon DynamoDB Service Disruption in the Northern Virginia (US-EAST-1) Region." 2025. https://aws.amazon.com/message/101925/
Vincent C. Tam 외. "Frequency, type and clinical importance of medication history errors at admission to hospital: a systematic review." CMAJ 2005. https://www.cmaj.ca/content/173/5/510