LLM의 긴 답변을 사실 확인하려면 먼저 문장을 ‘확인할 수 있는 주장’으로 쪼개야 합니다. 그런데 무엇을, 어디까지, 어떤 맥락과 함께 쪼개야 잘 쪼갠 것일까요? Microsoft Research의 Claimify 논문(ACL 2025)은 수반·커버리지·탈맥락화라는 세 잣대와, 해석이 갈리면 아예 뽑지 않는 3단계 추출기를 내놓았습니다. 팩트체킹의 역사에서 이 문제가 어떻게 나왔는지, 논문의 표와 그림이 무엇을 말하는지, 2026년에 이 기술이 어디에 쓰이는지 정리하고, 논문 프롬프트를 그대로 로컬 9B 모델에 넣어 한국어 답변으로 직접 돌려 보니, 문장 고르기와 물러서기는 재현됐지만 수반은 76%에 그쳤고, 주어가 생략된 문장에서는 모호성을 절반도 못 알아봤으며, 세 번 생성해 다수결하는 설정을 줄이자 틀린 사실이 검증대에서 사라졌습니다.
코어닷투데이2026-11-0197분
🧩
문제
긴 AI 답변을 통째로 맞다·틀리다 할 수는 없습니다. 문장을 작은 ‘주장’으로 쪼개 하나씩 확인해야 하는데, 쪼개는 방법에 따라 같은 답변의 사실성 점수가 달라집니다. 쪼개기를 평가하는 표준이 없었습니다.
✂️
논문의 답
좋은 주장의 세 조건(수반·커버리지·탈맥락화)을 자동으로 재는 방법, 그리고 선별 → 모호성 해소 → 분해의 3단계 추출기 Claimify. 해석이 갈리고 문맥으로도 못 정하면 그 문장은 뽑지 않습니다.
📏
코어닷투데이 실측
논문 프롬프트를 그대로 로컬 9B 모델에 넣어 한국어 89문장과 모호한 문장 44개로 돌렸습니다. 문장 고르기와 물러서기는 재현됐고(정확도 89.5%, 한 번에 뽑는 프롬프트 71.9%), 수반은 재현되지 않았습니다(76%, 논문 99%). 지시어를 지우면 보류 표가 20표에서 9표로 줄었고, ‘세 번 뽑아 두 번’을 한 번으로 줄이자 틀린 사실 8개 중 5개가 검증대에서 사라졌습니다.
프롤로그: 한 문장, 세 개의 사실, 하나의 거짓
이 글을 준비하면서 코어닷투데이 맥에 깔린 로컬 모델(qwen3.5 9B)에게 아주 쉬운 질문을 하나 던졌습니다. "한 문장으로: 조선 세종의 업적은?" 돌아온 답은 이렇습니다.
조선 세종은 한글 창제와 과학 기술 발전, 그리고 정전 (경국대전) 편찬 등 문화와 제도 개혁을 통해 국가 기반을 다지는 등 한국 역사상 가장 위대한 군주 중 한 명으로 평가받습니다.
읽기에는 그럴듯합니다. 그런데 이 문장은 맞을까요, 틀릴까요? 질문 자체가 잘못됐습니다. 이 한 문장에는 성격이 다른 진술이 여러 개 섞여 있습니다.
문장 속 조각
성격
확인 결과
세종은 한글(훈민정음)을 창제했다
확인할 수 있는 사실
참
세종 때 과학 기술이 발전했다
사실이지만 넓고 흐릿함
대체로 참 (측우기·자격루 등)
세종이 경국대전을 편찬했다
확인할 수 있는 사실
거짓 — 세조 때 시작해 성종 16년(1485) 완성
국가 기반을 다졌다
해석·평가
참·거짓을 가릴 수 없음
가장 위대한 군주 중 한 명으로 평가받는다
‘그렇게 평가받는다’는 사실 + 평가
평가가 있다는 것은 확인 가능, 위대함 자체는 불가
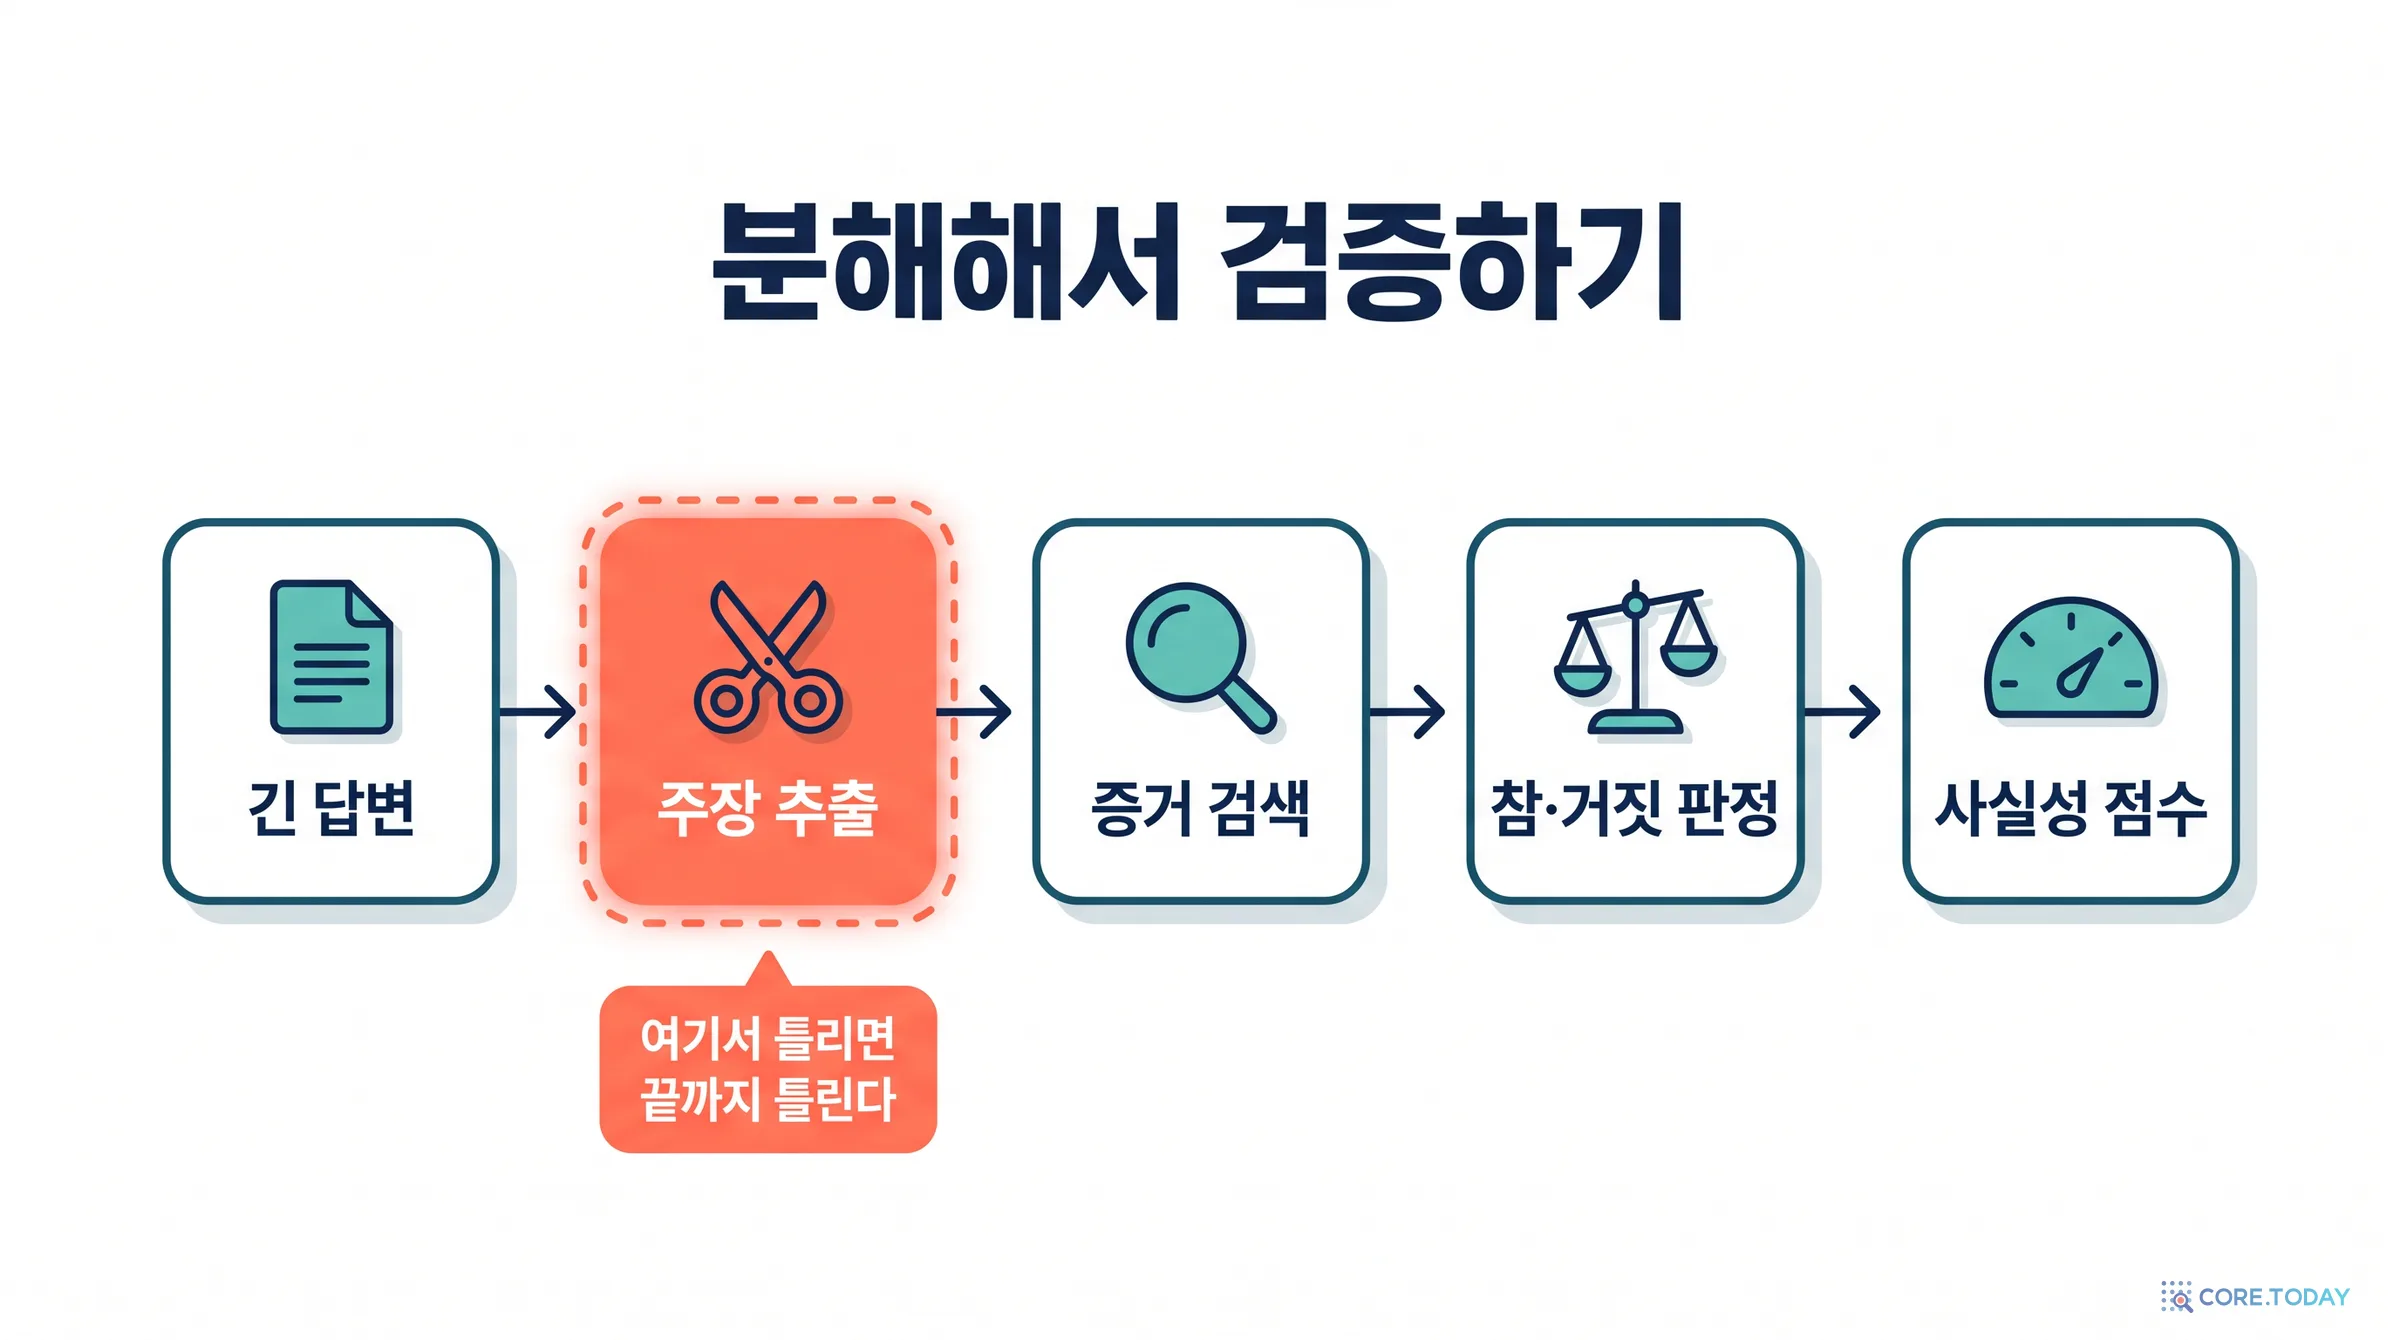
문장 전체에 ‘참’ 도장을 찍으면 경국대전이 틀렸다는 사실이 묻힙니다. ‘거짓’ 도장을 찍으면 한글 창제까지 거짓이 됩니다. 그래서 긴 글을 사실 확인하는 쪽은 오래전부터 한 가지 전략을 씁니다. 글을 확인할 수 있는 작은 주장(claim)들로 쪼갠 뒤, 하나씩 증거를 찾아 판정한다. 연구자들은 이것을 ‘분해 후 검증(decompose-then-verify)’이라고 부릅니다.
문제는 그 쪼개는 칼입니다. 위 표만 봐도 고민거리가 줄줄이 나옵니다. ‘과학 기술 발전’처럼 흐릿한 조각은 주장으로 뽑아야 할까요? ‘국가 기반을 다졌다’ 같은 평가는 버려야 할까요, 아니면 ‘그렇게 평가하는 사람이 있다’로 바꿔 살려야 할까요? 문장이 "그는 이후 이를 반포했다"였다면 ‘그’와 ‘이’를 누구로 채워야 할까요? 칼질을 잘못하면, 뒤에 붙은 검색과 판정이 아무리 훌륭해도 엉뚱한 결론이 나옵니다.
Microsoft Research의 Dasha Metropolitansky와 Jonathan Larson이 2025년 2월 arXiv에 올린 「Towards Effective Extraction and Evaluation of Factual Claims」(arXiv 2502.10855)는 바로 이 칼을 다룹니다. 논문은 두 가지를 내놓습니다. 하나는 주장 추출을 평가하는 틀입니다. 좋은 주장의 조건 세 가지를 정하고 각각을 자동으로 재는 방법을 만들었습니다. 다른 하나는 Claimify라는 추출기입니다. 이 추출기의 가장 큰 특징은 해석이 둘 이상으로 갈리는데 문맥으로도 정할 수 없는 문장을 만나면 뽑지 않고 물러선다는 점입니다.
코어닷투데이는 2026년 4월 「AI가 말한 건 사실일까?」에서 이 논문을 한 차례 소개했습니다. 이번 글은 그 후속 특집입니다. 세 가지를 더 깊이 다룹니다. 첫째, 이 문제가 팩트체킹의 역사에서 어떻게 나왔는지. 둘째, 논문의 평가 방법과 표를 한 칸씩 읽는 법. 셋째, 논문 부록의 프롬프트를 그대로 한국어 답변에 돌렸을 때 실제로 어떤 일이 벌어지는지입니다. 먼저 바로잡을 것이 하나 있습니다. 4월 글은 이 논문을 ‘ACL 2025 최우수 논문’이라고 소개했지만, 확인해 보니 사실이 아니었습니다. 이 논문은 ACL 2025 본회의 장문 논문(1권 6996–7045쪽)으로 실렸고, ACL 2025의 어떤 수상 목록에도 없습니다. 주장 추출을 다루는 글에서 이런 오류가 나왔으니, 이 글에서는 수치와 출처를 더 꼼꼼히 확인했습니다.
1장. 사실 확인의 첫 단계는 언제나 ‘고르기’였다
사람 팩트체커의 작업대
전문 팩트체킹은 2000년대 미국에서 하나의 직업으로 자리 잡았습니다. 펜실베이니아대 애넌버그 공공정책센터가 2003년 12월 FactCheck.org를 열었고, 2007년 8월에는 세인트피터즈버그 타임스가 PolitiFact를 시작했습니다. PolitiFact는 2008년 대선 기간에 "750개가 넘는 정치적 주장"을 확인한 작업으로 2009년 퓰리처상 전국보도 부문을 받았습니다. 영국의 Full Fact는 2009년에 설립돼 2010년부터 활동했습니다. 2016년 9월에는 국제팩트체킹네트워크(IFCN)가 27개국 35개 기관의 서명으로 원칙 강령을 발표했습니다.
듀크대 리포터스랩의 집계를 보면 이 분야가 얼마나 커졌다가 꺾였는지 알 수 있습니다. 활동 중인 팩트체킹 프로젝트는 2014년 110개에서 2022년 말 453개까지 늘었습니다. 그 뒤로는 줄기 시작해 2025년 말 441개, 2026년 6월 1일 437개가 됐습니다. 2025년 한 해에 새로 생긴 곳은 10곳이었고 문을 닫은 곳은 30곳이 넘었습니다.
이 사람들의 작업은 보통 세 단계로 정리됩니다. ① 확인할 주장을 고르고, ② 증거를 찾고, ③ 판정을 내립니다. 자동 팩트체킹 연구를 정리한 2022년 TACL 서베이(Guo, Schlichtkrull, Vlachos)도 같은 세 단계, 즉 주장 탐지 → 증거 검색 → 판정을 기본 틀로 씁니다. 눈여겨볼 것은 첫 단계가 ‘고르기’라는 점입니다. 정치인의 연설 한 편에는 문장이 수백 개 있지만, 확인할 수 있고 확인할 만한 문장은 그중 일부입니다.
‘고르기’를 기계에 처음 본격적으로 맡긴 시스템은 텍사스대 알링턴의 ClaimBuster입니다. 2014년 12월 개발을 시작해 2015년 CIKM에 첫 논문을, 2017년 KDD에 시스템 논문을 냈습니다. 1960년부터 2012년까지 미국 대선 토론 30회에서 20,617문장을 뽑아 사람이 세 갈래로 라벨을 붙였습니다.
사실 아님
66.3%
사실이지만 중요하지 않음
10.2%
확인할 가치가 있는 사실
23.5%
ClaimBuster가 매긴 점수는 ‘이 문장이 확인할 가치가 있는(check-worthy) 사실 문장일 확률’이었습니다. 이 방향은 유럽의 CLEF CheckThat! 공동 과제(2018년 시작, 2025년 8회)로 이어졌습니다. 그런데 ‘확인할 가치’는 누가 정할까요? 공익성, 해로움, 특정 주제와의 관련성 같은 기준이 연구마다 다르게 쓰였습니다. Claimify 논문은 이 대목에서 선을 긋습니다. 확인할 가치는 주관적이므로, 자기들은 확인할 수 있는가(verifiability)만 보겠다는 것입니다. 정치 토론이 아니라 AI 답변을 다루는 맥락에서는 이 선택이 자연스럽습니다. 사용자가 받은 답변 속 사실은 하나하나가 그 사용자에게 중요하기 때문입니다.
2018년 NAACL에 나온 FEVER는 판정 쪽의 기준점을 만들었습니다. 위키백과 문장을 바탕으로 사람이 쓴 주장 185,445개에 ‘지지됨·반박됨·정보 부족’ 라벨을 붙인 데이터셋입니다. 다만 FEVER의 주장은 사람이 이미 깔끔한 한 문장으로 써서 준 것이었습니다. 현실의 글에는 이렇게 손질된 주장이 없습니다. 누군가 그 손질을 대신해야 합니다.
문장을 홀로 서게 하기: 탈맥락화
2021년 구글의 Choi 등은 TACL 논문 「Decontextualization: Making Sentences Stand-Alone」에서 이 손질의 핵심을 짚었습니다. 문서에서 떼어 낸 문장은 대명사, 생략, ‘이 회사’ 같은 지시어 때문에 혼자서는 뜻이 통하지 않습니다. 이 논문은 위키백과 문장을 사람이 고쳐 쓰게 해 보고 분포를 쟀습니다. 약 30%는 그대로 떼어도 됐고, 60% 남짓은 고치면 홀로 설 수 있었으며, 약 10%는 고쳐도 홀로 세울 수 없었습니다. 마지막 10%를 기억해 두세요. Claimify의 ‘모호성 해소 불가’ 판정은 바로 이 범주를 정면으로 다룹니다.
같은 흐름에서 2024년 EMNLP의 Dense X Retrieval(Chen 등)은 검색 단위를 문단이나 문장이 아니라 명제(proposition), 즉 하나의 사실을 담은 자기완결적 짧은 문장으로 바꾸자고 제안했습니다. GPT-4로 만든 42,857개 예시로 Flan-T5-Large를 미세조정해 ‘명제 생성기’를 만들었고, 위키백과를 2억 5,700만 개 명제로 쪼갰습니다. 비지도 검색기에서 Recall@20이 평균 10.1점 올랐습니다. 주장 추출은 팩트체킹만의 기술이 아니라 검색의 기본 단위를 다시 정하는 일이기도 하다는 뜻입니다.
LLM 시대: 원자 사실과 그 부작용
ChatGPT 이후 확인해야 할 글의 성격이 바뀌었습니다. 정치인의 발언 한 줄이 아니라, 수십 문장짜리 AI 답변이 하루에도 수억 개씩 쏟아집니다. 2023년 EMNLP의 FActScore(Min 등)는 이 상황을 겨냥한 첫 표준 도구였습니다. 생성된 인물 전기를 ‘원자 사실(atomic fact)’로 쪼갠 뒤, 위키백과가 받쳐 주는 원자 사실의 비율을 점수로 삼았습니다. 사람이 183명의 전기를 채점한 결과는 이렇습니다.
InstructGPT
42.5%
ChatGPT
58.3%
PerplexityAI (검색 결합)
71.5%
ChatGPT가 쓴 전기에서 원자 사실 열 개 중 네 개는 근거가 없었다는 뜻입니다. 사람 채점 비용은 생성물 하나에 4달러였습니다. FActScore는 이를 자동화한 추정기를 함께 내놓았는데, 오차는 2% 미만이었습니다. 13개 모델의 6,500개 생성물을 사람이 채점했다면 2만 6천 달러가 들었을 일입니다.
2024년 구글 딥마인드의 SAFE(Wei 등, NeurIPS 2024)는 같은 일을 검색 엔진으로 넓혔습니다. 답변을 개별 사실로 쪼개고, 사실마다 구글 검색 질의를 여러 번 만들어 증거를 모은 뒤 판정했습니다. 16,011개 사실에서 사람 주석자와 72.0% 일치했고, 둘이 엇갈린 100건을 다시 보니 SAFE가 맞은 경우가 76%, 사람이 맞은 경우가 19%였습니다. 비용은 답변 하나에 0.19달러로, 사람(4달러)의 20분의 1 수준이었습니다. 다만 여기서 ‘사람’은 FActScore의 크라우드 주석자였고, 엇갈린 사례의 정답도 저자들이 정했다는 점은 감안해야 합니다.
같은 해 매사추세츠대의 VeriScore(Song, Kim, Iyyer, EMNLP Findings 2024)는 중요한 수정을 가했습니다. 모든 문장을 원자 사실로 쪼개면 "AI는 의료를 바꿀 수 있다" 같은 추측이나 조언까지 ‘사실’로 채점됩니다. VeriScore는 확인할 수 있는 주장만 뽑자고 했습니다. Claimify가 정면으로 비교하는 상대가 바로 이 방법입니다.
칼을 바꾸면 점수가 바뀐다
방법이 늘자 이상한 일이 드러났습니다. 2024년 *SEM에 실린 「A Closer Look at Claim Decomposition」(Wanner 등)은 같은 답변이라도 분해 방법을 바꾸면 FActScore가 달라진다는 것을 보였습니다. 2025년 NAACL의 「Decomposition Dilemmas」(Hu 등)는 한 걸음 더 나아갔습니다. 분해는 약한 판정기에는 도움이 되지만 강한 판정기에는 오히려 성능을 떨어뜨릴 수 있었습니다. 단순한 입력을 쪼개면 손해였고, 너무 잘게 쪼개도 손해였습니다. 이 논문은 분해가 만드는 오류를 네 가지로 나눴습니다. 맥락 누락, 모호성, 과잉 분해, 의미 변경입니다.
여기까지 오면 질문이 분명해집니다. 사실성 점수는 결국 ‘몇 개의 주장 중 몇 개가 참인가’입니다. 그렇다면 분모를 만드는 칼질이 얼마나 정확한지부터 재야 합니다. 그런데 그것을 재는 표준이 없었습니다. 연구마다 원자성, 충실성, 일관성 같은 이름으로 서로 다른 것을 쟀고, 대부분 사람이 직접 봐야 했습니다. Claimify 논문은 바로 이 빈칸을 채우려고 나왔습니다.
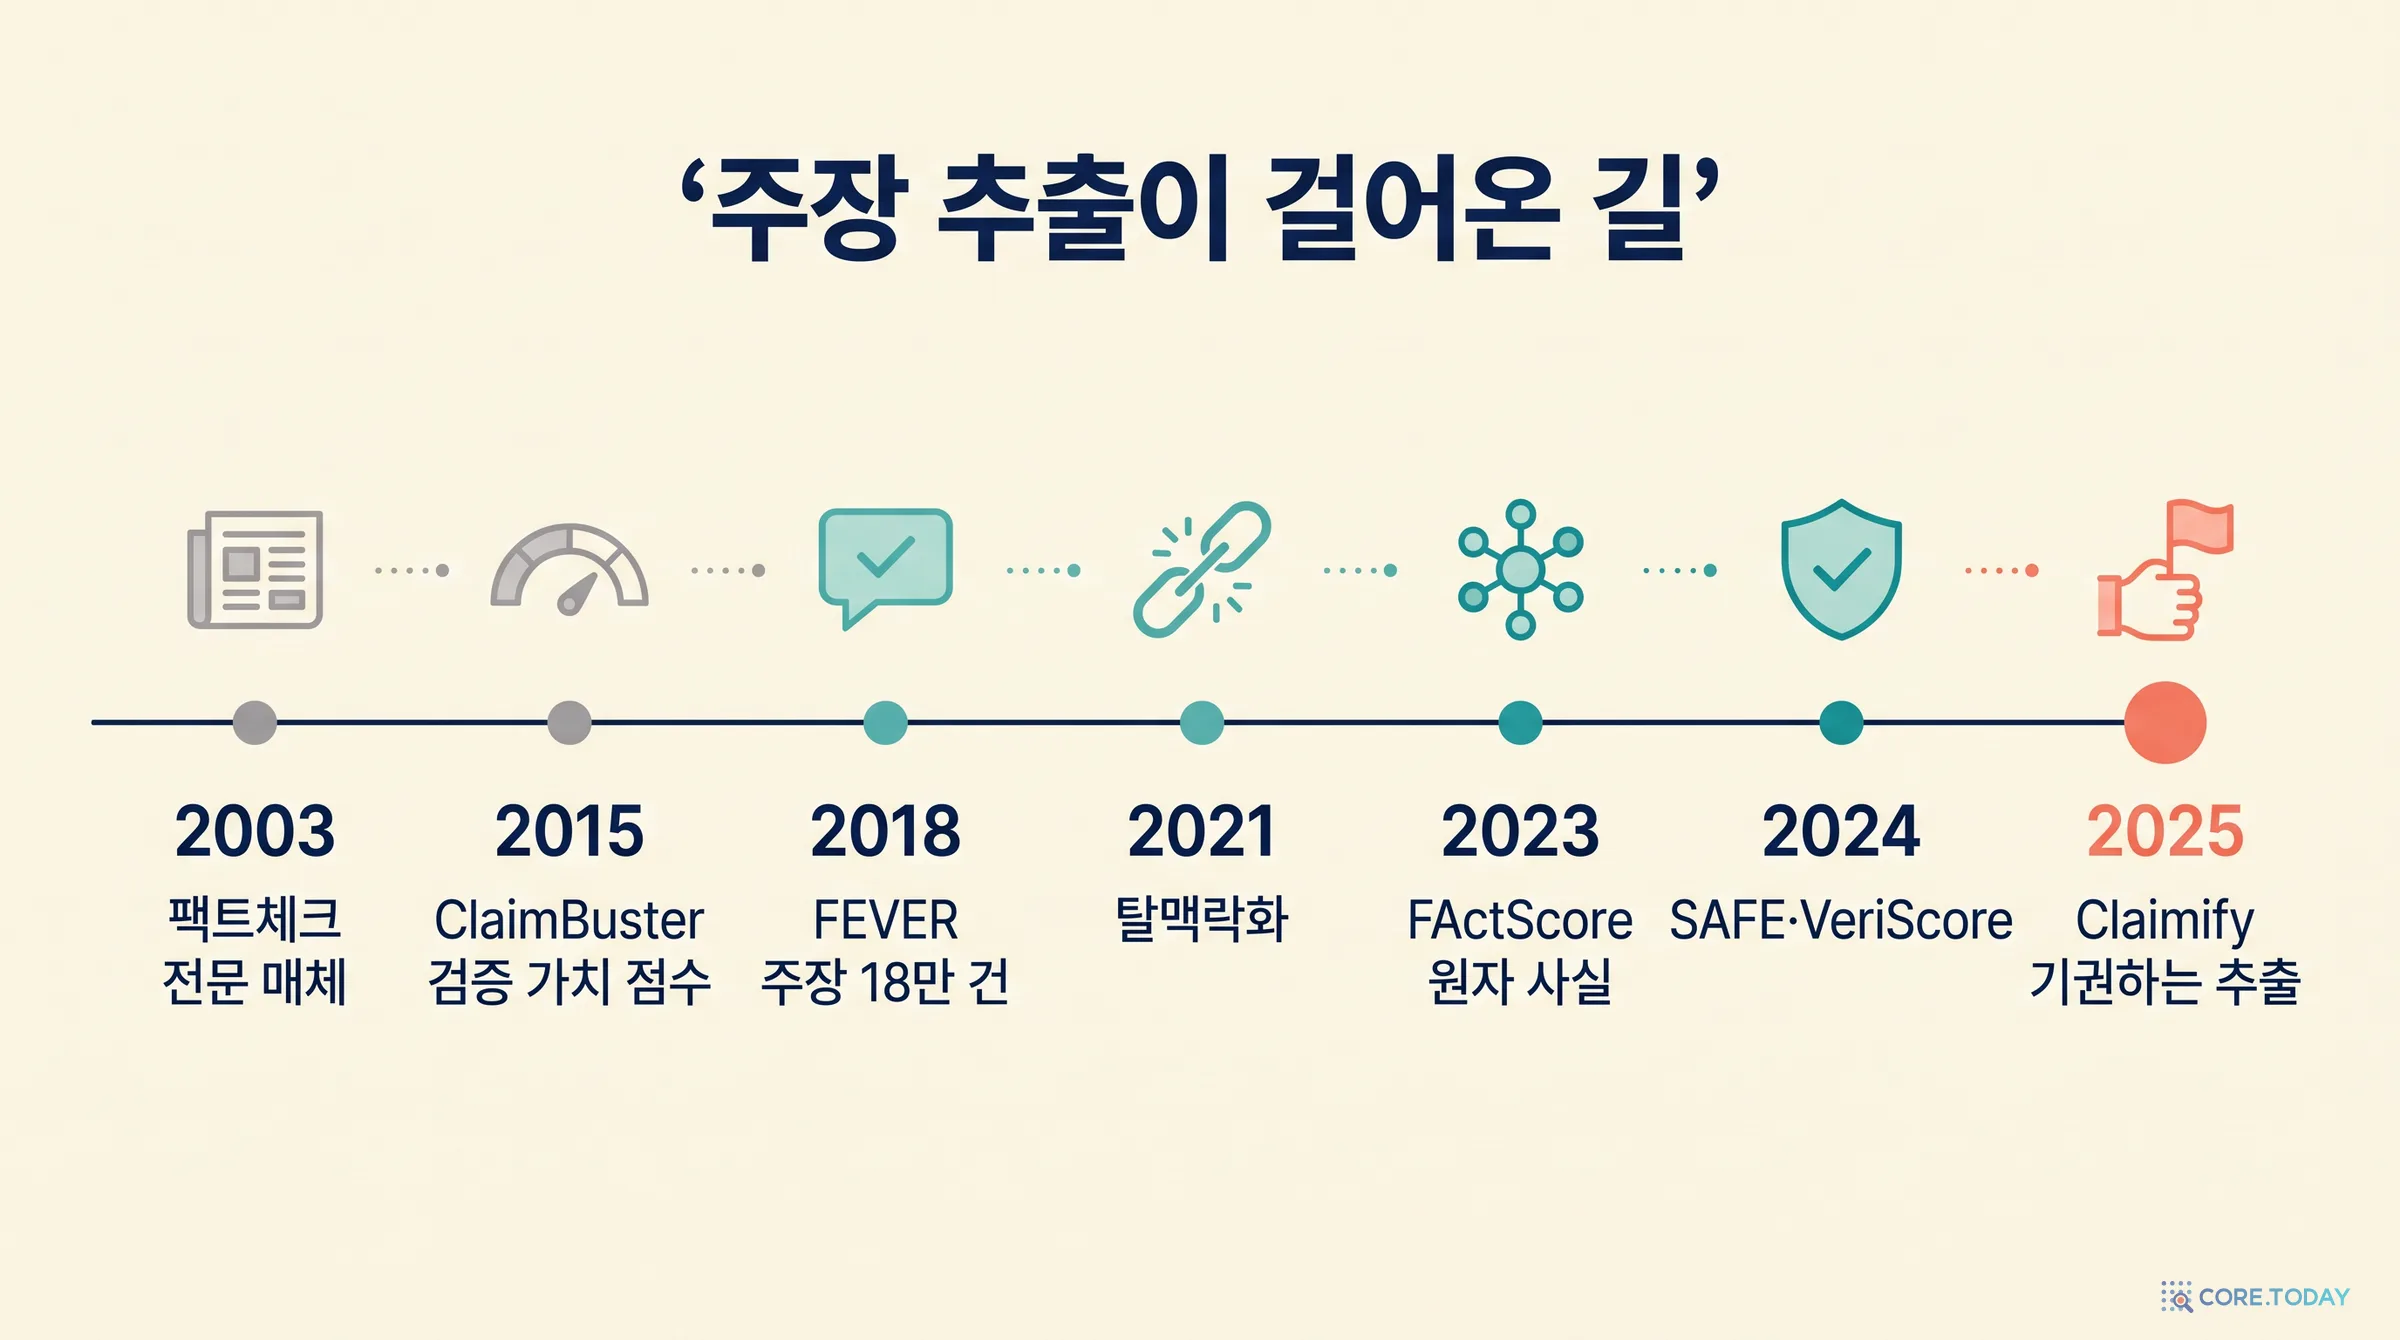
사람 팩트체킹의 제도화 — FactCheck.org(2003), PolitiFact(2007, 2009 퓰리처), Full Fact(2009~10), IFCN 원칙 강령(2016). 첫 단계는 언제나 ‘확인할 주장 고르기’.
2015~2018
고르기의 자동화 — ClaimBuster가 ‘확인할 가치’ 점수를 매기고, FEVER가 손질된 주장 18만 5천 개로 판정 기준점을 만듦.
2021~2024
쪼개기와 홀로 서기 — 탈맥락화(2021), 명제 단위 검색(2024), 원자 사실 FActScore(2023), 검색 판정 SAFE(2024), 확인 가능한 주장만 VeriScore(2024).
2024~2025
칼질 자체가 문제 — 분해 방법에 따라 점수가 바뀐다는 보고가 이어지고, Claimify 논문이 주장 추출을 따로 평가하는 틀을 제안.
2장. 무엇이 ‘주장’인가: 확인할 수 있다는 것의 경계
논문은 주장(claim)의 정의를 AFaCTA(Ni 등, ACL 2024)에서 빌려 옵니다. "경험적 증거나 현실에 비추어 객관적으로 참이나 거짓을 가릴 수 있는 진술." 논문은 이를 ‘확인 가능한 사실적 주장’의 줄임말로 ‘사실적 주장(factual claim)’이라고 부릅니다.
이 정의에는 두 가지 함정이 숨어 있습니다. 첫째, 참일 필요가 없습니다. "에펠탑은 세계에서 가장 높은 건물이다"는 거짓이지만 확인할 수 있으므로 주장입니다. 둘째, 문장의 형태만 보고 정할 수 없습니다. 앞 문장이 "X사의 CEO는 누구인가요?"라면 "김철수입니다."라는 짧은 문장도 확인할 수 있는 주장이 됩니다. 반대로 "21세기에는 인류사에 대한 이해를 바꾼 발견이 많았다"는 그럴듯한 사실 문장처럼 보입니다. 하지만 뒤에 구체적인 발견이 줄줄이 이어지는 머리말이라면, 그 자체로는 확인할 게 없는 도입문입니다.
논문의 주석 지침은 확인할 수 없는 문장을 다섯 부류로 묶습니다. 넓거나 일반적인 진술, 의견, 해석, 추측, 조언입니다. LLM 답변에서 특히 흔한 것은 사실 하나에 해석 한 줄을 덧붙인 문장입니다. "X사와 Y사의 제휴는 혁신의 힘을 보여 준다"가 대표적입니다. 이런 문장은 통째로 버리면 ‘두 회사가 제휴했다’는 사실을 잃고, 통째로 뽑으면 ‘혁신의 힘’이라는 해석까지 사실처럼 검증대에 오릅니다. 아래 퀴즈로 감을 잡아 보세요.
원자성은 왜 버렸나
FActScore 이래 많은 연구가 주장은 원자적이어야 한다고 했습니다. "캘리포니아와 뉴욕이 비닐봉지 금지법을 시행했다"는 원자적이지 않으니 "캘리포니아가 시행했다"와 "뉴욕이 시행했다"로 나눠야 한다는 식입니다. Claimify 논문은 이 잣대를 평가 틀에서 일부러 뺐습니다. 이유는 두 가지입니다. 하나는 끝이 없다는 것입니다. 위 문장은 "적어도 한 주가 금지법을 시행했다", "캘리포니아가 금지법을 시행했다", 심지어 "캘리포니아가 존재한다"까지 계속 쪼갤 수 있습니다. 다른 하나는 앞선 연구들에서 원자성이 판정 성능을 일관되게 올리지 못했다는 것입니다. 그래서 논문은 ‘얼마나 잘게’ 대신 ‘무엇을 빠뜨리지 않고, 무엇을 넣지 않았나’를 재기로 했습니다. 그것이 다음 장의 세 조건입니다.
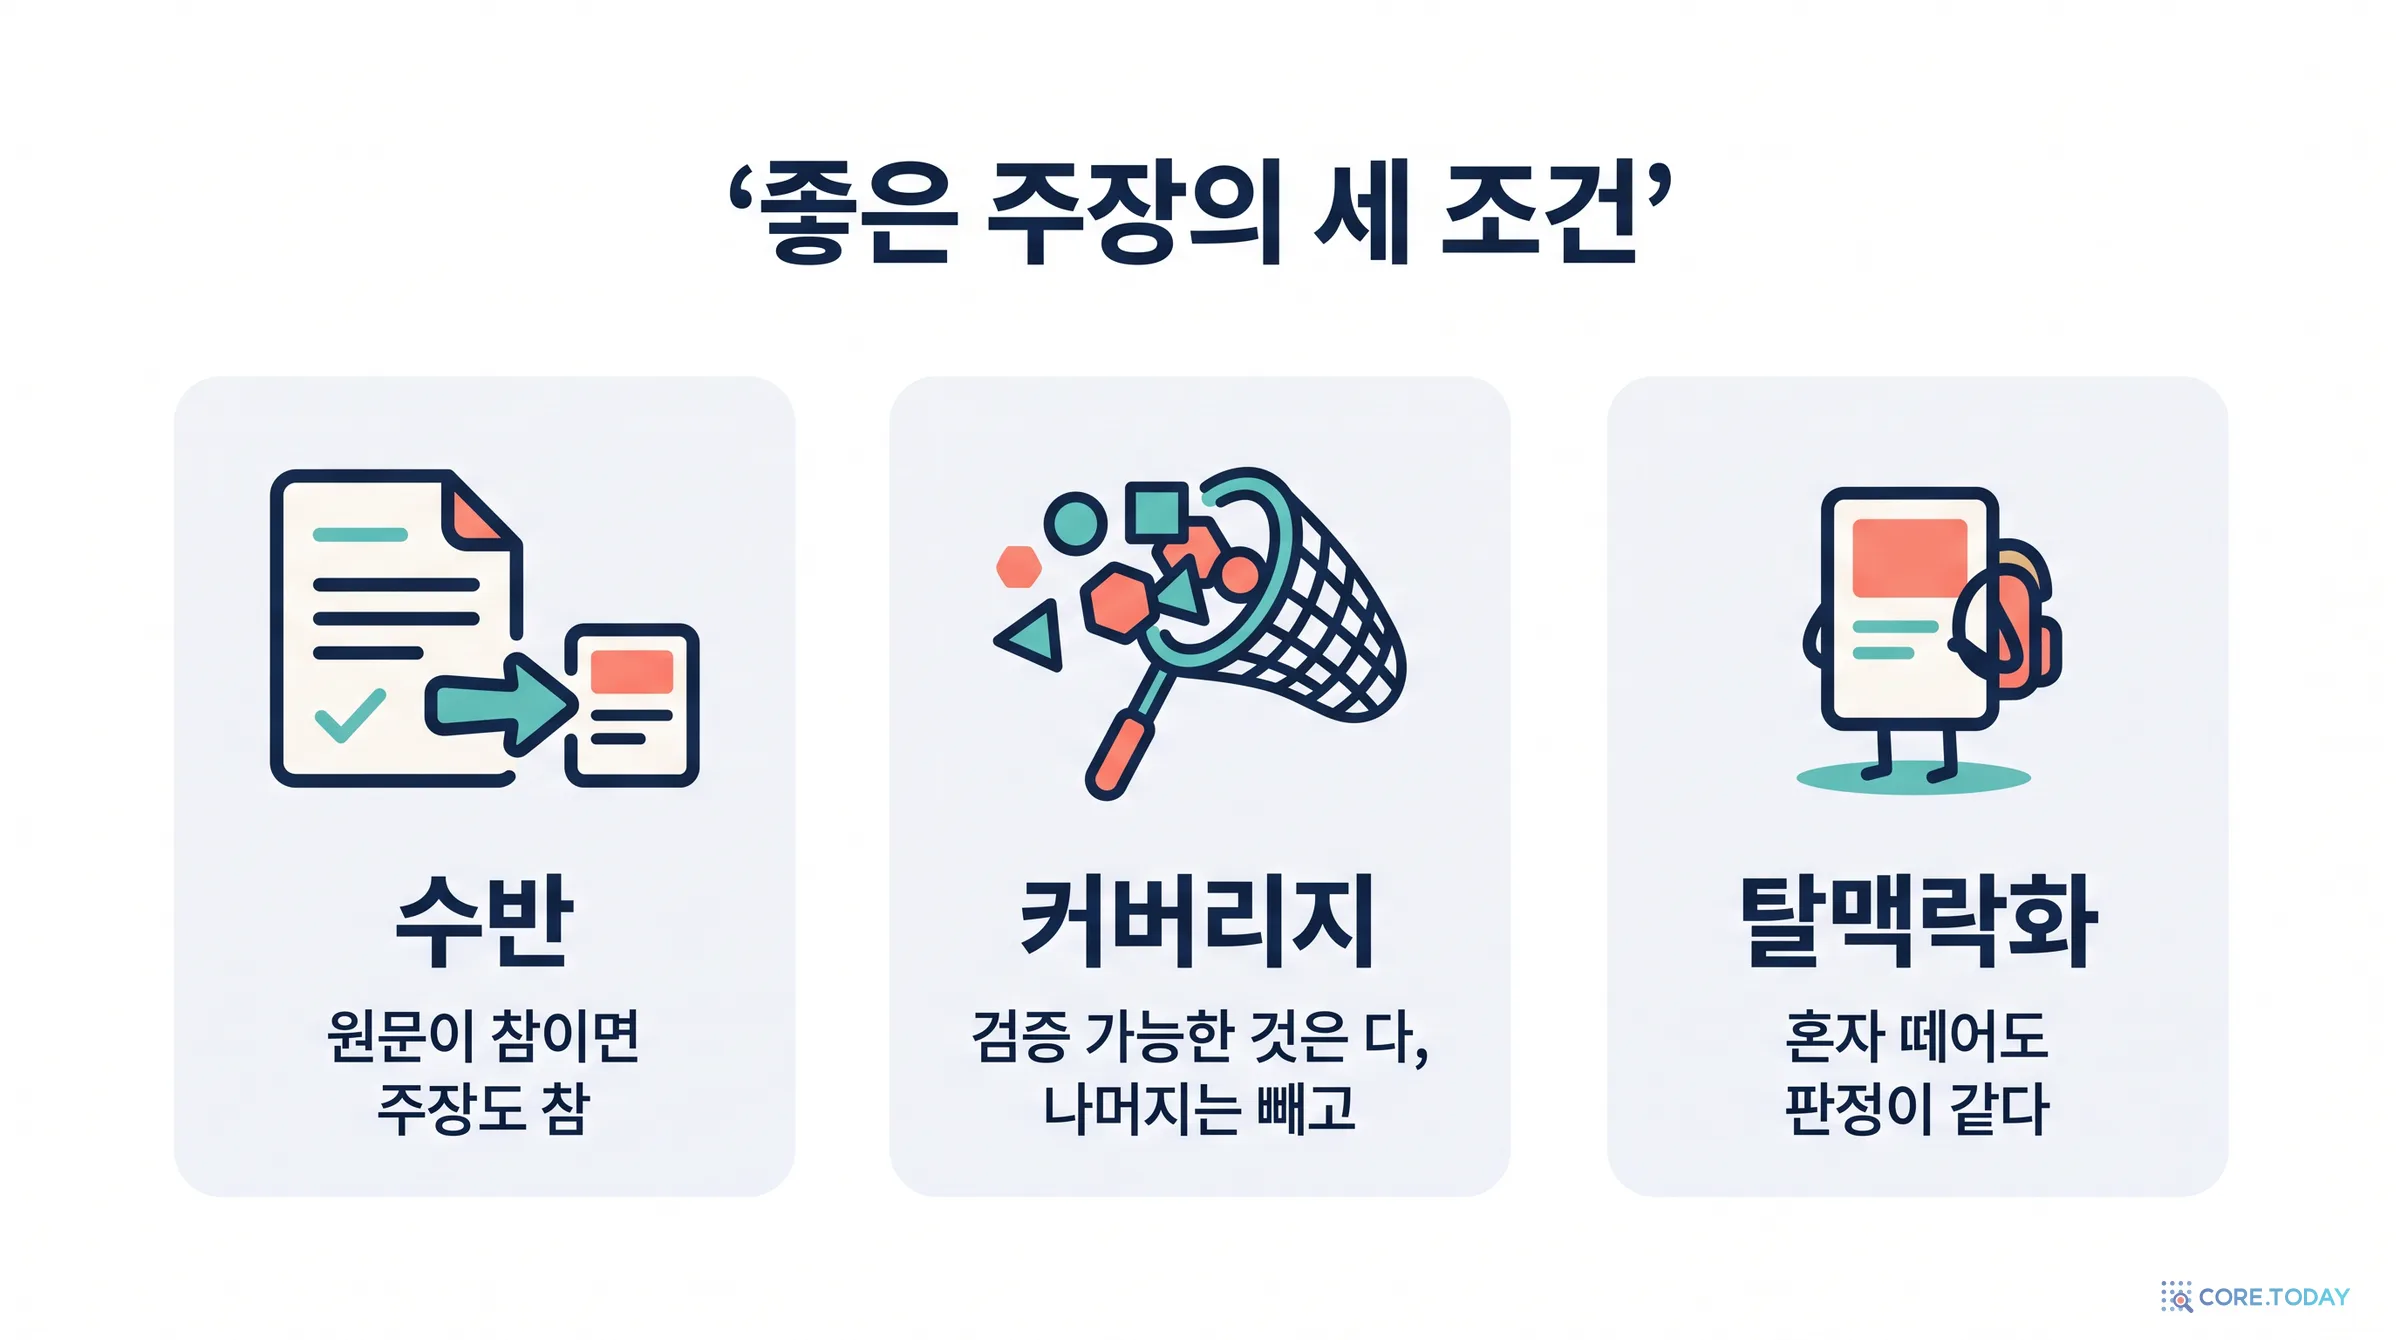
수반(entailment) — 원문이 참이라면, 거기서 뽑은 주장도 반드시 참이어야 합니다. 원문에 없는 내용을 지어 넣거나 뜻을 바꾸면 안 된다는 뜻입니다. 앞선 연구들이 충실성(faithfulness), 일관성(coherence), 정확성(correctness)이라고 부르던 것과 같은 원칙입니다.
커버리지(coverage) — 원문에 있는 확인 가능한 정보는 빠짐없이 담고, 확인할 수 없는 정보는 대놓고 담지 않아야 합니다.
탈맥락화(decontextualization) — 주장 하나만 떼어 놓아도 원래 맥락에서와 같은 뜻으로 이해되어야 합니다. 논문은 이 조건을 기존과 다른 방식으로 재정의합니다.
수반은 개념이 단순하니 재는 방법만 짚겠습니다. 저자들은 처음에 기존 연구처럼 자연어 추론(NLI) 모델(RoBERTa-large 계열)로 판정해 봤다가 한계에 부딪혔습니다. "그러나 그것은 1998년에야 구현되었다"라는 문장과 "프로그래밍 언어 플랑칼퀼은 1998년에야 구현되었다"라는 주장을 넣으면 NLI 모델은 ‘중립’이라고 답합니다. 문장만 보면 ‘그것’이 플랑칼퀼인지 알 수 없기 때문입니다. 앞 문장까지 넣으면 이번에는 512토큰 입력 한도에 걸렸습니다. 결국 저자들은 질문, 문맥, 원문 문장을 함께 보고 판정하는 LLM 프롬프트를 새로 만들었습니다. 무작위 80개 주장에 직접 라벨을 붙여 맞춰 보니 LLM 프롬프트는 5건만 저자들과 달랐고, NLI 모델은 설정에 따라 32건과 12건이 달랐습니다.
커버리지: 문장이 아니라 ‘요소’로 세라
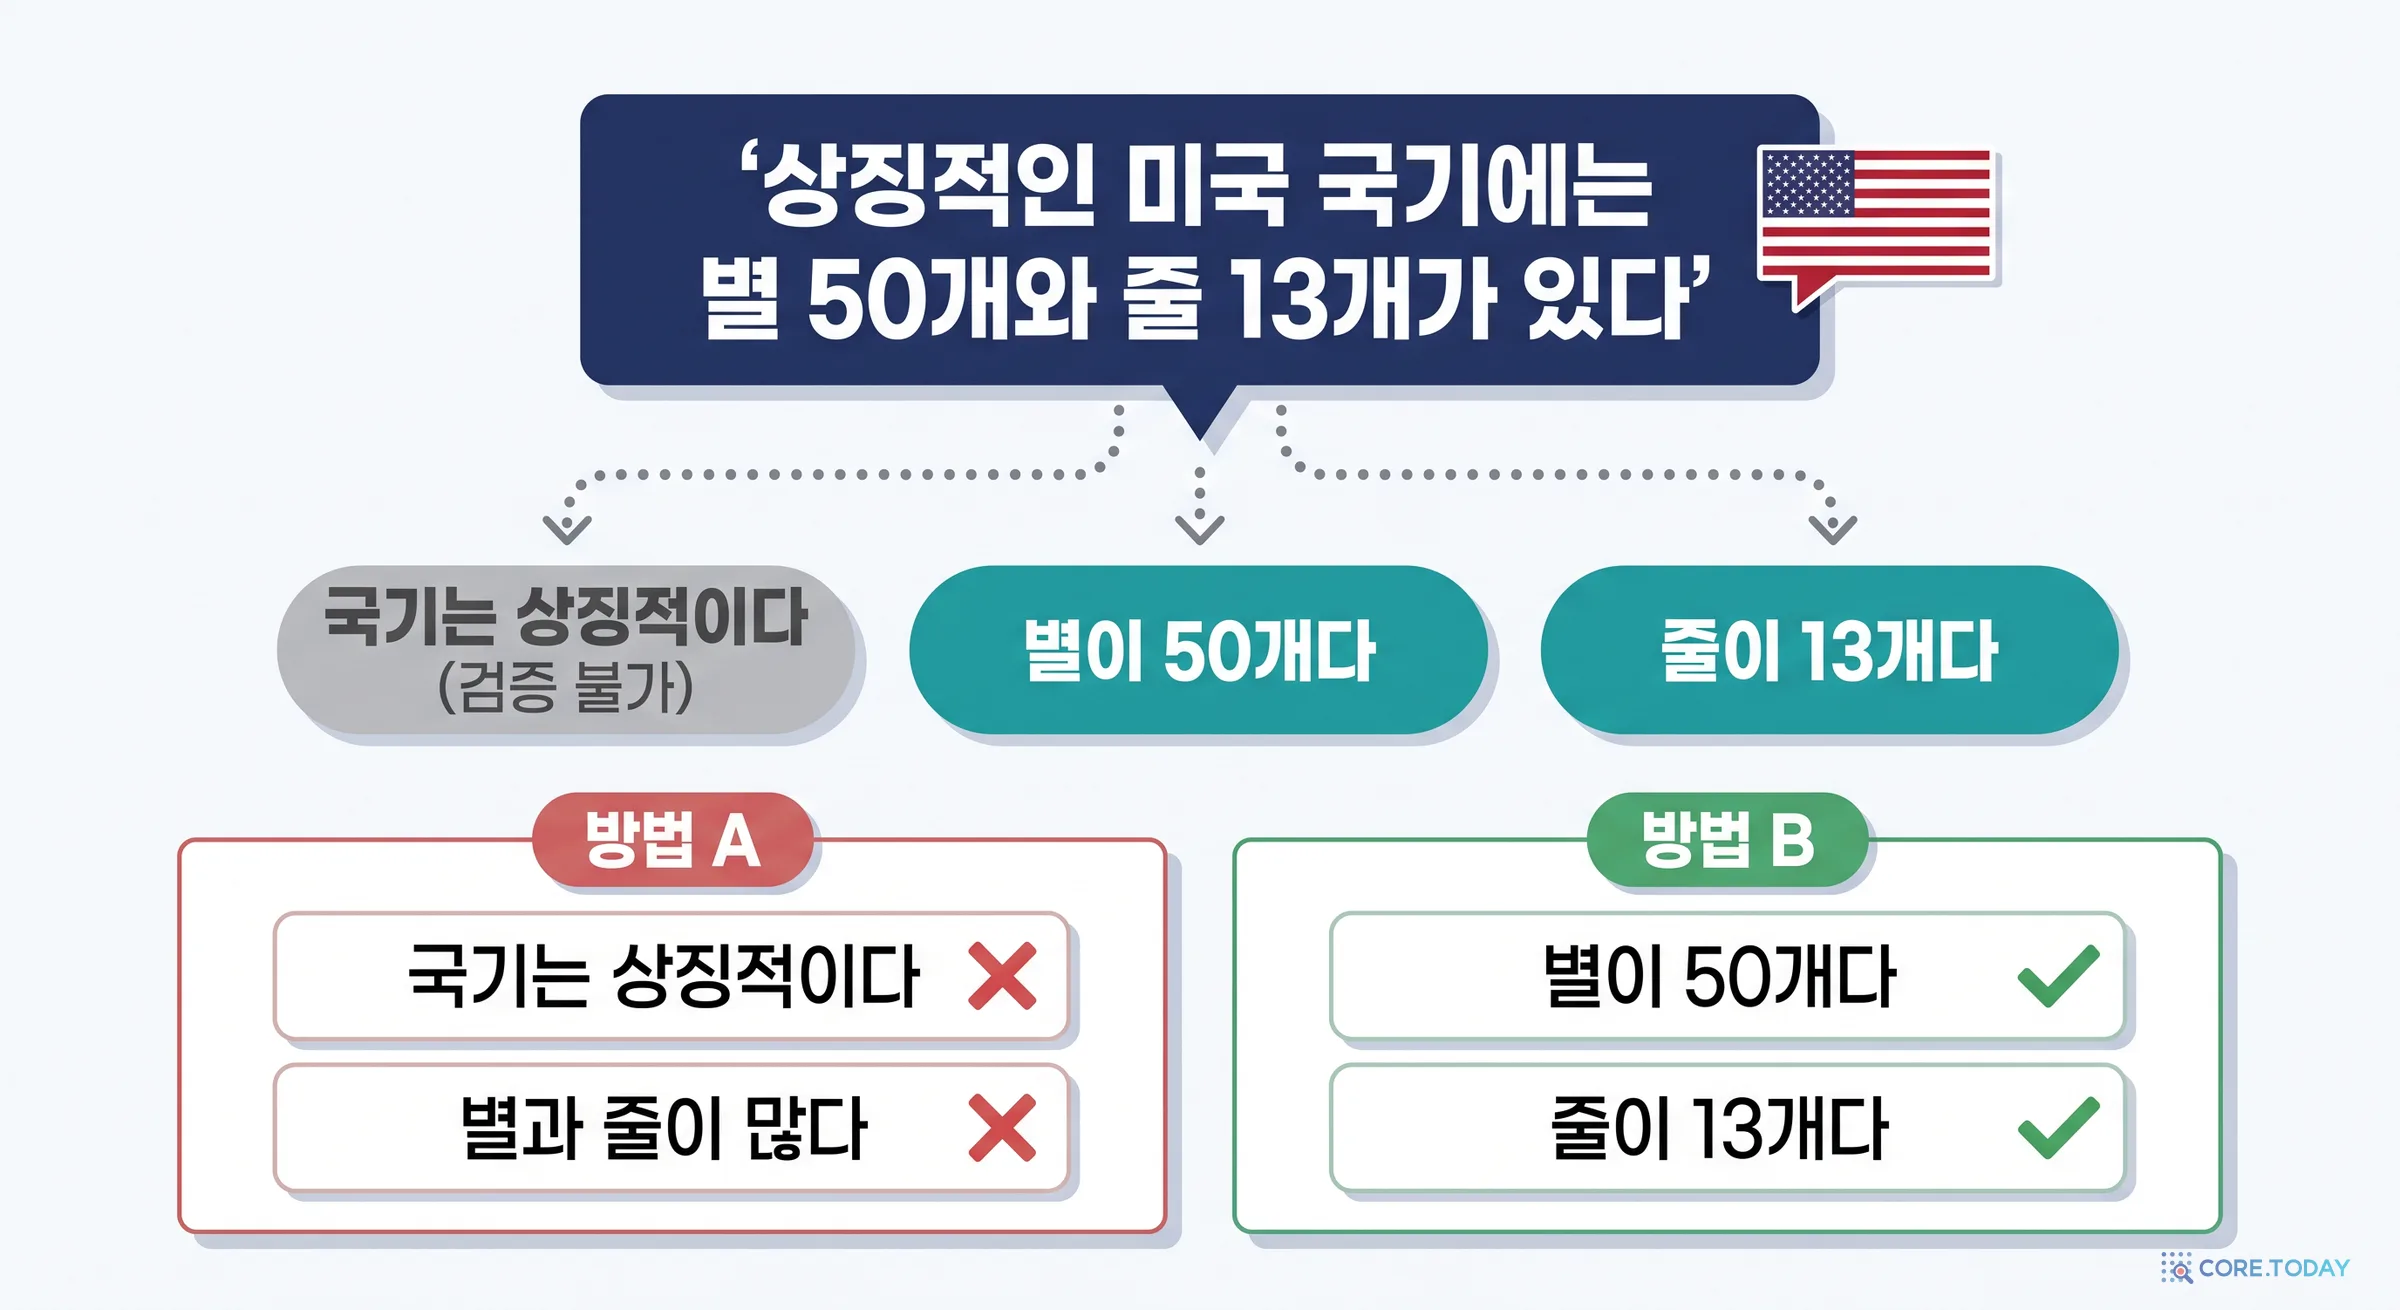
커버리지를 재는 기존 방식은 대개 문장 수준이었습니다. 한 문장에 사실이 하나라도 있는지를 맞혔으면 그 문장은 정답이라는 식입니다. 논문은 이 방식이 놓치는 것을 국기 예로 보여 줍니다.
"상징적인 미국 국기에는 별 50개와 줄 13개가 있다"에서 방법 A는 [국기는 상징적이다, 국기에는 별과 줄이 많다]를, 방법 B는 [국기에는 별이 50개 있다, 국기에는 줄이 13개 있다]를 뽑았다고 해 봅시다. 둘 다 ‘이 문장에 사실이 있다’고 판단했으니 문장 수준 점수는 똑같습니다. 하지만 누가 봐도 B가 낫습니다.
그래서 논문은 요소 수준 커버리지를 도입합니다. 문장을 서로 다른 정보 조각인 ‘요소(element)’로 쪼개고, 요소마다 확인 가능·불가를 붙입니다. 그다음 뽑힌 주장들이 각 요소를 ‘대놓고(explicitly)’ 담았는지, ‘은근히(implicitly)’ 비쳤는지, 아예 안 담았는지 판정해 네 칸으로 셉니다.
요소의 성격
대놓고 담김
은근히만 비침
안 담김
확인 가능
TP (맞게 뽑음)
TP (맞게 뽑음)
FN (놓침)
확인 불가
FP (헛뽑음)
TN (봐줌)
TN (맞게 뺌)
왜 확인 불가 요소가 ‘은근히’ 비친 경우는 봐줄까요? 논문 부록 A의 신약 예가 답입니다. "신약 X가 승인된 뒤 환자 생존율이 세 배가 되었고, 이는 현대 의학의 힘을 보여 준다." 방법 A는 [생존율이 세 배가 되었다]만, 방법 B는 거기에 [그 증가는 현대 의학의 힘을 보여 준다]까지 뽑았습니다. A의 주장도 ‘현대 의학의 힘’을 어느 정도 풍긴다고 우길 수는 있습니다. 하지만 그것까지 FP로 치면 A와 B의 점수가 같아집니다. 해석을 일부러 집어넣은 B와 그러지 않은 A를 구별하려면, 대놓고 넣었을 때만 벌점을 줘야 합니다.
이 판정은 두 개의 LLM 프롬프트가 합니다. 하나는 문장을 요소로 쪼개고 확인 가능 여부를 붙이고, 다른 하나는 주장 목록이 각 요소를 담았는지 판정합니다. 모든 방법을 같은 요소 세트로 비교하도록 문장마다 요소는 한 번만 뽑았습니다. 저자들이 무작위 80문장을 직접 검토해 보니 95%의 문장에서 요소가 모든 품질 기준을 통과했고, 담김 라벨 806개 중 97%에 동의했습니다. 틀린 25건 중 24건은 ‘담겼다’고 후하게 본 경우였습니다. 예를 들어 [음악은 뇌 화학물질 분비를 자극할 수 있다]와 [도파민은 뇌 화학물질이다]라는 두 주장을 합쳐 [음악은 도파민 같은 화학물질 분비를 자극한다]가 담겼다고 본 것입니다. 두 주장을 합쳐도 음악이 도파민을 자극한다는 말은 나오지 않습니다.
탈맥락화: ‘충분히 홀로 섰나’ 대신 ‘판정이 바뀌나’
탈맥락화의 통상 정의는 두 가지입니다. ① 주장이 그 자체로 이해되어야 하고, ② 원래 맥락에서의 뜻을 유지해야 합니다. 대부분의 연구는 사람이 주장을 보고 ‘충분히 홀로 섰다’고 판단하는 식으로 이것을 평가했습니다. 논문은 이 방식이 주관적이고, 일관되게 적용하기 어렵고, 무엇보다 팩트체킹에 쓸모 있는지와 상관이 없다고 비판합니다. 두 예가 그 이유를 보여 줍니다.
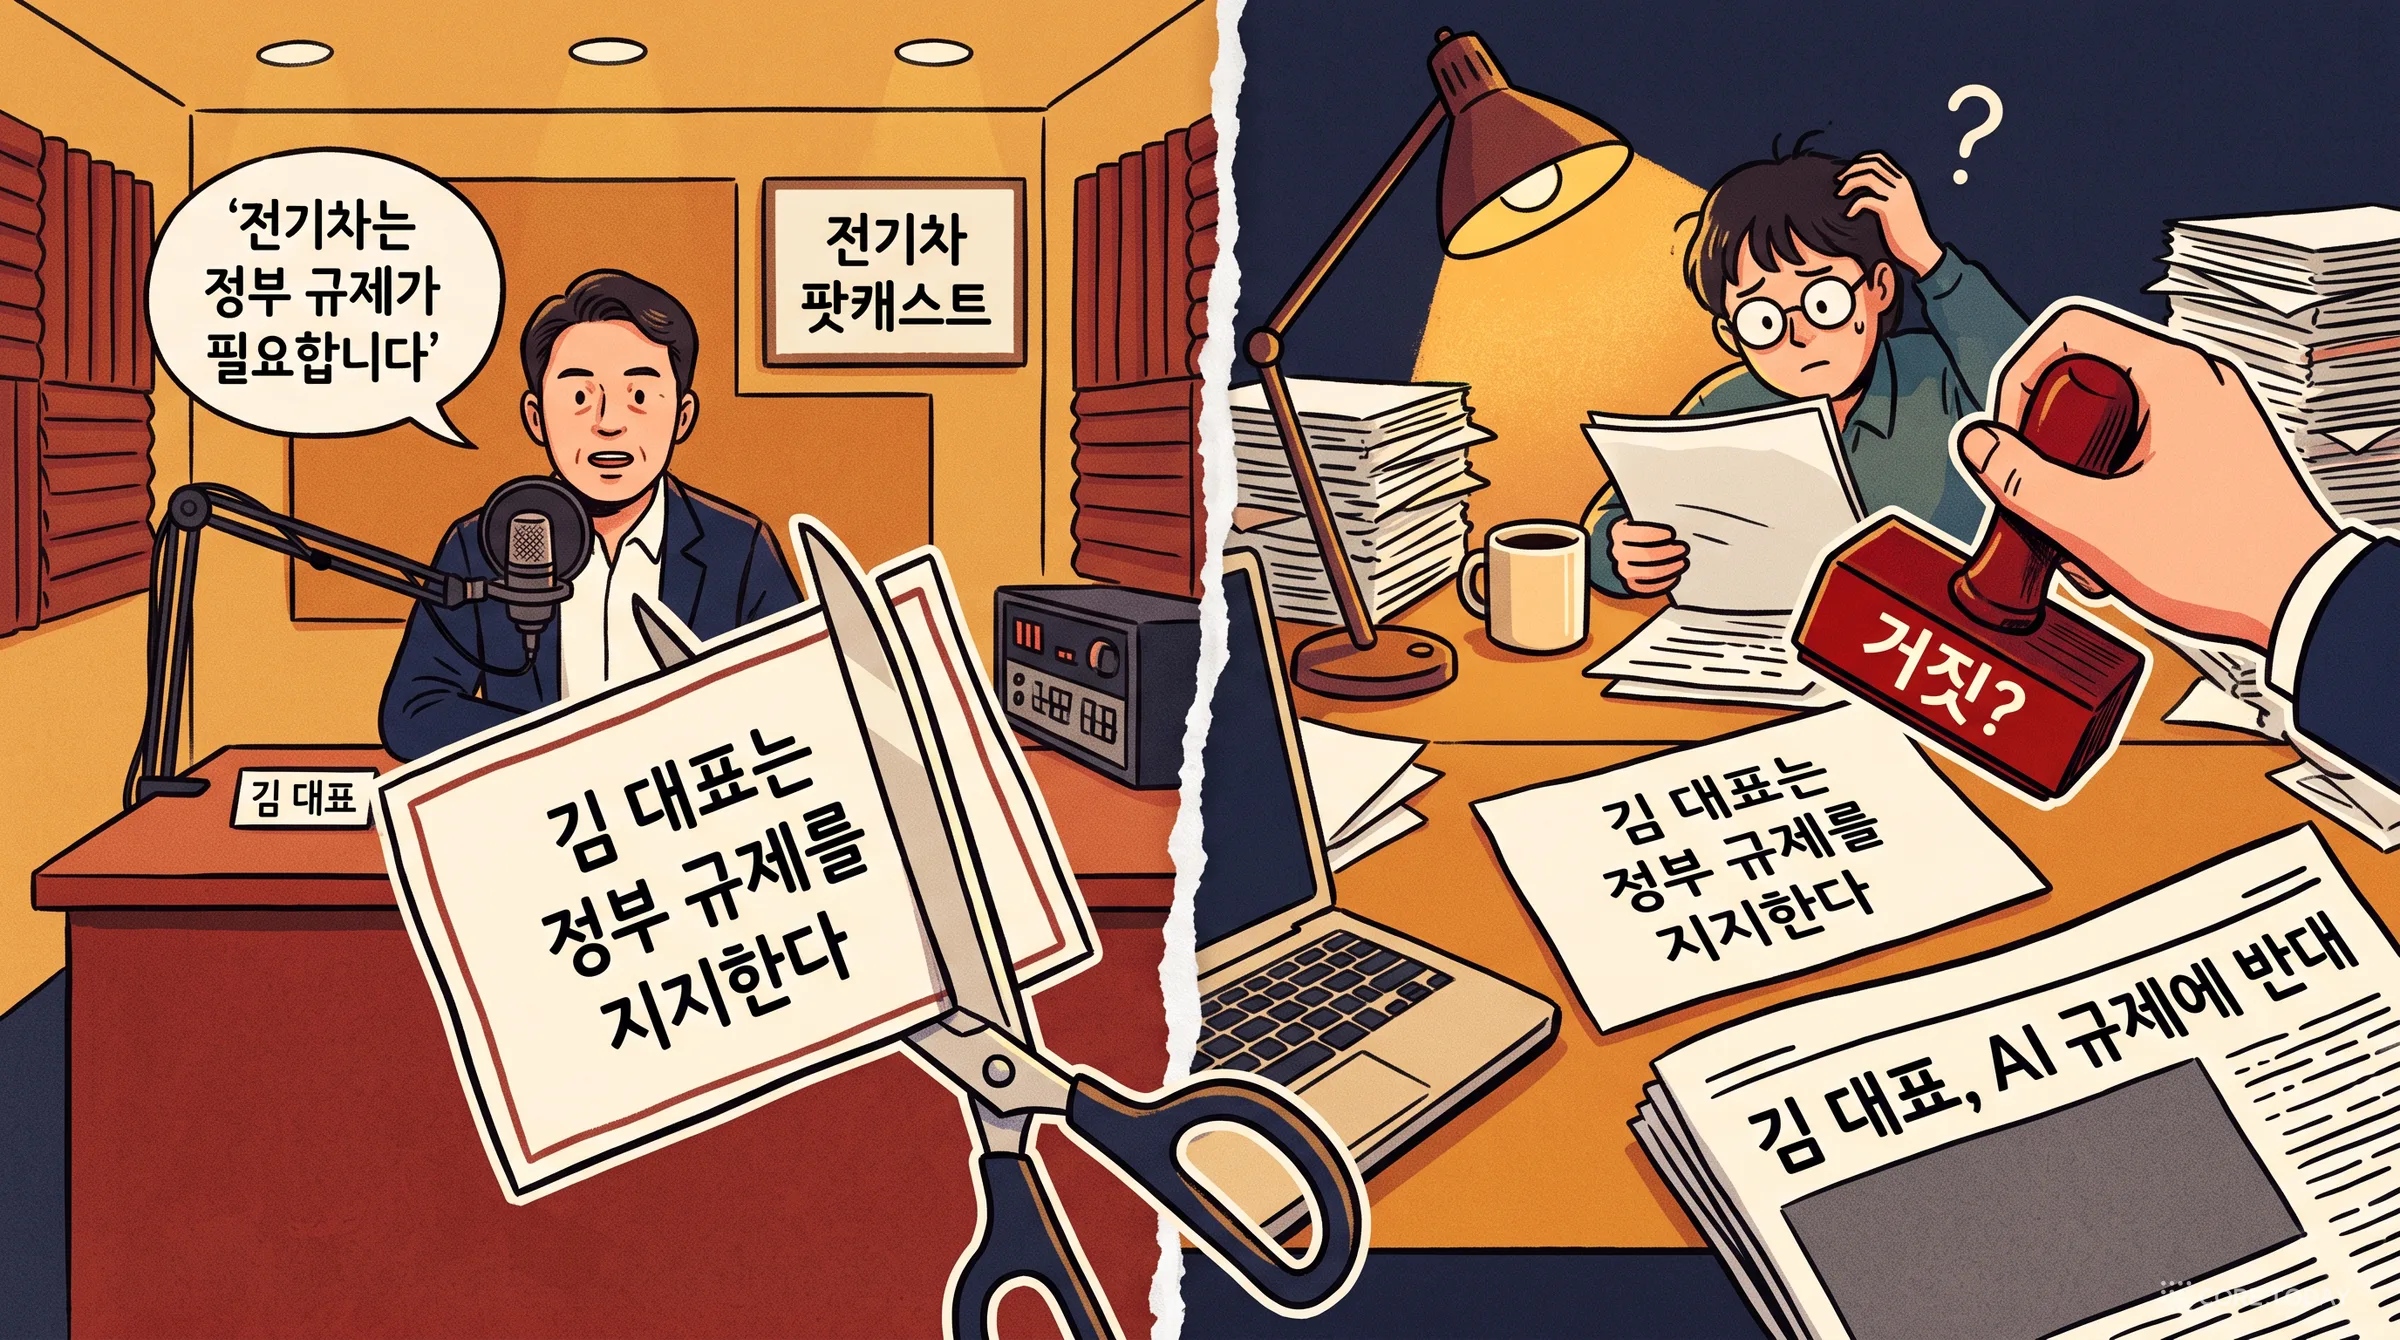
첫 번째 예. 원문은 "전기차를 다룬 제인 도의 팟캐스트 최신 회차에서, 도의 자유시장 견해는 존 스미스의 정부 규제 지지와 부딪혔다"입니다. 여기서 [존 스미스는 정부 규제를 지지한다]를 뽑으면 사람 눈에는 충분히 홀로 선 문장으로 보입니다. 그런데 이 주장을 실제로 검증해 보면 존 스미스가 AI나 의료 분야에서는 규제에 반대한 기사가 나올 수 있습니다. 그러면 판정은 ‘거짓’입니다. 원문은 틀리지 않았는데도 그렇습니다. ‘전기차 팟캐스트에서’라는 맥락이 빠졌다는 문제는 판정을 해 본 뒤에야 드러났습니다.
두 번째 예는 반대 방향입니다. [그 법원은 플로리다 재검표를 중단시킨 갈린 판결로 부시의 대통령직 확보를 도왔다]에서 ‘그 법원’은 정의되지 않았으니 탈맥락화가 부족해 보입니다. 하지만 팩트체킹에는 문제가 없습니다. 이 주장이 가리킬 수 있는 것은 미국 연방대법원의 부시 대 고어 판결뿐이기 때문입니다.
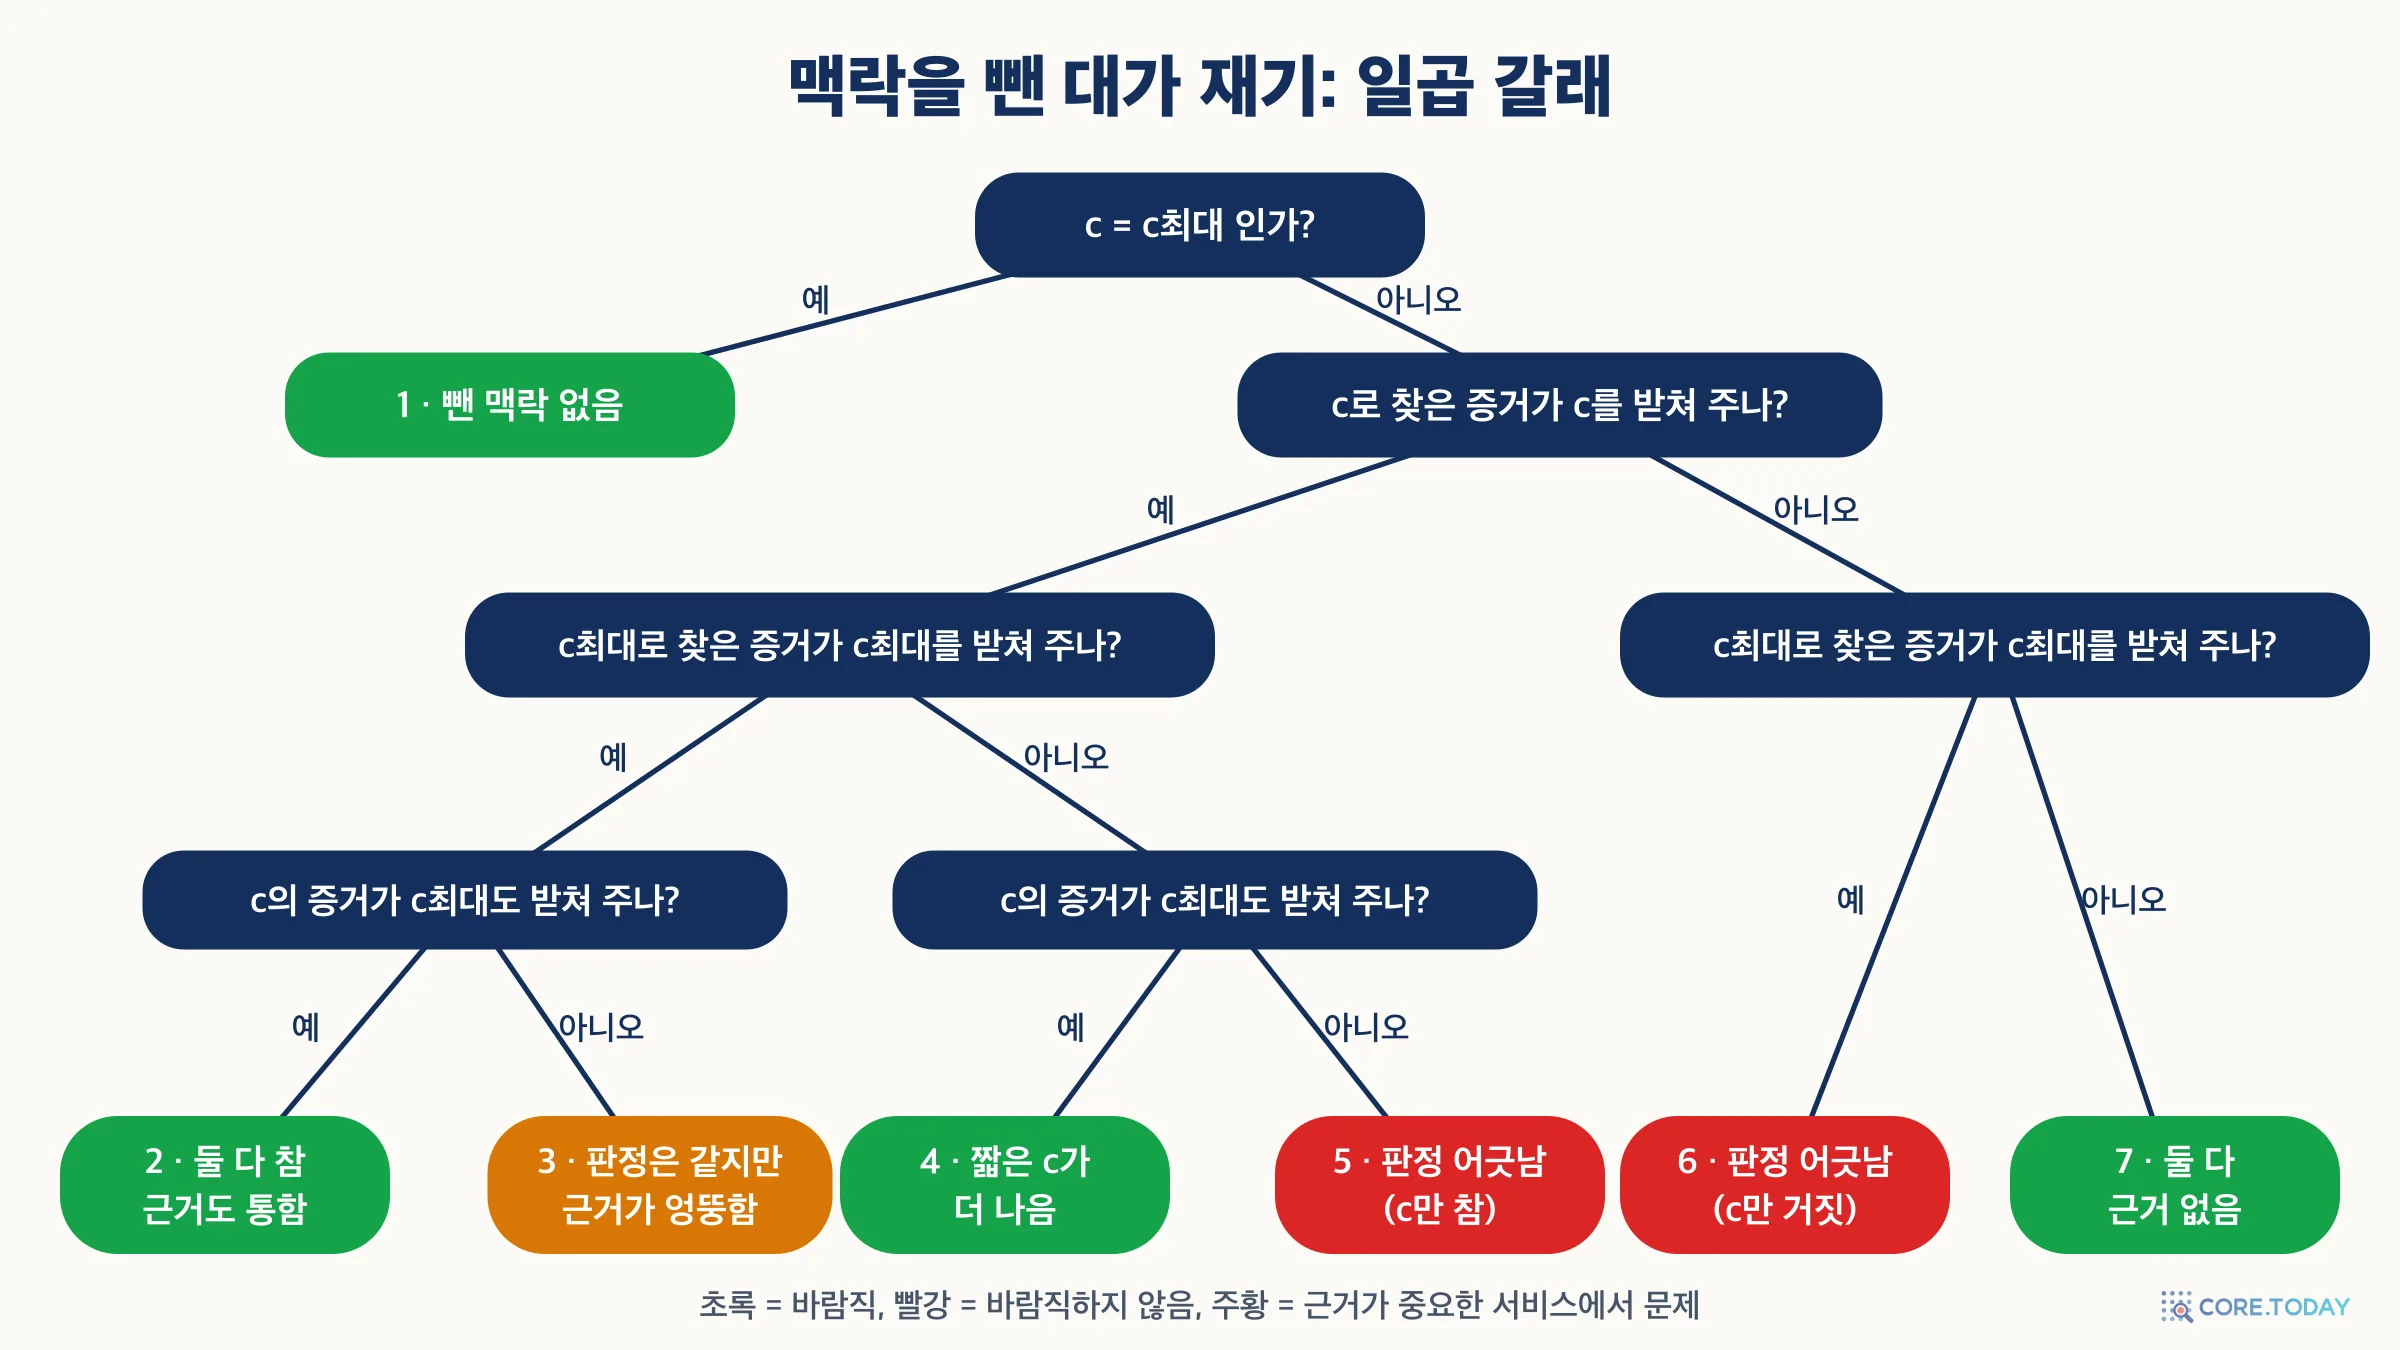
그래서 논문은 주관적 판단 대신 결과를 재자고 합니다. 주장은 증거를 찾는 질의가 되고, 찾은 증거가 판정을 정합니다. 빠진 맥락이 문제가 되는 것은 그 맥락을 넣었을 때 판정이 참에서 거짓으로, 또는 그 반대로 뒤집히는 경우뿐입니다. 이를 재는 절차는 세 단계입니다.
1. 빠진 맥락 찾기
주장 c와 그 문맥을 보고, 담을 수 있는 맥락을 최대한 담은 판본 cmax를 만든다(cmax는 c를 함의해야 함). 이미 최대라면 c = cmax로 끝.
2. 증거 찾기
팩트체킹용 문서 모음에서 c와 cmax로 각각 증거를 찾는다. 결과는 증거 묶음 Ec와 Emax.
3. 판정 맞대기
Ec가 c를 받쳐 주나, Emax가 cmax를 받쳐 주나, 그리고 앞이 예라면 Ec가 cmax까지 받쳐 주나를 본다.
‘가장 맥락이 풍부한 판본’을 만드는 일도 정답이 하나뿐인 것은 아닙니다. 그래도 논문은 이 쪽이 ‘충분히 홀로 섰나’를 판단하는 것보다 덜 주관적이라고 주장합니다. 최대한 넣으라는 지시는 어디서 멈출지를 묻지 않기 때문입니다. 세 질문의 답을 조합하면 결과는 일곱 가지로 갈립니다.
결과 1(뺀 맥락 없음), 2(둘 다 참이고 근거도 통함), 7(둘 다 근거 없음)은 판정이 일치하니 바람직합니다. 결과 4는 흥미롭습니다. c로 찾은 증거는 c와 cmax를 모두 받쳐 주는데, 긴 cmax로 찾은 증거는 cmax를 받쳐 주지 못한 경우입니다. 맥락을 덜 넣은 c가 오히려 더 좋은 검색 질의였다는 뜻이므로 바람직한 쪽으로 분류합니다. 결과 5와 6은 판정이 어긋나니 바람직하지 않습니다.
결과 3은 미묘합니다. 판정은 둘 다 ‘참’인데 근거가 엉뚱한 경우입니다. 논문의 예는 이렇습니다. 원문은 "밀러는 트럼프의 논란 많은 이민 정책의 설계자(architect)로 묘사되어 왔다"이고, 뽑힌 주장은 [밀러는 설계자로 묘사되어 왔다]입니다. 이 주장으로 검색하면 존 밀러라는 건축가(architect)의 기사가 나오고, 판정은 ‘참’입니다. 원문 문장으로 검색하면 스티븐 밀러에 대한 기사가 나오고 역시 ‘참’입니다. 판정은 같지만, 팩트체킹 시스템이 건축가 기사를 근거로 내민다면 큰 문제입니다. 그래서 결과 3은 근거가 중요한 서비스에서는 문제로 칩니다.
이 평가 틀에서 가장 쓸모 있는 생각은 이것입니다. 주장의 품질은 주장만 봐서는 알 수 없고, 그 주장이 하류에서 낸 결과를 봐야 안다. 검색 시스템을 평가할 때 문서 자체가 아니라 사용자가 찾는 답을 얻었는지를 보는 것과 같은 발상입니다.
4장. Claimify 해부: 세 개의 관문
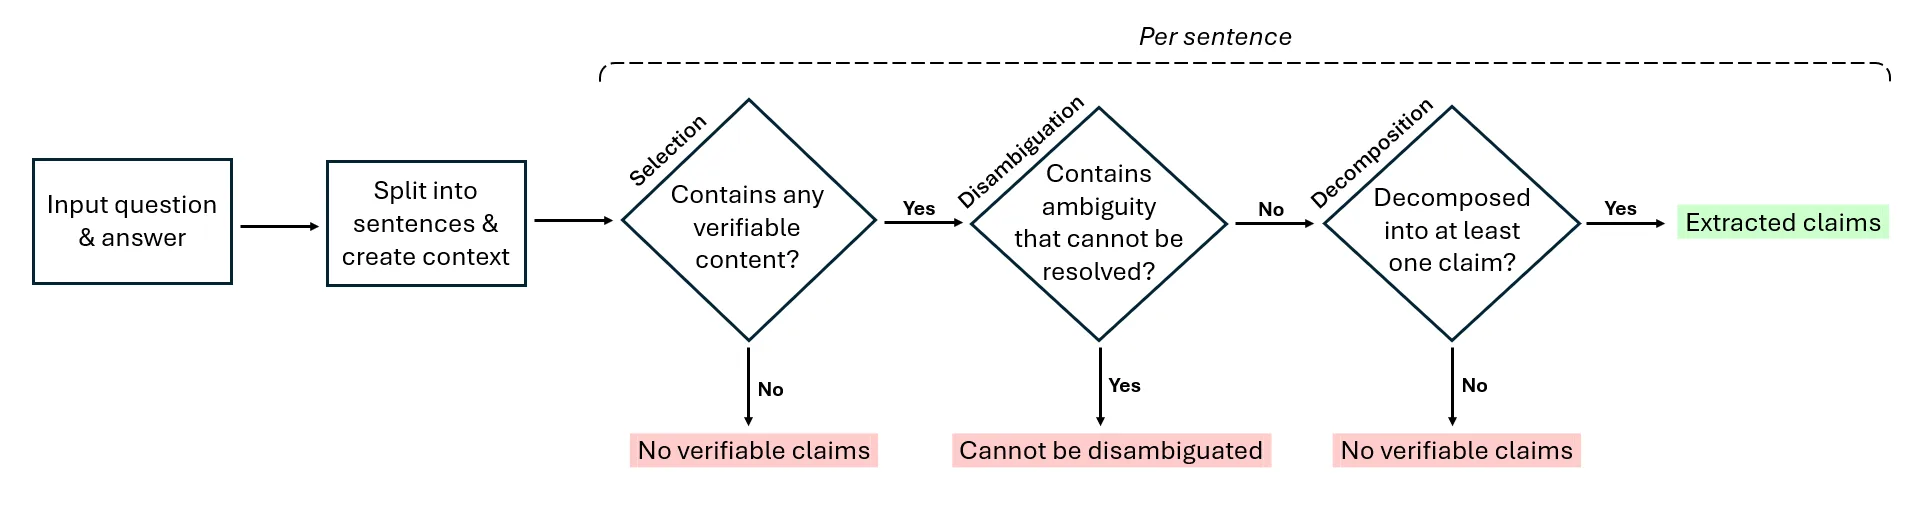
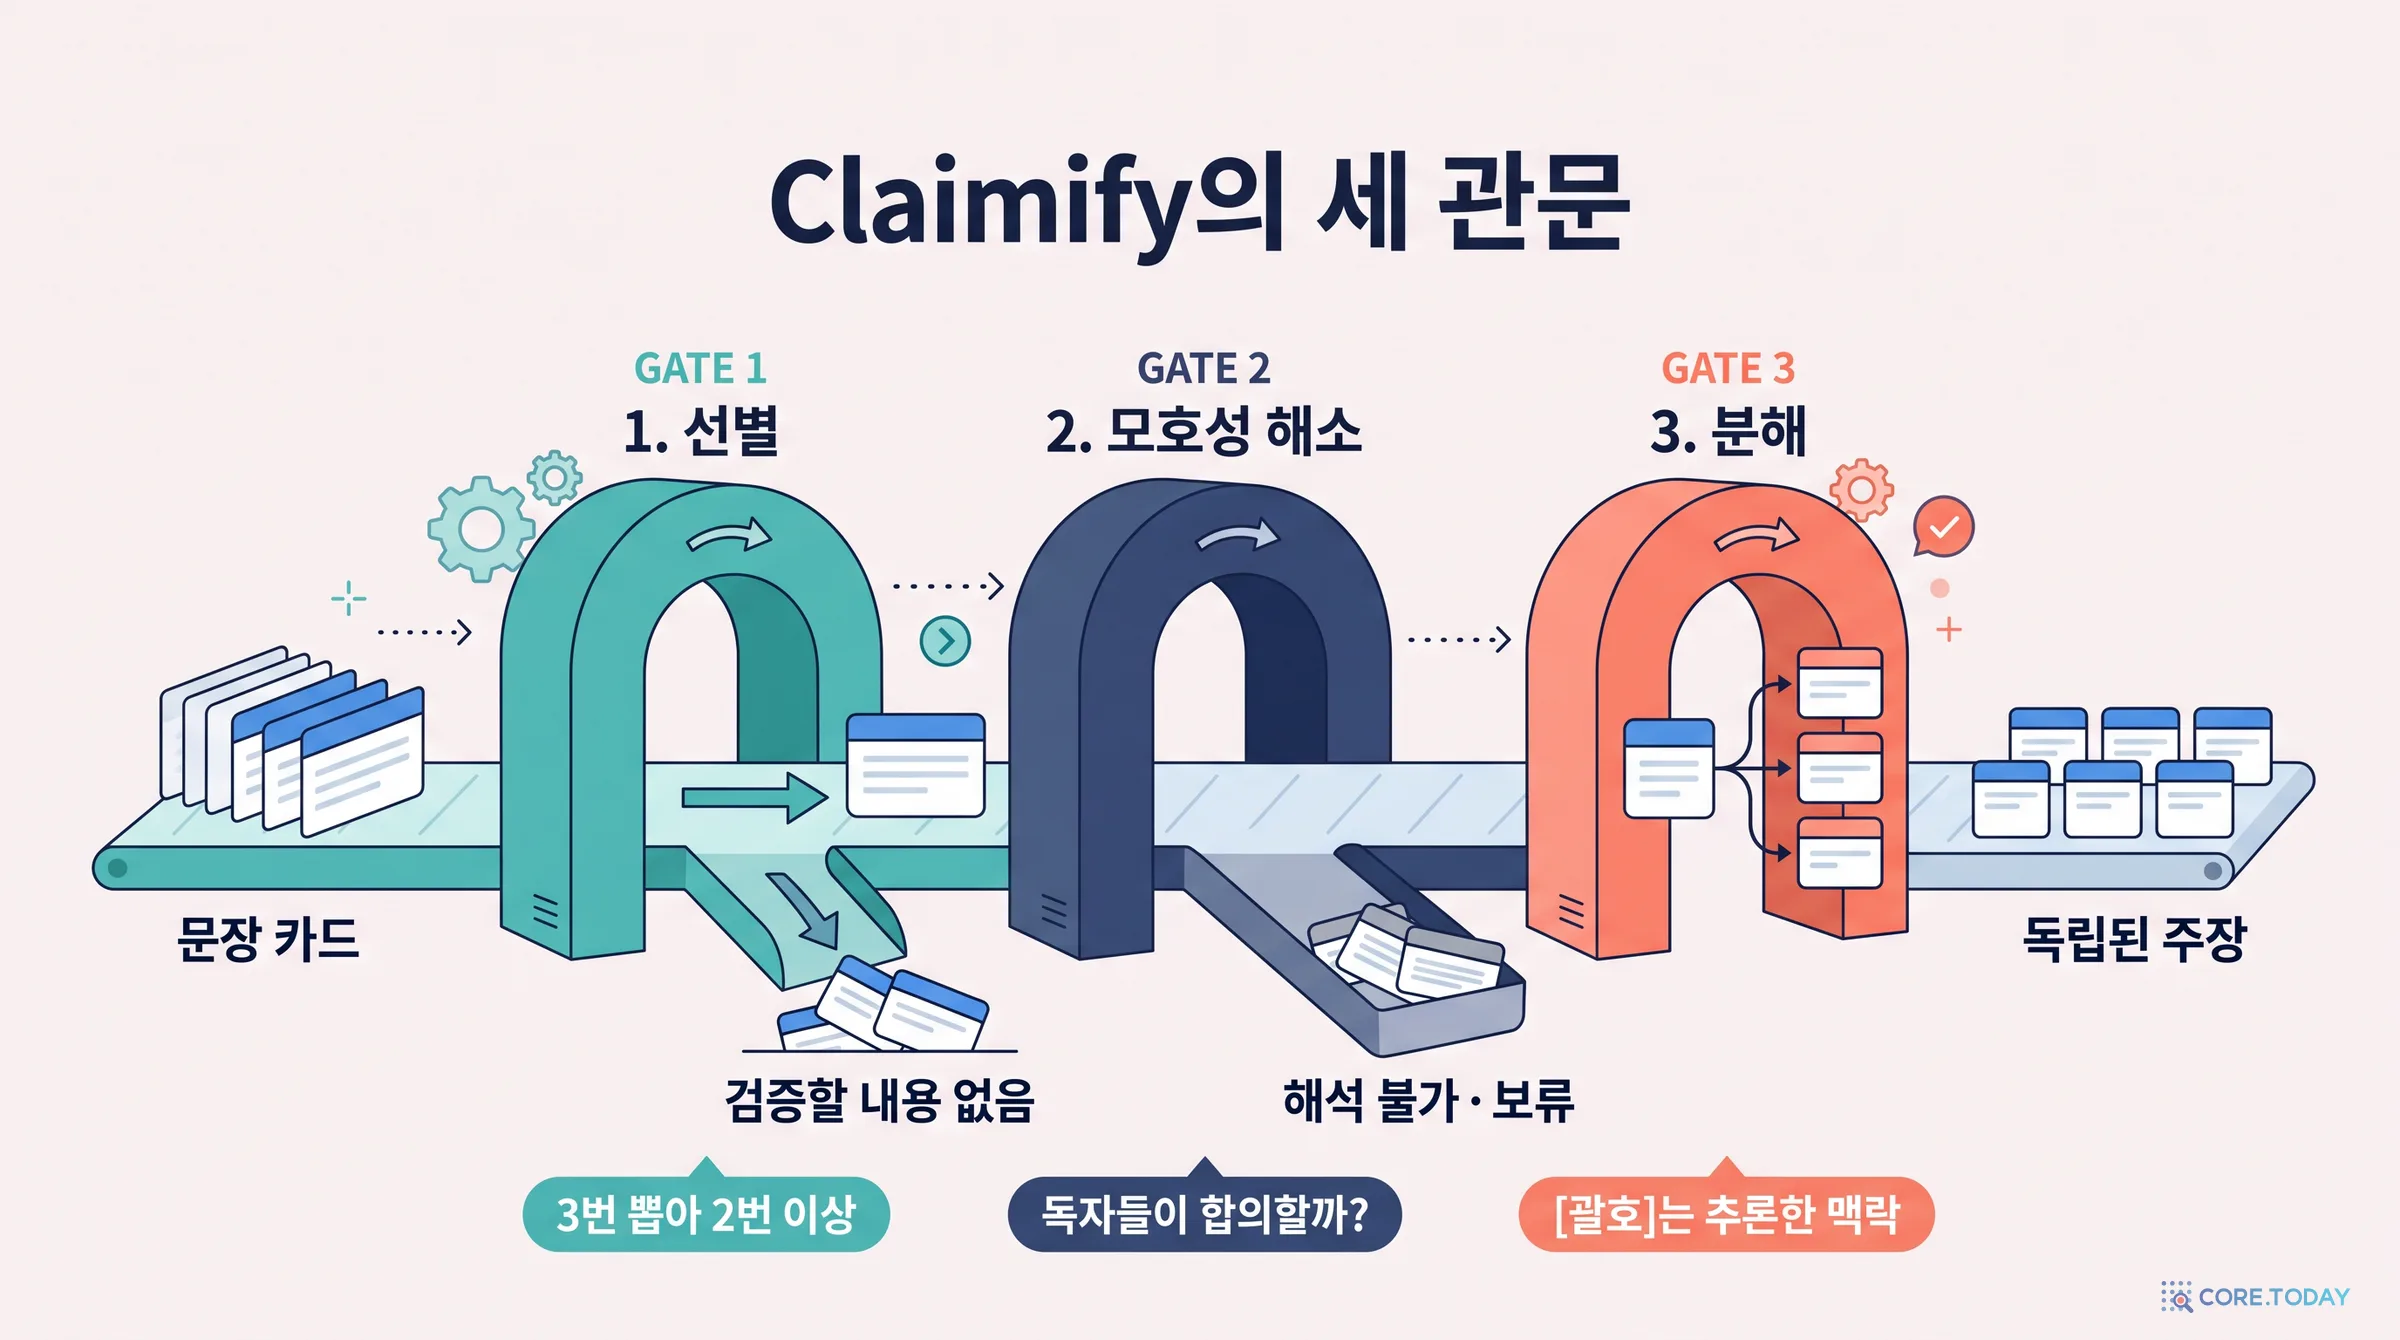
평가 틀을 세운 저자들은 그 틀에서 좋은 점수를 받도록 설계한 추출기 Claimify를 내놓습니다. 입력은 질문과 답변 한 쌍이고, 출력은 문장마다 뽑힌 주장 목록입니다. 문장마다 결과는 셋 중 하나입니다. 확인할 내용 없음, 모호성 해소 불가, 아니면 주장 목록입니다.
논문 그림 1. 질문과 답변을 받아 문장으로 나누고 문맥을 만든 뒤, 문장마다 세 개의 마름모를 통과시킨다. 선별(Selection)에서 ‘확인할 내용이 있나?’, 모호성 해소(Disambiguation)에서 ‘해소할 수 없는 모호성이 있나?’, 분해(Decomposition)에서 ‘주장이 하나라도 나왔나?’를 묻는다. 빨간 칸은 탈락, 초록 칸이 최종 주장이다. 출처: Metropolitansky & Larson (2025), Figure 1.
Claimify는 답변을 NLTK의 문장 분리기로 자릅니다. 실험에서는 먼저 줄바꿈으로 문단을 나눴는데, 글머리표 항목이 마침표 없이 끝나 한 문장으로 붙어 버리는 것을 막기 위해서였습니다. 그다음 문장마다 앞 문장 p개와 뒤 문장 f개로 문맥을 만듭니다. 이 값을 단계마다 따로 줄 수 있다는 것이 작은 묘수입니다. 실험 설정은 다음과 같았습니다.
설정값
선별
모호성 해소
분해
앞 문장 수 (p)
5
5
5
뒤 문장 수 (f)
5
0
0
생성 횟수 (completions)
3
3
1
통과에 필요한 성공 횟수
2
2
1
temperature
0.2
0.2
0
형식 오류 시 재시도
2
2
2
선별에만 뒷문장을 주는 이유가 있습니다. 어떤 문장이 머리말인지 아닌지는 뒤에 무엇이 오는지 봐야 알 수 있기 때문입니다. 반대로 모호성 해소와 분해에서는 뒷문장을 빼서, 뒤에 나오는 정보를 끌어와 문장의 뜻을 바꾸는 일을 막습니다. 선별과 모호성 해소는 세 번 생성해 두 번 이상 ‘통과’가 나와야 다음으로 넘어갑니다. 일종의 다수결입니다.
1관문: 선별 — 확인할 것만 남기고 다시 쓴다
LLM은 문맥과 질문을 보고 셋 중 하나를 고릅니다. ① 확인할 수 있는 내용이 없다, ② 확인할 수 있는 부분만 남겨 문장을 다시 쓴다, ③ 그대로 둔다. ①이면 그 문장은 ‘확인할 내용 없음’으로 빠집니다. 프롬프트는 모델에게 네 단계 생각을 적게 합니다. 기준을 떠올리고, 문장과 주변을 객관적으로 묘사하고, 확인할 내용이 있는지 여러 관점에서 따지고, 있다면 무엇을 고쳐야 하는지 적는 순서입니다. 프롬프트에 박힌 규칙도 눈여겨볼 만합니다.
주장이 참인지 거짓인지는 상관없다.
질문과 관련 있는지도 상관없다.
대명사처럼 모호한 표현이 있어도 상관없다. 그건 다음 단계의 일이다.
인용 표시([2] 같은 것)가 있는지 없는지는 판단에 넣지 않는다.
"자료에 X에 대한 정보가 없다"처럼 정보가 없다는 말은 확인할 명제가 아니다.
논문 표 5의 실제 출력을 보면 이 단계가 무슨 일을 하는지 바로 보입니다. "폭발은 중성자별을 놀라운 속도, 초당 최대 600회까지 돌릴 수 있다"에서는 ‘놀라운’만 지우고 수치를 남겼습니다. "어떤 생물들은 벌목·채굴·방목·기후 변화로 위협받고 있으며, 보전 노력 없이는 오래 살아남지 못할 수 있다"에서는 뒷부분의 추측을 잘라 냈습니다. 그리고 5장의 표 4에서 보겠지만, 이 단계를 빼면 Claimify의 성능이 가장 크게 무너졌습니다.
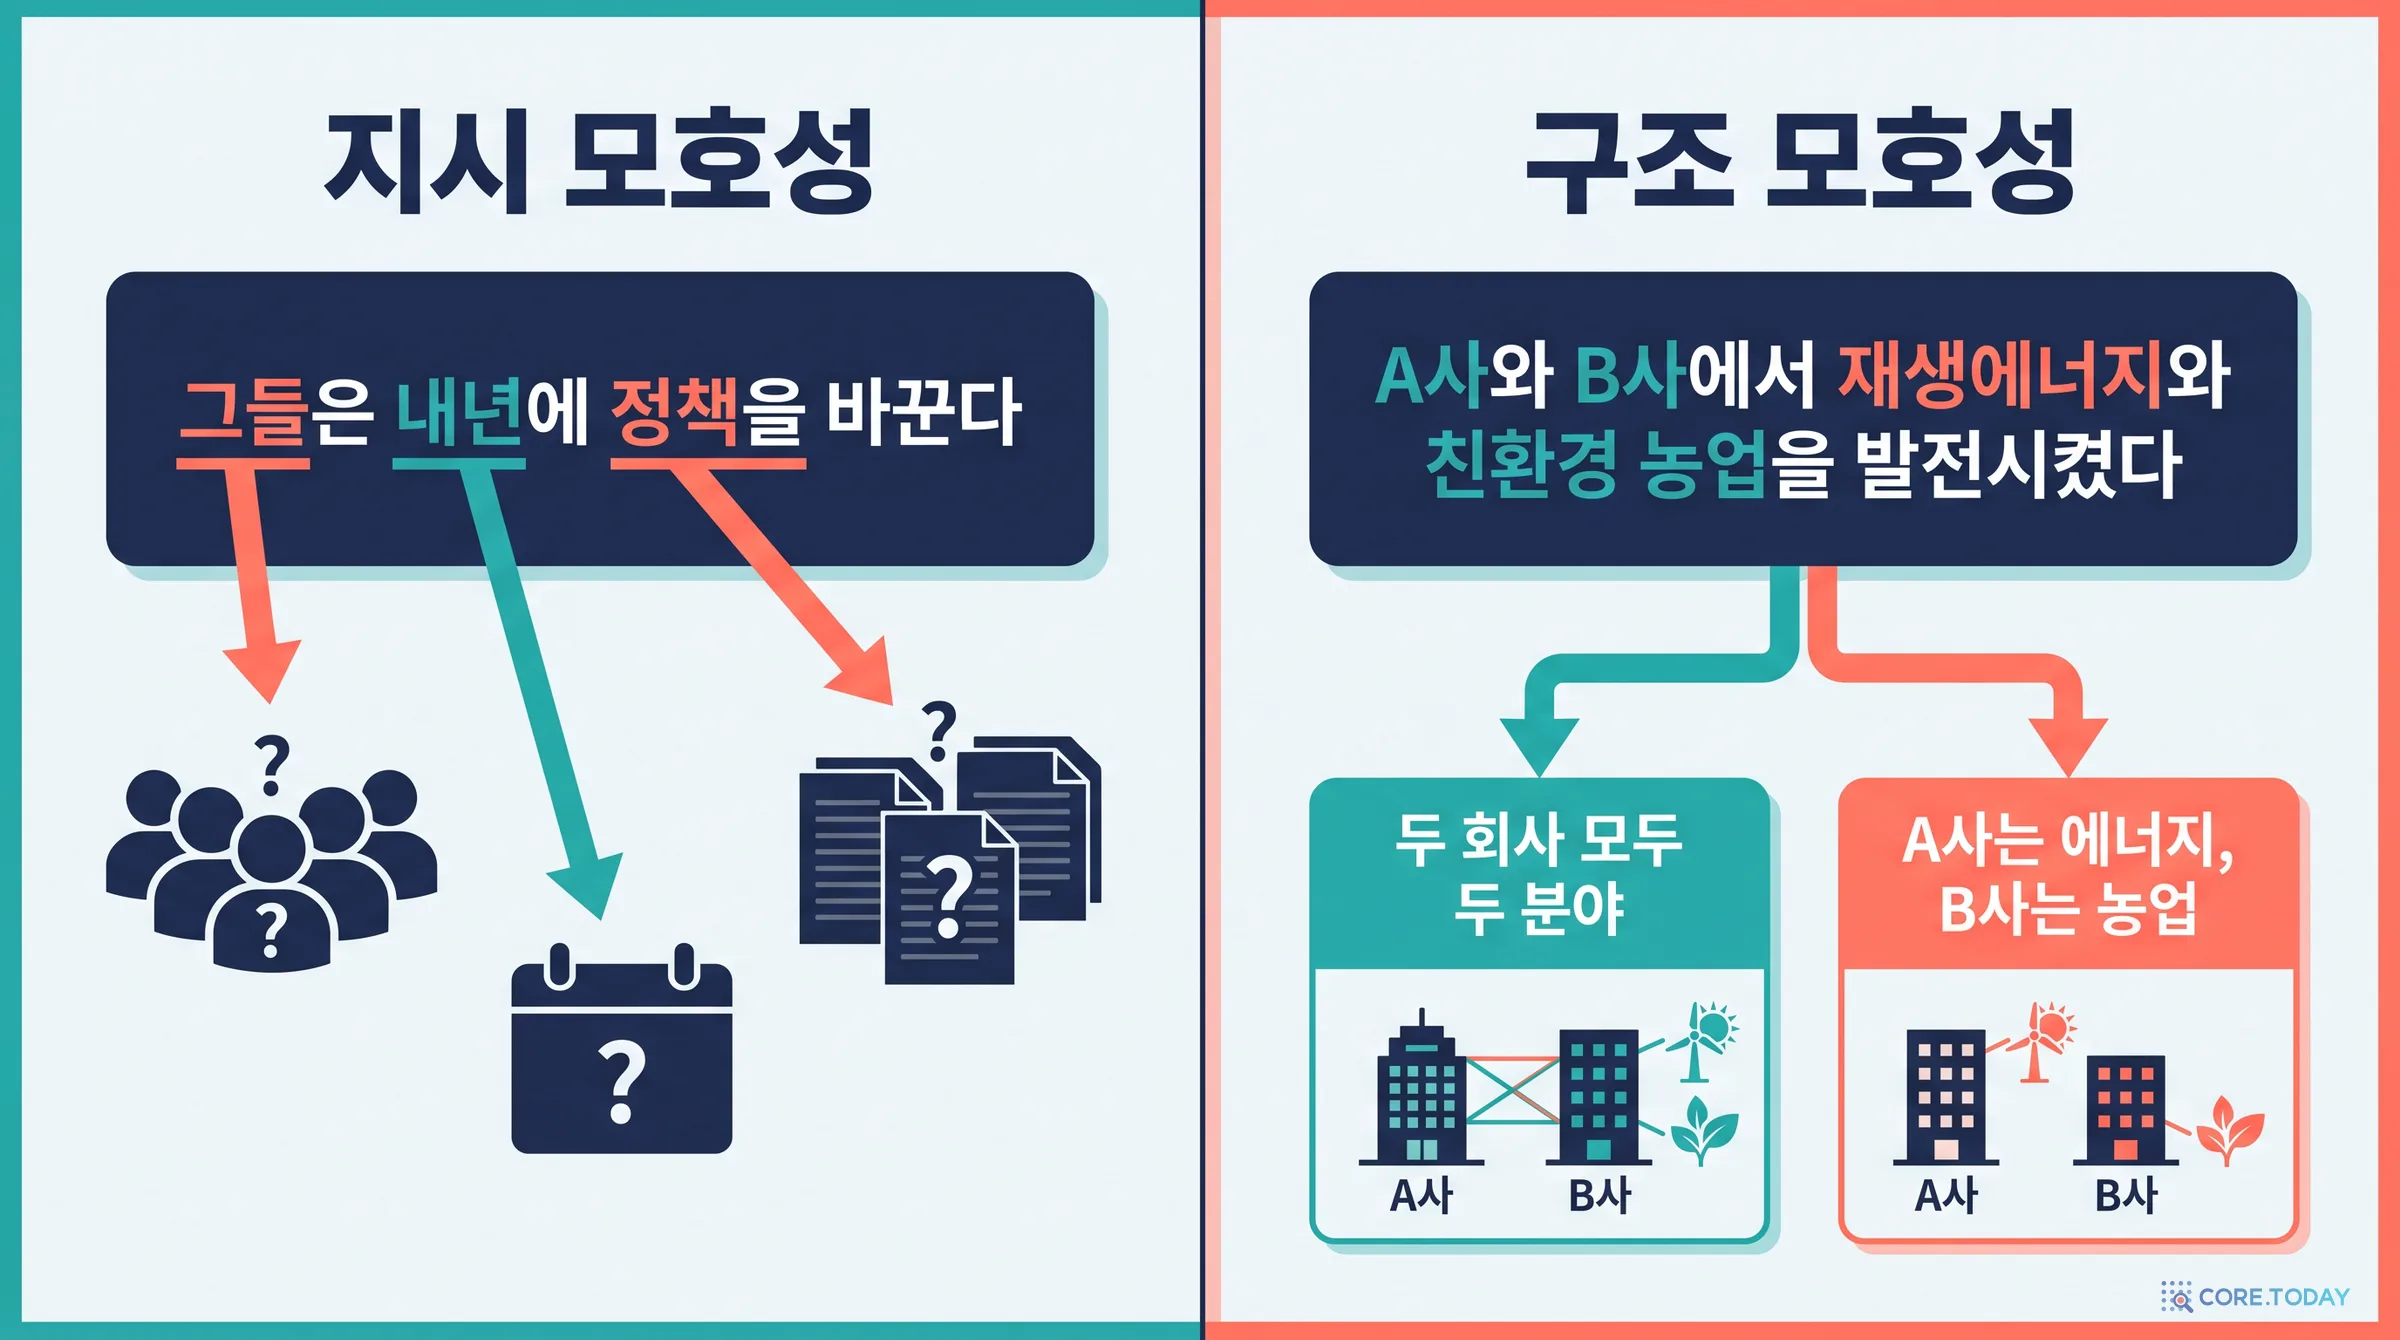
지시 모호성(referential ambiguity) 은 단어가 무엇을 가리키는지 불분명한 경우입니다. "그들은 내년에 정책을 바꿀 것이다"에서 ‘그들’, ‘정책’, ‘내년’이 모두 그렇습니다. 논문은 ‘내년’ 같은 시간 모호성을 지시 모호성의 한 종류로 다룹니다.
구조 모호성(structural ambiguity) 은 문장 구조 때문에 해석이 갈리는 경우입니다. "AI는 A사와 B사에서 재생에너지와 지속가능 농업을 발전시켰다"는 ‘두 회사 모두에서 두 분야를’로도, ‘A사에서는 에너지를, B사에서는 농업을’로도 읽힙니다. 특히 중요한 하위 유형이 있습니다. 사실과, 글쓴이가 덧붙인 해석이 한 문장에 섞인 경우입니다. "존은 경력 내내 받은 임원들의 지원을 강조하며 멘토링의 중요성을 부각했다"는 존이 멘토링의 중요성까지 말한 것일 수도 있고, 존은 지원 이야기만 했는데 멘토링 이야기는 글쓴이의 해석일 수도 있습니다. LLM이 쓴 답변에는 이런 문장이 정말 많습니다.
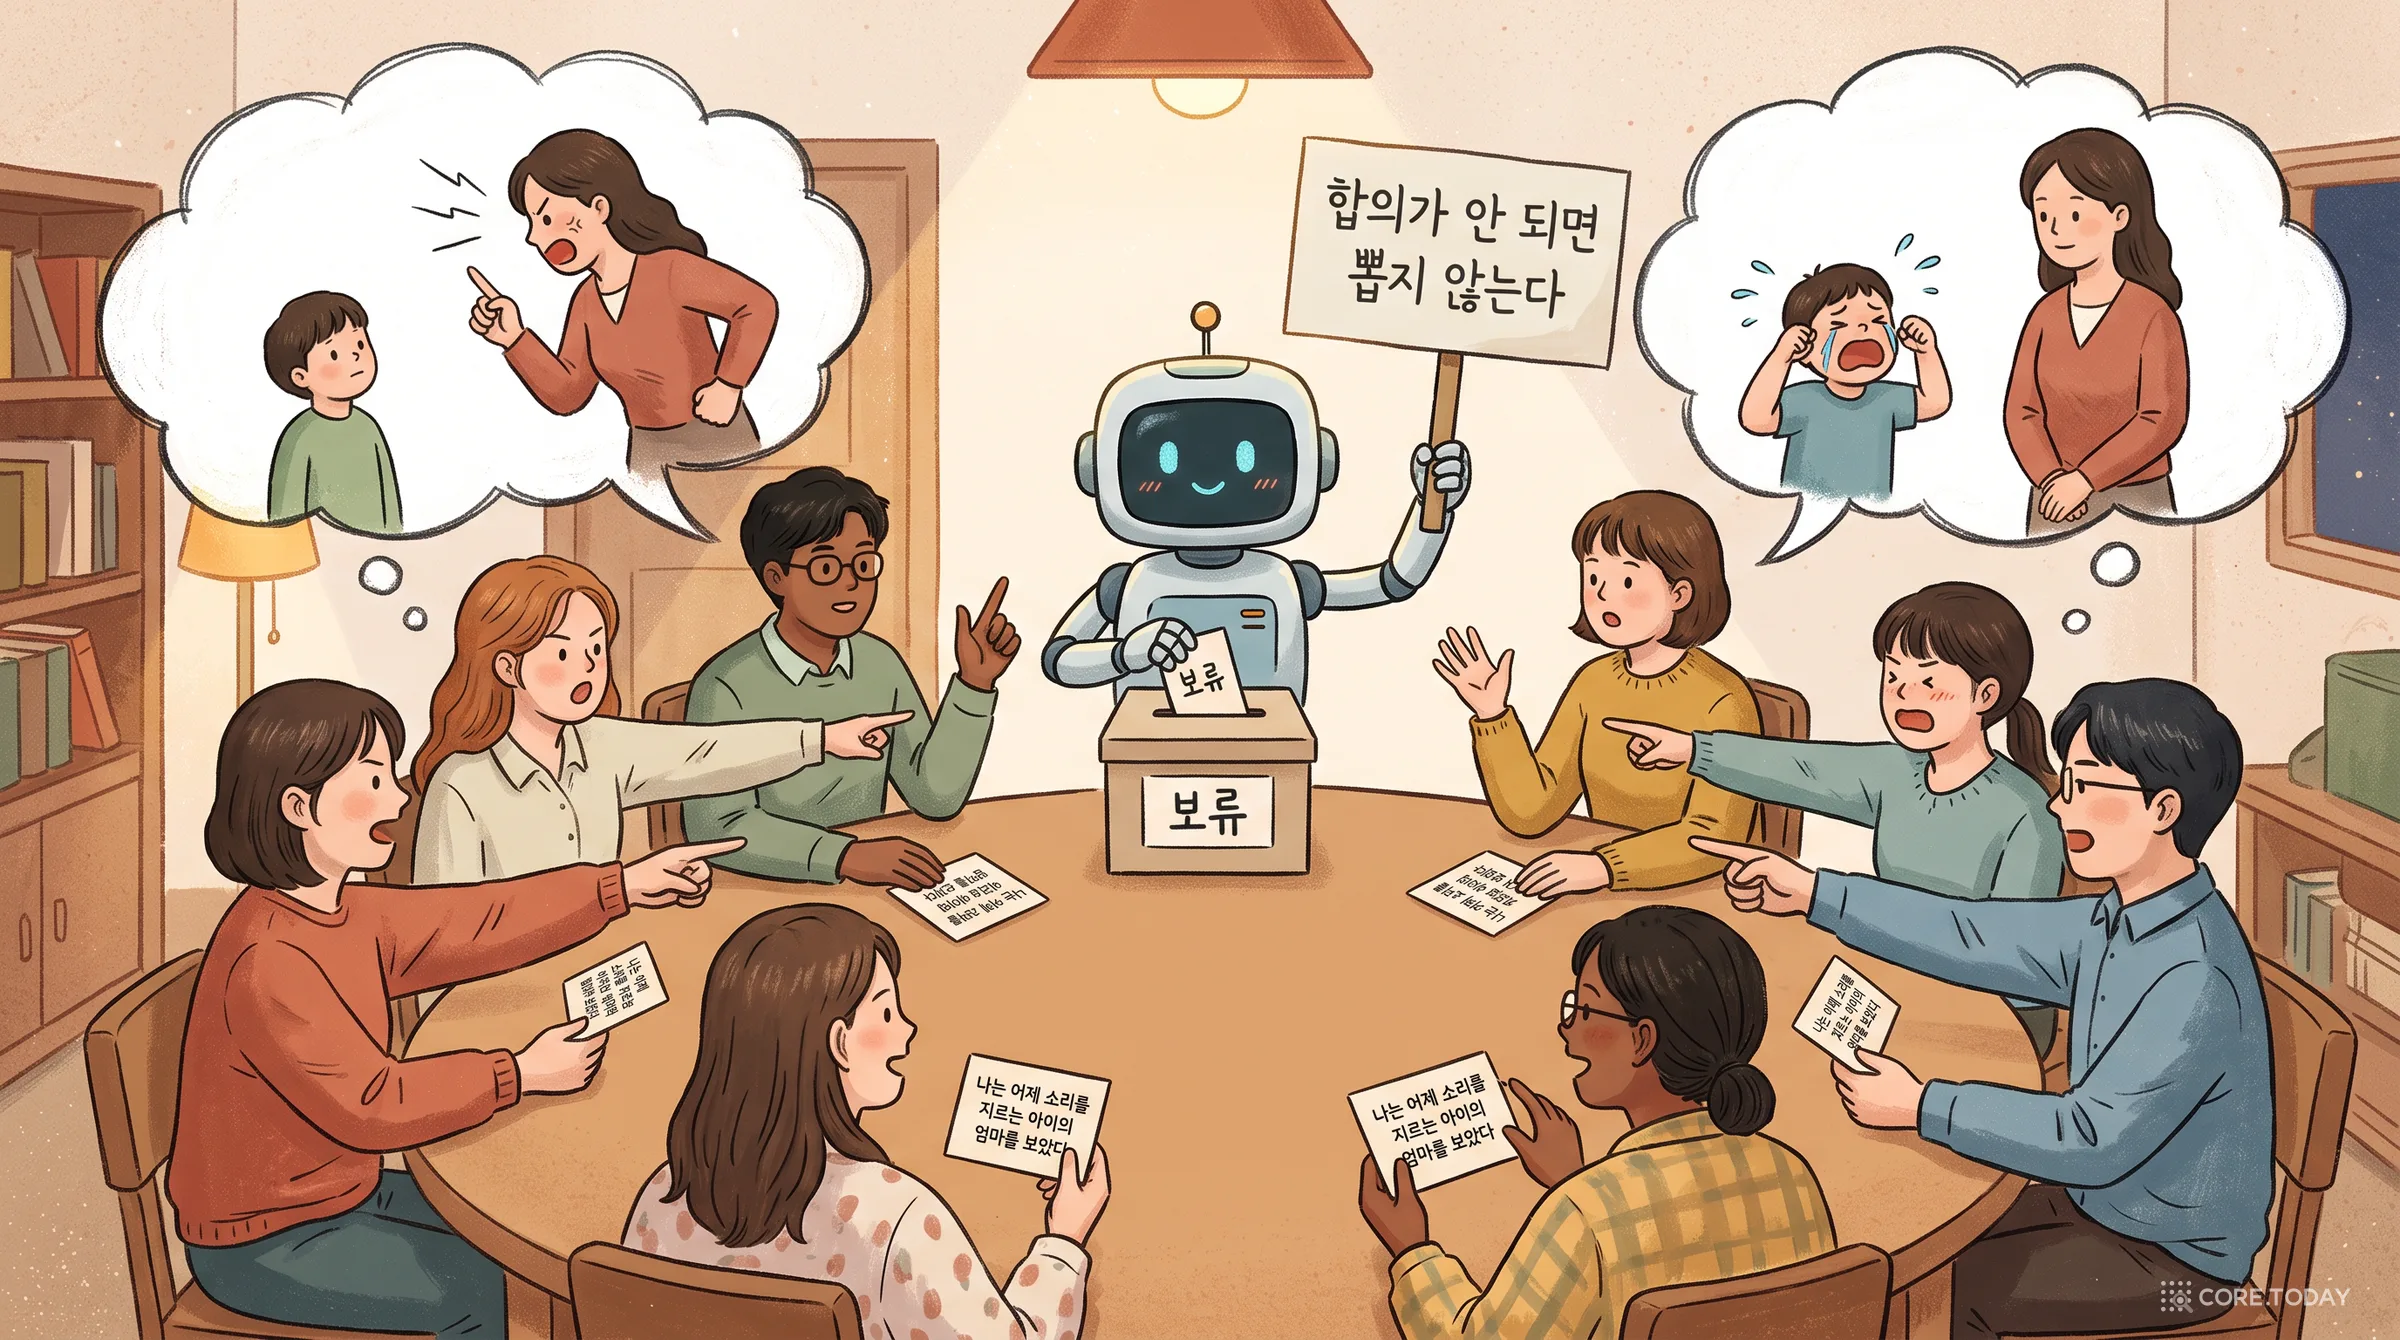
모호성을 찾은 다음, LLM은 그것을 질문과 문맥으로 해소할 수 있는지 판단합니다. 기준은 이렇습니다. "이 질문과 문맥을 본 독자 여럿이 올바른 해석에 합의할 것인가?" 문맥에 "A사는 태양광 패널을 만들고 B사는 농장의 물 사용을 줄인다"가 있다면 독자들은 쉽게 합의합니다. 문맥이 두 회사를 "환경 분야의 선구자"라고만 했다면 합의하지 못합니다.
해소할 수 없는 모호성이 하나라도 있으면 그 문장은 ‘모호성 해소 불가(Cannot be disambiguated)’로 빠집니다. 그 문장에 모호하지 않은 확인 가능한 부분이 섞여 있어도 마찬가지입니다. 모든 모호성을 해소했다면 명확해진 문장을, 모호성이 없었다면 원문을 그대로 다음 단계로 넘깁니다. 이름 일부만 나오거나 약어가 쓰인 경우에는 질문이나 문맥에 전체 이름이 있으면 채우고, 없으면 그대로 둡니다. 모델이 자기 지식으로 ‘아마 이 사람이겠지’ 하고 채우면 사실 오류가 생기기 때문입니다.
이 단계가 실제로 얼마나 많은 문장을 버리는지는 모델마다 달랐습니다. Mistral-large-2411은 5.4%, GPT-4o는 3.2%, DeepSeek-V3는 2.4%의 문장을 ‘해소 불가’로 판정했습니다. 표 6의 실제 사례를 보면 대부분 글머리표 항목입니다. "– 교통과 산업의 대체 연료로서 수소와 바이오연료의 개발"은 두 연료가 두 분야 모두에 쓰인다는 뜻인지, 수소는 교통에 바이오연료는 산업에 쓰인다는 뜻인지 정할 수 없었습니다. "CNN에 따르면 태양광은 기후 위기의 가장 좋은 해법 중 하나이며 10년 안에 미국 전력망을 지배할 수 있다"는 두 가지가 겹쳤습니다. ‘10년 안에’의 기준 연도를 알 수 없었고, 뒷부분까지 CNN의 말인지 글쓴이의 말인지도 정할 수 없었습니다.
저자들은 이것이 기존 방법과의 핵심 차이라고 강조합니다. 기존의 분해·탈맥락화 방법은 모호성을 무시하거나, 언제나 해소할 수 있다고 가정했습니다. 예를 들어 Molecular Facts(Gunjal & Durrett, 2024)는 동명이인 같은 모호성을 다루지만 반드시 해소하게 만들고, 그 과정에서 문맥이 아니라 모델의 내부 지식에 기댑니다. 사실 확인용 주장에 확인되지 않은 지식이 섞여 들어가는 셈입니다.
3관문: 분해 — 대괄호로 ‘추론한 맥락’을 표시한다
마지막 단계에서 LLM은 명확해진 문장을 홀로 서는 주장들로 분해합니다. 프롬프트는 먼저 ‘최대로 명확히 한 문장(MaxClarifiedSentence)’을 쓰게 하고, 가능한 명제 개수의 범위를 어림하게 한 뒤, 명제 목록을 내게 합니다. 마지막으로 "팩트체커 한 명 한 명은 명제 하나만 받고, 질문도 문맥도 다른 명제도 보지 못한다" 는 점을 상기시키고, 꼭 필요한 맥락을 대괄호 안에 넣은 최종 목록을 쓰게 합니다.
예를 들어 질문이 "중동 문제에 대한 유명인들의 입장을 정리해 줘"이고 문장이 "존은 평화를 촉구했다"라면 결과는 [존[유명인]은 [중동에서의] 평화를 촉구했다]가 됩니다. 대괄호 표기는 Eisenstein 등(2024)의 ‘markup-and-mask’에서 빌린 것입니다. 장점은 원문에 명시된 내용과 문맥에서 추론해 넣은 내용을 구별해 준다는 점입니다. 추론한 내용은 본질적으로 덜 믿을 만하니, 판정 단계에서 따로 의심해 볼 수 있습니다.
분해 프롬프트에는 화자를 지키라는 규칙도 있습니다. "존은 투명한 소통의 중요성을 강조했다"를 [투명한 소통은 중요하다]로 바꾸면 안 됩니다. 확인할 대상은 ‘소통이 중요한가’가 아니라 ‘존이 그렇게 말했나’이기 때문입니다. 반대로 "존의 경력은 투명한 소통의 중요성을 보여 준다"는 존이 한 말이 아니라 글쓴이의 해석이므로 확인할 명제가 아닙니다. 분해 단계에서 주장이 하나도 나오지 않은 경우는 전체의 0.8%뿐이었습니다.
5장. 숫자로 읽기: 다 뽑는 기계, 아끼는 기계, 가려 뽑는 기계
실험 무대: BingCheck 396개 답변
저자들은 BingCheck(Li 등, 2024)를 무대로 썼습니다. 마이크로소프트 코파일럿(당시 Bing Chat)이 웹 검색 결과를 바탕으로 쓴 답변 396개로, 주제와 질문 유형이 다양하고 비슷한 데이터셋보다 답변이 훨씬 깁니다. 검색 기반 답변이라 주장마다 증거가 웹에 있을 가능성이 높다는 점도 탈맥락화 평가에 유리했습니다.
답변을 6,490문장으로 나눈 뒤 세 사람이 문장마다 ‘사실적 주장이 있다·없다’를 붙였습니다. 한 사람은 저자 본인이었고, 나머지 둘은 같은 연구 그룹에서 Claimify 개발에 참여하지 않은 사람이었습니다. 연습 두 회차를 거치며 일치도(크리펜도르프 알파)는 0.44 → 0.54로 올랐고, 본 작업에서는 0.72였습니다. 둘 다 ‘확신’이라고 표시한 문장(82%)만 보면 0.86이었습니다. 결과적으로 문장의 63%가 ‘사실 있음’ 이었습니다. 이 라벨은 2025년 8월 허깅페이스(microsoft/claimify-dataset)에 공개됐습니다. 다만 공개본은 문장 단위 라벨이고, 각 방법이 뽑은 주장들은 들어 있지 않습니다.
비교 대상은 다섯 방법입니다. 문장을 분류만 하는 AFaCTA와 Factcheck-GPT, 분류·분해·탈맥락화를 프롬프트 하나에 넣은 VeriScore, 분해와 탈맥락화를 한 번에 하는 DnD, FActScore의 분해 프롬프트에 탈맥락화 프롬프트를 덧붙인 SAFE입니다. 공정하게 비교하려고 모든 방법에 같은 문장 분리를 쓰고, 모든 프롬프트에 질문을 넣었습니다. 네 추출 방법이 뽑은 주장은 모두 73,681개였고, 문장 안 중복을 지우니 73,229개가 남았습니다. 모든 결과는 GPT-4o(2024-08-06), temperature 0으로 냈습니다.
표 1·표 7: 얼마나 뽑았나
방법
주장 수
‘사실 있음’으로 본 문장
문장당 주장
수반률
엉터리 주장
Claimify
12,533
58.3%
3.31
99.0%
0.55%
DnD
29,036
96.5%
4.64
89.1%
0.77%
SAFE
24,185
98.7%
3.78
96.6%
2.25%
VeriScore
7,475
40.4%
2.85
99.2%
0.03%
사람이 본 정답은 ‘63% 문장에 사실 있음’입니다. DnD와 SAFE는 거의 모든 문장(96~99%)에서 주장을 뽑았습니다. 의견, 조언, 머리말도 주장으로 만들었다는 뜻입니다. VeriScore는 40%만 뽑았습니다. 깨끗하지만 사실이 있는 문장의 상당수를 버렸습니다. Claimify는 58%로 정답에 가장 가깝습니다.
수반률(표 1)은 원문이 참이면 주장도 참인 비율입니다. Claimify 99.0%와 VeriScore 99.2%는 통계적으로 차이가 없었고(p = 0.145), DnD는 89.1%로 열 개 중 하나가 원문에 없는 내용을 담았습니다. 저자들이 본 수반 오류는 주로 두 유형이었습니다. 하나는 외부 지식을 끌어온 경우입니다. 문맥에는 큐리오시티 탐사차라고만 나오는데 주장에 ‘NASA의’를 붙였습니다. 다른 하나는 잘못된 추론입니다. 에펠탑이 1889년 만국박람회의 중심 건축물이었고 일부 비평가가 싫어했다는 문맥에서 ‘박람회에 온 비평가들이 싫어했다’는 주장을 만들었습니다. ‘엉터리 주장’은 핵심 정보가 빠져 뜻이 안 통하거나, 서술문이 아니거나, 머리말·참고문헌 줄인 경우입니다. 엉터리 주장의 90% 이상이 SAFE와 DnD에서 나왔습니다.
표 2: 놓침과 헛뽑음의 저울
표 2를 읽는 열쇠는 재현율 두 개입니다. ‘재현율 V’는 사실이 있는 문장(또는 요소)을 놓치지 않은 비율이고, ‘재현율 UV’는 사실이 없는 문장을 제대로 걸러 낸 비율입니다. 문장 수준에서 DnD는 재현율 V가 99.6%지만 재현율 UV는 2.7%입니다. 확인할 게 없는 문장 100개 중 97개에서도 주장을 뽑았다는 뜻입니다. VeriScore는 정반대로 재현율 UV 97.9%, 재현율 V 67.8%입니다. 사실 있는 문장 셋 중 하나를 버렸습니다. Claimify는 두 재현율이 각각 93.9%와 88.3%로 둘 다 높은 유일한 방법이고, 그래서 정확도(91.8%)와 매크로 F1(91.2%)이 모두 1위였습니다.
요소 수준(문장 안으로 들어간 평가)에서도 순위는 같았습니다. Claimify가 정확도 87.9%, 매크로 F1 83.7%로 1위였습니다. 정확도 2위는 DnD(76.9%), 매크로 F1 2위는 VeriScore(62.5%)였습니다. 흔히 인용되는 ‘커버리지 87.9%’는 정확도이고, 저자들이 주 지표로 쓰는 매크로 F1은 83.7%라는 점을 구별해 두면 좋습니다.
표 3: 탈맥락화는 접전이었다
탈맥락화에서는 차이가 작았습니다. 바람직한 결과(1·2·4·7)의 비율은 구글 검색 설정에서 Claimify 80.6%, DnD 78.4%, VeriScore 78.3%, SAFE 78.2%였습니다. 빙 설정에서는 Claimify 80.5%, VeriScore 79.3%였고, 이 둘의 차이는 통계적으로 의미가 없었습니다(p = 0.159). Claimify가 앞선 이유는 주로 결과 1, 즉 애초에 뺀 맥락이 없는 주장의 비율(16.3%)이었습니다. 앞의 일곱 갈래 위젯에서 보듯 판정이 어긋나는 결과 5·6은 모든 방법에서 11.5~13.5%가 남았습니다. 탈맥락화는 아직 풀린 문제가 아닙니다.
표 4: 어느 단계가 일했나
Claimify 전체
83.7
모호성 해소 없이
75.9
선별은 판별만 (다시 쓰기 없음)
74.7
선별 없이
54.4
요소 수준 매크로 F1(100점 만점)로 단계를 하나씩 뺀 결과입니다. 선별을 빼면 83.7에서 54.4로 무너집니다. 이 단계 없이는 Claimify도 DnD·SAFE처럼 ‘다 뽑는 기계’가 됩니다. 다시 쓰기만 빼도 74.7로 떨어집니다. ‘사실 하나 + 해석 한 줄’ 문장에서 해석을 덜어 내는 일이 그만큼 중요했다는 뜻입니다. 모호성 해소를 빼면 75.9였습니다. 탈맥락화 점수는 변형들 사이에 통계적 차이가 없었습니다. 흥미롭게도 단계를 하나 뺀 변형들도 대부분의 기존 방법과 같거나 나았습니다. 저자들은 이를 Claimify를 단순화해도 여전히 쓸 만하다는 신호로 읽습니다.
표 8: 모델을 바꿔도 그럴까
저자들은 Mistral-large-2411과 DeepSeek-V3로도 같은 실험을 돌렸습니다. Claimify는 세 모델 모두에서 요소 커버리지 1위였고 수반률도 95% 이상이었습니다. 다만 차이가 늘 큰 것은 아니었습니다. DeepSeek-V3에서는 VeriScore가 요소 커버리지 76.6으로 Claimify(76.7)에 0.1점 차까지 따라왔습니다. Mistral에서는 VeriScore의 수반률이 80.2%로 크게 떨어졌습니다. 같은 프롬프트라도 모델이 바뀌면 다른 방법이 되는 셈입니다. 세 모델 평균은 Claimify가 수반 97.2%, 요소 커버리지 78.4, 탈맥락화 80.8%였습니다.
이 표들을 읽을 때 주의할 점
논문을 꼼꼼히 읽으면 몇 가지 단서가 보입니다. 평가를 깎아내리려는 것이 아니라 숫자의 범위를 정확히 알기 위해서입니다.
채점자도 LLM입니다. 수반·요소·담김·cmax·판정을 모두 GPT-4o 프롬프트가 했고, 주 실험의 추출기도 GPT-4o였습니다. 저자들은 단계마다 80개 표본을 직접 검토해 95~97% 동의를 확인했지만, 표본 검토자는 저자 본인들이었습니다.
정답 라벨에 저자가 섞여 있습니다. 본 작업에서 저자가 참여한 두 그룹의 이견은 저자 라벨을 우선해 정했고, 세 번째 그룹은 저자가 검토해 정했습니다.
‘해소 불가’ 문장은 문장 수준 평가에서 빠졌습니다. 분해 단계까지 가지 않아 주장이 나왔을지 알 수 없다는 이유입니다. 전체 방법에 똑같이 적용했지만, 어떤 문장을 뺄지를 Claimify의 판정이 정한 셈입니다.
데이터셋은 하나입니다. 코파일럿의 영어 답변뿐이고, 정치 연설이나 소셜미디어 글로 일반화되는지는 저자들도 앞으로의 과제로 남겼습니다.
비용: 모든 방법의 추출에 약 10시간, 평가에 약 145시간이 걸렸습니다(API 호출, 노트북 CPU 기준). Claimify는 문장 하나에 LLM 호출이 최대 7번(3+3+1)입니다. 프롬프트 한 번으로 끝내는 VeriScore보다 몇 배 비쌉니다.
6장. 코어닷투데이 실측: 한국어 답변에 그대로 돌려 보면
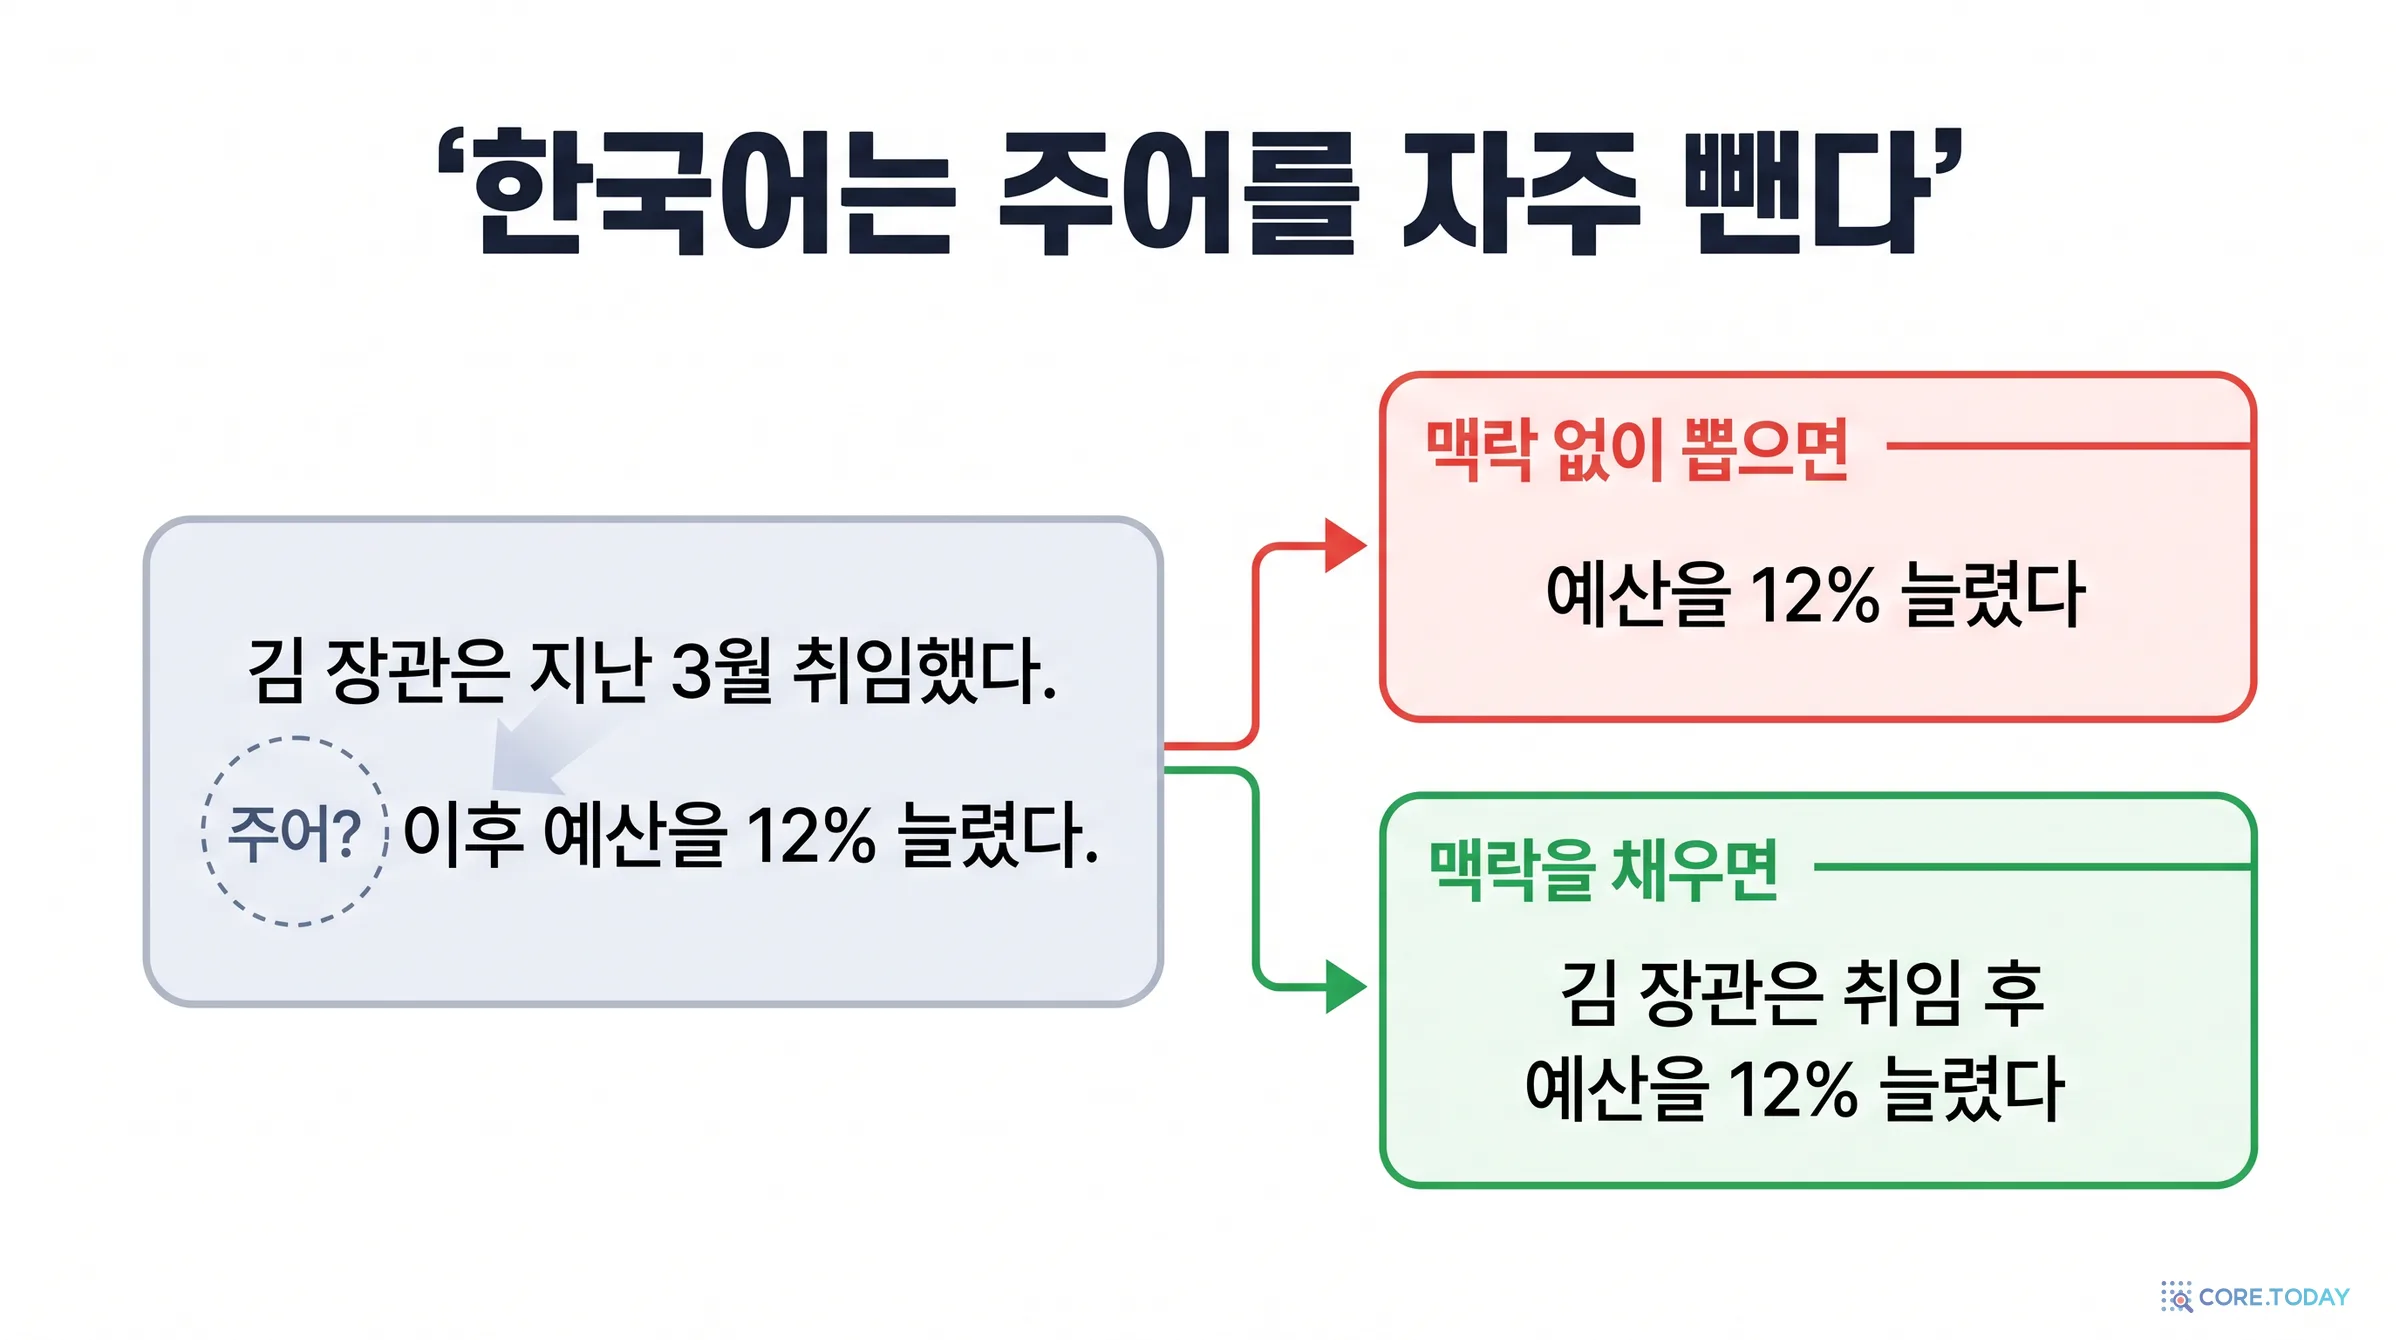
논문은 영어 코파일럿 답변만 다뤘고, 프롬프트도 영어입니다. 한국어에서는 어떨까요? 특히 한국어는 주어를 자주 생략합니다. "김 장관은 지난 3월 취임했다. 이후 예산을 12% 늘렸다."의 두 번째 문장에는 주어가 없습니다. 영어라면 ‘He’라도 남았을 자리입니다. 대명사가 없으니 문장만 보고는 무엇이 모호한지조차 드러나지 않습니다. 이런 문장을 떼어 내 주장으로 만들면 [예산을 12% 늘렸다]처럼 누가 했는지 모를 주장이 나옵니다.
그래서 두 가지를 직접 쟀습니다. 크레딧이 드는 외부 API는 쓰지 않았고, 모든 추출은 코어닷투데이 맥의 로컬 모델 qwen3.5 9B(Ollama, 생각 모드 끔)로 했습니다.
실험 A
모호한 한국어 문장 28개와 짝 문장 8쌍. 문맥으로 풀리는 모호성 10개, 문맥으로도 안 풀리는 모호성 12개, 모호성 없는 대조군 6개를 직접 만들었다. 지시·구조·주어 생략·시간·출처 귀속·‘각각’ 유형을 섞었다. 여기에 문맥은 같고 지시어(그는·이 회사는)만 넣고 뺀 짝 문장 8쌍을 더했다. 논문의 모호성 해소 프롬프트를 그대로 써서 3번 생성 중 2번 이상 ‘해소 불가’면 보류로 쳤다. 같은 문장을 ‘한 번에 추출’ 프롬프트에도 넣어 비교했다. 저자들이 ‘앞으로의 과제’로 남긴 모호성 탐지 정확도를 한국어로 재 보는 실험이다.
실험 B
로컬 모델이 쓴 한국어 답변 6개(89문장). 역사·여행·의학·AI·스포츠·전쟁 질문에 같은 9B 모델이 답한 글을 논문 방식(줄바꿈 → 문장 끝)으로 나눴다. 세 방법으로 주장을 뽑았다. ① 단순 분해: FActScore식으로 문맥 없이 “독립된 사실로 쪼개라”. ② 한 번에 추출: VeriScore를 본뜬 프롬프트 한 번으로, 문맥(앞 3·뒤 1문장)을 주고 확인 가능한 주장만 홀로 서게 뽑거나 ‘없음’. ③ Claimify: 부록 N.1의 세 프롬프트를 영어 원문 그대로 쓰고 “출력은 한국어로”라는 한 줄만 덧붙였다. 단계마다 1번씩 생성한 판과, 논문 기본값(선별·모호성 해소를 3번 생성해 2번 이상 통과)대로 생성한 판을 모두 돌렸다.
정답과 채점
문장마다 ‘확인 가능한 사실이 있나’는 Claude(서브에이전트)가 논문 부록 C.4의 주석 지침으로, 추출 결과를 보지 않은 채 붙였다(89문장 중 43.8%가 ‘있음’). 뽑힌 주장의 수반·홀로 서기·검증 가능성은 방법별 무작위 45개를 방법을 가린 채 따로 채점했다. 사람 주석이 아니라는 점, 답변을 쓴 모델과 추출한 모델이 같다는 점, 표본이 작다는 점은 이 실측의 한계다.
결과 1: 물러설 줄은 안다, 그러나 주어가 없으면 덜 물러선다
문장 종류 (실험 A)
개수
Claimify 보류
한 번에 추출 보류
문맥으로도 안 풀리는 모호성 (보류가 정답)
12
8
0
문맥으로 풀리는 모호성 (통과가 정답)
10
0
0
모호성 없음 (통과가 정답)
6
0
0
결과는 기대 이상이었습니다. 로컬 9B 모델에 영어 프롬프트를 그대로 줬는데도, Claimify의 보류 판단은 28개 중 24개가 맞았습니다. 특히 괜히 물러선 경우가 한 건도 없었습니다. "이듬해 그는 노량 해전에서 전사했다"는 ‘1598년 이순신 장군은…’으로 풀어냈고, "다음 달에도 한 차례 더 인하했다"는 ‘2024년 11월 한국은행은…’으로 풀었습니다. 프롬프트 한 번으로 뽑는 방법은 28개 모두에서 주장을 냈습니다. 보류가 정답인 12개에서도 전부 무언가를 뽑았다는 뜻입니다.
한 번에 추출이 어떻게 뽑았는지가 더 중요합니다. "그들은 내년에 정책을 바꿀 예정이다"는 ‘여러 도시는 내년에…’가 됐습니다. "한국과 일본의 수출과 수입이 각각 5%와 3% 늘었다"는 한국 수출 5%, 일본 수출 3%, 한국 수입 5%, 일본 수입 3%로 못 박았습니다. 문장을 읽는 또 다른 길(수출 5%, 수입 3%)은 사라졌습니다. 이렇게 뽑힌 주장은 깔끔해 보이고, 검증에서 ‘거짓’이 나오면 원문이 틀린 것처럼 보입니다. 잘못은 원문이 아니라 칼에 있었는데도 그렇습니다.
Claimify가 놓친 4개도 눈여겨볼 만합니다. 해석이 누구의 것인지 갈리는 문장("임원들의 지원을 강조하며 멘토링의 중요성을 보여 주었다"), 무엇의 결과인지 없는 문장("그 결과 사망률이 절반으로 줄었다"), 글머리표 조각, 그리고 주어가 아예 없는 문장("예산을 12% 늘리겠다고 밝혔다")이었습니다. 정답으로 맞힌 8개 안에도 흠이 있었습니다. 구조 모호성 예문("A사와 B사에서 재생에너지와 지속가능 농업을…")은 세 번 모두 보류했지만, 이유는 구조가 아니라 ‘AI가 무슨 약어인지 정의되지 않았다’였습니다. 논문 프롬프트가 모호성으로 치지 말라고 적은 바로 그 이유입니다.
주어 없는 문장이 마음에 걸려 짝 문장을 만들어 다시 쟀습니다. 앞 문장은 똑같이 두 후보를 주고("최 감독과 한 코치가 기자회견에 나왔다"), 뒤 문장만 지시어를 넣고 뺐습니다.
지시어 있음 (“그는 사퇴 의사를…”)
20/24표
주어 생략 (“사퇴 의사를…”)
9/24표
같은 문맥, 같은 뜻인데 ‘그는’이라는 글자 하나를 지우자 보류 표가 절반 아래로 줄었습니다. 지시어가 있으면 모델은 "누구를 가리키는지 모르겠다"고 인식합니다. 주어가 없으면 가리키는 말 자체가 없으니, 앞 문장의 두 사람을 그대로 주어로 채워 넣습니다. "사퇴 의사를 밝혔다"는 세 번 모두 ‘최 감독과 한 코치는 사퇴 의사를 밝혔다’가 됐습니다. 두 사람이 함께 사퇴했다는 말은 문맥 어디에도 없습니다. 물론 한국어 독자도 주어가 빠지면 앞 문장의 주제를 잇는 쪽으로 읽는 경향이 있어서, 모든 짝에서 ‘보류’가 유일한 정답은 아닙니다. "영업이익이 30% 줄었다"는 두 회사를 함께 말한 것으로 읽을 여지도 있습니다. 그래도 "합병을 제안했다"처럼 어느 한쪽의 행동으로 읽는 편이 자연스러운 문장까지 세 번 모두 ‘두 회사의 대표는…’으로 채웠습니다. 한 번에 추출은 "승부차기 끝에 우승했다"를 ‘한국과 일본 대표팀이 우승했다’로 썼습니다. 두 팀이 함께 우승할 수는 없는데도 그렇습니다.
한 번에 추출은 16문장 모두에서 주장을 냈습니다. 지시어가 있는 문장에서는 더 대담했습니다. "그는 예산을 12% 늘리겠다고 밝혔다"는 ‘김 장관은…’ 이 됐고, "이 회사는 영업이익이 30% 줄었다"는 ‘A사의…’, "그는 사퇴 의사를 밝혔다"는 ‘최 감독은…’ 이 됐습니다. 8쌍 중 4쌍에서 문맥에 먼저 나온 이름을 골랐습니다. 다시 말해, 근거 없이 찍었습니다. 저희가 짠 프롬프트가 "대명사와 생략된 주어를 문맥으로 풀라"고만 지시했기 때문이기도 합니다. 그러나 이것이 현장에서 가장 흔히 쓰는 프롬프트의 모습입니다.
결과 2: 표의 모양은 재현됐다, 수반은 재현되지 않았다
실험 B의 89문장 결과입니다. Claude 정답 기준으로 43.8%의 문장에 확인할 사실이 있었습니다.
방법
주장 뽑은 문장
주장 수
보류
문장 정확도
재현율 V
재현율 UV
수반
홀로 서기
검증 가능
단순 분해
82.0%
213
–
59.6%
97.4%
30.0%
41/45
11/45
21/45
한 번에 추출
71.9%
156
–
71.9%
100%
50.0%
44/45
33/45
27/45
Claimify 1회
33.7%
89
9
85.0%
76.5%
91.3%
35/45
37/45
36/45
Claimify 3회 (논문 기본값)
37.1%
97
3
89.5%
83.3%
94.0%
34/45
35/45
35/45
보류 문장은 논문과 같이 문장 정확도·재현율 계산에서 뺐습니다. 수반·홀로 서기·검증 가능은 방법별 무작위 주장 45개를 방법을 가린 채 채점한 값입니다.
논문의 저울이 한국어에서도 그대로 나타났습니다. 단순 분해는 ‘다 뽑는 기계’였습니다. 사실이 없는 문장의 70%에서도 주장을 뽑았고, 뽑은 주장 중 혼자 뜻이 통하는 것은 네 개 중 하나뿐이었습니다("이는 교육 기회를 확대했습니다", "감염 위험이 없습니다"). 문맥을 준 한 번에 추출은 홀로 서기를 73%까지 끌어올렸습니다. Claimify는 문장 정확도 89.5%로 앞섰고, 확인할 게 없는 문장의 94%를 걸러 냈습니다. 정답 라벨에서 주석자가 확신한 문장만 보면 Claimify 3회의 정확도는 95.4%, 단순 분해와 한 번에 추출은 61.8%와 77.9%로 순서가 같습니다.
그러나 수반은 재현되지 않았습니다. 논문의 Claimify는 수반률 99%였지만 여기서는 45개 중 34~35개(76~78%)였습니다. 가장 단순한 프롬프트인 한 번에 추출(44/45)보다도 낮습니다. 틀린 주장을 열어 보니 절반 가까이가 ‘A나 B’를 쪼개다 생긴 문제였습니다. "약물 치료법이나 수술 방법을 제시합니다"가 [수술 방법을 제시합니다]가 되고, "중문동굴마을이나 성산리조트 인근"이 [성산리조트는 중문동굴마을 인근에 있다]가 됐습니다. 분해 프롬프트의 예시는 대부분 ‘A와 B’의 나열을 쪼개는 내용이고, ‘A나 B’를 쪼개지 말라는 명시 규칙은 없습니다. 모델이 ‘이나’까지 나열로 처리한 것으로 보입니다. 나머지는 의미 변경이었습니다. "응용 가능성을 열어 주었습니다"가 [응용 사례가 있습니다]로 바뀌었고, "휴전 협정이 체결되었다"가 [휴전 협정으로 종료되었다]가 됐습니다. DMZ를 풀다가 ‘군사분계선이 북방위성지대라고 불립니다’라는 없는 말을 지어내기도 했습니다. 1회 쪽 오류 가운데 두 개는 저희 문장 분리 탓이었습니다(번호 ‘2.’가 한 문장으로 잘렸습니다).
논문의 분해 프롬프트는 영어 예시가 열 개나 붙은 약 1만 7천 자의 지시문입니다. GPT-4o는 이것을 소화해 99%를 냈지만, 작은 로컬 모델에서는 지시가 길수록 말을 바꿀 기회가 늘어난 듯합니다. 프롬프트의 성능은 모델의 성능이기도 합니다. 논문 표 8에서 VeriScore의 수반률이 모델에 따라 80~99%로 흔들린 것과 같은 현상입니다.
대괄호도 샜습니다. 주장의 80~90%에 대괄호가 붙었고, 그중 일부는 짧은 맥락이 아니라 앞 문장의 평가를 통째로 옮겨 왔습니다. [세종대왕 [조선 500년 역사에서 가장 빛나는 통치자로 평가받는 인물]은…]이 대표적입니다. 선별 단계에서 뺀 평가가 분해 단계의 대괄호로 돌아온 셈입니다. "[제주도 동부 지역]의 대정읍"처럼 문맥에 없는 잘못된 정보를 넣기도 했습니다(대정읍은 제주 서쪽입니다). 그나마 대괄호로 표시됐으니 의심할 곳은 분명합니다. 논문이 대괄호를 쓴 이유가 여기서 드러납니다.
결과 3: ‘세 번 뽑아 두 번’은 장식이 아니었다
가장 중요한 결과는 표 밖에 있었습니다. 코어닷투데이는 답변 속 오류를 직접 찾아 표시한 뒤, 각 오류가 주장으로 검증대에 올랐는지 세어 봤습니다. 논문이 말한 ‘하류의 결과로 재기’를 가장 소박하게 따라 해 본 것입니다.
답변 속 오류
실제
단순 분해
한 번에
Claimify 1회
Claimify 3회
세종이 <고려연도>를 편찬
없는 책. 세종 때 역법서는 《칠정산》
△
○
○
○
자격루는 해시계
자격루는 물시계
△
○
✕
○
앙부일구가 자오선을 측정
앙부일구는 해시계
△
○
✕
○
세종이 <악학궤범>을 편찬
성종 때인 1493년 편찬
△
○
✕
○
세종이 ‘진양조’를 만듦
판소리·산조의 장단
△
○
✕
○
한글은 세계 유일의 표음문자
표음문자는 많다
○
○
✕
○
북한군이 한 달 만에 서울 점령
개전 3일 만인 6월 28일
○
○
△
△
손흥민이 잉글랜드 대표팀 스트라이커
한국 대표팀
△
○
○
○
○ 오류가 주장으로 뽑힘, △ 뽑혔지만 주어가 없어 그대로는 확인할 수 없거나 뜻이 바뀜, ✕ 뽑히지 않음.
처음에는 단계마다 1번씩만 생성해 돌렸습니다. 세 번씩 돌리면 시간이 2.5배(문장당 24초 → 60초) 들기 때문입니다. 그랬더니 오류 8개 중 5개가 사라졌습니다. "자격루는 해시계"는 선별 단계가 꾸밈말을 덜어 내면서 함께 지워졌고, "한글은 세계 유일의 표음문자"가 든 문장은 ‘확인할 내용 없음’으로 탈락했으며, 악학궤범과 진양조가 든 문장은 사소한 구조 차이를 이유로 보류됐습니다. 평가 지표로는 깨끗해 보였지만, 팩트체커가 정작 봐야 할 조각은 검증대에 오르지 않았습니다.
논문 기본값대로 세 번 생성해 두 번 이상 통과시키자 결과가 달라졌습니다. 같은 문장에서 오류 7개가 주장으로 살아났습니다. 보류율도 10.1%에서 3.4%로 떨어져 논문의 GPT-4o(3.2%)와 거의 같아졌고, 문장 정확도도 85.0%에서 89.5%로 올랐습니다. 한 번의 생성이 문장을 버리는 판단은 대부분 모델의 변덕이었던 것입니다. 부록 D의 건조한 한 문단(completions=3, min_successes=2)은 설정값처럼 보이지만, 실제로는 Claimify의 핵심 부품이었습니다. 비용을 아끼려고 먼저 줄이고 싶은 바로 그 값입니다.
그래도 한 번에 추출이 8개를 모두 올렸고, 3회 설정도 "한 달 만에 서울 점령"은 놓쳤습니다. ‘한 달 만에’가 서울 점령에서 떨어져 나가 남쪽 진격에 붙었습니다(1회 설정에서는 ‘한 달 이내’로 바뀌어 거짓 문장이 참 주장으로 변했습니다. 3일은 한 달 이내이니까요). 보류된 3문장에도 ‘인천 상륙 작전’처럼 확인할 수 있는 사실이 들어 있었습니다. 오류 표본은 답변 세 개에서 나온 8건뿐이고 모델도 GPT-4o가 아니니 일반화하기는 이릅니다. 다만 평가 틀이 재는 것(수반·커버리지·탈맥락화)과 우리가 진짜 원하는 것(틀린 사실을 잡는 것) 사이에 틈이 있다는 점은 분명합니다. 커버리지가 높아도, 빠진 조각이 하필 틀린 조각이면 팩트체킹은 실패합니다. 그리고 환각은 대체로 꾸밈과 세부 사이에 숨어 있습니다. ‘해시계인’, ‘한 달 만에’, ‘세계 유일의’처럼 평가와 사실의 경계에 놓인 말들입니다. 선별 단계가 덜어 내려는 바로 그 자리입니다.
실측의 결론을 정리하면 이렇습니다. 작은 로컬 모델로도 Claimify의 문장 고르기와 물러서기는 재현됩니다. 대신 다수결을 줄이면 안 되고, 분해 결과의 수반은 믿으면 안 됩니다. 주어 없는 문장은 따로 검사해야 하고, 보류·탈락 문장은 버리지 말고 다른 대기열로 보내야 합니다. 다시 쓰기 전후의 수치와 고유명사가 보존됐는지는 코드로 확인하는 편이 낫습니다.
7장. 2026년, 주장 추출은 어디서 일하고 있나
논문이 나온 지 1년 반이 지났습니다. Claimify 자체는 마이크로소프트가 "연구 목적으로만 쓰이며 상용 제공되지 않는다"고 밝힌 도구이고, 공식 코드도 없습니다. 그래도 ‘답변을 주장으로 쪼개 하나씩 확인한다’는 생각은 그사이 AI 품질 관리의 기본 단위가 됐습니다.
마이크로소프트 안에서: 평가의 자 → 환각 추적기
Claimify는 처음부터 다른 연구의 자로 쓰였습니다. 2025년 2월 갱신된 GraphRAG 논문 2판(arXiv 2404.16130v2)은 답변이 얼마나 포괄적이고 다양한지를 재는 데 Claimify를 썼습니다. 답변에서 고유한 주장 47,075개를 뽑았고 답변 하나에 평균 31개였습니다. 포괄성은 답변당 주장 수, 다양성은 주장들을 묶었을 때의 군집 수로 정의했습니다. 막연한 ‘더 풍부한 답’을 셀 수 있는 단위로 바꾼 것입니다.
2025년 8월 공개된 VeriTrail(arXiv 2505.21786, ICLR 2026)은 한 걸음 더 나아갑니다. 여러 단계를 거쳐 만든 AI 결과물(긴 책 요약, 여러 기사 종합 등)에서 각 주장이 원문 어디서 왔는지를 거꾸로 추적해 환각을 잡는 시스템입니다. 그 첫 단계가 Claimify로 최종 출력에서 주장을 뽑는 것이고, 하위 주장 분해에도 Claimify의 분해 모듈을 그대로 씁니다. 책 요약 데이터 FABLES+(주장 734개)에서 매크로 F1 84.5로, 가장 강한 비교 방법(RAG, 69.6)을 크게 앞섰습니다. 기사 종합 데이터 DiverseSumm+(주장 560개)에서는 79.5 대 75.1이었습니다. 주장 추출이 평가 도구에서 운영 도구로 옮겨 가는 장면입니다.
업계: 이제 환각률은 ‘주장 단위’로 보고된다
OpenAI GPT-5 시스템 카드2025-08o3가 답변의 사실적 주장을 나열하고, 10개씩 묶어 웹 검색으로 판정. 환각률 = 오류가 있는 주장의 비율
구글 AI 개요 측정 연구IMC 2026AI 개요 답변을 원자 주장 98,020개로 쪼개 보니 11.0%가 인용한 페이지로 뒷받침되지 않음. 주된 실패는 누락
RAG 평가 도구Ragas · DeepEval충실성(faithfulness) = 근거로 뒷받침되는 주장 수 ÷ 전체 주장 수. 답변을 주장으로 쪼개는 것이 첫 단계
클라우드 근거 검사Vertex AI · Citations답변을 주장(대개 문장)으로 나눠 인용 조각과 연결. 문서를 문장 단위로 쪼개 인용하게 하는 API도 등장
OpenAI는 2025년 8월 GPT-5 시스템 카드에서 환각률을 "사소하거나 큰 오류를 담은 사실적 주장의 비율" 로 정의했습니다. 실제 사용 트래픽과 비슷한 프롬프트에서 브라우징을 켰을 때, 주장 중 틀린 비율은 gpt-5-thinking 4.5%, gpt-5-main 9.6%, o3 12.7%, GPT-4o 12.9%였습니다(그림 1에서 읽은 값). 채점은 웹 접근이 가능한 LLM 채점기가 했고, 사람과의 일치율은 75%였습니다. 모델 회사가 자기 모델의 정확성을 문장이 아니라 주장의 개수로 세어 발표한다는 것 자체가 이 분야의 변화를 보여 줍니다.
같은 흐름에서 2026년 IMC 학회에 실린 구글 AI 개요(AI Overviews) 측정 연구는 40일 동안 인기 검색어 55,393개를 따라갔습니다. AI 개요 답변을 원자 주장 98,020개로 분해해 보니 11.0%가 답변이 인용한 페이지로 뒷받침되지 않았고, 가장 흔한 실패는 틀린 말보다 중요한 조건을 빠뜨리는 누락이었습니다. Claimify 논문이 커버리지와 탈맥락화를 따로 잰 이유가 여기서 다시 확인됩니다.
사람 팩트체킹은 줄고, 기계의 주장 확인은 늘었다
이 흐름에는 쓸쓸한 반대편이 있습니다. 메타는 2025년 4월 7일 미국에서 제3자 팩트체킹 프로그램을 끝냈습니다. 구글은 2025년 6월 검색 결과의 팩트체크 표시(ClaimReview 스니펫)를 내렸고, 2025년 10월에는 영국 Full Fact에 대한 지원을 끊었습니다(Full Fact는 전년에 구글에서 100만 파운드 넘게 받았습니다). Full Fact의 AI 도구는 문장을 "작업의 원자 단위"로 삼아, BERT 분류기로 예측 같은 확인 불가 문장을 걸러 냅니다. 평일 하루 약 33만 문장을 처리하고 30개국 40여 기관이 씁니다. Claimify의 선별 단계와 같은 일을 몇 년째 현장에서 해 온 셈입니다.
한국의 사정은 더 어둡습니다. 서울대 언론정보연구소의 SNU팩트체크는 2023년 네이버의 지원 중단 이후 버티다가 2024년 8월 18일 무기한 운영을 멈췄습니다. 약 7년 반 동안 5천 건가량의 팩트체크를 쌓은 곳이었습니다. 그보다 앞서 언론사 연합 팩트체크 플랫폼 팩트체크넷도 2023년 2월 예산 삭감으로 문을 닫았습니다. 연구 자원으로는 ETRI의 KorFactScore(한국어 위키백과 기반 원자 사실 검증)와 네이버의 KoSimpleQA 같은 사실성 벤치마크가 있습니다. 하지만 Claimify처럼 한국어 답변에서 확인할 문장을 고르고 모호성을 가려 주장을 뽑는 과정 자체를 평가하는 공개 데이터는 찾지 못했습니다. 6장의 작은 실험을 직접 한 이유입니다.
코어닷투데이가 이 논문을 다시 읽은 이유
코어닷투데이는 공적 기록에서 ‘지금 참인 것’을 유지하고, 근거와 함께 답하거나 기권하는 사실탐색기 v2를 만들고 있습니다. 사실탐색기의 첫 관문도 결국 문장을 확인할 수 있는 단위로 쪼개는 일입니다. 시의회 회의록의 "20만원 수준으로 편성하겠습니다"는 사실이 아니라 약속이고, 보도자료의 "획기적인 성과"는 평가입니다. 그 안에서 확인할 수 있는 조각만 골라야 합니다. Claimify의 선별 단계가 하는 일이 정확히 이것입니다.
더 와닿은 것은 기권입니다. Claimify는 독자들이 합의할 수 없는 문장에서 물러섭니다. 사실탐색기는 근거의 자격이 모자라면 답하지 않습니다. 둘 다 "틀린 것을 자신 있게 말하는 것보다 모른다고 하는 편이 낫다"는 같은 원칙에 서 있습니다. 반대로 Claimify의 한계로 남은 시간 모호성은 사실탐색기가 정면으로 다뤄 온 문제입니다. "실업률이 줄었다"는 언제 기준인지가 빠지면 확인할 수 없습니다. 최신 기사≠최신 사실 실측에서 본 것처럼, 같은 사실의 값이 시점마다 바뀌기 때문입니다.
8장. 반론과 한계: 칼은 아직 무디다
① 분해가 늘 이득은 아니다. 「Decomposition Dilemmas」는 강한 판정기에서는 분해가 오히려 성능을 떨어뜨릴 수 있다고 보고했습니다. 2026년 EMNLP Findings의 ElementCheck도 분해–검색–판정 방식이 "분해에서 오는 잡음과 고정된 판정 단위"에 시달린다고 지적합니다. 그래서 일률적인 원자 주장 대신 개체 쌍 단위의 ‘요소’를 검증합니다. Claimify가 원자성을 평가에서 뺀 판단과 같은 방향입니다. 그래도 분해 자체가 잡음원이라는 비판은 Claimify에도 그대로 적용됩니다.
② 기권에는 값이 있다. 해소할 수 없는 모호성이 하나라도 있으면 문장 전체가 빠집니다. 그 문장에 명백한 사실이 함께 있어도 그렇습니다. GPT-4o 기준으로 문장의 3.2%였지만, 글머리표가 많은 답변이나 대명사가 잦은 글에서는 이 비율이 훨씬 커질 수 있습니다. 확인하지 않은 문장은 ‘틀렸다’도 ‘맞았다’도 아닌 채로 남습니다. 서비스에서는 이 문장들을 사람에게 넘기는 길을 따로 마련해야 합니다.
③ 시간은 모호성으로 잡히지 않는다. 저자들이 직접 쓴 한계입니다. "캘리포니아의 실업률이 감소했다"에는 해석이 갈리는 단어가 없어서 ‘해소 불가’로 걸리지 않습니다. 하지만 기간이 빠져 있어 확인이 사실상 불가능합니다. 시간 정보가 없는 문장을 모두 탈락시키면 쓸 수 있는 주장이 거의 남지 않으니, 저자들도 답을 미뤘습니다.
④ 좁은 문맥 창. 앞 문장 다섯 개로는 긴 목록의 머리말이 잘려 나갈 수 있습니다. "– 재생에너지원에 투자하기"는 머리말이 "기업이 취해야 할 조치"면 조언이고, "X사가 한 일"이면 사실입니다. 저자들은 문맥을 늘리면 나아질 것으로 예상했습니다.
⑤ 같은 방식으로 재고 같은 방식으로 이겼다. 평가 틀과 추출기를 같은 저자가 같은 철학으로 만들었습니다. 채점도 같은 계열의 LLM이 했습니다. 평가 틀 자체는 다른 방법들에도 공정하게 설계됐지만, 독립적인 재현은 아직 드뭅니다. 시맨틱 스칼라 기준으로 이 논문을 인용한 연구는 2026년 10월 현재 28편이고, Claimify를 그대로 재현해 반박한 연구는 찾지 못했습니다. 2025년 CLEF CheckThat! 소셜미디어 주장 정규화 과제에서 Claimify 방식의 프롬프팅을 쓴 팀(UNH)은 METEOR 0.331로, 미세조정한 FLAN-T5(0.557)보다 낮았습니다. 영역이 바뀌면 이 프롬프트가 늘 이기는 것은 아니라는 신호입니다.
9장. 실무 체크리스트: 내 서비스에 주장 추출을 넣는다면
1. 정의‘확인할 가치’가 아니라 ‘확인할 수 있음’으로 주장을 정의하고, 의견·추측·조언·머리말·정보 부재 문장의 예를 프롬프트에 적는다.
2. 선별을 따로분해 전에 선별 단계를 두고, ‘사실 + 해석’ 문장은 통째로 버리지 말고 다시 써서 사실만 남긴다. 논문에서 가장 큰 차이를 만든 단계다.
3. 기권 경로‘독자들이 합의할까?’를 묻고, 아니면 뽑지 않는다. 대신 그 문장은 사람 검토 대기열로 보낸다. 버린 문장을 세지 않으면 커버리지가 거짓으로 좋아 보인다.
4. 문맥 설계선별에는 뒷문장까지, 분해에는 앞문장만 준다. 목록이 긴 문서는 머리말을 메타데이터로 붙인다(논문은 제목 계층을 메타데이터로 넣을 수 있게 설계했다).
5. 대괄호 표시문맥에서 추론해 넣은 말은 [대괄호]로 남겨 원문에 있던 말과 구별한다. 판정에서 틀리면 대괄호 안부터 의심한다.
6. 결과로 평가‘잘 쪼갰나’를 눈으로 보지 말고, 요소 커버리지와 c 대 cmax 판정 일치로 잰다. 판정이 어긋나는 비율(결과 5·6)을 지표로 둔다.
7. 시간을 따로모호성 검사와 별도로 ‘시점이 비었나’를 검사한다. 비어 있으면 문서 날짜를 대괄호로 붙이거나, 시점 미상 주장으로 따로 표시한다.
8. 다수결 유지‘3번 생성 중 2번 통과’를 비용 때문에 1번으로 줄이지 않는다. 6장에서 이 설정 하나가 틀린 사실 8개 중 5개의 생사를 갈랐다.
9. 한국어라면주어가 없는 문장은 모호성 해소가 잘 잡지 못하므로 주어 유무를 따로 검사한다. ‘A나 B’는 쪼개지 말라는 규칙을 프롬프트에 넣는다. 다시 쓰기 전후의 수치·고유명사 보존을 코드로 확인하고, 형식 오류 재시도를 둔다.
에필로그: 칼보다 먼저, 물러설 줄 아는 손
프롤로그의 세종 문장으로 돌아가 봅시다. 좋은 주장 추출기라면 [세종은 한글을 창제했다]와 [세종은 경국대전을 편찬했다]를 따로 뽑았을 것입니다. ‘국가 기반을 다졌다’는 평가로 보고 내려놓았을 것입니다. 그러면 판정 단계가 두 번째 주장에서 정확히 멈춰 설 수 있습니다. 문장 전체를 ‘대체로 맞다’로 뭉개지 않고, 어느 조각이 틀렸는지 짚을 수 있다는 것. 사실 확인에서 주장 추출이 하는 일은 결국 그것입니다.
Claimify 논문이 남긴 가장 오래갈 생각은 두 가지라고 봅니다. 하나는 주장의 품질을 하류의 결과로 재자는 것입니다. 다른 하나는 해석이 갈리면 뽑지 말자는 것입니다. 전자는 평가를, 후자는 설계를 바꿉니다. AI가 쓴 글이 사람이 쓴 글보다 많아지는 2026년에, 기계가 기계의 글을 확인하는 일은 점점 더 많아질 것입니다. 그 첫 칼질이 무엇을 자르고 무엇을 남기는지, 그리고 언제 칼을 내려놓는지가 확인 전체의 품질을 정합니다.
참고문헌
본 논문
Metropolitansky, D., & Larson, J. (2025). Towards Effective Extraction and Evaluation of Factual Claims. ACL 2025 (Long Papers), 6996–7045. arXiv 2502.10855 · ACL Anthology
Microsoft Research Blog (2025-03-19). Claimify: Extracting high-quality claims from language model outputs. 링크