사건 추출Event ExtractionEAGER강화학습RLVR검증 가능한 보상GRPODAPOGDPO어드밴티지 붕괴SCAEGoLLIE정보 추출한국어
사건을 뽑는 AI에게 채점표를 주다 — EAGER로 읽는 사건 추출 40년과 '검증 가능한 보상'
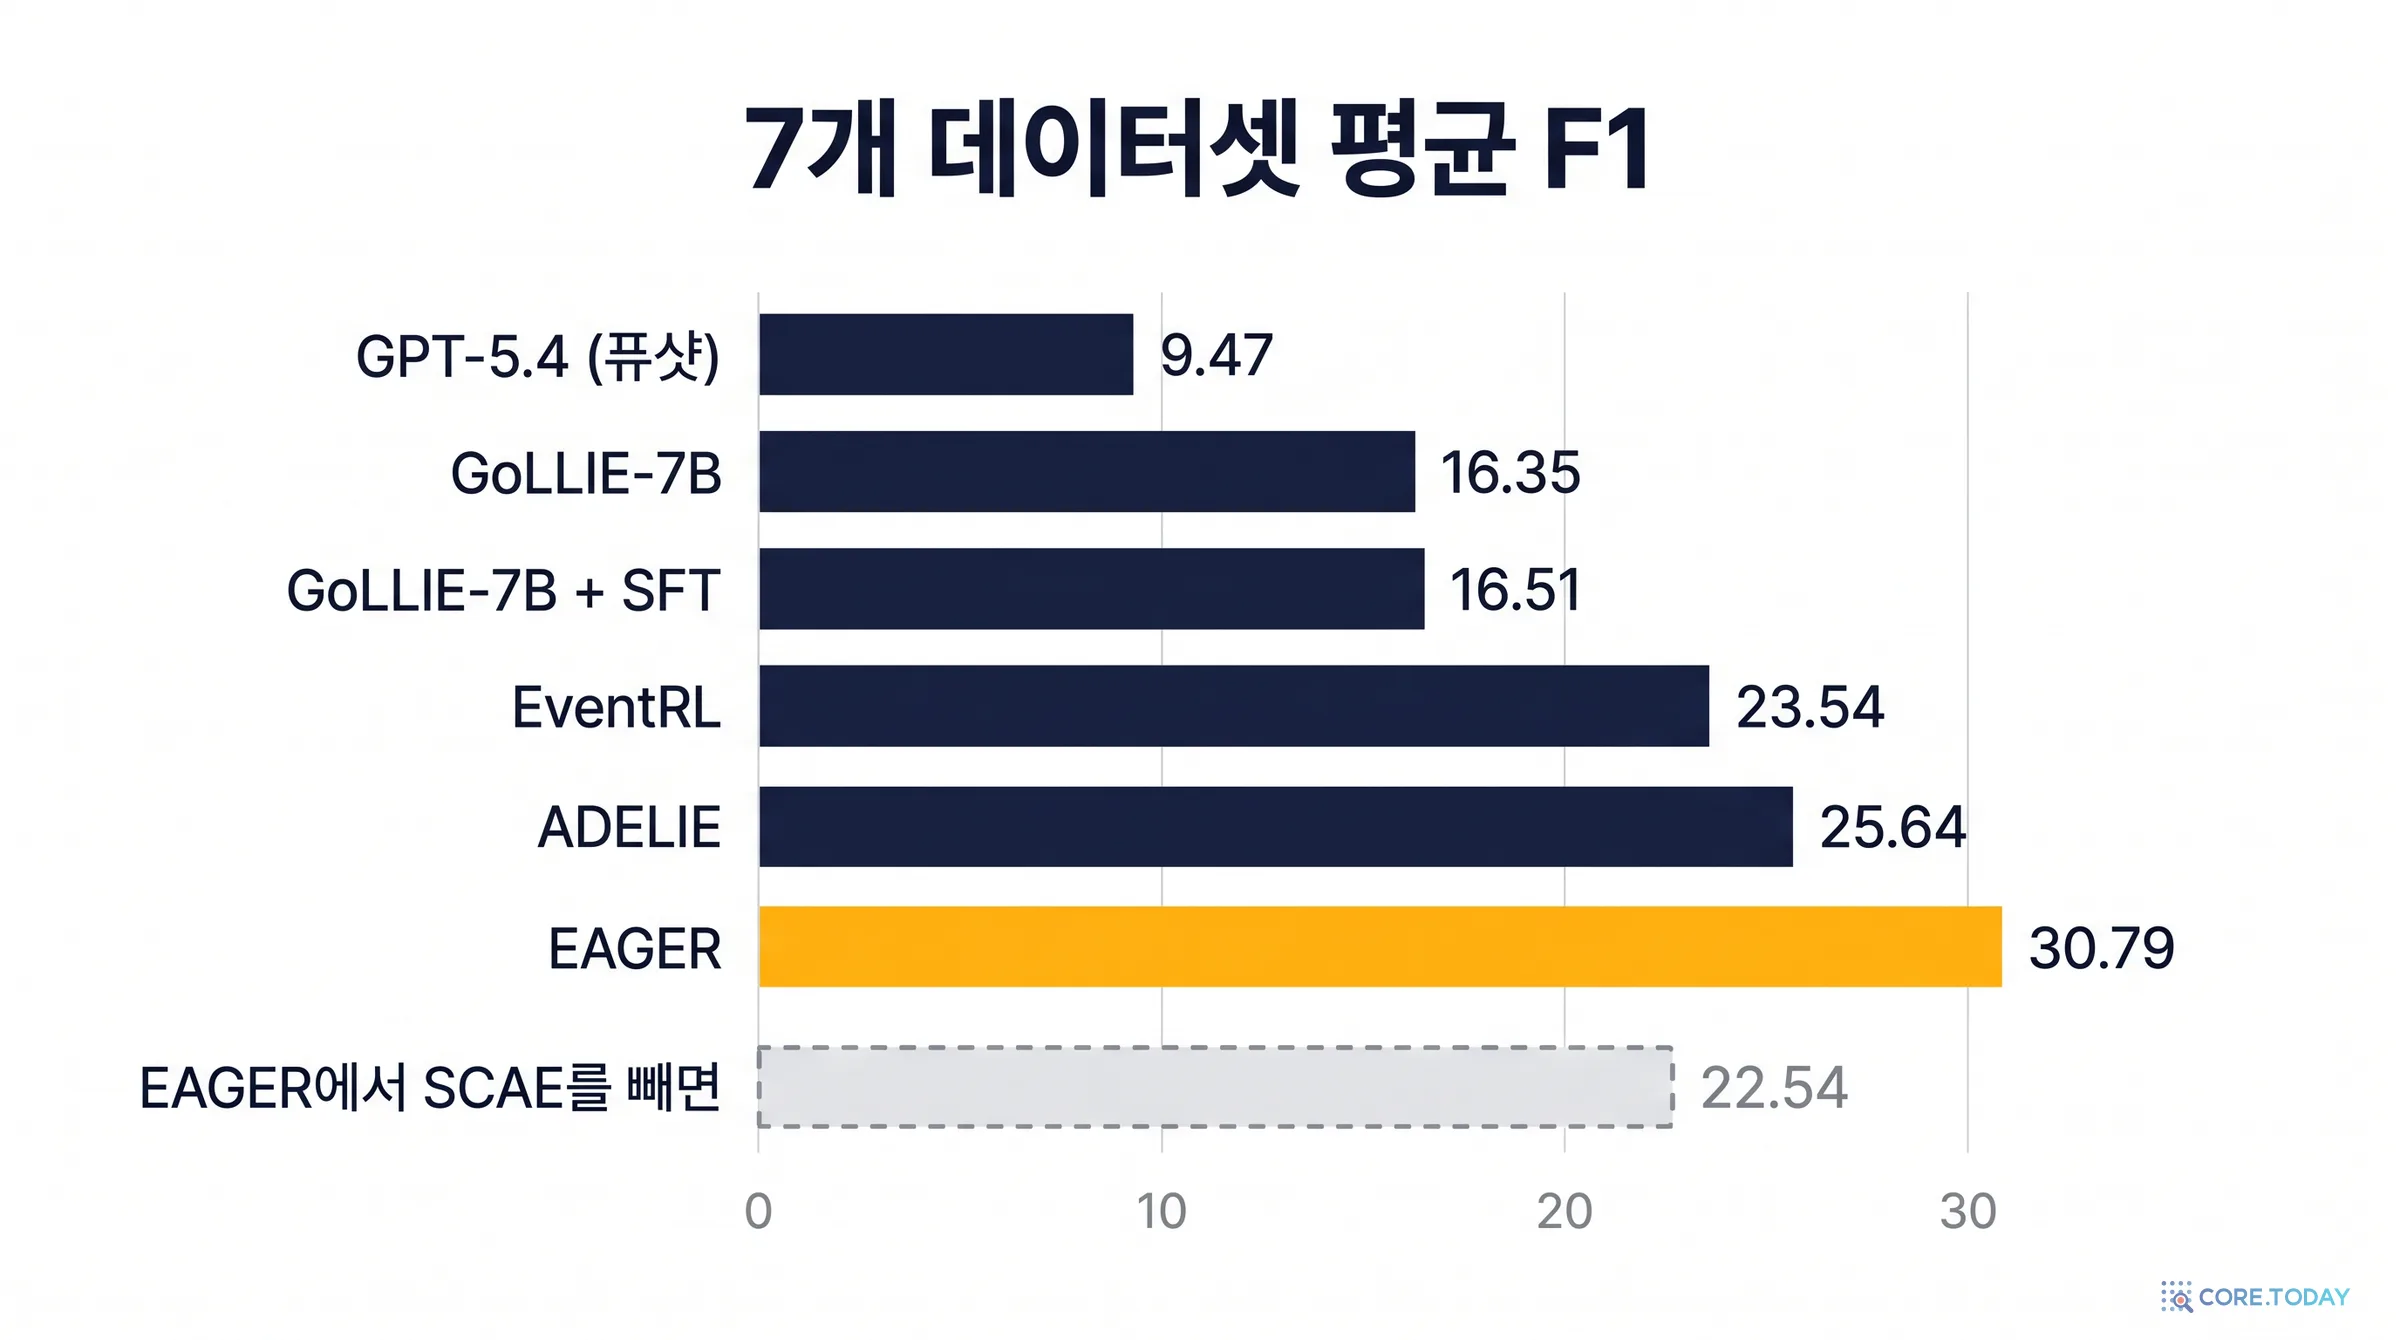
GPT-5.4에게 기사를 주고 사건을 뽑으라고 하면 평균 F1이 10점 안팎입니다. 독일 DFKI의 EAGER는 70억 매개변수 모델에 '여섯 명의 채점관'과 '문제지마다 다른 오답 보기'를 붙여 평균 30.79점까지 끌어올렸습니다. 사건 추출이 1987년 MUC의 템플릿 채우기에서 어떻게 지금의 코드 생성·강화학습까지 왔는지, 검증 가능한 보상(RLVR)이 수학 밖으로 나오면 무엇이 달라지는지, 그리고 그룹 점수가 모두 같아져 학습이 멈추는 '어드밴티지 붕괴'를 SCAE가 어떻게 푸는지 풀어 씁니다. 본문과 부록 표의 숫자가 엇갈리는 곳, 보상 식을 글자 그대로 구현하면 생기는 문제도 짚었습니다. 한국어 문장 40개로 로컬 4B 모델을 360번 돌려 같은 채점표를 직접 대 봤습니다.
최신 범용 LLM도 사건 추출 시험에서는 평균 F1 10점 안팎입니다. 뜻은 알아도 정해진 칸에, 정해진 글자 경계로, 정해진 역할 이름을 쓰지 못합니다. 지도 미세조정은 거의 효과가 없습니다.
!
EAGER의 해법
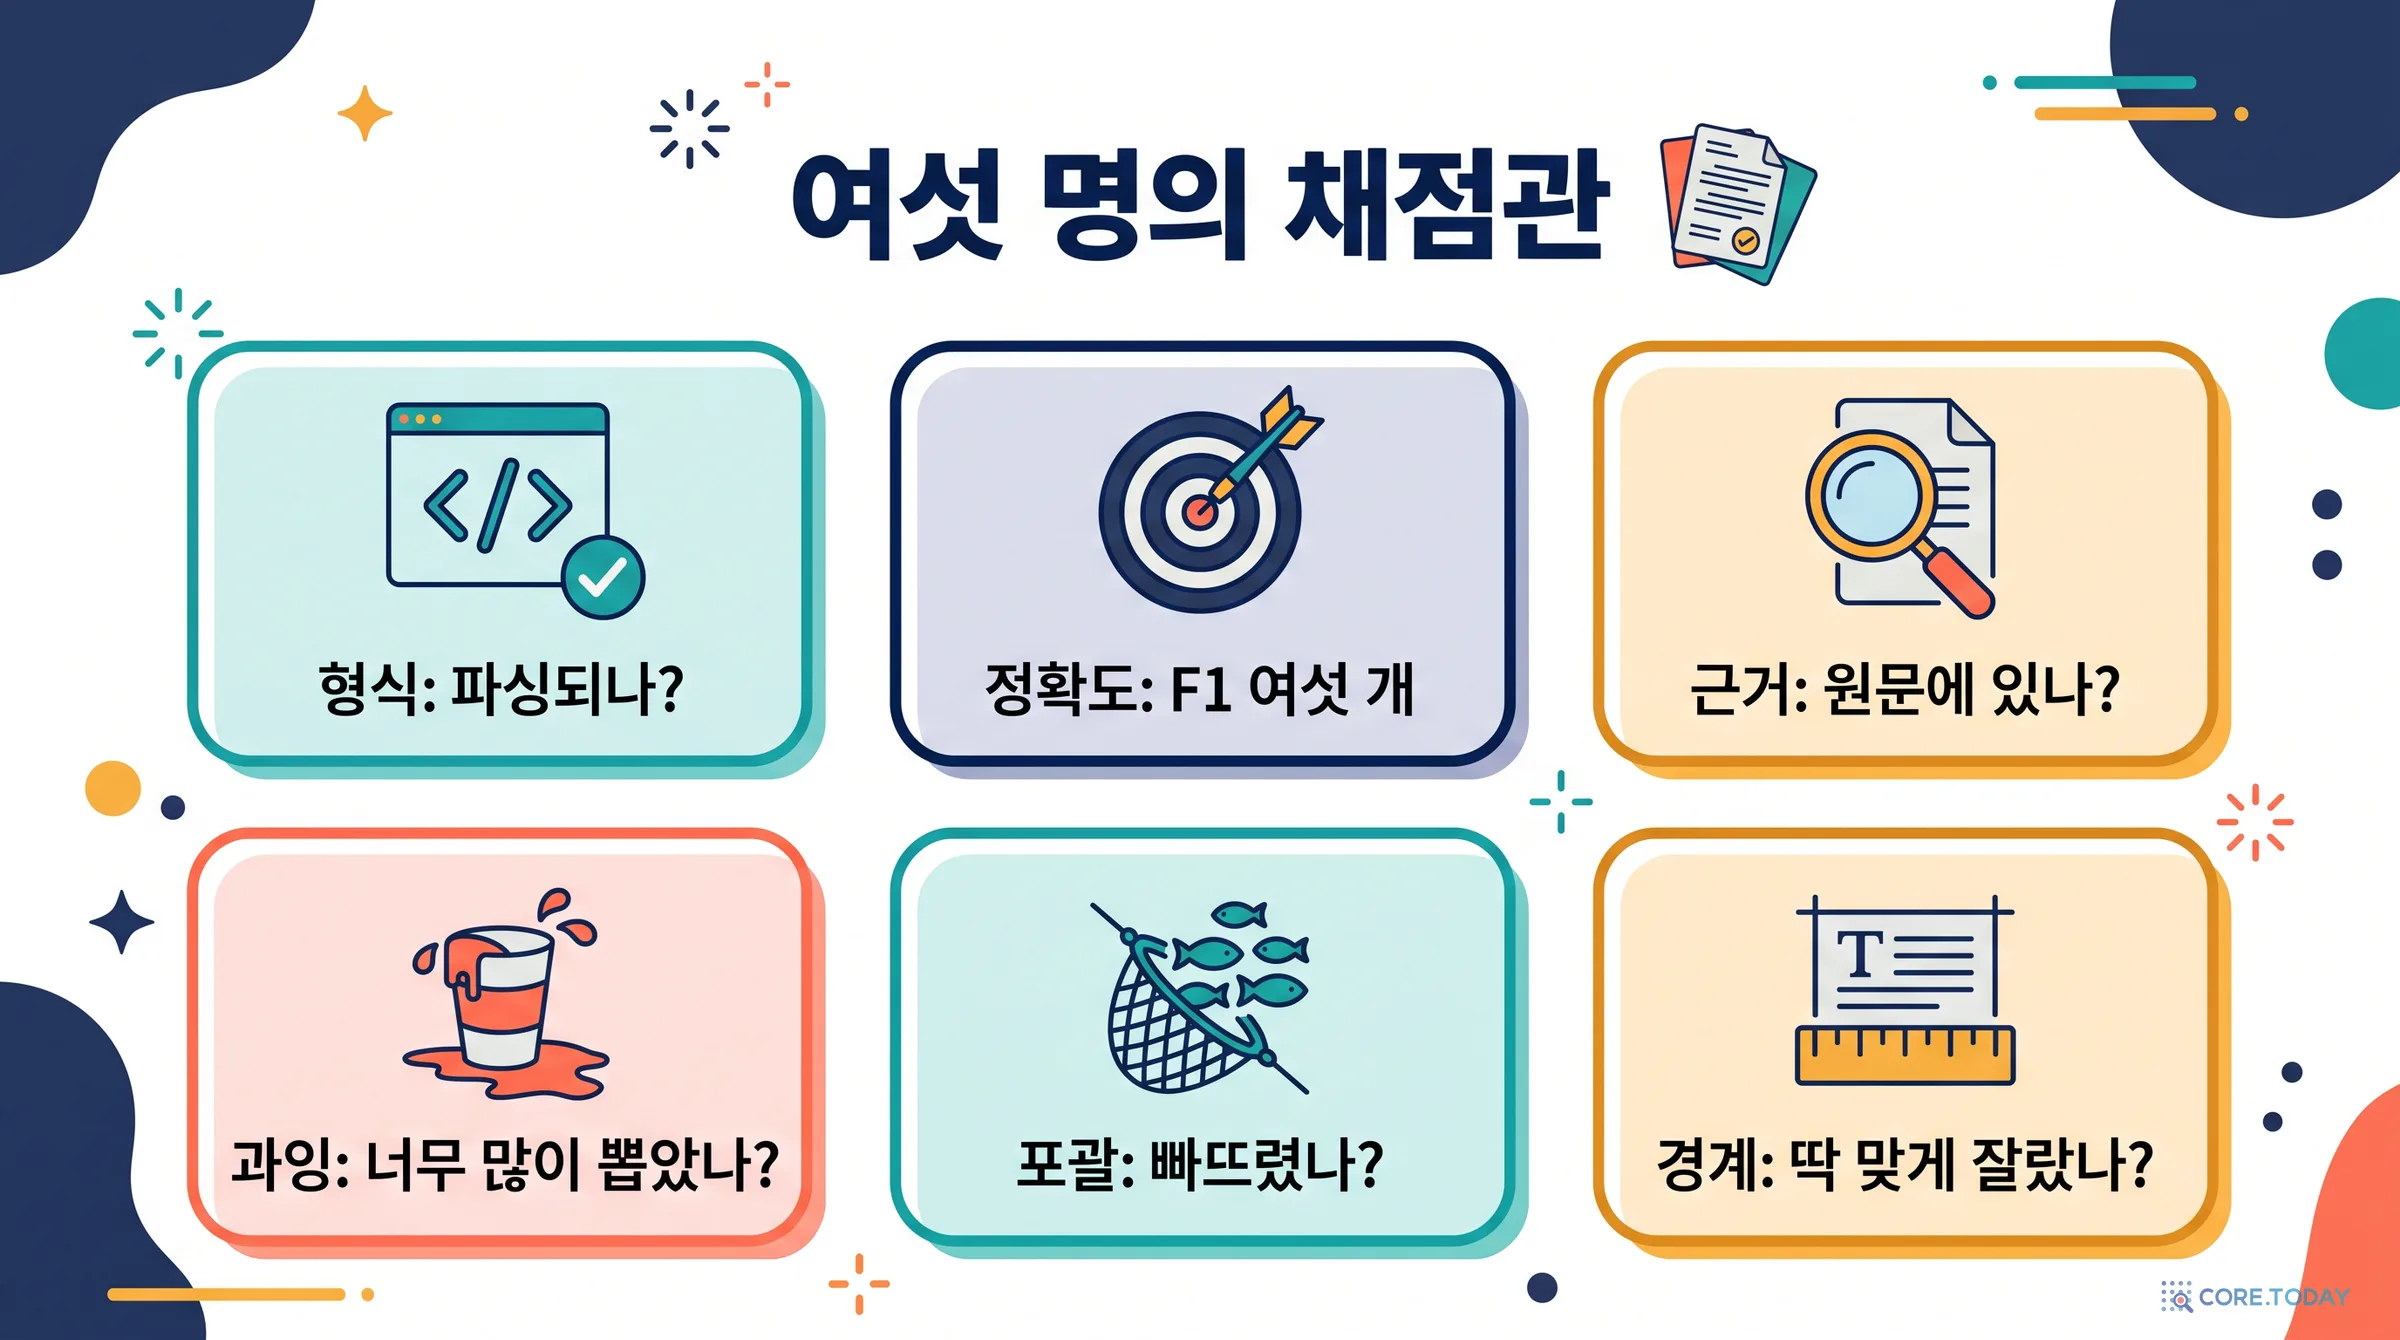
출력을 파이썬 코드로 받아 자동 채점할 수 있게 만들고, 채점을 여섯 갈래(형식·정확도·근거·과잉·포괄·경계)로 쪼갰습니다. 그리고 한 문제를 네 번 풀게 할 때 문제지마다 오답 보기를 다르게 줘서(SCAE) 네 답이 모두 같은 점수를 받아 학습이 멈추는 일을 줄였습니다.
✓
결과와 단서
7개 데이터셋 평균 30.79로 기존 강화학습 최고(25.64)보다 5.15점 높습니다. 다만 SCAE를 빼면 22.54로 기존 방법보다 낮아지고, 부록 표로 다시 계산하면 격차는 2.64점으로 줄어듭니다. 코드는 아직 공개되지 않았습니다.
프롤로그 — 똑똑한데 왜 9점일까
다음 문장을 읽어 봅시다.
경찰은 시청 앞에서 공무원을 폭행한 50대 남성을 현장에서 체포했다.
무슨 일이 있었는지 묻는다면 누구나 답할 수 있습니다. 폭행이 있었고, 체포가 있었습니다. 요즘 LLM이라면 한 줄 요약도, 육하원칙 정리도 막힘없이 해 줍니다.
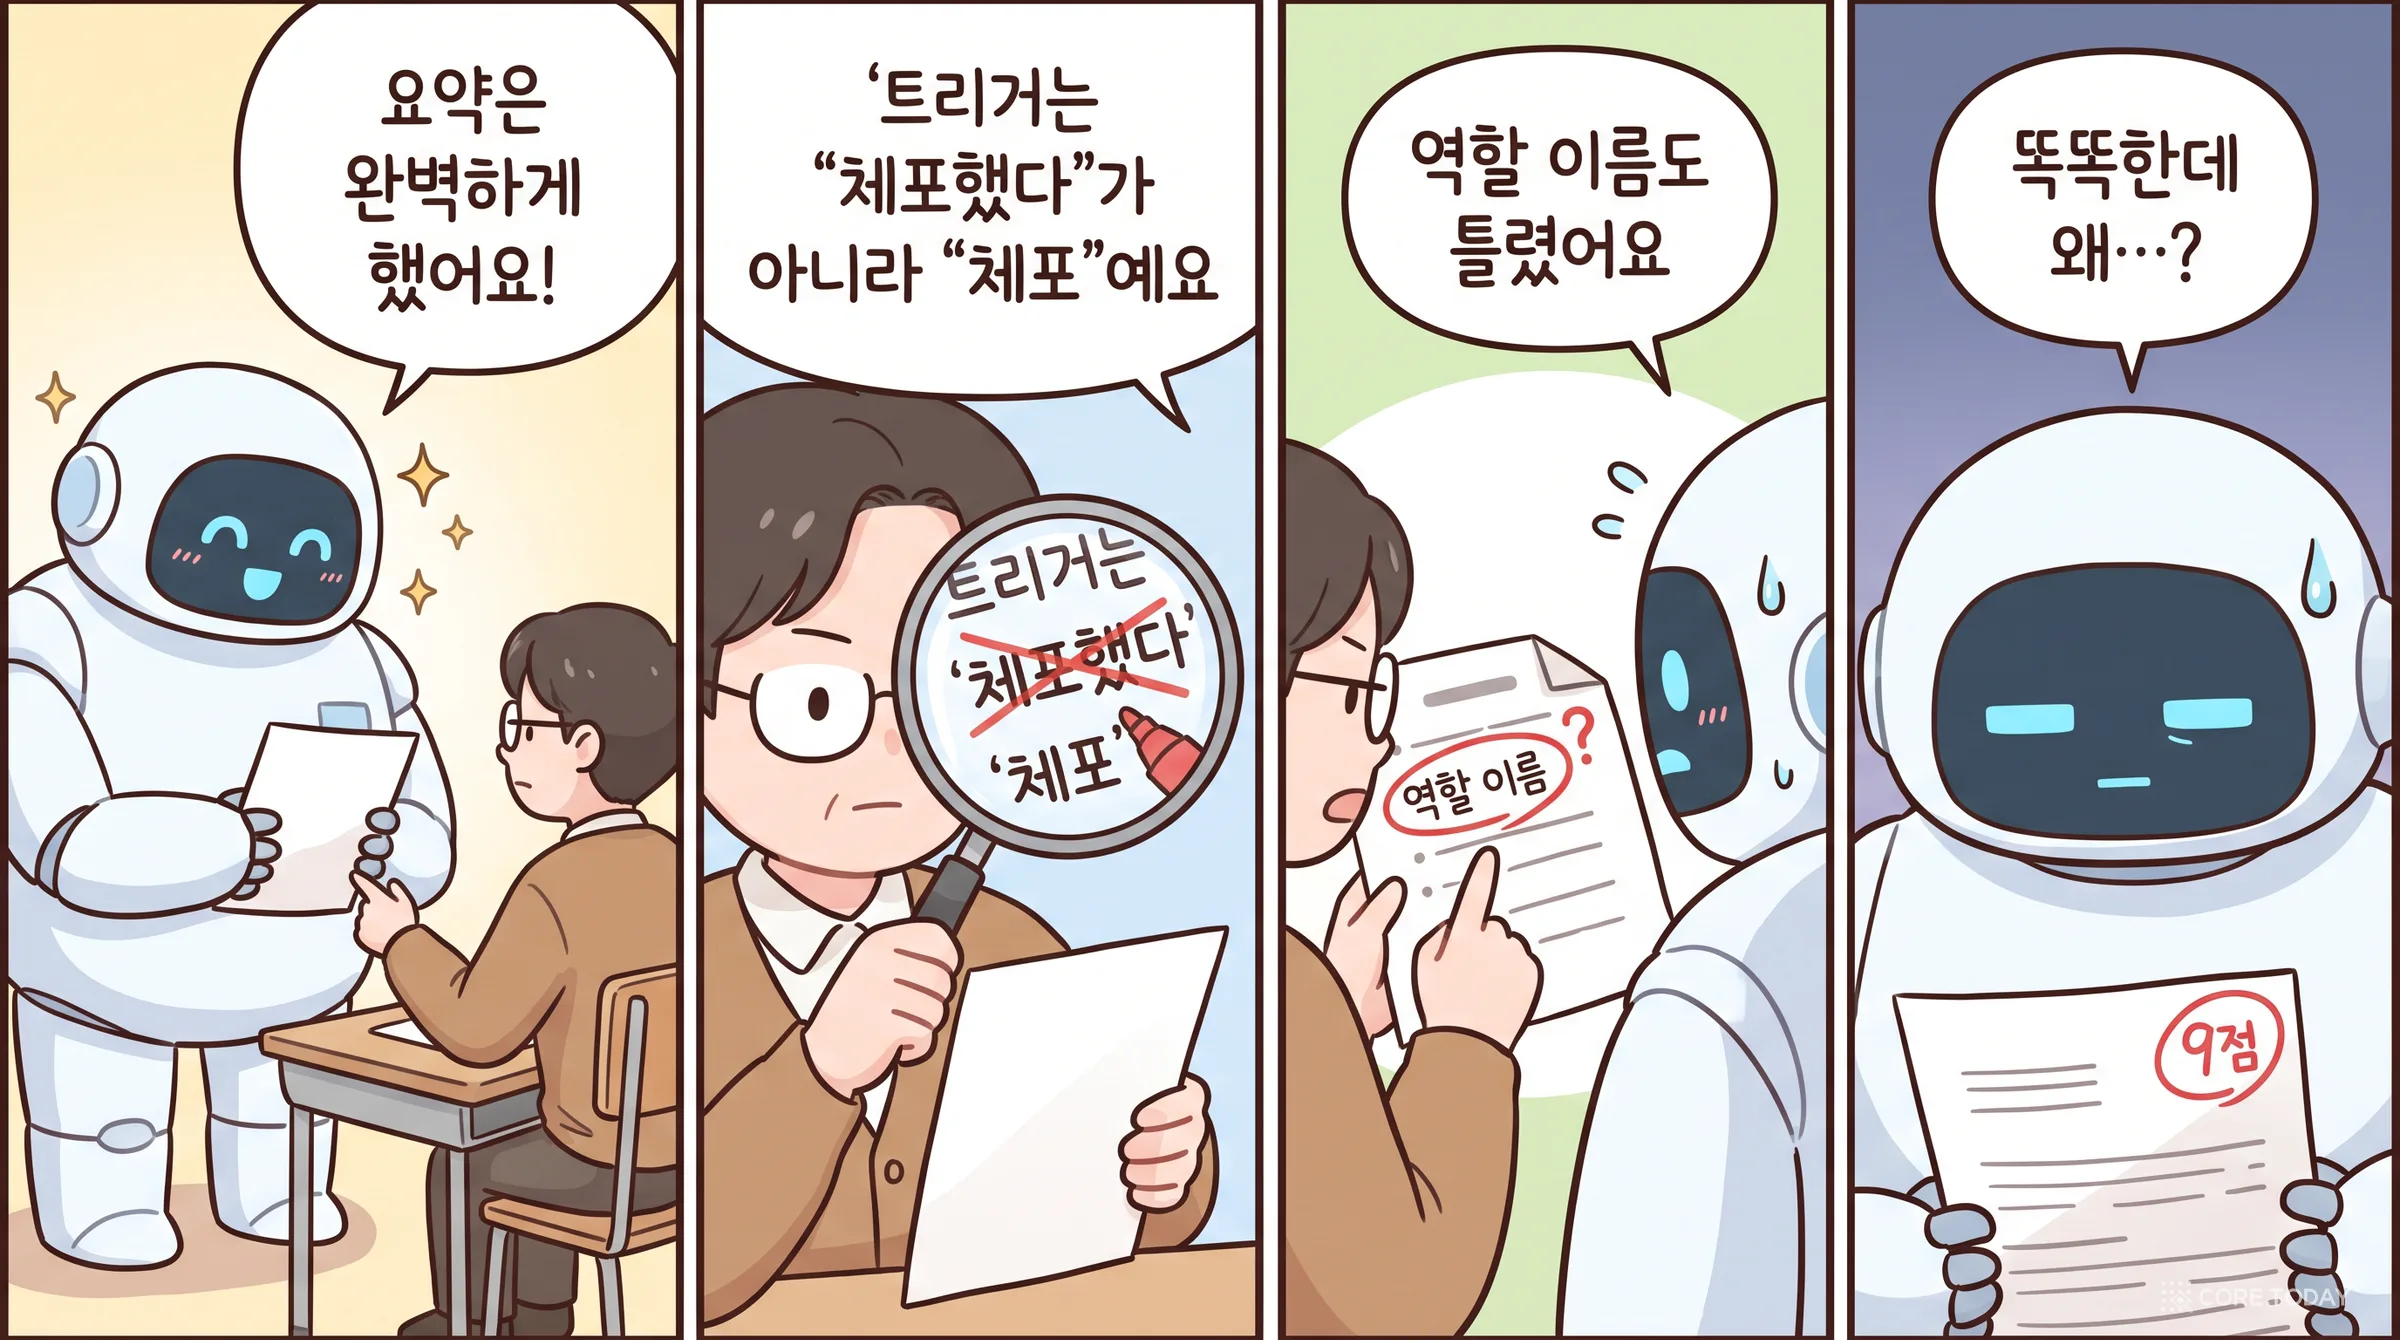
그런데 이 문장을 사건 추출(event extraction) 시험지로 바꾸면 이야기가 달라집니다. 시험은 이렇게 묻습니다. 사건을 가리키는 단어(트리거)는 정확히 어디부터 어디까지인가? '체포'인가, '체포했다'인가? 그 사건은 미리 정한 33가지 유형 가운데 무엇인가? '50대 남성'은 공격 사건에서 무슨 역할이고 체포 사건에서는 무슨 역할인가? '시청 앞'이 장소라면 '시청 앞에서'라고 쓴 답은 맞았나, 틀렸나?
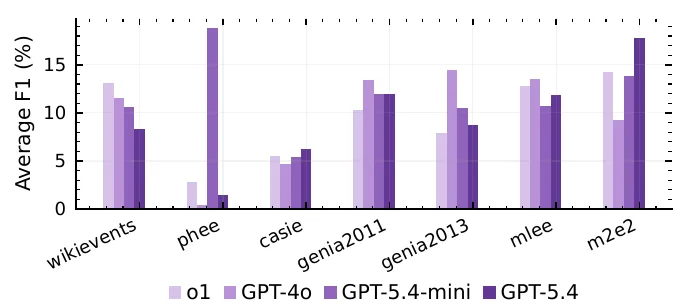
2026년 9월 24일 arXiv에 올라온 독일 인공지능연구소(DFKI)와 올덴부르크대학의 논문 「EAGER: Enhancing Generative Event Extraction via Reinforcement Learning with Verifiable Rewards」는 첫 페이지에 그림 하나를 걸어 둡니다. o1, GPT-4o, GPT-5.4-mini, GPT-5.4에게 일곱 가지 사건 추출 시험을 퓨샷(few-shot, 예시 몇 개를 보여 주는 방식)으로 풀게 한 결과입니다.
논문 그림 1(Adjali 외, 2026). 막대 높이가 대부분 15를 넘지 못합니다. GPT-5.4의 일곱 데이터셋 평균은 9.47, GPT-4o는 9.20입니다. 의약품 부작용 데이터셋 PHEE에서는 GPT-5.4가 1.42점, 같은 회사의 작은 모델 GPT-5.4-mini는 18.86점입니다.
10점 안팎입니다. 같은 시험에서 2023년에 나온 70억 매개변수짜리 정보 추출 전용 모델 GoLLIE-7B가 16.35점입니다. 수학 올림피아드 문제를 푸는 모델이 신문 기사 한 문단에서 '누가 누구를 체포했는지'를 칸에 맞춰 쓰는 시험에서는 낙제점을 받는 셈입니다.
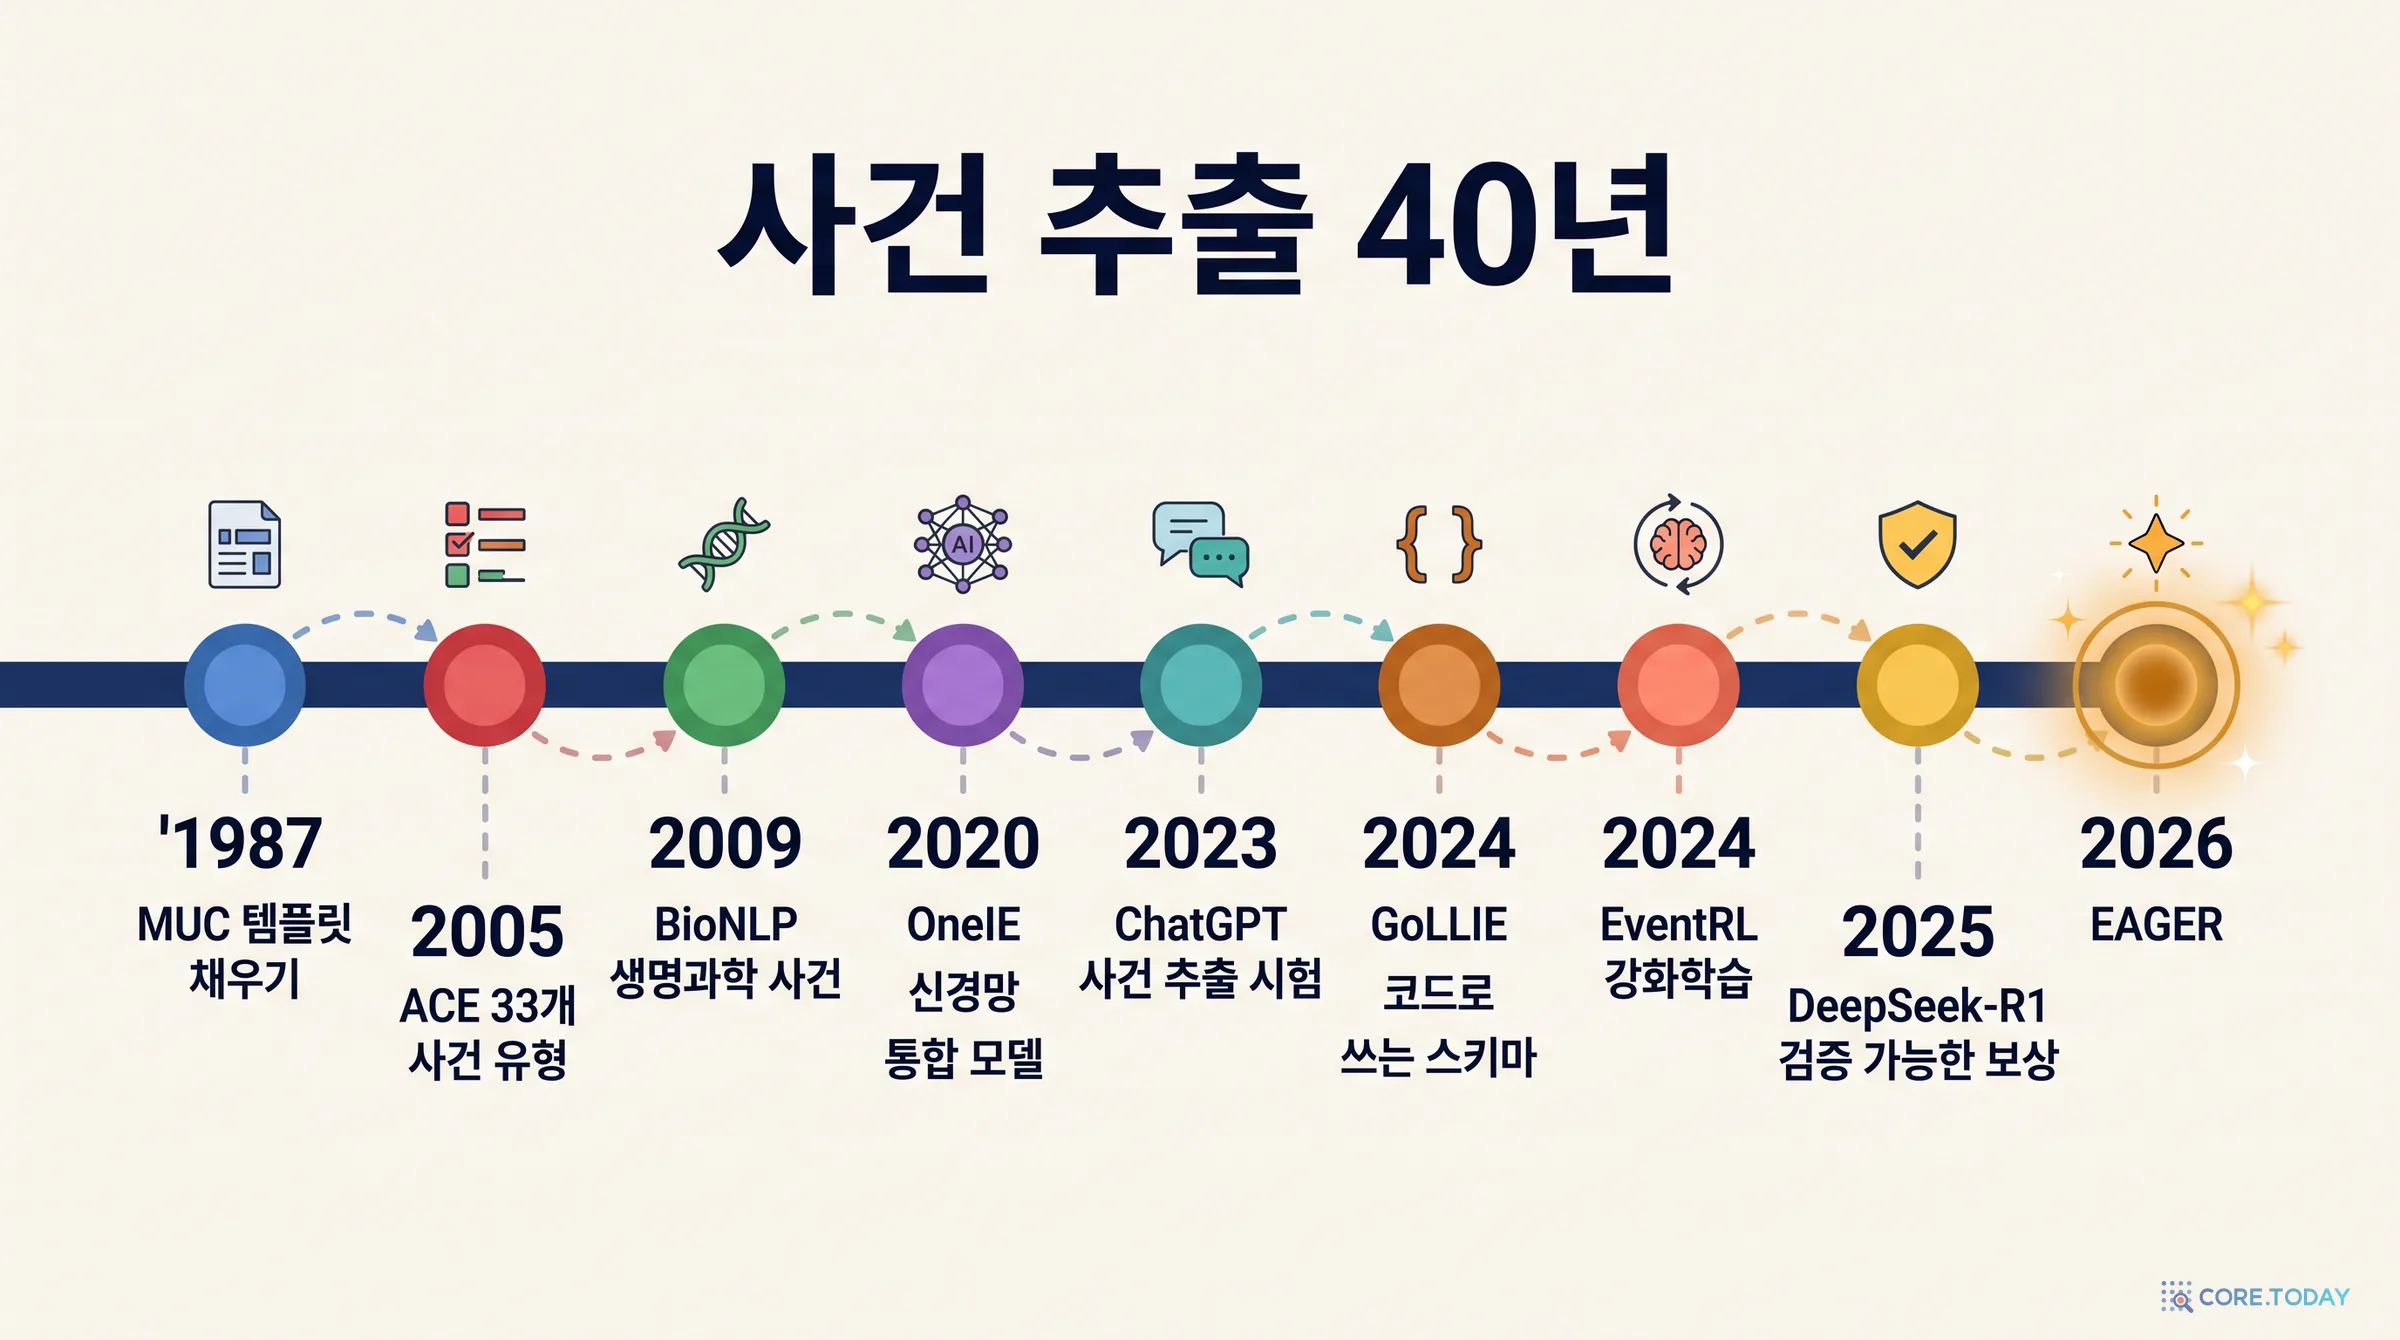
사건 추출은 왜 이렇게 어려운가. 1987년 미 해군이 군사 전문을 자동으로 읽으려던 시도부터 40년 동안 이 문제가 어떤 모양으로 변해 왔는지 봅니다.
'검증 가능한 보상'은 수학 밖에서도 통하는가. DeepSeek-R1 이후 강화학습의 대세가 된 RLVR(Reinforcement Learning with Verifiable Rewards)을 정답이 하나로 떨어지지 않는 구조화 추출에 붙이면 무엇을 새로 설계해야 하는지 EAGER의 답을 하나씩 뜯어봅니다.
그래서 얼마나 믿을 수 있는가. 결과표를 직접 다시 읽고, 본문과 부록의 숫자가 엇갈리는 곳과 보상 식의 함정을 짚습니다. 마지막으로 한국어 문장 40개에 같은 채점표를 적용해 로컬 4B 모델로 실측한 결과를 붙였습니다.
코어닷투데이는 지난 몇 달 동안 뉴스 육하원칙 추출, 같은 사건 묶기 연작, 사실탐색기 v2를 거치며 '문장에서 사건을 꺼내 기록으로 만드는 일'을 계속 다뤄 왔습니다. EAGER는 그 일의 가장 엄격한 형태인 학술 벤치마크 쪽에서 나온 답입니다. 둘을 나란히 놓고 읽으면 서로의 빈 곳이 잘 보입니다.
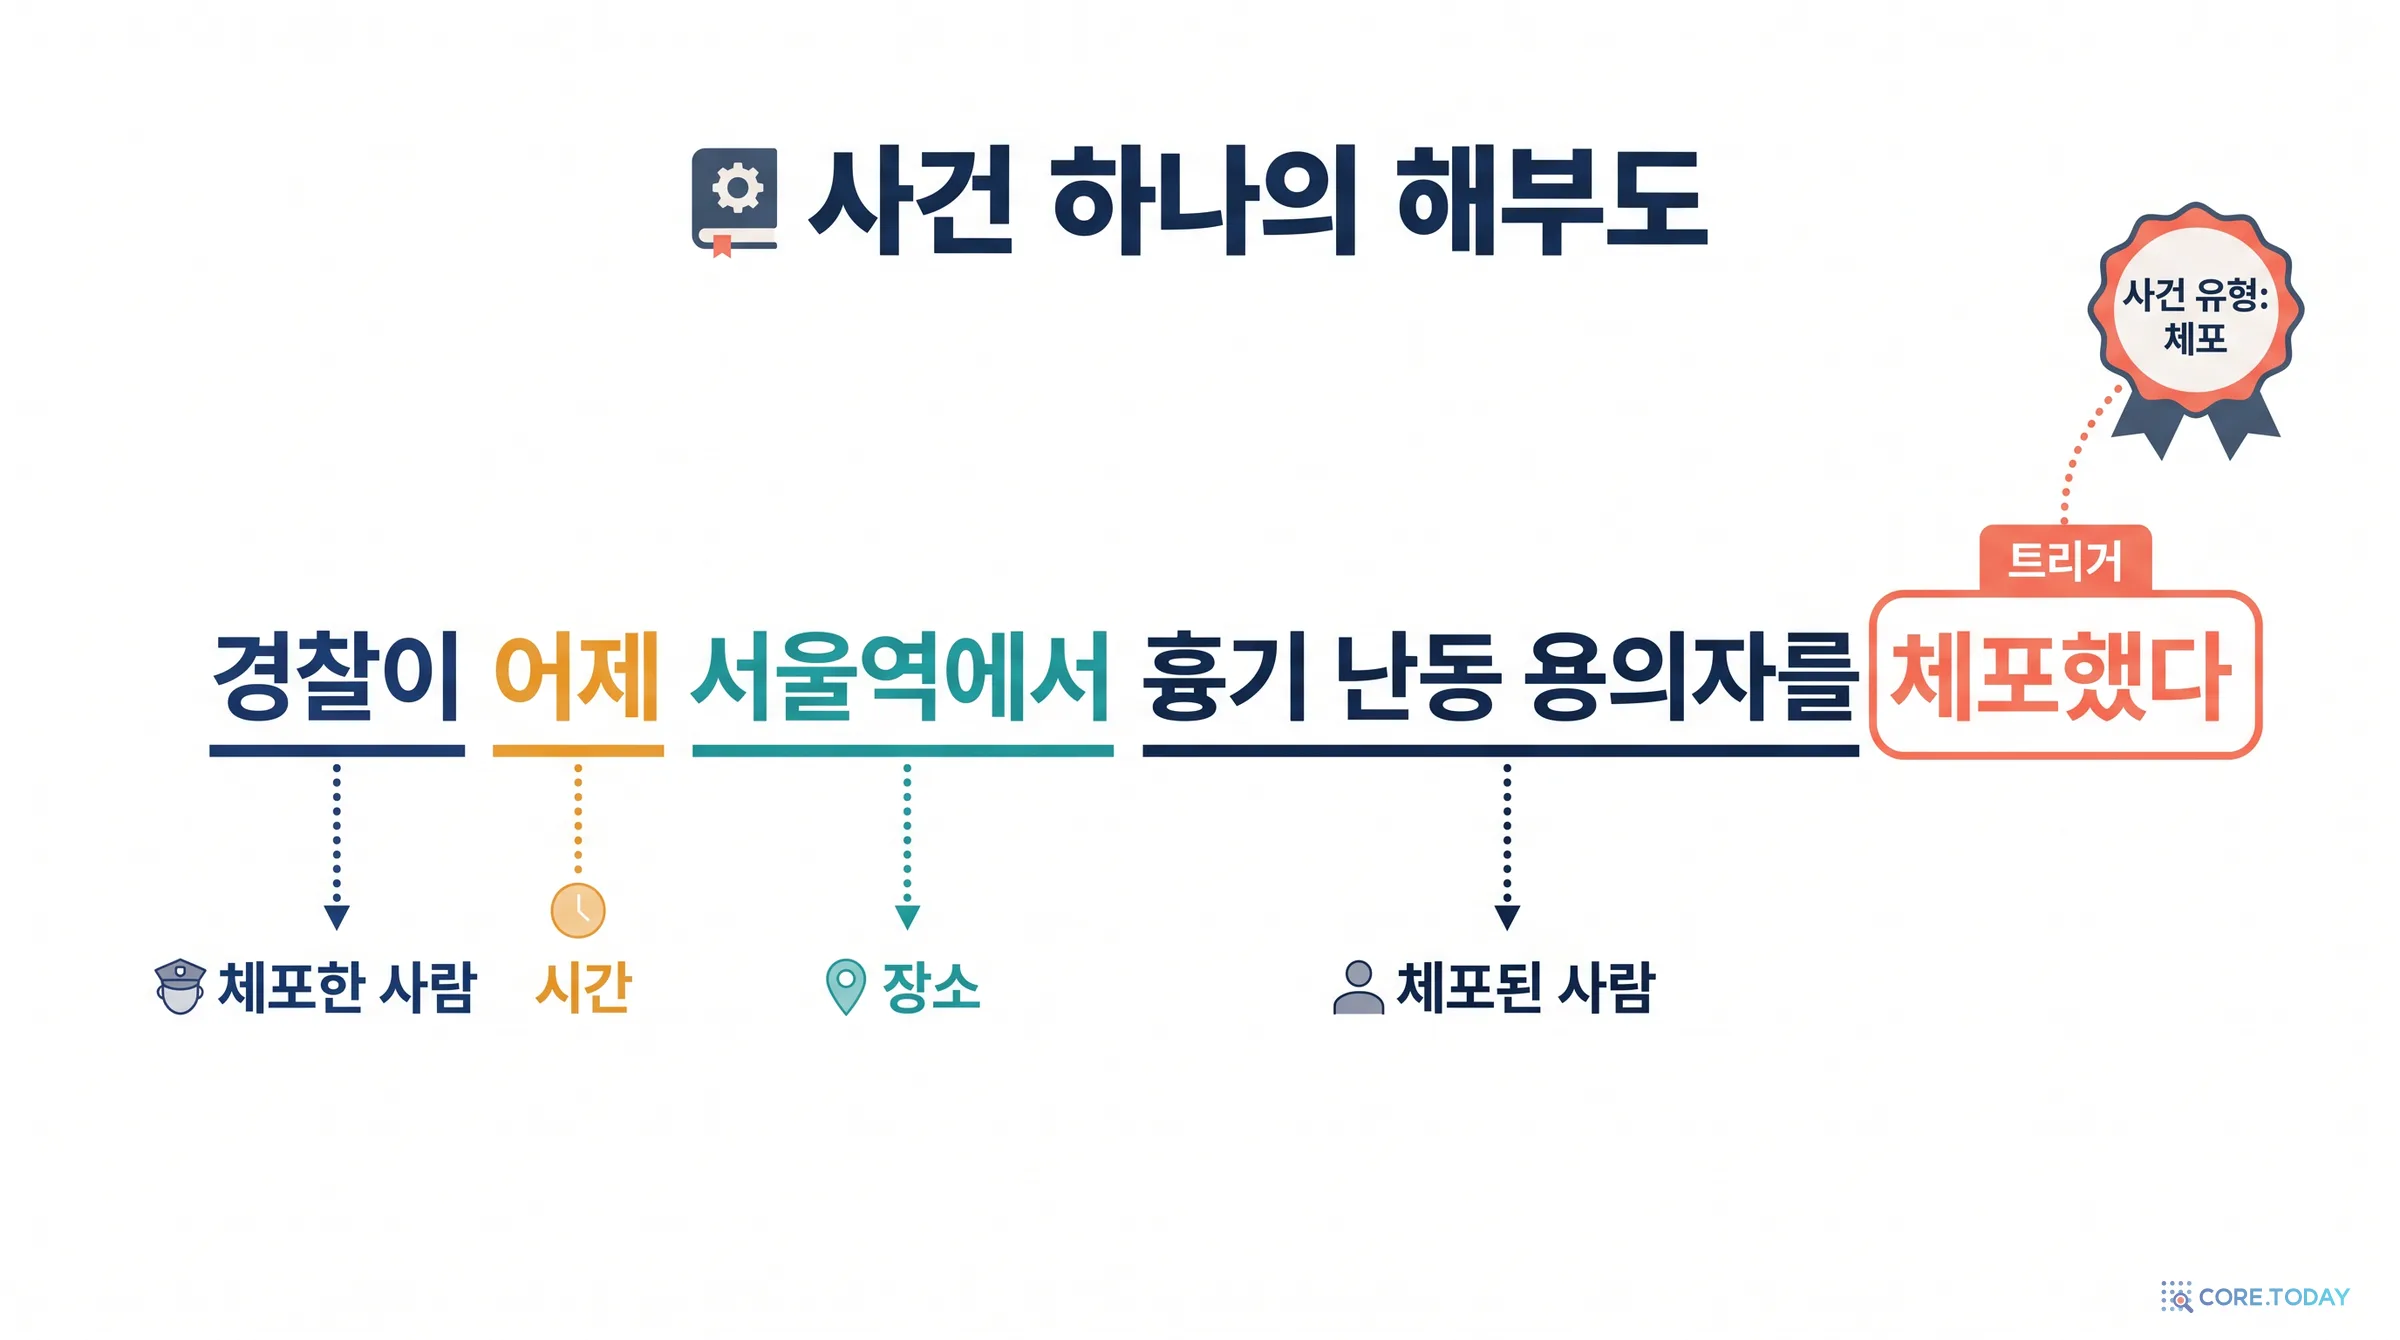
그림은 이해를 돕기 위해 활용형 전체('체포했다')를 트리거로 표시했습니다. 실제 채점에서는 주석 지침에 따라 '체포'처럼 더 짧은 단어만 정답일 수 있고, 이 차이가 곧 점수 차이가 됩니다.
사건 추출은 정보 추출(Information Extraction, IE)의 한 갈래입니다. 개체명 인식이 '이 단어는 사람 이름'이라고 표시하고, 관계 추출이 '이 사람은 이 회사의 대표'라고 잇는다면, 사건 추출은 "무슨 일이 일어났고, 거기에 누가 어떤 역할로 참여했는가"를 한 장의 카드로 만듭니다. 카드는 네 겹으로 이루어집니다.
트리거사건이 일어났음을 가장 분명하게 드러내는 단어. 미국 언어자료컨소시엄(LDC)의 ACE 2005 지침은 이를 "사건의 발생을 가장 분명하게 표현하는 단어"라고 정의합니다. 위 문장에서는 '체포'.
사건 유형미리 정해 둔 유형 목록(스키마) 가운데 하나. ACE 2005는 8개 대분류 아래 33개 소분류를 둡니다. 법(Justice) 분야에만 체포·기소·선고·사면 같은 소분류가 13개 있습니다.
인자사건에 참여한 사람·장소·시간·물건을 가리키는 문장 속 글자 구간(스팬). '경찰', '서울역', '어제'.
역할그 인자가 사건에서 맡은 자리. 체포 사건이라면 체포한 쪽, 체포된 쪽, 장소, 시간. 같은 '50대 남성'도 공격 사건에서는 공격자, 체포 사건에서는 체포된 사람입니다.
EAGER 논문은 이 일을 네 개의 하위 과제로 나눕니다. 트리거 찾기(Trigger Identification, TI), 트리거 분류(Trigger Classification, TC), 인자 찾기(Argument Identification, AI), 인자 분류(Argument Classification, AC)입니다. 여기에 인자가 어느 트리거에 붙어 있는지까지 맞혀야 점수를 주는 엄격한 변형 AI+와 AC+가 더해집니다. 논문이 대표 점수로 쓰는 'Mean-F1'은 이 여섯 F1의 평균입니다.
F1이 무엇인지 잠깐 짚고 가겠습니다. 모델이 낸 답 묶음과 정답 묶음을 비교해서, 낸 답 가운데 맞은 비율이 정밀도(precision), 정답 가운데 찾아낸 비율이 재현율(recall)입니다. F1은 둘의 조화평균입니다. 많이 내면 재현율은 오르고 정밀도는 떨어집니다. 적게 내면 반대입니다. 둘 다 높아야 F1이 높습니다.
아래 위젯에서 예문을 바꿔 가며 같은 정답이 여섯 가지 채점 단위로 어떻게 쪼개지는지 보세요.
왜 이게 어려운가 — 네 가지 엄격함
사람에게는 쉬운 이 일이 모델에게 어려운 이유는 '이해'보다 '규약'에 있습니다.
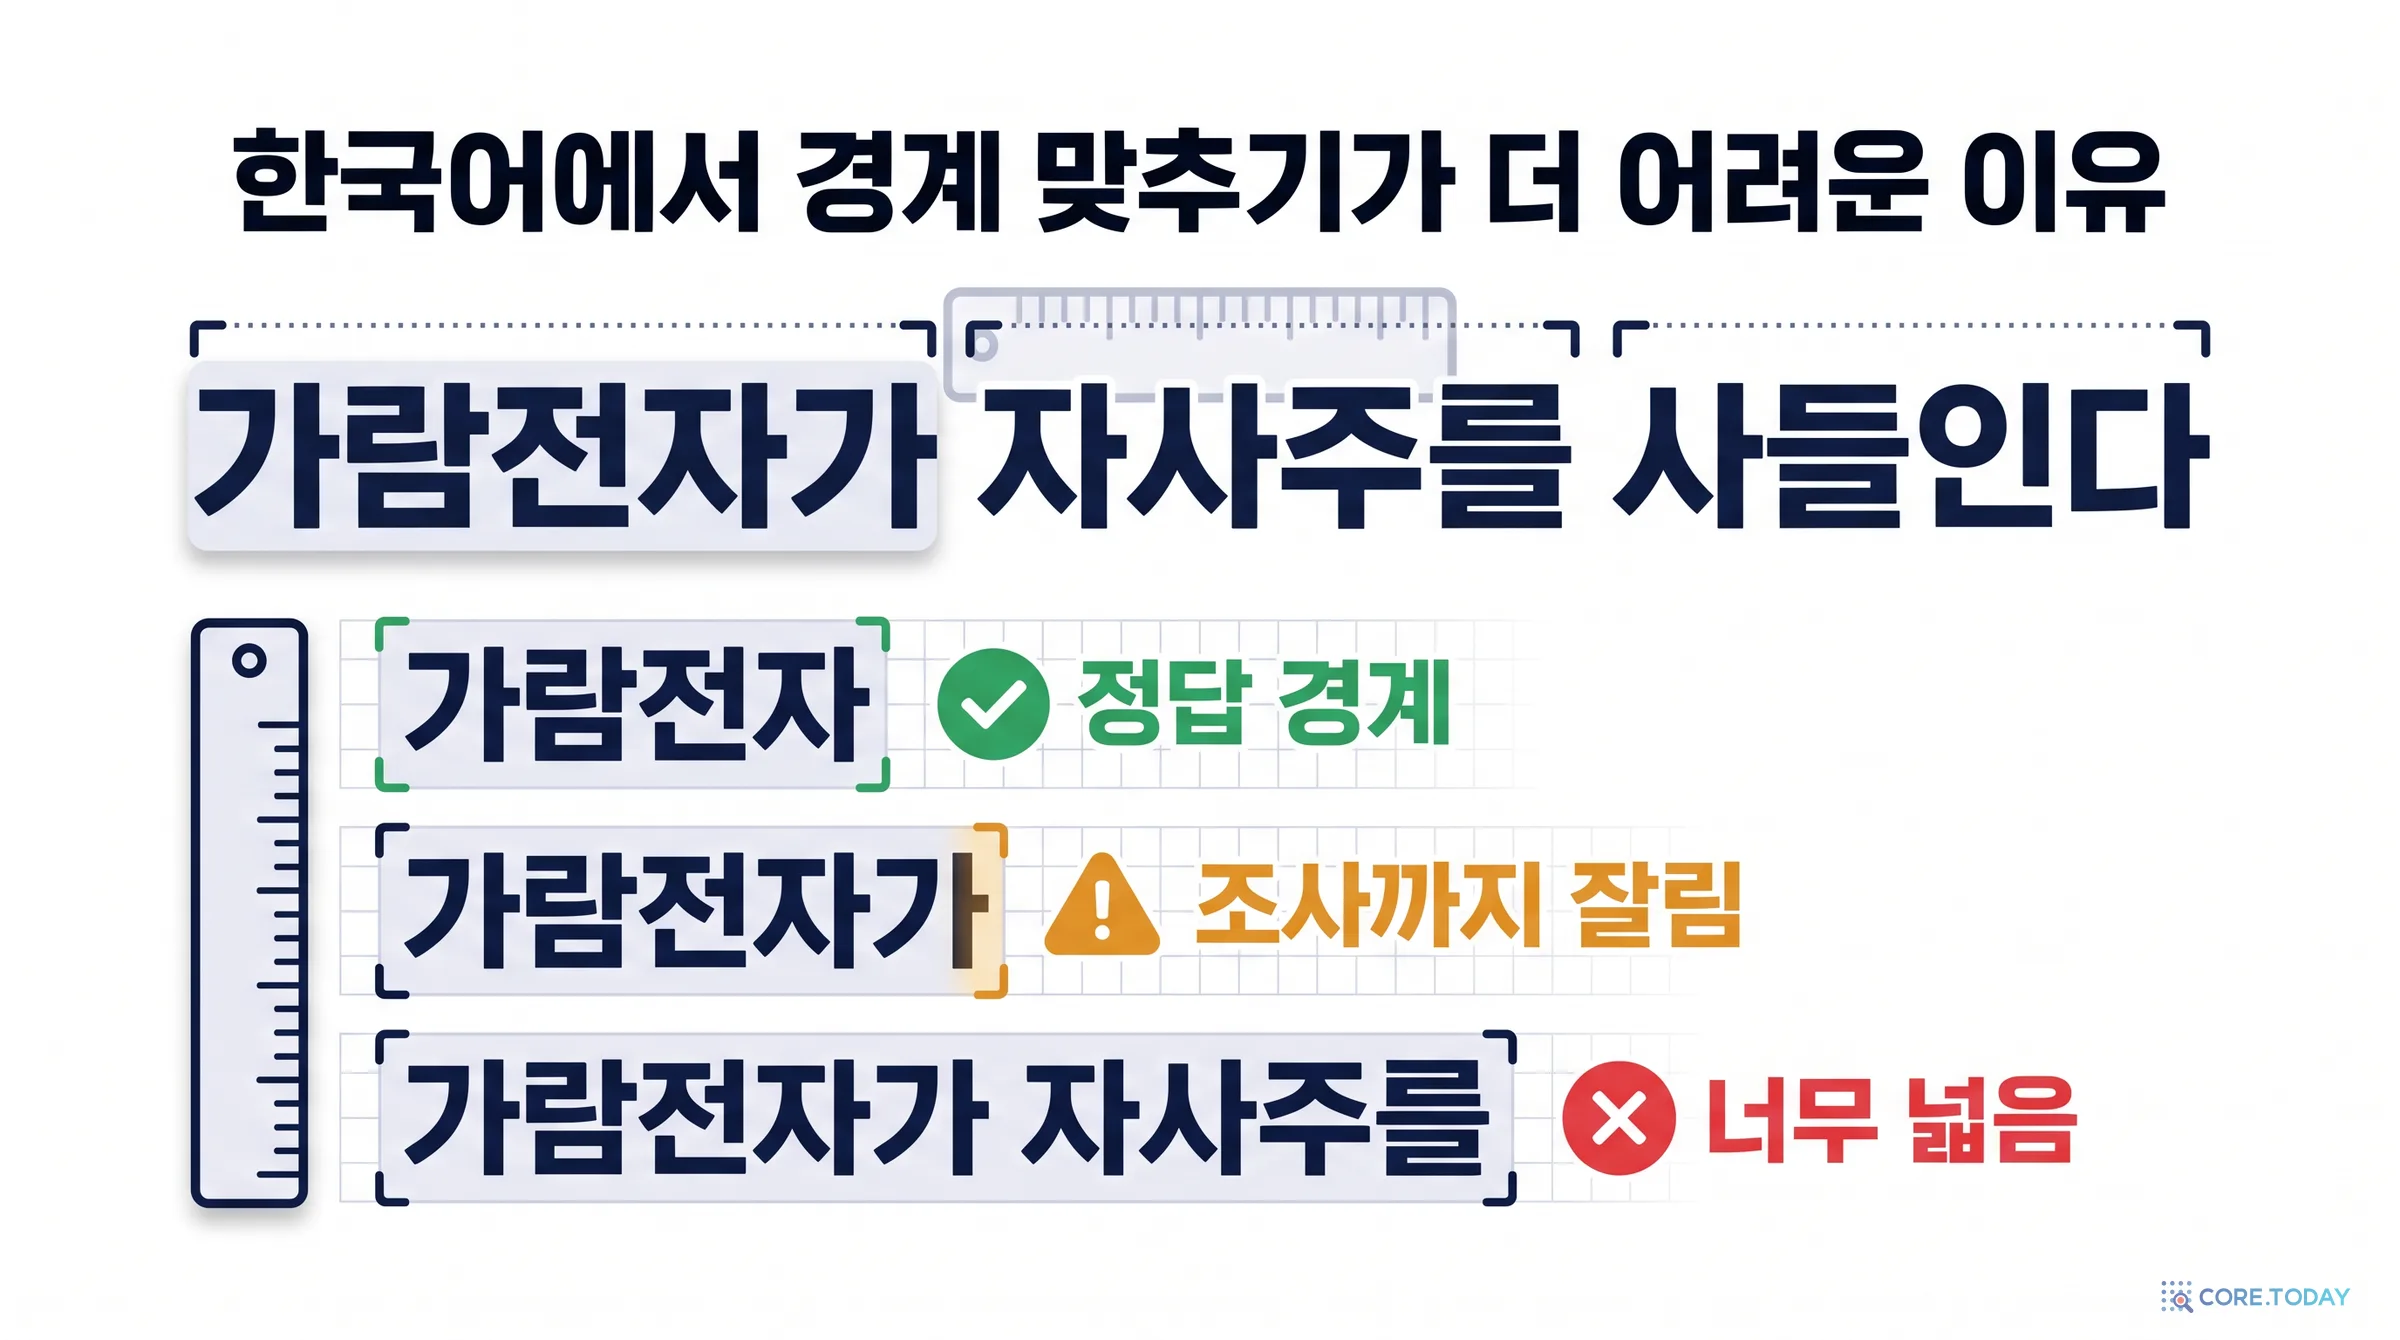
첫째, 글자 경계가 정확해야 합니다. 대부분의 사건 추출 벤치마크는 트리거와 인자를 글자 그대로 맞혀야 점수를 줍니다. 정답이 '체포'인데 '체포했다'를 쓰면 TI가 틀리고, 그 트리거에 매달린 AI+·AC+도 모두 틀립니다. 한국어에서는 조사가 문제를 키웁니다. '서울역'과 '서울역에서'는 사람에게 같은 장소지만 채점기에게는 다른 문자열입니다.
둘째, 스키마가 시험마다 다릅니다. 논문이 쓴 일곱 데이터셋은 사건 유형이 2개(PHEE)부터 50개(WikiEvents)까지 다르고, 같은 '공격'이라도 역할 이름이 다릅니다. 모델은 매번 처음 보는 표를 받아 그 표의 말로 답해야 합니다.
셋째, 주석 관행(annotation convention)을 따라야 합니다. '흉기 난동 용의자 김모 씨'를 통째로 인자로 볼지, '김모 씨'만 볼지는 언어학적 진리가 아니라 주석 지침이 정한 약속입니다. 지침을 보지 못한 모델은 그 약속을 맞힐 방법이 없습니다.
넷째, 무엇을 빼야 하는지도 알아야 합니다. 2024년 TextEE 재평가(Huang 외, ACL Findings)에 실린 사례가 유명합니다. LLM이 'detained(구금됐다)'라는 한 단어를 보고 공격·사망·이동·체포 사건을 한꺼번에 만들어 낸 것입니다. 많이 내면 일부는 맞지만 나머지는 모두 감점입니다. 같은 연구에서 LLM 최고 성적(Mixtral, 예시 64개)은 트리거 분류 F1 14.6이었고, 2020년의 전용 모델 OneIE는 69.5였습니다.
💡 정리하면 사건 추출은 '문장을 이해했는가'가 아니라 '남이 정한 표에, 남이 정한 경계로, 남이 정한 이름을 써 넣었는가'를 묻는 시험입니다. 그래서 범용 지능이 높아도 점수가 잘 오르지 않고, 반대로 작은 모델이 그 표에 길들여지면 크게 오릅니다.
EAGER가 왜 '코드로 출력하고, 강화학습으로 다듬고, 보상을 쪼개는' 모양이 되었는지는 이 분야가 걸어온 길을 보면 자연스럽게 이해됩니다.
1987~1998: MUC, 군사 전문에서 시작된 '템플릿 채우기'
사건 추출의 출발점은 미 해군입니다. 해군 해양시스템센터(NOSC)가 군사 메시지를 자동으로 분석하려고 1987년에 연 첫 메시지 이해 학회(Message Understanding Conference, MUC-1)는 정식 평가 없는 탐색 모임이었습니다. 1989년 MUC-2부터 과제가 '템플릿 채우기'로 정해졌습니다. 해군의 목격·교전 메시지를 읽고 칸이 10개인 양식을 채우는 일이었습니다. 이후 DARPA의 지원으로 해마다 주제가 바뀌었습니다.
회차
해
주제
양식의 크기
MUC-2
1989
해군 목격·교전 메시지
칸 10개
MUC-3
1991
중남미 테러 기사
칸 18개
MUC-4
1992
같은 주제
칸 24개
MUC-5
1993
합작투자·마이크로전자 (영어·일본어)
템플릿 11개, 칸 47개, 과제 설명서 40쪽 이상
MUC-6
1995
경영진 교체 (월스트리트저널)
개체명 인식 분리 평가 시작
MUC-7
1997~98
로켓 발사
항공기 사고로 훈련
이 시기의 숫자 하나가 지금까지 이어지는 이 분야의 성격을 보여 줍니다. 미국 국립표준기술연구소(NIST)가 정리한 최고 성적을 보면, 시나리오 템플릿(사건 채우기) F1은 MUC-4에서 56% 미만, MUC-6에서 57% 미만, MUC-7에서 51% 미만으로 10년 가까이 제자리였습니다. 같은 MUC-7에서 개체명 인식은 94%에 가까웠습니다. 이름 찾기는 풀렸지만 사건 채우기는 풀리지 않는다는 구도가 이때 이미 생겼습니다. 당시 시스템 대부분은 사람이 손으로 짠 패턴을 여러 단계로 잇는 구조였습니다.
2005: ACE, '트리거'와 '인자'라는 말이 생기다
MUC가 주제마다 다른 양식을 썼다면, LDC의 자동 내용 추출(Automatic Content Extraction, ACE) 사업은 범용 사건 체계를 만들었습니다. 2006년 2월에 공개된 ACE 2005 말뭉치(LDC2006T06)는 영어·아랍어·중국어로 개체·관계·사건을 주석했고, 사건은 8개 대분류 33개 소분류로 나눴습니다. 영어 부분만 666개 파일, 30만 단어입니다. 오늘날 쓰는 '트리거', '인자', '역할'이라는 용어와 '트리거 하나 + 역할이 붙은 인자 여러 개'라는 사건 표현이 이 지침에서 굳어졌습니다. EAGER의 식 (1), 사건을 (트리거, 역할, 인자) 묶음으로 쓰는 방식도 이 전통을 그대로 잇습니다.
이후 DARPA DEFT 사업의 ERE(2015), TAC KBP의 사건 인자·사건 조각(nugget) 평가(2014~2015)가 뒤를 이었습니다. 생명과학에서는 2009년 BioNLP 공동 과제가 단백질 사이의 결합·조절 같은 분자 사건을 같은 틀로 다뤘습니다. 24개 팀이 결과를 냈고 최고 F1은 51.95였습니다. EAGER가 쓴 GENIA2011·GENIA2013·MLEE가 이 계보의 후손입니다.
사회과학의 평행선: 사건 데이터
같은 시기 정치학에서는 전혀 다른 이유로 사건을 셌습니다. 국가 사이의 갈등과 협력을 통계로 다루려면 '누가 누구에게 무엇을 했는가'를 대량으로 모아야 했기 때문입니다. 찰스 매클렐런드의 WEIS(1966~1978년 자료)를 시작으로, 2000년대 캔자스대학의 CAMEO 코드북이 '공개 성명'부터 '비관습적 대량 폭력'까지 20개 상위 범주를 정했습니다. DARPA의 ICEWS(2008)와 2013년 공개된 GDELT가 이를 기계 추출로 키웠습니다. GDELT는 2015년부터 15분마다 갱신되며 100개 넘는 언어에서 2억 5천만 건 이상의 사건 기록을 쌓았다고 밝힙니다.
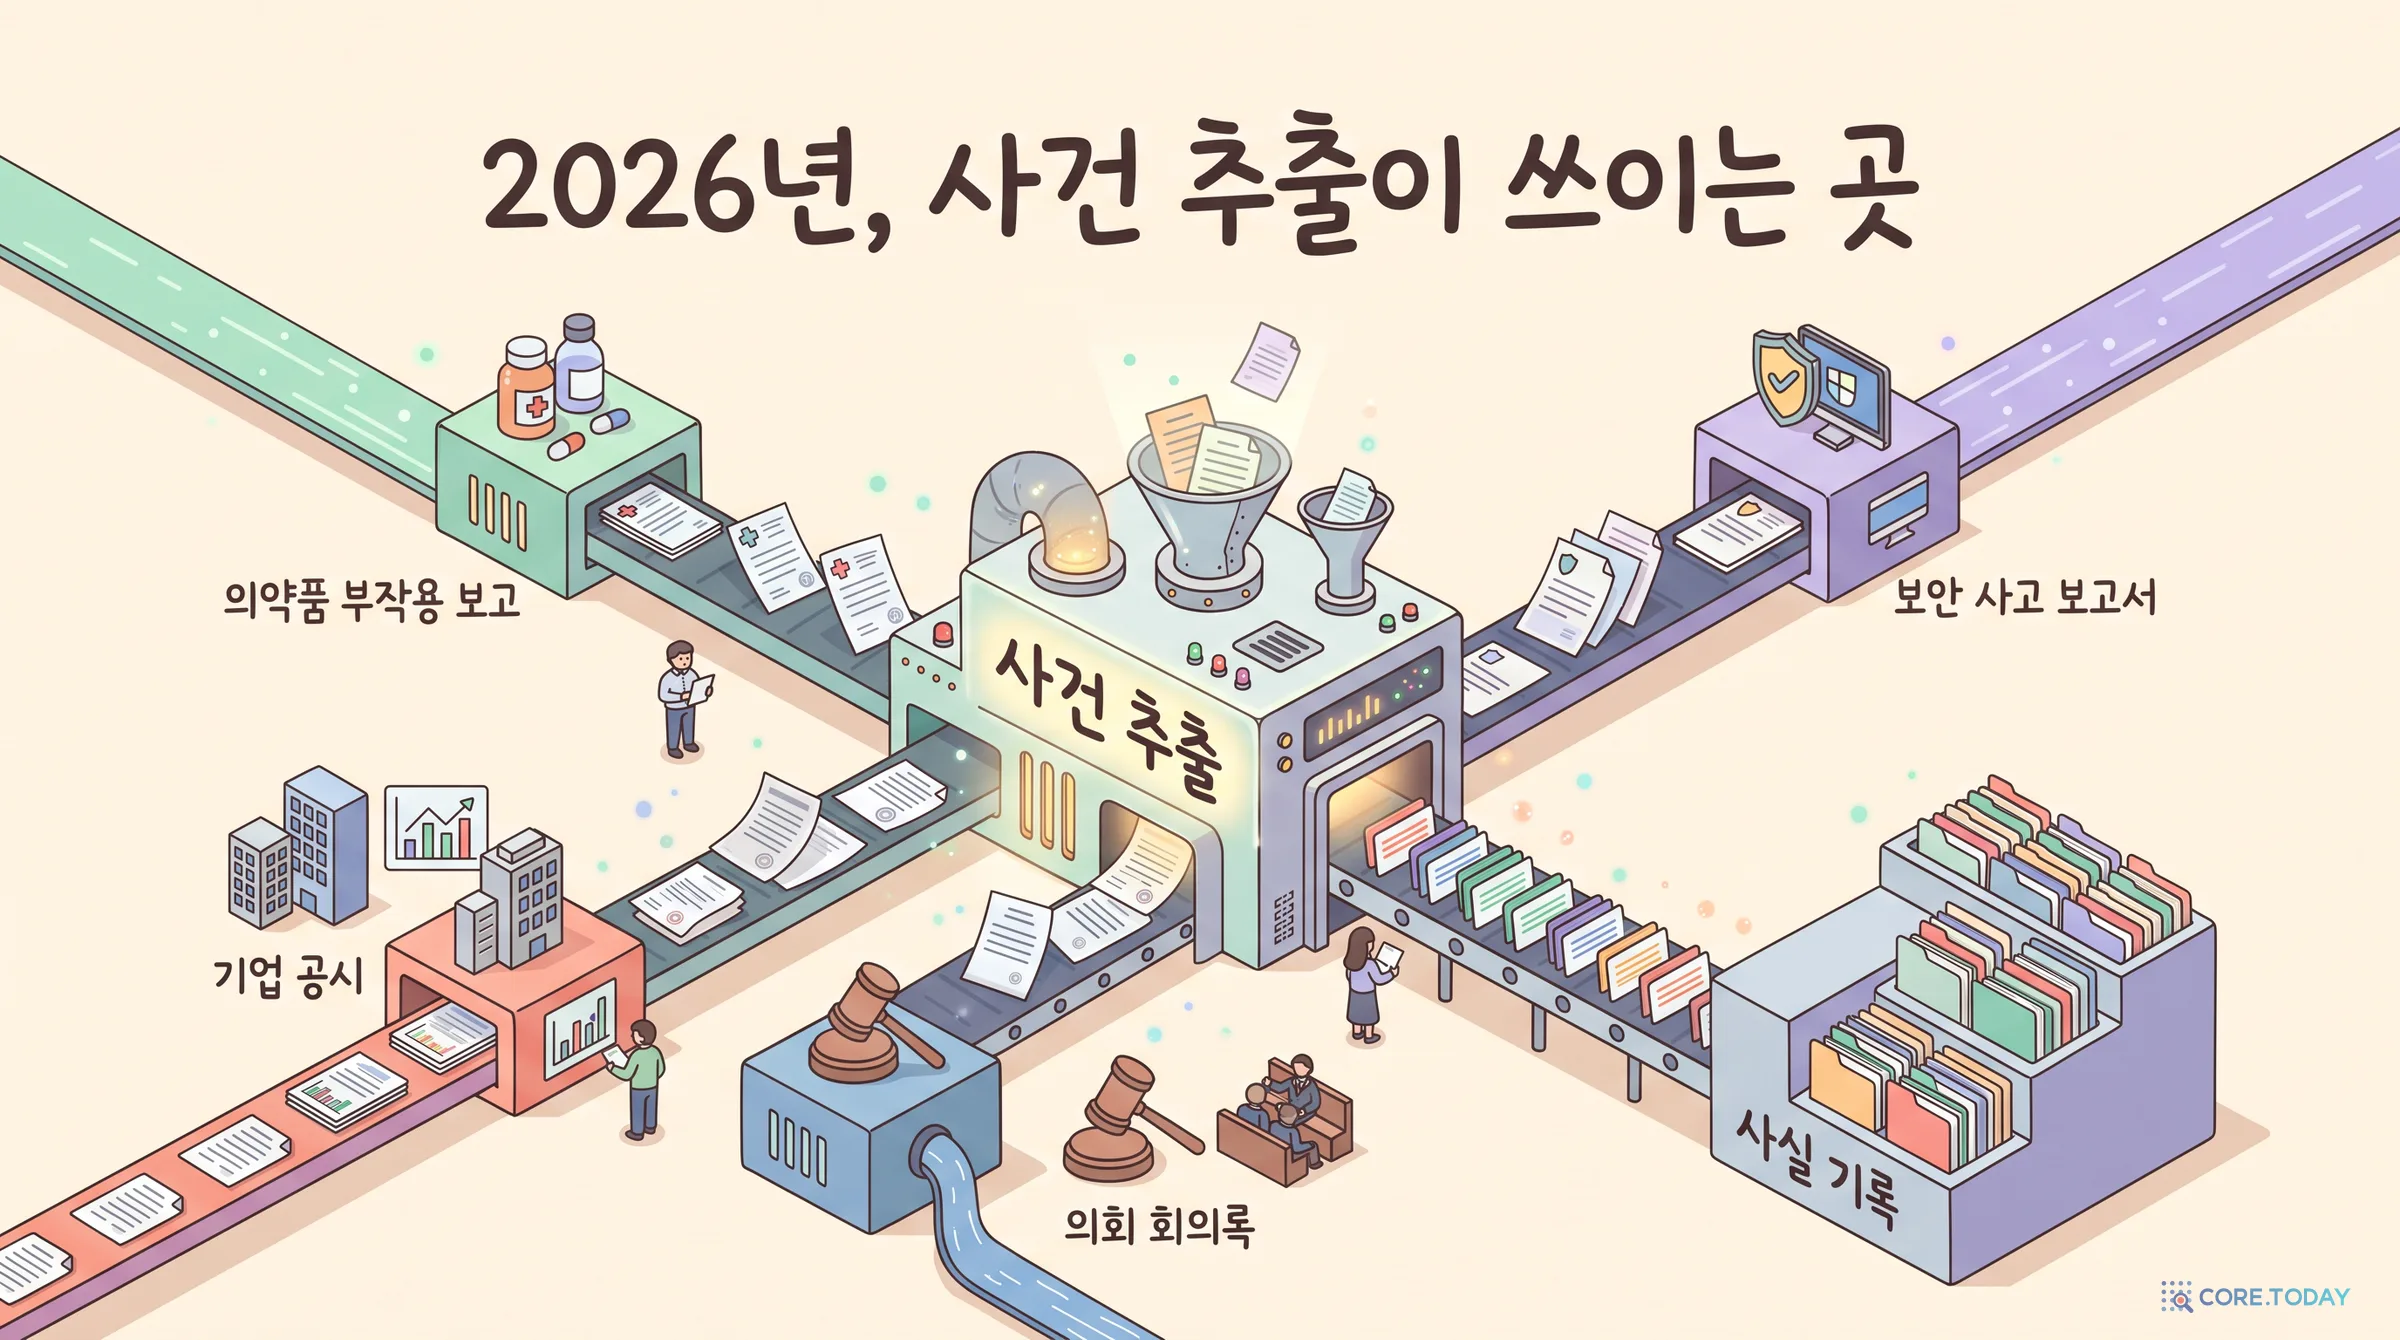
이 줄기가 중요한 이유는 사건 추출의 쓰임새를 보여 주기 때문입니다. 학술 벤치마크는 F1을 다투지만, 현실에서 사건 기록은 분쟁 조기 경보, 금융 신호, 약물 감시, 위협 정보처럼 '대량으로, 빠짐없이, 지어내지 않고' 모아야 의미가 있는 곳에 쓰입니다. EAGER의 보상 가운데 '근거(지어내지 않기)'와 '포괄(빠뜨리지 않기)'이 왜 따로 있는지가 여기서 이해됩니다.
2015~2022: 신경망, 그리고 '생성'으로
DMCNN (2015) 합성곱 + 트리거 위치로 나눈 풀링
→
JRNN (2016) 트리거·인자를 함께 예측
→
DyGIE++ (2019) BERT 스팬 + 그래프 전파
OneIE (2020) 개체·관계·사건을 한 그래프로
→
Text2Event (2021) 문장 → 구조를 '생성'
→
DEGREE (2022) 템플릿 문장을 채워 생성
2015년 DMCNN이 사람이 만든 특징 없이 합성곱 신경망으로 사건을 찾기 시작했고, 2020년 OneIE가 개체·관계·사건을 한 그래프로 함께 풀며 정점을 찍었습니다. 이 모델들은 '분류기'였습니다. 단어마다 "이건 트리거인가, 어떤 유형인가"를 표시하는 방식입니다.
2021년 Text2Event가 방향을 틀었습니다. 문장을 넣으면 사건 구조를 글자로 생성하게 한 것입니다. 분류기는 스키마가 바뀌면 출력층을 다시 만들어야 하지만, 생성 모델은 출력 형식만 바꾸면 됩니다. 2022년 DEGREE는 "누가 어디서 누구를 체포했다" 같은 템플릿 문장을 주고 빈칸을 채우게 해서 적은 데이터로도 배우게 했습니다. EAGER 제목의 'Generative Event Extraction'이 바로 이 흐름입니다.
2023~2024: LLM과 코드, 그리고 '지침'
ChatGPT가 나오자 곧바로 "그냥 시키면 되지 않나"라는 실험이 나왔습니다. 2023년 Gao 외의 연구는 ChatGPT가 길고 복잡한 경우에 전용 모델(EEQA) 성능의 평균 51.04%에 그친다고 보고했습니다(다만 ACE 시험 문장 20개라는 작은 표본이었습니다). 이후 두 가지 아이디어가 나와 지금까지 이어집니다.
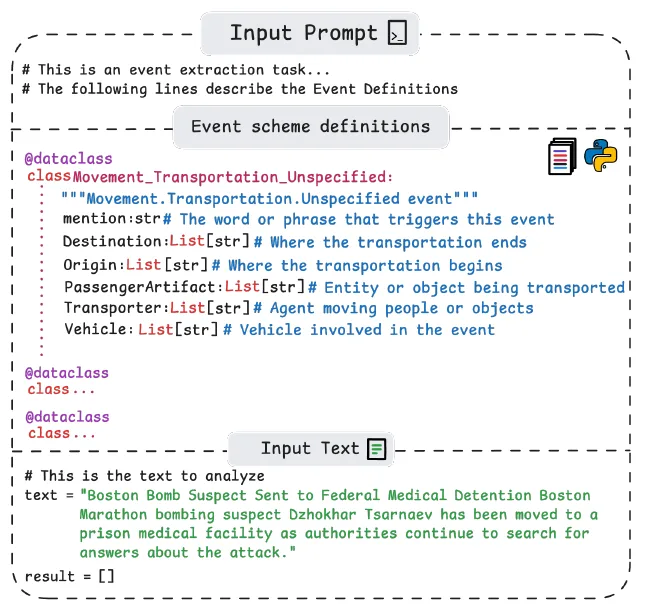
하나는 코드다. 2023년 Code4Struct는 사건 스키마를 파이썬 클래스로, 추출 결과를 클래스 인스턴스로 쓰게 했습니다. LLM이 사전학습에서 엄청난 양의 코드를 봤기 때문에 '클래스 정의에 맞춰 인스턴스를 만드는 일'은 자연어 지시보다 훨씬 덜 헷갈립니다. 유형당 예시 20개로 4,202개를 학습한 지도 모델과 비슷한 성능을 냈습니다.
또 하나는 지침이다. 2024년 ICLR에 실린 스페인 바스크대학의 GoLLIE(Guideline-following Large Language model for IE)는 Code-LLaMA를 '주석 지침을 읽고 따르는' 방향으로 미세조정했습니다. 클래스의 독스트링(docstring)에 사람이 쓰는 주석 지침을 그대로 넣은 것입니다. 처음 보는 스키마에서 GoLLIE-7B의 영점(zero-shot) 평균이 55.3으로, 지침 없이 같은 방식으로 학습한 기준선(42.3)보다 13점 높았습니다. EAGER는 바로 이 GoLLIE-7B를 바탕 모델로 씁니다.
논문 그림 2. 사건 유형 'Movement_Transportation_Unspecified'를 dataclass로 쓰고, 역할마다 주석으로 설명을 붙였습니다. 모델은 맨 아래 result = []의 대괄호 안을 채웁니다. 이렇게 하면 출력이 파이썬 문법으로 파싱되는지만 봐도 형식을 자동 검사할 수 있습니다. 이 '자동 검사 가능성'이 뒤에서 강화학습을 붙일 수 있게 해 줍니다.
2024: 사건 추출에 강화학습이 들어오다
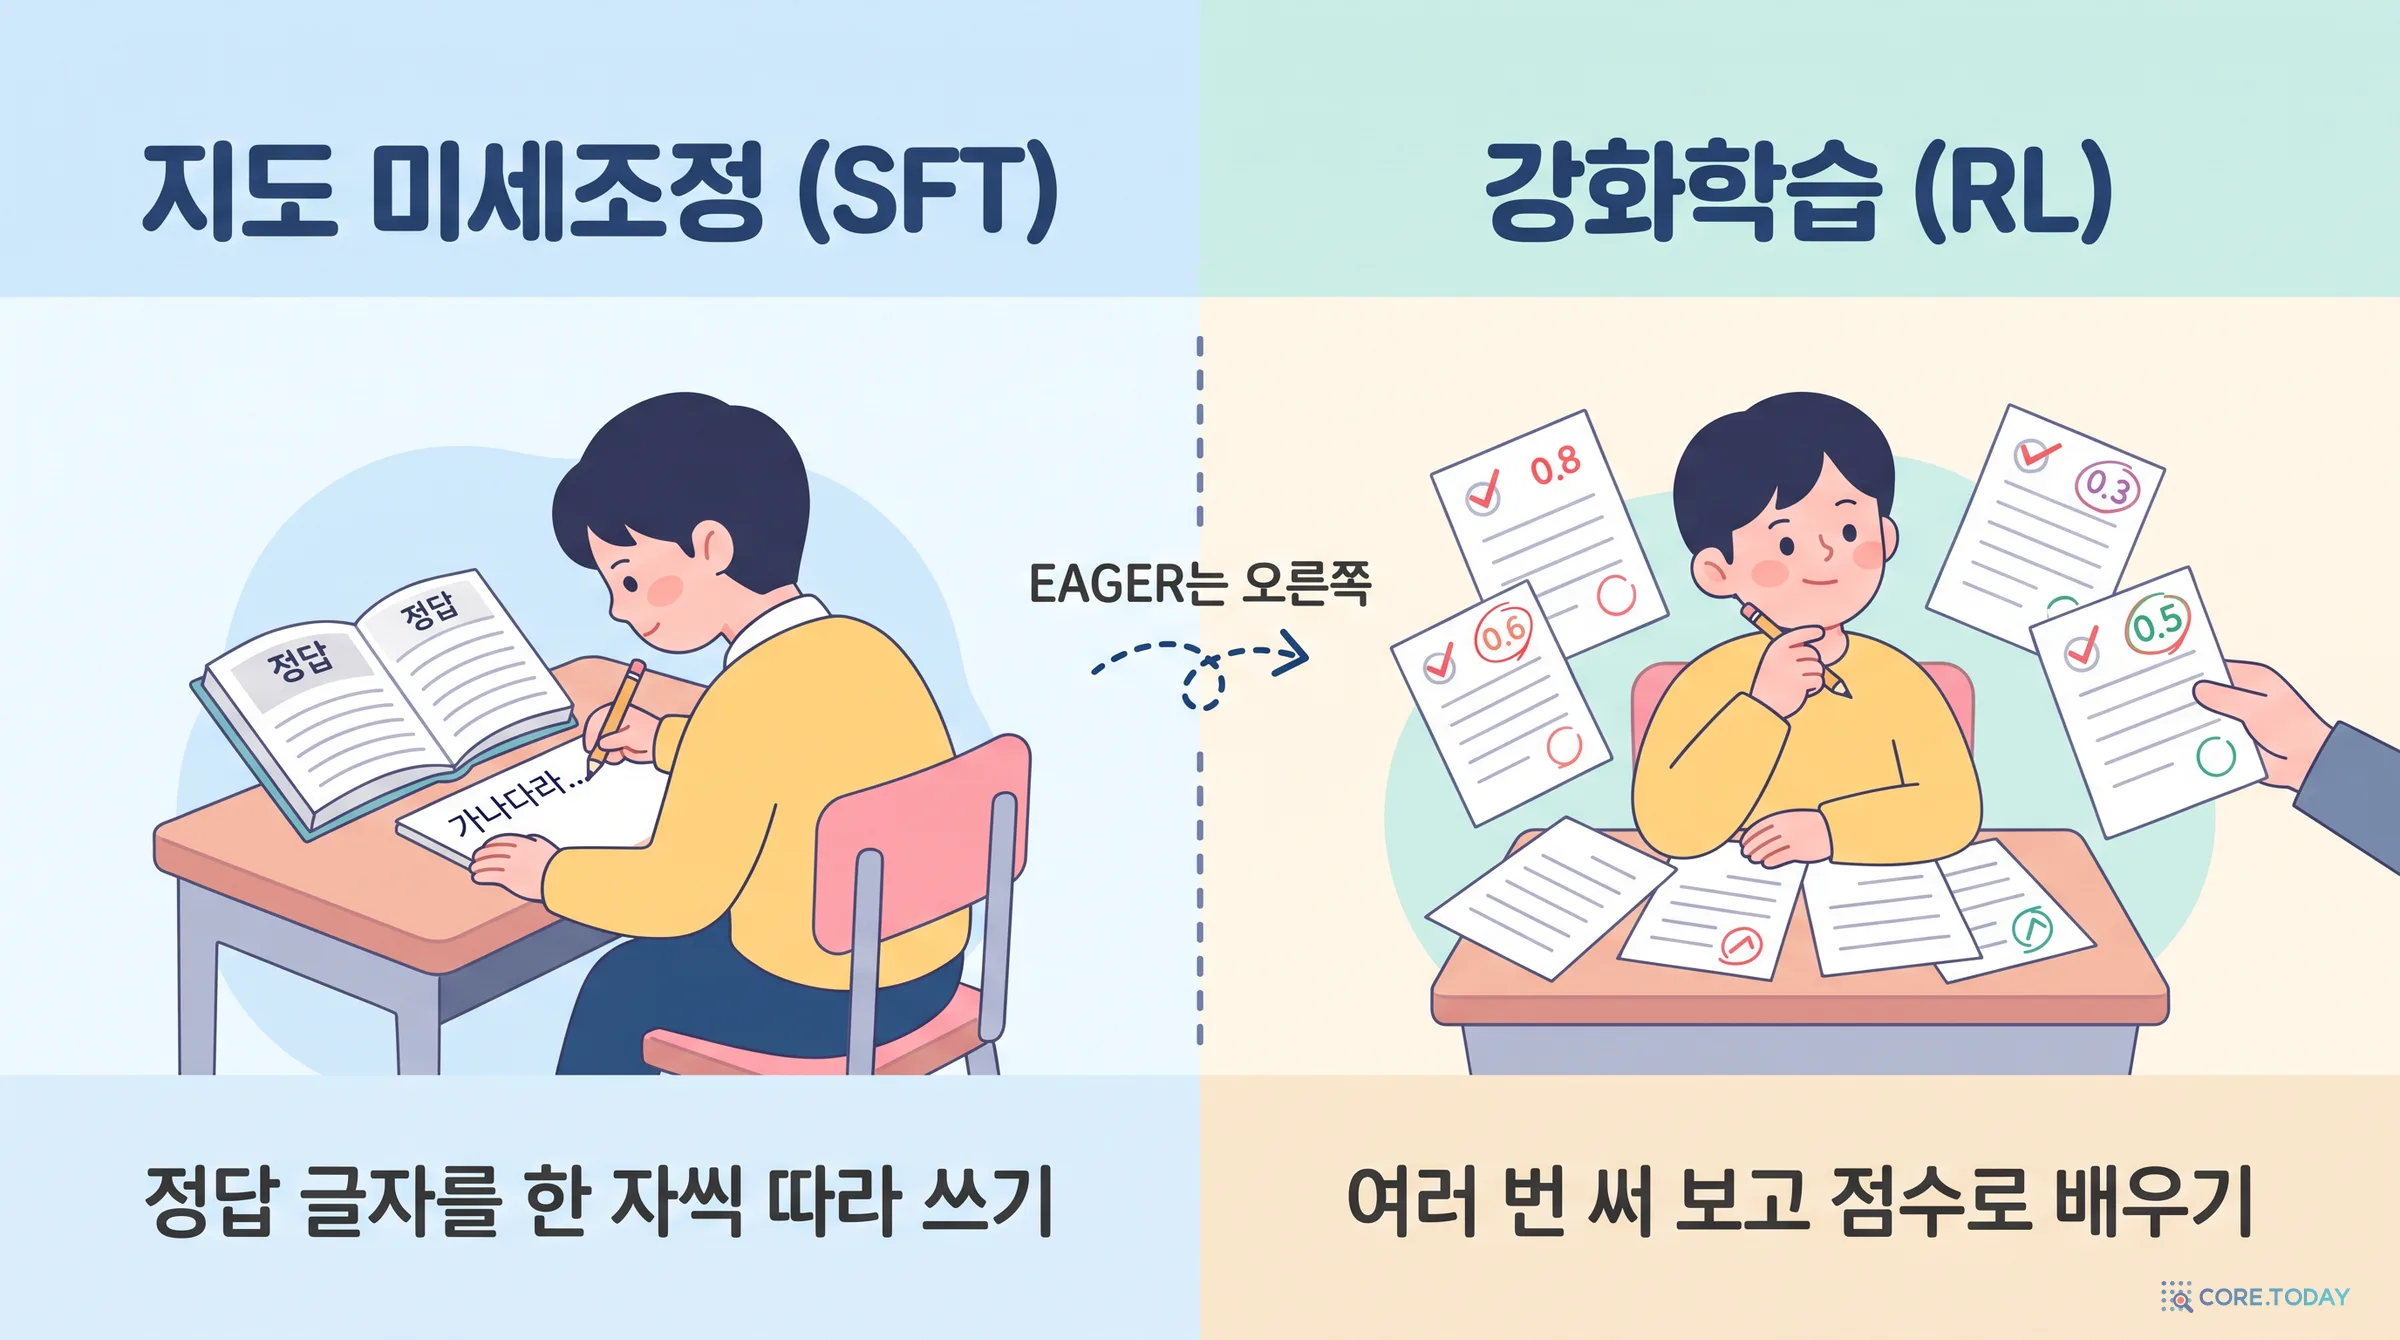
여기까지는 모두 지도학습입니다. 정답 출력을 한 글자씩 따라 쓰게 하는 방식입니다. 2024년 두 연구가 다른 길을 냈습니다.
EventRL(Gao 외, 2024)은 출력 전체를 정답과 비교해 F1을 보상으로 줬습니다. 인자 F1, 평균 F1, 곱 F1 세 가지를 시험했고, 어드밴티지(이 답이 평소보다 얼마나 나은가)는 '무작위로 뽑은 답의 보상 − 가장 그럴듯한 답(greedy)의 보상'으로 계산했습니다. LLaMA와 CodeLLaMA 7B~34B에서 지도 미세조정보다 1~5점 올렸습니다.
ADELIE(Qi 외, EMNLP 2024)는 LLaMA 2 7B를 정보 추출 지시 데이터 8만 3,585개로 미세조정한 뒤, 정보 추출용 선호 쌍 1만 개(온라인 3천, 오프라인 7천)로 DPO를 했습니다. "이 답이 저 답보다 낫다"는 비교로 스키마 준수와 인자 완결성을 가르친 것입니다.
EAGER는 이 둘을 기준선으로 삼고, 그 사이에 등장한 새 무기를 가져옵니다. 바로 '검증 가능한 보상'입니다.
계보 한 줄 요약
손으로 짠 패턴(MUC) → 공통 표준과 용어(ACE) → 신경망 분류기(DMCNN·OneIE) → 구조를 글로 생성(Text2Event) → 코드로 생성하고 지침을 읽힘(Code4Struct·GoLLIE) → 결과 점수로 다듬음(EventRL·ADELIE) → 채점을 쪼개고 학습 신호가 꺼지지 않게 함(EAGER)
지도 미세조정(Supervised Fine-Tuning, SFT)은 정답 출력을 주고 "다음 글자로 이걸 써라"를 반복합니다. 목표는 정답 문자열의 확률을 높이는 것입니다. 문제는 정답과 다르게 썼지만 거의 맞은 답과 완전히 엉뚱한 답을 구별하지 못한다는 점입니다. 둘 다 '정답 글자가 아니다'로 똑같이 처리됩니다. 사건 추출처럼 출력이 구조인 과제에서는 이게 특히 아깝습니다. 인자 다섯 개 중 넷을 맞힌 답과 하나도 못 맞힌 답의 차이를 SFT는 직접 배우지 못합니다.
강화학습은 거꾸로 갑니다. 모델이 직접 답을 써 보게 하고, 그 답에 점수를 매겨, 점수가 높았던 답의 확률을 올립니다. 2025년 Chu 외의 연구 제목이 이 차이를 요약합니다. "SFT는 외우고, RL은 일반화한다(SFT Memorizes, RL Generalizes)". 규칙이나 화면이 조금 바뀐 변형 문제에서 결과 보상으로 학습한 모델은 버텼고 SFT 모델은 무너졌습니다. EAGER 논문도 이 연구를 인용하며, 실제로 자기 실험에서 SFT가 거의 효과가 없었다고 보고합니다(GoLLIE-7B 16.35 → SFT 16.51). 그래서 EAGER는 SFT로 먼저 길들이는 단계 없이 바로 강화학습을 합니다.
'검증 가능한' 보상이란
강화학습에서 가장 비싼 것은 점수를 매기는 사람입니다. ChatGPT를 만든 RLHF(사람 피드백 강화학습)는 사람의 선호를 흉내 내는 보상 모델을 따로 학습했습니다. 보상 모델은 틀리기도 하고, 모델이 그 빈틈을 파고드는 '보상 해킹'도 생깁니다.
2024년 11월 앨런 인공지능연구소(Ai2)의 Tülu 3 보고서가 이름을 붙인 검증 가능한 보상 강화학습(RLVR)은 이 문제를 피해 갑니다. 수학 문제의 최종 답, 코드의 테스트 통과 여부처럼 프로그램이 기계적으로 맞고 틀림을 판정할 수 있는 과제에서는 보상 모델이 필요 없습니다. 2025년 1월 DeepSeek-R1이 이 방식만으로 추론 능력을 끌어올리면서 RLVR은 단숨에 대세가 됐습니다. R1-Zero는 미국 수학 경시 AIME 2024에서 정답률을 15.6%에서 71.0%로 올렸습니다(최초 공개본 기준).
사건 추출은 RLVR을 붙이기 좋은 과제입니다. 출력이 파이썬 코드라 파싱되는지 자동으로 확인할 수 있고, 정답 주석이 있으니 F1을 자동으로 셀 수 있습니다. 다만 수학과 다른 점이 하나 있습니다. '검증기'가 곧 사람이 만든 정답 주석이라는 점입니다. 수학 답은 세상이 정해 주지만 사건 주석은 주석가가 정합니다. 이 차이는 8장에서 다시 다룹니다.
GRPO와 DAPO — 비평가 없이 '그룹 안 상대 점수'로 배우기
강화학습의 고전 알고리즘 PPO는 "이 상황에서 평균적으로 몇 점쯤 받을까"를 예측하는 가치 네트워크(비평가)를 따로 둡니다. 실제 점수에서 이 예측을 뺀 것이 어드밴티지입니다. 2024년 2월 DeepSeekMath 논문의 GRPO(Group Relative Policy Optimization)는 비평가를 없앴습니다. 대신 같은 문제를 여러 번(G번) 풀게 하고, 그 그룹 안의 평균과 표준편차로 점수를 표준화합니다.
A^i=std({Rj}j=1G)Ri−mean({Rj}j=1G)
예를 들어 한 문장에 대해 답을 네 개 뽑았더니 보상이 0.8, 0.3, 0.6, 0.5였다면 평균은 0.55, 표준편차는 약 0.18입니다. 어드밴티지는 +1.39, −1.39, +0.28, −0.28이 됩니다. 첫 답은 "평소보다 훨씬 잘했다", 둘째 답은 "훨씬 못했다"는 신호를 받습니다. 모델은 첫 답을 쓸 때의 선택을 강화하고 둘째 답의 선택을 약화합니다.
EAGER가 쓰는 DAPO(2025년 3월, 바이트댄스·칭화대)는 GRPO를 대규모로 돌릴 때 생기는 문제 네 가지를 고친 판입니다. Qwen2.5-32B로 AIME 2024에서 50점을 내며 DeepSeek-R1-Zero의 같은 크기 모델(47점)을 절반의 학습 단계로 넘었습니다. EAGER 부록 E가 정리한 네 가지는 이렇습니다.
기법
무엇을 고치나
EAGER에서의 설정
Clip-Higher
확률을 올리는 쪽의 상한을 더 넓게 열어 탐색이 일찍 죽는 것(엔트로피 붕괴)을 막음
εlow 0.2, εhigh 0.28
토큰 단위 손실
긴 답의 토큰이 짧은 답보다 덜 반영되는 길이 편향 제거
식 (3)의 1/Σ|oi|
동적 샘플링
그룹 안 점수가 모두 같아 신호가 0인 그룹을 버리고 다시 뽑음
알고리즘 1의 13~15행(σ=0이면 건너뜀)
KL 제거
원래 모델에서 멀어지지 말라는 벌점을 없앰
β = 0
KL 제거에 대한 저자들의 설명이 흥미롭습니다. 대화 모델을 다듬는 RLHF에서는 원래 모델의 말투를 지키는 게 중요하지만, 사건 추출은 오히려 원래 분포에서 멀리 벗어나야 스키마에 딱 맞는 출력 습관을 얻는다는 것입니다. 엄격한 형식을 배우는 과제에서는 '원래 모습 유지'가 족쇄가 됩니다.
여기서 기억해 둘 것은 동적 샘플링입니다. DAPO는 그룹 점수가 모두 같으면 그 그룹을 버립니다. 버린 만큼 다시 뽑아야 하니 계산이 낭비됩니다. 그런 그룹이 너무 많으면 학습이 사실상 멈춥니다. EAGER의 두 번째 기여 SCAE는 이 문제를 겨냥합니다.
4장. EAGER의 입력 — 코드 스키마, 지침, 그리고 '오답 보기'
EAGER의 입력은 GoLLIE의 형식을 그대로 따릅니다. 과제 지시문 I, 사건 스키마 E, 분석할 문장 X를 이어 붙인 프롬프트입니다. 여기에 두 가지가 더해집니다.
지침을 LLM이 쓰게 하기
GoLLIE의 핵심은 클래스 독스트링에 주석 지침을 넣는 것이었습니다. 그런데 일곱 데이터셋, 수백 개 사건 유형마다 사람이 지침을 쓰는 건 비쌉니다. EAGER는 2025년 Srivastava·Pati·Yao(ACL Findings)의 'Guideline-PN' 방식으로 지침을 자동 생성합니다. Llama-3.1-8B-Instruct에게 한 사건 유형마다 그 유형의 주석 예시 10개(긍정)와 그 유형이 없는 다른 문장 15개(부정)를 보여 주고, ① 역할 목록, ② 유형의 정확한 정의, ③ 역할마다 의미·대표 표현·헷갈리는 경우를 쓰게 합니다. 부정 예시를 함께 주는 이유는 "이건 체포가 아니라 소환이다" 같은 경계를 스스로 찾게 하려는 것입니다.
보거나 듣거나 만지는 등 감각으로 무언가를 관찰·조사하는 행위. 카메라·현미경 같은 도구를 쓸 수 있다. Justice_Convict(유죄 판결)나 Transaction(거래)과 달리 법적·금전적 거래를 포함하지 않는다. 'searched', 'found', 'looked', 'reviewing'은 다른 유형이 아니라 이 유형의 트리거다.
효과는 큽니다. 표 4에서 지침을 빼면 EAGER의 평균 F1은 30.79에서 22.61로 8.18점 떨어집니다. 바탕 모델 GoLLIE-7B는 16.35에서 5.81로 3분의 1이 됩니다. 이 글 뒤에서 보겠지만, 지침 하나를 빼는 효과가 보상 네 개를 빼는 효과(3.43점)보다 두 배 이상 큽니다.
오답 보기: 음성 스키마
학습 프롬프트에는 정답 사건 유형의 스키마만 넣지 않습니다. 그 문장에 없는 사건 유형의 스키마도 K개 섞습니다. 이를 음성 스키마(negative schema)라고 부릅니다. 2024년 IEPile 연구가 보인 방법으로, 객관식 시험에 오답 보기를 섞는 것과 같습니다. 정답 스키마만 주면 모델은 "주어진 유형은 무조건 있다"고 배웁니다. 오답 보기가 섞여 있어야 "이 문장에 이 유형은 없다"를 배웁니다. EAGER는 K=10을 썼습니다. GPU 메모리와 프롬프트 길이 상한 1만 6천 토큰이 허락하는 최대치였다고 합니다.
추론할 때는 다릅니다. 부록 D에 따르면 시험 문장에는 그 데이터셋의 모든 스키마를 한꺼번에 주고, 모델이 한 번에 사건 목록을 씁니다. 학습 때는 '정답 + 오답 10개', 시험 때는 '전부'입니다.
EventRL은 F1 하나를 보상으로 썼습니다. EAGER의 첫 번째 주장은 F1 하나로는 '어떻게 틀렸는지'를 알려 줄 수 없다는 것입니다. F1이 0.6인 답이 두 개 있다고 합시다. 하나는 원문에 없는 인자를 지어냈고, 하나는 인자를 두 개 빠뜨렸습니다. 고쳐야 할 방향은 정반대인데 점수는 같습니다. 그래서 EAGER는 논문 표 1과 부록 F에서 보상을 여섯 개로 나눕니다.
보상
무엇을 재나
식 (부록 F)
겨냥하는 실수
형식 Rfmt
출력이 파이썬 코드로 파싱되는가
되면 1, 안 되면 0
구조 붕괴
정확도 REE
정답과 얼마나 겹치나
TI·TC·AI·AC·AI+·AC+ 여섯 F1의 합(평균)
전반적 오답
근거 Rgrd
트리거·인자가 원문에 글자 그대로 있나
(트리거 지지율 + 인자 지지율) / 2
환각
과잉 억제 Rovr
정답 개수보다 많이 냈나
max(0, 1 − 초과 개수 / 정답 개수)
지어내기·남발
포괄 Rcov
정답 개수만큼 냈나
½(min(1, 낸 사건/정답 사건) + min(1, 낸 인자/정답 인자))
빠뜨리기
경계 Rspan
스팬을 정답보다 넓게 잘랐나
자카드 유사도 − 넓힌 만큼 벌점, 넓힌 게 없으면 0
경계 부풀리기
몇 가지 설계가 눈에 띕니다.
근거 보상은 유형이 맞는지 보지 않습니다. 원문에 있는 글자인지만 봅니다. "있는 글자로 틀리는 것"과 "없는 글자를 지어내는 것"을 따로 다루겠다는 뜻입니다.
과잉 억제와 포괄은 짝입니다. 과잉 억제만 있으면 모델은 아무것도 안 내는 쪽으로 도망칩니다. 그래서 포괄 보상이 '덜 내면 손해'를 줍니다. 포괄의 min(1, ·)은 많이 낸다고 점수가 1을 넘지 않게 막아 둘이 서로를 상쇄하지 않게 합니다.
과잉 억제와 포괄은 '개수'만 봅니다. 맞았는지는 보지 않습니다. 엉뚱한 인자 다섯 개를 내도 정답이 다섯 개면 둘 다 만점입니다. 내용은 정확도 보상에 맡긴 것입니다.
경계 보상은 '거의 맞은 답'을 구하려고 만든 것입니다. 정답이 '서울역'인데 '서울역 광장'을 냈다면 정확 일치로는 0점이지만, 의미는 거의 맞았습니다. 자카드 유사도로 부분 점수를 주되, 정답을 품은 채 넓어진 만큼은 깎습니다.
아래 계산기에서 실수를 하나씩 켜 보세요. 이진 보상(전부 맞으면 1)은 실수가 하나든 다섯이든 0이지만, 여섯 보상은 실수의 종류에 따라 다르게 움직입니다.
여섯 개를 어떻게 합치나 — 보상 분리 정규화(RDN)
보상이 여러 개면 합치는 방법이 문제입니다. 가장 쉬운 건 가중치를 정해 더하는 것인데, 두 가지 문제가 있습니다. 가중치를 손으로 골라야 하고, 크게 흔들리는 보상 하나가 합계를 지배합니다. EAGER는 2026년 1월 엔비디아의 GDPO(Group reward-Decoupled normalization Policy Optimization)가 제안한 방법을 씁니다. 보상마다 먼저 그룹 안에서 표준화한 다음 더하는 것입니다.
R~i(m)=σ(m)+ϵRi(m)−μ(m),R^i=∑m=1MR~i(m)
GDPO 논문이 지적한 문제는 이렇습니다. 보상을 그냥 더하면 서로 다른 보상 조합이 같은 합계, 같은 어드밴티지로 뭉개집니다. "정확도는 높고 과잉은 많은 답"과 "정확도는 낮고 과잉은 없는 답"이 같은 신호를 받습니다. 보상마다 표준화하면 각 보상이 같은 크기의 목소리를 냅니다.
3장의 GRPO 식을 다시 보세요. 어드밴티지는 '그룹 평균과의 차이 ÷ 그룹 표준편차'입니다. 네 답이 모두 1.0을 받으면 평균과의 차이가 모두 0입니다. 모두 0을 받아도 마찬가지입니다. 어드밴티지가 0이면 그 문제에서는 기울기가 0, 즉 아무것도 배우지 않습니다. 이걸 어드밴티지 붕괴(advantage collapse)라고 합니다.
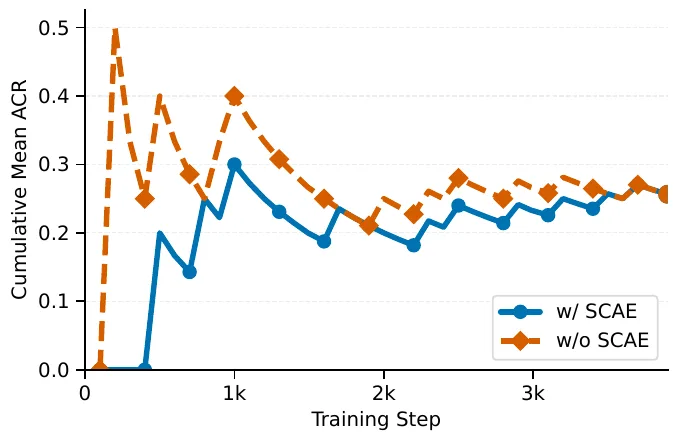
이 현상은 2026년 들어 따로 이름이 붙을 만큼 주목받았습니다. He 외의 「Advantage Collapse in Group Relative Policy Optimization: Diagnosis and Mitigation」(arXiv 2605.21125, ICML 2026)은 이를 재는 지표로 어드밴티지 붕괴율(Advantage Collapse Rate, ACR)을 정의했습니다. 학습 그룹 가운데 보상 표준편차가 사실상 0(τ ≈ 10−6)인 그룹의 비율입니다.
ACR=N1∑j=1NI(σRj<τ)
ACR이 0이면 거의 모든 그룹이 학습 신호를 주고, 1이면 학습이 완전히 멈춥니다. 수학 문제에서는 너무 쉬운 문제(네 번 다 맞힘)와 너무 어려운 문제(네 번 다 틀림)가 붕괴를 만듭니다. DAPO의 동적 샘플링은 이런 그룹을 버리고 다시 뽑는 처방이었고, He 외는 가상의 보상 표본을 끼워 넣는 AVSPO로 붕괴를 58~63% 줄였다고 보고합니다.
사건 추출에서는 왜 더 자주 붕괴하나
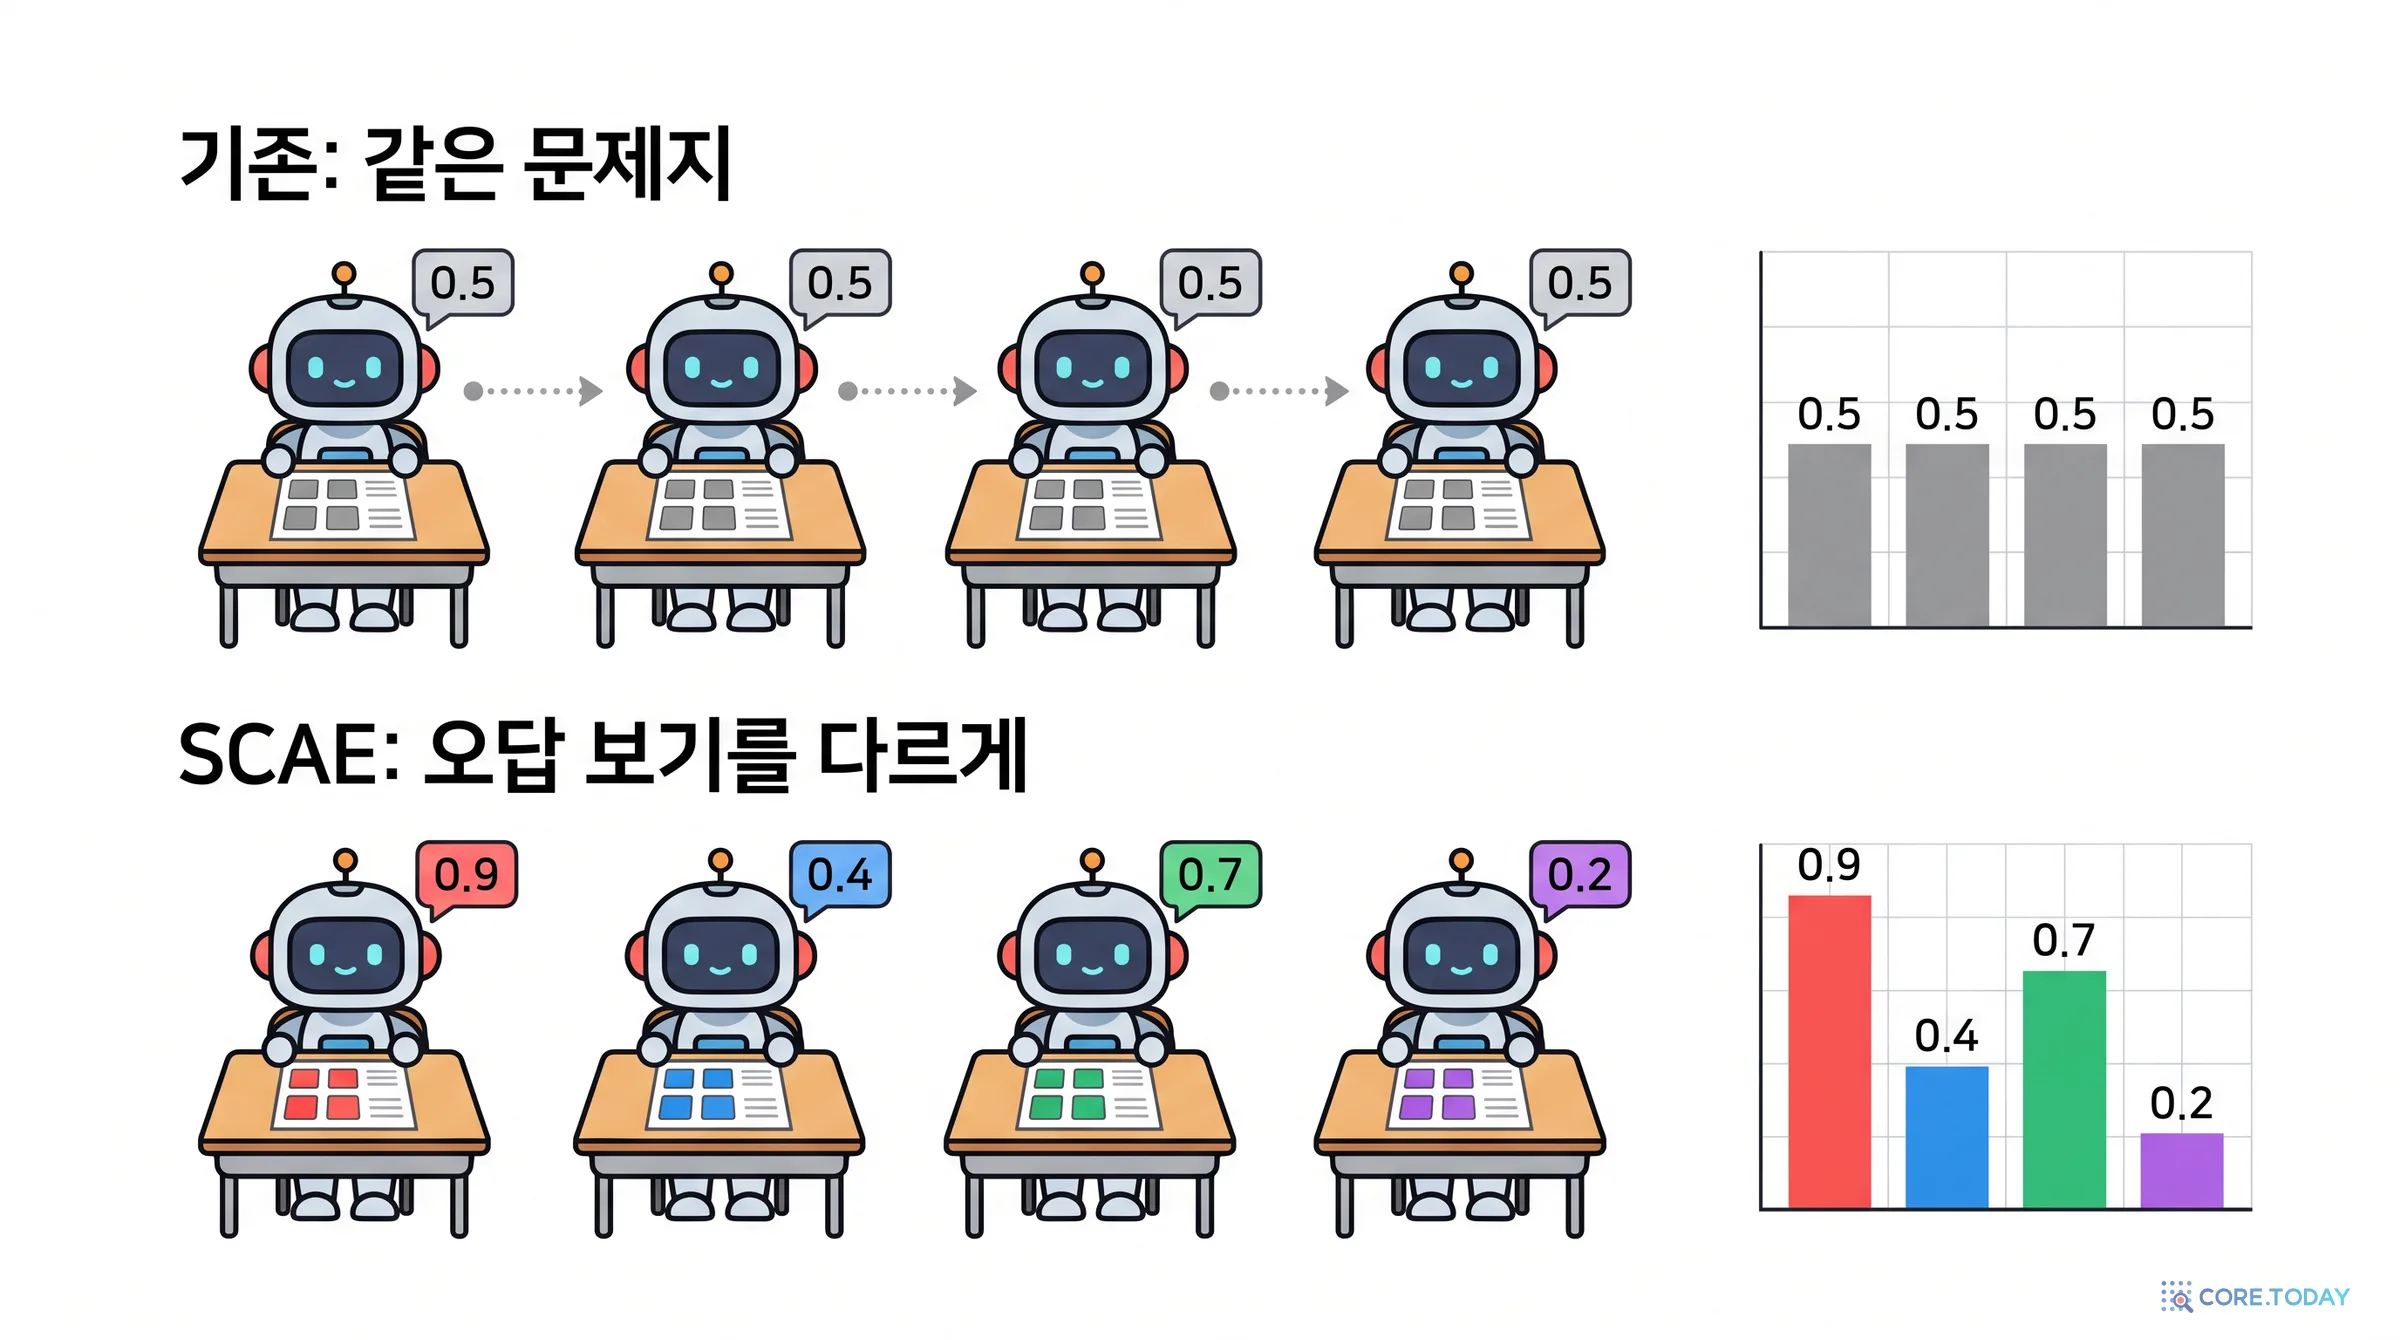
EAGER 저자들은 사건 추출에 고유한 원인을 하나 더 짚습니다. 같은 그룹의 답 네 개가 모두 똑같은 프롬프트, 똑같은 오답 보기를 보고 쓴다는 점입니다. 오답 보기(음성 스키마)는 "이 문장에 어떤 유형이 있나"를 가르는 결정적인 단서입니다. 그게 같으면 모델은 네 번 모두 비슷한 판단을 내리고, 비슷한 출력을 냅니다. 온도 0.6으로 샘플링해도 구조화된 코드 출력은 크게 흔들리지 않습니다. 결과적으로 Var({Ri} | P) ≈ 0인 그룹이 많아집니다.
EAGER의 처방은 간단합니다. 그룹 안의 답 G개를 쓸 때 답마다 음성 스키마 묶음을 따로 뽑아 프롬프트를 다르게 만드는 것입니다. 논문은 이를 스키마 대조 어드밴티지 추정(Schema-Contrastive Advantage Estimation, SCAE)이라고 부릅니다.
Pi=I⊕EeG⊕Si⊕X,Si∼i.i.d.(KN)
정답 스키마 EeG와 문장 X는 같고, 오답 묶음 Si만 답마다 다릅니다. 어떤 답은 헷갈리기 쉬운 유형(체포 문장에 '기소'가 섞임)을 받고, 어떤 답은 쉬운 유형(체포 문장에 '배당결정'이 섞임)을 받습니다. 난이도가 달라지니 점수가 흩어지고, 그룹 안 분산이 커집니다.
Var({Ri}i=1G)≫Var({Ri}i=1G∣P)
어드밴티지는 이렇게 만든 '대조 그룹' 안에서 똑같이 표준화하고, 나머지는 DAPO와 같습니다. 부록 알고리즘 1을 보면 바뀐 곳은 7~8행, 답마다 음성 스키마를 새로 뽑아 프롬프트를 만드는 두 줄뿐입니다.
이 처방이 기묘하게 느껴질 수 있습니다. GRPO의 어드밴티지는 "같은 조건에서 이 답이 다른 답보다 나았나"를 묻는 상대 평가입니다. SCAE는 조건(프롬프트)을 일부러 다르게 만듭니다. 그러면 어떤 답의 점수가 높은 이유가 답을 잘 써서인지 쉬운 문제지를 받아서인지 섞입니다. 논문은 이 점을 따로 논의하지 않습니다. 그래도 정답 스키마와 문장이 같고 바뀌는 것이 '방해 요소'뿐이라면, 쉬운 문제지에서 맞힌 답의 습관과 어려운 문제지에서 틀린 답의 습관을 비교하는 것도 쓸모 있는 신호입니다. 방해 요소에 덜 흔들리는 습관을 강화하는 셈이기 때문입니다.
논문 그림 3. 누적 평균 ACR입니다. 학습 초반 1천 단계 동안은 SCAE가 붕괴율을 확실히 낮춥니다. 다만 그래프가 보여 주는 약 3,800단계(전체 학습은 1만 4천 단계 이상, 그림 4 참고) 끝에서는 두 선이 0.25 안팎으로 거의 붙어 있습니다. 본문은 "학습 내내 일관되게 훨씬 낮다"고 쓰지만, 그림으로 확인되는 건 '초반에 확실히 낮다'까지입니다.
아래 위젯의 위쪽 칸에서는 네 답의 점수를 직접 움직여 어드밴티지가 어떻게 바뀌는지 볼 수 있습니다. 아래쪽 칸은 코어닷투데이가 한국어 문장 40개로 실제로 잰 그룹들입니다(9장에서 자세히 다룹니다).
7장. 결과 읽기 — 무엇이 이겼고, 무엇 덕분인가
실험 설정 한눈에
항목
설정
바탕 모델
GoLLIE-7B (Code-LLaMA 7B를 지침 따르기로 미세조정한 2023년 모델)
미세조정 방식
QLoRA, 어텐션 투영층, 랭크 8, α 16
강화학습
DAPO + SCAE + RDN, TRL 라이브러리, 학습률 1×10⁻⁶, 배치 4
그룹
G = 4 (2보다 4가 좋았고 8은 계산 예산 밖), 음성 스키마 K = 10
샘플링
핵 샘플링 p = 0.9, 온도 0.6 / 평가는 탐욕 디코딩
학습 데이터
일곱 데이터셋 학습 세트를 이어 붙여 섞음 (도메인·스키마가 섞인 배치)
계산
H100 4장, 1에폭 약 4시간, 최대 10에폭, 검증 3회 연속 개선 없으면 조기 종료
일곱 데이터셋은 도메인이 넓게 퍼져 있습니다. 위키백과 기반 뉴스 사건(WikiEvents, 50개 유형), 의약품 부작용 보고(PHEE, 2개 유형, 아스트라제네카와 함께 만든 5천 건 넘는 약물 안전 사건), 사이버보안 사고 기사(CASIE, 1천 건, 5개 유형), PubMed 초록의 생명과학 사건(GENIA2011·2013, MLEE), 멀티미디어 뉴스의 글 부분(M2E2)입니다.
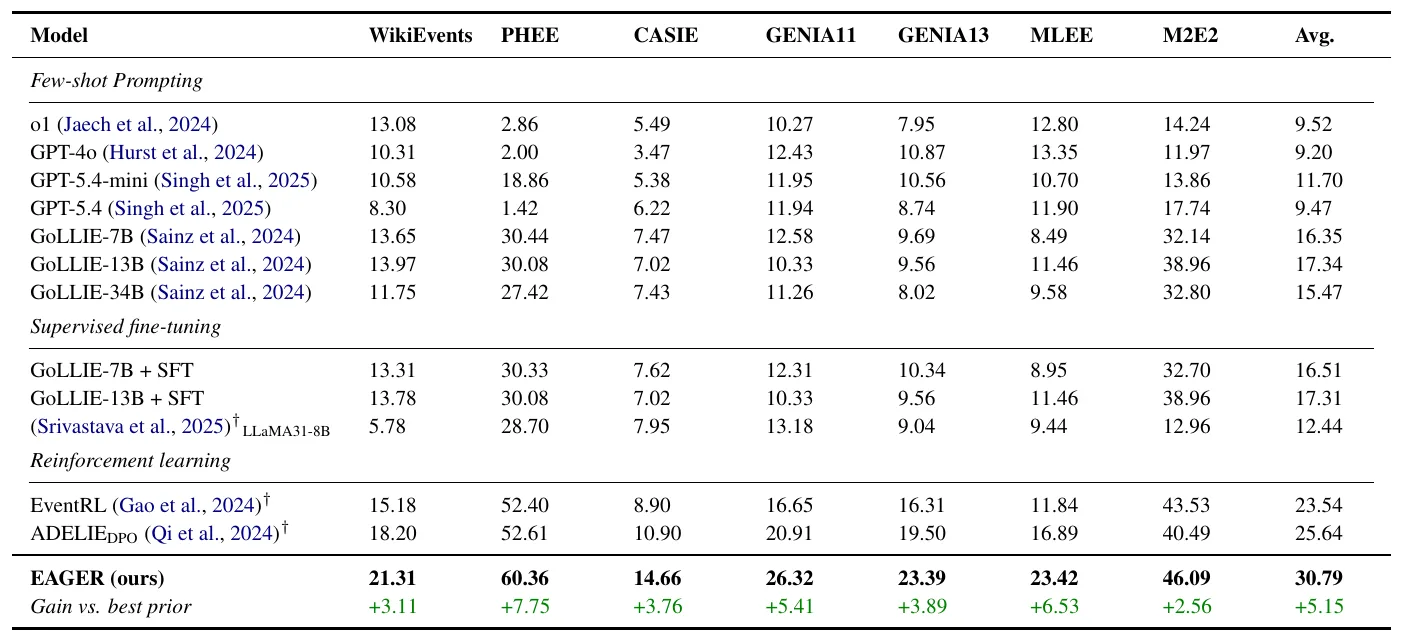
논문 표 2. 초록색 숫자가 기존 최고 대비 이득입니다. 가장 크게 오른 곳은 PHEE(+7.75)와 MLEE(+6.53)입니다.
읽을 점은 세 가지입니다.
크기보다 적응이다. 퓨샷 프런티어 모델은 평균 9~12점, 정보 추출 전용 GoLLIE는 크기와 상관없이 15~17점입니다(34B가 7B보다 낮습니다). 강화학습을 거친 7B는 23~31점입니다.
SFT는 거의 효과가 없다. GoLLIE-7B에 SFT를 하면 16.35에서 16.51로 0.16점 오릅니다. 저자들은 "SFT가 빨리 포화된다"고 해석합니다.
강화학습끼리도 차이가 크다. EventRL(23.54) → ADELIE-DPO(25.64) → EAGER(30.79). 같은 7B 바탕에서 보상 설계와 학습 방식만으로 7점이 갈립니다.
절제 실험: 무엇이 효과였나
결과가 좋을 때 가장 중요한 질문은 "무엇 덕분인가"입니다. 논문은 표 3·4·6에서 구성 요소를 하나씩 뺍니다. 아래 위젯의 두 번째 탭에서 같은 숫자를 데이터셋별로 볼 수 있습니다.
절제 결과를 낙폭 순서로 정리하면 이렇습니다.
SCAE 빼기
−8.25
주석 지침 빼기
−8.18
추가 보상 4개 빼기
−3.43
보상 3개 빼기(경계는 남김)
−1.80
EAGER 평균 30.79에서 각 요소를 뺐을 때의 평균 F1 하락폭. 막대 길이는 가장 큰 낙폭(8.25)을 100%로 둔 비율입니다. '보상 3개 빼기'는 근거·과잉·포괄을 빼고 경계만 남긴 설정(28.99)과의 차이입니다.
여섯 보상이 논문의 첫 번째 기여로 소개되지만, 숫자로 보면 가장 큰 두 기둥은 SCAE와 주석 지침입니다. 저자들도 RQ1의 답으로 "보상 설계만으로는 부족하다"고 씁니다.
보상은 인자를 고친다
표 7은 보상을 하나씩 붙였을 때의 평균 이득을 트리거(TI·TC)와 인자(AI·AC·AI+·AC+)로 나눠 보여 줍니다.
더한 보상
트리거 평균 이득
인자 평균 이득
+ 근거
+0.3
+1.6
+ 과잉 억제
−0.4
+3.1
+ 포괄
+0.7
+0.5
+ 경계
+0.9
+4.2
전부
+2.1
+7.4
트리거는 정확도+형식 보상만으로도 이미 꽤 잘 찾습니다. 차이는 인자에서 납니다. 가장 효과가 큰 단일 보상은 경계 보상이고(PHEE의 AC +14.15), 넷을 합치면 어느 하나보다 크게 오릅니다. 부록 M은 특히 M2E2에서 '어느 트리거의 인자인가'를 맞히는 AC+가 17.65점 올랐다고 보고합니다. 보상을 여러 개 주면 트리거와 인자의 짝을 맞추는 능력이 따로따로는 생기지 않던 방식으로 생긴다는 해석입니다.
학습 곡선(그림 4)도 같은 이야기를 합니다. 형식 보상은 몇천 단계 만에 1 가까이 올라가 평평해지고, 근거·포괄·경계 보상은 학습 내내 천천히 오릅니다. 형식은 입장권이고, 그 뒤에야 의미의 정밀함을 배운다는 순서입니다. 부록 J를 보면 학습이 진행될수록 출력 길이가 평균 160토큰에서 176토큰으로 늘어납니다. 모델이 칸을 비워 두는 대신 더 많은 사건과 인자를 채우는 쪽으로 간다는 뜻입니다.
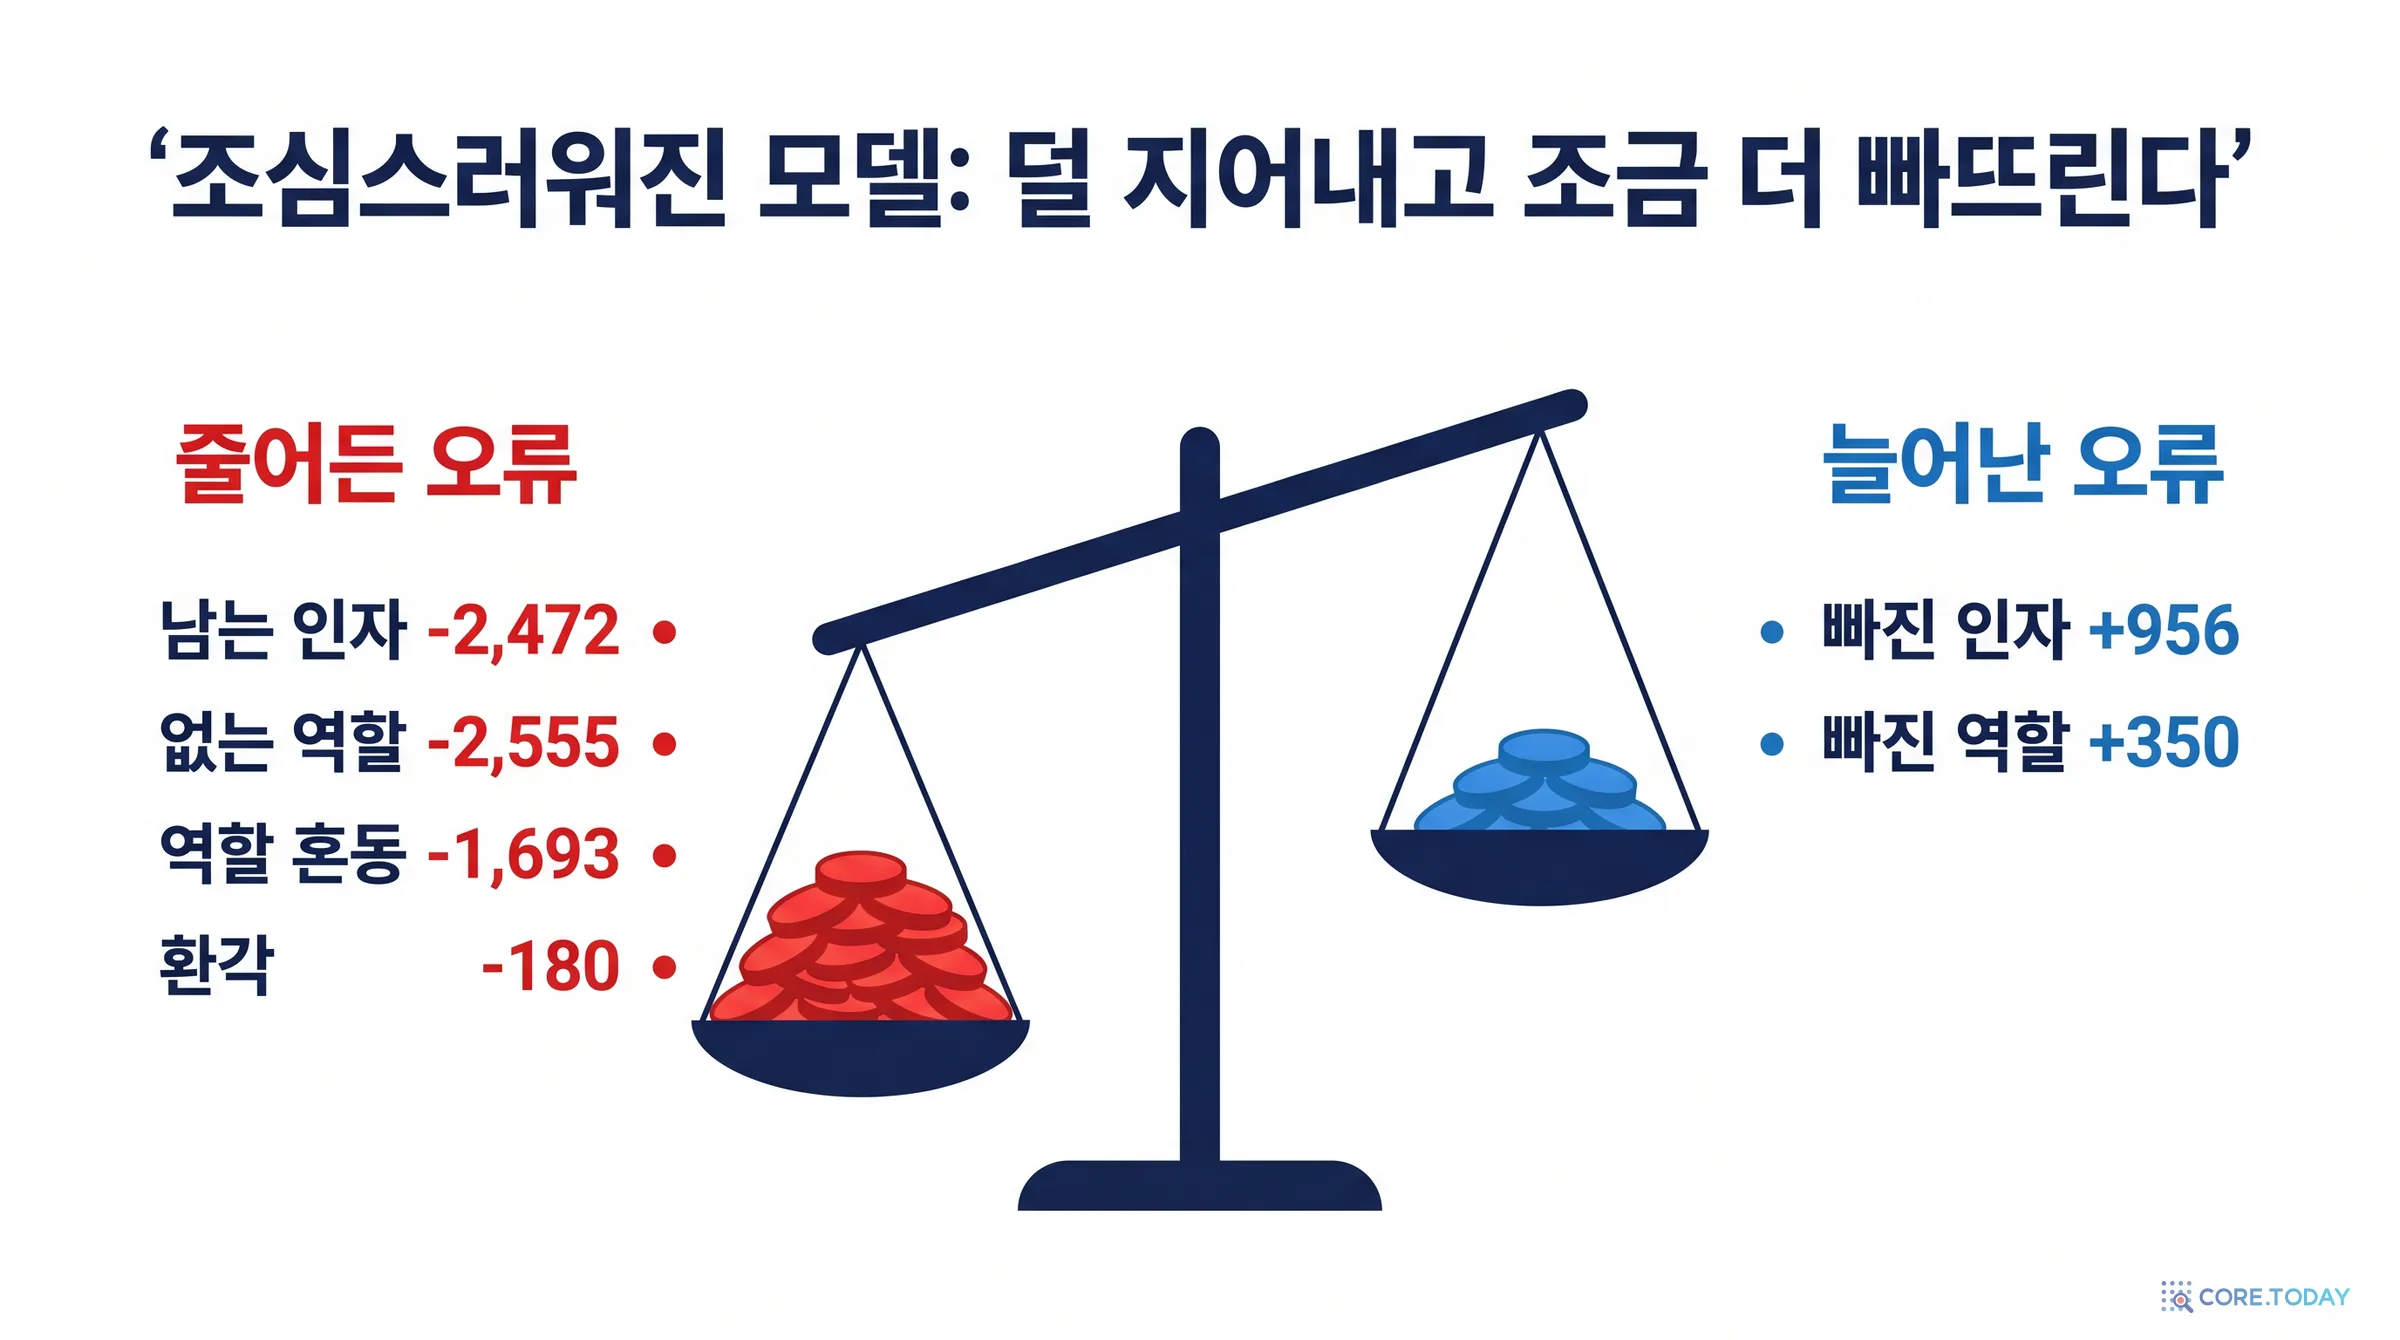
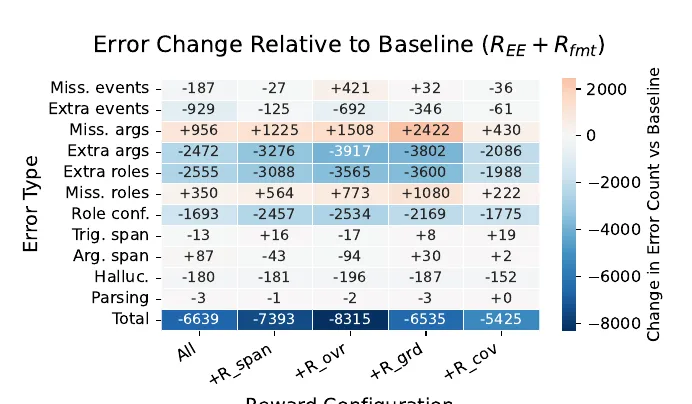
그림 5는 정확도+형식 보상만 쓴 기준선과 비교해 오류 개수가 어떻게 바뀌었는지를 열한 가지 범주로 보여 줍니다. 기준선의 가장 큰 문제는 넘치기였습니다. 정답에 없는 인자와 역할을 채우고, 역할 이름을 헷갈렸습니다. 보상을 더하면 이 오류가 수천 건씩 줄어듭니다. 대신 빠진 인자와 빠진 역할이 늘어납니다. 어느 보상 조합에서나 똑같이 나타나는 패턴입니다.
이 그림에서 얻을 실용적인 교훈이 있습니다. '근거' 보상 하나만 세게 걸면 모델이 겁쟁이가 됩니다. "원문에 있는 글자만 써라"를 배운 모델은 확신이 없을 때 칸을 비웁니다. 빠진 인자가 2,422건 늘어난 이유입니다. 환각을 줄이려고 근거 검사를 붙이는 RAG·추출 시스템이 흔히 겪는 일이기도 합니다. 근거 검사는 포괄 쪽 압력과 짝을 지어야 합니다.
논문 그림 5 원본. 경계 오류와 파싱 오류는 어느 설정에서나 수십 건 안쪽으로 작고 안정적입니다. 저자들은 이를 "저수준 구조 품질은 주된 병목이 아니다"라고 해석합니다. 병목은 무엇을 낼지, 무엇을 뺄지의 판단입니다.
8장. 의심해 볼 것들 — 표를 한 번 더 읽으면 보이는 것
EAGER의 아이디어는 설득력이 있고, 실험도 일곱 데이터셋에 걸쳐 넓습니다. 그래도 이 논문을 근거로 무언가를 결정하려면 짚어 둘 곳이 있습니다. 코어닷투데이가 논문 본문·부록·참고문헌을 대조하면서 찾은 것을 중요한 순서로 적습니다.
① 본문 표 2와 부록 표 12~14의 숫자가 다르다
부록 M의 표 12~14는 데이터셋마다 여섯 지표를 모두 펼쳐 보여 주고, 마지막 열에 그 평균(Avg.)을 둡니다. 본문 표 2의 Mean-F1과 같은 지표입니다. 실제로 ADELIE-DPO와 GoLLIE 계열은 두 곳의 숫자가 소수점 둘째 자리까지 같습니다. 그런데 EventRL은 일곱 데이터셋 모두에서 다르고, EAGER도 조금씩 다릅니다.
데이터셋
EventRL 본문
EventRL 부록
EAGER 본문
EAGER 부록
WikiEvents
15.18
20.21
21.31
20.51
PHEE
52.40
53.59
60.36
59.47
CASIE
8.90
15.68
14.66
15.11
GENIA11
16.65
26.14
26.32
25.51
GENIA13
16.31
24.14
23.39
24.16
MLEE
11.84
21.90
23.42
24.21
M2E2
43.53
30.16
46.09
41.33
평균
23.54
27.40
30.79
30.04
부록 평균은 코어닷투데이가 부록의 데이터셋별 Avg. 일곱 개로 다시 계산한 값입니다. 초록 칸은 부록 기준으로 EventRL이 EAGER를 앞서는 곳입니다.
부록 숫자를 믿으면 그림이 꽤 달라집니다. EventRL의 평균은 27.40으로 ADELIE(25.64)를 넘어 '기존 최고'가 되고, EAGER와의 격차는 +5.15가 아니라 +2.64입니다. CASIE와 GENIA11에서는 EventRL이 앞서고, GENIA13과 WikiEvents는 사실상 비깁니다. EAGER의 우위는 주로 PHEE(+5.88)와 M2E2(+11.17)에서 나옵니다. 어느 표가 맞는지, 또는 두 표가 서로 다른 실행 결과인지는 논문만으로는 알 수 없습니다. 하나 덧붙이면, 부록 기준 EventRL 평균(27.40)은 SCAE를 켠 채 정확도+형식 보상만 쓴 EAGER 변형(27.36)과 거의 같습니다. EventRL도 F1 결과 보상만 쓰는 방법이라는 점을 생각하면 흥미로운 일치입니다.
같은 부록 표에는 작은 이상도 있습니다. GoLLIE-13B + SFT와 GoLLIE-34B + SFT의 행은 SFT 전 행과 숫자가 거의 또는 완전히 같습니다(13B는 WikiEvents 하나만 다릅니다). SFT가 정말 아무 변화도 만들지 않았을 수도 있지만, 표를 옮기다 생긴 실수일 가능성도 배제할 수 없습니다.
② SCAE가 없으면 EAGER는 기존 방법보다 낮다
표 6에서 SCAE를 빼면 EAGER의 평균은 22.54입니다. 본문 표 2의 EventRL(23.54)·ADELIE(25.64)보다 낮습니다. 더 이상한 건 같은 표의 다른 줄입니다. SCAE 없이 정확도+형식 보상만 쓰면 23.56으로, 보상 여섯 개를 다 쓴 것(22.54)보다 높습니다. SCAE가 없는 세계에서는 세분화한 보상이 오히려 손해였다는 뜻입니다.
저자들은 이를 "SCAE가 있어야 세분화한 보상이 살아난다"고 해석합니다(RQ1). 가능한 해석입니다. 보상이 여섯 개면 보상마다 그룹 안 분산이 필요하고, 붕괴가 잦은 상황에서는 RDN이 0으로 나뉘는 보상만 늘리는 셈이기 때문입니다. 하지만 다른 해석도 가능합니다. SCAE는 답마다 다른 오답 보기를 주므로, 학습 중에 모델이 보는 음성 스키마의 가짓수가 G배로 늘어납니다. 이건 어드밴티지 분산과 상관없는 '데이터 증강' 효과일 수 있습니다. 그림 3에서 학습 후반 두 조건의 ACR이 거의 같아진다는 점을 생각하면, 최종 성능 차이 8점 전부를 '붕괴 완화'로 설명하기는 어렵습니다. 둘을 가르는 실험(예: 그룹 안 오답 보기는 같게 두되 에폭마다 오답 보기를 바꾸는 대조군)은 논문에 없습니다.
③ 경계 보상을 식 그대로 구현하면 넓게 자른 답이 이득을 본다
부록 F.6은 경계 보상을 이렇게 정의합니다. 예측한 인자마다 가장 비슷한 정답과 자카드 유사도를 재고, 정답을 품은 채 넓어졌으면 넓어진 만큼 깎습니다. 그리고 "넓게 잡은 예측이 하나도 없으면 보상을 0으로 막는다"고 씁니다. 잘 행동한 답에서는 결과 보상과 겹치지 않게 하려는 의도입니다.
그런데 이걸 글자 그대로 구현하면 이상한 일이 생깁니다. 완벽한 답은 경계 보상 0, 한 인자를 조금 넓게 자른 답은 0.9 안팎을 받습니다. 5장의 계산기에서 '조사를 붙임'을 켜면 바로 보입니다. RDN은 이 보상도 그룹 안에서 표준화하므로, 같은 그룹에 넓게 자른 답이 섞여 있으면 그 답이 경계 보상에서 양의 어드밴티지를 받습니다. 정확도 보상이 반대 방향으로 끌어 주니 전체로는 상쇄될 수 있지만, 설계 의도와는 거꾸로 가는 신호입니다. 부호를 뒤집어 벌점으로 쓰는 것이 원래 의도였을 수도 있습니다. 저자 코드가 공개되지 않아 실제 구현은 확인할 수 없습니다. 코어닷투데이의 9장 실측도 식을 글자 그대로 따랐고, 그 결과를 함께 보고합니다.
④ '이진 보상'이라는 설명과 실제 보상이 다르다
3.7절은 어드밴티지 붕괴를 설명하면서 "이진 결과 보상 {Ri}"를 가정하고, 초록도 "희소한 이진 보상에서의 어드밴티지 붕괴"를 말합니다. 그런데 EAGER가 실제로 쓰는 보상 여섯 개 가운데 이진인 것은 형식 보상 하나뿐이고, 나머지는 연속값입니다. 연속 보상에서는 네 답의 점수가 정확히 같아지려면 출력이 사실상 같아야 합니다. 그래도 그림 3에서 ACR이 0.25 안팎으로 나오는 것은 구조화 출력이 그만큼 자주 똑같이 나온다는 뜻이고, 이게 사건 추출 고유의 문제라는 저자들의 진단을 오히려 뒷받침합니다. 다만 '희소한 이진 보상'이라는 말은 문제 설정을 실제보다 극적으로 보이게 합니다.
⑤ 정답 스키마가 항상 맨 앞에 있다면
식 (2)와 (5)는 프롬프트를 '지시문 ⊕ 정답 스키마 ⊕ 오답 스키마 ⊕ 문장' 순서로 씁니다. 부록 그림 7의 예시도 정답 스키마를 먼저 쓰고 "나머지 정답 스키마 + 음성 스키마 목록"을 이어 붙입니다. 학습 때 정답이 늘 앞자리에 있었다면 모델은 '앞에 있는 클래스가 답'이라는 지름길을 배울 수 있습니다. 시험 때는 모든 스키마를 한꺼번에 주므로 이 지름길은 통하지 않고, 오히려 해가 됩니다. 학습 프롬프트에서 스키마 순서를 섞었는지는 적혀 있지 않습니다. 수식이 순서를 정확히 뜻하지 않을 수도 있으니 확정할 수는 없지만, 재현하려는 사람이라면 꼭 섞어야 할 부분입니다.
⑥ 비교의 조건들
프런티어 모델의 점수는 프롬프트에 크게 좌우됩니다. GPT-5.4가 PHEE에서 1.42점, 같은 회사의 mini가 18.86점이라는 건 능력 차이라기보다 출력 형식이나 스키마 해석이 어긋났을 가능성을 시사합니다. 퓨샷 예시 수, 지침 포함 여부, 파싱 실패 처리 방식이 본문에 자세히 나오지 않습니다. 그림 1의 GPT-4o 막대도 표 2와 맞지 않습니다(그림의 PHEE는 거의 0, WikiEvents는 약 11.5인데 표 2는 2.00과 10.31).
바탕 모델이 2023년 모델입니다. GoLLIE-7B는 Code-LLaMA 7B 기반입니다. 2026년의 Qwen 계열이나 Llama 4 계열 바탕에서도 같은 크기의 이득이 나는지는 알 수 없습니다.
반복 실행과 분산이 없습니다. 모든 숫자가 한 번의 실행으로 보입니다. GENIA2013은 문서 20개짜리 데이터셋이라 1~2점 차이는 실행마다 흔들릴 수 있습니다.
코드가 없습니다. 논문은 github.com/OA256864/EE_RL에 코드를 공개하겠다고 적었지만, 2026년 10월 31일 확인 결과 이 저장소는 존재하지 않습니다(GitHub API 404). 같은 계정에는 다른 공개 저장소 4개가 있습니다.
⑦ '검증 가능'의 진짜 비용
마지막은 논문의 결함이라기보다 RLVR을 구조화 추출로 옮길 때 생기는 근본적인 조건입니다. 수학 RLVR은 정답만 있으면 됩니다. 풀이 과정은 모델이 알아서 찾습니다. 사건 추출의 '검증기'는 트리거·인자·역할을 글자 경계까지 주석한 정답 데이터입니다. EAGER가 쓴 일곱 데이터셋에 주석된 사건은 모두 4만 1천 건이 넘습니다(논문 표 10). 보상을 아무리 정교하게 쪼개도, 결국은 사람이 만든 주석 관행을 더 잘 흉내 내는 방향으로 학습합니다. 주석 지침을 빼면 8점이 떨어지는 것도 같은 맥락입니다. 이 방법이 가장 빛나는 곳은 정답 주석이 이미 대량으로 존재하는 곳입니다. 10장에서 한국에 그런 곳이 있는지 봅니다.
9장. 코어닷투데이 실측 — 한국어 문장 40개에 같은 채점표를 대 보니
EAGER는 영어 데이터셋 일곱 개로만 실험했고, 저자들도 다국어를 한계로 꼽았습니다. 그래서 코어닷투데이는 논문의 학습 조건 일부를 한국어로 옮겨 직접 재 봤습니다. 강화학습 자체를 돌리지는 않았습니다. 대신 강화학습이 매 단계 하는 일, 즉 '한 문장에 답을 네 개 뽑아 채점하고 그룹 안에서 비교하는 일'을 그대로 재현했습니다. 학습이 시작되기 직전, 첫 그룹들이 어떤 신호를 만들어 내는지 보는 실험입니다.
항목
코어닷투데이 실측
EAGER 논문
문장
가상 인물·회사로 만든 한국어 문장 40개 (뉴스·공시·판결·약물 부작용·재난·보안 사고)
영어 7개 데이터셋 학습 세트
정답
사건 48개, 인자 138개 (코어닷투데이가 직접 주석)
사람 주석
스키마
사건 유형 16개, 파이썬 dataclass + 한국어 지침 독스트링
데이터셋별 스키마 + LLM 생성 지침
모델
로컬 qwen3.5:4b (학습 없음)
GoLLIE-7B (학습함)
그룹
G = 4, 음성 스키마 K = 4, 온도 0.6, top-p 0.9
G = 4, K = 10, 온도 0.6, top-p 0.9
채점
부록 F의 여섯 보상을 식 그대로 구현 + 이진 보상
여섯 보상 + RDN
문장마다 세 조건을 돌렸습니다. 고정(네 답이 같은 음성 스키마 4개를 봄), SCAE(답마다 다른 음성 스키마 4개), 그리고 시험 상황을 흉내 낸 추론(스키마 16개를 모두 주고 온도 0으로 한 번)입니다. 모두 합쳐 360번 생성했습니다. 처음에는 9B 모델로 시작했지만, 같은 기계에서 다른 실험이 9B를 쓰고 있어 호출당 1분 가까이 걸렸습니다. 그래서 같은 계열의 4B로 바꿨습니다.
발견 1. 이진 보상이면 거의 모든 그룹이 붕괴한다
이진 · 고정
97.5%
이진 · SCAE
100%
정확도 R_EE · 고정
22.5%
정확도 R_EE · SCAE
25.0%
여섯 보상 RDN · 고정
20.0%
여섯 보상 RDN · SCAE
25.0%
그룹 40개 가운데 네 답의 점수 표준편차가 10−6 미만인 그룹의 비율(ACR). 막대 길이는 100%를 만점으로 둔 비율입니다.
'전부 맞아야 1점'인 이진 보상으로 채점하면 고정 조건은 그룹 40개 가운데 39개, SCAE 조건은 40개 모두가 붕괴합니다. 정답을 글자 그대로 맞힌 출력이 320개 가운데 단 1개였기 때문입니다. 네 답 모두 0점이면 비교할 것이 없습니다. 학습 초기 모델에 이진 보상을 주면 신호가 거의 나오지 않는다는 논문의 문제의식이 숫자로 확인됩니다.
같은 출력을 연속값으로 채점하면 그림이 달라집니다. 정확도 보상 하나만으로도 붕괴율이 20%대로 내려옵니다. 여섯 보상 RDN은 고정 조건에서 20.0%로 정확도 보상(22.5%)보다 조금 낮습니다. 논문 그림 3의 학습 중 ACR(0.25 안팎)과 비슷한 수준입니다.
붕괴한 그룹을 열어 보면 논문의 설명과 조금 다른 모습이 보입니다. 고정 조건에서 붕괴한 9개 그룹 가운데 네 답이 글자까지 똑같은 경우는 2개뿐입니다. 4개는 네 답 모두 정확도 0점이었고, 그중 3개는 모두 파싱에 실패했습니다. 출력이 획일화돼서라기보다, 서로 다른 답이 같은 점수를 받아서 붕괴하는 경우가 더 많았습니다.
발견 2. SCAE의 효과는 학습 전에는 보이지 않았다
SCAE가 붕괴를 줄일까요? 적어도 학습 전의 이 모델에서는 그렇지 않았습니다. 정확도 보상 기준 고정 22.5%(9개), SCAE 25.0%(10개)입니다. RDN에서는 20.0%(8개)와 25.0%(10개)로 오히려 조금 높습니다. 그룹별로 맞대 보면 정확도 보상에서 둘 다 붕괴한 곳이 5개, 고정만 붕괴한 곳이 4개, SCAE만 붕괴한 곳이 5개입니다. 동전 던지기에 가깝고, 40개 표본으로는 차이가 있다고 말할 수 없습니다.
출력 자체는 조금 다양해졌습니다. 네 답 가운데 서로 다른 출력이 2.8개에서 3.1개로 늘었습니다. 하지만 그룹 안 점수의 표준편차는 거의 그대로입니다(0.102 → 0.105). 출력은 흔들려도 점수는 흔들리지 않은 것입니다.
이유는 오류의 출처에서 찾을 수 있습니다. 학습 전 모델의 실수는 대부분 오답 보기와 관계가 없습니다. 파싱 실패가 22%(79/360)이고, 그중 49건은 클래스 대신 딕셔너리로 쓴 경우입니다. 트리거를 활용형으로 쓰거나 숫자를 띄어 쓰는 습관도 오답 보기가 바뀐다고 달라지지 않습니다. 고정 조건에서 붕괴하지 않은 31개 그룹 가운데 12개는 '파싱 성공과 실패가 섞여서' 분산이 생긴 경우입니다. 이런 상황에서는 오답 보기를 바꿔도 점수를 움직일 지렛대가 없습니다.
논문의 그림 3은 학습 초반에 SCAE가 ACR을 낮춘다고 보여 주므로 이 결과와는 차이가 있습니다. 모델(GoLLIE-7B 대 Qwen 4B), K(10 대 4), 언어, 학습 여부가 모두 다르니 어느 쪽이 틀렸다고 말할 수는 없습니다. 다만 이 실측은 8장 ②의 질문을 다시 떠올리게 합니다. SCAE의 효과가 '그룹 안 분산'에서 오는지, 학습 중 더 많은 오답 보기를 보여 주는 데서 오는지는 따로 재 봐야 합니다.
지표 (그룹 40개 평균)
고정
SCAE
네 답 가운데 서로 다른 출력 수
2.8개
3.1개
그룹 안 정확도 표준편차
0.102
0.105
형식 보상 평균 (파싱 성공률)
0.78
0.76
정확도 보상 평균
0.34
0.33
근거 보상 평균
0.68
0.67
경계 보상 평균
0.03
0.02
6장의 위젯 아래쪽 칸에서 이 그룹 40개를 하나씩 눌러 네 답과 각자 받은 오답 보기를 직접 볼 수 있습니다.
고정·SCAE 표본에서 나온 인자 677개를 모양별로 나눴습니다. 정답과 글자까지 같은 것이 416개(61.4%)이고, 조사가 붙어서 틀린 것은 4개(0.6%)뿐입니다. 프롬프트에 "인자에는 조사를 붙이지 말라"고 한 줄 적은 지시가 잘 통했습니다.
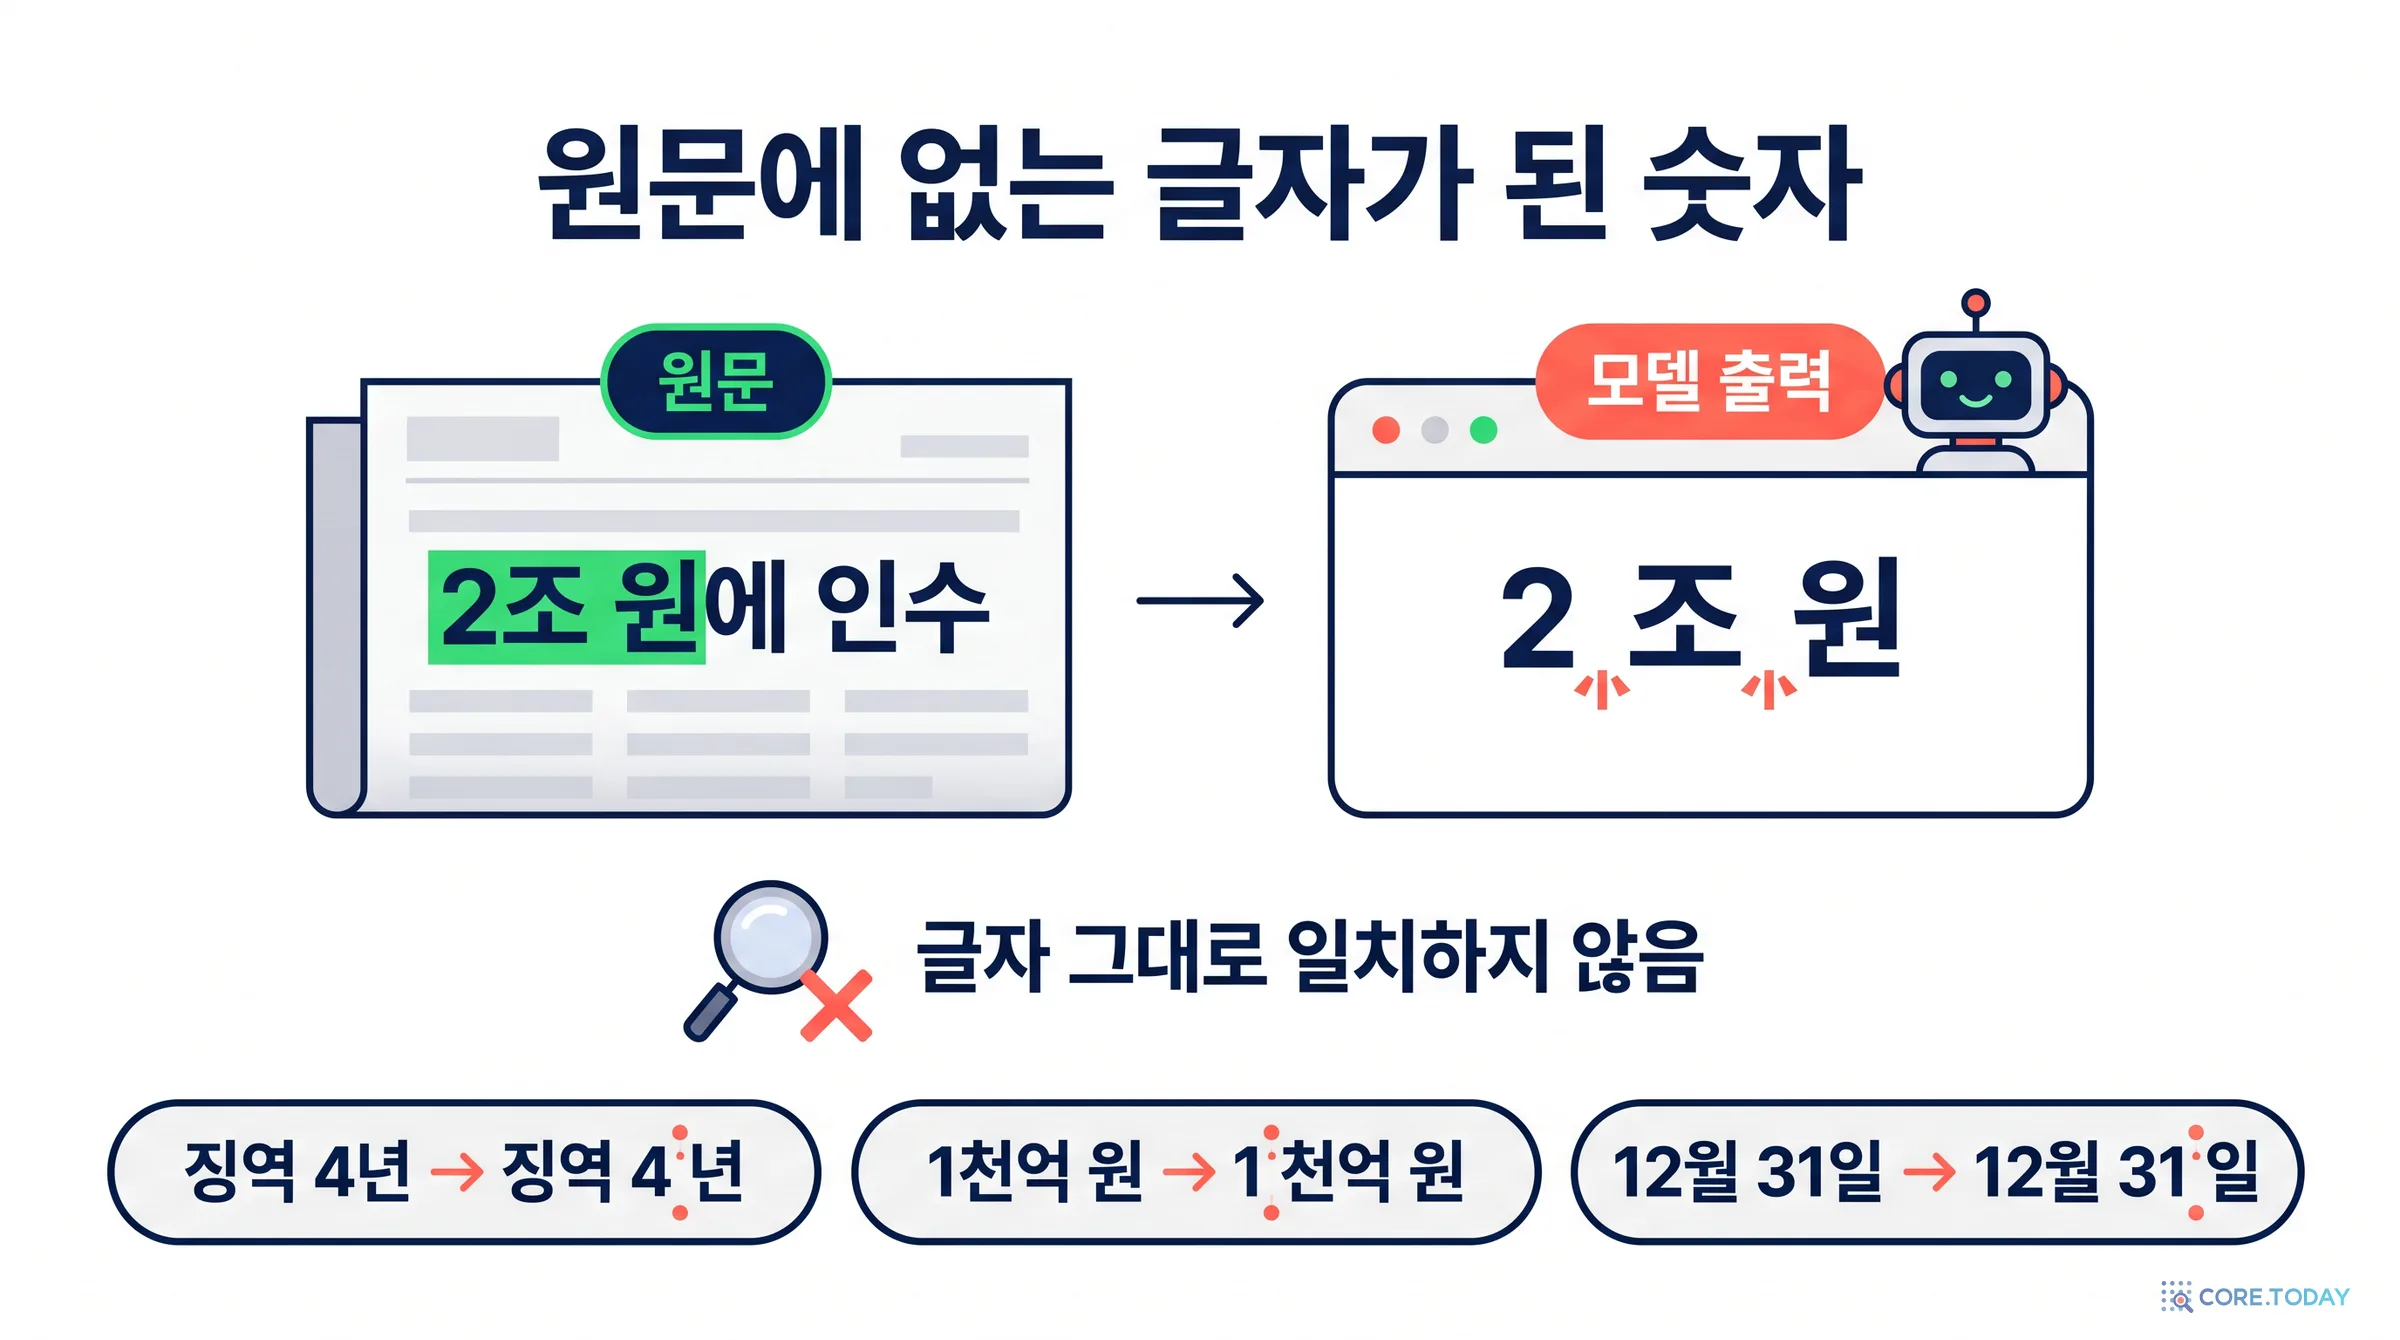
대신 예상하지 못한 문제가 115개(17.0%)에서 나왔습니다. 숫자와 단위 사이에 공백을 넣는 것입니다. '2조 원'을 '2 조 원'으로, '징역 4년'을 '징역 4 년'으로, '12월 31일'을 '12월 31 일'로 씁니다. 사람 눈에는 같아도 원문에 없는 문자열이 됩니다. 정확 일치에서 틀리고, 근거 보상은 이를 환각처럼 깎습니다. 원인은 확인하지 못했지만 숫자와 한글이 붙은 표기에서 규칙적으로 나타납니다. 이런 오류는 근거 보상이 고치기 좋은 대상이기도 합니다. 다만 공백을 정규화하지 않고 채점하면 '표기 습관'과 '지어내기'가 같은 벌점으로 섞입니다.
그 밖의 모습도 흥미롭습니다. 원문에 아예 없는 인자는 11개(1.6%)로 적었는데, '한길로지스'를 '한길로직스'로, '지난달'을 '지난월'로 쓴 식이었습니다. 역할 이름 '수량'을 한자가 섞인 '수量'으로 쓴 경우도 15번 나왔습니다. 원문에 있는 글자지만 정답이 아닌 인자는 131개(19.3%)입니다. 경계나 역할을 잘못 고른 경우로, 강화학습이 가장 공을 들여야 할 몫입니다.
8장 ③에서 걱정한 경계 보상의 뒤집힘도 실제로 나왔습니다. "미래자동차는 배터리 과열 우려로 전기차 3만 2천 대를 리콜한다"의 고정 그룹에서 답 2는 제품 칸에 '배터리 과열 우려로 전기차'를 통째로 넣었습니다. 네 답 가운데 정확도가 가장 낮습니다(0.56). 그런데 경계 보상은 이 답만 0.50을 받고, 정확도가 가장 높은 답 3(0.83)은 0입니다. 경계 보상에 차이가 있던 그룹은 320개 표본에서 나온 80개 그룹 가운데 5개로 드물었지만, 그 5개 중 2개에서 경계 보상 1등이 정확도 1등이 아니었습니다.
발견 4. 스키마를 16개 다 주면 작은 모델은 목록을 베낀다
시험 상황처럼 스키마 16개를 모두 주고 온도 0으로 돌렸더니, 모델은 정답 사건 48개에 대해 사건 282개를 냈습니다. 그중 263개가 체포()처럼 트리거도 인자도 없는 빈 인스턴스입니다. 문장과 상관없이 클래스 목록을 순서대로 베껴 쓴 것입니다. 파싱 실패도 40건 중 6건 나왔습니다. 여섯 F1 평균은 엄격 채점으로 17.2, 빈 인스턴스를 빼고 관대하게 채점해도 20.9입니다.
주목할 점은 학습 프롬프트와 시험 프롬프트의 차이입니다. 정답 스키마에 오답 4개만 섞은 조건에서는 파싱된 출력 하나당 빈 인스턴스가 0.11~0.18개였습니다. 스키마 16개를 다 주면 7.74개로 40배 넘게 늡니다. 스키마 개수가 늘면 나타나는 실패가 작은 프롬프트에서는 보이지 않습니다. EAGER도 학습 때는 정답 + 오답 10개, 시험 때는 전체 스키마를 줍니다. 학습 중 검증도 시험과 같은 조건으로 해야 하는 이유입니다.
트리거 쪽을 보면 빈 인스턴스를 뺀 19개 가운데 정답 그대로가 8개, '체포했다'처럼 활용형까지 쓴 것이 6개입니다. 인자 찾기(AI·AC)는 32.1인데 트리거에 붙은 인자(AI+·AC+)는 9.6으로 떨어집니다. 트리거 글자 하나가 어긋나면 그 밑의 인자가 모두 틀리기 때문입니다. 논문 부록이 지적한 '트리거-인자 불일치'가 한국어에서도 그대로 나타납니다.
이 실측이 말해 주는 것
1
이진 보상은 한국어 사건 추출에서 쓸 수 없다
정답을 글자까지 맞히는 일이 드문 초기 모델에서 네 답이 모두 0점인 그룹이 97.5~100%입니다. 연속값 보상이 출발 조건입니다.
2
SCAE는 모델이 오답 보기에 흔들려야 효과가 있다
학습 전 모델에서는 오답 보기를 바꿔도 붕괴율이 줄지 않았습니다. 오류 대부분이 오답 보기와 무관하기 때문입니다. 형식과 표기를 먼저 잡고, 학습 곡선에서 ACR을 재서 판단해야 합니다.
3
한국어 채점표는 정규화부터
조사는 지시문 한 줄로 거의 사라졌지만 숫자 띄어쓰기는 17% 남았습니다. 채점 전 공백 정규화 여부를 정하고, 경계 보상은 부호부터 시험해야 합니다.
한계: 문장 40개는 작은 표본이고, 정답은 한 사람이 붙였습니다. 학습을 하지 않았으므로 EAGER의 성능을 재현한 것이 아니라 학습 첫 단계의 신호를 들여다본 것입니다. 문장과 정답, 모델이 낸 출력은 6장과 9장의 위젯에서 그대로 볼 수 있습니다.
2025년의 RLVR은 거의 수학과 코드의 이야기였습니다. 정답이 하나로 떨어지고 채점기가 공짜인 곳에서 먼저 터졌습니다. 2026년의 흐름은 "출력을 파싱하고 정답과 비교할 수 있으면 무엇이든 보상이 된다"로 넓어지고 있습니다. 정보 추출은 그 확장의 가장 자연스러운 다음 칸입니다. 출력이 구조이고, 학계에 수십 년 쌓인 주석 데이터가 있고, 결과를 F1으로 셀 수 있습니다.
EAGER가 이 확장에 보태는 교훈은 두 가지로 요약됩니다.
채점을 쪼개면 '어떻게 틀렸는지'를 가르칠 수 있다. 결과 F1 하나는 지어낸 답과 빠뜨린 답을 구별하지 못합니다. 근거·과잉·포괄·경계를 따로 재면 오류 유형마다 다른 압력을 줄 수 있습니다. 대신 압력끼리 부딪칩니다(7장의 정밀도-재현율 줄다리기).
구조화 출력은 그룹이 쉽게 '획일화'된다. 자유로운 풀이를 쓰는 수학과 달리 코드 형식의 짧은 출력은 샘플링을 해도 서로 비슷합니다. 그룹 상대 평가에 기대는 GRPO 계열을 쓸 때는 그룹 안에 다양성을 일부러 심는 장치가 필요합니다. EAGER는 오답 보기를 바꿨지만, 같은 생각은 문맥 순서를 섞거나 지시문 표현을 바꾸는 식으로 다른 과제에도 옮길 수 있습니다.
쓰임새: '대량으로, 빠짐없이, 지어내지 않고'
2장에서 본 사건 데이터의 쓰임새는 2026년에도 그대로이고, LLM 덕분에 오히려 넓어졌습니다.
약물 감시. PHEE가 다루는 의약품 부작용 보고는 환자·약물·증상·용량을 구조화해야 신호 탐지가 됩니다. EAGER가 가장 크게 오른 곳(PHEE 60.36, +7.75)이 이 분야라는 점은 실용적으로 의미가 있습니다. 다만 사례 보고의 인과성 판단까지 LLM에 맡기는 연구는 아직 정확도 0.6~0.8 수준에 머문다는 보고가 있어, 추출과 판단은 나눠서 봐야 합니다.
보안 위협 정보. CASIE처럼 사고 기사에서 공격자·피해 기관·유출 정보·취약점을 뽑는 일은 위협 정보 공유의 기초입니다. EAGER도 이 데이터셋에서는 14.66점으로 아직 낮습니다.
에이전트의 기억과 지식 그래프. 코어닷투데이가 다룬 시간 그래프 기억이나 사실탐색기처럼, 문서를 '언제 누가 무엇을 했다'는 기록으로 바꿔 두면 검색과 추론이 쉬워집니다. 여기서 환각 하나는 기록 전체의 신뢰를 깎으므로, EAGER의 근거 보상 같은 장치가 특히 중요합니다.
한국어에서는: 정답지가 이미 쌓여 있는 곳
8장 ⑦에서 이 방법이 가장 빛나는 곳은 정답 주석이 이미 대량으로 있는 곳이라고 했습니다. 한국에는 그런 곳이 의외로 있습니다.
DART 주요사항보고서금융감독원 OpenDART구조화된 사건 API 36종 (자기주식 취득 결정, 유상증자 결정, 부도 발생 등)
공시 본문 + 표같은 공시의 원문회사·금액·일자가 문장과 표로 함께 실림
정답 = 구조화 필드사람이 따로 주석할 필요 없음원문 스팬과 맞추는 정렬 작업만 필요
보상 = EAGER식 채점형식·정확도·근거·과잉·포괄·경계한국어 경계 규칙(조사·띄어쓰기)을 지침에 명시
금융감독원 OpenDART의 주요사항보고서 API 묶음(DS005)은 자기주식 취득 결정, 유상증자 결정, 전환사채권 발행 결정, 부도 발생 같은 사건 36종을 이미 구조화된 필드로 내려줍니다. 같은 공시의 본문에는 그 사건이 문장과 표로 적혀 있습니다. 둘을 짝지으면 사람이 주석하지 않아도 되는 한국어 사건 추출 정답지가 매일 생깁니다. 코어닷투데이가 사실탐색기 실측에서 DART 배당결정 공시 551건을 LLM 없이 표 파서로 읽었을 때 Claude Sonnet이 뽑은 사실과 97.0% 일치했던 것도 같은 성질 덕분입니다. 정형 공시는 그 자체로 정답지에 가깝습니다. 의회 회의록의 의결 결과, 법원 판결문의 주문처럼 '형식이 정해진 결과'가 공개되는 영역도 같은 방식으로 정답지가 될 수 있습니다.
남는 문제는 9장에서 본 한국어 고유의 경계입니다. 조사, 띄어쓰기, 숫자와 단위 사이의 공백, 활용형 트리거를 지침에 명시하고 경계 보상을 한국어에 맞게 고치지 않으면, 강화학습은 영어 벤치마크에서 배운 관행을 한국어에 그대로 옮기려 할 것입니다.
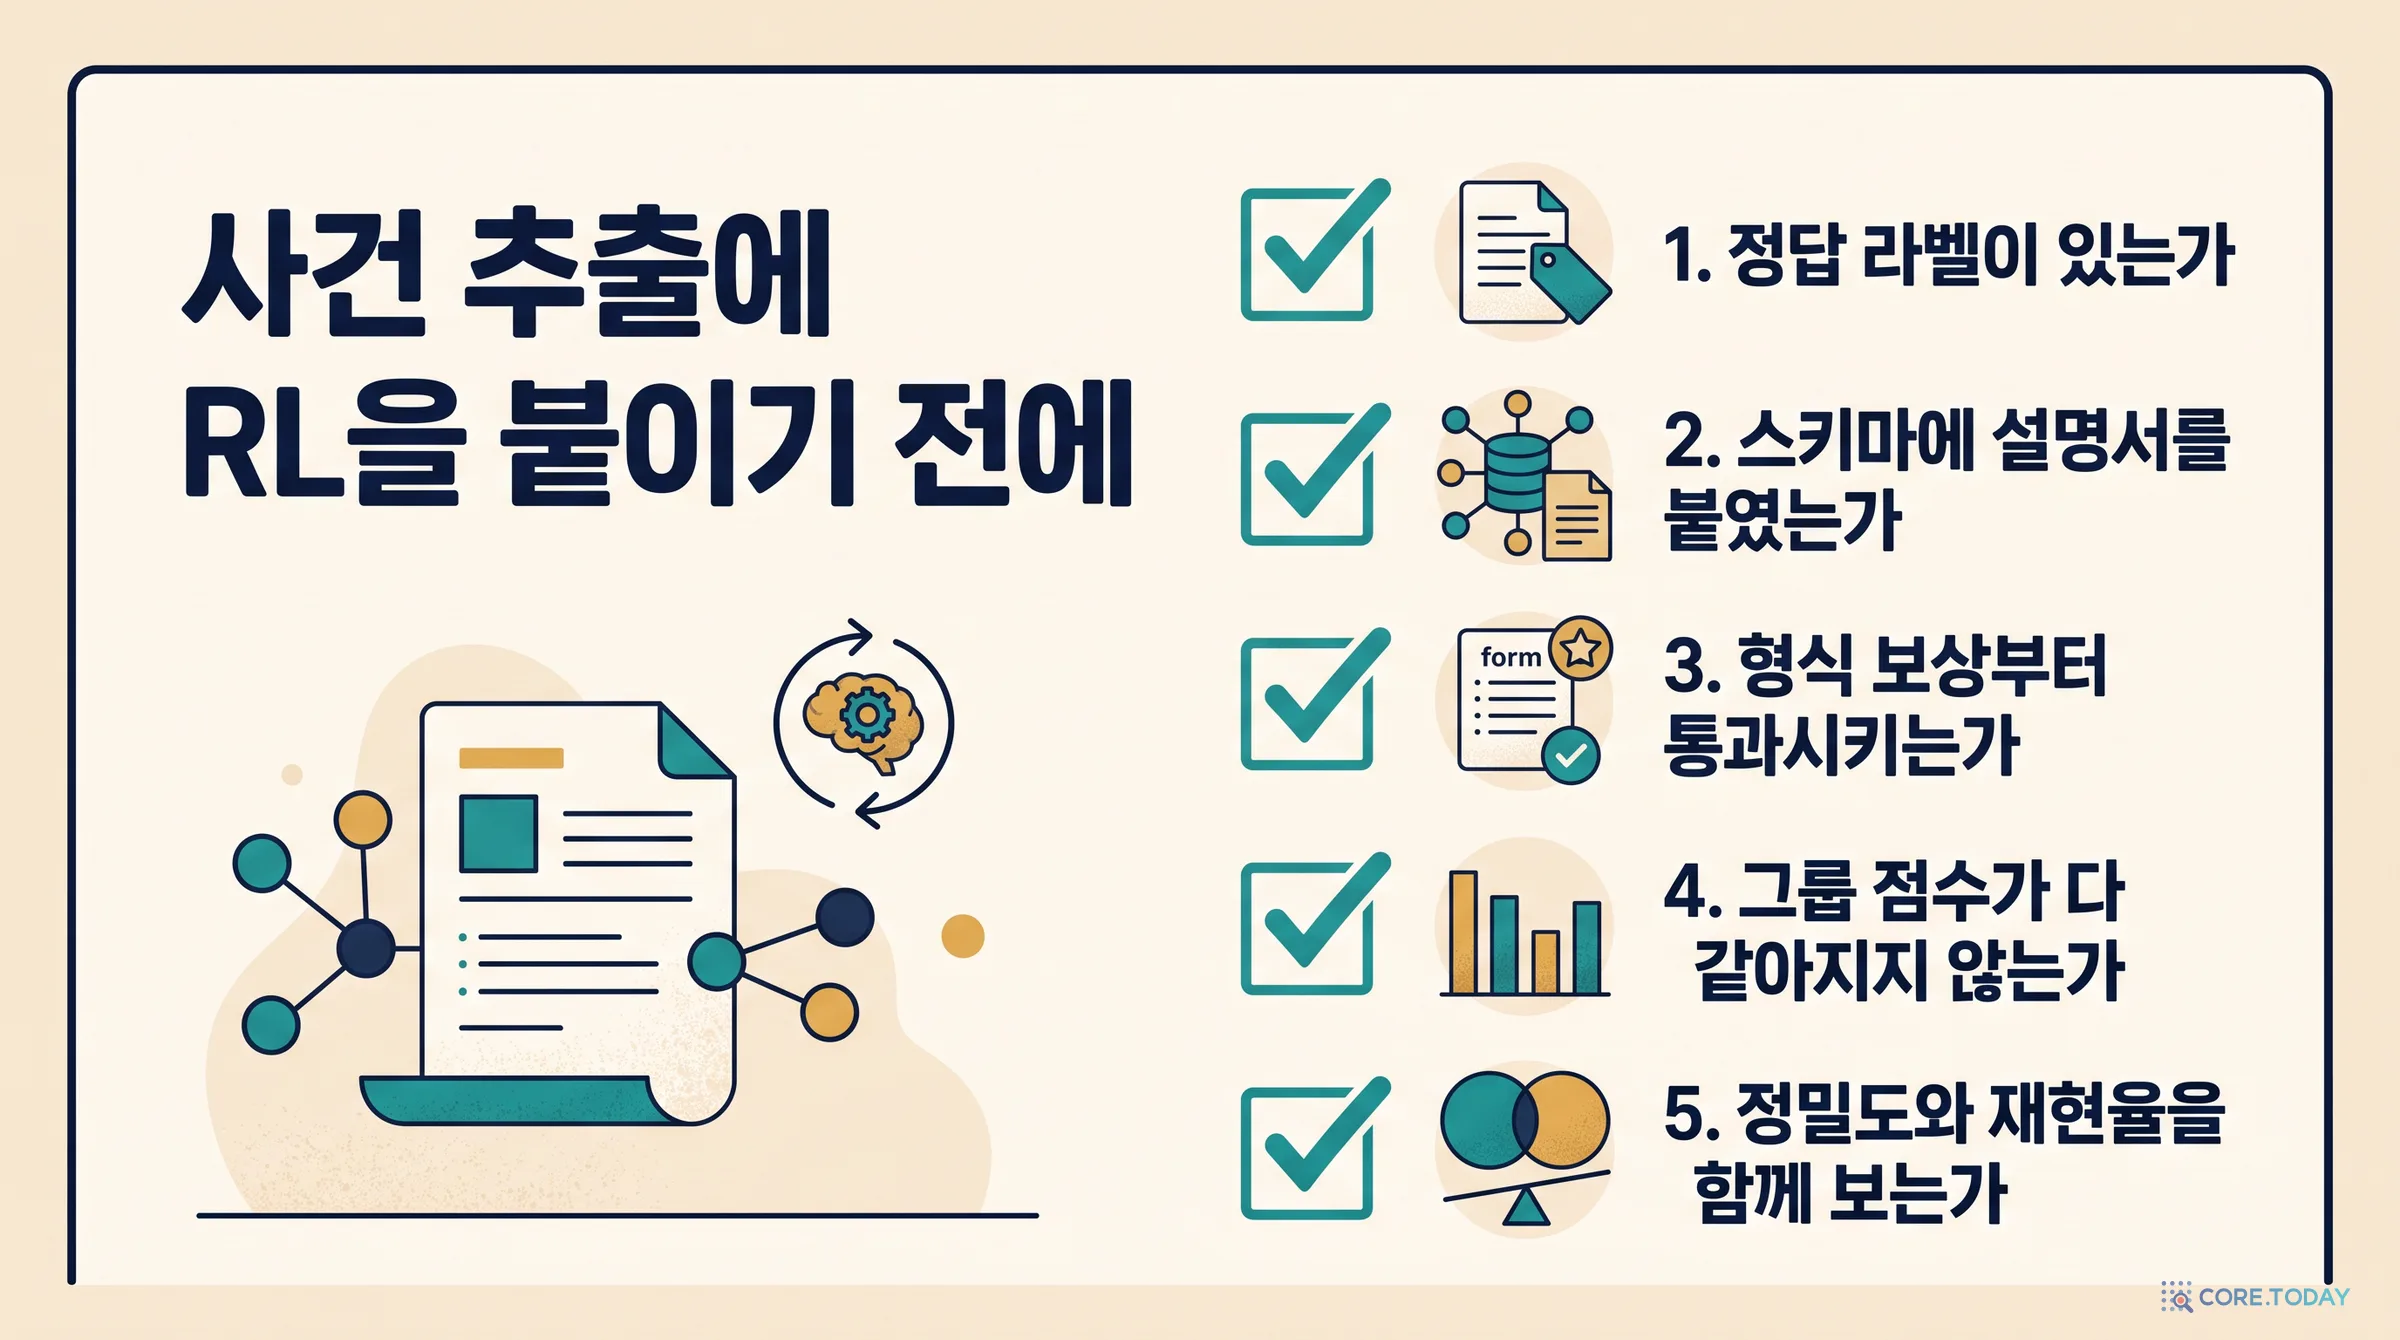
1. 정답지'검증 가능'은 정답 주석이 있다는 뜻입니다. 주석이 없다면 강화학습보다 주석 지침과 소량의 정답 세트를 먼저 만드세요. DART 같은 구조화 원천이 있으면 그것부터 정렬합니다.
2. 지침스키마에 정의·역할 설명·헷갈리는 경우를 붙이세요. EAGER에서 지침을 빼면 8점이 떨어졌습니다. 보상 네 개를 빼는 것보다 두 배 이상 큽니다. 한국어라면 조사·활용형·숫자 표기 규칙을 지침에 적습니다.
3. 형식 먼저출력을 코드나 JSON 스키마로 받고 파싱 성공을 첫 관문으로 두세요. 형식 보상은 빨리 수렴하고, 그 뒤에야 의미 보상이 일합니다. 작은 모델은 클래스 대신 딕셔너리를 쓰는 식으로 형식에서 먼저 무너집니다.
4. 붕괴율 감시학습 중 ACR(그룹 점수가 모두 같은 비율)을 로그로 남기세요. 높으면 이진 보상을 연속 보상으로 바꾸고, SCAE처럼 그룹 안에 오답 보기·순서 같은 다양성을 심습니다. 스키마 순서는 반드시 섞습니다.
5. 보상 식 단위 시험보상마다 '완벽한 답'과 '전형적 실수' 몇 개를 넣어 점수 방향이 맞는지 먼저 확인하세요. EAGER의 경계 보상처럼 식 그대로면 넓게 자른 답이 이득을 보는 경우가 있습니다.
6. 정밀도·재현율 따로F1 하나만 보지 말고 남는 인자와 빠진 인자를 따로 세세요. 근거 보상을 세게 걸면 모델이 칸을 비우는 겁쟁이가 됩니다. 용도에 맞게 어느 쪽 실수가 더 비싼지 먼저 정하세요.
맺으며 — 채점표가 곧 커리큘럼이다
EAGER가 보여 주는 가장 큰 메시지는 의외로 소박합니다. 무엇을 어떻게 채점하느냐가 무엇을 배우느냐를 정한다. 프런티어 모델이 10점을 받는 시험에서 7B 모델이 30점을 받은 비결은 더 큰 모델이 아니라, 시험의 규약(지침)을 읽히고, 실수의 종류마다 따로 점수를 매기고, 비교할 거리가 사라지지 않게 문제지를 흔든 데 있었습니다.
동시에 표를 한 번 더 읽으면, 이 성과의 큰 몫이 '보상을 여섯 개로 쪼갠 것'보다 '지침'과 '문제지 흔들기'에서 나왔고, 기존 방법과의 격차도 어느 표를 믿느냐에 따라 5점이 되기도 2.6점이 되기도 한다는 것이 보입니다. 사건 추출은 여전히 평균 30점짜리 과제이고, 한국어에서는 숫자 뒤 공백 하나가 채점표를 흔듭니다.
1987년 해군 연구자들이 전문의 칸을 채우려던 문제는 40년이 지나 강화학습의 언어로 다시 쓰였습니다. 바뀌지 않은 것도 있습니다. 좋은 사건 기록은 여전히 좋은 주석 지침과 좋은 채점표에서 나옵니다.
참고문헌
이 글의 중심 논문
Adjali, O., Liang, S., Bhatti, O. S., Sonntag, D. (2026). EAGER: Enhancing Generative Event Extraction via Reinforcement Learning with Verifiable Rewards. arXiv:2609.29230v1. 본문의 그림 1·2·3·5와 표 2는 이 논문에서 가져왔습니다. 코드 주소로 적힌 github.com/OA256864/EE_RL은 2026-10-31 기준 존재하지 않습니다.
Adjali, O. 외 (2026). Aligning Instruction-Tuned LLMs for Event Extraction with Multi-Objective Reinforcement Learning. ECIR 2026 (단편). GRPO에 형식·BM25 일치·과제 보상을 결합한 선행 연구.
사건 추출의 역사
Grishman, R., Sundheim, B. (1996). Message Understanding Conference-6: A Brief History. COLING 1996.
NIST. MUC-7 Proceedings Overview (1998).
Linguistic Data Consortium (2005). ACE (Automatic Content Extraction) English Annotation Guidelines for Events, v5.4.3 / ACE 2005 Multilingual Training Corpus (LDC2006T06).
Song, Z. 외 (2015). From Light to Rich ERE: Annotation of Entities, Relations, and Events. NAACL 워크숍.
Kim, J.-D. 외 (2009, 2011). Overview of BioNLP'09 Shared Task on Event Extraction / Overview of Genia Event Task in BioNLP Shared Task 2011.
Gerner, D., Schrodt, P., Yilmaz, Ö. CAMEO Conflict and Mediation Event Observations Codebook. / Leetaru, K., Schrodt, P. (2013). GDELT: Global Data on Events, Location and Tone. ISA 2013.
Chen, Y. 외 (2015). DMCNN. ACL. / Nguyen, T. H. 외 (2016). JRNN. NAACL. / Wadden, D. 외 (2019). DyGIE++. EMNLP. / Lin, Y. 외 (2020). OneIE. ACL. / Lu, Y. 외 (2021). Text2Event. ACL. / Hsu, I.-H. 외 (2022). DEGREE. NAACL.
LLM 시대의 정보 추출
Gao, J. 외 (2023). Exploring the Feasibility of ChatGPT for Event Extraction. arXiv:2303.03836.
Wang, X., Li, S., Ji, H. (2023). Code4Struct: Code Generation for Few-Shot Event Structure Prediction. ACL 2023.
Sainz, O. 외 (2024). GoLLIE: Annotation Guidelines Improve Zero-Shot Information-Extraction. ICLR 2024.
Huang, K.-H. 외 (2024). TextEE: Benchmark, Reevaluation, Reflections, and Future Challenges in Event Extraction. Findings of ACL 2024.
Gui, H. 외 (2024). IEPile: Unearthing Large Scale Schema-Conditioned Information Extraction Corpus. ACL 2024.
Srivastava, S., Pati, S., Yao, Z. (2025). Instruction-Tuning LLMs for Event Extraction with Annotation Guidelines. Findings of ACL 2025.
Gao, J. 외 (2024). EventRL: Enhancing Event Extraction with Outcome Supervision for Large Language Models. arXiv:2402.11430.
Qi, Y. 외 (2024). ADELIE: Aligning Large Language Models on Information Extraction. EMNLP 2024.
강화학습과 검증 가능한 보상
Shao, Z. 외 (2024). DeepSeekMath (GRPO). arXiv:2402.03300.
Lambert, N. 외 (2024). Tülu 3: Pushing Frontiers in Open Language Model Post-Training (RLVR 명명). arXiv:2411.15124.
DeepSeek-AI (2025). DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning. arXiv:2501.12948.
Yu, Q. 외 (2025). DAPO: An Open-Source LLM Reinforcement Learning System at Scale. arXiv:2503.14476.
Liu, S.-Y. 외 (2026). GDPO: Group Reward-Decoupled Normalization Policy Optimization for Multi-Reward RL Optimization. arXiv:2601.05242.
He, X. 외 (2026). Advantage Collapse in Group Relative Policy Optimization: Diagnosis and Mitigation. arXiv:2605.21125 (ICML 2026).
Chu, T. 외 (2025). SFT Memorizes, RL Generalizes: A Comparative Study of Foundation Model Post-training. arXiv:2501.17161.
데이터셋과 응용
Sun, Z. 외 (2022). PHEE: A Dataset for Pharmacovigilance Event Extraction from Text. EMNLP 2022.
Satyapanich, T., Ferraro, F., Finin, T. (2020). CASIE: Extracting Cybersecurity Event Information from Text. AAAI 2020.