
TECH BLOG
기술 블로그
AI 기술 인사이트와 엔지니어링 경험을 공유합니다.
ALL POSTS
모든 포스트
[특집] 맞는 기억, 틀린 맥락 — AI 에이전트의 장기 기억에 '증거능력'을 묻다: 검색 허용성(Retrieval Admissibility) 완전 해부
AI 에이전트가 기억을 '못 찾는' 문제는 지난 몇 년간 많이 풀렸다. 2026년의 새 문제는 반대편에 있다. 너무 잘 찾는다. 질문과 딱 맞는 기억을 꺼냈는데 그게 다른 사람의 기억이거나, 이미 바뀐 옛 값이거나, 사용자가 잊어 달라고 한 내용이다. 2026년 10월 5일 아칸소 리틀록 대학 연구진이 arXiv에 올린 「The Right Memory in the Wrong Context」는 이 문제를 '관련성(relevance)'과 '허용성(admissibility)'의 분리로 정식화한다. 법정의 증명력과 증거능력처럼. 기억 한 건마다 범위·정책·수명 주기를 1/0/? 세 값으로 판정하고, 덜 가져와서 안전해 보이는 꼼수를 막기 위해 '같은 재현율'에서 경로를 비교하며, 기억 ID 하나를 저장→검색→노출→발설까지 추적한다. 3,767개 질의에서 네임스페이스를 먼저 걸면 필수 증거 재현율이 0.432에서 0.533으로 오르고 계산은 98.3% 줄었다. 본문만 읽는 LLM 검증기는 위반을 거의 잡지 못한 채 필수 증거를 지웠다. 논문의 그림과 표를 하나씩 풀고, RAG에서 MemGPT·ChatGPT 메모리·2026년 벤치마크까지의 역사, 클레이니 논리·맥락적 무결성·ABAC라는 오래된 뿌리, 벡터 DB의 사전·사후 필터 실무, 한국 개인정보 보호법과 AI 기본법까지 인터랙티브 여섯 개와 함께 읽는다.
[특집] 기능 경쟁은 끝났다 — Bannerbear 창업자가 그린 'AI 시대 SaaS 피벗' 일곱 갈래 길, 역사·논문·사례로 완전 해부
"기능 하나에 2022년엔 일주일, 지금은 오후 한나절." 9년째 외부 투자 없이 이미지 자동화 SaaS를 키워 온 Bannerbear의 창업자 Jon Yongfook은 2026년 9월, 기쁨이 공포로 바뀐 순간을 이렇게 적었습니다. 내가 빨라진 만큼 모든 경쟁자도 빨라졌다는 것. 그는 '기능 경쟁은 죽었다'고 선언하고, SaaS 회사가 갈 수 있는 일곱 갈래 길을 내놓았습니다. 지루한 운영을 팔 것, 유통이 있는 곳에서 지을 것, 사람 말고 에이전트를 위해 만들 것, 기술이 없는 산업으로 갈 것, 하드웨어로 갈 것, 가격을 내릴 것, 올인원이 될 것. 그리고 '두세 개만 고르라'. 이 특집은 그 일곱 갈래를 1969년 IBM의 언번들링부터 2026년 NBER 논문까지 겹쳐 읽습니다. 자율 코딩 에이전트로 커밋은 240% 늘었는데 출시는 30%만 늘었고, 앱스토어 신규 앱은 세 배 가까이 늘었는데 총사용량은 그대로라는 데이터가 왜 이 글의 핵심 증거인지, 2025년 12월 해커뉴스에 올라온 'Bannerbear 클론' 두 개가 열 달 뒤 어떻게 됐는지, 베르트랑·크리스텐슨·헬머의 이론이 일곱 갈래를 어떻게 설명하는지, 그리고 토스·카카오·더존 같은 한국 사례까지. 인터랙티브 6개와 삽화 11장, 논문 그림 4장으로 함께 읽어 보세요.
[특집] 5분이 아니라 5년 — Zotero 20주년, 「오래가는 소프트웨어는 천천히 만들어진다」 완전 해부
2026년 10월 6일, Zotero 20주년을 맞아 공동 창시자 댄 코언이 쓴 회고 「The Slow Formation of Durable Software」가 해커뉴스 290점·댓글 116개를 모았다. 주장은 한 문장이다 — 'AI가 있었더라도 Zotero의 구상을 앞당길 수 없었다. 우리는 무엇을 원하는지 정확히 몰랐고, 그러니 LLM에 줄 일관된 프롬프트도 쓸 수 없었다.' 이 글은 2002년의 웹 스크랩북과 스크라이브라는 두 반쪽에서 출발해, 점심 테이블과 화이트보드, Firefox 출시일 밤의 이메일, 알바니아어 사전으로 지은 이름을 거쳐 2,000만 명이 쓰는 연구 도구가 된 과정을 따라간다. 1986년 브룩스의 '고객은 자기가 뭘 원하는지 모른다', 갈의 법칙, 나우르의 '이론 만들기', 브랜드의 페이스 레이어링과 린디 효과로 그 주장을 해부하고, XUL 확장에서 Firefox 엔진을 품은 독립 앱으로 이어진 Zotero의 아키텍처 — 번역기 750개, 인용 스타일 1만 865개, 로컬 SQLite — 를 그림과 다섯 개의 인터랙티브 도구로 풀었다. 해커뉴스의 반론, 로빈 슬론의 '집밥 앱', METR·GitClear·DORA·스택오버플로 2026의 데이터까지 놓고, 무엇이든 5분이면 만들어지는 2026년에 '오래가는 것'을 만드는 법을 정리했다.
[특집] 5년 계획을 태워라 — 사힐 블룸의 '인접 가능성', 지도 대신 나침반으로 사는 법
"5년 뒤 당신은 어디에 있을 것 같습니까?" 2021년 1월, 사모펀드 7년 차였던 사힐 블룸은 멘토의 이 질문에 그럴듯한 답을 셋 내놓았다. 5년 반이 지난 2026년 7월 그는 이렇게 썼다 — '그때 100개의 시나리오를 써 보라고 했다면, 그중 단 하나도 근처에도 가지 못했을 것이다.' 「5년 계획을 그만 세워라(대신 이걸 하라)」는 계획이 사실은 과거의 외삽이라는 진단과, 이론생물학자 스튜어트 카우프먼의 '인접 가능성(Adjacent Possible)'이라는 처방으로 이루어진 짧은 글이다. 이 특집은 그 짧은 글이 딛고 선 긴 지층을 파낸다. 1928년 소련의 5개년 계획에서 면접장의 단골 질문까지, '역사의 종말 착각'과 '계획 오류'의 실험, 카우프먼의 TAP 방정식과 트리아·스트로가츠의 '트리거가 있는 항아리', 스탠리의 '목표를 버려야 찾는다', 그라노베터에서 링크드인 2천만 명 실험까지 이어지는 약한 연결의 과학, 크럼볼츠의 '계획된 우연'과 사라스바티의 '효과화'. 그리고 AI가 해마다 문의 지도를 다시 그리는 2026년, 한국의 청년 통계 위에서 '지도는 태우고 나침반은 지켜라'가 무엇을 뜻하는지 일곱 개의 인터랙티브 도구로 풀었다.
'빼고'를 공짜로 고칠 수 있나 — 임베딩 트릭 대 Jev, 한국어 제외 질문 50개 실측 (한국어 검색 스택 9편)
8편에서 '쿠버네티스는 빼고 도커만'이라고 물으면 임베딩이 상위 10개의 절반을 쿠버네티스 글로 채운다는 것을 봤고, Jev가 그것을 고쳤습니다. 그런데 8월과 9월에 나온 두 논문(EXCISE, E-SENS)은 학습도 큰 모델도 없이 이 문제를 줄이는 방법을 내놓았습니다. 이 글은 한국어 제외 질문 50개(표지어가 분명한 30개, 돌려 말한 10개, 두 가지를 동시에 빼는 10개)로 그 공짜 방법들과 Jev를 정면으로 비교했습니다. 가장 큰 한 걸음은 놀랍도록 단순했습니다. 질문에서 빼라는 말을 떼어 내기만 해도 nDCG@10이 0.245에서 0.555로 뛰었습니다. 빼라는 단어가 든 글을 아래로 내리는 공짜 규칙은 0.676으로 8편의 Jev 방식(0.672)과 같은 자리까지 올라왔습니다. 하지만 그 규칙은 평범한 질문을 제외 질문으로 오인했을 때 정답을 100위로 보내는 위험도 있었습니다. 글자 강등으로 정리한 상위 20개만 Jev가 판정하는 조합이 0.790으로 가장 높았지만 강등의 위험을 그대로 물려받았고, 원래 질문과 뗀 질문의 후보를 합쳐 Jev에 주면(0.759) 평범한 질문을 하나도 해치지 않았습니다. Jev 3,405회 호출에 0.1달러. 인터랙티브 5개와 삽화 7장.
[특집] '이거 누가 알아요?'를 없애는 법 — 한 엔지니어링 매니저가 만든 AI 하이브 마인드, 조직의 암묵지를 끌어올리다
“시스템이 어떻게 돌아가는지 알아내려면 늘 3~4명을 한 방에 모아야 했다.” 핀테크 기업 SumUp의 엔지니어링 매니저 칸도스트가 2026년 8월 공개한 글은 이 한 문장에서 출발한다. 그는 저장소 66개를 git 서브모듈로 한 저장소에 묶고, 도메인마다 AGENTS.md를 두고, 저장소 하나만 보는 배경 에이전트와 그들을 지휘하는 주 에이전트를 나눠 ‘하이브 마인드’를 만들었다. 에이전트끼리는 Zod 스키마로 정한 JSON 보고서로만 인계하고, 매주 슬랙·노션의 변화를 모아 AGENTS.md를 고치는 PR을 사람이 검토한다. 이 글은 그 구조를 하나씩 뜯어보고, 폴라니의 ‘암묵지’(1966)와 노나카의 SECI 나선(1995), 콘웨이의 법칙(1968), 웨그너의 ‘누가 무엇을 아는가’(1985), ‘Lost in the Middle’과 ‘Context Rot’, 앤트로픽의 멀티 에이전트 연구와 버클리의 실패 분류(MAST)까지 이 설계가 왜 이런 모양이 됐는지를 사례와 함께 풀었다. AGENTS.md가 오히려 성능을 떨어뜨린다는 ETH 취리히의 반론과 2026년의 의미, 그리고 우리 팀에서 시작하는 법까지 여섯 개의 인터랙티브 도구와 함께 정리했다.
[특집] 수학의 미래 — 타오의 블로그에 실린 아비가드의 편지: '더 어려운 문제를 풀고, 더 큰 생각을 하고, 새로운 것을 시도하라'
2026년 10월 5일, 테런스 타오의 블로그에 카네기멜런 대학의 논리학자이자 Lean 수학 라이브러리의 산파인 제러미 아비가드의 글 「수학의 미래」가 실렸다. 한 달 내내 경고와 선언이 쏟아지던 블로그에 처음으로 '대체로 긍정적'이라는 진단과 함께 세 개의 동사가 나왔다 — 더 어려운 문제를 풀어라, 더 큰 생각을 하라, 새로운 것을 시도하라. 그리고 다음 세대에게 '우리는 당신들과 함께 선다'는 문장이 붙었다. 이 글은 왜 화제가 됐는가. 리만의 1854년 강연을 '어떤 강화학습 채점기도 평가할 수 없었을 것'이라고 한 기술적 주장은 무슨 뜻인가. 추론 모델이 실제로 어떻게 훈련되는지(GRPO·결과 보상·AlphaProof의 탐색 트리)부터, 수학이 '낯선 기술'을 삼켜 온 400년의 역사, 댓글창의 반론, 같은 주에 바뀐 arXiv·Erdős 사이트의 규칙, 그리고 2026년 한국의 자리까지, 원문과 논문·댓글 100여 건을 읽고 인터랙티브 다섯 개와 함께 풀어본다.
[특집] AI가 코드를 쓸수록 설계가 중요해진다 — 「도메인 주도 설계는 AI가 코드를 쓸 때 더 중요해진다」 완전 해부
2026년 8월 20일, 폴란드의 Go 백엔드 교육 회사 스리 닷 랩스의 공동창업자 미워시 스몰카가 올린 에세이 한 편이 두 달에 걸쳐 조용히 퍼졌다. 주장은 단순하다 — '에이전트를 어떻게 설정하고 어떤 LLM을 쓰는지는 해법에 대한 명확한 정신 모델만큼 중요하지 않다. 둘 중 하나를 골라야 한다면 나는 생각을 건너뛰느니 코드를 한 줄도 직접 쓰지 않겠다.' 이 글은 그 주장을 끝까지 파고든다. 2003년 에릭 에반스의 '파란 책'이 왜 나왔고 지식 탐구·유비쿼터스 언어·바운디드 컨텍스트가 정확히 무엇을 뜻하는지, 1985년 피터 나우르의 '이론 만들기'부터 2026년 OpenAI의 하니스 엔지니어링까지 어떤 계보 위에 서 있는지, 월 1달러를 아낀 에이전트 일화가 왜 팀 커뮤니케이션의 축소판인지, 그리고 Faros·METR·GitClear·LinearB의 2025~2026년 데이터가 '쓰기가 싸지자 읽기가 비싸졌다'를 어떻게 증명하는지를 사례와 함께 풀었다. 본 버논의 '에이전트는 아직 도메인 모델을 못 만든다'는 증언, 에반스의 2026년 기조연설, 네이버·카카오·삼성·토스의 AI 코딩 도입과 GeekNews의 차가운 반응까지 — 다섯 개의 인터랙티브 도구로 2026년 가을 한국의 독자가 이 글에서 가져갈 것을 정리했다.
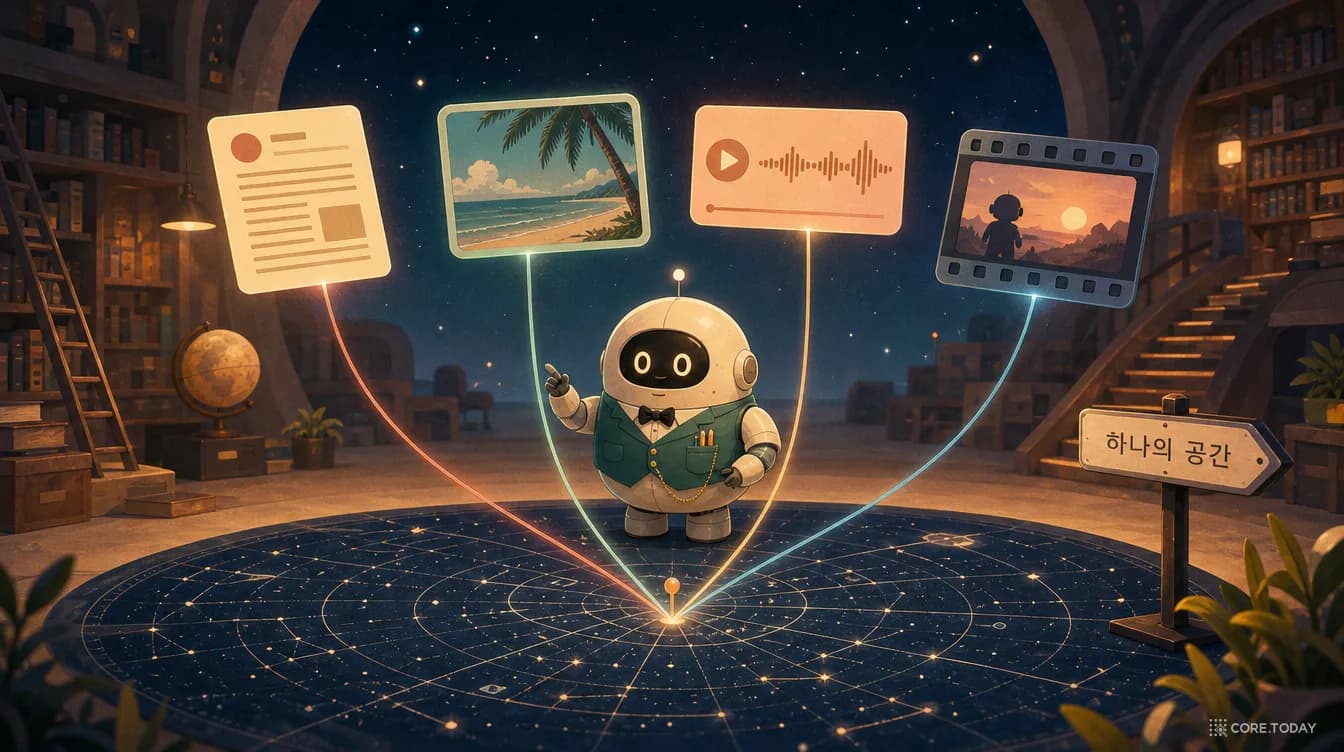
글·사진·소리·영상을 하나의 좌표로 — 내 폰 안에서 도는 740M 임베딩 모델, EmbeddingGemma 2 특집
2026년 10월 6일 구글 딥마인드가 공개한 EmbeddingGemma 2는 텍스트·코드·이미지·비디오·오디오를 하나의 768차원 공간에 놓는 7억 4천만 파라미터짜리 공개 임베딩 모델입니다. 텍스트만 쓰면 191MB, 전부 켜도 567MB로 스마트폰 안에서 돌고, 음성 메모로 영상을 찾고 사진으로 문서를 찾는 일이 서버 없이 가능해집니다. 이 글은 '단어는 친구를 보면 안다'는 1950년대 가설에서 word2vec의 왕−남자+여자=여왕, SBERT의 65시간→5초, CLIP의 N×N 행렬, ImageBind와 Gemini Embedding 2까지 임베딩이 걸어온 길을 되짚고, EmbeddingGemma 2의 모듈 구조·토큰 예산·마트료시카 절단·양자화를 논문 그림과 표로 뜯어봅니다. 구글이 비교하지 않은 경쟁 모델, 해커뉴스의 반론, 한국의 망분리·KURE, 그리고 단일 벡터의 이론적 한계까지 함께 다룹니다. 위젯 5개와 일러스트 9장.