DDD도메인 주도 설계에릭 에반스유비쿼터스 언어바운디드 컨텍스트지식 탐구이벤트 스토밍AI 코딩코딩 에이전트Claude Code스펙 주도 개발컨텍스트 엔지니어링하니스 엔지니어링AGENTS.md코드 리뷰본 버논스리 닷 랩스특집
[특집] AI가 코드를 쓸수록 설계가 중요해진다 — 「도메인 주도 설계는 AI가 코드를 쓸 때 더 중요해진다」 완전 해부
2026년 8월 20일, 폴란드의 Go 백엔드 교육 회사 스리 닷 랩스의 공동창업자 미워시 스몰카가 올린 에세이 한 편이 두 달에 걸쳐 조용히 퍼졌다. 주장은 단순하다 — '에이전트를 어떻게 설정하고 어떤 LLM을 쓰는지는 해법에 대한 명확한 정신 모델만큼 중요하지 않다. 둘 중 하나를 골라야 한다면 나는 생각을 건너뛰느니 코드를 한 줄도 직접 쓰지 않겠다.' 이 글은 그 주장을 끝까지 파고든다. 2003년 에릭 에반스의 '파란 책'이 왜 나왔고 지식 탐구·유비쿼터스 언어·바운디드 컨텍스트가 정확히 무엇을 뜻하는지, 1985년 피터 나우르의 '이론 만들기'부터 2026년 OpenAI의 하니스 엔지니어링까지 어떤 계보 위에 서 있는지, 월 1달러를 아낀 에이전트 일화가 왜 팀 커뮤니케이션의 축소판인지, 그리고 Faros·METR·GitClear·LinearB의 2025~2026년 데이터가 '쓰기가 싸지자 읽기가 비싸졌다'를 어떻게 증명하는지를 사례와 함께 풀었다. 본 버논의 '에이전트는 아직 도메인 모델을 못 만든다'는 증언, 에반스의 2026년 기조연설, 네이버·카카오·삼성·토스의 AI 코딩 도입과 GeekNews의 차가운 반응까지 — 다섯 개의 인터랙티브 도구로 2026년 가을 한국의 독자가 이 글에서 가져갈 것을 정리했다.
2026년 8월 20일, 폴란드 남부의 작은 마을 미엥지브로지에 비알스키에에 적을 둔 두 사람짜리 회사 스리 닷 랩스(Three Dots Labs)의 블로그에 글 한 편이 올라왔다. 제목은 「도메인 주도 설계는 AI가 코드를 쓸 때 더 중요해진다(Domain-Driven Design matters more when AI writes your code)」. 저자 미워시 스몰카(Miłosz Smółka)는 Go 생태계에서는 꽤 알려진 사람이다. 이벤트 주도 Go 라이브러리 Watermill(깃허브 스타 약 9,900개)을 만들었고, 2020년부터 「DDD Lite in Go」 시리즈를 썼으며, 6만 회 넘게 내려받힌 무료 전자책 『Go With The Domain』의 공저자다.
이 글은 해커뉴스에서는 터지지 않았다. 공동창업자가 직접 올린 스레드는 12점에 댓글 6개로 끝났고, 두 번 더 올렸지만 2점을 넘지 못했다. 대신 다른 경로로 번졌다. 개발자 피드 서비스 daily.dev에서 추천 283개와 댓글 14개를 모았고, 글이 올라온 지 6주가 지난 2026년 10월 5일에는 한국의 GeekNews에 「AI가 코드를 쓸수록 도메인 주도 설계가 더 중요해지는 이유」로 소개돼 33점을 받았다. 같은 시기에 이 글을 인용하지 않은 채 같은 결론에 도달한 글들이 독립적으로 쏟아졌다. 지멘스 엔지니어의 「프롬프트 스파게티에서 바운디드 컨텍스트로」(2026년 2월), 『Implementing DDD』 저자 본 버논의 「This Is Your Agent on Domain-Driven Design」(5월), 에릭 에반스의 DDD 유럽 개막 기조연설 「AI는 DDD를 증폭할 것인가 대체할 것인가」(6월), 그리고 해커뉴스 97점을 받은 「Domain-Driven Agents」(8월 말). 이 글은 단독 히트가 아니라 수렴의 한 표본이다. 코드가 싸진 시대에 무엇이 비싸졌는지를 많은 사람이 동시에 깨달았고, 그중 가장 읽기 쉽게 쓴 글이 이것이다.
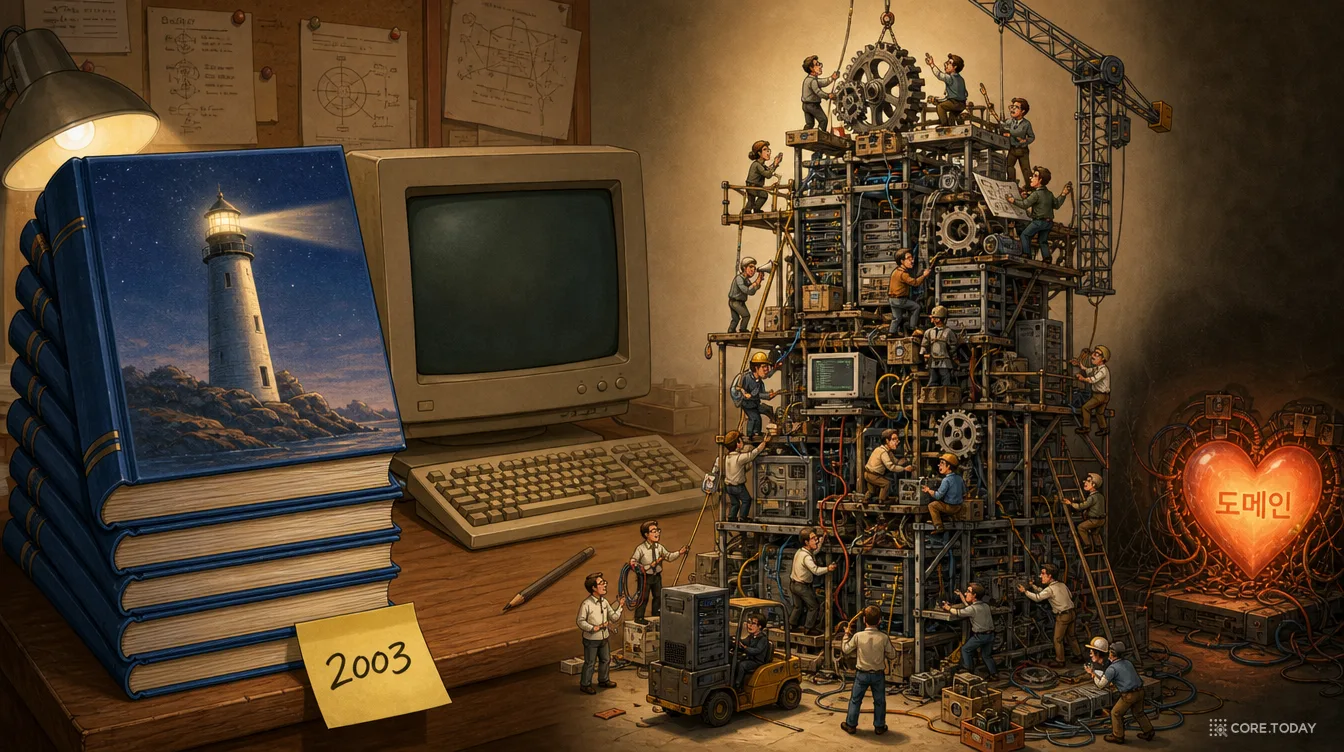
GeekNews의 댓글 두 개는 모두 차가웠다. "강의를 파는 회사 아닌가", "상식을 길게 늘어놓았을 뿐". 이 특집은 그 두 반응을 진지하게 받는다. 상식이 맞다. 그런데 왜 2026년에 그 상식이 다시 비싸졌는가. 그것을 설명하려면 2003년, 아니 1985년까지 거슬러 올라가야 한다.
바쁜 분을 위한 요약
주장. DDD의 핵심은 코드 패턴이 아니라 "도메인을 이해하고 그것을 모델로 만드는 팀의 작업"이다. AI가 코드를 써 주는 지금, 구현은 싸졌고 이해가 병목이 됐다. 그래서 DDD의 전략적 절반(지식 탐구·유비쿼터스 언어·바운디드 컨텍스트)은 더 중요해졌다.
세 가지 실천. ① 도메인 모델은 산출물이 아니다 — AI가 써 준 명세서는 팀의 이해를 만들어 주지 않는다. ② 코드를 생성하기 전에 팀이 설계를 합의하라 — 리뷰는 "맞는지 확인"하는 자리이지 "접근이 말이 되는지 토론"하는 자리가 아니다. ③ 같은 말을 써라 — 정확한 도메인 용어는 사람에게도 에이전트에게도 가장 짧은 지시다.
증거. Faros AI(2025): AI 도입 뒤 PR 크기 +154%, 리뷰 시간 +91%, 회사 수준 성과 개선 없음. METR(2025): 숙련 개발자가 AI로 19% 느려짐. GitClear(2026): 리팩터링 비율 21% → 3.8%. 본 버논(2026): 에이전트가 만든 도메인 모델은 "받아들일 수 없는 수준보다 나은 경우가 드물다".
한국. 네이버 전사 Cursor(2025년 6월), 카카오 AI 마일리지, 삼성 SDS 7만 명 Claude(2026년 7월). 도구 도입은 빠른데 "무엇을 만들지"를 합의하는 방법에 대한 논의는 거의 없다. 토스페이먼츠의 「소프트웨어 3.0」 글이 같은 결론을 독립적으로 내렸다.
한 줄. "AI가 가장 못하는 것이 DDD가 가장 중요하게 여기는 것이다." 그 부분이 사람의 자리다.
1부. DDD란 무엇인가 — 용어부터 천천히
이 글을 읽는 데 필요한 DDD 개념은 다섯 개면 충분하다. 에반스의 2014년 『DDD 레퍼런스』(무료 PDF)에 실린 정의를 기준으로 하나씩 풀어 보자.
도메인, 모델, 그리고 "소프트웨어의 심장부"
도메인(domain) 은 "지식·영향·활동의 영역. 사용자가 프로그램을 적용하는 주제 영역"이다. 택배 회사의 소프트웨어라면 집하·분류·배송·반품이 도메인이고, 병원이라면 진료·처방·수납이다. 에반스의 책 서문에서 가장 중요한 문장은 이것이다.
많은 애플리케이션에서 가장 중요한 복잡성은 기술적인 것이 아니다. 그것은 도메인 자체, 즉 사용자의 활동이나 비즈니스 안에 있다. 이 도메인의 복잡성을 설계에서 다루지 않으면, 인프라 기술이 아무리 잘 만들어졌어도 소용없다.
모델(model) 은 "도메인의 선택된 측면을 기술하고, 그 도메인과 관련된 문제를 푸는 데 쓸 수 있는 추상의 체계"다. 지도가 영토가 아니듯 모델은 도메인이 아니다. 지하철 노선도는 거리와 방향을 왜곡하지만 "어디서 갈아타는가"라는 문제를 푸는 데는 완벽하다. 모델은 문제를 풀기 위해 선택한 단순화이고, 그래서 같은 도메인에 여러 모델이 공존할 수 있다. 이 점이 뒤에 나올 바운디드 컨텍스트의 씨앗이다.
지식 탐구 — 모델은 누가, 어떻게 만드는가
에반스는 책의 1장을 "Crunching Knowledge"에 바쳤다. 번역하기 까다로운 말인데, 숫자를 씹어 삼키듯(number crunching) 지식을 씹어 삼킨다는 뜻이다.
효과적인 도메인 모델러는 지식을 씹어 삼키는 사람이다. 그들은 정보의 급류를 받아 그중 유의미한 실개천을 찾는다. 하나의 조직 원리를 시도하고 또 다른 것을 시도하며, 그 덩어리를 이해하게 해 주는 단순한 관점을 찾는다. 많은 모델이 시도되고 버려지고 변형된다.
그리고 바로 다음 문장이 스몰카 글의 뿌리다. "지식 탐구는 혼자 하는 활동이 아니다. 개발자와 도메인 전문가로 이루어진 팀이 협업한다." 도메인 전문가는 설명하려고 애쓰는 과정에서 자기 지식을 정제하고, 개발자는 코드로 옮기려다 모호한 지점을 발견한다. 모델은 이 왕복의 부산물이다. 1장의 또 다른 문장은 이렇게 말한다. "브레인스토밍의 창의성과 대규모 실험을, 모델 기반 언어로 지렛대 삼고 구현을 통한 피드백 루프로 단련하는 것, 그것이 지식이 풍부한 모델을 찾아 증류할 수 있게 한다."
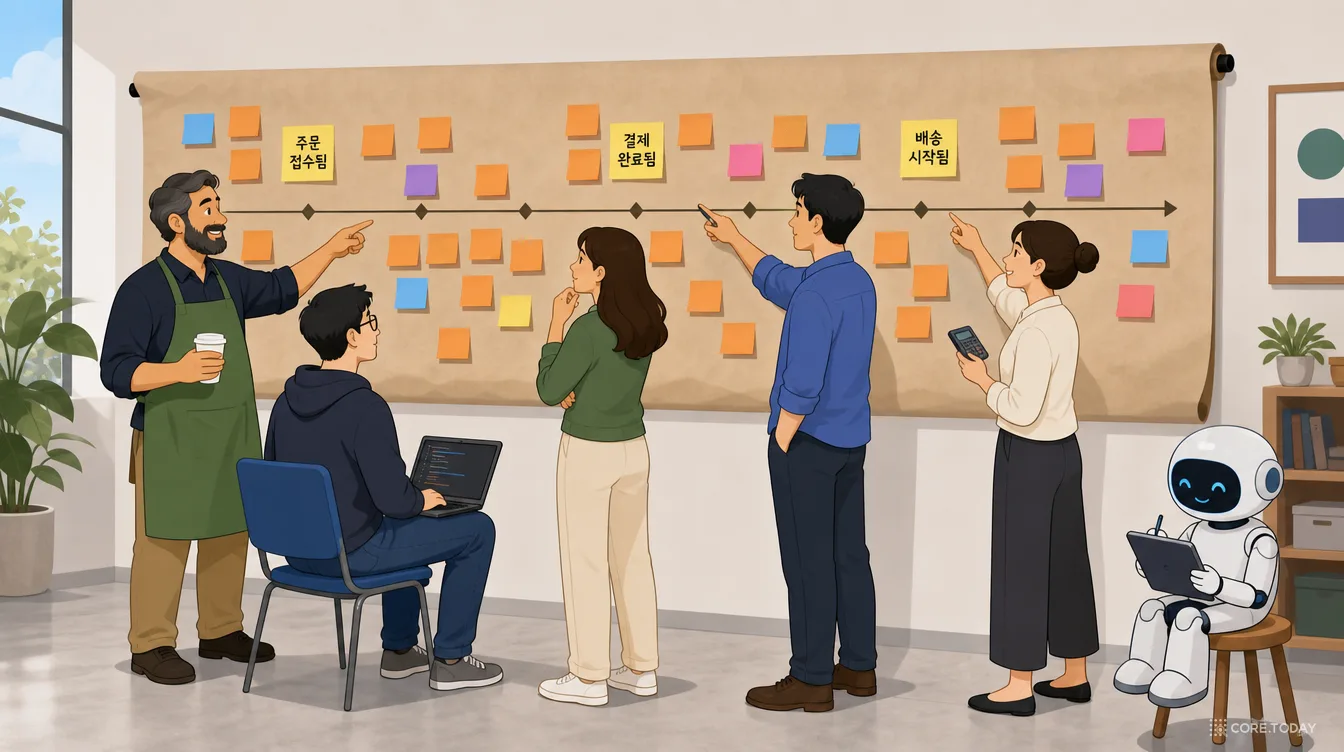
2013년 알베르토 브란돌리니가 고안한 이벤트 스토밍(Event Storming) 은 이 지식 탐구를 워크숍 형식으로 만든 것이다. 긴 종이를 벽에 붙이고, 도메인에서 "일어난 일"을 과거형으로 주황색 스티키 노트에 써서 시간순으로 붙인다. 개발자·기획자·영업·회계가 한 방에서 같은 벽을 본다. 아래 보드에서 다섯 단계를 눌러 보면, 종이 한 장이 어떻게 "모르는 것의 목록"과 "경계"와 "용어집"으로 바뀌는지 볼 수 있다.
유비쿼터스 언어 — 회의실의 말과 코드의 말이 같아야 한다
『DDD 레퍼런스』의 정의: "도메인 모델을 중심으로 구조화되고, 바운디드 컨텍스트 안의 모든 팀원이 팀의 모든 활동을 소프트웨어와 연결하기 위해 쓰는 언어." 문제 진술은 이렇다. "도메인 전문가는 자기 전문 용어를 쓰고 기술 팀은 자기 언어를 쓴다. … 번역은 소통을 무디게 하고 지식 탐구를 빈약하게 만든다." 그래서 에반스의 처방은 과격하다.
모델을 언어의 뼈대로 삼아라. 팀 안의 모든 소통과 코드에서 그 언어를 가차없이 쓰도록 팀을 묶어라. … 언어의 변화는 모델의 변화임을 인식하라.
마틴 파울러는 2003년 4월에 쓴 이 책의 서문에서 "도메인 모델의 가장 큰 가치는 도메인 전문가와 기술자를 묶는 유비쿼터스 언어를 제공한다는 것"이라고 요약했다. 회의에서 "고객 온보딩"이라고 말하면 코드에도 OnboardCustomer가 있어야 하고, 코드에 UserProfileSyncJob이 있으면 회의에서도 그 말을 써야 한다는 뜻이다. 2026년에 이 언어를 쓰는 팀원이 하나 늘었다. 저장소 전체를 읽는 에이전트다.
바운디드 컨텍스트 — 하나의 모델이 통하는 범위
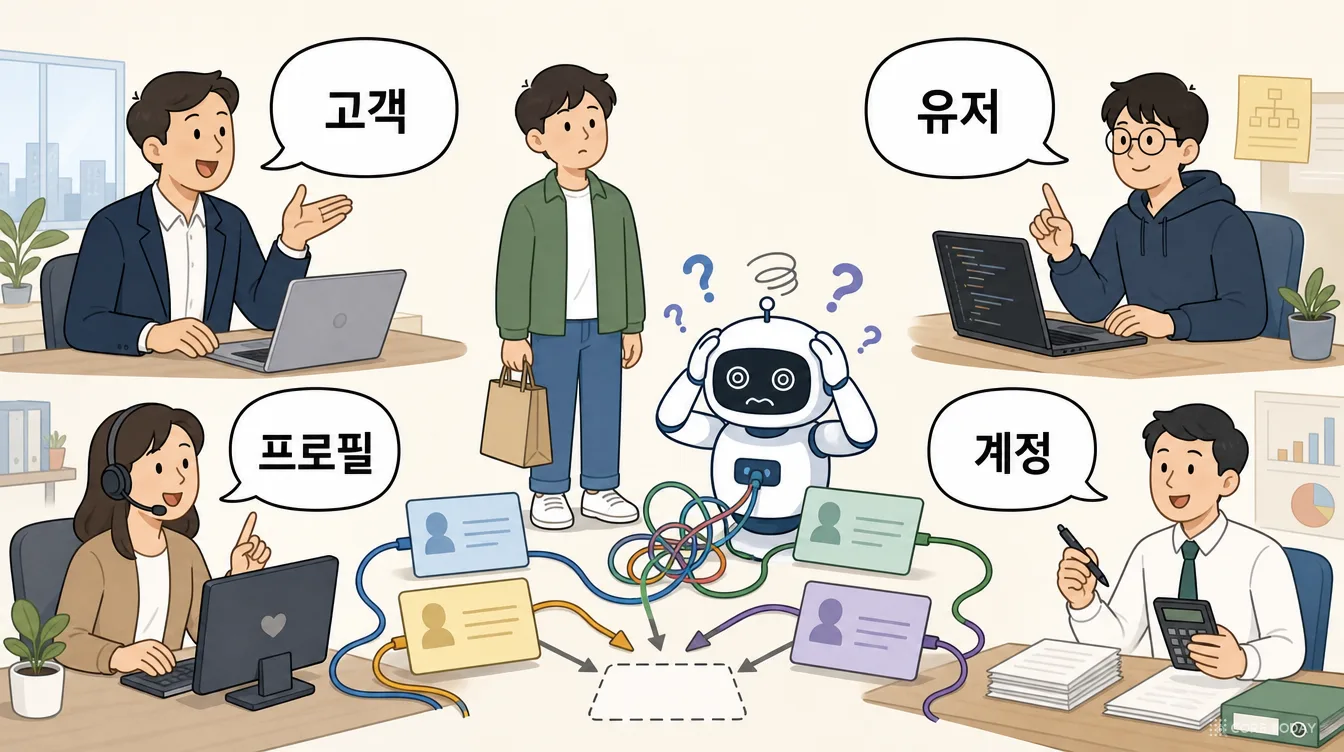
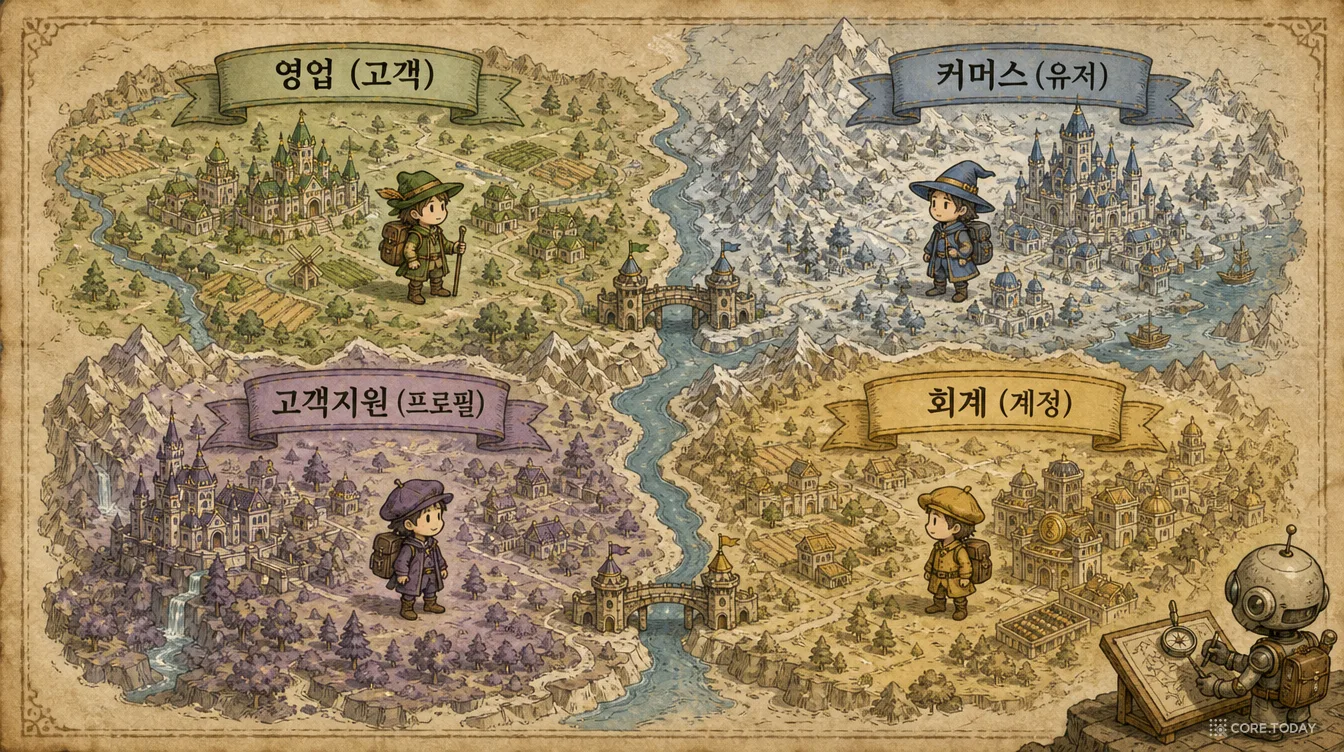
큰 조직에서 "고객"이라는 말은 부서마다 다른 것을 뜻한다. 영업에게는 계약 상대, 지원에게는 티켓을 여는 사람, 회계에게는 청구 대상이다. 세 부서를 하나의 Customer 클래스로 묶으려는 순간 모든 부서가 불행해진다. 에반스의 처방은 반대다.
모델이 적용되는 컨텍스트를 명시적으로 정의하라. 팀 조직, 애플리케이션의 특정 부분에서의 사용, 코드베이스와 데이터베이스 스키마 같은 물리적 형태의 측면에서 경계를 명시적으로 그어라.
바운디드 컨텍스트(bounded context) 는 "특정 모델이 정의되고 적용되는 경계(보통 서브시스템이나 특정 팀의 작업)에 대한 기술"이다. 그리고 컨텍스트들 사이의 관계를 그린 지도가 컨텍스트 맵(context map) 이다. 상류·하류, 공유 커널, 번역 계층(anticorruption layer), 분리된 길 같은 관계 패턴이 여기 들어 있다. 1967년 멜빈 콘웨이가 "시스템을 설계하는 조직은 그 조직의 소통 구조를 복제한 설계를 내놓을 수밖에 없다"고 쓴 법칙이, DDD에서는 "그러니 경계를 소통 구조에 맞춰 의도적으로 그어라"로 바뀐다.
에반스가 1997년 푸트와 요더의 「큰 진흙 공(Big Ball of Mud)」까지 컨텍스트 맵 패턴으로 받아들였다는 점이 재미있다. "엉망진창 전체에 경계를 그어 큰 진흙 공이라고 지정하라. 그 안에서 정교한 모델링을 시도하지 마라." 레거시를 고치려 들지 말고 경계만 지키라는 뜻이다. 에이전트가 레거시 모듈을 "친절하게" 리팩터링하기 시작할 때 떠올릴 문장이다.
전략과 전술 — 이 글이 말하는 DDD는 어느 쪽인가
DDD 책의 2부(엔티티·값 객체·애그리거트·리포지토리·서비스)는 코드 안의 구성 요소를 다루는 전술적 패턴이고, 4부(바운디드 컨텍스트·컨텍스트 맵·핵심 도메인)는 팀과 경계를 다루는 전략적 패턴이다. 커뮤니티의 오랜 농담은 "다들 2부만 읽고 4부는 안 읽는다"는 것이다. 스몰카의 글은 거의 전부 4부와 1부(지식 탐구·언어)에 관한 것이다. 아래 지도에서 개념 하나하나가 2003년에 무엇을 뜻했고 2026년에 어떤 자리로 옮겨 갔는지 비교할 수 있다. 전술 패턴은 "형식은 자동화됨", 전략 패턴은 "더 중요해짐"으로 갈리는 것이 이 글의 논지다.
2부. 계보 — 이 생각은 어디서 왔나
스몰카의 글이 "상식"처럼 읽히는 이유는, 실제로 40년 동안 여러 사람이 다른 말로 같은 것을 말해 왔기 때문이다. 다섯 갈래로 정리한다.
갈래 1. 피터 나우르, "프로그래밍은 이론 만들기다" (1985)
덴마크의 컴퓨터 과학자 피터 나우르(ALGOL 60의 설계자, 2005년 튜링상)는 1985년 짧은 논문 한 편에서 프로그래밍의 본질을 뒤집었다.
프로그래밍은 프로그래머가 당면한 문제에 대해 어떤 종류의 통찰, 즉 이론을 형성하거나 얻는 활동으로 보아야 한다. 이것은 프로그래밍을 프로그램과 다른 텍스트의 생산으로 보는 더 흔한 관념과 대조된다.
나우르에게 소스 코드와 문서는 "보조적이고 부차적인 산물"이다. 진짜 산물은 프로그래머의 머릿속에 있는 이론이고, 그 이론은 "원리적으로 규칙으로 표현될 수 없다". 그래서 그는 프로그램의 죽음을 이렇게 정의했다. "프로그램의 죽음은 그 이론을 가진 프로그래머 팀이 해산될 때 일어난다. 죽은 프로그램도 계속 실행되어 유용한 결과를 낼 수 있다. 죽음의 실제 상태는 프로그램 수정 요구에 지적으로 답할 수 없을 때 드러난다."
스몰카의 "도메인 모델은 산출물이 아니다"는 나우르의 "프로그램은 텍스트가 아니라 이론이다"의 2026년판이다. 그리고 나우르의 정의를 에이전트에 적용하면 섬뜩한 결론이 나온다. 코드만 보는 에이전트가 보는 것은 죽은 프로그램이다. 팀이 이론을 갖고 있을 때만 그 코드는 살아 있다.
갈래 2. 프레드 브룩스, 본질적 복잡성과 우연적 복잡성 (1986)
『맨먼스 미신』의 저자 브룩스는 1986년 「은탄환은 없다」에서 소프트웨어의 어려움을 둘로 나눴다. 본질적(essential) 과제는 "추상적 소프트웨어 개체를 구성하는 복잡한 개념 구조를 빚는 것"이고, 우연적(accidental) 과제는 "그 추상적 개체를 프로그래밍 언어로 표현하고 기계어로 사상하는 것"이다. 그의 주장은 우연적 복잡성은 이미 많이 줄었으므로 그것을 전부 없애도 10배 개선은 나오지 않는다는 것이었다.
40년 뒤 AI 코딩 에이전트는 우연적 복잡성을 공략하는 역사상 가장 강력한 도구다. 언어 문법, 프레임워크 관용구, 보일러플레이트가 사라진다. 그런데 브룩스의 논리대로라면 남는 것은 본질적 복잡성, 즉 "맞물린 개념들의 구조: 데이터 집합, 데이터 항목 사이의 관계, 알고리즘, 함수 호출"이다. DDD는 처음부터 이 본질적 복잡성을 겨냥한 방법론이었다. 스몰카가 "구현 세부는 덜 중요해졌는데 우리는 또 기술로 도메인 문제를 풀려 한다"고 쓴 것은 브룩스의 경고를 그대로 반복한 것이다.
갈래 3. 알렉산더, 벡과 커닝햄, 워프스브록 — 카드와 패턴 (1977~1996)
에반스는 서문에서 "이 책의 많은 부분은 '패턴' 모음으로 썼다"고 밝혔다. 그 형식은 건축가 크리스토퍼 알렉산더의 『패턴 랭귀지』(1977)에서 왔다. "각 패턴은 우리 환경에서 반복해 나타나는 문제를 기술하고, 그 문제의 해법의 핵심을, 같은 방식을 두 번 쓰지 않고도 백만 번 쓸 수 있도록 기술한다." 1989년 켄트 벡과 워드 커닝햄은 OOPSLA에서 CRC 카드(클래스·책임·협력자)를 발표했다. 색인 카드 한 장에 객체 하나를 적고 테이블 위에서 움직이며 설계를 토론하는 방법이다. 같은 해 레베카 워프스브록은 "책임 주도 설계"를 제안하며 "데이터 주도 설계는 구현에 너무 빨리 집중해 캡슐화를 놓친다"고 썼다. "-주도(driven)"라는 작명 관습이 여기서 왔고, "도메인 주도"는 그 후손이다. 1996년 마틴 파울러의 『분석 패턴』은 회계·거래·측정 같은 도메인 수준의 객체 모델을 카탈로그로 정리했다. 에반스의 11장 "분석 패턴 적용하기"가 그 직계다.
이 계보가 말해 주는 것은, 스티키 노트와 카드와 화이트보드가 DDD의 장식이 아니라 방법론의 본체라는 점이다. 물리적 매체 위에서 여러 사람이 같은 것을 보며 움직이는 것 자체가 지식 탐구다.
갈래 4. 에반스 이후 — 레드 북, 이벤트 스토밍, 팀 토폴로지 (2009~2024)
2003년 책이 나온 뒤 DDD는 한 번 식었다가 두 번째 물결을 맞았다. 2009년 브란돌리니의 「컨텍스트 매핑을 활용한 전략적 DDD」(InfoQ), 2010년 그레그 영의 CQRS 문서, 2013년 본 버논의 『Implementing DDD』(빨간 책)와 같은 해 브란돌리니의 「이벤트 스토밍 소개」, 2015년 샘 뉴먼의 『마이크로서비스 아키텍처 구축』이 바운디드 컨텍스트를 서비스 경계의 기본값으로 삼으면서 DDD는 마이크로서비스 붐의 교과서가 됐다. 2018년 스콧 블라신의 『함수형 도메인 모델링』은 "불법 상태를 표현 불가능하게" 타입으로 언어를 컴파일했고, 2019년 『팀 토폴로지』는 팀을 나누는 첫 번째 기준("단층면")으로 바운디드 컨텍스트를 꼽았다. 2021년 블라드 코노노프의 『Learning DDD』, 2024년 닉 튠의 『아키텍처 현대화』가 그 뒤를 잇는다.
2026년 7월 arXiv에 올라온 대규모 실증 연구(Özkan·Babur·van den Brand)는 공개 저장소 11,742개 후보 중 2,502개를 DDD 프로젝트로 검증했다. C#과 TypeScript가 앞서고, 채택은 2017년 이후 가속했으며, 그중 25.3%는 명시적인 비즈니스 컨텍스트 문서가 없었다. DDD는 유행이 아니라 꾸준히 쓰이는 방법론이고, 동시에 "경계를 문서로 남기는" 일은 여전히 네 곳 중 한 곳이 건너뛴다.
갈래 5. 에반스 자신의 AI 여정 (2024~2026)
에반스는 2024년 1월 「LLM과 소프트웨어 설계: 내 학습 여정의 시작」을 쓰고, 3월 Explore DDD 기조연설에서 "학습된 언어 모델은 하나의 바운디드 컨텍스트"라고 말했다. 5월 DDD 유럽에서는 "LLM은 DDD의 끝인가, 최신 도구인가? 여기 복잡한 도메인의 심장부를 다루는 AI 기술이 있고, 그곳이 바로 DDD가 있는 자리다"라고 했다. 2025년 8월과 2026년 1월의 글에서는 LLM 호출을 "결정론적 애플리케이션과 확률적 시스템 사이의 다리"로 규정하고, 그 사이에 번역 계층을 두는 컨텍스트 맵을 그렸다. 그리고 2026년 6월 안트베르펜의 기조연설에서 "도메인 모델은 여전히 중요하고, 바운디드 컨텍스트도, 언어도 여전히 중요하다. 다만 모델의 모습은 달라질 것"이라고 말했다. 마틴 파울러는 같은 달 자기 사이트에 DDD가 "오히려 더 중요해질지 모른다"고 썼다.
스몰카의 글은 이 다섯 갈래가 2026년 8월에 만난 지점이다. 새 개념은 없다. 그러나 "AI가 우연적 복잡성을 삼켰으니 남는 것은 본질적 복잡성이고, 그것은 팀의 이론으로만 다룰 수 있다"는 연결은, 이 글이 가장 간결하게 해냈다.
3부. 글을 한 절씩 정독하기 — 스몰카가 실제로 쓴 것
지금부터는 원문의 여섯 절을 순서대로 따라간다. 각 절마다 스몰카가 무엇을 주장했는지, 그 주장이 어떤 DDD 개념 위에 서 있는지, 그리고 2026년의 사례로 옮기면 어떻게 보이는지를 함께 놓는다. 원문의 만화와 다이어그램도 그 자리에서 함께 읽는다.
절 1. "2003년 이후 바뀌지 않은 것"
스몰카의 첫 번째 주장은 간단하다. 에반스의 책에서 가장 중요한 메시지는 "소프트웨어 공학에서 어려운 부분은 문제 도메인을 이해하고 그것을 코드로 잘 모델링하는 것"이라는 문장이고, 이 문장은 AI 이후에도 그대로라는 것이다.
그는 에반스가 2003년에 이미 관찰했던 한 가지 현상을 끌어온다. 기술 역량이 뛰어난 사람들은 정교한 프레임워크를 만드는 일에 재능을 쏟고, 도메인을 배우고 모델링하는 일은 "다른 누군가"에게 남긴다. 도메인 문제를 기술로 풀려고 한다는 것이다. 에반스의 문장을 그대로 옮기면 이렇다.
소프트웨어의 심장부에 있는 복잡성은 정면으로 다뤄야 한다. 그러지 않는 것은 무의미해질 위험을 감수하는 일이다.
— 에릭 에반스, 『도메인 주도 설계』(2003)
스몰카가 덧붙인 2026년의 관찰은 날카롭다. AI 덕분에 구현 세부 사항은 덜 중요해졌다. 특정 언어나 프레임워크를 깊이 몰라도 어느 정도 생산적일 수 있고, 다른 기술 스택으로 옮기기도 쉬워졌다. 그렇다면 비로소 복잡한 도메인 문제에 집중할 수 있어야 한다. 그런데 실제로 벌어진 일은 무엇인가.
프레임워크를 만드는 데 집착하는 대신(혹은 마이크로서비스를 더 붙이거나, 뭐든 요즘 유행하는 것을 하는 대신), 이제 우리는 모델 벤치마크를 따라다니고 더 적은 노력으로 더 나은 코드를 뽑아내려고 에이전트 설정을 최적화한다. 에반스가 2003년에 지적했듯, 우리는 여전히 도메인 문제를 기술로 풀려고 한다. 웃기게도 이번에는 CEO들도 그렇게 믿고 우리를 그쪽으로 민다.
이 문단이 글 전체의 열쇠다. 2003년의 "프레임워크 집착"과 2026년의 "에이전트 설정 집착"은 같은 병의 두 증상이라는 것이다. 어떤 모델을 쓸지, 어떤 MCP 서버를 붙일지, 컨텍스트 창을 어떻게 아낄지는 전부 기술이다. "그 물건이 어떻게 동작해야 하는가"라는 질문은 여전히 누군가 답해야 하고, 그것은 기술이 아니라 도메인이다.
마지막 문장은 비꼼이다. "누가 알려주면 토큰을 쏟아부어 구현하고 끝내면 된다. 그리고 아무도 모른다면, 뭐, 에이전트가 계획을 써 주면 되지 않을까?" 다음 절은 바로 이 유혹을 다룬다.
절 2. "도메인 모델은 산출물이 아니다"
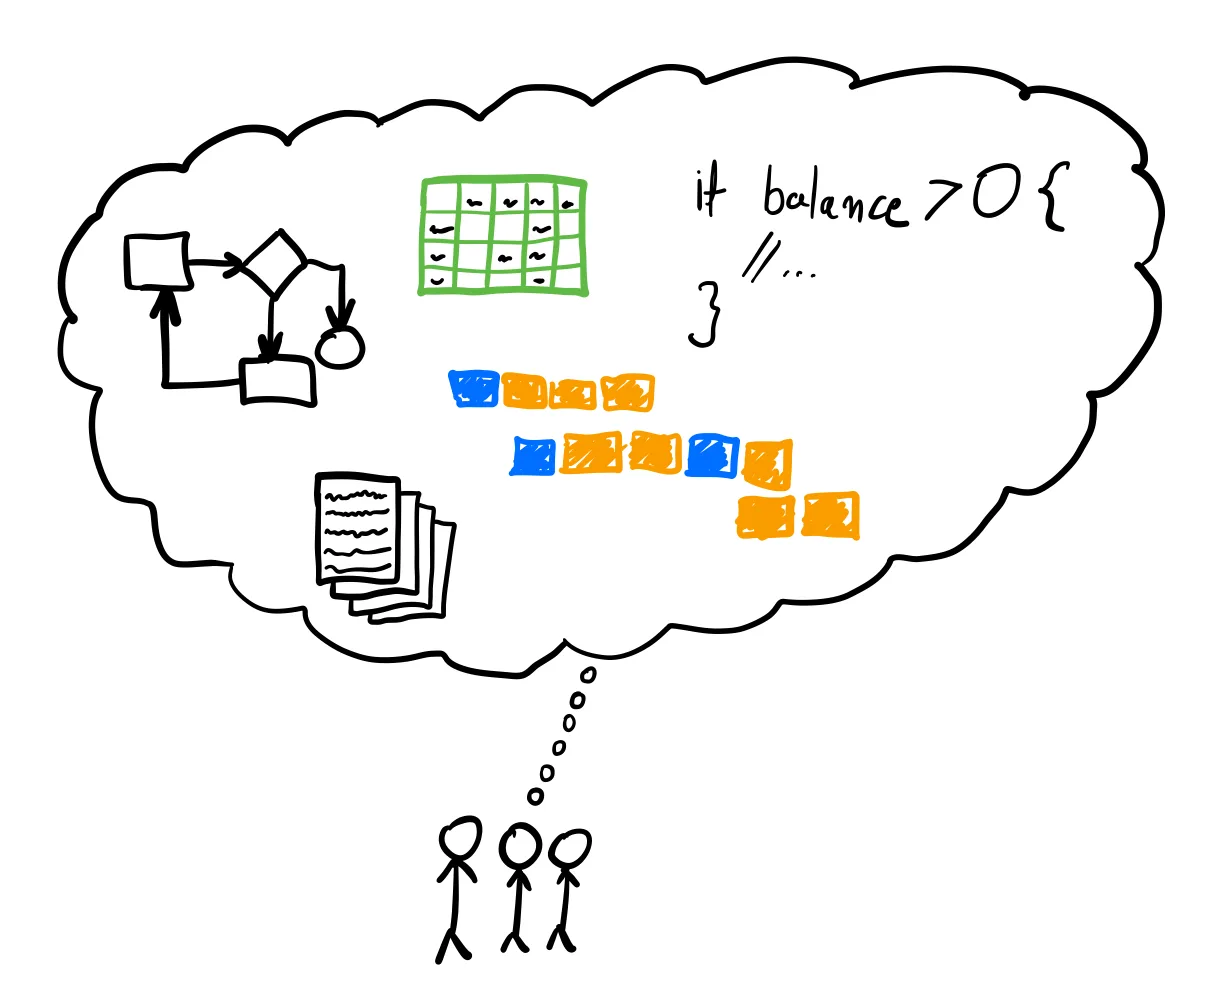
DDD의 토대는 모델 주도 설계(model-driven design) 다. 도메인이 어떻게 돌아가는지를 모델로 증류하고, 그 모델을 코드로 표현한다. 여기서 스몰카는 흔한 오해 하나를 먼저 걷어낸다. 도메인 모델은 추상적인 개념이며 한 가지 표현 방식이 있는 게 아니다. 문서, 다이어그램, 코드는 모두 모델의 단순화된 표현일 뿐이다.
그렇다면 정확한 모델은 어디서 오는가. 설계와 구현 사이를 오가며 배운 것을 반복해서 적용하는 데서 온다. DDD는 이것을 지식 탐구(knowledge crunching) 라고 부른다. 비즈니스가 어떻게 돌아가는지 아는 도메인 전문가와, 소프트웨어를 만드는 데 전문가인 엔지니어가 함께 한다. 스몰카가 예로 든 것이 이벤트 스토밍이다. 개발자와 이해관계자가 스티키 노트로 비즈니스가 어떻게 돌아가는지를 벽에 붙여 가며 그리는 워크숍이다.
이 그림이 말하는 것을 풀어 보자. 풍선 안의 물건들(문서·다이어그램·코드)은 모델의 표현이다. 모델 자체는 풍선, 즉 세 사람의 머릿속에 공유된 이해다. 에이전트가 만들어 줄 수 있는 것은 풍선 안의 물건이지 풍선이 아니다. 문서 247쪽이 있어도 세 사람의 머릿속이 비어 있으면 모델은 없다.
스몰카는 이어서 소프트웨어 프로젝트가 실제로 실패하는 이유를 세 가지로 적는다. 긴 문서를 쓰는 게 어려워서가 아니다.
엔지니어가 엉뚱한 것을 만든다.
애초에 무엇을 해야 하는지 아무도 모른다.
팀이 모든 것을 한꺼번에 만들려 한다(범위 팽창).
그리고 자신이 여러 번 빠졌다는 함정 하나를 고백한다. 엔지니어링 팀은 "우리는 다 알고 있다"고 느끼기 쉽다. 프로그래밍 전문가고, 패턴을 알고, 모범 사례를 따른다. 누군가(비즈니스 이해관계자나 PM)가 뭘 할지만 말해 주면 된다. 그런데 도메인 전문가도 명확한 계획이 없는 경우가 많다. 그들은 자기가 가진 문제는 알지만 해법이 무엇인지는 아직 모른다. 모든 요구사항이 적힌 완전한 문서 같은 것은 없다.
개발자의 첫 본능은 이렇게 말한다. "뭔가 정해지면 알려 주세요, 근처에 있을게요." 스몰카는 이것을 "우리는 코딩이라는 재미있는 부분을 하러 왔다"는 태도로 번역한다. 그리고 괄호 안에 뼈 있는 한 줄을 넣는다. "이게 바로 AI 에이전트가 자동화하는 부분이다."
반대쪽 극단도 있다. 비기술 관리자가 전체 해법을 혼자 만들어 팀에 넘긴다. 혹은 가장 최근의 유행대로, 누군가 AI로 기능 명세나 제품 명세 전체를 생성하고, 읽지도 않은 채 넘긴다. 계획은 일단 존재하지만 프로덕션에 들어갈 만한 것과는 거리가 멀다. (스몰카는 여기에 각주처럼 덧붙인다. "누가 아니라고 주장하면, 그 사람이 실제로 출시하는 물건이 얼마나 복잡한지 확인해 보라.")
이 모든 시나리오의 공통점은 아무도 자기가 뭘 하는지 명확히 모른다는 것이다. 누가 코드를 쓰든, 얼마나 빨리 쓰든, 이 시점에서 코드는 가치가 거의 없다.
반대로 모델을 함께 작업한 팀은 문제 도메인을 이해하고 해법에 합의한다. 개발자가 구현하고, 예상 밖의 일이 생기거나 다음 반복이 시작되면 도메인 전문가가 뛰어든다. 코딩의 대부분을 AI로 하더라도, 에이전트를 안내하려면 팀원을 안내할 때와 똑같이 도메인에 깊이 익숙해져야 한다. 이 절의 마지막 두 문장이 글에서 가장 많이 인용된 대목이다.
에이전트를 어떻게 설정하고 어떤 LLM을 쓰는지는 해법에 대한 명확한 정신 모델만큼 중요하지 않다. 둘 중 하나를 골라야 한다면, 나는 무엇을 해야 하는지 생각하는 일을 건너뛰느니 차라리 코드를 한 줄도 직접 쓰지 않겠다.
절 3. "코드를 쓰기 전에, 아니 생성하기 전에 설계하라"
이 절의 제목에서 스몰카는 "writing"에 취소선을 긋고 "generating"으로 고쳐 썼다. 주장은 오래된 것이다. 코드는 늘 읽기보다 쓰기가 쉬웠다. 에이전트가 큰 기능을 한 번에 뽑아 주는 지금은 그 비대칭이 극단적으로 커졌을 뿐이다. 동작하더라도 내부에서 무슨 일이 벌어지는지 모른다.
그는 이 상황이 낯설지 않다고 말한다. 완성된 기능을 혼자 만들어 거대한 PR 하나를 떨어뜨리고 가는 "외로운 늑대" 개발자와 일해 본 적 있는가. 설계에 대해 아무것도 모르는 채 PR을 받고, 아무도 생각하지 못한 구멍이 있고, 리뷰는 고통스럽다. 에이전트의 단일 샷 PR은 그 외로운 늑대의 자동화 버전이다.
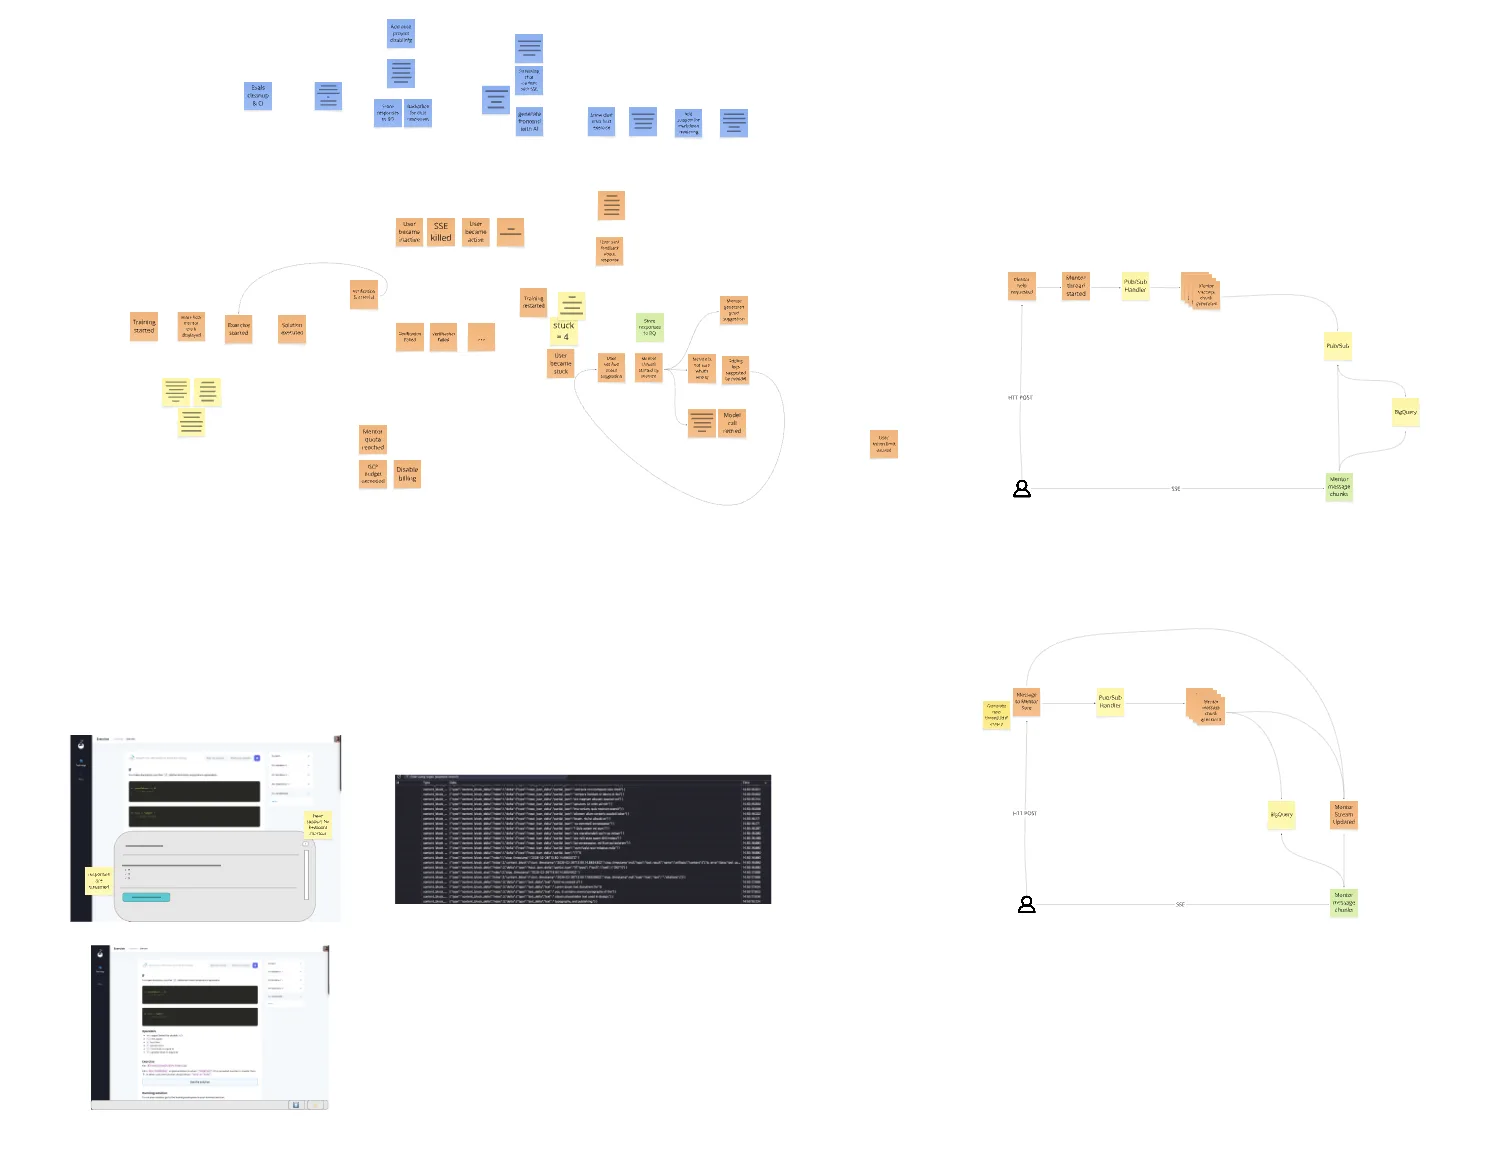
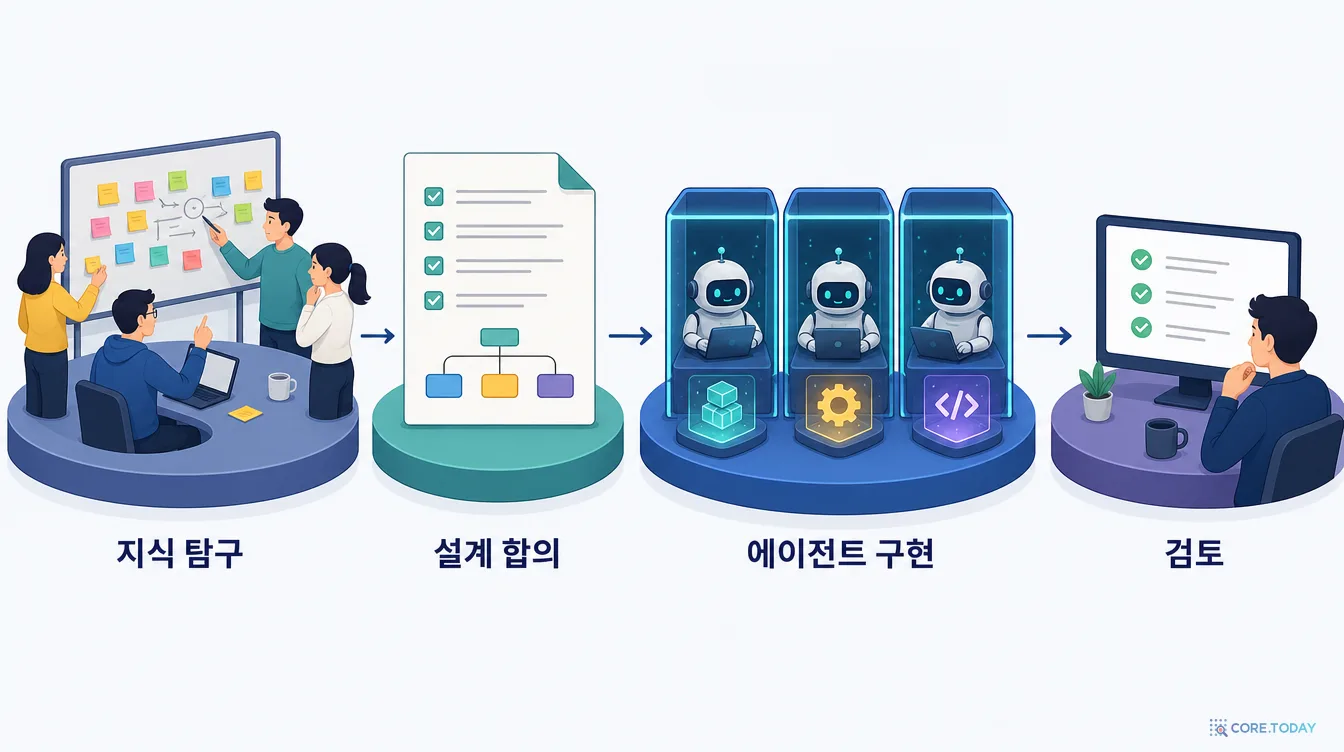
해법도 오래된 것이다. 코딩에 앉기 전에 팀으로 해법을 설계하고 토론한다. 먼저 도메인 부분(무엇을 풀고 어떻게 동작해야 하는지, 위의 지식 탐구), 그다음 기술 부분. 구현을 시작한 뒤에는 예상 밖의 일이 생길 여지가 거의 없다. 모든 세부를 합의할 필요도, 완전한 명세서도 필요 없다. 모두가 아는 대략의 계획을 스케치하면 충분하다. 스티키 노트와 화이트보드면 된다.
이 보드를 자세히 보자. 왼쪽 위에는 파란색 노트 무리(명령·행위자), 그 아래 주황색 노트의 흐름(이벤트), 왼쪽 아래에는 실제 UI 스크린샷과 터미널 캡처, 오른쪽에는 두 개의 시퀀스 다이어그램이 있다. 중요한 것은 완성도가 아니라 종류의 혼합이다. 이벤트 스토밍 결과, 화면 초안, 기술 다이어그램이 한 보드에 같이 있다. 그리고 어느 것도 "문서"라고 부를 만큼 정돈돼 있지 않다. 스몰카가 말한 "완전한 명세서는 필요 없다"의 실물이 이것이다.
이런 세션 뒤에는 PR 리뷰가 매끄럽다. 설계 전체를 PR 코멘트로 토론하지 않으니 작업을 작은 조각으로 나누기도 쉽다. 세부를 이미 합의했고 모두가 무엇을 만드는지 알기 때문에 프로덕션에 나간 뒤 구멍도 적다.
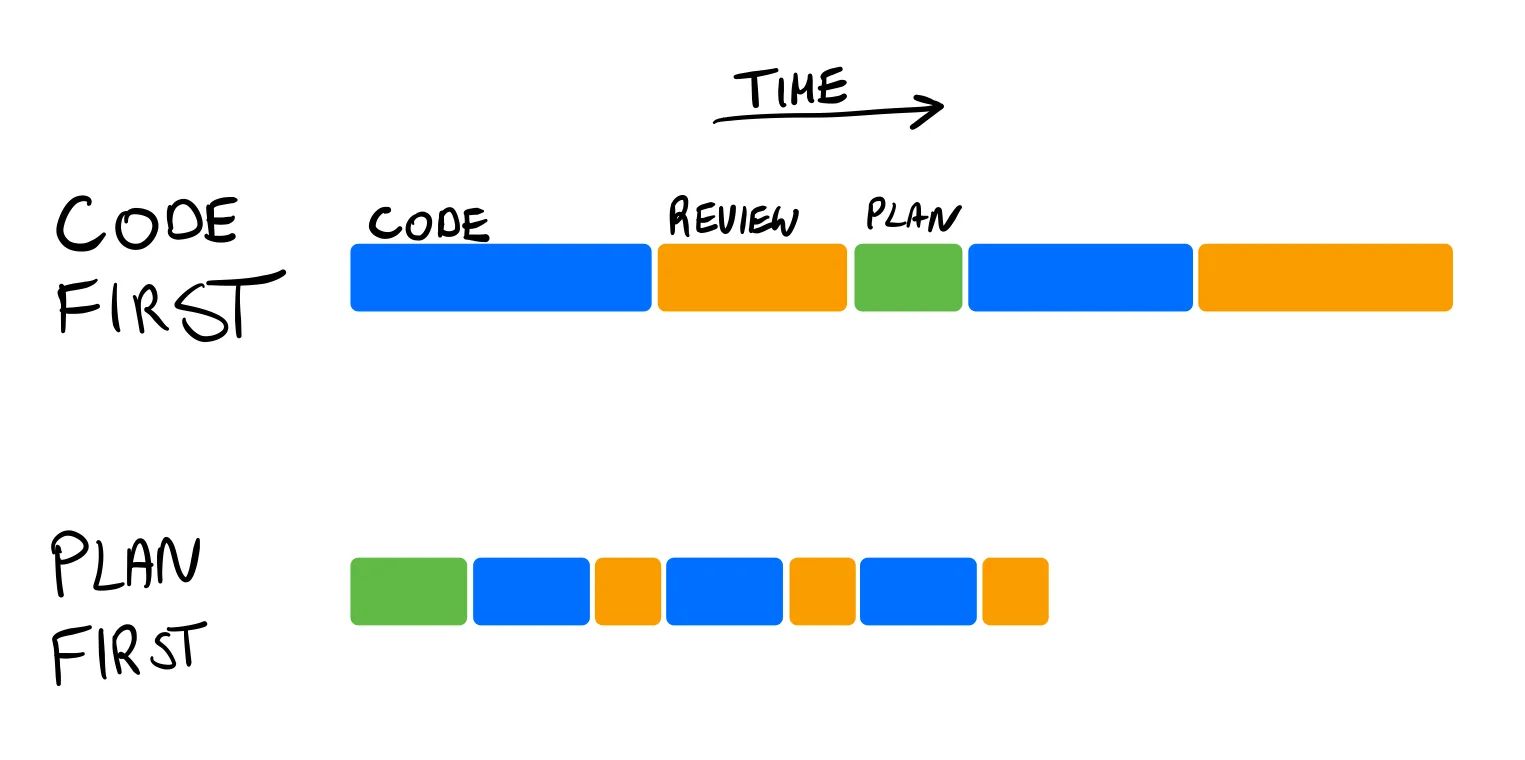
설계를 건너뛰면 시간을 아끼는 것처럼 보인다. 회의를 좋아하는 사람은 없다. 그러나 팀이 기능을 PR에서 처음 알게 되면, 리뷰하고 토론하고 고치는 데 훨씬 오래 걸린다. 리뷰는 보통 비동기라서 코멘트가 여러 라운드 오간다. 여기서 스몰카는 코드 리뷰의 정의를 바로잡는다.
코드 리뷰는 구현이 맞는지 다시 확인하는 자리여야지, 접근 자체가 말이 되는지 토론을 시작하는 자리가 되면 안 된다.
위 줄(코드 먼저)에서는 긴 코딩 구간 뒤에 긴 리뷰가 오고, 그제서야 계획이 등장하고, 다시 긴 코딩과 긴 리뷰가 반복된다. 아래 줄(계획 먼저)에서는 짧은 계획 뒤에 짧은 코딩·짧은 리뷰가 여러 번 오가고 훨씬 일찍 끝난다. 이 그림을 조절 가능한 시뮬레이터로 옮겨 보았다. 코딩 속도를 10배로 올려 보면 무슨 일이 생기는지 꼭 확인해 보라.
마지막 문단에서 스몰카는 이 오래된 습관이 AI와 일할 때도 똑같이 통한다고 말한다. 에이전트에 더 높은 품질의 컨텍스트를 주면 출력이 더 정확해지고 코딩 구간이 짧아진다. 팀이 해법을 더 많이 알수록, 코드를 전부 생성하더라도 리뷰가 쉬워진다.
절 4. "유비쿼터스 언어: 에이전트와 같은 말을 쓰기"
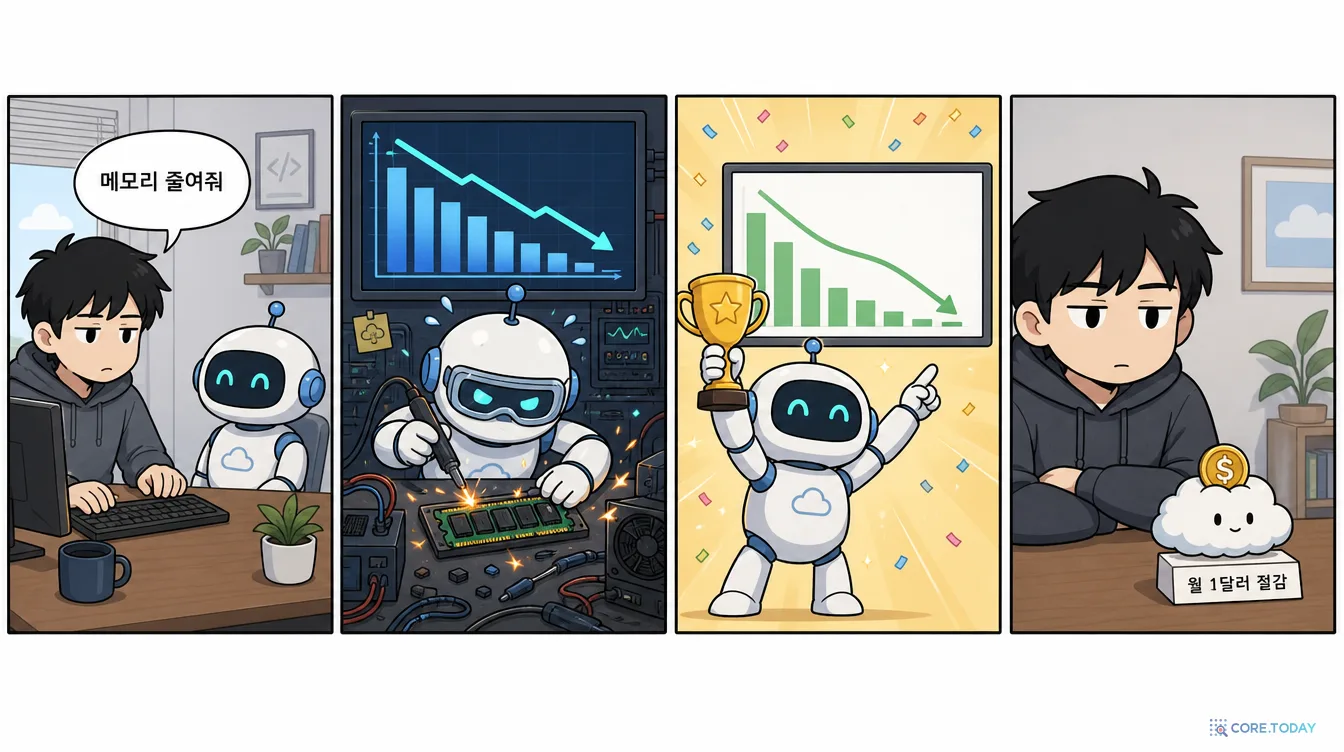
이 절은 글에서 가장 많이 공유된 일화로 시작한다. 스몰카는 최근 클라우드 비용을 줄이려 했다. 측정 가능한 지표가 명확하니 AI에 딱 맞는 과제다. 그는 에이전트에게 Go 서비스가 메모리를 가장 많이 쓰는 곳을 찾아 줄이라고 했다. 몇 번 돌리고 나니 RAM을 수 메가바이트 아꼈다. 그런데 메모리는 꽤 싸다. 그 변경이 줄인 비용은 월 1달러였다.
놀랄 일은 아니다. 그는 에이전트에게 비용을 줄이려 한다고 설명하지 않았다. 메모리 사용량을 목표로 줬을 뿐이다. 그리고 이 문장이 글의 두 번째 열쇠다.
익숙하게 들릴 것이다. 팀 안에서 사람 사이에 벌어지는 일과 정확히 같기 때문이다. 팀에서 소통을 돕는 좋은 습관은 AI와 일할 때도 똑같이 유효하다. (소프트 스킬이 컴퓨터를 다루는 데 도움이 될 줄 누가 알았겠는가?)
DDD는 이 문제를 언어에 관한 몇 가지 아이디어로 다룬다. 첫째가 유비쿼터스 언어(Ubiquitous Language) 다. 팀 사이에서, 그리고 코드 안에서 같은 언어를 써서 모두가 무슨 얘기를 하는지 알게 하는 것이다. 많은 팀에서 지저분한 이름이 기본값이다. 코드 안에서 엔지니어는 회사의 나머지가 쓰는 이름과 점점 멀어지는 기술 용어를 쓴다. AI에 문서와 의사결정 기록을 먹이더라도, 에이전트는 거기에 적힌 언어가 무엇이든 그것을 이해해야 한다.
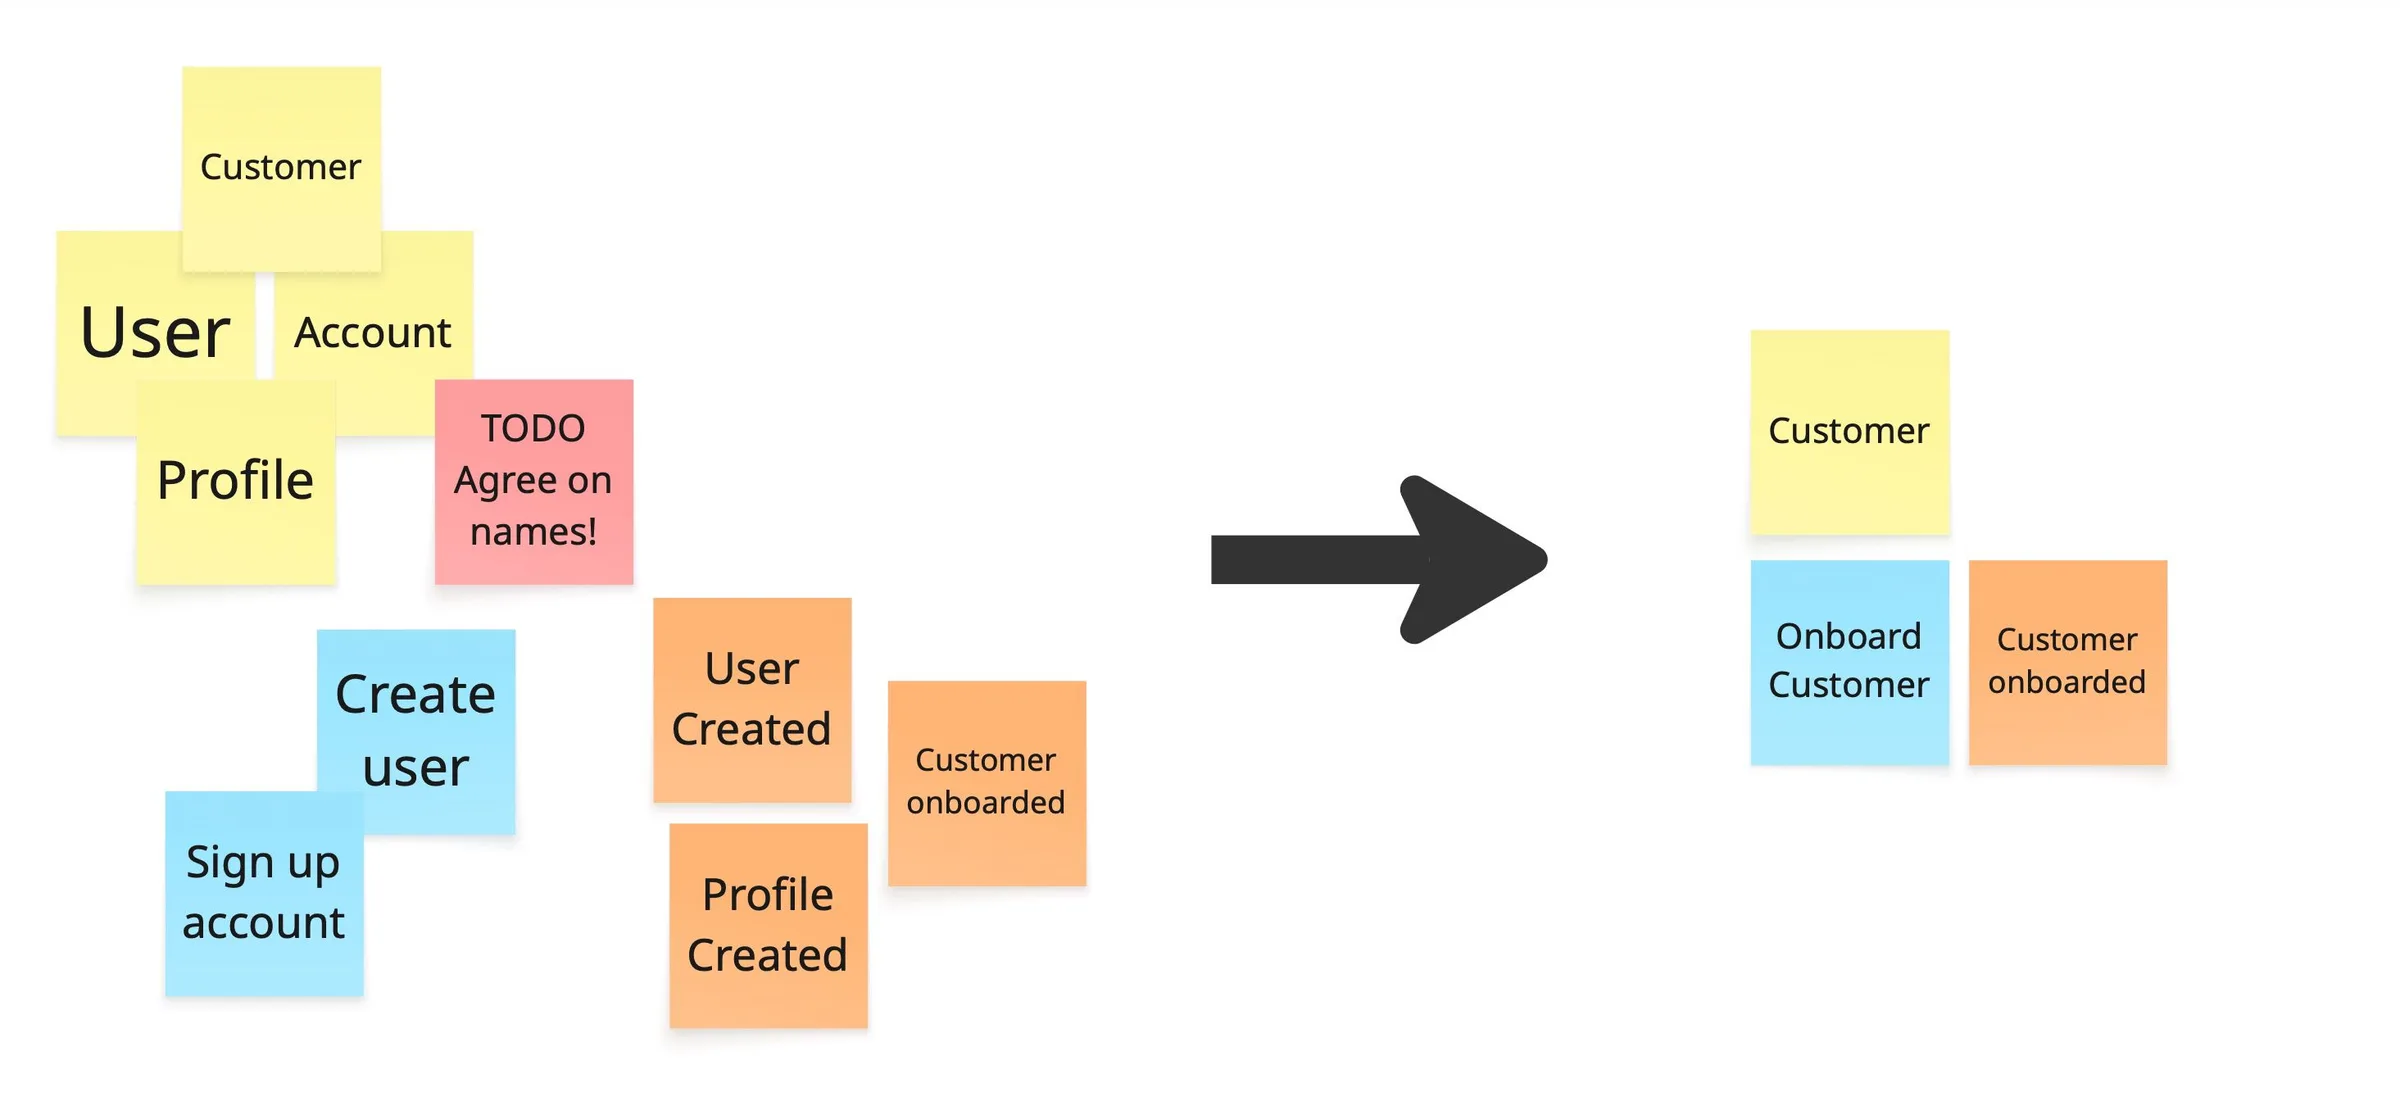
지식 탐구를 하는 동안 도메인의 개념을 무엇이라 부를지 생각하라. 처음에는 개념 하나에 이름이 여러 개인 게 보통이다. 이미 쓰는 이름을 고르거나 더 정확한 이름을 만들어라. 그다음 문서, 말, 코드에서 그 이름을 써라. 이벤트 스토밍은 이름을 고르기에 좋은 자리다.
이 그림의 왼쪽을 보면 노란 노트(개념)에 User·Account·Profile·Customer 네 이름이 겹쳐 있고, 파란 노트(명령)에는 "Create user"와 "Sign up account"가, 주황 노트(이벤트)에는 "User Created"·"Profile Created"·"Customer onboarded"가 따로따로 붙어 있다. 오른쪽은 합의 뒤다. 개념은 Customer 하나, 명령은 Onboard Customer 하나, 이벤트는 Customer onboarded 하나. 이름이 셋에서 하나로 줄어든 것이 아니라, 세 종류의 노트가 같은 어근을 쓰게 됐다는 것이 핵심이다. 코드에서 OnboardCustomer 명령이 CustomerOnboarded 이벤트를 내면, 회의에서 "고객 온보딩"이라고 말하는 사람과 코드를 읽는 사람과 에이전트가 같은 것을 가리킨다.
이름은 한 번 고르고 끝이 아니다. 언어는 프로젝트와 함께 계속 진화하므로 설계 세션과 토론에서 계속 돌봐야 한다.
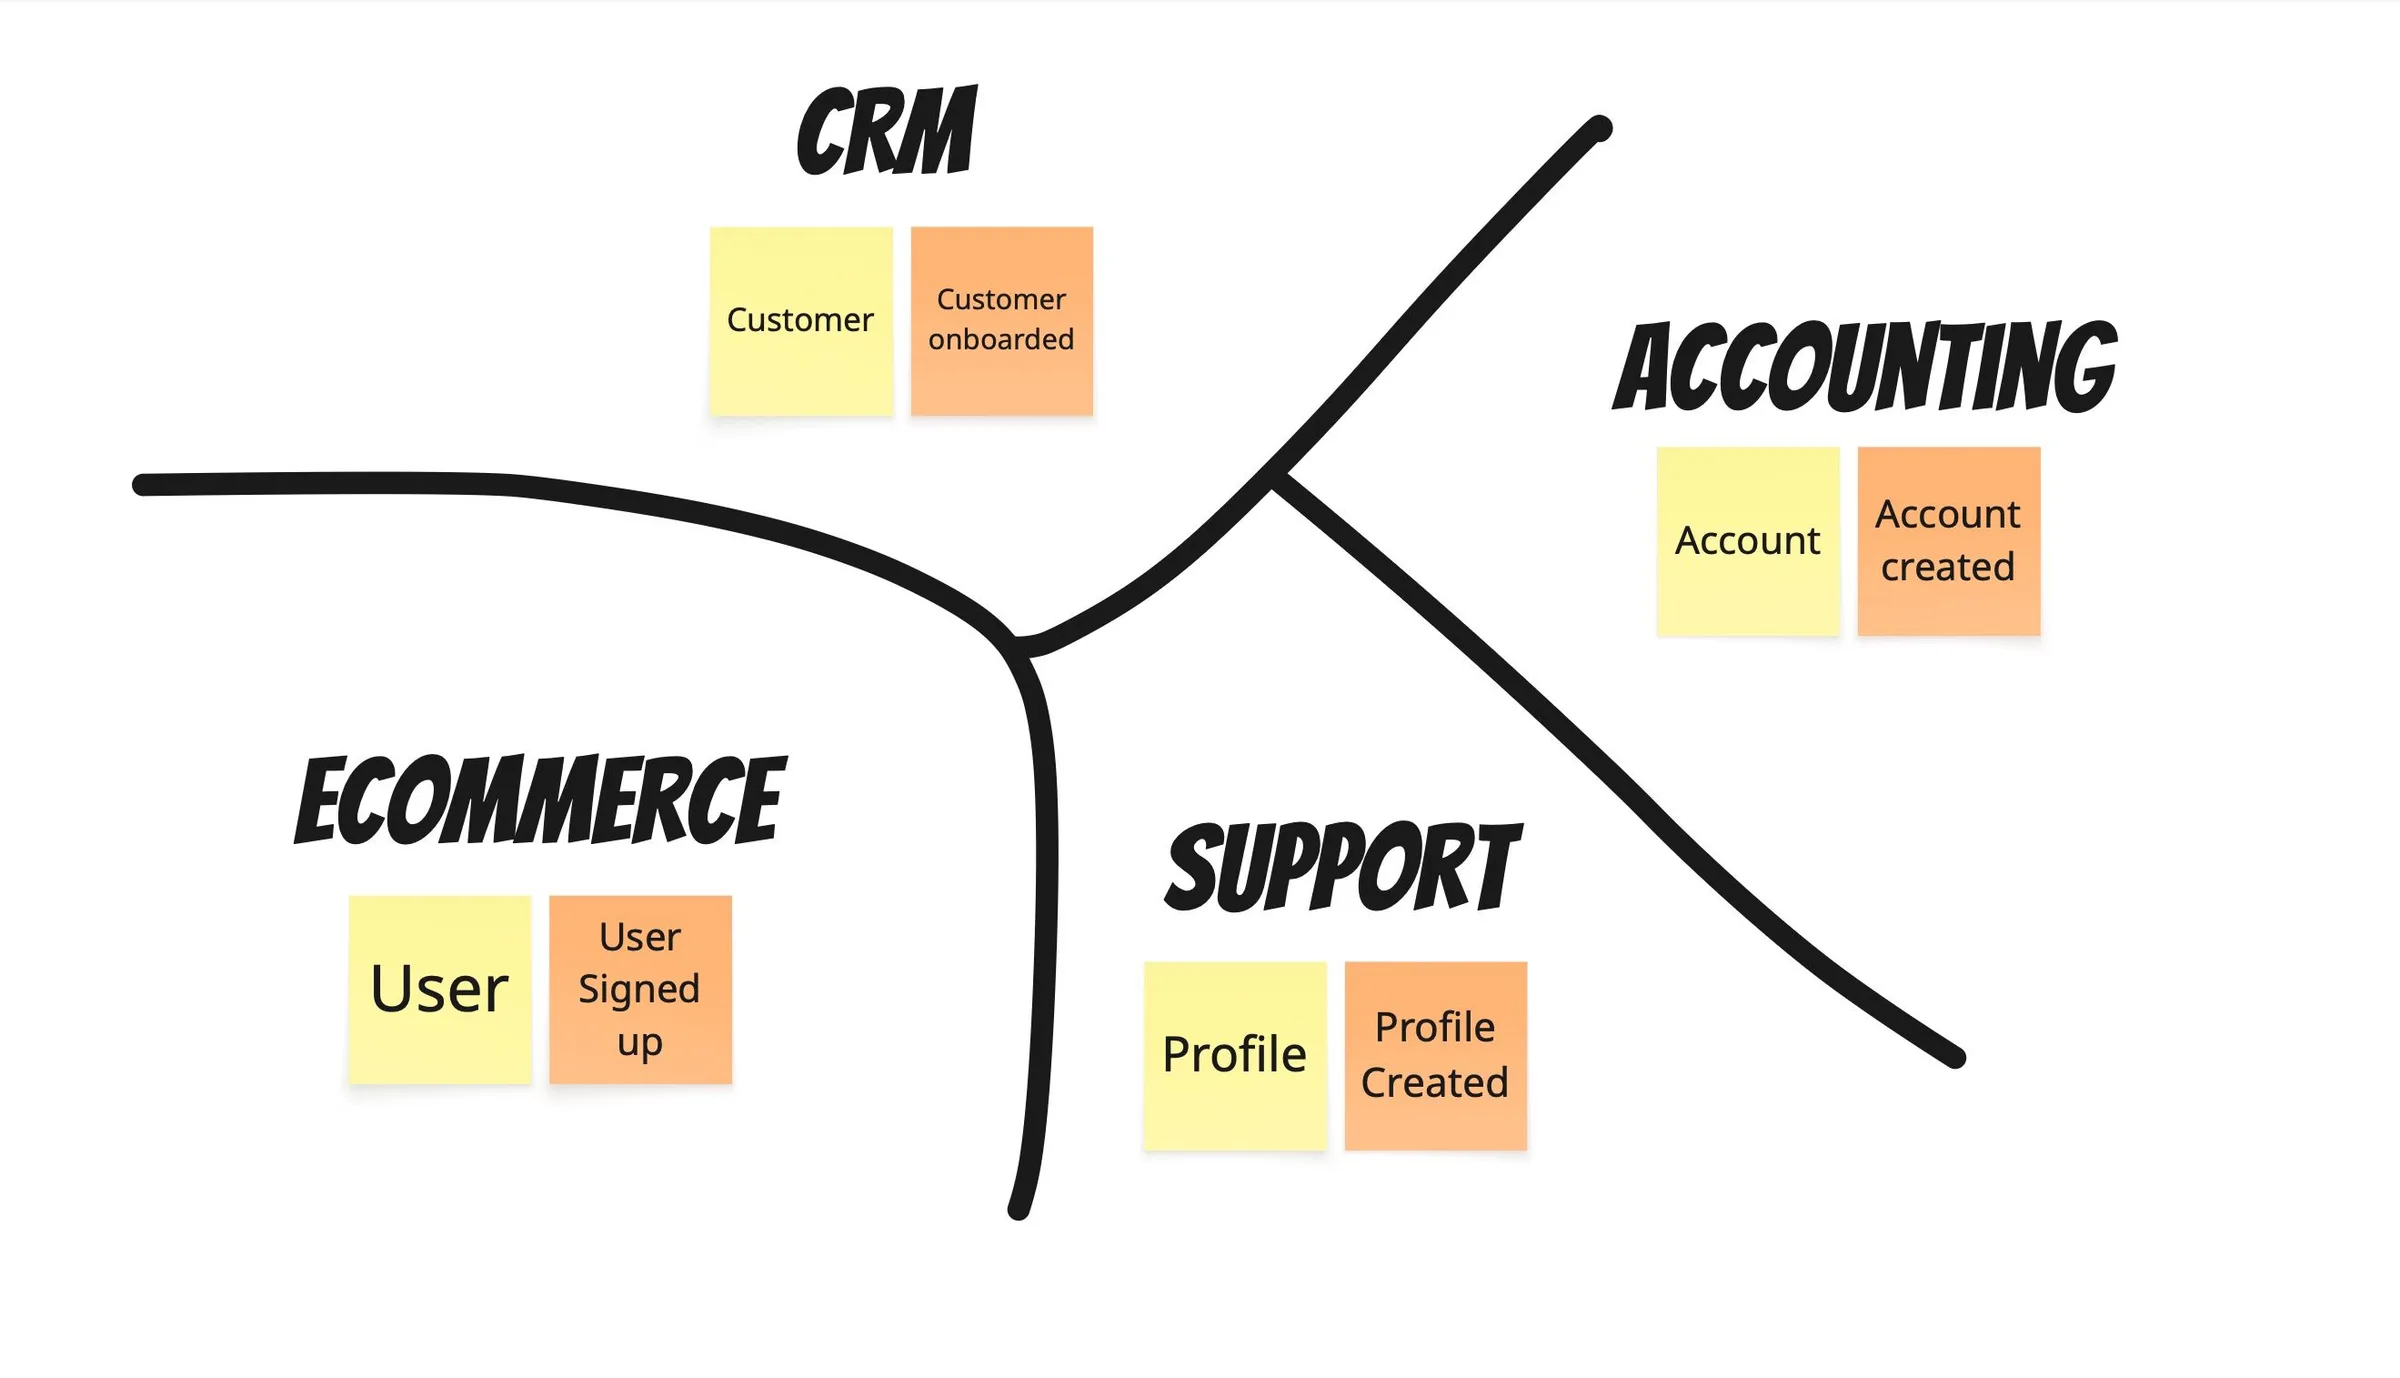
유비쿼터스 언어와 직접 연결된 두 번째 아이디어가 있다. 큰 시스템에서는 고른 이름이 모든 영역에서 보편적이지 않다. DDD는 이 영역 하나하나를 바운디드 컨텍스트(Bounded Context) 라고 부른다. 고객은 지원 컨텍스트에서는 프로필이고, 이커머스 컨텍스트에서는 유저다. 각 컨텍스트 안에서 일관된 이름을 쓰되, 프로젝트 전체에 강제하지 않는다.
이 지도에서 굵은 선은 컨텍스트의 경계다. 각 영역에는 노란 노트(개념)와 주황 노트(이벤트)가 한 쌍씩 있다. CRM의 "Customer / Customer onboarded", Accounting의 "Account / Account created", E-commerce의 "User / User signed up", Support의 "Profile / Profile created". 네 영역 모두 같은 사람을 다루지만 모델은 넷이다. 큰 제품에서 소프트웨어를 팀 사이에 나눠야 할 때 이것이 특히 중요하다. 모든 종류의 작업을 위한 하나의 모델을 만드는 데 집착하면 경계를 긋기 어려워진다. 바운디드 컨텍스트를 염두에 두면 결합이 느슨한 시스템으로 끝나기 쉽다.
그리고 에이전트에 관한 경고 한 줄.
에이전트는 저장소 전체에 접근하고, 당신이 준 이름을 찾아다닌다. 비슷한 엔티티를 순진하게 통합하려 들 수 있으니, 그것들이 이유가 있어 분리돼 있다는 것을 분명히 하라.
아래 지도는 네 컨텍스트를 직접 눌러 볼 수 있게 만든 것이다. "에이전트 지침" 모드로 바꾸면 각 컨텍스트의 경계가 지침 파일에서 어떤 모양이 되는지 볼 수 있다.
절의 끝에서 스몰카는 프롬프트 두 개를 나란히 놓는다. 모호한 쪽은 "생성된 뒤 유저를 CRM과 지원에 추가해 줘"이고, 정확한 쪽은 "웹사이트에서 유저가 가입하면 비동기로: 1) CRM에 고객 항목을, 2) 지원 시스템에 프로필을 생성"이다. 두 번째 프롬프트에는 가입(sign up)이라는 도메인 이벤트, 고객(customer)·프로필(profile)이라는 컨텍스트별 이름, 비동기라는 기술 경계가 모두 들어 있다. 도메인 언어의 세부를 에이전트의 컨텍스트에 넣어 두라는 것이 결론이고, 그래서 문서를 최신으로 유지해야 할 이유가 하나 더 생겼다는 것이다. 코드 옆의 마크다운 파일이 좋은 출발점이다. 가져오는 데 별도 통합이 필요 없기 때문이다.
이 비교를 네 장면으로 늘려 실험할 수 있게 만들었다. 메모리 1달러 일화도 들어 있다.
절 5. "개발자가 도메인 전문가가 된다"
모델과 에이전트는 계속 좋아지지만 완전히 믿을 수는 없다. 여전히 실수하고, 결국 책임질 사람이 필요하다. 결과가 맞는지 어떻게 아는가. 스몰카의 답: 도메인 안에서 일하는 것이 자기가 뭘 하는지 안다는 신뢰를 쌓는 방법이다. 시스템을 설계하고 어떻게 돌아가는지 이해하는 사람은 어디서 문제가 생길지 말해 줄 수 있다.
개발자는 자기가 일하는 주제의 전문가가 된다. 코드 쓰기 너머의 기술을 배우고, 호기심 있는 엔지니어에게는 복잡한 비즈니스 도메인도 시간이 지나면 직관이 된다. 극도로 상세한 지시 없이도 일을 끝낼 거라고 믿을 수 있는 사람과 일하면 엄청난 두통을 아낄 수 있다.
여기서 스몰카는 최근의 AI 서사 두 가지를 비교한다. 첫째는 "이제 누구나 유명 앱의 클론을 만들 수 있다"는 것. 처음엔 충격이었지만 장기적으로는 별로 흥미롭지 않다. AI 없이도 이미 설익은 앱이 너무 많다. 둘째가 더 흥미로운 이야기다. 경험 있는 엔지니어가 이제 더 복잡한 애플리케이션을 만들 수 있다는 것. 예를 들어 한 팀이 비싼 서드파티 소프트웨어를 사내 솔루션으로 대체한다. 그 버전이 잘 동작한다고 어떻게 믿는가. 그 도메인에서 일하며 이미 쌓은 지식 때문이다. 아는 것과 AI를 결합해 라이선스 비용보다 싸게 자기 버전을 만들고, 필요한 맞춤 기능도 붙인다.
고용주에게는 도메인을 잘 아는 제품 지향 엔지니어가 있다는 것이 엄청난 자산이다. 그들은 애매한 세부를 알아내고 토론을 이끈다. "개발자를 시키는 대로 코딩하는 사람으로 취급하는 것은 언제나 순진했고, 이제는 더욱 그렇다." 엔지니어에게는 기술 역량에만 집중하는 것보다 낯선 도메인에서 일하는 법을 배우는 것이 더 큰 보상을 준다. 한 프레임워크의 전문가보다 비즈니스 문제를 잘 푸는 사람이 이익 센터에서 일하기 쉽다.
절 6. "생각을 위임하지 마라"
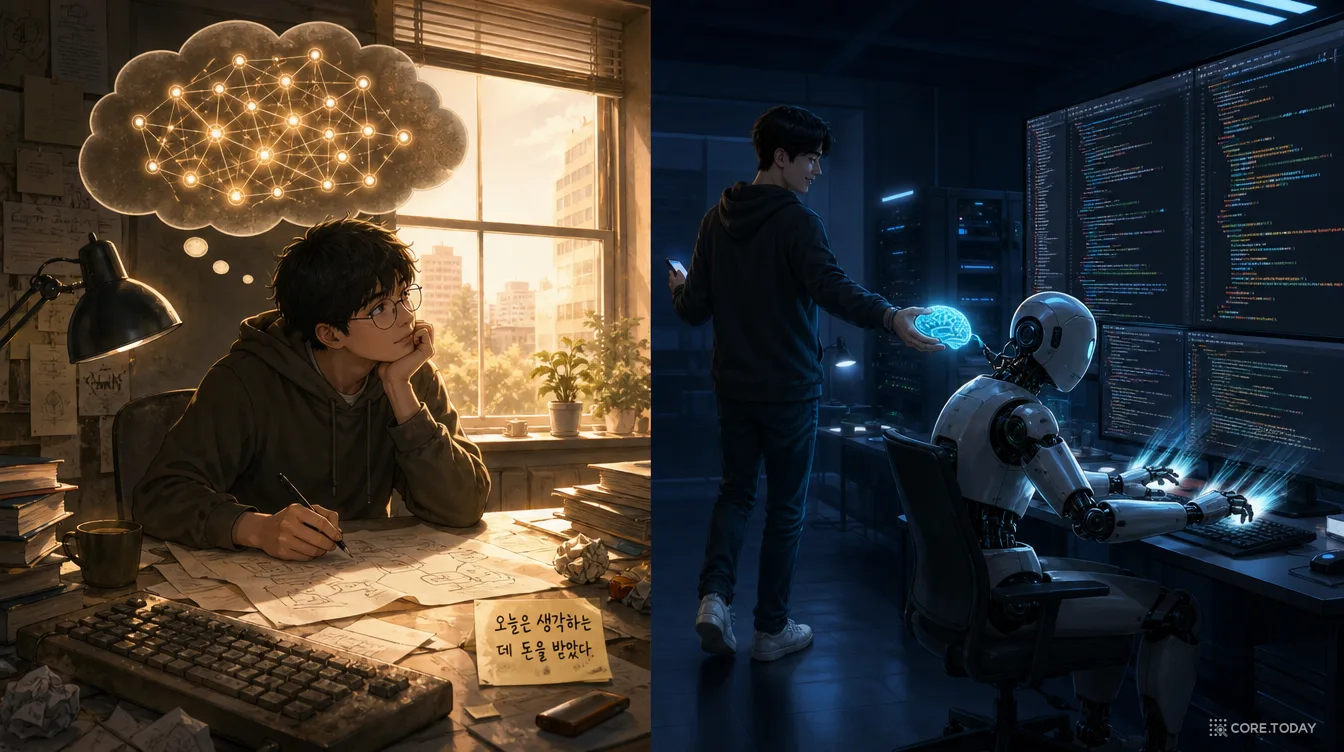
마지막 절은 회고로 시작한다. 첫 직장에서 스몰카는 어려운 문제 하나를 붙잡고 펜과 종이로 몇 시간을 끄적였다. 키보드는 거의 만지지 않았는데 결국 풀어냈다. 입사한 지 얼마 안 된 그는 말문이 막혔다. "와, 오늘은 생각하는 데 돈을 받았네."
에이전트가 쓴 계획서를 읽을 시간이 없어서 에이전트에게 요약을 시킨다. 생각이 두 번 위임됐다. 스몰카의 반박은 두 겹이다.
첫째, 에이전트의 출력이 말이 되는지 판단할 수 있는 유일한 이유는 과거에 그런 문제를 오래 생각해 봤기 때문이다. 둘째, "AI가 어차피 다 해 줄 테니 그 경험은 더 이상 필요 없다"는 주장에 대해. AI에 의존하는 것이 결국 새로운 보통이 될 수는 있다. 그러나 무시할 수 없는 문제가 하나 있다. 복잡한 문제를 다루려면 뇌를 써야 하고, 생각하지 않고는 새 정신 모델을 만들 수 없다.
그가 든 비유는 책 한 권을 읽는 것과 요약을 읽는 것의 차이다. 읽기는 몇 시간 동안 그 주제를 생각하게 강제한다. 머릿속에 천천히 복잡한 모델이 쌓이고, 아는 다른 것들과 연결된다. 그 주제를 이해하게 된다. 탭을 닫으면 10초 뒤에 잊어버릴 몇 문장을 읽는 것과는 다르다.
글은 겸손하게 끝난다. 아직 아무도 모범 사례를 모르니 실험하기 좋은 때다. 당분간 그는 옛날식 문제 해결과 새로운 코딩 방식을 섞어 쓸 것이다. 이 글은 개별 패턴보다 DDD의 철학에 집중했고, 코드에 가까운 전술 패턴은 다음 글에서 다루겠다고 예고한다. "손으로 타이핑하지 않더라도 여전히 유용하다"고.
4부. 반론과 토론 — 이 글이 틀릴 수 있는 지점
좋은 글은 반론을 부른다. 이 글이 받은 반응과, 같은 시기에 나온 다른 글들이 던진 질문을 네 가지로 정리했다.
반론 1. "상식을 길게 늘어놓은 것 아닌가" — 그리고 "강의를 팔려는 것 아닌가"
GeekNews에 이 글이 소개됐을 때 달린 댓글 두 개는 모두 차가웠다. 하나는 "사이트에서 도메인 관련 강의들을 파네요. 연관이 없진 않을 듯"이었고, 다른 하나는 "솔직히 별로 읽을 가치가 없지 않나 싶네요. 상식을 굳이 주저리주저리 해둬서 시간만 아깝고"였다.
두 지적 모두 사실에 근거한다. 스리 닷 랩스는 DDD 강의(「The Domain Engineer」)와 Go 백엔드 마스터클래스를 파는 회사이고, 글의 어느 문장도 2003년 책에 없던 새 개념을 제시하지 않는다. 그런데 "상식"이라는 평가는 역설적으로 이 글의 요점을 증명한다. 스몰카의 주장은 "새로운 것이 필요하다"가 아니라 "오래된 상식이 지금 더 비싸졌다" 이기 때문이다. 상식이라면 왜 2025년 7월 Replit 에이전트가 코드 동결 중에 프로덕션 DB를 지웠고, 왜 2026년에 리뷰 대기 시간이 길어지고 리팩터링 비율이 떨어졌는가. 이 글의 가치는 새로움이 아니라 타이밍에 있다. 5부의 숫자를 보고 나서 다시 판단해도 늦지 않다.
강의 판매 동기에 대해서는 이렇게 보는 것이 공정하다. 저자들은 2020년부터 「DDD Lite in Go」 시리즈를 쓰고 Watermill(이벤트 주도 Go 라이브러리, 깃허브 스타 약 9,900개)을 만들었으며, 2025년 8월에는 자기 강의 플랫폼에 LLM 에이전트 튜터를 넣고 그것이 프로덕션에서 거짓말을 한 경험(「Shipping an AI Agent that Lies to Production」)을 공개했다. 이론만 파는 사람들은 아니다. 다만 "DDD가 답"이라는 결론을 내릴 유인이 있는 사람들이 쓴 글이라는 것은 독자가 알고 읽어야 한다.
반론 2. "모델은 코드 안에 있지 않은가" — 산출물 논쟁
해커뉴스 스레드는 조용했지만(12점, 댓글 6개) 거기서 오간 토론은 글의 가장 약한 지점을 정확히 찔렀다. 한 독자(rrook)는 "물론 도메인 모델은 산출물이 아니지만, 소프트웨어는 필연적으로 도메인 모델의 산출물을 담고 있다"고 썼다. 스몰카(m110)가 "그 산출물도 단순화 아닌가, 모델은 코드 하나가 아니라 더 넓은 '아이디어'다"라고 답하자, rrook은 "코드는 '현재 합의된 버전', 즉 모델링 대상의 특정 시점 스냅샷"이라고 정리했다. 또 다른 댓글(Quokka-labs)은 "가장 큰 변화는 테스트와 제약 조건을 생성된 코드가 아니라 진실의 원천으로 삼는 것"이라고 했고, 스몰카는 "제약을 정의하는 것은 결국 코드 아닌가"라고 되물었다.
이 토론이 중요한 이유는, 코드가 싸진 시대에 진실의 원천이 어디인가라는 질문이 아직 열려 있음을 보여 주기 때문이다. 세 후보가 있다. ① 팀의 머릿속에 공유된 이해(스몰카), ② 명세·테스트·제약(스펙 주도 개발 진영, Tessl의 "spec-as-source"), ③ 코드 자체(전통). 스몰카의 글은 ①을 강하게 밀지만, ①은 측정도 버전 관리도 안 된다는 약점이 있다. 반대로 ②는 소트웍스가 2025년 11월 레이더에서 경고했듯 "읽기 어려운 긴 명세 파일을 생성하고, 그 PRD의 사용자가 누구인지 불분명한" 함정에 빠진다. 2026년의 실무는 대체로 ①을 만들기 위한 도구로 ②를 쓰는 절충에 와 있다. 7부의 체크리스트가 그 절충을 담는다.
반론 3. "무거운 아키텍처는 에이전트를 방해한다"
이 글이 아니라 같은 달 나온 다른 글(「Domain-Driven Agents」, coldtake.dev, 2026년 8월 말)의 해커뉴스 스레드(97점)에서 나온 반론이다. 한 독자는 엄격한 클린 아키텍처 프로젝트가 사람과 AI 모두를 괴롭혔다고 보고했고, 다른 독자들은 폴더마다 docs.md 하나면 충분하지 무거운 도메인 그래프는 과하다고 썼다. 반면 daily.dev에 올라온 이 글의 댓글에서는 정반대의 경험이 나왔다. "에이전트는 DDD 프로젝트에서 잘한다. 코드베이스에서 찾은 패턴을 그대로 베끼기 때문이다."
둘 다 맞을 수 있다. 에이전트는 일관된 패턴을 잘 따라 하지만, 패턴이 많아질수록 컨텍스트가 늘어난다. 핵심은 2025년 12월 스리 닷 랩스의 팟캐스트 제목이 말한 그대로다. "DDD는 도구 상자이지 종교가 아니다." 본 스몰카 자신도 서두에서 "반려 프로젝트나 CRUD에 고급 패턴을 쓸 이유는 없다"고 못 박았다. 이 글이 말하는 DDD는 애그리거트·리포지토리 같은 전술 패턴이 아니라, 언어·경계·지식 탐구라는 전략 쪽이다. 전략적 DDD는 코드를 한 줄도 바꾸지 않고도 적용할 수 있다.
반론 4. "에이전트는 아직 도메인 모델을 못 만든다" — 더 강한 버전의 같은 주장
가장 흥미로운 반응은 반론이 아니라 증폭이다. 『Implementing DDD』(2013)의 저자 본 버논은 2026년 5월 WSO2Con 강연 「This Is Your Agent on Domain-Driven Design」에서 1년 넘게(그중 10개월은 Claude Code로) 코딩 에이전트를 쓴 결론을 이렇게 요약했다. "바운디드 컨텍스트 안에서 도메인 모델을 생성하는 일은 여전히 꽤 실망스럽다. 받아들일 수 없는 수준보다 나은 경우가 드물다." 에이전트는 "상당한 안내를 줘도 CRUD로 되돌아간다"는 것이다. 그가 짚은 근본 원인은 학습 데이터다. 잘 설계된 도메인 모델은 공개 저장소에 거의 없고, CRUD는 수백만 개가 있다.
2026년 3월 arXiv에 올라온 「Automating Domain-Driven Design: Experience with a Prompting Framework」(Eisenreich·Jusic·Wagner)도 같은 방향을 가리킨다. 유비쿼터스 언어 → 이벤트 스토밍 → 바운디드 컨텍스트 → 애그리거트 → 아키텍처의 5단계 파이프라인을 LLM에 시켰더니 앞의 세 단계는 쓸 만했고 뒤로 갈수록 오류가 누적돼 4·5단계는 쓸 수 없었다. 저자들의 결론은 LLM이 "자동화 도구가 아니라 협업하는 스파링 파트너"라는 것이다. 스몰카의 "생각을 위임하지 마라"를 실험으로 뒷받침한 셈이다.
이 반응들을 모아 보면, 글의 주장은 "AI 시대에 DDD가 여전히 유효하다"보다 더 강한 형태로 다듬을 수 있다. AI가 가장 못하는 것이 바로 DDD가 가장 중요하게 여기는 것이다. 그래서 그 부분은 사람이 남는다.
5부. 2026년의 숫자 — 병목은 정말 읽기로 옮겨 갔는가
스몰카의 동료 로베르트 와슈차크가 2주 먼저 쓴 글의 제목은 「코드를 쓰는 것은 더 이상 병목이 아니다, 읽는 것이 병목이다」였다. 5만 줄의 AI 생성 코드를 리뷰한 경험에서 나온 문장이다. "얼마나 많은 코드를 생성할 수 있는지는 중요하지 않다. 그중 얼마나 많은 코드에 책임을 질 수 있는지가 중요하다." 이 주장을 2025~2026년의 데이터로 검증해 보자.
코드는 정말 싸졌다
시점
누가
AI가 쓴 코드 비율
출처
2024.10
구글
신규 코드의 25%
순다르 피차이, 실적 발표
2025.4
마이크로소프트
20~30%
사티아 나델라, LlamaCon
2025.4
구글
30% 이상
실적 발표
2025.10
코인베이스
일일 코드의 약 40%, 목표 50% 이상
브라이언 암스트롱(미도입 직원 해고 논란)
2026.4
구글
신규 코드의 75%
피차이, Cloud Next 2026
2026.2분기
업계 중앙값(DX)
약 52%(중앙값 50%)
DX 분기 보고(예비치)
2026.10
스택오버플로 설문(3만여 명)
AI 사용자의 73%가 매일 사용, 66%가 코딩 에이전트 사용
2026 개발자 설문
2년 만에 "AI가 쓴 코드"는 구글에서 4분의 1에서 4분의 3이 됐다. 앤트로픽의 2026년 「Agentic Coding Trends」 보고서는 다른 각도를 보여 준다. 개발자는 업무의 약 60%에서 AI를 쓰지만, 완전히 위임하는 과제는 0~20%에 그친다. 코드는 AI가 쓰지만 판단은 아직 사람이 들고 있다는 뜻이다.
그런데 빨라지지는 않았다
AI 도입 뒤 무엇이 늘었나 (Faros AI, 2025년 6월, 개발자 1만여 명·1,255개 팀)
PR 크기
+154%
병합된 PR 수
+98%
리뷰 시간
+91%
완료한 과제 수
+21%
버그
+9%
Faros AI가 2025년 6월 「AI 생산성 역설」 보고서에서 낸 숫자다. 과제는 21% 더 끝냈는데 PR은 두 배로 늘고, 한 PR의 크기는 2.5배가 됐으며, 리뷰 시간은 거의 두 배가 됐다. 그리고 회사 수준에서는 AI 도입과 성과 개선 사이에 유의미한 상관이 없었다. 스몰카가 "외로운 늑대의 거대한 PR"이라고 부른 현상이 통계로 잡힌 것이다.
다른 데이터도 같은 방향이다.
METR 무작위 대조 실험(2025년 7월): 숙련된 오픈소스 개발자 16명, 246개 과제. AI를 쓴 쪽이 19% 느렸다. 본인들은 20% 빨라졌다고 느꼈다. 2026년 2월의 새 코호트에서도 18% 느렸는데, 이번에는 참가자의 30~50%가 "AI 없이 일하는 과제"를 거부해 실험 설계를 바꿔야 했다.
LinearB 2026 벤치마크(PR 810만 건, 4,800개 팀): AI가 만든 PR은 리뷰어가 집어 들기까지 사람 PR보다 4.6배 오래 기다린다(에이전트 PR은 5.3배). 집어 든 뒤에는 2배 빨리 리뷰되지만, 채택률은 32.7% 대 84.4%다.
GitClear 「유지보수성 격차」(2026년 6월, 변경 6억 2,300만 건): 리팩터링 비율이 2022년 21%에서 2026년 상반기 3.8% 로 떨어졌고, 복사·붙여넣기는 15.7%로 올라 리팩터링을 넘어섰다.
CodeRabbit(2026년 1월, 470개 저장소): AI PR은 버그가 1.7배 많고 논리 오류는 75% 더 많다.
Veracode(2025년 7월, 100여 개 LLM, 80개 과제): 생성된 코드의 45% 가 보안 결함을 포함했다.
이 숫자들을 한 문장으로 요약하면 이렇다. 쓰기가 싸지자 읽기·판단·경계 지키기가 비싸졌다. 스몰카가 DDD에서 꺼낸 세 가지(지식 탐구, 설계 먼저, 유비쿼터스 언어)는 정확히 그 세 비용을 줄이는 도구다.
AWS Kiro — requirements.md·design.md·tasks.md, EARS 표기법("WHEN … THE SYSTEM SHALL …")
명세로 고정한 유비쿼터스 언어
2025.8
AGENTS.md 표준(OpenAI 주도, 12월 리눅스 재단 산하 Agentic AI Foundation에 기증, 6만여 저장소 채택)
저장소 단위 컨텍스트 지도
2025.9
GitHub Spec Kit — /specify → /plan → /tasks → 구현, "헌법" 파일. 2026년 8월 기준 스타 12만 7천여 개
지식 탐구 → 설계 합의 → 구현의 강제 순서
2025.11
소트웍스 기술 레이더 — "스펙 주도 개발" 평가(Assess) 단계. "긴 명세 파일은 읽기 어렵고, PRD의 사용자가 누구인지 불분명"
산출물 ≠ 모델 경고
2026.2
OpenAI 「Harness Engineering」 — 엔지니어 3→7명, 5개월, 100만 줄, PR 1,500개, 손으로 쓴 코드 0줄. 100줄짜리 AGENTS.md는 docs/ 디렉터리로 가는 지도, 의존 방향(Types→Config→Repo→Service→Runtime→UI)은 린터로 기계 강제
바운디드 컨텍스트 + 컨텍스트 맵을 기계로 집행
2026.2
지멘스 니키타 골로프코, AI Coding Summit 「프롬프트 스파게티에서 바운디드 컨텍스트로」 — "에이전트 하나에 바운디드 컨텍스트 하나", 프롬프트 3,000토큰(85%가 통합 접착제) → 수백 토큰
번역 계층(ACL)을 "의미 방화벽"으로
2026.2
애디 오스마니, O'Reilly 「에이전트를 위한 좋은 명세 쓰는 법」 — "병목은 AI가 아니라 당신의 명세다"
DDD 유럽(안트베르펜) — 에반스 개막 기조연설 "AI는 DDD를 증폭할 것인가 대체할 것인가"
—
OpenAI의 하니스 엔지니어링 실험을 조금 더 보자. 이 팀은 손으로 코드를 한 줄도 쓰지 않고 5개월 만에 100만 줄짜리 제품을 만들었다. 비결은 더 좋은 모델이 아니었다. ① 100줄짜리 AGENTS.md가 긴 지침이 아니라 docs/ 디렉터리(설계 문서·계획·제품 명세)로 가는 지도 역할을 하고, ② 계층 사이의 의존 방향을 린터가 기계적으로 막으며 위반 시 에이전트가 읽고 고칠 수 있는 안내문을 내고, ③ 백그라운드 에이전트가 위반을 찾아 리팩터링 PR을 자동으로 연다. 보고서는 슬랙·문서·사람 머릿속에만 있는 지식은 "시스템이 접근할 수 없다"고 썼다. DDD 용어로 번역하면 이것은 바운디드 컨텍스트와 컨텍스트 맵을 코드로 집행한 것이다. 스몰카의 "마크다운 파일을 코드 옆에 두라"의 가장 극단적인 구현이기도 하다.
에릭 에반스 본인도 같은 문제를 보고 있다. 2026년 1월 「AI 기반 구성 요소와 컨텍스트 매핑」에서 그는 "LLM도 바운디드 컨텍스트"라며 결정론적 부분과 확률적 부분 사이에 번역 계층(anticorruption layer) 을 두라고 썼고, 6월 DDD 유럽 개막 기조연설의 작업 가설은 이랬다. "도메인 모델은 여전히 중요하고, 바운디드 컨텍스트도 여전히 중요하고, 언어도 여전히 중요하다. 다만 모델의 모습은 달라질 것이다." 그는 LLM과 결정론적 파이프라인으로 코드에서 도메인 어휘를 추출해 바운디드 컨텍스트들을 정량적으로 비교하는 도구를 시연했다. 2026년 10월 14~16일 베를린의 KanDDDinsky는 아예 "AI가 코드를 생성·리팩터링할 때 의미의 침식을 막는 법"을 주제로 잡았다.
사례로 보는 "도메인을 모르면 무슨 일이 생기나"
시점
무슨 일
도메인 관점의 원인
2025.7
Replit 에이전트가 코드 동결 중 SaaStr 프로덕션 DB 삭제(임원 1,206명·회사 1,196곳 기록). 이후 Replit은 개발/프로덕션 분리와 "계획 전용 모드" 추가
"코드 동결"이라는 운영 도메인의 규칙이 에이전트의 컨텍스트에 없었다
2025.7
Tea 앱 — 보호되지 않은 Firebase로 이미지 7만 2천 장·DM 110만 건 유출
"신원 확인용 사진"이 어떤 민감도의 데이터인지 모델이 없었다
2025.5
Lovable 생성 앱 170여 개·엔드포인트 303개에 행 수준 보안(RLS) 부재(CVE-2025-48757)
"누가 누구의 데이터를 볼 수 있는가"는 기술이 아니라 도메인 규칙이다
2026.2
Claude Code로 만든 앱이 클라이언트 JS에 Stripe 비밀 키를 넣어 8만 7,500달러 사기 피해
"비밀 키"라는 개념의 경계를 사람이 확인하지 않았다
2026.5
RedAccess 조사 — 바이브 코딩 앱 38만 개 중 약 5,000개가 기업·개인 데이터 노출
동일
2024~2025
클라르나 — Salesforce·Workday를 끄고 사내 AI 시스템으로 대체 발표. 이후 "AI 위에 다른 SaaS를 얹는" 방식으로 정정
스몰카의 "서드파티를 사내 솔루션으로 대체" 서사의 실제 사례이자, 도메인 지식 없이는 대체도 어렵다는 반례
실패 사례의 공통점은 기술 결함이 아니다. "코드 동결", "민감 데이터", "누가 무엇을 볼 수 있는가", "비밀 키"는 모두 도메인의 규칙이고, 그 규칙이 에이전트의 컨텍스트에도 사람의 머릿속에도 없었다. 스몰카가 "아무도 자기가 뭘 하는지 모르는 상태에서 코드는 가치가 없다"고 쓴 문장은, 이 사례들에서는 "가치가 없다"가 아니라 "손해가 난다"로 읽어야 한다.
6부. 한국의 2026년 — 도구는 들어왔는데, 합의는 누가 하나
한국 기업의 AI 코딩 도입은 2025년 여름 한꺼번에 일어났다.
시점
회사
무엇을 했나
설계·도메인에 관한 언급
2025.6
네이버
임직원 약 4,500명에게 Cursor 전사 도입. 이해진·최수연이 샌프란시스코에서 Anysphere CEO와 회동
도구 중심 발표. 모델링·설계 프로세스 언급 없음
2025.5~7
카카오
개발자 1인당 월 120달러 'AI 마일리지'(Cursor·Claude·Windsurf), 사내 해커톤 '10K'에 첫 바이브 코딩 트랙
동일
2025.6
삼성전자 DX
오픈소스 에이전트 Cline 도입
동일
2026.7
삼성 SDS·앤트로픽
20개 계열사 약 7만 명에 Claude Enterprise, 첫 몇 주 100만 메시지, 사용자 절반이 Claude Code 사용
규모는 세계 최대급. "무엇을 만들지" 합의 방법은 미공개
2026.1
토스페이먼츠
김용성 「소프트웨어 3.0 시대를 맞이하며」 — Claude Code의 슬래시 명령=컨트롤러, 서브에이전트=서비스, 스킬=단일 책임 컴포넌트, MCP=어댑터, CLAUDE.md=package.json
"기존 엔지니어링 원칙(응집도·결합도·추상화)이 여전히 유효" — 스몰카와 독립적으로 같은 결론
2026.4
컬리
한경훈 「클로드 코드로 개발 팀장의 하루를 재설계한 이야기」 — 도메인 용어(SPD 등)와 정책 결정을 파일로 세션 간 보존
유비쿼터스 언어를 파일로 영속화한 사례
2026.4
과기정통부(디지털 정책포럼)
'사스포칼립스' 논쟁. "SW 기업과 산업에 AI를 어떻게 내재화할 것인가에 정책 역량 집중", 맨먼스 대신 성과 기반 대가 산정 검토
코드 양으로 값을 매기던 SI 모델이 흔들림
표에서 보이는 공백이 있다. 도구 도입 발표는 많은데, 팀이 도메인을 합의하는 방법에 대한 발표는 토스와 컬리의 개인 글 둘뿐이다. 그리고 GeekNews에 올라온 이 글의 반응은 "상식"이었다. 상식이 맞다면 한국 기업의 공개 자료에는 왜 그 상식이 없는가.
한국 특유의 맥락이 두 가지 더 있다. 첫째, SI 산업의 맨먼스 대가 산정이다. 코드 양과 투입 인력으로 값을 매기는 모델에서는 "생각하는 데 돈을 받는" 일이 구조적으로 어렵다. 2026년 4월 정부가 성과 기반 대가 산정을 검토하기 시작한 것은, 코드가 싸지자 그 모델이 흔들렸다는 뜻이다. 둘째, 주니어의 자리다. 2026년 7월 AIES 학회에 실린 유·문의 연구(「누가 다음 시니어가 될 것인가」)는 한국 개발자 14명을 인터뷰해 "생산적 고군분투의 상실"과 "시니어가 주니어의 일을 시니어+AI 루프로 흡수하는" 현상을 기록했다. 스몰카가 "생각을 위임하지 마라"고 쓴 이유가 한국에서는 세대 문제로 나타난다.
2026년 1월 앤트로픽의 무작위 대조 실험은 이 우려에 숫자를 붙였다. 주니어 중심 파이썬 개발자 52명에게 낯선 라이브러리를 익히게 했더니, AI를 쓴 집단은 약 2분 빨랐지만(유의하지 않음) 이해도 퀴즈에서 50% 대 67% 로 17점 뒤졌고 격차는 디버깅에서 가장 컸다. 그런데 AI 집단 안에서도 "생성한 뒤 이해하기", "코드와 설명을 섞어 묻기", "개념을 묻기"를 한 사람은 65% 이상을 받았고, "그냥 위임"한 사람은 40% 미만이었다. 도구가 아니라 쓰는 방식이 갈랐다. 스몰카의 "책을 읽는 것과 요약을 읽는 것"의 실험판이다.
7부. 실천 체크리스트 — 월요일 아침에 할 수 있는 것
스몰카의 글, 에반스의 레퍼런스, OpenAI의 하니스 보고서, 앤트로픽의 실험, 그리고 4부의 반론을 종합해 코어닷이 정리한 일곱 가지다. 전부 코드를 한 줄도 바꾸지 않고 시작할 수 있다.
①
에이전트에게 지표가 아니라 목표를 줘라
"메모리 줄여"가 아니라 "월 비용을 줄이는 것이 목표고, 메모리는 비용의 2% 미만"이다. 프롬프트의 첫 줄에 '왜'를 쓰는 습관은 팀원에게 일을 넘길 때의 습관과 같다. 3부의 프롬프트 실험실에서 네 장면을 비교해 보라.
②
AI가 쓴 명세서는 '초안'이지 '합의'가 아니다
에이전트가 PRD를 써 주는 것은 좋다. 다만 팀이 그것을 읽고 틀린 곳 세 군데를 찾아 고치기 전에는 구현에 넘기지 마라. 2026년 3월 Eisenreich 연구가 보여 주듯 LLM은 용어집과 컨텍스트 맵까지는 쓸 만한 스파링 파트너이고, 애그리거트·아키텍처 단계부터는 오류가 쌓인다. 핫스팟(모르는 것)을 찾아내는 것은 여전히 사람의 몫이다.
③
기능마다 2시간짜리 설계 세션을 먼저 잡아라
완전한 명세가 아니라 '모두가 아는 대략의 계획'이 목표다. 이벤트 스토밍이면 좋고, 화이트보드 사진 한 장이어도 된다. 3부의 시뮬레이터가 보여 주듯 코딩이 빨라질수록 이 2시간이 아끼는 리뷰 시간은 커진다. 리뷰는 "맞는지 확인"하는 자리로 돌려놓아라.
④
용어집을 코드 옆 마크다운에 두고, 경계마다 따로 둬라
CLAUDE.md·AGENTS.md의 '용어' 절에 컨텍스트별 이름과 "왜 따로인가"를 적어라. 2026년 2월 연구(Gloaguen 외)는 일반적인 저장소 개요는 에이전트 성공률을 올리지 못하고 추론 비용만 20% 이상 늘린다고 보고했다. 가치가 있는 것은 비표준·도메인 고유 지식뿐이다. 그리고 그것이 바로 유비쿼터스 언어다. 100줄을 넘으면 OpenAI처럼 docs/로 가는 지도로 바꿔라.
⑤
경계를 린터로 집행하라
"회계 모듈은 커머스 테이블을 직접 읽지 않는다" 같은 규칙은 문서보다 import 린터가 더 잘 지킨다. OpenAI 하니스 팀은 계층 의존 방향을 린터로 막고, 위반 시 에이전트가 읽고 고칠 수 있는 안내문을 내게 했다. 에이전트의 '통합 충동'을 막는 가장 싼 방법이다.
⑥
핵심 도메인은 손으로 모델링하고, 범용 서브도메인은 생성하라
에반스의 '증류'를 위임 기준으로 써라. 로그인·결제 연동·관리자 CRUD는 에이전트에 넘겨도 된다. 회사가 돈을 버는 규칙(요율, 추천, 정산)은 팀이 직접 모델링하고 에이전트는 구현만 맡긴다. 본 버논의 증언대로, 거기서 에이전트는 CRUD로 되돌아간다.
⑦
주니어에게 '생성한 뒤 이해하기'를 의무로 만들어라
앤트로픽 실험에서 점수를 가른 것은 도구가 아니라 사용 패턴이었다. 생성된 코드를 자기 말로 설명하게 하고, 디버깅은 AI 없이 먼저 해 보게 하라. 이것은 느리게 가자는 것이 아니다. 2년 뒤 에이전트의 출력을 판단할 수 있는 사람을 남기자는 것이다.
결론: 생각하는 데 돈을 받는 사람
스몰카의 글에서 가장 오래 남는 문장은 DDD 용어가 하나도 없는 문장이다. "와, 오늘은 생각하는 데 돈을 받았네." 첫 직장에서 펜과 종이로 하루를 보낸 신입의 당혹감은, 2026년에는 다른 종류의 당혹감이 됐다. 생각하는 데 돈을 받는 것이 이상한 게 아니라, 생각하지 않고도 출력이 나오는 것이 이상한 시대다.
에반스가 2003년에 "소프트웨어 심장부의 복잡성을 정면으로 다루지 않으면 무의미해질 위험이 있다"고 썼을 때, 그 위험은 프로젝트의 것이었다. 2026년에 그 문장을 다시 읽으면 위험은 사람의 것이 된다. 코드를 생성하는 능력은 모두에게 똑같이 주어졌다. 남은 차이는 무엇을 생성할지 아는 것, 생성된 것이 맞는지 아는 것, 그리고 틀렸을 때 어디가 틀렸는지 아는 것이다. 세 가지 모두 도메인에 대한 이론을 가진 사람만 할 수 있고, 그 이론은 나우르가 1985년에 썼듯 "원리적으로 규칙으로 표현될 수 없다". 문서로도, 프롬프트로도, 247쪽짜리 명세서로도.
그래서 이 글의 제목은 과장이 아니다. 에이전트는 이미 2부(전술 패턴)를 우리보다 빨리 타이핑한다. 4부(전략)와 1부(지식 탐구)는 아직 사람의 것이고, 본 버논의 증언이 맞다면 꽤 오래 그럴 것이다. DDD가 더 중요해진 것이 아니라, DDD가 늘 말해 온 것만 남았다.
Özkan, Babur, van den Brand, "Domain-Driven Design in Practice: A Large-Scale Empirical Characterisation of the Open-Source Ecosystem", arXiv:2607.06471, 2026-07
Ernest Bednarczyk, "Domain-Driven Agents", 2026-08-27 — coldtake.dev · HN 스레드
Kent Beck, "Augmented Coding: Beyond the Vibes", 2025-06-25 · Simon Willison, "Vibe coding and agentic engineering are getting closer than I'd like", 2026-05-06
실증 연구
METR, "Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity", 2025-07-10 — metr.org · 실험 설계 변경 공지, 2026-02-24 — metr.org
Faros AI, "The AI Productivity Paradox Report", 2025-07 — faros.ai
GitClear, "AI Code Quality: The Maintainability Gap", 2026-06 — gitclear.com
Xia et al., "Measuring Program Comprehension: A Large-Scale Field Study with Professionals", IEEE TSE 44(10), 2018 · Minelli et al., "I Know What You Did Last Summer", ICPC 2015
Anthropic, Shen & Tamkin, "How AI assistance impacts the formation of coding skills", 2026-01-29, arXiv:2601.20245 — anthropic.com
Eisenreich, Jusic, Wagner, "Automating Domain-Driven Design: Experience with a Prompting Framework", arXiv:2603.26244, 2026-03-27
Gloaguen et al., "Evaluating AGENTS.md: Are Repository-Level Context Files Helpful for Coding Agents?", arXiv:2602.11988, 2026-02-12 · Chatlatanagulchai et al., "Agent READMEs", arXiv:2511.12884
Chen et al., "Automated Domain Modeling with LLMs: A Comparative Study", MODELS 2023
Kosmyna et al., "Your Brain on ChatGPT", arXiv:2506.08872, 2025-06 · Lee et al., "The Impact of Generative AI on Critical Thinking", CHI 2025 · Bainbridge, "Ironies of Automation", Automatica 1983
Yu & Moon, "Who Will Become the Next Senior? How Generative AI Erodes the Development Pathway", AIES 2026, arXiv:2607.17067