
TECH BLOG
기술 블로그
AI 기술 인사이트와 엔지니어링 경험을 공유합니다.
ALL POSTS
모든 포스트
옛 사실은 정말 닫히나 — Graphiti에 한국어 상담 로그 240건을 넣어 직접 재 봤다
지난 글에서 코드를 읽고 짚은 Graphiti의 약점을 도커 위에서 직접 재 봤습니다. 가상의 고객 10명이 1년 동안 남긴 한국어 상담 240마디를 넣고, 7일 간격으로 '그래프는 이 사실을 참이라고 보는가'를 정답과 대조했습니다. 결과는 한 문장으로 요약됩니다. 시간 그래프의 품질은 추출 모델이 아니라 모순을 판정하는 '작은 모델'이 정합니다. 기본값(gpt-4.1-nano)으로 두면 클라이밍을 시작했다는 한 마디가 집·직장·약 기록을 한꺼번에 닫았고, 판정만 gpt-4.1-mini로 바꾸자 잘못 닫힌 사실이 0건이 됐습니다. 그래도 이사·이직의 40%는 끝까지 닫히지 않았고, 이를 고치려는 PR #1729는 반대로 변경 반영률을 20%까지 떨어뜨렸습니다. 한국어 키워드 검색은 기본 분석기에서 질문 80개 중 43개가 빈 결과였고, cjk 분석기로 바꾸자 적중률이 23.7%에서 58.8%로 올랐습니다. 실행 8번, 에피소드 1,920건, 인터랙티브 5개.
기억에 유효기간을 적다 — Graphiti 시간 그래프, 개념부터 코드까지
AI 비서가 '서울 사세요?'라고 묻는다면, 그건 기억을 못 해서가 아니라 기억은 하는데 언제의 기억인지를 몰라서입니다. Graphiti는 사실마다 '참이었던 기간'과 '알게 된 때'라는 두 개의 시계를 달아, 옛 사실을 지우지 않고 닫습니다. 1986년 데이터베이스 연구자들이 만든 이중 시간 모델이 어떻게 2026년 에이전트 메모리의 핵심이 됐는지, 네 개의 타임스탬프가 무엇을 뜻하는지, 옛 사실이 닫히는 규칙이 실제 코드에서 어떻게 생겼는지를 처음부터 따라갑니다. 다섯 개의 인터랙티브와 그림으로 시간 그래프를 직접 만져 봅니다.
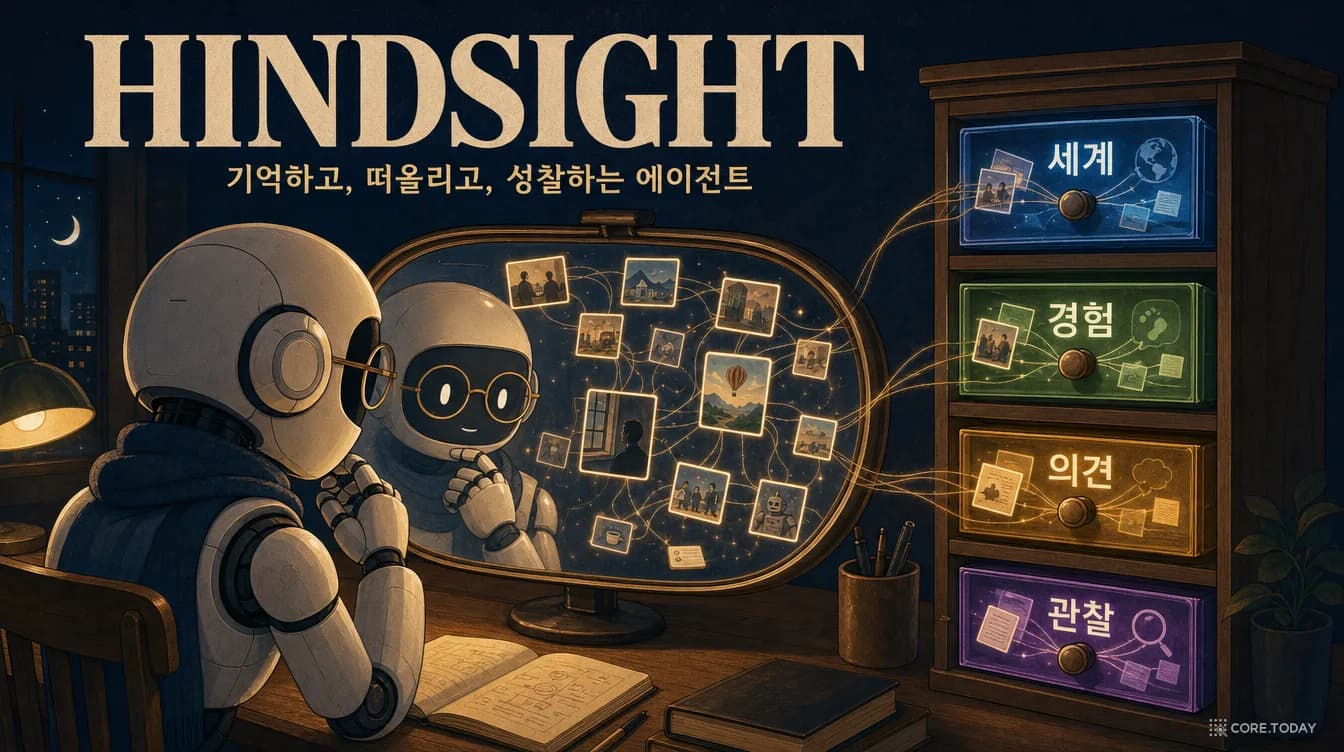
Hindsight 완전 해부 — 에이전트에게 '본 것'과 '믿는 것'을 따로 기억하게 했더니 생긴 일
11개월 만에 GitHub 별 4만 7천 개. 오픈소스 에이전트 메모리 Hindsight는 기억을 하나의 벡터 창고가 아니라 네 개의 서랍 — 세계·경험·의견·관찰 — 으로 나누고, 저장(retain)·회상(recall)·성찰(reflect) 세 동작으로 다룬다. 같은 20B 모델의 LongMemEval 점수가 39.0%에서 83.6%로 뛰었다. 왜 '증거와 믿음의 분리'가 중요한지, 네 갈래 검색과 역순위 융합·확산 활성화가 어떻게 돌아가는지, 성격 다이얼과 의견 강화 공식은 무엇인지, 그리고 2026년의 제품은 논문과 어떻게 달라졌는지 — 심리학의 140년 계보부터 벤치마크의 함정, 경쟁 설계와의 비교까지 인터랙티브 위젯 7개로 완전 해부한다.
기억은 미리 만들지 말고, 물어볼 때 지어라 — Just-In-Time 에이전트 메모리(JAM) 완전 해부
석 달 전 회의 요약에는 '가격 협의함'이라고만 적혀 있다. 그런데 오늘 필요한 건 '1,240만 원, VAT 별도'라는 한 줄이다. 대부분의 에이전트 메모리는 질문이 오기 전에 기록을 요약·추출해 두는 AOT(Ahead-of-Time) 방식이고, 그래서 '그때는 사소했던' 디테일을 먼저 버린다. BAAI·베이징대·홍콩이공대 연구진의 JAM은 발상을 뒤집는다. 원본은 폴더에 그대로 두고 README 색인만 미리 만든 뒤, 질문이 오면 작은 Researcher 에이전트가 open·search·browse로 찾아 들어가 그 질문만을 위한 맥락을 짓는다. 4B 모델로 14B 메모리 에이전트를 이기고, 4배 빨랐다. 토요타 공장과 JIT 컴파일러에서 시작해 Memory-Gym 데이터 합성, 힌트를 주는 강화학습, 결과표와 한계, 2026년의 다른 기억 설계와의 비교까지 인터랙티브 위젯 6종과 함께 해부한다.
[특집] 기억의 교통정리 — MemAgent: '만능 메모리는 없다'는 발견과, 13개의 기억 중 하나를 고르는 4B 라우터
에이전트에게 기억을 달아 주는 방법은 이미 수십 가지다. 궤적 요약, 실패에서 뽑은 경고, 변수 자리를 비운 워크플로, 실행 가능한 파이썬 함수, 통찰의 그래프. 각자 자기 시험에서는 1등이라고 보고했다. 칭화대와 텐센트 연구진은 13개 방식을 같은 에이전트에 하나씩 붙여 세 개의 시험을 치르게 했고, 세 시험 모두에서 상위권에 드는 방식은 하나도 없다는 걸 확인했다. 그런데 '문제마다 맞는 기억을 골랐다면'의 점수는 89.6% — 최고의 단일 기억(71.0%)보다 18%p 이상 높았다. 그래서 그들은 더 나은 기억을 만드는 대신 기억을 고르는 4B 모델, MemAgent를 학습시켰다. 시작 전엔 13개 서랍을 살짝 열어 보고, 진행 중엔 메모를 보여 줄지 정하고, 끝나면 어느 서랍에 넣을지 고른다. 인지과학의 다중 기억 체계부터 SAT 솔버 포트폴리오의 '오라클', 2026년 ChatGPT·Claude·Mem0·Letta의 메모리 설계까지, 논문과 코드, 그림과 표를 바탕으로 인터랙티브 일곱 개와 함께 풀어본다.
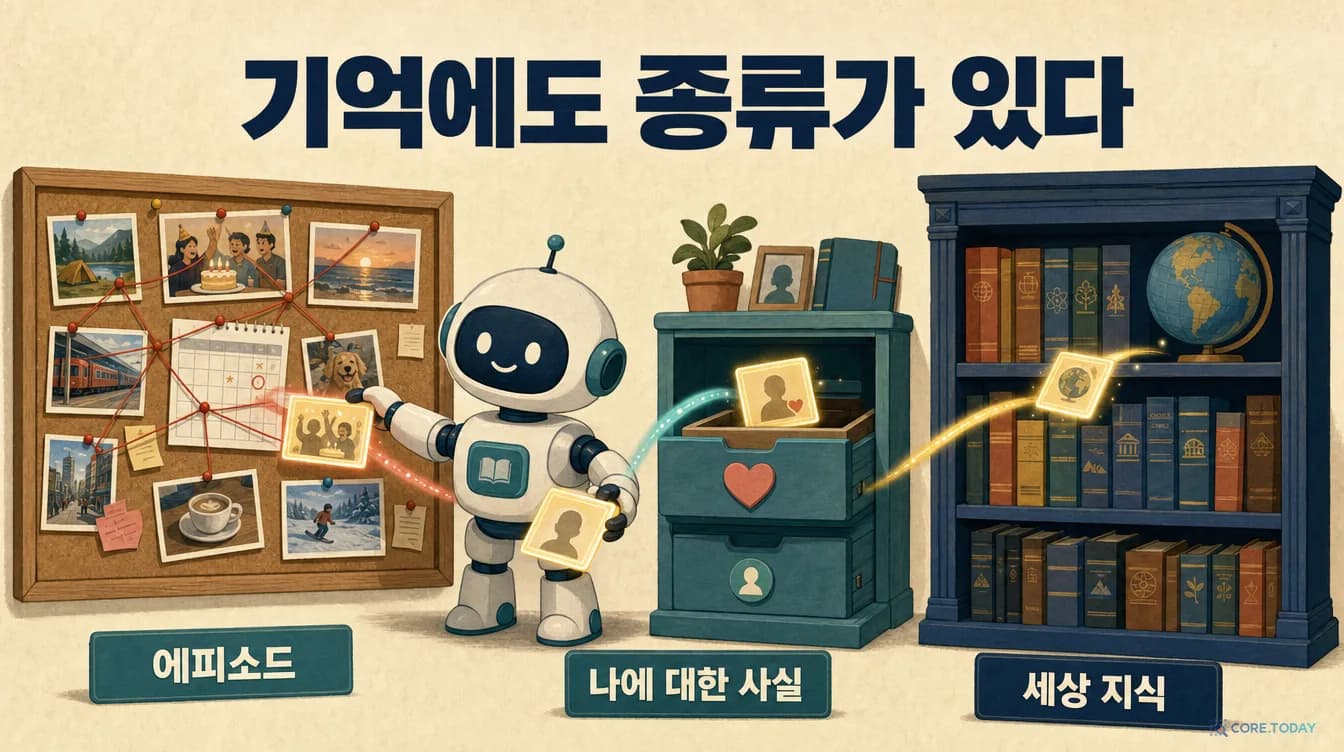
[특집] 기억에도 종류가 있다 — MemoType이 바꾼 질문: 'AI는 무엇을 기억하나'에서 '어떤 기억을, 어떻게 찾나'로
"지난달 조지랑 태산 다녀왔어"라고 말해 둔 AI에게 4주 뒤 "조지는 어디 갔었지?"라고 물으면 왜 엉뚱한 답이 돌아올까. 2026년 10월 8일 arXiv에 올라온 NeurIPS 2026 채택 논문 「Memory Type Varies」는 원인을 '모든 기억을 같은 방식으로 찾기 때문'이라고 진단한다. 1972년 심리학자 엔델 털빙이 나눈 일화 기억과 의미 기억을 대화 AI에 맞게 세 갈래(에피소드·개인 의미·일반 의미)로 다시 나누고, 6,000개 대화에 라벨을 단 TriMEM 데이터셋으로 1.7B 라우터를 학습시켜, 기억의 종류마다 다른 검색법을 쓰는 MemoType을 만들었다. 단일 검색 전략에는 넘을 수 없는 천장이 있다는 정리, 기억 구축 비용을 최대 248분의 1로 줄인 비용표까지 — 논문의 그림과 표를 하나씩 읽고, 털빙에서 ChatGPT·Claude·Gemini의 2026년 메모리까지 이어지는 계보와 함께 인터랙티브 다섯 개로 풀어 본다.
조건이 둘, 셋이 되면 — 질문을 쪼개는 검색과 Jev의 조건별 판정, 한국어 실측 (한국어 검색 스택 10편)
8편이 풀지 못한 숙제가 있었습니다. 'AWS 보안 글', 'Claude Code에서 MCP를 쓰는 글'처럼 두 주제를 모두 만족해야 하는 질문입니다. 이 글은 조건 1개·2개·3개짜리 한국어 질문 52개와 조건 순서만 바꾼 쌍둥이 질문 40개로, 조건이 늘 때 검색이 어떻게 무너지는지와 그것을 어떻게 막는지를 쟀습니다. 질문을 한 번에 임베딩하면 nDCG@10이 조건 1개 0.940에서 2개 0.519, 3개 0.387로 떨어졌습니다. 질문을 조건별로 쪼개 따로 찾고 합치기만 해도 3개에서 0.592로 버텼고, 그 후보를 Jev가 판정하면 2개와 3개 모두 0.725였습니다. Jev는 한 호출에 질문을 여러 개 받으므로 조건마다 따로 물어도 조건 하나당 토큰 90개, 지연 2ms만 늘었고, 어느 조건이 빠졌는지까지 알려 줬습니다. 의외의 발견도 있었습니다. 판정할 문장 자체가 바뀌는 탓에 'Jev 한 질문'이 조건 순서에 가장 민감했고, 조건별로 묻자 그 흔들림이 사라졌습니다. Jev 9,544회 호출에 0.27달러. 인터랙티브 4개와 삽화 7장.
[특집] 프로그래밍은 특별하지 않다 — 글리프의 질문: '예술가들은 AI가 예술에 나쁘다는 걸 안다. 왜 프로그래머는 자신이 예술가라는 걸 모를까?'
2026년 10월 9일, Twisted의 창시자이자 비동기 프로그래밍의 'Deferred'를 만든 글리프 레프코위츠가 짧은 글 하나를 올렸다. 「프로그래밍은 특별하지 않다」. 작가는 파업하고 화가는 서명하고 음악가는 소송하는데, 왜 프로그래머만 싫다면서도 AI를 쓰는가. 그의 답은 이렇다. 프로그래밍도 예술이고, 예술은 평범한 일까지 포함하며, 그 평범한 일이 위대함으로 가는 유일한 연습장이다. 해커뉴스에서 신고로 내려갔다가 운영자가 되살린 이 글을, 존 버저의 '신비화'부터 크누스의 1974년 튜링상 강연, 나우르의 '이론 세우기', Deferred의 내부 구조와 25년의 계보, 비틀스의 함부르크, 자동화의 아이러니, Anthropic의 기술 형성 실험, 한국은행의 청년 고용 보고서까지 따라가며 읽는다. 인터랙티브 일곱 개와 함께.
어제의 실수를 오늘 반복하지 않는 AI — ReMe, '기억하고 다듬는' 절차 기억의 모든 것
AI 에이전트는 똑똑하지만 매일 아침 기억이 지워지는 신입사원과 같다. 어제 주가를 지어내 주문을 망쳤어도 오늘 또 지어낸다. 경험을 쌓아 두면 해결될까? 알리바바 통이 연구소와 상하이교통대의 ReMe(Remember Me, Refine Me)는 '쌓기만 하는 기억은 결국 독이 된다'고 답한다. 성공·실패·비교의 세 렌즈로 경험을 한 줄짜리 요령으로 증류하고, '언제 쓰나'로 색인해 꺼내 고쳐 쓰고, 불려 나온 횟수 대비 쓸모가 없는 경험은 지운다. 그 결과 Qwen3-8B가 기억 없는 14B를 넘어섰다. 1962년 거울 속 별을 그리던 환자 H.M.부터 2026년 '기억을 파일로' 진화한 ReMe 0.4까지, 논문의 그림·표·코드와 인터랙티브 위젯 6개로 절차 기억을 완전히 풀어 본다.