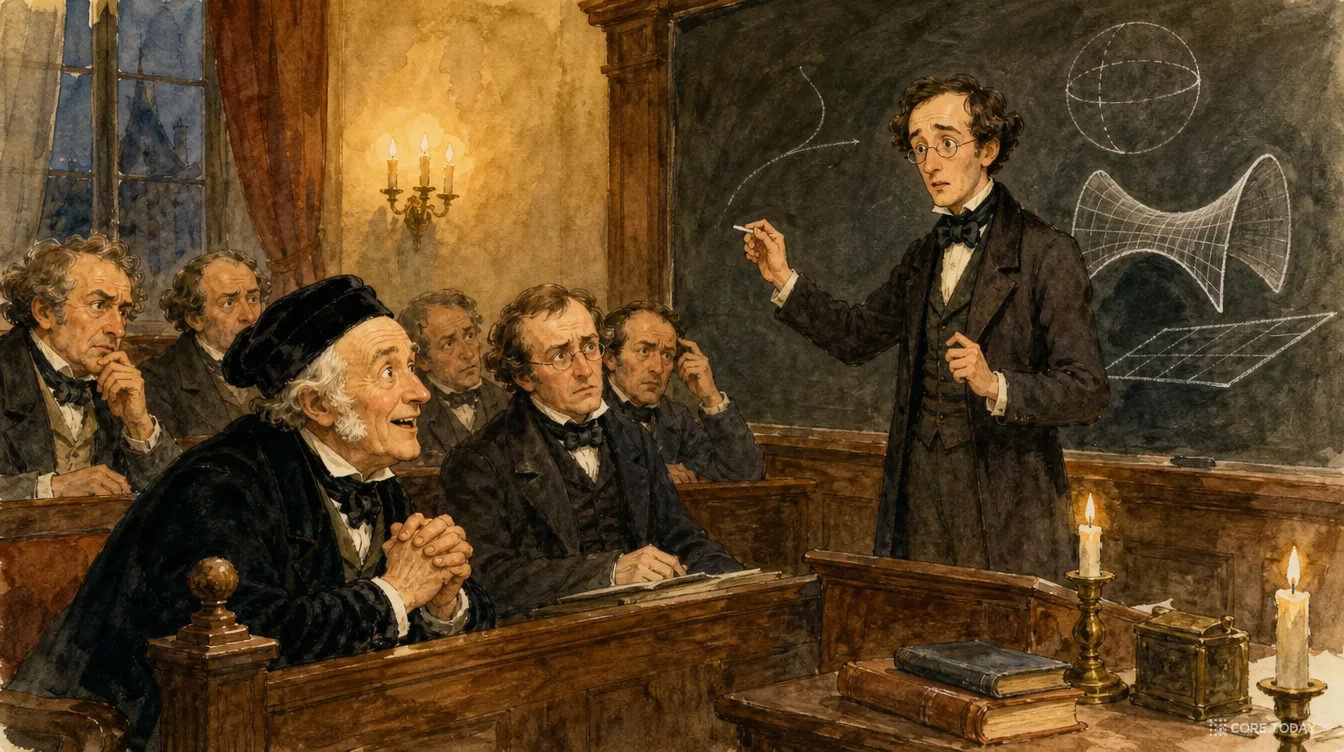[특집] 수학의 미래 — 타오의 블로그에 실린 아비가드의 편지: '더 어려운 문제를 풀고, 더 큰 생각을 하고, 새로운 것을 시도하라'
2026년 10월 5일, 테런스 타오의 블로그에 카네기멜런 대학의 논리학자이자 Lean 수학 라이브러리의 산파인 제러미 아비가드의 글 「수학의 미래」가 실렸다. 한 달 내내 경고와 선언이 쏟아지던 블로그에 처음으로 '대체로 긍정적'이라는 진단과 함께 세 개의 동사가 나왔다 — 더 어려운 문제를 풀어라, 더 큰 생각을 하라, 새로운 것을 시도하라. 그리고 다음 세대에게 '우리는 당신들과 함께 선다'는 문장이 붙었다. 이 글은 왜 화제가 됐는가. 리만의 1854년 강연을 '어떤 강화학습 채점기도 평가할 수 없었을 것'이라고 한 기술적 주장은 무슨 뜻인가. 추론 모델이 실제로 어떻게 훈련되는지(GRPO·결과 보상·AlphaProof의 탐색 트리)부터, 수학이 '낯선 기술'을 삼켜 온 400년의 역사, 댓글창의 반론, 같은 주에 바뀐 arXiv·Erdős 사이트의 규칙, 그리고 2026년 한국의 자리까지, 원문과 논문·댓글 100여 건을 읽고 인터랙티브 다섯 개와 함께 풀어본다.
10월 1일, 논문 사전 공개 서버 arXiv가 "제출의 지수적 증가"를 이유로 한 사람당 한 달에 두 편만 올릴 수 있게 규칙을 바꾼다고 발표했다. 10월 6일, 에르되시가 남긴 난제 1,221개를 모아 둔 Erdős 문제 사이트가 댓글과 해결 주장 접수를 중단하고, 문제마다 붙어 있던 '풀림/안 풀림' 색 표시와 공로 표기를 없애겠다고 발표했다. 같은 날, LLM이 만든 결과를 위한 새 논문 저장소 'Hexagon'이 문을 열었다. "사람이 이해하지 못한다고 밝힌 제출도 받는다"는 조건과 함께. 그리고 10월 7일, 가워스·헤어러·위튼 등 9인의 자문 그룹 AGMAI가 성명을 냈다. OpenAI가 내부 모델로 미해결 문제 372개의 풀이와 원고 722편을 한꺼번에 공개했으니, "이것은 인간 이해 과정의 시작이지 완성이 아니다"라고.
그 한가운데, 10월 5일에 테런스 타오의 블로그에 한 편의 글이 올라왔다. 제목은 단순하다. 「수학의 미래(The Future of Mathematics)」. 글머리에 타오의 짧은 주석이 붙어 있다.
[이 글은 제러미 아비가드의 손님 글이다. 원래 다른 파일 형식으로 쓰였고 AI로 변환했다. — T.]
9월 한 달 동안 타오의 블로그에는 글이 39편 실렸다. 대부분이 손님 글이었고, 거의 전부가 AI와 수학에 관한 것이었다. 필즈상 수상자 25인의 선언이 있었고, 사하이의 "수학자가 훨씬 더 많이 필요하다"가 있었고, 울었다는 수학자의 고백과 서명을 거부한 수학자의 변명이 있었다. 분위기는 대체로 경고와 걱정이었다. 아비가드의 글은 그 흐름에서 처음으로 "수학계의 반응이 대체로 긍정적이고 고무적"이라고 쓴 글이다. 그리고 걱정 대신 동사 세 개를 내놓는다.
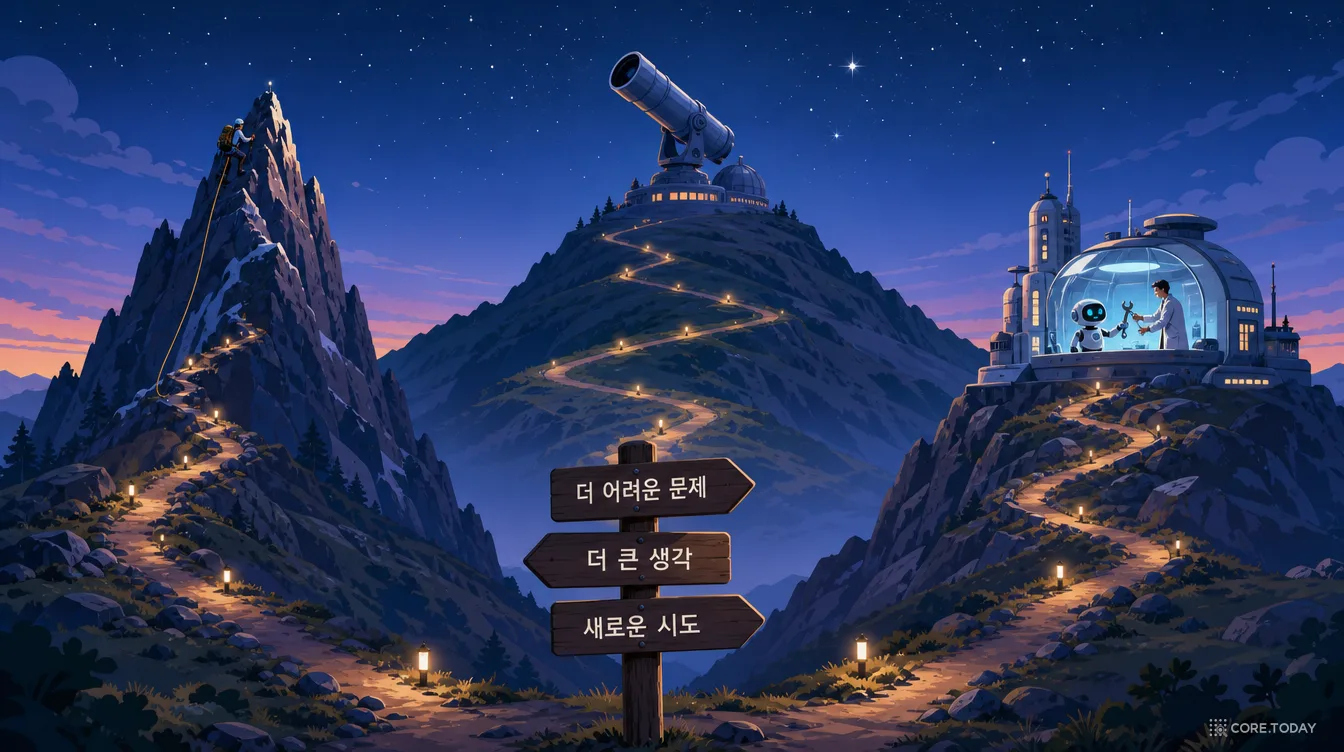
더 어려운 문제를 풀어라 Solve harder problems
더 큰 생각을 하라 Think bigger thoughts
새로운 것을 시도하라 Try new things
마지막 절에서 그는 수신인을 바꾼다. 동료가 아니라 "발밑의 땅이 움직이는 것을 느끼는" 학생과 초기 경력 연구자에게. "우리는 당신들과 함께 선다. … 수학은 지금도 그 어느 때 못지않게 중요하고, 우리는 당신들이 필요하다."
이 글이 화제가 된 이유는 둘이다. 하나는 때다. 규칙이 바뀌는 주에, 바뀌는 규칙의 한쪽 당사자(그는 Lean 생태계를 20년 가까이 만들어 온 사람이다)가 "그래도 괜찮다, 이유는 이렇다"고 쓴 글이기 때문이다. 다른 하나는 글 안에 숨은 기술적 주장이다. 1854년 리만의 강연을 두고 그는 "어떤 강화학습 설정도 리만의 결정을 평가할 수 없었을 것"이라고 썼다. 이 한 문장은 오늘날 추론 모델이 어떻게 훈련되는지를 정확히 알아야 이해할 수 있고, 이해하고 나면 "AI가 수학을 대체할 것인가"라는 질문이 왜 잘못 놓인 질문인지가 보인다.
이 글은 원문을 한 문단씩 따라 읽으면서, 그 뒤에 있는 역사(리만·갈루아·버클리·지겔)와 기술(GRPO·결과 보상·AlphaProof·에이전트 떼)과 논쟁(댓글 23개, 그리고 같은 주의 다른 글들)을 풀어 놓는다. 수학자가 아니어도 읽을 수 있게 썼다. 수학 자리에 자기 일을 넣어 읽으면 대부분의 문장이 그대로 통한다.
아비가드의 글을 읽으려면 그 앞의 한 달을 알아야 한다. 아래 장부는 9월 7일 알페게·버크마스터의 유체 방정식 결과 공개에서 10월 7일 AGMAI 성명까지, 타오 블로그와 수학계 제도에서 일어난 일을 한 줄에 놓은 것이다. 종류별로 걸러 보면 흐름이 보인다. 9월은 글의 달이었고, 10월 첫 주는 규칙의 주였다. 아비가드의 글은 정확히 그 경계에 놓여 있다.
세 가지가 눈에 띈다.
첫째, 글의 홍수가 제도의 변화로 번역되기 시작했다. 9월에 "이해 없는 증명이 쌓인다"고 걱정하던 글들이 10월 들어 arXiv 제출 제한, Erdős 사이트의 '해결 주장 접수 중단', "옛 문제의 새 증명"으로 주제를 바꾼 칼텍 매스어톤으로 나타났다. Erdős 사이트를 운영하는 토머스 블룸의 표현을 빌리면, 미해결 문제 목록이 "영광을 좇는 게임화된 태도"의 무대가 되자 "도살장에 식당을 열지는 않는다"며 토론 공간과 저장소를 분리하기로 한 것이다.
둘째, 같은 주에 정반대 방향의 실험도 시작됐다. Hexagon 저장소는 "LLM이 전부 만들었고 제출자가 이해하지 못한다고 밝힌" 논문도 받는다. 창립자 벤 앤티오는 "LLM 보조로 증명된 결과의 급증은 논문을 모으는 새 모델을 요구한다"고 썼다. 블룸이 '이해 없는 결과'를 밀어내는 동안 앤티오는 그것을 담을 그릇을 만든 셈이다. 수학계가 한 방향으로 움직이고 있지 않다는 뜻이다.
셋째, 아비가드는 이 흐름의 구경꾼이 아니다. 그는 Lean 수학 라이브러리를 키워 온 핵심 인물 중 한 사람이고, 10월 7일 AGMAI가 "Lean 형식화와 함께 공개됐다"고 평가한 OpenAI의 372개 풀이는 그가 만드는 데 기여한 도구 위에 서 있다. 그가 "대체로 긍정적"이라고 쓸 때, 그것은 바깥에서 들어온 낙관이 아니라 안에서 나온 책임의 언어다. 그가 누구인지부터 보자.
2장. 글쓴이 — 논리학자, 철학자, 그리고 Lean의 산파
제러미 아비가드(Jeremy Avigad, 1968~)는 카네기멜런 대학(CMU)의 철학과 교수이자 수리과학과 교수다. 하버드에서 수학을 공부하고 1995년 버클리에서 집합론자 잭 실버의 지도로 박사 학위를 받았다. 전공은 수리논리학과 증명론이었고, 2000년대부터 두 갈래 일을 병행했다. 하나는 19세기 수학사와 수학철학(데데킨트·크로네커·힐베르트 시대의 기초 논쟁), 다른 하나는 증명을 컴퓨터가 검사할 수 있게 쓰는 형식 검증이다.
시기
무엇을 했나
이 글과의 연결
1995~2000년대
증명론·수리논리학 연구. 바이어슈트라스·데데킨트 시대의 "현대 수학으로의 이행"에 관한 역사·철학 논문 다수
글의 첫 인용문(스타인의 '두 번째 탄생')과 6장의 역사 사례들은 그의 본업에서 나온 것이다
2010년대
증명 보조기 Lean의 초기부터 참여. 수학 라이브러리 mathlib의 설계와 교재 『Lean으로 정리 증명하기(Theorem Proving in Lean)』 공저. 중심극한정리·소수 정리 등의 형식화
"증명 보조기를 수학에 쓰려는 사람을 기술자로 치부하지 말라"는 6장의 주장은 자기 이야기다
2021년~
암호화폐 기업가 찰스 호스킨슨이 CMU에 2천만 달러를 기부해 세운 호스킨슨 형식 수학 센터 초대 소장
Lean 생태계의 학계 쪽 허브를 맡고 있다
2022년
교과서 『수리논리학과 계산(Mathematical Logic and Computation)』 출간
논리학자로서의 정체성
2023년
논문 「수학과 형식적 전환(Mathematics and the Formal Turn)」 — "우리가 기술로 많은 것을 할 수 있지만, 그것으로 추상하고·소통하고·문제를 풀고·합의에 이르는 일을 하지 않는다면 아마 수학을 하고 있는 게 아니다"
이번 글의 '넓은 시각'(수학 = 추론과 소통의 문화)의 원형
2026년 8월
에세이 「수학은 지금 무엇이고, 무엇이어야 하는가」(arXiv 2608.23218, 미국수학회 소식지 게재 예정). 공저 논문 「문제가 문제다: 확장 가능한 수학적 발견을 향해」(FAR 파이프라인)
이번 글이 "다른 글에서 주장했다"고 가리키는 바로 그 글. 8장에서 보듯 FAR 논문은 댓글창에서 역공의 빌미가 된다
2026년 10월
타오 블로그에 「수학의 미래」
이 특집
그가 글 첫머리에서 언급한 컨버전트 리서치(Convergent Research)는 "과학의 병목을 찾아 그것을 뚫을 공공재를 만드는 비영리 스타트업을 출범시키는" 조직이다. 이들이 만드는 조직 형태를 집중 연구 조직(FRO, Focused Research Organization)이라 부른다. 기한이 정해져 있고, 기술적으로 야심 차고, 논문이 아니라 도구·데이터·인프라 같은 공공재를 목표로 한다. Lean FRO는 2023년 7월 Lean의 창시자 레오나르도 드 모라와 제바스티안 울리히가 이 틀 안에서 세운 비영리 조직으로, 사이먼스 재단·슬론 재단·알렉스 거코 등의 후원을 받으며 Lean 언어 자체와 수학 라이브러리를 개발한다. 2025년 한 해에만 Lean은 12번 릴리스됐고, 50개 이상 대학 강의에 쓰였으며, "Lean 위에 세워진 AI 스타트업"이 다섯 곳을 넘었다. mathlib은 2026년 기준 정리 약 28만 개, 정의 13만 개, 200만 줄이 넘는 코드로 자랐다.
아비가드가 "이어 붙이기" 분석의 공을 돌린 매튜 밸러드(Matthew Ballard)는 사우스캐롤라이나 대학의 대수기하학자이자 mathlib 관리자, 그리고 2025년 미국 국립과학재단(NSF)이 CMU에 세운 수학의 컴퓨터 보조 추론 연구소(ICARM)의 부소장이다. 글에 두 번 이름이 나오는 이유는 간단하다. 두 사람은 같은 조직에서 매일 AI가 만든 증명을 들여다보는 사람들이다.
이 이력이 중요한 이유가 있다. 아비가드는 AI가 수학을 하는 것을 가장 가까이에서, 가장 오래 본 수학자 중 한 명이다. 그의 낙관은 모델의 능력을 몰라서 나온 것이 아니고, 그의 걱정은 소문으로 들은 것이 아니다. 그래서 그가 "아직 거기 이르지 못했다"고 쓸 때 그 문장은 무게가 다르다.
3장. 서문 읽기 — 세 개의 인용문과 '좁은 시각'
글은 본문보다 먼저 세 개의 인용문을 세워 둔다. 짧은 글에서 인용문 세 개는 사치다. 아비가드가 굳이 셋을 고른 이유는, 셋이 합쳐져야 이 글의 자세가 보이기 때문이다.
인용
누구의 말인가
이 글에서 맡은 역할
"수학은 19세기에 너무나 깊은 변형을 겪어서, 그것을 이 학문의 두 번째 탄생이라 불러도 지나치지 않다 — 첫 번째 탄생은 고대 그리스인들 사이에서 일어났다."
하워드 스타인(Howard Stein), 1988년 논문 「로고스, 로직, 로지스티케」
수학은 이미 한 번 '다시 태어난' 적이 있다. 지금의 격변도 죽음이 아니라 탄생일 수 있다는 역사적 전제
"내 죽음에 대한 보도는 과장이었다."
마크 트웨인(1897년, 자신의 부고 오보에 대해)
'수학자는 끝났다'는 2026년 가을의 분위기를 한 문장으로 받아치는 유머
"흥미로운 시대에 살기를."
출처 불명의 '중국 저주'로 알려진 관용구(실제로는 20세기 영어권에서 만들어진 표현)
축복인지 저주인지 알 수 없는 시대에 대한 양가감정. 글의 마지막 절 "앞으로 몇 년은 극도로 흥미로울 것"으로 되돌아온다
세 인용문 다음에 글쓴이는 자기가 어디 있었는지 말한다. 컨버전트 리서치(Convergent Research)가 후원하는 과학기술 스타트업 모임이었다. 컨버전트 리서치는 '집중 연구 조직(Focused Research Organization, FRO)'이라는 새로운 형태의 비영리 연구소를 여럿 만든 단체로, 증명 보조기 Lean을 개발하는 Lean FRO가 그중 하나다. 모임에서 수학자라고 자기소개를 하자, 사람들이 몰려와 물었다고 한다. 요즘 AI 사건들에 수학계는 어떻게 반응하고 있느냐고.
아비가드의 답은 그들을 놀라게 했다. "대체로 긍정적이고 고무적"이라는 것이다. 타오의 블로그나 '프루프스 앤드 프롬프츠(Proofs and Prompts)' 같은 곳에 올라오는 수학자들의 글이, 일상적 직업 생활의 근본이 바뀔 것을 모두가 알면서도 침울하지 않더라는 관찰이다. 바깥에서 보기엔 수학계가 공황 상태일 것 같은데, 안에서 보니 그렇지 않더라는 이 온도 차가 글의 출발점이다.
'좁은 시각'과 '넓은 시각'
그다음 문단이 이 글의 진단이다. 아비가드는 수학자가 하는 일에 대한 좁은 시각을 이렇게 요약한다.
우리는 문제를 풀려고 한다. 어려운 문제가 너무 어려우면, 더 쉬운 근사 문제를 만들어 그것을 풀고, 그다음 매개변수를 바꿔 본다.
이것이 "일상의 작업 흐름에 새겨진" 수학자의 자화상이다. 그리고 아비가드는 인정한다. 바로 이 작업 흐름이 지난 몇 달 사이에 무너졌다고. "1년 전이라면 충분히 존경받을 만한 출판물이 됐을 종류의 결과를, 이제는 AI의 도움으로 쉽게 만들어 낼 수 있다." 이 문장은 2026년 가을 수학계에서 가장 솔직한 고백 가운데 하나다. 다른 글들이 "AI가 유명 난제를 벤치마크로 삼는 것"을 걱정했다면, 아비가드는 그보다 훨씬 평범한 층위, 즉 보통 수학자가 보통 논문을 쓰는 방식 자체가 무의미해졌다는 데서 시작한다.
그래서 그는 역사로 눈을 돌린다. 수백 년의 변화에도 변하지 않은 것은 무엇인가.
수학은 엄밀한 추론과 소통의 문화이며, 우리가 더 믿을 만하고 더 효율적으로 생각하고 소통할 수 있게 해 주는 언어와 추상을 제공한다.
이 정의에는 '정리'도 '증명'도 '문제'도 없다. 문화, 추론, 소통, 언어, 추상뿐이다. 이것이 '넓은 시각'이다. 그리고 여기서 글은 한 가지 대담한 가설을 꺼낸다. 수학이 아름답게 느껴지는 이유는 그것이 쓸모 있기 때문이라는 것이다.
많은 사람이 수학을 미적으로 즐긴다는 사실은 수학의 실용적 유용성을 깎아내리지 않는다. 오히려 그 유용성으로 설명된다. 수학을 할 때 기분이 좋은 이유는, 그것이 우리 종의 생존에 너무나 근본적이어서 DNA에 새겨진 능력을 발휘하는 일이기 때문이라고 나는 짐작한다. 그렇다면 수학적 사고는 조만간 사라지지 않을 것이다.
진화심리학적 주장이라 논쟁의 여지가 크고, 댓글창에서도 바로 이 대목이 도마에 올랐다(8장). 그러나 글의 논리 구조에서 이 문장이 하는 일은 분명하다. AI가 문제를 다 풀어도, 추론하는 기쁨은 인간 쪽에 남는다는 전제를 깔아 두는 것이다.
그다음 글은 문제를 한 문장으로 다시 쓴다.
우리가 수십 년간 풀어 온 종류의 문제를 푸는 일이, AI에게 맡기는 순간 수학적 이해를 넓힌다는 목표와 분리된다는 것이 어려움이다. 따라서 질문은 '우리에게 여전히 수학이 필요한가'가 아니라, 'AI의 시대에 어떻게 수학적 이해를 추구할 것인가'다.
"문제 풀기"와 "이해 넓히기"가 분리됐다는 진단은, 9월 11일 선언문이 말한 "문제를 푸는 것과 수학을 하는 것의 불일치"와 같은 뿌리다. 다만 선언문이 AI 기업을 향해 쓴 경고였다면, 아비가드는 같은 진단을 수학자 자신을 향해 돌린다. 그리고 세 개의 답을 내놓는다.
4장. 첫 번째 답 — 더 어려운 문제를 풀어라
오늘의 모델이 가진 두 가지 특징
아비가드는 첫 번째 답을 기술 진단에서 시작한다. 오늘의 기초 모델(foundation model)에는 두드러진 특징이 둘 있다.
① 문헌 전체를 봤다 수학 문헌 전부가 훈련 데이터에 들어 있다. 어떤 기법이 어디에 쓰였는지, 사람 수학자 누구보다 넓게 안다.
② 지치지 않는다 에이전트 떼(swarm)가 셀 수 없이 많은 변형을 시도하며 해에 다가갈 수 있다. 사람은 한 주에 열 가지 시도를 하지만 기계는 하룻밤에 만 가지를 한다.
↓
따라서 지금까지 AI가 푼 공개 문제들은 모두 비슷한 성격을 띤다 — "이미 있는 기법들을 이어 붙여서(cobbling together) 풀 수 있는 문제"였다.
이 "이어 붙이기"라는 특징 묘사와 그에 이은 분석은 사우스캐롤라이나 대학의 대수기하학자이자 Lean 기여자인 매튜 밸러드(Matthew Ballard)의 것이라고 아비가드는 밝힌다. 2026년에 AI가 해결했다고 발표된 결과들을 돌아보면 이 묘사는 꽤 정확하다. 이 블로그가 5월에 다룬 Erdős #1196의 경우 폰 망골트 가중치와 마르코프 연쇄라는, 각각은 교과서에 있는 두 도구를 사람들이 한 번도 시도하지 않은 방식으로 결합한 것이었다. 9월의 나비에–스토크스 발표도 "새로운 아이디어가 있는가"를 두고 전문가들이 가장 먼저 물었다(→ 25인 선언 특집 4장).
모든 질문이 그렇게 풀릴까
아비가드의 답은 "아마 아닐 것"이다. 그리고 설령 그렇게 풀리는 문제라도 "새로운 아이디어와 통찰을 부르는, 더 흥미롭고 더 만족스러운 풀이"가 따로 있을 수 있다고 덧붙인다. 여기서 그는 조심스럽다. "가까운 미래에 AI 시스템이 그런 통찰을 내놓을 수 있을지도 모른다. 그러나 적어도, 아직은 거기 이르지 못했다는 것을 인정하자."
왜 아직인가. 이 글에서 가장 기술적인 문단이 이어진다.
강화학습 훈련 체계는 시스템이 관습적인 수(手)를 이어 붙이게 하고, 실패와 성공의 이력으로부터 주어진 상태에서 어떤 수가 가장 유망한지를 배우게 한다. 행동의 가치가 오직 최종 궤적의 성공 여부로만 매겨진다는 사실은 초인적 영리함을 길러 내지만, 창의성과 상위 수준의 전략 수립은 놓칠 수 있다.
이 문단을 제대로 이해하려면 2024~2026년 추론 모델이 실제로 어떻게 훈련되는지를 알아야 한다. 다음 절에서 자세히 본다.
아키텍처 ① — 추론 모델은 어떻게 '관습적인 수'를 배우나
2024년 9월 OpenAI가 o1을 공개하면서 한 문장을 썼다. "대규모 강화학습 알고리즘이 모델에게 사고 사슬(chain of thought)을 생산적으로 쓰는 법을 가르친다. … 성능은 강화학습을 더 할수록(훈련 시간 계산), 그리고 생각하는 시간을 더 줄수록(추론 시간 계산) 꾸준히 좋아진다." 그 뒤 2년간 수학에서 일어난 일의 기술적 뿌리가 이 문장에 있다. 2025년 1월 DeepSeek가 R1 논문으로 그 방법을 상세히 공개하면서 널리 알려졌다. 검증 가능한 보상을 이용한 강화학습(RLVR, Reinforcement Learning with Verifiable Rewards). 이름 자체는 2024년 11월 앨런 AI 연구소의 Tülu 3 논문이 먼저 붙였다.
핵심은 세 단계다.
① 풀게 한다
문제 하나를 주고 모델이 답을 여러 개(예: 16개) 쓰게 한다. 답마다 <think> 태그 안에 긴 사고 과정이 들어 있다.
② 채점한다
사람이 아니라 규칙이 채점한다. 수학이면 최종 답이 정답 상자와 일치하는가, 코드면 테스트를 통과하는가, Lean이면 커널이 증명을 받아들이는가. 맞으면 1, 틀리면 0. 중간 과정은 보지 않는다.
③ 밀고 당긴다
같은 문제의 답 16개 중 평균보다 잘한 답에 들어 있던 모든 단어의 확률을 올리고, 못한 답의 단어 확률을 내린다. 이것을 수만 번 반복한다.
③이 DeepSeek가 2024년 2월 제안한 GRPO(Group Relative Policy Optimization)다. 식으로 쓰면 이렇다. 문제 q에 대해 답 o1,…,oG를 뽑고 각각 보상 ri를 받았을 때, 답 i의 '이득(advantage)'은
A^i=std(r1,…,rG)ri−mean(r1,…,rG)
이고, 모델은 이 이득이 양수인 답을 더 자주, 음수인 답을 덜 내도록 바뀐다. 이전 방법(PPO)이 "이 상태의 가치는 얼마인가"를 따로 예측하는 가치 모델을 하나 더 두었던 것과 달리, GRPO는 그것을 없애고 같은 문제에 대한 답들끼리의 상대 비교로 대신한다. 메모리를 절반으로 줄여 대규모 훈련을 가능하게 한 설계다. 그리고 바로 이 설계가 아비가드 문장의 전반부, "실패와 성공의 이력으로부터 주어진 상태에서 어떤 수가 가장 유망한지를 배운다"의 정확한 뜻이다.
주목할 것은 식에서 A^i에 첨자 t(시점)가 없다는 점이다. 결과 보상 방식에서는 한 답에 들어 있는 모든 토큰, 즉 첫 줄의 "이 문제는 ~로 보인다"부터 마지막 줄의 답까지 전부 같은 점수를 받는다. 훌륭한 첫 발상 뒤에 계산 실수가 있었으면 첫 발상도 벌을 받고, 엉뚱한 발상이 요행으로 맞았으면 엉뚱한 발상도 상을 받는다. 아비가드가 쓴 "행동의 가치가 오직 최종 궤적의 성공 여부로만 매겨진다"가 이것이다.
아키텍처 ② — DeepSeek-R1의 그림 두 장이 보여 주는 것
R1 논문(2025년 1월 arXiv, 같은 해 9월 『네이처』 게재)에서 가장 많이 인용된 그림 두 장이 있다. 하나는 미국 수학 경시대회 AIME 2024 정답률이 훈련 단계에 따라 올라가는 곡선이다. 사람이 쓴 풀이를 한 줄도 보여 주지 않고 규칙 보상만으로 훈련한 R1-Zero는 정답률 15.6%에서 시작해 71.0%(네이처판 기준 77.9%)에 이르렀고, 16개 답의 다수결을 쓰면 86.7%였다. 다른 하나는 답의 평균 길이 곡선이다. 훈련이 진행될수록 모델은 아무도 시키지 않았는데 더 길게 생각했다. 수백 토큰에서 시작해 1만 토큰이 넘는 사고 과정으로. 논문은 이렇게 썼다.
모델이 이전 단계를 되짚어 다시 평가하는 '반성(reflection)'과 대안 접근의 탐색 같은 행동이 자발적으로 나타난다. 이 행동들은 명시적으로 프로그래밍된 것이 아니라 모델이 강화학습 환경과 상호작용한 결과로 출현한다.
가장 유명한 것은 '아하 모먼트'다. 어떤 중간 체크포인트에서 모델이 방정식을 풀다 말고 이렇게 썼다. "잠깐, 잠깐. 잠깐. 여기서 아하 모먼트를 표시할 수 있겠다. 단계별로 다시 평가해 보자…" 네이처판은 이를 수치로 보여 준다. 훈련 초기에는 거의 없던 단어 'wait'가 4,000~7,000단계 사이에 산발적으로 나타나다가 8,000단계 이후 급증한다.
R1-Zero 훈련의 핵심 설정 (네이처판 Methods)
보상 = 정답 여부(규칙) + 형식 준수(<think> 태그). 신경망 보상 모델은 쓰지 않음 — "대규모 RL에서 보상 해킹에 취약"
문제당 샘플 16개, 최대 길이 32,768 토큰 → 8,200단계 이후 65,536 토큰
훈련 단계 10,400단계(1.6 에포크), 단계당 문제 32개 × 16 = 배치 512
비용 H800 GPU 64×8대로 R1-Zero 약 198시간, R1 약 80시간. 합계 GPU 14만 7천 시간 ≈ 29만 4천 달러 (기반 모델 V3의 사전 훈련 비용 제외)
여기서 아비가드의 "초인적 영리함(superhuman cleverness)"이 어디서 오는지 보인다. 결과 보상은 모델이 이미 알고 있는 수들을 더 길게, 더 끈질기게, 더 자주 되짚으며 이어 붙이게 만든다. 이것은 실제로 초인적이다. 사람은 한 문제를 1만 토큰 분량으로 열여섯 번 다시 생각하지 않는다.
아키텍처 ③ — 왜 '창의성'은 놓치는가: 1961년의 문제
그런데 이 방식에는 1961년부터 알려진 약점이 있다. 마빈 민스키는 그해 논문 「인공지능을 향한 발걸음」에 "복잡한 강화학습 시스템의 기본적 신용 할당 문제(credit-assignment problem)"라는 절을 두고 이렇게 물었다. "체스 한 판을 이기는 것 같은 복잡한 과제에 백만 개의 결정이 들어간다고 하자. 각 결정에 성공의 백만분의 일씩 공을 돌릴 수 있을까?" 서튼과 바토의 강화학습 교과서는 "이 책에서 다루는 모든 방법은 어떤 의미에서 이 문제를 풀기 위한 것"이라고 쓴다.
결과 보상 RL은 이 문제를 푸는 대신 우회한다. 모든 단계에 같은 점수를 주고, 샘플을 아주 많이 뽑아 통계로 뭉개는 것이다. 이 우회가 통하려면 두 조건이 필요하다. 보상이 궤적이 끝나는 즉시 와야 하고, 궤적이 충분히 짧아야 한다. 수학 경시 문제는 두 조건을 다 만족한다. 답은 몇 분 안에 나오고, 채점은 즉시다.
이제 리만을 보자. 1854년 6월 10일에 끝난 궤적(강연)의 보상은 언제 왔는가. 1868년(출판), 1915년(일반 상대성이론), 1994년(확산텐서 MRI), 2003년(페렐만의 리치 흐름). 그것도 "리만이 옳았다/틀렸다"의 1과 0이 아니라, 수천 명의 사고방식에 스며드는 확산된 형태로. 아비가드가 밸러드의 말을 빌려 쓴 "이익은 확산적이고 추적하기 어려우며 시간 지평은 너무나 길다"가 정확히 신용 할당 문제의 두 축이다. 5장의 리만 절에 이 비대칭을 직접 만져 볼 수 있는 시뮬레이터를 두었다.
이 지적은 2025년 이후 연구에서도 실증적 뒷받침을 얻고 있다. 칭화대 연구진(Yue 외, 2025)은 RLVR로 훈련한 모델과 훈련 전 기반 모델을 "답을 k번 뽑았을 때 하나라도 맞는 비율(pass@k)"로 비교했다. k가 작을 때는 RL 모델이 앞섰지만, k를 수백으로 늘리자 기반 모델이 따라잡고 추월했다. 결론은 "현재의 RLVR은 근본적으로 새로운 추론 패턴을 끌어내지 않는다. 이미 기반 모델 안에 있던 경로를 더 자주 뽑게 할 뿐이다"였다. DeepSeek 자신도 2024년 논문에서 "RL은 Maj@K는 올리지만 Pass@K는 올리지 않는다"고 적었다. 반론도 있다. 엔비디아의 ProRL(2025)은 KL 제어와 참조 모델 초기화를 곁들여 2,000단계 이상 길게 훈련하면 "기반 모델이 아무리 많이 뽑아도 못 푸는 문제를 RL 모델이 100% 푸는" 영역이 생긴다고 보고했다. 그리고 2026년의 논문들은 아예 민스키의 문제로 돌아가 검증 가능한 중간 보상(부분 문제별 보상, 단계별 신용 추적)을 설계하고 있다. 아비가드의 "아직은"이라는 단서는 이 논쟁의 현재 위치를 정확히 반영한다.
아키텍처 ④ — 형식 증명기는 어떻게 생겼나: AlphaProof
아비가드는 Lean 쪽 사람이므로, 자연어 추론 모델만이 아니라 형식 증명기도 봐야 한다. 2025년 11월 『네이처』에 실린 구글 딥마인드의 AlphaProof 논문이 가장 자세한 공개 설계도다.
자동 형식화기 Gemini 1.5 Pro를 미세조정해 자연어 문제를 Lean 문장으로 번역. 약 100만 개의 자연어 문제 → 약 8천만 개의 형식 문제 (TPU 10만 일 소요)
증명 신경망 30억 매개변수 인코더–디코더. 현재 Lean 상태를 읽고 ① 다음에 시도할 전술(tactic) 후보 N개 ② 이 상태에서 증명이 얼마나 가까운지의 가치 추정을 낸다
Lean 환경 전술을 적용하면 새 상태가 나오거나 실패한다. 매 단계 보상 −1(짧은 증명 유도), 커널이 증명을 받아들이면 종료
↓
알파제로식 트리 탐색 신경망의 제안과 가치로 유망한 가지를 깊게 판다. 증명이 여러 하위 목표로 갈라지면 모두 풀어야 하므로 AND–OR 트리를 쓴다
테스트 시점 RL(TTRL) 가장 어려운 문제는 그 문제의 변형(단순화·일반화)을 수십만 개 만들어 그 자리에서 다시 학습. IMO 2024 문제당 2~3일
숫자 몇 개가 이 설계의 성격을 말해 준다. 사전 훈련 3천억 토큰, mathlib에서 뽑은 사람 증명 30만 쌍으로 미세조정, 그다음 TPU 8만 일(TPU 4천 개로 20일)의 강화학습. 결과는 경시 수학 형식 벤치마크 miniF2F에서 2 TPU분 예산으로 96.3%, TTRL에 500 TPU일을 쓰면 99.6%. 역대 IMO 비기하 문제 258개로 만든 벤치마크에서는 58.3%. IMO 2024에서는 비기하 3문제를 풀었고, 기하 문제를 푼 AlphaGeometry 2와 합쳐 은메달 점수(28/42)를 냈다.
논문의 한계 절이 아비가드와 같은 말을 한다.
AlphaProof의 현재 성공은 주로 고등학교 심화·학부 수준 경시 수학의 영역 안에 있다. 극도로 어렵기는 하지만 이 문제들은 알려진 고정된 수학 개념의 라이브러리 안에서, 어느 정도의 주제적 일관성을 가지고 작동한다. … 궁극적으로 AI에 수학적 취향, 흥미로움, 아름다움에 대한 이해를 불어넣는 일은 매혹적인 미해결 연구 질문으로 남아 있다.
2026년 5월 후속작 AlphaProof Nexus는 이 설계를 연구 수학에 돌렸다. Erdős 미해결 문제 353개에 시도해 9개를 자율적으로 해결했고, 문제당 비용은 수백 달러였다. 성공률 약 2.5%. 뒤집어 읽으면 97.5%는 "기존 기법을 이어 붙여 닿는 거리"에 있지 않았다는 뜻이고, 이것이 아비가드의 첫 번째 답, "더 어려운 문제는 아직 많다"의 실측치다.
아키텍처 ⑤ — 에이전트 떼: 1만 개가 88시간 동안 한 일
"지치지 않는 에이전트 떼"의 가장 큰 사례는 9월 8일 OpenAI의 나비에–스토크스 발표다. 약 1만 개의 에이전트가 88시간 동안 돌아 외력이 있는 경우의 유한 시간 폭발 증명을 만들었다. 그러나 이 사례가 드러낸 것은 떼의 힘만이 아니다. 같은 문제를 1년간 팠던 트리스탄 버크마스터는 9월 7일 공개 성명에서 과정을 이렇게 적었다.
우리가 한 일은 코르도바와 마르티네스-소로아의 프로그램을 가져다 LLM의 큰 도움으로 끝까지 밀어붙인 것이다. 이 공격 경로를 가능하게 한 아이디어는 그들의 것이다. … "외력 있는"이라는 말을 들었을 때 그것은 빨간 깃발이었다. 문제 서술을 모델에 주고 며칠 만에 도달하는 방향이 아니기 때문이다.
그리고 그는 자기 결과에 대해 "제가 읽어 본 것 중 가장 끔찍한 증명"이었고 "오일러 원고는 AI 슬롭이라고밖에 부를 수 없다"고 썼다. OpenAI 쪽에서도 "매우 적은 인간 입력"이라던 설명이 통화 중에 "팀 전체가 작업했고, 더 쉬운 문제부터 시도했고, 프롬프트조차 코덱스로 썼다"로 바뀌었다고 그는 적었다. 10월 4일 타오 블로그에는 바로 그 프로그램을 연 두 사람, 코르도바와 마르티네스-소로아가 직접 쓴 해설이 실렸다.
이 에피소드는 "이어 붙이기" 진단의 가장 강력한 증거다. 떼는 누군가 열어 둔 길을 끝까지 달리는 데 압도적이다. 길을 여는 일은 아직 사람(코르도바·마르티네스-소로아)이 수년에 걸쳐 했다. 그래서 다음 질문이 자연스럽다. 2025~2026년에 AI가 냈다는 결과들은 정말 모두 '조합'이었나. 직접 분류해 보자.
5장. 두 번째 답 — 더 큰 생각을 하라
외계인이 내준 숙제가 아니다
두 번째 답은 첫 문장부터 비유로 시작한다.
수학이 외계인이 우리에게 부과한 문제들을 하나씩 지워 나가는 일, 끝없는 연습문제와 시험의 연속이었다면 지금 우리의 처지는 훨씬 더 우울했을 것이다. 좋은 소식은, 우리가 수학을 할 때 문제를 고르고, 풀이를 채점하고, 가장 마음에 드는 것을 택하는 사람이 우리 자신이라는 것이다. 무엇이 흥미로운지, 어떤 질문을 좇을지, 왜 그런지는 우리가 정한다. 우리의 운명은 우리 손에 있다.
이 문단은 벤치마크 경쟁에 대한 가장 짧은 반론이기도 하다. 벤치마크는 "외계인이 낸 문제 목록"의 가장 순수한 형태다. 문제가 미리 정해져 있고, 채점 기준도 정해져 있고, 푸는 쪽은 선택권이 없다. 그런 틀 안에서 기계가 사람을 이기는 것은 당연하다. 그러나 수학은 그 틀 바깥에서 문제 목록 자체를 만드는 일이었다는 것이다.
여기서 아비가드는 역사에서 가장 좋아하는 사례를 꺼낸다. 1853년 말, 스물일곱 살의 베른하르트 리만은 괴팅겐 대학에서 강의할 자격(Habilitation)을 얻기 위해 시범 강연을 해야 했고, 관례대로 세 가지 주제를 제출했다. 둘은 전기에 관한 것이었고 하나는 기하학의 기초에 관한 것이었다. 심사자는 일흔여섯 살의 카를 프리드리히 가우스였다. 가우스는 관례를 깨고 리만이 가장 준비가 덜 된 세 번째 주제, 기하학의 기초를 골랐다. 리만이 그것으로 무엇을 만들어 내는지 보고 싶었다는 것이다.
1854년 6월 10일에 열린 그 강연의 제목이 「기하학의 기초에 놓인 가설들에 관하여」다. 리만은 공간의 계량적 성질(거리와 각도, 즉 '얼마나 떨어져 있는가')과 위상적 성질(연결 방식, 즉 '어떻게 이어져 있는가')을 구분했고, 임의 차원의 '다양체(manifold)'라는 개념을 도입했다. 핵심은 공간의 성질을 바깥에서 보지 않고 안에서 정의한 것이다. 지구 표면이 둥글다는 것을 우주에서 내려다보지 않고도, 표면 위에서 삼각형의 내각을 재는 것만으로 알 수 있다는 식이다. 아비가드는 이 "내재적 성질"에 대한 집중이 수십 년 뒤 아인슈타인의 일반 상대성이론의 열쇠가 됐고, 리만이 상상도 못 했을 응용(로봇공학, 의료 영상, 통계 분석)으로 이어졌다고 쓴다.
강연이 끝난 뒤 가우스는 동료 물리학자 빌헬름 베버에게 "더없는 찬사와 보기 드문 열의로" 리만이 펼친 생각의 깊이를 이야기했다고 데데킨트는 전한다. 평생 남을 칭찬하는 데 인색했던 가우스에게서 나온 드문 반응이었다. 강연은 리만이 죽은 뒤인 1868년에야 데데킨트의 손으로 출판됐다. 윌리엄 이월드(William Ewald)의 사료집 『칸트에서 힐베르트까지』가 이 논문을 소개하면서 인용한 펠릭스 클라인의 회고가 글에 실려 있다.
리만 강연이 출판된 것은 내가 막 독자적으로 수학 문제에 몰두하기 시작하던 때였다. 그래서 나는 리만의 사고의 흐름이 당시 젊은 수학자들에게 준 비범한 충격을 아직도 생생히 기억한다. 많은 것이 우리에게 어둡고 이해하기 어려워 보였으나, 헤아릴 수 없이 깊었다. 반면 이 모든 것을 처음부터 자기 사고방식에 흡수한 현대 수학자는 그 서술의 명료함과 풍요로움에 감탄할 뿐이다.
아비가드가 이 인용문을 고른 이유는 마지막 문장에 있다. "젊은 클라인에게 어둡고 신비로웠던 것이 이제는 정전(canon)의 일부"가 됐고, 기초 모델은 그것을 훈련을 통해 흡수하고 내면화했다. 젊은 수학자들이 그러듯이. 모델이 리만 기하를 아는 것은 놀랍지 않다. 교과서에 있기 때문이다. 문제는 교과서에 없을 때 그것을 쓸 수 있느냐다.
"어떤 강화학습 설정도 리만의 결정을 평가할 수 없었다"
그다음 문장이 이 글에서 가장 날카로운 기술적 주장이다. 역시 밸러드의 지적이라고 밝히면서 아비가드는 쓴다.
어떤 강화학습 설정도 리만의 결정을 평가할 수 없었을 것이다. 이익은 확산적(diffuse)이고 추적하기 어려우며, 시간 지평은 너무나 길다.
4장에서 본 "최종 궤적의 성공으로만 채점한다"는 묘사와 합치면 논리가 완성된다. 1854년의 리만에게 보상을 줄 검증기는 없었다. 일반 상대성이론은 61년 뒤, 뇌 영상은 140년 뒤에 왔다. 그 사이 이익은 특정한 누군가의 '정답'이 아니라 수천 명의 사고방식에 스며드는 형태로 퍼졌다. 아래 시뮬레이터로 이 비대칭을 직접 느껴 보자.
같은 이야기를 아비가드는 세 사람으로 더 한다. 방정식의 가해성을 연구하며 치환군에 초점을 맞춘 갈루아, 동역학계를 정량적 해가 아니라 정성적으로 연구한 푸앵카레, 그리고 그로텐디크의 광범위한 개념적 혁신. 셋 다 "새로운 전망을 열어젖힌" 사례이고, 셋 다 당대에는 이상하게 보였다.
그리고 질문을 뒤집는다. "AI가 언젠가 이런 진전을 이룰 수 있을까? 그것은 올바른 질문조차 아니다."
어떤 AI 에이전트가 자기와 다른 AI 에이전트들에게 매우 흥미로운 정리들을 쏟아 내고 있다고 말해 봐야 우리에게는 아무 소용이 없다. 우리가 AI에 신경 써야 하는 것은 오직 그 결과가 우리에게 흥미롭고 중요한 한에서이며, 결국 그것이 무엇을 뜻하는지는 우리가 정한다. 우리가 수학적 발전에 매기는 가치는 우리의 역사와 문화에 묻혀 있다.
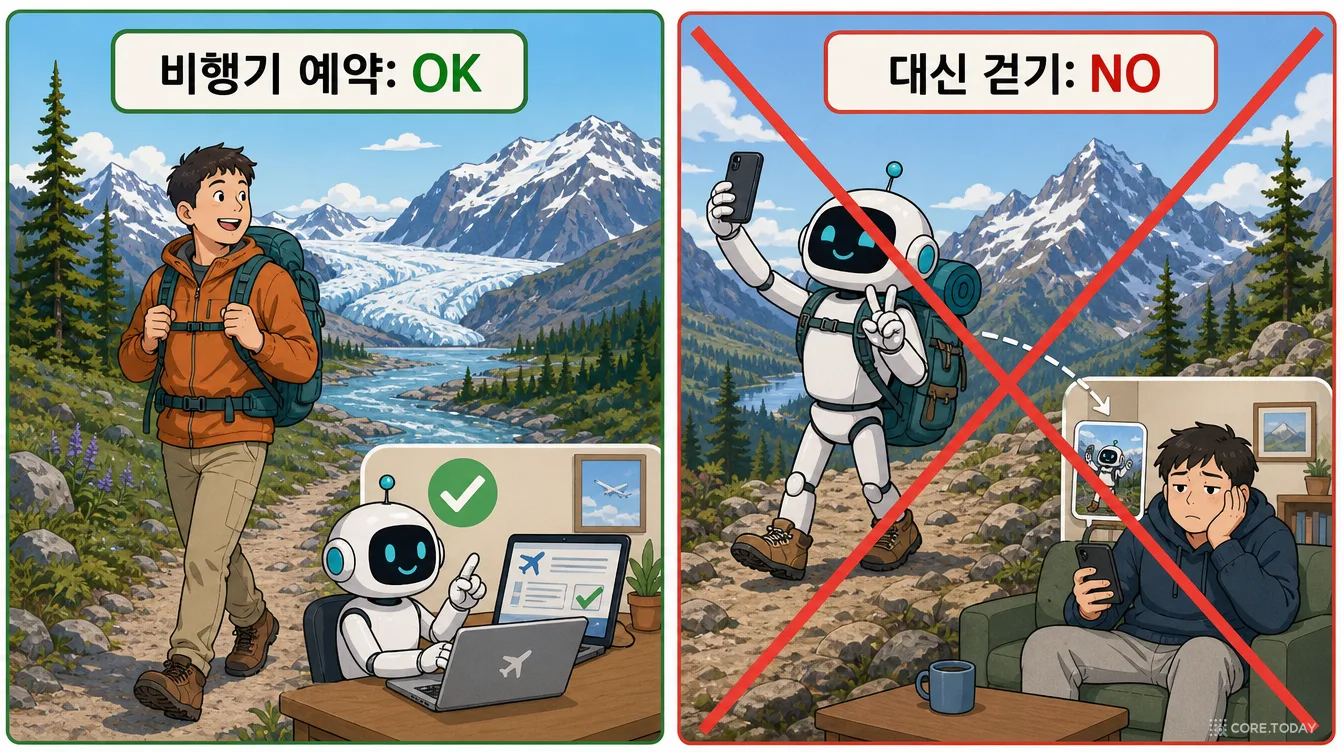
운동과 휴식을 위해 알래스카 황야로 배낭여행을 계획한다고 상상해 보라. 비행기 예약은 AI에게 기꺼이 맡기겠지만, AI가 대신 하이킹을 하고 사진을 보내 주게 하지는 않을 것이다. 수학에서 걸린 것은 우리의 여가가 아니라 우리의 추론과 숙의에 대한 주체성(agency)이다. AI가 생각할 수 있든 없든, AI가 우리를 대신해 생각할 수는 없다. 우리에게는 우리의 삶이 있다. 수학은 우리가 들려줄 이야기이고, 어떻게 들려줄지는 우리가 정한다.
비유의 힘은 "AI가 생각할 수 있는가"라는 끝없는 논쟁을 비껴간다는 데 있다. 그 질문에 어느 쪽으로 답하든, "대신 걷기"는 여행의 목적을 지워 버린다. 그렇다면 수학 연구에서 무엇이 '비행기 예약'이고 무엇이 '하이킹'인가. 아래에서 직접 분류해 보고 글의 기준과 비교해 보자.
6장. 세 번째 답 — 새로운 것을 시도하라
"기술 자체가 새 질문을 낳는다"
앞의 두 답이 "AI로 우리가 하던 일을 더 잘하기"에 관한 것이었다면, 세 번째 답은 방향이 다르다. 기술 자체가 새로운 질문을 낳고, 우리는 아직 그것을 효과적으로 쓰는 법을 거의 모른다는 것이다. 아비가드는 다른 글(arXiv 2608.23218, 미국수학회 소식지 Notices of the AMS 게재 예정)에서 수학자들이 이 기술이 어떻게 작동하는지 이해하는 데 적극 참여하고, 그것으로 새로운 수학을 하는 새롭고 창의적인 방법을 궁리해야 한다고 주장했다고 밝힌다(그 글의 내용은 이 장 뒤에서 따로 본다).
그리고 역사로 돌아간다. 이번엔 리만 한 사람이 아니라, 수학이 "낯설고 불편한" 새 기술을 받아들인 다섯 번의 순간이다.
17세기에 기하 문제를 푸는 데 대수적 방법을 쓴 것은 새로운 기술이었고, 모두가 좋아하지는 않았다. 그러나 우리는 새 기법을 익혔고 그것을 큰 효과를 내도록 쓰는 법을 배웠다. 그 세기 후반의 무한소, 19세기의 대수 구조, 20세기 초의 집합론적 추상과 구조적 언어, 그리고 더 최근의 수치·기호 계산도 마찬가지다. 이것들은 모두 처음 나왔을 때 낯설고 불안했다.
증명 보조기와 신경망이 새 수학을 발견하는 데 도움이 되게 만드는 데 시간과 에너지를 쏟는 사람들을, 단순한 기술자로 치부할 것이 아니라 수학 그 자체를 하는 사람으로 봐야 한다. AI 시대에는 기호 자동화를 개발하거나 신경망을 훈련하는 일이, 정리를 증명하기 위해 손으로 추론을 이어 붙이는 일 못지않은 수학적 기여일 수 있다.
이 문장은 글쓴이의 이력을 알면 다르게 읽힌다. 아비가드는 Lean의 수학 라이브러리 mathlib 초창기부터 그 '기술자' 일을 해 온 사람이다(2장). 수십 년간 "그건 수학이 아니라 프로그래밍"이라는 말을 들어 온 사람이, 수학계 전체가 흔들리는 순간에 "그것도 수학"이라고 쓰는 것이다.
마지막 문단은 현실적인 반론에 답한다. 일자리가 줄어드는데 전통적 수학 기술을 지키기 위해 안으로 돌아서야 하지 않느냐는 주장이다. 아비가드는 정반대라고 말한다.
새 기술과 씨름하고 그것으로 추론하고 새 수학을 발견하는 능력을 키우는 법을 배우는 것이 학문을 강하게 지킬 것이다. 수학에 대한 시각을 넓히는 것이 직업을 넓히고 적실성을 유지하는 최선의 길이다.
함께 읽기 — 「수학은 지금 무엇이고, 무엇이어야 하는가」
세 번째 답이 가리키는 "다른 글"은 2026년 8월 24일 arXiv에 올라온 6쪽짜리 에세이다. 제목부터 역사다. 1888년 데데킨트가 쓴 「수란 무엇이고 무엇이어야 하는가(Was sind und was sollen die Zahlen?)」를 비튼 것이다. 데데킨트는 그 글에서 자연수를 공리로 규정하고, 공리를 만족하는 체계는 모두 동형이므로 "수가 무엇인지는 중요하지 않다, 공리를 만족하는 것이면 무엇이든 수로 삼을 수 있다"고 답했다. 당시 베를린 학파(크로네커·바이어슈트라스)에게 이것은 수학을 '빈 추상'으로 만드는 위험한 사고였다. 아비가드는 같은 질문 형식을 2026년에 다시 던진다.
글의 구조는 여섯 절이다.
절
핵심 주장
기억할 문장
1. AI에 대한 걱정
일자리보다 "수학을 하는 경험(현상학)"이 바뀌는 것을 사람들이 더 두려워한다. 샤워 중에, 커피 줄에서, 칠판 앞에서 문제에 빠져드는 순간을 AI가 빼앗는다는 것
"ChatGPT가 몇 초 만에 답을 주는데 질문과 씨름할 동기를 찾기는 어렵다." 수학-AI 연구자 이규환(Kyu-Hwan Lee)이 워크숍 폐회사에서 "사랑에 빠졌던 과목이 바뀌는 데 적응하는 감정적 어려움"을 개인적으로 털어놓았다는 일화
2. 역사적 관점
19세기 말~20세기 초 추상적 방법으로의 전환도 "독설이 오가는" 논쟁이었다. 1964년 카를 루트비히 지겔이 모르델에게 보낸 편지가 그 증거
지겔: "아름다운 정원에 돼지가 들어와 꽃과 나무를 다 파헤치는 것을 본다. … 의미 없는 추상화 — 나는 그것을 '빈 집합의 이론'이라 부른다 — 를 막지 못하면 수학은 금세기 안에 망할 것이다." 아비가드: "이제 우리 모두 그들에게 공감할 위치에 있다. 수학이 낯설고 이상한 것이 되는 걸 보는 일은 쉽지 않다."
3. '수학을 위한 AI'란 무엇인가
신경 증명기의 성공이 다른 모든 것을 밀어내고 있다. 형식화·디지털 라이브러리·SAT/SMT 솔버·기호 최적화·패턴 발견·PDE 해 계산 등 훨씬 넓은 영역이 '수학을 위한 AI'다
"빅테크가 LLM으로 유명 추측을 최대한 많이 해결하려는 전력 질주, 수학자들이 이야기하는 건 그것뿐이다. 그게 방 안의 공기를 다 빨아들이고 있다." "우리가 이 새 길을 탐험하지 않으면 아무도 하지 않을 것이다."
4. 수학적 가치
AI는 기술일 뿐이며 경쟁 상대가 아니다. 진짜 대체의 위험은 다른 곳에 있다: 과학·공학·산업이 이해를 위해 수학 대신 AI를 찾게 되는 것
"차를 몰 때 우리는 누가 더 빠른지 경쟁하지 않는다." 다익스트라 인용: "컴퓨터가 생각할 수 있느냐는 질문은 잠수함이 헤엄칠 수 있느냐는 질문만큼 흥미롭지 않다." "수학이 줄 수 있는 조언이 'ChatGPT에 의지하라'뿐이라면 수학의 중요성은 줄어들 것이다."
5. 도전
형식 라이브러리를 만들고, 신경망을 튜닝하고, SAT 인코딩을 실험하는 젊은 연구자들을 수학계는 "수학이 아니다"라며 밀어냈다. 그들은 빅테크로 떠났다
"우리 학문은 그들에게 친절하지 않았다. … 인정하고 싶지 않겠지만, 우리가 그들을 필요로 하는 것이 그들이 우리를 필요로 하는 것보다 크다."
6. 미래
모든 수학자가 기계학습 전문가가 될 필요는 없지만, 박사과정이 대수·해석·기하를 요구하듯 계산 추론 도구의 기본 역량을 요구해야 한다. 소비자가 아니라 기여자가 되어야
"첫걸음은 어떻게 거기 갈지가 아니라 우리가 수학이 무엇이기를 바라는지에 대한 더 명확한 합의에 이르는 것이다."
10월 5일의 짧은 글과 8월의 긴 글을 겹쳐 읽으면 세 번째 답의 날이 선다. 블로그 글의 "새로운 것을 시도하라"는 교양 있는 권유처럼 들린다. 에세이의 같은 주장은 고발에 가깝다. 수학계가 자기 손으로 Lean·SAT·신경망을 다루는 젊은이들을 "기술자"로 분류해 내보냈고, 그 결과 AI 시대의 수학을 바깥 기업이 정의하게 됐다는 것이다. "우리가 그들을 더 필요로 한다"는 문장은 10월 글의 "우리는 당신들과 함께 선다"의 쓴 버전이다.
미래에 대한 나의 장밋빛 전망과, '더 어려운 문제를 풀고 더 큰 생각을 하고 새로운 것을 시도하라'는 가벼운 조언은, 발밑의 땅이 움직이는 것을 느끼는 학생과 초기 경력 연구자에게 별 위안이 되지 않을 것이다.
"rosy(장밋빛)"와 "glib(입만 번지르르한)"은 자기 글에 쓰기엔 가혹한 형용사다. 그는 이것이 도전을 축소하거나 쉬운 답을 제시하려는 것이 아니라고 덧붙이고, 지금 수학과·학회·학술지 편집위원회가 "곳곳에서 긴급 회의를 열고" 있다고 쓴다. 바깥에서 보기에 수학계가 평온해 보인다면, 그것은 평온해서가 아니라 회의실 안에 있어서라는 뜻이다.
그러고 나서 다음 세대에게 세 가지 메시지를 보낸다.
첫째
"우리는 당신들과 함께 선다." 학문의 건강과 다음 세대가 번영하는 것보다 중요한 일은 없다. 우리의 경험과 전문성이 제한돼 있고, 우리가 알고 있다고 생각했던 것 중 일부가 더는 유효하지 않다는 것을 인정할 겸손이 있다.
둘째
"수학은 지금도 그 어느 때 못지않게 중요하고, 우리는 당신들이 필요하다." AI가 우리의 집단적 추론·숙의 능력을 대체해서는 안 되며, 수학은 그 능력의 핵심이다.
셋째
"앞으로 몇 년은 극도로 흥미로울 것이다." 공동체의 규범·가치·기대가 무너지기 시작한 새 변경(frontier)에 서 있고, 그것을 무엇으로 대체할지 정하는 것은 우리 모두의 몫이다. 미래의 역사가는 이 순간을 수학의 새 시대의 시작으로 볼 것이다.
마지막 문장은 이렇다. "수학은 한 번도 심약한 사람을 위한 것이었던 적이 없다. 이것은 함께 도전에 맞서 기회를 살릴 우리의 기회다."
두 가지가 눈에 띈다. 하나는 이 글의 수신인이 바뀌었다는 점이다. 앞 절까지는 동료 수학자와 바깥 세상이 독자였다면, 이 절은 분명히 대학원생과 포스닥을 향해 쓰였다. 타오의 블로그가 9월 한 달간 "우리는 수학자가 훨씬 더 많이 필요하다"(사하이), "왜 인간 수학자가 아직 필요한가" 같은 글을 잇달아 실은 것과 같은 흐름이다. 다른 하나는 "첫째" 메시지의 겸손이다. 자기 분야에서 세계 최고인 사람들이 "우리가 알고 있다고 생각했던 것 중 일부가 더는 유효하지 않다"고 공개적으로 쓰는 일은 드물다. 이 문장이 이 글이 화제가 된 이유의 절반이다. 나머지 절반은 그 겸손이 체념이 아니라 "함께 선다"는 약속으로 끝난다는 데 있다.
8장. 반론 — 댓글창 23개의 목소리
타오의 블로그 댓글은 수학계의 가장 솔직한 여론 조사다. 아비가드의 글에는 사흘 동안 23개의 댓글이 달렸다. 9월 11일 선언문의 수백 개에 비하면 조용하지만, 밀도는 높다. 반론을 유형별로 정리하면 다섯 갈래다.
① "이어 붙여 푸는 시스템이 왜 더 어려운 문제를 풀 것이라 기대하는가"
가장 논리적인 반론이다. 아나톨 베그너(Anatol Wegner)는 글의 세 답을 하나씩 뒤집는다. 현재 시스템이 "기존 기법을 이어 붙여" 푼다면 그것이 훨씬 더 어려운 문제를 풀게 해 줄 이유가 없고, 리만식 "더 큰 생각"은 현 시스템으로 원리적으로도 가능하다고 믿을 근거가 없으며, "새로운 시도"는 어떤 계산 도구에나 해당하는 말이지 AI만 특별할 이유가 없다는 것이다. 남는 것은 "AI가 수학을 더 빠르고 효율적으로 하게 해 준다"는 주장뿐인데, 수학에서 속도의 가치는 의심스럽고, 모델을 훈련하고 돌리는 데 들어가는 자원(수학 박사들의 시간 포함)을 생각하면 효율도 의심스럽다고 그는 쓴다. 더 뼈아픈 지적은 그다음이다.
수학자들이 이 기술을 이해하고 발전시키는 데 참여하라는 요청은 환영한다. 그러나 지금 수학자들은 불가능한 처지에 있다. 최근 결과를 낸 모델과 방법, 거기 들어간 인간 입력의 수준에 대해 아무 정보도 받지 못한다. 대신 불투명한 기업 발표를 받아들이라는 요구를 받는다. 다른 어떤 과학에서 공개되지 않은 실험 장치의 능력 주장을 맹목적으로 받아들이겠는가.
이 반론은 아비가드 자신의 8월 에세이가 "우리가 기술이 어떻게 작동하는지 이해해야 한다"고 한 것과 충돌하지 않는다. 오히려 그 요구가 현재 조건에서는 실행 불가능하다는 지적이다. 9월 29일 AGMAI 권고안이 "내부 전용 모델로 수학 연구를 하면 2층 체계가 생긴다"며 AI 기업에 "공동체가 접근할 수 없는 모델로 어려운 문제를 시험하는 일을 중단하라"고 한 것이 같은 문제의식이다.
② "장밋빛 그림, 그리고 '함께 선다'는 말의 진정성"
익명의 한 댓글은 가장 날카로운 어조로 쓴다. "또 하나의 기성 수학자가 AI가 자기 좋아하는 문제를 푸는 데 도움이 된다는 장밋빛 그림을 그리면서, 가장 심각한 우려에는 입에 발린 말 이상으로 관여하지 않는 글." 이 댓글은 AI를 기업과 분리해서 볼 수 없다며 "당신들은 경력이 확립됐고 AI 기업이 접근권을 기꺼이 주기 때문에 보호받는 것"이라고 쓴다. 글 끝에는 "[이 댓글은 LLM과 전혀 상호작용하지 않고 썼다]"는 표시가 붙었다. 2026년 가을 수학계 글쓰기의 새 관습이다.
또 다른 익명 댓글은 아비가드가 8월에 공저한 논문을 끌어온다. 「문제가 문제다: 확장 가능한 수학적 발견을 향해」. 이 논문은 FAR(Find, Attempt, Recommend)라는 파이프라인을 제안한다. 조합론 논문 5,245편에서 미해결 추측 후보 6,453개를 자동으로 찾아내고(Find), 그중 잘 정의되고 아직 열려 있는 4,717개를 AI로 시도하고(Attempt), 출판할 만하다고 자동 평가된 77개를 전문가 검토에 올려(Recommend) 15개가 맞는 것으로 확인됐다는 것이다. 댓글은 묻는다. "'우리는 당신들과 함께 선다'고 하면서 실제로는 우리를 없애는 일을 하고 있는 것 아닌가?" 이것은 이 글이 받은 가장 아픈 질문이고, 아비가드의 입장에서 답하자면 FAR는 그가 말한 "새로운 것을 시도하라"의 실천이다. 희소한 전문가 검토를 어디에 쓸지 자동화로 정하는 일 말이다. 그러나 두 글을 나란히 놓으면, '함께 선다'는 약속이 무엇을 함께 하자는 것인지가 아직 비어 있다는 점은 분명하다.
③ "비행기 예약과 하이킹의 비유는 틀렸다"
맥길 대학에서 정수론으로 박사 학위를 받고 수학을 떠났다는 jpolak은 알래스카 비유를 정면으로 공격한다. "수학계가 학문적 '공로'를 배분하는 방식에서는 당신이 멋진 수학적 여정을 하고 아름다운 것을 배웠는지 아무도 신경 쓰지 않는다. 결과, 더 많은 추상, 더 많은 일반화, 출판물만 본다." 그러니 하이킹을 직접 하라는 말은 개인의 즐거움에는 맞을지 몰라도 제도의 보상 구조와는 무관하다는 것이다. 그는 비유를 하나 더 보탠다. 사람 동료 대신 AI 로봇을 데리고 하이킹을 가면 다리가 부러졌을 때는 더 잘 도와주겠지만, "새로운 공동체가 형성되는 일"이 사라진다고. 그리고 이렇게 끝맺는다. "미래가 이럴 줄 알았으면 수학 박사를 하지 않았을 것이다."
이 반론은 중요하다. 아비가드의 글은 "우리가 문제를 고르고 채점한다"고 하지만, 실제로 채점하는 것은 학술지와 임용위원회이고, 그들이 2026년에도 "결과"를 센다면 리만식 '큰 생각'은 보상받지 못한다. 글 안에서 이 간극을 메우는 문장은 없다. 9월 25일 크라·워드의 박사 교육 권고안(구술 평가, AI 사용 공개, 논문보다 디펜스)이 그 빈칸을 채우려는 첫 시도다.
④ "이해는 아웃소싱할 수 없다 — 그런데 수학계가 이해를 중시하긴 했나"
첫 댓글은 안드레이 카르파티의 말 한 줄이다. "생각은 아웃소싱할 수 있지만 이해는 못 한다." 이 짧은 문장이 작은 토론을 낳았다. "이해의 수학적 정의가 뭐냐"는 반문, "4색 정리나 케플러 추측의 증명을 진정으로 이해하는 수학자가 몇이나 되냐, 증명과 이해의 분리는 AI 전부터 문제였다"는 지적, 그리고 "그렇다고 AI로 그 문제를 더 키워야 하느냐"는 재반박. jpolak은 여기서도 냉소적이다. "학술지에 논문이 실릴 때 그들이 내가 그것을 이해했는지 신경 썼나? 아니다. 명료하고 옳고 새로운지만 봤다."
한 익명 댓글이 이전 글에서 본 문장을 옮겨 적었다. "모치즈키의 문제는 모치즈키를 무시하면 된다는 것이다. LLM의 문제는 백만 명의 모치즈키를 만들어 이해할 수 없는 논문으로 수학을 범람시켜 세상이 그것을 무시할 수 없게 만든다는 것이다." 10월 1일 arXiv가 월 2편 제한을 건 이유를 이보다 잘 요약한 문장은 없다.
⑤ 다른 결의 목소리들
모두가 비판은 아니다. 아르헨티나 코르도바 국립대학의 논리학자 페드로 산체스 테라프는 자기 블로그에서 비슷한 "DNA" 아이디어에 이르렀다며 반가워했다. "사티아"라는 댓글은 컴퓨터과학과 수학이 다시 합쳐지는 것을 환영하며 "다른 시대에는 다른 재능이 빛난다. 일부 대학원생에게는 기회의 시대"라고 썼다. 그리고 그는 "마지막 논문에 AI를 안 썼다는 증거로 관사가 빠진 문장을 일부러 남겼다"고 덧붙였다. 한 댓글은 OpenAI가 8월에 발표한 콘(Connes) 강성 추측 '반증'이 추측의 전제를 만족하지 않는 군을 만든 것이었다는 J. L. 닐슨의 분석을 인용하며 "수학은 100% 확실성이 필요한데 AI의 작업은 때로 확실하지 않다"고 썼다. 한 자바 개발자는 "프레임워크만 쓰고 설계를 이해 못 해 한 줄씩 디버깅만 하던 동료들"이 떠오른다고 했다.
종합하면 댓글창의 합의는 이렇다. 아비가드의 진단(이어 붙이기, 신용 할당의 한계)에는 거의 이견이 없다. 처방(세 동사)이 제도와 권력의 현실을 비껴간다는 데 비판이 모인다. 그리고 그 비판의 상당 부분은 아비가드 자신이 8월 에세이에서 더 거칠게 한 말들이다.
9장. 2026년, 이 글의 자리 — 숫자와 한국
숫자로 보는 2026년 10월
지표
2026년 10월 기준
글과의 연결
AI가 공개한 미해결 문제 풀이
OpenAI 내부 모델 372개(원고 722편, Lean 형식화 포함), AlphaProof Nexus 9/353(Erdős)
"1년 전이면 훌륭한 논문감"이 수백 편 단위로 쏟아진다는 첫 문단의 실체
Erdős 문제 데이터베이스
문제 1,221개, 댓글 9천 개 이상, 등록 사용자 약 2천 명, 하루 방문 1만~2만 5천
10월 6일부터 해결 주장 접수 중단, 공로 표기 삭제
arXiv
10월 1일 발표: 1인당 월 2편 제한
"백만 명의 모치즈키" 문제에 대한 첫 제도적 대응
경시 수학 벤치마크
IMO 2026에서 화웨이 Celia, 샤오훙수 dots-note-3.0이 공식 채점으로 42/42 만점. 연구 수준 벤치마크 FrontierMath 4단계는 집계 사이트 기준 최상위 모델이 80~90%대(공식 수치는 아님)
"외계인이 낸 문제 목록"은 사실상 포화됐다. 2장의 벤치마크 비판이 가리키는 현실
형식 수학 인프라
mathlib 정리 약 28만 개·200만 줄, Lean 2025년 12회 릴리스·대학 강의 50곳 이상, Lean FRO 2025년 신규 기금 1천만 달러(알렉스 거코, mathlib 500만 + 차세대 UX 500만)
"기호 자동화 개발도 수학적 기여"가 이미 산업 규모라는 증거
훈련 비용의 비대칭
DeepSeek-R1 RL 단계 약 29만 달러 vs AlphaProof RL TPU 8만 일, OpenAI 나비에–스토크스 추정 수백억 원
베그너의 "효율성 주장은 유지하기 어렵다"는 반론의 근거
한국에서 읽기
한국 언론은 9월 9일 OpenAI 발표를 "90년 수학 난제, AI가 88시간 만에 풀었다"(SBS Biz·머니투데이)로 전했고, 바이라인네트워크는 버크마스터의 "딥블루–카스파로프의 순간"을 인용했다. 일주일 뒤 오마이뉴스는 "인공지능이 나비에–스토크스 방정식을 풀었다는 거짓말"이라는 제목으로 "일반 풀이를 AI가 찾아낸 것이 절대 아니"며, 연구원들이 에이전트 그룹 사이에서 중간 수식을 수집해 다른 그룹에 "힌트로 강제 주입"했다는 과정을 비판적으로 짚었다. 두 기사 사이의 거리가 이 글이 다루는 "문제 풀기와 이해의 분리" 그 자체다. 다만 아비가드의 글이나 10월 첫 주의 제도 변화를 다룬 한국어 기사는 아직 찾지 못했다. 한국 수학계 차원의 공식 입장도 확인되지 않는다.
한편 7월 상하이 IMO 2026에서 한국 대표 이현준 학생이 42점 만점으로 전체 1위를 했고, 변서진·심성진 학생도 금메달을 받았다. 같은 대회에서 AI 두 개가 공식 채점으로 만점을 받았다. 아비가드의 글은 이 두 사실을 함께 읽으라고 말하는 글이다. 경시 문제를 AI가 만점 받는 것은 "외계인이 낸 문제 목록"에서의 승리이고, 열여덟 살이 같은 점수를 받는 것은 그 학생이 앞으로 어떤 문제를 고를 사람이 될지의 시작이다. 전자가 후자를 무의미하게 만들지 않는다.
한국 독자에게 이 글이 특히 와닿는 지점이 둘 있다. 하나는 "일자리가 줄어드니 안으로 돌아서자"는 주장에 대한 아비가드의 반대다. 수학과 정원이 줄고 의대 쏠림이 심한 한국 대학에서 "전통적 수학 기술을 지키자"는 처방은 매력적이다. 그러나 8월 에세이가 보여 주듯 그 처방의 결과는 Lean·SAT·신경망을 다루는 학생들이 수학과를 떠나 컴퓨터과학과 기업으로 가는 것이었다. 다른 하나는 "기술자가 아니라 수학자"라는 문장이다. 한국의 산업 현장에서 수학 전공자는 흔히 '모델 돌리는 사람'으로 분류된다. 아비가드는 그 분류 자체를 뒤집자고 말한다. 신경망을 길들이는 일이 정리를 증명하는 일과 같은 종류의 지적 기여라면, 그 일을 하는 사람을 부르는 이름도 바뀌어야 한다.
실무자의 체크리스트 — 세 동사를 내 일에 옮기면
①
더 어려운 문제를 풀어라 → "기존 기법의 조합으로 풀리는 일"을 먼저 목록화하라
내 팀의 일 중 "문헌에 있는 방법 A와 B를 결합하면 되는" 일은 이제 희소하지 않다. 그 일을 AI와 에이전트에 넘기는 것은 패배가 아니라 아비가드의 '비행기 예약'이다. 대신 "어떤 기법이 필요한지 아무도 모르는" 문제가 무엇인지 적어 보라. 그것이 남는 일이다.
②
더 큰 생각을 하라 → 보상이 늦게 오는 결정을 보호하라
결과로만 채점하는 시스템(KPI든 RL이든)은 1854년의 리만을 0점 처리한다. 조직에 "지평이 긴 결정"을 평가하는 별도의 눈이 있는지 보라. 가우스가 그 눈이었다. 사람의 안목을 대체할 결과 보상은 아직 없다.
③
새로운 것을 시도하라 → 도구를 만지는 사람을 '기술자'로 부르지 마라
증명 보조기·에이전트 파이프라인·평가 벤치마크를 만드는 사람이 조직에서 어떤 직함과 평가를 받는지 보라. 아비가드의 진단이 맞다면, 그들을 밀어낸 조직은 자기 분야의 미래를 바깥 기업이 정의하게 둔 수학계와 같은 길을 간다.
마지막으로, 글의 네 번째 메시지에 해당하는 것 하나. 다음 세대에게 무엇이라고 말할 것인가. 아비가드의 답은 "우리는 모른다, 그러나 함께 선다"였다. 이것은 리더가 할 수 있는 가장 어려운 말 중 하나이고, 2026년 가을에 수학계가 그 말을 공개적으로 한 첫 글이 이것이다.
용어 사전
결과 보상(outcome reward) — 답의 최종 결과(정답 여부, 테스트 통과, Lean 커널 승인)만으로 1/0을 주는 보상. 중간 과정은 채점하지 않는다. 반대는 과정 보상(process reward).
RLVR(검증 가능한 보상을 이용한 강화학습) — 사람 선호 모델 대신 규칙·검증기가 주는 보상으로 언어 모델을 훈련하는 방식. Tülu 3(2024.11)가 이름을 붙였고 DeepSeek-R1(2025.1)로 널리 알려졌다.
GRPO — DeepSeek가 제안한 RL 알고리즘. 같은 문제의 답 여러 개를 뽑아 평균 대비 상대 점수로 '이득'을 계산하고, 가치 모델을 쓰지 않는다.
신용 할당 문제(credit assignment problem) — 긴 결정 사슬 끝에 온 성공·실패의 공을 각 결정에 어떻게 나눌 것인가. 민스키(1961)가 명명했다.
pass@k — 답을 k번 뽑았을 때 하나라도 맞는 비율. k가 클 때 RL 모델이 기반 모델에 뒤지는 현상이 "RL은 새 능력을 만들지 않고 있는 능력을 자주 뽑게 할 뿐"이라는 주장의 근거다.
Lean / mathlib — 증명 보조기(프로그래밍 언어이기도 함)와 그 위에 공동체가 쌓은 수학 라이브러리. 증명을 기계가 한 줄씩 검사한다.
자동 형식화(autoformalization) — 자연어 수학 문장을 Lean 같은 형식 언어로 자동 번역하는 일. AlphaProof는 이것으로 8천만 개의 훈련 문제를 만들었다.
테스트 시점 RL(TTRL) — 풀어야 할 문제의 변형들을 즉석에서 만들어 그 자리에서 다시 학습하는 AlphaProof의 기법. 문제당 2~3일.
FRO(집중 연구 조직) — 컨버전트 리서치가 만드는, 기한이 있고 공공재(도구·데이터)를 목표로 하는 비영리 연구 조직. Lean FRO가 한 예.
다양체(manifold) — 국소적으로는 평평한 공간처럼 보이지만 전체적으로는 휘어 있을 수 있는 공간. 리만이 1854년 강연에서 도입했다.
내재적 성질(intrinsic property) — 공간을 더 큰 공간에 넣지 않고 그 안에서 재는 것만으로 정해지는 성질. 일반 상대성이론의 수학적 기반.
AGMAI — 수학과 인공지능 자문 그룹. 2026년 9월 21일 출범한 9인의 독립 자문 기구(가워스·헤어러·위튼 등).
마치며 — 지도의 끝에서
이 글의 표지 그림은 오래된 지도다. 알려진 수학의 땅에는 길과 도시가 빽빽이 그려져 있고, 작은 기계들이 그 위를 날며 빈칸을 메운다. 지도의 오른쪽 끝은 아직 비어 있고, 등불을 든 사람 하나가 거기 서서 새 선을 긋는다.
아비가드의 글은 그 사람에게 쓴 글이다. 기계들이 메우는 빈칸은 한때 당신의 논문이었다. 그것을 인정하자. 그러나 지도의 끝은 여전히 있고, 거기서 어느 쪽으로 선을 그을지는 지도를 읽는 사람만 정할 수 있다. 1854년 괴팅겐에서 가우스가 리만에게 가장 준비 안 된 주제를 골라 준 것은, 그 끝에서 무엇이 나오는지 보고 싶어서였다. 어떤 채점기도 그날 리만에게 점수를 주지 못했을 것이다. 가우스는 주었다.
"수학은 한 번도 심약한 사람을 위한 것이었던 적이 없다." 10월 5일, 한 논리학자가 그렇게 썼다. 다음 날 Erdős 사이트는 색 표시를 지웠고, Hexagon은 문을 열었고, 그다음 날 372개의 풀이가 쏟아졌다. 흥미로운 시대다. 저주인지 축복인지는, 글의 마지막 문장대로, 아직 우리 손에 있다.
Leonardo de Moura, The State of Lean — Lean Together 2026 발표 (2026.1)
역사
Howard Stein, "Logos, Logic, and Logistiké: Some Philosophical Remarks on Nineteenth-Century Transformation of Mathematics", in Aspray & Kitcher (eds.), History and Philosophy of Modern Mathematics, 1988