글·사진·소리·영상을 하나의 좌표로 — 내 폰 안에서 도는 740M 임베딩 모델, EmbeddingGemma 2 특집
2026년 10월 6일 구글 딥마인드가 공개한 EmbeddingGemma 2는 텍스트·코드·이미지·비디오·오디오를 하나의 768차원 공간에 놓는 7억 4천만 파라미터짜리 공개 임베딩 모델입니다. 텍스트만 쓰면 191MB, 전부 켜도 567MB로 스마트폰 안에서 돌고, 음성 메모로 영상을 찾고 사진으로 문서를 찾는 일이 서버 없이 가능해집니다. 이 글은 '단어는 친구를 보면 안다'는 1950년대 가설에서 word2vec의 왕−남자+여자=여왕, SBERT의 65시간→5초, CLIP의 N×N 행렬, ImageBind와 Gemini Embedding 2까지 임베딩이 걸어온 길을 되짚고, EmbeddingGemma 2의 모듈 구조·토큰 예산·마트료시카 절단·양자화를 논문 그림과 표로 뜯어봅니다. 구글이 비교하지 않은 경쟁 모델, 해커뉴스의 반론, 한국의 망분리·KURE, 그리고 단일 벡터의 이론적 한계까지 함께 다룹니다. 위젯 5개와 일러스트 9장.
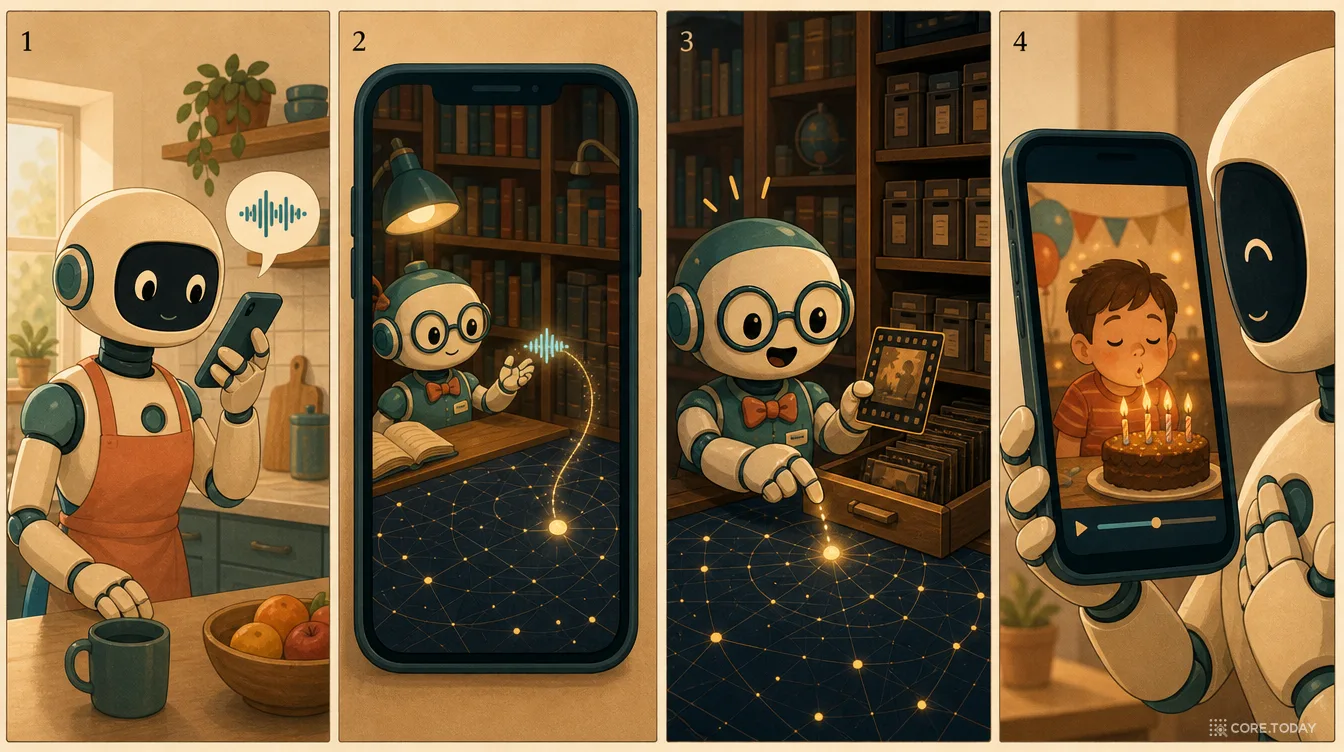
주방에서 설거지를 하다가 문득 생각이 납니다. "작년 생일에 아이가 촛불 끄던 영상, 어디 있더라." 손이 젖어 있으니 폰에 대고 말합니다. "작년 생일 촛불 끄는 거." 폰은 그 말을 글로 받아 적지 않습니다. 녹음된 소리를 그대로 숫자 768개로 바꾸고, 사진첩에 있는 수만 개 파일이 저마다 가진 숫자 768개와 거리를 잽니다. 가장 가까운 곳에 그 영상이 있습니다. 통신은 한 번도 일어나지 않았고, 음성이 서버로 간 적도 없습니다.
2026년 10월 6일 구글 딥마인드가 공개한 EmbeddingGemma 2가 하려는 일이 이것입니다. 발표문의 첫 문장은 이렇습니다. "EmbeddingGemma 2는 온디바이스 멀티모달 임베딩을 위한 가장 유능한 모델로, 텍스트·이미지·오디오·비디오의 조합을 하나의 통합된 임베딩 공간에 자연스럽게 매핑합니다."
이 발표가 화제가 된 이유는 셋입니다. 첫째, 1세대 EmbeddingGemma는 텍스트만 다뤘는데 2,000만 번 넘게 내려받혔습니다. 둘째, 2세대는 7억 4천만 파라미터로 다섯 가지 입력을 받으면서도 Pixel 11 Pro에서 텍스트만 쓰면 약 191MB, 전부 켜도 약 567MB의 메모리로 돕니다. 셋째, 라이선스가 Apache 2.0이고 다운로드에 약관 동의 게이트가 없습니다. 해커뉴스 토론은 하루 만에 400점을 넘겼고, 독립 개발자 사이먼 윌리슨은 "임베딩 모델만큼은 폐쇄형·호스팅 전용 모델을 쓰는 것이 말이 안 된다"는 글을 썼습니다. 벤더가 모델을 은퇴시키면 쌓아 둔 벡터 전부를 다시 만들어야 하기 때문입니다.
이 글은 이 모델을 소개하는 데서 그치지 않습니다. "임베딩"이라는 말이 1950년대 언어학에서 어떻게 출발해 2013년 단어 벡터, 2019년 문장 벡터, 2021년 이미지-텍스트 공동 공간을 거쳐 2026년 다섯 모달리티의 통합 공간까지 왔는지, 각 단계의 논문 그림을 직접 보면서 따라갑니다. 그다음 EmbeddingGemma 2의 구조를 표 단위로 뜯고, 구글이 보여 주지 않은 비교와 반론, 한국의 조건, 그리고 단일 벡터 검색의 이론적 한계까지 짚습니다.
✅
바쁜 분을 위한 요약.
① 임베딩은 "의미가 비슷하면 숫자 벡터도 가깝다"는 약속입니다. 검색·추천·분류·RAG가 전부 이 약속 위에 서 있습니다.
② EmbeddingGemma 2는 텍스트 코어 270M에 비전 인코더 170M, 오디오 인코더 300M을 선택해 붙이는 모듈 구조입니다. 다섯 입력이 같은 768차원 공간에 놓입니다.
③ 8,192토큰 창을 모달리티가 나눠 씁니다. 이미지 1장 280토큰(최대 29장), 비디오 프레임 140토큰(최대 58장), 오디오 1초 25토큰(최대 5.5분).
④ 마트료시카 학습으로 768차원을 512·256·128로 잘라 써도 됩니다. 256에서 텍스트·코드는 거의 그대로이고, 128에서 멀티모달은 눈에 띄게 떨어집니다.
⑤ 1세대 대비 코드 검색은 +9.92점(78.68), 다국어 텍스트는 +0.21점(61.36), 영어는 −1.21점(68.46)입니다. 이미지·오디오·비디오는 1세대에 없던 기능입니다.
⑥ 구글은 경쟁 모델과의 직접 비교표를 내지 않았습니다. 2B급 Qwen3-VL-Embedding은 MMEB에서 73.2, EmbeddingGemma 2는 59.01입니다. 크기 대비 효율이 핵심이지 절대 1위가 아닙니다.
⑦ 기술 보고서는 아직 없습니다. 레시피는 1세대 논문(인코더-디코더 초기화, Gemini Embedding 증류, 스프레드아웃 정규화, 모델 수핑, 양자화 인지 학습)에서 유추할 수밖에 없습니다.
⑧ 2026년의 의미: 클라우드 임베딩 API로 영상 1시간을 벡터화하면 약 6달러가 들지만 폰에서는 0원입니다. 망분리·의료·법률처럼 데이터가 밖으로 못 나가는 곳에서 "검색 가능한 로컬 데이터"가 처음으로 값싸졌습니다.
⑨ 한계: 단일 벡터는 차원 수가 정하는 이론적 천장이 있고(LIMIT 논문), 한국어 성능은 공개되지 않았으며, 텍스트만 쓸 거라면 1세대나 Qwen3-Embedding-0.6B와 큰 차이가 없습니다.
컴퓨터는 글자를 모릅니다. "사과"라는 단어는 컴퓨터에게 유니코드 번호 두 개일 뿐이고, "배"와 가까운지 "자동차"와 가까운지 알 길이 없습니다. 임베딩(embedding)은 이 문제에 대한 답입니다. 단어든 문장이든 사진이든, 입력 하나를 숫자 몇백 개로 된 벡터로 바꾸되, 의미가 비슷한 것끼리 벡터도 가깝게 만든다. 이 약속 하나가 성립하면 검색은 거리 계산이 되고, 추천은 이웃 찾기가 되며, 분류는 영역 나누기가 됩니다.
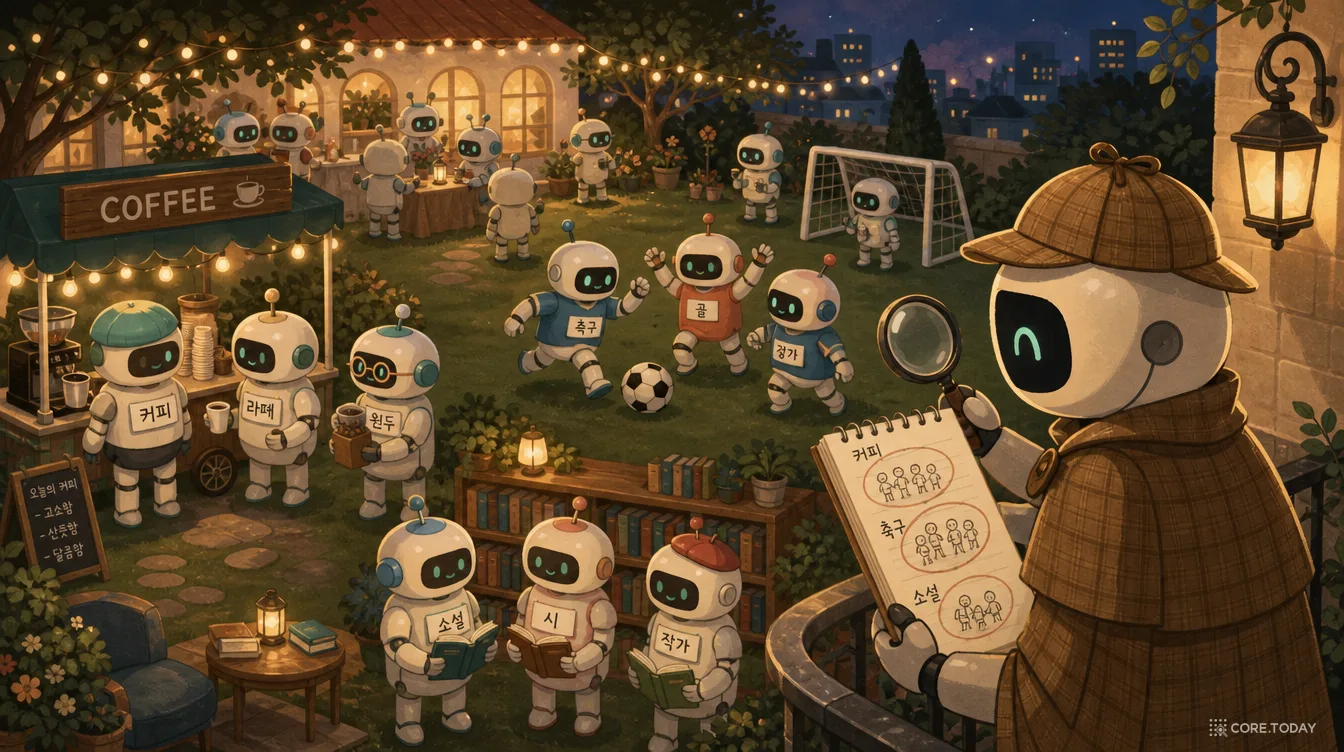
그런데 "의미가 비슷하다"를 컴퓨터가 어떻게 압니까. 1954년 언어학자 젤리그 해리스가 「분포 구조(Distributional Structure)」에서, 1957년 존 루퍼트 퍼스가 "You shall know a word by the company it keeps"라는 한 문장으로 답을 내놓았습니다. 단어의 뜻은 그 단어가 어떤 단어들과 함께 나타나는지로 정의된다는 것입니다. "커피"는 "마시다", "따뜻한", "원두", "카페인" 곁에 나타나고, "라떼"도 거의 같은 이웃을 갖습니다. 사전을 보지 않아도 두 단어가 비슷하다는 사실은 통계만으로 드러납니다. 이것이 분포 가설(distributional hypothesis)이고, 이후 70년 동안 나온 모든 임베딩은 이 가설을 점점 더 큰 데이터와 모델로 실행한 것입니다.
1990년: 행렬을 분해하면 벡터가 나온다
처음으로 이 가설을 벡터로 만든 것은 1990년의 잠재 의미 분석(LSA, Latent Semantic Analysis)입니다. 디어웨스터와 두메이 등은 "어떤 단어가 어떤 문서에 몇 번 나왔는지"를 적은 거대한 표(단어×문서 행렬)를 만들고, 특이값 분해(SVD)로 그 표를 100개 안팎의 축으로 압축했습니다. 압축된 축 위에서 "자동차"와 "승용차"는 같은 방향을 가리켰습니다. 두 단어가 같은 문서에 나란히 등장한 적이 없어도, 비슷한 문서들에 나타났다는 사실만으로 가까워진 것입니다. 오늘날 "768차원"이라고 부르는 그 차원이 바로 이 축의 후손입니다.
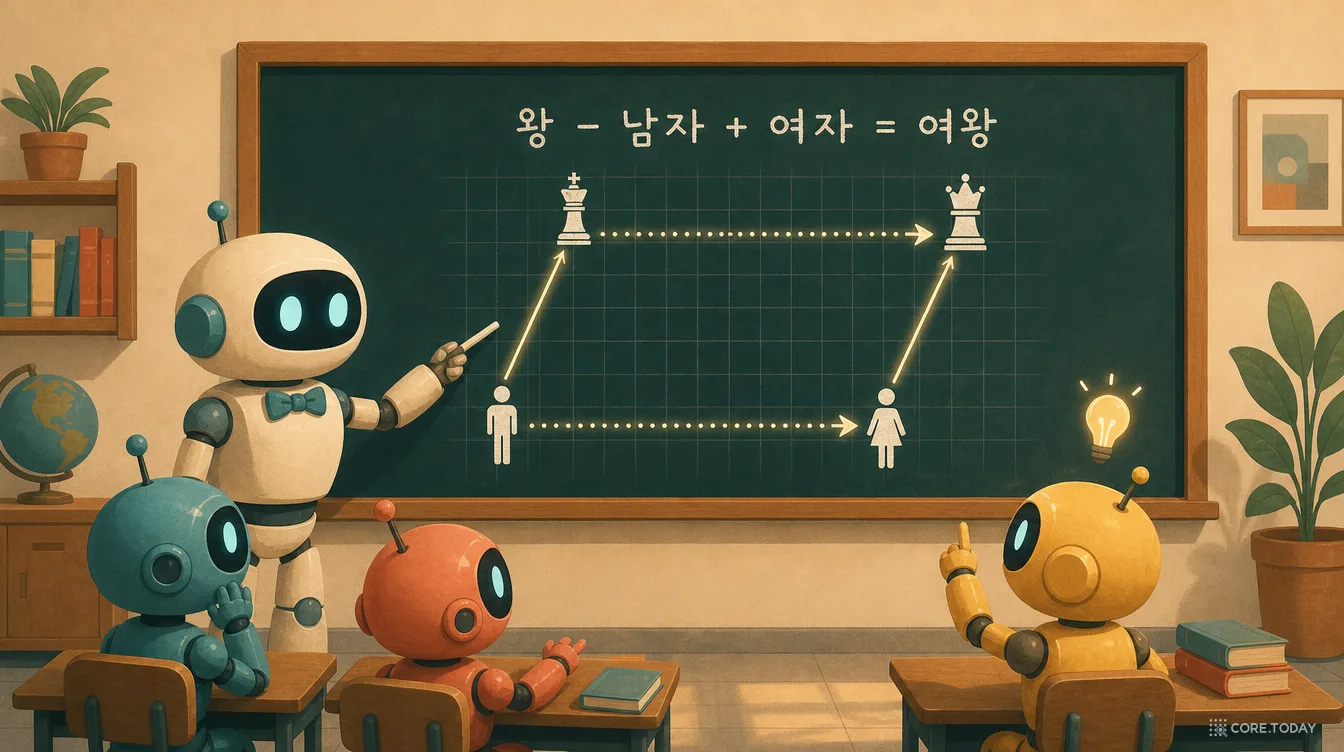
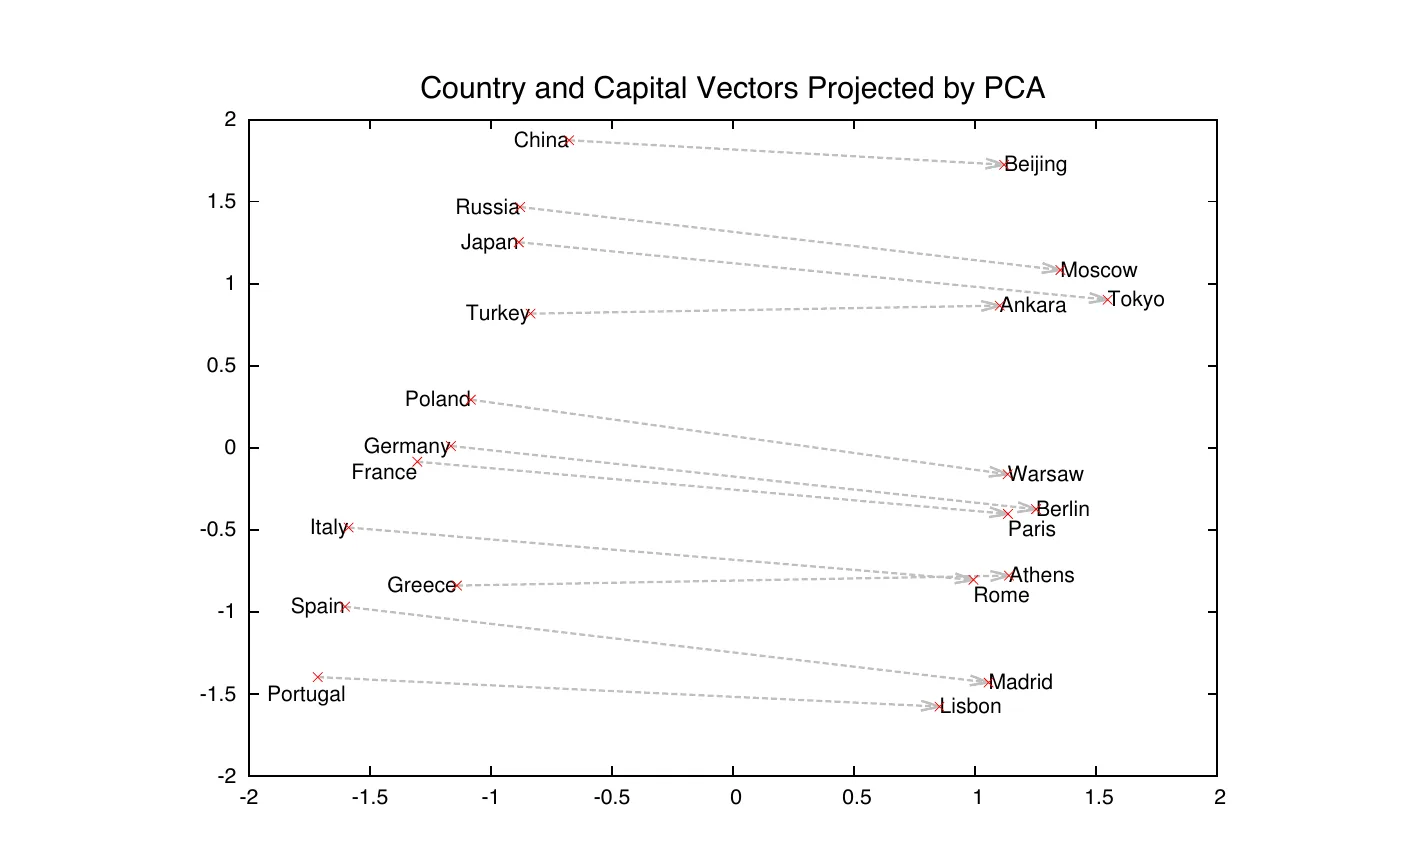
2013년 구글의 토마시 미콜로프 팀이 낸 두 편의 논문(arXiv 1301.3781, 1310.4546)은 임베딩을 대중화한 사건입니다. word2vec이라 불린 이 방법은 거대한 행렬을 분해하는 대신 아주 얕은 신경망에 예측 문제를 풀게 했습니다. 스킵그램(skip-gram) 방식은 가운데 단어를 주고 양옆에 올 단어를 맞히게 합니다. "따뜻한 ___ 한 잔"의 빈칸에 "커피"도 "라떼"도 잘 맞으니, 두 단어의 벡터는 비슷한 방향으로 밀려갑니다. 300차원 벡터, 구글 뉴스 1,000억 단어, 어휘 300만 개. 그리고 유명한 산술이 나왔습니다. 벡터(왕) − 벡터(남자) + 벡터(여자)를 계산하면 벡터(여왕)에 가장 가까웠습니다.
위 그림은 1310.4546 논문의 Figure 2입니다. 나라 벡터와 수도 벡터를 2차원으로 눌러 그렸는데, 나라에서 수도로 가는 화살표가 모두 같은 방향, 비슷한 길이입니다. 아무도 "수도"라는 관계를 가르친 적이 없습니다. 분포 통계만 배운 모델이 "관계"를 일정한 방향의 이동으로 저장한 것입니다. 이 그림이 중요한 이유는 임베딩 공간이 단순한 유사도 사전이 아니라 구조를 가진 기하학이라는 것을 처음 눈으로 보여 줬기 때문입니다. 2014년 스탠퍼드의 GloVe는 같은 결과를 전역 동시 등장 행렬의 로그를 맞추는 회귀로 얻었고, 두 방식이 수학적으로 거의 같은 일을 한다는 것이 곧 밝혀졌습니다.
두 번째 논문의 또 다른 기여는 "네거티브 샘플링"입니다. 어휘 300만 개 전체에 대해 확률을 계산하는 대신, 진짜 이웃 단어 하나와 무작위로 뽑은 가짜 단어 5~20개를 구분하는 이진 문제로 바꿨습니다. "진짜 짝은 당기고 가짜는 밀어낸다." 이 발상이 8년 뒤 CLIP의 손실 함수로, 13년 뒤 EmbeddingGemma 2의 학습으로 이어집니다.
2019년: 65시간이 5초가 되다
2018년 BERT가 등장하면서 단어는 문맥에 따라 다른 벡터를 갖게 됐습니다. "배를 타다"의 배와 "배가 고프다"의 배가 다른 벡터가 됩니다. 그런데 문장 전체를 하나의 벡터로 만드는 일은 오히려 퇴보했습니다. BERT의 맨 앞 토큰 [CLS] 출력을 문장 벡터로 쓰면 의미 유사도 과제에서 옛날 GloVe 평균(58.0)보다도 못한 16.5점이 나왔습니다. BERT는 두 문장을 한꺼번에 넣고 비교할 때는 훌륭했지만, 그 방식으로 문장 1만 개 가운데 가장 비슷한 쌍을 찾으려면 약 5,000만 번의 추론이 필요했습니다.
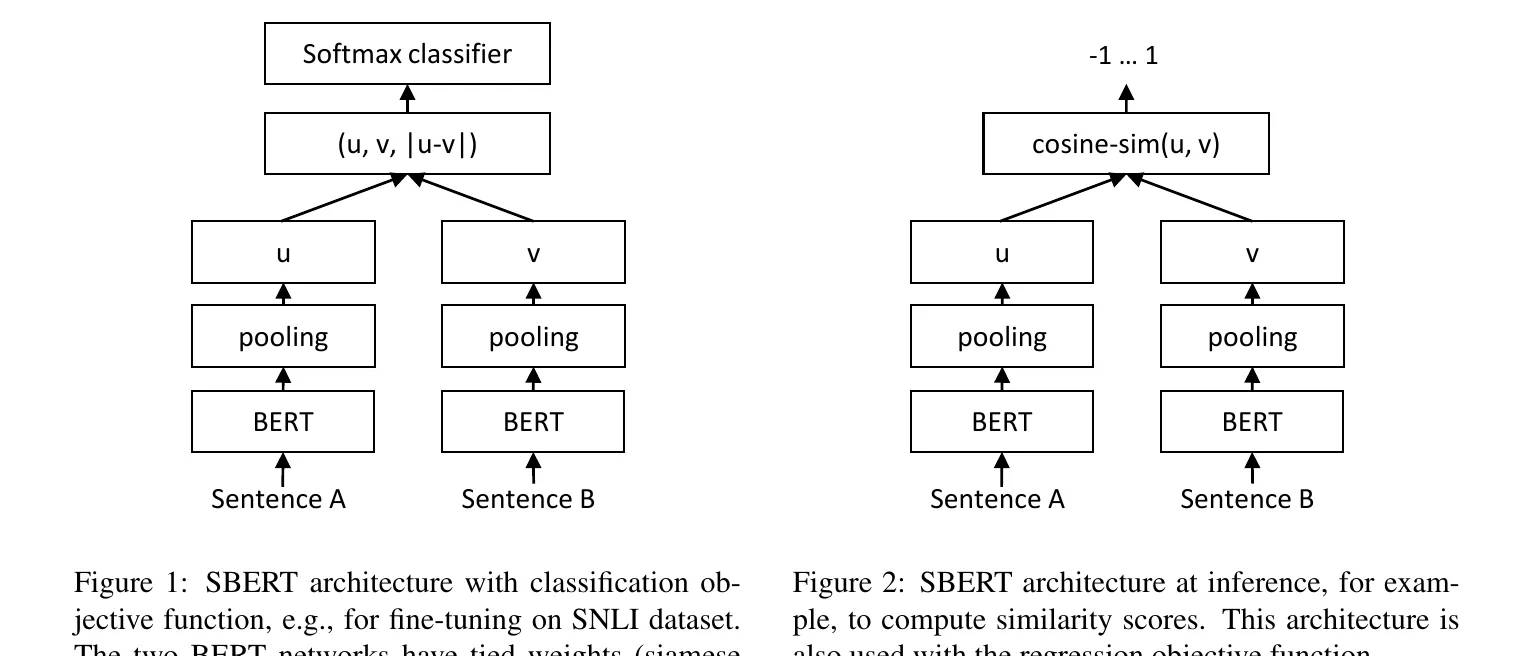
2019년 닐스 라이머스와 이리나 구레비치의 Sentence-BERT가 이 문제를 풀었습니다. 위 그림의 왼쪽이 학습, 오른쪽이 추론입니다. 핵심은 가중치를 공유하는 두 개의 BERT(샴 네트워크) 에 문장을 따로따로 넣고, 각각의 토큰 출력을 평균(pooling)해 벡터 u, v를 얻은 뒤, 두 벡터의 코사인 유사도가 정답과 맞도록 학습한 것입니다. 학습이 끝나면 문장마다 벡터 하나를 한 번만 계산해 두면 됩니다. 논문 초록의 숫자가 그 효과를 말합니다. "BERT로 약 65시간 걸리던 일을 SBERT는 약 5초로 줄이면서 정확도를 유지한다."
이 그림을 기억해 두십시오. 입력을 따로 인코딩하고 → 평균 풀링하고 → 코사인 유사도로 비교한다. EmbeddingGemma 2의 모델 카드에 적힌 "Pooling: Mean pooling"은 바로 이 2019년의 설계입니다. 7년 동안 모델은 BERT에서 Gemma 4로, 입력은 문장에서 영상과 소리로 바뀌었지만 뼈대는 그대로입니다.
SBERT는 "비슷한 문장 쌍에 비슷한 점수"라는 정답 레이블이 필요했습니다. 그런데 사람이 점수를 매긴 문장 쌍은 수십만 개가 한계입니다. 인터넷에는 레이블 없는 (질문, 답변), (제목, 본문), (사진, 캡션) 쌍이 수십억 개 있습니다. 이것을 쓰려면 "쌍이 맞다/틀리다"만으로 학습하는 방법이 필요했고, 그 답이 대조 학습(contrastive learning) 입니다.
말로 풀면 이렇습니다. 질의 q에 대해 후보 N개가 있고 그중 하나(p_i)만 진짜 짝입니다. 모든 후보와의 유사도를 구해 softmax를 취하면 "이것이 짝일 확률"이 나오고, 진짜 짝의 확률을 1에 가깝게 만들면 됩니다. 결국 N지선다 객관식 문제입니다. 분모가 커질수록(후보가 많을수록) 문제가 어려워지고, 논문은 이 손실이 질의와 짝 사이의 상호정보량의 하한을 log N만큼 끌어올린다는 것을 증명했습니다. 후보가 많을수록 더 많이 배운다는 이론적 근거입니다.
여기서 세 가지 용어가 나옵니다.
배치 내 음성(in-batch negatives): 후보 N개를 따로 모을 필요가 없습니다. 한 배치에 (질의, 짝) 쌍이 N개 있으면, 내 짝을 제외한 다른 N−1개의 짝이 자동으로 "틀린 후보"가 됩니다. 2020년 페이스북의 DPR 논문이 이것을 위키피디아 검색에 적용해 BM25를 10~19점 앞질렀고, 이후 모든 임베딩 모델의 기본 학습법이 됐습니다.
어려운 음성(hard negatives): 무작위 후보는 금방 너무 쉬워집니다. "강아지" 질의에 "피자 사진"을 구분하는 건 학습 초반에 끝납니다. 그래서 BM25나 이전 체크포인트로 "비슷해 보이지만 틀린" 후보를 일부러 캐 와서 배치에 넣습니다. 1세대 EmbeddingGemma 논문은 어려운 음성에 유사도가 높을수록 더 큰 가중치를 주는 식(w = exp(α·sim), α=5)을 썼습니다.
온도(temperature) τ: 유사도를 τ로 나눈 뒤 softmax를 취합니다. τ가 작을수록 1등과 2등의 작은 차이가 큰 확률 차이로 증폭되어, 어려운 음성이 손실의 대부분을 차지합니다. 텍스트 모델은 보통 0.01~0.05를 씁니다.
아래 실험실에서 이 세 가지를 직접 돌려 볼 수 있습니다. 5개 쌍의 유사도 행렬을 두고 온도를 바꾸며 학습 걸음을 밟으면, 대각선이 밝아지고 "자전거↔기타"처럼 엉뚱하게 비슷한 어려운 음성이 가장 늦게 떨어지는 것을 볼 수 있습니다.
2022~2023년: 접두사와 지시문
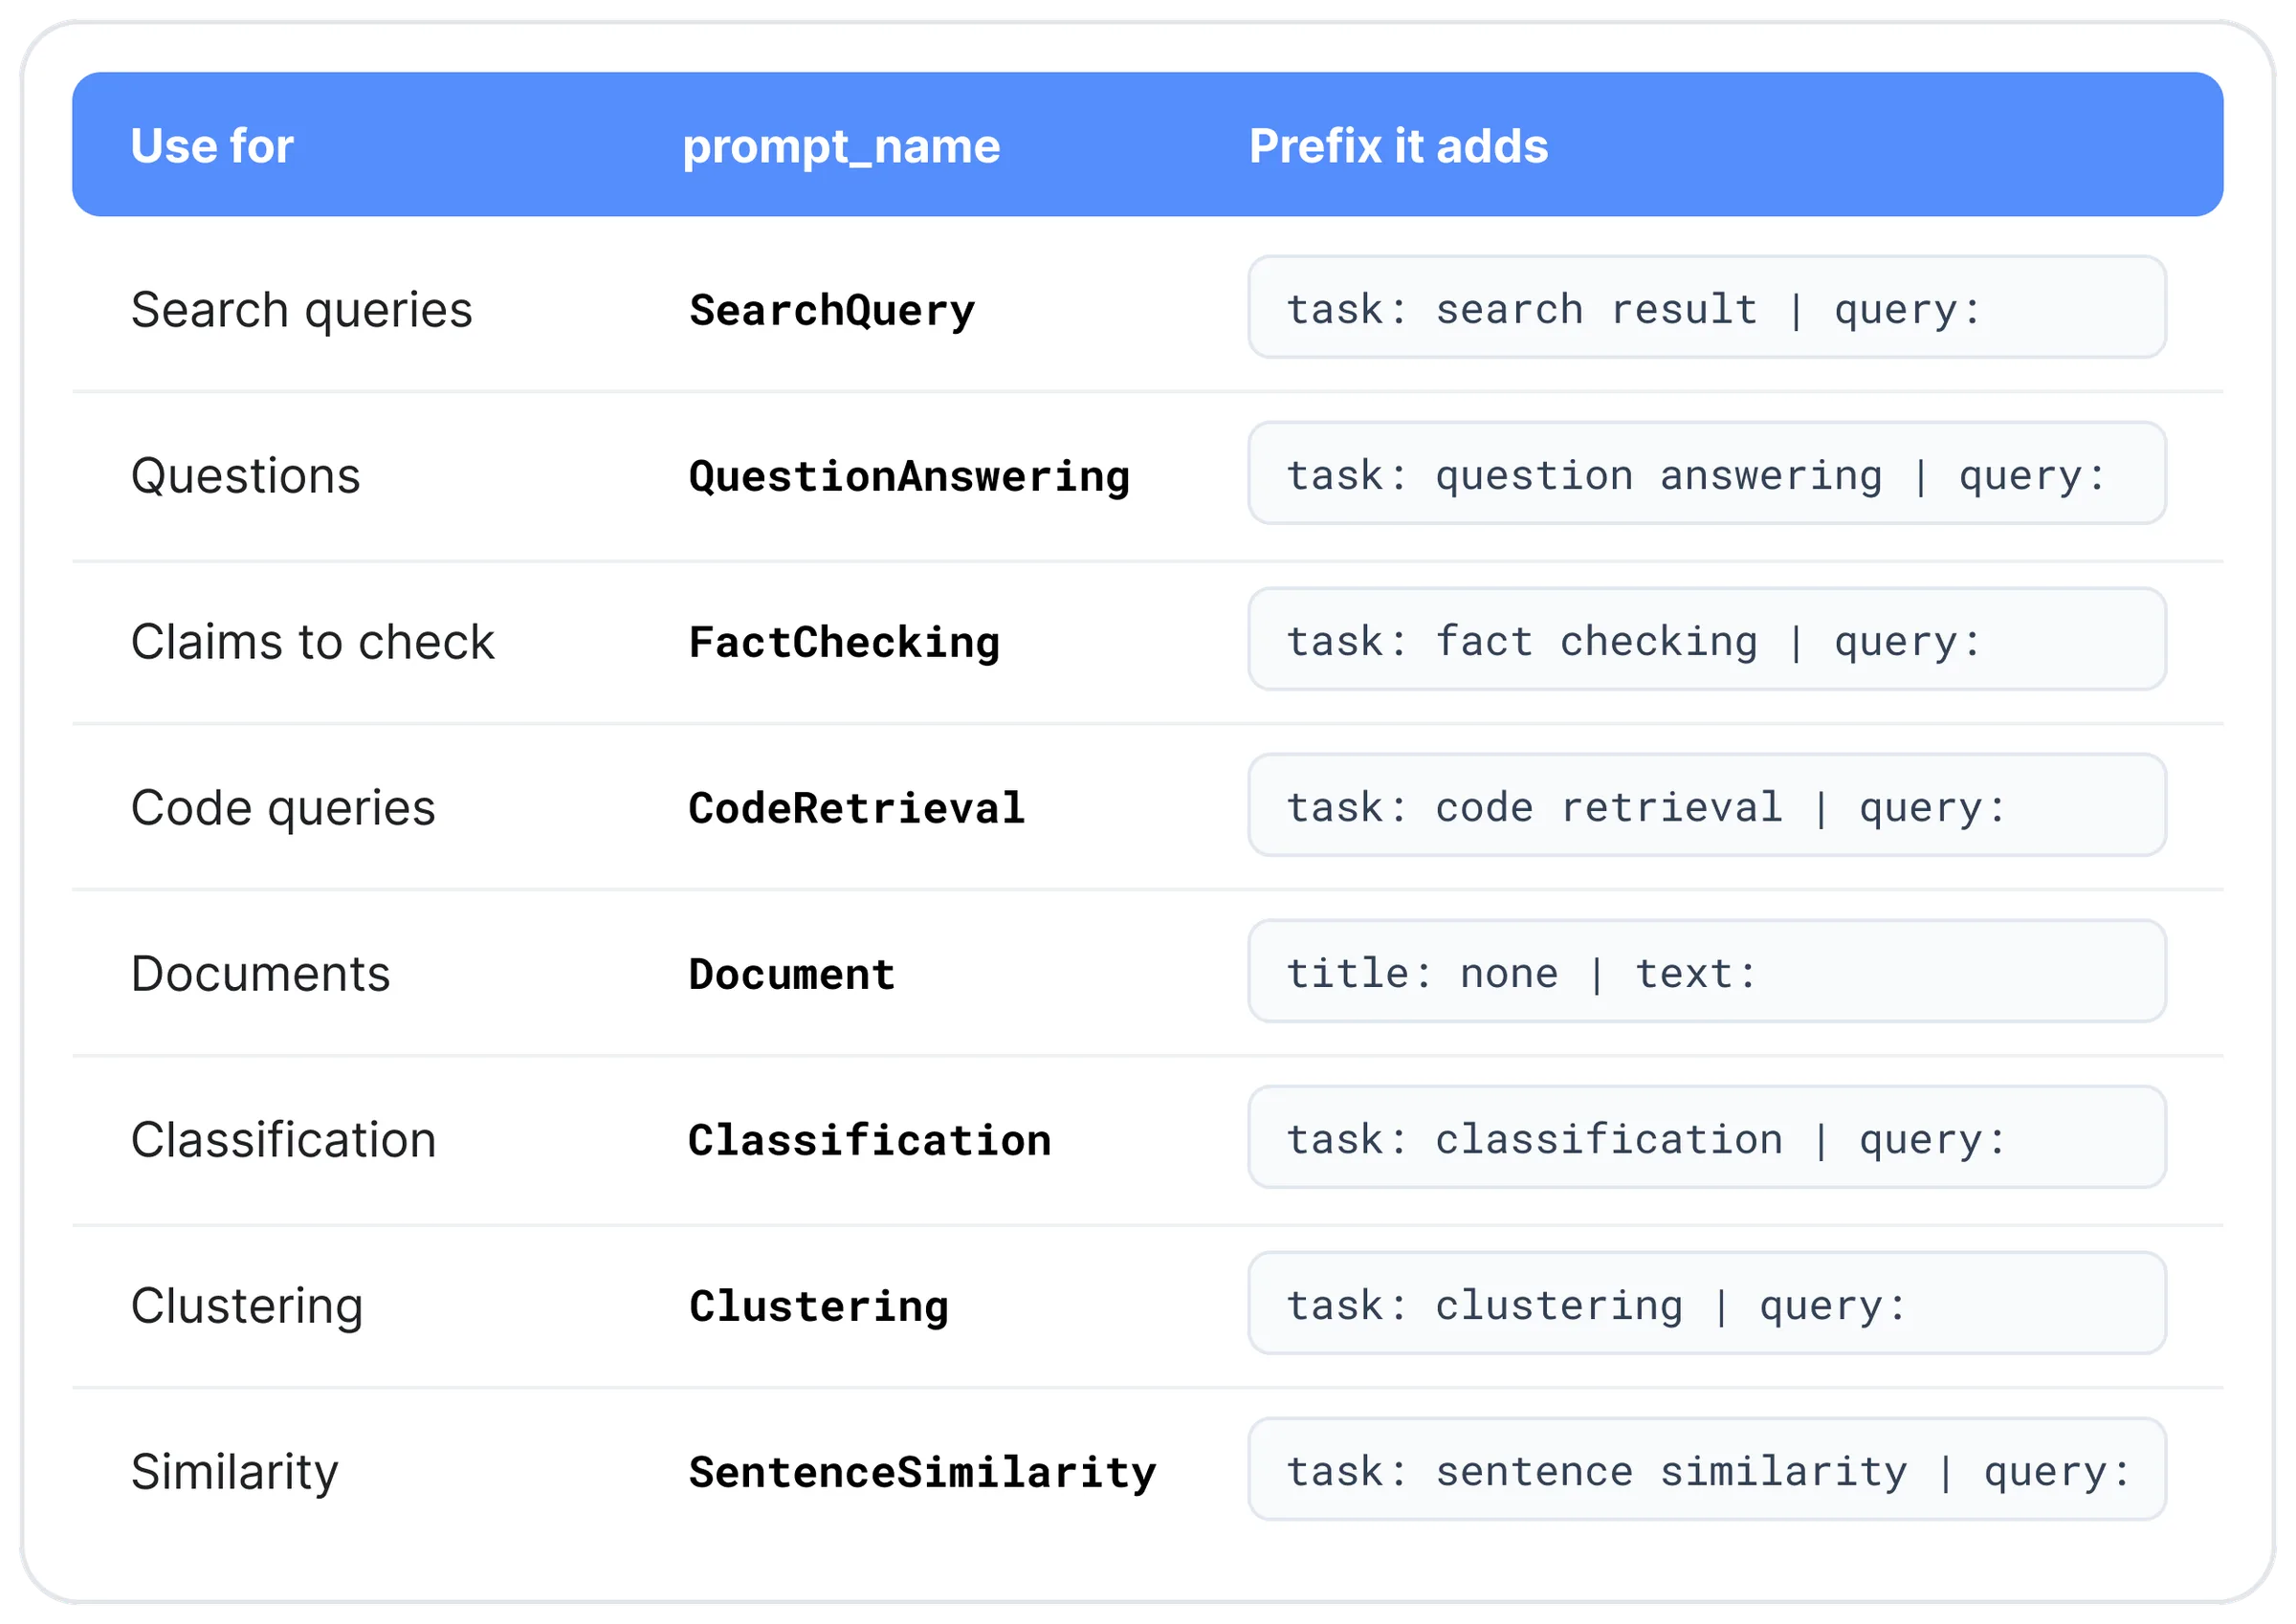
마이크로소프트의 E5(2022), 알리바바의 GTE, BAAI의 BGE(2023)는 이 레시피를 "약하게 레이블된 수억 쌍으로 사전 학습 → 정제된 데이터로 미세 조정"의 2단계로 정착시켰습니다. E5는 또 하나의 관습을 남겼습니다. 질의 앞에는 query:, 문서 앞에는 passage:를 붙여 같은 모델이 질의와 문서를 다르게 인코딩하게 한 것입니다. 질문 "파리의 인구는?"과 문서 "파리는 인구 210만의 프랑스 수도다"는 글자로는 다르지만 짝이어야 하니, 역할을 알려 주는 편이 낫습니다. Instructor(2022)는 이것을 자연어 지시문으로 일반화했고, 구글 계열은 task: search result | query: … 같은 고정 템플릿을 씁니다. EmbeddingGemma 2 모델 카드의 프롬프트 표가 아래에 있습니다.
이 표가 말하는 것은 간단합니다. 모델은 하나지만 "지금 무슨 일을 하는 중인지"를 접두사로 알려 줘야 제 성능이 납니다. 모델 카드는 접두사를 빼면 품질이 떨어진다고 명시합니다. 로컬 검색 앱을 만들 때 가장 흔한 실수가 질의와 문서에 같은 접두사를 쓰거나 아예 안 쓰는 것입니다.
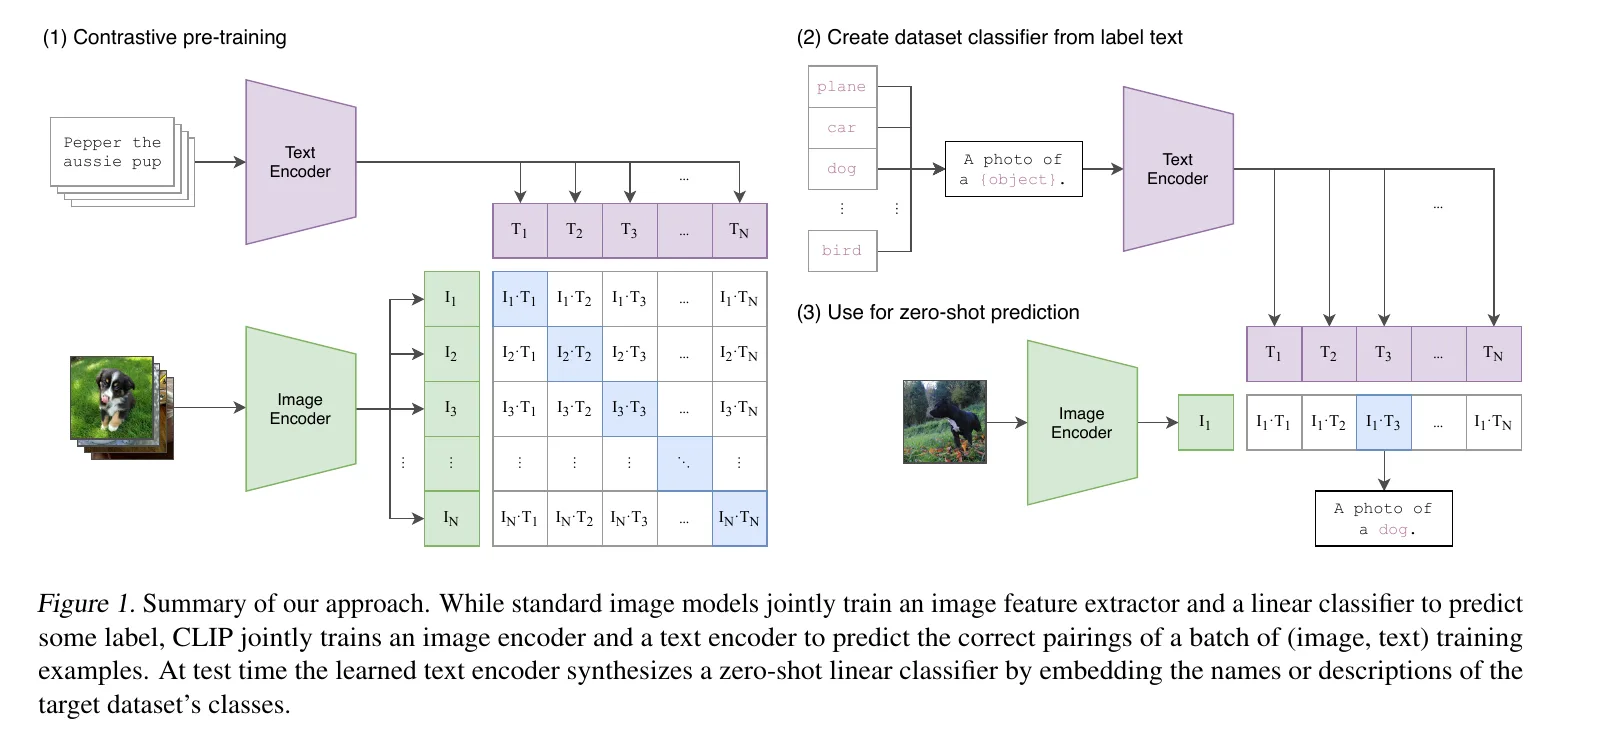
2021년 OpenAI의 CLIP은 대조 학습을 두 종류의 입력 사이에 적용했습니다. 위 그림 왼쪽이 전부입니다. 배치에 (이미지, 캡션) 쌍이 N개 있습니다. 이미지 인코더가 I₁…I_N을, 텍스트 인코더가 T₁…T_N을 만듭니다. N×N 행렬의 (i, j) 칸에 Iᵢ·Tⱼ 내적을 채우면, 대각선 N개가 진짜 짝이고 나머지 N²−N개가 전부 공짜 음성입니다. 행 방향으로 한 번, 열 방향으로 한 번 InfoNCE를 계산해 더합니다. 4억 쌍의 웹 데이터, 배치 32,768. 그 결과 이미지와 텍스트가 같은 공간에 놓였고, 오른쪽 패널처럼 "a photo of a dog"라는 문장 벡터로 개 사진을 분류하는 제로샷 분류가 가능해졌습니다. 레이블 128만 장으로 학습한 ResNet-50과 같은 ImageNet 정확도를 레이블 0장으로 냈습니다.
이 그림의 행렬이 2절 위젯의 행렬과 같다는 점을 봐 주십시오. 텍스트-텍스트든 이미지-텍스트든 손실은 같습니다. 다른 것은 인코더뿐입니다. 그래서 "모달리티를 추가한다"는 말은 곧 "새 인코더를 붙이고 같은 행렬 게임을 시킨다"는 뜻이 됩니다.
2023년 구글의 SigLIP은 이 행렬에서 softmax를 떼어 냈습니다. 칸 하나하나를 독립된 이진 문제(이 쌍이 맞나?)로 보고 시그모이드 손실을 씁니다. 행·열 전체를 정규화할 필요가 없어 메모리가 줄고 작은 배치에서도 잘 되며, TPUv4 4칩으로 이틀 만에 ImageNet 제로샷 84.5%를 냈습니다. Gemma 계열의 비전 인코더는 이 SigLIP의 후손이고, EmbeddingGemma 2의 170M 비전 인코더도 그 계보에 있습니다.
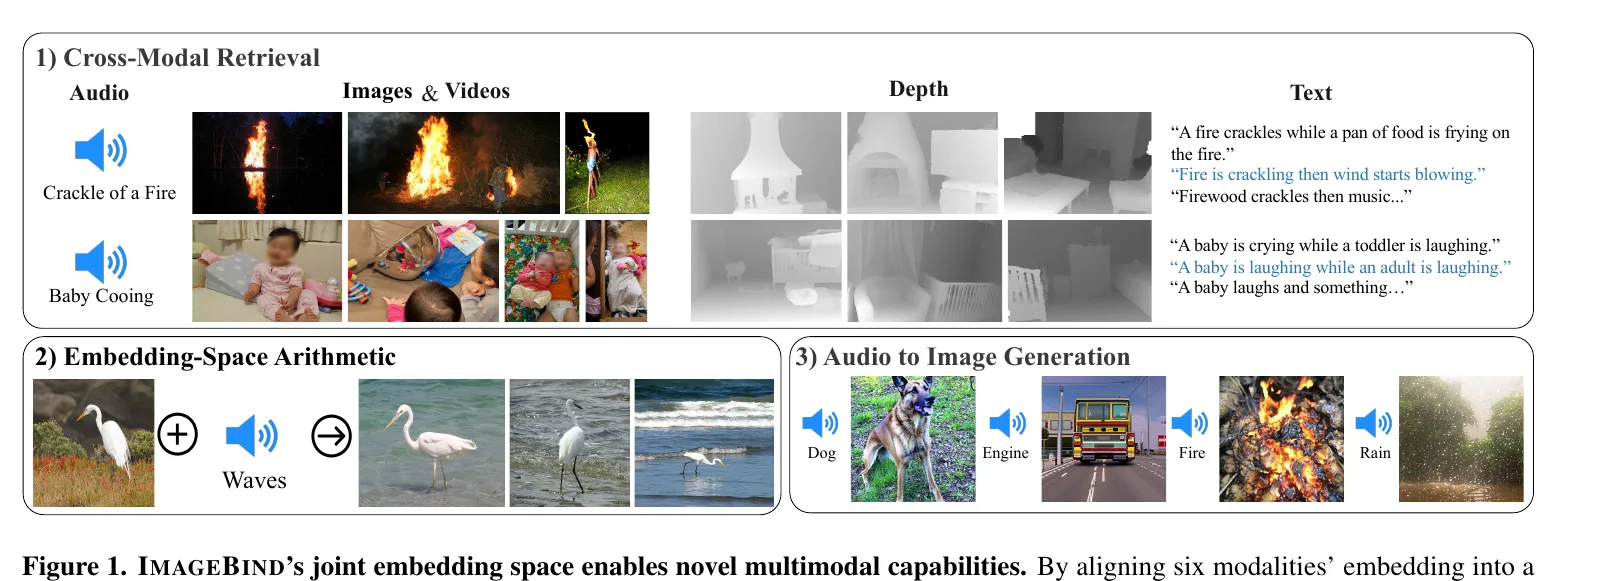
메타의 ImageBind(2023)는 재미있는 질문을 던졌습니다. "오디오-텍스트 쌍 데이터가 없는데 오디오와 텍스트를 같은 공간에 놓을 수 있을까?" 답은 "이미지를 축으로 쓰면 된다"였습니다. 이미지-텍스트 쌍(CLIP), 이미지-오디오 쌍(영상에서 추출), 이미지-깊이, 이미지-열화상, 이미지-IMU 쌍만으로 학습했더니, 한 번도 짝지어 본 적 없는 오디오와 텍스트가 저절로 정렬됐습니다. 위 그림의 (2)가 백미입니다. 백로 사진 벡터에 파도 소리 벡터를 더하면 바닷가 백로 사진이 검색됩니다. word2vec의 왕−남자+여자가 10년 뒤 사진+소리로 돌아온 것입니다.
2024~2026년: 통합 멀티모달 임베더의 시대
ImageBind 이후 "모든 것을 하나의 공간에"는 경쟁 종목이 됐습니다. 흐름만 짚습니다.
ColPali(2024): 문서를 OCR하지 않고 페이지 이미지 자체를 임베딩합니다. 토큰마다 128차원 벡터를 만들어 다중 벡터로 비교(late interaction)하며, 시각 문서 검색 벤치마크 ViDoRe를 만들었습니다. 표와 그림이 많은 매뉴얼 검색의 표준 접근이 됐습니다.
voyage-multimodal-3(2024), Cohere Embed v4, Nomic Embed Multimodal(2025): 상용·공개 양쪽에서 텍스트와 이미지를 섞은 입력(interleaved)을 한 모델로 받기 시작했습니다.
Qwen3-VL-Embedding(2026-01): 2B·8B 모델이 이미지·문서·비디오를 받으며 MMEB-v2에서 73.2·77.8점으로 공개 모델 1위에 올랐습니다.
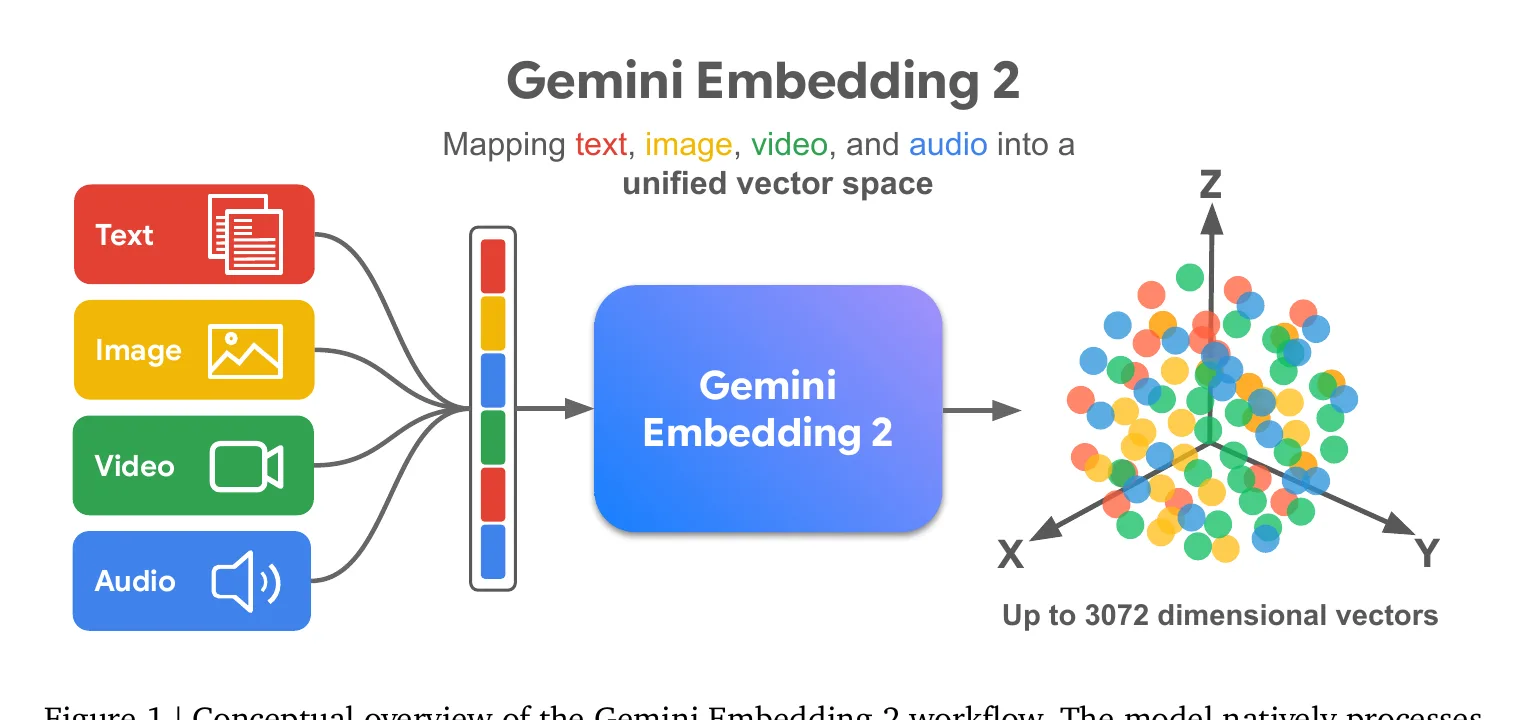
Gemini Embedding 2(2026-03 프리뷰, 5월 논문): 구글의 첫 네이티브 멀티모달 임베딩. 텍스트 8,192토큰, 이미지 6장, 영상 120초, 오디오, PDF 6쪽을 한 요청에 섞어 넣고 3,072차원 벡터를 냅니다. 아래 그림이 논문의 Figure 1입니다.
jina-embeddings-v5-omni(2026-05): 얼린 텍스트 백본(Qwen3-0.6B)에 얼린 비전(SigLIP2)·오디오(Whisper) 인코더를 작은 투영층(전체의 0.35%)으로 이어 붙이는 "냉동 전문가 조립" 방식. 1.56B.
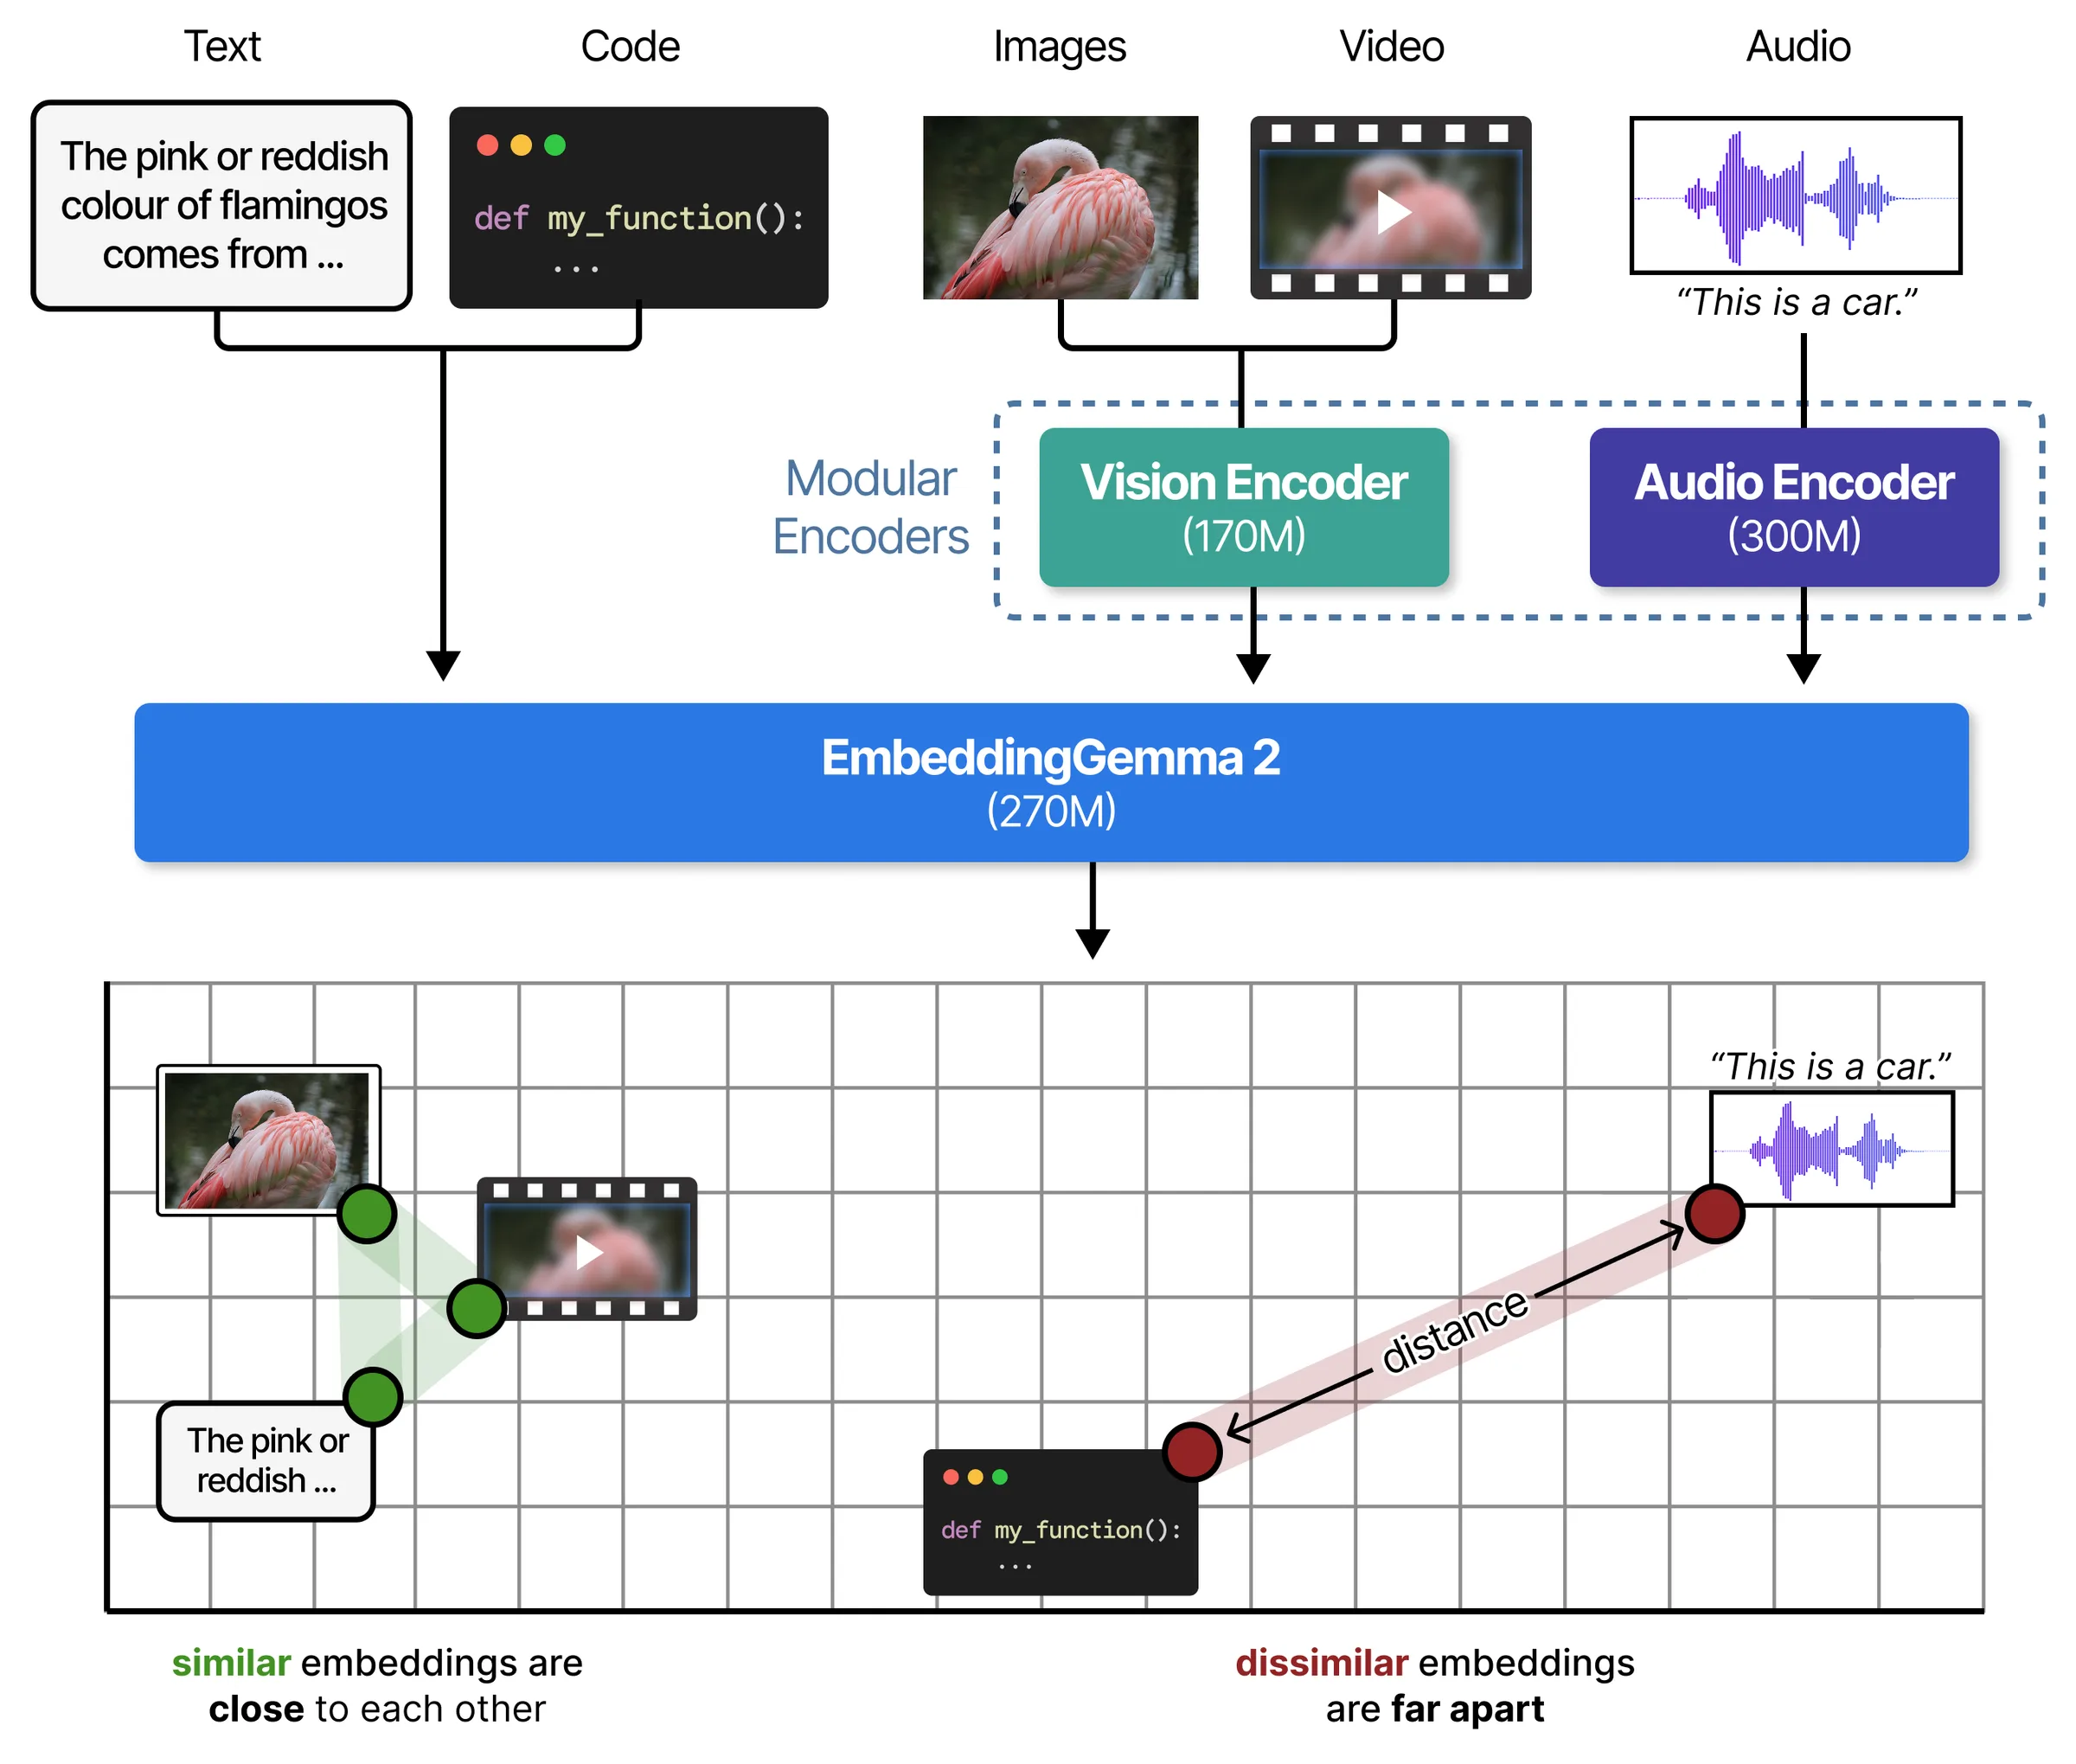
텍스트와 코드는 인코더 없이 바로 270M짜리 본체로 들어갑니다. 본체가 곧 텍스트 인코더입니다.
이미지와 비디오는 비전 인코더(170M) 를, 오디오는 오디오 인코더(300M) 를 먼저 거칩니다. 이 둘이 점선 상자 "Modular Encoders"로 묶여 있는 것은 "떼어 낼 수 있다"는 뜻입니다.
결과는 전부 같은 격자(768차원 공간)에 찍힙니다. 플라밍고 글·사진·영상은 가까이, 코드와 자동차 소리는 멀리.
모델 카드의 표를 한 줄씩
Hugging Face 모델 카드의 아키텍처 표를 옮기고, 각 항목이 무슨 뜻인지 붙였습니다.
항목
값
뜻
총 파라미터
740M
텍스트 270M + 비전 170M + 오디오 300M
텍스트 백본(트랜스포머)
130M
실제 연산을 하는 24층 트랜스포머
임베더(토큰 표)
140M
어휘 262,144개 × 512차원의 조회표. 연산은 거의 없지만 메모리를 차지
층 수
24
1세대와 같음
모델 차원 / FFN 차원
512 / 2,048
토큰 하나가 층을 지날 때의 폭. 1세대(768)보다 좁음
어텐션 헤드 / KV 헤드
4 / 2(로컬)·1(글로벌)
GQA·MQA. 키·값을 헤드끼리 공유해 메모리를 줄임
슬라이딩 윈도우
1,024토큰
로컬 층은 앞뒤 1,024토큰만 봄
로컬:글로벌 비율
5:1
층 6개 중 1개만 전체 문맥을 봄. Gemma 4의 설계
풀링
Mean pooling
토큰 벡터를 평균 (SBERT 그대로)
투영
512 → 768
평균 벡터를 선형층으로 768차원에 올림
문맥 길이
8,192토큰
1세대 2,048의 4배
MRL 차원
128·256·512·768
앞에서부터 잘라 써도 되는 길이
표에서 눈에 띄는 숫자는 "텍스트 백본 130M + 임베더 140M"입니다. 텍스트 모델 270M 중 절반 이상이 단어 조회표입니다. 262,144개 어휘는 Gemma 4의 토크나이저와 같고, 그래서 Gemma 4와 함께 돌리면 토크나이저를 공유해 메모리를 아낄 수 있다는 발표문의 주장이 나옵니다. 또 모델 차원이 512로 1세대(768)보다 좁아졌는데도 코드 성능이 10점 올랐습니다. 깊이와 데이터가 폭보다 중요했다는 뜻입니다.
비전 170M과 오디오 300M은 어디서 왔을까요. 구글은 "Gemma 4 기반"이라고만 적었습니다. Gemma 4 기술 보고서(arXiv 2607.02770)를 보면 소형 모델(E2B·E4B)에 305M USM 계열 컨포머 오디오 인코더와 150M ViT 비전 인코더가 붙어 있습니다. 숫자가 거의 맞고 발표문도 "Gemma 4와 오디오 인코더를 공유한다"고 했으니, 오디오 인코더는 Gemma 4의 것이고 비전 170M은 150M ViT에 투영층을 더한 값으로 보는 것이 합리적인 추정입니다. 확인된 사실이 아니라 추정이라는 점을 적어 둡니다.
토큰 예산: 8,192를 누가 얼마나 쓰나
멀티모달 모델에서 가장 중요한 숫자는 "입력 하나가 토큰 몇 개를 먹느냐"입니다. 문맥 창 8,192토큰을 모든 모달리티가 나눠 쓰기 때문입니다.
모달리티
토큰 비용
8,192 안에 들어가는 최대
비고
텍스트·코드
서브워드 1개당 1
8,192토큰
한국어는 글자당 약 1~2토큰
이미지
장당 280
약 29장
LiteRT 배포판은 70~140으로 줄임
비디오
프레임당 140
약 58프레임
기본 1fps → 약 1분
오디오
초당 25
약 327초(5.5분)
모노 16kHz
이 표를 보면 발표문의 "5.5분 오디오, 29장 이미지, 58프레임 비디오"가 어디서 나왔는지 알 수 있습니다. 전부 8,192를 토큰 비용으로 나눈 값입니다. 그리고 실무적 함의가 하나 있습니다. 1분짜리 영상을 1fps로 넣으면 60프레임 × 140 = 8,400토큰이라 창을 넘깁니다. 긴 영상은 잘라서 여러 벡터로 만들거나 프레임 간격을 늘려야 합니다. 발표문이 자랑한 "Video Moments Finder"가 영상을 장면 단위로 쪼개 색인하는 이유입니다.
상품 설명 글, 제품 사진 두 장, 시연 영상 하나가 벡터 하나가 됩니다. 쇼핑몰 검색에서 "젖은 길에서 미끄러지지 않는 신발"이라는 질의가 이 벡터를 찾아낼 수 있습니다.
선택적 로딩: 필요한 블록만 메모리에
sentence-transformers에서 인코더를 떼는 방법은 설정 한 줄입니다.
python
from sentence_transformers import SentenceTransformer

# 텍스트만 (270M)
m = SentenceTransformer("google/embeddinggemma-2",
        config_kwargs={"vision_config": None, "audio_config": None})
# 텍스트 + 이미지 (440M)
m = SentenceTransformer("google/embeddinggemma-2",
        config_kwargs={"audio_config": None})
# 전부 (740M)
m = SentenceTransformer("google/embeddinggemma-2")
아래 조립기에서 블록을 껐다 켜며 파라미터·메모리·가능한 입력이 어떻게 바뀌는지 보십시오.
인코더-디코더 초기화. Gemma 3는 디코더(생성 모델)입니다. 이것을 바로 임베딩 모델로 쓰지 않고, 먼저 T5Gemma 방식으로 인코더-디코더 모델로 바꿔 학습한 뒤 인코더만 떼어 임베딩 백본으로 썼습니다. 절제 실험(Table 2)에서 인코더-디코더 초기화 60.4 대 디코더 그대로 59.7 대 무작위 45.2였습니다. 생성 모델은 다음 토큰을 보지 못하도록 한 방향으로만 읽지만, 임베딩은 문장 전체를 양방향으로 봐야 하기 때문입니다.
기하 임베딩 증류. 훨씬 큰 Gemini Embedding을 교사로 두고, 질의·정답·어려운 음성의 벡터가 교사의 벡터와 같은 기하 관계를 갖도록 학생을 끌어당깁니다. 작은 모델이 큰 모델의 공간을 흉내 내는 것입니다.
스프레드아웃(spread-out) 정규화. 배치 안의 서로 다른 벡터끼리 내적의 제곱을 벌점으로 줘서 벡터들이 구 표면에 고르게 퍼지게 합니다. 벡터가 한쪽에 몰려 있으면 차원을 자르거나 양자화할 때 구분이 무너지는데, 이것을 막는 장치입니다. 마트료시카와 양자화가 잘 먹히는 이유입니다.
모델 수핑(souping). 데이터 배합을 달리해 미세 조정한 여러 체크포인트의 가중치를 그냥 평균냅니다. 개별 61.2 미만이던 점수가 평균 후 61.2로 올랐습니다.
폰에서 임베딩을 쓸 때 진짜 문제는 모델 크기보다 벡터 저장소 크기입니다. 사진 3만 장을 768차원 float32로 저장하면 92MB, 회사 위키 50만 청크면 1.5GB입니다. 벡터를 작게 만드는 칼이 두 자루 있습니다. 하나는 차원을 줄이는 것, 다른 하나는 숫자 하나의 정밀도를 줄이는 것입니다.
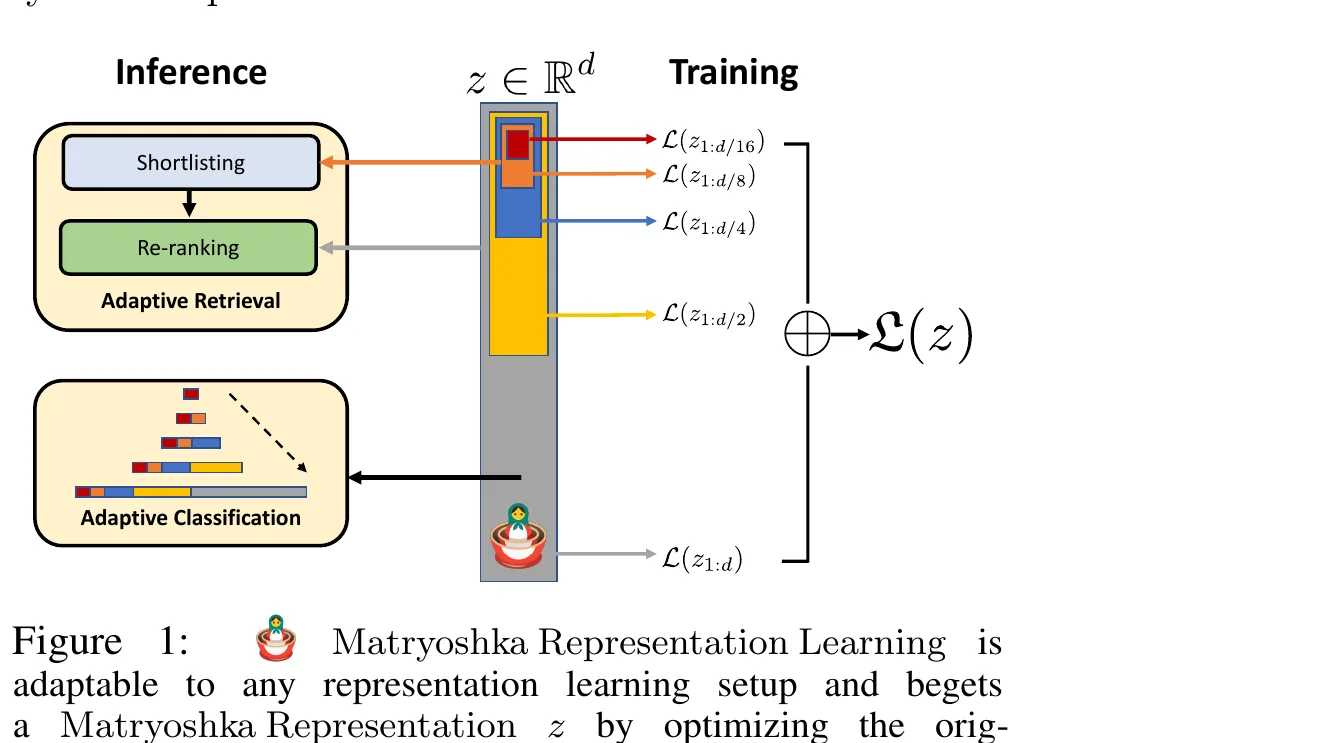
2022년 쿠수파티 등의 Matryoshka Representation Learning은 질문 하나로 시작합니다. "768차원 벡터의 앞 128개만 떼어 써도 괜찮게 만들 수 있을까?" 보통의 모델은 안 됩니다. 정보가 768개 차원에 고르게 흩어져 있어 앞부분만 쓰면 엉망이 됩니다. MRL은 학습 때 손실을 여러 길이에서 동시에 계산합니다. 위 그림의 오른쪽처럼 d/16, d/8, d/4, d/2, d 길이의 접두 벡터 각각에 대해 손실을 구하고 전부 더합니다. 그러면 모델은 중요한 정보를 앞쪽 차원에 몰아넣는 법을 배웁니다. 러시아 인형처럼 큰 벡터 안에 작은 벡터가 들어 있는 셈입니다.
논문의 주장은 ImageNet 검색에서 같은 정확도로 벡터를 14배 줄이거나 속도를 14배 높일 수 있다는 것이었고, 그림 왼쪽의 "적응형 검색"이 그 방법입니다. 짧은 벡터로 후보를 추리고(shortlisting) 긴 벡터로 후보만 재정렬(reranking)합니다. 2024년 1월 OpenAI가 text-embedding-3에 dimensions 파라미터를 넣으면서 이 기법이 대중화됐고, 3,072차원을 256으로 잘라도 이전 세대 1,536차원보다 나았습니다.
EmbeddingGemma 2 모델 카드의 MRL 표입니다. 768을 기준으로 얼마나 유지되는지가 핵심입니다.
차원
MTEB 다국어
MTEB 코드
MIEB 이미지
MMEB 전체
MSEB 오디오
MAEB
768
61.36
78.68
64.64
59.01
69.54
49.39
512
61.17
77.24
64.32
58.38
69.18
49.21
256
60.41
76.18
63.13
56.24
66.76
48.91
128
57.89
71.41
59.06
45.65
56.71
46.92
읽는 법은 이렇습니다. 256차원까지는 거의 공짜입니다. 텍스트 다국어는 1점, 코드는 2.5점, 이미지는 1.5점 빠지면서 저장은 3분의 1이 됩니다. 개발자 가이드도 "256차원에서 텍스트·코드는 원래 품질의 대부분, 이미지·비디오·음성 검색은 약 95%가 유지된다"고 적었습니다. 그런데 128에서 멀티모달이 무너집니다. MMEB 전체가 59.01에서 45.65로, 오디오 검색이 69.54에서 56.71로 떨어집니다. 발표문의 "최대 6배 저장 절감"은 128차원 기준인데, 그 6배는 텍스트 검색에서만 안전합니다.
양자화: 숫자 하나를 4바이트에서 1비트로
차원 수를 유지한 채 숫자 하나의 크기를 줄이는 것이 양자화입니다. float32(4바이트)를 int8(1바이트)로 바꾸면 4배, 부호 비트 하나만 남기는 binary로 바꾸면 32배 줄어듭니다. Qdrant의 측정에 따르면 int8은 보통 1점 안팎의 손실이고, binary는 float 재정렬을 붙이면 3,072차원 벡터에서 97~99%를 유지하지만 512차원에서는 71~91% 로 떨어집니다. 차원이 낮을수록 비트를 깎는 대가가 큽니다. 그래서 "128차원 + binary"를 겹쳐 쓰는 것은 EmbeddingGemma 2에서 특히 위험합니다. 128에서 이미 멀티모달이 13점 빠진 상태니까요.
모델 가중치 쪽의 양자화는 별개입니다. 1세대 논문은 양자화 인지 학습(QAT)으로 int4까지 줄여도 61.15가 60.62로 0.5점만 빠진다고 보고했고, 2세대의 LiteRT 배포판은 트랜스포머·임베딩 표는 int4, 비전은 int8, 오디오는 int2·int4·int8 혼합입니다. Pixel 11 Pro의 191MB·567MB는 이 양자화 상태의 숫자입니다. Hugging Face의 bf16 원본은 약 558MB(텍스트만)입니다.
아래 계산기에서 벡터 수·차원·정밀도를 바꿔 가며 저장 용량과 모델 카드의 품질 표를 함께 보십시오.
⚠️
float16은 쓰지 마십시오. 모델 카드가 굵게 경고합니다. 활성값의 범위가 float16의 표현 범위를 넘어 NaN이 나옵니다. bfloat16이나 float32로 추론해야 합니다. Unsloth 문서도 bf16=True, fp16=False를 명시합니다. MRL로 자른 뒤에는 벡터를 다시 정규화해야 코사인 유사도가 맞습니다.
6. 숫자 읽기: 어디서 올랐고, 누구와 비교해야 하나
벤치마크가 무엇을 재는지부터
임베딩 벤치마크 이름이 다섯 개나 나오니 먼저 정리합니다. 전부 "Massive ○○ Embedding Benchmark"의 약자입니다.
MTEB(2022, Muennighoff 등): 텍스트 임베딩의 표준 리더보드. 분류·클러스터링·검색·의미 유사도 등 8종류 58개 과제로 시작했고, 2025년 MMTEB(v2)로 확장되어 500개 이상 과제, 250개 이상 언어를 담습니다. "MTEB 다국어 v2"는 그중 131개 과제, "MTEB 코드"는 12개 코드 검색 과제입니다.
MIEB(2025, ICCV): 이미지·이미지-텍스트 임베딩. 130개 과제, 38개 언어. 검색·OCR 문서 이해·선형 프로빙·제로샷 분류·조합성 등 8범주. "lite"는 51개 과제 축약판.
MMEB-v2(2025): 이미지·시각 문서·비디오 세 트랙의 통합 멀티모달 벤치마크. Qwen3-VL-Embedding 같은 모델이 1위를 다투는 곳.
MSEB(2025, 구글): 음성·소리 검색 벤치마크. 8개 과제.
MAEB(2026-02): 오디오 임베딩. 30개 과제, 100개 이상 언어, 53개 인코더를 평가. CLAP 계열 모델이 환경음은 잘하지만 다국어 음성에서는 무작위 수준이고, 음성 모델은 그 반대라는 사실을 드러냈습니다.
모달리티마다 벤치마크가 먼저 생기고 그다음 해에 구글이 그 모달리티 모델을 냈다는 점이 흥미롭습니다. MIEB·MAEB가 있었기에 EmbeddingGemma 2의 점수표가 가능했습니다.
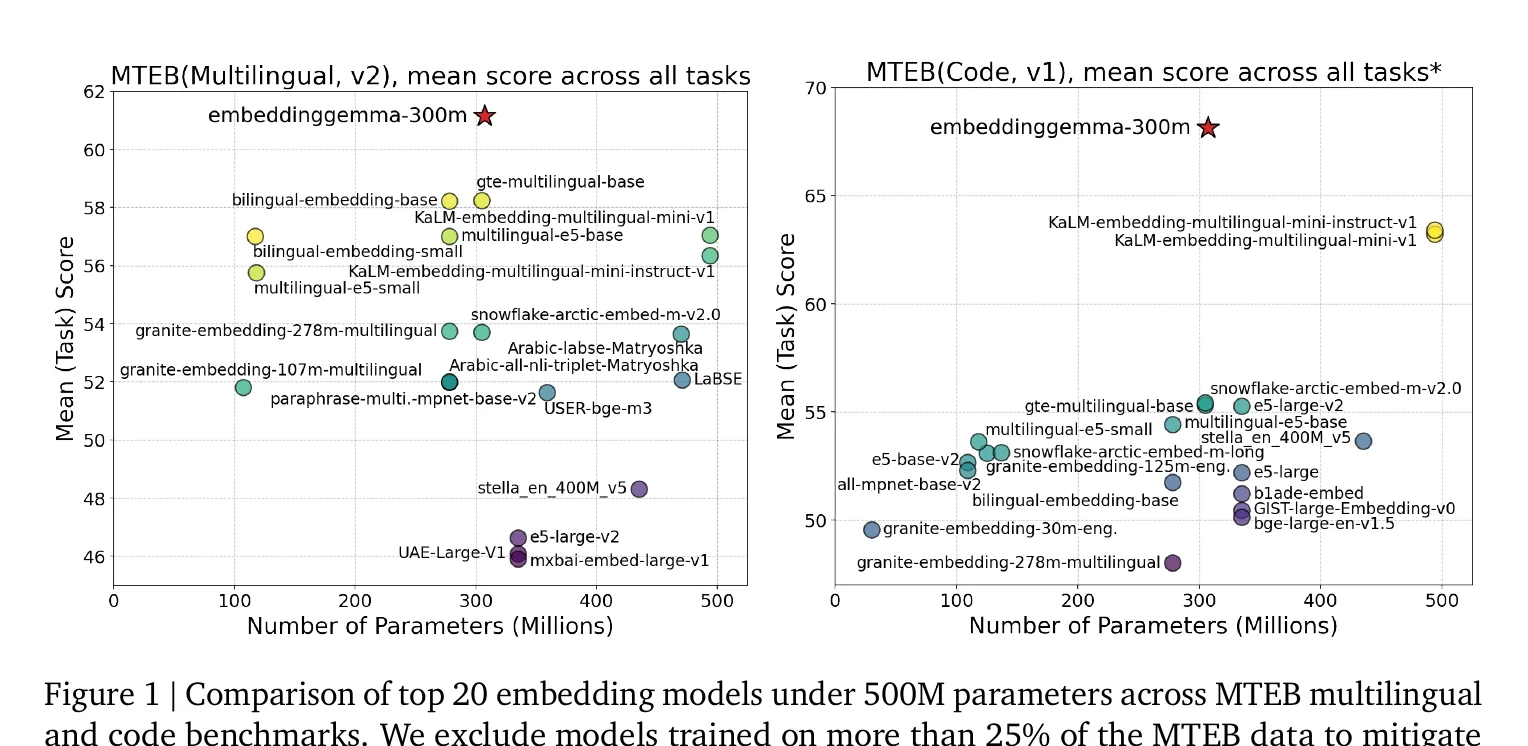
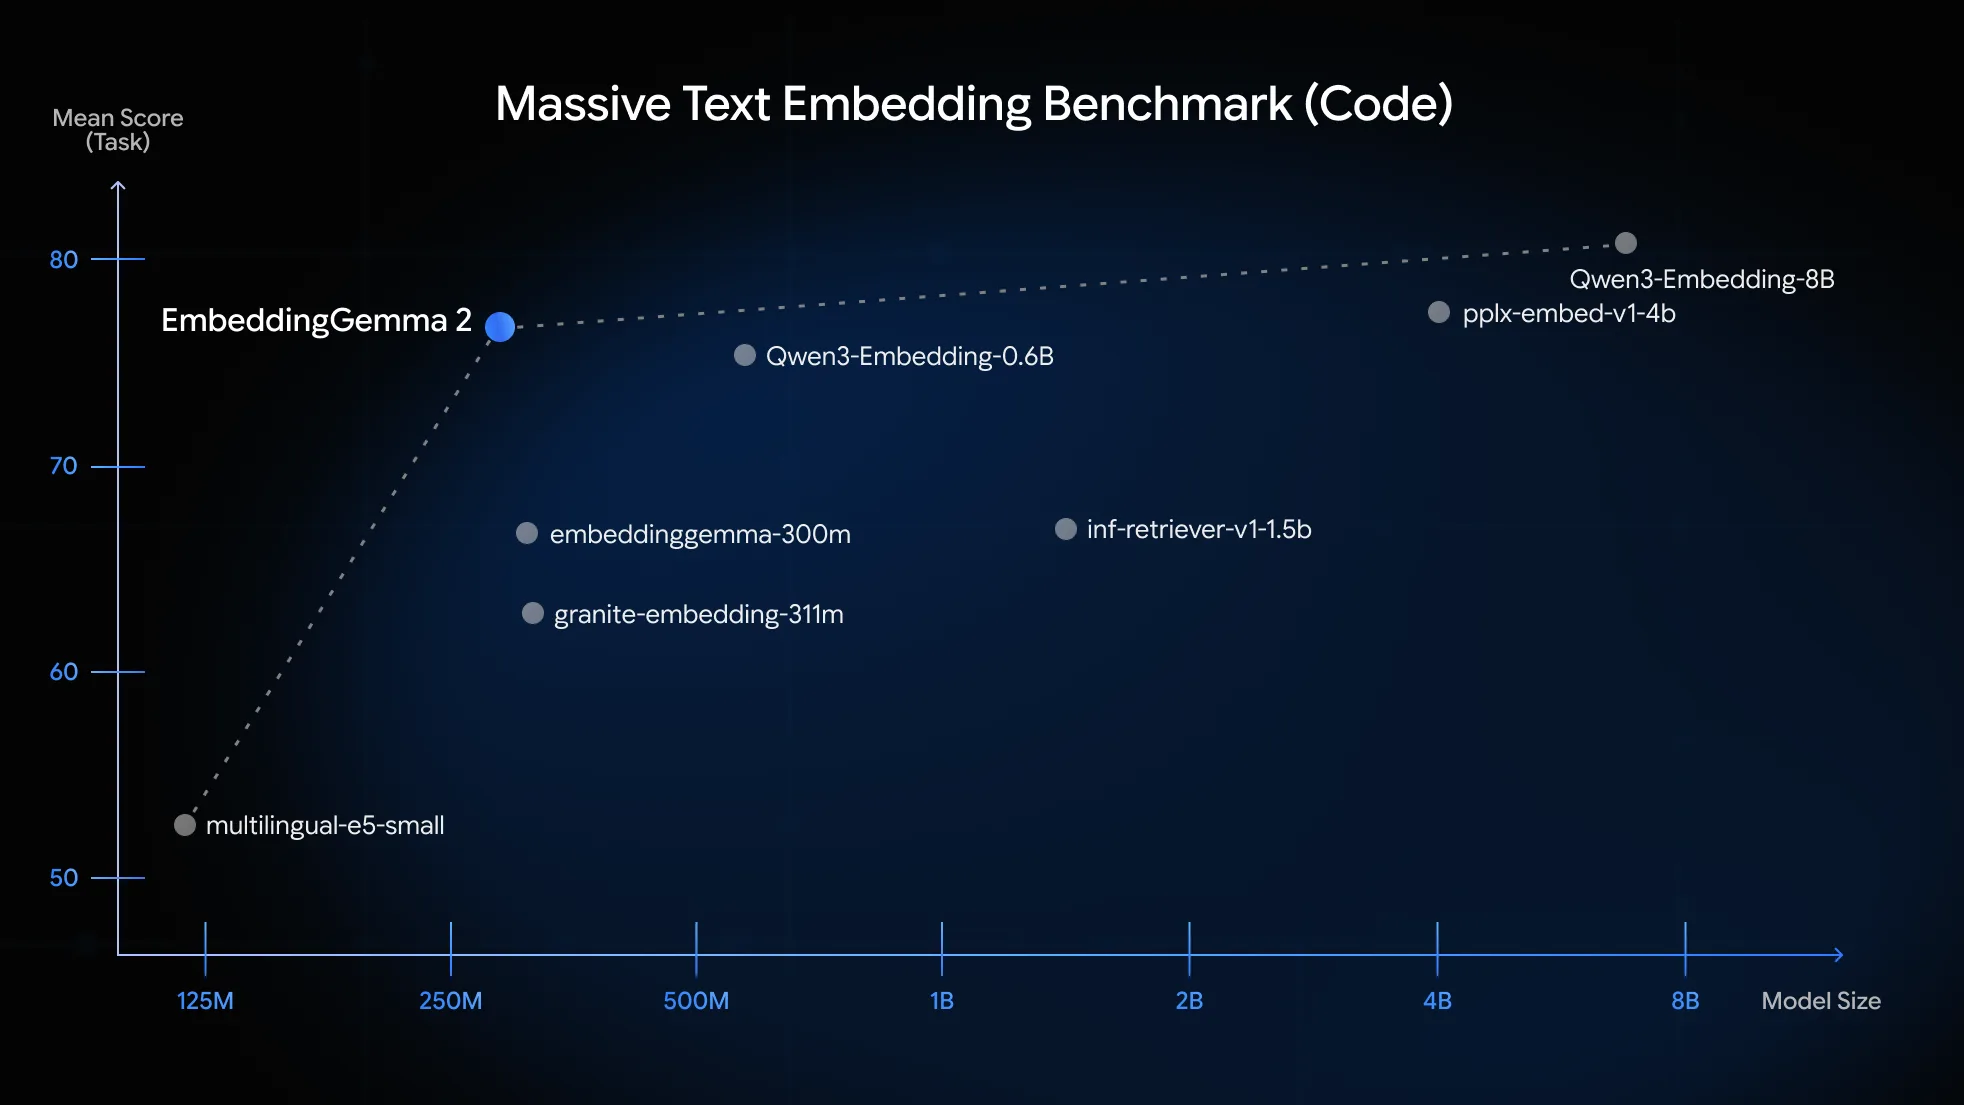
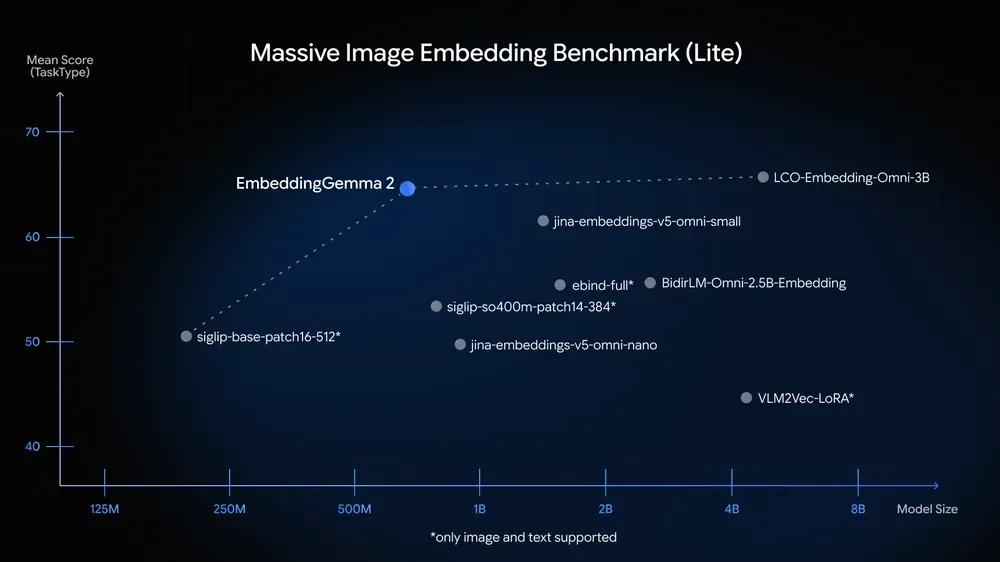
발표문의 코드 차트입니다. 가로축이 로그 스케일인 점에 주의하십시오. EmbeddingGemma 2는 Qwen3-Embedding-0.6B(2배 크기)보다 3점 높고, pplx-embed-v1-4b(13배)보다 약간 높으며, Qwen3-Embedding-8B(27배)에 2점 뒤집니다. "크기 대비"라는 조건이 붙을 때 이 모델은 분명히 파레토 선 위에 있습니다.
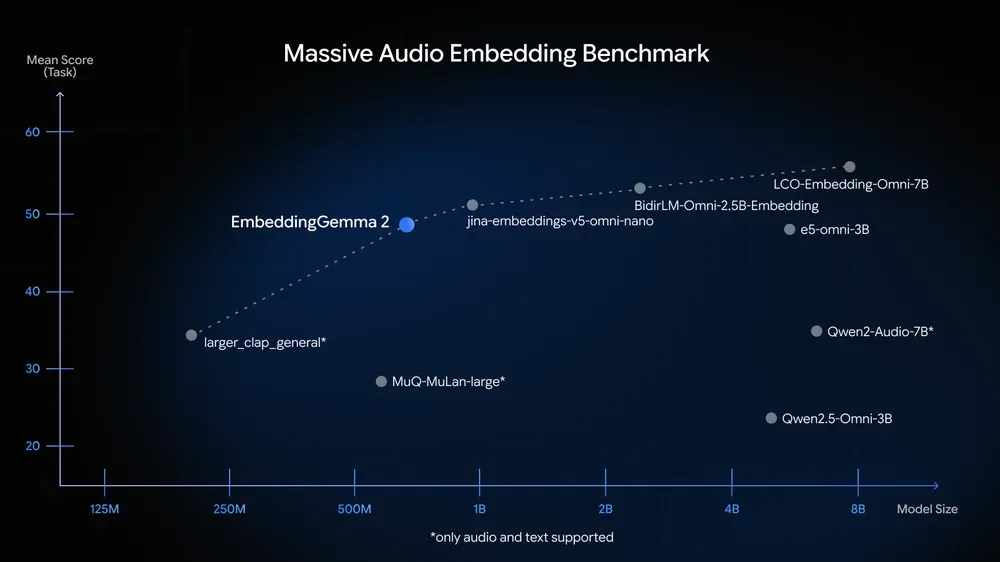
이미지와 오디오 차트는 다른 이야기를 합니다. 이미지에서 EmbeddingGemma 2(440M)는 3B짜리 LCO-Embedding-Omni와 같은 점수이고, 오디오에서는 1B급 jina-v5-omni-nano와 비슷하며 7B 모델에 7점 뒤집니다. 두 차트 모두 "이 크기에서 이 점수는 처음"이라는 메시지이지 "최고 점수"라는 메시지가 아닙니다.
구글이 보여 주지 않은 비교
발표문은 1세대와만 수치를 비교했고, 산점도에도 Qwen3-VL-Embedding·Gemini Embedding 2·SigLIP 2는 없습니다. 독일 매체 mixed-news는 "경쟁 모델과의 직접 비교를 피했다"고 지적했고, 해커뉴스에서는 "구글 자신의 SigLIP 2와 왜 비교하지 않았나"는 질문이 나왔습니다. 공개된 숫자를 모아 맥락을 만들면 이렇습니다.
해커뉴스의 한 사용자는 "텍스트 임베딩만 필요하다면 더 낫지도 빠르지도 않다"고 썼고, 이 표가 그 말을 뒷받침합니다. 이 모델의 가치는 다섯 모달리티를 폰 크기 안에 넣은 것이지 텍스트 검색의 새 기록이 아닙니다. 반대로 코드 검색은 진짜 도약이라서, 로컬 코드베이스 색인이라는 용도가 생겼습니다(7절).
얼마나 빠른가
LiteRT 커뮤니티가 기기 13종에서 잰 지연 표가 있습니다. 텍스트 하나를 임베딩하는 데 Pixel 11 Pro의 TPU에서 8.3ms, iPhone 18 Pro GPU에서 11.6ms, 맥북 M5 GPU에서 9.5ms입니다. 이미지를 더하면 50ms 안팎, 오디오를 더하면 150~200ms입니다. 라즈베리파이 5의 CPU는 텍스트 161ms, 전부 켜면 2.3초입니다. 해커뉴스의 minimaxir가 M3 Pro에서 잰 처리량은 텍스트 초당 78건, 이미지 초당 4건, 30초 오디오 초당 6건이었습니다. 아래 탐색기의 세 번째 탭에서 기기별로 비교할 수 있습니다.
구글이 AI Edge Gallery에 넣은 두 데모가 가장 직관적입니다. Instant Media Search는 사진첩 전체를 로컬 SQLite에 벡터로 저장해 두고 타이핑할 때마다 결과를 갱신합니다. Video Moments Finder는 "아이들이 웃는 장면", "개가 프리스비를 잡는 순간"처럼 글로 영상 속 시점을 찾되, 자막이나 캡션을 생성하지 않습니다. 프레임 벡터와 질의 벡터의 거리만 봅니다. 이것이 기존 방식과 다른 점입니다. 애플 사진의 자연어 검색이나 구글 포토의 "Ask Photos"는 사진에 설명을 붙이거나 클라우드에서 Gemini를 돌리지만, 이 방식은 설명 없이 좌표만으로 찾습니다.
오디오 쪽은 더 새롭습니다. 회의 녹음 42분짜리 파일을 25토큰/초로 자르면 5.5분 단위 벡터 8개가 됩니다. "지난달 매출 회의에서 예산 삭감 얘기 나온 부분"이라는 글 질의가 그 벡터 중 하나에 꽂히면 그 지점부터 재생하면 됩니다. 음성 인식(STT)을 거치지 않으니 화자가 웅얼거리거나 전문 용어가 섞여도 전사 오류가 끼어들 틈이 없습니다. 연구 쪽에서는 DCASE 2026의 "오디오 순간 검색" 과제가 같은 문제를 다루고 있고, 2026년 59개 시스템 가운데 최고가 기준선의 3.5배 재현율을 냈습니다.
코드베이스: 서버 없는 색인
코드 검색 78.68점이 실무에서 뜻하는 바를 Cursor와 Claude Code의 대비로 설명할 수 있습니다. Cursor는 코드를 청크로 잘라 서버에서 임베딩하고 Turbopuffer에 저장합니다. 파일 경로는 난독화하고 원문은 저장하지 않지만, 임베딩 역산(inversion) 연구를 "남은 위험"으로 스스로 인정합니다. Claude Code는 정반대로 색인을 아예 만들지 않고 grep과 파일 읽기로 매번 뒤집니다. 그 사이에 Continue.dev처럼 로컬에서 all-MiniLM(384차원)으로 임베딩하는 중간 노선이 있는데, 그 모델의 코드 검색 성능은 낮았습니다.
EmbeddingGemma 2의 텍스트 코어 270M은 191MB 메모리로 1.5B짜리 코드 전문 모델(jina-code 78.94)과 0.3점 차입니다. IDE 확장 프로그램 안에 들어가는 크기에서 처음으로 쓸 만한 코드 임베딩이 나온 것입니다. 모노레포 300만 청크를 256차원 int8로 저장하면 768MB입니다. 노트북 하나에 들어갑니다. 코드가 회사 밖으로 나가지 않는 코딩 에이전트 검색이 가능해졌다는 뜻이고, 발표문도 "로컬 코드베이스 색인, 시맨틱 코드 검색, 코딩 에이전트 검색"을 콕 집어 말했습니다.
법률·수사·보안: 영상 1시간에 6달러 대 0원
해커뉴스에서 한 변호사는 전자증거개시(e-discovery)를 예로 들었습니다. "허리케인 카트리나 이전에 지붕이 멀쩡했던 사진"을 사건 파일 수만 장에서 찾는 일입니다. 사진은 의뢰인의 것이고 클라우드에 올릴 수 없습니다. 경찰 바디캠과 CCTV도 같습니다. 미국 Axon은 2026년 4월 바디캠 영상에 대한 자연어 검색 도구를 내놨는데, 그 데이터는 CJIS 규정상 통제된 환경을 벗어날 수 없습니다.
비용도 봅니다. 구글의 클라우드 모델 Gemini Embedding 2는 오디오 100만 토큰에 6.50달러, 비디오 100만 토큰에 12달러입니다. EmbeddingGemma 2의 토큰 비율을 그대로 대입하면 오디오 1시간(9만 토큰)은 약 0.59달러, 1fps 비디오 1시간(50만 토큰)은 약 6달러입니다. 바디캠 1만 시간이면 6만 달러입니다. 온디바이스는 전기값뿐입니다. 텍스트 임베딩은 이미 100만 토큰에 2센트까지 떨어져 비용 논리가 약했지만, 오디오와 비디오에서는 비용 논리가 다시 살아납니다.
그림이 많은 매뉴얼: OCR 없는 문서 RAG
설비 매뉴얼, 회로도, 의료 영상 보고서처럼 표와 그림이 절반인 문서는 텍스트 추출이 망가지기 쉽습니다. ColPali(2024)가 페이지를 이미지로 임베딩하는 길을 열었고, EmbeddingGemma 2의 시각 문서 점수 67.84(MMEB v2 VisDoc)는 그 단일 벡터 버전입니다. 페이지 한 장이 280토큰이니 29쪽짜리 매뉴얼이 한 벡터에 들어가고, 쪽 단위로 자르면 "압력 밸브 교체 순서 그림"이라는 질의가 해당 쪽을 찾습니다. Gemma 4와 토크나이저를 공유하니 찾은 쪽을 그대로 Gemma 4에 넘겨 답을 생성하는 파이프라인이 메모리 한 벌로 돕니다. 발표문이 "온디바이스 RAG"라고 부른 구성입니다.
결정 엔진: 분류를 검색으로 바꾸기
MediaPipe의 Decision Task API는 임베딩의 덜 알려진 용도를 보여 줍니다. 미세 조정 없이, "가능한 행동 500개"의 설명을 벡터로 만들어 두고 들어오는 입력(이미지·텍스트·오디오)의 벡터와 가장 가까운 행동을 고릅니다. 100ms 안에 500개 선택지를 평가합니다. 분류기를 학습하는 대신 선택지를 글로 적어 두면 분류가 된다는 것이 CLIP의 제로샷 분류 그림(3절)이 10년 뒤 폰 안에서 구현된 모습입니다. 다만 해커뉴스에서는 "항공권 취소하고 카드 환불해 줘"라는 문장의 분류가 실패했다는 보고도 있었습니다. 제로샷 분류는 선택지 설명을 어떻게 쓰느냐에 크게 좌우됩니다.
2026년의 폰과 노트북은 이 모델을 돌릴 준비가 되어 있습니다. 8월에 나온 Pixel 11의 Tensor G6는 전 세대보다 TPU 연산이 50% 늘었고, 삼성 갤럭시 S26의 엑시노스 2600은 NPU 성능을 39% 올렸으며 삼성은 올해 말까지 갤럭시 AI 기기 8억 대를 목표로 잡았습니다. 애플은 WWDC26에서 온디바이스 파운데이션 모델에 Spotlight 기반 로컬 RAG 도구를 붙였고, 윈도우는 코파일럿+ PC의 40 TOPS NPU로 파일 탐색기 시맨틱 검색을 돌립니다. 파이어폭스는 브라우징 기록을 로컬 임베딩으로 검색하는 기능을 베타에 넣었습니다.
흥미로운 공백이 하나 있습니다. 안드로이드의 AICore·ML Kit GenAI와 크롬의 내장 AI는 요약·교정·번역 API를 제공하지만 임베딩 API는 없습니다. 그 자리를 채우는 것이 MediaPipe·LiteRT 위의 EmbeddingGemma이고, 구글은 "수 주 안에 ML Kit를 통해 NPU 가속 서비스로도 제공"하겠다고 했습니다. 즉 EmbeddingGemma 2는 안드로이드 플랫폼의 사실상 표준 임베딩이 될 가능성이 큽니다.
규제와 비용이 뒤에서 민다
EU AI법의 고위험 의무는 2026년 7월 옴니버스 개정으로 2027~2028년으로 미뤄졌지만, 투명성 의무와 GDPR은 그대로입니다. 의료에서는 환자 데이터의 임베딩 자체가 보호 대상 정보(PHI)로 취급되며, 임베딩 역산 공격 성공률 92%라는 보고가 규제 당국의 관심을 끌었습니다. "수집·검색·생성·로깅을 전부 병원 인프라 안에서"가 2026년 의료 AI의 기본 지침이고, 온디바이스 임베딩은 그 지침을 가장 싸게 만족시키는 방법입니다.
사이먼 윌리슨의 논점도 비용의 다른 얼굴입니다. 임베딩은 한 번 만들면 모델에 묶입니다. 다른 모델로 바꾸면 저장된 벡터 전부를 다시 계산해야 합니다. OpenAI는 2024년 4월 구모델 은퇴 때 재임베딩 비용을 보전해 줬지만 그것이 관례가 될 거라는 보장은 없습니다. 공개 가중치 모델이면 벤더가 사라져도 같은 벡터를 영원히 만들 수 있습니다. 그는 "직접 호스팅하고 싶지는 않다. 다만 호스팅이 끊겨도 내가 돌릴 수 있는 모델에 돈을 내고 싶다"고 썼습니다. Apache 2.0과 게이트 없는 다운로드가 이 모델의 기능 명세만큼 중요한 이유입니다.
한국: 망분리, KURE, 그리고 공개되지 않은 한국어 점수
한국의 조건은 온디바이스 임베딩에 특히 우호적입니다. 금융권 망분리 규정은 2026년 4월 개정으로 보안 평가를 받은 SaaS를 내부망에서 쓸 수 있게 됐지만, 고유식별정보와 개인신용정보 처리에는 예외가 없습니다. 2026년 6월 NextRise에서 한국증권금융 관계자가 요약한 딜레마가 그대로입니다. "외부 AI는 내부 데이터를 못 만지고, 내부망의 온프레미스 AI는 검색이 안 된다." 국정원의 「국가·공공기관 AI 보안 가이드북」(2025-12)과 개인정보위의 생성형 AI 안내서(2025-08)도 같은 방향입니다. 국내 기업의 55.7%가 이미 생성형 AI를 쓰고 2026년에는 85%를 넘을 전망인데, 그 대부분이 RAG를 필요로 합니다. 데이터가 밖으로 못 나가는 곳에서 RAG를 하려면 임베딩이 안에서 돌아야 합니다.
다만 한 가지를 분명히 해야 합니다. 구글은 EmbeddingGemma 2의 한국어 점수를 공개하지 않았습니다. MTEB 다국어 61.36은 131개 과제의 평균이고, 1세대와 사실상 같습니다. 한국에는 고려대 NLP&AI 연구실의 KURE가 있습니다. KURE-v2(2026-08)는 154M 파라미터로 MTEB-ko-retrieval에서 nDCG@10 0.816을 기록했고, bge-m3(0.751)·multilingual-e5-large(0.734)를 앞섭니다. 흥미롭게도 KURE-v2는 단일 벡터가 아니라 토큰마다 128차원을 두는 late interaction 방식입니다(9절의 논쟁과 이어집니다). 한국어 텍스트가 중심인 서비스라면 EmbeddingGemma 2를 쓰기 전에 MTEB-ko-retrieval에서 KURE·bge-m3-ko와 직접 비교해 보는 것이 맞습니다. 멀티모달이 필요할 때 비로소 이 모델의 비교 우위가 생깁니다. 국내 보도(AI타임스 10월 7일 등)는 사양을 전했지만 한국어 성능은 아직 아무도 재지 않았습니다.
9. 한계와 반론: 벡터 하나로는 안 되는 것
단일 벡터의 이론적 천장
2025년 8월 딥마인드와 존스홉킨스의 웰러 등이 낸 LIMIT 논문(ICLR 2026)은 임베딩 검색에 수학적 한계가 있음을 보였습니다. d차원 단일 벡터로 표현할 수 있는 "상위 k개 조합"의 수는 d에 의해 제한됩니다. 그들은 이 한계를 정확히 찌르는 데이터셋 LIMIT를 만들었습니다. 문서 5만 개, 질문 1천 개, 정답은 2개씩. 질문은 "누가 사과를 좋아하나?"처럼 쉽습니다. 그런데 최고 임베딩 모델들의 Recall@100이 8~19%였고, BM25는 Recall@2가 97.8%였습니다. 다중 벡터(GTE-ModernColBERT)는 54.8%였습니다. 이론상 문서 100만 개에서 상위 10개를 제대로 표현하려면 최소 52차원, 상위 100개면 425차원이 필요합니다. 128차원 마트료시카 절단이 어디서 한계에 부딪힐지를 이 논문이 알려 줍니다.
하이브리드가 기본값이다
2026년 실무의 합의는 "벡터만으로 검색하지 않는다"입니다. 벡터는 "활성화/비활성화 런북"처럼 단어 하나로 뜻이 뒤집히는 문서, 버전 번호, 에러 코드, 고유명사에 약합니다. BM25와 벡터 결과를 RRF로 합치고 상위 20~50개를 크로스 인코더로 재정렬하는 것이 표준 파이프라인입니다. 온디바이스에서도 같습니다. SQLite의 FTS5와 sqlite-vec를 나란히 두면 됩니다. 긴 문서는 8,192토큰 창이 있어도 청킹이 필요하고, 청크 경계에서 문맥이 끊기는 문제는 late chunking이나 contextual retrieval로 보완합니다.
단일 벡터 대 다중 벡터
ColBERT·ColPali·KURE-v2가 택한 late interaction은 토큰마다 벡터를 두고 MaxSim으로 비교합니다. 정확도는 높지만 저장이 10~50배 늘어납니다. 문서 100만 개 × 500토큰이면 128GB 대 12GB입니다. 폰에서는 단일 벡터가 현실적이고, 그래서 EmbeddingGemma 2는 단일 벡터입니다. 대신 LIMIT이 보여 준 천장을 안고 갑니다. "짧은 벡터로 후보를 추리고 비싼 방법으로 재정렬한다"는 MRL 논문의 적응형 검색이 이 둘을 잇는 실용적 타협입니다.
그 밖의 비판
마트료시카는 모델을 줄여 주지 않습니다. 해커뉴스의 지적대로 MRL은 출력 벡터만 자릅니다. 모델 자체를 줄이는 MatFormer와는 다릅니다. 128차원을 써도 연산량은 같습니다.
OCR이 아닙니다. 문서 이미지를 임베딩하지만 글자를 읽어 내지는 않습니다. 검색은 되지만 추출은 안 됩니다.
안전 조정이 없습니다. 생성 모델과 달리 사후 정렬·안전 튜닝을 거치지 않았다고 모델 카드가 명시합니다. 편향된 데이터가 편향된 공간을 만들 수 있고, 그것을 거르는 책임은 배포자에게 있습니다.
임베딩은 이해가 아닙니다. 2025~2026년의 여러 연구가 검색용 임베딩이 풍자·입장·프레이밍 같은 암묵적 의미에서 어휘 기준선과 큰 차이가 없음을 보였습니다. "비슷한 것을 찾는다"와 "뜻을 안다"는 다릅니다.
로컬 벡터 저장소도 데이터입니다. 임베딩에서 원문을 상당 부분 복원할 수 있습니다. 온디바이스는 전송 위험을 없애지만 기기 분실 위험은 그대로입니다. 벡터 DB도 암호화해야 합니다.
음악은 아직입니다. 음악 검색은 MuQ-MuLan 같은 전문 모델이 여전히 낫다는 보고가 있습니다. MAEB 차트에서도 음악 모델은 별도 점에 있습니다.
10. 실무자를 위한 체크리스트
텍스트만 쓸 거라면 굳이 바꿀 이유가 약합니다. 1세대 EmbeddingGemma나 Qwen3-Embedding-0.6B와 비교해 보십시오. 코드 검색이 주 용도라면 바꿀 이유가 충분합니다.
모달리티를 섞을 때 가치가 생깁니다. 사진·녹음·영상·스캔 문서를 글로 찾아야 하고 그것이 기기 밖으로 나갈 수 없다면, 2026년 10월 현재 이 크기에서 대안이 없습니다.
접두사를 지키십시오. 질의는 task: search result | query:, 문서는 title: none | text:. 코드는 task: code retrieval.
bf16 또는 float32. float16은 NaN.
긴 영상은 자르십시오. 1fps 기준 58프레임(약 1분)이 한 벡터의 한계입니다. 장면 단위로 색인하고 시작 시각을 함께 저장하십시오.
하이브리드로 가십시오. FTS5 + sqlite-vec, 또는 Qdrant의 sparse + dense. 상위 후보는 재정렬.
한국어는 직접 재십시오. MTEB-ko-retrieval에서 KURE-v2·bge-m3-ko와 비교한 뒤 결정.
Gemma 4와 짝지으십시오. 토크나이저와 오디오 인코더를 공유하니 RAG 파이프라인의 메모리가 한 벌로 줄어듭니다.
벡터 저장소를 암호화하십시오. 임베딩은 원문의 그림자입니다.
마무리: 좌표가 된 기억
1957년 퍼스의 문장은 단어에 관한 것이었습니다. 2026년 이 문장은 사진과 소리와 영상에도 적용됩니다. 어떤 것이든 "함께 나타나는 것"이 있으면 좌표를 얻습니다. EmbeddingGemma 2가 새로 발명한 것은 거의 없습니다. 평균 풀링은 2019년, 대조 손실은 2018년, N×N 행렬은 2021년, 마트료시카는 2022년의 것입니다. 이 모델이 한 일은 그 모든 것을 567MB 안에 넣고 Apache 2.0으로 내놓은 것입니다.
그것이 바꾸는 것은 데이터가 머무는 자리입니다. 지금까지 "검색 가능하다"는 말은 "서버에 올렸다"는 말과 거의 같았습니다. 이제 폰 안의 음성 메모, 노트북의 회사 코드, 병원의 영상 기록이 어디로도 가지 않은 채 좌표를 갖습니다. 그 좌표가 완벽하지는 않습니다. 단일 벡터의 천장이 있고, 한국어 점수는 아직 아무도 모르며, 텍스트만 보면 경쟁 모델이 더 낫습니다. 하지만 "내 기기 안의 모든 것을 하나의 공간에"라는 문장이 실제로 실행 가능해진 첫해로 2026년이 기록될 것이라는 점은 분명해 보입니다.