[특집] '이거 누가 알아요?'를 없애는 법 — 한 엔지니어링 매니저가 만든 AI 하이브 마인드, 조직의 암묵지를 끌어올리다
“시스템이 어떻게 돌아가는지 알아내려면 늘 3~4명을 한 방에 모아야 했다.” 핀테크 기업 SumUp의 엔지니어링 매니저 칸도스트가 2026년 8월 공개한 글은 이 한 문장에서 출발한다. 그는 저장소 66개를 git 서브모듈로 한 저장소에 묶고, 도메인마다 AGENTS.md를 두고, 저장소 하나만 보는 배경 에이전트와 그들을 지휘하는 주 에이전트를 나눠 ‘하이브 마인드’를 만들었다. 에이전트끼리는 Zod 스키마로 정한 JSON 보고서로만 인계하고, 매주 슬랙·노션의 변화를 모아 AGENTS.md를 고치는 PR을 사람이 검토한다. 이 글은 그 구조를 하나씩 뜯어보고, 폴라니의 ‘암묵지’(1966)와 노나카의 SECI 나선(1995), 콘웨이의 법칙(1968), 웨그너의 ‘누가 무엇을 아는가’(1985), ‘Lost in the Middle’과 ‘Context Rot’, 앤트로픽의 멀티 에이전트 연구와 버클리의 실패 분류(MAST)까지 이 설계가 왜 이런 모양이 됐는지를 사례와 함께 풀었다. AGENTS.md가 오히려 성능을 떨어뜨린다는 ETH 취리히의 반론과 2026년의 의미, 그리고 우리 팀에서 시작하는 법까지 여섯 개의 인터랙티브 도구와 함께 정리했다.
회사에서 이런 회의에 들어가 본 적이 있을 것이다. 새 기능을 기획하는데, 그 기능이 건드리는 시스템이 세 팀에 걸쳐 있다. 아무도 전체를 모른다. 그래서 각 팀에서 “그 부분을 제일 잘 아는 사람”을 한 명씩 불러 회의실에 앉힌다. 화이트보드에 상자와 화살표를 그리다 보면 한 사람이 “아, 그거 작년에 바뀌었어요”라고 말하고, 다른 사람이 “그건 저희 쪽에서 은퇴시키려던 건데요”라고 덧붙인다. 두 시간 뒤 그림은 완성되지만, 그 그림을 미로(Miro) 보드에 옮겨 적는 순간부터 그것은 낡기 시작한다.
2026년 8월 21일, 베를린에 사는 엔지니어링 매니저 칸도스트(Candost)가 자신의 블로그에 「Building an AI Hive Mind to Understand Systems as a Manager(관리자로서 시스템을 이해하기 위해 AI 하이브 마인드를 만들다)」라는 글을 올렸다. 그가 일하는 곳은 유럽의 결제 핀테크 SumUp이다. 400만 곳이 넘는 가맹점, 38개 시장, 3,000명 이상의 직원. 그의 표현으로는 “수천 개의 git 저장소, 수천 개의 슬랙 채널, 수백만 쪽의 문서”가 있는 회사다.
글의 출발점은 단 한 문장이다.
“I always had to gather 3-4 people in a room just to figure out how the system works.”
(시스템이 어떻게 돌아가는지 알아내려면 늘 3~4명을 한 방에 모아야 했다.)
이 글은 거창한 신제품 발표가 아니다. 한 관리자가 자기 일을 하려고 만든 사내 도구의 구축기다. 그런데 이 구축기에는 2026년 현재 AI 에이전트를 조직에 들이려는 거의 모든 팀이 부딪히는 문제가 다 들어 있다. 에이전트에게 무엇을, 얼마나, 어떤 순서로 보여 줄 것인가(컨텍스트 엔지니어링), 한 에이전트가 감당 못 하는 일을 어떻게 나눌 것인가(멀티 에이전트), 에이전트끼리 어떻게 일을 넘길 것인가(구조화된 인계), 그리고 가장 오래된 질문인 사람 머릿속에만 있는 지식을 어떻게 꺼낼 것인가(암묵지)까지.
이 특집은 원문을 처음부터 끝까지 따라가면서, 각 설계 결정 뒤에 있는 60년 치의 생각을 함께 꺼내 본다. 먼저 “3~4명을 방에 모으는 일”이 실제로 얼마나 비싼지부터 감을 잡아 보자.
1부. 왜 이런 개념이 나왔나 — 조직 지식이라는 오래된 문제
“우리는 말할 수 있는 것보다 더 많이 안다” (1966)
헝가리 출신의 화학자이자 철학자 마이클 폴라니(Michael Polanyi)는 1966년 책 『암묵적 영역(The Tacit Dimension)』에서 이렇게 썼다.
“We can know more than we can tell.”
(우리는 말할 수 있는 것보다 더 많이 안다.)
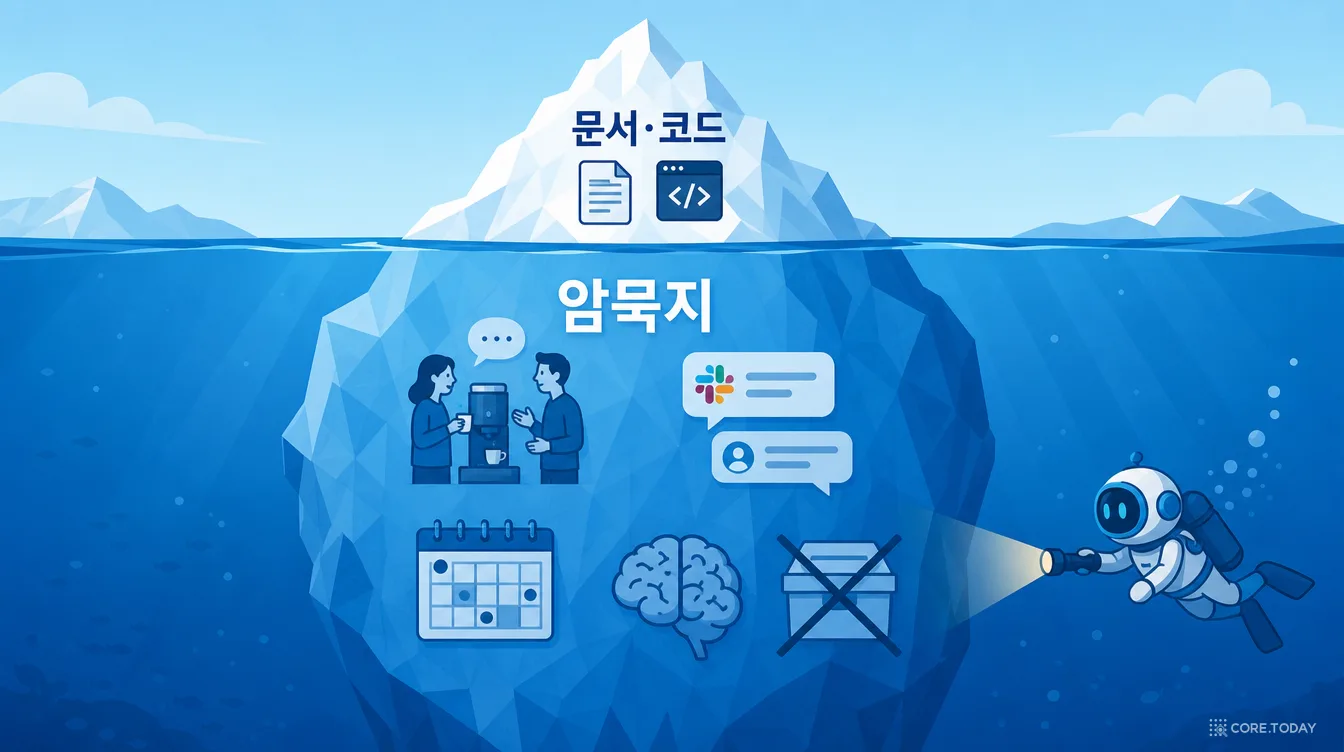
그가 든 예는 얼굴이다. 우리는 수천 명 사이에서 아는 얼굴 하나를 단번에 알아본다. 그런데 “어떻게 알아봤느냐”고 물으면 제대로 설명하지 못한다. 자전거 타는 법, 숙련된 의사의 진단 감각도 마찬가지다. 이렇게 글이나 규칙으로 옮기기 어렵고, 일을 할 때만 드러나는 지식을 암묵지(tacit knowledge)라고 부른다. 반대로 문서·코드·매뉴얼처럼 이미 꺼내져 있는 지식은 형식지(explicit knowledge)다.
소프트웨어 조직에서 암묵지는 무엇일까? 칸도스트는 자신이 매일 회의와 슬랙에서 주워 담는 정보를 이렇게 나열한다.
서로 다른 부족(tribe)과 스쿼드(squad)의 시스템이 어떻게 맞물려 돌아가는지
그들이 서로 어떤 데이터를 주고받는지
어느 팀이 어떤 흐름을 은퇴시키고 싶어 하는지, 어떤 흐름을 새로 시작하려 하는지
어떤 흐름은 꼭 필요하지 않으면 절대 건드리고 싶지 않은지
지금 겪는 문제와 곧 닥칠 문제
이 중 코드에 적혀 있는 것은 하나도 없다. settlement-core라는 저장소를 아무리 읽어도 “이건 오래돼서 다들 건드리기 무서워한다”는 사실은 나오지 않는다. 그런데 새 기능의 설계를 바꾸는 것은 바로 그런 정보다.
폴라니가 “말할 수 없는 지식이 있다”고 했다면, 일본의 경영학자 노나카 이쿠지로(野中郁次郎)와 다케우치 히로타카(竹内弘高)는 1995년 『지식 창조 기업(The Knowledge-Creating Company)』에서 그 지식이 조직 안에서 어떻게 움직이는지를 그렸다. 이것이 유명한 SECI 모델이다.
SECI는 2×2 표다. 세로는 지식이 어디서 출발하는지(암묵지/형식지), 가로는 무엇이 되는지(암묵지/형식지)를 뜻한다. 그러면 네 칸이 생긴다.
칸
변환
무슨 일이 일어나나
고전 사례
S 공동화(Socialization)
암묵지 → 암묵지
함께 일하며 몸으로 배운다
견습, 현장 실습, 옆자리에서 보고 배우기
E 표출화(Externalization)
암묵지 → 형식지
말·은유·모델·글로 끄집어낸다
노나카가 “지식 창조의 핵심”이라 부른 단계
C 연결화(Combination)
형식지 → 형식지
흩어진 문서를 엮어 더 큰 체계로
매뉴얼, 데이터베이스, 보고서 묶음
I 내면화(Internalization)
형식지 → 암묵지
문서를 읽고 해 보며 다시 내 것으로
매뉴얼을 따라 하다 손에 익는 순간
노나카가 1991년 하버드 비즈니스 리뷰에 소개한 사례가 유명하다. 1980년대 마쓰시타(현 파나소닉)는 가정용 제빵기를 만들고 있었는데, 시제품 빵이 도무지 맛이 없었다. 개발자 다나카 이쿠코는 오사카 국제호텔의 제빵장 옆에서 견습을 했다(공동화). 그리고 그가 반죽을 “비틀면서 늘리는(twisting stretch)” 독특한 동작을 한다는 것을 알아내, 그것을 기계 설계 사양으로 옮겼다(표출화). 제빵장 자신도 말로 설명하지 못하던 손놀림이 설계 문서가 된 것이다.
노나카는 이 네 단계가 한 번으로 끝나지 않고 S → E → C → I → S …로 계속 돌며, 개인에서 팀으로, 팀에서 조직으로 나선(spiral)처럼 넓어진다고 봤다. 그리고 이 나선이 돌려면 “바(場, ba)”, 즉 지식이 공유되는 장소가 필요하다고 했다. 회의실일 수도, 온라인 공간일 수도 있다.
이 이론을 왜 길게 설명했느냐 하면, 칸도스트의 하이브 마인드가 사실상 SECI 나선을 자동화한 장치이기 때문이다. 이 이야기는 2부 끝에서 위젯으로 다시 돌려 볼 것이다.
“누가 무엇을 아는가” — 트랜잭티브 메모리 (1985)
사회심리학자 대니얼 웨그너(Daniel Wegner)는 1985년, 오래 함께 산 부부를 연구하다 흥미로운 현상을 발견했다. 부부는 모든 것을 각자 기억하지 않는다. 남편은 자동차 보험 갱신일을, 아내는 친척 생일을 기억하고, 서로 “그건 저 사람이 알아”라는 색인만 갖고 있다. 웨그너는 이것을 트랜잭티브 메모리 시스템(transactive memory system)이라 불렀다. 집단 전체가 하나의 기억 장치처럼 움직이되, 각자는 내용 대신 “누가 무엇을 아는지”라는 목차를 들고 있는 구조다.
“이거 누가 알아요?”라는 질문은 바로 이 목차를 찾는 질문이다. 그리고 조직이 커질수록 목차가 망가진다. 사람이 바뀌고, 팀이 쪼개지고, 그 사람이 아는 줄 알았는데 이미 다른 팀으로 옮겨 갔다.
덴마크의 컴퓨터 과학자 피터 나우르(Peter Naur)는 1985년 논문 「이론 세우기로서의 프로그래밍(Programming as Theory Building)」에서 더 센 주장을 했다. 프로그래밍의 본질은 코드를 쓰는 게 아니라 프로그래머 머릿속에 “이 프로그램이 세상과 어떻게 연결되는지”에 대한 이론을 세우는 것이고, 그 이론은 코드나 문서에 완전히 담기지 않는다. 그래서 원래 팀이 모두 떠나면 그 프로그램은 돌아가고 있어도 “죽은” 것이라고 했다.
이게 과장이 아니라는 데이터도 있다. 브라질 미나스제라이스 연방대학의 아벨리노 등은 2016년 깃허브의 인기 프로젝트 133개를 분석해 “트럭 팩터(truck factor)”, 즉 몇 명이 트럭에 치이면(떠나면) 프로젝트가 멈추는지를 계산했다. 결과는 65%의 프로젝트가 2명 이하였다. 미국 지식 노동자 1,001명을 조사한 파놉토의 2018년 보고서는 직원이 가진 업무 지식의 42%가 그 사람만 아는 것이라고 답했다고 전한다.
조직도가 곧 시스템이 된다 — 콘웨이의 법칙 (1968)
멜빈 콘웨이(Melvin Conway)는 1968년 『데이터메이션』에 실린 짧은 글에서 이렇게 썼다.
“시스템을 설계하는 조직은 그 조직의 소통 구조를 복제한 설계를 만들어 낼 수밖에 없다.”
나중에 프레드 브룩스가 이를 “콘웨이의 법칙”이라 이름 붙였다. 하버드 경영대학원의 맥코맥(MacCormack) 등은 2012년, 같은 기능을 하는 소프트웨어를 긴밀하게 묶인 기업 조직과 느슨하게 흩어진 오픈소스 공동체가 각각 만든 경우를 비교했다. 느슨한 조직이 만든 쪽이 훨씬 모듈화돼 있었고, 한 부품의 변경이 다른 부품으로 번지는 정도(전파 비용)의 차이는 최대 8배였다. 이른바 “거울 가설(mirroring hypothesis)”의 실증이다.
이 법칙이 하이브 마인드에서 중요한 이유는 간단하다. 시스템의 경계가 조직의 경계를 따르므로, 시스템을 이해하려면 조직을 이해해야 한다. 그래서 칸도스트는 저장소를 “Kotlin 저장소, Go 저장소”처럼 기술로 나누지 않고 “제품과 팀이 어떻게 짜여 있는지”에 따라 나눴다. 그리고 에이전트 중 하나에게는 아예 콘웨이의 법칙, 도메인 주도 설계(DDD), 팀 토폴로지를 생각의 도구로 쥐여 줬다.
두 개념을 짧게 짚고 가자.
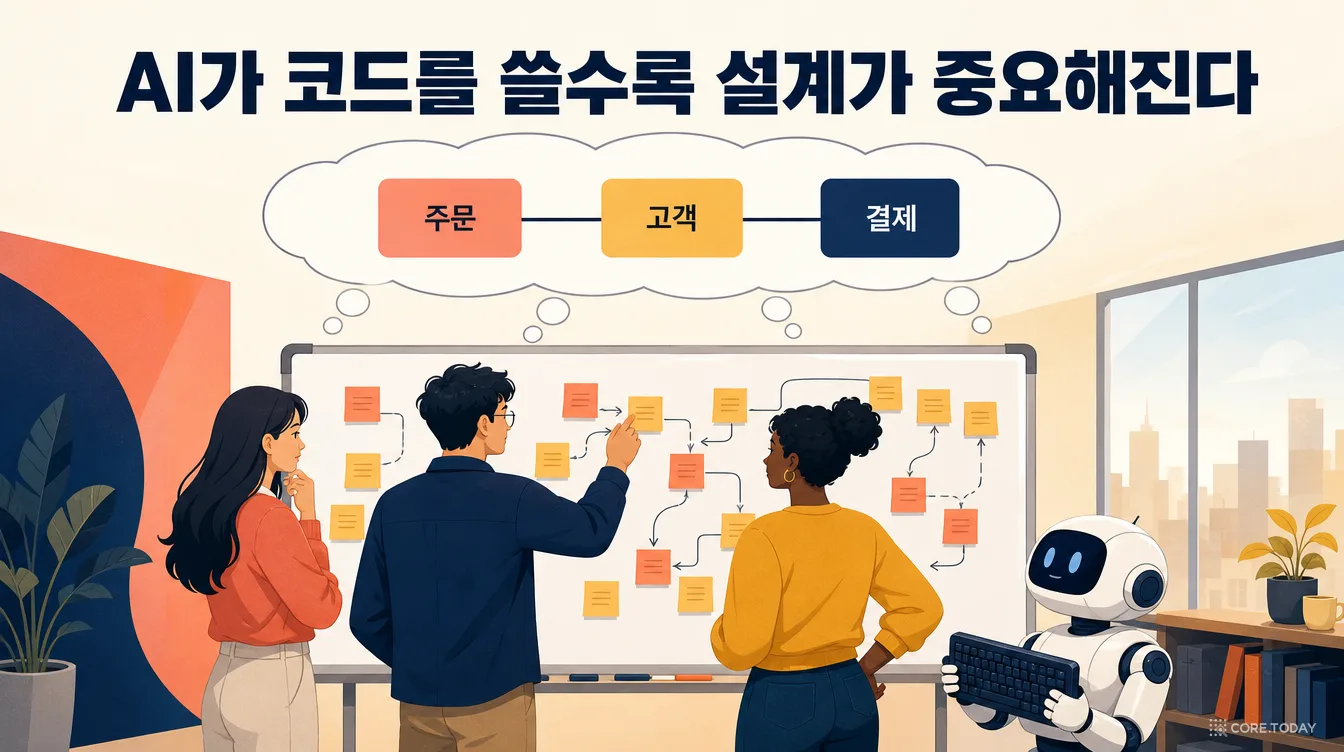
도메인 주도 설계(Domain-Driven Design, 에릭 에반스, 2003)의 “경계가 있는 맥락(bounded context)”: 같은 단어도 맥락마다 뜻이 다르다. 결제팀의 “고객”과 고객지원팀의 “고객”은 다른 개념이다. 그래서 하나의 모델과 하나의 용어 체계가 통하는 경계를 분명히 긋자는 생각이다. 하이브 마인드의 “저장소마다 경계가 있는 맥락이 있다”는 문장이 여기서 왔다.
팀 토폴로지(Team Topologies, 스켈턴·파이스, 2019)의 “인지 부하(cognitive load)”: 한 팀이 머릿속에 담을 수 있는 시스템의 양에는 한계가 있으니, 팀의 책임 범위를 그 한계에 맞춰 설계하자는 생각이다. 하이브 마인드에서 이 한계는 사람이 아니라 에이전트의 컨텍스트 창에 똑같이 적용된다.
숫자로 보는 “찾는 데 드는 시간”
이 문제가 얼마나 비싼지 보여 주는 숫자들이 있다. 출처와 성격이 다르니 하나씩 짚어 보자.
코드 이해에 쓰는 시간 (Xia 외, 2018)
58%
하루 30분+ 답을 찾는 개발자 (SO 2024)
60%+
주 10시간+ 잃는 개발자 (Atlassian 2025)
50%
그 사람만 아는 업무 지식 (Panopto 2018)
42%
샤 등(Xia et al., IEEE TSE 2018): 전문 개발자 78명의 실제 업무 3,148시간을 기록했더니 58%가 프로그램을 이해하는 데 쓰였다. 그중 상당 부분은 IDE가 아니라 웹 브라우저와 문서 편집기에서 일어났다. 개발자의 주 업무는 쓰기가 아니라 읽기와 찾기다.
스택 오버플로 개발자 설문 2024: 60% 이상이 매일 30분 넘게 답을 찾는 데 쓰고, 4명 중 1명은 1시간 넘게 쓴다. 30%는 지식 사일로가 일주일에 10번 이상 생산성을 떨어뜨린다고 답했고, 4명 중 3명은 이미 답한 질문에 또 답하고 있다고 했다.
아틀라시안 개발자 경험 보고서 2025 (개발자·관리자 3,500명): 절반이 주 10시간 이상을 비효율로 잃는다. 1위 원인은 정보 찾기(서비스, 문서, API)였다. 흥미로운 대목은 같은 응답자의 68%가 AI로 주 10시간 이상을 아낀다고 답했다는 점이다. AI로 번 시간을 조직의 마찰이 도로 가져가는 셈이다.
자주 인용되는 “지식 노동자는 업무 시간의 19%(하루 약 1.8시간)를 정보를 찾는 데 쓴다”는 맥킨지 글로벌 연구소(2012)의 숫자는 IDC의 추정치(2001, 15~35%)를 다시 계산한 것이라 직접 측정값은 아니다. 방향은 같지만 정밀한 숫자로 읽지는 말자.
지식 관리 도구 60년사 — 그리고 왜 아직도 회의를 잡는가
조직은 이 문제를 오래전부터 도구로 풀려 했다. 각 시대의 도구는 앞 시대의 한계를 풀었지만, 매번 새 한계에 부딪혔다.
1970~80년대
전문가 시스템(MYCIN, DEC의 XCON). 전문가의 지식을 “만약 ~이면 ~이다” 규칙으로 옮기려 했다. 가장 어려운 단계는 규칙을 실행하는 게 아니라 전문가 머릿속에서 규칙을 꺼내는 일이었다. 에드워드 파이겐바움은 이를 “지식 획득 병목”이라 불렀다. 폴라니의 문제가 그대로 돌아온 것이다.
1989~1995
그룹웨어와 위키. 로터스 노츠가 공유 문서 데이터베이스를, 워드 커닝햄의 WikiWikiWeb(1995)이 “누구나 고치는 문서”를 열었다. 쓰기는 쉬워졌지만 아무도 고치지 않는 문서가 쌓이기 시작했다.
2000~2010년대
컨플루언스, 사내 Q&A, 코드 검색. 기업 위키가 표준이 됐고, 스택 오버플로 포 팀즈와 소스그래프 같은 코드 검색이 등장했다. 문제는 여전히 낡음(staleness)이었다. 칸도스트의 말로는 미로 보드가 “텍스트 문서보다도 빨리 낡았다.”
2019~2023
엔터프라이즈 검색과 RAG. 글린(Glean) 같은 도구가 슬랙·드라이브·지라를 한꺼번에 검색해 주고, 루이스 등의 RAG(검색 증강 생성, NeurIPS 2020)가 “찾아서 읽고 답하는” LLM의 기본 구조가 됐다. 하지만 찾을 수 있는 것은 이미 적힌 것뿐이었다.
2023~2025
긴 컨텍스트와 그 한계. 컨텍스트 창이 수십만~백만 토큰으로 늘자 “다 넣으면 되지 않나?”라는 생각이 퍼졌다. 그러나 ‘Lost in the Middle’과 ‘Context Rot’ 연구가 많이 넣을수록 덜 정확해진다는 것을 보여 줬다(아래에서 자세히).
2025~2026
에이전트와 컨텍스트 엔지니어링. AGENTS.md가 표준이 되고(2025년 12월 리눅스 재단 산하 재단으로 이관), 에이전트가 직접 코드를 읽고 하위 에이전트를 부리는 시대. 칸도스트의 하이브 마인드는 이 위치에 서 있다. 처음으로 “읽는 쪽”이 지치지 않는 독자가 됐다.
다 넣으면 안 되는 이유: Lost in the Middle과 Context Rot
“컨텍스트 창이 100만 토큰인데, 저장소 66개를 그냥 다 넣으면 되지 않나?” 이 질문에 대한 답이 하이브 마인드 구조의 절반을 설명한다.
① Lost in the Middle (스탠퍼드 등, 2023). 넬슨 리우(Nelson Liu) 등은 모델에게 문서 10·20·30개를 주고, 그중 하나에만 정답이 있는 질문을 던졌다. 그리고 정답 문서의 위치를 맨 앞부터 맨 뒤까지 옮겨 가며 정확도를 쟀다. 결과 그래프는 U자였다.
Lost in the Middle — 정답 문서의 위치에 따른 정확도 (개념도)
정답 문서가 맨 앞
높음 (초두 효과)
정답 문서가 한가운데
가장 낮음
정답 문서가 맨 뒤
다시 높음 (최신 효과)
(바 길이는 U자 모양을 보여 주기 위한 개념도다.) 사람이 긴 목록의 처음과 끝을 잘 기억하는 것(초두 효과·최신 효과)과 비슷하게, 모델도 가운데 있는 정보를 놓쳤다. GPT-3.5-Turbo는 위치에 따라 정확도가 20%포인트 넘게 흔들렸고, 문서가 20~30개일 때 최악의 위치에서는 문서를 아예 주지 않았을 때(56.1%)보다도 낮았다. 정답을 줬는데 안 준 것보다 못한 것이다. 컨텍스트 창을 늘린 버전도 나아지지 않았다.
② Context Rot (크로마, 2025). 벡터 데이터베이스 회사 크로마는 2025년 7월, GPT-4.1·Claude 4·Gemini 2.5·Qwen3 등 18개 모델을 시험해 입력이 길어질수록 모든 모델이 덜 믿을 만해진다는 보고서를 냈다. 단어를 그대로 베껴 쓰는 것 같은 아주 쉬운 과제에서도 그랬다. 비슷하지만 틀린 정보(방해물)가 섞이면 더 나빠졌다. 이 현상에 붙은 이름이 “컨텍스트 부패(context rot)”다.
그래서 앤트로픽은 2025년 9월 「AI 에이전트를 위한 효과적인 컨텍스트 엔지니어링」에서 목표를 이렇게 정리했다. “원하는 결과를 낼 가능성을 최대로 하는, 가능한 가장 작은 고신호(high-signal) 토큰 묶음을 찾아라.” 쇼피파이의 토비 뤼트케와 안드레이 카르파티가 2025년 6월 “프롬프트 엔지니어링보다 컨텍스트 엔지니어링”이라는 말을 퍼뜨린 것도 같은 흐름이다. 카르파티의 표현으로는 “다음 단계에 딱 맞는 정보로 컨텍스트 창을 채우는 섬세한 기술이자 과학”이다.
칸도스트가 겪은 일은 이 연구들의 현장 버전이다. 그리고 그의 해법 — 저장소마다 따로 읽는 작은 에이전트를 보내고, 큰 에이전트는 요약 보고서만 읽게 하는 것 — 은 이 연구들이 가리키는 방향과 정확히 겹친다.
2부. 원문 정독 — 하이브 마인드는 어떻게 만들어졌나
첫 번째 시도: 범용 에이전트 하나
칸도스트의 첫 시도는 평범했다. SumUp이 노션을 쓰니 노션 커스텀 에이전트로 AI 프로젝트를 만들고, 깃허브 등 몇 가지 도구를 연결하고, 목적과 기대를 최대한 구체적으로 적은 지시문을 썼다. 거대한 노션 작업 공간과 여러 저장소를 탐색할 때 참고할 문서도 몇 개 따로 만들었다.
한 팀의 도메인 안에서는 쓸 만했다. 문제는 도메인 경계를 넘기 시작하면서 생겼다.
“더 많은 도메인과 저장소를 연결할수록, 올바른 정보를 끌어올리는 능력은 떨어졌다. 읽으라고 분명히 지시한 문서를 읽지 않고 넘어가는 일이 잦았다. 도구 호출은 가끔 시간 초과로 끝났고, 에이전트는 별다른 설명 없이 무작위로 실패했다.”
그의 결론은 이랬다. “신뢰도는 그럭저럭 괜찮았다. 하지만 내 일을 맡길 만큼 믿을 수는 없었다.” 그래서 그는 “궁극의 지식 노동자가 되겠다고 주장하는 다음 AI SaaS 제품”을 찾는 대신, 직접 만들기로 했다.
두 번째 시도: 하이브 마인드
두 번째 시도의 핵심은 범위를 좁힌 것이었다. 수천 개 저장소 전체가 아니라 SumUp의 세 가지 핵심 구성 요소 — 두 개의 도메인과 하나의 공유 모바일 앱 — 만, 그리고 자신이 맡은 도메인을 중심으로. 그는 결과를 한 문장으로 적었다. “This approach has worked(이 방식은 통했다).”
원문이 정리한 구성은 이렇다.
구성 요소
내용
역할
저장소 하나
관련 저장소 약 66개를 git 서브모듈로 연결
에이전트가 한곳에서 모든 코드를 본다
AI 도구 넷
OpenCode(심장, LLM 공급자에 연결) + 노션 + 커서
대화형 조사 / 주간 지식 갱신
커스텀 에이전트 6개
사용자용 주 에이전트 + 배경 에이전트
질문을 나눠 맡는다
문서들
여러 개의 AGENTS.md, MEMORY.md 하나, SOUL.md 하나
도메인 맥락, 기억, 성격
수집 에이전트 1
정보를 모아 보고서와 깃허브 이슈를 만든다
주간 표출화
갱신 에이전트 1
이슈를 읽고 지식 베이스·AGENTS.md를 고치는 PR
주간 연결화
사람 1명
보고서를 읽고, 실수를 고치고, 불필요한 부분을 지우고, 병합
품질의 마지막 관문
커스텀 CLI
서브모듈을 올리고 내리는 도구
디스크와 토큰 절약
그리고 그는 이렇게 덧붙인다. “That's it(그게 다다).” 정말로 이게 다다. 벡터 데이터베이스도, 지식 그래프도, 사내 플랫폼팀의 지원도 없다. 이제 하나씩 뜯어보자.
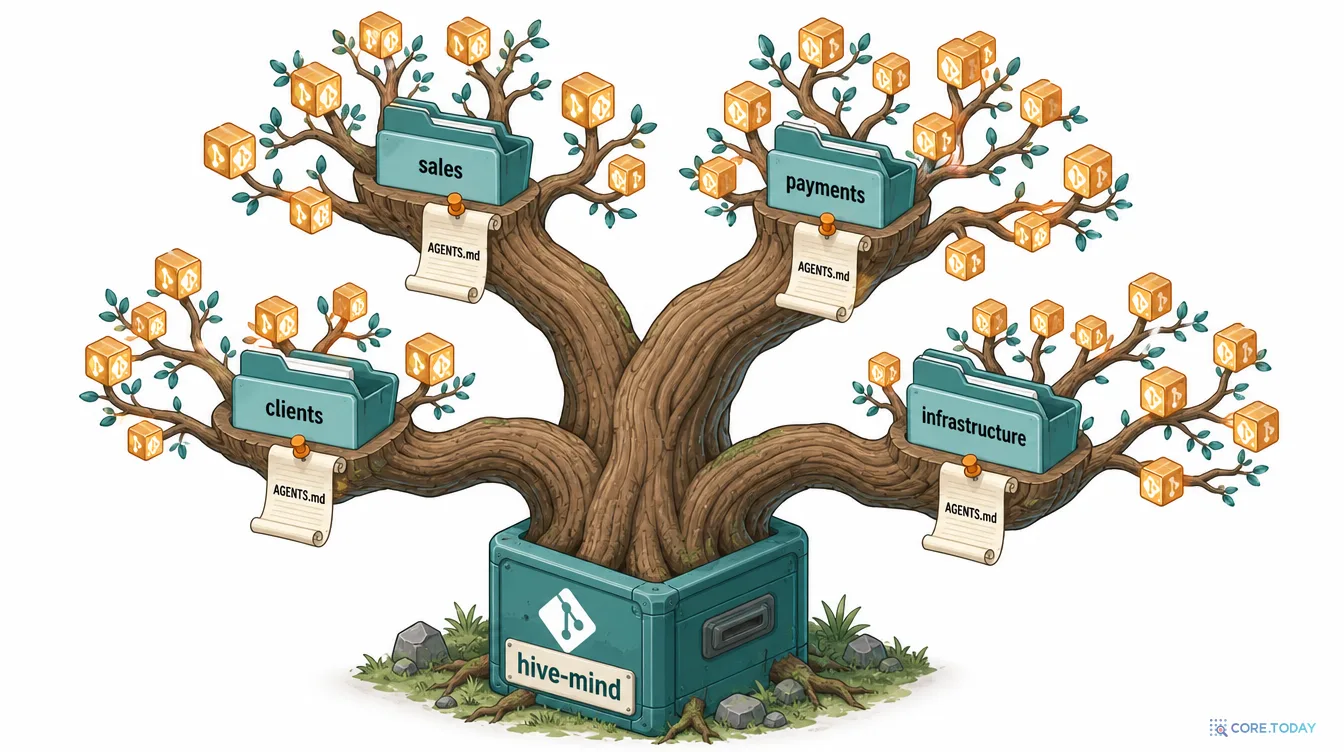
git 서브모듈(submodule)은 한 git 저장소 안에 다른 git 저장소를 “링크”처럼 넣는 기능이다. 실제 코드를 복사하는 게 아니라 “이 폴더에는 저 저장소의 이 커밋이 들어간다”는 포인터만 저장한다. 그래서 각 저장소는 원래 팀의 것으로 그대로 남고, 하이브 마인드 저장소는 그것들을 한 지붕 아래 모아 보여 주는 목차 역할만 한다.
60개가 넘으니 폴더 구조가 필요했다. 칸도스트는 여기서 중요한 결정을 한다. 기술 기준(언어별)이 아니라 제품과 팀의 구조를 따라 묶었다. 원문의 예시 구조를 옮기면 이렇다.
hive-mind/ (원문 예시 구조)
domains/
sales/ AGENTS.md ← 도메인 전체의 맥락
core/ → repos/ + AGENTS.md
reporting/ → repos/ + AGENTS.md
payments/
processing/ → repos/ + AGENTS.md
payouts/ → repos/ + AGENTS.md
clients/ ← Sales API를 부르는 앱들
infrastructure/ ← 플랫폼 공통
도메인 폴더의 AGENTS.md에는 특정 저장소의 설명이 들어가지 않는다. 대신 이런 것들이 들어간다.
도메인의 정의와 원칙, 구조
은퇴 계획 — 예를 들어 “어떤 팀이 이 서비스를 없애고 싶어 하지만 아직 활성 프로젝트는 없다”
진행 중인 중·대규모 프로젝트
다시 말해, 1부에서 본 암묵지 목록이 그대로 들어간다. 코드에서는 절대 안 나오는 정보다.
AGENTS.md란? AI 코딩 에이전트를 위한 README다. 사람용 README가 “이 프로젝트를 어떻게 쓰나”를 설명한다면, AGENTS.md는 “에이전트가 이 폴더에서 일할 때 알아야 할 것”을 적는다. 2025년 8월 오픈AI가 제안했고, 2025년 12월 9일 리눅스 재단이 에이전틱 AI 재단(AAIF)을 세우며 앤트로픽의 MCP, 블록의 goose와 함께 창립 프로젝트로 넘겨받았다. 발표 당시 6만 개 이상의 오픈소스 프로젝트와 Codex, 커서, 깃허브 코파일럿, 제미나이 CLI, 데빈 등이 이 형식을 쓰고 있었다. 규칙 중 하나가 하이브 마인드에 특히 중요하다. “편집하는 파일에서 가장 가까운 AGENTS.md가 이긴다.” 그래서 루트 → 도메인 → 서브도메인 → 저장소로 내려갈수록 더 구체적인 맥락이 덮어쓰는 계층 구조가 자연스럽게 생긴다.
칸도스트는 이 AGENTS.md를 어떻게 썼을까? 도메인 템플릿을 하나 만들고, AI로 노션과 슬랙에서 정보를 뽑아 채운 뒤, 자신의 조직 지식과 무작위 점검으로 검증했다. 그리고 이렇게 고백한다.
“이 부분이 가장 많은 시간을 잡아먹었다. 교차 도메인 질문에 좋은 답이 나올 때까지 AGENTS.md를 정말 많이 고쳤다.”
또 하나 눈여겨볼 점은 처음부터 다 넣지 않았다는 것이다. 몇 개 저장소만 넣고, 좋은 모델과 OpenCode로 교차 도메인 질문을 던져 보며 평가했다. 작게 시작해서 질문으로 검증하는 방식이다.
아래 탐색기에서 폴더를 눌러 층마다 AGENTS.md가 어떻게 달라지는지, 서브모듈을 올리고 내릴 때 디스크가 어떻게 변하는지 직접 만져 보자.
서브모듈 관리라는 숨은 비용. 원문의 괄호 속 고백이 현실적이다. 서브모듈 관리는 “상당한 부담”이었다. 이 시스템을 쓸 사람 중에는 git을 모르는 사람도 있고, 어떤 저장소는 혼자 수 GB였다. 그래서 그는 필요한 모듈만 내려받고 다 쓰면 지우는 CLI 도구를 만들었다(“바이브 코딩으로 만들어서 어떻게 돌아가는지 나도 모른다”고 한다). 기능은 소박하다. 모듈·그룹·도메인 단위로 올리기/내리기, 상태 보기, 연결은 유지한 채 파일만 지워 공간 확보하기, 자주 쓰는 묶음 정의하기. 중요한 건 에이전트도 git 대신 이 CLI를 쓴다는 점이다. 명령 하나로 묶음을 올리니 토큰이 덜 든다.
② 10개의 벽 — 모델이 “자기 마음대로” 하기 시작하는 지점
원문에서 가장 많이 인용될 만한 관찰은 괄호 속에 숨어 있다.
“앤트로픽의 Opus가 버거워하기 시작한 순간은 대략 저장소 10개 무렵이었다.”
10개를 넘자 이상한 일이 벌어졌다. 모델이 어떤 때는 하위 에이전트를 무작위로 띄워 일을 나누고, 어떤 때는 혼자 다 하려 했다. 이 들쭉날쭉함이 모델 자신을 헷갈리게 했다. 서로 다른 도메인의 저장소를 같은 범위로 착각한 것이다.
각 저장소에는 고유한 경계가 있는 맥락, 관행, 구조가 있고, 프로그래밍 언어도 다르다. 그런데 그는 이렇게 썼다.
“‘critical’이나 ‘must’ 같은 단어를 써서 아무리 분명하게 말해도, 모델은 제 ‘마음’대로 했다. 그래서 길들여야(taming) 했다.”
이 문장은 2025~2026년 에이전트를 만들어 본 사람이라면 다 공감할 것이다. 프롬프트에 대문자로 “반드시”를 써 봐야 구조를 이기지 못한다. 해법은 말이 아니라 구조였다. 하위 에이전트를 미리 정의해 두고, 주 에이전트가 정해진 형식의 명령으로만 파견하게 한 것이다.
아래 시뮬레이터로 그 차이를 느껴 보자. 질문 범위를 “도메인 교차”로 두고 연결된 저장소를 1개에서 66개로 늘려 보면, 단일 에이전트의 컨텍스트가 어떻게 차오르는지 보인다.
③ 에이전트 조직도 — 누가 누구에게 일을 시키나
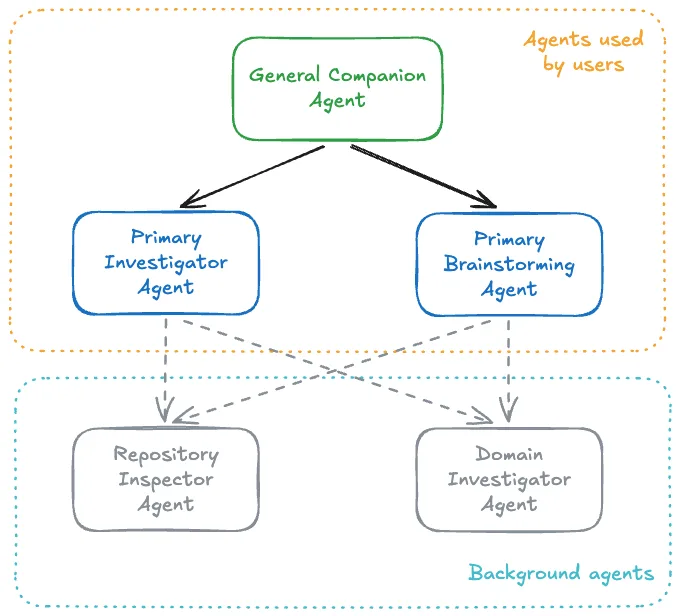
칸도스트는 OpenCode에서 에이전트를 직접 정의했다. 원문에 실린 그림이 구조를 잘 보여 준다.
위쪽 주황색 점선 상자 — “사용자가 쓰는 에이전트”. 사람이 직접 대화하는 에이전트들이다. 맨 위 초록색 General Companion(범용 동반자)이 두 개의 파란 상자 Primary Investigator(주 조사관)와 Primary Brainstorming(주 브레인스토머)를 부를 수 있다(실선 화살표).
아래쪽 하늘색 점선 상자 — “배경 에이전트”. 회색 Repository Inspector(저장소 점검관)와 Domain Investigator(도메인 조사관). 사용자는 이들을 직접 부를 수 없다. 오직 주 에이전트만 파견한다(점선 화살표).
점선 화살표가 X자로 교차한다는 데 주목하자. 두 주 에이전트가 같은 배경 에이전트 풀을 공유한다. 조사든 브레인스토밍이든, 저장소 하나·도메인 하나를 들여다보는 일은 같은 전문가에게 맡긴다.
본문에는 그림에 없는 에이전트도 하나 더 나온다. “하이브의 정신(The Mind of the Hive)”이라는 리더십 에이전트다(뒤에서 설명). 원문은 “6개의 커스텀 에이전트”라고 썼고, 본문에서 이름이 나오는 것은 이렇다.
컨텍스트를 작게 유지하려고. 저장소 하나로 범위를 제한한 에이전트를 보내야 그 에이전트의 컨텍스트가 작고 깨끗하다.
비용 때문에. 저장소 하나 안에서는 Opus나 Fable 같은 최상위 모델이 필요 없다. “Sonnet이나 GPT-Terra(심지어 Haiku)로 충분하다.” 하지만 전체 그림을 엮는 일에는 Opus나 GPT-Sol급이 필요하다. 그는 “Fable에 높은 추론 설정이면 아마 혼자서도 할 수 있겠지만, 내 예산으로는 큰돈이 든다”고 썼다.
인계의 일관성. 범용 하위 에이전트가 주 에이전트에게 일을 넘길 때 그 내용은 “무작위”였다. 도메인마다 같은 형식의 보고서가 와야 주 에이전트가 같은 입력을 받고, 나중에 사람도 읽을 수 있다.
배우고 싶어서. 구조화된 인계가 있는 시스템을 설계하는 법을 익히고 싶었다.
OpenCode에서는 이것을 어떻게 구현하나? OpenCode는 오픈소스 코딩 에이전트 도구(MIT 라이선스)로, 에이전트를 주 에이전트(primary)와 하위 에이전트(subagent)로 나눈다. 주 에이전트는 사용자가 탭 키로 전환하며 대화하고, 하위 에이전트는 @멘션이나 주 에이전트의 호출로만 움직인다. 각 에이전트마다 모델, 지시문, 권한을 따로 줄 수 있는데, 권한 중 task 항목이 “이 에이전트가 어떤 하위 에이전트를 부를 수 있는지”를 정한다. “사용자는 배경 에이전트를 직접 부를 수 없다”, “리더십 에이전트는 주 에이전트만 부를 수 있다” 같은 규칙이 이 권한으로 만들어진다. 프롬프트로 “부르지 마라”라고 비는 게 아니라 권한으로 막는 것이다.
사람의 팀과 닮았다. 칸도스트는 이 구조를 사람의 조직에 빗댄다. “각 팀이 도메인과 저장소를 소유하고, 그 도메인의 맥락에 따라 조사·브레인스토밍을 어떻게 할지 정한다. 프로젝트나 일을 넘길 때는 (이상적으로는) 인계 문서가 있다.” 배경 에이전트가 하나의 팀이고, 그들의 보고서가 인계 문서다.
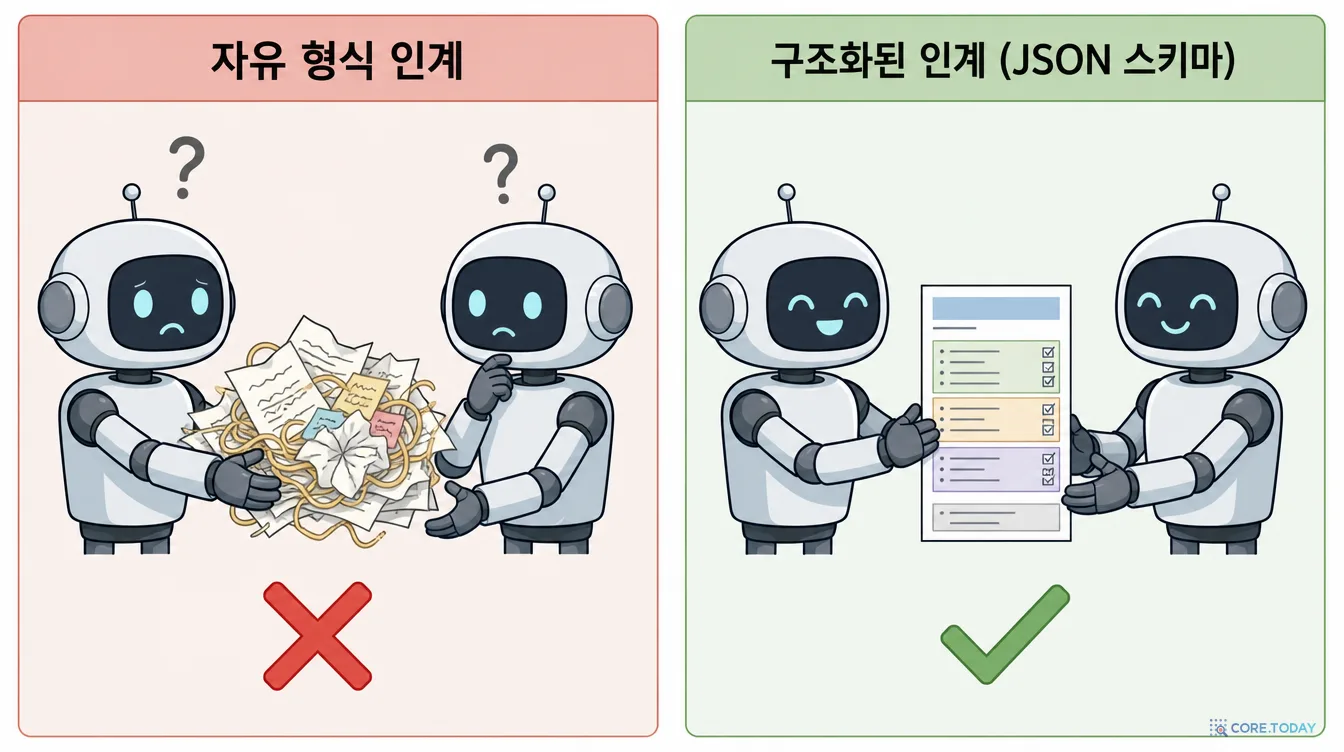
배경 에이전트는 일이 끝나면 Zod 스키마로 정의한 명확한 JSON 구조의 보고서를 낸다. Zod는 타입스크립트에서 “데이터가 이런 모양이어야 한다”를 선언하고 검사하는 라이브러리다. 예를 들어 “summary는 문자열, findings는 배열이고 각 항목에 근거와 확신도가 있어야 한다”고 적어 두면, 그 모양에 안 맞는 데이터는 거부된다.
칸도스트는 여기에 두 가지를 더했다.
보고서를 쓰고 읽는 전용 도구를 만들고, 에이전트가 보고서를 다룰 때 이 도구를 쓰도록 했다.
주 에이전트도 같은 스키마를 불러와 형식을 미리 안다. 그래서 보고서 전체를 다시 읽지 않고 필요한 부분만 바로 꺼내 읽는다. 그는 “에이전트가 더 이상 보고서 구조를 매번 알아낼 필요가 없어져 더 빨라졌다”고 썼다.
OpenCode의 커스텀 도구는 인자를 tool.schema로 정의하는데, 공식 문서에 따르면 이것이 “그냥 Zod”다. 그가 Zod를 고른 데는 도구의 구조적 이유도 있었던 셈이다.
이 설계가 왜 중요한지는 연구가 말해 준다.
앤트로픽의 멀티 에이전트 연구 시스템(2025년 6월): 하위 에이전트에게 일을 맡길 때는 목표, 출력 형식, 쓸 도구와 출처에 대한 안내, 분명한 작업 경계를 줘야 한다고 했다. 지시가 모호하면 하위 에이전트들이 같은 일을 중복해서 했다. 또 하위 에이전트의 결과를 파일 시스템에 직접 남겨 “전화 놀이(game of telephone)” — 말이 전달될수록 왜곡되는 현상 — 를 줄였다고 썼다.
메타GPT(2023, ICLR 2024): 여러 에이전트에게 제품 관리자·설계자·엔지니어 역할을 주고, 자유 대화 대신 PRD, 설계 문서, 인터페이스 명세 같은 구조화된 문서를 주고받게 했다. 논문은 이것을 “Code = SOP(Team)”, 즉 사람 조직의 표준 운영 절차(SOP)를 에이전트에게 입힌 것이라 불렀고, 구조화된 중간 산출물이 모호함과 환각의 전파를 줄인다고 했다.
“멀티 에이전트 LLM 시스템은 왜 실패하나?”(UC 버클리, 2025): 7개 프레임워크의 실행 기록 1,600여 건을 분석해 실패를 14가지 유형, 3개 범주로 분류했다(MAST). 비중을 보면 명세 문제 약 42%, 에이전트 간 불일치 약 37%, 검증 문제 약 21%. 즉 실패의 대부분은 모델이 멍청해서가 아니라 일을 불분명하게 맡기고, 서로 잘못 넘겨서 생긴다. 사람 조직의 문제와 똑같다.
아래 위젯에서 같은 질문에 대한 세 배경 에이전트의 인계를 자유 형식과 스키마 형식으로 비교해 보자. ③번 탭에서 touchpoints 필드만 모아 보면 앱 → 주문 → 정산으로 이어지는 경로가 저절로 드러난다.
⑤ 주 에이전트들 — 점을 잇는 일
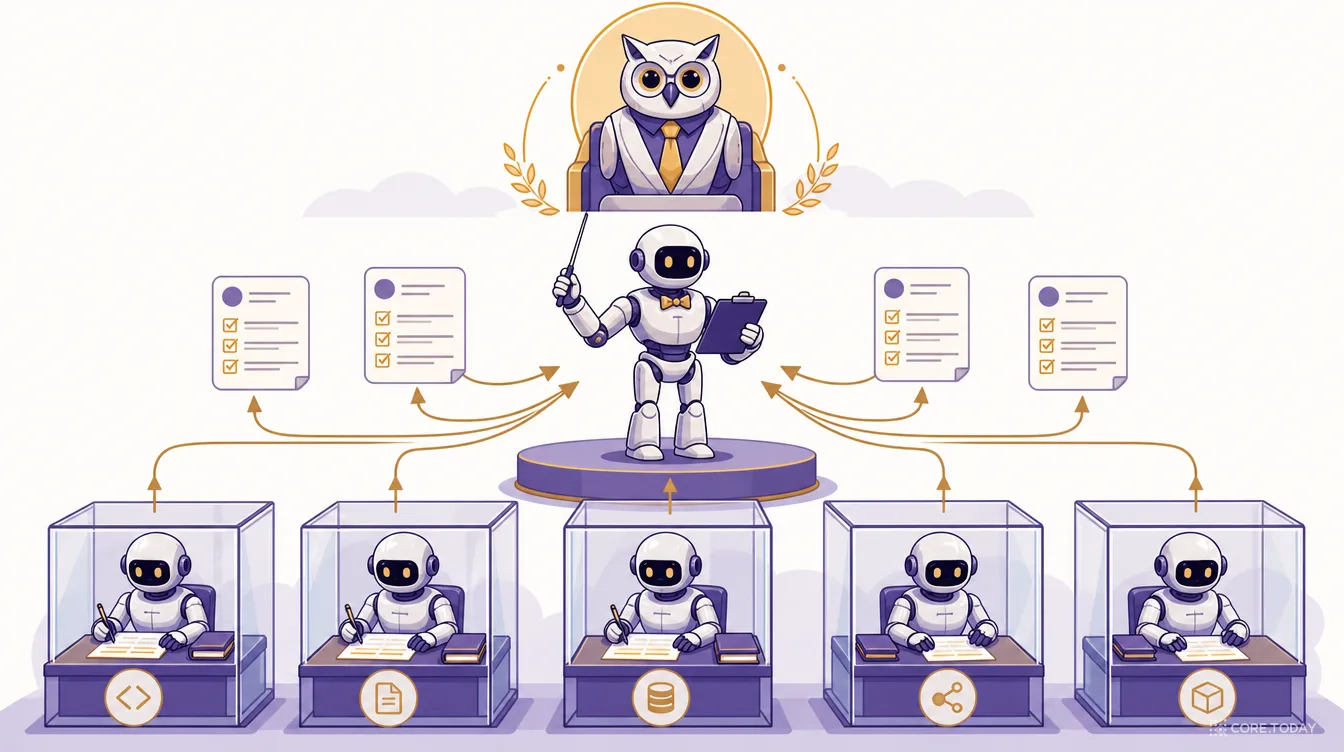
배경 에이전트 10개를 보내 저장소 10개가 각각 어떻게 돌아가는지 알아내는 것까지는 쉽다. 하지만 칸도스트가 지적하듯, 그것만으로는 “그것들이 어떻게 맞물리는지”는 알 수 없다. 그 일을 하는 게 주 에이전트다.
처음에는 주 에이전트가 없었다. 매번 프롬프트에 “저장소마다 조사관 에이전트를 보내라”고 썼다. 같은 말을 반복해야 했고, 다른 사람이 그 주문을 외울 거라 기대할 수도 없었다. 그래서 루트 AGENTS.md에 내용을 계속 덧붙였고, 파일은 점점 길어졌다. 그는 원래 풀려던 문제로 돌아갔다. “10명을 한 방에 모으지 않고 시스템을 이해하고 싶다.” 그러려면 점을 잇는 에이전트가 필요했다.
주 조사관(Primary Investigator)의 작업 순서는 이렇다.
① 사전 조사
하위 에이전트를 보내기 전에 직접 훑어보며 어느 도메인·저장소가 관련 있을지 가늠한다.
② 준비
필요한 저장소가 내려받아져 있지 않으면 CLI로 내려받는다. 조사 계획을 세운다.
③ 파견
배경 조사 에이전트들에게 구조화된 지시 + 사용자의 원래 질문을 함께 넘긴다.
④ 종합
보고서를 읽고 맥락을 합치고 점을 이어 “어떻게 돌아가는지”에 대한 추론을 세운다. 필요하면 머메이드(Mermaid)로 사용자 시퀀스나 시스템 컨텍스트 다이어그램을 그린다.
⑤ 보고
모든 JSON 보고서로 한 장짜리 HTML 최종 보고서를 만든다.
주 브레인스토머(Primary Brainstormer)는 구조가 같지만 목적이 다르다. 여러 도메인을 조사하면서 사용자와 함께 해법을 궁리한다. 칸도스트는 실제 브레인스토밍 워크숍의 경험을 옮겨 왔다. 여러 도메인을 한꺼번에 놓고 장단점을 나열하는 것보다 도메인별로 따로 해법을 검토한 뒤 비교할 때 더 흥미로운 토론과 분명한 트레이드오프가 나왔다는 것이다. 그래서 배경 브레인스토밍 에이전트들이 각 도메인의 모범 사례에 따라 여러 접근법과 장단점, 추천안을 담은 보고서를 내고, 주 브레인스토머는 그것을 “새” 컨텍스트 창으로 읽어 생태계 전체에 걸친 몇 가지 접근법과 최종 추천안을 만든다.
여기서 “새 컨텍스트”라는 말이 중요하다. 주 에이전트는 저장소 코드를 직접 읽느라 컨텍스트를 더럽히지 않았다. 깨끗한 머리로 요약된 판단들만 비교한다. 1부에서 본 Lost in the Middle과 Context Rot에 대한 구조적인 답이다.
하이브의 정신(The Mind of the Hive)은 성격이 다르다. 모든 문제가 기술 문제는 아니기 때문이다. 어떤 문제는 조직 구조를 함께 봐야 풀린다. 그래서 칸도스트는 엔지니어링 리더처럼 생각하는 에이전트를 하나 더 만들었다. 이 에이전트는 팀 구조, SumUp의 조직 가치, 엔지니어링 전략을 알고, 도메인 주도 설계·콘웨이의 법칙·팀 토폴로지 같은 사고 모형을 우선한다. 다른 에이전트보다 자유로워서 주 에이전트를 필요에 따라 파견할 수 있지만, 배경 에이전트를 직접 부르지는 못한다. 조직으로 치면 임원이 팀장들에게 일을 맡기지, 실무자에게 직접 지시하지 않는 구조다.
원문에 이름만 나오는 SOUL.md는 에이전트 생태계에서 흔히 에이전트의 성격·말투·원칙(일종의 헌법)을 적는 파일이다. MEMORY.md는 대화가 끝나도 남겨 둘 기억을 적는 파일이다. 칸도스트는 이 두 파일의 내용을 자세히 밝히지 않았는데, “앞으로 모든 사용자의 실행마다 MEMORY.md를 갱신해 자동으로 푸시하고 싶다”는 계획을 적어 두었다.
⑥ 한 장짜리 HTML — 보고서가 곧 공유물
부록에서 그는 한 가지 실용적인 장치를 자세히 설명한다. 조사를 하다 남과 나누고 싶은 걸 발견하면, 보통은 대화 내용을 통째로 보내거나 AI에게 다시 요약해 달라고 한다. 둘 다 도메인별 맥락이 빠진다.
그래서 그는 모든 하위 에이전트와 주 에이전트의 보고서로 HTML 파일 하나를 만드는 도구를 OpenCode에 추가했다. 이 파일에는 핵심 발견, 도메인별 장단점, 최종 결론, 사용자의 프롬프트, 주 에이전트가 하위 에이전트에게 무엇을 지시했는지까지 다 들어 있다. 파일 하나니까 누구에게든 그냥 보내면 된다.
“결과만 필요한 사람을 위한 핵심 요약과, 더 필요한 사람을 위한 상세 발견이 함께 있다. 따로 보고서를 쓸 걱정을 할 필요가 없다.”
이 장치는 사소해 보이지만 1부의 SECI로 보면 큰 의미가 있다. 에이전트의 조사 결과가 한 사람의 대화창에 갇히지 않고 조직 안으로 다시 흘러간다. 그리고 에이전트에게 무엇을 지시했는지까지 남기 때문에, 읽는 사람이 결론뿐 아니라 그 결론이 어떻게 나왔는지를 검증할 수 있다.
⑦ 지식을 최신으로 — 매주 도는 표출화 기계
여기까지 만들고 나서 칸도스트는 하나를 더 깨닫는다. 시스템은 사용자에게 조사의 자율성을 줬지만, 맥락을 최신으로 유지하는 일은 여전히 한 사람(자신)에게 기대고 있었다. 그가 회의에서 듣고 슬랙에서 읽은 것을 AGENTS.md에 옮기지 않는 순간, 시스템은 조금씩 틀어진다. 자율적인 팀을 만드는 것보다 자율적인 팀을 유지하는 것이 더 어렵다는 그의 지론이 시스템에도 똑같이 적용된 것이다.
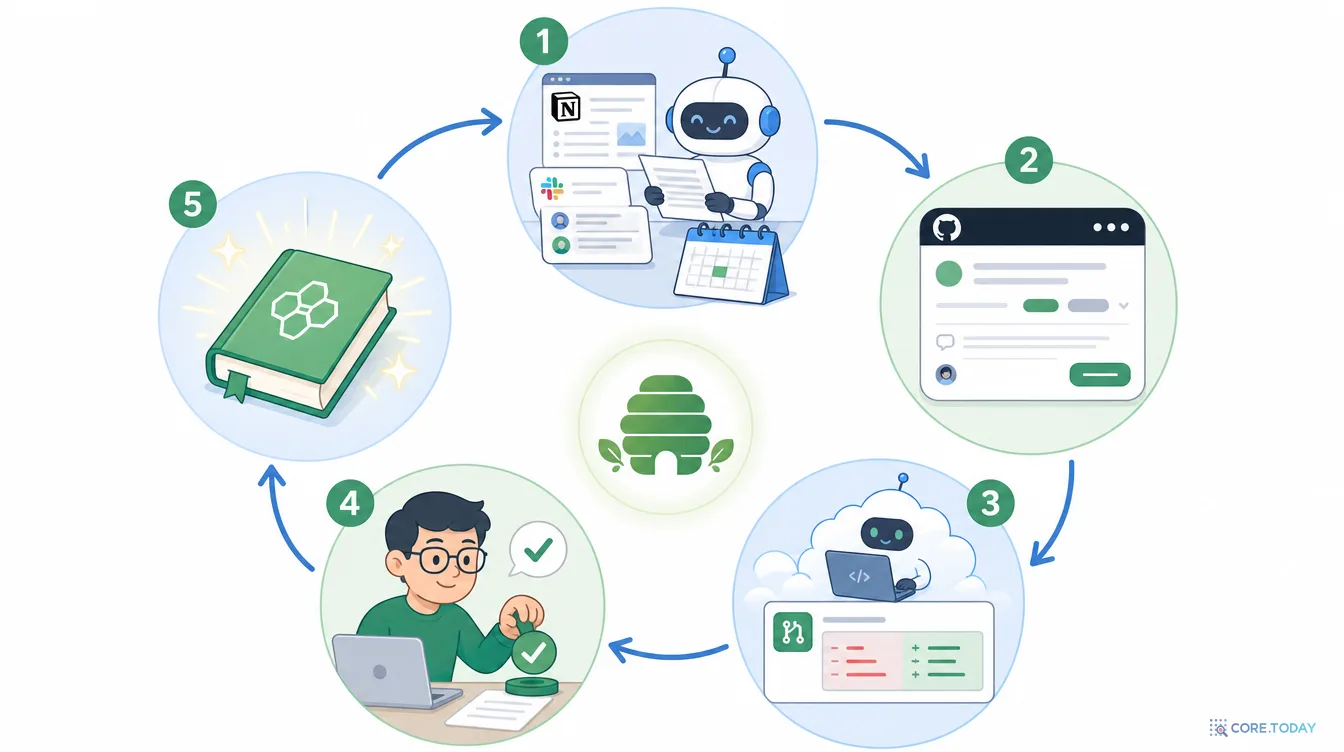
처음에는 RAG를 고려했다. 모든 제품·기술 문서와 암묵지를 넣고 동적으로 갱신하는 방식이다. 하지만 그는 “RAG는 과했다(overkill)”고 판단했다. 필요한 건 처음 한 번의 정보 세트와, 지난 한 주 동안 무슨 일이 있었는지에 대한 주간 업데이트뿐이었다. 그래서 크론처럼 도는 자동 에이전트를 만들었다.
커스텀 AI 에이전트가 안내된 프롬프트에 따라 지난 1주일의 노션·슬랙 변화를 조사한다. 이 에이전트에는 100만 토큰 컨텍스트 모델을 쓴다. “컨텍스트가 더 작은 모델은 실패했다.”
② 이슈
하이브 마인드 저장소의 폴더 구조를 따라 주간 보고서를 쓰고, 깃허브 이슈로 올린다.
③ PR
이슈에서 커서 클라우드 에이전트를 태그해 “보고서대로 맥락 파일을 갱신하고 PR을 만들어 달라”고 맡긴다. 커서 쪽에는 아무 커스터마이징도 없다. 끝나면 칸도스트를 리뷰어로 태그한다.
④ 검토
사람이 보고서와 PR을 둘 다 읽고, 필요하면 조금 고치고, 병합하고, 이슈를 닫는다.
⑤ 동기화
일주일에 한 번 모든 서브모듈을 갱신한다(아직 수동, 곧 자동화 예정).
초기 맥락과 주간 프롬프트를 만들 때는 각 도메인·팀의 슬랙 채널(자신이 속한 비공개 채널 포함)과 노션 팀 공간을 찾아, 하이브 마인드 저장소와 같은 폴더 구조로 정리했다. 덕분에 이제 조직의 누구든 정보가 어디서 어떻게 수집되는지 볼 수 있다. 수집 과정 자체가 투명해진 것이다.
이 루프를 1부의 SECI와 겹쳐 보면 흥미롭다. 회의와 슬랙에서 생겨난 암묵지(공동화)를 수집 에이전트가 글로 바꾸고(표출화), 커서 에이전트와 사람이 그 글을 기존 AGENTS.md 체계에 엮고(연결화), 다른 사람들이 주 에이전트에게 물으며 그것을 자기 이해로 만든다(내면화). 노나카가 1995년에 그린 나선이 2026년에는 주간 크론으로 돈다.
칸도스트는 이 지점에서 스스로 평가한다. “개선할 점은 많지만 전체 구성에 만족한다. 80%는 완성됐다고 생각한다. 나머지 20%는 내 시간의 80%를 잡아먹으면서도 전체에 비해 얻는 게 적을 것이다.”
⑧ 부록에서 건진 것들
왜 OpenCode인가? 한 독자가 이메일로 물었다고 한다. 답은 하나다. 모델을 바꿀 수 있어서. “Claude는 앤트로픽 모델에, Codex는 오픈AI에, Gemini는 구글에 묶인다. 여러 모델을 시험할 수 있는데 왜 하나에 묶이겠나?” 그는 Claude Code를 “정말 좋은 하네스”라고 평가하면서도 “서비스가 다운되면 아무것도 못 한다”고 지적한다. 개인 구독으로는 Claude Code를 쓰지만, 회사에서는 OpenCode로 공급자를 바꿔 가며 일을 이어 간다. OpenCode에는 비개발자도 쓸 수 있는 데스크톱 앱이 있어 그의 PM도 쓴다. 그리고 다음 도구로 옮겨야 하면 “AI에게 opencode.json을 옮겨 달라고 하면 된다”고 덧붙인다. 원문 끝의 추신도 같은 맥락이다. “특정 LLM 모델을 언급하지 않은 이유는 그게 이 구성에서 가장 자주 바뀌는 부분이기 때문이다.”
앞으로의 계획. 그가 적어 둔 개선 방향은 이렇다.
주 에이전트 실행 전에 필요한 서브모듈만 갱신하는 단계 (다만 저장소가 60개 가까이라 실행이 길어진다. 크론으로 모듈을 갱신·커밋하고 새 커밋만 검토하는 에이전트를 두는 방안도 고민 중)
깃허브 접근 없이, 클라우드에서 조사 실행 (터미널에 익숙하지 않은 사람들을 위해)
모든 사용자의 실행마다 MEMORY.md를 갱신해 자동 푸시
그리고 최종 목표: 슬랙에서 @멘션으로 주 에이전트 부르기
3부. 아키텍처 한눈에 보기
지금까지의 조각을 한 장에 모으면 이렇다. 위쪽은 질문에 답하는 경로, 아래쪽은 지식을 최신으로 유지하는 경로다.
사람 (엔지니어링 매니저, PM, 엔지니어)
↓ 질문
Mind of the Hive (조직·전략 관점)
→
General Companion / Primary Investigator / Primary Brainstormer (프런티어급 모델, 깨끗한 컨텍스트)
↑ Zod 스키마 JSON 보고서 → 주 에이전트가 종합 → 머메이드 + 한 장짜리 HTML
주간 수집 에이전트 (노션·슬랙, 100만 토큰 모델)
→
깃허브 이슈
→
커서 클라우드 에이전트 PR
→
사람 1명이 검토·병합
이 그림에서 읽어 낼 설계 원칙을 다섯 줄로 줄이면 이렇다.
1
경계는 조직을 따른다
폴더 구조 = 도메인 구조 = 팀 구조. 콘웨이의 법칙을 거꾸로 이용해, 시스템을 이해하는 지도를 조직도로 그렸다.
2
읽기는 나누고, 생각은 모은다
코드를 읽는 일은 작은 모델 여럿이 병렬로, 점을 잇는 일은 큰 모델 하나가 깨끗한 컨텍스트로.
3
말 대신 구조로 길들인다
“반드시”라는 단어 대신 미리 정의한 에이전트, 권한, 스키마로 행동을 제한한다.
4
인계에는 양식이 있다
에이전트 사이의 모든 인계는 스키마를 통과한 JSON. 그대로 사람에게 보낼 수 있는 HTML이 된다.
5
지식은 매주 갱신되고, 사람이 승인한다
RAG 대신 주간 PR. 기계가 초안을 쓰고 사람이 병합한다. git 이력이 곧 조직 지식의 변경 기록이 된다.
마지막 원칙은 따로 강조할 만하다. 지식 베이스를 git 저장소로 두면, 모든 지식 변경이 PR → 리뷰 → 병합이라는 개발자에게 익숙한 절차를 탄다. 누가 언제 무엇을 왜 바꿨는지가 커밋 이력에 남는다. 틀린 내용이 들어가면 되돌리면 된다. 위키가 수십 년 동안 풀지 못한 “누가 이걸 고쳤지?”와 “이게 아직 맞나?”라는 질문에, 개발 도구가 이미 갖고 있던 답을 빌려 온 셈이다.
4부. 같은 문제, 다른 해법들 — 2025~2026년의 지형
칸도스트만 이 문제와 씨름한 것은 아니다. 비슷한 시기의 시도들과 나란히 놓으면 하이브 마인드의 위치가 더 분명해진다.
접근
대표 사례
장점
한계
엔터프라이즈 검색
글린(Glean) 등
슬랙·드라이브·지라를 권한에 맞게 한 번에 검색
적힌 것만 찾는다. 시스템이 “어떻게 맞물리는지”는 답하지 못한다
그래프 RAG
마이크로소프트 GraphRAG (2024)
엔티티·관계 그래프와 커뮤니티 요약으로 “전체를 아우르는” 질문에 강함
색인 구축·갱신 비용이 크다
저장소 자동 위키
코그니션 DeepWiki (2025)
저장소 주소만 바꾸면 대화형 위키가 생긴다
저장소 단위. 은퇴 계획 같은 조직 맥락은 없다
메타 저장소
“The Meta-Repo Pattern”(2026.3), 슈퍼블록스 단일 작업 공간(2026.3)
에이전트가 여러 저장소를 한곳에서 본다
“에이전트는 낡은 지시를 자신 있게 따른다”
코드화된 맥락
Vasilopoulos, “Codified Context” (2026.2)
10만 줄 시스템에서 상시 ‘헌법’ + 도메인 전문 에이전트 19개 + 명세 문서 34개
한 사람이 설계·유지
하이브 마인드
칸도스트 @ SumUp (2026.8)
메타 저장소 + 계층형 AGENTS.md + 구조화된 인계 + 주간 암묵지 수집
사람 1명이 검토하는 병목, 범위를 3개 구성 요소로 제한
멀티 에이전트를 둘러싼 논쟁. 2025년 6월, 이틀 간격으로 정반대처럼 들리는 두 글이 나왔다.
코그니션(데빈 개발사)의 「멀티 에이전트를 만들지 마라」(6월 12일): 월든 얀은 “행동에는 암묵적 결정이 담기고, 서로 충돌하는 결정은 나쁜 결과를 낳는다”고 썼다. 예로 든 것이 플래피 버드 게임이다. 한 하위 에이전트는 마리오 스타일 배경을, 다른 하나는 그와 어울리지 않는 새를 만든다. 서로의 결정을 모르기 때문이다. 그래서 그는 컨텍스트를 통째로 공유하는 단일 흐름 에이전트를 권했다.
앤트로픽의 「멀티 에이전트 연구 시스템을 어떻게 만들었나」(6월 13일): Opus 4가 지휘하고 Sonnet 4 하위 에이전트들이 병렬로 조사하는 구조가 단일 Opus 4보다 90.2% 나은 성과를 냈다. 성과 차이의 80%는 토큰 사용량 하나로 설명됐다. 대가도 있다. 에이전트는 일반 채팅보다 약 4배, 멀티 에이전트는 약 15배의 토큰을 쓴다.
두 글은 모순이 아니다. 코그니션이 경계한 것은 서로의 결정이 얽히는 “쓰기” 작업을 쪼개는 것이고, 앤트로픽이 성공한 것은 서로 독립적인 “읽기·조사” 작업을 쪼개는 것이다. 하이브 마인드는 정확히 후자다. 배경 에이전트는 자기 저장소만 읽고 보고서만 쓴다. 다른 저장소의 코드를 바꾸지 않으니 결정이 충돌할 일이 적다. 그리고 결론을 내리는 일은 하나의 주 에이전트가 맡는다. 두 진영의 교훈을 다 가져온 구조다.
5부. 반론과 한계 — 이 글을 읽고 바로 따라 하기 전에
“AGENTS.md는 오히려 성능을 떨어뜨린다”
2026년 2월, ETH 취리히의 글로게(Gloaguen)·베체프(Vechev) 등은 「AGENTS.md 평가하기」라는 논문에서 불편한 결과를 냈다. 코딩 에이전트에게 맥락 파일을 주면 과제 성공률은 대체로 오르지 않고, 추론 비용은 20% 이상 늘었다. 특히 “저장소 개요” 식의 내용은 도움이 되지 않았다.
반대 결과도 있다. 같은 해 1월 룰라(Lulla) 등의 연구에서는 저장소 10개, PR 124개를 Codex로 실험했더니 AGENTS.md가 있을 때 실행 시간 중앙값이 28.6%, 출력 토큰이 16.6% 줄었고 완료율은 비슷했다.
이 둘을 하이브 마인드에 적용할 때는 과제의 종류를 봐야 한다. ETH 연구는 이슈 하나를 받아 패치를 만드는 SWE-bench 식 과제를 다뤘다. 이런 과제에서는 에이전트가 코드를 직접 읽는 게 더 정확하고, 개요는 방해가 될 수 있다. 하이브 마인드의 AGENTS.md는 성격이 다르다. 코드를 요약하는 게 아니라 코드에 없는 것 — 은퇴 계획, 진행 중 프로젝트, 도메인 원칙 — 을 적는다. 그리고 과제도 패치가 아니라 교차 도메인 조사다. 다만 ETH의 교훈은 그대로 새겨 둘 만하다. AGENTS.md에 코드에서 읽을 수 있는 내용을 반복하지 마라. 그건 토큰만 먹는다.
낡은 지식은 없는 지식보다 위험하다
메타 저장소 패턴을 정리한 한 뉴스레터의 경고가 정곡을 찌른다. “에이전트는 낡은 지시를 자신 있게 따른다.” 사람은 위키 문서가 2년 전 것이면 의심이라도 하지만, 에이전트는 AGENTS.md에 적힌 “legacy-receipts는 은퇴 예정”을 그대로 믿고 보고서에 쓴다. 이미 은퇴했든, 계획이 취소됐든.
칸도스트가 주간 갱신 루프를 만든 이유가 이것이다. 하지만 그 루프에는 사람 1명이라는 병목이 있다. 그가 휴가를 가면? 그가 회사를 떠나면? 아이러니하게도 하이브 마인드 자체의 트럭 팩터가 1이다. 조직에 정착시키려면 도메인마다 검토자를 나누고, AGENTS.md의 각 절에 소유 팀과 마지막 확인일을 적는 장치가 필요해 보인다.
슬랙을 읽는 에이전트, 그리고 신뢰
주간 수집 에이전트는 칸도스트가 속한 비공개 채널까지 읽는다. 그 결과가 조직 누구나 읽을 수 있는 저장소의 AGENTS.md로 들어간다. 사람이 PR을 검토하는 단계가 있지만, 비공개 대화의 맥락이 의도치 않게 공개 문서로 새어 나갈 위험은 구조적으로 존재한다. 반대 방향의 문제도 있다. 사람들이 “내 말이 AGENTS.md에 들어갈지 모른다”고 느끼면, 슬랙에서 솔직한 이야기를 덜 하게 될 수 있다. 암묵지를 꺼내려는 장치가 암묵지를 더 깊이 숨게 만들 수 있는 것이다. 수집 범위를 공개하고(칸도스트도 수집 방식 자체를 공개했다), 비공개 채널은 요약 수준만 쓰는 식의 합의가 필요하다.
나우르의 경고: 이론은 문서로 다 옮겨지지 않는다
1부에서 본 나우르의 주장을 다시 떠올리자. 프로그램의 진짜 지식은 프로그래머 머릿속의 “이론”이고, 그것은 글로 다 옮겨지지 않는다. 하이브 마인드는 그 이론의 상당 부분을 꺼내는 데 성공했지만, 전부는 아니다. 에이전트의 보고서는 “이렇게 동작한다”는 말은 잘하지만, “왜 이렇게 만들었고, 무엇을 시도했다 버렸는지”는 커밋 메시지와 사람의 기억에만 있다. 칸도스트의 목표도 사람을 대체하는 게 아니라 “3~4명을 한 방에 모으는 단계”를 없애는 것이었다. 사람에게 물어야 할 질문은 여전히 있다. 다만 이제는 더 좋은 질문을 들고 갈 수 있다.
비용과 범위
앤트로픽의 수치대로라면 멀티 에이전트는 채팅보다 15배 많은 토큰을 쓴다. 칸도스트가 배경 에이전트에 작은 모델을 쓴 이유다. 그리고 그는 범위를 SumUp 전체가 아니라 세 개의 구성 요소로 좁혔다. 이 구조가 수천 개 저장소로 그대로 늘어날지는 아무도 모른다. 그가 스스로 말했듯 “나머지 20%”가 남아 있다.
웨그너의 부부를 다시 떠올리자. 그들은 내용을 다 기억하는 대신 “누가 무엇을 아는지”라는 목차를 공유했다. 하이브 마인드가 하는 일이 바로 이 목차를 기계가 읽을 수 있는 형태로 만드는 것이다. 폴더 구조가 “어느 팀이 무엇을 소유하는지”를, AGENTS.md가 “그 팀이 무엇을 계획하고 무엇을 두려워하는지”를, 배경 에이전트가 “그 저장소를 가장 잘 아는 사람” 역할을 대신한다.
이것은 2026년 조직에 꽤 큰 변화다. 지금까지 이 목차는 오래 다닌 사람의 머릿속에만 있었다. 그래서 그 사람이 회의에 불려 다녔고, 그 사람이 떠나면 목차가 사라졌다. 이제 목차가 저장소에 있다. 신입이 첫 주에 “이거 누가 알아요?” 대신 주 조사관에게 물을 수 있다.
관리자의 일이 바뀐다
칸도스트의 글은 고백으로 시작한다. 관리자가 된 날부터 그는 해마다 엔지니어로서의 전문성을 조금씩 “조직의 제약”에 내줬다. 사람과 문제를 맞추고, 맥락을 모아 구조화하고, 매일 사람들의 말을 듣는 일이 그를 코드에서 멀어지게 했다. 그래도 “사람들이 생각하는 시스템이 아니라 실제로 돌아가는 시스템”을 이해하려고 애썼다.
하이브 마인드는 이 긴장을 푸는 하나의 방법이다. 관리자가 매일 하는 “맥락 모으기”가 개인의 머릿속에서 끝나지 않고 저장소에 쌓인다. 그리고 그 저장소를 통해 관리자는 다시 실제 시스템에 가까워진다. 2026년의 엔지니어링 리더에게 요구되는 능력이 “맥락을 많이 아는 것”에서 “맥락이 흐르는 구조를 설계하는 것”으로 옮겨 가고 있다는 신호로 읽을 수 있다.
모델은 바뀌고, 구조는 남는다
원문에서 가장 오래 남을 문장은 어쩌면 추신일지도 모른다. “특정 모델을 언급하지 않은 이유는 그게 가장 자주 바뀌는 부분이기 때문이다.” 실제로 원문이 나온 지 두 달도 안 된 지금도 모델 이름은 계속 바뀌고 있다. 하지만 도메인별 폴더, 계층형 AGENTS.md, 저장소 단위 에이전트, 스키마로 정한 인계, 사람이 승인하는 주간 갱신이라는 구조는 어떤 모델을 끼워도 그대로 쓸 수 있다. 칸도스트가 특정 도구에 묶이지 않으려고 OpenCode를 고른 것도 같은 생각이다. 2026년에 조직이 쌓아야 할 자산은 특정 AI 제품이 아니라 AI가 읽을 수 있게 정리된 조직의 맥락이다.
한국 조직에 주는 시사점
한국 기업의 지식은 유독 카카오톡 단톡방, 구두 보고, “그건 김 책임님한테 물어보세요”에 많이 머문다. 문서화 문화가 약하다는 이야기는 오래됐다. 역설적으로 그래서 하이브 마인드식 접근이 더 맞을 수 있다. 사람들에게 문서를 쓰라고 요구하는 대신, 사람들이 이미 대화하는 곳에서 에이전트가 초안을 뽑고 사람은 검토만 하는 구조이기 때문이다. 노나카가 말한 “바(場)”가 회의실과 단톡방이라면, 하이브 마인드는 그 바에서 생긴 지식이 사라지기 전에 붙잡는 그물이다. 다만 앞서 말한 대로, 무엇을 수집하고 무엇은 수집하지 않을지에 대한 투명한 합의가 먼저다.
7부. 우리 팀에서 시작하기 — 실천 체크리스트
원문의 구축 순서를 따라, 작게 시작하는 법을 정리하면 이렇다.
통증을 세어라. “시스템을 파악하려고 사람을 모으는 회의”가 한 달에 몇 번인지 세어 보자. 맨 앞의 계산기에 넣어 보면 이 프로젝트에 시간을 쓸 근거가 생긴다.
범위를 좁혀라. 전사가 아니라 내가 책임지는 도메인과 그 이웃 2~3곳. 칸도스트도 수천 개 저장소 중 3개 구성 요소만 골랐다.
조직도대로 폴더를 만들어라. 언어나 기술이 아니라 제품·팀 구조로. 처음엔 저장소 몇 개만.
AGENTS.md에는 코드에 없는 것을 써라. 정의, 원칙, 은퇴 계획, 진행 중 프로젝트, “건드리기 무서운 곳.” 코드 요약은 쓰지 마라(ETH의 교훈).
질문으로 검증하라. 실제로 궁금했던 교차 도메인 질문을 던지고, 답이 틀린 곳의 AGENTS.md를 고친다. 가장 오래 걸리는 단계다.
10개가 넘으면 나눠라. 저장소 단위 하위 에이전트를 미리 정의하고 작은 모델을 배정한다. 파견은 권한으로 제한한다.
인계에 양식을 줘라. 요약·발견(근거와 확신도)·다른 도메인과의 접점·열린 질문. 사람이 그대로 읽을 수 있는 형태로 남긴다.
매주 갱신하고, 사람이 승인하라. 수집 → 이슈 → PR → 검토. 검토자는 한 명이 아니라 도메인마다 나누는 게 좋다.
에필로그: 회의실이 사라지는 게 아니라
칸도스트의 하이브 마인드는 회의를 없애지 않는다. 바뀌는 것은 회의의 목적이다. “이 시스템이 어떻게 돌아가는지”를 알아내려고 모이던 회의는 에이전트에게 넘어간다. 그 대신 사람들은 “그래서 우리는 무엇을 해야 하는가”를 정하려고 모인다. 손에는 주 조사관이 만든 한 장짜리 HTML 보고서가 들려 있다. 그 보고서에는 도메인마다 어떤 해법이 가능한지, 무엇이 트레이드오프인지, 그리고 그 결론이 어떤 질문과 지시에서 나왔는지가 다 적혀 있다.
폴라니는 “우리는 말할 수 있는 것보다 더 많이 안다”고 했다. 60년이 지난 지금도 그 말은 맞다. 다만 2026년에는 말하지 못한 것 중 일부를, 매주 조용히 돌아가는 에이전트가 대신 받아 적는다. 그리고 월요일 아침, 누군가 그 PR을 읽고 “맞아, 이거였지” 하며 병합 버튼을 누른다.
벌집은 한 마리의 꿀벌이 짓지 않는다. 그리고 벌집이 무너지지 않게 매일 고치는 것도 결국 꿀벌들이다.
Ikujiro Nonaka, “The Knowledge-Creating Company,” Harvard Business Review, 1991; Nonaka & Takeuchi, The Knowledge-Creating Company, Oxford University Press, 1995.
Nonaka & Konno, “The Concept of ‘Ba’,” California Management Review 40(3), 1998.
Daniel Wegner, “Transactive memory: A contemporary analysis of the group mind,” 1987 (Wegner, Giuliano & Hertel, 1985).
Peter Naur, “Programming as Theory Building,” Microprocessing and Microprogramming 15(5), 1985.
Walsh & Ungson, “Organizational Memory,” Academy of Management Review 16(1), 1991.