[특집] 5분이 아니라 5년 — Zotero 20주년, 「오래가는 소프트웨어는 천천히 만들어진다」 완전 해부
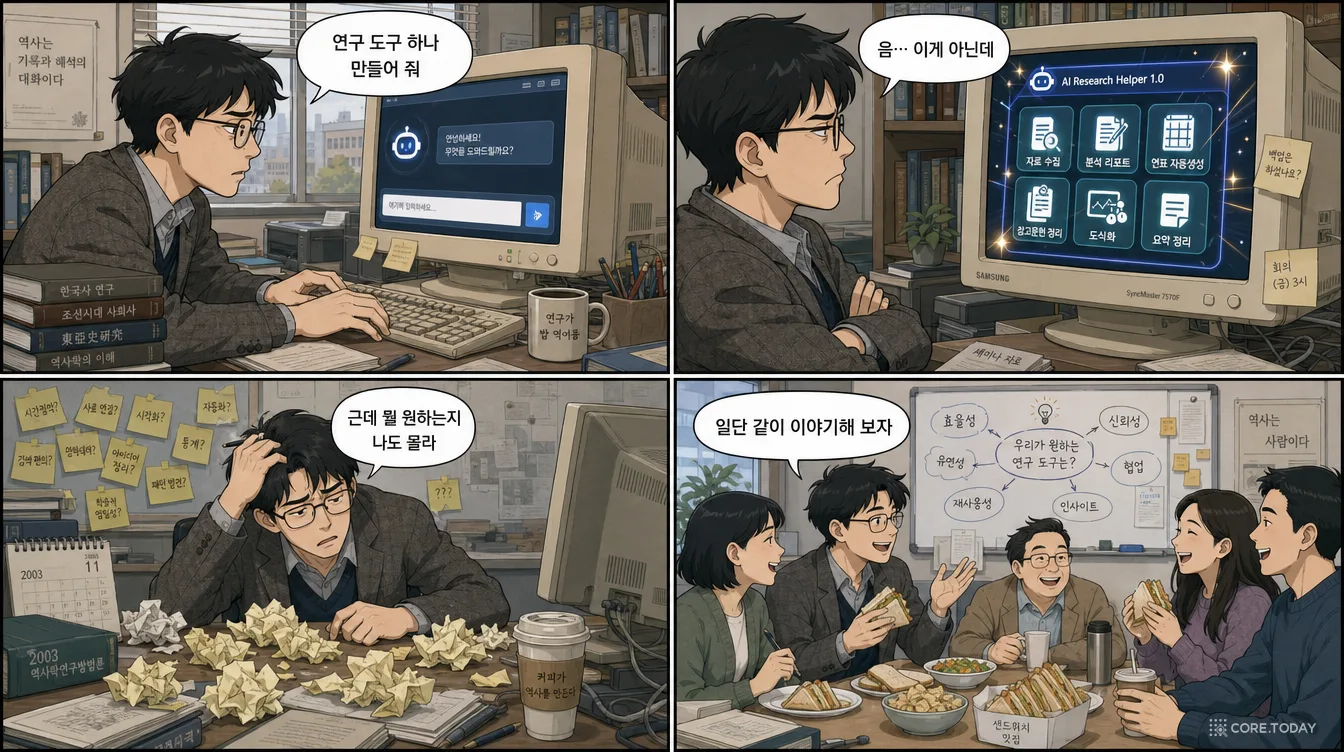
2026년 10월 6일, Zotero 20주년을 맞아 공동 창시자 댄 코언이 쓴 회고 「The Slow Formation of Durable Software」가 해커뉴스 290점·댓글 116개를 모았다. 주장은 한 문장이다 — 'AI가 있었더라도 Zotero의 구상을 앞당길 수 없었다. 우리는 무엇을 원하는지 정확히 몰랐고, 그러니 LLM에 줄 일관된 프롬프트도 쓸 수 없었다.' 이 글은 2002년의 웹 스크랩북과 스크라이브라는 두 반쪽에서 출발해, 점심 테이블과 화이트보드, Firefox 출시일 밤의 이메일, 알바니아어 사전으로 지은 이름을 거쳐 2,000만 명이 쓰는 연구 도구가 된 과정을 따라간다. 1986년 브룩스의 '고객은 자기가 뭘 원하는지 모른다', 갈의 법칙, 나우르의 '이론 만들기', 브랜드의 페이스 레이어링과 린디 효과로 그 주장을 해부하고, XUL 확장에서 Firefox 엔진을 품은 독립 앱으로 이어진 Zotero의 아키텍처 — 번역기 750개, 인용 스타일 1만 865개, 로컬 SQLite — 를 그림과 다섯 개의 인터랙티브 도구로 풀었다. 해커뉴스의 반론, 로빈 슬론의 '집밥 앱', METR·GitClear·DORA·스택오버플로 2026의 데이터까지 놓고, 무엇이든 5분이면 만들어지는 2026년에 '오래가는 것'을 만드는 법을 정리했다.
올봄, 미국의 한 대학 졸업식장에서 있었던 일입니다. 아이의 졸업을 축하하러 온 한 중년 남성에게, 낯선 사람이 다가와 그를 와락 끌어안았습니다. 한참 동안이나요. 그 사람은 그가 Zotero(조테로) 를 만든 사람 중 하나라는 이야기를 어디선가 들었던 겁니다.
안긴 사람은 댄 코언(Dan Cohen), 지금은 노스이스턴대학교 도서관을 이끄는 역사학자입니다. 그는 이 일을 이렇게 적었습니다.
"내 학술 논문 때문에 누가 나를 안아 준 적은 한 번도 없었고, 앞으로도 없을 것이다."
학위논문의 참고문헌 200개를 손으로 정리해 본 사람이라면, 그 포옹이 무엇에 대한 감사였는지 압니다. 마감 전날 밤 지도교수가 "학회지 양식이 바뀌었다"고 말했을 때, 버튼 하나로 각주 수백 개를 새 양식으로 바꿔 준 무언가에 대한 감사입니다.
2026년 10월 6일, 코언은 자신의 뉴스레터에 Zotero 탄생 20주년을 기념하는 회고를 올립니다. 제목은 「The Slow Formation of Durable Software(오래가는 소프트웨어는 천천히 만들어진다)」. 처음에는 아무도 주목하지 않았습니다. 해커뉴스에 올라온 첫날엔 4점, 댓글 0개. 그런데 이틀 뒤 다시 첫 화면에 떠오르더니 290점, 댓글 116개를 모으며 개발자들 사이에서 꽤 진지한 논쟁거리가 됐습니다. 블루스카이에서는 코언의 공유 글에 130여 명이 '좋아요'를 눌렀고, 국내에서는 GeekNews에 「오래가는 소프트웨어가 천천히 만들어지는 과정 — Zotero의 탄생」이라는 제목으로 소개됐습니다.
사람들이 붙잡은 문장은 이것이었습니다.
"If AI had existed in the early aughts, we could not have accelerated Zotero's conception, because we did not know exactly what we wanted, and so could not have written coherent prompts for an LLM."
2000년대 초에 AI가 있었더라도 우리는 Zotero의 구상을 앞당길 수 없었을 것이다. 우리는 무엇을 원하는지 정확히 몰랐고, 그러니 LLM에 줄 일관된 프롬프트도 쓸 수 없었다.
무엇이든 "원하는 걸 말하면" 몇 분 만에 앱이 되어 나오는 2026년에, 이 문장은 두 갈래의 반응을 불렀습니다. 한쪽은 "바로 이거다"라며 고개를 끄덕였고, 다른 쪽은 "낭만화된 창업 신화일 뿐, LLM이 있었다면 5년을 5개월로 줄였을 것"이라고 반박했습니다.
이 특집은 그 논쟁의 한가운데로 들어갑니다. 순서는 이렇습니다.
Zotero가 뭐길래 — 연구자가 아니라면 낯선 이 도구가 무엇을 하는지부터
5년의 형성기 — 2002년 두 개의 반쪽 앱에서 2006년 1.0까지, 원문의 이메일과 스크린샷으로
"원하는 것을 몰랐다"의 해부 — 브룩스, 사악한 문제, 갈의 법칙, 나우르의 이론으로
아키텍처 깊이 보기 — XUL과 XPCOM, 번역기, CSL, 로컬 SQLite, 그리고 2017년의 대격변
오래간다는 것의 조건 — 린디 효과, 페이스 레이어, 경쟁자들의 20년
반론 — 해커뉴스의 회의론과 로빈 슬론의 '집밥 앱'
2026년의 데이터 — AI 코딩 시대, 무엇이 빨라지고 무엇이 그대로인가
실전 체크리스트 — 지금 무언가를 만드는 사람에게
중간중간 다섯 개의 인터랙티브 도구가 있습니다. 특히 2장 끝의 '프롬프트 타임머신' 은 꼭 한번 움직여 보세요. 코언의 주장을 가장 직관적으로 확인할 수 있는 장치입니다.
1. Zotero가 뭐길래 — 연구자의 서재이자 각주 공장
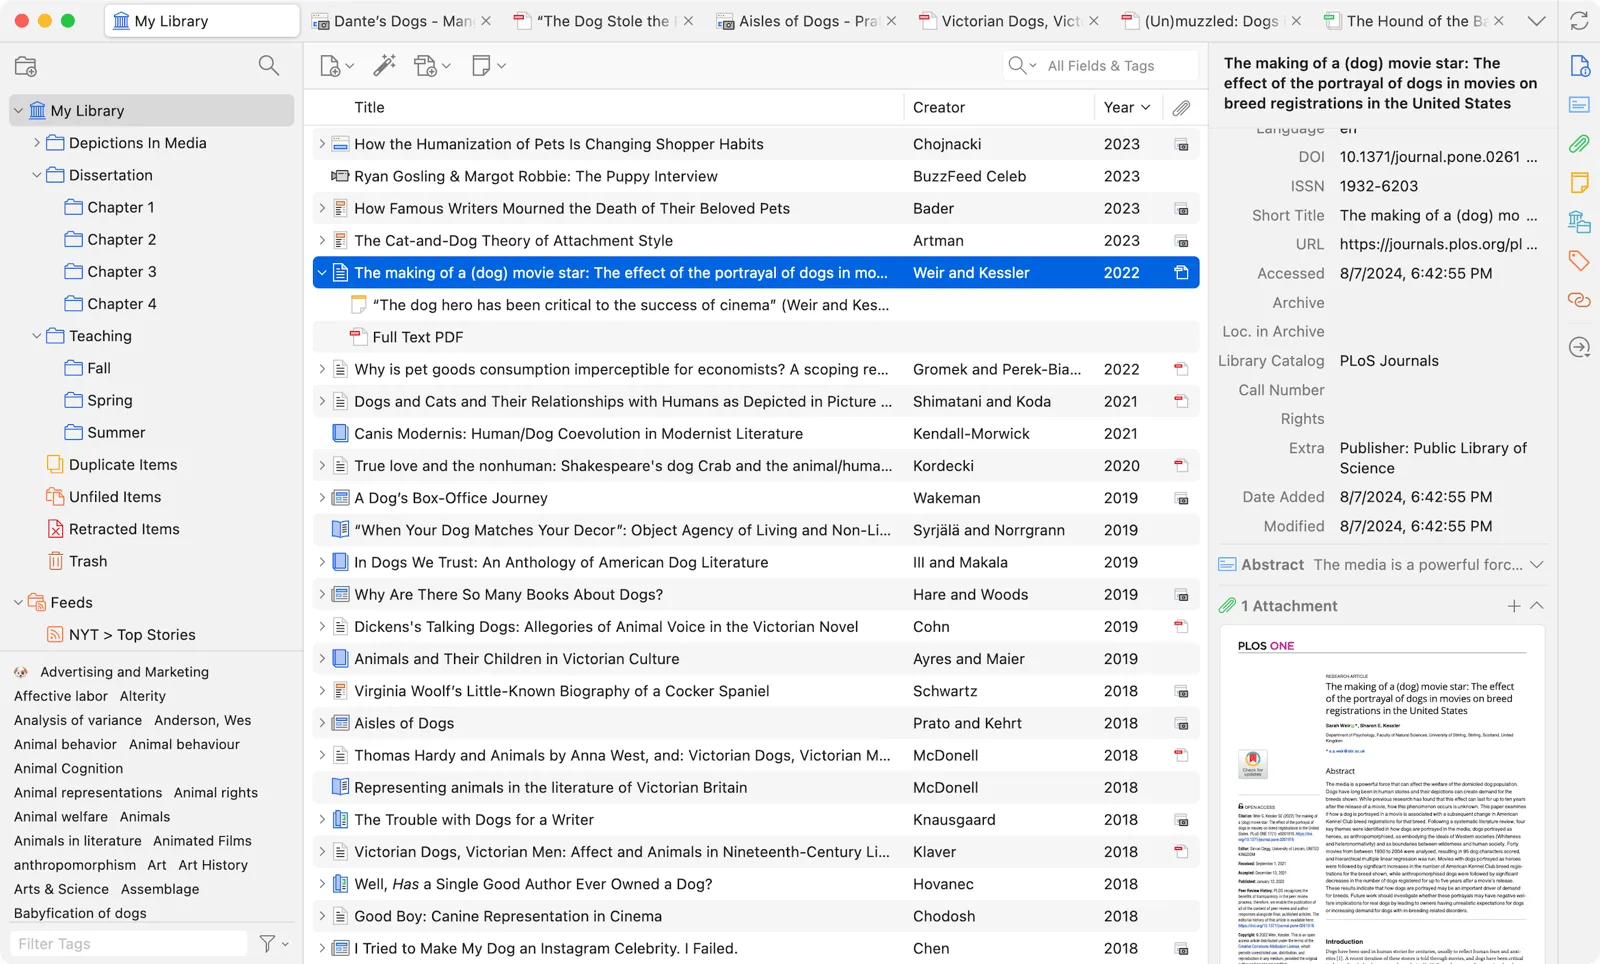
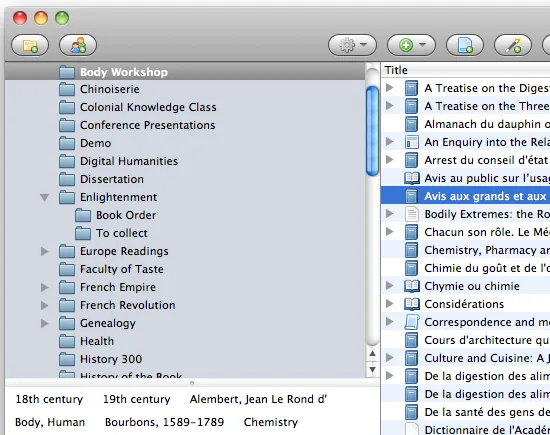
크게 보기2026년 8월 17일 출시된 Zotero 10.0의 화면. 왼쪽은 컬렉션(폴더), 가운데는 항목 목록, 오른쪽은 선택한 항목의 메타데이터와 첨부 파일이다. (출처: Dan Cohen, "The Slow Formation of Durable Software")
Zotero를 한 줄로 소개하면 공식 문구 그대로 "연구 자료를 모으고, 정리하고, 주석을 달고, 인용하고, 공유하는 것을 도와주는 무료 도구"입니다. 하지만 이 다섯 개의 동사가 실제로 어떤 고통을 덜어 주는지 감이 오지 않을 수 있으니, 대학원생 민지 씨의 하루로 바꿔 보겠습니다.
모으기 — 민지 씨는 DBpia에서 논문 페이지를 열고 브라우저 오른쪽 위의 작은 문서 아이콘을 누릅니다. 제목·저자·학술지명·권호·쪽수·초록이 한 번에 저장되고, 가능하면 PDF까지 함께 들어옵니다. 손으로 옮겨 적은 것은 하나도 없습니다.
정리하기 — 저장한 논문은 '학위논문 > 2장 선행연구' 같은 컬렉션(폴더)에 넣고, '방법론', '반론' 같은 태그를 붙입니다. 한 논문이 여러 폴더에 동시에 있을 수 있습니다.
주석 달기 — Zotero 안에서 PDF를 열어 형광펜을 칠하고 메모를 답니다. 이 주석은 나중에 노트로 모아 볼 수 있습니다.
인용하기 — 워드에서 문장을 쓰다가 Zotero 버튼을 누르고 저자 이름 몇 글자를 치면 각주가 들어갑니다. 문서 끝의 참고문헌 목록은 저절로 만들어지고 저절로 갱신됩니다. 지도교수가 "APA 말고 시카고 양식으로"라고 하면? 스타일을 하나 바꾸면 각주 300개가 한꺼번에 다시 그려집니다.
공유하기 — 연구실 동료들과 '그룹 라이브러리'를 만들어 같은 자료 목록을 함께 씁니다.
이것이 왜 대단한지는 Zotero 이전의 세상을 떠올리면 분명해집니다. 학술 인용 양식은 학문 분야와 학술지마다 다릅니다. 저자 이름을 성-이름 순으로 쓸지, 연도를 괄호에 넣을지, 학술지명을 이탤릭으로 쓸지, 쪽수 앞에 "pp."를 붙일지… 이런 규칙이 수천 가지 조합으로 존재합니다. 연구자들은 오랫동안 이 일을 손으로 해 왔고, EndNote 같은 상용 프로그램은 비쌌습니다.
숫자로 보면 Zotero가 지금 어떤 자리에 있는지 보입니다.
항목
수치 (2026년 10월)
출처
사용자
2,000만 명 이상, 그중 절반 이상이 최근 3년 사이 가입
코언 원문, 숀 타캣츠 「Zotero at Twenty」
인용 스타일
10,865개 (독립 2,864 + 종속 8,001)
CSL 스타일 저장소
사이트별 번역기
750개, 기여자 269명
github.com/zotero/translators
운영 인력
전업 개발자·디자이너 12명, 7개국에서 근무
타캣츠
본체 저장소
커밋 약 16,900개, 첫 커밋 2006-02-21, AGPL-3.0
github.com/zotero/zotero
리드 개발자의 커밋
댄 스틸먼 9,408개 (2006년부터 지금까지)
GitHub 기여 통계
운영 자금
저장 공간 구독 (300MB 무료, 무제한 연 120달러) — 2014년부터 자체 수입만으로 운영
zotero.org, 타캣츠
비영리 단체가 열두 명으로, 광고도 투자도 없이, 2,000만 명이 쓰는 소프트웨어를 20년째 운영하고 있습니다. 대부분의 연구 도서관이 학생과 교수에게 Zotero 사용법 워크숍을 열고, 코언이 지금 이끄는 도서관도 마찬가지입니다. 그의 표현대로 Zotero는 "학계라는 천의 일부(part of the fabric of academia)"가 됐습니다.
그런데 코언의 글이 정말 하고 싶은 이야기는 Zotero의 성공담이 아닙니다. 이 소프트웨어가 어떻게 태어났는가, 그리고 그 탄생 방식이 2026년의 우리에게 무엇을 말해 주는가입니다.
2. 5년의 형성기 — 두 개의 반쪽에서 Zotero까지
2.1 '뉴미디어'라는 이름의 연구소
이야기는 미국 버지니아주 조지메이슨대학교의 역사와 뉴미디어 센터(Center for History and New Media, CHNM) 에서 시작합니다. 1994년, 웹이 태어난 지 몇 년 안 됐을 때 역사학자 로이 로젠츠바이크(Roy Rosenzweig) 가 세운 곳입니다. 코언은 이름부터 "기분 좋게 레트로한, 세기 전환기의 이름"이라고 놀립니다. '디지털'이 아니라 '뉴미디어'라니까요.
로젠츠바이크는 사실상 디지털 역사학이라는 분야를 만든 사람입니다. 2003년 미국역사학회지(AHR)에 쓴 논문 「희소성인가 풍요인가? 디지털 시대의 과거 보존」에서 그는 역사학이 "희소성의 문화에서 풍요의 문화로" 근본적으로 이동하고 있다고 썼습니다. 그리고 이렇게 물었습니다. "그런데 풍요가 더 낫고 더 사려 깊은 역사를 가져올까?" 자료가 넘쳐나는 시대에 연구자에게 필요한 것은 자료를 다루는 도구였습니다. Zotero는 그 질문에 대한 답 중 하나가 됩니다.
CHNM은 원래 소프트웨어를 만드는 곳이 아니었습니다. 주로 웹사이트를 만들었죠. 2001년 1월, 갓 박사 학위를 받은 코언이 과학사 프로젝트를 하러 합류합니다. 기술사를 전공한 동료 짐 스패로와 함께 만든 사이트가 ECHO(Exploring and Collecting History Online) 였습니다. 과학은 기하급수적으로 커지는데 과학사학자의 수는 늘지 않으니, 과학자들이 웹으로 자기 연구를 스스로 기록하게 하자는 발상이었죠. 그러려면 사이트가 상호작용 해야 했고, 그래서 센터는 '도구(tool)' — 작은 웹 앱 — 를 만지작거리기 시작합니다.
2.2 첫 번째 반쪽 — 웹 스크랩북 (PHP, 2002년경)
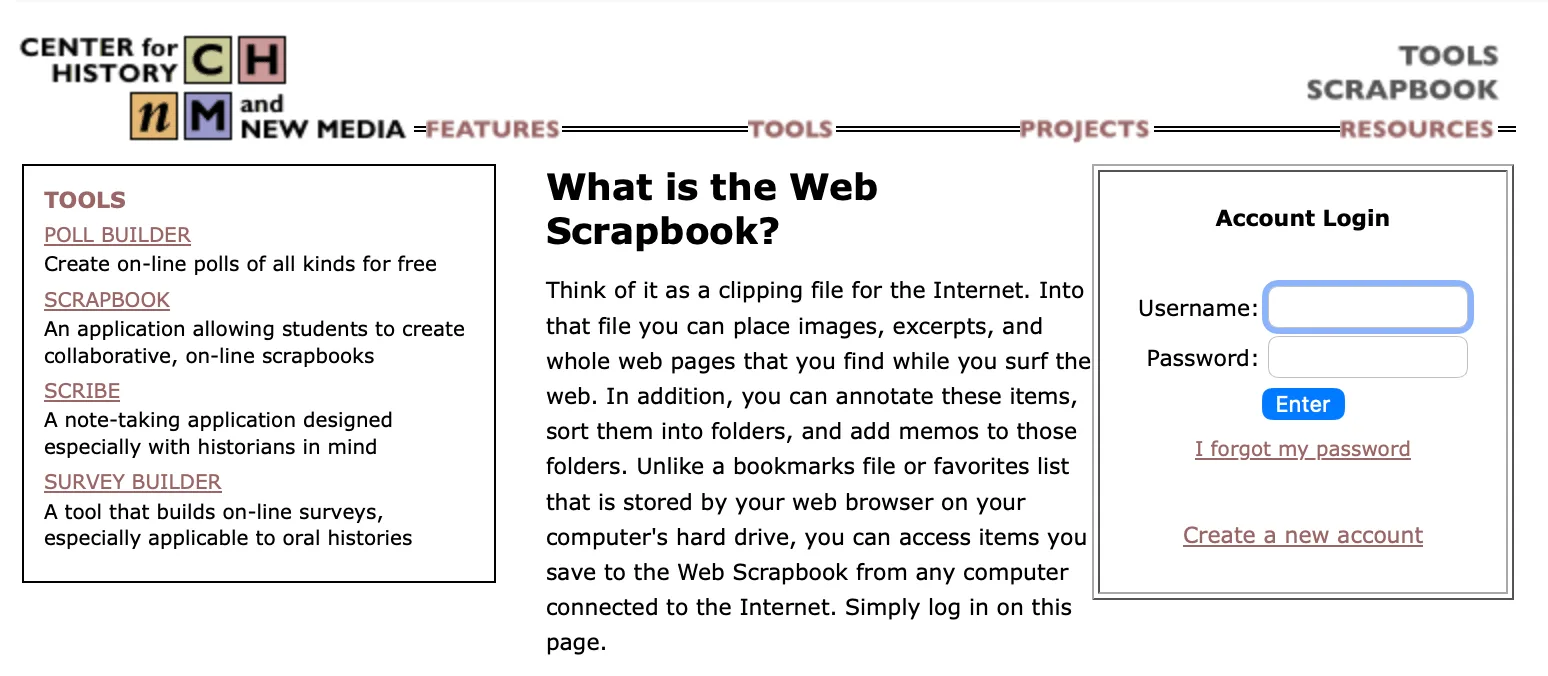
크게 보기"조심하라, 2002년경 내 웹 앱에 감히 로그인하려는 자여." 웹 스크랩북의 첫 화면. (출처: Dan Cohen)
코언은 당시 웹 앱의 표준 언어로 떠오르던 PHP로 몇 개의 앱을 씁니다. 그중 웹 스크랩북(Web Scrapbook) 이 수업에서 꽤 인기를 끌었습니다. 학생들이 브라우저에서 이미지·링크 같은 자료를 붙잡아 모음집으로 만들고, 반 친구·교수와 공유하는 앱이었죠.
작동 방식이 흥미롭습니다. 사용자는 브라우저 즐겨찾기 막대에 저장해 둔 특별한 북마크를 누릅니다. 그 북마크 안에는 작은 자바스크립트가 들어 있어서(이런 것을 북마클릿이라고 합니다), 지금 보고 있는 페이지에서 원하는 항목을 골라 웹 앱으로 보내 줍니다. "지금 보고 있는 웹 페이지에서 무언가를 붙잡는다"는 아이디어는 훗날 Zotero의 핵심 동작이 됩니다.
하지만 코언 스스로 인정하듯, 이 앱은 "엄밀한 소프트웨어"가 아니었습니다. 첫 버전은 비밀번호를 암호화하지 않은 채 인터넷으로 보냈고, 논문이나 책을 쓸 때 필요한 메타데이터(저자·출판사·연도 같은 서지 정보)와 각주를 만드는 데 필요한 정보에는 기초적인 관심만 기울였습니다.
2.3 두 번째 반쪽 — 스크라이브 (FileMaker, 2002년경)
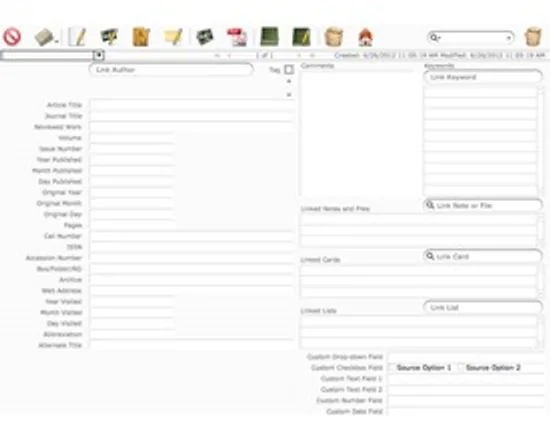
크게 보기엘레나 라즐로고바가 FileMaker로 만든 스크라이브, 2002년경. (출처: Dan Cohen)
같은 시기, 센터의 웹마스터이자 박사과정생이던 엘레나 라즐로고바(Elena Razlogova) — 지금은 캐나다 콘코디아대학교 역사학 교수 — 는 훨씬 학술적인 앱을 만들고 있었습니다. 노트를 쓰고 인용 정보를 저장하는 스크라이브(Scribe) 입니다. FileMaker라는 데이터베이스 프로그램으로 만들었고, 사용자가 내려받아 자기 PC에서 실행했습니다.
스크라이브는 동료 역사학자들 사이에서 EndNote 같은 상용 소프트웨어의 좋은 무료 대안으로 인기를 얻었습니다. 내 컴퓨터에서 돌아가고, 정리·검색·메타데이터·주석 기능을 갖췄죠. 훗날 Zotero가 확장하게 될 기능들입니다.
2003년이 되자 센터 사람들은 두 종류의 앱을 모두 만들 줄 알게 됐습니다. 웹 앱과 데스크톱 앱. 코언의 표현으로는 "둘 다 도움이 되지만, 둘 다 어딘가 찜찜하게 부족했습니다(both helpful but both also naggingly insufficient)."
웹 스크랩북 (웹 앱)
스크라이브 (데스크톱 앱)
잘하는 것
웹에서 자료를 바로 붙잡기, 공유
정밀한 서지 정보, 노트, 검색, 오프라인
못하는 것
학술 메타데이터, 각주, 보안
웹과 단절 — 정보를 손으로 옮겨 적어야 함
사는 곳
서버
내 컴퓨터
연구는 점점 웹에서 시작되고 있었습니다. 1차 사료와 2차 문헌이 도서관 목록의 메타데이터로, 혹은 디지털화된 원본으로 웹에 쌓이고 있었죠. 그렇다면 미래의 연구 도구는 웹과 연결돼 있어야 했습니다. 필요한 것은 스크라이브의 일부와 웹 스크랩북의 일부를 합친 것 — 웹과 독립적으로 존재하면서도, 연구자가 디지털 컬렉션과 도서관 목록을 돌아다니는 동안 브라우저에서 무슨 일이 벌어지는지 완전히 알고 있는 연구 도구였습니다.
말로 하면 쉽습니다. 하지만 바로 이 문장에 도달하기까지가 오래 걸렸습니다.
2.5 2003년 12월 1일, 엘레나의 목록
2003년 11월 29일, 로젠츠바이크가 엘레나에게 이메일로 묻습니다. 스크라이브 다음 버전에서 뭘 하고 싶으냐고요. 마침 로이, 코언, 그리고 9·11 디지털 아카이브 일을 하던 톰 샤인펠트가 ECHO의 다음 단계 연구비 신청서를 쓰던 참이었습니다. 12월 1일, 엘레나의 답장이 옵니다.
From: elena · 2003-12-01 · Re: Scribe 다음 버전
로이에게 — 하고 싶은 건 이래요.
· 온라인 서지 데이터베이스에 연결되도록
· 인용 스타일 추가 (최소한 APA와 법률 양식)
· 사용자가 인용 스타일을 직접 추가할 수 있게
· 필드와 문헌 유형을 더 추가할 수 있게
· 사용자/비밀번호로 온라인 서지·노트를 공유하고 함께 편집
· 로컬에서 작업하고 서지·노트의 전부 또는 일부를 온라인에 게시 (iCal처럼)
· 외국어 지원
· 더 나은 매뉴얼
· 온라인 토론 목록 (마티가 설치해 둔 소프트웨어로)
best, elena
코언은 "좋은 목록이었다"고 씁니다. 실제로 이 목록을 지금 보면 소름이 돋습니다. 사용자 정의 인용 스타일(훗날 CSL), 온라인 공유와 공동 편집(그룹 라이브러리), 로컬에서 작업하고 동기화(Zotero의 로컬 우선 + 동기화 구조), 외국어 지원(현재 수십 개 언어) — 20년 뒤 Zotero의 뼈대가 여기 거의 다 있습니다.
그런데 결정적인 것 하나가 빠져 있습니다. 브라우저. 이 목록대로 만들면 '아주 좋은 스크라이브 2.0', 즉 더 나은 EndNote가 나옵니다. 톰이 답장에 덧붙인 한 단어가 방향을 틀었습니다. "스크라이브를 업데이트해서 '웹화(webify)' 하면 좋겠다." 네 사람은 합의합니다. 스크라이브를 웹 브라우저 안으로 넣되, 꼼꼼한 연구 도구라는 정체성은 지키자고.
코언은 훗날(2008년) 학술지 First Monday 에 실은 글에서 그 '성배'를 이렇게 요약합니다.
우리는 두 세계의 장점을 모두 원했다. 독립 실행형 애플리케이션의 가장 좋은 부분과 웹 애플리케이션의 가장 좋은 부분. 우리가 그린 도구는 브라우저 안에 살면서 브라우저에서 벌어지는 일을 아주 영리하게 알아채고 — 학술 메타데이터와 대상을 인식하는 것을 포함해 — 데스크톱의 워드프로세서 같은 프로그램과도, 웹 곳곳의 표준·서비스·통신 규약을 통해 다른 도구와 자원과도 상호작용하는 도구였다.
그리고 바로 다음 문장이 이 이야기의 핵심입니다.
"하지만 이질적인 두 세계를 어떻게 합칠 것인가? 2003년에는 그게 전혀 분명하지 않았다."
무엇을 원하는지는 어렴풋이 알았습니다. 하지만 그것을 어떻게 실현할지, 그리고 그 '어떻게'가 '무엇'을 어떻게 바꿀지는 아직 몰랐습니다.
CHNM에는 커다란 화이트보드가 있었습니다. 진지한 아이디어와 실없는 아이디어가 섞여 적혀 있었고, 누구나 볼 수 있었습니다. "혹시 누군가에게 불씨가 될지 모르니까." 단체 점심 자리에서 교수와 직원들은 새로 들은 기술 이야기를 나누며 그걸 역사 연구에 쓸 수 있을지 궁리했습니다.
코언은 이 시간을 이렇게 묘사합니다. "기술을 잘 알고 코딩을 — 주 기술이 아니라 부 기술로 — 할 줄 아는 역사학자 무리가, 큰 테이블에 둘러앉아 수다를 떨며 많은 시간을, 그중 일부는 낭비된 시간을 보낸 이야기." 그 대화가 마침내 학술 연구의 미래에 대한 생각으로 굳어졌다고요.
흥미롭게도 로젠츠바이크는 앞서 소개한 2003년 논문에서 디지털 보존의 어려운 질문들이 흔히 "점심시간의 가벼운 대화로 밀려난다"고 아쉬워했습니다. 그런데 그의 연구소에서는 바로 그 점심 대화가 소프트웨어 하나를 키워 냅니다.
2004년 여름, 테이블에 새 얼굴들이 앉습니다. 과학기술학 박사 조시 그린버그(지금은 슬론 재단 프로그램 디렉터), 미국사 박사 샤론 리언, 그리고 로이의 친구인 역사학자의 아들이자 소프트웨어 개발에 "진정으로 재능 있는" 10대 소년 사이먼 콘블리스(Simon Kornblith). 코언은 괄호 안에 덧붙입니다. 사이먼은 훗날 MIT에서 뇌·인지과학 박사 학위를 받고, 미래의 노벨상 수상자 제프리 힌턴과 중요한 AI 논문을 쓰고, 앤트로픽(Anthropic) 에서 일하게 된다고요. Zotero 본체 저장소의 커밋 기여 2위(2,421개)가 바로 그입니다. AI 시대를 성찰하는 글에 이런 인연이 숨어 있습니다.
2.7 2004년 11월 9일, Firefox가 나온 밤
그해 여름 테이블의 화제 중 하나는 오픈소스 브라우저 Mozilla에서 갈라져 나온, 곧 Firefox라고 불리게 될 프로젝트였습니다. 넷스케이프에서 내려온 원조 Mozilla는 세월이 지나며 느리고 비대해졌는데, Firefox는 빠르고 가벼웠습니다. 하지만 센터 사람들을 정말 흥분시킨 건 따로 있었습니다. XUL — 코언의 말로는 "1950년대 SF 영화의 외계 신 이름 같지만" XML User Interface Language의 약자 — 이었습니다. XUL을 쓰면 브라우저를 "— 오 자비로우신 —" 원하는 대로 고치고 확장할 수 있었습니다.
2004년 11월 9일, Firefox 1.0이 세상에 나온 날. "언제나 얼리어답터 중의 얼리어답터"였던 코언과 조시는 바로 내려받아 이리저리 만져 봅니다. 그날 밤 코언은 조시·엘레나·톰·로이에게 이런 제목의 메일을 보냅니다.
Firefox + XUL + AWS = OpenScribe/Online Scribe?
여기서 AWS는 우리가 아는 아마존 클라우드가 아닙니다. 아마존이 책 정보를 조회할 수 있게 열어 둔 API였죠. XUL로 만든 Firefox 확장과 아마존 같은 서비스를 묶으면 "인용 정보를 필드에 자동으로 불러올" 수 있겠다는 생각이었습니다. 자정 직전, 조시의 답장이 옵니다.
"말을 좀 험하게 해도 용서해 주세요. '와, 이거 끝내주는데!(Holy crap, that's cool!)'
가능성이 놀라워요 — XPCOM용 MySQL 래퍼가 있는 것 같으니 데이터베이스(원격이든 로컬이든)에 접근할 수 있고, 관계형 데이터베이스로 스크라이브를 완전히 재현할 수 있어요. 아니면 데이터베이스를 버리고 Firefox 인터페이스로 스크라이브 XML 데이터를 직접 탐색해도 되고요. 어느 쪽이든, 즉시 크로스플랫폼이에요. (…) 아마존과 ProQuest/ISI 인용 색인을 묶으면 서지 객체를 만드는 게 훨씬 쉬워질 거예요. (…) 끝내준다!"
FileMaker 대신 오픈소스 데이터베이스에 서지 정보와 노트를 저장하고, 제대로 짠 Firefox 확장을 붙이면 — "꿈의 연구 도구를 만들 재료가 모두 손에 닿는 곳에" 있었습니다.
이 장면에서 눈여겨볼 것이 있습니다. 결정적 돌파구는 누군가 더 오래 생각해서가 아니라 바깥 세계의 변화(Firefox 출시) 와 동료의 즉각적인 반응(조시의 답장) 에서 나왔습니다. 1년 전 엘레나의 목록에서 빠져 있던 '어떻게'가, 2004년 11월의 어느 밤에야 비로소 손에 잡힌 겁니다.
2.8 SmartFox — 연구비 신청서가 보여 주는 '선명해진 생각'
그해 겨울, 로이를 연구 책임자로, 조시와 코언을 공동 책임자로 미국 박물관·도서관 서비스 기구(IMLS)에 연구비를 신청합니다. 제목은 「SmartFox: 디지털 컬렉션을 위한 학자의 브라우저」. 초록의 일부를 옮깁니다.
웹 브라우저는 정보·문서·유물에 접근하는 주된 수단이 됐다. (…) 그러나 학자들에게는 불행하게도, 디지털 자원을 만드는 데 수천만 달러가 쓰였지만 그 자원을 활용하는 도구 개발에 배정된 자금과 노력은 훨씬 적다. 브라우저는 여전히 대상을 보게만 해 줄 뿐, 쉽게 모으거나 주석을 달거나 다루게 해 주지 못하는 수동적인 창에 머물러 있다. (…)
SmartFox는 (…) 두 가지 핵심적인 면에서 '더 똑똑한' 브라우저를 만든다. 첫째, 한 도구는 사용자가 디지털 도서관이나 박물관의 대상을 보고 있음을 브라우저가 지능적으로 감지하게 해, 제작자·제목·제작일·저작권 정보 같은 것을 페이지에서 자동으로 캡처하게 한다. 둘째, 다른 도구는 이 정보를 — 원하면 인용 정보만이 아니라 항목과 웹 페이지의 전체 사본까지 — 저장하고 정리한다. (…) 이 모든 일은 별도의 독립 앱이 아니라 웹 브라우저 안에서 일어난다.
2003년의 목록과 비교하면 생각이 얼마나 선명해졌는지 보입니다. 문제가 정의됐습니다("브라우저는 수동적인 창이다"). 핵심 동사 두 개가 굵은 글씨로 박혔습니다(캡처와 정리). 하지만 여전히 "도구 모음(set of tools)" 입니다. 하나의 앱이 아니라요. 그리고 'Firefox'를 비튼 이름은 상표 문제의 씨앗이었습니다(뒤에서 터집니다).
2.9 SmartFox 0.0.1 — 화면을 보고서야 알게 된 것
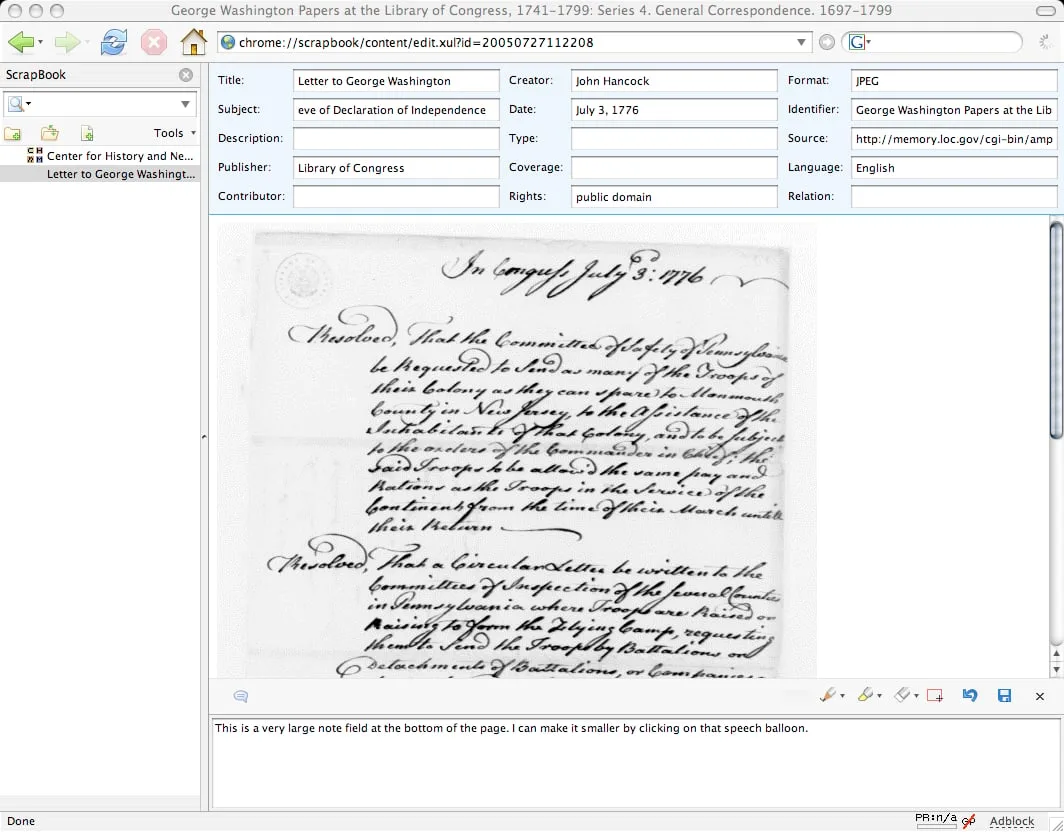
크게 보기SmartFox 0.0.1, 2005년 7월 27일. 미국 의회도서관의 조지 워싱턴 문서(1776년 7월 3일 존 핸콕의 편지)를 띄워 놓고 위에는 메타데이터, 아래는 노트, 왼쪽은 폴더. (출처: Dan Cohen)
연구비가 나오기도 전에 사이먼은 개발자 데이비드 노턴과 함께 SmartFox의 프로토타입 작업을 시작했습니다. 2005년 7월, 아주 이른 '0.0.1' 버전이 나옵니다.
화면을 자세히 보면 재미있는 것들이 보입니다.
주소창: chrome://scrapbook/content/edit.xul?id=… — 웹 주소가 아니라 chrome://로 시작합니다. 브라우저 내부의 XUL 화면이라는 뜻입니다. 이것이 '브라우저 안에 사는 도구'의 실체였습니다.
위쪽 메타데이터 칸: Title, Creator, Subject, Date, Publisher, Rights, Format, Identifier, Source, Language, Relation, Coverage… 이 필드 이름들은 더블린 코어(Dublin Core) 라는 도서관·아카이브 분야의 표준 메타데이터 항목과 거의 일치합니다. 처음부터 '표준'을 따르려 한 흔적입니다.
아래쪽 노트: "이건 페이지 아래쪽의 아주 큰 노트 칸이다. 말풍선을 누르면 작게 만들 수 있다." — 개발자가 남긴 메모가 그대로 찍혀 있습니다.
왼쪽 폴더: 'Center for History and New Media' 아래에 방금 저장한 편지.
코언에 따르면 이 셋은 "나중에 훨씬 나은 하나의 통합 서랍(drawer)으로 합쳐집니다". 흩어진 패널이 불편하다는 사실은 실제로 화면을 띄우고 써 봐야 알 수 있는 종류의 지식입니다.
같은 여름, 사이먼은 Firefox의 공개 릴리스뿐 아니라 핵심 코드 개발 과정 자체를 지켜보다가 하나를 발견합니다. Mozilla가 데이터베이스 인터페이스 역할을 할 mozStorage를 Firefox에 넣을 계획이라는 것. Firefox는 결국 오픈소스 데이터베이스 SQLite를 내장하게 되고, Zotero의 모든 데이터는 지금도 zotero.sqlite라는 SQLite 파일 하나에 들어 있습니다. 2004년 11월 조시의 메일에서 고민하던 "MySQL 래퍼냐, XML 직접 탐색이냐"의 답은 이렇게 바깥에서 왔습니다.
2.10 팀이 갖춰지고, 6개월 만에
2005년 여름, 센터의 늘어나는 서버와 복잡해지는 디지털 플랫폼을 돌보라고 댄 스틸먼(Dan Stillman) 을 채용합니다. 직원의 친구였죠. 그가 쌓여 있던 문제를 너무 잘 고쳐서, 2006년 1월 코언과 조시는 그를 개발팀에 합류시킵니다. 코언은 괄호 안에 감탄합니다. "지금까지도 댄은 Zotero의 리드 개발자다. 이 얼마나 긴 질주인가." Zotero 저장소의 첫 커밋(2006년 2월 21일, "초기 임포트… 기본 확장 구조와 DB 추상화·스키마 관리 함수")을 남긴 사람도 그입니다.
프랑스사 박사이자 기술 경험이 풍부한 숀 타캣츠(Sean Takats) — 이후 20년 가까이 Zotero의 디렉터 — , 기술 전도사 카리 크라우스, 그리고 그해 말 아웃리치 담당 트레버 오언스까지 합류합니다.
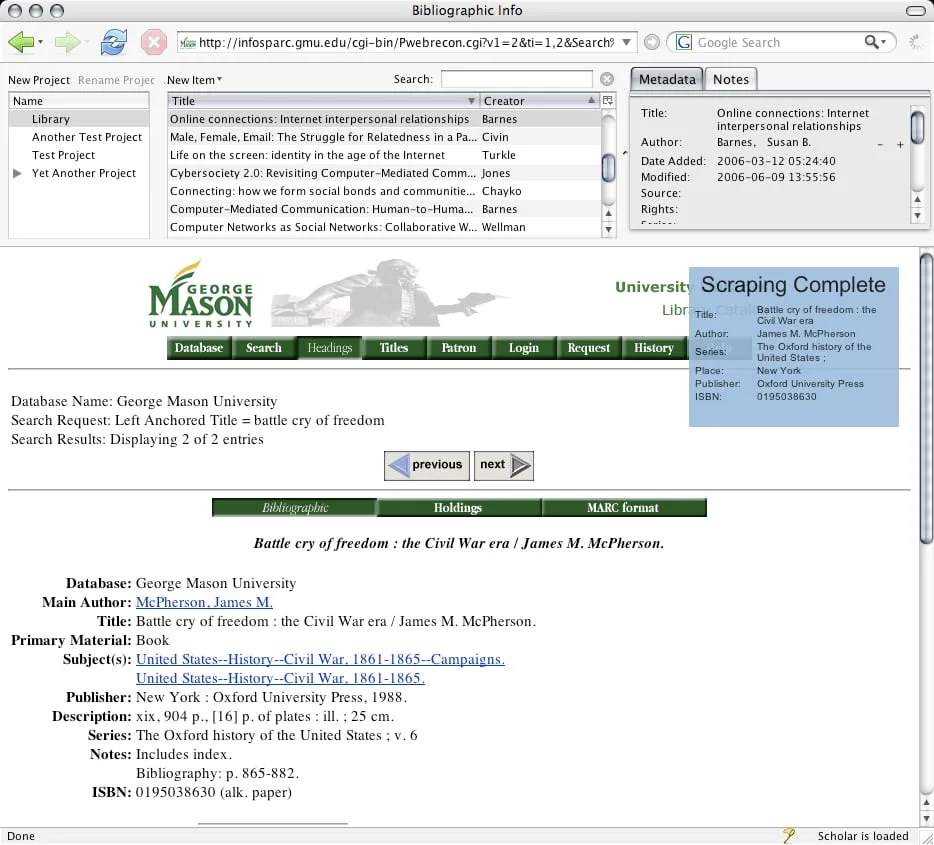
크게 보기2006년 6월, 'Firefox Scholar' 알파. 아래는 조지메이슨대 도서관 목록에서 제임스 맥퍼슨의 『자유의 함성』을 띄운 화면이고, 오른쪽 위 파란 상자는 'Scraping Complete' — 페이지에서 서지 정보를 뽑아냈다는 알림이다. 위쪽 세 칸은 프로젝트·항목·메타데이터/노트. 오른쪽 아래 상태 표시줄에 "Scholar is loaded"가 보인다. (출처: Dan Cohen)
팀이 갖춰지자 개발이 빨라집니다. 대략 6개월 만에 훨씬 일관된 디자인과 기능이 나왔습니다. 1년 전 0.0.1과 비교해 보세요. 메타데이터·노트·폴더가 흩어져 있던 화면이 위쪽 하나의 영역에 세 칸으로 정리됐고, 무엇보다 도서관 목록 페이지를 알아보고 서지 정보를 긁어 오는(scraping) 동작이 들어왔습니다. 2003년 성배의 "브라우저에서 벌어지는 일을 영리하게 알아챈다"가 드디어 화면에 나타난 겁니다. 이것이 훗날 번역기(translator) 라는 구조로 발전합니다(4장).
남은 문제는 이름이었습니다. 코언은 "2006년 여름 디자인을 다듬는 데 쓴 시간만큼 이름을 다시 생각하는 데 썼을 것"이라고 고백합니다. 'SmartFox'는 진작 버렸고 'Firefox Scholar'로 부르고 있었는데, 변호사에게서 'Firefox'가 들어간 브랜드는 문제가 될 거라는 말을 듣습니다. 게다가 이 소프트웨어가 정말 '학자(scholar)'만을 위한 것인가 하는 의문도 생겼습니다. 쓰임새가 훨씬 넓어 보였거든요.
후보들은 이랬습니다. 누가 냈는지는 "모두를 민망함에서 보호하기 위해" 밝히지 않는답니다.
iScholar — 아이팟의 시대였으니까
Scholr — 플리커(Flickr)의 시대였으니까
Citopia, FreeCite, CiteHound, DynoCite
FireScribe, FireHoard, MetaFox, ClioFox — 그리고 불(fire)·여우(fox)·각주(footnote)로 만들 수 있는 온갖 말장난
도메인 이름도 비어 있어야 했는데, "우리가 생각해 낸 나쁜 이름 중 놀랍도록 많은 것을 다른 바보들이 이미 등록해 놓았다"고 합니다.
시간이 바닥나던 늦여름, 팀은 영어 밖으로 눈을 돌립니다. 아프리카 언어에서 빌린 '우분투(Ubuntu)', 하와이어로 '빠르다'는 뜻의 위키(wiki)에서 온 '위키백과'처럼요. 동유럽사 전공인 동료 밀스 켈리가 알바니아어 사전을 찾아보자고 제안합니다. "다른 미국인이 — 무슨 이유로든, 하물며 남는 도메인 이름을 찾으려고 — 알바니아어 사전을 들춰 봤을 리 없으니" 좋은 생각이었죠.
그렇게 고른 단어가 zotero — 알바니아어로 "잘 배우다, 숙달하다" 라는 뜻입니다. 기억하기 쉽고, 여러 언어에서 쉽게 발음할 수 있을 것 같았고, .org·.com·.net이 모두 비어 있었습니다.
크게 보기2006년 8월 29일 코언이 만든 첫 로고타입. Eurostile 서체. (출처: Dan Cohen)
8월 29일, 코언은 댄 스틸먼에게 Eurostile 서체로 만든 로고타입 포토샵 파일을 보냅니다. 앞의 빨간 Z가 집 근처 피자 가게 'Zpizza'에서 영감을 받았을지도 모른다는 사실은 "확인도 부인도 할 수 없다"면서요(그 가게는 같은 빨간 Z를 Futura Bold로 썼는데, 그 "참사" 때문에 곧 문을 닫았다는 농담과 함께). 서체는 조금 바뀌었지만 그 로고타입은 지금까지 살아 있습니다.
2.12 2006년 10월 5일 — "try it out!"
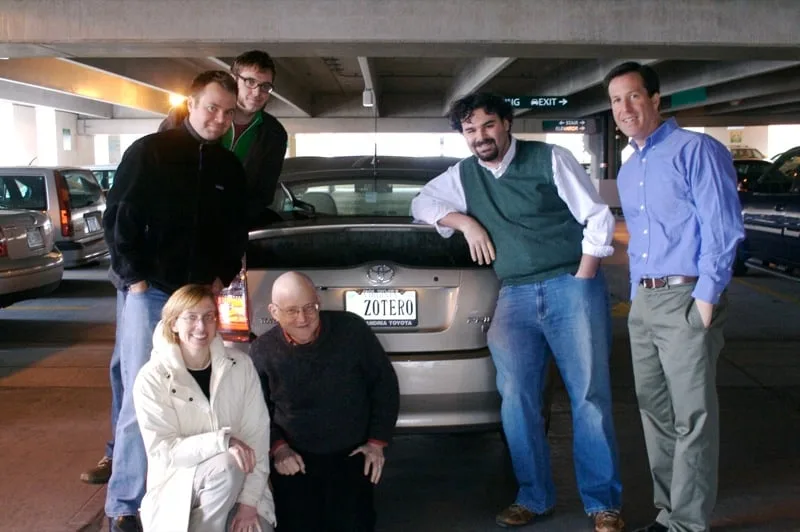
크게 보기2006년 말 Zotero 팀. 가운데 무릎 꿇은 사람이 항암 치료 중이던 로이 로젠츠바이크다. 그는 자기 프리우스에 'ZOTERO' 번호판을 막 달았다. 서 있는 사람은 왼쪽부터 숀 타캣츠, 트레버 오언스, 조시 그린버그, 댄 코언. 무릎 꿇은 사람은 카리 크라우스와 로이. (사진: Sharon Leon, 출처: Dan Cohen)
2006년 10월 5일, 코언은 Zotero 블로그에 1.0 공개 베타를 알리는 짧은 글을 올립니다. 마지막 문장은 약간 들뜬 "다운로드해서 써 보세요(try it out)!"였습니다. 사람들은 정말 써 봤습니다. 한 달 만에 사용자 6만 명. 숫자는 빠르게 불어났고 멜런 재단과 슬론 재단의 추가 지원이 이어졌습니다. 덕분에 연구팀끼리 컬렉션을 동기화할 수 있게 됐고, 결국 Firefox에서 독립해 다른 브라우저와도 함께 쓸 수 있게 됩니다. 2008년 First Monday 기고 시점에 Zotero는 이미 "35개 언어로 100만 명 이상"이 쓰고 있었습니다.
하지만 이 이야기에는 짙은 그림자가 드리워 있습니다. 사진 속 로이 로젠츠바이크는 1.0 출시 1년 뒤인 2007년 10월 11일, 57세로 세상을 떠났습니다. 코언은 그의 투병과 죽음이 "이 이야기 위에 먹구름처럼 걸려 있다"고 씁니다. 센터는 2011년 그의 이름을 붙여 로이 로젠츠바이크 역사와 뉴미디어 센터(RRCHNM)가 됐습니다. 그는 Zotero가 20년을 살아남는 것을 보지 못했지만, 그 20년의 토대는 그의 점심 테이블에서 만들어졌습니다.
정리하면 이렇습니다.
2002
두 개의 반쪽 — 웹 스크랩북(PHP 웹 앱)과 스크라이브(FileMaker 데스크톱 앱)가 따로 자란다.
2003.12
엘레나의 9줄 목록, 톰의 '웹화'. 목표는 보이지만 "두 세계를 어떻게 합칠지는 전혀 분명하지 않았다".
2004 여름
큰 테이블과 화이트보드. 새 동료들이 합류하고, 베타 중인 Firefox와 XUL이 눈에 들어온다.
2004.11.9
Firefox 1.0 출시일 밤의 메일 "Firefox + XUL + AWS = OpenScribe?" — '어떻게'가 처음으로 손에 잡힌다.
2004~05 겨울
SmartFox 연구비 신청서. '캡처'와 '정리'라는 두 동사. 아직은 '도구 모음'.
2005.7
SmartFox 0.0.1. 흩어진 패널의 불편함을 화면으로 확인. mozStorage(SQLite) 발견.
2006.1~6
댄 스틸먼 등 합류, 6개월 만에 Firefox Scholar 알파. 도서관 목록을 긁어 오는 'Scraping Complete'.
2006.10.5
알바니아어 'zotero'라는 이름으로 1.0 베타. 한 달 만에 6만 명.
자, 이제 직접 시간을 거슬러 가 봅시다. 아래 도구에서 시점을 옮기며, 그 순간 팀이 쓸 수 있었던 최선의 프롬프트와 AI가 만들었을 법한 결과를 보세요. 그리고 아래쪽의 '깨달음의 출처' 집계를 지켜보세요.
AI는 구상(conception)을 앞당기지 못했을 것이다. 원하는 것을 몰랐으므로 일관된 프롬프트를 쓸 수 없었다.
느린 형성(slow formation)이 오래가는 소프트웨어를 낳았다. 시간과 협업이 명확한 비전을 만들었고, 그 위에 계속 쌓을 수 있는 튼튼한 토대가 됐다.
그리고 결론으로, "프로그래밍이 마법 같은 봇과 함께하는 카페인 과다 폭주(a caffeinated bender with magical bots)가 되어 가는 지금, 이 절제된 속도와 공동의 사고에 대한 강조는 중요한 교훈을 담고 있을 것"이라고 말합니다.
3.1 로빈 슬론에게 보내는 답장
코언이 글 첫 문단에서 링크한 글이 있습니다. 소설가이자 프로그래머인 로빈 슬론(Robin Sloan) 이 2026년 9월 18일에 쓴 「Ask for what you want(원하는 것을 요청하라)」입니다. 슬론은 이 글에서 AI의 도움으로 단 하룻저녁 만에 자기만의 노트 앱 'Rocksteady'를 만든 이야기를 합니다. 그는 한 시간 동안 VISION.md라는 비전 문서를 쓰고, AI에게 만들게 하고, 코드는 보지 않습니다. "소원을 이루고, 지니를 다시 램프에 밀어 넣어라."
그런데 슬론의 글에는 코언의 글과 정확히 맞물리는 문장이 하나 있습니다.
"원하는 것을 요청하려면 (…) 원하는 것을 알아야 한다."
코언의 글은 사실상 이 문장에 대한 긴 답장입니다. 그렇다, 원하는 것을 알아야 한다. 그런데 원하는 것을 아는 데 5년이 걸리는 종류의 소프트웨어가 있다. 슬론의 노트 앱은 슬론 자신이 수십 년간 노트를 써 왔기 때문에 한 시간짜리 비전 문서로 충분했습니다. Zotero는 2003년의 누구도 — 만든 사람들 자신조차 — 그런 비전 문서를 쓸 수 없었습니다.
3.2 40년 전의 같은 문장 — 브룩스 「은탄환은 없다」 (1986)
코언의 주장은 새롭지 않습니다. 정확히 40년 전, IBM System/360의 아버지 프레드 브룩스(Fred Brooks) 가 거의 같은 말을 했습니다. 소프트웨어 공학의 고전 「은탄환은 없다(No Silver Bullet)」(1986)에서요.
브룩스는 소프트웨어 개발의 어려움을 두 종류로 나눕니다.
구분
본질적 복잡성 (essential)
우연적 복잡성 (accidental)
무엇인가
복잡한 개념 구조를 만드는 일 — 무엇을, 왜, 어떤 관계로
그 개념을 프로그래밍 언어와 기계로 표현하는 일
Zotero에서
"브라우저 안에 살며 학술 페이지를 알아보고, 로컬에 저장하고, 각주로 이어지는 도구"라는 생각 자체
XUL 문법, SQL 쿼리, PHP 코드, 메모리 관리
2026년 AI가
거의 줄여 주지 못한다
극적으로 줄여 준다
그리고 이렇게 말합니다. "우연적 활동이 전체 노력의 9/10 이상이 아니라면, 그것을 전부 0으로 줄여도 한 자릿수(10배) 개선은 오지 않는다." 2026년의 AI 코딩 도구는 브룩스가 말한 우연적 복잡성을 놀랍도록 삼켰습니다. 하지만 Zotero의 5년은 대부분 본질적 복잡성 쪽에 있었습니다.
브룩스의 다음 문장들은 코언의 글과 겹쳐 읽으면 섬뜩할 정도입니다.
"소프트웨어 시스템을 만드는 일에서 가장 어려운 단 하나의 부분은 무엇을 만들지 정확히 결정하는 것이다. (…) 일이 잘못됐을 때 이보다 시스템을 망가뜨리는 부분은 없다. 나중에 바로잡기가 이보다 어려운 부분도 없다."
"진실은, 고객은 자기가 무엇을 원하는지 모른다는 것이다."
"고객이 (…) 몇 가지 버전을 만들어 보고 써 보기 전에 정확한 요구사항을 완전하고 정밀하고 올바르게 명세하는 것은 사실상 불가능하다."
Zotero 이야기에서 '고객'은 개발자 자신이었습니다. 역사학자들이 역사학자를 위한 도구를 만들었으니까요. 그런데도 원하는 것을 몰랐습니다. 브룩스는 같은 글에서 해법도 제시합니다. "소프트웨어는 짓는(build) 것이 아니라 기르는(grow) 것이다." 점진적으로, 작동하는 것을 먼저 만들고 거기에 살을 붙여 가라는 뜻이죠.
3.3 사악한 문제 — 풀어 봐야 문제가 보인다
1973년, 도시계획 이론가 호르스트 리텔과 멜빈 웨버는 '사악한 문제(wicked problem)'라는 개념을 내놓았습니다. 수학 문제처럼 정의가 깔끔한 '길들여진 문제(tame problem)'와 달리, 사회 정책이나 도시 계획 같은 문제는 이런 특징을 가진다는 것이었죠.
문제를 확정적으로 정식화할 수 없다. 문제를 정의하는 것 자체가 해법의 방향을 정한다.
멈춤 규칙이 없다. "다 풀었다"고 말할 수 있는 지점이 없다.
후대 연구자들의 요약을 빌리면: "해법을 정식화해 보기 전까지는 문제가 이해되지 않는다."
'연구자를 위한 미래의 도구'는 전형적인 사악한 문제였습니다. 웹 스크랩북을 만들어 봐야 메타데이터가 부족하다는 걸 알았고, 스크라이브를 만들어 봐야 웹과 단절돼 있다는 걸 알았고, 0.0.1을 만들어 봐야 패널이 흩어져 있다는 걸 알았습니다. 매번 해법을 만들어 본 뒤에야 문제가 한 겹씩 드러났습니다. 프롬프트는 문제를 정식화한 결과물입니다. 정식화할 수 없는 문제에는 프롬프트도 쓸 수 없습니다.
3.4 갈의 법칙 — 작동하는 단순한 것에서 자란다
1975년 소아과 의사 존 갈(John Gall) 은 『시스템학(Systemantics)』이라는 반쯤 풍자적인 책에서 이런 문장을 남깁니다. 훗날 '갈의 법칙'으로 불리게 된 문장입니다.
"작동하는 복잡한 시스템은 예외 없이 작동하는 단순한 시스템에서 진화한 것이다. 처음부터 설계한 복잡한 시스템은 결코 작동하지 않으며, 땜질해서 작동하게 만들 수도 없다. 작동하는 단순한 시스템에서 다시 시작해야 한다."
Zotero의 계보가 정확히 이렇습니다. 웹 스크랩북(작동하는 단순한 웹 앱) + 스크라이브(작동하는 단순한 데스크톱 앱) → SmartFox 0.0.1(작동하는 아주 단순한 확장) → Firefox Scholar 알파 → Zotero 1.0. 한 번도 "완벽한 연구 도구"를 처음부터 설계하지 않았습니다. 해커뉴스의 한 댓글(skydhash)은 이를 이렇게 표현했습니다. "대성당이 아니라 작은 오두막에서 시작한다."
여기서 2026년의 AI 코딩과 미묘한 긴장이 생깁니다. AI는 '처음부터 설계한 복잡한 시스템'을 몇 분 만에 생성할 수 있습니다. 화면 수십 개, 데이터베이스 스키마, 인증, 결제까지. 갈의 법칙이 옳다면, 그렇게 생성된 복잡한 시스템은 작동하는 것처럼 보여도 실제 사용자의 요구에 부딪히는 순간 땜질로는 고칠 수 없는 상태가 될 가능성이 큽니다. 해커뉴스의 josephg는 이렇게 썼습니다. "LLM은 코드를 지우는 걸 꽤 못한다. (…) 코드베이스는 계속 자란다. 언제나 자란다. 그래도 프로토타입은 기막히게 만든다."
3.5 나우르 — 프로그램의 진짜 산물은 '이론'이다
1985년, 덴마크의 컴퓨터 과학자 피터 나우르(Peter Naur) — 프로그래밍 언어 문법 표기법 BNF의 'N' — 는 「이론 만들기로서의 프로그래밍(Programming as Theory Building)」이라는 짧은 논문을 씁니다. 그의 주장은 이렇습니다. 프로그래밍의 산물은 코드나 문서가 아니라 프로그래머의 머릿속에 생기는 '이론' — 이 프로그램이 세상의 어떤 문제에 어떻게 대응하는지, 왜 이렇게 생겼는지, 무엇을 바꾸면 무엇이 깨지는지에 대한 통찰 — 이라는 것.
"프로그램의 죽음은, 그 이론을 가진 프로그래머 팀이 해산될 때 일어난다."
"문서만으로 프로그램의 이론을 다시 세우는 것은 엄밀히 말해 불가능하다."
이 관점에서 보면 Zotero가 20년을 산 이유 중 하나가 분명해집니다. 리드 개발자 댄 스틸먼은 2006년 2월 첫 커밋부터 지금까지 Zotero를 만들고 있습니다(커밋 9,408개). 숀 타캣츠는 20년 가까이 디렉터입니다. Zotero의 '이론'을 가진 사람들이 한 번도 흩어지지 않았습니다.
반대로 생각해 보면 2026년의 질문이 날카로워집니다. AI가 하룻밤에 생성하고 사람이 코드를 한 줄도 읽지 않은 소프트웨어에는, 처음부터 그 이론을 가진 사람이 없습니다. 나우르의 정의대로라면 그 프로그램은 태어날 때부터 죽어 있는 셈입니다. 슬론처럼 혼자 쓰는 앱이라면 상관없습니다. 고장 나면 다시 만들면 되니까요. 하지만 2,000만 명의 연구 자료가 그 위에 쌓인다면 이야기가 다릅니다.
코언은 '느림'만 강조하지 않습니다. 그가 함께 강조하는 단어는 공동의 사고(communal thinking) 입니다. 앞의 프롬프트 타임머신에서 '깨달음의 출처'를 세어 보면 흥미로운 사실이 드러납니다. 선명도를 끌어올린 깨달음 가운데 '한 사람이 더 오래 혼자 생각해서' 나온 것은 하나도 없습니다.
해커뉴스에서 가장 날카로운 댓글로 꼽을 만한 scruple의 글이 이 점을 정확히 짚습니다.
"어려웠던 부분은, 로컬 SQLite 데이터베이스를 조작하는 브라우저 확장이 로컬 오프라인 저장과 임의의 학술 목록에서의 실시간 DOM 스크래핑을 화해시킬 수 있는 유일한 아키텍처라는 사실을 발견하는 일이었다. 에이전트는 기존 해법을 종합할 수는 있지만, 프롬프트를 쓰는 사람이 아직 이해하지 못한 긴장을 해소하는 아키텍처를 종합할 수는 없다. (…) 문제를 푸는 데 필요한 작동 원소(operational primitives)가 아직 지도에 없다면, 그걸 만들라고 프롬프트할 수 없다. 2003년에 '스크라이브와 웹 스크랩북을 바탕으로 도구를 만들어 줘'라고 했다면 허술한 PHP 래퍼가 나왔을 것이다. 그게 당시의 풍경이었으니까."
2003년에는 아직 'XUL 확장이 SQLite를 만질 수 있다'는 작동 원소가 세상에 없었습니다(Firefox는 2004년 11월, mozStorage는 그 뒤). 아무리 뛰어난 AI라도 존재하지 않는 부품으로 설계할 수는 없습니다. 그 부품이 세상에 나타났을 때 알아보고 "Holy crap!"이라고 외칠 수 있었던 건, 그 문제를 1년 넘게 붙들고 대화해 온 사람들이었습니다.
그로스 마케팅 일을 한다는 _fw의 댓글도 같은 지점을 다른 각도에서 봅니다. "놀랍도록 많은 소프트웨어 제품이, 어쩌면 오늘날의 사업들까지도, 문제를 찾아 헤매는 해법이다. (…) 사람들이 원하는 것을 만드는 것이, 내가 만든 것을 사람들이 원하게 만드는 것보다 훨씬 쉽다."
4. 아키텍처 깊이 보기 — 오래가는 구조는 어떻게 생겼나
이제 Zotero의 내부로 들어가 봅시다. 개발자가 아니어도 따라올 수 있도록, 비유를 곁들여 하나씩 설명하겠습니다. 이 장의 요점을 먼저 말하면 이렇습니다. Zotero의 코드는 20년 동안 여러 번 갈아엎어졌지만, 몇 가지 '형식'은 거의 그대로 살아남았다. 오래가는 소프트웨어의 비밀은 코드가 아니라 그 형식들에 있습니다.
4.1 2006년의 구조 — Firefox라는 집에 세 든 연구 도구
2006년의 Zotero는 독립된 프로그램이 아니라 Firefox 확장(extension) 이었습니다. 집에 비유하면, Firefox라는 집에 세 들어 사는 세입자였죠. 세 가지 기술이 이를 가능하게 했습니다.
XUL (XML User Interface Language) — Mozilla가 만든, XML로 화면을 그리는 언어. Firefox의 메뉴·도구 모음·창 자체가 XUL로 그려져 있었기 때문에, 확장도 XUL로 브라우저 화면에 새 부분을 '덧붙일(overlay)' 수 있었습니다. Zotero는 Firefox 창 아래쪽에서 쓱 올라오는 서랍(pane) 을 붙였습니다.
XPCOM (Cross-Platform Component Object Model) — Mozilla의 내부 부품 시스템. 확장은 XPCOM을 통해 데이터베이스, 파일시스템, 네트워크 같은 브라우저 내부 부품을 직접 호출할 수 있었습니다. 세입자에게 집의 배전반과 수도관 열쇠까지 준 셈입니다.
mozStorage — Mozilla가 SQLite를 감싼 계층. Zotero는 이를 이용해 Firefox 프로필 폴더 안에 zotero.sqlite라는 데이터베이스 파일을 만들었습니다.
이 구조는 2003년의 성배 — "브라우저 안에 살면서 브라우저에서 벌어지는 일을 영리하게 알아채는" — 를 거의 완벽하게 실현했습니다. 사용자가 보는 페이지와 연구 도구가 한 창, 한 프로세스 안에 있었으니까요. 하지만 이 구조에는 숨은 위험이 있었습니다. 세입자의 운명이 집주인의 규칙에 묶여 있다는 것. 이 위험은 11년 뒤에 현실이 됩니다(4.5절).
Firefox Scholar 알파의 'Scraping Complete'는 어떻게 동작했을까요? 핵심은 번역기(translator) 입니다. 숀 타캣츠는 20주년 회고에서 Zotero의 두 가지 결정적 혁신 중 첫 번째로 번역기를 꼽습니다.
문제는 이랬습니다. 세상의 도서관 목록, 학술지 사이트, 아카이브는 저마다 페이지 구조가 다릅니다. 저자 이름이 어디에 있는지, 출판 연도가 어떤 형식인지 사이트마다 제각각입니다. 2005년 연구비 신청서가 지적했듯 "각 도서관과 박물관 컬렉션은 서로 다른 디자인과 서로 다른 정보 표시 방식을 가진 별개의 웹사이트"였습니다.
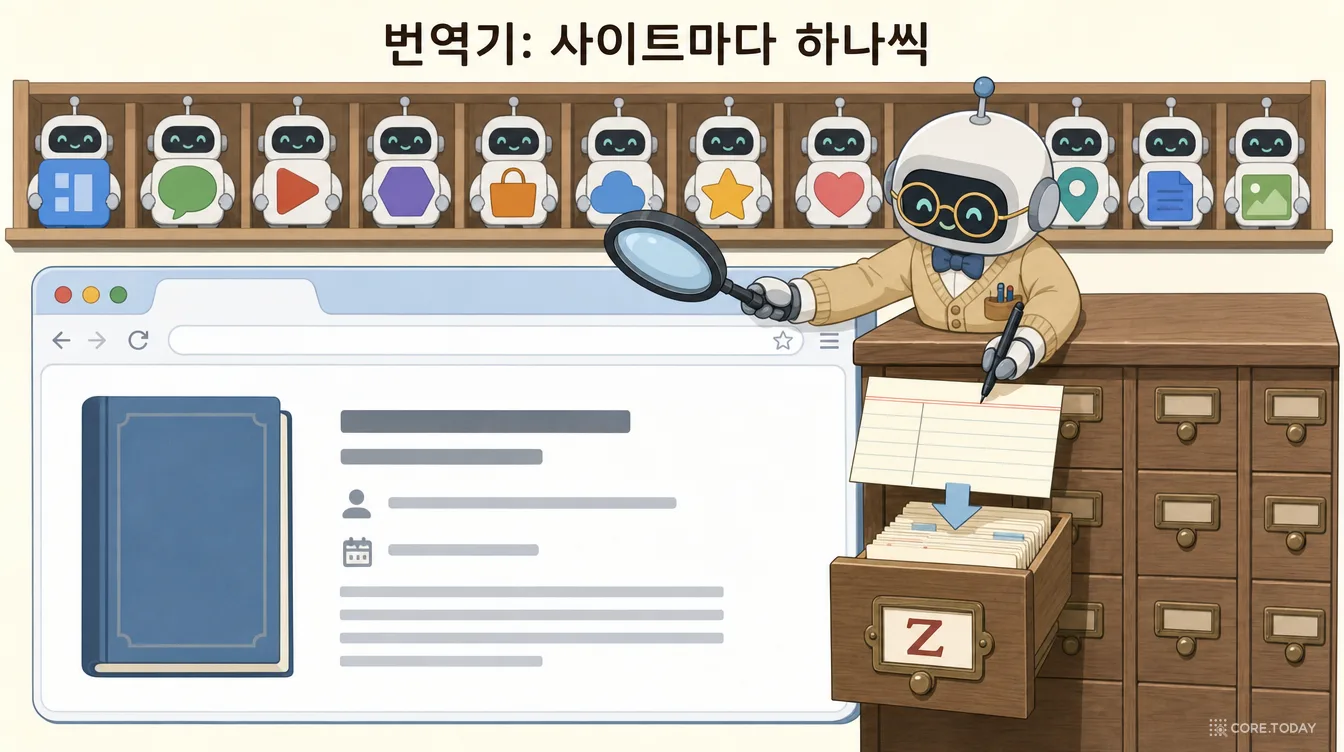
Zotero의 해법은 사이트마다 작은 자바스크립트 프로그램을 하나씩 쓰는 것이었습니다. 이 프로그램은 그 사이트의 '언어'를 Zotero의 공통 '언어'(항목 유형·필드)로 옮긴다는 뜻에서 번역기라고 불립니다. 웹 번역기는 기본적으로 두 개의 함수를 가집니다. 아래는 이해를 돕기 위해 크게 단순화한 예시입니다.
javascript
// 가상의 학술지 사이트용 번역기 (단순화한 예시)// ① 이 페이지에 저장할 만한 게 있나? — 페이지를 열 때마다 조용히 실행된다functiondetectWeb(doc, url) {
if (url.includes('/article/')) return'journalArticle'; // 논문 한 편if (doc.querySelector('.search-results')) return'multiple'; // 검색 결과 목록returnfalse; // 저장할 것 없음
}
// ② 저장 버튼을 누르면 — 실제로 정보를 뽑아낸다asyncfunctiondoWeb(doc, url) {
let item = newZotero.Item('journalArticle');
item.title = text(doc, 'h1.article-title');
item.publicationTitle = text(doc, '.journal-name');
item.date = attr(doc, 'meta[name="citation_date"]', 'content');
for (let name of doc.querySelectorAll('.author-name')) {
item.creators.push(ZU.cleanAuthor(name.textContent, 'author'));
}
item.attachments.push({ title: 'Full Text PDF', mimeType: 'application/pdf',
url: attr(doc, 'a.pdf-link', 'href') });
item.complete(); // Zotero 라이브러리로 넘긴다
}
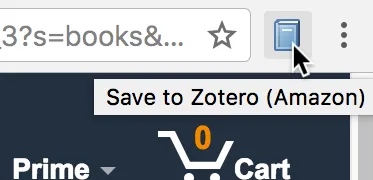
detectWeb이 'journalArticle'을 돌려주면 브라우저 툴바의 저장 아이콘이 논문 모양으로, 'book'이면 책 모양으로, 'multiple'이면 폴더 모양으로 바뀝니다.
크게 보기번역기가 페이지를 알아보면 저장 버튼의 모양이 바뀐다. 여기서는 아마존의 책 페이지를 알아보고 'Save to Zotero (Amazon)'이라고 알려 준다. 2004년 코언의 메일에 있던 'AWS'(아마존 도서 API)의 후손인 셈이다. (출처: zotero.org 블로그)
이 구조가 왜 오래갔을까요? 세 가지 이유가 있습니다.
작고 독립적이다. 번역기 하나가 고장 나도(사이트가 디자인을 바꾸면 흔히 그렇습니다) 나머지 749개는 멀쩡합니다. 고치는 것도 파일 하나만 고치면 됩니다.
바깥 사람이 기여할 수 있다. 번역기는 별도 저장소(github.com/zotero/translators)에 있고, 지금까지 269명이 기여했습니다. 2026년 10월 현재 번역기는 750개(웹 702, 가져오기 25, 내보내기 22, 검색 19). Zotero 개발팀 12명이 750개 사이트를 다 챙길 필요가 없습니다.
같은 번역기를 여러 곳에서 쓴다. 데스크톱 앱, 브라우저 커넥터, 그리고 앱 없이 번역기를 돌리는 서버(translation-server)가 같은 번역기를 씁니다. 타캣츠에 따르면 위키백과의 인용 자동 생성 기능도 Zotero 번역기를 쓰고, ProQuest는 이 방식을 베꼈습니다.
번역기가 없는 사이트는 어떻게 할까요? 이때는 페이지에 심어진 표준 메타데이터 태그가 빛을 발합니다. 구글 스칼라가 권장하는 citation_title, citation_author 같은 메타 태그, 도서관계의 더블린 코어, 그리고 COinS(페이지 안에 서지 정보를 숨겨 두는 규약) 같은 것들이요. 코언은 2008년 글에서 이런 일화를 소개합니다. 세계 최대 도서관 목록 OCLC WorldCat이 "우리가 개입하지도 않았는데" 자기 목록 페이지에 COinS 태그를 넣었고, 그 순간 WorldCat 전체가 Zotero와 호환됐다고요. 그는 이렇게 결론짓습니다. "도구가 디지털 생태계와 연결되도록 하는 이 화려하지 않은 일이 Zotero의 숨은 힘이었다." 그리고 "어떤 애플리케이션이나 저장소도 섬이어서는 안 된다."
한국 연구자에게는? 번역기 저장소에는 DBpia, KISS(한국학술정보), 국립중앙도서관(2026년 4월 갱신), 한국민족문화대백과사전 같은 한국 사이트 전용 번역기가 있습니다. 반면 RISS·KCI·ScienceON 전용 번역기는 없습니다. KCI는 표준 citation_* 태그를 갖춰 범용 메타데이터 번역기로 읽힐 가능성이 높지만 값이 영문판이고, RISS는 기본적인 더블린 코어 태그만 있어 공저자가 한 칸에 합쳐지고 학술지·권호·쪽수가 빠지는 식입니다(대신 RIS 내보내기를 제공하니, 그 파일을 Zotero로 가져오면 됩니다). 한국 학술 사이트의 번역기는 누구나 기여할 수 있는 열린 자리입니다.
4.3 CSL — 인용 양식을 '데이터'로 만든 발명
타캣츠가 꼽은 두 번째 혁신은 CSL(Citation Style Language, 인용 스타일 언어) 입니다. 브루스 다커스(Bruce D'Arcus)가 설계한 이 언어는 인용 양식을 프로그램 코드가 아니라 XML 데이터 파일로 기술합니다. "저자 이름은 성을 먼저, 이름은 이니셜로, 저자가 셋 이상이면 'et al.'"같은 규칙을 파일에 적어 두면, 인용 엔진이 그 규칙대로 각주와 참고문헌을 찍어 냅니다.
xml
<!-- APA 비슷한 본문 인용 "(Cohen, 2008)"을 만드는 CSL의 일부 (단순화) --><citation><layoutprefix="("suffix=")"delimiter="; "><groupdelimiter=", "><namesvariable="author"><nameform="short"and="symbol"/><!-- 성만, 'and' 대신 & --></names><datevariable="issued"><date-partname="year"/><!-- 연도만 --></date></group></layout></citation>
이것이 왜 혁명적이었을까요? 인용 양식을 바꾸는 일이 프로그래머의 일에서 사서와 연구자의 일이 됐기 때문입니다. 새 학회지 양식이 필요하면 XML 파일 하나를 쓰면 됩니다. 비슷한 양식은 기존 스타일을 '부모'로 지정하고 이름만 바꾸는 종속 스타일로 만들 수 있습니다. 그 결과 CSL 스타일 저장소에는 2026년 10월 9일 기준 10,865개(독립 2,864 + 종속 8,001)의 스타일이 쌓였습니다.
CSL 스타일
10,865
그중 독립 스타일
2,864
사이트별 번역기
750
번역기 기여자
269
Zotero 전업 인력
12
막대 길이는 CSL 스타일 수(10,865)를 100%로 한 상대 비율. 12명이 만든 것이 아니라, 12명이 지킨 '형식' 위에 수천 명이 쌓은 것이다.
이 인용 규칙을 실제로 해석하는 엔진은 citeproc-js로, 일본 나고야의 법학 교수 프랭크 베넷(Frank Bennett) 이 만들어 Zotero 2.1(2011)부터 쓰였습니다. 법학 교수가 자기 분야의 까다로운 법률 인용을 다루려다 범용 엔진을 만든 것이죠. 2003년 엘레나의 목록에 있던 "최소한 APA와 법률 양식"이 이렇게 실현됐습니다.
더 놀라운 건 CSL이 Zotero만의 것이 아니게 됐다는 점입니다. 타캣츠는 "Zotero의 CSL 구현은 이 명세가 실제로, 대규모로 작동할 수 있음을 보여 준 첫 사례"였고, 지금은 "경쟁자 대부분"의 인용 기능을 CSL이 움직인다고 씁니다. 경쟁사인 Mendeley(엘스비어), Papers(스프링거), RefWorks가 각각 CSL 프로젝트에 5,000달러씩 기부한 기록도 있습니다. 경쟁자들이 같은 '형식'을 쓰게 되면, 그 형식은 쉽게 죽지 않습니다.
한국어 스타일은? CSL에는 한국어 로캘 파일(날짜·'편집'·'역' 같은 용어의 한국어 표기)이 2009년부터 있고 Zotero 화면도 한국어로 번역돼 있습니다. 그런데 공식 스타일 저장소에서 'Korean'이 들어간 스타일 7개는 모두 영문 서식이고, 한국어 서식 스타일은 0개입니다. 국내 학회지 양식을 CSL로 기여하는 것은 아직 비어 있는 일입니다.
4.4 로컬 우선 데이터 — 서버가 사라져도 남는 것
Zotero의 모든 서지 정보·노트·태그·컬렉션은 내 컴퓨터의 zotero.sqlite 파일 하나에 들어 있습니다. 현재 스키마는 테이블 54개, 항목 유형 40개(학술지 논문, 책, 학위논문, 신문 기사, 법률, 특허…), 필드 121개로 이뤄져 있습니다. PDF·스냅숏 같은 첨부 파일은 storage/ 폴더에, 매일 자동 백업(.bak)도 따로 생깁니다.
동기화는 두 갈래입니다.
무엇을
어디로
비용
메타데이터 (서지·노트·태그)
zotero.org 서버
무료, 무제한
첨부 파일 (PDF 등)
Zotero Storage 또는 내 WebDAV 서버
300MB 무료 · 2GB 연 20달러 · 6GB 연 60달러 · 무제한 연 120달러
이 설계에는 두 가지 철학이 담겨 있습니다. 첫째, 데이터의 원본은 사용자의 컴퓨터에 있다. 인터넷이 끊겨도, zotero.org가 내일 사라져도 내 라이브러리는 남습니다. 게다가 RIS·BibTeX·CSL JSON 같은 공개 형식으로 언제든 내보낼 수 있습니다. 2019년 연구 그룹 Ink & Switch는 「로컬 우선 소프트웨어(Local-first software)」라는 영향력 있는 글에서 이상적인 소프트웨어의 일곱 가지 조건을 제시했는데, 그중 다섯 번째가 '긴 지금(The Long Now)' 이었습니다. "당신의 작업은 그 소프트웨어를 만든 회사가 사라진 뒤에도 무기한 접근할 수 있어야 한다." Zotero는 이 글보다 13년 먼저 그렇게 설계됐습니다. 2007년 Zotero 블로그 글의 제목은 「Zotero: 열려 있고, 무료이며, 영원히(Open, Free, Forever)」였습니다.
둘째, 돈은 데이터가 아니라 '편의'에서 번다. 메타데이터 동기화는 무료이고, 파일 저장 공간만 유료입니다. 데이터를 인질로 잡지 않는 수익 모델이죠. 공식 문서에는 이런 정직한 경고도 있습니다. "동기화는 백업이 아니다(서버는 최신 버전만 보관한다)."
2011년 2월, Zotero는 Firefox 없이 혼자 실행되는 Zotero Standalone 알파를 내놓습니다(정식 3.0은 2012년 1월 31일). 멜런 재단이 지원한 'Zotero Everywhere' 계획의 일부였습니다. Chrome과 Safari 사용자도 쓸 수 있게 하려는 것이었죠. 이때부터 Zotero는 두 형태로 존재합니다. Firefox 확장판과 독립 앱판.
크게 보기Zotero Standalone 초기 화면. Firefox 창이 아니라 독립된 창이다. 계몽주의·프랑스 혁명 같은 18세기 프랑스사 컬렉션이 보인다. (출처: zotero.org 블로그)
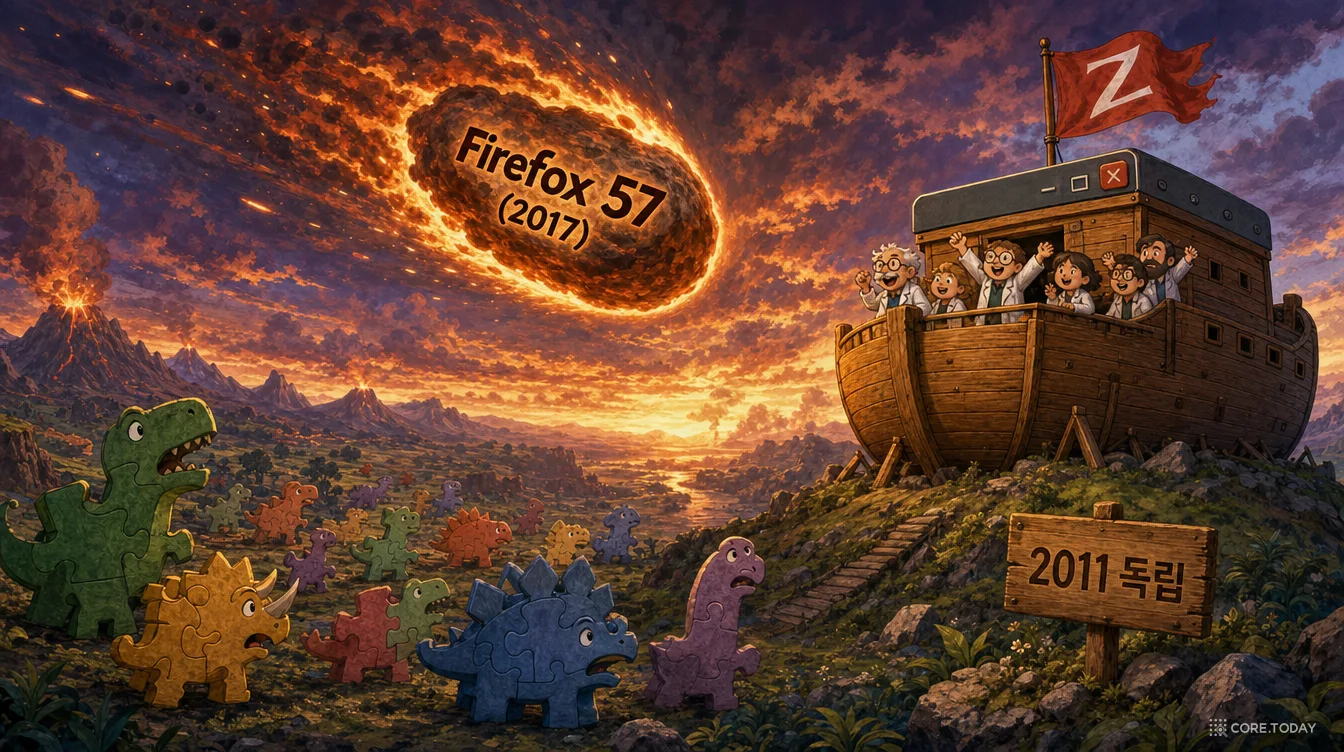
그리고 2017년이 옵니다. Mozilla는 Firefox를 빠르고 안전하게 만들기 위해 대대적인 재설계(프로젝트명 Quantum)를 진행하고 있었고, 그 과정에서 결단을 내립니다. 2017년 11월 14일 출시된 Firefox 57부터 옛 방식(XUL/XPCOM)의 확장을 전부 퇴출하고, 크롬과 호환되는 새 확장 규격(WebExtension)만 허용하기로요. 새 규격의 확장은 보안상 훨씬 제한된 권한만 가집니다. Zotero의 공식 설명에 따르면 새 확장은 "데이터베이스를 관리하거나, 파일시스템에 접근하거나, 로컬 프로그램을 실행할 수 없"었습니다. 세입자에게서 배전반과 수도관 열쇠를 회수한 겁니다. 그날 수많은 인기 확장이 사라지거나 기능을 잃었습니다.
!
문제 — 집주인이 규칙을 바꾼다
Firefox 57(2017-11-14)은 XUL/XPCOM 확장을 퇴출한다. 2006년 구조의 Zotero는 확장 안에서 DB와 파일시스템을 직접 다뤘으므로, 그대로라면 존재 자체가 불가능해진다.
→
해법 — 6년 전에 지어 둔 집으로 이사
넉 달 앞선 2017-07-10, Zotero 5.0은 Firefox 확장판을 접고 독립 앱 + 가벼운 브라우저 커넥터로 일원화했다. 커넥터는 페이지를 읽기만 하고, 무거운 일은 로컬 포트 23119로 앱에 넘긴다. 데이터 폴더는 Firefox 프로필 밖으로 자동 이사했다.
✓
결과 — 코드는 바뀌고 형식은 살아남았다
번역기, CSL 스타일, SQLite 라이브러리는 그대로 새 구조로 옮겨 갔다. 사용자 입장에서는 라이브러리가 한 건도 사라지지 않았다. FAQ의 "마음을 바꿀 생각은 없나요?"라는 질문에 대한 답은 단 두 단어였다: "See above(위를 보세요)."
재미있는 디테일이 있습니다. 커넥터와 앱이 대화하는 로컬 포트 번호 23119는 소스 코드 주석에 따르면 아스키 코드로 "ZO" 입니다(Z=0x5A=90, O=0x4F=79 → 90×256+79 = 23,119). 20년 된 소프트웨어의 장난기 섞인 화석이죠.
그리고 더 흥미로운 사실. Zotero는 Firefox 브라우저를 떠났지만 Mozilla 플랫폼을 떠나지는 않았습니다. 지금의 Zotero 앱은 Firefox의 장기 지원판(ESR) 엔진을 통째로 품고 다닙니다. Zotero 6은 Firefox 60 ESR, Zotero 7은 115 ESR(개발 문서가 "코드베이스의 대규모 재작성"이라고 부른 이행), Zotero 8부터는 140 ESR, 그리고 개발 브랜치는 2026년 7월 28일 153 ESR로 옮겨 가는 중입니다. 핵심 코드 폴더의 이름은 지금도 chrome/content/zotero/xpcom/입니다. 2006년 구조의 이름이 화석처럼 남아 있는 거죠.
이것이 의미하는 바는 이렇습니다. Zotero는 집주인에게서 독립했지만, 집을 짓는 자재(엔진)는 여전히 Mozilla에서 가져옵니다. 다만 이제는 언제 자재를 바꿀지 스스로 정합니다. 플랫폼에 '종속'되는 것과 플랫폼을 '사용'하는 것의 차이입니다.
4.6 보이지 않는 일 — 아무것도 바뀌지 않은 가장 큰 변화
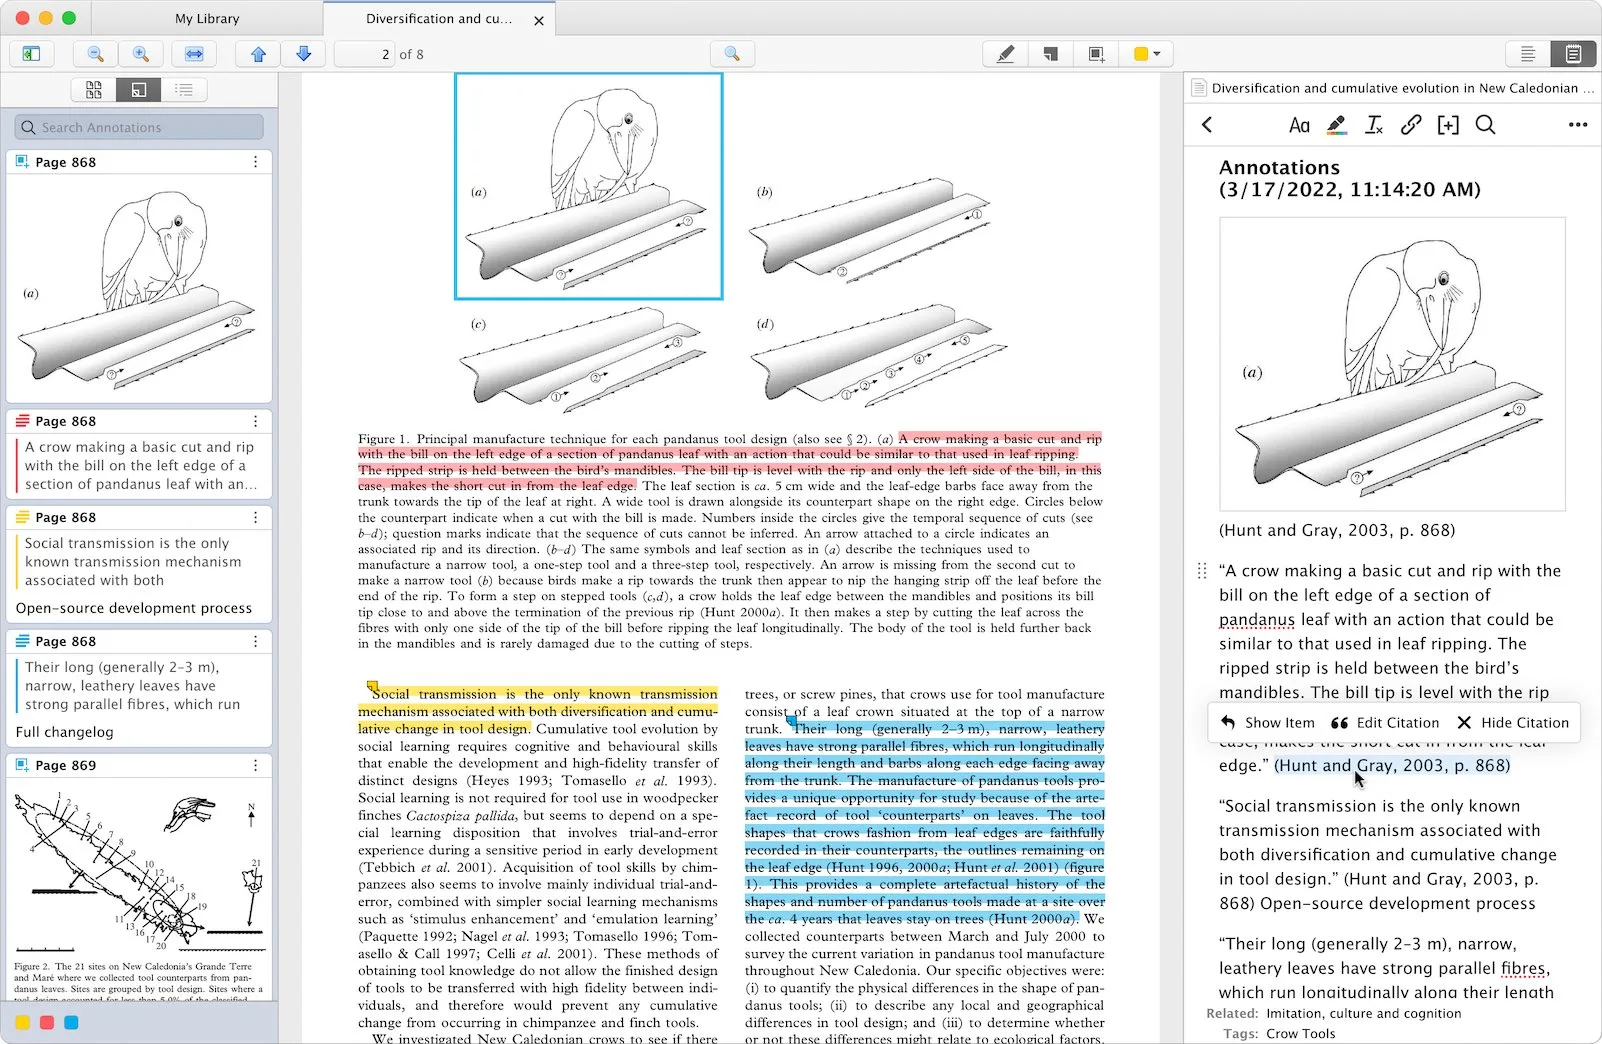
크게 보기2022년 Zotero 6에 들어온 내장 PDF 리더와 주석. 2003년 엘레나의 목록에도, 2005년 연구비 신청서에도 '주석(annotate)'은 있었다. 그것이 지금의 모습이 되기까지 17년이 걸렸다. (출처: zotero.org 블로그)
타캣츠의 회고에서 가장 인상적인 문장 하나를 꼽으라면 이것입니다. Zotero의 서버를 AWS로 옮긴 일은 "처음에는 겉으로 보기에 기능 변화가 전혀 없었지만, 손쉽게 Zotero의 지난 20년 중 가장 중요한 기술적 이동으로 증명됐다."
사용자 눈에는 아무것도 바뀌지 않은 일이 가장 중요했다는 겁니다. 오래가는 소프트웨어의 일 대부분은 이렇게 보이지 않습니다. 데이터베이스 스키마 업그레이드, 엔진 교체, 서버 이전, 수백 개 번역기의 유지보수. 2,000만 명의 라이브러리를 한 건도 잃지 않고 옮기는 일.
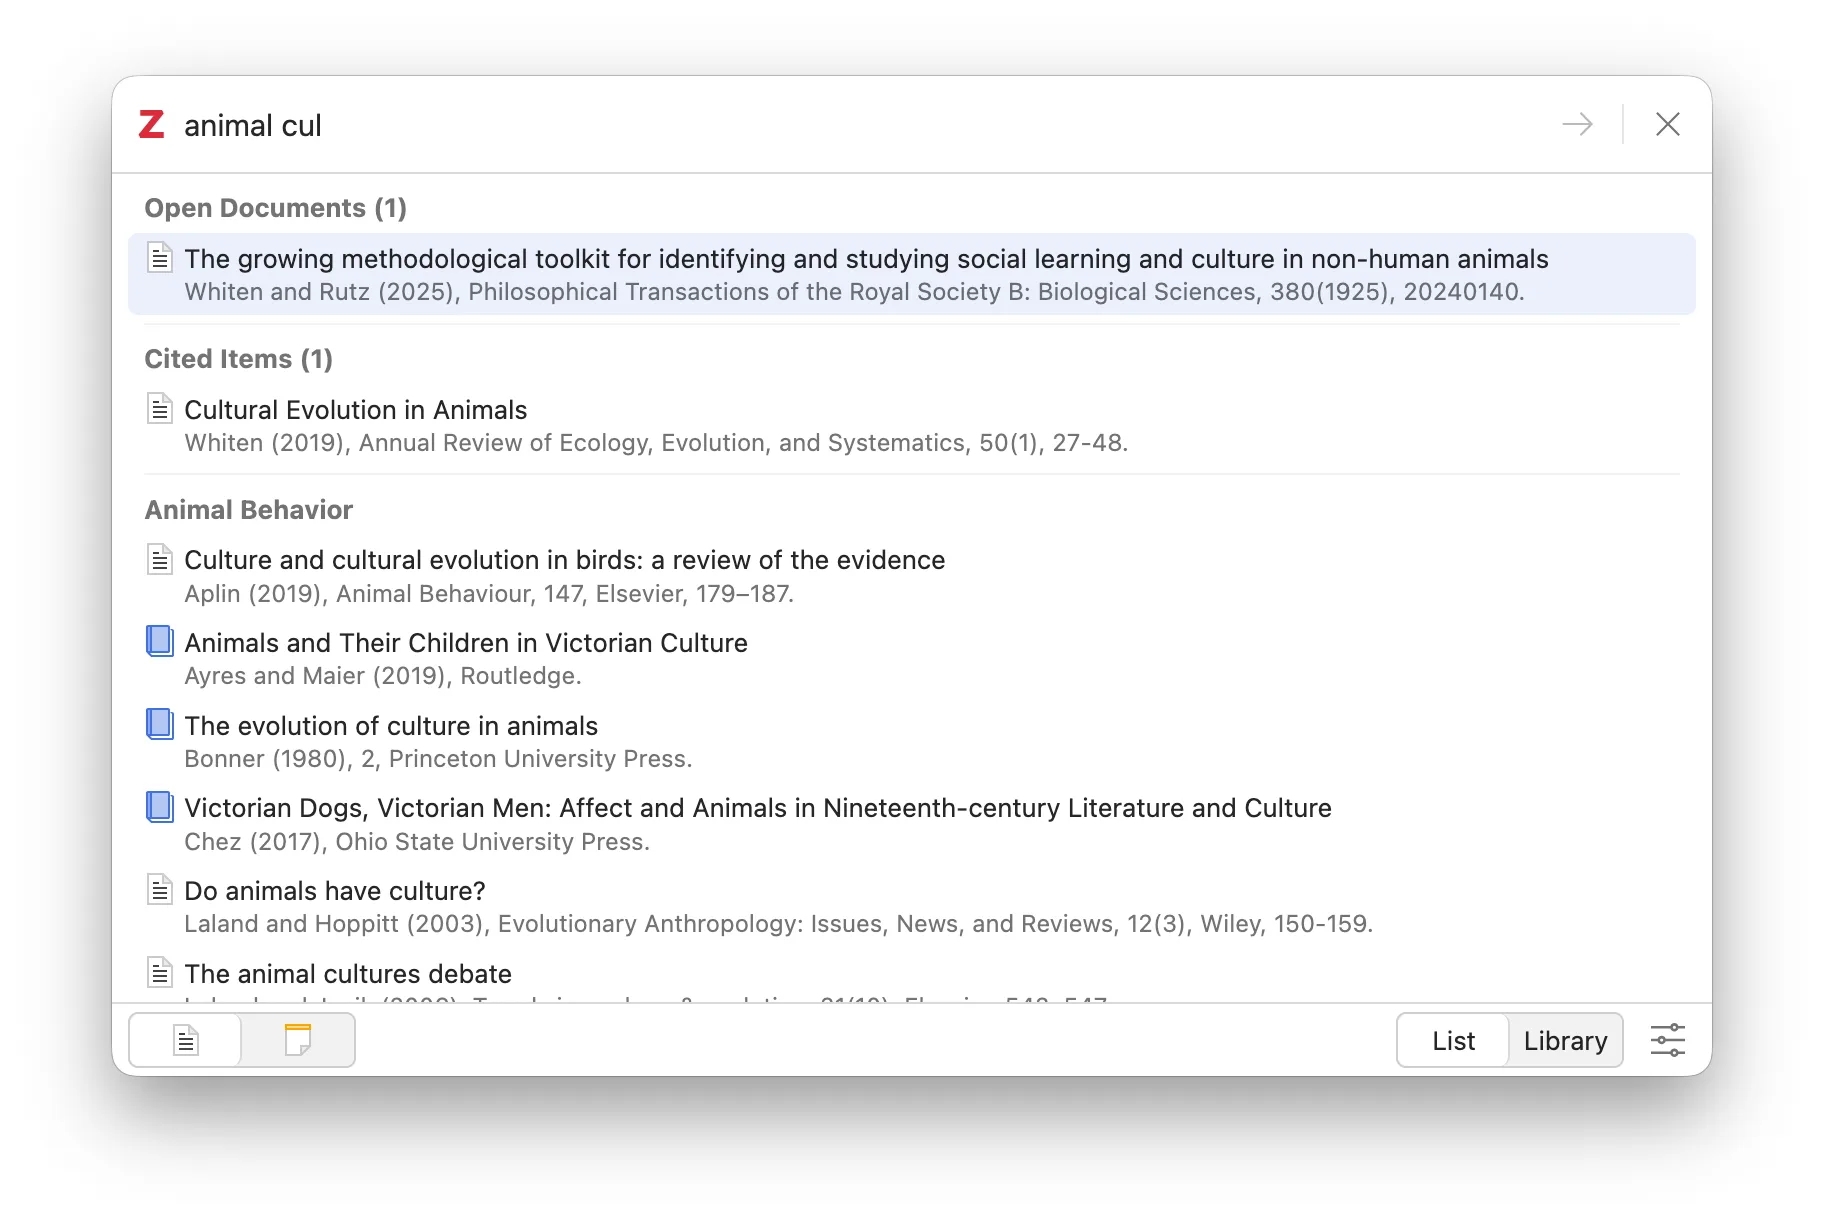
크게 보기2026년 1월 Zotero 8의 통합 인용 대화상자. 워드에서 인용을 넣을 때 뜨는 창이다. 2007년 1월 워드 플러그인 알파에서 출발한 기능이 19년째 다듬어지고 있다. (출처: zotero.org 블로그)
아래 도구에서 2006년 구조와 2026년 구조를 비교해 보세요. '논문 페이지에서 저장하기'와 '워드에서 각주 넣기'를 한 단계씩 따라가면 부품들이 어떻게 맞물리는지 보이고, '2017년의 충격'을 고르면 옛 구조의 어디가 끊어졌는지 보입니다.
코언은 글을 이렇게 맺습니다. "앞으로 20년, 혹은 그 이상 살아남기를(May it last another 20 years, or more)." 이 바람에는 의외로 근거가 있습니다.
1964년, 작가 앨버트 골드먼은 뉴욕의 델리 '린디스(Lindy's)'에 모이던 코미디언들 사이의 속설을 소개했습니다. 코미디언의 남은 수명은 그가 지금까지 TV에 나온 횟수에 비례한다는 것. 나심 탈레브는 2012년 『안티프래질』에서 이를 린디 효과(Lindy effect) 라고 이름 붙이고 일반화합니다. 사람처럼 늙어 죽는 것이 아니라 부패하지 않는 것 — 책, 아이디어, 기술 — 은 지금까지 살아남은 기간만큼 앞으로도 살아남을 것으로 기대된다는 거죠. "멸종하지 않고 한 해가 지날 때마다 추가 기대 수명은 두 배가 된다."
이 효과가 소프트웨어에도 통할까요? 몇 가지 실증 연구가 비슷한 모양을 보여 줍니다. 2021년 디오미디스 스피넬리스 등의 연구(PeerJ Computer Science)는 코드 한 줄의 수명 중앙값이 약 2.4년이고, 새로 쓴 줄일수록 수정·삭제될 확률이 높으며 시간이 지날수록 위험률이 떨어진다고 보고했습니다. 코드 한 줄 수준에서 나타나는 린디 패턴입니다. 소프트웨어 공학 연구자 데릭 존스는 구글 서비스들의 반감기를 약 4.1년으로 추정했습니다.
20년을 산 Zotero의 린디 기대 수명은 대략 20년 더. 코언의 바람과 정확히 일치합니다. 하지만 린디 효과에는 조건이 있습니다. 살아남은 이유가 계속 유지돼야 합니다. 그 이유가 무엇이었는지, 같은 시기 경쟁자들의 20년과 나란히 놓고 보면 선명해집니다.
공정하게 말하자면, 상용 도구들도 대부분 '죽지는' 않았습니다. EndNote는 37년째 팔리고 있고, Mendeley Desktop은 종료 예고를 철회했습니다. 하지만 사용자 입장에서 중요한 질문은 "회사가 살아 있나?"가 아니라 "내 라이브러리와 내 작업 방식이 계속 유지되나?" 입니다. 인수될 때마다, 제품 전략이 바뀔 때마다 사용자는 이삿짐을 싸야 할지 고민해야 했습니다. 2022년 Mendeley Desktop 신규 배포가 중단됐을 때 많은 연구자가 Zotero로 옮겼고, 타캣츠가 "2,000만 명 중 절반 이상이 최근 3년 사이에 가입했다"고 말한 배경 중 하나가 이런 이동입니다.
2008년의 소송 이야기도 짚고 갈 만합니다. EndNote를 소유한 톰슨 로이터는 Zotero가 EndNote의 스타일 파일을 변환하는 기능을 문제 삼아 조지메이슨대를 상대로 1,000만 달러 소송을 냈습니다. 대학은 오히려 EndNote 사이트 라이선스 갱신을 중단하는 것으로 응수했고, 타캣츠는 그 결과를 "결국 아무것도 아니었다(ultimately nugatory)"고 회고합니다. 이듬해 Zotero는 비영리 법인을 세워 대학 바깥에 독립적인 집을 마련합니다.
5.3 페이스 레이어 — 빠른 층과 느린 층
이 차이를 설명하는 가장 좋은 틀은 미국의 미래학자이자 『홀 어스 카탈로그』 편집자였던 스튜어트 브랜드(Stewart Brand) 에게서 빌릴 수 있습니다.
브랜드는 1994년 『건물은 어떻게 배우는가(How Buildings Learn)』에서 건물이 지어진 뒤 사용자들에 의해 어떻게 변해 가는지를 추적했습니다. 그 대표 사례가 500년에 걸쳐 고쳐 지어진 이탈리아 시에나의 시청사(팔라초 푸블리코)였죠. 그리고 1999년 『긴 지금의 시계(The Clock of the Long Now)』에서 이를 문명 전체로 넓힌 페이스 레이어링(pace layering) 이라는 도식을 내놓습니다. 사회는 속도가 다른 여러 층으로 이뤄져 있다는 겁니다. 위에서부터 패션 → 상업 → 인프라 → 거버넌스 → 문화 → 자연. 위층은 빠르게, 아래층은 느리게 변합니다. 브랜드는 이렇게 씁니다.
"빠른 층은 배우고, 느린 층은 기억한다. 빠른 층은 제안하고, 느린 층은 결정한다. (…) 빠른 층이 우리의 관심을 모두 가져가지만, 힘은 모두 느린 층에 있다."
이 도식을 Zotero에 옮기면 오래가는 소프트웨어의 구조가 보입니다. 화면과 기능(패션)은 계속 바뀌었습니다. 코드와 구현(상업)도 여러 번 갈아엎었습니다. 플랫폼(인프라)은 Firefox 확장에서 독립 앱으로 이사했습니다. 그러나 데이터 형식과 규약(거버넌스) — 번역기 형식, CSL, SQLite 라이브러리, 공개 내보내기 형식 — 은 20년 동안 거의 그대로였고, 공동체와 관행(문화) — 도서관 워크숍, 번역기·스타일 기여자, 비영리 운영 — 은 천천히 두꺼워졌습니다. 그리고 맨 아래에는 수백 년 된 학문의 본질적 행위(자연) — 모으고, 정리하고, 인용하는 일 — 가 있습니다.
흥미로운 역설이 하나 있습니다. Zotero는 2026년 1월 Zotero 8부터 릴리스 주기를 "대략 6~10주마다" 로 바꿨습니다. '느린 형성'을 이야기하는 글의 주인공이 지금은 꽤 빠르게 움직이고 있는 거죠. 모순이 아닙니다. 느린 층이 단단하기 때문에 빠른 층이 빨라질 수 있는 겁니다. 새 인용 스타일을 하루 만에 추가할 수 있는 건 CSL이라는 형식이 20년 동안 흔들리지 않았기 때문입니다.
아래 도구에서 변화 카드를 골라 보고, 'AI 가속'을 켜 보세요. AI는 위 두 층을 극적으로 빠르게 만들지만, 아래 층의 속도는 거의 바꾸지 못합니다.
해커뉴스의 shieldagent는 이 모든 것을 한 문장으로 요약했습니다. "내구성은 대개 지루한 결정들이 복리로 쌓인 결과다. 열린 형식, 내보낼 수 있는 데이터, 그리고 공급업체의 기분에 의존하지 않는 것."
6. 반론 — "낭만화된 창업 신화 아닌가?"
코언의 글이 290점을 받았다고 모두가 동의한 건 아닙니다. 해커뉴스 댓글 116개 중 상당수는 날카로운 반론이었습니다. 이 반론들을 진지하게 다뤄야 코언의 주장이 정확히 어디까지 유효한지 보입니다.
6.1 "LLM이 있었다면 5년을 5개월로 줄였을 것"
doug_durham의 반론은 가장 직설적입니다. "이건 기원 설화를 상당히 낭만화해서 다시 쓴 것 같다. LLM이 있었다면 5년을 5개월로 줄였을 가능성이 더 크다."
일리가 있습니다. 프롬프트 타임머신을 다시 보면, 2005년 7월의 0.0.1 이후 — 즉 화면을 가리키며 "이걸 이렇게 바꿔 줘"라고 말할 수 있게 된 뒤 — 의 개발은 AI가 크게 앞당길 수 있었을 것입니다. 실제로 Zotero 팀도 그 뒤로는 6개월 만에 큰 진전을 이뤘습니다. 2003~2004년의 구상 단계에서도 AI가 빠른 프로토타입을 여럿 만들어 줬다면, 웹 스크랩북·스크라이브의 한계를 더 빨리 깨달았을 수 있습니다. 갈의 법칙이 말하는 '작동하는 단순한 시스템'을 더 싸게, 더 많이 만들 수 있으니까요.
하지만 줄일 수 없었던 부분도 분명합니다. Firefox 1.0은 2004년 11월에 나왔고 mozStorage는 그 뒤에 들어왔습니다. 결정적인 '작동 원소'가 세상에 없던 시기는 아무리 빠른 AI로도 건너뛸 수 없습니다. 그리고 "브라우저는 수동적인 창"이라는 문제 정의, "캡처와 정리"라는 두 동사, "학자만을 위한 도구가 아니다"라는 범위 판단은 모두 사람들 사이의 대화에서 나왔습니다. AI는 형성기를 압축할 수는 있어도, 형성기를 없앨 수는 없다 — 이것이 공정한 결론일 것입니다.
6.2 "이제는 기존 제품을 보고 에이전트에게 만들라고 하면 된다"
lmz는 더 영리한 반론을 폅니다. "글은 튼튼한 토대가 코드라고 주장하지 않는다. 제품 설계라는 거다. (…) 그렇다면 지금은 기존 제품을 연구하고 에이전트에게 그걸 바탕으로 만들라고 하지 못할 이유가 없다."
맞습니다. 2026년의 AI 에이전트는 Zotero를 꽤 그럴듯하게 복제할 수 있을 겁니다. 하지만 이 반론은 역설적으로 코언의 주장을 강화합니다. 복제가 싼 이유는 누군가 이미 발견을 끝냈기 때문입니다. 5년의 형성기가 만든 것은 코드가 아니라 '무엇을 만들어야 하는가'에 대한 답이었고, 그 답이 공개돼 있으니 베낄 수 있는 겁니다. 아직 아무도 답을 찾지 않은 문제 — 2026년의 새로운 연구 방식, 새로운 협업 방식 — 에는 베낄 Zotero가 없습니다.
그리고 복제된 Zotero는 Zotero의 코드는 가져와도 느린 층 — 269명의 번역기 기여자, 1만 개의 스타일을 관리하는 공동체, 2,000만 명의 신뢰, 20년치 사용자 라이브러리 — 은 가져오지 못합니다.
6.3 "좋은 소프트웨어는 느려서가 아니라, 범위가 처음부터 정해져 있어서 좋다"
TeMPOraL의 반론은 결이 다릅니다. "좋은 것은 대부분 빠르게 만들어진다. 어느 정도 이상 느려지면 아예 만들어지지 않기 때문이다. (…) 가장 좋은, 천천히 개발된 고품질 소프트웨어가 최고인 이유는 프로그래머들이 언제 멈출지 알아서가 아니다. 범위와 일정이 처음부터 제한돼 있었기 때문이다."
이 지적은 '느림' 자체를 미덕으로 읽는 것을 경계하게 합니다. 실제로 Zotero 이야기에도 마감이 있었습니다. 연구비 일정, "2006년 가을 출시", "시간이 바닥나던 늦여름"의 이름 짓기. 코언이 말하는 '느림'은 게으름이 아니라 구상에 충분한 시간을 들이는 것이고, 그 시간에도 연구비 신청서와 프로토타입이라는 구체적인 결과물이 있었습니다.
6.4 "그건 학계의 사치다"
jkhdigital은 "학계 냄새가 많이 난다"고 했고, piker는 사진 속 'ZOTERO' 번호판을 보며 "실질적인 경제적·소셜 미디어 인센티브가 없는" 학자들이었기에 가능한 일이라고 지적했습니다. 투자자에게 분기마다 성과를 보여 줘야 하는 스타트업이 5년간 점심 테이블에서 수다를 떨 수는 없다는 거죠.
이 반론에는 뼈아픈 후속편이 있습니다. anon7725가 지적했듯, SmartFox에 연구비를 준 미국 박물관·도서관 서비스 기구(IMLS)는 2025년 3월의 행정명령으로 사실상 해체 수준의 타격을 받았습니다. 공공 연구비로 '느린 형성'을 떠받치던 구조 자체가 흔들리고 있는 겁니다. 코언의 교훈이 옳더라도, 그 교훈을 실천할 수 있는 재정적 조건은 누가 만들 것인가 — 이것은 2026년의 열린 질문입니다.
한편 cxr는 Zotero가 "그냥 잘 돌아간다"는 칭찬에도 이의를 제기했습니다. 오래된 코드베이스는 빌드하기가 점점 어려워져 새 기여자가 들어오기 힘들어진다고요. 오래간다는 것에도 비용이 있다는 정직한 지적입니다.
가장 중요한 균형추는 코언이 링크한 바로 그 사람, 로빈 슬론에게서 옵니다. 슬론은 2020년 「앱은 집밥일 수 있다(An app can be a home-cooked meal)」라는 유명한 글을 썼습니다. 가족끼리 사진을 주고받는 앱 'BoopSnoop'을 직접 만든 이야기였죠. "일일 활성 사용자 4명, 이탈률 0%." 그는 자신을 "프로그래밍계의 가정 요리사"라고 불렀습니다. 그리고 2026년 2월의 후기에 이렇게 덧붙였습니다. "아직도 잘 돌아간다. 새 기능은 없다." 사용자 4명짜리 앱이 6년을 살아남은 겁니다.
이 계보는 더 깁니다. 2004년 클레이 셔키는 「상황적 소프트웨어(Situated Software)」에서 "특정한 사회적 상황과 맥락 속에서, 그 맥락을 위해 설계된 소프트웨어"를 옹호했습니다. 사용자는 "수십 명, 터무니없이 작은 목표 집단". 2024년 매기 애플턴은 「집밥 소프트웨어와 맨발의 개발자」에서 LLM이 "지역적이고 집에서 만든 소프트웨어의 황금기"를 열 것이라고 내다봤습니다. 그리고 2025년 2월 '바이브 코딩'이라는 말을 만든 안드레이 카파시도, 원래 트윗에서 이것이 "버려도 되는 주말 프로젝트에는 그리 나쁘지 않다" 고 분명히 선을 그었습니다.
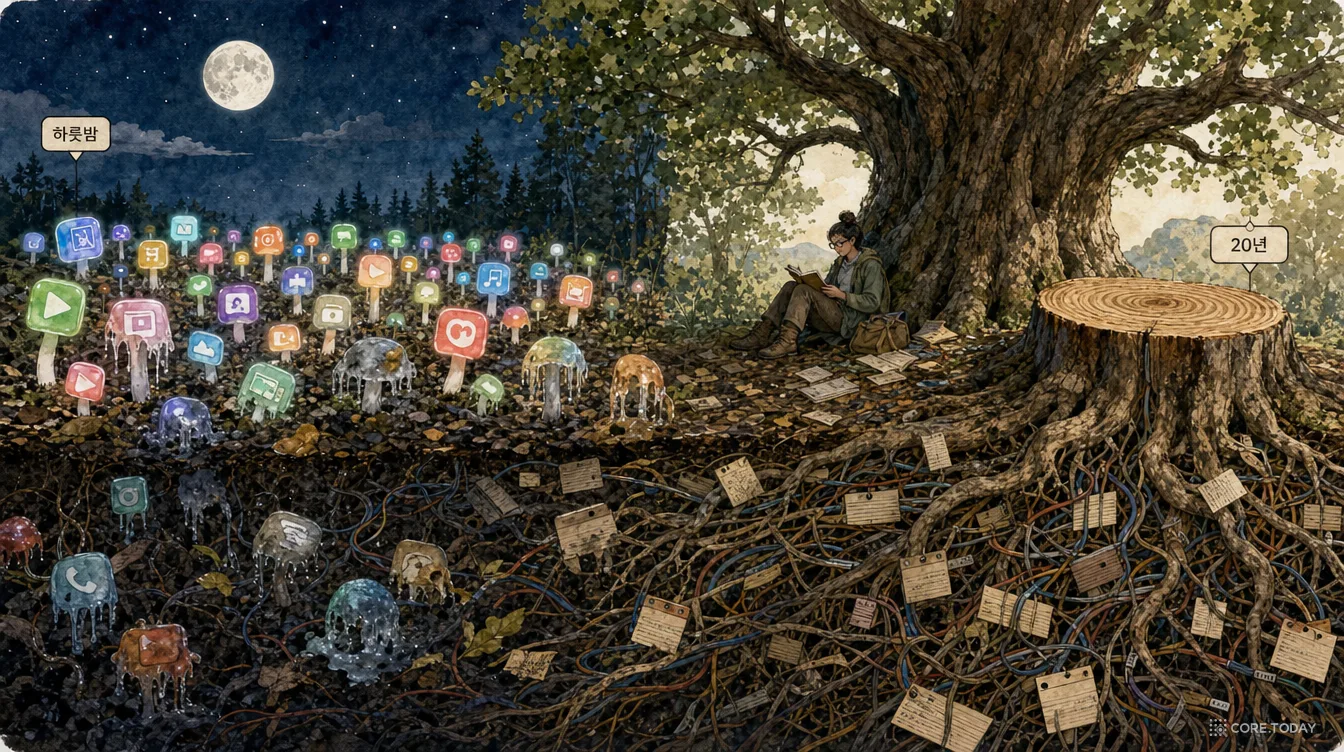
그러니 코언의 글을 "AI로 빨리 만드는 소프트웨어는 나쁘다"로 읽으면 오독입니다. 일회용 소프트웨어는 2026년의 축복입니다. 회의 하나를 위한 계산기, 아이를 위한 수학 게임, 가족 식단 앱 — 이런 것을 5년에 걸쳐 만들 이유는 없습니다. 허니콤의 CTO 채리티 메이저스는 2025년 7월의 글 제목에서 이 균형을 정확히 잡았습니다. 「일회용 코드는 계속 남는다. 하지만 세상을 돌리는 건 오래가는 코드다」.
"일회용 코드가 싼 이유는 유지보수하려는 시도조차 하지 않기 때문이다. (…) 이 세상 어떤 테스트 스위트도, 2년 동안 프로덕션에서 돌아온 코드보다 새 코드 덩어리를 더 믿게 만들 수는 없다. 신뢰는 그렇게 작동한다. 시간이 걸린다. (…) 일회용 소프트웨어는 기술이고, 오래가는 코드는 직업이다."
문제는 일회용 앱이 아니라 어긋남입니다. 오래 살아야 할 소프트웨어를 일회용처럼 만들 때, 혹은 일회용으로 만든 것이 어느새 다른 사람들의 몇 년치 데이터를 떠안게 될 때. 아래 진단 도구에서 예시를 바꿔 가며 확인해 보세요.
버섯과 참나무는 경쟁 관계가 아닙니다. 숲에는 둘 다 필요합니다. 다만 그 위에 집을 지을 때는 무엇이 버섯이고 무엇이 참나무인지 알아야 합니다.
7. 2026년의 데이터 — 무엇이 빨라졌고, 무엇이 그대로인가
코언의 글은 에세이지만, 그 주장은 2025~2026년의 데이터와 대조해 볼 수 있습니다. 공교롭게도 스택오버플로 2026 개발자 설문 결과는 코언의 글과 같은 날(2026년 10월 6일) 공개됐습니다.
7.1 AI는 코딩을 얼마나 빠르게 했나
연구
무엇을 봤나
결과
METR 무작위 대조 실험 (2025.7)
숙련 오픈소스 개발자 16명, 실제 과제 246개
AI를 쓰면 19% 더 오래 걸림. 개발자들은 끝난 뒤에도 20% 빨라졌다고 믿음
METR 후속 연구 (2026.2)
개발자 57명, 저장소 143개, 과제 800여 개
재참여자는 과제 시간 18% 단축(신뢰구간 −38%~+9%). 다만 METR 스스로 "AI 없이는 일하지 않겠다"는 거부·선택 편향으로 데이터를 신뢰하기 어렵다고 경고
구글 DORA 2025 (2025.9)
AI 보조 소프트웨어 개발 현황
90%가 업무에 AI 사용, 80% 이상이 생산성 향상 체감. 그러나 소프트웨어 배포 안정성과는 음의 관계. "AI는 팀을 고치지 않는다. 이미 있는 것을 증폭할 뿐"
스택오버플로 2026 (2026.10.6)
응답자 3만여 명
AI 도구 사용자의 73%가 매일 사용(Claude Code 66%, Copilot 59%). 그러나 프로덕션 배포·운영에 AI를 쓰는 비율은 20%. 48%는 "쉽게 검증할 수 있을 때만" 신뢰
METR 후속 연구는 일부 2차 보도에서 '18% 느려졌다'로 잘못 인용되기도 했다. 원문은 단축이다.
숫자들이 그리는 그림은 이렇습니다. 코드를 쓰는 일은 분명히 빨라지고 있다. 하지만 그 코드를 믿고 오래 운영하는 일은 그만큼 빨라지지 않았다. DORA의 한 문장이 코언과 정확히 겹칩니다. "AI는 명확한 문제를 겨냥할 때 가장 유용해진다." 명확한 문제 — 그것이 Zotero 팀이 5년에 걸쳐 만든 것이었습니다.
스택오버플로 2026에서 개발자들이 AI에게 줄 때 가장 신뢰하는 맥락(context)이 무엇이었는지도 흥미롭습니다. "프로젝트 목표와 요구사항"(85%). 40년 전 브룩스가 "가장 어려운 단 하나의 부분"이라고 부른 바로 그것입니다.
7.2 오래된 지층이 얼어붙는다
코드베이스의 '내구성'을 가장 직접적으로 보여 주는 데이터는 코드 분석 회사 GitClear에서 나옵니다.
리팩터링 비율 2021
25%
리팩터링 비율 2024
10% 미만
복사·붙여넣기 2021
8.3%
복사·붙여넣기 2024
12.3%
GitClear 2025 보고서(변경된 코드 2억 1,100만 줄, 2020~2024). 막대 길이는 25%를 100%로 한 상대 비율.
2026년 보고서 「유지보수성 격차(The Maintainability Gap)」는 더 날카롭습니다. 중복 코드 블록은 변경 100만 줄당 40.3개에서 73.0개로 81% 늘었고, 코드를 옮겨 정리하는(moved) 비율은 2022년 21%에서 3.8%로 떨어졌습니다. 그리고 가장 의미심장한 수치 — 12개월 넘게 손대지 않은 코드를 수정하는 비율이 1.7%에서 0.46%로 74% 줄었습니다. 보고서는 이렇게 표현합니다. "오래된 지층이 얼어붙은 채 남겨진다(older strata are left frozen)."
새 코드는 빠르게 쌓이는데 오래된 코드는 아무도 돌보지 않는다. 페이스 레이어로 말하면, 위층만 빠르게 자라고 아래층은 방치되는 상황입니다. Zotero가 20년 동안 해 온 '보이지 않는 일' — 스키마 업그레이드, 엔진 교체, AWS 이전 — 의 정반대입니다.
7.3 사라지는 웹, 그리고 각주
인용 도구의 이야기에서 빼놓을 수 없는 데이터가 하나 더 있습니다. 2024년 퓨 리서치 센터의 조사에 따르면 2013년에 존재했던 웹 페이지의 38%가 사라졌고, 2013~2023년의 전체 페이지 중 25%가 더 이상 접근할 수 없으며, 위키백과 페이지의 54%에 죽은 참조 링크가 하나 이상 있습니다.
2005년 SmartFox 연구비 신청서가 "인용 정보만이 아니라 전체 사본까지" 저장하겠다고 약속한 이유가 여기 있습니다. 웹은 일회용이 됐고, 각주는 그 일회용 웹을 가리키고 있습니다. 2003년 로젠츠바이크가 「희소성인가 풍요인가」에서 경고했던 문제 — 디지털 풍요 속의 보존 — 는 20년 뒤 더 커졌습니다. 오래가는 도구의 가치는 오래가지 않는 세상에서 더 커집니다.
7.4 한국은?
한국은행의 2025년 8월 조사에 따르면 한국 근로자의 63.5%가 생성형 AI를 사용하고, 업무용 사용률은 51.8%로 미국(26.5%)의 두 배에 가깝습니다. 그런데 이로 인한 생산성 향상 추정치는 약 1% 에 머물렀고, 2026년 6월 후속 분석에서도 비슷했습니다. 많이, 열심히 쓰는데 생산성은 그만큼 오르지 않는 현상 — DORA가 말한 '증폭기' 이야기의 한국판입니다.
국내 개발자 커뮤니티의 반응도 비슷한 결을 보였습니다. 2025년 4월 GeekNews 주간 정리는 바이브 코딩에 대한 커뮤니티 반응을 "품질 없는 속도는 위험하다", "AI가 증폭시키는 것은 능력뿐 아니라 실수도 포함"으로 요약했습니다.
7.5 Zotero 자신은 AI를 어떻게 대하나
마지막으로, 20주년을 맞은 Zotero 자신의 태도도 흥미롭습니다. 2026년 6월 Zotero 포럼의 한 관리자는 "Zotero 어디에도 AI라고 부를 만한 것은(생성형 AI·대형 언어 모델은 확실히) 쓰이지 않는다. (…) 특히 인용 생성에는 Zotero에서 앞으로도 결코 AI를 쓰지 않을 것"이라고 답했습니다. 공식 정책 문서는 아니지만, 각주라는 '느린 층'에는 확률적 생성을 들이지 않겠다는 태도로 읽힙니다. LLM 기능은 모두 서드파티 플러그인(GPT 연동 플러그인 zotero-gpt는 GitHub 별 7,400여 개)의 몫입니다. 다만 Zotero 9의 '소리 내어 읽기' 프리미엄 음성은 외부 제공자의 음성 기술을 쓰고, 이 경우 문서 텍스트가 외부로 전송된다고 개인정보 처리방침에 적혀 있습니다.
그런데 번역기 저장소에는 2025년 10월, AI 코딩 에이전트를 위한 AGENTS.md 가 추가됐습니다. 새 사이트용 번역기를 쓰는 일 — 빠른 층의 일 — 에는 AI 에이전트를 기여자로 받아들이겠다는 뜻입니다. 빠른 층에는 AI를, 느린 층에는 사람의 판단을. 20년 된 소프트웨어가 2026년에 내린 결정은 페이스 레이어 도식과 정확히 맞아떨어집니다.
8. 실전 체크리스트 — 2026년에 오래가는 것을 만들려면
코언의 글과 지금까지의 이야기를 2026년에 무언가를 만드는 사람을 위한 질문으로 정리해 봅니다.
1. 수명이것은 얼마나 오래 살아야 하는가? 오늘 하루라면 AI로 빨리 만들고 버려라. 다른 사람의 시간과 데이터가 그 위에 쌓인다면, 아래의 질문으로 넘어가라.
2. 원함무엇을 원하는지 한 쪽짜리 비전 문서로 쓸 수 있는가? 쓸 수 없다면 프롬프트 전에 대화가 필요하다. 화이트보드와 점심 테이블은 낭비가 아니라 요구사항을 만드는 공정이다.
3. 반쪽작동하는 단순한 것을 먼저 만들어 실제로 써 봤는가? 웹 스크랩북과 스크라이브처럼, '부족한 반쪽'을 만들어 봐야 무엇이 부족한지 안다. AI는 이 반쪽들을 싸게 여러 개 만들어 볼 수 있게 해 준다 — 여기가 AI의 진짜 쓸모다.
4. 형식느린 층을 먼저 고정했는가? 데이터 형식은 열려 있고 내보낼 수 있는가? 바깥 사람이 기여할 확장점(번역기·스타일 같은)이 있는가? 공유된 표준을 따르는가?
5. 집주인당신의 Firefox는 무엇인가? 2026년의 집주인은 특정 클라우드, 특정 앱 스토어, 그리고 특정 LLM API일 수 있다. 집주인이 규칙을 바꿔도 이사할 수 있는 구조인가?
6. 이론왜 이렇게 만들었는지 아는 사람이 팀에 남아 있는가? AI가 코드를 썼다면, 그 코드의 '이론'을 누가 가지고 있는가? 나우르의 말대로 이론을 가진 사람이 떠나면 프로그램은 죽는다.
7. 돈10년 뒤에도 이것을 돌볼 사람의 월급은 어디서 나오는가? 데이터를 인질로 잡지 않고도 지속 가능한 구조인가?
한국의 연구자·학생에게 덧붙이는 실용 팁
DBpia·KISS·국립중앙도서관은 전용 번역기가 있어 브라우저 커넥터로 바로 저장된다. RISS는 메타데이터가 빈약하게 잡힐 수 있으니 RISS의 RIS 내보내기 파일을 Zotero로 가져오는 편이 정확하다. KCI는 표준 메타 태그가 있지만 값이 영문판일 수 있으니 저장 후 한글 서지를 확인하자.
Zotero 10부터 따옴표 없이 한국어로 검색해도 구문 전체가 맞는다. 예전에는 한 글자씩 따로 맞았다.
학위논문 양식이 공식 CSL 저장소에 없다면, 비슷한 스타일을 복제해 고치거나 새 한국어 스타일을 기여할 수 있다. 공식 저장소에는 한국어 서식 스타일이 아직 하나도 없다.
동기화는 백업이 아니다. zotero.sqlite와 storage/ 폴더가 들어 있는 데이터 디렉터리를 따로 백업하자.
개발자에게 덧붙이는 한 줄
AI 에이전트에게 프로젝트를 맡기기 전에, 슬론처럼 VISION.md를 한 시간 동안 써 보세요. 한 시간 만에 쓸 수 있다면 그 프로젝트는 AI로 빠르게 만들어도 되는 종류입니다. 쓸 수 없다면 — 그건 실패가 아니라, 당신이 지금 Zotero의 2003년에 서 있다는 신호입니다. 그때 필요한 건 더 좋은 모델이 아니라 같이 이야기할 사람입니다.
그 포옹은 코드에 대한 감사가 아니었을 겁니다. 그 사람은 Zotero의 소스 코드를 본 적도, XUL이 뭔지 알지도 못했을 겁니다. 그가 감사한 것은 아마 이런 것들이었을 겁니다. 몇 년치 연구 자료가 한 번도 사라지지 않았다는 것. 학위논문 마감 전날 밤 인용 양식이 바뀌었을 때 버튼 하나로 해결됐다는 것. 노트북을 바꾸고, 운영체제를 바꾸고, 브라우저를 바꿔도 라이브러리가 그대로 따라왔다는 것. 10년 전에 저장한 논문이 지금도 그 자리에 있다는 것.
그것은 모두 느린 층의 선물입니다. 그리고 그 느린 층은 2003년 엘레나의 목록, 2004년 점심 테이블의 수다, Firefox가 나온 밤의 "Holy crap!", 2005년 화면 위에서 흩어진 패널을 보며 느낀 불편함, 2006년 여름 알바니아어 사전에서 시작됐습니다.
zotero는 알바니아어로 '잘 배우다, 숙달하다' 라는 뜻입니다. 이름을 고를 때 그들이 그것까지 의도했는지는 모르지만, 지금 돌아보면 꼭 맞는 이름입니다. 잘 배운다는 것은 원래 천천히, 함께, 직접 해 보면서 배우는 것이니까요. 무엇이든 5분이면 만들어지는 시대에, 무엇을 만들어야 하는지 배우는 일만큼은 여전히 5년이 걸리기도 합니다.
코언의 마지막 문장을 빌려 이 특집을 맺습니다.
"그 가치는 다정한 역사학자 무리의 공동 사고에서 느리게 피어났고, 놀랍도록 오래갔다. 앞으로 20년, 혹은 그 이상 살아남기를."