제외 질문부정 검색E-SENSEXCISEExcluIRTypeSafeJev임베딩Qwen3-EmbeddingBGE-M3질문 분해리랭킹한국어 검색RAGOllama한국어 검색 스택실측 벤치마크
'빼고'를 공짜로 고칠 수 있나 — 임베딩 트릭 대 Jev, 한국어 제외 질문 50개 실측 (한국어 검색 스택 9편)
8편에서 '쿠버네티스는 빼고 도커만'이라고 물으면 임베딩이 상위 10개의 절반을 쿠버네티스 글로 채운다는 것을 봤고, Jev가 그것을 고쳤습니다. 그런데 8월과 9월에 나온 두 논문(EXCISE, E-SENS)은 학습도 큰 모델도 없이 이 문제를 줄이는 방법을 내놓았습니다. 이 글은 한국어 제외 질문 50개(표지어가 분명한 30개, 돌려 말한 10개, 두 가지를 동시에 빼는 10개)로 그 공짜 방법들과 Jev를 정면으로 비교했습니다. 가장 큰 한 걸음은 놀랍도록 단순했습니다. 질문에서 빼라는 말을 떼어 내기만 해도 nDCG@10이 0.245에서 0.555로 뛰었습니다. 빼라는 단어가 든 글을 아래로 내리는 공짜 규칙은 0.676으로 8편의 Jev 방식(0.672)과 같은 자리까지 올라왔습니다. 하지만 그 규칙은 평범한 질문을 제외 질문으로 오인했을 때 정답을 100위로 보내는 위험도 있었습니다. 글자 강등으로 정리한 상위 20개만 Jev가 판정하는 조합이 0.790으로 가장 높았지만 강등의 위험을 그대로 물려받았고, 원래 질문과 뗀 질문의 후보를 합쳐 Jev에 주면(0.759) 평범한 질문을 하나도 해치지 않았습니다. Jev 3,405회 호출에 0.1달러. 인터랙티브 5개와 삽화 7장.
8편에서 가장 눈에 띈 장면은 이것이었습니다. "쿠버네티스는 빼고 도커만 다룬 글"이라고 물었더니 Qwen3-Embedding-8B의 1~3위가 '쿠버네티스 첫걸음' 1·4·2편이었습니다. 제외 질문 17개 전체로 보면 Jev 없는 검색은 상위 10개의 46~52%를 질문이 빼라고 한 주제로 채웠고, Jev가 후보 40개를 판정해 그 비율을 19%로 내렸습니다.
그 글을 내고 나서 두 편의 논문이 눈에 들어왔습니다.
EXCISE(Ali·Abdallah·Jatowt, 2026년 8월, arXiv:2608.05497)는 이 현상에 '제외 역전(exclusion inversion)'이라는 이름을 붙였습니다. ColBERT 같은 검색기가 빼라는 주제와 맞는 문서를 오히려 위로 올린다는 뜻입니다. 문서 인덱스는 그대로 두고, 질문 쪽에 150만 파라미터짜리 작은 모듈 둘과 '빼라는 주제와 맞는 후보를 아래로 내리는' 파라미터 없는 규칙을 붙여, ExcluIR의 제외 성공률을 0.058에서 0.691로 올렸습니다.
E-SENS(Kim·Myung·Han, 2026년 8~9월, arXiv:2608.30130)는 학습이 아예 없습니다. 질문에서 빼라는 개념만 담은 짧은 '함정 질문'을 뽑아, 그 유사도를 원래 점수에서 뺍니다. 임베딩 모델 네 개에서 '위반은 줄고 재현율은 지키는' 지점이 있음을 보였습니다.
그렇다면 질문은 이것입니다. 공짜 방법만으로 Jev에 얼마나 다가갈 수 있나? 그리고 어디서 갈리나? 한국어 제외 질문 50개로 쟀습니다.
1
가장 큰 한 걸음은 '떼어 내기'
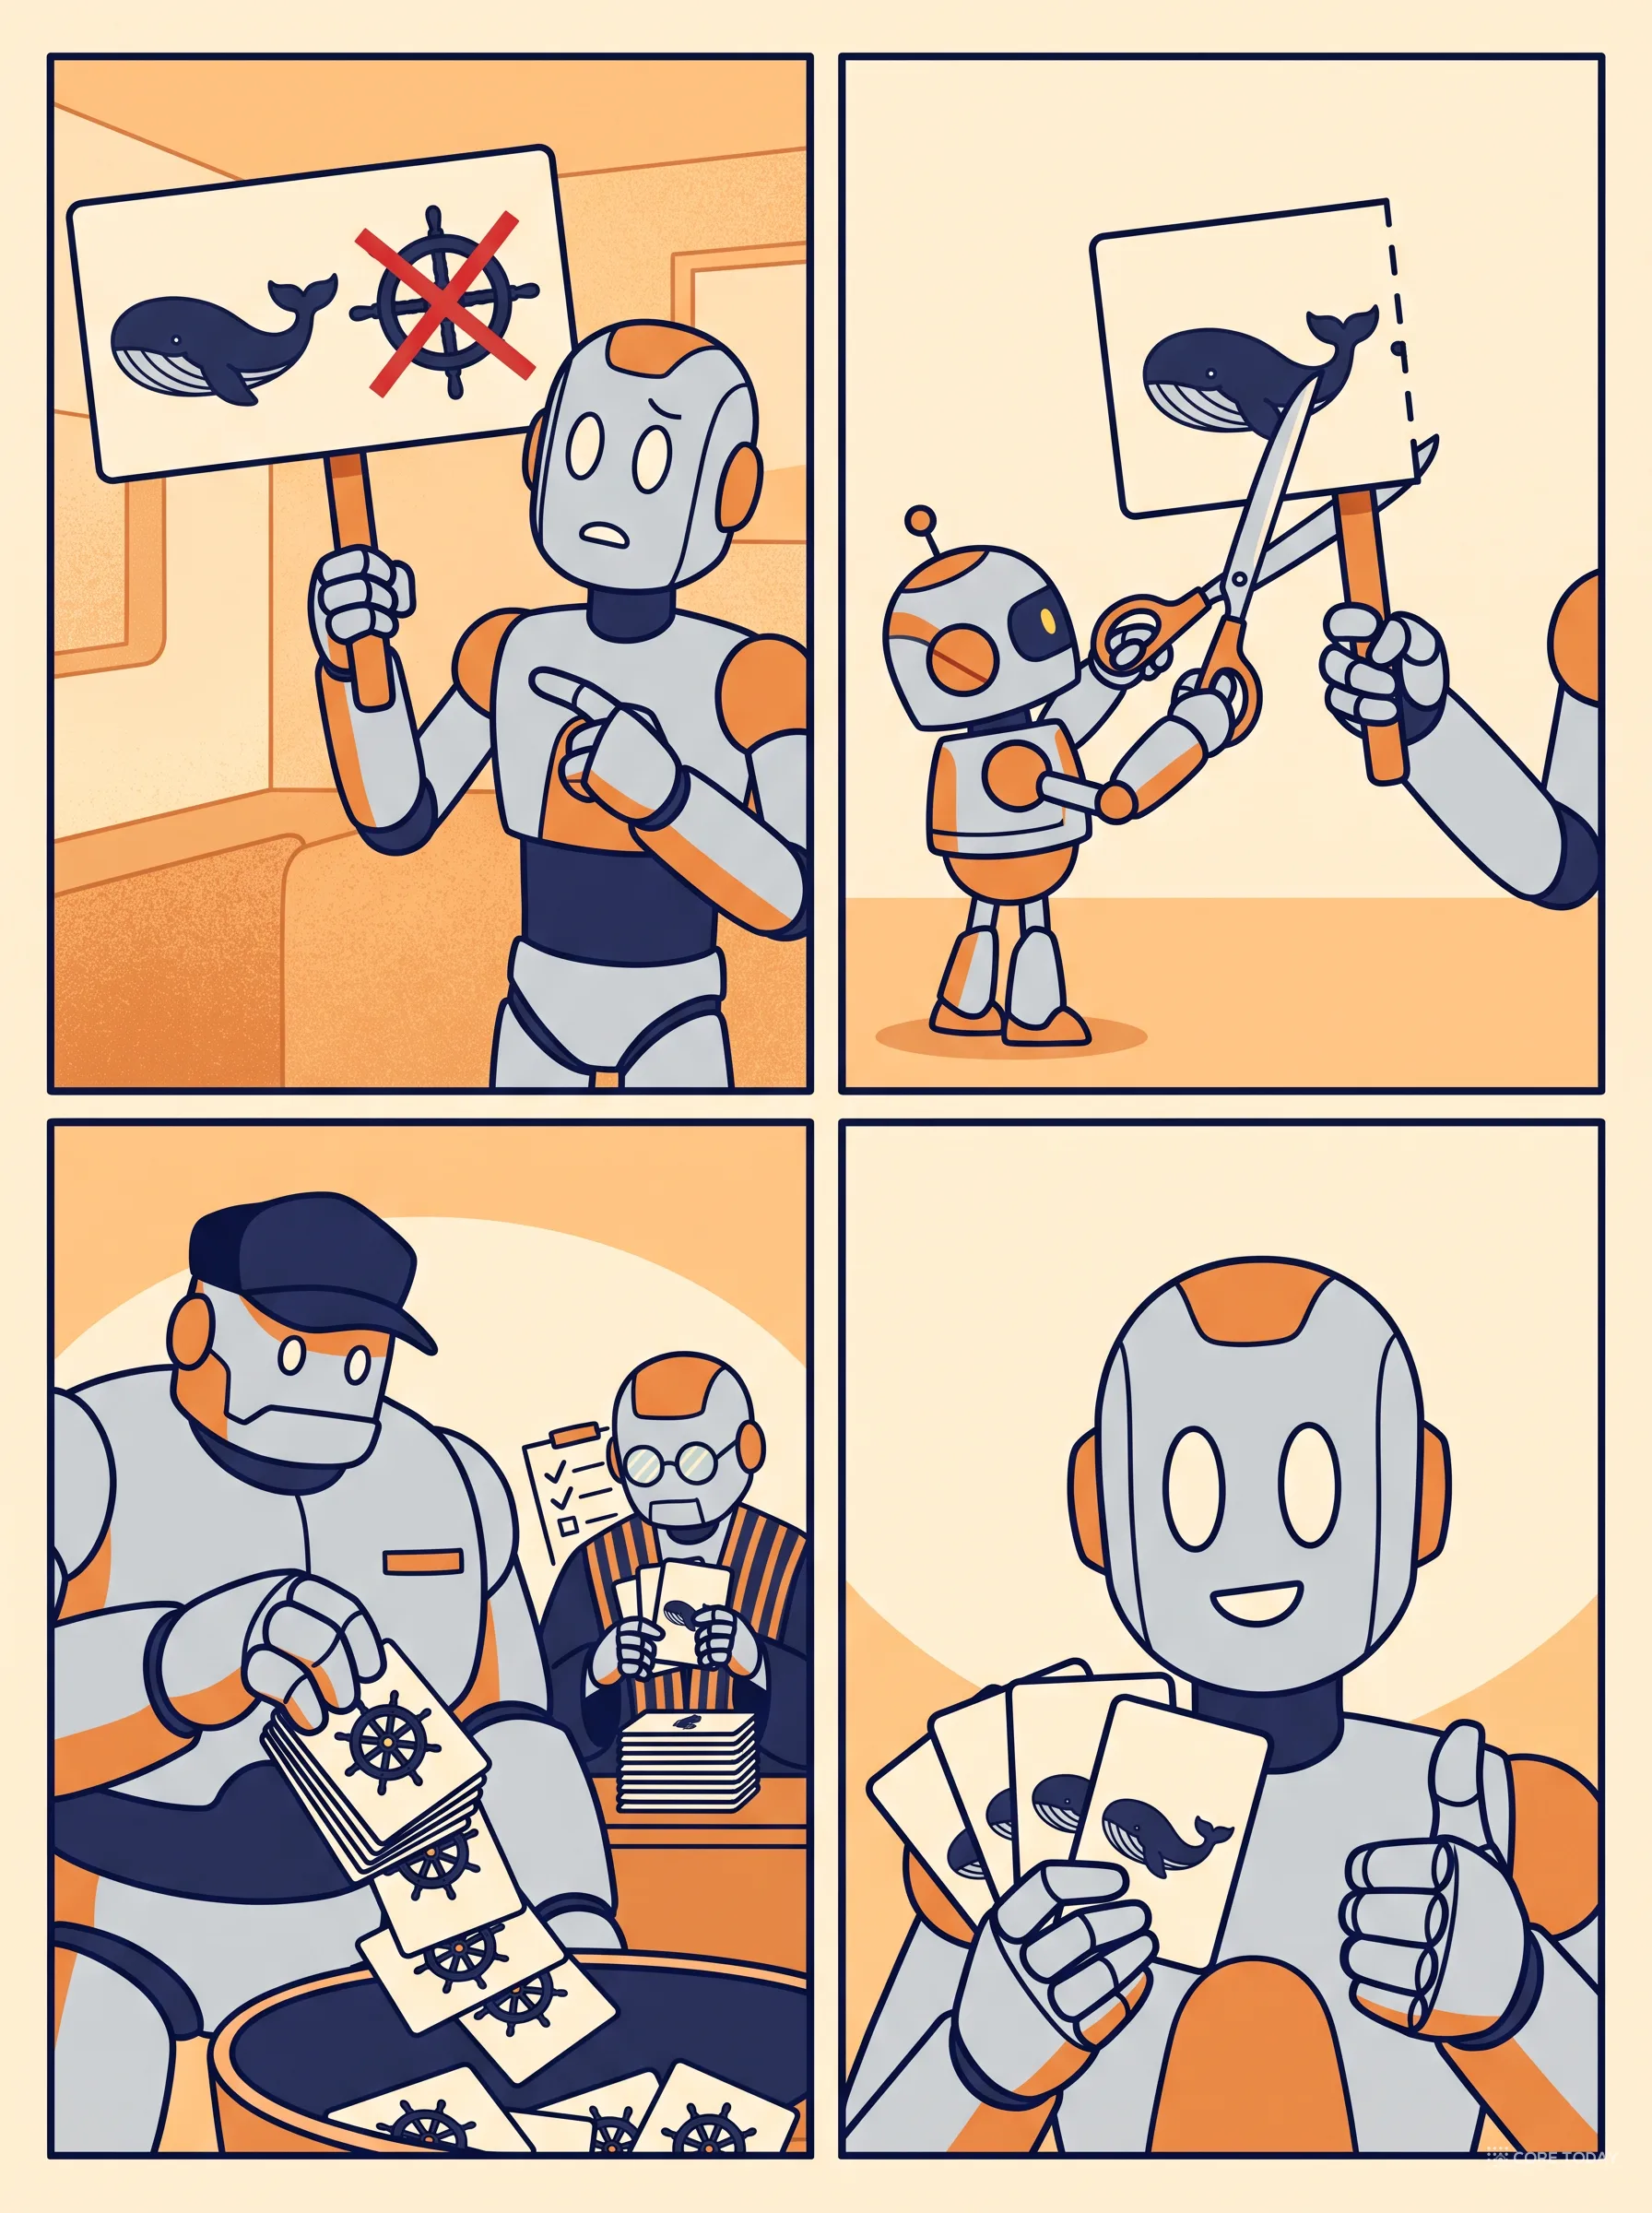
질문에서 '쿠버네티스는 빼고'를 떼어 내고 '도커'만으로 검색하면 nDCG가 0.245에서 0.555가 된다. 빼라는 단어를 질문에 남겨 두는 것 자체가 문제였다.
2
공짜 강등 규칙이 8편의 Jev와 비긴다
빼라는 단어가 든 글을 아래로 내리는 규칙 하나가 0.676. 다만 평범한 질문을 제외로 오인하면 정답을 맨 아래로 보낸다.
3
공짜로 거르고 Jev로 판정하면 최고, 안전장치는 따로
글자 강등 → 상위 20개만 Jev가 0.790(위반 11%)으로 가장 높다. 하지만 오인에 약하다. 평범한 질문을 하나도 해치지 않는 조합은 '두 질문 합친 후보 → Jev 40'(0.759)과 '임베딩 강등 → Jev 20'(0.751).
1부. 실험 설계: 빼는 방식 세 가지, 방법 열둘
질문 50개
문서는 1~8편과 같은 코어닷투데이 블로그·뉴스 589건입니다. 제외 질문은 세 종류로 만들었습니다.
종류
예시
개수
표지어 분명
쿠버네티스는 빼고 도커만 다룬 글 · 보안과 관계없는 Git 사용법 글 · MCP 없이 Claude Code를 쓰는 글
30 (8편 17 + 신규 13)
돌려 말하기
도커 글을 찾는데 쿠버네티스까지 가면 너무 멀어요 · MCP 자체가 궁금해요, Claude Code 사용기는 이미 읽었어요
10
두 가지 빼기
지식 그래프와 에이전트 둘 다 빼고 RAG 글 · AWS도 에이전트도 아닌 보안 글
10
정답은 8편과 같은 방식으로 정했습니다. 주제 X에 해당하는 글(필자가 붙인 태그나 제목·요약의 정확한 용어) 중 빼라는 주제 Y에 해당하는 글을 뺀 나머지 전부입니다. 'Y에도 해당하는 X 글'은 위반 으로 셉니다.
빼라는 말을 떼어 내는 일
공짜 방법 대부분은 질문을 '찾을 것'과 '뺄 것'으로 나눠야 쓸 수 있습니다. 이 일은 로컬 LLM(qwen3.8, Ollama)에게 맡겼습니다. 질문당 1.4초가 걸렸고, 50개 중 86% 에서 뺄 것을 정답과 똑같이 뽑았습니다. 돌려 말한 질문도 잘 나눴습니다. "도커 글을 찾는데 쿠버네티스까지 가면 너무 멀어요"는 찾을 것 '도커', 뺄 것 '쿠버네티스'가 됐습니다.
뗀 질문의 상위 100개 중 제목·요약에 빼라는 단어가 글자로 있으면 맨 아래로. 파라미터 없음
임베딩 강등
찾을 것보다 뺄 것에 더 가까운 문서를 맨 아래로. 파라미터 없음
Jev
후보 40개 판정
8편과 같은 질문("이 문서가 질문이 찾는 글이고 조건을 모두 만족하나")을 후보마다 Noul로. 후보는 원래 질문 / 뗀 질문 / 둘을 합친 것 세 가지
공짜 단계 → Jev
감점·강등으로 먼저 정렬한 상위 10개나 20개만 Jev에
EXCISE의 학습된 모듈(150만 파라미터)은 코드가 공개되지 않아 재현하지 않았고, 파라미터 없는 강등 규칙만 우리 방식으로 옮겼습니다. 임베딩은 Qwen3-Embedding-8B와 BGE-M3, 하이브리드는 둘의 RRF입니다.
2부. 결과: 계단을 한 칸씩
첫 계단: 떼어 내기만 해도 두 배
원래 질문을 그대로 임베딩하면 nDCG@10이 0.245, 위반율이 45%입니다. 빼라는 말을 떼어 내고 '도커'만으로 찾으면 0.555 가 됩니다. 아무것도 빼지 않았는데 점수가 두 배 넘게 오른 것입니다.
이유는 7편과 8편에서 본 그대로입니다. 임베딩에게 "쿠버네티스는 빼고 도커만 다룬 글"은 '쿠버네티스와 도커에 관한 문장'입니다. 빼라는 단어를 질문에 남겨 두면 검색이 그 단어 쪽으로 끌려갑니다. 그러니 첫 번째 처방은 무언가를 하는 것이 아니라 질문에서 그 단어를 치우는 것 입니다. 다만 위반율은 여전히 35%입니다. 도커 글 중 쿠버네티스도 다루는 글은 '도커'로만 찾아도 그대로 올라오기 때문입니다.
E-SENS식 감점은 '쿠버네티스'와 가까운 정도에 λ를 곱해 뺍니다. 결과는 λ에 따라 크게 달랐습니다.
곡선은 모두 올라갔다가 꺾입니다. Qwen3-8B에 원래 질문 기준으로 빼면 λ=1.0에서 0.632(위반 23%)로 정점이고, 1.5로 더 세게 빼면 0.596으로 내려옵니다. 정답 글도 빼라는 주제를 조금씩 언급하는 탓에 같이 깎이기 때문입니다. E-SENS 논문이 말한 '재현율과 위반의 맞교환'이 한국어에서도 그대로 나타났습니다. 네 조합 중 가장 좋았던 것은 BGE-M3에 뗀 질문 기준으로 λ=0.5를 쓴 0.659(위반 22%)입니다. 뗀 질문을 기준으로 빼면 λ에 덜 민감했습니다(Qwen3-8B 기준 0.588~0.627 사이에서 움직임).
가장 단순한 규칙이 가장 잘했습니다. 뗀 질문으로 상위 100개를 뽑고, 제목·요약에 '쿠버네티스'라는 글자가 있는 글을 맨 아래로 내립니다. 그것뿐인데 0.676(위반 18%)입니다. 8편의 Jev 방식(원래 질문의 후보 40개를 Jev가 판정, 0.672·위반 19%)과 사실상 같은 자리입니다. 특히 두 가지를 동시에 빼는 질문에서 강했습니다(0.632). 빼라는 단어 두 개를 글자로 확인하는 일은 단순하고 정확합니다.
반면 '뺄 것에 더 가까우면 내린다'는 임베딩 강등은 0.563으로 떼어 내기(0.555)와 거의 차이가 없었습니다. 도커 글 대부분은 '쿠버네티스'보다 '도커'에 더 가까우니 거의 아무것도 내리지 않은 것입니다.
글자 강등에도 약점은 있습니다. 'Kubernetes'나 'k8s'로 쓴 글은 '쿠버네티스'라는 글자가 없으니 그대로 남고, 반대로 '쿠버네티스와 비교하면…'처럼 지나가듯 언급한 정답 글은 억울하게 내려갑니다. 돌려 말한 질문에서 0.558로 약했던 이유입니다.
마지막 계단: 판정
Jev를 쓰는 세 방식의 차이가 흥미롭습니다.
Jev가 받는 후보 40개
nDCG@10
위반율
원래 질문의 상위 40 (8편 방식)
0.672
19%
뗀 질문의 상위 40
0.766
13%
두 질문의 후보를 RRF로 합친 상위 40
0.759
14%
판정하는 질문은 셋 다 원래 질문으로 같습니다. 다른 것은 후보 뿐인데, 뗀 질문으로 모은 후보를 주자 0.672가 0.766이 됐습니다. 원래 질문의 상위 40개는 빼야 할 글이 절반 가까이 차지하니, Jev가 아무리 잘 걸러도 남는 정답이 적습니다. 8편의 교훈('심판은 눈앞에 온 서류만 본다')이 여기서도 반복됩니다. 표지어가 분명한 질문에서는 위반율이 8%까지 내려갔습니다.
아래에서 질문을 골라 네 방법의 상위 10개를 직접 비교해 보세요.
3부. 먼저, 해치지 말 것
EXCISE 논문이 공들여 강조한 것이 하나 있습니다. 제외 처리를 붙여도 평범한 질문의 성능이 떨어지면 안 된다(no-harm)는 것입니다. 실제 서비스에서는 어떤 질문이 제외 질문인지 미리 알 수 없고, 분해 모델이 평범한 질문에서 '뺄 것'을 잘못 찾아낼 수 있으니까요.
그래서 1편의 평범한 질문 85개(키워드 18, 의미 67)를 같은 LLM에 넣어 봤습니다. 2개에서 '뺄 것'이 나왔습니다. "전문가 없이도 지구 환경 변화를 빠르게 분석하는 AI는 무엇"에서 '전문가', "보상 모델 없이 언어 모델을 인간 취향에 맞추는 수학적 접근법"에서 '보상 모델'. 둘 다 빼 달라는 뜻이 아닙니다.
두 번째 질문의 정답은 'DPO 특집: 강화학습 없이 AI를 정렬하는 법 — AI는 사실 보상 모델이었다'입니다. 원래 질문으로는 2위였습니다. 그런데 제목에 '보상 모델'이 들어 있으니 글자 강등은 이 글을 100위로 보냅니다. 뗀 질문("언어 모델 인간 취향 수학적 접근")으로 후보를 모으면 이 글은 53위로 밀려나 Jev의 후보 40개에 들지도 못합니다. 결과적으로 평범한 질문 85개의 평균이 글자 강등에서 0.889 → 0.870, 뗀 질문 후보 + Jev에서 0.889 → 0.882로 떨어졌습니다.
해법은 단순했습니다. 후보는 두 질문으로 모으고, 판정은 원래 질문으로 한다. 원래 질문의 후보와 뗀 질문의 후보를 RRF로 합쳐 상위 40개를 Jev에 주면, 오인된 질문에서도 DPO 글이 후보에 남고, Jev는 원래 질문("보상 모델 없이 …")을 읽고 그 글을 1위로 올립니다. 평범한 질문 85개의 평균은 0.894로 오히려 조금 올랐고, 제외 질문 50개에서는 0.759로 최고점(0.766)과 거의 같았습니다. 판정 모델이 원래 질문을 끝까지 읽기 때문에 분해의 실수를 되돌릴 수 있는 것입니다. 공짜 방법은 분해가 틀리면 그 실수를 그대로 실행합니다.
4부. Jev를 몇 번이나 불러야 하나
Jev 40번이 비싼 것은 아닙니다(질문 1만 건당 약 11달러). 그래도 줄일 수 있다면 줄이는 편이 지연과 한도에 유리합니다. 공짜 단계를 앞에 두면 몇 번까지 줄일 수 있을까요?
같은 20번이라도 앞단이 중요했습니다. 뗀 질문의 상위 20개를 그대로 주면 0.729, E-SENS 감점이나 임베딩 강등으로 한 번 정리하면 0.751, 글자 강등으로 정리하면 0.790 으로 이 실험 전체의 최고점입니다(위반 11%). 공짜 단계가 빼라는 글을 미리 밀어내고 그 자리를 정답 후보로 채워 주기 때문입니다. Jev 40번(0.766)보다 20번이 더 높은 셈입니다. 10번까지 줄여도 글자 강등 앞단은 0.724로 버텼습니다.
파이프라인
제외 질문 nDCG
위반율
평범한 질문 피해
Jev 호출 · 1만 건당
떼어 내기만
0.555
35%
있음 (분해 오인)
0 · $0
떼어 내기 + 글자 강등
0.676
18%
가장 큼 (−0.019)
0 · $0
글자 강등 → Jev 10
0.724
18%
큼 (−0.019, Jev도 못 되돌림)
10 · $2.8
글자 강등 → Jev 20
0.790
11%
큼 (−0.019)
20 · $5.6
임베딩 강등 → Jev 20
0.751
14%
없음 (+0.004)
20 · $5.6
두 질문 합친 후보 → Jev 40
0.759
14%
없음 (+0.005)
40 · $11.2
뗀 질문 후보 → Jev 40
0.766
13%
작음 (−0.007)
40 · $11.2
평범한 질문의 피해까지 함께 보면 선택이 갈립니다. 제외 질문만 보면 글자 강등 → Jev 20(0.790)이 최고지만, 글자 강등을 앞에 두면 Jev를 붙여도 평범한 질문의 피해가 그대로 남았습니다. 해치지 않는 조합 중에서는 임베딩 강등 → Jev 20(0.751)이 호출이 가장 적고, 두 질문 합친 후보 → Jev 40(0.759)이 조금 더 높습니다. 강등이 정답을 상위 10개 밖으로 이미 밀어냈기 때문에, 판정할 기회 자체가 없었던 것입니다. 앞단의 실수는 뒷단이 그 후보를 볼 수 있을 때만 되돌릴 수 있습니다.
5부. 실무 처방
① 떼어 내기
질문에 제외 표지('빼고·말고·없는·아닌', 또는 돌려 말하기)가 보이면 LLM으로 '찾을 것'과 '뺄 것'을 나눈다. 이것만으로 점수가 두 배
② 후보는 둘로
원래 질문과 뗀 질문으로 각각 후보를 모아 RRF로 합친다. 분해가 틀려도 정답이 후보에서 사라지지 않게 하는 안전장치
③ 공짜로 한 번 정리
빼라는 주제와 가까운 후보를 감점하거나 내린다. Jev 호출을 줄일 때 효과가 크다. 단독으로 쓸 거면 평범한 질문을 해칠 수 있음을 감안
④ 판정은 원래 질문으로
상위 20~40개에 Jev를 쓰되 판정 질문은 원래 문장 그대로. 분해의 실수를 판정 단계가 되돌린다
예산이 0이라면 ①과 글자 강등만으로도 8편의 Jev 방식만큼 나옵니다. 예산이 있다면 ③을 무엇으로 두느냐가 핵심 결정입니다. 제외 질문을 확실히 가려낼 수 있는 서비스(제외 표지가 분명하거나 사용자가 필터로 직접 고르는 경우)라면 글자 강등 → Jev 20(0.790)이 가장 좋습니다. '없이', '없는'이 들어간 평범한 질문이 섞이는 서비스라면 임베딩 강등 → Jev 20(0.751)이나 두 질문 합친 후보 → Jev 40(0.759)처럼 평범한 질문을 해치지 않는 조합이 안전합니다. 판정 모델의 진짜 가치는 점수 몇 포인트보다, 앞단의 실수를 되돌릴 수 있다 는 데 있었습니다.