
TECH BLOG
기술 블로그
AI 기술 인사이트와 엔지니어링 경험을 공유합니다.
ALL POSTS
모든 포스트
[특집] 722편의 원고 — OpenAI가 하룻밤에 공개한 372개의 '해결된' 수학 문제, 그 저장소를 열어 보다
2026년 10월 6일 밤, OpenAI는 일곱 문단짜리 글 「수학에서의 AI 진전을 공유합니다」와 함께 GitHub 저장소 하나를 열었다. 미공개 내부 모델이 쓴 수학 원고 722편, 결과 계열 372개. 준(準) 리만 가설, 4차원 카케야 추측, 행렬 곱셈 지수 2.25, 유일 게임 추측, 톰프슨 군 F의 비순종성 — 각각이 사람이 했다면 경력을 통째로 바칠 만한 문제들이 '거의 전부 프롬프트 하나, 에이전트 하나, 평균 세 시간'으로 나왔다고 적혀 있다. 이 글은 저장소를 직접 열어 README·카탈로그·Lean 라이브러리·추론 요약 10건을 읽고, 헤드라인 결과를 비전공자도 이해할 수 있게 풀고, '검증됨'과 '이해됨' 사이의 거리를 재고, 사흘간 쏟아진 수학자들의 반응('즉시 필즈상'에서 '힘의 시연'까지)을 지도에 놓는다. 그리고 하루 전 같은 블로그에 실린 아비가드의 편지와 겹쳐 읽는다.
도구는 넷, 자리는 넷 — BM25·임베딩·Jev·코드를 적재적소에 쓰는 한국어 검색 실측 (한국어 검색 스택 8편)
6편에서 Jev는 리랭커로 강했고, 7편에서는 환각 검문소로 강했습니다. 그렇다면 검색의 모든 단계를 Jev에 맡기면 될까요? 이 글은 한국어 질문 134개를 다섯 가족(키워드·의미·제외 조건·두 주제·날짜·카테고리)으로 나눠 BM25, 임베딩 둘, 하이브리드, Jev, 그리고 정규식 몇 줄짜리 코드 필터를 열세 가지 방식으로 조합해 실측했습니다. 질문의 종류가 바뀌면 이기는 도구가 바뀌었습니다. '쿠버네티스는 빼고'라고 하면 임베딩과 BM25는 쿠버네티스 글을 상위 10개의 절반쯤 가져왔고 Jev가 그것을 19%로 줄였습니다. 날짜 질문에서는 Jev가 날짜 판정 807쌍을 전부 맞혔는데도 코드 필터에 졌습니다. 판정이 아니라 후보가 문제였기 때문입니다. 각 도구를 제자리에 둔 설계는 모든 질문에 Jev를 쓰는 방식보다 점수가 높으면서 Jev 호출은 40%였습니다. Jev 9,521회 호출에 0.26달러. 인터랙티브 5개와 삽화 7장.
에이전트 네이티브 메모리, 준비됐나? — 12개 AI 기억 시스템을 데이터베이스의 눈으로 해부한 2026년 보고서
ChatGPT도, Claude도, Copilot도 이제 '기억'을 판다. 그런데 어떤 기억이 좋은 기억인지 아무도 같은 자로 재 본 적이 없었다. 상하이교통대·칭화대·MemTensor 연구진이 12개 메모리 시스템을 11개 데이터셋에서 같은 조건으로 돌리고, 기억을 '표현·추출·검색·유지보수' 네 모듈로 뜯어 한 부품씩 바꿔 가며 측정했다. 결론은 불편하다. 만능 챔피언은 없고, 요약은 정보를 지우며, 정밀한 사실 추출은 추론을 무너뜨리고, 그래프는 정확하지만 100배 느리다. 역사·개념·실험·실무 가이드까지, 인터랙티브 위젯과 함께 완전 해부한다.
임베딩은 '아니다'를 못 읽는다 — Jev를 RAG 환각 검문소에 세우다 (한국어 검색 스택 7편)
임베딩 모델은 '매출이 30% 늘었다'와 '매출이 30% 줄었다'를 거의 같은 문장으로 봅니다. 검색에는 맞는 판단이지만, RAG 답변의 마지막 관문에서는 치명적입니다. 이 글은 6편에 이어 TypeSafe의 Jev를 한국어 검색 파이프라인의 새 자리, 답변 뒤의 '환각 검문소'에 세웁니다. 코어닷투데이 블로그 문단 87개로 참 주장 257개와 숫자·방향·주체를 바꾸거나 없는 사실을 덧붙인 거짓 주장 344개를 만들고, 임베딩 둘·크로스 인코더·NLI 모델·로컬 LLM 둘·Jev에게 같은 601쌍을 판정시켰습니다. 참 주장의 90%를 통과시키는 임계값에서 BGE-M3 코사인은 숫자를 바꾼 거짓의 3%만 잡았고, Jev는 100%를 잡았습니다(AUROC 0.995). 0.3B NLI 모델이 의외의 복병이었고(0.959), 숫자를 1만 바꿔도 잡던 Jev는 문서의 숫자로 계산해야 하는 주장에서 약해졌습니다. 601번 검문에 0.021달러. 인터랙티브 7개와 삽화 8장.
[특집] 일만 잘하면 된다는 거짓말 — 전 아마존 VP가 털어놓은 '사내 정치의 어두운 면', 그리고 그 뒤의 50년 연구
2026년 9월 말, 15년 동안 Amazon에서 VP까지 오른 이선 에반스가 3시간짜리 인터뷰에서 '성과만으로는 부족하다'고 말했습니다. 먼저 말하는 사람이 공을 가져가고, HR은 신뢰받는 관리자 편이며, 모두가 좋아하는 평범한 직원은 자르기 어렵다는 이야기였습니다. 불편하지만 낯설지는 않은 이 이야기는 사실 50년 동안 조직심리학이 숫자로 확인해 온 결론과 거의 정확히 겹칩니다. 마키아벨리에서 민츠버그의 13가지 정치 게임, 부부의 집안일 기여도 합이 103%가 되는 이유, '유능한 밉상'이 조용히 밀려나는 메커니즘, 우버와 마이크로소프트와 아마존이 겪은 평가 제도의 실패, 한국 직장인의 96%가 '있다'고 답한 사내 정치, 그리고 중간관리자가 사라지는 2026년에 이 기술이 더 중요해지는 이유까지. 왜 옳은 일을 열심히 하는 것만으로는 충분하지 않은지, 그리고 그 현실에 '지지하지 않으면서 대응하는' 법을 끝까지 따라갑니다.
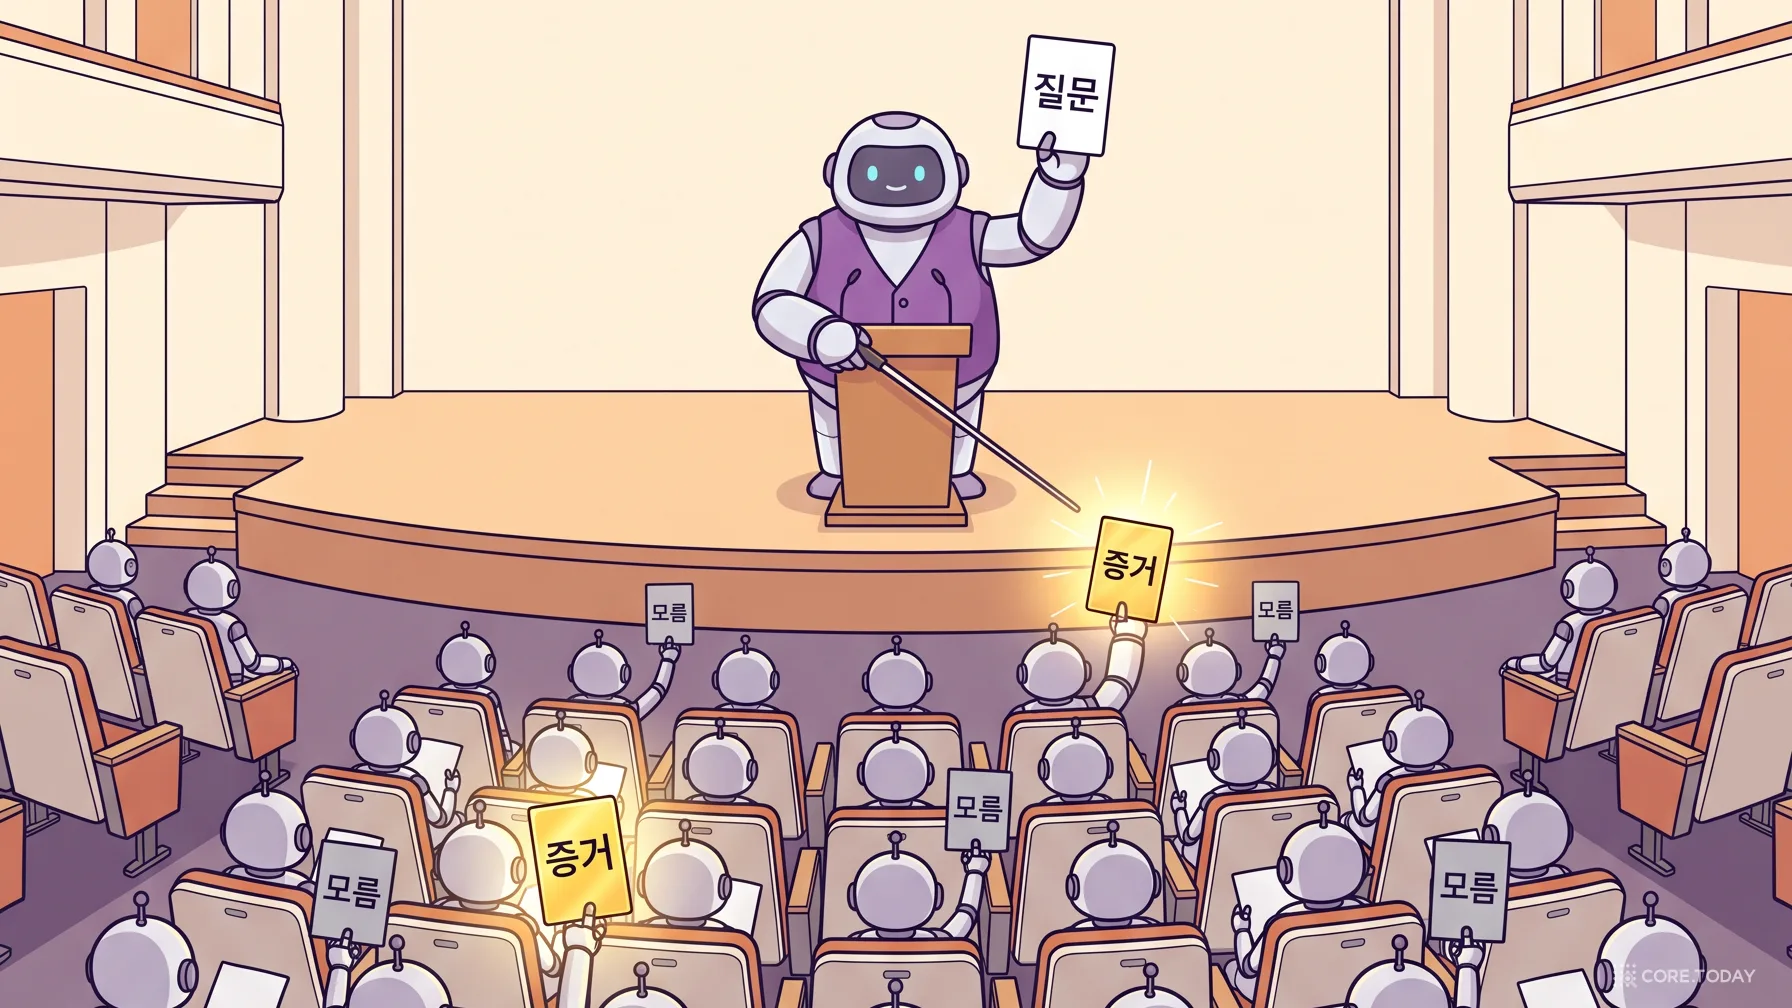
읽기는 병렬로, 추론은 깊게 — 896K 토큰 문서를 4B 모델이 읽어 내는 법, PARSER 논문 특집
100만 토큰짜리 창을 가진 모델도 긴 문서 앞에서는 정확도가 수십 점씩 떨어집니다. 홍콩중문대 연구진이 2026년 9월에 내놓은 PARSER는 '문서를 읽는 순서는 문서가 정하지만, 질문을 푸는 순서는 질문이 정해야 한다'는 한 문장에서 출발합니다. 문서를 보지 않는 리드 에이전트가 질문을 쪼개 수천 개의 청크 담당 서브에이전트에게 동시에 흩뿌리고, 돌아온 증거로 다음 질문을 다듬습니다. 4B 모델이 896K 토큰에서 순차 메모리 에이전트를 12점 앞서고, 9B 모델이 DeepSeek-V4-Pro를 6.3점 앞섰으며, 지연은 11배 줄었습니다. 이 글은 Transformer의 어텐션 창에서 시작해 'Lost in the Middle'과 Context Rot, MemAgent의 순차 메모리까지 이 논문이 서 있는 자리를 되짚고, 흩뿌리기-모으기 구조와 리드 에이전트만 강화학습하는 설계, 세 가지 통제 실험, 실패 사례와 한계, 그리고 2026년 멀티 에이전트 지형에서의 의미를 사례와 함께 풀어 씁니다. 시뮬레이터·결과 탐색기·접근법 가이드 위젯 3개.
[특집] 읽는 순간 조종당한다 — 프롬프트 인젝션, 55년 된 버그는 왜 AI에서 되살아났나
2026년 2월, 누군가 깃허브 이슈의 제목 칸에 문장 하나를 적었습니다. 그 문장을 읽은 AI 봇이 배포 자격 증명을 노출했고, 변조된 패키지가 8시간 동안 약 4,000번 설치됐습니다. 해킹 도구도 악성코드도 없었습니다. 글을 읽게 했을 뿐입니다. 이것이 프롬프트 인젝션입니다. 이 글은 이 문제의 뿌리를 1971년 휘파람으로 전화 교환기를 조종하던 '블루박스'와 1998년의 SQL 인젝션에서 찾고, 2022년 9월 이름이 붙던 순간부터 2026년까지의 공격과 방어를 따라갑니다. 전화망과 데이터베이스는 '명령과 데이터의 통로를 나누는' 것으로 문제를 끝냈는데, 왜 언어 모델에서는 그 해법이 통하지 않는지. 세 연구소가 함께 쓴 논문이 최신 방어 12종을 어떻게 90% 이상 뚫었는지. 그리고 '고칠 수 없다면 속았을 때 할 수 있는 일을 줄인다'는 설계 원칙이 무엇인지 정리합니다.
[특집] 그림자 속의 동료 — 섀도 AI, 회사가 모르는 AI는 어떻게 가장 흔한 보안 사고가 되었나
2026년 1월, 미국의 사이버보안 책임 기관을 이끌던 국장대행이 대외비 표시가 붙은 문서를 공개 ChatGPT에 올린 사실이 보도됐습니다. 보안의 최고 책임자도 하는 일이라면, 우리 회사 직원은 어떨까요. 국내 재직자 조사에서 생성형 AI 사용 사례의 38%는 회사 승인 없이 개인 돈으로 쓰는 것이었고, 하루 2시간 이상 쓰는 사람은 반년 만에 18%에서 72%가 됐습니다. 이 글은 '섀도 AI'를 1981년 은행 직원들이 PC를 사무용품으로 몰래 사던 때부터 따라갑니다. 왜 사람들은 AI 사용을 숨기는지, 붙여넣은 자료는 어디로 가는지, 2023년의 금지령은 왜 3년 만에 공식 도입으로 바뀌었는지, 그리고 이제 사람이 아니라 '에이전트'가 그림자 속에서 일하기 시작한 2026년에 회사가 무엇을 해야 하는지 정리합니다.
[특집] 엔지니어의 '소모율'이 연봉을 따라잡을 때 — 토큰 예산은 누가, 얼마나, 어떻게 정하는가
2026년 봄, 같은 규모의 두 회사가 엔지니어 한 명에게 허락한 월 토큰 한도는 5,000달러와 200달러였다. 25배 차이. 3월에 젠슨 황은 '연봉 50만 달러 엔지니어라면 토큰을 25만 달러어치는 써야 한다'고 했고, 4월에 메타의 사용량 순위표는 30일간 60조 토큰을 태우다 닫혔으며, 6월에 우버는 1인당 월 1,500달러 상한을 걸었다. 넉 달 만에 '토큰을 최대로'가 '토큰을 최소로'로 뒤집힌 것이다. 이 글은 그 소동의 한가운데 있는 질문 하나를 붙든다 — 엔지니어 한 명에게 얼마를 쓰게 할 것인가, 그리고 그걸 누가 어떻게 정하는가. 1969년 멀틱스의 '자원 예산'부터 구글의 사내 계산 자원 경매, 클라우드 FinOps까지 60년 된 문제의 계보를 따라가고, 에이전트 코딩의 토큰이 왜 예측 불가능한지(같은 과제에서 최대 30배 차이)를 논문으로 풀며, 한도라는 숫자 하나 밑에 깔려야 하는 여섯 층의 통제 구조와 다섯 가지 정책의 득실, 굿하트의 법칙이 순위표를 무너뜨린 과정, 손익분기 계산, 그리고 네이버·LG·삼성 등 한국 기업의 실제 선택까지 다섯 개의 인터랙티브 도구와 함께 정리했다.