word2vec분포 가설단어 임베딩워드 임베딩FirthHarrisskip-gramCBOW네거티브 샘플링벡터 산술king - man + womanGloVefastTextLSAPMI임베딩 편향문맥 임베딩다의어Kiwi형태소 분석LLM 임베딩 층선형 표현 가설
‘왕 − 남자 + 여자 = 여왕’은 정말일까? — word2vec과 분포 가설, 이웃이 단어의 뜻을 정하기까지 (특집)
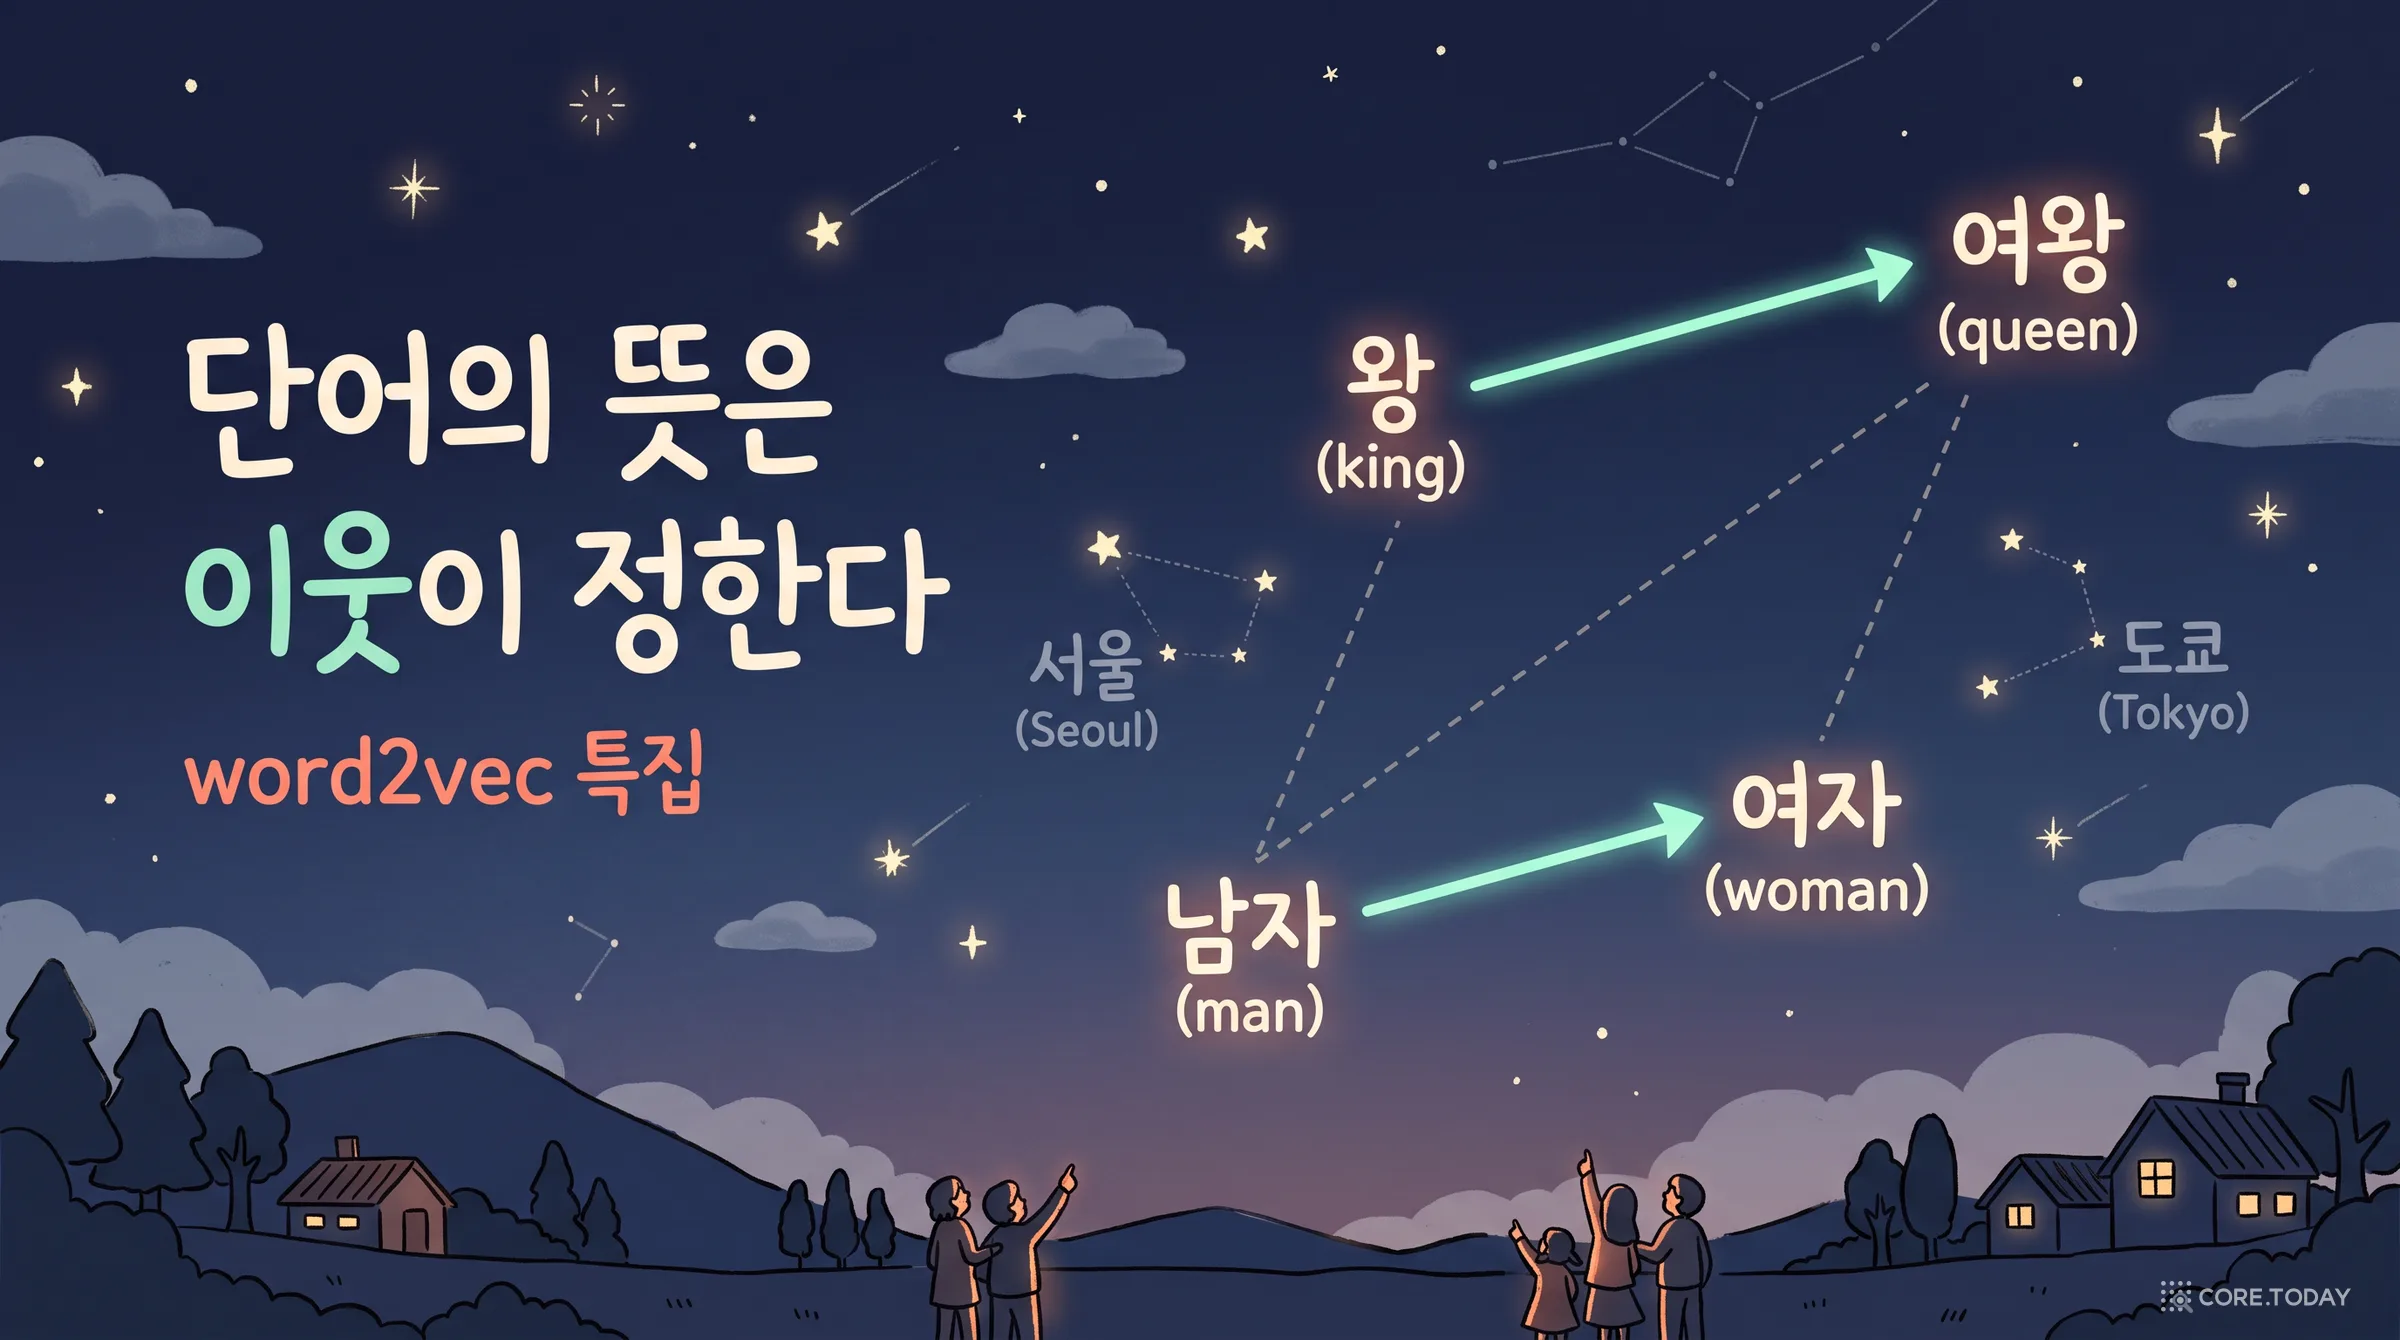
1957년 영국의 언어학자 퍼스는 ‘단어는 함께 다니는 이웃을 보면 안다’고 썼다. 56년 뒤 구글의 word2vec은 이 문장을 계산으로 옮겼다. 16억 단어를 하루 만에 읽고 단어마다 수백 개의 숫자를 붙였더니 ‘왕 − 남자 + 여자’가 ‘여왕’ 근처에 떨어졌다. 이 글은 처음 보는 단어의 뜻을 문장만 보고 맞히는 놀이에서 시작해, 세는 방법(LSA)과 맞히는 방법(word2vec)이 사실은 같은 일을 하고 있었다는 발견, 유명한 벡터 산술에 숨은 규칙, 임베딩이 배운 고정관념, ‘배’처럼 뜻이 여럿인 단어의 한계까지 따라간다. 한국어 위키백과로 word2vec을 직접 학습한 실측, 최신 LLM의 입력 임베딩 표에서 여왕을 찾은 실측, 문장마다 달라지는 ‘배’ 벡터 실측을 담았다. 인터랙티브 위젯 6종, 코어닷투데이 실측, 삽화 12장.
영어 위키백과 1,700만 단어로 word2vec을 학습했다. 맥 한 대(Apple M5 Pro)로 2분 40초가 걸렸다. 그리고 유명한 계산을 해 봤다.
king − man + woman = ?
답은 queen이었다. 코사인 유사도 0.55로 7만 1천 개 단어 가운데 1등이다. 10년 넘게 교과서에 실린 결과가 그대로 나왔다.
그런데 계산 규칙 하나를 바꾸자 답이 달라졌다. 질문에 쓴 세 단어(king, man, woman)도 후보에 넣으면 1등은 king 자신이다(0.74). queen은 2등으로 밀린다. 같은 방식으로 doctor − man + woman을 계산하면, 세 단어를 뺐을 때 1·2등이 ‘pregnancy(임신)’와 ‘nurse(간호사)’다. 빼지 않으면 1등은 다시 doctor다.
⟦STAT_GRID⟧
이 계산 뒤에는 70년 된 아이디어 하나가 있다. 단어의 뜻은 그 단어와 함께 쓰이는 이웃이 정한다. 언어학에서는 이를 분포 가설(distributional hypothesis)이라고 부른다. 2013년 구글의 word2vec은 이 아이디어를 빠르고 값싸게 계산하는 방법을 내놓았다. 그 뒤 단어를 숫자 벡터로 바꾸는 임베딩(embedding)은 자연어 처리의 출발점이 됐다. 지금 ChatGPT나 Claude 같은 대형 언어 모델(LLM)도 맨 앞에 단어를 벡터로 바꾸는 표를 갖고 있다.
컴퓨터는 숫자만 다룬다. 단어를 숫자로 바꾸는 가장 쉬운 방법은 번호를 붙이는 것이다. 어휘가 10만 개라면 길이 10만짜리 벡터를 만들고, 자기 번호 자리에만 1을 넣는다. 이것을 원-핫(one-hot) 벡터라고 부른다.
호텔 = [0, 0, …, 1(3,812번째), …, 0]
모텔 = [0, 0, …, 1(57,104번째), …, 0]
문제는 이 방식에서 모든 단어가 서로 똑같이 멀다는 것이다. 두 벡터의 내적은 0이다. ‘호텔’과 ‘모텔’ 사이의 거리는 ‘호텔’과 ‘바나나’ 사이의 거리와 같다. 검색 엔진이 ‘서울 호텔’을 검색한 사람에게 ‘서울 모텔’ 페이지를 보여 줄 근거가 없다. 스팸 필터가 ‘무료’를 배워도 ‘공짜’에는 써먹지 못한다. 단어가 정확히 일치해야만 같은 것으로 본다.
1.2 사전을 손으로 만들면?
그렇다면 사람이 단어 사이의 관계를 직접 적어 주면 된다. 실제로 1985년 프린스턴 대학교는 영어 단어를 동의어 묶음으로 엮은 사전 WordNet을 만들기 시작했다. ‘자동차’는 ‘탈것’의 하위어이고 ‘바퀴’를 부분으로 갖는다는 식이다.
손으로 만든 사전은 정확하다. 하지만 비싸고 느리다. ‘댕댕이’나 ‘킹받다’ 같은 신조어는 사전에 들어가기까지 몇 년이 걸린다. ‘좋다’와 ‘훌륭하다’가 얼마나 비슷한지 같은 정도의 차이도 담기 어렵다. 분야마다(의학, 법률, 게임) 다시 만들어야 한다.
필요한 것은 사람이 가르쳐 주지 않아도, 글을 많이 읽기만 하면 단어 사이의 관계를 스스로 알아내는 방법이었다. 그 실마리는 컴퓨터가 나오기 전, 언어학자들이 먼저 찾아 두었다.
언어학 교재에 자주 나오는 예가 있다. ‘테즈귀노(tezgüino)’라는 단어를 처음 들었다고 하자. 다음 네 문장을 차례로 읽는다.
식탁 위에 테즈귀노 한 병이 있다.
다들 테즈귀노를 좋아한다.
테즈귀노를 마시면 취한다.
우리는 옥수수로 테즈귀노를 만든다.
네 문장 어디에도 ‘술’이라는 말은 없다. 그래도 다 읽고 나면 누구나 ‘옥수수로 빚은 술’이라고 짐작한다. 실제로 테즈귀노는 멕시코 북부 원주민이 빚는 옥수수 맥주다. 우리는 단어의 정의를 몰라도, 그 단어 주변에 어떤 단어가 오는지를 보고 뜻을 알아낸다. 아래 위젯에서 직접 해 보자.
아이들이 말을 배우는 방식도 이와 비슷하다. 사전을 찾아보며 배우는 단어보다, 여러 문장 속에서 마주치며 저절로 익히는 단어가 훨씬 많다.
비트겐슈타인(1953) — 『철학적 탐구』에서 “낱말의 의미는 언어 속에서 그 낱말의 쓰임이다”라고 썼다. 뜻을 머릿속 그림이 아니라 쓰임에서 찾자는 제안이다.
해리스(1954) — 미국 언어학자 젤리그 해리스는 논문 「분포 구조(Distributional Structure)」에서 이렇게 정리했다. A와 B의 뜻이 A와 C보다 더 다르다면, A와 B가 나타나는 환경도 대개 더 다르다. 뜻의 차이를 분포(어떤 환경에 나타나는가)의 차이로 잴 수 있다는 것이다.
퍼스(1957) — 영국 언어학자 J. R. 퍼스는 이것을 가장 유명한 한 문장으로 남겼다.
“You shall know a word by the company it keeps!”
— 단어는 그 단어가 어울리는 이웃을 보면 안다.
같은 1957년, 미국의 심리학자 오스굿은 『의미의 측정』에서 사람들에게 단어를 ‘좋다–나쁘다’, ‘강하다–약하다’, ‘빠르다–느리다’ 같은 척도로 평가하게 했다. 그리고 단어의 뜻을 이 축들이 만드는 공간 속의 점으로 나타냈다. ‘뜻은 이웃이 정한다’와 ‘뜻은 공간 속의 점이다’라는 두 아이디어가 같은 해에 나온 셈이다. 두 아이디어가 하나로 합쳐지기까지는 반세기가 더 걸렸다.
2.3 이웃을 세어 보자 — 동시 출현과 PMI
분포 가설을 계산으로 옮기는 가장 직접적인 방법은 세는 것이다. 큰 말뭉치를 훑으며, 각 단어 앞뒤 몇 칸 안에 어떤 단어가 나왔는지 센다. 아래는 우리가 한국어 위키백과(형태소 약 1억 개)에서 앞뒤 다섯 칸 안의 동시 출현을 직접 센 결과다.
⟦COOC_TABLE⟧
‘커피’와 ‘맥주’는 둘 다 ‘마시다’, ‘잔’과 자주 함께 나온다. ‘고양이’와 ‘강아지’는 ‘키우다’, ‘귀엽다’와 어울린다. ‘서울’과 ‘부산’은 ‘도시’와 붙어 다닌다. 각 단어의 행(가로줄)을 벡터로 보면, 같은 종류의 단어는 비슷한 모양의 벡터를 갖는다.
다만 그냥 센 숫자는 흔한 단어에 휘둘린다. ‘서울’은 위키백과에 2만 9천 번 나와서 웬만한 단어와 몇 번씩은 함께 나온다. 그래서 점별 상호정보량(PMI, pointwise mutual information)으로 보정한다.
PMI(w,c)=logP(w)P(c)P(w,c)
두 단어가 우연히 마주칠 확률보다 실제로 얼마나 더 자주 함께 나왔는지를 잰다. 우리 말뭉치에서 PMI는 ‘강아지–키우다’가 5.1, ‘커피–마시다’가 5.0이었다. ‘서울–여행’은 0.0으로 우연 수준이다. 서울은 여행 이야기에도 나오지만 그 밖의 모든 이야기에도 나오기 때문이다.
2.4 LSA — 세고 나서 압축하기
동시 출현 표는 크다. 어휘가 10만 개면 10만×10만 칸이고, 그 대부분은 0이다. 1990년 벨 연구소의 Deerwester 등은 단어×문서 빈도표를 특이값 분해(SVD)라는 행렬 분해로 100차원 남짓까지 눌렀다. 이것이 잠재 의미 분석(LSA)이다. 압축 과정에서 비슷한 문맥에 나오는 단어들이 비슷한 좌표를 갖게 된다. 그래서 ‘자동차’로 검색해도 ‘승용차’만 쓴 문서를 찾을 수 있었다.
LSA는 분포 가설이 계산으로 작동한다는 것을 보여 줬다. 하지만 어휘와 문서가 늘면 행렬 분해 비용이 급격히 커진다. 새 문서가 들어올 때마다 다시 분해해야 한다는 문제도 있었다. 2000년대 연구자들은 다른 길을 찾기 시작했다. 세지 말고, 맞혀 보면 어떨까?
3부. word2vec — 세지 말고 맞혀라
3.1 신경망 언어 모델, 그리고 속도의 벽
2003년 몬트리올 대학교의 요슈아 벤지오 등은 신경망 언어 모델을 발표했다. 단어마다 실수 벡터를 하나씩 두고, 앞 단어들의 벡터로 다음 단어를 맞히는 신경망을 함께 학습했다. 맞히는 과정에서 단어 벡터는 저절로 쓸모 있는 모양이 된다. 논문은 이렇게 설명했다. “고양이가 침실에서 걷는다”를 학습한 모델은 ‘고양이’와 ‘개’, ‘침실’과 ‘방’의 벡터가 비슷하므로 “개가 방에서 뛴다”도 그럴듯한 문장이라고 판단할 수 있다.
아이디어는 훌륭했지만 느렸다. 매 단어마다 어휘 전체(1만 7천 개)에 대한 확률을 계산해야 했다. 2008년 Collobert와 Weston이 위키백과로 학습한 단어 벡터를 여러 과제에 함께 쓰는 방법을 보여 줬을 때도, 학습에는 몇 주가 걸렸다.
2013년 1월, 구글의 토마시 미콜로프(Tomáš Mikolov) 팀이 논문 「벡터 공간에서 단어 표현의 효율적 추정」을 arXiv에 올렸다. 핵심은 덜어 내기였다. 신경망 언어 모델에서 가장 비싼 숨은 층을 통째로 뺐다. 남은 것은 단어 벡터 두 벌과 그 사이의 내적뿐이다. 모델이 너무 단순해서 문장을 제대로 이해할 수는 없다. 대신 아주 많은 글을 아주 빨리 읽을 수 있다. 논문은 16억 단어를 하루 안에 학습했다고 보고했다.
같은 해 10월, 두 번째 논문 「단어와 구의 분산 표현과 그 합성성」이 나왔다. 여기에 네거티브 샘플링과 빈출 단어 솎아 내기가 더해져 속도와 품질이 함께 올라갔다. 구글은 C로 쓴 코드와, 구글 뉴스 약 1,000억 단어로 학습한 300차원 벡터 300만 개를 함께 공개했다. 누구나 내려받아 쓸 수 있었다. word2vec이 순식간에 퍼진 이유다.
뒷이야기도 있다. 첫 논문은 2013년 처음 열린 학회 ICLR에서 탈락했다. 10년 뒤인 2023년 12월, 두 번째 논문은 NeurIPS에서 10년 동안 가장 큰 영향을 남긴 논문에 주는 ‘시간의 시험(Test of Time)’ 상을 받았다. 미콜로프는 수상 직후 SNS에 글을 올려 첫 논문이 거절당했던 일을 직접 꺼냈다.
word2vec의 학습 데이터는 그냥 글이다. 사람이 붙인 정답이 하나도 필요 없다. 문장 위에 창(window)을 하나 놓고 미끄러뜨리면, 창 안에서 문제가 저절로 만들어진다.
skip-gram — 가운데 단어를 보고, 창 안의 이웃 단어를 하나씩 맞힌다. ‘커피’를 보고 ‘따뜻한’, ‘마셨다’가 나올지 맞힌다.
CBOW(continuous bag-of-words) — 이웃 단어들을 합쳐서 가운데 빈칸을 맞힌다. ‘따뜻한 ___ 를 마셨다’의 빈칸이 ‘커피’라고 맞힌다.
이 문제를 잘 풀려면 모델은 ‘커피’와 ‘녹차’에 비슷한 벡터를 줘야 한다. 둘 다 ‘마시다’, ‘잔’, ‘따뜻한’을 이웃으로 맞혀야 하기 때문이다. 같은 이웃을 맞히는 단어는 같은 쪽으로 밀려간다. 분포 가설이 학습 목표 안에 그대로 들어 있다.
우리 실측(영어 text8, 같은 설정)에서 CBOW는 skip-gram보다 2.5배 빨랐다(65초 대 160초). 유추 문제 정확도는 skip-gram이 39.2%, CBOW가 33.3%로 skip-gram이 앞섰다. 미콜로프의 논문도 의미 관계 문제에서는 skip-gram이 낫다고 보고했다.
‘커피’ 다음에 올 단어를 맞히려면 원래는 어휘 10만 개 모두에 확률을 매겨야 한다. 매 단어마다 그렇게 하면 느리다. 두 번째 논문은 문제를 바꿨다. “이 단어가 진짜 이웃인가, 가짜 이웃인가?”만 맞히게 했다.
진짜 쌍: (커피, 마셨다) — 실제로 창 안에 있었다.
가짜 쌍: (커피, 공룡), (커피, 은하수) — 어휘에서 무작위로 뽑았다.
진짜 쌍에는 1을, 가짜 쌍에는 0을 내도록 학습한다. 중심 단어 벡터를 vc, 이웃 단어의 문맥 벡터를 uo라고 하면 목표는 다음과 같다.
logσ(uo⊤vc)+∑i=1klogσ(−uni⊤vc)
σ는 0과 1 사이로 눌러 주는 시그모이드 함수, k는 가짜 이웃의 수(보통 5~20)다. 진짜 이웃과는 내적이 커지도록, 가짜 이웃과는 작아지도록 벡터를 조금씩 민다. 계산량은 어휘 크기와 상관없이 k+1번의 내적이다.
작은 비결이 두 개 더 있다. 가짜 이웃은 단어 빈도의 3/4제곱에 비례해 뽑는다. 너무 흔한 단어만 뽑히지 않게 하는 경험적 보정이다. 또 ‘의’, ‘the’처럼 너무 흔한 단어는 학습 중에 확률적으로 건너뛴다. 이것이 빈출 단어 솎아 내기(subsampling)다. 흔한 단어에 쓰던 시간을 드문 단어에 쓴다.
3.5 직접 학습시켜 보기
아래 위젯은 위의 식을 브라우저에서 그대로 실행한다. 문장 60개짜리 작은 말뭉치로 16차원 벡터를 학습하고, 2차원으로 눌러서 보여 준다. 모델에게 ‘커피는 음료다’라고 알려 준 적은 없다. 색은 사람이 보기 좋으라고 칠한 것이다.
‘커피’와 ‘녹차’는 이 말뭉치에서 한 문장에 함께 나온 적이 한 번도 없다. 그런데도 가까워진다. 분포 가설의 핵심이 여기 있다. 비슷해지는 것은 함께 쓰이는 단어가 아니라 같은 이웃을 갖는 단어다. ‘커피’와 ‘마시다’는 늘 함께 나오지만 서로 닮은 단어는 아니다.
3.6 사실은 세고 있었다 — GloVe와 PMI 행렬
맞히는 방법(word2vec)은 세는 방법(LSA)과 완전히 다른 것처럼 보였다. 2014년 두 연구가 이 구분을 흐렸다.
GloVe — 스탠퍼드의 Pennington, Socher, Manning은 동시 출현 표를 먼저 센 다음, 두 단어 벡터의 내적이 동시 출현 횟수의 로그에 맞도록 학습했다. word2vec과 비슷하거나 더 나은 성능이 나왔다. 이들은 ‘얼음’과 ‘수증기’의 차이가 ‘고체’와 ‘기체’라는 이웃과의 동시 출현 비율에 담긴다는 점을 근거로 들었다.
Levy와 Goldberg — 이스라엘 바르일란 대학교의 두 연구자는 네거티브 샘플링 skip-gram이 학습을 마치면 다음 관계가 성립한다는 것을 보였다.
vw⊤uc≈PMI(w,c)−logk
word2vec은 2.3절에서 손으로 센 PMI 표를, 세지 않고 맞히는 방식으로 압축하고 있었던 것이다. 이듬해 같은 연구진은 창 크기, 가짜 이웃 분포 같은 설정만 맞춰 주면 세는 방법도 word2vec과 비슷한 성능을 낸다고 보고했다. word2vec이 이긴 비결의 상당 부분은 새로운 원리가 아니라 속도, 공개된 코드, 잘 고른 설정이었다.
word2vec을 세상에 알린 것은 정확도 표가 아니라 그림 한 장이었다. 2013년 미콜로프, Yih, Zweig는 단어 벡터 사이의 차이가 관계를 담는다는 것을 보였다. 남자에서 여자로 가는 화살표와 왕에서 여왕으로 가는 화살표가 거의 평행하다. 그래서 다음 식이 성립한다.
vking−vman+vwoman≈vqueen
나라와 수도(프랑스→파리, 독일→베를린), 형용사의 비교급(big→bigger, small→smaller), 동사의 시제(walk→walked)도 같은 식으로 풀린다. 미콜로프 팀은 이런 문제 1만 9,544개를 묶어 유추 평가 세트로 공개했고, 이 세트는 이후 몇 년 동안 단어 벡터의 표준 시험지가 됐다.
왜 이런 일이 생길까? 앞 절의 PMI 관계로 대략 설명할 수 있다. ‘king’과 ‘queen’의 차이는 주로 ‘he/she’, ‘his/her’ 같은 성별 이웃과의 동시 출현 차이에서 온다. ‘man’과 ‘woman’의 차이도 같은 이웃들에서 온다. 두 차이가 같은 이웃 목록에서 나오므로 같은 방향을 가리킨다. 2019년 Ethayarajh 등과 Allen·Hospedales는 이 설명을 수학적으로 다듬었다.
4.2 직접 돌려 봤다
이 결과가 정말 재현되는지 직접 확인했다. 영어는 word2vec 저자들이 데모로 쓰던 영어 위키백과 1,700만 단어(text8), 한국어는 한국어 위키백과 2023년 11월 덤프의 3분의 2를 썼다.
⟦ANALOGY_TABLE⟧
⟦ANALOGY_COMMENT⟧
4.3 입력 단어를 빼는 규칙
들어가며에서 본 이상한 결과를 다시 보자. 유추 문제를 풀 때는 관례상 질문에 쓴 세 단어를 답 후보에서 뺀다. 2013년 원래 코드부터 그렇게 했다. 이 규칙을 끄면 결과는 이렇다.
⟦RAW_TABLE⟧
a − b + c는 대부분 a 근처에 머문다. 남자와 여자의 차이는 작은 화살표다. 그 화살표를 king에 더해도 king에서 그리 멀리 가지 못한다. queen은 그 근처에 있는 두 번째 단어다.
이 문제를 정면으로 지적한 논문이 2020년 Nissim, van Noord, van der Goot의 「공정한 것이 선정적인 것보다 낫다: 남자가 의사라면 여자도 의사다」이다. 이들은 편향 연구에서 자주 인용되던 결과 상당수가 이 제외 규칙의 효과라고 보였다. ‘man : doctor = woman : ?’의 정직한 답은 ‘doctor’다. 입력을 빼라고 강제하니 그다음 단어인 ‘nurse’가 나왔을 뿐이다. 2016년 Linzen도 유추 정확도의 상당 부분이 c 근처의 가장 가까운 이웃만으로 설명된다고 지적했다.
그렇다고 벡터 산술이 가짜라는 뜻은 아니다. 관계의 방향은 실제로 있다. 다만 그 방향은 생각보다 짧고 흐릿하다. ‘queen이 정확히 거기 있다’가 아니라 ‘queen 쪽으로 조금 움직인다’에 가깝다.
4.4 벡터 산술 실험실
우리가 학습한 벡터 일부를 실었다. 프리셋을 눌러 보거나 직접 단어를 바꿔 보자. ‘입력 단어 빼기’를 끄면 무엇이 1등이 되는지도 확인해 보자.
4.5 창 크기가 ‘비슷함’의 종류를 바꾼다
창 크기는 단순한 설정값처럼 보이지만, 벡터가 담는 ‘비슷함’의 종류를 바꾼다. 같은 영어 말뭉치에서 창만 바꿔 학습해 이웃을 비교했다.
⟦WINDOW_TABLE⟧
창이 좁으면(앞뒤 2칸) 문장 안에서 같은 자리에 들어갈 수 있는 단어가 이웃이 된다. ‘doctor’의 이웃은 ‘teacher’, ‘headmaster’다. 직업이라는 같은 종류다. 창이 넓으면(앞뒤 15칸) 같은 주제의 글에 나오는 단어가 이웃이 된다. ‘doctor’의 이웃이 영국 드라마 「닥터 후」의 배우(pertwee, mcgann)와 악당(daleks)으로 바뀐다. 위키백과에서 ‘Doctor’가 가장 길게 다뤄지는 주제가 그 드라마이기 때문이다.
유추 정확도도 달라졌다. 창 15는 나라–수도 같은 의미 문제에서 49.0%, 창 2는 18.1%였다. 비교급·시제 같은 문법 문제는 창 2가 37.6%, 창 15가 42.8%로 차이가 작았다. 2014년 Levy와 Goldberg가 보고한 경향과 같다. 검색이나 추천처럼 ‘같은 주제’를 찾으려면 넓은 창이, 동의어나 대체어를 찾으려면 좁은 창이 낫다.
5부. 한국어로 word2vec을 학습하면
5.1 어절의 함정 — 서울, 서울은, 서울에서
영어는 띄어쓰기 단위가 거의 단어다. 한국어는 다르다. 띄어쓰기 단위인 어절에 조사와 어미가 붙는다. ‘서울’, ‘서울은’, ‘서울에서’, ‘서울의’가 모두 다른 어절이다. 띄어쓰기대로 잘라 word2vec을 학습하면 이들이 모두 다른 단어가 된다.
⟦FRAGMENT⟧
같은 단어의 출현이 수십 개 형태로 흩어지면, 각 형태는 적은 데이터로 따로 학습된다. 그래서 형태소 분석기로 ‘서울/에서’처럼 먼저 나눈 다음 학습하는 것이 한국어의 표준 방법이 됐다. 우리는 오픈소스 형태소 분석기 Kiwi를 썼다. 두 방식을 같은 말뭉치, 같은 설정으로 비교했다.
⟦EOJEOL_VS_MORPH⟧
BPE 특집에서 다룬 것처럼, 지금의 LLM은 형태소 분석 대신 서브워드 토크나이저로 이 문제를 푼다. 2016년 페이스북의 fastText는 그 중간 단계였다. 단어를 글자 조각(n-gram)의 합으로 만들어, 처음 보는 활용형도 조각을 모아 벡터를 얻는다. 2018년 KAIST의 박성준 등은 한국어 글자를 자모 단위까지 쪼개 fastText 방식으로 학습하면 한국어 유추·유사도 평가에서 성능이 오른다고 보고했다.
분포 가설은 공정하다. 데이터에 있는 것을 그대로 배운다. 그래서 문제가 된다. 데이터에 있는 고정관념도 그대로 배우기 때문이다.
2016년 보스턴 대학교와 마이크로소프트 연구소의 Bolukbasi 등은 구글 뉴스 벡터에서 ‘man : computer programmer = woman : homemaker(주부)’라는 결과를 보고했다. 논문 제목도 이 문장이었다. 2017년 프린스턴의 Caliskan 등은 심리학의 암묵적 연관 검사(IAT)를 단어 벡터에 옮긴 WEAT로, 사람들이 갖고 있는 편견 상당수가 단어 벡터에서도 재현된다는 것을 『사이언스』에 발표했다. 2018년 스탠퍼드의 Garg 등은 미국 100년치 문서로 시대별 벡터를 학습했다. 직업 단어와 여성 단어 사이의 거리 변화가 실제 미국 인구조사의 여성 직업 비율 변화와 함께 움직였다.
우리 한국어 벡터에서도 확인했다. 남자→여자, 아버지→어머니처럼 성별만 다른 단어 쌍 8개의 차이 벡터를 평균해 ‘성별 축’을 만들었다. 그리고 직업 단어를 이 축에 투영했다.
⟦GENDER_AXIS⟧
이 결과를 해석할 때는 두 가지를 조심해야 한다. 첫째, 이것은 위키백과에서 그 직업이 어떤 단어와 함께 쓰였는지의 통계다. 직업의 실제 성비도, 누군가의 의견도 아니다. 둘째, 4.3절에서 본 것처럼 유추 계산의 ‘선정적인’ 결과는 제외 규칙 때문에 부풀려질 수 있다. 그래서 위에서는 유추 대신 축 투영을 썼다.
그래도 문제는 실제다. 이력서 검색 시스템이 ‘엔지니어’와 가까운 단어로 지원자를 찾는다면, 이 축은 순위에 그대로 스며든다. 2016년 Bolukbasi 등은 성별 축을 찾아 중립이어야 할 단어에서 그 성분을 빼는 편향 제거(debiasing)를 제안했다. 2019년 Gonen과 Goldberg는 그렇게 해도 편향이 다른 방향에 숨어 남는다는 것을 보였다. 하나의 축을 지운다고 해결되지 않는다는 뜻이다. 이 논쟁은 지금 LLM의 편향 평가로 그대로 이어지고 있다.
word2vec에는 근본적인 한계가 있다. 단어 하나에 벡터 하나다. 한국어 ‘배’를 생각해 보자. 타는 배, 먹는 배, 몸의 배, ‘두 배’의 배. 네 뜻이 모두 한 벡터에 섞인다. 우리 한국어 벡터에서 ‘배’의 이웃은 다음과 같았다.
⟦BAE_NEIGHBORS⟧
2018년 앨런 AI 연구소의 ELMo와 구글의 BERT가 이 문제를 풀었다. 단어 벡터를 미리 정해 두지 않고, 문장을 읽을 때마다 새로 계산한다. 이것을 문맥 임베딩(contextual embedding)이라고 부른다. 고정된 단어 벡터는 사라지지 않았다. 모델의 첫 층, 입력 임베딩 표로 자리를 옮겼을 뿐이다.
이를 직접 확인했다. 공개 언어 모델 Qwen3-0.6B에 ‘배’가 들어간 문장 12개(네 가지 뜻 × 3문장)를 넣고, 층마다 ‘배’ 토큰의 벡터를 꺼내 비교했다.
0층(입력 임베딩)에서는 12문장의 ‘배’가 모두 같은 벡터다. word2vec과 같은 상태다. 2층만 지나도 같은 뜻끼리 평균 유사도가 0.17, 다른 뜻끼리는 −0.13으로 갈라지기 시작한다. 7층부터 마지막 28층까지는 12문장 중 8~11문장(대부분 9~10문장)에서 가장 닮은 ‘배’가 같은 뜻의 ‘배’였다. 같은 뜻끼리 유사도는 22층에서 0.45로 가장 높았다. 모델은 ‘항구’, ‘깎은’, ‘아프다’, ‘두’ 같은 이웃을 보고 ‘배’의 뜻을 정한다. 퍼스의 문장이 이번에는 단어 하나하나의 벡터 안에서 일어나고 있다.
word2vec의 진짜 유산은 단어 벡터 자체보다 ‘순서 있는 나열이 있으면 무엇이든 벡터로 만들 수 있다’는 깨달음이다. 단어 대신 다른 것을 넣어도 분포 가설은 그대로 작동한다. 함께 나오는 것끼리 비슷하다.
상품(prod2vec, 2015) — 야후의 Grbovic 등은 이메일 영수증에서 사람들이 산 상품 순서를 ‘문장’으로 보고 word2vec을 돌렸다. 같은 사람이 연달아 산 상품이 가까워졌다. 이를 이메일 광고 추천에 썼다.
숙소(Airbnb, 2018) — 에어비앤비는 사용자가 한 번의 검색에서 연달아 클릭한 숙소를 문장으로 보고 숙소 벡터를 학습했다. 450만 개 숙소, 8억 건 이상의 클릭 세션을 썼다. 예약으로 끝난 세션의 숙소는 모든 창에 넣어 ‘예약’ 신호를 강화했다. 이 논문은 KDD 2018 응용 데이터 과학 부문 최우수 논문상을 받았다.
그래프의 노드(DeepWalk 2014, node2vec 2016) — 그래프 위를 무작위로 걸은 경로를 문장으로 본다. 소셜 네트워크의 사람, 논문 인용망의 논문, 단백질 상호작용망의 단백질이 벡터가 된다.
단백질(ProtVec, 2015) — 아미노산 서열을 세 글자씩 끊어 ‘단어’로 보고 학습했다.
신소재(2019) — 미국 로런스 버클리 국립연구소의 Tshitoyan 등은 재료과학 논문 초록 330만 편으로 word2vec을 학습했다. 화합물 이름 중 ‘thermoelectric(열전)’ 벡터와 가까운 것을 순위로 매기자, 과거 특정 연도까지의 논문만으로 학습한 벡터가 몇 년 뒤에야 열전 소재로 보고된 물질을 미리 상위에 올렸다. 결과는 『네이처』에 실렸다. 논문들 속에 아직 아무도 연결하지 않은 지식이 이웃 관계로 숨어 있었다는 뜻이다.
말의 뜻 변화(2016) — 스탠퍼드의 Hamilton 등은 10년 단위로 따로 학습한 벡터를 정렬해 단어 뜻의 변화를 추적했다. 영어 ‘gay’의 이웃은 1900년대 ‘cheerful(쾌활한)’, ‘frolicsome’에서 1990년대 ‘lesbian’, ‘homosexual’로 옮겨 갔다. ‘broadcast’는 ‘씨를 뿌리다’에서 ‘방송하다’로 바뀌었다.
같은 방법이 음악 스트리밍의 재생 목록, 온라인 쇼핑의 장바구니, 검색 로그 분석에 두루 쓰였다. 추천 시스템 업계에서 ‘item2vec’, ‘아무거나2vec’이 농담처럼 쓰일 정도였다.
word2vec을 직접 쓰는 일은 2026년에는 드물다. 그러나 word2vec이 만든 생각은 지금의 AI 곳곳에 남아 있다.
9.1 LLM의 첫 층은 여전히 ‘단어 → 벡터’ 표다
ChatGPT, Claude, Llama, Qwen 같은 LLM은 입력 문장을 토큰으로 자른 다음, 맨 먼저 입력 임베딩 표에서 토큰마다 벡터를 꺼낸다. 이 표는 word2vec과 거의 같은 모양이다. 토큰 수만큼의 행이 있고, 행마다 수천 개의 숫자가 있다. 차이는 word2vec처럼 따로 학습하는 것이 아니라, 다음 토큰을 맞히는 거대한 모델 전체와 함께 학습된다는 점이다.
그렇다면 이 표 안에도 king − man + woman이 있을까? 공개 LLM 세 개의 입력 임베딩 표에서 직접 계산했다. 어휘 10만~15만 개 전체가 후보다.
⟦LLM_TABLE⟧
세 모델 모두 입력 단어를 빼면 ‘queen’, ‘Seoul’, ‘sister’, ‘actress’, ‘aunt’가 1등이었다. 빼지 않으면 대부분 king, Tokyo 같은 입력 단어가 1등이고 정답은 2~4등이다. 2013년 word2vec과 똑같은 패턴이다. 한국어 토큰으로도 해 봤다. EXAONE 4.0의 표에서 서울 − 한국 + 일본은 ‘도쿄’, 아버지 − 남자 + 여자는 ‘어머니’, 아들 − 남자 + 여자는 ‘딸’이 1등이었다. 왕 − 남자 + 여자는 여왕을 찾지 못하고 ‘왕’(띄어쓰기 없는 토큰), ‘여성’, ‘왕실’을 내놓았다. 다음 토큰 예측만으로 학습한 수십억 파라미터 모델의 첫 층이, 2013년의 얕은 모델과 같은 기하 구조를 스스로 만들어 낸 셈이다.
9.2 검색과 RAG — 단어에서 문장으로
word2vec의 ‘비슷한 것은 가까운 점’이라는 생각은 지금 문장 임베딩으로 이어졌다. 질문과 문서를 각각 하나의 벡터로 바꾸고 코사인 유사도로 가장 가까운 문서를 찾는다. 이것이 LLM에게 외부 문서를 찾아 붙여 주는 RAG(검색 증강 생성)의 기본 구조다. 벡터 데이터베이스는 이 점들을 빠르게 찾기 위한 저장소다. 우리가 한국어 임베딩 모델을 직접 비교한 글도 결국 ‘어느 모델이 비슷한 뜻을 가까운 점으로 만드나’를 잰 것이다.
차이는 범위다. word2vec은 단어 하나, 창 몇 칸을 봤다. 지금의 임베딩 모델은 수천 토큰짜리 문서 전체를 읽고, 문맥 임베딩을 모아 하나의 벡터로 만든다. 그 바탕에 있는 원리는 같다. 비슷한 맥락에 쓰이는 것은 비슷한 뜻을 갖는다.
9.3 개념은 방향이다
word2vec의 평행사변형은 LLM 해석 연구로 이어졌다. 2024년 Park, Choe, Veitch는 LLM 내부에서 ‘남성→여성’, ‘영어→프랑스어’ 같은 개념이 특정 방향으로 표현된다는 선형 표현 가설을 형식화했다. 같은 아이디어로 모델의 중간 층에 특정 방향의 벡터를 더해 말투나 주제를 바꾸는 스티어링 벡터 기법이 연구되고 있다. LLM 내부의 수많은 특징(feature)을 방향으로 찾아내는 희소 오토인코더 연구도 같은 직관 위에 서 있다. 2013년의 king − man + woman이 2026년에는 ‘모델의 생각을 읽고 고치는 법’의 출발점이 됐다.
9.4 지금도 word2vec이 쓸모 있는 때
거대한 모델이 있는데 굳이 word2vec을 쓸 이유가 있을까? 다음 경우에는 여전히 좋은 선택이다.
상황
word2vec류가 맞는 이유
주의할 점
상품·콘텐츠 추천(클릭·구매 순서)
순서 데이터만 있으면 학습. 수백만 개 아이템도 CPU 몇 분
새 아이템은 벡터가 없다(콜드 스타트)
사내 전문 용어 사전 확장
우리 문서에서 ‘같은 자리에 쓰이는 말’을 찾아 동의어 후보로
좁은 창을 쓰고 사람이 검수
말뭉치의 시대·집단별 비교
시기별로 따로 학습해 이웃 변화를 추적(Hamilton 2016 방식)
벡터 공간을 정렬해야 비교 가능
아주 작은 장비·오프라인
벡터 표 하나와 내적만 있으면 된다
문맥에 따른 뜻 차이는 못 잡는다
문장·문서 검색
권하지 않는다 — 문장 임베딩 모델이 훨씬 낫다
단어 벡터 평균은 어순과 부정을 놓친다
9.5 연표로 다시 보기
마치며
퍼스의 문장 하나가 숫자가 되기까지 56년이 걸렸다. 그 뒤 13년 동안 그 숫자는 검색, 추천, 번역을 거쳐 LLM의 첫 층이 됐다.
뜻은 이웃에서 나온다. 사전을 만들지 않아도, 글을 많이 읽고 어떤 단어가 어떤 이웃과 쓰이는지만 보면 단어 사이의 관계를 얻는다. 처음 보는 ‘테즈귀노’의 뜻을 우리가 알아내는 방식과 같다.
word2vec의 혁신은 단순함과 속도였다. 숨은 층을 빼고, 어휘 전체 대신 가짜 이웃 몇 개만 비교했다. 그래서 16억 단어를 하루에 읽었다. 나중에 보니 그것은 세는 방법(PMI 행렬)을 맞히는 방법으로 압축한 것이었다.
벡터 산술은 진짜지만 과장됐다. 관계는 방향으로 존재한다. 하지만 입력 단어를 빼는 규칙 없이 계산하면 king − man + woman의 1등은 king이다. 우리 실측에서도, 최신 LLM의 임베딩 표에서도 그랬다.
데이터의 습관을 그대로 배운다. 고정관념도, 위키백과가 ‘Doctor’라는 드라마를 길게 다룬다는 사실도 함께 배운다. 임베딩을 쓸 때는 어떤 말뭉치에서 왔는지를 먼저 물어야 한다.
단어 하나에 점 하나의 한계는 문맥 임베딩이 풀었다. 그래도 LLM은 여전히 word2vec 모양의 표에서 출발해, 몇 층을 지나며 ‘배’를 배와 배와 배로 나눈다.
다음에 AI가 내 질문의 뜻을 ‘알아들었다’고 느낄 때, 그 아래에서 일어나는 일을 떠올려 보자. 모델은 내 단어들이 지금까지 어떤 이웃과 함께 쓰여 왔는지를 기억하고 있다.
Wittgenstein, L. (1953). Philosophical Investigations. Blackwell. §43.
Harris, Z. S. (1954). Distributional Structure. Word, 10(2–3), 146–162.
Firth, J. R. (1957). A synopsis of linguistic theory, 1930–1955. In Studies in Linguistic Analysis, 1–32. Blackwell.
Osgood, C. E., Suci, G. J., & Tannenbaum, P. H. (1957). The Measurement of Meaning. University of Illinois Press.
Nida, E. A. (1975). Componential Analysis of Meaning. Mouton. · Lin, D. (1998). Automatic Retrieval and Clustering of Similar Words. COLING-ACL 1998. (‘tezgüino’ 예)
Miller, G. A. (1995). WordNet: A Lexical Database for English. Communications of the ACM, 38(11).
Deerwester, S., Dumais, S. T., Furnas, G. W., Landauer, T. K., & Harshman, R. (1990). Indexing by Latent Semantic Analysis. JASIS, 41(6), 391–407.
Church, K. W., & Hanks, P. (1990). Word Association Norms, Mutual Information, and Lexicography. Computational Linguistics, 16(1).
Bengio, Y., Ducharme, R., Vincent, P., & Jauvin, C. (2003). A Neural Probabilistic Language Model. JMLR, 3, 1137–1155.
Collobert, R., & Weston, J. (2008). A Unified Architecture for Natural Language Processing. ICML 2008. · Collobert, R. et al. (2011). Natural Language Processing (Almost) from Scratch. JMLR, 12.
Mikolov, T., Chen, K., Corrado, G., & Dean, J. (2013a). Efficient Estimation of Word Representations in Vector Space. arXiv:1301.3781
Mikolov, T., Sutskever, I., Chen, K., Corrado, G., & Dean, J. (2013b). Distributed Representations of Words and Phrases and their Compositionality. NIPS 2013. arXiv:1310.4546 (NeurIPS 2023 Test of Time Award)
Mikolov, T., Yih, W., & Zweig, G. (2013c). Linguistic Regularities in Continuous Space Word Representations. NAACL-HLT 2013.
Pennington, J., Socher, R., & Manning, C. D. (2014). GloVe: Global Vectors for Word Representation. EMNLP 2014.
Levy, O., & Goldberg, Y. (2014). Neural Word Embedding as Implicit Matrix Factorization. NIPS 2014. · Levy, O., & Goldberg, Y. (2014). Dependency-Based Word Embeddings. ACL 2014.
Levy, O., Goldberg, Y., & Dagan, I. (2015). Improving Distributional Similarity with Lessons Learned from Word Embeddings. TACL, 3.
Bojanowski, P., Grave, E., Joulin, A., & Mikolov, T. (2017). Enriching Word Vectors with Subword Information. TACL, 5. arXiv:1607.04606
Park, S., Byun, J., Baek, S., Cho, Y., & Oh, A. (2018). Subword-level Word Vector Representations for Korean. ACL 2018.
Linzen, T. (2016). Issues in Evaluating Semantic Spaces Using Word Analogies. RepEval 2016.
Nissim, M., van Noord, R., & van der Goot, R. (2020). Fair Is Better than Sensational: Man Is to Doctor as Woman Is to Doctor. Computational Linguistics, 46(2).
Ethayarajh, K., Duvenaud, D., & Hirst, G. (2019). Towards Understanding Linear Word Analogies. ACL 2019. · Allen, C., & Hospedales, T. (2019). Analogies Explained: Towards Understanding Word Embeddings. ICML 2019.
Bolukbasi, T., Chang, K.-W., Zou, J., Saligrama, V., & Kalai, A. (2016). Man is to Computer Programmer as Woman is to Homemaker? Debiasing Word Embeddings. NIPS 2016.
Caliskan, A., Bryson, J. J., & Narayanan, A. (2017). Semantics Derived Automatically from Language Corpora Contain Human-like Biases. Science, 356(6334).
Garg, N., Schiebinger, L., Jurafsky, D., & Zou, J. (2018). Word Embeddings Quantify 100 Years of Gender and Ethnic Stereotypes. PNAS, 115(16).
Gonen, H., & Goldberg, Y. (2019). Lipstick on a Pig: Debiasing Methods Cover up Systematic Gender Biases in Word Embeddings But do not Remove Them. NAACL 2019.
Hamilton, W. L., Leskovec, J., & Jurafsky, D. (2016). Diachronic Word Embeddings Reveal Statistical Laws of Semantic Change. ACL 2016.
Perozzi, B., Al-Rfou, R., & Skiena, S. (2014). DeepWalk: Online Learning of Social Representations. KDD 2014. · Grover, A., & Leskovec, J. (2016). node2vec. KDD 2016.
Grbovic, M. et al. (2015). E-commerce in Your Inbox: Product Recommendations at Scale. KDD 2015.
Asgari, E., & Mofrad, M. R. K. (2015). Continuous Distributed Representation of Biological Sequences for Deep Proteomics and Genomics. PLoS ONE, 10(11).
Grbovic, M., & Cheng, H. (2018). Real-time Personalization using Embeddings for Search Ranking at Airbnb. KDD 2018.
Tshitoyan, V. et al. (2019). Unsupervised Word Embeddings Capture Latent Knowledge from Materials Science Literature. Nature, 571, 95–98.
Peters, M. E. et al. (2018). Deep Contextualized Word Representations (ELMo). NAACL 2018.
Devlin, J. et al. (2019). BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding. NAACL 2019.
Park, K., Choe, Y. J., & Veitch, V. (2024). The Linear Representation Hypothesis and the Geometry of Large Language Models. ICML 2024. arXiv:2311.03658
Mahoney, M. (2006). text8 — 영어 위키백과 2006년 덤프 앞부분 1억 글자. mattmahoney.net/dc/textdata
Lee, M. (bab2min). Kiwi: 지능형 한국어 형태소 분석기. github.com/bab2min/Kiwi