판결문의 이름을 지우는 AI — Thunder-DeID로 읽는 비실명화의 역사, 729개의 꼬리표, 그리고 2026년
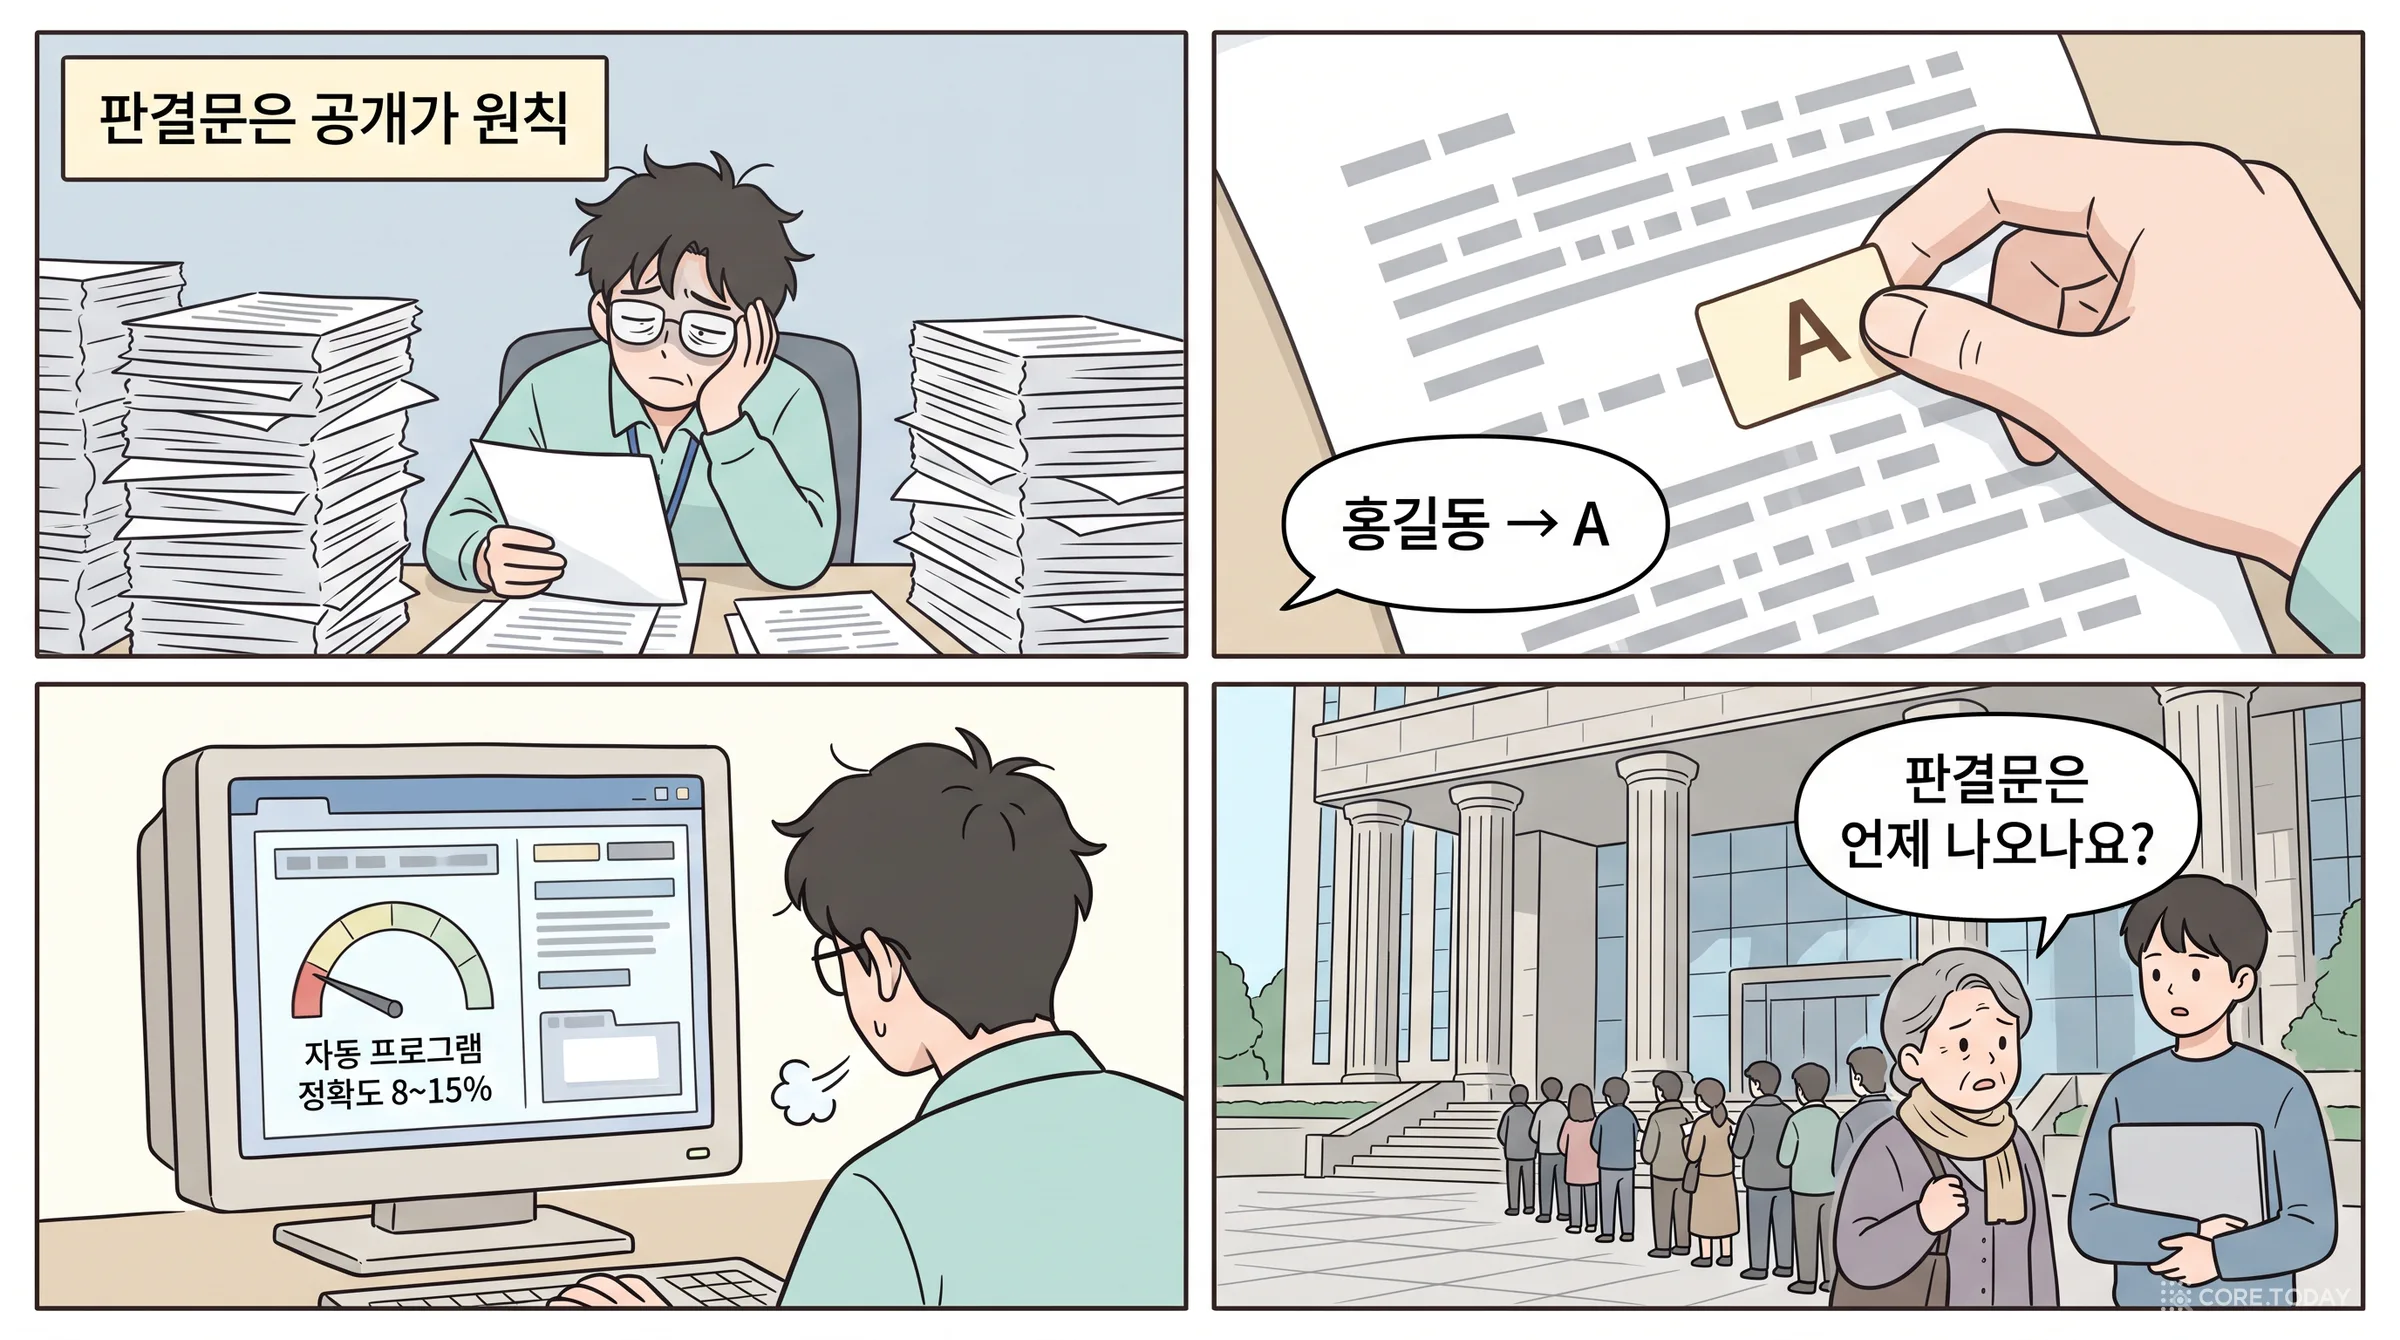
한국의 판결문은 공개가 원칙이지만, 공개 전에 사람 이름과 주소, 가게 이름까지 지워야 합니다. 이 일은 지금도 대부분 사람 손으로 이뤄지고, 법원의 자동 프로그램은 2019년 자료에서 정확도 15%, 2025년 자료에서 처리율 8%로 보고됐습니다. 서울대 연구진의 Thunder-DeID(EMNLP 2025 Findings)는 이 문제를 토큰 분류 모델로 풉니다. 원본 판결문을 구할 수 없다는 제약을 뒤집어, 이미 지워진 판결문 6,700건에 사람이 종류 꼬리표 48,306개를 붙이고 그 자리에 진짜 같은 이름을 채워 넣어 학습 데이터를 만들었습니다. 그 과정에서 나온 2단·16갈래·80가지·729개 라벨의 분류 체계, 조사를 떼어 내는 토크나이저, 에폭마다 이름을 갈아 끼우는 증강, 처음부터 사전학습한 DeBERTa 계열 모델(이진 F1 0.98, 종류 F1 0.91)을 그림과 표와 함께 하나씩 풉니다. 스위니의 87%에서 2026년 9월 법원 홈페이지 사고까지 재식별의 역사를 따라가고, 코어닷투데이가 로컬 모델로 직접 돌려 본 ‘다시 쓰게 하기’와 ‘가리킬 곳만 말하게 하기’의 차이, 논문이 말하지 않는 한계, 형사 판결문 공개 확대를 앞둔 2026년에 이 기술이 놓인 자리를 정리했습니다.
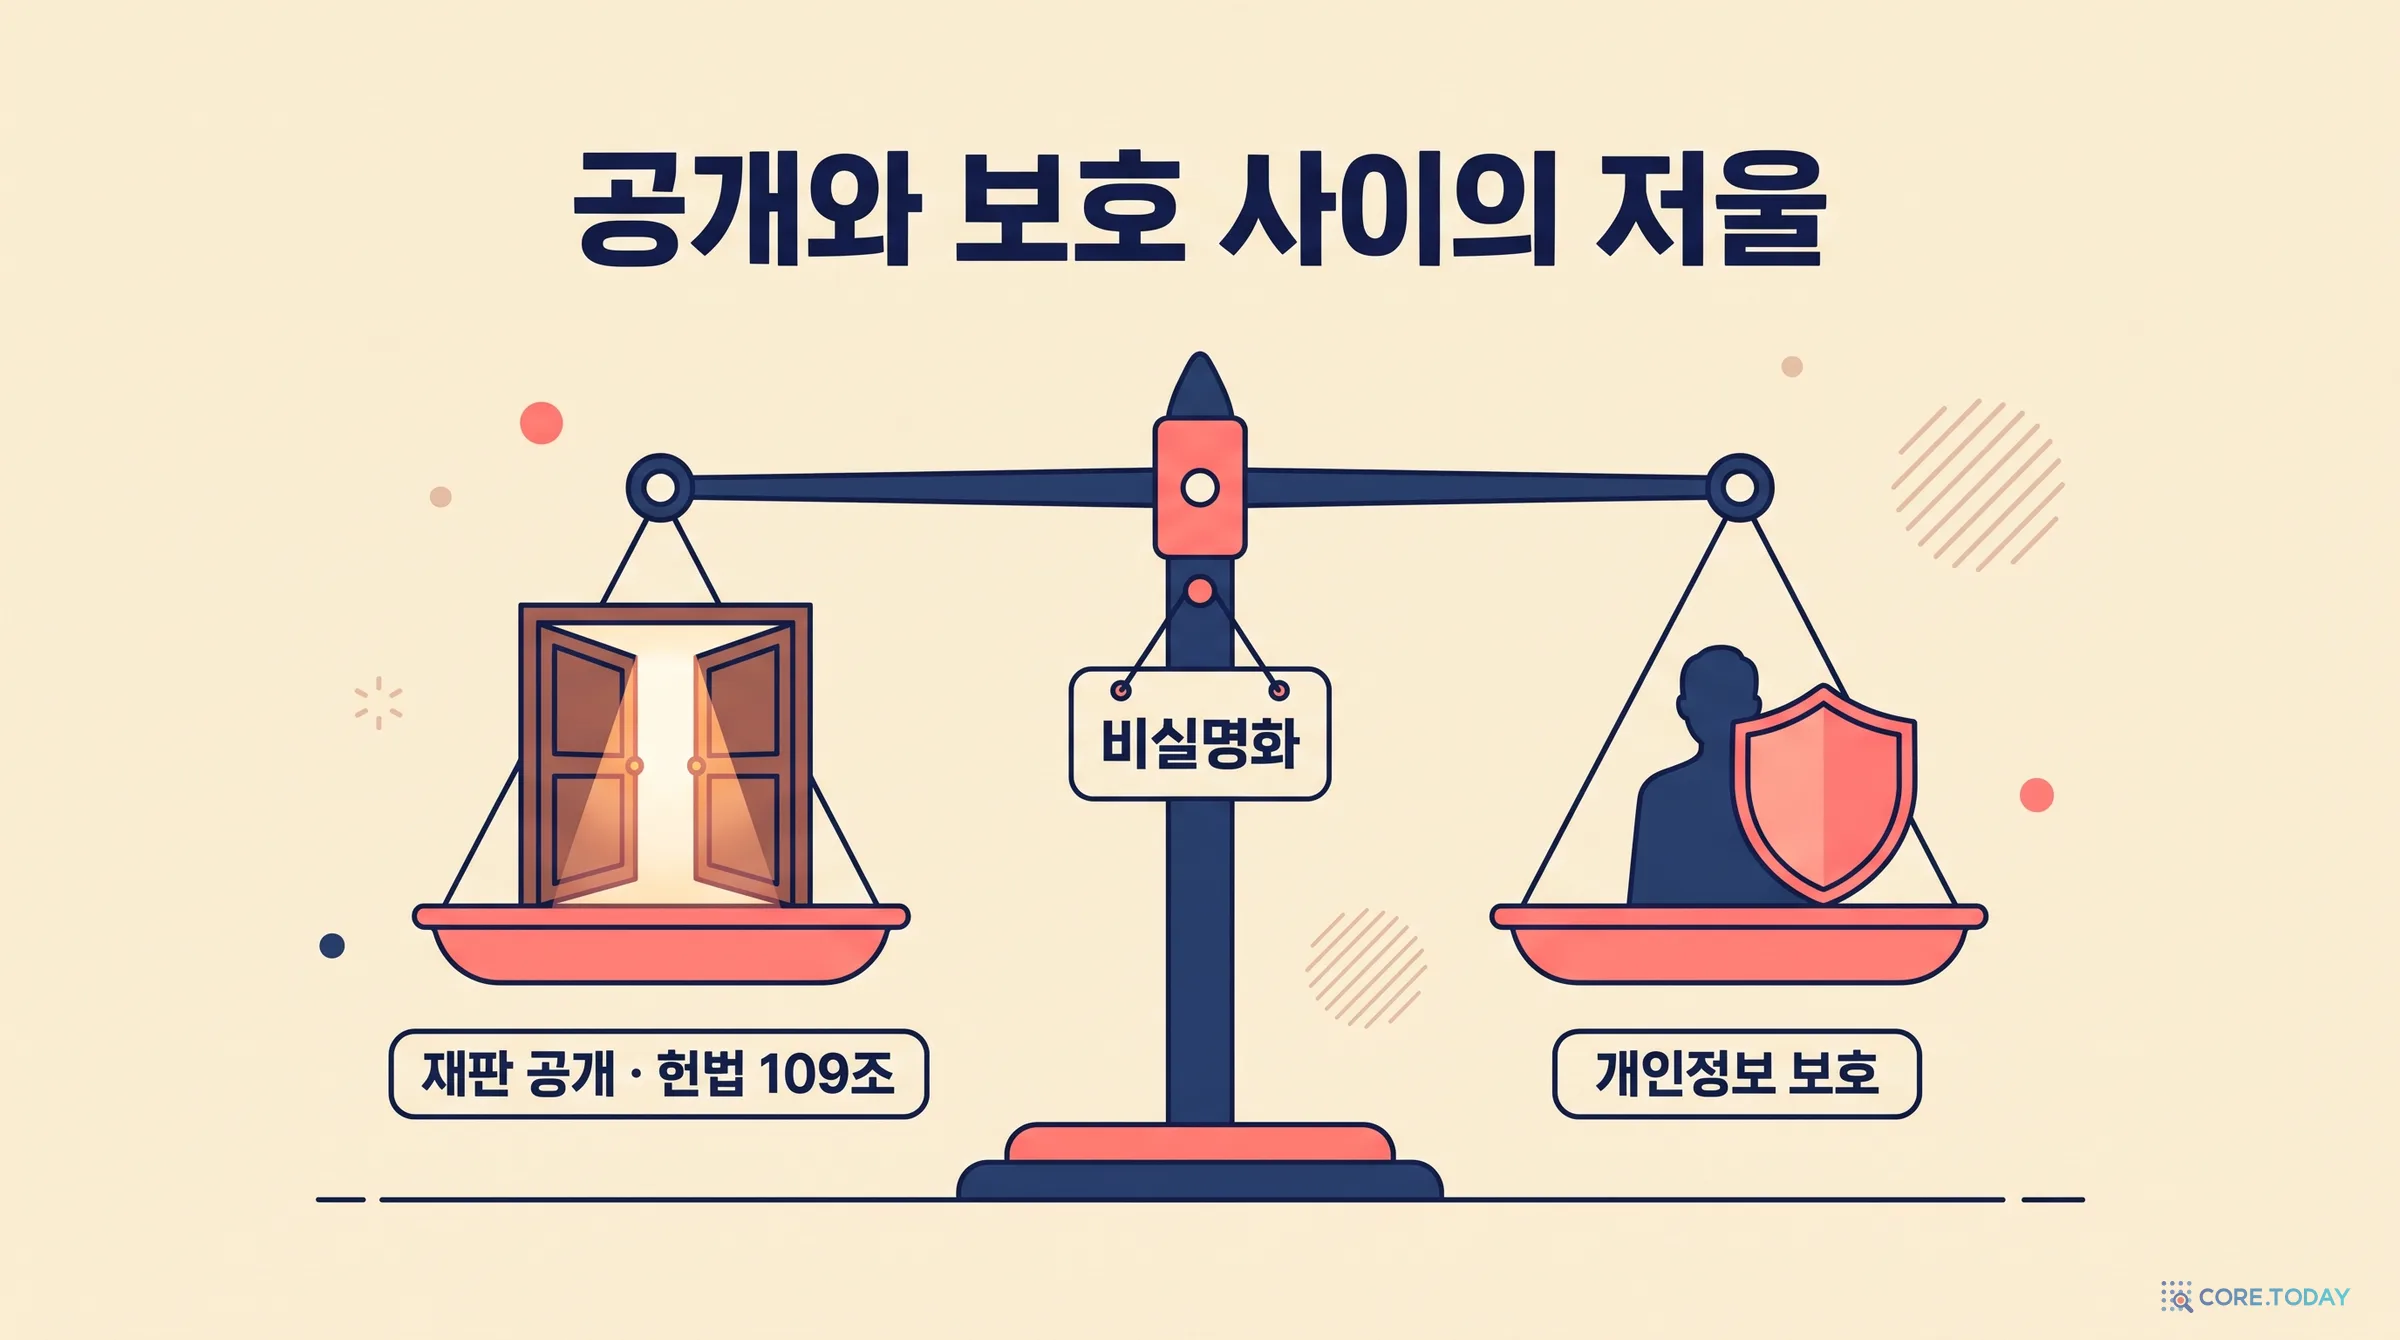
대한민국 헌법 109조는 "재판의 심리와 판결은 공개한다"고 적습니다. 법정 문이 열려 있어야 한다는 뜻이고, 그 결과물인 판결문도 누구나 읽을 수 있어야 한다는 뜻으로 이어집니다. 판결문은 법이 실제로 어떻게 적용되는지를 보여 주는 거의 유일한 기록입니다. 변호사는 비슷한 사건의 결론을 찾고, 연구자는 양형의 경향을 분석하고, 리걸테크 회사는 검색 엔진과 AI 모델을 만듭니다. 판결문이 없으면 이 일들이 모두 멈춥니다.
그런데 한국에서 판결문을 구하기는 쉽지 않았습니다. 법률신문 보도에 따르면 2019년 국회 토론회에서 공개된 수치로, 법원이 누구나 무료로 볼 수 있게 종합법률정보에 올린 판결은 대법원 판결의 3.2%, 각급 법원 판결의 0.003%였습니다. 건당 1,000원을 내고 보는 인터넷 열람 서비스에 등록된 비율은 2019~2022년 기준 45% 안팎이지만(2022년 834,799건 가운데 418,288건), 이쪽은 사건번호나 검색어를 알아야 하고 한 번에 다섯 건까지만 결제할 수 있습니다. 두 숫자는 분모와 서비스가 달라 직접 비교할 수 없지만, "원칙은 공개, 현실은 좁은 문"이라는 사정은 같습니다.
문이 좁은 이유 가운데 하나가 이 글의 주제입니다. 판결문에는 사람이 있습니다. 피고인, 피해자, 증인의 이름과 주민등록번호, 집 주소, 다니는 회사, 범행 장소인 가게 이름이 그대로 적혀 있습니다. 이것을 그대로 공개하면 재판 공개라는 원칙이 사생활 침해로 이어집니다. 그래서 법원은 공개 전에 이 정보를 지웁니다. 이 작업을 비실명화(비식별화, de-identification)라고 부릅니다.
문제는 이 작업의 대부분이 사람 손으로 이뤄진다는 점입니다. 2017년 법원도서관 조사심의관의 글에 따르면, 열람용 판결문은 법원행정처 산하 사업소에서 외주 인력이 처리 기준에 따라 이름과 주소를 A, B, C 같은 알파벳으로 바꿉니다. 2015회계연도에 이 일에 들어간 예산은 42억 원이었습니다. 자동 프로그램도 있지만 성적이 좋지 않습니다. 2019년 국회 토론회 자료에는 법원 자동 비식별 시스템의 정확도가 15%로, 2025년 법원행정처의 재판지원 AI 정보화전략계획(ISP) 보고서에는 처리율이 8%로 적혀 있습니다. 두 수치는 측정한 것이 다르지만(정확도와 처리율), 어느 쪽이든 사람이 거의 전부를 다시 봐야 한다는 뜻입니다.
2025년 6월, 서울대학교 데이터사이언스대학원과 컴퓨터공학부 연구진(Sungeun Hahm, Heejin Kim, Gyuseong Lee, Hyunji M. Park, 이재진 교수)이 이 문제를 정면으로 다룬 논문을 arXiv에 올렸습니다. 제목은 「Thunder-DeID: 한국 법원 판결문을 위한 정확하고 효율적인 비식별화 프레임워크」이고, 같은 해 EMNLP 2025 Findings에 실렸습니다. 이 글은 그 논문을 처음부터 끝까지 읽으며, 비실명화라는 문제가 어디서 왔고 왜 어려우며 2026년 지금 어디에 와 있는지를 풉니다.
?
문제
판결문은 공개 전에 사람을 특정할 수 있는 정보를 지워야 한다. 지금은 사람이 하고, 느리고, 자동 프로그램은 대부분 놓친다. 무엇을 지워야 하는지의 기준도 "그 밖에 특정할 수 있는 정보"처럼 열려 있다.
⚡
Thunder-DeID의 해법
문장을 다시 쓰지 않고 토큰마다 꼬리표를 붙이는 모델을 만든다. 원본 판결문이 없으므로, 이미 지워진 판결문 6,700건에 종류 꼬리표를 붙이고 그 자리에 진짜 같은 값을 채워 학습 데이터를 만든다.
✓
결과
가릴지 여부를 맞히는 이진 F1 0.98, 729가지 종류까지 맞히는 F1 0.91. 한국 판결문에 맞춘 첫 공개 데이터셋과 3단 분류 체계가 함께 나왔다.
읽는 순서는 이렇습니다. 1~2장에서 왜 지워야 하고 왜 이름만 지워서는 안 되는지를 재식별 사건의 역사로 봅니다. 3~4장에서 이 일을 기계에 맡기려던 시도와, "그냥 LLM에게 시키면 되지 않나"라는 질문을 다룹니다. 5~10장이 논문 본문입니다. 데이터, 분류 체계, 토크나이저, 증강, 모델, 결과를 차례로 봅니다. 11장은 한계와 반론, 12장은 2026년의 자리, 13장은 실무 점검표입니다.
재판 공개와 사생활 보호를 어떻게 저울질할지는 나라마다 다릅니다. 미국 연방법원의 전자기록 시스템 PACER는 쪽당 10센트(문서당 상한 3달러)를 받고 기록을 그대로 보여 줍니다. 당사자 이름은 원칙적으로 실명입니다. 사건 이름 자체가 "브라운 대 교육위원회"처럼 사람 이름인 나라입니다. 반대편에는 대륙법계 나라들이 있습니다. 프랑스는 2016년 디지털공화국법으로 모든 판결의 무료 공개를 정하면서 사생활 보호를 조건으로 달았고, 파기원(최고법원)이 직접 가명 처리 시스템을 만들어 운영합니다. 네덜란드는 선별한 판결을 모두 익명화해 공개합니다.
한국은 그중에서도 지우는 범위가 넓은 편입니다. 논문은 서론에서 한국을 "법정에서 익명화할 개인 식별자의 범위가 더 넓고 조건이 엄격한 나라 가운데 하나"라고 적습니다. 근거 법령은 형사소송법 59조의3과 민사소송법 163조의2이고, 구체적인 방법은 대법원 규칙과 재판예규(「판결서 등의 열람 및 복사를 위한 비실명 처리 기준」)가 정합니다. 논문이 인용하는 예규의 뼈대는 이렇습니다.
대상
처리 방법
예시
사람 이름
알파벳 대문자로 바꾼다. 사람이 많으면 AA, AB처럼 글자를 조합한다.
피고인 홍길동 → 피고인 A
주민등록번호 등 번호
번호를 지우고 종류와 순번을 적는다.
(561231-1234567) → (주민등록번호 1 생략)
주소
상위 행정구역은 남기고 하위 주소(동, 번지 등)를 가린다.
서울 관악구 봉천동 → 서울 관악구 B
상호·장소 이름
고유한 부분만 바꾸고 '식당', '은행' 같은 일반 명사는 남긴다.
나리식당 → A식당
그 밖에 사건관계인이나 제3자를 특정할 수 있는 정보
담당자가 문맥을 보고 판단한다.
근무한 교도소 이름, 사건이 난 날짜 등
마지막 줄이 문제의 핵심입니다. 앞의 네 줄은 규칙으로 쓸 수 있지만, "그 밖에 특정할 수 있는 정보"는 목록으로 적을 수 없습니다. 예규도 이것을 담당자의 재량과 문맥 판단에 맡깁니다. 사람에게는 통하는 지시지만 프로그램에게는 지시가 아닙니다. 논문이 "법적 정의와 분류가 모호해서 기술적 해법에 맞지 않는다"고 쓴 대목이 이것입니다.
한국 제도의 걸음
판결문 공개는 조금씩 넓어져 왔습니다.
2013형사 확정 판결문 인터넷 열람 시작(2013년 1월 1일 이후 확정분).
2015민사·행정·특허 확정 판결문으로 확대(2015년 1월 1일 이후 확정분). 건당 수수료 1,000원.
2019통합 열람 사이트에서 임의어(자유 검색어) 검색 도입. 같은 해 국회 토론회에서 공개율과 자동 비식별 정확도 15%가 논의됨.
20232023년 1월 1일 이후 선고된 민사·행정·특허 사건은 확정 전 판결문도 열람 가능.
202512월 12일, 확정 전 하급심 형사 판결문의 열람·복사와 문자열 검색을 허용하는 형사소송법 개정안 국회 통과. 시행은 공포 2년 뒤(보도 기준 2027년 12월).
2026재판지원 AI 플랫폼 시범 운영, 지능형 판결문 검색 추진 발표. 9월에는 법원 홈페이지에 올린 판결문의 비식별 처리가 풀리는 사고가 알려짐(2장).
걸음마다 같은 병목이 따라옵니다. 공개 대상이 늘면 지워야 할 판결문도 그만큼 늘어납니다. 2025년 사법부 인공지능위원회가 판결문 공개와 활용에 관한 건의문에서 비식별 처리 비용을 주요 장애로 꼽은 까닭입니다.
2장. 이름만 지우면 안 되는 이유: 재식별의 역사
"이름하고 주민등록번호만 지우면 되지 않나요?" 비실명화 이야기를 처음 듣는 사람이 가장 먼저 하는 질문입니다. 지난 30년의 역사는 이 질문에 일관되게 아니라고 답해 왔습니다.
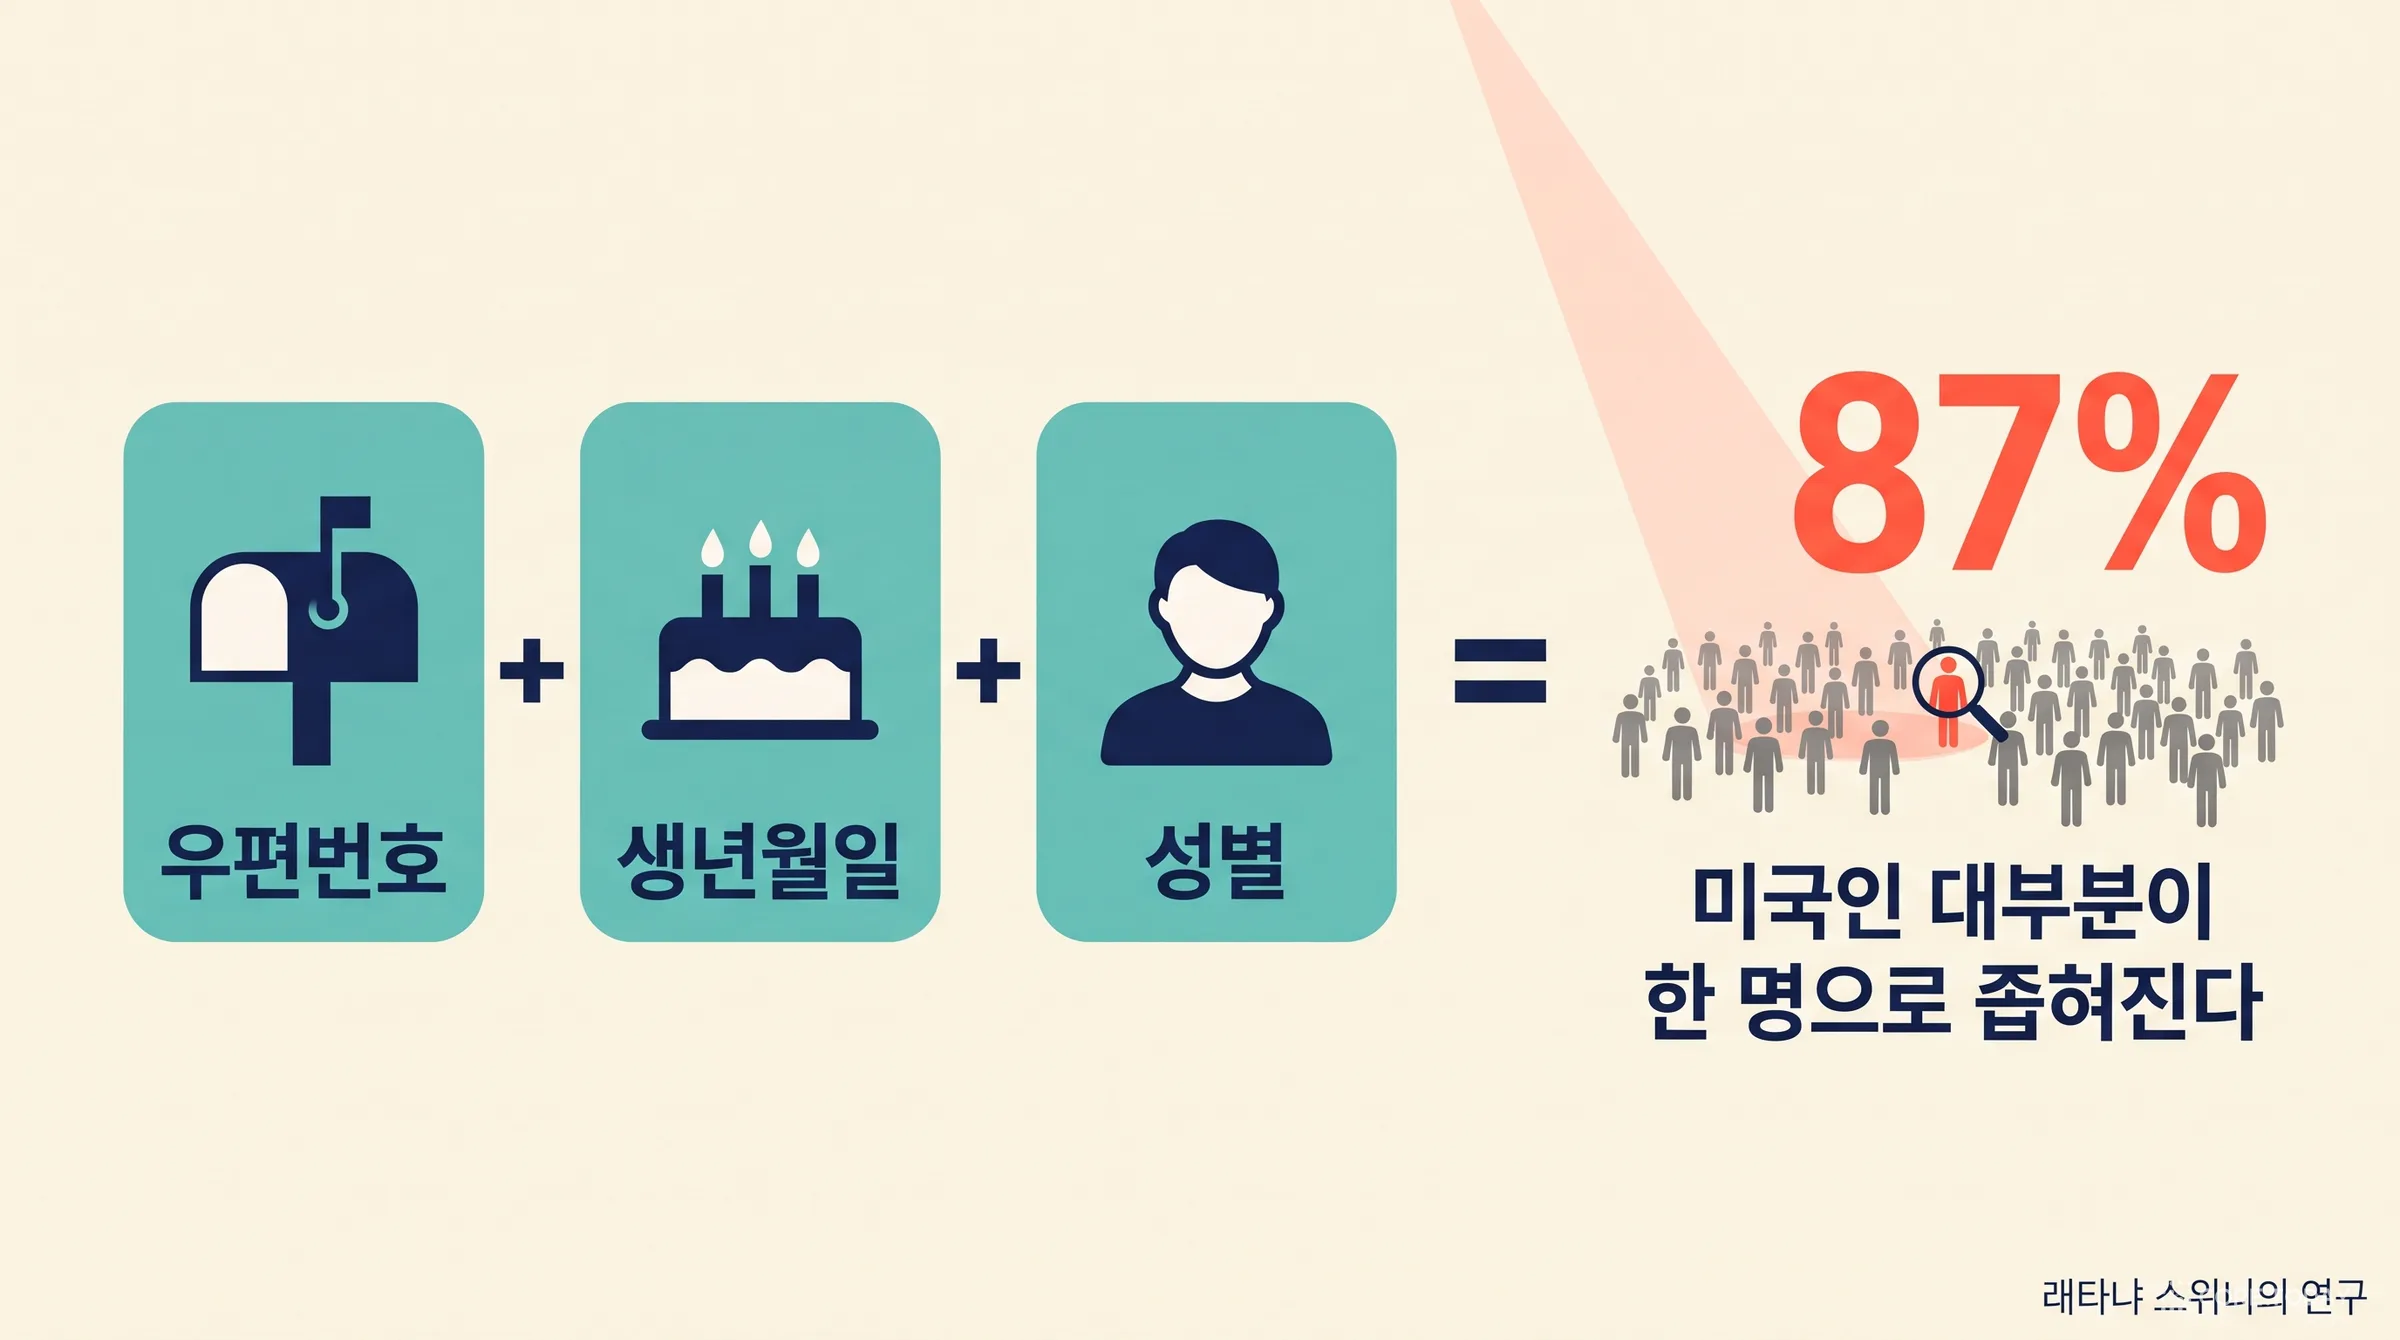
1990년대 중반 미국 매사추세츠주는 주 공무원 13만 5천 명의 병원 진료 자료를 연구용으로 공개했습니다. 이름, 주소, 사회보장번호는 지웠습니다. 당시 MIT 대학원생이던 래타냐 스위니는 20달러를 내고 케임브리지시의 유권자 명부를 샀습니다. 명부에는 이름과 함께 우편번호, 생년월일, 성별이 있었고, 진료 자료에도 같은 세 가지가 남아 있었습니다. 주지사 윌리엄 웰드는 케임브리지에 살았습니다. 그와 생년월일이 같은 유권자는 여섯 명, 그중 남성은 셋, 같은 우편번호에 사는 사람은 주지사 한 명이었습니다. 스위니는 주지사의 진료 기록을 찾아 그의 사무실로 보냈습니다.
스위니는 2000년 보고서에서 이 문제를 일반화했습니다. 1990년 인구조사 자료로 계산해 보니 미국 인구 2억 4,800만 명 가운데 87%(2억 1,600만 명)가 5자리 우편번호, 성별, 생년월일 세 가지만으로 유일하게 특정된다는 것입니다. 이 수치는 상한에 가까운 추정이라는 비판도 있지만, 메시지는 분명했습니다. 하나씩 보면 평범한 정보가 겹치면 지문이 됩니다.
여기서 두 가지 용어가 나옵니다.
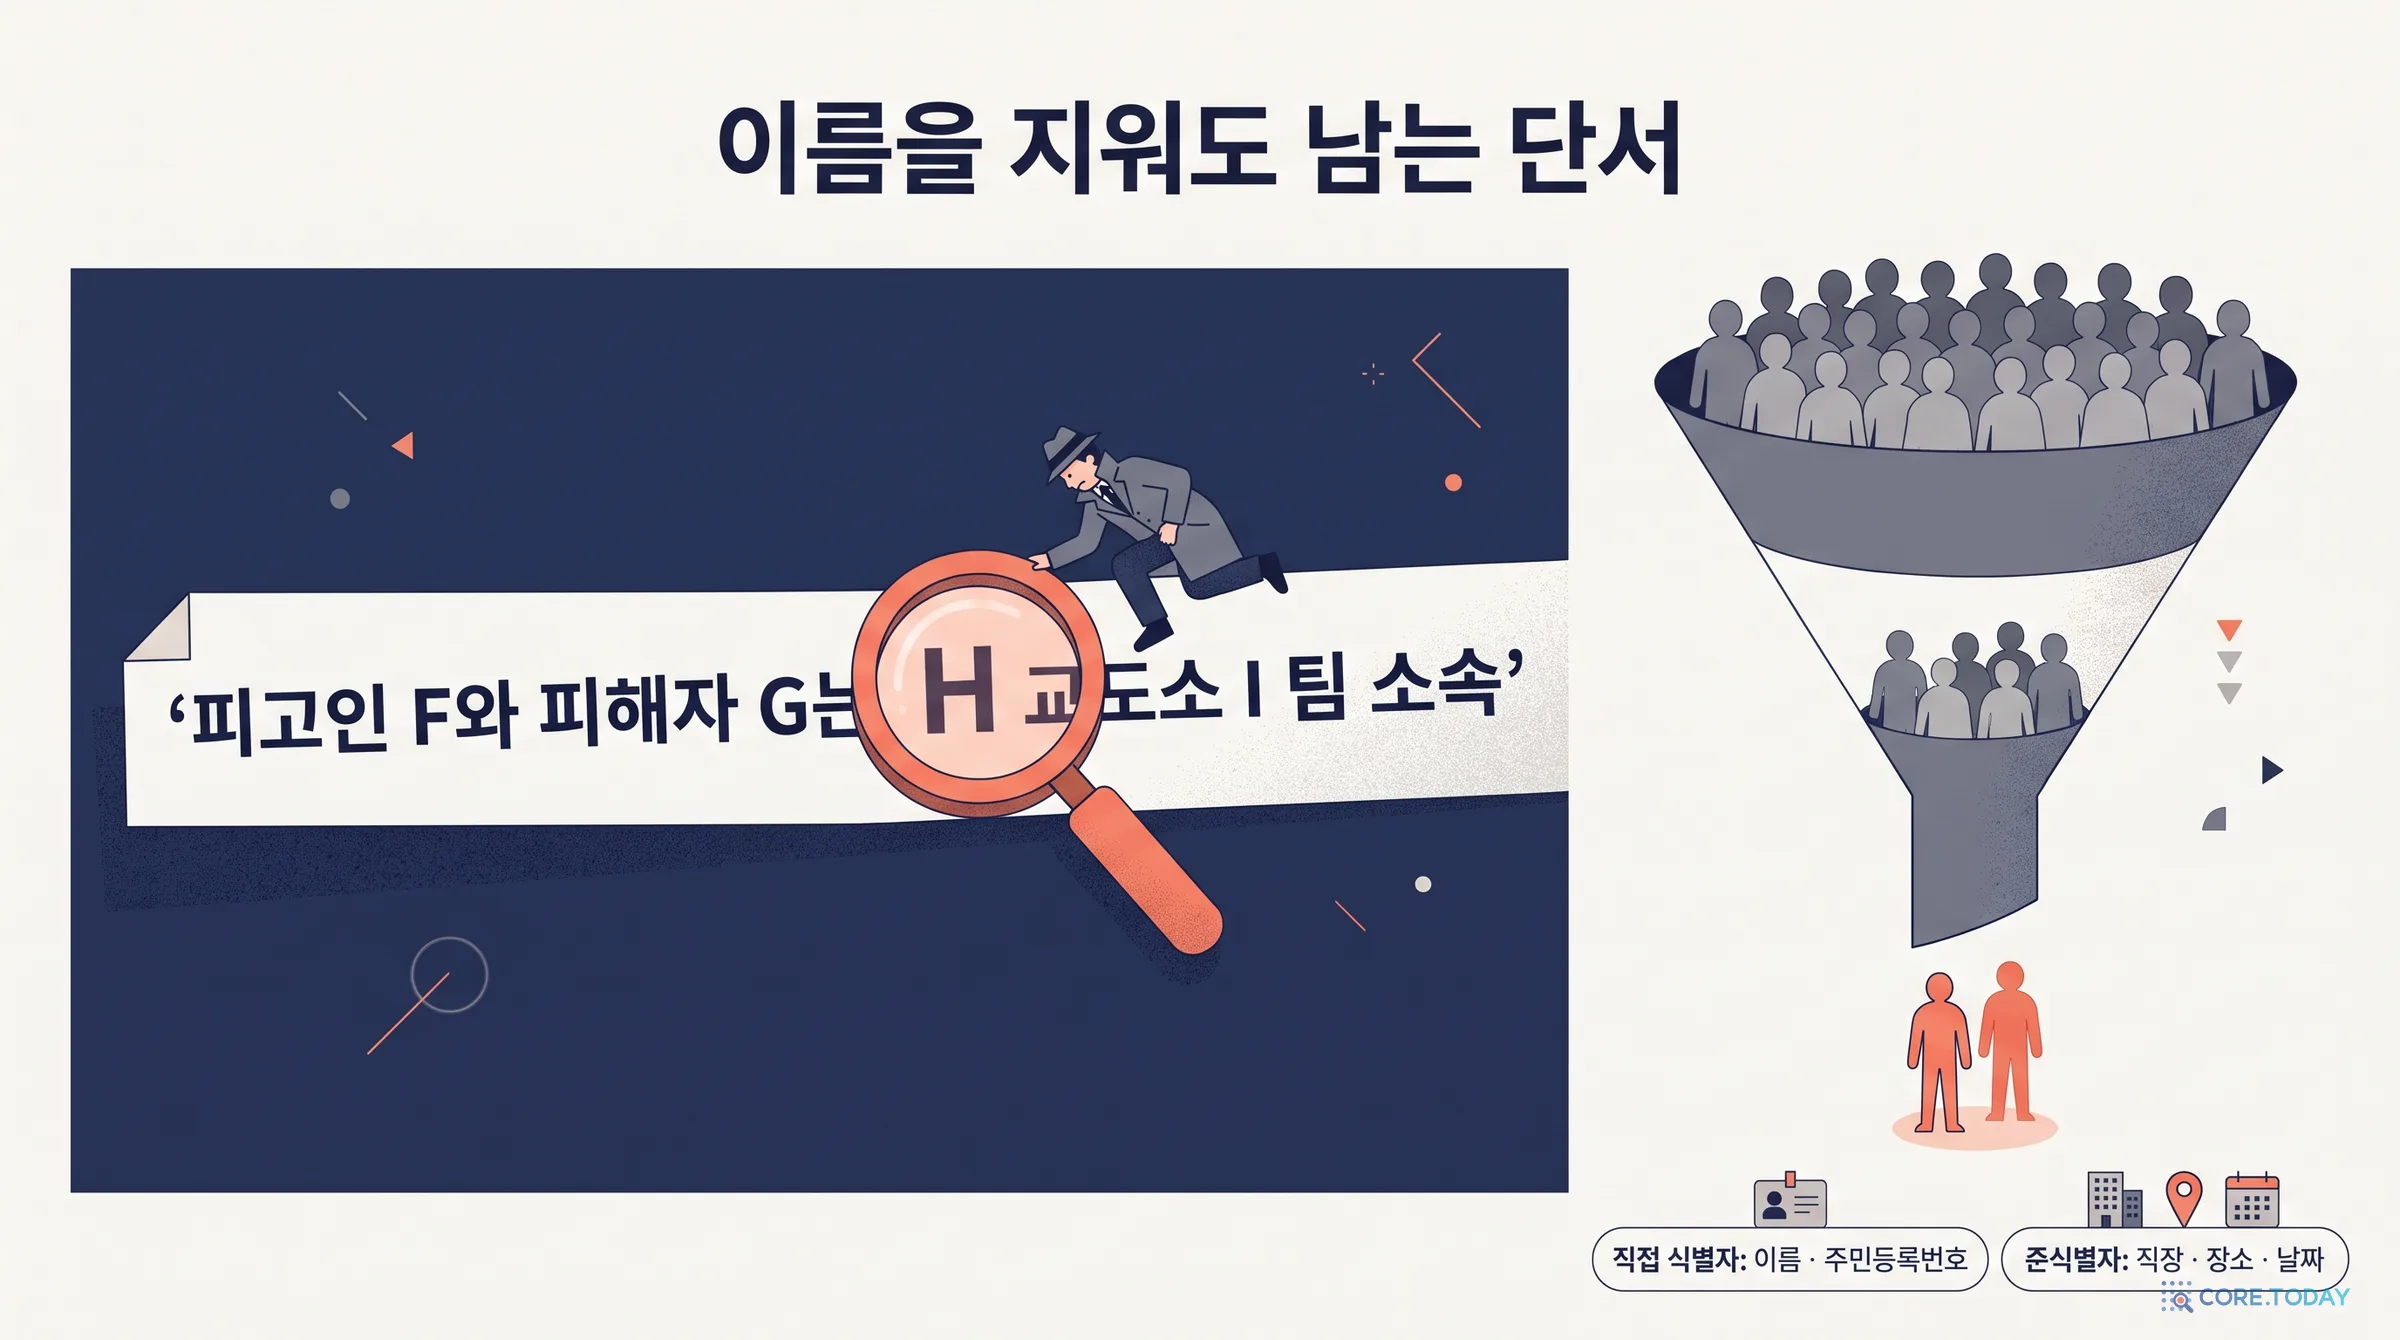
직접 식별자(direct identifier): 그것 하나만으로 사람을 가리키는 정보. 이름, 주민등록번호, 이메일 주소.
준식별자(quasi-identifier): 하나로는 사람을 가리키지 못하지만 다른 정보와 결합하면 가리키게 되는 정보. 우편번호, 생년월일, 성별, 직장, 장소, 날짜.
2006~2014년, 같은 일의 반복
같은 종류의 사고가 그 뒤로 이어졌습니다.
연도
공개된 자료
지운 것
무엇으로 다시 찾았나
2006
AOL 검색 기록 2,000만 건(약 65만 명)
이용자 이름을 번호로 교체
뉴욕타임스가 검색어만으로 4417749번 이용자를 조지아주 릴번의 62세 셀마 아널드로 특정
2006~2008
넷플릭스 프라이즈 평점 자료(가입자 약 50만 명)
가입자 정보
나라야난과 슈마티코프가 공개된 IMDb 평점과 대조해 가입자를 재식별(IEEE S&P 2008)
2014
뉴욕시 택시 운행 기록 1억 7,300만 건
면허·차량 번호를 해시로 변환
번호 형식이 정해져 있어 해시를 통째로 역산
AOL 자료에는 이름이 없었습니다. 있었던 것은 "릴번의 조경업자", 자기 성씨와 같은 사람들 검색 같은 문장들이었습니다. 문장은 준식별자의 덩어리입니다. 판결문은 문장으로만 이뤄져 있습니다.
판결문에서 벌어진 일
판결문도 예외가 아닙니다. 스위스에서는 2019년 포킹어와 뮐레마터가 연방대법원 판결 12만여 건을 연방행정법원과 보건 당국의 공개 자료와 연결했습니다. 판결문에서 익명 처리된 제약회사 사건의 84%를 한 시간 안에 다시 찾아냈습니다. 판결문 안의 날짜, 약 이름, 절차 번호가 다른 공개 자료에도 있었기 때문입니다. 독일에서는 2023년 USENIX Security에 발표된 실험에서 법대생 54명이 익명화된 판결 50건의 당사자를 찾는 과제를 받았고, 어떤 익명화 방식도 안전하지 않았으며 이름을 머리글자로 바꾸는 방식이 특히 약했습니다.
한국에서도 2026년 9월에 사고가 알려졌습니다. 서울중앙지방법원이 홈페이지 '우리 법원 주요판결'에 올린 판결문에서 "인공지능을 활용하거나 특정한 편집 작업을 거치면" 비식별 처리가 풀린다는 사실이 확인됐습니다. 법원은 최근 10년 치 게시물을 전수 조사했고, 한 사건 판결문에서 소송관계인 20명의 이름과 소속, 학력이 게시 시점부터 노출돼 있었다고 공지했습니다. 이 사고는 무엇을 지울지가 아니라 어떻게 지웠는지(문서 위에 덧씌웠는지, 글자를 실제로 바꿨는지)의 문제였지만, 비실명화가 한 번의 실수로 되돌릴 수 없는 결과를 낳는 일이라는 점을 다시 보여 줬습니다.
원칙대로라면 국가기관의 이름은 지우지 않습니다. 서울경찰청이나 서울구치소는 공공기관이고, 그 이름이 누군가의 사생활은 아닙니다. 그런데 이 문장에서 교도소 이름이 공개되면 사정이 달라집니다. 그 교도소의 그 팀에서 같은 시기에 근무한 두 사람이라는 조건을 만족하는 사람은 몇 명 되지 않습니다. 이름을 F와 G로 바꿨어도, 동료나 가족은 누구 이야기인지 바로 압니다. 그래서 실무에서는 이 교도소 이름을 가립니다. 같은 '교도소'라는 단어가 어떤 판결문에서는 가려지고 어떤 판결문에서는 남습니다. 무엇이 식별자인지는 단어가 아니라 문맥이 정합니다.
아래 위젯에서 직접 확인해 보세요. 이름은 이미 지워진 상태에서, 남은 단서를 하나씩 공개로 바꾸면 후보가 몇 명으로 줄어드는지 보여 줍니다.
논문은 이 밖에도 주석 작업에서 마주친 어려운 경우를 듭니다. 사기 사건에는 피해자가 수십 명이고 범죄 조직의 구성원마다 역할이 다릅니다. 공범 재판에서는 증인, 감정인, 포렌식 전문가 같은 제3자의 정보도 보복 위험 때문에 가려야 합니다. 범행 장소의 이름과 사건 날짜도 문맥에 따라 준식별자가 됩니다. 이 모든 것을 "그 밖에 특정할 수 있는 정보"라는 한 줄이 떠안고 있었습니다.
3장. 기계에게 맡기려는 시도: 병원에서 법원으로
비실명화를 자동화하려는 연구는 법원이 아니라 병원에서 먼저 시작됐습니다. 의무기록은 판결문과 닮았습니다. 자유롭게 쓴 문장이고, 사람에 관한 민감한 내용이며, 연구에 쓰려면 식별 정보를 지워야 합니다.
의료: 규칙에서 신경망까지
미국의 건강보험 이동성과 책임에 관한 법(HIPAA)은 의료 정보 비식별화의 두 가지 길을 정합니다. 하나는 세이프 하버(Safe Harbor)로, 이름·주소·날짜·전화번호 등 18가지 식별자를 지우면 비식별화된 것으로 봅니다. 다른 하나는 전문가 판단(Expert Determination)으로, 통계 전문가가 재식별 위험이 매우 낮다고 확인하는 방식입니다. 18가지 목록은 프로그램으로 만들기 좋은 명세였고, 이것이 자동화 연구의 출발점이 됐습니다.
2006i2b2 비식별화 대회. 퇴원 요약 889건으로 7개 팀이 겨뤘다. 사전과 정규식 규칙, 초기 통계 모델이 주류였다(Uzuner 외, 2007).
2014i2b2/UTHealth 대회. 환자 296명의 기록 1,304건. 최고 F1 0.964. 조건부 무작위장(CRF)에 손으로 만든 특징을 넣는 방식이 우세했다.
2016순환 신경망. Dernoncourt 외가 손으로 만든 특징 없이 양방향 LSTM만으로 i2b2 2014에서 F1 97.85를 기록했다. 이 논문이 쓴 '이진 토큰 단위 채점'을 Thunder-DeID도 그대로 쓴다.
2019~사전학습 인코더. BERT 계열 모델을 미세조정하는 방식이 표준이 됐다. 한국어 임상 기록에도 적용됐다.
2023~LLM 프롬프트. GPT-4에 "식별 정보를 지워 달라"고 지시하는 제로샷 방식이 시도됐다(DeID-GPT 등). 성능은 높게 보고됐지만 실제 병원 도입은 제한적이다. 환자 정보를 외부 API로 보내는 것 자체가 규제에 걸리기 때문이다.
이 흐름에서 개체명 인식(NER)이라는 틀이 굳어졌습니다. 문장을 토큰으로 자르고, 토큰마다 "이건 사람 이름", "이건 날짜", "이건 아무것도 아님(O)" 같은 꼬리표를 붙이는 문제로 바꾸는 것입니다. 코어닷투데이가 GLiNER2 해부에서 다룬 개체명 인식 30년사의 한 갈래가 바로 이 비식별화입니다.
법원: 나라마다 같은 고민
2020년 전후로 여러 나라 법원이 같은 방법을 판결문에 적용하기 시작했습니다. 논문이 관련 연구에서 정리한 사례에 조사한 내용을 더하면 이렇습니다.
나라
무엇을 했나
보고된 성능 (정밀도 / 재현율 / F1)
프랑스
파기원이 2018~2019년 규칙 기반 도구를 쓰다가(오류율 5% 가까이) 신경망 개체명 인식에 규칙을 더한 자체 시스템으로 교체. 사람 검수팀이 함께 일한다. 연 18만 건가량을 처리해 Judilibre로 공개.
공개 수치 확인 못 함
스위스
연방대법원이 익명화 보조 도구(Anom2)를 운영. 법률 문서로 사전학습한 모델이 F1을 5% 넘게 올림(Niklaus 외, 2023).
92.26 / 92.57 / 92.40 (독·프·이 3개 언어)
핀란드
통계 모델과 규칙을 결합한 ANOPPI. 사람이 결과를 고치는 것을 전제로 설계.
—
이탈리아
감사원 결정문용 법률 언어 모델 GiusBERTo(Salierno 외, 2024). 수작업이 공개를 늦춘다는 문제의식에서 출발.
85.00 / 92.46 / 88.60
우루과이
스페인어 판결문 익명화(Garat·Wonsever, 2022). 찾은 뒤 무엇으로 바꿀지(후처리)를 짧게나마 다룬 드문 연구.
89.92 / 90.50 / 91.90
인도
판결 물량이 압도적으로 많아 자동화가 필수(Kalamkar 외, 2022).
92.00 / 90.20 / 91.10
아랍어권
아랍어 판결문 익명화(Moussaoui 외, 2023).
96.43 / 95.86 / 96.14
표의 수치는 논문이 인용한 값을 그대로 옮겼습니다(우루과이 행처럼 F1이 정밀도와 재현율보다 높은 곳은 원 논문들의 채점 단위가 달라서로 보입니다). 언어도 데이터도 채점 방식도 달라 나라 사이의 순위로 읽으면 안 됩니다. 읽을 것은 두 가지입니다. 첫째, 모두 사람 검수를 전제로 한 보조 도구로 설계됐다는 점. 둘째, 대부분 "어떻게 찾을 것인가"에 집중했고 "찾은 것을 무엇으로 바꿀 것인가"는 거의 다루지 않았다는 점입니다. 논문은 이 둘째 지점을 자신의 차별점으로 삼습니다. 한국 예규는 이름은 A로, 계좌번호는 '계좌번호 1 생략'으로 바꾸라고 종류마다 다른 방법을 정하므로, 찾는 것만으로는 일이 끝나지 않고 무슨 종류인지까지 알아야 합니다. 과하게 지우거나 원칙 없이 지우면 판결문을 읽을 수 없게 된다는 사법정책연구원의 지적도 논문은 함께 인용합니다.
4장. 그냥 LLM에게 시키면 되지 않나
2026년에 이 문제를 처음 듣는 개발자라면 이렇게 생각할 것입니다. "프롬프트에 예규를 붙여 넣고 판결문을 주면 되잖아요." 논문은 서론과 부록 A에서 이 길을 택하지 않은 이유를 두 가지로 밝힙니다.
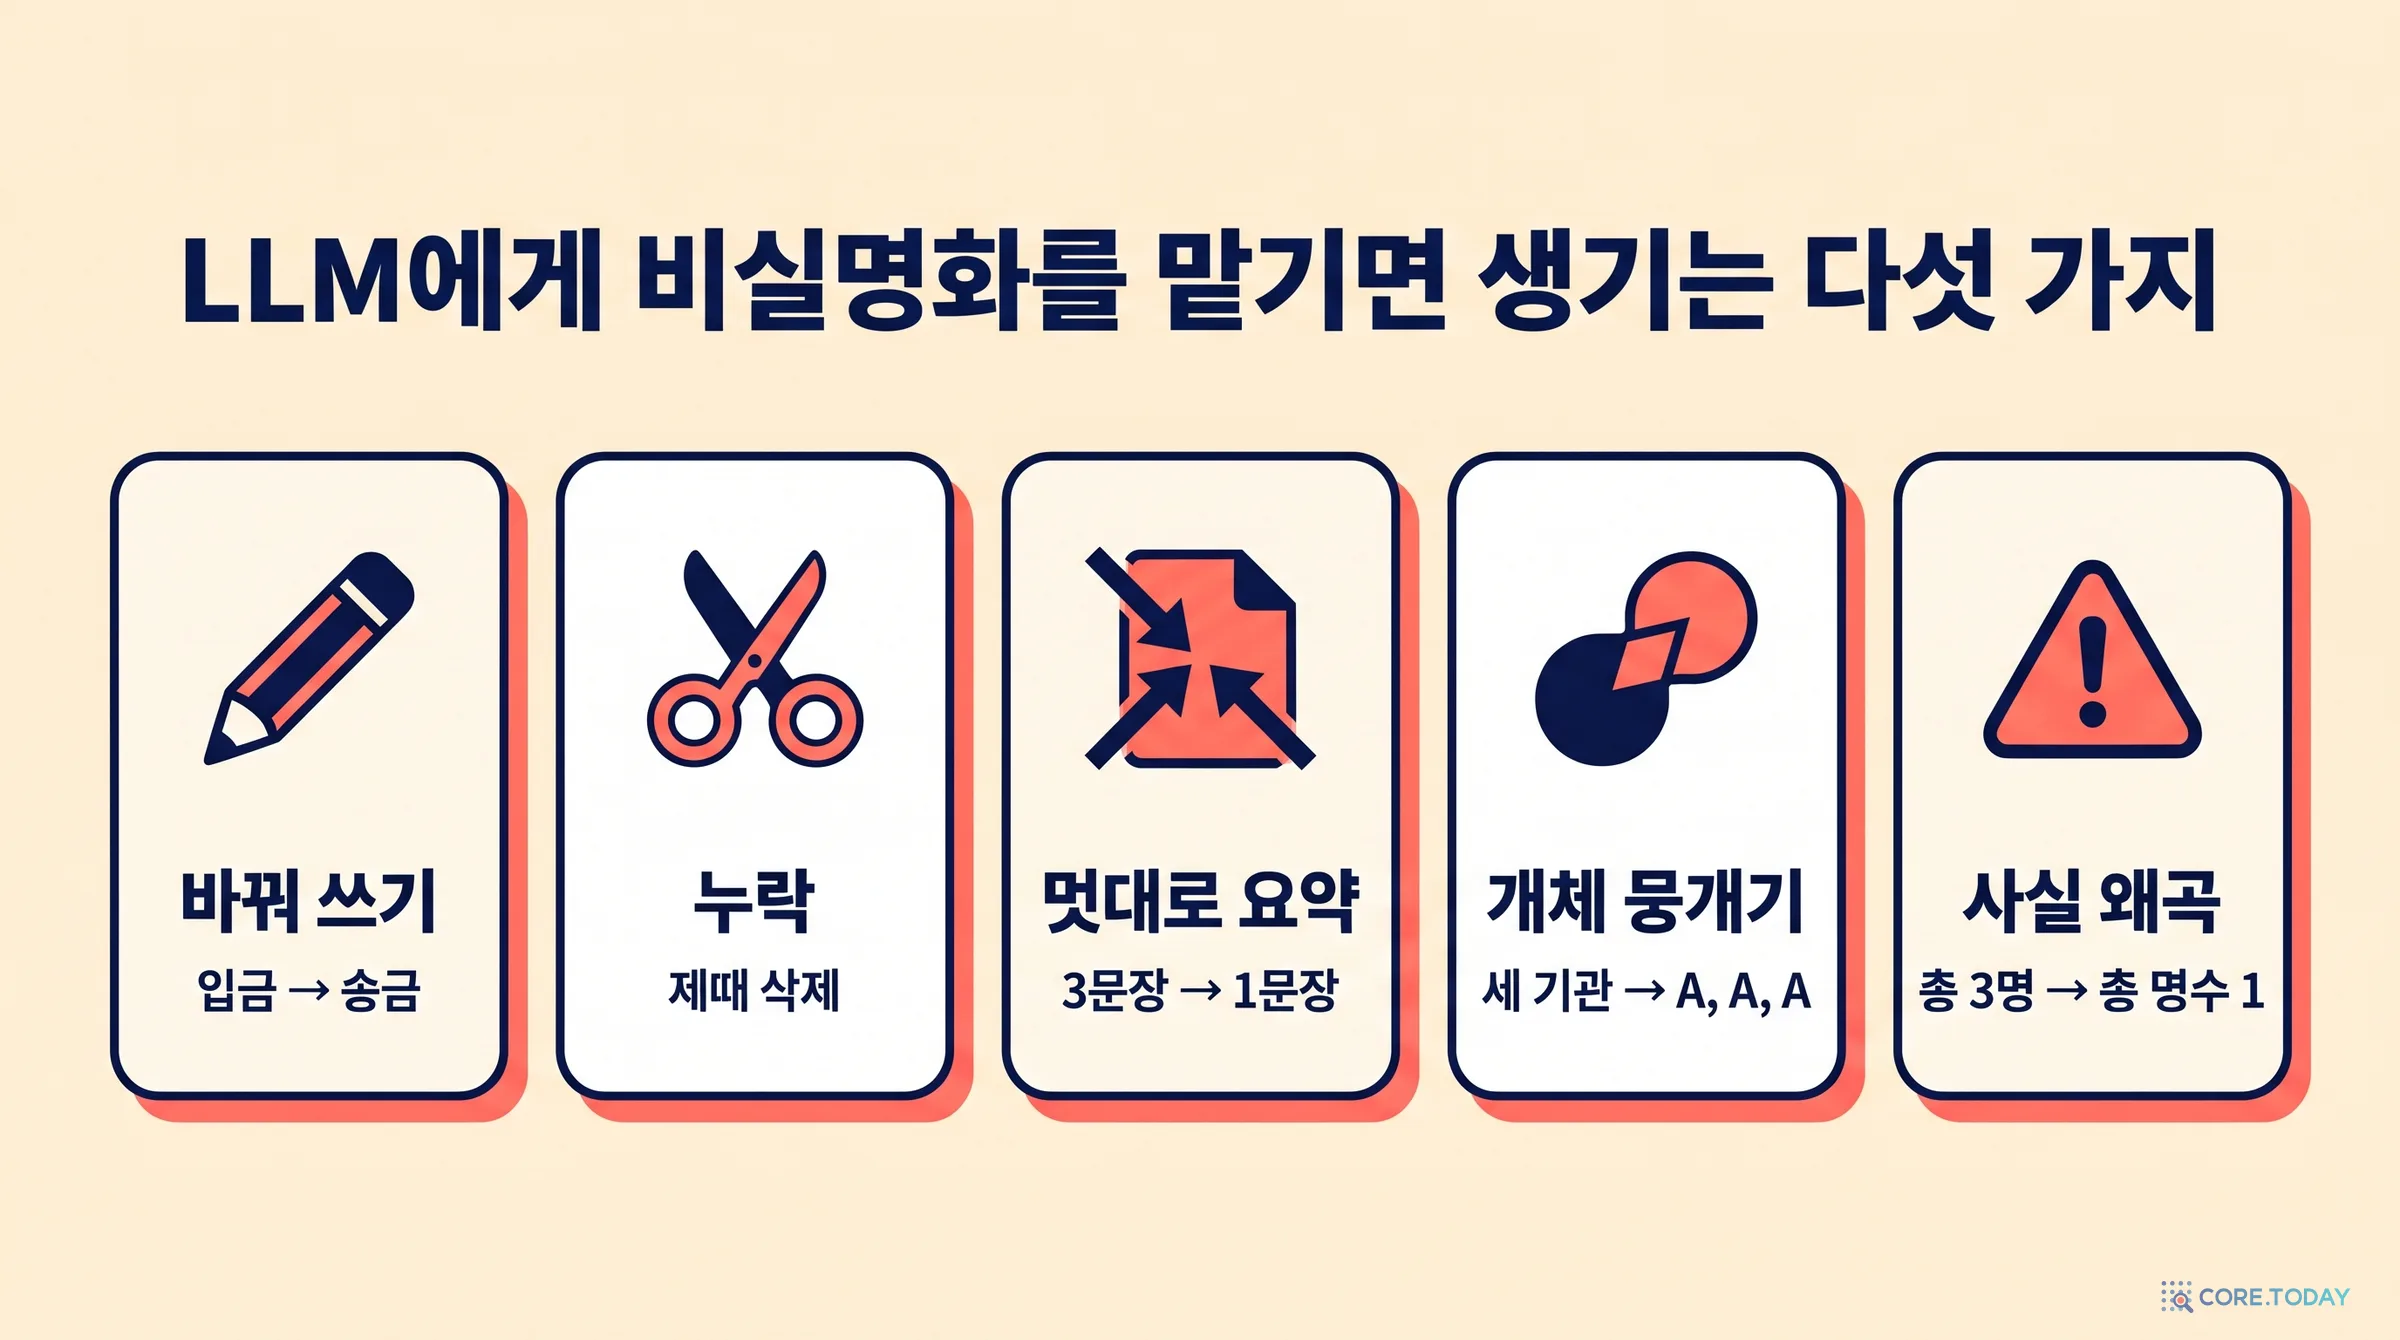
생성형 모델에게 비실명화를 시키면, 모델은 판결문을 처음부터 끝까지 다시 씁니다. 지운 곳만 다르고 나머지는 같아야 하지만, 다시 쓰는 과정에서 다른 곳도 달라질 수 있습니다. 연구진은 GPT 계열 모델로 시험했을 때 자주 나타난 문제를 다섯 가지로 정리했습니다.
유형
원문
모델 출력
왜 문제인가
① 바꿔 쓰기
입금하였다
송금하였다
둘 다 돈을 보내는 일이지만 법률·금융 맥락에서 행위의 형태와 함의가 다르다.
② 누락
그 대금을 제때 변제하여
대금을 변제하여
'제때'는 채무를 기한 안에 이행했는지를 가르는 표현이다.
③ 멋대로 요약
피고인의 편취 의도와 계획, 피해액을 적은 세 문장
"피고인은 이를 개인 용도로 사용하였다" 한 문장
범행의 구체적 사실과 수법이 사라진다.
④ 개체 뭉개기
광주은행, 우정사업본부, 부산은행
A, A, A
서로 다른 기관이 같은 글자가 되어 돈의 흐름을 따라갈 수 없다.
⑤ 사실 왜곡
총 3명
총 명수 1
숫자를 식별자로 오해해 가리면서 사실이 바뀐다.
판결문은 공문서입니다. 요약본이나 해설이 아니라 원문 그대로여야 하고, 한 글자의 차이가 권리 관계를 바꿀 수 있습니다. 비실명화의 요구 사항은 "식별자를 지워라"가 아니라 "식별자만 지워라"입니다.
아래 위젯은 같은 문단에 세 가지 방법을 적용한 결과를 보여 줍니다. 정규식 규칙, LLM에게 다시 쓰게 하기, 토큰 분류입니다.
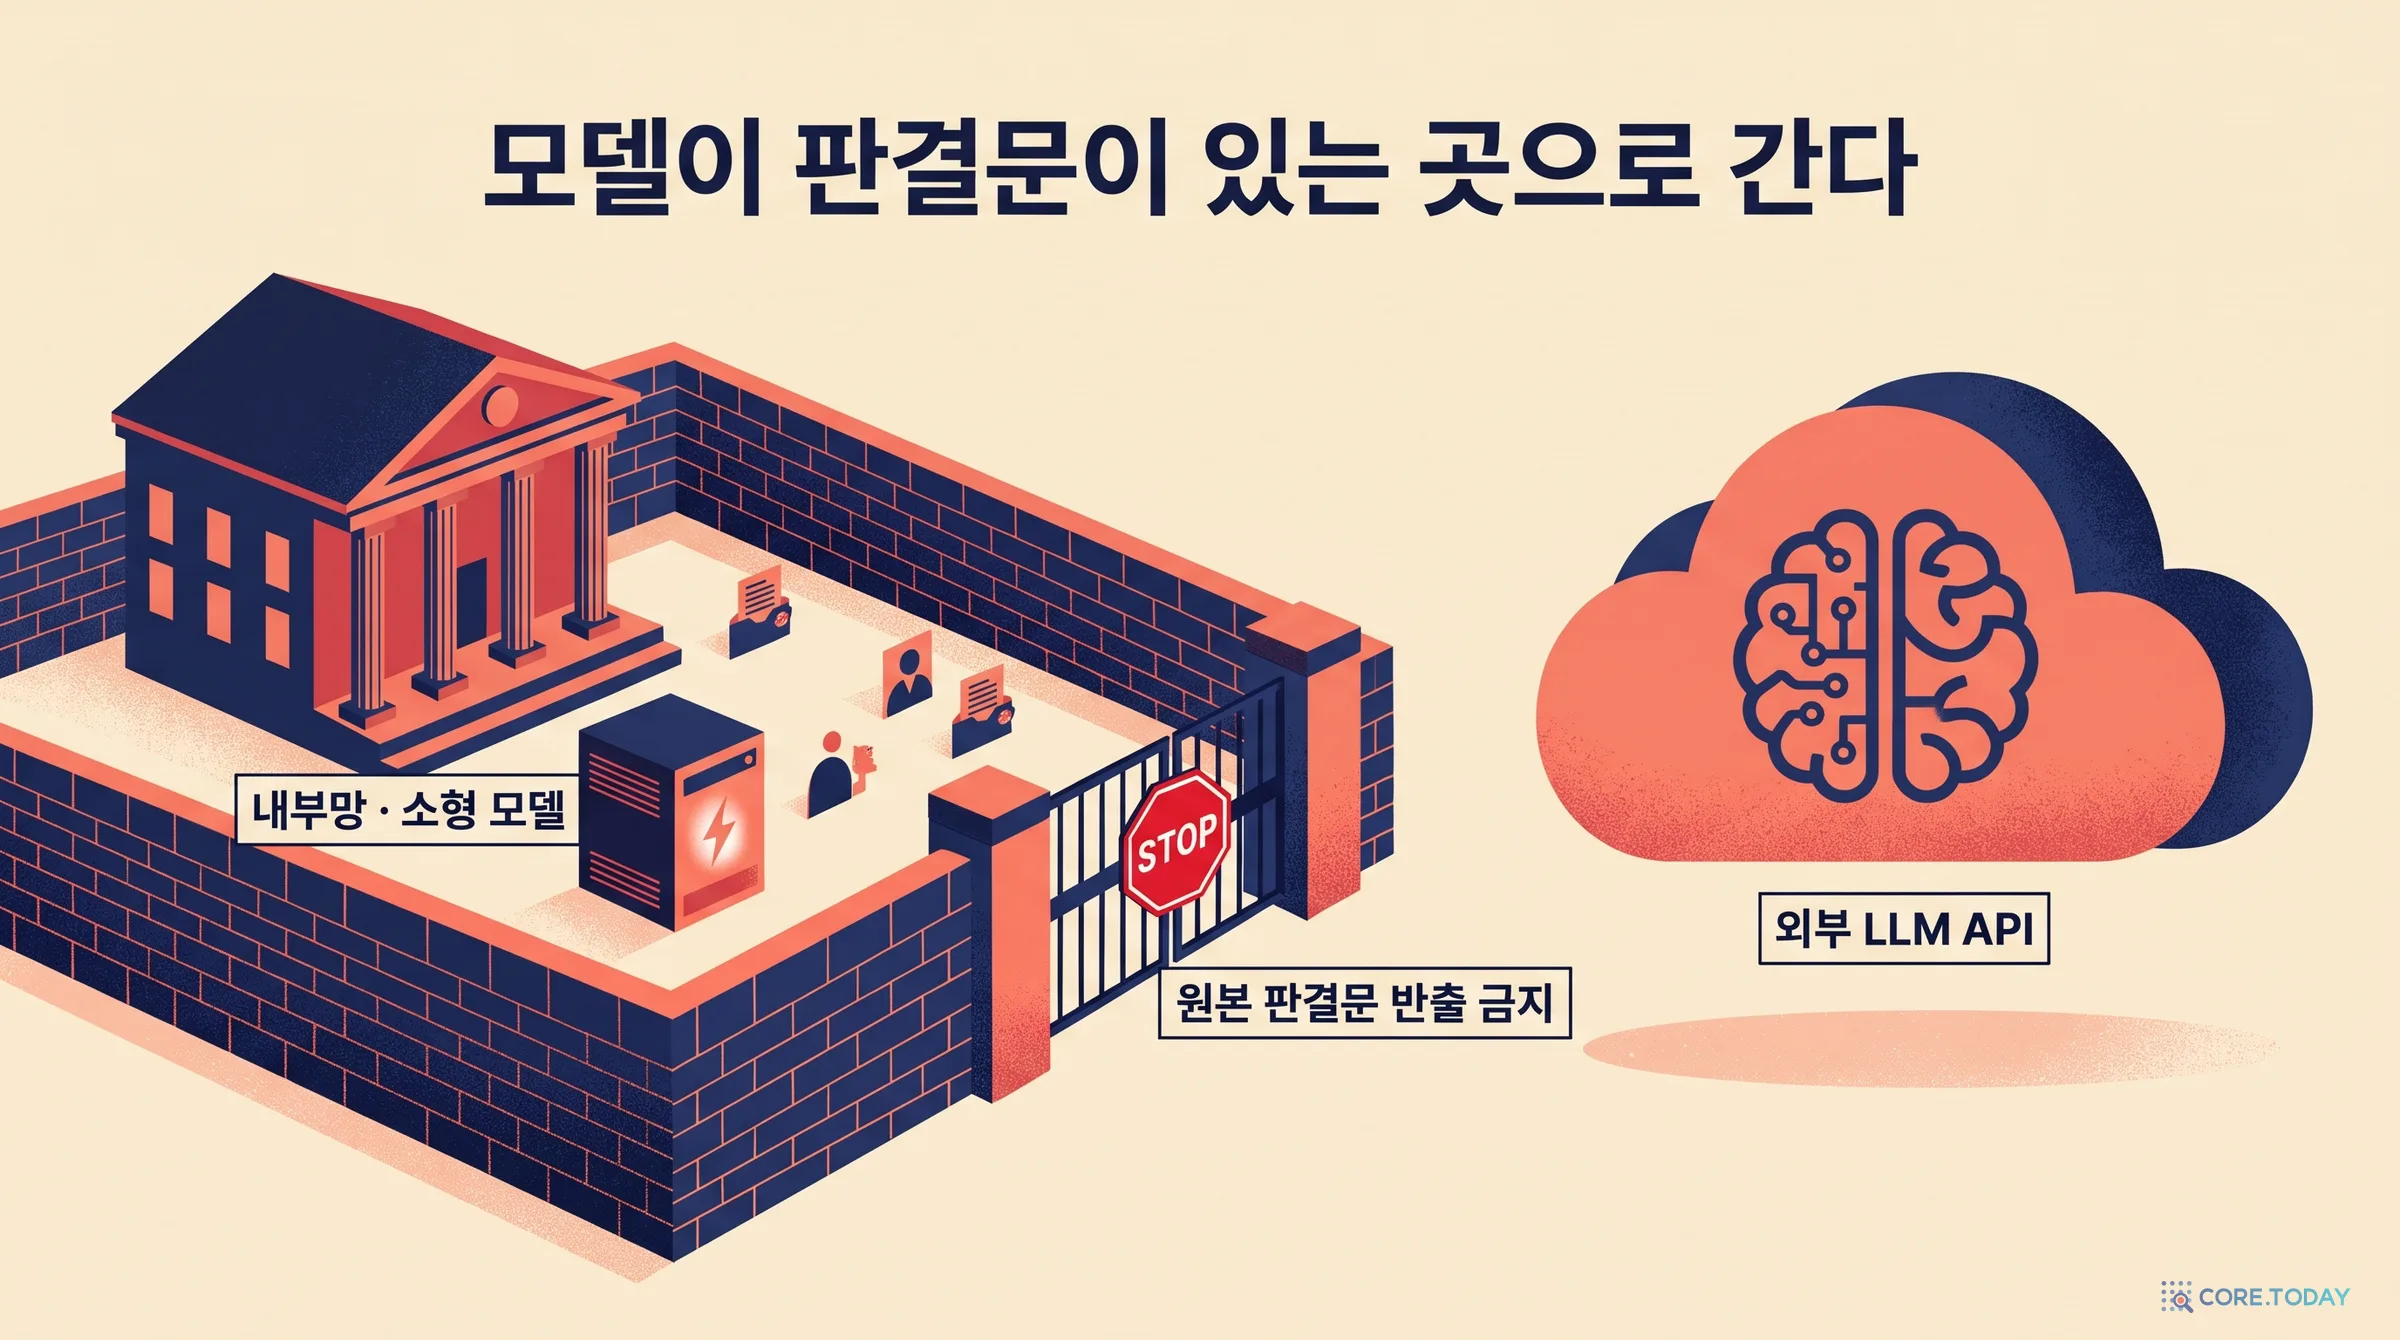
이유 2: 원본 판결문은 법원 밖으로 나갈 수 없다
두 번째 이유는 기술이 아니라 보안입니다. 비실명화의 입력은 정의상 아직 지워지지 않은 원본입니다. 이것을 외부 회사의 API로 보내는 일은, 지우기 위해 먼저 유출하는 셈입니다. 국가정보원은 2023년 6월 「챗GPT 등 생성형 AI 활용 보안 가이드라인」을 내면서 첫 수칙으로 비공개 정보와 개인정보 등 민감한 내용의 입력 금지를 들었습니다. 논문은 이 지침을 인용하며, 한국의 주요 정부 기관에서 API 기반 LLM 서비스 사용이 제한된다고 적습니다.
그래서 해법은 법원 내부망 안에서, 법원이 가진 장비로 돌릴 수 있어야 합니다. 이 조건이 모델의 크기를 정합니다. Thunder-DeID의 가장 큰 모델이 15억 파라미터, 가장 작은 모델이 3억 7천만 파라미터인 것은 우연이 아닙니다.
코어닷투데이 실측: 다시 쓰게 하기 대 가리킬 곳만 말하게 하기
논문의 부록 A는 사례 목록이고 빈도는 밝히지 않습니다. 얼마나 자주 그런 일이 생기는지, 그리고 LLM을 쓰더라도 다른 방식으로 쓰면 피할 수 있는지를 코어닷투데이가 작게 확인해 봤습니다. 외부 API는 쓰지 않고 로컬에서 도는 공개 모델 두 개(Qwen3.5 9B와 4B, Ollama, 온도 0, 사고 모드 끔)만 썼습니다.
시험 자료. 사기·음주운전·임대차·상해·절도·해고 등 판결문 문체의 단락 틀 10개를 쓰고, 가상의 이름·주민등록번호·동 이름·상호·은행 이름·계좌번호·전화번호·차량번호를 무작위로 채워 30개 단락을 만들었습니다. 가려야 할 식별자는 모두 195개이고 위치를 알고 있으므로 자동으로 채점할 수 있습니다. 논문이 학습 데이터를 만든 방법(5장)을 흉내 낸 것입니다.
두 가지 지시. 같은 처리 기준(이름은 알파벳, 번호는 '○○번호 1 생략', 상호는 고유한 부분만, 날짜·금액·그 밖의 문장은 한 글자도 바꾸지 말 것)을 주고 방식만 달리했습니다.
다시 쓰기: 비실명화한 본문 전체를 출력하게 한다.
가리키기: 본문은 다시 쓰지 말고, 가려야 할 문자열만 원문에 적힌 그대로 JSON 목록으로 출력하게 한다. 실제로 가리는 일은 코드가 한다.
측정한 것 (30개 단락, 식별자 195개)
Qwen3.5 9B
Qwen3.5 4B
다시 쓰기 — 가리지 못하고 남은 식별자
63개 (32%)
88개 (45%)
다시 쓰기 — 식별자 밖 문장이 글자 하나까지 그대로인 단락
30개 중 1개
30개 중 3개
다시 쓰기 — 띄어쓰기 차이를 무시했을 때 그대로인 단락
30개 중 27개
30개 중 25개
가리키기 — 찾아낸 식별자 (재현율)
165개 (85%)
161개 (83%)
가리키기 — 내놓은 문자열 가운데 실제 식별자와 겹치는 비율 (정밀도)
97%
91%
가리키기 — 원문에 없는 문자열을 내놓은 횟수
170개 중 2개
175개 중 2개
가리키기 — 식별자 밖 문장 보존
30개 중 30개 (구조상 보장)
30개 중 30개 (구조상 보장)
세 가지를 읽을 수 있었습니다.
첫째, 다시 쓰게 하면 거의 항상 무언가 바뀝니다. 가장 흔한 변화는 띄어쓰기였습니다. "500만 원"이 "500 만 원"으로, "3회"가 "3 회"로, "A는"이 "A 는"으로 바뀌었습니다. 사소해 보이지만 "한 글자도 바꾸지 말라"는 지시를 30번 가운데 27~29번 어긴 것입니다. 낱말이 바뀐 경우도 있었습니다. 9B 모델은 상해 사건 틀의 세 단락 모두에서 "약 3주간의 치료가 필요한 상해"를 "약 3 주의 치료가 필요한 상해"로 고쳐 썼습니다. 4B 모델은 "피고인의 휴대전화"를 "A 의 휴대전화"로, "수원 팔달구 봉천동"을 "B C D"로(시와 구까지 가림), "한마음운수 주식회사"를 "B"로(일반 명사까지 가림) 바꿨습니다. 논문 부록 A의 유형 가운데 바꿔 쓰기와 과잉 처리가 작은 모델에서도 재현된 셈입니다. 요약이나 숫자 왜곡은 이 짧은 단락들에서는 나오지 않았습니다.
둘째, 놓치는 것이 많았고 그 양상이 뜻밖이었습니다. 사람 이름은 두 모델 모두 거의 다 가렸습니다(9B는 87개 전부, 4B는 85개). 그런데 주민등록번호는 두 모델 모두 6개 전부를 그대로 남겼고, 계좌번호도 9B가 18개 전부를 남겼습니다. 정규식 한 줄이면 잡히는 번호를 LLM은 놓치고, 정규식으로는 잡을 수 없는 이름을 LLM은 잡았습니다. 두 방식의 강점이 정반대라는 뜻입니다.
이름 (87개)
100% 가림
동 이름 (24개)
62%
은행 이름 (18개)
61%
상호 (21개)
52%
전화번호 (12개)
50%
차량번호 (9개)
22%
주민등록번호 (6개)
0%
계좌번호 (18개)
0%
위 막대는 9B 모델이 '다시 쓰기'에서 종류별로 식별자를 가린 비율입니다.
셋째, 가리키게 하면 문장은 안전해지지만 찾는 실력은 여전히 부족합니다. 가리키기 방식은 출력이 문자열 목록이고 치환은 코드가 하므로, 식별자가 아닌 문장이 바뀔 길이 없습니다. 원문에 없는 문자열을 내놓은 것은 두 모델 모두 2번뿐이었고, 그런 문자열은 치환할 곳이 없어 저절로 무시됩니다. 대신 재현율이 85% 안팎에 머물렀습니다. 동 이름은 9B가 24개 가운데 7개만 찾았고, 상호는 "나리식당"을 통째로 내놓아 고유한 부분 "나리"만 가리라는 기준을 한 번도 정확히 지키지 못했습니다.
이 작은 실험의 결론은 논문의 설계와 같은 방향을 가리킵니다. 문장을 보존하려면 출력의 형식이 문장을 바꿀 수 없게 되어 있어야 하고(가리키기, 또는 토큰 분류), 준식별자를 제대로 찾으려면 그 일을 위해 학습된 모델이 필요합니다. 범용 모델에게 규칙 몇 줄을 주는 것으로는 동 이름과 상호의 경계를 배우지 못했습니다.
실험의 한계도 적어 둡니다. 단락은 30개뿐이고 틀이 10가지라 같은 틀의 결과가 함께 움직입니다. 모델은 작은 로컬 모델 두 개이며, 더 큰 모델이나 다른 프롬프트에서는 수치가 달라질 것입니다. 또 무작위로 이름을 채우다 보니 "조현우과", "황보람가"처럼 받침과 맞지 않는 조사가 생겼고, 모델이 이것을 "A 와", "E 가"로 고쳐 쓴 경우가 있었습니다. 이 고쳐 쓰기는 조사가 식별자 구간과 맞닿아 있어 위 표의 '문장 보존' 채점에는 들어가지 않았습니다. 이 조사 문제는 8장에서 다시 나옵니다.
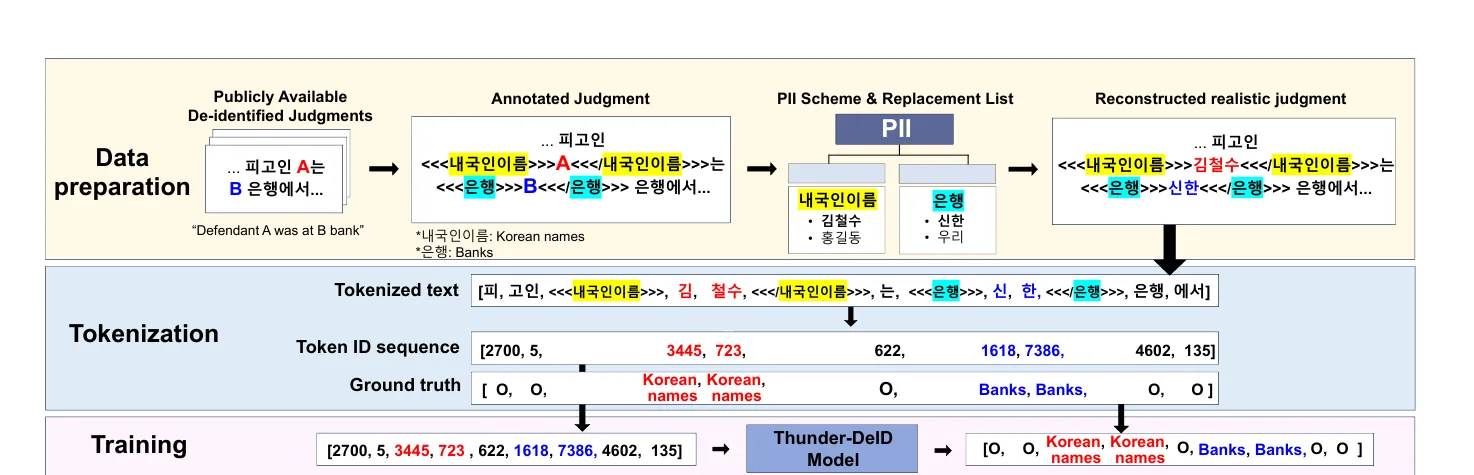
논문 그림 1. 출처: Hahm 외, Thunder-DeID (arXiv 2506.15266).
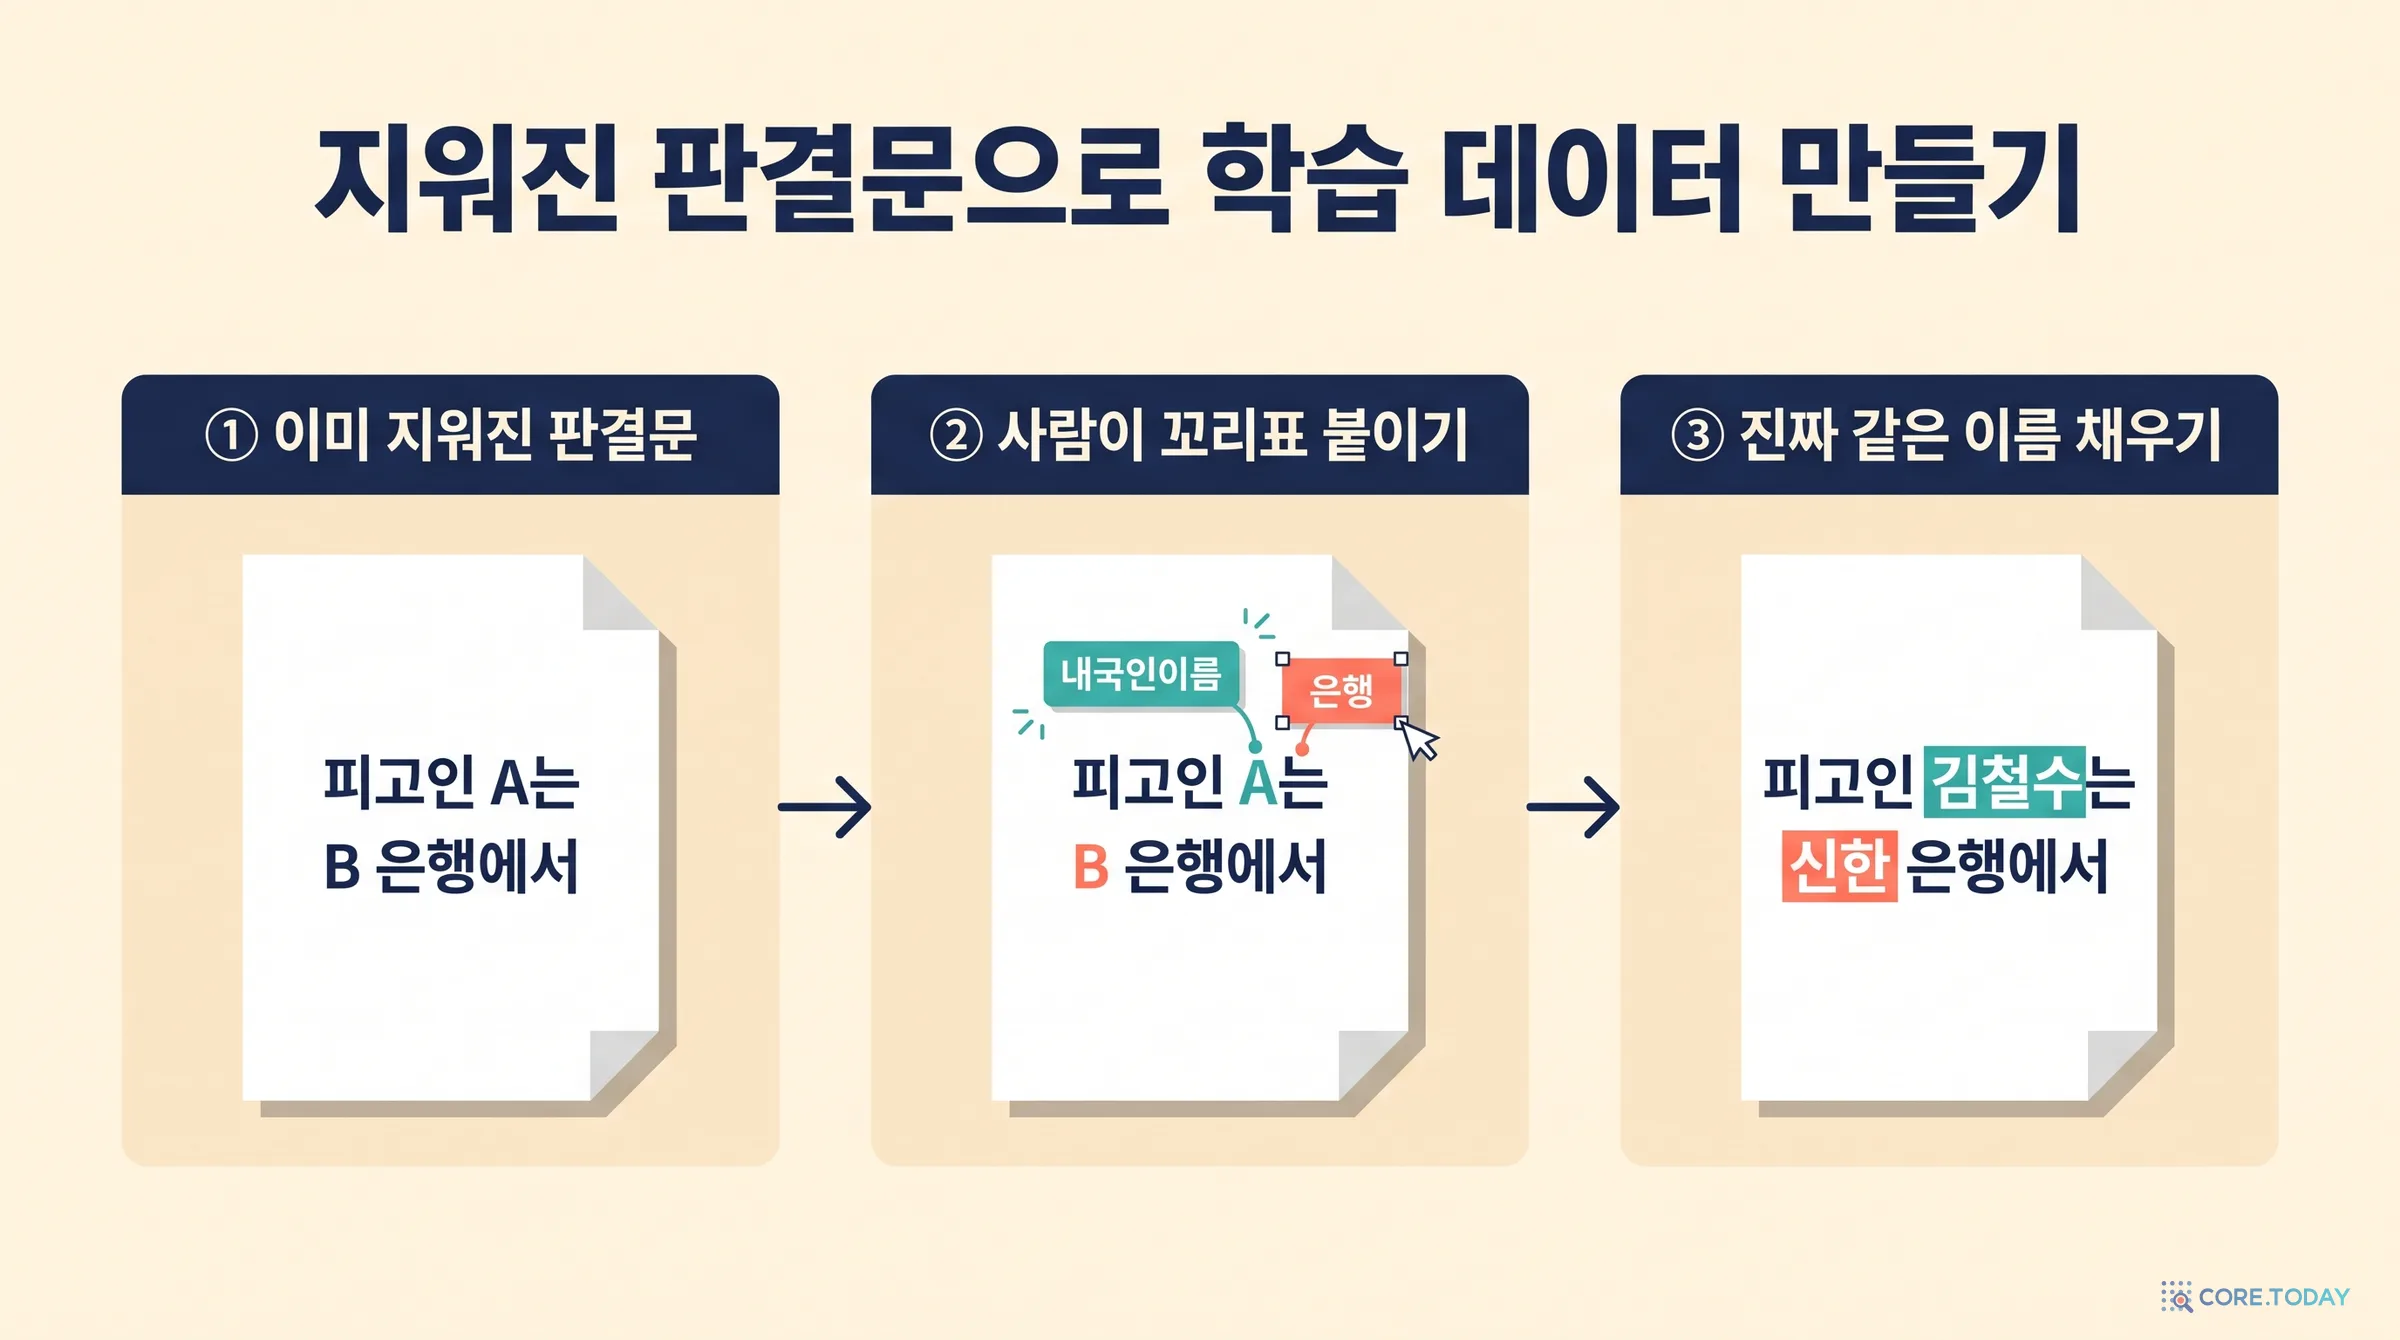
그림을 위에서 아래로 읽습니다. 맨 위 줄(데이터 준비)은 왼쪽에서 오른쪽으로 네 단계입니다. 공개된 비실명 판결문("피고인 A는 B 은행에서…")을 모으고, 사람이 A와 B에 종류 꼬리표를 답니다(A는 '내국인이름', B는 '은행'). 꼬리표마다 실제 값의 목록을 준비해 두고(내국인이름: 김철수, 홍길동 / 은행: 신한, 우리), 목록에서 뽑은 값으로 A와 B를 채우면 "피고인 김철수는 신한 은행에서…"라는, 원본처럼 보이는 문장이 됩니다. 가운데 줄(토큰화)은 이 문장을 토큰 번호의 열로 바꾸고 토큰마다 정답 꼬리표를 붙입니다. 맨 아래 줄(학습)은 토큰 번호 열을 넣으면 꼬리표 열이 나오도록 모델을 가르칩니다.
세 가지 제약
이 구조는 한국의 사정에서 나온 것입니다. 논문은 데이터를 만들 때 부딪힌 제약을 셋으로 정리합니다.
원본을 구할 수 없다. 비실명화는 법원의 법적 의무이고, 외부에는 이미 지워진 판결문만 나옵니다. 보통의 개체명 인식 연구라면 원문에 사람이 표시를 해서 정답을 만들지만, 여기서는 그 원문이 없습니다.
무엇을 지울지의 목록이 없다. 법령은 직접 식별자와 "그 밖의 정보"라는 넓은 범주만 줍니다.
지워진 판결문조차 많지 않다. 수작업 의존으로 공개 물량 자체가 적어, 바로 학습에 쓸 큰 말뭉치가 없습니다.
첫 번째 제약에 대한 답이 이 논문에서 가장 영리한 부분입니다. 비실명 판결문에서 A, B, '주민등록번호 1 생략' 같은 자리표시자는 "여기에 식별자가 있었다"는 표시입니다. 법원 직원이 이미 어디를 지울지는 정답을 적어 둔 셈입니다. 빠진 것은 무엇이 있었는지입니다. 그리고 모델을 가르치는 데는 진짜 이름이 필요하지 않습니다. 그 자리에 들어갈 법한 이름이면 됩니다. 지워진 판결문을 문제집으로 보면, 답의 위치는 이미 인쇄돼 있고 빈칸만 그럴듯하게 채우면 되는 것입니다.
6,700건을 모으다
연구진은 법제처 자료, AI 허브, 그리고 LBox Open(황원석 외, NeurIPS 2022)에서 비실명 판결문을 모아 중복을 걸러 6,700건을 골랐습니다. 민사 3,000건, 형사 3,000건, 행정 700건입니다.
분야
사건 유형
문서
식별자
문서당
민사
손해배상
901
9,223
10.2
임대차보증금
696
5,187
7.5
매매대금
557
4,983
8.9
건물인도(명도)
846
6,816
8.1
형사
상해
600
2,562
4.3
폭행
600
2,583
4.3
성범죄
600
2,732
4.6
절도·사기
600
4,376
7.3
음주운전
600
2,354
3.9
행정
행정소송
700
7,490
10.7
합계
6,700
48,306
7.2
논문 표 1에 문서당 식별자 수(오른쪽 열, 코어닷투데이 계산)를 더했습니다. 음주운전 판결문에는 식별자가 평균 4개가 안 되지만 손해배상과 행정소송에는 10개가 넘습니다. 형사 단독 사건은 피고인 한 명과 장소 하나로 끝나는 경우가 많고, 민사와 행정 사건에는 당사자, 회사, 부동산, 계좌, 기관이 여럿 나오기 때문입니다. 이 차이는 10장에서 사건 유형별 성적을 볼 때 다시 중요해집니다.
1심 판결문만 모은 데에도 이유가 있습니다. 한국의 1심은 사실심입니다. 증거를 조사하고 다툼이 있는 사실을 확정하는 데 판결문의 많은 분량을 쓰므로, 누가 언제 어디서 무엇을 했는지가 가장 자세히 적혀 있습니다. 법리만 다루는 상급심 판결문보다 식별자가 훨씬 많고 다양합니다.
사람이 한 일
주석 작업은 네 단계로 진행됐습니다.
1주석자가 판결문에서 자리표시자(A, B, '계좌번호 1 생략' 등)를 찾아, 법령과 실무를 분석해 미리 만든 범주로 꼬리표를 단다.
2연구진이 주석자 사이의 일관성을 검토하면서, 미리 만든 범주에 맞지 않는 것들을 모아 3단 계층 분류 체계를 새로 세운다.
3주석자가 새 체계에 맞춰 꼬리표를 고친다.
4의견이 갈리거나 확신이 없는 경우를 연구진이 정리한다.
주석은 저자들과 외부 주석자 17명이 했습니다. 부록 G에 따르면 저자들은 주 20시간씩 4주, 외부 주석자는 주 12시간씩 4주를 일했고 시급 1만 원으로 한 사람당 48만 원을 받았습니다. 외부 주석자의 작업 시간만 더하면 816시간입니다. 6,700건, 48,306개 꼬리표가 이 시간에서 나왔습니다.
꼬리표의 형식은 이렇습니다. 원래 판결문이 "피고인 홍길동(561231-1234567)"이었다면 법원이 공개한 문장은 "피고인 A(주민등록번호 1 생략)"이고, 주석자는 여기에 종류를 적어 넣습니다.
주석 형식
공개된 문장 … 피고인 A (주민등록번호 1 생략) …
주석 뒤 … 피고인 ≪내국인이름≫A≪/내국인이름≫ (≪주민등록번호≫주민등록번호 1 생략≪/주민등록번호≫) …
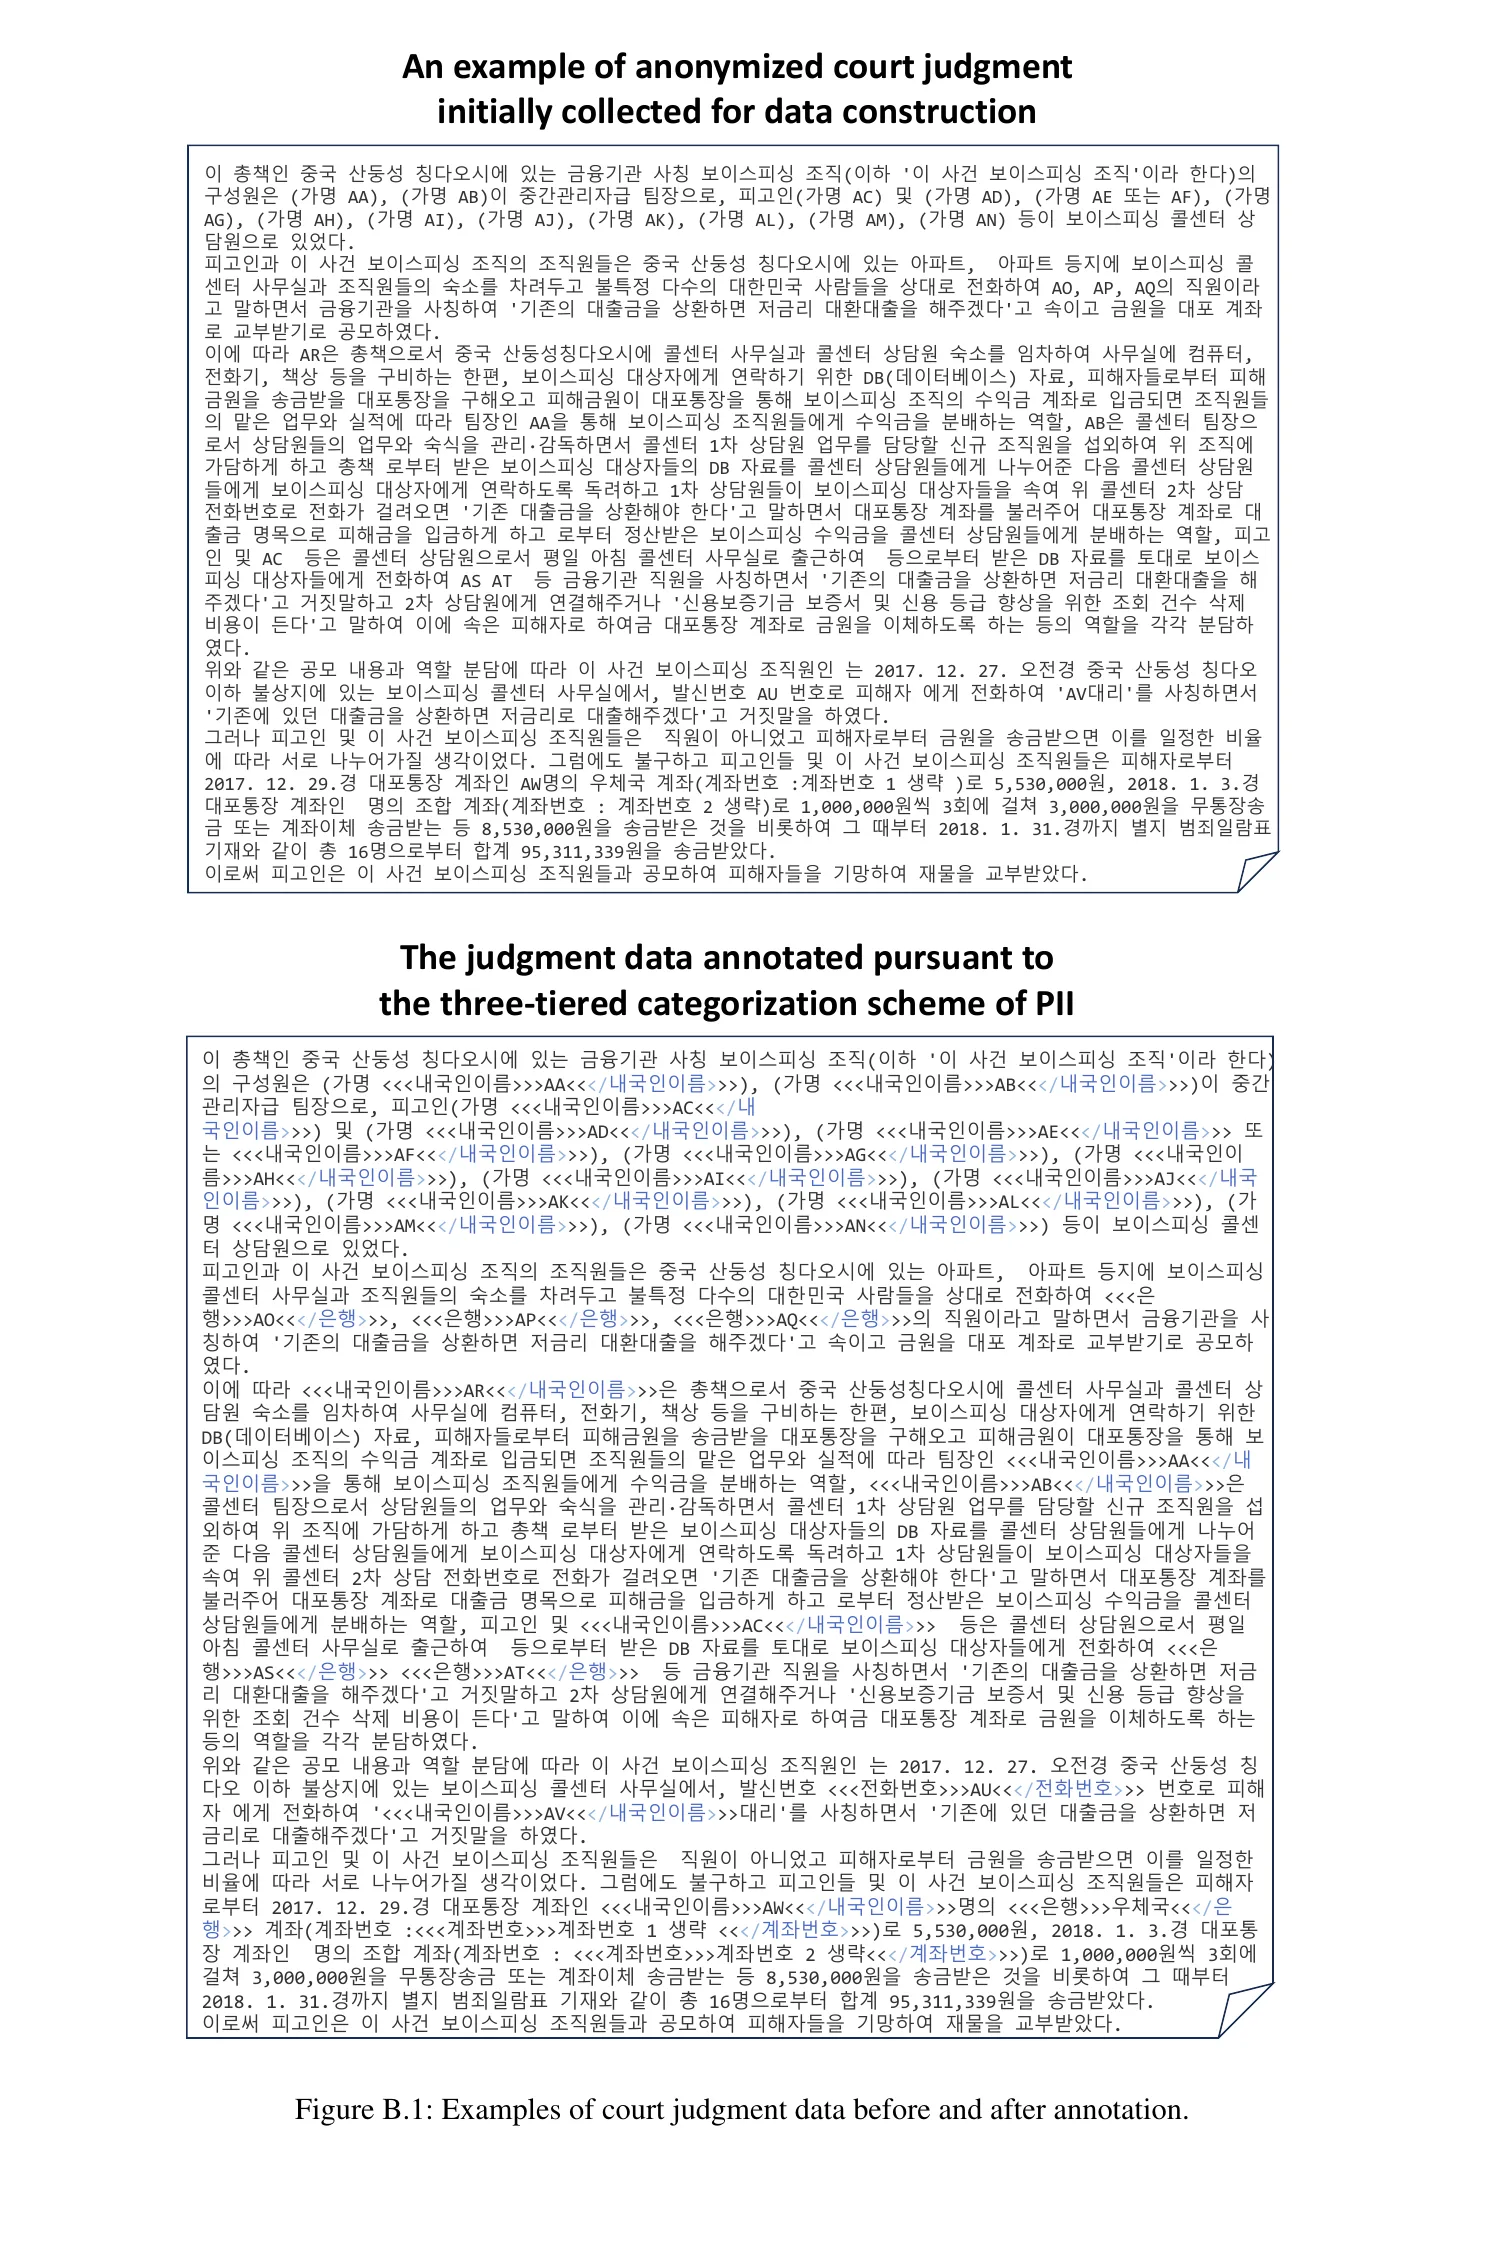
여는 표지와 닫는 표지 사이가 식별자가 있던 자리이고, 표지 안의 글자가 그 종류입니다. 부록 B의 실제 예시를 보면 이 작업이 어떤 것인지 감이 옵니다.
논문 그림 B.1. 중국 칭다오의 보이스피싱 조직 사건 판결문. 출처: Hahm 외, Thunder-DeID.
위쪽이 법원이 공개한 그대로이고 아래쪽이 꼬리표를 단 것입니다. 한 단락에 가명이 AA부터 AW까지 나옵니다. 이 예시에서 눈여겨볼 곳이 세 군데 있습니다. 첫째, "이 총책인", "총책 로부터", "피해자 에게"처럼 이름이 통째로 사라진 자리가 있습니다. 공개된 판결문의 비실명 처리 자체가 고르지 않다는 뜻이고, 이런 자리에는 꼬리표를 달 자리표시자가 없습니다. 둘째, "AO, AP, AQ의 직원이라고 말하면서"의 AO·AP·AQ는 사칭당한 금융기관이어서 주석자가 문맥을 읽고 '은행'이라고 달았습니다. 글자만 봐서는 사람인지 기관인지 알 수 없습니다. 셋째, "우체국 계좌"의 우체국은 법원이 가리지 않았지만 주석자는 '은행' 꼬리표를 달았습니다. 가려지지 않은 식별자도 학습 대상에 넣은 것입니다.
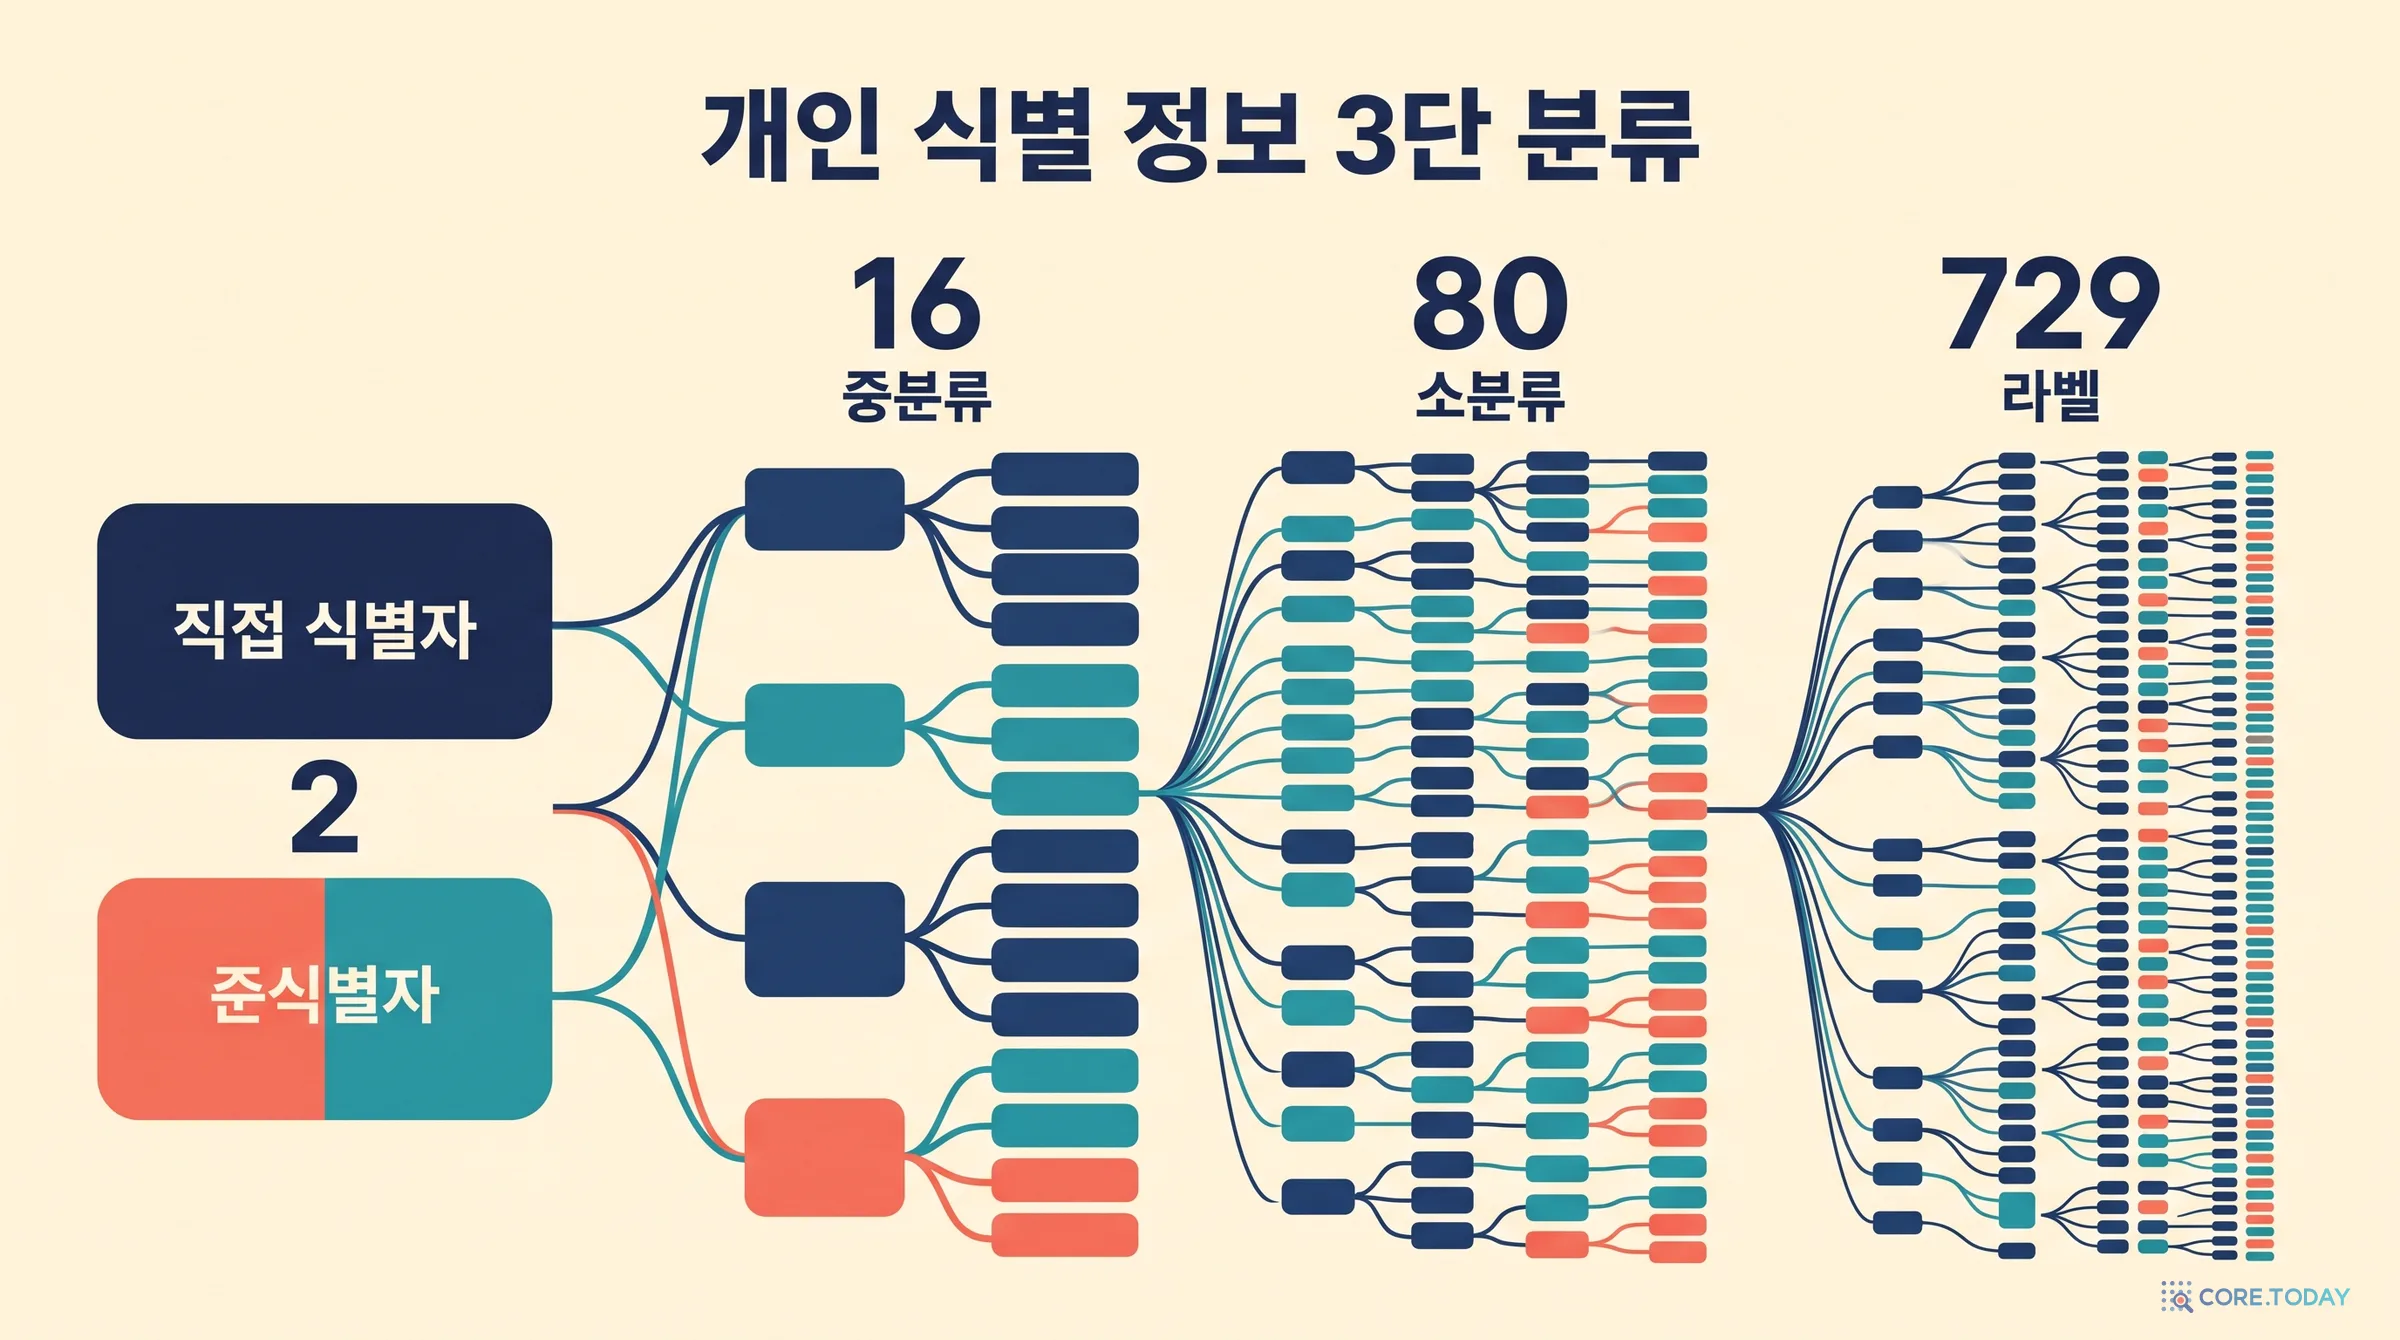
연구진은 법조문에서 출발해 위에서 아래로 분류를 짜지 않았습니다. 48,306개의 실제 자리표시자를 하나하나 보면서, 법원 직원들이 실제로 무엇을 가렸는지를 아래에서 위로 정리했습니다. 논문의 표현으로 "귀납적 분석"입니다. 결과는 대분류 2개, 중분류 16개, 소분류 80개, 그리고 그 아래 729개의 라벨입니다.
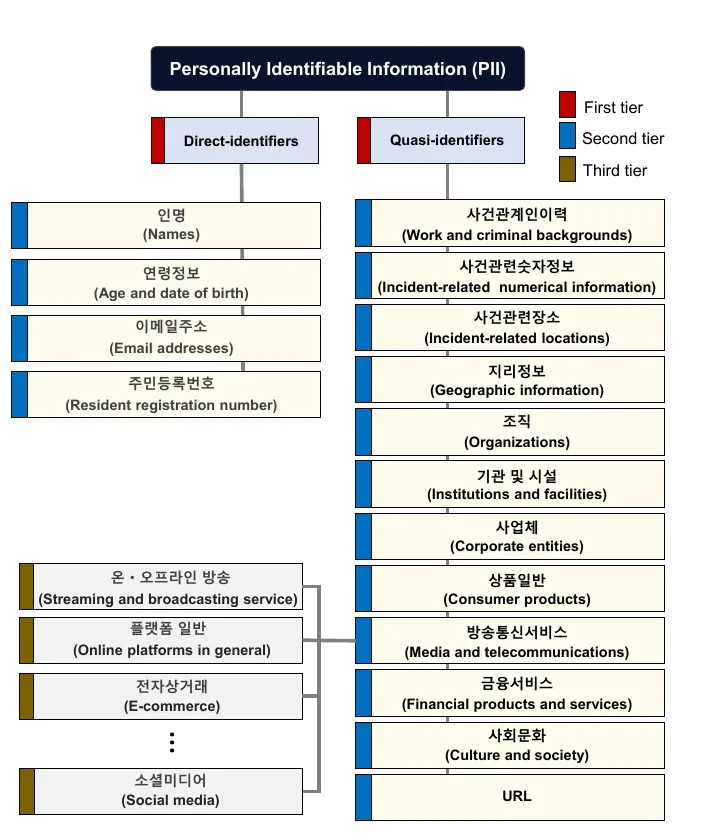
논문 그림 2. 빨강이 1단(대분류), 파랑이 2단(중분류), 갈색이 3단(소분류). 출처: Hahm 외, Thunder-DeID.
그림의 왼쪽 위가 직접 식별자(예규의 '사건관계인 특정 정보')로 인명, 연령정보, 이메일주소, 주민등록번호 네 갈래입니다. 오른쪽이 준식별자(예규의 '그 밖에 특정할 수 있는 정보')로 열두 갈래입니다. 사건관계인 이력, 사건 관련 숫자 정보, 사건 관련 장소, 지리정보, 조직, 기관 및 시설, 사업체, 상품 일반, 방송통신서비스, 금융서비스, 사회·문화, URL. 왼쪽 아래는 그 가운데 '방송통신서비스'를 펼친 예로, 온·오프라인 방송, 플랫폼 일반, 전자상거래, 소셜미디어 같은 소분류가 달려 있습니다. 소분류 아래에 실제 주석에 쓰는 라벨이 붙습니다. 예를 들어 소셜미디어 아래에는 'SNS', '소개팅어플리케이션', '온라인대화방명' 같은 라벨이 있습니다.
부록 D에는 이 목록이 전부 실려 있습니다. 아래 위젯에 그대로 옮겼습니다.
목록을 훑어보면 몇 가지가 눈에 들어옵니다.
이름은 일부일 뿐입니다. 직접 식별자의 라벨은 24개입니다. 내국인이름, 외국인이름 11종(몽골인이름, 베트남이름, 세례명, 법명 등), 아이디·닉네임 7종, 나이·출생연도·생년월일, 이메일주소, 주민등록번호. 나머지 700개 가까운 라벨이 전부 준식별자입니다.
가게와 회사가 가장 많습니다. '사업체' 한 갈래에 라벨이 290개로 전체의 40%입니다. 도·소매 및 유통에만 60개(과일가게, 떡집, 안경점, 휴대폰케이스매장, 유압벨브판매업체…), 서비스 일반에 47개(대리운전회사, 철학관, 산후조리원…), 제조업에 40개가 있습니다. 판결문 속 사람들은 어딘가에서 일하고, 무언가를 사고, 누군가에게 돈을 보냅니다. 그 '어딘가'의 이름이 이름 다음으로 강한 단서입니다.
사건의 흔적이 그대로 보입니다. '금괴일련번호', '비트코인개인지갑', '보이스피싱어플리케이션', '게임아이템거래카페', '재직정보제공업체', '국정원비밀조직', '베트남전관련지명'. 책상에서 설계한 분류라면 나올 수 없는 라벨들입니다. 어떤 판결문에 그런 것이 가려져 있었기 때문에 생긴 항목입니다.
종류가 치환 방법을 정합니다. 3장 끝에서 본 대로, 한국 예규는 종류마다 바꾸는 방법이 다릅니다. '내국인이름'은 A로, '계좌번호'는 '계좌번호 1 생략'으로, '식당'은 고유한 부분만 A로. 그래서 이 분류는 연구용 장식이 아니라 후처리 규칙의 입력입니다. 종류를 틀리면 계좌번호 자리에 '전화번호 1 생략'이 들어갑니다.
일반 명사는 남기고 고유한 부분만
부록 C는 장소 이름의 처리 원칙을 두 가지 예로 보여 줍니다.
경우
원문
비실명 처리
꼬리표
기능을 나타내는 말이 붙어 있을 때
나리 식당에서 근무하는 피고인 홍길동은
A 식당에 근무하는 피고인 B는
≪식당≫A≪/식당≫ 식당 · ≪내국인이름≫B≪/내국인이름≫
기능을 나타내는 말이 없을 때
피해자 김철수를 기다리며 맥도날드에서 음식을 주문하고
피해자 D를 기다리며 E에서 음식을 주문하고
≪내국인이름≫D≪/내국인이름≫ · ≪식당≫E≪/식당≫
'나리 식당'에서 '식당'은 그곳이 무엇을 하는 곳인지 알려 주는 말입니다. 사건을 이해하는 데 필요하고 누구도 특정하지 않으므로 남깁니다. '맥도날드'에는 그런 말이 없으므로 통째로 E가 됩니다. 두 경우 모두 꼬리표는 '식당'입니다. 모델이 배워야 하는 것은 "식당 이름을 찾아라"가 아니라 "식당 이름 가운데 고유한 부분의 경계를 찾아라"입니다. 4장의 실측에서 범용 LLM이 '나리식당'을 통째로 내놓았던 것을 떠올리면, 이 경계가 따로 배워야 하는 것임을 알 수 있습니다.
빈칸은 LLM으로 메운다
6,700건으로는 세상의 모든 식별자 종류를 볼 수 없습니다. 논문은 라벨이 유독 적은 소분류를 골라, LLM(ChatGPT)에게 그 소분류에 들어갈 만한 라벨을 더 만들어 달라고 한 뒤 사람이 각 라벨의 값을 직접 채웠다고 밝힙니다(3.8절). 예로 든 것이 사회·문화 아래의 '각종 행사'입니다. 낚시대회, 등산행사, 임플란트세미나처럼 판결문에 우연히 나온 몇 개만으로는 부족하니, 같은 결의 행사 종류를 더 늘린 것입니다. 4장에서 LLM을 비실명화 실행에는 쓰지 않겠다고 한 논문이, 분류 체계의 보강에는 LLM을 씁니다. 민감한 원문이 들어가지 않는 일이기 때문입니다.
토큰 분류 모델은 토큰 단위로만 꼬리표를 붙입니다. 그러니 토큰을 어떻게 자르느냐가 무엇을 가릴 수 있느냐를 정합니다. 영어에서는 큰 문제가 아닙니다. "Hong Gildong was"에서 이름은 띄어쓰기로 떨어져 있습니다. 한국어는 다릅니다. "홍길동이", "홍길동을", "홍길동에게서". 이름 뒤에 조사가 붙어 한 어절이 됩니다.
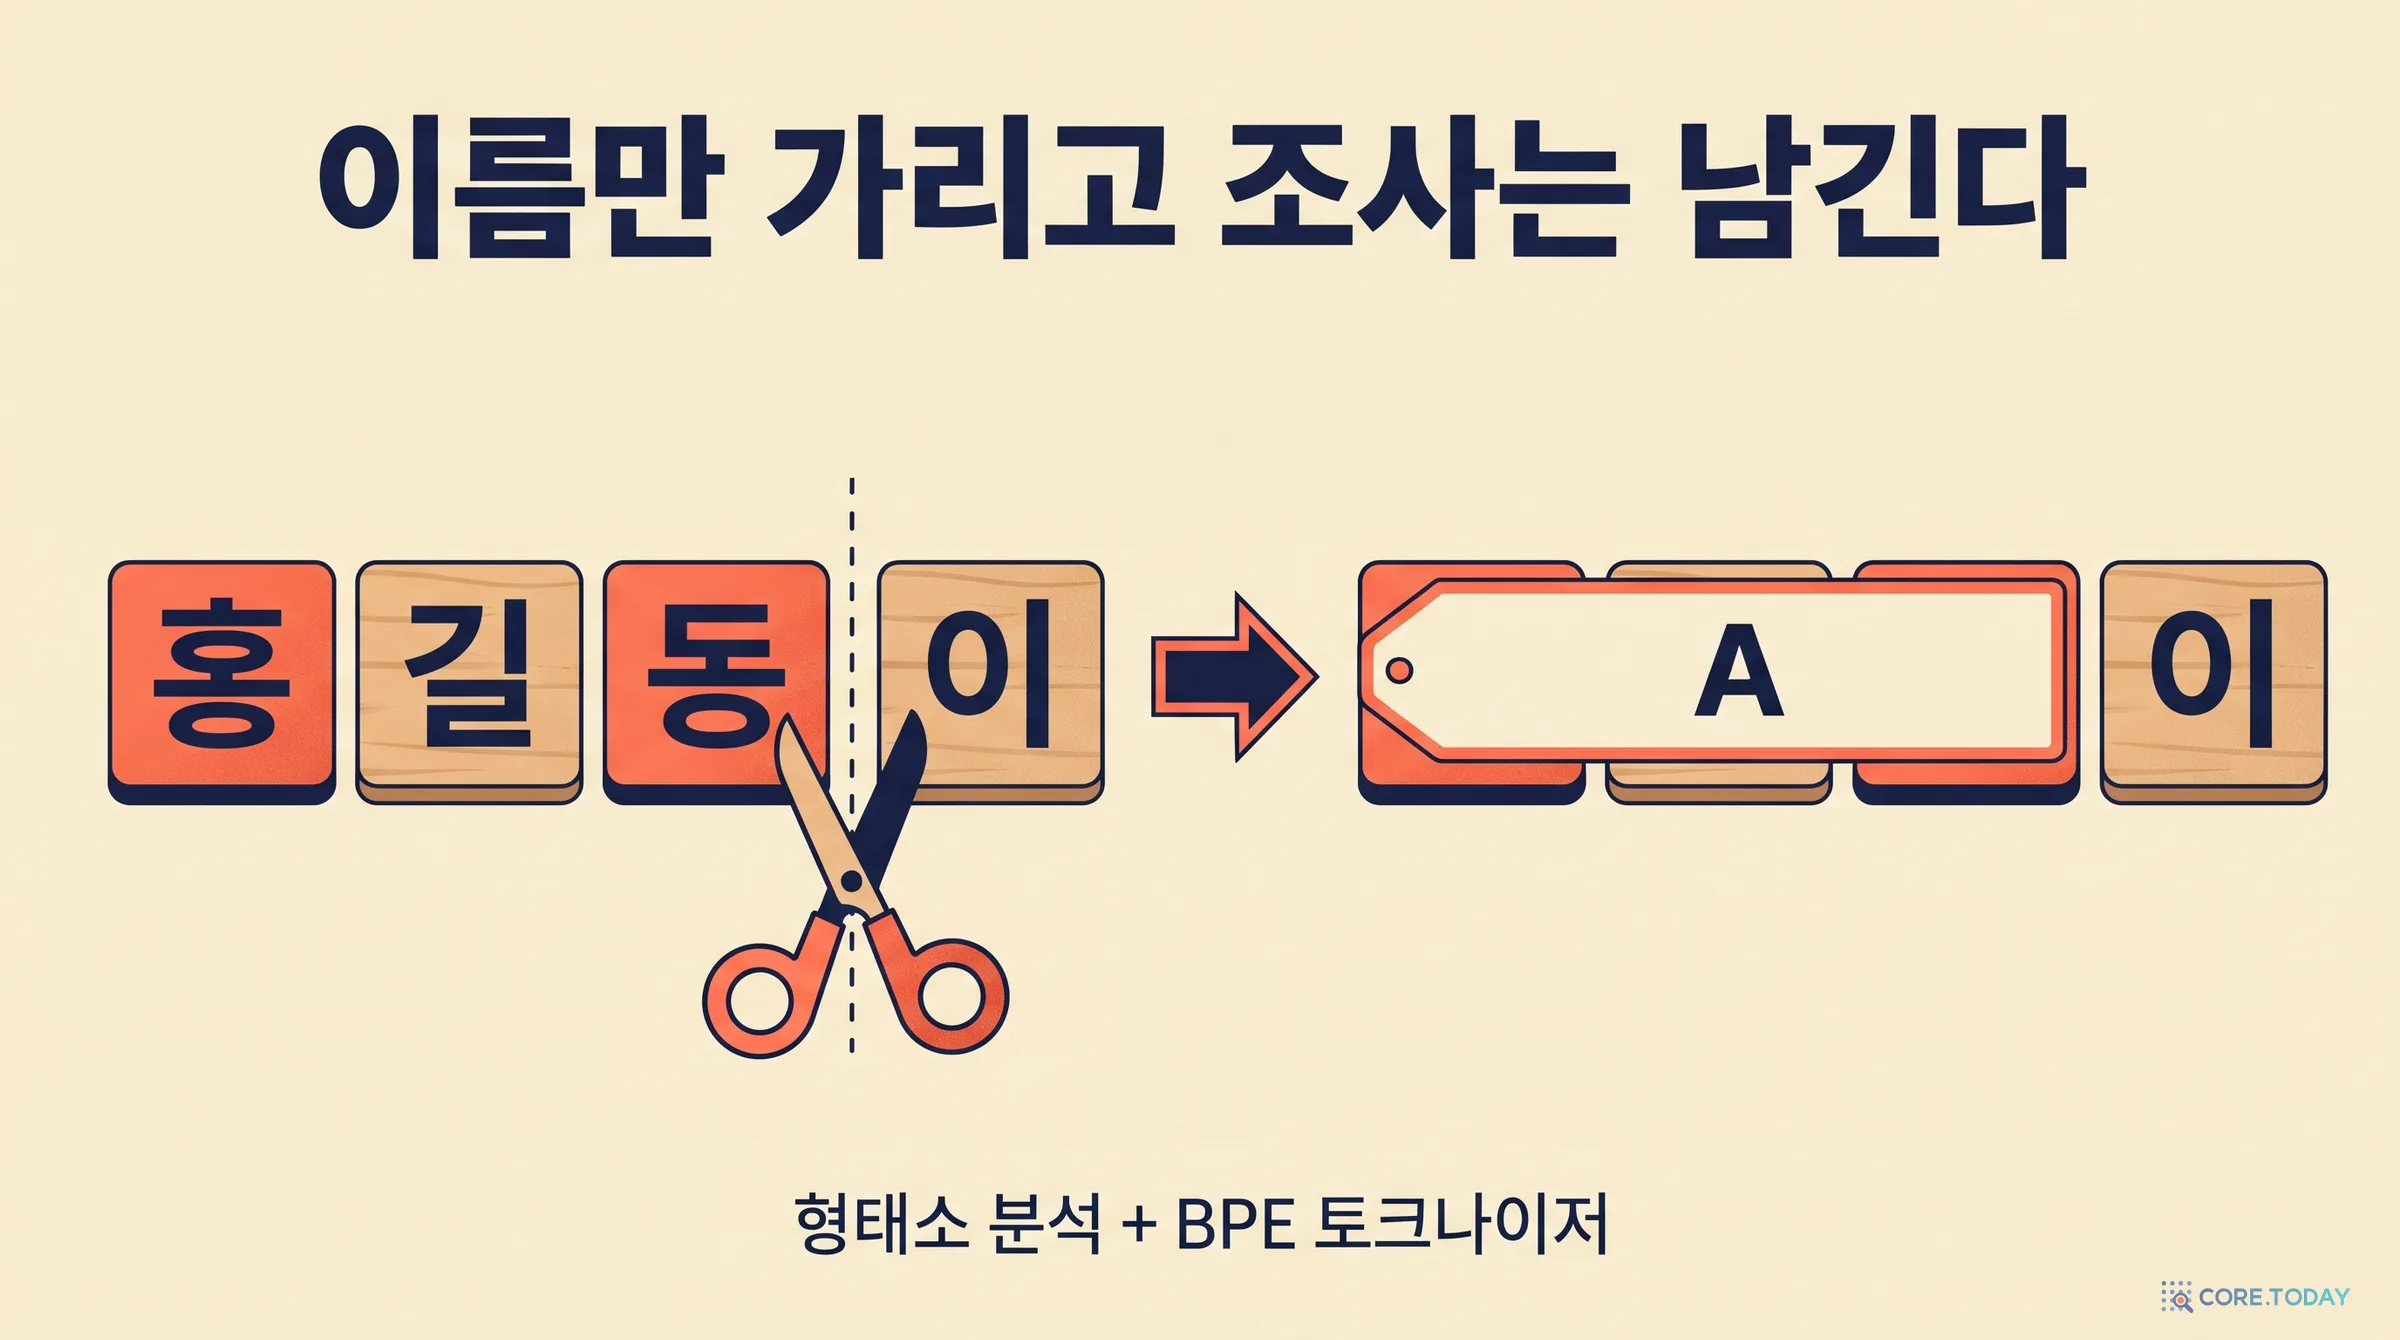
요즘 언어 모델이 쓰는 BPE(Byte Pair Encoding)는 말뭉치에서 자주 붙어 나오는 글자 쌍을 반복해서 합쳐 어휘를 만드는 방법입니다. 자주 나오는 덩어리는 한 토큰이 되고 드문 단어는 여러 조각으로 쪼개집니다. 이 방법은 글자의 통계만 볼 뿐 문법을 모릅니다. '길동이'가 자주 나오면 그것을 한 토큰으로 만들 수 있습니다. 그러면 이름 조각 '길동'과 조사 '이'가 한 토큰 안에 들어가, 이름만 가리고 조사는 남기는 일이 불가능해집니다.
논문의 해법은 두 단계입니다. 먼저 사전 기반 형태소 분석기 MeCab-ko로 문장을 형태소 단위로 가릅니다. MeCab-ko는 품사 사전을 써서 명사, 조사, 접사, 어미를 구분하므로 '홍길동이'를 '홍길동'과 '이'로 나눕니다. 그런 다음 각 형태소 안에서 BPE를 적용합니다. 사전에 없는 낯선 고유명사나 드문 법률 용어는 형태소 분석기가 통째로 한 덩어리로 넘기더라도 BPE가 아는 조각들로 쪼개 표현하므로, 어휘 밖 단어(OOV) 문제가 생기지 않습니다. 이 토크나이저는 말뭉치에서 뽑은 100만 문장으로 학습했습니다.
논문은 이 정밀함이 꼭 필요한 이유를 하나 더 듭니다. 실제 원본 판결문에는 식별자의 경계 표시가 없습니다. 학습 데이터에서는 ≪ ≫ 표지가 경계를 알려 주지만, 현장에서 모델이 받는 것은 "피고인 홍길동이 피해자 김영희를" 같은 날것의 문장입니다. 토크나이저가 이름과 조사를 같은 토큰에 넣어 버리면 모델이 아무리 정확해도 깨끗하게 가릴 수 없습니다.
표지를 특수 토큰으로
꼬리표 표지(≪내국인이름≫ 등)도 토크나이저가 알아야 합니다. 라벨 729개마다 여는 표지와 닫는 표지가 하나씩 있으므로 특수 토큰 1,458개를 어휘에 추가했습니다. 논문은 이것이 "고유명사가 다른 조사와 합쳐지지 않게" 하는 장치이기도 하다고 설명합니다. 표지가 하나의 토큰으로 굳어 있으면 그 앞뒤에서 토큰이 반드시 끊기기 때문입니다.
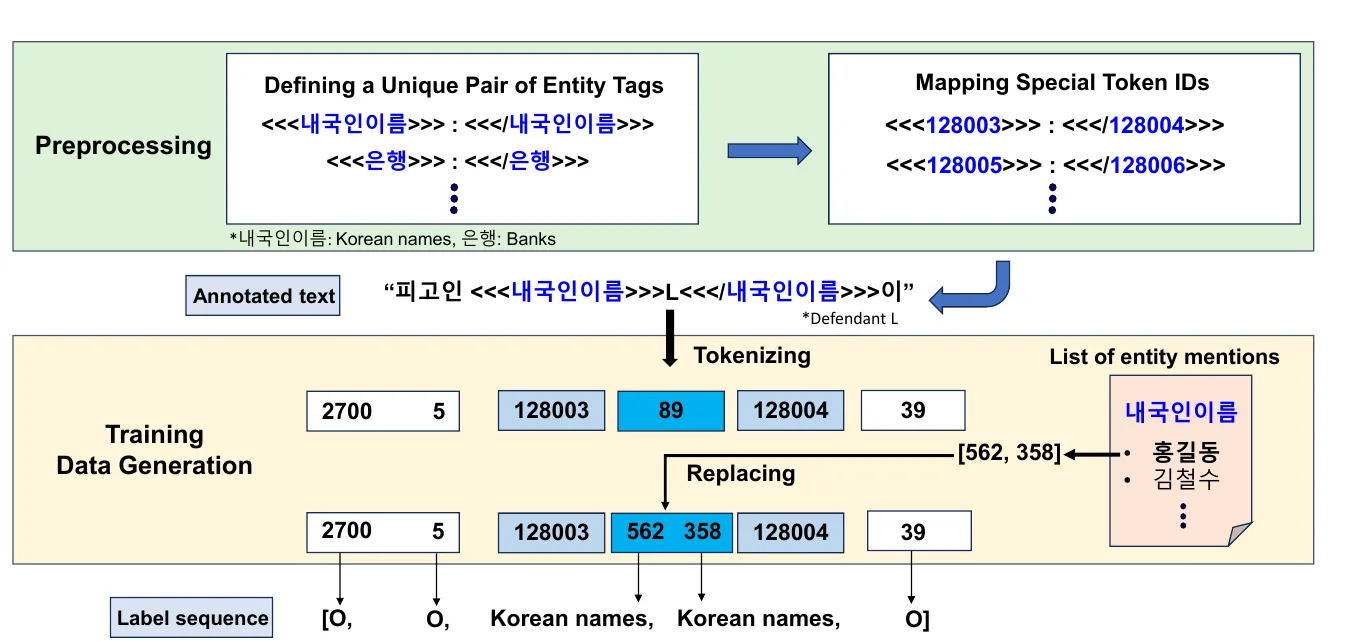
그림 3은 한 문장이 학습 데이터가 되는 과정을 숫자로 보여 줍니다. 차례로 따라가 보겠습니다.
전처리라벨마다 표지 한 쌍을 정하고 특수 토큰 번호를 준다. ≪내국인이름≫은 128003, ≪/내국인이름≫은 128004. ≪은행≫은 128005, ≪/은행≫은 128006.
토큰화주석 문장 "피고인 ≪내국인이름≫L≪/내국인이름≫이"를 토큰 번호로 바꾼다. [2700, 5, 128003, 82, 128004, 39]. 앞의 두 개가 '피고인', 82가 자리표시자 L, 39가 조사 '이'.
구간 찾기번호 열을 훑어 여는 표지(128003)와 닫는 표지(128004)를 찾고, 그 사이를 치환할 구간으로 잡는다. [128003, 82, 128004].
치환'내국인이름' 목록에서 값을 하나 뽑는다. '홍길동'의 토큰 번호는 [562, 358]. 구간 전체를 이것으로 바꾼다. [2700, 5, 562, 358, 39].
정답 열치환한 자리에는 그 라벨을, 나머지에는 O(해당 없음)를 적는다. [O, O, 내국인이름, 내국인이름, O]. 이 두 열이 학습 예시 하나다.
조사 '이'(39번)가 처음부터 끝까지 따로 떨어져 있고 정답도 O라는 점이 핵심입니다. 모델은 '홍길동'까지만 가리고 '이'는 건드리지 않도록 배웁니다.
그림과 본문 사이에 작은 어긋남이 둘 있습니다. 본문은 자리표시자 L의 토큰 번호를 82라고 쓰는데 그림에는 89로 그려져 있고, 본문은 치환 뒤 표지 토큰이 사라진 [2700, 5, 562, 358, 39]를 최종 열로 제시하는데 그림의 아랫줄에는 128003과 128004가 남아 있습니다. 그림 1의 '학습' 줄에는 표지 없는 열이 모델 입력으로 그려져 있고 실제 판결문에도 표지가 없으니, 본문 쪽이 맞는 설명으로 보입니다.
8장. 치환 목록, 그리고 에폭마다 갈아 끼우기
목록은 어디서 왔나
빈칸을 채울 값이 필요합니다. 라벨 729개 각각에 대해 "그 종류에 속하는 실제 이름들"의 목록을 만들어야 합니다. 논문은 두 가지 방법을 씁니다.
손으로 모으기. 729개 가운데 691개 라벨은 사람이 직접 모았습니다. 지방행정 인허가 데이터(localdata.go.kr), 공공데이터포털(data.go.kr), 서울 열린데이터광장 같은 공개 자료가 주된 출처입니다. 음식점, 미용실, 노래방, 약국처럼 인허가를 받아야 하는 업종은 전국의 실제 상호가 공개돼 있습니다. 특수한 종류는 그 분야의 사이트를 찾았습니다. 전시장 이름은 코엑스에서, 선박 이름은 한국선원복지고용센터에서, 고물상과 재활용 업체 이름은 관련 기관에서 가져왔습니다. 목표는 라벨마다 평균 100개 이상입니다.
규칙으로 만들기. 형식이 정해진 것은 규칙으로 생성했습니다. 한국 이름, 한국 주소, 주민등록번호, 전화번호, 계좌번호가 여기에 듭니다.
윤리 서술에서 연구진은 치환 목록을 공개 출처에서만 만들었고 개인정보보호법의 원칙을 따랐다고 밝힙니다. 가게 이름은 실제 상호지만 사람 이름과 번호는 규칙으로 만든 가짜이고, 가짜 이름과 실제 상호를 무작위로 짝지은 문장은 어떤 실제 사건도 가리키지 않습니다.
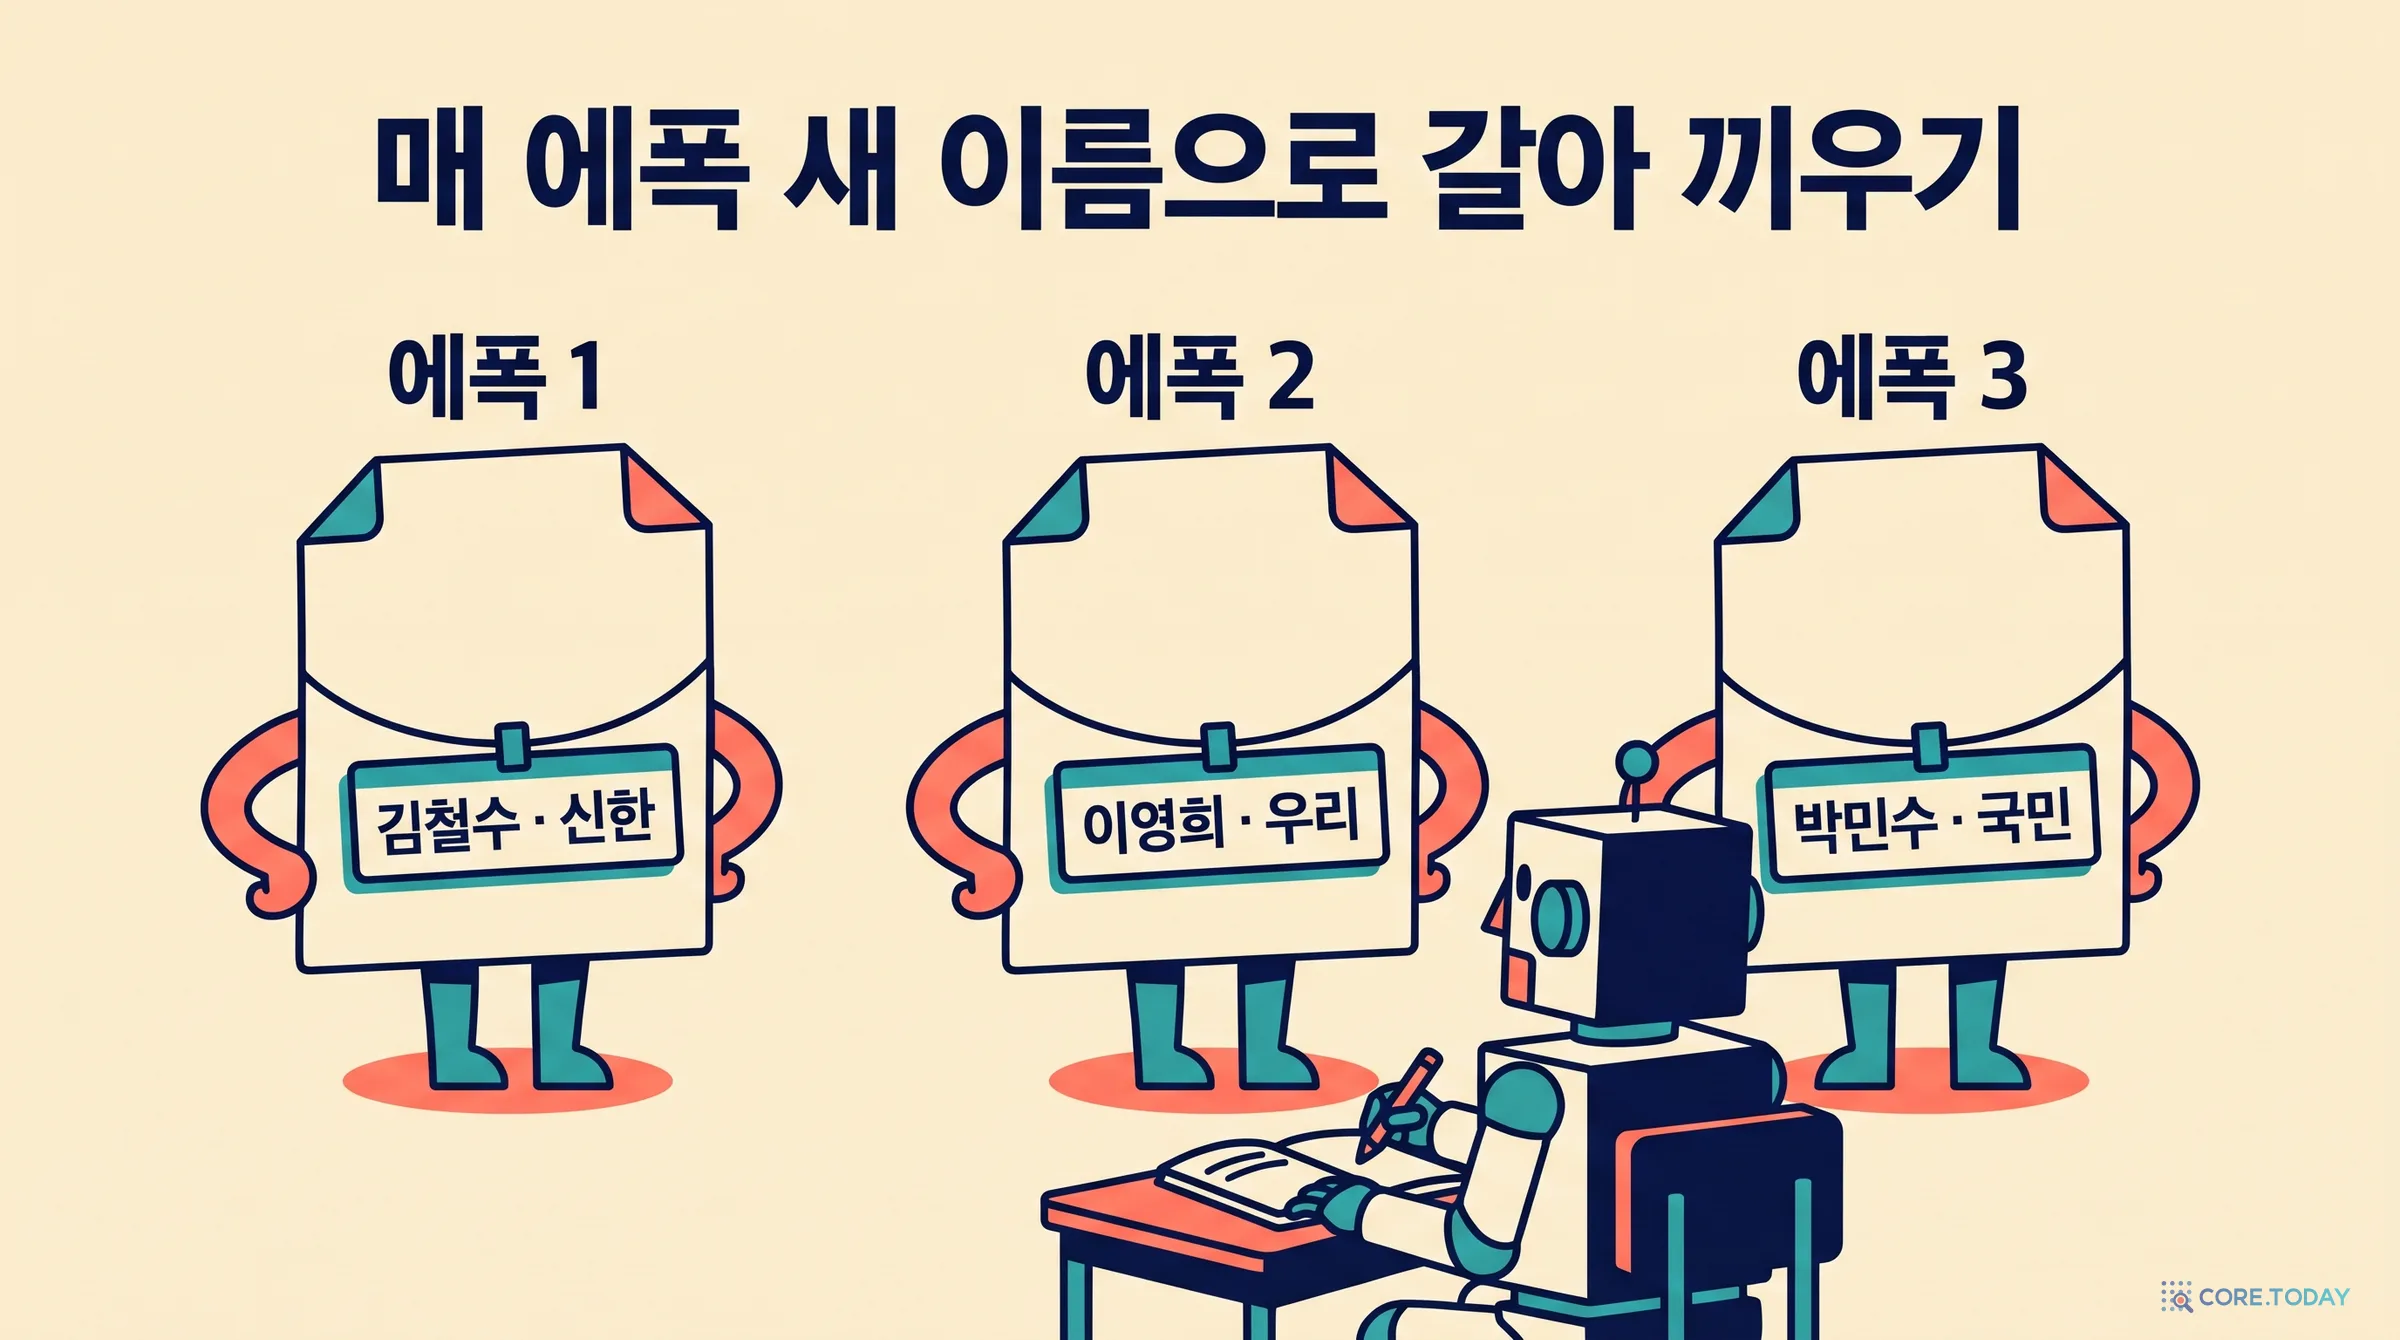
채우는 방법에 선택지가 있습니다. 학습을 시작하기 전에 한 번 채워서 고정할 수도 있고(단일 치환, Single Replacement), 학습이 한 바퀴(에폭) 돌 때마다 새로 뽑아 채울 수도 있습니다(에폭별 치환, Per-Epoch Entity Replacement). 논문은 30 에폭을 돌리므로, 에폭별 치환에서는 같은 판결문이 서른 가지 다른 이름을 달고 모델 앞에 나타납니다. 검증용 문서는 비교가 흔들리지 않도록 고정합니다.
왜 효과가 있을까요. 모델이 "김철수"라는 글자를 보고 이름이라고 판단한다면 그것은 암기입니다. 처음 보는 이름 "설보람"이 나오면 틀립니다. 같은 문장 틀에 이름이 계속 바뀌어 들어오면 모델은 글자 대신 자리를 봐야 합니다. "피고인" 다음, 조사 앞, 괄호 안 주민등록번호 앞. 문맥으로 판단하는 법을 배웁니다. 의료 비식별화 연구에서도 같은 발상이 쓰였고(PHICON, 2020), 이 논문의 저자 일부는 2024년 EMNLP에서 GPT-4로 임상 기록의 치환용 값을 만들어 일반화를 높이는 연구를 발표했습니다. Thunder-DeID는 그 방법을 판결문과 729개 라벨로 옮긴 것입니다.
결과는 위젯 아래쪽의 그래프대로입니다. 다섯 모델 모두 에폭별 치환에서 F1이 올랐고, 가장 작은 Thunder-DeID 360M이 가장 많이 올랐습니다(종류 F1 0.8660 → 0.8871, 이진 F1 0.9509 → 0.9654). 큰 모델의 이득은 0.1~0.6점으로 작습니다. 논문은 이 개선을 "유의하게 앞선다"고 표현하지만, 큰 모델에서의 차이는 시드 평균의 소수점 셋째 자리 수준이므로 "일관되게 조금 낫다"가 더 정확한 요약입니다. 뚜렷한 것은 재현율의 변화입니다. 360M의 이진 재현율은 0.9264에서 0.9679로 올랐습니다. 가려야 할 토큰 1,000개 가운데 놓치는 수가 74개에서 32개로 준 것입니다. 정밀도는 대체로 조금 내려갔습니다. 다양한 이름을 본 모델은 더 많이 가리는 쪽으로 움직입니다. 비실명화에서는 놓치는 것이 더 큰 사고이므로 바람직한 방향입니다.
논문이 말하지 않는 것: 조사가 안 맞는다
여기에 논문이 다루지 않은 부작용이 하나 있습니다. 한국어 조사는 앞 글자에 받침이 있는지에 따라 모양이 바뀝니다. "홍길동이"지만 "김철수가"입니다. 주석 문장의 자리표시자 뒤에는 조사가 이미 적혀 있습니다. "L이". 여기에 받침 없는 이름을 채우면 "김철수이"가 됩니다. 그림 1에도 흔적이 있습니다. "피고인 A는"의 A에 '김철수'를 넣으면 "김철수는"으로 맞지만, 만약 '홍길동'이 뽑혔다면 "홍길동는"이 됐을 것입니다.
코어닷투데이가 4장의 실측 자료를 같은 방식으로 만들었을 때도 "조현우과", "황보람가" 같은 문장이 그대로 나왔습니다. 이것이 학습에 해로운지는 논문의 실험으로는 알 수 없습니다. 모델이 조사의 모양에 기대지 않고 이름을 찾도록 만드는 뜻밖의 규제 효과가 있을 수도 있고, 반대로 "받침과 안 맞는 조사 앞의 글자는 식별자"라는, 실제 판결문에는 없는 단서를 배울 수도 있습니다. 시험 문서도 같은 방식으로 만들어졌으므로, 후자라면 시험 점수가 실제 성능보다 높게 나올 수 있습니다. 치환할 때 조사를 받침에 맞게 고쳐 주는 한 줄이면 없앨 수 있는 변수여서, 후속 연구에서 확인되면 좋을 대목입니다.
9장. 모델: 왜 작은 인코더를 처음부터 만들었나
인코더와 디코더
2026년의 언어 모델 대부분은 디코더입니다. 앞에 나온 토큰들을 보고 다음 토큰을 예측하는 구조로, 글을 왼쪽에서 오른쪽으로만 읽습니다. 글을 쓰는 데는 이 구조가 맞습니다. 그런데 꼬리표를 붙이는 일은 다릅니다. "나리 식당에서 근무하는"의 '나리'가 사람 이름인지 가게 이름인지는 뒤에 오는 '식당'을 봐야 압니다. 인코더는 문장 전체를 한꺼번에 보고 각 토큰의 표현을 만듭니다. 앞뒤를 모두 본 뒤에 판단하므로 토큰 분류에 구조적으로 유리하고, 같은 일을 훨씬 작은 크기로 해냅니다.
Thunder-DeID는 인코더 계열인 DeBERTa-v3를 바탕으로 합니다. DeBERTa는 토큰의 내용과 위치를 따로 표현해 주의(attention)를 계산하고, v3는 ELECTRA 방식의 사전학습(일부 토큰을 바꿔치기한 뒤 어느 것이 바뀌었는지 맞히게 하는 과제)을 씁니다. 연구진은 공개된 가중치를 가져다 쓰지 않고, 자신들의 토크나이저에 맞춰 처음부터 사전학습했습니다. 7장의 형태소 기반 토크나이저를 쓰려면 어휘가 달라지므로 기존 모델의 가중치를 그대로 쓸 수 없기 때문입니다.
항목
Thunder-DeID 360M
Thunder-DeID 800M
Thunder-DeID 1.5B
Polyglot-Ko
EXAONE-3.5
구조
인코더
인코더
인코더
디코더
디코더
파라미터
3.7억
8억
15억
13억
24억
은닉 차원 / 층 / 헤드
1024 / 24 / 16
1280 / 36 / 20
2048 / 24 / 32
2048 / 24 / 16
2560 / 30 / 32
어휘 크기
32,000
32,000
128,000
30,080
102,400
사전학습 말뭉치
140억 토큰 (한 70억 / 영 70억)
300억 (한 150억 / 영 150억)
600억 (한 220억 / 영 380억)
—
—
사전학습 장비·시간
H100 32장 · 2시간
H100 32장 · 9시간
H100 32장 · 19시간
—
—
미세조정
H100 8장 · 배치 32 · 최대 2,048토큰 · 30 에폭
논문 표 E.1을 옮긴 것입니다. 몇 가지 설계 선택에 설명이 붙어 있습니다.
사전 층 정규화(pre-LayerNorm). 원래 DeBERTa-v3는 각 층의 출력에 정규화를 거는 사후 방식인데, 연구진은 큰 모델에서 사후 방식이 수렴하지 않았고 같은 설정에서 사전 방식은 안정적으로 수렴했다고 보고합니다.
작은 모델에는 작은 어휘. 360M과 800M은 어휘를 32,000개로, 1.5B는 128,000개로 잡았습니다. 어휘가 크면 임베딩 표가 커지는데, 작은 모델에서는 이 표가 본체에 비해 지나치게 커지기 때문입니다.
한국어와 영어 두 언어. 공개 웹에서 모은 76.7GB의 한·영 말뭉치로 사전학습했습니다.
기준선으로는 한국어 디코더 두 개(Polyglot-Ko 1.3B, EXAONE-3.5 2.4B)를 같은 데이터로 미세조정해 토큰 분류를 시켰습니다. "LLM에게 프롬프트로 시키는 것"과의 비교가 아니라 "디코더를 분류기로 미세조정한 것"과의 비교라는 점을 기억해 둘 필요가 있습니다.
모델 크기 표기에는 혼선이 있습니다. 논문 본문은 가장 작은 모델을 370M이라고 쓰고 표는 360M이라고 씁니다. 연구실 소개 페이지는 340M·750M·1.5B로 적고 있어, 공개 과정에서 구성이 조금 바뀐 것으로 보입니다. 이 글에서는 표의 표기(360M·800M·1.5B)를 따릅니다.
숫자 하나가 눈에 띕니다. 가장 큰 모델의 사전학습이 H100 32장으로 19시간입니다. 대학 연구실이 감당할 수 있는 규모이고, 법원이 자체 데이터로 다시 학습시키는 것도 현실적인 범위입니다. 수천억 파라미터 모델의 학습과는 자릿수가 다릅니다.
10장. 결과 읽기
두 가지 채점
논문은 성능을 두 가지 방식으로 잽니다. 무엇을 재는지가 다르고, 그 차이가 이 과제의 성격을 잘 보여 줍니다.
이진 토큰 F1(binary token-level). 꼬리표의 종류는 무시하고 "가려야 하는 토큰인가, 아닌가"만 봅니다. 이름을 은행이라고 잘못 불렀어도 가리기만 했으면 맞은 것입니다. 사생활 보호에 직결되는 점수입니다. 논문도 "가려야 할 토큰을 하나만 놓쳐도 곧바로 그 사람이 특정될 가능성이 커진다"며 이 지표가 핵심이라고 적습니다.
토큰 Micro F1(token-level). 729가지 종류까지 맞아야 맞은 것으로 칩니다. 후처리 품질에 직결됩니다. 종류가 틀리면 계좌번호 자리에 '전화번호 1 생략'이 들어가고, 사업체로 잘못 분류되면 'A'가 들어가 예규에 어긋납니다.
F1은 정밀도와 재현율의 조화평균입니다. 정밀도는 모델이 가리겠다고 한 것 가운데 실제로 가려야 했던 것의 비율이고(낮으면 과하게 지워 판결문이 읽기 어려워짐), 재현율은 가려야 했던 것 가운데 모델이 가린 것의 비율입니다(낮으면 식별자가 그대로 노출됨). 아래 위젯에서 토큰을 눌러 예측을 바꿔 가며 두 점수가 어떻게 갈라지는지 확인할 수 있습니다.
표 2: 전체 성적
시험 문서는 671건(민사 300, 형사 301, 행정 70)이고, 모든 수치는 무작위 시드 3개의 평균입니다. 에폭별 치환 기준으로 정리하면 이렇습니다.
모델
이진 정밀도
이진 재현율
이진 F1
종류 정밀도
종류 재현율
종류 Micro F1
Polyglot-Ko 1.3B
0.9710
0.9695
0.9701
0.8772
0.8758
0.8765
EXAONE-3.5 2.4B
0.9688
0.9666
0.9677
0.8762
0.8742
0.8752
Thunder-DeID 360M
0.9628
0.9679
0.9654
0.8848
0.8895
0.8871
Thunder-DeID 800M
0.9757
0.9826
0.9791
0.9073
0.9137
0.9105
Thunder-DeID 1.5B
0.9755
0.9862
0.9808
0.9021
0.9120
0.9071
읽을 거리를 다섯 가지로 정리합니다.
하나, 가리는 일은 꽤 잘합니다. 1.5B 모델의 이진 재현율 0.9862는 가려야 할 토큰 1,000개 가운데 986개를 가린다는 뜻입니다. 3장의 다른 나라 수치(F1 0.89~0.96)와 견줘도 높은 편입니다. 다만 데이터와 채점 단위가 다르니 직접 비교는 아닙니다.
둘, 종류를 맞히는 일은 그보다 어렵습니다. 이진 F1 0.98과 종류 F1 0.91 사이의 7점이 "가리긴 했는데 종류는 틀린" 토큰들입니다. 선택지가 729개라는 점을 생각하면 0.91은 낮지 않습니다. 틀리는 곳은 주로 드문 라벨입니다. 논문은 '뷔페'(외식업)를 '기계설비회사'(제조업)로, '불특정제품명'(상품 일반)을 '불특정회사명'(기업 일반)으로 잘못 붙인 사례를 듭니다. 뒤의 것은 주석자도 완전히 비실명화된 문장만 보고는 A가 제품인지 회사인지 판단하기 어려웠던 경우라고 합니다. 정답 자체가 흔들리는 영역입니다.
셋, 크다고 낫지는 않았습니다. 종류 F1은 800M(0.9105)이 1.5B(0.9071)보다 높습니다. 논문은 학습 문서가 5,361건뿐인 상황에서 1.5B가 드문 라벨에 과적합했을 수 있다고 해석하고, 차이가 아주 작아 데이터를 늘리거나 규제를 강하게 하면 사라질 수 있다고 덧붙입니다. 실무 관점에서는 좋은 소식입니다. 절반 크기 모델로 같은 성능이 나온다는 뜻이기 때문입니다.
넷, 작은 인코더가 큰 디코더를 이깁니다. 360M 모델(종류 F1 0.8871)이 4배 가까이 큰 Polyglot-Ko 1.3B(0.8765)와 6배 넘게 큰 EXAONE-3.5 2.4B(0.8752)를 앞섭니다. 9장의 구조 이야기가 숫자로 확인되는 대목입니다. 다만 이진 F1에서는 360M(0.9654)이 두 디코더(0.9701, 0.9677)보다 조금 낮습니다. "가장 작은 모델도 기준선을 앞선다"는 논문의 문장은 종류 F1에 한한 이야기입니다.
다섯, 평균 뒤에 역전이 숨어 있습니다. 부록의 사건 유형별 표를 보면 손해배상 사건의 종류 F1은 Polyglot-Ko가 0.8730으로 가장 높고, Thunder-DeID는 1.5B가 0.8179, 360M은 0.7493에 그칩니다. 다른 아홉 유형에서는 Thunder-DeID가 앞서는데 이 한 유형에서만 5점 넘게 뒤집힙니다. 반대로 임대차보증금과 상해 사건에서는 Thunder-DeID가 0.95를 넘깁니다. 5장의 표에서 손해배상은 문서당 식별자가 가장 많은 축이었습니다. 교통사고, 의료사고, 공사 분쟁처럼 온갖 사건이 손해배상이라는 한 이름 아래 모이므로 등장하는 업종과 시설이 다양하고 드문 라벨이 많을 것이라고 짐작할 수 있습니다. 논문 본문은 이 역전을 언급하지 않습니다. 위젯에서 '종류까지 · 손해배상'을 골라 직접 확인해 보세요.
"8~15%를 크게 앞선다"는 말에 대하여
논문은 결과 절 끝에서 Thunder-DeID가 법원이 쓰는 규칙 기반 시스템(전체 정확도 8~15%)을 크게 앞선다고 씁니다. 방향은 맞겠지만 이 비교에는 주의가 필요합니다. 조사해 보면 15%는 2019년 국회 토론회 자료에 나온 '정확도'이고 8%는 2025년 법원행정처 보고서에 나온 '처리율'입니다. 둘 다 토큰 단위 F1이 아니고, 문서 한 건을 사람 손 없이 끝낼 수 있었는지에 가까운 지표로 보입니다. 같은 기준으로 Thunder-DeID를 재면 수치는 0.98보다 훨씬 낮을 것입니다. 식별자가 10개인 판결문에서 토큰 하나라도 놓치면 그 문서는 '자동 처리 실패'이기 때문입니다. 또 법원 시스템은 실제 원문에서 잰 값이고 Thunder-DeID는 재구성한 문서에서 잰 값입니다. 두 숫자는 나란히 놓을 수 있는 숫자가 아닙니다.
11장. 한계와 반론
논문이 스스로 밝힌 한계 두 가지에, 읽으면서 보인 것들을 더합니다.
1. 진짜 원문으로 시험하지 못했습니다. 논문이 첫째로 꼽는 한계입니다. 시험 문서 671건도 학습 문서와 같은 방식, 곧 비실명 판결문에 치환 목록의 값을 채워 만든 것입니다. 실제 원문에는 치환 목록에 없는 이름, 오타, 띄어쓰기 오류, 줄바꿈으로 끊긴 주소, 표와 별지가 있습니다. 또 5장에서 봤듯 공개 판결문에는 이름이 통째로 사라져 자리표시자조차 없는 곳이 있는데, 그런 자리는 학습에도 시험에도 들어가지 않습니다. 0.98이라는 숫자는 "재구성한 세계에서의 0.98"입니다. 실제 성능은 법원만 잴 수 있습니다.
2. 세 분야의 열 가지 사건만 다뤘습니다. 가사, 소년, 파산, 특허 사건은 없습니다. 논문은 직접 식별자는 사건 종류와 무관하게 비슷하니 어느 정도 통할 것이라고 기대하지만 확인하지는 않았습니다. 가사 사건의 가족 관계, 특허 사건의 기술 명칭처럼 그 분야에만 있는 준식별자는 729개 라벨 밖에 있을 수 있습니다.
3. 2,048토큰에서 잘립니다. 부록 E에 조용히 적힌 문장입니다. 입력이 2,048토큰을 넘으면 뒤를 잘라 버리므로 "매우 긴 판결문, 특히 민사와 행정 사건은 전부 다뤄지지 않을 수 있다"고 합니다. 실제로 쓰려면 긴 문서를 겹치게 나눠 처리하고 결과를 이어 붙이는 장치가 필요합니다. 그때 문서 앞에서 A였던 사람이 뒤 조각에서도 A가 되도록 맞추는 일은 모델 밖의 문제로 남습니다.
4. 98.6%는 사람을 대체하는 숫자가 아닙니다. 식별자 하나가 3토큰쯤이고 판결문 한 건에 식별자가 10개라고 가정하면, 가려야 할 토큰은 30개입니다. 토큰 재현율 0.986에서 30개를 모두 가릴 확률은 단순 계산으로 약 65%입니다. 세 건 가운데 한 건에는 무언가 남습니다. 3장에서 본 다른 나라 시스템이 모두 사람 검수를 전제로 설계된 까닭입니다. 이 모델의 현실적인 역할은 "사람 대신"이 아니라 "사람이 처음부터 찾는 대신 모델이 표시한 것을 확인하는" 쪽입니다. 그것만으로도 병목은 크게 풀립니다.
5. 찾았다고 해서 안전한 것은 아닙니다. 논문의 채점은 "법원 직원이 가린 곳을 모델도 가렸는가"입니다. 그런데 2장의 재식별 사건들은 지침대로 다 가린 뒤에 일어났습니다. 유럽인권재판소 판결로 만든 TAB 벤치마크(Pilán 외, 2022)처럼, 가린 결과물에서 남은 단서로 당사자를 다시 찾을 수 있는지를 직접 재는 평가가 따로 있습니다. LLM이 텍스트에서 개인 속성을 추론하는 능력이 커지면서(Staab 외, ICLR 2024) 이 관점은 더 중요해졌습니다. Thunder-DeID는 이 평가를 하지 않았습니다. 사건 날짜, 금액, 범행 수법의 조합처럼 729개 라벨로도 잡히지 않는 단서는 여전히 남습니다.
6. 문맥 판단은 모델이 얼마나 배웠는지 알 수 없습니다. 2장의 교도소 예처럼 같은 단어가 어떤 판결문에서는 가려지고 어떤 판결문에서는 남습니다. 모델이 이 구분을 배웠는지, 아니면 "교도소 이름은 일단 가린다"를 배웠는지는 평균 F1로는 알 수 없습니다. 학습 데이터에서는 가려진 기관만 꼬리표가 달리고 가려지지 않은 기관은 O이므로 원리상 배울 수 있는 구조이긴 합니다. 하지만 그런 사례가 몇 건이고 정확도가 얼마인지는 보고되지 않았습니다.
7. 조사 불일치. 8장에서 다룬 문제입니다. 치환한 이름과 뒤따르는 조사가 맞지 않는 문장이 학습과 시험에 모두 들어갑니다.
8. 자잘한 불일치들. 모델 크기(360M 대 370M), 그림 3의 토큰 번호(82 대 89), 라벨 수(본문 729개, 부록 D에서 세면 710개 남짓)가 조금씩 어긋납니다. 결론을 흔드는 것은 아니지만 재현하려는 사람은 알아 둘 일입니다.
9. 공개 자료의 접근 상태. 논문과 연구실 페이지는 데이터셋과 모델을 허깅페이스에 공개했다고 안내합니다. 이 글을 쓰는 2026년 11월 12일 현재, 허깅페이스의 해당 모델 주소는 로그인 없이는 열리지 않았고(401) 공개 검색에도 나타나지 않았습니다. 승인제로 운영되는 것인지 일시적인 상태인지는 확인하지 못했습니다. 코어닷투데이가 4장의 실측에서 Thunder-DeID 자체를 돌려 비교하지 못한 이유입니다.
2025년 12월 12일 국회는 확정되지 않은 하급심 형사 판결문도 열람·복사할 수 있게 하고 문자열 검색을 허용하는 형사소송법 개정안을 통과시켰습니다. 시행은 공포 2년 뒤로, 보도에 따르면 2027년 12월입니다. 형사 사건은 해마다 수십만 건이 선고되고, 5장의 표에서 봤듯 형사 판결문에는 피해자와 증인, 범행 장소가 촘촘히 적혀 있습니다. 확정 전 판결문은 사건이 아직 진행 중이라 민감도도 더 높습니다. 시행까지 남은 1년 남짓이 비실명화 처리 능력을 끌어올려야 하는 시간입니다.
법원이 직접 AI를 짓고 있다
2025년 4월 출범한 사법부 인공지능위원회는 같은 해 7월 판결문 공개와 활용에 관한 건의를 내면서 비식별 처리 비용을 주요 장애로 꼽았습니다. 같은 달 법원행정처는 재판업무 지원 AI 플랫폼 구축 사업을 KT 컨소시엄(엘박스, 코난테크놀로지 등)과 계약했습니다. 약 4년간 145억 원 규모입니다. 2026년 초에는 시범 운영 계획이 보도됐고, 6월에는 자연어로 묻는 지능형 판결문 검색 추진이 발표됐습니다. 논문이 인용한 "8%"의 출처가 바로 이 사업의 사전 계획 보고서입니다. 법원이 자기 문제를 숫자로 적고 예산을 붙였다는 뜻입니다. 다만 Thunder-DeID가 법원에 채택됐다는 공개된 근거는 찾지 못했습니다.
코어닷투데이가 법률 AI 생태계 지도 2026에서 정리했듯, 한국 리걸테크의 원료는 판결문입니다. 2024년 엘박스가 케이스노트를 인수하면서 밝힌 두 회사의 전문 판례는 합쳐서 약 500만 건입니다. 이 숫자가 얼마나 빨리 늘어나는지는 법원이 얼마나 빨리 지우느냐에 달려 있습니다.
전용 개인정보 모델이 쏟아졌다
Thunder-DeID가 택한 길, 곧 "작은 전용 모델로 꼬리표를 붙인다"는 2026년에 주류가 됐습니다.
OpenAI는 2026년 4월 개인정보 탐지 전용 모델 Privacy Filter를 오픈 웨이트로 공개했습니다. 15억 파라미터 규모이고 8개 범주를 찾습니다. LLM을 만드는 회사가 개인정보 탐지에는 생성 모델이 아니라 분류 모델을 내놓았다는 점이 눈에 띕니다.
GLiNER 계열은 라벨 이름을 입력으로 받아 학습 없이 새 종류를 찾습니다. 60개가 넘는 범주의 개인정보 전용 모델들이 공개돼 있습니다. 코어닷투데이가 GLiNER2 해부에서 한국어로 직접 재 봤을 때 가장 큰 걸림돌은 역시 조사였습니다. 공백 기준으로는 조사가 붙은 채 뽑혀 엄격 F1이 34.9였고, 끝의 조사를 잘라 내자 62.5로 올랐습니다. Thunder-DeID가 토크나이저 단계에서 푼 문제를 범용 모델은 후처리로 풀어야 했던 셈입니다.
같은 연구실은 후속작 Thunder-DeID+를 EMNLP 2026에 발표했습니다. 초록에 따르면 한국어의 교착어 구조 때문에 BPE가 식별자와 조사를 자주 합친다는 문제를 정면으로 다루고, 경계를 인식하는 토크나이저로 엄격한 어절 단위 F1을 0.76~0.77에서 0.87~0.88로 올렸습니다. 개선은 모델 크기가 아니라 주로 정밀도에서 나왔습니다. 그리고 판결문으로 학습한 모델을 일반 민감 문서 1,000건으로 미세조정해 0.93을 얻었습니다. 주목할 점은 평가 방식을 토크나이저에 의존하지 않는 어절 단위로 바꾸고 전체 길이 판결문으로 쟀다는 것입니다. 그 기준에서의 출발점이 0.76~0.77이었다는 사실은, 11장에서 짚은 대로 토큰 단위 0.98이라는 숫자를 조심해서 읽어야 함을 저자들 스스로 보여 준 것이기도 합니다.
접근
강점
약점
맞는 자리
정규식·사전 규칙
형식이 정해진 번호는 거의 완벽. 빠르고 설명 가능.
이름, 상호, 문맥에 따라 달라지는 것은 못 잡음.
주민등록번호·계좌·전화번호의 안전망
전용 토큰 분류 모델 (Thunder-DeID)
문장을 바꿀 수 없는 구조. 종류까지 세밀. 내부망에서 실행.
학습한 분야 밖에서는 불확실. 주석 데이터가 필요.
대량 처리의 본체
제로샷 추출기 (GLiNER 계열)
라벨을 글로 적으면 바로 동작. 가볍다.
한국어 조사 경계, 세밀한 분류는 약함.
새 문서 종류의 빠른 출발점
LLM에게 다시 쓰게 하기
지시만으로 시작. 문맥 이해가 넓음.
문장을 바꿈. 형식 번호를 놓침. 원문 반출 문제.
공문서에는 부적합
LLM에게 가리킬 곳만 말하게 하기
문장 보존. 문맥 판단 가능.
재현율이 부족. 느리고 비쌈.
전용 모델이 놓친 문맥 단서의 2차 검토 (내부 모델로)
2026년의 그림은 "어느 하나"가 아니라 조합입니다. 규칙이 번호를 잡고, 전용 모델이 이름과 상호와 주소를 종류까지 붙여 가리고, 내부망에서 도는 LLM이 "이 교도소 이름이 이 사건에서 사람을 특정하는가" 같은 문맥 질문을 검토하고, 사람이 마지막에 확인합니다. Thunder-DeID는 이 가운데 본체에 해당하는 부품입니다.
판결문 밖에서도 같은 문제
이 구조는 법원만의 것이 아닙니다. 기업이 고객 상담 기록을 모델 학습에 쓰려 할 때, 병원이 진료 기록을 연구에 내놓을 때, 에이전트가 사내 문서를 외부 모델에 보내기 전에 걸러야 할 때 모두 같은 질문을 만납니다. 식별자만 지우고 나머지는 한 글자도 바꾸지 않을 수 있는가. 이름 말고 무엇이 사람을 드러내는가. 원문을 밖으로 내보내지 않고 처리할 수 있는가. Thunder-DeID가 판결문에서 내놓은 답, 곧 귀납적으로 만든 세밀한 분류, 빈칸 채우기로 만든 학습 데이터, 언어의 문법에 맞춘 토크나이저, 내부에서 도는 작은 인코더는 다른 분야에도 그대로 옮길 수 있는 설계입니다. 후속작이 "판결문에서 더 넓은 민감 문서로"를 제목에 건 것도 같은 방향입니다.
민감한 문서를 비실명화해야 하는 팀을 위해, 이 논문과 주변 연구에서 얻은 것을 질문으로 정리합니다.
무엇을 지울지
직접 식별자 목록만 갖고 있지는 않습니까. 이름과 번호를 지운 뒤 남는 직장·가게·장소·날짜로 사람을 좁힐 수 있는지 2장의 깔때기처럼 따져 봤습니까.
분류 체계를 법조문이나 책상에서 만들었습니까, 실제로 사람이 가린 사례에서 귀납했습니까. 후자가 빈틈이 적습니다.
종류마다 치환 방법이 다릅니까. 그렇다면 '찾기'가 아니라 '종류까지 맞히기'가 요구 사항입니다.
어떻게 지울지
출력의 형식이 원문을 바꿀 수 없게 되어 있습니까. 생성 모델에게 본문을 다시 쓰게 하고 있다면, 띄어쓰기 하나까지 원문과 비교하는 검사를 붙였습니까.
형식이 정해진 번호는 규칙으로 따로 잡고 있습니까. 4장의 실측에서 LLM은 이름은 다 가리고 주민등록번호는 다 남겼습니다.
한국어 조사를 어떻게 처리합니까. 식별자와 조사가 같은 토큰에 들어가지 않습니까. 가린 뒤 조사가 사라지거나 어색해지지 않습니까.
같은 사람이 문서 전체에서 같은 자리표시자를 받습니까. 서로 다른 개체가 같은 글자로 뭉개지지 않습니까.
문서를 덮어 가리는 것이 아니라 글자를 실제로 바꿉니까. 2026년 9월의 사고는 가린 것처럼 보이지만 지워지지 않은 처리에서 나왔습니다.
어디서 돌릴지
원문이 조직 밖으로 나갑니까. 비실명화 전의 문서는 정의상 가장 민감한 상태입니다.
내부 장비로 돌릴 수 있는 크기입니까. 수억~십수억 파라미터의 인코더는 GPU 한 장으로 충분합니다.
어떻게 확인할지
토큰 단위 점수만 보고 있지는 않습니까. 문서 단위로 "하나도 놓치지 않은 비율"을 따로 재십시오. 토큰 재현율 98.6%는 식별자 10개짜리 문서에서 세 건 가운데 한 건에 무언가 남는 수준입니다.
평균 뒤의 약한 유형을 봤습니까. 이 논문에서는 손해배상 사건이 그랬습니다.
합성한 시험 자료로 잰 점수와 실제 문서에서의 성능을 구분하고 있습니까.
가린 결과물을 놓고 "다시 찾을 수 있는가"를 시험해 봤습니까. 지침대로 가렸는지와 안전한지는 다른 질문입니다.
사람 검수가 설계에 들어 있습니까. 모델이 표시하고 사람이 확인하는 구조가 지금까지 모든 나라 법원의 답이었습니다.
맺으며
Thunder-DeID의 성과를 한 줄로 줄이면 "이진 F1 0.98"이겠지만, 이 논문에서 오래 남을 것은 숫자보다 문제를 푼 방식입니다. 원본을 구할 수 없다는 제약을 "지워진 자리가 곧 정답의 위치"라는 관찰로 뒤집었습니다. "그 밖에 특정할 수 있는 정보"라는 열린 문장을, 법원 직원들이 실제로 가린 4만 8천 개의 자리에서 귀납해 729개의 이름 붙은 항목으로 닫았습니다. 한국어에서는 이름에 조사가 붙는다는, 한국어 화자라면 누구나 아는 사실을 토크나이저 설계의 출발점으로 삼았습니다. 그리고 판결문은 다시 쓰는 대상이 아니라 꼬리표를 붙이는 대상이라는 원칙을 모델 구조로 못 박았습니다.
공개와 보호 사이의 저울은 기술로 없어지지 않습니다. 무엇이 사람을 특정하는지는 끝내 문맥의 문제이고, 마지막 확인은 사람의 몫으로 남을 것입니다. 하지만 저울을 다는 데 드는 시간과 비용이 줄면, 그동안 비용 때문에 닫혀 있던 문이 열립니다. 판결문 한 건을 읽기 위해 1,000원과 사건번호가 필요했던 시절에서, 누구나 판결을 검색하고 읽는 시절로 가는 길목에 이런 작은 모델들이 서 있습니다.
참고문헌
이 글이 다룬 논문
Sungeun Hahm, Heejin Kim, Gyuseong Lee, Hyunji M. Park, Jaejin Lee. Thunder-DeID: Accurate and Efficient De-identification Framework for Korean Court Judgments. arXiv:2506.15266 (v3, 2025-10-16). Findings of EMNLP 2025, pp. 12728–12755. arxiv.org/abs/2506.15266 · aclanthology.org/2025.findings-emnlp.682
Gyuseong Lee 외. Thunder-DeID+: Boundary-Aware Korean De-identification from Court Judgments to Broader Sensitive Documents. EMNLP 2026. aclanthology.org/2026.emnlp-main.2582
Latanya Sweeney. Simple Demographics Often Identify People Uniquely. Carnegie Mellon University, Data Privacy Working Paper 3, 2000. dataprivacylab.org
Arvind Narayanan, Vitaly Shmatikov. Robust De-anonymization of Large Sparse Datasets. IEEE S&P 2008. arxiv.org/abs/cs/0610105
Kerstin Noëlle Vokinger, Urs Jakob Mühlematter. 스위스 연방대법원 판결 재식별 연구, Jusletter 2019. 보도: swissinfo.ch
Dominic Deuber 외. 독일 판결문 재식별 실험, USENIX Security 2023. usenix.org
Robin Staab 외. Beyond Memorization: Violating Privacy via Inference with Large Language Models. ICLR 2024. arxiv.org/abs/2310.07298
Ildikó Pilán 외. The Text Anonymization Benchmark (TAB). Computational Linguistics 48(4), 2022. aclanthology.org/2022.cl-4.19
Giulio Salierno 외. GiusBERTo. arXiv:2406.15032 · Diego Garat, Dina Wonsever. Automatic Curation of Court Documents. Information 13(1), 2022 · Prathamesh Kalamkar 외. Named Entity Recognition in Indian Court Judgments. arXiv:2211.03442 · Taoufiq El Moussaoui 외. IEEE Access 11, 2023 · Arttu Oksanen 외. ANOPPI.
Wonseok Hwang 외. A Multi-Task Benchmark for Korean Legal Language Understanding and Judgement Prediction (LBox Open). NeurIPS 2022. arxiv.org/abs/2206.05224