질문을 미리 배운 검색 — 애플 '상각 MIPS'가 RAG 검색을 빠르게 만드는 법, 지지 함수부터 한국어 실측까지
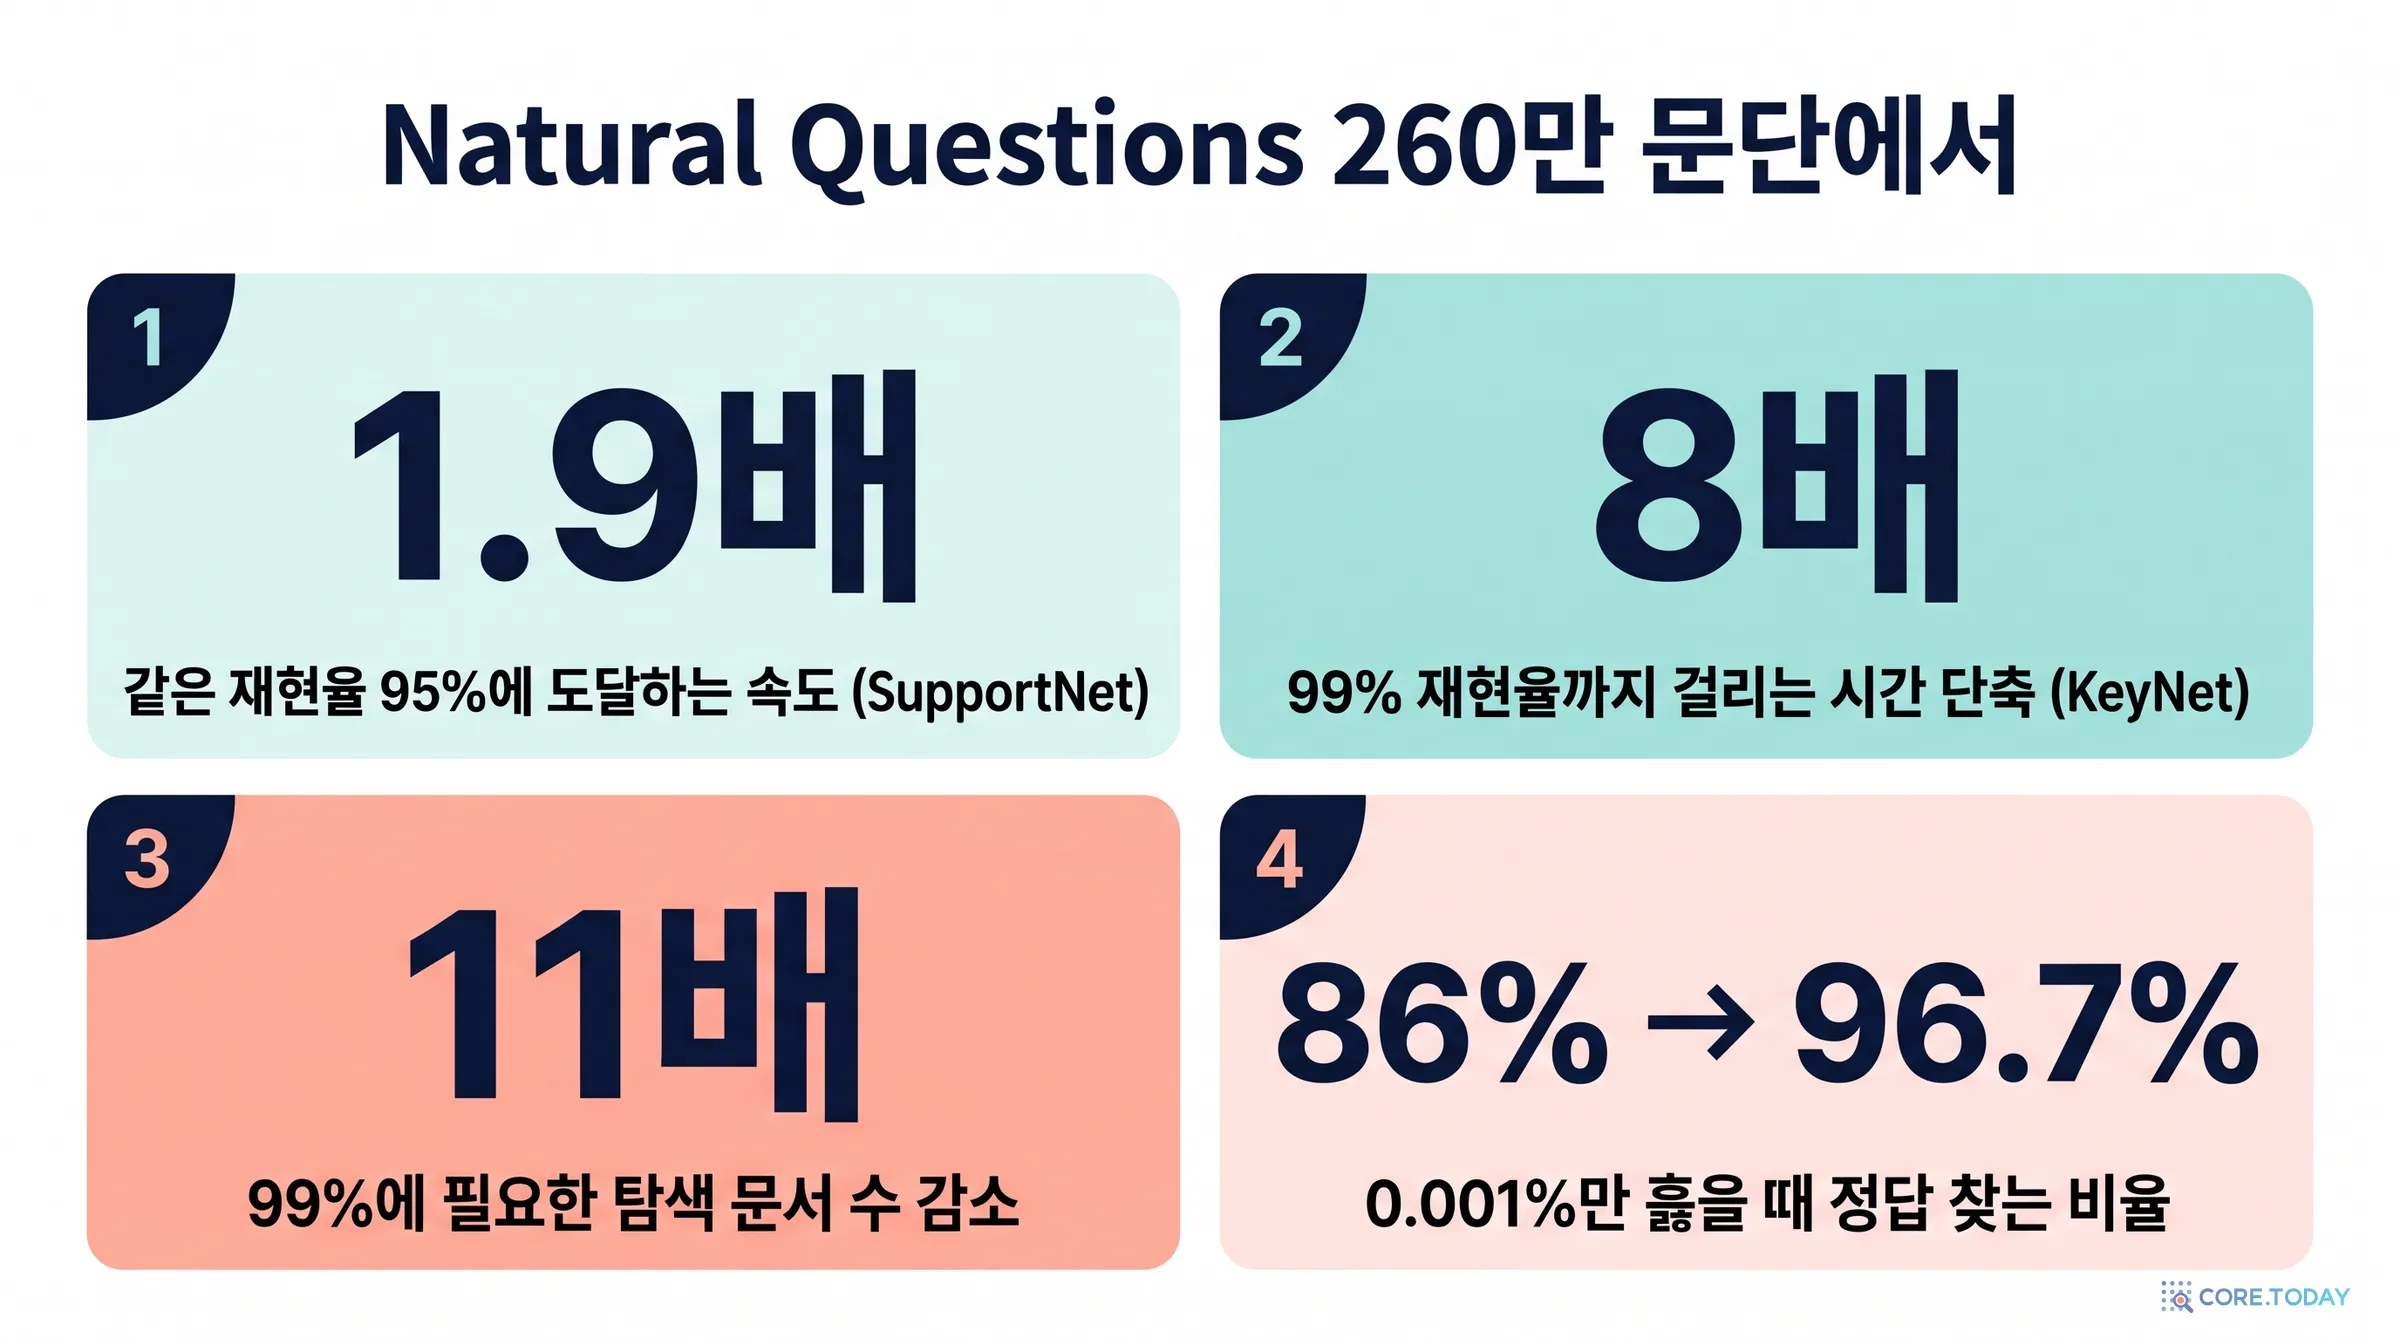
애플 머신러닝 연구팀이 2026년 11월 5일 「Faster Retrieval for Better, More Efficient RAG」를 올렸습니다. RAG의 맨 밑바닥에서 돌아가는 '최대 내적 검색(MIPS)'을, 색인을 더 잘 짓는 대신 '들어올 질문을 미리 배우는' 신경망으로 빠르게 하자는 제안입니다. 핵심은 볼록 해석의 오래된 도구인 지지 함수입니다. 문서 집합에 대한 최고 점수는 질문의 볼록 함수이고, 그 기울기가 곧 정답 문서입니다. 그래서 점수를 배우는 SupportNet은 방(클러스터) 고르기에, 정답 위치를 바로 배우는 KeyNet은 질문 고쳐 쓰기에 씁니다. Natural Questions 260만 문단에서 같은 품질을 1.9배·8배 빠르게 냈다는 결과입니다. 이 글은 50년 근사 검색의 역사에서 이 아이디어가 왜 나왔는지, 논문 그림과 수식을 하나씩 풀고, 연산량으로 다시 셈한 비용, 공개 코드의 시험셋 구성, 생성 질의라는 데이터의 성격까지 따져 봅니다. 그리고 KorQuAD 6만 질문·2만 8천 문단과 KURE-v3로 KeyNet과 라우터를 직접 학습해 쟀습니다. 논문 방식의 시험(학습 질문의 잡음 복제본)에서는 방 하나로 정답 방을 고르는 비율이 46.7%에서 KeyNet 60.0~69.8%, 라우터 76.7%로 뛰었지만, 같은 시험에서 '가장 비슷한 학습 질문의 답 베끼기'가 96.3%였습니다. 처음 보는 질문에서는 KeyNet의 이득이 1~5%포인트로 줄고 라우터는 12%포인트를 지켰으며, 처음 보는 문서의 질문에서는 KeyNet이 8~10%포인트 손해를 봤습니다. 인터랙티브 7개, 삽화 12장.
RAG는 질문마다 수백만 문서 중 가장 잘 맞는 것을 찾아야 합니다. 전부 비교하면 질문 하나에 곱셈 10억 번입니다. 그래서 문서를 방으로 나누고 몇 방만 여는 근사 검색을 쓰지만, 방을 고르는 기준(중심점)이 거칠어 정답이 든 방을 자주 놓칩니다. 게다가 이 색인들은 ‘문서’만 보고 지어져, 실제로 들어오는 ‘질문’이 어떻게 생겼는지는 쓰지 않습니다.
→
애플의 해법
질문 분포에서 표본을 뽑아 정답을 미리 다 계산해 두고, 작은 신경망이 그 답을 흉내 내게 학습합니다(상각). 문서 집합의 최고 점수는 ‘지지 함수’라는 볼록 함수이고, 그 기울기가 정답 문서라는 성질을 이용해 두 모델을 만듭니다. SupportNet은 방마다 ‘그 방 최고 점수’를 예측해 방을 고르고, KeyNet은 질문을 ‘정답 문서가 있을 자리’로 옮겨 기존 색인에 그대로 넣습니다.
✓
결과와 단서
Natural Questions(약 260만 문단)에서 라우팅은 같은 품질에 1.9배 빠르고, KeyNet은 재현율 99%에 걸리는 시간이 1.8ms → 0.23ms였습니다. 다만 곱셈 수로 세면 큰 KeyNet은 전수 검색의 20%만큼 비싸고, 이득은 GPU의 묶음 처리에서 나옵니다. 코어닷투데이의 한국어 실측에서는 ‘본 적 있는 질문’에서 크던 이득이 ‘처음 보는 질문’에서 줄었고, 방 고르기(라우터)가 질문 고쳐 쓰기(KeyNet)보다 훨씬 잘 버텼습니다.
프롤로그 — 도서관 사서가 질문을 미리 공부한다면
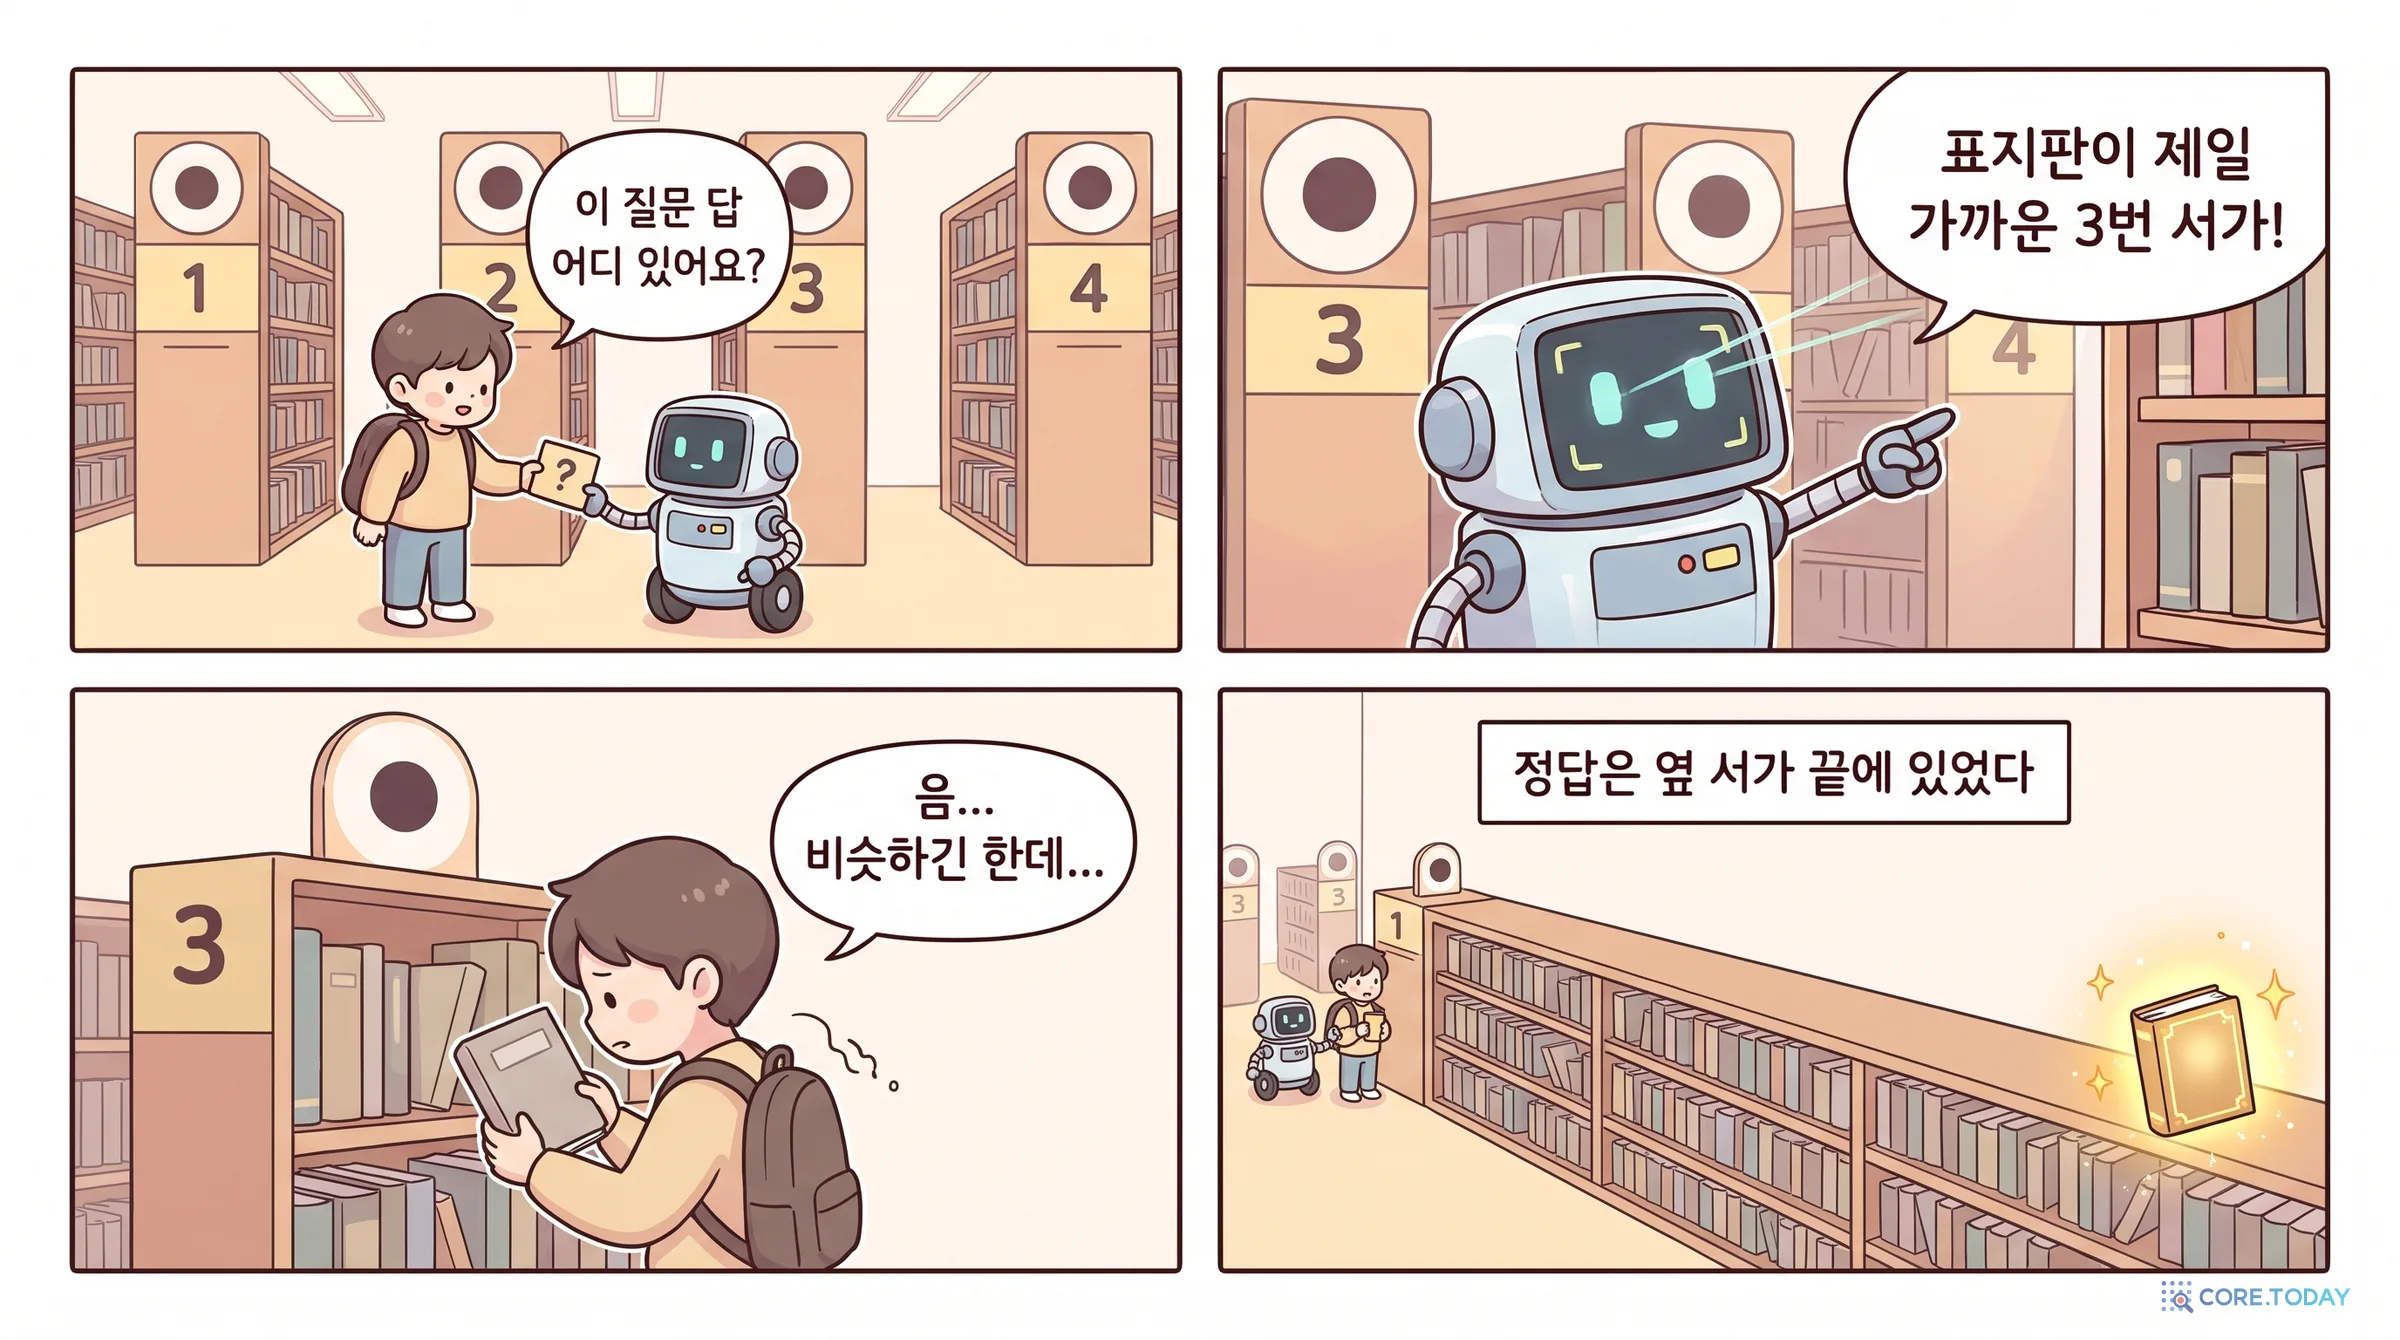
큰 도서관에 사서 로봇이 하나 있다고 해 봅시다. 책은 260만 권이고, 하루에 수십만 명이 와서 “이 질문의 답이 어디 있어요?”라고 묻습니다. 가장 확실한 방법은 질문이 올 때마다 260만 권을 전부 펼쳐 보는 것입니다. 틀릴 일은 없지만, 손님은 오래 기다려야 합니다.
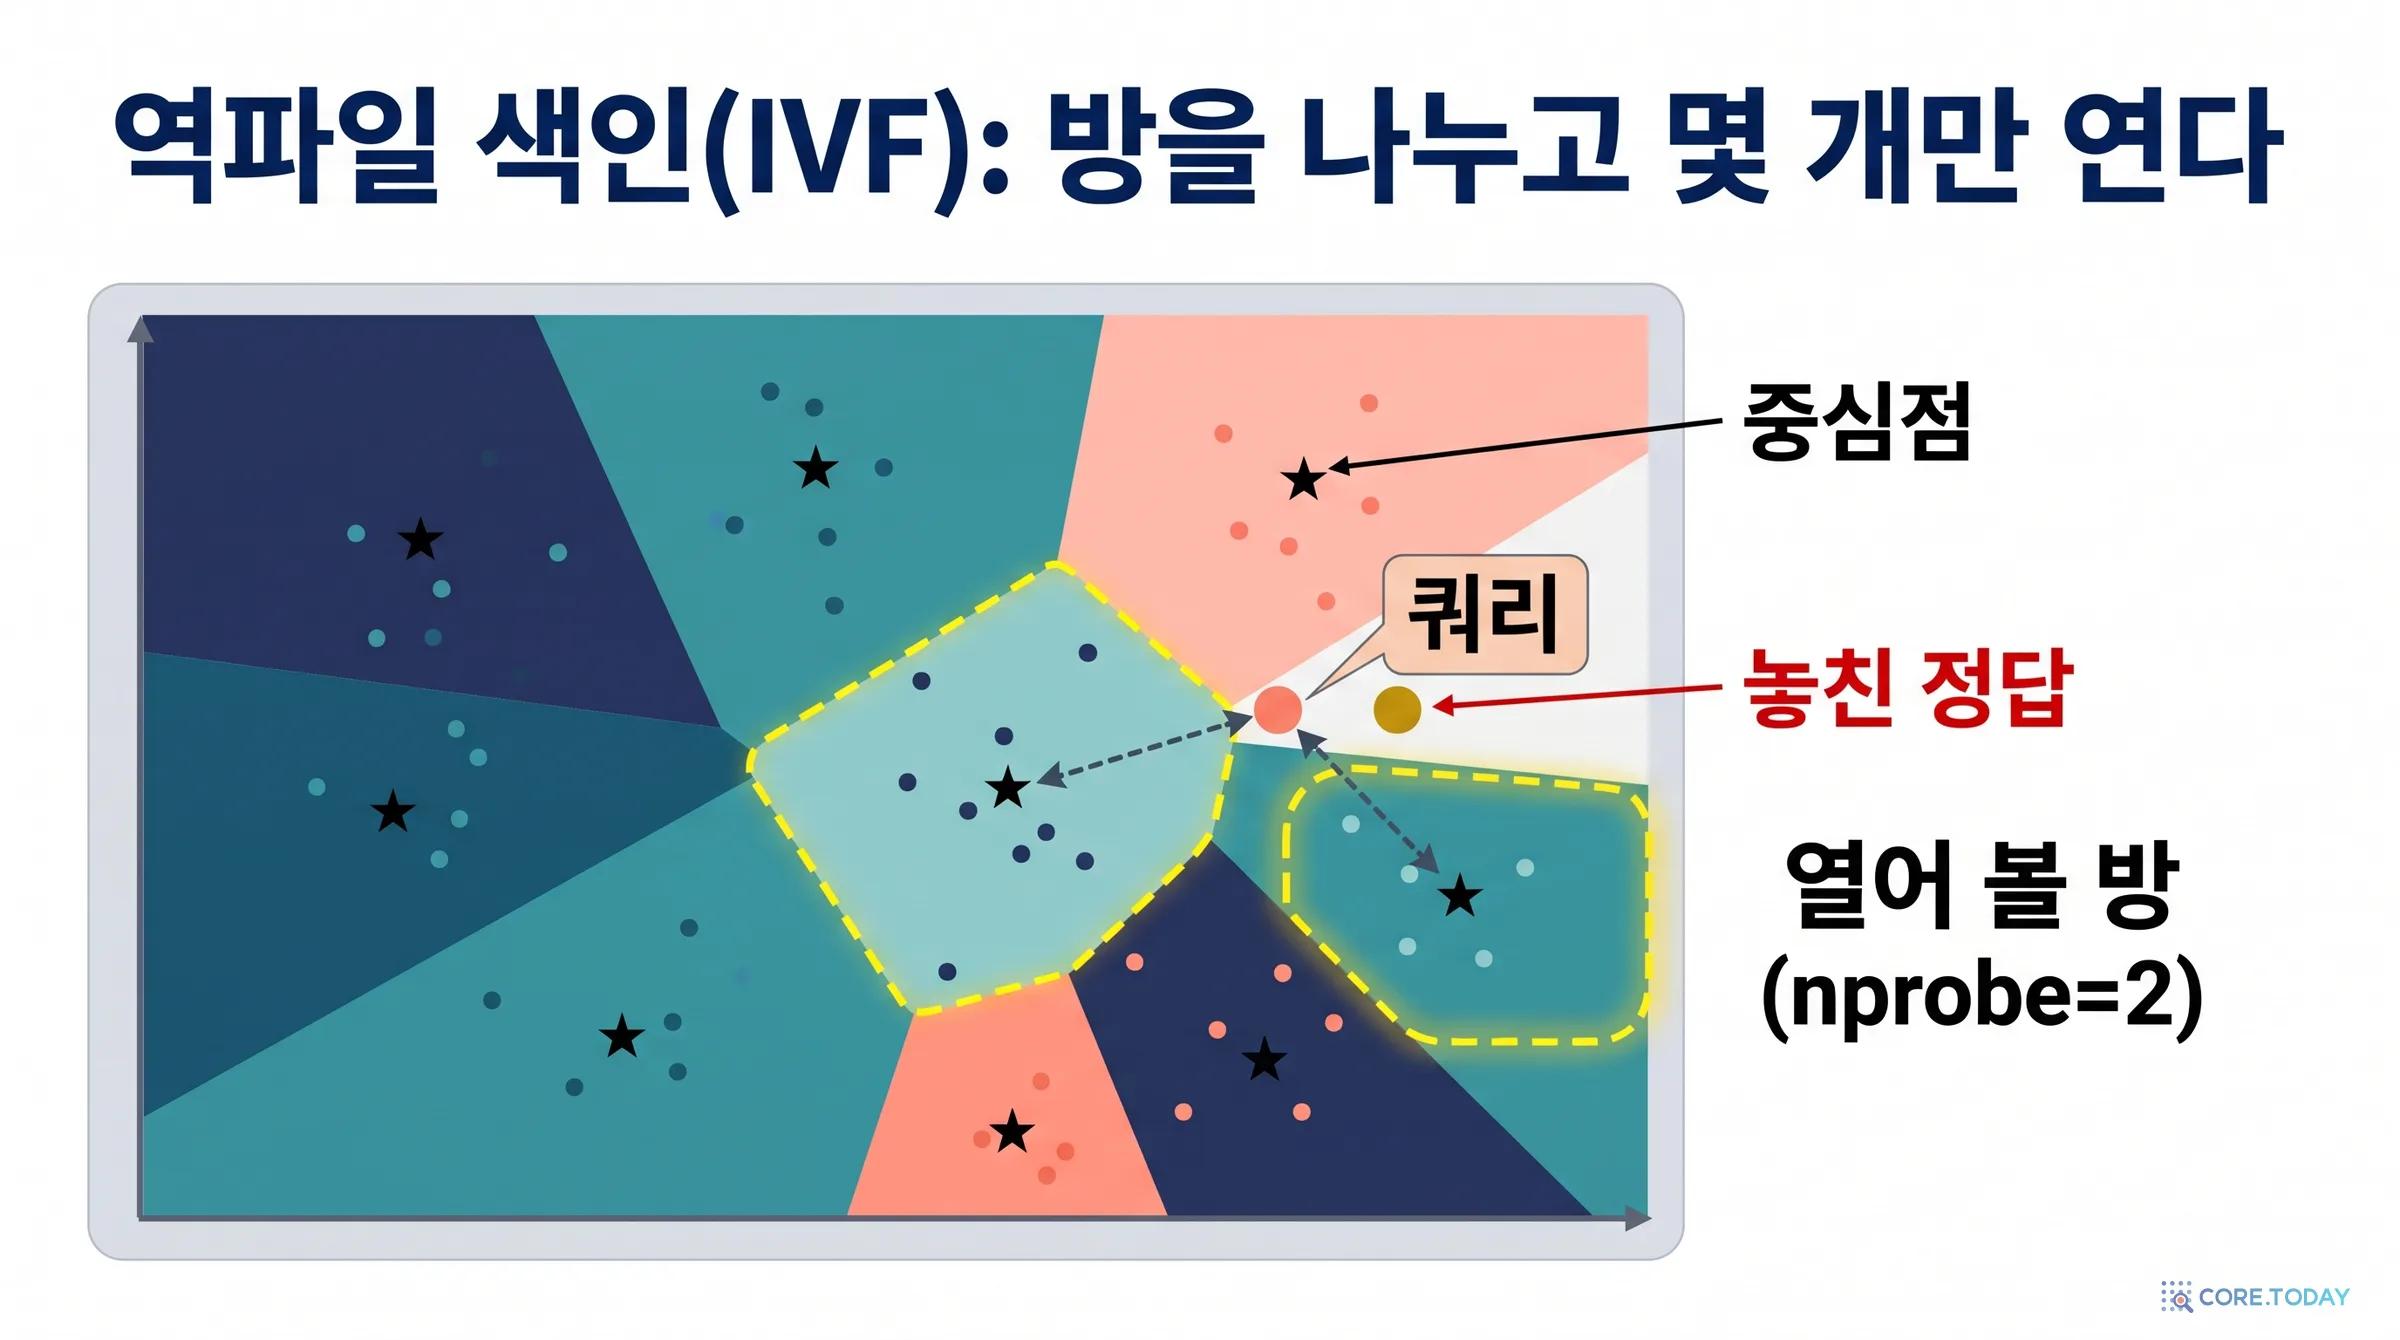
그래서 도서관은 서가를 나눕니다. 비슷한 책끼리 128개 서가에 모으고, 서가마다 “이 서가는 대략 이런 책들”이라는 표지판을 답니다. 로봇은 질문을 받으면 표지판만 훑어 가장 비슷한 서가 몇 개로 가서, 그 안의 책만 펼쳐 봅니다. 260만 권 대신 몇만 권만 보니 훨씬 빠릅니다. 오늘날 거의 모든 벡터 데이터베이스가 이렇게 일합니다.
문제는 표지판이 서가의 평균만 알려 준다는 점입니다. 어떤 서가는 길쭉하게 늘어져 있어서, 그 서가 끝자락에 있는 책은 표지판과 꽤 다릅니다. 하필 그 책이 질문의 정답이라면 로봇은 엉뚱한 서가로 갑니다. 그리고 표지판은 책만 보고 만들었습니다. 이 도서관에 매일 오는 손님들이 어떤 질문을 하는지는 표지판에 전혀 반영되어 있지 않습니다.
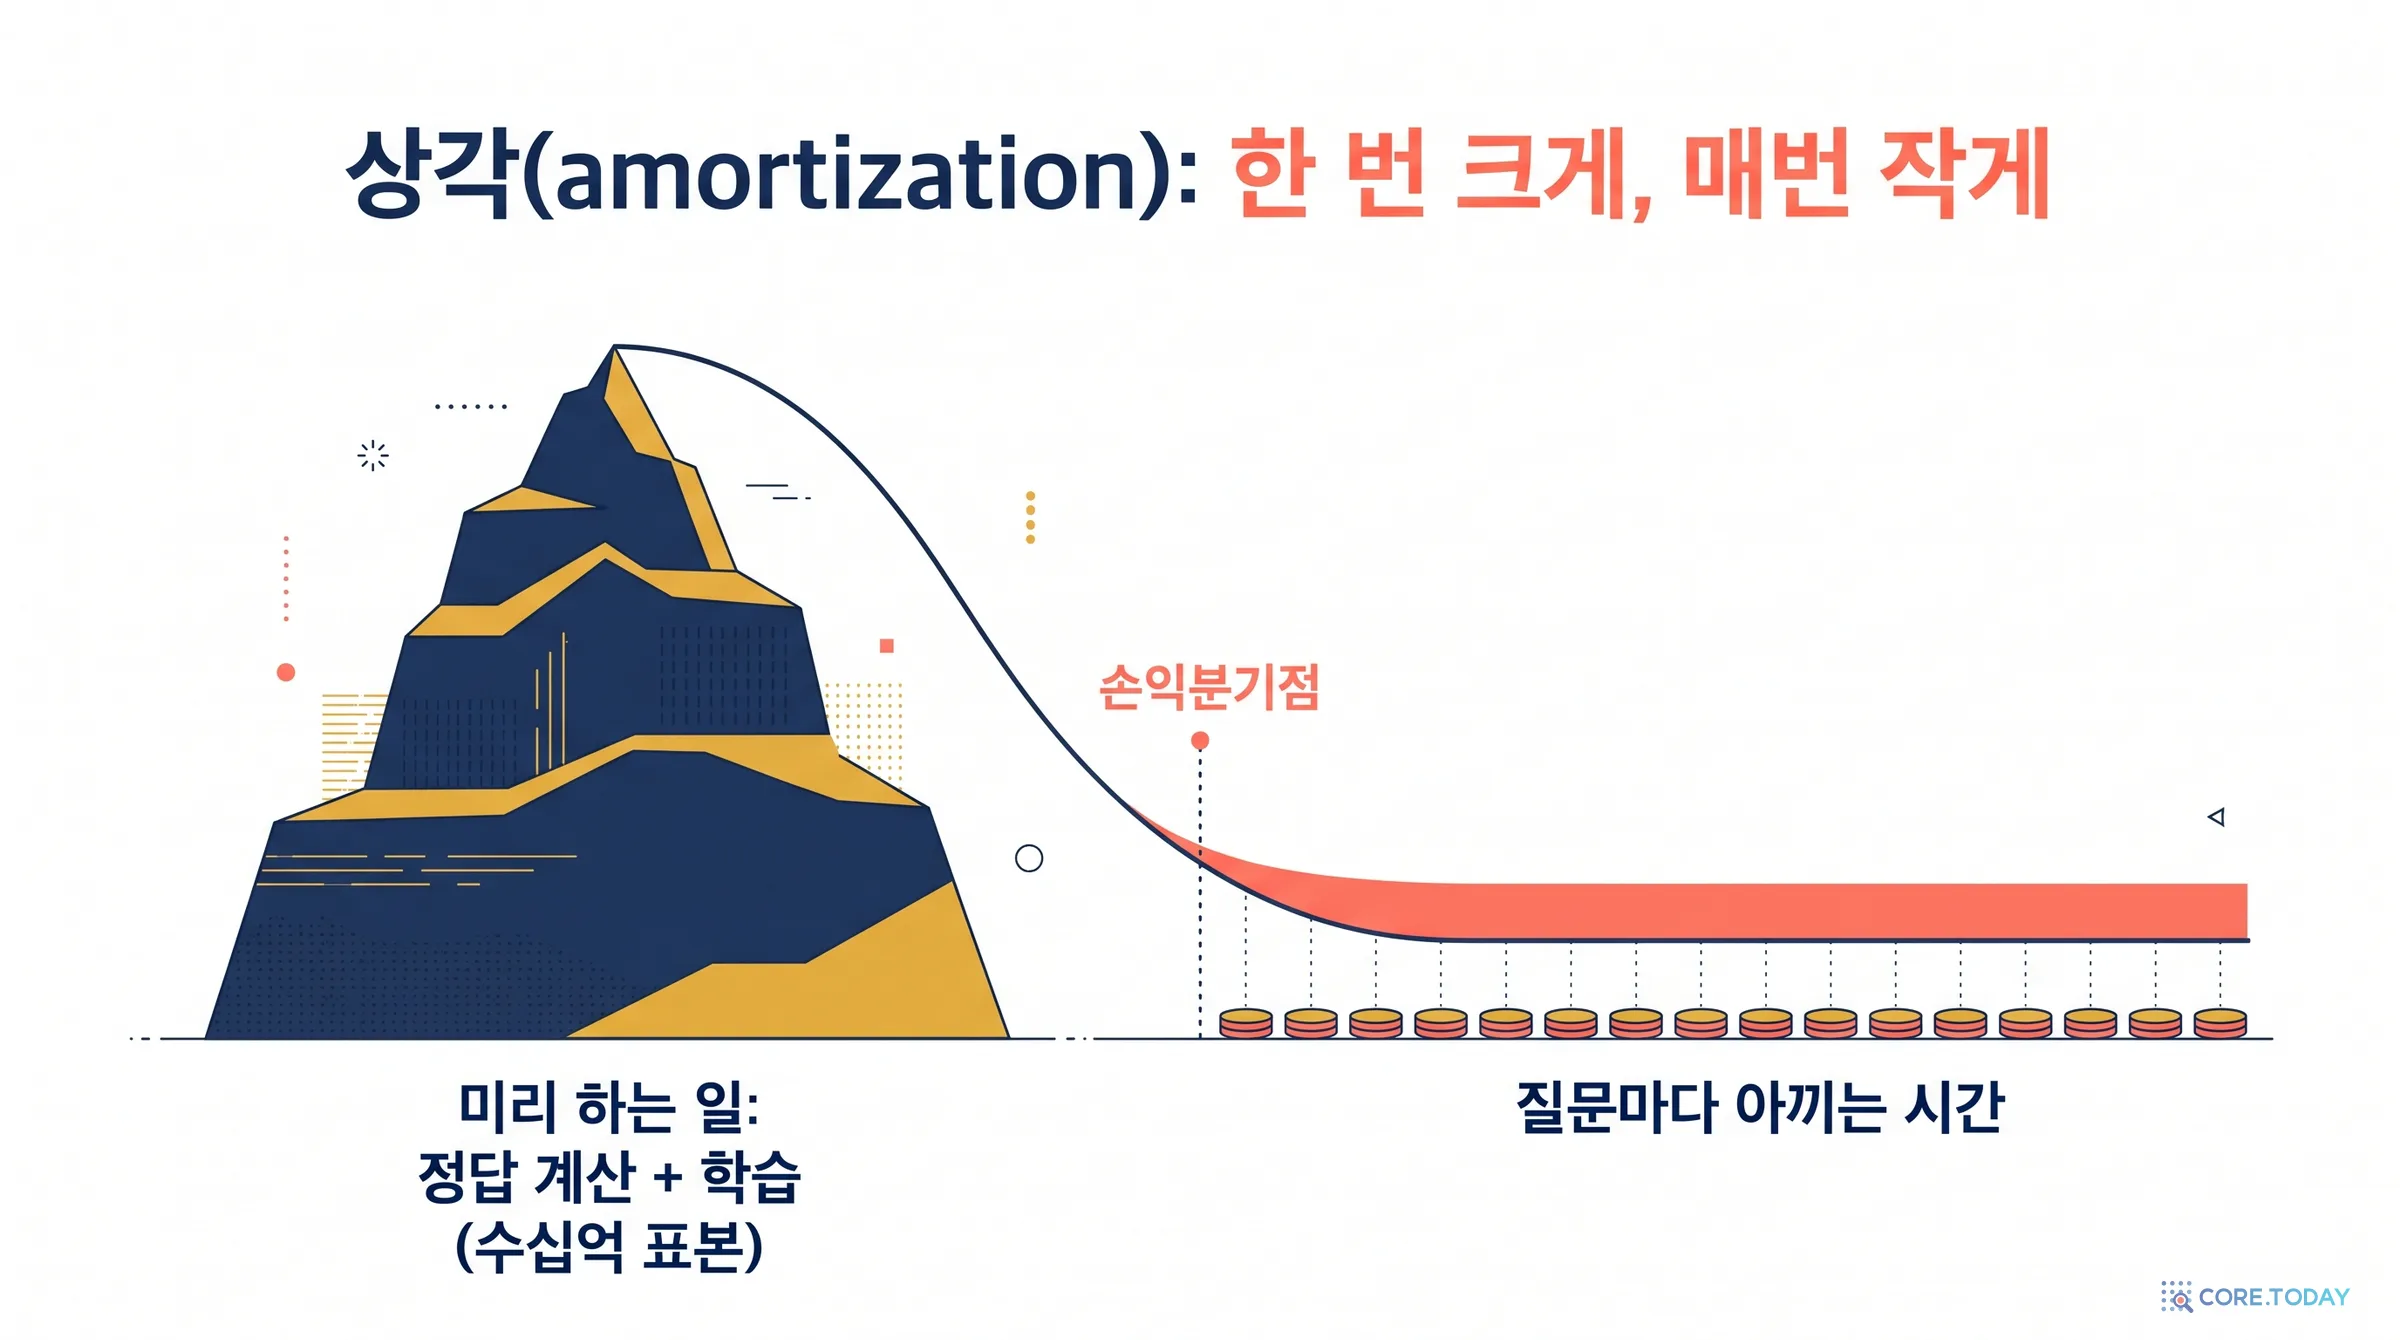
애플 머신러닝 연구팀이 2026년 11월 5일 공개한 「Faster Retrieval for Better, More Efficient RAG」는 이 두 번째 지점을 파고듭니다. 손님이 하는 질문이 대체로 정해져 있다면, 사서가 그 질문들을 미리 공부해 두면 되지 않을까? 질문 수백만 개를 뽑아 정답을 미리 다 찾아 두고, 작은 신경망에게 “이런 질문이면 정답은 이쯤에 있다”를 외우게 하는 것입니다. 한 번 크게 공부해 두고, 손님이 올 때마다 그 공부를 조금씩 돌려받습니다. 금융에서 큰 비용을 여러 해에 나눠 갚는 것을 ‘상각(amortization)’이라 부르는데, 이 방법의 이름이 바로 상각 MIPS(Amortized Maximum Inner Product Search)입니다.
이 글은 애플 블로그와, 그 바탕인 ICML 2026 논문 「Amortized Maximum Inner Product Search with Learned Support Functions」(Theo X. Olausson·João Monteiro·Michal Klein·Marco Cuturi, arXiv 2603.08001)을 함께 읽습니다. 순서는 이렇습니다.
1장최대 내적 검색(MIPS)이 무엇이고, RAG의 어디서 돌아가는가
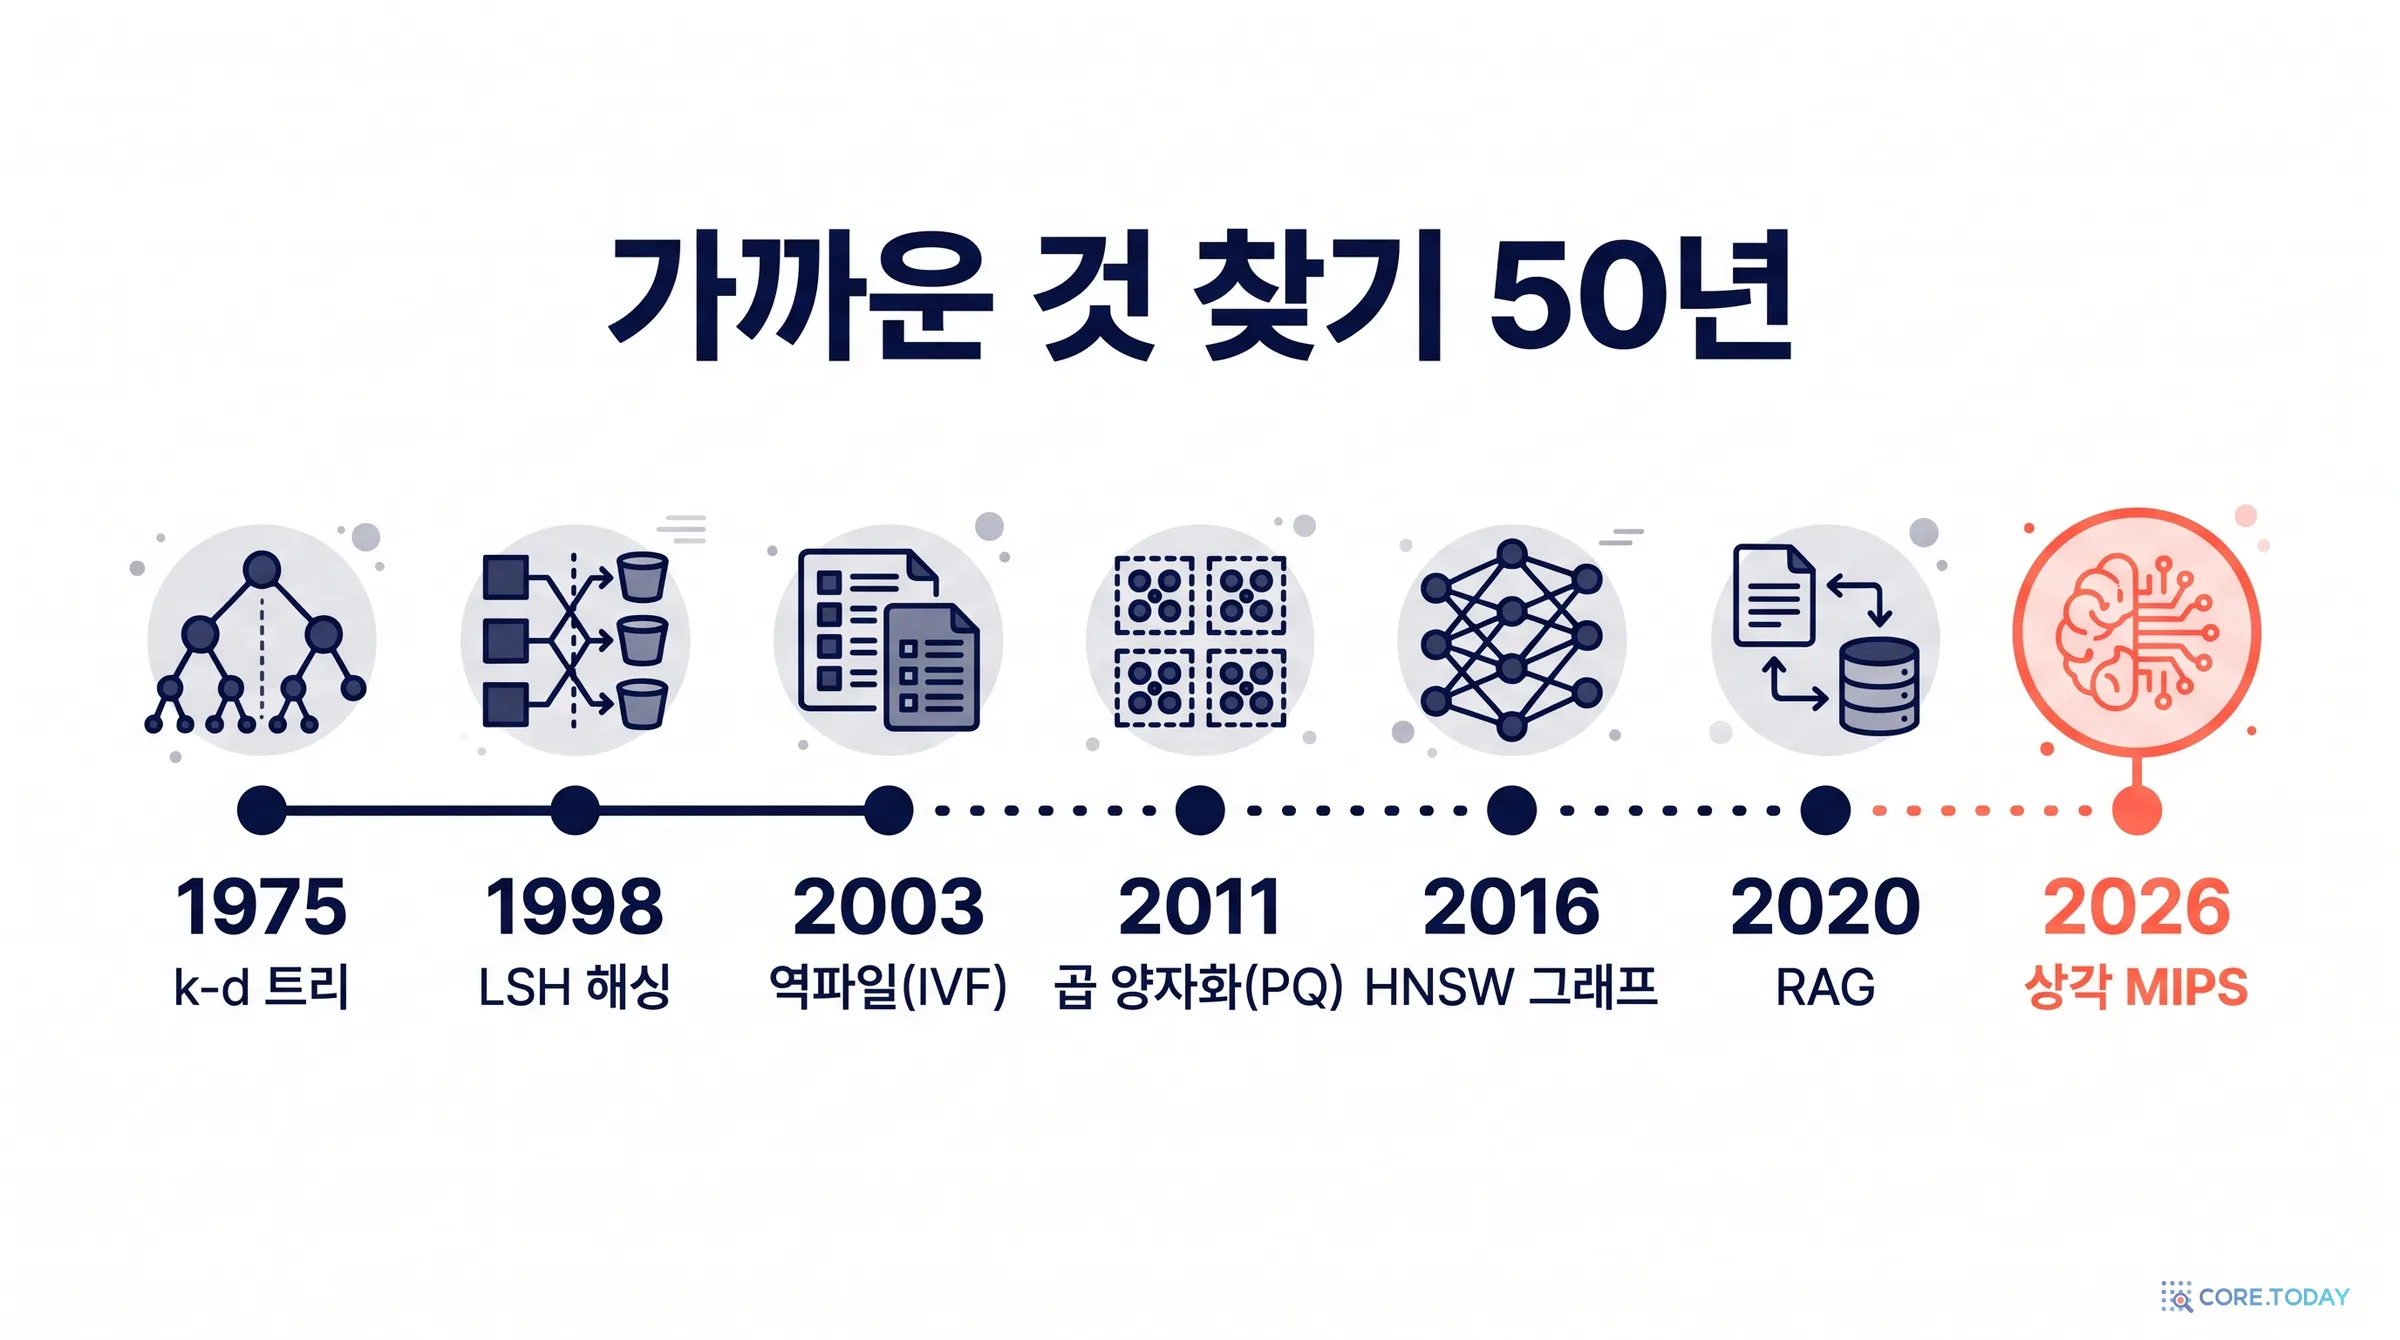
2장가까운 것 찾기 50년 — k-d 트리부터 FAISS·HNSW까지, 그리고 그 모두가 ‘문서만 본다’는 공통점
3장질문과 문서는 사는 동네가 다르다 — 분포의 비대칭
4장역파일 색인과 중심점의 함정
5~6장지지 함수와 상각 최적화 — 볼록 해석에서 빌려 온 열쇠
7~8장SupportNet과 KeyNet의 구조·손실·학습, 그리고 결과 읽기
9~10장꼼꼼히 따져 보기, 그리고 코어닷투데이의 한국어 실측
11~13장이웃 아이디어들, 2026년 이 기술의 자리, 실무 체크리스트
1. 검색의 심장, 최대 내적 검색
문장이 숫자가 되면 검색은 곱셈이 된다
요즘 검색과 RAG는 거의 모두 임베딩 위에서 돌아갑니다. 임베딩 모델은 문장 하나를 수백~수천 개 숫자로 된 벡터로 바꿉니다. 뜻이 비슷한 문장은 비슷한 방향을 가리키도록 학습되어 있습니다. “바그너는 파우스트를 읽고 무엇을 쓰려 했나?”라는 질문과 “1839년 바그너는 괴테의 파우스트를 읽고 교향곡을 쓰려는 뜻을 품었다”라는 문단은, 글자는 꽤 달라도 벡터 공간에서는 가까운 곳에 놓입니다.
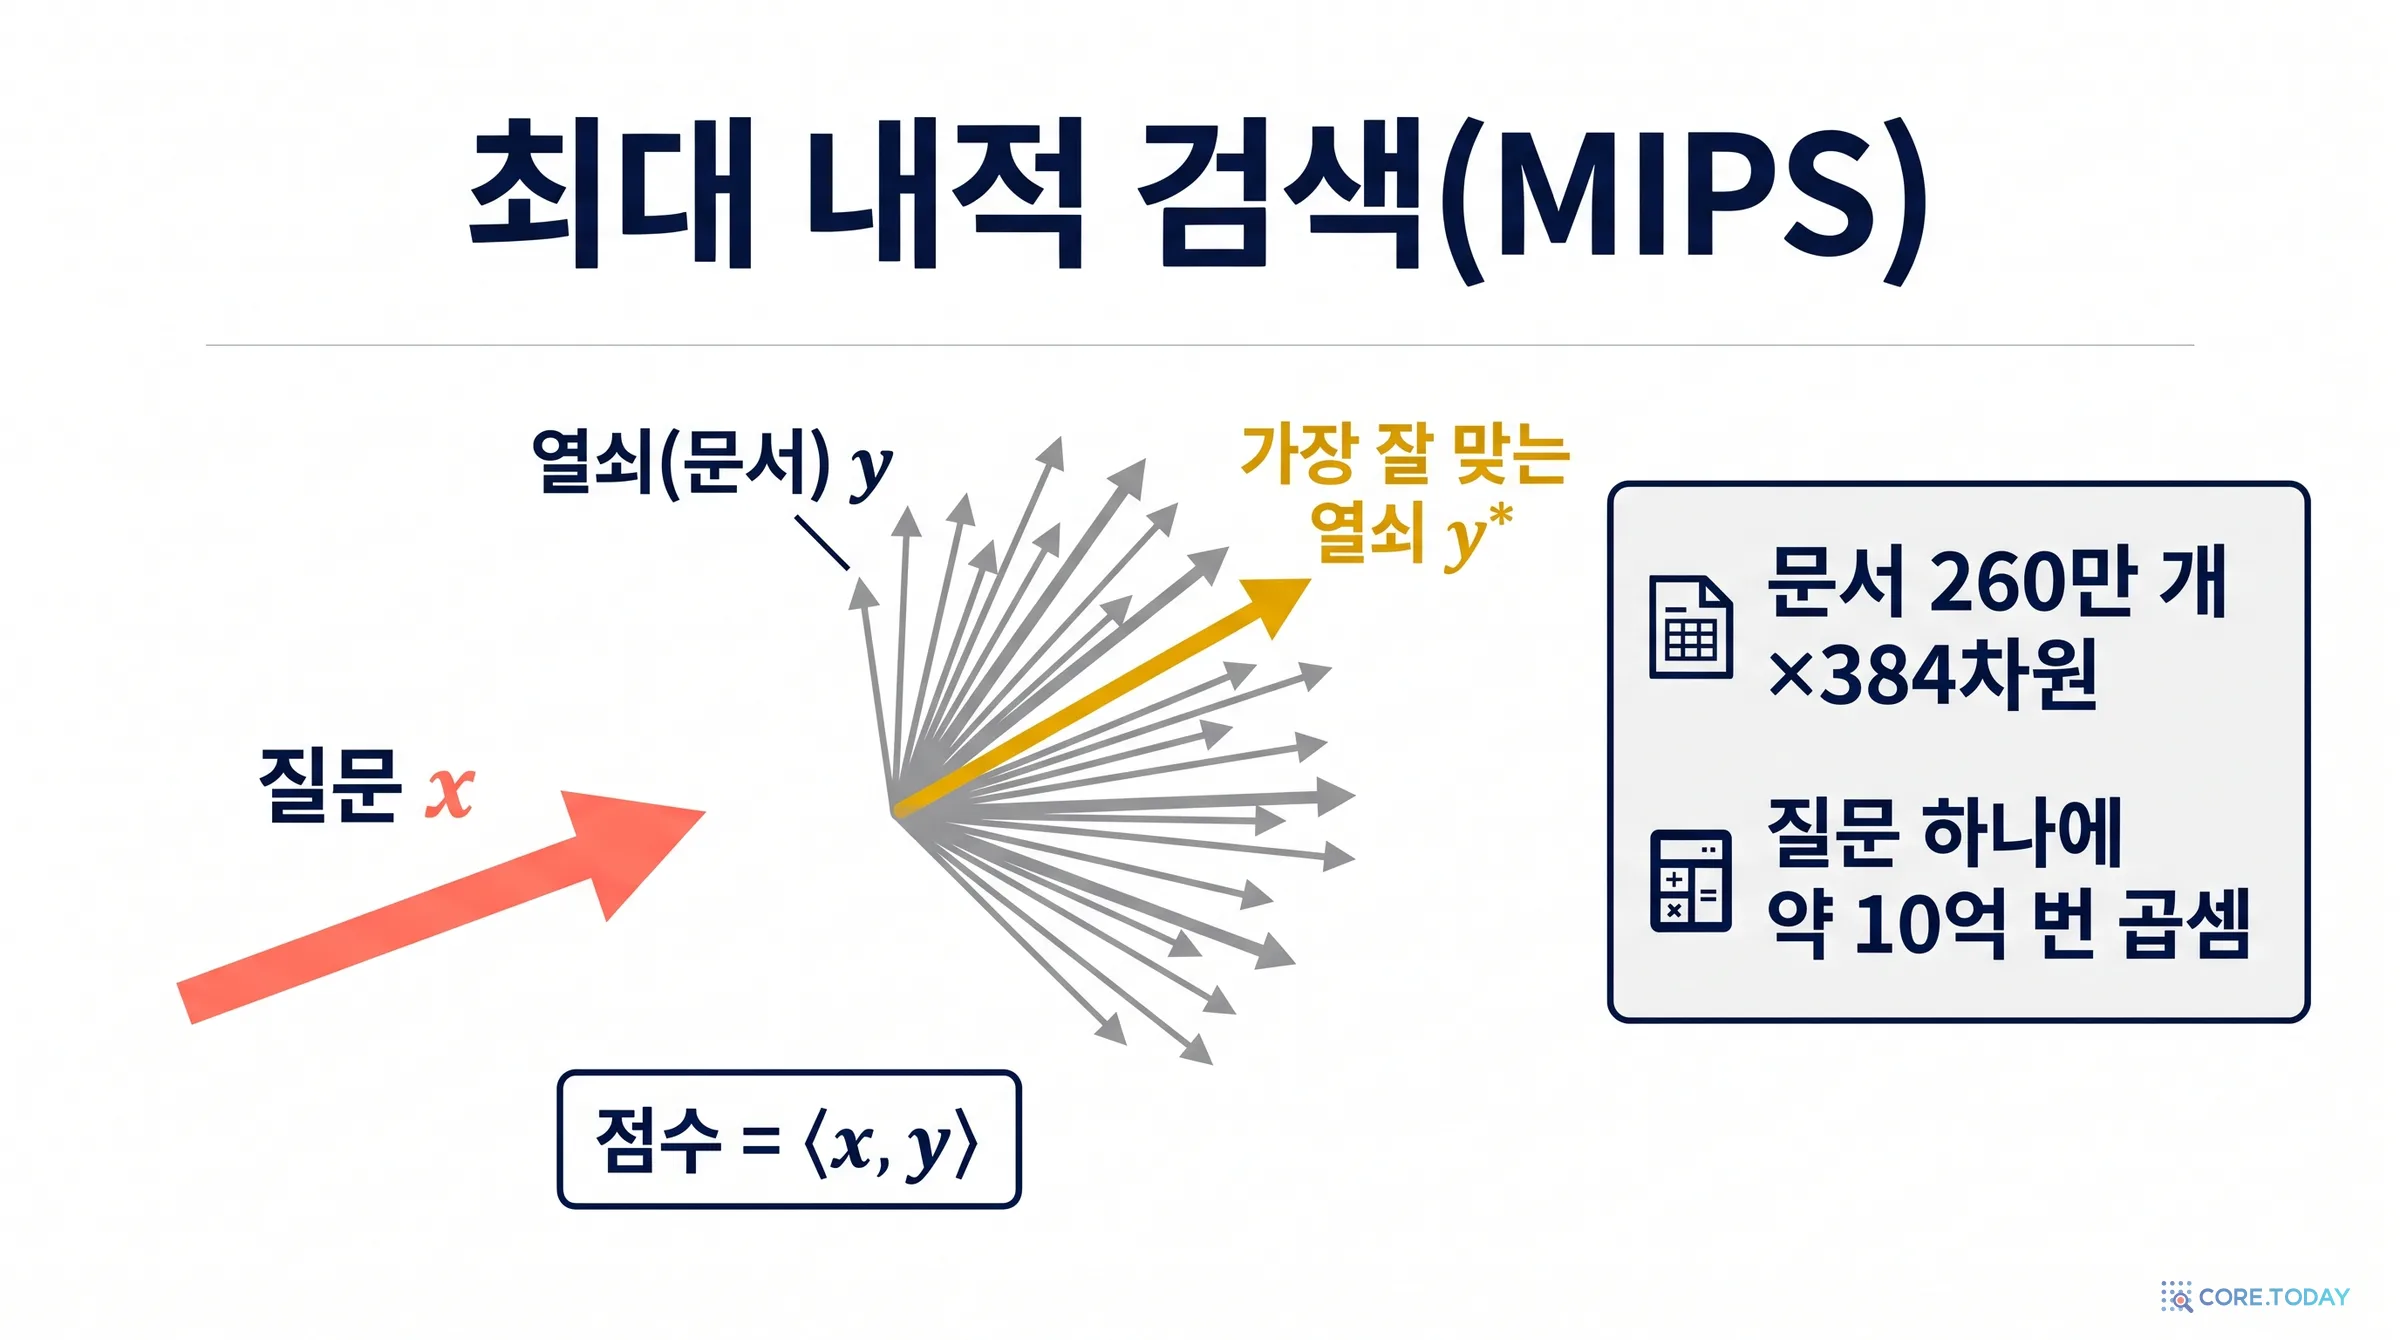
두 벡터가 얼마나 잘 맞는지는 대개 내적으로 잽니다. 같은 자리의 숫자끼리 곱해서 모두 더한 값입니다. 그러면 검색은 이렇게 정리됩니다. 질문 벡터 x와 문서 벡터들의 모음 Y={y1,…,yn}이 있을 때, 내적이 가장 큰 문서를 찾는 것입니다.
y⋆(x)=argy∈Ymax⟨x,y⟩
이것이 최대 내적 검색(Maximum Inner Product Search, MIPS)입니다. 논문은 이 문제를 “검색의 일꾼(workhorse)”이라 부릅니다. 추천 시스템(사용자 벡터와 내적이 가장 큰 상품), 정보 검색, RAG(질문과 가장 잘 맞는 문단을 찾아 LLM 프롬프트 앞에 붙이기), 클래스가 수십만 개인 분류(마지막 층이 결국 ‘가장 큰 내적’을 고르는 일)가 모두 이 한 줄 위에 서 있습니다. 논문에서는 문서 벡터를 ‘열쇠(key)’라고 부릅니다. 이 글도 같은 말을 씁니다.
꼭 그렇지는 않습니다. 순수한 내적은 방향뿐 아니라 길이에도 영향을 받습니다. 방향이 조금 덜 맞아도 길이가 긴 벡터가 이길 수 있습니다. 추천 시스템에서 인기 많은 상품의 벡터가 길게 학습되면, 그 상품이 여기저기 추천되는 것이 이 때문입니다. 2014년 마이크로소프트 연구진이 Xbox 추천 시스템을 빠르게 하려고 내적 문제를 거리 문제로 바꾸는 변환을 고안한 것도, 기존의 빠른 최근접 이웃 도구들을 그대로 쓸 수 없었기 때문입니다(Bachrach 외, RecSys 2014).
다만 오늘날 문장 임베딩은 대부분 길이를 1로 맞춥니다. 그러면 내적은 코사인 유사도와 같아지고, 내적 최대는 ‘각도가 가장 가까운 점’ 찾기와 정확히 같습니다. 애플 논문의 실험도 길이 1로 정규화한 384차원 임베딩(all-MiniLM-L6-v2)을 씁니다. 아래 놀이터에서 둘의 차이를 직접 확인할 수 있습니다.
왜 빠르게 해야 하나
전수 검색은 정답을 보장합니다. 대신 비용이 문서 수 n과 차원 d에 정비례합니다. 애플이 실험한 Natural Questions(약 260만 문단, 384차원)라면 질문 하나에 약 10억 번 곱셈입니다. GPU로 묶어 돌리면 감당할 수 있지만, 문서가 1억·10억 조각으로 늘고 질문이 초당 수천 개로 늘면 이야기가 달라집니다.
2026년에는 이 압력이 더 커졌습니다. 사람이 검색창에 한 번 묻던 시절과 달리, 에이전트는 과제 하나를 풀면서 검색을 수십 번씩 부릅니다. 코어닷투데이가 에이전트형 검색 특집에서 다뤘듯이, 질문이 사람의 손이 아니라 모델의 반복 루프에서 나오기 시작하면 검색 한 번의 비용이 전체 비용과 지연 시간을 좌우합니다. 근사 검색은 ‘있으면 좋은 최적화’가 아니라 RAG의 기본 부품입니다.
2. 가까운 것 찾기 50년 — 모두가 ‘문서’만 보았다
상각 MIPS가 무엇이 새로운지 알려면, 그전까지 사람들이 어떻게 이 문제를 풀어 왔는지 봐야 합니다. 큰 줄기만 따라가 보겠습니다.
1975년 존 벤틀리의 k-d 트리는 공간을 x축, y축 차례로 반씩 잘라 나무에 담습니다. 2~3차원에서는 훌륭하지만 차원이 수십을 넘으면 거의 모든 가지를 다 열어 봐야 해서 전수 검색과 다를 바가 없어집니다. 이른바 차원의 저주입니다. 코어닷투데이의 HNSW 글이 이 벽을 자세히 다뤘습니다.
1998년 피오트르 인디크와 라지브 모트와니는 정반대 길을 택했습니다. 정확한 나무 대신 무작위 해싱을 쓰되, 가까운 점끼리는 같은 칸에 떨어질 확률이 높도록 해시 함수를 고릅니다(LSH). 질문이 오면 같은 칸에 떨어진 점만 봅니다. “정답을 확률적으로 거의 맞히되 대부분은 보지 않는다”는 근사 검색의 철학이 여기서 자리 잡았습니다.
역파일 — 방을 나누고 몇 개만 연다
애플 논문이 개선하려는 대상인 역파일 색인(Inverted File, IVF)의 직계 조상은 2003년 요제프 시비치와 앤드루 지서먼의 「Video Google」입니다. 영화 장면의 국소 특징을 k-평균으로 묶어 ‘시각 단어’를 만들고, 검색엔진이 단어로 문서를 찾듯 장면을 찾았습니다. 오늘의 IVF도 똑같습니다. 문서 벡터를 k-평균으로 c개 방(클러스터, 보로노이 칸)으로 나누고, 질문이 오면 방의 중심점과 먼저 비교해 점수가 높은 방 몇 개(nprobe)만 열어 그 안을 전부 훑습니다.
방이 k개이고 크기가 고르다면, 방 하나를 여는 비용은 전체의 1/k입니다. 애플 블로그의 설명대로 ‘k배 빨라지는’ 셈입니다. 2011년 곱 양자화(PQ)가 방 안의 벡터를 압축해 메모리를 줄였고, 2017년 메타(당시 페이스북)의 FAISS가 이 조합을 GPU에서 10억 규모로 돌리면서 IVF-PQ는 업계 표준이 되었습니다. 애플이 실험에 쓴 색인도 FAISS IVF입니다.
그래프, 그리고 ‘학습된 색인’
2016년 공개된 HNSW는 점들을 층층이 놓인 그래프로 잇고, 위층의 급행 간선으로 크게 이동한 뒤 아래층에서 세밀하게 걸어 내려갑니다. 지금 pgvector·OpenSearch·대부분의 벡터 DB가 기본으로 쓰는 방식입니다. 2020년 구글의 ScaNN은 양자화할 때 ‘내적 값을 크게 틀리게 만드는 방향’의 오차를 더 무겁게 벌주는 비등방 양자화를 내놓았습니다. 데이터 분포를 색인 설계에 반영한 사례입니다.
다른 줄기도 있습니다. 2018년 팀 크라스카와 제프 딘 등은 「The Case for Learned Index Structures」에서, B-트리 같은 고전 색인을 ‘키를 넣으면 위치를 예측하는 모델’로 바꿀 수 있다고 주장했습니다. 색인이 데이터를 학습할 수 있다는 생각입니다. 2024년 SIGIR의 Vecchiato 외 연구는 IVF의 방 고르기를 순위 학습(learning-to-rank) 문제로 풀었습니다.
그런데 이 모두가 공통으로 놓친 것
위 표의 마지막 열을 보면 이 50년 역사의 공통점이 보입니다. 거의 모든 방법이 문서(열쇠)만 보고 색인을 짓습니다. 질문이 어떻게 생겼는지는 기껏해야 ‘질문도 문서와 비슷하게 생겼겠지’라는 암묵적 가정으로만 들어갑니다. 애플 블로그의 표현을 빌리면, 기존 방법들의 기하학적 논리는 ‘질문이 열쇠처럼 생겼다’고 느슨하게 가정하거나 질문의 구조를 아예 무시합니다. 논문도 배경 절에서 기존 방법들이 “추론 시점에는 대체로 질문과 무관하다(query-agnostic)”고 정리합니다. 일부 연구(RoarGraph 2024, Wei 외 2025)가 색인을 지을 때 질문 통계를 조금 쓰긴 하지만, 논문은 자기 접근을 질문 분포로 신경망을 직접 학습해 답을 예측하는 데까지 간 것은 이번이 처음이라는 것이 논문의 주장입니다.lsquo;근본적으로 다른 길질문 분포로 신경망을 직접 학습해 답을 예측하는 데까지 간 것은 이번이 처음이라는 것이 논문의 주장입니다.rsquo;이라고 부릅니다. 질문 분포로 신경망을 직접 학습해, 색인을 뒤지기 전에 답을 예측한다는 것입니다.
3. 질문과 문서는 사는 동네가 다르다
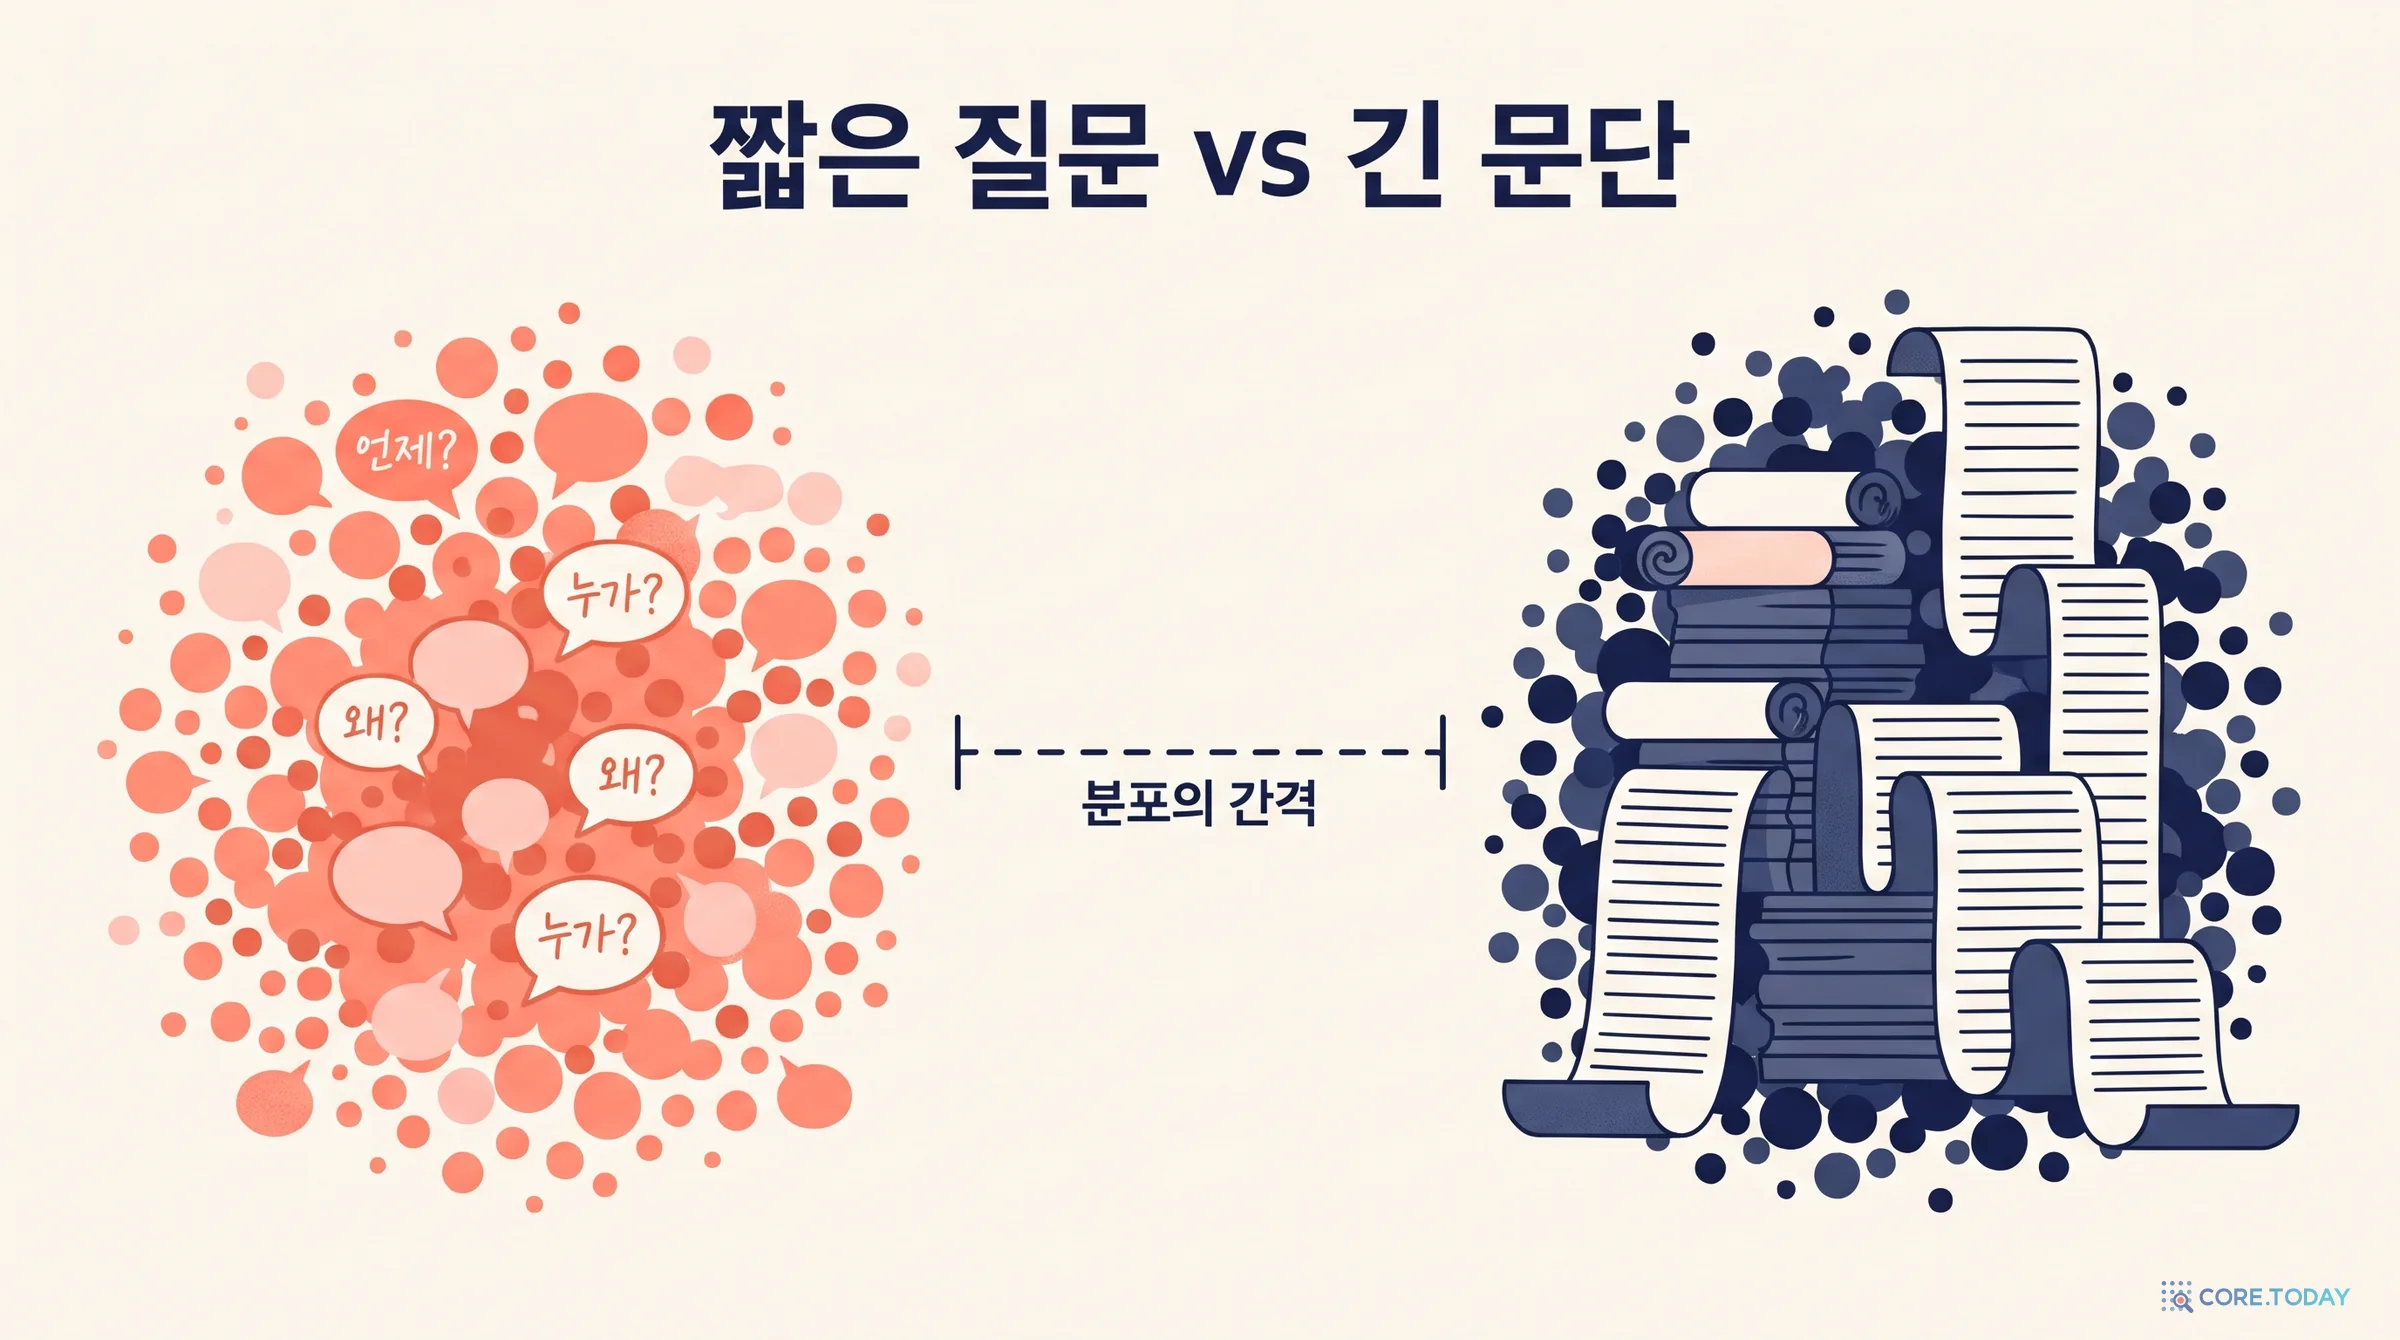
‘질문이 문서처럼 생겼다’는 가정은 RAG에서 특히 잘 깨집니다. 질문은 짧고, 문서는 깁니다. “매치박스 트웬티가 뭐야?”와, 그 밴드의 결성·멤버·히트곡을 담은 위키백과 문단은 같은 대상을 말하지만 문장의 생김새가 전혀 다릅니다.
코어닷투데이가 실측에 쓴 KorQuAD 1.0에서도 이 차이가 선명합니다. 질문은 평균 34자, 문단을 두세 문장씩 자른 조각은 평균 194자로 거의 여섯 배입니다. 질문은 “누가·언제·무엇을”로 끝나는 의문문이고, 문단은 날짜·이름·사건이 빽빽한 서술문입니다. 임베딩 모델이 둘을 같은 공간에 놓도록 학습되어 있어도, 질문들이 모이는 구역과 문단들이 모이는 구역은 어긋나 있습니다. 많은 한국어 임베딩 모델이 질문 앞에 query: , 문단 앞에 passage: 라는 접두사를 붙이게 하는 것도 이 비대칭 때문입니다. 코어닷투데이의 한국어 임베딩 14종 실측에서 KURE-v3의 접두사를 빼자 주어 찾기 정확도가 69.5%에서 31.4%로 무너졌던 것도 같은 현상의 다른 얼굴입니다.
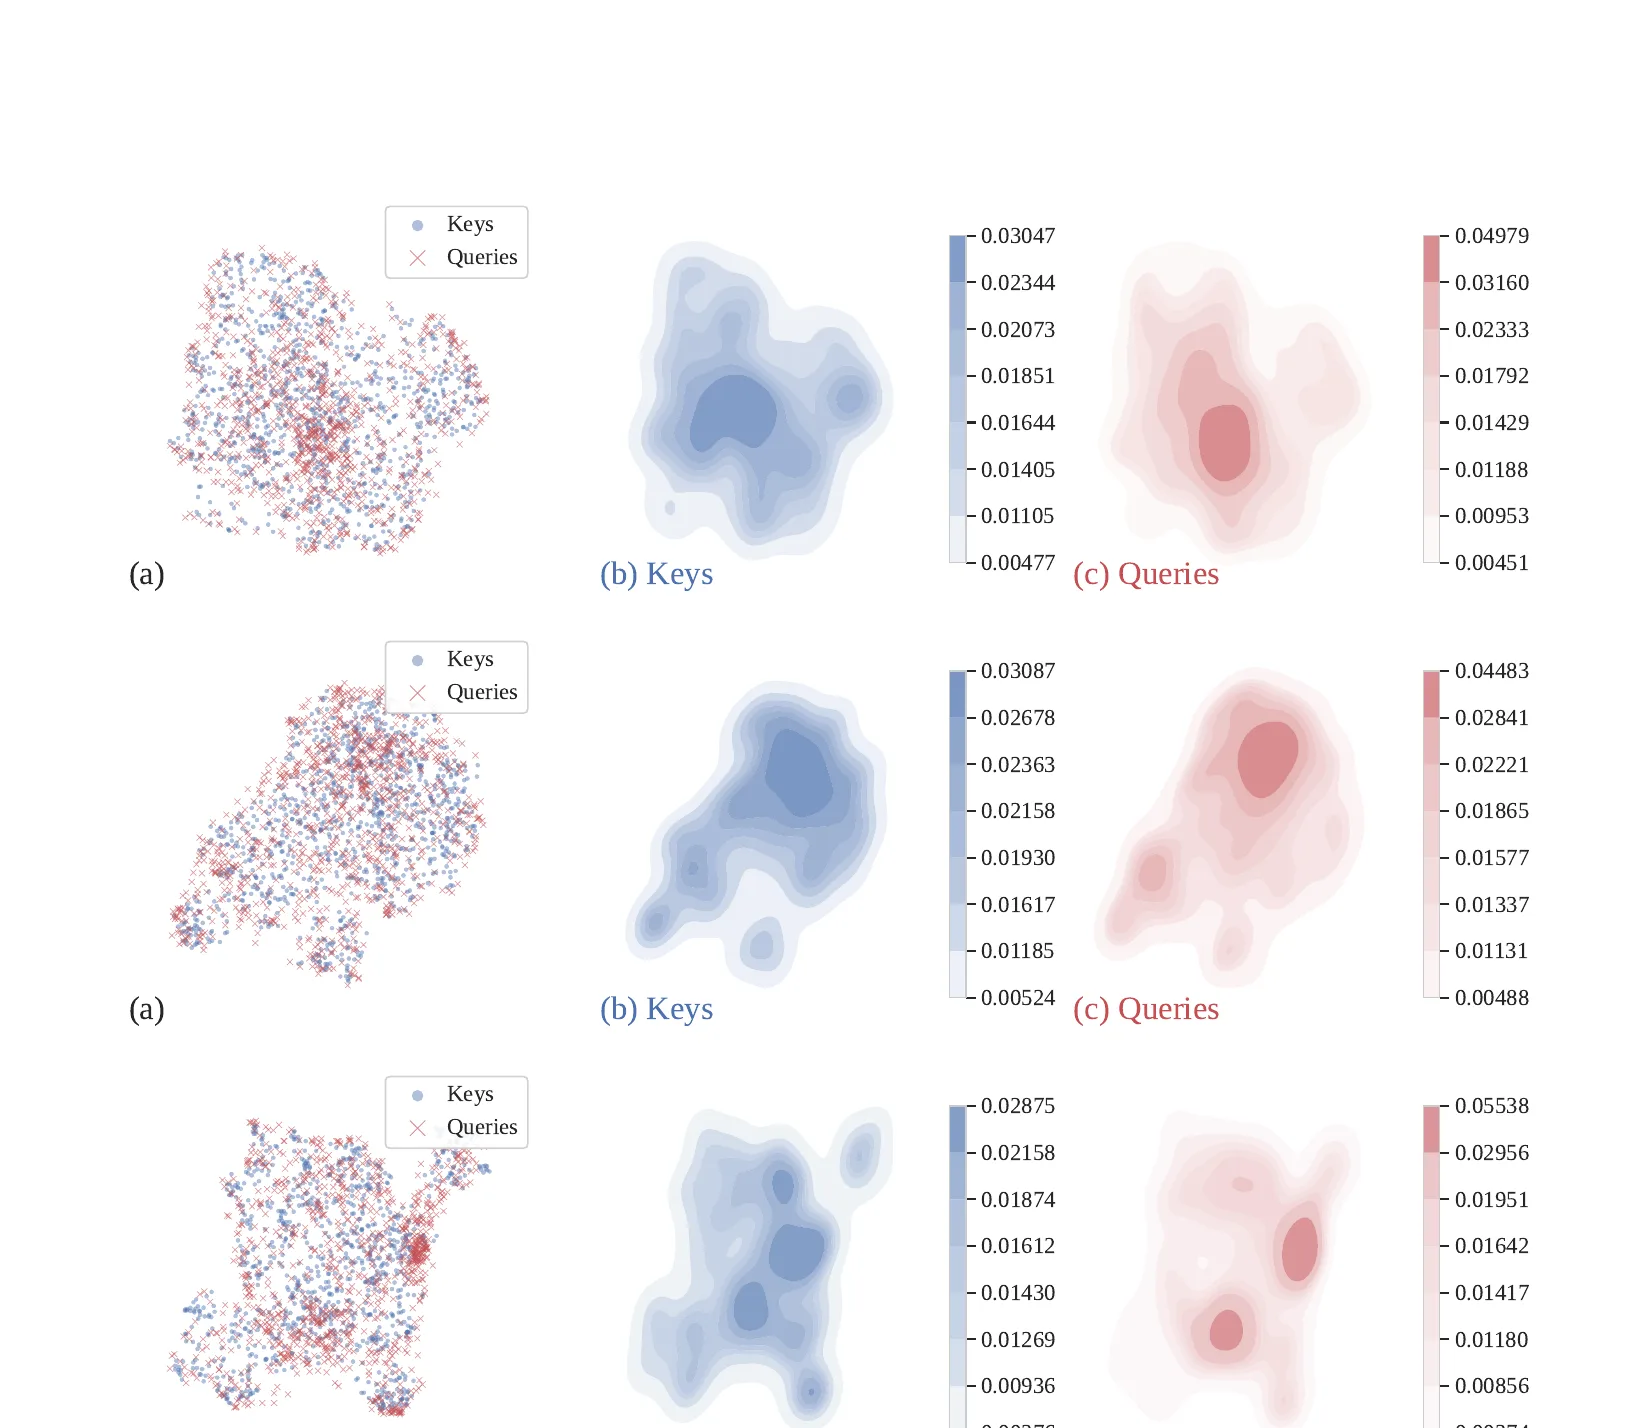
읽는 법은 간단합니다. 가운데 열(b)이 문서가 모인 곳, 오른쪽 열(c)이 질문이 모인 곳입니다. 위쪽 Quora는 ‘같은 질문 찾기’ 과제라 질문도 문서도 모두 짧은 질문이고, 두 분포가 거의 겹칩니다. 가운데 NQ와 아래 HotpotQA에서는 질문의 봉우리가 문서의 봉우리와 다른 곳에 솟아 있습니다. 질문 쪽에는 같은 밀도의 문서 짝이 없는 봉우리가 여럿 있습니다.
같은 부록의 그림 30은 질문과 그 정답 문서의 내적(1등 점수) 분포를 보여 줍니다. Quora는 평균 0.86(중앙값 0.88)으로 1에 몰려 있고, NQ는 0.71, HotpotQA는 0.74로 한참 아래에 넓게 퍼져 있습니다. 질문이 자기 정답 문서와도 그리 가깝지 않다는 뜻입니다. 논문은 “분포의 간격이 클수록 학습된 사상이 질문을 문서 쪽으로 옮겨 줄 여지가 크다”고 쓰고, 실제로 KeyNet의 이득은 NQ·HotpotQA에서 크고 Quora에서 가장 먼저 포화했습니다.
두 번째 사실: 질문은 대체로 ‘정해진 사람들’에게서 온다
애플 블로그가 짚는 두 번째 지점은 운영 현실입니다. 실서비스의 검색 시스템은 대개 안정적이고 알려진 사용자층을 상대합니다. 사내 문서 검색이라면 그 회사 직원들이 묻고, 쇼핑 검색이라면 그 쇼핑몰 손님이 묻습니다. 어제 들어온 질문과 오늘 들어올 질문은 비슷합니다. 그런데 질문과 무관하게 지은 색인은 이 정보를 한 번도 쓰지 않습니다. 애플은 이것을 “입력에 맞춰 방법을 조정하는 것은 머신러닝의 핵심 원리이고, 계산을 더 효율적인 곳으로 돌린다”고 표현합니다.
4. 역파일 색인과 중심점의 함정
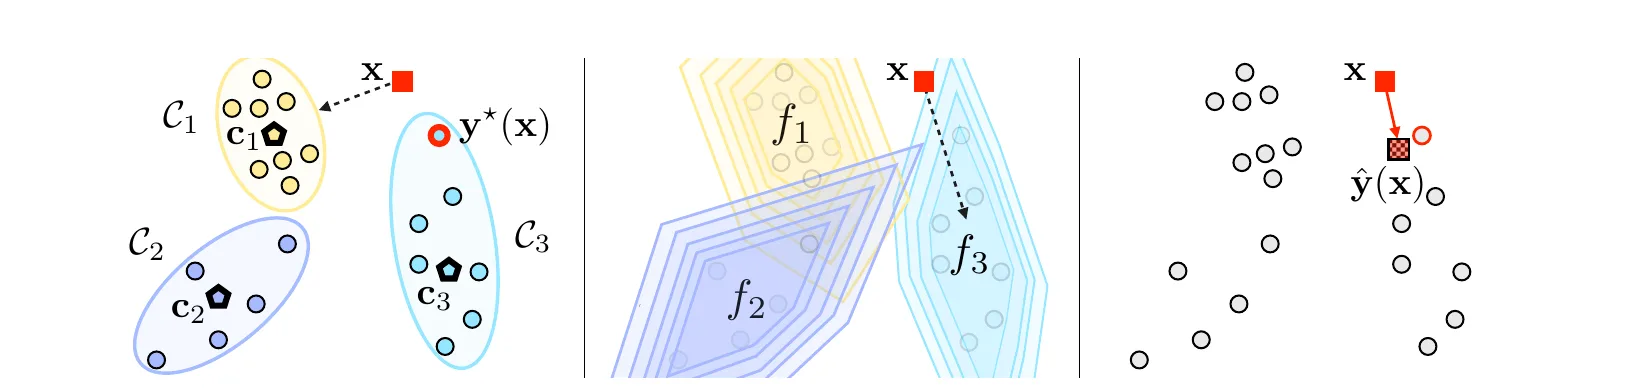
이제 IVF가 정확히 어디서 틀리는지 보겠습니다. 아래 그림은 논문 그림 1입니다. 상각 MIPS의 두 가지 쓰임새를 한 장에 담았습니다.
왼쪽은 기본 IVF입니다. 질문 x(빨간 네모)는 중심점 c1(오각형)과 가장 가깝습니다. 그래서 노란 방 C1을 엽니다. 하지만 진짜 정답 y⋆(x)(빨간 동그라미)는 세로로 길게 늘어진 하늘색 방 C3의 맨 위 끝에 있습니다. C3의 중심점은 방 한가운데 아래쪽에 있어서 질문에서 멉니다. 표지판(중심점)은 방이 얼마나 길게 퍼져 있는지 모릅니다.
가운데는 SupportNet의 해법입니다. 방마다 ‘질문이 이 자리에 오면 이 방에서 얻을 수 있는 최고 점수’를 등고선으로 그린 함수 f1,f2,f3를 학습합니다. 질문 위치에서는 f3이 가장 큽니다. 중심점으로는 ⟨x,c1⟩>⟨x,c3⟩인데도 f3(x)>f1(x)입니다. 그래서 정답 방을 엽니다.
오른쪽은 KeyNet의 해법입니다. 방 고르는 규칙은 그대로 두고, 질문 x를 정답 근처의 y^(x)로 옮겨서 색인에 넣습니다. 옮긴 벡터는 정답 바로 옆에 있으니 중심점 규칙으로도 맞는 방이 열립니다.
아래 놀이터에서 직접 질문을 놓아 보세요. 빨갛게 칠해지는 곳이 ‘중심점 라우팅이 정답 방을 열지 못하는 질문 위치’입니다. 세로로 긴 방3의 위·아래 끝 근처와 방 경계에 몰려 있습니다. 방을 2개, 3개 열면 빨간 영역이 줄지만, 그만큼 훑는 문서가 늘어납니다. 이것이 IVF의 근본적인 거래입니다. 정확도를 사려면 더 많은 방을 열어야 한다.
애플이 Natural Questions를 128개 방으로 나눠 잰 바로는, 중심점 라우팅으로 데이터베이스의 5%를 훑을 때 정답 방을 고른 비율이 87.5%였습니다. 열 번에 한 번 넘게, 전체의 5%나 뒤지고도 정답이 든 방을 열지 못한 것입니다.
5. 지지 함수 — 볼록 해석에서 빌려 온 열쇠
이 논문의 가장 아름다운 대목은, 검색의 ‘최고 점수’를 수학의 오래된 물건에 이어 붙인 데 있습니다.
최고 점수를 질문의 함수로 보기
질문 x를 하나 정하면 최고 점수가 하나 나옵니다. 질문을 조금씩 움직이면 최고 점수도 따라 움직입니다. 그러니 최고 점수를 질문의 함수로 볼 수 있습니다.
σY(x)=y∈Ymax⟨x,y⟩
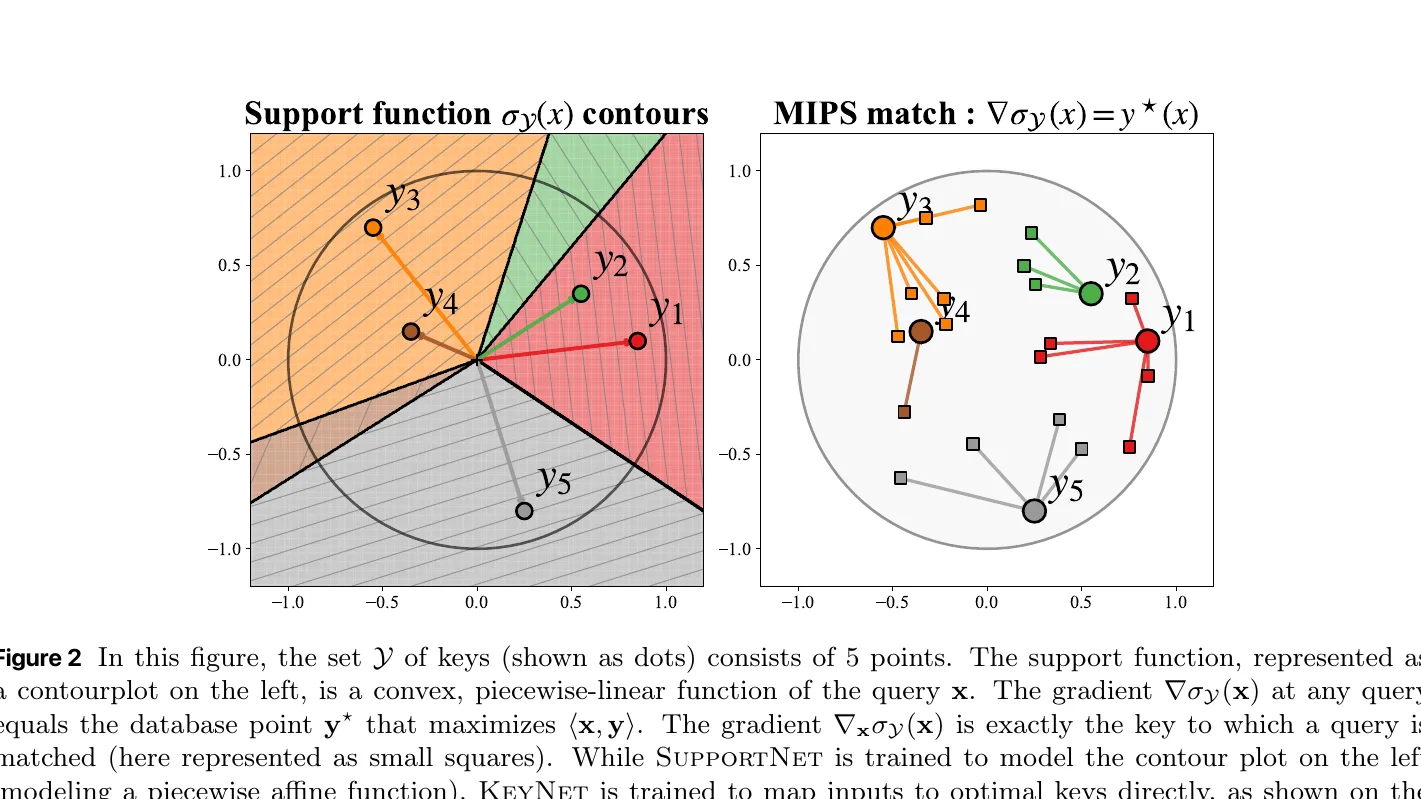
볼록 해석에서는 이 함수를 집합 Y의 지지 함수(support function)라고 부릅니다. 20세기 초 헤르만 민코프스키가 볼록체의 부피와 겉넓이를 연구하며 다룬 이래, 록펠러의 『Convex Analysis』(1970) 같은 교과서에 빠짐없이 나오는 기본 도구입니다. 이름의 유래는 기하학적입니다. 방향 x로 평면을 밀고 들어가다가 집합 Y에 처음 닿는 ‘받침 평면(supporting hyperplane)’의 위치가 바로 σY(x)입니다.
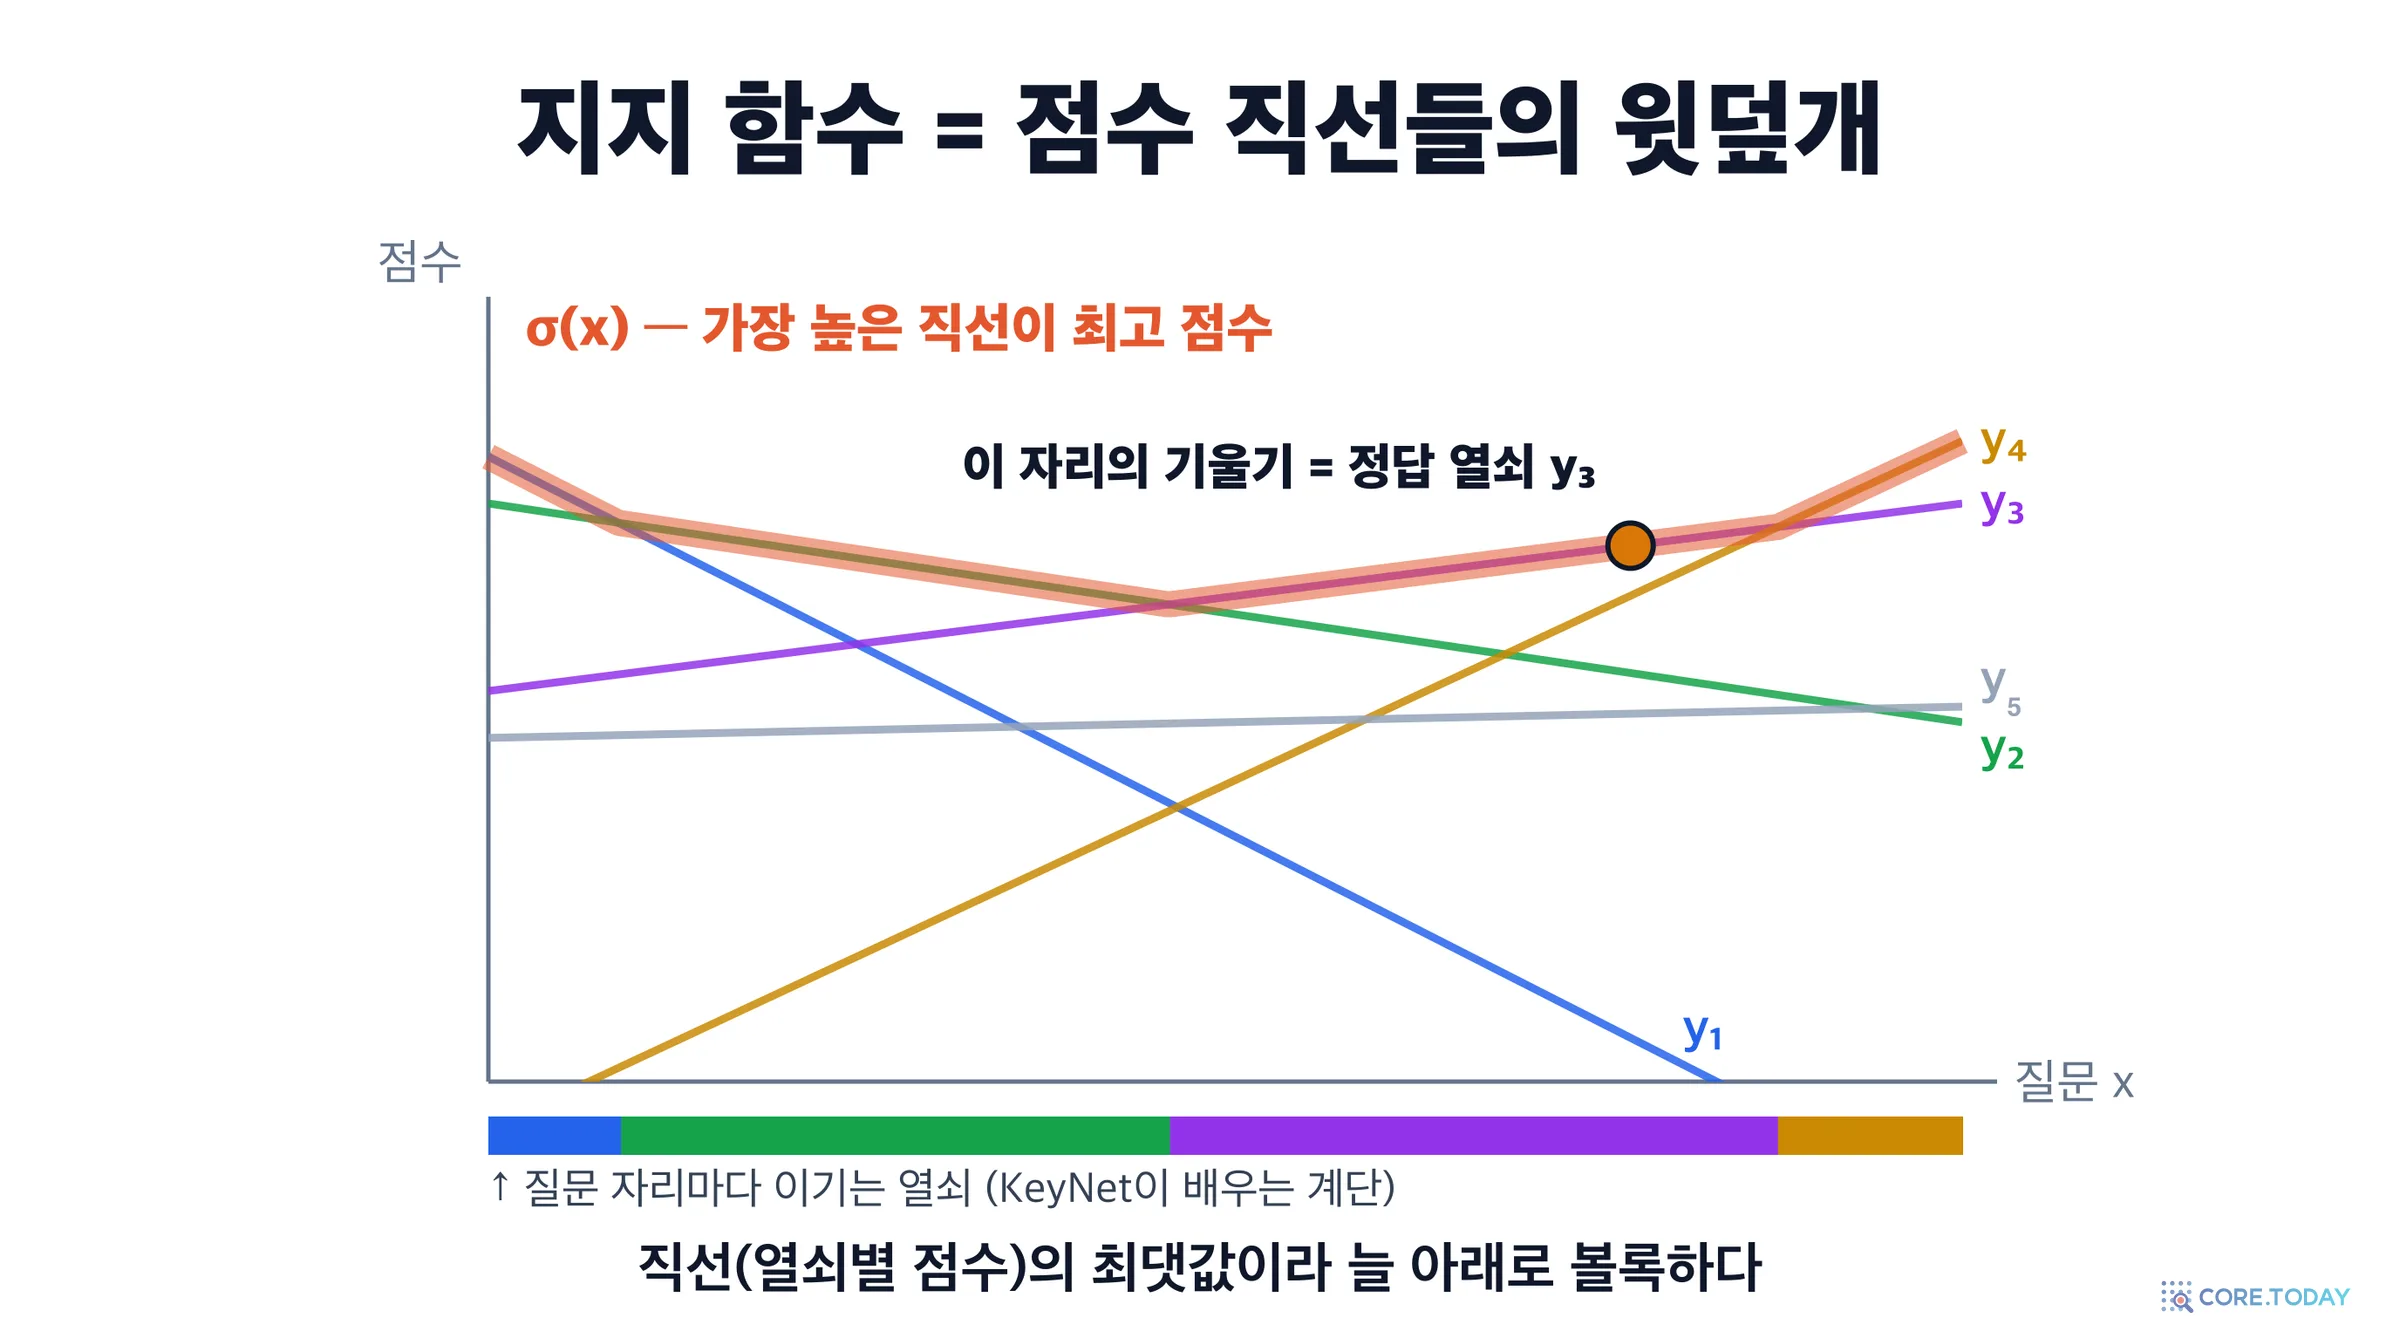
① 볼록하다. 열쇠 하나 yi에 대한 점수 ⟨x,yi⟩는 x의 1차 함수, 즉 평평한 평면입니다. 지지 함수는 이 평면들 중 가장 높은 것을 고른 ‘윗덮개’입니다. 평면들의 최댓값은 언제나 볼록합니다. 지붕을 떠올리면 됩니다. 평평한 판자를 여러 장 기울여 덮으면, 가장 위에 보이는 판자들이 아래로 볼록한 그릇 모양(위에서 보면 지붕)을 이룹니다. 그래서 입력에 대해 볼록함이 보장되는 신경망으로 근사하기에 알맞습니다.
② 기울기가 곧 정답이다. 어떤 질문 x에서 지붕의 가장 위에 있는 판자가 y7의 판자라면, 그 근처에서 지붕은 ⟨x,y7⟩ 그 자체이고, 그 기울기는 y7입니다. 이것이 포락선 정리(또는 Danskin 정리)의 내용입니다.
∇σY(x)=y⋆(x)
점수를 배우면 정답 위치도 미분 한 번으로 따라 나온다는 뜻입니다.
③ 양의 1차 동차(homogeneous)다. 질문을 두 배 늘리면 모든 점수가 두 배가 되니 최고 점수도 정확히 두 배이고, 정답은 그대로입니다. 즉 σY(αx)=ασY(x)(α>0)입니다. 동차 함수에 대한 오일러 정리를 쓰면 여기서 하나가 더 나옵니다.
⟨∇σY(x),x⟩=σY(x)
정답 열쇠와 질문의 내적이 최고 점수와 같다는, 당연해 보이는 식입니다. 하지만 이 식은 뒤에서 KeyNet을 훈련하는 ‘일관성 손실’의 근거가 됩니다.
아래 놀이터는 논문 그림 2를 1차원으로 펼친 것입니다. 열쇠 다섯 개의 점수 곡선과 그 지붕, 그리고 각도마다 어느 열쇠가 이기는지를 색 띠로 보여 줍니다. 질문 길이를 바꿔 동차성도 확인해 보세요.
논문 그림 2의 왼쪽은 2차원 질문 평면 위에 지지 함수를 등고선으로 그린 것입니다. 색이 다른 면은 각기 다른 열쇠가 이기는 영역이고, 각 면 안에서 함수는 평평한 조각(1차 함수)입니다. 오른쪽은 질문(작은 네모)마다 기울기를 따라가 짝지어지는 열쇠를 이은 그림입니다. 캡션의 설명대로 SupportNet은 왼쪽의 조각마다 평평한 함수(점수)를, KeyNet은 오른쪽의 조각마다 상수인 벡터 함수(정답 위치)를 배웁니다.
최적 수송과의 뜻밖의 연결
저자 중 마르코 쿠투리는 최적 수송(optimal transport) 분야에서 이름난 연구자입니다. 2013년 「Sinkhorn Distances」로 최적 수송 계산을 실용적인 속도로 끌어내렸고, 애플에서 JAX 기반 수송 라이브러리 OTT-JAX를 이끌고 있습니다. 공개 코드도 이 라이브러리의 ICNN·KeyNet 모듈을 씁니다. 논문 기여 표기에 따르면 “MIPS를 볼록 함수 회귀로 보자”는 틀을 처음 제안한 사람도 쿠투리입니다.
이 배경을 알면 논문이 왜 최적 수송 이야기를 꺼내는지 이해됩니다. 1991년 얀 브레니에는 ‘제곱 거리 비용의 최적 수송 사상은 언제나 어떤 볼록 함수의 기울기’임을 보였습니다. 그런데 x↦y⋆(x)=∇σY(x)도 볼록 함수(지지 함수)의 기울기입니다. 그러니 질문을 정답으로 보내는 사상은 정의상 브레니에 사상입니다. 보통의 최적 수송 학습에서는 그 볼록 함수를 모른 채 표본만으로 찾아내야 해서 어렵습니다. MIPS는 다릅니다. 아무 질문이나 하나 골라 전수 검색을 돌리면, 그 자리의 기울기(y⋆)와 함수값(σ)을 정답으로 얻을 수 있습니다. 논문은 그래서 상각 MIPS를 “지도 학습판 최적 수송”이라고 부릅니다.
6. 상각 최적화 — 한 번 크게 풀고, 매번 조금씩 돌려받기
같은 문제를 반복해서 풀 때
‘상각(amortized) 최적화’는 이 논문이 만든 말이 아닙니다. 논문이 인용하는 브랜든 에이머스의 2023년 튜토리얼이 이 개념을 정리했습니다. 기본 생각은 이렇습니다. 모양은 같고 입력만 다른 최적화 문제를 수없이 반복해서 풀어야 한다면, 매번 처음부터 풀지 말고 입력을 넣으면 답을 바로 내놓는 모델을 한 번 학습해 두자는 것입니다.
일상에서도 이런 일은 흔합니다. 택시 기사는 처음에는 지도를 펴고 길을 찾지만, 몇 년이 지나면 출발지와 목적지만 듣고 경로가 바로 떠오릅니다. 수많은 운행 경험이 머릿속 ‘경로 예측기’로 상각된 것입니다. 머신러닝에서는 변분 오토인코더(VAE, 2013)의 인코더가 대표적입니다. 데이터마다 사후 분포를 최적화로 따로 구하는 대신, ‘데이터를 넣으면 사후 분포를 바로 내놓는 신경망’을 배웁니다. 크라스카의 학습된 색인도 ‘키를 넣으면 위치를 내놓는 모델’이라는 점에서 같은 계열입니다.
상각 MIPS에서 ‘반복해서 푸는 문제’는 매 질문의 MIPS입니다. 학습 절차는 놀랄 만큼 평범한 지도 학습입니다.
1. 표본실제로 들어올 법한 질문 분포 pX에서 질문을 많이 뽑는다. 부족하면 질문 벡터에 작은 가우스 잡음을 더해 수를 늘린다(논문은 σ = 0.02로 5~100배).
2. 정답 계산뽑은 질문마다 전수 검색을 한 번씩 돌려 정답 열쇠 y⋆(x)와 최고 점수 σ(x)를 구해 저장한다. 방이 여러 개면 방마다 따로 구한다.
3. 회귀작은 신경망이 질문을 받아 그 점수(SupportNet) 또는 그 열쇠(KeyNet)를 내놓도록 학습한다. 표본 10억~100억 개, 30억 개 즈음부터 지표가 포화.
4. 사용추론 때는 전수 검색 대신 신경망을 한 번 돌리고, 그 결과로 방을 고르거나 질문을 고쳐 써서 기존 색인에 넣는다.
여기에는 분명한 조건이 붙습니다. 첫째, 열쇠 데이터베이스가 고정되어 있어야 합니다. 정답을 미리 계산해 두었으니, 문서가 바뀌면 정답도 바뀝니다. 둘째, 질문 분포를 알고 있어야 합니다. 학습 때 본 질문과 비슷한 질문이 올 때 잘 맞힙니다. 논문 제목의 ‘amortized’라는 말이 이 거래를 정직하게 드러냅니다. 9장에서 이 조건들을 다시 따져 보겠습니다.
7. 두 개의 신경망 — SupportNet과 KeyNet
이론상으로는 신경망 하나면 됩니다. 지지 함수를 배우게 한 뒤 자동 미분으로 기울기를 꺼내면 정답 열쇠까지 나오니까요. 그런데 저자들은 실제로는 역할을 나눈 두 신경망이 더 잘 된다는 것을 발견했습니다.
SupportNet — 볼록한 신경망으로 점수를 배운다
SupportNet은 입력 볼록 신경망(Input Convex Neural Network, ICNN)입니다. 2017년 브랜든 에이머스·레이 쉬·지코 콜터가 ICML에서 제안한 구조로, 출력이 입력에 대해 언제나 볼록하도록 설계되어 있습니다. 비결은 두 가지입니다.
층 사이 가중치 ≥ 0이전 층의 출력 z에 곱하는 가중치 W(z)를 음수가 되지 않게 한다. 볼록 함수에 양수를 곱해 더하고, 볼록하고 단조 증가하는 활성화를 씌우면 여전히 볼록하다.
입력 지름길각 층에 원래 입력 x를 가중치 W(x)로 다시 넣어 준다. 이 가중치에는 제약이 없어서, 표현력을 잃지 않는다(볼록 연속 함수를 모두 근사할 수 있다).
출력 c개방이 c개면 출력도 c개. j번째 출력이 j번 방의 지지 함수(그 방 최고 점수)를 근사한다. 질문은 출력이 가장 큰 방들로 보낸다.
애플 블로그는 이것을 ‘느슨하게 제약된(loosely constrained)’ ICNN이라고 부릅니다. 가중치를 매번 잘라 음수를 없애는 대신, 음수인 부분에 벌점(∑i∥ReLU(−Wi(z))∥2)을 주어 ‘대체로’ 지키게 하기 때문입니다. 초기화는 Hoedt·Klambauer(2023)의 ICNN 전용 방법을 쓰고, 동차성을 맞추려고 아무 모델 g를 H[g](x)=∥x∥⋅g(x/∥x∥)로 감싸는 ‘동차화 포장’을 씌웁니다.
손실은 두 가지를 섞습니다. 방마다 예측 점수가 진짜 최고 점수와 같아지도록 하는 점수 회귀, 그리고 예측 점수의 기울기(자동 미분)가 진짜 정답 열쇠와 같아지도록 하는 기울기 맞추기입니다.
기본 가중치는 점수 0.01, 기울기 1.0입니다. 논문 부록 A.6의 절제 실험을 보면, 점수만 쓰면 점수 오차는 가장 낮지만 기울기(열쇠) 오차가 가장 크고, 기울기만 쓰면 그 반대입니다. 기울기 쪽에 무게를 두고 점수를 조금만 섞으면, 기울기 오차는 거의 그대로 두고 점수 오차만 눈에 띄게 줄일 수 있었습니다.
KeyNet — 정답 위치를 바로 배운다
SupportNet의 약점은 정답 열쇠를 얻으려면 역전파를 한 번 더 해야 한다는 것입니다. 논문 표 1을 보면 SupportNet의 ‘열쇠 꺼내기’는 ‘점수 내기’의 거의 두 배 시간이 걸립니다. KeyNet은 이 단계를 건너뜁니다. 같은 모양의 신경망이지만 가중치 제약이 없고, 출력이 열쇠와 같은 d차원 벡터입니다. 질문을 넣으면 ‘정답 열쇠가 있을 자리’를 바로 내놓습니다.
손실은 예측 벡터와 정답 열쇠의 거리를 줄이는 열쇠 회귀에, 앞에서 본 오일러 정리에서 나온 점수 일관성을 더합니다.
KeyNet은 볼록 함수의 기울기라는 구조를 강제하지 않습니다. 대신 ‘예측 열쇠와 질문의 내적이 최고 점수와 같아야 한다’는 조건을 걸어, 마치 1차 동차 함수의 기울기처럼 행동하게 유도합니다. 가중치는 열쇠 1.0, 일관성 0.01입니다. 저자들은 기울기 구조를 보장하는 더 정교한 구조(입력 볼록 기울기 신경망, 2021)와 수송 사상 정규화(Monge gap, 2023)도 시도했지만, 규모가 너무 크거나 정답 짝을 아는 이 설정에서는 이득이 없었다고 적었습니다.
두 신경망 모두 폭이 일정한 직사각형 MLP이고, 크기는 데이터베이스 크기(n×d)에 대한 비율 ρ로 정합니다. XS = 1%, S = 5%, M = 10%, L = 20%입니다(부록 실험에는 XL 40%, XXL 50%도 있습니다). 논문은 층 수 L, 입력 재주입 횟수 nx와 함께 매개변수 예산 P=ρ⋅n⋅d를 맞추는 폭 h를 2차 방정식으로 구합니다.
(L−1)h2+(1+nx)dh≈P
숫자로 감을 잡아 보면 이렇습니다. Natural Questions(약 260만 × 384)에서 XS는 약 1천만 개, L은 약 2억 개 매개변수입니다. 작은 언어 모델 하나와 맞먹는 크기입니다. 이 사실은 9장에서 다시 중요해집니다.
학습의 세부
활성화 함수는 ‘부드러운 새는 ReLU’ σα,β(x)=αx+β1−αlog(1+eβx)입니다(α=0.1, β=20). 진짜 지지 함수는 꺾인 면들로 되어 있어 β가 무한대에 가까워야 맞지만, 기울기가 잘 흐르도록 β=20으로 타협했습니다. 최적화는 Adam에 코사인 학습률(정점 약 10−4), 지수 이동 평균(EMA) 가중치로 평가합니다. 묶음 크기는 512~16,384이고 학습 표본은 보통 10억~100억 개입니다.
부록 A.7은 ‘얼마나 오래 학습해야 하나’에 답합니다. NQ의 S 모델을 10억·30억·50억·70억 표본으로 학습했더니 학습 손실은 끝까지 내려가지만, 실제로 중요한 지표는 30억 개 즈음 멈췄습니다. 상대 수송 오차의 지수값이 10억 개에서 0.40, 30억 개에서 0.375, 70억 개에서 0.365였고, 평균 역순위(MRR)는 30억~70억 사이에 약 0.002밖에 오르지 않았습니다. 저자들은 30억 개를 ‘실용적인 최적점’으로 봅니다.
여기서 나온 상대 수송 오차Erel은 논문이 만든 평가 지표입니다. 예측이 정답에 얼마나 가까워졌는지를, 원래 질문이 정답에서 떨어져 있던 거리와 비교합니다.
Erel=Ex[log∥x−y⋆∥2∥y^(x)−y⋆∥2]
0이면 예측이 원래 질문만큼 정답에서 멀고, −1이면 그 거리의 약 0.37배(e−1)로 가까워졌다는 뜻입니다. 저자들은 이 값이 −1 아래로 내려가면 모델이 쓸 만해진다고 적었습니다.
8. 결과 읽기 — 같은 품질을 얼마나 싸게 얻었나
실험 무대
논문은 BEIR 벤치마크의 네 데이터셋을 씁니다. 금융 질의응답 FIQA(열쇠 약 5만 2천 개), 같은 질문 찾기 Quora(약 51만 3천 개), 위키백과 사실 질문 Natural Questions(NQ, 약 260만 개), 여러 문서를 건너 추론하는 HotpotQA(약 520만 개)입니다. 부록에서는 생의학 질의응답 BioASQ(약 1,500만 개)로 규모를 더 키웠습니다. 모든 글은 all-MiniLM-L6-v2로 384차원 정규화 임베딩을 만들고, 부록 A.5에서 768차원 인코더 두 개(MPNet, DistilRoBERTa)로도 같은 결론을 확인했습니다.
평가는 ‘같은 비용을 들였을 때 정답을 얼마나 자주 찾는가’입니다. 비용은 세 가지 잣대로 잽니다. 열어 본 방 수(또는 훑은 비율), 곱셈 수(FLOPs), 실제 걸린 시간(ms)입니다. 그래프에서 같은 높이(재현율)에 더 왼쪽(적은 비용)으로 닿는 곡선이 이깁니다.
애플 블로그의 그림 4는 NQ를 128개 방으로 나누고, 크기가 다른 SupportNet 네 개(XS·S·M·L, 모두 16층)를 중심점 라우터와 비교합니다. 실행 시간까지 포함하면, 작은 SupportNet은 라우팅 재현율 95%에 1.74ms에 닿았고 중심점 라우팅은 3.36ms가 걸렸습니다. 약 1.9배입니다. 큰 모델은 같은 1.74ms에 97%까지 갔습니다. 신경망 실행 비용을 빼고 ‘열어 본 비율’만 보면, 데이터베이스의 5%를 훑을 때 학습된 라우터는 90~93%(M이 92.6%), 중심점은 87.5%였습니다.
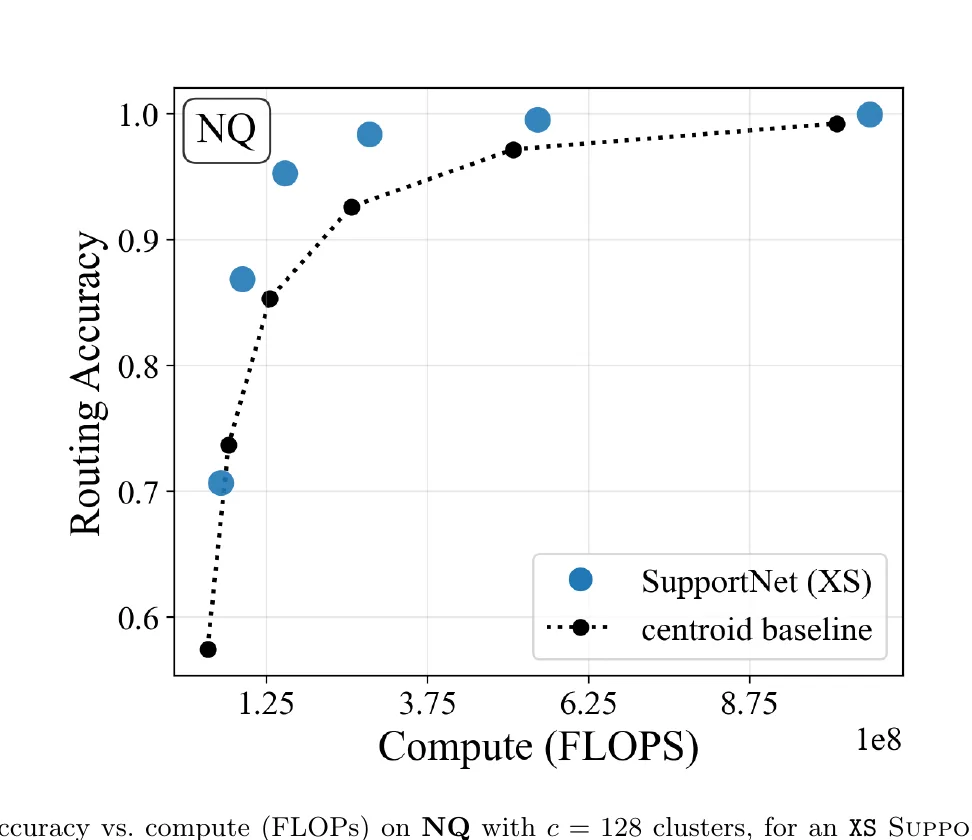
논문 그림 4는 같은 128개 방을 FLOPs 축으로 다시 봅니다. 여기서는 8층짜리 XS SupportNet을 표본 10억 개로 학습했습니다.
방을 하나만 열면 SupportNet이 약 72%, 중심점이 약 56%로 정답 방을 고릅니다. 4개를 열면 SupportNet은 약 95%인데, 중심점은 16개(연산량 약 4배)를 열어야 95%에 닿습니다. 저자들의 요약은 “학습된 라우터의 이점은 예산이 빠듯할 때 가장 크다”입니다. 방 10개짜리 실험(본문 4.3절)에서는 데이터에 따라 달랐습니다. NQ에서는 모든 예산에서 이겼고 방 하나만 열 때 10%포인트 넘게 앞섰지만, 더 작은 Quora에서는 아주 적은 예산 구간에서 오히려 중심점이 나았습니다.
방이 128개쯤 되면 방 고르기에는 SupportNet이 맞습니다. KeyNet으로 방마다 열쇠를 예측하면 출력이 c×d(128 × 384 ≈ 4만 9천 차원)로 너무 커지기 때문입니다. SupportNet의 출력은 방마다 점수 하나, 즉 128개면 됩니다.
KeyNet을 질문 고쳐 쓰기에 쓰면
KeyNet은 색인을 전혀 건드리지 않습니다. 질문 x 대신 예측 열쇠 y^(x)를 그대로 FAISS IVF에 넣을 뿐입니다. 애플 블로그 그림 6의 결과입니다.
원래 질문 (0.001% 훑기)
86%
KeyNet L로 고친 질문
96.7%
원래 질문: 99%까지 시간
1.8 ms
KeyNet L: 99%까지 시간
0.23 ms
데이터베이스의 0.001%(260만 개 중 약 26개)만 훑을 때, 원래 질문은 정답 열쇠를 86% 찾았고 KeyNet으로 고친 질문은 크기에 따라 89~97%(L은 96.7%) 찾았습니다. 재현율 99%에 필요한 탐색 비율은 원래 질문 0.10%, 고친 질문 0.009%로 약 11배 차이입니다. 질문 변환과 검색을 합친 시간은 1.8ms 대 0.23ms로 약 8배입니다. 애플은 이것을 “같은 비용에 더 높은 재현율, 또는 같은 재현율을 몇 분의 일 비용에”라고 요약합니다.
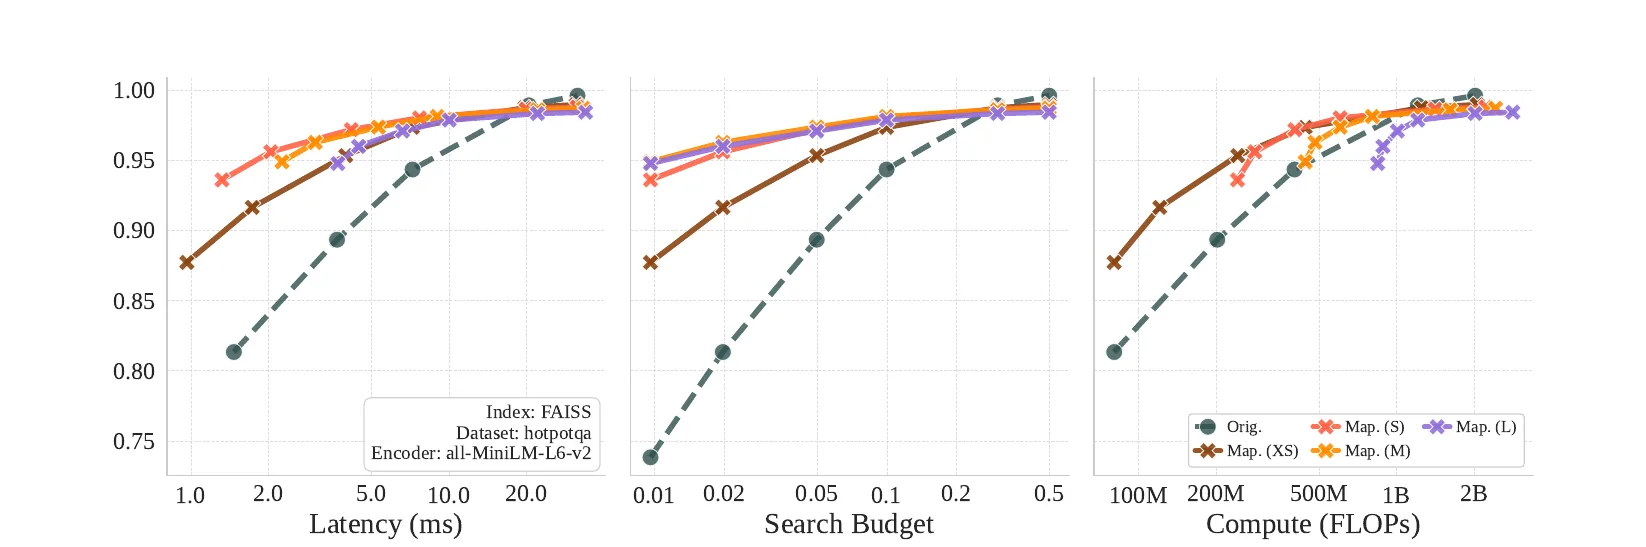
논문 그림 5는 가장 큰 HotpotQA(약 520만 개)에서 같은 실험을 세 가지 비용 축으로 보여 줍니다.
세 패널을 나란히 보면 흥미로운 것이 보입니다. 가운데(탐색 예산)에서는 큰 모델일수록 위에 있습니다. 하지만 오른쪽(연산량)에서는 L(보라)이 한참 오른쪽에서 시작합니다. KeyNet 자체를 돌리는 곱셈이 많기 때문입니다. 왼쪽(지연 시간)에서는 L이 다시 경쟁력을 되찾습니다. 논문은 이를 “GPU의 병렬성과 효율적인 묶음 처리 덕”이라고 설명하고, 연산량이 빠듯하면 XS·S를, 지연 시간이 기준이면 큰 모델을 고르라고 권합니다. 아주 큰 예산 구간에서는 원래 질문이 다시 따라잡거나 살짝 앞서는 것도 보입니다.
다른 색인, 더 큰 데이터에서도
부록 A.8은 FAISS 말고도 세 가지 색인에 같은 방식을 얹었습니다. 비등방 양자화의 ScaNN, 점 하나를 여러 방에 겹쳐 넣는 SOAR, 학습된 선형 압축의 LeanVec입니다. 결론은 같았습니다. 중간 예산 구간에서 고친 질문이 이겼고, 작은 XS·S의 이득이 가장 컸습니다. 다만 색인이 강할수록 이득의 폭은 좁아졌습니다. SOAR는 적당한 예산에서 이미 높은 재현율에 빨리 닿아, Quora에서는 두 곡선이 사실상 겹쳤습니다. 1,500만 개짜리 BioASQ(부록 A.9)에서도 절대 재현율은 내려갔지만, 원래 질문과 고친 질문의 상대적 차이는 무너지지 않았습니다.
실제 질문으로 보면
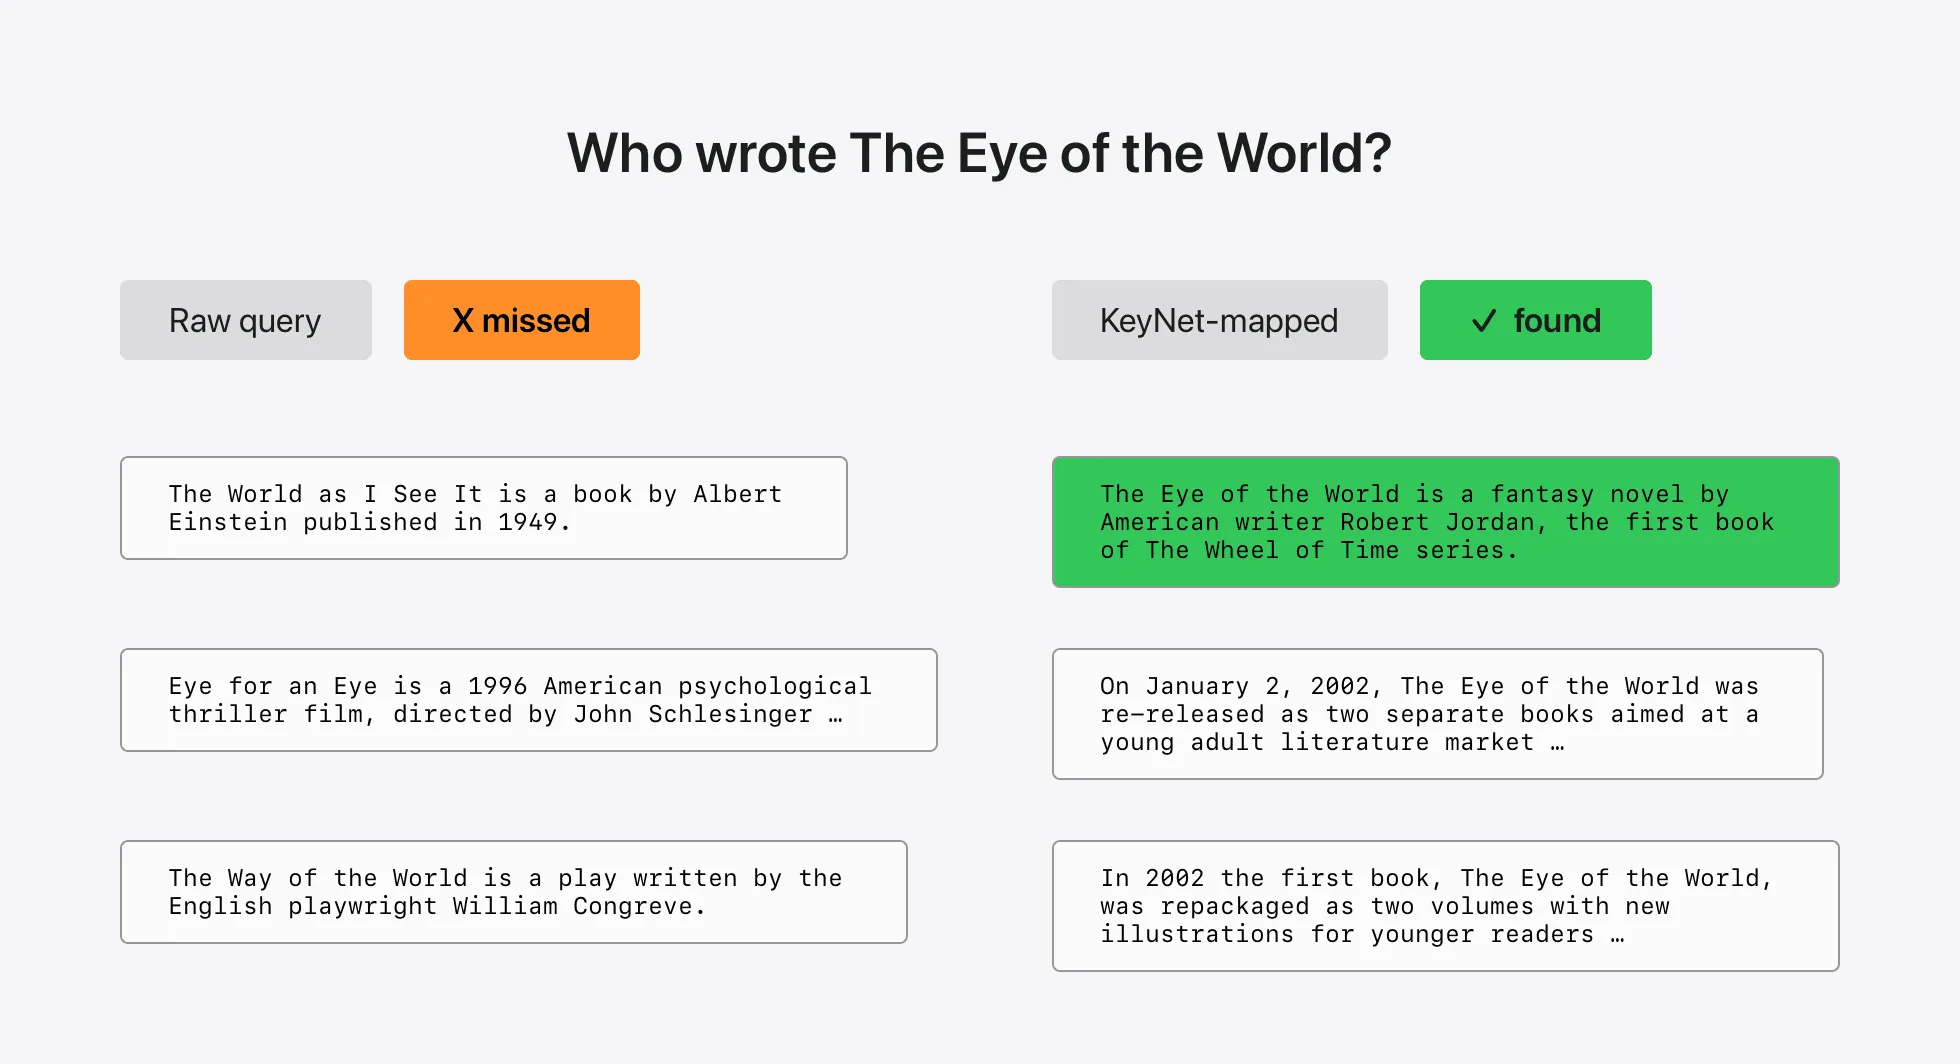
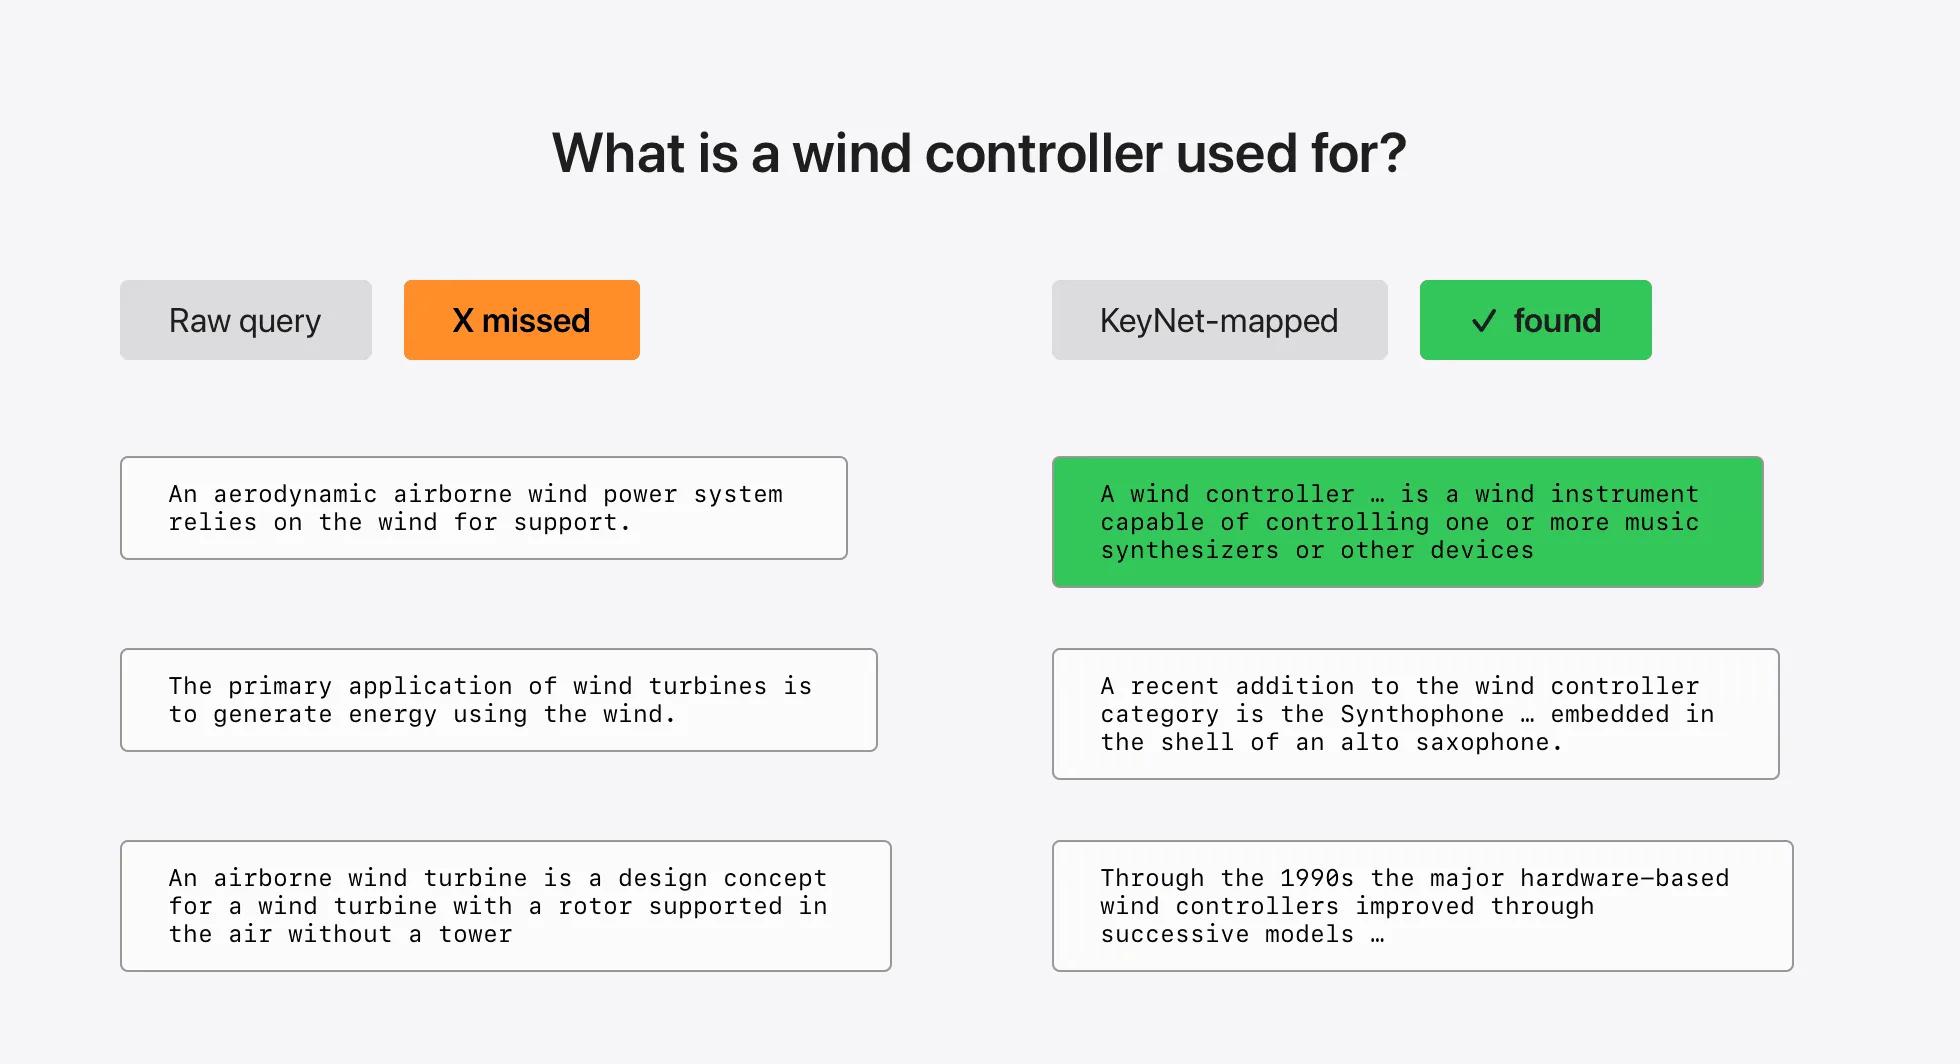
애플 블로그는 NQ 질문 다섯 개에 대해, 아주 적은 예산의 FAISS IVF가 원래 질문과 고친 질문으로 내놓은 상위 3개를 보여 줍니다. 둘을 옮깁니다.
출처: Apple Machine Learning Research, “Faster Retrieval for Better, More Efficient RAG”, 그림 7.
원래 질문은 ‘World’, ‘Eye’, ‘wind’ 같은 겉모양 단어가 비슷한 문단들의 방으로 갔습니다. “무엇에 쓰이나”라는 질문의 뜻 대신 ‘바람’이라는 단어에 끌린 셈입니다. KeyNet으로 고친 질문은 ‘이런 질문의 답이 될 만한 문단은 이렇게 생겼다’는 쪽으로 옮겨져, 악기 컨트롤러를 설명하는 문단이 사는 방을 열었습니다. 한 가지 짚어 둘 점이 있습니다. 여기서 ‘정답’은 원래 질문으로 전수 검색했을 때의 1등입니다. 즉 원래 질문도 전부 뒤졌다면 이 문단을 찾았을 것입니다. 원래 질문이 놓친 것은 임베딩이 틀려서가 아니라, 몇 개 안 되는 방을 고를 때 엉뚱한 방을 골랐기 때문입니다.
어떤 신경망을 쓸까
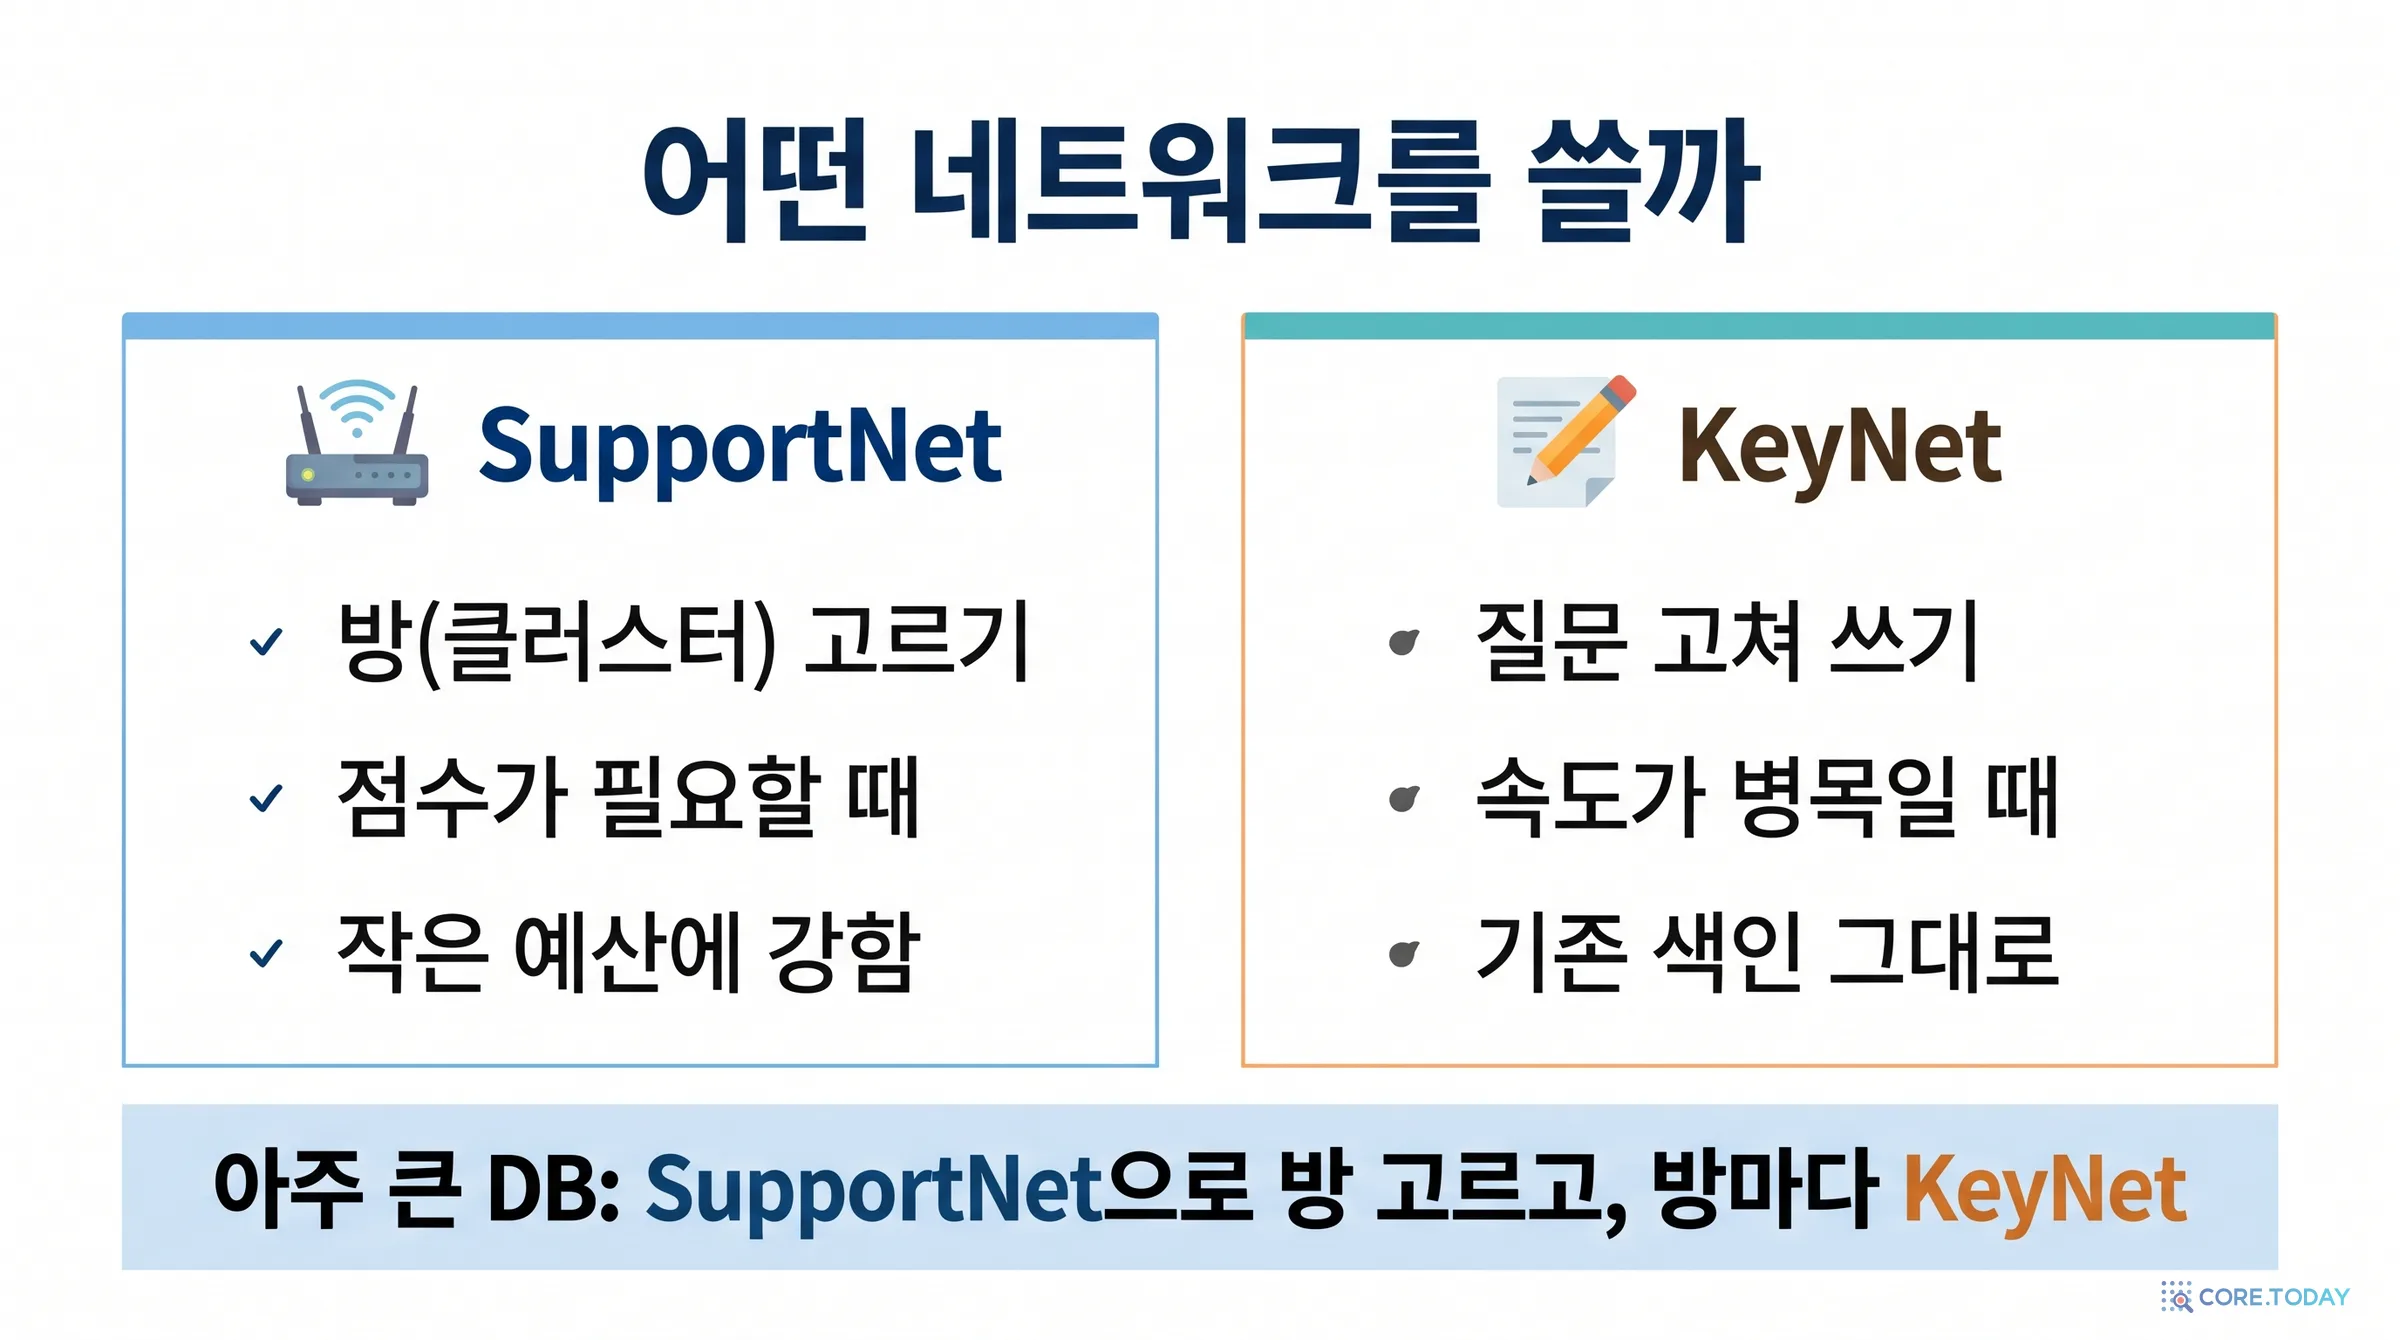
애플 블로그는 이렇게 정리합니다. 추론 속도가 병목이고 대략의 정답 열쇠만 있으면 되면 KeyNet. 재정렬·문턱값 같은 후속 처리에 보정된 점수도 필요하거나, 모델을 아주 작게 써야 하면 SupportNet. 데이터가 아주 크면 둘을 겹칩니다. SupportNet 하나로 방을 고르고, 방마다 KeyNet을 하나씩 두어 그 방의 색인이 정답을 더 빨리 찾게 합니다. 논문은 10억 규모로 가려면 이 조합이 필요할 것이라고 적었습니다.
결과는 인상적입니다. 하지만 논문과 공개 코드를 함께 읽으면, 숫자를 해석할 때 알아 둘 점이 몇 가지 보입니다. 논문이 스스로 밝힌 한계도 있고, 코드를 읽어야 보이는 것도 있습니다.
① 무엇을 비용으로 세는가 — 곱셈으로는 비싸다
KeyNet의 매개변수는 데이터베이스 크기의 ρ배입니다. 밀집 신경망을 한 번 돌리는 곱셈 수는 대략 매개변수 수와 같으니, KeyNet을 한 번 실행하는 비용은 전수 검색의 ρ배입니다. L(ρ = 20%)이면 전수 검색의 5분의 1입니다.
NQ에 대입하면 이렇습니다. 원래 질문으로 재현율 99%를 얻으려고 0.10%를 훑는 데 곱셈 약 100만 번이 듭니다. 고친 질문으로 0.009%를 훑는 데는 약 9만 번이면 됩니다. 그런데 그 전에 KeyNet L을 돌리는 데 약 2억 번이 듭니다. 곱셈만 세면 고친 쪽이 약 200배 비쌉니다. ‘11배 적은 문서’는 신경망 비용을 뺀 탐색 비율이고, ‘8배 빠른 시간’은 GPU에서 질문을 묶어 돌린 결과입니다. 이 차이는 하드웨어의 성격에서 나옵니다. 신경망의 촘촘한 행렬 곱은 GPU가 가장 잘하는 일이고, 색인 탐색은 메모리 이곳저곳을 읽어야 해서 연산 장치가 놀기 쉽습니다.
이것은 결과가 틀렸다는 뜻이 아닙니다. 논문도 그림 5에 FLOPs 축을 함께 그렸고, 연산량이 기준이면 작은 모델을 쓰라고 분명히 적었습니다. 다만 CPU 서버에서 질문을 하나씩 처리하는 서비스라면 ‘8배’를 그대로 기대하면 안 됩니다. 결과 탐색기의 마지막 탭과 아래 계산기에서 직접 확인할 수 있습니다.
② 메모리 — 색인 옆에 또 하나의 큰 모델
같은 이유로 메모리도 듭니다. NQ의 L 모델은 매개변수 약 2억 개, fp16으로 약 0.4GB입니다. 원래 임베딩(260만 × 384 × 2바이트 ≈ 2GB)의 20%입니다. 벡터를 양자화해 몇 분의 일로 줄여 쓰는 서비스라면, 이 모델이 색인보다 커질 수도 있습니다. 반대로 XS(1%)는 거의 부담이 없습니다. 논문이 거듭 ‘XS·S가 가장 좋은 거래’라고 말하는 데는 이런 사정도 있습니다.
③ 시험 질문은 학습 질문의 ‘형제’다 — 공개 코드 기준
이 부분은 코드를 읽어야 보입니다. 논문 4.1절은 질문을 임베딩한 뒤 가우스 잡음을 더해 5~100배로 늘리고, “늘린 임베딩을 다시 정규화해 학습용과 1,000개짜리 검증용으로 나눈다”고 씁니다. 애플이 공개한 코드(scripts/precompute_top1.py)는 실제로 이렇게 합니다. 원래 질문과 잡음 복제본을 모두 한데 모아 섞은 뒤 시험셋을 떼어 냅니다. 그러면 시험 질문 거의 전부가 학습셋에 ‘형제’를 둡니다. 같은 원래 질문에서 나온 다른 잡음 복제본이나 원래 질문 자체가 학습셋에 들어 있는 것입니다.
형제가 얼마나 가까운지 계산해 볼 수 있습니다. 384차원 단위 벡터에 차원마다 표준편차 0.02인 잡음을 더하면 잡음 벡터의 길이는 약 $0.02 \times \sqrt{384} \approx 0.39$입니다. 다시 정규화하면 원래 질문과의 코사인은 약 0.93입니다. 그런데 NQ에서 질문과 그 정답 문단의 평균 코사인은 0.71입니다. 시험 질문은 자기 정답 문단보다 학습셋의 형제와 훨씬 가깝습니다.
질문 분포가 ‘알려져 있다’는 논문의 전제에서 보면 이것은 반칙이 아닙니다. 실서비스에서도 같은 질문이 조금씩 다르게 반복해서 들어오니까요. 하지만 측정된 이득이 ‘처음 보는 질문을 일반화하는 능력’인지, ‘본 질문 근처를 외운 효과’인지는 이 설정만으로는 가를 수 없습니다. 논문의 분포 이동 실험(4.5절)도 시험 질문에 잡음을 더 세게 넣는 방식이라, 진짜로 새로운 질문에 대한 답은 아닙니다. 코어닷투데이가 10장에서 직접 잰 것이 바로 이 차이입니다.
④ NQ의 질문은 사람이 아니라 모델이 썼다
애플 블로그가 링크한 데이터는 BeIR/nq-generated-queries이고, 공개 코드의 예시 명령도 이 데이터를 씁니다. 이름대로 이것은 NQ 문단마다 T5 모델(docT5query 계열)로 생성한 질문 모음입니다. 2019년 노게이라 등이 제안한 doc2query 방식으로, 원래는 문서에 ‘이 문서가 답할 법한 질문’을 덧붙여 키워드 검색을 돕는 데 쓰였습니다. 생성 질문은 문단마다 고르게 퍼져 있고 문체가 균일합니다. 실제 사용자의 질문 로그는 그렇지 않습니다. 인기 주제에 몰리고, 오타와 줄임말이 섞이며, 시간에 따라 바뀝니다. ‘질문 분포를 안다’는 전제를 시험하기에는, 생성 질문이 실제보다 다루기 쉬운 분포일 가능성이 있습니다.
⑤ 문서는 고정되어 있어야 한다
상각 MIPS는 ‘고정된 열쇠 데이터베이스’를 가정합니다. 정답을 미리 계산해 두었으니, 문서를 추가·삭제·수정하면 일부 질문의 정답이 바뀝니다. 매일 새 기사가 들어오는 뉴스 검색이나, 문서가 수시로 고쳐지는 사내 위키에서는 다시 학습하는 주기와 비용이 문제가 됩니다. 논문은 향후 과제로 ‘질문 이동에 대한 온라인 적응’을 들지만, 문서 갱신은 따로 다루지 않습니다. KeyNet은 색인을 바꾸지 않으니 새 문서도 색인에는 들어가지만, KeyNet이 그 문서 쪽으로 질문을 옮겨 줄지는 보장되지 않습니다.
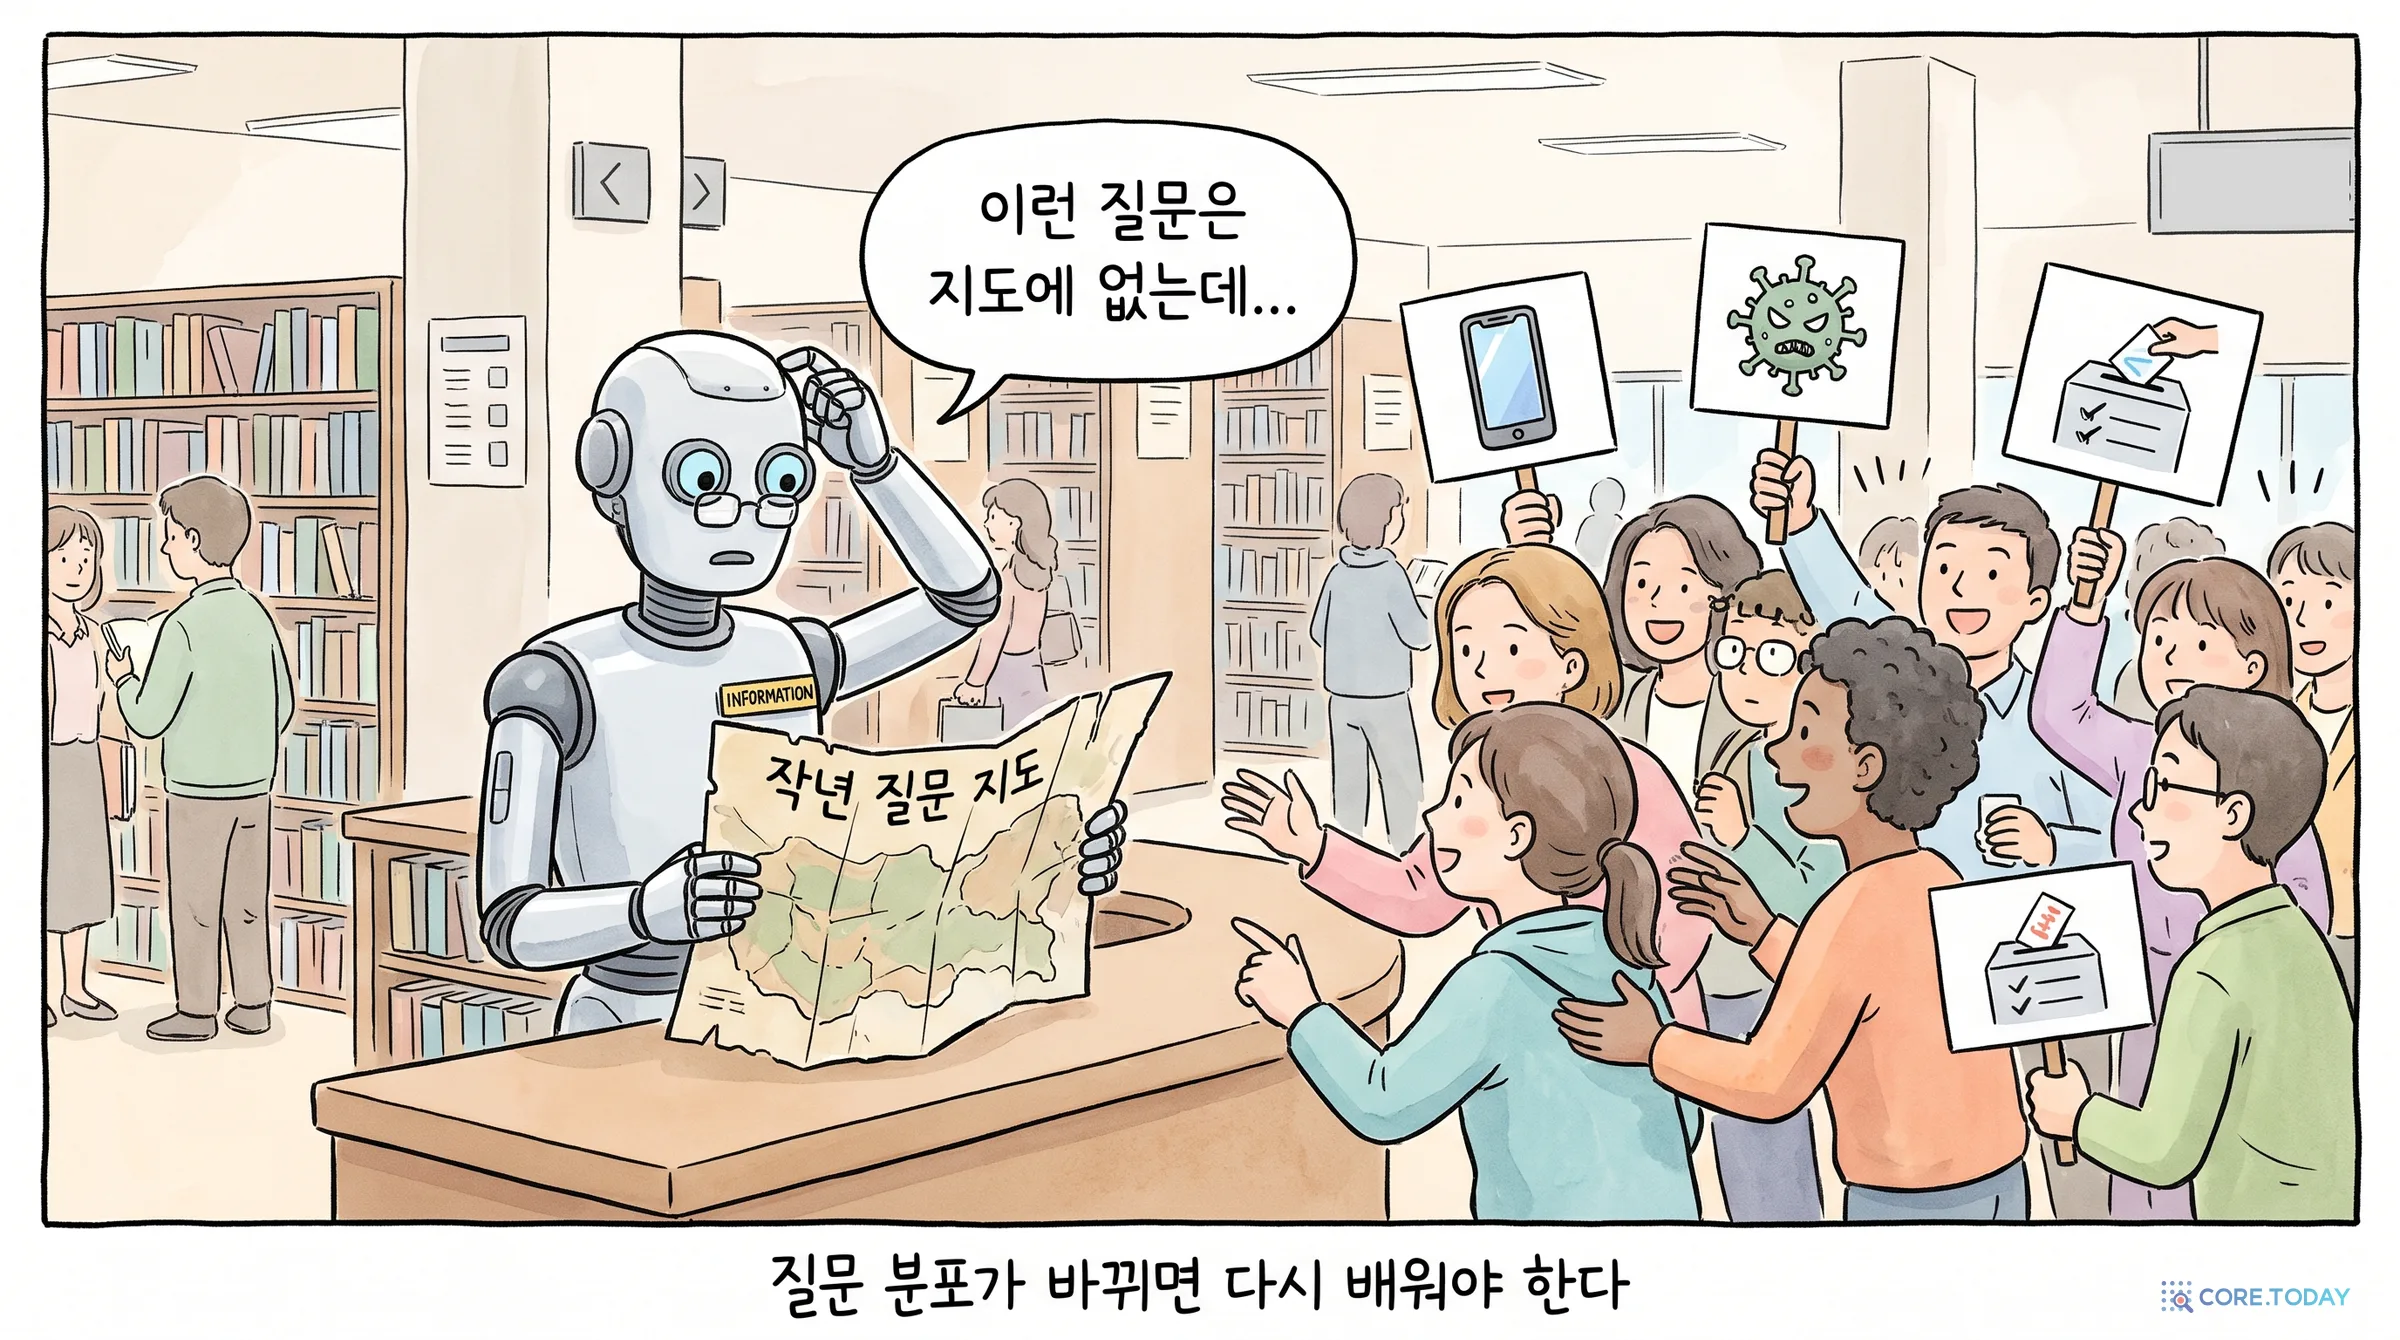
⑥ 질문이 바뀌면 다시 배워야 한다
논문이 스스로 첫 번째로 꼽은 한계입니다. 대표적인 질문 분포가 필요하고, 분포가 바뀌면 성능이 떨어집니다. 4.5절과 부록 A.2의 실험에서 시험 질문의 잡음을 학습 때(σ = 0.02)보다 키워 가자 성능이 떨어졌습니다. 다만 ‘파국적이지는 않았다’고 적었습니다. σ = 0.03까지는 중간 예산 구간에서 여전히 원래 질문보다 나았고, 차이는 예산의 양 끝에서 가장 컸습니다. 아래 장난감 모형에서 ‘새 유형 질문’을 눌러 보면, 학습해 둔 보정이 엉뚱한 방향으로 질문을 밀어 오히려 손해를 보는 경우가 어떻게 생기는지 볼 수 있습니다.
9장의 ③에서 남긴 질문을 직접 재 보았습니다. 상각 MIPS의 이득은 ‘처음 보는 질문’에도 남을까요? 그리고 그 질문이 처음 보는 문서를 묻는다면?
실험 구성
데이터KorQuAD 1.0(한국어 위키백과 기계 독해). 문맥 10,563개를 두세 문장씩 잘라 문단 조각 28,159개(평균 194자)를 열쇠로, 질문 66,000개(평균 34자)를 질문으로 썼다.
임베딩KURE-v3를 512차원으로 잘라 정규화(질문엔 query:, 문단엔 passage: 접두사). 코어닷투데이의 임베딩 실측에서 1위였던 모델이다.
학습 질문KorQuAD 학습 질문의 90%(54,209개)에 잡음 복제본을 10개씩 붙여 594,299행. 잡음 세기는 형제 코사인 0.93이 되도록 맞춰 논문 설정과 같은 수준으로 했다. 정답은 전수 검색으로 구했다.
모델논문 설정을 PyTorch로 옮겼다. 8층 직사각형 MLP, 2층마다 입력 재주입, 부드러운 새는 ReLU, EMA. KeyNet은 열쇠 거리 + 0.01 × 점수 일관성. 라우터는 방 128개의 최고 점수를 회귀하는 SupportNet 방식(볼록성 제약은 생략한 단순화판). 크기는 데이터베이스(n×d)의 1~20%.
색인k-평균 방 128개. 방을 1·2·4·8·16·32개 열고, 연 방 안은 원래 질문으로 정확히 훑는다. 재현율 = 원래 질문의 전수 검색 1등이 든 방을 열었는가.
시험 질문은 세 종류입니다.
시험셋
무엇인가
학습 질문과의 거리
A · 논문 방식
잡음 복제본을 섞은 뒤 떼어 낸 2,000개. 100%가 학습셋에 형제를 둔다
가장 가까운 학습 질문과 코사인 0.963
C · 처음 보는 질문
학습에서 통째로 뺀 학습 질문 6,023개. 같은 문서들에 대한 다른 질문
0.629
B · 처음 보는 문서
KorQuAD 개발셋 5,764개. 학습 질문이 다루지 않은 위키백과 문서들
0.411
결과 — 본 질문에서는 크게, 처음 보는 질문에서는 조금, 처음 보는 문서에서는 손해
방 128개 중 하나만 열 때(문단의 약 0.9%)와 8개를 열 때(약 6.7%), 정답 문단이 든 방을 연 비율입니다. 방 안은 원래 질문으로 정확히 훑으므로, 이 비율이 곧 최종 재현율입니다.
방법 (크기 = n×d 대비)
A · 논문 방식 방 1 / 방 8
C · 처음 보는 질문 방 1 / 방 8
B · 처음 보는 문서 방 1 / 방 8
중심점 (원래 질문)
46.7 / 77.4
45.5 / 78.0
46.1 / 78.1
KeyNet XS (1%, 매개변수 14만)
43.5 / 78.3
36.4 / 73.9
30.5 / 66.9
KeyNet S (5%, 72만)
60.0 / 90.6
46.4 / 80.6
36.2 / 70.7
KeyNet L (20%, 288만)
69.8 / 95.3
50.4 / 83.2
38.2 / 71.1
라우터 XS (1%)
46.1 / 85.7
42.4 / 82.7
37.6 / 77.5
라우터 S (5%)
76.7 / 95.8
57.6 / 90.7
39.8 / 80.8
학습 질문 베끼기 (신경망 없음)
정답률 96.3
정답률 56.2
정답률 3.5
단위는 %입니다. ‘학습 질문 베끼기’는 방을 고르지 않고, 가장 비슷한 학습 질문의 정답 문단을 그대로 답으로 낸 비율입니다. 아래 위젯에서 방 수를 1~32개로 바꿔 가며 곡선 전체를 볼 수 있습니다.
결과를 세 갈래로 정리합니다.
논문 방식(A)에서는 논문과 같은 그림이 나왔습니다. 방 하나만 열 때 정답 방을 고르는 비율이 중심점 46.7%에서 KeyNet S로 고친 질문 60.0%, KeyNet L 69.8%로 올랐습니다. 방 8개를 열면 77.4%가 90.6%(S), 95.3%(L)가 됩니다. 모델이 클수록 이득이 큰 것도 논문과 같습니다. 애플이 보고한 ‘같은 예산에 더 높은 재현율’이 한국어에서도 재현됩니다.
그런데 A에서는 신경망 없는 기준선이 KeyNet보다 낫습니다. 시험 질문마다 가장 가까운 학습 질문을 찾아 그 정답을 그대로 베끼면 96.3%가 맞습니다. KeyNet이 색인 없이 혼자 낸 정답률(예측 벡터의 최근접 문단이 정답인 비율)은 S 89.3%, L 95.5%로, 가장 큰 모델도 베끼기에 못 미쳤습니다. A의 시험 질문은 학습 질문과 코사인 0.963으로 붙어 있어서, ‘외운 답을 찾아오는 것’이 최선입니다. 이 설정에서 측정된 이득의 상당 부분은 일반화가 아니라 기억에서 나왔다고 보는 것이 자연스럽습니다.
처음 보는 질문(C)에서는 이득이 크게 줄었습니다. 같은 문서들에 대한 다른 질문인데도, 방 하나에서 KeyNet S는 45.5% → 46.4%로 1%포인트 남짓, 가장 큰 L도 50.4%로 5%포인트였습니다. 방 8개에서는 78.0%가 80.6%(S), 83.2%(L)였습니다. 베끼기 기준선은 56.2%로 무너졌고, KeyNet 단독 정답률은 S 71.0%, L 79.3%로 베끼기보다 높았습니다. KeyNet이 무언가를 일반화하긴 했지만, A에서 본 이득의 대부분은 사라졌습니다.
처음 보는 문서(B)에서는 손해를 봤습니다. 방 하나에서 46.1%가 KeyNet S 36.2%, L 38.2%로 8~10%포인트 떨어졌습니다. 방 32개를 열어도 91.6% 대 87.8~87.9%로 뒤졌습니다. 모델을 네 배 키워도 손해는 거의 줄지 않았습니다. 원인은 분석에서 바로 보였습니다(KeyNet S 기준). B 질문의 정답은 94.6%가 개발셋 문서의 문단인데, KeyNet이 가리킨 곳은 64.5%만 그 문서였습니다. 나머지는 학습 때 정답으로 자주 본 문단 쪽으로 끌려갔습니다. 학습 질문 59만 행이 정답으로 한 번이라도 가리킨 문단은 전체의 76.6%(21,575개)뿐이었고, 나머지 23%는 KeyNet에게 ‘지도에 없는 곳’이었습니다.
학습 질문이 가리킨 문단 76.6%
→
KeyNet은 질문을 이쪽으로 당기는 법을 배운다
한 번도 정답이 아니었던 문단 23.4%
→
새 문서의 질문이 오면 엉뚱한 ‘익숙한 곳’으로 밀린다
방 고르기(SupportNet 방식)는 처음 보는 질문에도 남았다
같은 데이터로 방 128개의 최고 점수를 회귀하는 라우터도 학습했습니다. 결과는 KeyNet과 달랐습니다.
C · 중심점, 방 1개
45.5%
C · KeyNet S, 방 1개
46.4%
C · 라우터 S, 방 1개
57.6%
C · 중심점, 방 8개
78.0%
C · 라우터 S, 방 8개
90.7%
처음 보는 질문(C)에서 라우터 S(데이터베이스의 5% 크기)는 방 하나로 57.6%를 골라 중심점(45.5%)보다 12%포인트 높았습니다. 방 4개에서는 82.9% 대 69.2%, 방 8개에서는 90.7% 대 78.0%였습니다. 중심점이 방 16개(85.5%)를 열어야 닿는 수준을 라우터는 방 4~8개로 넘었습니다. 논문 방식(A)에서는 방 하나로 76.7%까지 올라 이득이 더 컸습니다.
처음 보는 문서(B)에서는 모양이 특이했습니다. 방을 적게 열면 손해(방 1개 39.8% 대 46.1%)지만, 4개에서 비기고(70.0% 대 69.9%), 그 이상에서는 앞섰습니다(방 8개 80.8% 대 78.1%, 32개 95.3% 대 91.6%). 1등 방은 익숙한 쪽으로 쏠려도, 방들의 순서 전체에는 ‘어느 방이 넓게 퍼져 있는가’라는, 질문과 무관한 지식이 담겨 있기 때문으로 보입니다. 놀이터 2에서 본 ‘중심점은 방의 모양을 모른다’를 라우터는 배웠다는 뜻입니다.
왜 라우터가 KeyNet보다 잘 일반화했을까요? 라우터가 맞혀야 하는 것은 ‘128개 방 각각의 최고 점수’라는 매끄러운 값 128개입니다. KeyNet이 맞혀야 하는 것은 2만 8천 개 문단 중 하나의 위치라는, 계단처럼 끊기는 512차원 벡터입니다. 앞쪽이 훨씬 쉬운 문제입니다. 애플이 방 고르기에는 SupportNet을, 질문 고쳐 쓰기에는 KeyNet을 짝지은 것도 이 차이와 맞닿아 있습니다. 다만 우리 데이터베이스가 작아서, 라우터 S를 한 번 돌리는 곱셈은 문단 5%를 훑는 것과 같습니다. 이 규모에서는 곱셈 수로 이득을 보기 어렵고, 문서가 수백만 개 이상일 때 의미가 생깁니다.
이 실험이 말하는 것과 말하지 않는 것
이 실험은 애플의 결과를 반박하지 않습니다. 애플의 설정(A형 시험)을 그대로 따라 하면 한국어에서도 같은 방향의 큰 이득이 나왔습니다. 이 실험이 보여 주는 것은 이득이 어디서 오는지입니다. 상각 MIPS는 이름 그대로, 학습 때 본 질문과 문서의 범위 안에서 가장 크게 돌려받습니다.
조건도 분명히 적어 둡니다. 데이터베이스가 2만 8천 개로 논문(수십만~수천만)보다 작고, 학습 질문 수(5만 4천 개)도 적습니다. 학습 표본은 1억~2억 개로 논문(10억~100억)보다 적어서, 우리 KeyNet의 상대 수송 오차는 A에서도 −0.3(S)·−0.6(L) 수준으로 논문이 ‘쓸 만해지는’ 기준이라 한 −1에 못 미쳤습니다(L 학습에 맥 GPU로 39분). 또 데이터베이스가 작아서, 곱셈 수로 따지면 KeyNet L 한 번이 문단 20%를 훑는 값과 같습니다. 이 규모에서는 그 비용으로 중심점 방 32개(약 26%)를 여는 편이 더 낫습니다. 더 큰 질문 로그로 더 오래 학습하면 C의 이득은 커질 수 있습니다. 한편 B의 손해는 학습량보다 구조의 문제에 가깝습니다. 정답으로 본 적 없는 문서는, 정답을 미리 계산해 두는 방식으로는 배울 방법이 없습니다.
실무로 옮기면 이렇게 됩니다. 시험셋은 학습 질문의 잡음 복제가 아니라 나중 기간의 실제 질문으로 따로 떼어야 하고, 새 문서가 들어오는 서비스라면 ‘새 문서에 대한 질문’을 따로 재야 합니다. 그리고 그 둘에서 이득이 없으면, 원래 질문 경로로 되돌리는 스위치가 있어야 합니다.
11. 이웃 아이디어들 — 질문을 고쳐 쓰는 여러 방법
‘질문을 정답처럼 바꿔서 찾는다’는 생각 자체는 새롭지 않습니다. 새로운 것은 그 일을 어느 층에서, 얼마의 비용으로 하느냐입니다.
방법
무엇을 바꾸나
비용
학습에 필요한 것
doc2query / docT5query (2019)
문서 쪽에 ‘예상 질문’을 덧붙임
색인 만들 때 한 번 (생성 모델)
질문-문서 쌍
HyDE (2022)
LLM이 ‘가상의 정답 문서’를 써서 그걸로 검색
질문마다 LLM 생성 (수백 ms~초)
없음 (제로샷)
질의 확장·재작성 (LLM)
질문 문장을 다듬거나 여러 개로 늘림
질문마다 LLM 호출
없음 또는 미세조정
학습된 IVF 라우팅 (2024)
방 고르는 순위를 학습
작은 모델
질문과 정답 방
KeyNet (2026)
임베딩 벡터를 정답 열쇠 자리로 옮김
작은 MLP 한 번 (GPU 묶음이면 질문당 µs 단위)
질문 분포 + 전수 검색 정답
가장 닮은 것은 HyDE(Hypothetical Document Embeddings, Gao 외 2022)입니다. HyDE도 질문을 그대로 쓰지 않고, LLM에게 “이 질문에 답하는 문서를 하나 써 봐”라고 시킨 뒤 그 가상 문서의 임베딩으로 검색합니다. 질문과 문서의 비대칭을 ‘문서처럼 생긴 것’으로 메운다는 점에서 KeyNet과 같은 문제를 풉니다. 차이는 층과 비용입니다. HyDE는 글을 생성하니 질문마다 LLM 호출이 필요하고, 그 대신 학습 데이터가 필요 없습니다. KeyNet은 벡터 공간에서 바로 옮기니 아주 싸지만, 그 대신 데이터베이스와 질문 분포에 맞춰 학습해야 합니다. 코어닷투데이가 재정렬기 실측에서 HyDE 계열을 바꿔 써 봤을 때는, 작은 LLM이 자신 없는 질문에 그럴듯한 가짜 조례 이름을 지어내는 문제도 보였습니다. KeyNet은 글을 만들지 않으니 이런 지어내기는 없지만, 대신 학습한 범위 밖에서는 조용히 엉뚱한 곳을 가리킬 수 있습니다.
한 가지 더 짚을 점이 있습니다. KeyNet의 목표는 ‘원래 질문으로 전수 검색했을 때의 1등’입니다. 즉 KeyNet은 근사 검색을 전수 검색에 가깝게 만들 뿐, 임베딩 모델이 놓친 정답을 찾아 주지는 않습니다. HyDE나 질의 재작성은 임베딩의 의미 판단 자체를 바꿀 수 있습니다. 둘은 경쟁 관계가 아니라 다른 층의 도구입니다. 임베딩이 ‘무엇이 정답인가’를 정하고, 색인과 KeyNet은 ‘그 정답을 얼마나 싸게 찾나’를 정합니다.
12. 2026년, 이 기술의 자리
왜 지금 이런 연구가 나오나
몇 년 전까지 근사 검색은 ‘이미 풀린 문제’처럼 여겨졌습니다. HNSW와 IVF-PQ로 충분히 빨랐고, 병목은 임베딩 품질이나 LLM 생성에 있었습니다. 2026년에 다시 검색 속도가 화두가 된 이유는 세 가지입니다.
첫째, 질문의 수가 폭발했습니다. 에이전트는 한 과제에서 검색을 수십 번 부릅니다. 딥 리서치형 서비스는 질문 하나에 수백 번 검색하기도 합니다. 질문당 1ms를 아끼는 것이 사용자 한 명이 아니라 루프 한 바퀴마다 쌓입니다.
둘째, 데이터베이스가 커졌습니다. 문서를 잘게 쪼개 넣는 청크 기반 RAG, 멀티모달 임베딩(이미지·표·슬라이드 조각), 대화 기록을 통째로 넣는 에이전트 기억까지 더해지면서, 기업 하나의 벡터 수가 수억 개를 넘는 일이 흔해졌습니다.
셋째, 질문 로그가 쌓였습니다. RAG를 2~3년 운영한 회사라면 실제 사용자 질문이 수백만 건 쌓여 있습니다. ‘질문 분포를 안다’는 상각 MIPS의 전제가 처음으로 현실적이 되었습니다.
어디에 잘 맞나
사내 문서 검색잘 맞음사용자층 안정, 질문 반복 많음, 문서는 주기적 갱신
추천 시스템잘 맞음사용자 벡터 분포가 알려져 있음 — MIPS의 원래 고향
기기 안 검색조건부작은 모델이면 이득, 단 메모리 예산 확인
뉴스·실시간 검색어려움문서와 질문이 매일 바뀜 — 재학습 비용
작은 데이터베이스불필요수십만 개 이하면 전수 검색이 더 단순
CPU 단건 처리신중히곱셈 비용이 그대로 지연 — XS부터
애플이 이 연구를 하는 이유도 짐작할 수 있습니다. 애플은 2024년 개인 정보를 지키는 대규모 검색 시스템 Wally를 발표했고(애플 블로그도 이 글을 관련 연구로 링크합니다), 수억 대 기기의 사용자를 상대합니다. 사용자층이 크고 질문이 반복되며, 서버 비용과 지연 시간이 곧 사용자 경험입니다. 질문을 미리 배워 검색을 줄이는 접근은 이런 환경에 자연스럽게 맞습니다. 다만 이 논문은 실제 제품 적용을 밝히지 않았으니, 어디까지나 연구 결과로 읽어야 합니다.
한국어 서비스에서는
한국어 RAG에서 질문과 문서의 비대칭은 영어보다 클 수 있습니다. 질문은 “~했나요?”, “~언제야” 같은 구어체이고, 문서는 공문서·법령·보고서의 문어체입니다. 조사와 어미가 붙어 같은 단어도 겉모양이 달라집니다. 10장 실측에서 KorQuAD 질문과 1등 문단의 평균 코사인은 0.49 안팎이었습니다(임베딩 모델마다 점수 눈금이 달라 논문의 0.71과 바로 비교할 수는 없습니다). 분포 간격이 크다는 것은 상각 MIPS가 파고들 여지가 크다는 뜻이기도 합니다. 반대로 실측이 보여 주듯, 처음 보는 질문에 일반화하려면 학습 질문의 양과 다양성이 관건입니다.
13. 실무 체크리스트 — 도입 전에 물어볼 것
질문 1지금 병목이 정말 검색인가? 임베딩·재정렬·LLM 생성 시간을 먼저 재 본다. 대부분의 RAG에서 검색은 전체 지연의 일부다.
질문 2데이터베이스가 충분히 큰가? 수십만 개 이하면 GPU 전수 검색이나 기본 HNSW로 충분하다. 수백만~수억 개에서 IVF의 nprobe를 올려야 할 때가 상각 MIPS의 자리다.
질문 3실제 질문 로그가 있나? 생성 질문이 아니라 사용자 질문이 수십만 건 이상 있어야 한다. 시험셋은 학습 질문의 잡음 복제가 아니라 ‘나중 기간의 질문’으로 따로 떼어 잰다.
질문 4문서가 얼마나 자주 바뀌나? 바뀐 문서 비율과 재학습 주기·비용을 계산한다. 정답 사전 계산은 학습 질문 × 전체 문서의 전수 검색이다.
질문 5무엇을 비용으로 세나? GPU 묶음 처리면 지연 시간 기준으로 큰 모델도 이득이지만, CPU 단건 처리면 곱셈 수가 곧 지연이다. XS(데이터베이스의 1%)부터 시작한다.
질문 6감시 장치가 있나? 질문 분포가 바뀌면 이득이 손해로 뒤집힐 수 있다. 원래 질문 경로를 함께 돌려 두 결과의 1등이 얼마나 자주 다른지 지표로 본다.
붙이기 가장 쉬운 형태는 KeyNet XS를 ‘질문 고쳐 쓰기’로 기존 색인 앞에 두는 것입니다. 색인을 다시 짓지 않아도 되고, 문제가 생기면 원래 질문 경로로 바로 되돌릴 수 있습니다. 다만 코어닷투데이 실측에서는 처음 보는 질문이 많을수록 질문 고쳐 쓰기의 이득이 사라졌고, 방 고르기 라우터가 더 잘 버텼습니다. 질문이 자주 반복되는 서비스라면 KeyNet부터, 새 질문이 많은 서비스라면 라우터부터 시험해 볼 만합니다. 애플이 코드(apple-aiml-research/ml-amips, JAX)를 공개했으니 BEIR 형식의 데이터라면 세 단계(임베딩 → 정답 계산 → 학습)로 재현할 수 있습니다.
맺음말 — 색인이 질문을 배우기 시작했다
50년 동안 근사 검색은 ‘문서를 어떻게 정리해 둘까’의 역사였습니다. 나무로, 해시로, 방으로, 그래프로 정리했고, 그 정리는 질문이 무엇이든 똑같이 쓰였습니다. 애플의 상각 MIPS는 여기에 다른 질문을 던집니다. “누가 무엇을 물을지 대충 안다면, 그걸 왜 안 쓰나?”
그 답을 떠받치는 것이 지지 함수라는 오래된 수학이라는 점이 이 연구의 매력입니다. 최고 점수는 볼록하고, 그 기울기는 정답입니다. 이 한 문장에서 볼록 신경망으로 점수를 배우는 SupportNet과, 정답 위치를 바로 배우는 KeyNet이 나왔습니다. 결과도 분명합니다. 방 고르기는 1.9배 빨라졌고, 질문 고쳐 쓰기는 같은 재현율을 8분의 1 시간에 냈습니다.
동시에 이 거래의 조건도 분명합니다. 질문 분포가 안정적이어야 하고, 문서가 자주 바뀌지 않아야 하며, 무엇을 비용으로 세는지 정직해야 합니다. 코어닷투데이의 한국어 실측에서 그 경계가 숫자로 보였습니다. 많이 본 질문 근처에서는 크게 이기지만, 그 자리에서는 ‘비슷한 학습 질문의 답 베끼기’가 더 잘했습니다. 처음 보는 질문에서는 질문 고쳐 쓰기의 이득이 거의 사라졌고, 방 고르기만 이득을 지켰습니다. 처음 보는 문서의 질문에서는 질문 고쳐 쓰기가 오히려 손해였습니다. 결국 ‘상각’이라는 이름 그대로입니다. 미리 쓴 공부는, 비슷한 질문이 다시 올 때만 돌려받습니다.
그래도 방향은 분명해 보입니다. RAG가 회사마다 몇 년씩 운영되며 질문 로그가 쌓이는 2026년에, 색인이 문서만이 아니라 질문도 배우는 것은 자연스러운 다음 걸음입니다. 사서 로봇이 손님들의 질문을 공부하기 시작한 것입니다.
Theo X. Olausson, João Monteiro, Michal Klein, Marco Cuturi, “Amortized Maximum Inner Product Search with Learned Support Functions”, ICML 2026, arXiv:2603.08001 v3 (2026-07-01). arxiv.org/abs/2603.08001