‘비슷하다’는 네 가지 질문이다 — 알프스 꽃밭의 자카드에서 2026년 한국어 사실탐색기까지, 유사도 125년
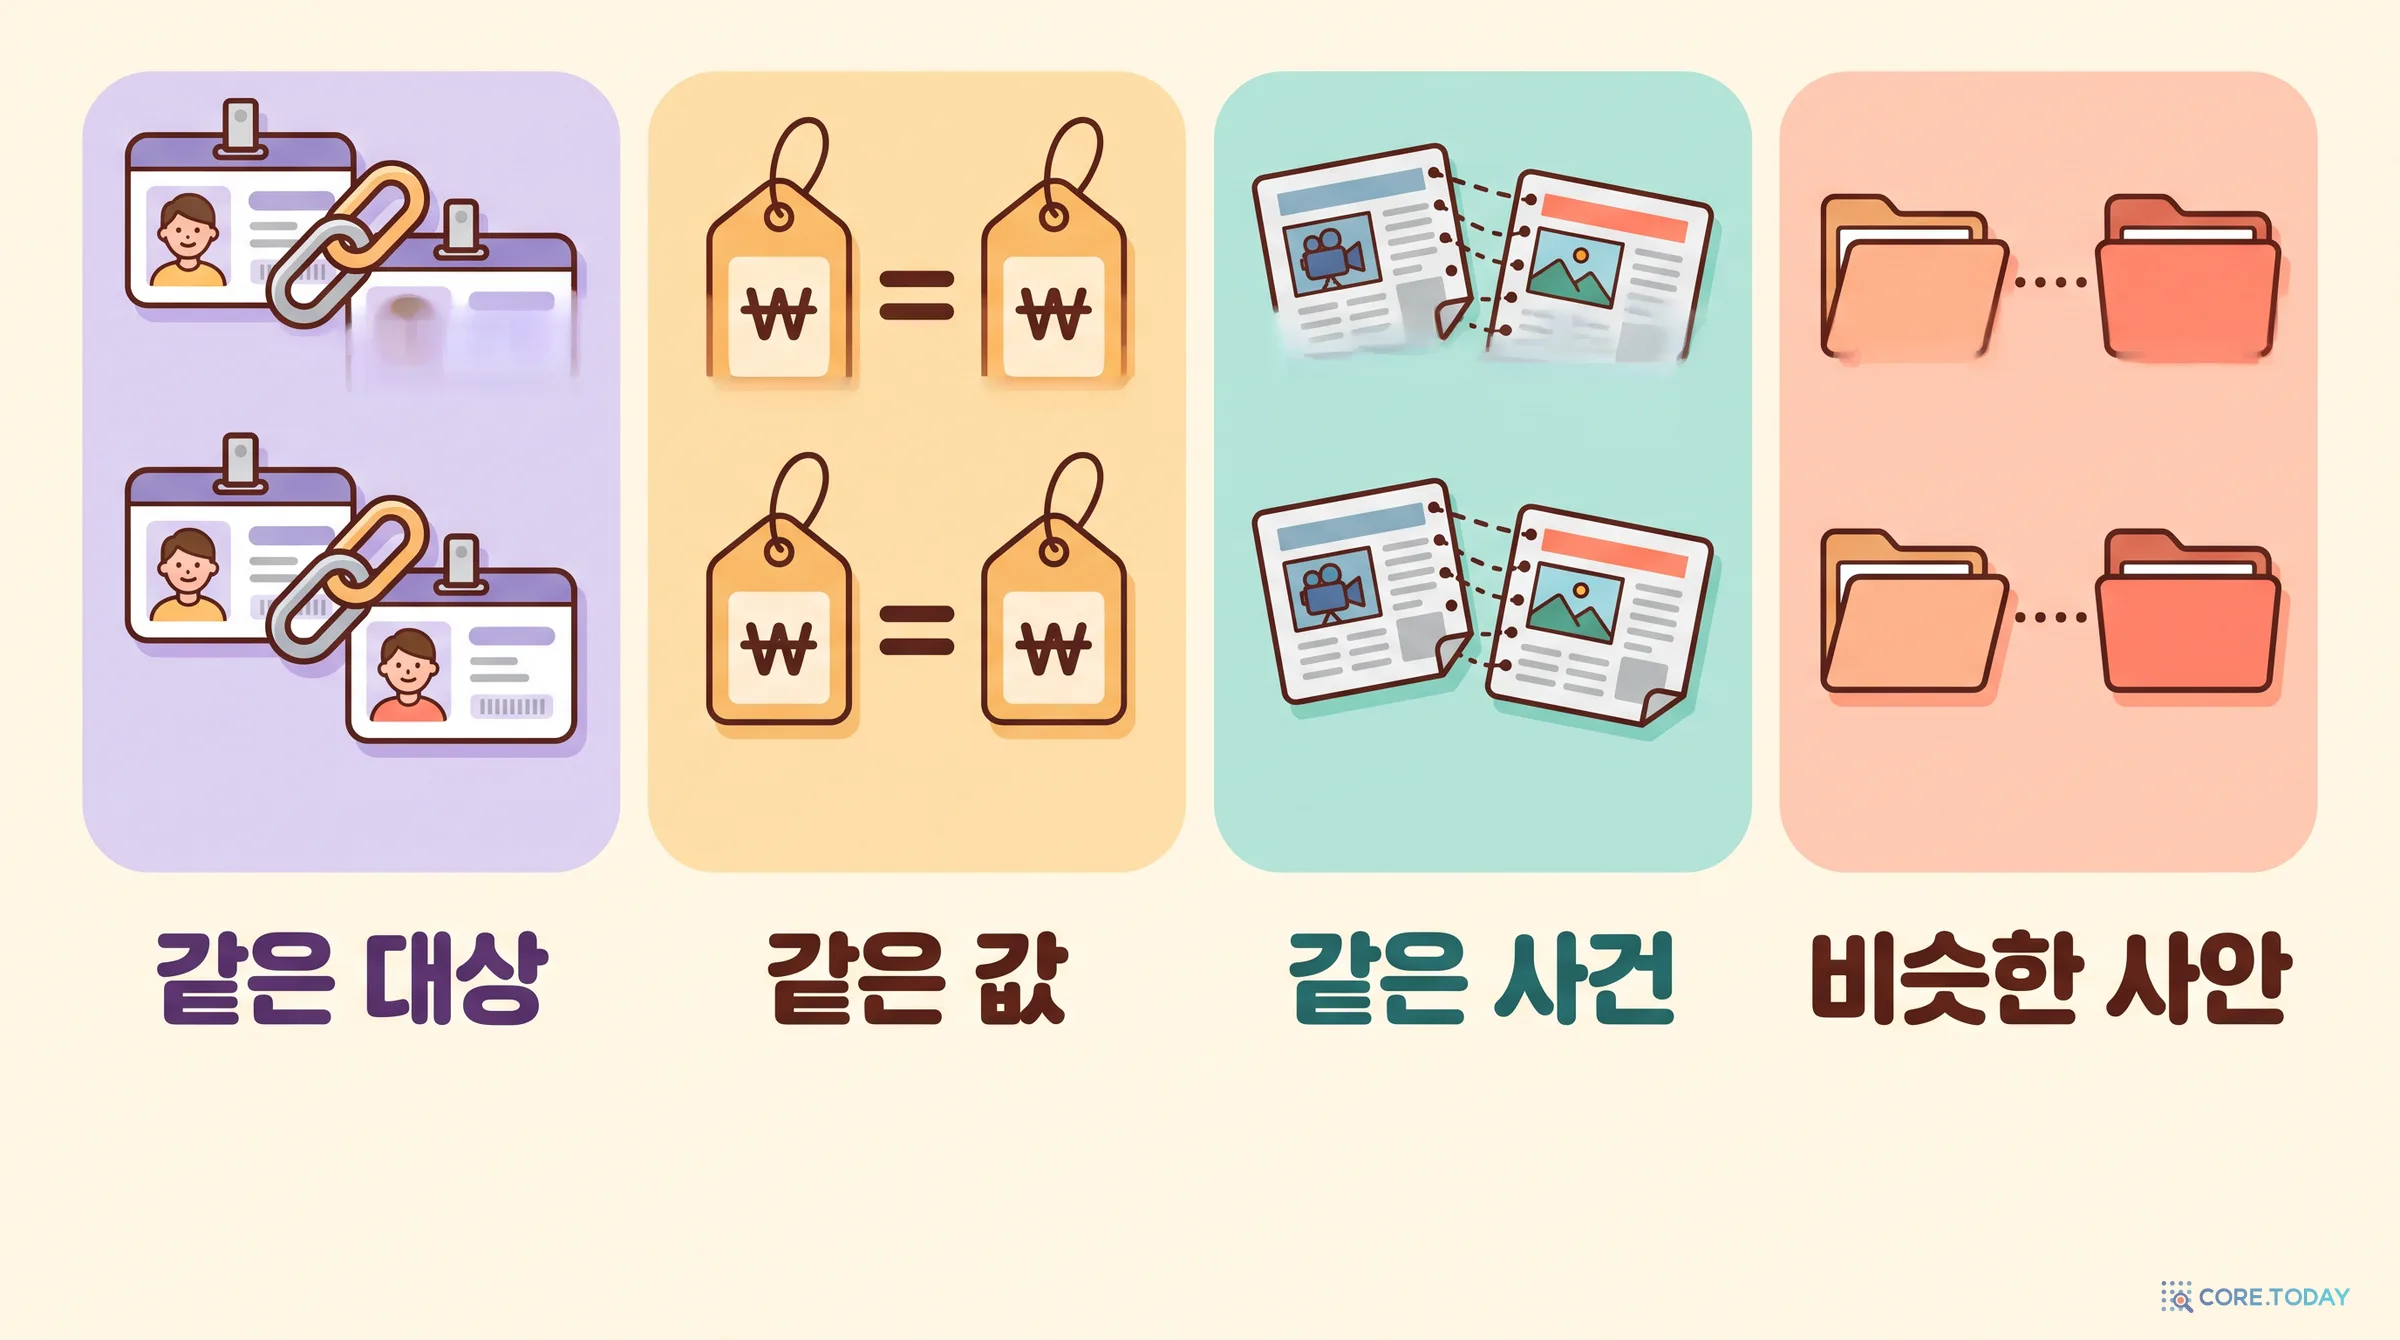
2026년 10월, 코어닷투데이 사실탐색기는 부산 조례 부칙의 '1981년 1월 1일부터 시행'과 '1984년 1월 1일부터 시행'을 같은 값으로 묶었습니다. 두 문장이 71% 비슷하다는 계산 때문이었습니다. 이 글은 '비슷하다'를 재는 기술이 왜 생겨났는지부터 시작합니다. 1901년 알프스 식물 목록을 비교한 자카드, 인구조사 이름을 소리로 묶은 사운덱스, 단어를 벡터로 바꾼 설턴과 IDF의 스파크 존스, 뜻을 좌표로 만든 임베딩까지요. 그리고 같은 기술이 한국어 공적 기록 앞에서 어디서 미끄러지는지, 2026년 임베딩 14종 실측과 최신 논문으로 따라갑니다. 결론은 하나입니다. '비슷하다'는 같은 대상·같은 값·같은 사건·비슷한 사안이라는 네 가지 다른 질문이고, 질문마다 도구가 다릅니다.
코어닷투데이2026-10-2795분
?
질문
컴퓨터는 두 글자열이 '얼마나 비슷한지'를 숫자로 잽니다. 그 숫자로 같은 사람을 찾고, 같은 기사를 묶고, 질문에 맞는 기록을 고릅니다. 그런데 '1981년'과 '1984년'이 71% 비슷하다면, 두 날짜는 같은 걸까요?
→
이 글이 하는 일
1901년 자카드 계수부터 2026년 한국어 임베딩까지, 유사도가 어떤 문제를 풀려고 생겨났는지 따라갑니다. 그리고 코어닷투데이 사실탐색기가 부산 공적 기록 362건 앞에서 겪은 실제 실패 사례로, 각 도구가 어디서 통하고 어디서 미끄러지는지 봅니다.
!
핵심
'비슷하다'는 네 가지 다른 질문입니다. 같은 대상인가, 같은 값인가, 같은 사건인가, 비슷한 사안인가. 값은 유사도로 재지 말고 풀어서 비교하고, 임베딩은 후보를 내는 데까지만 쓰며, 문턱은 사례로 고정합니다.
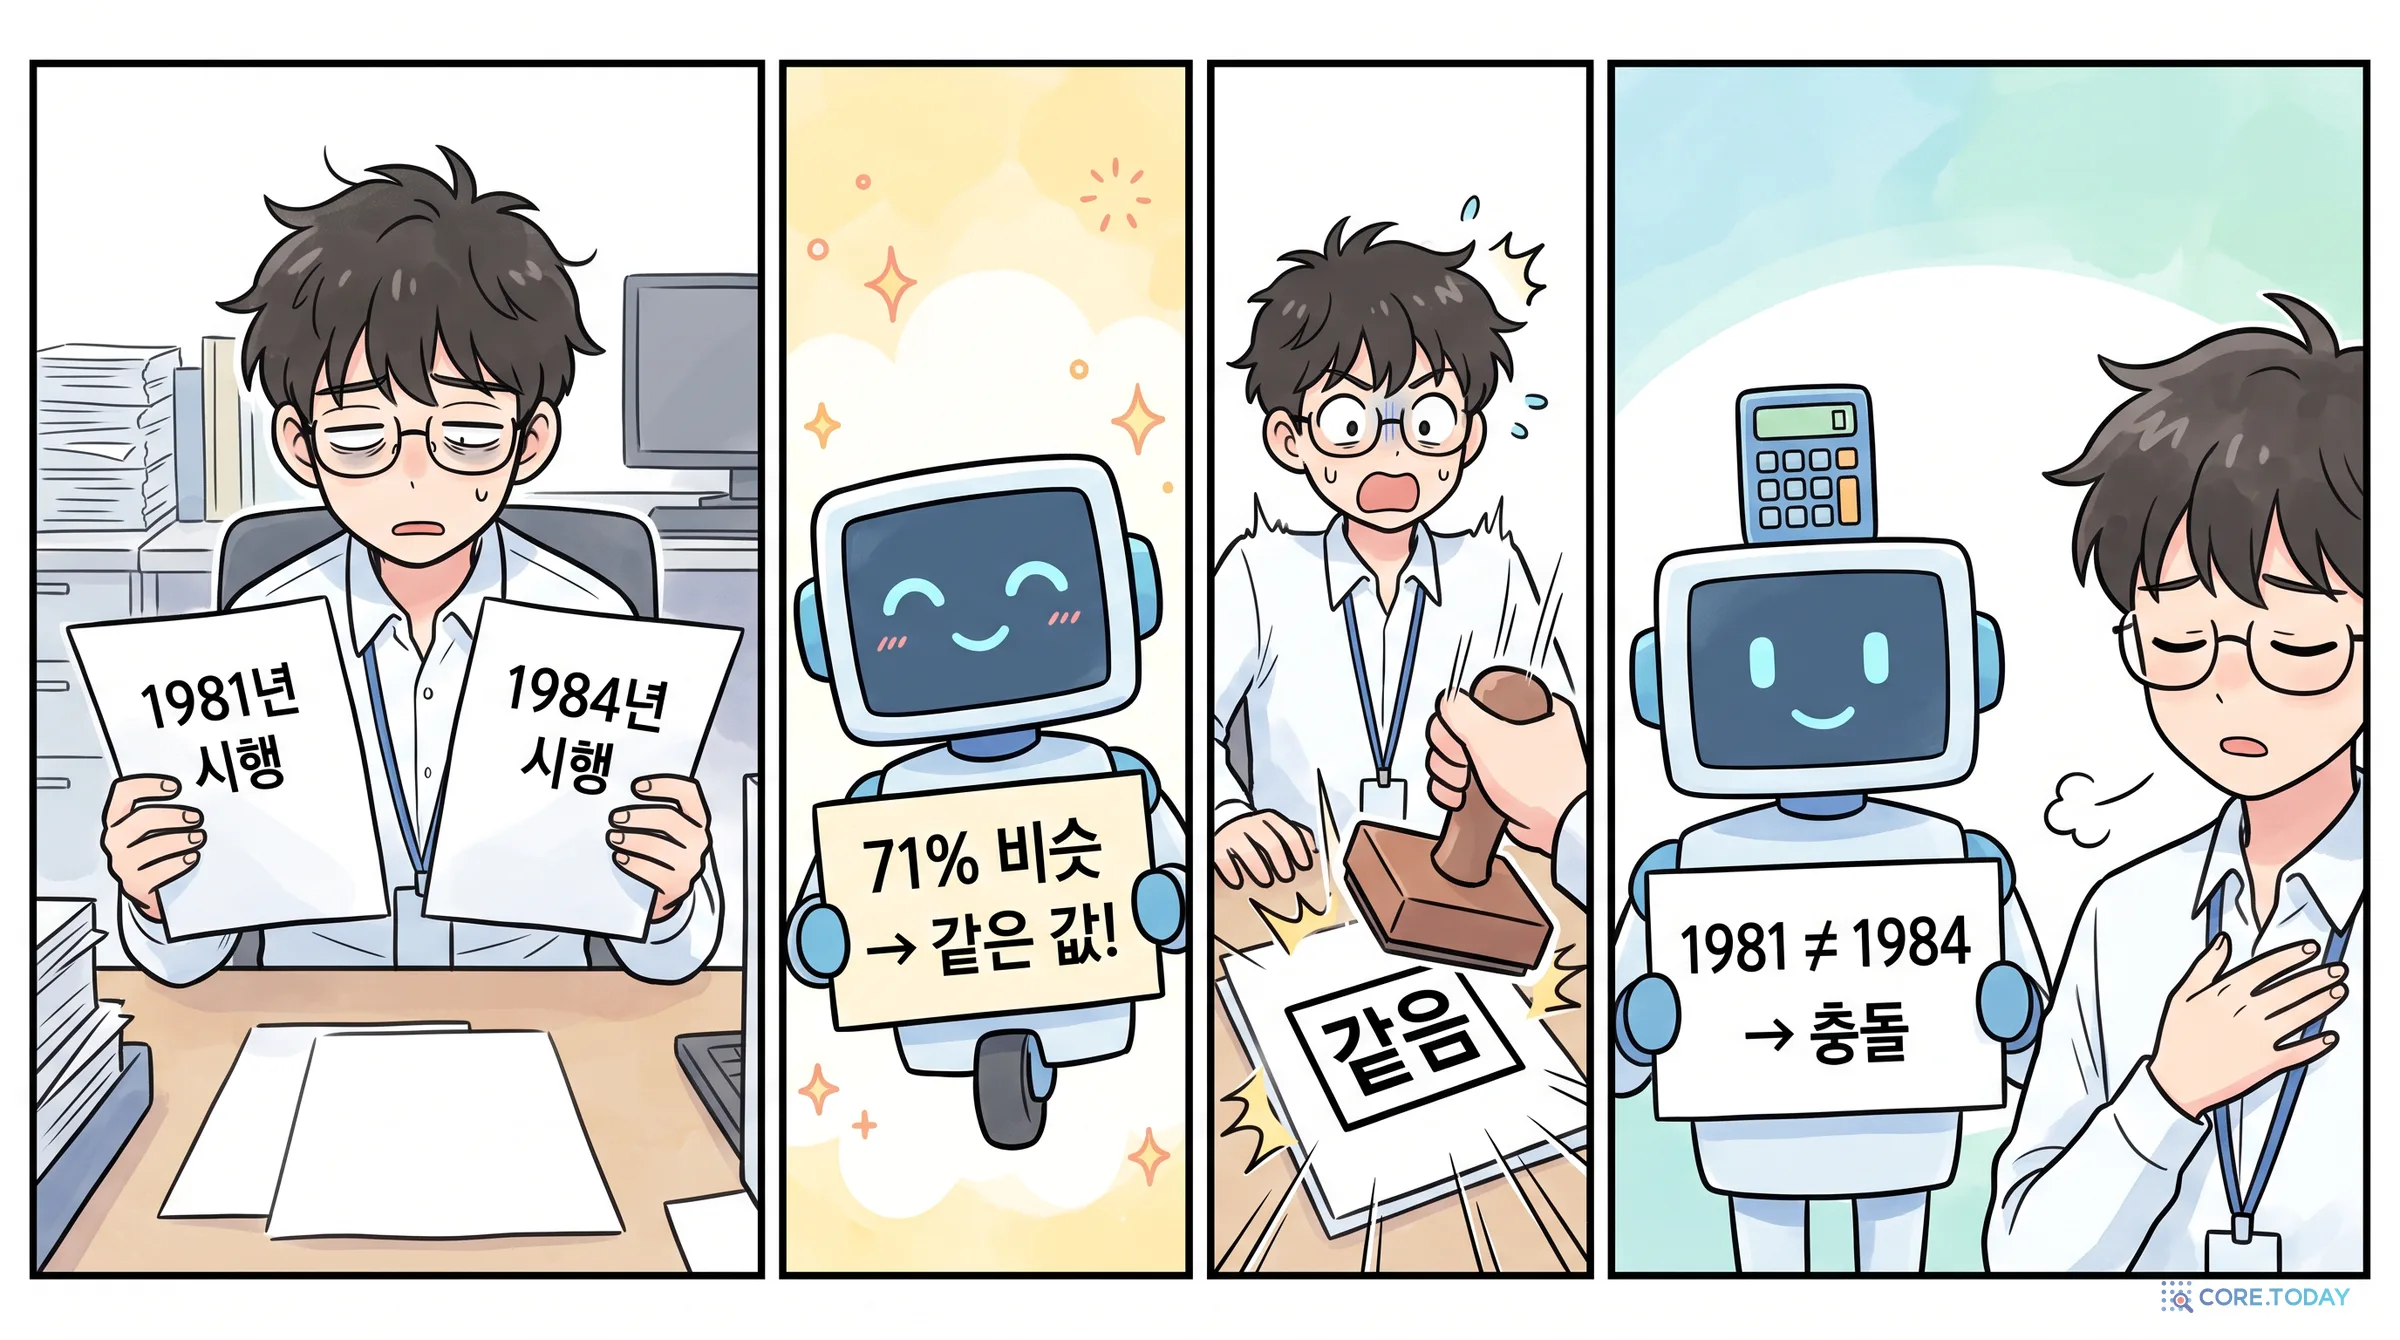
2026년 10월 27일 새벽, 코어닷투데이는 사실탐색기에 넣을 임베딩 모델을 고르려고 실험 데이터를 뽑고 있었습니다. 부산 공적 기록에서 실제 값 585개를 꺼내 '같은 값의 다른 표기'와 '숫자 하나만 다른 값'을 만드는 작업이었습니다. 그러다 이상한 명제 하나가 눈에 걸렸습니다. 한 조례의 부칙에서 '1981년 1월 1일부터 시행'과 '1984년 1월 1일부터 시행'이 한 명제의 같은 값으로 묶여 있었습니다.
사실탐색기는 같은 사실(주어 + 속성)에 다른 값이 들어오면 둘 중 더 권위 있는 쪽이 옛 값을 닫는 엔진입니다. 그런데 이 두 값은 '다르다'는 판정을 받지 못했습니다. 텍스트 값이 같은지는 두 글자씩 끊은 조각이 얼마나 겹치는지(음절 bigram 자카드 유사도)로 판단했고, 문턱은 0.6이었습니다. 두 문장의 점수는 0.71이었습니다. 연도 숫자 한 자리를 빼면 나머지가 모두 같으니, 계산은 틀리지 않았습니다. 틀린 것은 질문이었습니다.
이 작은 사고는 오래된 질문 하나를 꺼냅니다. 컴퓨터는 어떻게 '비슷하다'를 재게 되었을까요? 그리고 그 비슷함은 언제 믿을 수 있고 언제 믿으면 안 될까요?
유사도는 검색창, 추천, 표절 검사, 중복 기사 제거, 고객 명부 정리, 그리고 지금의 RAG와 AI 에이전트 기억까지 거의 모든 정보 시스템의 바닥에 깔려 있습니다. 너무 깊이 깔려 있어서 평소에는 보이지 않습니다. 그러다 동명이인이 한 사람으로 합쳐지거나, 정정 공고가 원래 공고와 '같은 내용'으로 처리되거나, 질문과 상관없는 기록이 '가장 비슷한 문서'로 올라올 때 비로소 드러납니다. 이 글은 그런 순간들을 따라가며 유사도라는 개념을 처음부터 다시 세워 봅니다.
1. 세상의 같은 것은 같은 글자로 오지 않는다
컴퓨터에게 가장 쉬운 비교는 '완전히 같은가'입니다. 두 글자열의 바이트가 하나도 다르지 않으면 같고, 하나라도 다르면 다릅니다. 문제는 세상의 같은 것이 거의 언제나 다른 글자로 온다는 점입니다.
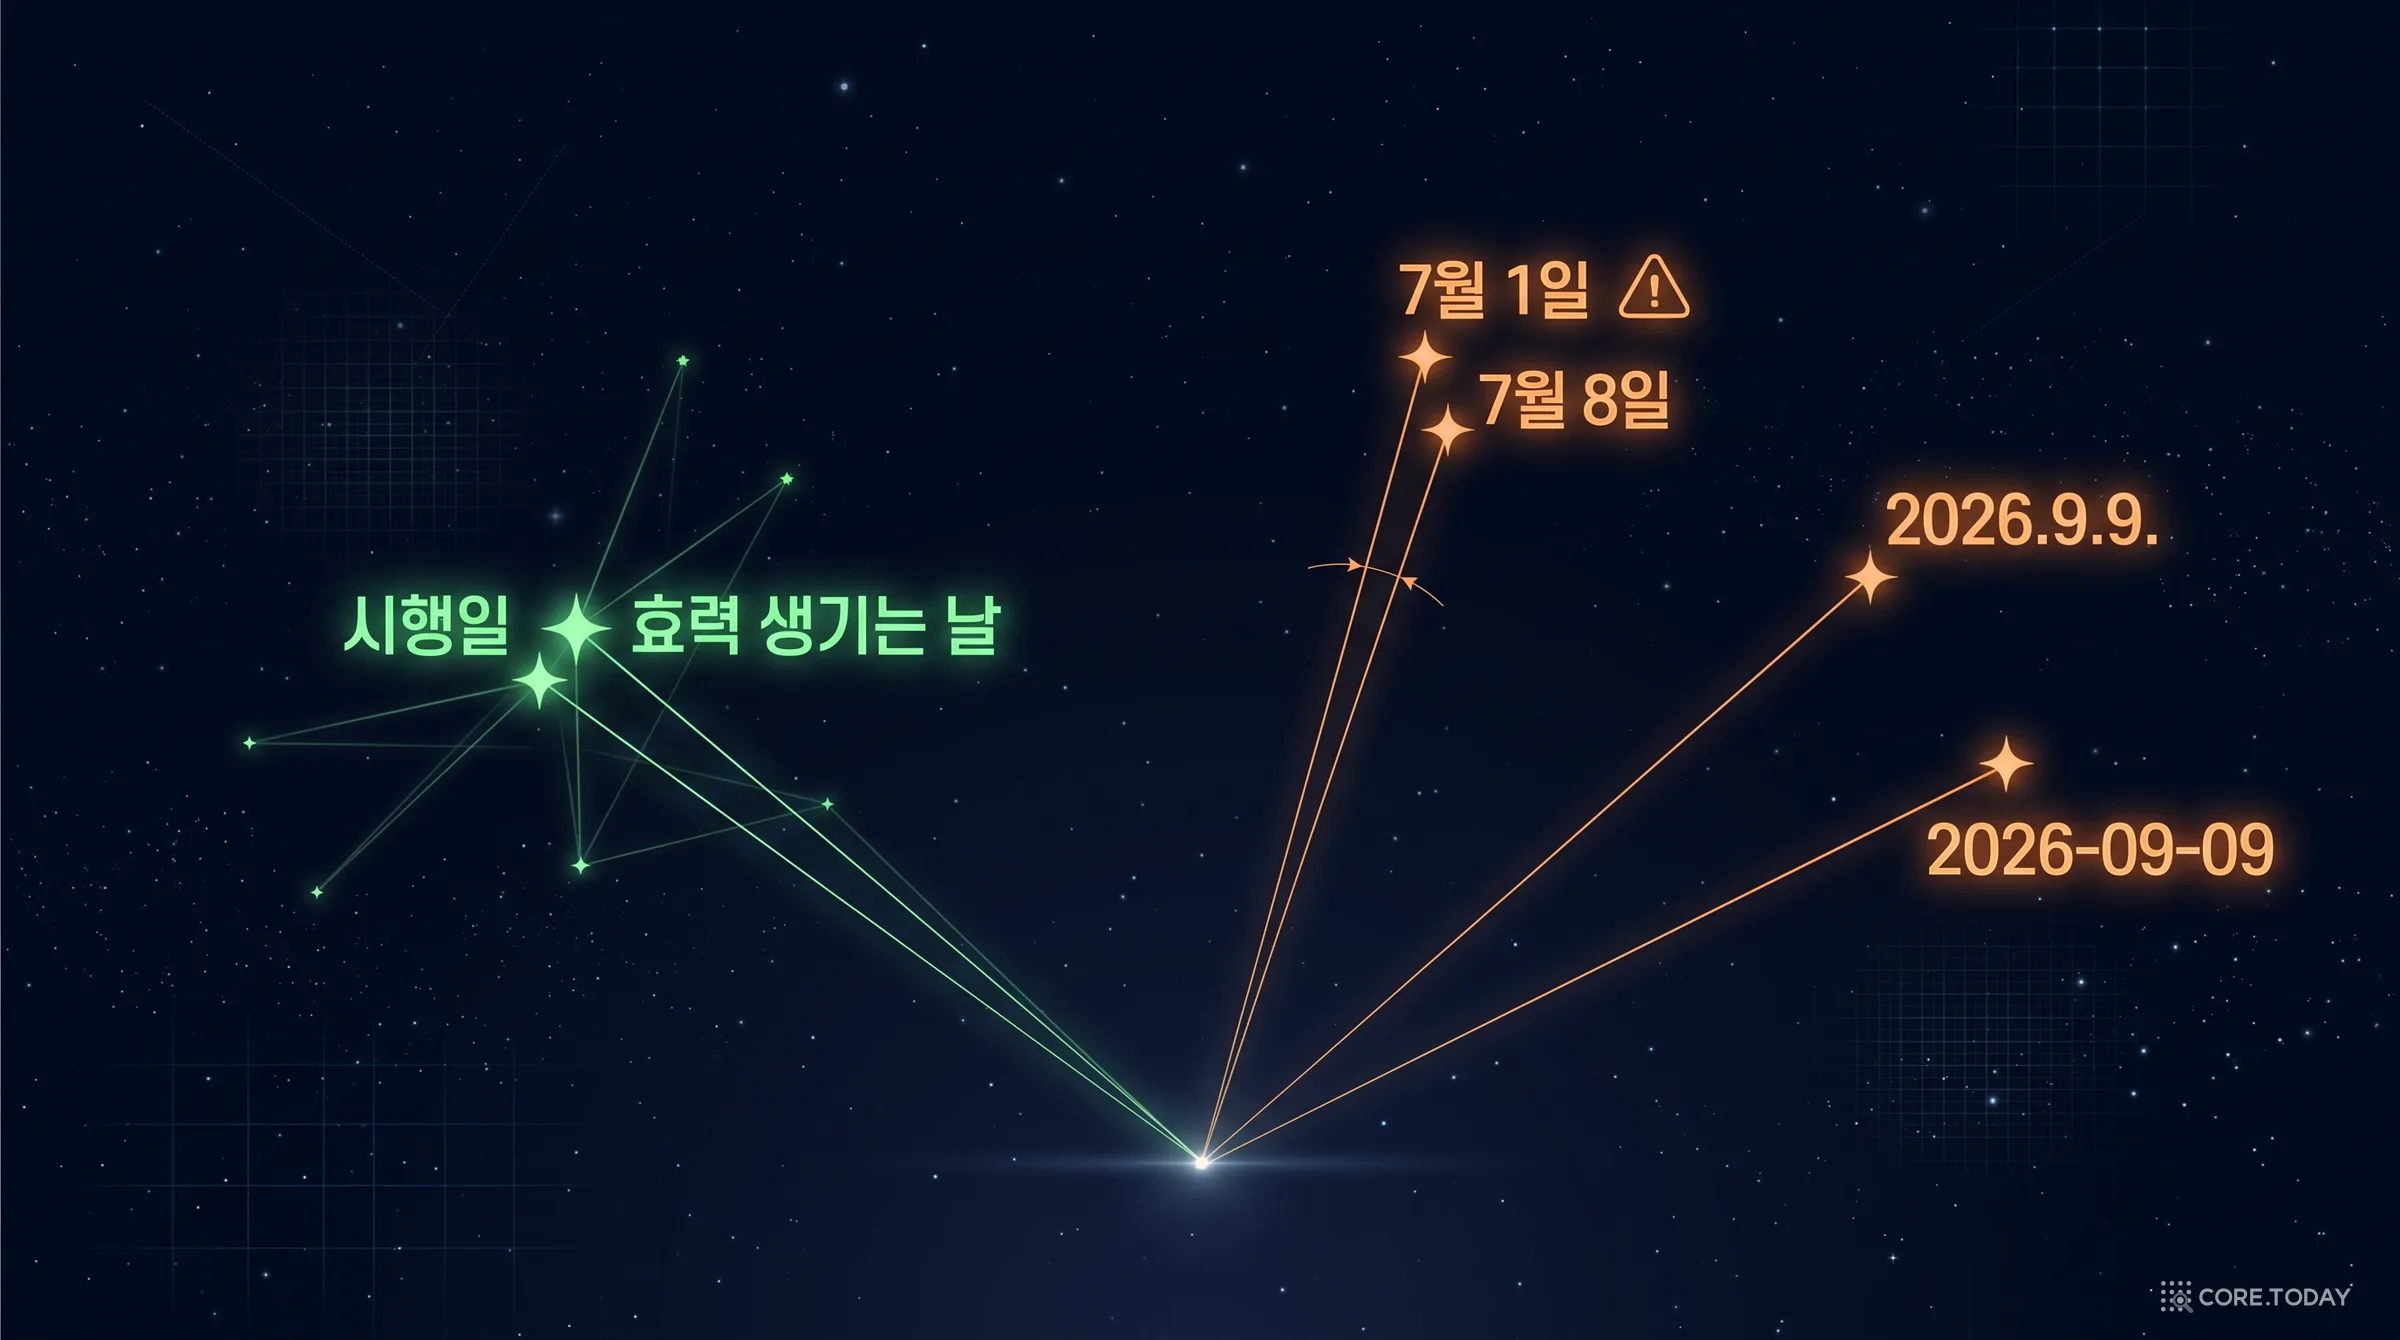
부산의 한 야구장은 회의록에서 '사직야구장', 보도자료에서 '사직구장', 시민의 질문에서 '롯데 홈구장'으로 불립니다. 같은 날짜는 '2026. 9. 22.', '2026-09-22', '9월 22일(화)'로 적힙니다. 같은 지원 대상은 '만 19세부터 34세까지'와 '만 19세~34세'로 적힙니다. 같은 사람은 '김민지 의원', '민지 의원', '김 의원'으로, 같은 기관은 '부산광역시의회'와 '부산시의회'로 적힙니다. 반대로 다른 것이 거의 같은 글자로 오기도 합니다. '부산교통공사'와 '부산도시공사'는 두 글자만 다른 별개 기관이고, '해운대구'라는 글자 안에는 다른 도시 '대구'가 들어 있습니다.
그래서 정보 시스템에는 '완전히 같다'와 '완전히 다르다' 사이를 재는 자가 필요해졌습니다. 그 자가 유사도입니다. 그런데 이 자는 하나가 아닙니다. 위의 예들을 다시 보면, 사실 서로 다른 질문을 하고 있습니다.
못 묶으면 같은 일이 여러 번 일어난 것처럼 보이고, 잘못 묶으면 계획 발표와 착공이 한 사건이 된다
비슷한 사안인가
'청년 월세 지원'과 '청년 창업 지원센터'는 함께 볼 만한가?
엉뚱한 이웃이 '이 둘은 관련 있다'는 거짓 주장이 된다
이 글의 거의 모든 사례는 이 네 질문 가운데 하나를 다른 질문의 도구로 풀려다 생긴 일입니다. 1981/1984 사고도 그렇습니다. '두 문장이 얼마나 겹치는가'는 비슷한 사안을 찾을 때는 좋은 질문이지만, 같은 값인지를 물을 때는 엉뚱한 질문입니다. 아래 카드로 먼저 감을 잡아 보세요.
2. 1부 — 세는 시대: 꽃밭과 인구조사에서 시작된 유사도
알프스의 각주 하나 (1901)
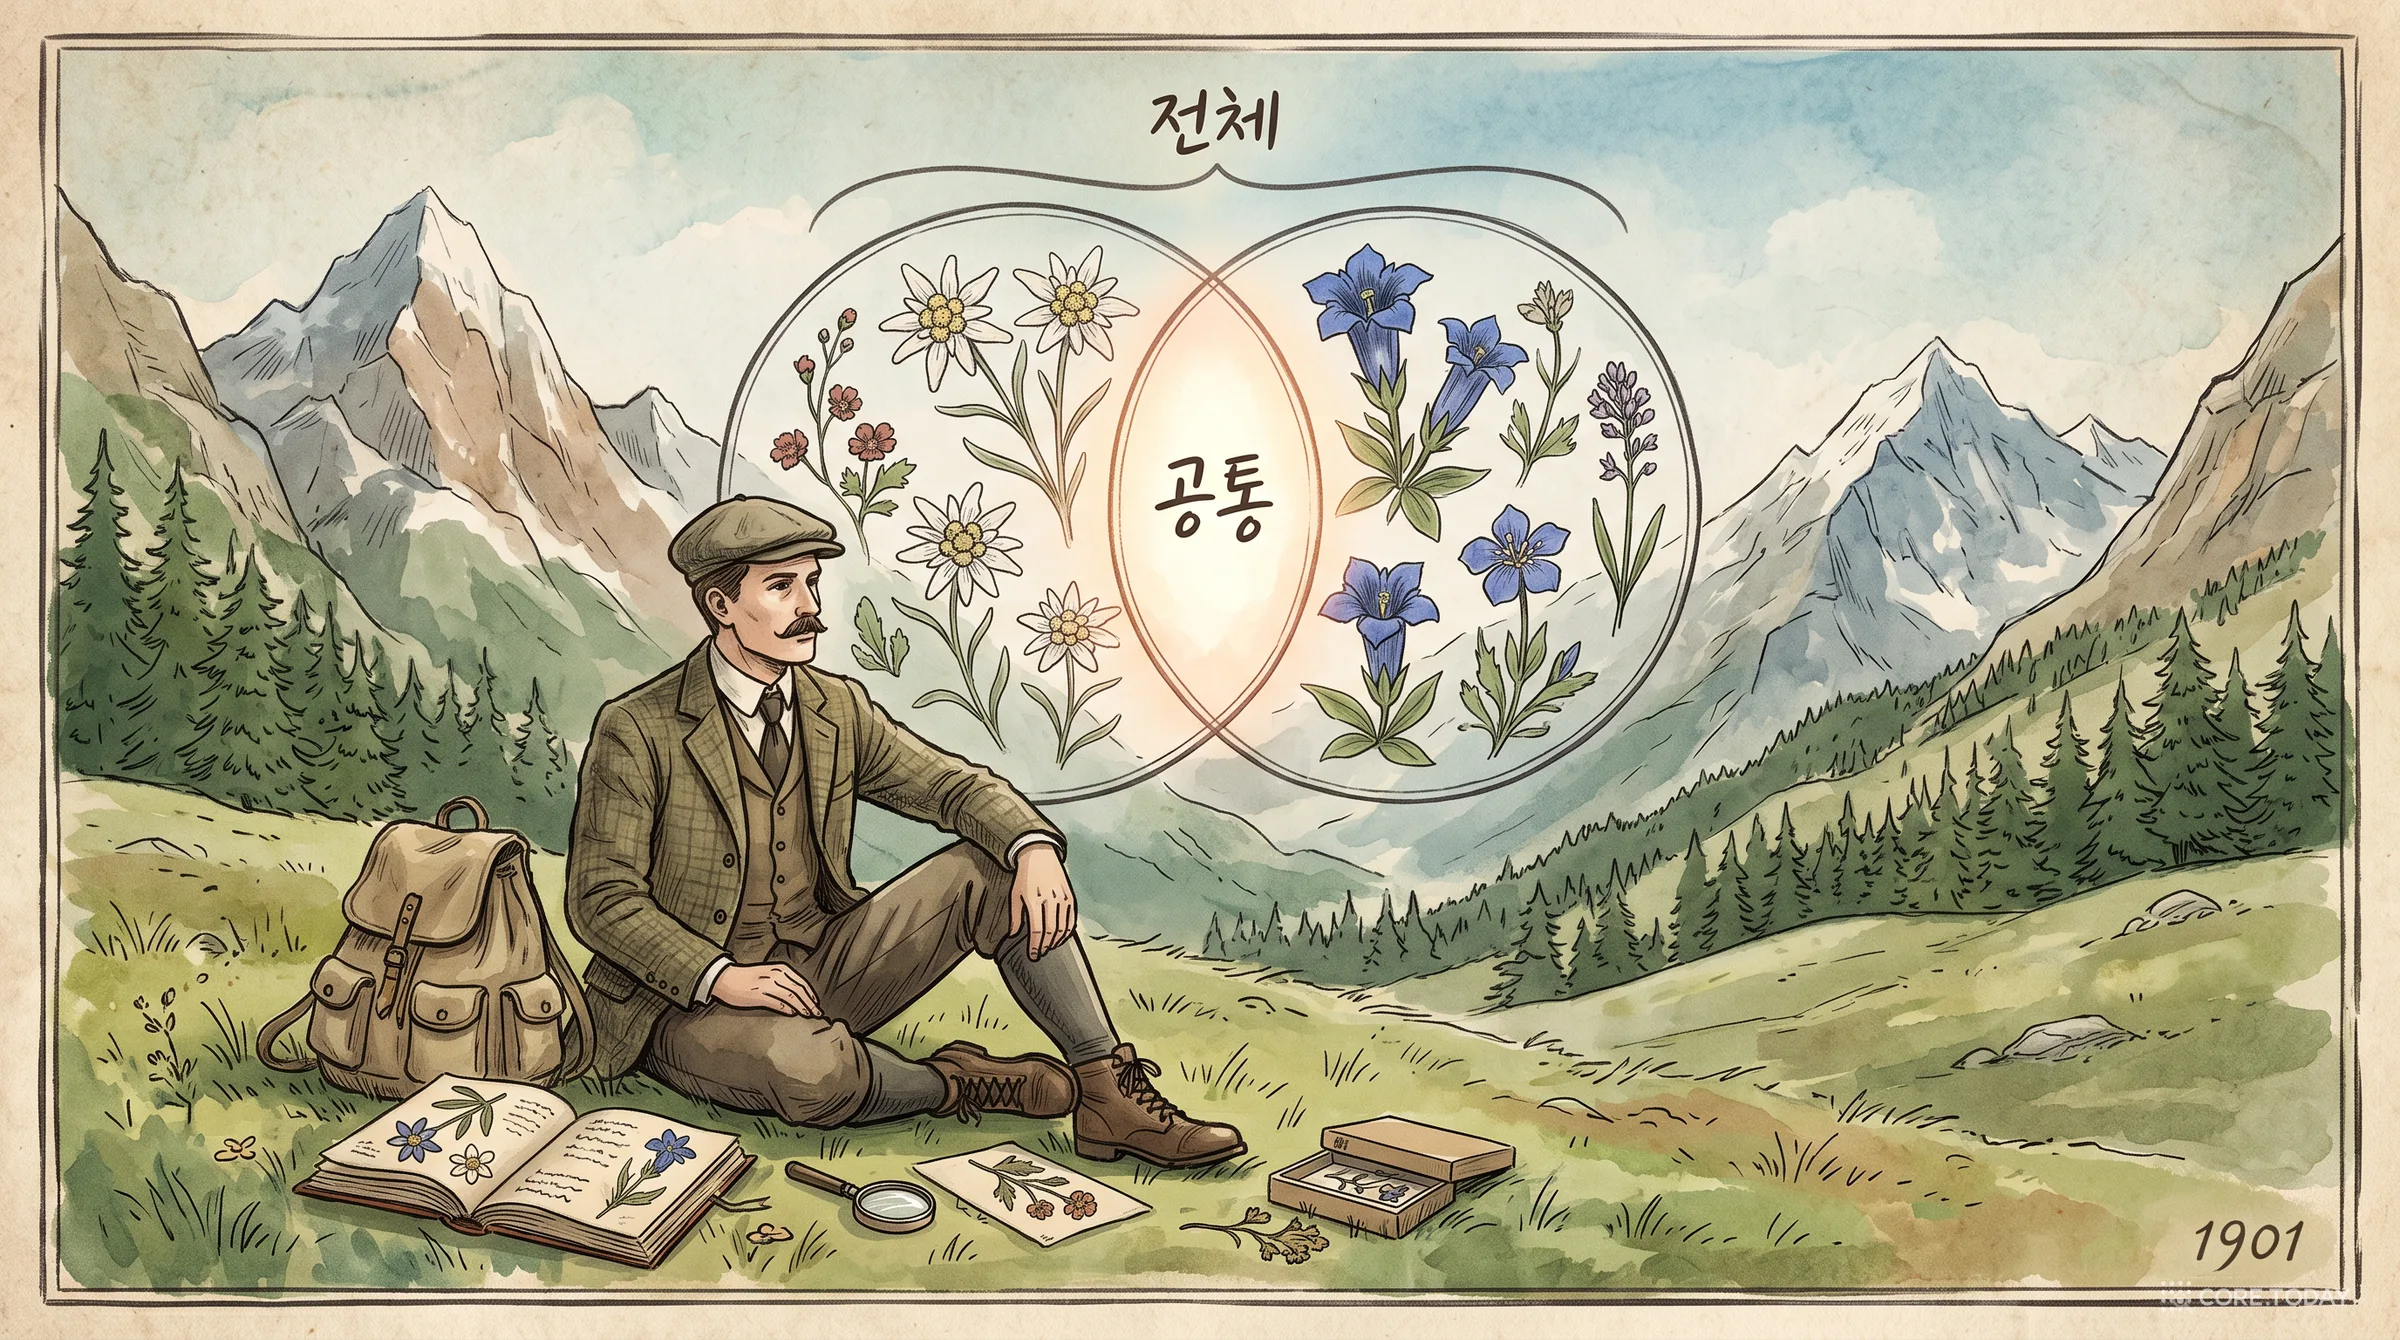
유사도의 역사는 컴퓨터보다 오래됐고, 출발점은 뜻밖에 식물학입니다. 스위스 로잔의 식물학자 폴 자카드는 알프스의 여러 골짜기에 어떤 식물이 자라는지 조사하고 있었습니다. 그가 궁금했던 것은 '두 지역의 식물상이 얼마나 닮았나'였습니다. 그래서 두 지역에 함께 자라는 종의 수를, 두 지역 어느 한 곳에라도 자라는 종의 수로 나눴습니다.
1901년 논문 「드랑스 분지와 인근 지역의 고산 식물 분포」에서 이 비율은 처음에 각주로 등장했습니다. 트리앙 분지에는 470종, 와일드호른 산괴에는 350종이 있었고, 공통 종은 295종이었습니다. 두 지역을 합친 종 수는 470 + 350 − 295 = 525이고, 295 ÷ 525 ≈ 0.56입니다. 식물학자 포다니가 2021년 원문을 대조해 계산한 첫 공개 값은 0.5619였습니다. 자카드는 이것을 '식물상 공동체 계수'라고 불렀고, 평생 기호로 된 공식을 한 번도 쓰지 않았습니다. 오늘날 모든 프로그래밍 언어에 들어 있는 '교집합 ÷ 합집합' 공식은 1941년에야 다른 사람이 수식으로 적은 것입니다.
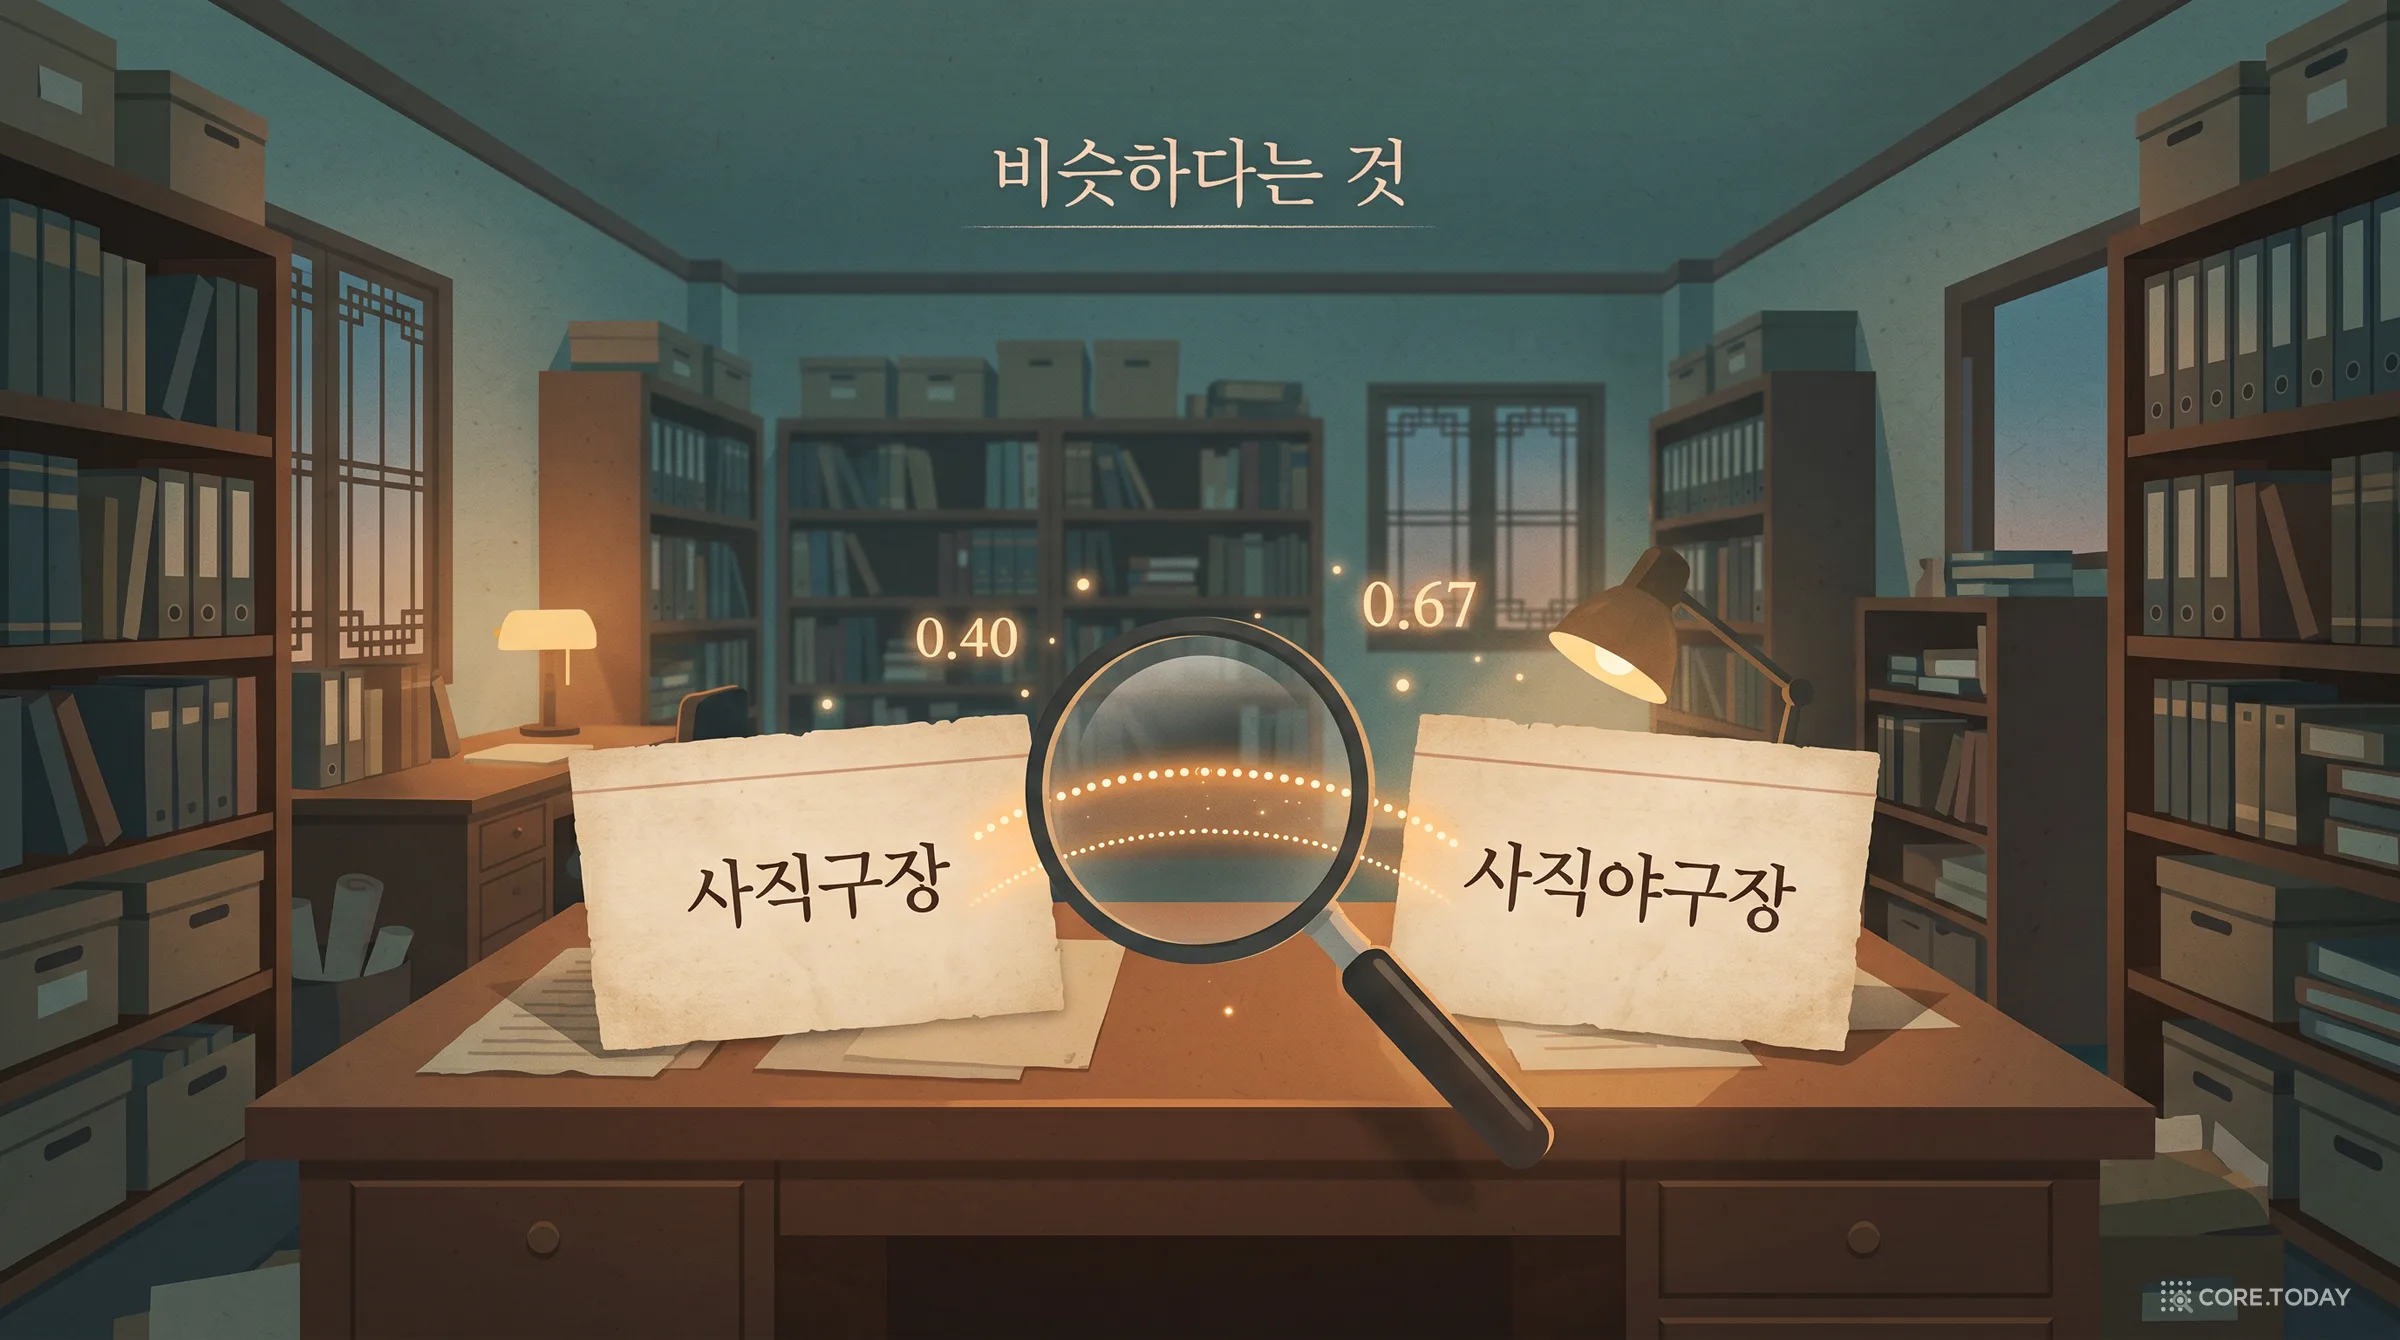
자카드 계수가 125년 동안 살아남은 이유는 그 단순함에 있습니다. 두 집합만 있으면 됩니다. 식물 종이든, 문서에 나온 단어든, 이름을 두 글자씩 끊은 조각이든요. 사실탐색기가 '사직구장'과 '사직야구장'을 비교할 때 쓰는 것도 이 계수입니다. '사직, 직구, 구장'과 '사직, 직야, 야구, 구장'에서 공통은 2개, 전체는 5개이니 0.40입니다. 그리고 바로 이 단순함이 약점이기도 합니다. 자카드는 무엇이 겹쳤는지는 보지 않고 얼마나 겹쳤는지만 셉니다. '1981년 1월 1일부터 시행'과 '1984년 1월 1일부터 시행'에서 다른 조각은 연도를 담은 두 개뿐이고, 나머지는 모두 겹칩니다.
소리가 같은 이름: 사운덱스와 인구조사 (1918~1940)
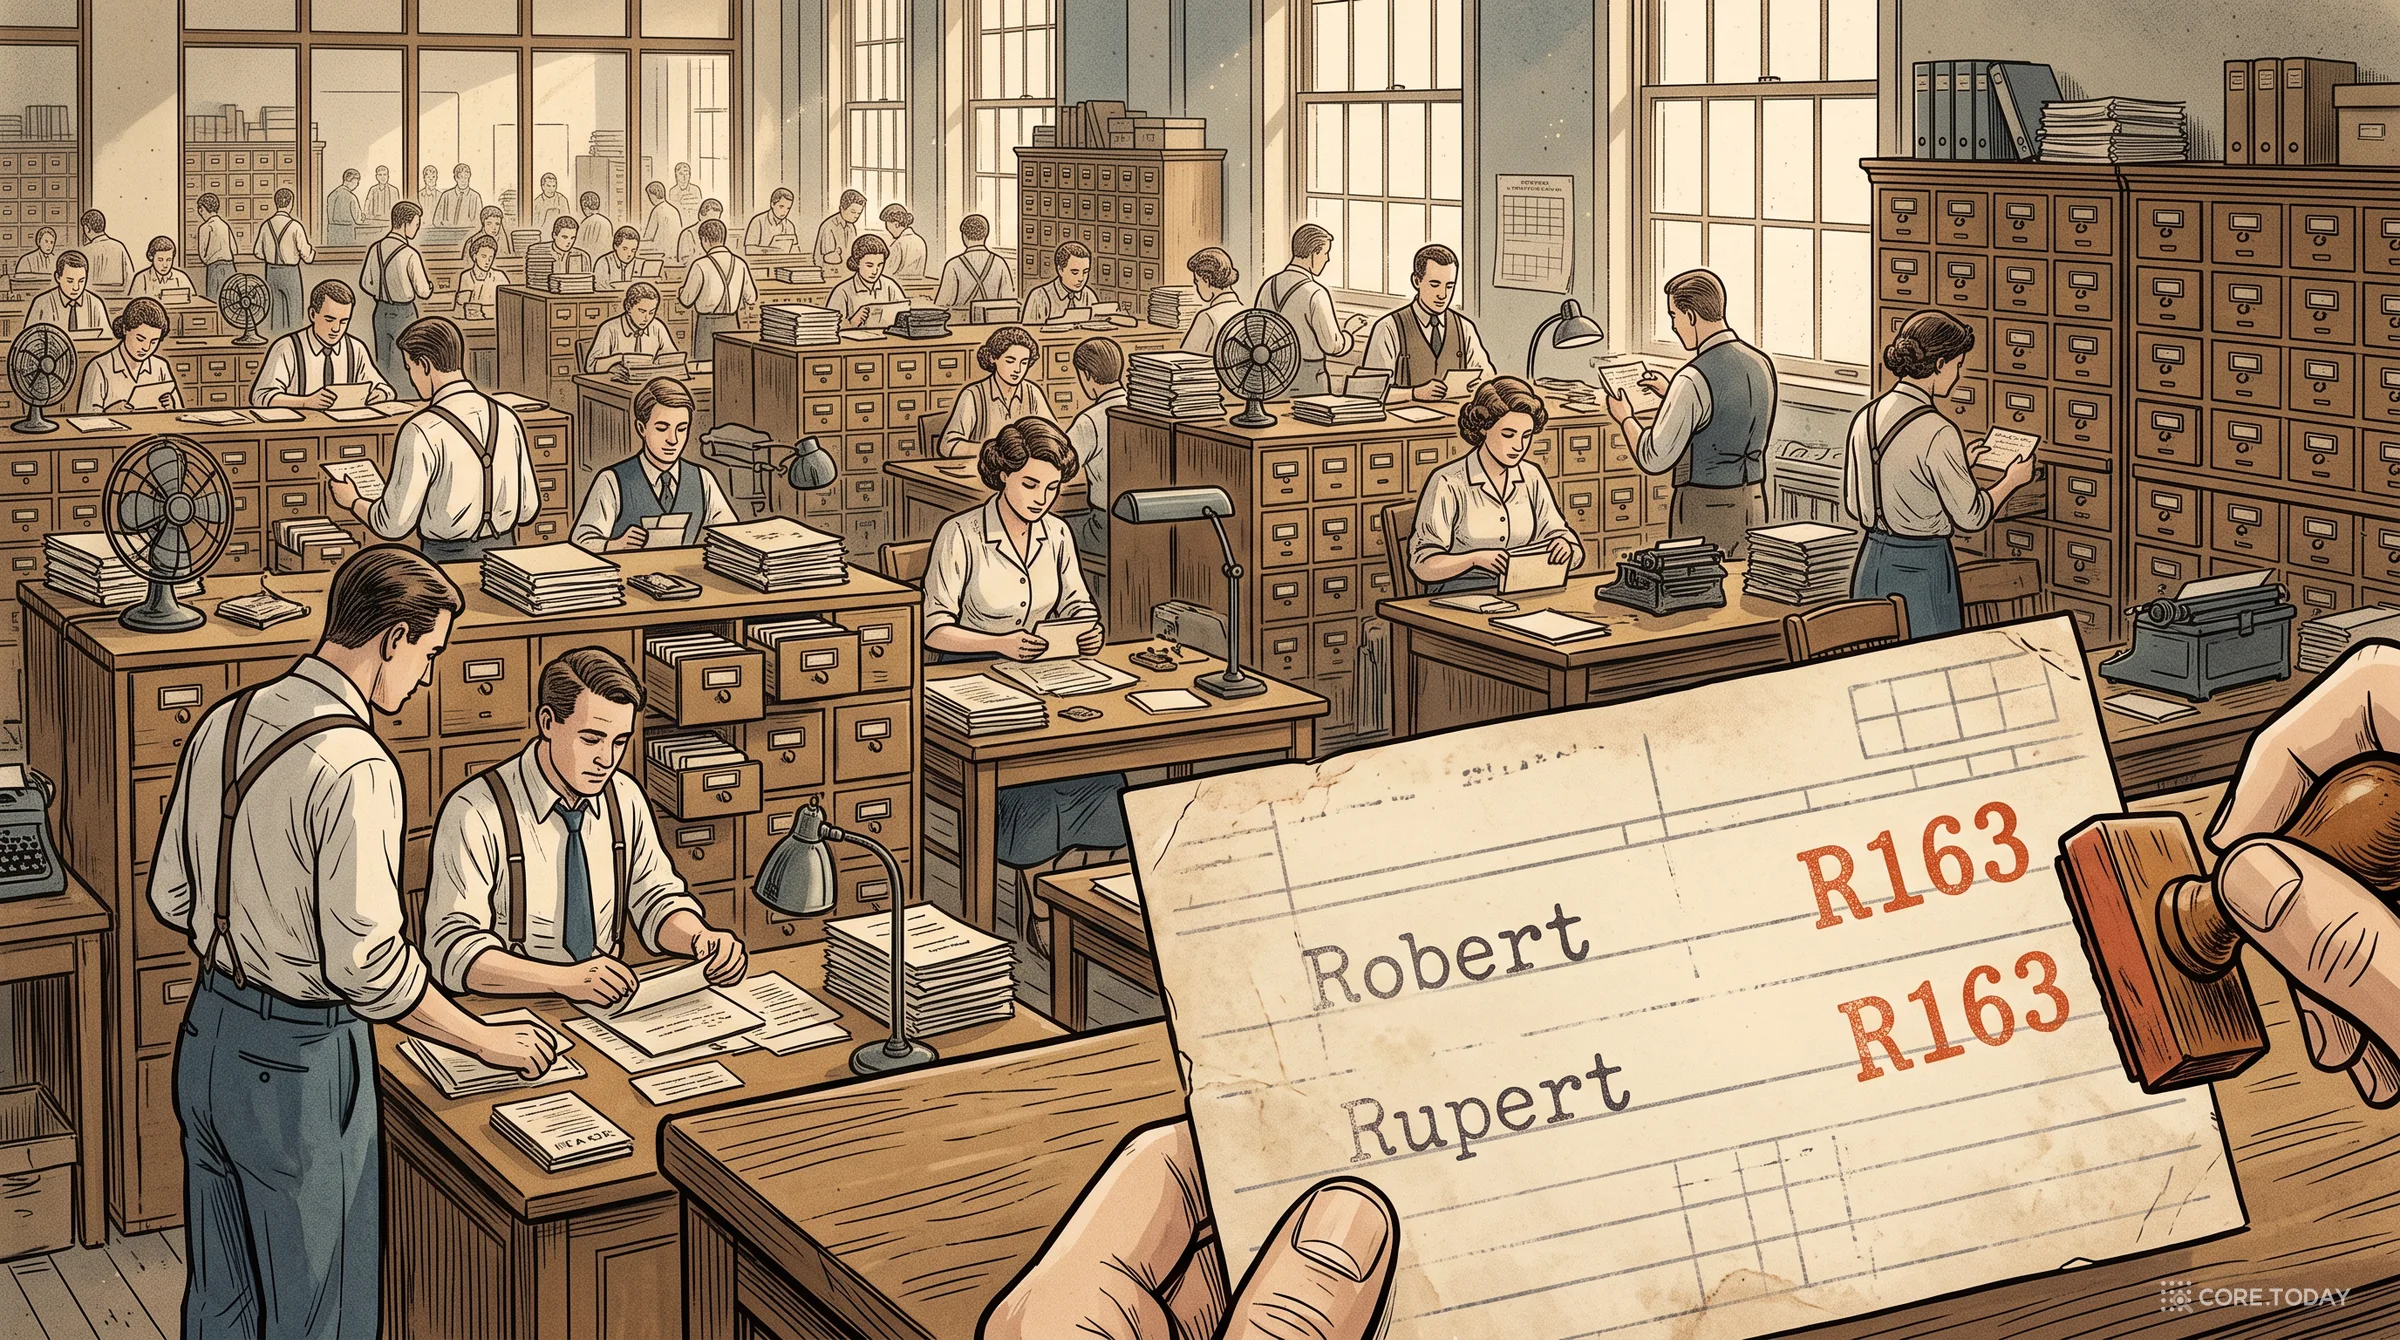
20세기 초 미국 정부에는 다른 종류의 '비슷함' 문제가 있었습니다. 같은 사람의 이름이 기록마다 다르게 적혔습니다. 이민자의 이름은 받아 적는 사람의 귀에 따라 철자가 달라졌고, 'Smith'와 'Smyth', 'Robert'와 'Rupert'는 알파벳 순 색인에서 멀리 떨어져 있었습니다.
1918년 피츠버그의 로버트 C. 러셀은 사운덱스라는 색인 방식으로 특허를 받았습니다. 소리가 같지만 철자가 다른 이름이 같은 부호를 받게 하는 방법입니다. 첫 글자를 남기고, 모음은 버리고, 비슷한 소리가 나는 자음끼리 같은 숫자로 바꿉니다. 'Robert'와 'Rupert'는 둘 다 R163이 됩니다. (흔히 마거릿 킹 오델이 공동 발명자로 소개되지만, 1918년과 1922년 두 특허의 발명자 칸에는 러셀의 이름만 있습니다.)
사운덱스가 대규모로 쓰인 것은 1930년대 대공황기였습니다. 1935년 사회보장제도가 생기자 노인들은 연금을 받으려면 나이를 증명해야 했는데, 출생 등록이 없던 세대가 많았습니다. 그 증거가 옛 인구조사 기록이었습니다. 미국 국립문서보관소 기록에 따르면, 1900년 인구조사 색인 작업에는 약 2,865명이 투입돼 1937년 4월에 끝났고, 만들어진 카드는 약 3,400만 장이었습니다. 숙련된 사무원은 한 시간에 카드 50장을 사운덱스로 부호화했습니다. 나이 확인 요청은 1929 회계연도 4,166건에서 1939 회계연도 163,132건으로 늘었습니다. 당시 한 수석 사무관은 사운덱스에 반대하며 "누군가 새 장난감에 빠졌을 뿐"이라고 적었다고 합니다.
생명의 책을 묶는 일: 레코드 연결 (1946~1969)
1946년 미국 인구동태통계국장 핼버트 던은 한 공중보건 학술지에 다섯 쪽짜리 글을 실었습니다. "모든 사람은 생명의 책을 만든다. 이 책은 출생으로 시작해 죽음으로 끝나고, 그 쪽들은 삶의 주요 사건 기록으로 이뤄진다. 레코드 연결은 이 책의 쪽들을 한 권으로 묶는 일의 이름이다." 흩어진 기록에서 같은 사람을 찾는 일이 처음으로 이름을 얻은 순간입니다.
이 일을 컴퓨터가 처음 해낸 것은 1959년 캐나다였습니다. 하워드 뉴컴과 동료들은 방사선이 사람의 유전에 미치는 영향을 연구하려고, 브리티시컬럼비아의 1955년 출생 기록 34,138건과 1946~1955년 혼인 기록 114,471건을 이었습니다. 이름은 사운덱스로 먼저 묶고(혼인 기록의 'Ayad'와 출생 기록의 'Ayot'는 둘 다 A300입니다), 여러 항목의 일치·불일치를 확률로 따져 같은 가족인지 판정했습니다. 결과는 실제 짝의 98.3%를 찾고 잘못 이은 것이 약 0.7%였습니다. 비슷함을 '같다/다르다'가 아니라 확률로 다루기 시작한 것입니다.
1969년 캐나다 통계청의 이반 펠레기와 앨런 선터는 이 방법을 수학 이론으로 정리했습니다. 그들의 결론에서 가장 오래 살아남은 것은 공식보다 결정의 구조입니다. 두 기록 쌍에 대한 결정은 셋입니다. 연결한다, 연결하지 않는다, 그리고 사람이 본다. 문턱이 두 개 있고, 그 사이의 회색지대는 기계가 정하지 않습니다. 57년이 지난 지금 사실탐색기의 이름 해석기도 '확실히 같음 / 같을 수도 있음 / 관련 있지만 다름'으로 상태를 나누고, 가운데 상태는 검토 대기열로 보냅니다. 같은 구조입니다.
같은 시기에 철자의 차이를 재는 자도 나왔습니다. 1965년 소련의 블라디미르 레벤시테인은 글자를 몇 번 지우고, 넣고, 바꾸면 두 문자열이 같아지는지를 거리로 정의했습니다. 원래는 통신 중 생기는 삭제·삽입 오류를 고치는 부호 이론의 일부였지만, 오늘날 맞춤법 검사기와 퍼지 검색의 기본 도구가 됐습니다. 1989~1990년에는 미국 인구조사국의 매슈 자로와 윌리엄 윙클러가 이름 비교에 특화된 점수를 만들었습니다. 1990년 인구조사 사후 조사에 실제로 쓰인 이 점수는 앞 글자가 같을수록 점수를 더 줍니다. 윙클러 논문의 표에서 'martha'와 'marhta'는 0.9667입니다. 사람이 이름을 틀릴 때 첫 글자는 잘 틀리지 않는다는 관찰을 반영한 것입니다. 이 가정이 한국어 기관명 앞에서 어떻게 무너지는지는 6장에서 봅니다.
문턱은 기술이 아니라 정책이다: 이름 유사도가 사람을 다치게 한 사건들
이름 유사도는 실험실 밖에서 사람을 다치게 하기도 했습니다. 몇 가지 기록된 사례를 보겠습니다.
2000년 플로리다 유권자 명부 정리. 플로리다주는 대선을 앞두고 중죄 전과자를 유권자 명부에서 빼려고 민간 업체에 명단 대조를 맡겼습니다. 미국 민권위원회 보고서에 따르면 대조 규칙은 성이 '90% 일치'하면 같은 사람으로 보는 것이었고, 이름은 앞뒤를 바꿔도 일치로 쳤습니다. 업체는 이름을 정확히 맞추자고 권했지만, 주 선거국이 더 넓은 방식을 골랐습니다. 선거국 관계자의 말은 이랬습니다. "같은 사람이 아닐 수도 있는 이름까지 더 잡고 싶었다." 수정된 명단에 중죄인으로 오른 사람은 5만 7,746명이었고, 이의를 제기한 약 5,000명 중 절반가량은 플로리다 중죄 기록이 없었습니다. 그해 대선은 플로리다에서 수백 표 차로 갈렸습니다.
2004년 테드 케네디 상원의원. 현직 상원의원이 동부 공항에서 다섯 차례 탑승 제지를 당했습니다. 테러 의심자 명단의 누군가가 'T. Kennedy'라는 가명을 썼기 때문이었고, 명단에서 빠지는 데 3주가 넘게 걸렸습니다(엄밀히는 탑승 금지 명단이 아니라 추가 검색 대상 명단이었습니다). 2010년에는 뉴저지의 여덟 살 컵스카우트가 두 살 때부터 공항에서 몸수색을 받아 왔다는 사실이 보도됐습니다. 감시 명단의 인물과 이름이 같았기 때문입니다. 교통보안청은 그 뒤 생년월일과 성별로 교차 확인하겠다고 밝혔습니다. 두 번째 속성 하나면 막을 수 있었던 병합입니다.
한국에도 같은 구조의 사건이 있습니다.
사건
무엇이 '같다'고 처리됐나
결과
나주시 주민 37명 사망 처리 (2017, 2018년 보도)
행정안전부가 통보한 주민등록 '이중 신고자' 명단을 정리하며 생존 확인 없이 처리
두 등록 중 하나가 아니라 둘 다 사망 처리. 한 주민은 교통경찰 신원 확인에서 자신이 사망자임을 알았고, 정정이 다른 기관에 자동으로 전달되지 않아 병원 진료를 못 받았다
화순군 20년 재산세 (2026년 3월 보도)
실제 땅 주인과 납세자의 선친이 이름이 같고, 두 땅이 붙어 있었다
2006년부터 약 20년간 남의 땅 재산세를 냈다. 군은 처음에 소멸시효를 들어 일부만 돌려주려다 전액 환급했다
병원 동명이인 환자 경보 (2021)
이름과 생년월일까지 같은 두 환자
응급실·외래에서 다른 환자의 차트로 접수·진료. 의료기관평가인증원이 초진 때 4가지 지표 확인을 권고했다
대구 회사원 수갑 (2010)
이름이 같고 나이·용모가 비슷한 기소중지자
신분증 확인 전에 수갑. 2년 전에도 같은 사람으로 오인됐다가 신분증으로 풀려난 적이 있었다
네 사건에는 공통된 교훈이 있습니다. 첫째, 문턱은 기술 선택이 아니라 정책 선택입니다. '놓치느니 더 잡자'는 결정은 거짓 양성의 비용을 엉뚱한 사람에게 떠넘깁니다. 둘째, 약한 신호 둘이 겹치면 강한 확신처럼 보입니다. 이름이 같고 땅이 붙어 있으면, 이름이 같고 나이가 비슷하면 그럴듯해 보이지만, 둘을 합쳐도 식별자가 되지는 않습니다. 셋째, 틀린 병합은 기록으로 남겨야 반복되지 않습니다. 대구의 회사원은 같은 오인을 두 번 겪었습니다. '이 둘은 다른 사람'이라는 부정 기록이 없었기 때문입니다. 사실탐색기가 사안 묶기에서 '합치지 말 것' 규칙을 따로 두는 이유이기도 합니다.
이 문제는 2017년 구글에서도 일어났습니다. 뉴욕타임스 기자 레이철 에이브럼스는 구글 검색의 인물 정보 패널이 자신의 사진을 2013년에 사망한 같은 이름의 작가 약력과 합쳐 놓은 것을 발견했습니다. 지인이 그의 부고를 봤다며 연락했고, 사촌의 음성 비서는 그가 사망했다고 답했습니다. 그가 쓴 기사 제목은 「구글은 내가 죽었다고 생각한다(나는 아니라는 걸 안다)」였습니다. 틀린 병합은 한 시스템에서 끝나지 않고, 그 데이터를 빌려 쓰는 다른 시스템으로 퍼집니다.
컴퓨터가 문서를 다루기 시작하자 '비슷함'의 대상이 이름에서 문서로 넓어졌습니다. 1957년 IBM의 한스 페터 룬은 문서를 단어 빈도로 바꾸자고 제안하며 이렇게 썼습니다. 정보를 기계가 다룰 수 있는 형태로 바꿔야 "비로소 두 기록 사이의 유사도를 자동으로 정할 수 있다." 유사도를 검색의 중심에 놓은 초기 문장 가운데 하나입니다.
이 생각을 체계로 만든 사람이 하버드와 코넬의 제라드 설턴입니다. 그의 SMART 시스템은 문서를 '단어마다 한 축'인 공간의 점으로 놓았습니다. 1975년 CACM 논문 「자동 색인을 위한 벡터 공간 모델」은 두 문서의 유사도를 두 벡터의 내적, 또는 두 벡터 사이 각도의 역함수로 정의했습니다. "두 벡터의 단어 배정이 같으면 각도는 0이 되고 유사도는 최대가 된다." 이것이 오늘날 임베딩 검색까지 이어지는 코사인 유사도입니다. 문서를 길이 1로 맞추면 모든 문서가 공 표면의 점이 되고, 가까운 점이 비슷한 문서입니다.
여기에 재미있는 각주가 하나 있습니다. 벡터 공간 모델의 출처로 수백 번 인용된 「A vector space model for information retrieval」(1975, JASIS)이라는 논문은 존재하지 않습니다. 2004년 정보학자 데이비드 더빈은 이 인용이 같은 해 설턴의 두 논문 서지가 섞여 만들어진 '유령 인용'임을 밝히고, 글 제목을 「제라드 설턴이 쓰지 않은 가장 영향력 있는 논문」이라고 붙였습니다. 서로 '비슷한' 두 서지가 한 논문으로 합쳐진 셈이니, 유사도의 역사에 어울리는 사고입니다.
흔한 말은 두 문서를 가르지 못한다: IDF (1972)
벡터 공간에는 큰 구멍이 하나 있었습니다. 모든 단어가 같은 무게를 가졌습니다. 1972년 케임브리지의 카렌 스파크 존스는 단어의 '구체성'을 뜻이 아니라 통계로 해석하자고 제안했습니다. 많은 문서에 나오는 단어일수록 무게를 낮추라는 것입니다. 이것이 역문서빈도(IDF)입니다. 그의 논문에서 Cranfield 문서 200건 가운데 90건에 나오는 단어의 가중치는 2, 3건에만 나오는 단어의 가중치는 7이었습니다.
IDF는 이후 거의 모든 검색 엔진의 바닥이 됐습니다. 스파크 존스는 정보 검색 분야의 개척자로 2007년 영국 컴퓨터학회 러브레이스 메달을 받았고, 그때 인터뷰에서 이런 말을 남겼습니다. "내 구호는 이것이다. 컴퓨팅은 남자들에게만 맡겨 두기엔 너무 중요하다."
IDF가 풀려던 문제는 사실탐색기의 '비슷한 사안' 화면에서 그대로 다시 나타났습니다. '센터'라는 흔한 두 글자 말이 가족센터 건립과 치매안심센터 확충을 이웃으로 만들었습니다. 12장에서 이 이야기를 다시 합니다.
BM25: 반복은 포화되고 긴 문서는 깎인다 (1994)
1994년 런던 시티대의 스티븐 로버트슨 연구팀은 미국 국립표준기술연구소의 검색 경진대회 TREC-3에 'Okapi'라는 시스템을 냈습니다. 그 논문에서 이전 대회의 두 함수 BM11과 BM15를 사실상 하나로 합친 것이 BM25입니다. BM은 '최적 일치(Best Match)'의 약자이고, 25는 연구실 소프트웨어에서 함수에 붙인 일련번호라는 설명이 시티대 쪽 자료에 있습니다(원 논문은 이름의 이유를 설명하지 않습니다). BM25는 두 가지를 더했습니다. 같은 단어가 열 번 나온다고 열 배 관련 있지는 않으니 반복의 효과는 포화되게 하고, 긴 문서는 단어가 많이 나올 수밖에 없으니 길이로 깎습니다. 그 논문의 실험 기본값 b = 0.75가 지금도 거의 모든 검색 엔진의 기본값입니다.
30년이 지난 2026년에도 BM25는 강한 기준선입니다. 코어닷투데이의 부산 기록 실측에서 근거 문단 찾기는 BM25만으로 상위 5개 안 정답률 84.9%였고, 임베딩이 더한 것은 3~9점이었습니다. 공적 기록의 질문은 '금고지정심의위원회'처럼 고유한 낱말을 담기 마련이고, 그 낱말이 문단에 그대로 있기 때문입니다.
거의 같은 문서: 웹의 절반은 복사본이었다 (1997~2007)
1990년대 후반 웹 검색 엔진은 새 문제를 만났습니다. 같은 문서가 수없이 복사돼 있었습니다. 1997년 알타비스타의 안드레이 브로더는 문서를 겹치는 조각의 집합으로 보고 자카드 유사도를 빠르게 추정하는 방법(MinHash)을 내놨습니다. 모든 쌍을 비교할 수 없으니 문서마다 작은 '스케치'를 만들어 두는 방식입니다. 그가 웹 문서 3,000만 건 이상을 '50% 이상 비슷하면 묶기'로 정리하자, 1,230만 건이 360만 묶음으로 모였고 그중 530만 건은 완전한 복사본이었습니다. 2007년 구글은 80억 웹페이지에 64비트 SimHash를 매기고, 64개 비트 가운데 3개 이하만 다르면 거의 중복으로 보는 기준이 적절하다고 보고했습니다.
사실탐색기에서도 같은 기술이 쓰일 자리가 있습니다. 재공고와 정정 공고는 원래 공고와 거의 같은 글입니다. 숫자와 날짜만 다릅니다. 그래서 '거의 같은 문서'를 찾는 기술과 '숫자만 다른 값'을 가르는 기술이 한 문서 안에서 함께 필요합니다. 날짜와 숫자를 자리표시로 바꾼 뒤 문서끼리 비교하고, 그 자리표시에 들어갈 값은 따로 비교하는 식입니다.
4. 3부 — 뜻의 시대: 같은 것은 다른 단어로 불린다
어휘 문제: 두 사람이 같은 단어를 고를 확률 20% (1987~1990)
단어 기반 검색에는 넘을 수 없는 벽이 있었습니다. 1987년 벨 연구소 계열의 연구자들은 사람들에게 같은 대상의 이름을 지어 보게 했는데, 두 사람이 같은 핵심어를 고르는 경우가 20%도 되지 않았습니다. '어휘 문제'입니다. 이용자는 '자동차'로 찾는데 문서는 '차량'이라고 쓰고, 시민은 '롯데 홈구장'이라고 묻는데 기록은 '사직야구장'이라고 씁니다.
1990년 디어웨스터와 두마이스 등은 단어-문서 행렬을 수학적으로 압축해(특이값 분해) 숨은 의미 차원을 찾는 잠재 의미 분석(LSA)을 내놨습니다. 같은 문서들에 함께 나오는 단어는 한 차원으로 모입니다. 단어가 달라도 뜻이 가까우면 가까워지는, 뜻으로 재는 유사도의 첫 본격적인 시도였습니다.
단어는 그 동무로 안다: 분포 가설에서 word2vec까지 (1954~2013)
뜻을 재는 유사도의 이론적 뿌리는 1950년대 언어학에 있습니다. 1954년 젤리그 해리스는 '뜻의 차이는 분포의 차이와 맞물린다'고 썼습니다. 'oculist'와 'eye-doctor'는 거의 같은 문맥에 나오지만 'oculist'와 'lawyer'는 그렇지 않습니다. 1957년 영국 언어학자 J. R. 퍼스의 문장은 더 유명합니다. "단어는 그것이 어울리는 동무로 알게 된다."
2013년 구글의 토마시 미콜로프 연구팀은 이 생각을 신경망으로 구현했습니다. word2vec은 주변 단어를 예측하는 과제로 단어를 벡터로 배웠고, 16억 단어를 하루 안에 학습했습니다. 그리고 유명한 예를 남겼습니다. 'king − man + woman'을 계산하면 'queen'에 가장 가까운 벡터가 나온다는 것입니다.
이 예에도 각주가 있습니다. 2020년 니심 등은 원래 구현이 입력으로 쓴 단어(king, man, woman)를 답에서 빼는 규칙을 갖고 있었다고 지적했습니다. 그 규칙을 풀면 'man:king = woman:?'의 답으로 'king' 자신이 나오는 경우가 많았습니다. '가장 비슷한 것'을 고르는 규칙 하나가 결과의 인상을 바꾼 것입니다. 유사도의 숫자만큼, 그 숫자로 무엇을 고르는지의 규칙이 중요하다는 교훈입니다.
2018년 구글의 BERT는 문장 속 단어의 뜻을 문맥에 따라 다르게 표현하는 언어 모델로, 거의 모든 자연어 과제의 성능을 끌어올렸습니다. 하지만 두 문장이 비슷한지 재려면 두 문장을 함께 넣고 모델을 매번 돌려야 했습니다. 2019년 닐스 라이머스와 이리나 구레비치는 이 비용을 이렇게 계산했습니다. 1만 문장에서 가장 비슷한 쌍을 찾으려면 약 5천만 번의 추론, 약 65시간이 걸린다. 그들의 Sentence-BERT는 문장마다 벡터를 한 번만 만들어 두고 코사인으로 비교하게 했습니다. 같은 일이 약 5초로 줄었습니다. 오늘날 'RAG'와 '벡터 데이터베이스'라고 부르는 것들은 모두 이 구조 위에 서 있습니다.
2020년에는 두 갈래가 나왔습니다. 페이스북의 DPR은 질문과 문단을 따로 벡터로 만드는 밀집 검색으로, 위키백과 2,100만 문단에서 상위 20개 정확도를 BM25보다 9~19%포인트 높였습니다. 스탠퍼드의 ColBERT는 문서를 벡터 하나로 누르지 않고 토큰마다 벡터를 남겨 두는 '늦은 상호작용' 방식을 내놨습니다. 이 무렵 서로 다른 검색기를 섞는 방법으로는 2009년에 나온 RRF가 표준처럼 쓰이게 됩니다. 10장에서 이 공식의 산수를 자세히 봅니다.
2022년의 MTEB는 임베딩 평가판을 하나로 모았습니다. 8개 과제, 58개 데이터셋, 112개 언어였습니다. 그 논문의 결론 한 줄은 지금도 유효합니다. "모든 과제를 지배하는 임베딩 방법은 없다." 2024년 BAAI의 BGE-M3는 100개가 넘는 언어, 최대 8,192 토큰, 밀집·희소·다중 벡터 출력을 한 모델에 담았고, 코어닷투데이 사실탐색기의 현재 기본 임베딩이 됐습니다.
가장 가까운 벡터는 언제나 존재한다
뜻으로 재는 유사도는 강력하지만, 새로운 종류의 사고도 만들었습니다. 이 사고들의 공통점은 '가장 비슷한 것'은 언제나 있다는 점입니다.
2020년 디트로이트. 얼굴 인식 검색이 2018년 시계 매장 절도 CCTV 속 인물을 로버트 윌리엄스와 연결했습니다. 그는 가족 앞에서 체포돼 약 30시간 구금됐습니다. 2024년 6월 합의로 30만 달러를 받았고, 디트로이트 경찰은 얼굴 인식 결과만으로는 체포하지 않는다는 규칙을 받아들였습니다. 가장 가까운 얼굴 벡터는 단서이지 증거가 아니라는 것을 합의문이 규칙으로 만든 셈입니다.
2024년 법률 AI. 스탠퍼드 연구진은 검색 증강 생성(RAG)을 쓰는 상용 법률 AI 도구들도 질의의 17~33%에서 틀린 답을 낸다고 보고했습니다. 업체들은 RAG가 환각을 없앤다고 광고했지만, 한 유형은 법은 맞게 말하면서 그 주장을 뒷받침하지 않는 판례를 인용하는 것이었습니다. 비슷한 판례가 질문에 답하는 근거라는 보장은 없습니다.
2024년 구글 'AI 개요'. 피자 치즈가 흘러내리지 않게 하는 법을 묻자 AI가 '접착제를 넣으라'고 답했습니다. 구글 검색 부사장은 공식 블로그에서 토론 게시판의 풍자·장난 글이 근거로 쓰였다고 인정했습니다. 질문과 가장 비슷한 문장이 가장 믿을 만한 문장은 아닙니다.
2018년 백색소음 저작권. 한 음악 연구자가 올린 10시간짜리 백색소음 영상에 유튜브의 자동 저작권 시스템이 저작권 주장 5건을 걸었습니다. 다른 사람들이 올린 백색소음과 '닮았다'는 것이었습니다. 특징이 없는 신호끼리는 서로 닮아 보입니다. 정보가 거의 없는 입력의 유사도는 의미가 없습니다. '센터'라는 두 글자가 사안을 잇는 것과 같은 문제입니다.
5. 125년이 남긴 세 가지 교훈
역사를 이렇게 정리할 수 있습니다. 1부는 같은 사람을 찾으려고 이름의 소리와 철자를 셌고, 2부는 같은 주제의 문서를 찾으려고 단어를 셌으며, 3부는 같은 뜻을 찾으려고 문장을 좌표로 바꿨습니다. 세 시대는 서로를 지우지 않았습니다. 2026년 사실탐색기 안에서도 1901년의 자카드, 1965년의 편집 거리, 1972년의 IDF, 2009년의 RRF, 2024년의 임베딩이 함께 돕니다. 그리고 125년의 사례들은 세 가지를 반복해서 말합니다.
1
비슷함은 질문에 묶여 있다
자카드는 식물상이 얼마나 겹치는지 물었고, 사운덱스는 소리가 같은지, 설턴은 같은 단어를 쓰는지, 임베딩은 뜻이 가까운지 물었습니다. 공식을 빌려 올 때는 질문도 함께 따라온다는 것을 잊으면 안 됩니다.
2
문턱은 정책이고, 회색지대는 사람에게
펠레기와 선터의 세 결정(연결·검토·비연결)부터 디트로이트 경찰의 합의까지, 유사도가 높다는 사실은 결정의 근거가 아니라 후보의 근거였습니다. 플로리다는 문턱을 넓히기로 '선택'했습니다.
3
가장 비슷한 것은 언제나 있다
얼굴 벡터도, 판례 검색도, 백색소음도 '가장 가까운 것'을 돌려줍니다. 그래서 '이 중에는 없다'고 말하는 장치, 곧 기권이 유사도 시스템의 일부여야 합니다.
6. 한국어라는 난제: 글자 한 칸에 소리 세 개, 낱말 끝에 조사
지금까지의 역사는 대부분 영어에서 쓰였습니다. 영어에서는 띄어쓰기가 곧 낱말 경계이고, 'Robert'와 'Rupert'의 차이는 철자 몇 개입니다. 한국어로 오면 같은 도구가 낯선 방식으로 미끄러집니다. 사실탐색기가 부산 공적 기록에서 실제로 부딪힌 다섯 가지를 보겠습니다.
한국어 쪽 도구의 역사는 짧습니다. 2018년 8월 Elasticsearch 6.4에 공식 한국어 분석기 nori가 들어갔는데, 21세기 세종계획 말뭉치에서 나온 mecab-ko-dic 사전을 썼습니다(81만여 개 용어). 형태소 분석기 Kiwi의 저장소는 2017년 2월에 만들어졌습니다. 문장 유사도의 한국어 평가판은 2020년 카카오브레인의 KorNLI·KorSTS가 처음이었는데, 영어 데이터를 기계 번역해 학습용으로, 사람이 번역·검수해 평가용으로 만든 것이었습니다. 한국어 원문으로 새로 만든 평가판은 2021년 KLUE에서 나왔습니다. 그리고 2026년 지금도, 3~30자짜리 한국어 이름끼리의 유사도를 재는 공개 평가판은 찾을 수 없습니다.
첫째, 조사가 낱말에 붙습니다. '사직야구장은', '사직야구장을', '사직야구장에서'는 모두 같은 대상입니다. 띄어쓰기로 자르면 셋이 다른 낱말이 됩니다. 그래서 조사를 떼야 하는데, 떼는 규칙이 너무 단순하면 낱말 머리를 다칩니다. 사실탐색기의 조사 제거 함수는 '도시철도'의 '도'를 조사로 보고 '도시철'로 잘랐습니다. 엔티티 이름과 질문이 같은 함수를 거쳐 양쪽이 똑같이 잘리기 때문에 대부분은 우연히 맞아떨어지지만, 두 글자씩 비교하는 점수에서는 손해가 납니다. 코어닷투데이 블로그의 BM25 토크나이저 실험에서는 같은 BM25 공식에 토크나이저만 여덟 가지로 바꿔도 검색 품질(nDCG@10)이 0.42에서 0.62까지 벌어졌습니다.
둘째, 이름 안에 다른 이름이 들어 있습니다. '해운대구'에는 '대구'가, '부산디자인진흥센터'에는 '센터'가 글자 그대로 들어 있습니다. 포함 여부만 보면 해운대구 이야기에 대구 기록이 붙습니다. 사실탐색기의 장소 사전은 그래서 '앞 글자가 한글이면 이름이 아니다'라는 규칙을 따로 둡니다. '제주은행'·'인천도시가스'의 지명은 이름 뒤 조사가 낱말을 끝낼 때만 지명으로 인정합니다.
셋째, 음절 하나가 소리 셋입니다. '희'와 '휘'는 컴퓨터 입장에서 완전히 다른 글자입니다. 하지만 초성 'ㅎ'은 같고, 모음만 'ㅢ'와 'ㅟ'로 다릅니다. 음절 단위로 비교하면 오타 하나가 글자 하나를 통째로 바꾼 것으로 보이고, 자모(초성·중성·종성) 단위로 풀면 세 조각 중 하나만 다른 것으로 보입니다. 한국어 유니코드는 완성형 음절을 조합형 자모로 푸는 정규화(NFD)를 표준으로 갖고 있어서, 추가 라이브러리 없이 이 분해를 할 수 있습니다.
넷째, 줄임말이 많습니다. '사직야구장'은 '사직구장'으로, '부산광역시의회'는 '부산시의회'로, '도시철도 2호선'은 '2호선'으로 불립니다. 줄임말은 긴 이름에서 글자를 순서대로 몇 개 뽑은 모양이라, 두 글자씩 비교하는 점수로는 생각보다 멀어 보입니다.
다섯째, 이름이 겹칩니다. '김민지'와 '민지'는 성을 뗀 같은 사람일 수도, 다른 사람일 수도 있습니다. 회의록의 '이 의원'은 그 회의에 이씨 의원이 한 명뿐일 때만 특정됩니다. '부산시'는 성씨 '부'에 이름 '산시'로도 읽힐 수 있어서, 사실탐색기의 이름 해석기는 기관 접미사를 먼저 보는 규칙을 둡니다.
아래 실험실에서 이 쌍들을 직접 재 보세요. 같은 두 문자열인데 점수마다 판정이 갈립니다.
표로 정리하면 이렇습니다. 숫자는 위 실험실과 같은 함수로 잰 값입니다.
쌍
정답
음절 bigram 자카드
자모 bigram 자카드
겹침 계수
Jaro-Winkler
사직구장 · 사직야구장
같음
0.40
0.67
0.67
0.95
김민희 · 김민휘 (가상 이름)
같음(오타)
0.33
0.75
0.50
0.82
부산광역시의회 · 부산시의회
같음
0.43
0.53
0.75
0.92
해운대구 · 대구
다름
0.33
0.38
1.00
0.00
센터 · 부산디자인진흥센터
다름
0.13
0.19
1.00
0.00
부산교통공사 · 부산도시공사
다름
0.25
0.41
0.40
0.82
점수 하나로 여섯 쌍을 다 맞히는 방법은 없습니다. 자모 자카드는 오타와 줄임말을 살리지만, 겹침 계수는 '해운대구 ⊃ 대구'에 만점을 줍니다. Jaro-Winkler는 접미만 겹친 쌍을 정확히 0점으로 거르지만, '부산'으로 시작해 '공사'로 끝나는 서로 다른 두 기관에 0.82를 줍니다. 한국 기관명은 '지역 + 분야 + 기관 종류' 구조라 앞뒤가 같은 다른 이름이 아주 많습니다. 영어 이름을 위해 만든 '앞글자 가중'이 한국어 기관명에서는 거짓 양성의 원천이 됩니다.
그래서 조사가 권하는 방향은 점수 하나를 고르는 것이 아니라 실패마다 작은 규칙을 차례로 세우는 것입니다.
1정규화 후 정확 일치 — 공백·괄호·'광역시→시'를 맞춘 뒤 같은가. 사실탐색기는 이미 이 단계에서 '부산광역시의회 = 부산시의회'를 1.0으로 만든다.
2별칭표 — 사람이 확인한 별칭(사직구장 → 사직야구장)을 먼저 본다.
3약어 검사 — 짧은 쪽이 긴 쪽의 글자를 순서대로 품고 첫 글자·끝 글자가 같으면 줄임말로 본다.
4자모 점수, 흔한 조각은 덜 세기 — '센터'·'위원회'·'부산'처럼 많은 이름에 나오는 조각은 무게를 낮춘다(IDF).
5낱말 경계에서만 포함 인정 — '해운대구' 안의 '대구'는 경계가 아니므로 포함이 아니다. 경계는 형태소 분석기(Kiwi)로 미리 만든 사전으로 판단한다.
형태소 분석기 이야기를 덧붙이면, 2026년 10월 20일에 나온 Kiwi 0.24.1은 Apache-2.0 라이선스이고, 조사 분리 시험에서 '도시철도'를 '도시철'로 자르지 않았으며 '해운대구'를 한 덩어리로 유지했습니다. 다만 같은 '도시철도'도 '도시철도를'에서는 '도시+철도'로, '도시철도에서'에서는 통째로 나뉘는 등 문맥에 따라 흔들렸고, 모르는 인명은 엉뚱하게 갈랐습니다. 그래서 사실탐색기처럼 결정을 재현해야 하는 엔진에서는 분석기를 실시간으로 부르기보다, 미리 돌려 낱말 사전을 만들고 그 사전을 데이터 파일로 굳혀 쓰는 편이 맞습니다.
7. 사실탐색기 안에서 유사도가 하는 다섯 가지 일
이제 유사도가 실제 엔진의 어디에 들어가는지 보겠습니다. 코어닷투데이 사실탐색기는 부산시의회 회의록·조례·공고·보도자료와 DART 공시 같은 공적 기록에서 '지금 참인 값'을 근거와 함께 답하고, 근거가 모자라면 답하지 않는 엔진입니다(설계편, 실측편). 이 엔진에는 유사도를 재는 자리가 다섯 군데 있고, 자리마다 묻는 질문이 다릅니다.
① 이름 해석같은 대상인가'김민지' = '민지'? 음절 bigram 자카드 0.5 관문 + 문서·소속·직함 문맥 점수
② 값 비교 (C3)같은 값인가'만 19세~34세' = '만 19세부터 34세까지'? 수량은 정확 비교, 나머지는 bigram 0.6
③ 질문 해석질문이 무엇을 가리키나'롯데 홈구장 새로 짓는 거' → '사직야구장 재건축'. 글자 포함 → bigram → 임베딩(BGE-M3) + RRF
④ 재정렬후보 중 무엇이 맞나점수가 엇비슷할 때 LLM이 다시 매기기 — 실측 결과 해로워 꺼 둠
⑤ 사안 묶기함께 볼 만한가닻 낱말 + 멈춤말 목록, '비슷한 사안'은 드문 낱말·같은 이야기·장소·기관
다섯 자리에는 공통 원칙이 하나 있습니다. LLM은 제안하고 코드가 결정한다. 임베딩과 언어 모델은 '이것일지도 모른다'는 후보를 내놓는 데까지만 쓰고, 최종 판정은 재현 가능한 규칙과 권위 있는 기록이 합니다. 그리고 규칙의 문턱값(0.5, 0.6 같은 숫자)은 감으로 정하지 않고 회귀 사례로 고정합니다. 문턱을 바꾸려면 그 이유가 되는 사례를 회귀 세트에 먼저 추가해야 합니다.
다섯 자리 가운데 가장 많이 바뀌고 있는 곳은 ③ 질문 해석이고, 가장 위험한 곳은 ② 값 비교입니다. 둘을 차례로 보겠습니다.
8. 2026년의 임베딩 경주: 크기보다 한국어, 평균보다 내 과제
③ 질문 해석의 핵심 과제는 글자가 겹치지 않는 질문을 기록 속 이름에 잇는 일입니다. 시민이 "롯데 홈구장 새로 짓는 계획 언제 시작해?"라고 물으면, 사실탐색기는 기록 속 이름 '사직야구장 재건축'을 찾아야 답할 수 있습니다. 두 문장은 글자가 하나도 겹치지 않습니다. 이 다리를 놓는 것이 임베딩입니다.
2024년 초에 나온 BGE-M3는 100개가 넘는 언어를 지원하는 다국어 모델로, 하나의 모델이 밀집 벡터·희소 가중치·토큰별 다중 벡터를 함께 내는 것이 특징이었습니다. 그 논문의 MIRACL 한국어 결과에서 밀집 벡터 하나로 69.9, 세 출력을 합치면 72.1이었습니다(같은 표에서 BM25는 37.1). 이후 2025~2026년에 한국어 특화 모델과 8B급 대형 모델이 쏟아졌습니다. 공개 한국어 순위표(MTEB 한국어 검색)에서는 고려대 NLP&AI 연구실이 2026년 8월 공개한 ColBERT 계열 KURE-v2(약 150M)가 nDCG@10 평균 0.816으로 8B 모델들을 앞섰고(BGE-M3는 0.751), 코어닷투데이도 KURE-v2 특집에서 이 '토큰마다 벡터를 남기는' 방식을 다뤘습니다.
그런데 공개 순위표는 거의 모두 질문 → 문단 검색을 잽니다. 사실탐색기가 하는 일은 질문 속 짧은 표현 → 3~30자짜리 이름입니다. 이 일을 재는 한국어 벤치마크는 찾을 수 없었습니다. 그래서 코어닷투데이는 2026년 10월 27일 부산 공적 기록 362건으로 직접 시험지를 만들어 임베딩 14종을 쟀습니다(전체 실측 글). 엔티티 3,822개를 찾는 주어 찾기 질의 453개, 술어 80개를 찾는 질의 240개, 근거 단위 3,768개를 찾는 질의 159개, 그리고 값 쌍 1,365개입니다.
KURE-v3 (1.1B)
69.5%
Nemotron 8B
67.3%
EmbeddingGemma 1세대 (308M)
66.4%
KURE-v1 (568M)
66.2%
Qwen3-Embedding 8B
65.1%
BGE-M3 (현재 기본값)
59.4%
KURE-v2 (ColBERT, 약 150M)
56.5%
EmbeddingGemma 2
54.1%
글자 기준선
49.2%
주어 찾기 첫 결과 정답률입니다. 여기서 세 가지를 배울 수 있습니다.
첫째, 공개 1위와 우리 과제 1위가 다릅니다. 공개 순위표 1위였던 KURE-v2는 짧은 이름 찾기에서 56.5%로 BGE-M3보다도 낮았습니다. 대신 근거 문단 찾기에서는 첫 결과 정답률 79.2%로 강했습니다. 토큰마다 벡터를 두는 방식은 긴 문단 속 한 구절을 잘 잡지만, 몇 글자짜리 이름에서는 이점이 사라집니다. 공개 순위표에서 KURE-v2가 크게 앞선 것도 대부분 긴 문서 과제 덕분이었고, 짧은 지문 과제(MrTidy)에서는 BGE-M3가 0.647로 KURE-v2(0.597)보다 높았습니다.
둘째, 크기보다 한국어 학습입니다. 1.1B짜리 KURE-v3가 8B 모델 셋을 모두 앞섰습니다. BGE-M3를 한국어로 다시 가르친 KURE-v1은 59.4%에서 66.2%로 7점 올랐지만, 이미 큰 Qwen3 8B를 한국어로 다시 가르친 comsat은 65.1%에서 64.9%로 그대로였습니다.
셋째, 평균은 가장 중요한 칸을 숨깁니다. 핵심 낱말을 하나도 쓰지 않은 '어려운' 질의만 보면, 글자 기준선은 4.6%로 사실상 0이고 BGE-M3는 29.8%, KURE-v3는 44.4%입니다. 임베딩을 쓰는 이유가 이 칸에 있고, 동시에 한계도 이 칸에 있습니다. 최고 모델도 절반을 넘지 못합니다. '큰 건물이 차량 몰리게 해서 내는 분담금 깎아주는 규정'에서 '교통유발부담금 경감 조례'까지 가려면 행정 용어를 알아야 하고, 임베딩 하나로는 반쯤만 됩니다. 그래서 벡터 이웃은 답이 아니라 후보여야 합니다.
아래는 실측 글의 위젯을 그대로 가져온 것입니다. 모델 사이에 결과가 반반쯤 갈린 질의를 직접 볼 수 있습니다.
과제마다 1위도 바뀌었습니다. 속성 이름(술어)을 찾는 과제에서는 KURE-v1과 comsat이 62.5%로 공동 1위였고, 주어 찾기 1위 KURE-v3는 50.0%에 그쳤습니다. '효력 생기는 날'을 '시행일'에, '최소 몇 명 찬성해야 돼'를 '정족수'에 잇는 일은 긴 이름을 찾는 일과 다른 능력입니다. 하나의 엔진 안에서도 자리마다 다른 모델이 나을 수 있다는 뜻입니다.
모델 카드의 '권장 접두사'도 장식이 아니었습니다. KURE-v3는 질의에 query:, 문서에 passage:를 붙이도록 학습됐는데, 이걸 빼면 주어 찾기가 69.5%에서 31.4%로, 근거 찾기가 25.2%로 무너졌습니다. 글자 검색보다 한참 아래입니다. 반대로 Qwen3 8B는 우리가 붙인 영어 지시문을 빼자 근거 찾기가 86.8%에서 92.4%로 올랐습니다. 공개 자료는 Qwen3에 지시문을 붙이라고 권하지만, 우리 과제에서는 빼는 쪽이 나았습니다. 접두사를 쓰는 모델을 고르면 접두사가 시스템의 계약이 됩니다. 색인할 때와 질문할 때 한 번이라도 어긋나면 오류 없이 조용히 망가집니다.
2026년 10월 6일 나온 EmbeddingGemma 2는 1세대보다 낮았습니다(주어 54.1% 대 66.4%). 처음에는 Ollama판의 4비트 양자화를 의심했지만, 구글이 올린 원본 가중치를 A100에서 BF16으로 돌려도 55.6%로 거의 같았습니다. 벤치마크 평균이 오른 새 판이 내 과제에서도 오른다는 보장은 없습니다. 코어닷투데이가 EmbeddingGemma 2 특집에서 소개한 멀티모달 능력과는 별개로, 한국어 행정 용어를 바꿔 말한 질의에서는 1세대가 낫습니다.
9. 가장 위험한 자리: '두 값이 같은가'
이제 ② 값 비교로 갑니다. 사실탐색기의 핵심 연산인 AGS(권위 기반 대체)는 같은 사실에 대해 값이 다른 기록이 들어오면, 더 권위 있는 쪽이 옛 값을 닫습니다. 값이 같으면 근거를 하나 더 붙입니다. 그래서 '두 값이 같은가'는 엔진에서 가장 위험한 판단입니다. 같은 값을 다르다고 하면 멀쩡한 사실이 닫히고, 다른 값을 같다고 하면 정정이 묻힙니다.
이 판단을 임베딩에 맡길 수 있을까요. 실측 결과는 극단적으로 갈렸습니다. 같은 값을 다르게 쓴 쌍('2026. 9. 22.' ↔ '2026-09-22', '97명' ↔ '97 명') 749개와 숫자 하나만 바꾼 쌍('2003년 7월 1일' ↔ '2003년 7월 8일') 585개를 만들었습니다. 같은 값을 95% 받아들이도록 문턱을 잡았을 때 숫자 다른 쌍이 '같은 값'으로 넘어오는 비율은 Qwen3 8B 6%, KURE-v3 7%, BGE-M3 82%, 글자 bigram 89%였습니다. BGE-M3에서 '2003년 7월 1일'과 '7월 8일'의 유사도는 0.906인데, 같은 날짜를 '2026.9.9.'와 '2026-09-09'로 쓴 쌍은 0.763입니다. 다른 날짜가 같은 날짜보다 더 가깝습니다.
가장 잘 가르는 모델도 6%를 흘립니다. 숫자 하나가 바뀐 정정 1,000건 가운데 60건이 '같은 값'으로 묻힌다는 뜻이고, 옛 값을 닫는 엔진에서는 받아들일 수 없는 숫자입니다.
값을 '비슷한 모양'으로 다루다 생긴 사고는 유사도 밖에도 많습니다. 2016년 한 연구는 유전체 논문의 보충 엑셀 파일을 조사해, 유전자 목록이 있는 논문 3,597편 중 704편(19.6%)에서 'SEPT2' 같은 유전자 이름이 날짜로 바뀌어 있었다고 보고했습니다. 결국 2020년 국제 유전자 명명위원회가 SEPT1을 SEPTIN1로, MARCH1을 MARCHF1로 이름을 바꿨습니다. 2018년 삼성증권에서는 우리사주 배당을 '주당 1,000원' 대신 '1,000주'로 입력해 존재하지 않는 주식 28억여 주가 직원 계좌에 들어갔습니다. 숫자 '1000'은 문자열로는 똑같습니다. 단위와 자리라는 필드를 보지 않으면 의미를 놓칩니다. 그런데 이 실험을 하다가 더 놀라운 일이 드러났습니다. 글자 유사도 규칙도 같은 실수를 하고 있었습니다.
부산 조례 부칙에 '1981년 1월 1일부터 시행'과 '1984년 1월 1일부터 시행'이 있었습니다. 사실탐색기는 텍스트 값의 같음을 음절 bigram 자카드 0.6 이상으로 판정했는데, 이 둘의 점수는 0.71이었습니다. 연도의 숫자 한 자리만 다를 뿐 나머지 조각이 모두 같기 때문입니다. 엔진은 두 시행일을 한 명제의 같은 값으로 묶었습니다. 2026년 10월 27일 fact-explorer-v2 작업 트리에는 이 버그를 고치는 수정이 들어갔습니다. 글자 점수를 보기 전에 두 값에 든 수의 묶음을 비교해서, 서로를 포함하지 않으면 충돌로 보는 검사입니다. 회귀 사례 넷(1981/1984, 같은 부칙의 월만 다른 시행일, '제3조/제4조', 같은 수의 다른 표기)도 함께 추가됐습니다.
하지만 수 검사로 끝나지 않습니다. 이 버그의 뿌리는 더 깊습니다. 아래 위젯에서 두 값 앞에 똑같이 붙는 문맥을 늘려 보세요.
자카드 점수는 두 값이 공유하는 문맥의 길이에 휘둘립니다. 사실탐색기의 회귀 사례에는 '부산광역시에 주민등록을 둔 만 19세부터 34세까지의 무주택 청년'과 '…만 19세~34세 무주택 청년'이 같은 값이라는 사례가 있고, 이 쌍은 긴 공통 문맥 덕에 0.68로 통과합니다. 그런데 범위만 떼어 '만 19세부터 34세까지'와 '만 19세~34세'를 비교하면 0.42로 '충돌'이 됩니다. 거꾸로 문맥이 길면 숫자 한 자리 차이는 묻힙니다. 1981과 1984가 0.71이었던 이유입니다. 수 검사는 '다른 수'를 잡지만 '같은 범위의 다른 표기'와 '한쪽이 다른 쪽을 품는 값'('10월 31일'과 '2025년 10월 31일')은 여전히 가르지 못합니다.
그래서 이 자리의 답은 더 좋은 유사도가 아닙니다. 값이 무엇인지 풀어 버리는 것입니다. '만 19세부터 34세까지'와 '만 19세~34세'는 둘 다 [19, 34]라는 구간으로 풀리고, 두 구간이 같으니 같은 값입니다. 문맥 길이와 상관이 없습니다. 2026년 지식베이스 일관성 연구 SKG-Eval도 같은 설계를 씁니다. 정렬된 관계 아래에서 수치를 기호로 먼저 뽑아 모순을 잡고, 흐릿한 검출기는 기호 검사가 판단을 보류한 뒤에만 돌립니다. 한국어에는 영어의 Duckling·SUTime 같은 유지보수 중인 날짜·수량 정규화기가 아직 없어서, 이 부분은 직접 만들어야 합니다(Lucene의 한국어 숫자 필터가 '3.2천 → 3200' 같은 규칙의 좋은 참고가 됩니다).
여기서 하나 더 짚을 것이 있습니다. '포함'은 같음이 아닙니다. 지원 대상이 '만 19~34세'에서 '만 19~39세'로 바뀌었다면 앞 구간은 뒤 구간에 포함되지만, 값은 바뀐 것입니다. 사실탐색기가 판정 모델(qwen3.5:9b)에 '같은가, 다른가'를 물었을 때 포함 관계에 0.95 확신으로 '다르다'고 답한 것도 이상한 일이 아닙니다. 같다/다르다 두 칸에는 'A가 B를 품는다'는 답을 적을 칸이 없기 때문입니다. 그래서 판정 모델을 쓴다면 '같음 / A가 B를 품음 / B가 A를 품음 / 충돌 / 모름' 다섯 칸으로 묻고, 두 값의 순서를 바꿔 한 번 더 물어 답이 어긋나면 기권하는 편이 안전합니다. 포함을 어떻게 처리할지는 유사도가 아니라 정책이 정합니다.
10. 섞기의 산수: RRF는 보험이지 공짜 점심이 아니다
③ 질문 해석으로 돌아가서, 글자 순위와 임베딩 순위를 어떻게 합칠지의 문제가 남아 있습니다. 검색 업계의 정석은 RRF(Reciprocal Rank Fusion)입니다. 2009년 SIGIR에서 워털루 대학의 고든 코맥, 찰스 클라크, 슈테판 뷔트허가 두 쪽짜리 논문으로 제안했습니다. 공식은 단순합니다. 후보마다 각 순위표에서 받은 '1 ÷ (k + 순위)'를 더합니다. 점수의 눈금이 서로 다른 검색기(BM25 점수는 0~30, 코사인은 0~1)를 섞을 때 점수 대신 등수만 쓰니 정규화가 필요 없고, k=60이라는 값은 그 논문의 예비 실험에서 정해졌습니다. 이 단순함 덕에 RRF는 Elasticsearch·OpenSearch·Vespa 같은 검색 엔진의 하이브리드 검색 기능으로 들어갔습니다. 코어닷투데이는 하이브리드 검색 특집에서 이 공식의 내력을 자세히 다뤘습니다.
그런데 RRF에는 잘 드러나지 않는 성질이 있습니다. k=60이면 1위의 몫은 1/61, 5위의 몫은 1/65입니다. 거의 같습니다. 후보 목록이 짧으면 RRF는 '몇 위였나'보다 '양쪽 목록에 다 나왔나'를 보상합니다. 그래서 한쪽 검색기가 확실히 강하면, 약한 쪽의 오답이 점수를 나눠 가져 강한 쪽의 정답을 끌어내립니다.
2023년 ACM TOIS에 실린 세바스티안 브루흐 등의 분석도 같은 방향을 가리킵니다. 정규화한 점수를 가중치 하나로 더하는 볼록 결합(CC)이 RRF보다 도메인 안팎에서 모두 나았고, RRF는 k에 민감했으며, CC의 가중치는 라벨이 붙은 질의 몇 개면 맞출 수 있었습니다. 코어닷투데이 실측은 더 극단적이었습니다. 강한 임베딩일수록 RRF로 손해를 봤습니다.
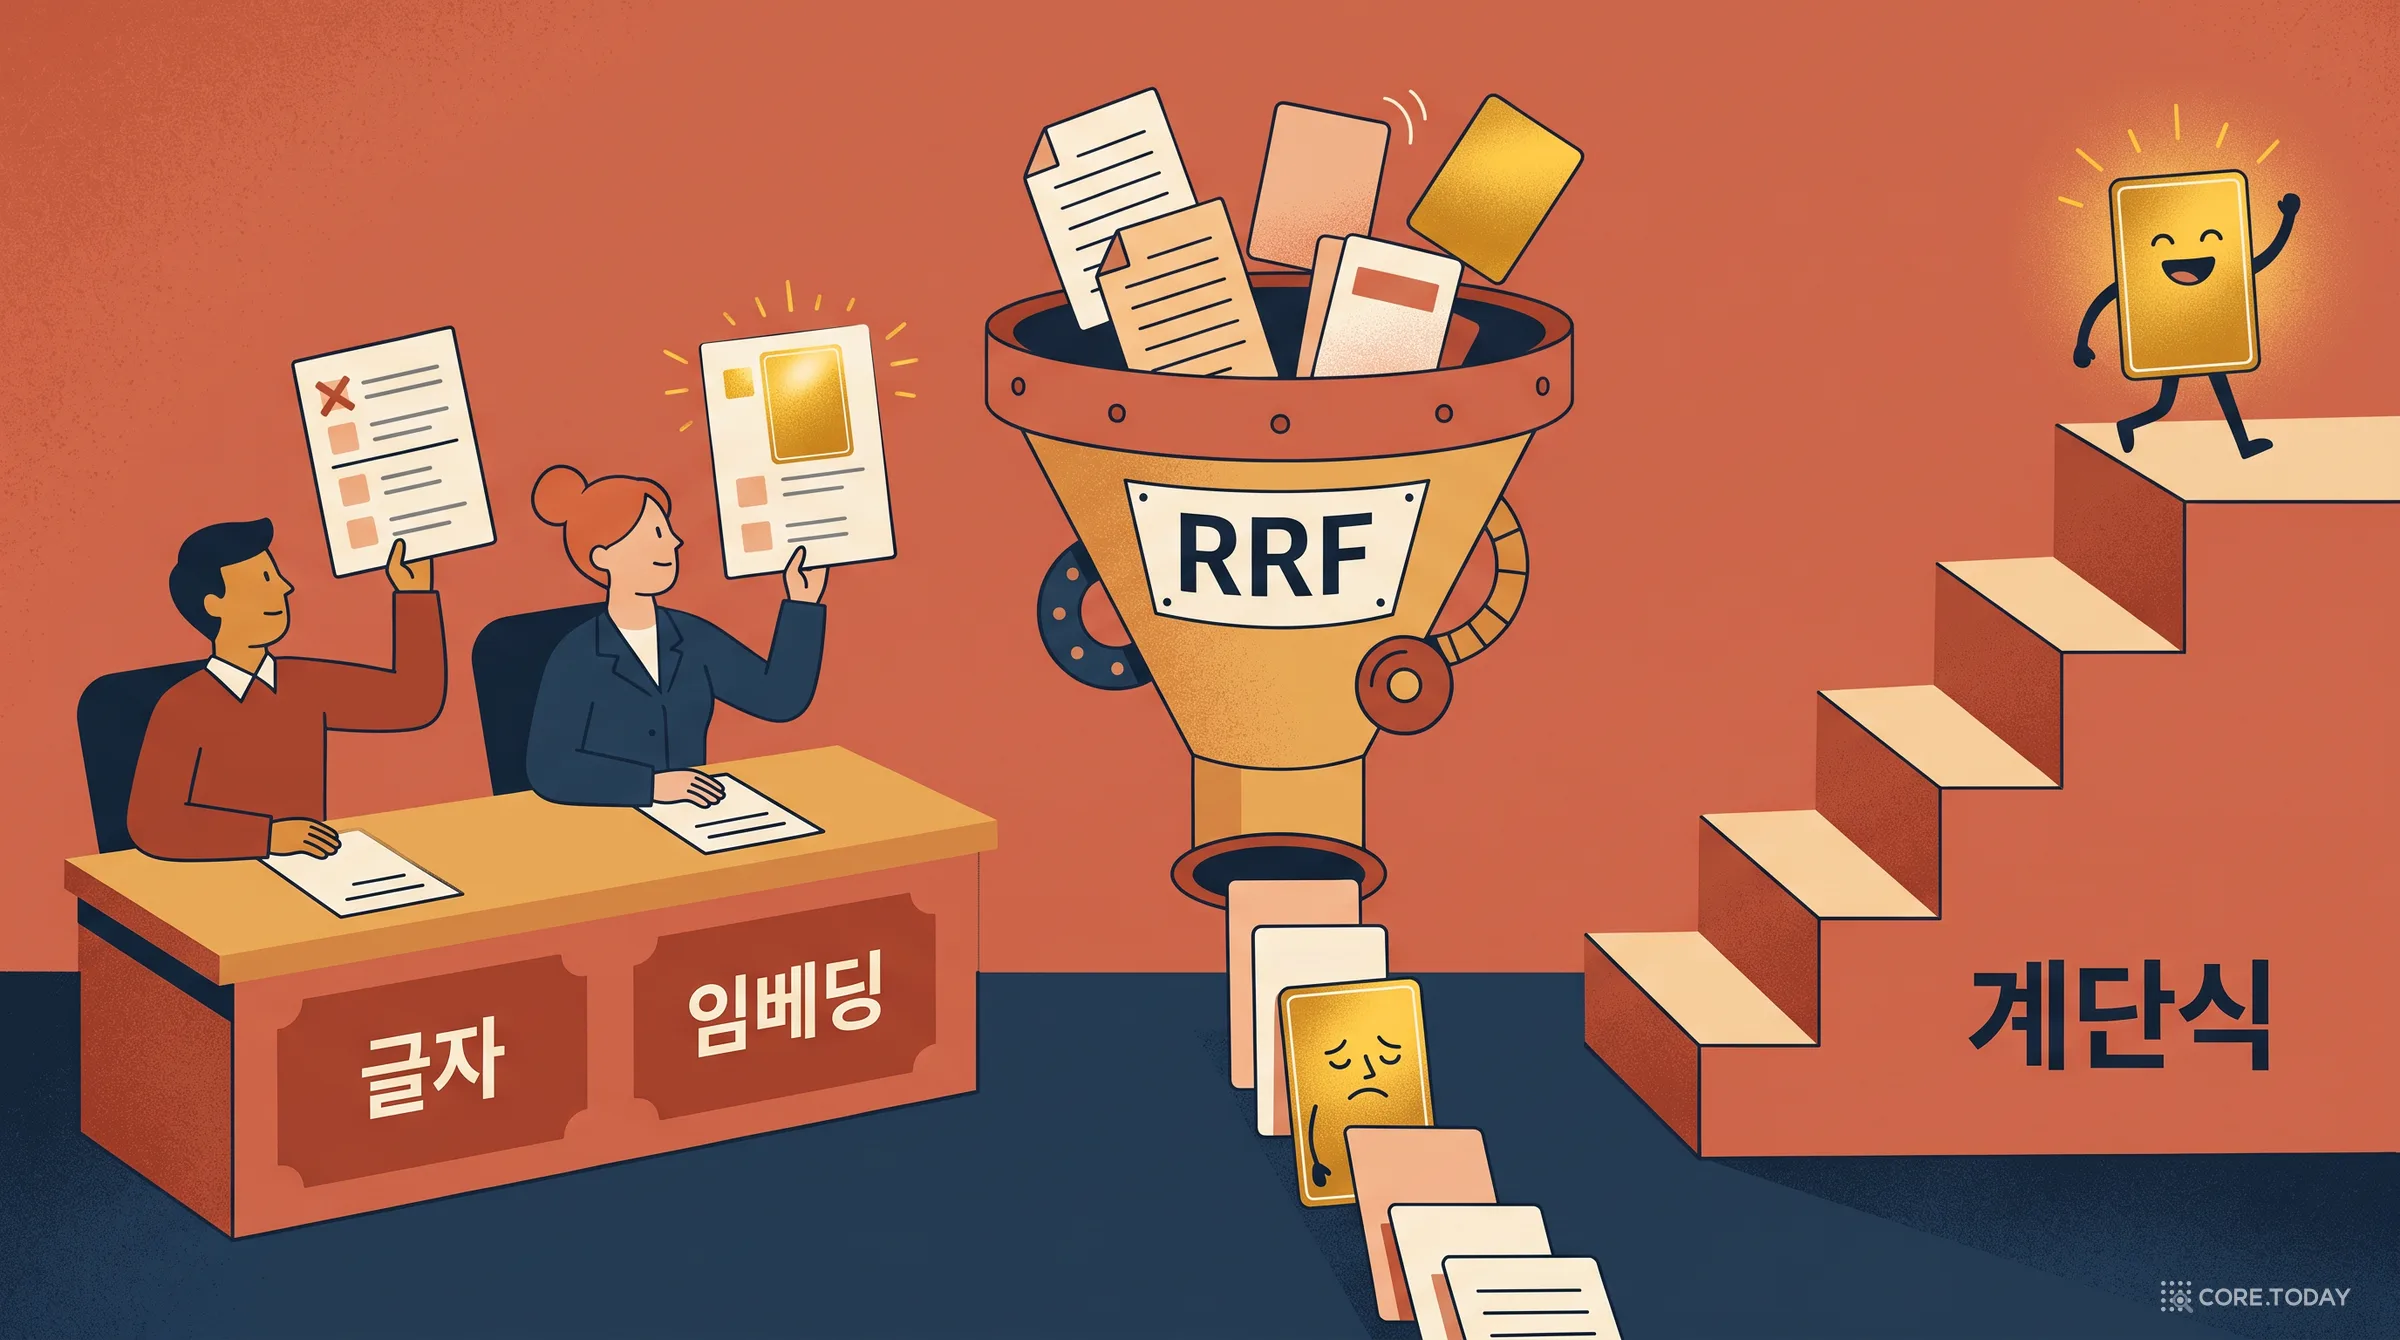
KURE-v3는 임베딩만 쓰면 69.5%인데, 글자 순위와 RRF로 섞으면 58.9%로 10점 넘게 떨어졌습니다. BGE-M3도 59.4%에서 55.8%로 떨어졌습니다. 반대로 혼자서는 30.2%였던 약한 희소 모델(KURE-Sparse)은 섞어서 52.3%가 됐습니다. 그리고 '글자로 이름을 그대로 찾았을 때만 글자, 아니면 임베딩'으로 나누는 계단식은 강한 임베딩 단독과 거의 같았습니다(KURE-v3 69.8%).
교훈은 RRF가 나쁘다는 것이 아닙니다. RRF는 어느 쪽이 맞는지 모를 때 드는 보험입니다. 두 검색기가 비슷하게 약하고 서로 다른 것을 놓친다면 RRF가 둘을 구합니다. 하지만 한쪽이 확실히 강하면 보험료만 냅니다. 사실탐색기의 실제 경로는 이미 계단식에 가깝습니다. 질문에 이름이 글자 그대로 들어 있으면 벡터를 아예 부르지 않고, 벡터 이웃은 코사인 문턱을 넘는 것만 받습니다. 임베딩을 KURE-v3로 바꾼다면 RRF를 빼고 이 계단을 그대로 쓰는 것이 맞습니다. 그리고 문턱 0.6도 다시 정해야 합니다. 같은 값 쌍의 평균 코사인이 KURE-v2는 0.69, Qwen3 8B는 0.98일 만큼 모델마다 눈금이 다르기 때문입니다.
11. 다시 매기기와 판정 모델: 꺼 둔 재정렬기가 옳았던 이유
④ 재정렬은 후보가 여럿이고 점수가 엇비슷할 때 한 번 더 따져 보는 단계입니다. 2019년 노구에이라와 조경현의 BERT 재정렬 연구 이후, 검색 업계의 표준 구성은 '빠른 검색기로 후보 100개 → 느리지만 정확한 교차 인코더로 다시 매기기'였습니다. 교차 인코더는 질문과 후보를 한 번에 읽고 관련도를 냅니다. 비교마다 모델을 다시 돌리니 정확하지만 비싸고, 그래서 후보를 줄인 뒤에만 씁니다. Sentence-BERT 논문이 지적한 '1만 문장에서 가장 비슷한 쌍 찾기에 65시간'이 바로 이 비용입니다.
사실탐색기는 교차 인코더 대신 로컬 생성 모델(qwen3.5:9b)에게 '이 후보가 질문의 주어가 맞는가'를 0~1 점수로 말하게 하는 방식을 시험했고, 측정 결과 해롭다고 보고 꺼 두었습니다. 2026년 문헌을 보면 이 판단은 옳았습니다. 생성 모델이 말로 내놓은 점수는 질문마다, 후보 묶음마다 눈금이 흔들립니다(RankSteer, RefRank). 2026년 워털루·MIT 연구는 점수를 매기기 전에 추론을 시켜도 나아지지 않았다고 보고했습니다.
하지만 이 결과로 재정렬기 전체를 버릴 수는 없습니다. Qwen3-Reranker 같은 2025년 이후의 학습된 재정렬기는 다른 물건입니다. 숫자를 말하게 하는 대신, '예/아니오' 중 '예'가 나올 확률을 모델 내부에서 직접 읽습니다. 다시 시험한다면 이런 모델을 쓰고, 1·2위 점수 차가 클 때는 손대지 않게 막고, 개입한 사례에서 '맞게 뒤집은 수 − 틀리게 뒤집은 수'로 평가하는 것이 맞습니다. 한국어 재정렬기를 공정하게 비교한 공개 벤치마크는 아직 없습니다. Qwen이 낸 표와 Jina가 낸 표는 순위가 정면으로 엇갈립니다(Qwen 표에서는 Qwen3-Reranker-4B가 bge-reranker-v2-m3를 앞서고, Jina의 MIRACL 표에서는 반대입니다). 남이 잰 순위표보다 내 과제에서 잰 결과를 믿어야 하는 이유가 여기서도 반복됩니다.
한 가지는 분명합니다. 재정렬기를 ② 값 비교에 쓰면 안 됩니다. 재정렬기는 '관련 있는가'를 배운 모델이라, '만 19~34세'와 '만 20~34세'를 둘 다 매우 관련 있다고 볼 것입니다. 관련도와 같음은 다른 질문입니다.
판정 모델을 쓸 때의 마지막 장치는 기권입니다. 2026년 ICML에 실린 것으로 표기된 SCOPE 연구는 두 순서로 물어 위치 편향을 상쇄한 뒤, 기권하지 않은 판정의 오류율을 목표치(예: 10%) 아래로 맞추는 방법을 보였습니다. 목표 10%에서 실측 오류율이 9.7~9.9%였습니다. 사실탐색기에 적용하면, 실제 값 쌍 수백 개에 '같음/포함/충돌' 라벨을 붙이고 절반으로 문턱 두 개(같음 쪽, 충돌 쪽)를 정한 뒤 그 사이를 사람에게 넘기는 구성이 됩니다. 이때 두 쪽의 오류 허용치는 달라야 합니다. 사실탐색기에서 거짓 '같음'은 진짜 정정을 숨기므로, 기권보다 훨씬 나쁩니다.
12. 비슷한 사안, 같은 사건: 흔한 말이 이웃을 만든다
⑤ 사안 묶기는 질문이 또 다릅니다. '같은 것인가'가 아니라 '함께 볼 만한가'입니다. 사실탐색기 화면의 '비슷한 사안'은 처음에 두 사안이 공유하는 낱말을 세는 방식으로 이웃을 골랐는데, '센터' 같은 두 글자 흔한 말이 엉뚱한 사안을 이어 붙였습니다. 가족센터 건립 사안 옆에 치매안심센터와 디자인진흥센터가 나란히 뜨는 식입니다. 그래서 지금 규칙은 '사안 8개 이하에만 나오는 세 글자 이상 낱말'만 이유로 씁니다.
이 문제는 1972년 카렌 스파크 존스가 IDF로 풀려던 바로 그 문제입니다. 많은 문서에 나오는 말일수록 두 문서를 가르는 힘이 약합니다. '8개 이하'라는 이진 규칙을 연속적인 IDF 무게로 바꾸고, 공유한 조각의 정보량 합이 모자라면 '비슷한 사안 없음'이라고 답하게 하면 같은 원리가 더 일반적으로 작동합니다. 아래에서 '금정구 가족센터 건립'을 골라 보세요.
'비슷한 사안 없음'이 정답일 수 있다는 점이 중요합니다. 추천 화면은 빈칸을 싫어해서 무엇이든 채우고 싶어지지만, 공적 기록 탐색기에서 엉뚱한 이웃은 '이 두 일이 관련 있다'는 거짓 주장이 됩니다.
같은 사건 묶기는 한 단계 더 어렵습니다. 코어닷투데이는 같은 사건 묶기 연작에서 하루치 연합뉴스 기사 603건으로 이 문제를 쟀습니다. 그 결론 가운데 이 글과 닿는 것이 셋입니다. 기사 원문끼리 비교하기보다 누가·무엇·언제·어디를 뽑은 사건 레코드끼리 비교하는 편이 나았고(F1 0.848), '이 둘은 합치지 말 것'이라는 금지 조건이 로컬 모델을 구했으며, 사건 사이의 관계는 이행적이지 않았습니다. A와 B가 같은 이야기이고 B와 C가 같은 이야기여도 A와 C는 아닐 수 있습니다. 2026년 KDD에 실린 뉴스 스트림 벤치마크(사건 605개, 문서 15,354건)도 사건별 사실 요약을 넣으면 묶기 성능이 최대 4.37% 오른다고 보고해, 같은 방향을 독립적으로 확인했습니다.
다른 시스템은 이 문제를 어떻게 풀까요. 에이전트 기억 엔진들의 소스를 열어 보면 유사도의 선택이 그대로 보입니다.
Graphiti(Zep)는 엔티티 이름을 문자 3-gram 자카드 0.9 이상에서만 자동으로 합칩니다. 그런데 정규화 단계에서 [a-z0-9' ] 밖의 글자를 모두 공백으로 바꿉니다. 한글 이름은 이 단계에서 글자가 지워져 흐릿한 비교 경로를 타지 못하고, 정확 일치가 아니면 곧바로 LLM 호출로 넘어갑니다. 영어를 전제로 한 정규화 한 줄이 한국어 사용자에게는 비용과 예측 불가능성으로 돌아옵니다. 사실 충돌 판단은 같은 두 엔티티 사이의 간선만 후보로 좁힌 뒤 임베딩·키워드 검색과 작은 LLM으로 하고, 무효화는 '나중 날짜가 이긴다'는 날짜 비교입니다(코어닷투데이의 Graphiti 한국어 실측 참고).
Mem0은 새 기억과 가장 비슷한 기존 기억을 찾아 LLM에게 '추가·수정·삭제·그대로' 중 하나를 고르게 합니다(2025년 논문). 고정 문턱이 없는 대신, 한 개발자 블로그는 추출 단계에서 범위를 한정하는 단서('주말에만'·'작년까지' 같은)가 떨어지면 아직 유효한 기억이 지워질 수 있다고 지적했습니다.
SemEval-2025 과제 7(이미 팩트체크된 주장 찾기)에서는 단일 언어 기준 상위 10개 안 정답률 0.96까지 나왔습니다. 기준선끼리 비교하면 BM25(0.81)가 영어 중심 임베딩 GTR-T5(0.73)를 이겼지만 다국어 E5(0.86)에는 졌고, 가장 흔한 승리 공식은 어려운 오답을 섞은 대조 학습이었습니다. 다만 한국어는 학습·검증 데이터에만 있고 시험 데이터에는 없었습니다.
세 사례가 말하는 것은 같습니다. 유사도는 '무엇을 같은 것으로 볼 것인가'라는 판단을 숫자 하나에 숨겨 둡니다. 그 숫자가 어느 언어에서, 어떤 길이의 문자열로, 어떤 정답을 두고 맞춰졌는지 모르면 그 판단을 빌려 쓰는 셈이 됩니다.
13. 2026년, AI는 유사도의 어디에 서야 하나
2026년의 AI는 유사도를 재는 방식 자체를 바꿨습니다. 임베딩은 글자가 하나도 겹치지 않는 두 문장 사이에 다리를 놓고, 판정 모델은 '같은 사건의 다른 단계'처럼 규칙으로 쓰기 어려운 구분을 해냅니다. 동시에 이 글의 사례들은 AI가 유사도의 모든 자리에 서면 안 된다는 것도 보여 줍니다. 자리마다 역할을 나누면 이렇습니다.
오프라인에서 '후보 k개 중 하나 또는 없음' 고르기 (ComEM, COLING 2025)
실시간으로 사람을 합치기
사람이 확인한 별칭표, 같은 회의·직함 규칙
사건·사안
애매한 쌍의 판정, 사건 레코드 뽑기
전체를 한 번에 묶기 (관계가 이행적이지 않다)
결정론 간선(정정 출처·절차·같은 회의) + 금지 조건
평가
시험 질의와 값 쌍을 대량으로 써 주기 (852개 질의를 서브에이전트가 작성)
정답을 스스로 정하기
사람의 검수, 회귀 세트
이 표의 마지막 줄이 2026년에 가장 크게 달라진 점입니다. 예전에는 유사도 문턱 하나를 정하려 해도 라벨 붙은 쌍 수백 개를 사람이 만들어야 했습니다. 이제는 AI가 시험지를 대량으로 쓰고, 사람은 검수와 정답 기준을 맡습니다. 코어닷투데이의 임베딩 실측도 그렇게 만들었습니다. 다만 AI가 쓴 질의는 사람이 실제로 치는 질의보다 어색할 수 있어서(조문 번호를 '열일곱째 조'로 풀어 쓰는 식), 절대 수치보다 모델 사이의 순위 비교에 쓰는 것이 안전합니다.
그리고 AI가 더 강해질수록 기권의 가치가 커집니다. 2026년 6월의 한 연구(「Right Knowledge, Wrong Answer」)는 위키데이터 직위 교체 8,746건으로, 모델이 새 사실을 알고 있는 경우에도 질문 앞에 날짜를 붙이면 최신 사실 선택이 61~81% 회복된다고 보고했습니다(초록 기준). 비슷함을 재는 기계는 언제나 무언가를 가장 비슷하다고 말할 수 있습니다. '이 중에는 없다'고 말할 수 있는 장치는 따로 만들어야 합니다.
14. 실무 체크리스트: 유사도를 쓰기 전에 묻는 일곱 가지
1무엇이 같아야 하나? 같은 대상, 같은 값, 같은 사건, 비슷한 사안 중 어느 질문인지 먼저 적는다. 질문이 넷이면 도구도 넷이다.
2풀 수 있으면 풀어라. 날짜·금액·범위·조문 번호처럼 값으로 풀리는 것은 유사도가 아니라 정규화로 비교한다.
3가장 싼 경로부터. 정확 일치 → 별칭 → 규칙 → 글자 점수 → 임베딩 순서로, 앞 단계가 확실하면 뒤 단계를 부르지 않는다.
4흔한 것은 덜 세라. '센터'·'위원회'·'부산'처럼 흔한 조각은 IDF로 무게를 낮추고, 정보량이 모자라면 '없음'이라 답한다.
5남의 순위표보다 내 시험지. 공개 1위(KURE-v2)가 내 과제 1위가 아니었다. 짧은 이름이면 짧은 이름으로, 내 코퍼스로 잰다.
6섞기와 문턱은 모델과 함께 바꿔라. RRF는 강한 모델을 깎을 수 있고, 코사인 0.6은 모델마다 다른 뜻이다. 접두사는 계약으로 적는다.
7문턱은 사례로 고정하라. 문턱을 바꿀 때는 그 이유가 되는 사례를 회귀 세트에 먼저 넣는다. '1981/1984'는 이제 회귀 사례다.
맺으며: 비슷함은 판단이다
1901년 폴 자카드는 알프스 골짜기 두 곳의 식물 목록을 놓고 '공통 ÷ 전체'를 셌습니다. 그로부터 125년 뒤, 같은 공식이 부산 조례 부칙의 두 시행일을 같은 값으로 묶었습니다. 공식이 틀린 것은 아닙니다. 자카드의 질문은 '두 골짜기의 식물상이 얼마나 겹치는가'였고, 그 질문에는 지금도 좋은 답입니다. 문제는 '두 시행일이 같은 날인가'라는 다른 질문에 같은 공식을 빌려 쓴 데 있었습니다.
유사도의 125년은 더 좋은 숫자를 찾아온 역사이면서, 동시에 '무엇이 같은가'라는 질문을 점점 더 잘게 나눠 온 역사입니다. 소리가 같은 이름(사운덱스), 철자 몇 개 차이(레벤시테인), 같은 단어를 쓰는 문서(벡터 공간), 드문 단어를 공유하는 문서(IDF), 뜻이 같은 문장(임베딩)으로요. 2026년의 임베딩은 놀랍도록 강해서 글자 하나 안 겹치는 질문을 절반쯤은 제자리에 데려다 놓습니다. 그래도 날짜 한 자리, 범위의 표기, 같은 이름의 두 사람 앞에서는 여전히 질문을 다시 물어야 합니다. 이것은 같은 대상인가, 같은 값인가, 같은 사건인가, 아니면 그저 비슷한 사안인가.
사실탐색기의 원칙인 'LLM은 제안하고 코드가 결정한다'는 결국 이 질문을 누가 붙들고 있을지에 대한 답입니다. 비슷함을 재는 일은 기계에게 맡길 수 있습니다. 하지만 무엇을 같다고 볼지는 시스템을 만드는 사람이 정해야 하고, 그 결정은 회귀 사례라는 형태로 남아야 합니다.
참고문헌
유사도의 역사
Podani, J. (2021). The wonder of the Jaccard coefficient: from alpine floras to bipartite networks. Flora Mediterranea 31 (SI): 105–123. PDF — 자카드 1901a 각주, 첫 값 0.5619
Jaccard, P. (1912). The distribution of the flora in the alpine zone. New Phytologist 11(2): 37–50.
Dunn, H. L. (1946). Record Linkage. American Journal of Public Health 36(12): 1412–1416.
Newcombe, H. B. et al. (1959). Automatic linkage of vital records. Science 130: 954–959. 재인쇄본 PDF
Fellegi, I. P., Sunter, A. B. (1969). A Theory for Record Linkage. JASA 64(328): 1183–1210. PDF
Levenshtein, V. I. (1965/1966). Binary codes capable of correcting deletions, insertions, and reversals. Math-Net.ru
Winkler, W. E. (1990). String Comparator Metrics and Enhanced Decision Rules in the Fellegi-Sunter Model of Record Linkage. PDF
Luhn, H. P. (1957). A Statistical Approach to Mechanized Encoding and Searching of Literary Information. IBM J. R&D 1(4). PDF
Salton, G., Wong, A., Yang, C. S. (1975). A Vector Space Model for Automatic Indexing. CACM 18(11): 613–620.
Dubin, D. (2004). The Most Influential Paper Gerard Salton Never Wrote. Library Trends 52(4). IDEALS
Spärck Jones, K. (1972). A statistical interpretation of term specificity and its application in retrieval. Journal of Documentation 28(1). PDF · BCS 인터뷰(2007)
Broder, A. Z. (1997). On the resemblance and containment of documents. PDF
Manku, G. S., Jain, A., Das Sarma, A. (2007). Detecting Near-Duplicates for Web Crawling. WWW 2007. PDF
Deerwester, S. et al. (1990). Indexing by Latent Semantic Analysis. JASIS 41(6). PDF
Harris, Z. (1954). Distributional Structure. Word 10(2–3). · Firth, J. R. (1957) 인용 출처: Quote Investigator
Mikolov, T., Yih, W., Zweig, G. (2013). Linguistic Regularities in Continuous Space Word Representations. NAACL · Nissim, M. et al. (2020). Fair is Better than Sensational. arXiv 1905.09866
Reimers, N., Gurevych, I. (2019). Sentence-BERT. arXiv 1908.10084
Karpukhin, V. et al. (2020). Dense Passage Retrieval. EMNLP 2020. · Khattab, O., Zaharia, M. (2020). ColBERT. SIGIR 2020.
Cormack, G. V., Clarke, C. L. A., Büttcher, S. (2009). Reciprocal Rank Fusion. SIGIR '09. PDF
Muennighoff, N. et al. (2023). MTEB. EACL 2023. arXiv 2210.07316 · Kusupati, A. et al. (2022). Matryoshka Representation Learning. arXiv 2205.13147
Chen, J. et al. (2024). M3-Embedding (BGE-M3). Findings of ACL 2024. arXiv 2402.03216
한국어 자원
Ham, J. et al. (2020). KorNLI and KorSTS. Findings of EMNLP 2020. arXiv 2004.03289 · Park, S. et al. (2021). KLUE. arXiv 2105.09680