
#LLM
57개의 포스트
[특집] 스키마 없이 9억 노드 — AutoSchemaKG 깊이 읽기: 사건 노드, 개념화, ATLAS, 그리고 초록의 숫자가 표에서 뜻하는 것
지식 그래프는 40년 동안 분류표(스키마)를 사람이 먼저 그리고 그 칸에 사실을 채우는 방식으로 만들어졌습니다. ACL 2026에 실린 AutoSchemaKG(홍콩과기대·화웨이)는 순서를 뒤집어, LLM으로 개체와 '사건'을 먼저 뽑고 뽑힌 것마다 개념 꼬리표를 붙여 스키마를 끌어냅니다. 문서 5천만 건에서 노드 13.6억·엣지 86억짜리 그래프 ATLAS가 나왔고 GPU 78,400시간이 들었습니다. 이 글은 Cyc·Freebase·OpenIE·허스트 패턴으로 이어지는 역사부터 논문의 세 아이디어를 풀고, 표를 한 줄씩 다시 읽습니다. 사건 노드는 문단 정보의 89%를 지켰지만(개체 트리플은 35%), '12~18% 향상'은 BM25 대비였고 같은 검색기의 원본 그래프와는 비기거나 졌으며, 개념 노드가 보탠 점수는 1점 안팎, '92% 정렬'은 정답률이 아니라 BERTScore였습니다. 코어닷투데이가 한국어 위키백과 25문단에 같은 프롬프트를 돌린 실측과, 저장소 이슈·IBM의 재현·저자들의 후속 논문까지 함께 정리했습니다.
[특집] 본문에 없는 사실은 받지 않는다 — 앵커로 묶은 지식 그래프 추출 AEVS, 그리고 출처를 글자 단위로 다는 시대
LLM에게 문서에서 사실(주어·관계·목적어)을 뽑게 하면 '세상에서는 참이지만 본문에는 없는' 트리플이 섞입니다. 2026년 3월 MDPI Computers에 실린 AEVS는 본문에서 개체·관계구·값과 그 글자 위치를 먼저 찾아 '앵커'로 삼고, 트리플을 앵커로만 조합한 뒤, 원소마다 원문으로 되돌려 검증합니다. 세 데이터셋에서 학습 모델과 EDC를 넘었고, 남은 오류의 95% 이상은 개체가 아니라 관계였습니다. 다만 'EDC 대비 최대 +0.152'는 서로 다른 모델끼리의 비교였고(같은 모델이면 +0.007~+0.074), 공개 코드는 논문과 달리 셋 중 둘만 맞아도 통과시켜 논문 자신의 환각 예시를 모두 받아들였습니다. 코어닷투데이가 로컬 모델로 한국어 30문장과 WebNLG 20문장을 다시 돌려 보니, 스키마를 준 '그냥 묻기'에서는 환각이 나오지 않았고 AEVS는 한국어에서 오히려 재현율을 잃었습니다(F1 0.80 대 0.72). 그냥 묻기에서 스키마를 빼면 F1이 0.18로 무너져, 향상의 상당 부분이 스키마 몫일 수 있음을 보여 줍니다. 검증 LLM은 본문에 충실한 반사실 트리플을 '현실과 다르다'며 거부하기도 했습니다. 역사, 논문의 주요 그림과 표, 2026년의 '글자 단위 출처' 도구들까지 함께 읽습니다.
AI에게 '얼마나 확신해?'라고 묻지 마세요 — 0.85는 계기판이 아니라 문장이다
LLM에게 확신도를 물으면 언제나 그럴듯한 숫자가 나옵니다. 앰루트 조시의 짧은 글은 그 숫자가 측정이 아니라 '다음에 올 법한 글자'라고 지적해 해커뉴스 첫 화면에 올랐습니다. 1950년 브라이어의 일기예보 채점에서 2017년 '현대 신경망은 과신한다', GPT-4의 RLHF 보정 붕괴, 2025년 '왜 언어 모델은 환각하는가'까지 확신도 연구 75년을 따라가고, 코어닷투데이가 대화형 모델 5개와 판정 모델 4개에 한국어 객관식 598문항과 SimpleQA 200문항을 직접 물어 확신도의 정체를 쟀습니다. 작은 모델은 '정말?' 한마디에 답의 55%를 뒤집으면서 확신도를 91에서 95로 올렸고, 앞에 쓴 한 문장에 확신도가 53점 움직였습니다. 반면 GPT-6.1 Sol과 Claude Sonnet 5.5의 숫자에는 분명한 정보가 있었는데, 같은 '90'이 모델마다 다른 뜻이었습니다. 판정 모델과 기록 기반 규칙이 내놓는 확률까지 비교합니다. 인터랙티브 6개와 삽화 10장, 논문 그림 6장.
코드를 쓰는 시간이 사라지면 무엇이 남나 — 「왜 Common Lisp가 이제 최고의 언어인가」 특집
2026년 10월, 「왜 Common Lisp가 이제 최고의 프로그래밍 언어인가」라는 짧은 글이 해커뉴스와 X를 뒤흔들었습니다. 논거는 단순합니다. LLM이 코드를 쓰는 시간은 몇 초로 줄었는데, 빌드하고 재시작하고 크래시 로그를 읽는 시간은 그대로이니, 이제는 피드백 루프의 길이가 개발 속도를 정한다는 것입니다. 그리고 돌아가는 프로그램을 멈추지 않고 함수를 바꾸고, 에러가 나면 죽는 대신 멈춰서 선택지를 내미는 언어가 이미 1994년에 완성돼 있었다는 것입니다. 이 글은 1960년 매카시의 논문에서 시작해 Lisp 머신, 조건 시스템, ANSI 표준, 폴 그레이엄의 Viaweb까지 글이 기대는 네 가지 성질의 역사를 되짚고, 아키텍처를 그림으로 풀고, 해커뉴스의 반론과 2026년 데이터(저자원 언어 벤치마크, 토큰 가격, npm 공급망 사고)로 주장을 검증합니다. 브라우저에서 도는 미니 Lisp, 피드백 루프 시뮬레이터, 조건 시스템 체험, 토큰 계산기, 연표 위젯 5개와 일러스트 8장.
8,722개의 트윗에서 41개의 사건을, 라벨 없이 — RAG와 구조 엔트로피로 사건의 생몰을 추적하다 (WWW 2026)
2012년 10월 29일 하루치 트윗 8,722건 안에 41개의 사건이 섞여 있다. 정답 라벨도, 사건 개수도 모르는 채로 이것을 갈라내고, 나아가 각 사건이 어느 날 태어나 어떻게 변하고 언제 끝났는지까지 추적할 수 있을까. 2026년 1월 arXiv에 올라와 The Web Conference 2026에 채택된 RagSEDE는 지난 5년간의 표준이던 '표현 후 군집'을 버리고, 사건 지식베이스를 만들어 LLM에게 직접 묻는 방식으로 이 문제를 다시 푼다. 그리고 1996년 DARPA의 TDT부터 2016년 구조 정보이론까지 30년치 아이디어가 여기서 만난다. 논문 전체를 뜯고, 공개된 코드를 열어 논문과 다른 여섯 군데를 찾고, 인터랙티브 위젯 8종으로 직접 만져 본다.
RAG는 생각보다 단순합니다 — 벡터 DB 없이 시작하는 6단계 레시피
RAG를 어렵게 느끼는 이유는 개념이 아니라 '처음부터 임베딩·벡터 DB·청킹을 다 갖춰야 한다'는 오해 때문입니다. 오픈북 시험 비유로 RAG의 뼈대를 3분 안에 잡고, 라이트하우스 뉴스레터가 정리한 6가지 RAG 레시피를 전문 검색부터 전체 임베딩까지 계단처럼 올라가며 살펴봅니다. 실제 시스템의 60%는 검색기 하나와 프롬프트 한 장으로 충분합니다. 우리 팀에 맞는 출발점을 고르는 진단 도구와, 같은 질문을 세 방식으로 검색해 보는 놀이터를 함께 담았습니다.
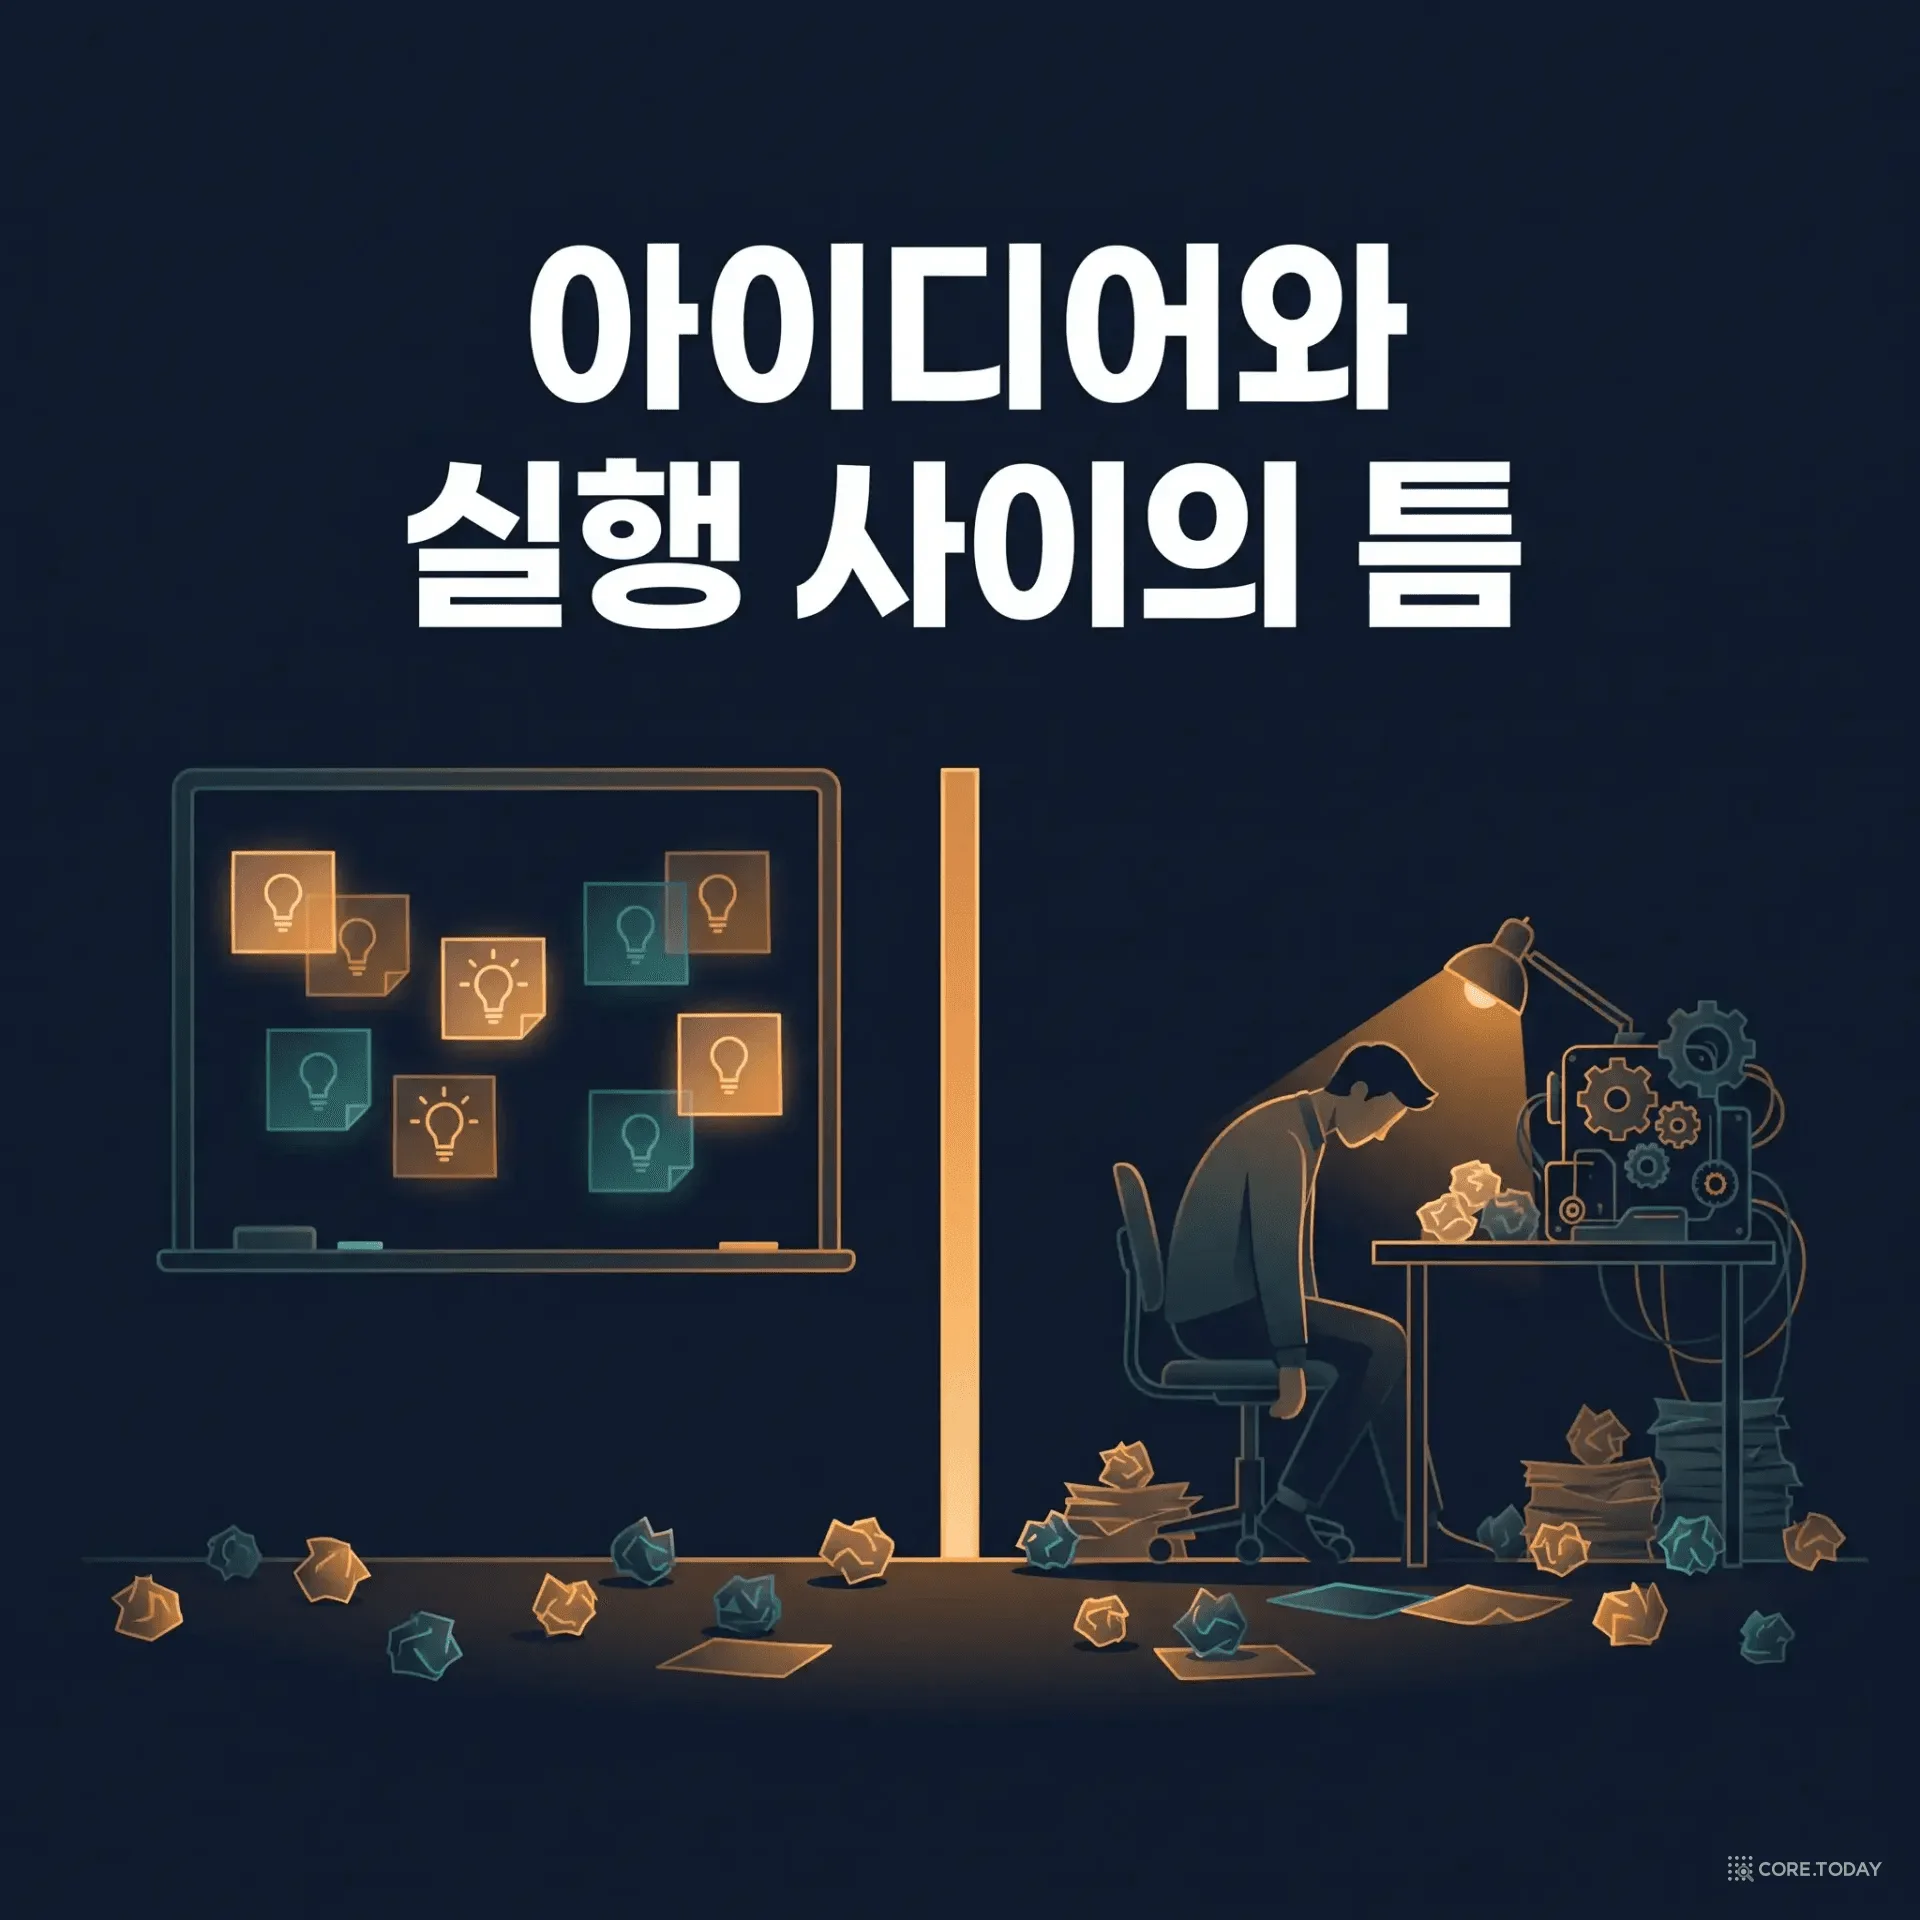
아이디어는 새로운데 왜 실행하면 무너지나 — Ideation–Execution Gap과 AI 브레인스토밍의 함정
79명의 전문가가 블라인드로 평가하자 AI 아이디어가 인간보다 '더 새롭다'는 결과가 나왔다. 1년 뒤 같은 팀이 43명에게 그 아이디어를 각각 100시간씩 실제로 구현하게 했다. 점수는 역전됐다. 왜 종이 위의 참신함은 실행을 견디지 못하는가 — 두 연구의 수치를 따라가며, AI 브레인스토밍을 도입한 조직이 겪는 일과 그 처방을 정리한다.
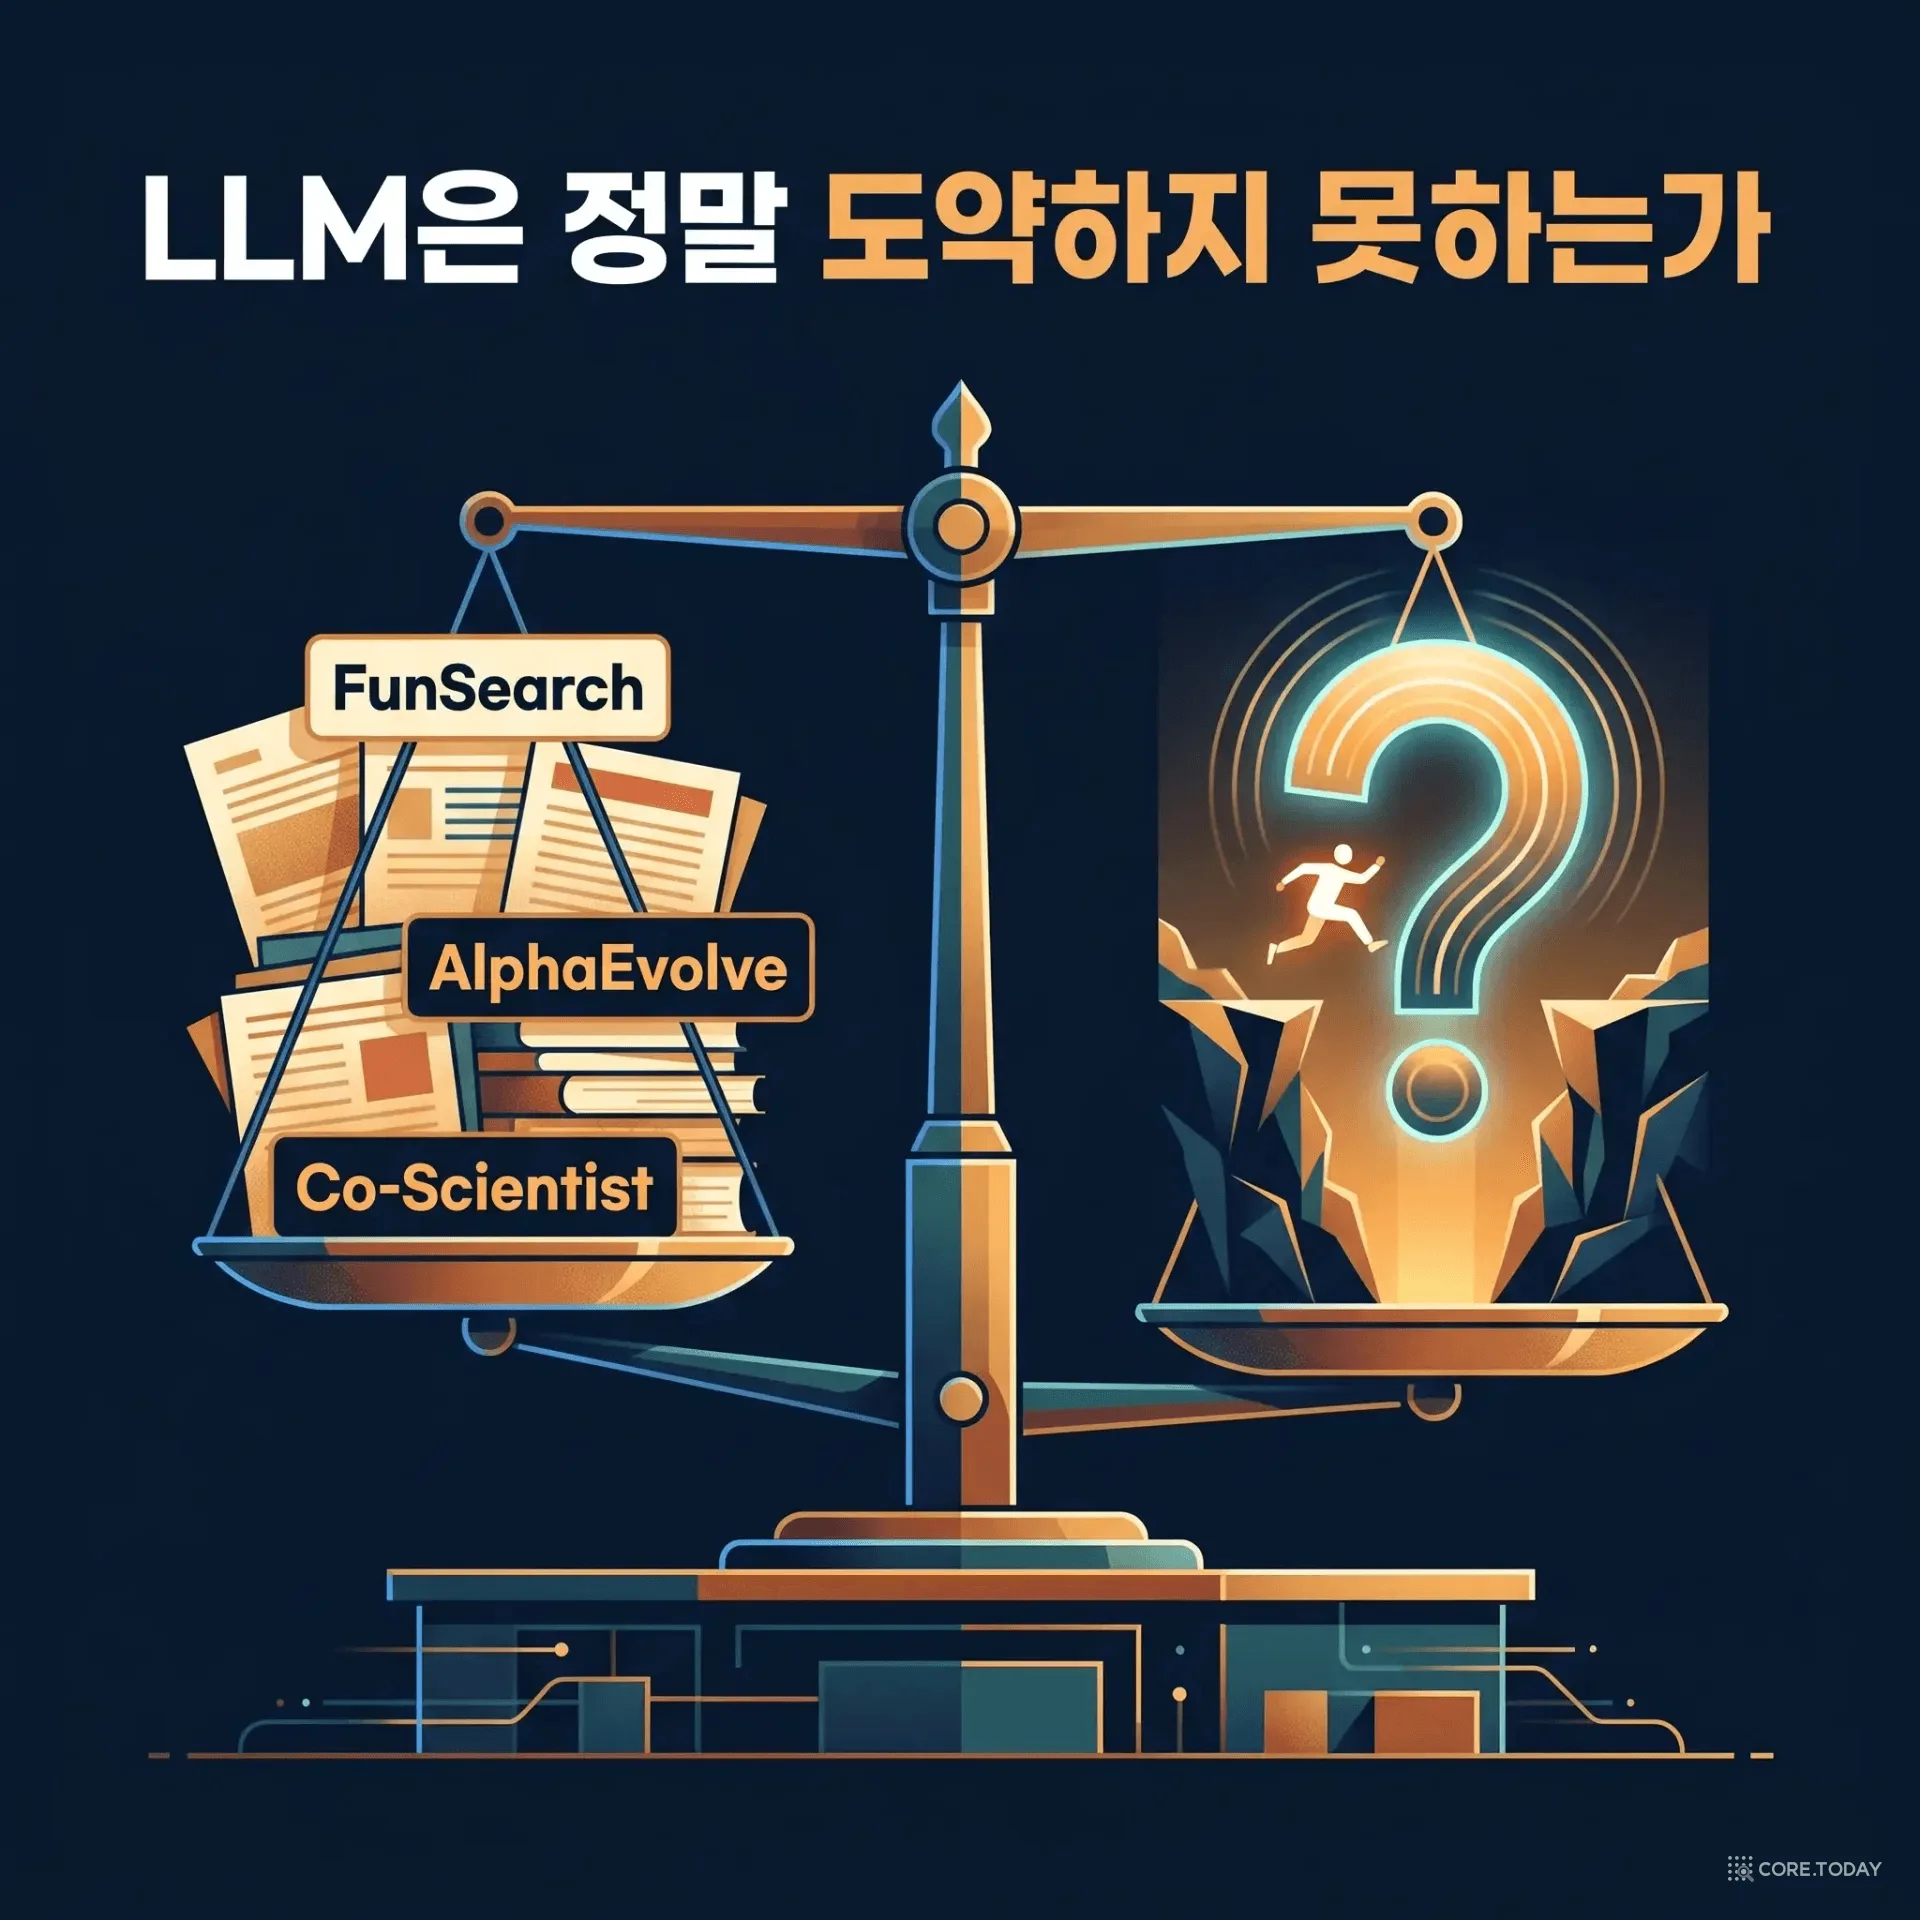
LLM은 정말 도약하지 못하는가 — 「LLMs can't jump」를 증거의 법정에 세우다
「LLMs can't jump」는 고립된 비관론이 아니다. 과학철학의 조작적 가추, 기호 접지 문제, '쉬운 문제와 어려운 문제', 그리고 2026년까지 쏟아진 실증 연구가 한 점에서 만난다. 6,749명의 과학자가 평가한 25,139세트의 아이디어, 43명이 100시간씩 실행해 본 결과, cap set과 48회 행렬곱을 찾아낸 FunSearch·AlphaEvolve, 그리고 '신체 없는 가추'라는 정면 반론까지 — 찬성과 반례를 다섯 단계의 저울에 올린다.
프롬프트 테크닉 지도 — 실무 이슈 12가지로 다시 읽는 프롬프트·컨텍스트·이미지 엔지니어링
블로그 44편을 다시 읽으며 발견한 사실 — 실무에서 부딪히는 문제는 결국 12가지로 수렴하고, 테크닉은 그 처방이다. 프롬프트에서 컨텍스트, 하니스, 루프, 그리고 이미지 프롬프트까지. 증상별 처방전과 글로벌 필독 자료 10선을 한 장의 지도로 묶었다.
보이지 않는 서명: AI가 쓴 글에 숨겨진 초록 단어들
2026년 8월, Claude가 쓰는 문장에 아무도 볼 수 없는 서명이 붙기 시작했다. 원리는 2023년 메릴랜드대 논문 한 편에서 나왔다. 단어를 초록과 빨강으로 나누고 초록 쪽을 슬쩍 밀어주는 것 — 그게 전부다. 744년 된 아이디어가 어떻게 로짓 위로 옮겨왔고, 무엇을 증명할 수 있으며, 무엇은 끝내 증명하지 못하는지 끝까지 따라간다.
LLM은 도약하지 못한다: 아인슈타인의 낙서 한 장이 2026년 AI에게 던진 질문
구글 딥마인드 톰 자하비의 ICML 2026 포지션 페이퍼 「Position: LLMs can't jump」를 정면으로 뜯어본다. 아인슈타인이 친구에게 그려 보낸 낙서 한 장에서 출발해, 왜 오늘의 AI가 정리를 증명하면서도 전제를 만들지 못하는지, 벌컨 행성과 엘리베이터 사고실험과 2026년의 월드 모델 경쟁까지 — 5개의 인터랙티브와 함께 끝까지 따라간다.
프롬프트 엔지니어링 실전 매뉴얼: 이 글 하나로 끝내는 68쪽 백서 완전 해설
구글이 낸 68쪽짜리 프롬프트 엔지니어링 백서를, 개념이 왜 생겼는지부터 오늘 당장 쓰는 법까지 풀어 정리했습니다. Temperature·Top-K·Top-P가 실제로 무슨 일을 하는지, 예시 하나가 왜 문장 열 줄보다 강한지, 프롬프트를 코드처럼 관리한다는 게 무슨 뜻인지 — 인터랙티브 실험실 4개와 함께 직접 만져보며 이해할 수 있게 만들었습니다.