검색 평가Recall@kMRRnDCGMAP정밀도재현율크랜필드TREC풀링MS MARCOBEIRMTEBRBP재정렬기리랭커RAG 평가LLM 판정자Ko-StrategyQA통계적 유의성NLP 기초
정답이 3위에 있으면 몇 점일까 — 1955년 도서관에서 2026년 RAG까지, 검색을 채점하는 법 Recall@k·MRR·nDCG (특집)
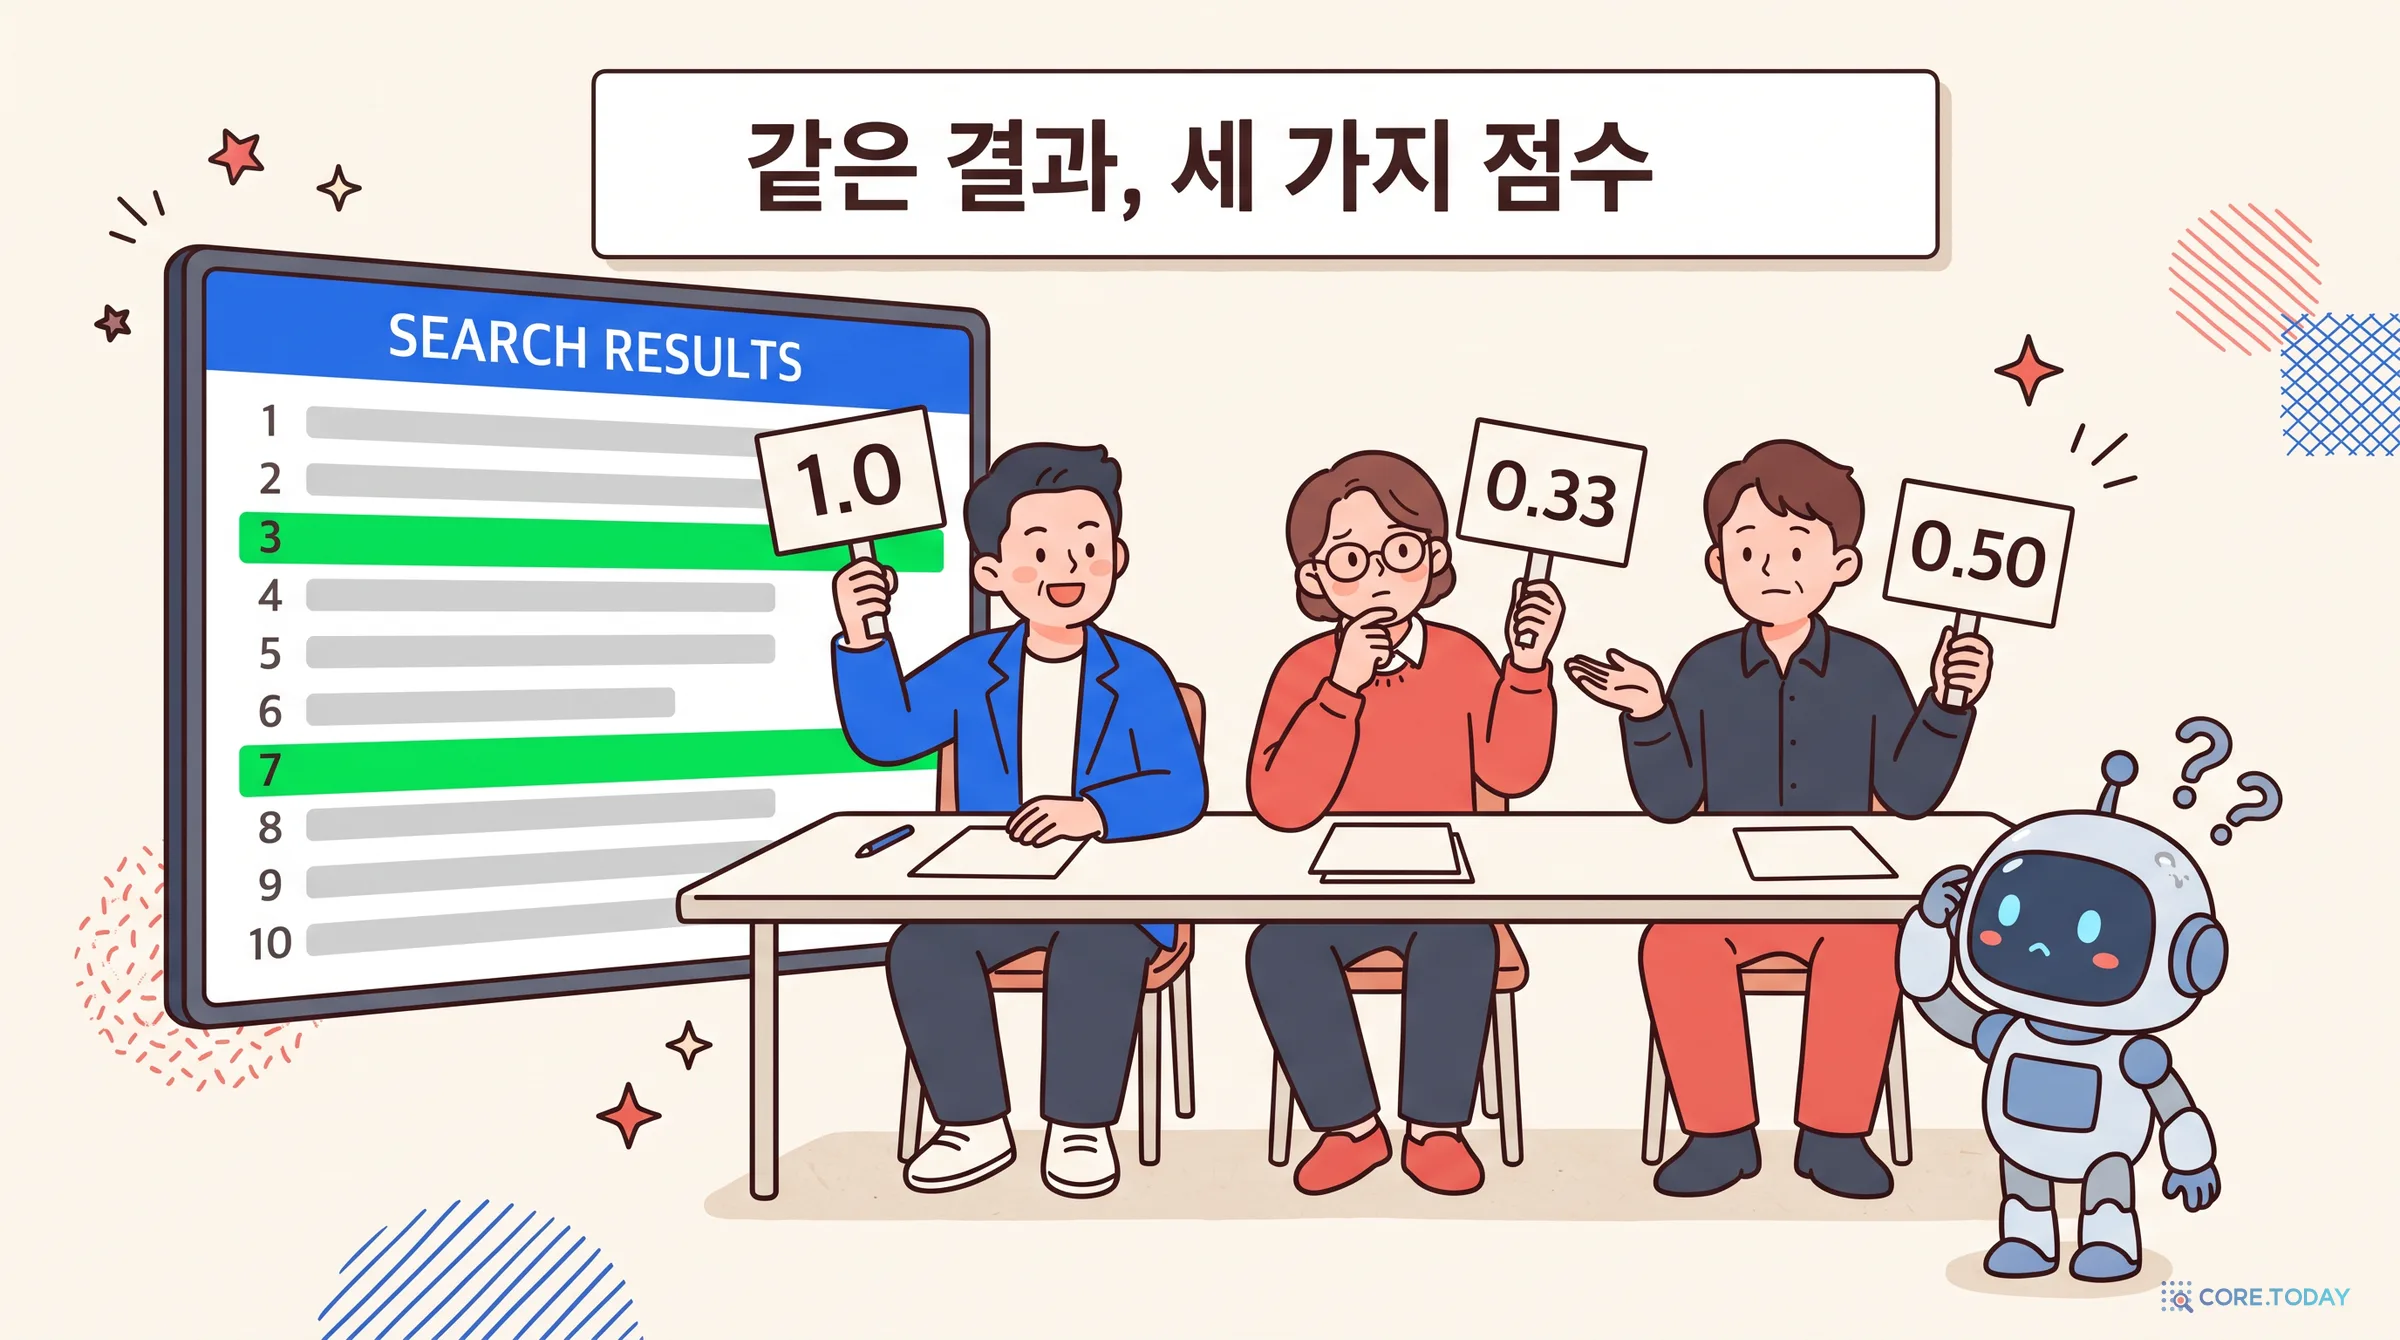
검색 결과 10개 중 정답이 3위에 하나 있다. Recall@10은 1.0, MRR은 0.33, nDCG@10은 0.5다. 같은 결과인데 점수가 셋이다. 지표마다 ‘사용자가 결과를 어떻게 보는가’에 대한 가정이 다르기 때문이다. 이 글은 1955년 재현율의 등장과 1960년대 크랜필드 실험에서 시작해, TREC의 풀링, 질의응답의 MRR, 등급과 할인의 nDCG, MS MARCO와 BEIR를 거쳐 LLM이 정답을 판정하는 2026년까지 검색 평가의 역사를 따라간다. 그리고 한국어 검색기 10개를 Ko-StrategyQA 질문 592개로 직접 재서 보여 준다. 지표를 바꾸면 순위가 바뀌고, 재정렬기는 MRR을 올리지만 Recall@30은 한 치도 못 올리며, 질문 50개로 비교하면 결론이 뒤집힐 확률이 15%다. 정답표의 구멍을 LLM 판정자로 메워 보려 했더니, 판정자는 쉬운 검증은 통과했지만 정작 헷갈리는 문서에서는 후했다. 인터랙티브 위젯 7종, 코어닷투데이 실측, 삽화 13장.
2차 세계대전이 끝나자 과학 논문이 폭발적으로 늘었다. 도서관 카드 목록만으로는 감당할 수 없었다. 1950년대에 펀치 카드와 초기 전자 기계로 문헌을 찾는 시스템들이 등장했고, 곧 질문이 하나 생겼다. 이 시스템은 얼마나 잘 찾는가?
1955년 미국 웨스턴리저브 대학의 켄트(Allen Kent)·베리·루어스·페리는 학술지 American Documentation에 실은 논문에서 두 가지 기준을 제안했다. 하나는 찾아야 할 문헌 가운데 실제로 찾은 비율, 곧 재현율(recall)이다. 다른 하나는 찾아온 문헌 가운데 쓸모 있는 것의 비율이었다. 이들은 이것을 ‘pertinency’라고 불렀다. 몇 년 뒤 이 개념은 ‘relevance’라는 이름으로 바뀌어 퍼진다.
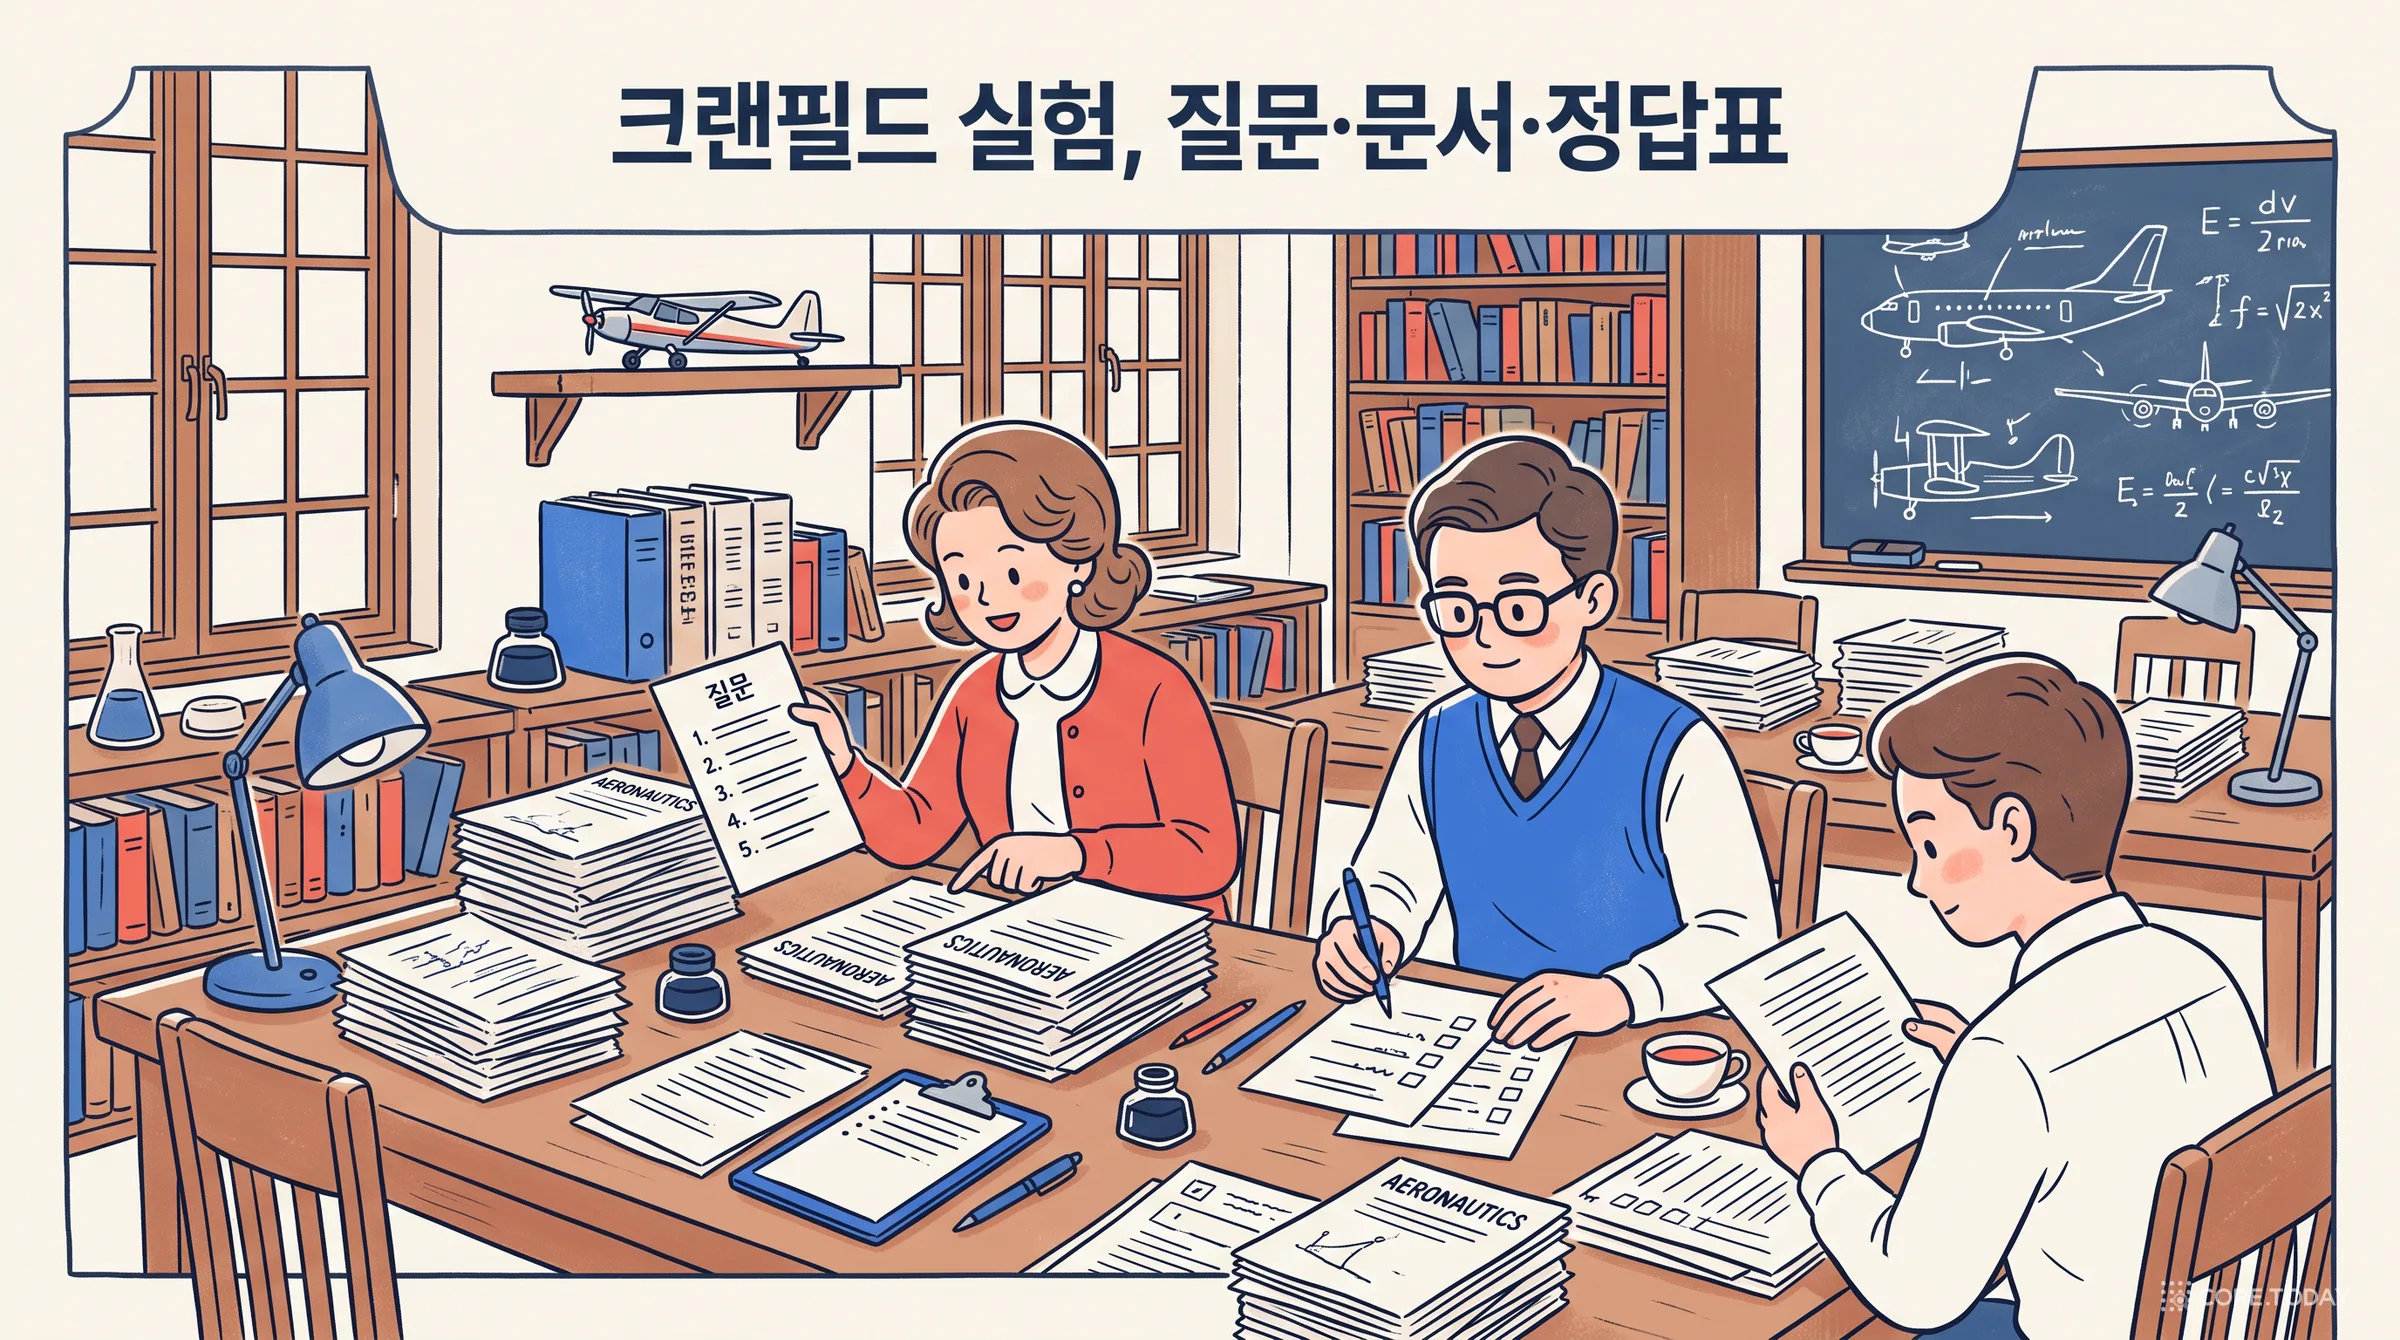
검색 평가의 틀을 만든 사람은 영국 크랜필드 항공대학의 사서 시릴 클레버던(Cyril Cleverdon)이다. 당시 도서관계는 어떤 분류·색인 체계가 가장 좋은지를 두고 다투고 있었다. 저마다 자기 방식이 낫다고 주장했지만 근거는 없었다.
클레버던의 생각은 단순했다. 같은 시험지로 시험을 보게 하자.
문서 묶음을 고정한다. 2차 실험(1960년대 중반)에서는 항공공학 논문 1,400편이었다.
질문을 모은다. 논문 저자들에게 ‘이 논문을 쓸 때 품었던 질문’을 받았다. 쓸 만한 질문이 279개였고, 결과는 그중 221개로 보고했다.
정답표를 만든다. 질문마다 어떤 문서가 관련 있는지 사람이 미리 판정해 둔다.
이 세 가지를 갖추면 어떤 색인 방식이든 같은 조건에서 비교할 수 있다. 오늘날 우리가 쓰는 모든 검색 벤치마크, BEIR도 MTEB도 사내 RAG 평가 세트도 이 틀 그대로다. 그래서 이 방식을 지금도 크랜필드 패러다임이라고 부른다.
결과는 도서관계를 놀라게 했다. 1966년 보고서의 결론은 이랬다.
가장 좋은 성능은 단일 용어를 쓰는 여덟 가지 색인 언어 묶음에서 나왔다.
정교한 개념 분류 체계보다 논문에 나온 단어를 그대로 색인하는 방식이 나았다. 오늘날 BM25 같은 단어 기반 검색이 여전히 강한 기준선인 이유를 60년 전에 이미 보여 준 셈이다.
1.3 ‘정밀도’라는 말이 생긴 날
클레버던은 처음에 ‘찾아온 문서 중 관련 문서의 비율’을 relevance ratio라고 불렀다. 그런데 이 말이 자꾸 ‘관련성’ 자체와 헷갈렸다. 1966년 보고서에 따르면, 1964년 워싱턴 회의에서 이 혼동이 거듭되자 클레버던은 용어를 바꾸기로 했다. 후보는 ‘acceptance rate’와 ‘precision ratio’였고, ‘precision ratio’가 골라졌다. 정밀도(precision)라는 이름은 이렇게 생겼다.
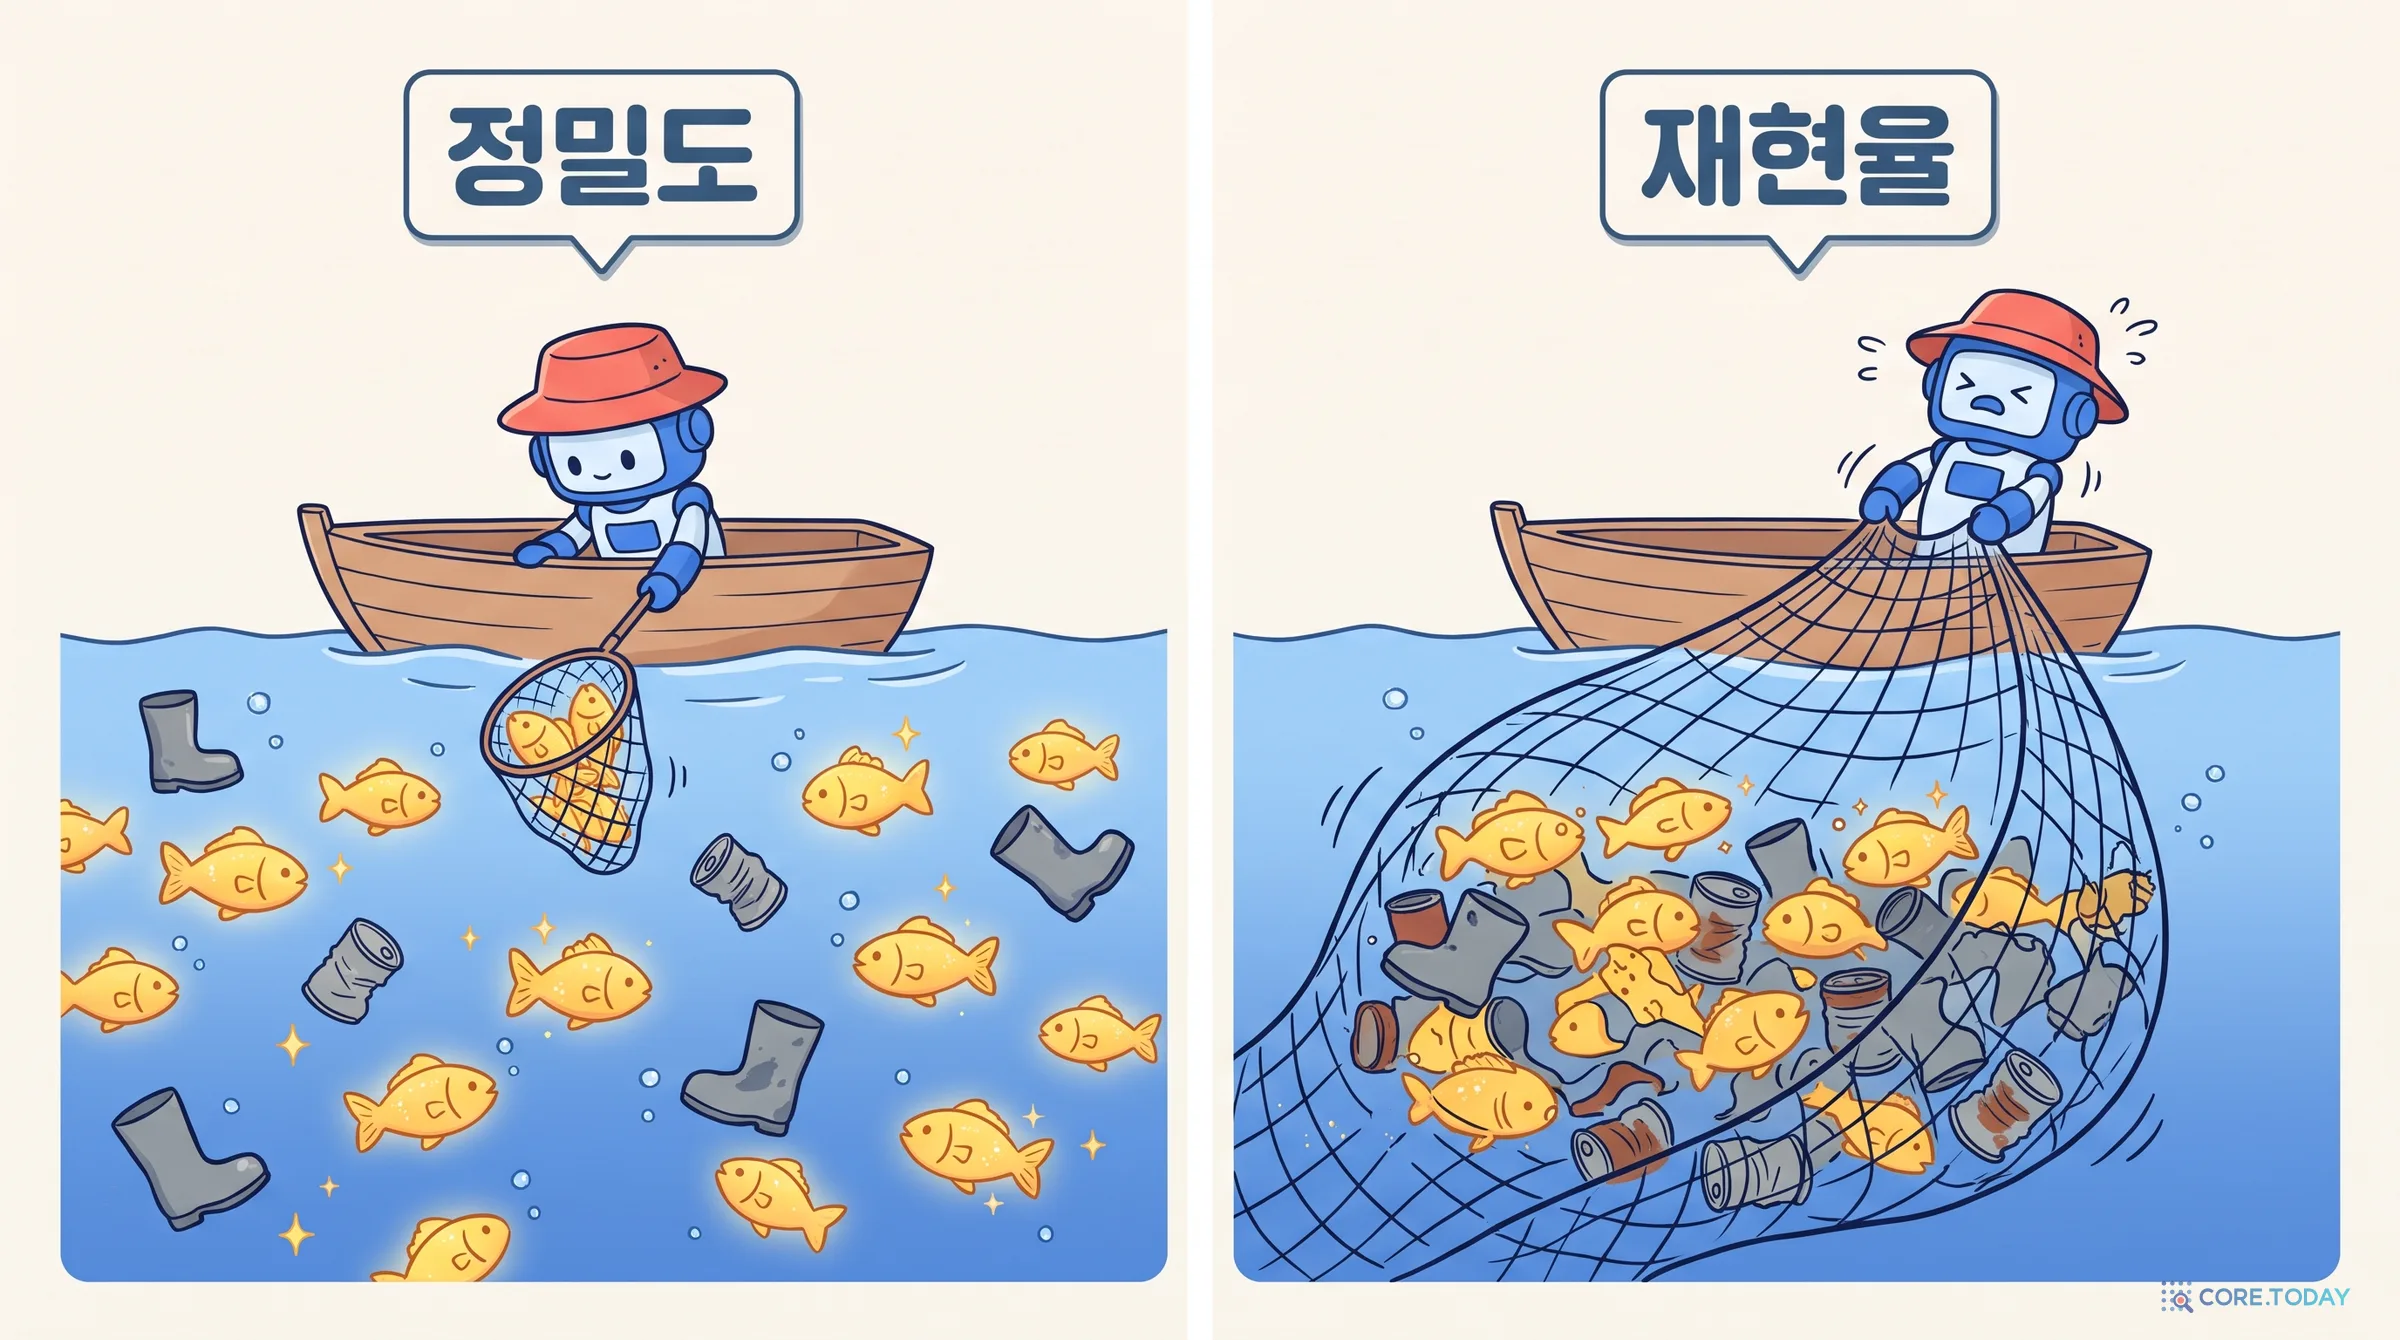
그물로 비유하면 쉽다. 작은 그물을 던지면 잡힌 것은 거의 다 금붕어지만(정밀도가 높음) 호수의 금붕어 대부분을 놓친다(재현율이 낮음). 큰 그물을 던지면 금붕어를 다 잡지만 장화와 깡통도 함께 올라온다. 크랜필드 실험은 이 관계를 데이터로 확인했다.
재현율과 정밀도 사이에는 반비례 관계가 있다는 것이 결정적으로 드러났다.
1979년 케이스 판 레이스베르헌(C. J. van Rijsbergen)은 교과서 『정보 검색(Information Retrieval)』에서 두 값을 하나로 합치는 E 척도를 정의했다. ‘재현율을 정밀도보다 β배 중요하게 여기는 사용자’를 위한 값이다. 여기서 F=1−E로 놓으면 오늘날의 F 척도가 되고, β=1이면 두 값의 조화 평균인 F1이 된다.
F1=정밀도+재현율2⋅정밀도⋅재현율
2부. 순위가 생기다 — P@k, Recall@k, 평균 정밀도
2.1 집합에서 순위로
크랜필드 시절의 검색은 ‘찾았다/못 찾았다’로 나뉘는 집합을 돌려줬다. 하지만 컴퓨터가 문서마다 점수를 매기게 되자 결과는 순위가 매겨진 목록이 됐다. 이제 질문이 바뀐다. 정답을 몇 개 찾았느냐가 아니라, 정답을 몇 위에 놓았느냐다.
가장 쉬운 방법은 목록을 k위에서 자르고 그 안에서 정밀도와 재현율을 재는 것이다.
P@k (Precision at k): 상위 k개 중 정답의 비율.
Recall@k: 전체 정답 중 상위 k개 안에 든 비율.
Hit@k: 상위 k개 안에 정답이 하나라도 있으면 1, 없으면 0.
이 셋은 k위 안에서의 순서를 보지 않는다. 정답이 1위에 있든 10위에 있든 Recall@10은 같다.
2.2 평균 정밀도 — 정답이 나올 때마다 잰다
순서를 반영하는 첫 번째 아이디어가 평균 정밀도(Average Precision, AP)다. 목록을 위에서부터 내려가다가 정답을 만날 때마다 그 자리에서의 정밀도를 재고, 그 값들을 전체 정답 수로 나눈다.
AP=R1k:k위가정답∑P@k
여기서 R은 전체 정답 수다. 목록에 끝내 나오지 않은 정답은 0으로 더해진다. 예를 들어 정답이 2위와 5위에 있고 전체 정답이 3개라면 (1/2+2/5)/3=0.30이다. 정답을 위로 올릴수록, 그리고 빠뜨리지 않을수록 AP가 오른다. 질문 전체에 대해 AP를 평균한 값이 MAP(Mean Average Precision)다.
아래 실험실에서 직접 채점해 보자. 결과를 누르면 관련도가 바뀌고, 지표 여섯 개가 각자의 방식으로 반응한다.
몇 가지를 눌러 보면 지표의 성격이 드러난다.
‘정답이 10위에 하나’로 바꾸면 Recall@10은 여전히 1.0이지만 RR은 0.1로 떨어진다.
k를 9로 줄이면 같은 목록인데 거의 모든 지표가 0이 된다. 컷오프 k도 지표의 일부다.
‘목록 밖에 있는 정답’을 늘리면 P@k는 그대로인데 Recall과 AP와 nDCG가 떨어진다. 이 셋은 못 찾은 정답까지 알아야 계산할 수 있다. 이것이 7부의 복선이다.
1990년대 초, 크랜필드 방식은 벽에 부딪혔다. 문서가 수십만 개로 늘자 모든 문서에 정답 여부를 매길 수가 없게 됐다.
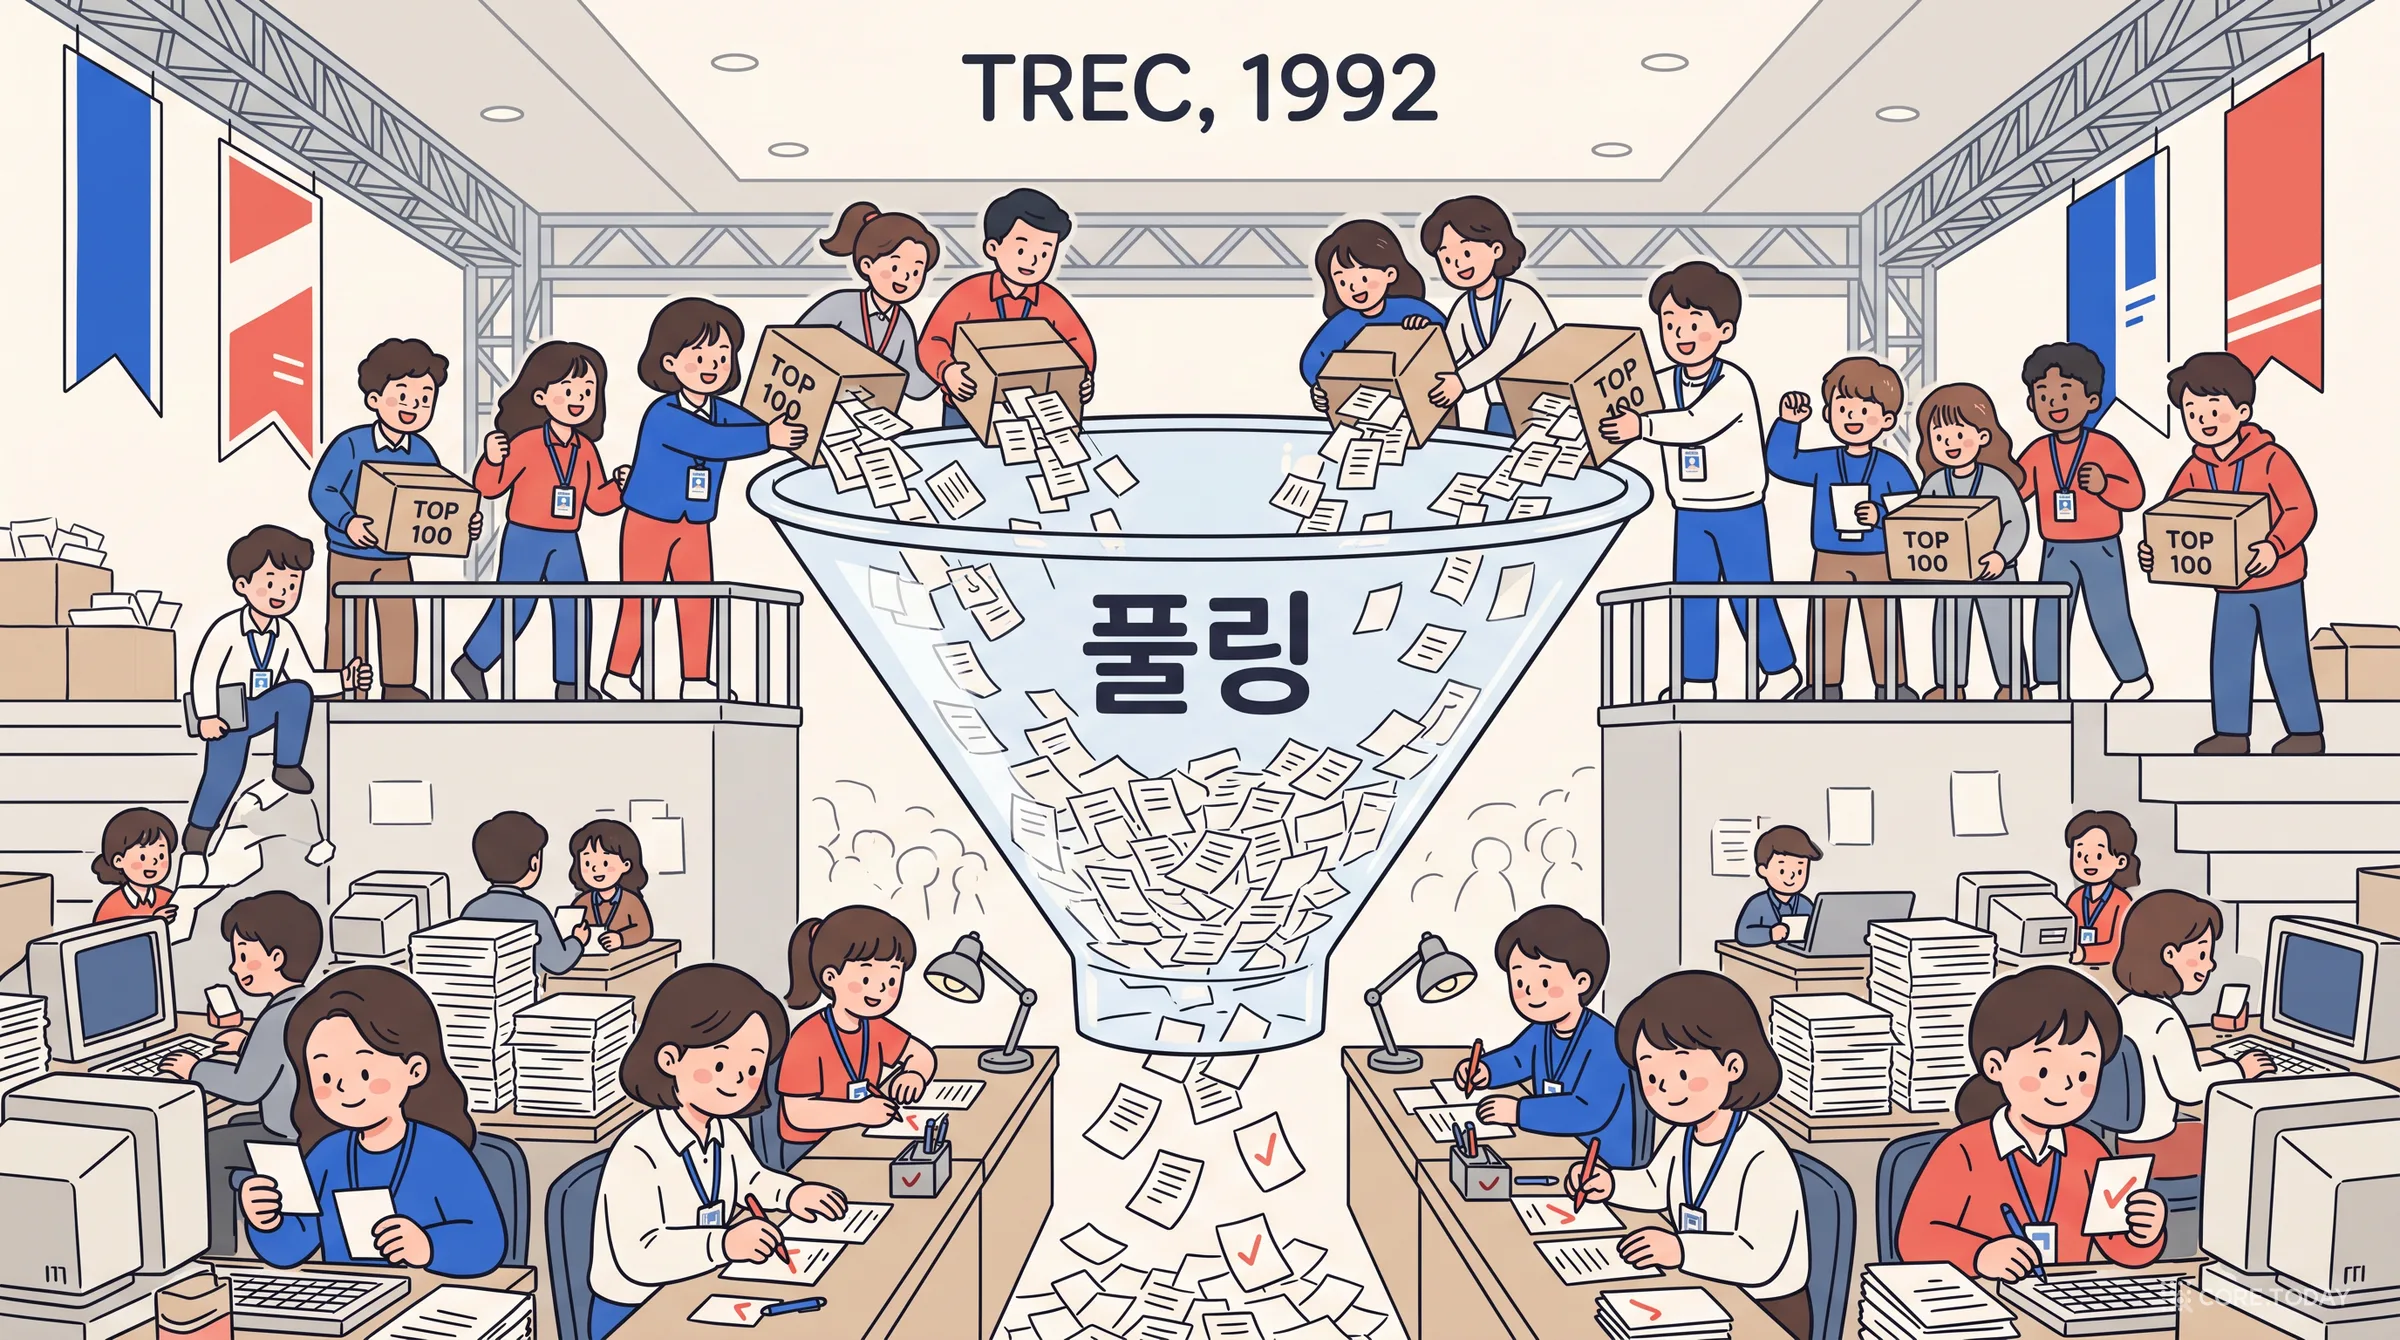
1992년 미국 국립표준기술연구소(NIST)의 도나 하먼(Donna Harman)이 TREC(Text REtrieval Conference)을 열었다. 첫해 TREC-1의 규모는 이랬다.
항목
TREC-1 (1992)
참가 시스템
25개
문서
742,611개 (약 2GB)
질문(토픽)
100개
전부 판정하면
7,400만 번 이상
실제 판정
질문당 평균 1,462개
비결은 풀링(pooling)이었다. 참가 시스템들이 낸 결과에서 상위 100개씩만 모아 한 바구니(풀)에 담고, 그 안의 문서만 사람이 판정한다. 풀에 들지 못한 문서는 모두 ‘관련 없음’으로 간주한다. 여러 시스템이 각자 다른 방식으로 찾았으니 정답이라면 어딘가에는 걸렸으리라는 가정이다. 풀링은 1975년 스파크 존스와 판 레이스베르헌이 제안한 아이디어였고, TREC이 이를 대규모로 실현했다.
TREC-1은 정밀도-재현율 곡선을 주로 썼고, 이듬해 TREC-2부터 순위 전체를 한 숫자로 요약하는 평균 정밀도가 대표 지표가 됐다. 이후 20년 가까이 MAP는 검색 연구의 표준 성적표였다. 이 풀링 가정이 나중에 어떤 문제를 낳는지는 7부에서 다룬다.
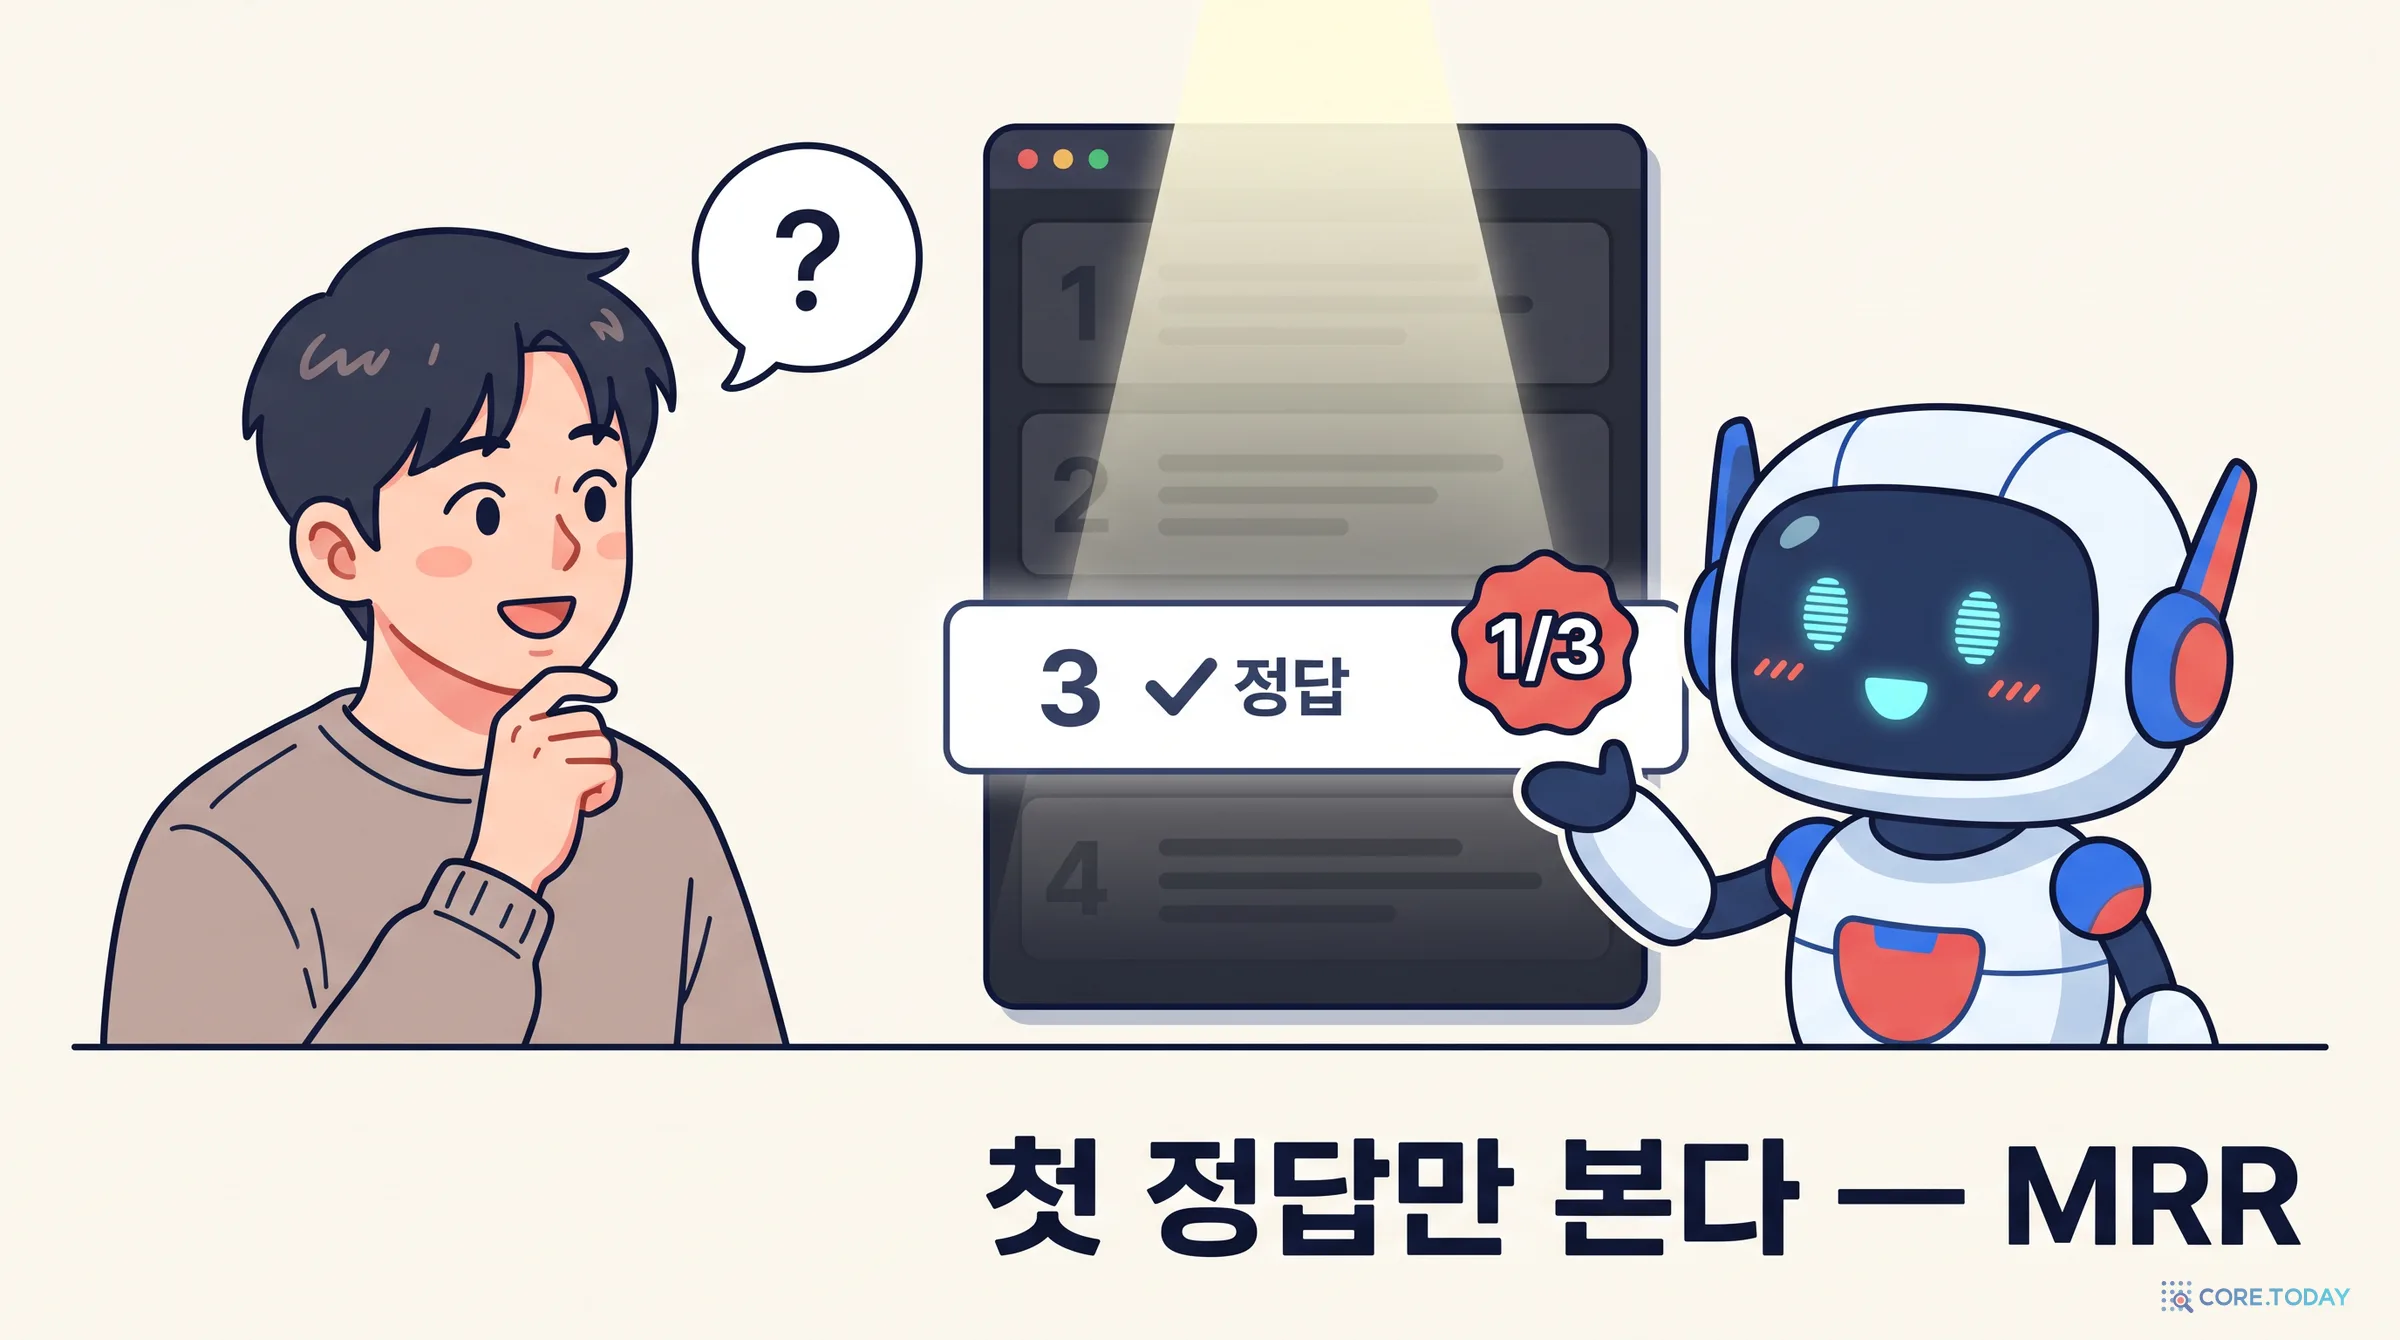
“에베레스트산의 높이는?” 같은 질문에는 문서 목록이 필요 없다. 정답 하나면 된다. 사용자는 위에서부터 읽다가 답을 찾으면 멈춘다. 그렇다면 첫 정답이 몇 위에 있느냐만 재면 된다.
역순위(Reciprocal Rank, RR)는 첫 정답 순위의 역수다. 1위면 1, 2위면 1/2, 3위면 1/3이고, 끝내 없으면 0이다. 질문 전체에 대해 평균한 값이 평균 역순위(Mean Reciprocal Rank, MRR)다.
MRR=∣Q∣1q∈Q∑rankq1
이 지표를 널리 알린 것은 1999년 TREC-8 질의응답(QA) 트랙이다. 시스템은 질문마다 답 후보 다섯 개를 냈고, 첫 정답의 순위 역수로 채점받았다. 20개 기관이 참가했는데 그중에는 서울대학교도 있었다. 사실 ‘mean reciprocal rank’라는 말은 1996년 TREC-5의 다른 트랙 보고서에 이미 나온다. 정답 문서가 하나뿐인 과제에서는 RR이 AP와 같아진다는 점도 그때 지적됐다.
주최 측은 약점도 숨기지 않았다. 답을 다섯 개만 보므로 RR이 가질 수 있는 값은 0, 0.2, 0.25, 0.33, 0.5, 1 여섯 개뿐이다. 그리고 두 번째 정답부터는 점수에 아무 영향이 없다.
3.2 MS MARCO — 정답이 하나뿐인 데이터
MRR이 다시 주목받은 것은 2016년 마이크로소프트의 MS MARCO 덕분이다. 빙 검색 질문 약 101만 개와 웹 문단 884만 개로 만든 이 데이터는 신경망 검색기를 학습시킬 만큼 컸다. 대신 질문당 정답 문단이 대개 하나뿐이었다. 논문도 정답 표시가 ‘불완전하다고 봐야 한다’고 적었다.
정답이 하나뿐이면 ‘몇 위에 놓았나’만 의미가 있다. 그래서 공식 저장소는 평가 지표로 MRR@10을 정했다. 10위 안에 정답이 없으면 0점이다. 2018~2020년 신경망 검색의 발전은 대부분 이 MRR@10 숫자로 보고됐다.
2019년 TREC 딥러닝 트랙은 같은 MS MARCO 문서를 쓰되 다른 길을 택했다. 질문 수를 43개로 줄이는 대신, 질문마다 수많은 문단을 네 단계 등급으로 꼼꼼히 판정하고 nDCG@10으로 쟀다. 주최 측은 두 방식의 시스템 순위가 대체로 일치한다고 보고하면서도, 촘촘한 판정으로 잰 nDCG 쪽이 ‘더 타당하다’고 적었다. 정답 하나만 맞히도록 최적화된 검색기는 튼튼하지 않을 수 있다는 이유였다.
3.3 MRR의 평균을 내도 될까
MRR에는 측정 이론상의 논쟁도 있다. 2017년 독일의 노르베르트 푸어(Norbert Fuhr)는 「IR 평가에서 흔한 실수들」이라는 글에서 ‘MRR을 계산하지 말라’고 썼다. 그의 예는 이렇다.
시스템 A는 질문 세 개에서 첫 정답을 1위, 2위, 4위에 놓았다. MRR은 (1+0.5+0.25)/3=0.58이다.
시스템 B는 세 질문 모두 2위에 놓았다. MRR은 0.5다.
MRR로는 A가 이기지만 평균 순위로는 A가 2.33위, B가 2위로 B가 낫다. 푸어는 1위와 2위 사이의 차이(0.5)와 2위와 3위 사이의 차이(0.17)가 같은 간격이 아니므로 평균을 내는 것 자체가 문제라고 봤다. 이후 페란테·페로·푸어(2021)는 지표를 등간격 척도로 바꾸면 ‘어느 시스템이 유의하게 다른가’에 대한 판단이 평균 25% 바뀐다고 보고했다.
반론도 만만치 않다. 알리스테어 모팻(2022)은 지표의 값은 사용자가 얻는 효용을 나타내는 것이고, 1위와 2위의 효용 차이가 2위와 3위의 차이보다 큰 것은 오히려 현실을 반영한다고 맞섰다. 아직 결론이 난 논쟁은 아니다. 실무에서 기억할 점은 하나다. MRR은 첫 정답이 맨 위에 올라오는 것을 강하게 보상하는 지표이고, 그 성질이 원하는 것과 맞을 때 써야 한다.
“청년 월세 지원 자격”을 물었을 때 자격 요건이 정확히 나온 공고문과, 청년 정책을 두루 소개하는 기사는 둘 다 ‘관련 있다’. 하지만 가치가 같지는 않다. 정밀도도 AP도 MRR도 이 둘을 똑같이 1로 친다.
핀란드 탐페레 대학의 칼레르보 예르벨린(Kalervo Järvelin)과 야나 케캘레이넨(Jaana Kekäläinen)은 2000년 SIGIR 학회에서 이 문제에 답했다. 관련도를 0~3의 등급으로 매기고, 순위대로 등급을 더해 가는 누적 이득(Cumulated Gain, CG)을 제안했다. 여기에 순위가 내려갈수록 이득을 깎는 할인을 더한 것이 DCG(Discounted Cumulated Gain)다.
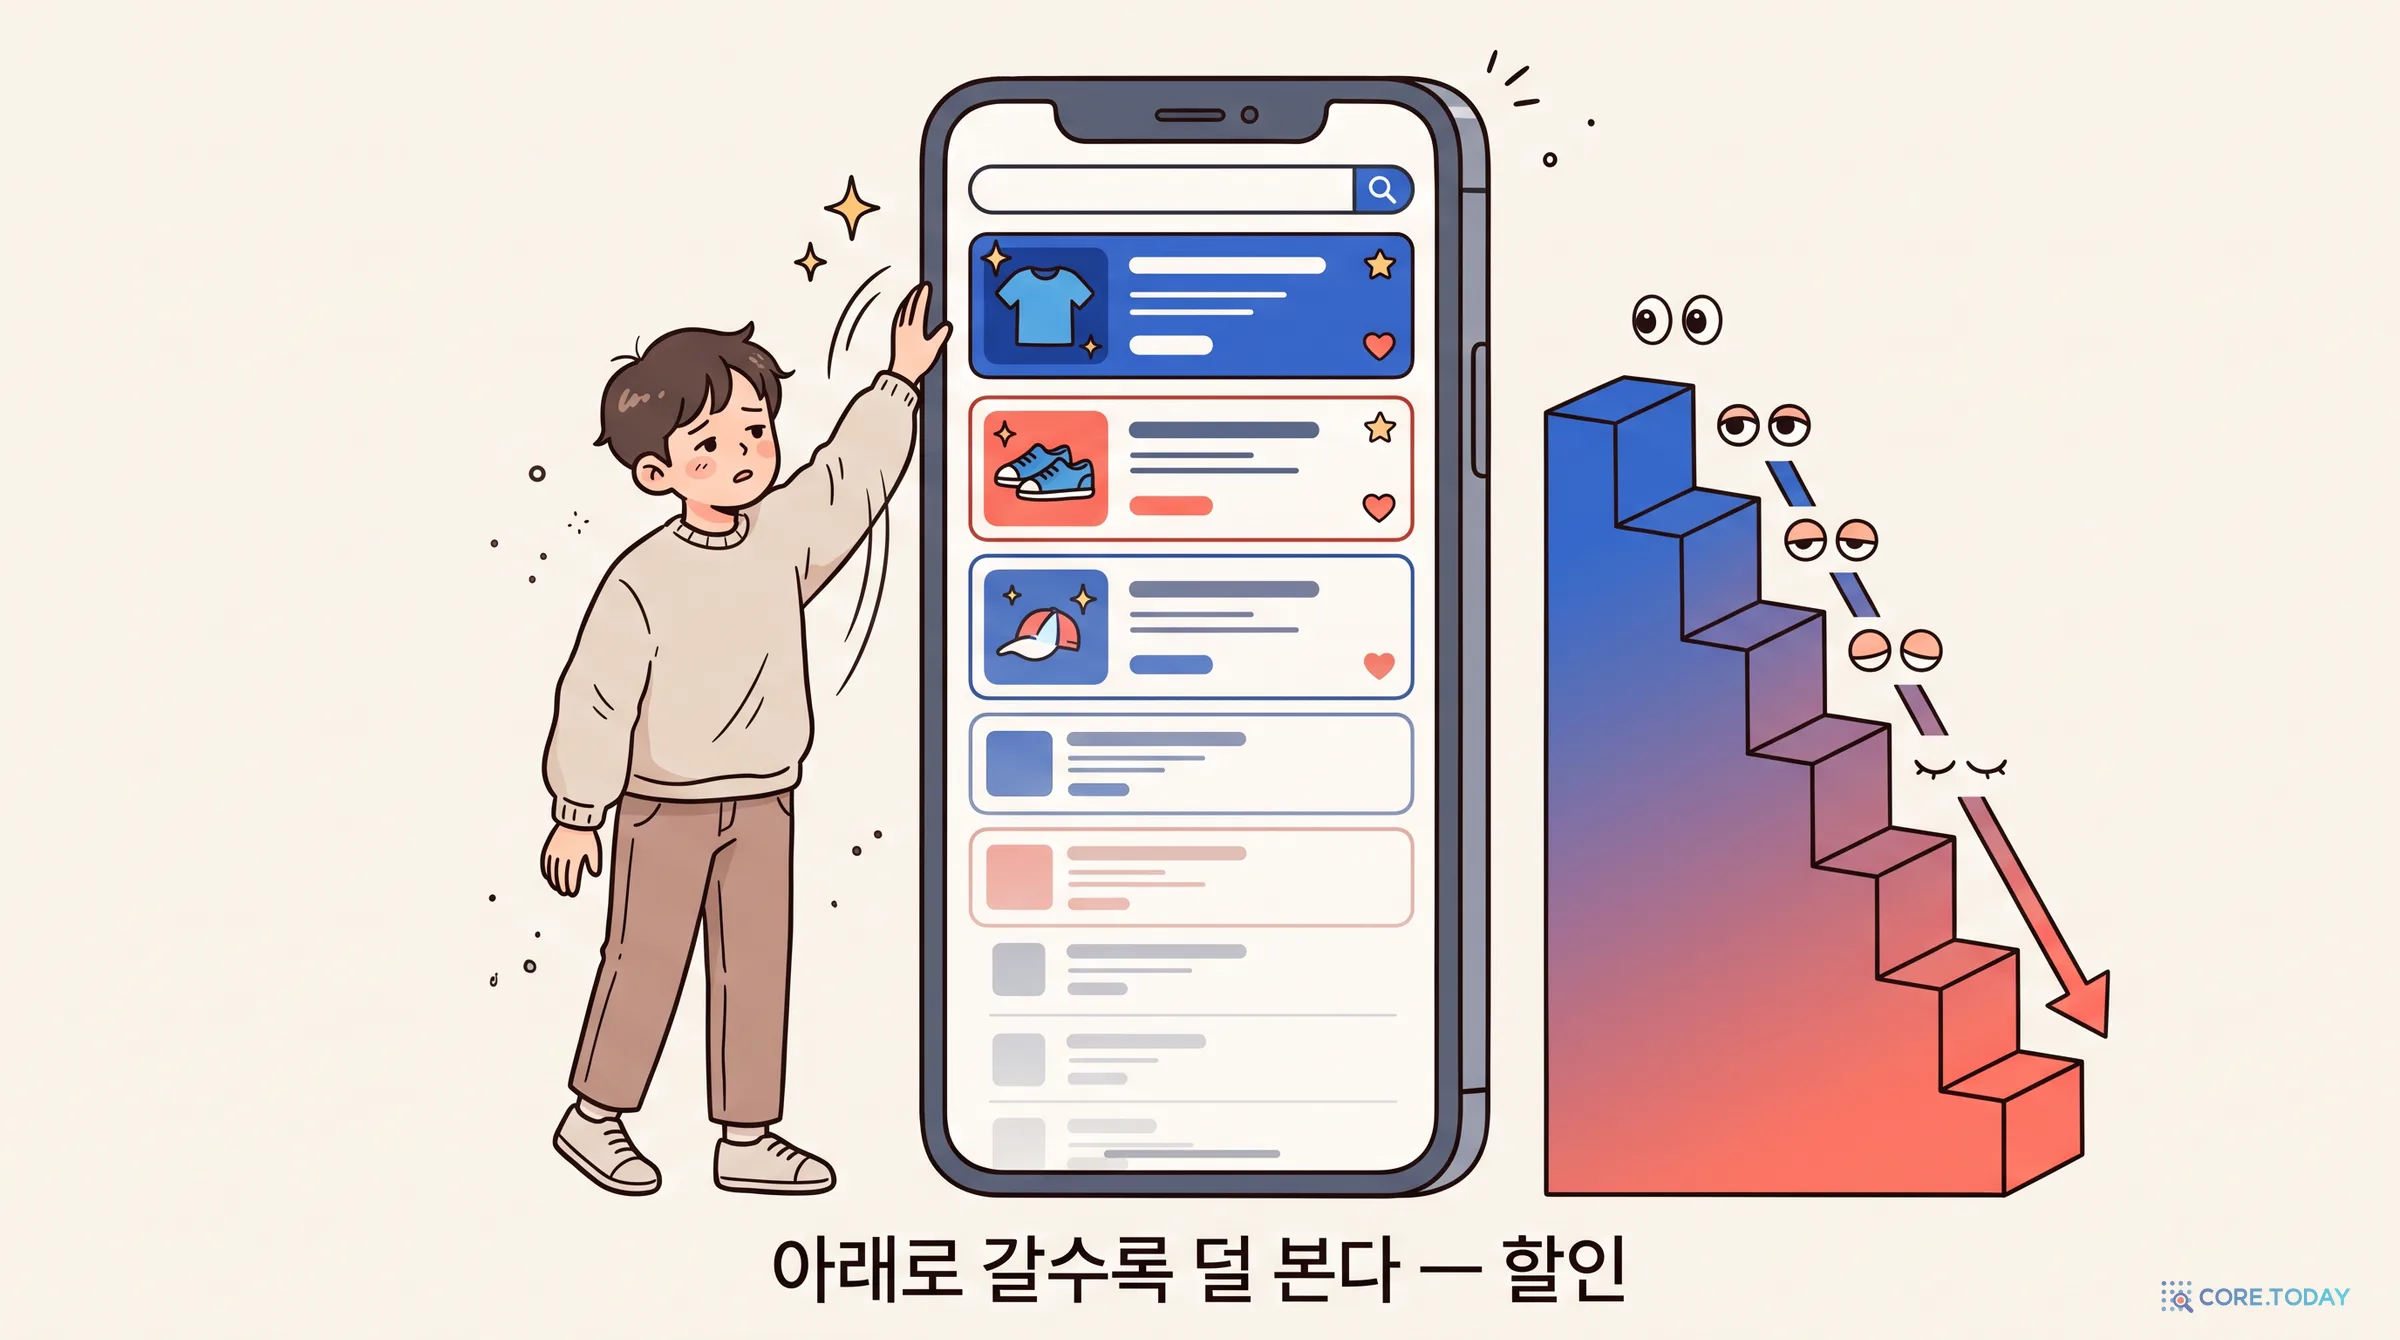
사용자는 아래로 내려갈수록 결과를 덜 본다. 그렇다고 10위의 정답을 0으로 치는 것은 지나치다. 예르벨린과 케캘레이넨은 순위의 로그로 나누는 부드러운 할인을 택했다. 2002년 ACM TOIS 논문에서 정리한 원래 식은 로그의 밑 b보다 앞선 순위에는 할인을 하지 않는다. 밑이 클수록 ‘사용자가 적어도 그 순위까지는 본다’는 가정이다.
같은 2002년 논문은 DCG를 이상적인 순서, 곧 정답을 등급 순으로 맨 위에 늘어놓았을 때의 DCG로 나누어 0~1 사이로 맞춘 값도 제시했다. 이것이 nDCG(normalized DCG)다. 질문마다 정답 수가 달라도 같은 눈금에서 비교할 수 있게 된다.
오늘날 가장 흔히 쓰는 nDCG@k는 이렇게 생겼다.
DCG@k=i=1∑klog2(i+1)gi,nDCG@k=IDCG@kDCG@k
gi는 i위 문서의 이득이다. 등급을 그대로 쓰기도 하고, 높은 등급을 더 크게 보상하려고 2등급−1을 쓰기도 한다. 이 지수형 이득과 log2(i+1) 할인을 함께 쓰는 형태는 2005년 마이크로소프트의 크리스 버지스 등이 순위 학습 모델 RankNet 논문에서 쓴 것이다. 그래서 같은 ‘nDCG@10’이라도 라이브러리마다 이득 공식이 달라 값이 조금씩 다를 수 있다. 정답이 0과 1로만 매겨진 데이터에서는 두 공식이 같아진다.
할인 1/log2(i+1)은 1위 1.00, 2위 0.63, 3위 0.50, 10위 0.29다. 들어가며의 ‘정답이 3위에 하나’가 nDCG@10 0.5를 받는 이유다.
4.3 지표 속에 숨은 사용자
모든 순위 지표는 ‘사용자가 결과를 어떻게 보는가’에 대한 모형을 품고 있다. 이 생각을 정면으로 꺼낸 것이 2008년 멜버른 대학의 모팻과 조벨이 제안한 순위 편향 정밀도(Rank-Biased Precision, RBP)다.
RBP의 사용자는 결과를 하나 볼 때마다 확률 p로 다음 결과로 넘어가고, 1−p로 멈춘다. p는 그 사용자의 인내심이다.
RBP=(1−p)i=1∑∞ripi−1
모팻과 조벨은 p=0.5를 ‘몹시 성급한’ 사용자라고 불렀다. 이 사용자는 평균 두 개만 본다. p=0.95면 평균 스무 개를 본다. 이듬해 야후의 샤펠 등은 사용자가 만족스러운 결과를 찾으면 멈춘다는 ‘폭포 모형’에서 ERR(Expected Reciprocal Rank)을 만들었고, 이 지표가 실제 클릭 기록과 더 잘 맞는다고 보고했다.
아래 위젯에서 정답 하나를 1위부터 20위까지 옮겨 보자. 지표마다 점수가 떨어지는 모양이 다르다.
RR은 가장 가파르다. 정답이 2위로만 내려가도 점수가 반이 된다. nDCG는 완만해서 10위에서도 1위의 29%를 준다. Recall@10은 10위까지 평평하다가 11위에서 절벽처럼 떨어진다. 어느 곡선이 옳은지는 누가 결과를 읽느냐에 달려 있다. 이 질문은 8부에서 다시 나온다.
5부. 코어닷투데이 실측 — 한국어 검색기 10개, 지표 일곱 개
5.1 실험 설계
이론은 여기까지다. 이제 한국어 검색기를 직접 재 보자. 데이터는 MTEB 한국어 검색 과제에도 들어 있는 Ko-StrategyQA다. 원본은 2021년 TACL에 실린 StrategyQA로, “아리스토텔레스는 노트북을 썼을까?”처럼 여러 단계의 추론이 필요한 질문을 위키백과 근거 문단과 함께 모은 데이터다. 국내 오픈소스 팀 NomaDamas가 질문과 문단을 DeepL로 번역했고, 이를 검색 벤치마크 형식으로 바꾼 버전을 썼다.
문서: 위키백과 문단 9,251개 (평균 305자)
질문: 개발 세트 592개. 원 질문을 쪼갠 하위 질문이다. 예: “토니 베넷의 중간 이름은 무엇인가요?”
정답표: 질문당 평균 1.93개, 모두 ‘관련 있음(1)’ 한 등급이다. 정답이 하나뿐인 질문이 36%다.
검색기는 세 계열 10개를 골랐다. 한국어 BM25는 토크나이저에 따라 성능이 크게 달라지므로(BM25 토크나이저 편) 세 가지로 나눴다.
문장을 벡터로 바꿔 코사인 유사도로 찾는다. KURE-v1은 고려대학교 연구진(nlpai-lab)이 BGE-M3를 한국어 검색용으로 더 학습한 모델
결합
BGE-M3 + BM25, KURE-v1 + BGE-M3
두 목록을 순위만으로 합치는 RRF(k=60)
재정렬
BGE-M3 → bge-reranker-v2-m3
BGE-M3의 상위 30개를 크로스 인코더가 다시 줄 세운다
검색기마다 질문당 상위 100개를 뽑고, 직접 짠 채점 코드로 지표를 계산했다. 같은 결과를 TREC 공식 채점기(trec_eval의 파이썬 판)로도 계산해 소수 넷째 자리까지 맞는지 확인했다. 한 가지 흥미로운 차이가 있었다. 점수가 똑같은 문서가 여러 개일 때 trec_eval은 문서 ID 순으로 순서를 다시 정한다. 띄어쓰기 BM25처럼 동점이 많은 검색기에서는 이 때문에 MRR이 0.420과 0.425로 갈렸다. 채점기의 구현 세부도 점수를 바꾼다.
5.2 지표를 바꾸면 순위가 바뀐다
결과에서 눈에 띄는 점을 정리하면 이렇다.
① 숫자의 크기는 지표마다 의미가 다르다. 1등 검색기의 P@10은 0.161이다. 얼핏 보면 열 개 중 1.6개만 맞히는 형편없는 검색기 같다. 하지만 질문당 정답이 평균 1.93개뿐이라 P@10의 만점은 0.193이다. 만점 대비로는 83%다. 반대로 Recall@100은 BM25 2-gram도 0.838이라 다들 잘하는 것처럼 보인다. 지표의 값은 데이터의 정답 수와 컷오프 k를 함께 봐야 읽을 수 있다.
② 순위가 지표에 따라 바뀐다. 가장 극적인 예는 BGE-M3에 BM25를 RRF로 섞은 결합이다.
지표
BGE-M3 단독
BGE-M3 + BM25 (RRF)
multilingual-e5-small
P@1
0.757
0.677
0.708
MRR@10
0.812
0.752
0.775
nDCG@10
0.794
0.728
0.751
Recall@100
0.914
0.913
0.890
BM25를 섞자 P@1이 8점 떨어졌다. BM25가 BGE-M3보다 한참 약한데 RRF가 둘을 같은 무게로 합쳤기 때문이다(하이브리드 검색 편에서 본 ‘약한 고리’ 현상과 같다). 그런데 Recall@100은 BGE-M3와 같다. 그리고 가장 작은 임베딩 모델인 e5-small과 비교하면, nDCG@10은 결합이 0.023 낮지만 Recall@100은 0.023 높다. 두 차이 모두 통계적으로 유의했다. 어느 쪽이 더 좋은 검색기인가? 1위 문서 하나만 보여 줄 거라면 e5-small이 낫고, 상위 100개를 재정렬기에 넘길 거라면 결합이 낫다. 질문에 대한 답은 지표가 아니라 시스템의 다음 단계가 정한다.
③ 평균은 두 봉우리를 숨긴다. BGE-M3의 nDCG@10 평균은 0.794다. 하지만 질문별로 보면 0.794 근처인 질문은 거의 없다. 592개 중 380개는 0.9 이상이고, 60개는 0이다. 대부분은 완벽하게 찾고, 일부는 완전히 놓친다. 평균 0.794는 ‘모든 질문을 79% 수준으로 찾는다’가 아니라 ‘열에 여덟은 맞히고 하나는 통째로 놓친다’에 가깝다. 실제로 BGE-M3는 592개 질문 중 448개에서 첫 정답을 1위에 놓았다.
그렇다면 0점을 받은 60개는 어떤 질문일까? 들여다보니 52개가 “1번은 어떤 신화의 일부인가요?” 같은 질문이었다. StrategyQA는 큰 질문을 하위 질문으로 쪼개면서 앞 질문의 답을 ‘#1’로 가리킨다. 영어 원문은 “Which myth is #1 a part of?”이고, ‘#1’은 앞 질문(“달 ‘유로파’의 이름은 무엇에서 따왔나요?”)의 답, 곧 신화 속 인물 유로파를 뜻한다. 이 질문만 따로 떼어 검색하면 무엇을 찾아야 할지 알 수 없다. 개발 세트의 12%(71개)가 이런 질문이었고, BGE-M3는 이들에서 nDCG@10 0.17, 나머지에서 0.88을 받았다. 검색기의 약점처럼 보이던 것의 대부분이 데이터의 문제였다. 평균만 봤다면 알 수 없었을 사실이다. 이 질문들은 모든 검색기에 똑같이 불리하므로 순위 비교에는 큰 영향이 없지만, 점수의 절대 수준은 끌어내린다.
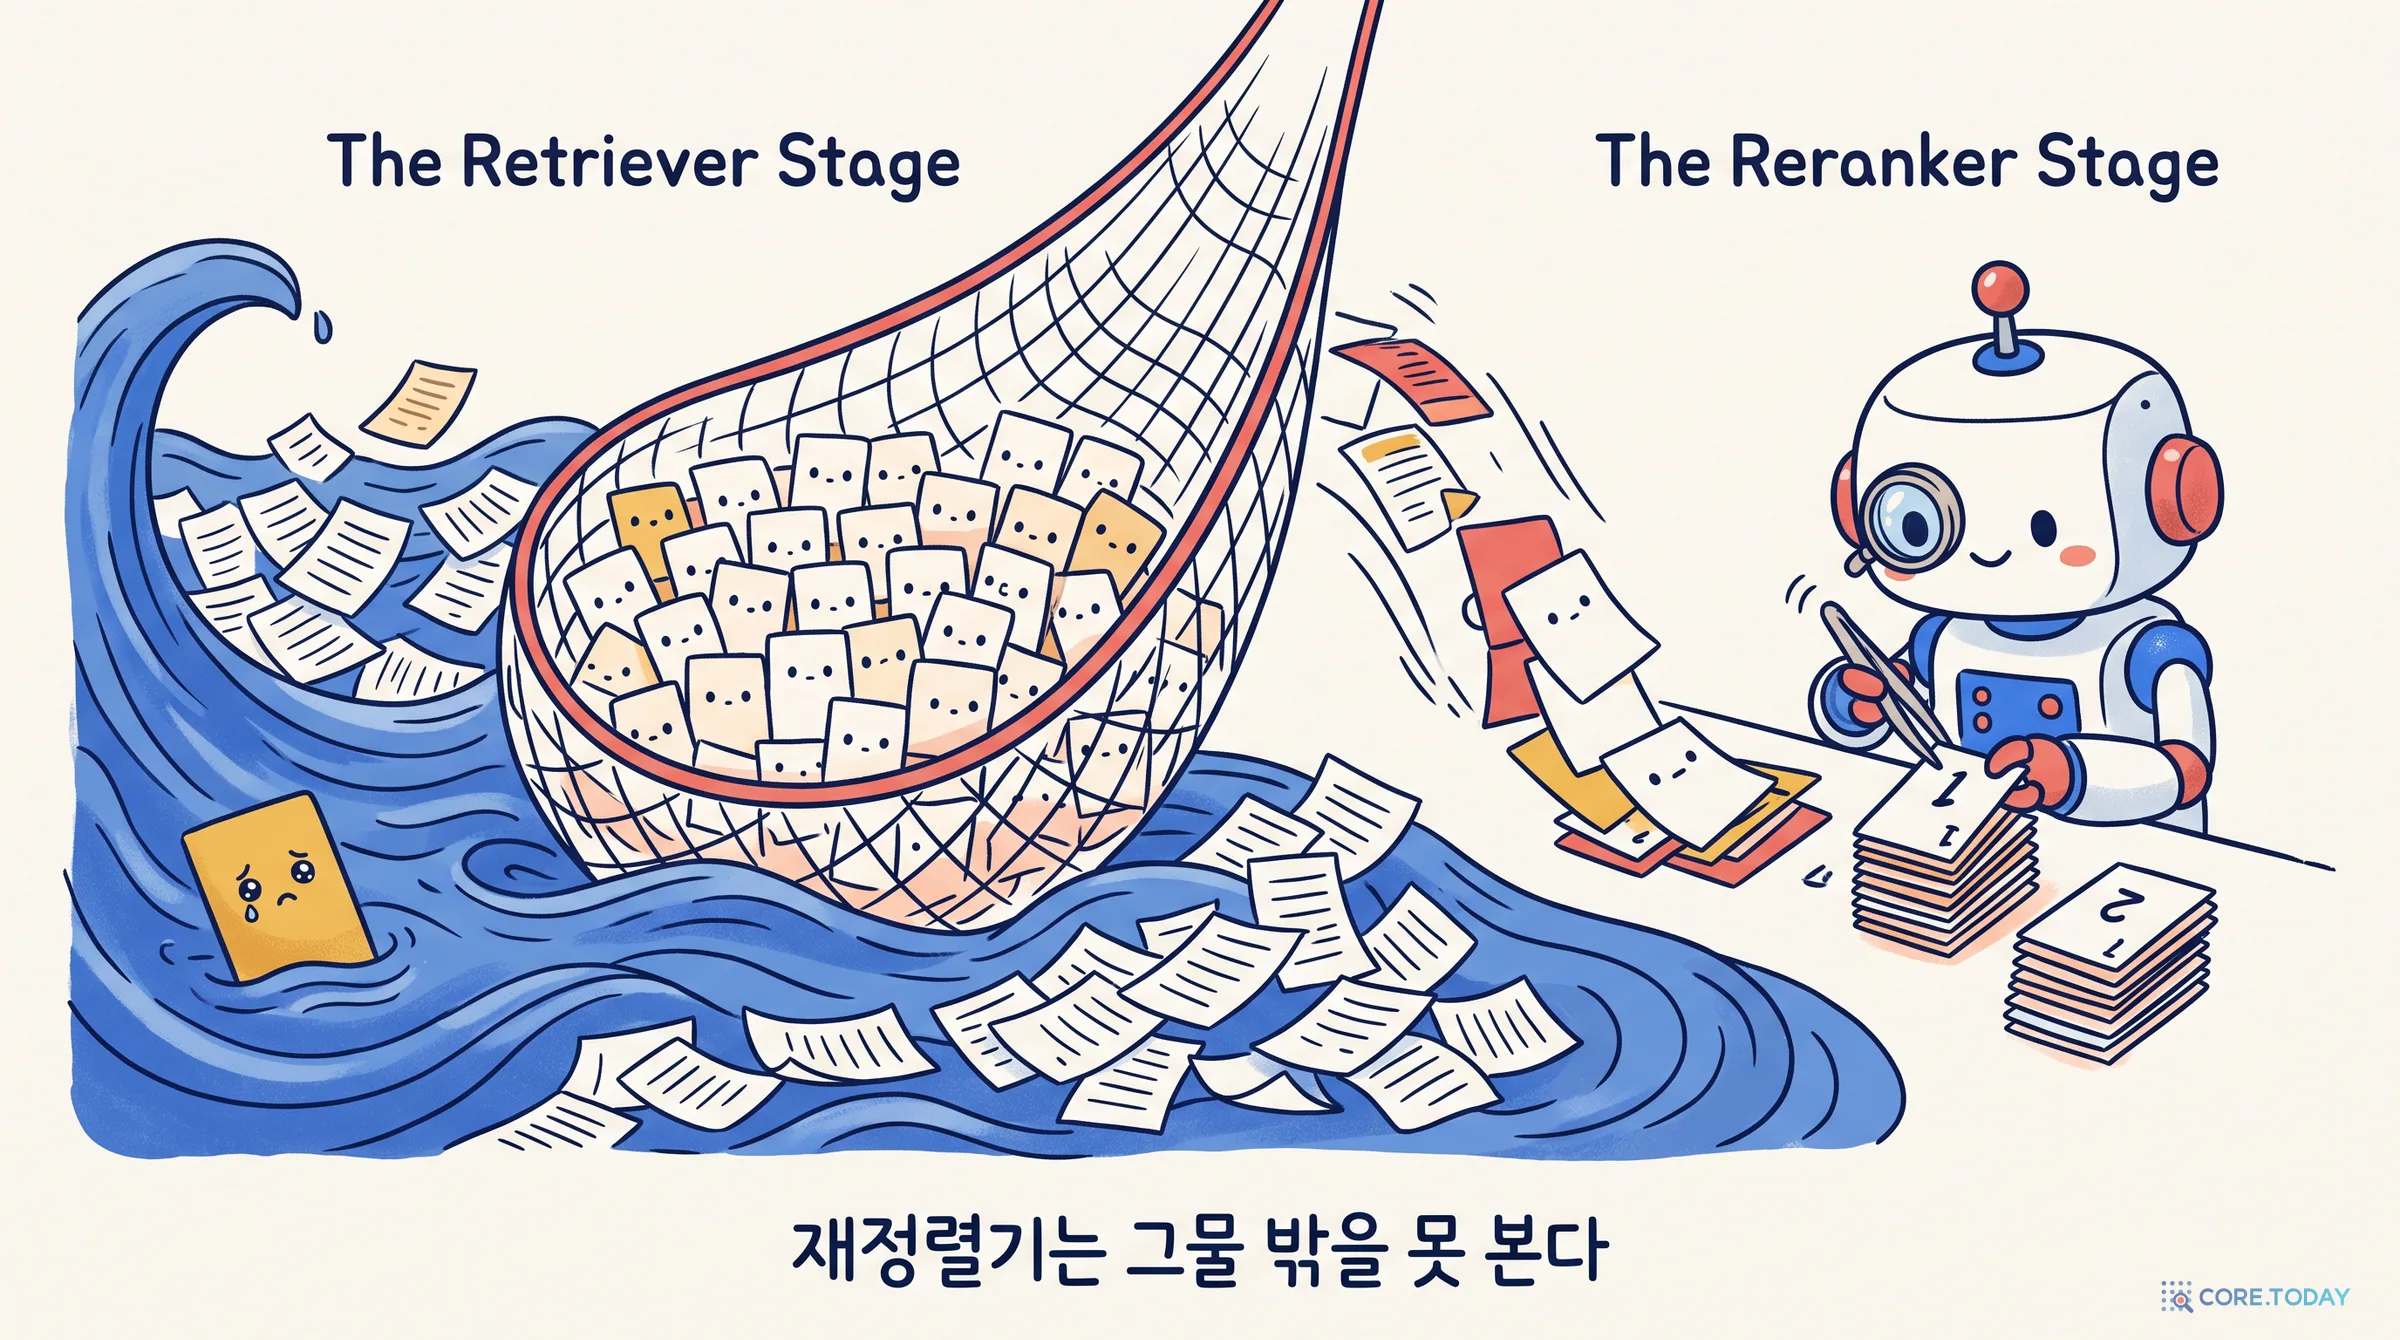
재정렬기(리랭커)는 1단계 검색기가 가져온 후보를 질문과 함께 다시 읽고 순서를 고친다. BGE-M3의 상위 30개에 bge-reranker-v2-m3를 붙인 결과는 이렇다.
지표
BGE-M3
+ 재정렬기 (상위 30)
변화
P@1
0.757
0.799
+0.042
MRR@10
0.812
0.844
+0.032
nDCG@10
0.794
0.823
+0.029
Recall@30
0.888
0.888
0
Recall@100
0.914
0.914
0
순위 지표는 모두 유의하게 올랐다(무작위 순열 검정 p<0.001). 하지만 Recall@30은 소수 셋째 자리까지 그대로다. 재정렬기는 30개의 순서만 바꿀 뿐, 30개 밖의 문서를 데려오지 못한다. 592개 질문 중 47개(7.9%)는 상위 30개 안에 정답이 하나도 없었고, 이 질문들은 재정렬기가 아무리 좋아도 0점이다.
그래서 2단계 검색을 설계할 때는 지표를 단계별로 나눠 봐야 한다. 1단계 검색기는 Recall@(후보 수)로, 재정렬기는 nDCG·MRR로 잰다. 1단계의 Recall이 재정렬기의 천장이다. 코어닷투데이가 사실 탐색기의 재정렬기 15종을 비교한 글에서 먼저 후보 50개의 천장(KURE-v3 기준 99%)을 확인하고 재정렬기를 고른 것도 같은 이유다.
5.4 질문 하나씩 들여다보기
평균 뒤에는 질문이 있다. 아래에서 실제 질문을 골라 세 검색기의 상위 5개를 나란히 볼 수 있다.
질문 몇 개만 봐도 평균이 말해 주지 않는 일들이 보인다.
‘밀집 검색이 이긴 질문’에서 BM25는 ‘머리카락’이라는 단어가 든 빗자루 문단을 가져왔다. 크랜필드가 발견한 단어 색인의 힘은 여전하지만, 단어가 같다고 뜻이 같지는 않다.
‘재정렬기가 망친 질문’에서 재정렬기는 ‘상온·브롬·액체’가 다 들어 있는 삼불화 브롬 문단을 1위로 올렸다. 재정렬기도 틀린다.
‘정답표가 이상한 질문’에서는 재정렬기가 더 나은 문서를 1위에 놓았는데 정답표 때문에 점수를 잃었다. 지표는 정답표만큼만 정확하다.
리더보드를 보면 KURE-v1(0.799)이 BGE-M3(0.794)보다 nDCG@10이 0.004 높다. KURE-v1이 더 좋은 모델일까?
질문별 차이를 놓고 무작위 순열 검정을 해 보면 답이 나온다. 질문마다 두 검색기의 점수를 동전 던지기로 맞바꿔 평균 차이를 1만 번 다시 계산하고, 실제 차이보다 큰 경우가 얼마나 자주 나오는지 센다.
비교 (nDCG@10)
평균 차이
이긴/진 질문
p값
판정
KURE-v1 대 BGE-M3
+0.004
80 / 66
0.26
구별 안 됨
BGE-M3 대 Qwen3-Emb-0.6B
+0.024
142 / 81
0.0002
유의함
Qwen3-Emb-0.6B 대 e5-small
+0.019
142 / 98
0.009
유의함
BM25 2-gram 대 Kiwi
+0.018
171 / 166
0.13
구별 안 됨
재정렬 대 BGE-M3
+0.029
125 / 62
0.0001
유의함
KURE-v1과 BGE-M3의 차이는 우연으로 충분히 설명된다. 흥미로운 것은 BM25의 두 토크나이저다. nDCG@10 차이(0.018)는 유의하지 않은데, 같은 두 시스템의 Recall@100 차이(0.034)는 p=0.0004로 유의했다. 2-gram은 상위권 순서를 크게 바꾸지는 못해도 깊은 곳에서 정답을 더 잘 건진다. 지표를 바꾸면 유의성도 바뀐다.
6.2 질문을 줄이면 무슨 일이 생기나
2002년 NIST의 엘런 부어히스와 크리스 버클리는 TREC 데이터로 질문 수와 결론의 신뢰도를 쟀다. 질문 집합을 무작위로 나눠 두 시스템의 우열이 뒤집히는 비율을 세는 방식이었다. 결론은, 질문 50개로 MAP를 비교할 때 오류율을 5% 이하로 낮추려면 절대 차이가 0.05는 돼야 한다는 것이었다.
같은 실험을 우리 데이터로 해 보자. 질문 592개에서 N개를 뽑아 두 검색기를 비교하고, 전체 결과와 반대 결론이 나오는 비율을 센다.
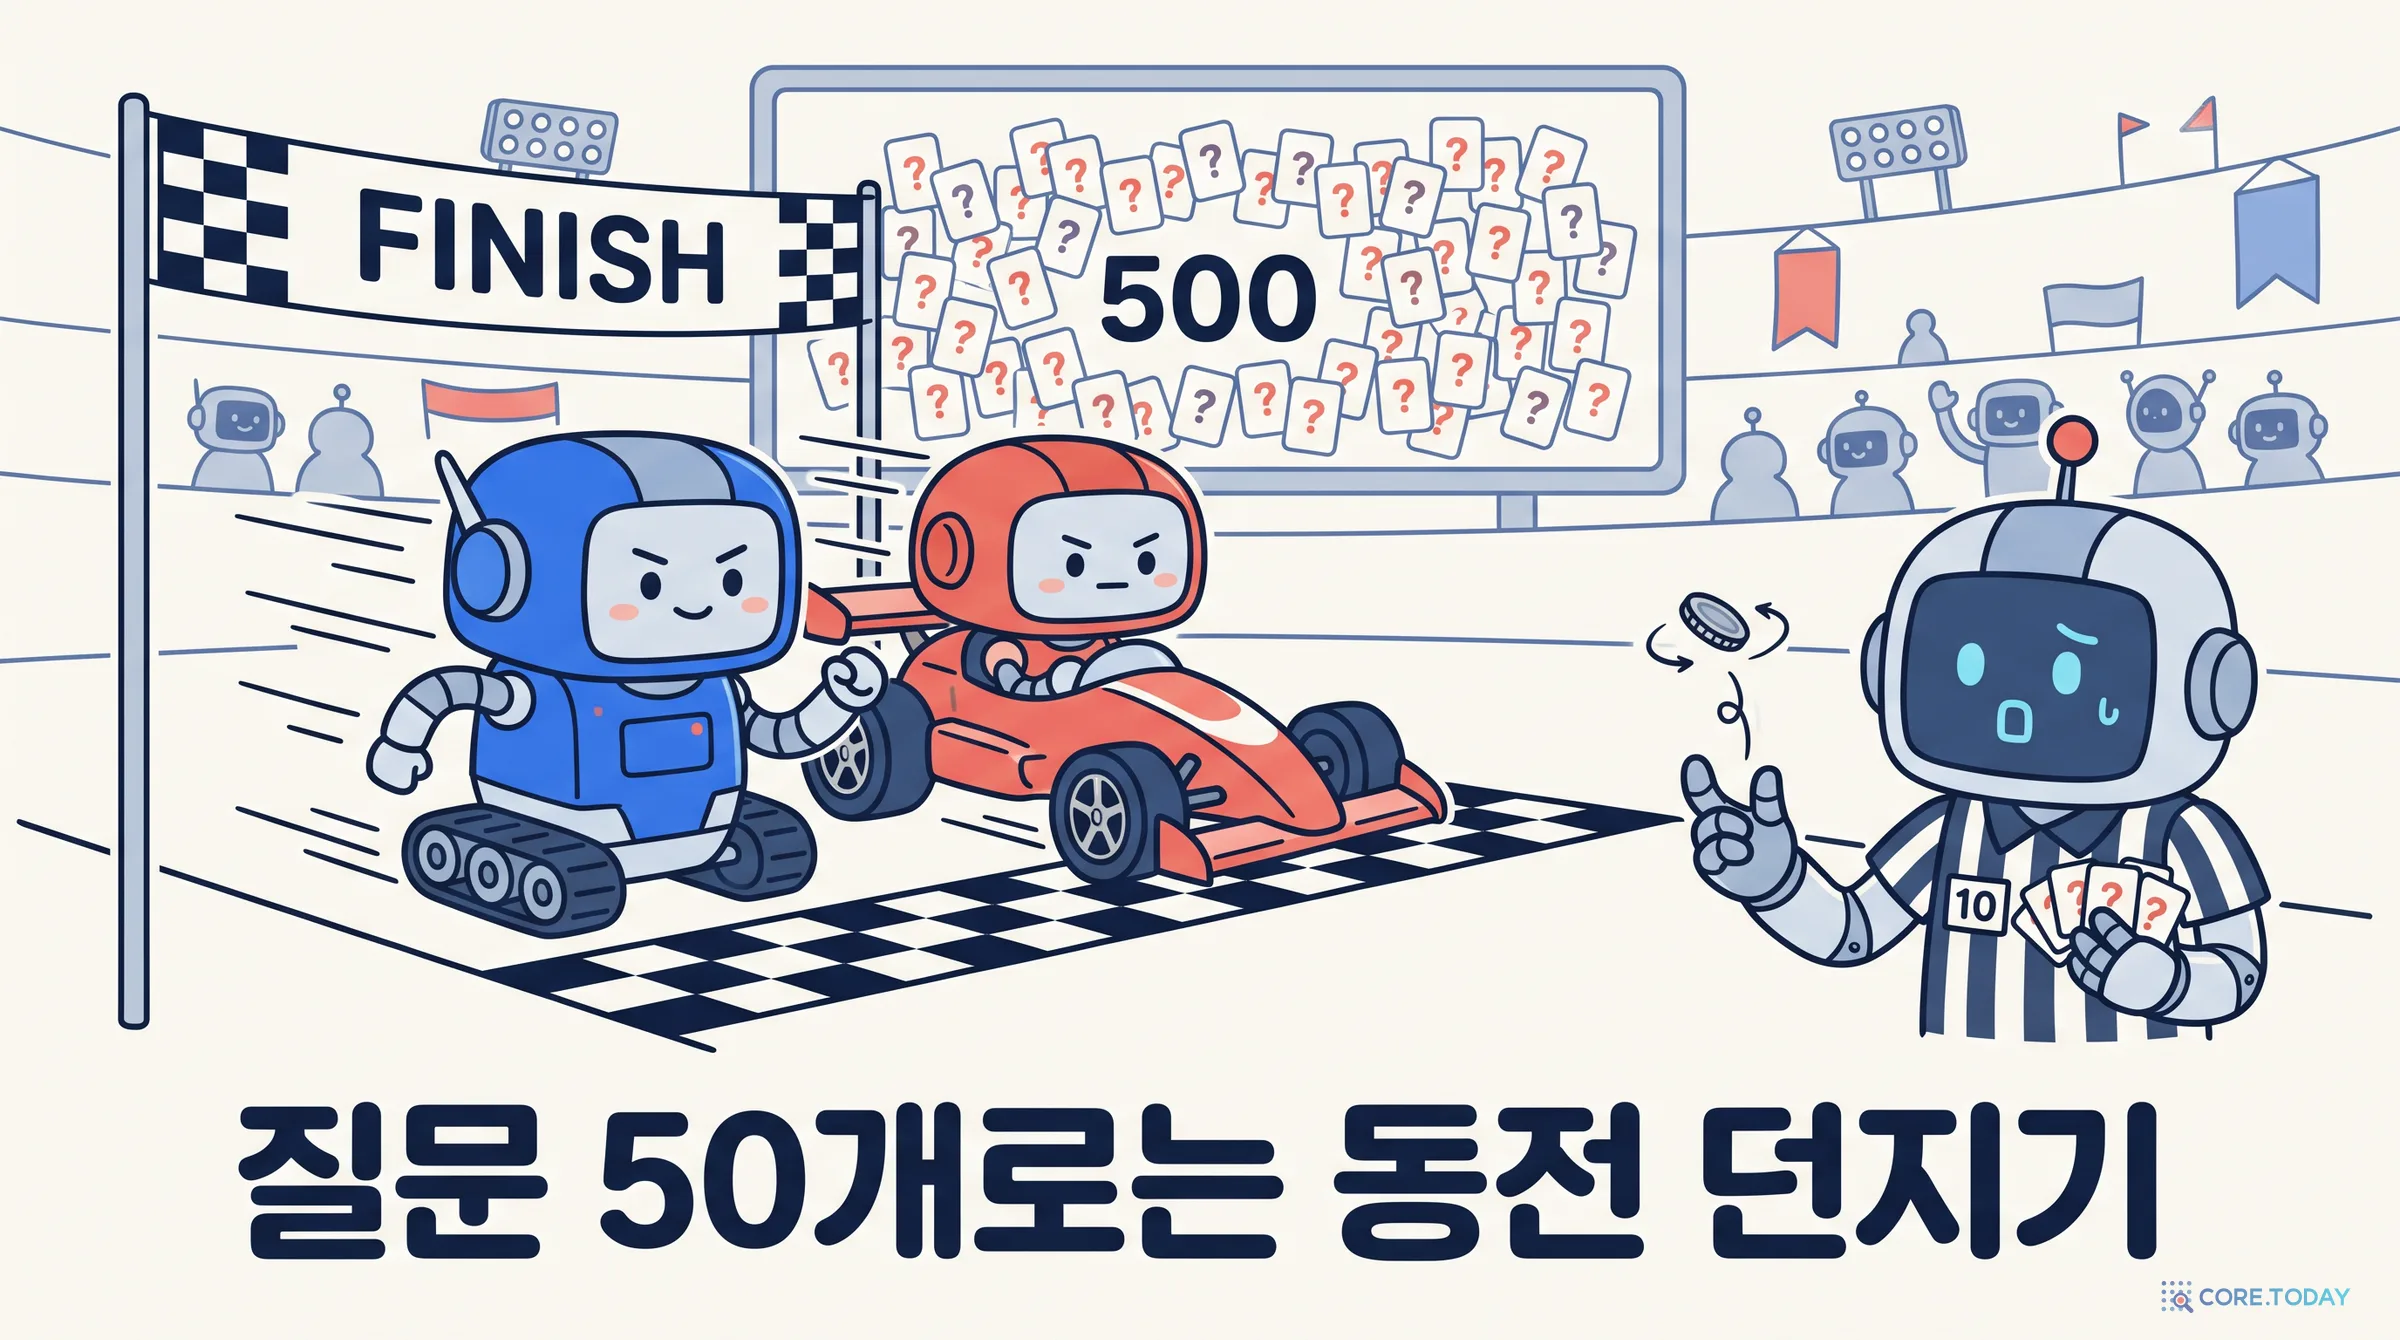
평균 차이가 0.024인 BGE-M3와 Qwen3-Embedding-0.6B는 592개 전체로는 확실히 구별된다. 그런데 질문 50개만 뽑아 비교하면 14.8%의 확률로 Qwen3 쪽이 더 낫다는 결론이 나온다. 질문 25개면 22.9%다. 반면 밀집 검색과 BM25처럼 차이가 0.16이나 나는 쌍은 질문 25개로도 거의 뒤집히지 않는다.
사내 RAG를 평가할 때 질문을 20~30개쯤 만드는 경우가 많다. 그 정도면 ‘임베딩을 BM25에서 밀집 모델로 바꾸면 좋아지나’ 같은 큰 질문에는 답할 수 있다. 하지만 ‘임베딩 모델 A와 B 중 무엇이 나은가’처럼 차이가 작은 질문에는 답하지 못한다. 그 차이는 동전 던지기일 수 있다.
2부에서 TREC은 풀에 들지 않은 문서를 모두 ‘관련 없음’으로 간주했다. 1998년 저스틴 조벨은 이 가정을 검증했다. 결론은 두 가지였다.
시스템 간 상대 순위는 대체로 믿을 만하다. 풀에 기여하지 않은 시스템이 받는 불이익은 평균 0.5% 정도였다.
하지만 재현율은 과대평가된다. 풀링으로 찾은 정답은 실제 정답의 ‘기껏해야 50~70%’로 추정됐다.
문제는 풀을 만든 시스템과 전혀 다른 방식으로 찾는 새 시스템이 나타날 때다. 그 시스템은 남들이 못 찾은 정답을 찾아도 정답표에 없으니 점수를 받지 못한다. 2004년 버클리와 부어히스는 판정되지 않은 문서를 건너뛰고 판정된 문서끼리의 순서만 보는 bpref를 제안했다.
이 문제가 크게 드러난 것이 2021년 BEIR 논문이다. 저자들은 코로나19 논문 검색 데이터(TREC-COVID)에서 검색기가 찾은 상위 10개 중 판정되지 않은 문서의 비율(Hole@10)을 쟀다.
검색기
Hole@10
원래 nDCG@10
구멍을 판정한 뒤
BM25 (어휘)
6.4%
—
—
docT5query (어휘 확장)
2.8%
0.713
0.714
TAS-B (밀집)
31.8%
0.481
0.555
DPR (밀집)
30.6%
0.332
0.445
TREC-COVID의 풀은 주로 단어 기반 시스템이 만들었다. 그래서 밀집 검색기가 찾은 상위 10개 중 30% 정도는 아무도 본 적 없는 문서였고, 이를 판정하자 DPR의 nDCG@10은 0.332에서 0.445로 뛰었다. 논문은 데이터셋 구축 과정의 어휘 편향이 ‘어휘 일치에 의존하지 않는 방식에 불리하다’고 결론지었다.
7.2 우리 데이터의 구멍을 LLM으로 찾아보다
Ko-StrategyQA의 정답표도 원 데이터의 근거 문단에서 왔으니 구멍이 있을 것이다. 사람이 1,800쌍을 다시 판정하기는 어려우니 2024년 이후의 방식을 따라 LLM 판정자를 썼다. 로컬 Qwen3-8B(4비트 양자화, 생각 모드 끔)에게 질문과 문단을 주고 0(무관)·1(관련)·2(답 있음) 중 하나를 고르게 했다.
대상: 무작위로 고른 질문 150개. 검색기 넷(BM25 2-gram, BGE-M3, KURE-v1, 재정렬기)의 상위 5개를 모두 판정했다.
검증용: 같은 질문들의 정답표 정답 전부, 그리고 질문마다 무작위 문단 하나.
모두 합쳐 1,799쌍.
먼저 판정자를 검증했다. 정답표의 정답 299개 중 247개(83%)에 ‘답 있음’을 줬고, 무작위 문단 150개 중 147개(98%)를 ‘무관’으로 걸렀다. 이 두 숫자만 보면 쓸 만한 판정자다.
다음으로 구멍을 셌다. 질문당 정답이 2개 남짓이니 상위 5개 중 상당수는 처음부터 정답표에 없는 문서다. 검색기 넷 모두 69~77%였다. 판정자는 그중 BM25가 가져온 문서의 34%, BGE-M3가 가져온 문서의 46%, 재정렬기가 올린 문서의 49%에 ‘답 있음’을 줬다. 단어가 아니라 뜻으로 찾는 검색기일수록 ‘정답표 밖의 답’을 더 많이 찾았다는 뜻이고, BEIR가 TREC-COVID에서 본 방향과 같다. 이 판정을 그대로 믿고 다시 채점하면 BGE-M3의 P@1은 0.740에서 0.933으로 뛴다.
하지만 여기서 멈추지 않았다. 판정자가 정답표 밖 문서에 ‘답 있음’을 준 509건 중 30건을 무작위로 뽑아 문단 전체를 다시 읽어 대조했다. 판정 기준은 위의 0·1·2 정의를 그대로 썼고, 이 검토는 Claude가 맡았다. 결과는 이랬다.
LLM이 ‘답 있음’이라 한 정답표 밖 문서 30건
건수
질문이 ‘1번’을 가리켜 판정할 수 없음
11
진짜로 답이 있음 (진짜 구멍)
5
답이 없음 (판정자가 후함)
14
질문이 온전한 19건 중 진짜 답이 있는 문단은 5건뿐이었다. 틀린 판정에는 뚜렷한 패턴이 있었다. “캔터베리 이야기는 언제 쓰여졌나요?”에 대해, 캔터베리 대주교에게 세례를 받은 해리 왕자 문단과 셰익스피어가 햄릿을 쓴 연도 문단에 ‘답 있음’을 줬다. “벅스 버니는 언제 만들어졌나요?”에는 1953년에 세워진 버거킹 문단에 ‘답 있음’을 줬다. 판정자는 누구에 대한 질문인지보다 ‘언제’를 묻는 질문에 연도가 있는가라는 형식에 반응했다. 반대로 벅스 버니가 ‘1940년 단편에서 데뷔했다’는 진짜 답 문단에는 0점을 줬다.
교훈은 판정자 검증의 방식에 있다. 아는 정답과 무작위 문단은 쉬운 시험이다. 무작위 문단은 질문과 아무 상관이 없어서 누구라도 ‘무관’을 고른다. 하지만 검색기가 가져온 상위 문서는 질문과 주제가 닮아서 헷갈리기 쉬운 문서들이다. 판정자를 정말로 써야 하는 곳이 바로 거기인데, 쉬운 시험으로는 그곳의 실력을 알 수 없다.
그렇다고 구멍이 없는 것은 아니다. 표본으로 어림하면 판정자가 ‘답 있음’이라 한 정답표 밖 문서 중 4분의 1가량은 진짜 답이었다. ‘머리카락은 무엇으로 만들어지나요?’에 대한 알파 케라틴 문단, ‘겨울을 경험하는 지역’에 대한 북반구 문단이 그런 예다. 다행히 검색기 간 순위는 판정을 믿든 안 믿든 거의 같았다. 판정자의 오차가 모든 검색기에 비슷하게 섞이기 때문이다. LLM 판정은 순위를 가르는 데는 쓸 수 있어도, 점수의 절대값을 바로잡는 데 쓰기에는 아직 위험하다.
7.3 LLM이 판정해도 될까
LLM 판정은 이제 연구용 장난감이 아니다. 마이크로소프트 빙 연구진은 2024년 SIGIR 논문에서 2022년 말부터 오프라인 지표 대부분에 LLM 판정을 써 왔다고 밝혔다. 그들의 비교에 따르면 GPT-4 판정은 일반 크라우드 작업자보다 정확도가 28% 높고, 처리량은 10배, 비용은 20분의 1이었다. 다만 같은 논문은 프롬프트를 살짝 바꿔 쓰기만 해도 성능이 예측할 수 없게 달라진다고 경고했다.
2024년 TREC RAG 트랙은 이 방식을 공식 평가에 시험했다. GPT-4o 기반 판정자 UMBRELA로 매긴 시스템 순위와 사람이 완전히 판정한 순위를 비교하니, 켄달 τ가 nDCG@20 기준 0.890, Recall@100 기준 0.929였다. 주최 측은 UMBRELA가 ‘완전 수작업 판정을 대체할 수 있다’고 결론지었다.
반론도 바로 나왔다. 워털루 대학의 찰스 클라크와 뉴햄프셔 대학의 로라 디에츠는 같은 데이터를 다시 분석했다. 전체 시스템으로는 τ가 0.89지만 상위 20개 시스템끼리만 보면 0.51로 떨어졌다. 자동 판정으로 1위인 시스템이 사람 판정으로는 5위였다. 더 큰 문제는 순환이었다. 어떤 팀은 GPT-4o 판정을 최종 재정렬기로 썼고, 같은 계열의 판정자에게서 부풀려진 점수를 받았다. 채점자가 시스템의 일부가 되면 그 채점은 의미를 잃는다.
LLM 판정을 쓰는 실무 원칙은 이렇게 정리할 수 있다.
사람이 판정한 일부와 반드시 대조하되, 헷갈리는 문서로 대조한다. 이미 아는 정답과 무작위 문단만으로 검증하면 우리 실험처럼 속는다. 검색기가 실제로 가져온 상위 문서에서 표본을 뽑아 확인해야 한다.
큰 차이를 가르는 데 쓰고, 작은 차이는 의심한다. 상위권 시스템끼리의 미세한 순위는 판정자 오차에 묻힌다.
70년 동안 검색 지표의 사용자 모형은 사람이었다. 위에서부터 읽고, 지치면 멈추고, 1위를 가장 많이 본다. MRR과 nDCG와 RBP의 할인 곡선은 모두 이 사람을 그린 것이다.
RAG에서 검색 결과를 읽는 것은 LLM이다. LLM은 상위 k개를 한꺼번에 프롬프트에 넣고 읽는다. 지치지도 않고 스크롤도 하지 않는다. 그렇다면 순위 할인은 의미가 줄고, ‘필요한 근거가 k개 안에 다 들어왔나’가 중요해진다. 4부 위젯의 Recall@10 곡선, 10위까지 평평하다가 절벽으로 떨어지는 모양이 LLM 독자에 더 가깝다. 물론 LLM도 긴 문맥의 중간을 놓치는 경향이 있으니 순서가 완전히 무의미하지는 않다. 하지만 RAG의 1단계 검색에서는 Recall@k가 답변 품질의 천장이라는 점은 분명하다. 검색이 근거를 못 가져오면 LLM은 지어내거나 기권할 수밖에 없다.
8.2 RAG 평가 도구들의 지표
RAG 평가 도구들은 고전 지표를 LLM 판정과 결합했다. 가장 널리 쓰이는 RAGAS를 예로 들면 이렇다.
2023년 원 논문은 문맥 관련도(context relevance)를 정의했다. 가져온 문맥에서 답에 꼭 필요한 문장의 비율을 LLM이 골라 잰다.
지금 라이브러리 문서의 Context Precision@K는 LLM이 판정한 관련도로 계산한 평균 정밀도(2부의 AP)와 같은 구조다.
Context Recall은 정답 문서 대신 참조 답변을 쓴다. 참조 답변의 주장 중 가져온 문맥이 뒷받침하는 주장의 비율이다. 정답 문서 목록을 만들기 어려운 현실에 맞춘 변형이다.
ARES는 소수의 사람 판정(수백 개)으로 LLM 판정자의 오차를 통계적으로 보정하는 방법을 붙였다. 결국 2026년의 RAG 평가도 크랜필드의 세 요소, 문서·질문·정답표 위에 서 있다. 정답표를 만드는 사람이 LLM으로 바뀌고 있을 뿐이다.
8.3 벤치마크가 쉬워질 때
밀집 검색기가 BEIR와 MTEB의 점수를 끌어올리자 새로운 질문이 나왔다. 단어가 겹치지 않고 추론해야 찾을 수 있는 문서도 찾을까? 2024년 공개되고 ICLR 2025에 실린 BRIGHT는 이런 질문 1,384개를 모았다. MTEB에서 nDCG@10 59.0을 받던 임베딩 모델(SFR-Embedding-Mistral)이 BRIGHT에서는 18.3에 그쳤다. 우리 실험의 Ko-StrategyQA도 원래는 여러 단계 추론이 필요한 질문이지만, 하위 질문으로 쪼개진 덕분에 단어 겹침만으로도 많이 풀린다. 벤치마크 점수는 그 벤치마크가 묻는 것만 말해 준다.
8.4 무엇을 재야 하나
정리하면, 지표는 ‘누가 결과를 읽고 다음에 무엇을 하는가’로 고른다.
상황
주 지표
이유
RAG 1단계 검색 (LLM이 상위 k개를 읽음)
Recall@k
근거가 k개 안에 없으면 답을 못 만든다. k는 실제로 넘기는 개수로
재정렬기에 넘길 후보 검색
Recall@(후보 수)
재정렬기의 천장이다
재정렬기, 사람이 보는 검색 결과
nDCG@10
좋은 것을 위에 놓는지 본다. 등급 판정이 있으면 더 좋다
답 하나만 보여 주는 챗봇·질의응답
P@1, MRR@k
첫 번째가 맞아야 한다
정답이 많고 빠짐없이 찾아야 하는 검색 (법률·특허·의료 문헌)
Recall@큰 k, MAP
하나라도 놓치면 비용이 크다
평가 세트가 작을 때 (질문 50개 이하)
유의성 검정 필수
작은 차이는 동전 던지기일 수 있다
마지막으로, 70년의 이야기를 한눈에 정리한 연표다.
맺으며 — 지표는 질문이다
정답이 3위에 있는 검색 결과는 Recall@10으로 1.0점, MRR로 0.33점, nDCG@10으로 0.5점이었다. 이제 왜 그런지 설명할 수 있다. Recall은 빠뜨리지 않았는지를 묻는다. MRR은 첫 정답에서 멈추는 성급한 사용자를 그린다. nDCG는 아래로 갈수록 덜 보는, 그러나 끝까지는 보는 사용자를 그린다.
1960년대 크랜필드의 사서들은 ‘어느 분류법이 좋은가’라는 논쟁을 문서·질문·정답표라는 시험지로 바꿨다. 그 시험지는 지금도 그대로다. 바뀐 것은 시험지를 읽는 쪽(사람에서 LLM으로)과 채점하는 쪽(사람에서 LLM으로)이다. 그래서 오래된 질문이 다시 중요해졌다. 내 시스템의 결과는 누가 읽는가? 정답표에는 구멍이 없는가? 질문은 충분히 많은가?
지표를 고른다는 것은 무엇이 중요한지를 정하는 일이다. 숫자 하나를 올리기 전에, 그 숫자가 어떤 질문에 대한 답인지부터 확인하자.
참고 문헌
역사와 고전 지표
Kent, A., Berry, M. M., Luehrs, F. U., & Perry, J. W. (1955). Machine literature searching VIII. Operational criteria for designing information retrieval systems. American Documentation, 6(2), 93–101.
Cleverdon, C. W., Mills, J., & Keen, E. M. (1966). Factors Determining the Performance of Indexing Systems, Vol. 1: Design. Cranfield.
Cleverdon, C. W., & Keen, E. M. (1966). Factors Determining the Performance of Indexing Systems, Vol. 2: Test Results. Cranfield.
van Rijsbergen, C. J. (1979). Information Retrieval (2nd ed.), Chapter 7. Butterworths.
Harman, D. (1993). Overview of the First Text REtrieval Conference (TREC-1). NIST.
Kantor, P., & Voorhees, E. (1996). Report on the TREC-5 Confusion Track. NIST.
Voorhees, E. M. (1999). The TREC-8 Question Answering Track Report. NIST.
Järvelin, K., & Kekäläinen, J. (2000). IR evaluation methods for retrieving highly relevant documents. SIGIR 2000.
Järvelin, K., & Kekäläinen, J. (2002). Cumulated gain-based evaluation of IR techniques. ACM TOIS, 20(4), 422–446.
Burges, C. et al. (2005). Learning to rank using gradient descent. ICML 2005.
Moffat, A., & Zobel, J. (2008). Rank-biased precision for measurement of retrieval effectiveness. ACM TOIS, 27(1).
Chapelle, O., Metzler, D., Zhang, Y., & Grinspan, P. (2009). Expected reciprocal rank for graded relevance. CIKM 2009.
평가의 신뢰도
Zobel, J. (1998). How reliable are the results of large-scale information retrieval experiments? SIGIR 1998.
Voorhees, E. M., & Buckley, C. (2002). The effect of topic set size on retrieval experiment error. SIGIR 2002.
Buckley, C., & Voorhees, E. M. (2004). Retrieval evaluation with incomplete information. SIGIR 2004.
Fuhr, N. (2017). Some common mistakes in IR evaluation, and how they can be avoided. SIGIR Forum, 51(3).
Ferrante, M., Ferro, N., & Fuhr, N. (2021). Towards meaningful statements in IR evaluation: Mapping evaluation measures to interval scales. IEEE Access. arXiv:2101.02668.
Moffat, A. (2022). Batch evaluation metrics in information retrieval: Measures, scales, and meaning. arXiv:2207.03103.
데이터셋과 벤치마크
Bajaj, P. et al. (2016). MS MARCO: A human generated machine reading comprehension dataset. arXiv:1611.09268. 평가 지표는 공식 저장소 microsoft/MSMARCO-Passage-Ranking.
Craswell, N. et al. (2020). Overview of the TREC 2019 Deep Learning Track. arXiv:2003.07820.
Thakur, N. et al. (2021). BEIR: A heterogeneous benchmark for zero-shot evaluation of information retrieval models. NeurIPS 2021 Datasets and Benchmarks.
Muennighoff, N. et al. (2023). MTEB: Massive Text Embedding Benchmark. EACL 2023.
Enevoldsen, K. et al. (2025). MMTEB: Massive Multilingual Text Embedding Benchmark. ICLR 2025.
Geva, M. et al. (2021). Did Aristotle use a laptop? A question answering benchmark with implicit reasoning strategies. TACL, 9.
NomaDamas. Ko-StrategyQA (Hugging Face 데이터셋 카드), taeminlee/Ko-StrategyQA (BEIR 형식).
Su, H. et al. (2025). BRIGHT: A realistic and challenging benchmark for reasoning-intensive retrieval. ICLR 2025.
LLM 판정과 RAG 평가
Thomas, P., Spielman, S., Craswell, N., & Mitra, B. (2024). Large language models can accurately predict searcher preferences. SIGIR 2024. arXiv:2309.10621.
Faggioli, G. et al. (2023). Perspectives on large language models for relevance judgment. ICTIR 2023.
Upadhyay, S. et al. (2024). UMBRELA: UMbrela is the (Open-Source Reproduction of the) Bing RELevance Assessor. arXiv:2406.06519.
Upadhyay, S., Pradeep, R., Thakur, N. et al. (2024). A large-scale study of relevance assessments with large language models: An initial look. arXiv:2411.08275.
Clarke, C. L. A., & Dietz, L. (2024). LLM-based relevance assessment still can't replace human relevance assessment. arXiv:2412.17156.
Es, S., James, J., Espinosa-Anke, L., & Schockaert, S. (2024). RAGAS: Automated evaluation of retrieval augmented generation. EACL 2024 Demo. arXiv:2309.15217. 지표 정의는 ragas 라이브러리 문서도 참고.
Saad-Falcon, J., Khattab, O., Potts, C., & Zaharia, M. (2023). ARES: An automated evaluation framework for retrieval-augmented generation systems. arXiv:2311.09476.