BLEUROUGE기계 번역자동 요약평가 지표n-gram정밀도재현율브레비티 페널티LCSchrFSacreBLEUCOMETBERTScoreLLM 심판굿하트의 법칙한국어 토큰화형태소NLP 평가
“연기되지 않았다”는 32점, “미뤄졌어요”는 0점 — 기계의 글을 채점해 온 대역 배우, BLEU와 ROUGE (특집)
2002년 IBM 연구진은 사람 평가자를 대신 무대에 세울 ‘대역 배우(understudy)’를 만들었다. 이름은 BLEU. 2년 뒤 요약을 위해 이를 뒤집은 ROUGE가 나왔다. 두 숫자는 20년 동안 번역과 요약 연구의 순위표를 지배했고, 같은 기간 내내 비판을 받았다. 이 글은 1966년 ALPAC 보고서에서 출발해 n-gram·클리핑·짧은 답 벌점·LCS를 하나씩 손으로 계산해 보고, 사람 평가 1위가 BLEU 6위였던 사건, ROUGE 논문 2,834편 중 재현 가능한 것이 20%뿐이었다는 조사, 한국어를 넣으면 0점이 나오는 라이브러리 기본값까지 사례로 따라간다. 마지막으로 LLM 심판의 시대인 2026년에 이 오래된 숫자가 맡은 역할을 정리한다. 인터랙티브 위젯 6종, 코어닷투데이 실측, 삽화 14장.
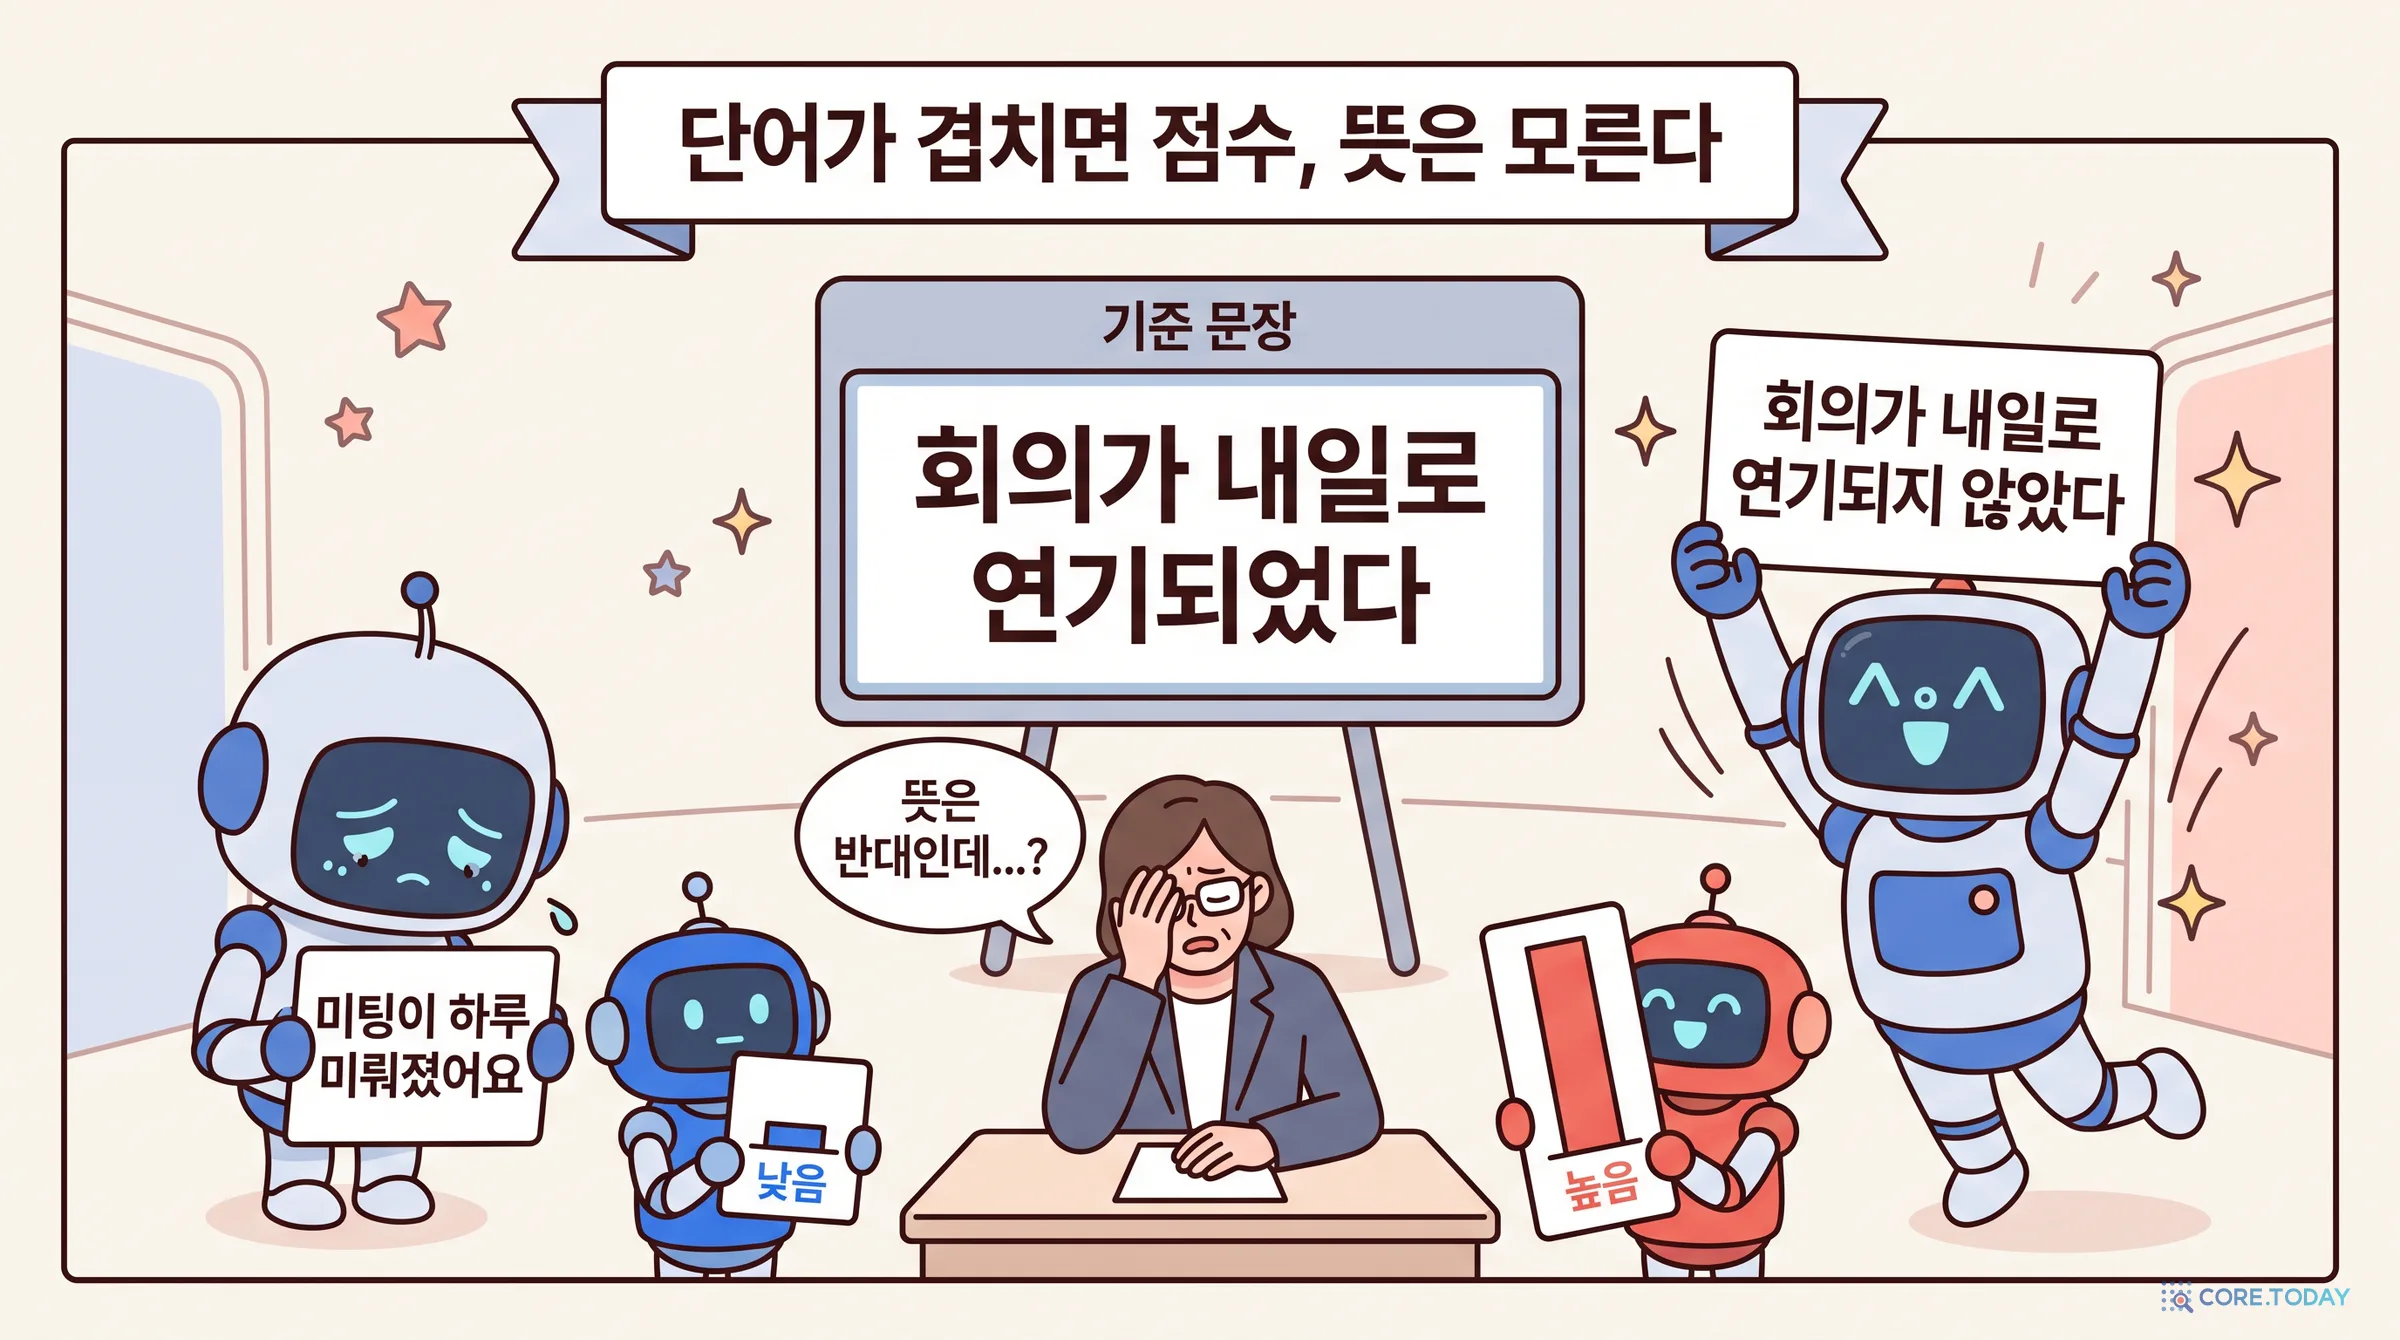
A는 표현이 다를 뿐 뜻은 정확하다. B는 정반대의 뜻이다. 회의가 열린다는 말이니, 이 번역을 믿은 사람은 다음 날 빈 회의실에 앉아 있게 된다.
이번엔 기계 번역 분야에서 20년 넘게 표준으로 써 온 채점기 BLEU에게 두 번역을 맡겨 보자. 표준 구현체 sacreBLEU 2.6으로 직접 돌린 결과다.
0.0
A “미팅이 하루 미뤄졌어요” — 뜻이 같은 번역
31.9
B “회의가 내일로 연기되지 않았다” — 뜻이 반대인 번역
66.5
B를 글자 단위로 자르면
73.5
B의 chrF 점수 (BLEU의 개량형)
채점기가 고장 난 것이 아니다. BLEU는 처음부터 이렇게 동작하도록 설계됐다. 이 채점기는 뜻을 읽지 않는다. 사람이 쓴 정답과 겹치는 단어 조각을 셀 뿐이다. A는 정답과 겹치는 조각이 하나도 없고, B는 앞의 세 어절이 정답과 똑같다.
그렇다면 이 단순한 채점기는 왜 만들어졌을까. 어떻게 20년 동안 수만 편의 논문이 이 숫자로 우열을 가렸을까. 같은 기간 내내 비판을 받으면서도 2026년 지금까지 쓰이는 이유는 무엇일까.
이 글은 그 질문을 순서대로 따라간다.
왜 이런 채점기가 필요했는가 — 1966년 한 보고서가 분야 하나를 멈춰 세운 이야기부터
BLEU는 어떻게 계산하는가 — 다섯 개의 부품을 하나씩 손으로 돌려 본다
ROUGE는 무엇을 뒤집었는가 — 번역이 아니라 요약을 채점해야 했던 이유
어디서 금이 갔는가 — 사람 평가 1위가 BLEU 6위였던 사건을 비롯한 사례들
한국어에서는 무엇이 더 어려운가 — 코어닷투데이가 직접 잰 값
2026년, 이 숫자는 어디에 있는가 — LLM 심판 시대의 역할 분담
먼저 위의 두 번역을 직접 채점해 보자. 퀴즈 형식이다. 채점기의 마음을 읽을 수 있는지 시험해 보시라.
1부. 채점이 연구보다 느리던 시절
1.1 1966년, 평가가 분야 하나를 멈춰 세우다
기계 번역은 컴퓨터만큼 오래된 꿈이다. 1954년 IBM과 조지타운대학이 러시아어 문장 60여 개를 영어로 옮기는 시연을 했을 때, 신문들은 3~5년 안에 기계 번역이 실용화될 것이라고 썼다. 냉전이었고 미국 정부에는 소련의 과학 문헌을 읽을 이유가 충분했다. 이후 10여 년간 연구비가 쏟아졌다.
1966년, 미국 국립과학원 산하 자동언어처리자문위원회(ALPAC)가 보고서 한 권을 냈다. 위원회가 한 일의 핵심은 평가였다. 사람 평가자들이 기계 번역문과 사람 번역문을 읽고 "알아들을 수 있는가(intelligibility)"와 "원문에 충실한가(fidelity)"를 척도로 매겼다. 결론은 냉정했다. 기계 번역은 사람 번역보다 느리고, 덜 정확하고, 두 배 비싸다. 그 뒤 미국의 기계 번역 연구비는 급격히 줄었고, 분야는 거의 20년간 겨울을 보냈다.
이 일화가 남긴 교훈은 두 가지다. 첫째, 평가는 연구의 운명을 정한다. 둘째, 그 평가는 사람이 했다. 그리고 사람의 평가에는 대가가 따랐다.
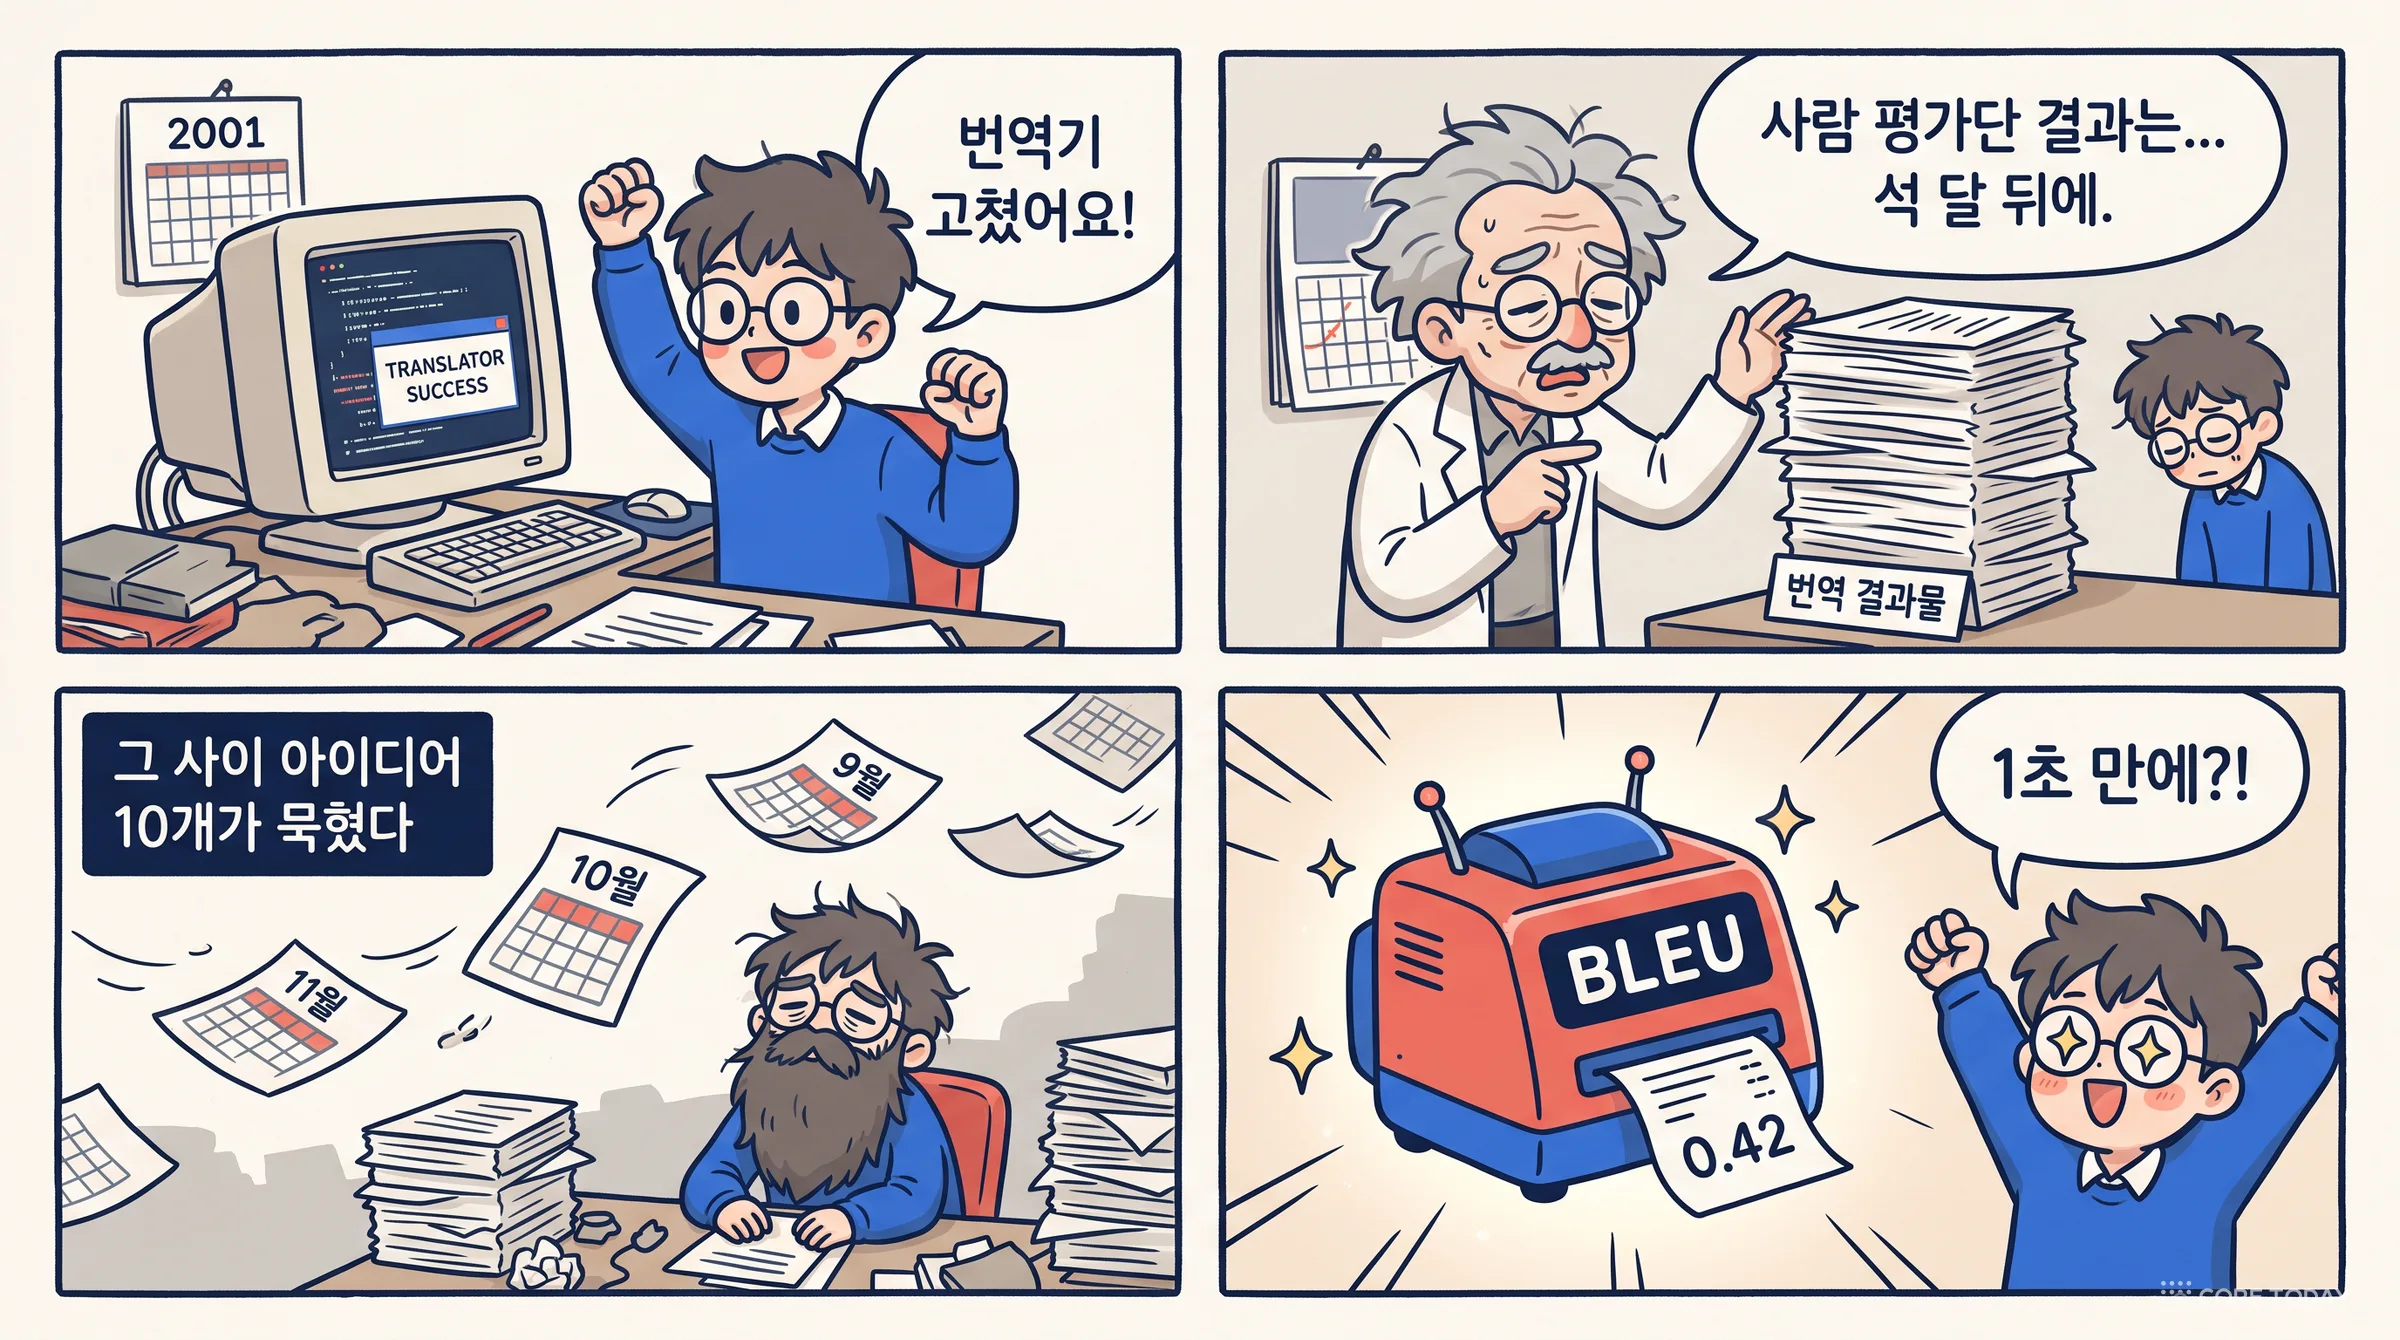
1990년대에 통계 기반 기계 번역이 부활하면서 연구 속도가 빨라졌다. 연구자들은 매일 시스템을 고쳤다. 정렬 모델의 파라미터를 바꾸고, 구(phrase) 테이블을 다시 만들고, 언어 모델을 바꿨다. 문제는 고친 결과가 나아졌는지 알 길이 없다는 것이었다.
번역 품질을 제대로 평가하려면 두 언어를 아는 사람이 수백 문장을 읽고 적절성(adequacy)과 유창성(fluency)을 점수로 매겨야 했다. BLEU 논문은 서론에서 이 상황을 이렇게 적었다.
사람의 평가는 대단히 비싸다. 게다가 끝나기까지 몇 주, 몇 달이 걸린다. (…) 기계 번역 시스템 개발자는 매일의 변경이 미치는 영향을 지켜보며 나쁜 아이디어와 좋은 아이디어를 가려내야 한다. 우리는 기계 번역의 진보가 평가에서 나온다고 믿으며, 평가라는 병목에 막혀 풀려나기를 기다리는 유망한 연구 아이디어들이 줄지어 쌓여 있다고 본다.
— Papineni et al., BLEU: a Method for Automatic Evaluation of Machine Translation, ACL 2002
연구자가 하루에 아이디어 세 개를 시도할 수 있는데 채점에 석 달이 걸린다면, 연구 속도의 상한은 연구자가 아니라 채점이 정한다. 게다가 사람 평가는 재사용할 수 없다. 시스템을 한 번 고치면 같은 평가를 처음부터 다시 해야 한다.
필요한 것은 분명했다. 싸고, 빠르고, 언어에 상관없이 쓸 수 있고, 사람의 판단과 대체로 맞는 채점기.
1.3 대역 배우라는 이름
2001년 IBM 왓슨 연구소의 Kishore Papineni, Salim Roukos, Todd Ward, Wei-Jing Zhu가 내부 기술 보고서(RC22176)로 해법을 내놨다. 이듬해 ACL 2002에 실린 정식 논문의 초록은 이렇게 끝난다.
우리는 이 방법을 숙련된 사람 평가자의 자동화된 대역(understudy)으로 내놓는다. 빠르게, 또는 자주 평가해야 할 때 그들을 대신한다.
Understudy는 연극 용어다. 주연 배우가 무대에 서지 못할 때 대신 오르는 대역 배우를 가리킨다. 이름에 그 단어가 들어갔다. BiLingual Evaluation Understudy, 줄여서 BLEU. 프랑스어로 '파랑'이고, IBM의 별명 '빅 블루'의 그 파랑이기도 하다. IBM은 2022년 BLEU 20주년 회고 글에서 이 색깔 이야기를 직접 꺼냈다.
이름에는 설계 철학이 담겨 있다. BLEU는 처음부터 주연을 대체하려고 만든 것이 아니다. 주연(사람 평가)이 매번 무대에 설 수 없으니, 리허설에서 대신 대사를 읽는 역할이다. 이 사실을 기억해 두자. 이 글의 마지막까지 다시 돌아올 것이다.
1.4 단 하나의 직관 — "사람 번역에 가까울수록 좋다"
BLEU의 출발점은 한 문장이다. 논문 1.2절에 그대로 나온다.
번역의 성능은 어떻게 재는가? 기계 번역이 전문가의 사람 번역에 가까울수록 더 좋다. 이것이 우리 제안의 핵심 아이디어다.
남은 문제는 "가깝다"를 어떻게 숫자로 만드느냐다. 저자들은 음성 인식 분야에서 성공한 단어 오류율(WER)을 참고하되, 번역의 두 가지 사정을 고려했다고 썼다. 하나, 정답 번역은 여러 개일 수 있다. 둘, 정당한 단어 선택과 어순의 차이를 허용해야 한다. 그 결과가 여러 길이의 단어 조각(n-gram)이 얼마나 겹치는지를 세는 것이었다.
2부. BLEU 해부 — 다섯 개의 부품
BLEU는 부품 다섯 개로 조립된다. 하나씩 끼워 보자. 각 부품은 앞 부품의 허점을 막으려고 추가됐다. 그 흐름을 따라가면 공식이 저절로 이해된다.
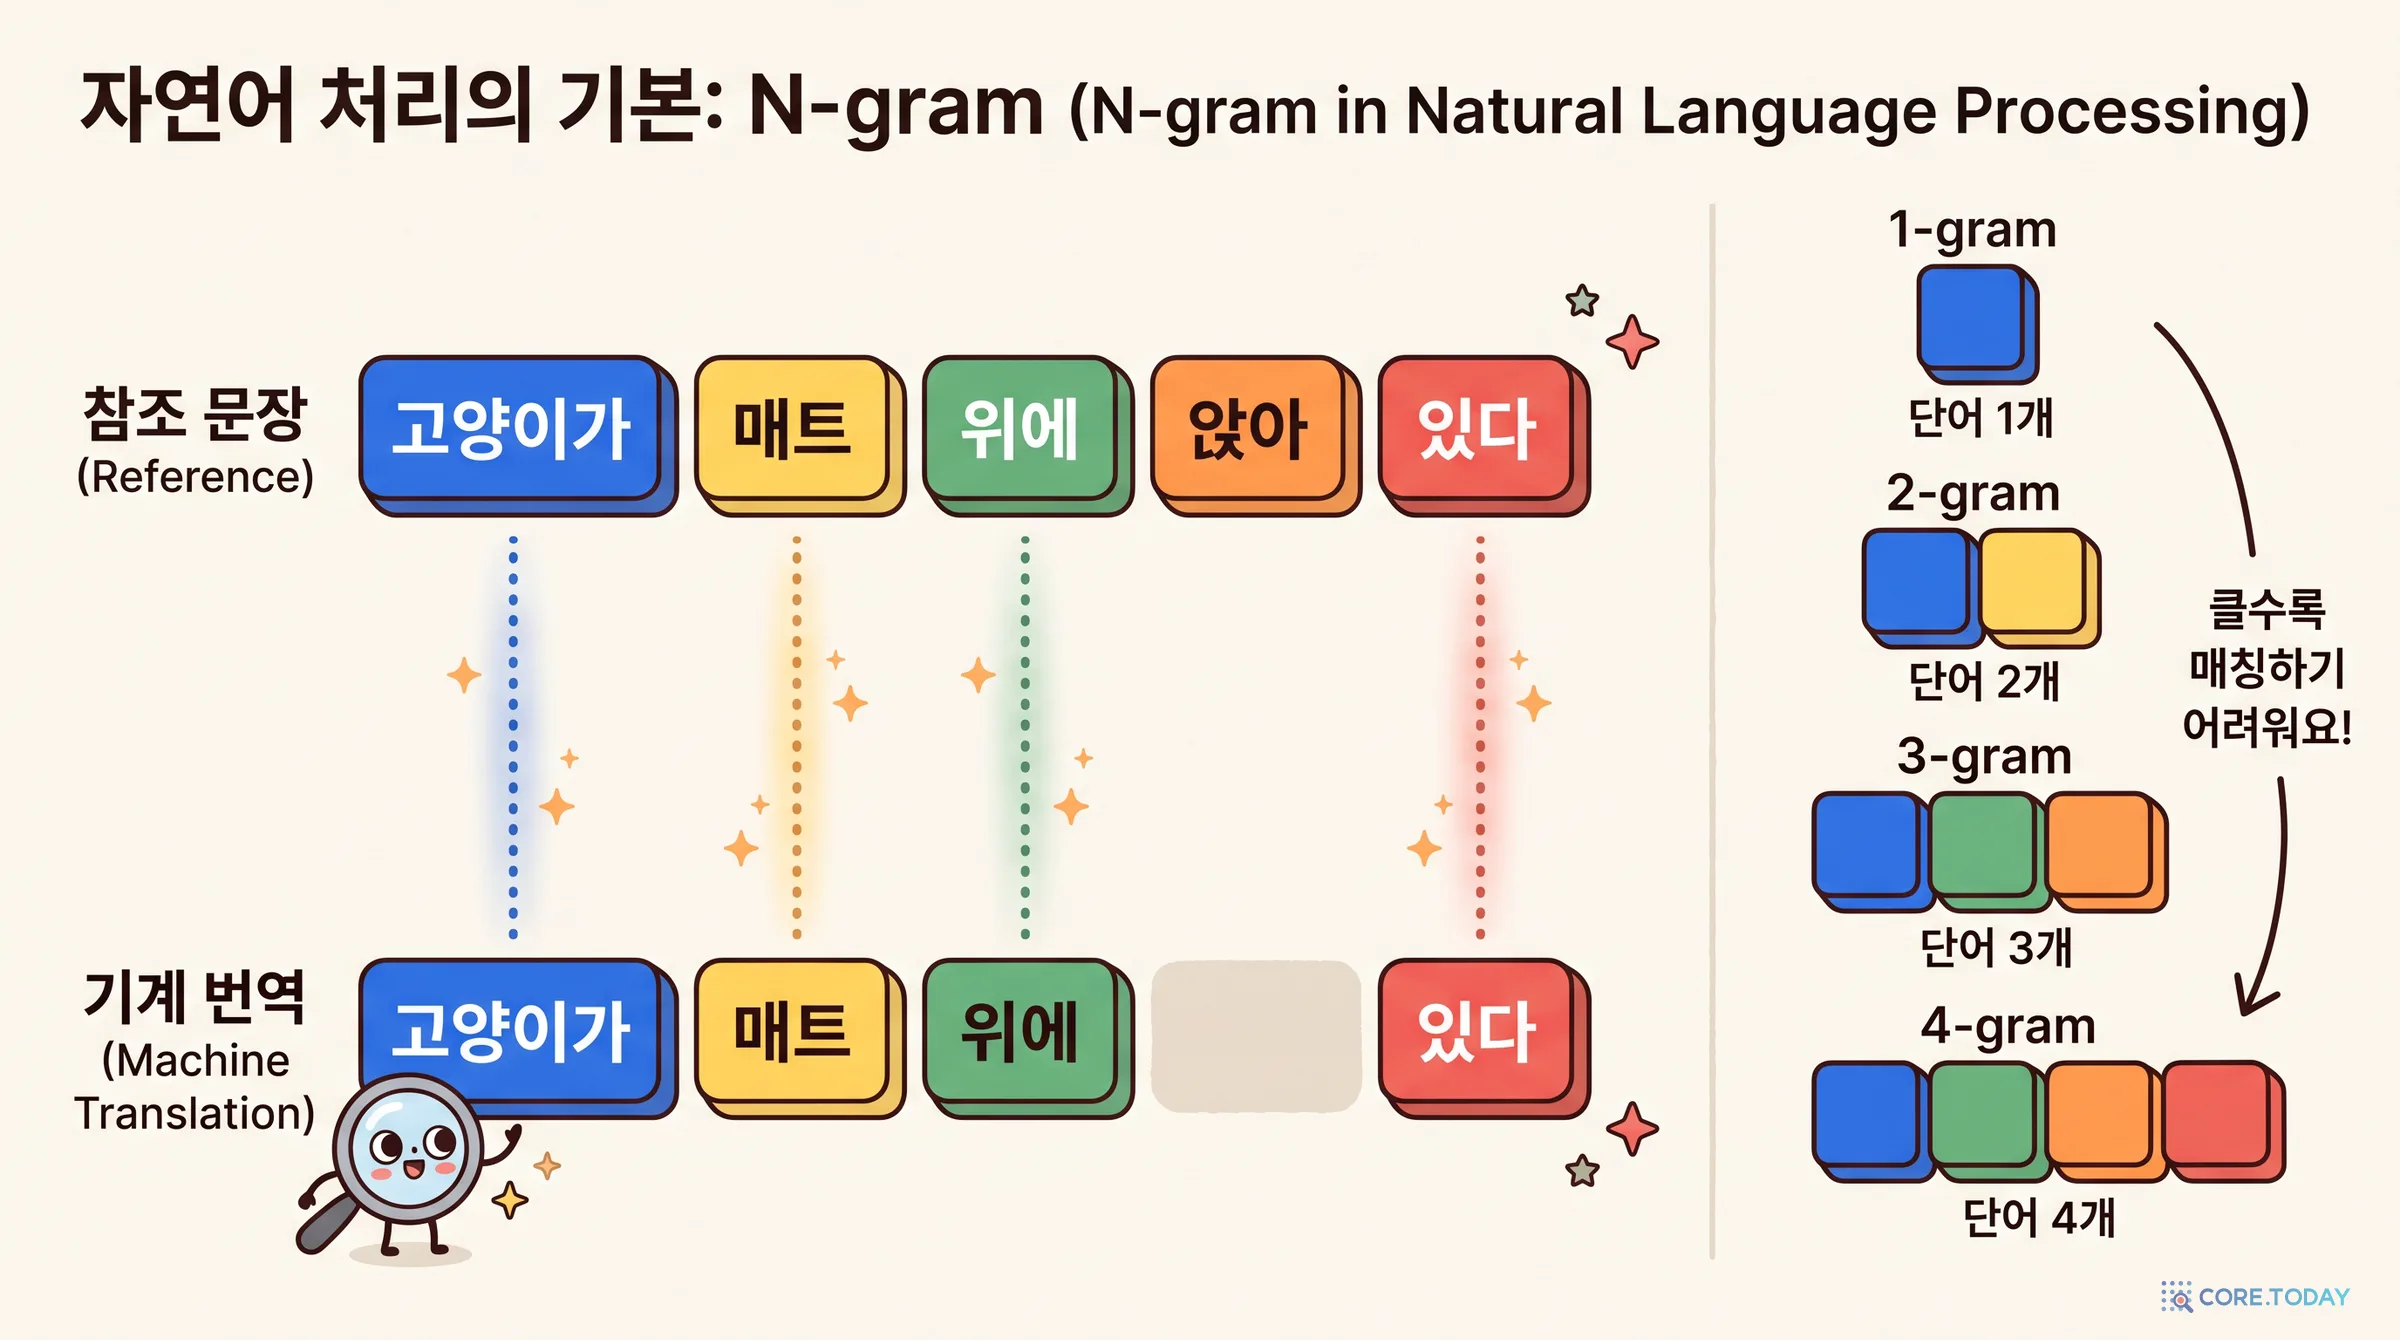
n-gram은 연속된 n개의 단어 묶음이다. "고양이가 매트 위에 앉아 있다"를 자르면 이렇다.
이름
조각
무엇을 보나
1-gram (유니그램)
고양이가 / 매트 / 위에 / 앉아 / 있다
맞는 단어를 골랐나
2-gram (바이그램)
고양이가 매트 / 매트 위에 / 위에 앉아 / 앉아 있다
단어를 자연스럽게 이었나
3-gram
고양이가 매트 위에 / 매트 위에 앉아 / 위에 앉아 있다
구절이 매끄러운가
4-gram
고양이가 매트 위에 앉아 / 매트 위에 앉아 있다
문장 흐름이 사람 같은가
논문은 조각의 길이마다 역할이 다르다고 봤다.
참조와 같은 단어(1-gram)를 쓴 번역은 적절성(adequacy)을 만족하는 경향이 있다. 더 긴 n-gram의 일치는 유창성(fluency)을 반영한다.
1-gram만 맞으면 단어는 골랐지만 엉터리로 늘어놓았을 수 있다. 4-gram까지 맞으면 사람이 쓴 문장과 흐름까지 닮았다는 뜻이다. BLEU는 1부터 4까지를 모두 본다.
2.2 부품 ② 정밀도 — "내가 쓴 조각 중 몇 개가 맞았나"
가장 단순한 채점법은 이렇다. 기계 번역(후보)에 나온 조각 하나하나가 사람 번역(참조)에도 나오는지 확인하고, 맞은 비율을 낸다. 이것이 정밀도(precision)다.
정밀도=후보의전체조각수참조에도나오는후보의조각수
논문의 첫 예제를 보자. 중국어 원문 하나에 사람 번역이 셋 있다.
참조 1
It is a guide to action that ensures that the military will forever heed Party commands.
참조 2
It is the guiding principle which guarantees the military forces always being under the command of the Party.
참조 3
It is the practical guide for the army always to heed the directions of the party.
후보 1 (좋은 번역)
It is a guide to action which ensures that the military always obeys the commands of the party.
후보 2 (나쁜 번역)
It is to insure the troops forever hearing the activity guidebook that party direct.
논문이 계산한 값은 이렇다. 후보 1의 1-gram 정밀도는 17/18, 2-gram은 10/17이다. 후보 2는 1-gram 8/14, 2-gram 1/13이다. 후보 2도 단어는 절반 넘게 맞혔다. 그러나 단어를 이어 붙인 조각은 거의 맞지 않는다. 1-gram은 비슷한데 2-gram에서 차이가 확 벌어진다. 긴 조각이 유창성을 잡아낸다는 말이 이런 뜻이다.
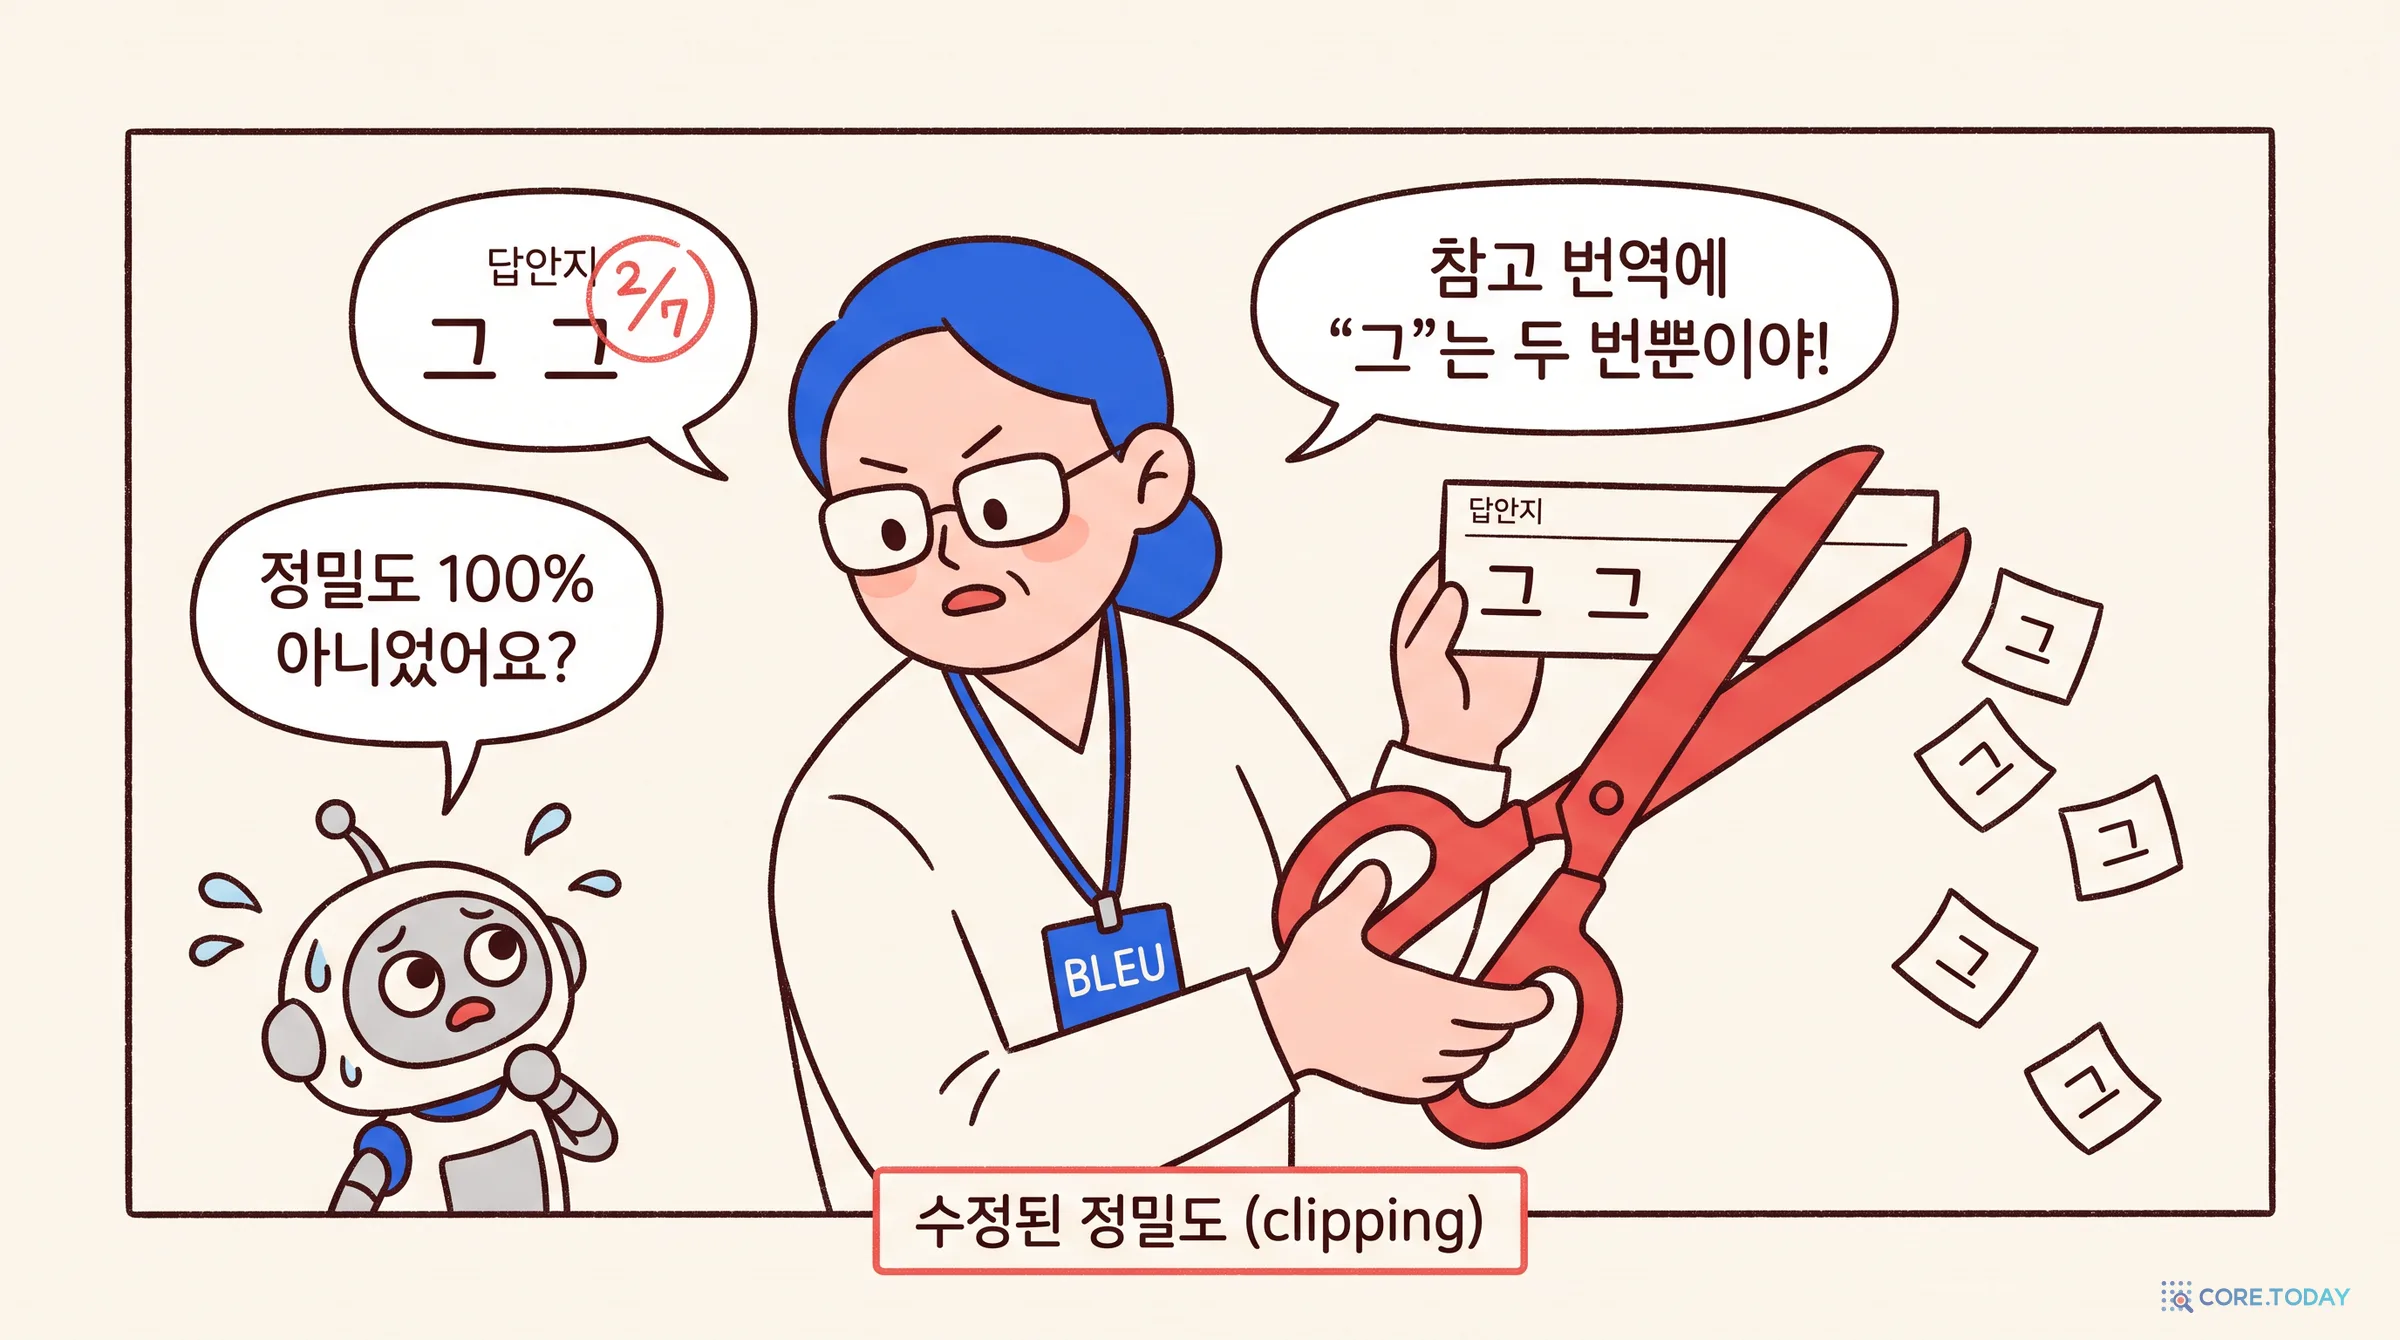
후보 : the the the the the the the 참조 1: The cat is on the mat. 참조 2: There is a cat on the mat.
단순 정밀도 = 7/7 = 100% ← "the"는 참조에 있으니까 수정 정밀도 = 2/7 ≈ 29% ← 참조 1에 "the"는 최대 두 번
"the" 일곱 개는 모두 참조에 나오는 단어다. 그러니 단순 정밀도는 만점이다. 하지만 이것은 번역이 아니다. 이 구멍을 막는 규칙이 클리핑(clipping)이다. 어떤 조각이든, 한 참조 안에 나오는 최대 횟수까지만 인정한다. 참조 1에 "the"가 두 번 나오므로 아무리 많이 써도 2개까지만 맞은 것으로 친다.
Countclip=min(후보에서나온횟수,한참조에서나온최대횟수)
논문은 이것을 수정된 n-gram 정밀도(modified n-gram precision)라고 불렀다. 같은 말을 반복해 점수를 부풀리는 꼼수는 이 규칙 하나로 막힌다.
2.4 부품 ④ 기하평균 — 네 개의 정밀도를 하나로
이제 1~4-gram 정밀도 네 개가 생겼다. 하나로 합쳐야 한다. 그냥 더해서 4로 나누면 될까?
논문의 그림 2가 문제를 보여 준다. 정밀도는 n이 커질수록 대략 지수적으로 떨어진다. 1-gram이 60%라면 4-gram은 10%가 안 되는 일이 흔하다. 산술평균을 내면 큰 값인 1-gram이 결과를 지배하고, 4-gram이 아무리 오르거나 내려도 티가 나지 않는다.
그래서 BLEU는 로그를 취해 평균을 낸다. 이것은 기하평균과 같다.
(p1⋅p2⋅p3⋅p4)1/4=exp(41n=1∑4logpn)
기하평균에는 성질이 하나 있다. 곱셈이므로 하나라도 0이면 전체가 0이다. 논문도 각주에서 "정밀도 중 하나라도 0이면 기하평균은 가혹하다. 하지만 적당한 크기의 말뭉치에서는 극히 드문 일"이라고 인정했다.
"적당한 크기의 말뭉치"라는 단서에 주목하자. 문장 하나만 채점하면 4-gram이 하나도 안 맞는 일은 흔하다. 그래서 문장 단위 BLEU를 쓸 때는 0을 작은 값으로 바꾸는 스무딩(smoothing)을 붙인다. Chen과 Cherry(2014)는 그런 기법 일곱 가지를 비교했다. 맨 앞의 퀴즈에서 B가 0점이 아니라 31.9점을 받은 것도 sacreBLEU의 기본 스무딩 덕분이다.
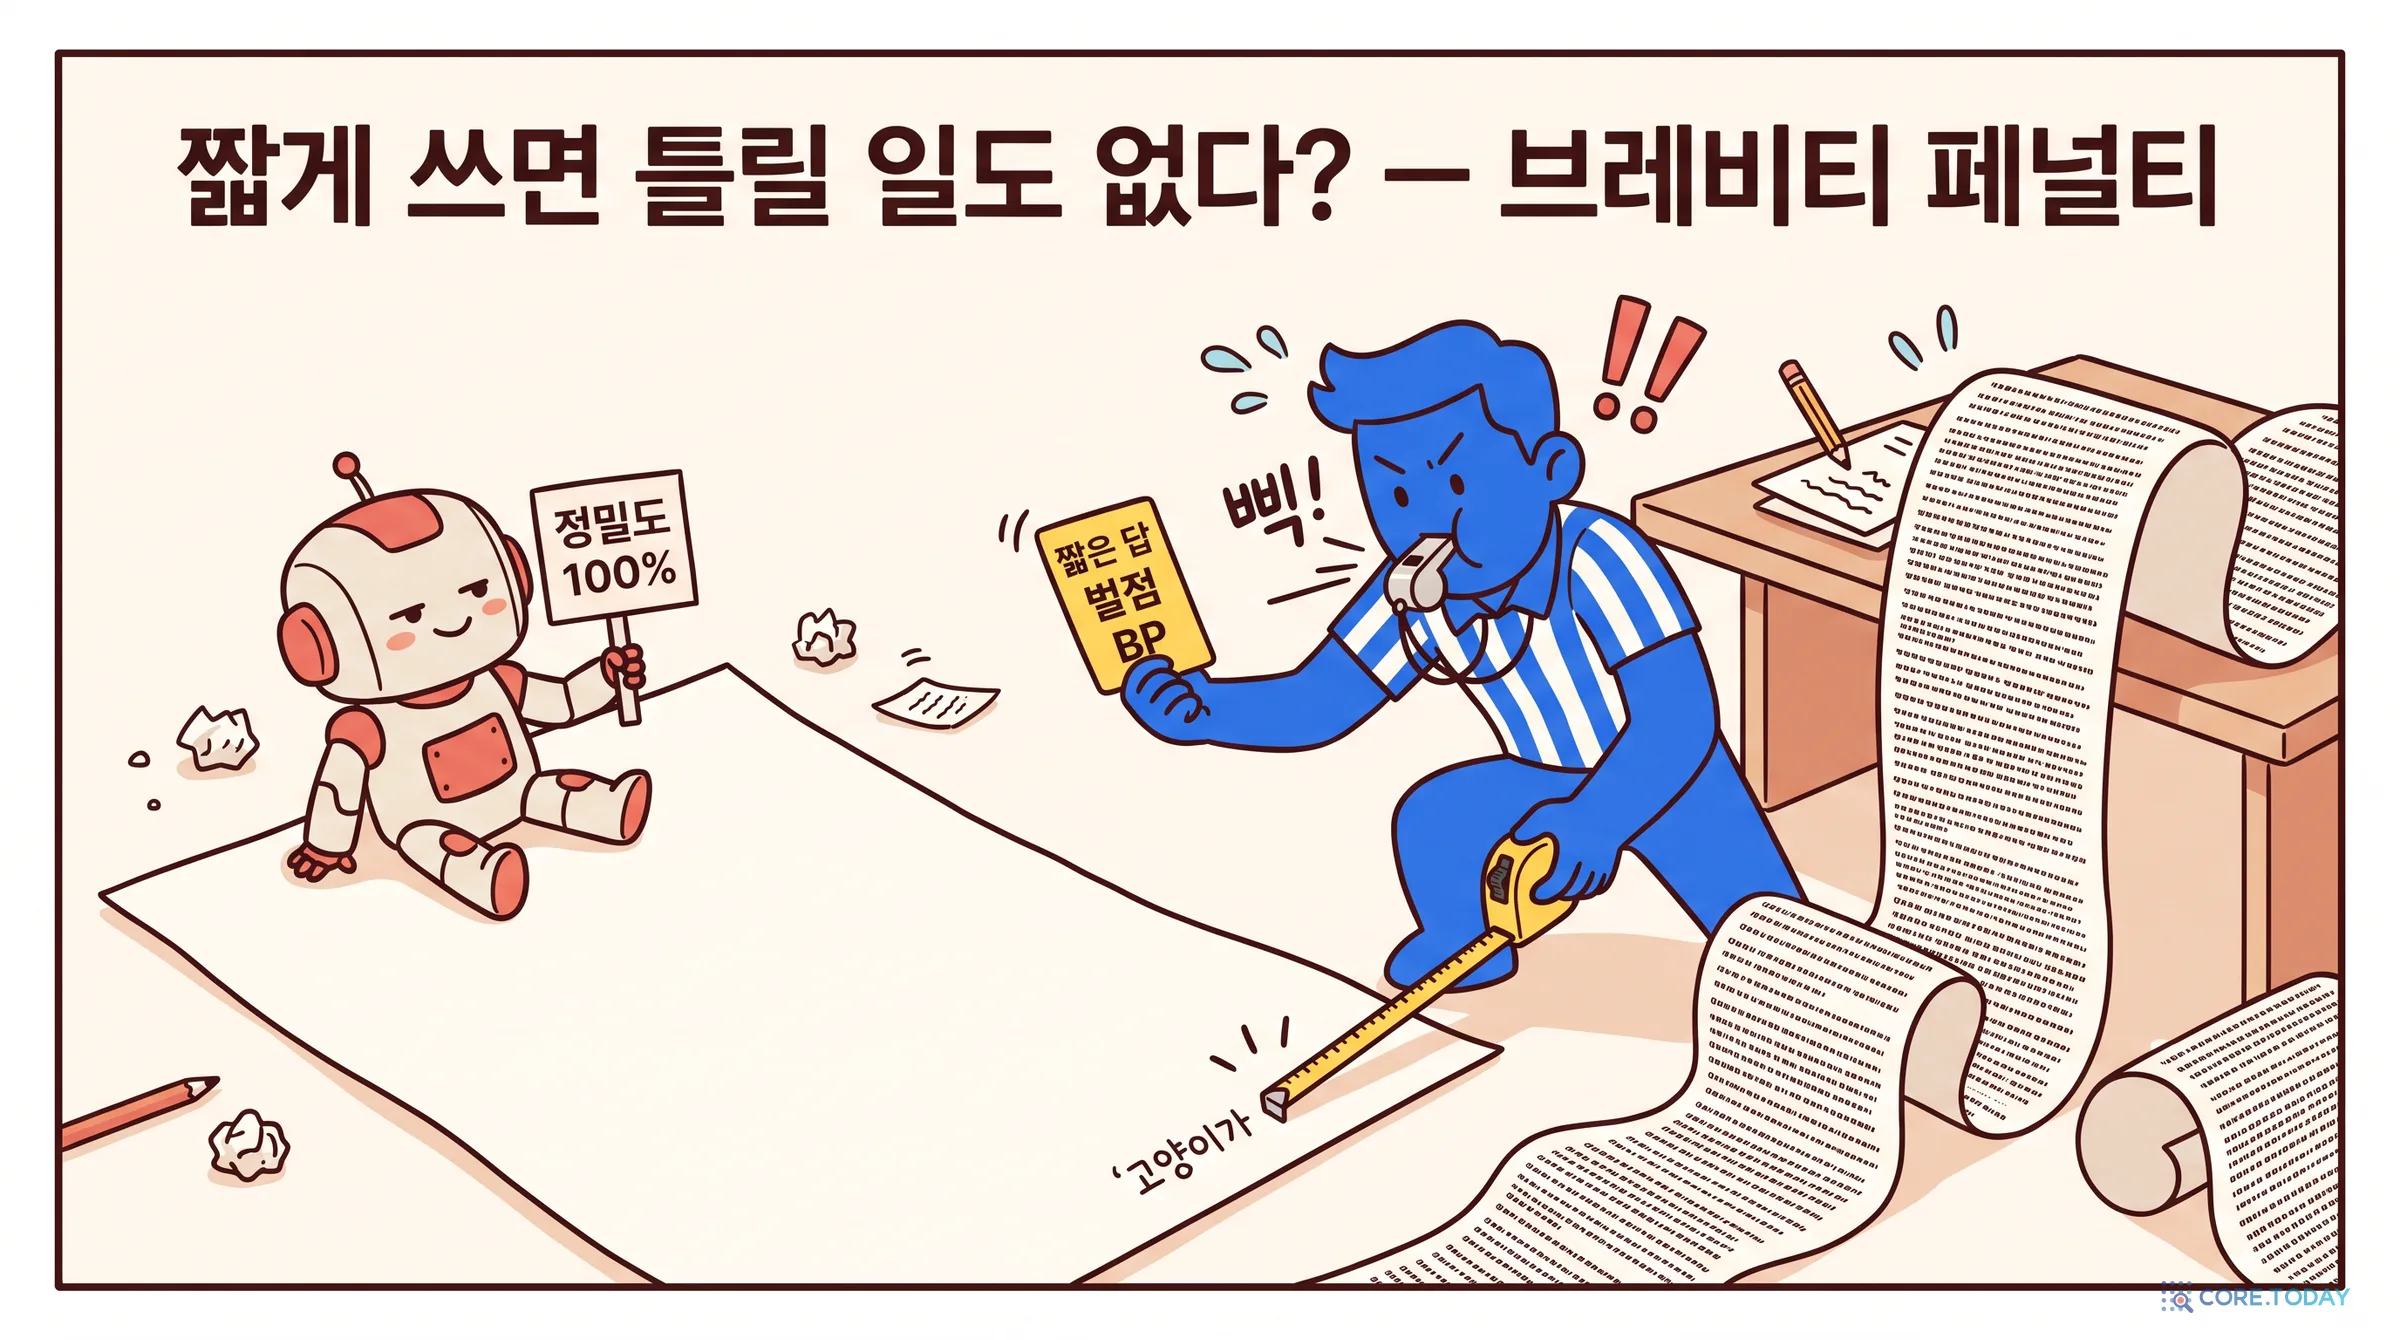
정밀도에는 허점이 하나 더 있다. 짧게 쓰면 이긴다. 참조가 "고양이가 매트 위에 앉아 있다"일 때 후보가 "고양이가 매트 위에"라고만 쓰면 어떻게 될까. 쓴 말이 전부 맞으니 1~3-gram 정밀도가 모두 100%다. 논문의 Example 3도 "of the" 두 단어로 1-gram 2/2, 2-gram 1/1을 받는 예를 보여 준다.
보통은 이럴 때 재현율(recall)을 함께 본다. "참조에 있는 말 중 몇 개를 썼나"를 세면 짧은 답이 걸린다. 그런데 BLEU는 재현율을 쓸 수 없었다. 참조가 여러 개이기 때문이다. 논문 2.2.1절의 예가 이 문제를 보여 준다.
재현율이 안 되는 이유 (Example 4)
후보 1: I always invariably perpetually do. 후보 2: I always do. 참조 1: I always do. 참조 2: I invariably do. 참조 3: I perpetually do.
후보 1은 세 참조의 단어를 모두 "기억"했다 → 재현율로는 후보 1이 이긴다 그러나 좋은 번역은 분명히 후보 2다
참조가 여럿이면 각 참조는 서로 다른 단어를 고른다. 그 단어를 전부 쓰라고 요구하는 것은 말이 안 된다. 그래서 BLEU는 재현율 대신 길이만 따로 본다. 후보가 참조보다 짧으면 벌점을 매긴다. 이것이 브레비티 페널티(Brevity Penalty, BP)다.
BP={1e1−r/cc>rc≤r
여기서 c는 후보의 길이, r은 참조의 길이다. 참조가 여럿이면 후보 길이에 가장 가까운 참조를 쓴다. 후보가 참조보다 길면 벌점이 없다. 길면 쓸데없는 조각이 늘어나 정밀도가 알아서 떨어지기 때문이다. 짧을 때만 지수적으로 깎는다. 참조의 절반 길이라면 BP는 e⁻¹ ≈ 0.37이다.
2.6 조립 완성 — 그리고 직접 돌려 보기
다섯 부품을 합친 공식이다.
BLEU=BP⋅exp(n=1∑441logpn)
원 논문의 점수 범위는 0~1이다. 지금은 보통 100을 곱해 0~100으로 쓴다. 사람 번역과 글자 하나까지 같아야 100이다.
아래 실험실에서 부품 하나하나를 켜고 꺼 보자. 클리핑을 끄면 "the the the…"의 점수가 어떻게 되는지, '짧게 쓰기 꼼수'에서 BP가 얼마나 깎는지, 한국어 의역은 왜 단위를 바꿔도 0점인지 직접 확인할 수 있다. 계산은 sacreBLEU와 같은 규칙으로 하고, 원본 파이썬 출력과 소수점 여섯째 자리까지 맞는지 자동 테스트로 대조했다.
실험실에서 논문 예시 ①을 보면 1-gram이 17/18이 아니라 18/19로 나온다. 논문은 마침표를 세지 않았고, 표준 구현체 sacreBLEU는 마침표도 조각 하나로 센다. 같은 'BLEU'라도 문장을 자르는 방식에 따라 숫자가 달라진다. 사소해 보이는 이 차이가 4부와 5부에서 큰 문제로 돌아온다.
2.7 문장 하나를 재는 도구가 아니다
BLEU에 대해 가장 많이 오해하는 점이 이것이다. BLEU는 말뭉치(corpus)를 재는 도구다. 논문의 각주 4는 이렇게 못 박는다.
BLEU는 테스트 말뭉치 전체에 대해 평균했을 때만 사람의 판단과 맞으면 된다. 개별 문장의 점수는 사람의 판단과 자주 어긋날 것이다. 예를 들어 유창한 표현 "East Asian economy"를 쓴 시스템은, 참조가 모두 "economy of East Asia"라고 쓰고 있다면 긴 n-gram 정밀도에서 큰 감점을 받는다.
이것은 들어가며의 "미팅이 하루 미뤄졌어요" 문제와 같다. 저자들은 2002년에 이미 이 한계를 알았다. 그래도 이 방식이 통한다고 본 근거는 이렇다. "모든 시스템이 똑같이 취급되고, 스타일이 다른 여러 번역가의 참조를 쓰므로 이런 효과는 시스템끼리 비교할 때 상쇄된다."
그래서 계산 방식도 문장 점수의 평균이 아니다. 모든 문장의 맞은 조각 수와 전체 조각 수를 먼저 더한 뒤 한 번에 나눈다. BP도 말뭉치 전체 길이로 계산한다. 문장 하나하나는 들쭉날쭉해도 수백 문장을 모으면 시스템 사이의 차이가 드러난다는 것이 BLEU의 기본 가정이다.
2.8 검증 — 상관계수 0.99
논문의 검증 실험은 지금 기준으로는 작다.
항목
설정
테스트 데이터
중국어→영어, 뉴스 기사 40건에서 뽑은 약 500문장
채점 대상
상용 기계 번역 3개(S1·S2·S3) + 사람 번역 2개(H1: 비원어민, H2: 영어 원어민)
사람 평가단
영어 원어민 10명(단일언어) + 중국어 원어민 10명(이중언어). 모두 전문 번역가는 아님
시스템 다섯 개의 순위를 BLEU가 사람과 거의 똑같이 매겼다. 하룻밤이면 끝나는 계산이 석 달짜리 평가의 결론을 재현한 것이다. 이 결과가 분야를 바꿨다.
하나 더 눈여겨볼 숫자가 있다. 같은 사람 번역 H2가 참조 2개로 채점하면 0.2571, 참조 4개로 채점하면 0.3468을 받았다. 번역은 그대로인데 정답지의 수가 바뀌니 점수가 35% 올랐다. BLEU 점수는 절대값이 아니라 조건부 값이다. "BLEU 30이면 좋은 번역인가?"라는 질문에는 답이 없다. 어떤 데이터에서, 참조 몇 개로, 어떻게 잘라서 쟀는지에 따라 달라진다.
3부. ROUGE — 요약을 위해 뒤집은 BLEU
3.1 요약은 무엇이 다른가
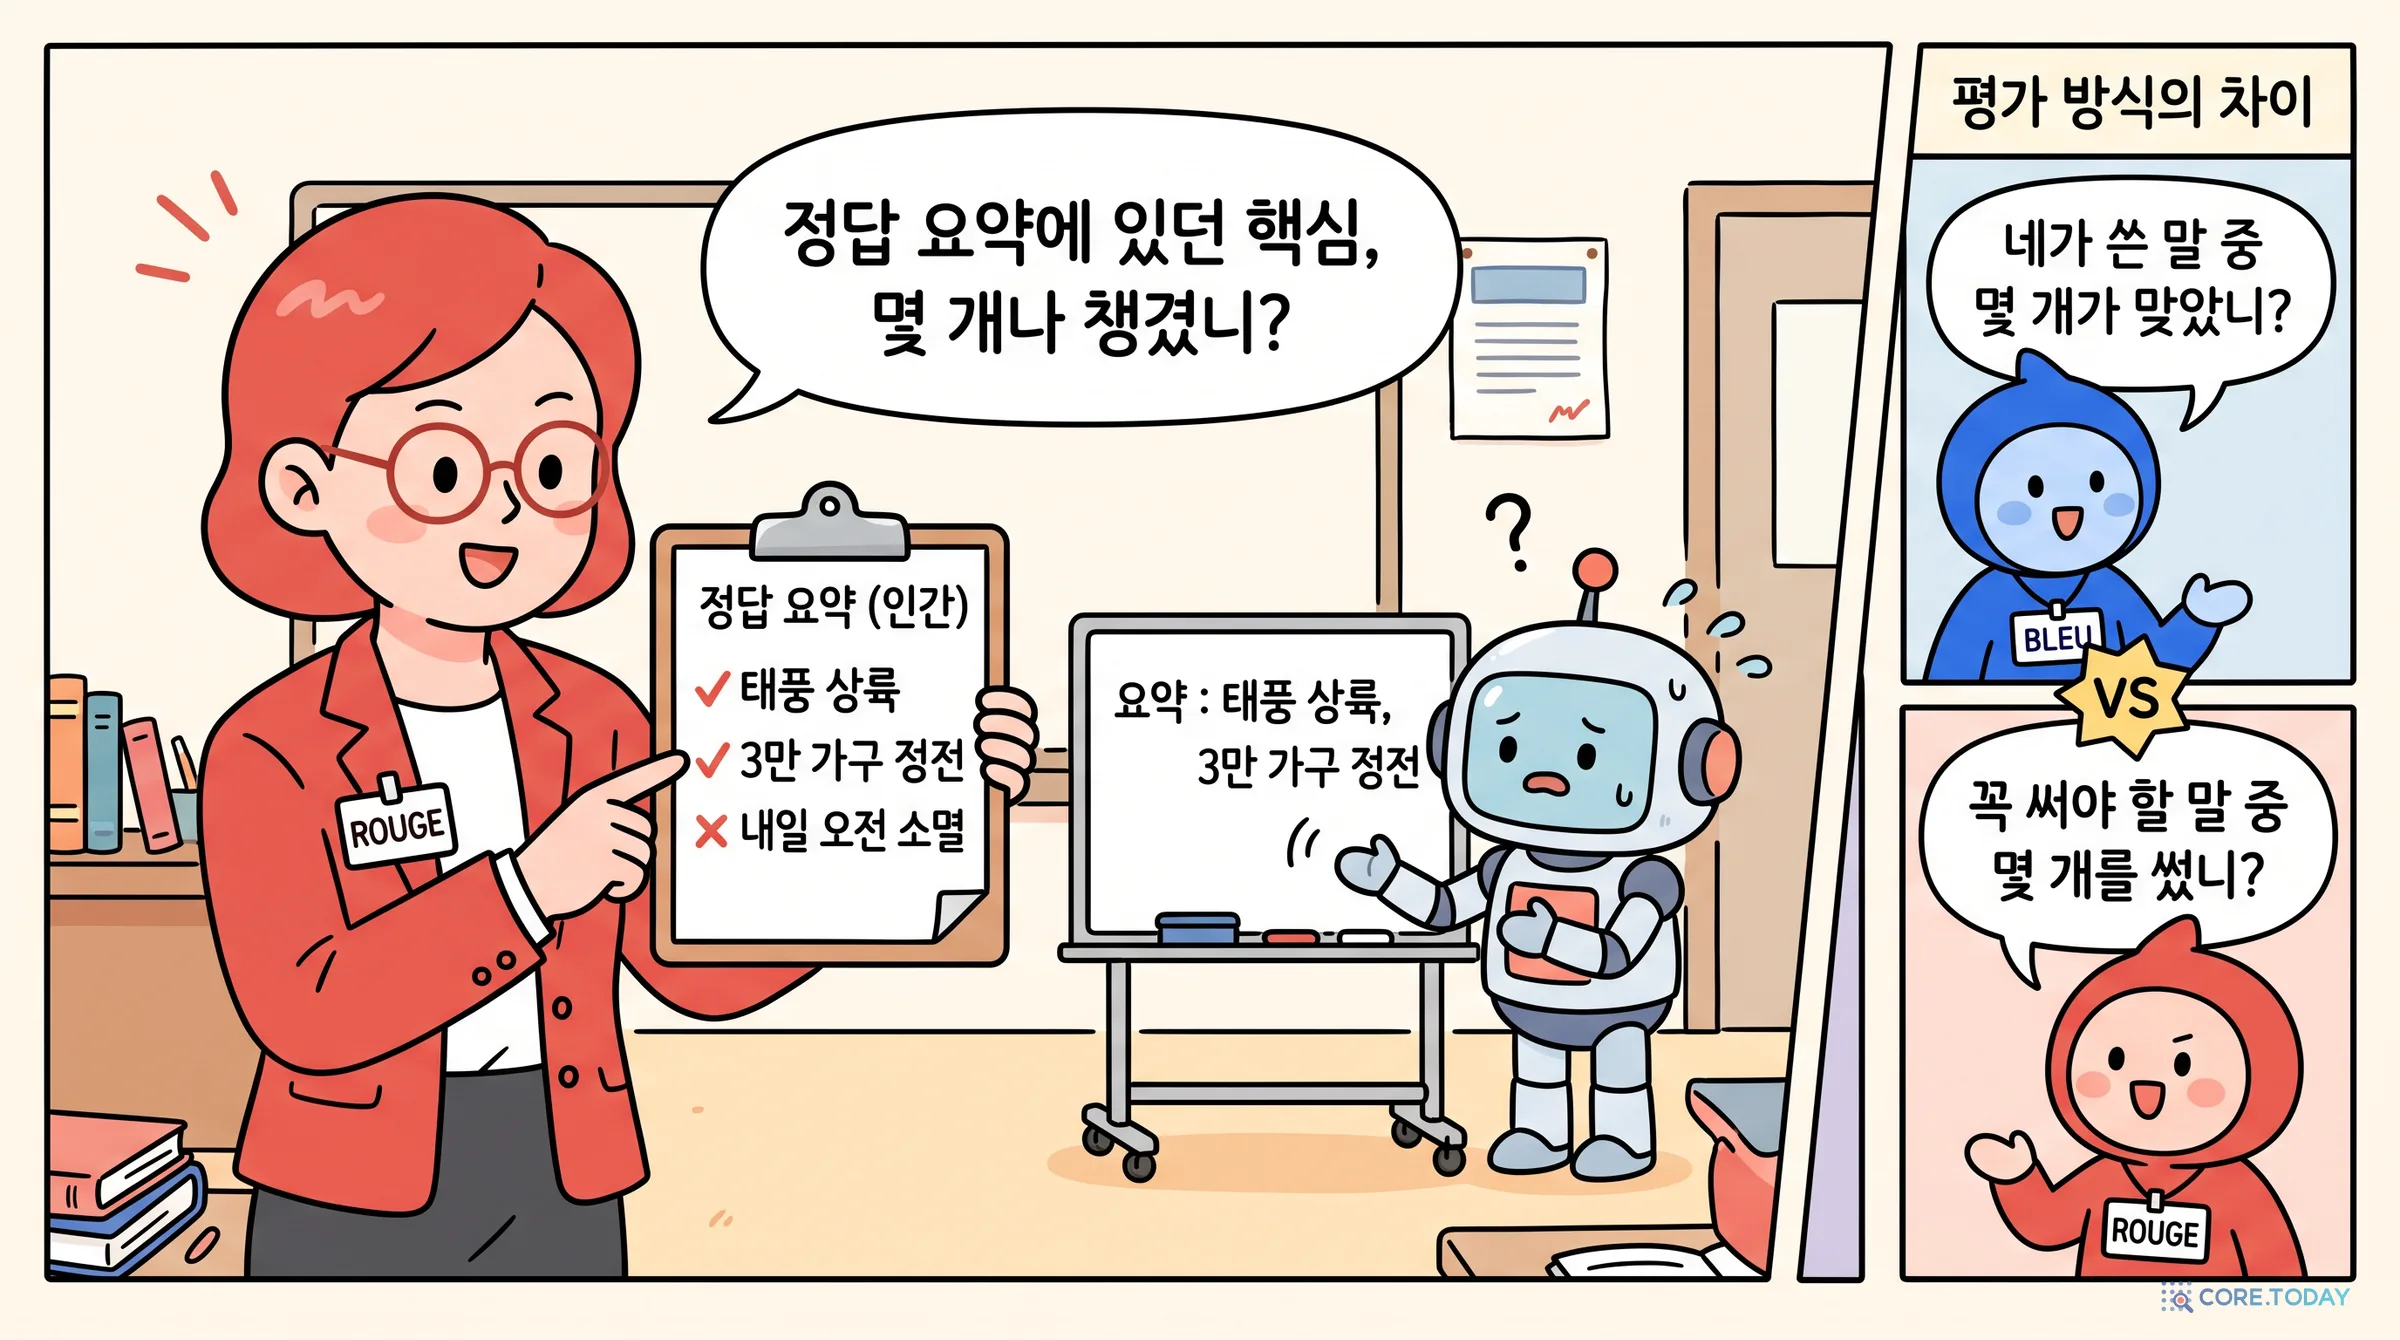
번역에서 가장 큰 죄는 틀린 말을 하는 것이다. 그래서 BLEU는 정밀도, 곧 "내가 쓴 말이 맞았나"를 중심에 뒀다.
요약은 사정이 다르다. 요약에서 가장 큰 죄는 중요한 것을 빠뜨리는 것이다. 태풍 기사를 요약하면서 "3만 가구 정전"을 빠뜨렸다면, 쓴 말이 전부 맞아도 나쁜 요약이다.
요약 평가도 번역만큼 비쌌다. 미국 NIST는 2001년부터 요약 평가대회 DUC(Document Understanding Conference)를 열었다. 2008년에는 TAC의 요약 트랙으로 이어진다. ROUGE 논문은 DUC 규모의 간단한 수동 평가에도 3,000시간이 넘는 사람의 노동이 들었다고 적었다.
BLEU가 번역에서 성공하자 요약 연구자들도 같은 길을 찾았다. BLEU 논문의 결론부에도 이런 문장이 있었다. "BLEU는 요약이나 비슷한 자연어 생성 과제의 평가에도 응용할 수 있을 것이다." 2003년 남캘리포니아대 정보과학연구소(ISI)의 Chin-Yew Lin과 Eduard Hovy는 n-gram 동시 출현 통계가 요약 평가에도 통한다는 것을 보였다. 2004년, Lin은 이를 정리한 패키지를 공개했다.
이름부터 짝이다. Recall-Oriented Understudy for Gisting Evaluation. '요지(gist) 평가를 위한 재현율 중심 대역 배우'다. 블루(파랑) 옆에 루주(빨강)를 세운 셈이다. 'Understudy'라는 단어도 BLEU에서 그대로 물려받았다.
ROUGE-N은 BLEU와 같은 n-gram을 센다. 분모가 다르다.
BLEU (정밀도)
ROUGE-N (재현율)
묻는 질문
내가 쓴 조각 중 몇 개가 정답에 있나?
정답의 조각 중 몇 개를 내가 썼나?
분모
후보(기계 출력)의 조각 수
참조(사람 정답)의 조각 수
막으려는 실수
틀린 말, 엉뚱한 말
빠뜨린 말
약점
짧게 쓰면 이김 → BP로 보정
길게 쓰면 이김 → 길이 제한·F1로 보정
ROUGE-N=∑참조참조의 n-gram 수∑참조겹친 n-gram 수
재현율의 약점은 정밀도와 정확히 반대다. 길게 쓰면 이긴다. 원문을 통째로 베끼면 참조의 단어는 거의 다 들어간다. DUC는 요약 길이를 "100단어"처럼 고정해 이 문제를 피했다. 요즘은 대개 정밀도와 재현율의 조화평균인 F1을 함께 보고한다.
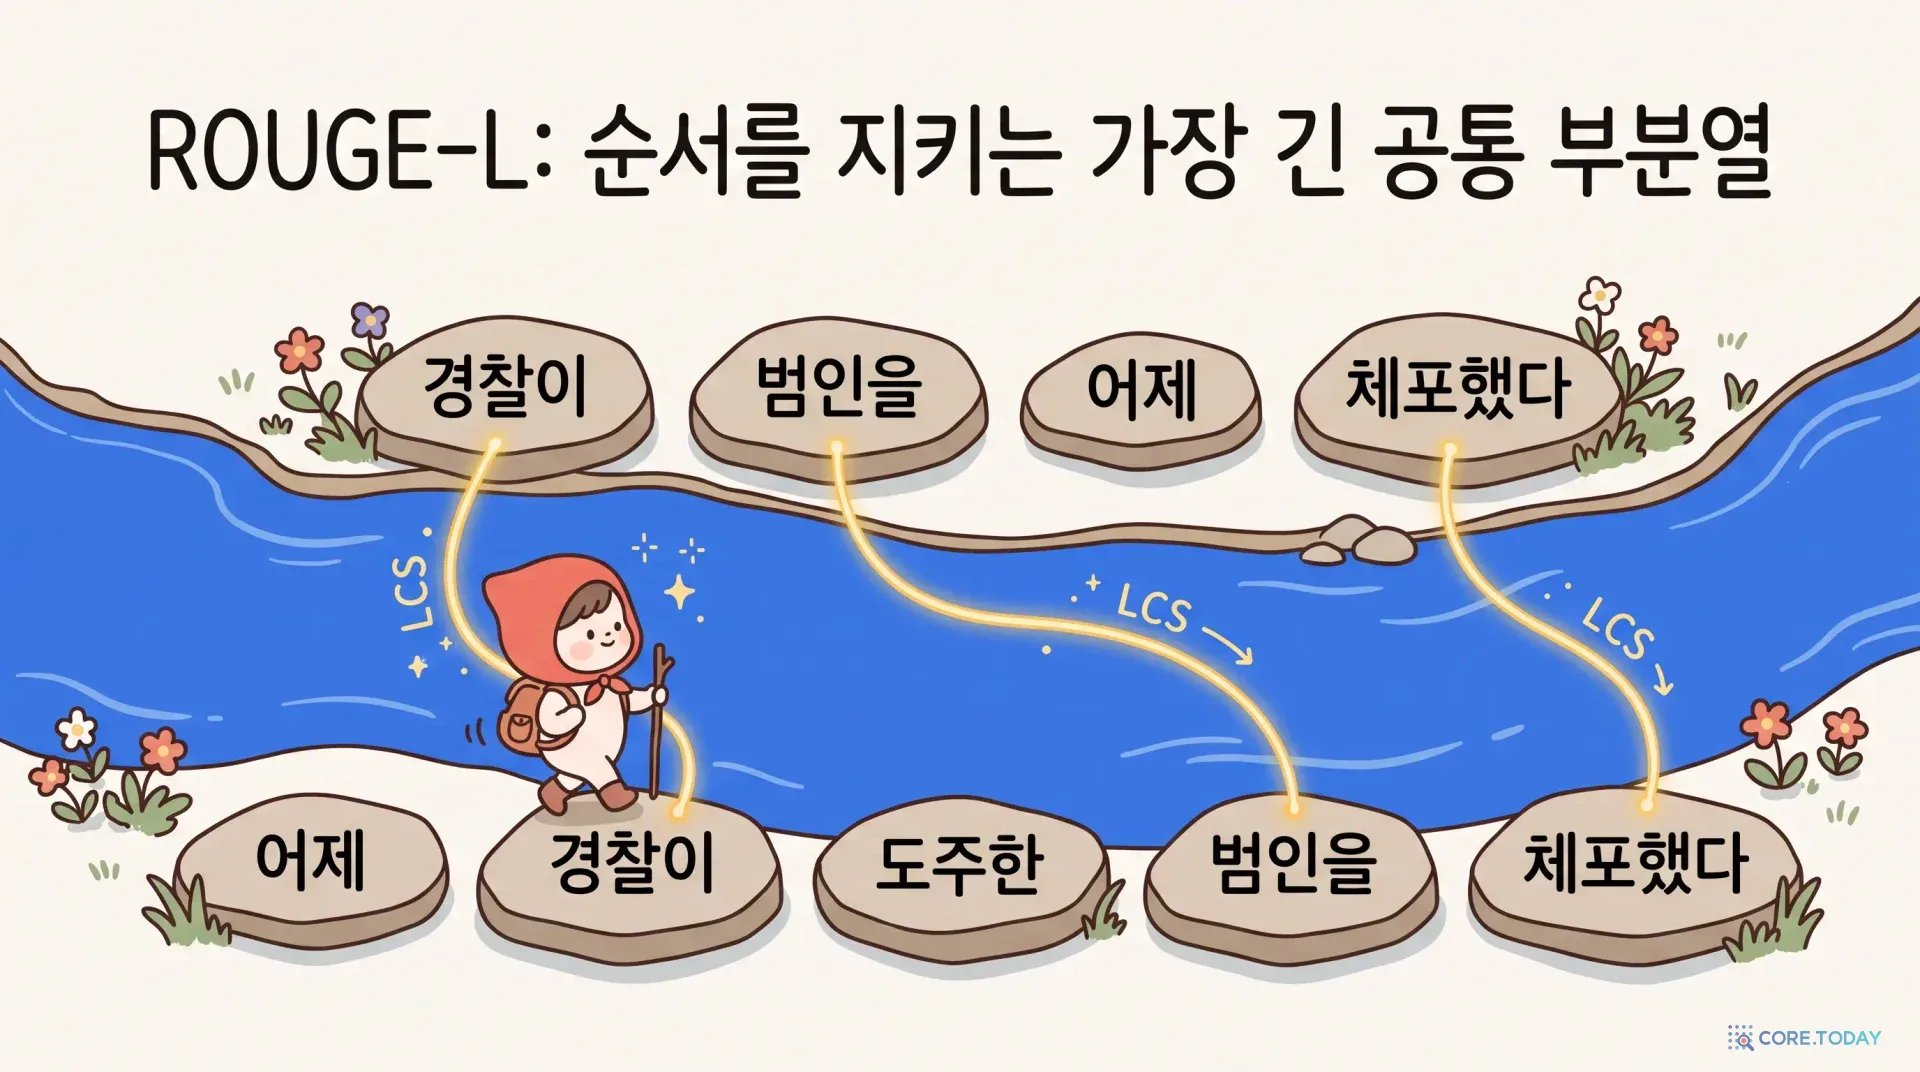
n-gram은 붙어 있는 조각만 본다. 그런데 요약에서는 단어 사이에 다른 말이 끼어드는 일이 흔하다. "경찰이 범인을 어제 체포했다"와 "어제 경찰이 도주한 범인을 체포했다"를 보자. 2-gram은 하나도 겹치지 않는다. 그런데 사람이 보기엔 거의 같은 문장이다.
ROUGE-L은 최장 공통 부분열(Longest Common Subsequence, LCS)을 쓴다. 순서는 지키되 붙어 있을 필요는 없는 가장 긴 공통 단어열이다. 위 예에서는 "경찰이 … 범인을 … 체포했다" 세 단어가 LCS다. "어제"도 양쪽에 있지만, 한쪽에서는 앞에 다른 쪽에서는 중간에 있어 순서를 지키며 함께 넣을 수 없다.
장점은 두 가지다. 연속된 조각을 몇 개로 정할지(n) 미리 고를 필요가 없다. 그리고 문장 구조가 비슷하면 사이에 다른 말이 끼어도 점수를 준다. 앞 문장을 참조, 뒤 문장을 후보로 놓고 계산하면 ROUGE-2는 0인데 ROUGE-L 재현율은 3/4 = 0.75다.
ROUGE에는 형제가 더 있다. ROUGE-W는 LCS 중에서도 연속으로 붙은 구간에 가중치를 더 준다. ROUGE-S는 사이에 다른 단어가 끼어도 되는 단어 쌍(스킵-바이그램)을 센다. ROUGE-SU는 거기에 1-gram을 더한다. Lin은 이 변형들을 모두 17가지 측정치로 시험했다.
결과는 이렇다. 단일 문서 요약(DUC 2002)에서 ROUGE-2·L·W·S가 사람 평가와 0.98~0.99의 상관을 보였다. 10단어짜리 헤드라인 요약에서는 ROUGE-1·L·W·SU가 잘 맞았다. 하지만 여러 문서를 하나로 요약하는 과제에서는 0.9대 상관을 얻기 어려웠다. 불용어를 빼면 상관이 대체로 올랐고, 참조 요약이 많을수록 상관도 올랐다.
3.4 직접 채점해 보기
같은 태풍 기사에 대한 요약 다섯 개를 채점해 보자. 특히 '단어 뒤섞기'와 '사실이 틀린 요약'의 점수를 눈여겨보자.
뒤섞기에서 ROUGE-1이 만점이 나오는 이유는 간단하다. 참조의 단어를 하나도 빠짐없이 갖고 있기 때문이다. 순서를 보는 ROUGE-2와 ROUGE-L만 반토막이 난다. 사실이 틀린 요약은 더 불편하다. 지명과 숫자 두 개가 틀린 오보가 꼼꼼한 요약보다 높은 점수를 받는다. ROUGE에게 "남해안"과 "서해안"은 그냥 다른 단어 하나일 뿐이다.
4부. 20년 동안 순위표를 지배한 숫자
4.1 BLEU가 바꾼 연구 방식
BLEU가 나온 뒤 기계 번역 연구는 말 그대로 빨라졌다. 매일 밤 실험을 돌리고 아침에 BLEU를 확인하는 생활이 가능해졌다. 2003년 Franz Och의 최소 오류율 학습(MERT)은 한 걸음 더 나갔다. 번역 시스템의 파라미터를 BLEU를 직접 최대화하도록 튜닝한 것이다. 채점기가 리허설용 대역에서 훈련 목표가 된 순간이다.
신경망 번역 시대에도 BLEU는 순위표의 언어였다. 몇 가지 유명한 숫자를 보자.
연도
사건
BLEU
2016
구글 신경망 번역(GNMT) — 8개 모델 앙상블
영→불 41.16, 영→독 26.30
2017
Transformer, "Attention Is All You Need"
WMT14 영→독 28.4, 영→불 41.0(학회본)·41.8(arXiv 최종판)
2018
BLEU 논문, NAACL 2018 '시간의 시험(Test-of-Time)' 상
—
Transformer 논문의 영→불 점수가 판본마다 다르다는 사실도 흥미롭다. 한 숫자가 논문 판본에 따라 41.0, 41.1, 41.8로 다르게 남아 있다. 인용할 때 어느 판본인지 밝혀야 하는 숫자가 된 것이다.
요약 분야에서는 ROUGE가 같은 역할을 했다. CNN/DailyMail, XSum 같은 데이터셋의 순위표는 ROUGE-1/2/L 세 숫자로 줄 세워졌다. 2022년 스탠퍼드의 대규모 언어 모델 평가 HELM도 요약 과제의 자동 지표로 ROUGE-2를 썼다.
인용 수도 그 지위를 보여 준다. OpenAlex 기준(2026년 11월) BLEU 논문은 21,696회, ROUGE 논문은 9,715회 인용됐다.
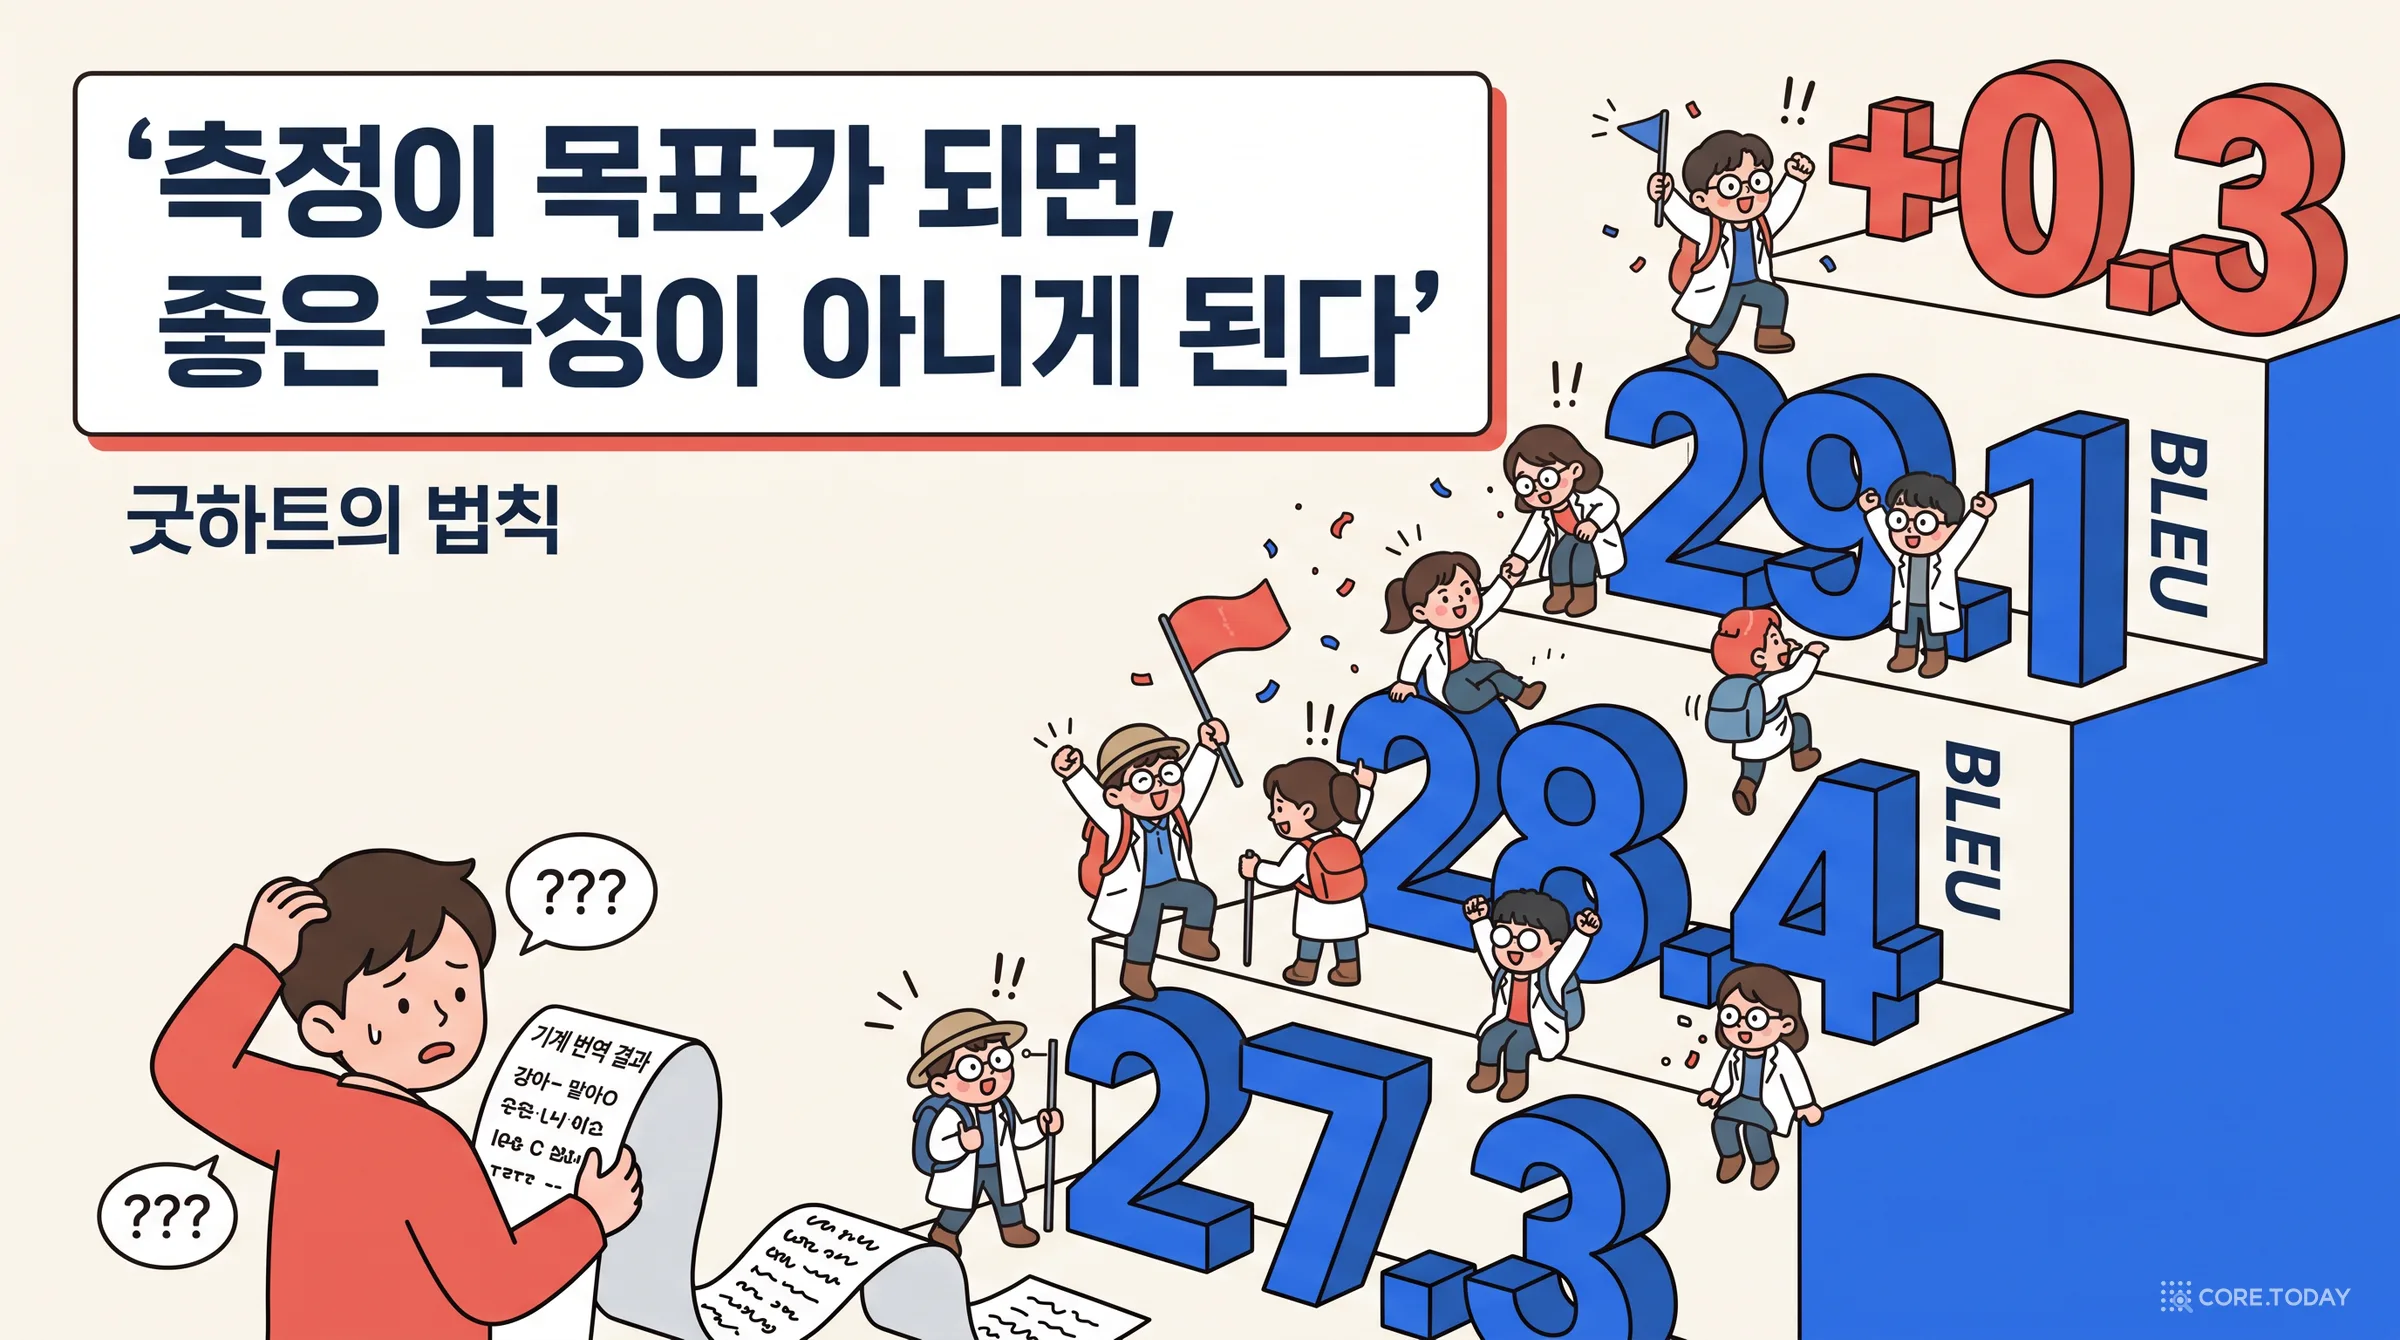
경제학자 찰스 굿하트의 이름이 붙은 법칙이 있다. 인류학자 메릴린 스트래선의 간결한 표현으로 널리 알려졌다. "측정이 목표가 되면, 더는 좋은 측정이 아니다."
BLEU와 ROUGE는 이 법칙의 교과서 같은 사례다. 처음에는 "사람이 좋다고 할 번역은 BLEU도 높다"는 관찰이 있었다. 그런데 연구자들이 BLEU를 직접 올리기 시작하자, 사람은 좋다고 하지 않는데 BLEU만 높은 번역이 나올 여지가 생겼다. 0.3점, 0.5점 차이로 "최신 기술(SOTA)"을 주장하는 논문이 쌓였다. 그 차이가 실제로 사람에게 보이는 차이인지는 아무도 확인하지 않았다.
대역 배우가 주연 자리에 오른 것이다. 이제 대역의 연기에 금이 가기 시작한 지점들을 사례로 살펴보자.
들어가며의 퀴즈가 첫 번째 사례다. BLEU와 ROUGE는 표면 형태만 비교한다. 동의어("회의"와 "미팅"), 어순 변화, 다른 문장 구조로 쓴 정답은 모두 감점이다. 반대로 뜻을 뒤집는 한 단어("않았다", "줄었다"), 틀린 숫자("20%"를 "200%"로), 틀린 고유명사("남해안"을 "서해안"으로)는 겨우 한 칸 차이로 취급된다.
퀴즈 2라운드의 결과를 다시 보자. 참조 "A사는 3분기 영업이익이 20% 늘었다고 밝혔다"에 대해 BLEU 1등은 "20% 줄었다"(64.3점)였다. 같은 사실을 다른 말로 쓴 "전년보다 5분의 1가량 증가했다"는 13.1점이었다. 투자자에게 어느 쪽이 더 위험한지는 말할 필요도 없다.
5.2 사례 ② 사람 평가 1위가 BLEU 6위 — NIST 2005
2006년, 에든버러대의 Chris Callison-Burch, Miles Osborne, Philipp Koehn이 EACL에 「BLEU의 역할 재평가(Re-evaluating the Role of BLEU in Machine Translation Research)」를 발표했다. 논문의 결론 문장은 지금도 자주 인용된다.
BLEU 점수의 향상은 실제 번역 품질 향상의 필요조건도 충분조건도 아니다.
근거는 두 가지였다. 첫째는 이론이다. BLEU는 n-gram이 어디에 있는지 보지 않는다. 그래서 한 번역문에서 n-gram을 뒤섞어 BLEU 점수가 똑같은 다른 문장을 엄청나게 만들 수 있다. 저자들은 바이그램 불일치만으로 만든 순열이 10⁷³개가 넘는 경우도 있다고 계산했다. 그 대부분은 읽을 수 없는 문장이다.
둘째는 실제 사건이다. 2005년 NIST 기계 번역 평가의 아랍어→영어 부문에서 이런 일이 있었다.
1
무슨 일이 있었나
사람 평가에서 1위를 한 시스템이 BLEU로는 6위였다. 이 시스템은 완전 자동이 아니었다. 영어 단일언어 화자가 번역 후보 구절을 고르고 다듬는 방식이었다. 나머지 시스템은 모두 BLEU를 최대화하도록 튜닝한 통계 번역기였다.
2
숫자로 보면
이 시스템을 포함하면 BLEU와 사람 평가(적절성)의 결정계수 R²는 0.14다. 빼면 0.87로 뛴다. 유창성은 0.002에서 0.742로 뛴다. 시스템 하나가 상관을 통째로 무너뜨렸다.
!
교훈
BLEU는 비슷한 방식의 시스템끼리 비교할 때는 쓸 만하다. 방식이 전혀 다른 시스템은 공정하게 비교하지 못한다. 같은 논문의 다른 실험(유럽의회 불→영 번역)에서도 BLEU는 규칙 기반 상용 번역기 Systran의 품질을 크게 과소평가했다.
이 사례는 이후 신경망 번역이 등장할 때 다시 문제가 됐다. 통계 번역과 신경망 번역은 오류의 종류가 다르다. 그래서 BLEU 차이가 실제 품질 차이를 제대로 보여 주는지 계속 의심을 받았다.
5.3 사례 ③ 1~2점 차이는 동전 던지기
2020년 멜버른대의 Nitika Mathur, Timothy Baldwin, Trevor Cohn은 「Tangled up in BLEU」로 ACL 2020 최우수 논문 후보(Honorable Mention)에 올랐다. 이들은 지표와 사람 평가의 상관을 계산할 때 이상치 시스템 하나가 상관계수를 크게 부풀린다는 점을 보였다. 아주 나쁜 시스템이 하나 끼어 있으면, 나머지 시스템끼리는 순서가 엉망이어도 상관이 높게 나온다.
더 실용적인 발견도 있었다.
출판된 연구 대부분은 BLEU 1~2점 차이를 보고한다. 그러나 이 수준의 차이가 실제 품질 향상에 해당하는 경우는 절반 정도뿐이다.
BLEU가 3~5점 차이 나는 경우에도 약 4분의 1은 사람이 보기에 품질이 비슷했다.
이듬해 Microsoft의 Tom Kocmi 연구팀은 훨씬 큰 규모로 같은 질문을 던졌다. 「To Ship or Not to Ship」은 실제 제품 출시 판단에 쓰던 사람 평가 데이터를 썼다. 문장 단위 사람 판정 230만 건, 시스템 4,380개, 101개 언어였다. 질문은 단순했다. "사람이 A가 B보다 낫다고 판정했을 때, 지표도 같은 쪽을 고르는가?"
COMET
83.4%
BLEURT
80.0%
BERTScore
78.3%
chrF
75.6%
BLEU
74.6%
지표
사람과 같은 쪽을 고른 비율
12개 중 순위
COMET
83.4%
1위
BLEURT
80.0%
4위
BERTScore
78.3%
6위
chrF
75.6%
7위
BLEU
74.6%
10위
막대 길이만 보면 차이가 작아 보인다. 하지만 수천 쌍의 비교에서 9%p는 큰 차이다. 저자들은 사람 판정으로 유의미한 차이가 있는데 BLEU가 순위를 거꾸로 매긴 쌍을 203개 찾았다. 그 쌍들의 BLEU 차이 중앙값은 1.3점이었다. 논문의 권고는 직설적이었다. "BLEU를 쓰지 말라. 다른 지표보다 열등하고, 지나치게 많이 쓰였다."
2022년 WMT 지표 공동과제 보고서는 아예 부제를 이렇게 달았다. 「Stop Using BLEU – Neural Metrics Are Better and More Robust」. 전문 번역가의 오류 주석(MQM)을 기준으로 했을 때 참조 기반 지표 13개 중 BLEU가 꼴찌였다.
5.4 사례 ④ 같은 "BLEU", 다른 숫자 — 재현성 위기
2.6절에서 본 "17/18이냐 18/19냐"의 차이가 여기서 커진다. 2018년 아마존의 Matt Post는 「BLEU 점수 보고를 명확히 하자(A Call for Clarity in Reporting BLEU Scores)」를 발표했다. 같은 번역 출력이라도 토크나이저, 대소문자 처리, 참조 전처리 방식에 따라 BLEU가 최대 1.8점 달라졌다. 주범은 참조 번역을 각 연구팀이 제각각 토큰화한 것이었다. 1.8점이면 많은 논문이 "SOTA 달성"을 주장하는 차이보다 크다.
Post의 해법은 SacreBLEU였다. 모두가 같은 구현체를 쓰고, 점수와 함께 설정을 요약한 서명(signature) 문자열을 적자는 것이다. 예를 들면 nrefs:1|case:mixed|eff:no|tok:13a|smooth:exp|version:2.6.0 같은 문자열이다. 이 논문의 표에서 GNMT와 Transformer 논문의 BLEU는 설정이 "불분명(unclear)"으로 분류됐다.
ROUGE는 사정이 더 나빴다. 2023년 Max Grusky는 ACL에 「Rogue Scores」를 발표했다. ROUGE를 쓴 논문 2,834편을 조사한 결과는 이렇다.
20%
결과를 재현할 수 있을 만큼 정보를 밝힌 평가의 비율
76%
ROUGE 패키지를 인용한 경우 중 결함 있는 소프트웨어를 인용한 비율
5%
설정 파라미터를 명시한 논문
97%
구글 rouge-score가 원본과 다르게 계산하는 ROUGE-L 비율 (rougeLsum을 쓰면 0%)
20년 동안 요약 순위표에 쓰인 숫자 상당수가 서로 다른 저울로 잰 값이었다는 뜻이다.
5.5 사례 ⑤ GPT-3 요약 — ROUGE는 졌는데 사람은 이겼다
2022년 텍사스대의 Tanya Goyal, Junyi Jessy Li, Greg Durrett는 GPT-3(text-davinci-002)에게 별도 학습 없이 지시만으로 뉴스 요약을 시켰다. 그리고 요약 전용으로 학습한 당시 최고 모델(BRIO)과 비교했다.
CNN 데이터
ROUGE-1 / 2 / L
사람이 '최고'로 뽑은 비율
사람이 '최악'으로 뽑은 비율
BRIO (요약 전용 학습)
38.49 / 17.08 / 31.44
36%
24%
GPT-3 (지시만)
31.86 / 11.31 / 24.71
58%
9%
T0
—
8%
67%
ROUGE-L로는 평균 7점 가까이 졌다. 그런데 사람은 GPT-3 요약을 압도적으로 골랐다. 이유 중 하나는 참조 요약 자체였다. 이런 데이터셋의 '정답 요약'은 기사에 붙은 하이라이트나 첫 문장에서 자동으로 만든 것이 많았다. 그 정답을 흉내 내도록 학습한 모델은 ROUGE가 높았다. 정답보다 나은 요약을 쓴 모델은 오히려 감점을 받았다.
HELM 보고서도 같은 관찰을 기록했다. "ROUGE 점수는 우리가 질적으로 판단한 요약 품질보다 훨씬 낮게 나오는 경향이 있다." 2024년 TACL에 실린 Zhang 등의 연구는 한발 더 나갔다. 프리랜서 작가가 새로 쓴 요약과 비교하면 LLM 요약이 사람 수준이었다. 낡은 참조 요약 때문에 성능이 과소평가돼 왔다는 것이다.
참조가 낡으면 채점기는 과거에 머문다. 대역 배우가 옛날 대본을 들고 무대에 오른 셈이다.
5.6 사례 ⑥ 대화와 사실성 — 애초에 맞지 않는 무대
2016년 Chia-Wei Liu 등은 「대화 시스템을 이렇게 평가하지 말라(How NOT To Evaluate Your Dialogue System)」를 발표했다. 트위터 대화에서 BLEU-4와 사람 평가의 상관은 Pearson 기준 0.14 수준이었다. 우분투 기술 지원 대화에서는 어떤 지표도 통계적으로 유의미하지 않았다. 사람 평가자끼리의 일치도는 0.95였다.
이유는 간단하다. "주말에 뭐 했어?"에 대한 좋은 대답은 수천 가지다. 참조 하나와 겹치는 단어를 세는 것은 의미가 없다.
2019년 Wojciech Kryściński 등은 요약의 사실성 문제를 짚었다. 생성형 요약 200쌍 중 30%에 원문과 맞지 않는 사실이 들어 있었다. ROUGE는 이를 전혀 잡지 못한다. 3.4절 위젯의 "서해안·30만 가구" 요약이 바로 이 경우다.
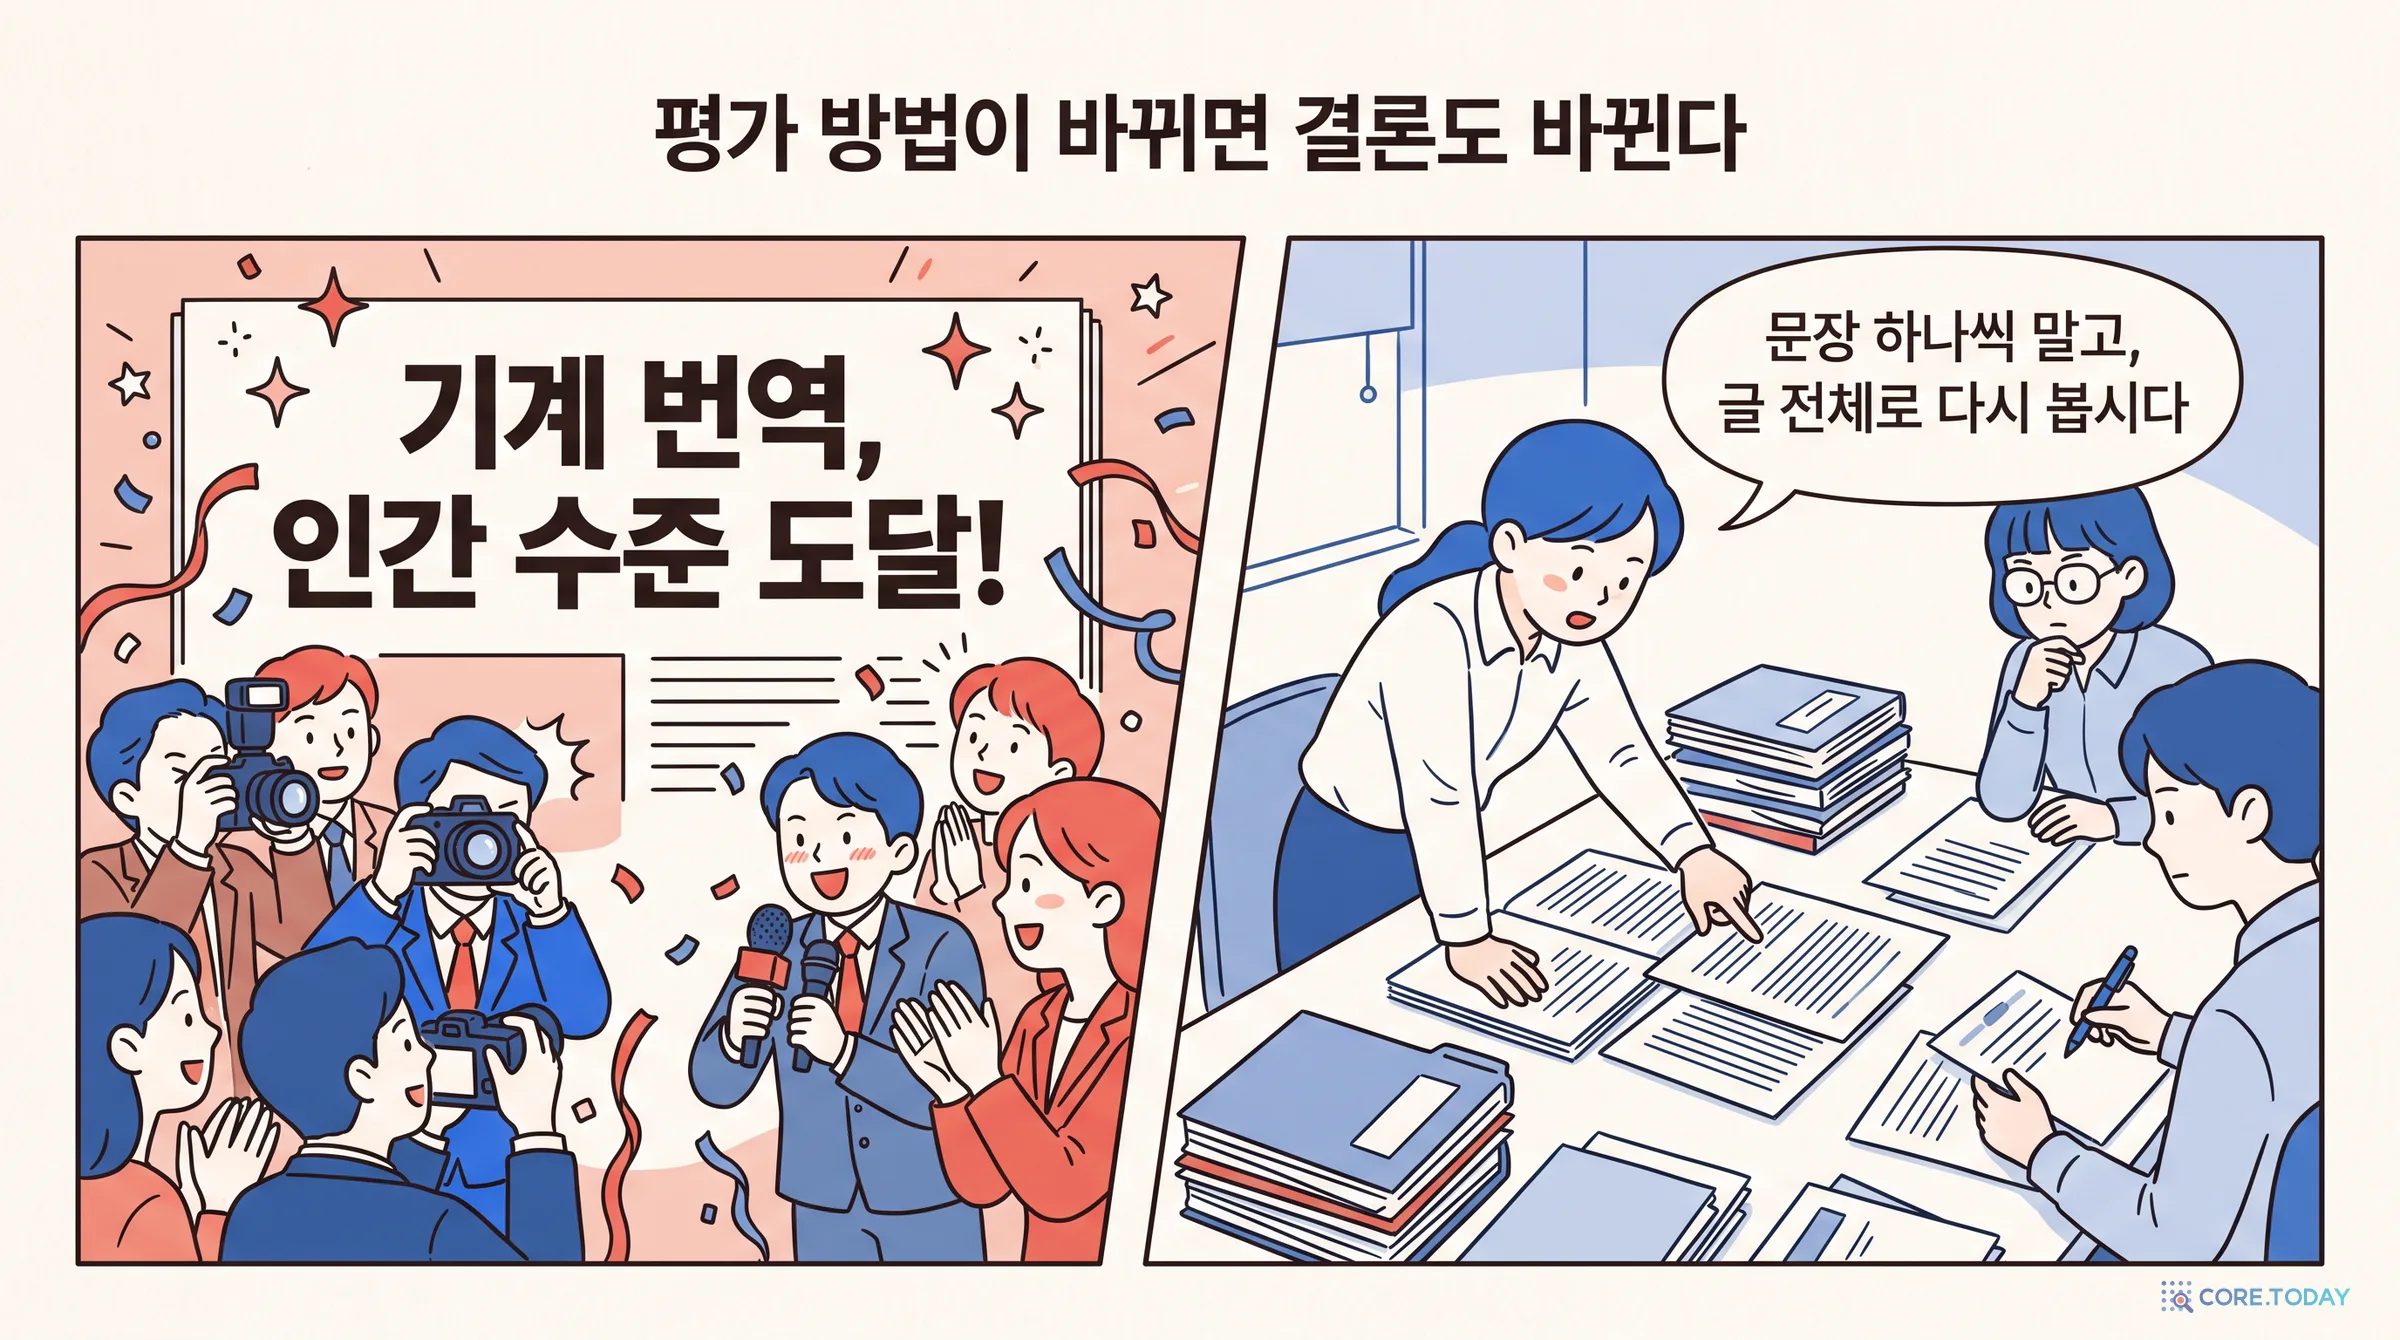
2018년 Microsoft는 중국어→영어 뉴스 번역에서 "전문 번역가와 동등한 수준(human parity)"에 도달했다고 발표했다. 이 주장은 자동 지표가 아니라 사람 평가에 근거했다. 하지만 문장을 하나씩 따로 떼어 보여 주는 방식이었다.
같은 해 취리히대의 Samuel Läubli, Rico Sennrich, Martin Volk는 평가 방식을 바꿨다. 전문 번역가에게 문서 전체를 보여 주고 비교하게 하자, 사람 번역이 유의미하게 더 선호됐다. 기계 번역을 고른 비율은 적절성에서 50%→37%, 유창성에서 32%→22%로 떨어졌다. 문장 하나만 보면 잘 번역됐지만, 문서 전체로 보면 앞뒤 문장 사이의 일관성(같은 대상을 같은 말로 부르기, 대명사 연결)이 깨져 있었다.
이 사례의 교훈은 BLEU에만 해당하지 않는다. 어떤 평가든 무엇을 보여 주고 무엇을 가렸는지에 따라 결론이 달라진다. 문장 단위로 재는 BLEU는 이 문서 수준의 문제를 원리적으로 볼 수 없다.
5.8 정리 — 어디까지 믿을 수 있나
2018년 애버딘대의 Ehud Reiter는 BLEU와 사람 평가의 상관을 다룬 논문 34편, 상관계수 284개를 체계적으로 검토했다. 결론은 지금까지 나온 판정 중 가장 균형 잡혀 있다.
증거는 기계 번역 시스템의 진단용 평가에 BLEU를 쓰는 것을 지지한다. 그러나 기계 번역 밖의 과제, 개별 텍스트의 평가, 과학적 가설 검증에 BLEU를 쓰는 것은 지지하지 않는다.
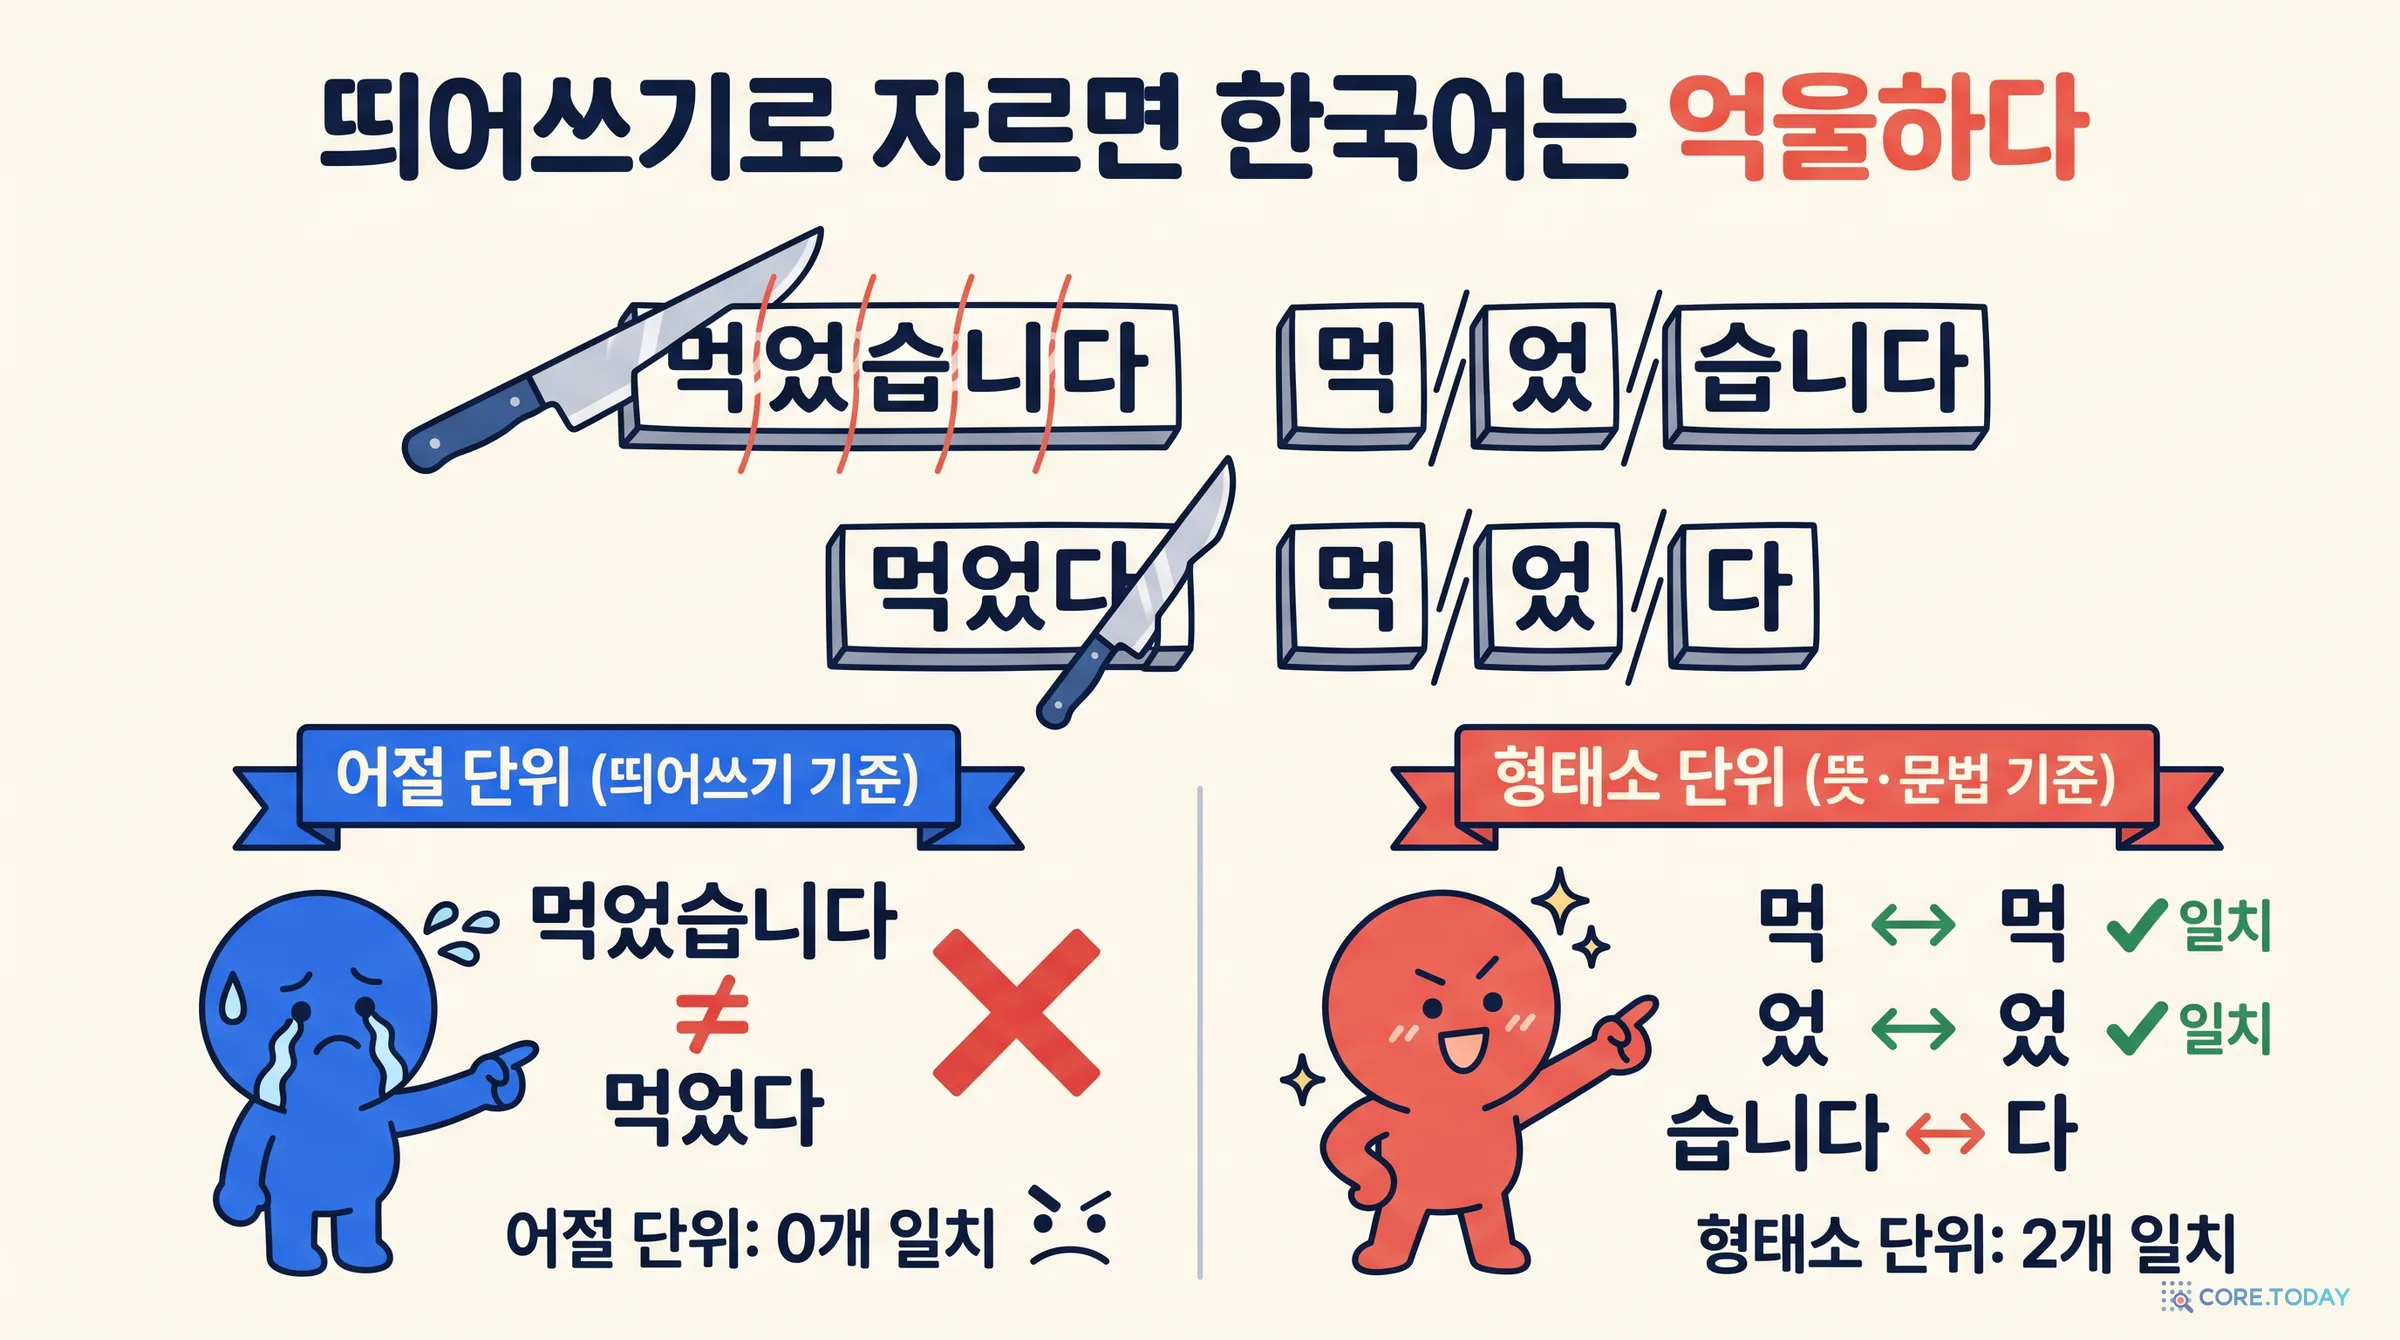
BLEU와 ROUGE는 영어를 기준으로 설계됐다. 영어는 단어가 거의 변하지 않고 띄어쓰기가 곧 단어 경계다. 한국어는 교착어다. 어간에 조사와 어미가 붙어 한 어절이 된다.
"먹었습니다"와 "먹었다"는 어간과 시제가 같다. 띄어쓰기 단위로 자르면 둘은 완전히 다른 단어다. "회의가"와 "회의는"도 다르고, "연기되었다"와 "연기되었습니다"도 다르다. 영어라면 단어 하나가 맞을 상황에서 한국어는 0개가 맞는다. 형태소 단위로 자르면 "먹/었/습니다"와 "먹/었/다"는 두 조각이 겹친다.
이 문제는 잘 알려져 있다. 표준 구현체 sacreBLEU는 2022년 7월 v2.2.0에서 한국어 형태소 분석기를 쓰는 ko-mecab 토크나이저를 추가했다. 대상 언어를 한국어로 지정하면 이 토크나이저를 자동으로 고른다. 그런데 실제로 얼마나 차이가 날까. 직접 재 봤다.
6.2 실측 ① 같은 번역, 칼만 바꾸기
코어닷투데이는 2026년 11월 7일, 한국어 번역 묶음 두 개를 만들어 채점했다. 각각 6문장이다. A는 참조를 거의 그대로 옮긴 직역이고, B는 뜻은 같지만 자연스럽게 다시 쓴 의역이다. 번역은 그대로 두고 문장을 자르는 방법만 바꿨다. sacreBLEU 2.6.0, rouge_score 0.1.2, 형태소 분석에는 sacreBLEU의 한국어 확장(mecab-ko 1.0.3, mecab-ko-dic)을 썼다.
세 가지가 보인다.
첫째, 같은 번역의 점수가 칼에 따라 세 배 차이 난다. B의 BLEU는 띄어쓰기(13a)로 자르면 7.3, 형태소로 자르면 11.0, 글자로 자르면 22.2다. 논문에 "BLEU 22.2"라고만 쓰여 있으면 독자는 어느 칼로 잘랐는지 알 수 없다. 다른 논문의 "BLEU 11"과 비교하는 것은 무의미하다.
둘째, 어떤 칼로 잘라도 의역은 직역에 한참 진다. B는 사람이 읽기에 A보다 더 자연스러운 한국어다. "이 약은 밥 먹고 30분 뒤에 드세요"는 "이 약은 식후 30분에 복용해야 한다"보다 환자에게 친절하다. 그런데 가장 관대한 지표로 재도 점수 차이가 네 배 가까이 난다. 참조가 하나뿐인 한국어 평가에서 BLEU는 결국 "참조 번역가의 문체를 얼마나 닮았나"를 잰다.
파이썬에서 ROUGE를 잴 때 가장 많이 쓰는 패키지는 구글의 rouge_score다. Hugging Face의 evaluate 라이브러리도 내부에서 이것을 쓴다. 이 패키지에 한국어 문장을 넣으면 이런 일이 벌어진다.
python
from rouge_score import rouge_scorer
scorer = rouge_scorer.RougeScorer(["rouge1", "rouge2", "rougeL"])
s = scorer.score("태풍이 남해안에 상륙했다", "태풍이 남해안에 상륙했다") # 정답과 완전히 같은 요약print(s["rouge1"].fmeasure) # 0.0
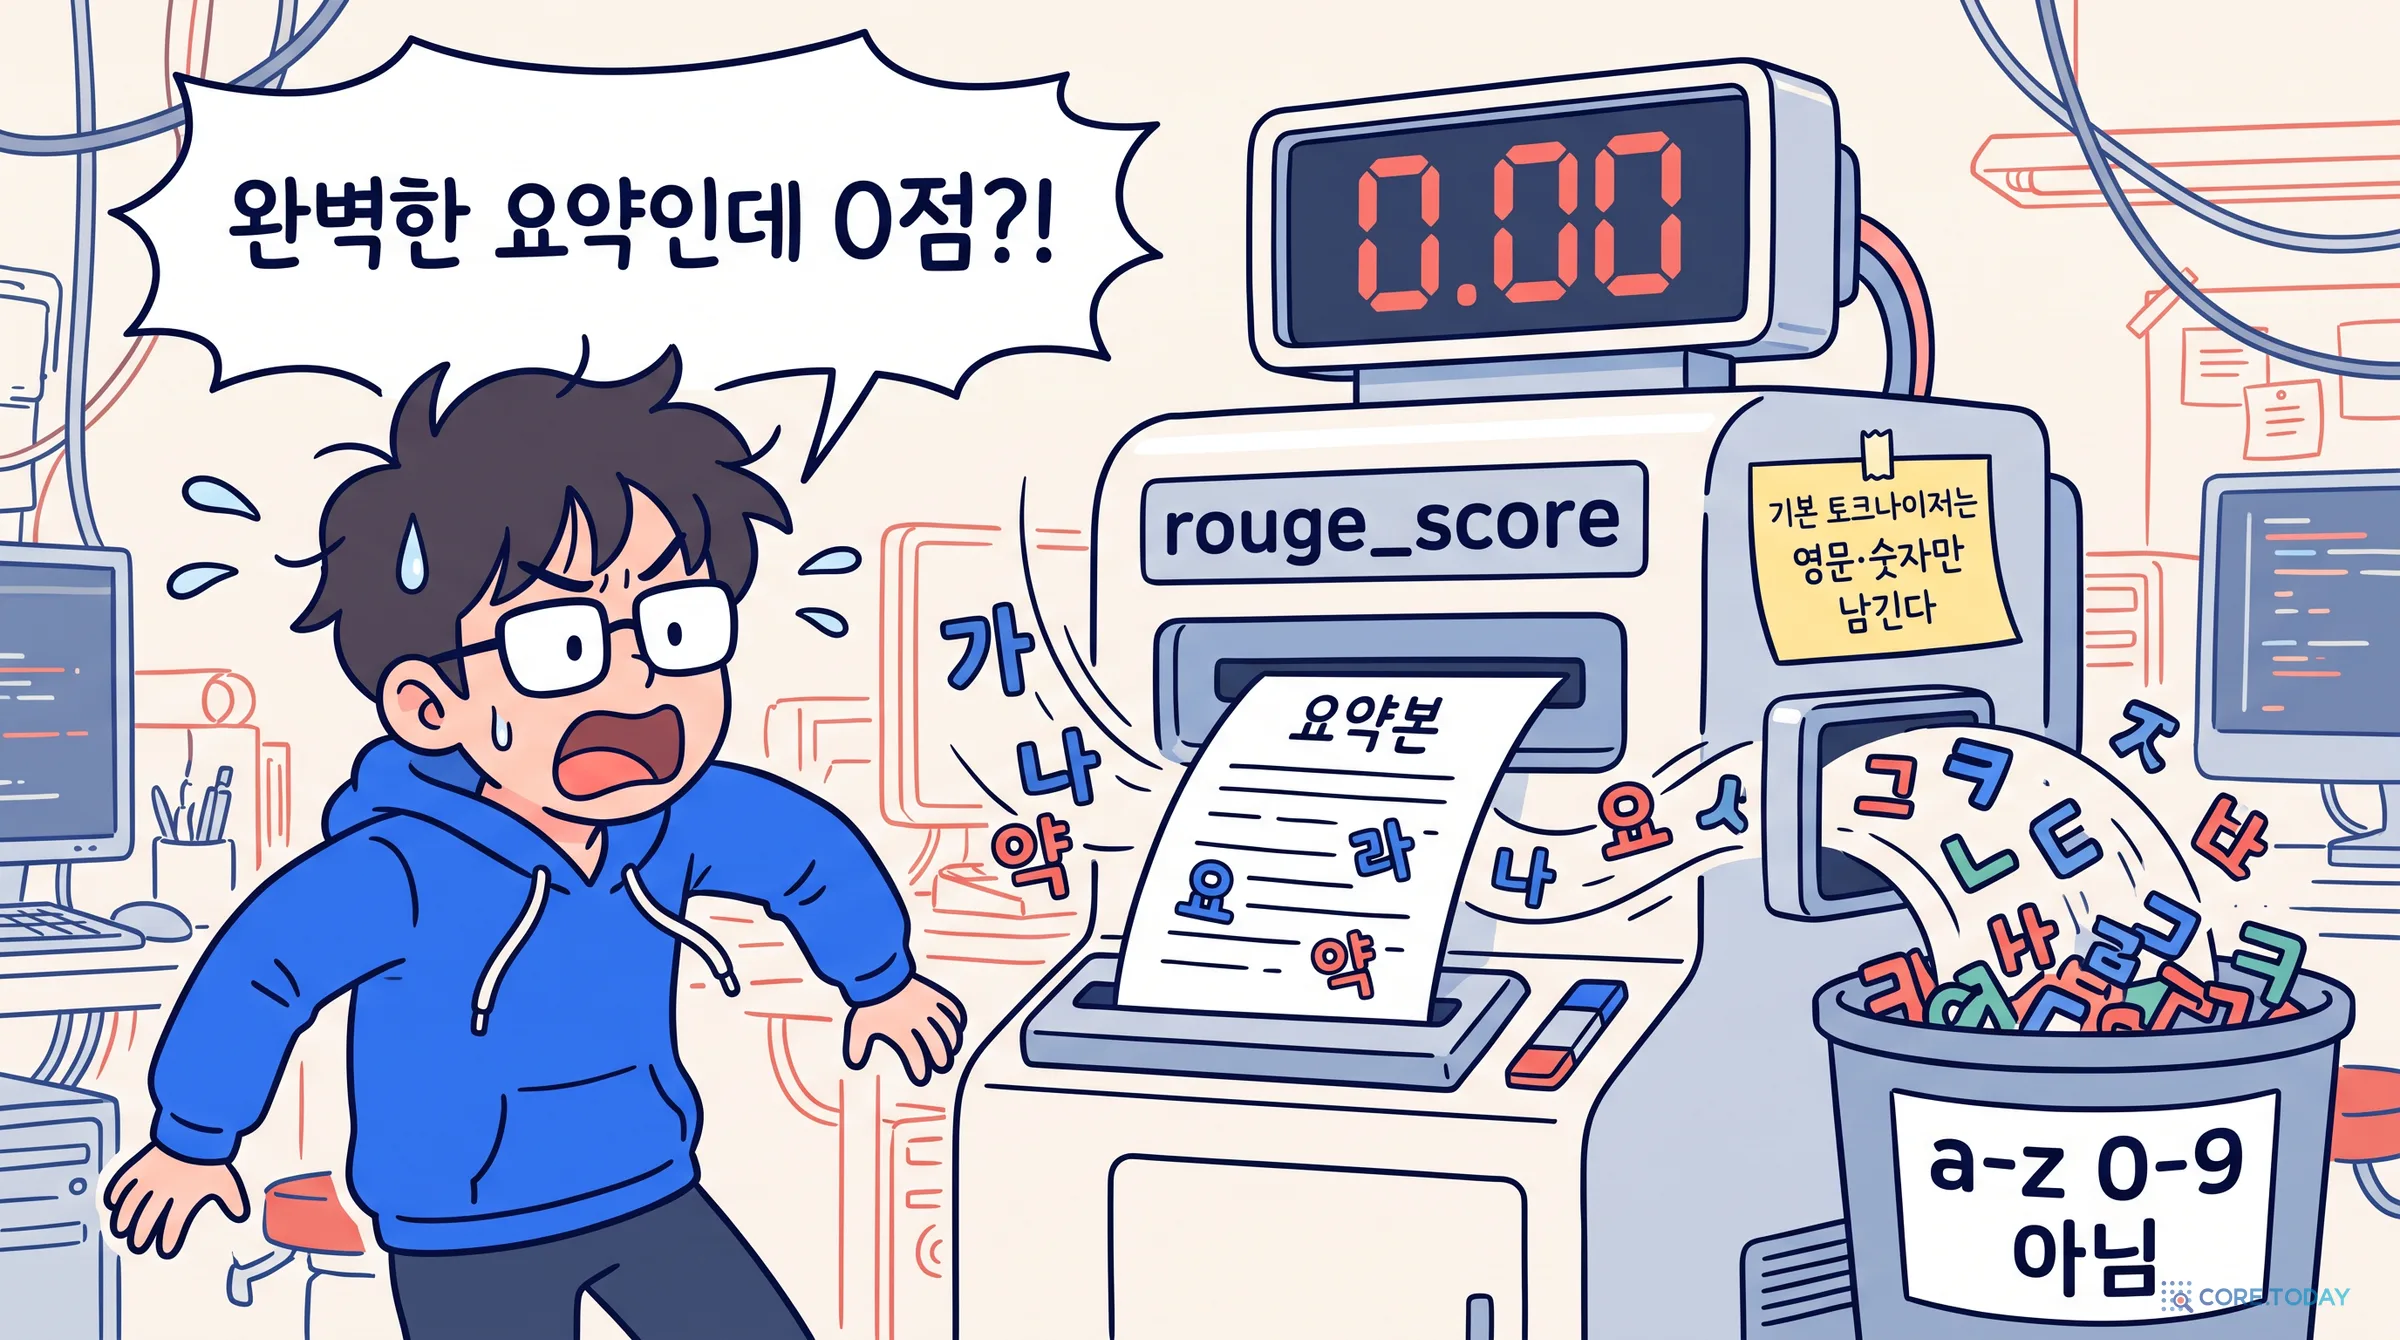
정답과 글자 하나 다르지 않은 요약이 0점이다. 원인은 기본 토크나이저의 정규식이다. 원래의 펄 스크립트 ROUGE를 흉내 내려고 텍스트를 소문자로 바꾼 뒤, [^a-z0-9]+, 곧 영어 소문자와 숫자가 아닌 모든 글자를 공백으로 바꾼다. 한글은 통째로 사라진다. "태풍이 남해안에 상륙했다 3만 가구 정전"을 넣으면 남는 토큰은 ['3'] 하나뿐이다.
위 실측 표에서 A와 B의 ROUGE-L이 똑같이 16.7인 이유가 이것이다. 6문장 중 "30분"이 든 마지막 문장에서만 30이 살아남아 만점을 받고, 나머지 다섯 문장은 0점이다. 평균하면 1/6 ≈ 0.167이다.
이 문제는 Hugging Face evaluate 저장소에도 이슈로 올라와 있다. 중국어로 같은 문장을 넣었더니 0점이 나왔다는 이슈 #465다. 이 글을 쓰는 시점에도 열려 있다. 해결책은 간단하다. 토크나이저를 직접 넘기면 된다.
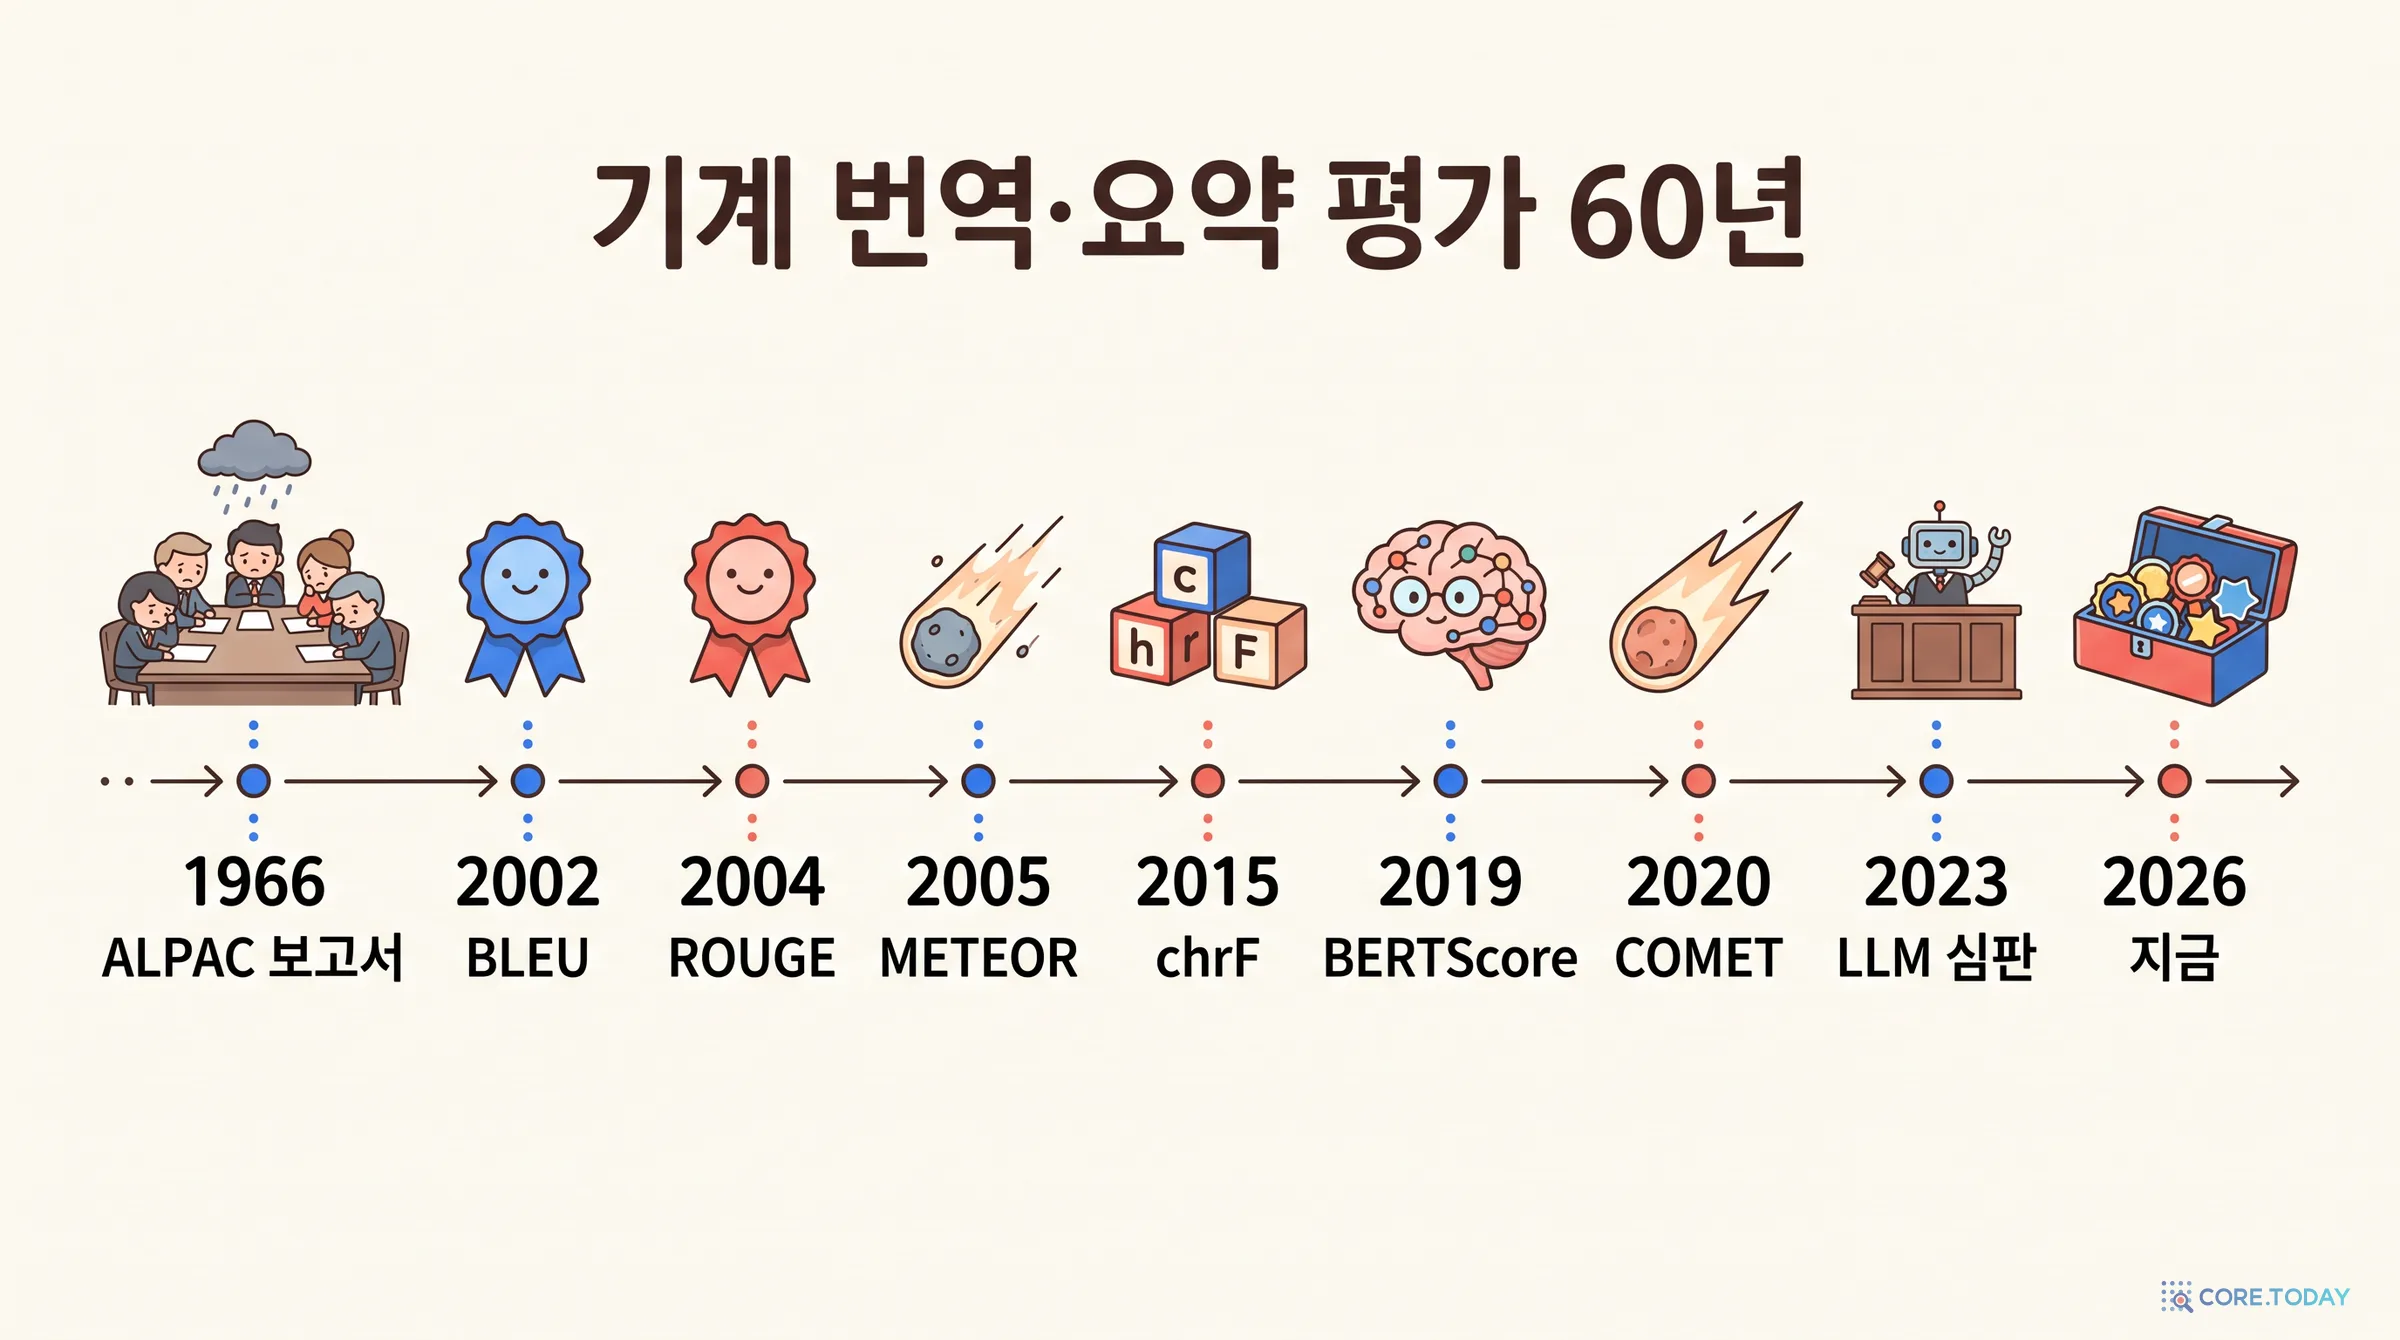
BLEU 이후의 평가 지표 역사는 BLEU가 못 잡은 것을 하나씩 잡으려는 시도의 연속이었다. 연표의 정거장을 눌러 보자. 각 시대가 무엇을 문제로 봤고 무엇으로 답했는지 나온다.
큰 흐름은 세 단계다.
1세대 — 조각을 더 똑똑하게 세기 (2005~2015). METEOR(2005)는 어간이 같거나("run"과 "running") 동의어인 단어도 일치로 인정하고 재현율을 함께 봤다. TER(2006)은 "사람이 몇 번 고쳐야 정답이 되나"를 셌다. chrF(2015)는 단어 대신 글자 n-gram을 써서 어형 변화를 부분적으로 인정했다. 들어가며에서 본 것처럼 chrF는 의역 A에 0점, 부정문 B에 73.5점을 줬다. 조각을 세는 방식인 이상 뜻은 여전히 볼 수 없다.
2세대 — 의미 공간에서 비교하기 (2019~2023). BERTScore는 두 문장의 단어를 문맥 임베딩으로 바꾼 뒤 가장 가까운 것끼리 짝지어 유사도를 낸다. "회의"와 "미팅"이 벡터 공간에서 가깝다면 점수를 준다. BLEURT와 COMET은 한 걸음 더 나가, 사람이 매긴 점수를 직접 학습했다. 지표 자체가 "사람이라면 몇 점을 줄까"를 예측하는 모델이 된 것이다. Google의 MetricX와 Unbabel의 xCOMET이 이 계열의 최신판이다. COMET-Kiwi 같은 일부 모델은 참조 없이 원문과 번역만 보고 품질을 추정한다.
3세대 — 대형 언어 모델에게 채점 맡기기 (2023~). GEMBA(Kocmi & Federmann, 2023)는 GPT-4급 모델에게 번역을 보여 주고 점수나 오류 목록을 직접 매기게 했다. GPT-3.5 이상에서만 통했고, 당시 WMT22 기준 최고 수준의 상관을 보였다. G-Eval(Liu et al., 2023)은 요약 같은 생성 과제에 같은 방법을 썼다. GPT-4에 단계별 사고(Chain-of-Thought)와 채점 양식을 주는 방식이다.
지표
무엇을 비교하나
참조 필요
비용·속도
결정적?
BLEU · ROUGE
단어 조각의 겹침
필요
CPU, 밀리초
예
chrF
글자 조각의 겹침
필요
CPU, 밀리초
예
METEOR
어간·동의어까지 인정한 단어 정렬
필요
CPU, 빠름
예
BERTScore
문맥 임베딩 유사도
필요
GPU 권장
모델 버전 고정 시
COMET · MetricX · BLEURT
사람 점수를 학습한 예측
필요(QE 변형은 불필요)
GPU
모델 버전 고정 시
LLM 심판 (GEMBA · G-Eval)
LLM의 판단
선택
API 비용, 초 단위
아니오(버전·샘플링 따라 변동)
사람 평가 (MQM · ESA)
전문가의 오류 주석·점수
불필요
가장 비쌈, 일~주 단위
평가자 간 편차
표의 마지막 열을 보자. 위로 갈수록 싸고 결정적이고, 아래로 갈수록 뜻을 잘 보지만 비싸고 흔들린다. 이 교환 관계가 다음 부의 주제다.
8부. 2026년, 대역 배우의 자리
8.1 현장은 어떻게 하고 있나
기계 번역 분야의 가장 큰 공동 평가인 WMT의 최근 방식을 보면 흐름이 분명하다.
WMT24: 공식 순위는 전문 평가자의 사람 평가(ESA)로 정했다. 사람이 평가할 시스템을 미리 고르는 데는 MetricX-23과 CometKiwi를 썼다. BLEU와 chrF는 제출 기간 리더보드에 참고용으로만 표시했다.
WMT25: 자동 사전 순위에 GEMBA-ESA(LLM 심판), MetricX-24, XCOMET, CometKiwi를 함께 썼다. BLEU는 빠졌다. chrF++만이 가장 자원이 적은 언어(보지푸리어, 마사이어)에 남았다. 신경망 지표가 제대로 학습되지 않은 언어에서는 여전히 글자 조각 세기가 가장 믿을 만한 도구라는 뜻이다.
WMT25 보고서에는 의미심장한 경고도 있다. 일부 참가팀이 GEMBA-ESA를 보상 모델로 써서 시스템을 학습시켰다는 것이다. 채점기를 최대화하도록 학습한 시스템은 그 채점기로 공정하게 잴 수 없다. 2003년 MERT가 BLEU를 훈련 목표로 삼았던 일이, 20여 년 뒤 LLM 심판을 상대로 똑같이 되풀이되고 있다. 굿하트의 법칙은 지표가 바뀌어도 그대로다.
8.2 LLM 심판도 대역이다
LLM 심판은 BLEU가 못 하던 일을 한다. 의역을 알아보고, 부정문을 잡아내고, 참조 없이도 채점한다. Zheng 등(NeurIPS 2023)은 GPT-4의 판정이 사람과 80% 넘게 일치한다고 보고했다. 사람끼리의 일치도와 비슷한 수준이다.
하지만 같은 논문은 새로운 편향 세 가지도 기록했다.
LLM 심판의 세 가지 편향Zheng et al. 2023
위치두 답을 비교할 때 먼저(또는 나중에) 보여 준 쪽을 선호한다. 순서를 바꿔 두 번 채점해야 한다.
장황함더 길고 자세해 보이는 답을 선호한다. ROUGE의 "길게 쓰면 이긴다"가 다른 모습으로 돌아왔다.
자기 선호자기가 쓴 것, 또는 같은 계열 모델이 쓴 답을 선호한다.
게다가 LLM 심판은 결정적이지 않다. 같은 입력에도 샘플링에 따라 점수가 흔들린다. API 뒤의 모델이 조용히 업데이트되면 지난달의 점수와 이번 달의 점수를 비교할 수 없게 된다. 한 번 채점할 때마다 비용도 든다.
LLM 심판은 BLEU보다 훨씬 뛰어난 배우다. 그래도 여전히 대역이다. 코어닷투데이는 LLM 심판 자체를 심판하는 벤치마크를 따로 다룬 적이 있다. 거기서도 결론은 같았다. 심판의 판정도 결국 사람의 판단과 대조해 검증해야 한다.
그렇다면 2026년에 BLEU와 ROUGE는 버려야 할 유물일까. 현장의 답은 "아니다"에 가깝다. 이 지표들에는 신경망 지표나 LLM 심판이 갖지 못한 성질이 있다.
1
결정적이다
같은 입력이면 10년 뒤에도 같은 숫자가 나온다. 모델 버전도, API 업데이트도, 샘플링 온도도 없다. 회귀 테스트에서 이 성질은 무엇보다 중요하다. "어제 대비 3점 떨어졌다"는 신호를 믿을 수 있기 때문이다.
2
공짜에 가깝다
CPU에서 수천 문장을 1초 안에 채점한다. 학습 중 매 체크포인트마다 돌려도 부담이 없다. LLM 심판으로 같은 일을 하면 수천 번의 API 호출이 든다.
3
투명하다
왜 이 점수가 나왔는지 n-gram 하나하나까지 추적할 수 있다. 신경망 지표의 점수는 설명하기 어렵다.
4
큰 사고는 잡는다
출력이 갑자기 다른 언어로 나오거나, 한 문장을 반복하거나, 빈 문자열을 내거나, 포맷이 깨지는 사고. 이런 것은 BLEU·ROUGE도 확실히 잡는다. 점수가 수십 점씩 떨어지기 때문이다. 미묘한 품질 차이는 못 봐도 큰 사고에는 빠르게 반응하는 경보기다.
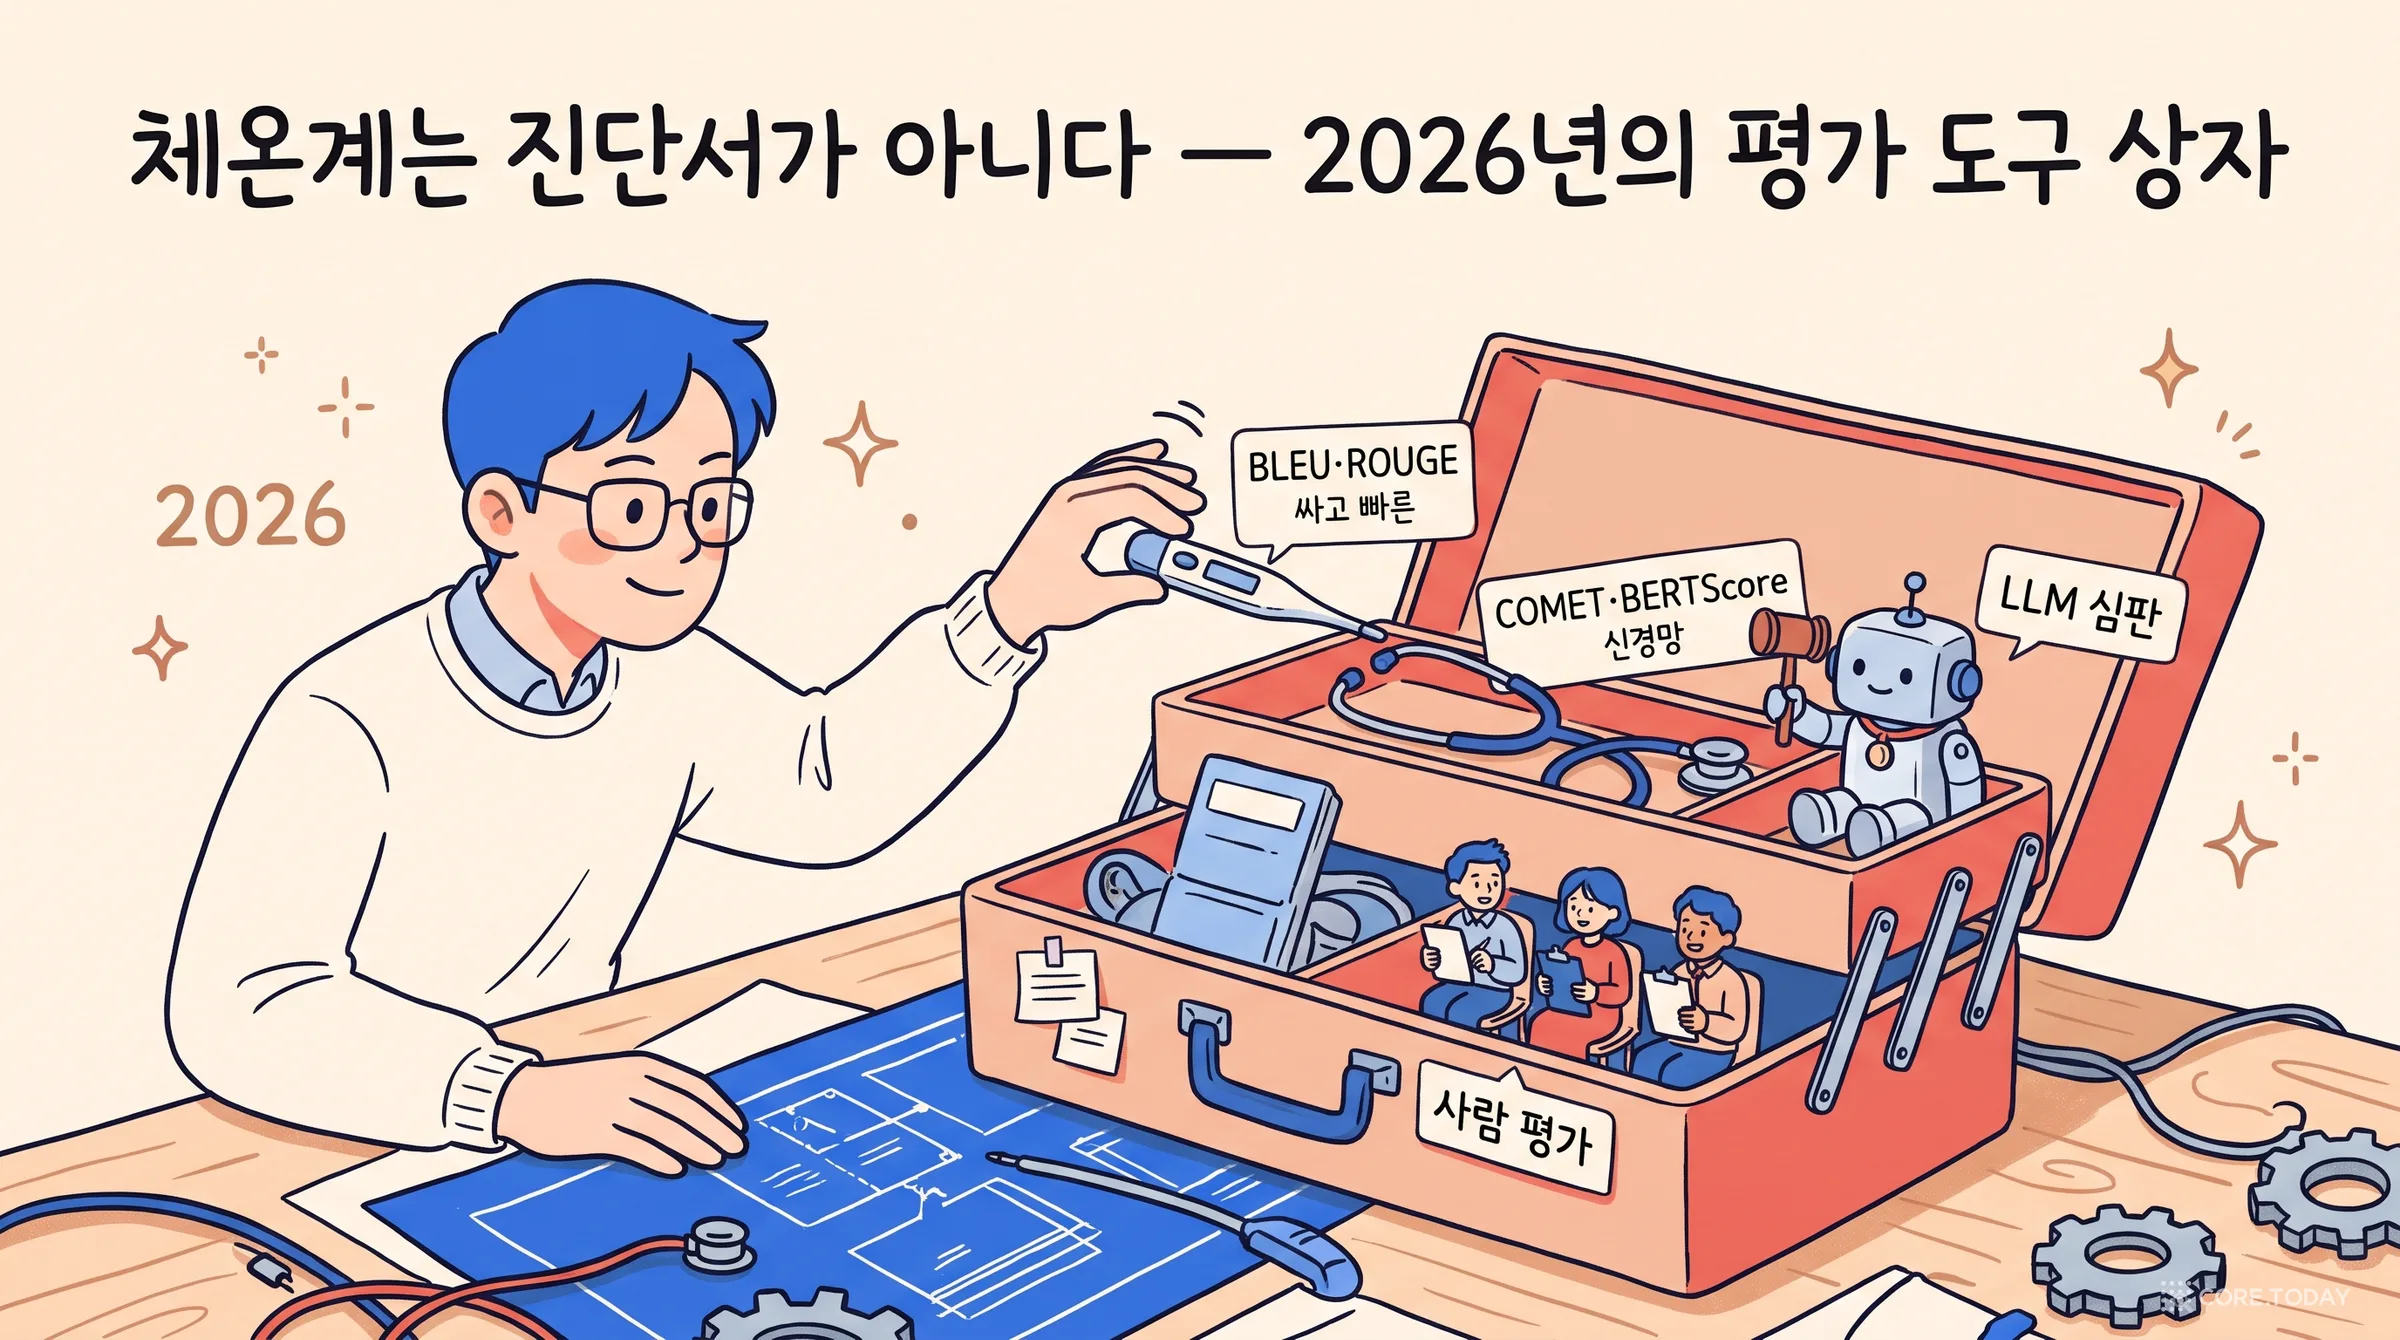
비유하자면 BLEU와 ROUGE는 체온계다. 체온계로 병명을 진단할 수는 없다. 하지만 체온이 40도라면 무언가 잘못됐다는 것은 확실히 안다. 의사가 환자를 볼 때마다 MRI를 찍지 않고 체온부터 재는 것처럼, 체온계는 싸고 빠르고 믿을 만하다. 진단서를 쓰는 일은 청진기(신경망 지표), 전문의(LLM 심판), 정밀 검사(사람 평가)의 몫이다.
2026년의 역할 분담은 대략 이렇다.
체온계 BLEU · ROUGE · chrF 매 커밋, 매 체크포인트
→
청진기 COMET · MetricX · BERTScore 매일 밤
→
전문의 LLM 심판 + 루브릭 후보 모델 비교
→
최종 판정 사람 평가 · 실행 테스트 출시 직전
아래 도우미로 내 과제에 맞는 조합을 찾아보자. 과제, 용도, 언어, 참조 유무를 고르면 도구 상자를 꾸려 준다.
8.4 다섯 가지 원칙
이 글에서 다룬 사례를 다섯 줄로 줄이면 이렇다.
1
문장이 아니라 말뭉치를 잰다. BLEU 한 문장 점수로 "이 번역은 나쁘다"고 말하지 않는다. 논문 저자들이 2002년에 각주로 경고한 일이다.
2
절대값이 아니라 같은 조건의 변화를 본다. 참조 수, 토크나이저, 구현체가 같을 때만 숫자를 비교한다. 서명을 남긴다.
3
작은 차이는 차이가 아니다. 1~2점 차이는 절반쯤 동전 던지기다. 통계적 유의성 검정을 하거나 다른 지표로 교차 확인한다.
4
뜻과 사실은 다른 도구로 잰다. 부정, 숫자, 고유명사, 사실 일치는 n-gram이 볼 수 없다. 사실 검증, 신경망 지표, LLM 심판을 붙인다.
5
최적화의 대상으로 삼지 않는다. 지표를 직접 올리기 시작하면 지표는 측정 도구의 자격을 잃는다. BLEU에서 일어난 일은 LLM 심판에서도 일어난다.
마치며 — 대역 배우의 이름
2002년 IBM의 네 연구자는 자기들이 만든 채점기를 대역 배우라고 불렀다. 주연을 대체하겠다는 이름이 아니었다. 주연이 매번 설 수 없는 리허설 무대를 대신 지키겠다는 이름이었다.
이후 20년 동안 대역은 자주 주연 자리에 올랐다. 시스템이 BLEU를 직접 최대화하도록 튜닝됐고, 0.3점 차이로 순위표가 바뀌었다. 한국어 요약은 아무 경고 없이 0점을 받았다. 대역에게 너무 많은 것을 맡긴 결과였다.
2026년의 평가 무대에는 배우가 훨씬 많다. 의미를 읽는 신경망 지표가 있고, 말로 이유를 설명하는 LLM 심판이 있다. 그래도 무대의 구조는 2002년과 같다. 그들도 모두 대역이다. 주연은 여전히 그 글을 읽을 사람이다.
BLEU와 ROUGE를 제대로 쓴다는 것은 결국 이 구분을 잊지 않는 일이다. 대역은 대역의 자리에서 가장 빛난다. 매일 밤 리허설 무대를 지키며, 무언가 크게 잘못됐을 때 가장 먼저 알려 주는 자리 말이다.
‘코어닷투데이 실측’의 수치는 2026년 11월 7일 sacreBLEU 2.6.0, rouge_score 0.1.2, mecab-ko 1.0.3(mecab-ko-dic)으로 직접 계산한 값이다. 실측에 쓴 번역 문장과 위젯의 요약 예시는 개념을 보이려고 편집부가 쓴 것이다. 퀴즈의 '뜻' 판정도 편집부의 판단이다. 위젯의 BLEU·chrF·ROUGE 계산은 원본 파이썬 구현과 같은 값을 내는지 자동 테스트로 확인했다. 논문의 영어 인용문은 편집부가 번역했다.