‘우리 회사가 이 사업에 신청할 수 있나요?’에 답하려면 신청 자격·예외 조건·마감일 변경 공지 세 가지가 모두 필요하다. 관련성 순으로 뽑은 top-5는 전부 신청 자격의 변형이고, 그런데도 Recall@k는 만점이다. 지표가 실패를 보지 못한다. 2026년 9월 17일 공개된 「The Missing Complement」는 검색을 ‘이슈와 닮은 것의 순위’가 아니라 ‘지금 이 결정에 아직 부족한 것의 회수’로 다시 정의하고, 45개 저장소 500개 에이전트 상태에서 집합 단위 충분성을 재는 SERBench를 만들었다. 같은 주 CIKM 2026에 실린 TRACE는 OCR이 깨진 1887년 프랑스 의회·신문 아카이브에서 ‘답을 만드는 대신 출처를 찾고 모든 판정에 근거를 남기는’ 검색을 질문당 0.02달러로 구현했다. 두 논문을 따라가며, 왜 개별 관련성 대신 집합 충분성을 재야 하는지, 검색 결과에 어떤 네 필드를 더해야 하는지, 출처를 찾는 RAG와 답하는 RAG를 왜 분리해야 하는지를 인터랙티브 위젯 6종으로 만져 본다. RAG 특집 시리즈 2편.
한 중소기업 담당자가 사내 AI에게 묻는다. "우리 회사가 이번 지원 사업에 신청할 수 있나요?"
이 질문에 책임지고 답하려면 세 가지를 알아야 한다. 공고 본문의 신청 자격(중소기업, 업력 3년 이상), 별표에 숨어 있는 예외 적용 조건(업력이 모자라도 특정 인증이 있으면 가능), 그리고 일주일 전에 올라온 마감일 변경 정정 공지. 셋 중 하나가 빠지면 답이 틀리거나, 맞아도 신청 기한을 놓친다.
이제 검색기가 하는 일을 보자. 질문을 임베딩하고 코퍼스의 모든 청크와 similarity(query, chunk)를 계산해 상위 다섯 개를 돌려준다. 결과는 이렇다. 공고 본문의 신청 자격 조항, 공고 요약본의 신청 자격, FAQ의 "신청 자격은 무엇인가요?", 지난해 공고의 신청 자격, 설명회 슬라이드의 신청 자격. 다섯 개 전부 "신청 자격"이다. 개별 점수는 모두 높다. 정답 문서(공고 본문 3조)는 1위에 있다. 이 시스템의 Recall@5는 1.0이다.
그런데 답을 낼 수 없다. 예외 조건과 마감 변경이 없기 때문이다.
1.0
Recall@5 — “정답 문서가 top-5에 있는가”. 만점.
1 / 3
확보한 필수 증거 그룹. 결정 불가.
4 / 5
같은 사실의 변형(중복)이 차지한 자리
53.3%
에이전트 상태를 그대로 질의로 넣었을 때, 상위 10개 중 이미 읽은 것의 비율 (논문 파일럿)
이것이 이 글의 문제다. 우리가 지난 3년간 검색 품질을 재 온 지표는 문단 하나의 관련성을 잰다. 그러나 결정에 필요한 것은 집합의 충분성이다. 둘은 다른 양이고, 앞의 것이 만점이어도 뒤의 것은 0일 수 있다.
🧭
이 글의 한 문장. 2026년 9월 17일 공개된 「The Missing Complement」의 표현을 빌리면 — “관련성은 문단마다 매기지만, 충분성은 집합에 속한다. 랭커는 필요한 사실 하나의 변형들로 예산을 채우고, 결정을 뒷받침하지 못한 채 남길 수 있다.” 검색의 목표가 ‘개별 청크의 관련성’에서 ‘현재 상태에 부족한 최소 충분 증거 집합’으로 옮겨 가면, 검색기의 설계도, 검색 결과의 스키마도, 평가 지표도 함께 바뀌어야 한다.
📚
RAG 특집 시리즈 2편.1편은 검색이 파이프라인에서 에이전트로 바뀐 가장 큰 변화(Agentic Search)를 다뤘고, 그 9장에서 “충분성 판정이 시스템의 필수 부품이 된다”고 적으며 무엇이 충분한가를 이 글로 미뤘다. 이 글이 그 답이다. 이어서 3편은 질의별 검색기·생성기·예산의 동적 선택, 4편은 검색 실패를 스스로 고치는 인덱스, 5편은 GraphRAG의 다변화, 6편은 멀티모달 문서 검색, 7편은 한국어 다중 벡터 검색, 8편은 오염 공격과 출처 신뢰도를 다루고, 총정리에서 2026년 9월의 스택 선택 기준을 정리한다.
🗺️
1장 — top-k의 근본 문제: 점수는 하나씩, 결정은 함께 (순위 vs 집합 시뮬레이터)
2장 — “이미 아는 것”을 조건으로: 상태 조건 검색과 보완 집합 (상태 조건 검색 데모)
3장 — SERBench: 45개 저장소, 500개 결정, 집합을 채점하는 법
4장 — MSS-Complement: 순위가 아니라 집합을 구성한다 (예산 채우기 · 결과 탐색기)
5장 — RAG 평가가 바뀌어야 하는 이유: 네 가지 질문과 네 개의 필드 (평가 필드 설계 도구)
6장 — TRACE: 출처를 찾는 RAG와 답하는 RAG의 분리 (파이프라인·결과 위젯)
7장 — 두 논문이 같은 말을 한다
8장 — 우리 시스템에 옮기는 순서
9장 — 한계와 반론
마무리 — 검색은 답을 찾는 일이 아니라 결정을 뒷받침하는 일이다
for chunk in corpus:
score[chunk] = similarity(query, chunk) # 청크 하나씩, 독립적으로return top_k(score) # 점수 순으로 자른다
이 계산에는 두 가지가 구조적으로 들어갈 자리가 없다. 「The Missing Complement」는 그 둘을 정확히 짚는다.
① 중복 (redundancy)
“어떤 문단은 최대로 관련 있으면서도 아무것도 더하지 않을 수 있다 — 에이전트가 이미 갖고 있기 때문에.”
점수 함수는 query와 chunk만 본다. “이 사람이 이미 읽었는가”는 입력에 없다. 그래서 이미 읽은 문서가 계속 1위로 돌아온다.
② 공동 충분성 (joint sufficiency)
“관련성은 한 항목씩 정의되므로, 그 점수로 만든 순서는 집합 전체만이 만족시킬 수 있는 제약을 표현할 수 없다.”
“자격·예외·마감이 모두 있어야 한다”는 조건은 어느 한 청크의 점수에도 들어 있지 않다. 순위를 아무리 잘 매겨도 나타나지 않는다.
직접 만져 보면 두 문제가 한눈에 보인다.
위젯에서 확인할 것은 세 가지다. 첫째, 관련성 순위 모드에서 k=5까지 상위는 전부 "신청 자격"의 변형이고, 그런데도 Recall@5는 1.0이다. 지표가 실패를 보지 못한다. 둘째, k를 7까지 늘리면 나머지 두 그룹이 들어오지만 중복 4건이 컨텍스트를 채운다 — 예산이 있는 시스템에서 이것은 비용이다. 셋째, 집합 구성 모드로 바꾸면 k=3만으로 세 그룹이 모두 들어온다. 후보는 똑같다. 바뀐 것은 무엇을 최적화하는가다.
이 문제는 새로운 것이 아니다. 정보 검색 분야는 오래전부터 "다양성(diversity)"과 "새로움(novelty)"을 다뤘고, 사실 검증 분야에는 "최소 증거 그룹" 연구가 있다. 그러나 2026년에 이 문제가 다시 중심에 선 이유는 검색의 사용자가 바뀌었기 때문이다. 사용자가 사람이면 다섯 개 중 겹치는 것을 보고 스스로 다시 검색한다. 사용자가 에이전트이고, 에이전트가 이미 문서의 절반을 읽은 상태에서 다음 행동을 결정해야 한다면, 검색기가 그 상태를 모른 채 "이슈와 가장 닮은 것"을 돌려주는 일은 매번 낭비가 된다.
UC 샌디에이고 연구진(Zhexi Feng, Ruiyi Zhang, Yongbo Yang, Pengtao Xie)의 「The Missing Complement: State-Conditioned Minimal Sufficient Evidence for Coding Agents」는 문제를 이렇게 다시 쓴다.
"현재 에이전트가 이미 알고 있는 내용은 무엇이며, 다음 결정을 내리는 데 아직 부족한 증거는 무엇인가?"
논문의 형식화는 단순하다. 결정 시점 t의 상태를 다섯 요소로 정의한다.
기호
뜻
코딩 에이전트 예시
x
이슈 (원래 과제)
“대용량 파일을 올리면 서버가 죽습니다”
n_t
현재 정보 요구
“크기 제한을 어디에, 어떤 오류 규약으로 넣어야 하나”
h_t
지금까지의 궤적 요약
“upload.py를 읽었고 README를 봤다”
O_t
관찰된 증거 (읽은 파일·검색 결과)
{upload.py L40–78, README §Upload}
ψ_t
가설과 하위 목표
“핸들러 앞단에서 검사하면 될 것 같다”
그리고 검색이 찾아야 할 곳은 코퍼스 전체가 아니라 보완 집합 1 — 아직 관찰하지 않은 부분이다. 논문 제목의 "Missing Complement"가 이것이다. 검색은 "이슈와 닮은 것을 다시 순위 매기는 일"이 아니라 "결정이 결여한 것을 회수하는 일"로 다시 자리 잡는다.
이 재정의가 실제로 얼마나 큰 차이를 만드는지, 논문은 작은 파일럿으로 먼저 보여 준다. 21개 상태에서 에이전트의 상태를 그대로 질의로 넣어 검색하면, 상위 10개 중 53.3%가 에이전트가 이미 본 증거의 반복이었다. 이슈 텍스트만으로 검색하면 18.1%였다. 직관과 반대다 — 상태를 "더 자세한 질의"로 쓰면 검색기는 에이전트가 이미 읽은 것과 닮은 것을 더 잘 찾아낸다. 상태는 질의에 더할 것이 아니라 결과에서 뺄 조건이다.
위젯에서 이미 읽은 파일을 하나씩 더 체크해 보면, A(이슈만으로 검색)는 체크한 것을 계속 돌려주고 B(상태 조건)는 부족한 그룹으로 이동한다. 이것이 논문이 말하는 "상태 조건(state-conditioned)"의 뜻이다.
🔗
RAFT와의 관계. 지난주 특집 「사건은 문서가 아니라 궤적이다 — Microsoft RAFT」도 “현재 상태를 보고 검색한다”는 발상을 공유한다. 다만 축이 다르다. RAFT는 시간 축 — 과거 사례를 상태의 사슬로 쪼개 “지금 내 사건과 같은 단계”의 중간 지점을 찾는다. 이 논문은 증거 축 — 지금 결정에 필요한 증거 그룹 중 아직 없는 것을 찾는다. 둘을 합치면 “이 단계에 온 사건이 다음 결정을 내리기 위해 아직 확보하지 못한 증거”가 되고, 그것이 고객지원·장애 대응 에이전트 검색의 자연스러운 목표 함수다.
2.1 충분성은 어떻게 정의하나 — 인증서와 그룹
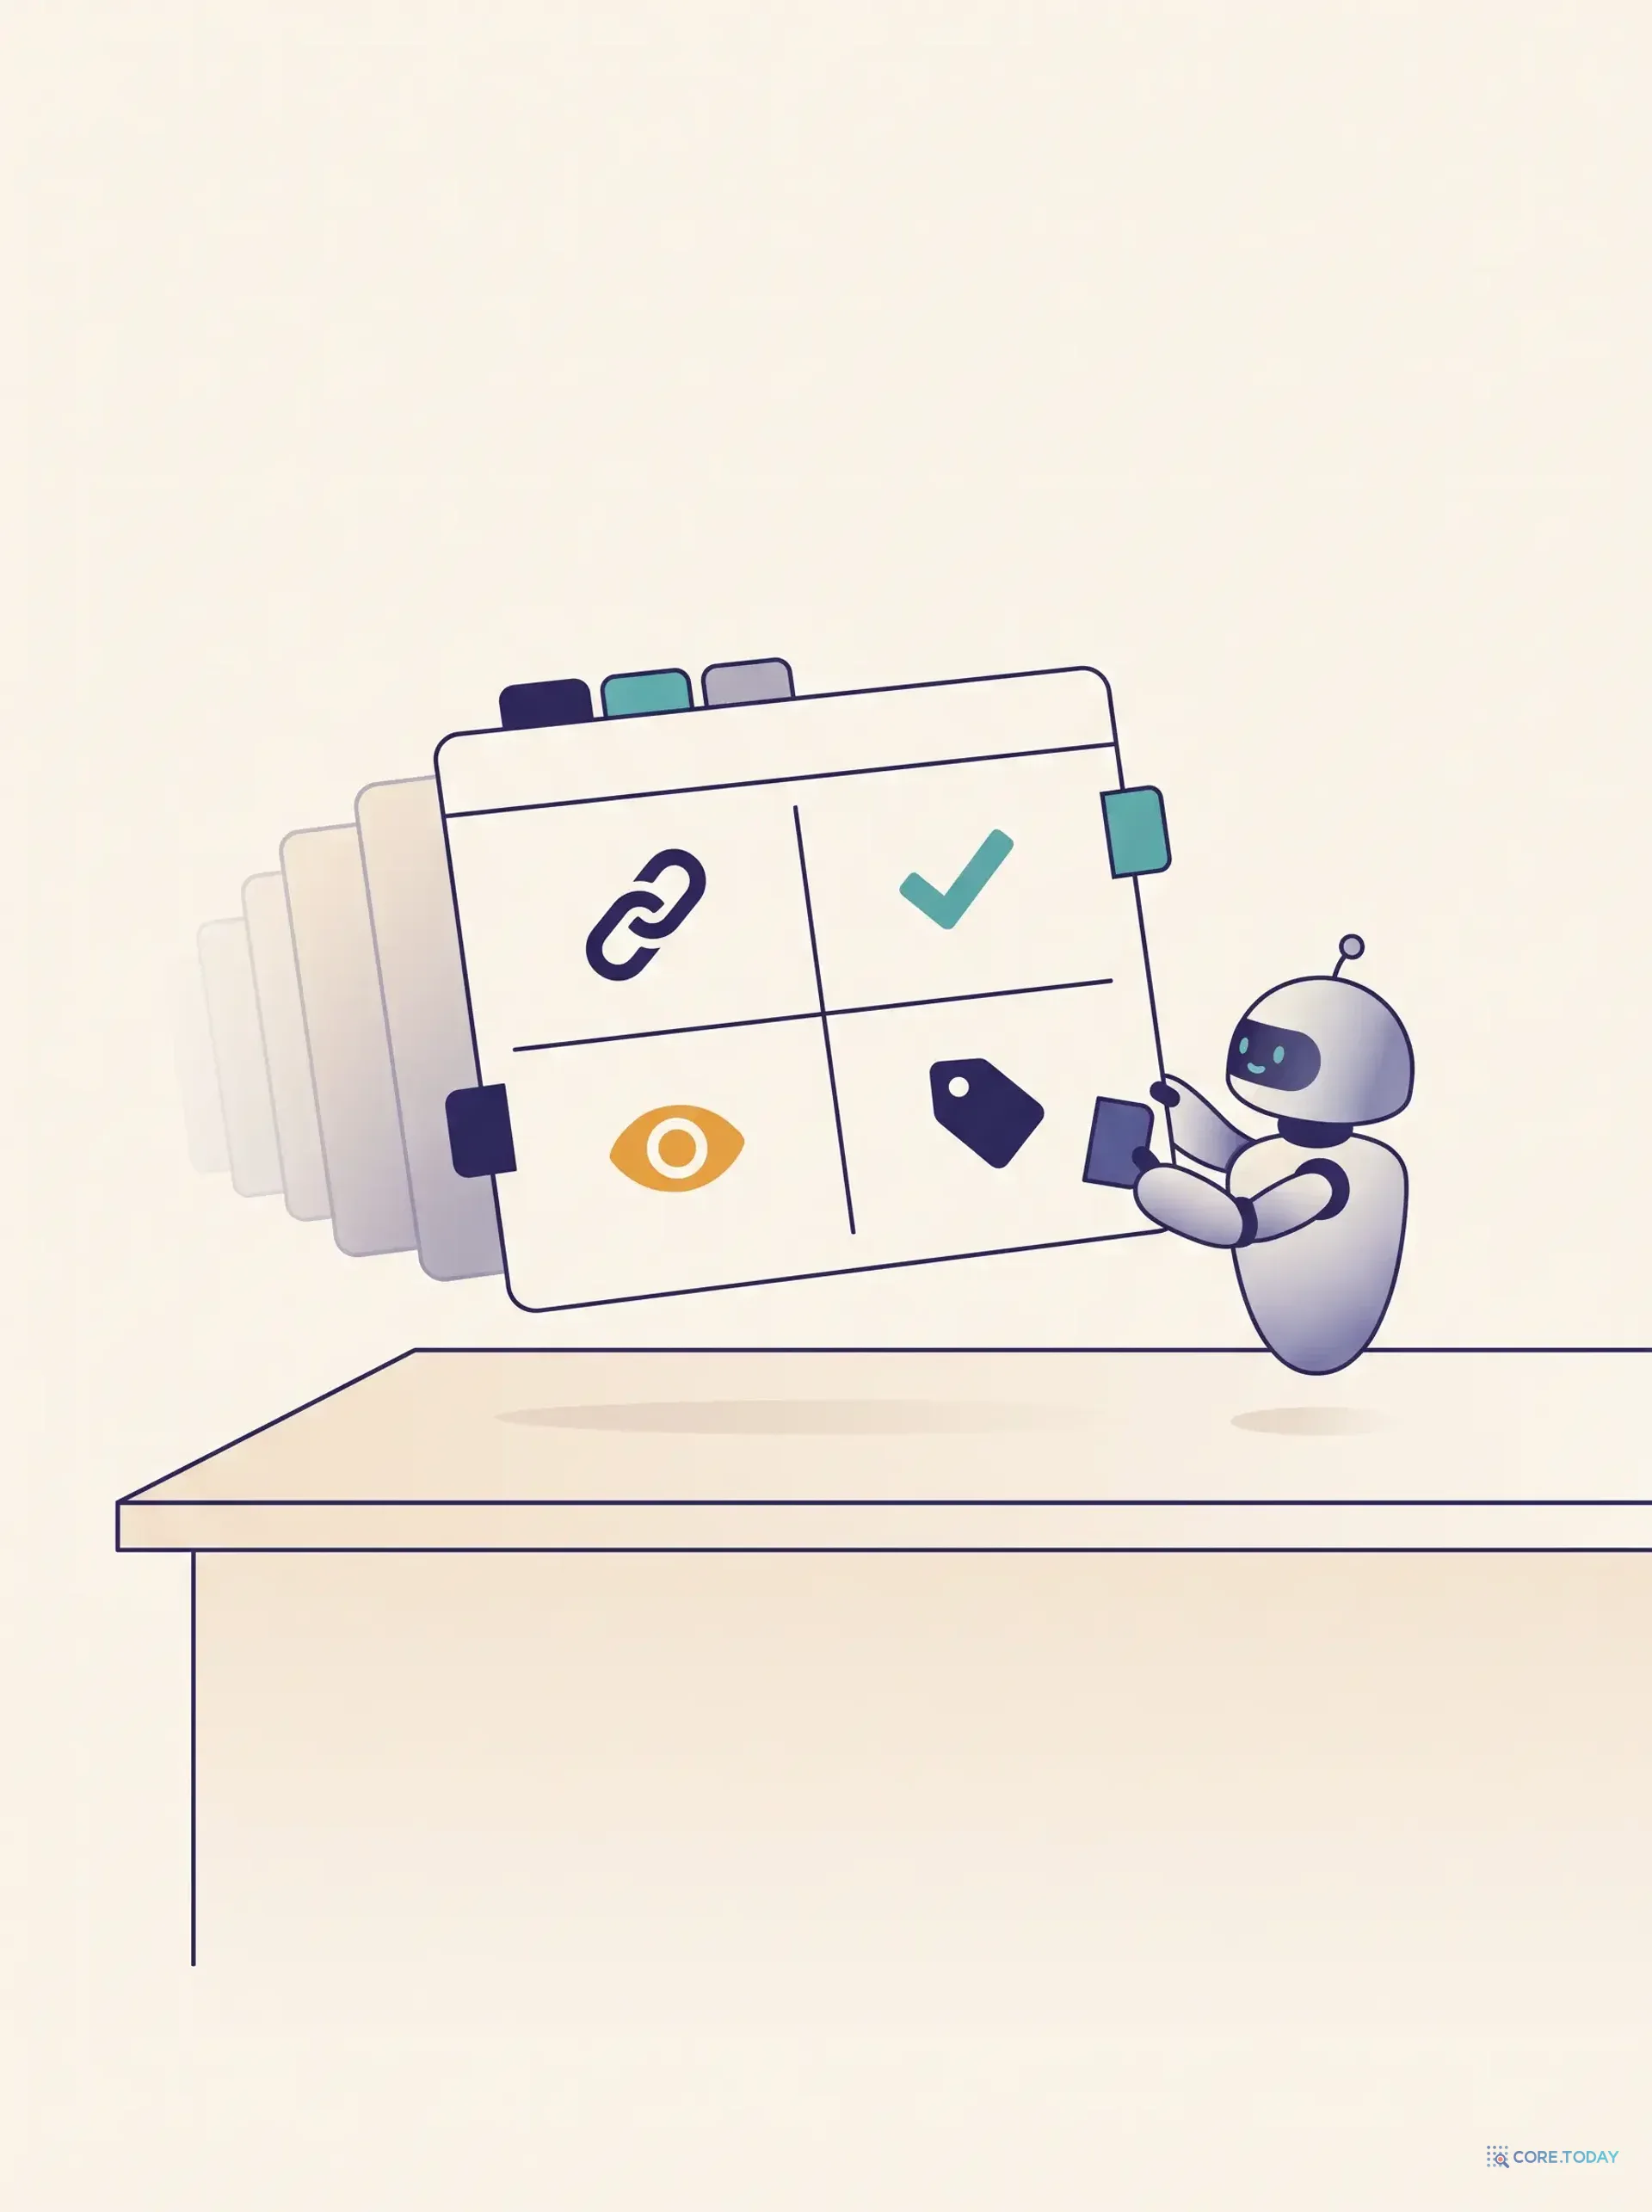
"충분하다"를 채점 가능하게 만들려면 정답이 문서 목록이 아니어야 한다. 논문은 각 상태에 인증서(certificate)G_t = {g_1, …, g_m}를 붙인다. 그룹 하나 g_j = (A_j, q_j, w_j, ρ_j)는 네 가지를 말한다.
A
허용 증거 집합 Aj. 이 요건을 채울 수 있는 소스 단위들의 ID. 같은 사실을 담은 문서가 셋이면 셋 다 들어간다 — 그중 하나면 된다.
q
필요 개수 qj. 대개 1이지만, “두 곳의 호출 지점을 모두 봐야 한다”면 2가 된다.
w
필요성 가중치 wj. 없으면 결정이 틀리는 요건과, 있으면 더 좋은 요건을 구별한다.
ρ
의미 역할 ρj. 원인 지점인가, 제약 조건인가, 검증 방법인가 — 나중에 “어느 종류의 증거를 놓치는가”를 분석할 때 쓴다.
그룹 j가 덮였는지는 |P_t(k) ∩ A_j| ≥ q_j — 돌려준 k개 중 허용 집합에 속한 것이 필요 개수 이상인가로 판정한다. 그리고 완전 충분은 모든 필수 그룹이 덮였거나, 명시된 대체 분기(alternative branch) 하나가 완전히 덮였을 때다. 대체 분기는 "A 경로로 고치려면 이 셋, B 경로로 고치려면 저 둘"처럼 해법이 여럿인 결정을 표현한다. Test500의 124개 상태가 그런 분기를 갖는다.
이 정의가 중요한 이유는 하나다. 정답을 문서 목록으로 두면 채점이 순위 지표로 되돌아간다. 정답을 "요건 그룹의 집합"으로 두어야 "집합이 요건을 다 덮었는가"를 물을 수 있다.
벤치마크의 이름은 SERBench(State-conditioned minimal sufficient Evidence Recovery)다. 도메인은 코딩 에이전트다 — 이 선택에는 이유가 있는데, 코딩 에이전트는 상태(어느 파일을 읽었나)가 도구 로그로 정확히 기록되고, 필요한 증거(어느 함수, 어느 설정, 어느 테스트)가 소스 단위로 명확히 잘리기 때문이다.
3.1 상태를 어떻게 얻었나
계측된 코딩 에이전트 하네스(DeepSeek-v4-Flash, 온도 0.1, 사고 비활성)를 실제 이슈에 돌리고, 궤적을 네 지점에서 동결했다.
200검색 전 — 이슈만 읽은 상태. 관찰 증거가 거의 없다.
124검색 후 — 첫 검색 결과를 받은 상태.
104파일 확인 후 — 몇 파일을 읽고 가설이 생긴 상태.
72편집 직전 — 수정 계획을 세웠고 마지막 확인이 필요한 상태.
관찰 증거 O_t는 궤적 앞부분의 파일 읽기와 검색 결과에서 자동으로 뽑는다(경로와 겹치는 줄 범위를 먼저 대조). 그런 뒤 사람이 각 상태에 대해 "이 결정의 미해결 요건은 무엇인가"를 짚고, 각 요건을 소스 단위에 근거시키고, 허용 대체안과 개수 임계값을 적는다. 요건은 "그것을 빼면 결정의 뒷받침이 약해질 때" 유지된다 — 즉 최소성이 주석 규칙에 들어 있다.
데이터는 두 분할이다. Cal500(개발용, 174개 저장소의 500 상태)과 Test500(평가용, Cal500과 겹치지 않는 45개 저장소의 500 상태). Test500은 상태 카드·후보 발췌·스키마·채점 코드·출처 필드를 공개하되, 인증서와 증거 역할은 별도 평가기에만 둔다. 정답이 새어 나가 방법이 정답에 과적합되는 것을 막기 위한 설계다. 코드는 MIT, 주석은 CC BY 4.0이다.
3.2 무엇을 재나
지표
정의
기존 Recall@k와의 차이
Complete-MSS@k (주 지표)
돌려준 k개가 모든 필수 그룹(또는 한 대체 분기)을 덮었는가 — 예/아니오
전부-아니면-전무. 그룹 하나만 빠져도 0. “결정을 내릴 수 있는가”와 같은 단위다.
Group Recall
상태 안에서 덮은 그룹의 비율을 먼저 평균한 뒤 상태 간 평균
부분 점수. 어디까지 왔는지 본다.
Necessity-weighted Recall
그룹 덮음에 필요성 가중치 wj를 적용
“없으면 틀리는” 요건을 더 무겁게
Grouped nDCG
새 그룹이 처음 덮일 때만 이득을 더하는 nDCG
같은 그룹의 두 번째 문서는 이득 0 — 중복을 순위 지표 안에서 벌한다
마지막 줄이 흥미롭다. 기존 nDCG는 관련 문서가 상위에 많을수록 점수가 오른다. Grouped nDCG는 같은 사실의 두 번째 문서에 이득을 주지 않는다. 순위 지표의 형식을 유지하면서도 "변형으로 예산을 채우는" 행동을 벌하는 방법이다. 우리 시스템의 오프라인 평가에 가장 옮기기 쉬운 지표이기도 하다.
논문이 제안하는 방법 MSS-Complement의 핵심은 한 문장이다. 획득을 순위 매기기가 아니라 집합 구성으로 다룬다. 세 번의 LLM 호출로 이뤄진다.
①
제안 (Proposal) — DeepSeek-v4-pro
상태, 현재 질문, 후보 소스 카드(요약)를 읽고 공동으로 충분해 보이는 8개 집합 S0를 고른다. 하나씩 점수 매기지 않고 집합을 고른다.
②
확장 (Expansion) — DeepSeek-v4-flash
S0와 아직 선택되지 않은 후보 요약을 받아, 제안에 빠진 사실 — 누락된 끝점, 조건, 전이 — 을 뒷받침할 소스를 찾는다. “무엇이 부족한가”를 명시적으로 묻는 단계다.
③
확정 (Finalization)
제안·확장 후보·순위 예비군을 출처 태그와 함께 읽고, 공동 지지를 검증해 선택을 고친 뒤 4~8개의 온전한 소스 단위를 6,144토큰 안에서 돌려준다.
"온전한 소스 단위(intact source units)"라는 표현에 주목할 만하다. 청크 경계에서 잘린 함수의 절반이 아니라 함수 전체, 설정 블록 전체를 돌려준다. 결정의 근거는 잘린 조각으로는 성립하지 않기 때문이다. 그리고 4~8개라는 가변 크기 — 결정마다 필요한 그룹 수가 다르므로 항상 k개를 채우지 않는다.
이 문제를 손으로 풀어 보면 제약이 어떻게 맞물리는지 감이 온다.
4.1 결과
위젯 ①에서 보듯 Test500에서 MSS-Complement의 Complete-MSS@5는 73.0%, @8은 80.6%다. 가장 강한 기준선 — Qwen3-Embedding-8B에 Qwen3-Reranker-8B를 얹은 것 — 은 61.4%와 72.4%. 격차는 k=5에서 +11.6pp(95% 신뢰구간 +6.9~+17.2), k=8에서 +8.2pp(+4.9~+13.9). k가 커질수록 격차가 줄어드는 것은 자연스럽다 — 자리가 넉넉하면 순위 기반도 결국 필요한 그룹을 담는다. 이 방식의 가치는 예산이 빠듯할 때 드러난다. BM25가 9.0%에 그친 것은 코드 저장소에서 어휘 일치가 얼마나 무력한지, 그리고 에이전트용 검색기 AgentIR-4B(38.6%)조차 임베딩+재랭커에 못 미친다는 점도 눈에 띈다.
위젯 ②의 이득 분포가 이 논문의 논지를 검증한다. 필요 그룹이 3개 이상인 149개 상태에서 이득은 +14.09pp, 그룹이 1개인 216개 상태에서는 +7.41pp — 여러 요건을 함께 덮어야 할 때 이득이 두 배다. 후보가 이미 본 것과 겹치는 186개 상태에서 +17.20pp, 겹치지 않는 314개에서 +8.28pp — 중복 제거의 효과다. 그리고 단 1개만 돌려줄 때는 −1.40pp로 차이가 없다 — 집합이 아니면 집합 구성이 할 일이 없다.
위젯 ③은 이 논문에서 가장 정직한 표다. 같은 LLM에게 "관련성 높은 것 7개를 골라라"고만 시킨 독립 유사도 제어군이 66.6%다 — 이미 기준선 61.4%보다 높다. 즉 이득의 상당 부분은 LLM이 후보 카드를 읽고 고른다는 데서 온다. 그 위에 "집합으로 판정하라"는 목표가 +3.2, "필요한 만큼만 담아라"는 크기 조절이 +3.0을 더해 총 +6.4pp(CI +3.4~+10.5). 선택 집합 피드백 단계의 기여는 +0.2로 통계적으로 0과 구별되지 않는다. 옮겨 쓸 때의 우선순위가 여기서 나온다 — 목표 함수와 크기 조절이 먼저, 정교한 다단계 루프는 나중.
⚖️
비용은 어디로 갔나. 세 번의 LLM 호출은 공짜가 아니다. 논문이 AMA-Bench에서 잰 온라인 총 토큰은 MSS-Complement 33.57K, 기준선 13.95K — 약 2.4배다. 1편 7장에서 본 “도구를 계층화하면 토큰이 준다”와 반대 방향처럼 보이지만 층이 다르다. 1편은 에이전트가 검색을 반복하는 비용을, 이 논문은 검색기 자체가 LLM으로 집합을 고르는 비용을 말한다. 후자는 결정마다 한 번 도는 고정 비용이고, 에이전트가 불충분한 증거로 잘못된 편집을 하고 되돌리는 비용과 비교해야 한다. 그 비교는 논문에 없고, 우리 데이터로 재야 한다.
오른쪽 네 질문은 검색 결과가 chunk_id · score · text 세 필드만 갖고 있으면 하나도 답할 수 없다. 그룹이 무엇인지, 무엇을 뒷받침하는지, 이미 봤는지, 어느 버전인지가 결과에 없기 때문이다. 그래서 검색 결과의 스키마 자체가 바뀌어야 한다.
네 필드를 모두 켜면 나타나는 문장이 이 장의 결론이다. 정답 데이터는 문서 목록이 아니라 결정별 필수 그룹 목록이어야 한다. SERBench가 "인증서"라고 부른 그것이다. 우리 도메인에서 그것을 만드는 방법은 8장에서 다룬다.
🔁
1편과의 연결.1편 10장의 여섯 번째 항목이 “평가 지표를 하나 더한다 — 증거 완전성”이었다. 이 장이 그 항목의 구체다. 그리고 1편 9장의 “충분성 판정”이 매 스텝 묻는 질문이 바로 위의 ④다. 에이전트 검색의 중단 규칙과 검색 시스템의 평가 지표는 같은 함수다 — 하나는 실행 시간에, 하나는 오프라인에서 계산될 뿐이다.
같은 주에 공개된 다른 논문이 같은 결론에 다른 길로 도달한다. 「TRACE: Accountable Agentic Retrieval for Source Discovery in Digital Archives」(Donghan Bian, Marie Puren, Florian Cafiero — 에콜 데 샤르트, EPITA, 제네바 국제개발대학원)는 2026년 11월 로마에서 열리는 CIKM 2026에 실린다.
6.1 왜 역사 아카이브인가
대상은 프랑스 제3공화국의 의회 속기록과 신문이다. 이 코퍼스는 일반 RAG가 가정하는 것과 세 가지가 다르다.
1
OCR이 깨져 있다. 국립도서관(BnF)이 디지털화한 19세기 신문은 “상당한 OCR 오류, 불규칙한 레이아웃, 장르 특수 어휘”를 갖는다. 정확한 문자열 일치도, 깨끗한 임베딩도 믿을 수 없다.
2
출처가 이질적이다. 속기록과 신문은 같은 사건을 완전히 다른 문체·구조·어휘로 기록한다. 하나의 질문이 두 장르를 가로질러야 한다.
3
출처 추적이 요건이다. “역사 연구에서 검색은 숨은 전처리 단계가 아니라 그 자체가 학술 행위다. 검색된 출처는 발견 가능하고, 검사 가능하고, 인용 가능해야 한다.” 답이 그럴듯한 것보다 왜 이 문서가 나왔는지가 중요하다.
세 번째 조건이 이 논문의 설계를 결정한다. TRACE는 답을 생성하지 않는다. 출처를 찾고, 왜 찾았는지를 남긴다. 저자들은 이를 "생성 지표가 아니라 검색 품질로 평가하는 출처 발견(source discovery) 문제"라고 다시 정의한다.
6.2 구조 — 판정에 근거를 남기는 루프
파이프라인은 여섯 단계다. 질문을 이 코퍼스에서 답할 수 있는 하위 질문으로 분해하고, BM25·밀집·시간 세 채널을 융합해 첫 후보를 채우고, 에이전트가 검색과 검토를 엄격히 교대하며 검토한 모든 청크에 accept / reject / hold 중 하나의 판정과 한 줄 근거를 붙이고, 보류한 것을 나중에 재평가하고, 구조화된 메모리를 갱신해 재계획하고, 채택된 문서를 병합해 여러 하위 질문에서 반복 지지된 것을 위로 올린다.
"학습 없음(training-free)"이라는 점도 실무적으로 중요하다. 강화학습도 파인튜닝도 없고, LLM 호출은 상태 없는 JSON 모드 출력이라 특정 벤더의 함수 호출 인터페이스에 묶이지 않는다. 백본은 DeepSeek-V4-Flash, 임베딩은 Qwen3-Embedding-8B. 질문당 평균 33.8회 LLM 호출, 기본 호스팅 구성에서 약 0.02달러. 1,752문항 전체 평가에 약 36달러가 들었다.
OCR 잡음은 따로 전처리하지 않고 채널의 상보성으로 넘는다. "BM25는 디지털화를 살아남은 토큰을 맞추고, 밀집 검색은 훼손된 텍스트의 의미적 재표현을 잡는다." 실제로 두 채널 top-20의 자카드 겹침은 0.19에 불과하고, 융합이 회수한 정답의 28.8%는 두 채널 중 하나로만 닿는다. 융합은 정답 문서의 78.9%를 회수하고, 더 좋은 단일 채널은 70.1%였다.
6.3 결과 — 그리고 1편의 주인공이 여기서 넘어진 이유
HistoriQA-ThirdRepublic 1,752문항(프랑스어, 단일 홉 889 · 다중 홉 일반 529 · 브릿지 엔티티 142 · 비교형 192)에서 TRACE의 전체 R@10은 0.856, MRR 0.653. 밀집 검색(0.734 / 0.535)과 HippoRAG 2(0.737 / 0.453)를 넘는다. 격차가 가장 큰 곳은 비교형 질문이다 — BM25 0.180, 밀집 0.302, TRACE 0.674. 두 대상을 각각 찾아 합쳐야 하는 질문은 한 번의 유사도 검색으로는 구조적으로 풀리지 않는다는, 1편의 결론이 다른 도메인에서 반복된다.
그런데 위젯 ②의 표에는 낯익은 이름이 낮은 자리에 있다. A-RAG — 1편 3장의 주인공 — 가 이 코퍼스에서 R@10 0.385로 BM25보다 낮다. 키워드·의미 검색·청크 읽기 세 도구를 준 에이전트가 OCR 잡음과 19세기 프랑스어 장르 어휘 앞에서 무너진 것이다. 저자들의 해석은 "일반 도메인용 에이전트 검색기가 이 조건에 그대로 옮겨지지 않는다"는 것이다. 우리에게 주는 교훈은 분명하다. 도구를 준다는 발상은 같아도, 코퍼스에 맞춘 분해·융합·판정 구조가 없으면 에이전트 검색은 기준선보다 나빠질 수 있다. 누적 제거 실험(위젯 ③)이 그 구조의 값을 보여 준다 — 코퍼스 지향 분해 +8.9pp, 세 채널 융합 +5.0pp.
TRACE의 가장 중요한 시사점은 벤치마크 수치가 아니라 구조다. RAG의 산출물이 항상 완성된 자연어 답변일 필요는 없다.
1출처 발견 (Source Discovery) — 신뢰할 수 있는 원문·페이지·기록을 찾고, 각 문서에 “어느 하위 질문 → 어느 검색 → 어떤 근거로 채택”의 경로를 붙인다.
2사람 검토 — 발견된 출처와 근거를 사람이 본다. 보류(hold)된 문서를 열어 보고, 분해가 이상하면 고치고, 채택 집합을 조정한다. TRACE 저자들이 “다음 작업”으로 명시한 체크포인트다.
3승인된 출처만으로 생성 — 답변이나 보고서는 2단계를 통과한 문서만 컨텍스트로 받는다. 생성 모델은 출처를 고르지 않는다.
이 구조가 맞는 곳은 출처 책임성이 답변의 유창함보다 중요한 시스템이다. 의정지원 AI(발언·회의록·조례의 정확한 인용), 공고·보도자료·뉴스 데이터 레이크(어느 기관이 언제 발표했는가), 행정 자료 분석(근거 문서 없는 요약은 쓸 수 없다), 법무·감사(인용 없는 결론은 결론이 아니다). 이런 곳에서 "바로 답을 생성하는 RAG"는 빠르지만, 틀렸을 때 누가 어디서 틀렸는지 추적할 수 없다. 출처 발견과 생성을 분리하면 1단계의 품질을 R@10·MRR·판정 정밀도로 따로 재고 개선할 수 있고, 2단계에서 사람이 개입할 자리가 생기고, 3단계의 환각은 "승인된 출처 밖의 주장"으로 기계적으로 검출된다.
TRACE는 이 구조를 실제로 돌리고 있다. DECIDON 프로젝트(의회 토론과 언론 사이의 정치 담론 순환 연구)의 내부 프로토타입으로 EPITA·EHESS-CRH·Inria·프랑스국립도서관·에콜 데 샤르트·LARHRA 여섯 기관의 연구자 24명이 2026년 3월부터 사용해 수백 건의 탐색 질의를 돌렸다. 저자들은 이것이 "공개 서비스가 아닌 초기 단계의 내부 연구 서비스"라고 분명히 적었고, 전문가의 신뢰를 실제로 높이는지, 검증 노력을 줄이는지는 "아직 열린 질문"이라고 했다.
7. 두 논문이 같은 말을 한다
코딩 에이전트와 19세기 프랑스 신문. 도메인은 이보다 멀 수 없지만, 두 논문은 한 가지를 공유한다. 검색의 산출물을 “관련 문서의 순위”에서 다른 것으로 바꿨다.
The Missing Complement
TRACE
검색의 산출물
결정을 뒷받침하는 최소 충분 증거 집합 (4~8개 온전한 소스 단위)
판정과 근거가 붙은 검사 가능한 출처 집합 (accept + 경로)
순위의 자리
집합 구성의 예비군(reserve)으로 격하
여러 하위 질문에서 반복 지지된 순서로만 사용
“충분”의 판정 주체
LLM이 공동 지지를 검증
LLM이 청크별 판정 → 사람이 최종 검토
기존 지표의 한계
Recall@k는 집합 충분성을 못 잰다 → Complete-MSS@k
생성 지표는 출처 책임성을 못 잰다 → 검색 우선 평가(R@10·MRR·판정 정밀도)
상태·맥락
에이전트의 관찰 이력 Ot를 조건으로
구조화된 메모리(발견·공백·다음 단계)를 조건으로
비용
기준선의 약 2.4배 토큰 (결정당)
질문당 약 0.02달러, 33.8회 호출
그리고 둘은 1편의 빈칸을 채운다. 1편은 에이전트가 "증거가 충분한지 판단하고 부족하면 다시 검색한다"고 썼지만 무엇이 충분한가는 열어 두었다. 이 두 논문의 답은 같다. 충분성은 개별 문서의 속성이 아니라 결정에 필요한 요건 그룹이 모두 덮였는가라는 집합의 속성이고, 그것을 판정하려면 검색 결과에 그룹·주장·이미 본 것·출처 경로가 붙어 있어야 한다.
두 논문의 방법을 그대로 가져올 필요는 없다. 그러나 다음 순서는 어느 도메인에서든 옮길 수 있다.
1
결정 단위를 정한다. 우리 시스템에서 “한 번의 결정”은 무엇인가. 고객지원이면 “다음 조치 제안”, 공고 검색이면 “신청 가능 판정”, 코드 에이전트면 “수정 계획”. 검색 평가의 단위가 질의가 아니라 결정이 된다.
2
결정 100개에 필수 그룹을 주석한다. 실패 사례부터 고른다. 각 결정에 “이것이 없으면 틀리는 요건”을 그룹으로 적고, 각 그룹을 채울 수 있는 문서(대체 포함)를 나열한다. SERBench의 인증서를 우리 규모로 만드는 것이다. 100개면 시작하기에 충분하다 — 논문의 파일럿은 21개였다.
3
Complete-set@k와 Grouped nDCG를 계산한다. 지금 시스템의 Recall@k 옆에 두 숫자를 나란히 놓는다. 대개 Recall@k는 높고 Complete-set@k는 낮다. 그 격차가 “지표가 못 보던 실패”의 크기다.
4
이미 본 것을 추적하고 제외한다. 대화형이면 이 세션에서 보여 준 청크 ID, 에이전트형이면 도구 로그의 읽기 기록. 검색 결과에 already_seen을 붙이고 기본값으로 제외한다. 논문에서 이득이 가장 컸던 조건(겹침 있음 +17.2pp)이 이것이다. 1편의 Mistral exclude_ids가 같은 장치다.
5
순위 위에 집합 선택기를 얹는다. 검색기는 후보 20~30개를 카드(제목·요약·그룹 태그)로 만들고, LLM이 카드를 읽고 “필수 그룹을 모두 덮는 최소 집합”을 고른다. 논문의 제어군이 보여 주듯 이 한 단계만으로 이득의 대부분이 나온다. 그룹 태그는 색인 시 LLM이 붙이거나 선택기가 판정 중에 붙인다.
6
크기를 고정하지 않는다. 항상 k개가 아니라 “필요한 그룹을 덮는 만큼 + 약간의 여유”. 논문은 4~8개, 6,144토큰이었다. 우리 예산에 맞춰 상한을 정하고, 선택기가 그 안에서 개수를 정하게 한다. 크기 조절만으로 +3.0pp였다.
7
책임성이 중요한 도메인이면 출처 발견과 생성을 분리한다. 1단계는 판정(accept/reject/hold)과 근거를 남기며 출처를 고르고, 사람이 검토할 수 있는 화면을 두고, 생성은 승인된 출처만 받는다. 1단계는 R@10·MRR·판정 정밀도로, 3단계는 “승인 출처 밖 주장 비율”로 따로 잰다.
마지막으로, 검색 결과의 스키마에 5장의 네 필드를 더한다. 이것이 없으면 위의 어느 단계도 측정할 수 없다.
9. 한계와 반론
9.1 논문이 직접 밝힌 것
The Missing Complement는 사전 공개(preprint) 연구다. 도메인이 코딩 에이전트 하나이고, 상태는 특정 하네스(DeepSeek-v4-Flash)의 궤적에서 나왔다. k=5에서 오라클조차 99.8%인 상태가 있다 — 여섯 그룹이 필요한데 다섯 개 안에 담을 분기가 없는 결정이 존재한다. 온라인 토큰은 기준선의 약 2.4배다.
TRACE의 벤치마크는 1887년 한 해, 프랑스어, 한 코퍼스다. 스텝·하위 질문 예산, 메모리 크기, 시간 확장 창은 이 코퍼스에서 개발 중 고정된 상수이고 질문 유형별로 튠되지 않았다. 속기록과 신문의 관계 같은 프롬프트 수준 가정은 코퍼스 특수적이다. 플래너가 다중 홉 질문을 하위 질문 하나로 뭉개면 재계획이 발동하지 않고 그런 질문의 72%가 실패한다(기저 20%). 소형 모델은 다단계 계획과 구조화 출력의 안정성에서 아직 부족해 로컬 배포에는 더 큰 인프라나 프로토콜 최적화 버전이 필요하다. 그리고 “전문가의 신뢰를 실제로 높이는가”는 측정되지 않았다.
9.2 이 특집이 덧붙이는 반론
주석 비용. 인증서는 사람이 만든다. 결정마다 “필수 그룹과 허용 대체안”을 적는 일은 정답 문서 하나를 표시하는 일보다 몇 배 비싸다. 8장에서 100개로 시작하라고 한 이유다. 다만 이 비용은 평가 데이터에만 들고 운영에는 들지 않는다 — 운영 시 그룹 판정은 선택기가 한다.
LLM 선택기의 순환성. 검색기가 LLM이면 검색 품질이 LLM 품질에 종속되고, 1편 3장에서 본 “병목이 검색에서 추론으로 이동”이 검색기 안에서 재현된다. 선택기가 그룹을 잘못 판정하면 Complete-set은 만점인데 실제로는 불충분한 집합이 나갈 수 있다. 인증서가 비공개 평가기에만 있는 이유가 이것이고, 우리도 선택기의 그룹 판정 정확도를 따로 재야 한다.
단일 홉의 과잉. TRACE의 표가 스스로 보여 주듯 단일 홉 질문에서 밀집 검색(0.879)과 TRACE(0.893)의 차이는 작다. 33.8회 호출을 모든 질의에 쓰는 것은 낭비다. 1편 8장의 라우팅이 여기서도 필요하다 — 집합 구성과 출처 발견 루프는 다중 요건·다중 홉·책임성 질의에만 켜야 한다. 그 라우팅이 3편의 주제다.
“집합”의 정의가 도메인마다 다르다. 코드에서는 함수·설정·테스트가 자연스러운 소스 단위지만, 계약서에서는 조항과 별표, 고객지원에서는 상태 전이가 단위다. 온전한 소스 단위가 무엇인지 정하는 일이 청킹 전략과 파싱(4편)에 선행한다.
마무리 — 검색은 답을 찾는 일이 아니라 결정을 뒷받침하는 일이다
이 글은 다섯 개를 다 맞히고도 답을 못 내는 검색으로 시작했다. 신청 자격 다섯 장. 개별 관련성은 최고, Recall@5는 만점, 결정은 불가. 그 장면이 보여 주는 것은 검색기의 실패가 아니라 우리가 검색에 부여한 목표의 실패다. "이 질문과 가장 닮은 것을 다오"라고 요구했고, 검색기는 정확히 그것을 했다.
2026년 9월의 두 논문은 목표를 바꾼다. 「The Missing Complement」는 "이 결정에 아직 부족한 것을 다오"로 — 그래서 이미 본 것을 빼고, 하나씩 점수 매기지 않고 집합을 고르고, 필요한 만큼만 담는다. TRACE는 "이 질문의 출처를 찾고 왜 찾았는지 남겨라"로 — 그래서 답을 생성하지 않고, 모든 판정에 근거를 붙이고, 사람이 검토할 자리를 남긴다. 둘 다 산출물이 "관련 문서의 순위"가 아니다. 하나는 결정을 뒷받침하는 증거 집합이고, 하나는 검사 가능한 출처 경로다.
그러면 평가도 바뀐다. "정답 문서가 top-10에 있는가"는 여전히 필요하지만 충분하지 않다. "필요한 그룹이 모두 있는가, 중복이 예산을 먹지 않았는가, 이미 본 것을 또 가져오지 않았는가, 이것으로 결정할 수 있는가" — 네 질문에 답하려면 검색 결과 한 줄에 네 필드가 더 필요하고, 정답 데이터는 문서 목록이 아니라 결정별 요건 목록이어야 한다.
1편이 검색을 에이전트로 만들었다면, 이 글은 그 에이전트가 무엇을 향해 검색하는지를 정했다. 다음 편은 그 에이전트를 언제 켜고 언제 끌지 — 질문마다 검색기·생성기·예산을 고르는 동적 라우팅이다.
참고자료
연구 논문
Feng, Z., Zhang, R., Yang, Y. & Xie, P. The Missing Complement: State-Conditioned Minimal Sufficient Evidence for Coding Agents.arXiv:2609.20050 (2026년 9월 17일, UC 샌디에이고) — 사전 공개
Bian, D., Puren, M. & Cafiero, F. TRACE: Accountable Agentic Retrieval for Source Discovery in Digital Archives.arXiv:2609.19897 — CIKM ’26 (2026년 11월 7–11일, 로마), doi:10.1145/3799682.3840134
HistoriQA-ThirdRepublic — 프랑스 제3공화국 의회 토론·신문 기반 다중 홉 질의응답 코퍼스, arXiv:2606.31325 · LREC 2026 (TRACE 평가는 이 중 1,752문항 사용)
Zhang, M. et al. RAFT: A Stateful Retrieval-Augmented Framework for Troubleshooting Agents.arXiv:2609.20754 — EMNLP 2026 Industry Track. “현재 상태를 조건으로 검색한다”의 시간 축 구현
출처와 수치에 대하여. 두 논문의 수치는 각 결과표(The Missing Complement Table 1·4, TRACE Table 1·2·3)와 본문에서 그대로 옮겼다. 사업 공고 예시(신청 자격·예외 조건·마감일 변경)와 코딩 에이전트 예시(upload.py 등)의 후보·점수·토큰은 이 특집이 설명용으로 만든 것이며 논문의 데이터가 아니다. 위젯 ‘평가 필드 설계 도구’의 네 필드 이름은 이 시리즈의 제안이고 표준이 아니다. 삽화는 코어닷투데이가 생성했다. 두 논문 모두 2026년 9월에 공개된 최신 연구로, The Missing Complement는 사전 공개 단계이며 TRACE는 CIKM 2026 채택본이다.