BM25한국어 토크나이저형태소 분석Kiwinori엘라스틱서치OpenSearch조사복합명사글자 n-gram사용자 사전k1b어휘 검색하이브리드 검색한국어 검색 스택튜토리얼
BM25는 한국어를 어떻게 쪼개나 — 조사·복합명사·영한 혼용, 토크나이저가 검색을 결정한다 (한국어 검색 스택 5편)
2편에서 BM25는 '약한 고리'였습니다. 왜 약했을까요. 이 글은 그 질문을 파고듭니다. 같은 문서, 같은 질문, 같은 BM25 공식에 토크나이저만 여덟 가지로 바꿔 보니 nDCG@10이 0.42에서 0.62까지 벌어졌습니다. 띄어쓰기로 자르면 '청년취업을'과 '청년취업'이 다른 단어가 되고, 형태소 분석기로 조사를 떼면 같은 단어가 되며, 글자 2-gram을 겹쳐 색인하면 사전에 없는 말까지 받아 줍니다. 한국어에서 어휘 검색이 어려운 세 가지 이유(교착어의 조사와 어미, 복합명사, 영한 혼용)를 예시 문장의 실제 토큰으로 보여 주고, 엘라스틱서치 nori의 decompound 모드와 불용 품사 기본값, Kiwi의 사용자 사전, BM25의 k1·b 다이얼을 실측으로 짚습니다. 결론은 BM25 자체가 약한 것이 아니라 한국어를 잘못 쪼갠 BM25가 약하다는 것입니다. 인터랙티브 4개와 삽화 8장.
2편에서 BM25는 nDCG@10 0.616으로 벡터 검색(0.889)에 크게 뒤졌고, 그래서 RRF로 합쳤을 때 전체를 끌어내리는 '약한 고리'가 됐습니다. 독자 몇 분이 물었습니다. BM25가 원래 그렇게 약한가요? 아니면 한국어라서 그런가요?
답은 둘 다 아닙니다. 한국어를 어떻게 쪼개느냐 가 BM25의 절반을 정합니다. 같은 문서 589건, 같은 질문 85개, 같은 BM25 공식에 토크나이저만 여덟 가지로 바꿔 봤습니다.
띄어쓰기로만 자르면 0.419, Kiwi 형태소 분석기로 조사와 어미를 떼면 0.616, 거기에 글자 2-gram을 겹치면 0.622입니다. 공식은 하나도 안 바꿨는데 47%가 올랐습니다. 이 글은 그 차이가 어디서 오는지를 한국어의 세 가지 특성으로 풀고, 실무에서 쓰는 도구(엘라스틱서치·OpenSearch의 nori, 파이썬의 Kiwi)의 설정을 실측으로 짚습니다.
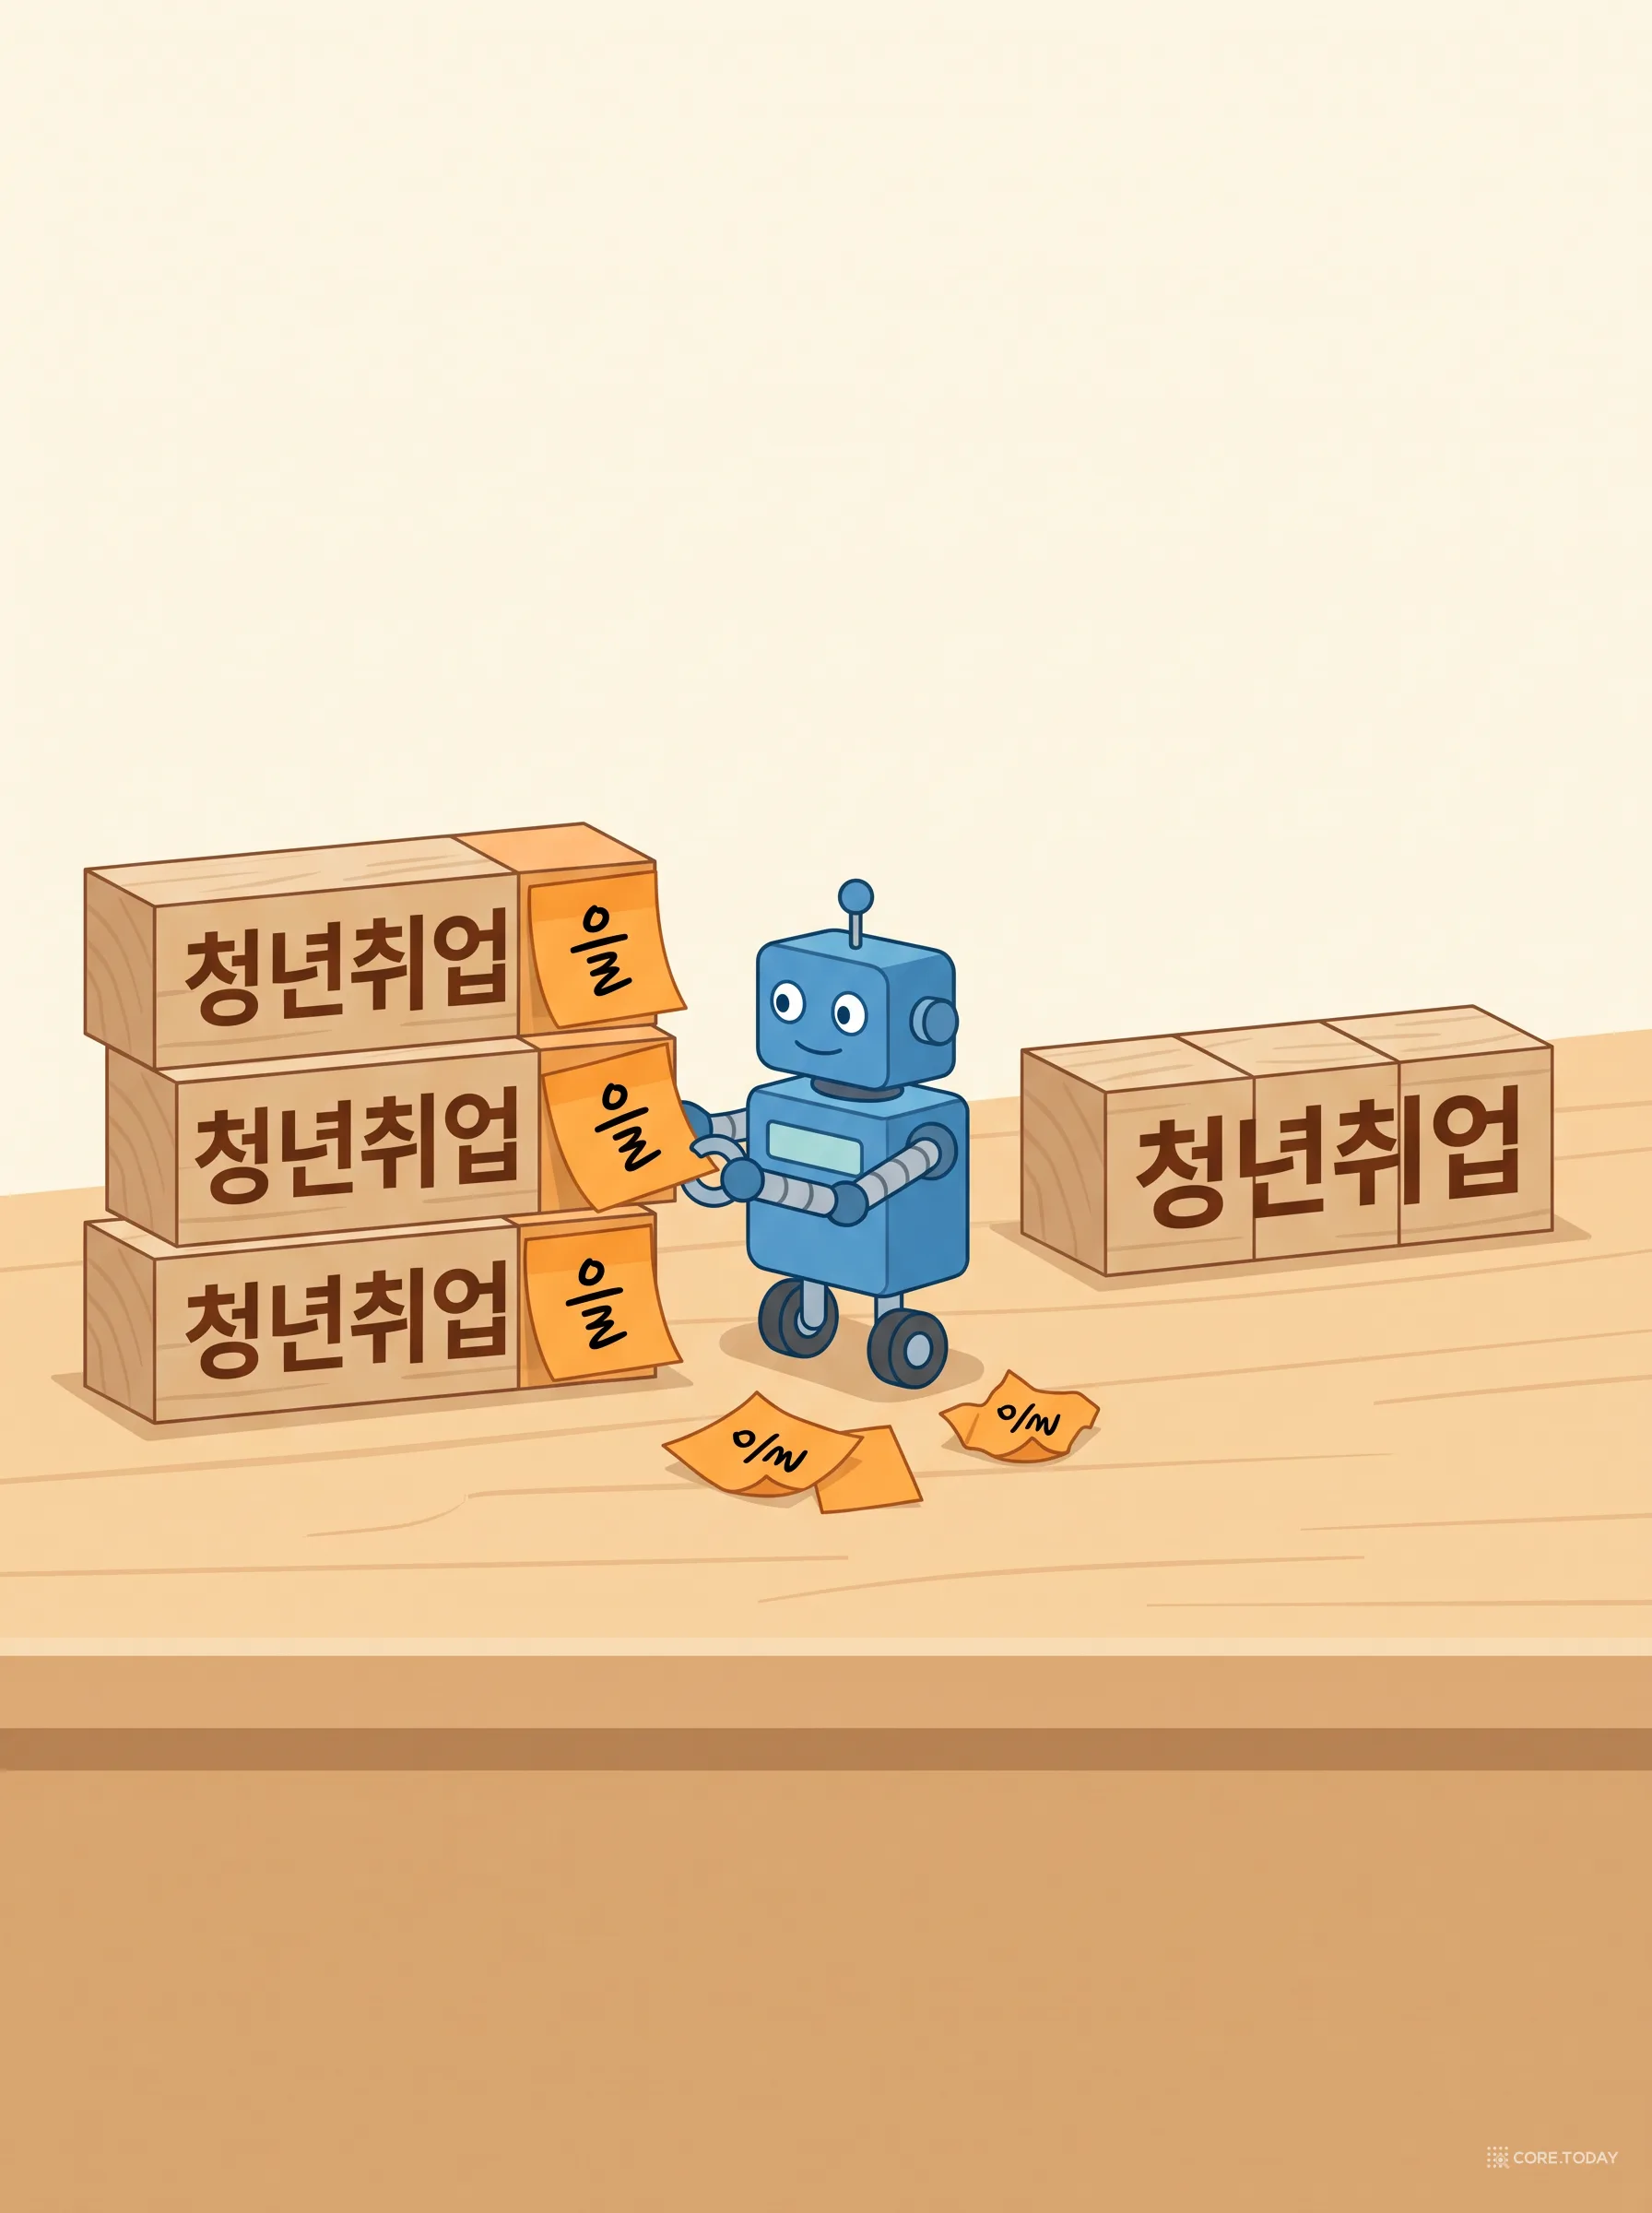
f(t, d)는 단어 t가 문서 d에 나온 횟수, |d|는 문서 길이, avgdl은 평균 문서 길이, IDF(t)는 t가 드물수록 커지는 가중치입니다. 이 공식에서 중요한 것은 f(t, d)가 정확히 같은 토큰 의 횟수라는 점입니다. '청년취업을'과 '청년취업'은 사람에게는 같은 말이지만 BM25에게는 다른 토큰이고, f는 0입니다.
영어에서는 이것이 큰 문제가 아닙니다. 'jobs'와 'job'은 어간 추출(stemming) 한 번이면 같아지고, 단어 사이에 공백이 있습니다. 한국어는 세 가지가 다릅니다.
2부. 한국어가 어려운 세 가지 이유
첫째, 조사와 어미가 단어에 붙어 있다
한국어는 교착어입니다. '일자리'라는 명사에 '와', '를', '에서', '은', '도'가 붙어 '일자리와', '일자리를', '일자리에서'가 됩니다. 띄어쓰기로 자르면 이 다섯이 전부 다른 토큰입니다. 동사는 더합니다. '추진하다'는 '추진된', '추진했다', '추진하여', '추진되는'으로 활용됩니다.
'청년취업', '지원사업', '지역주도형'은 한 단어처럼 붙여 쓰지만 안에 여러 명사가 들어 있습니다. 질문에는 '청년 일자리'처럼 띄어 쓰고 문서에는 '청년취업'처럼 붙여 쓰면, 띄어쓰기 색인에서는 '청년'이 문서 쪽에 없습니다. Kiwi는 기본으로 '청년취업'을 '청년'+'취업'으로 나눕니다. 1편의 예시 문장 "지역주도형 청년취업 지원사업 추진"은 Kiwi에서 '지역주도형 / 청년 / 취업 / 지원 / 사업 / 추진'이 됩니다. 그래서 질문의 '청년'과 맞습니다.
엘라스틱서치와 OpenSearch의 한국어 분석기 nori 는 이것을 decompound_mode라는 설정으로 다룹니다.
decompound_mode
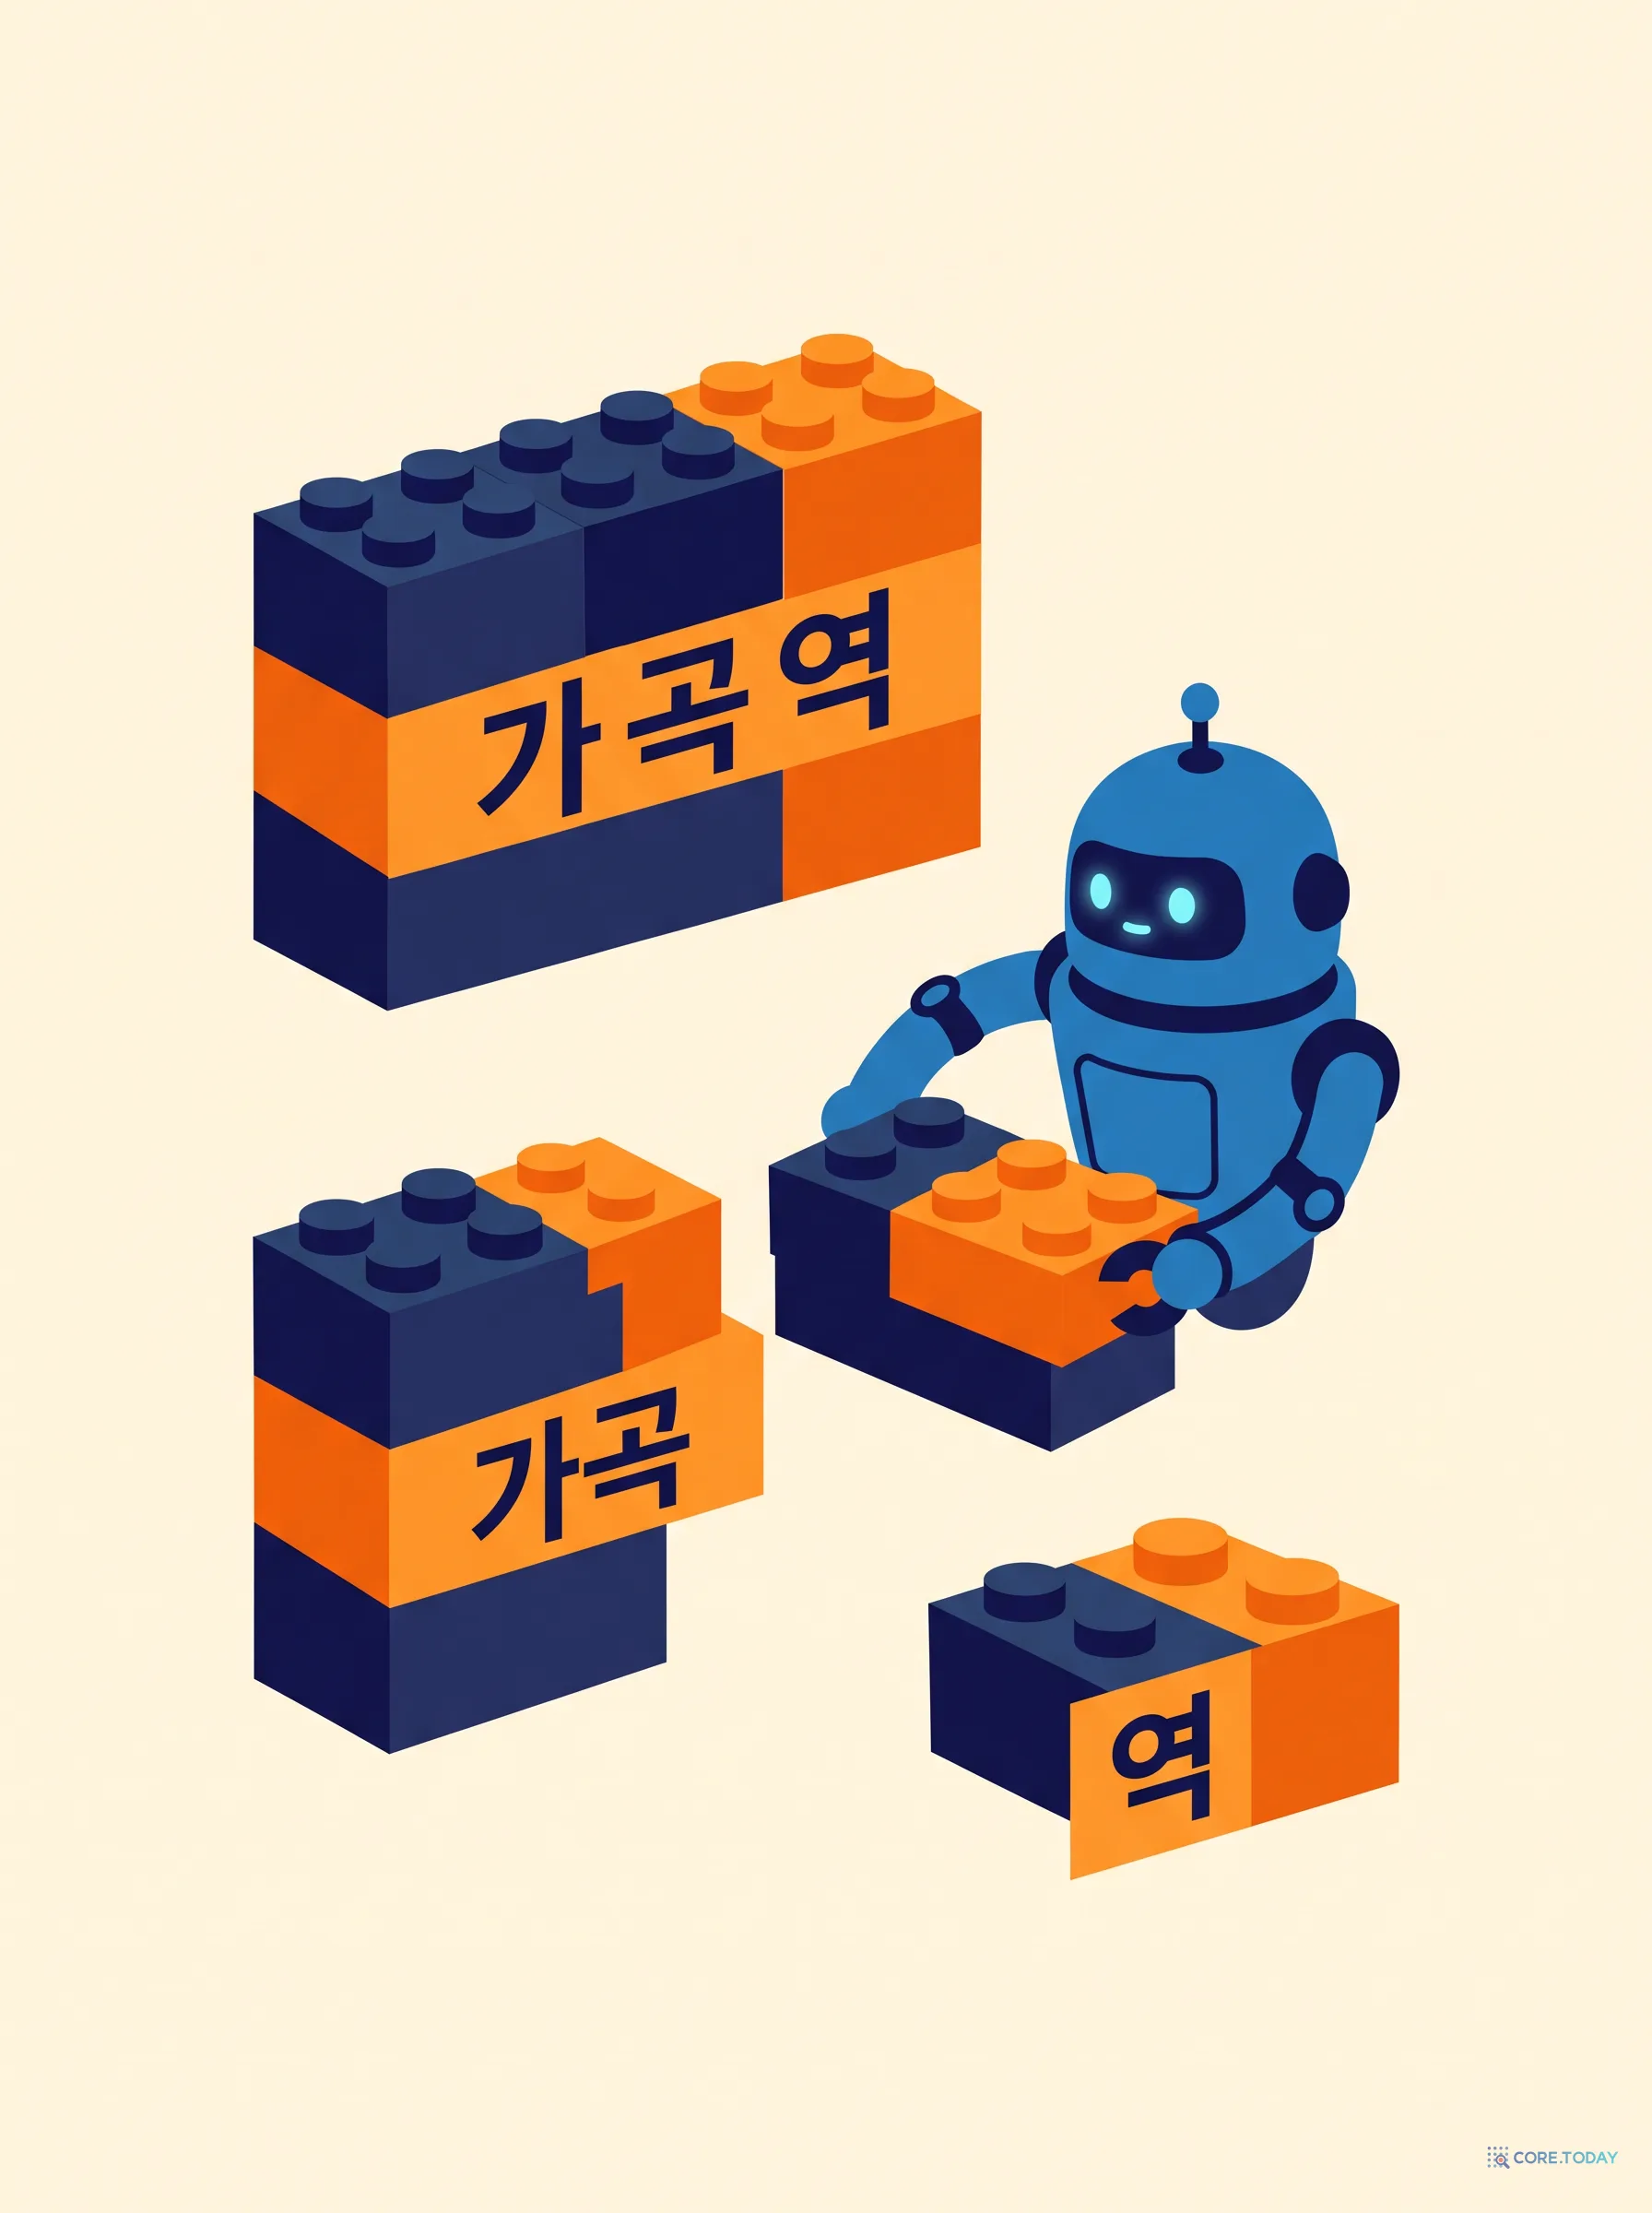
'가곡역'의 색인 결과
언제 쓰나
none
가곡역
복합명사를 그대로. '가곡'으로는 못 찾음
discard (기본)
가곡, 역
분리하고 원형은 버림. '가곡역'으로 검색해도 분리돼서 맞음
mixed
가곡역, 가곡, 역
둘 다 색인. 정확한 복합어 검색과 부분 검색을 모두 살림. 색인이 커짐
우리 실측에서 Kiwi의 복합명사 추가 분리(split_complex)와 혼합 색인(원형+분리)은 기본 설정보다 나아지지 않았습니다(0.606, 0.597). Kiwi가 이미 기본으로 흔한 복합명사를 나누기 때문이고, 더 잘게 나누면 '지원사업'의 '사업'처럼 너무 흔한 조각이 늘어 IDF가 무뎌집니다. nori의 mixed도 같은 논리로 항상 좋은 것은 아닙니다. 고유명사 검색이 많은 도메인(지명·기관명·제품명)에서 값어치가 있습니다.
기술 문서와 공고문에는 'Docker Compose', 'compose.yaml', 'KURE-v2', 'AWS WAF' 같은 문자열이 한글 사이에 섞입니다. 형태소 분석기는 여기서 자주 넘어집니다. 우리 실측에서 Kiwi는 'compose.yaml'을 'co'와 'mpose.yaml' 로 잘랐습니다. 아래 놀이터의 세 번째 문장에서 확인할 수 있습니다.
해법은 두 가지입니다. 하나는 영문·숫자·기호 구간을 형태소 분석기에 넣기 전에 정규식으로 따로 떼어 소문자화하는 것입니다(엘라스틱서치에서는 nori 앞에 char_filter나 별도 필드를 둡니다). 다른 하나는 글자 n-gram 을 함께 색인하는 것입니다. 우리 실측에서 Kiwi 내용어에 글자 2-gram을 겹친 색인이 0.622로 가장 높았던 이유가 이것입니다. 2-gram은 사전이 없어도 'mpose'와 'compose'가 'mp', 'po', 'os', 'se'로 겹치게 만들어 줍니다.
글자 2-gram만 쓴 색인도 0.592로 띄어쓰기(0.419)보다 훨씬 좋았습니다. 사전이 필요 없고, 오타와 신조어에 강하고, 조사 문제를 자연스럽게 우회합니다(청년취업을 → 청년/년취/취업/업을, '업을'은 잡음이지만 '청년'과 '취업'은 살아남음). 대가는 색인 크기(문서당 평균 토큰이 74개에서 103개로)와 잡음(IDF가 무뎌짐)입니다. 형태소 분석기를 못 쓰는 환경이라면 2-gram이 최소한의 안전망입니다.
3부. 무엇을 버릴 것인가
형태소로 나눈 뒤 무엇을 색인에 남기느냐 도 결과를 바꿉니다. 실측입니다.
남긴 품사
어휘 크기
문서당 토큰
nDCG@10 (85개)
사람 바꿔쓰기 22개
전체 형태소 (조사·어미·기호 포함)
6,395
108.7
0.614
0.509
내용어 (명사·용언·외국어·숫자)
6,142
73.7
0.616
0.497
명사만
5,536
45.8
0.608
0.463
셋의 차이는 작습니다. 조사와 어미는 모든 문서에 다 있어서 IDF가 0에 가깝고, 남겨 둬도 점수에 거의 기여하지 않습니다. 반대로 명사만 남기면 '추진된', '줄인', '헷갈리는' 같은 용언이 사라져 어려운 질문(사람 바꿔쓰기)에서 손해가 납니다. 색인 크기와 품질의 균형점은 '내용어'였습니다.
엘라스틱서치 nori의 nori_part_of_speech 필터는 기본으로 감탄사(IC), 부사(MAG·MAJ), 관형사(MM), 기호(SP·SSC·SSO·SC·SE), 접사(XPN·XSA·XSN·XSV), 미등록어(UNA·NA·VSV)를 버립니다. 조사(J*)와 어미(E*)는 기본 목록에 없어서 직접 추가해야 합니다. 그리고 주의할 것이 하나 있습니다. 기본값이 체언 접두사(XPN) 를 버리는데, '비정규직'의 '비', '재구축'의 '재'처럼 뜻을 바꾸는 접두사가 사라질 수 있습니다. 도메인에 따라 XPN은 남기는 것이 맞습니다.
형태소 분석기는 사전에 기댑니다. 사전에 없는 말은 엉뚱하게 잘리거나 미등록어로 처리됩니다. 회사 이름, 제품명, 사내 용어, 신조어가 그렇습니다. 코어닷투데이의 '토닥북'은 Kiwi 기본 사전에 없어서 '토닥'+'북'으로 나뉠 수 있고, 그러면 질문의 '토닥북'과 문서의 '토닥북'이 둘 다 같은 방식으로 나뉘어 우연히 맞기는 하지만, '토닥'이라는 흔한 의성어 문서까지 끌려옵니다.
Kiwi: kiwi.add_user_word("토닥북", "NNP")로 고유명사를 등록합니다. 점수를 주어 기본 사전보다 우선하게 할 수 있습니다.
nori: user_dictionary 파일이나 user_dictionary_rules에 한 줄에 한 단어씩 씁니다. 복합어의 분리 방식도 같이 지정할 수 있습니다("세종시 세종 시").
사용자 사전은 만들고 끝이 아니라 운영 입니다. 검색 로그에서 결과 0건인 질의를 주기적으로 뽑아 사전에 없는 고유명사를 찾는 것이 가장 효과적인 한 가지 작업입니다.
5부. k1과 b, 그리고 튜닝의 우선순위
BM25에는 다이얼이 둘 있습니다. k1은 같은 단어가 반복될 때 점수가 얼마나 더 오르는지(작을수록 빨리 포화), b는 긴 문서를 얼마나 깎는지입니다. 루씬 기본값은 k1=1.2, b=0.75이고, 파이썬 rank_bm25의 기본값은 k1=1.5입니다.
25가지 조합을 재 봤습니다. 최고는 k1=0.5, b=0.3의 0.628, 루씬 기본값은 0.616. 차이 0.012입니다. 엘라스틱의 「Practical BM25」 3부가 말한 그대로입니다. 짧고 길이가 고른 문서(뉴스, 요약문)는 반복이 빨리 포화하고 길이 보정이 덜 필요하며, 기본값은 대부분의 코퍼스에서 잘 작동하고, 튜닝은 마지막 수단 입니다. 우선순위를 정리하면 이렇습니다.
1. 형태소 분석기
띄어쓰기 → 형태소: +0.20. 가장 큰 한 걸음. nori(엘라스틱서치·OpenSearch) 또는 Kiwi·MeCab-ko(파이썬).
2. 품사 필터와 정규화
조사·어미·기호 제거, 소문자화, 영문·숫자 구간 분리. 접두사(XPN)는 도메인 보고 결정.
3. 사용자 사전
고유명사·제품명·사내 용어. 결과 0건 질의 로그에서 뽑는다.
4. 글자 n-gram 보조 필드
영한 혼용·오타·신조어 안전망: +0.006(우리 데이터). 색인 크기 1.4배.
5. k1·b 튜닝
검증 질문이 있을 때만, 마지막에: +0.012.
6부. 2편의 결과를 다시 읽으면
이 글의 실측으로 2편을 다시 보면, 2편의 BM25(Kiwi 내용어, 0.616)는 이미 한국어 처리를 제대로 한 BM25였습니다. 그런데도 벡터(0.889)에 크게 뒤진 이유는 토크나이저가 아니라 질문의 성격 입니다. 2편의 질문 67개는 일부러 문서와 다른 말로 썼습니다. '주변 장치'로 '하니스'를, '승인 단계'로 '플랜 모드'를 찾게 했습니다. 어떤 토크나이저도 '주변 장치'를 '하니스'로 바꿔 주지는 않습니다. 그것은 뜻의 문제이고 벡터의 몫입니다.
반대로 키워드 질문 18개에서는 Kiwi 색인의 BM25가 0.98~1.0으로 벡터와 같았고, 띄어쓰기 색인은 0.75였습니다. 즉 한국어 BM25의 성패는 두 가지가 정합니다. 토크나이저가 조사와 복합명사를 제대로 다루는가, 그리고 사용자가 문서의 말로 묻는가. 첫째는 이 글이 다뤘고, 둘째는 도메인이 정합니다. 공고문·법령·제품 카탈로그처럼 사용자가 문서의 용어를 그대로 쓰는 곳에서는 잘 쪼갠 BM25가 벡터의 동등한 짝이고, 2편의 3중 융합이 통합니다.
7부. 한계
형태소 분석기는 Kiwi 하나만 썼습니다. nori(mecab-ko-dic 기반)와 MeCab-ko는 사전과 분리 규칙이 달라 결과가 조금 다릅니다. 방향은 같을 것입니다.
BGE-M3의 학습된 희소 벡터(어휘 가중치)는 여전히 재지 못했습니다. 사전 없이 토큰 가중치를 학습하는 방식이라 이 글의 문제(사전 밖 단어, 영한 혼용) 일부를 우회합니다.
코퍼스가 요약문(평균 242자)이라 길이 보정(b)의 효과가 작게 나왔습니다. 긴 보고서에서는 b가 더 중요합니다.