‘299억’을 고른 재정렬기 — 재정렬기 15종·로컬 LLM·질의 고쳐 쓰기로 정한 사실탐색기 검색 설계
1편에서 고른 임베딩 KURE-v3 위에 무엇을 더 얹어야 할지 정하려고, 재정렬기 15종과 로컬 LLM 두 개, 질의 고쳐 쓰기, 문단에 제목 붙이기를 같은 부산 시험지로 쟀습니다. 재정렬기는 근거·술어 찾기를 올렸지만 주어 찾기는 대부분 깎았습니다. 작은 재정렬기는 '순천만 박람회 경제적 효과'에 대상 이름 대신 '299억'을 골랐습니다. 지시문 한 줄이 이 어긋남을 고쳤고, 값 가르기까지 거의 완벽하게 만들었습니다. 근거 찾기의 가장 큰 개선은 재정렬이 아니라 제목 붙이기였고, '기록에 없음'은 어떤 점수로도 잘 걸러지지 않았습니다. 프로덕트에 무엇을 넣을지 설치 환경별로 정리했습니다.
코어닷투데이2026-10-2739분
?
질문
1편에서 사실탐색기의 임베딩으로 KURE-v3를 골랐습니다. 요즘 검색 시스템은 그 위에 재정렬기(reranker)를 얹고, LLM으로 질의를 고쳐 쓰거나 후보를 다시 고릅니다. 무엇을 얹어야 실제로 오르고, 그 값은 얼마일까요?
→
실험
1편과 같은 부산 공적 기록 시험지(주어·술어·근거 찾기, 값 가르기)에 재정렬기 15종(지시문 변형 포함 19개 설정), 로컬 LLM 두 개(qwen3.5:9b·qwen3.8:27b)의 후보 고르기, 질의 고쳐 쓰기(HyDE식), 문단에 기록 제목 붙이기(Contextual Retrieval식)를 얹어 쟀습니다. A100 두 장과 맥 한 대를 썼고, API 크레딧은 쓰지 않았습니다.
!
답
주어 찾기는 지시문을 붙인 Qwen3-Reranker 8B를 KURE 점수와 섞을 때 69.5% → 82.8%(질의 고쳐 쓰기까지 더하면 84.8%), 근거 찾기는 문단에 기록 제목을 붙여 임베딩할 때 81.1% → 93.1%였습니다. GPU가 없으면 확신이 낮은 질의만 맥의 27B LLM에 넘겨 81.9%까지 갑니다. 반면 '기록에 없음'을 점수 문턱으로 거르는 일은 어느 방법도 못 했습니다.
들어가며: 1편이 남긴 숙제
1편에서는 사실탐색기가 바꿔 말한 질문을 기록 속 이름에 잇는 데 쓸 임베딩을 골랐습니다. 한국어로 다시 학습한 1.1B 모델 KURE-v3가 1위였고, 주어 찾기 69.5%, 근거 찾기 첫 결과 81.1%였습니다. 그 글의 한계 절에 이렇게 적었습니다. "재정렬기는 넣지 않았습니다."
이번 글은 그 숙제입니다. 질문은 연구 질문이 아니라 프로덕트 질문입니다. 사실탐색기를 의회·지자체에 설치할 때 검색 파이프라인에 무엇을 넣고 무엇을 뺄지, 넣는다면 GPU가 있는 서버와 맥 한 대뿐인 내부망에서 각각 무엇이 맞는지 정하는 것입니다.
그래서 정확도만 보지 않았습니다. 다섯 가지를 함께 쟀습니다.
정확도: 1편과 같은 시험지에서 첫 결과가 맞는 비율.
확인용 절반: 섞는 무게·문턱처럼 고르는 값이 있는 방법은 짝수 번 질의로 고르고, 홀수 번 질의 점수를 따로 적었습니다. 시험지에 맞춘 숫자를 걸러 내기 위해서입니다.
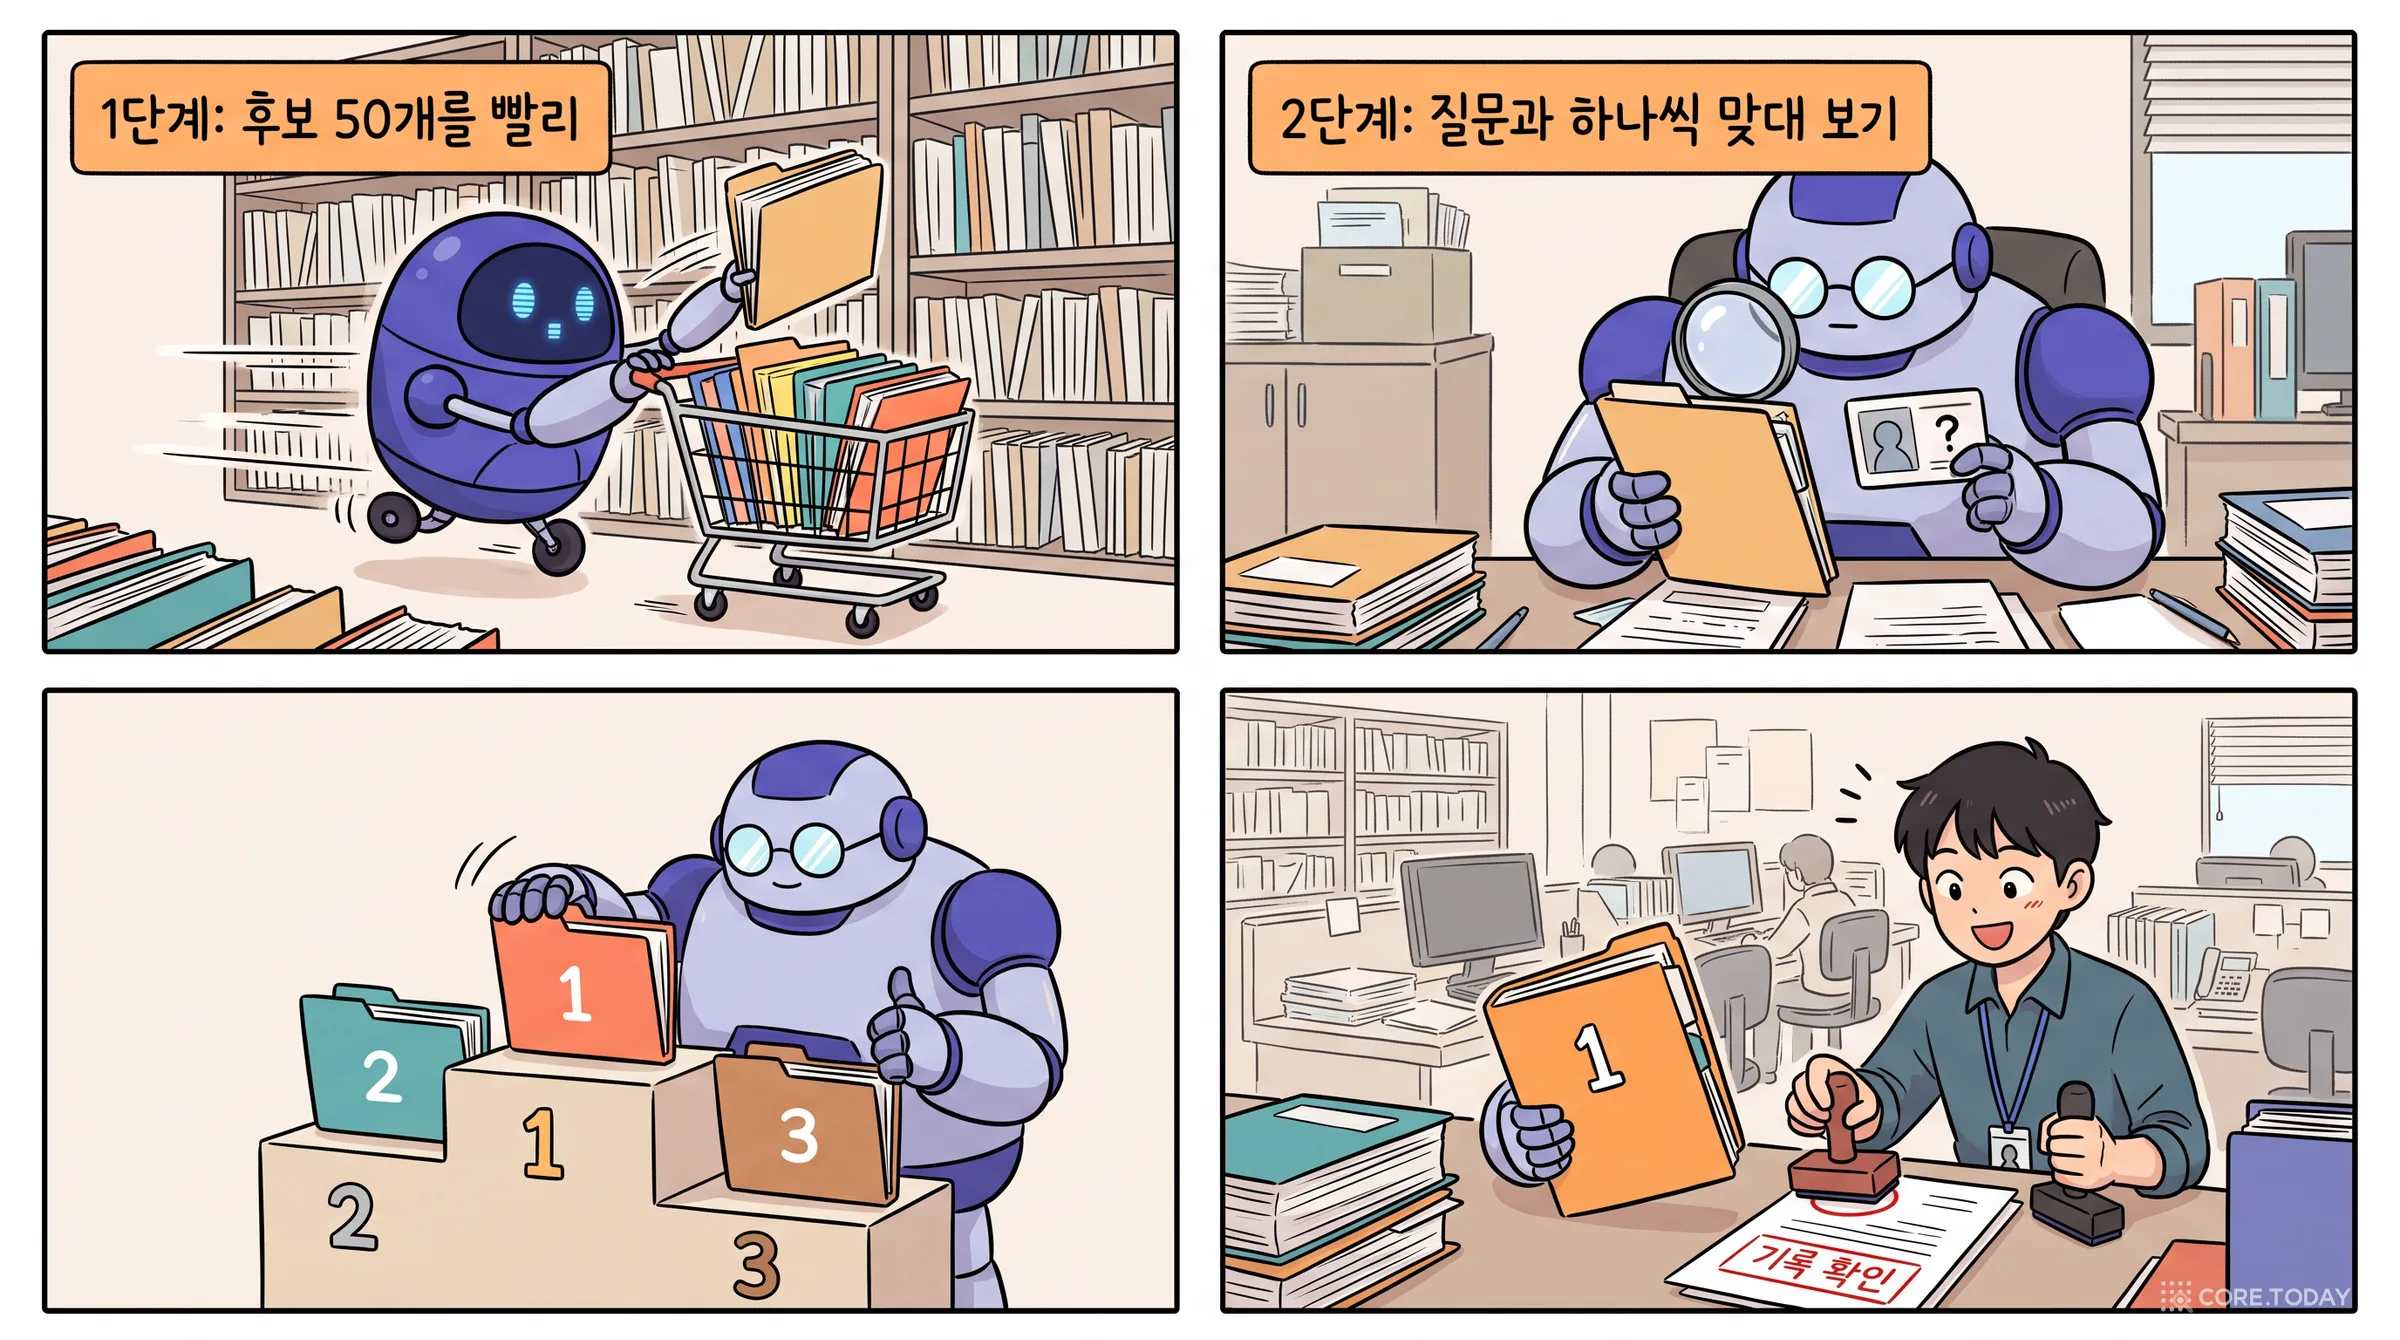
임베딩 검색은 질문과 문서를 따로 벡터로 바꾼 뒤 가까운 것을 찾습니다. 문서 벡터를 미리 만들어 둘 수 있어 빠르지만, 질문과 문서를 한 번도 같이 보지 않습니다. 재정렬기는 반대입니다. 질문과 후보 하나를 나란히 한 입력으로 넣고 "이 후보가 질문에 맞나"를 점수로 냅니다. 정확하지만 후보마다 모델을 한 번씩 돌려야 하므로, 임베딩이 고른 상위 수십 개에만 씁니다.
재정렬기에도 세대가 있습니다.
방식
어떻게 보나
이번 후보
인코더 교차 인코더
BERT·XLM-R 계열이 질문·후보 한 쌍을 함께 읽고 점수 하나
bge-reranker-v2-m3, 그 한국어 미세조정판(bge-reranker-v2-m3-ko), ko-reranker
LLM 점별
디코더 LLM이 "관련 있나? 예/아니오"의 확률(또는 점수 머리)을 낸다. 지시문을 받는 모델이 많다
일반 LLM에게 번호 붙인 후보 목록을 보여 주고 하나(또는 '없음')를 고르게 한다(RankGPT 계열)
qwen3.5:9b, qwen3.8:27b (맥 Ollama)
후보 목록은 다음과 같습니다. 모두 Hugging Face 공개 가중치이고, 크기·라이선스는 모델 카드 기준입니다(2026-10-27).
재정렬기
만든 곳
크기
라이선스
비고
bge-reranker-v2-m3
BAAI
0.57B
Apache-2.0
다국어 기본값으로 가장 널리 쓰임
bge-reranker-v2-m3-ko
dragonkue (개인 공개)
0.57B
Apache-2.0
위 모델의 한국어 미세조정
ko-reranker
Dongjin-kr (개인 공개)
0.56B
MIT
한국어 학습, 입력 512토큰
Qwen3-Reranker 0.6B·4B·8B
Alibaba Qwen
0.6~8.2B
Apache-2.0
지시문 지원
mxbai-rerank-base·large-v2
Mixedbread
0.5·1.5B
Apache-2.0
Qwen2.5 기반
ctxl-rerank-v2 1B·2B·6B
Contextual AI
1.3~6.8B
CC BY-NC-SA 4.0
지시문 지원, 비상업
llama-nemotron-rerank-1b-v2
NVIDIA
1.2B
OpenMDW-1.1
Nemotron-3.5-Rerank-8B
NVIDIA
8.4B
OpenMDW-1.1
2026-10-15 공개, 다중 모달
jina-reranker-v3·v3.5
Jina AI
0.6B
CC BY-NC 4.0
목록 방식, 비상업
Alibaba의 gte-multilingual-reranker-base도 넣으려 했지만, 원격 코드가 transformers 5.x에서 CUDA 오류로 돌지 않아 뺐습니다. 최신 라이브러리와 오래된 원격 코드가 부딪히는 일은 프로덕트에서도 그대로 위험입니다.
2. 시험지와 후보 풀
시험지는 1편과 같습니다. 부산 공적 기록 362건에서 만든 주어 찾기 질의 453개(어려운 것 151개), 술어 찾기 240개, 근거 찾기 159개, 값 쌍 1,365개입니다.
재정렬기에 줄 후보 풀은 세 1단계 검색기(글자 bigram, BGE-M3, KURE-v3)의 상위 50개를 합친 것입니다. 질의마다 100개 남짓이고, 재정렬기 하나가 채점한 질의-후보 쌍은 약 9만 개입니다. 풀 전체를 한 번 채점해 두면 "KURE 상위 20개만 다시 줄 세우면?", "상위 50개면?", "합집합 전체면?"을 다시 돌리지 않고 비교할 수 있습니다.
재정렬기가 아무리 좋아도 후보 안에 정답이 없으면 못 고칩니다. 그 천장부터 봤습니다.
1단계
주어: 상위 20 / 50 안에 정답
근거: 상위 20 / 50
술어: 상위 20 / 50
글자
76.8% / 81.2%
93.7% / 95.6%
33.8% / 47.1%
BGE-M3
92.5% / 95.6%
96.2% / 98.1%
92.1% / 94.6%
KURE-v3
96.7% / 99.1%
98.1% / 98.7%
88.8% / 94.2%
세 검색기 합집합
99.3%
98.7%
98.3%
KURE-v3 상위 50개에 정답이 99% 들어 있습니다. 첫 결과 적중률(69.5%)과의 차이 30점이 재정렬이 노릴 수 있는 몫입니다.
3. 결과 ①: 재정렬은 근거·술어를 올리고, 주어를 깎았다
KURE-v3 상위 50개를 다시 줄 세운 결과입니다(재정렬 점수만으로).
주어 @1
어려운 주어 @1
근거 @1
근거 @5
술어 @1
KURE-v3 단독
69.5%
44.4%
81.1%
93.7%
50.0%
Qwen3-Reranker 8B + 지시문
79.9%
64.9%
83.7%
95.0%
65.0%
Nemotron-3.5-Rerank-8B
75.9%
58.3%
87.4%
95.6%
72.5%
Qwen3-Reranker 4B + 지시문
74.8%
57.0%
86.2%
96.9%
64.2%
Qwen3-Reranker 4B
71.1%
49.0%
86.8%
96.2%
60.0%
Qwen3-Reranker 8B
67.1%
51.7%
86.2%
96.2%
64.6%
jina-reranker-v3.5
65.8%
25.2%
84.3%
95.0%
51.2%
ko-reranker
65.6%
45.0%
77.4%
93.7%
58.8%
bge-reranker-v2-m3-ko
64.2%
31.1%
78.0%
93.7%
49.2%
bge-reranker-v2-m3
57.0%
21.2%
78.6%
95.0%
61.3%
ctxl-rerank-v2 6B
47.9%
26.5%
79.9%
93.7%
35.0%
세 가지가 보입니다.
첫째, 과제마다 다르다. 근거 찾기에서는 Qwen3·Nemotron·jina v3.5가 KURE-v3를 3~6점 넘었고, 술어 찾기는 절반 남짓이 올렸습니다(Nemotron +22.5점). 그런데 주어 찾기에서는 재정렬기 19개 설정 가운데 KURE-v3 단독을 넘은 것이 넷뿐이었습니다(Nemotron-3.5, Qwen3 4B, 지시문을 붙인 Qwen3 4B·8B). 1편에서 "섞으면 좋아진다는 통념"이 강한 임베딩에는 틀렸던 것처럼, "재정렬하면 좋아진다"도 과제를 가립니다.
둘째, 큰 것이 늘 이기지 않는다. 기본 설정의 Qwen3-Reranker는 4B가 8B보다 주어 찾기에서 4점 높았고(지시문을 붙이면 뒤집힙니다, 5절), Contextual AI는 6B가 1B·2B보다 낮았습니다. 한국어 미세조정판(bge-ko)은 원판보다 주어 찾기를 7점 올렸지만, 근거는 그대로였고 술어는 오히려 12점 낮았습니다. '한국어 특화'가 모든 과제에서 낫다는 뜻은 아닙니다.
셋째, 후보를 넓혀도 거의 같다. 같은 재정렬기에 합집합(질의당 ~100개)을 줘도 KURE 상위 50개와 대개 1~3점 차이였고, 오히려 낮아지는 경우가 더 많았습니다. 천장이 이미 99%라서입니다. 재정렬 비용은 후보 수에 비례하므로, 이 코퍼스에서는 상위 20~50개로 충분합니다.
4. '299억'을 고른 재정렬기
주어 찾기에서 재정렬기가 왜 깎았는지 틀린 사례를 하나씩 봤습니다. 처음에는 "글자가 겹치는 이웃을 올리겠지"라고 짐작했는데, 재 보니 반대였습니다. 재정렬기가 고른 오답은 KURE가 고른 정답보다 질문과 글자가 덜 겹쳤습니다(bge-ko 오답 bigram 자카드 0.13 vs 정답 0.15).
진짜 패턴은 이랬습니다.
질의
정답(KURE 1위)
bge-reranker-v2-m3-ko 1위
순천만 박람회 경제적 효과 얼마
순천만 국제정원박람회
299억
교육청 내부 고발자 보호 보상 규정 개정내용
부산광역시교육청 공익제보 처리 및 제보자 보호·보상 등에 관한 조례
교육청
의회 두 번째 자리 의원들이 뽑는 시기
부의장 선거
나머지
사무 위임 조례 개정안 의결
부산광역시 사무위임 조례 일부개정조례안
조례 개정안
작은 재정렬기는 질문에 답이 되는 조각을 골랐습니다. "경제적 효과 얼마"라는 질문에 "299억"은 실제로 답입니다. 재정렬기는 대개 "이 글이 질문에 답하나"를 배운 모델이고(MS MARCO 같은 질문-답 문단 데이터), 사실탐색기의 주어 찾기는 "질문이 가리키는 대상의 이름은 무엇인가"를 묻습니다. 목적이 어긋나 있었던 것입니다. 오답의 71%가 정답보다 짧은 이름이었던 것도 같은 이유입니다.
큰 재정렬기의 오답은 결이 달랐습니다. Nemotron-3.5는 "방치된 낡은 집 철거하고 작은 주택 고치는 부산 규정"에 '부산광역시 빈집 및 소규모주택 정비 조례' 대신 그 조례의 '제26조의2의 개정 규정'을 골랐습니다. 대상은 맞혔지만 한 단계 더 구체적인 이웃을 고른 것입니다. 이건 등록부에 조문·개정이유가 별도 엔티티로 들어간 사실탐색기 쪽 사정이기도 합니다.
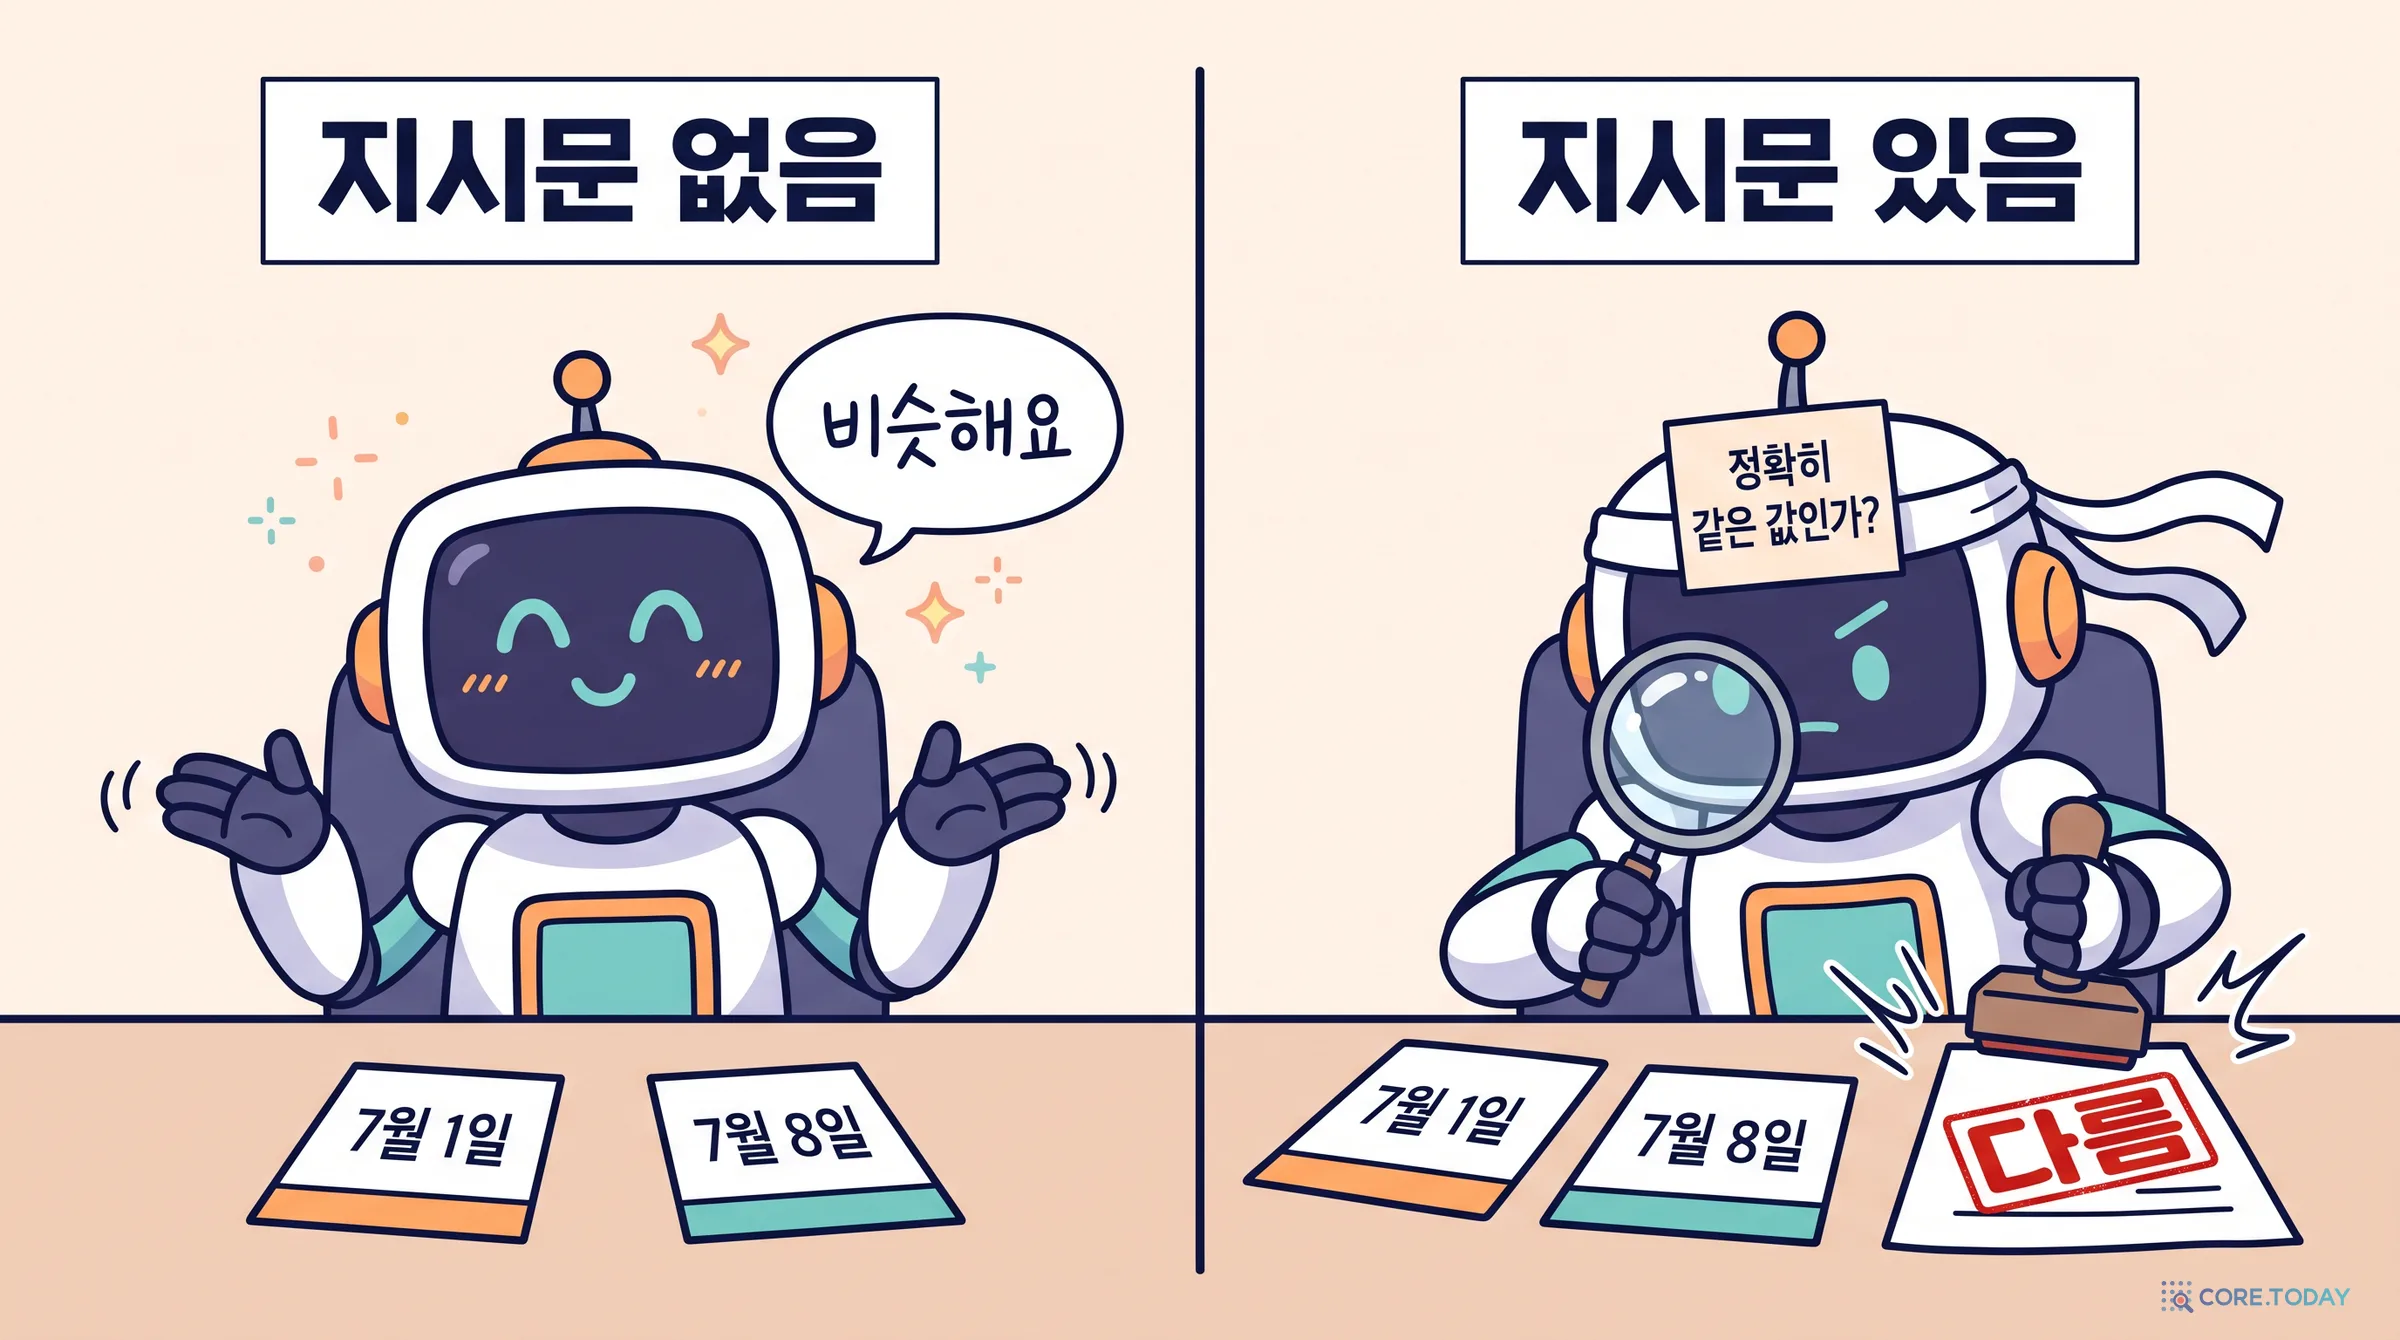
목적이 어긋났다면 목적을 알려 주면 됩니다. Qwen3-Reranker와 ctxl-rerank-v2는 지시문(instruction)을 받습니다. 과제마다 영어 한 문장을 붙였습니다. 주어 찾기에는 "질문이 가리키는 조례·사업·기관·장소의 공식 이름인지 판단하라", 값 가르기에는 "두 값 표현이 정확히 같은 값(같은 날짜·금액·수)인지 판단하라"는 식입니다.
Qwen3-Reranker 4B는 지시문 하나로 주어 찾기 71.1% → 74.8%, 어려운 주어 49.0% → 57.0%, 술어 60.0% → 64.2%가 됐습니다. 8B는 더 극적이었습니다. 주어 찾기 67.1% → 79.9%, 어려운 주어 51.7% → 64.9%로, 재정렬기 19개 설정 가운데 5위에서 1위가 됐습니다. 다만 근거 찾기는 86.2% → 83.7%로 조금 내려가서, 지시문은 과제마다 따로 골라야 합니다. 더 놀라운 것은 값 가르기였습니다.
값 가르기
AUROC
숫자 하나 다른 쌍이 '같은 값' 문턱을 넘는 비율
1편 최고 임베딩 (Qwen3-Embedding 8B)
0.975
6.0%
1편 KURE-v3
0.986
6.8%
Qwen3-Reranker 4B (기본)
0.900
23.6%
Qwen3-Reranker 4B + 지시문
0.990
0.2% (585쌍 중 1쌍)
Qwen3-Reranker 8B + 지시문
0.994
0%
Qwen3-Reranker 0.6B + 지시문
0.987
0.5%
"2003년 7월 1일"과 "2003년 7월 8일"을 재정렬기는 두 표현을 함께 읽으므로 숫자 한 자리 차이를 볼 수 있습니다. 임베딩은 두 값을 따로 벡터로 만든 뒤 견주기 때문에 이 차이가 뭉개졌습니다(1편 5절). 0.6B 모델이 맥에서도 돌 크기라는 점이 중요합니다.
그렇다고 값 비교를 재정렬기에 넘기자는 뜻은 아닙니다. 사실탐색기의 값 비교는 여전히 정규화 코드(kfact/quant.py)가 합니다. 다만 두 번째 의견으로는 쓸 만합니다. 코드가 "같다"고 했는데 재정렬기가 "다르다"고 하면 사람 검토 대기열로 보내는 식입니다. 1편에서 찾은 엔진 버그(부칙 '1981년 시행'과 '1984년 시행'이 같은 값으로 묶임)가 정확히 이런 경우였습니다.
반대 사례도 있습니다. Contextual AI의 ctxl-rerank-v2 2B는 같은 지시문에 근거 찾기 79.3% → 74.2%, 술어 52.5% → 39.6%로 나빠졌습니다. 이 모델의 지시문은 "최근 연구를 우선하라" 같은 선호를 질문 뒤에 덧붙이는 방식이라, 과제 설명을 넣으면 질문 자체가 흐려진 것으로 보입니다. 1편의 접두사처럼, 지시문도 모델마다 재 봐야 합니다.
재정렬기 대신 일반 LLM에게 후보 목록을 보여 주고 고르게 할 수도 있습니다(RankGPT 계열). 사실탐색기는 이미 판정 모델로 qwen3.5:9b를 맥에서 쓰고 있어, 그대로 시켜 봤습니다. KURE-v3 상위 20개(근거는 10개)를 번호로 보여 주고 "같은 대상인 후보 하나, 없으면 0"을 JSON으로 답하게 했습니다. 같은 맥에 있는 qwen3.8:27b도 같은 시험을 봤습니다.
qwen3.5:9b
qwen3.8:27b
주어 @1
61.2%
77.0%
어려운 주어 @1
53.6%
66.9%
근거 @1
68.6%
84.9%
목록 아래쪽(11~20번)을 고른 횟수 (주어 453개 중)
90
25
정답을 지웠을 때 '없음'이라고 한 비율 (주어 / 근거)
14% / 14%
43% / 35%
맥 질의당 시간 중앙값 (주어 / 근거)
0.8초 / 2.2초
2.6초 / 6.9초
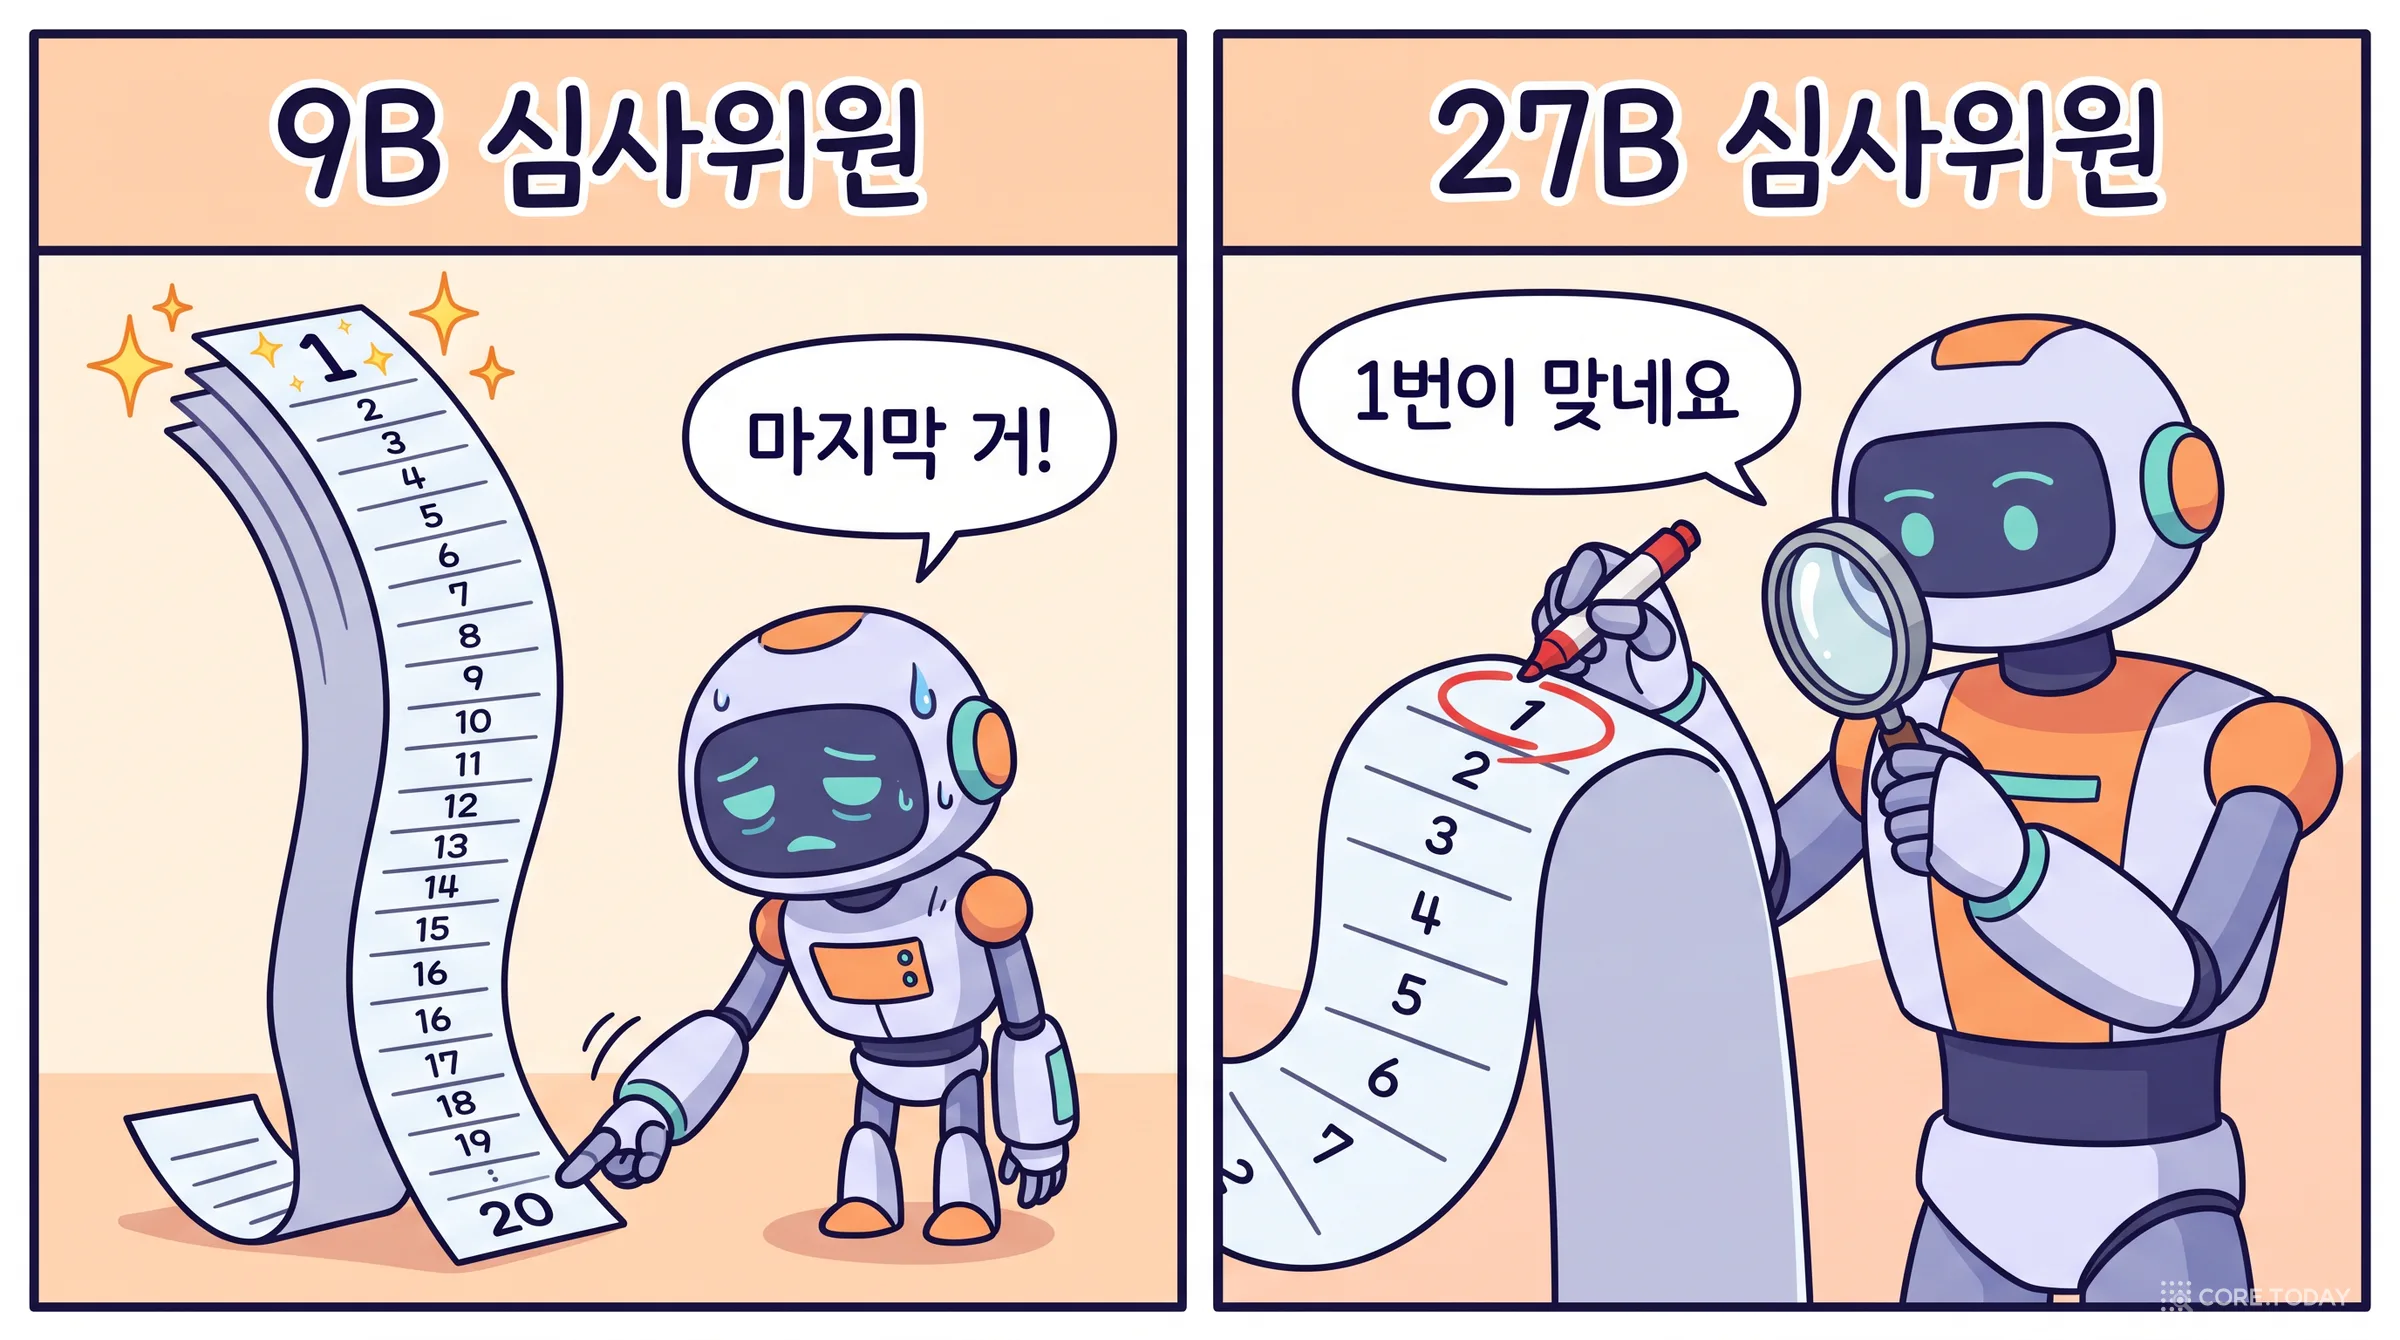
9B는 혼자 쓰면 KURE-v3보다 못했습니다. 정답이 1번에 있는데 19번·20번을 고르는 일이 잦았습니다. 긴 목록의 앞부분을 놓치는 위치 편향입니다. 27B는 이 버릇이 크게 줄었고, 어려운 질의에서는 재정렬기 어느 것보다 높았습니다(66.9%, 재정렬기 최고는 지시문 붙인 Qwen3 8B의 64.9%).
LLM을 모든 질의에 부를 필요는 없습니다. KURE-v3의 1위와 2위 코사인 차가 작을 때, 즉 임베딩이 헷갈릴 때만 부르는 계단식을 만들었습니다(문턱은 짝수 번 질의로 고름).
계단식
주어 @1
확인용 절반
LLM 부른 비율
KURE-v3 단독
69.5%
72.1%
0%
KURE-v3 → 애매하면 9B
73.5%
76.1%
42%
KURE-v3 → 애매하면 27B
81.9%
85.0%
61%
혼자서는 KURE보다 못했던 9B도, 헷갈리는 질의에만 쓰면 +4점이었습니다. 27B 계단식은 GPU 없이 맥 한 대로 재정렬기 단독 최고점(79.9%)을 넘었습니다. 대가는 시간입니다. 질의의 61%에 2.6초씩, 평균 1.6초가 더해집니다.
HyDE·Query2doc 계열 방법은 LLM에게 "이 질문의 답이 될 문서"를 먼저 쓰게 하고 그 가짜 문서로 검색합니다. 사실탐색기에 맞게 바꿨습니다. qwen3.5:9b에게 "이 질문이 가리키는 대상이 부산시 기록에 어떤 공식 이름으로 적혀 있을지 최대 3개 추정하라"고 했습니다. "방치된 낡은 집 철거하고 작은 주택 고치는 부산 규정"에는 '부산광역시 빈집 및 소규모주택 정비 조례'를 바로 맞혔고, 자신 없는 질문에는 그럴듯한 가짜 조례 이름을 지어냈습니다.
그래서 추정 이름만으로 검색하면 31%였습니다. 하지만 원래 질문의 점수에 추정 이름의 점수를 4분의 1 무게로 더하자 달라졌습니다.
주어 @1
어려운 주어 @1
짝수 / 홀수 질의
KURE-v3 단독
69.5%
44.4%
67.0% / 72.1%
추정 이름만
30.9%
12.6%
질문 + 0.25 × 추정 이름
76.6%
57.6%
73.6% / 79.7%
무게는 0.15~0.35 사이 어디를 골라도 75% 이상이었고, 짝수 번 질의로 고른 0.25가 홀수 번에서도 가장 좋았습니다. 질의당 비용은 9B 호출 한 번(중앙값 0.6초)입니다. LLM의 추정은 틀릴 수 있으니 답이 아니라 나침반의 보조 바늘로만 써야 한다는 것, 이것이 이번 실험에서 가장 쓸모 있는 교훈 중 하나였습니다.
Anthropic이 2024년에 소개한 Contextual Retrieval은 문단을 임베딩하기 전에 "이 문단이 어느 문서의 어디인지"를 붙이는 방법입니다. 사실탐색기의 근거 단위는 회의록 발언·조례 조문처럼 짧고, 정작 "몇 회 임시회인지", "무슨 조례인지"는 문단 밖 제목에만 있습니다. 그래서 LLM 요약 대신 가장 싼 문맥, 기록 제목과 갈래를 앞에 붙여 다시 임베딩했습니다.
근거 찾기
@1
@5
KURE-v3 (문단만)
81.1%
93.7%
KURE-v3 (제목 붙인 문단)
93.1%
98.7%
제목 붙인 문단 + Nemotron-3.5 재정렬
93.7%
98.7%
제목 붙인 문단 + Qwen3-Reranker 4B
91.2%
98.7%
재정렬기 최고점(87.4%)보다 6점 높고, 제목을 붙이고 나면 재정렬기가 더할 것이 거의 없었습니다. 1편의 실패 30건 가운데 18건이 같은 기록 안의 다른 문단을 고른 것이었는데, 이 혼동이 제목으로 풀렸습니다.
다만 이 숫자는 그대로 믿으면 안 됩니다. 시험지 질문을 만든 서브에이전트가 문단과 함께 제목을 봤기 때문입니다. 질문이 제목에만 있는 낱말을 쓰는지로 나눠 봤습니다.
질문 무리
질문 수
문단만
제목 붙인 문단
제목에만 있는 낱말을 씀 (예: "제339회 임시회에서…")
51
52.9%
88.2%
그렇지 않음
108
94.4%
95.4%
효과의 거의 전부가 제목 낱말을 쓴 질문에서 나왔습니다. 실제 시민 질문이 회의 이름·조례 이름을 얼마나 쓰는지에 따라 실제 효과는 +1점에서 +35점 사이 어딘가입니다. 의회 회의록을 찾는 질문은 "지난 임시회 본회의에서 시장이 한 말"처럼 회의를 가리키는 일이 흔하므로, 사실탐색기에는 넣을 가치가 분명합니다. 비용은 색인을 한 번 다시 만드는 것뿐, 질의 시간은 늘지 않습니다.
사실탐색기의 원칙은 "근거가 모자라면 답하지 않는다"입니다. 그렇다면 재정렬 점수가 그 판단을 도울 수 있을까요? 같은 질의에서 정답(동치 포함)을 후보에서 지운 판을 만들어, 정답이 있을 때의 1위 점수와 정답이 없을 때의 1위 점수를 견줬습니다.
방법
주어: 판별력(AUROC)
주어: 맞힌 답 90% 지킬 때 없는 질의에 답함
근거: AUROC
근거: 같은 조건
KURE-v3 코사인
0.71
73%
0.90
26%
Nemotron-3.5-Rerank-8B
0.70
74%
0.90
18%
Qwen3-Reranker 4B + 지시문
0.79
53%
0.87
36%
jina-reranker-v3.5 (목록 다시 채점)
0.83
49%
0.85
38%
qwen3.8:27b '없음' 선택지
57%
65%
근거 찾기에서는 문턱이 그럭저럭 듣습니다. 맞힌 답의 90%를 지키면서 없는 질의의 82%를 막는 설정(Nemotron)이 있습니다. 하지만 주어 찾기에서는 가장 나은 방법(jina v3.5)도 없는 질의의 절반 가까이(49%)에 답해 버렸고, 나머지는 절반을 넘었습니다. 기록에는 이름이 비슷한 이웃이 늘 있고, 정답이 없으면 그 이웃이 높은 점수로 1위에 오르기 때문입니다.
결론은 분명합니다. 기권은 검색 점수가 아니라 다음 단계가 맡아야 합니다. 사실탐색기는 고른 후보로 기록을 다시 열어, 질문의 슬롯(대상·술어·때)이 실제로 채워지는지를 코드로 확인한 뒤에만 답합니다. 이번 실험은 그 단계를 빼면 안 되는 이유를 숫자로 보여 줍니다.
10. 속도와 자원
질의 하나를 처리할 때 더해지는 시간(중앙값)입니다. 재정렬은 한 질의의 후보를 한 묶음으로 넣은 시간이고, 모두 같은 A100 40GB MIG 조각에서 sentence-transformers 기본 설정(BF16·FP16, 서빙 최적화 없음)으로 쟀습니다.
A100 40GB
이름 50개 (주어)
문단 20개 (근거)
문단 50개
GPU 메모리
ko-reranker
0.02초
0.07초
0.17초
1.9GB
bge-reranker-v2-m3-ko
0.02초
0.07초
0.36초
2.7GB
Qwen3-Reranker 0.6B
0.12초
0.24초
0.88초
2.2GB
Qwen3-Reranker 4B
0.43초
0.91초
3.3초
9.4GB
Qwen3-Reranker 8B
0.68초
1.4초
5.2초
17.3GB
Nemotron-3.5-Rerank-8B
0.34초
1.1초
5.3초
17.8GB
맥 (M1 Ultra)
주어
근거
qwen3.5:9b 질의 고쳐 쓰기
0.6초
–
qwen3.5:9b 고르기 (20개 / 10개)
0.8초
2.2초
qwen3.8:27b 고르기 (20개 / 10개)
2.6초
6.9초
bge-reranker-v2-m3(-ko), MPS (이름 20개 / 문단 20개)
0.06초
0.55초
Qwen3-Reranker 0.6B, MPS
0.27초
1.8초
이름은 짧아서 8B 재정렬기도 주어 찾기 50개에 0.7초 안이지만, 문단 50개는 5초가 넘습니다. 근거 찾기를 재정렬하려면 후보를 20개로 줄이거나, vLLM·TEI 같은 서빙 서버로 묶어야 합니다. 맥에서는 작은 인코더 재정렬기만 실용적입니다.
모든 조합(주어 30개, 근거 18개)을 같은 방식으로 쟀습니다. 섞는 무게와 문턱은 짝수 번 질의로 고르고 홀수 번 질의로 확인했습니다.
주어 찾기 조합
@1
확인용 절반
어려운 질의
질의당 더해지는 시간
KURE-v3 단독 (지금)
69.5%
72.1%
44.4%
–
KURE-v3 + 질의 고쳐 쓰기 (9B)
76.6%
79.7%
57.6%
맥 0.6초
KURE-v3 → 애매하면 27B
81.9%
85.0%
68.9%
맥 평균 1.6초
KURE-v3 + Qwen3-Reranker 4B 지시문 (섞기)
80.4%
82.7%
64.9%
GPU 0.43초
KURE-v3 + Qwen3-Reranker 8B 지시문 (섞기)
82.8%
85.8%
66.2%
GPU 0.68초
+ 질의 고쳐 쓰기
84.8%
88.1%
72.9%
GPU 0.68초 + 맥 0.6초
KURE-v3 + Qwen3 8B 지시문 → 애매하면 27B
83.4%
85.4%
71.5%
GPU 0.68초 + 맥 평균 1.3초
'섞기'는 재정렬 점수와 KURE 코사인을 질의마다 표준화해 1 : 0.25로 더한 것입니다. 재정렬 점수만 쓰면 79.9%, 섞으면 82.8%로, 임베딩의 판단을 조금 남겨 두는 편이 나았습니다. 재정렬기를 넣고 나면 27B 계단식은 더할 것이 거의 없었고(+0.6점), 질의 고쳐 쓰기는 오히려 +2점(어려운 질의 +6.6점)이 남았습니다. LLM의 추정 이름과 재정렬기가 서로 다른 실수를 하기 때문으로 보입니다.
근거 찾기는 KURE 상위 20개만 재정렬해도 상위 50개와 점수가 같았습니다(재정렬 단독 기준). 그래서 시간은 20개 기준으로 적었습니다.
근거 찾기 조합
@1
확인용 절반
질의당 더해지는 시간
KURE-v3 단독 (지금)
81.1%
81.0%
–
KURE-v3 + Qwen3-Reranker 4B (섞기)
88.7%
89.9%
GPU 0.9초(20개)
KURE-v3 → 애매하면 27B
86.8%
87.3%
맥 평균 2.1초
KURE-v3 (제목 붙인 문단)
93.1%
94.9%
없음 (재색인)
제목 붙인 문단 + Nemotron-3.5
93.7%
94.9%
GPU 1.1초(20개)
설치 환경별로 정리하면 이렇습니다.
설치 환경
주어 찾기
근거 찾기
값 비교
기권
GPU 서버가 있는 곳
KURE-v3 상위 50 → Qwen3-Reranker 8B(지시문) 섞기. 메모리가 빠듯하면 4B(9.4GB). 응답 시간에 0.6초 여유가 있으면 9B 질의 고쳐 쓰기
제목 붙인 문단으로 재색인. 재정렬은 생략
정규화 코드 + Qwen3-Reranker 0.6B(지시문) 두 번째 의견
기록 재확인 단계(점수 문턱 쓰지 않음)
맥 한 대·내부망
KURE-v3 → 애매할 때만 qwen3.8:27b(평균 1.6초). 빠듯하면 9B 질의 고쳐 쓰기(0.6초)
제목 붙인 문단으로 재색인
정규화 코드 + 0.6B 두 번째 의견(맥 0.3초)
같음
상업 서비스
위와 같음. jina·Contextual AI 재정렬기는 비상업 라이선스라 제외
같음
같음
같음
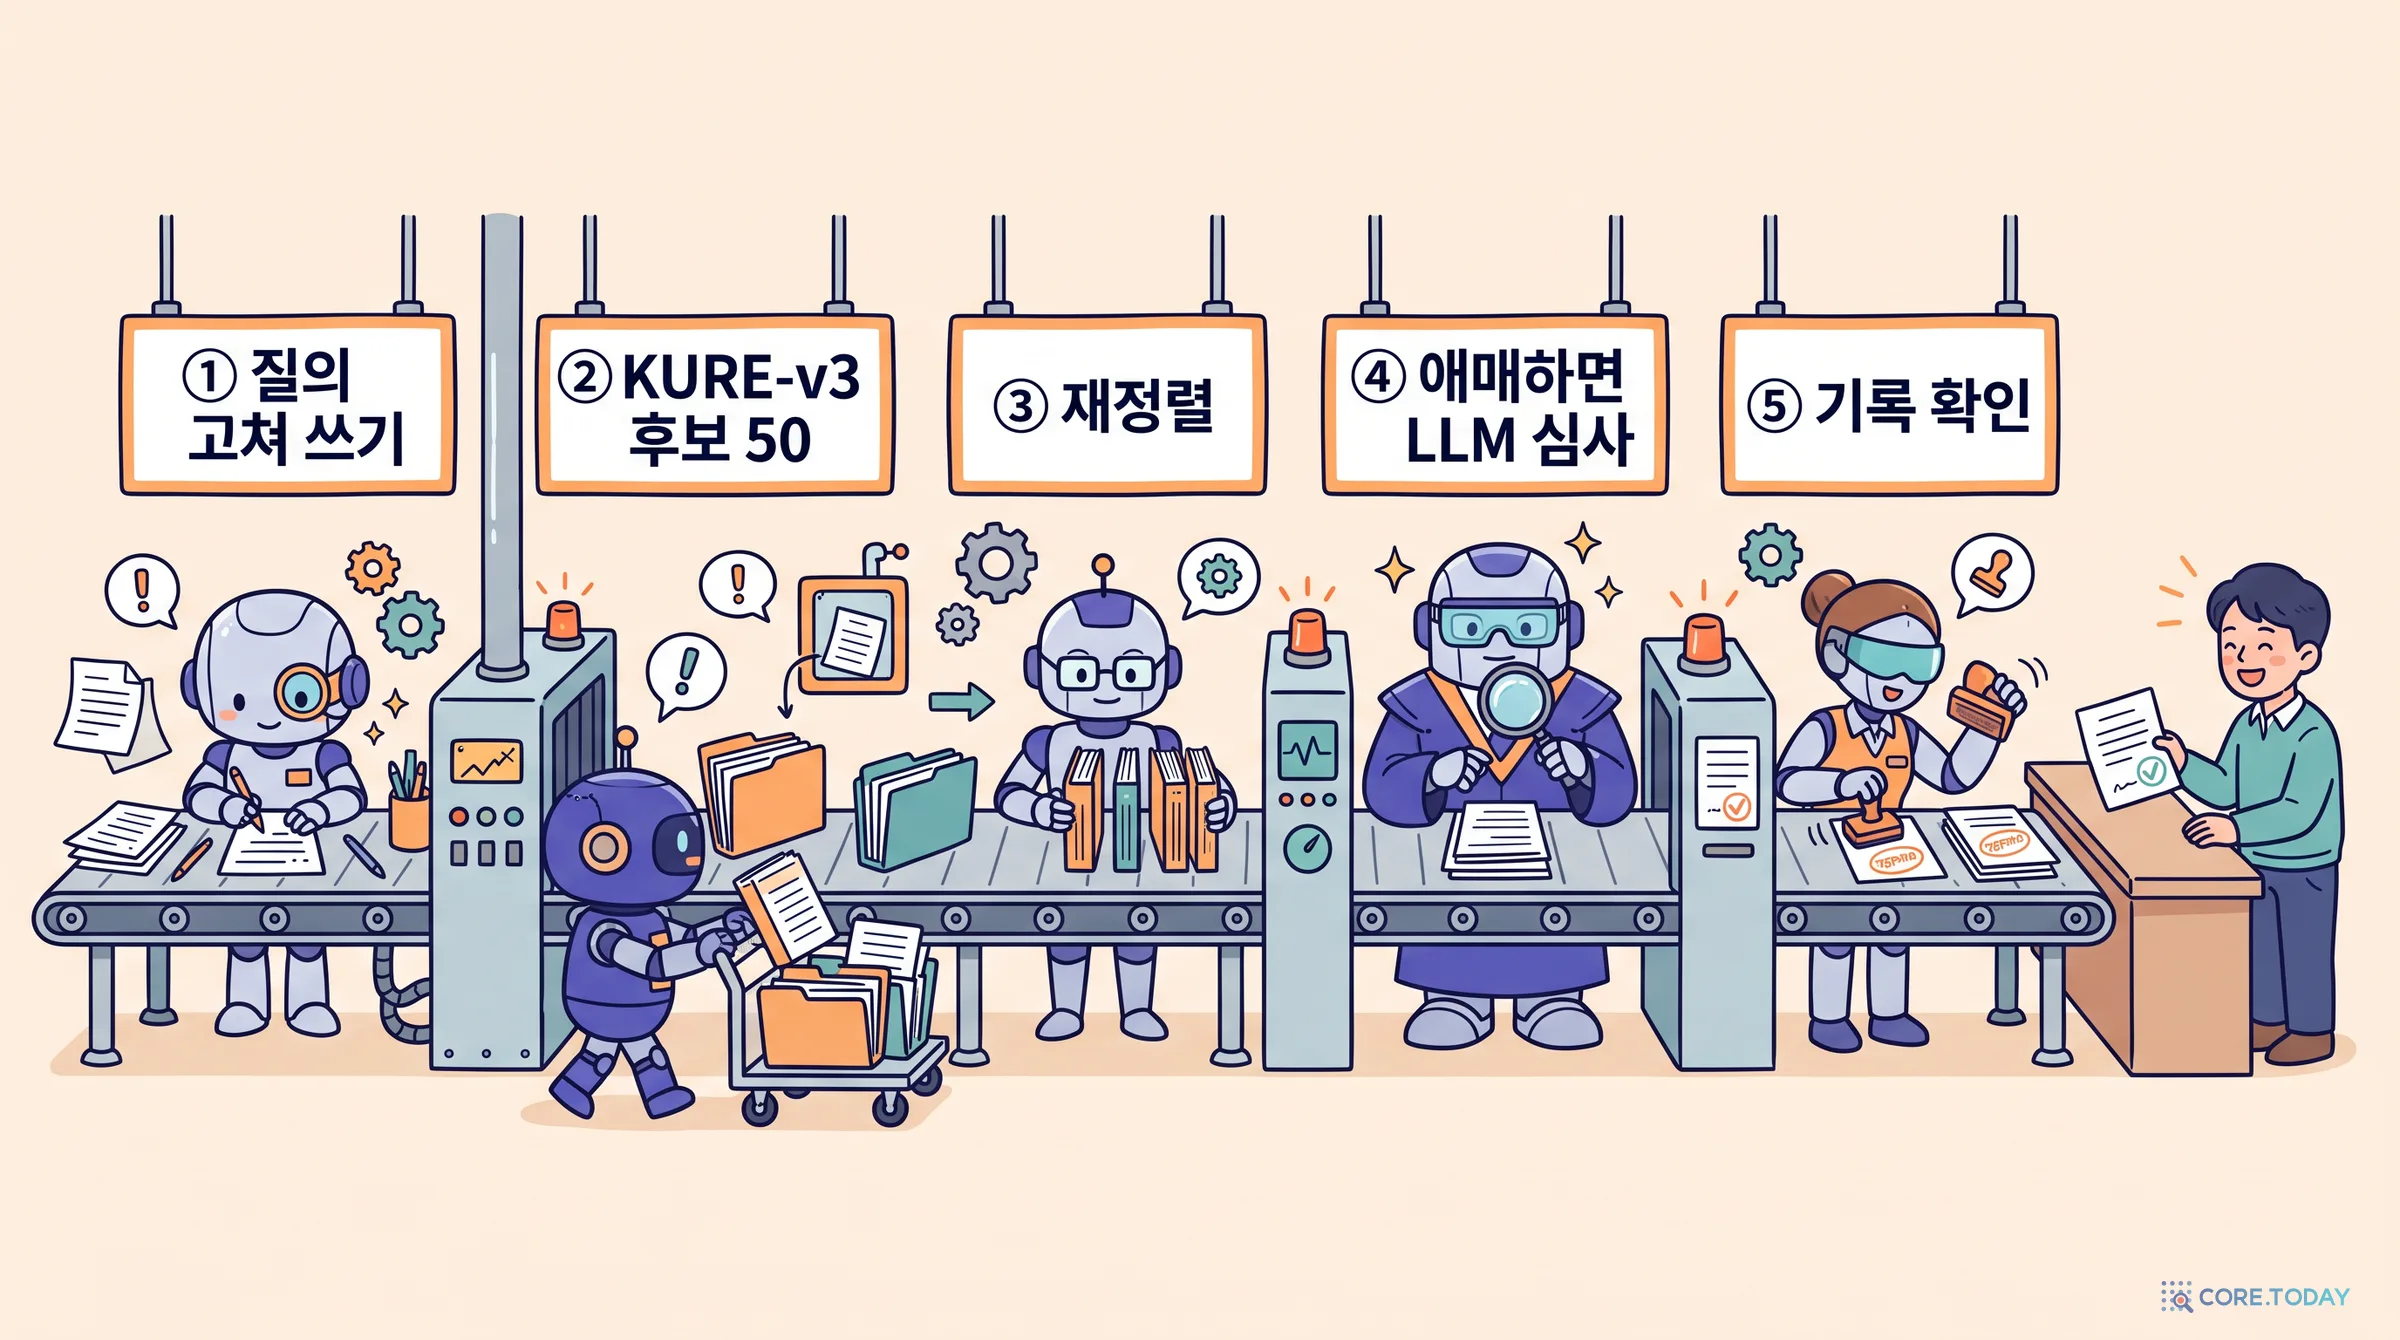
사실탐색기에는 이 순서로 넣을 계획입니다. 가장 싸고 큰 것부터입니다.
근거 단위에 제목 붙여 재색인: 질의 비용 0, 색인 한 번.
주어·술어 찾기에 지시문 재정렬기: 슬롯 경로가 실패하고 벡터 이웃을 쓸 때, KURE 상위 50개를 Qwen3-Reranker(지시문)로 다시 줄 세우고 KURE 점수와 섞습니다. 술어 어휘는 80개뿐이라 후보 20개면 충분합니다.
값 비교 두 번째 의견: 코드와 0.6B 재정렬기가 엇갈리면 검토 대기열로.
질의 고쳐 쓰기와 LLM 계단식은 설치처 사정에 따라: GPU가 없는 곳은 27B 계단식, 있는 곳은 9B 고쳐 쓰기. 응답 시간 예산이 빠듯한 화면에서는 끕니다.
12. 이 결과를 어디까지 믿을 수 있나
한 코퍼스, Claude가 쓴 질의입니다. 1편과 같은 한계입니다. 특히 8절의 제목 효과는 질문 만든 쪽이 제목을 본 탓에 부풀려져 있습니다.
목록 방식 재정렬기(jina)는 풀 전체를 한 목록으로 채점했습니다. KURE 상위 50개만 다시 줄 세운 숫자는 그 점수를 잘라 쓴 근사입니다. 기권 판별은 정답을 뺀 목록을 따로 다시 채점했습니다.
LLM 고르기의 후보는 KURE-v3 목록입니다. 계단식에서 재정렬기를 거친 뒤 LLM을 부르는 조합도 KURE 목록을 보여 준 결과를 재사용했습니다. 재정렬된 목록을 보여 주면 조금 더 오를 수 있습니다.
지연은 한 번 잰 값입니다. A100은 MIG 조각(40GB·80GB)이고 다른 작업과 GPU를 나눠 쓴 구간이 있습니다. vLLM·TEI 같은 서빙 서버로 묶으면 더 빨라집니다.
27B는 생각(thinking) 모드를 끄고 돌렸습니다. 켜면 더 오를 수 있지만 질의당 수십 초가 듭니다.
맺으며
재정렬기 15종을 재고 나서 가장 오래 남은 장면은 "순천만 박람회 경제적 효과 얼마"에 '299억'을 고른 재정렬기입니다. 틀린 답이 아니라 다른 질문에 대한 맞는 답이었습니다. 모델이 무엇을 배웠는지와 우리가 무엇을 시키는지가 어긋나면, 크기와 벤치마크 순위는 큰 의미가 없었습니다. 지시문 한 줄로 그 어긋남이 고쳐졌다는 것도 같은 이야기입니다.
프로덕트 쪽 결론은 단순합니다. 가장 큰 개선은 가장 화려한 방법에서 오지 않았습니다. 문단에 제목을 붙이는 일, 재정렬기에 과제를 한 문장으로 알려 주는 일, 헷갈릴 때만 큰 모델을 부르는 일이었습니다. 그리고 "기록에 없다"고 말하는 일은 어떤 모델의 점수에도 맡길 수 없었습니다. 사실탐색기에서 그 말은 지금처럼, 기록을 다시 열어 본 코드가 합니다.
출처
코어닷투데이 실측(2026-10-27): 1편과 같은 부산 공적 기록 시험지(사실탐색기 corpus/busan-real). 질의는 Claude Code 서브에이전트(Sonnet)가 작성.