키워드와 의미, 둘 다 쓴다 — BM25·벡터·RRF·리랭커, 논문과 실측으로 보는 하이브리드 검색 (한국어 검색 스택 2편)
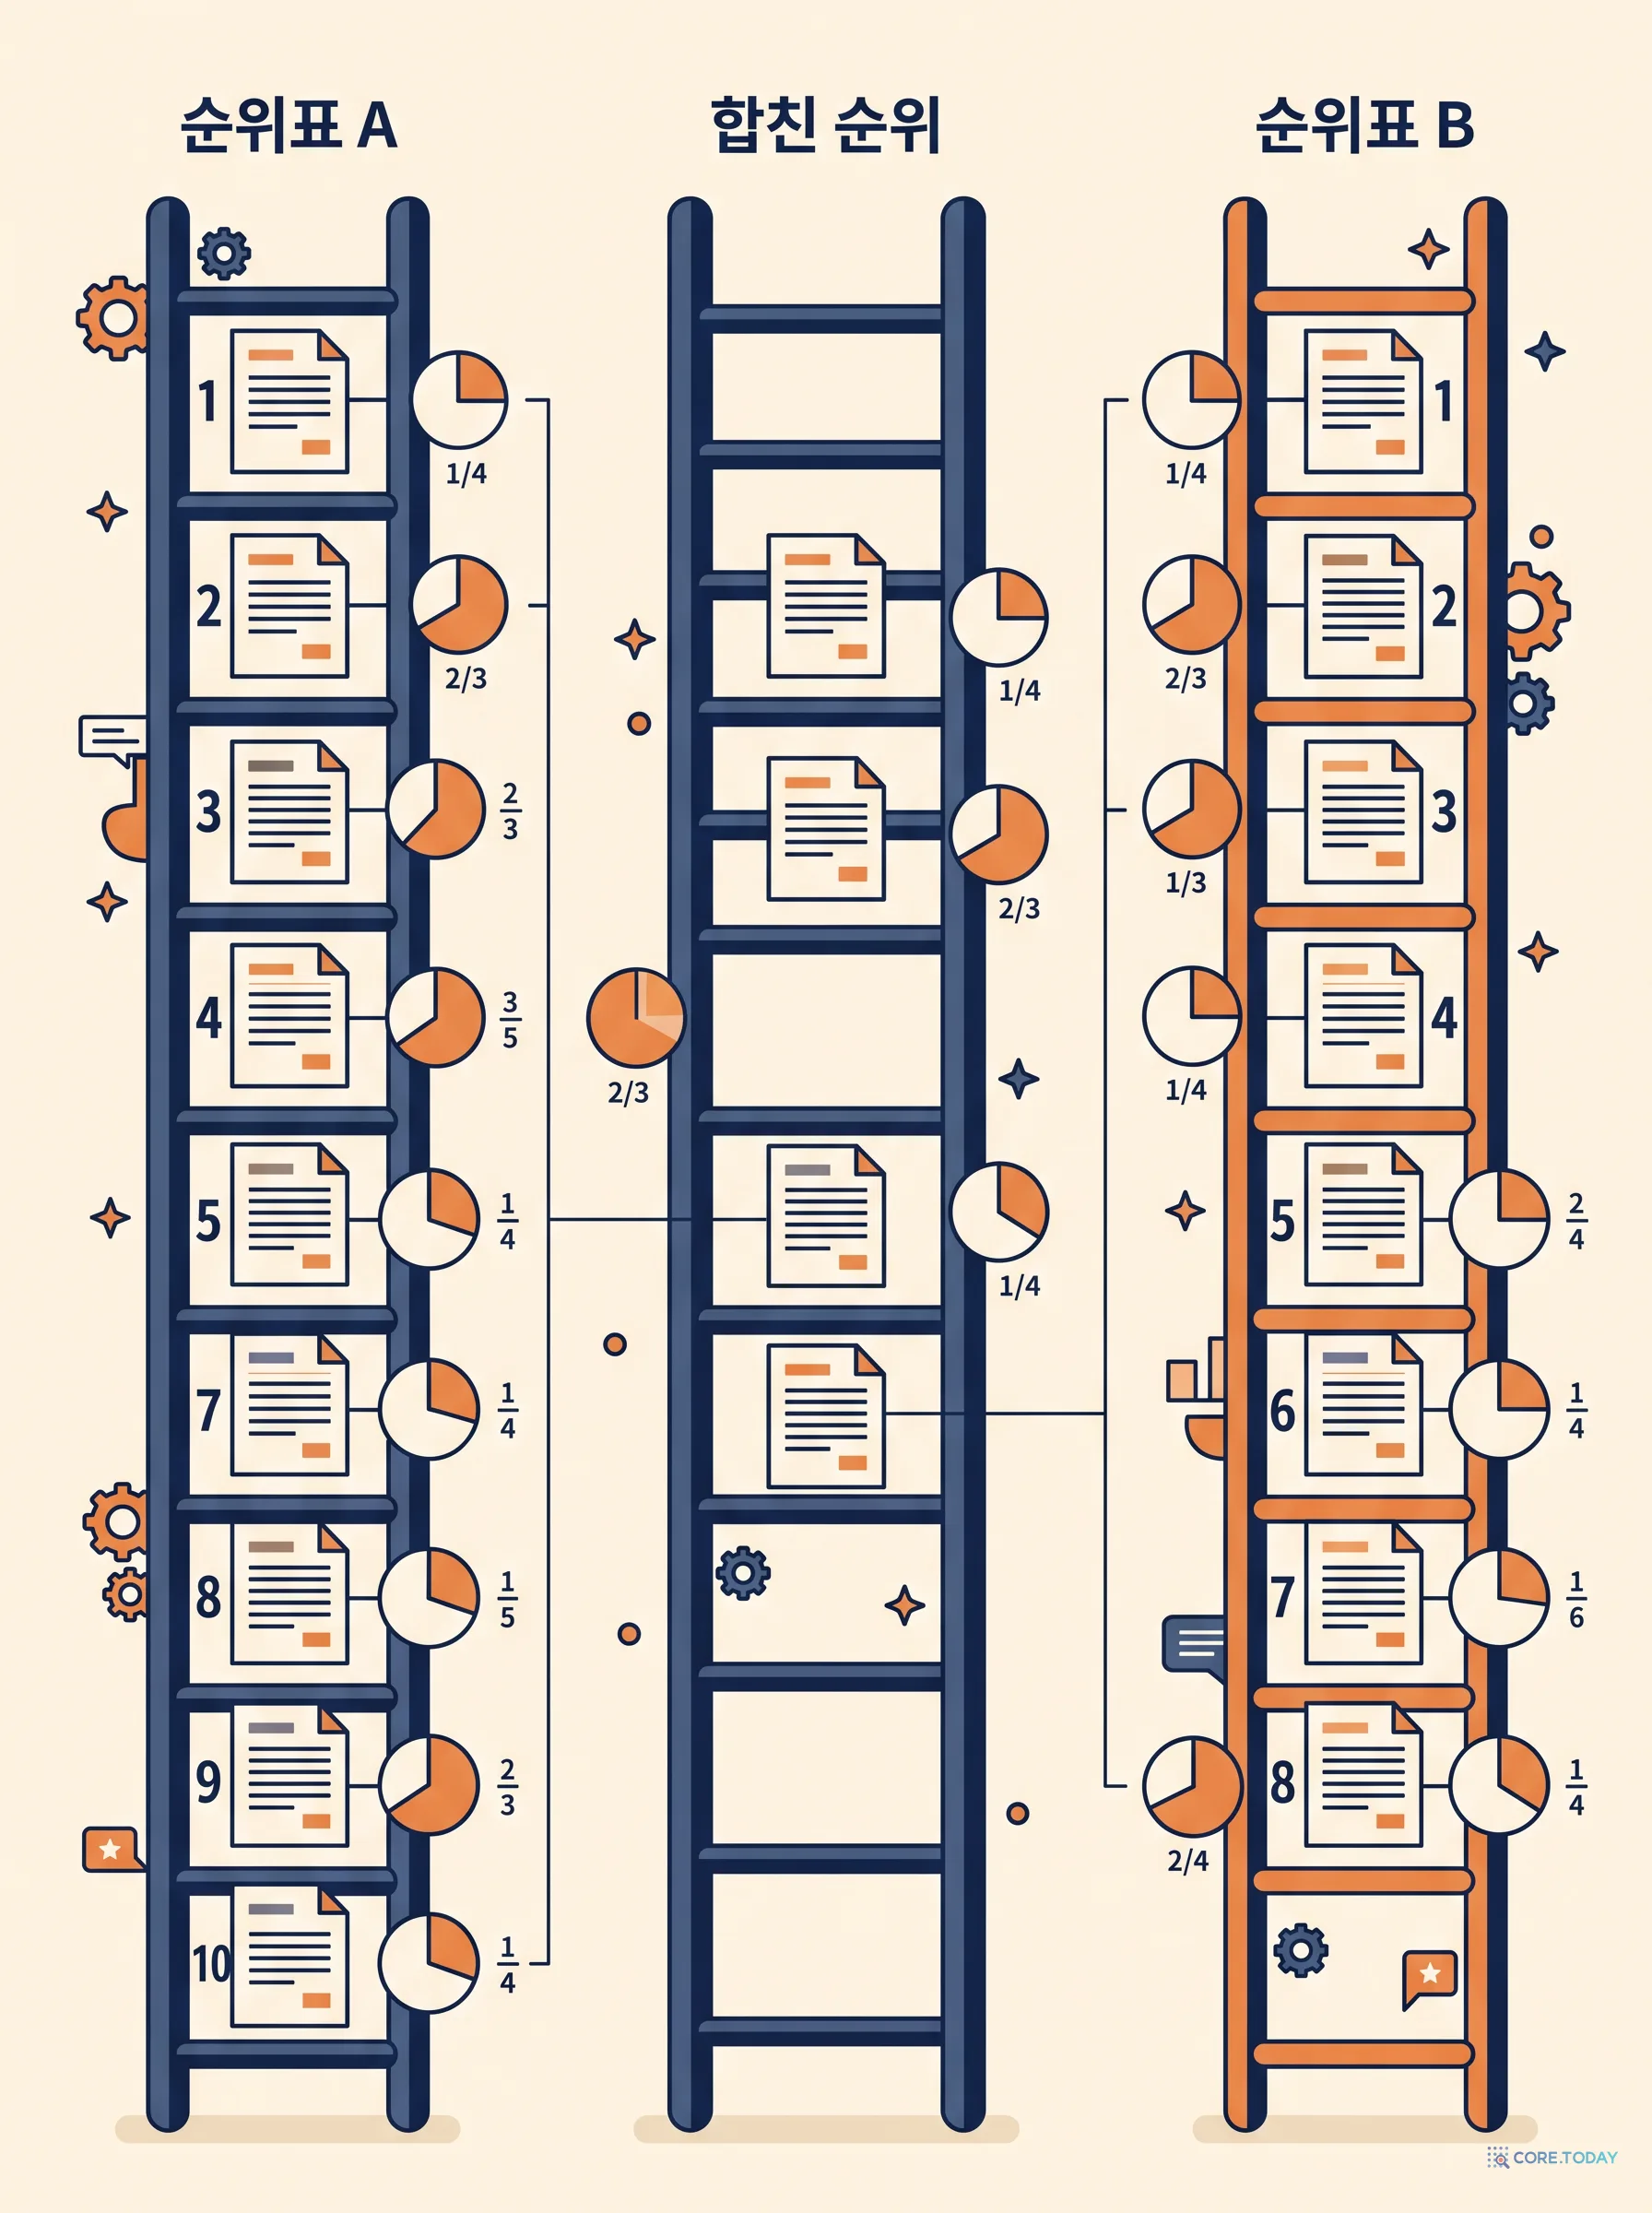
원문 메모의 그림은 이랬습니다. BM25와 벡터 검색을 나란히 돌리고, 결과를 RRF로 합치고, 리랭커로 다시 고른다. 이 글은 그 그림의 각 칸을 논문과 실측으로 채웁니다. 2009년 SIGIR의 두 쪽짜리 논문이 제안한 RRF는 점수 대신 등수만 쓰는 단순한 공식인데 왜 통하는지, k=60은 어디서 왔는지, 2023년 TOIS 논문은 왜 '점수 융합이 RRF보다 낫다'고 했는지, 2025년의 '약한 고리' 발견은 무엇인지. 그리고 1편의 한국어 코퍼스로 직접 재 보니, 등가중 RRF는 벡터 단독보다 오히려 나빴고 이유는 BM25가 약한 고리였기 때문이었습니다. 반면 강한 임베딩 둘(Qwen3-8B + BGE-M3)을 RRF로 합치자 어느 쪽 단독보다 좋아졌습니다. 리랭커는 '따로 읽고 비교'하는 바이 인코더와 '같이 읽고 판정'하는 크로스 인코더의 차이로 풀고, 로컬 LLM을 리랭커로 써서 상위 10개의 순서가 얼마나 바뀌는지 잽니다. 인터랙티브 5개와 삽화 8장.
메모는 "임베딩 모델의 등급 차이보다 이 구조가 더 중요하다"고 했고, 검색 품질의 기여도를 청킹 30%, 임베딩 25%, 하이브리드 20%, 리랭킹 20%로 어림했습니다. 그 숫자 자체는 감이지만 방향은 맞습니다. 1편에서 가장 좋은 임베딩 모델도 어휘가 어긋난 질문 67개 중 4개를 완전히 놓쳤고, BM25가 이긴 질문이 셋 있었습니다.
이 글은 그 그림의 각 칸을 논문과 실측으로 채웁니다. 1부에서 어휘 검색과 의미 검색이 왜 서로 다른 것을 놓치는지, 2부에서 RRF의 원논문과 그 뒤의 논쟁을, 3부에서 우리 데이터로 잰 융합 결과(예상과 달랐습니다)를, 4부에서 리랭커의 원리와 실측을, 5부에서 실제 스택 설계를 다룹니다.
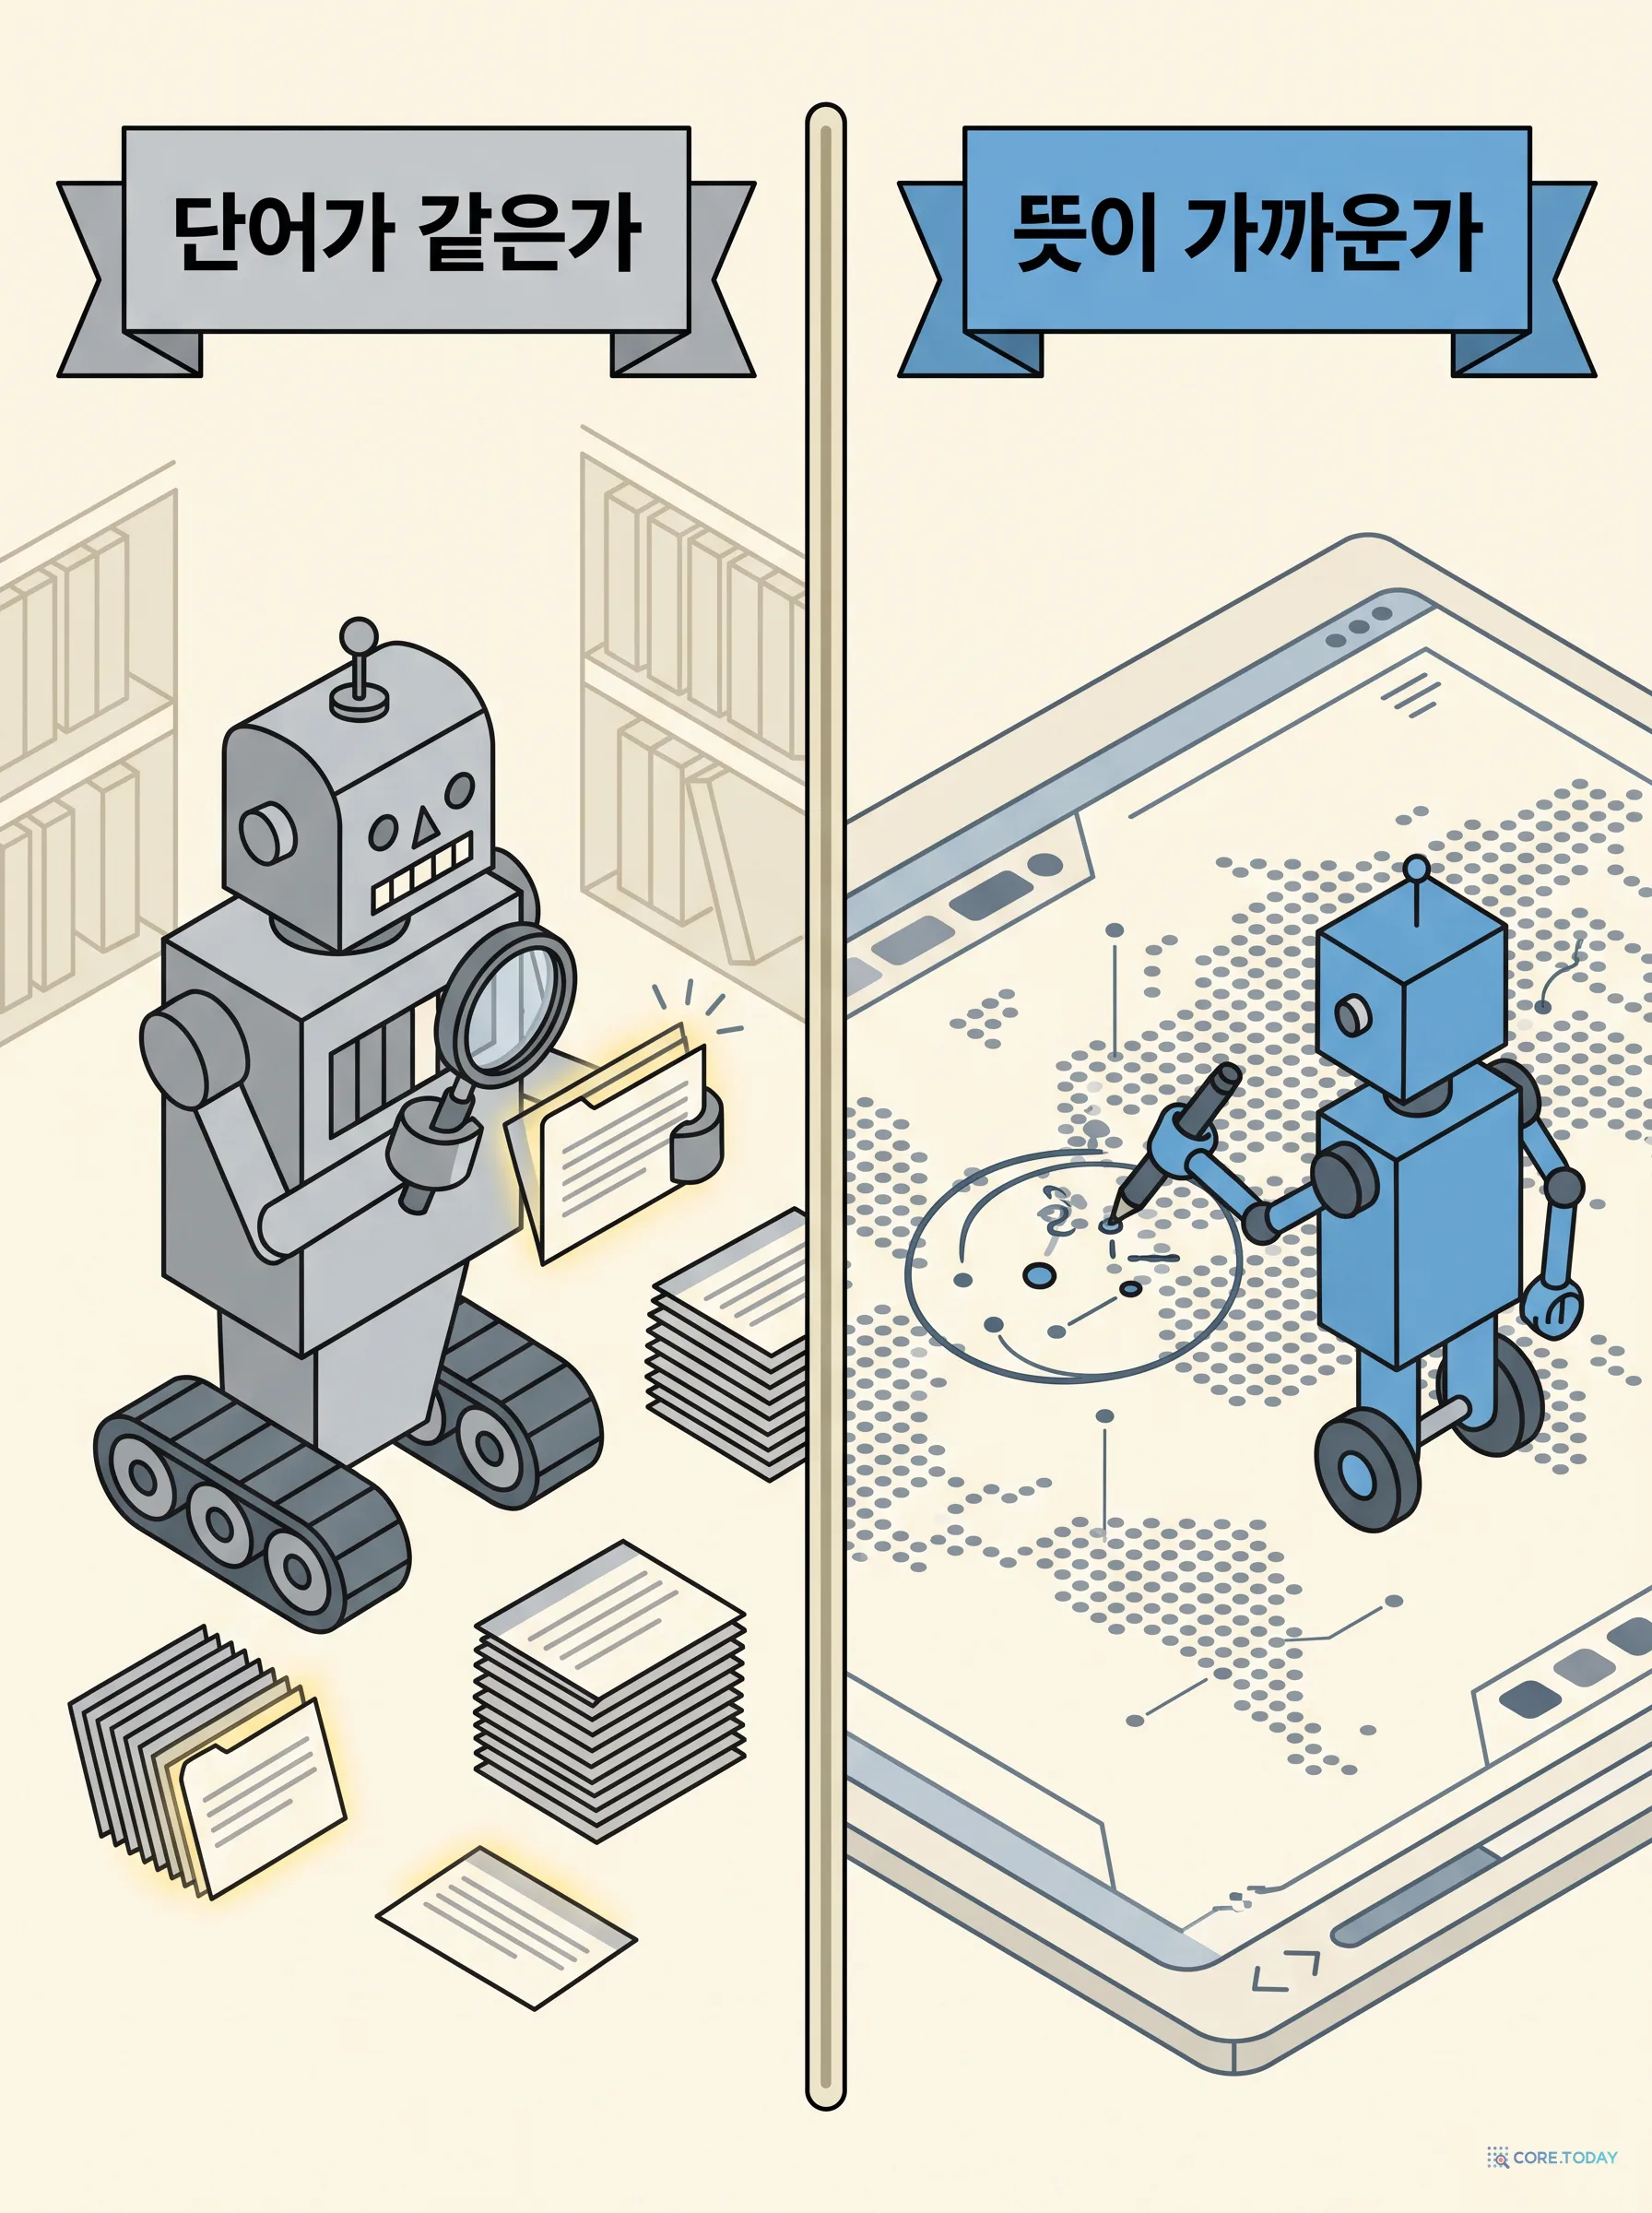
BM25 는 1990년대 확률적 검색 모델에서 나온 어휘 점수입니다. 질문의 단어가 문서에 얼마나 자주(TF), 그 단어가 전체 코퍼스에서 얼마나 드문지(IDF), 문서가 얼마나 긴지를 조합합니다. 단어가 정확히 같아야 점수가 납니다. '청년 일자리'로 검색하면 '청년취업'은 잡지 못합니다. 대신 '2603.07379'나 'Headlamp' 같은 정확한 식별자, 고유명사, 숫자는 놓치지 않습니다.
한국어에서 BM25를 쓰려면 먼저 형태소로 쪼개야 합니다. '청년취업을'을 통째로 한 단어로 보면 '청년취업'과 매칭이 안 됩니다. 이 글은 Kiwi 형태소 분석기로 명사·동사·외국어·숫자만 남겨 색인했습니다. OpenSearch나 Elasticsearch에서는 nori 분석기가 같은 역할을 합니다.
벡터 검색 은 1편에서 본 대로 뜻의 거리를 잽니다. 단어가 달라도 뜻이 가까우면 찾지만, 반대로 '취업'과 '창업'처럼 표면이 비슷한 다른 뜻을 헷갈리고, 학습 데이터에 없던 고유명사나 코드 번호에는 약합니다.
BM25가 이긴 질문 셋을 보면 공통점이 있습니다. "보상 모델 없이 언어 모델을 인간 취향에 맞추는 수학적 접근법"에서 '보상 모델'은 DPO 글의 요약에 그대로 있는 전문 용어입니다. "장애 대응 기록에서 지금 몇 번째 단계인지를 기준으로 찾는 검색"의 '단계'도 그렇습니다. 정확한 전문 용어가 문서에 그대로 있을 때 BM25는 벡터보다 확신이 있습니다. 벡터는 그 용어를 주변의 비슷한 개념과 섞어 버립니다.
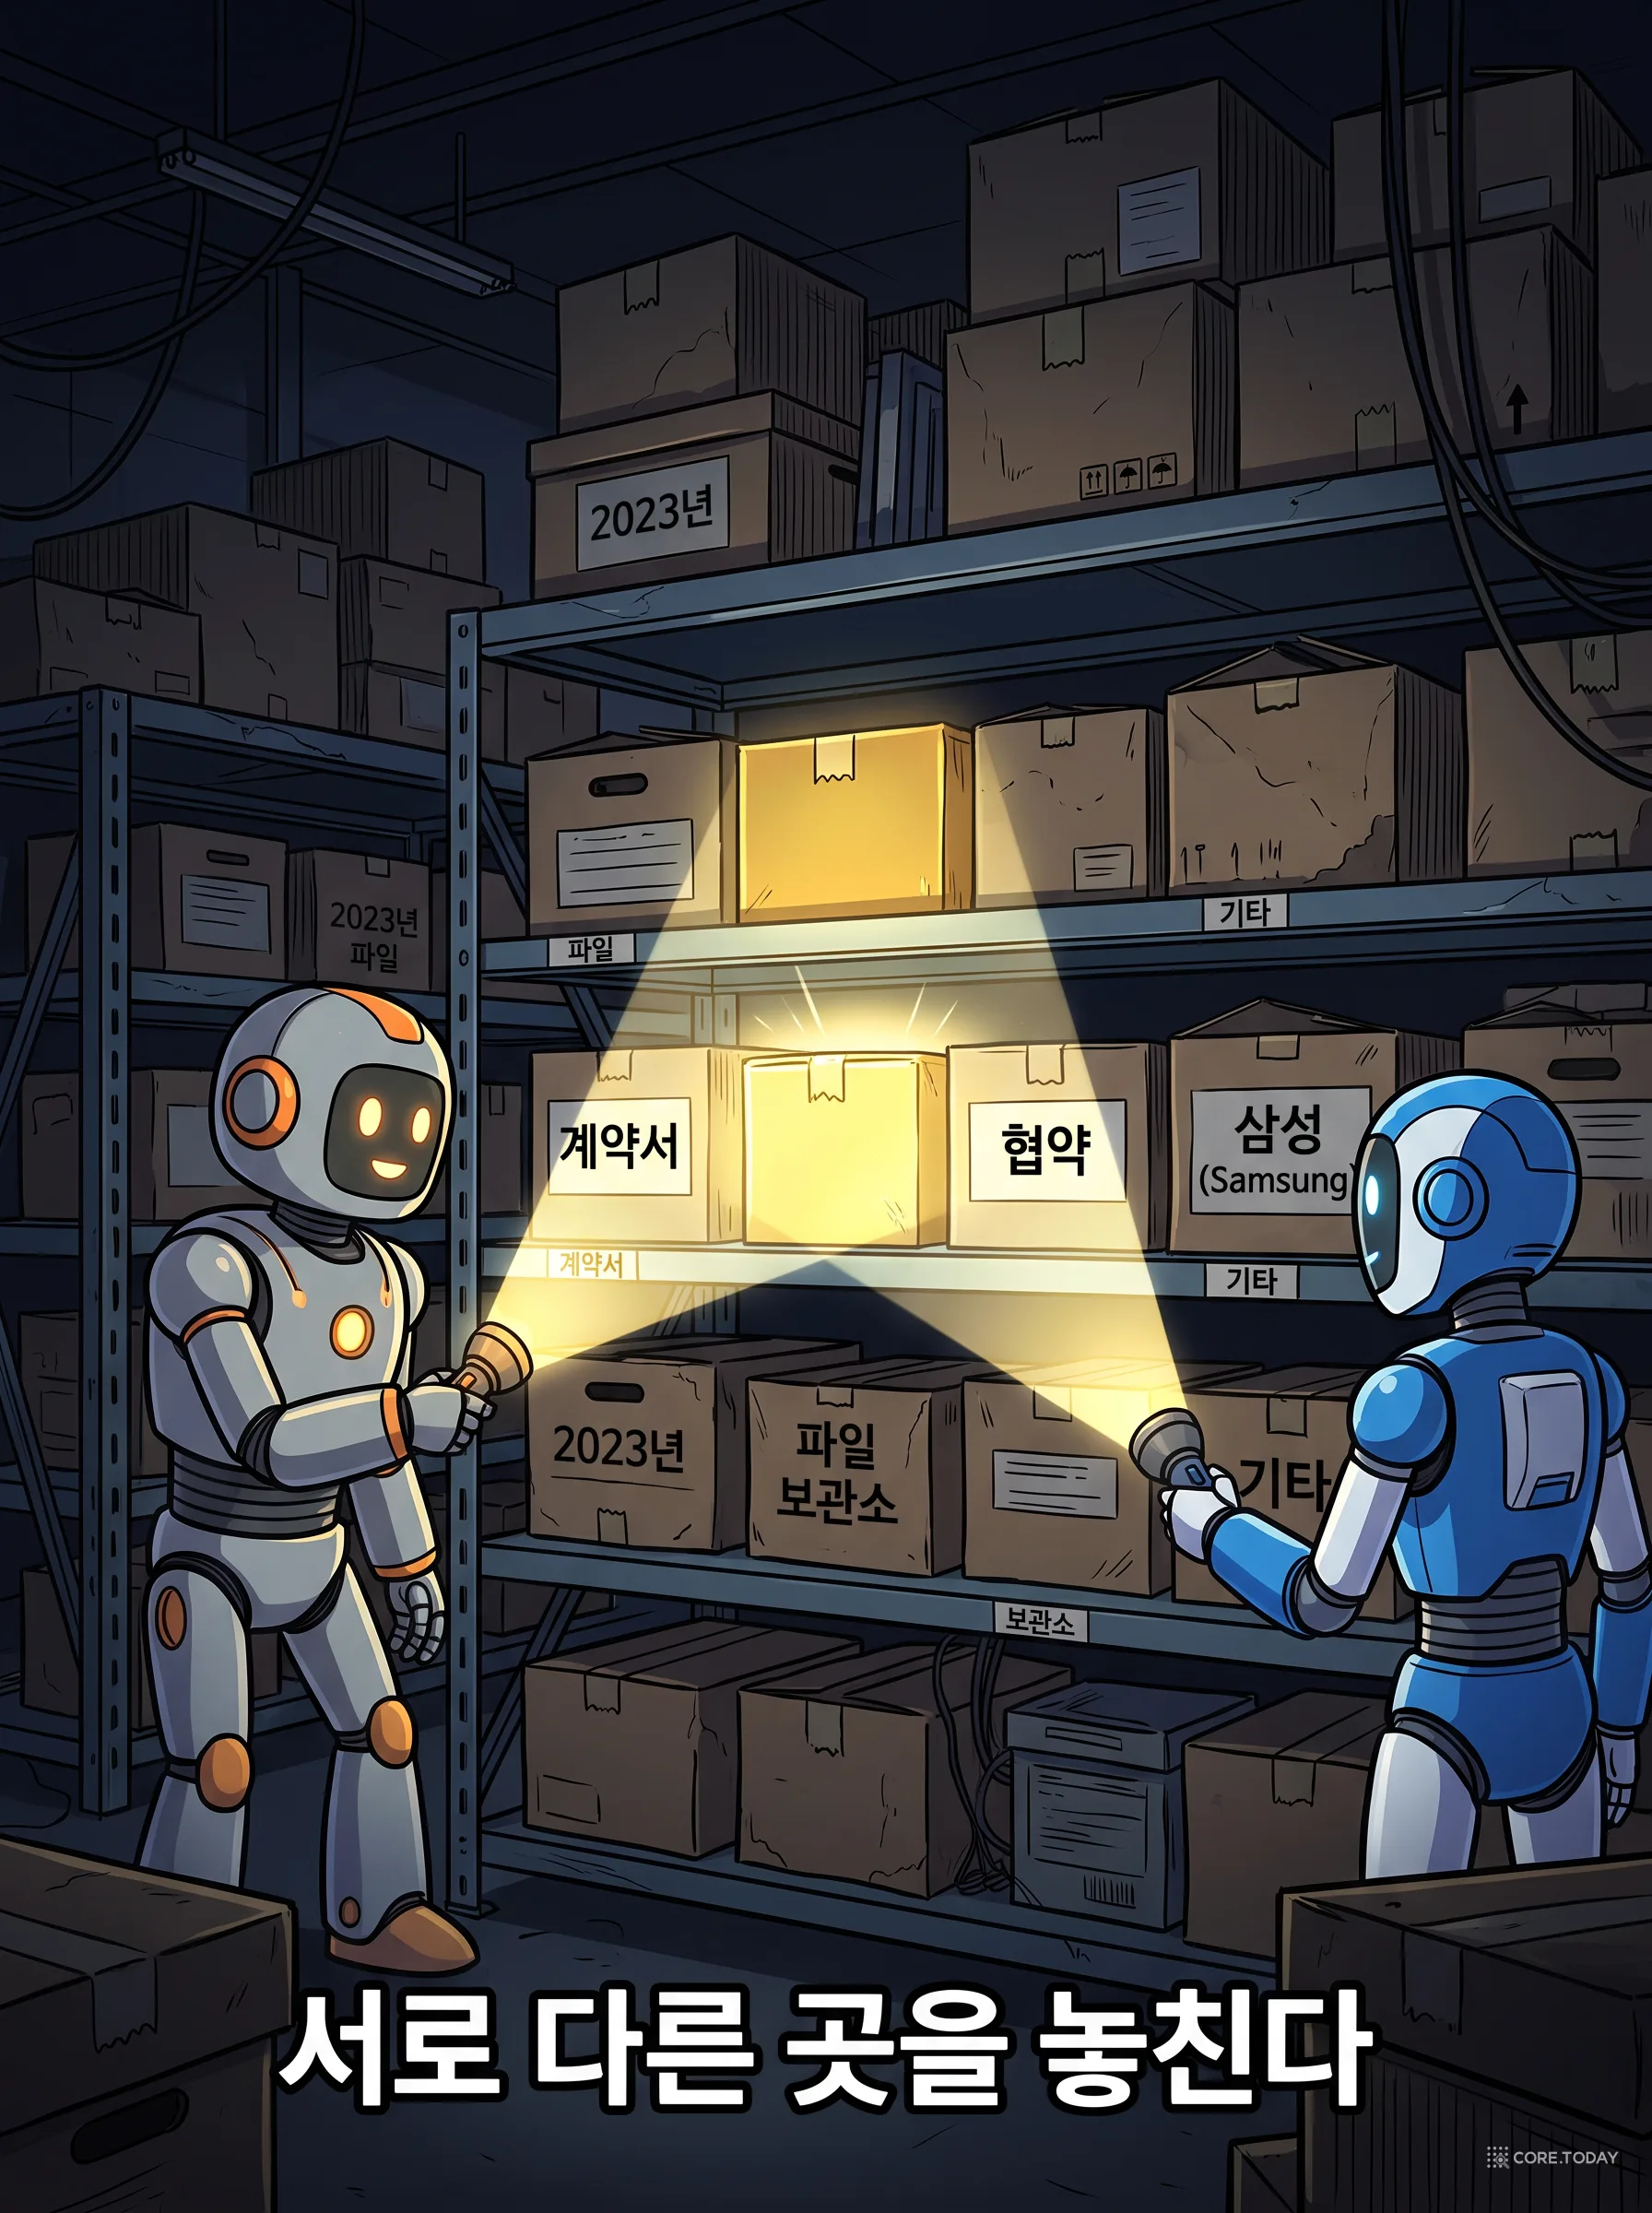
반대로 벡터가 이긴 36개 질문은 대부분 바꿔쓰기 질문입니다. 여기서 BM25는 단어가 하나도 안 겹쳐 손을 놓습니다. 둘이 서로 다른 곳을 놓친다면, 합치면 좋아질 것 같습니다. 정말 그런지는 3부에서 봅니다. 먼저 합치는 법부터.
2부. RRF: 점수를 버리고 등수만 쓴다
2009년, 두 쪽짜리 논문
Reciprocal Rank Fusion은 2009년 SIGIR에서 워털루대의 코맥·클라크와 구글의 뷔트허가 발표한 두 쪽짜리 포스터 논문입니다. 제목이 결론입니다. 「RRF는 콩도르세와 개별 순위 학습 방법들을 이긴다」. 공식은 이것뿐입니다.
RRFscore(d)=r∈R∑k+r(d)1
문서 d가 각 순위표 r에서 몇 등인지(r(d))를 보고, 1/(k + 등수)를 다 더합니다. 점수는 안 씁니다. BM25 점수는 0~30쯤이고 코사인은 0~1인데, 이 둘을 어떻게 더할지 고민할 필요가 없습니다. 등수는 어디서나 등수니까요.
논문의 표 1이 답입니다. TREC 주제 351~400에서 30개 시스템의 결과를 합치며 k를 0부터 500까지 바꿔 봤습니다.
RRF의 k에 따른 MAP (Cormack 외 2009, 표 1; 최댓값 0.2147 기준으로 0.20 이상만 표시)
k = 0
0.2072
k = 10
0.2123
k = 30
0.2139
k = 60
0.2145
k = 80
0.2147
k = 100
0.2142
k = 500
0.2098
(비교) 최고 단일 시스템
0.2016
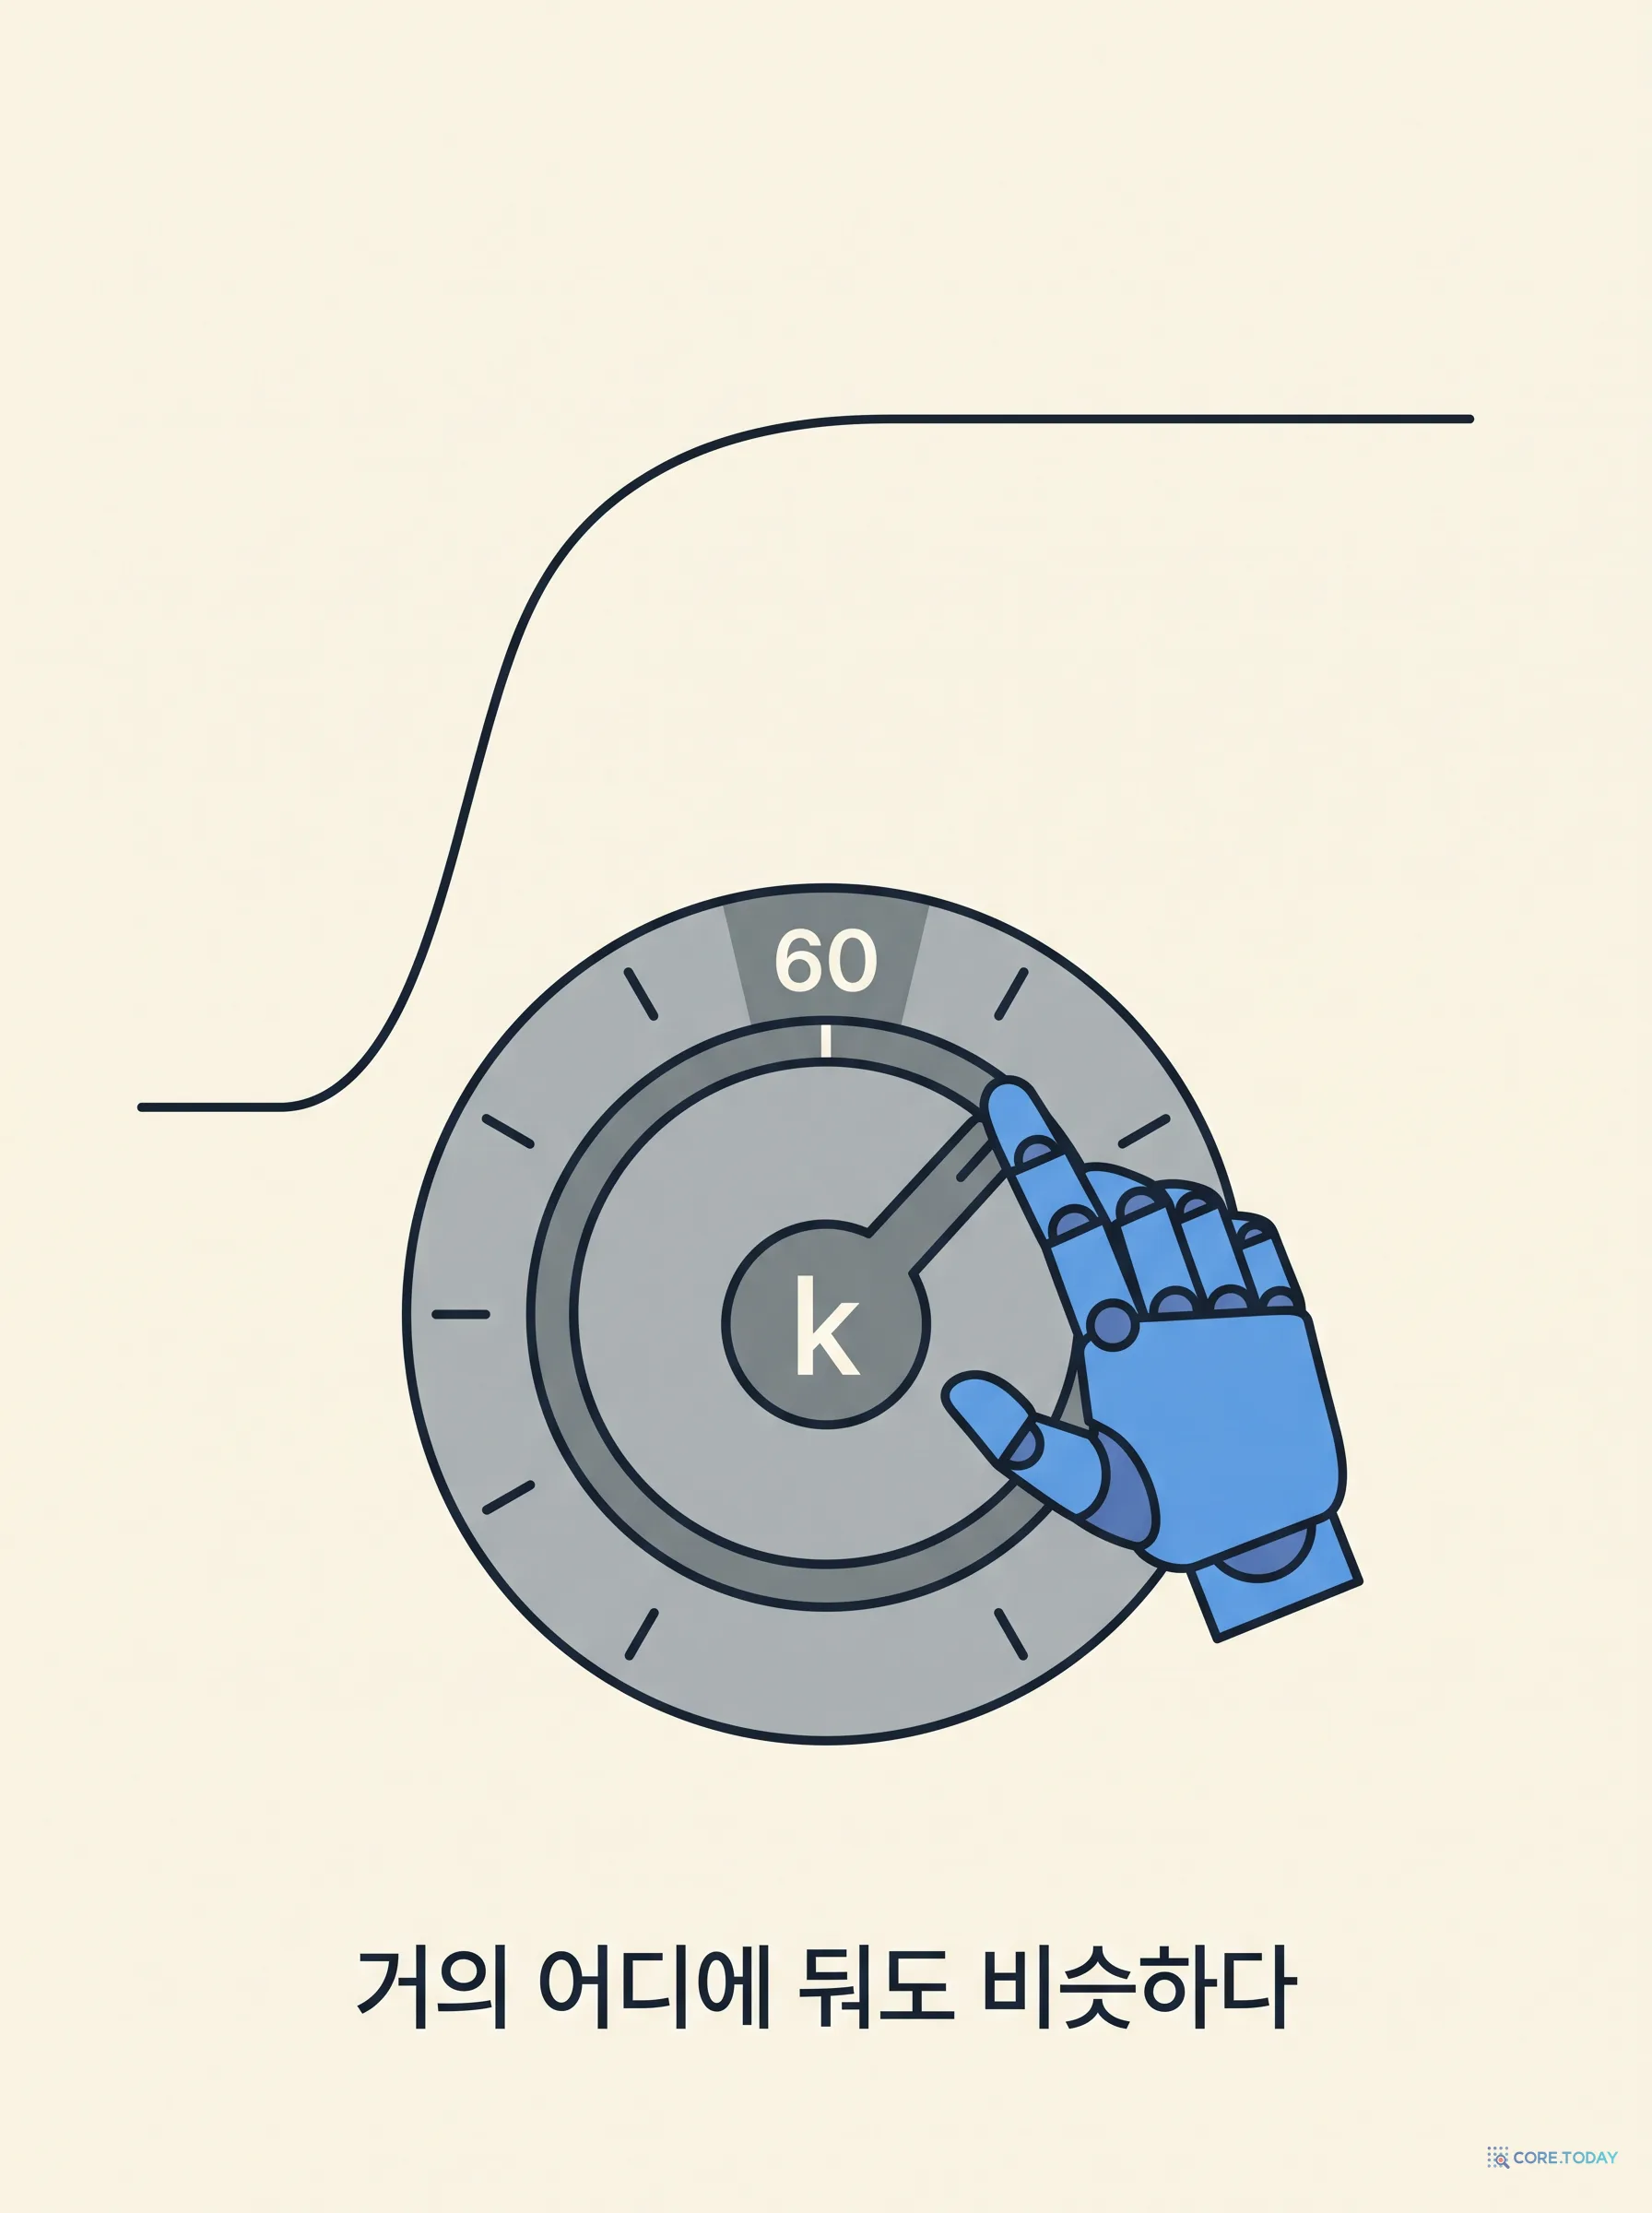
k가 10 이상이면 거의 평평합니다. 논문의 문장 그대로, "k=60이 거의 최적이었지만 그 선택이 결정적이지는 않았다." 그래서 이후 모든 구현이 60을 기본값으로 쓰게 됐습니다. 논문이 밝힌 직관도 기억할 만합니다. 상위 문서가 더 중요하지만, 하위 문서의 중요성이 지수함수를 썼을 때처럼 사라지지는 않는다. 1/(k+r)은 r이 커져도 천천히 줄어서, 5등과 50등의 차이가 1등과 2등의 차이보다 훨씬 작습니다. k는 그 완만함을 조절하는 손잡이입니다.
논문의 결과는 TREC 네 컬렉션에서 RRF가 최고 단일 시스템, 콩도르세 융합, CombMNZ를 평균 4~5% 앞섰다는 것입니다. 사람이 개입한 실행이 섞인 TREC 9 한 곳에서만 최고 단일 실행에 졌습니다. LETOR 3 데이터셋에서는 RRF(0.6051)가 순위 학습 방법들(ListNet 0.5846, RankSVM 0.5737 등)을 모두 이겼고, CombMNZ(0.6107)에만 통계적으로 무의미한 차이로 뒤졌습니다.
2023년의 반론: 점수를 버리는 것이 손해일 수 있다
RRF가 14년 동안 기본값으로 군림한 뒤, 2023년 ACM TOIS에 실린 브루흐·가이·잉버의 「하이브리드 검색을 위한 융합 함수 분석」이 두 가지를 짚었습니다. 첫째, RRF는 파라미터에 민감하다(원논문의 '결정적이지 않다'와 반대). 둘째, BM25 점수와 코사인을 각각 min-max로 정규화한 뒤 α·벡터 + (1−α)·BM25로 더하는 볼록 결합(convex combination)이 도메인 안팎 모두에서 RRF보다 낫고, α 하나는 적은 예시로도 맞출 수 있다. 등수만 쓰면 '1등이 2등보다 얼마나 확신 있게 앞섰는지'라는 정보를 버리는데, 그 정보가 쓸모 있다는 것입니다.
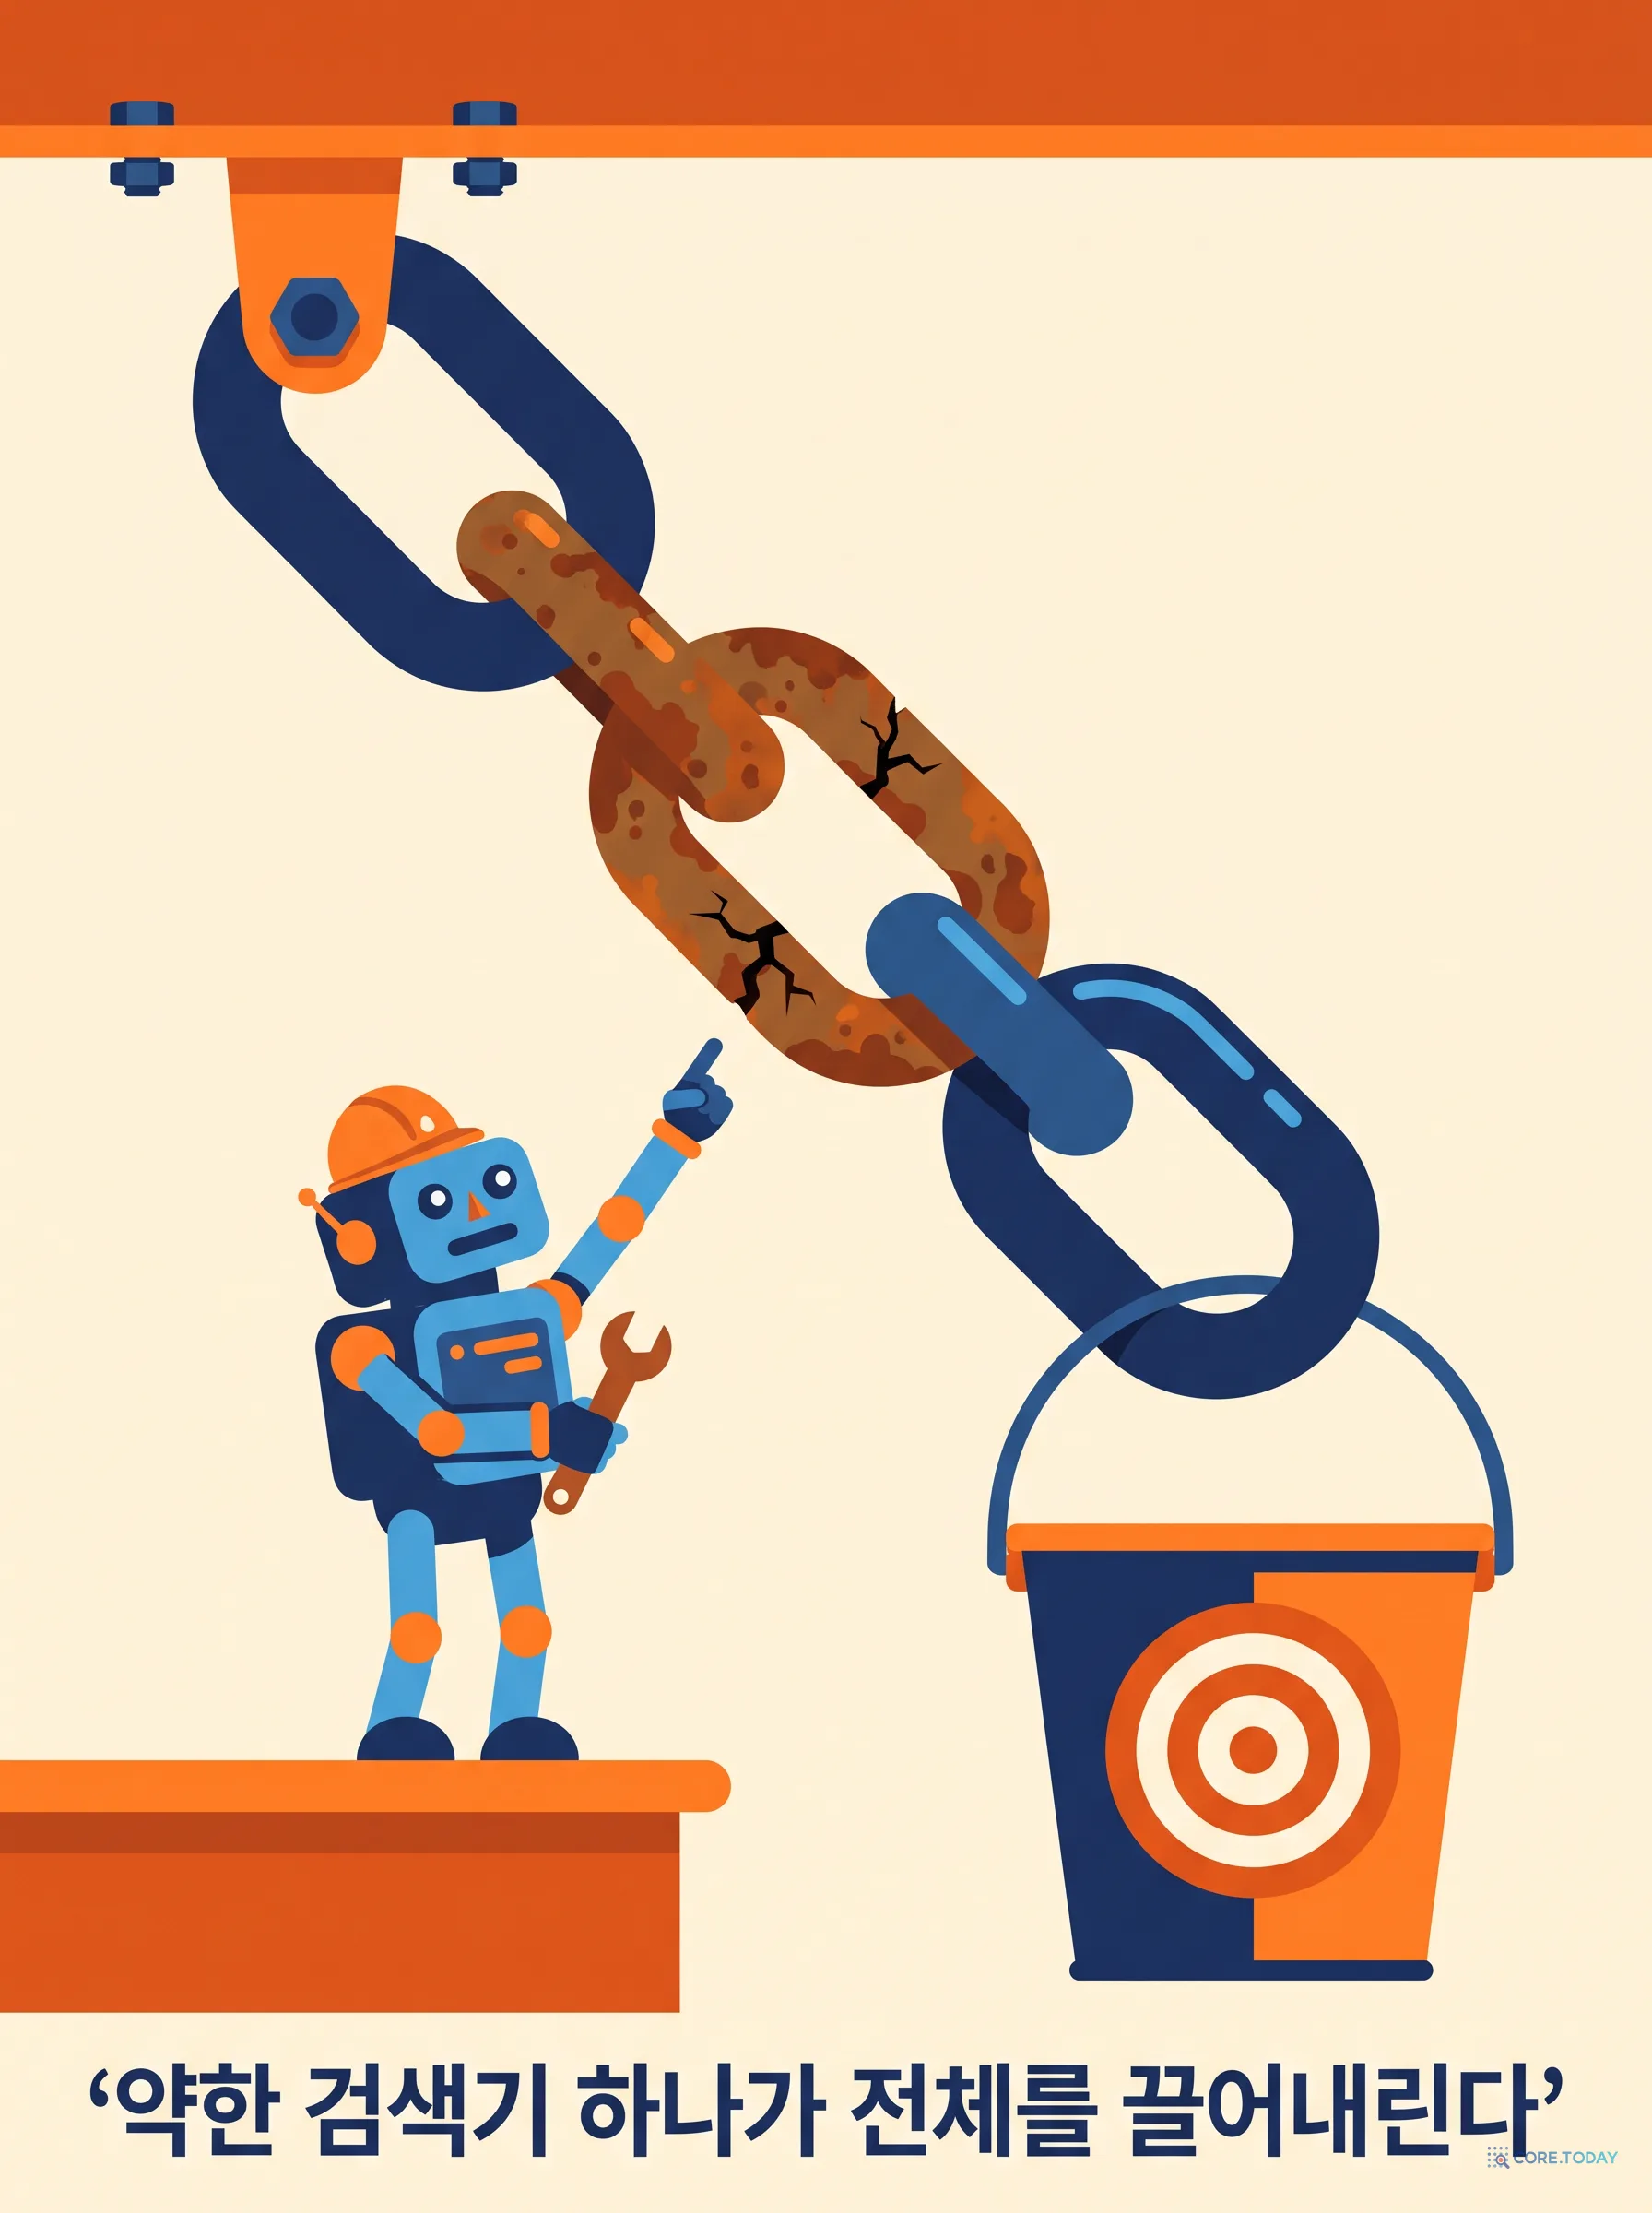
그리고 2025년 8월, 저장대·화중과기대 등의 「블렌드의 균형: 하이브리드 검색의 트레이드오프 실험 분석」이 11개 데이터셋에서 전문 검색·희소 벡터·밀집 벡터·텐서 검색을 조합하며 '약한 고리' 현상 을 보고했습니다. 성능이 떨어지는 검색기 하나가 전체 정확도를 상당히 끌어내리므로, 합치기 전에 각 검색기의 품질을 따로 재야 한다는 것입니다. 최적 구성은 데이터에 따라 달라서 만능 설정은 없다고도 했습니다.
이 세 논문을 한 줄로 요약하면 이렇습니다. RRF는 튜닝 없이 안전하게 합치는 법이고, 점수 융합은 검증 데이터가 있을 때 더 나은 법이며, 어느 쪽이든 약한 검색기를 같은 무게로 넣으면 손해다. 3부의 실측이 정확히 이 세 문장을 재현합니다.
3부. 실측: 합치면 정말 좋아지나
예상과 달랐던 결과
1편의 코퍼스와 질문으로 BM25와 각 임베딩 모델을 RRF(k=60)로 합쳤습니다. 결과는 예상과 달랐습니다.
조합 (nDCG@10, 어휘 불일치 67개 질문)
벡터 단독
BM25 + 벡터, RRF k=60
가중 RRF (BM25 0.3)
점수 융합 α=0.9
BM25 + Qwen3-8B
0.860
0.682
0.751
0.864
BM25 + Qwen3-4B
0.815
0.655
—
0.824
BM25 + BGE-M3
0.788
0.678
—
0.807
BM25 + Nomic v2
0.758
0.624
—
0.764
(참고) BM25 단독
0.519
등가중 RRF는 모든 모델에서 벡터 단독보다 나빴습니다. 8B는 0.860에서 0.682로 떨어졌습니다. 이유는 '약한 고리'입니다. 이 질문들은 일부러 어휘를 어긋나게 만들어서 BM25가 0.519밖에 못 냈는데, RRF는 두 순위표를 같은 무게로 더하므로 BM25가 엉뚱한 문서를 상위에 올린 것이 그대로 섞여 들어갑니다. 정답을 벡터가 1등에 뒀어도 BM25가 30등에 두면 RRF 점수는 1/61 + 1/90이고, BM25가 1등에 둔 엉뚱한 문서(벡터에서는 20등)가 1/61 + 1/80으로 앞지릅니다.
BM25의 가중치를 0.3으로 줄인 가중 RRF는 0.751로 회복했지만 여전히 단독보다 낮고, min-max 정규화 뒤 α=0.9로 점수를 섞은 볼록 결합은 0.864로 단독을 살짝 넘었습니다. 네 모델 모두에서 α=0.9의 점수 융합만이 단독을 넘었고, α를 0.7 아래로 내리면 어느 모델이든 단독보다 나빠졌습니다. 브루흐 외의 결론과 같은 방향입니다. 점수에는 '벡터가 얼마나 확신하는가'가 담겨 있어서, 벡터가 확신하는 1등을 BM25의 잡음이 끌어내리지 못합니다.
그런데 강한 둘을 합치면
같은 RRF로 BM25 대신 BGE-M3 를 Qwen3-8B와 합쳐 봤습니다. 둘 다 단독으로 0.79~0.86을 내는 유능한 검색기입니다.
nDCG@10 — 무엇을 무엇과 합치나 (67개 질문, 최댓값 0.875 기준)
Qwen3-8B + BGE-M3 (RRF)
0.875
Qwen3-8B 단독
0.860
BGE-M3 단독
0.788
BM25 + Qwen3-8B + BGE-M3 (RRF, 셋)
0.748
BM25 + Qwen3-8B (RRF)
0.682
두 강한 검색기의 RRF는 어느 쪽 단독보다 좋았습니다. 0.860 → 0.875, '정답이 1등' 비율은 74.6% → 77.6%. 두 모델이 서로 다른 질문을 틀리기 때문입니다(1편의 히트맵에서 확인할 수 있습니다). 그런데 여기에 BM25를 셋째 순위표로 넣자 0.748로 다시 떨어졌습니다. 약한 고리는 셋 중 하나여도 약한 고리입니다.
이 결과는 원문 메모의 그림을 부정하는 것이 아니라 조건을 붙입니다. 원문 메모가 그린 BM25 + BGE-M3 밀집 + BGE-M3 희소의 3중 융합은 세 검색기가 모두 유능한 도메인 에서 통합니다. 정확한 용어, 코드 번호, 고유명사가 많은 법령·기술 문서·제품 카탈로그가 그런 곳이고, 원문 메모의 예시였던 '울산 청년창업 지원사업 공고'처럼 사업명과 연도가 검색어가 되는 공고문이 그런 곳입니다. 반대로 이 글의 질문처럼 사용자가 자기 말로 바꿔 묻는 도메인(고객 문의, 사내 Q&A)에서는 BM25의 무게를 낮추거나 빼야 합니다.
실무 규칙은 하나입니다. 합치기 전에 각 검색기를 따로 재고, 약한 쪽은 가중치를 줄이거나 점수 융합으로 바꾸세요. 그리고 RRF의 k는 걱정하지 않아도 됩니다. 우리 실측에서도 k=20 이상은 거의 평평했습니다.
4부. 리랭커: 같이 읽고 판정한다
바이 인코더와 크로스 인코더
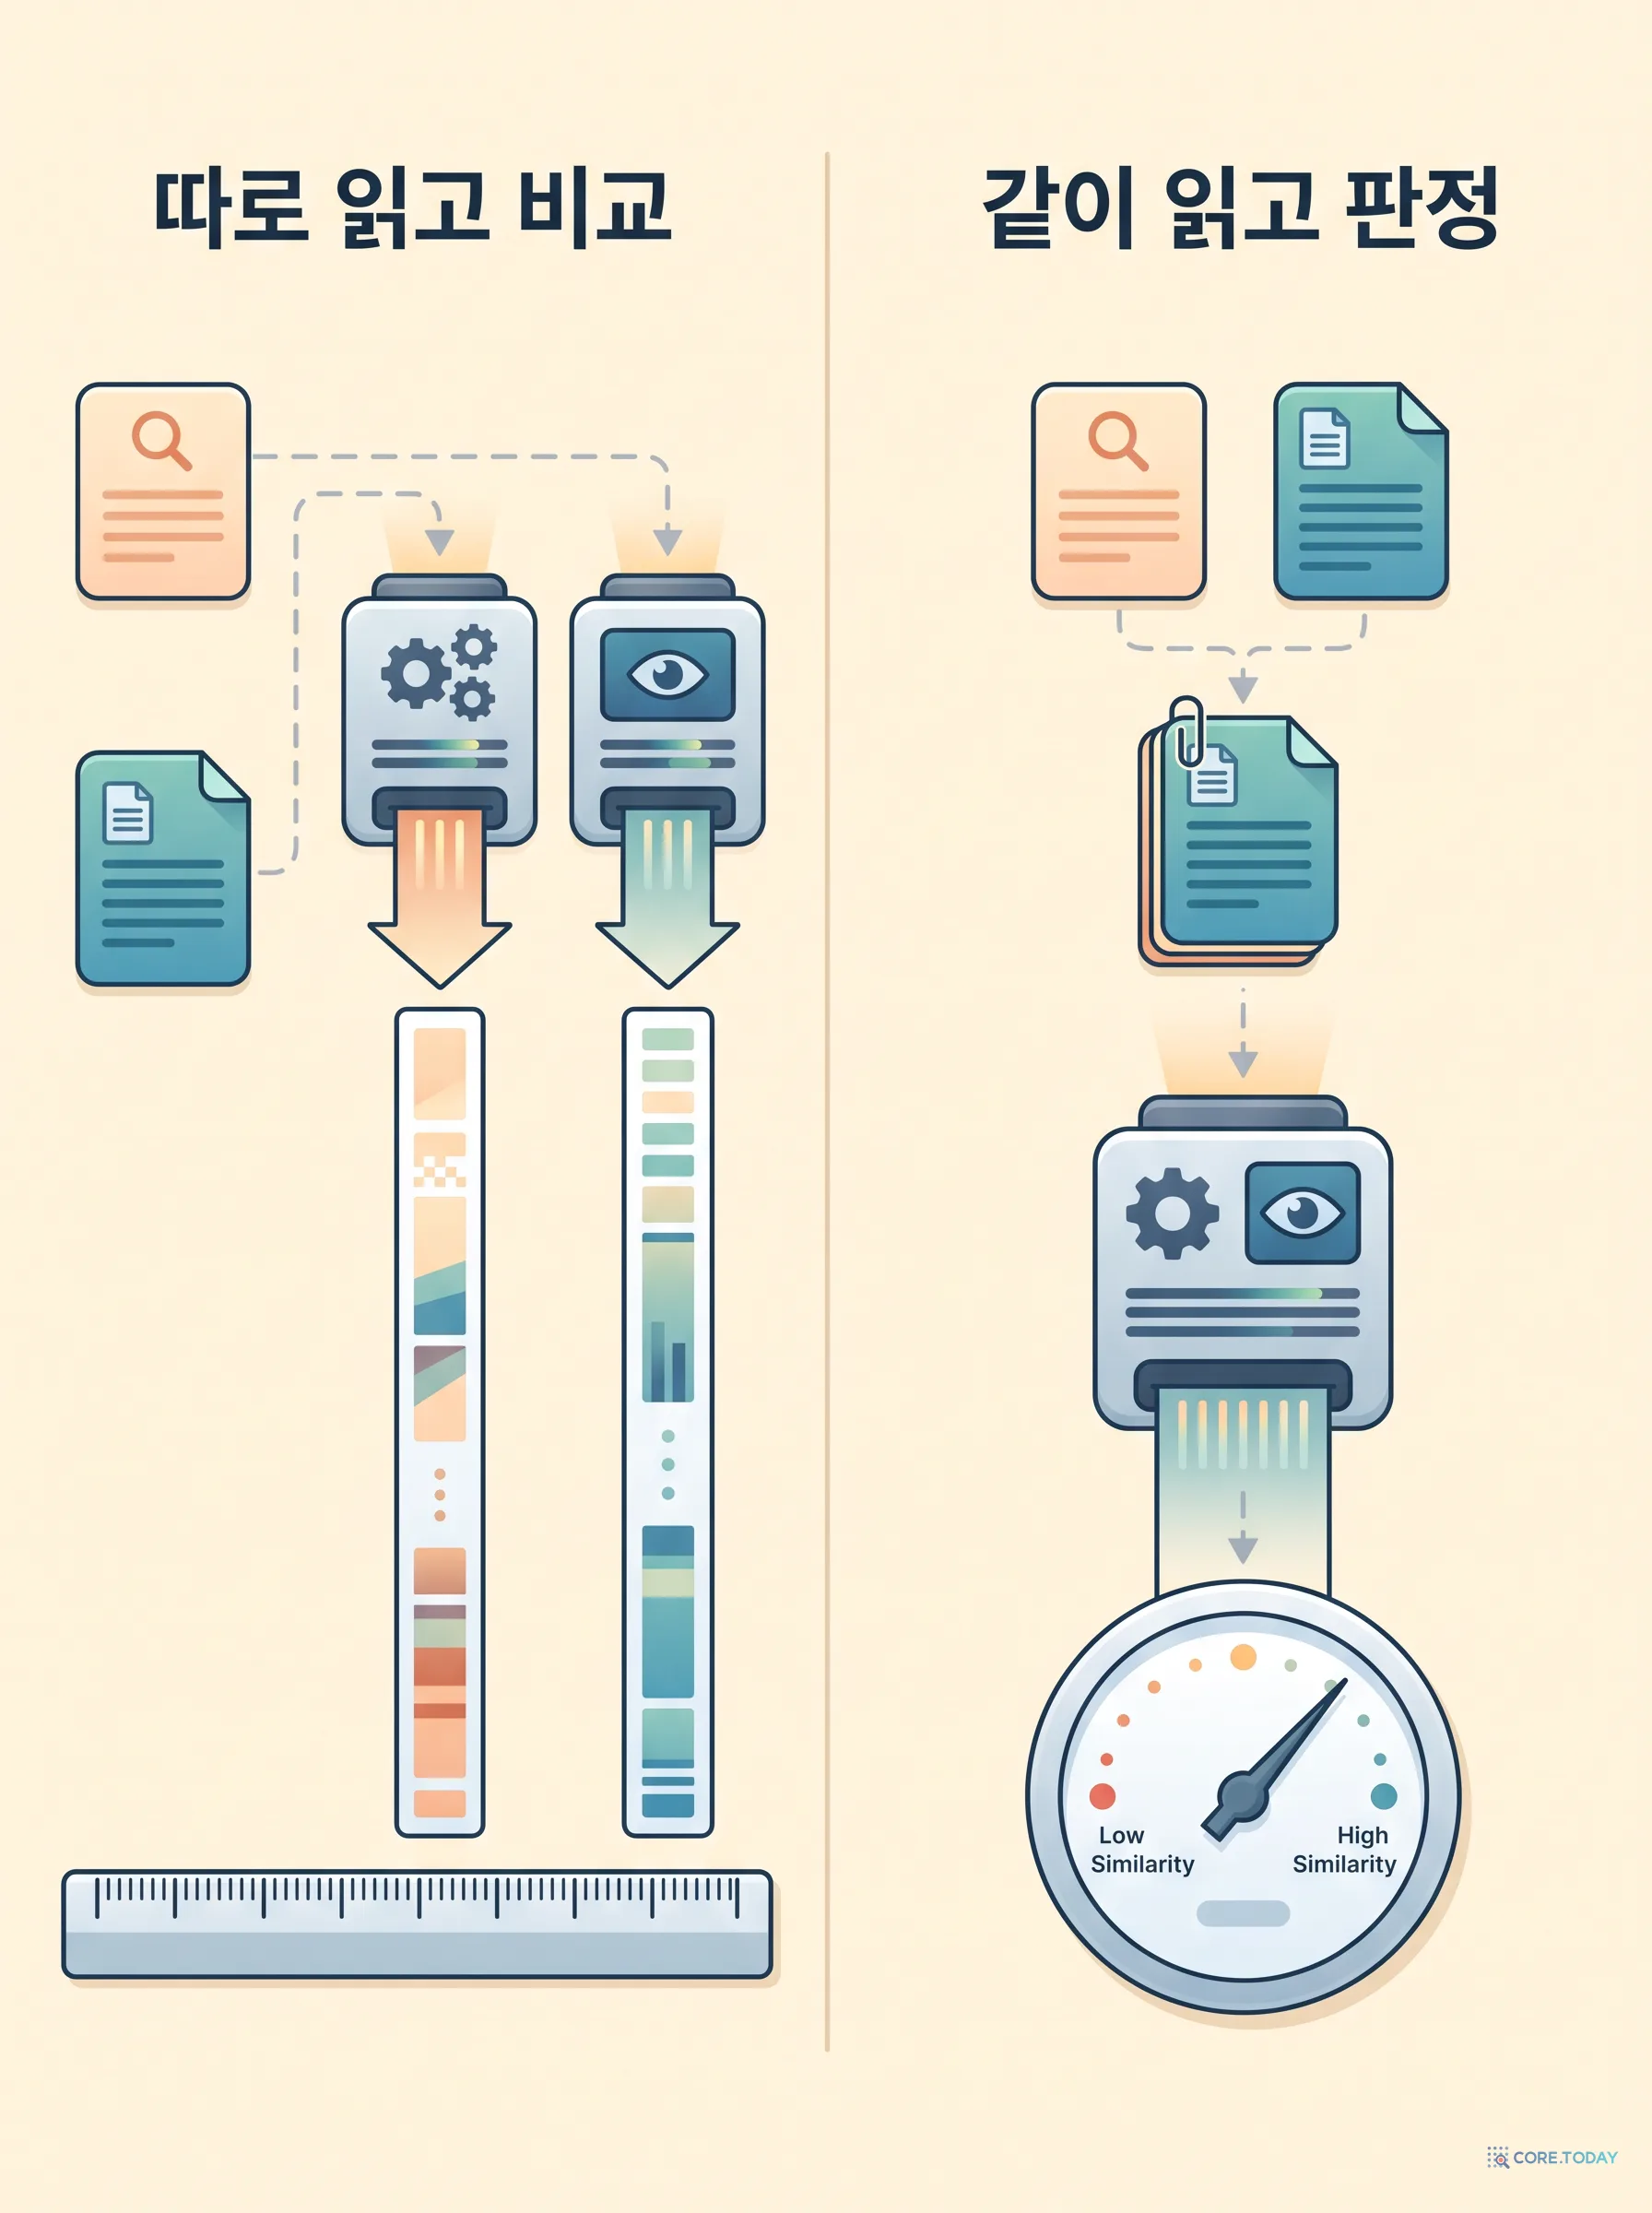
지금까지의 임베딩 검색은 바이 인코더(bi-encoder) 입니다. 질문과 문서를 각각 따로 벡터로 만들고, 나중에 코사인으로 비교합니다. 따로 만들기 때문에 문서 벡터를 미리 계산해 두고 질문이 올 때 비교만 하면 됩니다. 수천만 건도 밀리초 안에 훑는 이유입니다. 대가는 정밀도입니다. 문서를 벡터로 만들 때 모델은 어떤 질문이 올지 모르므로, 질문과 무관하게 '평균적으로 중요한' 정보를 담습니다.
크로스 인코더(cross-encoder) 는 질문과 문서를 함께 모델에 넣습니다. 모델은 질문의 단어와 문서의 단어를 서로 대조하며(트랜스포머의 어텐션이 두 텍스트를 가로지릅니다) '이 문서가 이 질문에 답하는가'를 하나의 점수로 냅니다. 질문을 알고 문서를 읽으므로 훨씬 정확합니다. 대가는 속도입니다. 문서마다 모델을 한 번씩 돌려야 하므로 미리 계산할 수 없고, 수천만 건에는 쓸 수 없습니다.
그래서 둘을 잇습니다. 바이 인코더(+BM25)로 수천만 개에서 수십 개를 고르고, 크로스 인코더로 그 수십 개를 다시 정렬합니다. 이것이 리랭킹 이고, 2019년 노게이라와 조가 BERT를 이 자리에 놓은 「Passage Re-ranking with BERT」가 출발점입니다. MS MARCO에서 이전 최고 대비 MRR@10을 27% 올렸습니다.
4B가 8B와 거의 같음. 0.6B도 bge-reranker-v2-m3(MMTEB-R 58.36)보다 8점 위
bge-reranker-v2-m3 (2024)
BGE-M3 기반 크로스 인코더, 568M
MMTEB-R 58.36, MLDR 59.51
가볍고 다국어. 2026년 기준 Qwen3-Reranker에 밀림
LLM 리스트와이즈
범용 LLM에 후보 10~20개를 한꺼번에 보여 주고 순서를 쓰게 함
—
전용 모델 없이 시도 가능. 느림. 이 글에서는 로컬 Ollama가 다른 작업으로 바빠 실험하지 못함
Ollama에는 리랭커 전용 API가 없습니다. Qwen3-Reranker는 yes/no 로짓이 필요한데 Ollama는 로짓을 노출하지 않습니다. 그래서 이 글의 리랭커 실험은 Ollama 밖에서 했습니다. sentence-transformers로 bge-reranker-v2-m3(568M)를 CPU에 올려, 1차 검색이 고른 상위 10개를 질문과 함께 다시 읽혔습니다. 질문당 10쌍에 0.36초, 맥의 CPU만으로도 실시간에 가깝습니다.
실측: 상위 10개를 다시 읽으면
결과가 세 줄로 갈립니다.
1차 검색 (상위 10개)
리랭킹 전 nDCG@10
bge-reranker-v2-m3 후
변화
Recall@10 (천장)
Qwen3-8B 벡터 단독
0.889
0.864
−0.025
0.963
BM25 + Qwen3-8B, RRF
0.794
0.857
+0.063
0.951
BM25 단독
0.616
0.677
+0.061
0.698
첫째, 1차가 이미 강하면 리랭커는 오히려 해칩니다. Qwen3-8B가 고른 상위 10개를 568M 리랭커가 다시 정렬하자 0.889에서 0.864로 떨어졌습니다. '정답이 1등' 비율은 80.0%에서 76.5%로. 8B 임베딩이 이 코퍼스에서 내린 판단이 그보다 14배 작은 리랭커의 판단보다 나았습니다. 리랭커는 항상 좋다는 통념과 다릅니다.
둘째, 1차가 약하면 리랭커가 그 손실을 거의 되찾습니다. 3부에서 등가중 RRF가 0.794로 떨어뜨린 결과에 리랭커를 얹자 0.857로 돌아왔습니다. BM25가 뒤섞어 놓은 순서를 리랭커가 질문을 읽고 바로잡은 것입니다. 원문 메모의 그림(RRF → 리랭커)이 통하는 조건이 이것입니다. RRF가 후보를 넓히고, 리랭커가 순서를 고칩니다.
셋째, 천장은 Recall@10입니다. BM25 단독의 상위 10개에는 정답이 69.8%만 들어 있었고, 리랭커는 0.616을 0.677로 올렸을 뿐 0.698을 넘지 못합니다. 후보에 없는 정답은 어떤 리랭커도 만들지 못합니다.
Qwen3-Reranker-0.6B도 같은 설정으로 돌리려 했지만, 디코더형 리랭커라 CPU에서는 질문당 수십 초가 걸려 마감까지 한 조건도 끝내지 못했습니다. GPU가 있는 환경의 숙제로 남깁니다. 공개 벤치마크로는 0.6B가 bge-reranker-v2-m3보다 다국어 MMTEB-R에서 8점 높습니다(4부 표).
리랭커에 관해 기억할 것은 두 가지입니다. 첫째, 리랭커는 후보 밖의 정답을 가져오지 못합니다. 1차 검색이 정답을 상위 10개(또는 20개)에 못 넣으면 리랭커도 못 고칩니다. Recall@10이 리랭커의 천장이고, 1편에서 8B의 Recall@10이 0.953이었으니 천장은 높았습니다. 둘째, 리랭커의 값어치는 '정답이 1등' 지표에서 납니다. 상위 3개만 LLM에 넘기는 RAG라면 정답이 1~3등 안에 있느냐가 답변 품질을 정하고, 그것이 리랭커의 일입니다.
5부. 스택으로 조립하기
지연 시간 예산 안에서 어디에 시간을 쓸지 계산해 보세요.
원문 메모가 그린 최종 구조에 이 글의 실측을 얹으면 이렇게 됩니다.
1. 각 검색기를 따로 잰다
여러분의 질문 200~500개로 BM25, 임베딩 모델(들)을 각각 nDCG@10과 Recall@20으로 잰다. Recall@20이 낮은 검색기는 융합에서 빼거나 가중치를 0.3 이하로. 이 글에서는 BM25가 그 경우였다.
2. 합치는 법을 고른다
검증 질문이 없으면 RRF(k=60). 있으면 min-max 정규화 후 α를 0.5~0.9에서 훑어 고른 점수 융합. 강한 검색기 둘(예: Qwen3-8B + BGE-M3)의 RRF는 거의 항상 이득이었다.
3. 도메인이 정하는 BM25의 자리
사업명·연도·조문 번호·제품 코드로 찾는 공고·법령·카탈로그 → BM25 필수, 가중치 높게. 사용자가 자기 말로 묻는 Q&A·고객 문의 → BM25 가중치 낮게, 또는 벡터 둘로.
4. 리랭커는 상위 20~50개에
1차 융합의 Recall@50이 0.95를 넘도록 후보를 잡고, 크로스 인코더(Qwen3-Reranker 4B가 8B와 동급)로 재정렬. 실시간이면 전용 모델, 배치·평가면 LLM 리스트와이즈도 가능.
5. 메타데이터 필터는 융합 전에
날짜·부서·문서 유형 필터는 RRF 전에 각 검색기에 걸어야 한다. 융합 뒤에 거르면 후보가 비어 버린다. OpenSearch의 하이브리드 쿼리와 대부분의 벡터 DB가 사전 필터를 지원한다.
BGE-M3의 희소 벡터(학습된 어휘 가중치)는 이 글에서 재지 못했습니다. Ollama가 밀집 벡터만 내기 때문입니다. FlagEmbedding으로 직접 서빙하면 BM25보다 나은 어휘 검색기가 되는데, 그때는 원문 메모의 3중 융합이 이 글의 결과보다 좋을 가능성이 큽니다. 다음 실험의 숙제입니다.
6부. 한계
융합 실험의 질문은 벡터에 유리하게 설계됐습니다(어휘 불일치). 키워드 질문 18개에서는 BM25도 0.98을 받아 모든 조합이 1.0 근처였습니다. 실제 서비스 질문의 분포가 어디쯤인지가 BM25 가중치를 정합니다.
BM25의 토크나이저(Kiwi, 명사·동사·외국어·숫자만)와 파라미터(k1=1.5, b=0.75 기본값)를 튜닝하지 않았습니다. 튜닝하면 BM25가 덜 약한 고리가 됩니다.
LLM 리랭커는 한 모델, 한 프롬프트, 온도 0의 단일 실행입니다. 프롬프트를 바꾸면 결과가 달라집니다.