
TECH BLOG
기술 블로그
AI 기술 인사이트와 엔지니어링 경험을 공유합니다.
EDITOR'S PICK
에디터 추천
코드를 쓰는 시간이 사라지면 무엇이 남나 — 「왜 Common Lisp가 이제 최고의 언어인가」 특집
2026년 10월, 「왜 Common Lisp가 이제 최고의 프로그래밍 언어인가」라는 짧은 글이 해커뉴스와 X를 뒤흔들었습니다. 논거는 단순합니다. LLM이 코드를 쓰는 시간은 몇 초로 줄었는데, 빌드하고 재시작하고 크래시 로그를 읽는 시간은 그대로이니, 이제는 피드백 루프의 길이가 개발 속도를 정한다는 것입니다. 그리고 돌아가는 프로그램을 멈추지 않고 함수를 바꾸고, 에러가 나면 죽는 대신 멈춰서 선택지를 내미는 언어가 이미 1994년에 완성돼 있었다는 것입니다. 이 글은 1960년 매카시의 논문에서 시작해 Lisp 머신, 조건 시스템, ANSI 표준, 폴 그레이엄의 Viaweb까지 글이 기대는 네 가지 성질의 역사를 되짚고, 아키텍처를 그림으로 풀고, 해커뉴스의 반론과 2026년 데이터(저자원 언어 벤치마크, 토큰 가격, npm 공급망 사고)로 주장을 검증합니다. 브라우저에서 도는 미니 Lisp, 피드백 루프 시뮬레이터, 조건 시스템 체험, 토큰 계산기, 연표 위젯 5개와 일러스트 8장.
글자를 쓰지 않는 로컬 모델 — Ollama 판정 모델 tev1·Nimble을 한국어로 시험하다 (로컬 모델 실측 2편)
ollama list에 낯선 이름 둘이 있었습니다. tev1:4b와 nimble. ollama show를 쳐 보니 Capabilities에 embedding도 completion도 아닌 'decision'이 적혀 있고, 시스템 프롬프트는 '선택지 중 하나를 고르고 글자 하나만 돌려줘라'였습니다. 9월 15일 TypeSafe가 Jev를 내놓은 뒤 2주 만에 Bespoke Labs(Nimble 9B)와 Together AI(tev1 4B·0.8B)가 열린 가중치로 같은 모양의 모델을 냈고, 9월 29일 Ollama가 /v1/systemone 엔드포인트로 그것을 받아들였고, 10월 1일 클라우드플레어가 27B짜리 Clef를 보탰습니다. 이 글은 그 판정 모델이 무엇이고 왜 빠른지(한 번의 전방 패스에서 선택지 글자의 확률만 읽는다)를 그림으로 풀고, 세 모델의 출신과 학습 레시피를 뜯어본 뒤, 1편과 같은 한국어 코퍼스로 리랭커 자리(85문항 × 10문서)와 분류 자리(625건)에 세워 TypeSafe의 Jev(4편에서 같은 조건으로 직접 실측), 임베딩 이웃 투표, 27B 채팅 모델과 비교했습니다. 결론은 '9B Nimble은 한국어로도 Jev의 자리를 대신하고, 0.8B는 아직 아니다'입니다. 확률이 얼마나 믿을 만한지, 한 번 호출에 몇 ms인지, 한국어 문의 라우팅·규정 적용·감정 점수 같은 실무 과제 7종의 성적도 함께 적었습니다. 인터랙티브 6개와 삽화 7장.
같은 사건 묶기 — 하루치 기사 603건에서 '같은 일'을 찾는 법
2026년 10월 13일 하루 연합뉴스 기사 603건 중 같은 사건을 다룬 기사끼리 묶으면 몇 묶음이 나올까요. 인천 흉기난동 하나에만 기사 아홉 건이 달렸습니다. 이 글은 후보 쌍 5,379개를 Claude·GPT로 '같은 사건 / 같은 이야기의 다른 사건 / 다른 사건'으로 판정하고, 둘이 갈린 73쌍을 직접 검수해 정답을 만든 뒤 임베딩 다섯 가지, 문자열 규칙 두 가지, 판정 모델, LLM을 비교했습니다. 육하원칙으로 묶으면 될 것 같지만 그렇지 않았습니다. 같은 사건을 다룬 기사도 같은 사람을 다른 이름으로 부르거나 주인공이 달라서, 육하원칙 칸 일치 규칙은 같은 사건 쌍의 3분의 1도 찾지 못했습니다. 임베딩은 같은 이야기의 다른 사건(유사도 0.86)과 다른 각도의 같은 사건(0.50)을 가르지 못했습니다. 이 둘을 가장 잘 가른 것은 판정 모델 Jev였고(AUROC 0.998), 다만 0.5가 아니라 0.9를 문턱값으로 써야 했습니다. 로컬 판정 모델(Nimble·Clef-Flash·tev1)은 확률이 과감해 오히려 묶음을 망쳤고, 로컬만 쓸 수 있다면 EmbeddingGemma 하나가 가장 나았습니다. 문턱값 탐색기·사건 각도 표·방법 비교표·함정 목록·묶음 게시판 위젯 5개.
[특집] 학교는 손실 함수다 — 340만 명이 읽은 'AI 시대의 커리어 조언', 채점할 수 없는 일을 찾아서
2026년 7월 3일 새벽, 전 OpenAI·딥마인드 연구자 필 첸이 X에 올린 에세이 한 편이 주말 사이 300만 명을 넘게 읽혔다. 첫 문장은 이랬다 — 'AI는 손실 함수를 쓸 수 있는 모든 것에서 좋아진다. 그리고 학교는 대부분 손실 함수다.' 이 글은 그 한 문장을 끝까지 파고든다. 손실 함수와 '검증 가능한 보상'이 모델을 어떻게 가르치는지(DeepSeek-R1의 AIME 15.6%→71.0% 곡선, GRPO의 구조), 제이슨 웨이의 '검증자의 법칙'이 왜 커리어 예언이 되는지, 그리고 '문제 찾기·가장 야심찬 형태·마지막 10%·xG와 효율·연구 진입'이라는 여섯 조언이 1938년 아인슈타인부터 2025년 '탄광 속 카나리아'까지 어떤 생각의 계보 위에 서 있는지를 사례와 데이터로 풀었다. 리트코드를 옹호한 반론과 '문제 선정도 결국 채점 가능해지지 않느냐'는 날카로운 질문, 메타의 AI 동반 면접과 우버의 토큰 예산 소진, 네이버·카카오의 신입 공채 실종까지 — 2026년 가을, 한국의 독자가 이 글에서 무엇을 가져가야 하는지 다섯 개의 인터랙티브 도구와 함께 정리했다.
ALL POSTS
모든 포스트
4B를 Flash로 가르치기 — 육하원칙 추출, 선생님 답 1,623개로 로컬 모델을 키우다
이 시리즈의 첫 글에서 클라우드 Gemini 3.8 Flash는 육하원칙 추출 0.86, 로컬 9B는 0.69였습니다. 그 0.16을 지식 증류로 좁혀 보려고 Flash에게 기사 1,709건의 답을 쓰게 하고(5.6달러), 그 답으로 Qwen3 4B를 맥 한 대에서 LoRA로 가르쳤습니다. 결과는 실패였습니다. 아무것도 가르치지 않은 Qwen3 4B 2507이 이미 9B와 같은 0.686이었고, 1,623개를 다 본 학생은 0.656으로 오히려 내려갔습니다. 학생은 선생님의 판단보다 버릇을 먼저 배웠습니다. 예제 200개 지점에서는 이유가 없는 기사 44건 중 42건에 이유를 지어냈고, 끝까지 배운 뒤에도 학습 전(0건)보다 많은 12건을 지어냈습니다. Flash와 Flash-Lite가 함께 채운 이유만 남긴 '보수적 교재'는 버릇을 고치고 같은 예제 수에서 점수를 0.04 올렸지만, 학습 전 모델은 넘지 못했습니다. 교훈은 하나입니다. 증류보다 먼저, 같은 크기의 최신 모델을 정의서만으로 재 보세요. 학습 곡선·칸별 비교·버릇 상속·전후 비교·손익분기 위젯 5개.
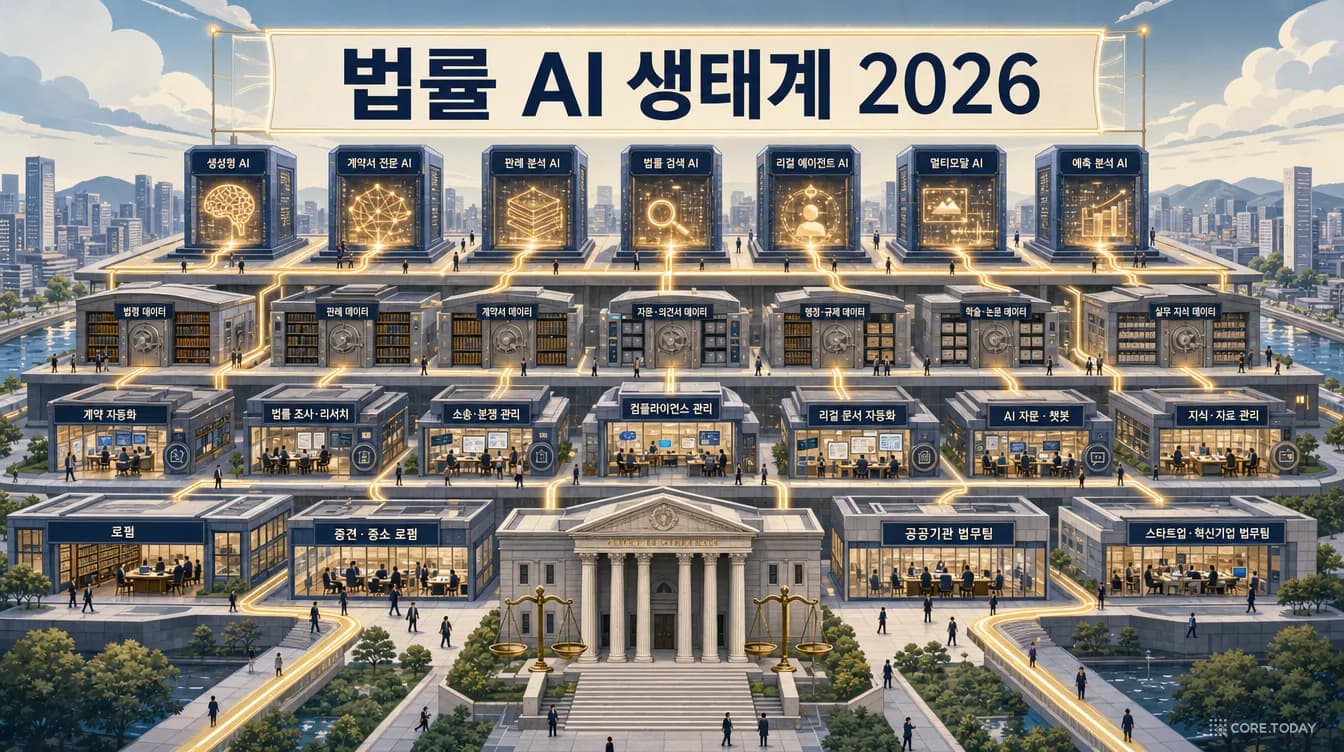
법률 AI 생태계 지도 2026 — 모델 회사는 법률로 내려오고, 법원은 검증을 요구하고, 돈은 '책임질 수 있는 결과물'로 모인다
2026년 2월 3일, Anthropic이 법률 업무 플러그인 하나를 내놓자 Thomson Reuters 주가가 하루에 16% 빠졌습니다. 그런데 반년 뒤 그 회사의 법률 매출은 10% 늘었고, 같은 해 법률 AI 스타트업 Harvey의 몸값은 80억 달러에서 155억 달러로 뛰었습니다. 한쪽에선 전 세계 법원이 AI가 지어낸 판례를 지적한 결정이 2,184건까지 쌓였고, 한국 법원 판결문에는 'AI Hallucination'이라는 영어가 그대로 적혔습니다. 모순처럼 보이는 이 장면들은 하나의 지도 위에 놓으면 이해됩니다. 모델·데이터·업무 도구·로펌·법원의 다섯 층이 2024년에서 2026년 사이 각각 어떻게 움직였는지, 법률 AI 시험지가 '변호사시험'에서 '실무 과제 전 항목 통과'로 바뀐 이유, 시간당 청구가 흔들리는 경제학, 신입 변호사의 사다리, 나홀로 소송의 역설, 그리고 한국 법원·로펌·리걸테크의 2026년까지. 논문과 판결과 실적 발표를 근거로 일곱 가지 인사이트를 뽑았습니다. 인터랙티브 6개, 논문·보고서 그림 8장, 삽화 9장.
채점이 순위를 바꾸는가 — 육하원칙 답 2,371개를 판사 여섯에게 다시 채점시키다
지난 글은 뉴스 72건에서 육하원칙을 꺼내는 24가지 방법을 글자 F1로 줄 세웠습니다. 그런데 그 자는 '50대 남성'과 'A(59)씨'를, '이날'과 '13일'을 다른 답으로 셉니다. 이번에는 같은 답 2,371개를 자 세 개(글자 F1·포함 일치·날짜 정규화)와 판사 여섯(Gemini 3.8 Flash·Claude Sonnet 5.5·GPT-5.4 mini·로컬 Qwen3.5 9B·Jev·로컬 Clef-Flash)에게 다시 채점시키고, 층화 표본 234개를 원문과 대조해 검수했습니다. 결과는 세 줄입니다. 강한 판사들로 바꿔도 방법의 순위는 거의 그대로였습니다(켄달 순위 상관 0.96~0.99). 대신 점수의 크기가 바뀌었고, 특히 '무엇을'에서 작은 모델이 0.15를 되찾았습니다. 그리고 판사에게는 버릇이 있었습니다. 같은 가족의 답을 후하게 주고, 검수자보다 엄격하며, 로컬 판사는 순위를 흔들었습니다. 판사 둘 이상이 정답을 의심한 칸은 다시 보니 모두 정답 쪽이 지나치게 엄격했습니다. 순위 기울기·검수 일치도·칸별 법정·자기 선호·칸별 회복 위젯 5개와 삽화 5장.
[특집] 월급은 엔진이지 목적지가 아니다 — 해커뉴스를 달군 '커리어로 부를 쌓는 법', 인적 자본을 소유로 바꾸는 70년의 경제학
2026년 10월 11일, 반년 전에 올라온 블로그 글 한 편이 해커뉴스 첫 화면에 올라 이틀 동안 166개의 댓글을 모았다. 나이지리아 급여 핀테크 창업자 아셔 아데니이가 쓴 「커리어로 부를 쌓는 법」 — 부는 창업가만의 몫이 아니며, 좋은 직장은 '엔진'이고 그 출력을 소유로 바꾸는 규율이 부를 만든다는 글이다. '저축하라는 말을 길게 늘였을 뿐'이라는 냉소와 '아이들에게 읽히겠다'는 찬사가 정면으로 부딪쳤다. 이 글은 그 논쟁을 출발점으로, 원문이 기대고 있는 70년 치 경제학을 처음부터 풀어 본다. 슐츠·베커·민서의 인적 자본 이론과 학교 1년의 수익률 9%, 스펜스의 신호 이론, 모딜리아니의 생애주기 가설과 '인적 자본이 금융 자본으로 옮겨 가는 곡선', 베블런에서 킬링스워스·카너먼까지 이어지는 쾌락의 쳇바퀴, 그리고 의지가 아니라 기본값이 저축률을 바꾼다는 매드리언·시어와 탈러·베나치의 실험까지. 2026년 노동소득 분배율이 1947년 이후 최저로 내려가고 AI가 커리어 사다리의 아래 칸을 바꾸는 지금, 한국 직장인이 이 글에서 무엇을 가져가야 하는지 여섯 개의 인터랙티브 도구와 함께 정리했다.
[특집] 「Fable이 내 일자리를 가져갔다」 — AI는 더 잘해서가 아니라 '더 싸서' 사람을 밀어낸다: 마지막 엔지니어의 고백으로 읽는 2026년 AI 감원의 구조
2026년 10월 11일, 보안·암호학 글로 알려진 블로거 Cendyne이 8분짜리 글 「Fable이 내 일자리를 가져갔다(Fable took my jorb)」를 올렸다. 회사의 '마지막 엔지니어'였던 그는 이렇게 쓴다. Fable이 내 일을 더 잘해서가 아니라, 내 연봉보다 쌌다. 그리고 'AI가 내 일을 가져갔다'는 말은 'AI가 내 자리를 없애는 데 한몫했다'보다 말하기 재미있을 뿐이라고. 해커뉴스에서 댓글 355개가 붙은 이 글을, 러다이트와 케인스부터 아제모을루의 '그저 그런 자동화', 브리뇰프슨의 '탄광 속 카나리아' 2026년 갱신판, 챌린저의 AI 감원 통계, 그리고 쇼피파이 Helix와 테오의 ts-rust가 보여 준 '하네스'의 구조, METR의 시간 지평, 'hmm-hmm-hmm' 반복의 정체까지 따라가며 읽는다. 인터랙티브 여섯 개와 함께.
GLM-Legal 완전 해부 — 가벼운 모델이 법률 에이전트 시험에서 프런티어를 이긴 방법: 중간학습, 하네스 공진화, 그리고 19.2%의 의미
2026년 10월 12일, 중국 Z.ai가 법률 특화 모델 GLM-Legal을 공개했습니다. 활성 파라미터 18B짜리 가벼운 모델(GLM-5.3-Flash) 위에 법률 중간학습과 수만 개의 법률 과제 환경 강화학습을 얹었더니, 로펌 실무 과제를 끝까지 해내야 하는 Harvey LAB에서 전 항목 통과율 19.2%로 Claude Fable 5(11.3%)와 GPT-6 Astra(5.4%)를 앞섰습니다. 과제당 비용은 0.15달러로 Fable 5의 약 130분의 1입니다. 그런데 19.2%는 열 건 중 여덟 건을 '불합격'했다는 뜻이기도 합니다. 1970년대 규칙 기반 법률 AI부터 가짜 판례 사건, LegalBench에서 Harvey LAB으로 바뀐 시험지, 중간학습과 하네스 공진화라는 아키텍처, 시연 세 장면, 순위표에서 빠진 모델과 퇴보한 지표까지, 이 발표를 둘러싼 모든 것을 쉽게 풀어 씁니다. 인터랙티브 6개, 논문·벤치마크 그림 11장, 삽화 10장.
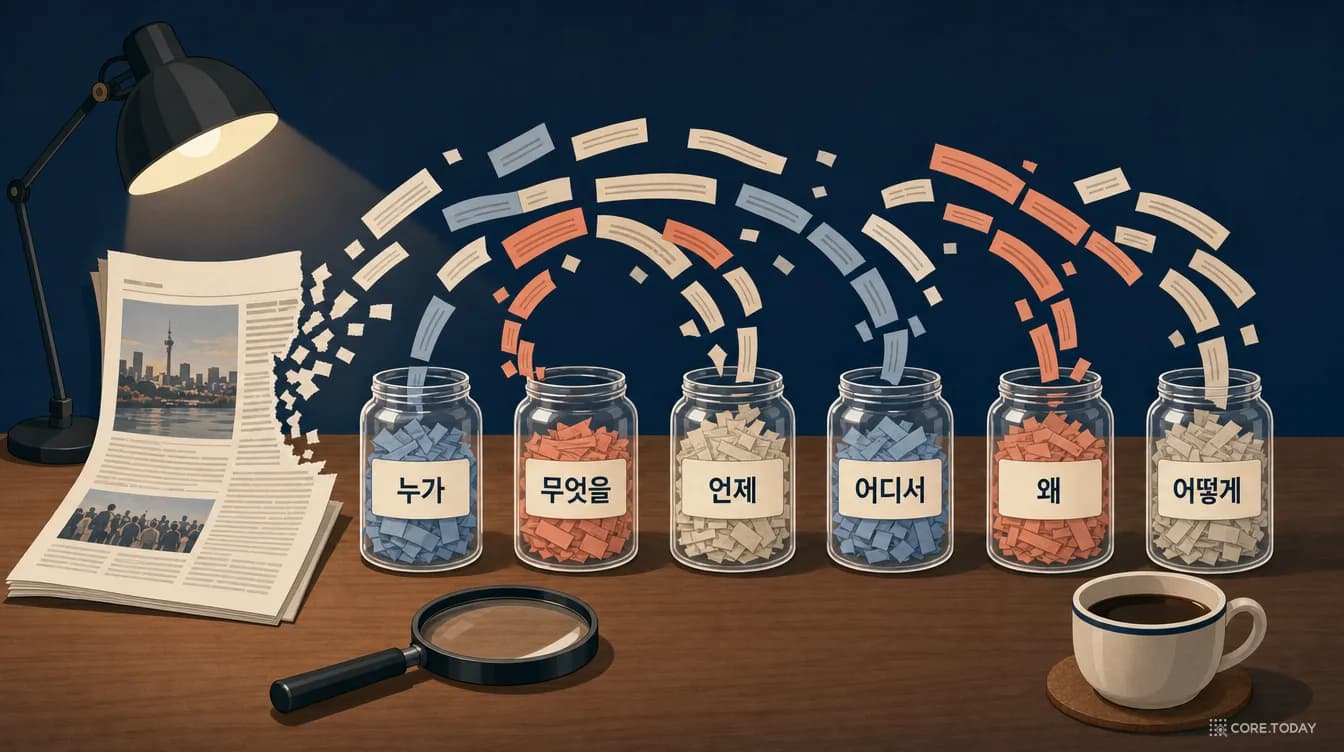
뉴스에서 육하원칙 뽑기 — 자르기·쓰기·고르기, 한국어 기사 72건으로 짠 추출 설계도
기자는 기사 첫 문장에서 여섯 질문에 답합니다. 누가, 무엇을, 언제, 어디서, 왜, 어떻게. 그걸 기계가 꺼내게 하는 손은 2026년에 네 종류입니다. 독해 모델은 자르고, 임베딩은 찾고, LLM은 쓰고, 판정 모델은 고릅니다. 연합뉴스 7개 섹션의 당일 기사 60건과 네이버 뉴스 12건, 합쳐 72건 432칸에 같은 정의서를 주고 스무 가지가 넘는 조합을 돌렸습니다. KorQuAD 독해 모델은 '이 사건의 주체는?' 같은 범용 질문에 '다소', '이미'를 잘라 와 평균 0.18에 그쳤고, 사고를 끈 Gemini 3.8 Flash가 0.86, 로컬 Qwen3.5 9B가 0.69였습니다. 판정 모델에게 후보 중 하나를 고르게 하면 정답이 후보 안에 있는데도(상한 0.9 이상) 단독 쓰기보다 낮았습니다. 반대로 '기사에 이유가 명시돼 있는가'를 따로 물으면 Nimble이 AUROC 0.85로 가려냈고, 이것을 Flash 뒤에 붙이자 '왜'가 0.73에서 0.79로, 쓰기 모델 셋의 다수결로는 0.85로 올랐습니다. 이 과제의 절반은 답을 찾는 일이고 나머지 절반은 '없다'고 말하는 일입니다. 방법별 점수표·기사별 탐색기·판정 앙상블·부재 탐지·파이프라인 설계기 위젯 5개와 삽화 6장.
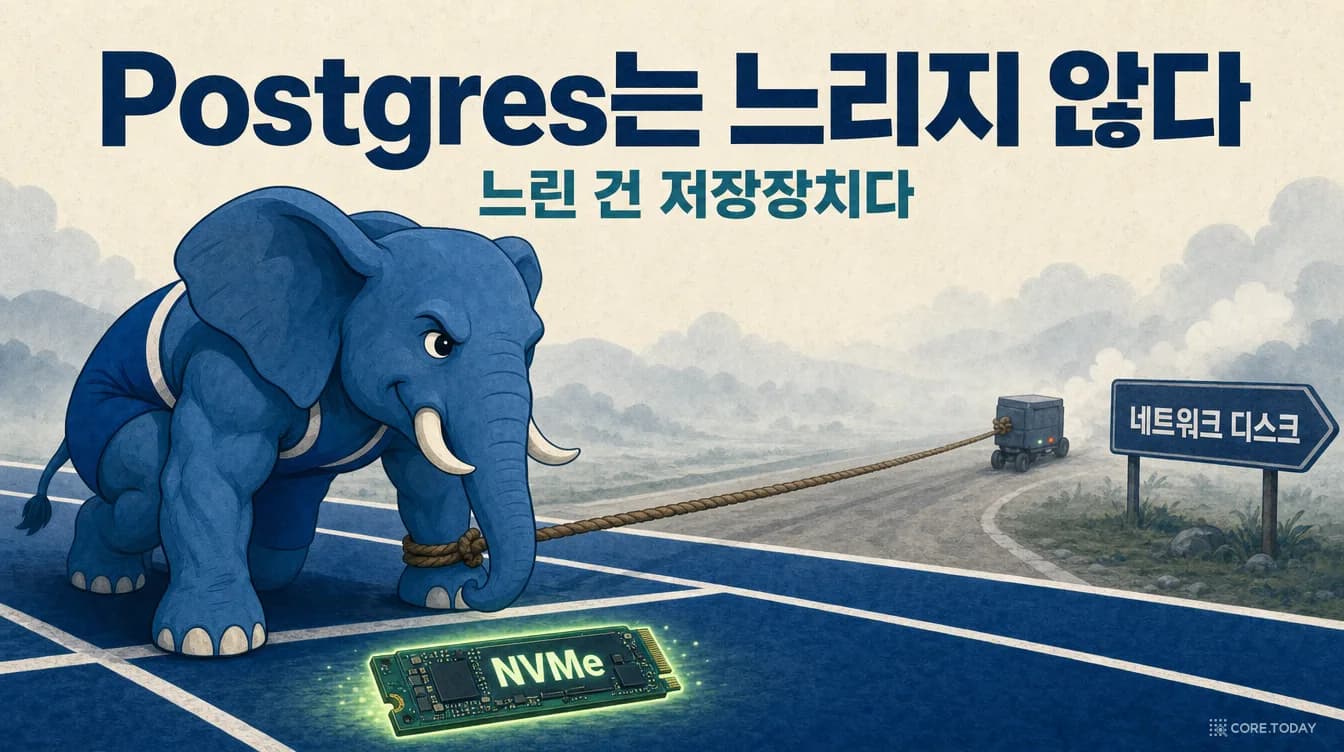
Postgres는 느리지 않다, 느린 건 저장장치다 — 37ms 영수증으로 읽는 데이터베이스와 디스크의 50년
2026년 8월 ClickHouse가 공개한 발표 요약 「Postgres는 느리지 않다, 느린 건 저장장치다」가 10월 해커뉴스에서 174점·댓글 185개를 받으며 다시 불붙었습니다. 같은 기계, 같은 Postgres, 같은 쿼리에서 저장장치만 네트워크 디스크(EBS gp3)에서 서버에 꽂힌 NVMe로 바꿨더니 처리량이 9.24배가 됐다는 실험입니다. 이 글은 그 37ms짜리 지연 영수증을 항목별로 뜯어보고, CPU가 왜 놀고 있었는지, 3,000 IOPS가 어떻게 정확히 1,734 TPS가 되는지 리틀의 법칙으로 계산합니다. UPDATE 한 줄이 Postgres 안에서 지나가는 아홉 정거장(B-트리, MVCC, WAL, fsync, 체크포인트, 논리 복제)을 따라가고, 하드디스크와 5분 규칙에서 EBS, Aurora, 다시 로컬 NVMe로 돌아오기까지 50년의 역사를 논문으로 짚습니다. 'gp3 기본값은 허수아비'라는 반론과 판매 맥락까지 공정하게 다루고, 디스크가 사라지는 세계에서 데이터를 지키는 운영 구조를 장애 훈련으로 확인한 뒤, 2026년 내 데이터베이스를 진단하는 체크리스트로 끝냅니다. 인터랙티브 6개와 삽화 9장.
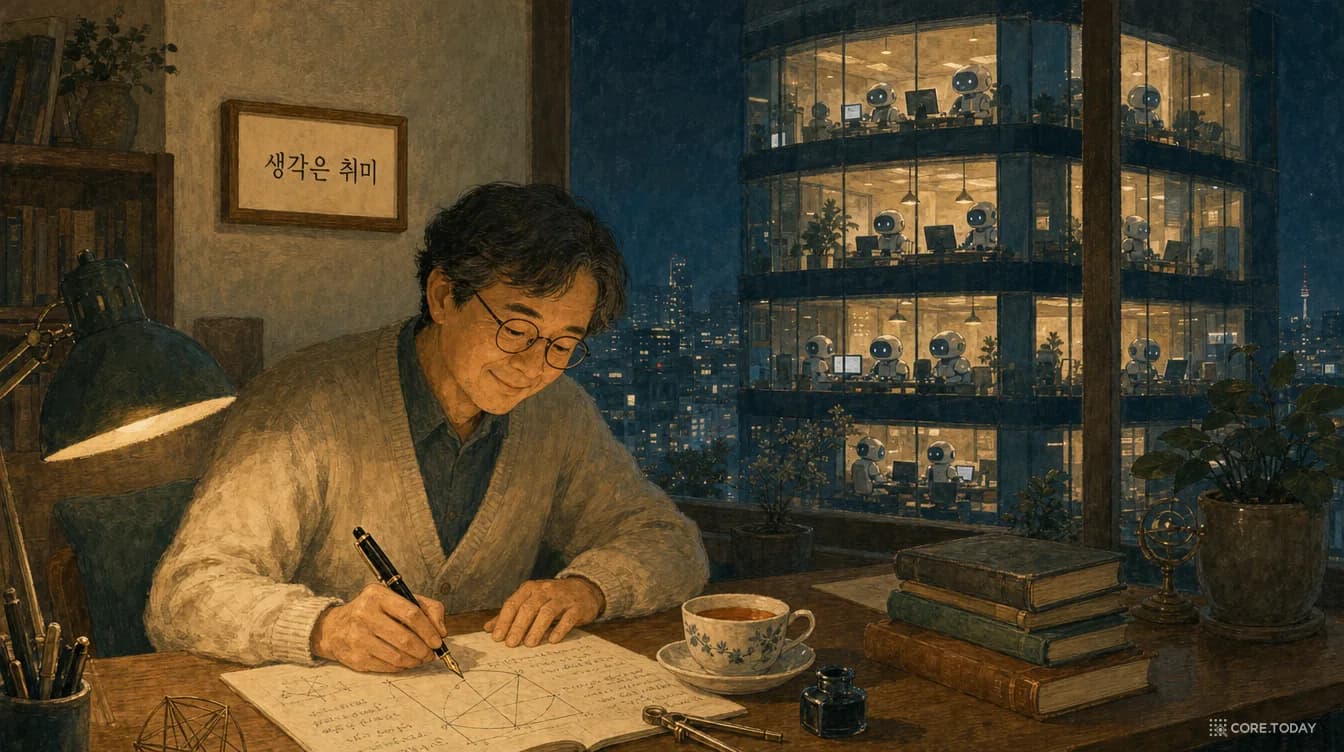
[특집] 생각이 취미가 되는 날 — 스피넬리스의 「생각은 취미가 될 것이다」, 사냥·서예·목공·승마의 길을 생각도 걷게 될까
2026년 10월 8일, 『코드 리딩』의 저자이자 소프트웨어 공학의 대가 디오미디스 스피넬리스가 600단어짜리 블로그 글을 올렸다. 첫 문장은 '내 무덤을 파는 기분'이었고, 결론은 '생각은 취미가 될 것이다'였다. 가축화 뒤의 사냥, 인쇄술 뒤의 서예, 산업화 뒤의 목공, 자동차 뒤의 승마처럼. 해커뉴스에서 421개의 댓글이 달린 이 글을 한 문단씩 읽고, 성능·비용·가용성이라는 세 전제를 OECD 성인역량조사·PISA 2025·OpenAI 수학 원고 722편으로 확인했다. 네 비유의 역사(왕실 사냥림, 필경사 예찬, 윌리엄 모리스, 말 2,520만 마리), AI에 진 뒤 66년 만에 강해진 프로 바둑(580만 수 분석, 신민규 외 PNAS), 1961년 골딩의 「취미로서의 생각」, 아리스토텔레스의 스콜레에서 케인스의 15시간·아렌트의 '노동 없는 노동자 사회'까지의 계보를 따라갔다. 과업 기반 모델로 본 경제학의 설계도, 인지 오프로딩 연구, 스피넬리스 자신의 3~7월 글과의 충돌, 그리고 청년 일자리 28.5만 개가 사라진 한국의 데이터까지 — 여섯 개의 인터랙티브 도구와 함께 정리했다.