X트위터웹 성능서버 사이드 렌더링SSR스트리밍 SSR하이드레이션앱 셸PWAReactRelayGraphQLViteFastify코어 웹 바이탈구글봇AI 코딩 에이전트AGENTS.md재작성교살자 무화과 패턴특집
[특집] 광장을 처음부터 다시 짓다 — X.com은 왜 서버 세 대를 한 대로 줄이고, 22초를 2.7초로 만들었나
2026년 11월 4일 X 엔지니어링 블로그는 x.com 웹 앱을 처음부터 다시 만든 과정을 공개했다. 사람·검색 크롤러·링크 미리보기 봇을 따로 맞던 서버 세 종류가 하나로 합쳐졌고, 느린 4G에서 첫 게시물이 보이기까지 걸리는 시간은 실험실 측정으로 23.9초에서 2.7초가 됐다. 첫 버전은 엔지니어 다섯 명이 AI 코딩 에이전트와 함께 여섯 달이 안 되어 만들었다고 한다. 이 글은 원문과 그림 일곱 장을 끝까지 읽고, 2010년 #NewTwitter에서 2017년 트위터 라이트까지 화면 그리는 자리가 서버와 브라우저를 오간 16년, 속도가 돈과 형평의 문제인 이유, '절대 다시 쓰지 마라'는 금언과 교살자 무화과 패턴, 스트리밍 SSR과 하이드레이션의 원리, 25ms짜리 응답에 1초 타임아웃이 터진 이벤트 루프 사례와 구글봇 2MB 한도를 비롯한 성능 작업 일곱 가지, 그리고 X의 숫자가 말하지 않는 것을 위젯 7개와 삽화로 풀어 설명한다.
2026년 11월 4일, X 엔지니어링 블로그에 올라온 글 「Rebuilding the global town square from scratch」(세계의 광장을 처음부터 다시 짓다)는 이 22초에서 출발합니다. 글쓴이는 X의 수석 엔지니어(Principal Engineer) 야으즈 니지플리(Yagiz Nizipli)입니다. 첫 문단이 곧 요약입니다. 옛 웹 앱에서는 첫 게시물이 보이기까지 X 로고를 22초 넘게 바라봐야 했고, 새 앱에서는 2.7초면 나타난다는 것입니다.
이 글을 특집으로 다루는 까닭은 숫자 하나 때문만이 아닙니다. 한 편의 글 안에 2026년 웹 개발의 굵직한 물음이 거의 다 들어 있기 때문입니다.
1
화면은 어디에서 그려야 하는가
브라우저에서 그리던 앱을 다시 서버에서 그리는 쪽으로 옮겼습니다. 트위터는 2010년에 브라우저로, 2012년에 서버로, 2017년에 다시 브라우저로 갔던 회사입니다. 이번이 네 번째 방향 전환입니다.
2
"절대 처음부터 다시 쓰지 마라"는 아직 유효한가
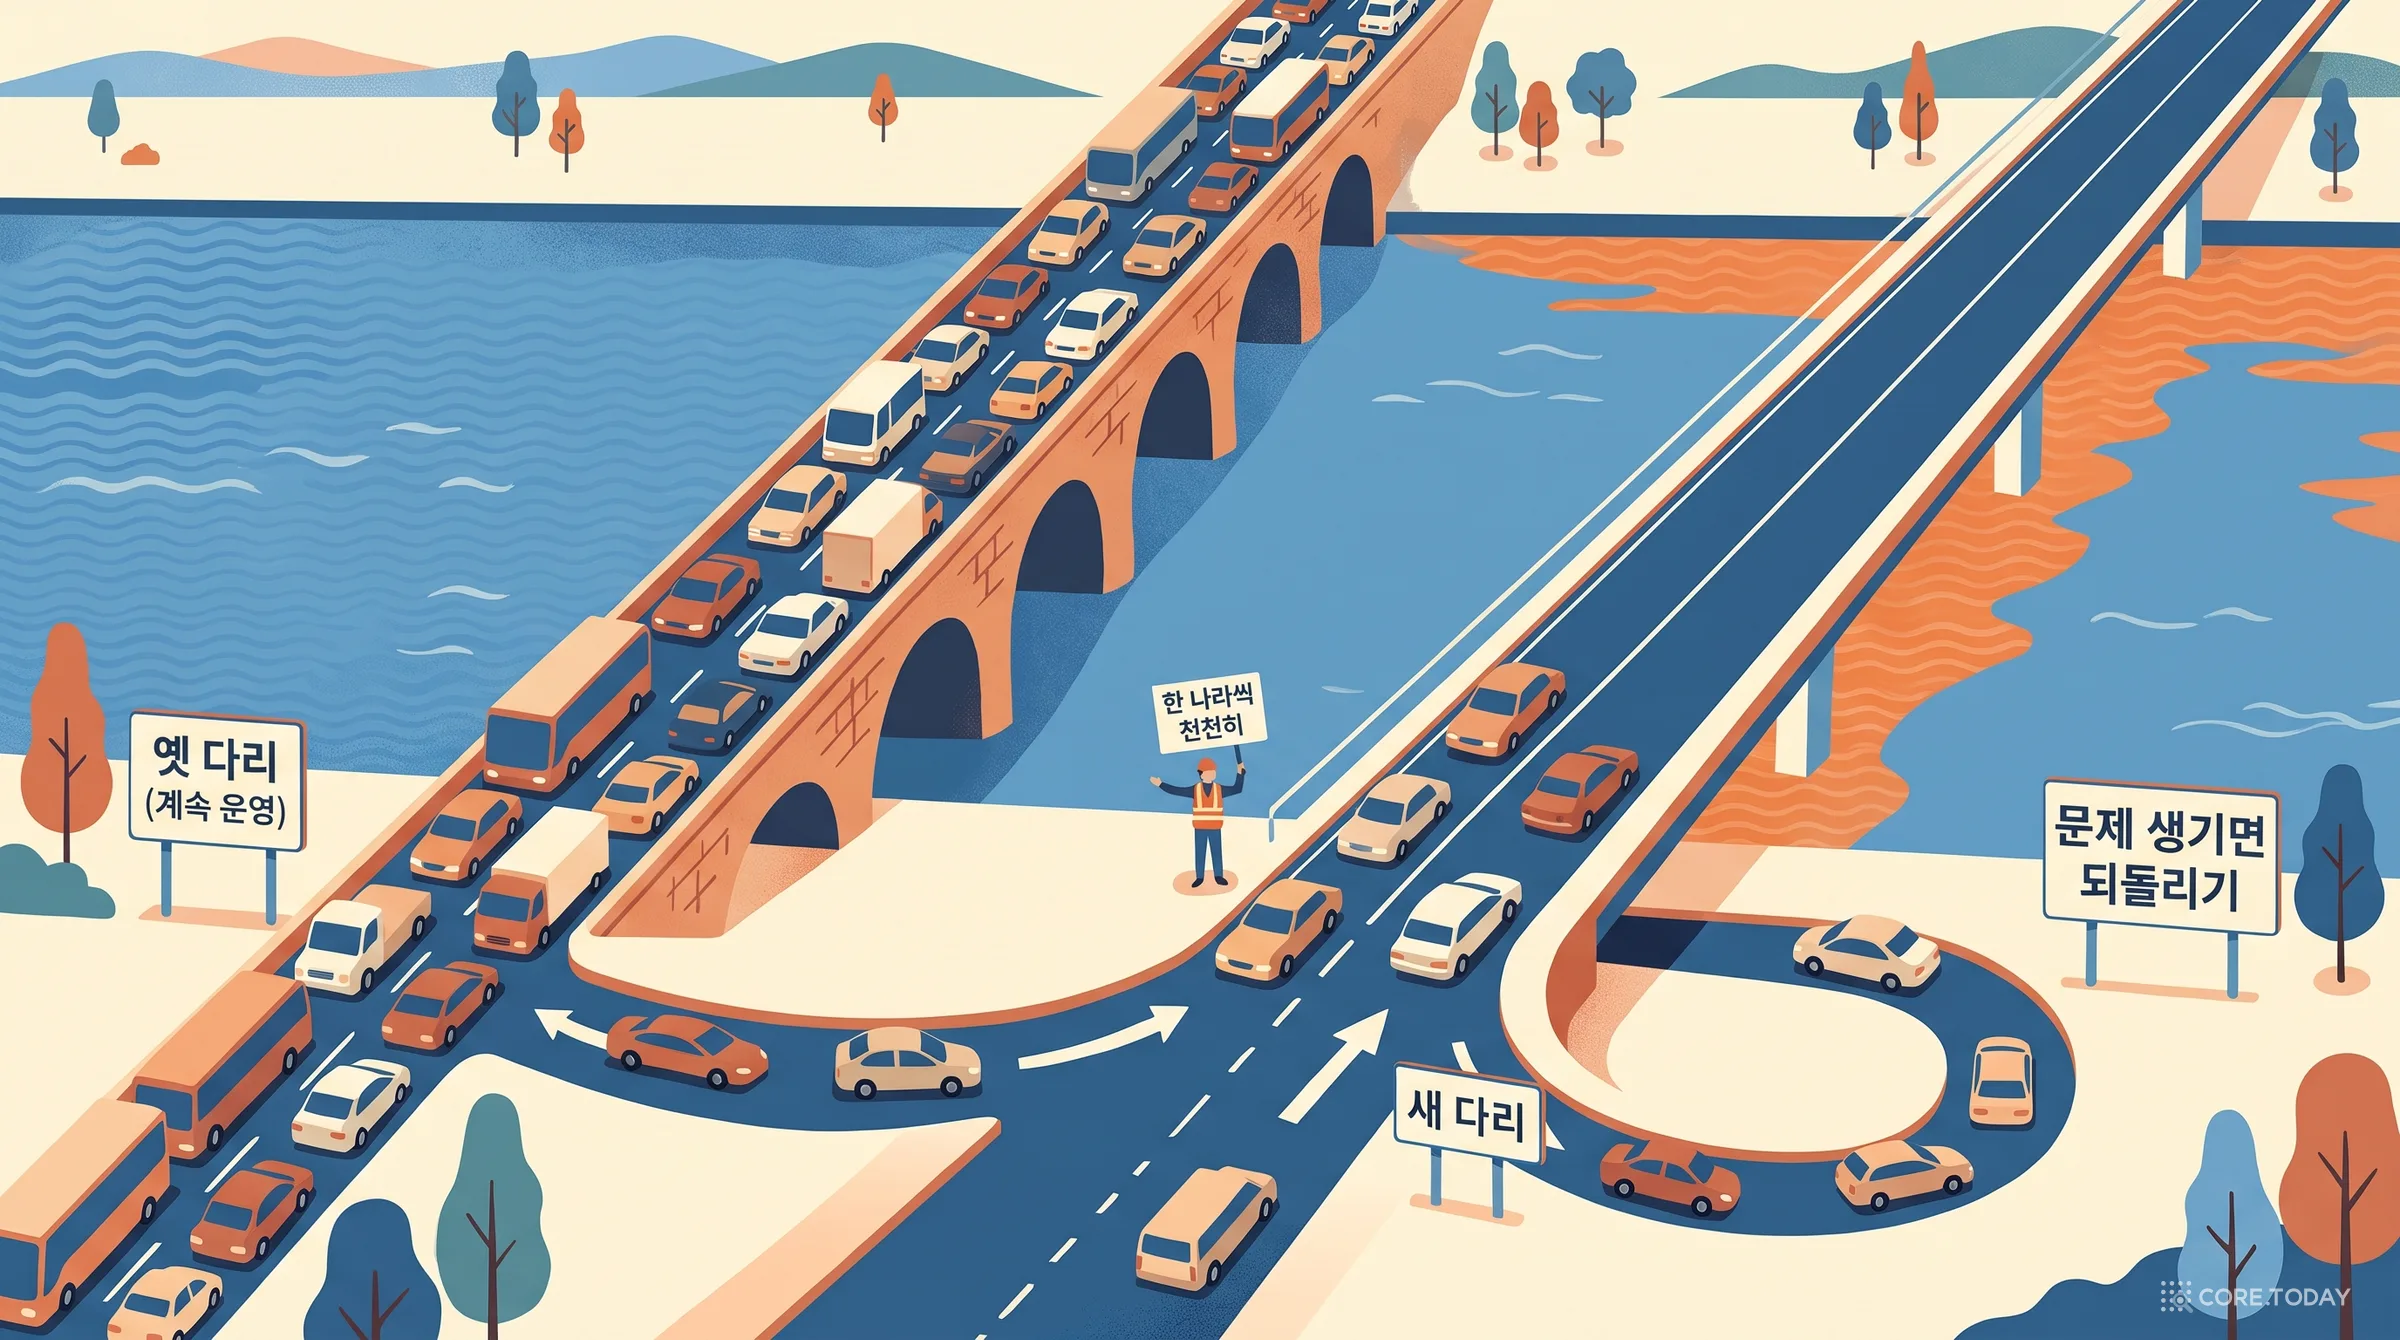
소프트웨어 업계에서 26년 동안 금언으로 통한 조언을 정면으로 거슬렀습니다. 그러면서도 그 조언이 경고한 위험은 피하려 했습니다.
3
AI 코딩 에이전트와 함께라면 팀은 얼마나 작아질 수 있는가
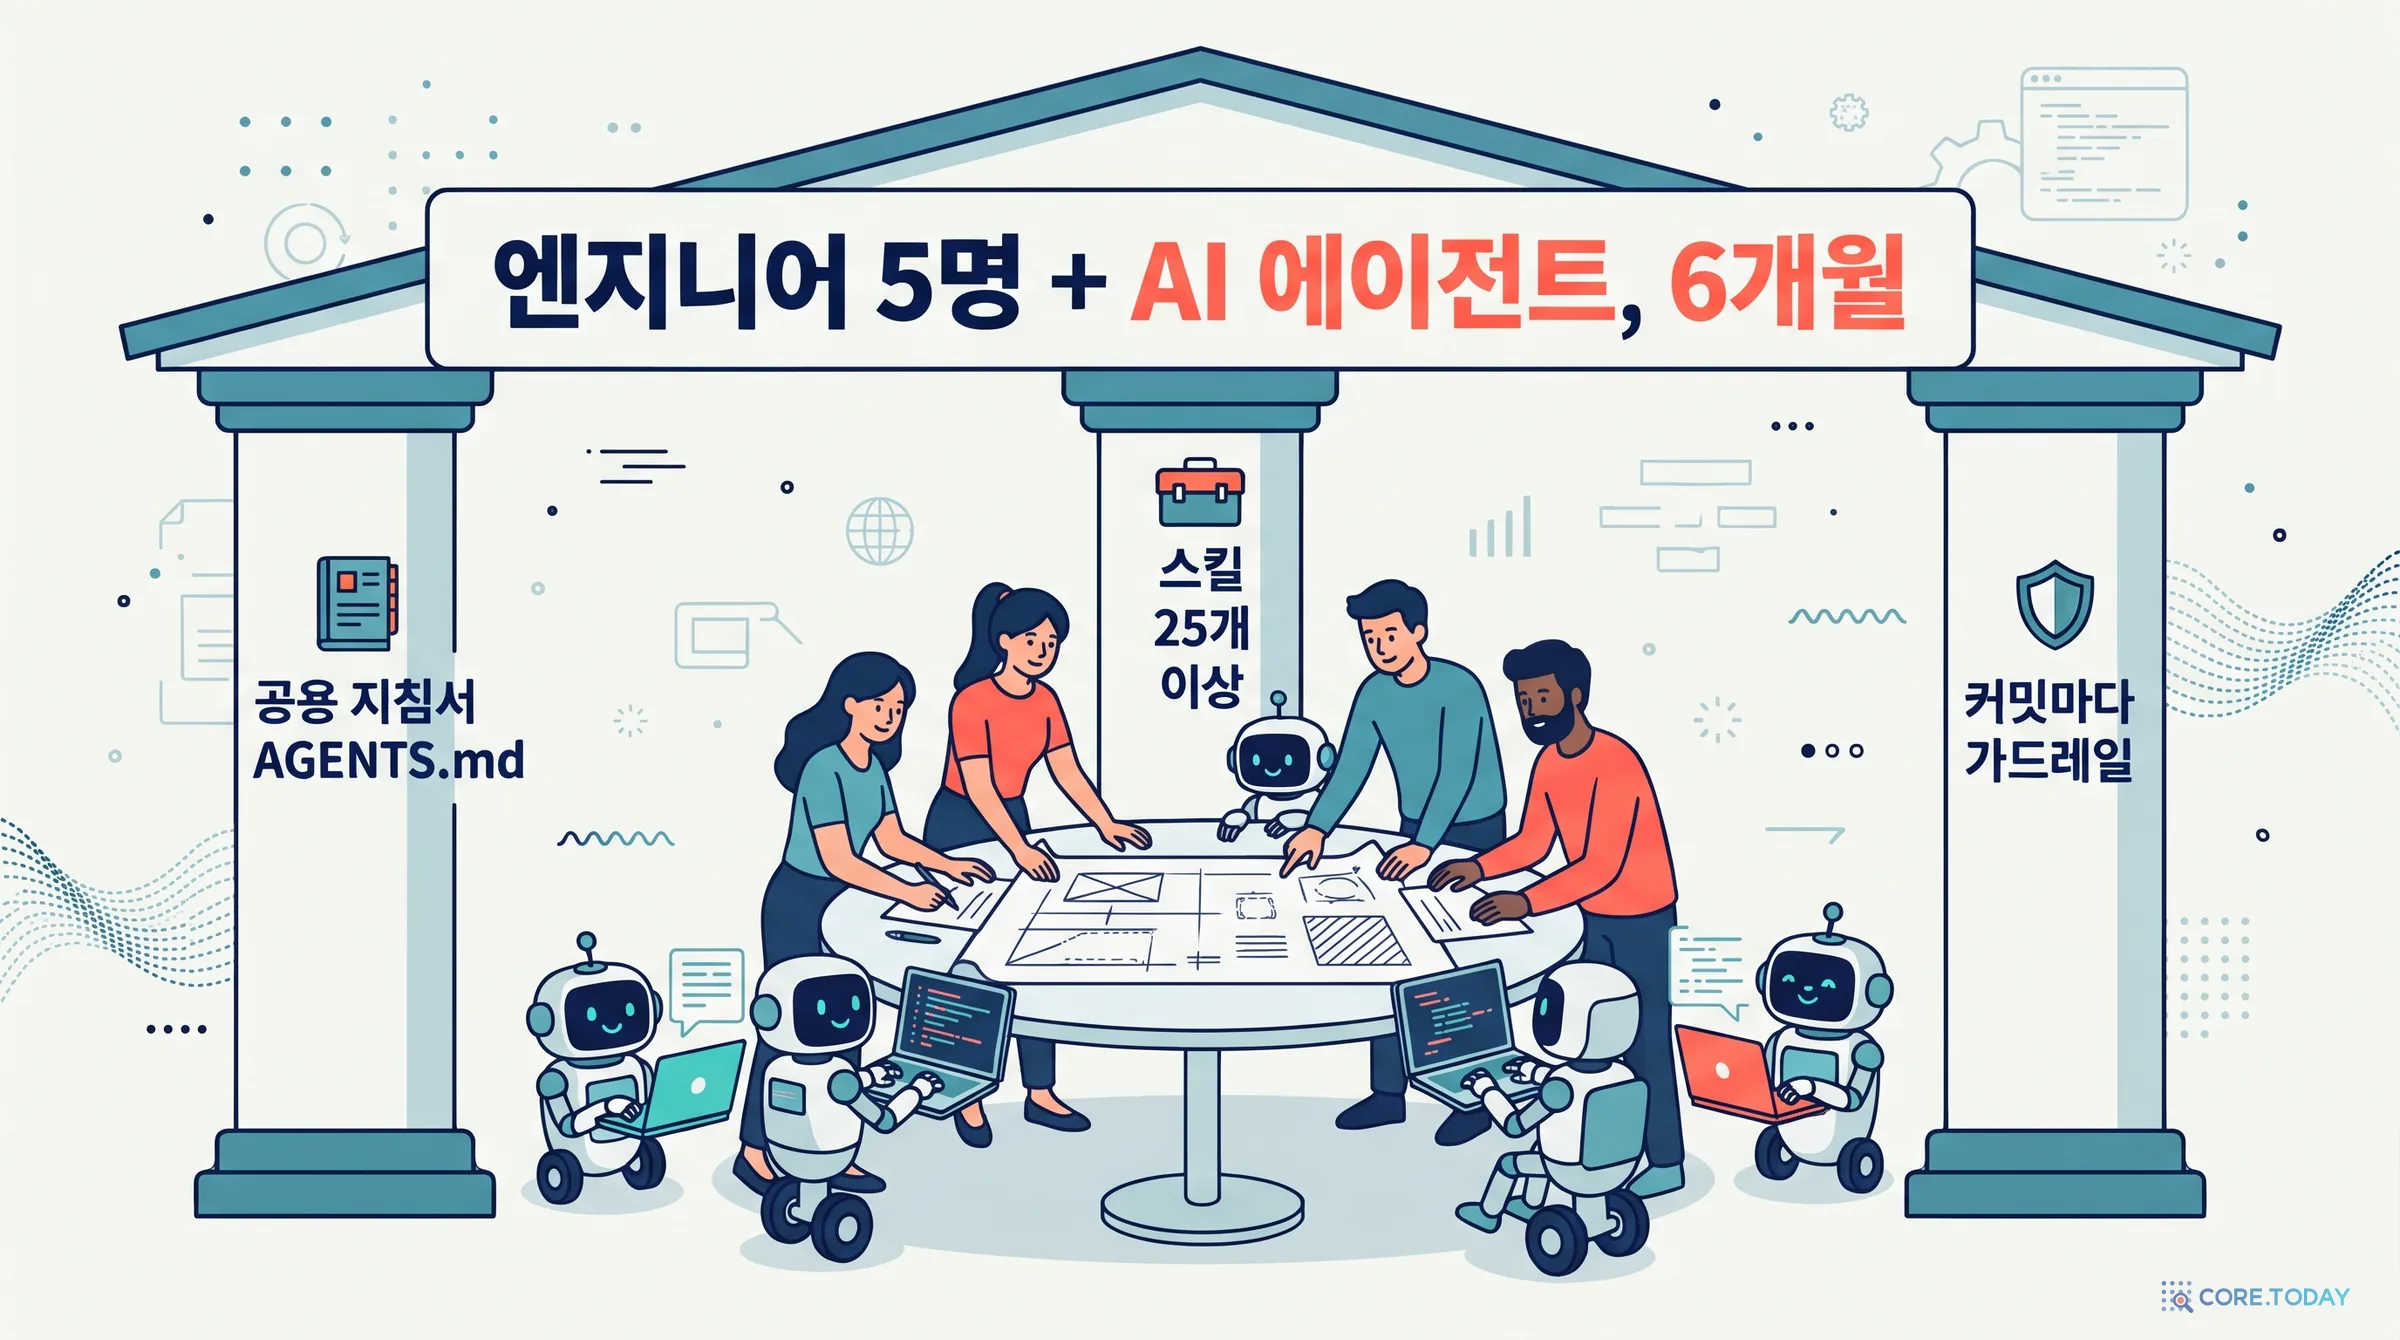
세계에서 여섯 번째로 많이 방문되는 웹사이트의 새 웹 앱 첫 버전을, 엔지니어 다섯 명이 AI 코딩 에이전트와 함께 여섯 달이 안 되어 만들었다고 밝혔습니다.
먼저 원문이 내놓은 숫자를 한자리에 모아 둡니다. 아래 표의 값은 모두 원문에서 옮긴 것입니다.
항목
옛 구조
새 구조
웹을 만드는 서버
3종 (rweb, rweb SSR, Jetfuel SSR)
1종
느린 4G에서 첫 게시물까지 (로그인, 녹화)
23.9초
2.7초
첫 게시물 전에 받는 자바스크립트 (프로필)
3.6MB
0
로그아웃 트래픽용 rweb 서버
데이터센터당 1,400대
700대
rweb SSR 서버
2,400대 → 1,200대
종료
첫 버전을 만든 사람
—
엔지니어 5명 + AI 코딩 에이전트, 6개월 미만
지금 상태
로그인 사용자 대부분을 아직 담당
로그아웃 방문자와 검색 크롤러 전부, 로그인은 나라별 이전 중
22초와 2.7초의 차이가 어디서 오는지는 직접 움직여 보는 편이 빠릅니다. 아래 위젯에서 통신 조건을 바꿔 가며 두 앱이 거치는 단계를 겹쳐 보세요. 시간은 코어닷투데이가 원문의 단계 순서를 바탕으로 만든 단순 모형이고, X의 실측값은 위젯 아래에 따로 적었습니다.
느린 조건에서 옛 앱의 막대는 대부분 주황색입니다. 자바스크립트를 받는 시간입니다. 옛 앱은 이 코드가 전부 도착해서 실행된 다음에야 서버에 "프로필 좀 주세요"라고 말할 수 있었습니다. 새 앱은 첫 응답에 이미 게시물이 들어 있습니다.
이 글의 순서는 이렇습니다.
같은 주소를 여는 세 종류의 손님, 그리고 서버가 세 대로 불어난 사정
트위터 웹 16년사: 화면 그리는 곳이 서버와 브라우저 사이를 오간 까닭
속도가 왜 돈이고, 왜 형평의 문제인가
"절대 다시 쓰지 마라"를 거스른 결정과, 그 조언에서 건진 것
새 구조의 해부: 스트리밍, 하이드레이션, 데이터 싣기
엔지니어 다섯 명과 에이전트가 일한 방식
성능 작업 일곱 가지를 하나씩 뜯어 보기
X가 내놓은 숫자를 어디까지 믿을 것인가, 그리고 2026년의 우리에게 남는 것
코어닷투데이는 원문 전체와 그림 일곱 장의 수치를 읽었습니다. 위젯 가운데 원문 수치를 그대로 옮긴 것과, 원리를 보여 주려고 따로 모형을 만든 것은 위젯마다 구분해 적었습니다.
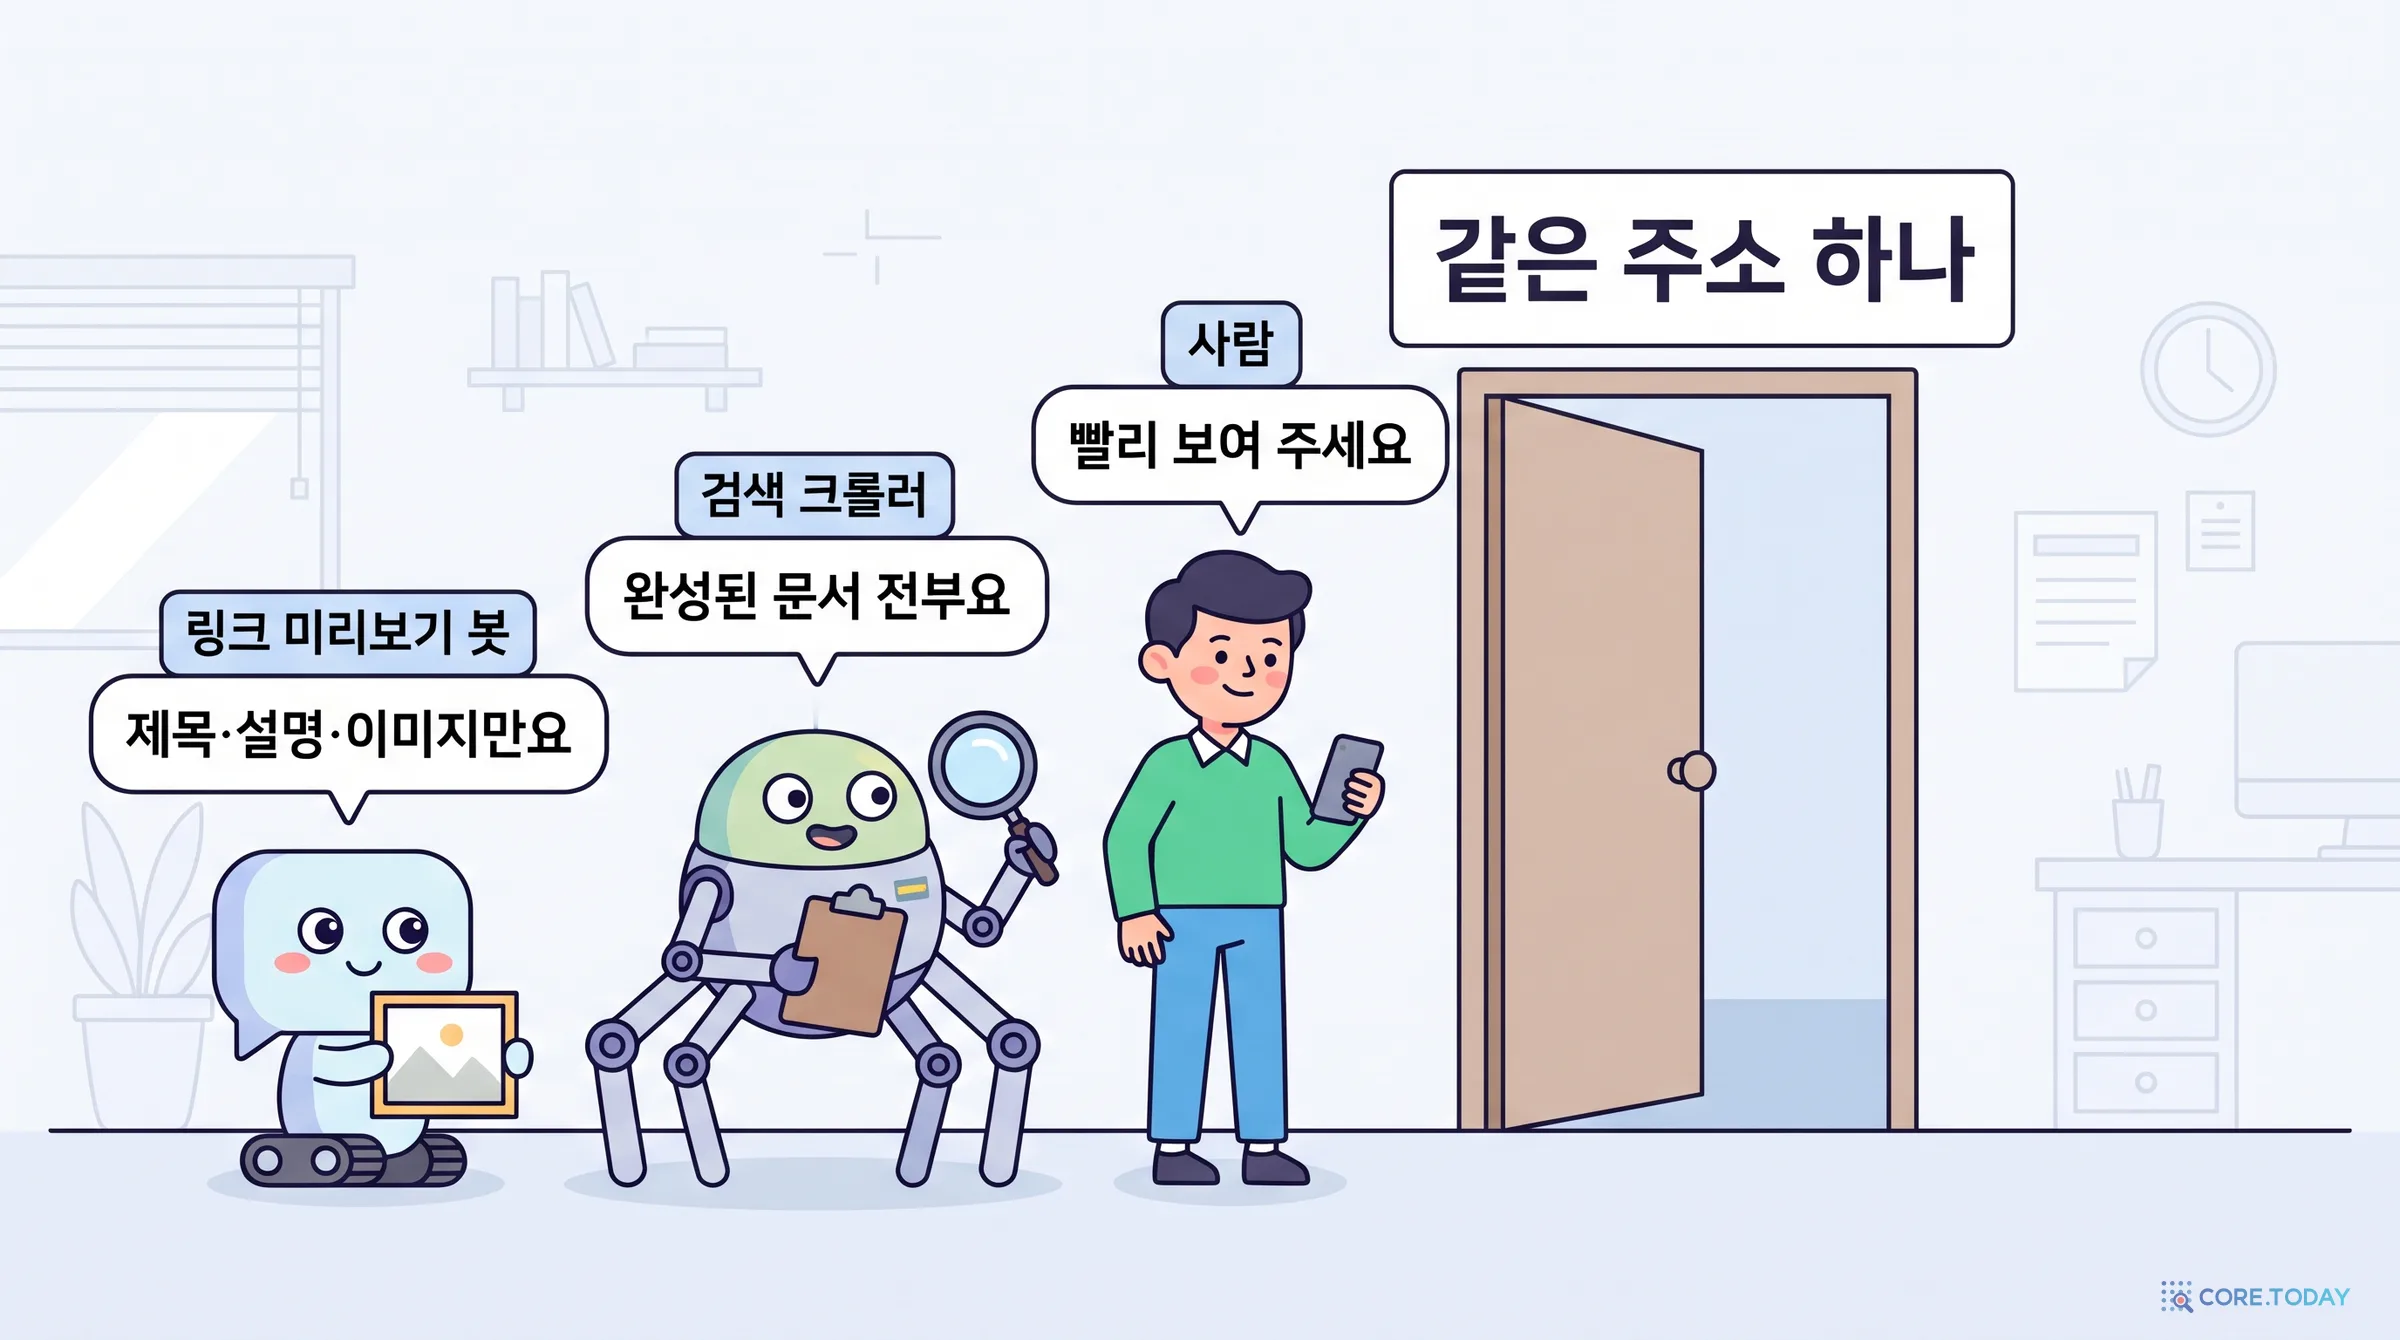
첫째 손님은 사람입니다. 휴대전화나 노트북으로 들어와 프로필과 최신 게시물을 되도록 빨리 보고 싶어 합니다. 그러고 나서 스크롤을 내리고, 마음에 들면 가입합니다.
둘째 손님은 검색 크롤러입니다. 구글봇이나 빙봇 같은 프로그램입니다. 크롤러는 스크롤하지 않고, 기다려 주지도 않습니다. 완성된 HTML을 원합니다. 게시물 본문, 그 게시물을 기계가 읽을 수 있게 설명한 구조화 데이터, 같은 페이지의 다른 언어판으로 가는 링크, 그리고 계정이 없을 때는 "없다"는 뜻의 정확한 상태 코드(404)가 필요합니다.
셋째 손님은 링크 미리보기 봇입니다. 메신저에 링크를 붙여 넣으면 제목과 그림이 든 카드가 펼쳐집니다. 그 카드를 만들려고 아이메시지, 슬랙, 디스코드, 카카오톡 같은 앱이 대신 페이지를 열어 보는데, 이때 오는 요청이 미리보기 봇입니다. 이 손님이 읽는 것은 제목, 설명, 이미지 한 장뿐입니다. 원문 표현을 빌리면, 페이지의 나머지는 이 손님에게 전부 헛일입니다.
식당에 비유하면 이렇습니다. 사람은 자리에 앉아 요리를 먹으러 온 손님입니다. 검색 크롤러는 메뉴 전체와 원산지 표시까지 꼼꼼히 적어 가는 식당 평가원입니다. 미리보기 봇은 간판 사진 한 장만 찍고 가는 지도 앱 촬영 기사입니다. 세 사람에게 똑같이 풀코스를 내는 식당은 없습니다.
서버가 세 대가 된 사정
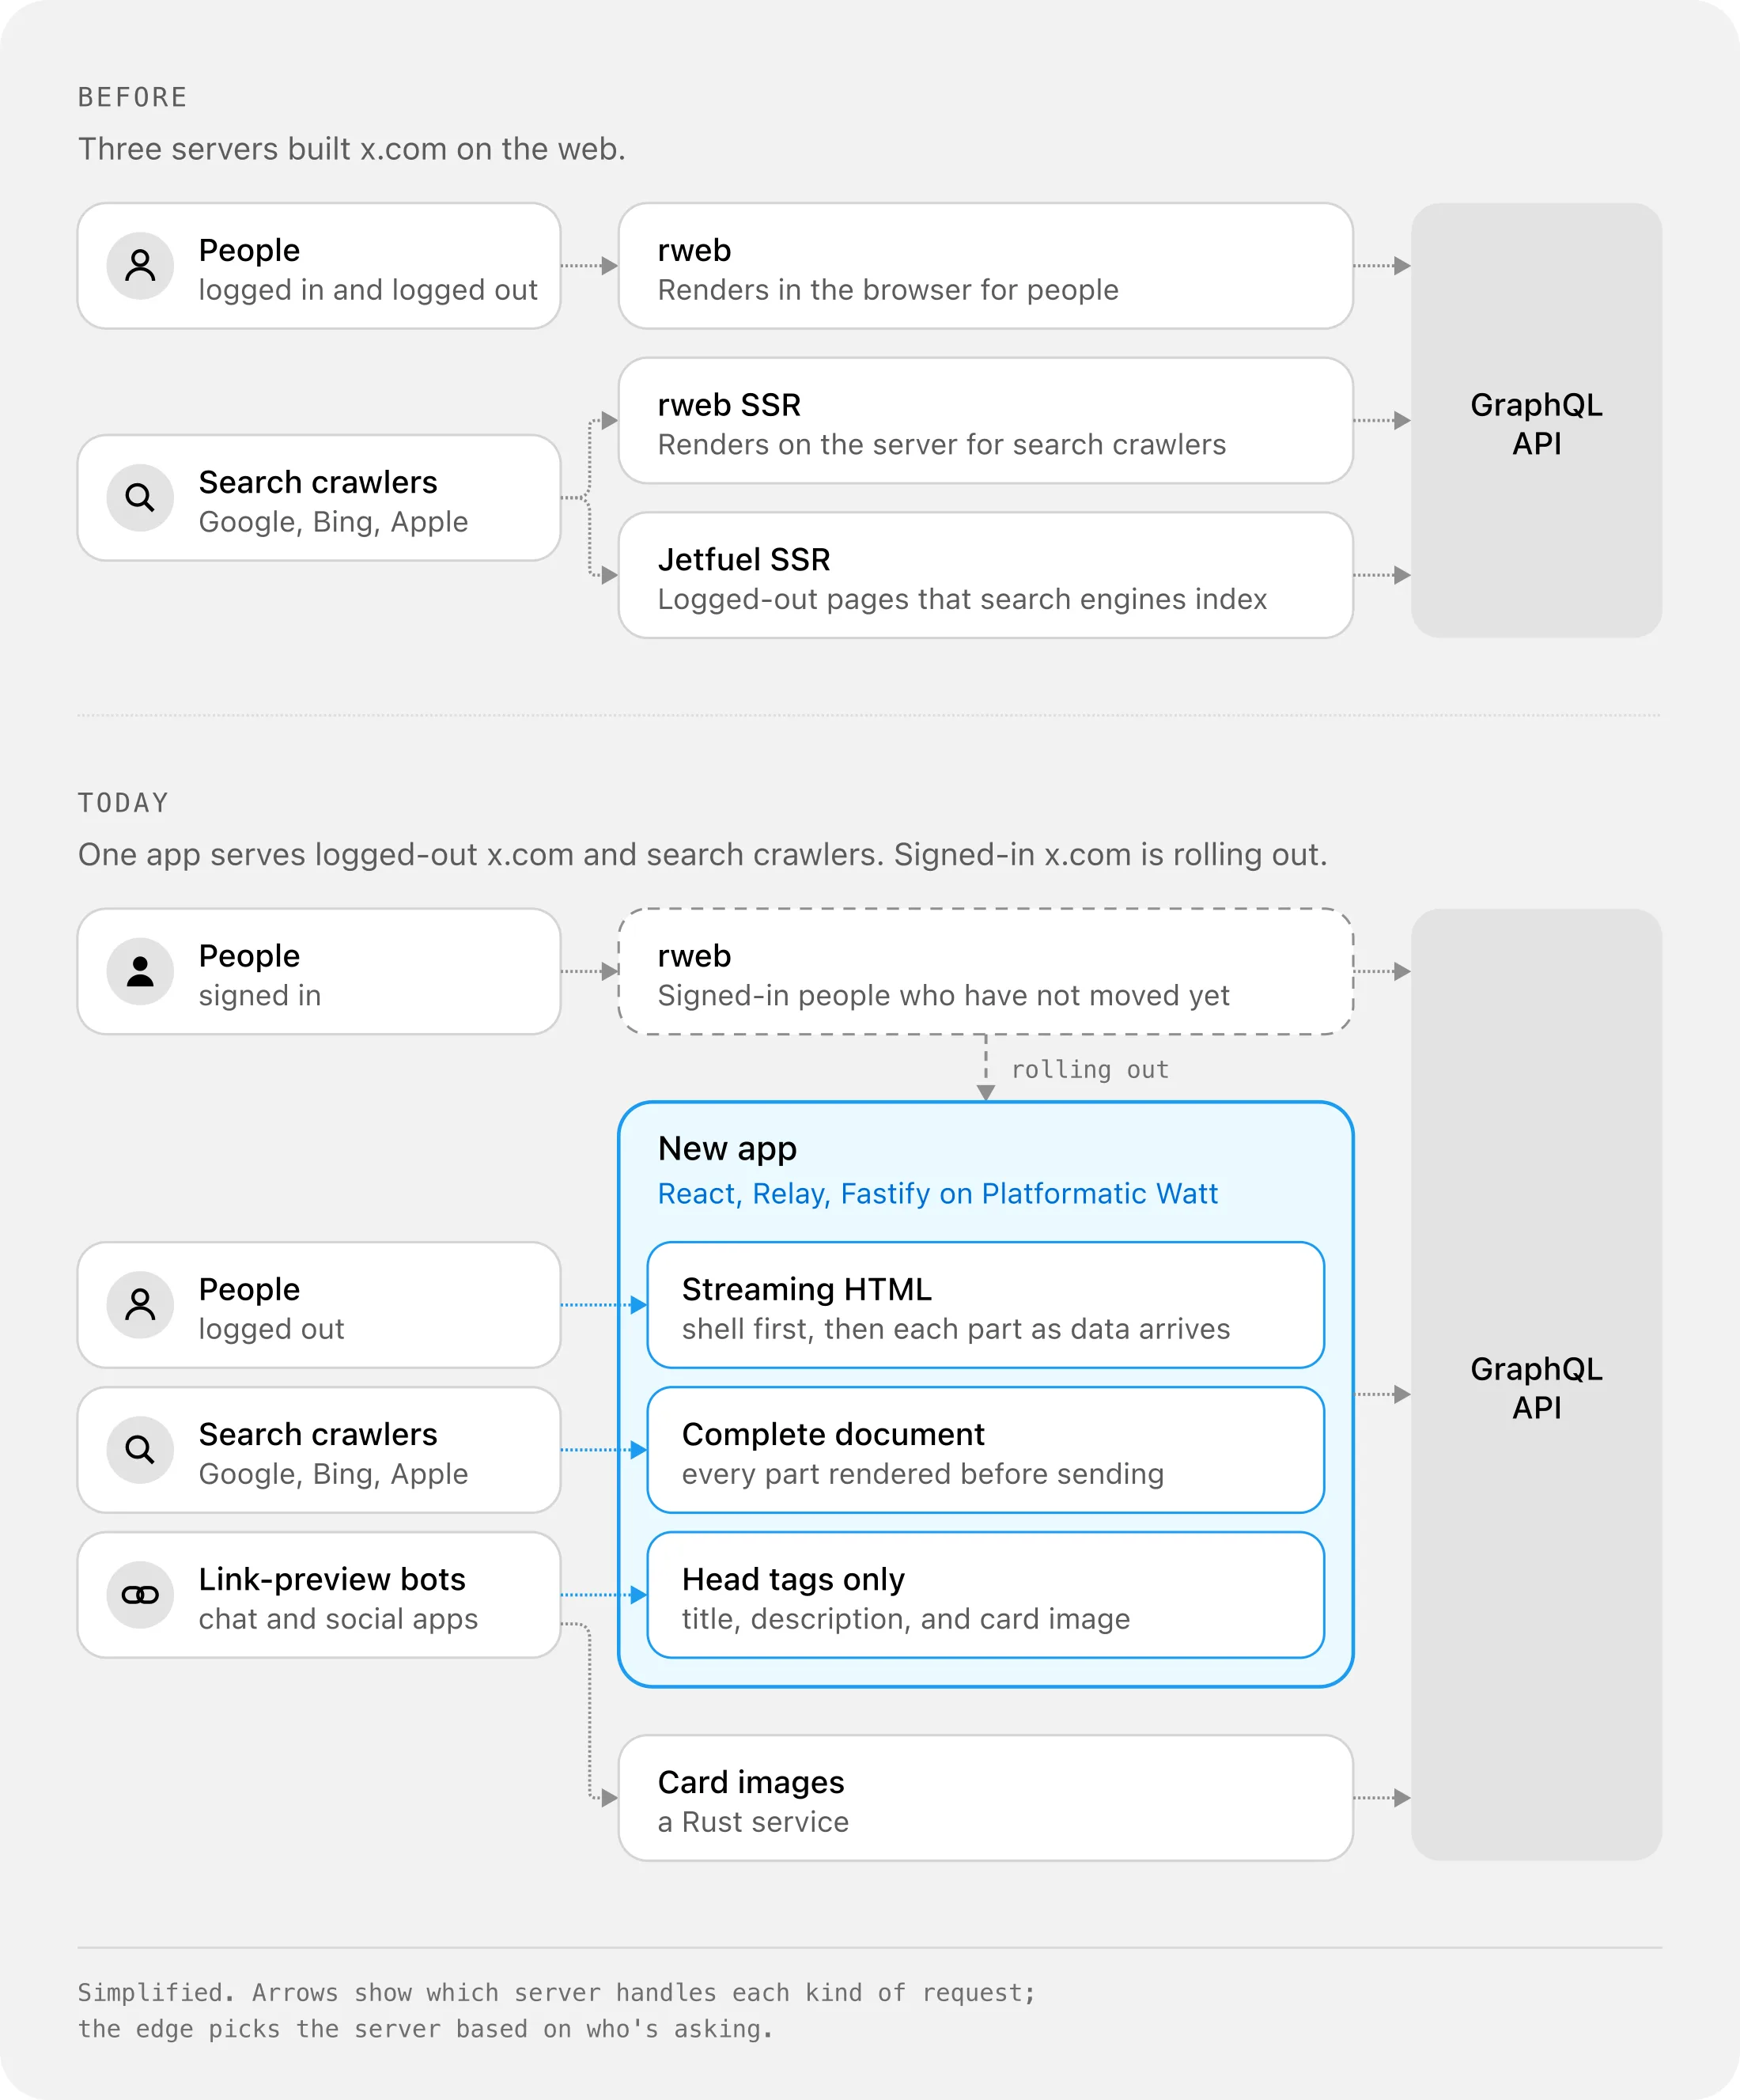
X의 옛 웹은 이 세 손님을 서버 세 종류로 나눠 맞았습니다.
rwebresponsive web사람용. 빈 뼈대만 보내고 브라우저가 화면을 그림. 로그인·로그아웃 모두 담당
rweb SSR같은 앱을 서버에서 렌더링검색 크롤러용. 깨진 주소를 바로잡는 자체 규칙 보유
Jetfuel SSR별도의 서버 렌더링 사이트검색에 잡히는 로그아웃 페이지용. 이벤트, 스페이스, 커뮤니티, 트렌드, 검색, 뉴스 기사
SSR은 서버 사이드 렌더링(Server-Side Rendering), 곧 서버가 완성된 HTML을 만들어 보내는 방식입니다. 반대는 CSR(Client-Side Rendering)로, 서버는 빈 뼈대와 자바스크립트만 보내고 화면은 브라우저가 그립니다.
원문은 세 서버를 깎아내리지 않습니다. 저마다 제 일을 잘했다고 적습니다. 문제는 셋이라는 사실 자체였습니다. 같은 페이지 하나가 세 가지 방식으로 만들어질 수 있었으니까요. 아래는 원문의 첫 번째 그림입니다. 위쪽이 이전, 아래쪽이 지금입니다.
출처: X Engineering, "Rebuilding the global town square from scratch" (2026. 11. 4.) 그림 1. 화살표는 어떤 요청을 어느 서버가 받는지를 뜻하고, 누가 묻는지에 따라 에지(edge, 사용자와 가까운 앞단 서버)가 서버를 고릅니다.
세 서버를 여러 해 운영하면서 드러난 문제를 원문은 세 가지로 정리합니다. 설계 문서에는 보이지 않고, 굴려 봐야 보이는 종류의 문제입니다.
표류
세 서버는 서로 어긋난다. 검색 최적화(SEO) 수정 하나가 한 서버에는 들어가고 다른 서버에는 빠집니다. 페이지 설명 문구, 구조화 데이터, 404 동작을 고치려면 코드 세 벌을 고쳐야 할 수 있었습니다. 원문은 이를 "꾸준하고 대개 보이지 않는 세금"이라고 부릅니다.
역설
로그아웃한 사람이 가장 느린 길을 걸었다. 크롤러는 SSR 서버에게서 완성된 HTML을 받았습니다. 로그인하지 않은 사람은 rweb의 빈 뼈대를 받고 자바스크립트가 화면을 그릴 때까지 기다렸습니다. 원문은 한 줄로 적었습니다. 더 좋은 대접을 받은 쪽은 봇이었다고.
노화
기술 스택이 고르지 않게 낡았다. 정규화한 Redux 저장소와 Relay의 공존, React Native for Web을 거친 스타일 컴포넌트, Flow 타입 검사, 최신·구형 브라우저용으로 따로 내보내는 번들. 하나하나는 도입 당시 합리적인 선택이었습니다. 합쳐 놓으니 일상적인 수정이 필요 이상으로 느려졌습니다.
원문은 이 상태를 "천 번 베여 죽는 죽음(death by a thousand cuts)"이라고 부릅니다. 하나하나는 작은 문제인데, 모이면 앱을 유지하기도 빠르게 지키기도 어려워진다는 뜻입니다.
두 번째 문제는 곱씹을 만합니다. 로그아웃 방문자는 대개 처음 온 사람입니다. 검색 결과를 눌렀거나, 누군가 보내 준 링크를 눌렀거나, 뉴스 기사에 인용된 게시물을 따라온 사람입니다. 서비스가 가장 좋은 첫인상을 줘야 할 손님에게 가장 느린 길을 내주고 있었던 셈입니다.
지금은 어떻게 달라졌는지 아래 위젯에서 손님을 바꿔 가며 확인해 보세요. '구글봇인 척하는 요청'도 넣어 두었습니다. 이 손님을 어떻게 대하느냐에 꽤 영리한 설계가 숨어 있습니다.
2. 16년의 진자 — 화면은 서버에서 그릴까, 브라우저에서 그릴까
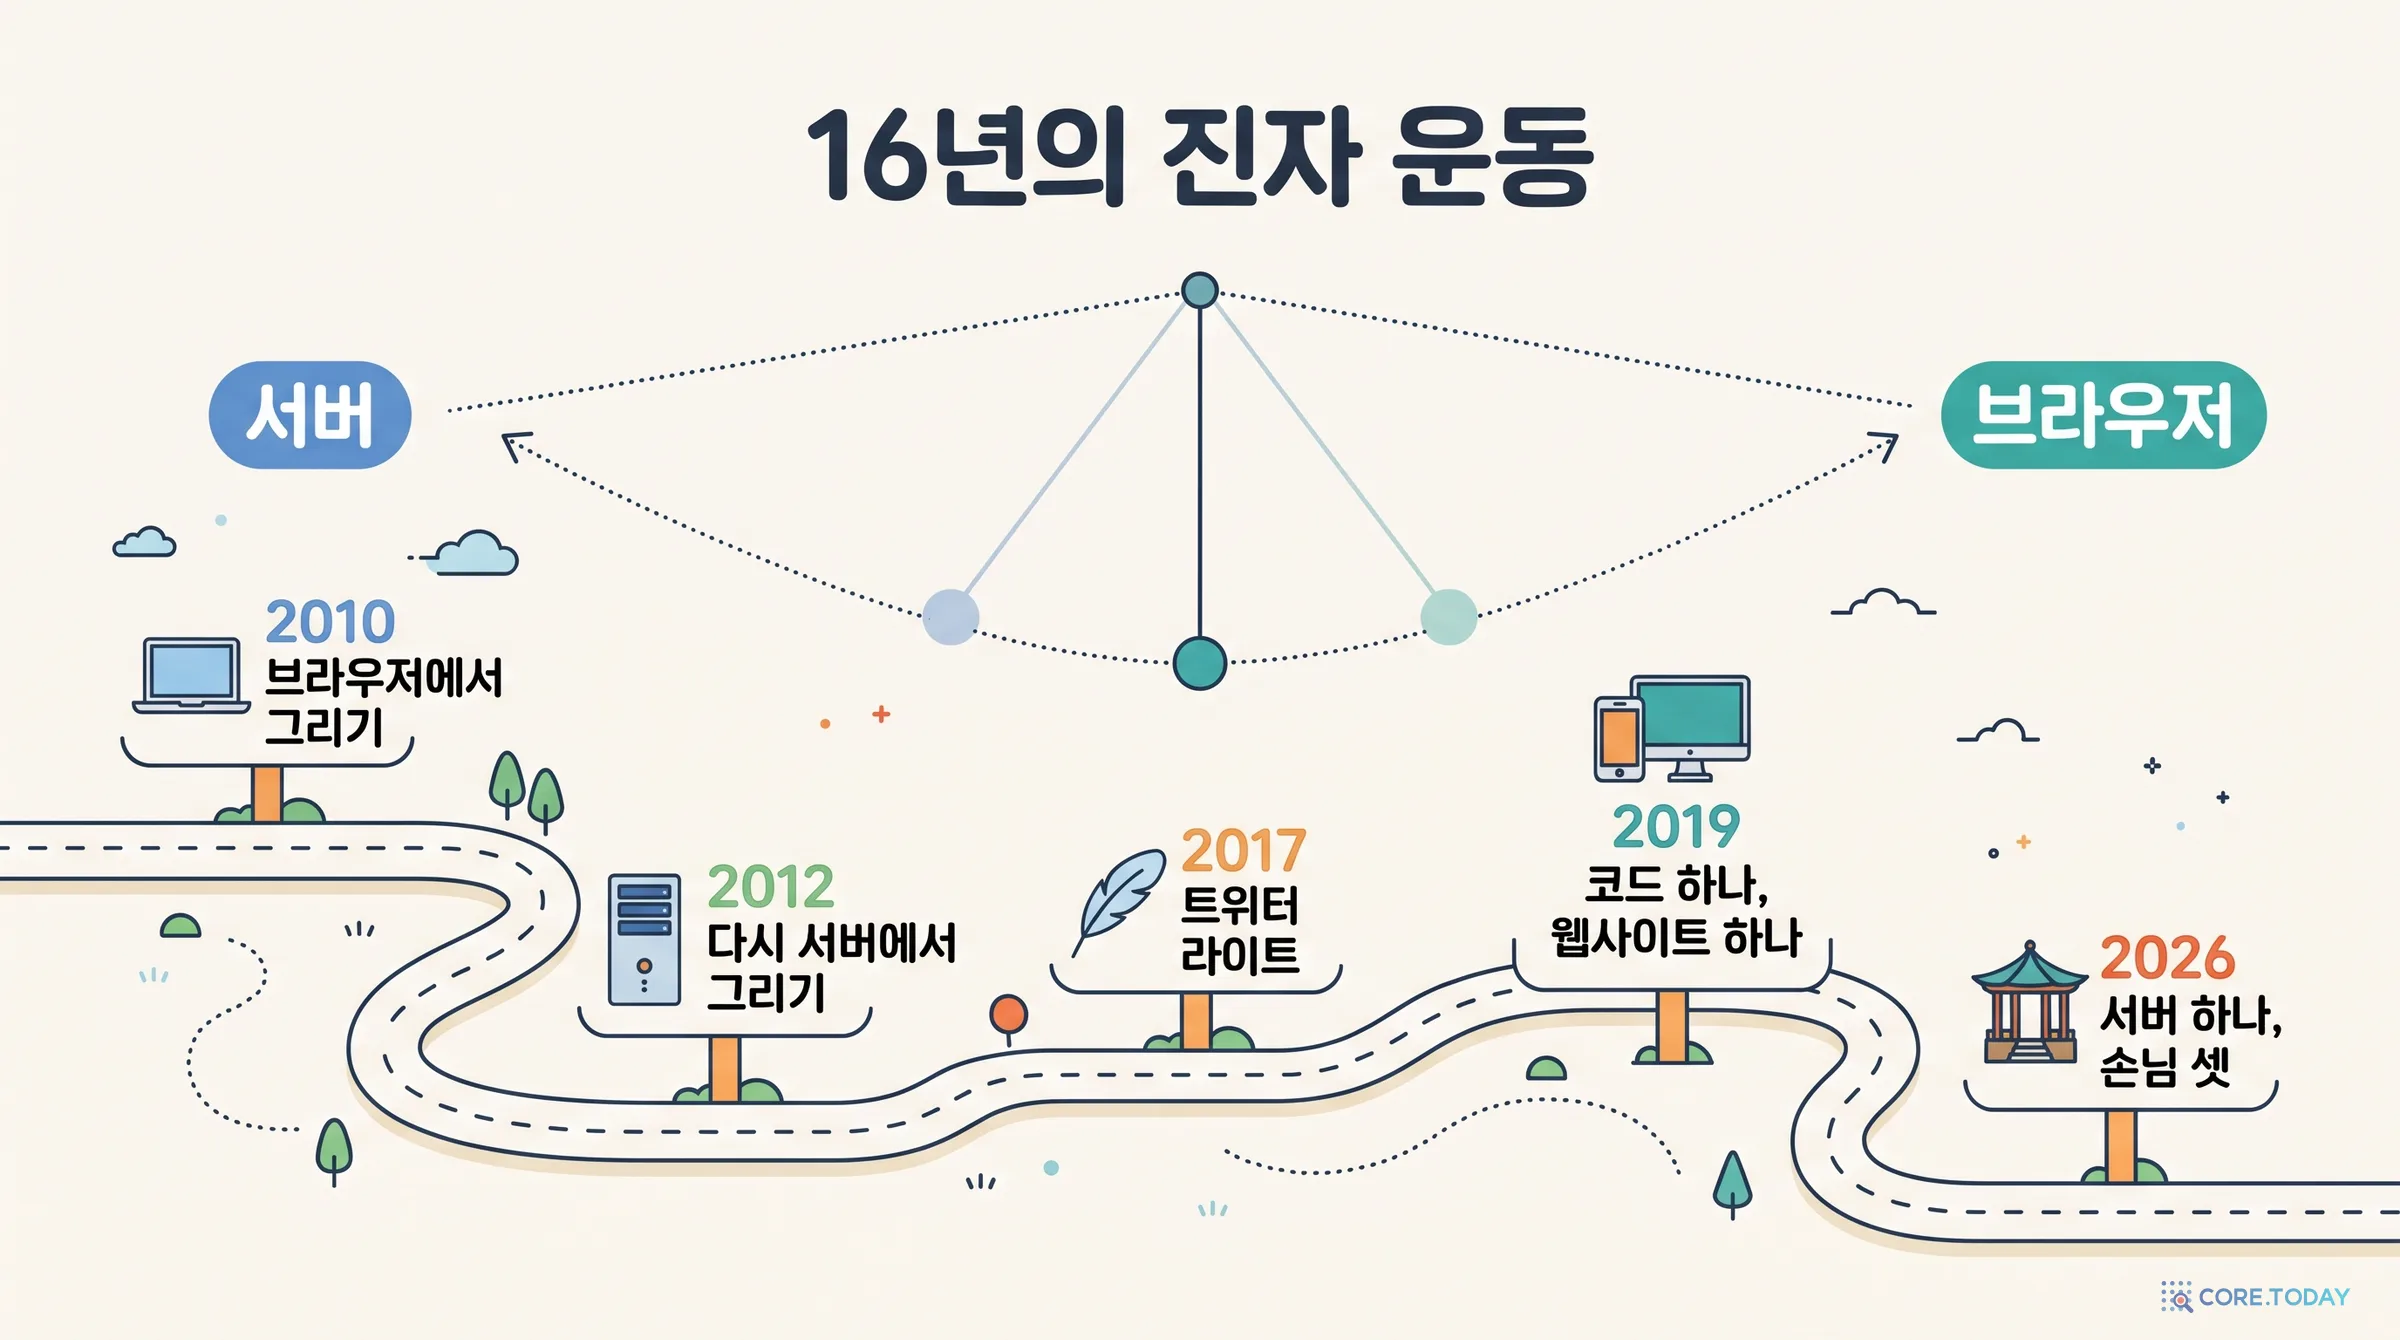
이번 재구축을 이해하려면 트위터가 이 문제를 처음 겪는 회사가 아니라는 점부터 알아야 합니다. 트위터 웹의 역사는 "화면을 어디에서 그릴 것인가"라는 물음 하나를 놓고 서버와 브라우저 사이를 오간 기록입니다.
2010년 9월, 트위터는 웹사이트를 통째로 새로 내놓았습니다. 엔지니어링 블로그의 글 「The Tech Behind the New Twitter.com」은 이 사이트가 "거의 전부 자바스크립트로 된 새 구조"이고 "핵심 엔지니어 일곱 명이 넉 달 만에" 만들었다고 적었습니다.
핵심 생각은 지금 봐도 깔끔합니다. 트위터 웹사이트가 트위터 API의 손님이 된다는 것입니다. 모바일 앱이 쓰는 것과 똑같은 API에서 데이터를 받아, 브라우저 안에서 화면을 조립합니다. 주소는 # 뒤에 붙는 문자열(URL 해시)로 구분했습니다. 한때 twitter.com/#!/계정 꼴의 주소가 흔했던 까닭입니다.
장점은 분명했습니다. 한 번 불러온 뒤에는 화면 사이를 오갈 때 페이지를 새로 받지 않아도 됩니다. 앱처럼 매끄럽습니다.
2012년: 다시 서버로 — "첫 트윗까지 걸리는 시간"
20개월 뒤인 2012년 5월 29일, 트위터는 방향을 되돌립니다. 웹 코어 팀의 댄 웹(Dan Webb)이 쓴 「Improving performance on twitter.com」입니다.
이 글에서 트위터는 지표 하나를 만들었습니다. 첫 트윗까지 걸리는 시간(time to first Tweet). 링크를 누른 순간부터 타임라인의 첫 트윗이 눈에 보일 때까지를 실제 사용자 표본에서 잰 값입니다. 재 보니 문제가 드러났습니다. 브라우저에서 그리는 구조에서는 "자바스크립트를 내려받아 실행하기 전까지 아무것도 보이지 않는다"는 것, 그리고 자바스크립트를 해석하고 실행하는 시간이 기기에 따라 크게 튄다는 것입니다.
트위터는 렌더링을 서버로 되돌려 "프런트엔드 성능의 통제권을 되찾겠다"고 썼고, 그 결과 첫 트윗까지 걸리는 시간이 5분의 1로 줄었다고 보고했습니다. #! 주소도 이때 없앴습니다.
여기서 기억해 둘 것이 있습니다. 2026년의 X가 고른 지표 이름이 첫 게시물까지 걸리는 시간(time to first post)입니다. 14년 전과 같은 지표, 같은 진단, 같은 처방입니다.
2017년: 다시 브라우저로 — 트위터 라이트
그런데 5년 뒤 트위터는 또 브라우저 쪽으로 갑니다. 이번에는 사정이 달랐습니다. 스마트폰이 세계로 퍼지면서, 느리고 비싼 통신망을 쓰는 수억 명이 새 사용자로 들어오고 있었습니다.
2017년 4월 6일 니콜라스 갤러거(Nicolas Gallagher)가 쓴 「How we built Twitter Lite」가 소개한 트위터 라이트는 프로그레시브 웹 앱(PWA, Progressive Web App)이었습니다. PWA는 2015년 6월 구글의 알렉스 러셀(Alex Russell)이 디자이너 프랜시스 베리먼(Frances Berriman)과 저녁을 먹다 붙인 이름입니다. 웹사이트이면서 설치형 앱처럼 동작하는 웹 앱을 가리킵니다.
트위터 라이트의 뼈대는 앱 셸(app shell) 모델이었습니다. 구글의 애디 오스마니(Addy Osmani)와 맷 곤트(Matt Gaunt)가 2015년에 정리한 설계로, 앱 셸은 "사용자 인터페이스를 움직이는 최소한의 HTML, CSS, 자바스크립트"를 뜻합니다. 서버는 이 껍데기만 보내고, 내용은 브라우저가 API에서 직접 받아 옵니다.
① 작은 서버가 빈 껍데기(셸) HTML 전송
→
② 브라우저가 자바스크립트를 받아 실행
→
③ 브라우저가 API에 직접 데이터 요청
→
④ 화면 그리기
왜 이 구조가 느린 망에 좋다고 여겨졌을까요. 열쇠는 두 번째 방문입니다. 껍데기는 내용과 상관없이 늘 똑같으므로 서비스 워커(브라우저 안에서 요청을 가로채 캐시를 관리하는 스크립트)가 통째로 저장해 둘 수 있습니다. 두 번째부터는 껍데기가 통신 없이 즉시 뜨고, 바뀐 데이터만 받으면 됩니다.
성과는 숫자로 남았습니다.
트위터 라이트 (2017)
수치
출처
3G에서 첫 로딩
대부분의 기기에서 5초 안에 조작 가능
트위터 엔지니어링
앱 크기
네이티브 앱의 1~3%
트위터 엔지니어링
운영 비용
서버 렌더링 데스크톱 사이트보다 한 자릿수 저렴
트위터 엔지니어링
세션당 페이지 수
+65%
구글 사례 연구
보낸 트윗 수
+75%
구글 사례 연구
이탈률
−20%
구글 사례 연구
표의 셋째 줄이 중요합니다. 앱 셸은 서버 입장에서 쌉니다. 서버가 하는 일이 껍데기 하나를 건네는 것뿐이니까요. 화면 그리는 계산은 사용자의 전화기가 대신 합니다.
2019년 7월, 이 코드가 데스크톱까지 넓어집니다. 「Building the new Twitter.com」의 구호는 "코드 하나, 웹사이트 하나"였습니다. 화면 크기와 입력 방식에 맞춰 모양을 바꾸는 반응형 코드 한 벌로 모든 기기를 맡는다는 뜻입니다. X 내부에서 rweb(responsive web)이라고 부르는 앱이 이것이고, 그 뒤로 거의 10년 가까이 x.com을 맡아 왔습니다.
앱 셸이 아픈 자리
그렇다면 무엇이 문제였을까요. 원문은 트위터 라이트를 소개하면서 독자에게 한 가지를 기억해 두라고 합니다. 껍데기가 뜬 뒤 브라우저가 API에서 직접 데이터를 가져온다는 대목입니다. 느린 망 문제의 뿌리가 여기 있다는 것입니다.
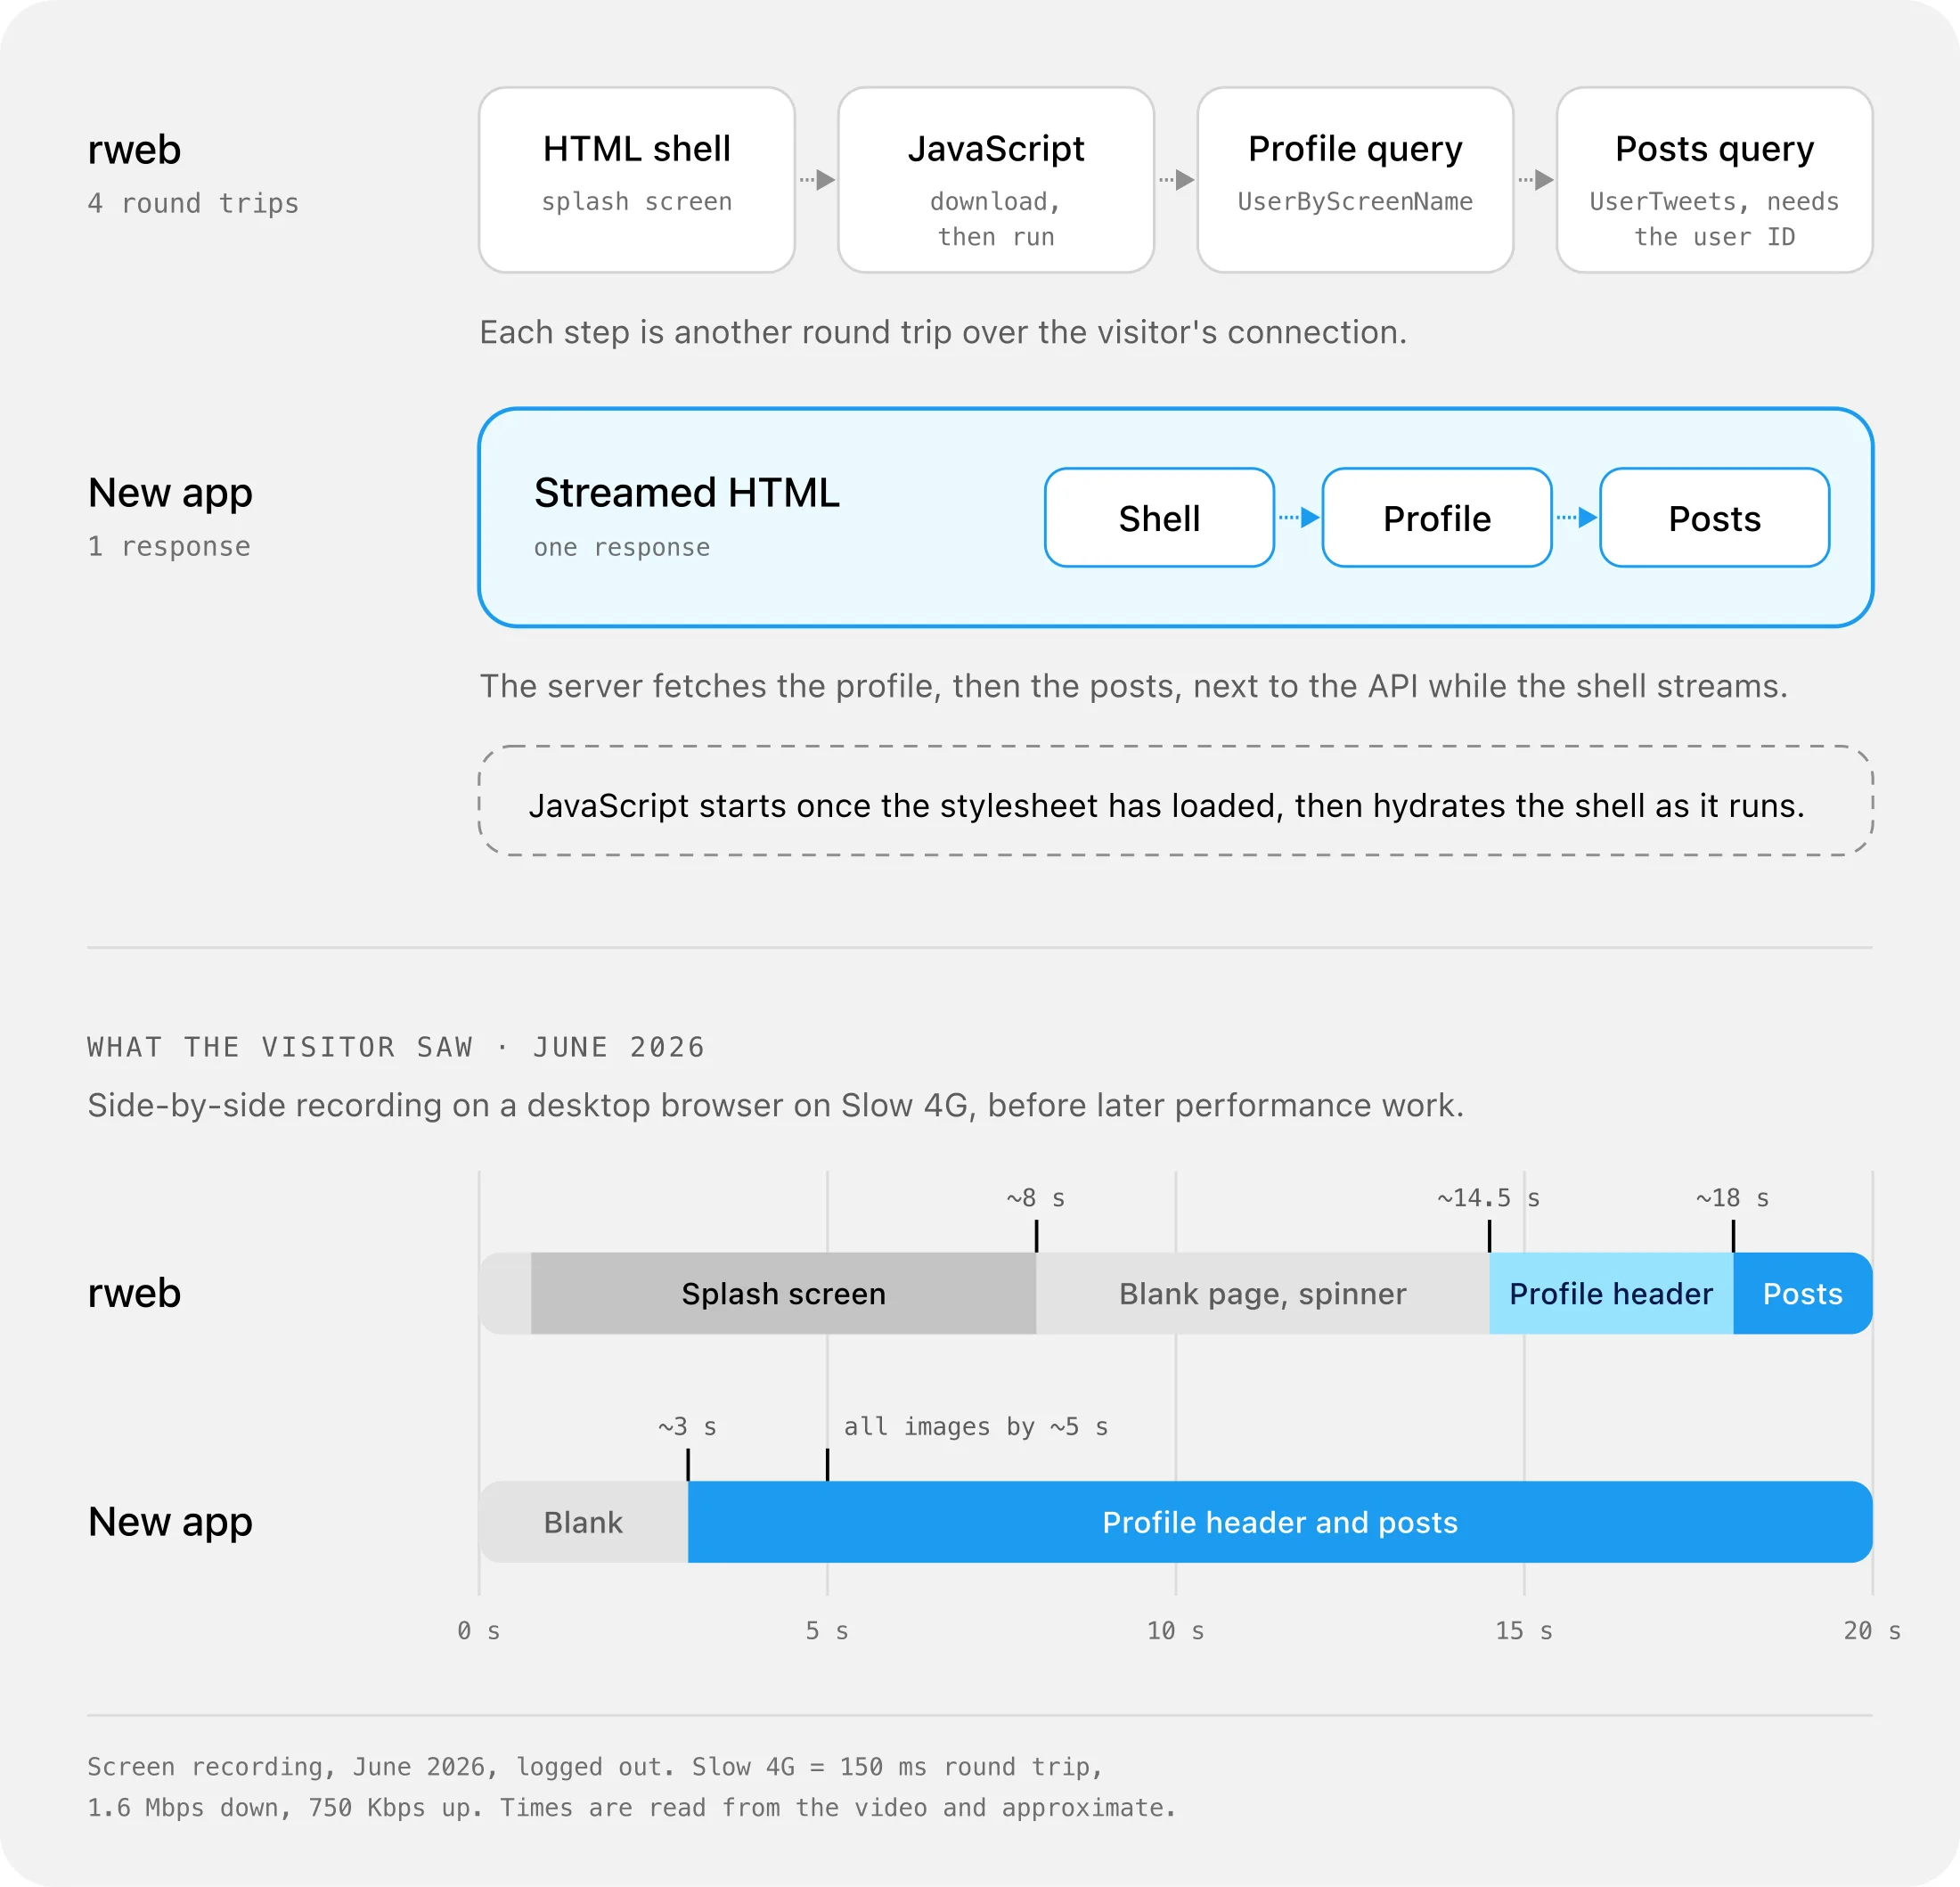
X의 데이터는 그래프입니다. 게시물에는 작성자가 있고, 작성자에게는 프로필이 있고, 게시물은 다른 게시물을 인용할 수 있고, 인용된 게시물에는 또 작성자와 사진이 있습니다. 이 사슬을 따라가려면 질문을 여러 번 해야 합니다. 예를 들어 프로필 화면에서는 먼저 "이 이름을 가진 계정이 누구인가"를 묻고, 답으로 받은 계정 번호를 들고 "이 계정의 게시물을 달라"고 다시 물어야 합니다.
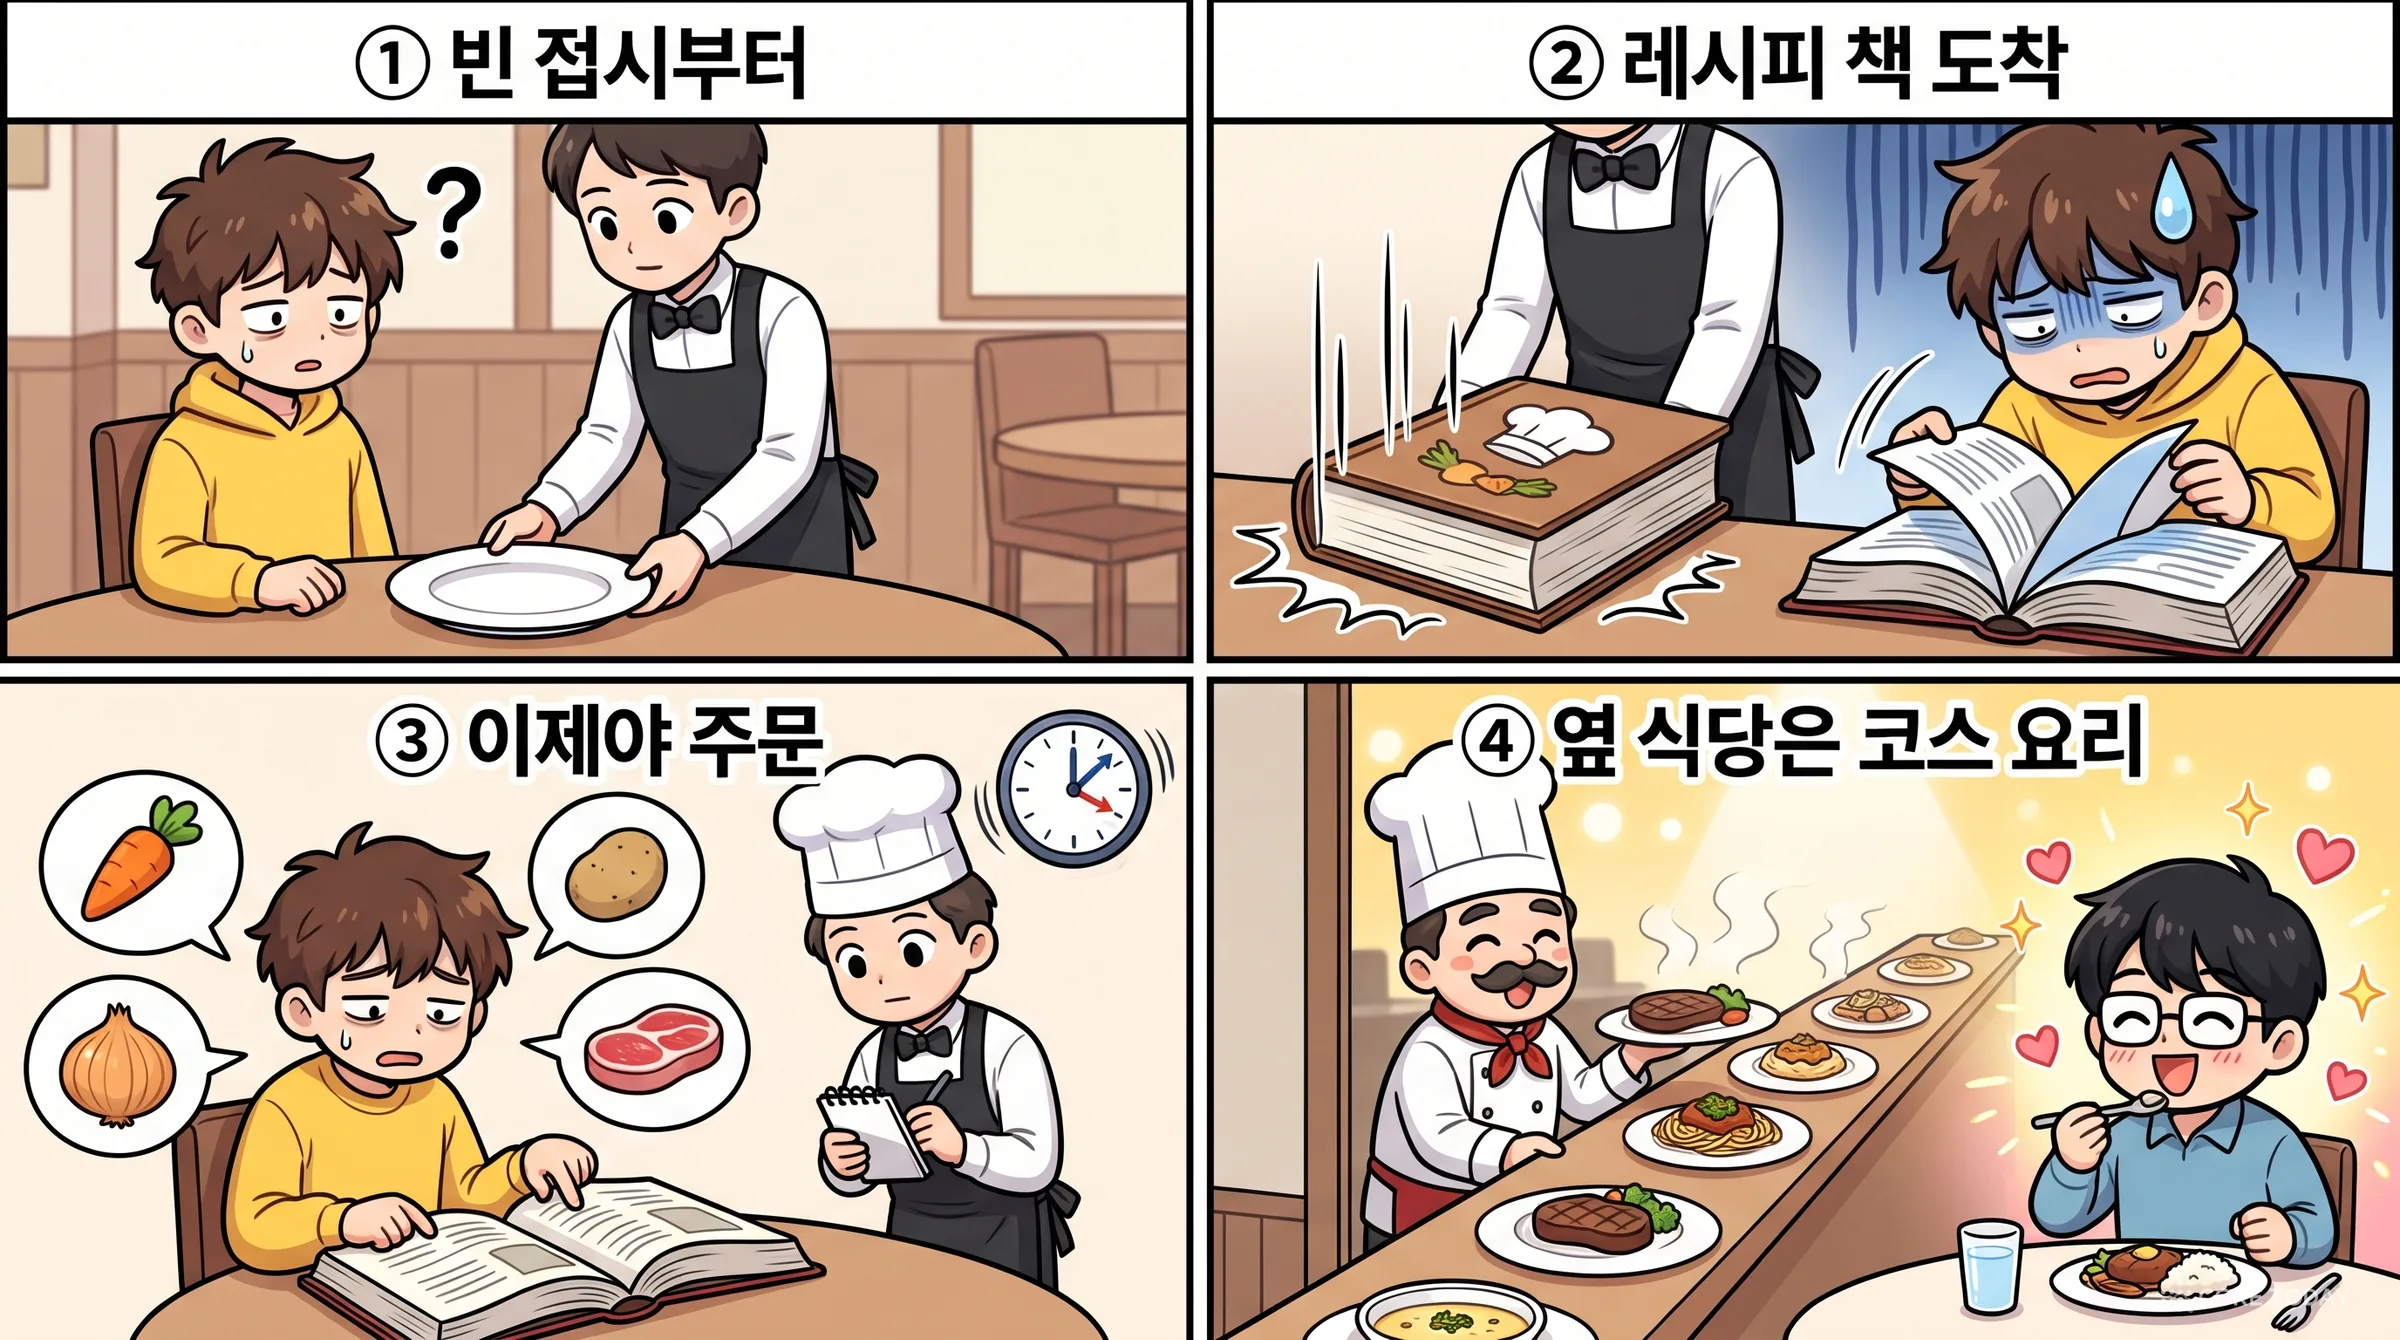
브라우저는 이 질문들을 코드를 내려받아 실행한 뒤에야 시작할 수 있습니다. 식당으로 옮기면 이런 모습입니다.
빈 접시(껍데기)를 받고, 두꺼운 요리책(자바스크립트)을 받아 읽고, 그제야 재료(데이터)를 주문합니다. 재료 주문도 한 번이 아니라 두 번입니다. 주방이 가깝고 손이 빠르면 견딜 만합니다. 주방이 멀면, 곧 통신이 느리면 한 단계마다 왕복 한 번씩이 고스란히 쌓입니다.
출처: X Engineering, 같은 글 그림 2. 아래쪽 막대는 2026년 6월 로그아웃 상태 화면 녹화에서 읽은 대략의 시각입니다. 이때는 뒤에서 다룰 성능 작업을 하기 전이라 새 앱이 약 3초였습니다.
여기서 한 가지를 짚어야 공정합니다. 앱 셸이 틀린 설계였다는 뜻은 아닙니다. 2017년의 가정은 "사용자는 자주 다시 온다, 그러니 두 번째 방문을 빠르게 하자"였습니다. 단골에게는 맞는 가정입니다. 그런데 검색 결과나 공유 링크를 타고 처음 들어온 로그아웃 방문자에게는 캐시가 없습니다. 그 사람에게 앱 셸은 가장 나쁜 경우만 보여 줍니다. 게다가 2017년에 수백 KB이던 자바스크립트는 기능이 붙으면서 MB 단위가 됐습니다. 원문 측정으로 옛 앱은 첫 게시물이 보이기 전에 압축된 자바스크립트만 3.0~3.6MB를 받았습니다.
진자가 멈추지 않는 까닭
이 왕복은 트위터만의 일이 아닙니다. 웹 전체가 같은 진자를 탔습니다.
시기
누가
무엇을 내놓았나
2010. 6.
페이스북, 창하오 장(Changhao Jiang)
BigPipe — 페이지를 '페이지렛' 조각으로 나눠, 뼈대부터 보내고 조각은 완성되는 대로 흘려보냄. 체감 지연을 대부분의 브라우저에서 절반으로 줄였다고 보고
2013. 11.
에어비앤비, 스파이크 브렘(Spike Brehm)
동형(isomorphic) 자바스크립트 — 같은 코드를 서버와 브라우저 양쪽에서 실행. 브라우저 전용 앱은 "크롤러에게 HTML을 줄 수 없다"는 문제의식
2015
구글, 러셀·오스마니
PWA와 앱 셸 — 껍데기를 캐시해 두 번째 방문을 즉시로
2016. 12.
구글, 폴 루이스(Paul Lewis)
불쾌한 골짜기 — 서버가 그린 화면이 "조작할 수 있어 보이지만 실제로는 안 되는" 구간을 지적
"하이드레이션은 순전한 낭비" — 서버가 이미 한 일을 브라우저가 되풀이한다는 비판, 재개 가능성(resumability) 제안
진자가 멈추지 않는 까닭은 양쪽이 서로 다른 것을 잘하기 때문입니다. 서버에서 그리면 첫 화면이 빠릅니다. 브라우저에서 그리면 그다음 화면들이 빠르고 서버 비용이 쌉니다. 16년 동안 업계가 찾아온 것은 한쪽의 승리가 아니라 둘을 잇는 방법이었습니다. 첫 화면은 서버가 조각조각 흘려보내고, 그 뒤는 브라우저가 이어받는 방식입니다. X의 새 앱이 선 자리가 바로 거기이고, 2010년 페이스북 BigPipe의 문장 하나가 그 이유를 가장 잘 말해 줍니다. 느린 질의 하나가 나머지 전부를 붙들고 있어서는 안 된다는 것입니다.
3. 22초는 왜 문제인가 — 속도가 돈이 되고, 형평이 되는 이유
"몇 초 빨라지는 게 그렇게 대수인가" 하는 물음이 남습니다. 답은 20년 치 사례가 쌓여 있습니다. 다만 유명한 숫자일수록 출처가 허술한 경우가 있어서, 근거의 단단함까지 함께 적습니다.
사례
보고된 수치
근거의 성격
구글 (2006)
검색 결과를 10개에서 30개로 늘려 0.4초가 0.9초가 되자 트래픽 20% 감소
머리사 메이어의 강연을 그렉 린든이 받아 적은 기록. 공식 논문 아님
아마존 (2006)
100ms 느려질 때마다 매출 1% 감소
그렉 린든의 스탠퍼드 강연 슬라이드 한 줄
구글·더블클릭 (2016. 9.)
3초 넘게 걸리면 모바일 방문의 53%가 떠남. 3G에서 모바일 사이트 평균 로딩 19초
모바일 도메인 1만여 곳 분석 보고서
BBC
로딩이 1초 늘 때마다 사용자의 10%가 떠남
BBC 수석 기술 아키텍트 매슈 클라크의 발언
핀터레스트 (2017~2018)
조작 가능 시점 23초 → 5.6초. 핵심 번들 650KB → 150KB. 체류 시간 +40%, 광고 수익 +44%. 1년 뒤 주간 활성 사용자 +103%, 가입 +843%
구글 애디 오스마니의 사례 연구, 핀터레스트 엔지니어링의 1년 회고
핀터레스트 사례는 X의 이번 일과 닮은 점이 많습니다. 23초를 5.6초로 줄였고, 처음부터 다시 썼고, 석 달 만에 내놓았습니다. 그리고 효과가 가장 컸던 곳은 통신 사정이 나쁜 시장이었습니다. 주간 활성 사용자가 브라질에서 156%, 인도에서 312% 늘었습니다.
빠른 나라에서는 보이지 않는 문제
여기서 속도는 돈을 넘어 형평의 문제가 됩니다. 앞에서 본 위젯으로 돌아가 '한국 가정 유선'을 눌러 보면 두 앱의 차이가 한눈에 줄어듭니다. 한국에서 x.com을 쓰는 사람은 22초를 본 적이 없을 가능성이 큽니다.
숫자로 보면 간격이 실감 납니다.
한국 모바일 중앙값
244Mbps
세계 모바일 중앙값
110Mbps
나이지리아
43Mbps
리비아 (100위)
20Mbps
러셀의 2026 기준선
9Mbps
X가 시험한 느린 4G
1.6Mbps
위 넷은 우클라 스피드테스트 글로벌 인덱스 2026년 9월의 모바일 내려받기 중앙값입니다. 러셀의 기준선은 「The Performance Inequality Gap, 2026」이 75번째 백분위 사용자를 흉내 내려고 잡은 값(9Mbps, 왕복 100ms)입니다. 막대는 244Mbps를 100%로 놓았습니다.
X가 시험에 쓴 느린 4G 조건(1.6Mbps, 왕복 150ms)은 한국 중앙값의 150분의 1쯤입니다. 한국의 감각으로는 극단처럼 보이지만, 중앙값은 말 그대로 가운데 값일 뿐입니다. 터널, 엘리베이터, 붐비는 경기장, 데이터가 소진돼 속도가 제한된 요금제에서는 한국에서도 이 속도를 만납니다. 그리고 세계에는 이것이 일상인 사람이 많습니다. 세계이동통신사업자연합회(GSMA)의 2026년 보고서에 따르면 모바일 인터넷 가입자의 13%가 아직 3G 스마트폰이나 피처폰을 씁니다. 사하라 이남 아프리카에서는 그 비율이 50%입니다. 저소득·중소득 국가의 가장 가난한 20%에게 보급형 단말기 한 대 값은 월 소득의 44%에 해당합니다.
PWA라는 이름을 붙였던 알렉스 러셀은 「성능 불평등 격차(The Performance Inequality Gap)」라는 연재를 여러 해째 고쳐 쓰고 있고, 2026년판이 여덟 번째입니다. 그의 논지는 단순합니다. 웹 개발자는 가장 좋은 기기와 가장 빠른 망으로 일하고, 그 책상 위에서 "충분히 빠르다"고 판단한 것을 세상에 내보냅니다. 그런데 자바스크립트는 내려받는 데서 끝나지 않고 전화기의 프로세서가 해석하고 실행해야 합니다. 값싼 전화기일수록 같은 코드가 몇 배 오래 걸립니다. 2026년판에서 그는 5초 안에 뜨는 페이지를 만들려면 자바스크립트를 많이 쓰는 사이트라도 전체 2.3MiB, 그 가운데 자바스크립트 1.15MiB 안에 들어와야 한다고 계산했습니다. 옛 x.com은 첫 게시물을 보여 주기도 전에 그 세 배를 받고 있었습니다.
트위터 라이트가 2017년에 내건 목표는 "느리거나, 불안정하거나, 비싼 연결에서 트위터를 쓰는 가장 좋은 방법"이었습니다. X의 원문은 마지막 문단에서 이 문장을 되불러 옵니다. 9년이 지났지만 목표는 같다고요. 광장이라는 말이 뜻을 가지려면, 광장에 들어오는 데 걸리는 시간이 사는 곳에 따라 열 배씩 달라서는 안 됩니다.
4. "절대 처음부터 다시 쓰지 마라"를 거스르기
문제를 알았다고 곧바로 새로 짓는 것은 아닙니다. 원문에 따르면 X 앞에는 세 가지 길이 있었습니다.
선택지
내용
원문이 든 한계
① 고쳐 쓰기
rweb을 지금 자리에서 계속 개선
서버 세 대가 그대로 남음. 로그아웃 방문자에게 서버 렌더링 HTML을 주려면 네 번째 렌더링 경로를 만들어야 함
② 도구만 바꾸기
구조는 두고 도구를 교체 — Webpack·Babel을 Vite로, Flow를 TypeScript로, Express를 Fastify로
교체 하나하나가 코드의 거의 모든 파일을 건드림. 다 끝나도 문제를 만든 구조는 그대로
③ 새로 짓기
모든 손님을 서버 하나로 맞는 새 앱을 만들고, rweb이 나머지를 맡는 동안 트래픽을 조금씩 옮기며 SSR 서버 둘을 흡수
—
X는 셋째를 골랐습니다. 그리고 이 선택이 업계의 오랜 금언과 부딪친다는 것을 스스로 알고 있었습니다.
2000년의 경고
2000년 4월 6일, 조엘 스폴스키(Joel Spolsky)는 「Things You Should Never Do, Part I」(절대 하지 말아야 할 일, 1부)이라는 글을 썼습니다. 넷스케이프 6의 첫 공개 베타가 막 나온 때였습니다. 넷스케이프는 브라우저 시장을 지배하던 회사였는데, 1998년에 기존 코드를 버리고 처음부터 다시 쓰기로 결정했습니다. 버전 4가 나온 지 거의 3년이 지나서야 다음 버전의 베타가 나왔고, 그 사이 시장은 넘어갔습니다. 스폴스키는 코드를 처음부터 다시 쓰는 것을 "소프트웨어 회사가 저지를 수 있는 단 하나의 가장 나쁜 전략적 실수"라고 불렀습니다.
그의 논거는 두 가지로 줄일 수 있습니다.
옛 코드는 지저분해 보여도 지식 덩어리다. 이상해 보이는 조건문 하나하나가 실제 사용자가 겪은 버그를 고친 흔적입니다. 새로 쓰면 그 지식을 버리고 같은 버그를 다시 만납니다. 그는 코드는 쓰기보다 읽기가 어렵고, 그래서 개발자는 늘 옛 코드를 실제보다 나쁘게 본다고 적었습니다.
다시 쓰는 동안 제품이 멈춘다. 새 코드가 옛 코드를 따라잡을 때까지 사용자에게 줄 새것이 없고, 경쟁자는 그동안 앞서갑니다.
그보다 훨씬 앞선 고전인 프레드 브룩스의 『맨먼스 미신』(1975)에는 '두 번째 시스템 효과'라는 말도 있습니다. 설계자가 첫 작품에서 참았던 욕심을 두 번째 작품에 전부 쏟아부어 비대한 물건을 만들게 된다는 경고입니다.
X의 답: 다시 쓰되, 한꺼번에 갈아타지 않는다
X의 원문은 이 반론을 직접 인용하고 답합니다. 답의 요지는 "우리는 넷스케이프처럼 하지 않았다"입니다.
트래픽을 조금씩 옮겼다. 로그아웃 방문자가 먼저, 그다음 로그인 사용자를 나라 단위로. 옮긴 집단은 언제든 되돌릴 수 있습니다.
옛 서버를 명세서로 썼다. 옛 서버가 주소 하나, 페이지 종류 하나를 어떻게 다뤘는지를 읽고 그대로 옮긴 뒤, 그 동작을 고정하는 테스트를 붙였습니다. 스폴스키가 말한 '코드에 쌓인 지식'을 버리지 않고 테스트로 옮겨 적은 셈입니다.
기간이 짧았다. 에이전트가 구현의 많은 부분을 맡아 재작성이 몇 달 만에 끝났고, 옛 제품이 앞서 달아날 시간이 거의 없었다고 원문은 적습니다.
이 방식에는 이름이 있습니다. 마틴 파울러(Martin Fowler)가 2004년에 붙인 교살자 무화과(Strangler Fig) 패턴입니다. 호주 퀸즐랜드의 열대 우림에서 본 무화과나무에서 따온 이름입니다. 이 나무는 다른 나무의 가지 위에서 싹을 틔워 뿌리를 아래로 내리고, 여러 해에 걸쳐 숙주 나무를 감싸며 자랍니다. 마침내 숙주가 사라지면 무화과나무가 그 자리에 홀로 서 있습니다. 옛 시스템의 가장자리부터 새 시스템이 기능을 하나씩 넘겨받고, 다 넘겨받은 뒤에 옛것을 치우는 이전 방식을 이렇게 부릅니다.
다시 쓰기가 늘 실패한 것도 아닙니다. 슬랙은 2019년 데스크톱 앱을 새로 만들면서 글 제목을 "다시 쓰기가 아닌 다시 쓰기"라고 붙였습니다. 한 코드 안에서 옛 부분과 새 부분 사이에 규칙을 두고 조금씩 바꿨기 때문입니다. 베이스캠프의 DHH는 2015년에 "우리는 처음부터 다시 썼고 훌륭하게 끝났다"고 썼는데, 조건이 있었습니다. 옛 제품을 기존 고객을 위해 계속 운영했다는 것입니다. 성공한 사례들의 공통점은 스폴스키의 경고를 무시한 것이 아니라, 경고가 가리킨 두 위험(지식을 잃는 것, 제품이 멈추는 것)을 따로 막았다는 데 있습니다.
버리지 않은 것들
원문에서 가장 어른스러운 대목은 「What we kept」(우리가 지킨 것)입니다. 다시 쓰기는 옛 코드를 실제보다 나쁘게 말하게 만드는 버릇이 있다고 먼저 인정하고, 옛 서버 셋에게서 무엇을 물려받았는지를 하나씩 적습니다.
rweb에게서제품 모델화면 크기·입력 방식·통신 조건에 맞춰 바뀌는 반응형 코드 한 벌. 그리고 GraphQL과 Relay
rweb SSR에게서주소가 깨지는 방식에 대한 지식끝에 문장부호가 붙은 검색어, 질의에 달라붙은 언어 매개변수, 메신저가 군더더기 문자로 감싼 링크를 바로잡는 규칙
Jetfuel SSR에게서검색을 진지하게 대하는 태도상세한 구조화 데이터, 모든 언어판으로 가는 링크, 없는 콘텐츠에 대한 진짜 404
그대로 가져간 것의 목록은 이렇습니다. 사람과 크롤러가 이미 의존하는 주소와 리다이렉트 전부, rweb SSR의 주소 정리 규칙, Jetfuel의 구조화 데이터·언어 링크·404 페이지(공용 컴포넌트로 다시 만듦), 그리고 Jetfuel이 그리던 링크 미리보기 카드 이미지. 카드 이미지는 새 Rust 서비스가 픽셀 하나까지 똑같이 다시 그립니다.
두 번째 카드가 스폴스키의 말을 그대로 증명합니다. "끝에 문장부호가 붙은 검색어"를 바로잡는 규칙은 설계 회의에서 나오지 않습니다. 누군가 메신저에 링크를 붙여 넣으며 마침표까지 함께 복사했고, 그 주소가 404를 냈고, 누군가 그것을 고쳤기 때문에 생긴 규칙입니다. 그런 수정 수백 개가 모여 있는 것이 오래된 서버입니다.
5. 새 구조 해부 — 서버 하나가 세 손님을 맞는 법
부품 목록
새 앱의 구성 요소를 원문은 이렇게 소개합니다. 낯선 이름이 많으니 역할로 풀어 적습니다.
부품
맡은 일
덧붙일 것
Vite + Rolldown
코드를 묶어 브라우저용·서버용 번들을 만들고 개발 서버를 돌림
로그아웃용과 로그인용 진입점을 따로 둬서, 로그아웃 페이지는 로그아웃 코드만 받음. Rolldown은 Rust로 쓴 번들러로 2026년 3월 Vite 8부터 Vite의 단일 번들러
React
서버와 브라우저 양쪽에서 화면을 그림
스트리밍 서버 렌더링과 Suspense 사용
Fastify
미들웨어부터 마지막 HTML 스트림까지 모든 요청을 처리하는 웹 서버
자체 패키지 @x-clients/server가 보안 헤더·쿠키·지표·스트리밍·안전한 종료를 설정으로 조립
Platformatic Watt
Node.js v26 위에서 한 프로세스 안에 워커 스레드 여러 개로 서버를 실행
이벤트 루프나 메모리가 한도를 넘긴 채 머무는 워커를 교체. 렌더 하나가 멈춰도 그 워커의 요청만 영향
Relay + GraphQL
데이터를 가져오고 캐시함
컴포넌트마다 자기가 필요한 데이터를 선언
XDS
X의 새 컴포넌트 라이브러리
버튼·메뉴·대화 상자·툴팁 등 40개 이상. Base UI와 Tailwind CSS 기반. X의 다른 웹 앱 다섯 개도 사용
TypeScript + tsrs
타입 검사
tsrs는 TypeScript 컴파일러의 Rust 이식판
Rust 카드 서비스
링크 미리보기에 뜨는 카드 PNG를 요청마다 그림
옛 자바스크립트 서비스는 장애 때 응답에 약 2분이 걸린 적이 있음
표에서 눈에 띄는 것은 tsrs입니다. 원문은 한 줄로 지나가지만, tsrs는 X 내부 도구가 아니라 공개 프로젝트입니다. 2026년 10월 20일 클라우드플레어가 보이드제로(VoidZero) 등과 함께 발표한 TypeScript 7 타입 검사기의 Rust 이식판으로, 발표문 스스로 실험 단계라고 밝혔고 아직 안정판이 없습니다. 인포큐 보도에 따르면 이 이식 작업 자체도 AI 에이전트가 적합성 시험 15,197건에 맞춰 수행했습니다. X의 글이 나온 날은 그 발표로부터 보름 뒤입니다. 발표된 지 몇 주 된 실험적 도구를 세계 6위 사이트의 개발 과정에 넣었다는 점은, 이 팀이 도구를 고르는 속도를 보여 주는 동시에 조심스럽게 볼 대목이기도 합니다.
하나 더. 원문에는 없지만, 2026년 7월 로그아웃 페이지가 새 앱으로 넘어갔을 때 이를 처음 알린 제인 만춘 웡(Jane Manchun Wong)의 관찰과 글쓴이의 확인에 따르면 라우터는 TanStack Router입니다. 원문은 "우리 라우터", "파일 기반 라우트 트리"라고만 적었습니다.
요청 하나가 들어오면
이제 핵심입니다. 새 서버는 누가 묻는지에 따라 같은 페이지를 세 가지 방식으로 내보냅니다.
사람에게는 스트리밍 HTML. 서버는 페이지 뼈대가 준비되는 즉시 보내고, 각 부분은 그 부분의 데이터가 도착하는 대로 이어서 흘려보냅니다. 응답 하나가 끝나지 않은 채 조금씩 길어지는 것입니다. 식당으로 치면 코스 요리입니다. 모든 요리가 다 될 때까지 손님을 굶기지 않고, 되는 것부터 내갑니다.
이를 가능하게 하는 React의 장치가 Suspense입니다. 화면의 한 구역을 Suspense로 감싸 두면 "이 구역은 데이터가 아직 안 왔으니 일단 자리표시자를 보내고, 준비되면 진짜 내용으로 바꿔 끼우라"는 뜻이 됩니다. 2021년 React 18이 이 방식을 내놓으면서 든 이유가 정확히 지금의 문제였습니다. 이전의 서버 렌더링은 모든 데이터를 다 가져와야 무엇이든 보여 줄 수 있었고, 느린 부분 하나가 페이지 전체를 붙들었습니다.
검증된 검색 크롤러에게는 완성 문서. 크롤러는 스트리밍의 덕을 보지 못합니다. 그래서 서버는 모든 구역이 다 그려질 때까지 기다렸다가 문서를 통째로 한 번에 보냅니다. 구조화 데이터가 들어 있고, Suspense 구역도 전부 제자리에 채워진 문서입니다.
여기에 영리한 판단이 하나 들어 있습니다. 크롤러인지 아닌지를 무엇으로 알아볼까요. 흔한 방법은 요청에 달려 오는 User-Agent 헤더(브라우저나 봇이 자기 이름을 적는 칸)를 보는 것입니다. X는 이 방법을 쓰지 않고, 에지가 크롤러의 IP 주소를 검증한 결과로 판단합니다. 원문이 든 이유는 둘입니다.
헤더로 판단하면 라이트하우스 같은 성능 측정 도구까지 크롤러로 취급돼 '다 기다렸다 보내는' 경로를 타게 됩니다. 그러면 측정 도구가 재는 페이지와 사람이 받는 페이지가 달라집니다.
헤더는 누구나 바꿀 수 있습니다. 헤더만 고치면 서버에 더 비싼 일을 시킬 수 있다는 뜻이고, 그것은 공격 통로입니다.
구글도 같은 조언을 합니다. 구글 검색 문서는 구글봇을 사칭하는 요청이 있다는 점을 들어, IP 주소를 역방향 DNS로 조회해 구글 도메인인지 확인하거나 구글이 공개한 IP 대역과 대조하라고 안내합니다. X의 새 서버에서 확인되지 않은 IP가 구글봇을 자처하면, 그 요청은 로그아웃한 사람과 똑같은 대접을 받습니다.
이 대목은 구글이 오래 조심시켜 온 문제와도 닿아 있습니다. 봇에게만 미리 그려 둔 페이지를 주는 방식을 구글은 '동적 렌더링'이라고 부릅니다. 구글 문서는 2019년에 이미 이것을 임시방편이라 했고, 2022년에는 권장하는 해법이 아니라고 고쳐 적었으며, 지금은 서버 렌더링이나 하이드레이션을 쓰라고 권합니다. X의 옛 구조(사람은 rweb, 크롤러는 SSR 서버)는 사실상 그 임시방편을 큰 규모로 굴린 것이었습니다. 새 구조에서 사람과 크롤러가 받는 것은 같은 코드가 만든 같은 내용이고, 다른 것은 보내는 방식뿐입니다.
크롤러용 문서에는 한 가지가 더 빠져 있습니다. 하이드레이션을 하지 않습니다. 크롤러는 버튼을 누르지 않으니까요. 그래서 클라이언트 자바스크립트 번들도, 라우터 상태도, 자바스크립트가 나중에 바꿔 끼울 자리표시자도 싣지 않습니다. 이것이 왜 중요한지는 8장에서 2MB라는 숫자와 함께 다시 나옵니다.
링크 미리보기 봇에게는 머리 태그만. 서버는 데이터 로딩과 머리 태그(제목, 설명, 카드 이미지 주소) 생성만 하고 본문 렌더링을 통째로 건너뜁니다. 본문에만 필요한 타임라인·대화 요청은 보내지도 않습니다. 원문이 이름을 든 봇은 슬랙, 아이메시지, 디스코드, 왓츠앱, 시그널, 페이스북, 링크드인, 텔레그램, 스냅챗입니다. 이 카드 규격의 뿌리는 페이스북이 만든 오픈 그래프 프로토콜과 트위터 자신이 2012년 6월에 내놓은 트위터 카드입니다. 트위터가 만든 규격을 14년 뒤 X가 가장 싸게 서빙하는 방법을 찾은 셈입니다.
하이드레이션: 그림에 숨을 불어넣기
여기까지 읽으면 궁금해집니다. 서버가 HTML을 다 그려 보냈다면 자바스크립트는 왜 또 필요할까요.
서버가 보낸 HTML은 그림입니다. 좋아요 버튼이 그려져 있지만, 누르면 무슨 일이 일어나야 하는지는 그림에 없습니다. 브라우저에서 자바스크립트가 실행되면서 그려진 버튼 하나하나에 동작을 연결하는데, 이 과정을 하이드레이션(hydration)이라고 부릅니다. 말린 식재료에 물을 부어 되살린다는 뜻에서 온 말입니다.
문제는 그림이 도착한 때와 숨이 붙는 때 사이의 틈입니다. 버튼은 보이는데 눌러도 반응이 없습니다. 2016년 폴 루이스가 '불쾌한 골짜기'라고 부른 구간입니다. 스트리밍과 만나면 이 틈이 뜻밖의 방식으로 벌어지는데, X가 실제로 겪고 고친 문제입니다. 아래 위젯에서 직접 눌러 보세요.
원인은 스크립트를 불러오는 방식 한 단어였습니다. HTML 표준에서 defer가 붙은 스크립트는 "문서 파싱이 끝났을 때" 실행됩니다. 모듈 스크립트(type="module")는 따로 적지 않아도 이 방식이 기본입니다. 보통 문서라면 문제가 없습니다. 그런데 스트리밍 문서는 마지막 조각이 도착해야 파싱이 끝납니다. 답글 목록 하나가 5초 늦으면, 이미 화면에 떠 있는 뼈대와 원 게시물까지 5초 동안 죽어 있게 됩니다. 빨리 보내려고 스트리밍을 했는데, 하이드레이션은 가장 느린 조각을 기다리고 있었던 것입니다.
X는 진입 스크립트를 async 모듈로 바꿨습니다. async는 "내려받는 즉시, 파싱이 끝나기 전이라도" 실행하라는 뜻입니다. React가 뼈대에 먼저 붙고, 각 구역은 HTML이 도착하는 대로 살아납니다. 대화 질의에 서버 쪽 지연 5초를 건 시험에서, React는 589ms에 페이지에 붙었고 문서 파싱은 6,017ms에 끝났습니다. 속성 하나를 바꿔 5초 넘는 틈을 없앤 것입니다.
데이터를 한 번만 묻기
서버에서 그리는 앱에는 오래된 낭비가 하나 있습니다. 서버가 게시물 데이터를 가져와 HTML을 만들었는데, 브라우저가 하이드레이션하면서 같은 데이터를 또 요청하는 것입니다. 브라우저의 React도 무엇을 그려야 하는지 알아야 하니까요.
새 앱의 방식은 이렇습니다.
서버
모든 경로(route)가 필요한 데이터를 미리 선언합니다. 요청이 오면 서버가 렌더링을 하는 동안 경로 로더가 GraphQL 요청을 시작합니다. 그리기 시작한 뒤에 데이터를 찾는 것이 아니라, 둘을 나란히 돌립니다.
페이지
서버가 받은 GraphQL 응답을 한 번씩, JSON 글자 그대로 페이지에 실어 보냅니다.
브라우저
빈 Relay 저장소로 시작해 그 응답들을 재생해 넣습니다. 컴포넌트가 서버가 이미 가져온 데이터를 찾으면 통신 없이 그 응답을 받습니다. 아무도 읽지 않은 응답은 스트림이 끝난 뒤 30초 동안 쥐고 있어서, 곧 열리는 탭이나 대화 상자도 그것을 찾아 씁니다.
Relay는 페이스북이 GraphQL과 함께 만든 데이터 라이브러리입니다. GraphQL은 2012년 페이스북이 모바일 앱을 다시 만들면서 내부에서 쓰기 시작해 2015년에 공개한 질의 언어로, "필요한 것을 필요한 모양 그대로 한 번에 묻는다"는 생각이 뼈대입니다. Relay는 여기에 한 가지를 더합니다. 화면의 각 컴포넌트가 자기에게 필요한 데이터를 조각(fragment)으로 선언하면, Relay가 그 조각들을 모아 질문 하나로 만듭니다. 컴포넌트마다 따로 물으면 "느리고 순차적인 왕복이 여러 번" 생긴다는 것이 Relay 문서가 드는 이유입니다. 앱 셸의 병을 고치는 약이 이미 그 안에 있었던 셈입니다. rweb이 X를 GraphQL과 Relay로 옮겨 둔 덕에 새 앱이 그 위에 바로 설 수 있었다고 원문은 적습니다.
화면 사이를 오갈 때도 같은 원리를 씁니다. 링크에 마우스를 올리거나 초점을 주면, 곧 가려는 의도를 보이면 그 경로의 코드와 데이터를 미리 받습니다. 타임라인의 게시물은 단순한 링크가 아니라서 규칙이 따로 있습니다. 마우스가 게시물 위에 올라가 100ms 머물거나 눌렀을 때 미리 받습니다. 가만히 있는 마우스 아래로 스크롤되어 지나가는 게시물은 미리 받지 않습니다. 사소해 보이지만, 이 한 줄이 없으면 스크롤할 때마다 지나가는 게시물 수십 개를 헛되이 받아 오게 됩니다.
원문은 여기서 옛 앱의 손을 들어 주기도 합니다. rweb은 브라우저 캐시에 데이터를 워낙 많이 쥐고 있어서 화면 사이 이동이 즉시처럼 느껴질 때가 많았고, 이 점은 새 앱이 아직 따라잡는 중이라는 것입니다. 첫 화면은 서버가, 그다음 화면은 브라우저가 잘한다는 2장의 진자가 여기서도 그대로 보입니다.
6. 엔지니어 다섯 명과 에이전트들
원문에서 가장 많이 인용될 문장은 아마 이것입니다. 세계 6위 사이트의 새 웹 앱 첫 버전을 엔지니어 다섯 명이 AI 코딩 에이전트와 함께 여섯 달이 안 되어 만들었다. (원문은 앞에서 "다섯 명", 뒤에서 "다섯 명 미만"이라고 적어 표현이 조금 엇갈립니다. 로그인 페이지가 넘어오면서 팀은 커졌고, 9월 말 이후 이 앱에 커밋한 사람은 20명이 넘습니다.)
역할 분담은 분명합니다. 엔지니어가 구조를 정하고, 무엇을 만들지 결정하고, 모든 변경을 검토했습니다. 에이전트는 구현의 많은 부분을 맡았습니다. 옛 서버의 동작 옮기기, 페이지 변환, 테스트 작성, CI와 검토자가 지적한 것 고치기.
이것이 통하려면 에이전트가 내놓는 결과물을 믿을 수 있어야 합니다. 원문은 그 신뢰를 만든 장치 셋을 듭니다.
① 공용 지침서. 저장소 맨 위에 AGENTS.md라는 파일 하나를 둡니다. 이 팀이 코드를 쓰는 방식이 적혀 있습니다. 이름 붙인 내보내기만 쓸 것, 배럴 파일(여러 모듈을 한데 모아 다시 내보내는 파일)을 만들지 말 것, 외부에서 온 데이터는 신뢰 경계에서 검증할 것, 어떤 테스트가 쓸 가치가 있는지, 그리고 린트·타입 검사·관련 테스트가 통과하기 전에는 아무것도 커밋하지 말 것. 에이전트도, 새로 온 엔지니어도 같은 규칙에서 출발합니다. AGENTS.md는 코딩 에이전트에게 주는 지침을 담는 공개 형식으로, 지금은 리눅스 재단 산하 재단이 관리하고 공식 사이트 기준 6만 개가 넘는 오픈소스 프로젝트가 씁니다.
② 저장소 안의 스킬. 되풀이되는 작업 절차를 코드 옆에 '스킬'로 적어 두고 에이전트가 단계별로 따르게 합니다. 25개가 넘습니다. 커밋 작성, 풀 리퀘스트 열기와 쌓기, 코드 검토, 풀 리퀘스트를 CI 끝까지 몰고 가기, 의존성 변경, 번역 추가, Relay와 라우터 다루기. 절차가 바뀌면 스킬을 한 번 고치고, 모든 에이전트가 그것을 따릅니다.
③ 커밋마다 걸리는 가드레일. 팀의 관례를 린트 규칙으로 바꿨습니다. 자체 oxlint 플러그인이 Relay 사용법, Tailwind 클래스, 테스트, 번역을 검사합니다. 그리고 원문이 "네, 있습니다" 하고 덧붙이는 것이 안티 슬롭(anti-slop) 플러그인입니다. 에이전트가 잘 만들어 내는 무늬를 거부합니다. 연쇄 타입 단언, unknown으로 적은 매개변수, 빈 객체의 조건부 전개 같은 것들입니다. 커밋 전 훅이 모든 변경을 포맷·린트·타입 검사하고, 푸시 전 훅은 그 변경을 가져다 쓰는 패키지까지 린트합니다.
세 장치를 겹쳐 보면 설계 원리가 보입니다. 말로 부탁할 수 있는 것은 지침서에, 절차는 스킬에, 어겨서는 안 되는 것은 기계가 막는 규칙에. 사람 팀에서도 똑같이 통하는 원칙이지만, 에이전트와 일할 때는 셋째가 훨씬 무거워집니다. 지침서는 읽고도 어길 수 있지만 린트 오류는 어길 수 없으니까요.
왜 이 일이 에이전트에게 잘 맞았나
원문은 이 이전 작업이 에이전트에게 유독 잘 맞았던 이유를 한 문장으로 설명합니다. 옛 서버 둘이 '작동하는 명세서'였기 때문입니다.
읽기에이전트가 옛 서버가 어떤 주소나 페이지 종류를 어떻게 처리했는지 읽는다
옮기기그 동작을 새 앱에 옮기고, 동작을 고정하는 테스트를 쓴다
대조검토자가 결과를 원본과 견줘 확인한다. 대조 스크립트가 두 서버의 응답을 나란히 비교한다
이 구조가 중요한 이유는 정답이 이미 존재한다는 데 있습니다. "좋은 프로필 페이지를 만들어 줘"는 정답이 없는 주문입니다. "이 주소를 옛 서버에 넣으면 이 응답이 나온다, 새 서버도 똑같이 나오게 해 줘"는 채점할 수 있는 주문입니다. 에이전트가 틀리면 대조 스크립트가 잡아냅니다.
2026년에 나온 큰 규모의 에이전트 재작성 사례들을 나란히 놓으면 같은 무늬가 보입니다.
사례
규모
정답 구실을 한 것
뒤따른 지적
구글 내부 코드 이전 (2025. 4. 논문)
이전 39건, 개발자 3명, 12개월. 변경 595건 중 74%를 LLM이 생성
기존 코드와 테스트
개발자 추정으로 시간 50% 절감 — 자체 보고
클라우드플레어 vinext (2026. 2.)
엔지니어 1명, 1주 미만, 토큰 약 1,100달러. Next.js 16 API의 94%
Next.js의 공개 API와 테스트 2천여 개
보안 업체 핵트론이 취약점 24건 확인(치명 4, 높음 7). "모델의 목표는 테스트 통과"
Bun의 Zig → Rust 이식 (2026. 7.)
Zig 53만 줄, 에이전트 64개, 병합까지 11일, API 가격으로 약 16만 5천 달러
기존 테스트 모음
병합 뒤 의미상 퇴행 19건, 보안 검토 11회. Zig 창시자는 "검토 안 된 100만 줄"이라 비판
tsrs (2026. 10.)
TypeScript 7 타입 검사기의 Rust 이식
적합성 시험 15,197건
아직 실험 단계, 감시 모드·언어 서버 없음
X 웹 (2026. 11.)
엔지니어 5명, 6개월 미만
작동 중인 옛 서버 둘 + 대조 스크립트
팀 규모·기간은 자체 보고. 독립 검증 없음
표의 셋째 열이 전부 채워져 있다는 점이 핵심입니다. 에이전트가 빠르게 다시 쓴 사례는 예외 없이 기계가 채점할 수 있는 정답을 쥐고 있었습니다. 그리고 넷째 열이 경고합니다. 테스트를 통과했다는 것과 안전하다는 것은 다릅니다. vinext가 보여 줬듯 에이전트는 테스트가 재지 않는 것(보안, 유지보수성)을 스스로 챙기지 않습니다.
X의 방식이 이 사례들과 갈리는 지점은 두 가지입니다. 하나는 모든 변경을 사람이 검토했다고 밝힌 것입니다. Bun 사례에서 가장 크게 비판받은 것이 바로 검토되지 않은 분량이었습니다. 다른 하나는 한꺼번에 갈아타지 않았다는 것입니다. 새 코드에 문제가 있어도 그 영향은 지금 옮겨 놓은 집단에 그치고, 스위치 하나로 되돌릴 수 있습니다. 점진 이전은 스폴스키의 경고에 대한 답이면서, 동시에 에이전트가 쓴 코드를 안전하게 받아들이는 장치이기도 합니다.
원문은 엔지니어의 일이 어떻게 바뀌었는지도 적습니다. 코드를 쓰는 시간이 줄고, 시스템이 무엇을 해야 하는지 결정하는 시간과 실제 브라우저에서 정말 그렇게 하는지 확인하는 시간이 늘었다는 것입니다. 마지막 구절이 눈에 남습니다. 테스트가 통과했다는 보고를 믿는 것이 아니라, 브라우저를 열어 확인합니다.
덧붙일 단서가 하나 있습니다. 한 기술 매체가 짚었듯, 에이전트 이야기가 속도 향상의 원인을 증명하는 것은 아닙니다. 22초가 2.7초가 된 것은 구조를 바꿨기 때문이고, 에이전트는 그 구조를 구현하는 데 걸린 시간을 줄였습니다. 둘은 다른 주장입니다.
7. 이사 — 가장 까다로운 손님부터
새 집을 다 지었다고 이사가 끝난 것은 아닙니다. 원문에서 이전 과정은 두 단계로 나옵니다.
검색 크롤러 먼저
뜻밖에도 X는 가장 위험한 손님부터 옮겼습니다. 원문의 표현으로는, 크롤러 트래픽을 옮기는 일이 웹 이전에서 가장 위험한 부분입니다. 검색 엔진은 모든 것을 알아차리기 때문입니다. 구조화 데이터 필드 하나가 빠진 것, 대표 주소(canonical URL)가 바뀐 것, 리다이렉트이던 것이 404가 된 것. 사람은 눈치채지 못할 차이가 검색 순위를 흔듭니다.
방법은 4장에서 본 그대로입니다. 두 SSR 서버를 명세서로 삼아, 페이지 종류마다 옛 서버가 돌려준 것과 새 앱이 돌려준 것을 비교하고 차이를 하나씩 메웠습니다. 이 비교를 되풀이할 수 있게 만든 것이 작은 대조(parity) 스크립트입니다. 같은 경로를 두 서버에 검증된 구글봇 자격으로 요청하고, 검색 엔진이 읽는 것만 골라 비교합니다.
대조 스크립트가 비교하는 항목 (원문)
응답
상태 코드와 리다이렉트
머리 태그
제목 · 설명 · 대표 주소(canonical) · robots 태그 · 오픈 그래프 태그와 X 카드 태그
구조
언어별 대체 링크의 개수 · 구조화 데이터의 종류
일정은 이렇게 흘렀습니다.
2026. 6.
새 앱과 옛 앱을 나란히 놓고 찍은 첫 녹화. 느린 4G에서 약 18초 대 약 3초
8. 1.
Jetfuel SSR 은퇴
9월 초
rweb SSR이 맡던 크롤러 트래픽 전부를 새 앱이 처리. rweb SSR 종료. 그 배포·빌드 설정을 걷어 내며 rweb에서 약 36,000줄 삭제
9월 중순
Jetfuel의 서버 렌더링·이미지 서비스 코드도 저장소에서 삭제
11월
로그아웃 x.com 전체가 새 앱. 로그인 사용자는 나라 단위로 이전 중
그다음 사람, 한 나라씩
로그인한 사용자는 나라 단위로 옮깁니다. 장치는 둘입니다.
에지가 요청마다 서버를 고릅니다. 경로와 '누가 묻는지'를 보고 어느 서버가 답할지 정합니다. 어떤 경로가 새 앱 것인지는 앱 스스로 알려 줍니다. 앱 옆에 놓인 설정 파일(ngroutes)이 앱의 파일 기반 경로 목록을 읽어 배포할 때마다 에지에 알립니다. 새 앱에 없는 경로는 rweb으로 갑니다. 사람이 경로 목록을 손으로 맞추지 않으니, 목록과 실제가 어긋날 틈이 없습니다.
기능 스위치가 누가 새 앱을 받을지 정합니다. 앱을 다시 배포하지 않고도 대상을 바꿀 수 있고, 빼낸 사람은 곧바로 rweb으로 돌아갑니다. 첫 나라에서는 로그인 사용자를 실험군과 대조군으로 나눠, 일부는 새 앱을 받고 나머지는 rweb에 남습니다. 실제 트래픽에서 두 앱을 견주기 위해서입니다.
로그인 페이지는 먼저 lite.x.com에서 다시 만들어지고 직원과 시험 참가자가 써 본 뒤 넘어옵니다. 주소 이름이 눈에 띕니다. 2017년의 '트위터 라이트'에서 온 이름일 것입니다.
이전 기간에는 두 앱이 같은 기능을 따로 만들지 않도록 하는 장치도 필요합니다. X 채팅이 대표적입니다. rweb과 새 앱 둘 다 모듈 페더레이션(Module Federation)으로 chat.x.com에서 채팅 코드를 실행 시점에 불러옵니다. 모듈 페더레이션은 따로 배포된 자바스크립트 앱끼리 코드를 실행 중에 나눠 쓰는 기술입니다. 덕분에 어느 쪽 앱을 쓰든 chat.x.com이 내놓는 같은 채팅이 돕니다. 통화(X Calls)와 송금(Money)도 같은 방식이고, 새 앱은 Money에 자기가 이미 가진 React와 공용 라이브러리를 빌려줘서 Money 첫 화면이 받는 코드를 590KB에서 509KB(gzip 기준)로 줄였습니다.
8. 2.7초는 공짜가 아니었다 — 성능 작업 일곱 가지
원문은 2.7초가 구조를 바꾸자마자 나온 숫자가 아니라고 분명히 합니다. 6월의 새 앱은 느린 망에서 옛 앱보다 약 여섯 배 빨랐지만 고칠 곳이 많았습니다. 9월 1일 이후 perf 꼬리표가 붙은 커밋이 80개 넘게 들어갔습니다.
이 장이 원문의 백미입니다. 하나하나가 "측정해 보니 예상과 달랐다"는 이야기이고, 웹 성능의 교과서 같은 사례들입니다. 원문은 숫자마다 어디서 잰 것인지(실험실의 프로덕션 빌드, 개발 서버, 변경 전 실제 서버군)를 밝혀 두었습니다.
① 답장은 왔는데 타임아웃 — 이벤트 루프 정지
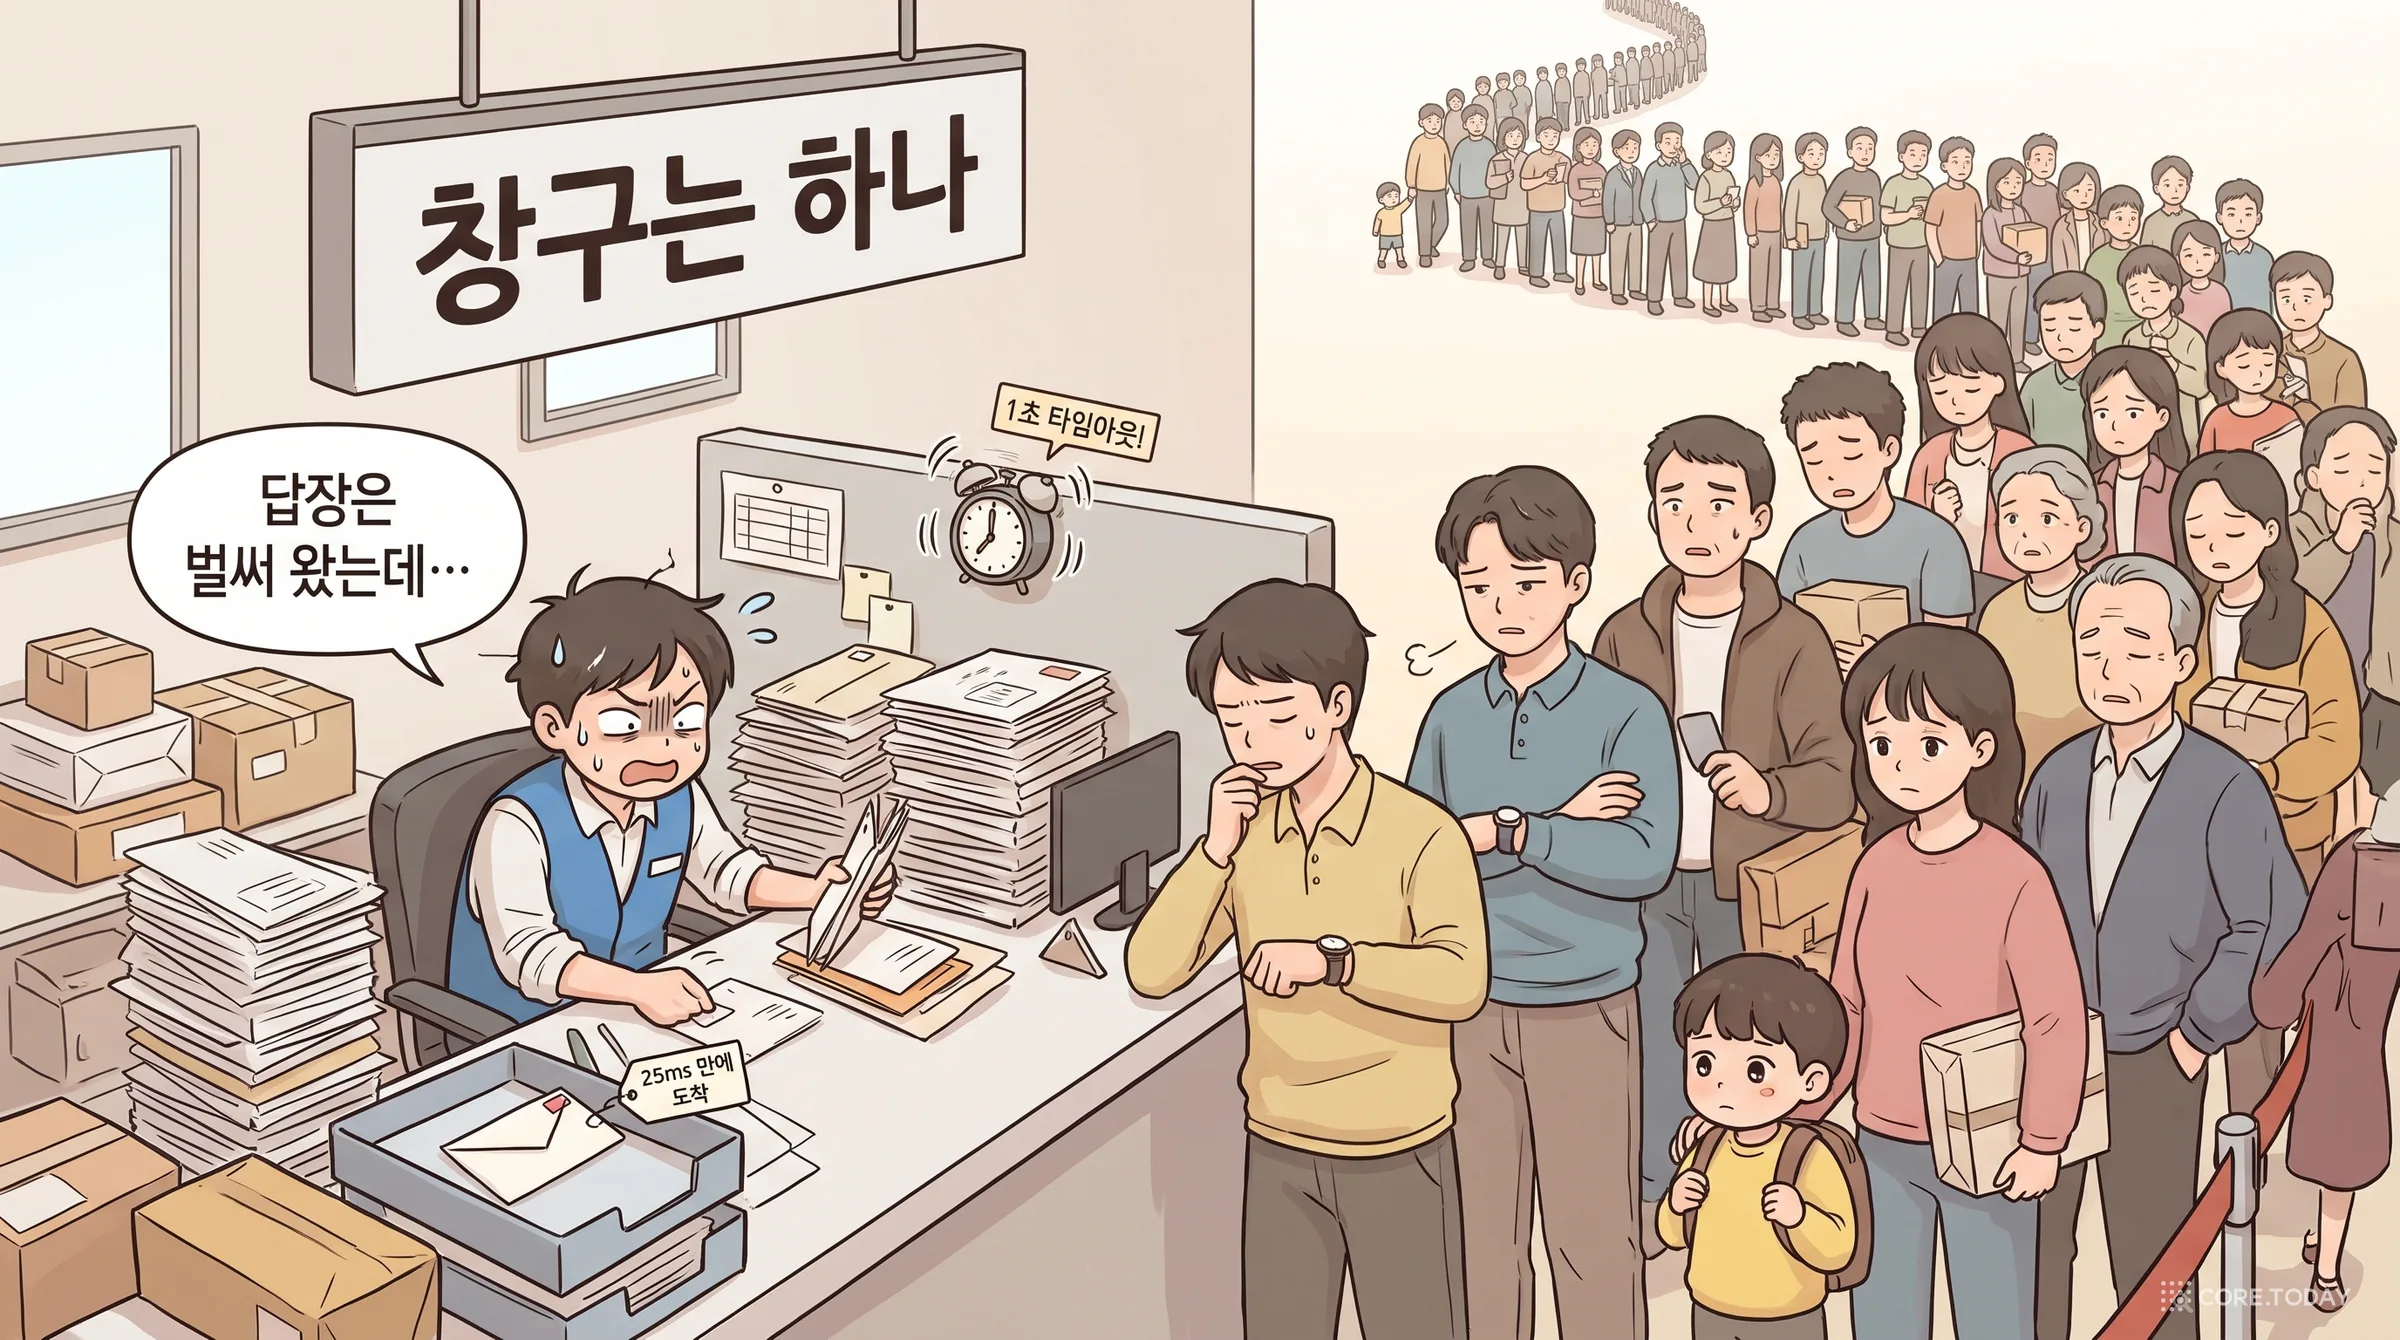
가장 재미있는 사례부터 봅니다. 로그아웃 렌더링 중에 어떤 내부 서비스로 보내는 요청에 1초 타임아웃이 걸려 있었습니다. 이 타임아웃이 로그아웃 렌더의 1~9%에서 터졌습니다. 그런데 그 서비스는 약 25ms 만에 답하고 있었습니다.
Node.js 서버는 이벤트 루프 하나로 일합니다. 창구 직원이 한 명인 우체국을 떠올리면 됩니다. 직원은 한 번에 한 가지 일만 하고, 하던 일을 끝내야 다음 일을 봅니다. 평소에는 일이 잘게 쪼개져 있어서 여러 손님을 번갈아 응대하는 것처럼 보입니다. 그런데 React가 큰 페이지를 그리는 계산처럼 쪼갤 수 없는 일이 들어오면, 그 일이 끝날 때까지 직원은 고개를 들지 못합니다. 이것이 이벤트 루프 정지입니다.
X가 10월에 실제 서버군에서 잰 값은 이랬습니다. 워커 하나의 이벤트 루프가 바쁜 시간의 비율이 중앙값 약 67%, p95(100대 중 95번째로 바쁜 워커)는 84%. 피크 때 가장 긴 정지는 중앙값 약 1.9초, p95는 3.7초.
이제 수수께끼가 풀립니다. 답장은 25ms에 우편함에 도착했습니다. 하지만 직원이 1.9초짜리 일에 붙들려 있습니다. 일을 마치고 고개를 든 직원 앞에는 뜯지 않은 답장과, 이미 기한이 지난 1초짜리 알람이 함께 놓여 있습니다. 원문의 표현으로, 정지한 이벤트 루프는 이미 도착한 응답을 처리하기 전에 타이머를 먼저 터뜨릴 수 있습니다. 서버 기록에는 "상대가 1초 안에 답하지 않았다"고 남습니다. 느렸던 쪽은 자기 자신인데도요.
이 사례의 교훈은 증상이 가리키는 곳과 원인이 있는 곳이 다르다는 것입니다. 타임아웃 기록만 보면 누구나 상대 서비스를 의심하거나 타임아웃을 2초로 늘리려 할 것입니다. 둘 다 헛일입니다. X의 처방은 렌더링 워커를 늘리는 것이었습니다. 워커 하나는 스레드 하나에서 렌더링하므로, 같은 트래픽을 더 많은 워커에 펴면 이벤트 루프 하나가 맡는 몫이 줄어듭니다. 5장의 부품 목록에 있던 Platformatic Watt가 여기서 일합니다. 한 프로세스 안에서 워커 스레드를 여럿 돌리고, 이벤트 루프나 메모리가 한도를 넘긴 채 머무는 워커를 갈아 끼웁니다.
② 필요 없는 줄서기 없애기 — 게스트 토큰
로그아웃 렌더에는 게스트 토큰(로그인하지 않은 방문자용 임시 신분증)과 그 방문자에게 적용할 기능 플래그가 필요합니다. 서버는 게스트 토큰 요청이 돌아온 뒤에 기능 플래그를 요청하고 있었습니다. 그런데 기능 플래그 요청은 토큰을 쓰지 않습니다. 기다릴 이유가 없었던 것입니다.
지금은 두 요청이 함께 출발합니다. 왕복 한 번이 사라졌고, 게스트 토큰 요청이 느리거나 속도 제한에 걸려도 기능 플래그는 늦어지지 않습니다. 코드에서 await 두 줄이 위아래로 놓여 있으면, 둘째 줄이 정말 첫째 줄의 결과를 쓰는지 물어볼 일입니다.
③ 정리된 장부 대신 원본 영수증 — Relay 저장소
5장에서 본 "서버가 받은 응답을 한 번씩 페이지에 싣는다"는 방식은 처음부터 그랬던 것이 아닙니다. 처음에는 서버가 자기 Relay 저장소를 직렬화해 페이지에 싣고, 저장소가 갱신될 때마다 그 내용을 흘려보냈습니다.
Relay 저장소는 정규화돼 있습니다. 같은 사용자가 게시물 열 개에 나오면 사용자 정보를 한 번만 저장하고 나머지는 참조로 잇는, 잘 정리된 장부입니다. 메모리 안에서는 효율적인 구조입니다. 그런데 이것을 글자로 풀어 페이지에 실으니 원래의 GraphQL 응답보다 네댓 배 컸습니다. 레코드마다 식별자와 참조 표기가 붙기 때문입니다.
지금은 정리된 장부 대신 원본 영수증(GraphQL 응답 JSON)을 그대로 싣고, 브라우저가 JSON.parse로 읽어 자기 저장소에 재생합니다. 정리는 받는 쪽이 합니다. "더 잘 정리된 형태가 전송에도 더 좋을 것"이라는 직관이 틀린 사례입니다.
④ 구글봇의 가위 — 2MB 예산
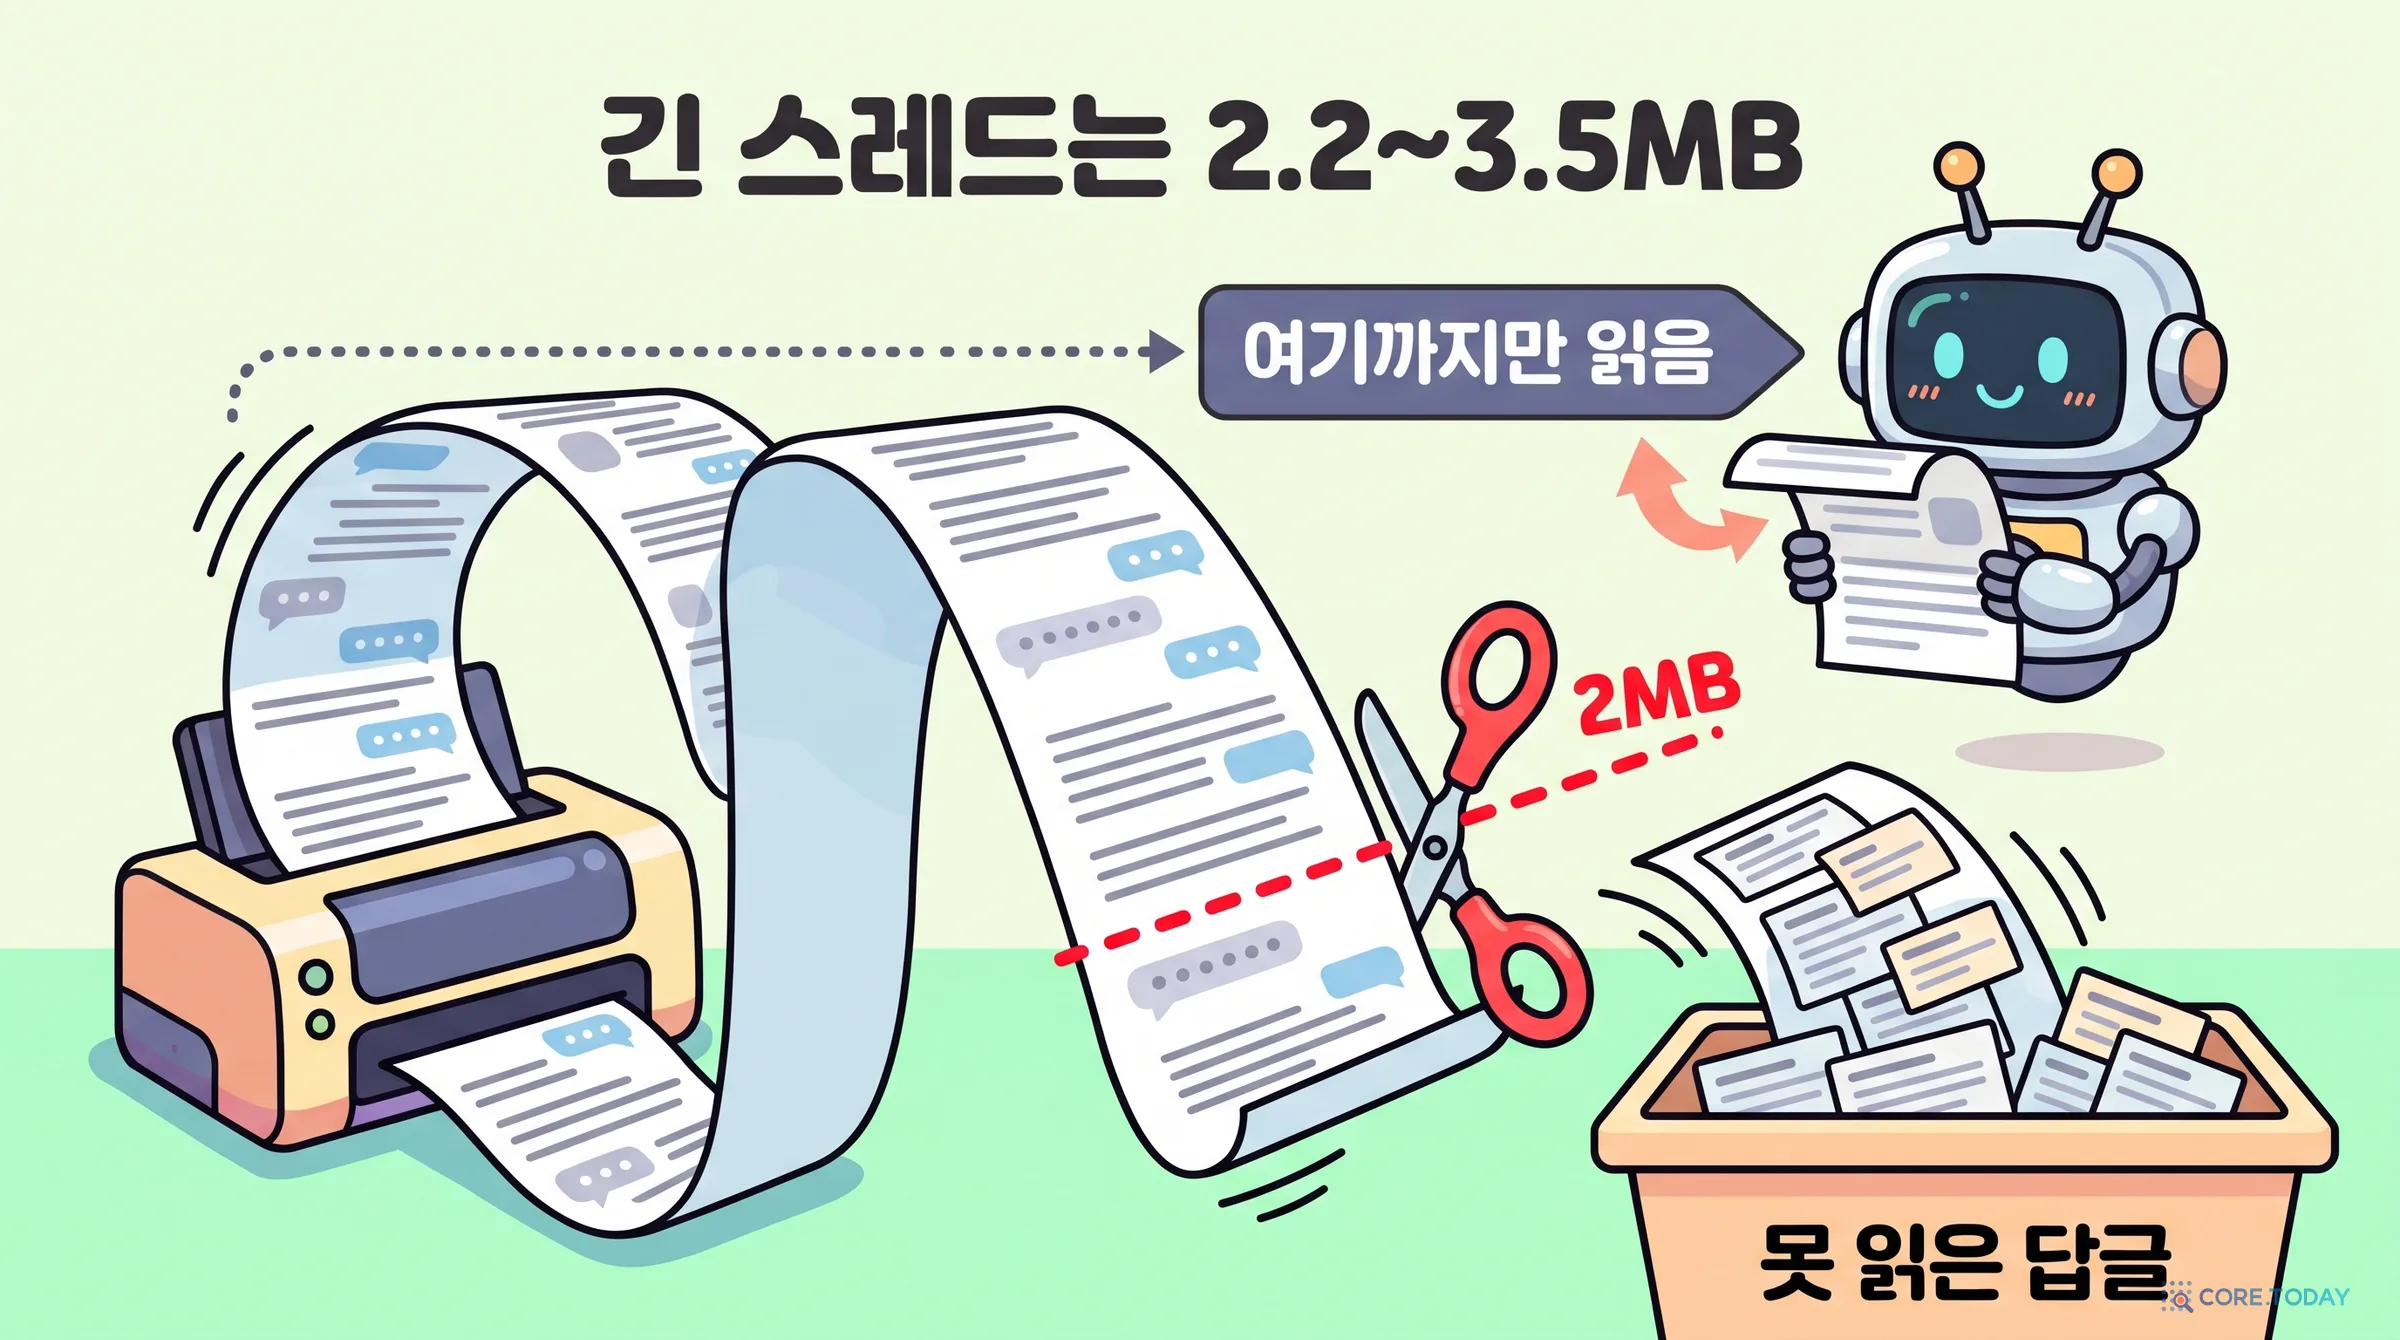
5장에서 미뤄 둔 이야기입니다. 구글 검색 문서에는 이런 문장이 있습니다. 구글 검색을 위해 크롤링할 때 구글봇은 지원하는 파일 형식의 앞쪽 2MB를 크롤링한다는 것입니다. 압축을 푼 크기 기준입니다. (구글은 오랫동안 이 한도를 15MB로 알려 왔고, 2026년 2월 3일 문서를 고치면서 15MB는 구글 크롤러 전반의 기본값이고 구글봇은 2MB라고 구분해 적었습니다. 구글은 이를 새 한도의 발표가 아니라 문서의 명확화라고 설명합니다.)
X에서 긴 스레드의 HTML은 2.2~3.5MB였습니다. 2MB에서 잘리면 그 뒤의 답글은 구글에게 없는 글입니다. 더 나쁜 것은 구조화 데이터입니다. "이 페이지에는 이런 게시물들이 있다"고 선언해 놓았는데, 그 게시물의 본문은 구글이 읽지 못한 뒤쪽에 있었습니다.
X는 세 가지를 고쳐 문서를 예산 안으로 넣었습니다.
수정
이전
이후
절감
아이콘 스프라이트
게시물마다 동작 아이콘 7개의 그림 전체(약 2KB)와 인증 배지(775바이트)를 반복
빌드 시점 플러그인이 아이콘을 문서 맨 위의 숨은 스프라이트에 한 번만 넣고, 게시물은 참조만
@elonmusk 프로필 165KB(14.2%), 긴 스레드 340KB(13.6%)
사진 구조화 데이터
사진마다 게시물 본문을 2번, 사진 주소를 3번 반복
구글이 이미지용으로 읽는 주소 하나만 남기고, 설명은 사진 자체의 대체 텍스트로
사진 많은 스레드 450KB(13.0%)
자바스크립트용 출력 제거
시간 표시 스크립트, 라우터 상태, 뼈대 게시물, 로그인 버튼
크롤러 문서에서는 뺌
게시물 137개 스레드 54KB
아래 위젯으로 스레드 길이와 사진 비율을 바꿔 가며, 세 수정이 각각 얼마나 벌어 주는지 확인해 보세요.
세 수정의 공통점은 사람이 보는 화면을 하나도 바꾸지 않았다는 것입니다. 같은 그림을 한 번만 그리고, 같은 말을 한 번만 했을 뿐입니다. 그리고 이 문제는 크롤러에게 '다 기다렸다 보내는 문서'를 따로 줄 수 있는 구조여야 풀 수 있습니다. 사람과 크롤러가 한 서버를 쓰면서도 보내는 방식을 달리한 5장의 설계가 여기서 값을 합니다.
⑤ 뼈대부터 숨 붙이기 — async 모듈
5장의 위젯에서 이미 다뤘습니다. defer 모듈을 async 모듈로 바꿔, 가장 느린 조각을 기다리지 않고 뼈대부터 하이드레이션하게 한 일입니다. 시험값은 React 부착 589ms, 문서 파싱 완료 6,017ms였습니다.
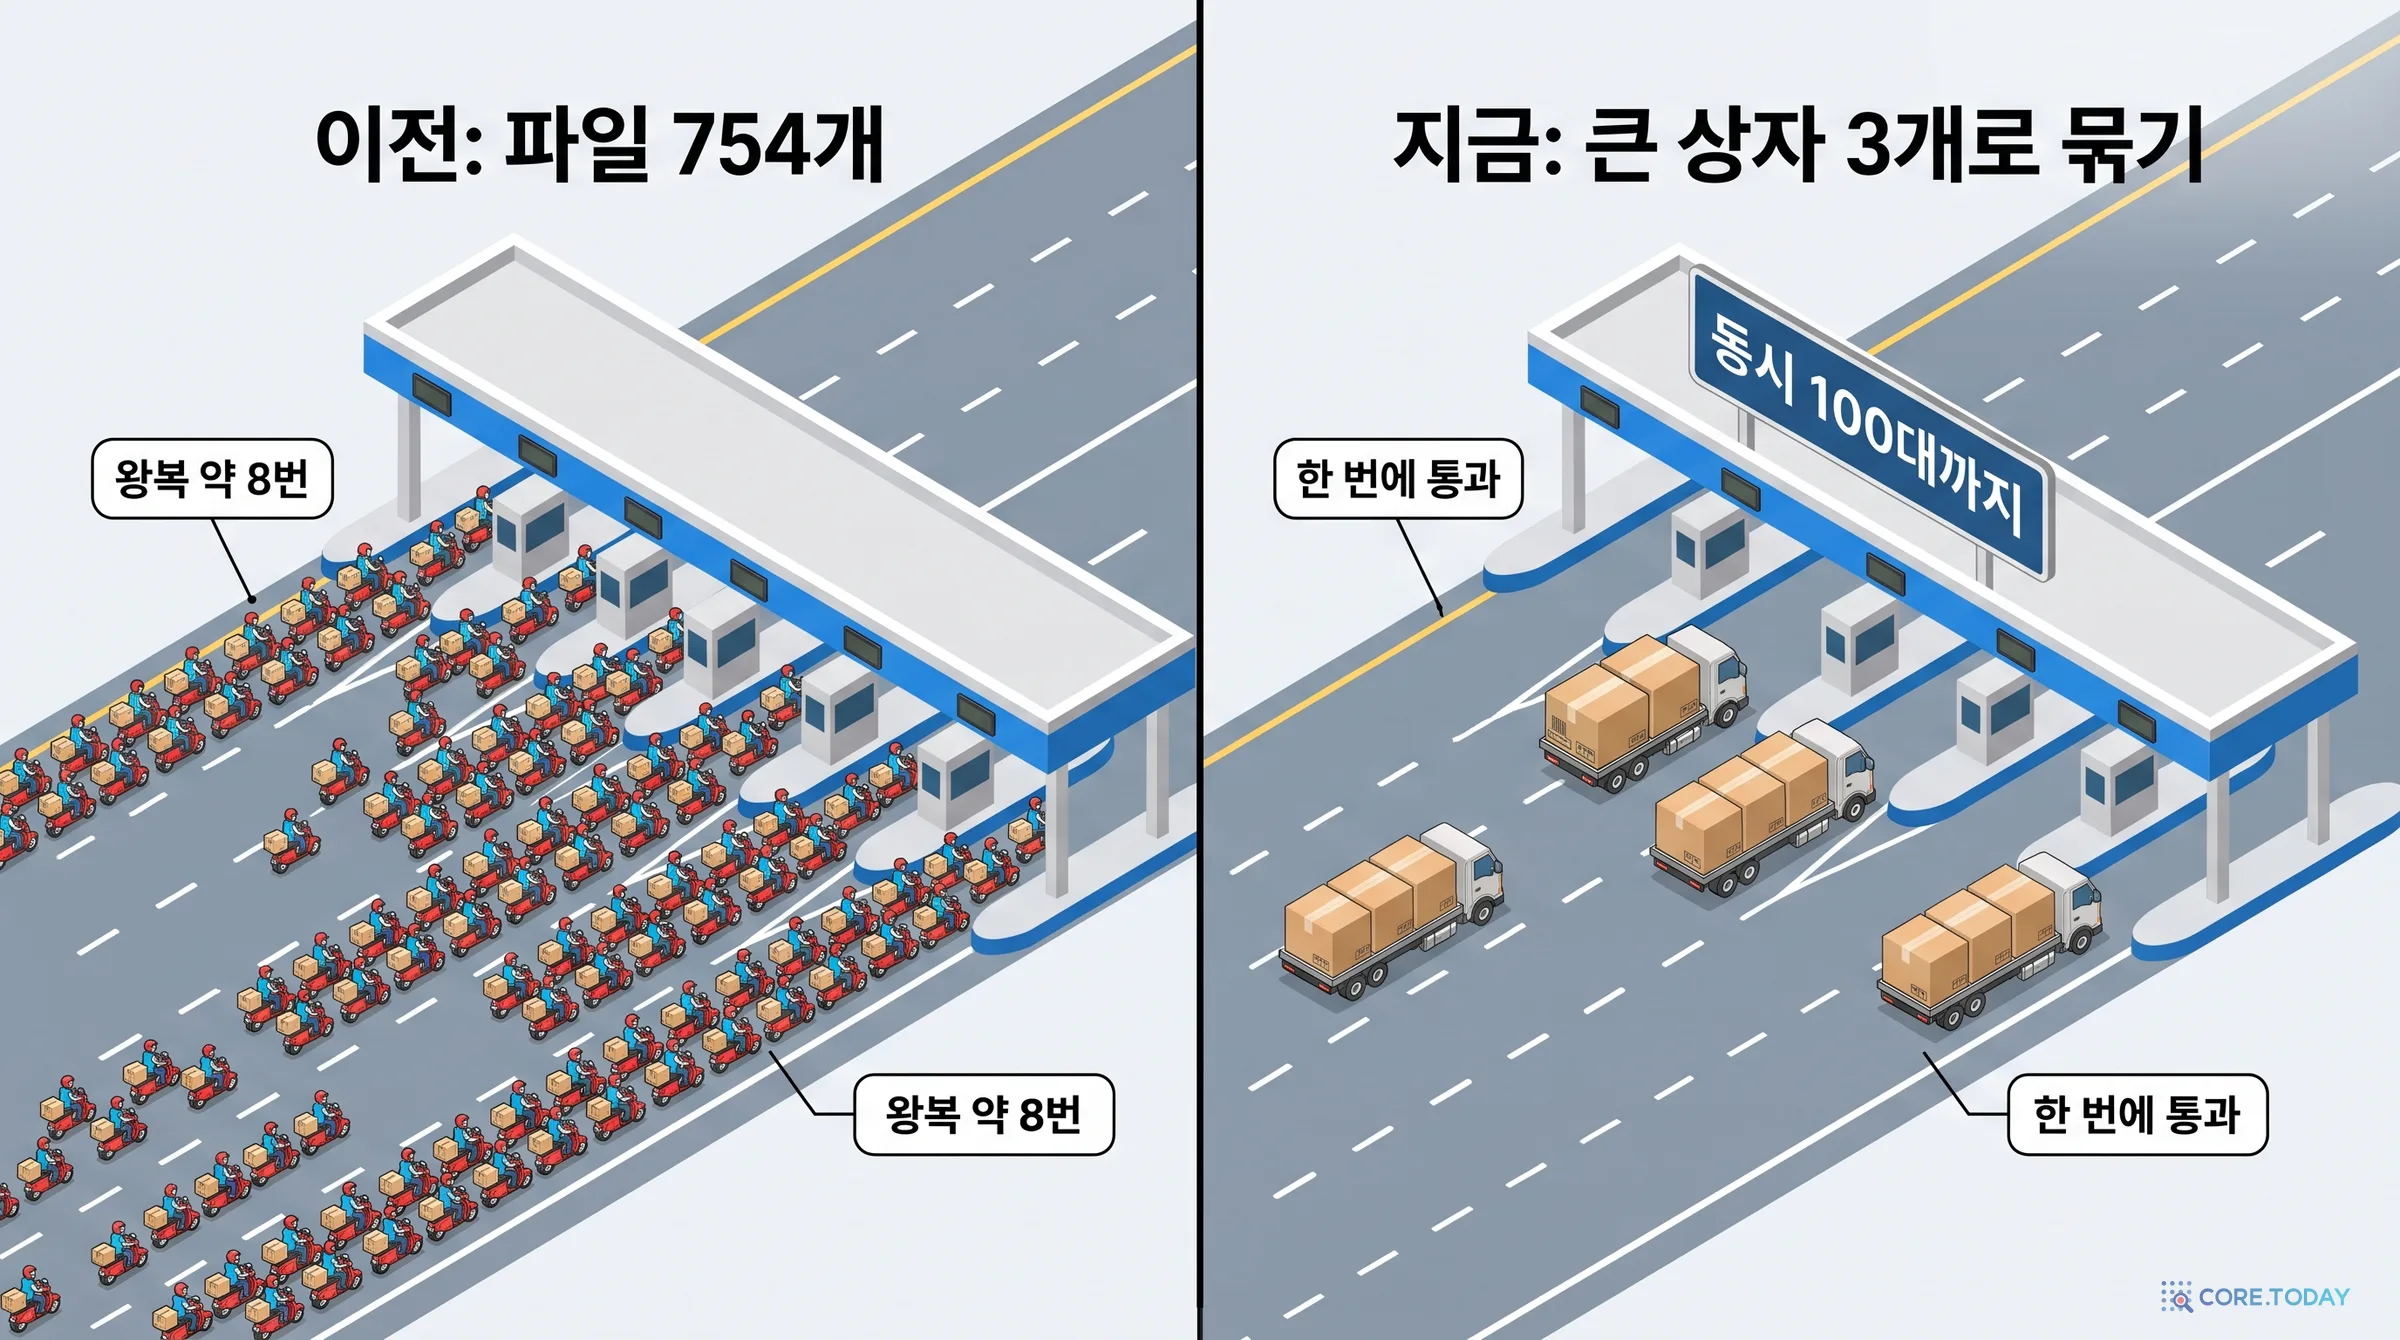
⑥ 파일 754개와 100차선 — 시작 파일 묶기
페이지는 진입 스크립트가 정적으로 가져오는 파일이 전부 도착해야 하이드레이션을 시작할 수 있습니다. Rolldown의 기본 분할로는 그 파일이 로그인용 754개, 로그아웃용 582개였습니다. 로그인 쪽 시작 파일 대부분은 모듈 하나짜리였습니다.
"요즘 HTTP/2는 연결 하나로 여러 파일을 동시에 받는데 뭐가 문제냐"고 할 수 있습니다. 문제는 동시에도 상한이 있다는 것입니다. HTTP/2 표준(RFC 9113)은 동시 스트림 수를 서버가 정하되 100보다 작지 않게 하라고 권고하고, 크롬은 서버가 다른 값을 알려 주기 전까지 100개를 상한으로 씁니다. X의 자산 CDN도 100개를 허용합니다. 그러니 754개는 브라우저가 한꺼번에 요청해도 약 여덟 번에 나뉘어 오갑니다.
X는 빌드 플러그인을 만들어, 모든 진입점이 시작할 때 쓰는 모듈을 세 덩어리로 묶었습니다. 외부 의존성, 자체 코드, 그리고 지연 로딩되는 조각들의 이름표. 셋으로 나눈 데는 이유가 있습니다. 지연 로딩 조각의 파일 이름은 거의 배포마다 바뀝니다. 그 이름표를 따로 떼어 두면, 자주 바뀌는 작은 덩어리 하나만 새로 받고 나머지 큰 덩어리는 브라우저 캐시에 남습니다.
결과는 로그인 진입점 754개 → 182개, 로그아웃 진입점 582개 → 10개. 페이지가 불러오는 모듈은 이전과 정확히 같습니다. 모든 자바스크립트 응답을 275ms(x.com 사용자 왕복 지연의 p90 근처) 늦춘 실험실 시험에서, 로그인 홈 타임라인은 6.63초에서 4.95초로 당겨졌습니다.
위젯의 기본값에서 계산이 측정과 맞아떨어지는 것을 볼 수 있습니다. 8번이 2번이 되면 여섯 번을 아끼고, 275ms를 곱하면 1,650ms입니다. X가 잰 차이는 1,680ms였습니다. 이 계산은 코어닷투데이가 한 것이고 원문에는 없지만, 줄어든 시간이 거의 전부 '왕복 횟수'였다는 원문의 설명을 숫자로 뒷받침합니다.
2010년대 후반 HTTP/2가 퍼지면서 "이제 파일을 묶을 필요가 없다, 잘게 쪼개는 편이 캐시에 유리하다"는 말이 널리 돌았습니다. 틀린 말은 아니지만 한계가 있었던 것입니다. 잘게 쪼갤수록 캐시는 좋아지고, 왕복은 늘어납니다.
⑦ 스타일시트 먼저 — 줄 세우기의 힘
마지막은 직관에 가장 어긋나는 사례입니다. 자바스크립트를 일부러 늦게 받기 시작했더니 페이지가 빨리 떴습니다.
느린 회선에서는 동시에 받는 모든 파일이 대역폭을 나눠 씁니다. 1.6Mbps짜리 빨대 하나로 여러 잔을 동시에 마시는 꼴입니다. 브라우저는 스타일시트(CSS)를 다 받기 전에는 화면을 그리지 않습니다. 그런데 자바스크립트가 스타일시트와 동시에 내려받기를 시작하고 있었습니다. 지금 당장 필요하지 않은 코드가, 화면을 막고 있는 스타일시트의 대역폭을 뺏고 있었던 것입니다.
지금은 작은 인라인 스크립트가 스타일시트 로딩이 끝난 뒤에 진입 스크립트와 서버가 그린 조각들의 프리로드를 추가합니다. 느린 조건(CPU 4배 감속, 왕복 150ms, 1.6Mbps)의 실험실 측정에서 첫 콘텐츠 페인트(FCP, 화면에 내용이 처음 그려지는 시점)는 이렇게 바뀌었습니다.
로그인 홈 · 이전
8,996ms
로그인 홈 · 이후
1,524ms
로그아웃 게시물 · 이전
7,216ms
로그아웃 게시물 · 이후
1,804ms
로그아웃 프로필 · 이전
3,064ms
로그아웃 프로필 · 이후
1,984ms
막대는 8,996ms를 100%로 놓았습니다. 출처: 원문 본문과 그림 4.
원문이 믿음직한 것은 대가도 함께 적기 때문입니다. 스크립트가 늦게 출발하니, 느린 페이지 다섯 가운데 둘에서 하이드레이션 완료가 0.3%, 0.6% 늦어졌습니다. 화면이 5초 넘게 일찍 뜨는 것과 버튼이 0.6% 늦게 살아나는 것을 맞바꾼 거래입니다.
자잘한 절감도 몇 가지 더 있습니다. 영어 페이지는 번역 사전 파일 다섯 개(gzip 49.5KB)를 기다리지 않게 했습니다(영어 사전은 모든 키를 자기 자신에 대응시키므로 사전 없이 키를 그대로 쓰면 됩니다). 브라우저의 ICU 메시지 파서를 실제로 쓰는 문법만 읽는 작은 파서로 바꿔 진입점마다 약 8KB를 줄였습니다. Sentry 빌드 플러그인이 아무도 읽지 않는 릴리스 ID를 모든 조각에 붙이던 것을 뺐습니다(@elonmusk 로그아웃 프로필에서 조각 211개, 12.4KB). 게시물 사진과 카드 이미지는 WebP로 요청합니다(JPEG의 약 절반).
일곱 가지를 꿰는 한 줄
작업
그럴듯했던 믿음
측정이 보여 준 것
① 이벤트 루프
타임아웃이 났으니 상대 서비스가 느리다
상대는 25ms에 답했다. 느린 것은 우리 루프
② 게스트 토큰
순서대로 요청하는 데는 이유가 있을 것이다
둘째 요청은 첫째의 결과를 쓰지 않는다
③ Relay 저장소
정규화된 데이터가 더 작다
글자로 풀면 네댓 배 크다
④ 2MB
서버 렌더링을 하면 검색은 해결된다
문서가 크면 뒤쪽은 읽히지 않는다
⑤ async
스트리밍하면 빨리 조작할 수 있다
실행 시점이 문서 끝에 묶여 있었다
⑥ 파일 묶기
HTTP/2에서는 파일 수가 문제가 안 된다
동시 100개 상한이 왕복 횟수를 만든다
⑦ 스타일시트
일찍 받기 시작할수록 빠르다
느린 회선에서는 순서가 속도다
일곱 줄 모두 왼쪽 칸은 틀린 말이 아닙니다. 대부분의 상황에서 맞습니다. 그래서 측정하기 전에는 의심하지 않게 됩니다.
X가 어떻게 재는지도 적혀 있습니다. 앱에 영향을 줄 수 있는 풀 리퀘스트마다 라이트하우스 CI가 돕니다. 대상은 트위터 공동 창업자 잭 도시의 프로필과, 2006년에 그가 올린 첫 게시물입니다. 변경을 만든 풀 리퀘스트는 프로덕션 빌드에서(대개 지연을 더하는 HTTP/2 프록시 뒤에서) 효과를 재고, 나아진 것 옆에 나빠진 것도 보고했습니다. 실제 방문에서는 코어 웹 바이탈(LCP, INP, CLS)과 FCP, TTFB를 perftown이라는 자체 수집 파이프라인으로 보냅니다.
9. 성적표 읽기 — 숫자가 말하는 것과 말하지 않는 것
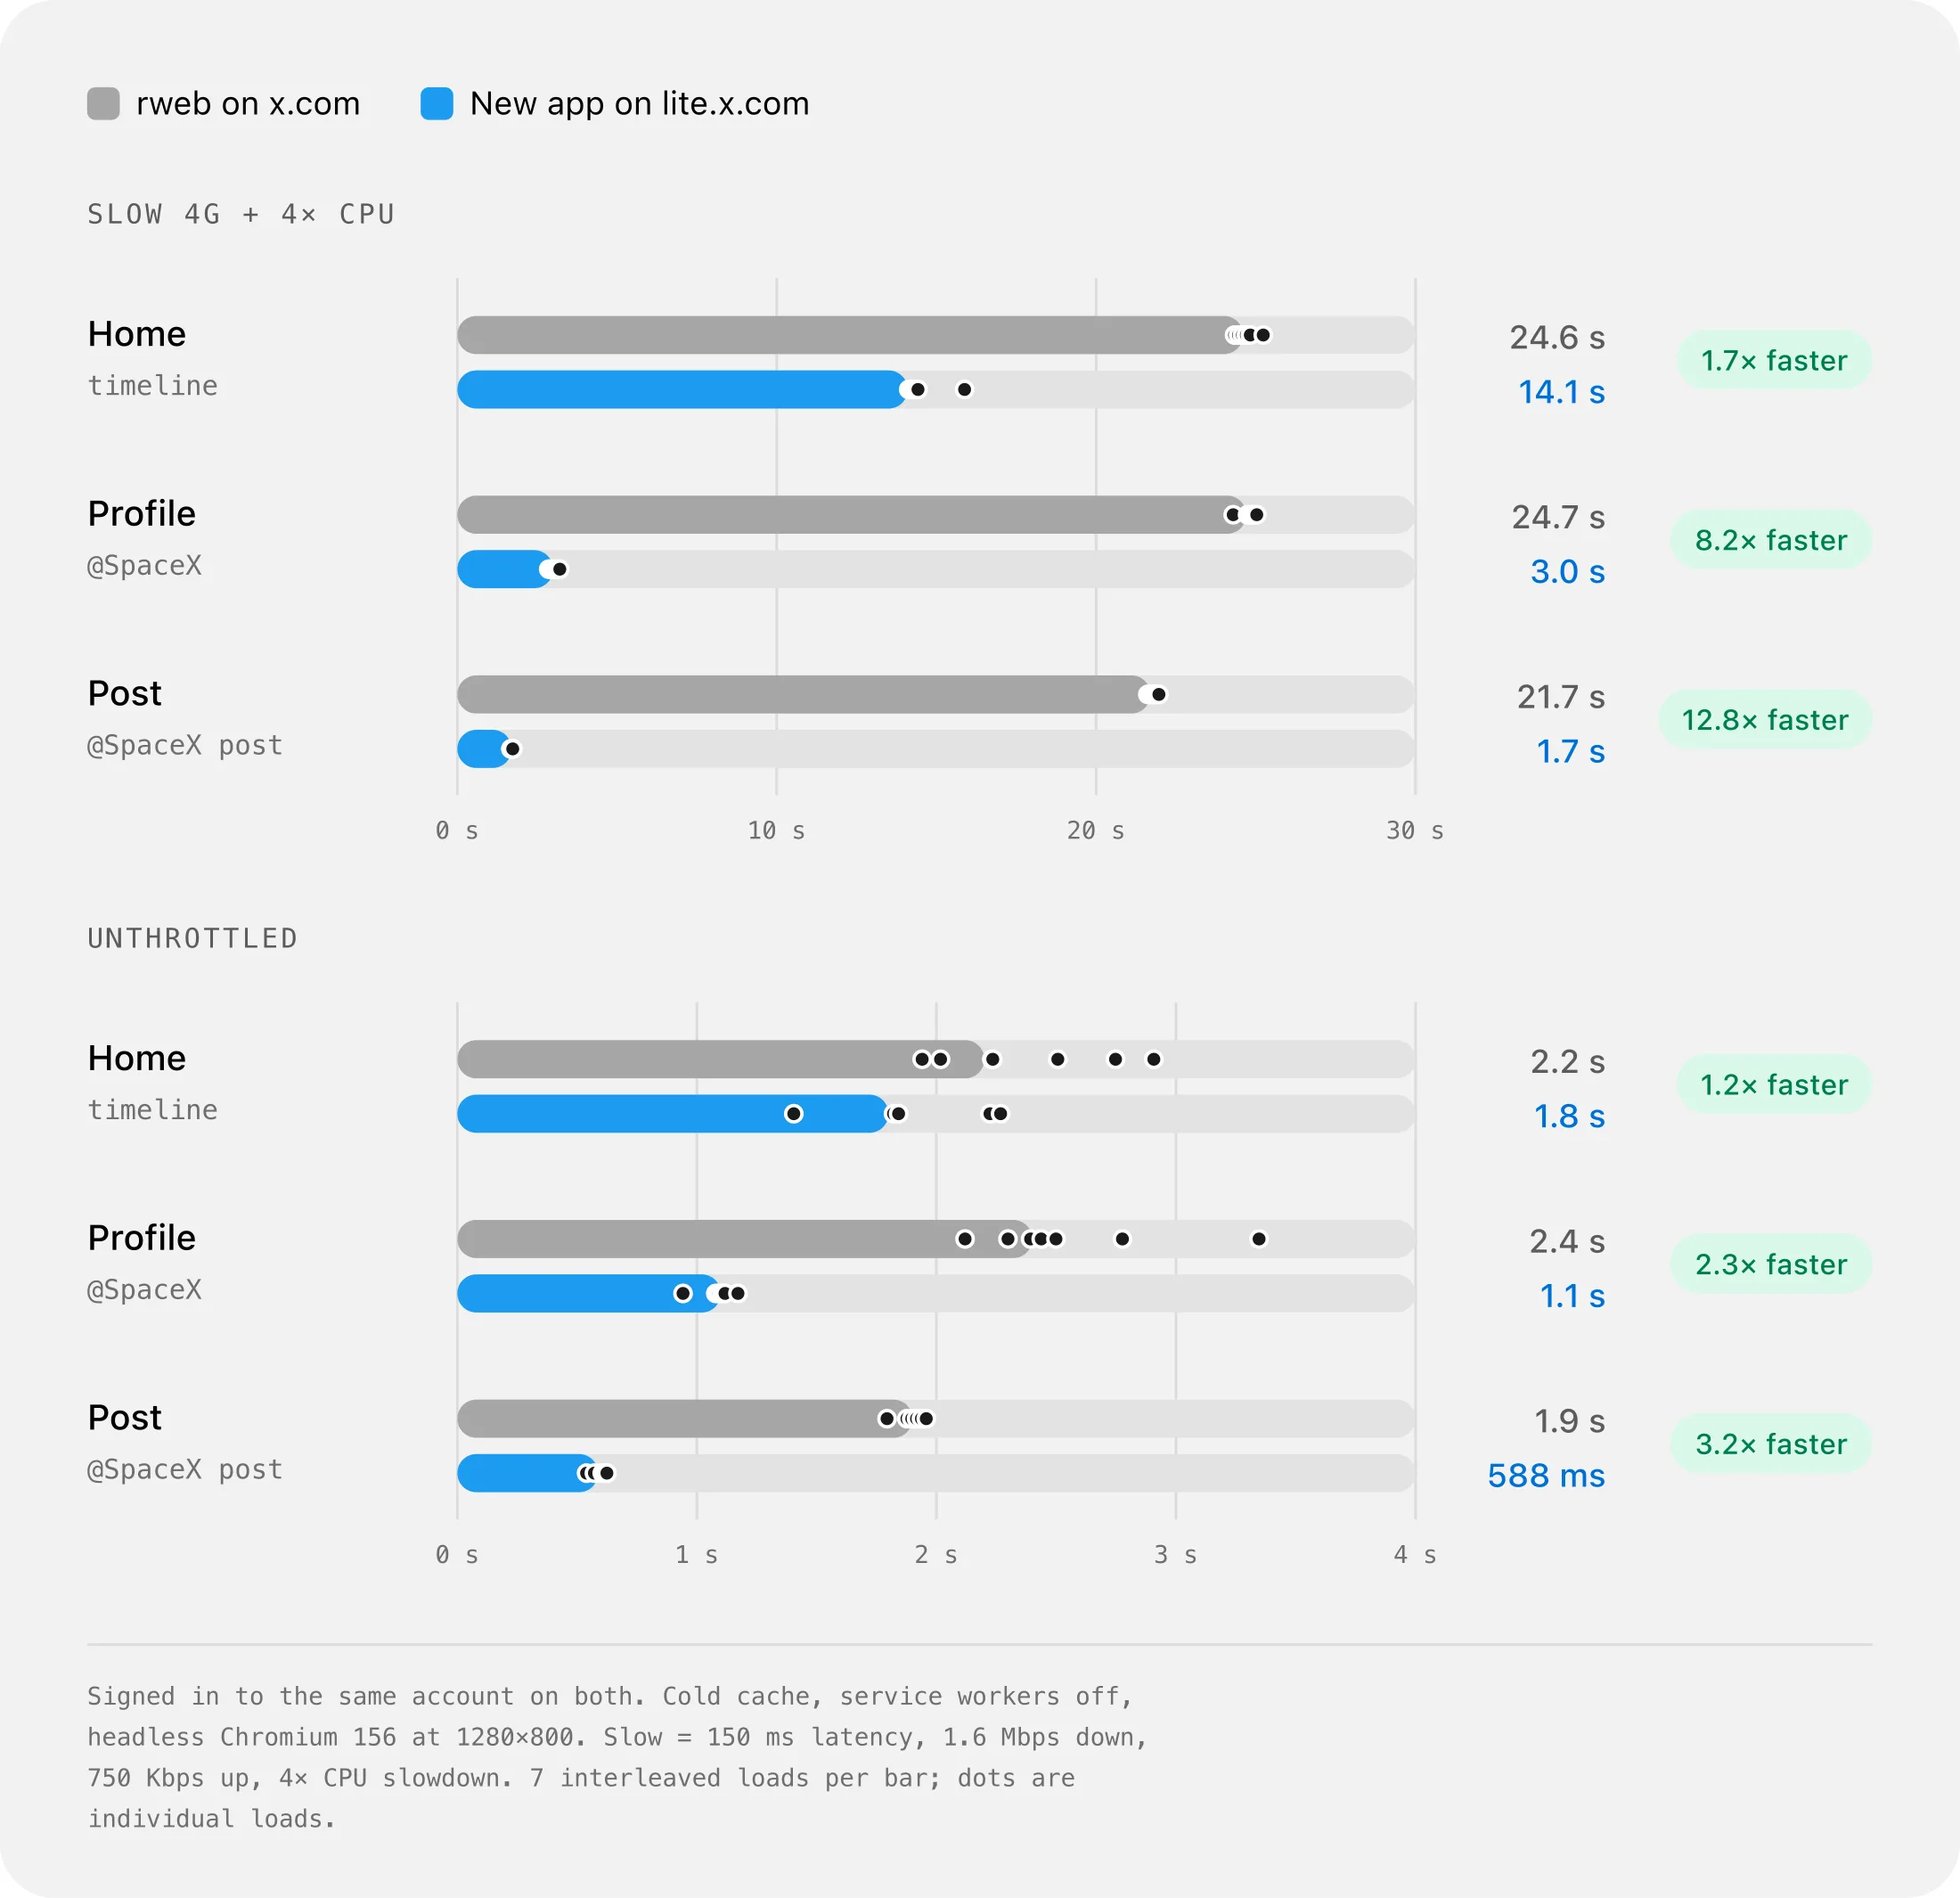
이제 결과입니다. X는 2026년 11월 3일 두 앱을 직접 견줬습니다. 조건을 먼저 봅니다. 매번 새 헤드리스 크로미움을 띄우고, 캐시를 비우고, 서비스 워커를 껐습니다. 어느 앱도 캐시의 덕을 보지 못하게 한 것입니다. 페이지마다 앱·조건별로 일곱 번씩, 두 앱을 번갈아 열었습니다.
출처: X Engineering, 같은 글 그림 5. 막대는 일곱 번의 중앙값, 점은 개별 측정입니다.
지표 선택에 주목할 만합니다. 주 지표는 첫 게시물까지 걸리는 시간입니다. 흔히 쓰는 첫 콘텐츠 페인트만 재면 옛 앱이 유리해집니다. 옛 앱의 첫 페인트는 스플래시 화면이기 때문입니다. 로고는 1.0초에 뜨지만 사용자가 원한 것은 로고가 아닙니다. 2012년에 댄 웹이 '첫 트윗까지 걸리는 시간'을 만든 것과 같은 이유입니다. 사용자가 얻으려던 것이 화면에 나타난 순간을 재야 합니다.
아래 위젯에 원문의 그림 넷을 조건별로 넘겨 볼 수 있게 모았습니다.
숫자를 읽을 때 붙들 점은 네 가지입니다.
첫째, 수혜자는 느린 쪽이다. 느린 조건에서 프로필과 게시물은 8.2배, 12.8배 빨라졌습니다. 제한 없는 조건에서는 2.3배, 3.2배입니다. 한국의 유선 인터넷에서 이 재구축은 "조금 빨라졌네" 정도로 느껴질 것입니다. 이 일이 겨냥한 사람은 다른 곳에 있습니다.
둘째, 홈은 아직이다. 로그인한 홈 타임라인은 느린 조건에서 24.6초가 14.1초가 됐습니다. 1.7배입니다. 새 앱도 홈은 브라우저에서만 그리기 때문에, 두 앱 모두 자바스크립트를 기다립니다. 로그인 사용자가 가장 자주 보는 화면이 가장 덜 나아졌다는 뜻이고, X 스스로 "가장 많이 남은 곳"이라고 적었습니다.
셋째, 공짜가 아니다. 로그인 상태에서 새 앱의 첫 바이트(TTFB)는 프로필과 게시물에서 중앙값 430~560ms에 도착했습니다. 옛 앱은 300ms 미만입니다. 서버가 데이터를 가져와 페이지를 그린 다음에 답하기 때문입니다. 녹화에서도 옛 앱은 1.0초에 스플래시를 띄웠고 새 앱은 2.4초에 처음 그렸습니다. 2장의 표에 있던 "앱 셸은 서버 입장에서 싸다"의 뒷면입니다. 화면 그리는 계산이 사용자 전화기에서 X의 서버로 옮겨 왔습니다. 그런데도 서버 대수는 줄었습니다. rweb의 로그아웃용 서버군은 데이터센터당 1,400대에서 700대로, rweb SSR은 종료 전에 2,400대에서 1,200대로 절반이 됐습니다. 다만 원문은 새 앱이 서버를 몇 대 쓰는지는 밝히지 않았습니다. 총비용이 줄었는지는 이 글만으로 알 수 없습니다.
넷째, 전부 실험실 숫자다. 노트북 한 대, 모의 통신망, 계정 하나, 일곱 번. 원문은 이 한계를 여러 번 스스로 적습니다. "실험실 녹화이니 차이를 보여 주는 예시로 받아들이라", "노트북 한 대의 실험실 숫자다", "실험실 숫자 옆에는 현장 숫자가 있어야 한다". 그런데 정작 현장 숫자, 곧 실제 사용자의 코어 웹 바이탈이 어떻게 변했는지는 이 글에 없습니다. 수집하고 있다고만 적었습니다.
10. 물음표들 — 받아들이기 전에 따져 볼 것
원문은 스스로에게 꽤 엄격한 글이지만, 회사가 자기 일을 설명한 글이라는 점은 변하지 않습니다. 바깥의 시선과 남는 물음을 정리합니다.
바깥의 반응은 조용했다. 해커 뉴스에 올라온 글은 13점에 댓글 2개였고, 그중 하나는 "23.9초에서 2.7초는 극적이지만 2.7초도 여전히 느려 보인다"였습니다. 몇몇 기술 매체가 보도했지만 X의 숫자를 옮겼을 뿐 직접 재 본 곳은 찾지 못했습니다. 7월의 로그아웃 이전을 처음 알렸던 제인 만춘 웡이 "빠릿하고 로딩이 빠르다"는 사용 소감을 남긴 정도입니다. 즉 이 글의 숫자는 아직 독립적으로 검증되지 않았습니다.
"90% 단축"에서 시작된 이야기. 2026년 6월 X의 제품 책임자 니키타 비어(Nikita Bier)는 웹 앱 로딩 시간을 90% 줄인 버전을 곧 내놓겠다고 예고했습니다. 당시 공개된 영상을 두고는 약 18초 대 5초, 70%쯤이라는 보도가 나왔습니다(원문 그림 2로 보면 5초는 이미지까지 다 뜬 시각이고 첫 게시물은 약 3초입니다). 11월 글의 23.9초 대 2.7초는 89%입니다. 다섯 달의 성능 작업이 예고를 따라잡은 셈이지만, 이 비교는 조건이 서로 다릅니다(6월은 로그아웃, 11월은 로그인). 숫자 하나로 요약된 주장은 늘 조건을 물어야 합니다.
첫 화면 대 두 번째 화면. 로그인 사용자의 하루는 대부분 '이미 열어 둔 앱 안에서의 이동'입니다. 이 구간에서는 옛 앱의 두꺼운 캐시가 강점이었고, 새 앱은 따라잡는 중이라고 원문이 인정합니다. 첫 로딩 숫자만으로 "새 앱이 더 빠르다"고 일반화할 수 없습니다. 나라별 실험(일부는 새 앱, 나머지는 rweb)의 결과가 이 물음의 답일 텐데, 아직 공개되지 않았습니다. 어느 나라부터 옮기는지도 밝히지 않았습니다.
다섯 명이라는 숫자. 팀 규모와 기간은 자체 보고이고, 무엇을 '첫 버전'으로 쳤는지는 정의되지 않았습니다. 다섯 명이 만든 것은 로그아웃 페이지와 크롤러 응답을 맡는 앱이고, 로그인 페이지를 옮기는 지금은 20명 넘게 커밋하고 있습니다. 또 이 팀은 맨땅에서 시작하지 않았습니다. 10년 가까이 다듬어진 GraphQL API, 이미 Relay로 옮겨진 데이터 계층, 명세서 구실을 한 서버 둘이 있었습니다. "다섯 명이 x.com을 다시 만들었다"보다는 "다섯 명이 x.com의 화면을 내보내는 층을 다시 만들었다"가 정확합니다.
새 도구의 위험. Rolldown, tsrs, oxlint의 자바스크립트 플러그인, Node.js 26. 모두 2026년에 안정판이 나왔거나 아직 실험 단계인 도구입니다. 빠른 도구가 에이전트와 일하는 방식의 일부라는 점은 이해할 만합니다. 에이전트는 커밋마다 린트와 타입 검사를 돌리므로 검사 속도가 곧 작업 속도입니다. 하지만 타입 검사기가 틀리면 그 위에 쌓은 가드레일이 함께 흔들립니다.
앱 설치 유도. 7월의 해커 뉴스 댓글에는 새 로그아웃 페이지가 방문자를 앱 설치나 가입으로 떠미는 쪽으로 만들어졌다는 불만이 있었습니다. 원문은 로그아웃 방문자가 "스크롤하고, 어쩌면 가입한다"고 적습니다. 빨라진 첫 화면이 광장의 문턱을 낮추는 데 쓰일지, 가입 창구를 빨리 띄우는 데 쓰일지는 기술이 아니라 제품의 선택입니다.
11. 2026년에 이 글이 놓인 자리
반대 방향의 답도 있다 — 한국의 사례
서버 렌더링이 유일한 답이 아니라는 것을 보여 주는 사례가 마침 같은 가을에 한국에서 나왔습니다. 우아한형제들 기술블로그의 2026년 10월 21일 글 「critical-script, 배달의민족 웹뷰 로딩 성능을 30% 개선한 인라인 스크립트 로딩 전략 이야기」입니다.
배달의민족은 X와 반대 방향을 골랐습니다. 서버 렌더링 없이 정적 CSR을 유지하면서, HTML 안에 최대 8KB짜리 인라인 스크립트를 넣어 본 스크립트가 오기 전에 API 요청과 대표 이미지 프리로드를 먼저 출발시킵니다. 실험실 LCP(가장 큰 콘텐츠가 그려지는 시점)는 1,340ms에서 847ms로 37% 줄었고, 실제 사용자의 p50·p75·p90 LCP가 25~35% 내려갔다고 보고했습니다. 약 80개 페이지에 적용했고 도구는 오픈소스로 공개했습니다.
두 사례를 나란히 놓으면 병은 같고 약이 다릅니다.
X (2026. 11.)
배달의민족 (2026. 10.)
진단
브라우저가 코드를 다 받고 실행한 뒤에야 데이터를 요청한다
처방
서버가 데이터를 가져와 HTML에 실어 보낸다
코드가 오기 전에 작은 스크립트가 데이터 요청을 먼저 보낸다
렌더링 위치
서버 (스트리밍)
브라우저 (정적 CSR 유지)
서버 부담
늘어남 (TTFB 300ms 미만 → 430~560ms)
그대로 (정적 파일)
검색 크롤러
핵심 손님
해당 없음 (앱 안의 웹뷰)
마지막 줄이 갈림길입니다. 배달의민족의 페이지는 앱 안에서 열리는 웹뷰라서 검색 크롤러도, 링크 미리보기 봇도, 처음 온 낯선 방문자도 없습니다. 손님이 한 종류면 약도 가벼워집니다. X는 손님이 셋이었고, 그 가운데 둘은 완성된 HTML이 아니면 받지 않는 손님이었습니다. 구조는 손님이 정합니다. 내 서비스의 손님이 누구인지 세어 보는 것이 구조를 고르는 첫 단계입니다.
이 글이 2026년에 뜻하는 것
하나. 다시 쓰기의 계산식이 바뀌었다. 스폴스키의 경고는 "다시 쓰는 데는 몇 년이 걸리고 그동안 경쟁자가 앞서간다"는 전제 위에 서 있었습니다. 구현 시간이 몇 년에서 몇 달로 줄면 전제 하나가 약해집니다. 하지만 다른 전제, "옛 코드에 쌓인 지식을 잃는다"는 그대로입니다. 오히려 더 중요해졌습니다. 에이전트가 빠르게 다시 쓸 수 있는 것은 그 지식이 기계가 채점할 수 있는 형태(작동하는 옛 서버, 테스트, 대조 스크립트)로 남아 있을 때뿐이었습니다. 2026년의 다시 쓰기에서 가장 값진 자산은 새 코드를 쓰는 능력이 아니라, 옛 시스템이 무엇을 했는지 확인하는 능력입니다.
둘. 엔지니어의 일이 '쓰기'에서 '정하기와 확인하기'로 옮겨 간다. 구조를 정하고, 규칙을 린트로 굳히고, 결과를 브라우저에서 확인하는 일입니다. 8장의 일곱 가지 성능 작업을 다시 보면, 어느 것도 "코드를 빨리 쓰는 능력"으로 풀린 문제가 아닙니다. 25ms짜리 응답에 타임아웃이 나는 것을 보고 이벤트 루프를 의심하는 것, 스트리밍 문서의 파싱이 언제 끝나는지 아는 것. 무엇을 재야 하는지 아는 사람이 있어야 에이전트에게 일을 시킬 수 있습니다.
셋. 웹의 진자는 '서버가 그리고 브라우저가 이어받는' 자리로 모이고 있다. 2010년의 BigPipe, 2013년의 동형 자바스크립트, 2021년의 스트리밍 SSR을 거쳐, 2026년에는 세계 6위 사이트가 그 구조로 넘어왔습니다. 다만 배달의민족 사례가 보여 주듯 이것은 유행이 아니라 조건부 선택입니다.
넷. 기계 손님이 늘고 있다. 원문의 세 손님 가운데 둘은 사람이 아닙니다. 그리고 2026년의 웹에는 넷째 손님이 빠르게 늘고 있습니다. 사람 대신 페이지를 읽는 AI 에이전트와 AI 검색의 수집기입니다. 이 손님들도 대개 자바스크립트를 실행하지 않거나 기다려 주지 않습니다. 완성된 HTML과 구조화 데이터를 첫 응답에 싣는 구조는 검색 크롤러만이 아니라 이 새 손님들에게도 읽히는 구조입니다. 원문은 이 점을 말하지 않지만, "누가 묻는지에 따라 같은 내용을 다른 방식으로 내보내는 서버"라는 설계는 손님 종류가 늘어날수록 값이 커집니다.
같은 주소를 여는 손님이 누구인지 적어 봅니다. 사람(처음 온 사람과 단골), 검색 크롤러, 링크 미리보기 봇, AI 에이전트. 손님마다 지금 무엇을 받고 있는지 실제로 요청해 확인합니다. 카카오톡이나 슬랙에 내 링크를 붙였을 때 카드가 제대로 뜨는지부터 볼 수 있습니다.
느리게 열기
크롬 개발자 도구에서 네트워크를 '느린 4G'로, 캐시를 비우고 내 페이지를 열어 봅니다. 첫 페인트가 아니라 사용자가 얻으려던 것(상품, 글, 게시물)이 뜨는 시각을 잽니다. 스플래시나 뼈대 화면은 세지 않습니다.
사슬 찾기
네트워크 탭의 폭포 그림에서 계단을 찾습니다. A가 끝나야 B가 시작되는 구간마다 "B는 정말 A의 결과를 쓰는가"를 묻습니다. X의 게스트 토큰처럼 이유 없이 줄 서 있는 요청이 흔합니다.
순서 정하기
느린 회선에서는 동시에 받는 것들이 서로의 속도를 깎습니다. 화면을 막는 자원(스타일시트)과 당장 필요 없는 자원(스크립트, 큰 이미지)이 같은 순간에 출발하는지 봅니다.
파일 수 세기
첫 화면이 살아나기까지 필요한 자바스크립트 파일이 몇 개인지 셉니다. 100개를 넘으면 왕복이 한 번씩 더 붙습니다.
문서 무게 달기
검색에 잡혀야 하는 페이지의 HTML이 압축을 푼 크기로 2MB를 넘는지 확인합니다. 반복되는 인라인 SVG 아이콘과 중복된 구조화 데이터가 가장 흔한 범인입니다.
타임아웃 의심
Node.js 서버에서 원인 모를 타임아웃이 난다면 상대 서비스보다 먼저 내 이벤트 루프의 지연을 잽니다. 서버 렌더링은 CPU를 오래 붙드는 일입니다.
에이전트와 일하기
에이전트에게 맡길 일은 정답이 있는 일부터 고릅니다. 옛 동작을 그대로 옮기는 이전 작업이 가장 좋습니다. 부탁은 지침서에, 절차는 스킬에, 어겨선 안 되는 것은 린트 규칙에 넣습니다. 그리고 옮긴 것은 한꺼번에 켜지 말고, 되돌릴 스위치를 달아 조금씩 켭니다.
맺으며 — 광장의 문턱
2012년에 트위터는 "첫 트윗까지 걸리는 시간"을 5분의 1로 줄였다고 썼습니다. 2026년에 X는 "첫 게시물까지 걸리는 시간"을 9분의 1로 줄였다고 씁니다. 14년 사이에 같은 문제가 다시 자라났다는 뜻입니다. 기능이 붙고, 코드가 불어나고, 개발자의 책상 위 회선이 빨라지는 동안 느린 쪽의 사용자는 조용히 로고를 바라보고 있었습니다.
그러니 이 글에서 가져갈 것은 "서버에서 그려라"가 아닙니다. 그 답은 진자가 다시 움직이면 바뀔 수 있습니다. 가져갈 것은 순서입니다. 손님이 누구인지 세고, 가장 불리한 손님의 자리에서 재고, 측정이 직관을 뒤집으면 직관을 버리고, 옛것에 쌓인 지식을 버리지 않은 채 조금씩 옮기는 것. 에이전트는 그 가운데 '옮기는' 단계를 놀랍도록 줄여 주었습니다. 나머지 단계는 여전히 사람의 몫으로 남아 있습니다.
원문의 마지막 문장은 2017년 트위터 라이트의 목표를 다시 꺼냅니다. 느리거나, 불안정하거나, 비싼 연결에서도 쓸 수 있을 것. 광장이 광장이려면 문턱이 낮아야 합니다. 22초는 문턱이었고, 이번에 그 문턱이 꽤 낮아졌습니다. 실제로 얼마나 낮아졌는지는 실험실이 아니라 그 문을 드나드는 사람들의 전화기에서 재어야 할 것이고, 그 숫자를 X가 다음 글에서 내놓기를 기다립니다.