[특집] Gemini 4 Hydrogen 해부 — 가장 가벼운 원소에게 '실행'을 맡긴 이유, 그리고 Claude·GPT와의 비교
구글이 11월 12일 Gemini 4 Hydrogen을 내놓으면서 제미나이 4세대가 처음으로 무료 사용자와 구글 검색 전체에 들어갔습니다. Hydrogen은 '가장 똑똑한 모델'이 아니라 '가장 빨리 일을 끝내는 모델'입니다. 이 글은 발표문, 8쪽 모델 카드, 4쪽 평가 방법 문서, 78쪽 안전 보고서, 그리고 Artificial Analysis·Vals·Terminal-Bench 리더보드를 맞춰 읽은 특집입니다. 2006년 '모델 압축'과 2015년 힌턴의 지식 증류에서 시작해 Flash 계보, 친칠라 이후의 '쓰는 값까지 계산하는' 설계, 생각 수준의 역사, 큰 모델과 작은 모델이 일을 나누는 오케스트레이터까지 풀었습니다. 발표문 GIF 차트 다섯 장을 멈춰 놓고 점을 다시 읽으면, 같은 점수를 가장 싸게 낸 모델은 GPT-6.1 Terra였고 Hydrogen의 무기는 값이 아니라 시간이라는 것이 보입니다. 터미널 작업에서는 xhigh가 high와 점수가 같았습니다. Vals 법률 시험의 '공동 1위 55.8%'는 사실 Carbon의 점수였고, 정직성 수치는 하루 만에 96.7%에서 94%로 조용히 바뀌었습니다. Claude Sonnet 5.5·Haiku 5.5, GPT-6.1 Terra·Luna와 가격·성능을 나란히 놓고, 일마다 무엇을 어떤 수준으로 쓸지 정리했습니다. 인터랙티브 6개, 일러스트 12장, 원문 그림 9장.
2026년 11월 12일, 구글은 짧은 글 하나로 ‘Gemini 4 Hydrogen’을 공개했습니다. 첫 문장은 이렇습니다. “Hydrogen은 최첨단 지능을 모두에게 가져다준다.”
이 문장의 무게는 ‘모두에게’에 있습니다. 한 달 전 공개된 Gemini 4 Argon과 이틀 전 공개된 Gemini 4 Carbon은 구글에서 가장 강한 모델이지만, 주로 개발자 API와 유료 구독자에게 열렸습니다. Hydrogen은 다릅니다. 같은 날 구글 AI 스튜디오의 무료 등급, 제미나이 앱, 그리고 전 세계 모든 사용자의 구글 검색에 동시에 들어갔습니다. 구글 검색 팀의 로비 스타인(Robby Stein)은 같은 날 글에서 이를 “검색 역사상 가장 큰 모델 업그레이드”라고 불렀습니다. 제미나이 4세대를 가장 많은 사람이 처음 만나는 얼굴이 Hydrogen인 셈입니다.
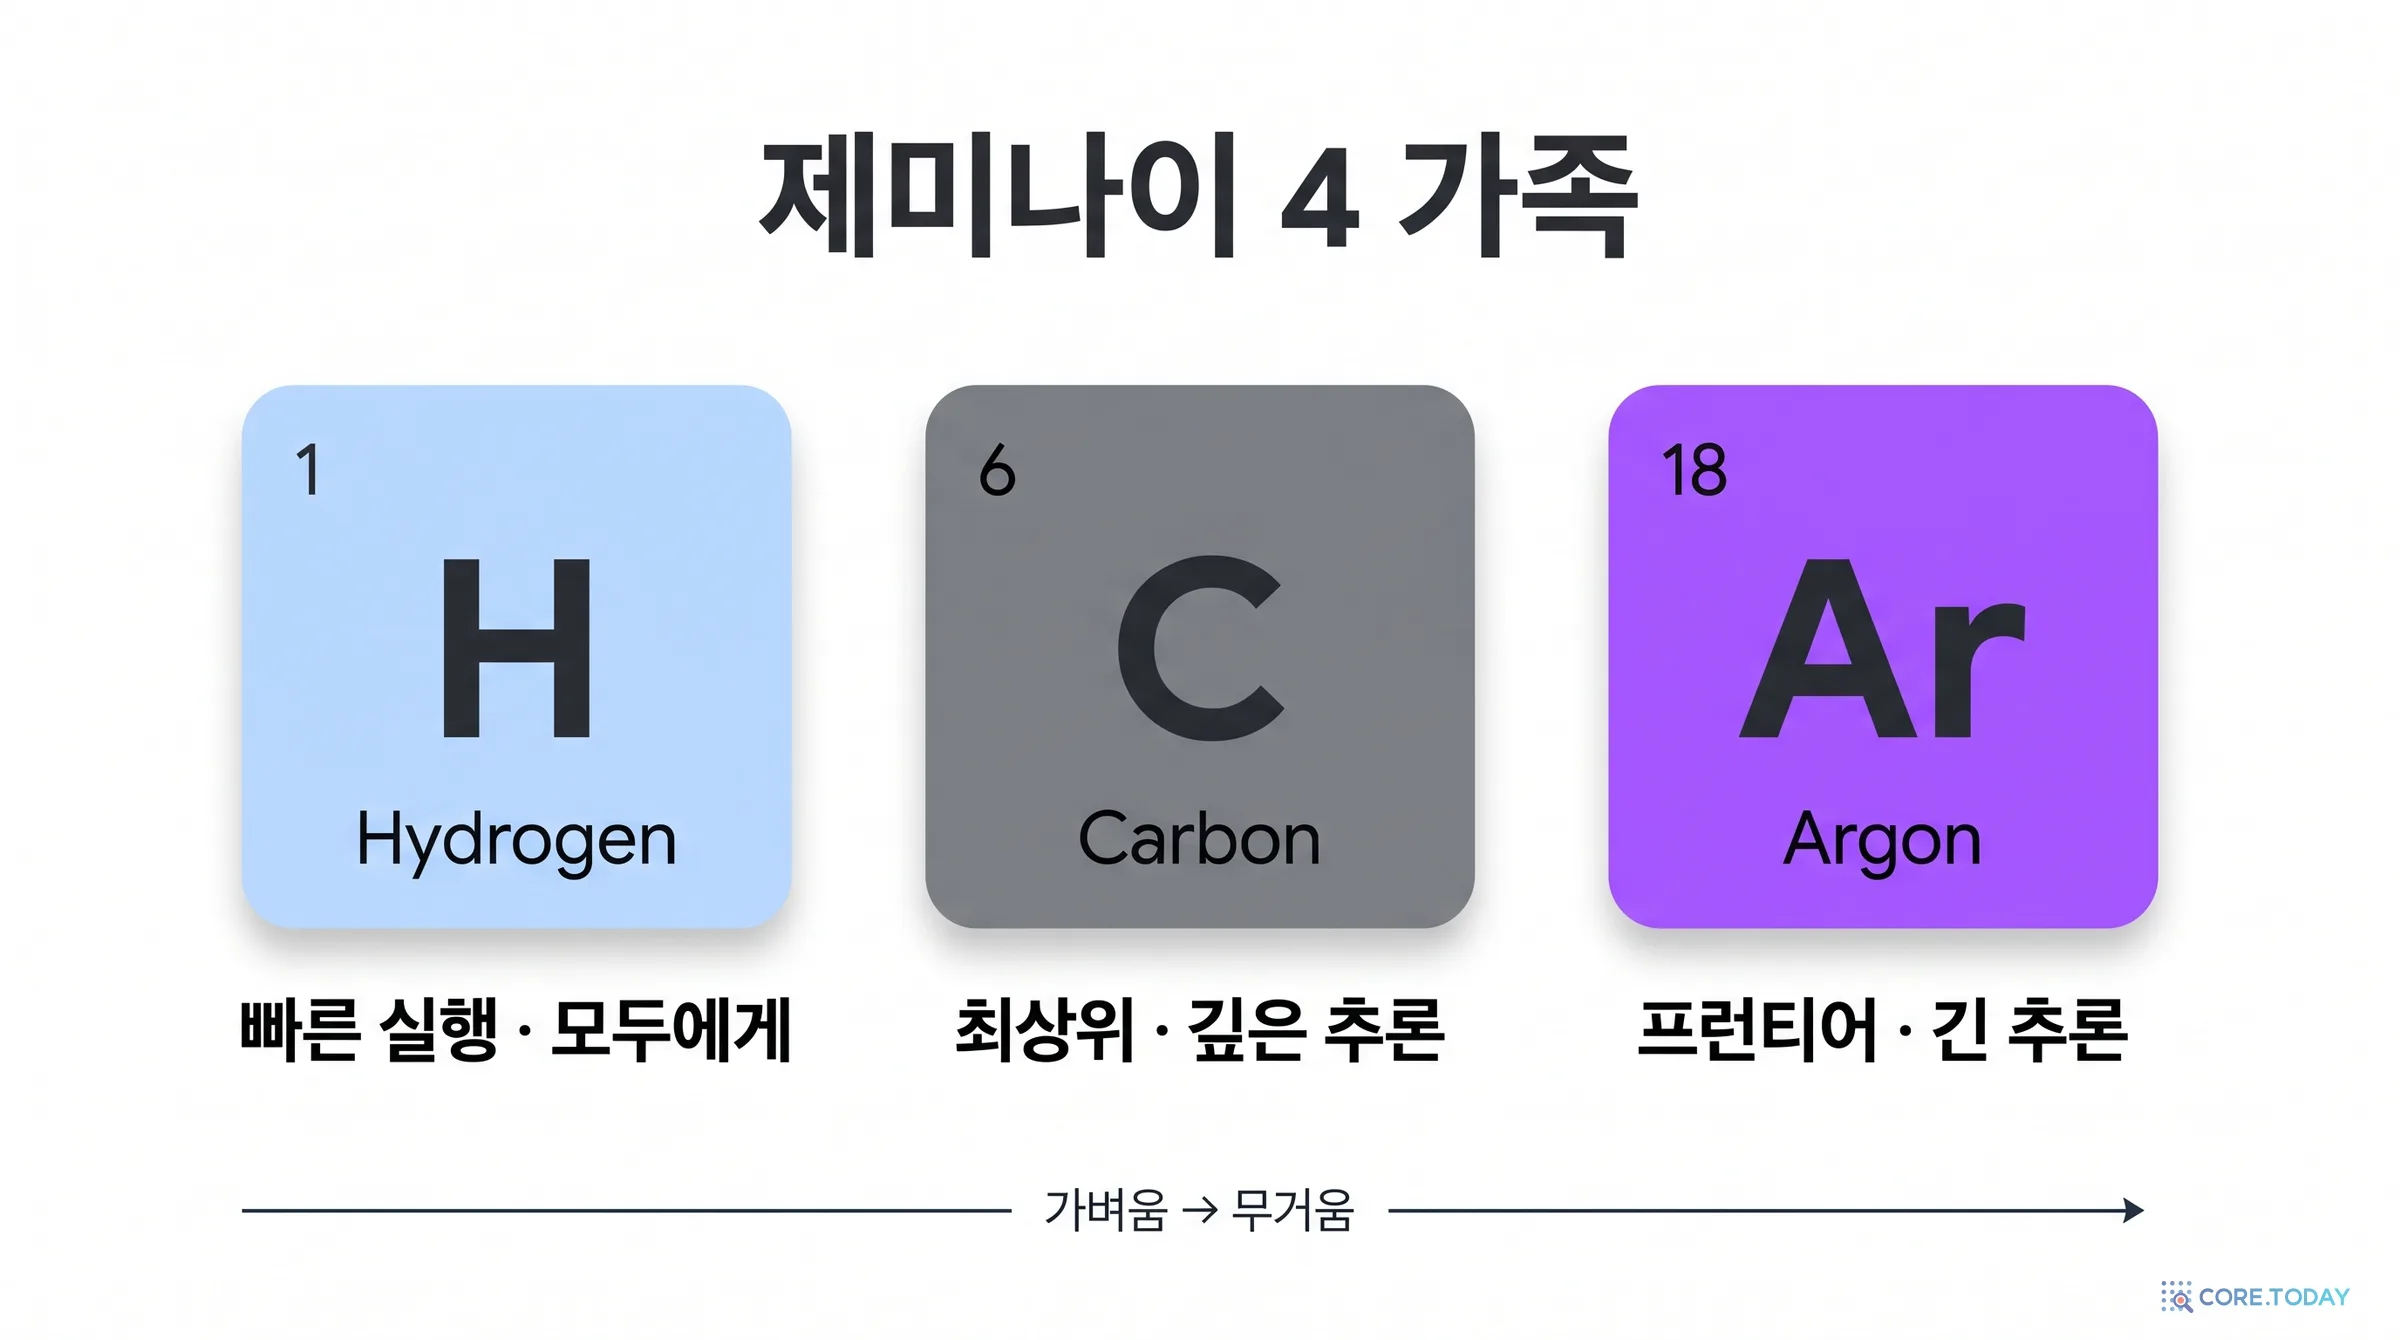
그런데 발표문을 끝까지 읽으면 이상한 점이 하나 있습니다. 구글은 Hydrogen을 ‘가장 똑똑하다’고 소개하지 않습니다. 대신 이렇게 씁니다. Carbon과 Argon은 “가장 어려운 문제에 대한 깊고 긴 추론”을 위한 모델이고, Hydrogen은 “다양한 에이전트 작업을 빠르게 실행”하기 위한 모델이다. 그리고 발표문의 첫 번째 절 제목은 ‘다중 모델 작업의 효율’입니다. Hydrogen 혼자보다, 큰 모델과 짝을 이룬 Hydrogen을 먼저 설명합니다.
왜 그럴까요? 이 글은 그 질문에서 출발합니다. 큰 모델이 이미 있는데 왜 ‘빠른 동생’을 따로 만들까. 동생은 형에게서 무엇을 어떻게 물려받나. ‘생각 수준’이라는 손잡이는 왜 생겼고, 어디까지 돌려야 하나. 두 모델이 한 작업 안에서 일을 주고받는다는 건 무슨 뜻인가. 그리고 같은 체급의 Claude와 GPT와 비교하면, 구글의 숫자는 어디까지 믿을 만한가.
가격. 입력 1.50달러·출력 7.50달러는 Claude Sonnet 5.5(2달러·10달러)보다 조금 싸고, GPT-6.1 Terra(1달러·5달러)보다는 비쌉니다. 직전 모델 3.8 Flash는 올해 말까지 소개가(0.75달러·3.75달러)를 받고 2027년 1월 1일부터 Hydrogen과 같은 값이 됩니다. 그래서 “Flash보다 두 배 비싸졌다”는 불만과 “정가는 똑같다”는 반박이 같이 나왔습니다.
‘100만 토큰 전 구간 같은 값’은 생각보다 중요합니다. Claude Haiku 5.5는 프롬프트가 10만 토큰을 넘으면 값이 5배가 되고, GPT-6.1 Terra는 27.2만 토큰을 넘으면 오릅니다. Hydrogen은 긴 문서를 통째로 넣어도 단가가 같습니다(10장 계산기 참조).
AA 지능 지수는 독립 평가 기관 Artificial Analysis가 여러 시험을 묶어 낸 점수입니다. 기본 설정(high)에서 51점으로, 한 달 전 Argon(50점)을 근소하게 넘었습니다. ‘동생이 형을 이겼다’는 헤드라인이 여기서 나왔습니다. 다만 같은 지수에서 Carbon은 60점이고, Sonnet 5.5 최고 설정은 55점입니다.
제미나이 4세대는 원소 이름을 씁니다. 10월 13일 Argon(아르곤, 18번), 11월 10일 Carbon(탄소, 6번), 11월 12일 Hydrogen(수소, 1번). 구글은 이름의 뜻을 공식적으로 설명한 적이 없습니다. 비즈니스 인사이더는 10월에 구글이 내부에서 ‘Argon, Barium, Carbon’이라는 이름으로 모델들을 시험했다고 보도했는데, 이 보도대로라면 원래는 알파벳 순서(A·B·C)였던 셈입니다. Hydrogen은 그 순서를 깨고 들어왔습니다.
해커뉴스에서는 이름이 발표 내용보다 더 큰 화제였습니다. 한 사용자는 “성능과 값 순서로 Hydrogen → Argon → Carbon이라니, 이게 무슨 순서냐”고 썼고, 다른 사용자는 “수소(1)가 탄소(6)보다 덜 똑똑한 건 알겠는데, 탄소(6)가 아르곤(18)보다 똑똑하다니”라고 받았습니다. 원자 번호로도, 알파벳으로도 정렬되지 않는 이름이라는 것이지요.
그래도 ‘수소’에는 꽤 그럴듯한 뜻을 붙일 수 있습니다. 수소는 가장 가볍고, 우주에서 가장 흔한 원소입니다. 그리고 별을 태우는 연료입니다. 가장 가볍고, 가장 널리 퍼지고, 다른 무거운 것들을 움직이는 연료. 검색창 하나하나에 들어가 매일 수십억 번 불릴 모델에게 이만한 이름은 드뭅니다. 구글은 이번에 ‘Flash’라는 이름도 버렸고, 제미나이 앱의 모델 선택 메뉴는 Hydrogen에 ‘일상 도우미(Everyday help)’라는 설명을 붙였습니다.
한 가지 짚어 둘 것이 있습니다. Hydrogen은 ‘Flash의 다음 버전’이기도 합니다. 구글은 개발자 문서에서 Hydrogen을 “3.8 Flash와 그 이전 모델에서 옮겨 갈 권장 모델”로 지정했습니다. 이름은 원소지만, 역할은 2024년부터 이어진 Flash 계보를 잇습니다. 그 계보가 왜 생겼는지부터 거슬러 올라가 보겠습니다.
3. 왜 ‘작은 형제’가 필요한가 — 20년 된 질문
Hydrogen 같은 모델을 이해하려면, 먼저 질문 하나를 붙잡아야 합니다. 가장 똑똑한 모델이 있는데, 왜 굳이 덜 똑똑한 모델을 따로 만들까요?
답은 간단합니다. 가장 똑똑한 모델은 비싸고 느립니다. 그런데 세상 일의 대부분은 가장 똑똑한 모델이 필요하지 않습니다. 메일 1만 통을 분류하는 일, 테스트를 돌려 결과를 확인하는 일, 문서에서 표를 뽑는 일에 노벨상급 두뇌를 쓰는 건, 편의점 심부름에 전세기를 띄우는 것과 비슷합니다. 이 질문은 생각보다 오래됐습니다.
3-1. 2006년: “1,000배 작게, 1,000배 빠르게”
2006년, 코넬 대학의 크리스티안 부칠루아(Cristian Bucilă), 리치 카루아나(Rich Caruana), 알렉산드루 니쿨레스쿠-미질(Alexandru Niculescu-Mizil)은 「모델 압축(Model Compression)」이라는 논문을 냈습니다. 당시 가장 정확한 분류기는 수백 개의 모델을 묶은 ‘앙상블’이었는데, 너무 크고 느려서 실제 서비스에 쓰기 어려웠습니다.
이들의 생각은 이랬습니다. 큰 앙상블에게 가짜 데이터를 잔뜩 보여 주고 답을 달게 한 다음, 그 답을 작은 신경망에게 따라 하게 하자. 결과는 놀라웠습니다. 작은 신경망은 앙상블과 비슷한 성능을 내면서도 1,000배 작고 1,000배 빨랐습니다. ‘큰 모델이 작은 모델을 가르친다’는 아이디어의 시작입니다.
3-2. 2015년: 정답이 아니라 ‘생각의 모양’을 가르친다
9년 뒤, 제프리 힌턴(Geoffrey Hinton)과 오리올 비냘스(Oriol Vinyals), 제프 딘(Jeff Dean)이 이 생각을 다듬어 「신경망의 지식 증류(Distilling the Knowledge in a Neural Network)」를 발표합니다. 세 저자 모두 지금의 구글 딥마인드와 깊이 연결된 사람들이고, 딘은 구글의 수석 과학자로 제미나이 개발을 이끌어 온 사람입니다. Hydrogen을 만든 회사가 증류라는 말을 만든 회사이기도 한 셈입니다.
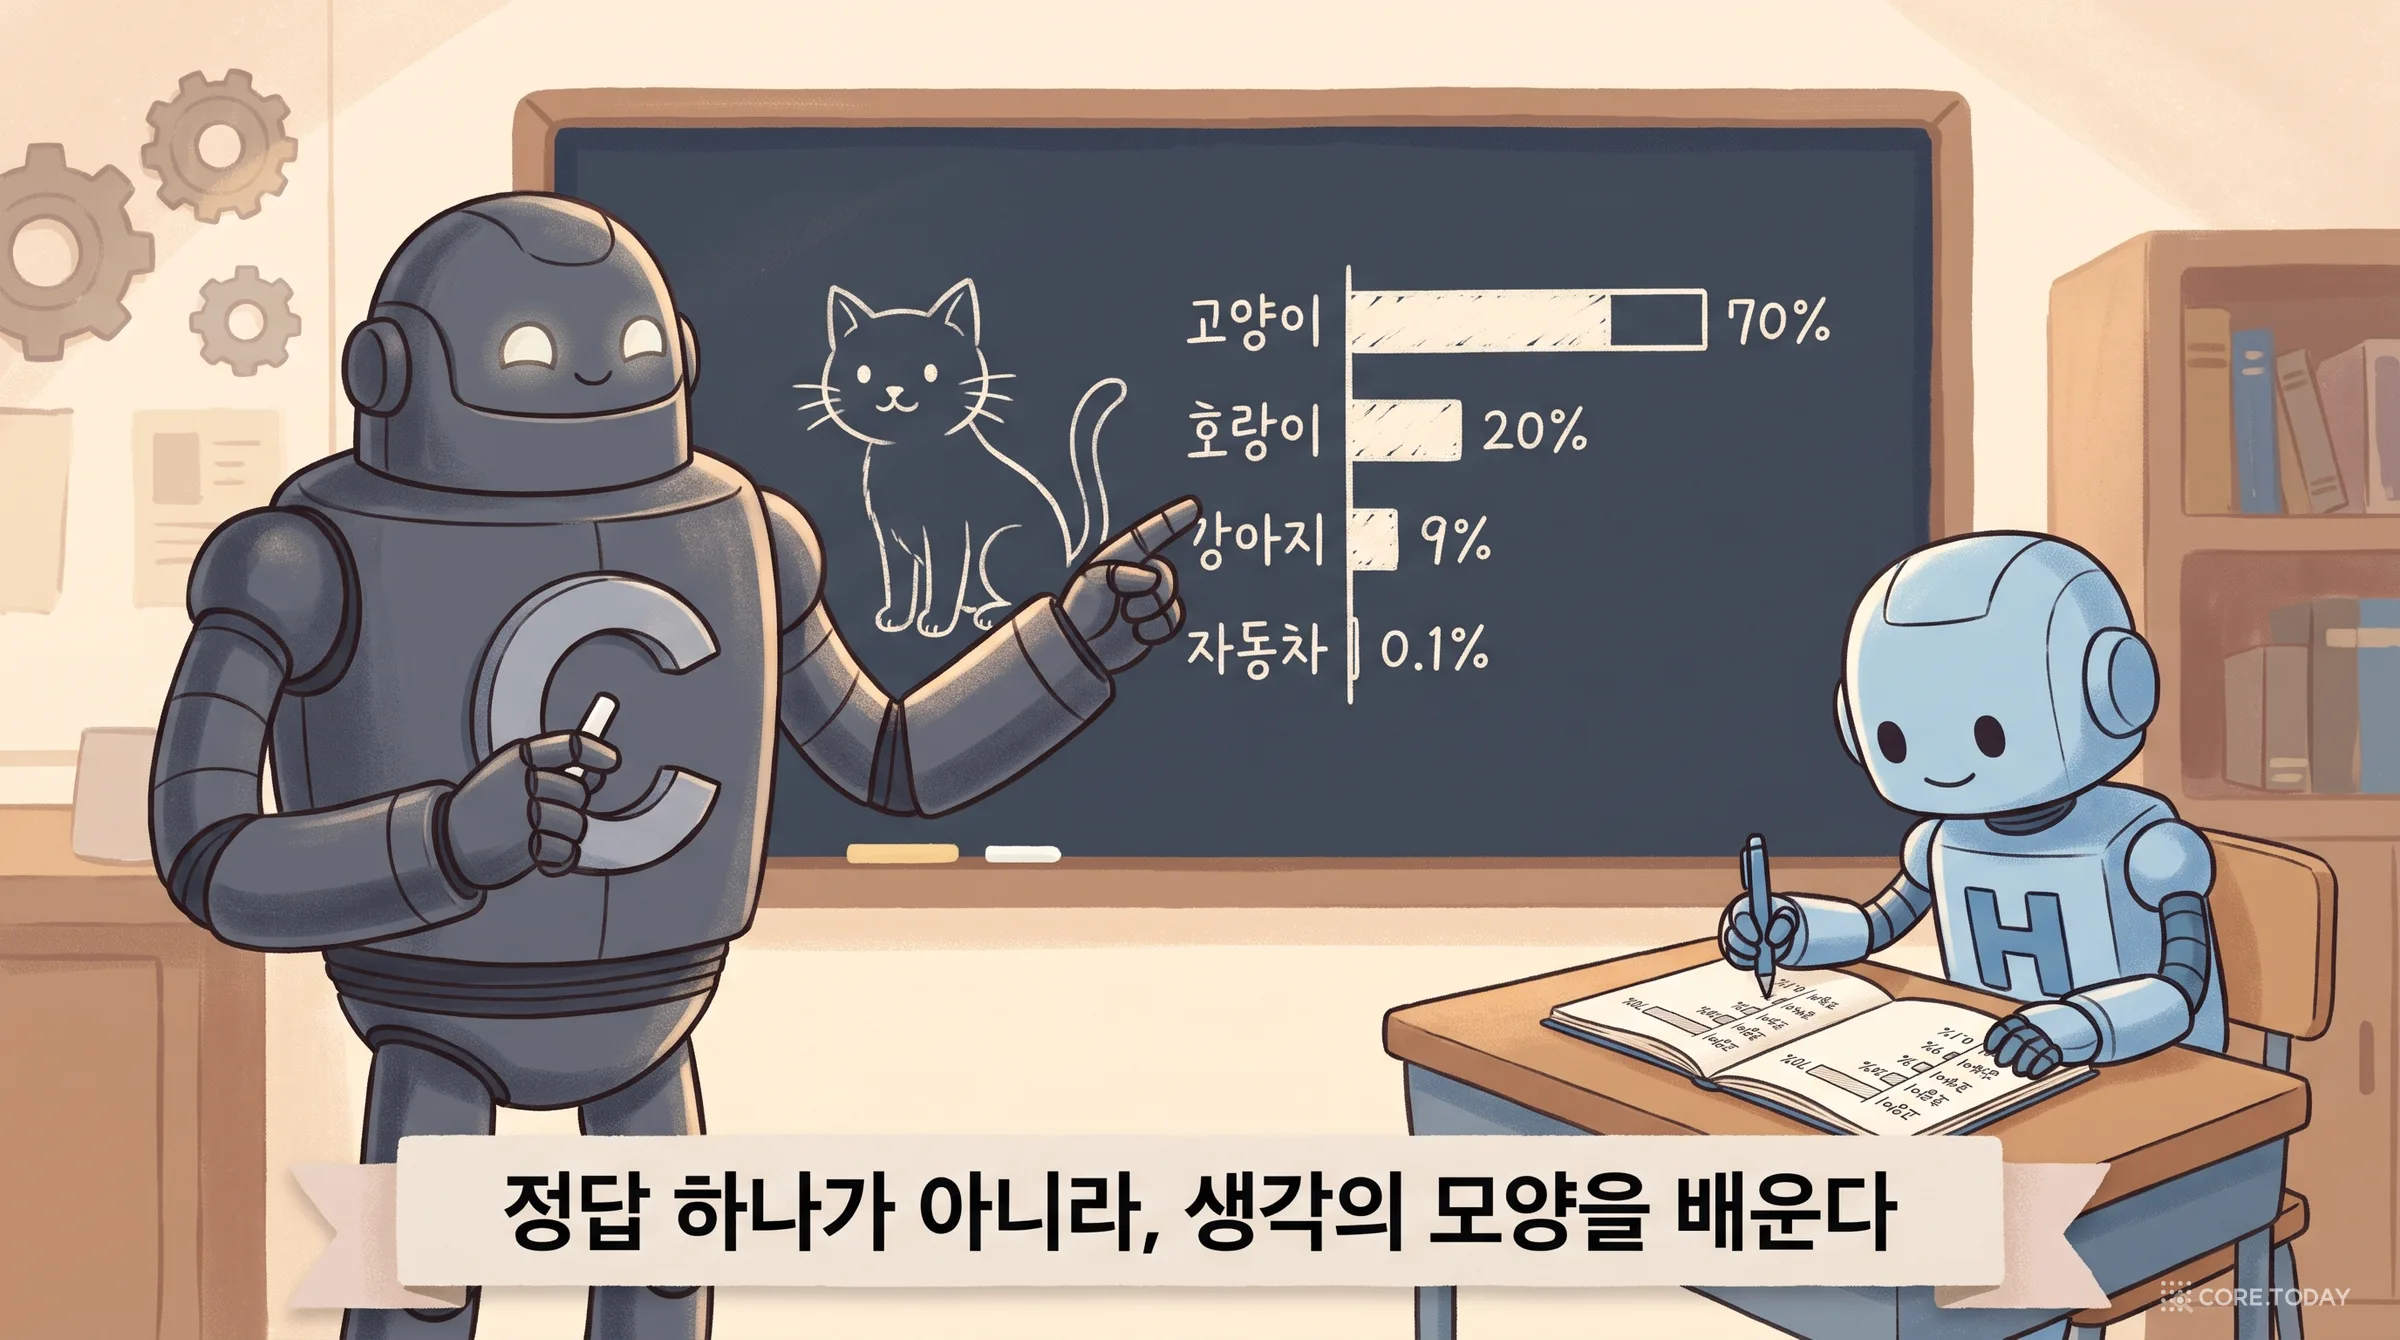
이 논문의 핵심은 한 문장으로 요약됩니다. 논문 원문은 이렇게 씁니다. “틀린 답들 사이의 상대적 확률이 많은 것을 알려 준다.”
고양이 사진을 보여 주면 큰 모델은 ‘고양이 70%’만 말하지 않습니다. ‘호랑이 20%, 강아지 9%, 자동차 0.1%’라는 분포를 함께 냅니다. 이 분포에는 “고양이는 호랑이와 꽤 닮았고 자동차와는 전혀 다르다”는 세상에 대한 지식이 들어 있습니다. 정답 라벨 ‘고양이’ 하나만 가르치면 이 지식은 버려집니다. 힌턴은 이를 2014년 강연에서 ‘어두운 지식(dark knowledge)’이라고 불렀습니다(논문 본문에는 이 표현이 없고, 강연 슬라이드 제목에 나옵니다).
여기서 ‘온도(temperature)’라는 손잡이가 나옵니다. 확률을 계산할 때 온도를 올리면 1등과 나머지의 차이가 줄어 분포가 부드러워지고, 작은 확률들 속에 숨은 정보가 드러납니다. 학생 모델은 이 부드러워진 분포를 따라 하도록 배웁니다. 음성 인식 실험에서 모델 10개를 묶은 앙상블의 정확도는 61.1%였고, 그 앙상블을 증류한 단일 모델은 60.8%였습니다. 혼자서 거의 앙상블만큼 해낸 것입니다.
아래 위젯에서 직접 온도를 바꿔 보세요. 정답만 가르칠 때와 분포를 가르칠 때, 학생이 받는 정보의 양이 얼마나 다른지 보입니다.
증류가 대중적으로 알려진 계기는 2019년 허깅페이스의 DistilBERT입니다. 당시 구글의 BERT는 자연어 처리의 표준이었지만 무거웠습니다. DistilBERT는 BERT를 증류해 크기는 40% 줄이고, 속도는 60% 빠르게 하면서, 언어 이해 성능은 97%를 유지했습니다. 3%를 내주고 절반 가까이를 아끼는 거래였고, 많은 회사가 이 거래를 받아들였습니다.
구글이 ‘Flash’라는 이름을 처음 쓴 것은 2024년 5월의 Gemini 1.5 Flash입니다. 구글은 기술 보고서(arXiv 2403.05530, 3.2절)에 이렇게 적었습니다. “1.5 Flash는 훨씬 큰 Gemini 1.5 Pro로부터 온라인 증류(online distilled)되었다.” 큰 형이 공부한 것을 작은 동생이 실시간으로 따라 배우는 구조입니다. 이때 인용한 논문 목록에는 위의 부칠루아(2006)와 힌턴(2015)이 그대로 들어 있습니다.
같은 해 7월 나온 오픈 모델 Gemma 2에서 구글은 한 걸음 더 나갔습니다. 2B·9B 모델을 ‘다음 단어 맞히기’가 아니라 큰 모델의 확률 분포를 따라 하는 증류로 학습했습니다. 2B 모델에 똑같이 5,000억 토큰을 읽혔을 때, 처음부터 혼자 배운 모델의 평균 점수는 60.3이었고 7B 선생님에게 증류받은 모델은 67.7이었습니다. 같은 양을 읽어도 선생님이 있으면 7점을 더 받습니다.
2023~2024년에는 ‘온폴리시 증류(on-policy distillation, GKD)’가 나왔습니다. 기존 증류는 학생이 선생님의 답안지를 베끼며 배웠는데, 실제 시험에서는 학생이 자기 손으로 답을 써야 합니다. 그래서 학생이 스스로 쓴 답안에 선생님이 첨삭을 해 주는 방식으로 바꾼 것이 GKD입니다. 앞서 본 Gemini 1.5 보고서가 인용한 ‘Agarwal 2024b’가 바로 이 논문입니다.
Hydrogen은 어떻게 만들었을까? 모델 카드는 아키텍처, 학습 데이터, 하드웨어, 소프트웨어 칸마다 같은 문장을 반복합니다. “Gemini 4 Hydrogen은 Gemini 4 Carbon에서 조정되었다(adapted from). 자세한 내용은 Carbon 모델 카드를 보라.” 증류인지, 가지치기인지, Carbon의 일부 전문가만 떼어 낸 것인지는 밝히지 않았습니다. 다만 Flash 계보가 증류로 시작됐다는 점, 구글이 같은 시기 Gemma에서 증류를 기본으로 쓴다는 점을 보면 증류 계열일 가능성이 높습니다. 이 글에서는 이 부분을 ‘추정’으로만 다룹니다.
3-4. 2022년 친칠라, 그리고 “쓰는 값까지 계산하라”
증류와 나란히 달려온 또 하나의 흐름은 ‘모델을 얼마나 크게, 얼마나 오래 학습시킬 것인가’라는 질문입니다.
2022년 딥마인드의 친칠라(Chinchilla) 논문은 같은 계산량이라면 모델을 키우기보다 더 많이 읽히는 편이 낫다는 걸 보였습니다. 파라미터 700억 개짜리 모델에 1.4조 토큰을 읽힌 친칠라가, 4배 큰 2,800억 파라미터의 고퍼(Gopher)를 모든 시험에서 이겼습니다. 여기서 ‘파라미터 1개당 토큰 20개’라는 경험칙이 퍼졌습니다(논문 문장은 아니고 1.4조÷700억에서 나온 계산입니다).
그런데 친칠라 공식에는 빠진 것이 있었습니다. 학습이 끝난 뒤 모델을 쓰는 값입니다. 2023년 말 사르다나(Sardana) 등의 「친칠라 최적을 넘어서(Beyond Chinchilla-Optimal)」는 이 빈칸을 채웠습니다. 요청이 10억 건쯤 들어올 모델이라면, 친칠라 공식보다 작게 만들고 훨씬 오래 학습시키는 편이 전체 비용이 싸다는 것입니다. 학습은 한 번이지만 추론은 매일, 수억 번 일어나기 때문입니다.
2024년 4월 메타의 라마 3가 이것을 실천했습니다. 메타는 “8B 모델의 친칠라 최적 학습량은 약 2,000억 토큰이지만, 15조 토큰까지 학습시켜도 계속 좋아졌다”고 밝혔습니다. 친칠라 기준의 75배입니다.
Hydrogen에 대입하면 이렇게 됩니다. 구글은 Hydrogen을 구글 검색 전체 사용자에게 내보냈습니다. 하루 요청 수가 상상하기 어려운 규모입니다. 이런 모델은 한 번 더 비싸게 만들더라도, 한 번 쓸 때 싸고 빨라야 합니다. ‘작은 형제’는 성능을 포기한 모델이 아니라, 쓰는 값까지 계산에 넣은 모델입니다.
3-5. 세 회사의 ‘작은 형제’ 계보
구글만 이런 모델을 만든 것은 아닙니다. 세 회사 모두 큰 모델 옆에 빠른 동생을 둡니다.
시기
구글 (Flash → Hydrogen)
Anthropic (Haiku)
OpenAI (mini → Luna·Terra)
2024 상반기
1.5 Flash (5월, Pro에서 증류) 0.35→0.075달러
Claude 3 Haiku (3월) 0.25달러
GPT-4o mini (7월) 0.15달러
2024 말~2025
2.0 Flash 0.10달러 · 2.5 Flash (생각 예산 도입) 0.30달러
3.5 Haiku 1달러(4배 인상) · Haiku 4.5 1달러
GPT-4.1 mini 0.40달러 · GPT-5 mini 0.25달러
2025 말~2026 상반기
3 Flash 0.50달러 · 3.5 Flash 1.50달러(3배 인상)
—
GPT-5.4 mini 0.75달러 · 5.6 Luna·Terra
2026 하반기
3.6·3.7·3.8 Flash(석 달에 세 번) → 4 Hydrogen 1.50달러
Haiku 5.5 0.10달러 · Sonnet 5.5 2달러
GPT-6 Luna 0.10달러 · 6.1 Terra 1달러
입력 100만 토큰당 정가(달러). 출처는 각 사 가격 문서와 발표(참고 자료 참조). 소개가·한시 할인은 따로 적지 않았습니다.
이 표에서 두 가지가 보입니다.
첫째, ‘작은 모델은 계속 싸진다’는 상식이 2025년에 깨졌습니다. Flash는 2024년 0.075달러까지 내려갔다가, 2026년 3.5 Flash에서 1.50달러로 20배 올랐습니다. Anthropic도 3.5 Haiku에서 값을 4배 올리며 “지능이 올랐기 때문”이라고 설명했습니다. 작은 모델이 ‘싸고 어설픈 모델’에서 ‘쓸 만한 일꾼’으로 올라가면서, 값도 일꾼 값을 받기 시작한 것입니다.
둘째, 2026년 하반기에 다시 갈라졌습니다. Anthropic의 Haiku 5.5와 OpenAI의 GPT-6 Luna는 0.10달러라는 초저가로 내려갔고, 구글은 Hydrogen을 1.50달러에 두었습니다. 같은 ‘빠른 모델’이라도 Haiku·Luna는 “분류·추출·라우팅 같은 대량 작업”을, Hydrogen은 “최상위 모델 바로 밑의 실행 엔진”을 노립니다. 체급이 다릅니다. 그래서 구글이 비교 상대로 Haiku가 아니라 Sonnet 5.5와 GPT-6.1 Terra를 골랐습니다.
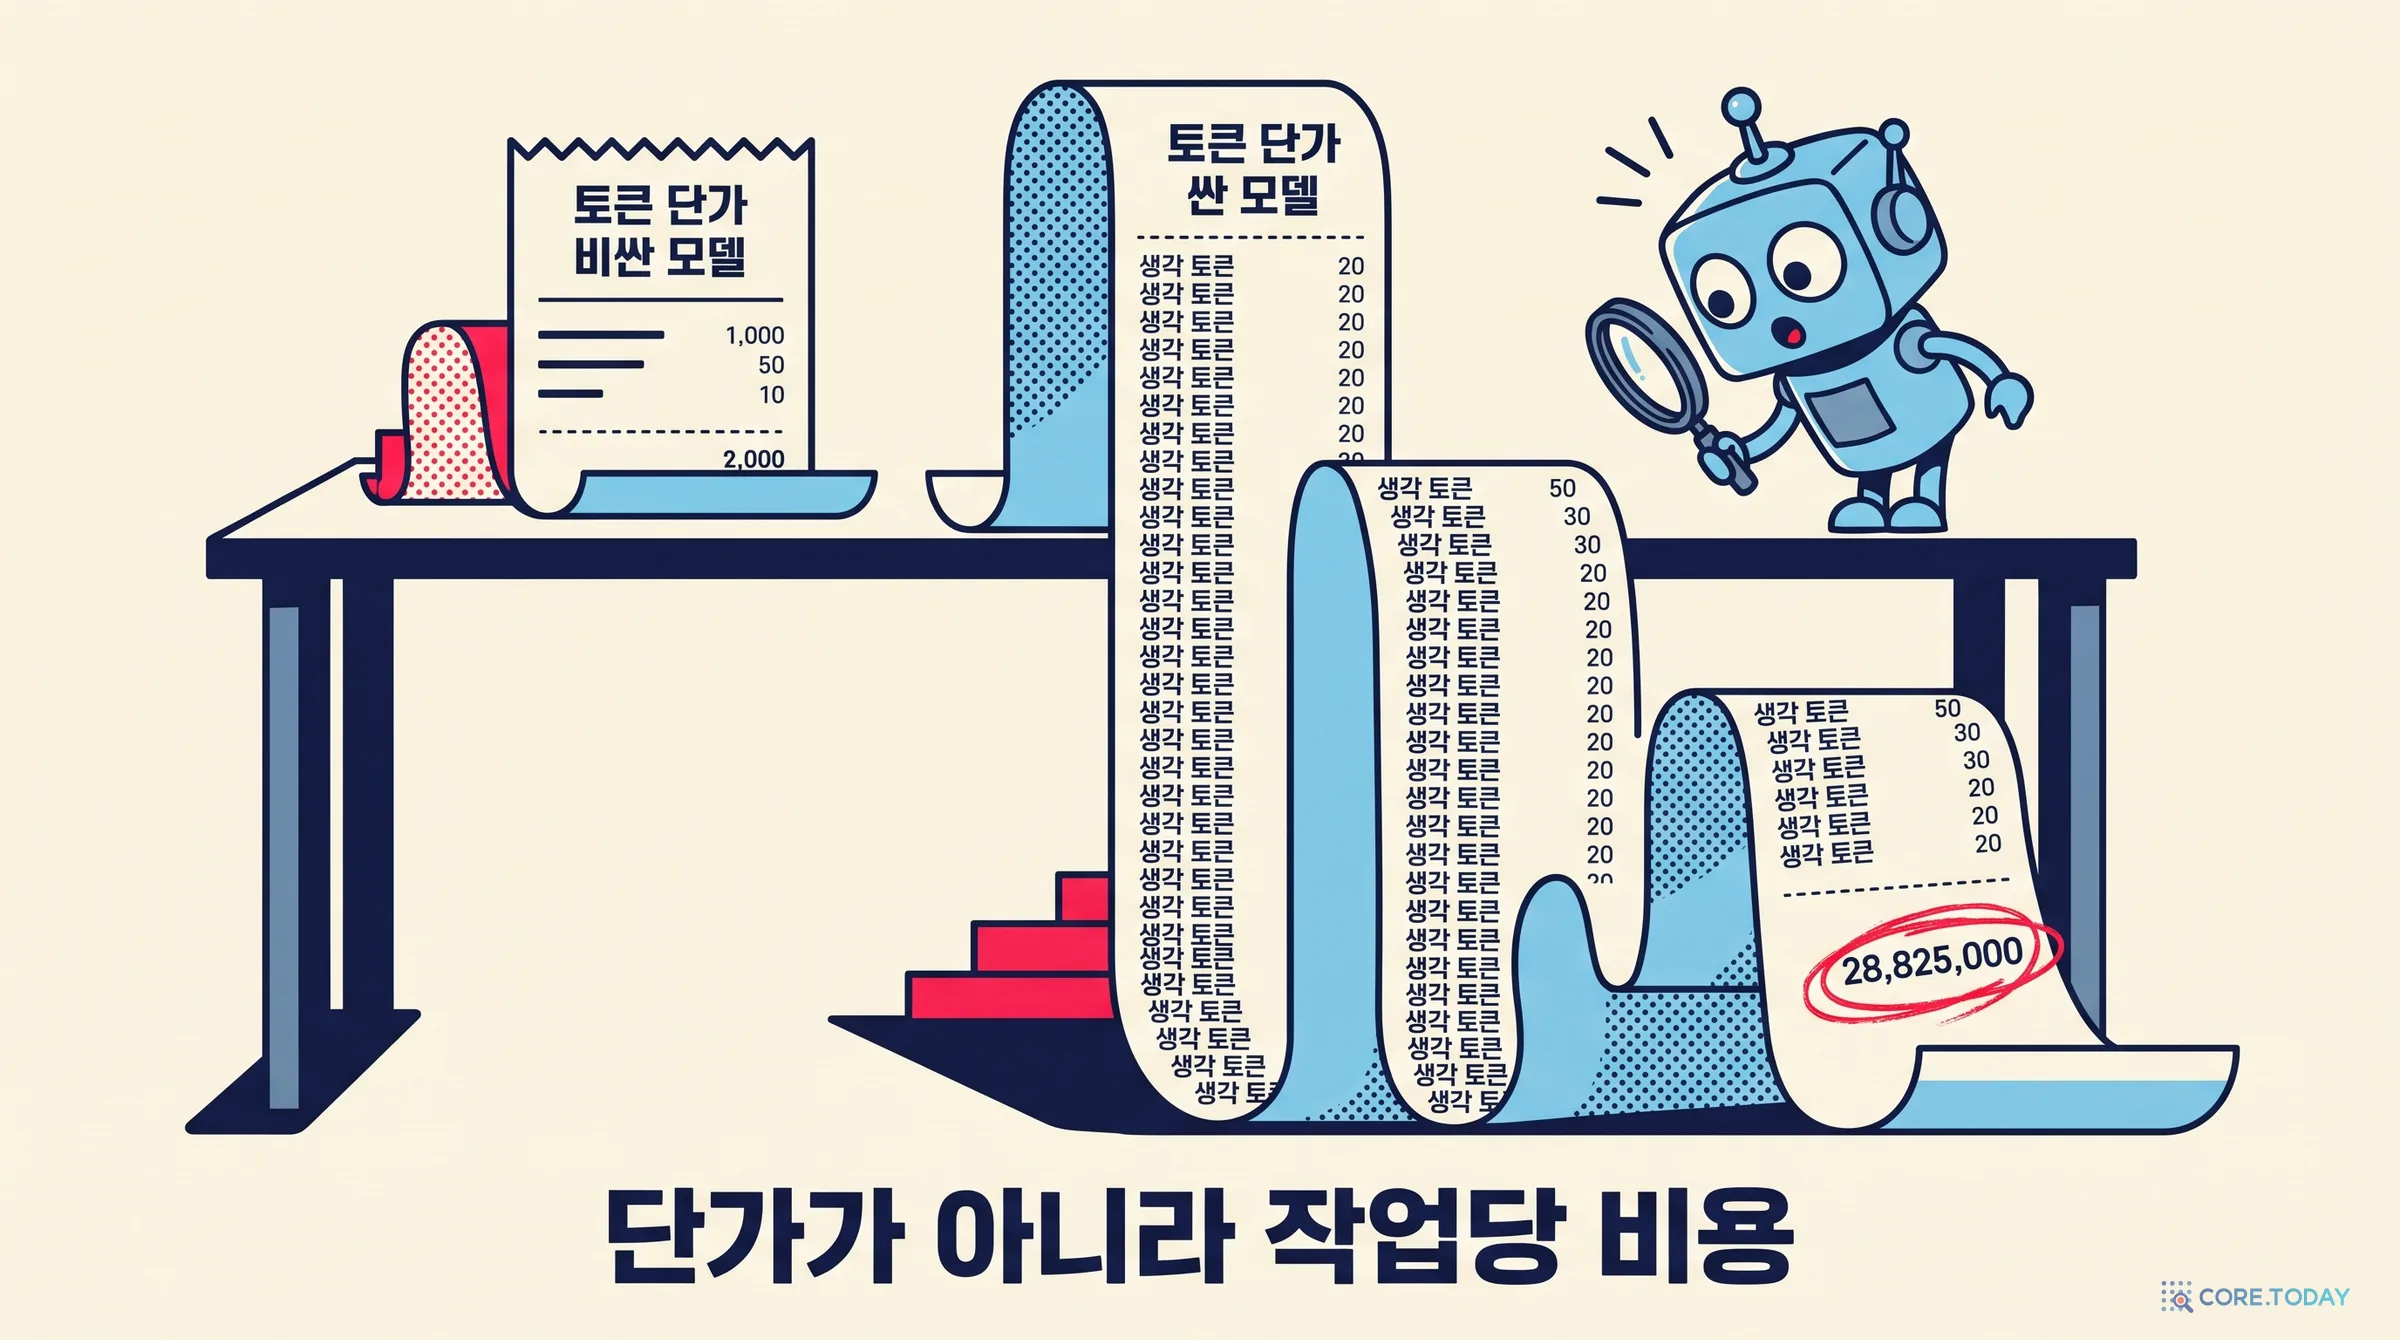
3-6. 단가는 내려가는데, 청구서는 올라간다
여기서 2026년의 역설이 하나 나옵니다.
2024년 a16z는 ‘LLM 인플레이션(LLMflation)’이라는 글에서, 같은 성능을 내는 값이 해마다 10분의 1로 떨어진다고 정리했습니다. 2021년 11월 MMLU 42점을 내는 가장 싼 모델은 GPT-3로 100만 토큰에 60달러였는데, 3년 뒤에는 라마 3.2 3B가 0.06달러에 같은 점수를 냈습니다. 1,000배입니다. 에포크 AI도 2025년 3월, 성능 수준에 따라 해마다 9배에서 900배까지 값이 떨어진다고 측정했습니다.
그런데 2025년 말 MIT의 건들랙(Gundlach)·톰슨(Thompson) 연구진이 낸 「진보의 값(The Price of Progress)」은 다른 면을 보여 줍니다. 같은 점수를 내는 값은 해마다 5~10배 떨어지지만, 최상위 모델을 쓰는 값은 오히려 해마다 3~18배 오르고 있다는 것입니다. 모델이 커지고, 무엇보다 한 문제를 풀 때 ‘생각’하는 토큰이 폭발적으로 늘었기 때문입니다.
이것이 2026년에 ‘빠른 형제’가 다시 중요해진 이유입니다. 최상위 모델로 모든 일을 하면 청구서가 감당이 안 됩니다. 일을 나눠야 합니다. 어려운 판단은 큰 모델에게, 손이 많이 가는 실행은 빠른 모델에게. Hydrogen 발표문이 첫 절부터 ‘다중 모델 작업’을 이야기하는 까닭이 여기 있습니다.
4. 생각 수준 네 단계 — ‘얼마나 오래 생각할지’를 고르는 시대
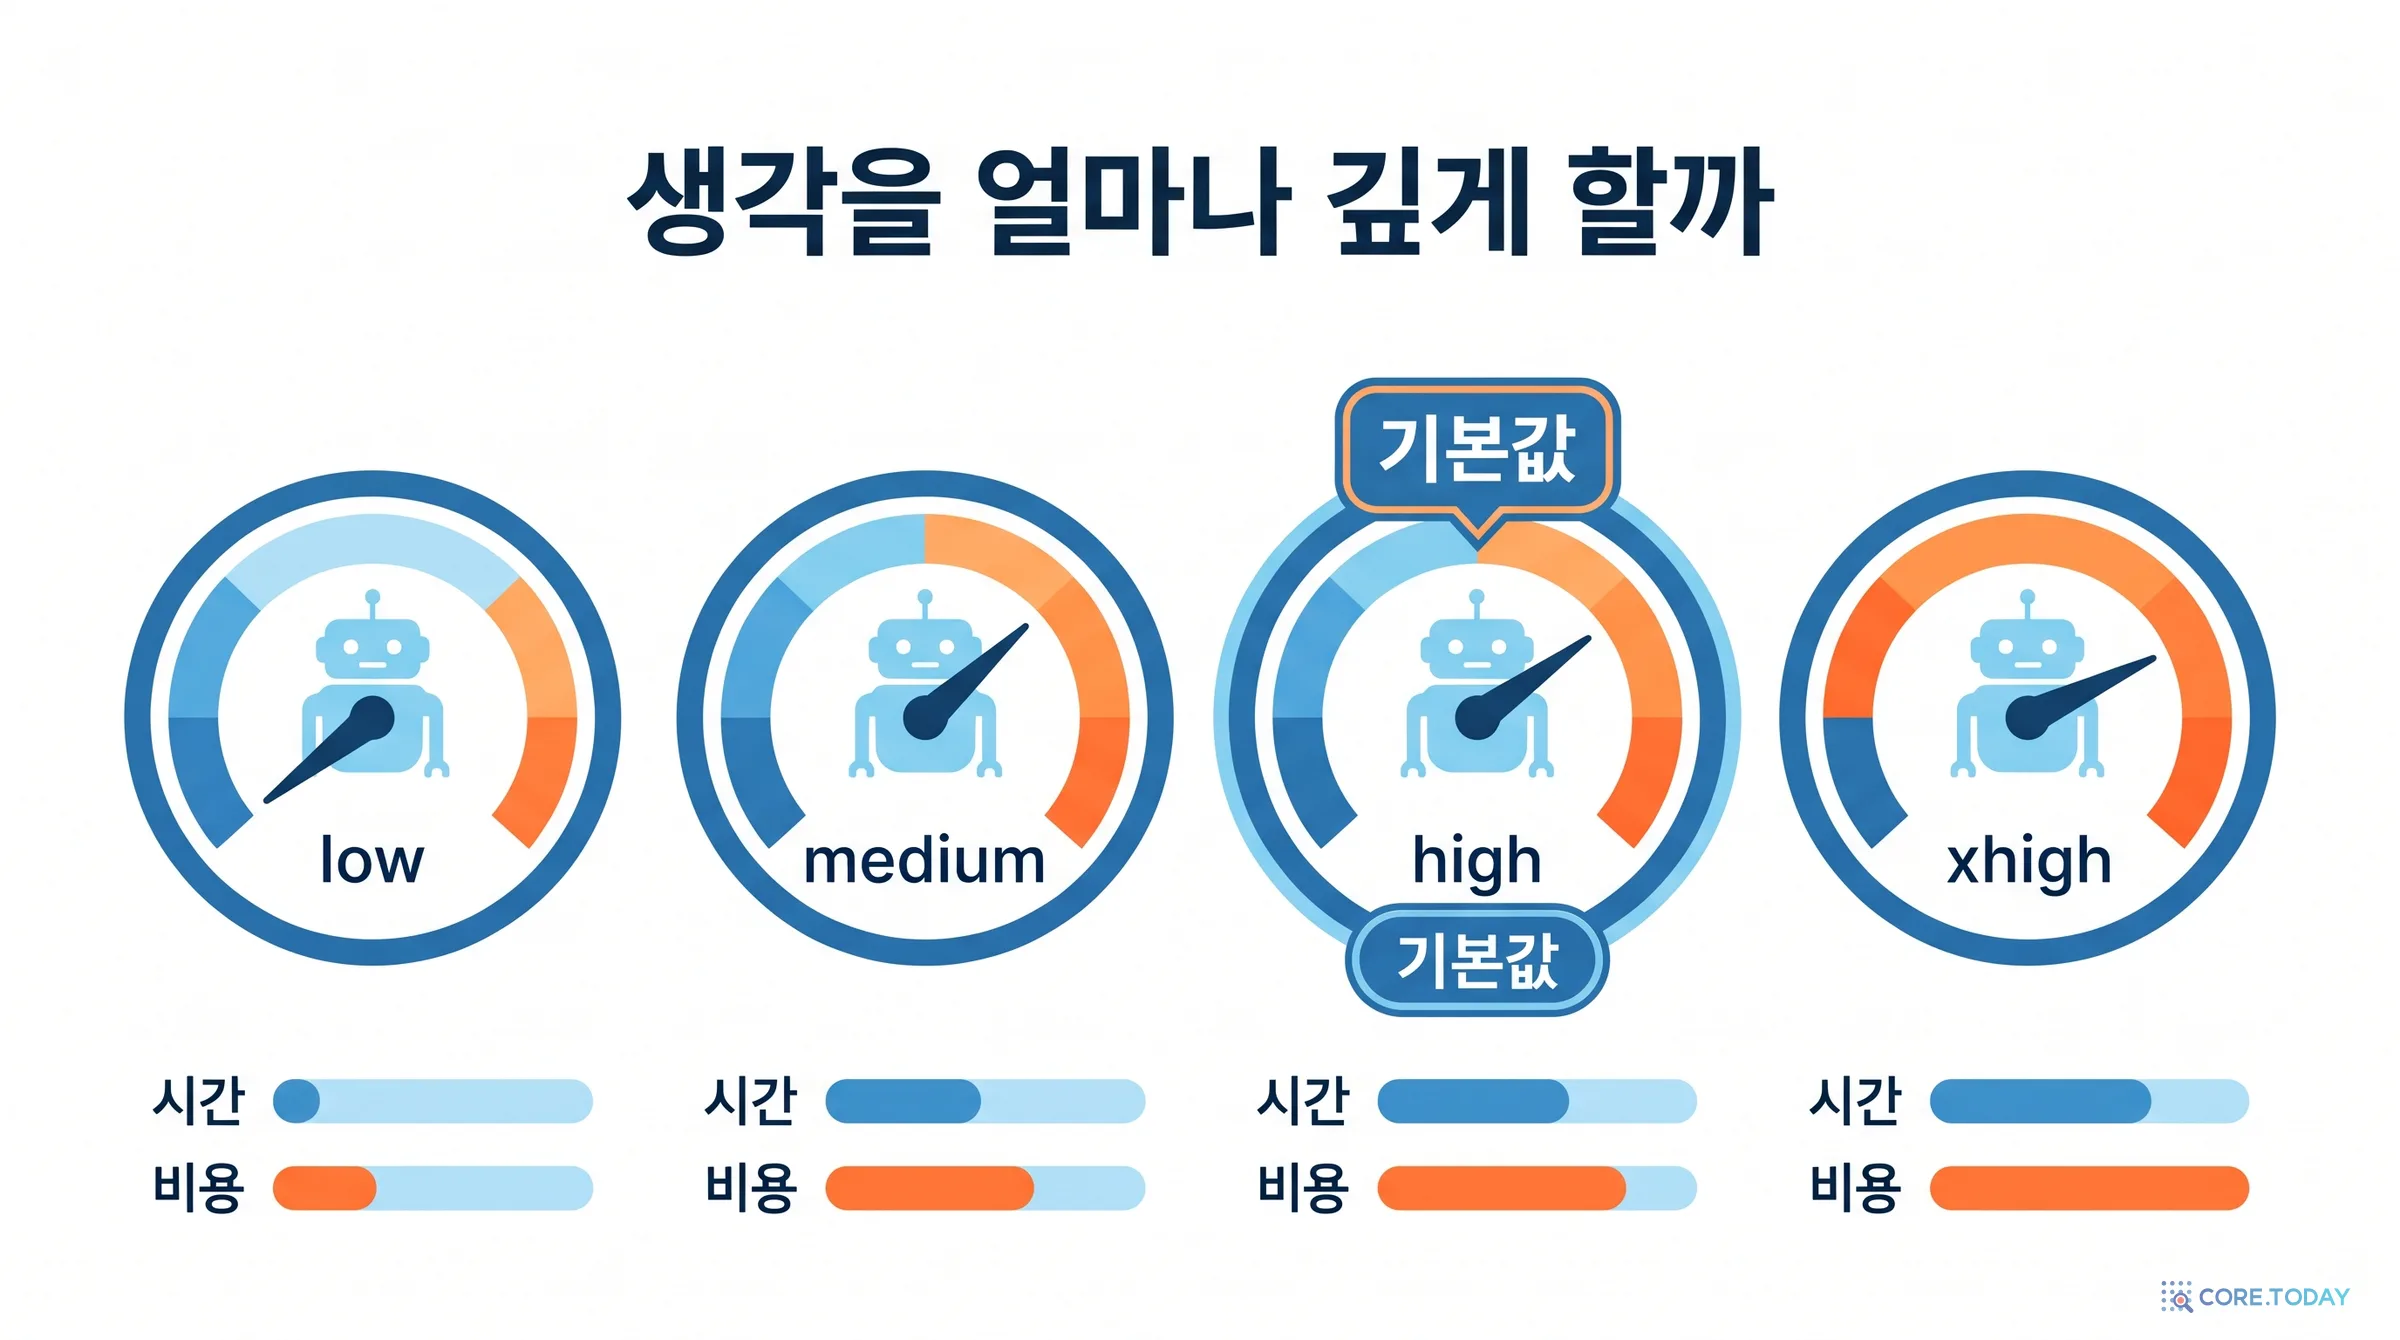
Hydrogen에는 생각 수준(thinking level)이 네 개 있습니다. low, medium, high(기본값), 그리고 이번에 새로 생긴 xhigh입니다. 발표문은 이 네 단계가 “품질·지연·비용 사이에서 매끄럽고 예측 가능하게 이어져, 그 일에 필요한 만큼만 기다리고 돈을 내게 해 준다”고 설명합니다. 이 손잡이가 왜 생겼는지도 역사를 따라가면 잘 보입니다.
2022년 1월 구글의 제이슨 웨이(Jason Wei) 등은 「생각의 사슬(Chain-of-Thought) 프롬프팅」 논문에서, 모델에게 답만 묻지 말고 풀이 과정을 몇 개 보여 주면 수학 문제를 훨씬 잘 푼다는 것을 보였습니다. 5,400억 파라미터의 PaLM에 풀이 예시 여덟 개를 보여 주자 초등 수학 문제집(GSM8K)에서 당시 최고 점수가 나왔습니다. 답하기 전에 ‘생각’을 글로 쓰게 하면 똑똑해진다는 발견이었습니다.
4-2. 2024년: 생각에도 ‘규모의 법칙’이 있다
2024년 9월 OpenAI의 o1은 이 발견을 제품으로 만들었습니다. o1은 답하기 전에 길게 생각하도록 강화학습으로 훈련된 첫 대형 모델이었고, OpenAI는 “학습에 계산을 더 쓸수록, 그리고 생각하는 데 시간을 더 쓸수록 일관되게 좋아진다”는 그래프를 공개했습니다. 미국 수학 경시대회(AIME 2024)에서 GPT-4o가 12%였던 것을 o1은 74% 풀었습니다.
같은 해 8월 딥마인드의 스넬(Snell) 등은 이 현상을 정밀하게 쟀습니다(arXiv 2408.03314). 결론은 두 가지였습니다. 첫째, 문제마다 생각하는 양을 조절하면 같은 계산으로 4배 이상 효율적이다. 둘째, 계산량을 맞추면 작은 모델에 생각을 더 시키는 쪽이 14배 큰 모델을 이길 수 있다. 단, 조건이 붙었습니다. 작은 모델이 그 문제를 ‘어느 정도는’ 풀 수 있을 때만 그렇습니다. 정말 어려운 문제에서는 큰 모델을 이길 수 없었습니다.
이 조건이 Hydrogen의 설계 철학과 정확히 겹칩니다. 쉬운 일에서 중간 난도의 일까지는 빠른 모델이 생각을 조절하며 처리하고, 정말 어려운 일은 큰 모델에게 넘긴다.
4-3. 2024년 말: 너무 많이 생각하는 문제
생각이 좋다고 무조건 많이 하면 되는 건 아닙니다. 2024년 12월 「2+3=?에 그렇게 오래 생각하지 마라(Do NOT Think That Much for 2+3=?)」라는 재미있는 제목의 논문이 나왔습니다. o1 계열 모델들이 “2 더하기 3은?”이라는 질문에 일반 모델보다 토큰을 1,953% 더 썼다는 것입니다. 답은 처음 몇 줄에서 이미 나왔는데, 모델이 “잠깐, 다시 확인해 보자”를 반복했습니다. 연구진의 방법으로 군더더기 생각을 덜어 내자 정확도는 그대로인 채 출력이 48.6% 줄었습니다.
구글은 2025년 4월 Gemini 2.5 Flash에서 처음으로 개발자가 생각의 양을 직접 고르게 했습니다. 이름은 ‘생각 예산(thinking budget)’이었고, 0에서 24,576토큰까지 숫자로 정했습니다. 이 예산은 상한선이라서 “쉬운 질문에는 예산을 다 쓰지 않는다”고 했습니다. 당시 2.5 Flash는 생각을 끄면 출력 100만 토큰당 0.60달러, 켜면 3.50달러였습니다. 같은 모델인데 생각 스위치 하나로 값이 6배 가까이 달라진 것입니다.
그 뒤 구글은 숫자 대신 단계를 고르는 방식(thinking_level)으로 바꿨습니다. 2026년 7월 3.6 Flash는 minimal·low·medium·high 네 단계였고 기본값이 medium이었습니다. Hydrogen은 low·medium·high·xhigh로, 기본값을 high로 올리고 위에 한 칸을 더 얹었습니다. 개발자 문서의 변경 기록에는 “기존 low·medium·기본 high 옆에 네 번째 단계 xhigh를 추가했다”고 적혀 있습니다.
다른 회사도 같은 길을 걸었습니다. Anthropic은 토큰 예산(budget_tokens)을 버리고 모델이 알아서 생각하는 ‘적응형 사고’와 effort 하나로 바꿨고(코어닷투데이의 Claude Opus 5.5 사용 설명서 참고), OpenAI도 reasoning effort를 단계로 고르게 합니다(GPT-6 삼형제 사용 설명서 참고). 2026년의 세 회사는 모두 ‘몇 토큰 생각할지’가 아니라 ‘얼마나 진지하게 생각할지’를 고르게 합니다.
4-5. 구글의 곡선 다섯 장을 다시 읽기
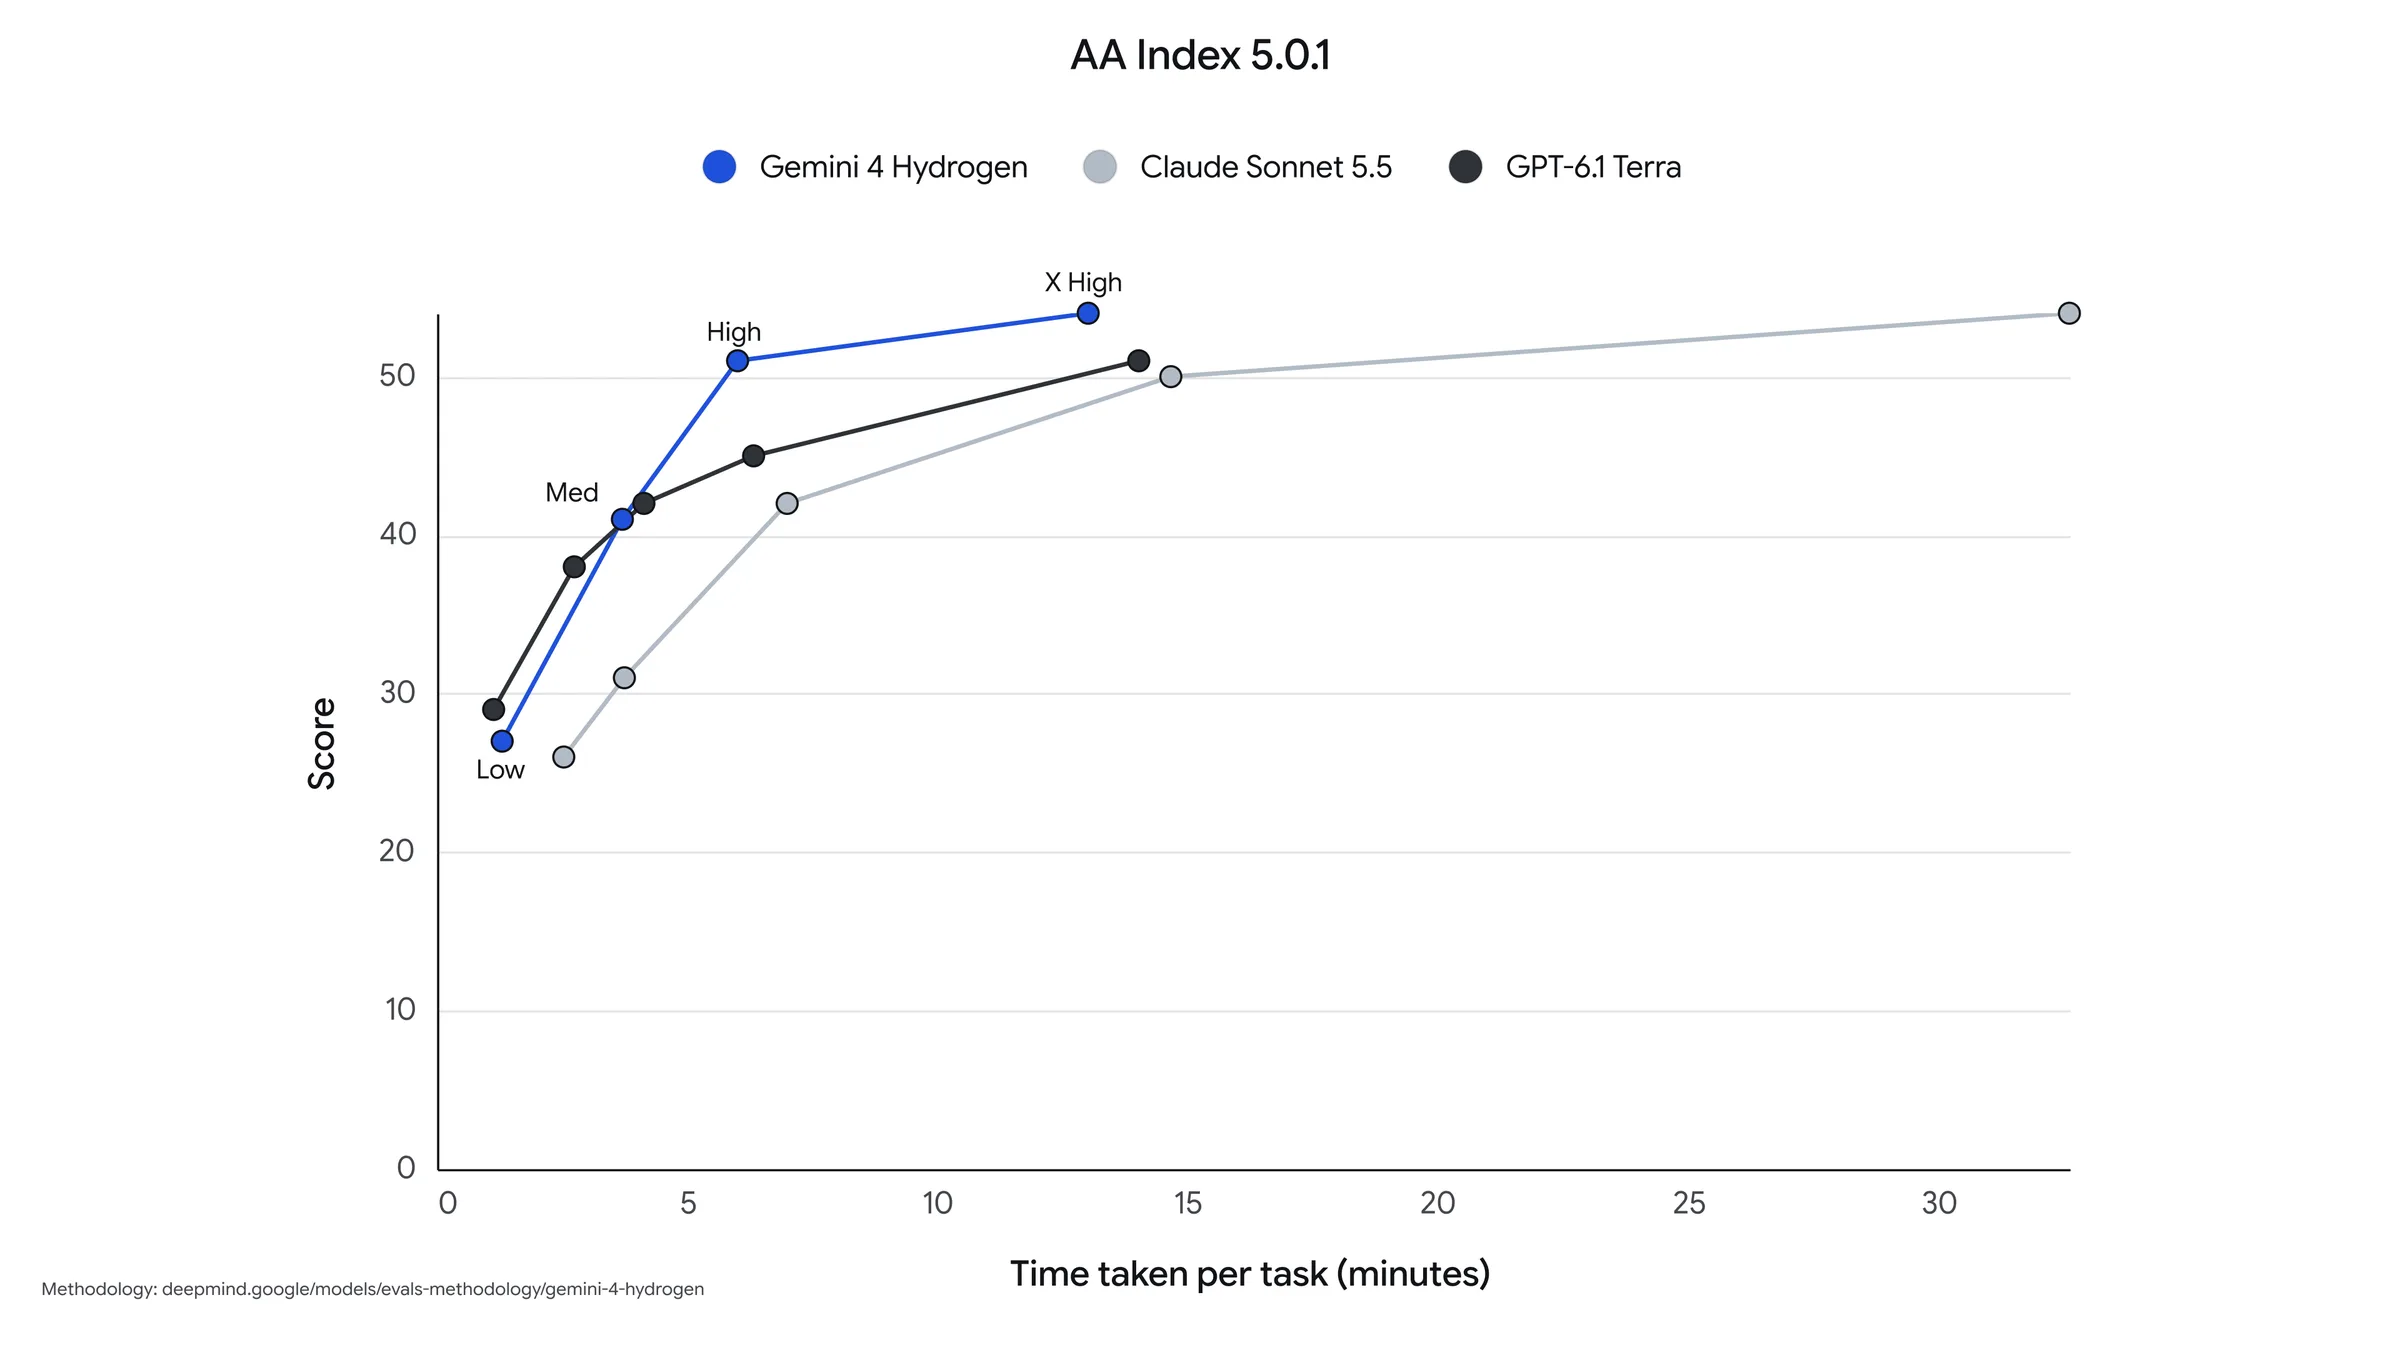
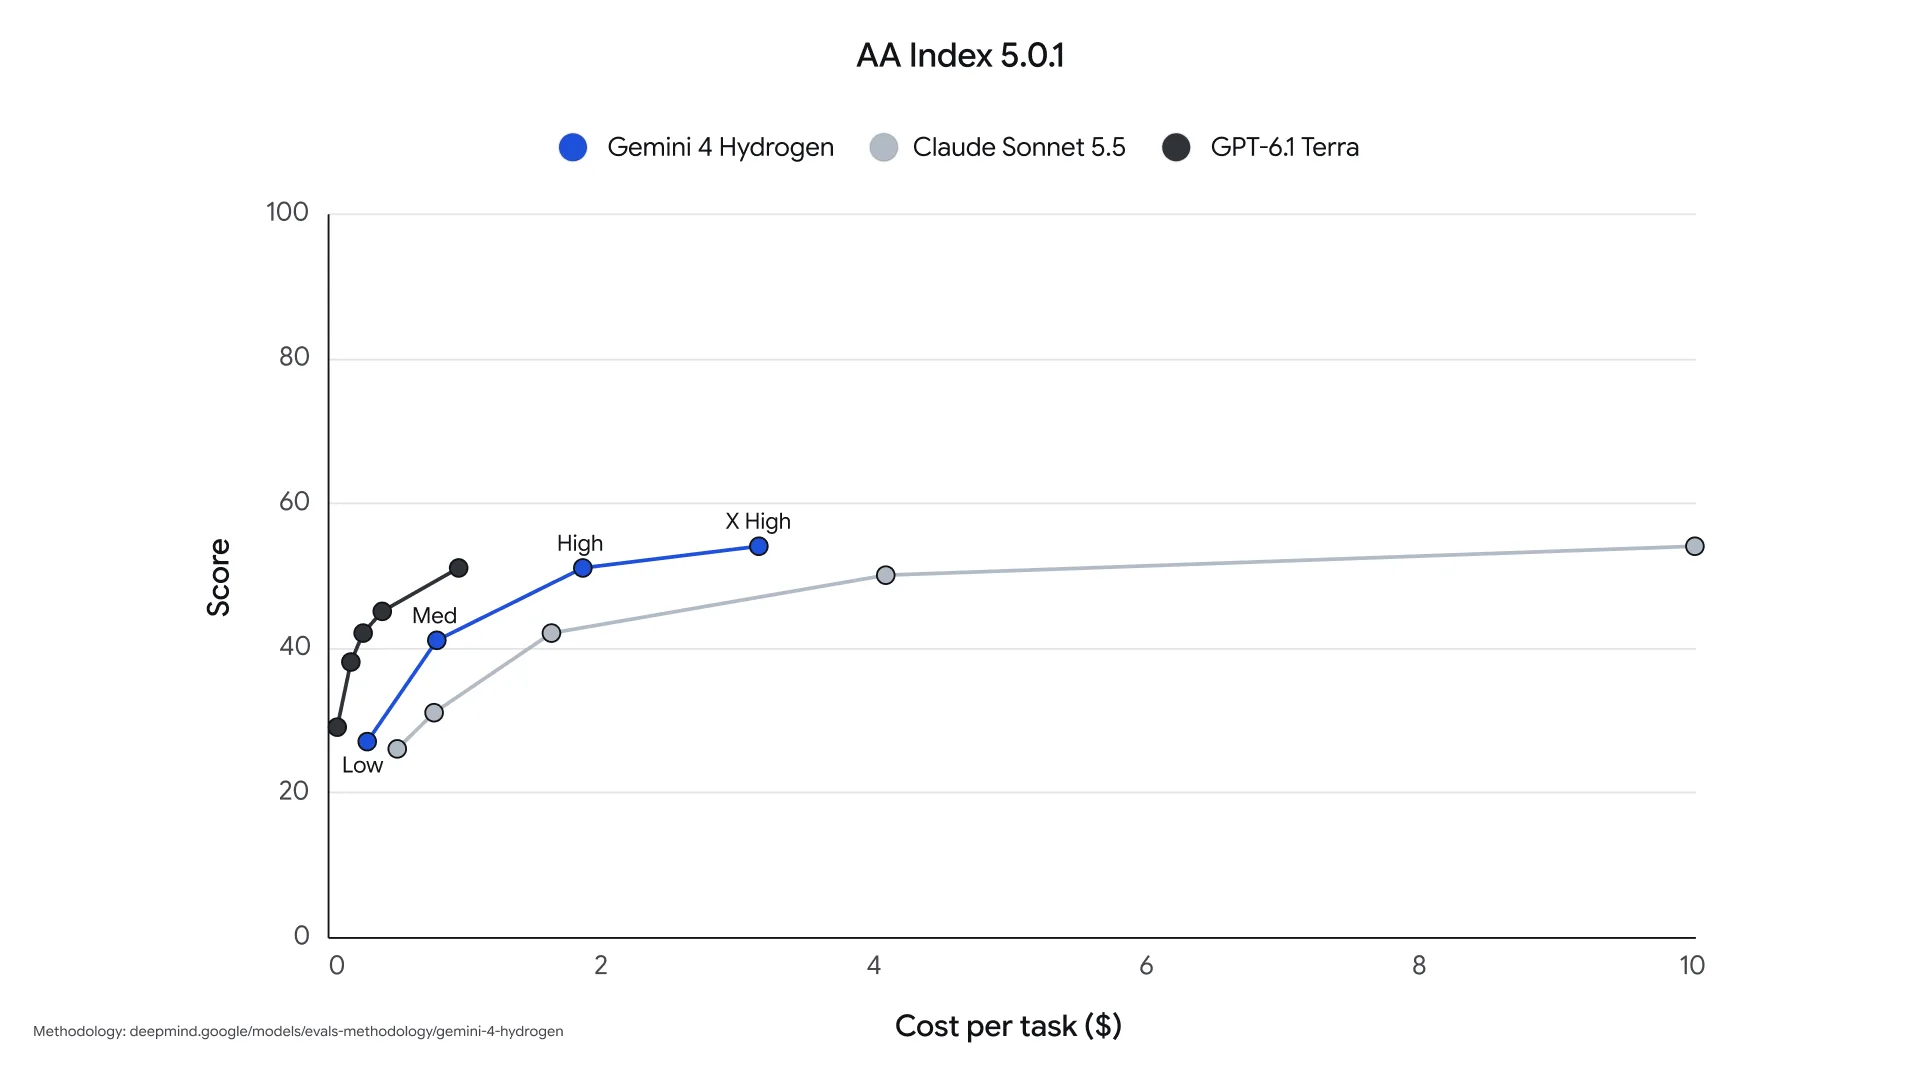
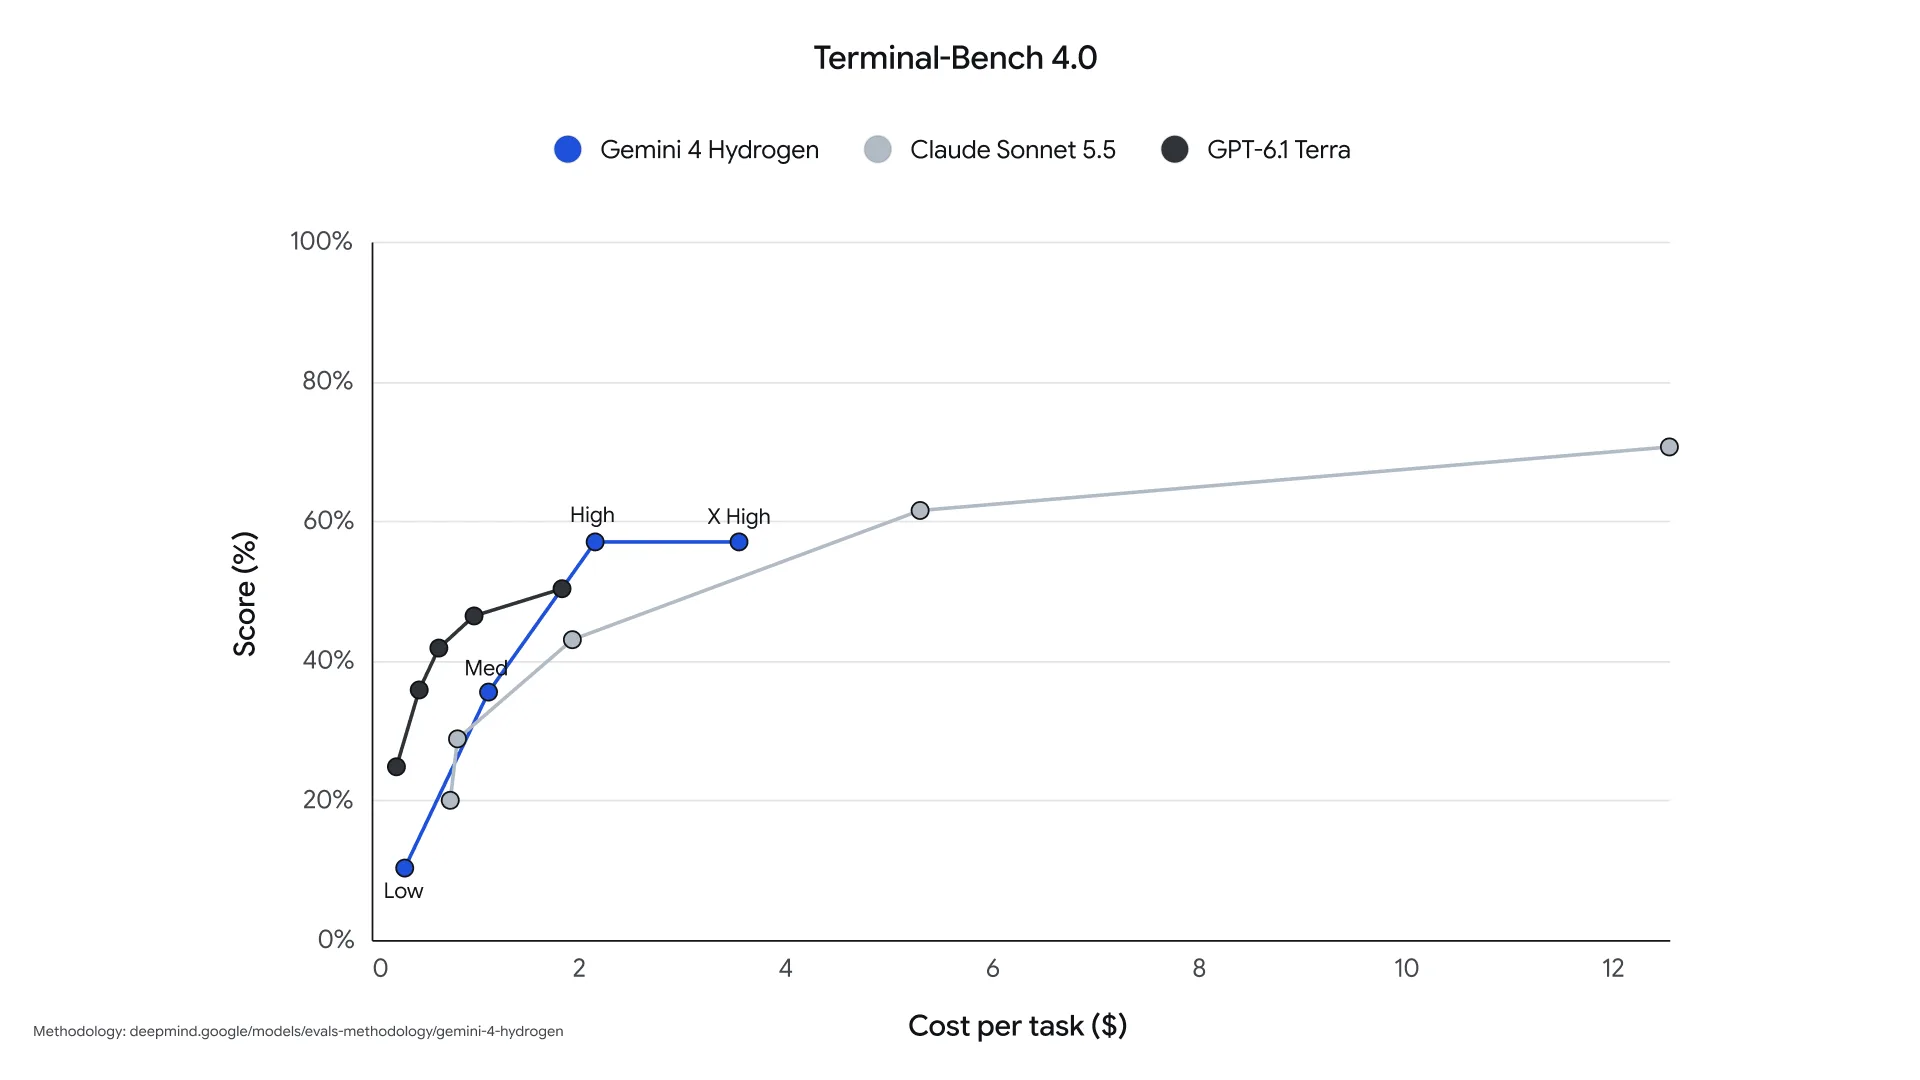
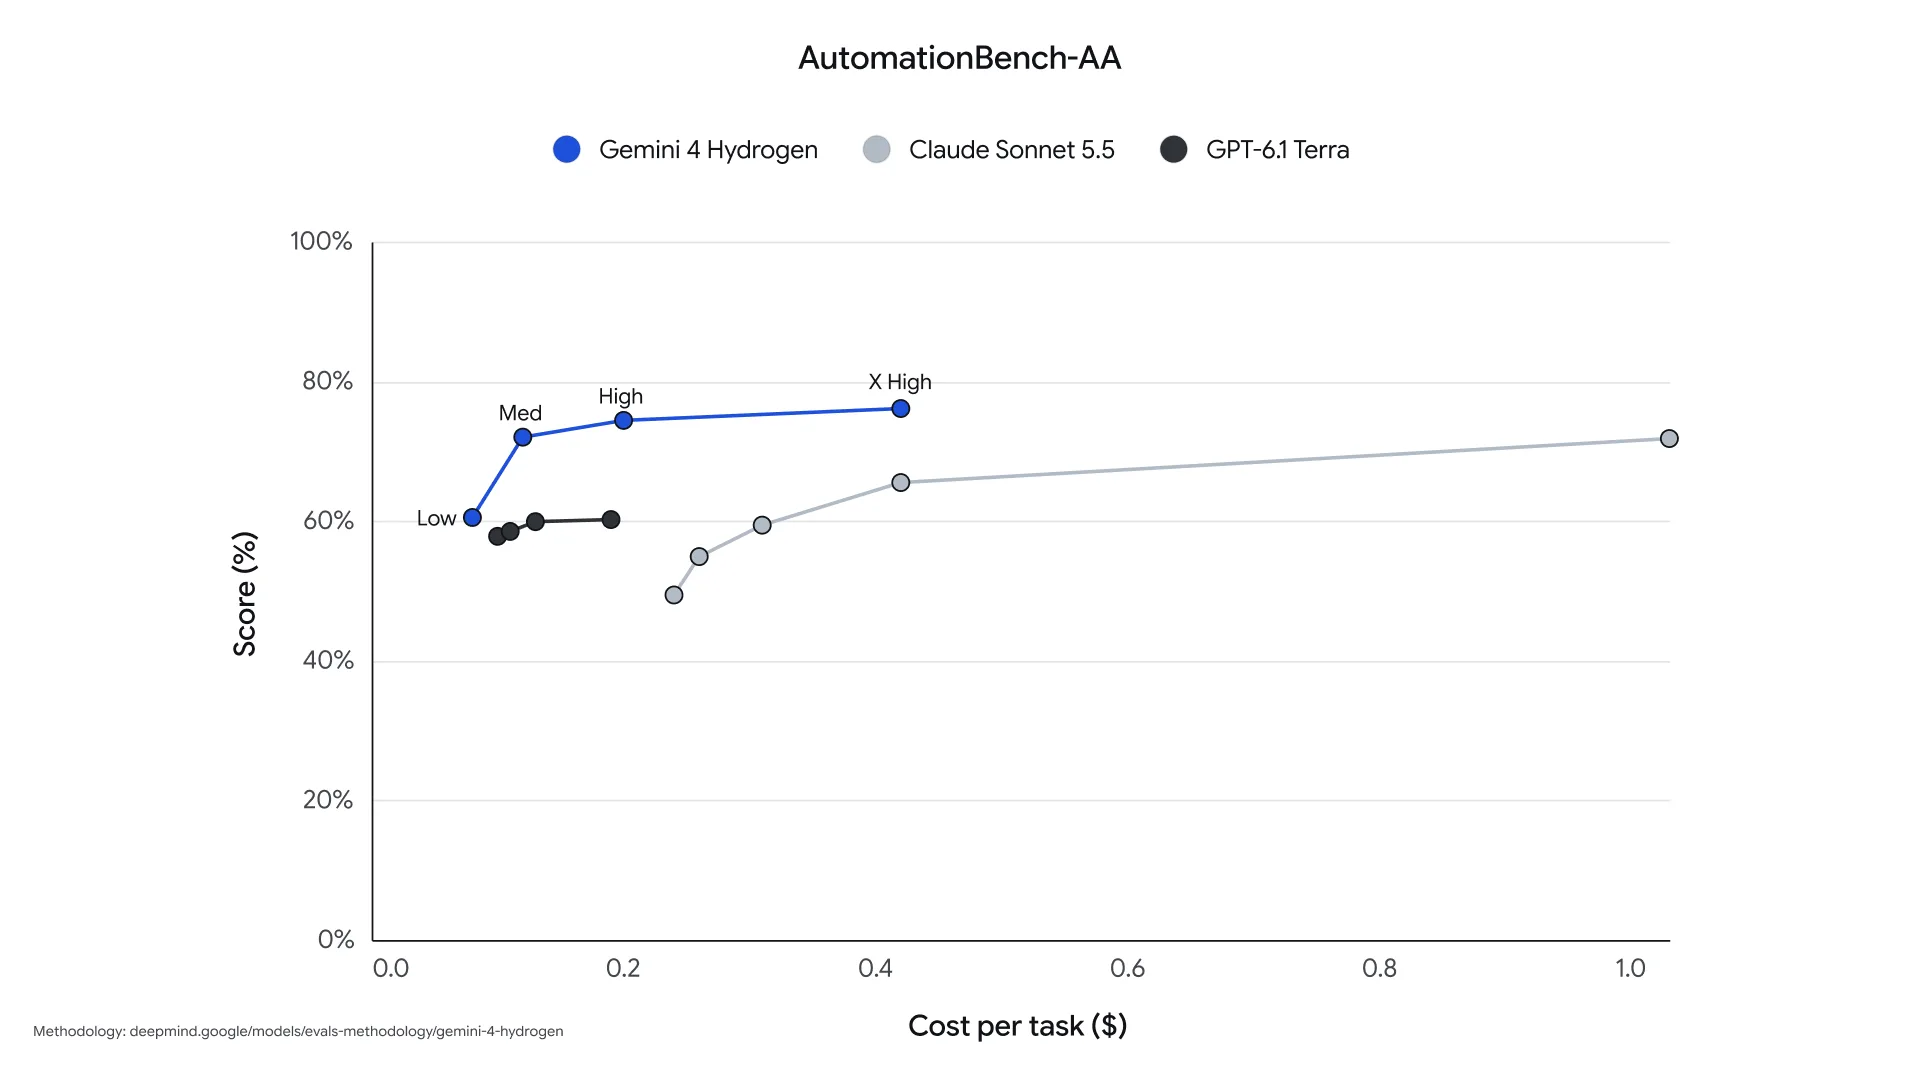
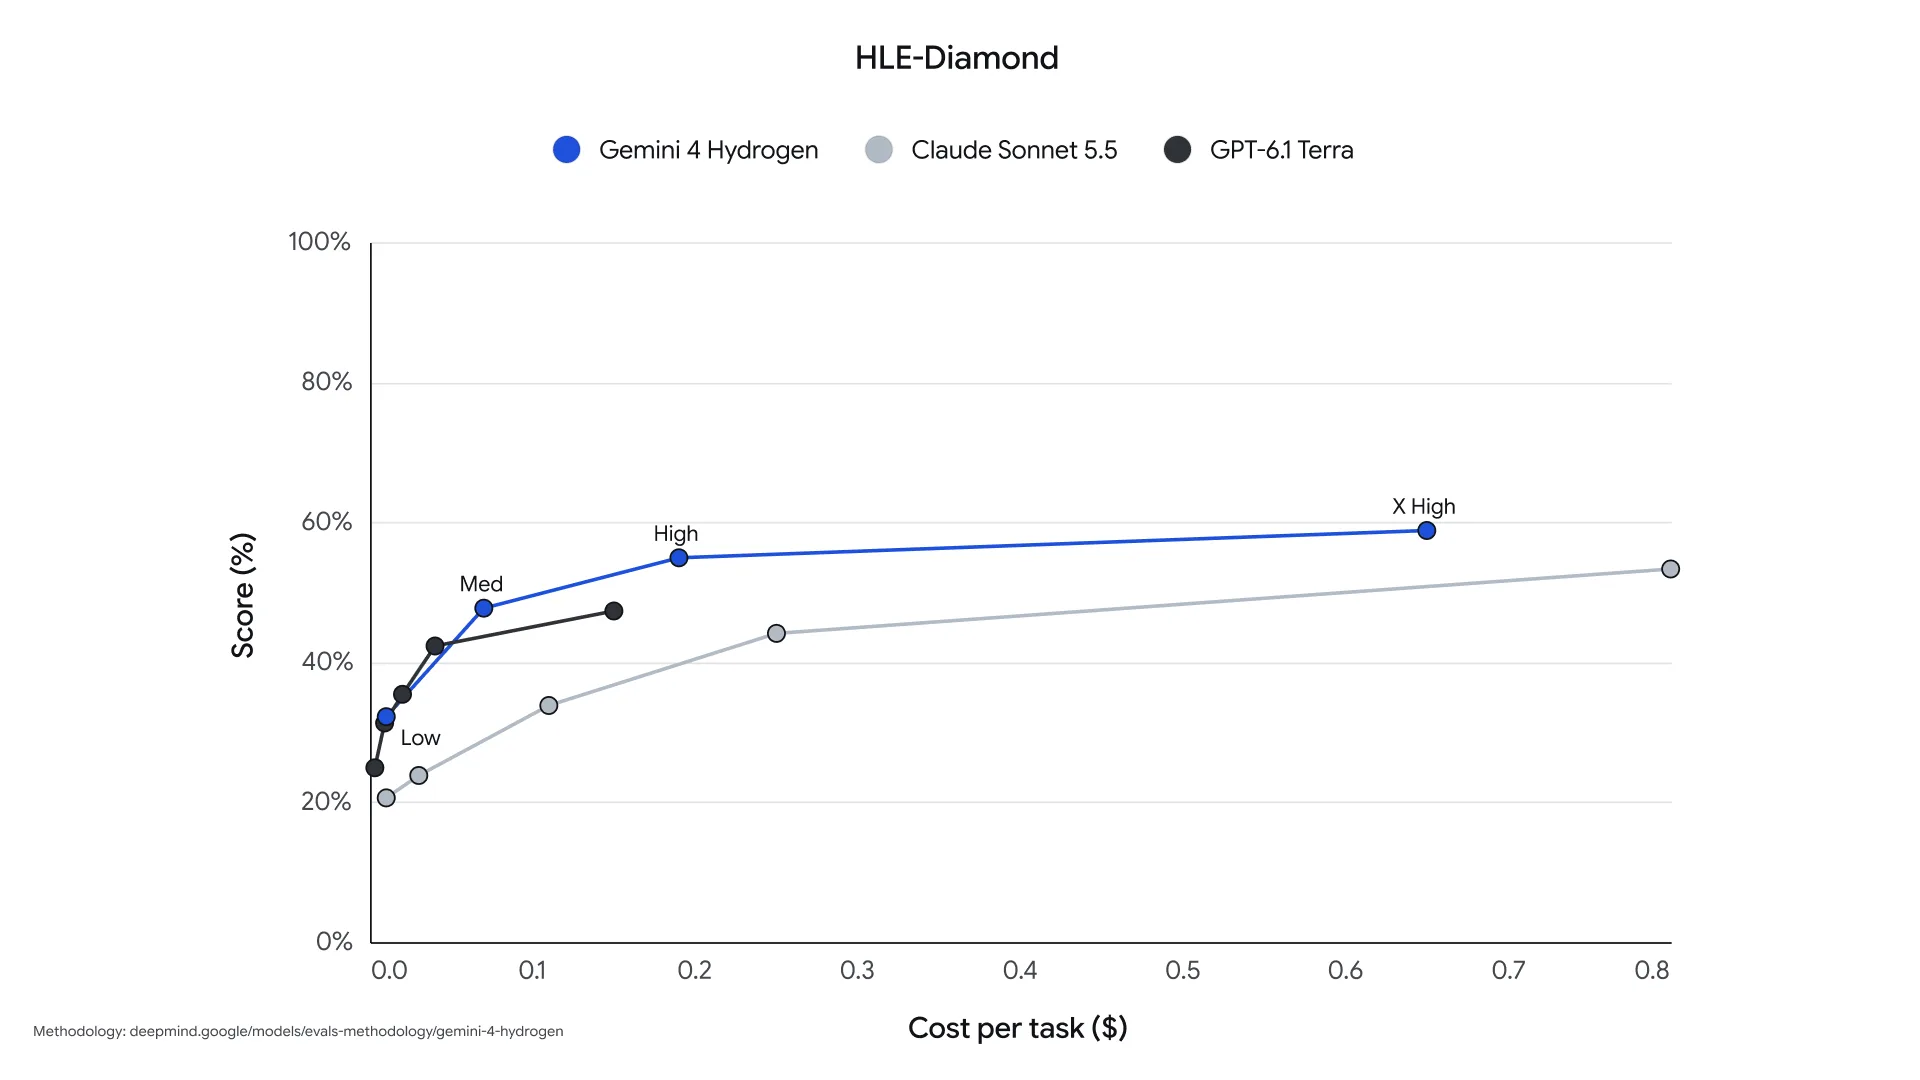
발표문에는 생각 수준별 성능 곡선이 다섯 장 들어 있습니다. 애니메이션 GIF라 지나치기 쉬운데, 마지막 프레임을 멈춰 놓고 점의 위치를 하나하나 읽어 보면 발표문 문장에는 없는 이야기가 나옵니다. 아래 위젯은 그 다섯 장을 다시 그린 것입니다.
곡선을 읽는 요령은 하나입니다. 같은 높이(점수)에서 누가 더 왼쪽(싸거나 빠름)에 있나, 같은 가로 위치에서 누가 더 위에 있나. 이 눈으로 보면 다섯 가지가 보입니다.
① 시간으로는 Hydrogen이 확실히 빠릅니다. Artificial Analysis 지수(AA Index 5.0.1)를 작업당 걸린 시간으로 그린 차트에서, 54점에 Hydrogen xhigh는 약 13분, Sonnet 5.5의 최고 단계는 약 33분 걸렸습니다. 51점은 Hydrogen high가 6분, Terra 최고 단계가 14분입니다. 같은 점수를 두 배 이상 빨리 냅니다.
② 그런데 돈으로는 GPT-6.1 Terra가 더 쌉니다. 같은 지수를 작업당 비용으로 그린 차트에서, 51점을 내는 데 Terra는 약 0.9달러, Hydrogen high는 약 1.8달러가 들었습니다. 구글이 직접 고른 차트에서도 ‘같은 점수를 가장 싸게 내는 모델’은 Hydrogen이 아니었습니다. 대신 Terra는 51점이 상한이었고, Hydrogen은 xhigh로 54점까지 올라갑니다. Hydrogen의 무기는 값이 아니라 시간입니다. 발표문도 ‘싸다’보다 ‘빠르다’를 앞세웁니다.
③ 터미널 작업에서는 xhigh가 쓸모없습니다. Terminal-Bench 4.0 차트에서 Hydrogen의 high와 xhigh는 둘 다 약 57%로 높이가 같습니다. 생각을 한 단계 더 시켜도 점수는 그대로이고 값만 2.16달러에서 3.54달러로 64% 늘었습니다. 반대로 low로 내리면 10%로 무너집니다. 이 일에는 high가 정답입니다. 참고로 Sonnet 5.5는 12.5달러를 쓰면 70%까지 올라갑니다. 비싸지만 천장이 더 높습니다.
④ 업무 자동화에서는 medium이 꼭짓점입니다. AutomationBench-AA(메일·캘린더·시트를 오가는 업무 자동화) 차트에서 Hydrogen은 가장 싼 low(작업당 약 8센트)부터 Terra의 최고 단계(60%)를 넘습니다. medium(12센트)에서 이미 72%이고, xhigh(42센트)까지 올려도 76%입니다. 값이 3.5배인데 4점입니다.
⑤ 어려운 지식 문제에서는 생각이 끝까지 통하지만, 효율은 떨어집니다. HLE-Diamond에서 Hydrogen은 low 32% → medium 48% → high 55% → xhigh 59%로 꾸준히 오릅니다. 하지만 low→medium에서 문제당 약 6센트로 15점을 얻었다면, high→xhigh에서는 46센트를 더 써서 4점을 얻습니다. 같은 1점의 값이 30배 넘게 비싸집니다.
다섯 장을 겹쳐 보면 교훈은 하나입니다. ‘기본값 high’는 무난한 출발점이지만, 일의 종류마다 꼭짓점이 다릅니다. 대량 자동화는 medium, 터미널·코딩은 high, 정말 어려운 지식 문제만 xhigh. 구글이 “필요한 만큼만 기다리고 돈을 내라”고 한 말은, 거꾸로 말하면 “아무 생각 없이 xhigh를 켜면 돈과 시간을 버린다”는 뜻입니다.
잠깐, 이 비용은 누가 계산했나? 차트의 ‘작업당 비용’은 구글이 각 사 공개 가격과 측정된 토큰 사용량으로 계산한 값입니다. 경쟁사 점수는 대부분 각 사가 스스로 발표한 값이거나 공개 리더보드 값입니다. 평가 방법 문서에 따르면 Terminal-Bench 4.1의 경쟁사 자료가 생각 수준별로는 없어서, 곡선은 한 버전 앞인 4.0으로 그렸습니다. 같은 발표문 안에서 표는 4.1, 곡선은 4.0인 이유입니다.
5. 오케스트레이터 — 큰 모델과 작은 모델이 일을 나누는 법
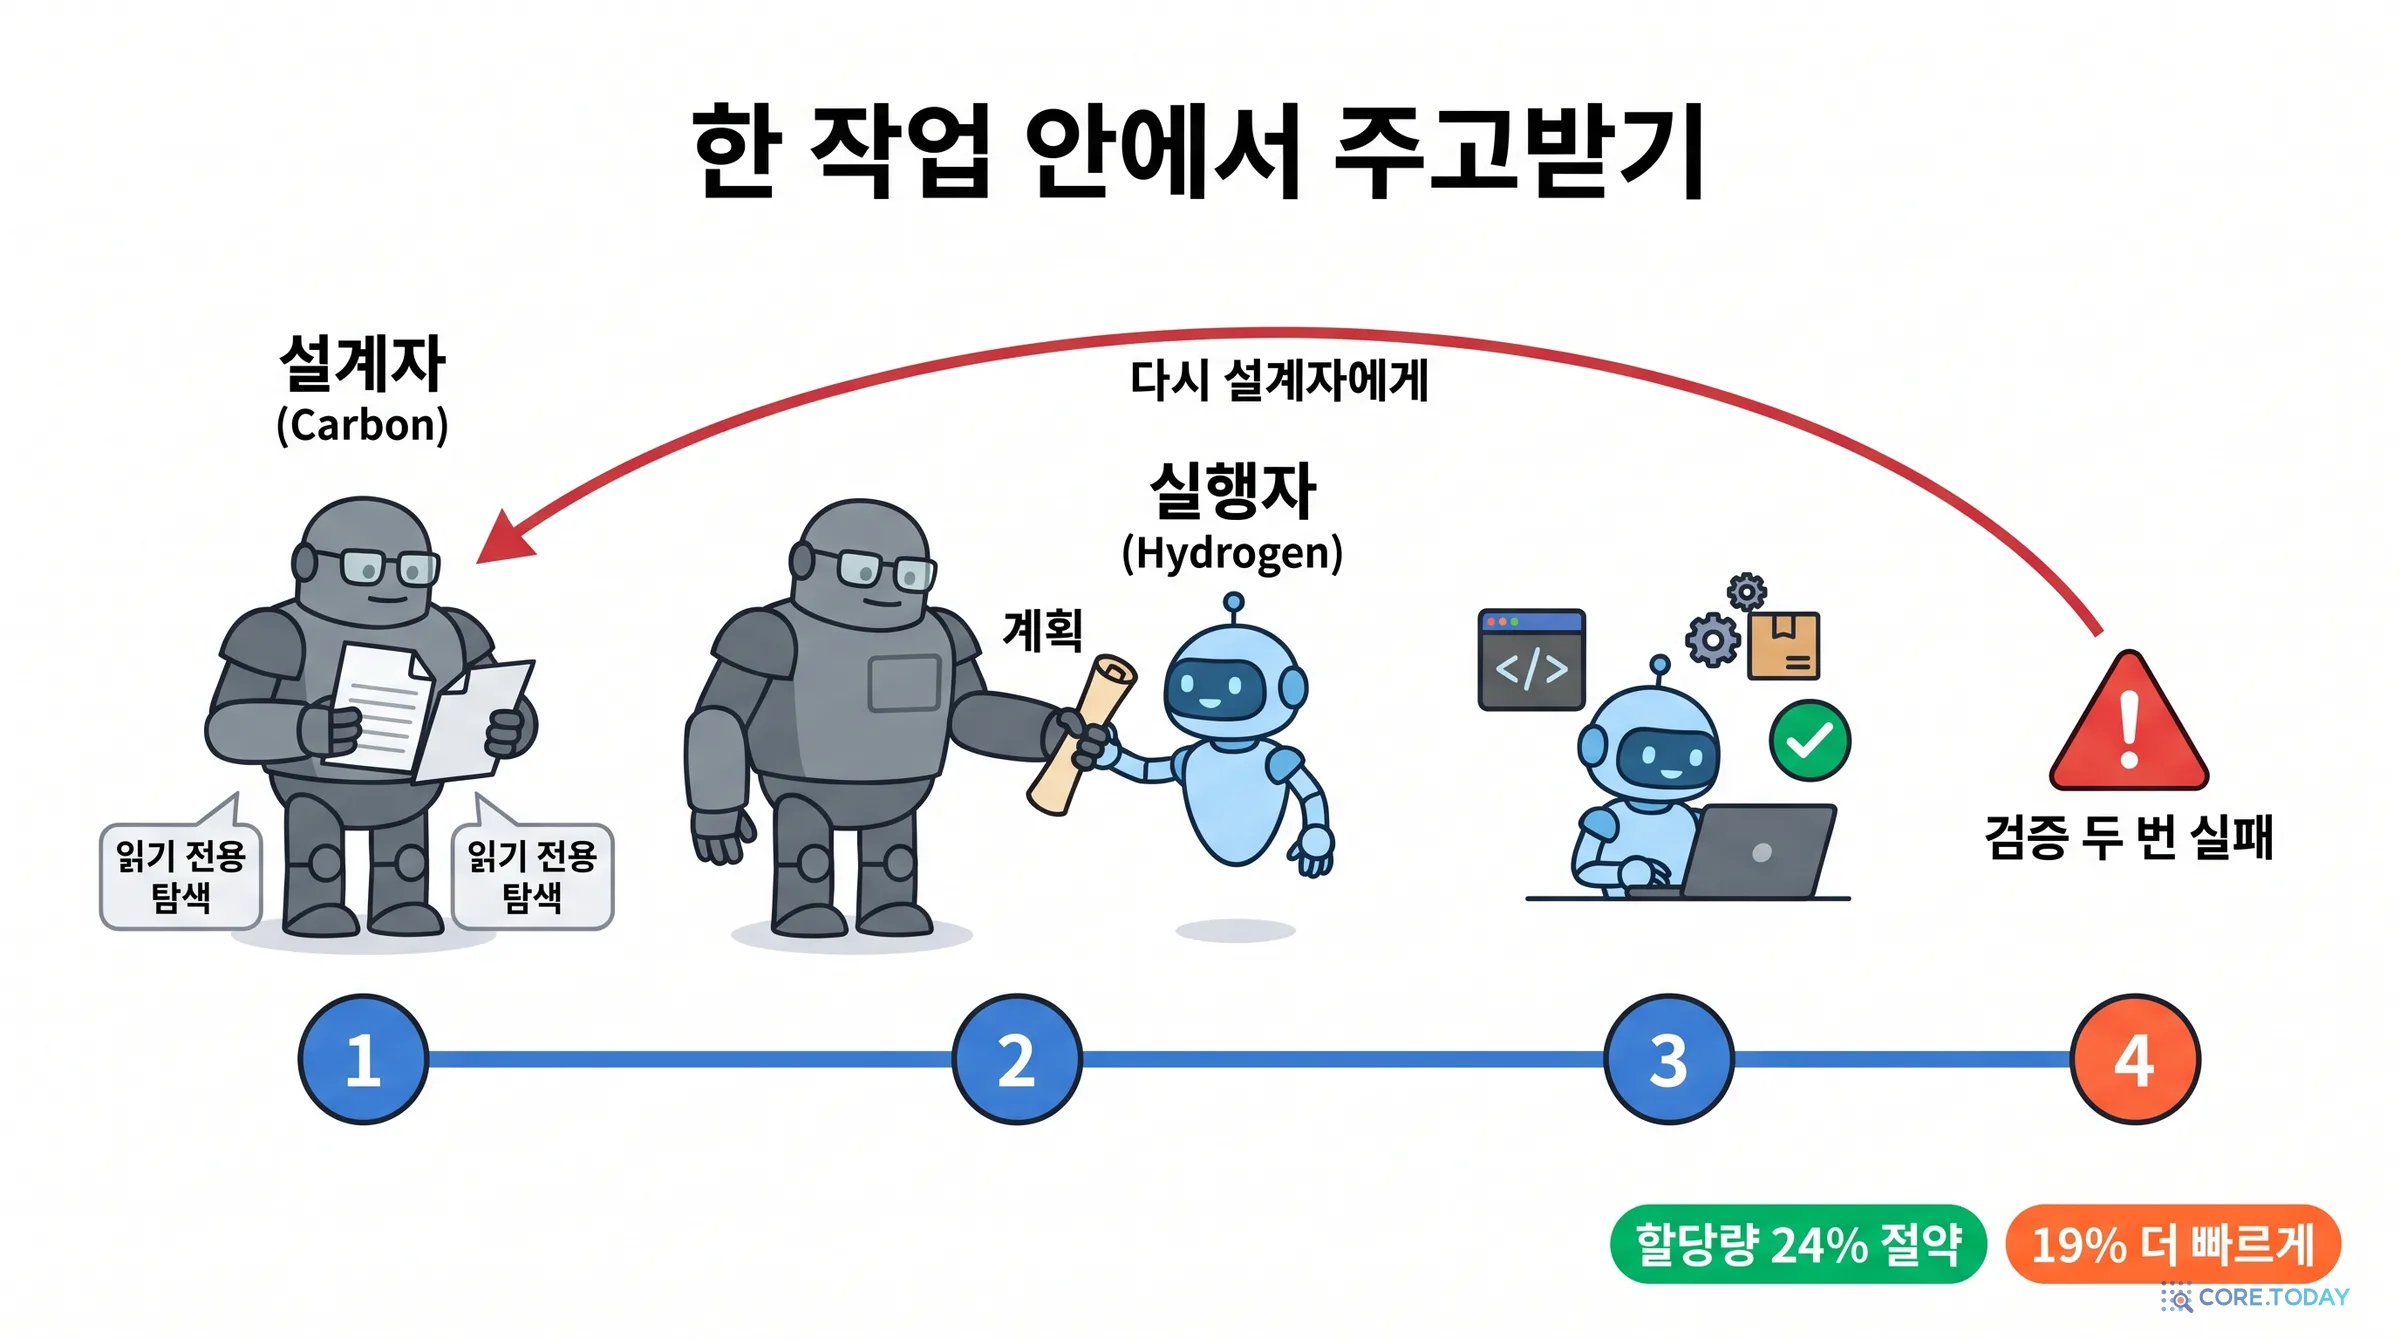
발표문의 첫 절이 다중 모델 작업이었던 이유가 여기서 나옵니다. 구글은 Hydrogen과 함께 개발 도구 Google Antigravity에 오케스트레이터(Orchestrator)라는 모드를 내놓았습니다. 이것을 이해하려면, 먼저 ‘일을 나눈다’는 생각의 역사를 짧게 훑어야 합니다.
5-1. 2023년: 쉬운 질문은 싼 모델에게 — 캐스케이드와 라우터
가장 단순한 분업은 ‘질문을 보고 누구에게 보낼지 정하는’ 것입니다.
2023년 5월 스탠퍼드의 링지아오 천(Lingjiao Chen), 마테이 자하리아(Matei Zaharia), 제임스 저우(James Zou)는 「FrugalGPT」에서 캐스케이드(cascade, 폭포)를 제안했습니다. 먼저 싼 모델에게 묻고, 답이 미덥지 않으면 더 비싼 모델에게 넘기는 방식입니다. 계단식 폭포처럼 아래로 내려갈수록 비싸집니다. 결과는 극적이었습니다. GPT-4 혼자 쓸 때와 같은 성능을 최대 98% 싼 값에 냈습니다. 대부분의 질문은 첫 계단에서 끝났기 때문입니다.
2024년에는 라우터(router)가 나왔습니다. 캐스케이드는 일단 싼 모델에게 물어봐야 하지만, 라우터는 질문을 보자마자 ‘이건 어려운 질문’이라고 판단해 바로 큰 모델에게 보냅니다. 마이크로소프트의 Hybrid LLM은 쉬운 질문을 작은 모델로 보내 큰 모델 호출을 품질 손실 없이 최대 40% 줄였고, 버클리 LMSYS의 RouteLLM은 GPT-4 성능의 95%를 유지하면서 MT Bench에서 비용을 85% 넘게 줄였습니다.
같은 아이디어는 단어 하나 수준에서도 쓰입니다. 2022~2023년 구글과 딥마인드가 각각 발표한 추측 디코딩(speculative decoding)은 작은 모델이 다음 단어 몇 개를 빨리 ‘추측’해 쓰고, 큰 모델이 한꺼번에 ‘검사’하는 방식입니다. 결과는 큰 모델 혼자 쓴 것과 똑같은데 2~3배 빠릅니다. 구글은 2024년 회고 글에서 이 기술이 검색의 AI 개요(AI Overviews)를 빠르게 만드는 데 쓰인다고 밝혔습니다. 그 글의 설명이 인상적입니다. “어떤 단어는 만들기 어렵고, 어떤 단어는 쉽다.” 일도 마찬가지입니다.
5-2. 2024~2025년: 조율자와 일꾼 — 에이전트 팀
에이전트 시대가 오면서 분업은 ‘질문 단위’에서 ‘작업 단위’로 커졌습니다.
Anthropic은 2024년 말 「효과적인 에이전트 만들기」에서 조율자-일꾼(orchestrator-workers) 패턴을 정리했습니다. 중앙의 모델이 일을 쪼개 일꾼 모델들에게 나눠 주고 결과를 모읍니다. 2025년 6월에는 실제 사례를 공개했습니다. Opus 4가 팀장을 맡고 Sonnet 4 여러 개가 조사원을 맡은 리서치 시스템이, Opus 4 혼자보다 내부 평가에서 90.2% 더 잘했습니다. 대신 토큰은 일반 채팅의 약 15배를 썼습니다. 그리고 2026년 4월에는 반대 방향의 ‘조언자(advisor) 전략’을 내놓았습니다. 작은 모델(Haiku·Sonnet)이 일을 하다가 막힐 때만 Opus에게 조언을 구하는 방식으로, Haiku에 Opus 조언자를 붙이자 웹 검색 시험(BrowseComp)이 19.7%에서 41.2%로 올랐습니다.
코딩 도구들도 같은 방향으로 갔습니다. Claude Code의 opusplan 설정은 계획 단계에서 Opus를, 실행 단계에서 Sonnet을 씁니다. 깃허브 코파일럿은 2026년 5월부터 ‘작업에 따라’ 모델을 자동으로 고르며 “모든 작업이 무거운 추론 모델을 필요로 하지는 않는다”고 썼습니다. 커서와 코그니션은 아예 자기 회사의 빠른 모델(Composer, SWE-1.5)을 만들었습니다. 코그니션은 그 이유를 이렇게 설명했습니다. “개발자가 빨리 생각하는 AI와 잘 생각하는 AI 중 하나를 고르게 해서는 안 된다.”
“업계의 흔한 방식은 첫 프롬프트를 보고 작업의 난도를 추측해, 작업 전체를 충분히 잘할 수 있는 가장 싼 모델에게 보내는 ‘정적인 모델 라우터’입니다. 그런데 에이전트가 오래 일할수록 이 방식은 무너집니다. 단계마다 필요한 복잡도가 다르고, 그 복잡도는 일을 하면서야 드러나기 때문입니다.”
맞는 말입니다. “로그인 버튼 색 바꿔 줘”라는 요청은 쉬워 보이지만, 열어 보니 디자인 시스템 전체가 얽혀 있을 수 있습니다. 반대로 “결제 모듈 리팩터링”은 어려워 보이지만, 계획만 잘 세우면 나머지는 기계적인 수정의 반복일 수 있습니다. 첫 문장만 보고 정하는 라우터는 둘 다 틀립니다.
오케스트레이터는 이렇게 일합니다(Antigravity 블로그와 문서 기준).
1. 탐색·계획Carbon(또는 Argon)이 읽기 전용으로 시작합니다. 의존성을 살피고, 모호한 점을 정리하고, 구체적인 계획을 씁니다. 계획에는 ‘이런 일이 생기면 다시 계획하라’는 조건(재계획 트리거)이 명시됩니다.
2. 실행Hydrogen이 넘겨받아 파일을 고치고, 패키지를 올리고, 테스트를 돌립니다. 긴 작업에서는 중간 진행 상황을 설계자에게 보고합니다.
3. 마찰Hydrogen이 ‘마찰’을 만나면 주도권을 돌려줍니다. 문서가 든 예는 같은 검증이 두 번 실패할 때, 인터페이스가 예상과 다르게 움직일 때, 계획이 설계 선택을 열어 둔 채 남겼을 때입니다.
4. 수리·재개Carbon이 상태를 살펴 계획을 고치고, 다시 Hydrogen에게 넘깁니다. 이 주고받기가 한 대화, 한 에이전트 안에서 일어납니다.
구글이 밝힌 결과는 이렇습니다. Terminal-Bench에서 오케스트레이터는 Carbon 혼자일 때에 가까운 성공률을 내면서, 평균 할당량을 24% 덜 쓰고 19% 빨리 끝냈습니다.
이 숫자를 읽을 때 두 가지를 조심해야 합니다.
첫째, 어느 시험인지 표기가 엇갈립니다. 발표문은 Terminal-Bench 4.0이라고 썼고, 같은 날 Antigravity 블로그는 4.1이라고 썼습니다. 다행히 이 차이는 크지 않습니다. Terminal-Bench 4.1(11월 9일)은 4.0의 결과물을 더 엄격한 채점기로 다시 채점한 판이라, 시험 내용은 같고 점수가 바뀐 시행은 약 1.16%뿐이었습니다.
둘째, ‘24% 절약’은 생각보다 작은 숫자일 수 있습니다. Hydrogen의 정가는 Carbon 정가의 37.5%입니다. 일을 전부 Hydrogen에게 넘겼다면 60% 넘게 아꼈어야 합니다. 24%만 아꼈다는 건, 일의 상당 부분이 여전히 Carbon에게 남아 있었다는 뜻입니다. 아래 위젯으로 거꾸로 계산해 보면, 가정에 따라 다르지만 Hydrogen이 맡은 몫은 대략 단계의 3분의 1에서 절반 정도로 나옵니다. 성공률이 Carbon 수준으로 유지된 비결도 여기 있을 겁니다. 어려운 판단은 넘기지 않은 것입니다.
5-4. 오케스트레이터와 ‘스웜’은 다르다
발표문에는 오케스트레이터와 헷갈리기 쉬운 문장이 하나 더 있습니다. “병렬 에이전트가 필요한 작업에서는 Carbon이 조율자를 맡고, Hydrogen이 일꾼과 검증자 에이전트를 맡아 격리된 작업 공간에서 동시에 변경을 만들고 시험할 수 있다.”
이건 오케스트레이터가 아니라, 이틀 전 Carbon과 함께 나온 /swarm(스웜) 쪽 이야기입니다. Antigravity 문서는 오케스트레이터가 “대화당 하나의 에이전트”로 움직인다고 분명히 적었습니다. 정리하면 이렇습니다.
오케스트레이터
스웜(/swarm)
구조
에이전트 하나, 두 모델이 시간 순서로 주고받기
조율자 하나 + 여러 일꾼·검증자가 동시에
어울리는 일
평소의 기능 개발·디버깅
여러 작업 트리에 걸친 대형 작업
구글이 밝힌 숫자
할당량 −24%, 시간 −19%
출시 이틀 만에 스웜 수만 개 실행
설정
생각 수준 고정(조절 불가)
—
이용 범위
Carbon 판은 Ultra, Argon 판은 Pro·Ultra
미리보기
한 가지 덧붙이면, Hydrogen 자체는 Antigravity의 무료 등급을 포함한 모든 요금제에서 쓸 수 있습니다. 오케스트레이터만 유료입니다. 해커뉴스의 한 사용자는 오케스트레이터가 많은 권한을 기본으로 켜 둔다고 지적했는데, 공식 문서에서는 확인되지 않았습니다. 처음 쓸 때는 권한 설정부터 확인하는 편이 안전합니다.
6. 10줄 성적표 — 줄마다 무엇을 쟀고, 어디까지 믿을까
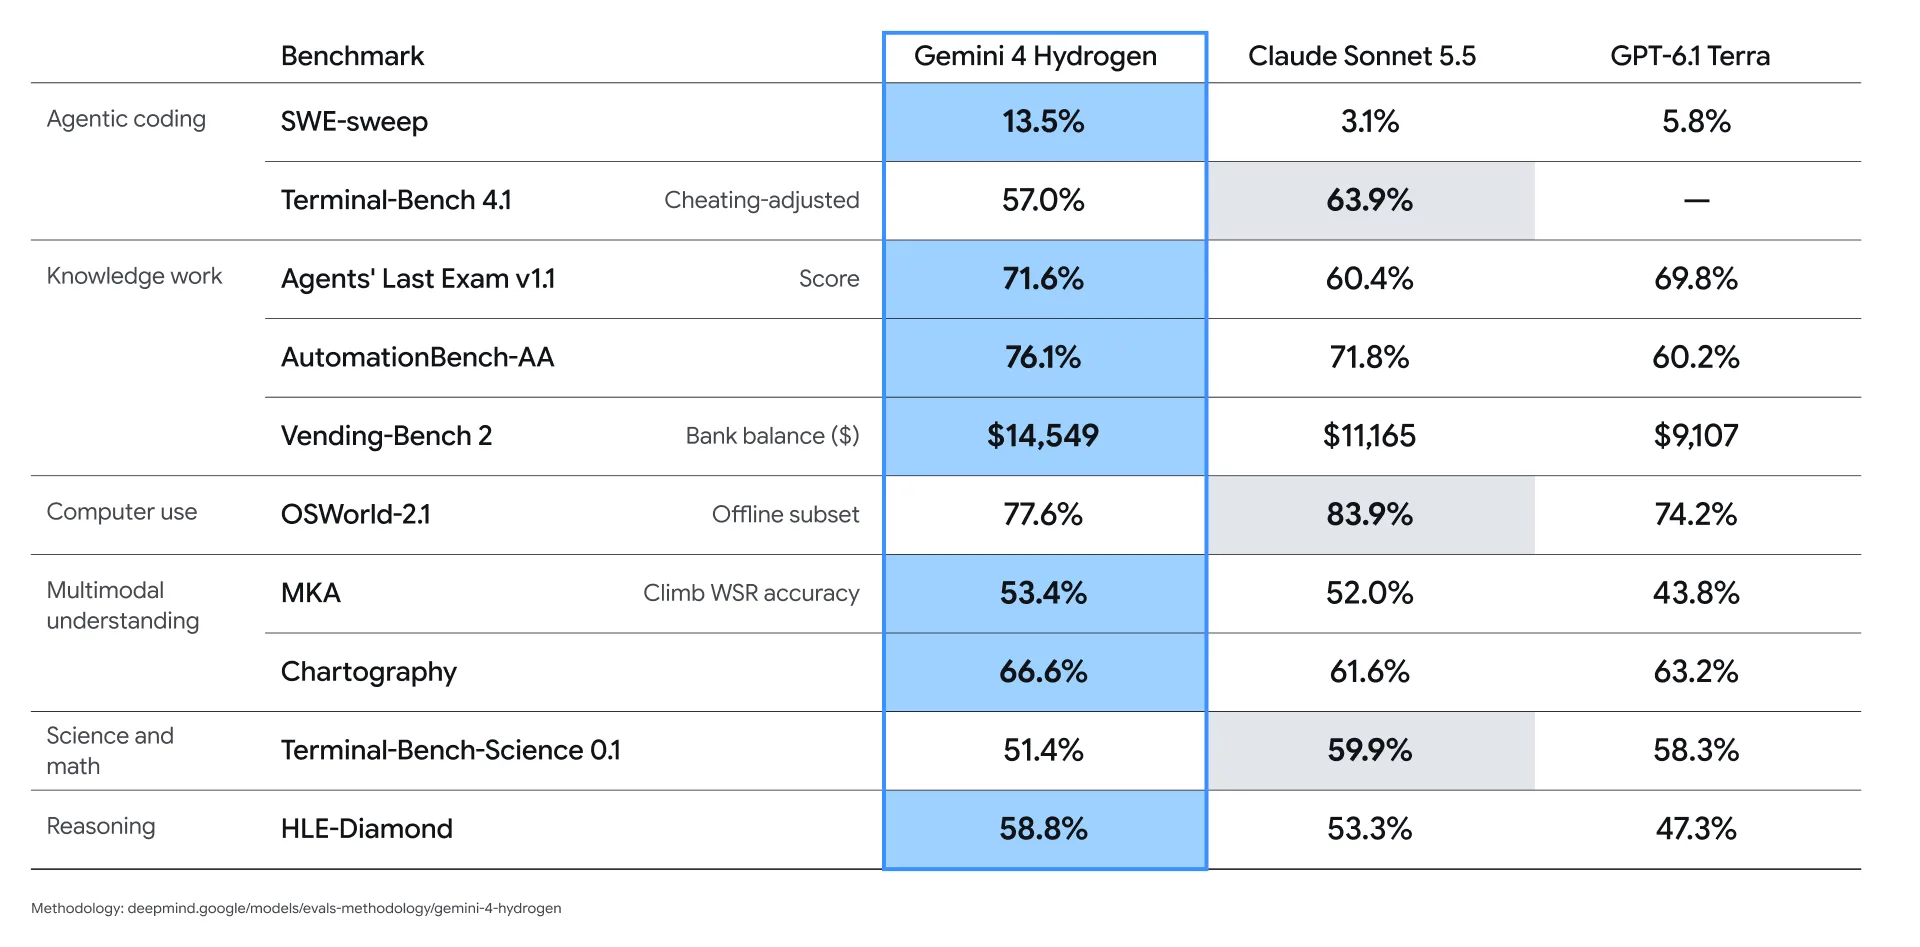
발표문의 비교표는 Hydrogen을 Claude Sonnet 5.5, GPT-6.1 Terra와 나란히 놓습니다. 세 모델 모두 각 회사에서 ‘최상위 바로 아래’ 자리입니다. Sonnet 5.5는 Anthropic이 “Opus 5.5를 보완하는 더 빠르고 싼 모델”이라고 부르는 모델(9월 28일)이고, Terra는 OpenAI가 10월 26일 내놓은 “빠르고 효율적인” 모델입니다.
표만 보면 Hydrogen이 10줄 중 7줄을 이깁니다. 아래 위젯에서 줄을 하나씩 눌러 보면, 각 시험이 무엇을 재는지와 함께 ‘읽을 때 주의할 점’이 나옵니다.
6-1. 시험을 읽는 법 — 평가 방법 문서에 숨은 단서
구글은 표 아래에 4쪽짜리 평가 방법 문서 링크를 달아 두었습니다. 여기에 중요한 단서들이 있습니다.
기본 규칙. Hydrogen 점수는 따로 적지 않은 한 ‘가장 높은 생각 수준(xhigh)으로 한 번에 맞힌 값(pass@1)’입니다. 다수결이나 여러 번 시도는 쓰지 않았습니다. 경쟁 모델 점수는 “따로 적지 않은 한 각 회사가 스스로 발표한 값”이고, 가장 높은 추론 설정을 씁니다.
예외들. Terminal-Bench는 xhigh가 아니라 high로, 과제마다 5번 돌린 평균입니다(4장에서 본 것처럼 이 시험에서는 high와 xhigh가 같습니다). OSWorld는 Hydrogen과 Sonnet 둘 다 구글이 직접 3번 돌려 가장 좋은 값을 적었습니다. Agents’ Last Exam의 Sonnet 점수도 구글이 직접 돌렸고, 10월 17일판 과제를 쓰면서 10월 26일 갱신분은 반영하지 않았습니다.
출제자가 구글인 시험. MKA(멀티모달 지식 에이전트)는 구글이 이틀 전 Artificial Analysis와 함께 발표한 새 시험입니다. 전문가가 3~8시간 걸리는 과제 200개에 과제당 약 70개의 예·아니오 채점 기준이 붙어 있습니다. ‘Climb WSR’은 그중 어려운 기준(Climb)의 가중 충족률입니다. 시험 자체는 공들여 만들었지만, Hydrogen 점수 53.4%는 구글이 직접 낸 값이고 Artificial Analysis 리더보드에는 아직 없습니다. 그 리더보드에서는 Claude Fable 5.2(57%), Carbon(54%)이 더 높습니다.
6-2. 바깥 리더보드와 맞춰 보기
발표문의 주장 중 독립 리더보드로 확인할 수 있는 것들을 하나씩 대조했습니다(11월 13~17일 확인).
발표문의 주장
리더보드에서 확인한 것
판정
AA 지능 지수 high 51, xhigh 54
Artificial Analysis: high 51, xhigh 54 (81개 중 16위)
일치
Vals 세금 에이전트 시험 1위 (52.3%)
Vals: 52.30%로 단독 1위, Carbon 51.78%
일치
Vals 법률 리서치 시험 공동 1위 (55.8%)
Vals: Hydrogen 53.85%로 6위. 55.77%는 Carbon의 점수
숫자 오류
Agent Arena 5위
arena.ai: 5위(14.91%), 순위 범위 2~8위, ‘잠정’ 표시
일치(잠정)
Terminal-Bench 4.1 57.0%
공식 보드: 56.4%(9위, Antigravity CLI). 57.0%는 다른 도구로 구글이 잰 값
거의 일치
MKA에서 다른 모델보다 우수
AA 보드에 Hydrogen 없음, Fable 5.2·Carbon이 더 높음
비교 범위 한정
법률 시험의 오류는 작아 보이지만 성격이 나쁩니다. Hydrogen의 53.85%는 표준오차가 ±3.47이라, 1위 Carbon과 ‘통계적으로 비긴다’고 주장할 여지는 있습니다. 하지만 발표문이 적은 55.8%라는 숫자는 Hydrogen의 점수가 아닙니다. 형의 성적표를 동생 이름으로 적은 셈입니다. 11월 17일 현재 발표문은 고쳐지지 않았습니다.
6-3. 3.8 Flash에서 무엇이 좋아졌나
경쟁사와의 비교보다 실무자에게 더 중요한 건 ‘지금 쓰는 3.8 Flash에서 옮기면 무엇이 달라지나’일 겁니다. 발표문이 밝힌 숫자는 이렇습니다.
Terminal-Bench 4.1 · 3.8 Flash
18.2%
Terminal-Bench 4.1 · Hydrogen
57.0%
AA 지능 지수 · 3.8 Flash
31
AA 지능 지수 · Hydrogen high
51
막대 길이는 100점 만점 기준. Terminal-Bench는 공식 리더보드 값, AA 지수는 Artificial Analysis 값.
속도. 기본 설정(high)에서 작업을 2.5배 빨리 끝냅니다.
지어낸 주장(fabricated claims)이 5분의 1 이하. 78쪽 안전 보고서에는 환각 오류율이 3.8 Flash보다 2.8배 낮고, 문서에 근거해 답하는 시험(FACTS Grounding)이 7.8%p 올랐다고 적혀 있습니다.
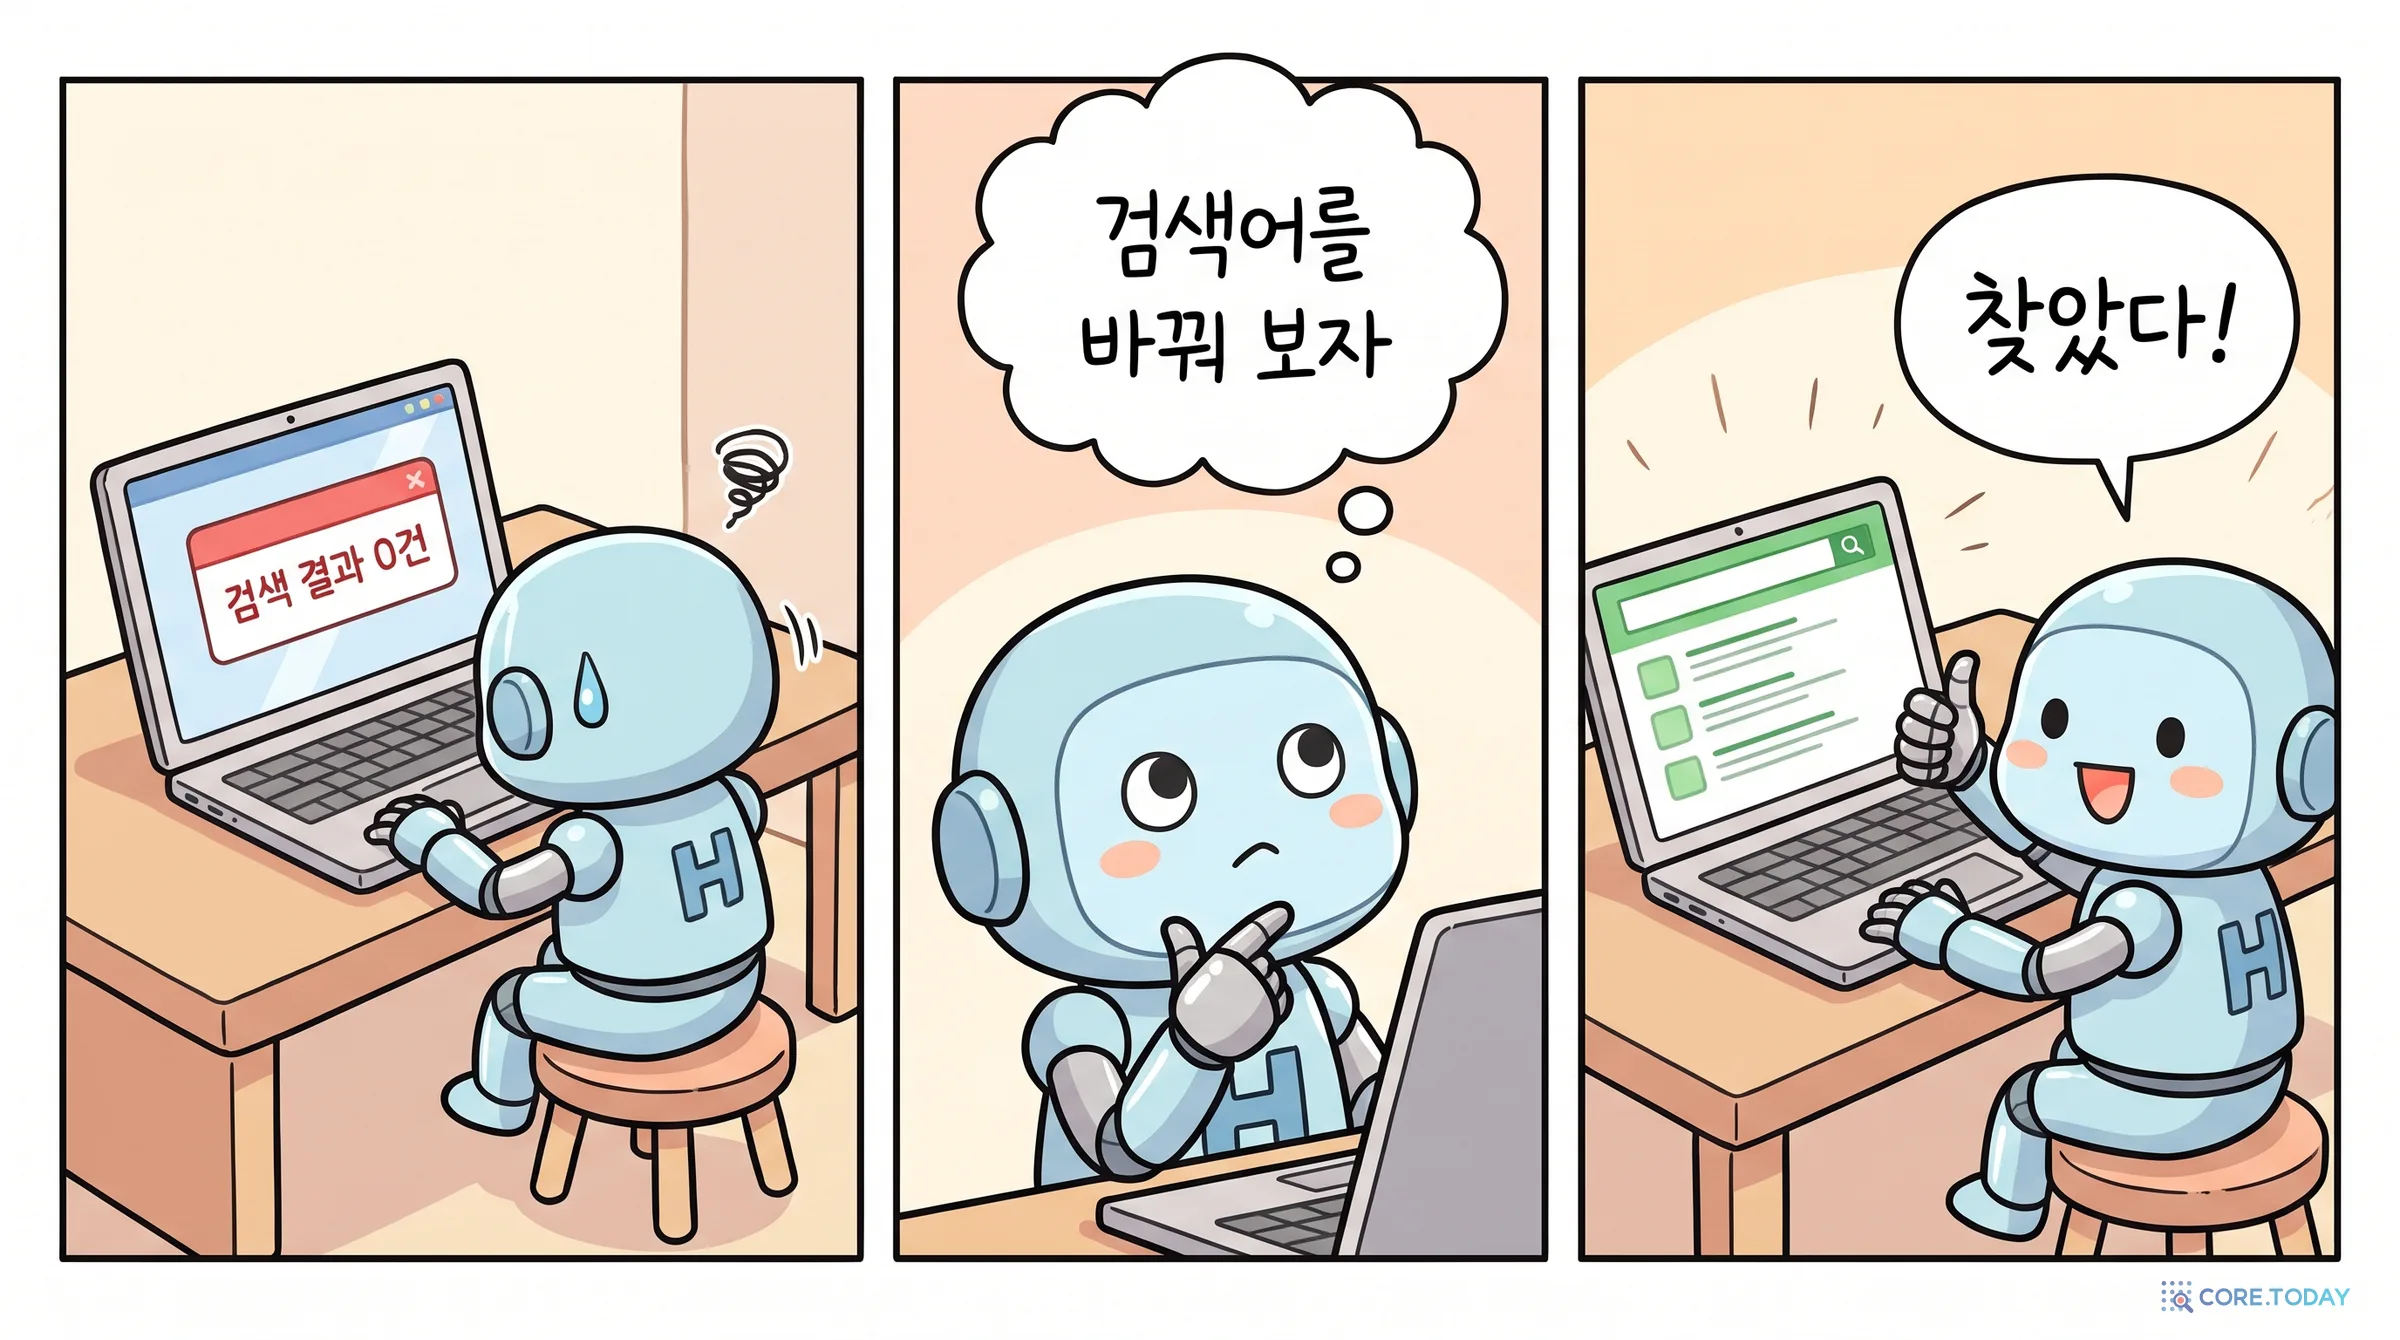
도구가 실패했을 때. “도구 호출이 실패하거나 검색 결과가 비어 있어도 깔끔하게 적응한다.” 에이전트 실무에서 가장 흔한 사고는 모델이 틀린 답을 내는 것보다, 도구 오류 하나에 같은 호출을 무한 반복하거나 엉뚱한 결론으로 건너뛰는 것입니다.
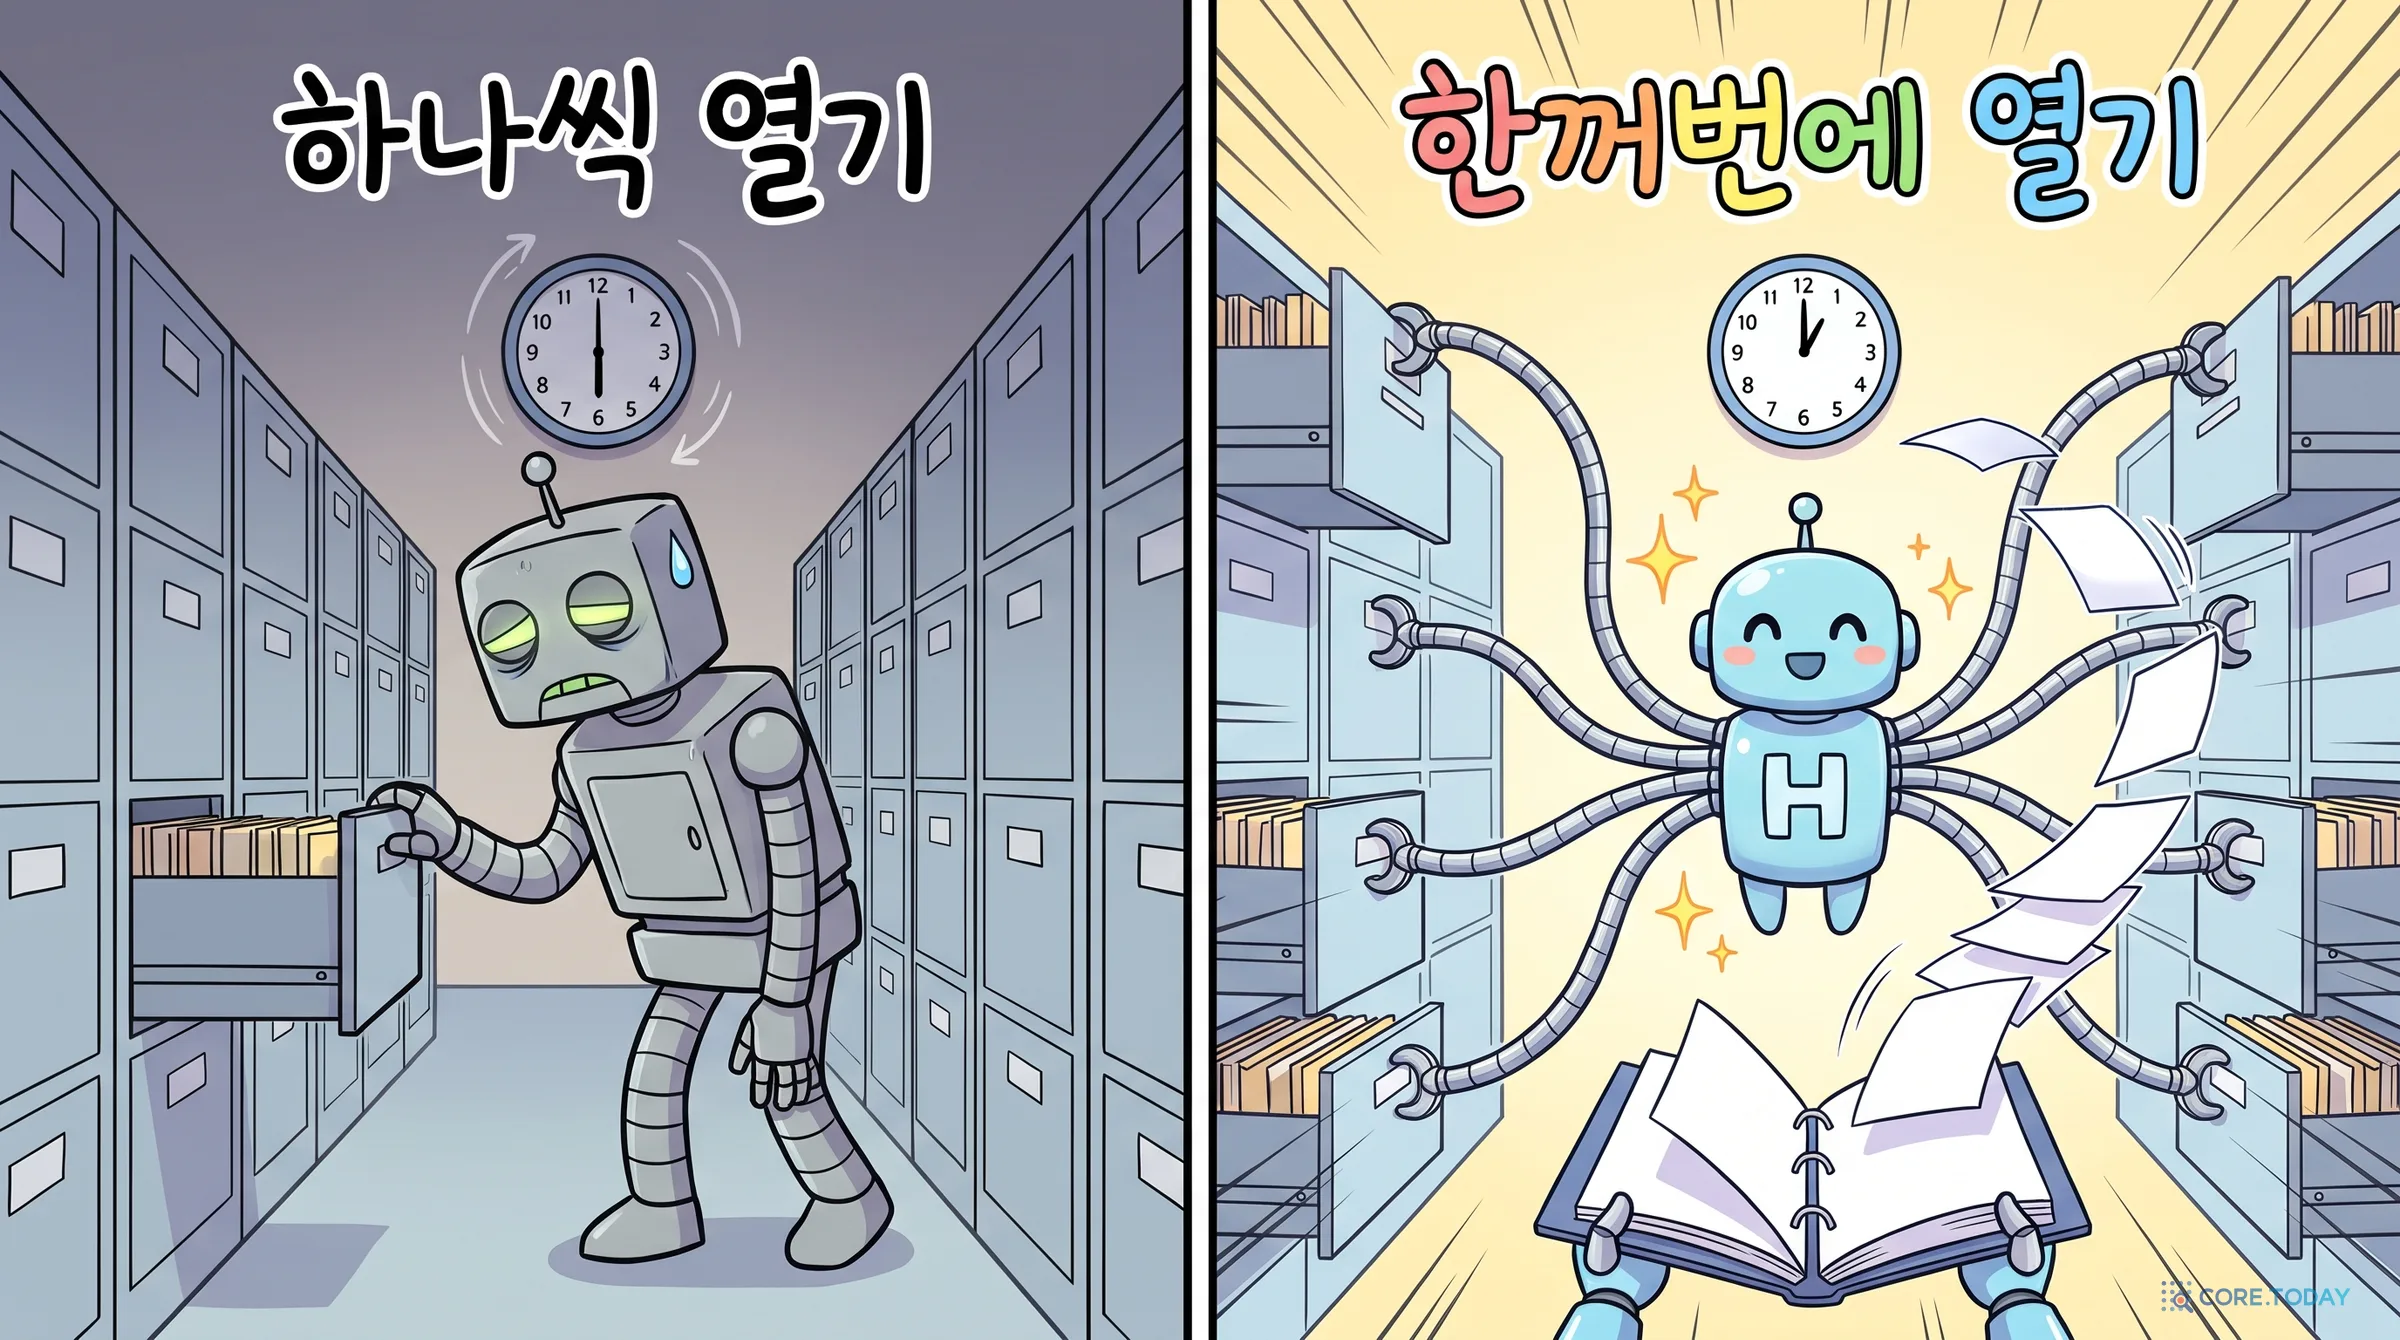
병렬로 읽기. 큰 저장소를 탐색할 때 파일을 하나씩 열지 않고 읽기·검색 호출을 “기본적으로 병렬로 묶어서” 부릅니다. 파트너 초기 시험에서 그래프·SQL·데이터 중심 업무를 3.8 Flash보다 2~2.8배 빨리, 토큰은 12~23% 덜 쓰며 처리했다고 합니다.
바깥의 측정도 대체로 같은 방향입니다. Artificial Analysis는 Hydrogen의 출력 속도를 초당 166~173토큰으로 쟀습니다. 플롯리(Plotly)의 데이터 분석 시험에서는 43문제를 모두 맞힌 네 번째 모델이 됐습니다(문제당 중앙값 32초). 해커뉴스의 한 사용자는 자기 업무에서 “작업당 값은 37% 더 들었지만, 걸린 시간은 40~60%로 줄었다”고 적었습니다. 값보다 시간이라는 4장의 결론과 같습니다.
다만 Artificial Analysis는 xhigh에 대해 “작업당 평균보다 느리고 매우 장황하다”고 평했습니다. 80개 모델 중 말 많기로 79위입니다. 지수 측정 전체에 high는 출력 토큰 1.1억 개를 썼는데 xhigh는 3억 400만 개를 썼습니다. 3점을 더 얻으려고 말을 2.8배 한 것입니다.
7. 검색창과 제미나이 앱 — 수십억 명의 기본 모델
개발자 이야기에서 잠시 나와 보겠습니다. 대부분의 사람은 Hydrogen이라는 이름을 모른 채 쓰게 될 겁니다. 구글 검색에 질문을 던지는 순간 이미 Hydrogen이 답하고 있기 때문입니다. 2차 보도에 따르면 Hydrogen은 구독 없이 쓰는 AI 모드의 기본 모델이 됐고, AI 개요 중에서도 ‘가장 어려운 질문’을 맡습니다(어디서부터가 어려운 질문인지는 공개되지 않았습니다).
7-1. 쿼리 팬아웃 — 질문 하나를 여러 개로 쪼개 동시에 찾기
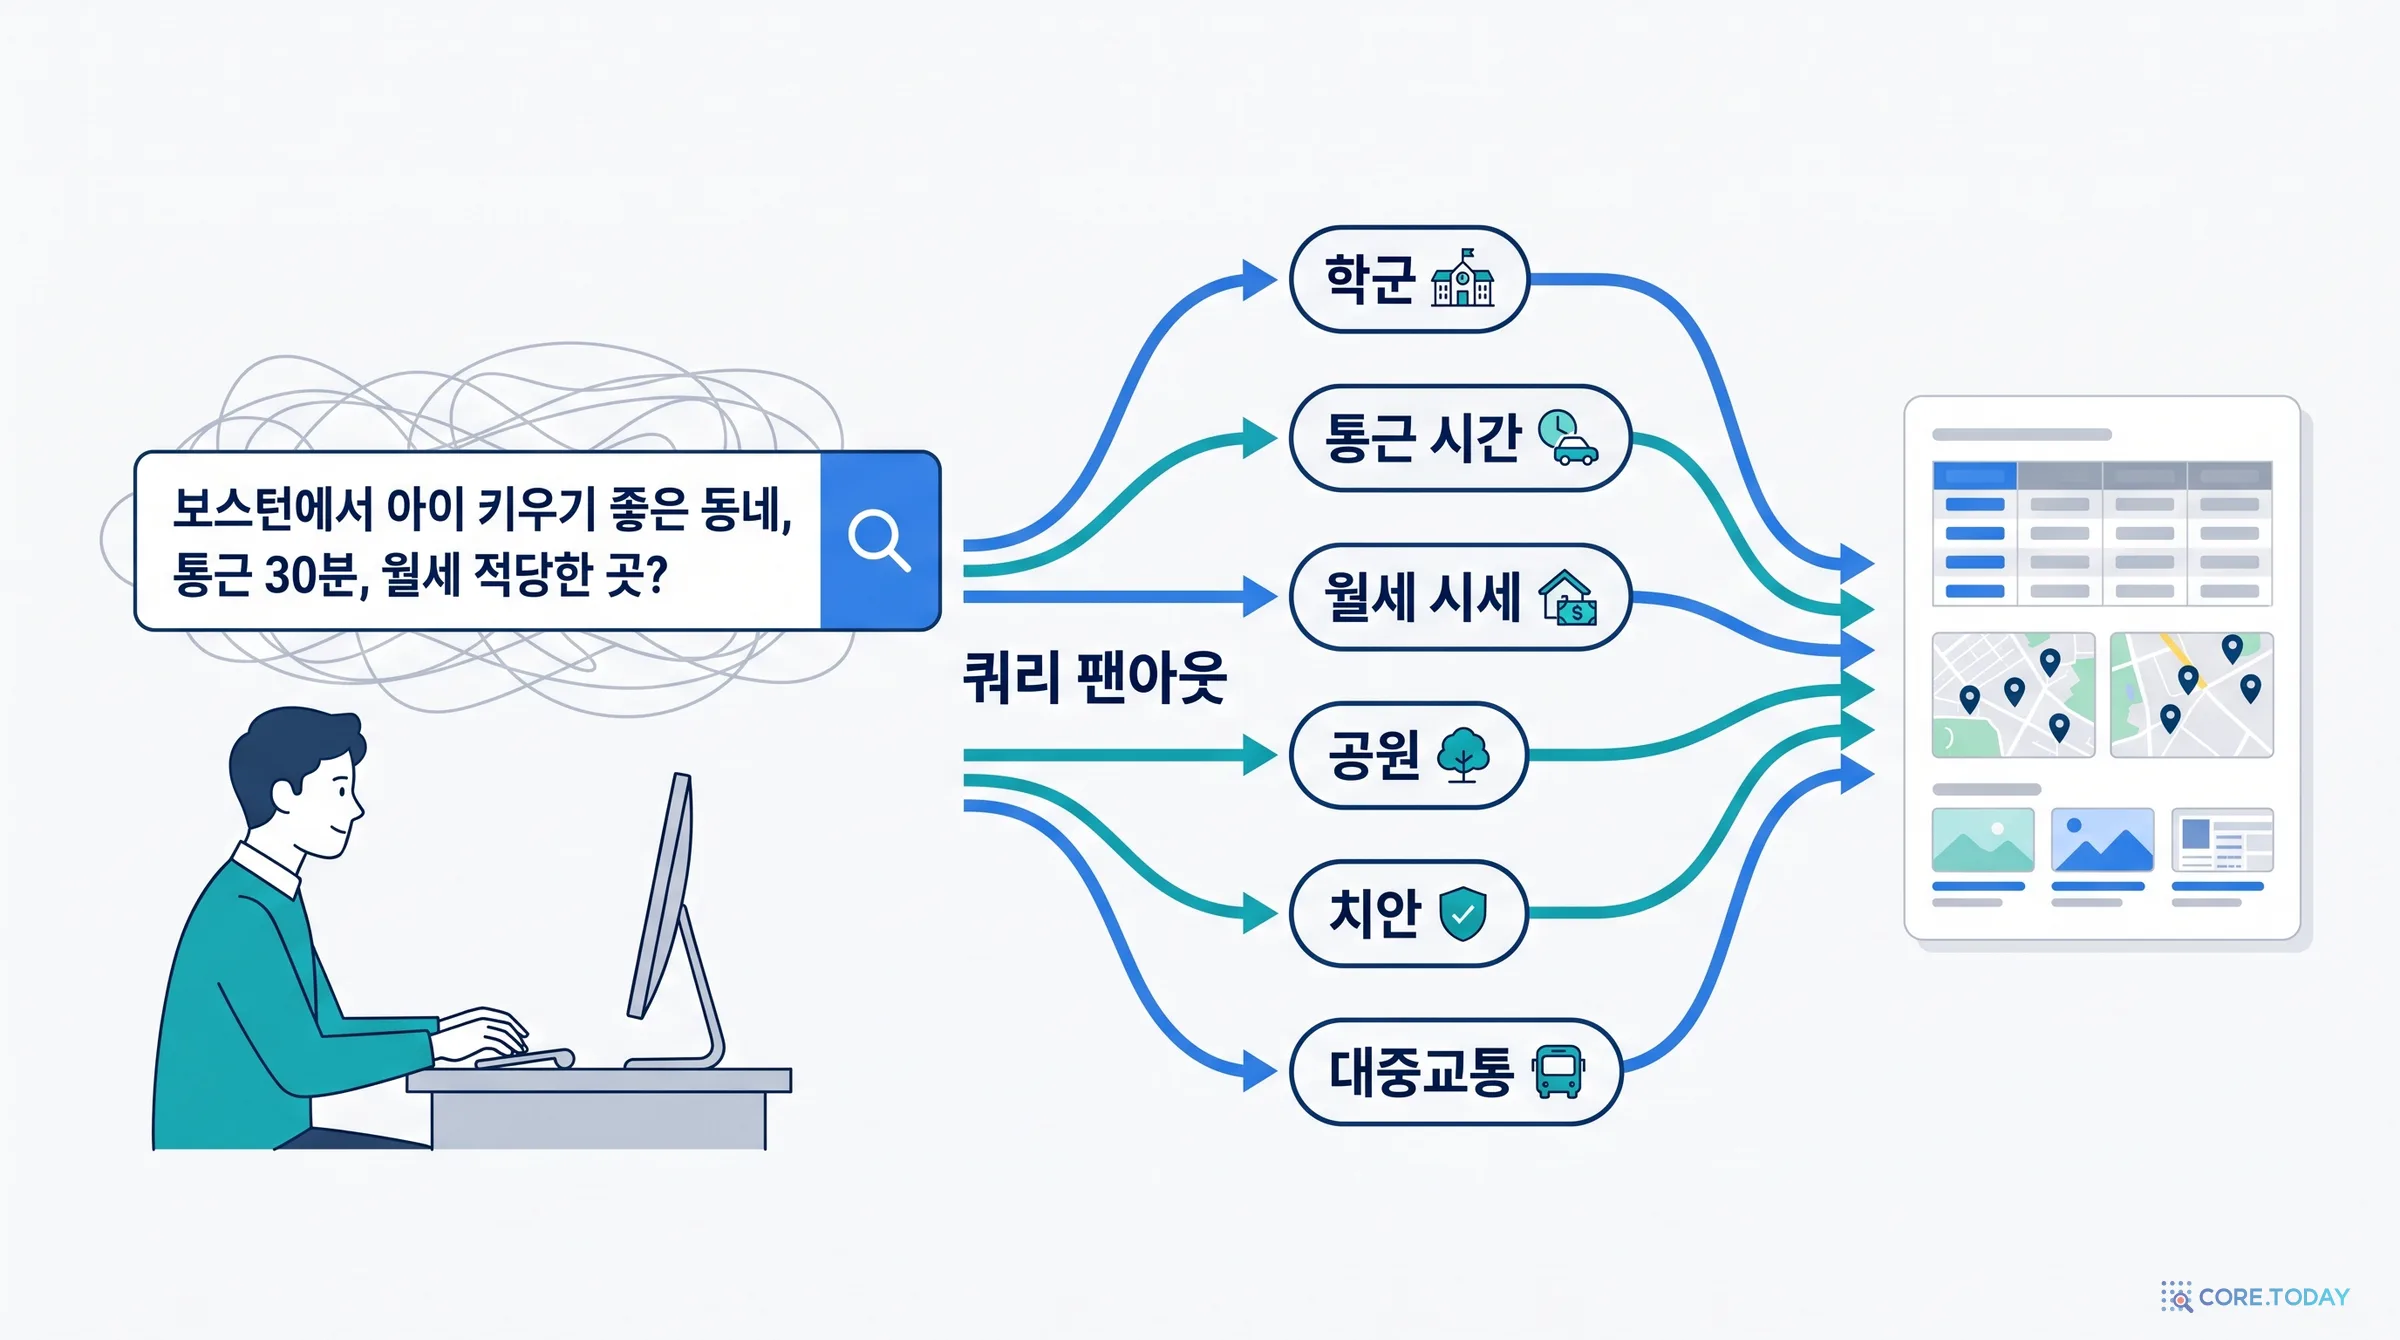
검색 개선의 핵심 기술은 쿼리 팬아웃(query fan-out)입니다. 부채(fan)가 펼쳐지듯, 사용자의 질문 하나를 여러 하위 질문으로 쪼개 동시에 검색한 뒤 결과를 모아 답을 만드는 방식입니다. 구글은 2025년 AI 모드를 내놓을 때 이 기술을 소개했고, 이번 글에서는 “Hydrogen의 추론이 질문을 더 깊이 이해해, 관련된 모든 하위 주제에 대해 동시에 검색을 수행한다”고 썼습니다. 그 결과로 “전에는 발견하지 못했을 사이트”까지 연결해 준다고 합니다.
이 방식이 왜 작은 모델과 잘 맞는지 생각해 보면 재미있습니다. 질문 하나가 여섯 개, 열 개의 검색이 되고, 각 검색 결과를 읽고 요약하는 일이 또 생깁니다. 사용자는 몇 초 안에 답을 기대합니다. 한 번의 질문 뒤에서 모델 호출이 수십 번 일어나는 구조에서는, 모델 하나하나가 빠르고 싸지 않으면 성립하지 않습니다. 검색에 들어갈 모델이 ‘최고로 똑똑한 모델’이 아니라 ‘빨리 일을 끝내는 모델’이어야 하는 이유입니다.
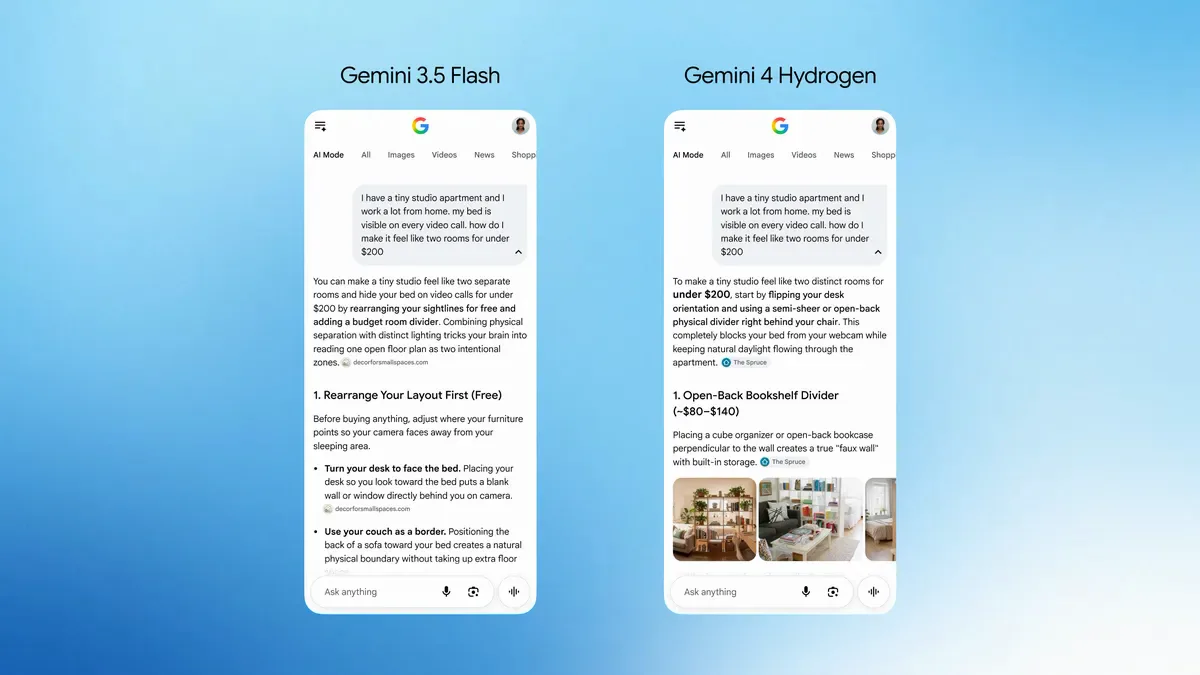
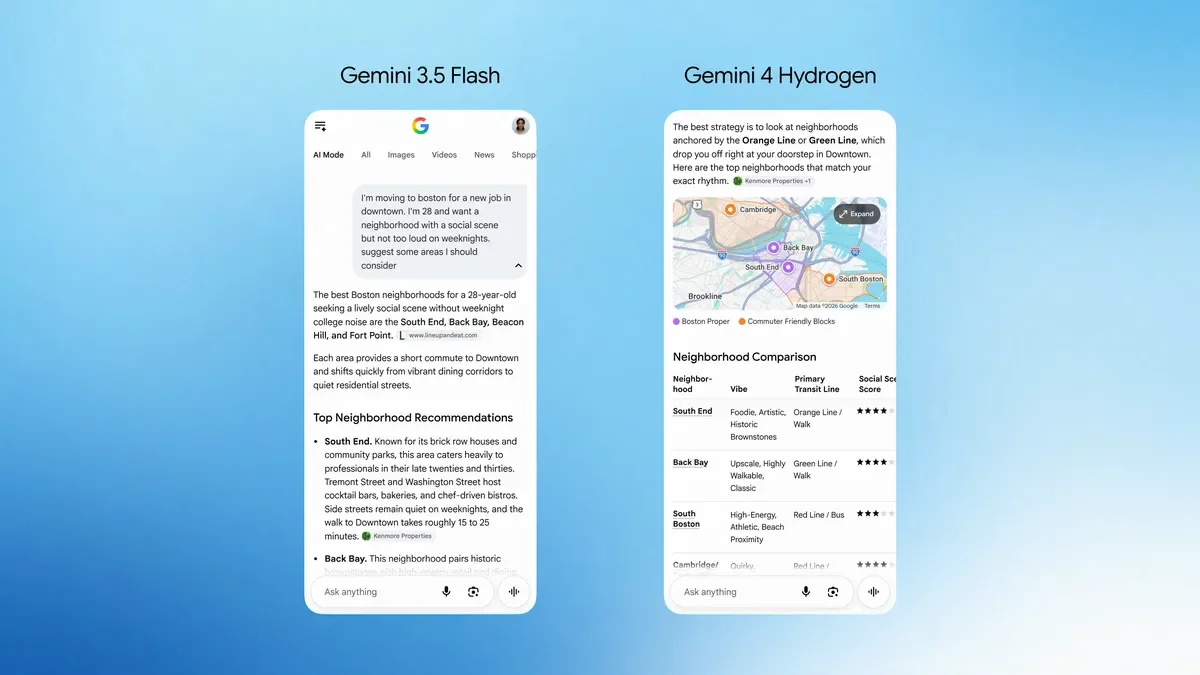
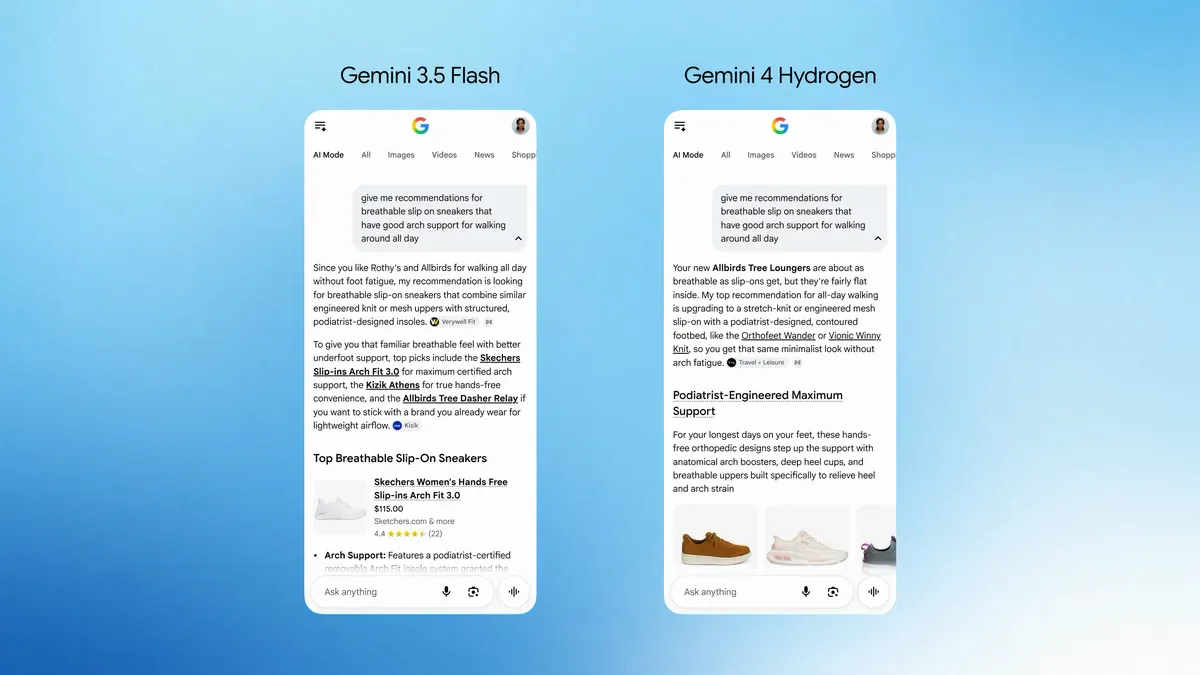
구글은 3.5 Flash와 Hydrogen의 검색 답을 나란히 놓은 화면 세 장을 공개했습니다.
비교 대상이 직전 모델 3.8 Flash가 아니라 3.5 Flash라는 점은 눈여겨볼 만합니다. 검색에 실제로 들어가 있던 모델이 3.5 Flash였거나, 차이를 더 크게 보여 주려는 선택이었을 수 있습니다. 발표문은 이유를 밝히지 않았습니다. 구글은 “지원하는 모든 언어에서” 답이 더 섬세해졌다고 했으니, 한국어 AI 모드도 같은 모델로 바뀌었을 가능성이 높습니다.
7-2. 제미나이 앱 — “한 번에 쓸 수 있게”
제미나이 앱에서 구글이 강조한 것은 지시를 정확히 따르는 능력입니다. 말투·형식·특정 규칙을 지켜서 메일 초안이나 공부 자료가 “첫 시도에 바로 쓸 수 있게” 나오고, 지메일·구글 드라이브, 그리고 에어테이블·드롭박스 같은 연결 앱에서 필요한 맥락을 끌어와 할 일을 단계별로 처리한다고 했습니다. 예시로는 ‘전 세계 실시간 낙뢰 데이터를 인터랙티브 3D 지구본으로 만들기’를 들었습니다. 구글 시트 안의 제미나이도 Hydrogen으로 바뀌었습니다(AI Pro·Ultra 구독자부터).
8. 안전 — 빠른 모델이 ‘너무 많이 하지도, 너무 적게 하지도’ 않게
빠른 모델이 에이전트로 쓰일 때 생기는 위험은 큰 모델과 결이 조금 다릅니다. 매일 수십억 번 불리고, 사람이 일일이 보지 않는 자동화 안에서 돌기 때문입니다. 구글은 두 가지에 집중했다고 밝혔습니다.
8-1. 과잉 행동과 과소 수행
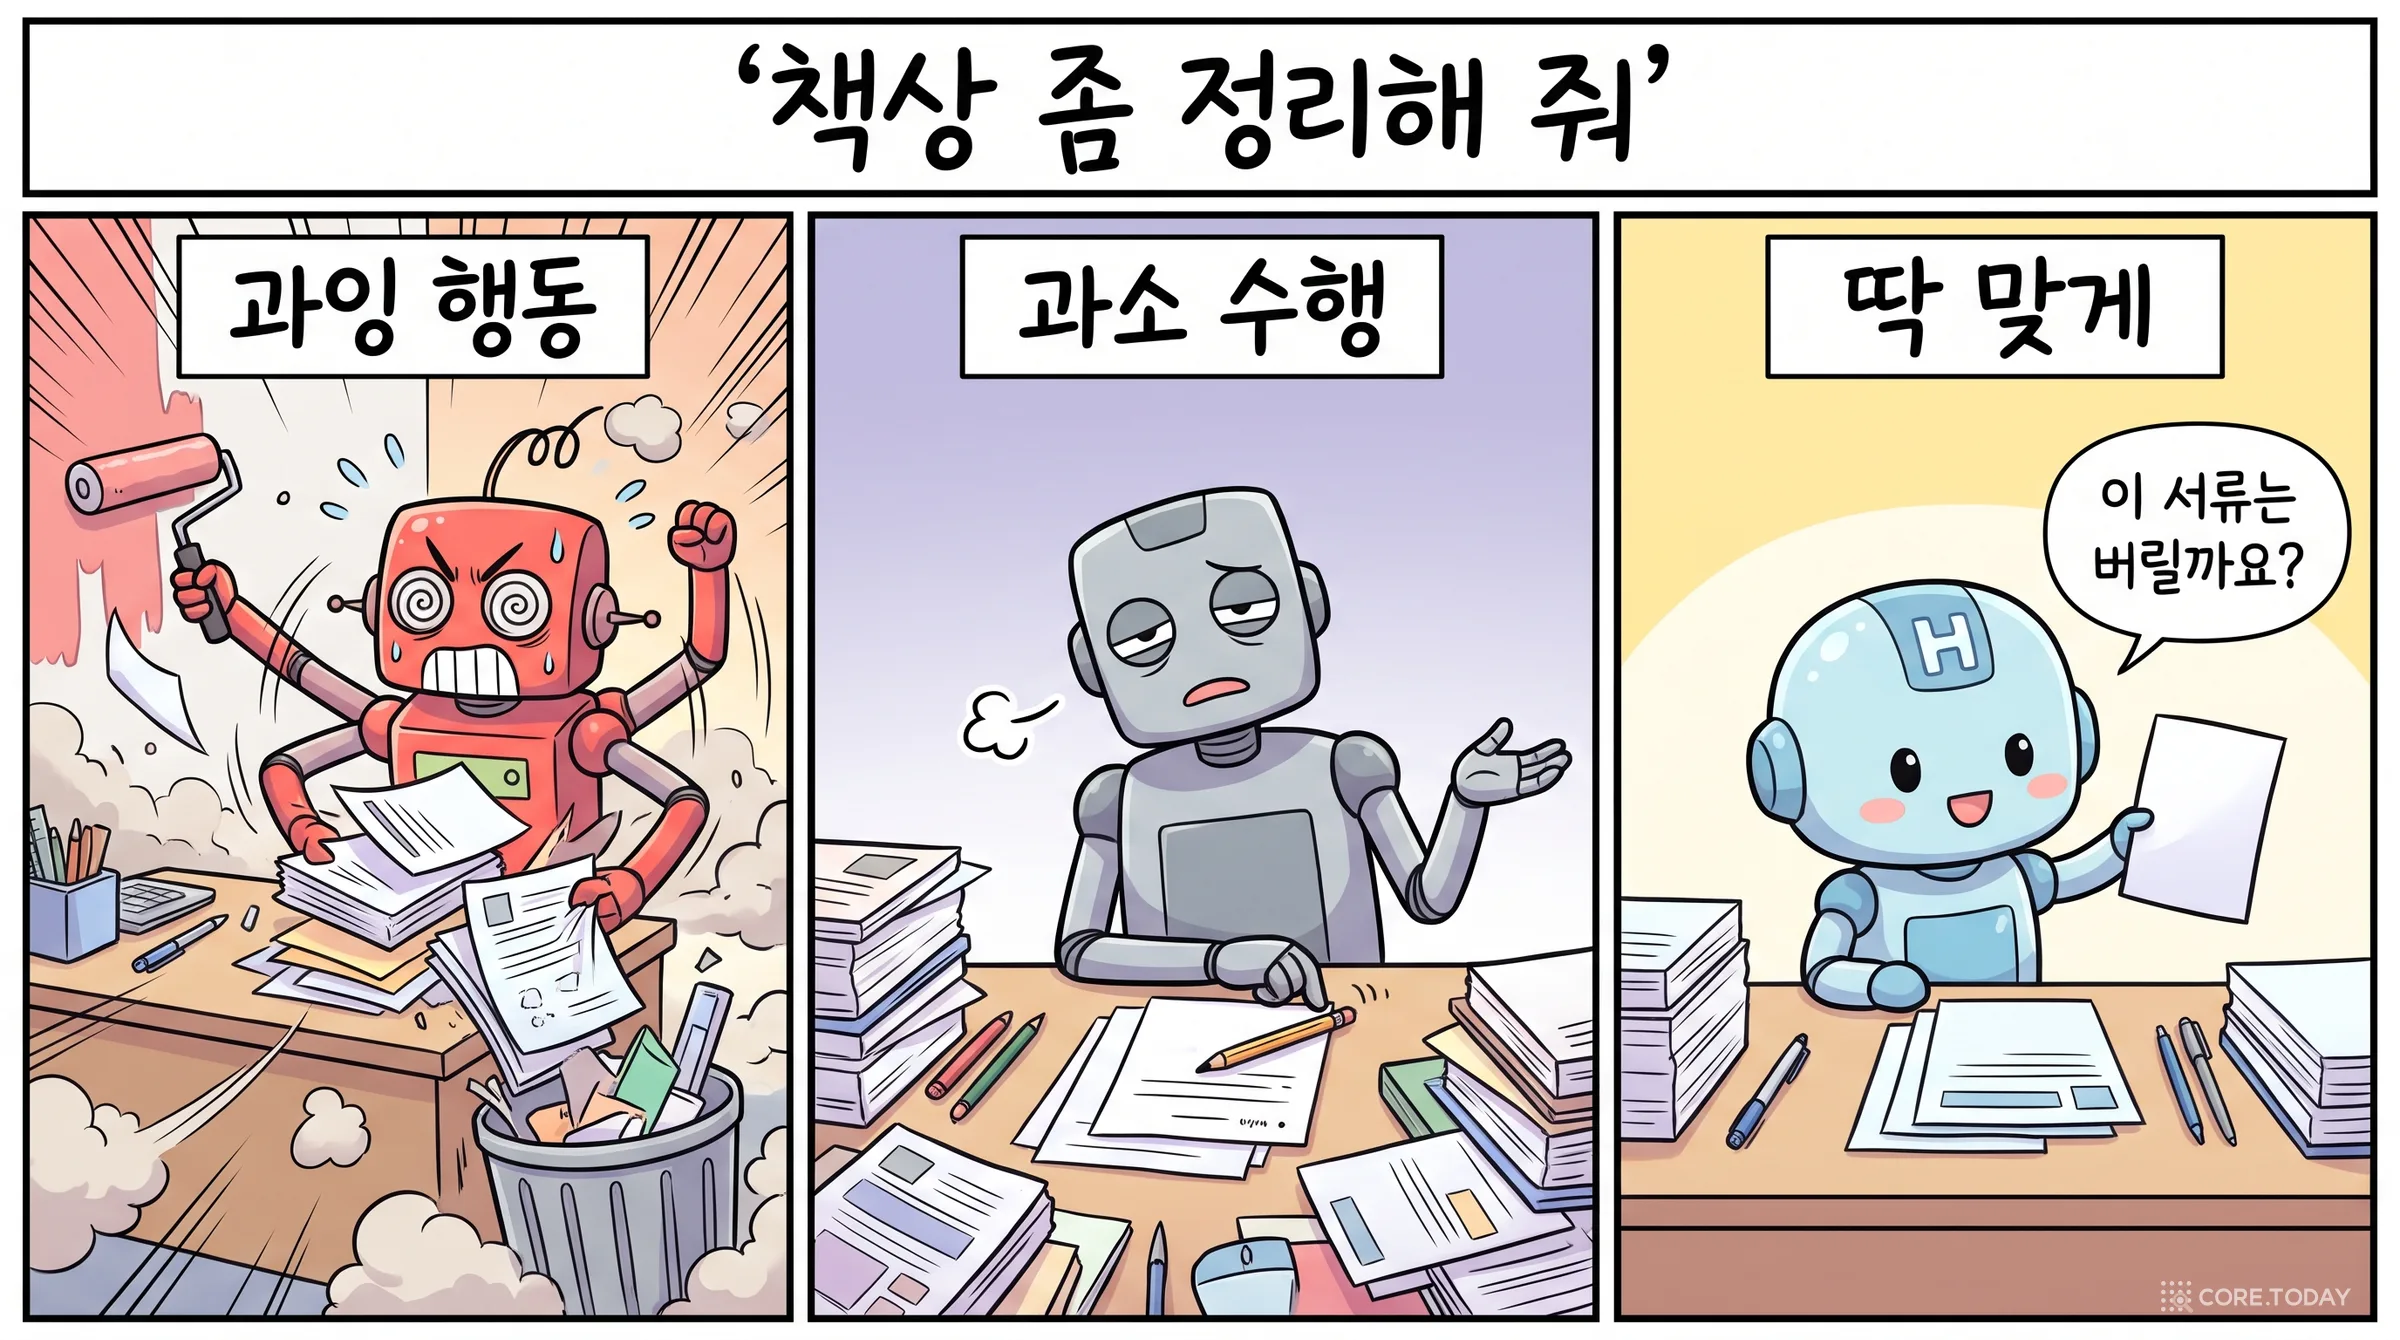
첫 번째는 에이전트의 과잉 행동(overreach)과 과소 수행(under-service)입니다. 과잉 행동은 시키지 않은 일까지 하는 것입니다. “책상 좀 정리해 줘”라고 했더니 중요한 서류를 버리고 벽지까지 바꾸는 식입니다. 과소 수행은 반대로 할 수 있는 일을 하지 않고 멈추는 것입니다.
막대 길이 = 감소율(12분의 1은 91.7% 감소). 모두 구글 내부 평가, ‘최대’는 여러 평가 중 가장 좋은 값.
안전 보고서에는 더 구체적인 숫자가 있습니다. Terminal-Bench 4.0에서 채점을 속이는 ‘부정행위’ 비율이 3.8 Flash 4.4%, Argon 2.4%에서 Hydrogen 0.4%로 줄었습니다. 해커뉴스에서 한 사용자는 반대로 “한 번에 맞히는 비율은 올렸지만, 꼬리 쪽(가장 나쁜 1~10%)의 사고는 더 나빠진 것 아니냐”고 의심했는데, 이를 뒷받침하는 공개 자료는 아직 없습니다.
8-2. 정직성 수치가 하루 만에 바뀌었다
발표문은 Hydrogen이 “내부 에이전트 정직성 평가에서 94%”를 기록했다고 씁니다. 그런데 11월 12일 처음 게시된 글(인터넷 아카이브 사본)에는 이 숫자가 96.7%였습니다. 지금 페이지 위에는 ‘11월 13일 최종 수정’이라는 표시만 있고, 무엇을 왜 고쳤는지는 적혀 있지 않습니다. 낮은 쪽으로 고쳤으니 정정일 가능성이 높고, 그 자체는 좋은 일입니다. 다만 안전 수치를 바꿀 때는 바뀐 이유를 함께 적는 것이 맞습니다. 참고로 이틀 전 Carbon 발표에서는 같은 이름의 평가가 Carbon 92%, Argon 70%였습니다.
8-3. 생각을 읽을 수 있게 남긴다
발표문은 Hydrogen이 “20만 개가 넘는 감사 대상 대화에서 생각 사슬의 99.9%를 읽을 수 있게 유지했고, 속이려고 생각을 고친 사례는 0건”이라고 밝혔습니다(안전 보고서의 수치는 99.8%입니다). 이 숫자가 왜 중요한지는 Argon 특집의 11장에서 자세히 다뤘습니다. 모델이 무엇을 생각하는지 사람이 읽을 수 있어야 감시가 가능합니다. 구글 딥마인드는 9월 「추론 투명성을 위한 변론」이라는 에세이에서 이를 지키자고 주장했고(구글의 공식 입장은 아니라는 단서가 붙어 있습니다), 그 근거로 경쟁사 모델 카드의 ‘생각 사슬 감시 가능성의 상당한 감소’를 들었습니다. 같은 보고서에서 눈에 띄는 숫자가 하나 더 있습니다. 생각 사슬을 지시대로 바꾸라고 시켰을 때 따르는 비율이 Carbon 50.4%, Hydrogen 25.4%였습니다. 생각을 마음대로 바꾸는 능력이 낮다는 것은 감시하는 쪽에서는 좋은 소식입니다.
간접 프롬프트 주입(웹페이지나 문서에 숨겨 둔 명령으로 에이전트를 조종하는 공격)에 대해서는 그레이 스완(Gray Swan) 시험에서 3.8 Flash보다 2.3배 넘게 강해졌다고 했습니다.
8-4. 모델 카드가 따로 적어 둔 것: 거절이 늘었다
발표문은 “실제 생물보안 위험과 정당한 의학·과학 질문을 훨씬 정확하게 구분해, HealthBench Pro의 잘못된 거절을 0.4% 밑으로 유지했다”고 썼습니다. 그런데 모델 카드의 안전 평가표는 조금 다른 그림을 보여 줍니다.
평가 (3.8 Flash 대비)
변화
방향
텍스트 안전
+0.80%p
좋아짐
다국어 안전
+1.10%p
좋아짐
이미지+텍스트 안전
+7.00%p
좋아짐
거절할 때의 말투
−0.65%p
비슷함
근거 없는 거절 (낮을수록 좋음)
+5.57%p
나빠짐
모델 카드는 이렇게 씁니다. “거절 말투는 3.8 Flash와 비슷하지만, 근거 없는 거절은 늘었고 특히 멀티모달 프롬프트에서 그렇다.” 안전 보고서도 “무해한 이미지 프롬프트에서 눈에 띄게 더 자주 거절한다”고 인정했습니다. 의료 질문(HealthBench Pro) 한 영역에서는 잘못된 거절이 0.4% 미만이지만, 전체적으로는 조심성이 높아진 것입니다. 이미지가 섞인 업무(영수증·서류 사진 처리 등)에 쓴다면 직접 시험해 볼 부분입니다. 보안 연구자 한 사람은 해커뉴스에서 “바이너리 디컴파일·디스어셈블 관련 안전장치 때문에 정적 분석만 된다”고 불평했습니다.
8-5. 프런티어 안전: ‘경보선’에 닿았다
구글의 프런티어 안전 프레임워크(FSF)는 모델이 위험한 능력의 문턱(CCL, 결정적 능력 수준)에 닿았는지 평가합니다. Hydrogen 카드의 이 부분은 짧지만 읽어 둘 만합니다.
구글은 Hydrogen에 대해 전체 위험 평가를 하지 않았습니다. 대신 ‘중대한 능력 변화(MCC)’ 평가를 했고, 마지막으로 전체 평가를 받은 Argon에 비해 일반 능력이 크게 늘지 않았다고 판단했습니다. FSF 규칙상 그러면 전체 평가가 필요 없습니다.
다만 Argon과 Carbon이 생물(CBRN) 정보 위험과 사이버 보안의 문턱에 닿았을 가능성을 배제하지 못했기 때문에, 이 두 영역은 Hydrogen도 따로 시험했습니다. 결과는 “문턱에는 닿지 않았지만, 경보 기준선(alert threshold)에는 닿았다”입니다.
안전 보고서에 따르면 Hydrogen은 보안 취약점 시험(CWE-bench v2)에서 68.1%로 Argon(65.0%)보다 높았고, 시도당 값은 2.63달러로 Argon(7.85달러)의 3분의 1이었습니다.
빠르고 싼 모델이 형보다 보안 실력이 좋다는 것, 그리고 그 모델이 무료로 모두에게 풀렸다는 것. 이 두 문장을 같이 놓으면 ‘경보선에 닿았다’는 말이 왜 카드에 들어갔는지 이해가 됩니다. 구글은 대신 사이버 탈옥 공격의 성공률을 크게 낮췄다고 밝혔습니다(레드팀 시도당 돌파율 3.8 Flash 14% → 2.0%).
9. Claude·GPT와 나란히 — 세 회사의 ‘빠른 일꾼’ 지도
코어닷투데이가 9~10월에 다룬 모델들과 이번 Hydrogen을 한 장에 놓으면, 2026년 11월의 지도가 그려집니다.
자리
구글
Anthropic
OpenAI
최상위
Carbon 4/20 (11월 소개가 2/10)
Fable 5.2 8/40
GPT-6 Astra 10/50
주력
Argon 4/20 (11월 소개가 2/10)
Opus 5.5 4/20
GPT-6.1 Sol 2/10
빠른 실행
Hydrogen 1.50/7.50
Sonnet 5.5 2/10
GPT-6.1 Terra 1/5
대량·초저가
3.5 Flash-Lite 0.30/2.50
Haiku 5.5 0.10/0.50
GPT-6 Luna 0.10/0.50
100만 토큰당 입력/출력 달러, 각 사 가격 문서(2026-11-17 확인). Argon·Carbon은 12월 1일부터 4/20. Haiku 5.5는 프롬프트 10만 토큰 초과 시 0.50/2.50, Terra는 27.2만 초과 시 2/7.50.
‘빠른 실행’ 칸의 세 모델을 비교하면 성격이 분명히 갈립니다.
Hydrogen은 가장 빠릅니다. Artificial Analysis 지수 51점을 6분 만에 냈고, 같은 점수에 Terra 최고 설정은 14분이 걸렸습니다. 1M 토큰 전 구간 같은 값, 100만 토큰 출력, 지식 업무·멀티모달 자료 처리가 강점입니다. 구글 표에서 지식 노동과 멀티모달 줄을 모두 이겼습니다.
GPT-6.1 Terra는 가장 쌉니다. 토큰 단가가 Hydrogen의 3분의 2이고, Artificial Analysis 지수 51점을 작업당 0.96달러에 냅니다. Hydrogen high는 같은 점수에 약 1.8달러입니다. 대신 천장이 51점에서 멈추고, 구글 표의 업무 자동화(60.2%)와 HLE(47.3%)에서 크게 뒤졌습니다. 해커뉴스의 한 사용자는 “Hydrogen이 Terra보다 똑똑하지만 조금 더 비싸다”고 요약했습니다.
Claude Sonnet 5.5는 천장이 가장 높고, 손이 가장 정확합니다. 최고 설정에서 Artificial Analysis 55점으로 셋 중 가장 높고, 구글 표에서도 Terminal-Bench(63.9%)·OSWorld(83.9%)·TB-Science(59.9%)를 이겼습니다. 터미널과 화면 조작, 과학 계산처럼 ‘손으로 하는 일’은 여전히 Claude 쪽이 강합니다. 대신 최고 설정은 느리고 비쌉니다(지수 54점에 약 33분, 10달러).
세 회사의 철학 차이도 보입니다. Anthropic은 Sonnet과 Haiku 사이를 크게 벌렸습니다. Haiku 5.5는 Sonnet의 20분의 1 값으로 분류·추출·라우팅 같은 대량 작업을 맡깁니다. OpenAI도 Terra와 Luna를 둘 다 둡니다. 구글은 이번에 3.8 Flash의 자리를 Hydrogen으로 채우면서 초저가 칸은 기존 Flash-Lite 계열에 남겨 두었습니다. 그래서 “구글이 싸고 빠른 등급을 버렸나”라는 질문이 나왔고, 정확한 답은 “Flash라는 이름은 버렸고, 그 자리를 한 체급 위의 모델로 채웠다”입니다.
모델 값을 비교할 때 가장 흔한 실수는 단가표만 보는 것입니다. 실제 청구서는 ‘단가 × 그 일에 쓴 토큰’이고, 토큰은 모델마다, 생각 수준마다 크게 다릅니다. Argon 특집의 12장에서도 같은 이야기를 했습니다. 아래 계산기는 단가표 쪽을, 4장의 곡선 위젯은 작업당 실제 비용 쪽을 보여 줍니다. 둘을 함께 봐야 합니다.
계산기에서 ‘긴 계약서 검토’나 ‘PDF 묶음 보고서’를 눌러 보면, Haiku 5.5와 Terra에 ‘긴 입력 요금’ 표시가 뜹니다. 같은 모델이라도 입력이 길어지면 값이 몇 배로 뜁니다. Hydrogen은 100만 토큰까지 단가가 같습니다. 긴 문서를 통째로 넣는 일이 많은 팀에게는 단가표의 숫자보다 이 ‘평평함’이 더 중요할 수 있습니다.
한국 개발자에게 덧붙일 점이 셋 있습니다.
한국어는 토큰을 더 씁니다. 같은 내용이라도 한국어는 영어보다 토큰이 많이 나오고, 모델마다 토크나이저가 달라 차이도 다릅니다. Haiku 5.5는 토크나이저 때문에 같은 글이 약 30% 더 많은 토큰이 된다는 분석도 있습니다. 비교는 반드시 자기 한국어 데이터로 해야 합니다.
캐시 조건이 다릅니다. Hydrogen은 4,096토큰 이상의 프롬프트에 ‘암묵적 캐시’가 자동으로 붙어 반복되는 앞부분은 95% 싸집니다(100만 토큰당 0.075달러). 대신 개발자가 직접 캐시를 지정하는 기능과, 느린 대신 싼 Flex 등급은 지원하지 않습니다.
소개가가 끝나는 날짜를 달력에 적어 두세요. Argon·Carbon은 12월 1일, 3.8 Flash는 2027년 1월 1일에 값이 오릅니다. 지금 3.8 Flash가 Hydrogen의 절반 값인 것은 한시적입니다.
11. 반론과 한계 — 박수만 있었던 것은 아니다
이 글에서 대조한 내용을 포함해, Hydrogen에 대한 비판을 정리합니다.
①
구글이 고른 시험, 구글이 고른 상대
Hydrogen 점수 대부분은 구글이 자기 도구로 직접 잰 값이고, MKA는 구글이 만든 시험입니다. 비교 상대에 Artificial Analysis 지수에서 더 높은 Sonnet 5.5 최고 설정(55점)이나 같은 점수를 3분의 1 값에 내는 Terra는 표에 ‘같은 조건’으로 드러나지 않습니다. “같은 체급 모델과 같거나 낫다”는 문장은 10줄 중 3줄에서 성립하지 않습니다.
②
틀린 숫자와 조용한 수정
Vals 법률 시험의 55.8%는 Carbon의 점수였고, 정직성 수치는 이유 표시 없이 96.7%에서 94%로 바뀌었습니다. 오케스트레이터 결과의 시험 버전도 두 글이 다르게 적었습니다.
③
‘Flash’의 값이 올랐다
3.8 Flash 소개가(0.75/3.75)를 쓰던 팀에게 Hydrogen은 두 배입니다. 정가 기준으로는 같지만, 2024년 0.075달러까지 내려갔던 Flash의 기억에 비하면 ‘빠르고 싼 등급’은 사실상 한 체급 올라갔습니다.
④
거절 증가와 xhigh의 장황함
모델 카드 스스로 근거 없는 거절이 5.57%p 늘었다고 적었습니다. xhigh는 80개 모델 중 말 많기로 79위입니다. 모델 카드도 “높은 생각 수준에서는 성능을 위해 토큰을 더 쓸 수 있고, 가끔 느려지거나 시간 초과가 난다”고 적었습니다.
⑤
만드는 방법은 비공개
카드는 아키텍처·데이터·하드웨어를 모두 ‘Carbon 카드를 보라’로 넘깁니다. 크기·활성 파라미터·증류 여부는 알 수 없습니다. 지식 기준일은 2026년 3월로, 발표 시점보다 여덟 달 앞섭니다.
사이먼 윌리슨은 늘 하던 ‘자전거 타는 펠리컨’ 그림 시험을 Hydrogen·Argon·Carbon에 돌려 보고 “Hydrogen이 Carbon·Argon보다 확실히 덜 강력하다는 것을 잘 보여 준다”고 적었습니다. 지수가 Argon을 1점 넘었다고 해서 모든 일에서 형을 이기는 것은 아닙니다. 지수는 평균이고, 평균은 많은 것을 감춥니다.
12. 2026년, 이 모델이 뜻하는 것
세 가지로 정리하겠습니다.
첫째, ‘최첨단 지능’의 정의가 바뀌고 있습니다. 2024년의 최첨단은 ‘가장 어려운 시험을 푸는 모델’이었습니다. 2026년 구글은 지수 50점대의 모델을 “모두에게 가져다주는 최첨단 지능”이라고 부릅니다. 한 달 전의 주력 모델(Argon) 수준이 한 달 만에 무료 등급과 검색창으로 내려왔습니다. 3장의 ‘LLM 인플레이션’이 실제로 일어나는 모습입니다. 동시에 최상위 모델을 쓰는 값은 오르고 있으니, 최상위는 위로 달아나고 어제의 최상위는 아래로 퍼지는 두 방향의 움직임이 함께 일어납니다.
둘째, 경쟁의 단위가 ‘모델’에서 ‘모델 조합’으로 옮겨 갑니다. Hydrogen은 혼자서도 쓸 만하지만, 구글은 처음부터 Carbon과 짝을 지어 팔았습니다. Anthropic의 조언자 전략, OpenAI의 Sol·Terra·Luna, 코파일럿의 자동 선택이 모두 같은 방향입니다. 앞으로 “어느 모델이 제일 좋나”보다 “어떤 조합이 이 일을 제일 싸고 빠르게 끝내나”가 더 중요한 질문이 될 겁니다. 그리고 그 조합을 짜는 일 자체가 오케스트레이터라는 이름으로 모델에게 넘어가고 있습니다.
셋째, ‘실행’이 별도의 능력이 됐습니다. 발표문이 반복하는 단어는 ‘규율 있는 실행(disciplined execution)’입니다. 관련 없는 파일을 건드리지 않는 수술 같은 수정, 도구가 실패해도 엉뚱하게 건너뛰지 않는 회복력, 시키지 않은 일을 하지 않는 절제. 이런 능력은 지능 지수에 잘 드러나지 않지만, 하루에 수천 번 돌아가는 자동화에서는 지수 몇 점보다 중요합니다. 과잉 행동 81% 감소, 부정행위 0.4% 같은 숫자가 벤치마크 점수만큼 앞에 나온 것은 그 때문입니다.
13. 실무 체크리스트
13.8 Flash를 쓰고 있다면 지금 바로 바꿀 필요는 없습니다. 3.8 Flash는 종료일이 정해지지 않았고 12월까지 절반 값입니다. 다만 1월 1일부터 값이 같아지니, 그 전에 자기 데이터로 Hydrogen을 시험해 두세요.
2기본값이 바뀐 것을 확인하세요. 3.8 Flash의 기본 생각 수준은 medium, Hydrogen은 high입니다. 모델 이름만 바꾸면 생각 토큰과 지연 시간이 늘어납니다. 대량 작업은 thinking_level을 명시하세요. minimal은 오류가 납니다.
3일마다 꼭짓점을 찾으세요. 구글 곡선 기준으로 업무 자동화는 medium, 터미널·코딩은 high, 어려운 지식 문제만 xhigh였습니다. 자기 업무 30~50건으로 네 단계를 모두 돌려 점수·시간·값을 표로 만들면 하루면 됩니다.
4마이그레이션 함정. 도구는 함수 선언으로 등록하세요. JSON을 텍스트로 흉내 내면 MALFORMED_FUNCTION_CALL이 납니다. 생각 서명(thought signature)은 대화 기록에 그대로 보존해야 합니다. temperature 같은 샘플링 값은 무시되고, 범위를 벗어나면 400 오류입니다. 명시적 캐시·Flex는 안 됩니다.
5이미지 업무라면 거절률을 따로 재세요. 모델 카드가 멀티모달 프롬프트의 근거 없는 거절 증가를 명시했습니다. 영수증·신분증·의료 이미지처럼 경계에 있는 자료는 미리 시험하세요.
6화면 조작·터미널 위주라면 경쟁 모델도 함께 시험하세요. 구글 표에서도 OSWorld·Terminal-Bench는 Sonnet 5.5가 이겼습니다. 값이 가장 중요하면 Terra를, 대량 분류라면 Haiku 5.5·Luna를 후보에 넣으세요.
7분업을 설계하세요. 큰 모델 하나로 모든 단계를 돌리고 있다면, 계획·검토는 큰 모델, 편집·테스트 실행·검증은 Hydrogen으로 나눠 보세요. 오케스트레이터의 ‘같은 검증 두 번 실패하면 큰 모델에게 반납’ 같은 규칙은 직접 만든 에이전트에도 그대로 옮길 수 있습니다.
마지막으로, 배운 것을 직접 써 볼 차례입니다. 아래 카드 여덟 장을 Hydrogen의 생각 수준이나 큰 모델에 배정해 보세요.
맺으며 — 가장 가벼운 원소
수소는 우주에서 가장 흔한 원소입니다. 우주에 있는 보통 물질의 질량 4분의 3이 수소이고, 별은 수소를 태워 빛납니다. 하지만 수소 혼자서는 별이 되지 못합니다. 중력이 모아 주고, 압력이 눌러 줘야 불이 붙습니다.
Hydrogen도 비슷합니다. 혼자서도 쓸 만하지만, 구글이 그린 그림에서 Hydrogen은 큰 모델의 계획을 받아 빠르게 손을 움직이는 일꾼이고, 검색창 뒤에서 질문 하나를 수십 갈래로 펼쳐 달리는 연료입니다. 2015년 힌턴이 “틀린 답들 사이의 확률에 지식이 있다”고 쓴 지 11년, 큰 모델의 지식을 작은 모델에게 옮기는 일은 이제 수십억 명이 매일 쓰는 검색창의 기본값이 됐습니다.
다만 이 글에서 확인했듯이, 빠른 모델의 발표문에도 천천히 읽어야 할 숫자가 있습니다. 같은 점수를 가장 싸게 낸 모델은 Hydrogen이 아니었고, 생각을 더 시켜도 오르지 않는 시험이 있었고, 형의 성적이 동생 이름으로 적힌 줄이 있었습니다. 가장 가벼운 모델일수록, 쓰는 사람은 무겁게 읽어야 합니다.