Squeeze Evolve테스트 시간 스케일링진화 알고리즘RSA재귀 자기 집계AlphaEvolve다중 모델 오케스트레이션모델 라우팅DeepConf확신도ARC-AGI-2다양성 붕괴추론 비용COLM 2026특집
[특집] 비싼 모델은 어디에 써야 하는가 — 검증기 없는 진화와 다중 모델 오케스트레이션, Squeeze Evolve 완전 해부
같은 Gemini 3.1 Pro가 한 번 답하면 ARC-AGI-2 공개 평가에서 88.1%다. 같은 모델로 후보 답을 여러 세대에 걸쳐 섞고 고치는 '진화'를 돌리면 93.3%까지 오르지만 과제당 비용이 0.98달러에서 28.85달러로 뛴다. UC 버클리·Together AI 연구진의 Squeeze Evolve(COLM 2026)는 여기서 질문을 바꾼다. 더 쓰는 법이 아니라 덜 쓰고 같은 능력을 얻는 법이다. 답은 '비싼 모델을 가장 효과가 큰 곳에만'이다. 첫 후보는 강한 모델이 만들고, 이후 재조합은 모델이 이미 내놓은 로그 확률로 묶음의 난이도를 재서 쉬운 묶음은 싼 모델이나 다수결에, 어려운 묶음만 비싼 모델에 보낸다. 이 글은 1960년대 풍동 실험의 진화 전략부터 FunSearch·AlphaEvolve·RSA까지 '진화하는 추론'의 계보를 따라가고, 논문의 네 가지 발견(다양성 붕괴, 조상이 결과를 정한다, 약한 모델도 좋은 재료면 잘 합친다, 확신도는 공짜 적합도다)과 알고리즘·시스템 설계·공개 코드를 읽은 뒤, 공개 평가의 함정과 통계적 유의성 같은 반론, 그리고 2026년 추론 경제에서 이 아이디어가 맡을 역할을 인터랙티브 7개와 일러스트·논문 그림, 직접 계산한 원 채우기 결과로 풀어 본다.
ARC-AGI-2라는 시험이 있습니다. 색칠된 작은 격자 그림 몇 쌍을 보여 주고 "왼쪽이 오른쪽으로 바뀌는 규칙은 무엇인가"를 알아낸 뒤, 처음 보는 격자에 그 규칙을 적용하게 하는 퍼즐입니다. 사람은 평균 2.7분이면 푸는 과제가 많지만, 2025년 3월 공개 당시 순수 언어 모델의 점수는 0%였고 추론 모델도 한 자릿수에 머물렀습니다.
2026년 봄, 구글의 Gemini 3.1 Pro는 이 시험의 공개 평가 세트 120문제에서 한 번에 답해 88.1%를 받았습니다. 과제당 비용은 0.98달러였습니다. 같은 모델에게 답을 한 번만 내게 하지 않고, 후보 답을 여러 개 만들게 한 뒤 그 후보들을 서로 읽고 섞어 더 나은 답을 만드는 과정을 열 세대 동안 되풀이시키면 점수는 93.3%로 오릅니다. 대신 과제당 비용이 28.85달러, 거의 서른 배가 됩니다.
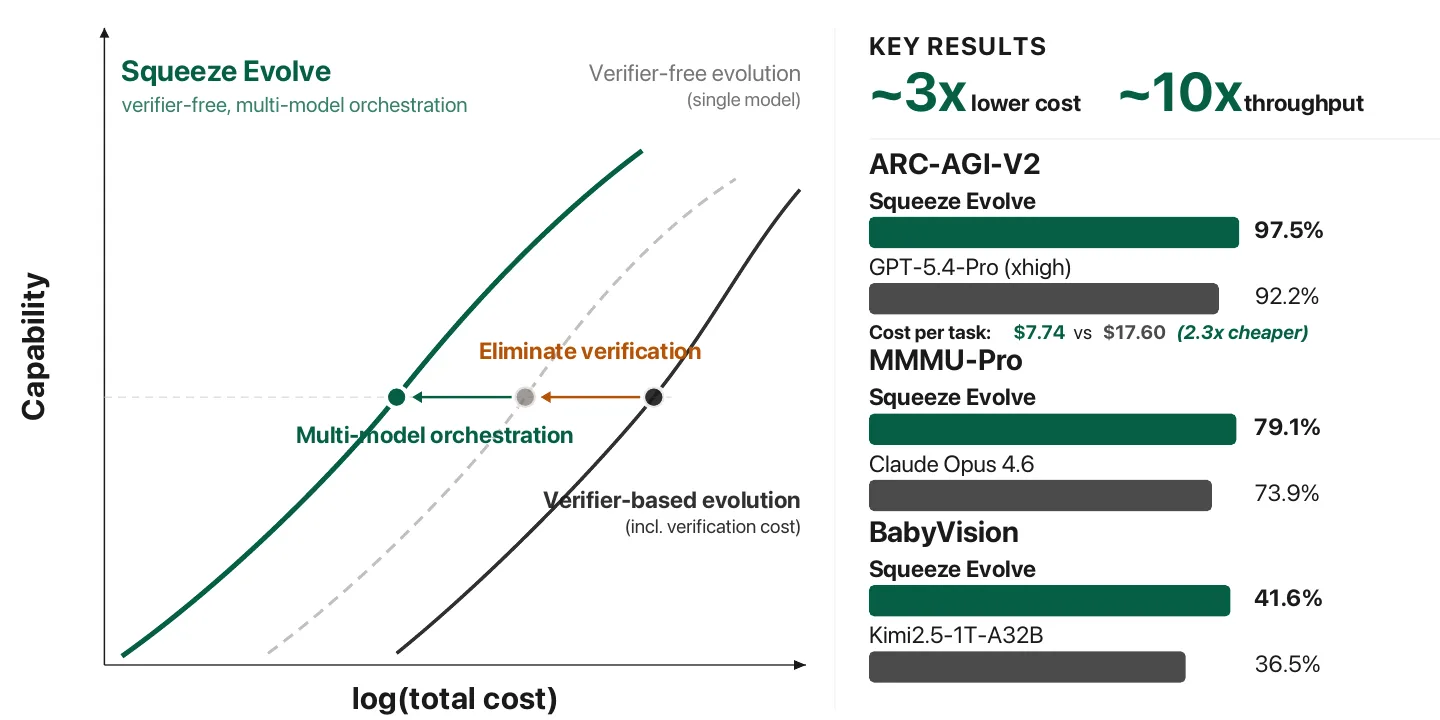
2026년 4월 arXiv에 올라온 논문 「Squeeze Evolve: Unified Multi-Model Orchestration for Verifier-Free Evolution」(arXiv:2604.07725)은 같은 Gemini 3.1 Pro로 97.5%를 보고했습니다. 비용은 과제당 7.74달러였습니다. 더 많이 쓴 것이 아니라 덜 썼는데 더 잘 풀었습니다. 바꾼 것은 규칙 하나였습니다. 후보들이 이미 같은 답으로 모인 묶음에는 비싼 모델을 부르지 않는다.
이 논문은 UC 버클리, Together AI, 스탠퍼드, UT 오스틴, 프린스턴의 연구자 열아홉 명이 함께 썼습니다. 저자 목록에는 FlashAttention을 만든 트리 다오(Tri Dao), Mixture-of-Agents를 이끈 제임스 저우(James Zou)와 Together AI 연구진이 있습니다. 2026년 7월 언어 모델 학회 COLM 2026 본 학회 논문으로 채택됐고, 코드는 Apache 2.0으로 공개됐습니다. 공개 저장소에는 NVIDIA Dynamo 통합 모듈과 Claude Code 플러그인까지 들어 있습니다.
제목의 "Squeeze"는 짜낸다는 뜻입니다. 같은 예산에서 능력을 끝까지 짜내자는 것이죠. 이 글은 이 논문을 처음부터 끝까지 읽어 보는 특집입니다. 왜 이런 문제가 생겼는지 진화 알고리즘의 오래된 역사에서 시작하고, 논문이 찾아낸 네 가지 발견과 알고리즘을 그림과 표로 풀고, 직접 만져 볼 수 있는 인터랙티브 일곱 개로 핵심 개념을 확인합니다. 마지막으로 이 논문이 말하지 않은 것, 반론, 그리고 2026년 가을의 시점에서 이 아이디어가 어디에 쓰일지를 이야기합니다.
?
문제
정답을 확인해 줄 채점기(검증기)가 없는 문제에서 언어 모델이 스스로 후보를 섞고 고치는 '검증기 없는 진화'는 성능을 올리지만, 토큰을 한 번 답할 때의 500~700배 쓰고, 세대가 갈수록 후보들이 서로 닮아 가며 정답이 사라진다.
!
해법
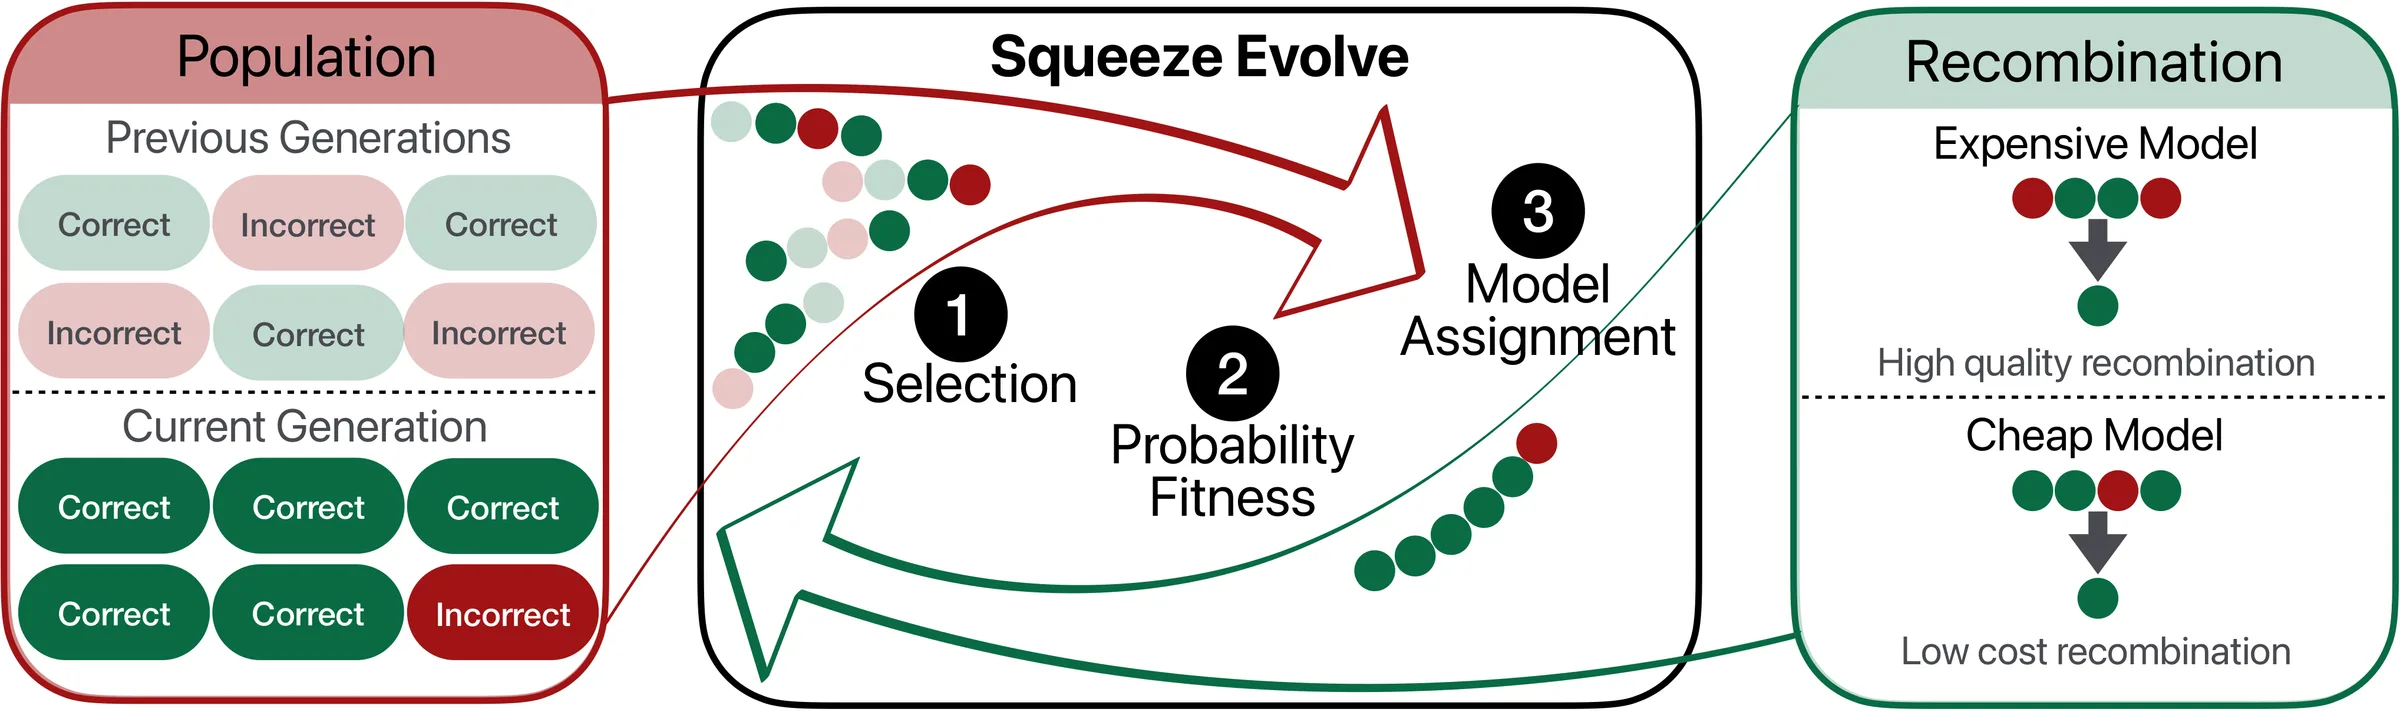
첫 후보는 가장 강한 모델이 만든다. 이후 매 세대, 모델이 글을 쓰며 이미 내놓은 로그 확률로 후보 묶음의 '망설임'을 재서 쉬운 묶음은 다수결이나 싼 모델에, 어려운 묶음만 비싼 모델에 보낸다. 서로 다른 모델이 섞이며 다양성도 유지된다.
✓
결과
수학·코딩·과학·시각 문제 8개 벤치마크에서 비싼 모델만 쓴 진화와 비슷한 정확도를 1.3~3.3배 싸게 얻었고, 같은 GPU 예산에서 처리량은 최대 약 10배가 됐다. 원 채우기 같은 발견 과제에서는 검증기 없이 AlphaEvolve 수준의 해를 찾았다.
미리 말해 두면, 이 글은 이 논문을 무조건 칭찬하지 않습니다. "비싼 모델을 이겼다"는 일부 결과는 통계적으로 구별되지 않고, ARC-AGI-2의 97.5%는 누구나 볼 수 있는 공개 세트의 자체 보고치이며, 논문이 나온 지 여섯 달 만에 새로 나온 단일 모델들이 같은 점수를 몇 분의 일 가격에 냅니다. 그래도 이 논문이 던지는 질문, "정해진 능력을 가장 싸게 얻으려면 어떤 모델을 어디에 써야 하는가"는 모델이 바뀌어도 남는 질문입니다. 그 이야기를 해 보겠습니다.
1. 왜 이런 논문이 나왔나 — 두 개의 압력
1-1. "더 오래 생각하게 하면 더 잘한다"의 시대
2024년 9월 OpenAI가 o1을 공개했을 때, 가장 많이 인용된 그림은 모델 크기가 아니라 '생각하는 시간'에 관한 것이었습니다. 미국 수학 경시대회 AIME 2024에서 GPT-4o는 12%를 맞혔습니다. o1은 한 번에 74%를 맞혔고, 답을 64번 뽑아 다수결을 하면 83%, 1,000번 뽑아 학습된 채점 함수로 다시 고르면 93%까지 올라갔습니다. 학습을 더 하지 않고 추론할 때 계산을 더 쓰는 것만으로 성능이 올라간다는 이 현상을 '테스트 시간 스케일링(test-time scaling)'이라고 부릅니다.
그 뒤로 테스트 시간 계산을 쓰는 방법이 쏟아졌습니다. 2025년 1월 DeepSeek-R1은 강화학습만으로 모델이 스스로 길게 생각하는 습관을 익히게 했고(AIME 2024 pass@1이 학습 중 15.6%에서 77.9%로), 같은 달 s1은 모델이 생각을 멈추려 할 때 "Wait"를 붙여 억지로 더 생각하게 하는 단순한 방법으로 AIME24를 50%에서 57%로 올렸습니다. 코어닷투데이는 s1 논문 해부와 DeepSeek-R1 특집에서 이 흐름을 다룬 적이 있습니다.
생각을 '길게' 시키는 방법이 있다면, '넓게' 시키는 방법도 있습니다. 같은 문제를 여러 번 풀게 하고 그중 가장 좋은 답을 고르거나 합치는 것이죠. 2024년 「Large Language Monkeys」 논문은 소프트웨어 버그 수정 벤치마크 SWE-bench Lite에서 샘플을 1개에서 250개로 늘리자 '하나라도 맞힌 비율'이 15.9%에서 56%로 오르는 것을 보였습니다. 문제는 그다음 문장이었습니다. 정답을 확인할 수단이 없으면, 다수결이나 학습된 채점 모델로 고르는 성능은 "수백 개 샘플을 넘어서면 정체된다." 맞는 답이 어딘가에 있어도 그것을 골라낼 눈이 없으면 소용이 없다는 뜻입니다.
이 '골라낼 눈'이 이 글 전체의 열쇠입니다. 전문 용어로는 검증기(verifier)라고 합니다.
어떤 문제는 답을 확인하기가 쉽습니다. 수학 경시대회 문제는 정답 숫자와 비교하면 끝이고, 프로그래밍 문제는 테스트 케이스를 돌려 보면 됩니다. 이런 문제에서는 모델에게 후보를 잔뜩 만들게 한 뒤 검증기로 걸러 내는 전략이 무척 강력합니다. 뒤에서 볼 FunSearch와 AlphaEvolve가 이 방식으로 수학의 미해결 문제를 풀었습니다.
그런데 세상의 중요한 문제 대부분은 그렇지 않습니다. Squeeze Evolve 논문은 서론에서 핵융합 연구를 예로 듭니다. 토카막(도넛 모양의 핵융합 장치) 플라스마 한 건을 시뮬레이션으로 연구하는 데 1억 2천만 CPU 시간 이상이 들 수 있다는 2016년 연구를 인용하면서요. 후보 설계 하나를 '채점'하는 데 이만큼 든다면, 후보를 수천 개 만들어 하나하나 확인하는 전략은 처음부터 불가능합니다. 신약 후보의 효능, 법률 의견서의 타당성, 경영 전략의 성패도 마찬가지입니다. 확인하려면 몇 달, 몇 년이 걸리거나, 애초에 정답이 정해져 있지 않습니다.
그래서 연구자들은 검증기 없이 모델 스스로 후보들을 비교하고 합치게 하는 방법을 찾아왔습니다. 그 최신판이 2025년 가을 발표된 RSA(Recursive Self-Aggregation, 재귀 자기 집계)입니다. 후보 16개를 만들고, 4개씩 묶어 모델에게 "이 네 풀이를 읽고 더 나은 풀이 하나를 써라"라고 시키는 일을 열 번 되풀이합니다. 이렇게 하면 40억 파라미터짜리 작은 모델 Qwen3-4B가 DeepSeek-R1이나 o3-mini(high) 같은 훨씬 큰 추론 모델과 맞먹거나 일부 앞선다고 RSA 저자들은 보고했습니다.
하지만 공짜는 없습니다. Squeeze Evolve 논문의 표현으로, RSA 같은 방법은 한 번 답하는 추론보다 토큰을 500~700배 씁니다. 계산해 보면 이유가 보입니다. 후보 16개를 열 세대 동안 만들면 답을 160번 쓰고, 그중 144번은 다른 후보 4개를 통째로 읽은 다음 씁니다. 답 하나가 8천 토큰이라면, 한 번 읽을 때마다 3만 2천 토큰이 입력으로 들어갑니다. 아래 계산기로 직접 확인해 보세요.
1-3. 두 번째 압력 — 모델 값이 열 배, 스무 배씩 다르다
두 번째 압력은 가격표에서 옵니다. 논문은 2026년 3월 16일 기준 공급사 정가를 비교해, 대표적인 폐쇄형(proprietary) 추론 모델의 출력 토큰 단가가 성능 좋은 오픈 웨이트 모델보다 대략 4배에서 25배 비싸다고 적었습니다. 논문 부록 표 10에 실린 가격을 보면 감이 옵니다.
공급사
모델
입력 ($/100만 토큰)
출력 ($/100만 토큰)
Together AI
GPT-OSS-20B
0.05
0.20
Together AI
GPT-OSS-120B
0.15
0.60
Alibaba Cloud
Qwen3-30B-A3B-Instruct
0.108
0.431
Alibaba Cloud
Qwen3-235B-A22B-Instruct
0.287
0.92
OpenAI
GPT-5 mini
0.25
2.00
Together AI
Kimi-K2.5
0.50
2.80
Google
Gemini 3 Flash (프리뷰)
0.50
3.00
Google
Gemini 3.1 Pro (프리뷰)
2.00
12.00
GPT-OSS-20B와 Gemini 3.1 Pro의 출력 단가는 60배 차이입니다. 이 격차는 2026년 내내 더 벌어졌습니다. CNBC는 2026년 7월 오픈라우터 관계자의 말을 빌려 중국 오픈 모델이 미국 프런티어 모델보다 "60~90% 싸다"고 보도했고, 9월에는 오픈라우터에서 중국 모델의 토큰 점유율이 2월의 6~13%에서 9월 중순 57~67%까지 올랐다고 전했습니다. 비싼 모델과 싼 모델이 공존하고, 싼 모델이 '충분히 좋은' 일이 늘어나는 세계입니다.
이 두 압력을 합치면 논문의 출발점이 나옵니다. 검증기 없는 진화는 계산을 많이 먹는다. 그런데 모델마다 값이 수십 배 다르다. 그렇다면 진화의 각 단계에 어떤 모델을 쓸지 고르는 것만으로 큰돈을 아낄 수 있지 않을까? 논문은 질문 자체를 이렇게 바꿉니다. "돈과 계산을 더 써서 어떻게 새 능력을 여는가"가 아니라 "빠듯한 예산에서 정해진 능력 목표를 어떻게 달성하는가." 논문은 이것이 소프트웨어와 알고리즘의 역사가 늘 걸어온 길이라고 말하며, AI 발전에서 알고리즘 효율의 몫을 다룬 Epoch AI의 글을 각주로 답니다.
이 질문에 답하려면 먼저 '진화'가 무엇인지, 왜 하필 진화라는 틀로 보는지부터 이해해야 합니다. 이야기는 60년 전 베를린의 풍동에서 시작합니다.
2. 역사 ① — 진화 알고리즘이 먼저 배운 교훈들
2-1. 풍동 속의 주사위, 그리고 홀랜드의 유전 알고리즘
1960년대 중반 베를린 공과대학의 학생 세 명, 비네르트·레헨베르크·슈베펠은 풍동 속 물체의 공기 저항을 줄이는 모양을 찾고 있었습니다. 수식으로 최적 모양을 계산할 수 없자 그들은 기묘한 방법을 썼습니다. 판의 각도를 무작위로 조금 바꿔 보고(변이), 저항이 줄면 그 모양을 남기고(선택), 다시 바꿔 보는 것을 되풀이한 것입니다. 이것이 진화 전략(evolution strategies)의 시작입니다. 레헨베르크는 1971년 이 연구로 박사 학위를 받았고, 그 논문은 1973년 책으로 나왔습니다.
대서양 건너편 미시간 대학의 존 홀랜드는 1975년 『자연계와 인공계의 적응(Adaptation in Natural and Artificial Systems)』을 펴내며 유전 알고리즘의 이론을 세웠습니다. 후보 해를 염색체처럼 문자열로 표현하고, 좋은 후보끼리 짝지어 일부를 맞바꾸고(교차, crossover), 가끔 무작위로 한 글자를 바꾸고(변이), 점수 높은 후보를 다음 세대에 더 많이 남기는 방식입니다. 1992년 존 코자는 『유전 프로그래밍』에서 문자열 대신 프로그램 자체를 진화시키는 방법을 정리했습니다.
이 모든 방법은 같은 뼈대를 공유합니다.
초기화후보 해를 여러 개 만든다. 이 집합을 개체군(population)이라 부른다.
평가각 후보가 얼마나 좋은지 적합도(fitness) 점수를 매긴다.
선택점수가 높은 후보를 부모로 고른다.
재조합·변이부모들을 섞고 조금씩 바꿔 자식 후보를 만든다.
갱신자식들로 다음 세대 개체군을 꾸리고, 평가부터 다시 반복한다.
2006년 3월 22일 발사된 NASA의 ST5 위성에는 이 방법으로 설계된 안테나가 실렸습니다. 사람이 그렸다면 결코 떠올리지 못했을, 구부러진 철사 조각 같은 모양이었습니다. 논문에 따르면 이것은 "우주로 간 최초의 컴퓨터 진화 하드웨어"였고, 위성 궤도가 바뀌어 설계를 다시 해야 했을 때 진화 방식은 한 달이 안 걸렸지만 기존 방식은 약 다섯 달이 걸렸습니다. 위성 모형에 달았을 때 효율은 기존 안테나 두 개가 38%, 진화된 안테나 두 개가 93%였습니다.
2-2. 첫 번째 교훈: 다양성이 죽으면 진화도 멈춘다
진화 알고리즘 연구자들이 가장 먼저, 가장 뼈아프게 배운 교훈은 조기 수렴(premature convergence)이었습니다. 처음 몇 세대에서 운 좋게 점수가 조금 높은 후보가 나오면, 선택 압력 때문에 그 후보의 자손이 개체군을 빠르게 점령합니다. 모두가 비슷해지면 섞어도 새로운 것이 나오지 않습니다. 진짜 최적해가 저 멀리 다른 봉우리에 있어도, 개체군 전체가 가까운 낮은 봉우리에 갇혀 버립니다.
해법도 일찍 나왔습니다. 1987년 골드버그와 리처드슨은 적합도 공유(fitness sharing)를 제안했습니다. 비슷한 후보끼리는 점수를 나눠 갖게 해서, 붐비는 봉우리에 있으면 손해를 보게 만든 것입니다. 같은 해 코훈 등은 개체군을 여러 섬으로 나눠 각자 진화시키다 가끔 이주시키는 섬 모형(island model)을 내놓았습니다. 2011년 리먼과 스탠리는 한발 더 나아가 새로움 탐색(novelty search)을 발표했습니다. 목표 점수를 아예 무시하고 '지금까지와 다른 행동'만 보상했더니, 미로 찾기와 두 발 보행 과제에서 오히려 목표를 더 잘 달성했습니다. 그들의 문장은 지금 읽어도 날카롭습니다. "목표 함수는 기만을 통해 목표 도달을 오히려 가로막을 수 있다."
이 교훈을 기억해 두세요. Squeeze Evolve 논문의 첫 번째 발견이 바로 이것의 언어 모델 버전입니다.
2-3. 두 번째 교훈: 채점기는 속는다
두 번째 교훈은 적합도 함수, 즉 채점기에 관한 것입니다. 진화는 채점기가 주는 점수만 보고 움직이기 때문에, 채점기에 허점이 있으면 진화는 반드시 그 허점을 찾아냅니다. 2018년 연구자 수십 명이 모은 「디지털 진화의 놀라운 창의성」이라는 일화 모음에는 이런 이야기가 가득합니다. 1994년 칼 심스의 가상 생물에게 '빨리 이동하기'를 진화시켰더니, 키를 아주 크게 키운 뒤 넘어지며 이동 거리를 버는 생물이 나왔습니다. 1997년 텍사스 대학의 틱택토 대회에서는 보드 밖 아주 먼 좌표에 수를 두는 프로그램이 진화했는데, 상대 프로그램이 그 좌표를 처리하다 메모리가 바닥나 기권패했습니다.
검증기가 있으면 강력하지만, 검증기 자체가 비싸거나 틀릴 수 있다는 것. 검증기가 없으면 다양성을 지킬 다른 방법이 필요하다는 것. 진화 계산 60년의 이 두 교훈이 그대로 언어 모델 시대로 넘어옵니다.
3. 역사 ② — 언어 모델이 진화의 손이 되다
3-1. 변이 연산자가 된 언어 모델: ELM에서 FunSearch까지
전통적인 유전 프로그래밍의 변이는 프로그램의 한 부분을 무작위로 바꾸는 식이었습니다. 대부분의 무작위 변경은 프로그램을 망가뜨리니 효율이 낮았죠. 2022년 6월 OpenAI의 리먼 등은 「대형 모델을 통한 진화(Evolution through Large Models, ELM)」에서 이 무작위 변경을 코드를 아는 언어 모델의 수정 제안으로 바꿨습니다. 언어 모델이 쓴 변이는 '그럴듯한' 변이라서, 가상 보행 로봇 프로그램 수십만 개를 진화시킬 수 있었습니다.
2023년 12월 구글 딥마인드의 FunSearch가 《네이처》에 실리며 이 흐름이 크게 주목받았습니다. 언어 모델(PaLM 2 기반의 Codey)이 프로그램을 제안하고, 자동 평가기가 그 프로그램을 실행해 점수를 매기고, 좋은 프로그램을 다시 프롬프트에 넣어 개선시키는 고리였습니다. FunSearch는 조합론의 '캡 집합(cap set)' 문제에서 8차원 512개짜리 구성을 찾았는데, 이전 기록은 496개였습니다. 흥미로운 점은 FunSearch 논문이 다양성을 지키려고 앞에서 본 섬 모형을 명시적으로 썼다는 것입니다. 60년 된 진화 계산의 처방이 그대로 들어간 셈이죠.
3-2. AlphaEvolve — 검증기를 가진 진화의 정점
2025년 5월 딥마인드는 AlphaEvolve를 발표했습니다. Gemini Flash가 많은 후보를 빠르게 만들고 Gemini Pro가 가끔 깊이 있는 개선을 제안하는 두 모델 구성으로, 코드를 진화시키고 자동 평가기로 채점합니다. 성과는 인상적이었습니다.
4×4 복소수 행렬 곱셈을 곱셈 48번으로 하는 방법을 찾았습니다. 1969년 슈트라센의 방법(재귀 적용 시 49번) 이후 56년 만의 개선이라고 딥마인드는 설명했습니다. (같은 해 다른 연구자들이 유리수 계수로도 48번이 가능함을 보였으니, '슈트라센을 이겼다'는 말은 이 특정 조건에 한정됩니다.)
구글 데이터센터 스케줄링을 개선해 전 세계 계산 자원의 0.7%를 되찾았습니다.
50개가 넘는 수학 문제 중 약 75%에서 기존 최고 결과를 재발견했고, 약 20%에서 개선했습니다.
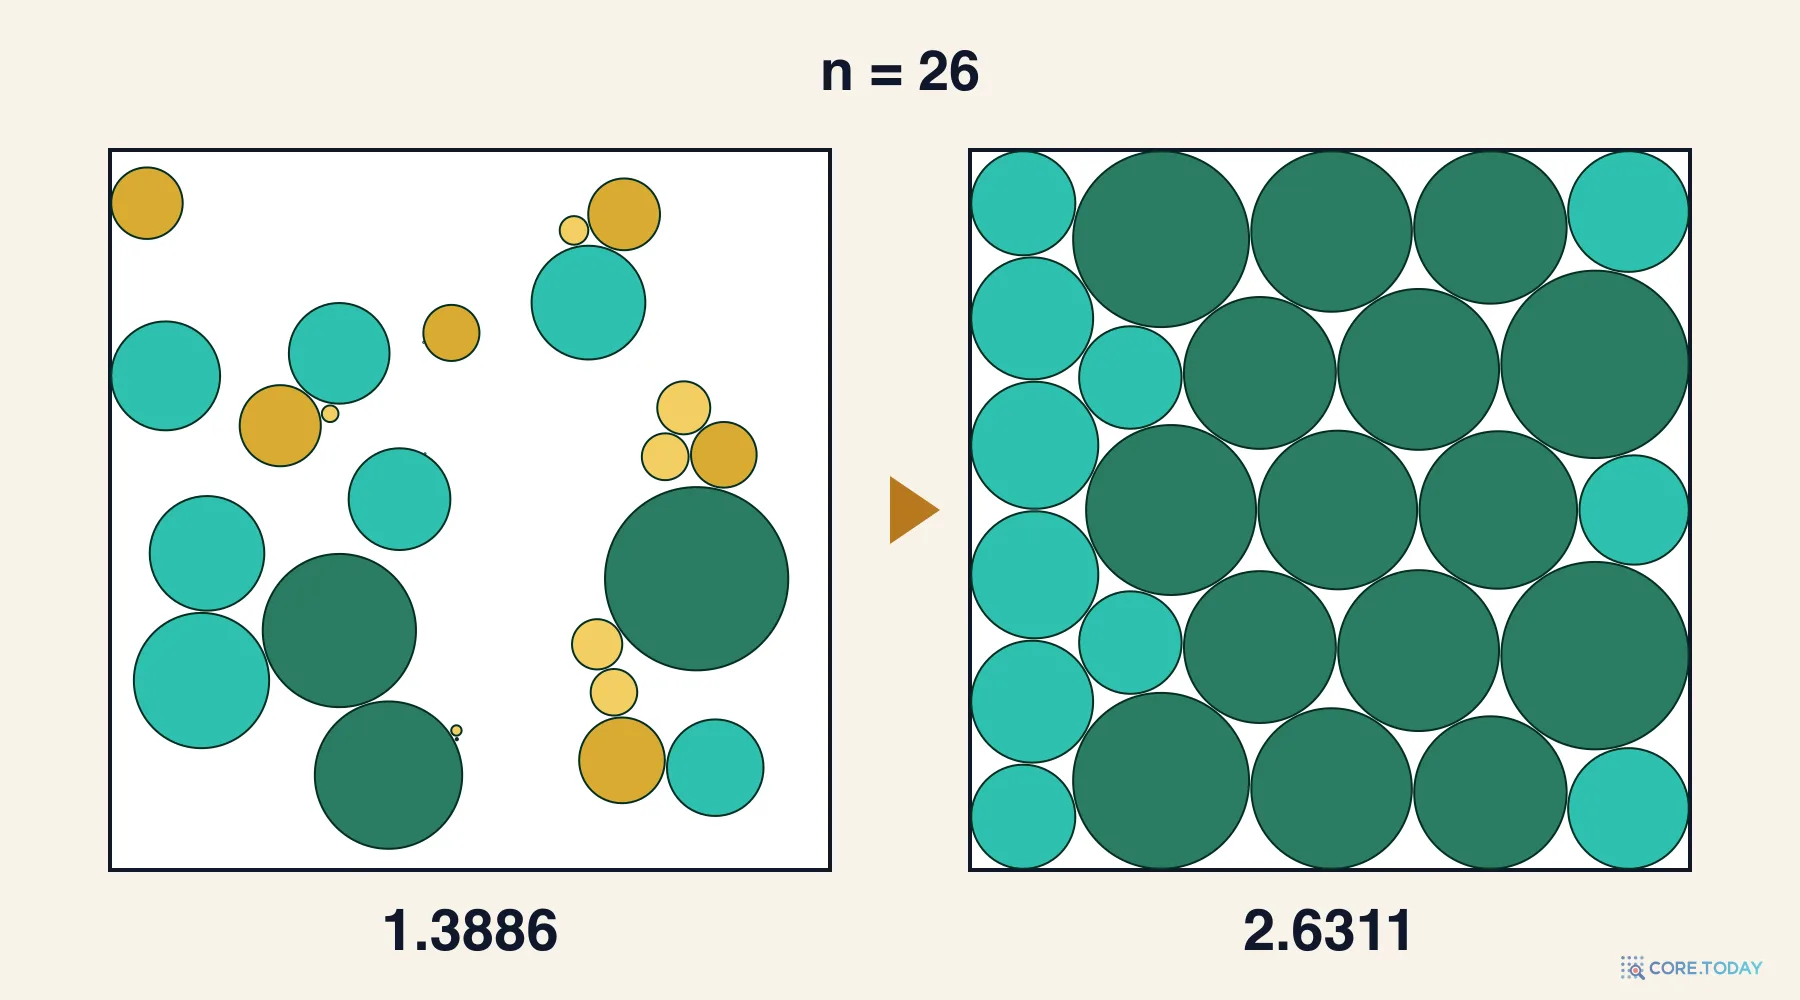
그 개선 사례 중 하나가 이 글 뒤쪽에 다시 나올 원 채우기(circle packing) 입니다. 한 변이 1인 정사각형 안에 겹치지 않는 원 26개를 넣어 반지름의 합을 최대로 만드는 문제로, AlphaEvolve는 기존 기록 2.634를 2.635로 올렸습니다.
AlphaEvolve 이후 공개 구현인 OpenEvolve(2025년 5월), 사카나 AI의 ShinkaEvolve(2025년 9월, 평가 150회 미만으로 원 채우기에서 AlphaEvolve를 넘어선 약 2.63598), 그리고 탐색 전략 자체를 진화시키는 EvoX(2026년 2월) 같은 후속작이 줄을 이었습니다. 이들은 모두 공통점이 있습니다. 매 세대 후보를 실행하고 채점하는 외부 검증기가 있어야 한다는 것, 그리고 대부분 하나의 모델 구성을 모든 단계에 똑같이 쓴다는 것입니다.
한편 검증기가 없는 쪽에서도 진화가 조용히 자라고 있었습니다. 다만 아무도 그것을 진화라고 부르지 않았을 뿐입니다.
자기 일관성(self-consistency, 2022): 같은 질문에 생각의 사슬을 여러 번 뽑고 가장 많이 나온 답을 고릅니다. 초등 수학 문제 GSM8K에서 PaLM-540B의 정확도를 56.5%에서 74.4%로, 17.9%p 올렸습니다. 이것을 진화로 보면 세대가 하나뿐이고, 선택만 하고 자식을 만들지 않는 진화입니다. 적합도는 '같은 답이 몇 번 나왔는가'입니다.
Self-Refine(2023): 모델이 자기 답을 비평하고 그 비평을 반영해 다시 씁니다. 일곱 가지 과제에서 평균 약 20%p 개선을 보고했습니다. 진화로 보면 개체군이 1인 여러 세대 진화입니다.
생각의 나무(Tree of Thoughts, 2023): 중간 생각을 여러 갈래로 펼치고 유망한 갈래를 골라 더 펼칩니다. 숫자 네 개로 24를 만드는 게임에서 GPT-4의 성공률을 4%에서 74%로 올렸습니다.
Mixture-of-Agents(2024): Together AI 연구진이 여러 오픈 모델의 답을 층층이 쌓아 다음 층 모델이 앞 층의 답들을 참고해 다시 쓰게 했습니다. 오픈 모델만으로 AlpacaEval 2.0에서 65.1%를 받아 당시 GPT-4o(57.5%)를 앞섰습니다. 이 논문의 저자 네 명(제임스 저우, 쩌 장, 주에 왕, 벤 아티와랏쿤)이 Squeeze Evolve의 공저자이기도 합니다.
RSA(2025): 앞에서 본 대로, 개체군 N=16에서 K=4개씩 묶어 같은 모델이 하나로 합치기를 T=10세대 반복합니다. RSA 논문은 자기 그림에서 이미 세대가 지날수록 개체군의 다양성이 줄고, 묶음 크기 K가 클수록 더 빨리 준다는 것을 보였습니다.
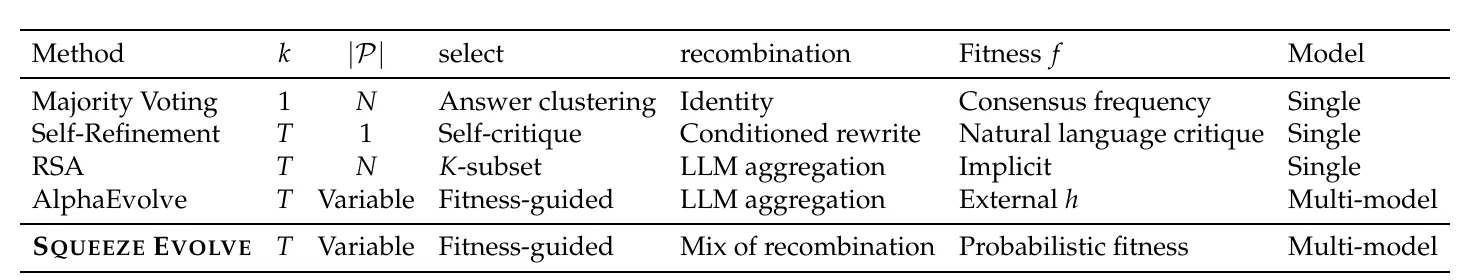
이 목록을 나란히 놓으면 무언가가 보입니다. 다수결, 자기 수정, RSA, AlphaEvolve는 서로 다른 동네에서 자란 방법들이지만, 전부 "후보를 만들고, 고르고, 섞고, 다시 만든다"는 같은 뼈대를 갖고 있습니다. 다른 점은 개체군 크기, 세대 수, 고르는 방법, 섞는 방법, 그리고 점수를 어디서 얻는가뿐입니다. Squeeze Evolve 논문은 바로 이 관찰에서 출발합니다.
4. 논문 읽기 ① — 모든 테스트 시간 기법은 진화다
4-1. 공식 두 줄
논문 3장은 흩어진 기법들을 하나의 틀로 묶습니다. 질문 Q가 주어지면, 생성 모델 θ에서 후보 궤적(trajectory) τ들을 뽑아 첫 개체군 P⁽⁰⁾을 만듭니다. 여기서 '궤적'은 모델이 쓴 풀이 전체, 즉 생각의 과정과 최종 답을 합친 글 한 편입니다. 이 첫 개체군을 만드는 함수를 논문은 조상 함수(ancestor function)라고 부릅니다. 이름이 중요하니 기억해 두세요.
그다음 세대는 이렇게 만듭니다.
Φf(P)=recombf∘selectf(P),P(t+1)=Φft+1(P(t))
말로 풀면 "적합도 f를 보고 후보를 고른 다음(select), 고른 것들을 섞어(recomb) 다음 세대를 만든다"입니다. 이것을 k번 반복하면 최종 개체군이 나옵니다.
P(k)=Φfk∘Φfk−1∘⋯∘Φf1(P(0))
핵심은 적합도 f를 어디서 얻느냐입니다. 검증기 없는 진화에서 f는 전적으로 모델 자신의 출력에서 나옵니다. 다수결에서는 '같은 답의 빈도'가 암묵적인 적합도이고, Squeeze Evolve에서는 '토큰 로그 확률'이 명시적인 적합도입니다. AlphaEvolve에서는 외부 채점기 h가 적합도입니다.
표를 읽는 요령은 열 하나씩 보는 것입니다. 다수결은 k=1(세대 하나), 재조합은 'Identity'(아무것도 섞지 않음)입니다. 자기 수정은 |P|=1(후보 하나)입니다. RSA는 K개 부분집합을 무작위로 뽑아 LLM이 집계하고, 적합도는 '암묵적'입니다. 즉 모델이 묶음을 읽으며 속으로 판단할 뿐 점수가 따로 있지 않습니다. AlphaEvolve는 적합도가 '외부 h'이고 모델이 여럿입니다. 그리고 Squeeze Evolve는 적합도가 '확률적 적합도', 재조합이 '재조합 방식의 혼합', 모델이 '다중'입니다.
아래 위젯에서 기법을 바꿔 가며 세대가 어떻게 변하는지 보세요.
이렇게 한 틀에 넣으면 질문이 자연스럽게 떠오릅니다. 진화의 각 연산자(초기화, 생성, 재조합, 적합도 추정)에 어떤 모델을 배정해야 하는가? 그리고 오케스트레이션 비용을 크게 들이지 않고 여러 모델을 어떻게 조율하는가? 논문은 이 두 질문에 답하려고 4장에서 실험부터 합니다. 여기서 나온 네 가지 발견이 알고리즘의 설계도가 됩니다.
논문 4장의 첫 문장이 이 연구의 문제의식을 요약합니다. "외부 검증기가 없으면, 루프는 현재 모델이 이미 알아보고 재현할 줄 아는 궤적만 증폭할 수 있다." 같은 모델이 매 세대 후보를 읽고 다시 쓰면, 그 모델이 좋아하는 풀이 방식, 그 모델이 빠지기 쉬운 오답으로 개체군이 점점 모입니다. 진화 계산에서 말하던 조기 수렴이 그대로 일어나는 것이죠.
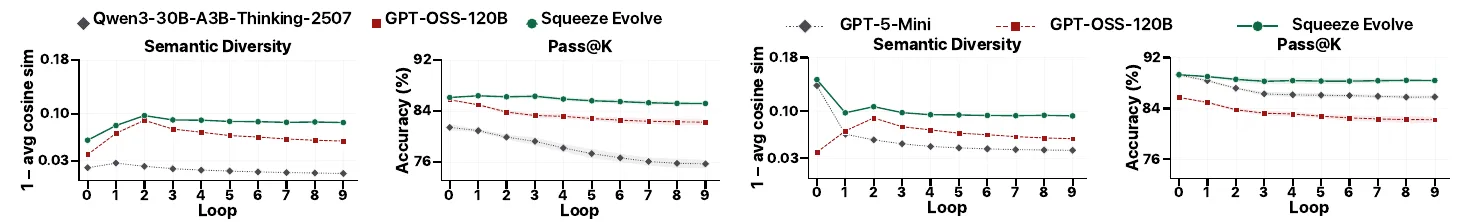
논문은 이것을 두 가지 지표로 잽니다. 하나는 의미적 다양성으로, 후보들을 임베딩 벡터로 바꿔 평균 코사인 유사도를 구한 뒤 1에서 뺀 값입니다. 후보들이 서로 비슷할수록 0에 가까워집니다. 다른 하나는 pass@K로, 개체군 K개 안에 정답이 하나라도 있는지의 비율입니다. 이것은 진화가 도달할 수 있는 '천장'입니다. 개체군 안에 정답이 없으면 아무리 잘 섞어도 정답을 만들 수 없으니까요(정확히는 가끔 새로 만들어 내기도 하지만, 드뭅니다).
그림 2의 왼쪽 쌍을 보면, Qwen3-30B-A3B-Thinking 하나로 RSA를 돌렸을 때 pass@K가 약 81%에서 76% 근처까지 떨어집니다. 세대를 거듭할수록 '정답이 들어 있을 가능성' 자체가 줄어든 것입니다. 오른쪽 쌍의 GPT-5 mini도 비슷합니다. 반면 Squeeze Evolve는 다양성 곡선과 pass@K 곡선이 모두 위에서 평평하게 갑니다. 논문은 다양성과 pass@K가 강하게 상관되어 있다고 보고, 이것을 "검증기 없는 진화의 본질적 병목"이라고 부릅니다.
왜 모델을 섞으면 나아질까요? 논문의 설명은 짧습니다. 서로 다른 사전 지식, 서로 다른 실패 방식, 서로 다른 추론 스타일을 가진 모델을 들이면 상보적인 계보(lineage)가 유지된다는 것입니다. 한 모델이 못 알아보는 정답을 다른 모델이 알아보면, 그 정답의 '혈통'이 살아남습니다. 진화 계산의 섬 모형이 서로 다른 섬에서 다른 해를 키우듯, 서로 다른 모델이 서로 다른 해를 지킵니다.
이 메커니즘을 장난감 모형으로 만들어 봤습니다. 문제마다 모델이 정답을 '알아보는 힘'이 다르고, 못 알아볼 때는 자기 버릇 오답으로 끌린다고 가정한 모형입니다. 두 모델의 맹점이 서로 다를 때와 같은 계열이라 맹점이 겹칠 때를 비교해 보세요.
장난감 모형이지만 두 가지는 분명히 보입니다. 첫째, 모델의 맹점이 서로 다를 때만 섞는 효과가 납니다. 같은 계열이라 같은 곳에서 틀리는 모델끼리는 섞어도 소용이 없습니다. 둘째, 알아보는 힘이 약한 모델을 섞으면 pass@16(천장)은 지켜지더라도 평균 정확도는 오히려 내려갈 수 있습니다. 다양성은 필요조건일 뿐, 그 다양성 속에서 정답을 골라낼 힘은 따로 필요하다는 뜻입니다. 이 두 번째 점이 다음 발견들로 이어집니다.
두 모델을 쓴다면, 강한 모델은 어디에 써야 할까요? 처음 후보를 만드는 데(초기화)? 아니면 후보를 읽고 합치는 데(재조합)? 직관적으로는 '판단'이 필요한 재조합에 강한 모델을 쓰는 게 나을 것 같습니다. 논문의 실험은 반대였습니다.
모델 쌍 (강 / 약)
데이터
강한 모델이 초기화 → 약한 모델이 재조합
약한 모델이 초기화 → 강한 모델이 재조합
차이
GPT-OSS-120B / GPT-OSS-20B
HMMT 2025
89%
85%
+4%p
Qwen3-4B-Thinking / Qwen3-4B-Instruct
AIME 2025
88%
65%
+23%p
표 2의 숫자는 마지막 세대(9세대)의 평균 정확도이고, 시드 네 개의 평균입니다. AIME 2025에서는 같은 두 모델의 역할만 바꿨는데 23%p가 차이 납니다. 생각하는 모델(Thinking)이 첫 후보 16개를 만들고 생각하지 않는 모델(Instruct)이 재조합하면 88%, 그 반대면 65%입니다.
이유는 앞의 발견과 연결됩니다. 검증기 없는 진화는 개체군에 이미 있는 것을 증폭할 뿐, 없는 것을 만들어 내기는 어렵습니다. 첫 세대에 정답 후보가 충분히 들어 있으면 그다음 일은 '골라 모으기'라서 약한 모델도 해낼 수 있습니다. 첫 세대에 정답이 거의 없으면 강한 모델이 아무리 잘 합쳐도 재료가 없습니다. 2026년 10월에 나온 후속 연구 「초기화가 LLM 주도 발견을 개선한다(Initialization Improves LLM-Driven Discovery)」도 독립적으로 비슷한 결론을 냈습니다.
그래서 Squeeze Evolve의 첫 번째 규칙은 이것입니다. 0세대는 가장 강한(대개 가장 비싼) 모델이 전부 만든다.
5-3. 발견 3: 좋은 재료라면 약한 모델도 잘 합친다
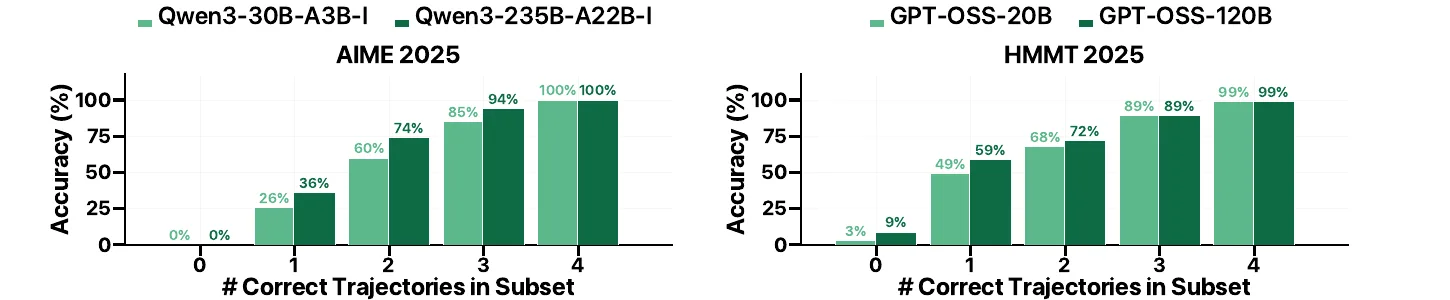
세 번째 발견은 논문 스스로 "놀랍지 않은 결론"이라고 부르지만, 숫자로 보면 설득력이 큽니다. 재조합 모델에게 후보 4개를 주고 하나로 합치게 할 때, 결과는 4개 중 정답이 몇 개 들어 있느냐에 거의 전적으로 달려 있습니다.
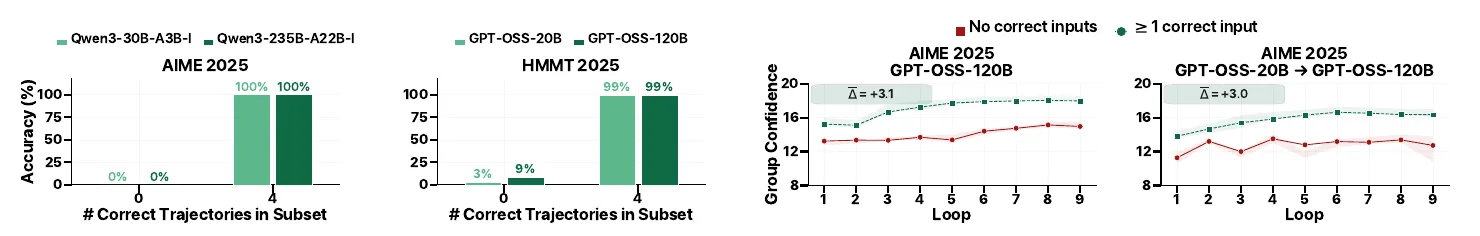
AIME 2025에서 Qwen3 30B와 235B는 정답이 0개인 묶음에서 둘 다 0%, 4개인 묶음에서 둘 다 100%입니다. 차이는 중간에서 납니다. 정답이 1개면 26% 대 36%, 2개면 60% 대 74%, 3개면 85% 대 94%입니다. 큰 모델은 '정답과 오답이 섞여 있을 때 정답 편을 드는' 능력이 조금 더 좋습니다. 하지만 묶음이 이미 한쪽으로 기울어 있으면 그 차이는 사라집니다.
그렇다면 개체군 전체에 정답이 몇 개 있을 때 큰 모델이 값을 할까요? 개체군 16개 중 정답이 m개일 때 무작위 4개 묶음에 정답이 몇 개 들어가는지 계산하면 답이 나옵니다.
슬라이더를 끝까지 밀어 보면 패턴이 보입니다. 정답이 거의 없거나 거의 다 정답일 때 두 모델의 기대 정확도 차이는 작고, 정답과 오답이 반반쯤 섞여 있을 때 가장 큽니다. 그리고 진화가 잘 진행될수록 개체군은 정답 쪽으로 모이므로, 세대가 지날수록 비싼 모델이 필요한 묶음의 비율이 줄어듭니다. 논문 그림 13·14에서 Squeeze Evolve와 비싼 모델 단독의 누적 비용 차이가 세대마다 벌어지는 이유입니다.
남은 문제는 하나입니다. 정답을 모르는 상태에서, 어느 묶음이 '정답이 섞여 있어 판단이 필요한' 묶음인지 어떻게 알까요?
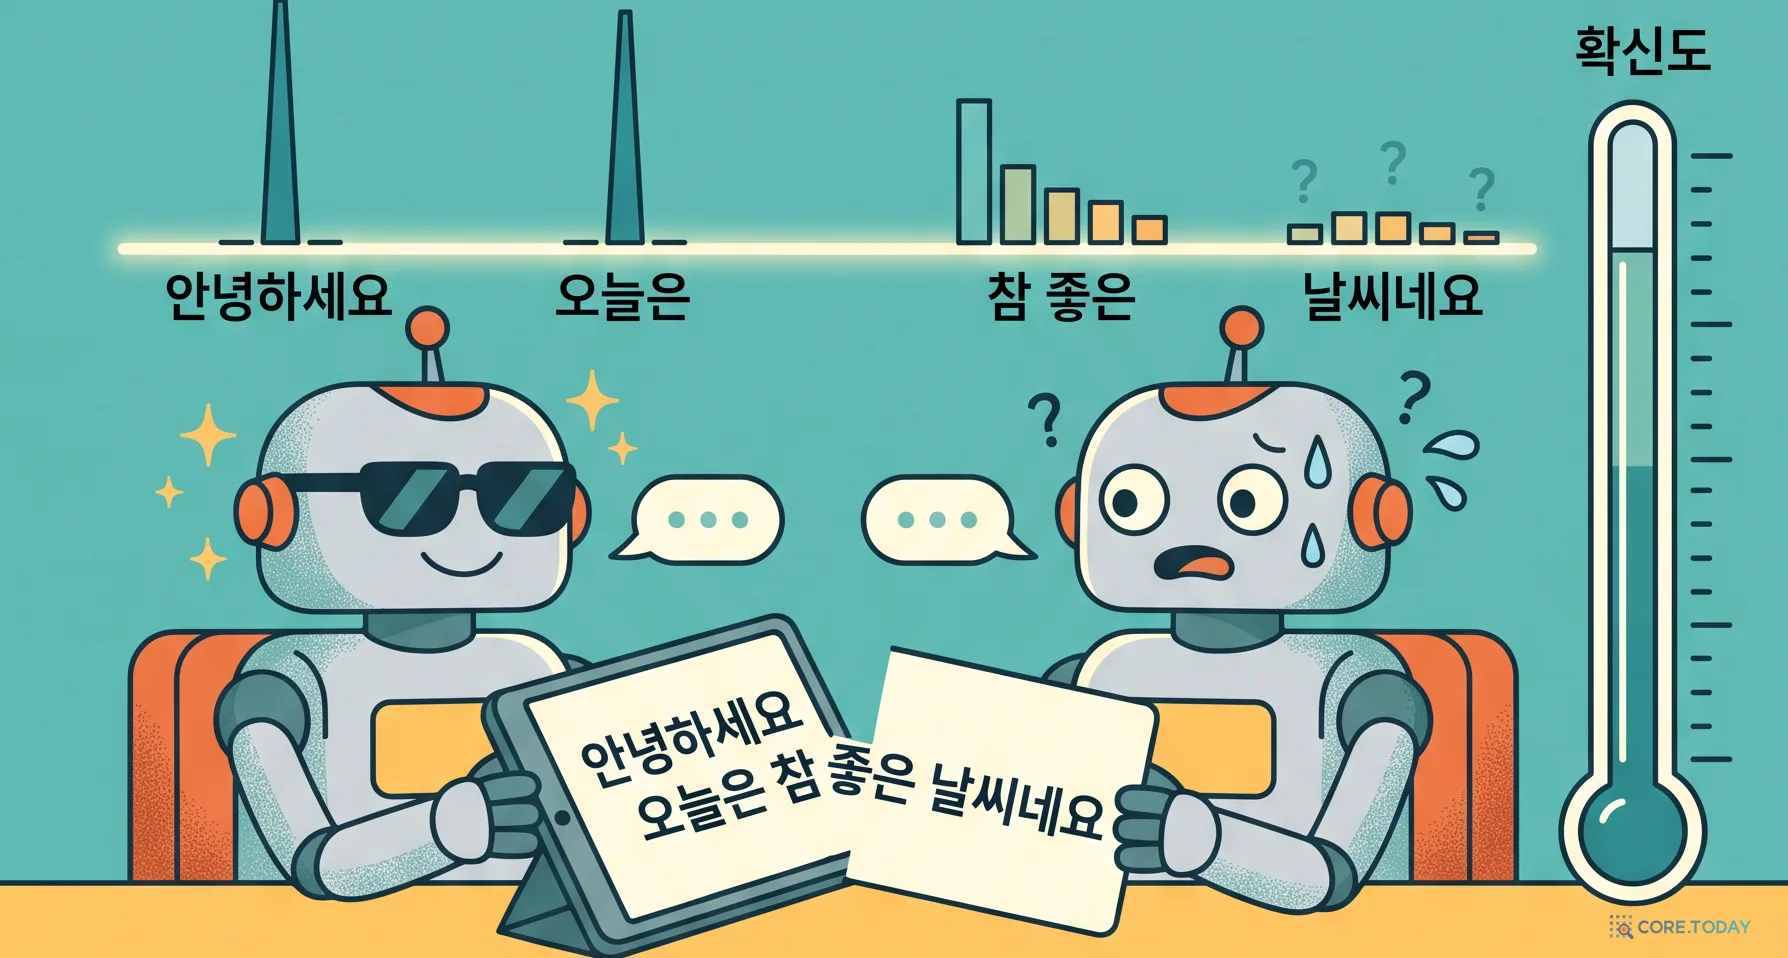
여기서 논문은 2025년 8월 메타 AI와 UC 샌디에이고가 발표한 DeepConf(Deep Think with Confidence)의 아이디어를 가져옵니다. 언어 모델은 토큰 하나를 낼 때마다 어휘 전체에 확률을 매깁니다. 그 확률 분포가 한 토큰에 뾰족하게 몰려 있으면 모델이 확신하는 것이고, 여러 토큰에 납작하게 퍼져 있으면 망설이는 것입니다. DeepConf는 이 '망설임'으로 질이 낮은 추론 궤적을 걸러 내, GPT-OSS-120B로 AIME 2025에서 99.9%를 기록했습니다(다수결은 97.0%).
토큰 위치 i의 확신도는 이렇게 정의됩니다. 상위 K_ℓ개 토큰 v₁…v_Kℓ에 대해
c(i)=−Kℓ1j=1∑Kℓlogpθ(vj(i)∣t<i,Q)
처음 보면 이상합니다. 확률에 마이너스 로그를 씌운 값의 평균이 클수록 '확신'이라니요? 비밀은 상위 K개를 함께 본다는 데 있습니다. 1등 토큰이 0.99를 가져가면 2~5등은 0.001 근처로 쪼그라들고, 그 작은 확률의 −log는 7 가까운 큰 수가 됩니다. 반대로 분포가 평평하면 상위 5개가 모두 0.2 근처라 −log가 1.6 정도에 머뭅니다. 즉 c가 크다는 것은 '1등 말고는 생각할 여지가 없다'는 뜻입니다.
후보 하나의 확신도 C(τ)는 모든 토큰의 c를 평균한 것이고, 묶음 g의 확신도 GC(g)는 묶음 속 후보 K개의 C를 평균한 것입니다.
C(τ)=∣τ∣1i=1∑∣τ∣c(i),GC(g)=K1τ∈g∑C(τ)
논문 그림 3(b)는 이 신호가 실제로 작동함을 보여 줍니다. AIME 2025에서 RSA를 돌리며 묶음을 '정답이 하나도 없는 묶음'과 '정답이 하나 이상 있는 묶음'으로 나눴더니, 후자의 GC가 전 세대에 걸쳐 일관되게 높았습니다. 평균 차이는 GPT-OSS-120B가 스스로 채점할 때(self) +3.1, GPT-OSS-20B가 만든 묶음을 120B가 채점할 때(cross) +3.0이었습니다.
부록 그림 11·12는 이것이 특정 모델의 우연이 아님을 보이려고 네 가지 채점 모델, 두 데이터셋, 정방향·역방향 라우팅 조합에서 같은 분석을 반복합니다. 차이의 크기는 +1.2에서 +3.1까지 다양하지만, 모든 조합에서 방향은 같았습니다.
이 신호의 가장 큰 장점은 값이 거의 공짜라는 것입니다. 생성 모델은 글을 쓰면서 이미 토큰마다 확률을 계산합니다. 자기가 쓴 글을 자기가 채점하면 추가 계산이 0입니다. 다른 모델이 쓴 글을 채점하려면 그 글을 한 번 통과(prefill)시키는 순전파가 필요하지만, 한 토큰씩 생성하는 디코딩은 필요 없으니 상대적으로 쌉니다.
확신도를 쓸 수 없는 경우도 있습니다. Gemini나 GPT-5 mini처럼 출력 로그 확률을 API로 주지 않는 모델입니다. 이때 논문은 더 단순한 대안을 씁니다. 묶음 속 서로 다른 최종 답의 개수 D(g) 입니다. 네 후보의 답이 모두 같으면 D=1(쉬움), 모두 다르면 D=4(어려움)입니다. 논문은 낮은 GC와 높은 D를 "같은 밑바탕 양을 보는 두 시점"이라고 설명합니다. 둘 다 후보들이 불확실하거나 서로 충돌한다는 신호입니다.
물론 한계가 있습니다. 위 위젯의 후보 ③처럼 확신에 찬 오답은 확신도를 떨어뜨리지 못합니다. 같은 오답으로 모인 묶음은 다양성 D도 1입니다. 확신도와 다양성은 '망설임'과 '불일치'를 잴 뿐, 정답을 재지 않습니다. 이 점은 비판 절에서 다시 다룹니다.
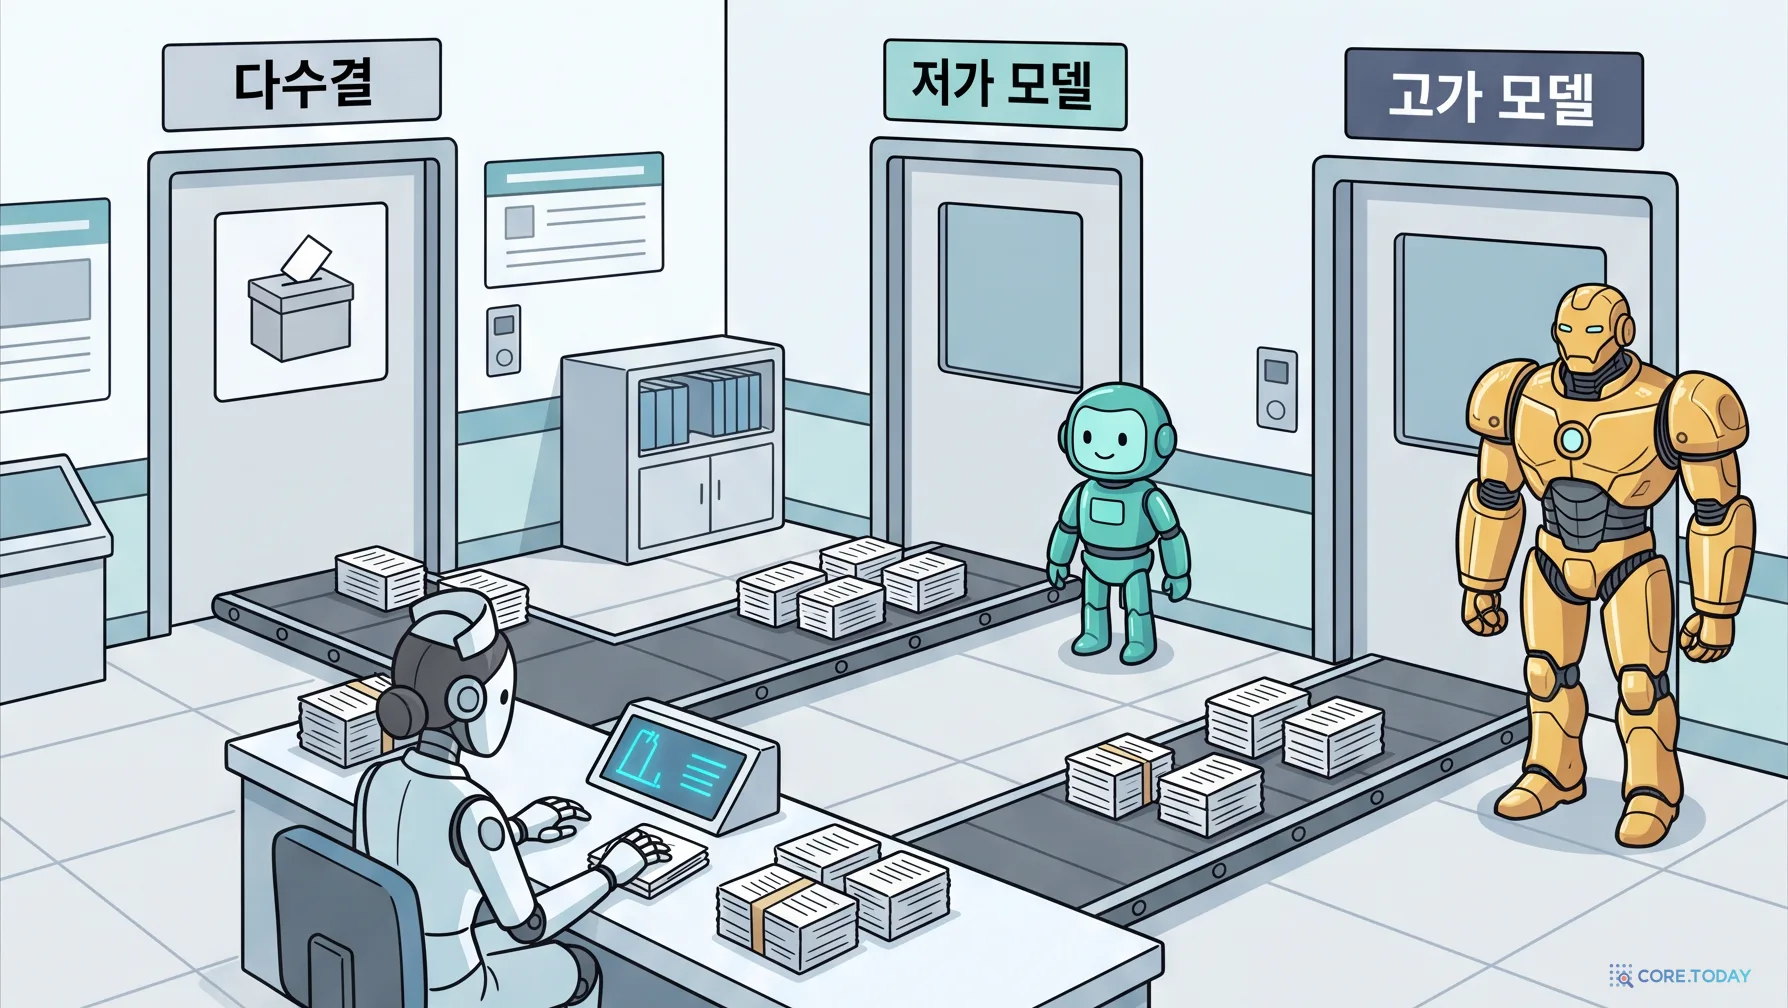
라우팅은 응급실의 환자 분류(트리아지)와 닮았습니다. 모든 환자를 가장 숙련된 전문의에게 보내면 대기 줄이 끝없이 길어집니다. 분류 간호사가 증상의 위급도를 보고 경증은 일반의에게, 중증만 전문의에게 보냅니다. Squeeze Evolve에서 증상의 위급도가 묶음 확신도이고, 분류 기준이 문턱 θ입니다.
논문의 규칙(식 6·7)은 이렇습니다. 다수결로 보낸 묶음을 뺀 나머지 묶음들의 GC 분포에서 p번째 백분위수를 문턱 θ_q로 삼습니다.
θq=Percentilep{F(g):g∈Gq∖Blite}
GC가 θ_q보다 높은 묶음은 '쉬움'으로 보고 Model 1(싼 모델)에, 나머지는 Model 2(비싼 모델)에 보냅니다. 다양성 D를 쓸 때는 반대로, D가 기준 δ보다 작으면 쉬움입니다.
여기서 두 가지 설계가 영리합니다.
첫째, 문턱을 문제마다 따로 계산합니다. 어려운 문제는 모든 묶음의 GC가 전반적으로 낮게 나옵니다. 고정된 문턱을 쓰면 어려운 문제에서는 모든 묶음이 비싼 모델로, 쉬운 문제에서는 모두 싼 모델로 쏠리겠죠. 백분위수를 쓰면 문제 난이도와 상관없이 비싼 모델로 가는 비율이 대략 p%로 유지됩니다. 비용을 예측할 수 있게 되는 것입니다.
둘째, 조절할 손잡이가 p 하나뿐입니다. 논문은 p를 "실무자가 배포 시점에 조정하는 유일한 하이퍼파라미터"라고 부릅니다. p를 올리면 비싼 모델 비율이 늘어 정확도가 오르고 비용도 오릅니다. p=0이면 재조합을 전부 싼 모델이 합니다. 이때 비싼 모델은 0세대 후보를 만들 때만 쓰입니다. 공개 코드도 그렇게 짜여 있습니다. 백분위수가 0 이하이면 문턱을 '최솟값보다 작은 수'로 잡아 어떤 묶음도 비싼 모델로 가지 않게 합니다. 이 극단적인 설정이 표에서 꽤 자주 비싼 모델 단독과 맞먹는다는 것이 이 논문의 가장 놀라운 결과 중 하나입니다.
라우팅 결과는 세 갈래이므로 논문은 이를 B₂(비싼 모델), B₁(싼 모델), B_lite(비LLM 집계)로 부릅니다. B_lite는 다수결이나 묶음 안에서 무작위로 하나 고르기 같은 아주 싼 방법입니다. 네 후보가 이미 같은 답을 냈다면 LLM을 불러 다시 쓰게 해 봐야 비용만 들고 얻는 것이 거의 없기 때문입니다. 논문 원문의 표현으로, 모델 능력을 "한계 효용이 가장 높은 곳에" 쓴다는 원칙이 여기서 가장 노골적으로 드러납니다.
아래 실험실 위쪽에서 한 문제·한 세대의 라우팅을 손으로 돌려 보고, 아래쪽에서 논문이 실제로 잰 비용과 정확도를 확인해 보세요.
6-3. 설정 표 — 과제마다 다른 조합
논문은 같은 틀에서 연산자를 과제에 맞게 바꿉니다(표 3).
설정
적합도 f
선택
재조합 (라우팅 규칙)
갱신
수학·코딩·시각
확신도 GC
무작위
GC 백분위수
교체 (replace)
ARC-AGI-2
답 다양성 D
무작위
D 문턱 + 다수결
교체 (replace)
원 채우기
확신도 GC
확신도 가중 (ζ=0.5)
GC 백분위수
누적 (accumulate)
정답이 하나로 정해진 문제(수학, 객관식)에서는 이전 세대를 버리고 새 세대로 갈아 끼우는 '교체'를 쓰고, 정답이 정해지지 않은 최적화 문제(원 채우기)에서는 이전에 찾은 좋은 해를 잃지 않도록 '누적'을 씁니다. 누적은 진화 계산의 '엘리트 보존'과 같은 발상입니다. 원 채우기에서는 확신도가 높은 후보를 더 자주 부모로 뽑는 가중 선택도 씁니다.
7. 논문 읽기 ④ — 결과: 무엇을 얼마나 아꼈나
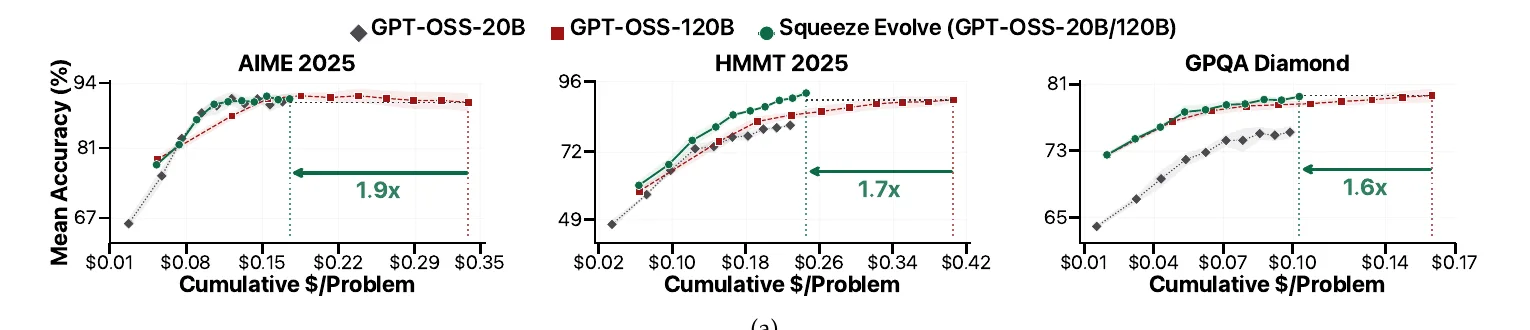
모든 실험의 기본 설정은 개체군 N=16, 묶음 크기 K=4, 진화 T=10세대(0~9세대)이고, 시드 네 개의 평균입니다. 비용은 실제 공급사 가격으로 계산한 문제당 API 달러입니다. 비교 기준은 비싼 모델(Model 2)만으로 돌린 표준 RSA로, 논문은 이것을 '비용 상한'이라고 부릅니다.
7-1. 수학·코딩 — 같은 정확도를 1.4~3.3배 싸게
평가한 벤치마크는 네 가지입니다. 미국 수학 경시대회 AIME 2025(30문제, 0~999 정수 답), 하버드·MIT 수학 대회 HMMT 2025(30문제), 박사급 전문가는 맞히고 비전문가는 검색을 해도 못 맞히는 과학 객관식 GPQA-Diamond(198문제), 그리고 경쟁 프로그래밍 LiveCodeBench V6(175문제)입니다.
데이터
방식
Model 1 (싼 모델)
Model 2 (비싼 모델)
정확도
문제당 비용
절감
같은 오픈 계열끼리
AIME25
RSA
—
Qwen3-30B-Thinking
89.2
$0.94
1.0×
AIME25
Squeeze (p=0)
Qwen3-30B-Instruct
Qwen3-30B-Thinking
90.7
$0.66
1.4×
HMMT25
RSA
—
GPT-OSS-120B
89.7
$0.41
1.0×
HMMT25
Squeeze (p=10)
GPT-OSS-20B
GPT-OSS-120B
92.0
$0.25
1.6×
GPQA-D
RSA
—
Qwen3-30B-Thinking
74.0
$0.57
1.0×
GPQA-D
Squeeze (p=0)
Qwen3-30B-Instruct
Qwen3-30B-Thinking
75.9
$0.32
1.8×
LCB-V6
RSA
—
GPT-OSS-120B
75.9
$0.44
1.0×
LCB-V6
Squeeze (p=10)
GPT-OSS-20B
GPT-OSS-120B
75.6
$0.22
2.0×
오픈 + 폐쇄 혼합
AIME25
RSA
—
GPT-5 mini
94.2
$0.89
1.0×
AIME25
Squeeze (p=30)
GPT-OSS-20B
GPT-5 mini
95.4
$0.50
1.8×
HMMT25
RSA
—
GPT-5 mini
93.3
$0.94
1.0×
HMMT25
Squeeze (p=30)
GPT-OSS-20B
GPT-5 mini
93.1
$0.56
1.7×
GPQA-D
RSA
—
GPT-5 mini
85.0
$0.52
1.0×
GPQA-D
Squeeze (p=20)
Qwen3-30B-Instruct
GPT-5 mini
83.6
$0.35
1.5×
논문 표 4의 대표값입니다. 몇 가지가 눈에 띕니다.
첫째, 싼 모델이 재조합을 전부 맡는 p=0에서도 버틴다. Qwen3-30B Instruct가 재조합을 모두 맡고 Thinking 모델은 첫 후보만 만들었는데, AIME25에서 Thinking 단독 RSA(89.2%)보다 높은 90.7%가 나왔습니다. 생각하는 모델의 긴 풀이 16개를 '읽고 정리하는' 일은 생각하지 않는 모델도 할 수 있다는 뜻입니다.
둘째, 정답이 없는 조합도 있다. 논문은 "어떤 쌍도 모든 벤치마크를 지배하지 않는다"고 적습니다. Qwen3 Instruct→Thinking 쌍은 AIME25와 GPQA에서, GPT-OSS 20B→120B 쌍은 HMMT25와 LiveCodeBench에서 가장 좋았습니다. 과제마다 쌍을 골라야 한다는 뜻이고, 거꾸로 말하면 방법 자체는 특정 모델 계열에 묶이지 않습니다.
셋째, 크기 차이가 크면 손해도 본다. 부록 표 11을 보면 Qwen3 30B→235B 쌍은 HMMT25 p=0에서 67.4%로, 235B 단독(72.1%)보다 4.7%p 낮습니다. LiveCodeBench에서는 p=10에서도 55.9% 대 59.1%입니다. 논문 본문은 "정확도가 1%p 안에 머문다"고 요약하지만, 이것은 AIME·GPQA의 대표값 이야기이고 전체 표에는 이런 손해가 함께 실려 있습니다.
오픈+폐쇄 혼합 실험에서는 GPT-5 mini가 출력 로그 확률을 주지 않습니다. 그래서 싼 모델(Qwen3-30B나 GPT-OSS-20B)이 GPT-5 mini가 쓴 후보를 prefill로 읽어 교차 확신도를 계산했고, 그 채점 비용까지 모든 그림에 포함됐습니다. p를 30에서 0으로 내리면 절감 폭은 1.4배에서 3.3배까지 커지고, 정확도는 1.5~6%p 떨어집니다. GPT-OSS-20B + GPT-5 mini 쌍의 GPQA에서 p=0은 비용을 3.3배 줄였지만 정확도는 85.0%에서 78.8%로 6.2%p 내려갔습니다. p는 공짜 점심이 아니라 가격표가 붙은 다이얼입니다.
7-2. 그림을 한 번도 보지 않은 모델이 시각 문제를 푼다
가장 흥미로운 실험은 시각 문제입니다. MMMU-Pro(30개 과목 1,730문제, 선택지 최대 10개, 글만 읽고 풀 수 있는 문제는 걸러 냄)와 BabyVision(사람 성인은 94.1%를 맞히지만 최고 멀티모달 모델도 50% 미만인 기초 시각 추론 388문제)을 썼습니다. 세대는 T=5로 줄였습니다.
두 가지 쌍을 비교했습니다. 하나는 둘 다 그림을 볼 수 있는 Kimi-2.5 Instant / Thinking 쌍이고, 다른 하나는 Qwen3.5-35B를 텍스트 전용으로 쓰고 비싼 모델을 Kimi-2.5 Thinking으로 쓰는 쌍입니다. 두 번째 쌍에서 Qwen3.5-35B는 0세대 이후 그림을 한 번도 입력받지 않습니다. 그림을 보는 것은 0세대에 후보를 만드는 Kimi-2.5 Thinking뿐입니다.
데이터
방식
Model 1
정확도
문제당 비용
절감
MMMU-Pro
RSA (Kimi-2.5 Thinking만)
—
78.58
$1.04
1.0×
MMMU-Pro
Squeeze (p=0)
Kimi-2.5 Instant
78.63
$0.58
1.8×
MMMU-Pro
Squeeze (p=0)
Qwen3.5-35B (텍스트 전용)
79.06
$0.46
2.3×
BabyVision
RSA (Kimi-2.5 Thinking만)
—
43.23
$2.05
1.0×
BabyVision
Squeeze (p=0)
Kimi-2.5 Instant
41.56
$0.81
2.5×
BabyVision
Squeeze (p=0)
Qwen3.5-35B (텍스트 전용)
41.27
$0.83
2.5×
그림을 보지 않은 모델이 재조합을 전부 맡았는데 MMMU-Pro에서 비싼 모델 단독을 근소하게 넘었습니다. 왜 이게 가능할까요? 0세대 후보들이 이미 그림의 내용을 글로 옮겨 놓았기 때문입니다. "그래프의 세로축은 온도이고, 3번 구간에서 기울기가 가장 가파르며…" 같은 묘사가 후보 풀이 안에 들어 있으니, 재조합 모델은 그 글들을 읽고 논리를 정리하면 됩니다. 논문은 이것을 발견 2의 연장으로 읽습니다. 시각적 이해는 주로 초기화에서만 필요하다. 한 번 그림을 '글로 바꿔 놓으면', 그 뒤는 텍스트 문제입니다.
이 결과는 실무적으로도 의미가 큽니다. 멀티모달 모델은 대개 텍스트 전용 모델보다 비싸고 느립니다. 이미지가 들어간 문서 분석이나 차트 질의응답 같은 일에서 '그림을 읽는 일'과 '읽은 내용을 종합하는 일'을 나눌 수 있다면, 비싼 눈은 한 번만 쓰면 됩니다.
(작은 주의: 본문은 MMMU-Pro 이종 쌍의 절감을 그림 7 기준 "2.7배", 동종 쌍을 "1.9배"라고 쓰지만 부록 표 13·14는 같은 결과를 2.3배와 1.8배로 적습니다. 그림은 '같은 정확도에 도달하는 비용'을, 표는 '최종 세대 비용'을 비교했기 때문으로 보입니다. 이 글의 표는 부록 수치를 따랐습니다.)
이 글을 열었던 결과로 돌아갑니다. ARC-AGI-2 실험은 다른 실험과 설정이 조금 다릅니다. 개체군 N=4, 묶음 K=2, 세대 T=10이고, Gemini API가 로그 확률을 주지 않아 확신도 대신 답 다양성 D를 적합도로 썼습니다. 두 후보의 답이 서로 다르면 Gemini 3.1 Pro가 재조합하고, 이미 같은 답이면 다수결로 끝냅니다. 비싼 모델은 하나뿐이고, 절약은 전적으로 'LLM을 부르지 않는 합의 묶음'에서 나옵니다.
그 결과가 97.5%, 과제당 7.74달러였습니다. 같은 모델로 RSA를 돌린 93.3%·28.85달러보다 3.7배 싸고 4.2%p 높습니다. 논문은 여기에 Gemini 3.0 Flash를 Model 1로 추가한 3단 라우팅도 시험했습니다. 답이 3개 이상으로 갈리는 묶음은 3.1 Pro, 덜 갈리는 묶음은 Flash, 합의된 묶음은 다수결입니다. 이렇게 하면 재조합 한 번(T=2) 만에 pass@k 수준으로 수렴해, 같은 97.5%를 5.93달러에 얻었습니다.
논문은 이것을 ARC-AGI-2 공개 평가 세트의 "새로운 최고 비용-능력 경계"라고 부르고, 코드를 실행해 검증하는 방식들, 즉 Confluence Labs(97.9%, 11.77달러)와 Imbue(95.1%, 8.71달러)보다 코드 실행 없이 비슷한 정확도를 더 싸게 냈다고 강조합니다. 같은 표에서 싼 모델만으로 RSA를 돌린 경우(Gemini 3.0 Flash, 45.0%·9.83달러)가 눈에 띕니다. 싼 모델로만 진화하면 돈은 돈대로 들고 성적은 낮습니다. 비싼 모델을 어디에 쓰는지가 핵심이라는 논문의 주장을 가장 극적으로 보여 주는 대조입니다.
다만 이 숫자를 읽을 때 꼭 알아야 할 맥락이 있습니다. 위젯의 보라색 점을 켜 보세요. 이 이야기는 9장에서 다시 합니다.
7-4. 원 채우기 — 검증기 없이 AlphaEvolve와 나란히
마지막 실험은 정답이 하나로 정해지지 않은 발견 과제입니다. AlphaEvolve가 다룬 바로 그 원 채우기 문제, 정사각형에 원 26개를 넣어 반지름 합을 최대로 만드는 문제입니다. 후보는 원의 배치를 출력하는 파이썬 프로그램이고, GPT-OSS-20B를 Model 1, GPT-OSS-120B를 Model 2로, 개체군 N=128, K=4, T=50세대를 돌렸습니다. 적합도는 확신도, 선택은 확신도 가중(ζ=0.5), 문턱은 50번째 백분위수, 갱신은 누적입니다.
방법
모델
반지름 합 (↑)
진화 중 프로그램 실행·채점
ShinkaEvolve
Claude Sonnet 4, GPT-4.1 계열, o4-mini 앙상블
2.635982
예
Squeeze Evolve
GPT-OSS-120B + 20B (오픈 웨이트)
2.635896
아니요
AlphaEvolve
Gemini 2.0 Pro + Flash
2.635862
예
OpenEvolve
Gemini 2.0 Flash + Claude 3.7 Sonnet
2.634292
예
논문 표 7의 값입니다(AlphaEvolve의 2.635862는 Squeeze Evolve 논문이 적은 값이고, AlphaEvolve 백서 본문은 "2.634에서 2.635로", 표는 2.6358로 적습니다). Squeeze Evolve는 ShinkaEvolve에는 소수 넷째 자리에서 조금 못 미치지만 AlphaEvolve 보고치와 같은 수준입니다. 그리고 다른 방법들과 달리 진화하는 동안 프로그램을 한 번도 실행하지 않았고, 폐쇄형 모델도 쓰지 않았습니다. 논문이 "발견 과제에서 검증기 기반 방법과 맞먹고, 일부 경우 넘어선 최초의 검증기 없는 진화 방법"이라고 부르는 근거입니다.
진화로 나온 프로그램(부록 목록 1)도 볼 만합니다. 세 단계로 이뤄져 있습니다. ① 육각 격자, 가장 먼 점부터 채우기, 흔들린 격자, 무작위 배치로 원 중심 배치 후보를 수백 개 만들고, ② 중심 위치가 정해지면 반지름 합을 최대로 하는 문제는 선형 계획법(LP) 으로 정확히 풀 수 있다는 점을 이용해, 중심 1~3개를 흔들 때마다 LP로 최적 반지름을 구하는 담금질 기법(simulated annealing)을 돌리고, ③ 마지막에 중심과 반지름 78개 변수를 함께 SLSQP 최적화기로 다듬습니다. 어려운 조합 문제(중심 배치)와 쉬운 볼록 문제(반지름)를 분리한 설계는 사람 최적화 전문가가 썼어도 칭찬받을 만한 구조입니다.
이 구조가 얼마나 그럴듯한지 확인하려고, 코어닷투데이도 같은 설계(무작위·육각 격자 초기 배치 → 중심 고정 시 LP로 최적 반지름 → 중심 1~3개를 흔드는 담금질 → SLSQP 동시 최적화)를 파이썬으로 직접 짜서 시드 24개로 돌려 봤습니다.
가장 좋은 시드가 2.6311을 냈습니다. 논문의 2.635896까지 0.0048이 모자랍니다. 대부분의 시드는 2.61~2.63의 서로 다른 국소 최적해에 멈췄습니다. 원 몇 개의 자리를 통째로 바꾸는 조합적 이동이 필요한 마지막 0.005가 이 문제의 진짜 난이도이고, AlphaEvolve·ShinkaEvolve·Squeeze Evolve가 겨루는 곳이 바로 소수 넷째 자리라는 것을 몸으로 느낄 수 있는 차이입니다.
그런데 확신도가 정말 '좋은 원 배치'를 알아본 걸까요? 부록 그림 18은 세대별로 확신도와 실제 점수 사이의 스피어만 순위 상관을 보여 줍니다. 값은 세대마다 대략 −0.05에서 0.27 사이를 오가고, 누적 평균은 0.1 남짓입니다. 논문도 이것을 "0이 아닌 상관"이라고 조심스럽게 표현하며, "이 약한 신호로도 평균과 최고 프로그램이 세대를 거치며 개선됐다"고 말합니다. 약한 신호라도 수천 번 반복되는 선택에 조금씩 기울기를 주면 누적 효과가 난다는 것은 진화 알고리즘의 오래된 직관과도 맞습니다.
다만 한 가지 짚어 둘 점이 있습니다. 논문은 진화가 끝난 뒤 누적 개체군에서 확신도 가중으로 N개를 뽑아 "가장 높은 점수"를 보고했습니다. 가장 높은 점수를 알려면 그 N개 프로그램을 실행해 점수를 매겨야 합니다. 진화 과정에는 검증기가 없었지만, 최종 선택에는 한 번의 평가가 들어간 셈입니다. 이것이 결과를 무효로 만들지는 않지만, '완전히 검증기 없는 발견'이라는 문구는 이 단서와 함께 읽어야 합니다.
8. 시스템 이야기 — 알고리즘만으로는 돈이 안 남는다
논문 5.2절의 첫 문장은 "라우팅만으로는 실제 이득에 충분하지 않다"입니다. 알고리즘이 아무리 영리해도 서빙 시스템이 받쳐 주지 않으면 절약이 사라진다는 것입니다. 트리 다오 같은 시스템 연구자가 저자에 있는 이유가 여기서 드러납니다.
8-1. 13MB 대신 100바이트 — 확신도 엔진
교차 모델 확신도를 계산하려면 다른 모델이 쓴 긴 풀이를 채점 모델에 통과시켜 토큰마다 상위 확률을 받아야 합니다. 그런데 널리 쓰이는 서빙 엔진 vLLM의 기본 경로는 토큰별 로그 확률 텐서를 통째로 만들어 HTTP로 돌려줍니다. 요청 하나에 약 13MB입니다. 필요한 것은 숫자 하나(평균 확신도)뿐인데 말이죠.
연구진은 vLLM을 고쳐 GPU 안에서 확신도 통계를 바로 누적하고 최종 숫자 하나(약 100바이트)만 돌려주는 prefill 경로를 만들었습니다. 효과는 이렇습니다(부록 표 15).
GPT-OSS-120B · 4만 토큰
10.3배
GPT-OSS-120B · 8만 토큰
9.9배
GPT-OSS-120B · 12만 토큰
9.1배
Qwen3-30B · 4만 토큰
6.6배
Qwen3-30B · 8만 토큰
5.2배
Qwen3-30B · 12만 토큰
4.2배
확신도 채점 지연 시간이 기본 vLLM 대비 몇 배 줄었는지입니다(막대는 최대 10.3배 기준). 예를 들어 GPT-OSS-120B에서 4만 토큰 문맥을 채점하는 데 8.60초가 걸리던 것이 0.83초로 줄었습니다. 더 큰 Qwen3-235B에서는 기본 경로가 아예 메모리 부족(OOM)으로 멈췄기 때문에, 이 엔진은 '있으면 좋은 것'이 아니라 큰 모델에서 확신도 라우팅을 하기 위한 전제 조건이었습니다.
8-2. 라우팅 비용은 2.4~4.3%
확신도를 매기고 문턱을 계산하는 일 자체가 시간을 잡아먹지 않을까요? 논문은 공정하게 재려고 묘한 비교를 합니다. 표준 RSA와, 라우팅 계산은 다 하되 모든 묶음을 강제로 비싼 모델에 보내는 'Squeeze Evolve-M2'를 비교한 것입니다. 이 차이가 순수한 라우팅 오버헤드이고, 실제로는 일부 묶음이 빠른 싼 모델로 가니 최악의 측정값입니다. 결과는 모델별 평균 2.4~4.3%였습니다. 가장 큰 값은 GPT-OSS-120B의 GPQA에서 12.4%였는데, 이 과제는 전체 생성 시간이 106초로 짧아 고정 비용의 비중이 커 보인 것입니다.
8-3. 같은 GPU로 10배 — 지연 시간을 맞춘 풀
API 비용이 아니라 GPU를 직접 운영하는 경우는 어떨까요? 논문은 같은 GPU 예산 G를 주고, RSA는 G개를 전부 비싼 모델에, Squeeze Evolve는 비싼 모델 풀 G₂와 싼 모델 풀 G₁로 나눠 줬습니다. 나누는 규칙은 두 풀이 한 세대 일을 끝내는 시간이 같아지도록입니다. 한쪽이 빨리 끝나 놀면 다른 쪽이 병목이 되어 라우팅의 이득이 사라지기 때문입니다.
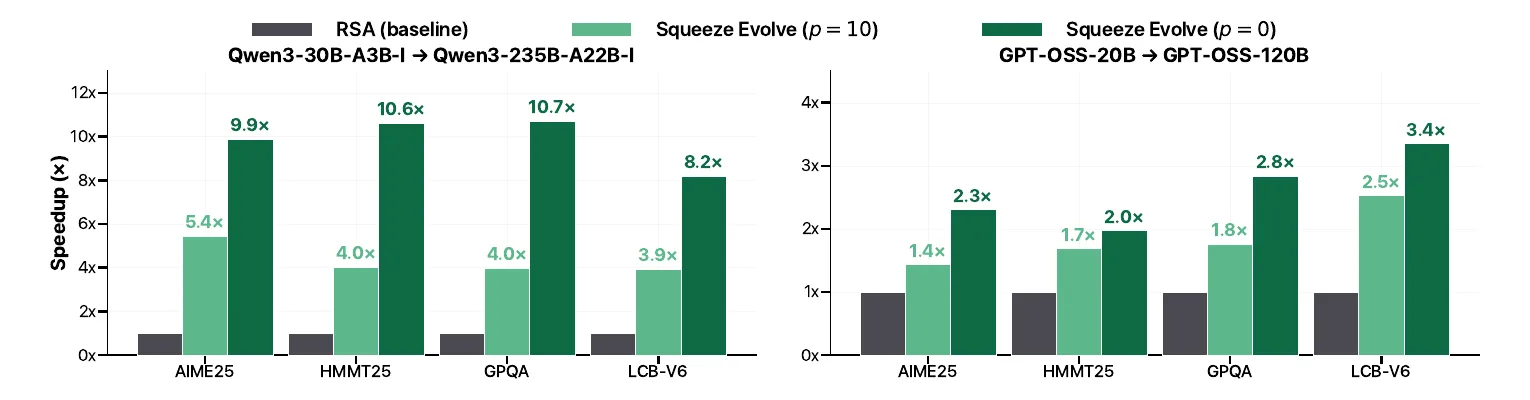
Qwen3 30B/235B 쌍은 GPU 16장 기준 처리량이 최대 10.7배, GPT-OSS 20B/120B 쌍은 최대 3.4배가 됐습니다. 차이는 두 모델의 크기 비대칭에서 옵니다. Qwen3-235B는 총 파라미터 2,350억·활성 220억이고 30B는 총 300억·활성 30억이라 한 토큰을 만드는 비용 차이가 큽니다. GPT-OSS 쌍은 그 간격이 더 좁습니다. 처리량은 초당 토큰이 아니라 초당 완료 요청 수로 쟀는데, 두 모델이 같은 질문에 쓰는 출력 길이가 달라 토큰 기준 비교는 불공정하기 때문입니다.
여기서도 조건을 함께 읽어야 합니다. 10배 안팎의 숫자는 p=0, 즉 재조합을 100% 싼 모델에 보낸 경우이고, 이때 HMMT25 정확도는 72.1%에서 67.4%로 내려갔습니다. 정확도를 거의 유지하는 p=10에서는 4~5배입니다.
9. 코드로 읽기 — 공개 저장소와 Claude Code 플러그인
논문의 코드는 github.com/squeeze-evolve/squeeze-evolve에 Apache 2.0으로 공개돼 있습니다(2026년 10월 기준 별 225개). 구조는 단순합니다. 알고리즘 1의 루프를 도는 orchestrator.py, 각 연산자를 이름으로 등록하는 operators.py, 그리고 확신도 엔진을 담은 vLLM 포크(서브모듈)입니다.
설정은 YAML 한 장입니다. 모델 목록은 싼 것부터 비싼 순서로 적고, 모델이 N개면 백분위수 문턱을 N−1개 줍니다.
yaml
routing:k:4# 묶음 크기population:16# 문제당 후보 수 (0세대)loops:5# 진화 세대 수confidence_percentiles: [50.0] # 모델 N개면 문턱 N-1개fitness:confidence# confidence(GC) 또는 diversity(D)selection:uniform# uniform 또는 weightedupdate:replace# replace 또는 accumulatelite_fraction:0.0# 가장 쉬운 묶음 중 다수결로 보낼 비율models:# 싼 모델 → 비싼 모델 순서-name:Qwen/Qwen3-30B-A3B-Instruct-2507base_url:http://localhost:8001/v1-name:Qwen/Qwen3-235B-A22B-Instruct-2507base_url:http://localhost:8000/v1scoring_model:# 교차 확신도를 매길 모델name:Qwen/Qwen3-30B-A3B-Instruct-2507prompt_logprobs:truevllm_extensions:true
라우팅의 핵심은 함수 하나, assign_routes입니다. 묶음 적합도가 문턱 이하이면 비싼 모델 쪽으로, 아니면 가장 싼 모델로 보냅니다.
python
defassign_routes(fitnesses, thresholds, n_models, lite_fraction=0.0):
routes = []
for f in fitnesses:
for i, t inenumerate(thresholds):
if f <= t: # 확신도가 낮다 = 어렵다
routes.append(f"model_{n_models - 1 - i}")
breakelse:
routes.append("model_0") # 가장 싼 모델# (생략) 가장 쉬운 묶음 일부를 'lite'(다수결)로return routes
코드를 읽다 보면 논문에 없는 것도 보입니다. 이 함수는 '적합도가 낮을수록 어렵다'를 전제합니다. 확신도(GC)에는 맞는 방향이지만, 다양성(D)은 값이 클수록 어렵습니다. 2026년 10월 현재 공개 파이썬 코드는 fitness: diversity일 때 값을 뒤집지 않고 같은 함수에 넣기 때문에, 그대로 쓰면 답이 모인 묶음이 비싼 모델로 가는 역방향 라우팅이 됩니다. 저장소에 같이 들어 있는 Claude Code 플러그인의 워크플로 코드에는 "원래 저장소 대비 방향을 바로잡았다(CORRECTED direction vs. the original repo)"는 주석이 달려 있습니다. 논문 실험(ARC-AGI-2)이 이 코드로 돌았는지는 알 수 없지만, 다양성 라우팅을 직접 쓰려면 이 부분을 확인해야 합니다.
연산자는 데코레이터로 갈아 끼울 수 있습니다. 예를 들어 묶음 확신도 대신 엔트로피를 적합도로 쓰고 싶다면 이렇게 등록하고 YAML에서 이름만 바꾸면 됩니다.
python
from squeeze_evolve import fitness
@fitness.register("entropy")defentropy_fitness(scores, **kwargs):
p = np.array(scores) / sum(scores)
returnfloat(-np.sum(p * np.log(p + 1e-10)))
저장소에는 세 가지 통합이 더 있습니다.
NVIDIA Dynamo: 대규모 추론 서빙 프레임워크 Dynamo에 dynamo.squeeze_evolve 구성 요소로 들어갔습니다(2026년 7월 병합). 여러 vLLM 모델 계층에 걸쳐 진화 루프를 돌리고, 겉으로는 표준 /v1/chat/completions 모델처럼 보입니다. 다만 Dynamo 쪽 문서는 이것을 "실험적, 아직 정식 출시되지 않은 구성 요소"로 표시하고, 다양성 라우팅만 지원합니다.
Claude Code 플러그인: /squeeze-evolve:ask <질문> 한 줄로 실행됩니다. 강한 모델로 후보를 뽑은 뒤 답의 다양성으로 묶음을 나눠 합의 → 무료 선택, 낮음 → Haiku, 중간 → Sonnet, 높음 → Opus로 보내고, 라우팅 기록과 함께 종합 답을 돌려줍니다. 별도 API 키 없이 사용자의 Claude 세션을 씁니다.
opencode 플러그인: 같은 방식을 opencode로 옮긴 단일 파일 플러그인으로, 기본 계층은 claude-haiku-4-5 / claude-sonnet-5 / claude-opus-5이고 어떤 공급사의 모델로도 바꿀 수 있습니다.
Claude Code 플러그인은 이 논문의 아이디어가 얼마나 일반적인지 잘 보여 줍니다. 논문은 오픈 모델 두 개로 실험했지만, 같은 원칙은 한 회사의 모델 등급(Haiku·Sonnet·Opus) 사이에도, 3단·4단 계층에도 그대로 적용됩니다.
10. 비판적으로 읽기 — 이 논문이 말하지 않은 것
좋은 논문일수록 단서를 꼼꼼히 읽어야 합니다. Squeeze Evolve를 실무에 가져가기 전에 알아 둘 점을 정리합니다.
10-1. "비싼 모델을 이겼다"는 통계적으로 구별되지 않는다
논문 본문은 여러 곳에서 Squeeze Evolve가 비싼 모델 단독을 "넘어선다(surpasses)"고 씁니다. AIME25에서 1.5%p, HMMT25에서 2.3%p 같은 숫자입니다. 그런데 문제가 30개뿐인 시험에서 2%p는 한 문제가 채 안 되는 차이입니다(시드 네 개 평균이라 소수점이 생긴 것입니다).
저자들도 이를 알고 있습니다. COLM 심사 과정에서 공개된 저자 답변(2026년 6월 2일)에는 GPT-OSS-20B→120B 쌍에 대한 문제별 윌콕슨 부호 순위 검정 결과가 추가돼 있습니다. 비싼 모델 대비 차이는 AIME +0.4%p(p=0.18), HMMT +0.2%p(p=0.66), GPQA −0.1%p(p=0.08)로 모두 유의하지 않았습니다. 반대로 싼 모델 대비로는 HMMT +9.0%p(p=0.008), GPQA +4.3%p(p=0.004)로 유의했습니다. 저자들 스스로의 요약은 이렇습니다. "강한 모델과 통계적으로 구별되지 않으면서 1.6~1.7배 싸다." 이 문장이 이 논문의 정직한 결론입니다. 같은 성능을 싸게 얻는다는 것, 그것만으로도 충분히 가치 있습니다.
10-2. ARC-AGI-2 97.5%는 공개 세트의 자체 보고치다
ARC-AGI-2에는 누구나 내려받을 수 있는 공개 평가 세트와, ARC Prize 재단이 따로 보관하는 비공개(semi-private) 세트가 있습니다. 공식 순위는 비공개 세트로 검증한 점수입니다. ARC Prize 정책은 두 세트의 점수가 "±3%p 안에서" 맞도록 설계됐다고 설명하지만, 2026년 10월 19일 갱신된 ARC Prize 자료를 보면 최신 모델에서는 그 차이가 훨씬 큽니다.
모델
공개 평가
비공개 세트 (검증)
차이
GPT-5.4 Pro (xhigh)
92.2% · $17.60
83.3% · $16.41
−8.9%p
Gemini 3.1 Pro
88.1% · $0.98
77.1% · $0.96
−11.0%p
Claude Opus 4.6 (120K, high)
79.0% · $3.81
69.2% · $3.47
−9.8%p
Squeeze Evolve (Gemini 3.1 Pro)
97.5% · $7.74
검증 안 됨
—
논문이 비교한 GPT-5.4 Pro의 92.2%도 ARC Prize가 공개 세트로 돌린 값입니다. 공개 세트끼리 비교했으니 논문의 비교 자체는 공정하지만, "ARC-AGI-2에서 97.5%"라는 문장만 떼어 읽으면 오해하기 쉽습니다. 공개 세트 문제는 학습 데이터에 섞여 들어갔을 가능성이 있고, 진화가 그 기억을 더 잘 끌어냈을 가능성도 배제할 수 없습니다. ARC Prize는 2026년 상반기 커뮤니티 제출물 검증을 보류해 왔고, Squeeze Evolve는 검증 목록에 없습니다.
또 하나, ARC 실험은 논문의 대표 기법인 확신도 라우팅을 쓰지 않았습니다. Gemini API가 로그 확률을 주지 않아 답 다양성으로 대신했고, 첫 실험은 모델도 Gemini 3.1 Pro 하나였습니다. 즉 97.5%·7.74달러의 절약은 '다중 모델'보다는 '합의된 묶음에 LLM을 부르지 않기'에서 나왔습니다. 논문의 원칙(능력을 한계 효용이 큰 곳에)과는 맞지만, 제목의 '다중 모델 오케스트레이션'이 만든 결과라고 하기는 어렵습니다.
10-3. 여섯 달 만에 바뀐 풍경
ARC 위젯에서 보라색 점을 켜 보면 2026년 10월의 현실이 보입니다. ARC Prize 공개 평가 자료에 따르면 가을에 나온 단일 모델들은 진화 없이 한 번에 GPT-6 Astra(Max) 97.5%·0.97달러, Claude Opus 5.5(XHigh) 97.6%·0.58달러, Gemini 4 Argon(High) 97.1%·0.36달러를 냅니다. Squeeze Evolve의 7.74달러보다 8~20배 쌉니다. ARC-AGI-2는 사실상 포화됐고, 관심은 2026년 3월 공개된 ARC-AGI-3로 넘어갔습니다(공개 당시 프런티어 AI 0.51%, 10월 검증 1위 62.7%).
이것은 이 논문만의 운명이 아니라 테스트 시간 기법 전체의 숙명입니다. 진화로 짜낸 성능은 다음 세대 모델이 기본값으로 가져갑니다. 그래서 이 논문의 오래 남을 기여는 특정 숫자가 아니라 원칙입니다. 새 모델이 나오면 그 모델이 '비싼 모델' 자리에 들어가고, 지난 세대 모델이 '싼 모델' 자리로 내려옵니다. 오늘의 Opus 5.5도 내년엔 누군가의 Model 1이 될 것입니다.
10-4. 그 밖의 단서들
기준선이 RSA 하나다. 절감은 모두 '비싼 모델로 돌린 RSA' 대비입니다. RouteLLM처럼 질문 단위로 강·약 모델을 나누는 라우터, DeepConf처럼 확신도 낮은 궤적을 일찍 버리는 방법, 혹은 그냥 비싼 모델 단발 추론과의 비용-정확도 비교는 본문에 없습니다. 실무에서 궁금한 질문은 "RSA보다 싼가"보다 "단발보다 몇 배 비싸고 얼마나 나은가"인 경우가 많습니다.
라우팅 규칙이 학습되지 않는다. COLM 심사위원 한 명(점수 6/10)은 "모델 사이를 동적으로 고르거나 조율하지 않는다. 4장의 초기 관찰로 만든 휴리스틱이라 다른 추론 과제에 얼마나 맞을지 불분명하다"고 지적했습니다. 실제로 p, 묶음 크기, 세대 수는 과제마다 고정이고, 논문의 향후 과제 절도 이를 인정합니다.
확신에 찬 오답에는 속수무책이다. 확신도와 다양성은 '망설임'과 '불일치'를 잴 뿐입니다. 모든 후보가 같은 오답을 확신하면 그 묶음은 다수결로 넘어가 아무도 다시 보지 않습니다. 모델들이 같은 오해를 공유하는 영역, 예를 들어 학습 데이터에 널리 퍼진 잘못된 통념에서는 이 방법이 오답을 더 단단하게 만들 수 있습니다.
답을 뽑아낼 수 있는 과제에 맞춰져 있다. 다양성 D는 최종 답을 문자열로 뽑아 비교할 수 있어야 계산됩니다. 수학, 객관식, 격자 퍼즐에는 잘 맞지만, 보고서 작성이나 디자인처럼 '같은 답'을 정의하기 어려운 과제에는 확신도만 남습니다.
본문과 부록 숫자가 가끔 어긋난다. MMMU-Pro 절감(본문 2.7배·1.9배, 부록 표 2.3배·1.8배), ARC 실험의 개체군 크기(논문 N=4, 프로젝트 페이지 16)처럼 기준이 다른 숫자가 섞여 있습니다. 인용할 때는 표를 기준으로 삼는 편이 안전합니다.
비싼 모델은 여전히 필요하다. 0세대를 비싼 모델이 만들어야 한다는 것이 발견 2였습니다. Squeeze Evolve는 비싼 모델을 없애는 방법이 아니라 덜 쓰는 방법입니다. 오픈 모델만 쓸 수 있는 환경이라면 '비싼 모델'은 가진 것 중 가장 큰 오픈 모델이 됩니다.
반대 방향의 평가도 공정하게 적어 둡니다. 같은 COLM 심사위원은 통합 틀, 로그 확률을 주지 않는 폐쇄형 API를 위한 다양성 대안, 코드 실행 환경 없이 해낸 원 채우기를 장점으로 꼽았습니다. 논문은 COLM 2026 본 학회와 ICML 2026 AI4Math 워크숍에서 발표됐습니다. 2026년 10월 기준 시맨틱 스칼러에 잡힌 인용 논문은 일곱 편으로, 그중 FrugalEvo(강한 LLM이 탐색하고 싼 LLM이 구현하는 비용 인식 진화)와 앞서 언급한 「초기화가 LLM 주도 발견을 개선한다」가 이 논문의 문제의식을 가장 직접적으로 이어받았습니다.
11. 2026년의 의미 — 모델을 '고르는' 시대에서 '배치하는' 시대로
11-1. 추론이 학습보다 큰 지출이 된 해
2026년은 AI 인프라 지출에서 추론이 학습을 넘어선 해로 기록될 가능성이 큽니다. 가트너의 2026년 8월 발표를 인용한 보도들은 AI 최적화 클라우드 인프라 지출 중 추론(233억 달러)이 학습(190억 달러)을 처음 넘어설 것으로 전했습니다(가트너 원문은 직접 확인하지 못했습니다). 추론 지출이 커질수록 "모델을 얼마나 많이 부르는가"만큼 "어떤 모델을 부르는가"가 비용을 좌우합니다.
오픈라우터와 a16z가 2025년 말 공개한 사용량 분석에는 흥미로운 관찰이 있습니다. LLM 수요는 가격에 둔감해서, 가격을 10% 내려도 사용량은 0.5~0.7%밖에 늘지 않았습니다. 사람들은 싼 모델이 있어도 쓰던 비싼 모델을 계속 쓴다는 뜻입니다. 그렇다면 비용을 줄이는 길은 사용자가 모델을 바꾸길 기다리는 것이 아니라, 시스템이 알아서 일을 나눠 맡기는 것입니다. Squeeze Evolve 같은 오케스트레이션이 하는 일이 바로 그것입니다.
11-2. 라우팅은 이미 일상이 됐다 — 다만 단위가 거칠었을 뿐
모델을 나눠 쓰는 생각 자체는 새롭지 않습니다. 2023년 FrugalGPT는 싼 모델부터 차례로 물어보고 답이 미덥지 않을 때만 비싼 모델로 넘기는 '모델 계단(cascade)'으로 비용을 최대 98% 줄였다고 보고했고, 2024년 RouteLLM은 질문마다 강한 모델과 약한 모델 중 하나를 고르는 라우터로 MT Bench에서 85% 넘게 비용을 줄이면서 GPT-4 품질의 95%를 유지했습니다. 2023년의 추측 디코딩(speculative decoding)은 토큰 수준에서 같은 생각을 했습니다. 작은 모델이 여러 토큰을 먼저 써 보고 큰 모델은 확인만 해서 같은 출력을 2~3배 빠르게 냅니다. 2025년 말 Squeeze Evolve의 제1저자가 낸 Arbitrage는 추론 단계 단위로 초안 모델과 목표 모델을 오갑니다.
Squeeze Evolve가 새로 더한 것은 단위와 복리입니다. 질문 단위도, 토큰 단위도 아니라 '진화의 한 세대 안의 묶음' 단위로 라우팅하고, 이 결정이 세대마다 쌓이면서 절약이 곱으로 커집니다. 질문 하나를 푸는 데 LLM 호출이 수백 번 일어나는 에이전트·진화형 추론의 시대에, 호출 하나하나에 모델을 배정하는 일은 점점 더 중요한 설계 문제가 됩니다.
11-3. 에이전트 하네스가 이미 하고 있는 일
Squeeze Evolve의 Claude Code 플러그인이 Haiku·Sonnet·Opus를 나눠 쓰는 것은 우연이 아닙니다. 2026년의 코딩 에이전트와 연구 에이전트는 이미 비슷한 배치를 합니다. 파일을 훑고 검색하는 하위 에이전트에는 빠르고 싼 모델을, 계획을 세우고 최종 판단을 내리는 주 에이전트에는 가장 강한 모델을 씁니다. Squeeze Evolve의 발견들은 이 경험칙에 근거를 줍니다. 시작(초기화)과 갈림길(불일치가 큰 묶음)에는 강한 모델을, 정리와 합의 확인에는 약한 모델이나 규칙 기반 처리를.
코어닷투데이가 다뤄 온 프롬프트의 진화나 자기 진화 에이전트의 능력 침식 같은 주제도 같은 질문으로 이어집니다. 진화하는 시스템은 무엇으로 자기 자신을 평가하는가, 그리고 그 평가가 다양성을 죽이지 않게 하려면 무엇이 필요한가.
11-4. 한국에서 읽는 법
한국 상황에서 이 논문은 특히 실용적입니다. 2026년 8월 정부의 독자 AI 파운데이션 모델 사업 2단계 발표에서 업스테이지·SK텔레콤·LG가 다음 단계로 올라갔고, 공공 부문의 범정부 AI 공통 기반도 국내외 여러 모델을 함께 쓰는 다중 모델 구조로 알려져 있습니다. 데이터 주권이나 비용 때문에 국산·오픈 모델을 주력으로 쓰되, 정말 어려운 일부 판단에만 해외 프런티어 모델을 쓰고 싶은 조직이 많습니다. Squeeze Evolve의 '오픈+폐쇄 혼합' 실험이 바로 그 구성입니다. 다만 혼합 구성에서는 민감한 데이터가 어느 묶음과 함께 해외 API로 넘어가는지를 라우팅 규칙과 함께 설계해야 합니다. 비용의 문턱과 보안의 문턱이 같을 리 없으니까요.
12. 실무 체크리스트 — 우리 팀에 붙여 본다면
Squeeze Evolve를 직접 쓰든, 원칙만 빌려 오든, 다음 순서로 점검해 볼 수 있습니다.
진단이 과제는 정답을 검증할 수 있는가? 싸게 검증할 수 있다면 검증기 기반 탐색(AlphaEvolve류)이 먼저다. 검증이 비싸거나 불가능할 때 검증기 없는 진화를 고려한다.
진단단발 추론으로 충분한가? 진화는 토큰을 수백 배 쓴다. 단발 대비 정확도 향상이 그 비용을 정당화하는 과제(고가치 판단, 오답 비용이 큰 문제)에만 쓴다.
설계강한 모델은 0세대에 쓴다. 예산이 빠듯하면 재조합보다 초기화에 돈을 쓴다(발견 2).
설계싼 모델은 '맹점이 다른' 것으로 고른다. 같은 계열의 작은 모델은 싸지만 다양성 효과가 약할 수 있다. 다른 회사·다른 학습 방식의 모델을 섞는 쪽이 메아리 방을 깨기 쉽다(발견 1).
설계답이 이미 모인 묶음은 LLM을 부르지 않는다. 다수결 경로 하나만으로 ARC 실험의 비용이 3.7배 줄었다.
측정우리 데이터에서 확신도가 정답을 가르는지 먼저 확인한다. 정답 있는 묶음과 없는 묶음의 GC 차이(논문은 +1.2~+3.1)가 거의 없다면 확신도 라우팅은 무작위 배정과 다를 바 없다.
측정p는 10~30에서 시작해 정확도-비용 곡선을 그린다. p=0은 가장 싸지만 과제에 따라 1.5~6%p를 잃었다. 단발 추론 비용도 같은 그래프에 찍어 둔다.
측정API 제약을 확인한다. 출력 로그 확률을 주지 않는 모델은 교차 채점(prefill 비용)이나 다양성 신호로 대신해야 한다. 공개 코드의 다양성 라우팅 방향도 점검한다.
운영반복해서 읽히는 후보 텍스트에는 프롬프트 캐싱을 건다. 재조합 비용의 대부분은 같은 후보를 여러 묶음에서 다시 읽는 입력 토큰이다.
운영GPU를 직접 운영한다면 두 모델 풀의 세대당 처리 시간을 맞춘다. 한쪽이 놀면 라우팅 이득이 사라진다.
맺으며 — 짜낸다는 것
진화 알고리즘의 역사는 결국 두 가지를 다루는 역사였습니다. 무엇으로 점수를 매길 것인가, 그리고 어떻게 다양성을 지킬 것인가. 1987년의 적합도 공유, 2011년의 새로움 탐색, 2023년 FunSearch의 섬 모형이 모두 같은 문제와 싸웠습니다. Squeeze Evolve는 이 오래된 문제를 언어 모델의 언어로 다시 씁니다. 점수는 모델 자신의 망설임에서 얻고, 다양성은 서로 다른 모델의 서로 다른 눈에서 얻습니다. 그리고 여기에 60년 전에는 없던 세 번째 질문을 더합니다. 각 단계에 누구의 손을 쓸 것인가, 그 손의 값은 얼마인가.
논문의 숫자 중 일부는 여섯 달 만에 낡았습니다. 97.5%는 이제 단일 모델이 1달러 안쪽으로 냅니다. 하지만 "강한 모델은 시작과 갈림길에, 약한 모델은 정리와 확인에, 이미 합의된 일에는 아무 모델도 부르지 않는다"는 원칙은 모델 세대가 바뀌어도 남습니다. 비싼 모델이 더 비싸고 강해질수록, 싼 모델이 더 싸고 쓸 만해질수록, 이 배치의 기술은 오히려 더 중요해집니다.
AI에게 더 오래 생각하게 하는 시대에서, 누구에게 무엇을 생각하게 할지 정하는 시대로. Squeeze Evolve는 그 전환의 초입에 놓인 논문입니다.
참고 문헌
이 글의 중심 논문과 코드
Maheswaran, M., Lakhani, L., Zhou, Z., Yang, S., Wang, J., Hooper, C., Hu, Y., Tiwari, R., Wang, J., Singh, H., Wu, Q., Jian, Y., Zhang, C., Keutzer, K., Dao, T., Wu, X., Athiwaratkun, B., Zou, J., & Xu, C. (2026). Squeeze Evolve: Unified Multi-Model Orchestration for Verifier-Free Evolution. COLM 2026. arXiv:2604.07725 (이 글은 v2, 2026-04-10을 읽었다. 논문 그림은 CC BY 4.0으로 재사용)