지식 그래프스키마 유도AutoSchemaKGATLAS개념화사건 그래프OpenIEGraphRAGHippoRAG멀티홉 QA온톨로지LLMRAGACL 2026한국어 NLP
[특집] 스키마 없이 9억 노드 — AutoSchemaKG 깊이 읽기: 사건 노드, 개념화, ATLAS, 그리고 초록의 숫자가 표에서 뜻하는 것
지식 그래프는 40년 동안 분류표(스키마)를 사람이 먼저 그리고 그 칸에 사실을 채우는 방식으로 만들어졌습니다. ACL 2026에 실린 AutoSchemaKG(홍콩과기대·화웨이)는 순서를 뒤집어, LLM으로 개체와 '사건'을 먼저 뽑고 뽑힌 것마다 개념 꼬리표를 붙여 스키마를 끌어냅니다. 문서 5천만 건에서 노드 13.6억·엣지 86억짜리 그래프 ATLAS가 나왔고 GPU 78,400시간이 들었습니다. 이 글은 Cyc·Freebase·OpenIE·허스트 패턴으로 이어지는 역사부터 논문의 세 아이디어를 풀고, 표를 한 줄씩 다시 읽습니다. 사건 노드는 문단 정보의 89%를 지켰지만(개체 트리플은 35%), '12~18% 향상'은 BM25 대비였고 같은 검색기의 원본 그래프와는 비기거나 졌으며, 개념 노드가 보탠 점수는 1점 안팎, '92% 정렬'은 정답률이 아니라 BERTScore였습니다. 코어닷투데이가 한국어 위키백과 25문단에 같은 프롬프트를 돌린 실측과, 저장소 이슈·IBM의 재현·저자들의 후속 논문까지 함께 정리했습니다.
코어닷투데이2026-11-15100분
?
문제
지식 그래프는 40년 동안 '분류표(스키마)를 먼저 그리고 그 칸에 사실을 채우는' 방식으로 만들어졌습니다. 분류표는 전문가가 손으로 그려야 했고, 영역이 바뀌면 다시 그려야 했습니다.
!
논문의 제안
AutoSchemaKG는 순서를 뒤집습니다. LLM으로 개체와 '사건'을 먼저 뽑고, 뽑힌 것마다 "이것은 무엇의 일종인가"를 다시 물어 개념 꼬리표를 붙입니다. 스키마는 설계하지 않고 글에서 끌어냅니다.
✓
결과와 단서
문서 5천만 건에서 노드 13.6억, 엣지 86억짜리 그래프 세 개(ATLAS)가 나왔습니다. 사건 노드는 문단 정보를 훨씬 잘 보존했습니다. 다만 개념 노드가 질문 답하기에 보탠 점수는 1점 안팎이었고, 초록의 '92% 정렬'과 '12~18% 향상'은 표를 따라가 보면 뜻이 꽤 좁습니다.
들어가며: 책을 꽂기 전에 분류표부터 그릴 것인가
새 도서관을 연다고 해 봅시다. 사서는 보통 책이 들어오기 전에 분류표부터 만듭니다. 000 총류, 100 철학, 800 문학. 서가마다 이름표를 붙이고 나서야 책을 꽂습니다. 이 방식은 깔끔합니다. 대신 분류표에 없는 책이 들어오면 곤란해집니다. '기타' 서가가 불어나거나, 분류표를 다시 그려야 합니다.
반대로 할 수도 있습니다. 책을 일단 다 받아 놓고, 쌓인 책을 훑어보면서 "이 무더기는 요리책이네", "이건 여행기와 지도가 섞여 있네" 하고 이름표를 나중에 붙입니다. 분류표를 미리 그릴 전문가가 필요 없고, 어떤 책이 와도 받을 수 있습니다. 대신 이름표가 수만 개로 불어나고, 같은 책에 '요리', '음식', '레시피'가 따로 붙을 수 있습니다.
컴퓨터가 지식을 저장하는 방식 가운데 하나인 지식 그래프(knowledge graph) 는 지난 40년 동안 주로 첫 번째 방식으로 만들어졌습니다. 여기서 분류표에 해당하는 것을 스키마(schema) 라고 부릅니다. 2026년 7월 미국 샌디에이고에서 열린 ACL 2026(자연어 처리 분야의 대표 학회)에 실린 논문 「AutoSchemaKG」는 두 번째 방식을 끝까지 밀어 봅니다. 홍콩과학기술대학교(HKUST) 송양추(Yangqiu Song) 교수 연구실과 화웨이 이론 연구소(Theory Lab)의 연구자 20명이 썼고, 2025년 5월 arXiv에 처음 올라온 뒤 1년 넘게 다듬어져 학회에 실렸습니다.
논문이 내세우는 숫자는 큽니다.
영어 위키백과, 논문 초록, 웹 문서를 합쳐 5천만 건이 넘는 문서를 처리했습니다.
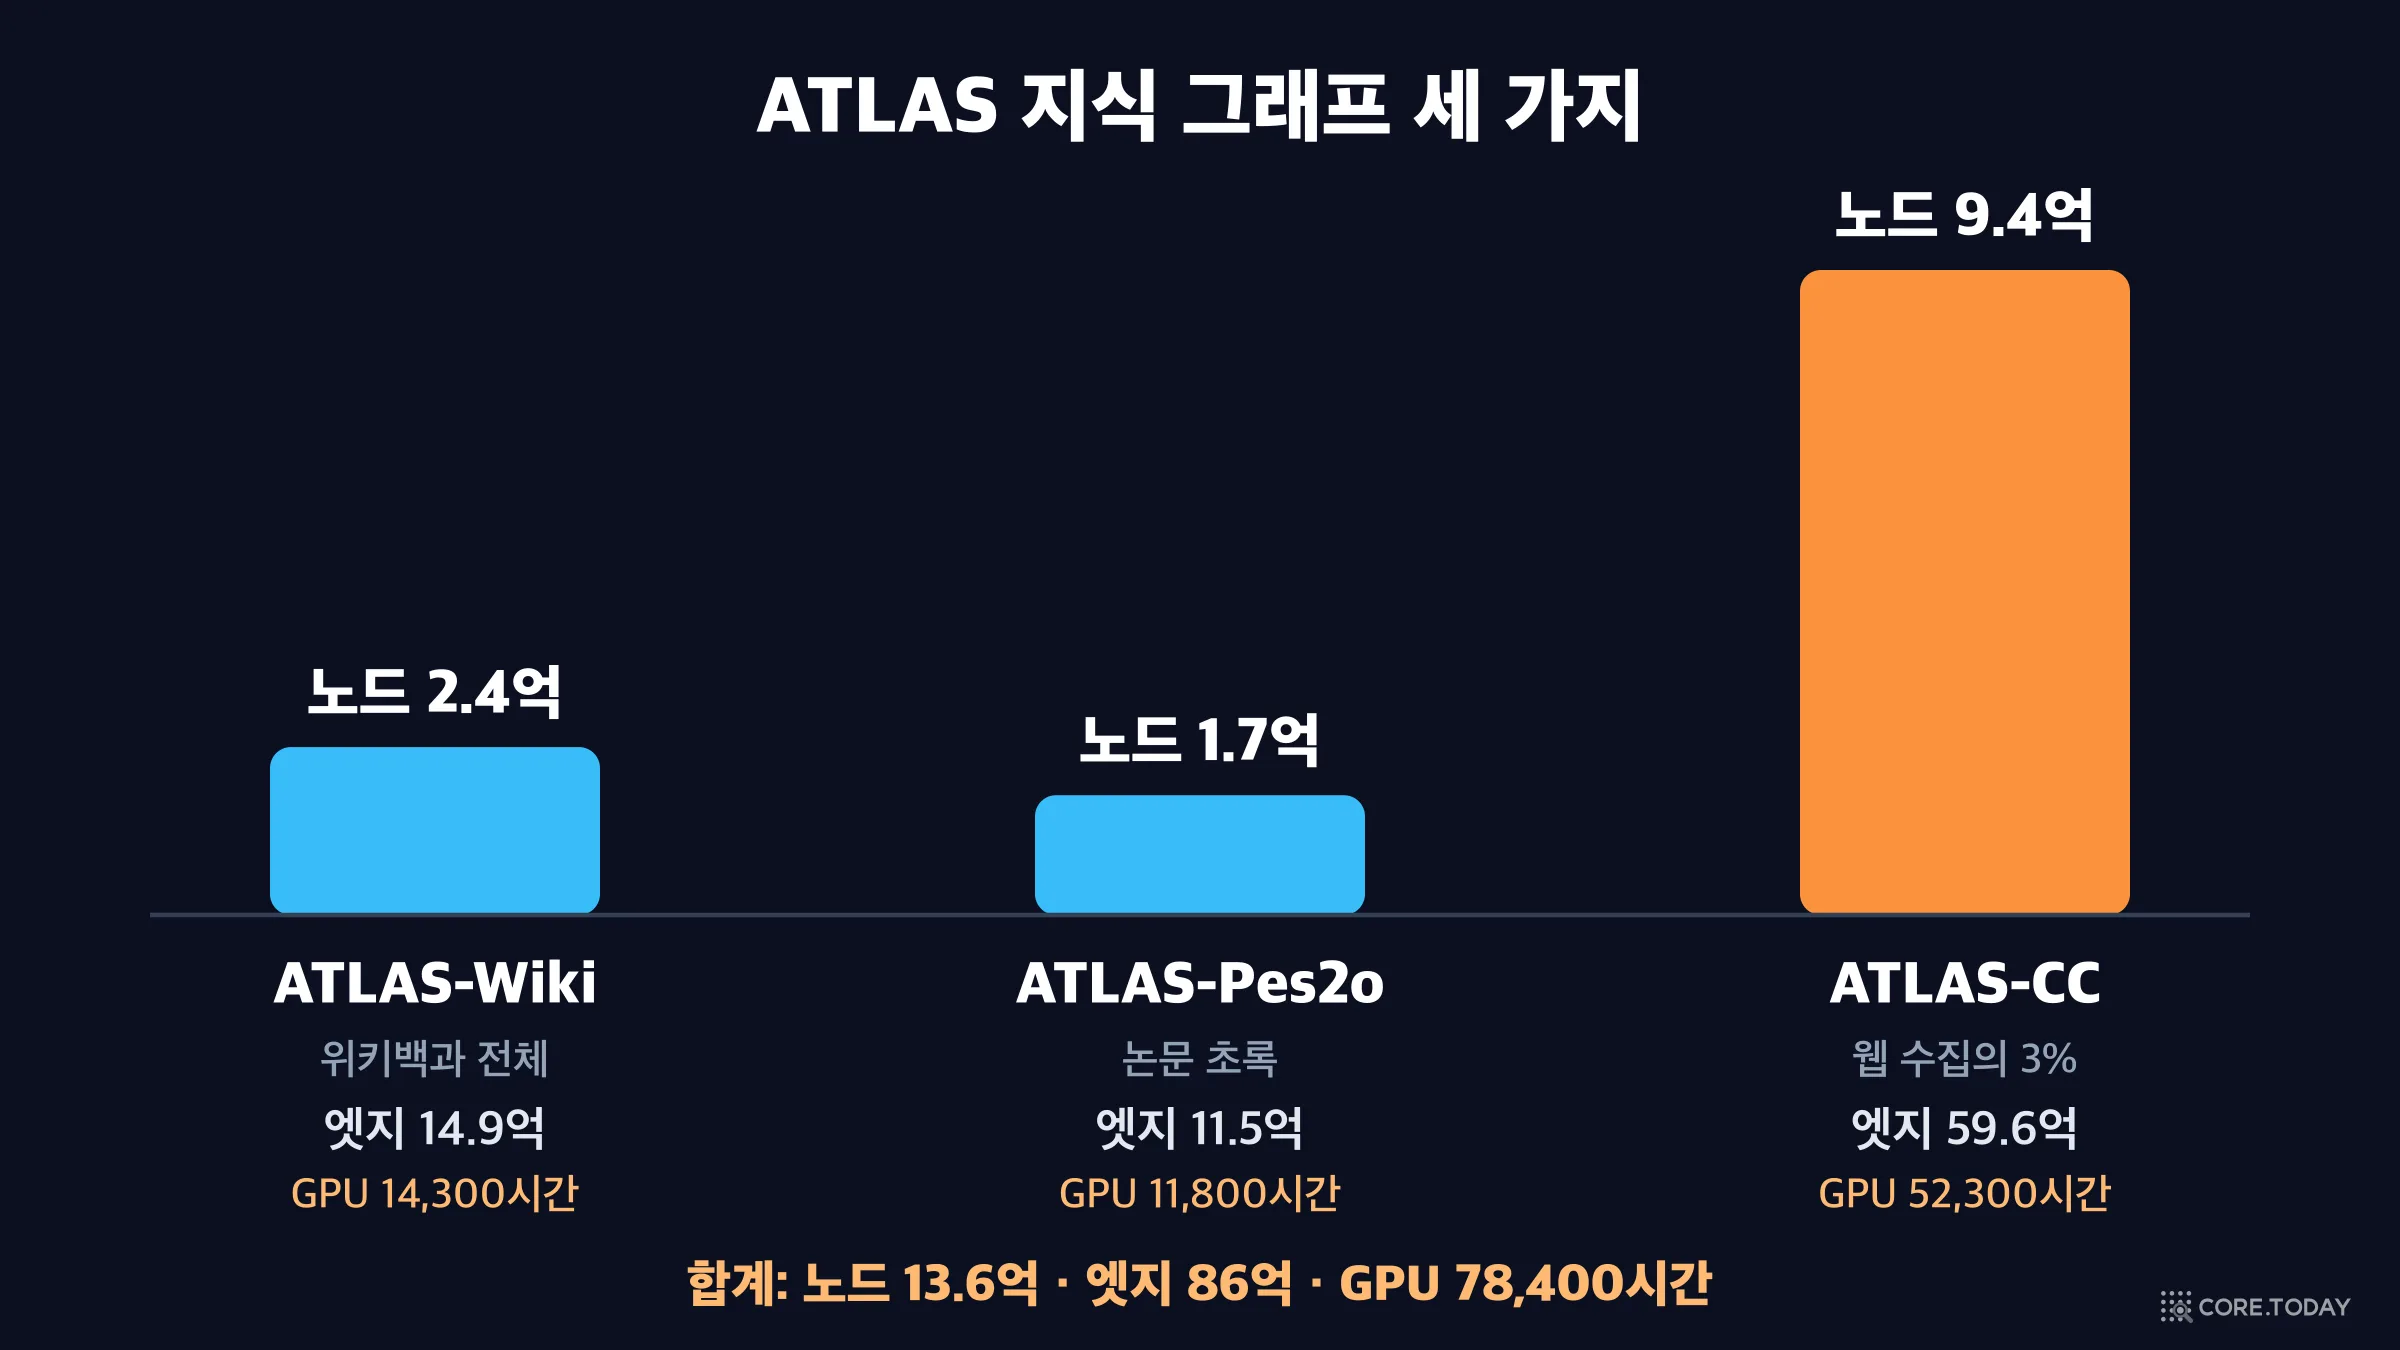
그 결과 ATLAS라는 이름의 지식 그래프 세 개가 나왔고, 가장 큰 것은 노드 9.4억 개, 엣지 59.6억 개입니다.
사람이 스키마를 한 줄도 쓰지 않았는데, 유도된 스키마가 사람이 만든 스키마와 92% 의미가 맞는다고 합니다.
여러 문서를 건너야 풀리는 질문에서 12~18% 나아졌다고 합니다.
여기에 GPU 78,400시간이 들었습니다.
이 글은 이 숫자들이 무엇을 뜻하는지 차근차근 풀어 봅니다. 먼저 지식 그래프와 스키마가 무엇이고 왜 '스키마 먼저'가 40년 동안 표준이었는지를 역사부터 살핍니다. 그다음 논문의 세 가지 아이디어(사건을 노드로 삼기, 개념화로 스키마 끌어내기, 웹 규모로 밀기)를 예시와 함께 뜯어봅니다. 그리고 논문의 표를 한 줄씩 다시 읽으며 초록의 숫자가 어디에서 왔는지 추적합니다. 코어닷투데이가 논문의 프롬프트를 우리말로 옮겨 한국어 문단 30개에 직접 돌려 본 결과와, 논문 발표 뒤 1년 반 동안 저장소 이슈·다른 연구진의 재현·저자들 자신의 후속 논문에서 나온 이야기도 함께 싣습니다.
미리 결론을 한 줄로 적어 두면 이렇습니다. 이 논문에서 가장 단단한 발견은 '스키마가 필요 없다'가 아니라 '사건을 노드로 삼으면 정보가 덜 샌다'입니다. 스키마 유도는 흥미롭지만 아직 증명이 덜 됐습니다.
1. 지식 그래프와 스키마, 5분 정리
트리플: 지식 그래프의 한 줄
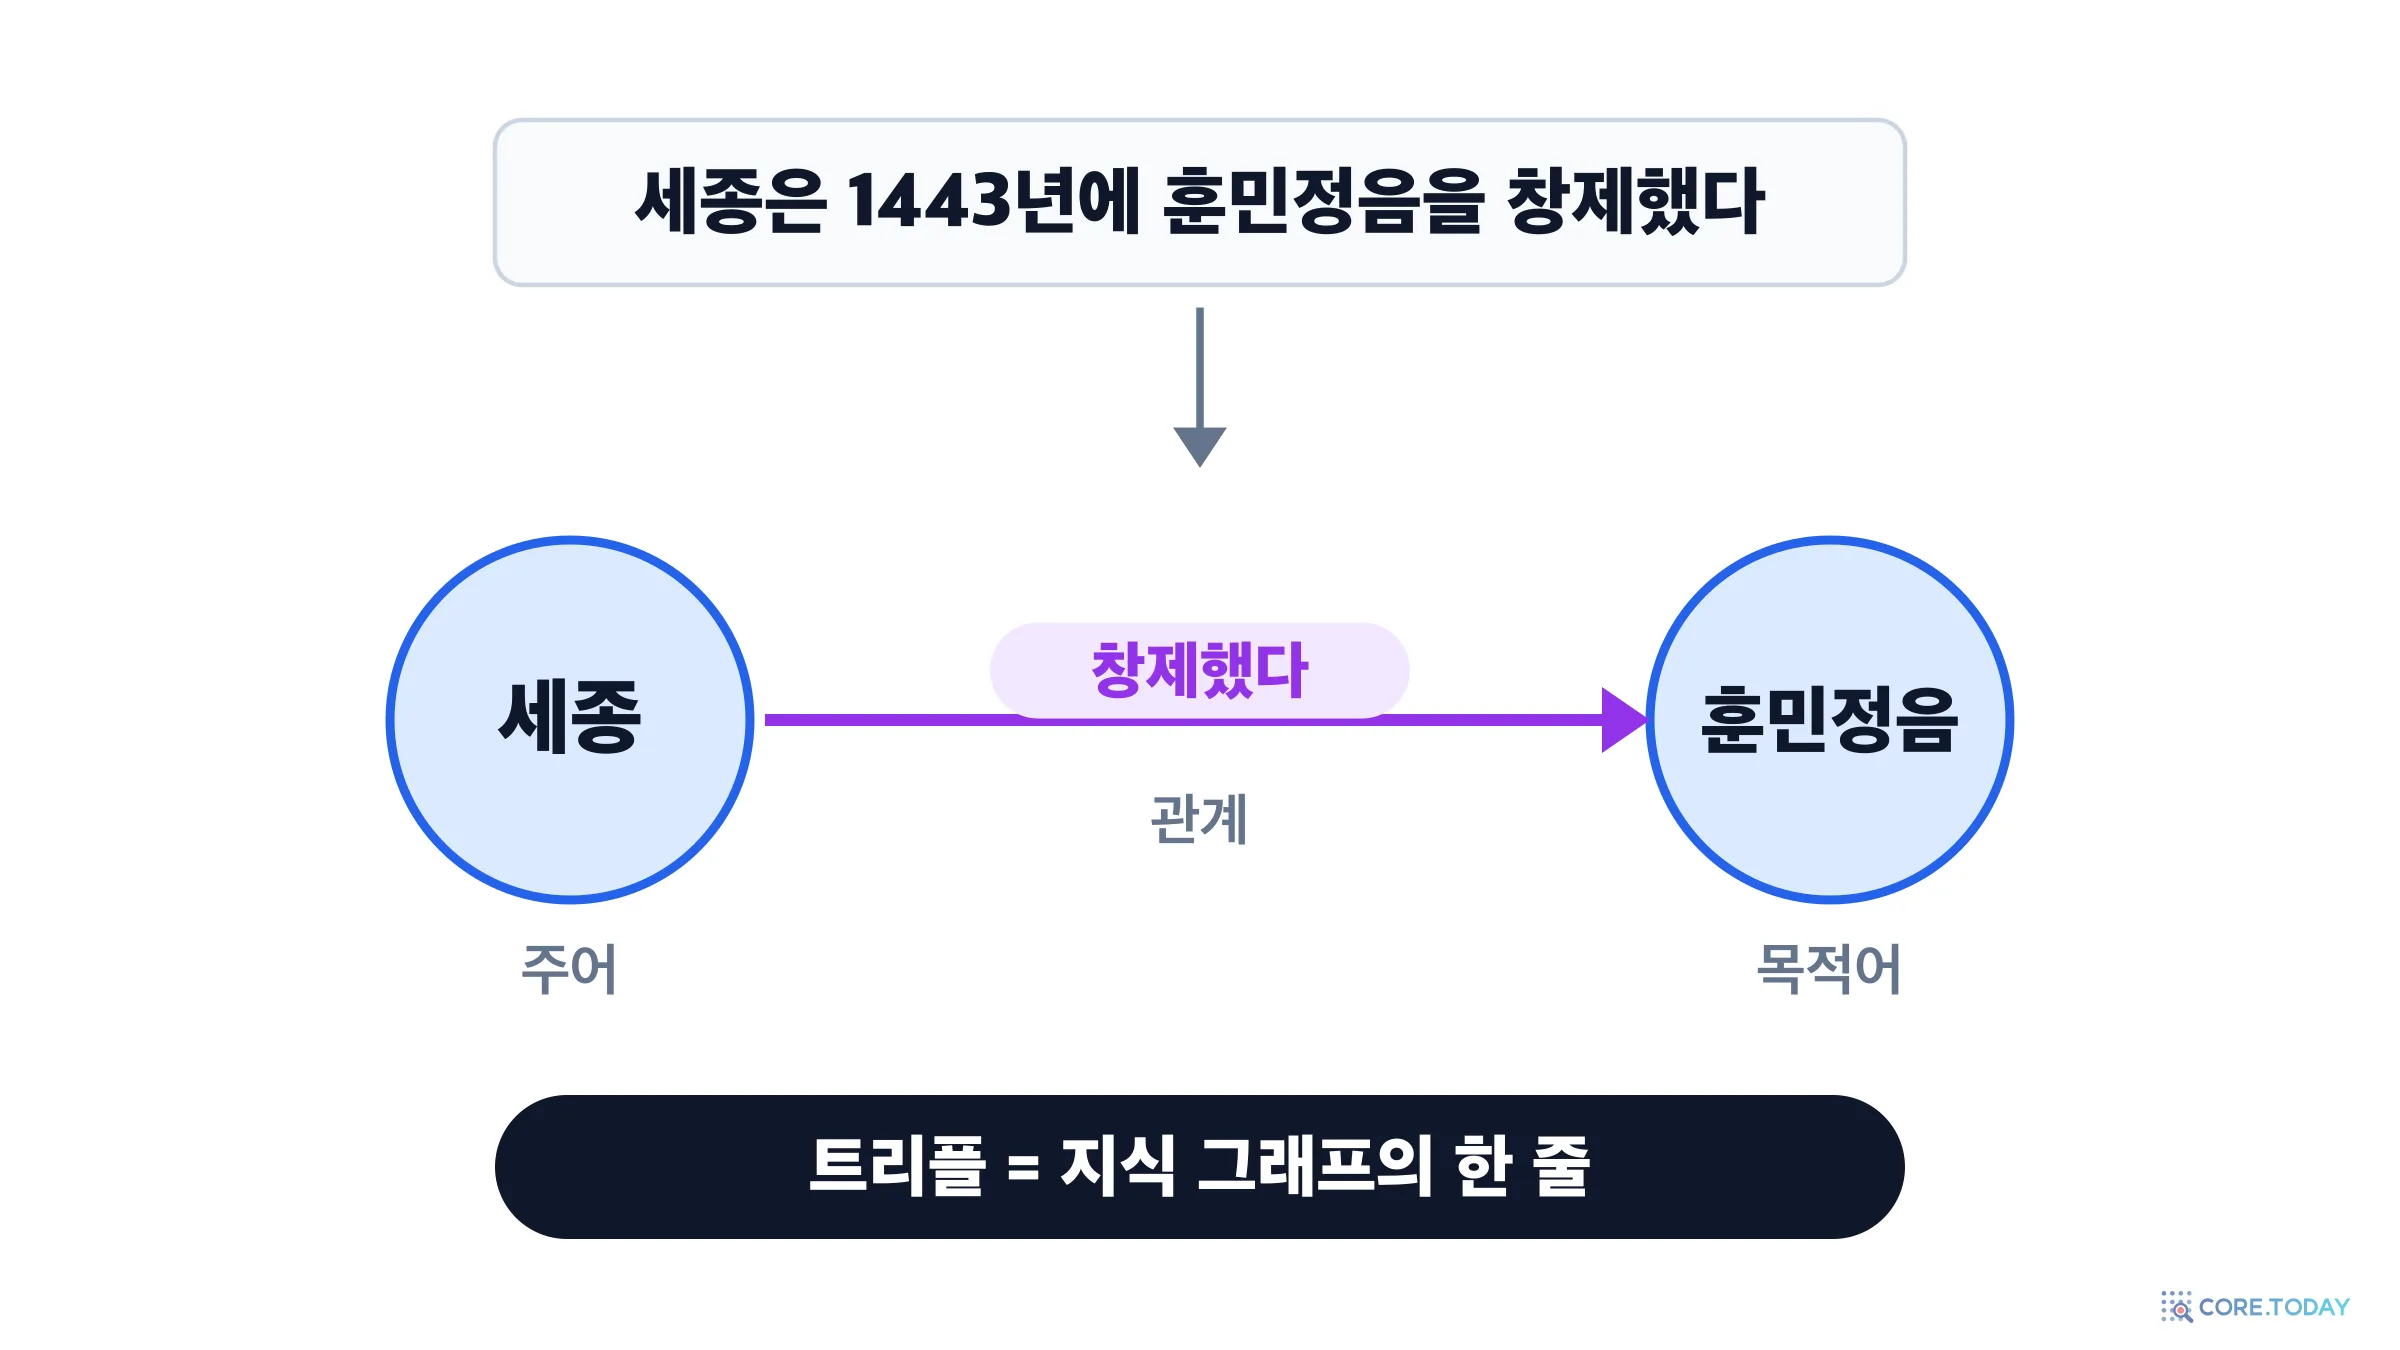
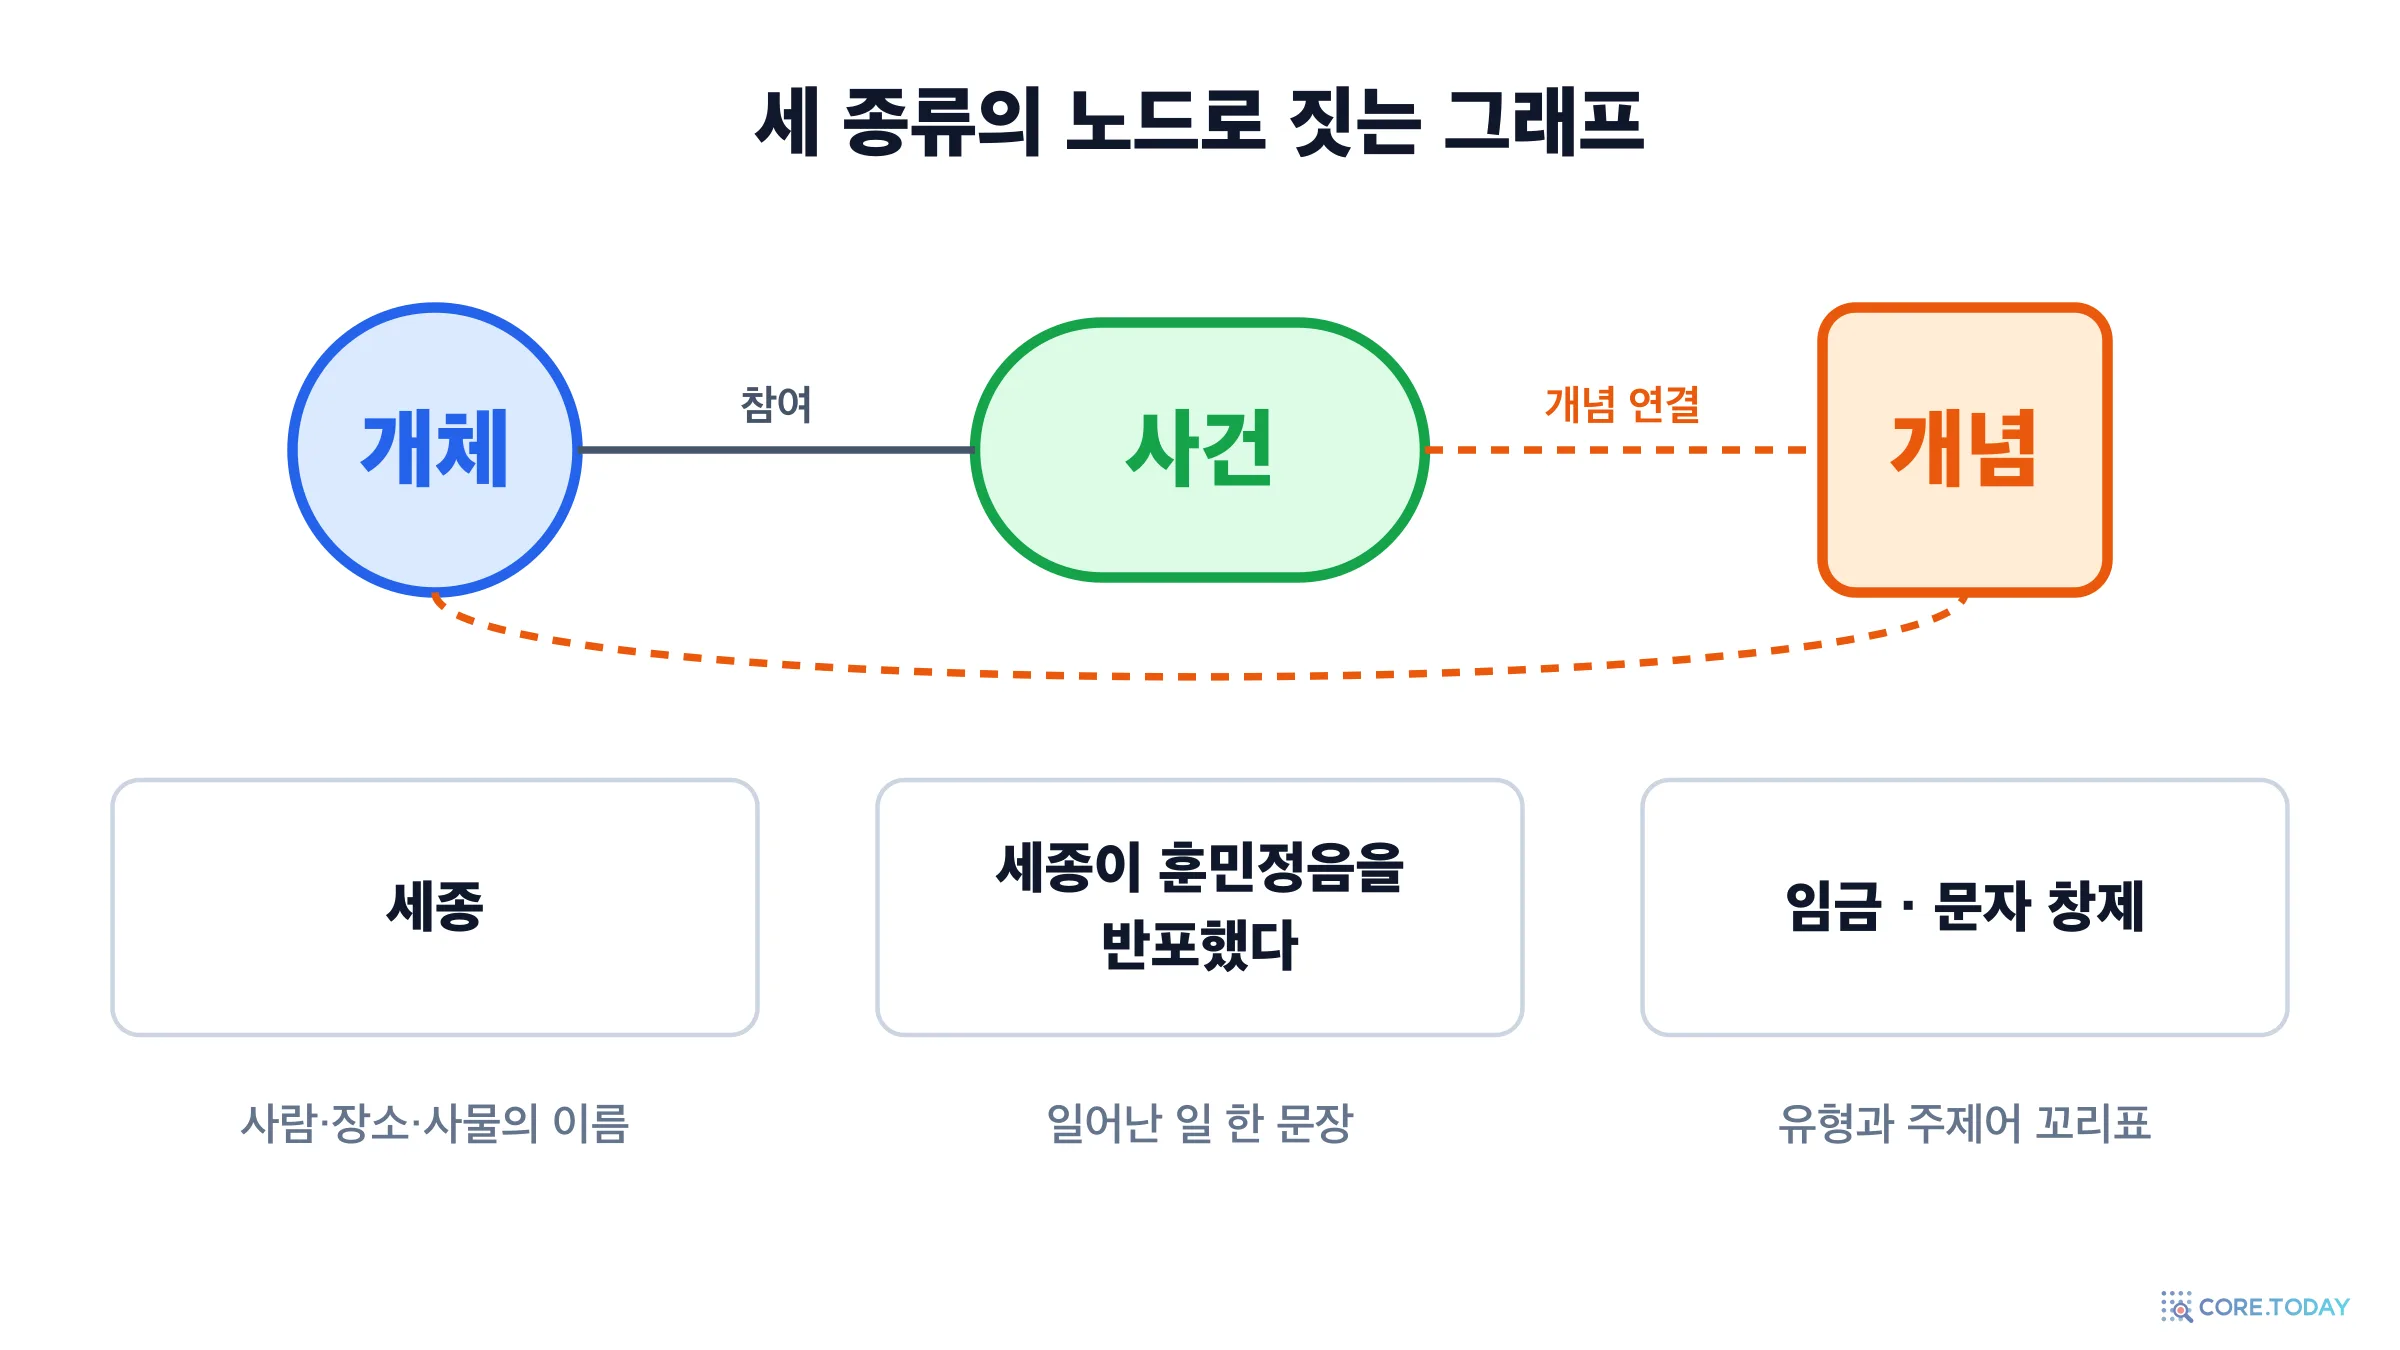
지식 그래프는 사실을 (주어, 관계, 목적어) 세 칸짜리 줄로 적어 모은 것입니다. 이 한 줄을 트리플(triple) 이라고 부릅니다. "세종은 1443년에 훈민정음을 창제했다"라는 문장은 (세종, 창제했다, 훈민정음)이 됩니다. 주어와 목적어는 점(노드), 관계는 점을 잇는 화살표(엣지)가 됩니다. 이런 줄이 수억 개 모이면 점과 화살표로 된 거대한 그물이 생깁니다.
글과 견주어 그래프가 좋은 점은 건너뛰기입니다. "훈민정음을 만든 임금의 아들이 세운 정책은?" 같은 질문은 문서 하나에 답이 없습니다. 그래프에서는 훈민정음 → 세종 → 문종·세조로 화살표를 따라가면 됩니다. 이렇게 여러 사실을 건너야 풀리는 질문을 멀티홉(multi-hop) 질문이라고 하고, 논문의 주 실험이 이것입니다.
스키마: 어떤 칸을 둘지 정한 약속
스키마는 그래프에 어떤 종류의 점과 어떤 종류의 화살표를 둘지 미리 정한 약속입니다. 예를 들어 이렇게 정합니다.
정하는 것
예
덕분에 할 수 있는 일
점의 유형
인물, 조직, 장소, 작품
"모든 인물을 나열하라" 같은 질의
화살표의 유형
출생지, 설립자, 저자
'태어난 곳', '출생지', '고향'을 한 관계로 묶기
제약
'출생지'의 주어는 인물, 목적어는 장소
(서울, 출생지, 세종) 같은 뒤집힌 사실 걸러 내기
계층
임금 ⊂ 정치인 ⊂ 인물
"정치인"을 물으면 임금도 함께 찾기
스키마가 있으면 그래프가 깨끗해집니다. 같은 뜻의 관계가 하나로 모이고, 말이 안 되는 사실이 걸러지고, 정해진 질의 언어로 정확하게 물을 수 있습니다. 구글 검색 오른쪽에 뜨는 인물 정보 상자, 은행의 고객·계좌·거래 그래프, 병원의 약물·질병 그래프가 모두 이렇게 만들어집니다.
문제는 비용입니다. 스키마는 그 영역을 아는 사람이 손으로 그려야 합니다. 의학 스키마를 그리려면 의사가, 법률 스키마를 그리려면 법률가가 필요합니다. 영역이 바뀌면 다시 그려야 합니다. 그리고 스키마에 없는 칸의 사실은 버려집니다. '출생지' 칸은 있는데 '첫 직장' 칸이 없으면, 문서에 첫 직장이 아무리 또렷이 적혀 있어도 그래프에는 들어가지 못합니다. 논문은 서론 첫 문단에서 이 상황을 이렇게 요약합니다.
현재의 지식 그래프 구축 방식은 타고난 역설에 묶여 있다. 영역 전문가가 미리 만든 스키마가 필요하고, 그것이 확장성과 영역 범위를 근본적으로 제한한다.
코어닷투데이는 스키마와 온톨로지의 역사를 「온톨로지의 모든 것」에서 길게 다뤘습니다. 이 글에서는 '스키마를 누가, 언제 만드느냐'라는 한 가지 질문만 따라갑니다.
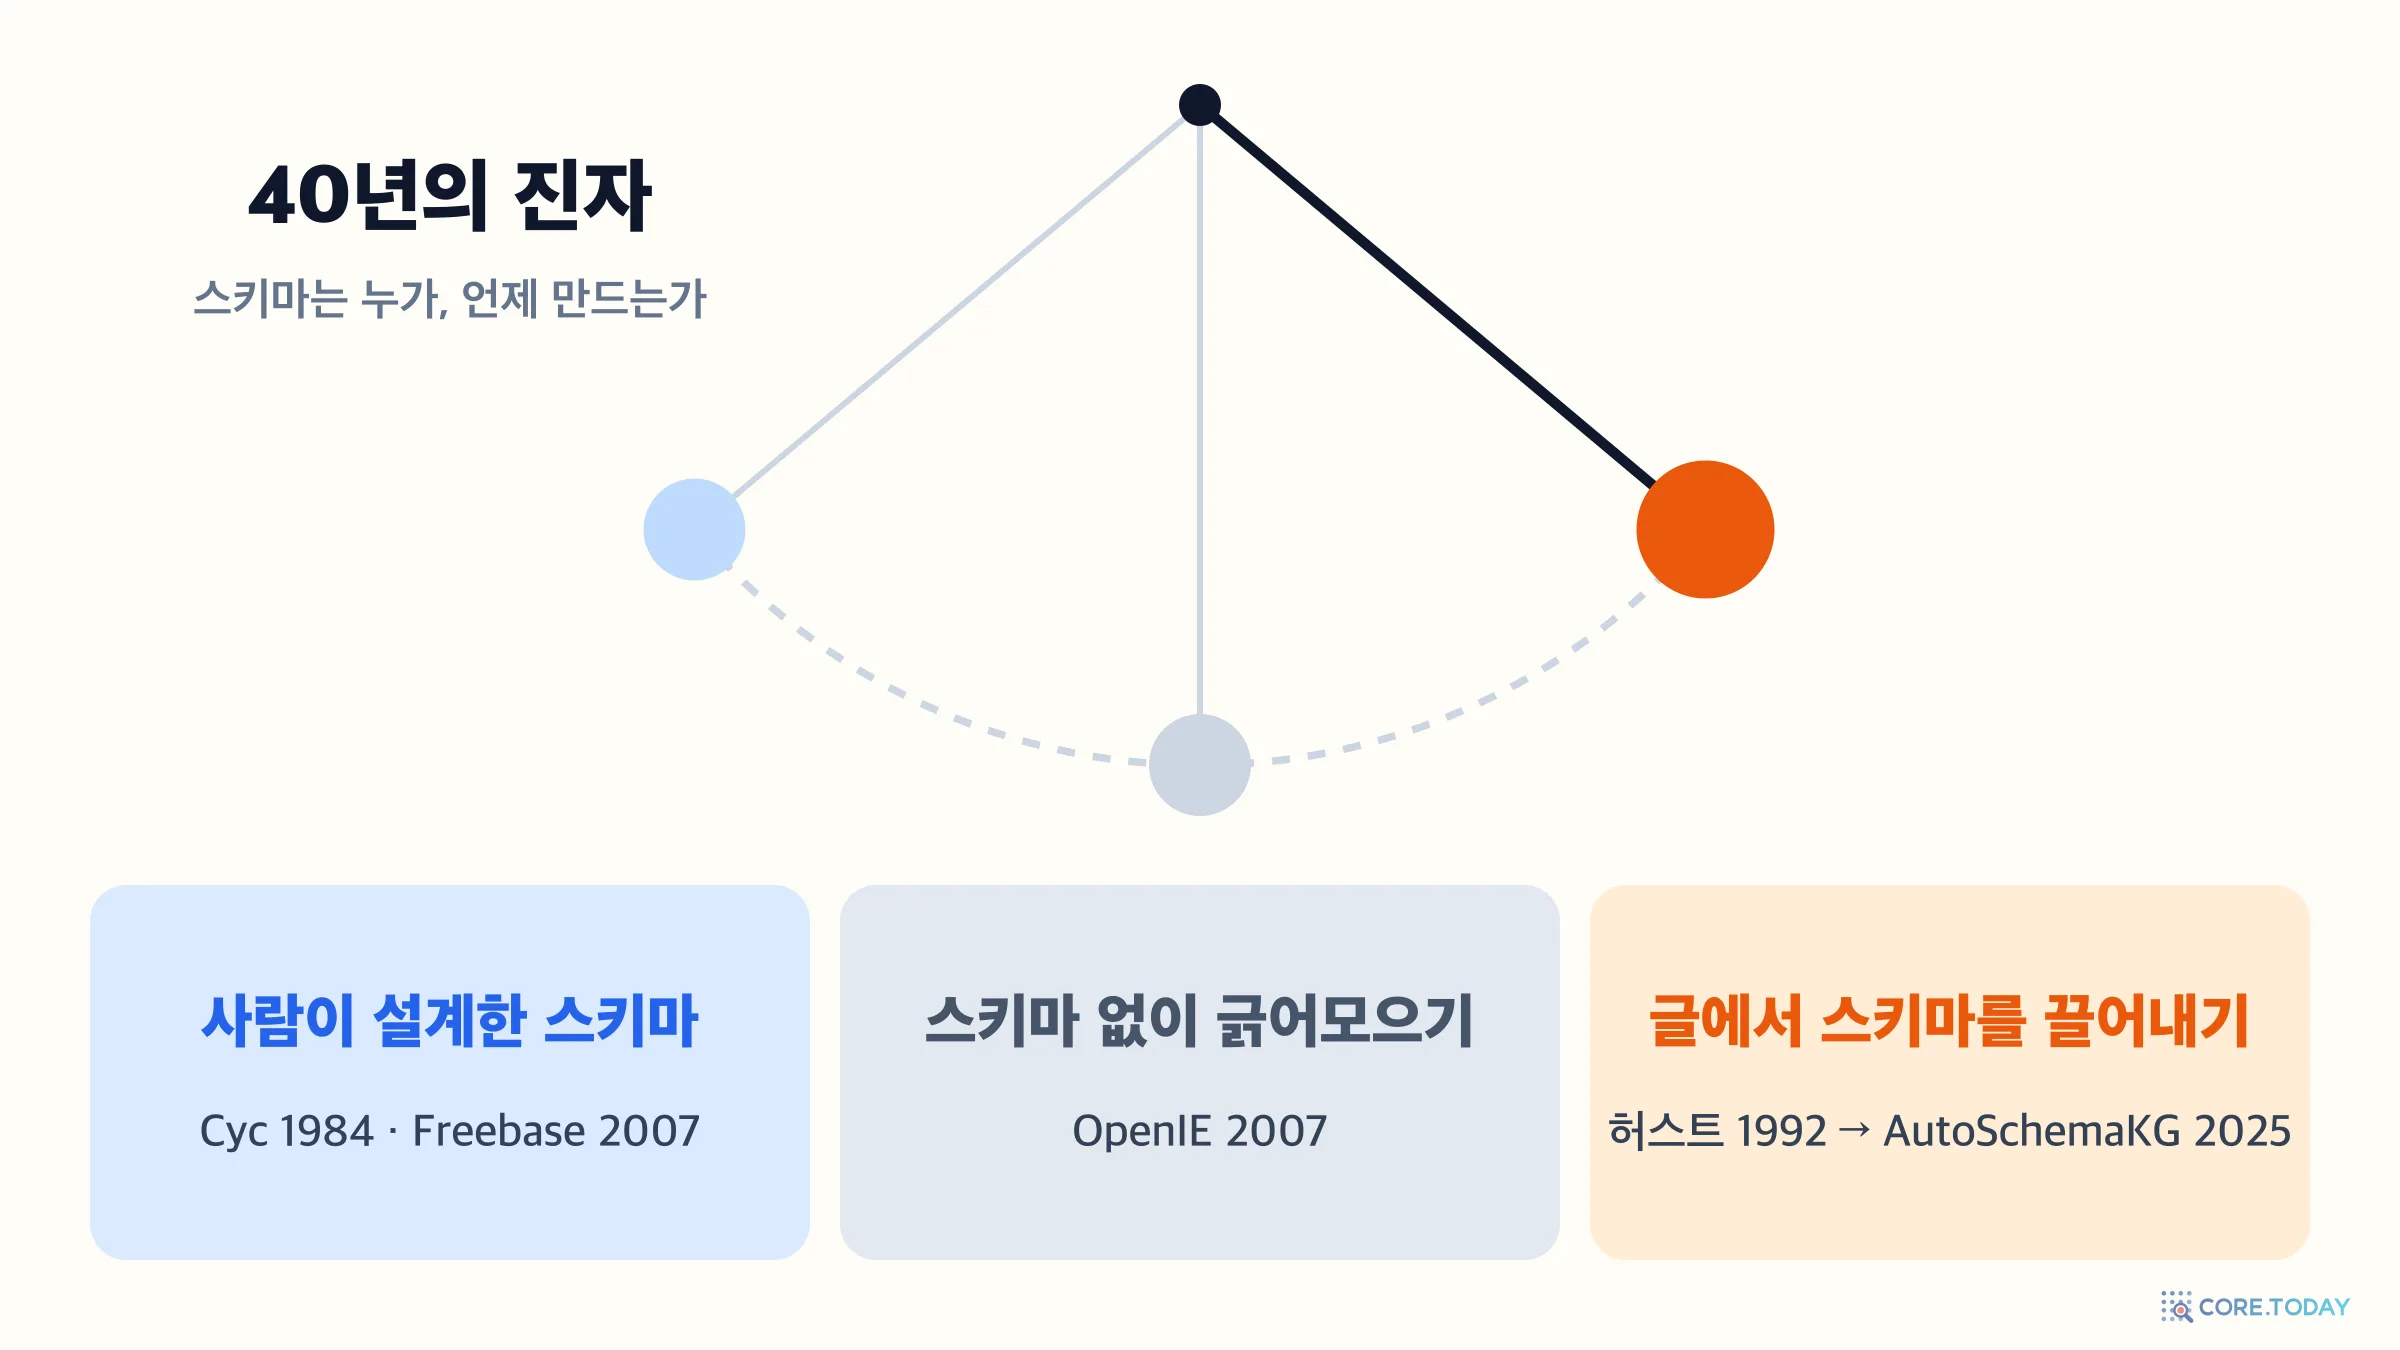
2. 40년의 진자: 그리고, 버리고, 끌어내고
지식 그래프의 역사는 스키마를 둘러싼 진자 운동으로 읽을 수 있습니다. 한쪽 끝에는 "사람이 설계해야 한다"가, 반대쪽 끝에는 "스키마 없이 긁어모으자"가 있고, 그 사이에 "글에서 스키마를 끌어내자"가 있습니다.
1984년 더글러스 레낫(Douglas Lenat)은 사람이 가진 상식을 전부 컴퓨터에 넣겠다며 Cyc 프로젝트를 시작했습니다. "물은 아래로 흐른다", "죽은 사람은 다시 태어나지 않는다" 같은 문장을 사람이 논리식으로 하나씩 입력했습니다. 2017년 기준으로 손으로 쓴 공리가 약 2,450만 개였다고 알려져 있습니다. 레낫은 2023년 세상을 떠날 때까지 이 일을 이어 갔습니다. Cyc는 스키마뿐 아니라 사실까지 전부 사람이 넣는 방식의 극단입니다.
이듬해인 1985년 프린스턴대의 조지 밀러(George Miller)는 영어 낱말을 뜻이 같은 묶음으로 정리하고 묶음 사이에 상·하위 관계(개는 포유류의 일종)를 건 WordNet을 만들기 시작했습니다. 3.0판 기준 묶음이 117,659개입니다. 사람 손으로 만든 '개념의 사다리'로는 지금도 가장 널리 쓰입니다.
2007년은 큰 지식 그래프가 한꺼번에 나온 해입니다. 메타웹(Metaweb)이 누구나 편집할 수 있는 Freebase를 열었고, 위키백과의 정보 상자를 긁어 만든 DBpedia와, 위키백과 분류를 WordNet에 이어 붙인 YAGO가 나왔습니다. 구글은 2010년 메타웹을 인수했고, 2012년 5월 "문자열이 아니라 사물(things, not strings)"이라는 구호와 함께 구글 지식 그래프를 검색에 붙였습니다. 출범 당시 객체 5억 개, 사실 35억 건이었습니다.
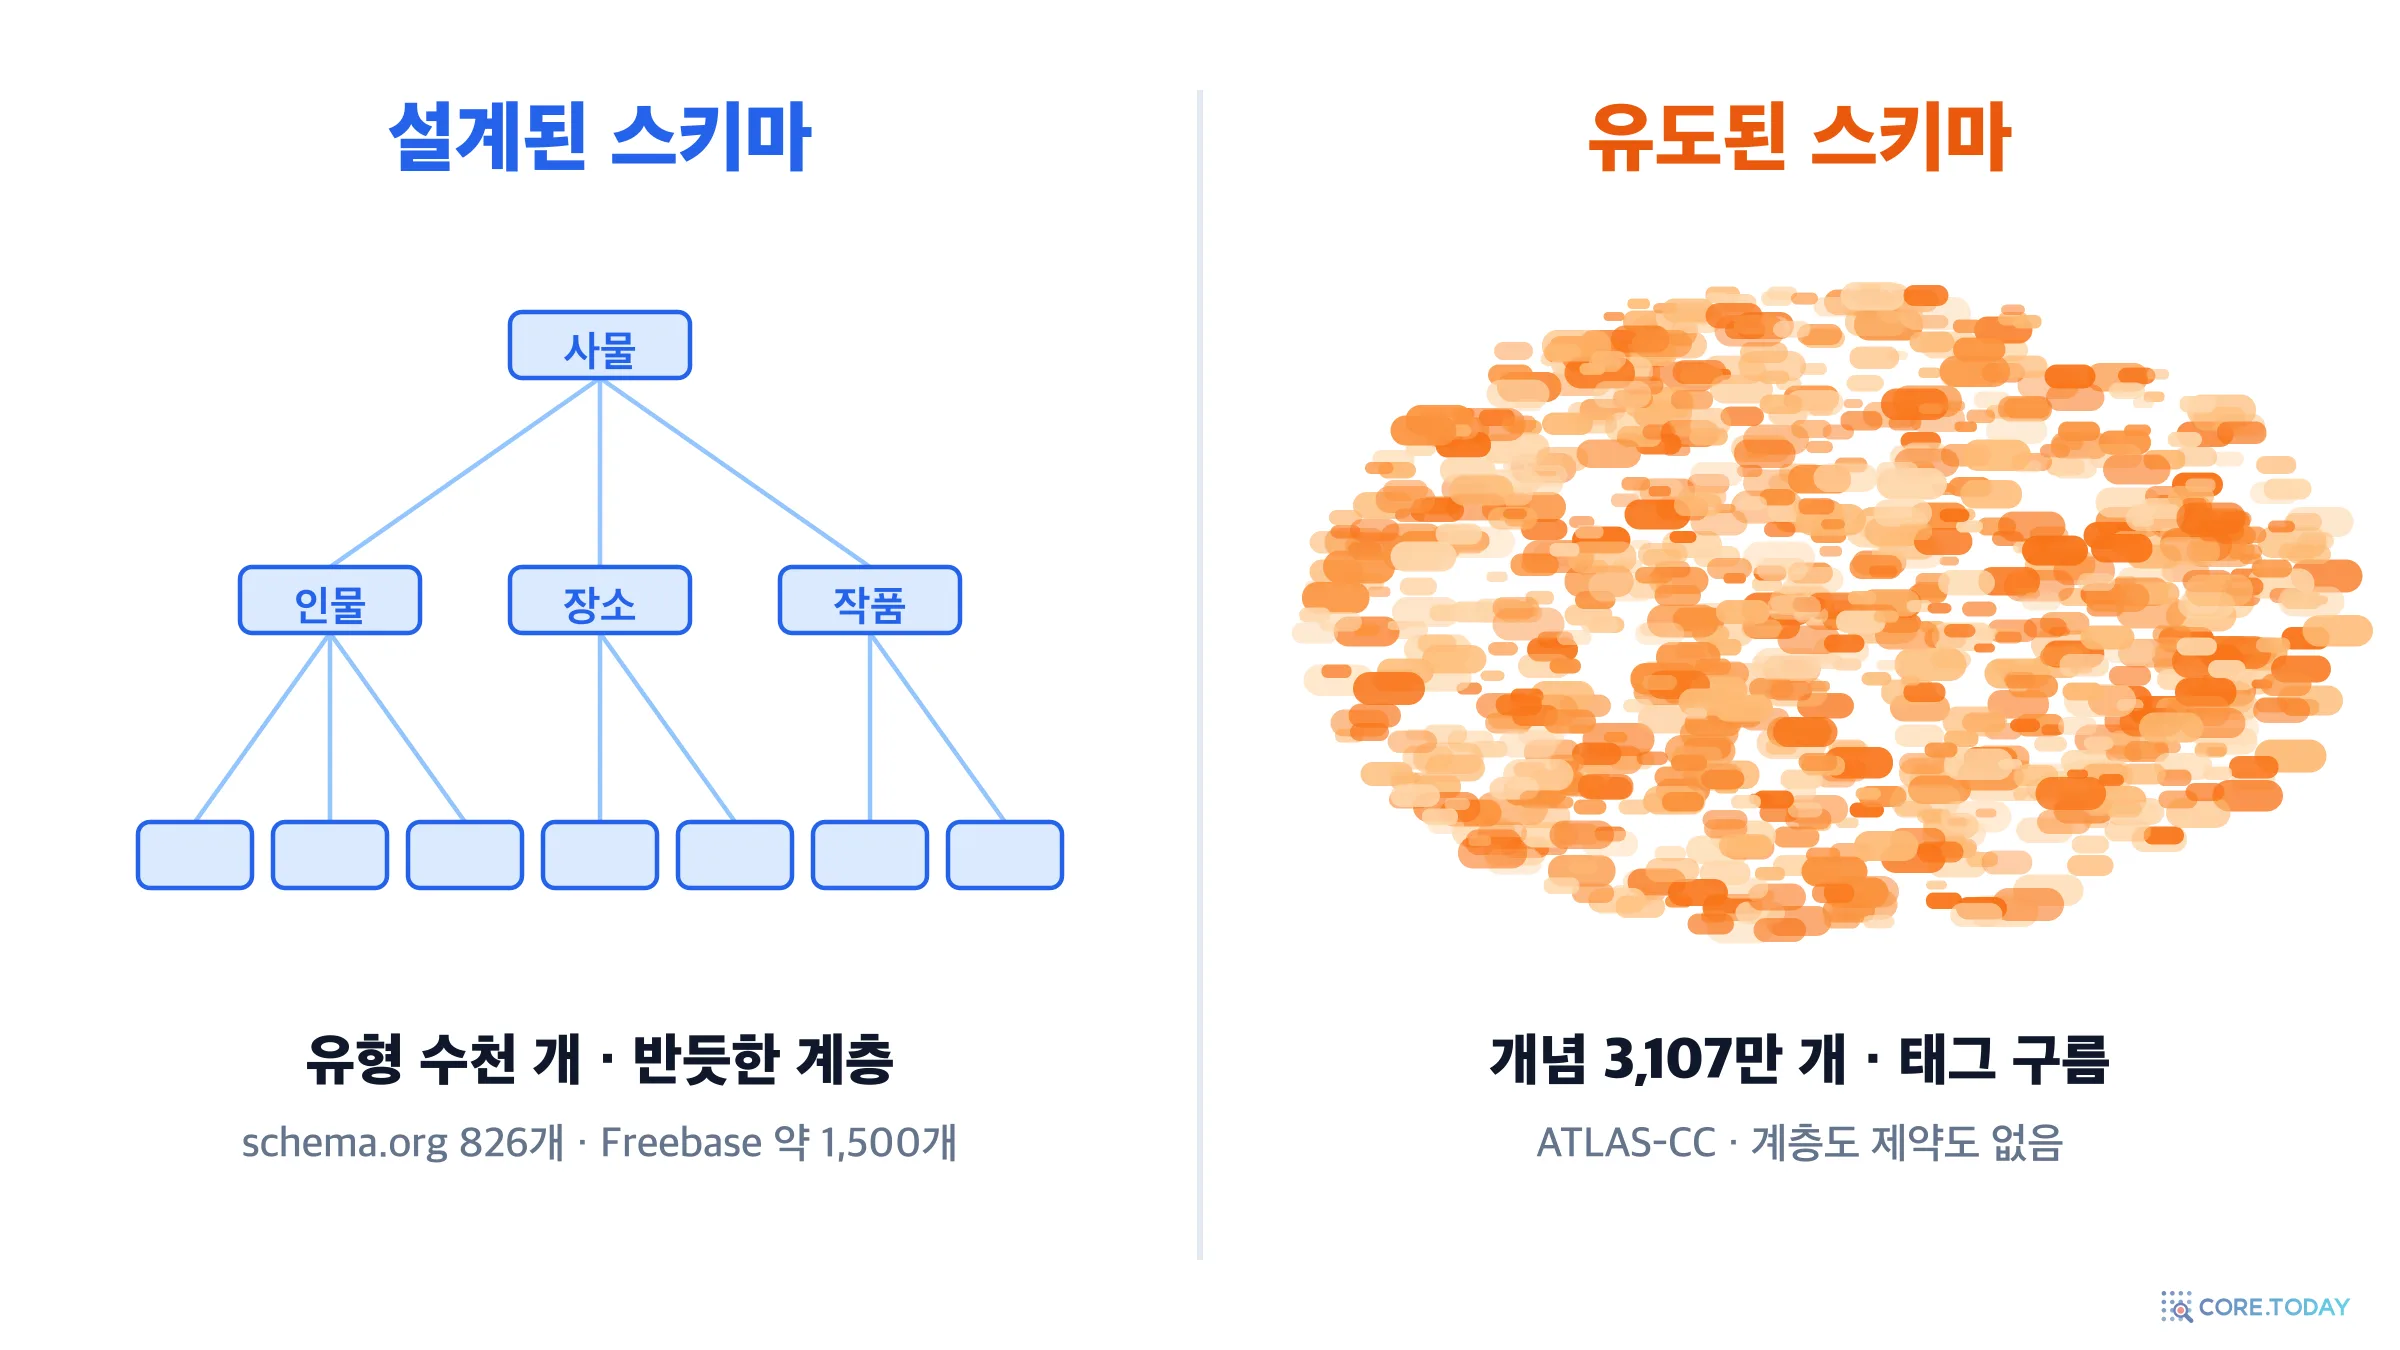
이 그래프들의 스키마는 사람이 정했습니다. 구글이 2014년에 낸 논문은 Freebase를 "개체 유형 약 1,500개, 관계 유형 약 35,000개, 개체 4,000만 개"로 요약합니다. 그 관계 35,000개 하나하나에 사람이 이름을 붙이고 주어·목적어 유형을 정했습니다. Freebase는 2016년 5월 문을 닫았고 데이터는 위키데이터로 옮겨졌습니다. 이번 논문이 스키마 품질을 잴 때 '사람이 만든 정답'으로 쓰는 것이 바로 이 Freebase의 유형입니다.
구글은 2014년 Knowledge Vault로 웹에서 트리플 16억 건을 자동으로 뽑았습니다. 사실 수집은 자동화했지만 스키마는 Freebase의 것을 그대로 썼습니다. 뽑을 수 있는 관계는 Freebase가 정해 둔 4,469종뿐이었습니다. '채우기'는 자동화됐지만 '칸 만들기'는 여전히 사람 몫이었던 셈입니다.
두 번째 갈래: 스키마를 버린다 (2007~)
같은 2007년, 워싱턴대의 미셸 뱅코(Michele Banko)와 오렌 에치오니(Oren Etzioni)는 정반대 길을 냈습니다. TextRunner는 관계 목록을 미리 받지 않습니다. 문장에서 명사구 두 개와 그 사이의 동사구를 찾아 그대로 트리플로 만듭니다. 이 방식에 열린 정보 추출(Open Information Extraction, OpenIE) 이라는 이름이 붙었습니다. 웹 문서 900만 쪽에서 구체적 사실 100만 건 이상을 뽑았습니다.
스키마가 없으니 어떤 관계든 담습니다. 대신 두 가지 병이 생겼습니다. 2011년 후속작 ReVerb 논문이 이 둘에 이름을 붙였습니다.
병
원문
추출된 트리플
무엇이 문제인가
정보 없는 추출
"Faust made a deal with the devil."
(Faust, made, a deal)
문법은 맞지만 '악마와'가 빠져 쓸모가 없음
앞뒤 안 맞는 추출
"The guide contains dead links and omits sites."
(The guide, contains omits, sites)
떨어져 있는 낱말을 이어 붙여 뜻이 안 됨
표기 흩어짐
세 문서의 "was born in", "is a native of", "hails from"
관계 세 개가 따로 생김
같은 뜻이 한 줄로 모이지 않아 건너뛰기가 끊김
세 번째 줄이 스키마를 버린 대가입니다. 스키마가 있었다면 셋 다 '출생지' 한 칸에 들어갔을 것입니다. 이번 논문이 비교 대상으로 삼는 Stanford OpenIE(2015)와 OpenIE 6(2020)이 이 갈래의 후손입니다.
세 번째 갈래: 글에서 끌어낸다 (1992~)
세 번째 갈래는 사실 가장 오래됐습니다. 1992년 마티 허스트(Marti Hearst)는 글에 반복해서 나타나는 문형에 주목했습니다. "작가들, 예컨대 헤밍웨이와 포크너는(authors such as Hemingway and Faulkner)"이라는 구절을 보면, 사전을 찾지 않고도 '헤밍웨이는 작가의 일종'임을 알 수 있습니다. 이런 문형 몇 개로 상·하위 관계를 자동으로 건지는 방법이 허스트 패턴입니다. 스키마의 한 조각인 '무엇이 무엇의 일종인가'를 사람이 적지 않고 글에서 끌어낸 첫 사례입니다. AutoSchemaKG 논문도 관련 연구 절에서 이 갈래의 시작으로 허스트를 꼽습니다.
2012년 마이크로소프트의 Probase는 웹 16.8억 쪽에 허스트 패턴을 돌려 개념 270만 개를 수확했습니다. Freebase의 유형이 1,500개였던 것과 견주면 차원이 다릅니다. "개념은 수천 개짜리 깔끔한 나무가 아니라 수백만 개짜리 덤불일 수 있다"는 생각이 여기서 나왔고, 이번 논문의 3,107만 개 개념으로 이어집니다.
이번 논문의 직계 조상은 같은 연구실의 전작들입니다. 송양추 교수 연구실은 2020년 ASER로 '사건(eventuality)'을 노드로 삼은 그래프를 만들었습니다. "나는 배가 고프다"와 "나는 점심을 먹는다" 같은 짧은 사건 문장 1.94억 개를 노드로 두고, 그 사이를 '그래서', '그 뒤에' 같은 관계로 이었습니다. 그리고 2022년부터 AbstractATOMIC, CAT, CANDLE로 이어지는 연구에서 개념화(conceptualization) 를 다듬었습니다. 개념화는 "샘이 개와 놀고 있다"라는 구체적 사건을 '놀이', '유대' 같은 추상 개념의 한 사례로 보는 일입니다. AutoSchemaKG는 이 두 줄기, 곧 사건 노드와 개념화를 LLM으로 합치고 웹 규모로 키운 것입니다.
LLM이 오고 나서 (2023~)
LLM이 나오자 '문서에서 트리플 뽑기'가 프롬프트 한 장으로 가능해졌습니다. 2024년 마이크로소프트의 GraphRAG와 오하이오주립대의 HippoRAG가 "LLM으로 문서에서 그래프를 뽑고, 그 그래프로 검색을 돕는다"는 방식을 유행시켰습니다. 이때 지식 그래프의 쓰임도 달라졌습니다. 예전에는 사람이나 검색 엔진이 그래프에 직접 물었다면, 이제는 LLM에 넣어 줄 근거 문단을 찾는 길잡이로 그래프를 씁니다. 길잡이로 쓸 그래프라면 스키마가 덜 엄격해도 되지 않을까 하는 생각이 자연스럽게 따라옵니다.
같은 해 싱가포르국립대의 EDC(추출 → 정의 → 정규화)는 LLM으로 먼저 열린 추출을 하고 스키마를 나중에 정리하는 3단계를 제안했습니다. 코어닷투데이가 AEVS 해설에서 다룬 흐름입니다. AutoSchemaKG는 이 흐름에서 가장 과감한 쪽에 섭니다. 정규화도 하지 않고, 스키마 정의도 하지 않고, 노드마다 개념 꼬리표만 붙입니다. 그리고 그 방식으로 얼마나 큰 그래프를 만들 수 있는지를 보여 줍니다.
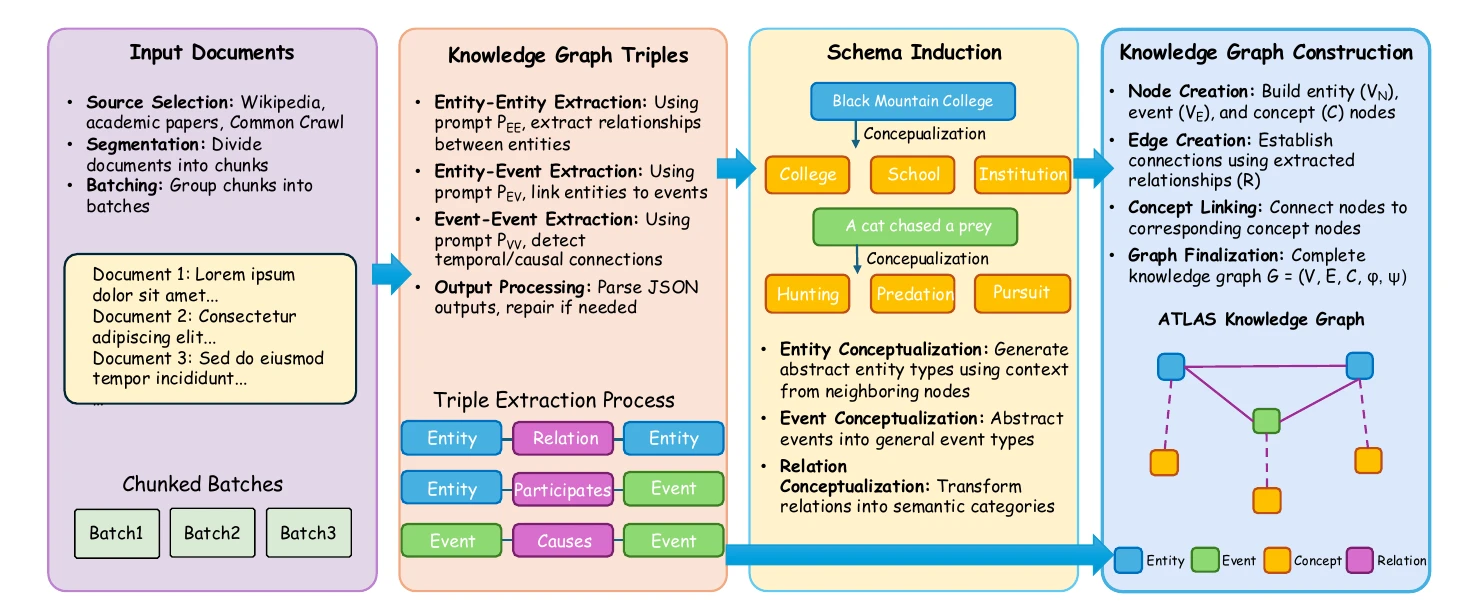
논문 그림 1. 파랑은 개체, 초록은 사건, 주황은 개념, 보라는 관계입니다. (Bai et al., ACL 2026)
칸마다 하는 일은 이렇습니다.
1 입력문서를 영어만 남기고, 1,024토큰을 넘으면 잘라 '청크'로 만들고, 16개씩 묶습니다.
2 추출청크마다 LLM을 세 번 부릅니다. 개체와 개체의 관계, 사건과 거기 참여한 개체, 사건과 사건의 시간·인과 관계를 차례로 뽑습니다. 출력은 JSON이고, 깨진 JSON은 고쳐 쓰거나 버립니다.
3 스키마 유도뽑힌 개체·사건·관계 하나하나를 LLM에 다시 보여 주고 "이것을 대표하는 1~2단어짜리 추상 표현을 셋 이상 적어라"고 시킵니다. 이 답들이 개념 노드가 됩니다.
4 조립개체 노드, 사건 노드, 개념 노드, 그리고 그 사이의 엣지를 한 그래프로 합칩니다. 이것이 ATLAS입니다.
논문은 이 결과물을 수식으로 G=(V,E,C,ϕ,ψ)라고 적습니다. 기호가 낯설어도 뜻은 단순합니다.
기호
뜻
예
V
노드. 개체 노드와 사건 노드 두 종류이고 서로 겹치지 않음
"세종" / "세종이 훈민정음을 반포했다"
E
엣지. 개체–개체, 개체–사건, 사건–사건을 이음
(세종, 창제했다, 훈민정음)
C
개념의 집합
임금, 문자, 반포, 창제
φ (파이)
노드마다 개념을 하나 이상 붙이는 대응
φ(세종) = {임금, 인물, 통치자}
ψ (프사이)
관계마다 개념을 하나 이상 붙이는 대응
ψ(창제했다) = {만들다, 발명하다}
여기서 눈여겨볼 점이 둘 있습니다. 첫째, 노드에 사건이 들어갑니다. 보통의 지식 그래프는 개체만 노드로 삼습니다. 둘째, 이 논문에서 '스키마'는 C와 φ, ψ가 전부입니다. 곧 '개념 목록과, 어느 노드에 어느 개념이 붙는가'입니다. 1절의 표에서 본 제약(출생지의 주어는 인물)이나 계층(임금 ⊂ 인물)은 정의에 없습니다. 이 차이는 5절에서 다시 따집니다.
형사 드라마에 나오는 수사 게시판을 떠올려 봅시다. 인물 사진을 붙이고 빨간 실로 잇습니다. 그런데 게시판에 이름과 실만 있고 "그날 무슨 일이 있었는지"를 적은 쪽지가 없다면 사건은 풀리지 않습니다.
개체만 노드로 삼는 지식 그래프가 바로 이 게시판입니다. (세종, 창제했다, 훈민정음)이라는 트리플은 깔끔하지만, 원래 문장에 있던 "1443년에", "집현전 학자들의 반대에도", "백성이 쉽게 익히도록" 같은 정보는 세 칸에 들어갈 자리가 없습니다. 주어·동사·목적어로 줄이는 순간 시간, 이유, 조건, 방식이 떨어져 나갑니다.
AutoSchemaKG의 답은 문장 자체를 노드로 삼는 것입니다. "세종이 1443년에 훈민정음을 창제했다"라는 한 문장짜리 사건이 통째로 노드가 되고, 거기에 세종과 훈민정음이라는 개체 노드가 '참여'라는 엣지로 매달립니다. 사건과 사건 사이에는 '이전에', '그 결과' 같은 엣지가 걸립니다.
논문이 직접 든 예: 사라진 '그 경주'
논문 5.2절의 예시가 이 차이를 잘 보여 줍니다. 원문은 미국 피닉스에서 열리는 자동차 경주에 관한 문단의 한 문장입니다.
After a hiatus of eleven years, the race was revived by the Verizon IndyCar Series in 2016.
(11년의 공백 끝에, 그 경주는 2016년 버라이즌 인디카 시리즈에 의해 부활했다.)
방법
무엇을 뽑았나
문제
Stanford OpenIE (2015)
"hiatus of eleven years", "revived by Verizon IndyCar Series in 2016" 같은 구절 조각
'그 경주'가 무엇인지 잡지 못해 그래프가 이어지지 않음
OpenIE 6 (2020)
"the race"를 개체로 잡음
앞 문장의 '데저트 다이아몬드 웨스트 밸리 피닉스 그랑프리'와 잇지 못하고, 부활을 사건으로 뽑지 못함
AutoSchemaKG
'the race'를 대회 이름으로 풀고, "그 경주는 2016년 버라이즌 인디카 시리즈에 의해 부활했다"를 사건 노드로 둠. 개념 '인디카 경주'로 관련 개체를 이음
문단 전체를 읽는 LLM이라 대명사·지시어를 풀 수 있음
옛 OpenIE는 문장의 문법 구조만 보고 낱말을 잘라 냅니다. LLM은 문단을 읽고 "the race가 앞 문장의 그 대회"라는 것을 압니다. 이 차이의 절반은 사건 노드라는 설계에서, 나머지 절반은 그냥 LLM이 더 똑똑해서 나옵니다. 둘을 가르는 실험은 뒤에서 봅니다.
한 청크에 세 번 묻는다
추출은 청크마다 LLM을 세 번 부르는 방식입니다. 논문 부록의 그림 2~4에 프롬프트가 그대로 실려 있습니다. 요지를 옮기면 이렇습니다.
추출 프롬프트 세 장 (논문 그림 2~4 요약 번역)
1단계 · 개체–개체
문단에서 중요한 개체와 그 사이 관계를 간결하게 정리하라. 관계는 두 개체의 연결을 짧게 나타내고, 개체는 가능한 한 구체적으로 적으며, 대명사는 개체로 삼지 않는다. 출력: [{"Head": 명사, "Relation": 동사, "Tail": 명사}, …]
2단계 · 사건–개체
문단 속 사건과 개체의 참여 관계를 정리하라. 각 사건은 독립된 한 문장이다. 사건에 참여한 개체를 모두 찾아라. 말줄임표를 쓰지 마라. 출력: [{"Event": 사건을 서술하는 단문, "Entity": [개체 1, 개체 2, …]}, …]
3단계 · 사건–사건
문단 속 사건들 사이의 시간·인과 관계를 다음 유형으로 찾아라: before, after, at the same time, because, as a result. 각 트리플은 구체적이고 혼자서도 이해되어야 한다. 출력: [{"Head": 사건 1 문장, "Relation": 관계, "Tail": 사건 2 문장}, …]
특별한 기법은 없습니다. 예시(few-shot)도 없고, 스키마도 없고, 검증 단계도 없습니다. 다만 세 가지 선택이 눈에 띕니다.
사건은 '독립된 한 문장' 이어야 합니다. 그래야 그 노드만 떼어 읽어도 뜻이 통합니다.
사건 사이의 관계는 다섯 가지로 고정했습니다(이전에, 이후에, 동시에, 왜냐하면, 그 결과). '스키마 없는' 방법이지만 이 칸만큼은 작은 스키마가 있는 셈입니다.
개체–개체 관계에는 제한이 없습니다. LLM이 쓰는 동사가 그대로 관계 이름이 됩니다.
아래는 코어닷투데이가 이 세 프롬프트를 우리말로 옮겨 한국어 위키백과 문단에 돌린 실제 출력입니다(방법은 8절). 단계 버튼을 눌러 같은 문단에서 무엇이 뽑히는지 견주어 보세요.
정보는 얼마나 보존되나: 문단을 지우고 시험 보기
"사건이 정보를 더 보존한다"는 주장을 논문은 이렇게 잽니다. 문단 하나마다 LLM(LLaMA-3.3-70B)에게 사실을 묻는 객관식 5문제를 만들게 합니다. 그다음 다른 LLM에게 문단은 숨기고 추출 결과만 보여 주며 그 문제를 풀게 합니다. 추출 결과에 정보가 남아 있으면 맞히고, 새어 나갔으면 틀립니다. 데이터셋마다 문단 200개, 문제 1,000개를 썼습니다.
위키백과 문단을 LLaMA-3.1-8B가 풀었을 때 개체 트리플만 보여 주면 65.1%, 사건까지 보여 주면 93.3%, 원문을 보여 주면 99.3%를 맞혔습니다. 논문 서론은 이를 "개체만으로는 70%, 우리 방식은 90% 이상"이라고 요약합니다.
이 표에서 세 가지를 더 읽을 수 있습니다.
첫째, 아무것도 안 보여 줘도 46~75%를 맞힙니다. 위키백과와 논문 초록은 LLM이 학습 때 이미 본 글이기 때문입니다. 그래서 '문단이 더해 준 몫'만 따로 재야 공정합니다. 위젯에서 그 버튼을 켜면 개체 트리플은 문단 정보의 35%만 되살리고 사건을 더하면 89%를 되살립니다. 사건 노드의 효과는 논문의 요약보다 오히려 큽니다.
둘째, 옛 방법인 OpenIE 6이 '개체 트리플만'보다 훨씬 높습니다(87.7% 대 65.1%). OpenIE 6은 문장을 여러 조각으로 쪼개 긴 구절을 그대로 남기기 때문입니다. 지저분하지만 정보는 덜 버립니다. 정보를 버리는 범인은 '옛 방법'이 아니라 (명사, 동사, 명사)라는 좁은 틀입니다. 사건 노드는 그 틀을 '문장'으로 넓혀 정보를 되찾습니다.
셋째, 사건만 보여 줘도 사건+개체와 거의 같습니다(92.7% 대 93.3%). 정보 보존이라는 잣대로는 개체 트리플이 보태는 것이 0.6점입니다. 사건 문장 안에 개체가 이미 들어 있으니 당연한 결과입니다.
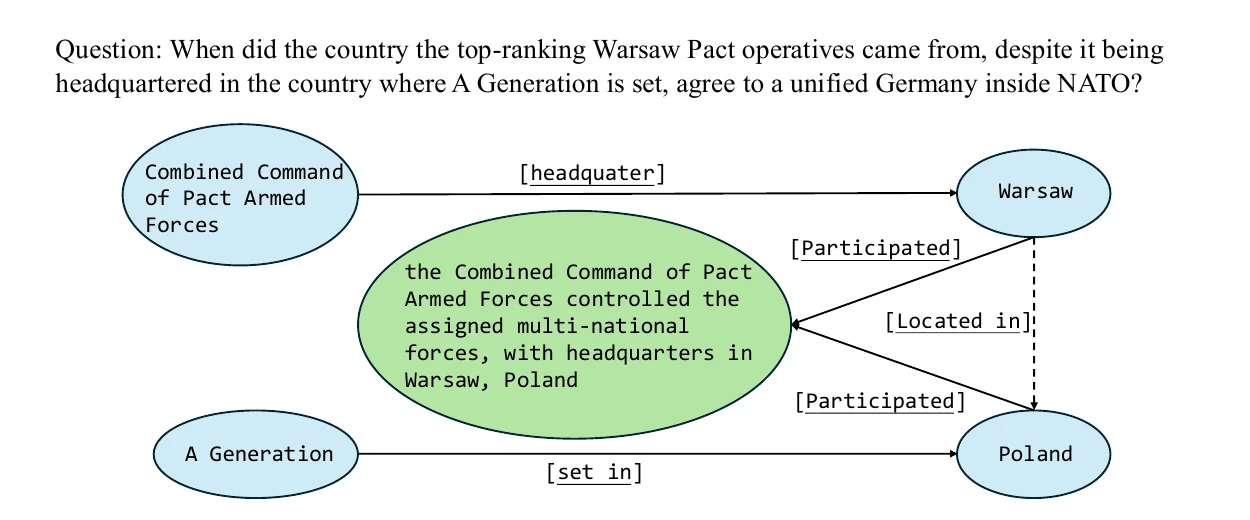
논문 그림 9. 초록이 사건 노드, 점선은 추출에서 빠진 엣지입니다. (Bai et al., ACL 2026)
질문에 답하려면 '바르샤바는 폴란드에 있다'를 건너야 하는데, 개체 트리플 추출이 (바르샤바, 위치, 폴란드)를 빠뜨렸습니다. 그래도 "…본부는 폴란드 바르샤바에 있었다"라는 사건 문장이 두 개체를 함께 품고 있어서 길이 이어집니다. 사건 노드는 트리플 추출이 놓친 것을 받아 내는 그물 역할을 합니다.
5. 두 번째 아이디어: 개념화로 스키마를 끌어낸다
"이것은 무엇의 일종인가"를 9억 번 묻는다
추출이 끝나면 그래프에는 개체 노드와 사건 노드가 있고, 그 사이에 엣지가 걸려 있습니다. 하지만 "세종"이 사람인지 지명인지, "참가했다"와 "출전했다"가 같은 부류인지 그래프는 모릅니다. 스키마가 없기 때문입니다.
AutoSchemaKG는 여기서 노드와 관계 하나하나를 LLM에 다시 보여 주고 묻습니다. 논문 그림 5~7의 프롬프트는 예시 몇 개와 함께 이렇게 시킵니다. "이 사건(개체, 관계)을 대표하는 1~2단어짜리 추상 표현을, 추상 수준이 서로 다르게 셋 이상 적어라. 유형일 수도 있고 관련 개념일 수도 있다." 프롬프트에 실린 예시가 방법을 가장 잘 설명합니다.
종류
입력
프롬프트 속 모범 답안 (개념)
사건
A cat chased a prey into its shelter (고양이가 먹잇감을 은신처까지 쫓았다)
become part of, attend, take part in, engage in, involve in
'Soul'은 영혼일 수도, 음악 장르일 수도, 픽사 영화일 수도 있습니다. 그래서 개체에만 맥락을 붙입니다. 그래프에서 그 개체의 이웃 노드를 앞뒤로 하나씩 무작위로 골라 "~에서 초연, ~가 됨" 같은 문자열을 만들어 함께 줍니다. 사건과 관계는 문장 자체에 뜻이 담겨 있다고 보고 맥락 없이 묻습니다.
이렇게 나온 답들이 개념 노드가 되고, 원래 노드와 '개념' 엣지로 이어집니다. 모범 답안을 보면 알 수 있듯이 개념은 엄밀한 '유형'만이 아닙니다. 고양이 사냥의 개념에 '도주(escape)'가 있고, 개와 노는 일에 '우정'이 있습니다. 상위어, 연관어, 주제어가 섞인 꼬리표에 가깝습니다. 철자가 틀린 'hidding'과 'Amarican'도 프롬프트에 그대로 들어 있습니다.
개념은 떨어진 섬을 잇는 다리
개념 노드의 쓸모는 다리입니다. 문서 A에서 뽑힌 "피닉스 그랑프리"와 문서 B에서 뽑힌 "인디카 시리즈"는 직접 이어지는 트리플이 없으면 그래프에서 서로 다른 섬에 있습니다. 둘 다 '자동차 경주'라는 개념에 매달리면 섬 사이에 다리가 놓입니다. 검색 알고리즘이 한 섬에서 출발해 다른 섬의 문단까지 닿을 수 있게 됩니다.
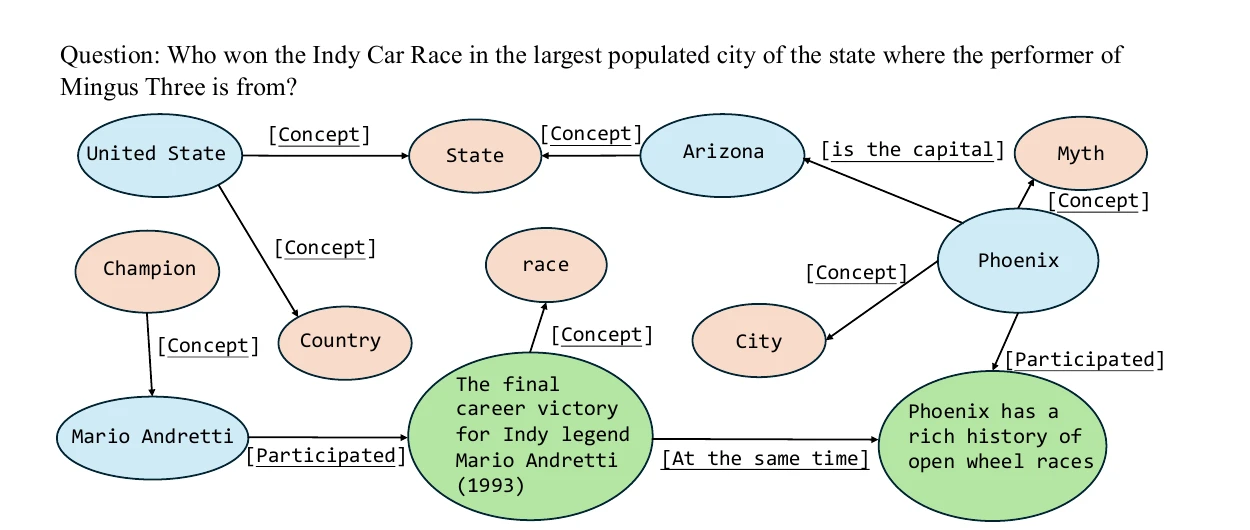
논문 그림 10이 이 다리를 보여 주는 사례입니다. 그림 아래의 위젯은 이 그림을 그대로 옮긴 것입니다. 노드 종류를 켜고 끄면서 답까지 가는 길이 어떻게 달라지는지 직접 확인해 보세요.
직접 걸어 보면 두 가지가 보입니다. 이 질문에서 답까지 가는 길을 여는 것은 개념이 아니라 사건 노드입니다. 그리고 개념 다리 가운데에는 이상한 것이 섞여 있습니다. 도시 '피닉스'에 '신화'라는 개념이 붙어 있습니다. 불사조로 읽은 것입니다. 'United States'에는 '주(State)'가 붙어 애리조나와 이어집니다. 이름에 State가 들어 있어서입니다.
이런 다리는 검색을 엉뚱한 섬으로 보낼 수 있습니다. 사람이 설계한 스키마였다면 '피닉스(도시)'와 '피닉스(신화)'는 처음부터 다른 노드였을 것입니다. 스키마를 끌어내는 방식이 치르는 값입니다.
3,107만 개짜리 '스키마'
여기서 '스키마'라는 말을 다시 봐야 합니다. ATLAS-CC에는 개념이 3,107만 개 있습니다. 세 그래프를 합치면 4,500만 개가 넘습니다(겹치는 것을 빼지 않은 수).
1절에서 스키마가 주는 것을 넷으로 나눴습니다. 유형, 관계 묶기, 제약, 계층. AutoSchemaKG의 유도 스키마는 이 가운데 앞의 둘을 느슨하게 줍니다. 노드마다 유형 비슷한 꼬리표가 붙고, 비슷한 관계는 같은 꼬리표를 나눠 가집니다. 하지만 다음은 없습니다.
제약이 없습니다. '출생지의 목적어는 장소'라는 규칙이 없으므로 틀린 트리플을 걸러 낼 수단이 없습니다.
계층이 없습니다. 프롬프트는 "추상 수준을 달리해" 적으라고 하지만, 나온 답에서 'college'가 'institution'의 아래라는 정보는 저장되지 않습니다. 모두 같은 층의 꼬리표입니다.
정규화가 없습니다. 'movie'와 'film', '대학'과 '대학교'는 서로 다른 개념 노드입니다. 같은 뜻의 개체 표기(예: '세종'과 '세종대왕')를 합치는 단계도 논문에는 없습니다.
그래서 이것은 도서관의 분류표보다 해시태그에 가깝습니다. 정보학에서는 이용자들이 자유롭게 붙인 태그의 모음을 '폭소노미(folksonomy)'라고 부르는데, ATLAS의 개념 층은 LLM이 만든 폭소노미라고 하는 편이 정확합니다. 그게 나쁘다는 뜻은 아닙니다. 검색의 길잡이로는 태그가 분류표보다 쓸모 있을 때가 많습니다. 다만 "스키마가 필요 없어졌다"는 말은 스키마라는 낱말의 뜻을 좁힌 뒤에야 성립합니다.
'92% 정렬'은 무엇을 잰 숫자인가
초록의 한 문장이 가장 많이 인용됩니다. "우리의 스키마 유도는 사람 손을 전혀 거치지 않고 사람이 만든 스키마와 92%의 의미 정렬을 달성한다." 이 숫자가 어디서 왔는지 따라가 봅니다.
실험은 이렇습니다. 사람이 유형을 붙여 둔 데이터셋 네 가지를 가져옵니다. Freebase와 YAGO의 개체 유형, 위키하우(wikiHow)의 사건 유형, Freebase의 관계 유형입니다. 개체·사건·관계를 AutoSchemaKG의 개념화 프롬프트에 넣어 개념을 만들고, 그것이 사람이 붙인 유형과 얼마나 비슷한지를 BERTScore로 잽니다. BERTScore는 두 문구를 언어 모델(RoBERTa)의 벡터로 바꿔 토큰끼리의 유사도를 평균한 값입니다.
모델
개체 (Freebase)
개체 (YAGO)
사건 (wikiHow)
관계 (Freebase)
Txt2onto (기준선)
85.96 / 75.73
88.06 / 23.27
93.51 / 31.94
78.41 / 13.27
LLaMA-3.1-8B
88.57 / 86.54
80.67 / 58.56
99.18 / 99.26
88.75 / 88.41
LLaMA-3.3-70B
89.49 / 87.30
94.26 / 90.56
98.97 / 99.33
88.58 / 88.66
논문 표 6. 칸마다 BS-R / BS-C(%). BS-R은 사례 하나 안에서, BS-C는 시험 세트 전체에서 정답 유형이 얼마나 덮였는지를 BERTScore로 잰 값입니다.
70B 모델의 네 칸을 평균하면 BS-R이 92.8, BS-C가 91.5입니다. 논문은 '92%'가 어느 칸의 값인지 밝히지 않지만 이 평균과 맞아떨어집니다. 이 숫자를 읽을 때 조심할 점이 넷 있습니다.
첫째, 이것은 정답률이 아니라 유사도 점수입니다. "유형 100개 중 92개를 맞혔다"가 아니라 "유도된 개념과 정답 유형의 벡터 유사도가 평균 0.92"입니다. BERTScore는 관련이 적은 짧은 구절 사이에서도 높게 나오는 경향이 있어서, 원 논문도 기준선으로 다시 눈금을 매기라고 권합니다. 실제로 이 표에서 기준선 Txt2onto의 BS-R도 78~94입니다.
둘째, 작은 모델이 큰 모델을 이깁니다. 논문 표 7에서 일곱 모델의 평균을 보면 LLaMA-3.2-1B가 93.63 / 94.67로 가장 높고 70B는 93.05 / 92.36입니다. 10억 매개변수짜리 모델이 700억짜리보다 스키마를 잘 유도한다기보다, 이 잣대가 품질 차이를 잘 가르지 못한다고 보는 편이 자연스럽습니다.
셋째, 실제로 ATLAS를 만든 모델의 점수는 더 낮습니다. ATLAS는 70B가 아니라 8B로 만들었습니다. 8B의 네 칸 평균은 89.3 / 83.2이고, YAGO 개체에서는 BS-C가 58.6입니다.
넷째, 이 숫자는 한 번 바뀌었습니다. 2025년 5월 arXiv 첫 판의 초록은 95% 였습니다. 2025년 9월 한 독자가 저장소 이슈(#28)에서 "초록은 95%, 서론은 92%인데 어느 쪽이 맞느냐, 표의 점수로는 어느 쪽도 바로 나오지 않는다"고 물었고, 저자는 "초록의 95%가 틀렸고 92%를 써야 한다"고 답했습니다. ACL판은 초록과 서론이 모두 92%입니다. 다른 이슈(#39)에서는 한 사용자가 지표를 직접 구현했더니 사건 유형 BS-C가 논문의 99%가 아니라 12%로 나왔다고 보고했고, 저자들은 공개 코드의 함수 이름이 헷갈리게 붙어 있다고 답했습니다.
정리하면 '92% 정렬'은 "LLM이 붙인 꼬리표가 사람이 붙인 유형 이름과 말뜻이 대체로 가깝다"는 뜻으로 읽어야 합니다. "사람이 설계한 스키마를 92% 재현했다"는 뜻이 아닙니다. 논문도 부록 E에서 이 평가가 부품 단위의 유형 맞히기일 뿐이라는 점을 인정하고, 스키마 전체가 쓸 만한지는 "뒤의 질문 답하기 성능이 보완 증거"라고 적습니다. 그 증거는 7절에서 봅니다.
6. 세 번째 아이디어: 웹 규모로 민다
ATLAS 세 가족
방법이 단순한 만큼 논문은 규모로 승부합니다. 연구진은 앨런 AI 연구소가 LLM 사전학습용으로 공개한 말뭉치 Dolma에서 세 덩어리를 골라 각각 그래프로 만들었습니다. 이름은 ATLAS(Automated Triple Linking And Schema induction)입니다.
엣지 10개 중 7개는 개념 꼬리표입니다. 문서에서 뽑은 사실(개체–개체, 사건–개체, 사건–사건)은 ATLAS-CC에서 약 17.7억 개이고 나머지 41.8억 개는 "이 노드는 이 개념에 속한다"입니다.
표의 노드 합계가 줄마다 다르게 세졌습니다. 위키와 Pes2o의 '노드' 줄은 개체+사건+개념의 합과 맞는데(예: 7,010만+1억 6,572만+809만=2억 4,391만), ATLAS-CC의 9억 3,726만은 개체+사건만의 합입니다. 같은 방식으로 세면 9억 6,833만이어야 합니다. 결론을 바꾸는 차이는 아니지만, 표를 인용할 때는 알아 둘 만합니다.
7만 8천 GPU 시간
비용은 부록 D에 적혀 있습니다. 세 그래프에 GPU 78,400시간이 들었습니다. GPU 한 장으로는 9년, 100장으로는 한 달 남짓입니다. 청크 수로 나누면 1,024토큰짜리 청크 하나에 GPU 약 5.4초이고, 세 그래프 모두 이 값이 거의 같습니다. 그 5.4초 동안 LLM은 추출 세 번과, 뽑힌 노드마다의 개념화를 합니다.
아래 계산기는 이 평균을 그대로 늘리고 줄여 "내 문서 더미를 이 방식으로 그래프로 만들면 얼마나 드나"를 어림합니다.
두 가지를 짚어 둡니다. 첫째, ATLAS-CC는 Common Crawl의 3% 입니다. 논문 제목의 '웹 규모'는 아직 웹의 3%를 뜻합니다. 같은 속도로 전부를 돌리면 GPU 약 174만 시간이 듭니다. 둘째, 논문은 왜 이 규모가 필요한지를 이렇게 적습니다. "지식 그래프가 최신 LLM의 매개변수 지식을 보완하려면 수십억 건의 사실에 닿아야 한다." LLM이 이미 웹을 통째로 읽은 시대에, 그보다 작은 그래프는 LLM이 아는 것을 다시 알려 줄 뿐이라는 판단입니다. 이 판단이 맞는지는 7절의 MMLU 실험이 시험합니다.
공개도 규모가 큽니다. 코드는 MIT 라이선스로 GitHub에 있고(pip install atlas-rag), 세 그래프는 허깅페이스에 Neo4j 덤프와 벡터 색인으로 올라와 있습니다. 압축본이 약 1.65TB, 풀린 CSV가 약 2.65TB입니다. 내려받아 띄우는 것만으로도 꽤 큰 서버가 필요합니다. 논문은 노드 임베딩에 작은 모델(MiniLM)을 쓴 이유도 여기서 찾습니다. 4,096차원 임베딩을 10억 노드에 달면 저장에만 16TB가 든다는 계산입니다.
7. 성적표 읽기
논문은 네 가지를 잽니다. 추출이 정확한가, 여러 단계 질문을 잘 푸는가, LLM의 사실 오류를 잡아내는가, 일반 지식 시험 점수를 올리는가.
7.1 추출 정확도: 정밀도 99%, 그런데 심판도 LLM
추출 품질은 이렇게 쟀습니다. 원문과 추출된 트리플을 다른 LLM(DeepSeek-V3)에게 함께 보여 주고, 잘못 뽑힌 트리플(정밀도)과 원문에 있는데 빠진 사실(재현율)을 세게 합니다.
ATLAS-Wiki 기준
정밀도
재현율
F1
OpenIE 6
45.92
81.16
52.65
Stanford OpenIE
78.50
93.31
82.00
AutoSchemaKG 개체–개체
99.13
90.10
94.09
AutoSchemaKG 사건–개체
100.0
92.59
95.60
AutoSchemaKG 사건–사건
99.60
93.59
96.01
논문 표 2 일부. 추출 모델은 LLaMA-3.1-8B, 심판은 DeepSeek-V3.
정밀도가 99~100%입니다. 8B 모델이 뽑은 트리플 가운데 틀린 것이 100개 중 하나도 안 된다는 뜻입니다. 재현율은 옛 방법과 비슷하거나 조금 낮습니다. LLM은 덜 뽑되 정확하게 뽑고, OpenIE는 많이 뽑되 지저분하게 뽑습니다.
다만 이 숫자는 LLM이 LLM을 채점한 결과입니다. 사람이 검수한 표본은 없습니다. 논문은 부록에서 다른 심판 둘(Kimi-K2, GPT-4o)로 다시 채점해도 순위가 같았다고 적지만 수치는 싣지 않았습니다. 그리고 여기서 재는 정밀도는 "트리플이 원문과 어긋나지 않는가"입니다. 5절에서 본 '피닉스 → 신화' 같은 개념화 오류는 이 표에 잡히지 않습니다. 개념은 원문에 없는 말이라 원문 대조로는 채점할 수 없기 때문입니다.
모델 크기별 결과(표 3)도 볼 만합니다. 1B 모델의 F1이 86.4, 8B가 92.2, 70B가 93.7입니다. 8B에서 70B로 가면 계산은 몇 배가 들지만 1.5점 오릅니다. 연구진이 ATLAS를 8B로 만든 이유입니다.
7.2 여러 단계 질문: '12~18%'의 출처
주 실험은 멀티홉 질문 답하기입니다. MuSiQue, 2WikiMultihopQA, HotpotQA 세 데이터셋에서 1,000문제씩 뽑았습니다. 문서 더미를 AutoSchemaKG로 그래프로 만들고, 그 그래프 위에서 기존 검색 알고리즘(HippoRAG 2 등)을 돌려 문단을 찾은 뒤, LLaMA-3.3-70B가 답을 씁니다.
여기서 알아 둘 점은 AutoSchemaKG가 검색 방법이 아니라 그래프를 짓는 방법이라는 것입니다. 검색은 남의 것(HippoRAG 2)을 빌려 씁니다. HippoRAG 2는 질문과 비슷한 엣지를 찾아 출발점으로 삼고, 거기서 그래프를 따라 점수를 퍼뜨리는(PageRank) 알고리즘입니다. 코어닷투데이가 「From RAG to Memory」에서 자세히 다뤘습니다. 그러니 공정한 질문은 "HippoRAG 2가 원래 쓰던 그래프를 AutoSchemaKG 그래프로 바꾸면 나아지는가"입니다.
위젯에서 비교 상대를 바꿔 보면 초록의 문장이 다르게 읽힙니다.
비교 상대
MuSiQue EM
2Wiki EM
HotpotQA EM
읽는 법
BM25 (1994년의 낱말 검색)
+11.5
+17.4
+9.8
초록의 '12~18%'에 해당
NV-Embed-v2 (그래프 없는 임베딩 검색)
−2.9
+7.8
−1.0
셋 중 둘에서 그래프 없는 쪽이 높음
HippoRAG 2 원본 그래프
−5.4
+0.3
−0.9
같은 검색기, 그래프만 바꾼 비교
HippoRAG 2 원본 (우리도 70B로 구축)
−0.9
−2.6
−1.3
부록 표 11. F1은 +1.9, −0.4, +3.2
자기 자신의 '개체만' 그래프
+0.4
+1.1
+0.9
사건과 개념을 더한 효과
AutoSchemaKG 전체 그래프 + HippoRAG 2의 EM에서 각 비교 상대의 EM을 뺀 값. 논문 표 8·11에서 계산.
초록은 "최신 기준선을 능가한다"고 쓰고, 서론은 "12~18% 향상"이라고 쓰고, 본문은 그 숫자가 "BM25와 Contriever 같은 전통적 검색 대비"라고 밝힙니다. 틀린 말은 아닙니다. 하지만 정작 궁금한 비교, 곧 같은 검색기에서 그래프만 바꾼 비교에서는 비기거나 조금 집니다. 논문의 반론은 "HippoRAG 2 원본은 그래프를 70B로 지었고 우리는 8B로 지었는데도 비슷하다"는 것입니다. 일리 있는 말입니다. 그런데 부록 표 11에서 70B로 맞춰 다시 지었을 때도 EM은 세 데이터셋 모두 원본보다 낮았습니다. F1은 둘에서 높았습니다. EM은 답이 글자 그대로 같아야 점수를 주고 F1은 낱말이 겹치면 부분 점수를 주므로, AutoSchemaKG 쪽이 '비슷하지만 표기가 다른 답'을 더 많이 낸다고 읽을 수 있습니다.
마지막 줄이 이 글의 관심사와 가장 가깝습니다. 개체만 뽑은 그래프에 사건과 개념을 더해서 얻는 것은 EM 0.4~1.1점입니다. 4절에서 사건 노드는 문단 정보의 89%를 보존했고 개체 트리플은 35%만 보존했습니다. 그 큰 차이가 질문 답하기에서는 거의 사라집니다. 까닭은 검색 방식에 있습니다. HippoRAG 2에서 그래프는 문단을 찾아가는 길일 뿐이고, 답은 찾아온 원문 문단을 LLM이 읽고 씁니다. 길만 맞게 나 있으면 노드에 정보가 얼마나 담겼는지는 크게 중요하지 않습니다. 사건 노드가 지키는 정보는, 원문을 버리고 그래프만 들고 다닐 때 값을 합니다.
개념 노드의 기여는 더 작습니다. '개체+사건'에서 '전체'로 가면 EM이 +0.2, +0.1, +1.8입니다. 검색 재현율(부록 표 13)로 보면 MuSiQue와 2Wiki에서는 상위 5개 문단에 정답 문단이 들어오는 비율이 오히려 조금 떨어집니다(72.7 → 72.5, 85.9 → 84.6). 엣지의 70%를 차지하는 개념 연결이 검색에 보태는 것은 지금까지의 증거로는 1점 안팎입니다.
7.3 사실 오류 잡기: 0.28점 차이
두 번째 실험은 FELM입니다. LLM이 쓴 답변 847건을 문장 단위로 쪼개 어느 조각에 사실 오류가 있는지 맞히는 벤치마크입니다. LLaMA-3.1-8B에게 근거 자료를 검색해 주고 오류 조각을 고르게 합니다.
지식 출처
검색 방법
균형 정확도
F1
없음
–
54.08
26.79
위키백과 글
BM25
56.15
30.43
위키백과 글
밀집 검색
56.04
30.33
Freebase
Think-on-Graph
53.75
24.81
ATLAS-Wiki
HippoRAG 2
56.43
30.48
Pes2o 초록 글
밀집 검색
55.43
29.19
ATLAS-Pes2o
HippoRAG 2
55.30
28.12
Common Crawl 글
밀집 검색
54.42
28.49
ATLAS-CC
HippoRAG 2
55.56
29.57
논문 표 9 일부.
ATLAS-Wiki가 가장 높습니다. 그런데 같은 위키백과를 그래프로 만들지 않고 BM25로 그냥 검색한 것과의 차이가 정확도 0.28점, F1 0.05점입니다. 14,300 GPU 시간을 들여 그래프를 지은 쪽과 색인만 만든 쪽이 사실상 비깁니다. 논문 초록의 "LLM 사실성을 최대 9% 높인다"는 표현의 출처를 논문은 밝히지 않습니다. 부록 표 14에서 가장 가까운 칸은 과학·기술 영역의 F1입니다(검색 없음 18.94 → ATLAS-Pes2o 27.89, +8.95점). 그런데 같은 칸에서 Pes2o 초록을 그래프 없이 밀집 검색한 쪽이 28.57로 조금 더 높습니다.
그래도 이 표에서 건질 것이 있습니다. 사람이 설계한 Freebase는 검색 없음보다 낮습니다. 2016년에 갱신이 멈춘 그래프라 덮는 범위가 좁기 때문입니다. '깨끗하지만 좁은 그래프'보다 '지저분하지만 넓은 그래프'가 이 과제에서는 낫습니다.
7.4 일반 지식 시험: 법은 오르고 수학은 떨어진다
마지막은 MMLU입니다. 57개 과목의 4지선다 시험으로, LLM의 일반 지식을 재는 표준 벤치마크입니다. 논문은 과목을 13개 영역으로 묶고, 본문 표 10에서는 그 가운데 "지식 집약적"이라고 본 8개 영역(역사, 법, 종교, 철학·윤리, 의학·보건, 세계 상식, 사회과학, 논리)만 보여 줍니다. 나머지 5개 영역은 부록 표 16에 있습니다.
본문의 8개 영역만 보면 이야기가 깔끔합니다. ATLAS를 붙인 여섯 줄이 모두 '검색 없음'보다 평균이 높고, 법 영역에서는 ATLAS-CC가 4점 올립니다(66.86 → 70.85). 같은 영역에서 글 검색은 대부분 점수를 깎습니다. 영역마다 잘하는 그래프가 다른 것도 그럴듯합니다. 논문 초록으로 만든 ATLAS-Pes2o는 의학·사회과학에서, 웹으로 만든 ATLAS-CC는 법과 역사에서 강합니다.
13개 영역 전체로 넓히면 그림이 달라집니다.
MMLU 전체 점수는 검색 없음이 69.18, ATLAS 가운데 가장 좋은 줄이 69.19입니다. 나머지 다섯 줄은 검색 없음보다 낮습니다.
수학은 최대 8.6점 떨어집니다(57.31 → 48.74). 경제, 컴퓨터·공학도 대체로 떨어집니다.
전체 점수가 가장 높은 줄은 Freebase + Think-on-Graph(70.36) 입니다. FELM에서는 꼴찌였던 그 그래프입니다.
논문은 이 사실을 숨기지 않았습니다. 본문에서 "검색 증강이 LLM 성능을 언제나 높이리라 기대하지 않는다"고 쓰고, 부록에서 "수학·논리 같은 추론 중심 과제에서는 성능에 부정적 영향을 줄 수 있다"고 적었습니다. 다만 초록과 결론만 읽은 독자는 "다양한 영역에서 일관되게 향상"이라는 문장을 13개 영역 전체의 이야기로 받아들이기 쉽습니다. 실제로는 이길 만한 8개 영역을 고른 뒤의 일관성입니다.
그래도 이 실험에는 눈여겨볼 발견이 하나 있습니다. ATLAS의 원천인 위키백과와 Common Crawl은 LLaMA가 학습 때 이미 본 글입니다. 모델이 이미 읽은 글을 그래프로 바꿔 다시 건네줬을 뿐인데 법·역사·사회과학 점수가 오릅니다. 읽은 것과 꺼내 쓸 수 있는 것은 다르다는 뜻입니다. 논문 제목 뒤에 숨은 진짜 주장, 곧 "구조화된 지식은 매개변수에 녹아든 지식을 보완한다"는 주장을 가장 잘 받쳐 주는 증거가 이 대목입니다. 효과의 크기는 1~4점입니다.
8. 코어닷투데이 실측: 한국어 문단에 같은 프롬프트를 돌리면
논문은 영어만 다룹니다. 같은 방법이 한국어에서 어떻게 움직이는지 보려고 작은 실험을 했습니다. 크기가 작아서 논문 수치와 견줄 수는 없고, 방향이 같은지와 출력이 실제로 어떻게 생겼는지를 보는 것이 목적입니다.
문단한국어 위키백과 표제어 25개(세종, 이순신, 임진왜란, 누리호, 삼성전자, 한강(작가), 기생충(영화), 독도, 인천국제공항, 한국 전쟁 등)의 첫머리 약 600자
추출논문 그림 2~4의 프롬프트를 우리말로 옮겨 Qwen3.5 9B로 세 번 호출. 문단 하나에 평균 12.6초(맥 한 대, 로컬)
개념화논문 그림 5~7의 프롬프트와 예시를 우리말로 옮겨, 뽑힌 개체 465개·사건 483개·관계 182개에 하나씩 적용
시험Qwen3.8 27B가 문단마다 객관식 5문제(모두 125문제)를 내고, 다섯 가지 맥락으로 풀게 함
사건이 정보를 지킨다는 결과는 한국어에서도 같았다
9B 모델이 답했을 때 맥락 없이 68.0%, 개체 트리플만으로 83.2%, 사건만으로 94.4%, 사건과 개체를 함께 주면 95.2%, 원문으로 98.4%를 맞혔습니다. 문단이 더해 준 몫으로 다시 재면 개체 트리플은 50%, 사건을 더하면 89% 를 되살립니다. 논문의 위키백과 결과(35%와 89%)와 방향이 같고, 사건 쪽 숫자는 우연히도 똑같습니다. 개체 트리플로는 틀렸는데 사건을 더하니 맞힌 문제가 17개, 그 반대가 2개였습니다.
4절 위젯의 '세종' 문단에서 까닭을 볼 수 있습니다. 개체–개체 추출은 (세종, 창제하였다, 훈민정음)을 남겼습니다. "세종이 훈민정음을 만든 직접적인 계기는?"이라는 문제의 답(백성이 글을 몰라 농사 책을 읽지 못하는 것을 보고)은 여기에 없습니다. 사건 추출은 "백성들이 글을 몰라 농사 책을 이해하지 못하였다."를 한 줄로 남겼습니다.
그런데 출력을 들여다보면
숫자는 논문과 같은 방향이지만, 출력을 한 줄씩 읽으면 논문의 표에는 잡히지 않는 문제가 보입니다.
문제
실제 출력
무슨 일이 일어났나
뜻을 잘못 고른 개념
한강 → 강, 하천, 지리
소설가 한강의 문단에서 뽑힌 개체인데, 맥락으로 "작가이다"를 함께 줬는데도 강으로 읽음. 논문 그림 10의 '피닉스 → 신화'와 같은 종류
뜻을 잘못 고른 개념
수반을 거친 인물 → 동행하다, 동반되다
임시정부의 '수반(首班)'을 '수반(隨伴)하다'로 읽음. 관계는 맥락 없이 개념화하므로 한자어 동음이의에 약함
방향이 뒤집힌 트리플
(세종, 형이다, 양녕대군)
원문은 "형인 양녕대군". 글자 그대로 읽으면 세종이 형이 됨
관계 칸에 사실이 들어감
(한강, 시인으로 등단하였다, 1993 년)
'동사' 칸에 내용이 들어가 관계 이름이 한 번만 쓰이는 문자열이 됨
혼자 서지 못하는 사건
"세자가 책봉되었다."
누가 세자가 됐는지 빠짐. 원문의 생략된 주어(세종)를 채우지 못함
갈라진 표기
세종 / 세종대왕, 기생충 / 《기생충》
같은 대상이 서로 다른 노드가 됨. 정규화 단계가 없기 때문
이 가운데 어느 것도 7.1절의 '정밀도 99%'를 깎지 않습니다. 원문과 어긋나지 않는 트리플이거나(등단 연도), 원문에 없는 층의 오류(개념)이기 때문입니다. 추출 정밀도와 그래프의 쓸모는 다른 것입니다.
걱정했던 조사 문제는 거의 나타나지 않았습니다. '세종은', '세종이'처럼 조사가 붙은 채 뽑힌 개체는 465개 가운데 눈으로 찾은 것이 1개('마하티르 빈 모하맛가')였습니다.
개념 다리는 너무 많이 놓인다
개념 층도 세어 봤습니다. 25개 문단에서 나온 개체·사건에 붙은 개념은 1,471가지입니다.
그 가운데 77%는 문단 하나에만 나옵니다. 다리 노릇을 하지 못하는 꼬리표입니다.
문단 두 개를 고르는 300가지 짝 가운데 같은 개체가 양쪽에 나오는 짝은 106개(35%)입니다. 개념까지 넣으면 288개(96%) 가 이어집니다.
여러 문단을 가장 많이 잇는 개념은 '국가'(문단 17개), '정부'(15개), '정치 체제'(14개), '지역'(13개), '인물'(12개)입니다.
개체가 하나도 겹치지 않는 문단끼리 어떻게 이어지는지 보면 성격이 드러납니다. 손흥민 문단의 "분데스리가에 데뷔했다"와 한강 문단의 "시인으로 등단했다"가 '데뷔'로 이어집니다. 쓸 만한 다리입니다. 손흥민의 "차범근의 기록을 경신했다"와 누리호의 "나로우주센터에서 발사했다"는 '성취'와 '도전'으로 이어집니다. 틀리지는 않지만 검색에 도움이 될 연결은 아닙니다. 세종 문단의 '측우기'와 한강 문단의 '한국소설가협회'는 둘 다 '기구'라는 개념에 매달렸습니다. 하나는 기구(器具)이고 하나는 기구(機構)입니다. 개념 다리는 모자라서가 아니라 너무 흔해서 문제입니다. 흔한 개념은 모든 섬을 잇는 큰 교차로가 되고, 그래프를 따라 점수를 퍼뜨리는 검색에서는 교차로가 점수를 사방으로 흩어 버립니다. 7.2절에서 개념 노드가 검색 재현율을 올리지 못한 것과 맞아떨어지는 관찰입니다. 논문도 대규모 그래프용 검색기(부록의 알고리즘 3)에 '흔한 낱말 걸러 내기'를 넣었습니다.
2단계와 3단계의 사건이 서로 만나지 못한다
가장 뜻밖의 관찰은 구조에 관한 것입니다. 사건은 두 번 뽑힙니다. 2단계에서 "사건과 거기 참여한 개체"를, 3단계에서 "사건과 사건의 관계"를 뽑습니다. 두 호출은 서로의 출력을 보지 못합니다. 그래서 같은 일을 다른 문장으로 적습니다.
2단계가 적은 사건 (개체가 매달림)
3단계가 적은 사건 (시간·인과 엣지가 걸림)
"태종이 양위를 하여 세종이 즉위하였다."
"태종과 원경왕후의 아들인 세종이 태종의 양위를 받아 즉위하였다."
"양녕대군이 폐세자가 되었다."
"형인 양녕대군이 폐세자가 되자 세자에 책봉되었다."
그래프에서 노드는 문자열이 같아야 같은 노드입니다. 이번 실험의 사건–사건 엣지 119개 가운데 양 끝이 모두 2단계 사건과 글자까지 같은 것은 1개였습니다. 나머지 엣지는 개체가 하나도 매달리지 않은 별개의 사건 노드끼리 잇습니다. 2단계 사건은 평균 30자, 3단계 사건은 평균 46자로 길이부터 다릅니다.
한국어와 작은 모델 탓일 수 있어서, 저자들이 저장소에 예제로 올려 둔 영어 출력(LLaMA-3.1-8B, 문서 두 건, 청크 19개)에서 같은 것을 세어 봤습니다. 사건–사건 엣지 224개 가운데 양 끝이 모두 2단계 사건과 일치하는 것은 48개(21%) 였습니다. 영어에서는 덜하지만 같은 현상입니다.
이 관찰이 맞다면 '개체 – 사건 – 사건 – 개체'로 이어져야 할 시간·인과의 길 가운데 상당수가 끊겨 있고, 그 끊긴 조각을 다시 이어 주는 것은 개념 노드뿐입니다. ATLAS 전체가 그런지는 이 표본으로는 말할 수 없습니다. 다만 논문에는 두 단계의 사건을 맞추는 절차가 적혀 있지 않습니다. 이 방식을 직접 쓰려는 분은 3단계 프롬프트에 2단계의 사건 목록을 넣어 주거나, 사건 문장을 임베딩으로 묶는 단계를 더하는 편이 좋겠습니다.
실측의 한계
문단 25개, 문제 125개짜리 실험입니다. 문제를 낸 모델과 답한 모델이 같은 계열이고, 한 번씩만 돌렸습니다. 한국어 프롬프트는 논문의 영어 프롬프트를 직접 옮긴 것이어서 다르게 옮기면 결과가 달라질 수 있습니다. 여기서 얻은 것은 수치가 아니라 "사건이 정보를 지킨다는 방향은 한국어에서도 같고, 개념화와 단계 사이 정합성에는 손볼 곳이 있다" 는 관찰입니다.
9. 논문 밖에서 온 검증: 이슈, 재현, 그리고 저자들의 다음 논문
논문은 2025년 5월에 arXiv에 올라왔고 코드와 데이터가 함께 공개됐습니다. 그 뒤 1년 반 동안 쌓인 바깥의 반응이 논문을 읽는 데 도움이 됩니다.
저장소 이슈에 남은 기록
GitHub 저장소(별 848개, MIT 라이선스)의 이슈에는 재현을 시도한 사람들의 질문이 남아 있습니다.
이슈
독자의 질문
저자의 답
#28 (2025-09)
초록은 95%, 서론은 92%. 어느 쪽인가
"초록의 95%가 틀렸다. 92%를 써야 한다."
#15
HippoRAG 2보다 낫지 않거나 조금 나은 정도라면 왜 써야 하나
HippoRAG 2는 70B로, 우리는 8B로 그래프를 지었다. (70B끼리 비교해 달라는 후속 질문에는 답이 달리지 않았고, 그 비교는 ACL판 부록 표 11로 들어갔습니다.)
#37
스키마 평가 데이터의 건수가 논문과 다르다
논문 수치는 '정제한' 데이터 기준이고 공개본은 원본이다. 논문에서 고치겠다.
#39
BS-C를 직접 구현하니 사건 유형이 99%가 아니라 12%다
공개 코드의 함수 이름이 헷갈리게 붙어 있다.
#42 (2026-04)
병렬 처리에서 데이터가 겹치거나 빠진다
무작위 섞기 때문에 조각이 겹치고 빠지는 것이 맞고, 변수 이름이 어긋나 개념 생성은 실제로 나뉘지 않은 채 돌았다.
마지막 줄은 공개 코드의 병렬 처리에 관한 것이라 논문의 ATLAS가 같은 영향을 받았는지는 알 수 없습니다. 다만 이 논문의 주장 가운데 '규모'가 큰 몫을 차지하는 만큼, 규모를 만드는 코드가 얼마나 단단한지는 물을 만한 질문입니다. 저자들이 이슈마다 오류를 인정하고 답한 점은 평가할 만합니다. 초록의 숫자가 arXiv판에서 ACL판으로 오며 95%에서 92%로 고쳐진 것도 이 과정의 결과입니다.
IBM의 재현: 구조를 많이 지을수록 좋은가
가장 직접적인 외부 검증은 IBM 연구진이 VLDB 2026의 에이전트·그래프 워크숍에 낸 논문 「에이전트의 그래프 기억은 글 검색을 위해 구조를 얼마나 지어야 하는가」입니다. 이 논문은 AutoSchemaKG식 파이프라인(개체+사건+개념)을 '구조를 가장 많이 짓는 쪽'의 기준점으로 삼고, 구조를 덜 짓는 방식들과 MuSiQue에서 견줍니다. 보고된 내용을 옮기면 이렇습니다.
AutoSchemaKG 논문 자신의 표에서 개체만 쓴 그래프(EM 31.4, F1 47.2)와 전체 그래프(31.8, 47.3)가 거의 같다는 점을 먼저 짚습니다. 이 글 7.2절에서 본 그 줄입니다.
전체 파이프라인을 다시 돌리니 토큰 1억 1,340만 개를 쓰고 EM 29.7, F1 43.3이 나왔습니다.
개체만 뽑되 프롬프트를 자동 최적화(GEPA)한 그래프는 토큰 약 1,360만 개로 EM 38.1, F1 52.8이 나왔습니다. 비용은 8분의 1, 점수는 더 높습니다.
전체 파이프라인은 네 단계를 건너야 하는 질문에서 F1이 28.1까지 떨어졌습니다.
IBM 연구진 스스로 단서를 답니다. 임베딩 모델이 달라서(논문은 NV-Embed-v2, 재현은 Granite) 원 논문 수치와의 차이 일부는 거기서 나온다는 것입니다. 그래도 방향은 분명합니다. 검색용 그래프에서는 '더 많은 구조'가 '더 좋은 검색'을 보장하지 않습니다. 사건과 개념을 더 짓는 데 드는 토큰을 개체 추출 프롬프트를 다듬는 데 쓰는 편이 나았다는 결과입니다.
저자들의 다음 논문: "자동화 ≠ 충분함"
가장 흥미로운 반응은 저자들 자신에게서 나왔습니다. 같은 ACL 2026 본 학회에 같은 연구실이 낸 AutoGraph-R1은 그래프를 짓는 LLM을 강화학습으로 훈련합니다. 보상은 "이 그래프로 검색했을 때 질문에 답할 수 있었는가"입니다. 송양추 교수의 2026년 발표 자료는 이 흐름을 "자동화 ≠ 하류 과제에 충분히 좋음", "병목은 그래프 품질이 아니라 과제 정렬"이라고 요약합니다.
이 문장은 AutoSchemaKG에 대한 저자들 스스로의 평가로 읽을 수 있습니다. 스키마 없이 무엇이든 뽑아 쌓는 그래프는 넓지만, 쓸 곳에 맞춰져 있지 않습니다. 추출 정밀도가 99%여도, 그 그래프로 질문에 답하는 일이 나아지지 않으면 소용이 없습니다. 1절에서 본 스키마의 역할을 떠올리면 되돌아온 자리가 보입니다. 스키마는 원래 "이 그래프를 어디에 쓸 것인가"를 미리 적어 둔 것이었습니다. 스키마를 버리면 그 질문이 사라지는 것이 아니라 뒤로 미뤄집니다.
같은 연구실의 또 다른 후속작 AtlasKV(ICLR 2026)는 반대 방향으로 갑니다. 검색기 없이, ATLAS의 트리플 10억 건을 20GB 메모리 안에서 LLM에 직접 꽂아 넣는 방법입니다. 그래프를 '찾아가는 길'이 아니라 '모델의 일부'로 쓰겠다는 시도입니다. 7.2절에서 본 대로 사건 노드의 정보 보존은 그래프만 들고 다닐 때 값을 하므로, ATLAS의 설계가 제 몫을 할 자리는 오히려 이쪽일 수 있습니다.
10. 2026년에 이 논문이 서 있는 자리
그래프 RAG의 숙취
2024년은 그래프 RAG의 해였습니다. GraphRAG, LightRAG, HippoRAG가 잇달아 나왔고, GitHub 별이 수만 개씩 붙었습니다. 2025~2026년에는 계산서가 날아왔습니다. ICLR 2026에 실린 GraphRAG-Bench는 "그래프 RAG는 실제 과제 다수에서 평범한 RAG보다 못하다"는 관찰에서 출발해 언제 그래프가 이기는지를 따졌고(코어닷투데이의 해설), 마이크로소프트는 색인 비용을 줄인 LazyGraphRAG를 내놨습니다. 그래프를 짓는 비용이 크고, 그 값을 하는 질문의 종류가 생각보다 좁다는 것이 공통된 교훈입니다. 코어닷투데이는 이 문제를 「GraphRAG는 언제 써야 할까?」에서 정리했습니다.
AutoSchemaKG의 성적표는 이 흐름과 맞아떨어집니다. 멀티홉 질문에서 그래프 없는 임베딩 검색(NV-Embed-v2)과 엎치락뒤치락하고, 사실 검증에서 BM25와 비기고, MMLU 전체에서 검색 없음과 같습니다. 7만 8천 GPU 시간을 들인 결과로는 소박합니다. 이 논문의 값은 점수가 아니라 다른 데 있습니다.
이 논문이 남긴 것
첫째, 사건 노드라는 설계. 4절의 정보 보존 실험은 이 논문에서 가장 깨끗한 결과입니다. (명사, 동사, 명사)로 줄이면 문단 정보의 3분의 2가 날아가고, 문장을 노드로 두면 대부분 남습니다. 2026년에 에이전트의 장기 기억을 그래프로 만드는 시스템들이 '사실 한 줄'이 아니라 '일어난 일 한 문장'을 단위로 삼는 흐름과 같은 방향입니다. 코어닷투데이가 다룬 Graphiti의 에피소드 노드, EventRAG의 사건 그래프가 그런 예입니다.
둘째, 공개된 그래프 그 자체. 13.6억 노드짜리 그래프를 누구나 내려받을 수 있다는 것은 연구 기반으로서 값이 있습니다. AtlasKV처럼 "10억 트리플을 모델에 넣으면 어떻게 되나"를 묻는 연구는 이런 자원이 있어야 시작할 수 있습니다. Freebase가 문을 닫은 뒤 10년 동안 그만한 크기의 공개 그래프는 위키데이터뿐이었습니다.
셋째, 스키마 없이 어디까지 가는지에 대한 정직한 눈금. 논문의 표를 끝까지 읽으면 "스키마 없이도 넓은 그래프는 만들 수 있다. 그 그래프는 어디서나 조금 돕고, 어디서도 크게 돕지는 않는다"는 그림이 나옵니다. 이것은 실패가 아니라 측정입니다.
스키마는 죽지 않았다
그러면 스키마를 설계하는 일은 끝났을까요. 코어닷투데이가 AEVS 해설에서 직접 잰 결과는 반대를 가리킵니다. 관계 목록을 프롬프트에 넣어 주는 것만으로 추출 F1이 0.18에서 0.59로 뛰었습니다. 향상의 대부분이 '틀을 씌운 효과'였습니다. 쓸 곳이 정해져 있고 관계의 종류를 미리 알면, 스키마를 주는 쪽이 압도적으로 정확합니다. 작은 모델에 스키마를 문장처럼 읽혀 추출하는 GLiNER2도 같은 이야기를 합니다.
두 방식은 경쟁자가 아니라 순서로 보는 편이 맞습니다.
① 낯선 문서 더미
→
② 스키마 없이 뽑고 개념화 (AutoSchemaKG식)
→
③ 자주 나오는 개념·관계를 사람이 훑어봄
④ 쓸 곳에 맞는 유형·관계 수십 개를 확정
→
⑤ 그 스키마로 다시 정밀 추출
→
⑥ 제약으로 검증하고 운영
스키마 유도는 사람이 스키마를 그리기 전에 무엇이 들어 있는지 훑어보는 도구로 가장 쓸모가 있습니다. 3,107만 개 개념 가운데 자주 나오는 수백 개만 봐도 그 문서 더미에 어떤 종류의 것이 있는지 알 수 있습니다. 1992년 허스트가 한 일, 곧 "글이 이미 말해 주는 분류를 건져서 사람의 분류 작업을 돕는다"와 본질적으로 같습니다. 도구가 정규식에서 LLM으로 바뀌었을 뿐입니다.
한국어로 하려면
실무에서 부딪힐 점도 적어 둡니다. ATLAS는 영어만 다룹니다. 전처리에서 영어가 아닌 문서를 버립니다. 공개 패키지에는 영어와 중국어(간체·번체) 프롬프트만 들어 있고, 한국어는 프롬프트를 직접 써서 넣어야 합니다. 8절의 실측에서 조사가 붙은 채 뽑히는 문제는 거의 없었지만, 한국어 특유의 걸림돌이 둘 보였습니다. 주어가 생략된 문장이 그대로 사건 노드가 되면 "혼자서도 이해되는 한 문장"이라는 조건이 깨집니다. 그리고 한자어 동음이의(한강, 수반, 기구)가 개념화에서 엉뚱한 다리를 놓습니다. 정규화와 검증 단계가 없는 이 방법에서는 이런 오류를 걸러 낼 곳이 없습니다.
11. 실무자를 위한 체크리스트
이 논문의 방식을 자기 문서에 써 볼지 고민하는 분을 위해 정리합니다.
질문
그렇다면
아니라면
문서 영역이 넓거나, 무엇이 들어 있는지 아직 모르는가
스키마 없는 추출 + 개념화로 먼저 훑어볼 만함
관계 목록을 정해 스키마 기반 추출을 쓰는 편이 정확
그래프를 '문단을 찾는 길'로만 쓰는가
개체만 뽑아도 충분할 가능성이 큼 (7.2절, IBM 재현)
원문 없이 그래프만 쓸 거라면 사건 노드가 필요 (4절)
질문이 여러 문서를 건너야 풀리는가
그래프 검색을 시도할 만함. 단, 좋은 임베딩 검색과 먼저 견줄 것
임베딩 검색이나 BM25로 충분
틀린 사실이 들어가면 안 되는 영역인가 (금융·의료·법)
제약 없는 유도 스키마만으로는 부족. 사람이 정한 스키마와 검증 단계가 필요
유도 스키마로 시작해도 됨
수학·코드·계산 문제를 푸는 데 쓸 것인가
그래프 검색을 붙이면 오히려 떨어질 수 있음 (7.4절)
역사·법·사회과학처럼 사실 관계가 중요한 영역에 한정
청크가 100만 개를 넘는가
8B급 모델로 GPU 약 1,500시간. 예산을 먼저 계산할 것 (6절 계산기)
작은 규모는 API로도 가능
그리고 도입한다면 다음 다섯 가지는 처음부터 넣기를 권합니다.
개체 이름 정규화. 논문에는 없는 단계입니다. 표기가 다른 같은 개체를 합치지 않으면 다리가 놓이지 않습니다.
개념의 빈도 문턱. 한 번만 나온 개념은 다리 역할을 하지 못합니다. 두 번 이상 나온 것만 노드로 두면 그래프가 훨씬 가벼워집니다.
동음이의 점검. '피닉스 → 신화'처럼 맥락을 잘못 읽은 개념이 섞입니다. 자주 쓰이는 개념부터 표본을 뽑아 눈으로 봅니다.
사건 문장의 자립성 검사. 주어가 빠졌거나 '이 회사', '그는'으로 시작하는 사건 노드를 걸러 다시 쓰게 합니다.
작은 평가 세트. 자기 문서에서 질문 50개를 만들어, 그래프 없는 검색과 견준 뒤에 규모를 키웁니다. 논문의 가장 큰 교훈은 "크게 짓기 전에 무엇과 견줄지 정하라"입니다.
마치며: 분류표는 사라지지 않고, 그리는 때가 바뀐다
도서관으로 돌아가 봅시다. AutoSchemaKG는 책 5천만 권을 일단 다 받아 쌓고, 로봇에게 권마다 이름표를 서너 개씩 붙이게 했습니다. 그렇게 만든 서고는 넓고, 어떤 책도 거절하지 않았고, 사람 손이 하나도 들지 않았습니다. 대신 이름표가 4천만 종이 넘고, '영화'와 '필름'이 따로 붙어 있고, 피닉스 시의 안내서에 '신화' 이름표가 붙어 있습니다.
이 논문이 보여 준 것은 두 가지입니다. 하나는 책을 요약 카드 한 장이 아니라 장면 단위로 남기면 내용이 덜 사라진다는 것, 곧 사건 노드입니다. 이것은 단단한 발견이고 2026년의 에이전트 기억 설계에 그대로 쓰입니다. 다른 하나는 분류표 없이 쌓은 서고가 어디까지 쓸 만한가에 대한 눈금입니다. 답은 "어디서나 조금, 어디서도 많이는 아님"이었고, 저자들은 다음 논문에서 "자동화만으로는 충분하지 않다"고 직접 적었습니다.
40년의 진자는 '사람이 그린다'와 '버린다' 사이를 오갔습니다. LLM은 세 번째 자리, '끌어낸다'를 값싸게 만들었습니다. 하지만 끌어낸 것을 다듬어 쓸 곳에 맞추는 일, 어떤 칸이 필요한지 정하는 일은 여전히 그래프를 쓸 사람의 몫입니다. 분류표는 사라지지 않았습니다. 그리는 때가 '책을 받기 전'에서 '책을 훑어본 뒤'로 옮겨 갔을 뿐입니다.
참고문헌
이번 글의 논문과 자료
Bai, J., Fan, W., Hu, Q., et al. (2026). AutoSchemaKG: Autonomous Knowledge Graph Construction through Dynamic Schema Induction from Web-Scale Corpora. ACL 2026 (Long Papers), 20557–20584. https://aclanthology.org/2026.acl-long.942/ (arXiv 2505.23628, 첫 판 2025-05-29)