지식 그래프정보 추출관계 추출트리플환각출처 추적provenance그라운딩AEVSLLMRAGGraphRAGLangExtract원거리 지도학습한국어 NLP
[특집] 본문에 없는 사실은 받지 않는다 — 앵커로 묶은 지식 그래프 추출 AEVS, 그리고 출처를 글자 단위로 다는 시대
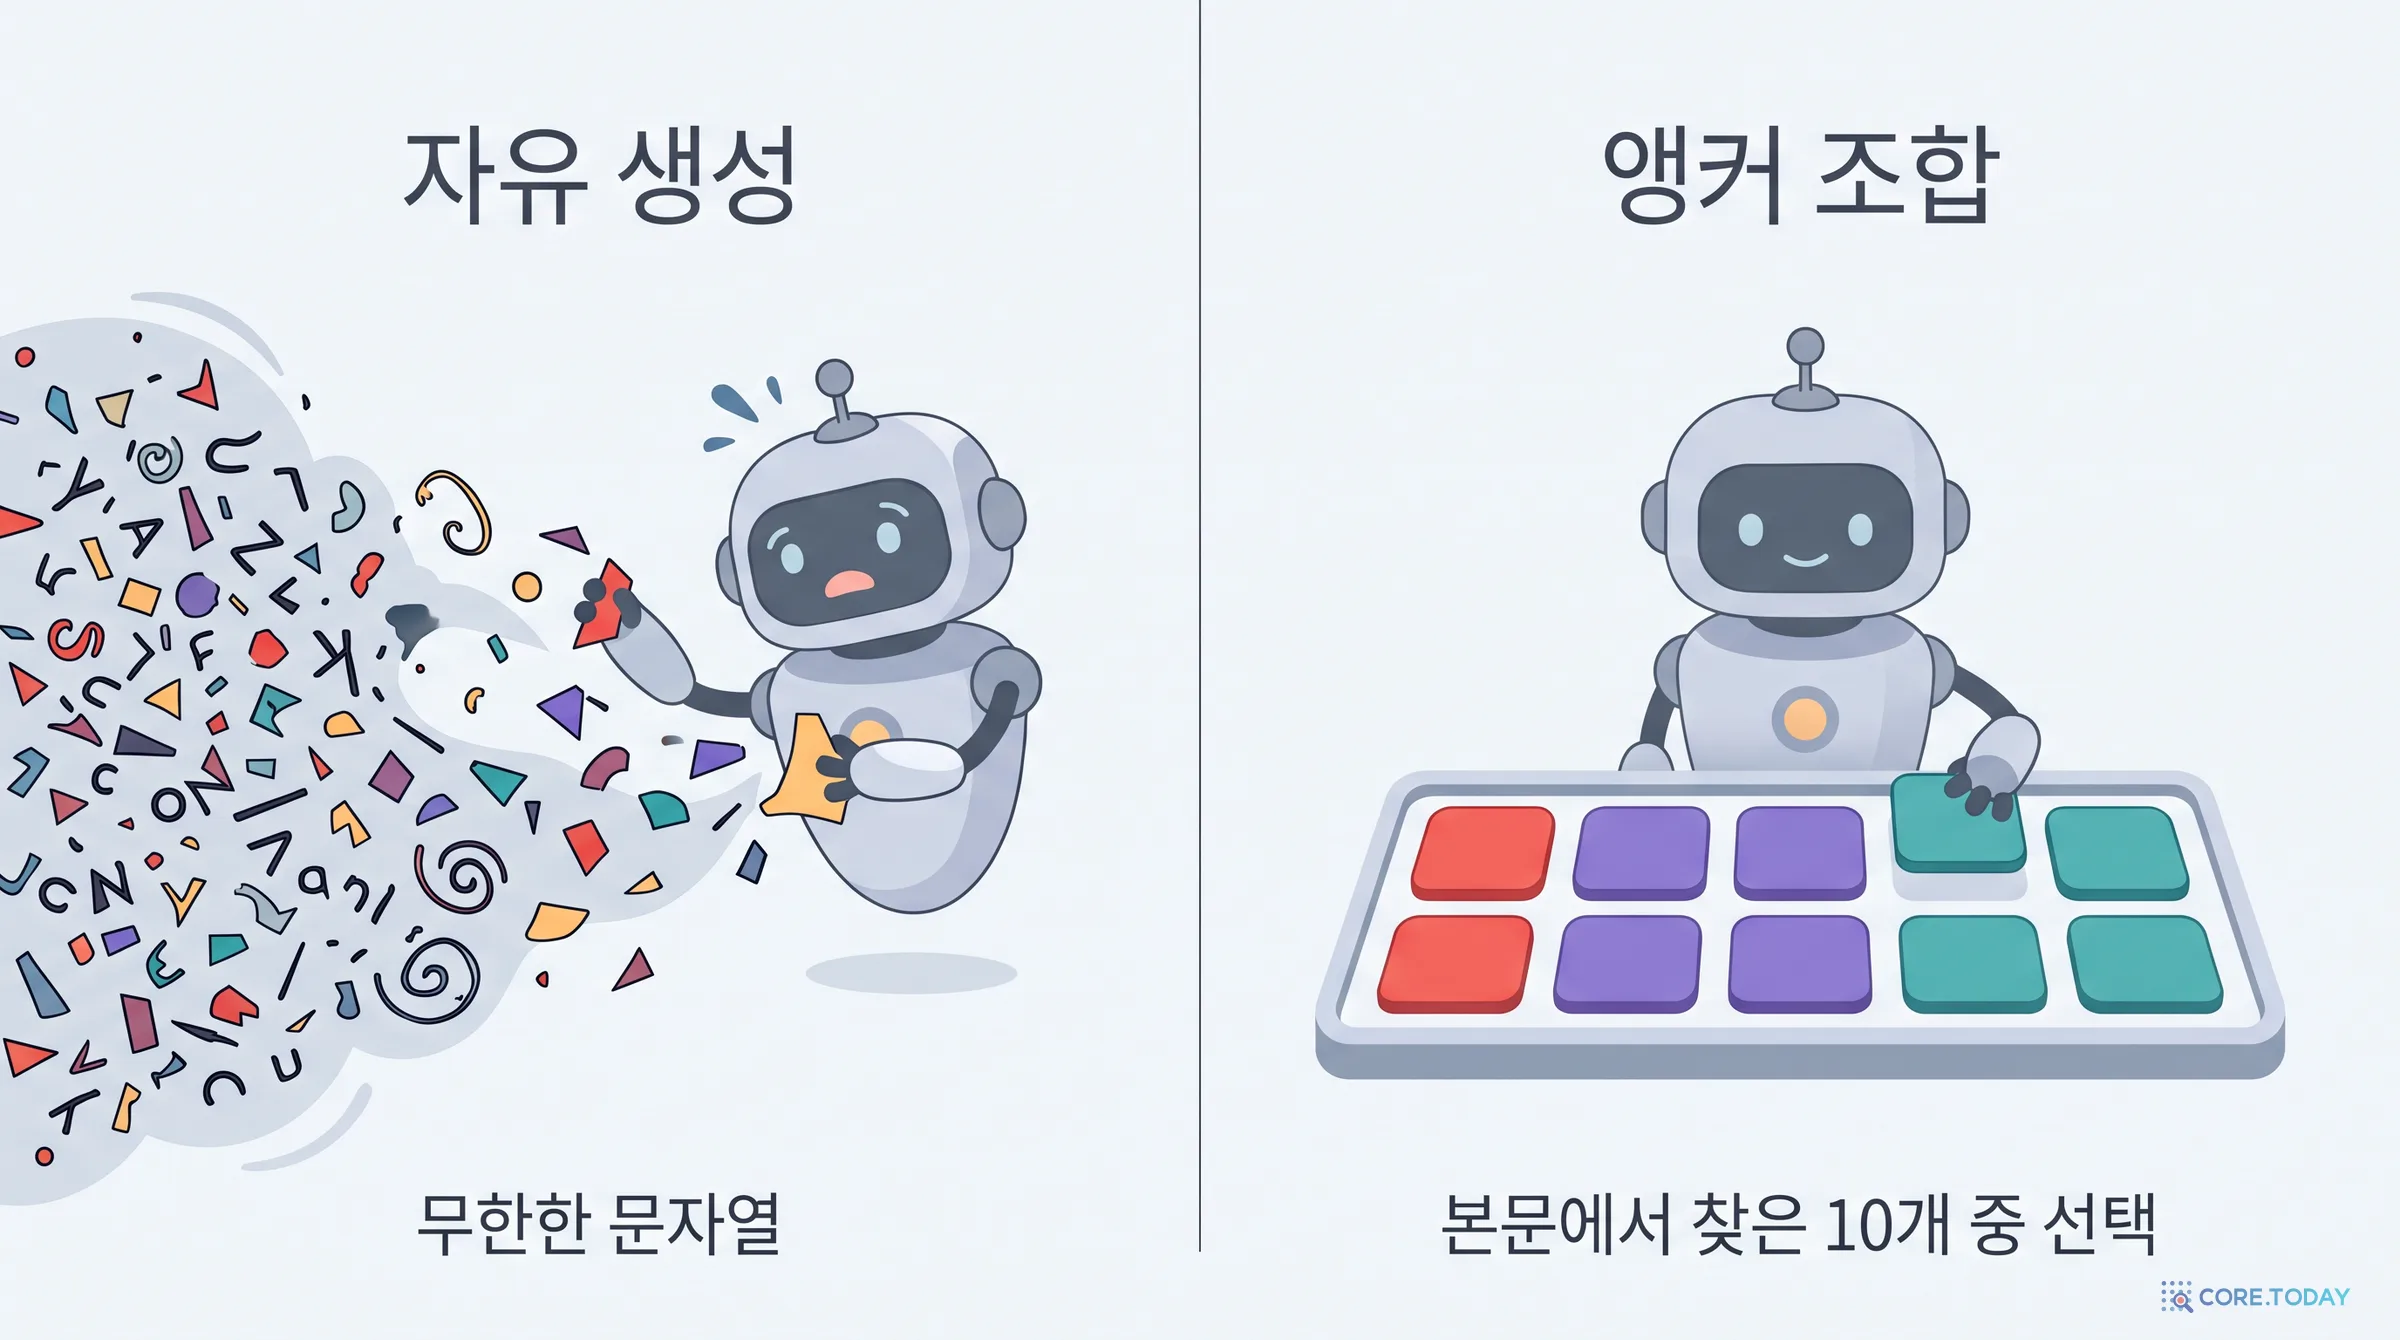
LLM에게 문서에서 사실(주어·관계·목적어)을 뽑게 하면 '세상에서는 참이지만 본문에는 없는' 트리플이 섞입니다. 2026년 3월 MDPI Computers에 실린 AEVS는 본문에서 개체·관계구·값과 그 글자 위치를 먼저 찾아 '앵커'로 삼고, 트리플을 앵커로만 조합한 뒤, 원소마다 원문으로 되돌려 검증합니다. 세 데이터셋에서 학습 모델과 EDC를 넘었고, 남은 오류의 95% 이상은 개체가 아니라 관계였습니다. 다만 'EDC 대비 최대 +0.152'는 서로 다른 모델끼리의 비교였고(같은 모델이면 +0.007~+0.074), 공개 코드는 논문과 달리 셋 중 둘만 맞아도 통과시켜 논문 자신의 환각 예시를 모두 받아들였습니다. 코어닷투데이가 로컬 모델로 한국어 30문장과 WebNLG 20문장을 다시 돌려 보니, 스키마를 준 '그냥 묻기'에서는 환각이 나오지 않았고 AEVS는 한국어에서 오히려 재현율을 잃었습니다(F1 0.80 대 0.72). 그냥 묻기에서 스키마를 빼면 F1이 0.18로 무너져, 향상의 상당 부분이 스키마 몫일 수 있음을 보여 줍니다. 검증 LLM은 본문에 충실한 반사실 트리플을 '현실과 다르다'며 거부하기도 했습니다. 역사, 논문의 주요 그림과 표, 2026년의 '글자 단위 출처' 도구들까지 함께 읽습니다.
코어닷투데이2026-11-01126분
?
문제
LLM으로 문서에서 지식 그래프를 만들면, 모델이 이미 알고 있는 사실이 '본문에서 뽑은 사실'인 척 섞여 들어옵니다. 어느 것이 본문에서 왔는지 가릴 방법이 없습니다.
→
방법
AEVS 논문(Computers 2026, 15(3), 178)과 공개 코드를 한 줄씩 읽고, 표 수치를 다시 계산하고, 논문의 예문을 공개 코드에 그대로 넣어 보고, 로컬 모델(qwen3.5:9b)로 한국어 30문장과 WebNLG 20문장을 다시 돌렸습니다.
✓
결론
논문에서는 '본문에서 찾은 말로만 조합하라'는 제약이 향상의 대부분을 만들었습니다. 그러나 이 제약은 개체만 닫고 관계는 닫지 못해 오류의 95% 이상이 관계에 남습니다. 우리 실측에서는 스키마를 준 프롬프트 한 번이 같거나 나은 점수를 냈고, 검증 LLM은 맞는 트리플을 지우기도 했습니다. AEVS의 값은 점수보다 '어느 글자에서 왔는지 확인할 수 있다'는 데 있습니다.
다음 두 문장을 AI에게 주고 "여기서 사실을 (주어, 관계, 목적어) 꼴로 뽑아 줘"라고 시킨다고 해 봅시다.
Steve Jobs co-founded Apple Inc. in Cupertino in 1976. He served as CEO until his resignation in 2011.
(스티브 잡스는 1976년 쿠퍼티노에서 애플을 공동 창업했다. 그는 2011년 사임할 때까지 CEO로 일했다.)
모델은 꽤 잘 해냅니다. (Steve Jobs, 설립자, Apple Inc.), (Apple Inc., 설립연도, 1976), (Steve Jobs, 직위, CEO). 그런데 목록 끝에 이런 줄이 슬쩍 붙어 나오기도 합니다.
(Steve Jobs, 사망연도, 2011)
(Steve Jobs, 국적, 미국)
(Steve Jobs, 출신 학교, 리드 칼리지)
이 세 줄은 이번 글이 읽을 논문 「Grounded Knowledge Graph Extraction via LLMs: An Anchor-Constrained Framework with Provenance Tracking」(Yang·Chen·He·Zhao, MDPI Computers 2026년 3월호)이 서론과 예제에서 직접 든 '환각'입니다. 묘한 점은 셋 다 세상에서는 참이라는 것입니다. 잡스는 실제로 2011년 10월 5일에 세상을 떠났고, 미국인이며, 리드 칼리지를 한 학기 다니다 그만두었습니다. 하지만 셋 다 이 두 문장에는 없습니다. 특히 '사망연도 2011'은 본문의 2011(사임한 해)을 다른 사건에 갖다 붙인 것입니다.
"맞는 말이면 됐지 뭐가 문제냐"고 물을 수 있습니다. 문제는 세 가지입니다.
확인할 수 없습니다. 모델은 근거를 내놓지 않습니다. 사람이 그래프에서 '국적: 미국'을 보고 그게 어느 문서의 몇 번째 줄에서 왔는지 물으면 답이 없습니다.
틀린 날이 옵니다. 모델의 머릿속 지식은 학습 시점에 멈춰 있습니다. 대표이사가 바뀐 회사의 공시, 개정된 조례, 정정 보도처럼 문서가 세상을 바꾸는 순간, 머릿속 지식은 낡은 사실이 됩니다.
믿음이 무너집니다. 그래프의 한 줄이 출처 없이 들어왔다는 걸 아는 순간, 사용자는 나머지 줄도 믿을 수 없게 됩니다.
그리고 이 사고실험에는 반전이 하나 더 있습니다. 논문이 예문으로 쓴 저 문장 자체가 세상과 다릅니다. 애플은 1976년 4월 1일 잡스 부모님 집이 있던 로스앨터스에서 동업으로 출발했고, 쿠퍼티노 사무실은 1977년에야 얻었습니다. 회사 이름이 'Apple Inc.'가 된 것은 2007년 1월(그전엔 Apple Computer, Inc.)입니다. 그리고 2011년까지 CEO였던 것은 1997년 복귀 뒤의 두 번째 임기 이야기입니다.
그런데도 AEVS는 이 문장에서 (Apple Inc., location, Cupertino)를 뽑아 '완벽하게 근거 있는 트리플'로 통과시킵니다. 그게 맞습니다. 이 방법이 보장하려는 것은 "이 문서가 그렇게 말했다"이지 "세상이 그렇다"가 아니기 때문입니다. 출처(provenance)와 진실(truth)은 다른 물건입니다. 이 글은 그 차이를 붙잡고 끝까지 갑니다.
4장 — AEVS 해부: 앵커 찾기 · 앵커로만 추출 · 원문으로 되돌려 검증 · 빠진 것 보충
5장 — 실험 읽기: 표 2~9와 그림 6~17을 한 장씩
6장 — 꼼꼼히 읽으면 보이는 것들: 비교의 함정, 환각률의 정체, 논문과 다른 공개 코드
7장 — 코어닷투데이 실측: 한국어 30문장과 WebNLG 20문장, 그리고 예상과 달랐던 결과
8장 — 2026년, 출처를 글자 단위로 다는 시대
9장 — 실무 체크리스트
1. 지식 그래프와 트리플 — 왜 사실을 세 칸으로 쪼개는가
1.1 문장은 사람이 읽고, 트리플은 기계가 읽는다
"스티브 잡스는 1976년 애플을 공동 창업했다"는 문장은 사람에게는 한눈에 읽히지만, 기계에게는 그저 글자의 줄입니다. "애플을 세운 사람은 누구인가?"라는 질문에 답하려면 기계는 문장 수백만 개를 매번 다시 읽어야 합니다.
지식 그래프(knowledge graph)는 이 문장을 미리 잘게 쪼개 둡니다. 가장 작은 단위가 트리플(triplet, 삼중항)입니다.
주어 (subject) 애플
→
관계 (relation) 설립자
→
목적어 (object) 스티브 잡스
트리플이 수백만 개 모이면 개체(애플, 잡스, 쿠퍼티노)가 점이 되고 관계가 선이 되는 거대한 그물이 됩니다. 이 그물 위에서는 "애플 설립자의 출신 학교가 있는 주(州)는?" 같은 여러 단계짜리 질문도 선을 따라가며 답할 수 있습니다. 구글은 2012년 5월 지식 그래프를 발표하며 이것을 "문자열이 아니라 사물(things, not strings)"이라고 불렀습니다. 출발 당시 객체 5억 개, 사실 35억 개였습니다.
1.2 그래프는 지금 어디에 쓰이나
검색과 질의응답: 검색 결과 오른쪽의 인물·회사 정보 상자, 음성 비서의 짧은 답.
추천: "이 배우가 나온 다른 영화" 같은 연결.
RAG(검색 증강 생성): LLM이 답하기 전에 근거를 찾아 넣는 구조. 2024년 마이크로소프트의 GraphRAG는 문서 더미에서 개체·관계 그래프를 먼저 만들고, 그 그래프의 '공동체'를 요약해 질문에 답했습니다. 그래프를 만드는 첫 단계가 바로 LLM 트리플 추출입니다.
기업·공공 기록: 공시(대표이사·최대주주·배당), 의회 회의록(누가 어떤 안건에 찬성했나), 판결문(당사자·청구·결과)처럼 '누가 무엇을 했다'의 기록이 쌓이는 곳.
1.3 한 줄의 오류가 그물 전체로 번진다
그래프의 힘은 연결에서 나오고, 약점도 연결에서 나옵니다. 논문 서론의 표현을 빌리면 잘못된 트리플은 "추론 사슬을 타고 퍼지고, 검색 결과를 오염시키고, 결국 사용자의 신뢰를 무너뜨립니다."
예를 하나 들겠습니다. 어떤 회사의 2026년 공시에 "대표이사 김OO"가 적혀 있는데, 추출 모델이 머릿속에 남은 2023년 지식으로 (회사, 대표이사, 박OO)를 덧붙였다고 합시다. 이 한 줄이 그래프에 들어가면 "박OO이 대표인 회사들의 배당 성향은?" 같은 질문이 조용히 틀립니다. 틀린 답에는 오류 표시가 없습니다. 그래서 어느 문서의 어느 글자에서 왔는지를 트리플마다 붙여 두는 일, 즉 출처 추적(provenance tracking)이 중요해집니다.
코어닷투데이는 같은 문제를 2026년 10월 사실탐색기 v2 설계에서 '근거와 함께 답하거나, 근거가 없으면 기권한다'는 원칙으로 다뤘습니다. 이번 논문은 그 원칙의 앞단, 즉 사실을 처음 뽑는 순간에 근거를 묶어 두는 방법에 관한 연구입니다.
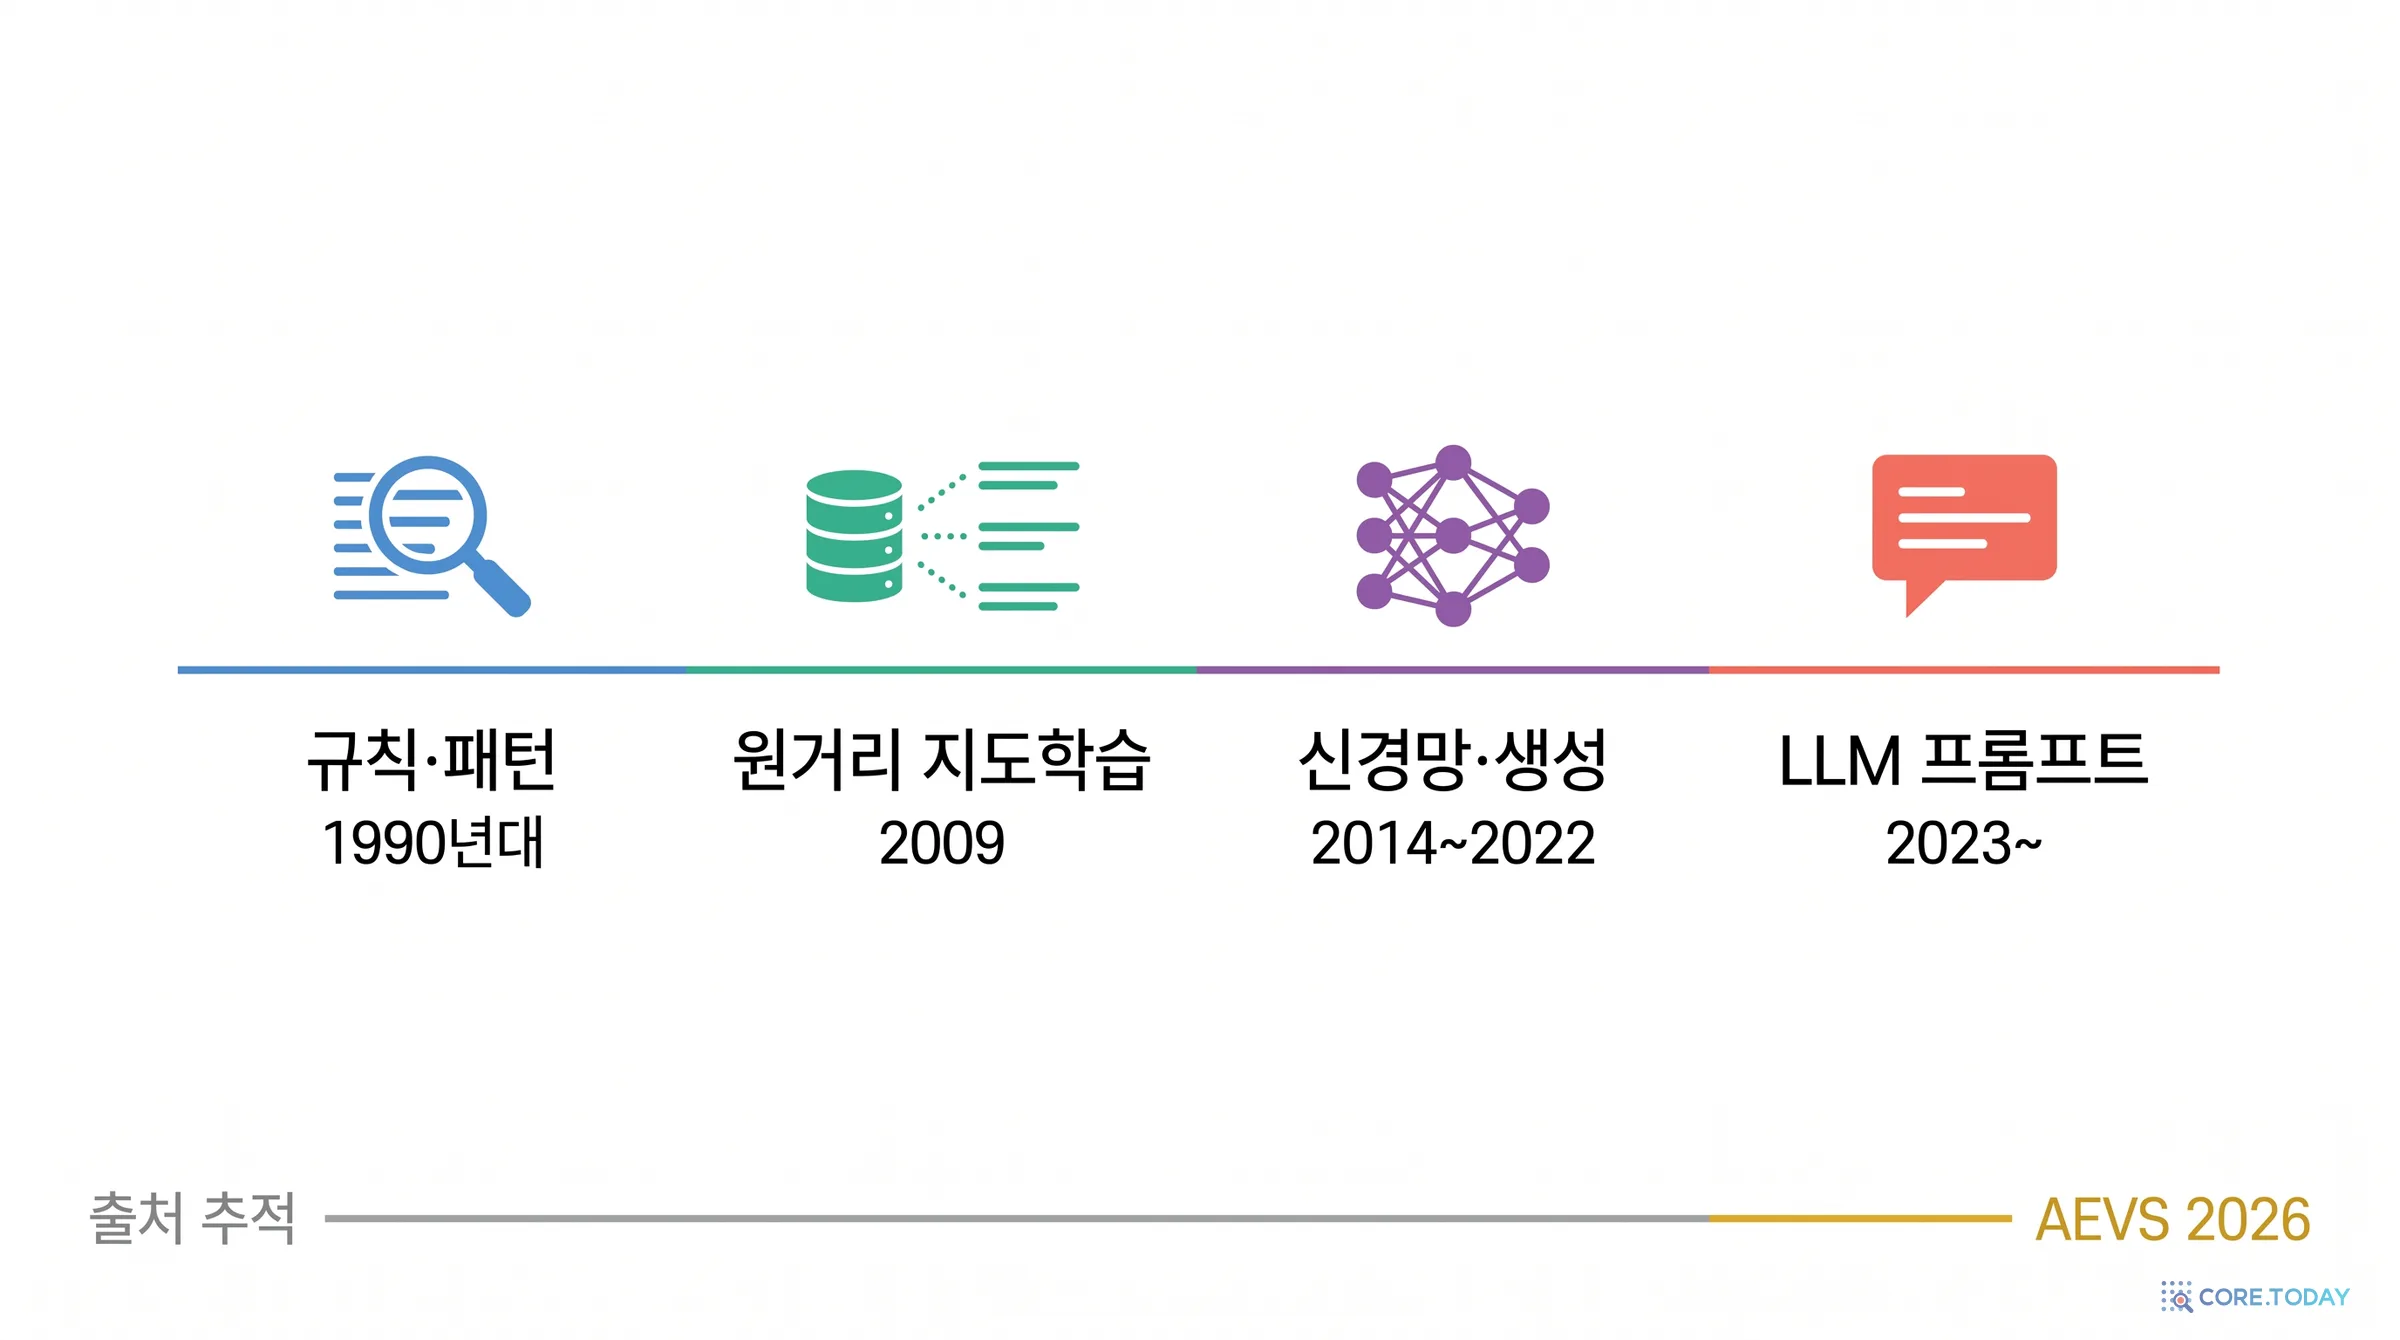
문서에서 트리플을 뽑는 일은 '관계 추출(relation extraction)'이라는 이름으로 40년 가까이 연구됐습니다. 흐름을 네 시대로 나눠 보면, AEVS가 왜 지금 이런 모양으로 나왔는지가 보입니다.
2.1 규칙과 패턴의 시대 (1984~2000년대 초)
1984년 더글러스 레나트는 사람이 상식을 하나하나 손으로 입력하는 지식베이스 Cyc를 시작했습니다. 사실을 모으는 일이 사람의 일이던 시절입니다.
문서에서 자동으로 뽑으려는 시도는 패턴에서 출발했습니다. 1992년 마티 허스트는 "X such as Y"(Y 같은 X) 같은 문형을 찾으면 "Y는 X의 일종"이라는 관계를 뽑을 수 있다는 것을 보였습니다. 미국 정부가 후원한 정보 추출 경진대회 MUC는 1998년 MUC-7에서 '템플릿 관계(Template Relation)' 과제를 새로 넣었습니다. EMPLOYEE_OF(누가 어디 직원), LOCATION_OF, PRODUCT_OF 세 관계를 뽑는 과제였습니다. 같은 해 세르게이 브린(구글 공동 창업자)은 (저자, 책 제목) 씨앗 몇 쌍에서 시작해 웹에서 패턴을 스스로 늘려 가는 DIPRE를 발표했습니다.
이 시대 방법은 정밀했지만 좁았습니다. 패턴에 걸린 문장은 그 자체로 근거였지만, 패턴 밖의 표현은 전부 놓쳤습니다.
2007년은 지식베이스의 해였습니다. 위키백과 정보상자에서 사실을 뽑은 DBpedia와 YAGO, 사람들이 함께 편집하는 Freebase가 같은 해에 나왔습니다. 워싱턴 대학의 TextRunner는 관계 목록을 미리 정하지 않고 "(주어, 동사구, 목적어)"를 웹에서 마구 뽑는 '열린 정보 추출(Open IE)'을 내놓았습니다. 웹 문서 900만 쪽에서 신뢰도 높은 튜플 1,100만 개를 뽑았습니다.
학습 데이터의 병목을 푼 것은 2009년 민츠(Mintz) 등의 원거리 지도학습(distant supervision)이었습니다. 아이디어는 대담합니다.
Freebase에서 어떤 관계로 이어진 두 개체가 한 문장에 함께 나오면, 그 문장은 아마 그 관계를 어떤 식으로든 표현할 것이다.
예를 들어 Freebase에 (스티브 잡스, 설립자, 애플)이 있으면, 위키백과에서 '잡스'와 '애플'이 함께 나오는 모든 문장에 '설립자' 꼬리표를 자동으로 붙입니다. 사람 손 없이 학습 데이터를 수십만 건 만들 수 있었습니다(102개 관계, 1만 건 정밀도 67.6%).
하지만 이 가정은 자주 틀립니다. "잡스는 애플 신제품 발표회에서 연설했다"는 '설립자'를 말하지 않습니다. 2010년 리델(Riedel) 등은 뉴욕타임스 기사에 Freebase를 맞춰 보니 이 가정이 약 31% 틀렸다고 보고했습니다(위키백과는 약 13%). 이 숫자는 이번 논문을 읽을 때 꼭 기억해야 합니다. AEVS가 평가한 세 데이터셋 중 둘(REBEL, Wiki-NRE)이 바로 이 방식으로 만든 정답을 쓰기 때문입니다. 정답에 빠진 사실도 있고 틀린 사실도 섞여 있습니다.
2012년 구글 지식 그래프가 검색에 들어갔고, 같은 해 10월 위키데이터가 문을 열었습니다. 위키데이터는 진술마다 '참고 문헌'을 달 수 있게 설계됐습니다. 출처를 데이터 모델 안에 넣은 것입니다. 2013년 4월에는 W3C가 출처 기록 표준 PROV(PROV-DM·PROV-O)를 권고안으로 확정했습니다(코어닷투데이의 PROV-O 해설 참고).
2014년 구글의 Knowledge Vault는 웹에서 트리플 16억 개를 뽑았지만, 신뢰도 0.9 이상은 2.71억 개(약 17%)뿐이었습니다. 많이 뽑을수록 믿을 만한 것의 비율은 작아집니다. 이 교훈은 LLM 시대에도 그대로입니다.
2.3 신경망과 생성의 시대 (2014~2022)
2014년 CNN으로 관계를 분류하는 연구를 시작으로 딥러닝이 들어왔습니다. 초기에는 파이프라인이었습니다. 먼저 개체명 인식(NER)으로 이름을 찾고, 그다음 이름 쌍마다 관계를 분류합니다. 첫 단계에서 놓친 이름은 영영 어떤 관계에도 들어가지 못하는 오류 전파가 약점이었습니다.
그래서 개체와 관계를 한 번에 뽑는 결합 추출(2017년 태깅 방식, 2020년 CasRel·TPLinker 등)이 나왔고, 이어 트리플을 아예 텍스트로 '생성'하는 방식이 나왔습니다. 2018년 CopyRE는 디코더가 개체 이름을 새로 쓰지 않고 입력 문장에서 복사하게 했습니다. '본문에 있는 말만 쓴다'는 생각의 이른 형태입니다. 2021년 REBEL은 BART 모델이 트리플을 문자열로 줄줄이 생성하게 했고, 위키백과 요약을 위키데이터에 맞춘 뒤 자연어 추론(NLI) 모델로 함의 점수 0.75 이상만 남겨 데이터를 만들었습니다. 2022년 GenIE는 접두사 트라이(prefix trie)로 디코딩을 묶어 위키데이터에 있는 이름만 생성하게 했습니다.
여기서 두 갈래의 '닫힌 어휘'가 보입니다. GenIE는 지식베이스를 닫힌 어휘로 썼고, CopyRE는 본문을 닫힌 어휘로 썼습니다. AEVS는 뒤쪽 갈래를 LLM 시대에 프롬프트 수준에서 되살린 것으로 볼 수 있습니다.
2.4 LLM 프롬프트의 시대 (2023~)
ChatGPT 이후에는 학습조차 필요 없어졌습니다. 2023년 ChatIE는 추출을 여러 차례의 대화로 쪼갰고, GPT-RE는 비슷한 예시를 골라 넣어 관계 추출 성능을 끌어올렸습니다. 다만 같은 해 평가 연구들은 LLM이 "소수 예시 추출기보다는 추론 보조로 낫다", "트리플 구조가 복잡해지면 크게 흔들린다"고 보고했습니다.
2024년 EMNLP의 EDC(Extract-Define-Canonicalize)는 이번 논문의 직접 비교 대상입니다. 세 단계로 갑니다.
추출스키마 없이 자유롭게 트리플을 뽑는다 (열린 정보 추출)
정의뽑힌 관계마다 자연어 정의를 쓴다 ("주어가 목적어를 세웠다")
정규화정의를 기준으로 미리 정한 스키마 관계에 사후 매핑한다
EDC는 스키마가 커서 프롬프트에 다 안 들어가는 문제를 잘 풀었지만, AEVS 저자들은 첫 단계의 실수를 되돌릴 방법이 없다고 지적합니다. 자유롭게 뽑는 순간 모델의 머릿속 지식이 섞여 들어오고, 사후 정규화는 그 트리플의 이름표만 바꿔 줄 뿐이기 때문입니다.
같은 해 GraphRAG는 개체와 관계마다 그것이 나온 원문 청크의 ID(text_unit_ids)를 붙였습니다. 출처가 '문서'에서 '청크'까지 내려온 셈입니다. 그리고 2025년, 출처는 마침내 글자 단위로 내려옵니다. 이 이야기는 8장에서 이어집니다.
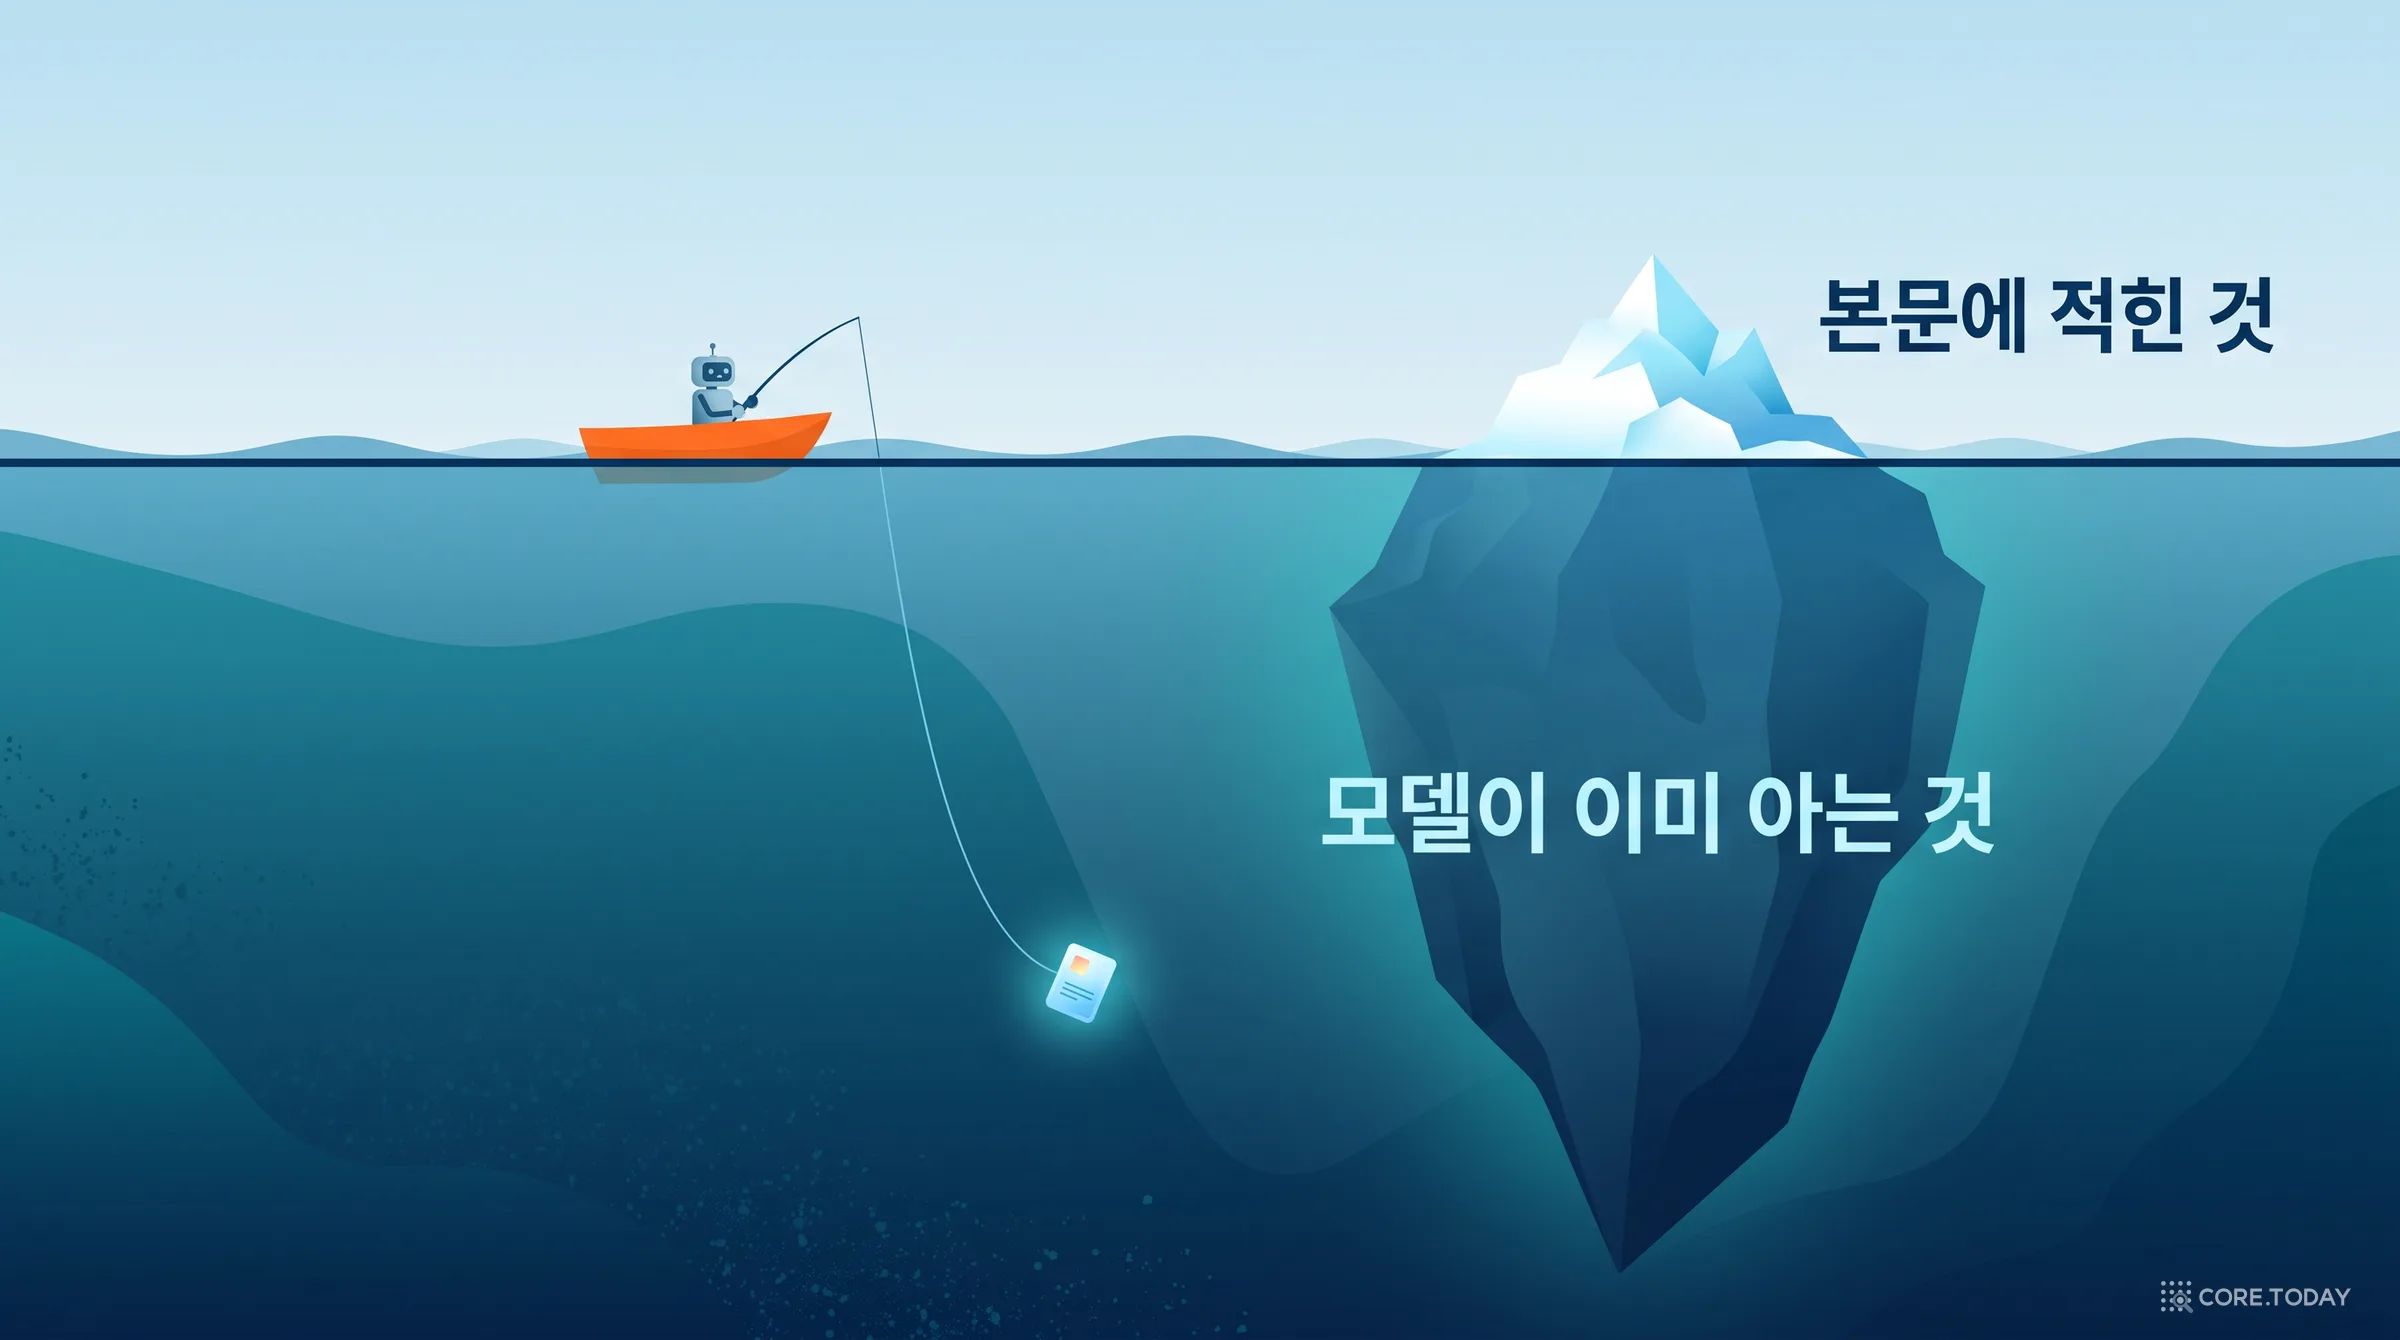
LLM은 두 군데에서 답을 꺼냅니다. 하나는 학습하면서 가중치에 새겨진 매개변수 지식(parametric knowledge)이고, 다른 하나는 지금 프롬프트에 들어온 맥락 지식(contextual knowledge)입니다. 추출 과제는 "맥락에서만 꺼내라"는 주문인데, 모델 입장에서 둘의 경계는 흐립니다. 위 빙산 그림처럼, 본문(수면 위)은 작고 머릿속 지식(수면 아래)은 거대합니다.
2021년 롱프리(Longpre) 등은 질의응답 모델에 본문과 머릿속 지식이 충돌하는 문서를 주면(예: 본문에서 인물 이름을 다른 이름으로 바꿔 둠) 모델이 본문을 무시하고 외운 답을 내는 경향이 있다고 보고했습니다. 그들은 이것을 환각의 원인으로 지목했습니다. 7장의 한국어 실험에 '반사실 문장'(일부러 세상과 다르게 쓴 문장)을 15개 넣은 이유가 이것입니다.
3.2 내재적 환각과 외재적 환각
요약 연구는 이 현상에 이름을 붙였습니다. 2020년 메이네즈(Maynez) 등은 BBC 기사 요약 500건을 사람이 검사해, 한 문장짜리 요약의 70% 이상에 환각이 있다고 보고했습니다. 그리고 환각을 둘로 나눴습니다.
종류
정의
스티브 잡스 예문에서
내재적(intrinsic)
본문에 있는 정보를 잘못 조합·왜곡
(Steve Jobs, 사망연도, 2011) — 본문의 2011을 다른 사건에 붙임
외재적(extrinsic)
본문에서 추론할 수 없는 정보를 덧붙임
(Steve Jobs, 국적, 미국) — 본문 어디에도 없음
메이네즈 등의 요약 실험에서는 외재적 환각의 90% 이상이 실제로도 틀린 내용이었습니다. 추출에서는 이 비율이 다를 수 있습니다. 위키백과처럼 유명한 대상을 다루는 문장이라면 모델의 머릿속 지식이 대체로 맞기 때문입니다. 그래서 더 위험합니다. 맞는 환각은 평가에서 잘 걸리지 않고, 그래프는 근거 없는 줄을 조용히 쌓아 갑니다.
3.3 근본 원인: 출처가 없다
AEVS 저자들의 진단은 한 문장입니다. 기존 방법은 학습 모델이든 LLM이든 트리플을 독립된 출력으로 내놓을 뿐, 각 원소와 원문 위치 사이의 연결을 남기지 않는다. 출처가 없으니 충실성(faithfulness)을 검증하는 것이 원리적으로 불가능하다는 것입니다.
그렇다면 처방도 한 문장입니다. 트리플의 모든 원소를 원문의 특정 구간으로 되짚을 수 있다면, 환각은 찾아낼 수 있고 지울 수 있다.
논문은 방법보다 정의를 먼저 바꿉니다. 입력 텍스트 T는 글자 n개의 줄이고, 목표는 트리플 집합 K={(si,ri,oi)}를 뽑는 것입니다. 여기까지는 기존과 같습니다. 새로 붙는 것은 추적 가능성 제약입니다.
트리플의 각 원소(주어 s, 관계 r, 목적어 o)에 대해 그 원소를 뒷받침하는 원문의 글자 위치 집합을 돌려주는 출처 함수π를 정의합니다. 원소 e의 출처는 [pstart,pend) 같은 글자 구간입니다. 그리고 트리플이 충실하다(faithful)는 것을 이렇게 정의합니다.
faithful(τ)⟺π(τ,e)=∅for all e∈{s,r,o}
말로 풀면, 주어·관계·목적어 셋 모두가 원문의 어딘가를 가리킬 수 있어야 한다는 것입니다. 하나라도 가리킬 곳이 없으면 그 트리플은 '본문에서 왔다'고 말할 수 없습니다.
이 정의가 중요한 이유는 '맞다/틀리다'를 '근거가 있다/없다'로 바꿔 놓기 때문입니다. 맞고 틀리고는 세상과 비교해야 알 수 있지만, 근거가 있고 없고는 원문만 보고 기계적으로 확인할 수 있습니다. AEVS의 모든 장치는 이 정의를 실제로 확인할 수 있게 만드는 도구입니다.
비유하자면 오픈북 시험에서 "답마다 교과서 쪽수와 줄 번호를 적어라"라는 규칙을 추가한 것입니다. 쪽수를 적을 수 없는 답은 아무리 그럴듯해도 감점입니다. 그리고 채점자는 답의 내용을 몰라도 그 쪽을 펼쳐 확인할 수 있습니다.
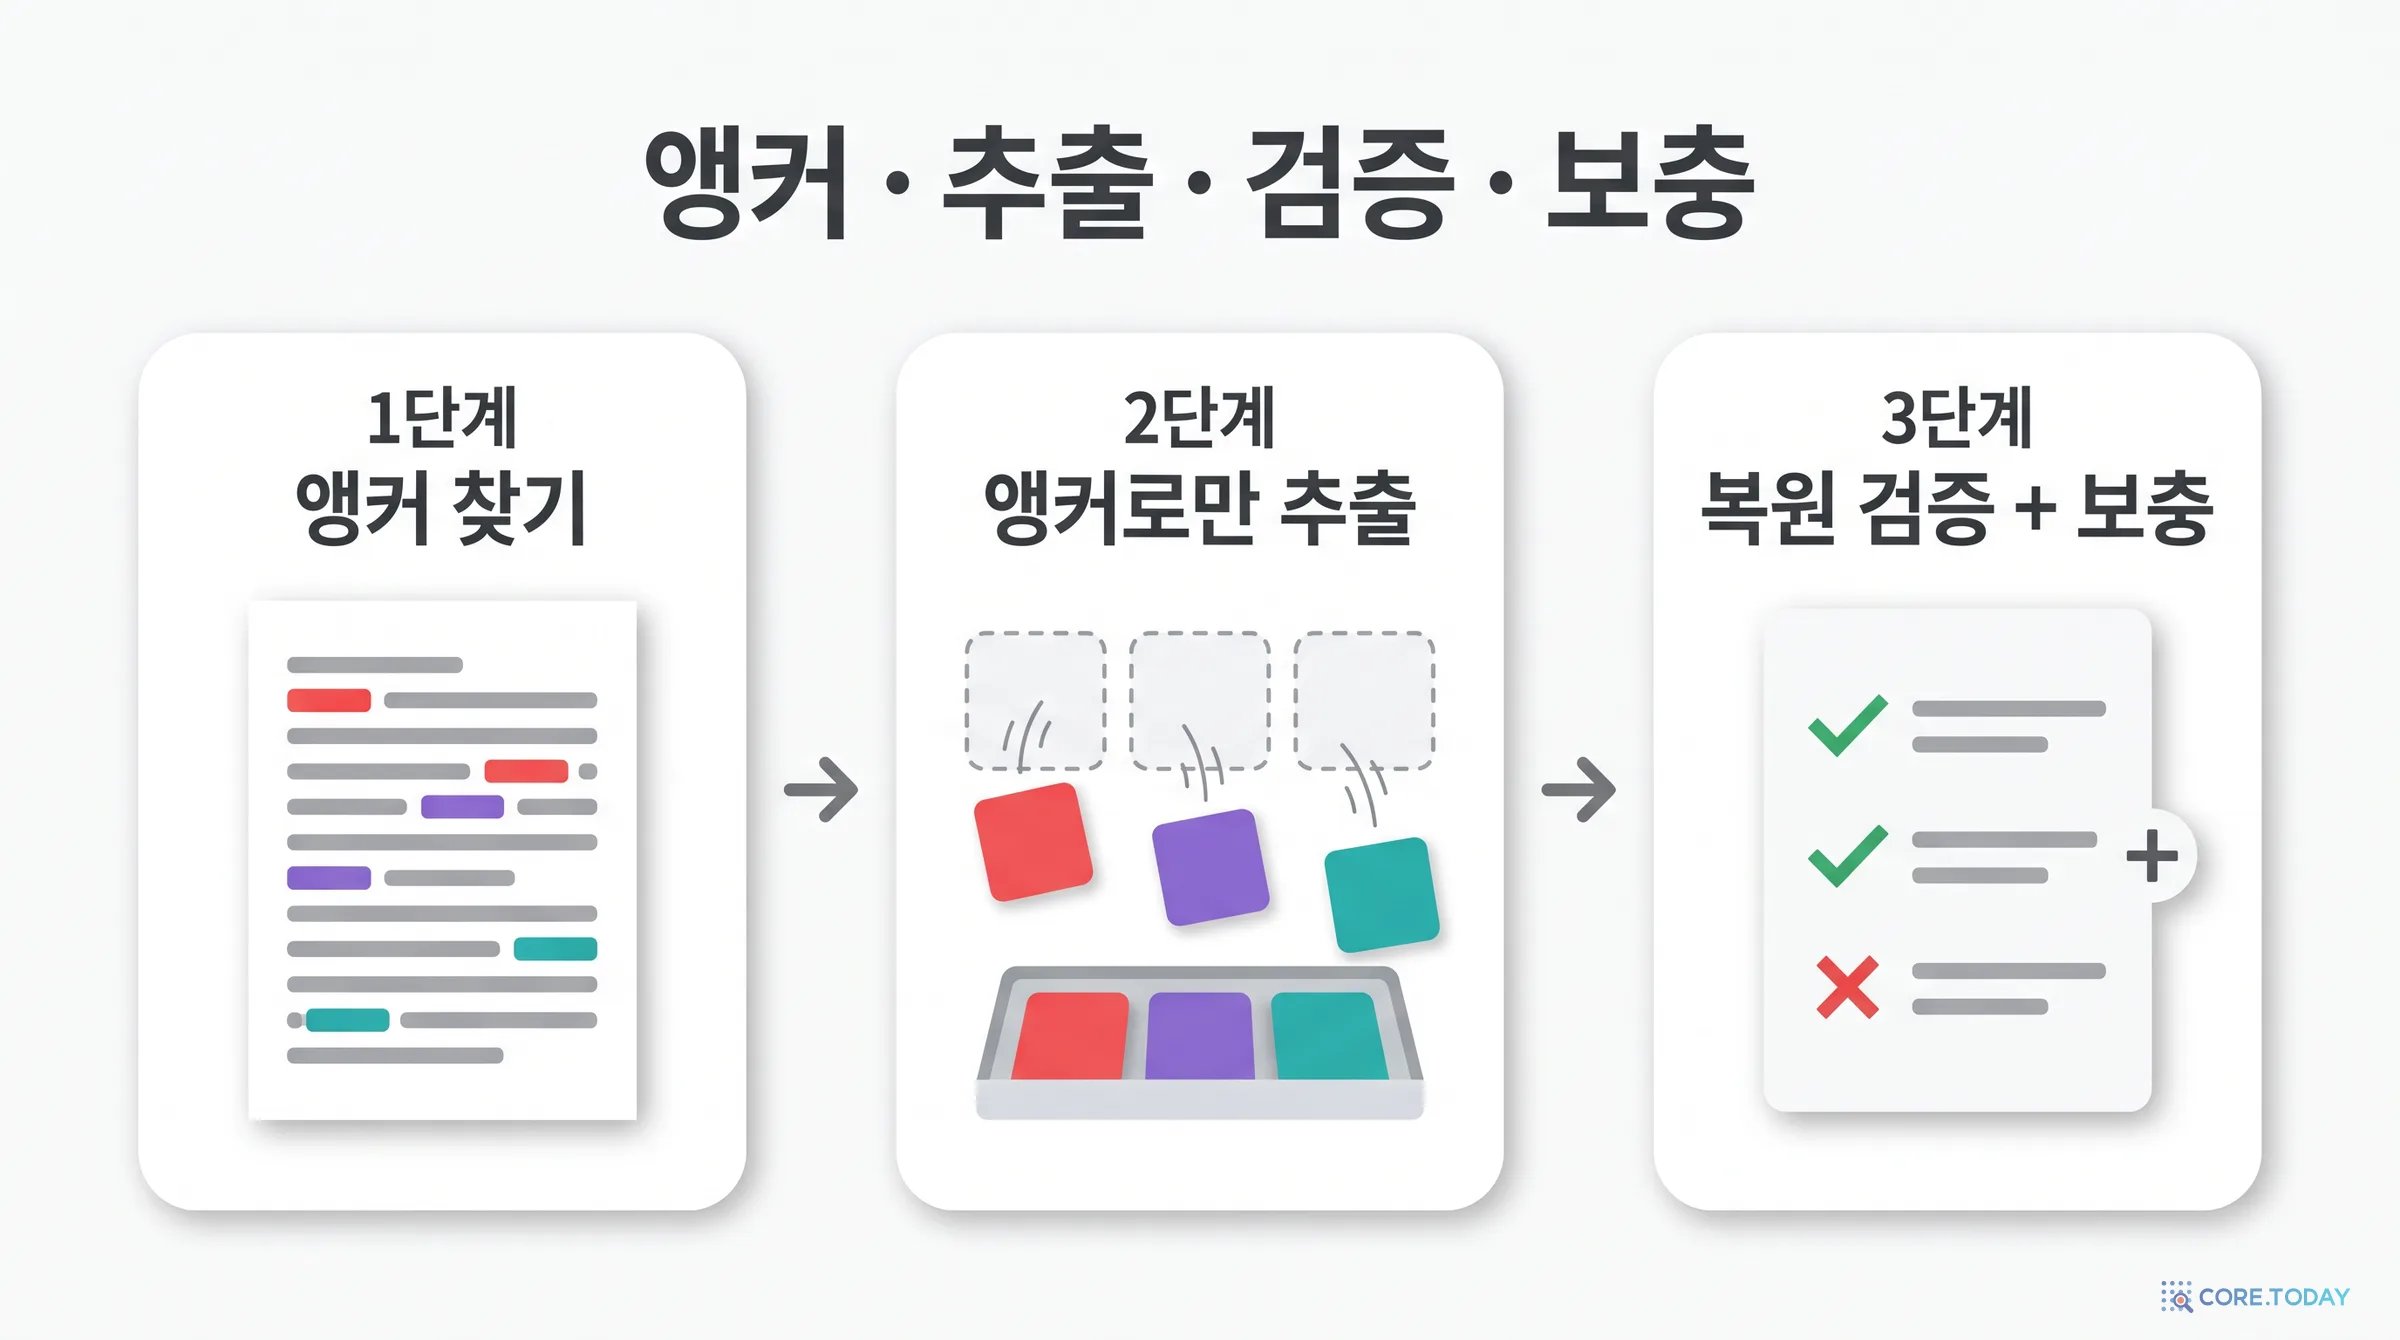
4.2 1단계 — 앵커 찾기: 본문에 무엇이 있는지 먼저 목록을 만든다
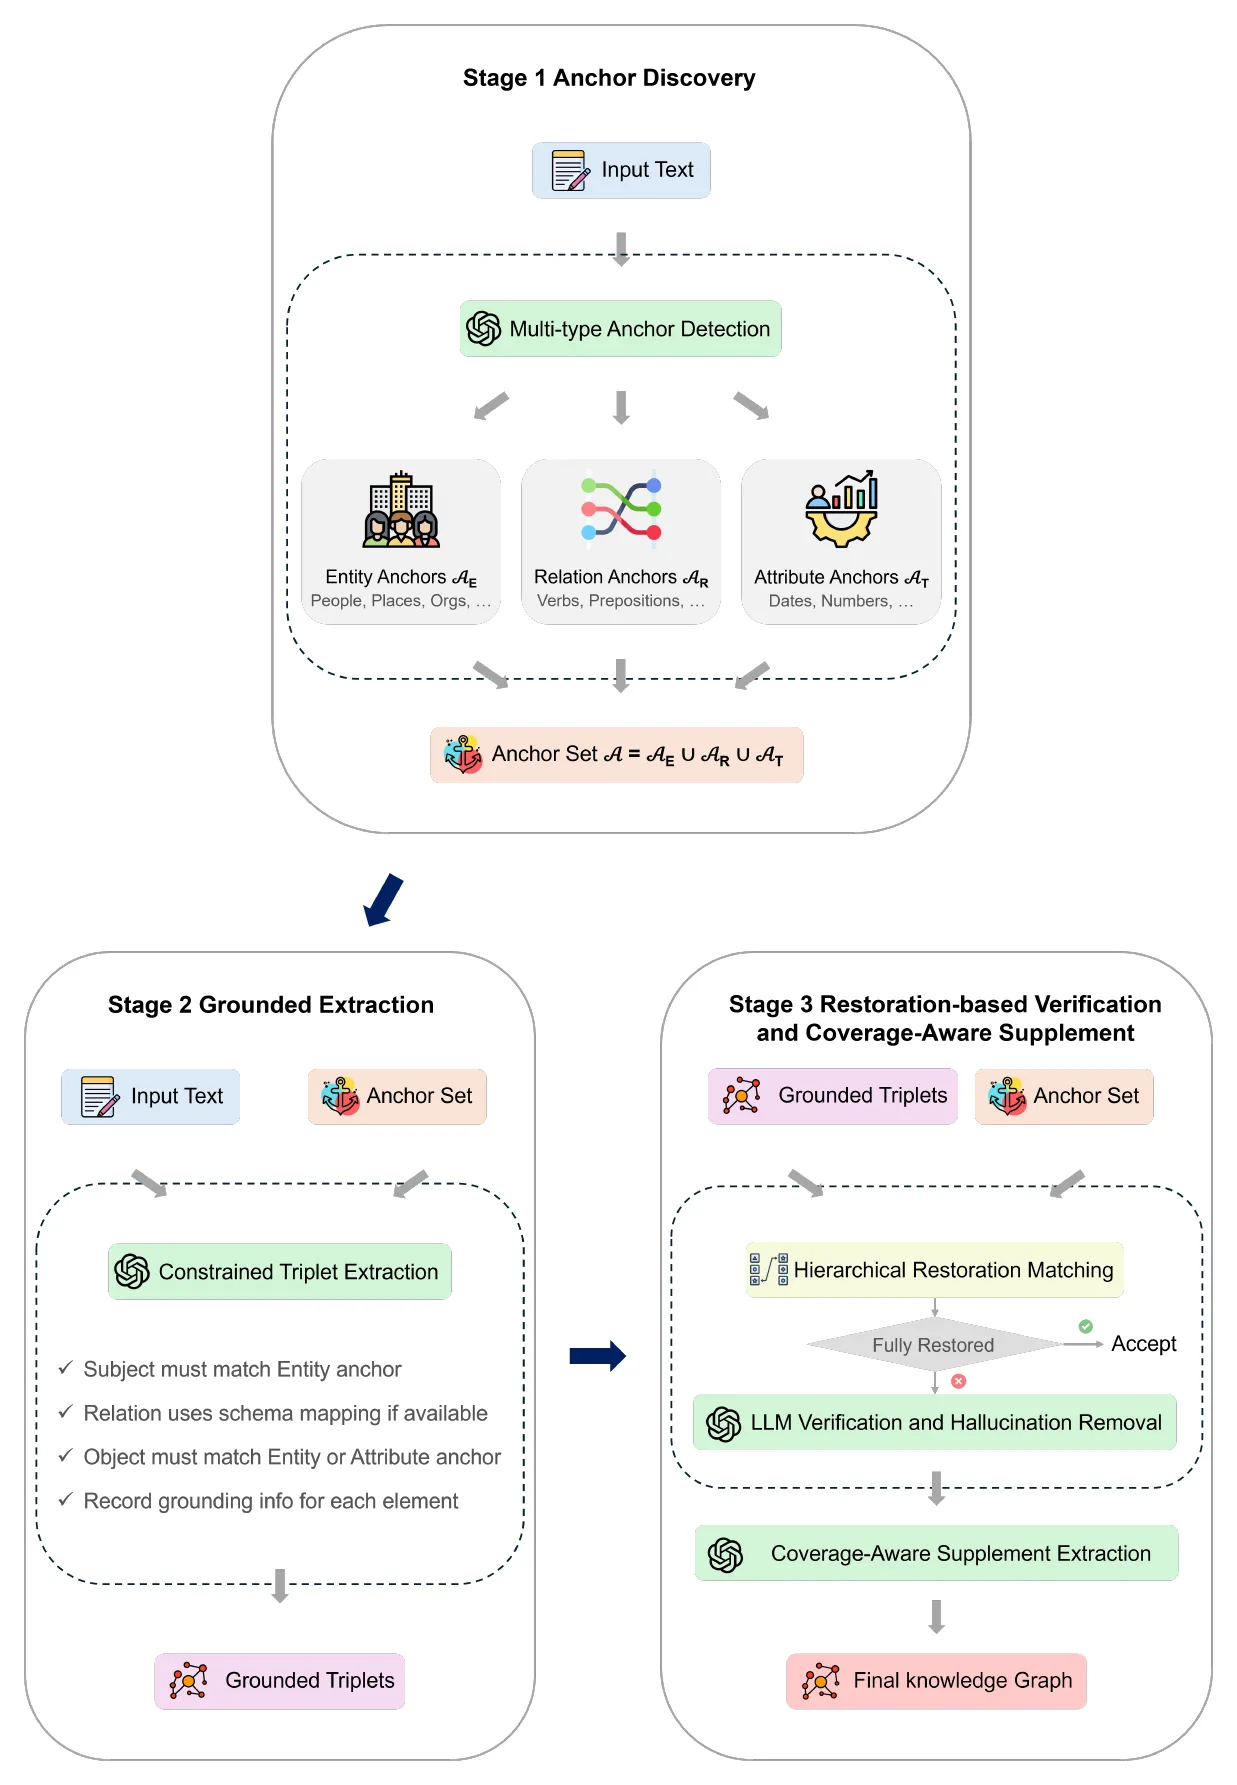
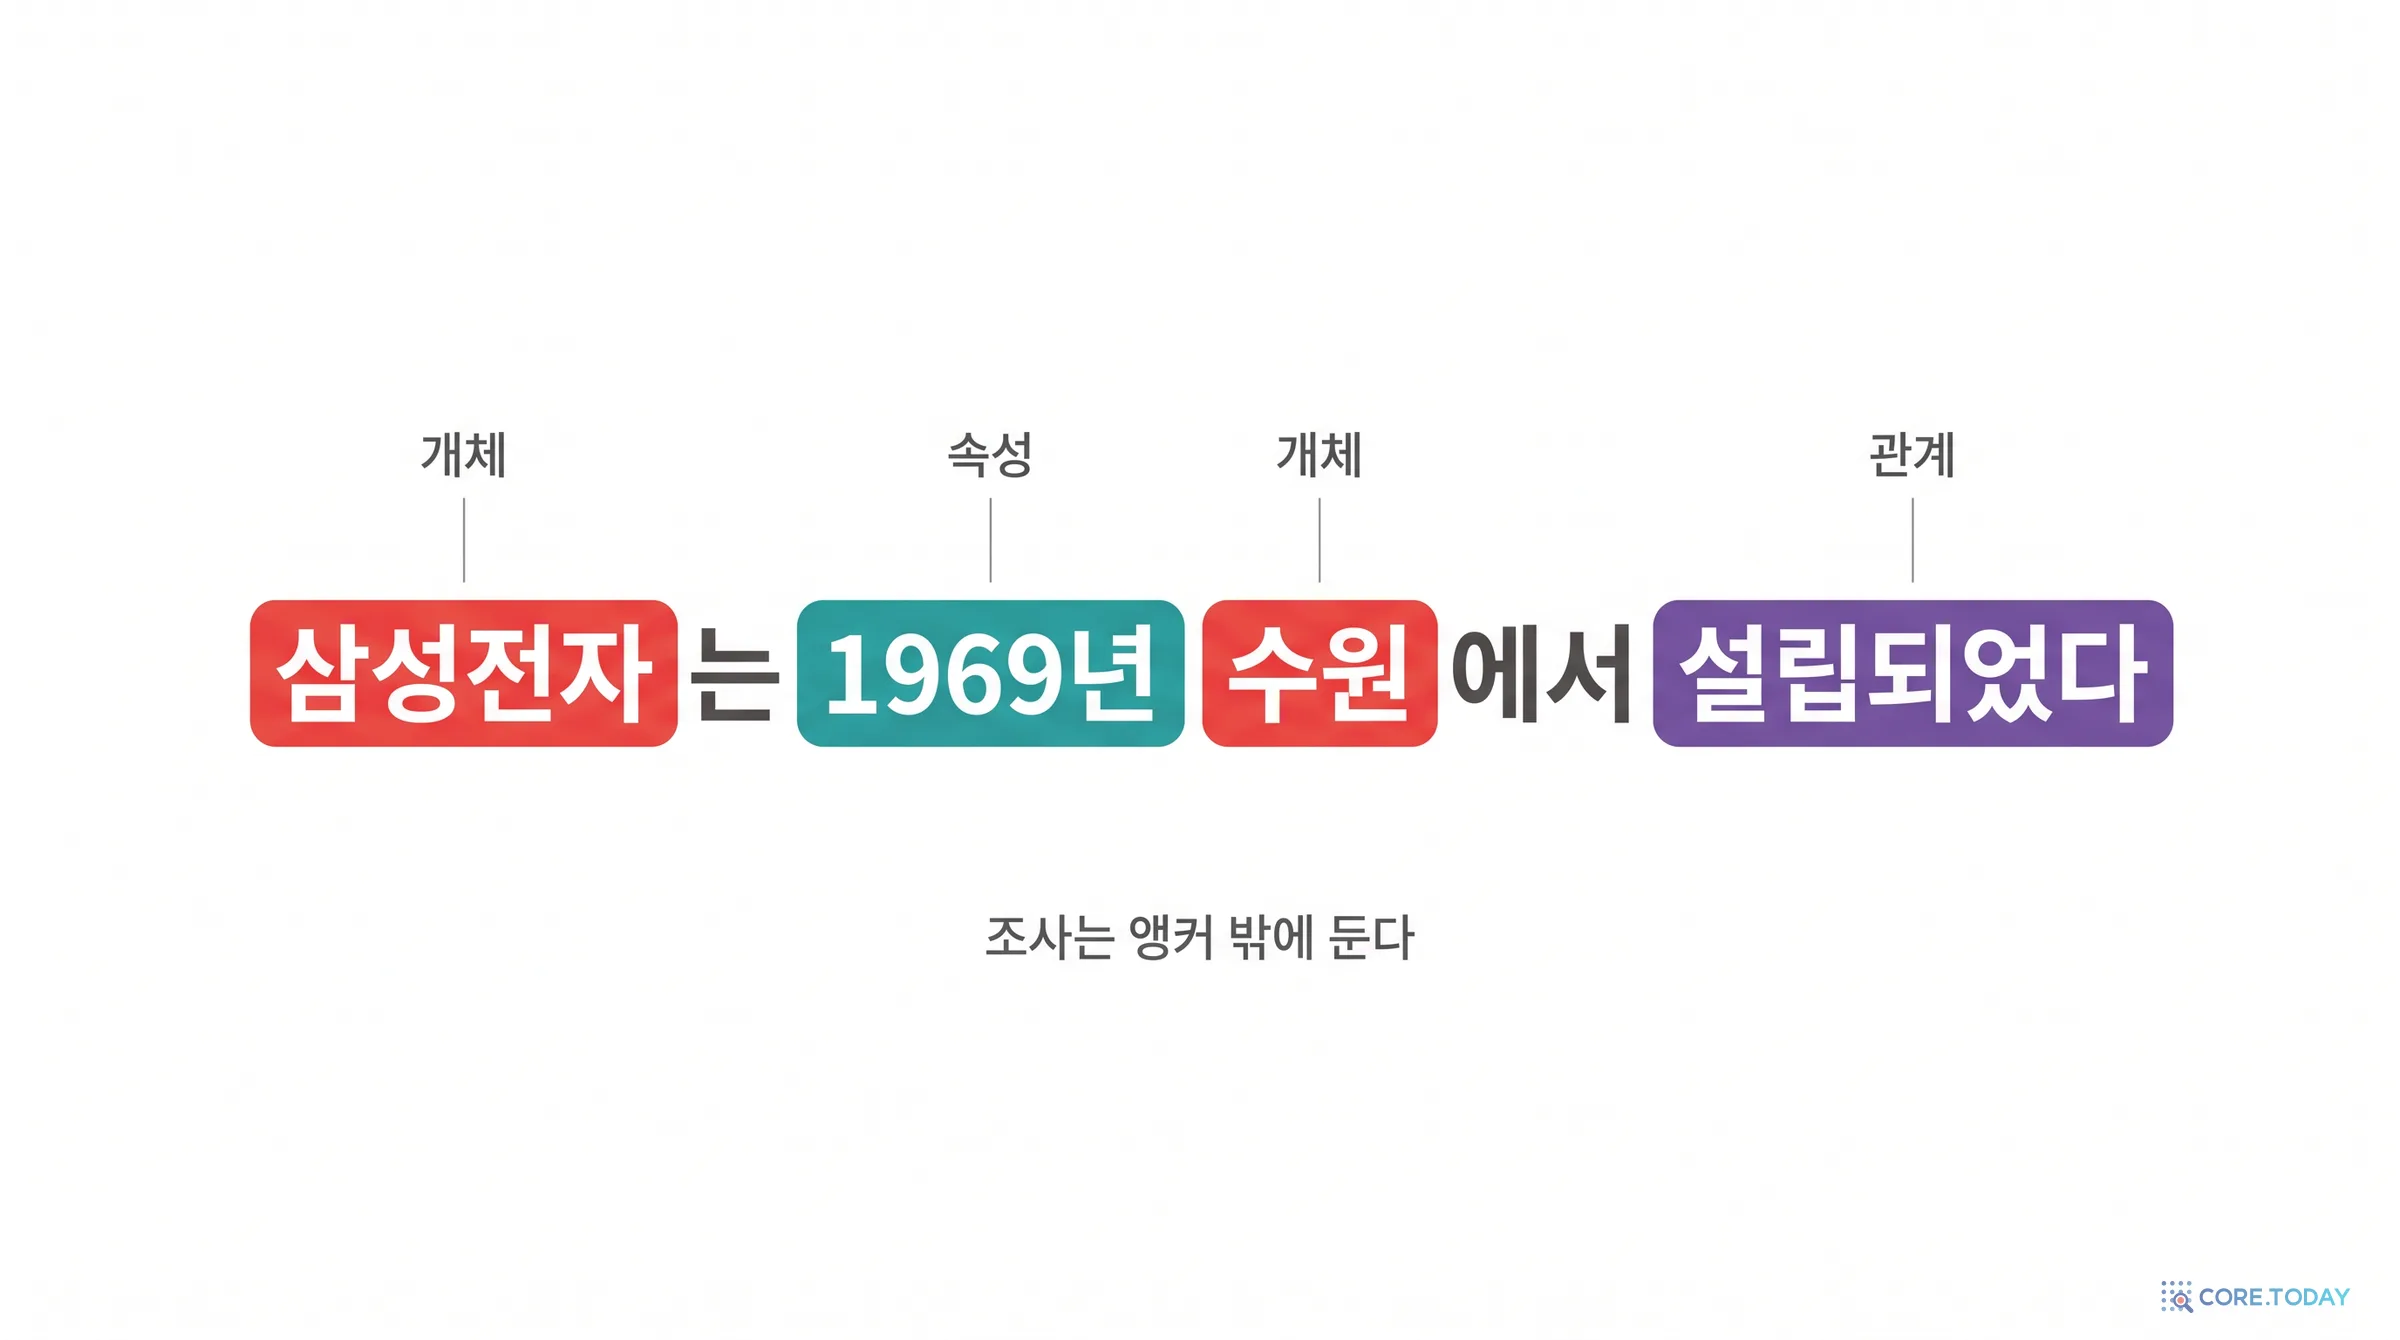
기존 LLM 추출은 문장을 주고 곧바로 "트리플을 뽑아"라고 합니다. AEVS는 그 전에 한 단계를 끼워 넣습니다. 본문에 있는 의미 있는 조각을 위치와 함께 전부 목록으로 만드는 것입니다. 이 조각을 앵커(anchor, 닻)라고 부릅니다. 배가 닻으로 바닥에 고정되듯, 트리플의 원소를 원문 바닥에 묶어 두는 말뚝입니다.
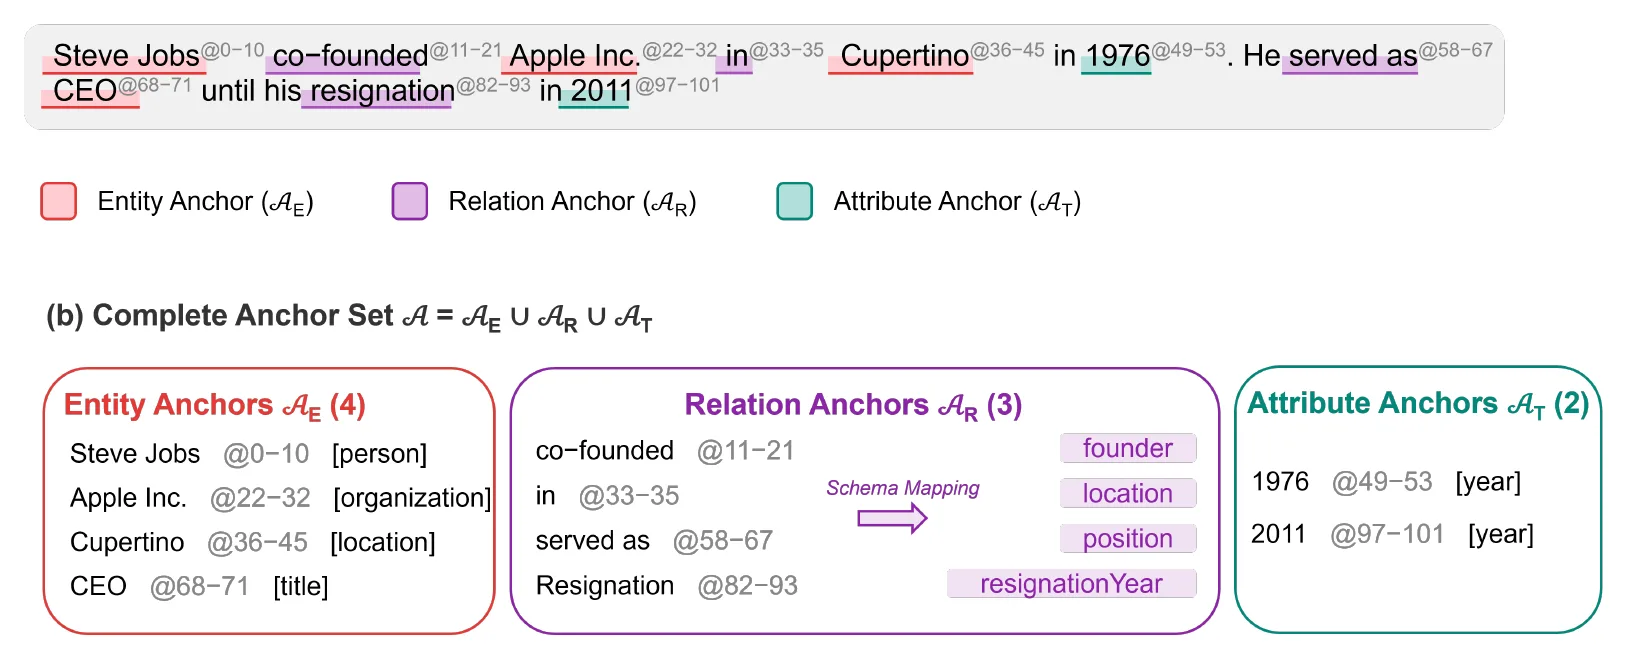
앵커는 다섯 칸짜리 묶음입니다.
a=(text,type,pstart,pend,μ)
칸
뜻
예
text
원문에서 잘라 낸 글자 그대로
"co-founded"
type
개체(entity) · 관계(relation) · 속성(attribute) 중 하나
relation
p_start, p_end
원문에서 몇 번째 글자부터 몇 번째 글자 앞까지
11, 21
μ (메타데이터)
개체면 세부 종류, 관계면 스키마 사상 결과, 속성이면 값의 종류
founder
세 종류의 앵커가 있습니다.
개체 앵커AE: 주어나 목적어가 될 수 있는 이름. 사람·장소·조직·제품·사건·작품 등.
관계 앵커AR: 관계를 표현하는 구절. "co-founded", "was born in", "served as". 그리고 핵심 장치인 스키마 사상 함수φ가 붙습니다. 표면 표현을 미리 정한 관계 이름으로 옮기는 함수로, φ("co-founded")=founder, φ("was born in")=birthPlace처럼 씁니다. "founded", "co-founded", "established"가 모두 founder로 모입니다.
속성 앵커AT: 개체가 아니라 값인 것. 날짜·연도·숫자·수량·직함·기간·백분율.
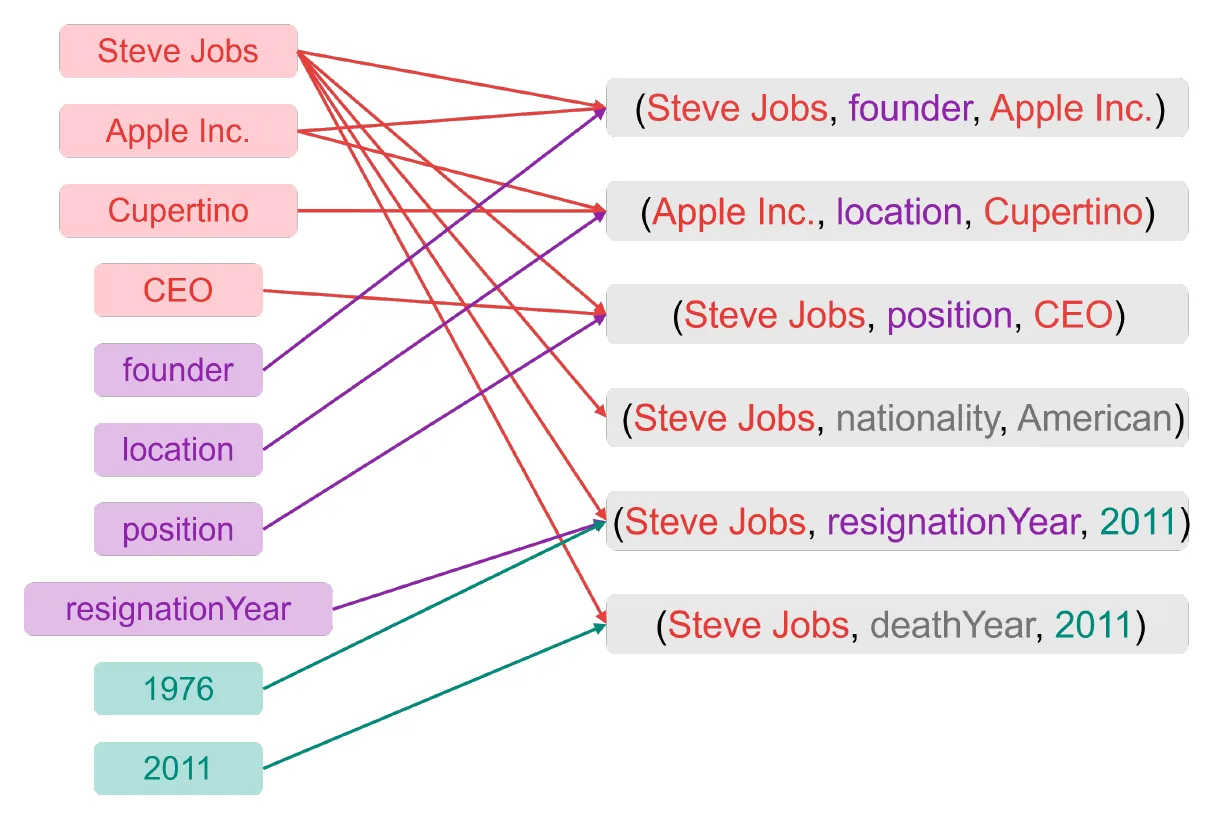
세 집합의 합집합 A=AE∪AR∪AT가 트리플에 나올 수 있는 말의 닫힌 목록이 됩니다. 이 목록에 없는 말이 트리플에 나타나면 그 자체로 의심 신호입니다.
그림 출처: Yang et al. (2026), Figure 3. CC BY 4.0. 그림 (b)의 관계 앵커 상자 제목은 '(3)'이지만 실제로는 4개가 들어 있습니다(본문도 4개라고 씁니다).
코어닷투데이가 예문의 글자 위치를 직접 세어 보니 논문의 10개 위치가 모두 맞았습니다. 흥미로운 것은 전치사 "in"(33–35)이 location으로 사상된 관계 앵커라는 점입니다. 한 단어짜리 전치사도 관계의 근거가 될 수 있다는 뜻이고, 동시에 6장에서 보듯 이것이 엉뚱한 부분 일치의 씨앗이 되기도 합니다.
앵커 찾기 프롬프트와 '스스로 고치는' 검증
앵커는 LLM이 찾습니다(논문 Box 1). 프롬프트는 원문, 쓸 수 있는 스키마 관계 목록, 세 앵커 종류의 정의, 규칙("관계구는 'was born in'처럼 쪼개지 말 것", "글자 위치를 정확히 줄 것", "관계 앵커는 가능하면 스키마로 사상할 것"), 사상 예시, JSON 출력 형식으로 이뤄져 있습니다.
LLM이 돌려준 앵커를 그대로 믿지는 않습니다. 알고리즘 1은 세 관문을 둡니다.
관문 1위치 범위 검사 — 시작이 0 이상, 끝이 본문 길이 이하, 시작 < 끝. 어기면 버린다.
관문 2글자-위치 일치 검사 — 보고된 위치에서 실제로 잘라 낸 글자가 앵커 text와 같은가? 다르면 본문 전체에서 그 text를 찾아 위치를 자동으로 고친다. 본문에서 아예 못 찾으면 버린다.
관문 3스키마 사상 검사 — 관계 앵커의 사상 결과가 스키마에 실제로 있는 이름인가? "locaton" 같은 오타는 퍼지 매칭으로 "location"으로 고친다.
관문 2가 왜 필요한지는 논문이 솔직하게 적었습니다. LLM은 글자 위치를 자주 틀립니다. 모델은 글자가 아니라 토큰 단위로 글을 보기 때문에, "몇 번째 글자"를 세는 일에 서툽니다. 그래서 위치는 '힌트'로만 받고, 진짜 위치는 코드가 문자열 검색으로 다시 정합니다. 7장에서 보겠지만, 로컬 모델은 영어에서도 위치를 열에 아홉 가까이 틀렸고, 한국어에서는 글자 자체가 본문과 달라져 고칠 수 없는 경우까지 더해졌습니다.
아래 위젯에서 앵커를 하나씩 눌러 보세요. 같은 앵커라도 '글자'로 세느냐, UTF-8 '바이트'로 세느냐, 한글을 자모로 풀어(NFD) 세느냐에 따라 주소가 달라집니다. '모델이 보고한 위치 보기'를 켜면 로컬 모델이 실제로 돌려준 한국어 앵커 위치가 나옵니다.
앵커 목록이 생기면, 트리플 추출은 이렇게 바뀝니다. 각 원소를 앵커에 연결하는 접지 함수γ를 두고, 다음 제약을 겁니다.
γ(s)∈AE,γ(r)∈AR∪{φ−1(r)},γ(o)∈AE∪AT
주어는 개체 앵커에서, 관계는 관계 앵커(또는 그 스키마 사상)에서, 목적어는 개체나 속성 앵커에서만 고르라는 뜻입니다. 논문은 이것을 "열린 생성 문제를 닫힌 조합 선택 문제로 바꾼다"고 표현합니다. 탐색 공간이 '아무 문자열 세 개'에서 다음으로 줄어듭니다.
Σ∗×Σ∗×Σ∗⟶AE×(AR∪R)×(AE∪AT)
잡스 예문으로 세어 보면 개체 4개, 관계 앵커 4개, 속성 2개입니다. 관계 칸을 관계 앵커로만 채운다면 조합은 4 × 4 × 6 = 96가지입니다. 그런데 식을 자세히 보면 관계 칸이 AR만이 아니라 스키마 전체 R과의 합집합입니다. WebNLG 스키마 159종을 넣으면 4 × (4 + 159) × 6 = 3,912가지가 됩니다. 개체 칸은 본문으로 닫혔지만 관계 칸은 스키마 전체에 열려 있는 것입니다. 이 작은 차이가 5장과 6장에서 '오류의 95%가 관계'라는 결과로 돌아옵니다.
추출 프롬프트(Box 2)는 원문과 함께 앵커 목록을 종류별로 위치와 함께 보여 주고, 규칙 네 가지를 겁니다.
추출 규칙 (논문 Box 2 요약)
1. 중요: 트리플의 각 원소는 반드시 앵커와 대응해야 한다 — 주어는 개체 앵커, 관계는 관계 앵커의 스키마 사상, 목적어는 개체·속성 앵커 2. 접지: 원소마다 출처 앵커의 글자와 시작·끝 위치를 적어라 3. 커버리지: 모든 앵커를 적어도 한 트리플에 써 보라 4. 환각 금지: 본문에 있는 정보만 뽑아라
그리고 저자들은 중요한 단서를 답니다. "환각 금지" 지시문에 기대지 않는다. 모델이 적어 낸 접지 정보(어느 앵커에서 왔는지)도 믿지 않고 '힌트'로만 씁니다. 실제 집행은 3단계의 독립적인 검증이 맡습니다. LLM에게 "거짓말하지 마"라고 말하는 것과, 거짓말을 해도 걸러지는 구조를 만드는 것은 다르다는 태도입니다.
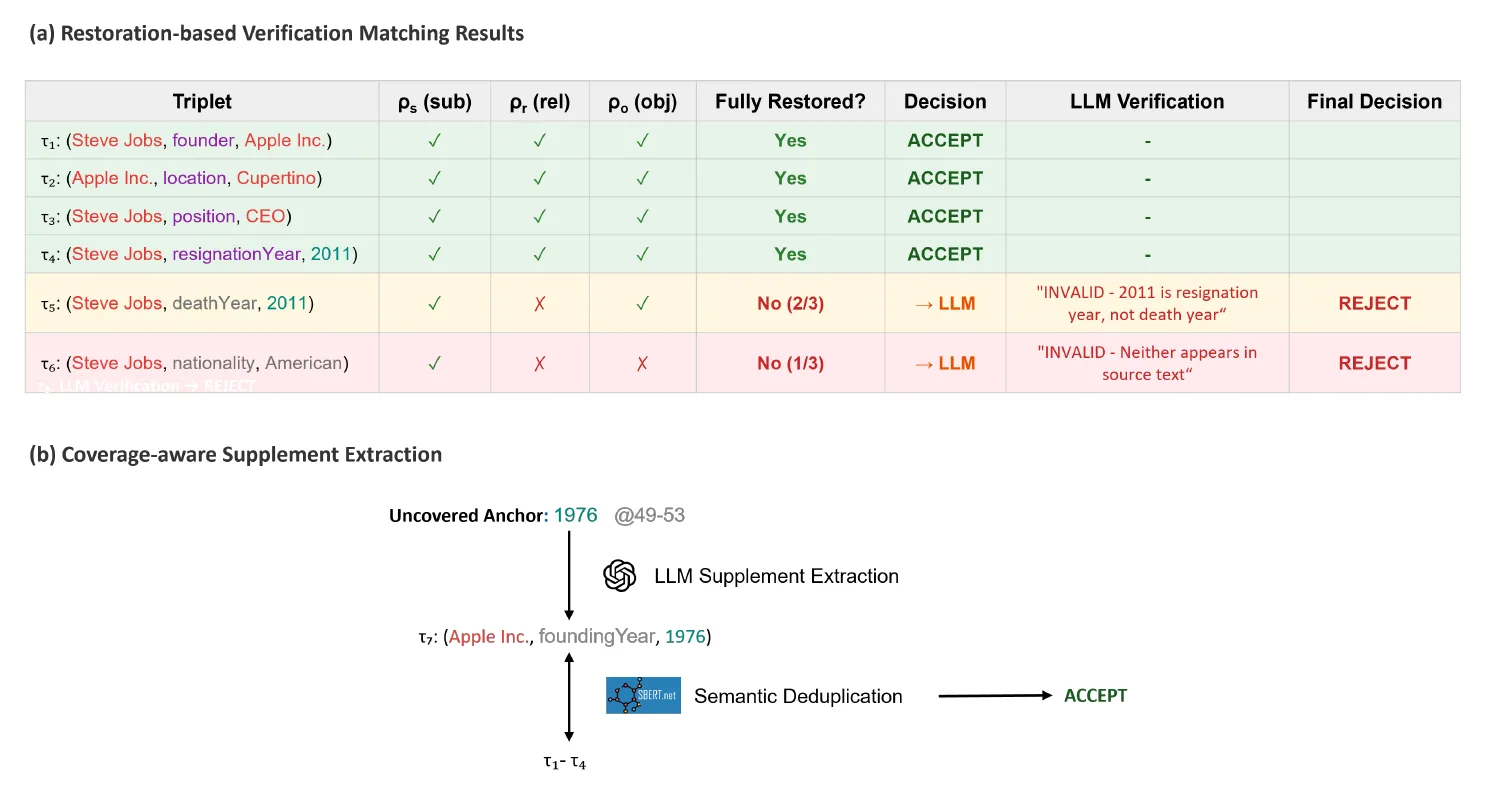
논문 그림 4는 2단계 결과입니다. 여섯 트리플 중 τ1~τ4는 모든 원소가 앵커에 연결됐고, τ5·τ6에는 회색(연결 안 된) 원소가 있습니다.
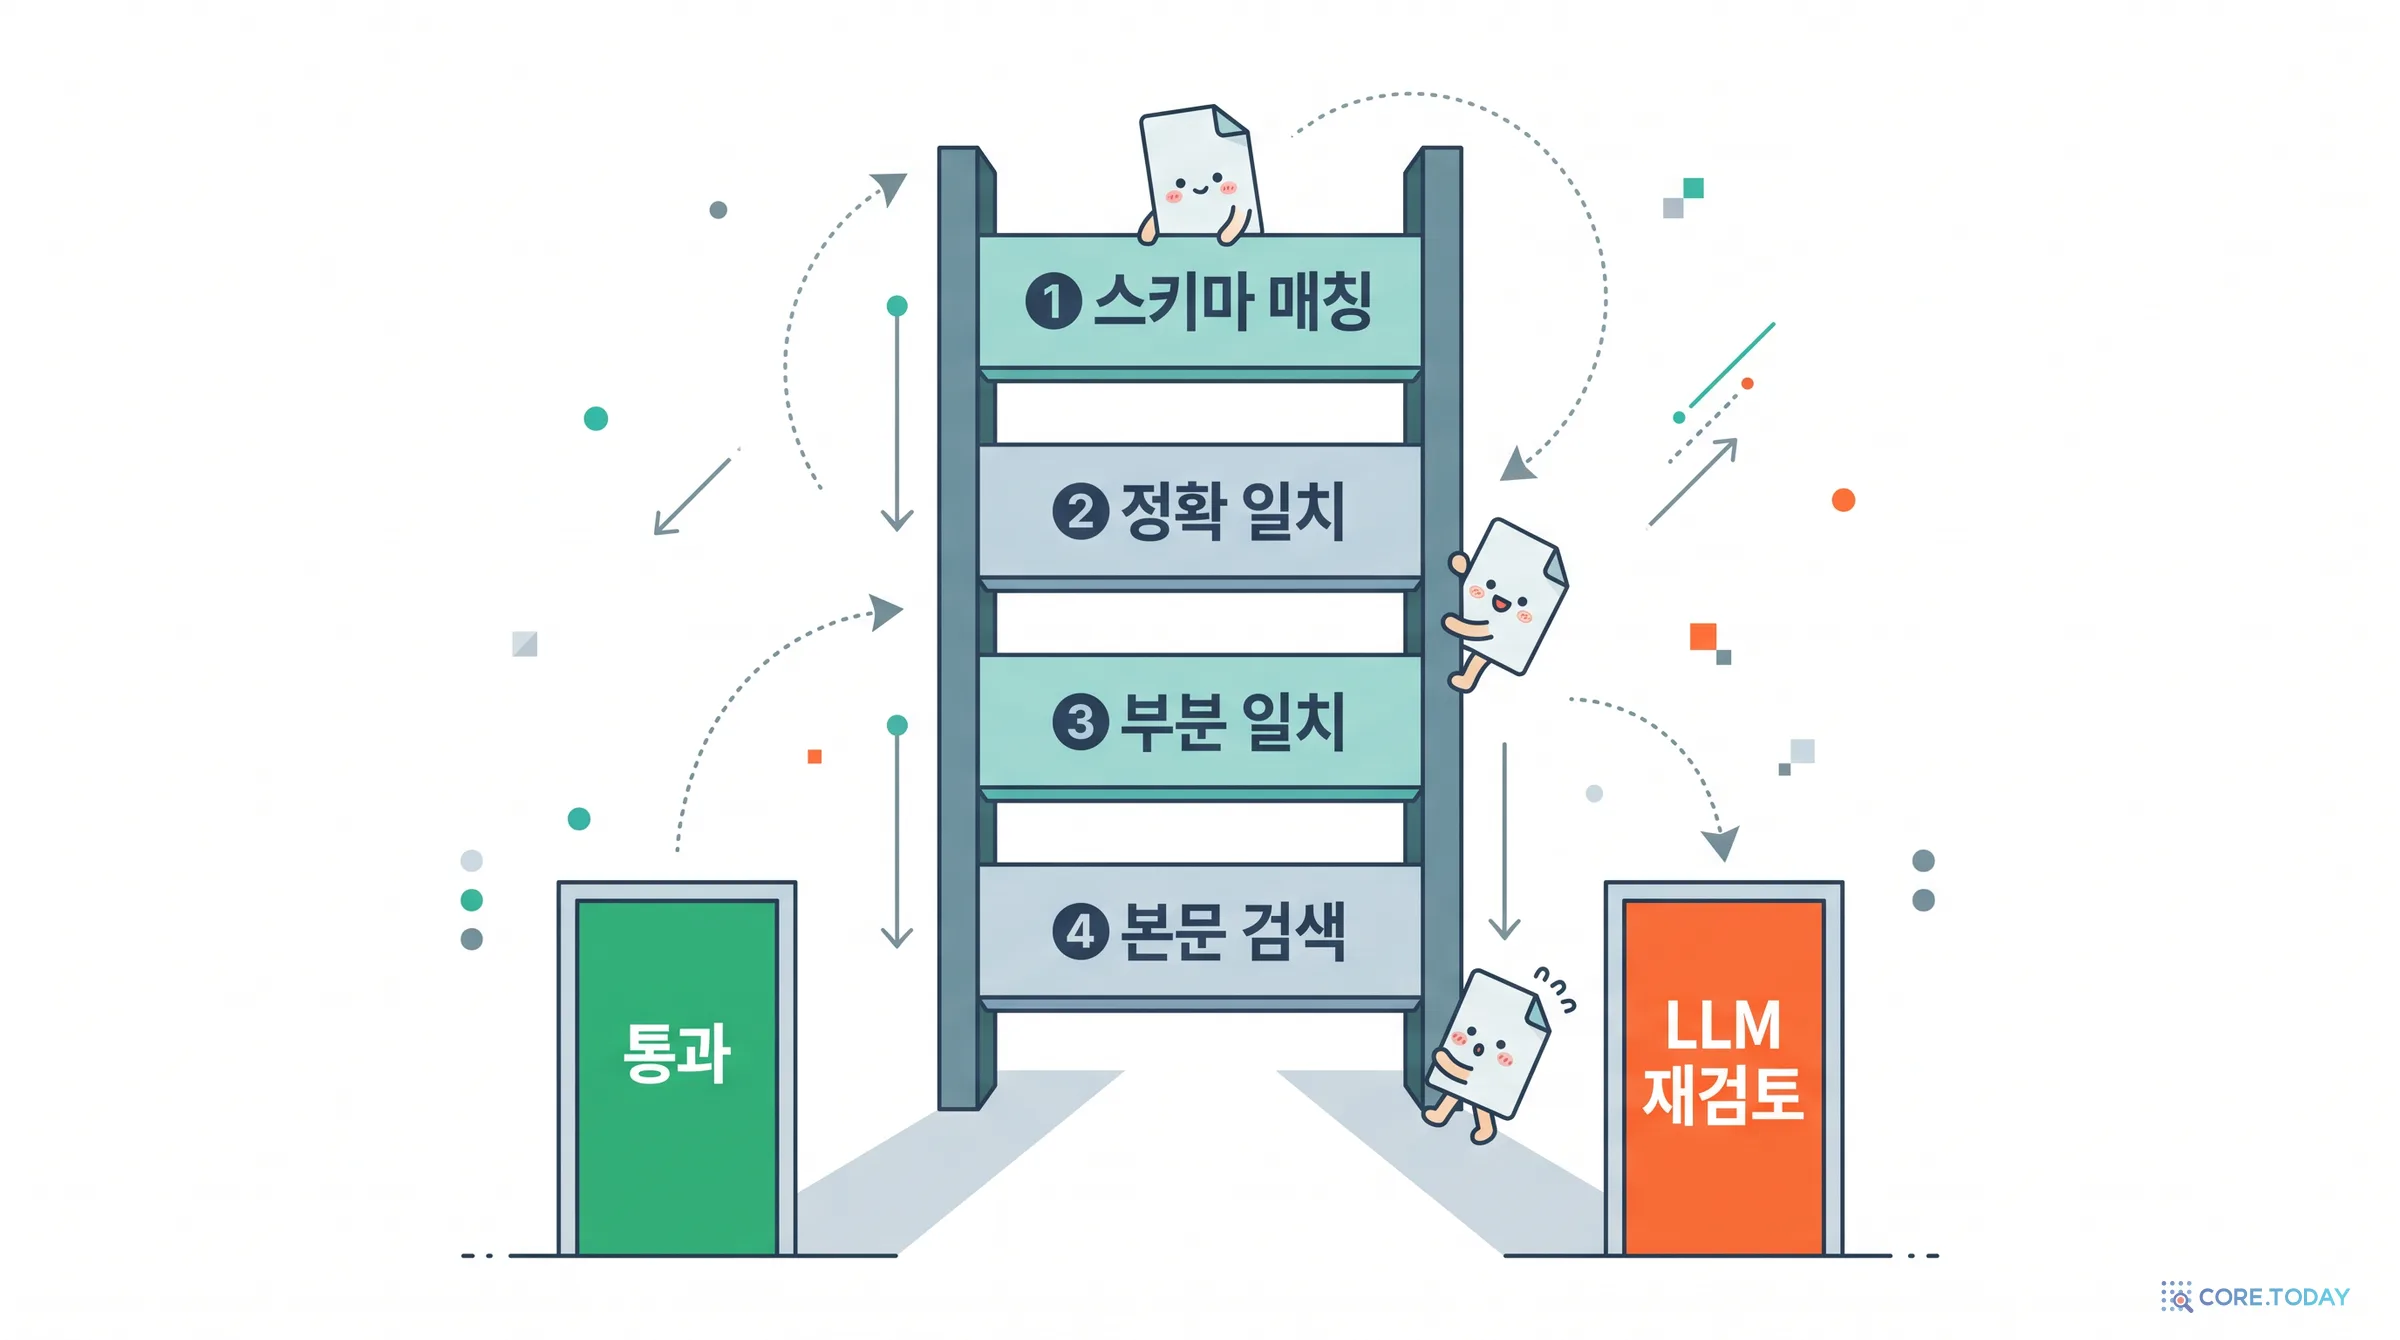
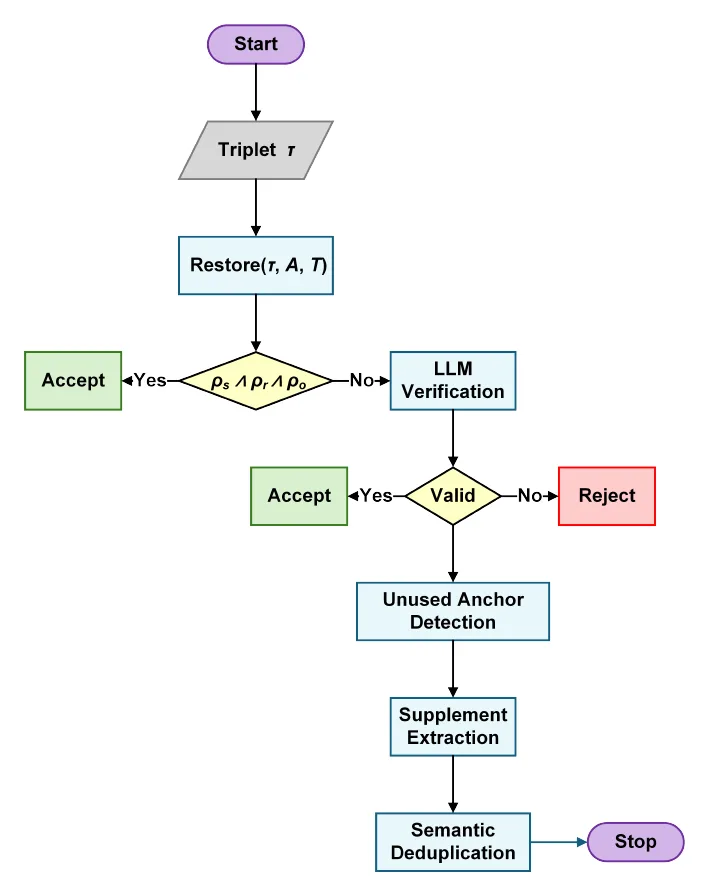
3단계의 핵심 생각은 이렇습니다. 트리플이 원문에 충실하다면, 그 원소 하나하나를 추출 과정과 상관없이 원문의 앵커로 '되돌릴(restore)' 수 있어야 한다. 되돌리기는 LLM 없이 문자열 비교로만 합니다. 추출과 완전히 분리된 교차 확인이고, 외부 지식베이스도 필요 없습니다.
되돌리는 방법은 확신이 큰 것부터 작은 것 순으로 네 칸짜리 사다리입니다(논문 표 1).
순서
방법
무엇을 보나
대상
1
스키마 매칭
트리플의 관계 이름이, 어떤 관계 앵커의 사상 결과 φ와 같은가 (예: founder ← "co-founded")
관계만
2
정확 일치
소문자로 바꾸고 앞뒤 공백을 지운 뒤 앵커 글자와 똑같은가
모든 원소
3
부분 일치
한쪽이 다른 쪽에 포함되는가 ("Apple" ⊂ "Apple Inc."). 관계는 밑줄·공백도 지우고 비교
모든 원소
4
본문 검색
최후 수단. 앵커는 아니어도 원문 어딘가에 그 글자가 있는가
모든 원소
세 원소를 각각 되돌려 보면 트리플마다 복원 상태 벡터ρ(τ)=(ρs,ρr,ρo)∈{0,1}3가 나옵니다. 판정은 단순합니다.
ρ = (1, 1, 1) 완전 복원
→
LLM을 부르지 않고 바로 통과
하나라도 0 부분 복원
→
LLM 재검토 — 어느 원소를 못 찾았는지 알려 주고 판단하게 한다
완전 복원된 트리플을 LLM에게 다시 묻지 않는 데는 두 가지 이유가 있습니다. 호출 비용을 아끼고, 검증하는 LLM이 오히려 오류를 만들 위험을 피하는 것입니다. 저자들은 완전 복원이 정답을 보장하지는 않는다고 인정합니다. 두 개체가 우연히 한 문장에 함께 있을 뿐 실제로는 관계가 없는 경우가 있을 수 있기 때문입니다(원거리 지도학습의 오래된 함정과 같은 모양입니다). 그러나 개체가 본문으로 묶여 있어 엉뚱한 쌍이 생길 여지가 적고, 실험에서 주된 오류는 '개체 쌍이 틀림'이 아니라 '관계가 근거 없음'이었다는 것을 근거로 듭니다.
표적 LLM 검증 (Box 3)
부분 복원 트리플은 LLM이 다시 봅니다. 이때 프롬프트에 원소별 복원 상태를 함께 줍니다.
검증 프롬프트 (논문 Box 3 일부)
1. (Steve Jobs, deathYear, 2011)
Status: subject 'Steve Jobs' found, relation 'deathYear' NOT found, object '2011' found in text
2. (Steve Jobs, nationality, American)
Status: subject 'Steve Jobs' found, relation 'nationality' NOT found, object 'American' NOT found in text
VALID: 본문에 명시됐거나, 외부 지식 없이 본문에서 직접 추론되거나, 단어는 달라도 뜻이 본문으로 뒷받침될 때
INVALID: 본문이 뒷받침하지 않거나, 지어낸 정보가 있거나, 주어-목적어 관계가 틀렸을 때
막연히 "이 트리플 맞아?"라고 묻는 대신 "관계 deathYear를 본문에서 못 찾았는데, 그래도 본문으로 뒷받침되는가?"라고 문제 지점을 짚어 주는 것이 요점입니다. 판단 근거는 원문 하나뿐이라고 못박아 모델의 머릿속 지식을 막습니다.
중복 제거, 그리고 빠진 것 보충
검증을 통과한 트리플은 두 겹으로 중복을 지웁니다. 정규화한 세 원소가 똑같으면 지우고, 세 원소가 각각 서로 포함 관계면("Apple" vs "Apple Inc.") 또 지웁니다.
그다음이 'S', 커버리지 기반 보충입니다. 앵커 목록은 '본문에 무엇이 있는가'의 재고 목록이므로, 트리플에 한 번도 쓰이지 않은 앵커는 '놓친 사실이 있을지 모른다'는 신호가 됩니다.
Coverage(K,A)=∣A∣∣{a∈A:∃τ∈K,a∈Anchors(τ)}∣
안 쓰인 앵커가 있으면 보충 추출을 한 번 더 부릅니다(Box 4). 프롬프트에는 이미 뽑은 트리플 목록을 "다시 뽑지 말 것, 비슷한 것도 안 됨"이라는 부정 지시로 넣고, 안 쓰인 앵커를 "이걸 써 보라"고 겨냥해 줍니다. 저자들은 부정 지시가 없으면 모델이 확신 높은 트리플을 또 뽑는 경향이 있다고 적었습니다.
보충 단계는 별도 호출이라 같은 사실을 다른 말로 다시 뽑을 수 있습니다("잡스가 애플을 세웠다" vs "애플은 잡스가 세웠다"). 그래서 여기서는 문자열 비교 대신 문장 임베딩(all-MiniLM-L6-v2)으로 트리플을 벡터로 바꿔 기존 트리플과의 코사인 유사도가 0.85 이상이면 버립니다.
최종 그래프는 다섯 줄 {τ1, τ2, τ3, τ4, τ7}입니다. 환각 둘이 걸러졌고, 처음에 놓친 창업 연도가 보충으로 들어왔습니다. 다음 위젯에서 이 트리플들을 하나씩 사다리에 넣어 보세요. 오른쪽 칸은 같은 트리플을 GitHub에 공개된 코드가 어떻게 판정하는지 보여 줍니다. 결과가 다릅니다. 이 이야기는 6장에서 자세히 합니다.
5. 실험 읽기 — 표와 그림을 한 장씩
5.1 시험지 세 장과 채점 기준 세 가지
AEVS는 관계 종류가 많은 데이터셋 세 개로 평가했습니다. 관계가 1~7종뿐인 ADE·SciERC·CoNLL04는 "실제 지식 그래프 구축의 다양성을 담지 못한다"며 일부러 뺐습니다.
데이터셋
관계 종류
문장 수
정답을 만든 방식
읽을 때 주의
WebNLG+ 2020
159
1,165
DBpedia 트리플을 보여 주고 사람(크라우드 작업자)이 문장을 썼다
본문과 정답이 거의 1:1. 가장 깨끗하다
REBEL
200
1,000
위키백과 요약 ↔ 위키데이터 자동 정렬 (EDC 논문이 뽑은 같은 1,000건)
원거리 지도학습: 빠진 정답·틀린 정답이 섞임
Wiki-NRE
45
1,000
위키백과 ↔ 위키데이터 자동 정렬 (같은 1,000건)
원거리 지도학습. 관계 목록이 작다
채점은 WebNLG 공식 평가 스크립트로 하고, 정밀도(P)·재현율(R)·F1을 세 가지 엄격도로 냅니다.
Partial: 후보와 정답 트리플의 토큰이 겹치는 만큼 점수. 표기 차이에 너그럽습니다.
비교 대상은 세 부류입니다. 데이터셋마다 학습시킨 전문 모델(WebNLG에서는 T5와 강화학습을 쓴 REGEN, REBEL·Wiki-NRE에서는 BART와 제약 디코딩을 쓴 GenIE), 같은 LLM에 틀 없이 그냥 묻기(Direct), 그리고 EDC입니다. 백본 LLM은 GPT-4o-mini, GPT-5.1, Claude 4.5 Haiku, Gemini 2.5 Flash 네 가지입니다. EDC는 "여러 단계를 큰 데이터셋에 여러 모델로 돌리는 비용 때문에" GPT-4o-mini로만 돌렸습니다. 이 한 줄이 6장에서 중요해집니다.
5.2 본 결과: 틀을 씌우면 크게 오르고, AEVS는 EDC를 조금 넘는다
세 가지가 읽힙니다.
첫째, 그냥 묻기와의 차이가 압도적으로 보고됐습니다. (7장에서 보듯 이 차이는 그냥 묻기에 스키마를 주느냐에 크게 좌우될 수 있습니다.) GPT-4o-mini로 WebNLG를 그냥 물으면 Strict F1이 0.458인데, AEVS로 감싸면 0.760입니다(+0.302). 네 모델, 세 데이터셋, 세 채점 기준 36칸 모두에서 올랐습니다. 특히 Partial보다 Strict·Exact에서 더 많이 올랐는데, 이는 내용만이 아니라 구조(누가 주어고 누가 목적어인지)도 바로잡혔다는 뜻으로 읽힙니다.
둘째, 학습 모델을 학습 없이 넘었습니다. WebNLG에서 Gemini 2.5 Flash AEVS는 REGEN보다 Exact F1이 0.105 높고, REBEL에서 Claude 4.5 Haiku AEVS는 GenIE보다 Partial F1이 0.412 높습니다(0.797 vs 0.385). 저자들은 GenIE가 지식베이스 이름으로만 생성하도록 묶여 있어 날짜·숫자 같은 리터럴 값에 약하다고 설명합니다. 앵커는 본문의 값을 그대로 집어 오므로 이 약점이 없습니다.
셋째, 같은 모델의 EDC는 근소하게 넘었습니다. GPT-4o-mini로 맞추면 WebNLG +0.007, REBEL +0.012, Wiki-NRE +0.074(Partial F1)입니다. 깨끗한 WebNLG에서는 사실상 비기고, 자동 정렬 데이터셋에서 차이가 벌어집니다. 저자들은 EDC의 사후 정규화가 "뽑은 관계가 스키마와 깔끔히 맞지 않을 때 오류를 만든다"고 해석합니다.
하나 더 흥미로운 관찰이 있습니다. 그냥 물을 때 강한 모델이 AEVS에서도 강하지는 않았습니다. REBEL에서 그냥 묻기는 GPT-5.1이 Claude 4.5 Haiku보다 모든 기준에서 높았는데(Partial 0.616 vs 0.535), AEVS를 씌우자 순서가 뒤집혔습니다(0.740 vs 0.797). 틀(프레임워크)에 얼마나 잘 맞춰 따라오느냐, 즉 지시 이행 성향이 원래 실력과 다른 축이라는 뜻입니다.
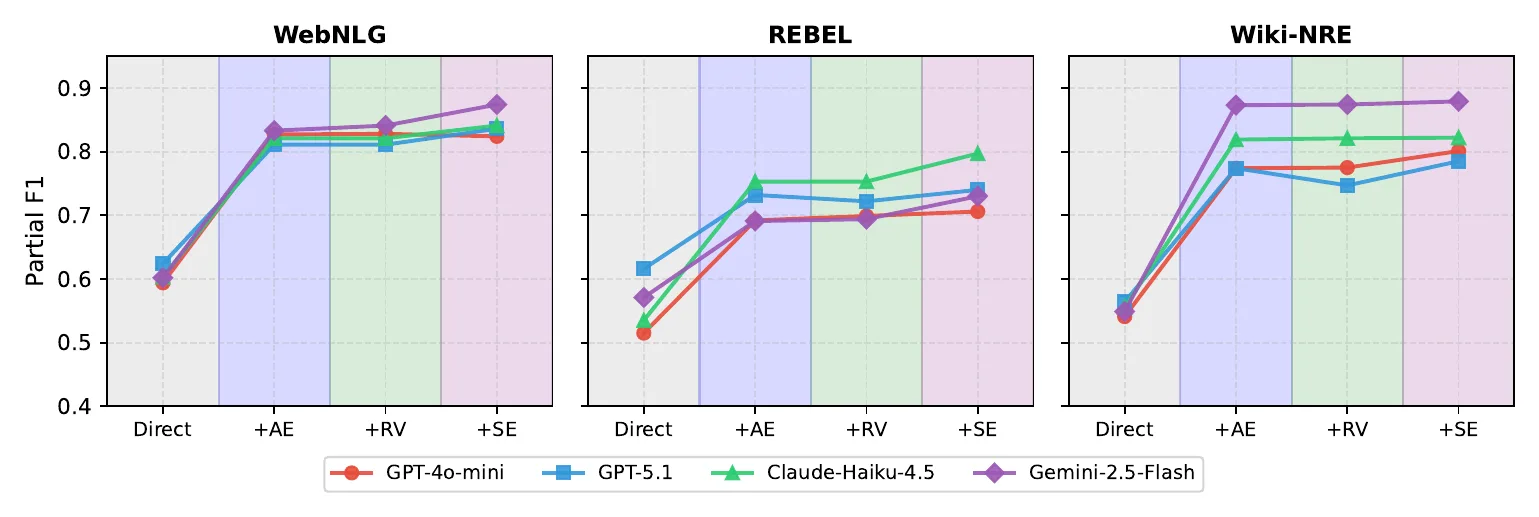
5.3 제거 실험: 성능의 대부분은 '앵커'에서 나왔다
저자들은 그냥 묻기에서 출발해 부품을 하나씩 더했습니다. +AE(앵커 찾기 + 앵커로만 추출), +RV(복원 검증), +SE(보충).
그림 출처: Yang et al. (2026), Figure 6. CC BY 4.0. Strict(그림 7)·Exact(그림 8)도 같은 모양입니다.
+AE (앵커)
+0.117 ~ +0.324
+RV (복원 검증)
−0.010 ~ +0.011
+SE (보충)
최대 +0.045
Partial F1 기준 각 부품이 더한 폭. 막대 길이는 최댓값 0.324 대비 비율입니다.
+AE가 거의 전부입니다. Partial F1로 +0.117~+0.324, Strict로는 Wiki-NRE에서 최대 +0.389까지 올랐습니다.
+RV는 점수를 거의 바꾸지 않았습니다(−0.010~+0.011, GPT-5.1·Wiki-NRE에서는 오히려 −0.028~−0.030). 저자들은 이것을 긍정적으로 해석합니다. 앵커 제약만으로 이미 대부분의 트리플이 추적 가능해졌다는 뜻이고, 복원 검증의 가치는 점수가 아니라 "이 트리플은 원문의 여기서 왔다"는 출처 보증에 있다는 것입니다. 의료·법률·과학처럼 사용자가 결과를 감사(audit)해야 하는 분야에서 필요한 성질입니다.
+SE는 원거리 지도학습 데이터셋에서 효과가 있었습니다(REBEL에서 Claude 4.5 Haiku +0.045, Wiki-NRE에서 GPT-5.1 +0.041). 특히 숫자·날짜 같은 속성 앵커가 처음 추출에서 잘 빠지는데, 보충이 이것을 주워 담았습니다.
5.4 온도: 뽑는 단계는 민감하고, 검증 단계는 무디다
LLM의 온도(temperature)는 출력의 무작위성입니다. AEVS에는 단계마다 온도가 넷(τ1 앵커, τ2 추출, τv 검증, τs 보충) 있습니다. 저자들은 각 데이터셋의 10% 표본에, 데이터셋별 최고 모델(WebNLG·Wiki-NRE는 Gemini 2.5 Flash, REBEL은 Claude 4.5 Haiku)로 0~0.8의 6단계 조합을 모두 돌렸습니다(1·2단계 36조합, 3단계 36조합).
데이터셋
1·2단계 최적 (τ1, τ2)
1·2단계 Partial F1 폭
3단계 Partial F1 폭
WebNLG
(0.5, 0.3)
0.782 ~ 0.852 (0.071)
0.862 ~ 0.877 (0.015)
REBEL
(0.2, 0.1)
0.710 ~ 0.735 (0.024)
0.749 ~ 0.769 (0.019)
Wiki-NRE
(0.3, 0.1) 세 기준 평균
0.774 ~ 0.832 (0.057)
0.830 ~ 0.842 (0.013)
뽑는 단계는 온도에 따라 F1이 최대 0.07 움직였지만, 검증·보충 단계는 0.02 안쪽이었습니다. 검증이 대부분 결정론적인 문자열 비교이기 때문입니다. 정답이 깨끗한 WebNLG는 적당한 무작위성(0.3~0.5)을, 소음이 많은 자동 정렬 데이터셋은 낮은 온도를 좋아했습니다. 다만 이 분석은 10% 표본 하나에서 한 번씩 돌린 결과이고, 논문이 '분산(variance)'이라 부른 값은 실제로는 최댓값과 최솟값의 차이(범위)입니다.
5.5 앵커는 얼마나 잘 찾나: 이름은 보이고 관계는 숨는다
앵커 자체의 품질을 재려면 '정답 앵커'가 필요한데, 벤치마크에는 없습니다. 그래서 저자들은 정답 트리플을 쪼개 유사 정답 앵커를 만들었습니다. 주어·목적어 문자열은 개체 앵커, 관계 문자열은 관계 앵커로 보고 비교한 것입니다.
결과는 한쪽으로 크게 기울었습니다.
개체 재현율 (REBEL·Wiki-NRE)
86.2 ~ 99.7%
관계 재현율 (REBEL·Wiki-NRE)
34.1 ~ 62.1%
관계 누락률 (전체)
20.6 ~ 65.9%
막대 길이는 각 범위의 중간값을 100% 기준으로 그렸습니다.
이름은 본문에 글자 그대로 있으니 찾기 쉽지만, 관계는 동사·전치사·문맥에 흩어져 있고 그것을 스키마 이름으로 옮기는 일에 모호함이 더해집니다. 관계 200종짜리 REBEL에서 GPT-4o-mini는 정답 관계의 65.9%를 앵커로 찾지 못했습니다.
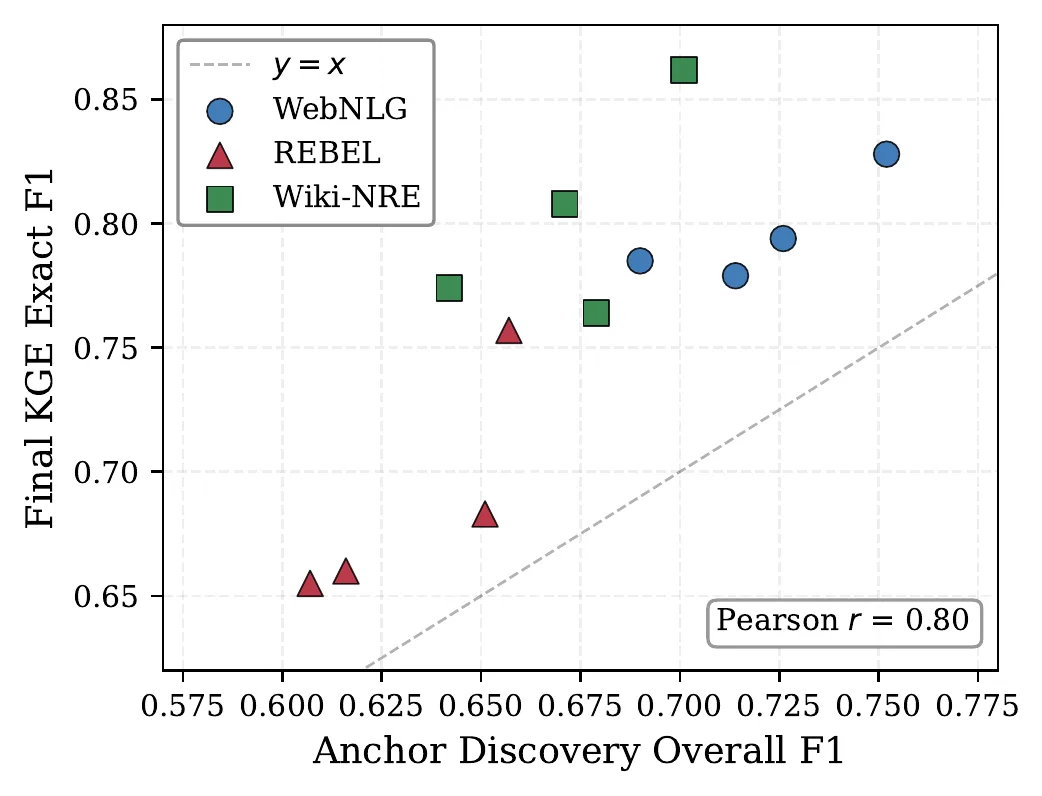
12개 조합 모두에서 최종 Exact F1이 앵커 F1보다 높았습니다(+0.032~+0.161, 평균 +0.087). 앵커 품질과 최종 성능의 상관은 0.80이었습니다. 저자들은 스키마 사상이 앵커로 못 잡은 관계 표현을 보완하고, 사다리의 부분 일치·본문 검색이 앵커 누락을 메우고, 보충 단계가 한 번 더 기회를 주기 때문에 앵커 찾기가 단일 실패 지점이 아니라고 결론짓습니다. (다만 두 축은 서로 다른 지표라 'y=x 위'를 곧바로 '보완'으로 읽는 데는 조심이 필요합니다. 6장에서 다시 짚습니다.)
5.6 비용: 문장 하나에 LLM 호출 2.83~4.28번
방법
문장당 호출
문장당 입력 토큰
그냥 묻기
1
—
EDC
약 3
—
AEVS (WebNLG)
2.83 ~ 3.60
9,694 ~ 12,014
AEVS (REBEL)
3.58 ~ 4.28
14,037 ~ 16,867
AEVS (Wiki-NRE)
3.36 ~ 4.14
3,754 ~ 4,618
최소 2번(앵커 + 추출)이고, 검증·보충이 조건부로 붙어 이론상 최대 5번입니다. 입력 토큰은 대부분 프롬프트에 통째로 넣는 관계 스키마 몫이라, 관계 200종인 REBEL이 가장 비싸고 45종인 Wiki-NRE가 가장 쌉니다. 호출당 입력 토큰은 모델과 상관없이 데이터셋마다 거의 일정했습니다(WebNLG 3,337~3,603, REBEL 3,921~4,117, Wiki-NRE 1,085~1,204). 저자들은 스키마가 아주 큰 분야라면 스키마를 쪼개거나 검색으로 필요한 관계만 골라 넣으라고 제안합니다.
가장 약한 GPT-4o-mini가 가장 많이 호출했다는 것도 눈여겨볼 만합니다. 처음 추출이 거칠수록 검증과 보충이 더 자주 불리기 때문입니다. 틀을 씌우면 약한 모델의 비용이 더 많이 늘어납니다.
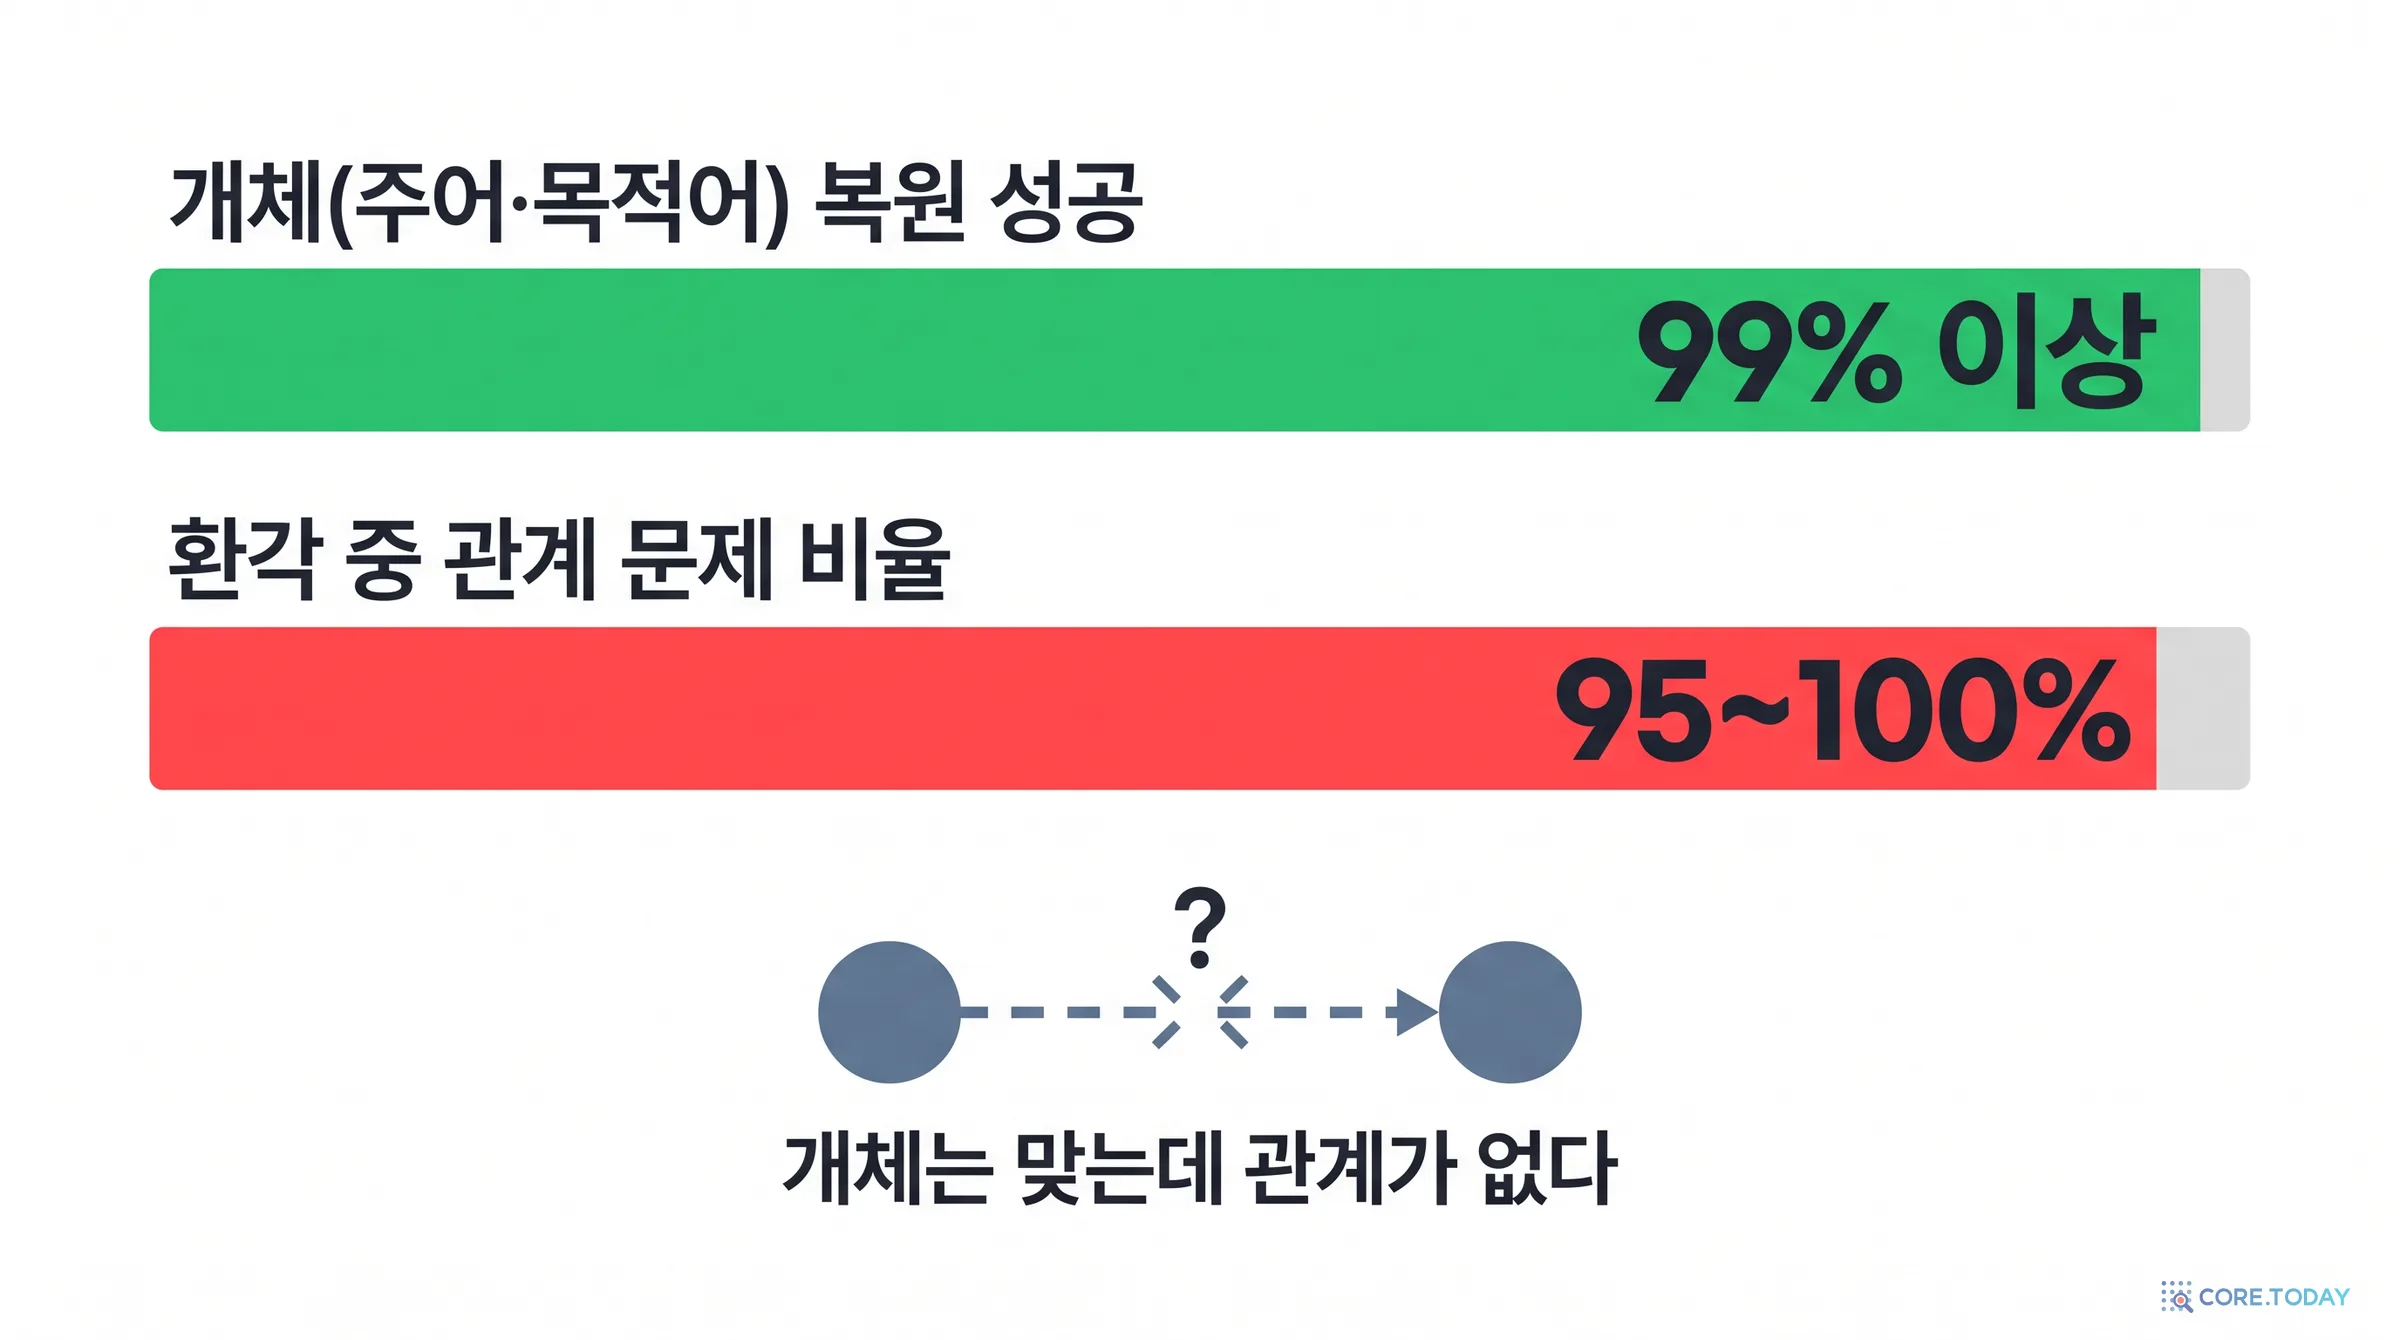
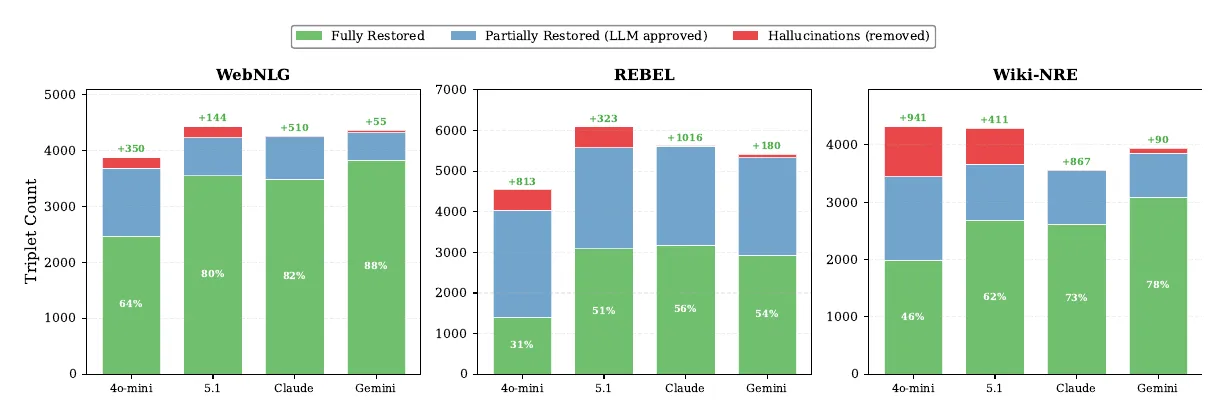
가장 눈에 띄는 발견은 이것입니다. 부분 복원 실패의 99% 이상이 '주어 ✓ 관계 × 목적어 ✓' 하나의 모양이었습니다. 주어와 목적어는 99% 넘게 정확 일치로 되돌아갔습니다. 앵커 제약이 개체 수준의 환각을 사실상 없앴고, 남은 문제는 두 개체 사이에 어떤 관계를 붙이느냐라는 뜻입니다. 4.3절에서 본 탐색 공간 식의 관계 칸이 스키마 전체에 열려 있던 것과 정확히 들어맞습니다.
완전 복원 비율은 WebNLG(63.8~87.7%) > Wiki-NRE(45.9~78.3%) > REBEL(30.8~56.4%) 순이었습니다. 사람이 쓴 WebNLG는 관계 표현이 스키마와 잘 맞고, 자동 정렬 데이터는 그렇지 않습니다.
모델별 성향도 갈렸습니다. 장부의 항등식은 최종 ≈ 처음 − 환각 + 보충입니다.
Claude 4.5 Haiku: 환각 제거는 10~25개뿐인데 보충은 510~1,016개. 최종 트리플이 11.4~23.8% 늘었습니다.
GPT-5.1: 처음에 많이 뽑고 많이 걸러져(523~632개 제거) 최종이 2.2~6.1% 줄었습니다.
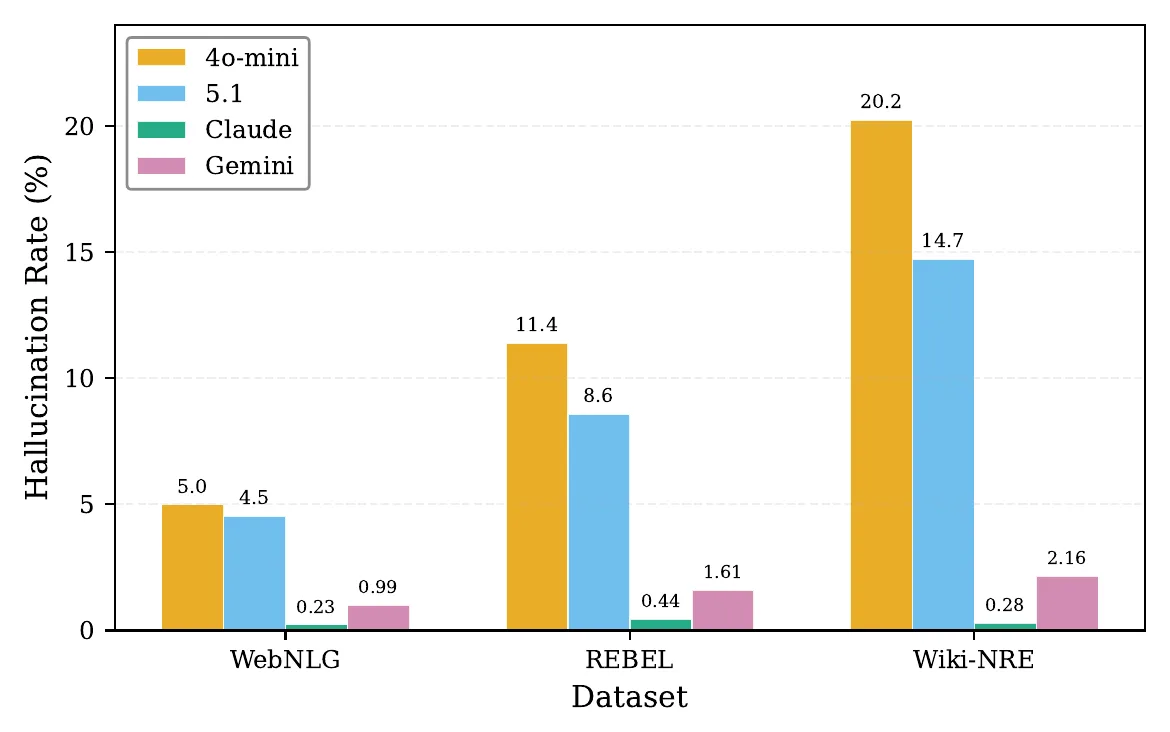
Claude 4.5 Haiku 0.23~0.44%, Gemini 2.5 Flash 0.99~2.16%, GPT-5.1 4.52~14.71%, GPT-4o-mini 4.99~20.23%. 데이터셋 난도에 따라서도 WebNLG < REBEL < Wiki-NRE 순으로 올랐습니다. 이 숫자를 어떻게 읽어야 하는지는 6장의 핵심 논점입니다.
5.8 오류의 다섯 얼굴
저자들은 걸러진 트리플을 어느 원소가 복원에 실패했는지로 다섯 가지로 나누고, 실제 사례를 붙였습니다(표 9).
유형
모양
논문의 실제 사례
비중
근거 없는 관계
S✓ R× O✓
"Los Trancos Creek … flows … from Monte Bello Ridge"에서 (Los Trancos Creek, named after, Las Trancas). 본문은 어원만 말할 뿐 '~의 이름을 땄다'는 관계는 없다
97~100%
외부 지식 주입
S✓ R× O×
"Addio Alexandra is an Italian romantic drama film, released in 1969"에서 (Addio Alexandra, country, Italy). "Italian"에서 나라를 추론했지만 country도 Italy도 본문에 없다
GPT-4o-mini에서 주로 (REBEL 10건, Wiki-NRE 5건)
틀린 목적어
R✓ O×
양궁 대회 글에서 (archery, instance of, sport). "sport"는 본문에 없다
드묾
지어낸 내용
S× R×
주어와 관계 모두 근거 없음
1% 미만
틀린 주어
R✓ S×
맞는 관계를 엉뚱한 개체에 붙임
드묾
'Addio Alexandra → Italy'는 곰곰이 볼 만합니다. "이탈리아 영화"에서 "나라: 이탈리아"를 뽑는 것은 사람에게는 너무 당연한 추론입니다. 하지만 엄밀히는 '이탈리아어로 만든 영화'일 수도, '이탈리아 감독의 영화'일 수도 있습니다. 앵커 체계는 이런 당연해 보이는 한 걸음을 기본적으로 의심합니다. 그 한 걸음을 허용할지 말지는 결국 3단계 LLM 검증의 "본문에서 직접 추론되면 VALID" 규칙이 정합니다. 이 경계가 바로 다음 장의 이야기입니다.
6. 꼼꼼히 읽으면 보이는 것들
AEVS의 생각은 단순하고 설득력이 있습니다. 그래서 더 꼼꼼히 읽었습니다. 표 수치를 다시 계산하고, 논문 본문과 알고리즘과 공개 코드를 서로 맞춰 봤습니다. 논문의 가치를 깎으려는 것이 아니라, 이 방법을 실제로 쓰려는 사람이 어디서 넘어질지 미리 표시해 두려는 것입니다.
6.1 "EDC보다 최대 +0.152"는 서로 다른 모델끼리의 비교다
결론 절은 AEVS가 "최신 LLM 기반 프레임워크 EDC를 최대 +0.152 F1 앞섰다"고 씁니다. 4.10.1절은 "+0.058~+0.152"라고 씁니다. 표에서 이 숫자를 찾으면 이렇습니다.
데이터셋 (Partial F1)
같은 GPT-4o-mini: AEVS − EDC
최고 AEVS − EDC(4o-mini)
최고 AEVS의 백본
WebNLG
+0.007
+0.057
Gemini 2.5 Flash
REBEL
+0.012
+0.103
Claude 4.5 Haiku
Wiki-NRE
+0.074
+0.152
Gemini 2.5 Flash
+0.152는 Gemini 2.5 Flash로 돌린 AEVS와 GPT-4o-mini로 돌린 EDC의 차이입니다. 그 안에는 방법의 차이와 모델의 차이가 섞여 있습니다. 논문 4.2.3절이 "공정한 비교를 위해 같은 백본으로 비교했다"며 보고한 값은 +0.007~+0.074이고, 이쪽이 방법만의 차이입니다. (WebNLG의 0.874 − 0.817은 0.057인데 본문은 0.058이라고 적었습니다.)
같은 모델 기준 +0.007~+0.074도 작지 않은 성과입니다. 특히 Wiki-NRE의 +0.074는 의미 있는 차이입니다. 다만 'EDC를 크게 이겼다'보다는 'EDC와 비슷하거나 조금 낫고, 대신 출처를 준다'가 정확한 요약입니다. 그리고 그냥 묻기 대비 +0.12~+0.40이라는 큰 폭은 EDC도 함께 누리는 '여러 단계로 틀을 씌운 효과'입니다.
6.2 환각률 0.23%는 '덜 지어냈다'인가, '너그럽게 통과시켰다'인가
논문은 Claude 4.5 Haiku의 환각률(0.23~0.44%)이 가장 낮고, 이것이 "지시 이행이 강한 모델과 결합하면 환각을 거의 0으로 만들 수 있다"는 증거라고 씁니다. 그런데 이 환각률의 정의를 다시 보면, '2단계 트리플 중 복원과 LLM 검증이 모두 거부한 것의 비율'입니다. 그리고 그 LLM 검증은 같은 백본 모델이 합니다. Claude가 뽑은 트리플을 Claude가 검증하고, GPT-4o-mini가 뽑은 것을 GPT-4o-mini가 검증합니다.
표 8에서 '부분 복원 트리플 중 LLM이 승인한 비율'을 직접 계산해 봤습니다.
모델
WebNLG
REBEL
Wiki-NRE
GPT-4o-mini
1,400개 중 86.2%
3,148개 중 83.5%
2,337개 중 62.6%
GPT-5.1
878개 중 77.2%
3,009개 중 82.6%
1,614개 중 60.8%
Claude 4.5 Haiku
770개 중 98.7%
2,456개 중 99.0%
951개 중 98.9%
Gemini 2.5 Flash
536개 중 92.0%
2,493개 중 96.5%
855개 중 90.1%
5.7절에서 봤듯 부분 복원 트리플의 99% 이상은 '관계를 스키마로 되돌리지 못한' 경우입니다. 즉 이 표는 "앵커로 확인되지 않은 관계를 각 모델이 얼마나 받아 줬나"의 표입니다. Claude 4.5 Haiku는 거의 다(99%) 받아 줬고, GPT 계열은 60~86%만 받아 줬습니다.
여기서 두 가지 해석이 모두 가능합니다.
Claude의 추출이 원래 좋아서, 관계가 앵커로 안 잡혔을 뿐 실제로는 본문이 뒷받침하는 경우가 대부분이었다.
Claude의 검증이 너그러워서, 근거가 약한 관계도 통과시켰다.
본 결과에서 Claude AEVS의 정밀도가 높다는 점(REBEL Exact P 0.755)은 1번 쪽 증거입니다. 하지만 그 정답 자체가 자동 정렬로 만든 것이라 결정적이지 않습니다. 둘을 가르려면 다른 모델로 교차 검증하거나(Claude의 추출을 GPT-5.1이 검증), 사람이 표본을 검수해야 합니다. 논문에는 둘 다 없고, 저자들도 "보류한 일부를 사람이 주석하는 것이 중요한 후속 과제"라고 적었습니다.
실무적인 결론은 이렇습니다. '환각률'을 품질 지표로 쓰려면 검증기와 추출기를 다른 모델로 두어야 합니다. 같은 모델이 문제를 내고 채점까지 하면 너그러움과 정확함이 구별되지 않습니다.
6.3 보충 단계의 트리플은 환각 집계에 들어가지 않는다
4.3.3절은 보충이 환각을 다시 들여오지 않느냐는 걱정에 이렇게 답합니다. "보충 트리플도 같은 복원·검증을 거치며, 환각 분석(4.8절)이 전체 환각률이 낮게 유지됨을 확인한다." 그런데 4.8절의 환각 정의는 "2단계가 만든 트리플 중" 근거를 세울 수 없는 것입니다. 보충 트리플은 애초에 분모에도 분자에도 없습니다. 게다가 전체 알고리즘(알고리즘 2)의 보충 부분은 의미 중복만 걸러 그대로 합칠 뿐, 복원이나 LLM 검증을 거치지 않습니다.
Claude 4.5 Haiku는 보충으로 510~1,016개를 더했습니다. 이 트리플들이 얼마나 근거 있는지는 표 8로는 알 수 없습니다. 본문 설명(검증을 거친다)과 알고리즘(거치지 않는다) 중 무엇이 실제 실험이었는지도 논문만으로는 확인되지 않습니다.
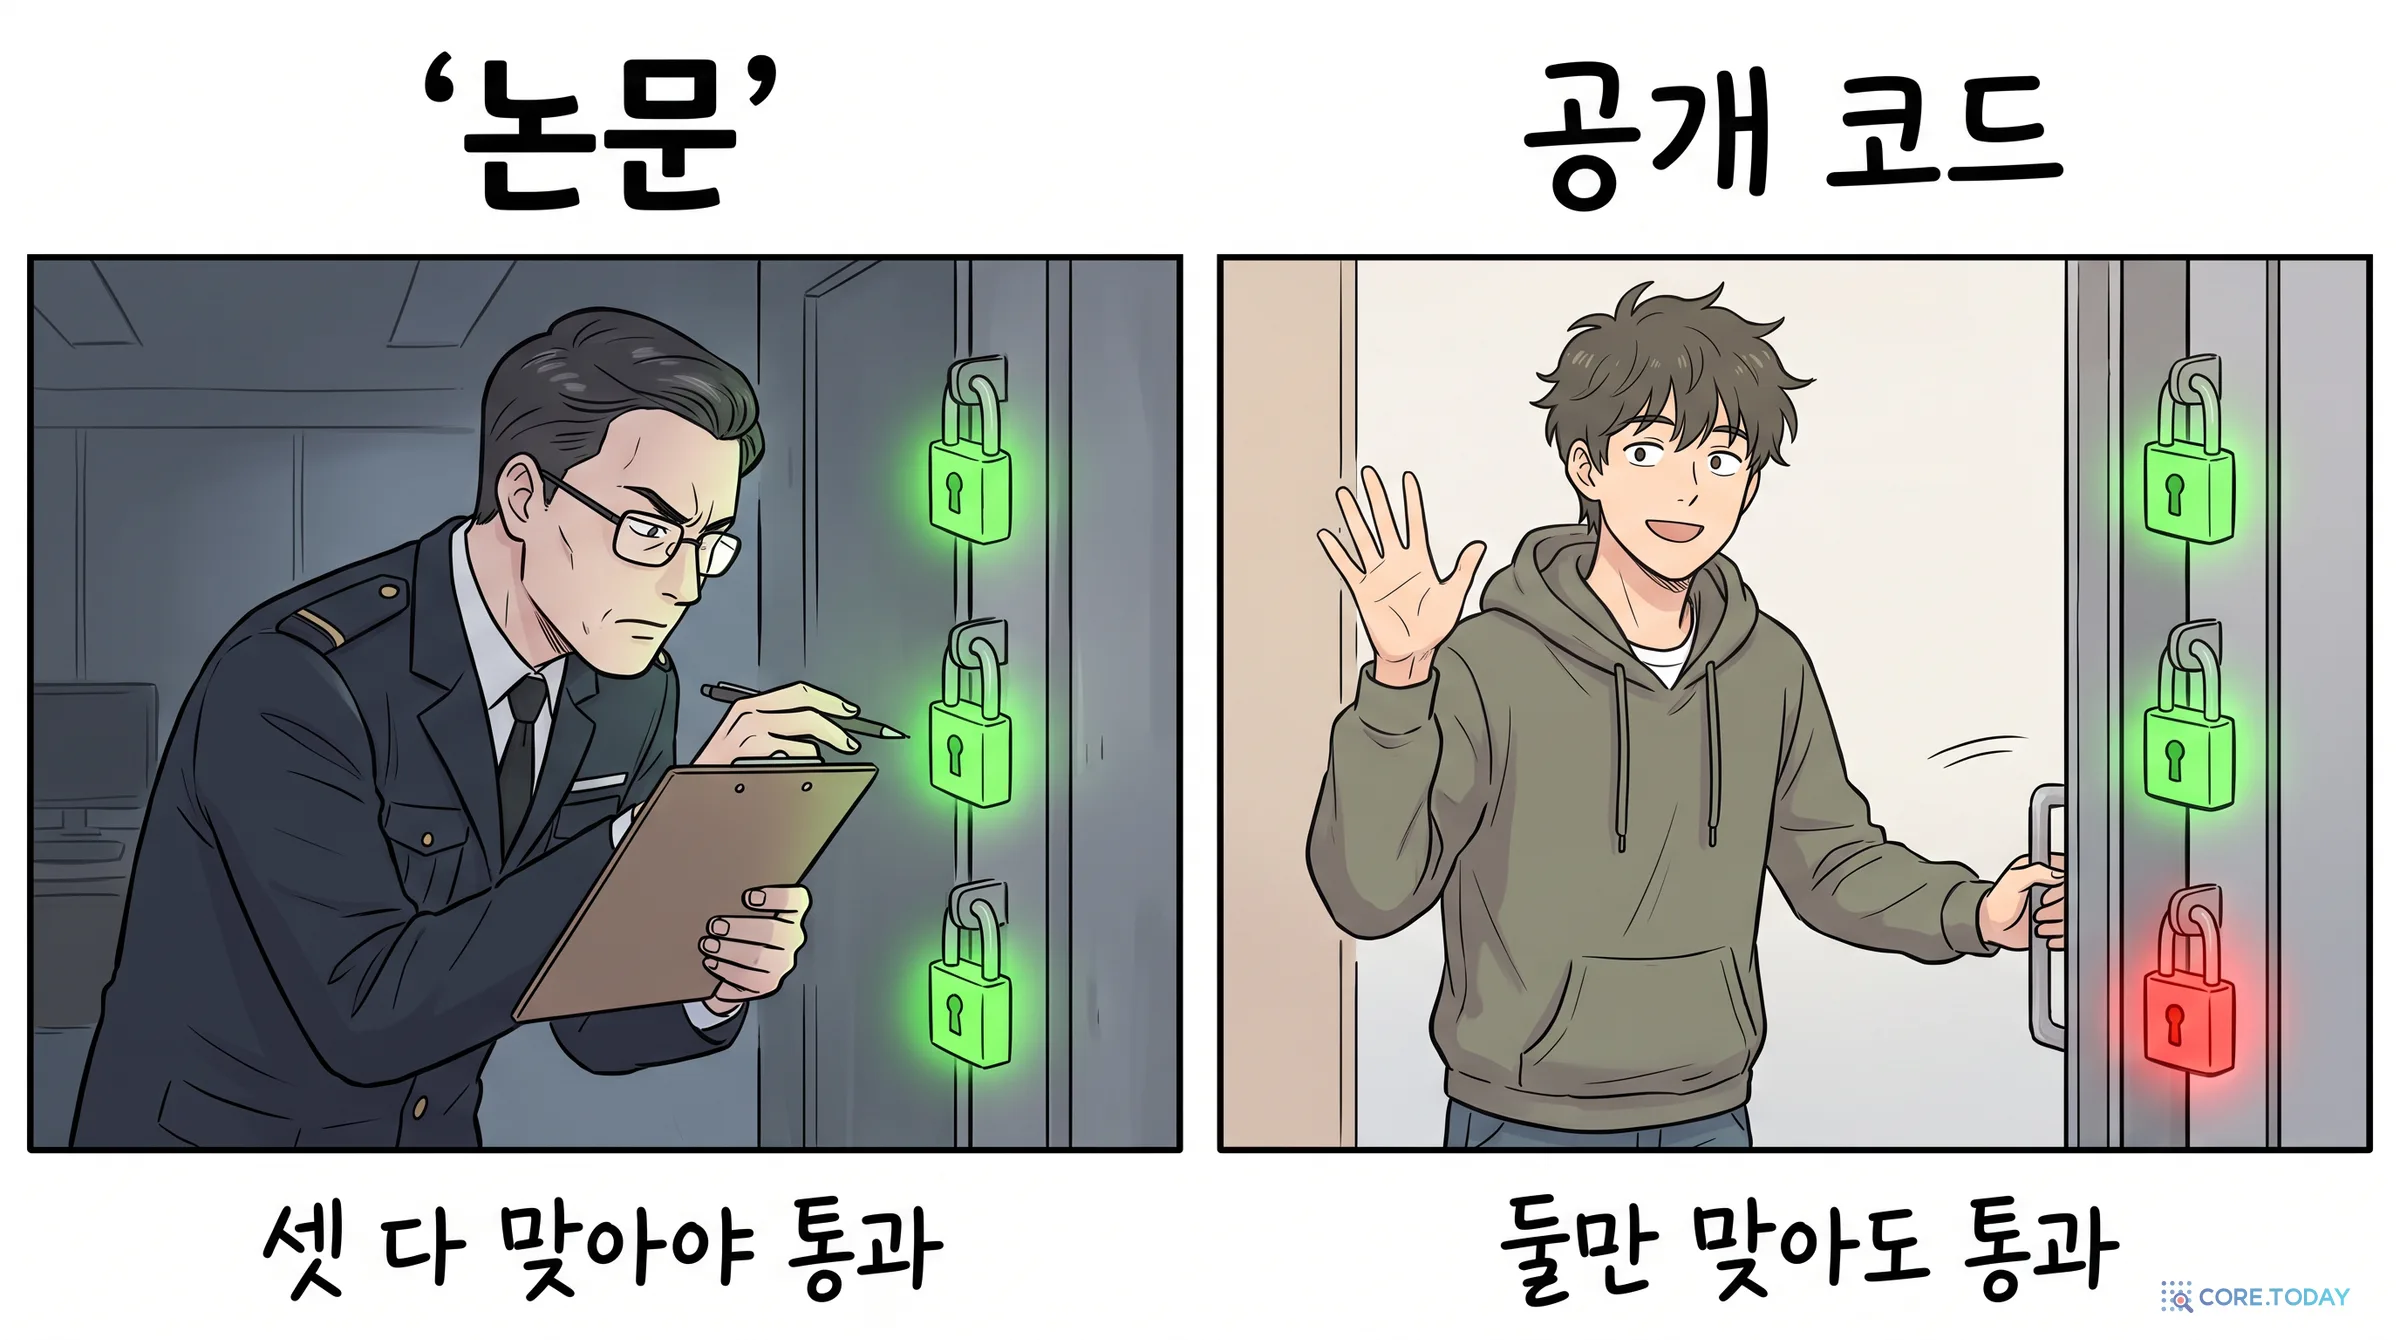
논문의 데이터 공개 절은 코드가 github.com/yyz-nbt/AEVS에 있다고 밝힙니다. 저장소는 2026년 1월 7일 두 번 커밋된 뒤 바뀌지 않았습니다(논문 투고 1월 13일, 수정 2월 7일, 게재 3월 9일). 코어닷투데이가 코드를 한 줄씩 읽은 결과, 3단계가 논문과 크게 달랐습니다.
항목
논문
공개 코드 (2026-01-07)
통과 기준
세 원소 모두 복원(완전 복원)이면 통과, 아니면 LLM 재검토
셋 중 둘 이상 복원이면 통과, 아니면 제거 (is_valid = restored >= 2)
관계 복원
그 관계로 사상된 본문 관계 앵커가 있어야 함 (식 12)
관계 이름이 스키마 목록에 있기만 하면 복원으로 침
LLM 재검토 (Box 3)
있음
없음
커버리지 보충 (Box 4)
있음
없음
본문에서 못 찾은 앵커
버림 (알고리즘 1, 17행)
위치만 못 고친 채 남겨 둠
의미 중복 문턱
0.85
0.9 (명령줄 기본값)
앵커 프롬프트
Box 1 (관계구 쪼개지 말 것, 사상 예시 5줄 등)
더 짧은 별도 프롬프트
온도
"기본값"
0.3 고정
말로만 하면 추상적이니 직접 돌려 봤습니다. 논문 그림 3의 앵커 10개를 그대로 만들고, 저장소의 TripletRestorer(3단계 복원 클래스)에 WebNLG 스키마를 넣어 트리플을 하나씩 판정시켰습니다. LLM 호출이 없는 결정론적 코드라 누가 돌려도 같은 결과가 나옵니다.
공개 코드 TripletRestorer 실행 결과 (코어닷투데이, 2026-10-31)
(Steve Jobs, founder, Apple Inc.) → S1 R1 O1 → 통과
(Apple Inc., location, Cupertino) → S1 R1 O1 → 통과
(Steve Jobs, position, CEO) → S1 R0 O1 → 통과 (2/3)
(Steve Jobs, resignationYear, 2011) → S1 R0 O1 → 통과 (2/3)
(Steve Jobs, deathYear, 2011) → S1 R0 O1 → 통과 (2/3) ← 논문 τ5, 논문에서는 거부
(Steve Jobs, deathDate, 2011) → S1 R1 O1 → 통과 (deathDate는 WebNLG 스키마에 있음)
(Steve Jobs, nationality, American) → S1 R1 O0 → 통과 (2/3) ← 논문 τ6, 논문에서는 거부
(Steve Jobs, almaMater, Reed College) → S1 R1 O0 → 통과 (2/3) ← 논문 서론의 환각 예
(Apple Inc., foundingYear, 1976) → S1 R1 O1 → 통과
논문이 환각의 대표 사례로 든 네 트리플이 공개 코드에서는 모두 통과합니다. nationality·almaMater·deathDate는 WebNLG 스키마에 있는 관계 이름이라 관계가 '복원'되고, deathYear는 주어와 목적어가 본문에 있어 2/3을 채웁니다.
공정하게 말하면, 논문의 수정 과정에서(4.7절은 "심사위원 요청에 따라" 추가됐다고 밝힙니다) 실험 코드가 발전했고 저장소가 갱신되지 않았을 가능성이 큽니다. 실제로 저장소의 anchor_verifier.py는 token_tagger.py에 존재하지 않는 이름(TaggingResult 등)을 불러오고 있어 다른 판본의 흔적이 보입니다. 그러나 독자가 지금 내려받아 쓸 수 있는 것은 이 코드입니다. 이 코드를 쓰면, 모델이 그런 트리플을 뽑았을 때 논문이 말한 안전장치가 작동하지 않습니다.
6.5 '복원'은 글자가 있다는 뜻이지, 관계가 맞다는 뜻이 아니다
이 지적은 공개 코드뿐 아니라 논문 설계에도 해당합니다.
첫째, 관계 복원은 1단계의 해석을 그대로 물려받습니다. 예문의 τ2 (Apple Inc., location, Cupertino)는 완전 복원으로 LLM 확인 없이 바로 통과합니다. 관계 location이 전치사 "in" 앵커의 스키마 사상과 같기 때문입니다. 그런데 원문은 "애플을 쿠퍼티노에서 창업했다"입니다. '쿠퍼티노에 있다'(소재지)가 아니라 '쿠퍼티노에서 세워졌다'(설립 장소)에 가깝습니다. 1단계 LLM이 "in"을 location으로 사상한 순간, 3단계는 그 해석을 '근거'로 삼아 통과시킵니다. 복원 검증은 원소가 원문에 있는지를 확인할 뿐, 그 원소들이 그 관계로 이어진다고 원문이 말하는지(함의)를 확인하지 않습니다.
둘째, 부분 일치는 짧은 앵커에 약합니다. 논문의 부분 일치(식 11·13)는 '한쪽이 다른 쪽에 포함되면' 일치입니다. 관계 앵커 "in"은 두 글자짜리라, WebNLG 관계 이름 "foundingYear"에도, "mainIngredient"·"training"에도 글자로 들어 있습니다. 예문의 τ7 (Apple Inc., foundingYear, 1976)은 foundingYear로 사상된 앵커가 없는데도, 사다리 3칸에서 "in"과 맞물려 '완전 복원'됩니다. 맞는 결론을 엉뚱한 이유로 얻은 것입니다. 위젯의 '직접 입력'에서 관계 칸에 in이 들어간 아무 이름이나 넣어 보면 확인할 수 있습니다.
셋째, 탐색 공간 식이 관계 칸을 열어 둡니다. 4.3절에서 본 대로 관계는 AR∪R, 즉 본문 앵커이거나 스키마의 아무 관계입니다. 개체는 본문으로 닫혔지만 관계는 159~200개 이름 중 무엇이든 될 수 있습니다. 오류의 95% 이상이 '근거 없는 관계'였던 것은 우연이 아니라 설계가 남긴 빈틈입니다. 저자들도 이것을 "주된 병목"으로 인정하고, 관계 정규화 모듈과 임베딩 기반 유사도를 후속 과제로 꼽았습니다.
REBEL 데이터셋이 정답을 만들 때 NLI 모델로 '이 문장이 이 트리플을 함의하는가'를 0.75 문턱으로 걸렀다는 점(2.3절)을 떠올리면, 다음 걸음이 보입니다. 원소의 위치(출처)와 관계의 함의(근거)를 따로 확인하는 것입니다.
6.6 그 밖의 작은 어긋남
위치
어긋남
표 3 GenIE Strict
P 0.353 · R 0.356인데 F1 0.362. F1은 P와 R의 최댓값을 넘을 수 없다(표본별 평균이어도 마찬가지)
그림 3(b)
관계 앵커 상자 제목은 '(3)'인데 4개가 들어 있다
4.1.4절
의미 중복 제거를 "앵커 발견 단계에서" 쓴다고 했지만, 방법 절에서는 3단계 보충에서 쓴다
4.5.3절
스키마 사상 φ를 "2단계"의 장치라고 했지만 정의는 1단계(앵커 찾기)에 있다
표 6
WebNLG·REBEL의 개체 누락률이 1 − 개체 재현율(표 5)과 맞지 않는다(예: 재현율 0.783인데 누락률 17.3%). 관계와 Wiki-NRE 개체는 정확히 맞는다
그림 15
가로축은 '앵커 F1'(유사 정답 앵커 기준), 세로축은 '트리플 Exact F1'로 단위가 다른 지표다. 모든 점이 y=x 위라는 것만으로 '파이프라인이 앵커 부족을 보완했다'고 결론 내리기는 어렵다
3.3절·표 3
REBEL 관계 "200종"이라 쓰지만 공개 스키마 파일은 196줄이다
4.4절
온도 분석은 10% 표본 1회 실행이고, '분산'으로 부른 값은 범위(최댓값 − 최솟값)다
4.1.3절
'그냥 묻기'에 관계 스키마를 주었는지 밝히지 않았다. 7장에서 보듯 이것이 결과를 크게 바꿀 수 있다
공개 평가 스크립트
논문의 Partial·Strict·Exact 세 값을 출력하지 않고 'Exact Match'와 'Full Triple'만 출력한다. 표 2~4를 저장소 그대로 재현할 수는 없다
공개 코드
모델이 위치에 null을 쓰면 grounded_extractor.py가 예외를 내고 그 문장의 트리플을 모두 잃는다
그리고 논문이 스스로 밝힌 한계도 다시 적어 둡니다. 문장(또는 짧은 단락) 단위로만 동작해 "He"가 누구인지(상호 참조)를 풀지 못하고, 미리 정한 관계 스키마가 있어야 하며, 글자 위치 추적은 UTF-8 일관성을 가정할 뿐 한중일 문자와 다국어 텍스트는 평가하지 않았습니다. 마지막 한계를 코어닷투데이가 직접 확인해 봤고, 그 과정에서 더 중요한 것을 찾았습니다.
7. 코어닷투데이 실측 — 한국어 30문장과 WebNLG 20문장
논문은 한중일 문자를 평가하지 않았다고 밝혔습니다. 그래서 직접 돌려 봤습니다. 처음 세운 예상은 "그냥 물으면 머릿속 지식이 섞여 나오고, AEVS가 그것을 걸러 낼 것"이었습니다. 결과는 그 예상과 달랐습니다. 예상이 빗나간 지점이 이 실험에서 가장 쓸모 있는 부분이어서, 그대로 적습니다.
7.1 실험 구성
항목
내용
모델
qwen3.5:9b (Ollama 로컬, 온도 0.3, 사고 모드 끔). 논문의 네 모델과 다르고, 더 약한 모델입니다
한국어 데이터
코어닷투데이가 직접 쓴 30문장, 정답 트리플 55개, 관계 스키마 25종. 참인 문장 15개에는 모델이 덧붙이고 싶을 함정(국적·설립자 등)을, 반사실 문장 15개에는 세상과 다른 값("에펠탑은 로마에 있다")을 넣었습니다
영어 데이터
WebNLG 시험셋에서 무작위로 뽑은 20문장, 정답 트리플 69개, 스키마 159종
그냥 묻기
프롬프트 한 번. 스키마를 함께 주었습니다(뒤에서 뺀 경우도 비교합니다)
공개 코드
저장소의 1·2단계 프롬프트와 3단계 코드 그대로
논문 3단계 / 논문 전체
위와 같은 1·2단계 출력에, 논문 식 10~18과 Box 3·4를 코어닷투데이가 구현해 적용. '전체'는 보충 트리플도 복원·재검토를 거칩니다(4.3.3절 설명 기준)
채점
주어·목적어는 조사와 띄어쓰기를 무시하고 비교, 관계는 스키마 이름이 같아야 정답(방향도 일치). WebNLG는 저장소의 평가 스크립트 값도 함께 적었습니다
한계를 먼저 밝혀 둡니다. 표본이 작고, 한 번씩만 돌렸고, 문장이 짧습니다. 한국어 정답은 코어닷투데이가 직접 만든 것입니다. 3단계는 저자들의 실험 코드가 아니라 논문을 읽고 구현한 것입니다. 그러니 아래 숫자는 논문을 반박하는 증거가 아니라, 한 가지 조건에서 일어난 일의 기록입니다.
7.2 점수: 예상과 반대로 나왔다
한국어 30문장
트리플 수
정밀도
재현율
F1
문장당 호출
그냥 묻기(스키마 제공)
50
0.840
0.764
0.800
1
공개 코드
40
0.800
0.582
0.674
2
논문 3단계(보충 없음)
35
0.829
0.527
0.644
3.47 (전체 기준)
논문 전체
40
0.850
0.618
0.716
WebNLG 20문장
트리플 수
정밀도
재현율
F1
저장소 스크립트 Exact F1
그냥 묻기(스키마 없음)
66
0.182
0.174
0.178
0.104
그냥 묻기(스키마 제공)
57
0.649
0.536
0.587
0.444
공개 코드
60
0.633
0.551
0.589
0.295
논문 3단계(보충 없음)
59
0.627
0.536
0.578
0.281
논문 전체
61
0.639
0.565
0.600
0.277
세 가지가 보입니다.
첫째, 한국어에서는 그냥 묻기가 이겼습니다. 정밀도는 사실상 같은데(0.84 대 0.85) 재현율이 0.764에서 0.618로 떨어졌습니다. 호출은 3.47배입니다. 걸러 낼 환각이 없는 곳에 거름망을 놓으면, 맞는 것만 흘립니다.
둘째, WebNLG에서는 비겼습니다. 0.587 대 0.600은 트리플 한두 개 차이로, 20문장 표본에서는 의미를 둘 수 없습니다. 논문의 그냥 묻기 대비 +0.2~+0.3은 이 조건에서 재현되지 않았습니다.
셋째, 스키마가 대부분의 일을 했습니다. 그냥 묻기에서 스키마를 빼면 F1이 0.178로 무너집니다. 모델이 "has members", "played in"처럼 제멋대로 관계 이름을 쓰기 때문입니다. 스키마 하나를 넣는 것만으로 0.178이 0.587이 됐고, 거기에 AEVS의 나머지 단계가 더한 것은 +0.013입니다. 논문은 '그냥 묻기'에 스키마를 주었는지 밝히지 않습니다. 어느 쪽이었느냐에 따라 '+0.2~+0.3'의 뜻이 크게 달라지므로, 재현하려는 분은 이 점부터 확인해야 합니다. 물론 논문 쪽 모델은 더 강하고, 위 숫자는 평가 방식도 다르므로 그대로 맞대 볼 수는 없습니다.
저장소 스크립트의 Exact F1에서 AEVS가 낮은 것(0.277 대 0.444)도 짚어 둘 만합니다. 앵커는 본문의 글자를 그대로 가져오기 때문에, 주어가 "the Acharya Institute of Technology of Bangalore, India"처럼 길어지곤 합니다. 정답은 "Acharya_Institute_of_Technology"입니다. 출처에 충실할수록 정규화된 이름에서는 멀어집니다. 출처 추적과 개체 정규화는 서로 다른 일이고, 둘 다 필요합니다.
7.3 환각이 없었다 — 함정도, 반사실도
가장 뜻밖이었던 것은 이것입니다.
그냥 묻기: 본문에 없는 값
50줄 중 0
그냥 묻기: 함정에 걸림(참인 문장)
0
그냥 묻기: 세상 값으로 고침(반사실 문장)
15문장 중 0
스키마를 주고 그냥 물었을 때 모델은 잡스의 국적도, 에베레스트의 높이도 덧붙이지 않았습니다. "에펠탑은 로마에 있다"에서는 (에펠탑, 위치, 로마)를 뽑았고, "해리 포터 시리즈는 톨킨이 썼다"에서는 저자를 톨킨이라고 적었습니다. 스키마 없이 물어도 세상 지식 주입은 0건이었습니다. 짧은 문장을 하나씩 주고 '이 글에서 뽑아라'라고 하면, 적어도 이 모델은 글을 벗어나지 않았습니다.
이 결과를 일반화하면 안 됩니다. 긴 문서, 약한 지시, 다른 모델에서는 다를 수 있고, 논문도 모델마다 큰 차이를 보고했습니다. 다만 환각이 얼마나 나오는지는 내 데이터로 먼저 재 봐야 한다는 교훈은 남습니다.
30문장 전체에서 본문에 없는 말이 나온 사례는 하나뿐이었고, 출처가 흥미롭습니다. "알베르트 아인슈타인은 1879년 독일 울름에서 태어났다"를 추출 단계에 넣자 (Albert Einstein, birthPlace, Ulm)이 나왔습니다. 한국어 문장인데 영어로, 그것도 한국어 스키마에 없는 관계 이름으로 나왔습니다. 공개 저장소의 프롬프트 예시가 바로 "subject": "Albert Einstein", "relation": "birthPlace", "object": "Ulm"이기 때문입니다. 환각을 막으려는 장치의 프롬프트 예시가 환각의 원인이 된 셈입니다. 이 줄은 LLM 재검토에서 걸러졌지만, 같은 문장의 (Albert Einstein, birthYear, 1879)는 승인되어 최종 결과에 남았습니다. 주어가 앵커로 복원되지 않았는데도 말입니다.
7.4 점수는 어디서 사라졌나
정밀도가 같으니 차이는 전부 재현율입니다. 원인은 세 군데였습니다.
앵커·추출2단계를 지나면 트리플이 50개에서 45개로 줄어듭니다. "이순신은 1610년 한산도에서…" 문장의 (이순신, 사망장소, 한산도)처럼 그냥 묻기가 뽑은 줄이 앵커를 거치면서 빠지기도 했습니다. 앵커와 그 사상이 곧 상한선이 되기 때문입니다.
코드 결함모델이 위치에 null을 쓰자 저장소 코드가 비교 중 예외를 내고("'<=' not supported between instances of 'int' and 'NoneType'") 그 문장의 트리플을 통째로 버렸습니다. "부산은 대한민국에서…" 문장이 이렇게 사라졌습니다.
재검토45개 중 완전 복원은 16개뿐이고 29개가 LLM 재검토로 갔습니다. 그중 10개가 거부됐는데, 6개가 정답이었습니다.
마지막 줄이 다음 절의 주제입니다.
7.5 검증기가 본문보다 세상을 믿을 때
거부된 정답 6개 중 5개가 반사실 문장에서 나왔습니다. 예를 들어 "스티브 잡스는 1980년 시애틀에서 애플을 창업했다"에서는 세 트리플이 모두 거부되어 최종 결과가 0줄이 됐습니다. 띄어쓰기 때문에 앵커를 못 찾은 경우도 섞여 있어 원인을 가려야 했습니다.
그래서 추출과 분리해 검증기만 따로 시험했습니다. 본문에 충실한 정답 트리플을 그대로 주고, 복원 상태 안내를 세 가지(모두 찾음, 관계 못 찾음, 목적어 못 찾음)로 바꿔 가며 물었습니다. 165건 중 응답을 해석할 수 있었던 161건의 결과입니다.
문장 종류
판정 수
거부
거부율
거부 이유가 '현실과 다름'
참인 문장
89
8
9.0%
0
반사실 문장
72
12
16.7%
7
모두 본문에 그대로 적힌 트리플이니, 이상적인 거부율은 0%입니다. 프롬프트는 본문이 유일한 기준이라고 말합니다. 그런데도 "에펠탑은 로마에 있다"의 (에펠탑, 위치, 로마)를 두고 모델은 이렇게 적고 거부했습니다.
The text states '에펠탑은 로마에 있다'… However, this statement contradicts factual reality (the Eiffel Tower is in Paris, not Rome).
"해리 포터 시리즈는 톨킨이 썼다"와 "에베레스트산은 페루에 있다"에서도 같은 일이 있었습니다. 추출기는 세상 지식을 꺼내지 않았는데, 그것을 심사하는 검증기가 꺼낸 것입니다. 3장에서 본 지식 충돌이 파이프라인의 마지막 관문에서 나타난 셈입니다. 나머지 거부는 "'개발자'라는 관계가 본문에 명시되지 않았다"처럼 지나치게 엄격한 판단이었고, 이는 참인 문장에서도 나왔습니다.
여기에는 프롤로그의 반전이 그대로 되풀이됩니다. 정정 공시나 개정 조례처럼 문서가 세상을 앞서가는 순간이 바로 이 상황입니다. 문서가 모델의 기억과 다를 때, 검증기는 맞는 사실을 지울 수 있습니다. 표본이 작아 비율 자체는 믿을 수 없지만, 일어날 수 있다는 것은 분명합니다.
글자 위치는 영어와 한국어 모두 열에 아홉 가까이 틀렸습니다. 논문의 '위치 자동 교정'이 없으면 출처 추적 자체가 성립하지 않는다는 뜻이고, 실무에서는 위치를 아예 모델에게 묻지 않는 편이 낫습니다.
차이는 다음 줄입니다. 영어는 위치가 틀려도 글자는 본문에 있어서 검색으로 고칠 수 있었습니다. 한국어는 앵커의 19%가 본문에서 찾아지지 않았고, 22개 중 20개가 원문에 없는 띄어쓰기 때문이었습니다. "1976 년"처럼 숫자와 '년' 사이를 띄운 경우가 대부분입니다. 그 밖에 본문에 없는 조사 "를"을 앵커로 잡거나, 떨어진 구절을 이어 붙인 "사임할 때까지 일했다"도 있었습니다. 이 띄어쓰기는 이 모델의 출력 습관일 수 있어 다른 모델로 일반화할 수는 없습니다. 그래도 글자 일치에 기대는 복원 검증은 공백 하나에 무너진다는 점은 한국어 파이프라인에서 꼭 대비해야 합니다. 비교 전에 공백을 정규화하고, 조사를 앵커 밖에 두어야 합니다.
아래 위젯에서 문장별 결과를 직접 볼 수 있습니다.
7.7 그래서 AEVS는 쓸모없는가
그렇지 않습니다. 이 실험이 보여 주는 것은 더 좁습니다.
F1을 올리려고 도입할 도구는 아닐 수 있습니다. 짧은 문장에서는 스키마를 준 프롬프트 한 번이 같거나 나은 점수를 냈습니다. 먼저 이 기준선을 재야 합니다.
출처를 남기는 값은 F1에 찍히지 않습니다. 그냥 묻기가 낸 50줄은 어느 글자에서 왔는지 말하지 못합니다. 감사가 필요한 곳이라면 3.47배의 호출은 F1이 아니라 확인 가능성을 사는 비용입니다.
거름망의 효과는 환각의 양에 달렸습니다. 환각이 드문 곳에서는 거름망의 오판이 이득보다 커집니다. 논문의 GPT-4o-mini처럼 환각이 많은 조건이라면 계산이 달라질 수 있습니다.
검증기는 세상 지식으로부터 자유롭지 않습니다. 문서가 사실의 원천인 곳에서는 LLM 재검토가 오히려 위험할 수 있습니다.
AEVS가 혼자 떨어진 아이디어가 아니라는 것은 최근 1년 반 사이의 도구들이 보여 줍니다.
도구 (공개 시점)
무엇에 출처를 다나
출처의 단위
못 찾으면
Microsoft GraphRAG (2024-04 논문, 2024-07 공개)
그래프의 개체·관계·주장
원문 청크 ID (text_unit_ids)
—
Anthropic Citations API (2025-01-23)
모델 답변의 문장
평문 문서는 글자 범위(char_location), PDF는 쪽
인용 없이 답함
Google LangExtract (2025-07-30)
추출한 항목(개체·속성)
글자 범위(char_interval)
char_interval을 비워 둠
AEVS (2026-03)
트리플의 주어·관계·목적어 각각
글자 범위 + 스키마 사상
LLM 재검토 → 거부
방향은 분명합니다. 출처의 단위가 문서 → 청크 → 문장 → 글자로 내려오고 있고, '근거를 못 찾으면 비워 두거나 버린다'는 태도가 제품 기능이 됐습니다. LangExtract 발표문의 한 줄, "추출된 모든 개체는 원문의 정확한 글자 위치로 매핑된다"는 AEVS 1단계와 거의 같은 문장입니다. Anthropic은 Citations API를 내놓으며 한 고객사의 사례로 "출처 환각이 10%에서 0%로 줄었다"고 소개했습니다.
AEVS가 이들과 다른 점은 트리플의 세 원소를 각각 추적하고, 관계에 대해 스키마 사상이라는 별도의 다리를 둔다는 것입니다. 답변 인용은 '이 문장은 저 구간에 근거한다'면 충분하지만, 지식 그래프는 '이 관계 이름은 저 동사구에서 왔다'까지 필요하기 때문입니다.
8.2 2026년에 이 기술이 맡는 자리
에이전트의 기억. 2026년의 에이전트는 대화와 문서에서 사실을 뽑아 기억(그래프나 파일)에 쌓습니다. 코어닷투데이가 10월에 다룬 Graphiti 시간 그래프나 기억 오염 특집이 보여 주듯, 근거 없는 한 줄이 기억에 들어가면 이후 모든 답에 스며듭니다. 사실을 기억에 쓰는 순간 출처를 함께 쓰는 것이 가장 싼 방어입니다.
규제와 감사. 의료 기록, 판결문, 공시처럼 '왜 그렇게 판단했나'를 나중에 설명해야 하는 분야에서는 점수가 1~2점 높은 것보다 각 줄을 원문으로 되짚을 수 있는 것이 훨씬 중요합니다. 논문이 복원 검증의 가치를 '점수가 아니라 출처 보증'이라고 말한 것이 이 맥락입니다.
문서가 세상을 바꾸는 곳. 공시의 대표이사 변경, 조례 개정, 정정 보도처럼 문서가 곧 사실의 원천인 곳에서는 모델의 머릿속 지식이 오히려 적입니다. 코어닷투데이의 사실탐색기 v2가 '지금 참인 것'을 권위 있는 기록의 대체 관계로 유지하고, 현장 실측에서 실패의 원인을 추출 단계의 '열쇠'에서 찾았던 것도 같은 문제의식입니다. 서론의 반전처럼, 문서가 세상과 다를 때에도 "이 문서가 그렇게 말했다"를 정확히 기록해 두어야 나중에 어느 문서가 틀렸는지 가릴 수 있습니다.
8.3 아직 풀리지 않은 것
1
관계의 근거
위치는 글자가 있는지를 알려 줄 뿐, 그 말이 그 관계를 뜻하는지는 알려 주지 않습니다. 원소의 출처(위치)와 관계의 근거(함의)를 따로 확인하는 장치, 예컨대 NLI 판정이나 다른 모델의 교차 검증이 필요합니다.
2
문장을 넘는 사실
"그는 2011년 사임했다"의 '그'는 앞 문장의 잡스입니다. 상호 참조를 풀지 못하면 앵커가 '그는'에 묶이고, 두 문장에 걸친 관계는 뽑히지 않습니다.
3
한국어와 글자 주소
조사·어미가 붙는 한국어에서 앵커의 경계를 어디에 그을지, 위치를 무엇으로 셀지(글자·바이트·자모)를 합의하지 않으면 출처는 엉뚱한 곳을 가리킵니다.
9. 실무 체크리스트 — AEVS식 추출을 직접 만든다면
논문과 공개 코드, 그리고 한국어 실측에서 얻은 교훈을 한 장으로 정리합니다.
단계
할 것
하지 말 것
기준선
스키마를 준 프롬프트 한 번을 먼저 내 데이터로 재고, 환각이 실제로 얼마나 나오는지 사람이 표본으로 세어 본다
스키마 없는 그냥 묻기와 비교해 틀의 효과라고 결론 내리기
프롬프트 예시
실존 인물·사실 대신 가상의 이름을 쓴다. 입력과 겹치면 예시가 그대로 복사된다
"Albert Einstein, Ulm" 같은 실제 사실을 예시로 넣기(공개 코드)
앵커 위치
LLM에게는 앵커 글자만 받고, 위치는 코드가 원문 검색으로 정한다. 같은 글자가 여러 번 나오면 문맥(앞뒤 글자)으로 고른다
LLM이 센 글자 위치를 그대로 저장
못 찾은 앵커
원문에서 찾지 못한 앵커는 버리고, 몇 개를 버렸는지 기록한다
위치만 못 고친 채 남겨 두기(공개 코드)
한국어 정규화
원문과 앵커를 모두 NFC로 맞추고, 숫자와 단위(1976년), 영문과 조사(CEO로) 사이의 띄어쓰기 차이를 비교 전에 흡수한다. 조사는 앵커 밖에 둔다
공백·자모 분해 차이로 '본문에 없음' 판정
관계 복원
'그 관계로 사상된 본문 관계 앵커가 있는가'로 판정한다
'스키마 목록에 있는 이름인가'로 판정(공개 코드)
부분 일치
최소 길이(예: 3글자)나 토큰 경계를 둔다
"in", "의", "에서" 같은 짧은 앵커로 포함 관계 판정
예외 처리
모델 출력의 null·형식 오류는 그 줄만 건너뛰고 건수를 기록한다
예외 하나로 문장 전체의 트리플을 잃기(공개 코드)
통과 기준
세 원소 모두 복원돼야 바로 통과. 하나라도 빠지면 재검토
2/3 규칙
재검토
추출기와 다른 모델(또는 NLI)로 관계의 근거를 묻는다. 승인율을 지표로 남긴다. 본문이 세상 지식과 다른 사례를 시험 문항에 넣어 검증기가 본문을 따르는지 확인한다
같은 모델이 뽑고 같은 모델이 채점. 재검토 거부를 곧 환각으로 간주
보충
보충 트리플도 같은 복원·재검토를 거친다
의미 중복만 걸러 그대로 합치기
평가
자동 정답과 함께 사람이 표본(예: 100건)을 검수해 '근거 있음'의 정밀도를 잰다
파이프라인이 스스로 매긴 환각률만 보고
대명사
문서 단위 작업이면 상호 참조를 먼저 풀거나, '그는' 같은 앵커를 개체로 쓰지 않는다
대명사를 개체 앵커로 저장
10. 맺으며 — 출처는 진실이 아니지만, 진실로 가는 유일한 길이다
다시 처음의 잡스 문장으로 돌아가 봅니다. AEVS는 (Steve Jobs, 국적, 미국)을 버리고 (Apple Inc., 소재지, 쿠퍼티노)를 받아들입니다. 앞의 것은 세상에서 참이고 뒤의 것은 엄밀히 따지면 문장이 잘못 말한 것인데도 그렇습니다. 처음에는 거꾸로 된 판단처럼 보입니다.
하지만 지식 그래프가 수천 개 문서에서 수백만 줄을 모으는 상황을 생각하면 이 선택이 옳습니다. 출처가 붙은 틀린 줄은 찾아서 고칠 수 있습니다. 어느 문서가 틀렸는지 알 수 있고, 같은 사실에 대한 다른 문서와 비교할 수 있고, 그 문서를 믿지 않기로 결정할 수 있습니다. 출처 없는 맞는 줄은 영원히 확인할 수 없습니다. 그리고 출처 없는 줄 중 어느 것이 맞고 어느 것이 틀렸는지는 아무도 모릅니다.
논문이 보고한 것은 '본문에 있는 말로만 조합하라'는 제약이 생각보다 많은 일을 한다는 것입니다. 개체 수준의 환각은 사실상 사라졌습니다. 동시에 꼼꼼히 읽으면, 글자 위치를 다는 일과 그 말이 정말 그 관계를 뜻하는지 확인하는 일이 다른 문제라는 것도 보입니다. 오류의 95%가 관계에 남았고, 그 관계를 통과시키는 마지막 판단은 LLM의 몫이었습니다. 공개 코드에서는 그 판단조차 빠져 있었습니다.
코어닷투데이의 작은 실측은 한 걸음 더 나갑니다. 스키마를 준 프롬프트 한 번이 이미 환각 없이 잘 뽑는 곳에서, 서너 번의 호출은 점수를 올리지 못했습니다. 그리고 마지막 관문의 LLM은 "에펠탑은 로마에 있다"는 본문을 현실과 다르다며 지웠습니다. 출처를 다는 일의 값은 점수에 있지 않습니다. 나중에 확인할 수 있다는 것에 있고, 그 확인은 끝내 사람과 문서의 몫으로 남습니다.
2026년의 도구들은 출처를 글자 단위까지 끌어내렸습니다. 다음 과제는 그 글자들이 무엇을 말하는지까지 증명하는 것입니다.
참고문헌
이번 글의 논문과 코드
Yang, Y., Chen, G., He, B., Zhao, Y. (2026). Grounded Knowledge Graph Extraction via LLMs: An Anchor-Constrained Framework with Provenance Tracking. Computers, 15(3), 178. https://doi.org/10.3390/computers15030178 (CC BY 4.0)