작은 모델, 큰 벤치마크 — K-LegalDeID로 읽는 BIO와 CRF의 귀환, 109만 건의 데이터, 그리고 0.99 뒤의 0.94
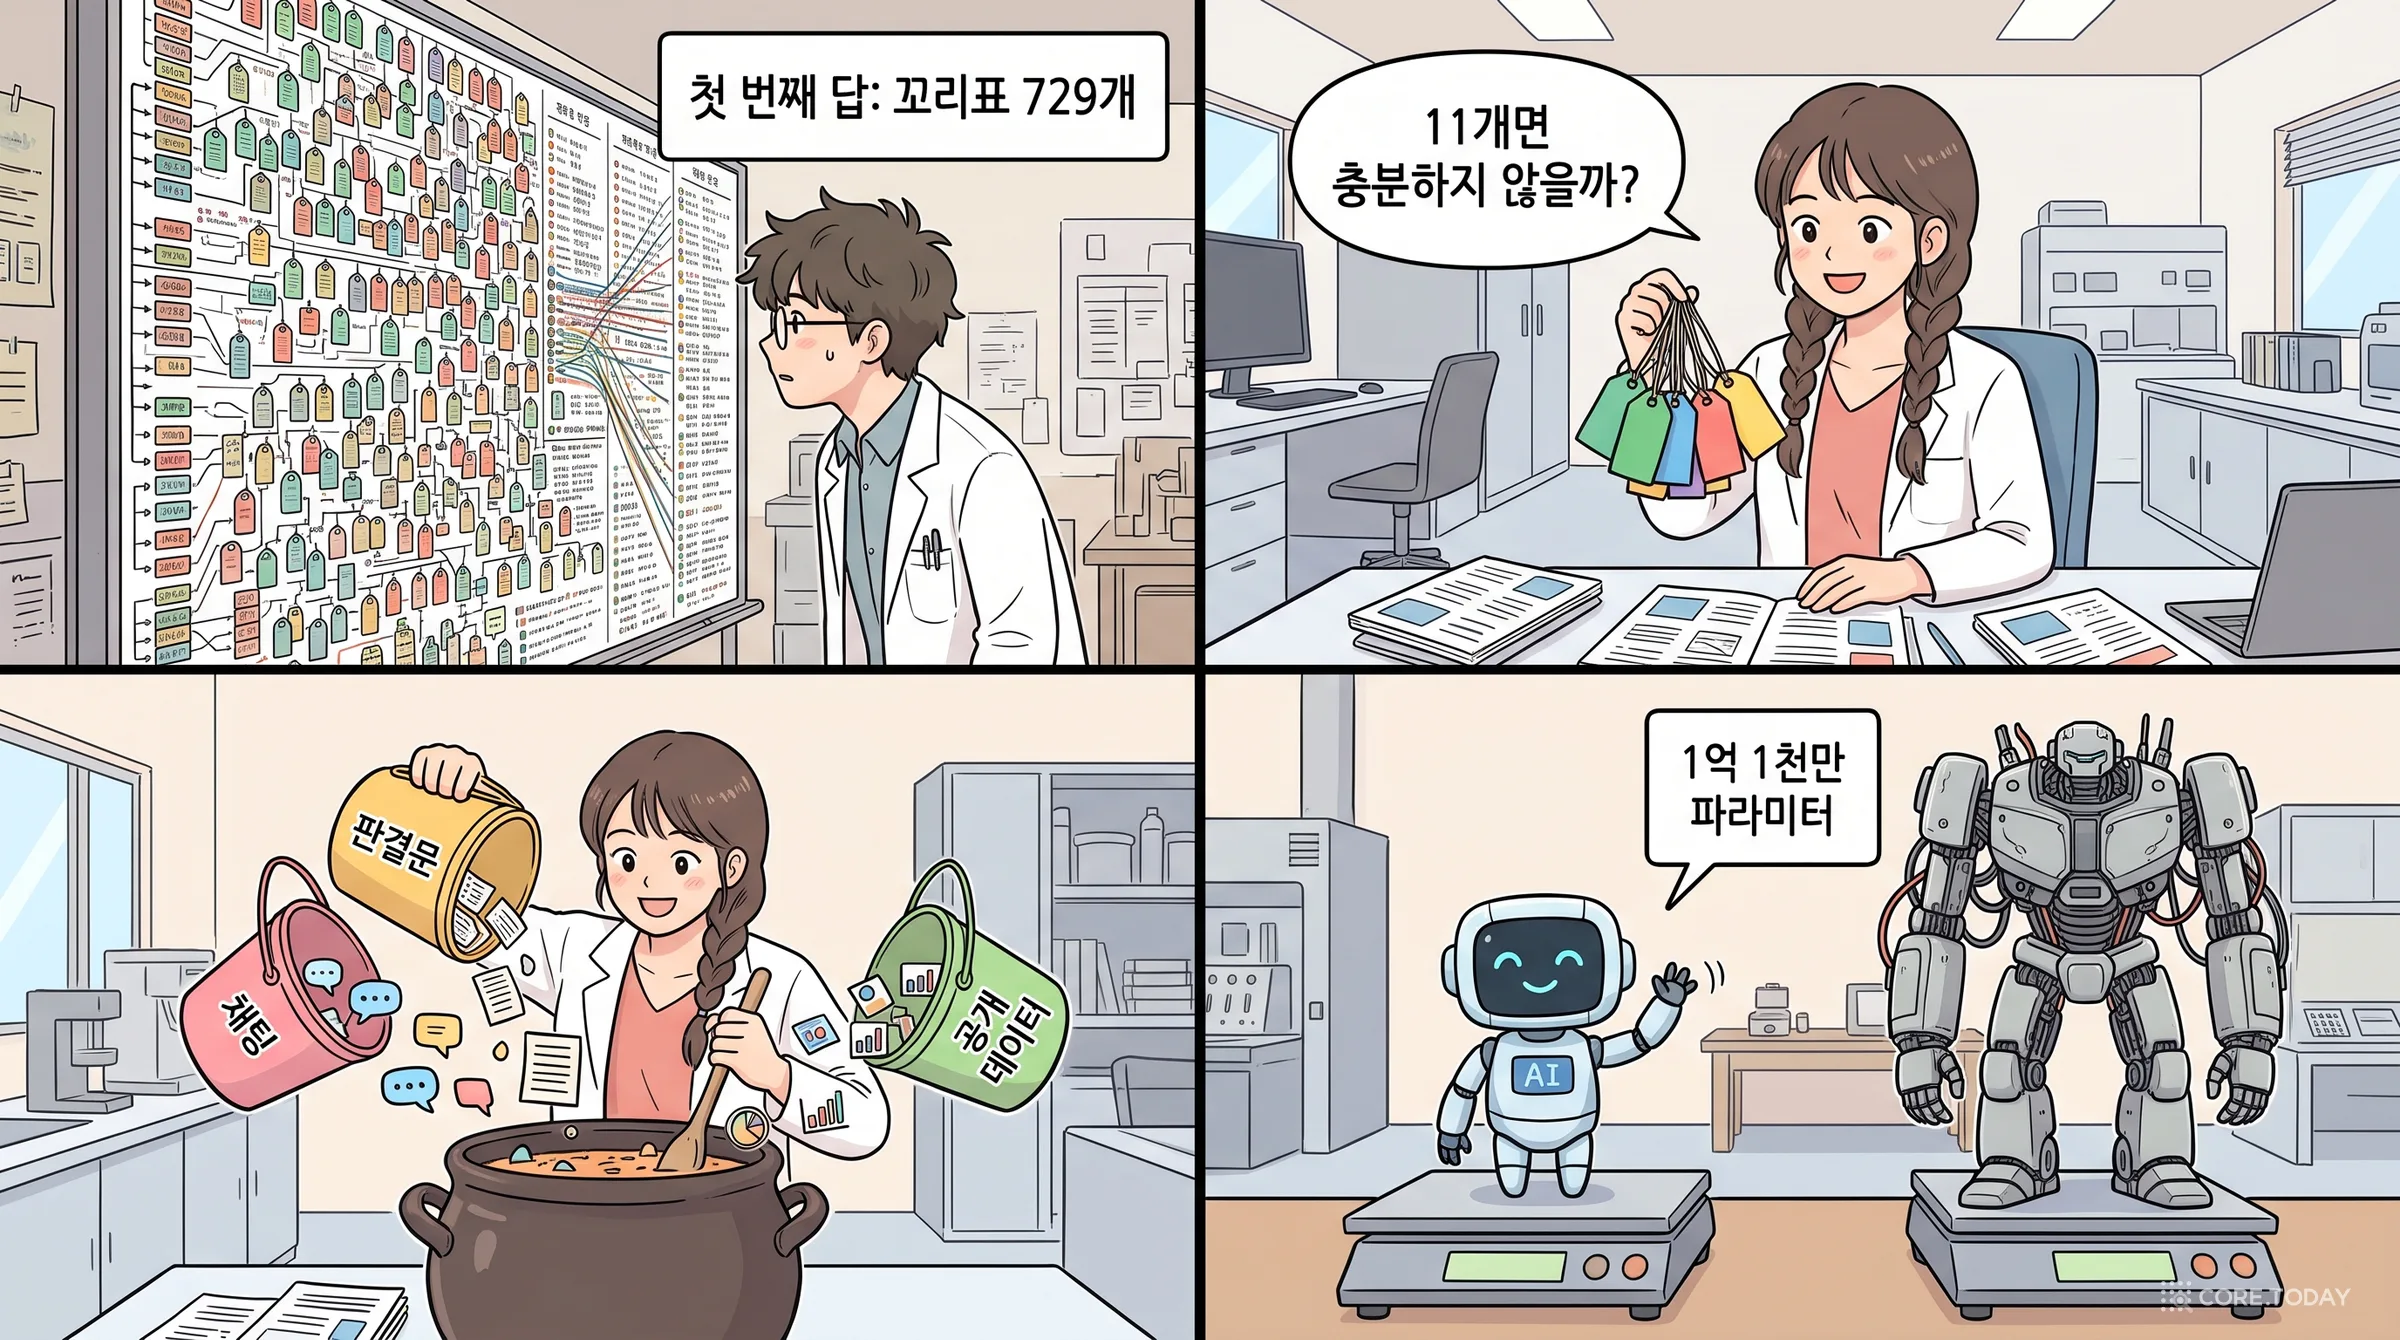
판결문 비실명화에 대한 두 번째 답이 2026년 3월 EACL에 나왔습니다. 고려대 연구진의 K-LegalDeID는 앞선 Thunder-DeID와 거의 모든 선택이 반대입니다. 라벨은 729개가 아니라 11개, 모델은 처음부터 사전학습한 15억 파라미터가 아니라 공개된 KLUE-BERT 1억 1천만에 CRF 층 하나, 데이터는 판결문 6,700건이 아니라 채팅·판결문·공개 데이터를 합친 109만 문장입니다. 그리고 엄격한 개체 단위 F1 0.9923을 보고합니다. 이 글은 1995년의 BIO 표기와 2001년의 CRF가 왜 2026년에 다시 쓰이는지부터 풀고, 39개 법 분야 2,000건의 새 데이터와 주석자 일치도 0.7352, 여섯 가지 채점 방식을 그림·표·위젯으로 따라갑니다. 숫자를 뜯어 보면 0.9923은 채팅이 대부분인 시험지의 점수이고, 새로 만든 판결문만으로는 0.94~0.97이며, 다른 연구실의 정답지로 채점하면 0.37로 떨어집니다. 코어닷투데이는 공개된 KLUE-BERT 어휘로 이름 2,000개에 조사를 붙여 직접 토큰화해, 경계가 맞아떨어지는 비율 97.3%와 ‘신한은행’이 한 토큰이 되는 문제를 확인했습니다.
코어닷투데이는 앞선 글 판결문의 이름을 지우는 AI에서 서울대 연구진의 Thunder-DeID를 읽었습니다. 판결문은 공개가 원칙이지만 공개 전에 사람을 특정할 수 있는 정보를 지워야 하고, 그 일이 대부분 사람 손으로 이뤄져 공개의 병목이 된다는 문제였습니다. Thunder-DeID의 답은 세밀함이었습니다. 실제로 가려진 4만 8천 개의 자리에서 729개의 라벨을 귀납하고, 형태소 분석기를 넣은 토크나이저를 따로 만들고, 그 토크나이저에 맞춰 모델을 처음부터 사전학습했습니다.
아홉 달 뒤인 2026년 3월, 모로코 라바트에서 열린 EACL 2026에 같은 문제를 다룬 두 번째 논문이 실렸습니다. 고려대학교 컴퓨터학과의 Wooseok Choi, Hyungbin Kim, Yon Dohn Chung 교수가 쓴 「K-LegalDeID: 한국 법원 판결문 비식별화를 위한 벤치마크 데이터셋과 KLUEBERT-CRF」입니다. 이 논문은 Thunder-DeID를 선행 연구로 인용하고, 그 공개 데이터를 자기 학습 자료에 넣고, 그 모델을 비교 대상으로 삼습니다. 그리고 거의 모든 설계에서 반대 방향을 택합니다.
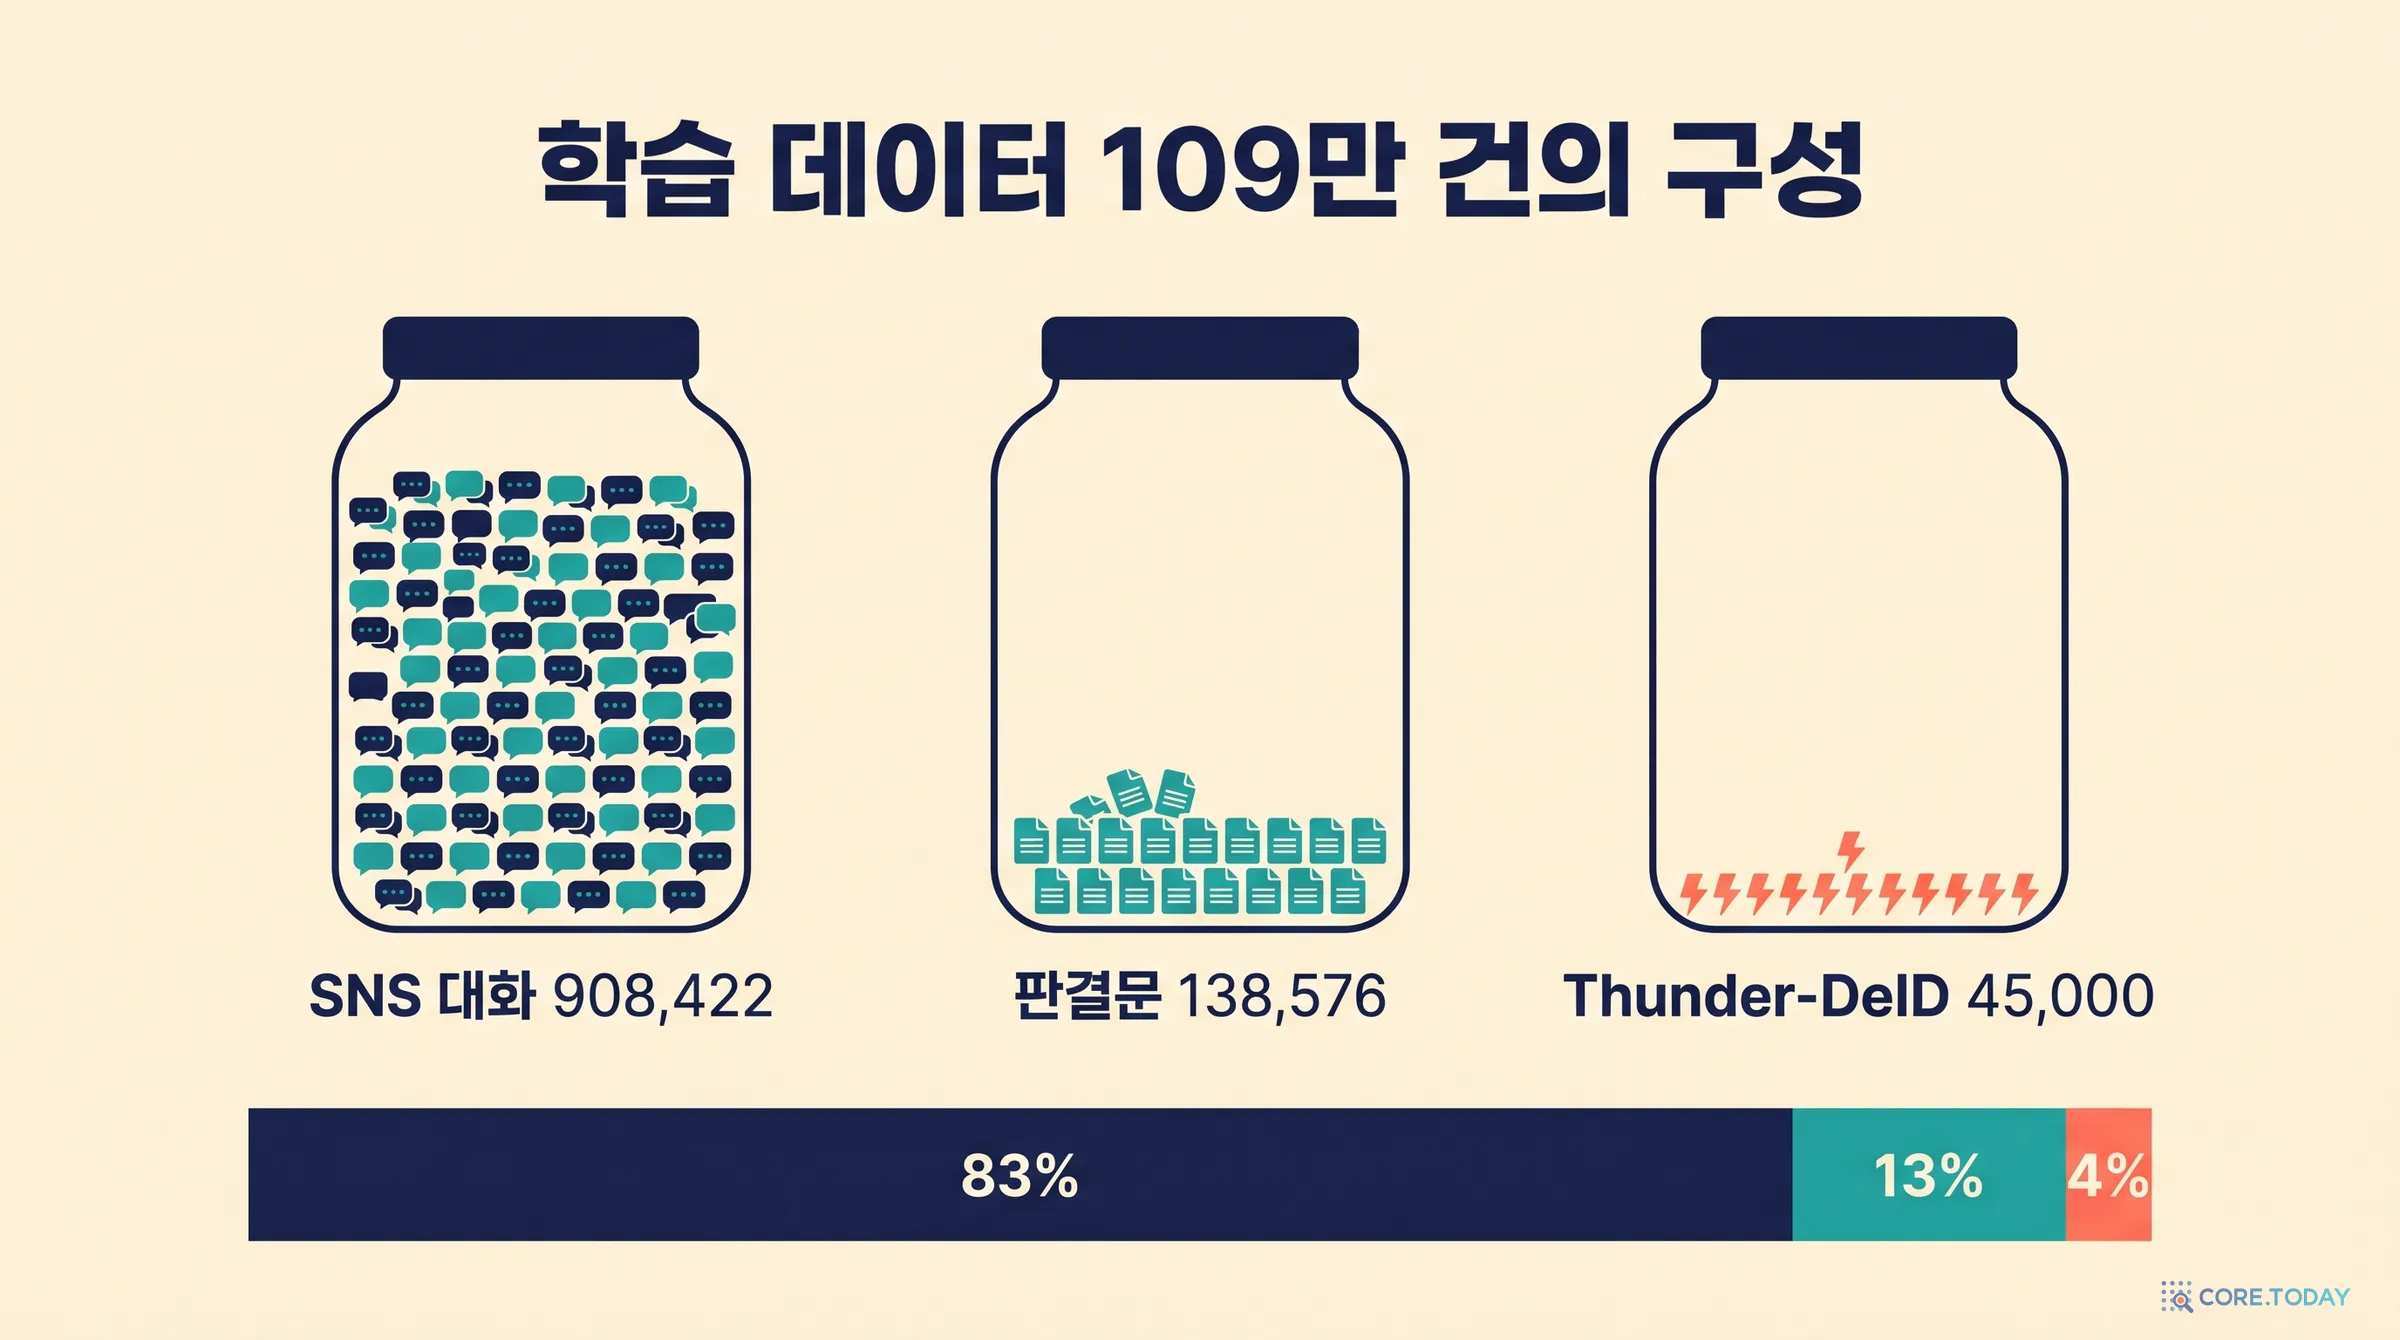
채팅 90.8만 + 판결문 13.9만 + Thunder-DeID 공개 데이터 4.5만 문장
처리 단위
문서 (최대 2,048토큰)
문장 (최대 512토큰)
대표 점수
토큰 이진 F1 0.98, 토큰 종류 F1 0.91
개체 엄격 F1 0.9923
두 논문을 나란히 놓으면 질문이 생깁니다. 729개가 필요한가, 11개면 되는가. 모델을 새로 만들어야 하는가, 있는 것을 가져다 쓰면 되는가. 그리고 0.91과 0.99는 같은 자로 잰 숫자인가. 이 글은 K-LegalDeID를 처음부터 끝까지 읽으며 앞의 두 질문에 대한 이 논문의 답을 정리하고, 세 번째 질문을 숫자로 확인합니다. 두 논문을 정면으로 견주고 앞으로의 방향을 논하는 일은 다음 글 두 논문이 남긴 숙제에서 이어 갑니다.
?
논문의 문제의식
공개된 학습 자료가 형사 사건 세 유형에 몰려 있고, 붙어 있는 식별자의 경계를 표시하지 않는다. 다양한 법 분야를 덮는 믿을 만한 벤치마크가 없다.
⚙
K-LegalDeID의 해법
39개 법 분야에서 판결문 2,000건을 모아 여덟 명이 주석하고(일치도 0.7352), 채팅 데이터와 기존 공개 데이터를 11개 라벨로 통일해 합친다. 모델은 KLUE-BERT에 CRF 층을 얹는다.
✓
결과와 단서
합친 시험에서 엄격한 개체 F1 0.9923. 다만 새 판결문만으로는 0.94~0.97이고, 본 적 없는 다른 데이터셋에서는 0.37이다.
1장. 논문이 그리는 현실: 2주, 5.97%, 8%
논문의 서론은 세 개의 숫자로 문제를 요약합니다.
약 2주. 수작업 비실명화에 문서 한 건당 걸리는 시간이라고 논문은 적습니다. 한 사람이 한 건에 2주를 쓴다는 뜻이 아니라, 접수부터 처리·검수를 거쳐 공개되기까지의 소요 기간으로 읽는 것이 자연스럽습니다. 논문은 출처를 밝히지 않았습니다.
5.97%. 비실명화를 거친 판결문은 약 160만 건으로 전체의 5.97%라고 합니다(2019년 법원행정처 자료 인용).
약 8%. 법원의 '지능형 판결문 비식별 시스템'이 식별 정보를 찾아 가리는 정확도라고 합니다(2025년 법원행정처 자료 인용).
마지막 숫자에는 주의가 필요합니다. 앞선 글에서 확인했듯 2025년 법원행정처 정보화전략계획 보고서의 8%는 '정확도'가 아니라 '처리율'로 적혀 있고, 2019년 국회 토론회 자료의 15%가 '정확도'입니다. 두 논문 모두 이 숫자를 자기 모델의 F1과 나란히 놓고 싶어 하지만, 재는 것이 다릅니다. 방향(지금의 자동 처리는 거의 쓸모가 없다)은 맞고 크기 비교는 성립하지 않습니다.
논문은 자동화가 어려운 이유를 셋으로 듭니다. 한국 법률 문서의 특수한 형식, 교착어 형태론과 불규칙한 띄어쓰기 같은 언어적 어려움, 그리고 질 좋은 학습 자료의 부족입니다. 이 논문의 무게 중심은 세 번째에 있습니다. 제목의 첫 단어가 '벤치마크 데이터셋'입니다.
2장. 앞선 연구에 대한 두 가지 지적
K-LegalDeID는 Thunder-DeID를 "중요한 진전"이라고 평가한 뒤 두 가지 한계를 짚습니다.
첫째, 데이터셋이 성폭력, 폭행, 사기라는 세 가지 형사 사건 유형에 집중돼 있다. 둘째, 주석 체계가 BIO 표기를 쓰지 않아 연달아 나오는 개체의 경계를 가르기 어렵다.
앞선 글을 읽은 분은 첫째 지적이 이상하게 들릴 것입니다. 우리가 읽은 Thunder-DeID 논문은 민사 3,000건, 형사 3,000건, 행정 700건으로 열 가지 사건 유형을 다뤘기 때문입니다. 어긋남의 원인은 판본입니다. Thunder-DeID의 arXiv 초기판과 공개 데이터는 형사 세 유형(폭행, 강제추행, 사기) 각 1,500건씩 4,500건, 개체 27,402개, 라벨 595종 규모였고, EMNLP 2025에 실린 최종판에서 6,700건, 48,306개, 729종으로 늘었습니다. 연구실 페이지는 지금도 공개 데이터를 4,500건 규모로 안내합니다. K-LegalDeID가 내려받아 쓴 것은 이 공개본입니다. 따라서 "세 유형뿐"이라는 지적은 누구나 쓸 수 있는 자료에 대해서는 맞고, 논문이 보고한 실험에 대해서는 맞지 않습니다. 학계에서 논문보다 공개된 자료가 더 오래 영향을 미친다는 점을 보여 주는 사례이기도 합니다.
둘째 지적은 기술적인 것이고, 이 논문의 설계 전체가 여기서 출발합니다. 3장과 4장에서 차례로 풉니다.
개체명 인식은 문장을 토큰으로 자르고 토큰마다 꼬리표를 붙이는 일입니다. 가장 단순한 방법은 꼬리표에 종류만 적는 것입니다. '김철수'의 토큰에는 '이름', '는'에는 '해당 없음'. Thunder-DeID가 이 방식입니다(논문 그림에서 정답 열은 "O, O, 내국인이름, 내국인이름, O"였습니다).
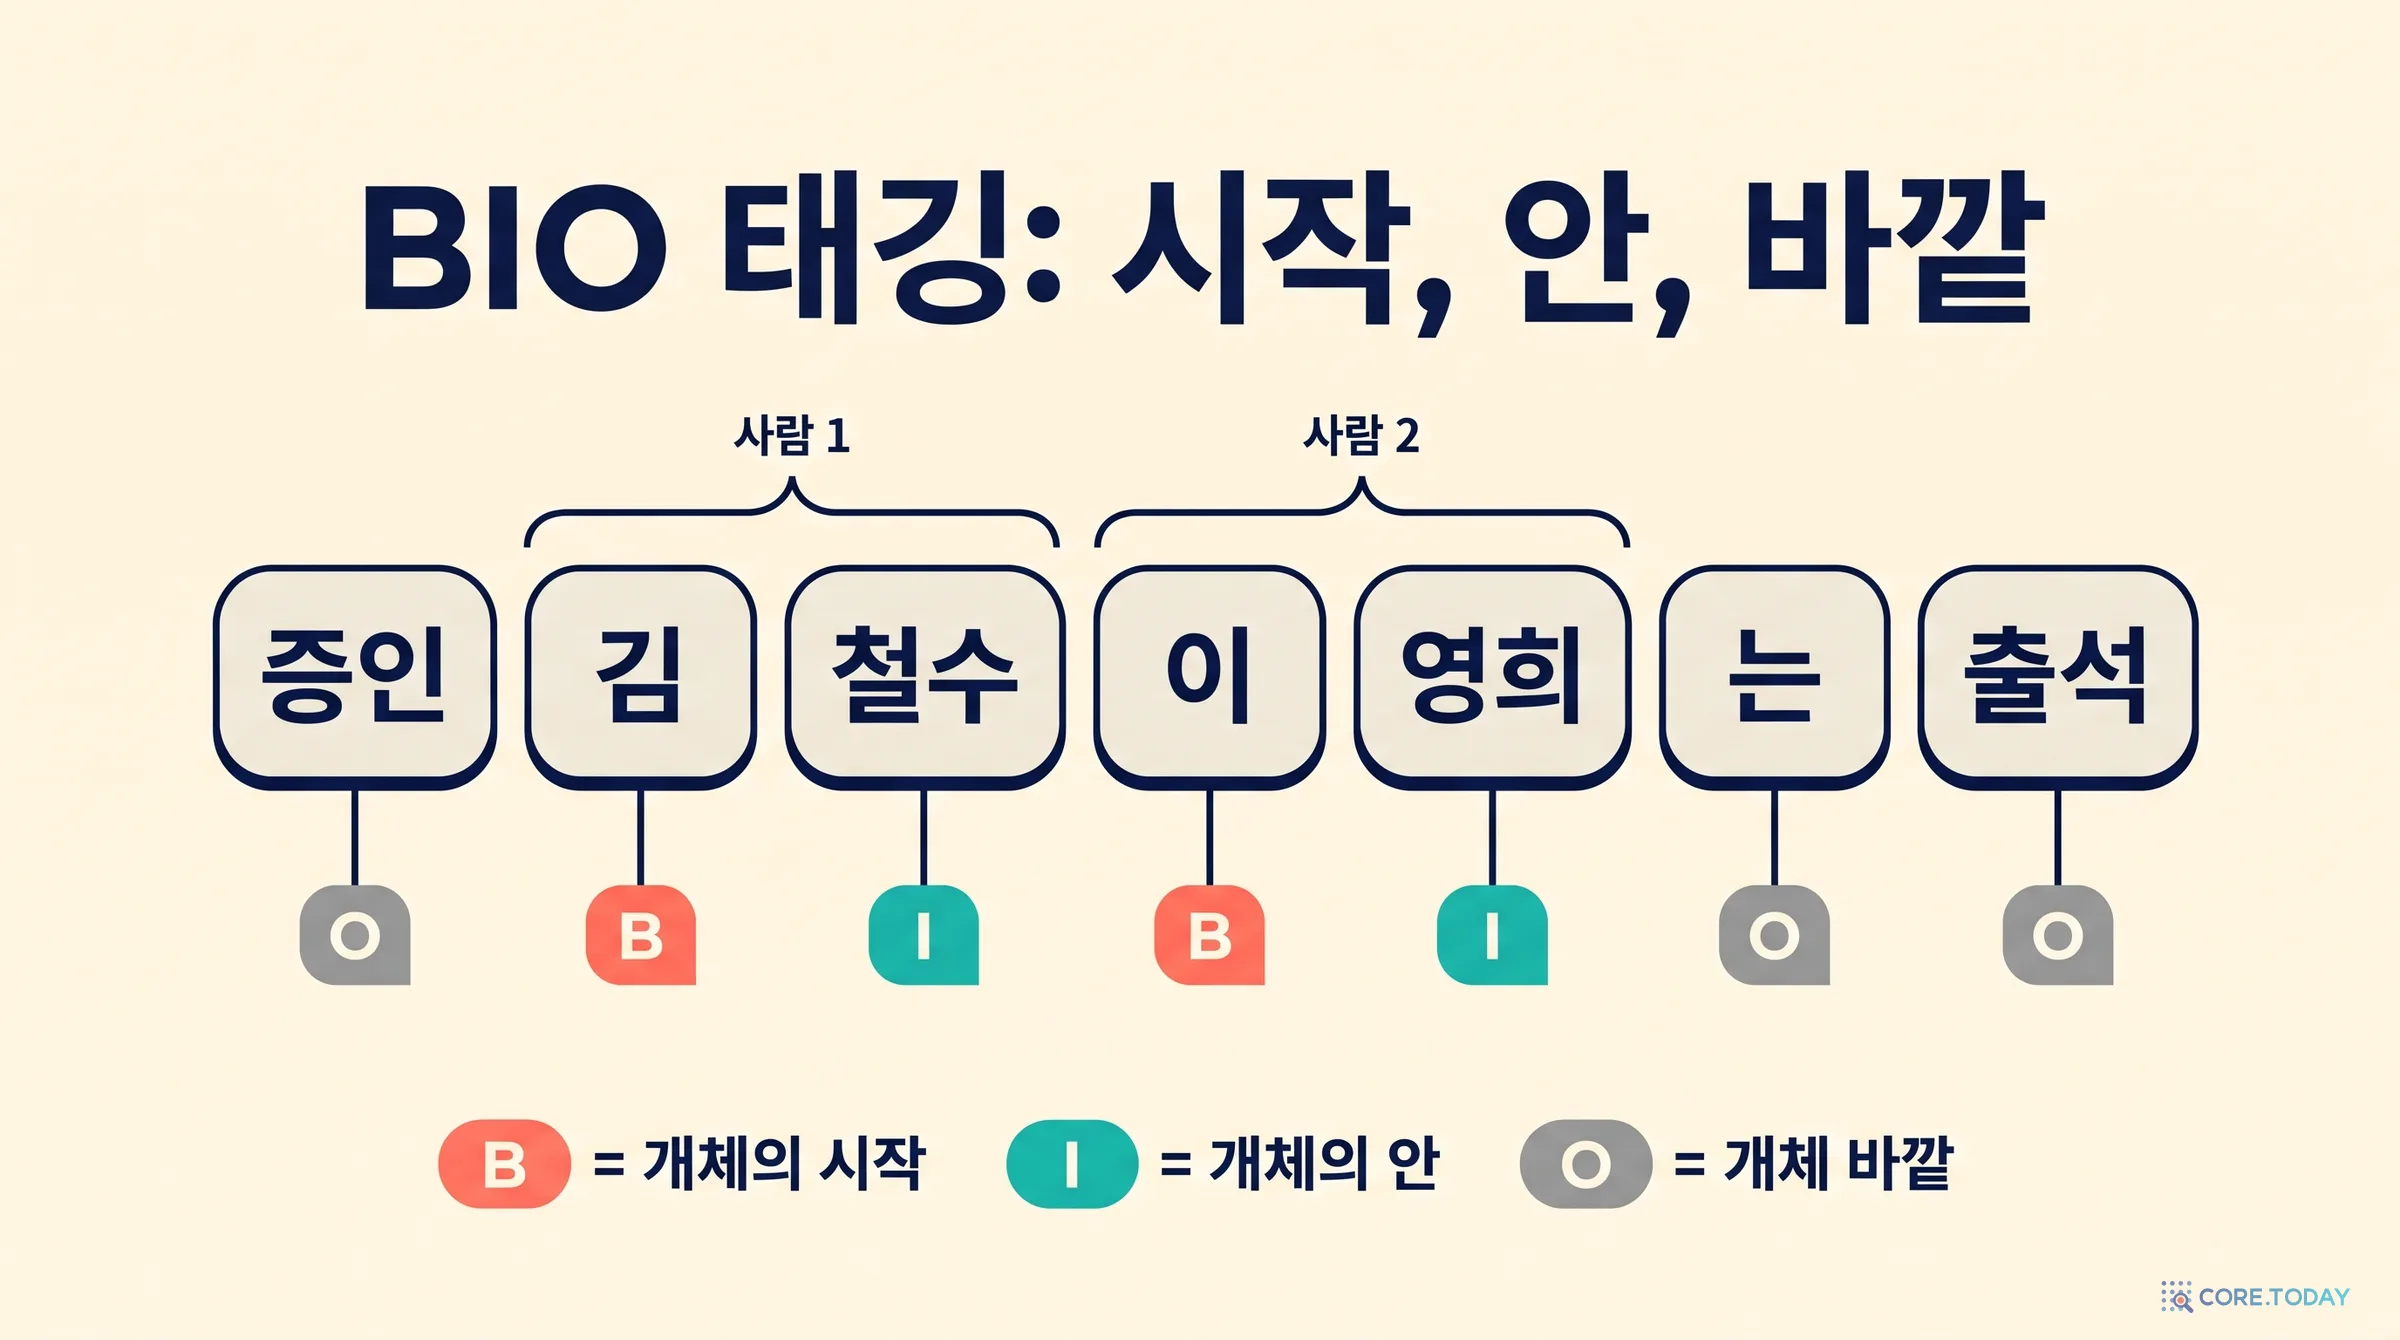
이 방식에는 빈틈이 있습니다. 같은 종류의 개체가 붙어서 나오면 어디서 하나가 끝나고 다음이 시작하는지 알 수 없습니다. "증인 김철수 이영희 박민수는"에서 세 이름의 토큰이 모두 '이름'이면, 이것이 세 사람인지 아주 긴 이름의 한 사람인지 꼬리표만으로는 구분되지 않습니다.
BIO 표기는 꼬리표에 위치 정보를 한 글자 더합니다.
B(Beginning): 개체가 여기서 시작한다.
I(Inside): 앞 토큰에서 시작한 개체가 이어진다.
O(Outside): 개체가 아니다.
'김철수'가 두 토큰 '김', '철수'로 쪼개졌다면 B-이름, I-이름이 되고, 바로 뒤의 '이영희'는 다시 B-이름으로 시작합니다. B가 나올 때마다 새 개체가 시작되므로 경계가 분명해집니다.
1995년의 발명
BIO는 새 기술이 아닙니다. 1995년 랜스 램쇼와 미치 마커스가 문장에서 명사구를 묶어 내는 문제(청킹)를 "단어마다 꼬리표 붙이기"로 바꾸면서 쓴 표기가 시작입니다. 괄호를 치는 문제를 꼬리표 문제로 바꾸면 당시 잘 발달해 있던 품사 태깅 기법을 그대로 쓸 수 있었기 때문입니다. 2003년 CoNLL 공유 과제가 개체명 인식 데이터를 이 형식으로 배포하면서 표준이 됐고, 그 뒤로 시작·안·끝·단독·바깥을 구분하는 BIOES 같은 변형이 나왔습니다. 30년 된 표기입니다.
판결문에서 왜 중요한가
비실명화에서 경계는 사소한 문제가 아닙니다. 한국 법원의 처리 기준은 사람마다 다른 알파벳을 붙이고(A, B, C), 번호마다 다른 순번을 붙이라고 합니다(계좌번호 1 생략, 계좌번호 2 생략). 세 사람이 한 덩어리로 묶이면 'A' 하나만 남아, 증인이 몇 명이었는지가 판결문에서 사라집니다. 앞선 글에서 LLM의 문제로 본 '개체 뭉개기'가 꼬리표 체계 때문에도 생길 수 있는 셈입니다.
다만 공정하게 보면, 이 문제가 실제로 얼마나 자주 생기는지는 따져 봐야 합니다. 종류가 다르면(주소 뒤에 회사) 종류만 적어도 갈라지고, 판결문에서 이름은 대개 조사나 쉼표로 떨어져 있습니다. 또 Thunder-DeID는 라벨이 729개로 잘아서 '식당' 옆에 '노래방'이 와도 서로 다른 라벨이 됩니다. BIO의 이득이 가장 큰 곳은 라벨이 굵을 때입니다. 11개 라벨에서는 PC방도 휴대폰 가게도 모두 '주소'가 되므로(6장), 붙어 있는 가게 둘을 가르려면 B가 꼭 필요합니다. 라벨을 줄이는 선택과 BIO를 쓰는 선택은 한 묶음입니다.
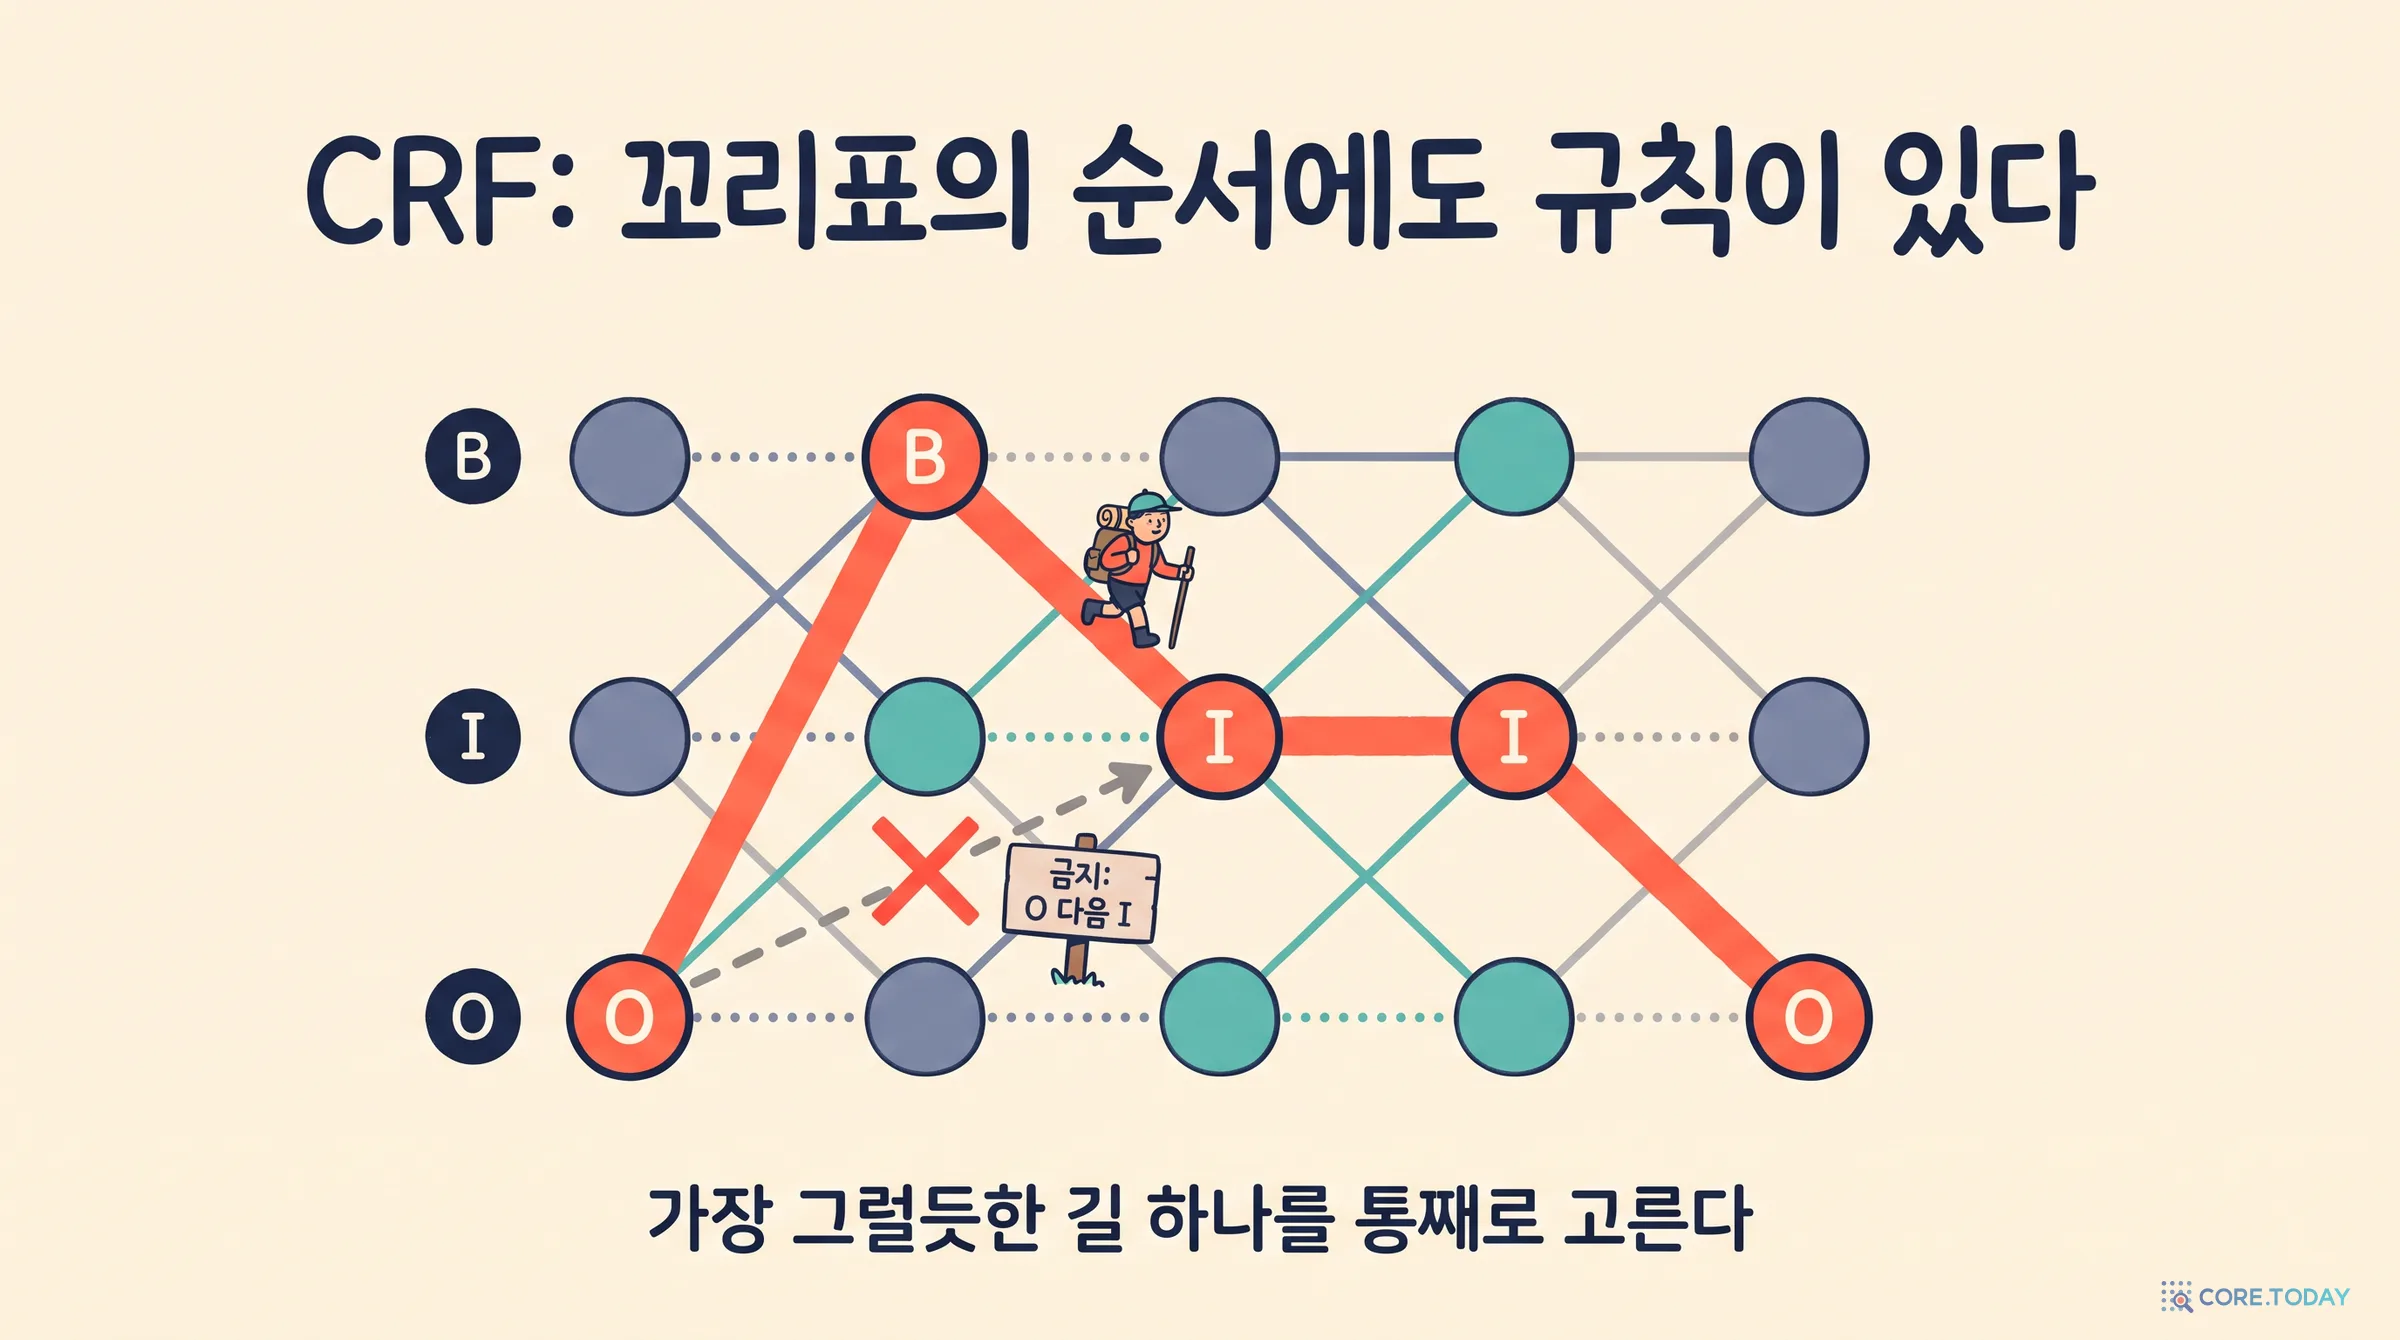
BIO를 쓰면 꼬리표 사이에 규칙이 생깁니다. I는 혼자 올 수 없습니다. 같은 종류의 B나 I 뒤에만 올 수 있습니다. "O 다음에 I-이름"이나 "B-이름 다음에 I-주소"는 표기상 있을 수 없는 순서입니다.
그런데 BERT 같은 인코더 위에 분류기를 얹은 보통의 모델은 토큰마다 따로 꼬리표를 고릅니다. 각 토큰의 표현은 문장 전체를 보고 만들어지지만, 마지막에 "이 토큰은 무엇인가"를 정할 때는 옆 토큰이 무엇으로 정해졌는지를 보지 않습니다. 그래서 이름 한가운데 토큰 하나가 O로 빠지고 그다음 토큰이 I로 이어지는, 규칙에 어긋난 결과가 나옵니다. 논문은 KLUE-BERT만 썼을 때 바로 이런 오류("O 다음의 I", "같은 개체 안에서 라벨이 바뀜")가 생긴다고 적습니다.
토큰 단위로 채점하면 이것은 토큰 하나의 실수입니다. 개체 단위로 채점하면 이야기가 달라집니다. 경계가 하나 틀리면 그 개체 전체가 틀린 것이 됩니다. 논문의 표현으로 "토큰 단위 F1이 높아도 경계 하나가 어긋나면 개체 단위 F1이 내려간다"는 것입니다.
조건부 무작위장
CRF(Conditional Random Field, 조건부 무작위장)는 이 문제를 위해 만들어진 모형입니다. 토큰마다 점수를 매기는 데 더해, 꼬리표에서 꼬리표로 넘어가는 전이에도 점수를 매깁니다. "B-이름 다음에 I-이름"은 높은 점수, "O 다음에 I-이름"은 아주 낮은 점수. 그리고 토큰별 점수와 전이 점수를 모두 더한 값이 가장 큰 꼬리표 열 전체를 한 번에 고릅니다.
가능한 꼬리표 열은 토큰이 늘 때마다 기하급수로 늘어납니다. 라벨이 23개(11종의 B와 I, 그리고 O)이고 토큰이 30개면 23의 30제곱 가지입니다. 이것을 다 따져 볼 수는 없지만, 비터비 알고리즘(1967)은 왼쪽부터 한 칸씩 가면서 "이 칸에서 이 꼬리표로 끝나는 열 가운데 최고 점수"만 기억하는 방법으로 최적의 열을 빠르게 찾습니다. 칸마다 라벨 수의 제곱만큼만 계산하면 됩니다.
2001년에서 2026년까지
2001CRF 발표. Lafferty, McCallum, Pereira. 앞선 은닉 마르코프 모형과 최대 엔트로피 마르코프 모형의 약점(특징을 자유롭게 못 쓰거나, 라벨 편향이 생김)을 고친 순차 라벨링 모형.
2003~2014손으로 만든 특징 + CRF. 개체명 인식과 의료 비식별화의 표준. 2014년 i2b2 비식별화 대회 상위권도 이 방식이었다.
2015~2016BiLSTM-CRF. Huang 외(2015), Lample 외(2016). 특징은 신경망이 배우고, 마지막 층만 CRF로 둔다.
2018~BERT의 시대. 사전학습 인코더가 워낙 강해 CRF 없이 토큰마다 분류해도 점수가 높게 나왔다. CRF는 '있으면 조금 낫고 없어도 되는' 부품이 됐다.
2026K-LegalDeID. 엄격한 개체 단위 채점과 굵은 라벨에서는 그 '조금'이 크다는 것을 다시 보여 준다. 논문은 CRF 층으로 개체 단위 Micro F1이 2.98% 올랐다고 보고한다.
CRF 층이 더하는 파라미터는 라벨 수의 제곱, 곧 수백 개에 불과합니다. 모델 크기에는 영향이 없고 얻는 것은 줄 전체의 일관성입니다. 화려하지 않지만 문제에 맞는 선택입니다.
5장. KLUE-BERT: 있는 것을 가져다 쓴다
1억 1천만 파라미터
Thunder-DeID는 토크나이저를 새로 만들었기 때문에 모델도 새로 사전학습해야 했습니다. H100 32장으로 최대 19시간이 걸리는 일이었습니다. K-LegalDeID는 그 일을 하지 않습니다. 2021년에 공개된 KLUE-BERT를 그대로 가져옵니다.
KLUE(Korean Language Understanding Evaluation)는 한국어 이해 과제 여덟 가지(주제 분류, 문장 유사도, 자연어 추론, 개체명 인식, 관계 추출, 의존 구문 분석, 기계 독해, 대화 상태 추적)를 묶은 벤치마크이고, KLUE-BERT는 그와 함께 공개된 사전학습 모델입니다. 12층, 은닉 차원 768, 약 1억 1천만 파라미터. 2026년 기준으로는 아주 작은 모델입니다. 논문은 Thunder-DeID의 가장 작은 모델(3억 6천만)과 견줘 크기가 3분의 1 이하라는 점을, 법원 시스템에 배치할 때 메모리 측면의 실용적 이점으로 내세웁니다.
항목
KLUE-BERT-CRF (제안)
Thunder-DeID 360M
Kanana-1.5
Qwen-2.5
구조
인코더 + CRF
인코더
디코더 (LoRA)
디코더 (LoRA)
파라미터
1.1억
3.6억
21억
15억
은닉 차원 / 층 / 헤드
768 / 12 / 12
1,024 / 24 / 16
1,792 / 32 / 24
1,536 / 28 / 14
어휘 크기
32,026
32,000
128,259
151,936
미세조정 장비
RTX 8000 2장 · 최대 512토큰
미세조정 시간
24시간
24시간
3일
4일
논문 표 11을 옮긴 것입니다. 장비가 눈에 띕니다. RTX 8000 두 장입니다. Thunder-DeID의 H100 32장과 견주면, 이 연구는 대학 연구실 한 곳의 평범한 장비로 끝까지 갈 수 있는 길을 택했습니다. 어휘 크기 32,026의 끝자리 26은 뒤에서 설명할 추가 어휘입니다.
형태소를 '미리' 반영한 토크나이저
흥미로운 것은 KLUE-BERT의 토크나이저가 Thunder-DeID와 같은 생각에서 출발했다는 점입니다. KLUE 논문은 형태소 기반 서브워드 토큰화를 씁니다. 원문을 먼저 형태소 분석기(MeCab-ko)로 가른 다음 그 위에서 서브워드 어휘를 만듭니다. 조사 '는', '을', '에서'가 독립된 조각(##는, ##을, ##에서)으로 어휘에 들어가게 하려는 것입니다.
차이는 추론할 때입니다. KLUE-BERT는 어휘를 다 만든 뒤에는 형태소 분석기를 쓰지 않습니다. 어휘와 '가장 긴 조각부터 맞추기' 규칙만으로 토큰을 나눕니다. 형태소 분석기를 설치할 필요가 없고 빠릅니다. 대신 조사가 떨어진다는 보장은 없습니다. 어휘에 이름의 끝 글자와 조사가 합쳐진 더 긴 조각이 있으면 그쪽이 먼저 맞기 때문입니다. Thunder-DeID는 추론 때도 분석기를 돌려 그 보장을 얻고, 대가로 전용 사전학습을 치렀습니다.
코어닷투데이 실측: 경계는 얼마나 자주 어긋나나
그 보장 없는 방식이 실제로 얼마나 잘 가르는지를 코어닷투데이가 직접 재 봤습니다. 허깅페이스에 공개된 KLUE-BERT의 어휘 파일(32,000개)을 받아 WordPiece 알고리즘을 구현했고, 논문 그림 1의 예문("피고는 주식회사스트롱시프트와 사이에 체결된")이 논문과 똑같이 [피고, ##는, 주식회사, ##스트, ##롱, ##시, ##프트, ##와, 사이, …]로 나뉘는 것을 확인한 뒤 측정했습니다. 외부 API나 유료 자원은 쓰지 않았습니다.
이름 + 조사. 흔한 성 30개와 이름 글자 50개를 무작위로 조합한 가상의 이름 2,000개에 조사 여덟 가지를 받침에 맞게 붙여 16,000개 어절을 만들었습니다. 이름과 조사 사이에 토큰 경계가 생긴 것은 15,566개, 97.3%였습니다.
은 · 는
100%
을 · 를
100%
에게
100%
(으)로부터
98.0%
과 · 와
97.9%
의
95.9%
(이)라는
94.2%
이 · 가
92.3%
어긋나는 경우에는 규칙이 있습니다. 이름의 끝 글자와 조사가 합쳐져 흔한 낱말 조각이 될 때입니다. '김민주의'는 [김민, ##주의]로, '강서은이'는 [강서, ##은이]로, '권미자와'는 [권, ##미, ##자와]로, '강철도로부터'는 [강철, ##도로, ##부터]로 나뉩니다. '주의', '도로'는 그 자체로 흔한 낱말이고, 가장 긴 조각부터 맞추는 규칙이 그쪽을 먼저 집습니다. 주격 조사 '이'가 가장 약한 것은 '은이', '성이', '진이'처럼 이름 끝 글자와 붙은 조각이 어휘에 많기 때문입니다.
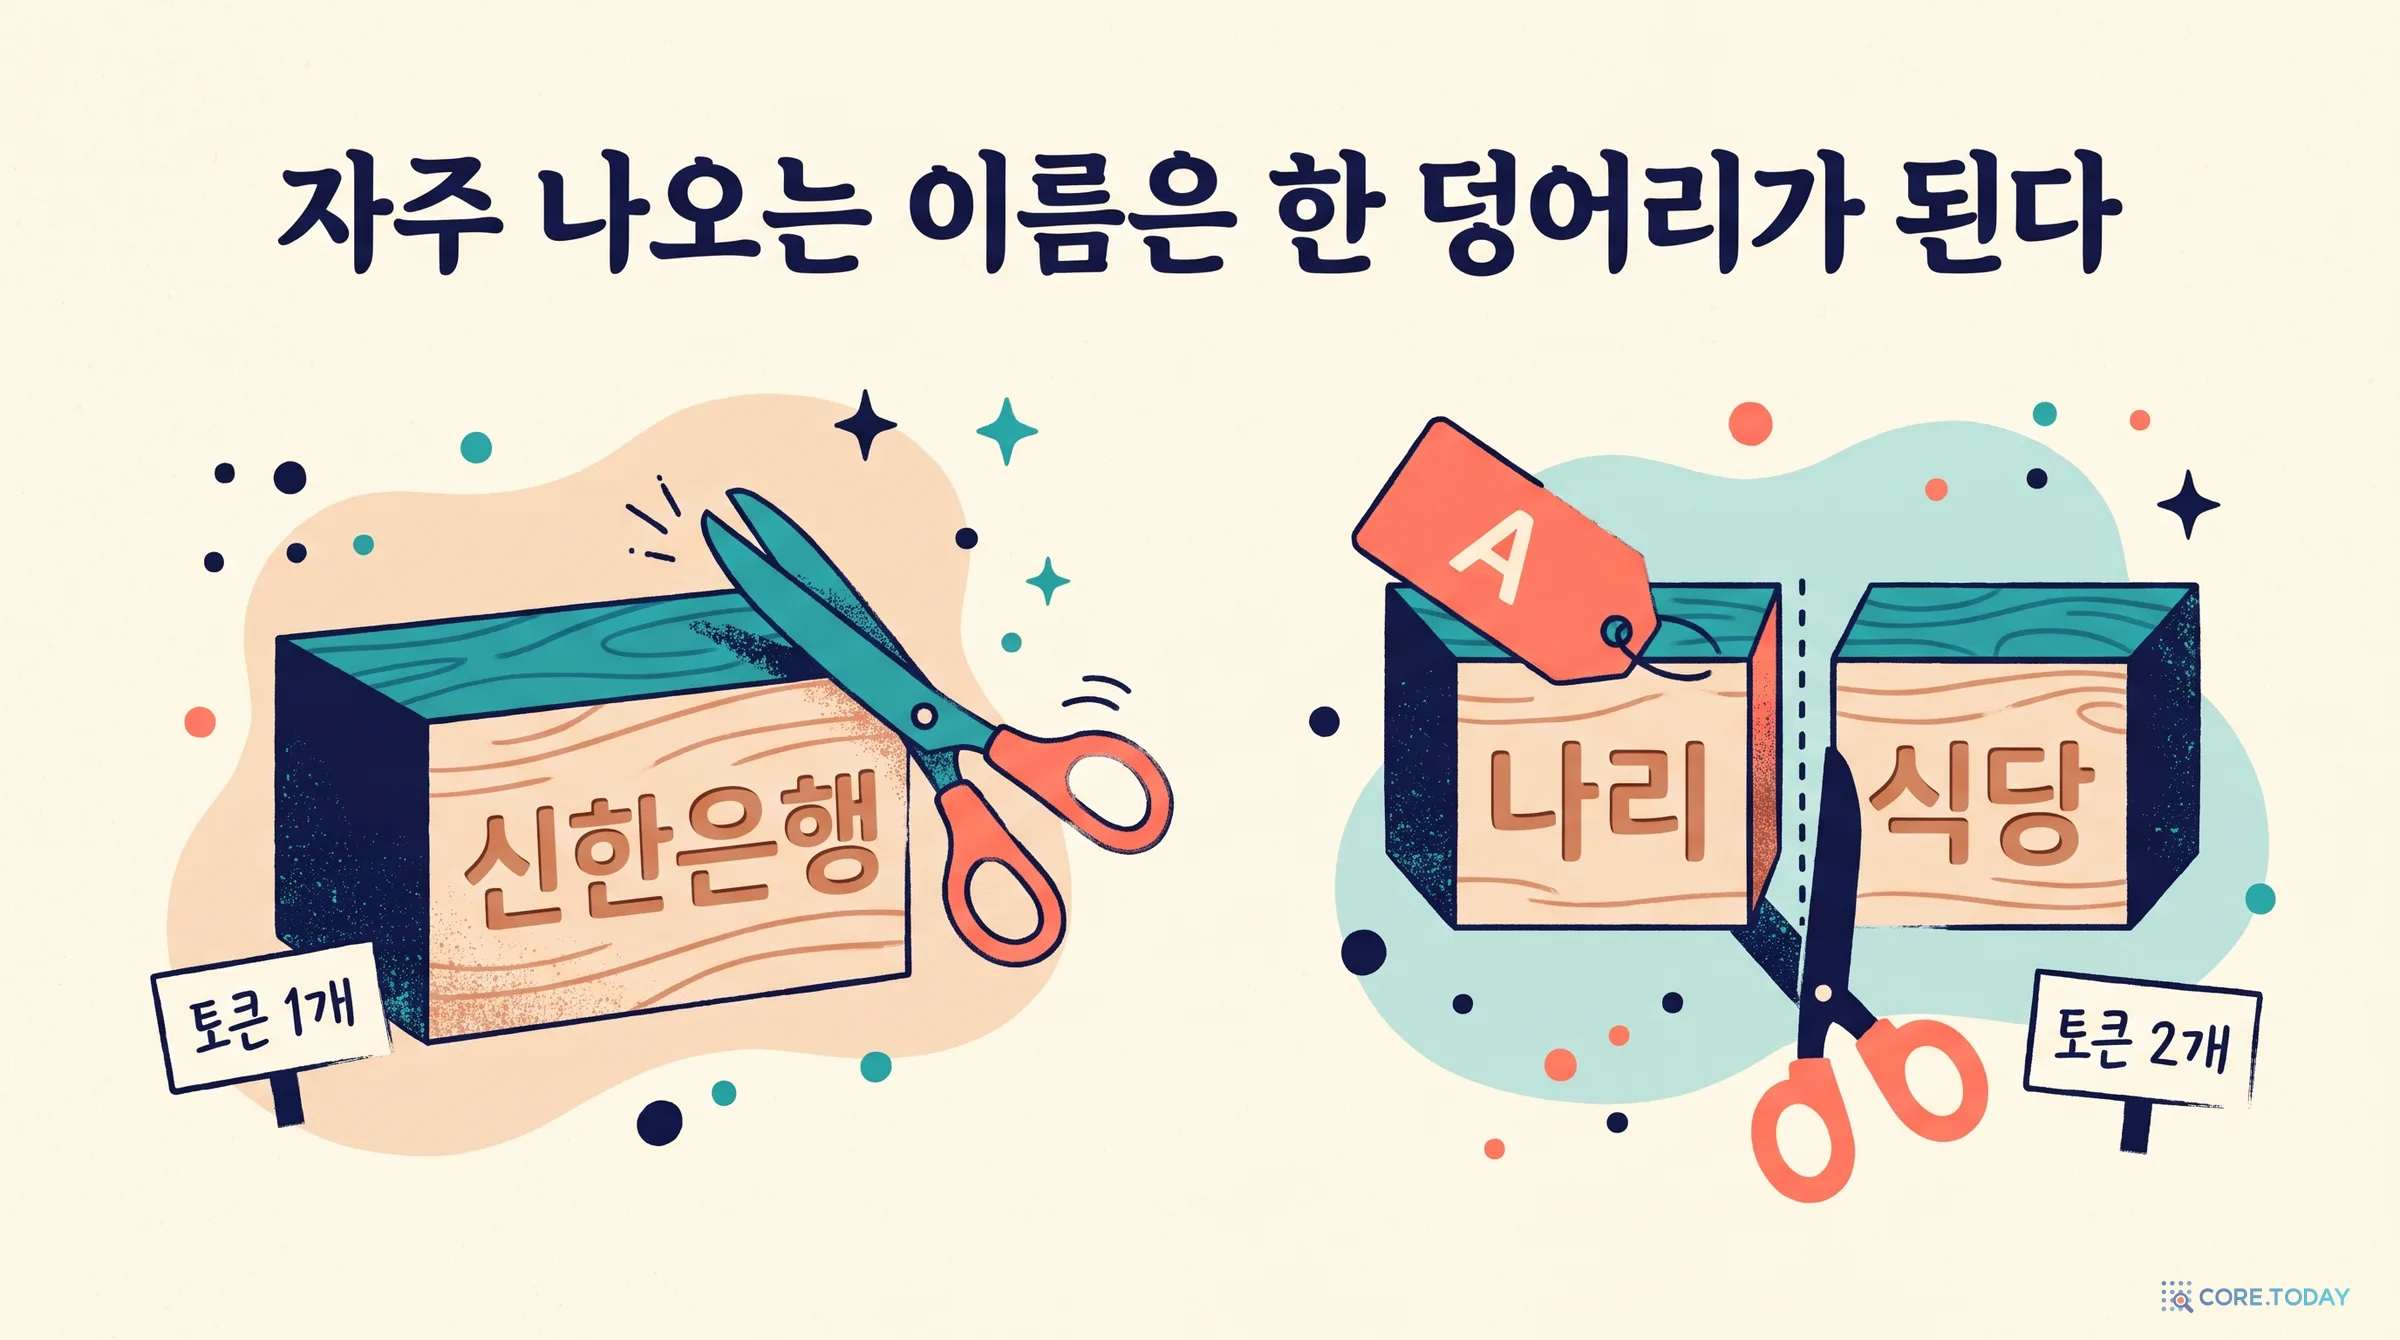
고유한 부분 + 일반 명사. 예규는 '나리식당'에서 '나리'만 가리고 '식당'은 남기라고 합니다. 식당·마트·노래방·초등학교는 시험한 이름 모두에서 경계가 생겼습니다([나리, ##식당]). 그런데 은행은 20개 가운데 8개, 대학교는 15개 가운데 6개가 어긋났습니다. '신한은행', '국민은행', '우리은행', '부산은행'은 이름 전체가 한 토큰으로 어휘에 들어 있고, '서울대학교'는 [서울대, ##학교]로 나뉩니다. 뉴스와 위키백과에 자주 나오는 이름일수록 통째로 어휘에 오르기 때문입니다.
이것이 뜻하는 바는 두 가지입니다. 첫째, 토큰 단위로 꼬리표를 붙이는 한, 이름과 조사가 한 토큰에 든 3% 안팎의 경우에는 조사까지 가리거나 이름 끝 글자를 남기는 둘 중 하나를 택해야 합니다. 어느 쪽이든 엄격한 개체 채점에서는 오답입니다. 둘째, 유명한 은행 이름은 고유한 부분만 가리는 처리를 토큰 단위로는 할 수 없습니다. K-LegalDeID는 은행 이름을 통째로 '은행명' 라벨로 다루므로 이 문제를 피해 가지만, 예규의 처리 방식과는 달라집니다.
논문에도 같은 문제의 흔적이 있습니다. 연구진은 학습 뒤 오류를 분석해, 토큰이 잘못 나뉘어 BIO 꼬리표가 틀린 경우가 오류의 약 5%(11,653건 가운데 600건)였다고 밝히고, 원인이 된 낱말 26개를 어휘에 추가해 다시 미세조정했습니다. 어휘 크기 32,026의 26이 이것입니다. 형태소 분석기를 통째로 넣는 대신 문제가 된 낱말만 고치는, 가벼운 처방입니다.
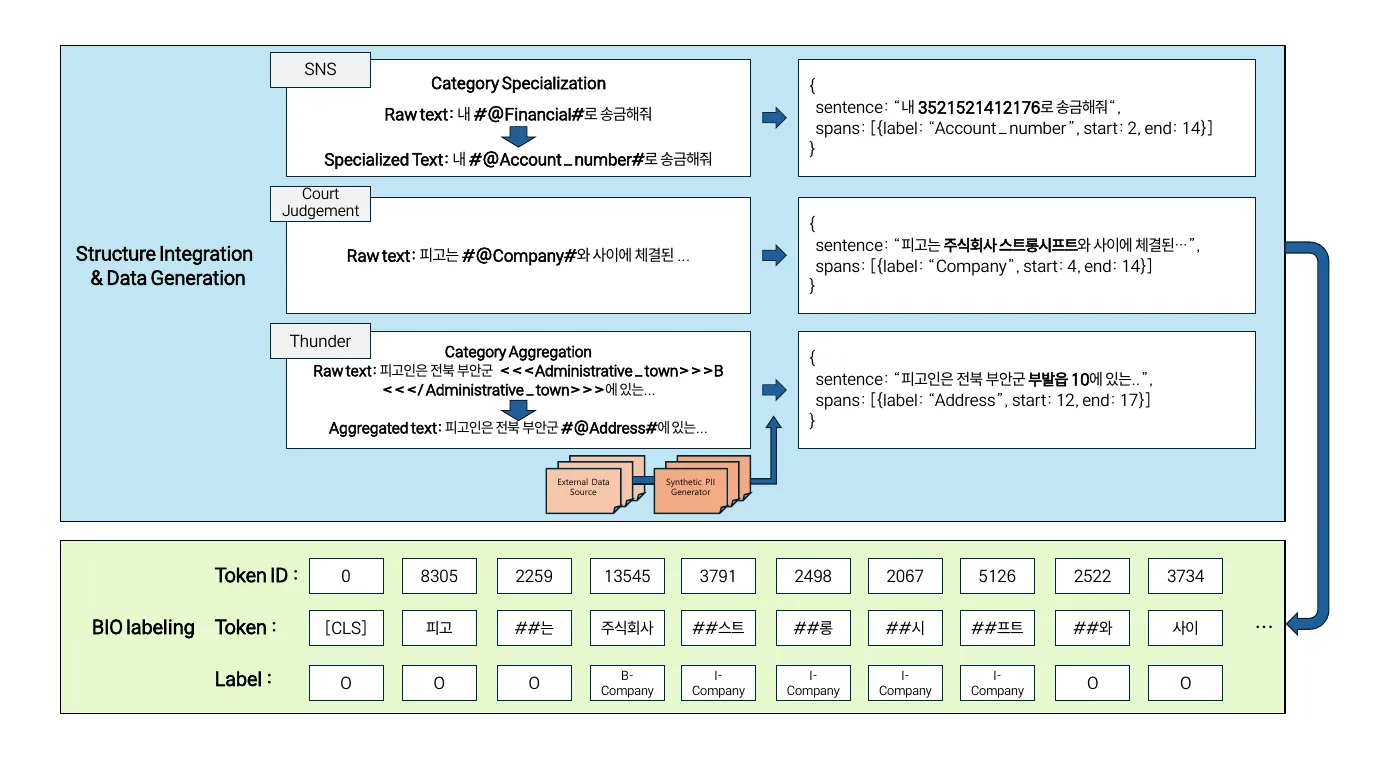
SNS(맨 위). AI 허브의 채팅 데이터는 개인정보가 "#@금융#" 같은 넓은 범주로 가려져 있습니다. 이것을 문맥에 맞는 좁은 범주로 바꿉니다(범주 세분화). "내 #@Financial#로 송금해줘"에서 가려진 것은 문맥상 계좌번호이므로 "#@Account_number#"가 됩니다.
판결문(가운데). 여덟 명의 주석자가 공개 판결문의 가려진 자리에 "#@Company#" 같은 표지를 답니다.
Thunder(아래). Thunder-DeID 공개 데이터의 잘디잔 라벨을 11개 가운데 하나로 합칩니다(범주 통합). "≪Administrative_town≫B≪/Administrative_town≫"(행정읍)이 "#@Address#"가 됩니다.
세 줄기가 모두 "#@종류#" 형식이 되면, 합성 생성기가 그 자리에 값을 채웁니다. 계좌번호 자리에는 "3521521412176", 회사 자리에는 "주식회사 스트롱시프트", 주소 자리에는 "부발읍 10". 채운 값의 시작과 끝 글자 위치를 기록해 둡니다(오른쪽 상자의 start, end). 아래쪽 초록 상자는 그 문장을 KLUE-BERT 토크나이저로 자르고 글자 위치를 토큰에 맞춰 BIO 라벨로 바꾼 결과입니다. '주식회사'가 B-Company, 이어지는 네 조각이 I-Company, 조사 '##와'는 O입니다.
원본 판결문을 구할 수 없으니 지워진 자리에 그럴듯한 값을 채워 학습 자료를 만든다는 발상은 Thunder-DeID와 같습니다. 다른 것은 세 가지입니다. 라벨이 굵고, BIO로 경계를 적고, 값을 한 번만 채웁니다. Thunder-DeID가 에폭마다 새 값을 채워 넣는 증강을 핵심 기법으로 삼은 것과 달리, K-LegalDeID는 자기 데이터(판결문, SNS)에 대해서는 자리마다 값 하나만 넣는 1:1 치환을 택했습니다. 부록 E는 그 이유를 "과도한 증강은 모델이 특정 문장 구조에 과적합하게 만들 수 있어서"라고 설명합니다. 같은 문장을 이름만 바꿔 여러 번 보여 주는 것을 한쪽은 일반화의 열쇠로, 다른 쪽은 과적합의 위험으로 본 것입니다.
줄기 1: 채팅 90만 문장
가장 큰 줄기는 판결문이 아닙니다. AI 허브의 '한국어 SNS 멀티턴 대화 데이터'로, 두세 명이 아홉 가지 주제(건강·식음료, 경제·사회, 과학·기술, 문화·생활·여가, 미용·패션, 스포츠, 여행, 정치, 콘텐츠)로 나눈 대화입니다. 전체 324만여 발화에서 개인정보가 있는 문장을 골라 908,422문장, 개체 970,129개를 얻었습니다.
범주 세분화는 OpenAI의 GPT-4o-mini에 일괄 처리로 맡겼습니다. 부록 A의 프롬프트는 대화 문맥과 가려진 자리("고객번호. #@소속#")를 주고 그 자리에 들어갈 정보의 종류를 한 단어로 답하게 합니다(응답 예: 'department'). 여기서 눈여겨볼 점이 있습니다. 이 논문도 Thunder-DeID처럼 LLM을 데이터를 만드는 데는 쓰고, 비실명화를 실행하는 데는 쓰지 않습니다. LLM에 들어가는 것은 이미 가려진 채팅이고 원본 판결문이 아닙니다.
채팅을 넣은 까닭은 양과 다양성입니다. 이름, 전화번호, 계좌번호, 주소가 온갖 말투와 문맥 속에 놓인 문장을 100만 개 가까이 볼 수 있습니다. 판결문만으로는 얻기 어려운 규모입니다.
줄기 2: 39개 법 분야의 판결문 2,000건
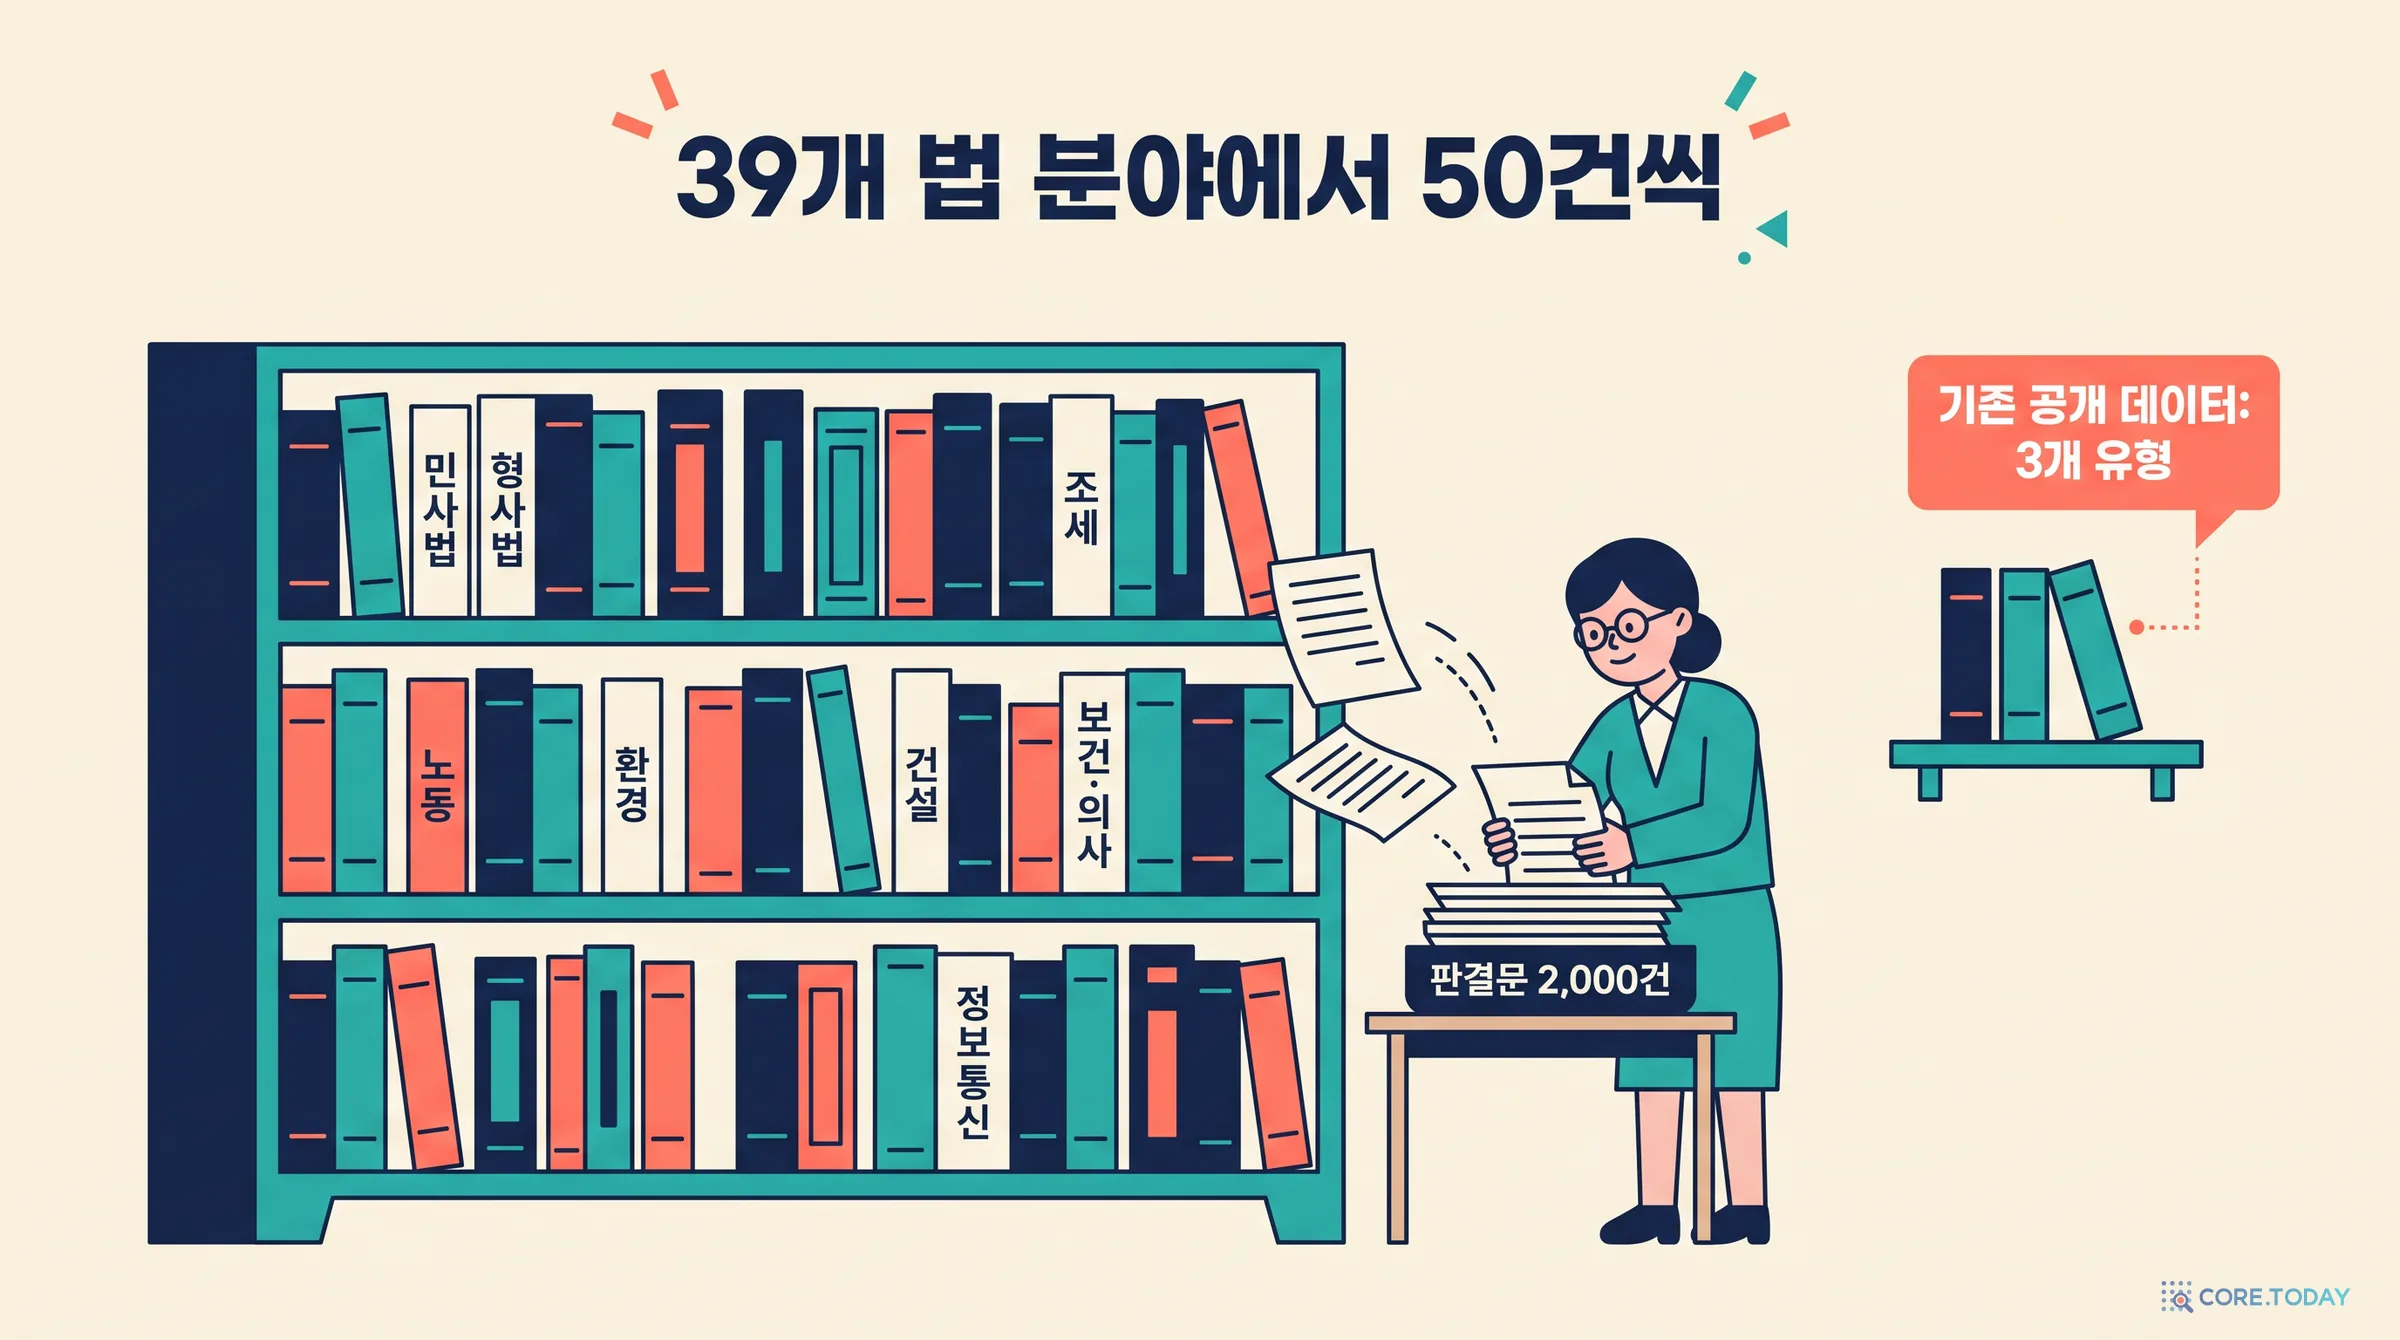
이 논문이 새로 만든 자료입니다. 법제처 국가법령정보센터에 공개된 판례를 법 분야별로 모았습니다. 법령 분류 44개 편 가운데 공개 판례가 50건이 안 되는 다섯 편(국회, 민방위·소방, 담배·인삼, 공업규격·계량, 외무)을 빼고 39개 편에서 50건씩, 민사법만 100건을 골라 2,000건입니다. 하급심과 대법원 판례를 섞었습니다.
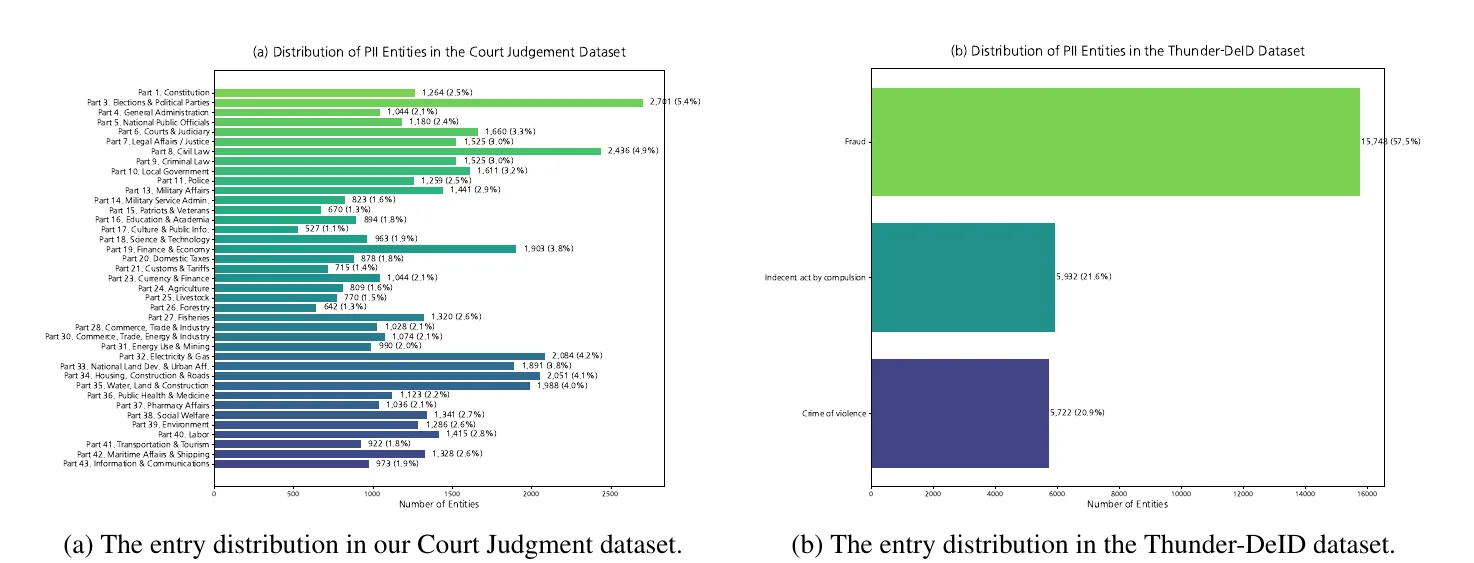
논문 그림 3. 왼쪽이 K-LegalDeID의 판결문 데이터, 오른쪽이 Thunder-DeID 공개 데이터. 출처: Choi 외, K-LegalDeID.
왼쪽 막대들은 길이가 비교적 고릅니다. 가장 많은 선거·정당(2,701개, 5.4%)과 가장 적은 문화·공보(527개, 1.1%)의 차이가 다섯 배 남짓입니다. 오른쪽은 사기 한 유형이 절반을 넘습니다. 선거법 위반 사건에는 후보자와 선거구와 정당이, 건설 사건에는 시공사와 공사 현장이, 조세 사건에는 세무서와 법인이 나옵니다. 분야가 넓으면 모델이 보는 문맥이 넓어집니다. 이 고른 분포가 이 논문의 가장 분명한 기여입니다.
2,000건을 문장으로 나누니 138,576문장이고, 그 안의 개체가 51,245개입니다. 문장 셋 가운데 둘은 식별자가 하나도 없다는 뜻입니다. 판결문의 대부분은 법리 서술이기 때문입니다. (논문 서론의 기여 목록에는 "46,973개의 주석된 문장"이라는 다른 숫자가 나옵니다. 식별자가 하나 이상 있는 문장의 수로 보이지만 논문은 설명하지 않습니다.)
여덟 명의 주석자, 일치도 0.7352
주석은 저자를 포함한 여덟 명이 2주 동안 했습니다. 법원행정처의 비실명 처리 기준을 바탕으로 한 지침을 따르고 서로 피드백을 주고받았습니다. 보수는 판결문 한 건당 1,000원이고, 논문은 평균 작업 시간으로 환산하면 최저임금(시급 10,030원)보다 높다고 밝힙니다.
품질의 근거로 내세우는 것이 플라이스 카파(Fleiss' Kappa) 0.7352입니다. 카파는 여러 사람이 같은 것에 같은 라벨을 붙인 정도에서 우연히 일치할 확률을 빼고 계산한 일치도입니다. 0이면 우연 수준, 1이면 완전 일치입니다. 흔히 쓰는 Landis와 Koch(1977)의 구간으로 0.61~0.80은 "상당한(substantial) 일치"에 해당합니다.
이 숫자는 두 방향으로 읽을 수 있습니다. 한편으로 Thunder-DeID는 주석자 일치도를 보고하지 않았으므로, 이 논문이 품질을 수치로 밝힌 것은 분명한 진전입니다. 다른 한편으로 0.74는 "거의 완벽한 일치"(0.81 이상)에 미치지 못합니다. 같은 지침을 읽고 훈련받은 여덟 사람도 무엇을 가리고 어떤 종류로 볼지에서 꽤 자주 갈렸다는 뜻입니다. 앞선 글에서 본 "그 밖에 특정할 수 있는 정보"의 모호함이 숫자로 드러난 셈입니다. 그리고 이 숫자는 뒤에서 볼 0.99라는 점수에 물음표를 답니다. 사람들 사이의 일치가 그 정도인 정답지에서 모델이 99%를 맞혔다면, 그 시험이 재는 것이 무엇인지 따져 볼 필요가 있습니다(8장).
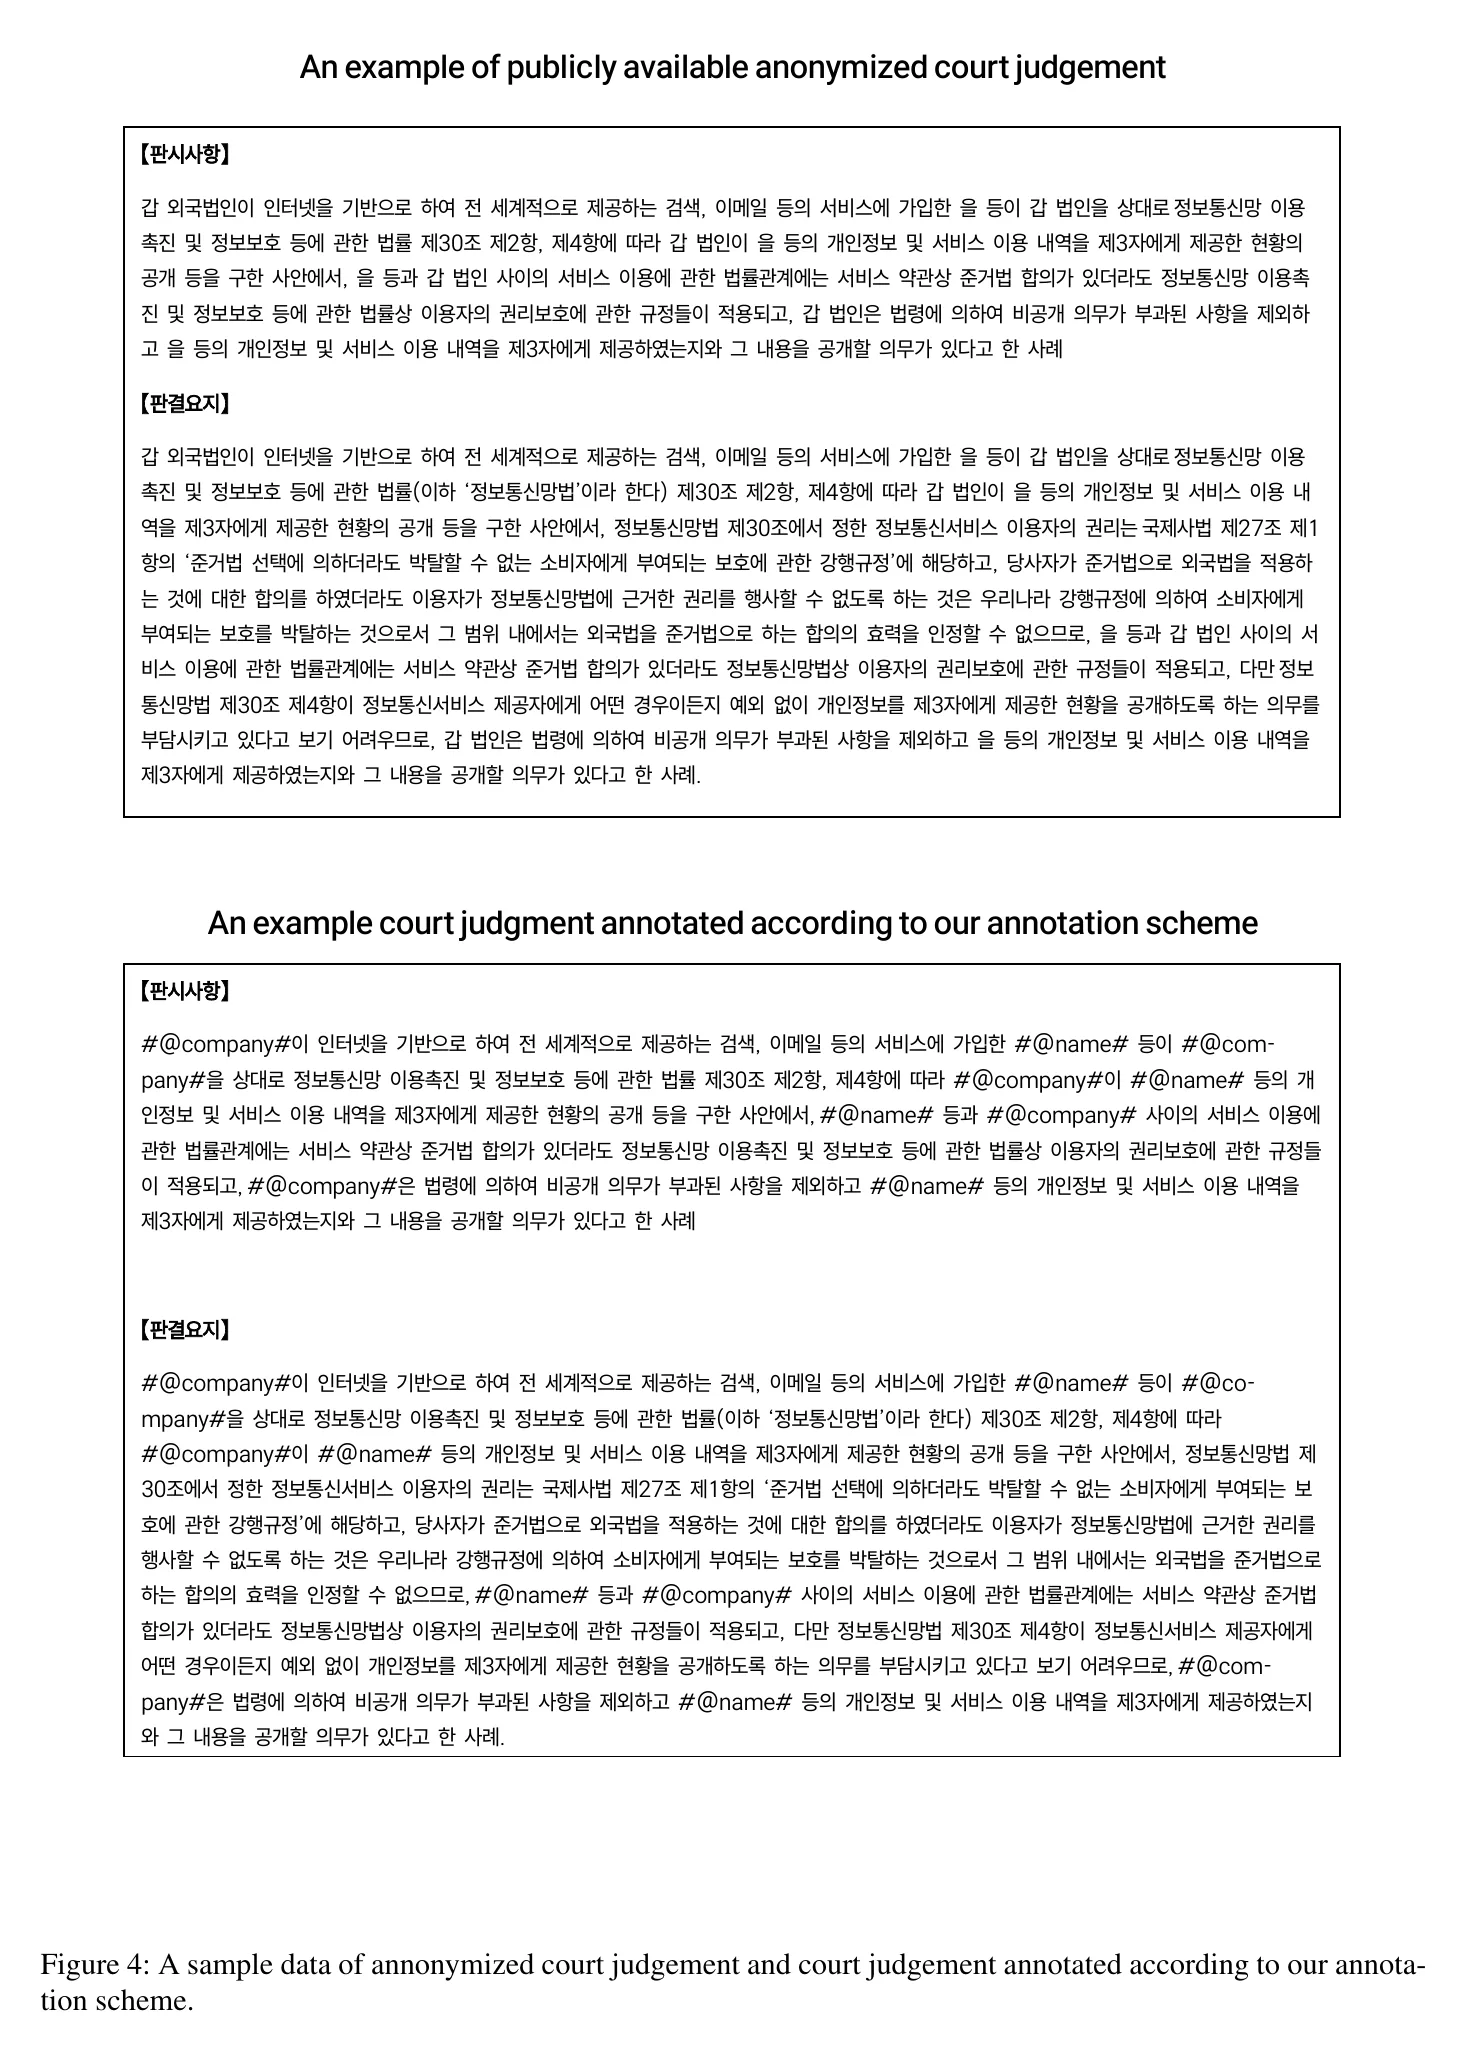
논문 그림 4. 사건번호 2014가합38116 판례의 판시사항과 판결요지. 출처: Choi 외, K-LegalDeID.
예시는 외국 법인의 이메일 서비스 가입자가 개인정보 제공 현황의 공개를 청구한 사건입니다. 원문은 "갑 외국법인이 … 서비스에 가입한 을 등이 갑 법인을 상대로"처럼 갑·을로 적혀 있고, 주석은 이를 "#@company#이 … #@name# 등이 #@company#을 상대로"로 바꿉니다. 여기서 두 가지가 보입니다. 첫째, 판시사항과 판결요지는 법원이 판례를 요약한 글이라 원래부터 갑·을로 쓰이고, 사실관계가 자세한 1심 판결 이유와는 문체도 식별자의 밀도도 다릅니다. Thunder-DeID가 사실 인정이 자세한 1심만 모은 것과 대조됩니다. 둘째, "갑 외국법인"이 "#@company#"로 바뀌면서 '외국법인'이라는 일반 명사까지 표지 안으로 들어갔습니다. 그림 1에서도 '주식회사'가 B-Company에 포함됩니다. 고유한 부분만 가리고 기능을 나타내는 말은 남긴다는 예규의 원칙보다 넓게 잡은 것입니다.
줄기 3: Thunder-DeID 공개 데이터, 그리고 595개에서 11개로
세 번째 줄기는 앞선 연구의 공개 데이터입니다. 4,500건, 개체 27,402개, 라벨 595종. 이것을 가져오려면 두 가지를 바꿔야 했습니다. 토큰 분할을 KLUE-BERT 기준으로 다시 맞추고, 595개 라벨을 11개로 접는 것입니다. 연구진은 'Thunder-To-Ours'라는 대응 규칙을 만들었습니다. 논문이 밝힌 예는 이렇습니다.
Thunder-DeID 라벨
K-LegalDeID 라벨
접히면서 사라지는 정보
IT회사
회사 (company)
업종
PC방
주소 (address)
가게라는 사실과 업종
휴대폰케이스매장
주소 (address)
가게라는 사실과 업종
행정읍
주소 (address)
행정 단위
PC방과 휴대폰 케이스 가게가 '회사'가 아니라 '주소'로 간 것이 눈에 띕니다. 사건이 벌어진 장소로 봤기 때문일 것입니다. 11개 라벨은 이름, 주소, 번호(전화번호), 은행명, 계좌번호, 보안코드, 학교, 회사, URL, 이메일, 아이디입니다. 처음에는 더 많았지만, 모델이 자주 헷갈리는 범주(학교와 학과, 회사와 부서, URL과 웹메일)를 합쳐 11개가 됐다고 논문은 설명합니다. 사람이 구분하기 어려운 것이 아니라 모델이 구분하기 어려운 것을 합쳤다는 점이 Thunder-DeID의 귀납적 분류와 다릅니다.
4,500건은 다른 두 줄기보다 훨씬 적어, 연구진은 이 줄기만 자리표시자 치환을 반복해 10배인 45,000건으로 불렸습니다. 불린 사본들이 학습과 시험에 나뉘어 들어가지 않도록 원문 단위로 나눴다고 밝힙니다. 전체는 학습 70%, 검증 20%, 시험 10%입니다.
11개와 729개 사이
라벨이 11개라는 것은 무엇을 뜻할까요. 얻는 것은 분명합니다. 라벨마다 학습 예시가 많아지고, 주석자가 고르기 쉬워지고, 모델이 종류를 틀릴 일이 줄어듭니다. 잃는 것도 있습니다.
첫째, 치환 방식을 정할 정보가 줄어듭니다. 예규는 '나리식당'을 'A식당'으로 바꾸라고 하지만 '주소' 라벨만으로는 그것이 식당인지 PC방인지 알 수 없습니다. 둘째, 더 중요한 것으로 11개에 들지 않는 식별자는 찾을 대상이 아닙니다. 앞선 글의 교도소 이름, 범죄 조직, 선박 이름, 사건 날짜, 게임 아이디가 아닌 게임 서버 이름 같은 준식별자는 11개 어디에도 깔끔하게 들어가지 않습니다. 729개 체계의 준식별자 열두 갈래 가운데 K-LegalDeID가 덮는 것은 주소·회사·학교·은행과 온라인 식별자 쪽입니다. 주민등록번호와 차량번호는 모델이 아니라 정규식으로 잡습니다(9장).
이것은 결함이라기보다 범위의 선택입니다. K-LegalDeID는 "가장 흔하고 분명한 식별자를 넓은 분야에서 정확하게", Thunder-DeID는 "판결문에 나오는 모든 종류의 단서를 종류까지"를 목표로 삼았습니다. 다만 두 논문의 점수를 견줄 때는 이 범위의 차이를 반드시 함께 봐야 합니다. 쉬운 문제의 0.99와 어려운 문제의 0.91은 순위가 아닙니다.
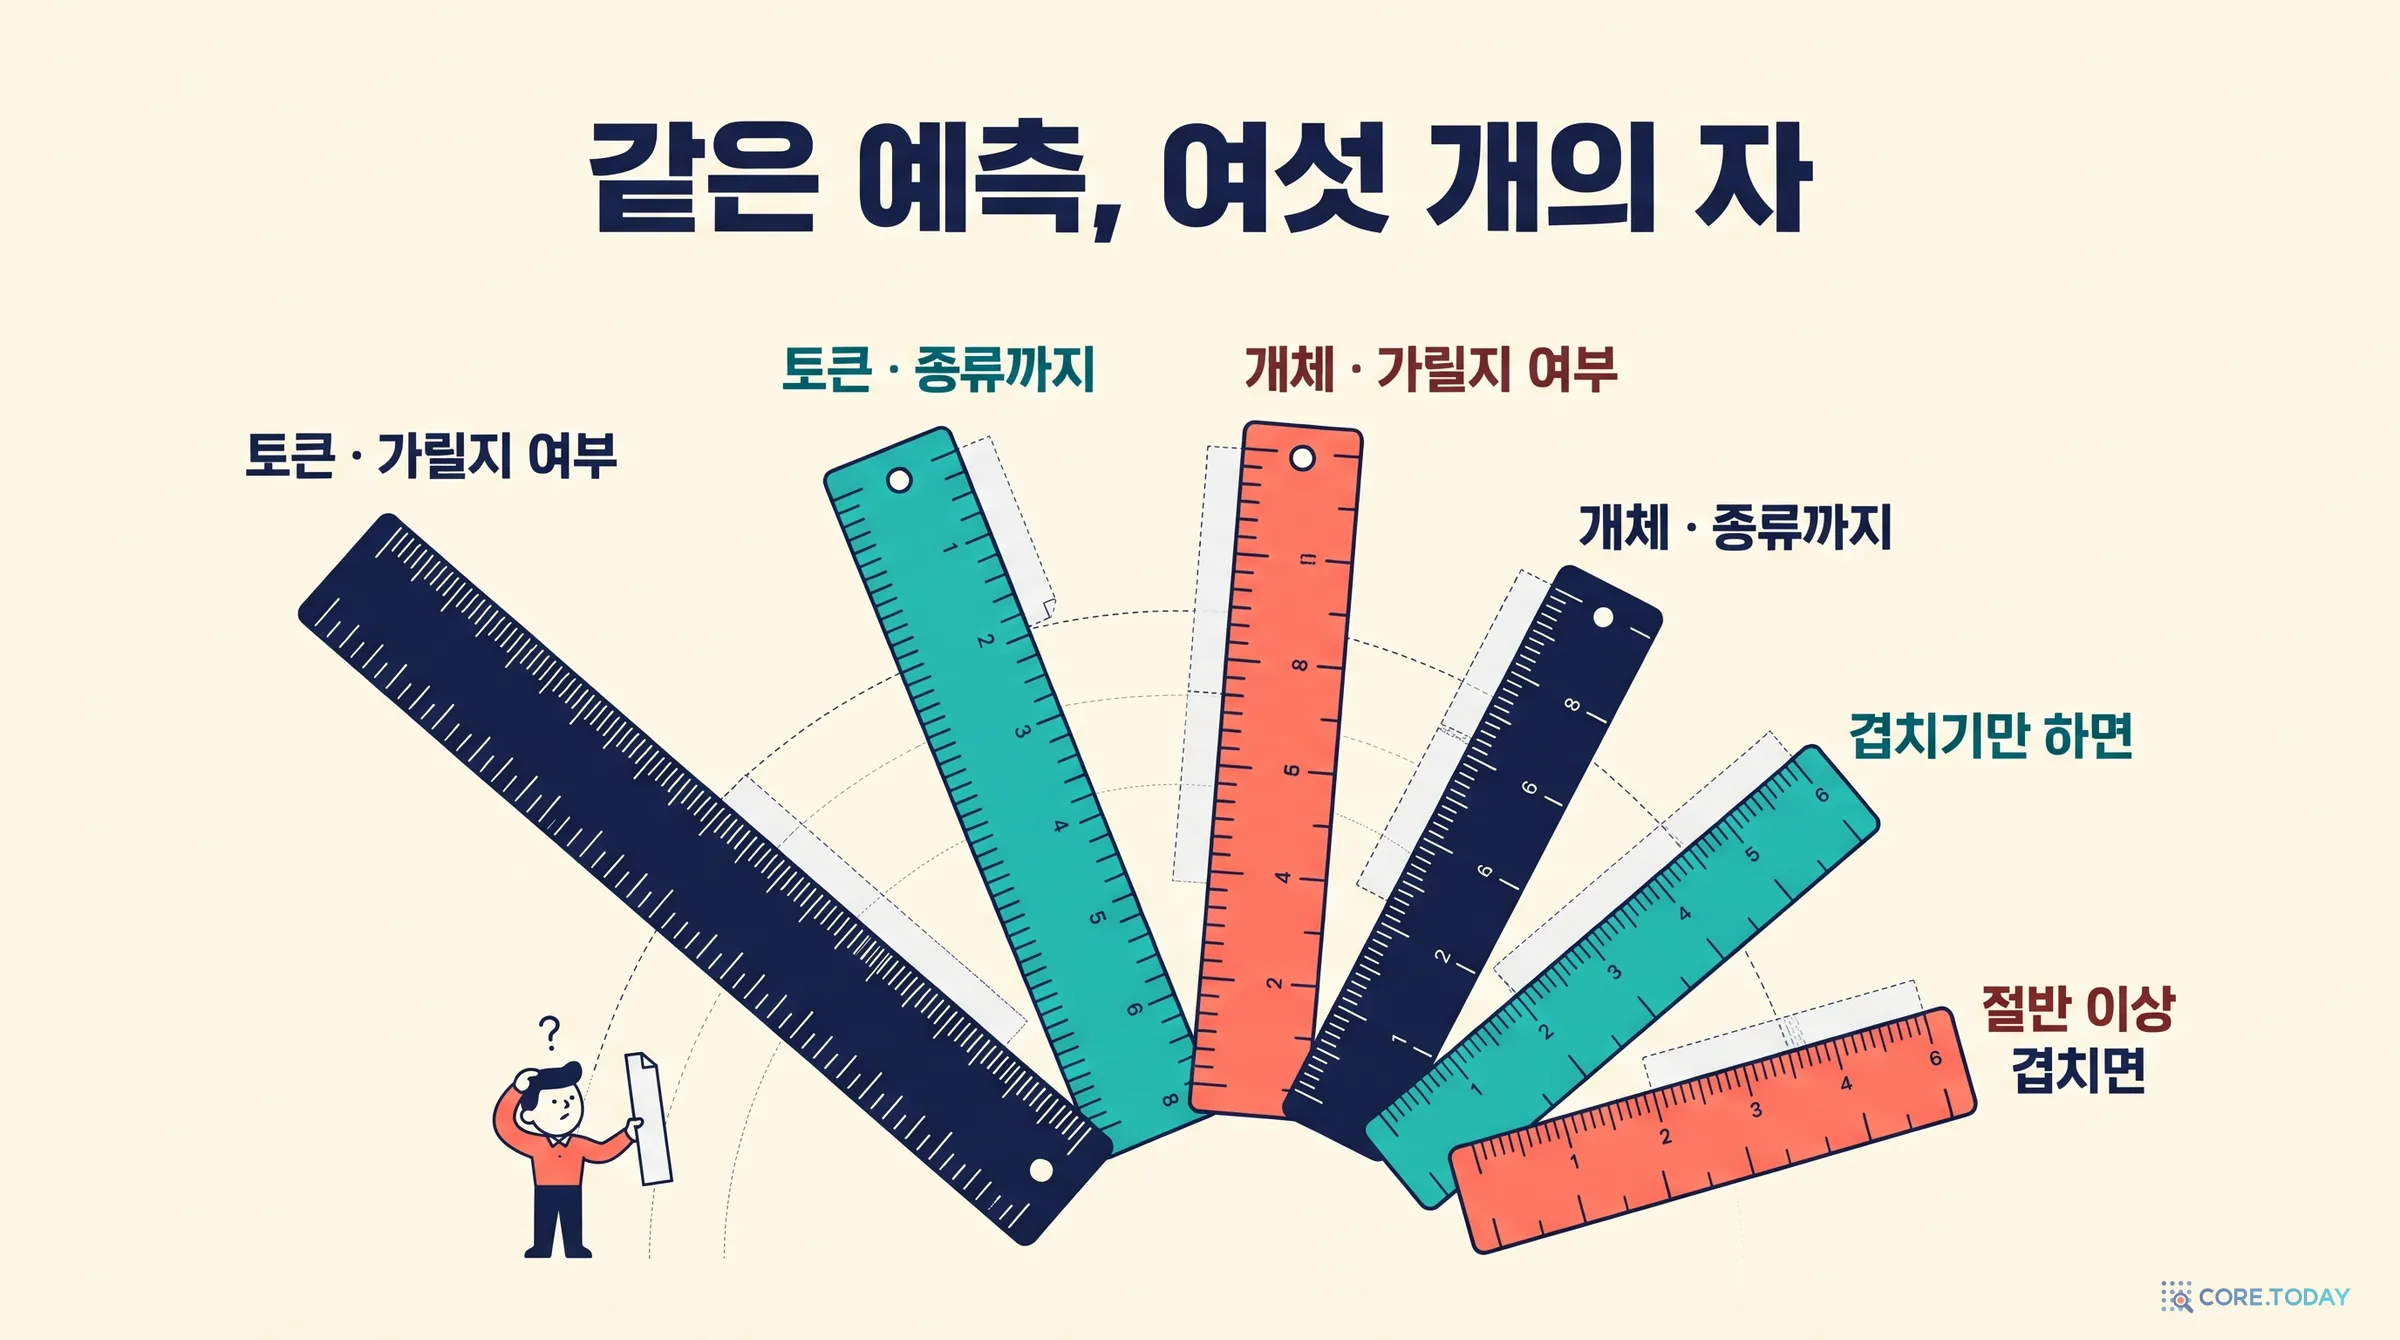
K-LegalDeID는 여섯 가지 지표를 보고합니다. Thunder-DeID의 두 가지(토큰 이진, 토큰 종류)에 넷을 더한 것입니다.
지표
무엇을 맞아야 정답인가
엄격함
토큰 이진 F1
이 토큰이 식별자인가 아닌가
가장 느슨
토큰 Micro F1
이 토큰의 종류까지
느슨
개체 이진 F1
개체의 시작과 끝이 정답과 정확히 같은가 (종류는 무관)
엄격
개체 Micro F1 (엄격 F1)
시작, 끝, 종류가 모두 같은가
가장 엄격
겹침 F1
같은 종류의 정답과 조금이라도 겹치는가
느슨
중간 F1
같은 종류의 정답과 토큰의 절반 이상이 겹치는가
중간
토큰 단위와 개체 단위의 차이가 핵심입니다. 일곱 토큰짜리 회사 이름에서 마지막 토큰 하나를 놓쳤다면, 토큰 단위로는 7개 가운데 6개를 맞힌 것이고 개체 단위로는 0개를 맞힌 것입니다. 긴 개체가 많을수록, 경계가 까다로울수록 두 점수의 간격이 벌어집니다. 한국어에서는 5장에서 본 조사 경계가 바로 그 까다로운 곳입니다.
이 논문이 엄격한 개체 단위 점수를 대표 숫자로 내세운 것은 옳은 방향입니다. 비실명화 결과물에서 중요한 것은 토큰이 아니라 식별자 하나하나이기 때문입니다. 이름의 앞 두 글자만 가리고 끝 글자를 남긴 것은 가린 것이 아닙니다. 앞선 글에서 Thunder-DeID의 후속작이 어절 단위의 엄격한 채점으로 바꾸자 0.98이던 숫자가 0.76~0.77에서 출발하게 됐다는 것을 봤습니다. 엄격한 자로 재는 것이 2026년의 흐름이고, K-LegalDeID는 그 흐름에 먼저 올라탔습니다.
8장. 결과 읽기: 0.99 뒤에 있는 0.94
표 1: 합친 시험
다섯 모델을 세 데이터를 합친 학습 세트로 미세조정하고, 역시 세 데이터를 합친 시험 세트로 쟀습니다.
모델
토큰 이진
토큰 종류
개체 이진
개체 종류 (엄격)
겹침
중간
KLUE-BERT 1.1억
0.9942
0.9906
0.9509
0.9451
0.9753
0.9739
Kanana-1.5 21억 (LoRA)
0.5354
0.2889
0.4504
0.2495
0.3148
0.3112
Qwen-2.5 15억 (LoRA)
0.6931
0.5863
0.5425
0.5233
0.6531
0.6074
Thunder-DeID 3.6억
0.9970
0.9929
0.9614
0.9608
0.9850
0.9844
KLUE-BERT-CRF 1.1억
0.9989
0.9988
0.9925
0.9923
0.9952
0.9951
세 가지가 눈에 들어옵니다.
CRF의 효과는 개체 단위에서 드러납니다. CRF가 없는 KLUE-BERT와 있는 모델의 토큰 점수 차이는 0.5~0.8점입니다. 엄격한 개체 점수의 차이는 4.7점(0.9451 대 0.9923)입니다. 4장의 설명 그대로입니다. 토큰 몇 개의 차이가 개체 단위에서 크게 증폭됩니다. (이 차이에는 어휘 26개 추가의 효과도 섞여 있습니다. 논문이 CRF만의 효과로 밝힌 수치는 2.98%입니다.)
작은 인코더가 큰 인코더를 이겼습니다. 파라미터가 3분의 1인 KLUE-BERT-CRF가 Thunder-DeID 360M을 여섯 지표 모두에서 앞섭니다. 다만 이 비교에서 Thunder-DeID는 자기 설계(729개 라벨, 2,048토큰, 종류만 적는 꼬리표)가 아니라 이 논문의 설계(11개 BIO 라벨, 512토큰)에 맞춰 다시 미세조정됐고, CRF 층도 없습니다. "KLUE-BERT-CRF가 Thunder-DeID보다 낫다"가 아니라 "이 과제 설정에서는 CRF 층이 사전학습의 차이보다 중요했다"로 읽는 것이 정확합니다. CRF 없는 KLUE-BERT는 Thunder-DeID에 뒤집니다.
카카오의 Kanana-1.5(21억)와 알리바바의 Qwen-2.5(15억)는 엄격한 개체 F1이 0.25와 0.52입니다. 인코더들의 0.95~0.99와 견주면 다른 종류의 숫자입니다. 이것을 "LLM은 비실명화를 못한다"로 읽으면 안 됩니다. 부록 B의 프롬프트를 보면 이유가 보입니다.
부록 B.1 — Kanana-1.5 미세조정 프롬프트
지시주어진 문장에서 모든 개인 식별 정보(PII)를 찾아서, 각 PII의 종류, 시작 인덱스, 끝 인덱스를 JSON 형식으로 추출하세요.
입력공소사실의 요지. 피고인은 경기도 이천시 부발읍 10에서 '주식회사더블에스메디칼'을 운영하는 사람이다.
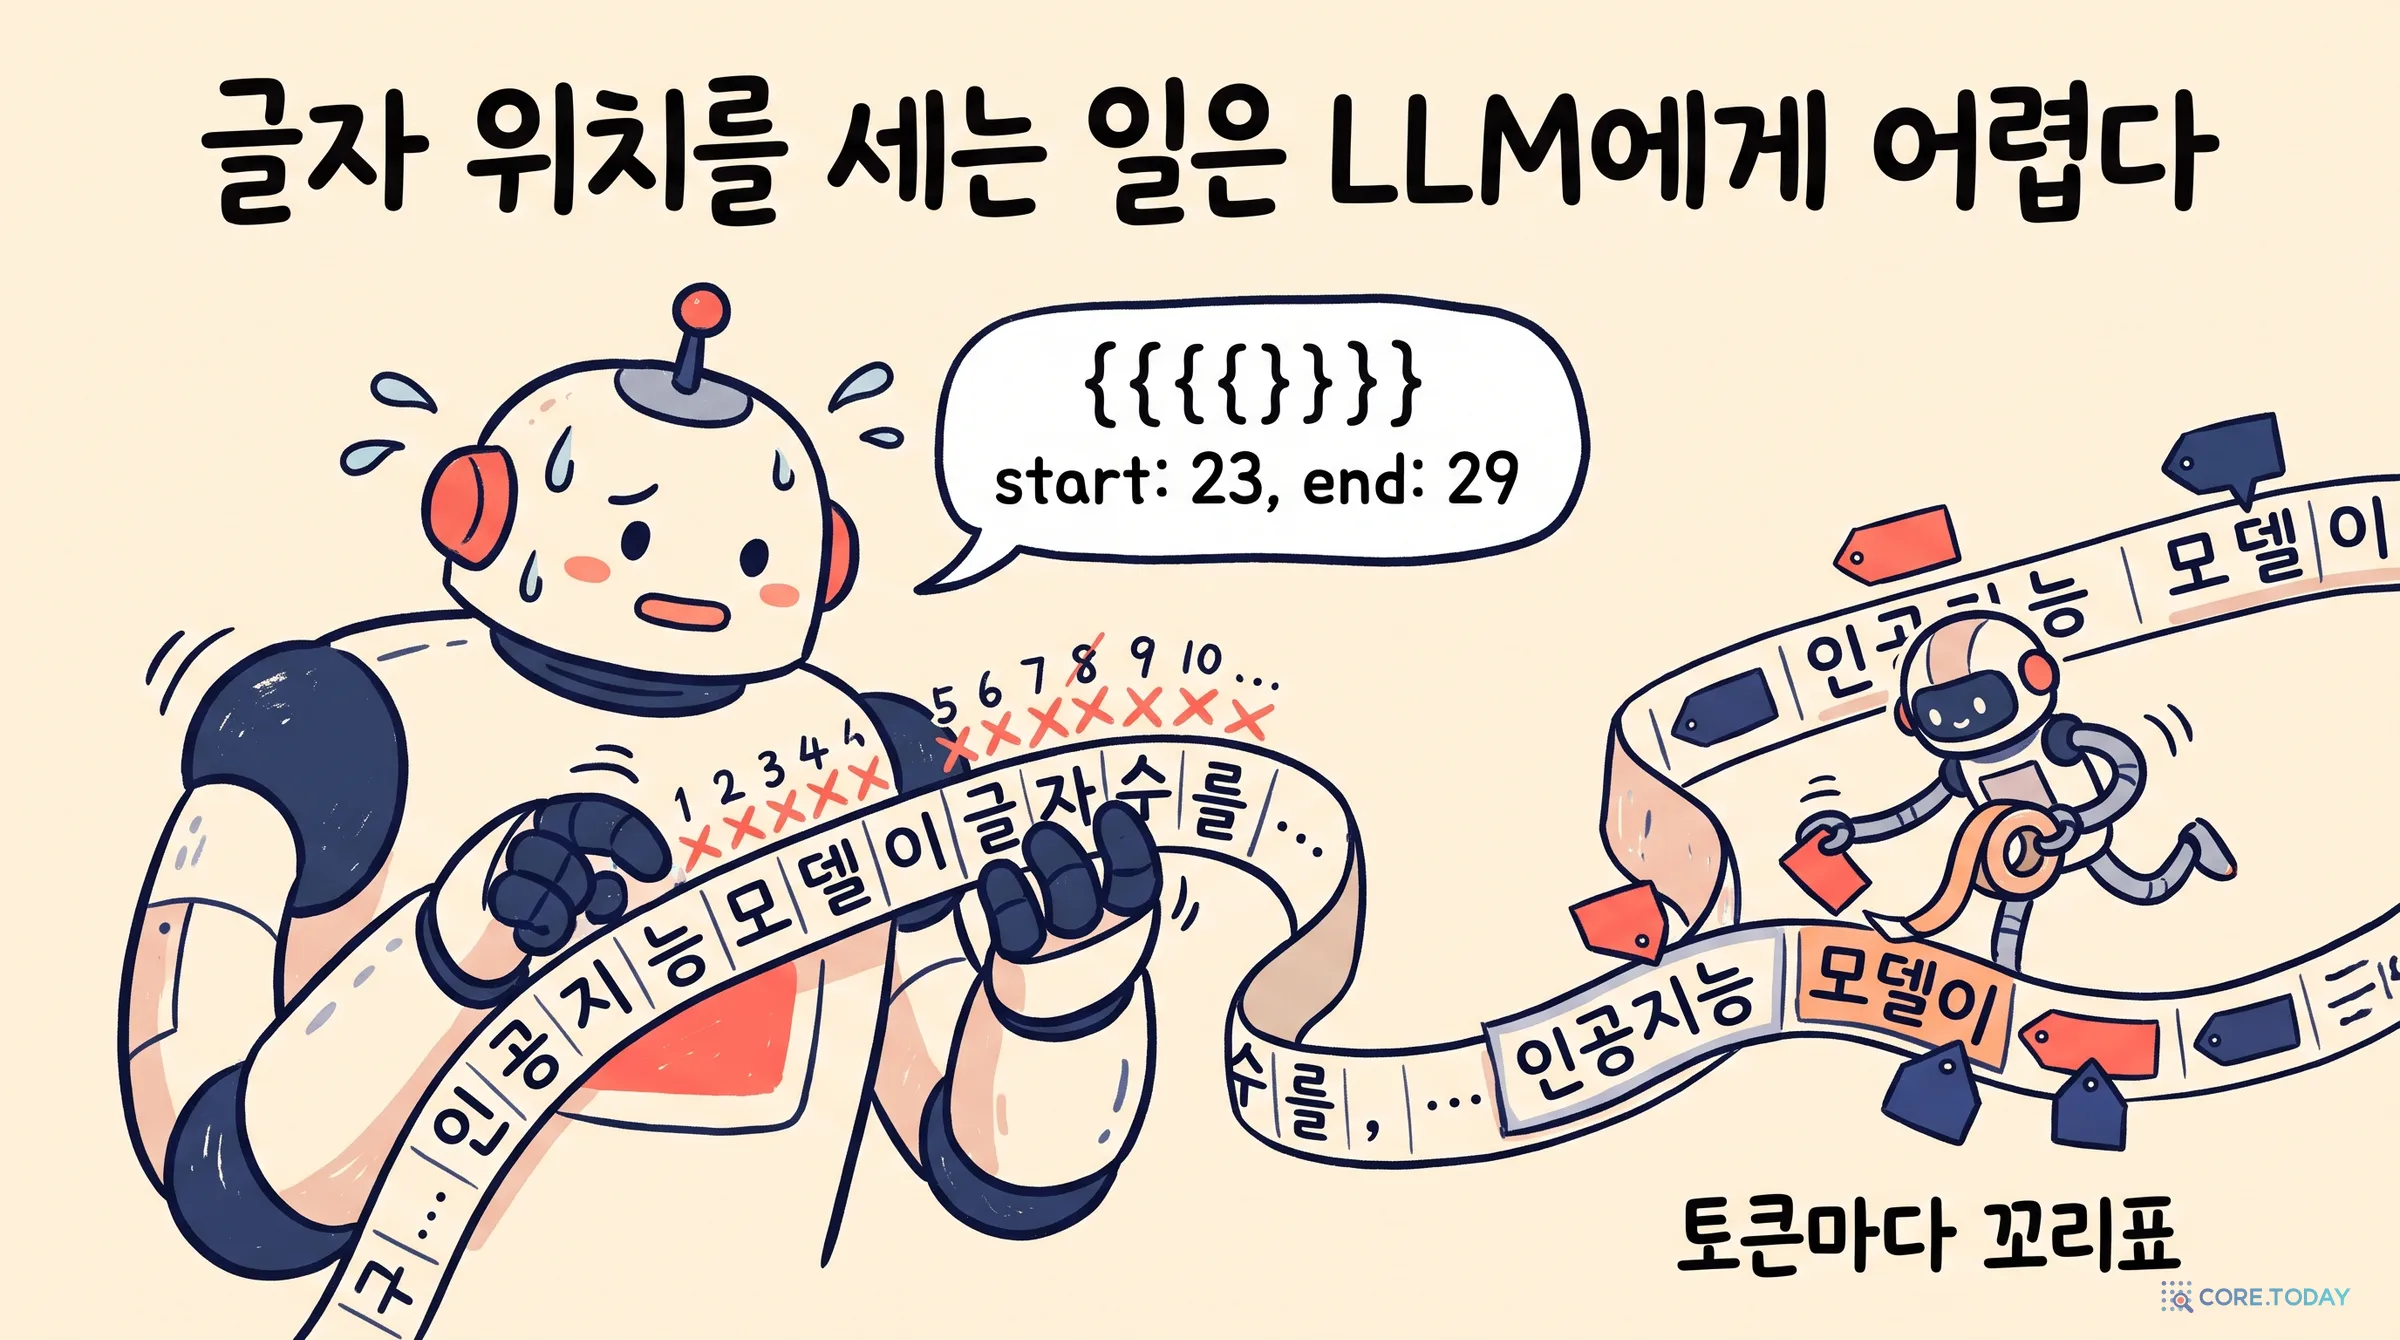
모델에게 요구한 출력은 식별자의 글자 위치 번호입니다. 언어 모델은 글자가 아니라 토큰 단위로 문장을 보기 때문에, "이 낱말이 문장의 몇 번째 글자에서 시작하는가"를 세는 일에 구조적으로 약합니다. 낱말은 맞게 찾고도 번호를 하나 틀리면 엄격한 채점에서는 오답입니다. 15억~21억 파라미터의 작은 모델을 LoRA로 가볍게 미세조정했다는 점도 있습니다.
코어닷투데이가 앞선 글에서 로컬 모델로 해 본 실험과 나란히 놓으면 그림이 맞춰집니다. 그때는 위치 번호가 아니라 문자열 그대로를 목록으로 내놓게 했고, Qwen3.5 9B가 식별자의 85%를 찾고 내놓은 문자열의 97%가 맞았습니다. 같은 계열의 모델이 출력 형식에 따라 0.5와 0.9 사이를 오갑니다. 이 표가 보여 주는 것은 디코더의 한계라기보다, 생성 모델에게 무엇을 출력하게 하느냐가 결과를 크게 좌우한다는 점입니다. 그리고 어떤 형식으로 시키든, 토큰마다 꼬리표를 붙이는 1억짜리 인코더가 이 일에는 더 잘 맞는 도구라는 결론은 두 논문이 같습니다.
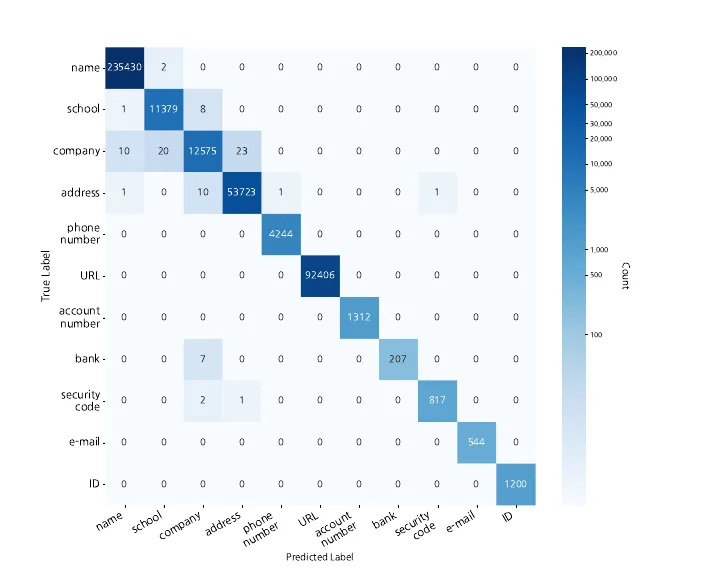
논문 그림 2(a). 세로가 정답, 가로가 예측. 출처: Choi 외, K-LegalDeID.
혼동 행렬은 정답 종류(세로)와 예측 종류(가로)를 교차해 센 표입니다. 대각선이 맞힌 것이고 그 밖이 종류를 헷갈린 것입니다. 대각선 밖의 가장 큰 수가 23(회사를 주소로)과 20(회사를 학교로)이고, 대각선은 수만에서 수십만입니다. 식별자라고 판단한 것의 종류를 틀리는 일은 거의 없습니다. 11개 라벨이 서로 헷갈리지 않도록 합쳐서 만든 체계이니 당연한 결과이기도 합니다.
이 그림에서 더 중요한 것은 숫자의 크기입니다. 이름이 23만 5천, URL이 9만 2천, 주소가 5만 4천입니다. 은행은 214, 이메일은 544입니다. 시험 세트의 식별자 가운데 이름과 URL이 79%입니다. URL이 이렇게 많은 까닭은 채팅 데이터 때문입니다. 판결문에는 URL이 드뭅니다.
시험지를 나눠 보면
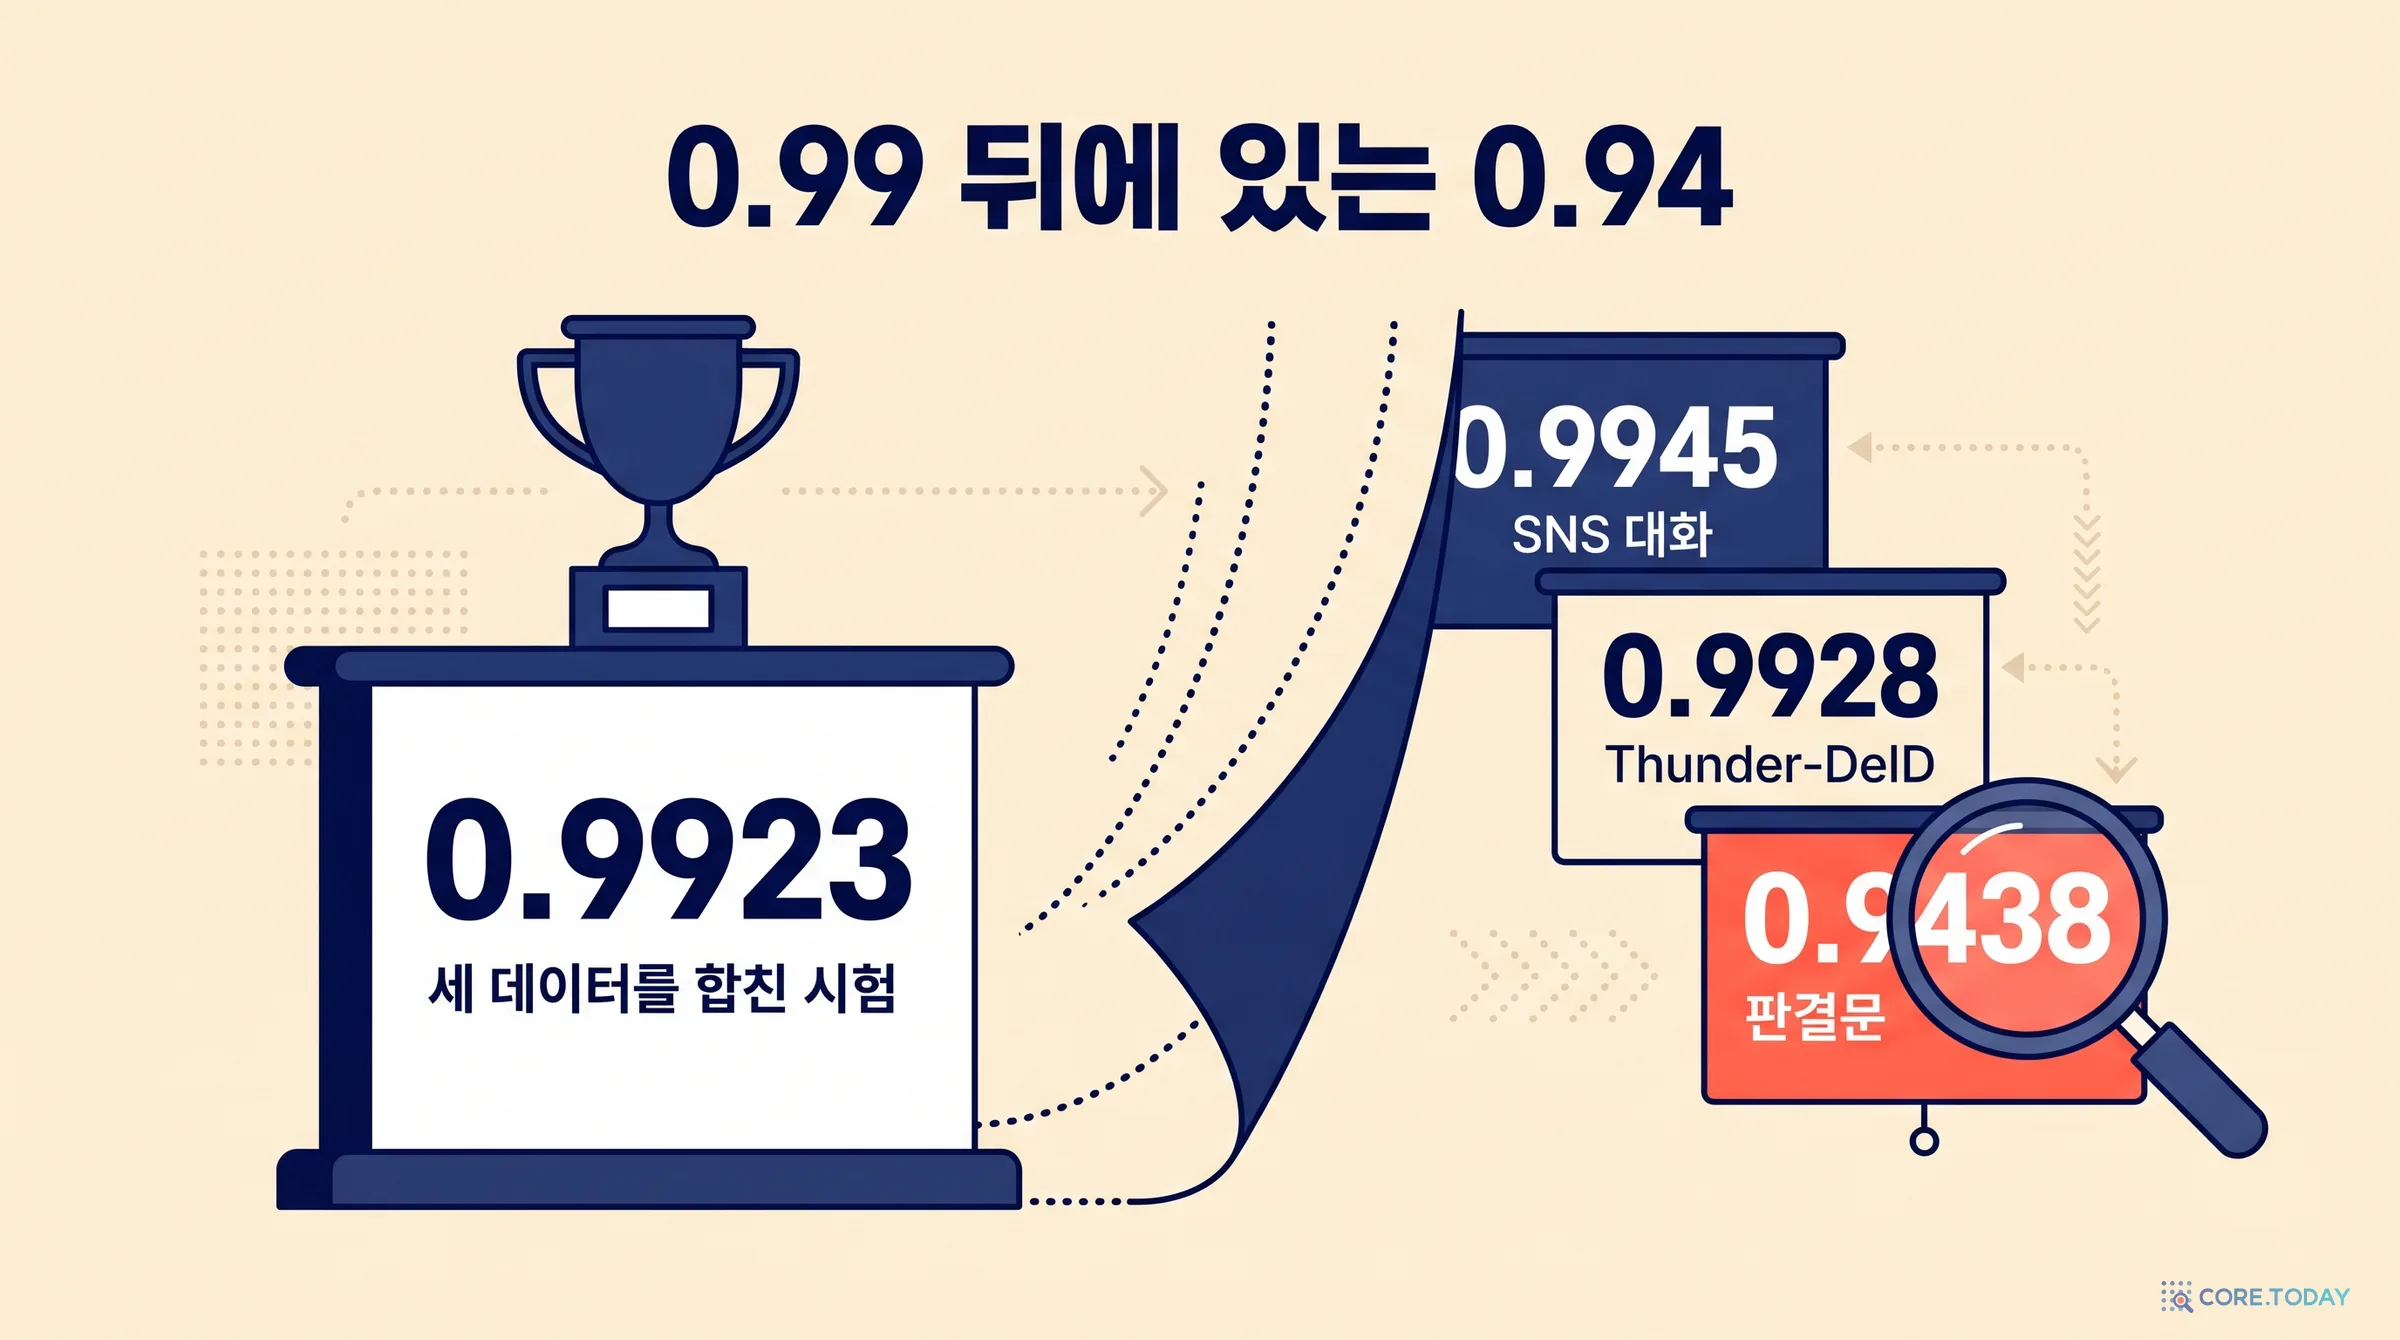
여기서부터가 이 논문을 읽는 핵심입니다. 초록의 0.9923은 합친 시험의 점수입니다. 부록 D는 같은 모델을 세 데이터로 따로 시험한 결과를 싣고 있습니다.
세 점수를 개체 수로 가중 평균하면 0.9921로, 합친 점수 0.9923과 거의 맞아떨어집니다. 0.9923은 채팅 75%, 불린 Thunder-DeID 21%, 새 판결문 4%로 이뤄진 숫자입니다. 이 논문의 제목이자 기여인 "한국 판결문 벤치마크"에서의 점수는 0.9438입니다.
0.94는 나쁜 숫자가 아닙니다. 그러나 0.99와는 다른 이야기입니다. 0.99는 식별자 100개 가운데 1개를 틀리는 것이고, 0.94는 6개를 틀리는 것입니다. 한 건에 개체가 평균 25개인 이 데이터의 판결문에서라면, 한 건마다 한두 개가 경계나 종류에서 어긋난다는 뜻입니다.
같은 표에서 두 가지를 더 읽을 수 있습니다.
느슨한 채점에서는 Thunder-DeID가 앞섭니다. 새 판결문 데이터에서 겹침 F1은 Thunder-DeID 0.9561 대 KLUE-BERT-CRF 0.9536, 중간 F1은 0.9552 대 0.9518입니다. 식별자가 있는 자리를 대략 찾는 능력은 더 큰 사전학습 모델이 조금 낫고, 경계를 정확히 맞추는 능력은 CRF를 단 모델이 낫다는 뜻입니다. 본문의 "모든 지표에서 앞선다"는 문장은 합친 시험에 한해 참입니다.
남의 데이터를 불려 넣으면 내 데이터의 점수가 내려갑니다. 부록 E는 Thunder-DeID 데이터를 10배로 불리기 전과 후를 비교합니다.
Thunder-DeID 시험 · 불리기 전
0.9031
Thunder-DeID 시험 · 불린 뒤
0.9928
새 판결문 시험 · 불리기 전
0.9703
새 판결문 시험 · 불린 뒤
0.9438
Thunder-DeID 쪽 점수는 9점 오르고, 새 판결문 쪽 점수는 2.7점 내립니다. 논문은 이 하락을 "두 데이터셋이 비실명 처리 지침을 해석하고 적용한 방식이 달라서"라고 설명합니다. 한쪽의 정답 방식을 많이 배울수록 다른 쪽의 정답에서 멀어진다는 것입니다. 합친 점수는 오르므로(0.9808 → 0.9923) 논문은 불린 쪽을 본문 결과로 택했지만, 판결문 벤치마크의 관점에서는 불리지 않은 쪽(0.9703)이 더 나은 모델입니다.
표 2: 서로의 정답지로 채점하면
가장 주목할 실험은 5.3절의 "보지 못한 데이터에 대한 견고성"입니다. KLUE-BERT-CRF를 채팅과 새 판결문만으로 학습시키고, 한 번도 보지 못한 Thunder-DeID 데이터로 시험했습니다.
Thunder-DeID 시험 세트
토큰 이진
토큰 종류
개체 이진
개체 종류 (엄격)
겹침
중간
KLUE-BERT-CRF (Thunder 데이터 없이 학습)
0.9268
0.9299
0.4201
0.3658
0.4484
0.4421
Thunder-DeID 360M (자기 데이터로 학습한 원래 모델)
0.9472
0.9223
0.01 미만
0.01 미만
0.3682
0.3682
토큰 점수는 0.93인데 엄격한 개체 점수는 0.37입니다. 0.99에서 0.37로의 낙차입니다. 논문은 이 결과를 "기준 모델에 견줄 만한 성능을 유지해 견고성을 입증한다"고 요약하지만, 숫자가 말하는 것은 다릅니다.
토큰 점수가 0.93이라는 것은 어디에 식별자가 있는지는 대체로 맞혔다는 뜻입니다. 개체 점수가 0.37이라는 것은 어디서부터 어디까지인지가 셋 가운데 둘에서 달랐다는 뜻입니다. 모델이 못해서가 아닙니다. 두 데이터셋이 같은 것을 두고 경계를 다르게 그었기 때문입니다. 6장에서 본 대로 K-LegalDeID는 '주식회사'까지 회사 이름에 넣고, Thunder-DeID는 예규대로 고유한 부분만 표시합니다. '나리식당'을 한쪽은 통째로, 다른 쪽은 '나리'만 정답으로 칩니다. 한쪽 방식을 배운 모델은 다른 쪽 채점에서 번번이 한두 토큰씩 어긋납니다.
아랫줄은 더 기묘합니다. Thunder-DeID 원래 모델은 자기 데이터인데도 개체 점수가 0.01 미만입니다. 종류만 적는 꼬리표로 학습한 모델의 출력을 11개 BIO 체계의 개체로 바꿔 채점하면 경계가 거의 하나도 맞지 않는다는 것입니다. 이 숫자는 Thunder-DeID 모델의 품질이 아니라 두 주석 체계 사이의 환산이 얼마나 안 되는지를 보여 줍니다.
이 표가 두 논문을 함께 읽을 때 가장 중요한 한 장입니다. 두 연구실은 같은 예규(재판예규 제1778호)를 따랐다고 밝힙니다. 그런데 한쪽의 0.99짜리 모델이 다른 쪽 정답지에서 0.37입니다. 벤치마크의 점수는 "판결문 비실명화를 얼마나 잘하는가"가 아니라 "이 연구실이 예규를 해석한 방식을 얼마나 잘 따라 하는가"를 재고 있습니다. 진짜 정답지, 곧 법원이 실제로 어떻게 가리는지에 대해서는 두 점수 모두 직접 말해 주지 않습니다. 이 문제는 다음 글의 중심 주제입니다.
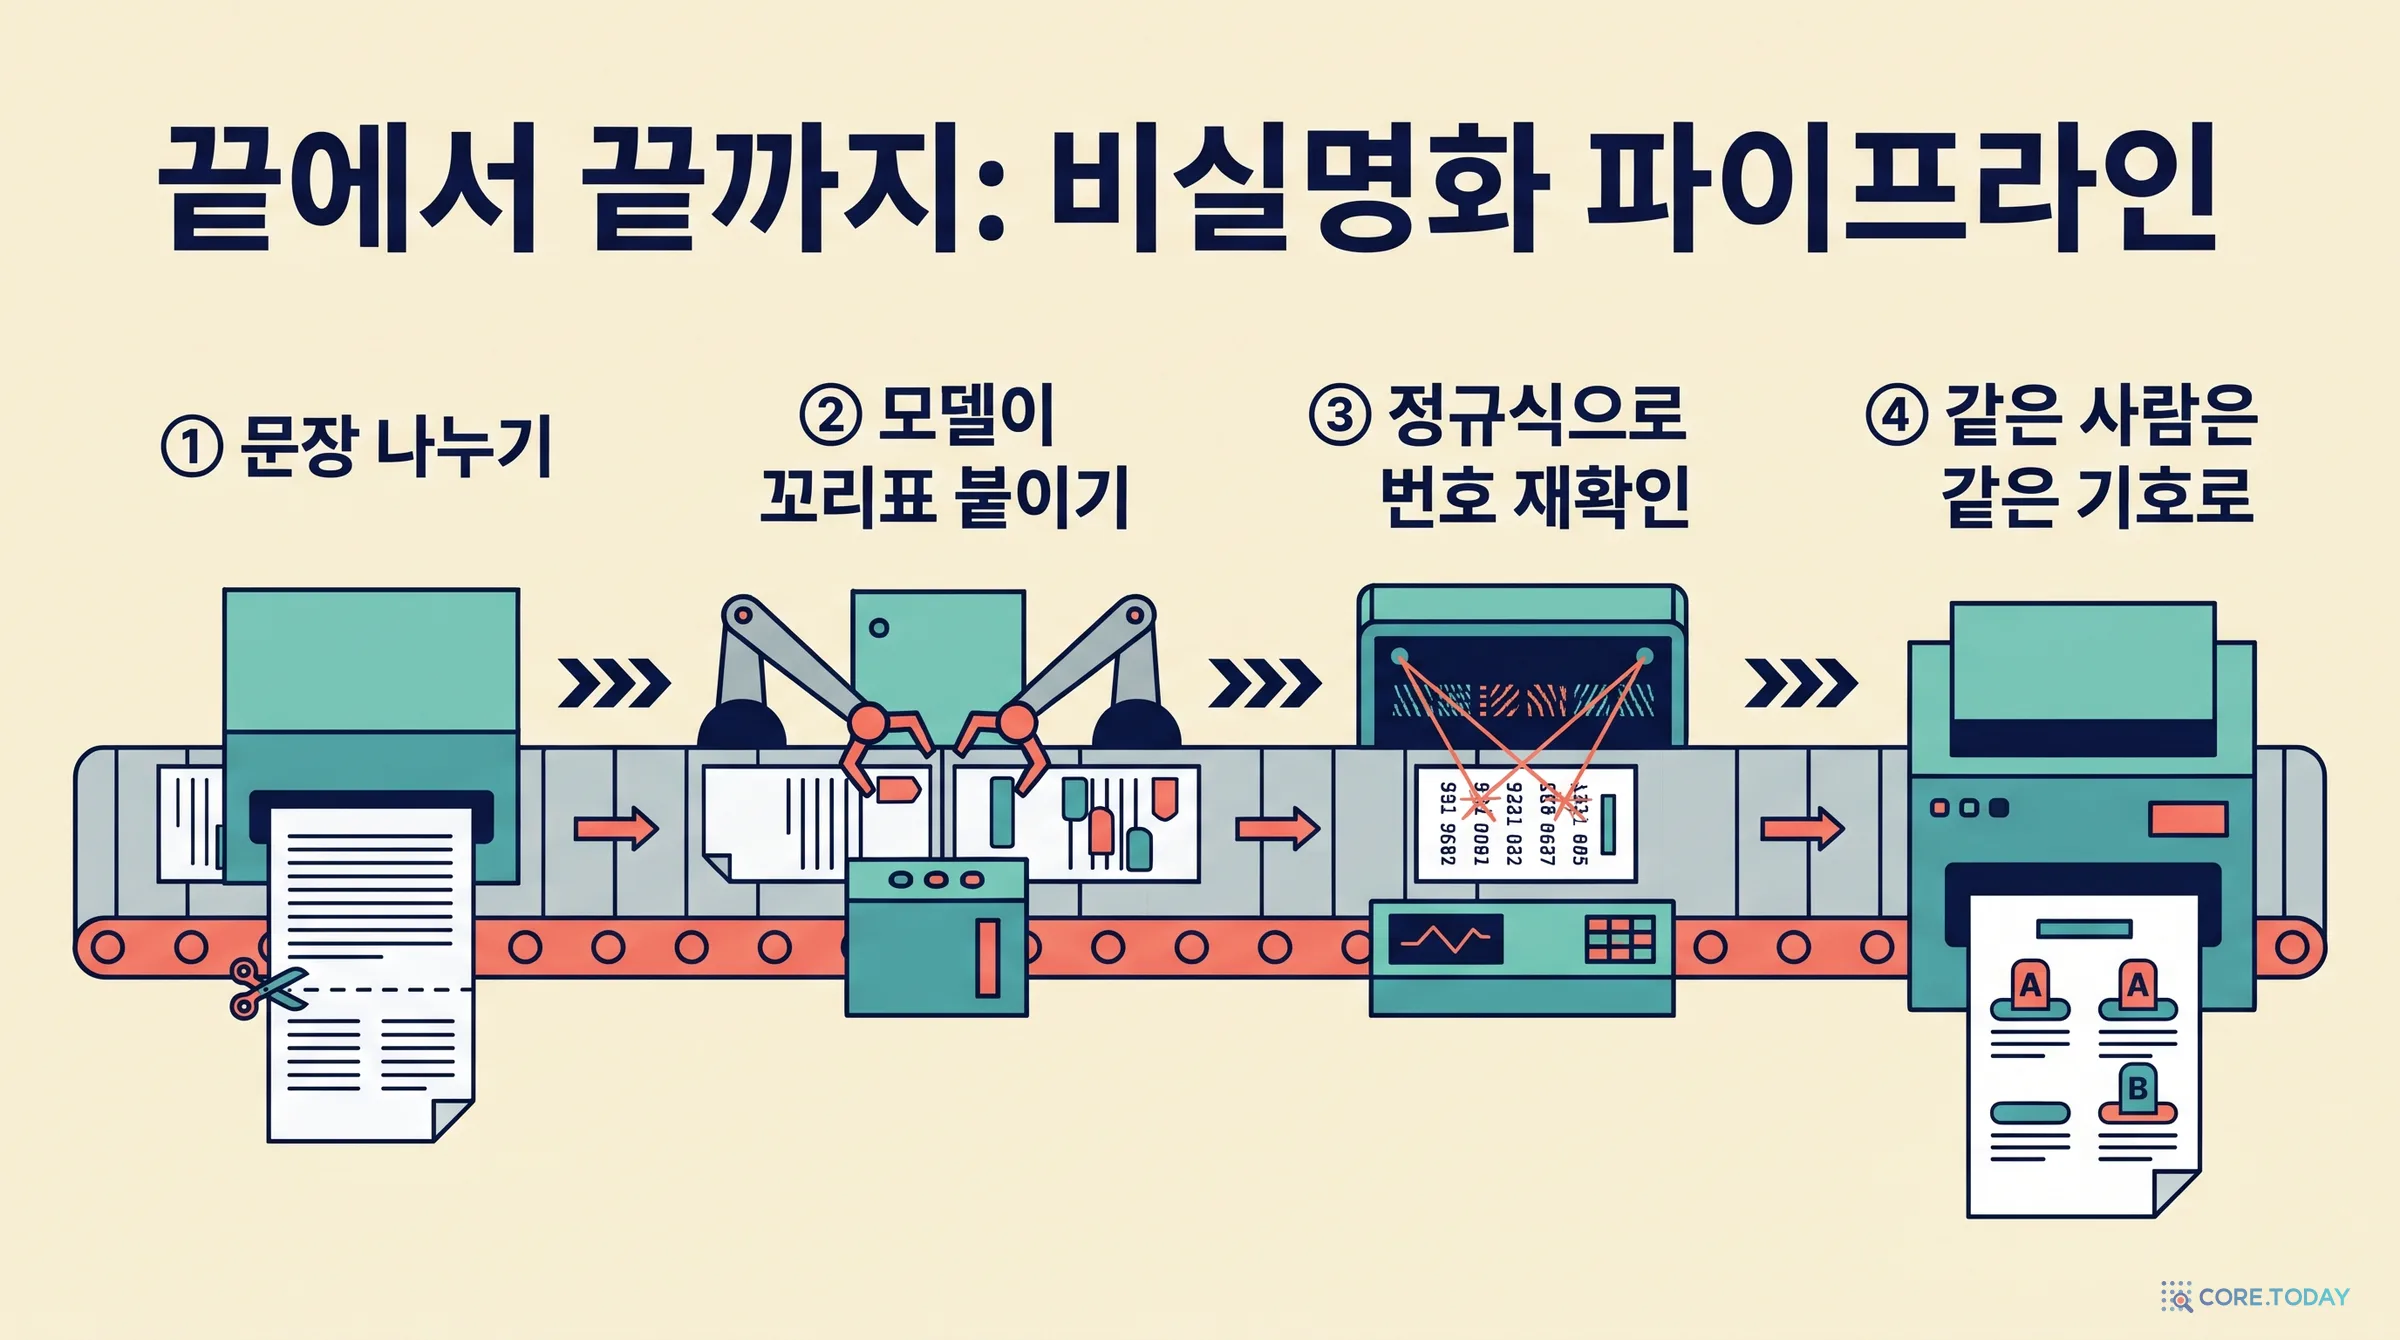
논문은 모델 하나가 아니라 처음부터 끝까지의 흐름을 제안한다고 강조합니다. 4.3절이 그리는 흐름은 네 단계입니다.
1문장 나누기. 판결문을 한국어 문장 분리기(KSS, 형태소 분석기 MeCab 기반)로 문장 단위로 자른다. 모델은 문장을 하나씩 본다.
2모델. KLUE-BERT-CRF가 토큰마다 BIO 꼬리표를 붙여 11종의 식별자를 찾는다.
3정규식 2차 거르기. 주민등록번호, 차량등록번호처럼 형식이 정해진 식별자는 정규식으로 한 번 더 찾는다.
4일관된 기호로 가리기. 법원 규정에 맞춰 가리되, 한 문서 안에서 같은 식별자가 여러 번 나오면 같은 기호를 쓴다.
3단계와 4단계는 Thunder-DeID 논문이 다루지 않은 부분이고, 실무에 가까운 설계입니다. 앞선 글의 로컬 실험에서 LLM이 이름은 다 가리면서 주민등록번호는 다 남겼던 것을 떠올리면, 형식이 정해진 번호를 규칙으로 따로 잡는 것은 모델의 종류와 무관하게 옳은 안전망입니다. 한 문서 안에서 김철수가 처음부터 끝까지 A여야 한다는 4단계도, 판결문을 읽을 수 있게 유지하려면 반드시 필요합니다.
다만 논문은 이 두 단계를 평가하지 않습니다. 모든 점수는 2단계의 문장 단위 꼬리표 정확도입니다. 정규식이 주민등록번호를 얼마나 잡는지, 같은 사람을 같은 기호로 묶는 일이 얼마나 정확한지("김철수"와 "피고인 김씨"와 "김"이 같은 사람인지를 어떻게 아는지)는 보고되지 않았습니다. 그리고 1단계에는 대가가 있습니다. 문장을 따로따로 보는 모델은 앞 문장의 정보를 쓸 수 없습니다. "위 병원"이 가려야 하는 병원인지는 세 문장 앞을 봐야 알 수 있습니다. 문서 단위로 2,048토큰을 보는 Thunder-DeID와 갈리는 지점이고, 2장의 교도소 사례 같은 문맥 판단은 문장 단위 모델이 원리상 하기 어렵습니다.
10장. 한계와 꼼꼼히 읽기
논문이 스스로 밝힌 한계는 둘입니다. 원본 판결문에 접근할 수 없어 합성 값을 채운 자료로 학습하고 시험했다는 것, 그리고 한국어 전용 도구(KSS, KLUE-BERT)에 의존한다는 것입니다. 뒤의 것은 다른 언어의 도구로 바꾸면 된다고 덧붙입니다. 여기에 읽으면서 보인 것을 더합니다.
1. 대표 점수의 구성. 8장에서 본 대로 0.9923의 96%는 채팅과 불린 Thunder-DeID 데이터에서 나옵니다. 새 판결문에서는 0.9438(본문 설정) 또는 0.9703(불리지 않은 설정)입니다. 초록과 서론만 읽으면 알 수 없고 부록 D와 E를 봐야 보입니다.
2. 합성 값으로 채운 시험지. Thunder-DeID와 같은 한계입니다. 시험 문장의 이름, 주소, 회사도 학습 때와 같은 생성기가 채웠습니다. 개체명 인식 연구에서는 학습과 시험에 같은 개체가 겹치면 점수가 부풀려진다는 것이 알려져 있습니다(ACL 2025 Findings의 한 연구는 본 개체와 못 본 개체 사이의 격차를 2~10%로 보고했습니다). 통계청 자료로 만든 성씨·이름·학교·회사 목록에서 학습 값과 시험 값이 얼마나 겹치는지는 논문에 없습니다. 형식이 뚜렷한 URL·전화번호·계좌번호가 시험 식별자의 4분의 1을 차지한다는 점도 점수를 끌어올립니다.
3. 주석자 일치도와 모델 점수의 간격. 사람 여덟 명의 카파가 0.74인데 모델의 F1이 0.99입니다. 두 지표가 같은 것을 재지는 않으므로 직접 비교할 수는 없지만, 모델이 사람보다 일관되게 정답을 맞힌다는 결과는 설명이 필요합니다. 가능한 설명은 시험이 원래의 판단(무엇을 가릴 것인가)이 아니라 그 판단의 결과로 생긴 합성 값을 찾는 일을 재고 있다는 것입니다. 주석자가 "#@company#"를 달지 않은 회사 이름은 원문 그대로 남아 있고 정답에서도 빠지므로, 모델은 생성기가 만든 값의 모양만 알아보면 됩니다.
4. 서로 맞지 않는 정답지. 표 2의 0.37. 이 논문만의 한계가 아니라 분야 전체의 숙제입니다.
5. 문장 단위 처리. 문맥을 문장 안으로 제한합니다. 512토큰보다 긴 문장(판결문에는 한 문장이 한 쪽을 넘는 경우가 드물지 않습니다)의 처리도 언급이 없습니다.
6. 11개 밖의 식별자. 앞선 글의 729개 가운데 상당수, 특히 문맥으로만 식별자가 되는 것들은 이 체계의 대상이 아닙니다. 주민등록번호와 차량번호는 정규식이 맡는다고 했지만 평가는 없습니다.
7. 공개 여부. 논문은 "기초가 되는 공개 자원을 만든다"고 쓰지만, 본문에 데이터나 모델의 주소는 없습니다. 이 글을 쓰는 2026년 11월 12일 현재 허깅페이스와 깃허브에서 공개된 저장소를 찾지 못했습니다. 2026년 4월의 언론 보도는 국내 특허 출원을 전하고 있습니다. 벤치마크는 남들이 같은 시험지로 재 볼 수 있어야 벤치마크가 되므로, 이 부분은 논문의 주장과 현재 상태 사이에 간격이 있습니다. KLUE-BERT의 라이선스(CC BY-NC-SA 4.0, 비영리)도 실제 도입 때 확인해야 할 조건입니다.
8. 자잘한 불일치들.
표 3과 표 6은 같은 조건(전체로 학습, Thunder-DeID로 시험)인데 KLUE-BERT 행의 개체 단위 네 값이 서로 다릅니다. 표 3의 값은 표 1의 값과 똑같아, 옮겨 적다가 생긴 착오로 보입니다.
표 2에서 제안 모델의 토큰 종류 F1(0.9299)이 토큰 이진 F1(0.9268)보다 높습니다. 종류까지 맞힌 토큰은 가릴지 여부도 맞힌 토큰이므로, 정의상 드문 일입니다.
판결문 데이터의 개체 수가 본문에서는 51,245개, 그림 3의 막대를 더하면 50,134개입니다. 문장 수는 138,576개와 46,973개 두 가지가 나옵니다.
Thunder-DeID 공개 데이터를 "4,500 문장"이라고 부르지만 원래는 판결문 4,500건입니다.
규칙 기반 비식별화의 선행 연구로 인용된 "Gupta 외(2004)"의 서지는 기업가적 리더십에 관한 경영학 논문입니다. 다른 논문을 가리키려던 것으로 보입니다.
결론을 뒤집는 것은 없습니다. 하지만 벤치마크를 내세우는 논문일수록 숫자의 정합성이 중요하고, 따라 하려는 사람은 이 점들을 미리 알고 있어야 합니다.
11장. 그래도 이 논문이 보여 준 것
비판적으로 읽었지만, K-LegalDeID가 분야에 보탠 것은 분명합니다.
하나, 넓이. 39개 법 분야에서 고르게 뽑은 2,000건은 공개 자료가 형사 세 유형에 몰려 있던 상황에서 의미 있는 확장입니다. 선거, 조세, 건설, 보건, 해운 사건의 판결문에는 형사 사건과 다른 식별자가 나옵니다.
둘, 품질의 수치화. 주석자 일치도를 보고한 첫 한국 판결문 비실명화 데이터입니다. 0.74라는 숫자는 이 과제의 정답이 사람 사이에서도 흔들린다는 사실을 처음으로 계량했습니다.
셋, 엄격한 채점. 토큰이 아니라 개체를, 그것도 경계까지 정확히 맞아야 하는 기준으로 대표 점수를 냈습니다. 느슨한 지표와 함께 여섯 가지를 모두 보고해 어디서 틀리는지 읽을 수 있게 했습니다.
넷, 가벼운 길의 증명. 공개된 1억짜리 모델과 RTX 8000 두 장, 30년 된 표기와 25년 된 모형으로 이 정도까지 갈 수 있음을 보였습니다. 법원이든 기업이든 "전용 모델을 처음부터 학습시킬 자원이 없다"는 이유로 망설이던 곳에는 실용적인 출발점입니다.
다섯, 교차 평가. 표 2는 저자들에게 유리한 결과가 아닙니다. 그런데도 실었습니다. 남의 데이터로 자기 모델을 시험하고 그 낙차를 보고한 것은 이 분야에서 드문 일이고, 그 덕분에 "두 정답지가 다르다"는 사실이 숫자로 남았습니다. 이 논문에서 가장 오래 인용될 표는 표 1이 아니라 표 2일 것입니다.
같은 종류의 식별자가 붙어 나올 때 몇 개인지 셀 수 있습니까. 라벨이 굵다면 BIO 같은 경계 표기가 필요합니다.
라벨을 몇 개로 할지를 무엇으로 정했습니까. 치환 규칙이 요구하는 구분은 남기고, 모델이 헷갈리는 구분은 합치는 두 기준을 모두 봤습니까.
'나리식당'의 정답이 '나리'입니까 '나리식당'입니까. 이 한 줄이 정해져 있지 않으면 데이터를 합칠 때 점수가 무너집니다.
모델
토큰마다 따로 고른 결과에 규칙에 어긋난 순서(O 다음 I)가 얼마나 있습니까. 있다면 CRF 층이나 그에 준하는 후처리를 붙이십시오.
쓰는 토크나이저가 이름과 조사를, 고유한 부분과 일반 명사를 얼마나 잘 가르는지 재 봤습니까. 5장의 측정은 어휘 파일 하나로 몇 분이면 됩니다.
자주 틀리는 낱말을 어휘에 추가하는 가벼운 처방을 먼저 해 봤습니까.
데이터
학습 자료의 몇 퍼센트가 실제로 다룰 문서와 같은 종류입니까. 다른 종류의 자료를 많이 섞었다면 시험은 반드시 종류별로 따로 하십시오.
남의 데이터를 불려 넣었을 때 내 문서에서의 점수가 오르는지 내리는지 확인했습니까.
주석자 일치도를 쟀습니까. 그 숫자가 모델 점수의 해석 상한입니다.
평가
대표 점수가 어느 시험지의 어느 지표인지 한 문장으로 말할 수 있습니까.
엄격한 개체 단위 점수와 느슨한 점수를 함께 봅니까. 둘의 차이가 경계 문제의 크기입니다.
다른 팀의 정답지로 채점해 봤습니까. 낙차가 크다면 모델이 아니라 정답의 정의를 먼저 맞춰야 합니다.
모델 뒤에 붙는 정규식과 기호 일관성 단계까지 포함해 문서 단위로 평가합니까.
맺으며
K-LegalDeID는 "작게, 넓게, 엄격하게"의 논문입니다. 모델은 작게, 데이터는 넓게, 채점은 엄격하게. 그 조합으로 0.99를 보고했고, 그 숫자를 뜯어 보면 판결문에서의 0.94와 남의 정답지에서의 0.37이 함께 나옵니다. 세 숫자 모두 사실이고, 세 숫자를 함께 읽어야 이 논문의 위치가 보입니다.
Thunder-DeID와 나란히 놓으면 두 논문은 경쟁자라기보다 같은 산을 다른 면에서 오른 두 팀입니다. 한쪽은 판결문에 나오는 모든 단서에 이름을 붙이려 했고, 다른 쪽은 가장 흔한 단서를 가장 넓은 분야에서 정확히 잡으려 했습니다. 한쪽은 한국어의 문법을 토크나이저에 새겼고, 다른 쪽은 꼬리표의 문법을 CRF에 새겼습니다. 그리고 두 팀 모두 같은 벽 앞에 섰습니다. 진짜 원문으로는 한 번도 시험해 보지 못했고, 서로의 정답지는 맞지 않습니다.
그 벽을 어떻게 넘을지가 다음 글의 주제입니다. 두 논문이 남긴 숙제 — 판결문 비실명화는 어디로 가야 하나에서 두 설계를 항목별로 견주고, 독일과 일본의 법원, 재식별 위험으로 채점하는 새 벤치마크 등 세계의 흐름을 살핀 뒤 한국이 택할 수 있는 길을 정리합니다.
참고문헌
이 글이 다룬 논문
Wooseok Choi, Hyungbin Kim, Yon Dohn Chung. K-LegalDeID: A Benchmark Dataset and KLUEBERT-CRF for De-identification in Korean Court Judgments. EACL 2026 (Long Papers), pp. 2308–2325. aclanthology.org/2026.eacl-long.103
Lance Ramshaw, Mitchell Marcus. Text Chunking using Transformation-Based Learning. Third Workshop on Very Large Corpora, 1995.
Erik Tjong Kim Sang, Fien De Meulder. Introduction to the CoNLL-2003 Shared Task: Language-Independent Named Entity Recognition. CoNLL 2003.
John Lafferty, Andrew McCallum, Fernando Pereira. Conditional Random Fields: Probabilistic Models for Segmenting and Labeling Sequence Data. ICML 2001.
Andrew Viterbi. Error Bounds for Convolutional Codes and an Asymptotically Optimum Decoding Algorithm. IEEE Transactions on Information Theory, 1967.
Zhiheng Huang, Wei Xu, Kai Yu. Bidirectional LSTM-CRF Models for Sequence Tagging. arXiv:1508.01991, 2015.
Guillaume Lample 외. Neural Architectures for Named Entity Recognition. NAACL 2016.
Charles Sutton, Andrew McCallum. An Introduction to Conditional Random Fields. Foundations and Trends in Machine Learning 4(4), 2012.