[특집] 워크플로를 버리지 말고 저금하라 — FlowBank, 문제마다 맞는 에이전트 워크플로를 '미리 만들어 골라 쓰는' 법
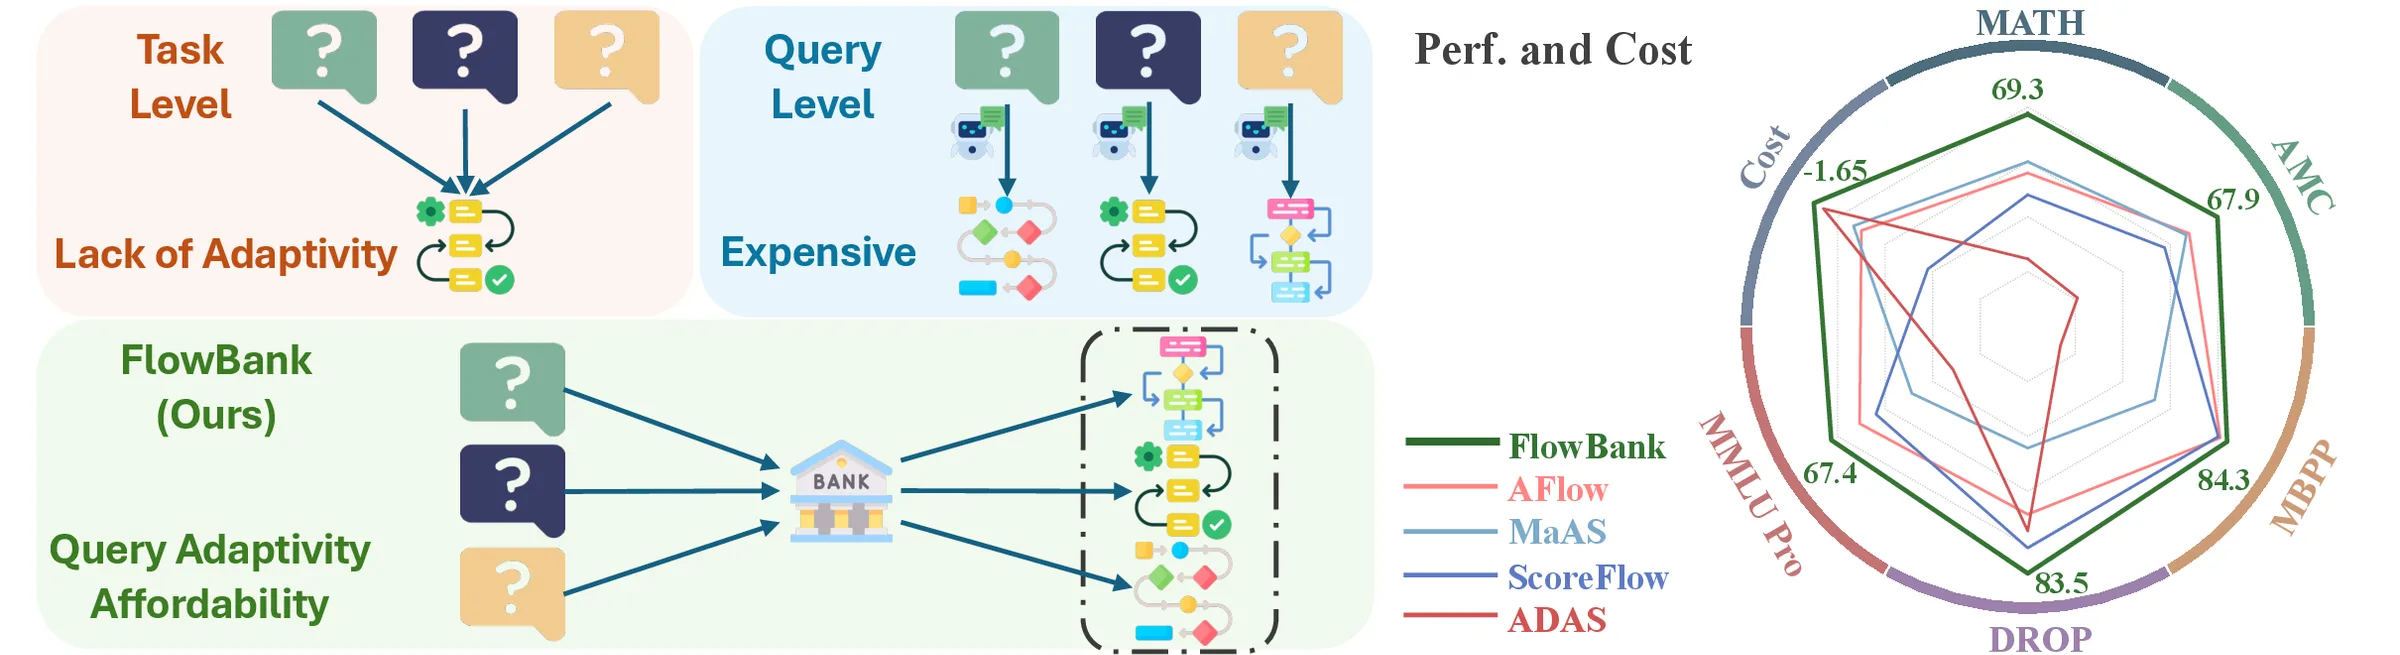
에이전트 워크플로를 자동으로 설계하는 방법은 지금까지 두 갈래였다. 오프라인에서 수십 개를 찾아 1등 하나만 배포하는 '과제 수준' 방식과, 질문이 올 때마다 새 워크플로를 즉석에서 짜는 '질의 수준' 방식이다. 메릴랜드대·아마존 연구진의 FlowBank(arXiv 2606.11290)는 둘 다 낭비가 있다고 지적한다. 버려진 후보들이 1등이 못 푼 문제를 풀고, 비싼 즉석 설계가 푸는 문제의 상당수는 미리 만든 싼 워크플로로도 풀린다. 그래서 '서로 다른 문제를 푸는' 워크플로 몇 개를 은행처럼 저금해 두고 문제마다 골라 보내자는 것이다. 이 글은 공식 저장소의 실제 데이터(MATH 후보 31개 × 119문제, 벤치마크별 테스트 예측 파일)를 직접 다시 계산하며 DiverseFlow·CuraFlow·그래프 매칭 세 단계를 풀어 보고, 1976년 '알고리즘 선택 문제'와 1997년 '알고리즘 포트폴리오', SAT 대회를 휩쓴 SATzilla에서 2025년 GPT-5 라우터까지 이어지는 계보 속에 이 논문을 놓는다. 또 표 1 수치가 저장소와 정확히 맞는다는 것, 그러나 선택기 체크포인트가 검증 세트 없이 테스트 점수로 골라졌다는 것까지 확인했다. 인터랙티브 6개와 일러스트 12장, 논문 그림 8장으로 2026년 '스킬'의 시대에 이 생각이 어떤 의미인지 정리한다.
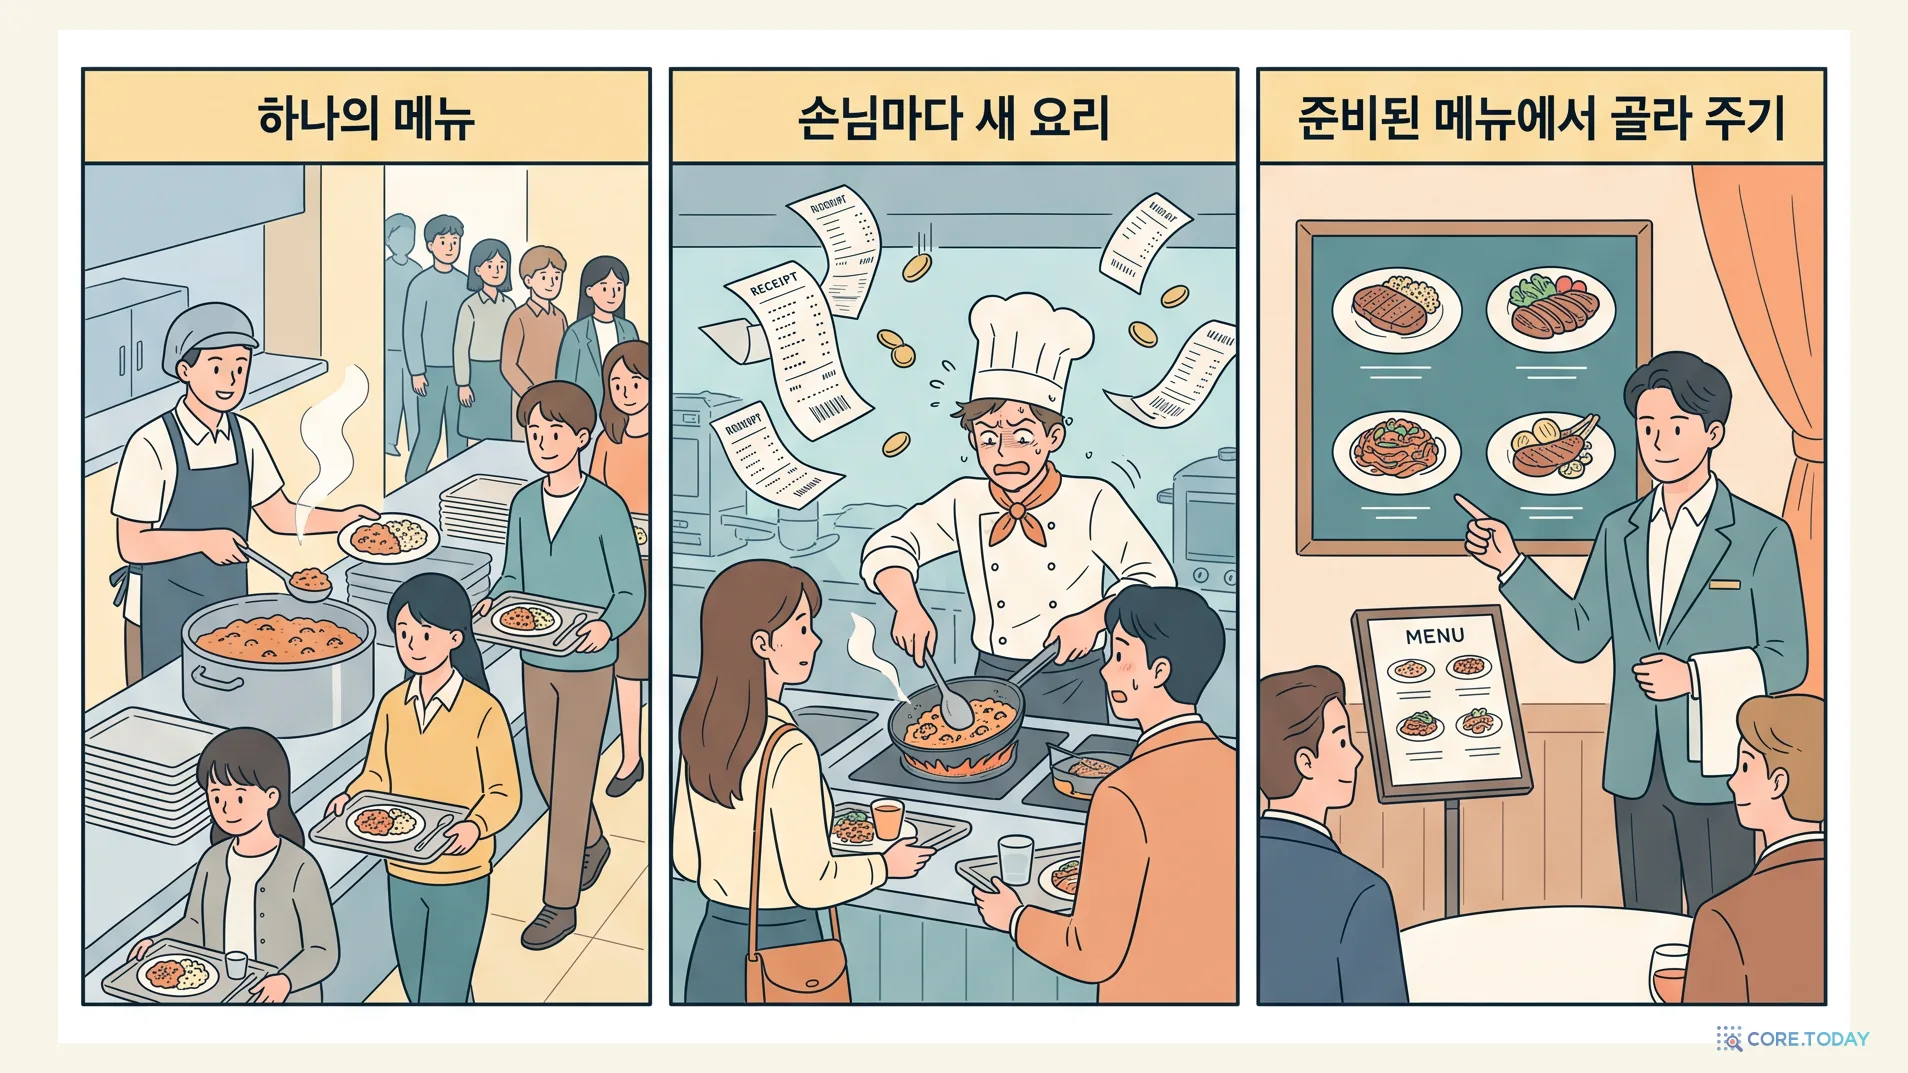
첫 번째 식당은 메뉴가 하나뿐입니다. 주인은 개업 전 몇 달 동안 서른 가지 요리를 시험해 보고, 손님 반응이 가장 좋았던 한 가지만 남겼습니다. 덕분에 주방은 단순하고 값도 쌉니다. 하지만 매운 걸 못 먹는 손님, 고기를 안 먹는 손님, 오늘따라 국물이 당기는 손님에게도 똑같은 접시가 나갑니다. 나머지 스물아홉 가지 요리의 레시피는 서랍 속에서 먼지를 뒤집어쓰고 있습니다.
두 번째 식당은 정반대입니다. 셰프가 손님 한 명 한 명과 이야기를 나눈 뒤 그 사람만을 위한 요리를 그 자리에서 설계합니다. 만족도는 높지만, 설계하는 시간과 재료 값이 매번 새로 들어갑니다. 그리고 막상 접시를 보면 ‘그냥 김치찌개’인 경우가 적지 않습니다. 김치찌개를 위해 매번 회의를 할 필요는 없었는데 말이죠.
세 번째 식당은 대표 메뉴를 다섯 개 갖고 있습니다. 서른 가지 시험 요리 중에서 ‘서로 다른 손님을 만족시키는’ 다섯 개를 골라 두었습니다. 지배인은 들어오는 손님을 한 번 훑어보고, 다섯 개 중 그 손님에게 가장 맞는 것을 권합니다. 설계 회의는 개업 전에 끝났고, 영업 중에는 ‘고르기’만 합니다.
이 비유는 2026년 6월 메릴랜드대학교(University of Maryland, College Park)와 아마존 연구진이 arXiv에 올린 논문 「FlowBank: Query-Adaptive Agentic Workflows Optimization through Precompute-and-Reuse」의 요지를 거의 그대로 옮긴 것입니다. 저자는 링즈 위안(Lingzhi Yuan), 청하오 덩(Chenghao Deng), 팡쉬 위(Fangxu Yu), 수라딥 차크라보르티(Souradip Chakraborty), 모하마드 로스타미(Mohammad Rostami, 아마존), 그리고 교신저자 푸롱 황(Furong Huang)입니다.
첫 번째 식당이 과제 수준(task-level) 워크플로 최적화, 두 번째 식당이 질의 수준(query-level) 워크플로 생성, 세 번째 식당이 논문이 제안하는 FlowBank입니다. 제목의 ‘Precompute-and-Reuse(미리 계산하고 다시 쓰기)’라는 말이 세 번째 식당의 영업 방식을 한마디로 요약합니다.
이 논문이 흥미로운 이유는 새로운 거대 모델이나 기발한 프롬프트가 아니라, 이미 만들어 놓고 버리던 것을 다시 보자는 관점의 전환에 있기 때문입니다. 연구진은 대표적인 과제 수준 최적화기인 AFlow가 MATH 문제로 20라운드 동안 찾아 낸 워크플로 20개를 들여다봤습니다. AFlow는 그중 1등 하나만 배포하고 나머지 19개는 버립니다. 그런데 버려진 19개가 1등이 틀린 문제를 상당수 맞히고 있었습니다.
이 글은 그 발견에서 출발해 다음 질문들을 차례로 풀어 갑니다.
‘에이전트 워크플로’란 정확히 무엇이고, 왜 사람이 손으로 짜다가 자동 설계로 넘어갔는가
과제 수준과 질의 수준이라는 두 갈래는 각각 무엇을 얻고 무엇을 잃는가
‘정확도가 높은 것’과 ‘함께 쓰면 많이 푸는 것’은 왜 다른가 — 커버리지라는 개념
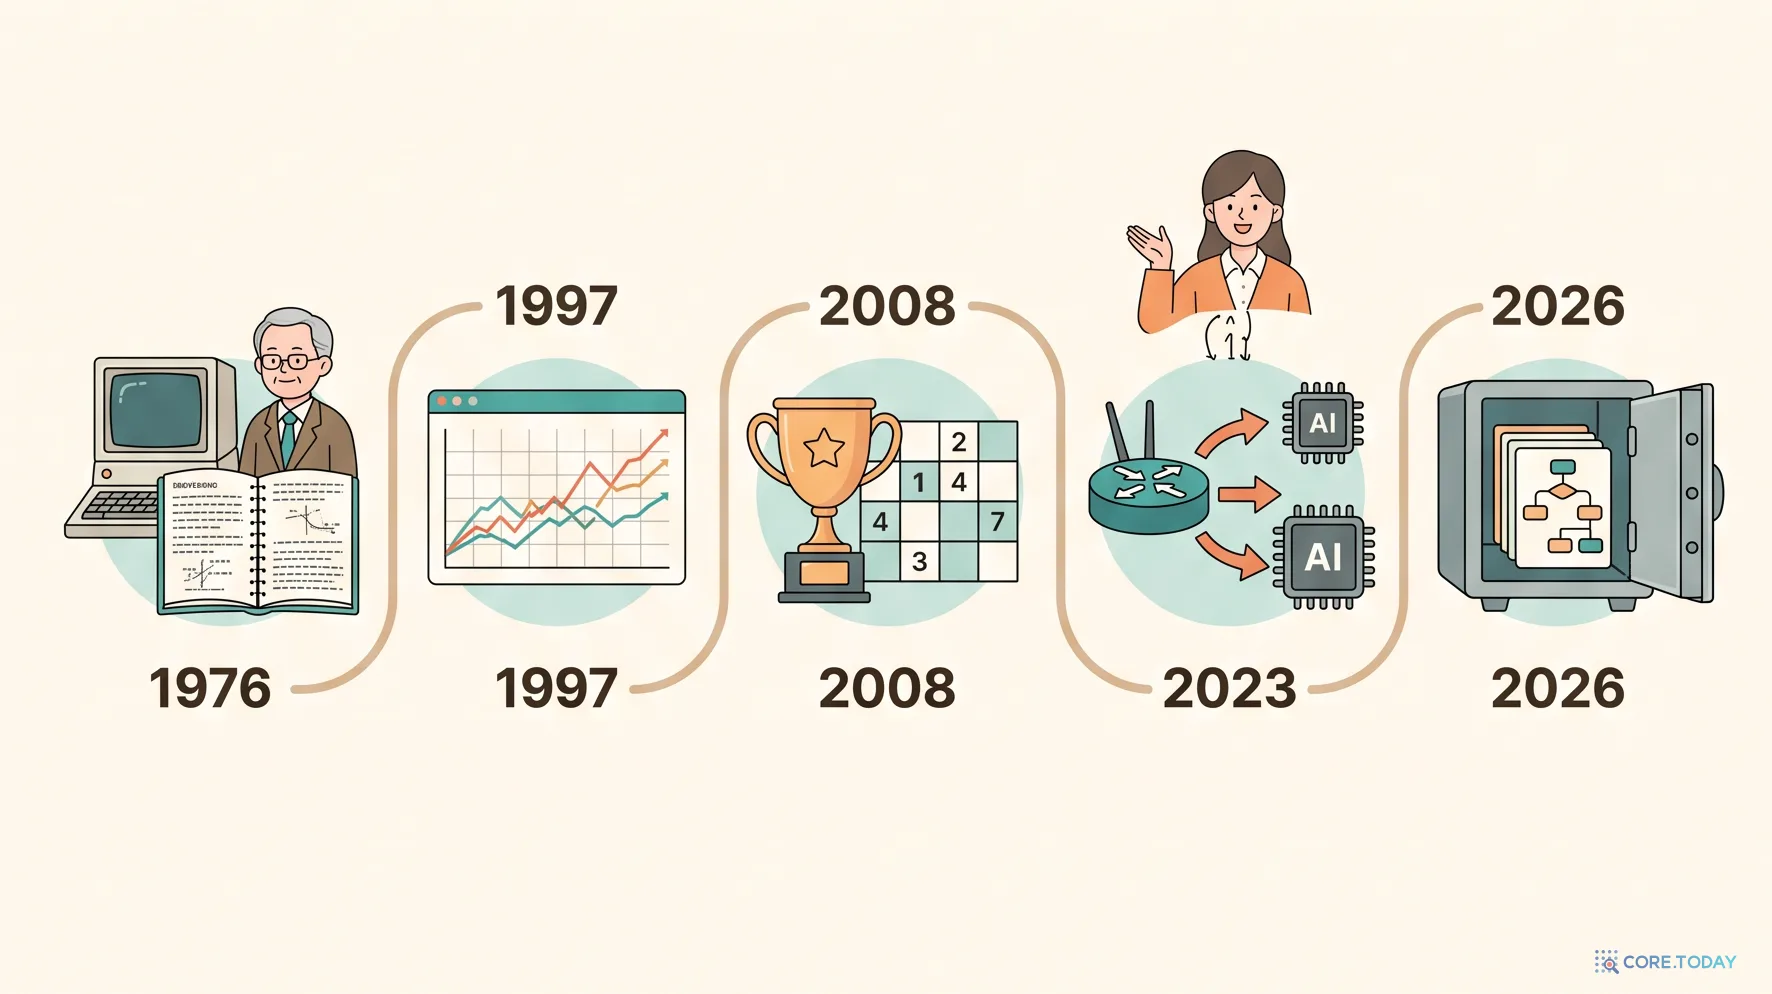
이 생각은 사실 50년 된 생각이다: 1976년 알고리즘 선택 문제, 1997년 알고리즘 포트폴리오, SAT 대회의 SATzilla, 그리고 2023년 이후의 LLM 라우터
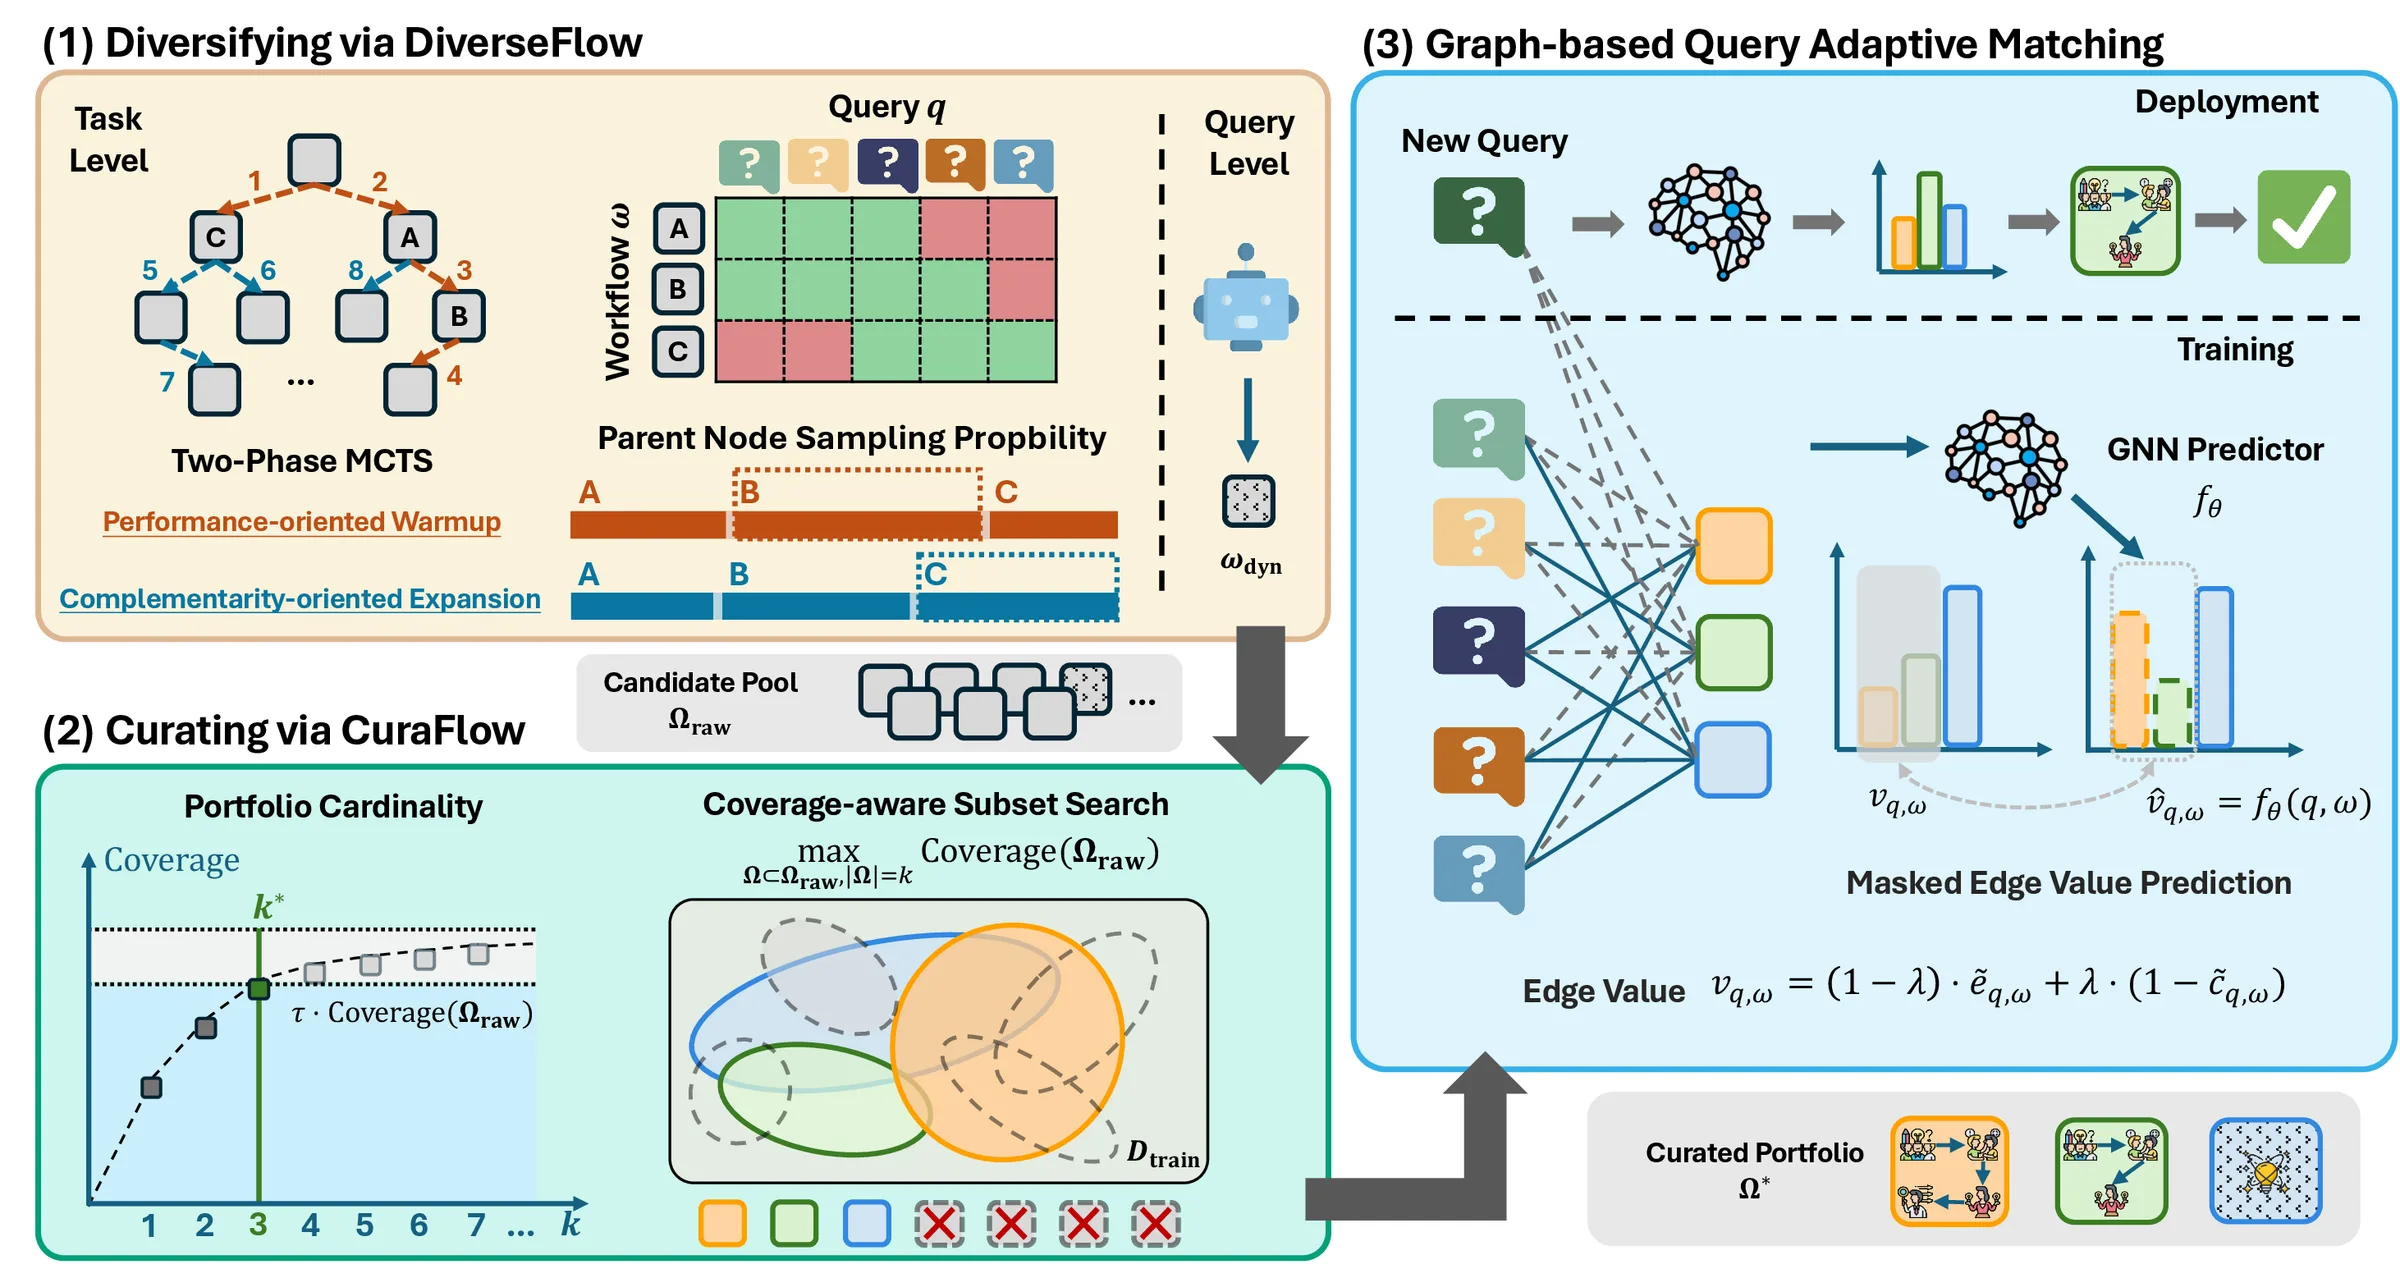
FlowBank의 세 단계(DiverseFlow·CuraFlow·그래프 매칭)는 각각 어떻게 동작하는가
결과 표는 무엇을 말하고, 무엇을 말하지 않는가 — 공식 저장소의 예측 파일로 직접 다시 계산해 본 것
2026년, ‘스킬’과 ‘플랜 캐싱’의 시대에 이 논문의 자리는 어디인가
코어닷투데이는 이 글을 쓰면서 논문 PDF(본문 12쪽 + 부록 29쪽)뿐 아니라 공식 저장소 umd-huang-lab/FlowBank에 공개된 실제 데이터를 내려받아 다시 계산했습니다. MATH 학습 문제 119개에 대한 후보 워크플로 31개의 문제별 점수, 그리고 네 벤치마크의 테스트 예측 파일입니다. 아래 위젯 대부분은 이 실제 데이터로 움직입니다.
1장. 에이전트 워크플로란 무엇인가 — 프롬프트 한 줄에서 작은 프로그램으로
한 번 묻기(IO)에서 생각의 사슬(CoT)로
대규모 언어 모델(LLM)에게 일을 시키는 가장 단순한 방법은 질문을 한 번 던지고 답을 받는 것입니다. 논문은 이것을 IO(Input–Output)라고 부르고 모든 비교의 기준선으로 씁니다.
2022년 구글의 제이슨 웨이(Jason Wei) 등은 질문에 ‘풀이 과정을 보여 주는 예시’를 붙이기만 해도 수학 문제 정답률이 크게 오른다는 것을 보였습니다. 이것이 생각의 사슬(Chain-of-Thought, CoT)입니다(NeurIPS 2022). 같은 해 쉬즈 왕(Xuezhi Wang) 등은 한 번이 아니라 여러 번 풀게 한 뒤 가장 많이 나온 답을 고르는 자기 일관성(Self-Consistency)을 내놓았습니다(ICLR 2023). GSM8K에서 17.9%포인트를 더 끌어올린 단순하고 강력한 방법이었죠.
여기서 중요한 변화가 일어납니다. LLM 호출이 ‘한 번’에서 ‘여러 번’이 되고, 그 호출들 사이에 흐름(flow)이 생깁니다. 다섯 번 풀고 → 투표한다. 풀고 → 스스로 비판하고 → 고친다(Self-Refine, NeurIPS 2023). 세 개의 모델 인스턴스가 각자 풀고 → 서로의 답을 보며 두 라운드 토론하고 → 결론을 낸다(Multi-agent Debate, Du 등, ICML 2024). 비슷한 예제를 검색해 붙이고 → 다섯 번 풀고 → 보기 순서를 섞어 가며 앙상블한다(마이크로소프트의 MedPrompt, 2023 — GPT-4로 MedQA 90.2%).
이렇게 LLM 호출과 도구(코드 실행, 검색, 테스트)를 정해진 순서와 조건으로 이어 붙인 작은 프로그램을 ‘에이전트 워크플로(agentic workflow)’라고 부릅니다. 논문은 이를 수학적으로 이렇게 정의합니다.
과제 데이터셋 D가 주어졌을 때, 에이전트 워크플로 ω(⋅)는 질의 q∈D를 예측 ω(q)로 보내는 LLM 호출들의 계산 그래프다.
그리고 워크플로를 평가하는 잣대를 두 개 둡니다. 문제 q에 대한 성능e(ω,q)∈[0,1](맞으면 1, 틀리면 0, 혹은 F1 같은 부분 점수)과 비용c(ω,q)>0(그 문제를 처리하는 데 쓴 토큰 비용)입니다. 이 두 글자 e와 c가 글 끝까지 따라다닙니다.
앤트로픽(Anthropic)이 2024년 12월 19일에 낸 글 「Building effective agents」는 이 구분을 실무 언어로 정리했습니다. 워크플로는 “LLM과 도구가 미리 정해진 코드 경로를 따라 조율되는 시스템”이고, 에이전트는 “LLM이 스스로 과정과 도구 사용을 동적으로 지휘하는 시스템”입니다. 이 글이 소개한 다섯 가지 워크플로 패턴(프롬프트 체이닝, 라우팅, 병렬화, 오케스트레이터–워커, 평가자–최적화자) 중 ‘라우팅’의 정의 — “입력을 분류해 전문화된 후속 작업으로 보낸다” — 를 기억해 두세요. FlowBank는 이 라우팅을 ‘워크플로 단위’로 한 단계 끌어올린 것이라고 볼 수 있습니다.
실제 워크플로는 어떻게 생겼나
말로만 들으면 추상적이니, 논문 부록에 실린 실제 워크플로를 봅시다. 아래는 FlowBank가 AMC(미국 수학 경시대회) 문제를 위해 은행에 넣어 둔 다섯 장의 카드입니다. 각 카드는 파이썬 코드 30~60줄짜리 프로그램이고, 연산자(operator)라 불리는 부품을 조립해 만듭니다.
Custom: 지시문을 붙여 LLM을 한 번 부른다
ScEnsemble: 여러 풀이 중 가장 일관된 답을 고른다(자기 일관성 투표)
Programmer: LLM이 파이썬 코드를 쓰게 하고 실제로 실행해 계산을 검증한다
Review: 풀이를 검토하게 한다
Test: (코드 문제에서) 단위 테스트를 돌린다
왼쪽의 문제 카드를 눌러 보세요. 그 문제가 실제로 어느 워크플로에 배정됐는지, 그 워크플로가 어떤 순서로 실행되는지 보입니다.
두 가지가 눈에 띕니다. 첫째, 가장 비싼 W5(ScoreFlow)는 단독 정답률이 오히려 가장 낮습니다(56.8%). 비싸다고 잘하는 게 아닙니다. 둘째, 다섯 구성원 중 가장 잘하는 W3도 단독으로는 64.7%인데, 문제마다 골라 보내면 67.9%가 됩니다. 이 3.2점이 바로 ‘포트폴리오의 값’이고, 이 글 전체가 이 숫자가 어디서 오는지에 관한 이야기입니다.
손으로 짜기의 한계
워크플로가 강력하다는 건 분명해졌지만, 문제가 하나 있습니다. 설계 공간이 너무 넓습니다. 연산자를 몇 개, 어떤 순서로, 어떤 지시문과, 어떤 조건문으로 이을 것인가. 몇 번 투표하고 언제 코드로 검증할 것인가. 논문의 표현을 빌리면 “가능한 에이전트 토폴로지, 통신 패턴, 구성의 설계 공간은 시스템 복잡도에 따라 빠르게 커지며, 수작업 설계는 점점 감당할 수 없게 된다”.
논문 표 1의 수작업 워크플로 일곱 개를 보면 이 한계가 숫자로 드러납니다. 실행 모델은 모두 GPT-4o mini(온도 0)로 같습니다.
수작업 워크플로
평균 성능
평균 비용(×10⁻³달러/문제)
한 줄 요약
IO (그냥 한 번)
60.44
0.22
기준선
CoT
60.98
0.23
“단계별로 생각하자” 한 줄 추가
Self-Consistency
61.49
1.51
다섯 번 풀고 투표 — 비용 7배
Multi-agent Debate
63.86
3.45
셋이 두 라운드 토론 — 비용 16배
MedPrompt
62.77
2.58
유사 예제 검색 + 앙상블
Self-Refine
57.96
0.62
스스로 고치다 오히려 나빠짐
MultiPersona
63.87
0.41
한 번의 호출 안에서 여러 인격이 협업
토론(Debate)은 IO보다 비용이 16배 들지만 성능은 3.4점 오를 뿐이고, 한 번의 호출로 여러 인격을 흉내 내는 MultiPersona와 사실상 같은 점수입니다. 자기 수정(Self-Refine)은 오히려 IO보다 낮습니다(특히 MMLU Pro에서 43.75로, IO의 50.89보다 7점 낮음). ‘더 복잡한 흐름 = 더 좋은 결과’가 아니며, 어떤 흐름이 좋은지는 과제마다 다릅니다. 그렇다면 기계에게 찾게 하자 — 여기서 자동 워크플로 최적화가 시작됩니다.
2장. 자동 설계의 두 갈래 — 하나를 고를 것인가, 매번 새로 짤 것인가
과제 수준: 오프라인에서 찾고, 하나를 배포한다
2024년을 전후해 ‘워크플로 자체를 탐색 대상으로 삼는’ 연구가 쏟아졌습니다.
GPTSwarm(Zhuge 등, ICML 2024 구두 발표): 언어 에이전트를 ‘최적화 가능한 그래프’로 보고, 노드(프롬프트)와 간선(연결)을 강화학습으로 다듬습니다. 저자 중에는 유르겐 슈미트후버(Jürgen Schmidhuber)도 있습니다.
ADAS / Meta Agent Search(Shengran Hu, Cong Lu, Jeff Clune, ICLR 2025): ‘메타 에이전트’가 새 에이전트를 코드로 직접 작성하고, 지금까지 발견한 에이전트들의 기록(아카이브)을 보며 계속 새 설계를 내놓습니다.
AgentSquare(Shang 등, ICLR 2025): 계획·추론·도구 사용·기억이라는 네 가지 모듈 공간에서 진화와 재조합으로 에이전트를 찾습니다.
AFlow(Jiayi Zhang 등, ICLR 2025 구두 발표): 워크플로를 코드로 표현하고, 몬테카를로 트리 탐색(MCTS)으로 수정안을 탐색합니다. 위에서 본 Custom·ScEnsemble·Programmer 같은 연산자 체계가 바로 AFlow에서 온 것이고, FlowBank의 첫 단계도 AFlow를 뼈대로 삼습니다.
이들의 공통점은 논문의 수식으로 이렇게 쓸 수 있습니다.
ωstat=argωmaxq∈Dtrain∑e(ω,q)
학습 문제 전체에서 평균 성능이 가장 높은 워크플로 하나를 찾아(‘stat’은 static, 정적이라는 뜻), 그것을 모든 문제에 씁니다. 장점은 분명합니다. 배포 비용이 예측 가능하고 쌉니다. 실행할 때는 워크플로를 돌리는 토큰만 듭니다. 단점도 분명합니다. 모든 손님에게 같은 접시가 나갑니다. 논문의 표현으로는 “one-size-fits-all policy(한 치수로 모두를 맞추는 정책)”입니다.
질의 수준: 문제를 보고 그 자리에서 짠다
반대쪽 갈래는 “문제마다 최적의 워크플로가 다르다면, 문제를 보고 워크플로를 만들면 되지 않나”라고 생각했습니다.
MaAS(Guibin Zhang 등, ICML 2025 구두 발표): 가능한 아키텍처들의 확률 분포인 ‘에이전트 슈퍼넷’을 학습하고, 질의마다 맞는 시스템을 샘플링합니다.
ScoreFlow(Yinjie Wang 등, 2025): 워크플로 생성기 LLM을 점수 기반 선호 최적화(Score-DPO)로 학습시켜, 문제를 넣으면 그 문제용 워크플로 코드를 뱉게 합니다.
MAS-GPT(Rui Ye 등, ICML 2025): 질의 → 멀티에이전트 시스템 코드 쌍으로 LLM을 학습시켜, 한 번의 추론으로 시스템을 생성합니다.
FlowReasoner(Hongcheng Gao 등, 2025): 추론 모델을 증류한 뒤 실행 피드백으로 강화학습한 ‘메타 에이전트’.
수식으로는 이렇습니다.
ωdynq=Gϕ(q),ϕ∗=argϕmaxq∈Dtrain∑e(Gϕ(q),q)
생성기 Gϕ가 문제 q를 받아 워크플로를 만들고(‘dyn’은 dynamic, 동적), 학습은 생성기의 파라미터 ϕ를 조정합니다. 장점은 적응성입니다. 단점은 비용이 추론 시점으로 밀려온다는 것입니다. 문제 하나마다 ‘워크플로를 설계하는 비용’과 ‘그 워크플로를 실행하는 비용’을 둘 다 냅니다. 논문 표 1에서 ScoreFlow의 평균 비용(2.37)이 AFlow(GPT-4o, 1.95)보다 높은 이유입니다.
연구진은 이 질문에 답하려고 커버리지(coverage)라는 개념을 정의합니다. 워크플로들의 집합 Ω가 있을 때,
Coverage(Ω)=∣D∣1q∈D∑ω∈Ωmaxe(ω,q)
말로 풀면 이렇습니다. 각 문제마다, 집합 안에서 가장 잘한 워크플로의 점수를 가져온다. 그것을 모든 문제에 대해 평균 낸다. 정답을 미리 아는 심판(오라클)이 문제마다 최적의 구성원을 골라 준다고 가정했을 때 집합이 낼 수 있는 점수의 상한선입니다.
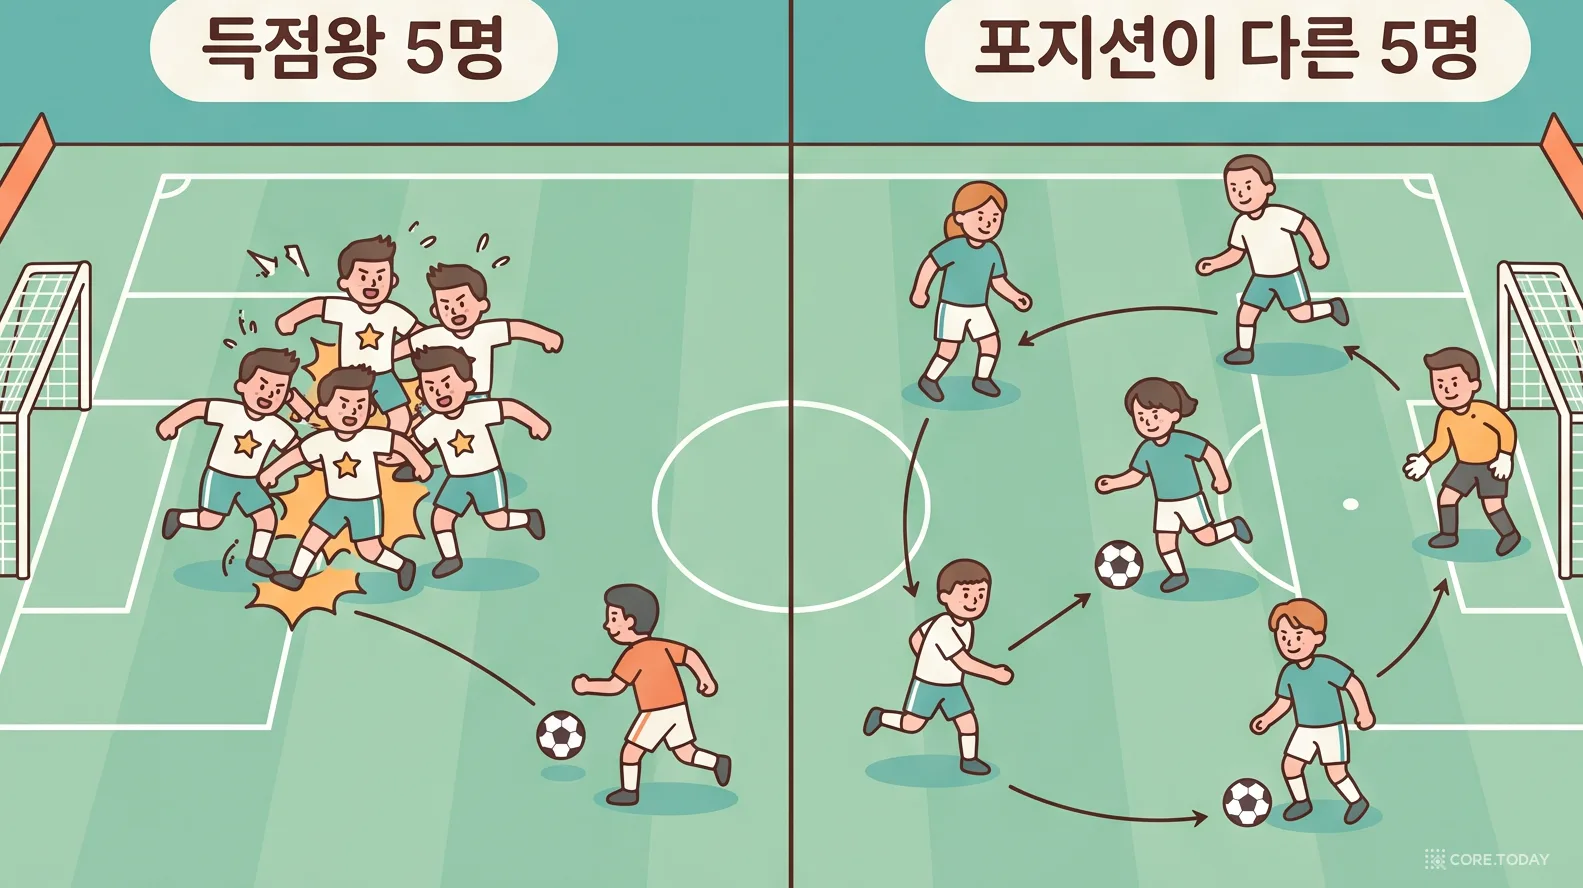
커버리지는 ‘팀 성적표’입니다. 개인 성적표(정확도)와 결정적으로 다른 점은, 다른 팀원이 이미 푼 문제를 또 푸는 것은 팀 점수에 아무것도 더하지 않는다는 것입니다. 축구로 치면 최고의 공격수 다섯 명을 뽑는 것과, 골키퍼·수비수·미드필더·공격수를 고루 뽑는 것의 차이입니다.
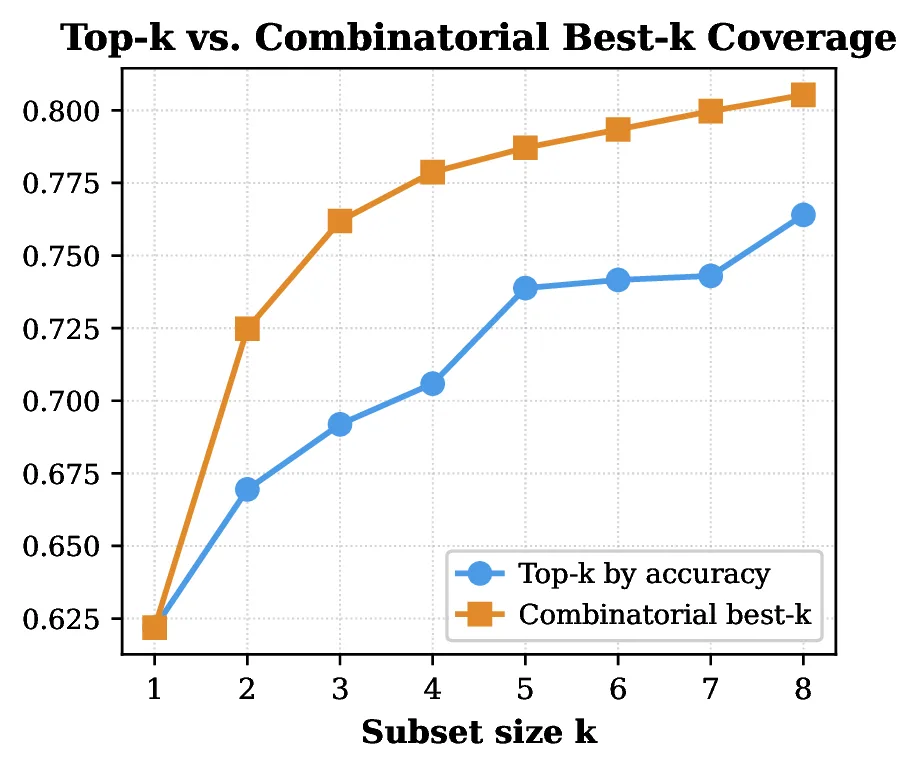
그림에서 두 가지를 읽을 수 있습니다. 첫째, 파란 선조차 k가 커질수록 꾸준히 오릅니다. 1등 하나(0.622)에서 여덟 개(약 0.764)까지 커버리지가 14점 넘게 늘어납니다. 배포되지 못한 후보들이 1등이 못 푼 문제를 풀고 있다는 뜻입니다. 둘째, 주황 선이 파란 선보다 항상 위에 있습니다. 두 개만 골라도 0.725 대 0.670으로 5점 넘게 차이 납니다. 개인 정확도로 팀을 짜면 최선의 팀이 나오지 않는다는 뜻입니다.
직접 해 보기 — 실제 후보 31개 × 문제 119개
공식 저장소의 CuraFlow/examples/ 폴더에는 이 분석에 쓰인 것과 같은 종류의 실제 데이터가 들어 있습니다. FlowBank의 첫 단계(DiverseFlow)가 MATH에서 30라운드 동안 찾은 워크플로 30개에 ScoreFlow를 더한 31개 후보가, MATH 학습 문제 119개 각각에서 몇 점을 받았는지가 기록된 표입니다.
이 표를 들여다보면 놀라운 점이 하나 있습니다. 31개 워크플로의 개인 정확도가 57.1%에서 62.2% 사이에 몰려 있습니다. 평균만 보면 ‘다 거기서 거기’입니다. 그런데 31개를 모두 합친 커버리지는 86.6%입니다. 고만고만한 개인들이 서로 다른 문제를 풀고 있다는 증거죠.
아래 위젯에서 직접 팀을 짜 보세요. 처음 담긴 F11과 F21은 개인 정확도 57.98%로 31개 중 하위권입니다.
정확도 하위권 둘(F11+F21)의 조합이 상위 두 개의 조합보다 많은 문제를 푼다는 것 — 이것이 커버리지라는 개념이 필요한 이유를 가장 짧게 보여 줍니다. 그리고 저장소의 전수 탐색 결과가 정확히 이 조합을 k=2의 최적으로 꼽았습니다(73.9%). 31개 중 2개를 고르는 465가지 조합을 모두 센 결과입니다.
같은 시기, 같은 결론에 이른 연구들
이 관찰은 FlowBank만의 것이 아닙니다. 2025년에서 2026년 사이 여러 연구가 같은 현상을 서로 다른 각도에서 보고했습니다.
스탠퍼드의 바투 엘(Batu El), 메르트 육세쿨(Mert Yuksekgonul), 제임스 저우(James Zou)는 「Inefficiencies of Meta Agents for Agent Design」(EMNLP 2025 Findings)에서 ADAS류 메타 에이전트를 30라운드 돌린 뒤, 설계된 에이전트들의 행동이 비슷한데도 메타 에이전트가 테스트 때 단 하나에 ‘올인’한다는 점을 지적했습니다. 그런데 질문의 약 94~96%는 설계된 에이전트 중 적어도 하나가 맞힌다는 것도 함께 보고했습니다. 모아 두면 쓸모가 있다는 뜻이죠. 이 논문은 경제성도 따졌습니다. 자동 설계 비용까지 넣으면 사람이 만든 에이전트보다 싸지는 경우는 DROP과 MMLU에서뿐이었고, 그것도 약 1만 5천 건 이상 처리해야 본전을 뽑았습니다.
중국과학원 계산기술연구소의 쯔쉬 왕(Zixu Wang) 등은 2026년 1월 「Do We Always Need Query-Level Workflows?」(Findings of ACL 2026)에서 더 직접적인 비교를 했습니다. AFlow가 찾은 상위 5개 워크플로를 ‘합친’ 커버리지가, 질의 수준 방법인 ScoreFlow가 푸는 문제 수와 같거나 더 많았습니다.
데이터셋
AFlow 상위 5개의 커버리지
ScoreFlow
DROP
93.87
91.48
HumanEval
100
98.91
MATH
87.04
84.35
GSM8K
97.35
97.79
물론 커버리지는 오라클을 가정한 상한선이고, ScoreFlow의 수치는 실제 성적이니 사과와 사과의 비교는 아닙니다. 하지만 방향은 분명합니다. ‘새로 만들기’의 상당 부분은 ‘잘 고르기’로 대체할 수 있다. FlowBank는 이 논문을 인용하며, 바로 그 ‘잘 고르기’를 구체적인 시스템으로 만든 셈입니다.
4장. 두 번째 관찰 — 비싼 맞춤 요리의 63%는 정식 메뉴로 충분했다
두 번째 관찰은 질의 수준 쪽을 겨눕니다. 문제마다 새 워크플로를 짜는 비용은 꼭 필요한가?
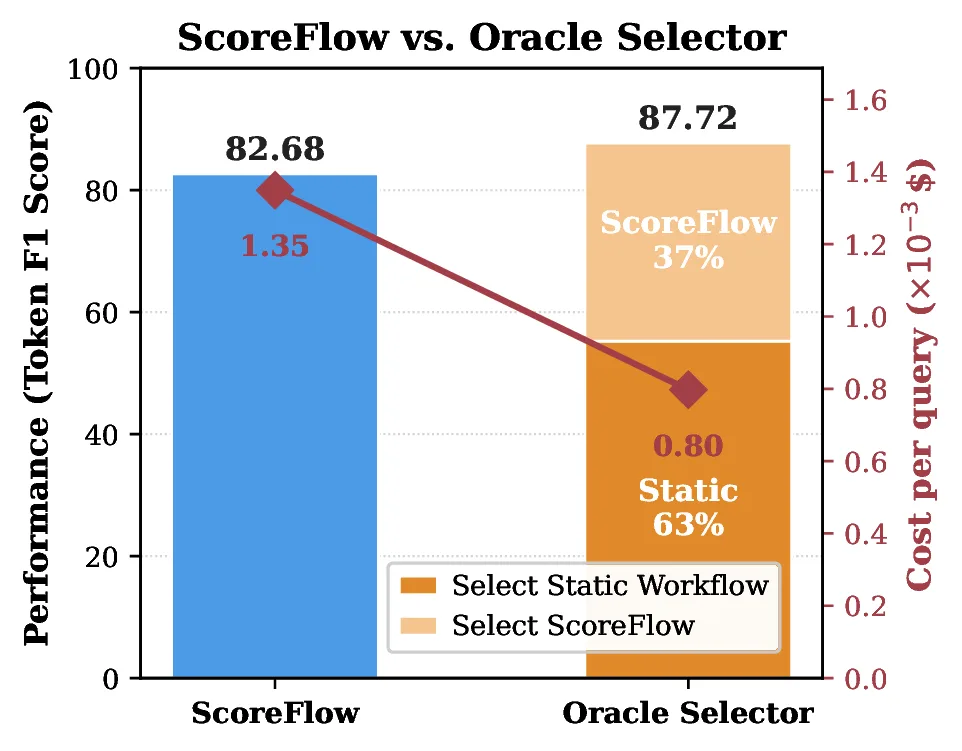
연구진은 DROP(문단을 읽고 숫자 계산이 섞인 질문에 답하는 독해 벤치마크)에서 ScoreFlow를 AFlow의 최고 정적 워크플로와 나란히 놓았습니다. 그리고 문제마다 ‘두 워크플로 중 성능이 더 높은 쪽, 같으면 더 싼 쪽’을 고르는 오라클을 만들었습니다.
결과는 극적입니다. 오라클은 문제의 63%를 싼 정적 워크플로로 보냈고, ScoreFlow에는 37%만 맡겼습니다. 그런데도 점수는 82.68에서 87.72로 5점 넘게 오르고, 문제당 비용은 1.35에서 0.80으로 41% 줄었습니다. 두 가지가 동시에 일어난 이유는 간단합니다.
ScoreFlow가 맞히는 문제의 상당수는 정적 워크플로도 맞힌다 → 그런 문제는 싼 쪽으로 보내면 비용만 준다
정적 워크플로만 맞히는 문제도 있다 → 그런 문제를 정적 쪽으로 보내면 점수가 오른다
‘김치찌개 주문에 매번 설계 회의를 열 필요는 없다’는 프롤로그의 비유가 바로 이 그림입니다. 다만 여기서도 오라클은 정답을 미리 아는 가상의 심판이라는 점을 잊으면 안 됩니다. 실제로는 문제를 보고 ‘이건 김치찌개 손님’임을 맞혀야 합니다. 이 ‘맞히기’가 얼마나 어려운지는 10장에서 실제 데이터로 확인합니다.
두 관찰이 합쳐지면
논문은 두 관찰을 이렇게 묶습니다.
①
관찰 1 — 과제 수준의 낭비
탐색 중 탈락한 워크플로들도 ‘집합으로서’ 재사용 가치가 있다. 그런데 정확도로 고르면 최선의 집합이 안 나온다.
②
관찰 2 — 질의 수준의 낭비
즉석 설계가 얻는 이득의 상당 부분은, 미리 만든 싼 워크플로를 문제별로 골라 쓰는 것만으로 회수할 수 있다.
→
새로운 목표
“모두에게 최고인 워크플로 하나”도, “문제마다 새 워크플로”도 아니다. 서로 보완하는 워크플로 몇 개를 은행처럼 모아 두고, 추론 시점에 문제마다 골라 쓴다.
!
풀어야 할 세 가지
(C1) 중복이 아니라 보완적인 후보를 만들기 · (C2) 작은 포트폴리오로 압축하기 · (C3) 문제마다 맞는 워크플로를 성능–비용 균형 속에서 고르기
이 세 과제가 FlowBank의 세 단계 — Diversifying(다양화), Curating(선별), Matching(매칭) — 에 하나씩 대응합니다. 그런데 세 단계를 해부하기 전에, 잠시 시간을 거슬러 올라가 보겠습니다. 이 ‘포트폴리오를 만들고 문제마다 고르자’는 생각은 사실 LLM보다 훨씬 오래됐습니다.
5장. 오래된 생각 — 알고리즘 포트폴리오의 50년
먼저 밝혀 둘 것이 있습니다. FlowBank 논문은 이 장에서 다룰 고전들 — 라이스의 알고리즘 선택 문제, 알고리즘 포트폴리오, SATzilla, 서브모듈러 최적화의 고전, 전문가 혼합, LLM 라우터 대부분 — 을 인용하지 않습니다. 논문이 직접 빌려 온 것은 매칭 단계의 구현 방식(GraphRouter) 정도입니다. 그러니 아래 계보는 코어닷투데이가 그린 지도입니다. 그럼에도 이 지도를 그리는 이유는, FlowBank의 거의 모든 구성 요소가 다른 분야에서 이미 이름을 갖고 있고, 그 이름들을 알면 논문의 강점과 약점이 훨씬 선명하게 보이기 때문입니다.
퍼듀대학교의 수치해석학자 존 라이스(John R. Rice)는 1976년 『Advances in Computers』 15권에 「The Algorithm Selection Problem」이라는 장을 실었습니다. 그가 제시한 틀은 놀랄 만큼 FlowBank와 닮았습니다.
문제 공간 P 풀어야 할 문제 x
→
특징 공간 F 문제에서 뽑은 특징 f(x)
→
선택 사상 S 어떤 알고리즘을 쓸까
→
알고리즘 공간 A 후보 알고리즘들
→
성능 공간 p(A, x)
라이스는 목표를 이렇게 적었습니다. “높은 성능을 내도록 S(x), 즉 문제를 알고리즘으로 보내는 사상을 정하는 것.” 그리고 이렇게 덧붙였습니다. “최선의(혹은 그저 좋은) 특징을 정하는 것은 알고리즘 선택 문제에서 가장 중요하면서도 가장 모호한 측면이다.”
이걸 FlowBank의 말로 옮기면 이렇습니다. 문제 공간 = 질의들, 특징 공간 = 질의 텍스트 임베딩, 알고리즘 공간 = 워크플로 포트폴리오, 성능 공간 = e와 c, 선택 사상 = GNN 선택기. 50년 전의 틀에서 바뀐 것은 ‘알고리즘’이 ‘LLM 워크플로’가 되었다는 점, 그리고 ‘알고리즘 공간’을 사람이 주는 게 아니라 LLM이 탐색해 만든다는 점입니다.
1997년 — 공짜 점심은 없다, 그러니 포트폴리오를
1997년은 이 계보에서 특별한 해입니다. 데이비드 월퍼트(David Wolpert)와 윌리엄 매크레디(William Macready)가 『IEEE Transactions on Evolutionary Computation』 창간호에 ‘공짜 점심은 없다(No Free Lunch)’ 정리를 발표했습니다. 초록의 문장 그대로 옮기면 “어떤 알고리즘이든, 한 부류의 문제에서 높아진 성능은 다른 부류의 문제에서 상쇄된다”. 모든 문제에서 이기는 만능 알고리즘은 (모든 문제를 고르게 평균 낼 때) 존재하지 않는다는 것이죠. 논문 서론은 이 결과가 던지는 질문을 “어떻게 알고리즘을 문제에 가장 잘 짝지을 것인가”라고 적었습니다.
물론 이 정리는 ‘가능한 모든 문제를 균등하게’ 평균 낸다는 강한 가정 위에 서 있고, 현실의 문제 분포는 균등하지 않습니다. 그래서 실무에서는 “만능은 없다”보다 “어떤 문제에 누가 강한지 배울 수 있다”가 더 쓸모 있는 교훈입니다.
같은 해 1월, 제록스 PARC의 버나도 후버만(Bernardo Huberman), 라즈 루코스(Rajan Lukose), 태드 호그(Tad Hogg)는 『Science』에 「An Economics Approach to Hard Computational Problems」를 실었습니다. 해리 마코위츠(Harry Markowitz)가 1952년 주식 포트폴리오 이론에서 보인 것 — 수익률이 들쭉날쭉한 자산들을 섞으면 위험은 줄고 기대 수익은 유지된다 — 을 알고리즘에 적용한 것입니다. 실행 시간이 들쭉날쭉한 알고리즘 여러 개를 나눠 돌리는 ‘계산 포트폴리오’를 잘 짜면, 어떤 단일 구성 알고리즘보다 확실히 나은 프로그램이 나온다는 것이죠. 2001년 코넬대의 카를라 고메스(Carla Gomes)와 바트 셀먼(Bart Selman)은 「Algorithm portfolios」(『Artificial Intelligence』 126권)에서 이를 더 밀어붙여, 혼자서는 들쭉날쭉해 쓸 수 없는 ‘위험 추구형’ 알고리즘이 포트폴리오 안에서는 오히려 승자가 될 수 있다는 것을 보였습니다.
3장의 F11+F21을 떠올려 보세요. 혼자서는 하위권인데 둘을 묶으면 상위권 조합을 이기는 것 — 고메스와 셀먼이 25년 전에 “포트폴리오 안에서만 빛나는 알고리즘”이라고 부른 바로 그 현상입니다.
2008년 — SATzilla, 대회를 휩쓴 ‘고르는 자’
이 계보의 가장 극적인 성공담은 SAT(명제 논리 충족 가능성) 문제에서 나왔습니다. SAT 풀이기(solver)는 수십 종이 있고, 매년 대회에서 경쟁합니다. 그런데 브리티시컬럼비아대학교의 린 쉬(Lin Xu), 프랑크 후터(Frank Hutter), 홀거 후스(Holger Hoos), 케빈 레이턴브라운(Kevin Leyton-Brown)이 만든 SATzilla는 새 풀이기를 만들지 않았습니다. 기존 풀이기들 중에서 문제마다 하나를 골라 주는 시스템이었습니다.
2008년 『JAIR』 논문의 초록이 문제의식을 정확히 요약합니다. “단 하나의 ‘지배적인’ SAT 풀이기는 없다. 서로 다른 풀이기가 서로 다른 문제에서 최고의 성능을 낸다. … 이 결정을 문제 단위로, 온라인으로 내리자.” SATzilla는 문제의 특징(변수 수, 절 수, 그래프 구조 등)에서 각 풀이기의 실행 시간을 예측하는 ‘경험적 난이도 모델’을 학습하고, 가장 빠를 것으로 예측된 풀이기를 실행합니다. 논문은 이 모델을 “완벽한 오라클의 휴리스틱 근사”라고 불렀습니다.
결과는 대회 메달로 나타났습니다. 2007년 SAT 대회에서 금 3, 은 1, 동 1개, 2009년에도 금 3개를 포함해 메달 5개를 땄고, 2012년 SAT Challenge에서도 우승했습니다. ‘고르는 자’가 ‘푸는 자’들을 이긴 겁니다.
FlowBank의 두 번째 단계(CuraFlow)와 정확히 겹치는 대목도 있습니다. SATzilla는 포트폴리오를 만들 때 검증 세트에서 풀이기들의 부분집합을 고르는 단계를 두었고, 논문에 이렇게 썼습니다. “포트폴리오에서 풀이기 하나를 아예 빼는 것이 포트폴리오 전체의 성능을 높일 수 있다.” 후보가 많을수록 고르는 쪽이 헷갈리기 때문입니다. FlowBank의 절제 실험(9장)이 18년 뒤에 똑같은 것을 다시 확인합니다.
VBS와 SBS — 이 분야가 오래 써 온 잣대
알고리즘 선택 분야는 성과를 재는 표준 잣대도 일찍부터 갖고 있었습니다. 2016년 『Artificial Intelligence』에 실린 벤치마크 라이브러리 ASlib(Bischl 등)의 정의를 옮기면 이렇습니다.
가상 최선 풀이기(Virtual Best Solver, VBS): 문제마다 최선의 풀이기를 완벽하게 골라 주는 가상의 풀이기 — FlowBank의 ‘오라클’이자 ‘커버리지’
단일 최선 풀이기(Single Best Solver, SBS): 모든 문제의 평균 성능이 가장 좋은 풀이기 하나 — 과제 수준 최적화가 배포하는 것
그리고 실제 선택기가 SBS에서 VBS까지의 거리 중 얼마를 메웠는지를 ‘메운 격차(gap closed)’로 잽니다. 정확도처럼 클수록 좋은 지표라면,
gap closed=AVBS−ASBSA선택기−ASBS
0이면 단일 최선과 같고, 1이면 오라클과 같으며, 음수면 단일 최선보다도 못하다는 뜻입니다. ASlib 논문이 든 예가 인상적입니다. 2014년 SAT 대회에서 풀이기 35개 중 단일 최선(Lingeling)은 문제 300개의 77%를 풀었지만, 문제마다 최선을 골랐다면 92%를 풀 수 있었습니다. 2017년 알고리즘 선택 대회의 최고 시스템들도 이 격차의 38%를 남겼습니다.
이 잣대를 기억해 두세요. FlowBank 논문은 이 지표를 보고하지 않지만, 공개 저장소의 예측 파일로 직접 계산할 수 있고, 10장에서 그렇게 해 봅니다.
1991년 — 전문가 혼합, 그리고 ‘하나만 고르는’ 게이트
신경망 쪽에서도 같은 생각이 자랐습니다. 1991년 로버트 제이컵스(Robert Jacobs), 마이클 조던(Michael Jordan), 스티븐 놀런(Steven Nowlan), 제프리 힌턴(Geoffrey Hinton)은 『Neural Computation』에 「Adaptive Mixtures of Local Experts」를 발표했습니다. 여러 ‘전문가’ 신경망과 함께, “각 학습 사례에 어느 전문가를 쓸지 정하는 게이팅 네트워크”를 두는 구조입니다. 흔히 전문가 혼합(Mixture of Experts, MoE)을 ‘여러 전문가의 답을 부드럽게 섞는 것’으로 기억하지만, 원 논문은 게이트가 매번 “단 하나의 전문가”를 확률적으로 고르게 하고 전문가들이 협력이 아니라 경쟁하도록 오차 함수를 짰습니다. 오늘날 대형 언어 모델 내부의 MoE 층이 토큰마다 일부 전문가만 켜는 것도 이 계보입니다.
FlowBank의 선택기도 ‘섞기’가 아니라 ‘하나 고르기’입니다. 워크플로 다섯 개의 답을 섞으려면 다섯 개를 다 돌려야 하고, 그러면 비용 절감이라는 목적이 사라지니까요.
2023년 이후 — LLM 라우터의 시대
LLM이 여럿 등장하자 ‘어느 모델에 보낼까’가 곧바로 비용 문제가 되었습니다.
FrugalGPT(Lingjiao Chen, Matei Zaharia, James Zou, 2023; TMLR 2024): 싼 모델부터 차례로 물어보고 답이 미덥지 않을 때만 비싼 모델로 넘기는 ‘계단식(cascade)’ 전략. “GPT-4의 성능을 최대 98% 적은 비용으로 맞추거나, 같은 비용으로 정확도를 4% 높인다.”(98%는 특정 데이터셋에서의 ‘최대’값입니다.)
Hybrid LLM(Dujian Ding 등, ICLR 2024): 질의 난이도를 예측해 작은 모델과 큰 모델 중 하나로 보내, 품질 저하 없이 큰 모델 호출을 최대 40% 줄임.
RouteLLM(Isaac Ong 등, LMSYS, 2024; ICLR 2025): 사람의 선호 데이터로 라우터를 학습. 블로그 발표 기준 MT-Bench에서 GPT-4 성능의 95%를 유지하며 비용을 85% 이상 절감(강한 모델 GPT-4 Turbo, 약한 모델 Mixtral 8x7B).
RouterBench(Qitian Jason Hu 등, 2024): 11개 모델, 40만 개가 넘는 샘플로 라우터를 평가하는 벤치마크. 여기서도 ‘오라클’은 “항상 최선의 LLM으로, 동점이면 가장 싼 LLM으로 보내는 라우터”로 정의됩니다 — FlowBank의 오라클과 같은 정의입니다.
GraphRouter(Tao Feng, Yanzhen Shen, Jiaxuan You, ICLR 2025): 과제·질의·LLM 노드로 이뤄진 이종 그래프를 만들고, 간선의 속성(효과와 비용)을 예측하는 방식으로 라우팅. FlowBank의 매칭 단계는 이 구현을 따랐다고 부록 C.4에 밝힙니다.
그리고 2025년 8월 7일, 라우팅은 수억 명이 쓰는 제품의 한복판에 들어왔습니다. 오픈AI는 GPT-5를 발표하며 이것을 “대부분의 질문에 답하는 똑똑하고 효율적인 모델, 더 어려운 문제를 위한 깊은 추론 모델(GPT-5 thinking), 그리고 대화의 유형·복잡도·도구 필요·명시적 의도에 따라 어느 쪽을 쓸지 빠르게 정하는 실시간 라우터로 이뤄진 통합 시스템”이라고 설명했습니다. 출시 다음 날 샘 올트먼이 “자동 전환기가 하루 중 상당 시간 고장 나 있었고, 그래서 GPT-5가 훨씬 멍청해 보였다”는 취지의 글을 올린 일은, 라우터가 틀리면 아무리 좋은 모델을 갖고 있어도 소용없다는 것을 대중에게 각인시킨 사건이었습니다.
그럼 FlowBank는 무엇이 새로운가
이 계보 위에 놓고 보면 FlowBank의 새로움은 세 가지로 좁혀집니다.
고르는 대상LLM 라우터가 ‘모델’을 고른다면, FlowBank는 같은 실행 모델(GPT-4o mini) 위에서 ‘워크플로’를 고른다. 모델이 하나뿐인 조직에도 라우팅의 이득이 생긴다.
후보의 출처SATzilla의 풀이기는 사람이 만들어 준 것이었다. FlowBank는 후보 자체를 LLM이 탐색해 만들고, 그 탐색을 처음부터 ‘포트폴리오에 보탬이 되는 쪽’으로 유도한다(DiverseFlow).
두 패러다임의 통합질의 수준 생성기(ScoreFlow) 자체를 은행의 카드 한 장으로 넣는다. ‘새로 짜기’는 버리는 것이 아니라 ‘가장 비싼 선택지’로 강등된다.
DiverseFlow는 AFlow의 탐색 구조를 그대로 물려받습니다. 한 라운드는 네 걸음입니다.
① 부모 고르기지금까지 찾은 워크플로 중 하나를 확률적으로 뽑는다.
② 수정안 내기최적화 LLM(여기서는 Qwen3-8B)이 부모의 코드와, 트리에 쌓인 과거 수정의 성공·실패 기록을 보고 새 워크플로 코드를 쓴다.
③ 평가하기새 워크플로를 학습 문제 전부에 실제로 돌려(실행 모델 GPT-4o mini) 문제별 점수와 비용을 기록하고 후보 풀에 넣는다.
④ 경험 남기기부모보다 나아졌으면 ‘성공’, 아니면 ‘실패’로 표시해 트리에 붙인다. 다음 라운드의 최적화 LLM이 이 기록을 참고한다.
부록 H에 실린 최적화 프롬프트를 보면 분위기를 알 수 있습니다. “주어진 그래프와 프롬프트를 참고해 재구성·최적화하라. 노드·파라미터·프롬프트를 추가·수정·삭제할 수 있다. 수정은 한 가지만 하라. … 검토, 수정, 앙상블(여러 답을 생성해 투표·통합·확인), 자기 질문 같은 비판적 사고 기법을 넣어 볼 수 있다. 파이썬의 반복문과 조건문을 고려하라.” LLM이 LLM 프로그램을 한 줄씩 고쳐 가는 진화 과정인 셈입니다.
핵심은 ①, 즉 누구를 부모로 삼느냐입니다. 여기서 DiverseFlow는 AFlow와 갈라집니다.
어려워 보이지만 두 부분의 혼합일 뿐입니다. 앞부분은 모두에게 똑같은 기회(1/n)를 주고, 뒷부분은 점수 η가 높을수록 기회를 몰아주는 소프트맥스입니다. ρ는 그 둘을 섞는 비율, α는 몰아주기의 날카로움입니다. 공개 코드의 기본값은 α=0.2, 균등 비율 0.3이고 점수는 백분율 단위로 씁니다. 탐험(아무나 뽑아 보기)과 활용(잘하는 놈 밀어주기)의 균형을 잡는 고전적인 장치입니다.
두 단계: 워밍업, 그리고 상보성 확장
DiverseFlow가 새로운 점은 점수 η를 도중에 바꾼다는 것입니다.
처음 N0라운드(논문 실험에서는 30라운드 중 7라운드)는 워밍업입니다. 점수는 그냥 학습 문제 전체 성능의 합, η(ω)=∑qe(ω,q)입니다. 잘하는 워크플로가 부모가 되어 잘하는 자식을 낳습니다. 일단 쓸 만한 후보들로 풀을 채우는 단계입니다.
그 뒤는 상보성 확장(complementarity-oriented expansion)입니다. 점수를 문제별 가중치를 곱한 성능으로 바꿉니다.
μˉ(q)는 그 문제를 이미 풀고 있는 워크플로가 몇 개인지에 반비례합니다. 아무도 못 푼 문제는 가중치가 최대(1)이고, 열 개가 푸는 문제는 1/11로 작아집니다. 그러니 남들이 못 푸는 어려운 문제를 푸는 워크플로가 점수를 많이 받아 부모로 자주 뽑힙니다. 그 자식들은 부모의 ‘특기’를 물려받아 그 근처를 더 탐색하게 되겠죠.
이것은 기계학습의 오래된 아이디어인 부스팅(boosting)을 떠올리게 합니다. 에이다부스트(AdaBoost)가 앞선 분류기들이 틀린 표본에 가중치를 높여 다음 분류기가 그것에 집중하게 하듯, DiverseFlow는 풀이 못 푼 문제에 가중치를 높여 탐색이 그쪽을 향하게 합니다. 다만 부스팅은 가중치를 ‘학습 데이터’에 걸고, DiverseFlow는 ‘부모 선택’에 건다는 차이가 있습니다.
아래 위젯에서 직접 확인해 보세요. 기본 판의 D는 정답률이 40%로 꼴찌지만, 남들이 아무도 못 푸는 세 문제(q8~q10)를 혼자 풉니다.
정말 더 보완적인 풀이 생기나 — 그림 9
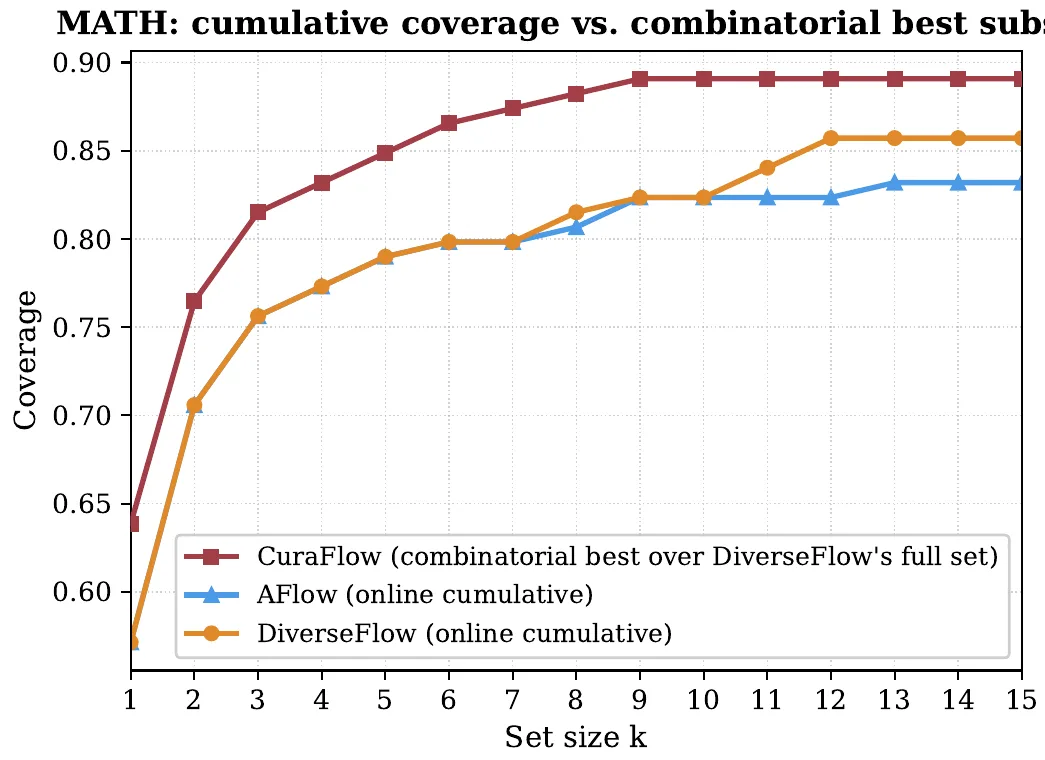
연구진은 통제 실험으로 이를 확인했습니다. MATH에서 AFlow와 DiverseFlow를 똑같이 20라운드 돌리되, DiverseFlow의 처음 7라운드는 AFlow와 완전히 같은 워크플로를 내도록 고정했습니다. 그다음 탐색 중에 쌓인 후보들의 누적 커버리지를 비교했습니다.
7라운드까지는 두 곡선이 겹칩니다(같은 워크플로니까요). 그 뒤 주황(DiverseFlow)이 파랑(AFlow) 위로 올라서고, 12개 시점에서 0.857 대 0.824로 차이가 벌어집니다. 상보성 가중치가 실제로 ‘다른 문제를 푸는’ 후보를 더 많이 찾아낸다는 증거입니다.
그런데 그림에는 빨간 선이 하나 더 있습니다. DiverseFlow가 다 찾은 뒤, 그 후보 전체에서 사후에 최적의 부분집합을 고른 곡선입니다. 빨간 선은 단 3개로 0.815에 도달합니다 — 주황 선이 8개를 쌓아야 닿는 높이입니다. 탐색은 ‘나중에 어떤 후보가 나올지’ 모른 채 순서대로 쌓기 때문에, 일찍 멈추면 최선의 팀이 안 됩니다. 그래서 두 번째 단계가 필요합니다.
마지막으로, 탐색이 끝난 풀에 ScoreFlow를 카드 한 장으로 추가합니다. 학습 문제마다 ScoreFlow가 워크플로를 생성하고 실행한 결과(생성 비용까지 포함한 토큰 비용)를 기록해 두면, ScoreFlow도 다른 정적 워크플로와 똑같은 ‘문제별 점수·비용’ 형식으로 표현됩니다. 이렇게 해서 MATH의 후보 풀 Ωraw는 30 + 1 = 31개가 됩니다. 3장의 위젯에서 본 바로 그 31개입니다.
7장. 2단계 CuraFlow — 31개 중 4개만 가방에 넣는다면
다 들고 가면 안 되나
후보 31개를 전부 은행에 넣고 선택기가 알아서 고르게 하면 안 될까요? 커버리지만 보면 다 넣는 게 가장 높습니다(MATH 86.6%). 하지만 논문은 두 가지 이유로 반대합니다.
수확 체감: 커버리지 곡선은 처음 몇 개에서 가파르게 오르다 금세 평평해집니다. 다섯 번째 이후 후보는 거의 아무것도 더하지 않습니다.
선택기의 부담: 선택지가 많을수록 ‘누구에게 보낼지’ 맞히기가 어려워집니다. 비슷비슷한 후보가 여럿이면 선택기는 그 미세한 차이를 배우느라 정작 중요한 차이를 놓칩니다. SATzilla가 2008년에 “풀이기를 빼면 오히려 좋아질 수 있다”고 쓴 이유와 같습니다.
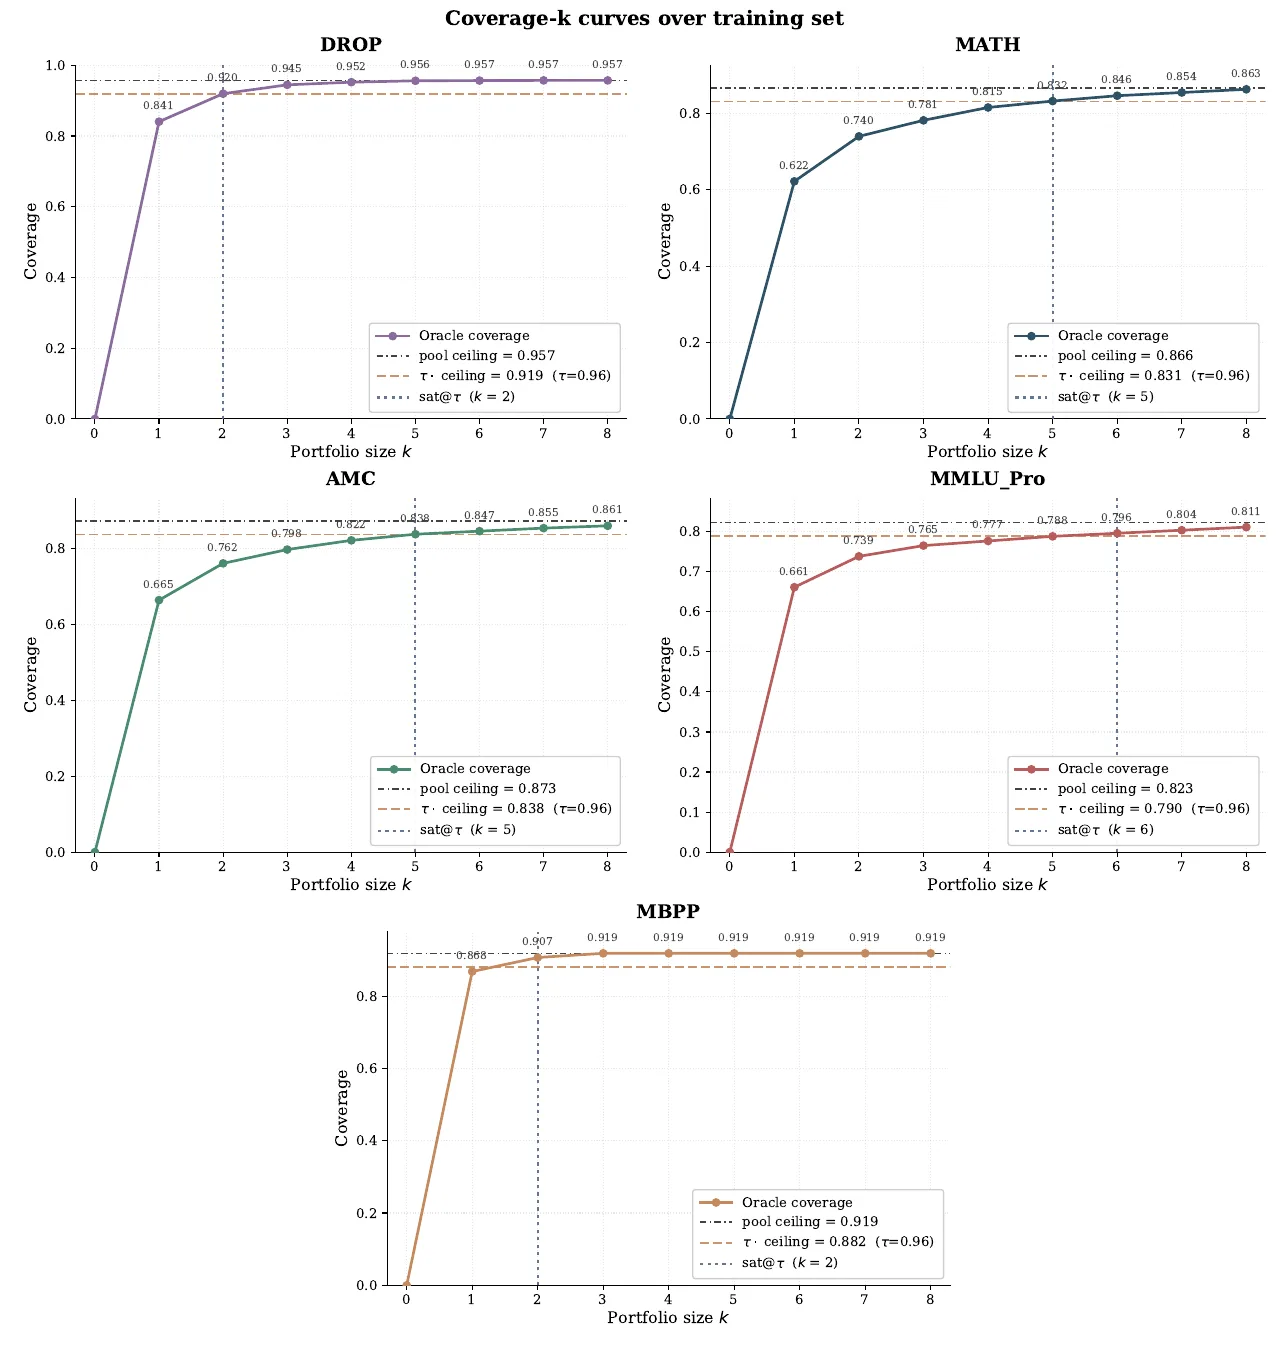
CuraFlow는 크기 k를 1부터 늘려 가며, 각 k에서 커버리지가 가장 큰 부분집합을 찾습니다.
Ωk∗=argΩ⊆Ωraw,∣Ω∣=kmaxCoverage(Ω)
이것은 조합 최적화의 고전인 최대 커버리지 문제(maximum coverage problem)입니다. 일반적으로는 NP-난해하지만, 후보가 31개이고 k가 6 이하라 모든 조합을 다 세어도 됩니다. 저장소의 결과 파일에 따르면 k=6에서 셈한 조합이 73만 6,281개입니다. 커버리지가 같은 조합이 여럿이면, 구성원들의 문제별 점수 벡터 사이 평균 상관계수가 가장 낮은 조합을 고릅니다. 행동이 서로 다른 팀을 선호하는 것이죠.
언제 멈출까 — 포화 비율 τ
몇 개를 넣을지는 식 (5)로 정합니다.
k∗=min{k:∣Ω∣=kmaxCoverage(Ω)≥τ⋅Coverage(Ωraw)}
‘전체 풀이 낼 수 있는 커버리지의 τ배에 처음 도달하는 크기’입니다. 논문은 τ=0.96을 썼습니다. 곡선이 평평한 구간에서 τ가 걸리면 k∗가 살짝 과대평가될 수 있어서, k∗와 k∗−1 두 크기의 포트폴리오를 모두 다음 단계에 넘기고 그중 나은 쪽을 씁니다.
그림 8에서 과제별 차이가 흥미롭습니다. DROP과 MBPP는 단 2개로 포화합니다. 첫 번째 워크플로 하나가 이미 커버리지 0.84~0.87을 차지하고, 두 번째가 남은 틈을 메우면 더 할 게 거의 없습니다. 반면 MATH·AMC·MMLU Pro는 5~6개가 필요합니다. 수학 경시 문제와 13개 분야에 걸친 지식 문제는 ‘어떤 풀이 전략이 통하는가’가 문제마다 크게 다르다는 뜻이겠죠. 다만 실제로 배포된 포트폴리오는 MATH 4개(k*−1을 택함), AMC 5개, DROP 2개, MBPP 2개였습니다.
탐욕 알고리즘과 1 − 1/e
후보가 수백 개로 늘면 전수 탐색은 불가능합니다. 이때를 위해 논문은 탐욕(greedy) 변형을 제시합니다. 빈 집합에서 시작해, 매번 커버리지를 가장 많이 늘리는 후보를 하나씩 더합니다.
이 단순한 방법에는 아름다운 보장이 붙어 있습니다. 커버리지 함수는 단조 서브모듈러(monotone submodular) 함수입니다. ‘서브모듈러’란 수확 체감의 수학적 표현으로, 집합이 클수록 새 원소 하나가 더해 주는 몫이 작아진다는 성질입니다(이미 팀이 많은 문제를 풀고 있으면, 새 팀원이 ‘혼자만 푸는’ 문제는 줄어드니까요). 1978년 조지 네멀하우저(George Nemhauser), 로런스 울시(Laurence Wolsey), 마셜 피셔(Marshall Fisher)는 이런 함수를 크기 제한 아래 최대화할 때 탐욕 알고리즘이 최적값의 최소 1−1/e≈63.2%를 보장한다는 것을 증명했습니다. 1998년 우리엘 파이기(Uriel Feige)는 P≠NP라면 다항 시간 알고리즘으로 이보다 나은 보장은 불가능하다는 것까지 보였습니다. 63.2%가 사실상 이 문제의 ‘자연 상수’인 셈입니다.
실제 데이터에서는 보장보다 훨씬 잘합니다. 3장 위젯의 MATH 31개 풀에서 탐욕 선택은 k=4에서 79.0%, 전수 최적은 81.5%였습니다. 최적의 97% 수준입니다. 그래도 2.5점 차이는 작지 않고, 후보가 수십 개 수준이라면 전수 탐색을 하는 편이 낫다는 것도 이 숫자가 말해 줍니다.
1단계와 2단계는 왜 모순이 아닌가
1단계는 후보를 ‘늘리고’, 2단계는 ‘줄입니다’. 모순처럼 보이지만 논문은 이렇게 정리합니다. DiverseFlow는 쓸모 있는 행동을 빠짐없이 찾는 재현율(recall)을 높이고, CuraFlow는 배포할 포트폴리오의 정밀도(precision)와 실용성을 높인다. DiverseFlow 없이는 CuraFlow가 보존할 보완적 재료가 없고, CuraFlow 없이는 DiverseFlow가 불필요하게 중복되고 비싼 풀을 남긴다.
8장. 3단계 매칭 — 문제와 워크플로를 잇는 이분 그래프
왜 그냥 분류기가 아닌가
포트폴리오가 정해졌으니 이제 ‘새 문제가 오면 누구에게 보낼까’만 남았습니다. 가장 쉬운 방법은 문제를 넣으면 워크플로 번호(W1~W4)를 맞히는 다중 분류기를 학습하는 것입니다. 하지만 논문은 두 가지 이유로 이를 피합니다.
동점이 흔하다: 쉬운 문제는 네 워크플로가 모두 맞힙니다. 분류기는 ‘정답 레이블’을 하나로 정해야 하니 임의로 하나를 골라야 하고, 그러면 의미 없는 구분을 억지로 배웁니다.
관계를 버린다: 분류기는 W1~W4를 서로 무관한 레이블로 취급합니다. ‘W2와 W3는 둘 다 코드 검증을 쓴다’ 같은 워크플로 사이의 유사성, ‘이 문제와 비슷한 문제들에서 누가 잘했나’ 같은 문제 사이의 유사성을 활용하지 못합니다.
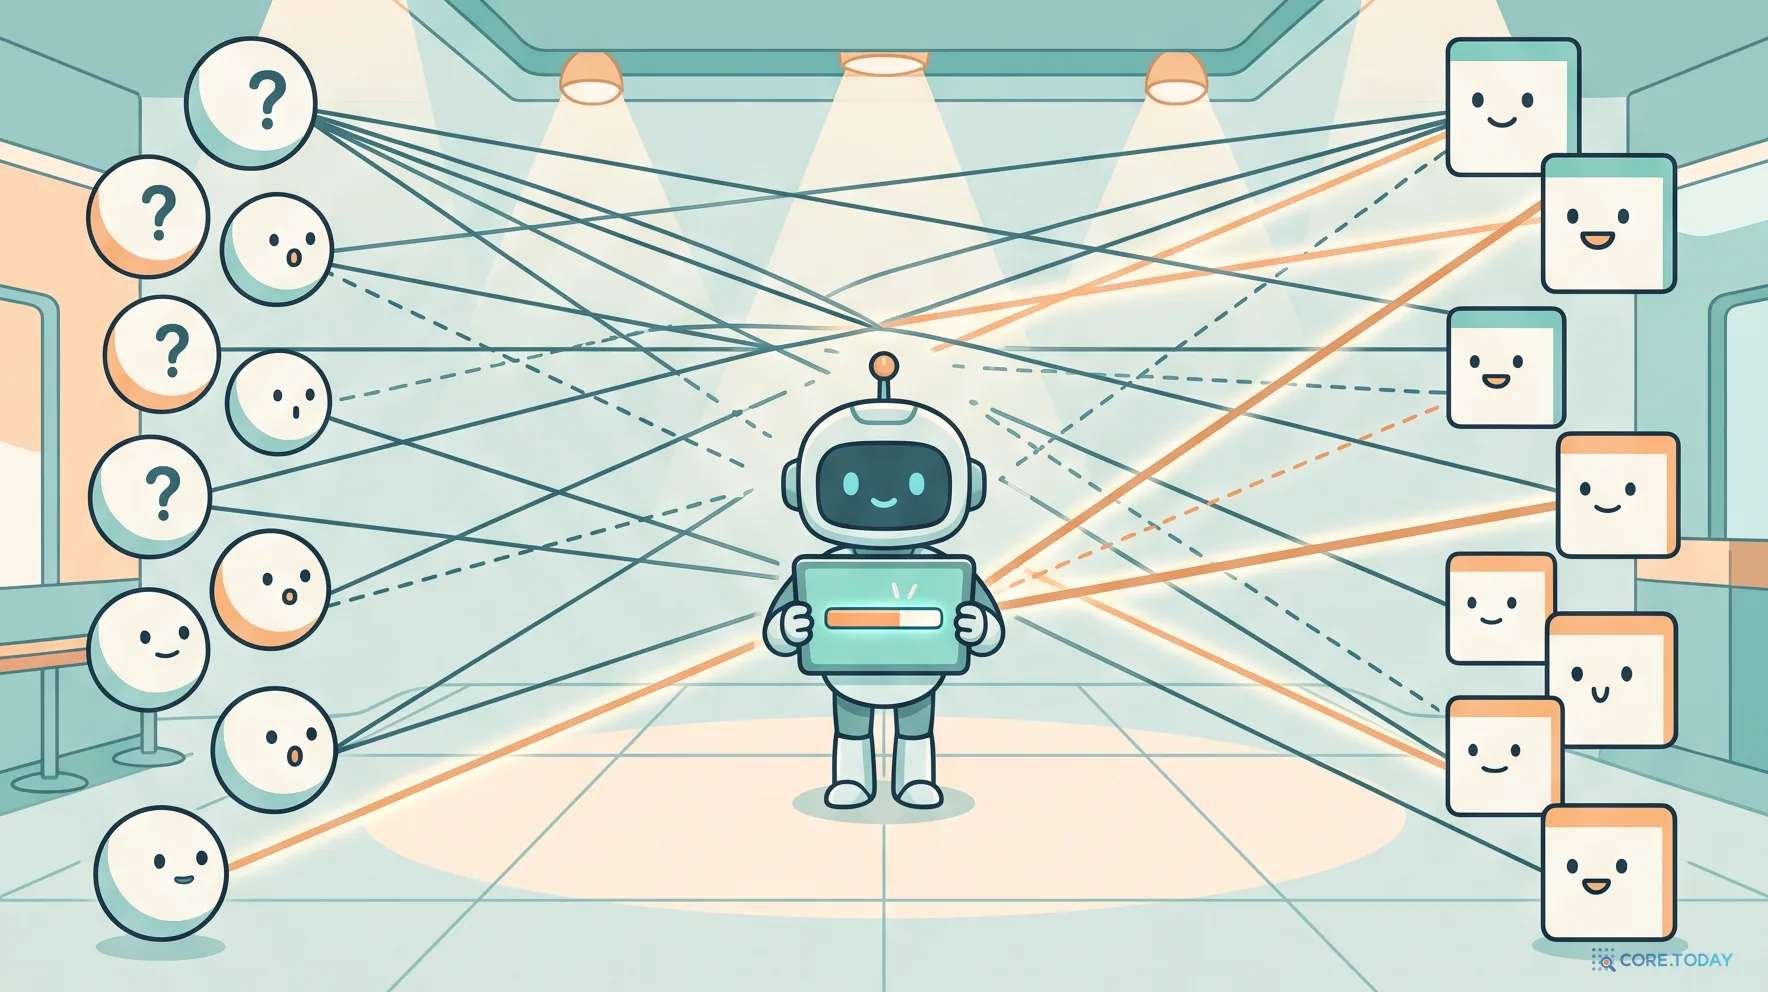
그래서 FlowBank는 문제를 이분 그래프(bipartite graph)로 바꿉니다. 한쪽에는 문제(질의) 노드, 다른 쪽에는 워크플로 노드를 놓고, 모든 문제–워크플로 쌍 사이에 간선을 긋습니다. 각 간선에는 ‘이 짝이 얼마나 좋은가’를 나타내는 값을 붙입니다.
vq,ω=(1−λ)⋅e~q,ω+λ⋅(1−c~q,ω)
e~와 c~는 학습 문제 전체에서 정규화한 성능과 비용이고, λ는 비용을 얼마나 중시할지 정하는 저울추입니다. λ=0이면 성능만, λ가 클수록 ‘싸게 맞히는’ 짝을 선호합니다.
이렇게 바꾸면 워크플로 선택은 추천 시스템의 문제와 같아집니다. 넷플릭스가 사용자–영화 이분 그래프에서 ‘이 사용자가 이 영화에 몇 점을 줄까’를 예측하듯, FlowBank는 문제–워크플로 그래프에서 ‘이 문제를 이 워크플로가 얼마나 잘 처리할까’를 예측합니다. 2006년 10월 시작해 2009년 9월 100만 달러 상금이 수여된 넷플릭스 프라이즈(1억 개 넘는 평점, 우승 팀 BellKor's Pragmatic Chaos의 개선율 10.06%)는 이런 협업 필터링을 대중에게 알린 사건이었고, 2017년 반 덴 베르흐(van den Berg)·키프(Kipf)·벨링(Welling)의 「그래프 합성곱 행렬 완성」은 이를 명시적으로 “사용자–아이템 이분 그래프에서의 링크 예측”으로 재정식화했습니다. FlowBank의 매칭은 이 흐름의 직계 후손입니다.
문제 노드: 질의 텍스트를 OpenAI의 text-embedding-3-small로 임베딩한 벡터
워크플로 노드: 워크플로 코드를 GPT-4o가 자연어로 요약한 설명문을 같은 모델로 임베딩한 벡터. 1장 위젯의 ‘세 가지 말투로 풀고 다수결, LLM 4회, 코드 검증 없음…’ 같은 설명이 바로 이것입니다.
두 종류의 노드를 이종(heterogeneous) GNN이 타입별 변환을 거쳐 같은 공간으로 보내고, 그래프 위로 정보를 주고받게 합니다. 2층 GNN 인코더 뒤에 MLP 디코더를 붙여 간선 값 v^q,ω=fθ(q,ω)를 예측합니다.
가리고 맞히기 — 마스킹 학습
학습 방식은 BERT의 마스크 언어 모델과 닮았습니다. 학습 문제 × 포트폴리오의 모든 간선 중 일부를 무작위로 골라 값을 가리고, 나머지 보이는 그래프로 정보를 전파해 가린 값을 맞히게 합니다. 손실은 간선마다의 이진 교차 엔트로피(목표값이 0~1 사이의 ‘부드러운’ 값)입니다. 동점은 자연스럽게 해결됩니다. 네 워크플로가 모두 맞힌 문제라면 네 간선이 같은 목표값을 갖고, 모델은 그중 하나를 억지로 구분할 필요가 없습니다.
새 문제가 오면
배포 시점에 새 문제가 오면 임베딩해서 그래프에 새 노드로 붙이고, 포트폴리오의 모든 워크플로 노드와 잇습니다. GNN을 한 번만 통과시키면 모든 워크플로에 대한 예측값이 나오고, 가장 큰 것을 고릅니다.
πθ(q)=argω∈Ω∗maxfθ(q,ω)
예측값이 같으면 학습 데이터에서 더 쌌던 워크플로를 고릅니다. 이 선택 비용은 작은 그래프 위의 순전파 한 번이라, 워크플로를 실행하는 LLM 호출 비용에 비하면 사실상 0입니다. 학습도 가볍습니다. 부록에 따르면 24GB짜리 RTX A5000 한 장에서 실행 하나가 GPU 메모리 300~400MB를 쓰고, 500스텝 학습이 7~8분, 하이퍼파라미터 전체 탐색이 한 시간 안에 끝났습니다. 다만 질의 임베딩에 외부 API 호출이 한 번 들어간다는 점은 실무에서 계산에 넣어야 합니다.
λ 다이얼 돌려 보기
λ가 실제로 어떻게 작동하는지, DROP 포트폴리오의 두 워크플로로 손 계산을 해 봅시다. W1은 질문 유형을 분류해 숫자 문제는 코드로, 날짜·이름 문제는 전용 프롬프트로 처리하는 LLM 2회짜리 싼 워크플로이고, W2는 문제마다 새 그래프를 짜는 ScoreFlow입니다. 저장소 기준 평균 비용은 W1이 문제당 0.22, W2가 1.42(×10⁻³달러)로 6배 넘게 차이 납니다.
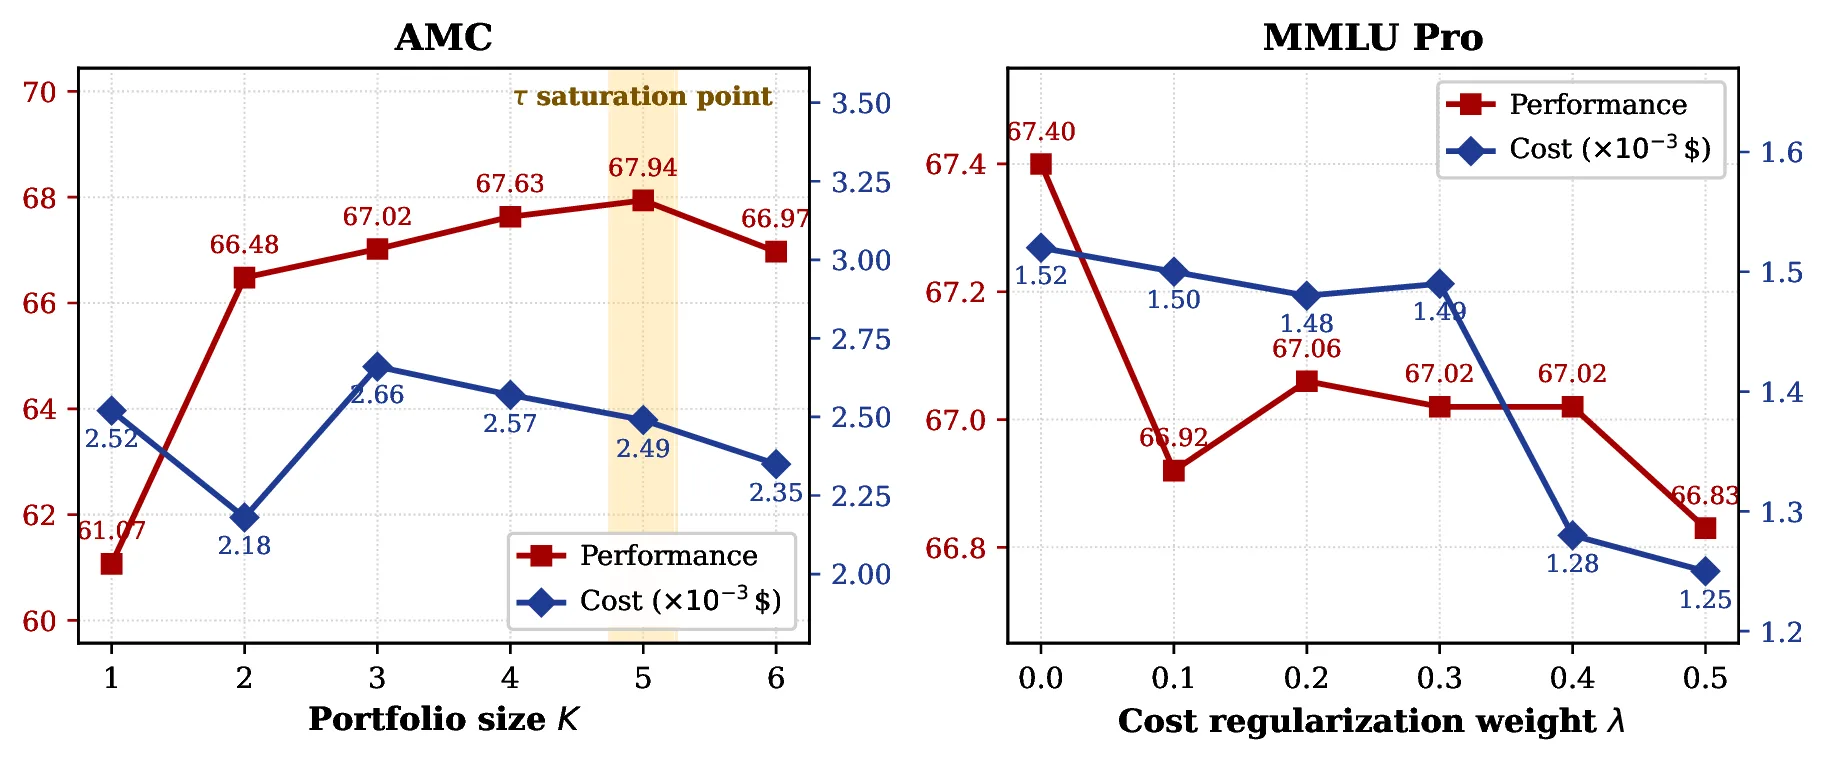
위젯에서 보듯 ‘둘 다 맞히는’ 문제에서는 λ가 아주 조금만 있어도 싼 쪽이 이깁니다. 4장의 그림 3에서 오라클이 문제의 63%를 정적 워크플로로 보낸 원리가 바로 이것입니다. 반면 비싼 쪽만 맞히는 문제에서는 λ가 0.54 남짓까지 올라가야 비용 때문에 정답을 포기합니다. 연구진은 λ∈{0,0.1,…,0.5}를 격자로 탐색했고, 실제 공개된 체크포인트는 DROP에서 0.0, MATH·MBPP에서 0.1, AMC에서 0.3을 썼습니다.
최적화 모델 대목이 중요합니다. FlowBank는 탐색에 80억 파라미터의 작은 오픈 모델(Qwen3-8B)을 썼는데, 가장 강한 비교 대상인 AFlow는 GPT-4o 버전입니다. 탐색기가 더 약한데도 이겼다면, 성과가 ‘더 좋은 모델’이 아니라 ‘포트폴리오라는 구조’에서 왔다는 주장에 힘이 실립니다.
표 1 — 다섯 벤치마크 모두 1위
방법
MATH
AMC
MBPP
DROP
MMLU Pro
평균 성능
평균 비용
MultiPersona (최고 수작업)
57.41
53.74
70.38
76.13
61.70
63.87
0.41
AgentSquare
62.76
58.78
72.73
76.84
63.75
66.70
1.02
AFlow (GPT-4o)
63.99
63.77
83.77
80.26
65.61
70.40
1.95
MaAS
65.02
63.36
79.08
76.64
62.31
68.09
1.90
ScoreFlow
62.00
60.15
83.63
82.10
64.58
69.51
2.37
FlowBank
69.34
67.94
84.26
83.49
67.40
73.40
1.65
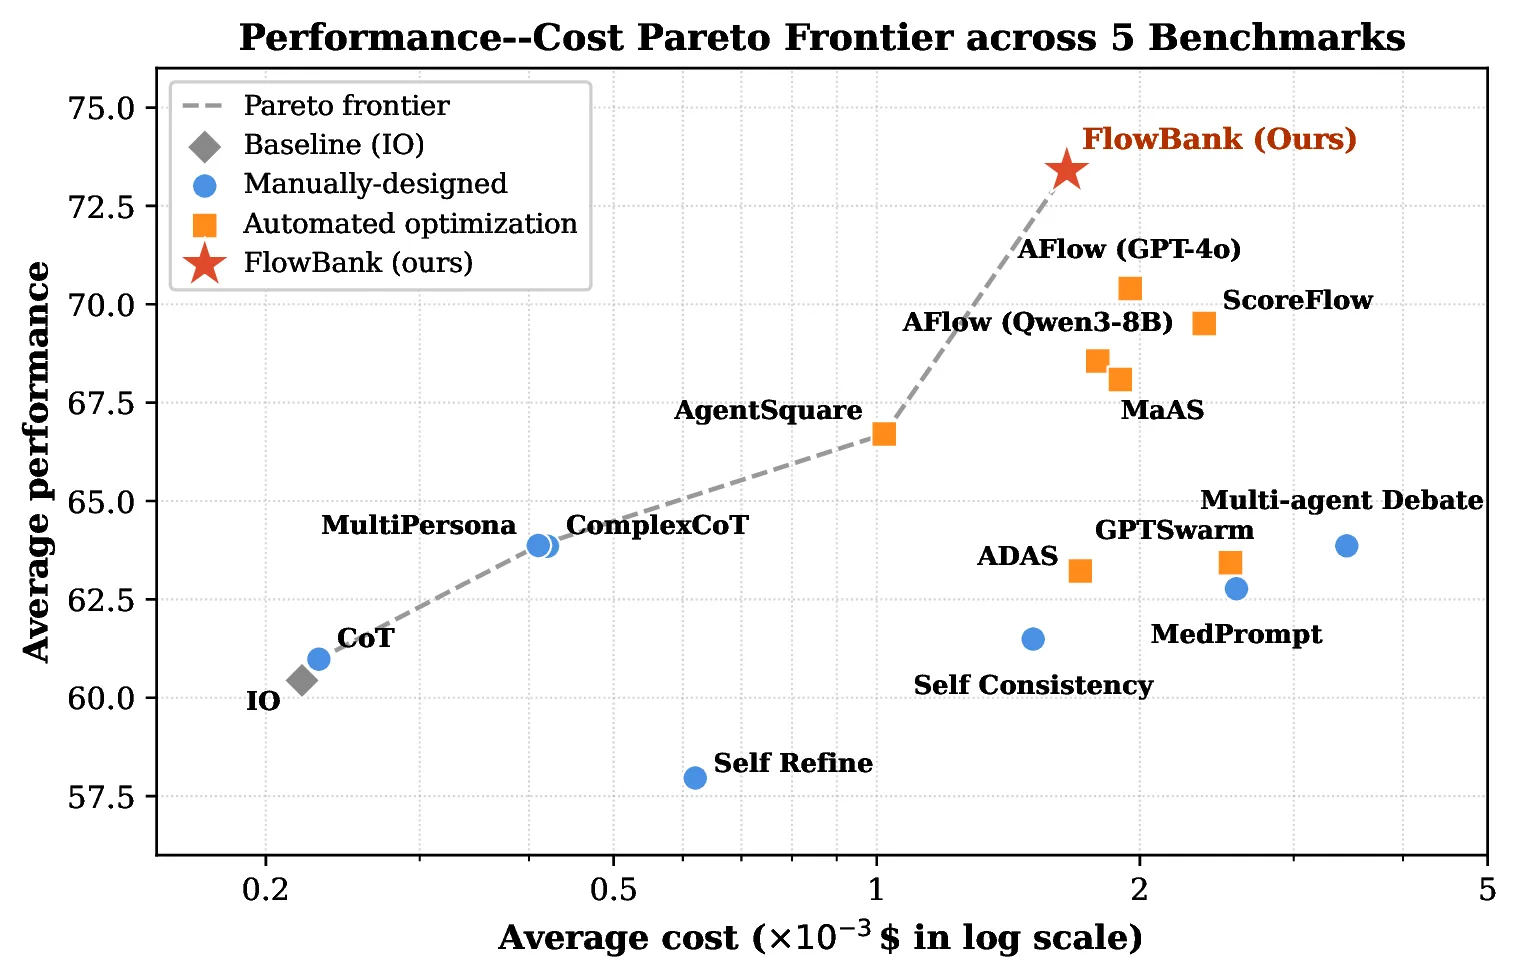
FlowBank는 다섯 벤치마크 모두에서 1위이고, 평균 73.40으로 가장 강한 자동화 기준선 AFlow(GPT-4o)의 70.40보다 3.00점(상대 4.26%), 가장 강한 수작업 기준선 MultiPersona의 63.87보다 9.53점(상대 14.92%) 높습니다. 초록의 ‘4.26%와 14.92%’는 이 상대 개선율입니다. 평균 비용 1.65는 AFlow(1.95)·ScoreFlow(2.37)보다 낮습니다. AgentSquare가 1.02로 더 싸지만 성능이 6.70점 낮습니다.
다만 벤치마크마다 우위의 크기가 꽤 다릅니다. 수학 두 개(MATH +4.32점, AMC +4.17점 — 각 벤치마크 2위 대비)에서는 차이가 뚜렷하지만, MMLU Pro(+1.79), DROP(+1.39), MBPP(+0.49)에서는 작습니다. 이 차이가 의미하는 바는 10장에서 다시 따집니다.
아래 위젯은 같은 표를 벤치마크별로 쪼개고, 하루 처리량을 넣으면 ‘정답 1만 개를 얻는 데 얼마가 드는지’를 계산해 줍니다. 벤치마크를 바꿔 가며 파레토 경계가 어떻게 달라지는지 보세요. 예를 들어 MBPP에서는 IO와 CoT가 거의 공짜로 70%대를 내고 있어, 코드 문제에서 복잡한 워크플로가 버는 몫이 생각보다 작다는 것도 드러납니다.
이 ‘성능과 비용을 함께 그리는’ 습관 자체가 이 분야에서 중요한 진전입니다. 2024년 프린스턴의 사야시 카푸르(Sayash Kapoor)와 아빈드 나라야난(Arvind Narayanan) 등은 「AI Agents That Matter」(TMLR)에서, HumanEval 코딩 에이전트들을 비용과 함께 비교했더니 단순히 실패 시 재시도하는 GPT-4 기준선(정확도 92.0%, 총비용 2.51달러)이 복잡한 트리 탐색 에이전트 LATS(88.0%, 134.50달러)보다 정확하면서 50배 넘게 쌌다고 보고했습니다. “정확도가 비슷해도 비용은 거의 100배까지 차이 날 수 있다.” 정확도만 적힌 리더보드는 반쪽짜리 성적표라는 것이죠. FlowBank의 그림 5는 이 교훈을 반영한 보고 방식입니다.
절제 실험 — 세 단계 중 하나라도 빼면
표 2는 세 단계 각각을 다른 것으로 갈아 끼웠을 때의 성능입니다. ‘오라클’ 열은 그 포트폴리오에서 문제마다 정답을 아는 심판이 골랐을 때(테스트 세트 기준)의 상한입니다.
설정
MATH 성능
MATH 오라클
DROP 성능
DROP 오라클
전체 (세 단계 모두)
69.34
83.74
83.49
90.47
1단계 → AFlow로 교체
67.69
79.01
82.98
89.95
2단계 → 정확도 상위 k로 교체
67.90
80.66
82.37
86.73
2단계 생략 (후보 전체 사용)
68.11
92.04
82.45
96.59
3단계 → 단순 MLP 분류기로 교체
68.72
83.74
82.83
90.47
네 줄 모두 흥미롭지만, 가장 많은 것을 말해 주는 건 넷째 줄입니다. 후보 전체를 쓰면 오라클은 92.04로 치솟는데, 실제 성능은 68.11로 오히려 떨어집니다. 선택지가 31개가 되자 선택기가 헷갈린 겁니다. 오라클이 높다고 좋은 포트폴리오가 아닙니다. 선택기가 실제로 활용할 수 있는 크기의 포트폴리오가 좋은 포트폴리오입니다. SATzilla의 “풀이기를 빼면 오히려 좋아질 수 있다”가 2026년에 그대로 재현된 셈입니다.
둘째 줄과 셋째 줄은 1·2단계의 기여를 보여 줍니다. AFlow 후보로 만든 포트폴리오는 오라클이 4.7점 낮고(79.01 vs 83.74), 정확도 상위 k로 고르면 3.1점 낮습니다(80.66). 이 차이가 실제 성능 1.4~1.7점 차이로 이어졌습니다. 마지막 줄은 GNN 대신 단순 MLP 분류기를 쓴 경우로, 같은 포트폴리오(오라클 동일)에서 0.6점 낮습니다.
솔직히 말하면 이 차이들은 크지 않습니다. MATH 테스트 문제가 486개이니, 1점은 약 5문제입니다. 0.6점(약 3문제)의 차이가 GNN의 우위를 입증한다고 말하기에는 이 실험 하나로는 부족합니다. 표에는 반복 실행이나 신뢰구간이 없습니다.
그림 6 왼쪽은 절제 실험의 넷째 줄을 연속적으로 보여 줍니다. AMC에서 워크플로 하나(K=1)일 때 61.07이던 성능이 다섯 개(K=5)에서 67.94까지 오르다가, 여섯 개에서 66.97로 떨어집니다. ‘많을수록 좋다’가 아니라 ‘포화점에서 멈춰라’입니다. 오른쪽의 λ 실험은 8장 위젯에서 이미 봤습니다. λ를 0에서 0.4로 올리면 비용이 16% 줄고 성능은 0.38점 떨어집니다.
10장. 비판적으로 읽기 — 공개 저장소로 다시 계산해 본 것들
좋은 논문일수록 꼼꼼히 읽을 가치가 있습니다. FlowBank는 코드와 중간 산출물, 학습된 선택기와 테스트 예측 파일까지 공개했고, 덕분에 독자가 숫자를 직접 검증할 수 있습니다. 이것은 그 자체로 칭찬받을 일입니다. 코어닷투데이가 저장소의 experiments/example/*/test_predictions.json 네 개를 문제 단위로 다시 집계해 보니, 선택기의 정확도가 표 1과 소수점 둘째 자리까지 정확히 일치했습니다(MATH 69.34, AMC 67.94, MBPP 84.26, DROP 83.49). 오라클도 표 2와 같았습니다(MATH 83.74, DROP 90.47). 테스트 문제 배정 비율도 MATH(3.3·30.2·30.7·35.8%)와 DROP(27.9·72.1%)는 그림 7과 똑같았습니다.
그 위에서, 몇 가지를 더 따져 봅니다.
① 선택기는 오라클이 보여 준 길의 2할 남짓을 걸었다
5장에서 소개한 알고리즘 선택 분야의 잣대, ‘메운 격차’를 계산해 봅시다. 단일 최선(SBS) 자리에는 ‘포트폴리오 구성원 중 테스트 성적이 가장 좋은 워크플로’를 놓았습니다(테스트 성적을 보고 고른 것이니 선택기에 불리한, 엄격한 기준입니다).
네 벤치마크에서 메운 격차는 MATH 24.7%, DROP 16.6%, AMC 17.9%, MBPP 18.6%입니다. 선택기는 분명히 최고 단독 구성원보다 낫습니다(+0.6~4.7점). 하지만 오라클까지 남은 거리의 4분의 3 이상이 여전히 남아 있습니다. MATH에서는 선택기 69.34와 오라클 83.74 사이에 14.4점, 즉 테스트 문제 70개 정도가 ‘포트폴리오 안의 누군가는 맞히는데 엉뚱한 곳으로 보낸’ 문제입니다.
이것은 FlowBank의 약점이라기보다 이 문제가 얼마나 어려운지를 보여 줍니다. 질의 텍스트의 임베딩만 보고 ‘이 수학 문제는 코드 검증이 필요한 유형’임을 맞히는 것은 쉽지 않습니다. SAT 분야에서도 2017년 최고 시스템들이 격차의 38%를 남겼으니, FlowBank의 선택기에는 아직 개선 여지가 크다는 뜻이고, 동시에 포트폴리오라는 아이디어의 잠재력이 실제 성과보다 훨씬 크다는 뜻이기도 합니다. 연구 방향으로 보면 ‘더 좋은 후보 찾기’보다 ‘더 좋은 선택기 만들기’에 남은 이득이 더 많습니다.
② 선택기 체크포인트는 테스트 점수로 골랐다
위젯 아래쪽의 학습 곡선을 보세요. 공개된 네 설정의 데이터 분할 비율은 모두 split_ratio: [0.2, 0.0, 0.8], 즉 검증 세트가 없습니다. 학습 코드(QueryMatching/model/graph_nn.py)는 검증 세트가 있으면 검증 점수로, 없으면 테스트 점수로 가장 좋은 에폭의 모델을 저장합니다. 코드 주석이 이를 스스로 “potential data leakage but no alternative without val set(데이터 누출 가능성이 있지만 검증 세트 없이는 대안이 없다)”이라고 적고 있습니다.
graph_nn.py — 체크포인트 선택 부분 (원문 주석)
# Model selection: if val set exists, use val_result (selector-effect on val,
# higher=better, same metric as test_result). Otherwise fall back to test_result
# (potential data leakage but no alternative without val set).
if has_val:
select_metric = val_result
else:
select_metric = test_result
학습 로그를 보면 저장된 체크포인트는 MATH 291에폭, DROP 50에폭, AMC 165에폭, 그리고 MBPP는 0에폭(학습 시작 전)입니다. 저장 지점의 테스트 결합 점수는 마지막 100에폭의 중앙값보다 0.017~0.026 높습니다. 결합 점수에는 비용 항이 섞여 있어 정확도로 정확히 환산할 수는 없지만, 대략 1~3점 정도의 낙관 편향이 들어갔을 수 있다고 보는 게 합리적입니다. λ 격자(6개 값)와 포트폴리오 크기(k∗ 또는 k∗−1)를 무엇을 보고 골랐는지도 논문에 적혀 있지 않습니다.
이 편향의 크기를 공정하게 놓고 보면 이렇습니다. MATH(+4.32점)와 AMC(+4.17점)에서의 우위는 편향의 추정 범위보다 크므로 결론이 뒤집히지 않을 가능성이 높습니다. 반면 DROP(+1.39점)과 MBPP(+0.49점)의 우위는 편향 범위 안에 있어, 이 두 벤치마크에서 ‘1위’라는 결론은 검증 세트를 둔 재실험 전까지 유보하는 게 맞습니다. 학습 문제가 86~260개로 작아서 검증 세트를 떼기 어려웠던 사정은 이해되지만, 그렇다면 교차 검증이나 학습 세트 일부를 검증용으로 돌리는 방법이 있었을 것입니다.
③ ‘즉석 생성 없이’라고 하기엔, 은행 안에 ScoreFlow가 있다
FlowBank의 서사는 “질의 수준 생성의 비용을 치르지 않고 적응성을 얻는다”입니다. 그런데 실제 포트폴리오를 열어 보면 다섯 벤치마크 중 적어도 세 곳(DROP, AMC, MBPP)에 ScoreFlow가 구성원으로 들어 있고, 공개 체크포인트 기준으로 DROP 테스트 문제의 72.1%, MBPP의 96.2%가 ScoreFlow로 갑니다.
MBPP를 자세히 보면, 포트폴리오는 ScoreFlow(W1)와 정적 워크플로 하나(W2)뿐이고, 선택기는 341문제 중 328문제를 ScoreFlow로 보냅니다. FlowBank의 MBPP 성능 84.26은 ScoreFlow 단독(같은 테스트 세트에서 83.68)보다 0.58점 높고, 비용은 1.66으로 ScoreFlow(1.70)와 거의 같습니다. 이 벤치마크에서 FlowBank는 사실상 ‘ScoreFlow에 가끔 우회로를 붙인 것’입니다.
이것이 잘못이라는 뜻은 아닙니다. 오히려 FlowBank의 설계 철학 — 즉석 생성기를 ‘가장 비싼 카드 한 장’으로 강등시켜 꼭 필요한 문제에만 쓴다 — 이 의도대로 작동한 결과일 수 있습니다. DROP에서는 문제의 28%를 6분의 1 가격의 W1로 돌려 비용을 1.42에서 1.06으로 줄이면서 점수도 올렸습니다. 다만 “문제마다 워크플로를 생성하지 않는다”는 인상과 실제는 다르니, 읽을 때 구분해야 합니다. 또 MATH와 AMC처럼 ScoreFlow 비중이 0~1%인 벤치마크에서 FlowBank의 우위가 가장 컸다는 점은, 이 방법의 진짜 힘이 ‘정적 워크플로들 사이의 상보성’에서 나온다는 것을 시사합니다.
④ 장부에 안 적힌 비용
표 1의 비용은 추론 시점의 문제당 토큰 비용뿐입니다. FlowBank를 만들기 위해 쓴 오프라인 비용 — DiverseFlow 30라운드(매 라운드 새 워크플로를 학습 문제 전부에 실행), ScoreFlow 생성기의 DPO 학습과 학습 문제 전부에 대한 생성·실행, 워크플로 설명문 생성, 임베딩 — 은 들어 있지 않습니다. 과제 수준 기준선들도 탐색 비용이 빠져 있으니 비교 자체는 공정하지만, 처리량이 적은 서비스라면 이 고정비가 문제당 절감액을 압도할 수 있습니다. 3장에서 본 엘 등의 연구가 “자동 설계는 1만 5천 건 이상 처리해야 본전”이라고 한 것과 같은 계산이 FlowBank에도 필요합니다.
⑤ 그 밖에 기억할 것들
작은 학습 세트와 2024년 시절 벤치마크: 학습 문제가 86~260개이고, MATH·MBPP·DROP은 최신 모델에겐 이미 쉬운 편입니다. 다섯 벤치마크 모두 정답이 분명한 과제라, 정답 판정이 애매한 실무 과제(요약, 고객 응대, 장문 작성)에서 e(ω,q)를 어떻게 매길지는 열린 문제입니다.
실행 모델 하나: 모든 실험이 GPT-4o mini 하나로 돌았습니다. 실행 모델이 바뀌면 워크플로들의 상대적 강약도 바뀔 수 있어, 은행을 다시 만들어야 할 수 있습니다.
고정된 은행: 논문 스스로 한계로 꼽듯, 포트폴리오는 한 번 만들면 고정됩니다. 문제 분포가 바뀌거나(새로운 유형의 질문) 새 워크플로가 나와도 자동으로 반영되지 않습니다.
작은 재현 차이: MBPP의 공개 체크포인트는 배정 비율(96.2% 대 그림 7의 93.8%)과 비용(1.66 대 1.62)이 논문과 조금 다르고, AMC도 W2·W5 비율이 소수점 수준에서 다릅니다. 정확도는 일치하므로 결론에 영향은 없습니다.
그래도 남는 것
이 비판들을 다 감안해도, 이 논문이 남기는 핵심 통찰은 흔들리지 않습니다. 표 2의 오라클 열과 그림 8의 커버리지 곡선은 테스트 체크포인트 선택과 무관하게 성립합니다. 고만고만한 워크플로들이 서로 다른 문제를 푼다는 것, 정확도로 고른 팀보다 커버리지로 고른 팀이 낫다는 것, 너무 많은 후보는 선택기를 헷갈리게 한다는 것 — 이 세 가지는 공개 데이터로 누구나 확인할 수 있는 사실입니다.
11장. 2026년의 FlowBank — 스킬, 플랜 캐시, 그리고 라우터의 시대
토큰은 폭발하고 있다
왜 지금 이런 논문이 중요한지는 숫자가 말해 줍니다. 오픈라우터(OpenRouter)와 a16z가 2025년 12월 공개한 ‘100조 토큰’ 분석(2026년 1월 arXiv)에 따르면, 2025년 초 미미했던 추론 모델의 토큰 비중이 연말에는 전체의 절반을 넘었고, 요청당 평균 프롬프트 길이는 약 1,500토큰에서 6,000토큰 이상으로 4배가 됐습니다. 보고서의 한 절 제목은 “에이전트 추론이 새로운 기본값(Agentic Inference Is the New Default)”입니다. 구글은 2026년 5월 I/O에서 자사 서비스 전체의 월간 처리 토큰이 3.2천조(quadrillion) 개로, 1년 전(약 480조)의 약 7배가 됐다고 밝혔습니다(자체 발표 수치이며 API만이 아니라 전 서비스 합계입니다).
이런 세계에서 “문제마다 워크플로를 새로 설계한다”는 것은, 이미 폭증하는 토큰 위에 ‘설계 토큰’을 한 겹 더 얹는 일입니다. 반대로 “모두에게 같은 워크플로”는 쉬운 질문에 토론 세 라운드를 돌리는 낭비를 낳습니다. FlowBank가 겨냥하는 것은 그 사이, 미리 만든 것을 골라 쓰는 경제학입니다.
스킬은 사람이 만든 워크플로 은행이다
2026년의 독자에게 FlowBank가 가장 친숙하게 느껴질 대목은 아마 에이전트 스킬(Agent Skills)일 겁니다. 앤트로픽은 2025년 10월 16일 스킬을 공개했습니다. 스킬은 특정 일을 하는 절차와 스크립트를 담은 폴더이고, 모든 스킬의 이름과 설명만 미리 시스템 프롬프트에 올려 두었다가, 모델이 그 설명을 보고 지금 요청에 맞는 스킬을 골라 본문(SKILL.md)을 읽습니다(‘점진적 공개’). 2025년 12월에는 이것이 agentskills.io라는 개방 표준이 되었고, 커서·깃허브 코파일럿·VS Code·제미나이 CLI·오픈AI 코덱스 등이 채택했습니다. 코어닷투데이는 이 흐름을 「에이전트를 만들지 말고 스킬을 만들라」에서 자세히 다뤘습니다.
마지막 두 줄이 FlowBank가 스킬 생태계에 던지는 질문입니다. 조직의 스킬이 50개, 100개로 늘어날 때 ‘이 스킬이 기존 스킬들이 못 하던 무엇을 하는가’를 재는 사람이 있습니까? 비슷한 스킬이 여럿이면 표 2의 넷째 줄처럼 고르는 쪽이 헷갈려 오히려 성능이 떨어질 수 있습니다. 그리고 ‘모델이 적절한 스킬을 골랐는가’를 오라클과 비교해 잰 적이 있습니까? FlowBank의 커버리지·포화점·메운 격차는 스킬 라이브러리를 관리하는 데 그대로 가져다 쓸 수 있는 잣대입니다.
플랜 캐시와 절차 기억 — ‘다시 쓰기’의 다른 얼굴들
‘미리 만들고 다시 쓰기’는 2024~2026년 여러 갈래에서 동시에 자라났습니다.
Buffer of Thoughts(Ling Yang 등, NeurIPS 2024 스포트라이트): 문제를 푼 경험에서 ‘생각 템플릿’을 뽑아 메타 버퍼에 모아 두고, 새 문제에 맞는 템플릿을 꺼내 쓴다. 생각의 나무 같은 다중 질의 방법 대비 평균 비용 약 12%.
Agent Workflow Memory(Zora Wang 등, ICML 2025): 웹 에이전트가 성공한 작업에서 재사용 가능한 워크플로를 귀납해 기억. WebArena 성공률 상대 51.1% 향상.
Agentic Plan Caching(스탠퍼드 Qizheng Zhang 등, NeurIPS 2025): 끝난 실행에서 계획 템플릿을 뽑아 캐시하고, 새 요청이 오면 키워드로 맞는 템플릿을 찾아 작은 모델로 고쳐 쓴다. 비용 50.31%, 지연 27.28% 절감.
ReasoningBank(구글, ICLR 2026): 성공뿐 아니라 실패한 궤적에서도 전략을 증류해 기억.
FlowBank의 논문 스스로 미래 과제로 “워크플로를 일회성 산출물이 아니라 재사용 가능한 기억(reusable memory)으로 다뤄야 한다”고 쓰며, A-Mem·ReasoningBank 같은 기억 프레임워크와의 결합을 제안합니다. 코어닷투데이가 다룬 「ReMe — 절차 기억」, 「MemAgent — 만능 메모리는 없다」, 「동적 라우팅과 DRAG」도 모두 같은 지도 위의 다른 지점입니다. MemAgent가 “만능 메모리는 없다”에서 출발해 13개 기억 중 하나를 고르는 라우터를 만들었다면, FlowBank는 “만능 워크플로는 없다”에서 출발해 워크플로 중 하나를 고르는 라우터를 만든 셈입니다. 1997년의 ‘공짜 점심은 없다’가 층위만 바꿔 계속 돌아오고 있습니다.
무엇이 남고 무엇이 바뀔까
FlowBank가 다룬 벤치마크와 모델(GPT-4o mini)은 2026년 하반기 기준으로 이미 한 세대 전의 것입니다. 실행 모델이 강해질수록 ‘쉬운 문제’의 비중이 늘고, 워크플로 사이의 차이가 ‘어려운 꼬리’에 집중될 것입니다. 그렇다면 은행의 역할은 오히려 커질 수 있습니다. 대부분의 문제는 가장 싼 카드로 보내고, 소수의 어려운 문제에만 비싼 카드를 쓰는 것 — 바로 GPT-5 라우터가 모델 수준에서 하는 일을, 워크플로 수준에서 하는 것이니까요.
반대로 바뀔 것도 있습니다. 2026년의 프런티어 모델들은 스스로 ‘얼마나 오래 생각할지’를 조절하고, 도구를 언제 쓸지 스스로 정합니다. 워크플로의 상당 부분이 모델 안으로 흡수되면, 바깥에서 고를 ‘워크플로’의 의미도 바뀔 겁니다. 오픈AI가 GPT-5 발표에서 “가까운 미래에 이 기능들을 하나의 모델로 통합할 계획”이라고 쓴 것처럼요. 하지만 그때도 ‘서로 다른 강점을 가진 선택지들 중 무엇을 쓸지 고르는 일’은 어딘가에 남을 것이고, 그 일을 평가하는 잣대 — 커버리지, 오라클, 메운 격차 — 는 계속 유효할 것입니다.
12장. 실무 체크리스트 — 우리 팀의 ‘플로우 뱅크’ 만들기
FlowBank의 전체 시스템을 그대로 재현하지 않아도, 그 생각은 지금 당장 쓸 수 있습니다. 프롬프트 몇 개, 체인 몇 개, 스킬 몇 개를 운영하는 팀이라면 다음 순서를 권합니다.
1. 버리지 말고 기록하기프롬프트·체인·에이전트 설정을 실험할 때, 평균 점수만 남기지 말고 문제별 점수와 비용을 표로 남긴다. 행 = 변형, 열 = 평가 문항. 이 표가 은행의 원장이다.
2. 커버리지 계산하기문항마다 최고점을 뽑아 평균 낸다(오라클 상한). 단일 최선과의 차이가 몇 점인가? 차이가 1~2점이면 라우팅은 수고할 가치가 없다. 10점 이상이면 금광이다.
3. 정확도가 아니라 커버리지로 고르기변형이 수십 개면 탐욕 선택으로, 몇 개면 전수 탐색으로 커버리지 곡선을 그리고 포화점에서 멈춘다. 비슷한 변형 여럿보다 서로 다른 소수가 낫다.
4. 단순한 선택기부터임베딩 + k-최근접 이웃(비슷한 과거 문항에서 누가 잘했나)이나 작은 분류기로 시작한다. GNN은 그다음이다. 표 2에서 MLP와 GNN의 차이는 0.6점이었다.
5. 검증 세트를 따로 두기선택기의 체크포인트·λ·포트폴리오 크기는 테스트가 아닌 검증 세트로 고른다. 데이터가 적으면 교차 검증을 쓴다. FlowBank 저장소가 남긴 가장 실용적인 반면교사다.
6. 메운 격차로 보고하기“라우터 정확도 84%” 대신 “단일 최선 대비 +2점, 오라클까지 격차의 20%를 메움, 비용 −25%”로 보고한다. 개선 여지가 어디 있는지 보인다.
7. 은행은 살아 있게새 변형이 나오면 원장에 한 줄 추가해 커버리지가 오르는지 본다. 질문 분포가 바뀌면(신제품, 새 고객군) 재평가한다. 비싼 ‘즉석 설계’는 은행의 마지막 카드로 남겨 두고, 그 카드로 가는 비율을 모니터링한다.
그리고 몇 가지 경고도 덧붙입니다.
정답이 분명한 과제에서 시작하세요. 코드 테스트 통과, 수치 답, 분류 레이블처럼 e(ω,q)를 자동으로 매길 수 있는 곳이 출발점입니다. 정답이 애매한 과제에서 LLM 채점기를 쓰면, 채점기의 편향이 은행 구성까지 왜곡합니다.
고정비를 계산하세요. 변형 하나를 평가 세트 전체에 돌리는 비용 × 변형 수가 오프라인 비용입니다. 하루 처리량 × 문제당 절감액으로 몇 날이면 회수되는지 먼저 따져 보세요.
최악의 경우를 보세요. 평균이 올라도, 선택기가 특정 유형(예: 날짜 계산)을 체계적으로 엉뚱한 곳에 보내고 있을 수 있습니다. 유형별로 쪼개 보는 습관이 필요합니다.
맺음말 — 워크플로는 일회용 산출물이 아니라 자산이다
FlowBank 논문의 결론부에는 이런 문장이 있습니다. “우리는 하나의 보편적으로 최선인 워크플로를 찾는 것에서, 커버리지와 적응성과 효율이 시간이 갈수록 자라는 재사용 가능한 워크플로 라이브러리를 만드는 것으로 분야의 관점이 옮겨 가기를 바란다.”
이 글을 쓰며 공개 데이터를 다시 계산해 본 코어닷투데이의 결론은 이렇습니다.
커버리지라는 렌즈는 진짜다. 정확도 57~62%의 고만고만한 워크플로 31개가 합쳐서 86.6%를 덮고, 하위권 둘의 조합이 상위권 둘의 조합을 이긴다. 이것은 데이터로 누구나 확인할 수 있다.
고르는 일은 아직 어렵다. 선택기는 오라클까지의 격차 중 17~25%를 메웠다. 포트폴리오의 잠재력은 현재 성과보다 훨씬 크고, 다음 연구의 금광은 선택기에 있다.
보고된 우위의 일부는 유보해야 한다. 선택기 체크포인트가 테스트 점수로 골라졌으므로, 특히 DROP·MBPP의 근소한 1위는 검증 세트를 둔 재현이 필요하다.
이 생각은 50년 묵은, 검증된 생각이다. 라이스의 1976년 틀, 포트폴리오 이론, SATzilla의 메달, LLM 라우터의 성공이 모두 같은 방향을 가리킨다. FlowBank는 그 생각을 ‘LLM이 스스로 탐색해 만든 워크플로’라는 새 재료에 적용했다.
세 번째 식당으로 돌아가 봅시다. 지배인이 손님을 보고 메뉴를 권하는 일은, 서른 가지 요리를 개발하는 일보다 쉬워 보입니다. 하지만 이 논문의 숫자들은 그 반대를 말합니다. 좋은 요리를 만드는 것보다, 누구에게 무엇을 내갈지 아는 것이 더 어렵고, 그래서 더 값지다. 2026년, 우리 모두의 서랍 속에는 버려진 프롬프트와 체인과 스킬이 쌓여 가고 있습니다. 그것들을 다시 꺼내 ‘누가 무엇을 푸는지’ 표로 그려 보는 것 — 그것이 FlowBank가 오늘 당장 건네는 가장 실용적인 조언입니다.
참고문헌
이 글이 다룬 논문과 공개 자료
Yuan, L., Deng, C., Yu, F., Chakraborty, S., Rostami, M., & Huang, F. (2026). FlowBank: Query-Adaptive Agentic Workflows Optimization through Precompute-and-Reuse. arXiv:2606.11290. 프로젝트 페이지 agentic-flowbank.github.io
umd-huang-lab/FlowBank (GitHub). CuraFlow/examples(MATH 후보 31개 × 119문제), experiments/example/*/test_predictions.json·training_log.csv, QueryMatching/model/graph_nn.py — 이 글의 위젯과 재계산 수치의 출처
워크플로와 자동 설계
Wei, J., et al. (2022). Chain-of-thought prompting elicits reasoning in large language models. NeurIPS 2022. arXiv:2201.11903
Wang, X., et al. (2023). Self-consistency improves chain of thought reasoning in language models. ICLR 2023. arXiv:2203.11171
Madaan, A., et al. (2023). Self-Refine: Iterative refinement with self-feedback. NeurIPS 2023. arXiv:2303.17651
Du, Y., Li, S., Torralba, A., Tenenbaum, J. B., & Mordatch, I. (2024). Improving factuality and reasoning in language models through multiagent debate. ICML 2024. arXiv:2305.14325
Nori, H., et al. (2023). Can generalist foundation models outcompete special-purpose tuning? Case study in medicine. arXiv:2311.16452
Zhuge, M., et al. (2024). GPTSwarm: Language agents as optimizable graphs. ICML 2024. arXiv:2402.16823
Hu, S., Lu, C., & Clune, J. (2025). Automated design of agentic systems. ICLR 2025. arXiv:2408.08435
Shang, Y., et al. (2025). AgentSquare: Automatic LLM agent search in modular design space. ICLR 2025. arXiv:2410.06153
Zhang, G., et al. (2025). Multi-agent architecture search via agentic supernet (MaAS). ICML 2025. arXiv:2502.04180
Wang, Y., Yang, L., Li, G., Wang, M., & Aragam, B. (2025). ScoreFlow: Mastering LLM agent workflows via score-based preference optimization. arXiv:2502.04306
Ye, R., et al. (2025). MAS-GPT: Training LLMs to build LLM-based multi-agent systems. ICML 2025. arXiv:2503.03686
Gao, H., et al. (2025). FlowReasoner: Reinforcing query-level meta-agents. arXiv:2504.15257
Anthropic (2024. 12. 19.). Building effective agents. anthropic.com/engineering/building-effective-agents
비판과 재검토
Kapoor, S., Stroebl, B., Siegel, Z. S., Nadgir, N., & Narayanan, A. (2024). AI agents that matter. TMLR. arXiv:2407.01502
El, B., Yuksekgonul, M., & Zou, J. (2025). Inefficiencies of meta agents for agent design. Findings of EMNLP 2025. arXiv:2510.06711
Wang, Z., Xu, B., Yuan, Y., Shen, H., & Cheng, X. (2026). Do we always need query-level workflows? Rethinking agentic workflow generation for multi-agent systems. Findings of ACL 2026. arXiv:2601.11147
Cemri, M., et al. (2025). Why do multi-agent LLM systems fail? NeurIPS 2025 Datasets & Benchmarks. arXiv:2503.13657
알고리즘 선택·포트폴리오·서브모듈러 최적화
Rice, J. R. (1976). The algorithm selection problem. Advances in Computers, 15, 65–118.
Wolpert, D. H., & Macready, W. G. (1997). No free lunch theorems for optimization. IEEE Transactions on Evolutionary Computation, 1(1), 67–82.
Markowitz, H. (1952). Portfolio selection. Journal of Finance, 7(1), 77–91.
Huberman, B. A., Lukose, R. M., & Hogg, T. (1997). An economics approach to hard computational problems. Science, 275(5296), 51–54.
Gomes, C. P., & Selman, B. (2001). Algorithm portfolios. Artificial Intelligence, 126, 43–62.
Xu, L., Hutter, F., Hoos, H. H., & Leyton-Brown, K. (2008). SATzilla: Portfolio-based algorithm selection for SAT. JAIR, 32, 565–606.
Bischl, B., et al. (2016). ASlib: A benchmark library for algorithm selection. Artificial Intelligence, 237, 41–58.
Lindauer, M., van Rijn, J. N., & Kotthoff, L. (2019). The algorithm selection competitions 2015 and 2017. Artificial Intelligence, 272, 86–100.
Kerschke, P., Hoos, H. H., Neumann, F., & Trautmann, H. (2019). Automated algorithm selection: Survey and perspectives. Evolutionary Computation, 27(1), 3–45.
Jacobs, R. A., Jordan, M. I., Nowlan, S. J., & Hinton, G. E. (1991). Adaptive mixtures of local experts. Neural Computation, 3(1), 79–87.
Nemhauser, G. L., Wolsey, L. A., & Fisher, M. L. (1978). An analysis of approximations for maximizing submodular set functions—I. Mathematical Programming, 14, 265–294.
Feige, U. (1998). A threshold of ln n for approximating set cover. Journal of the ACM, 45(4), 634–652.
LLM 라우팅과 추천
Chen, L., Zaharia, M., & Zou, J. (2024). FrugalGPT: How to use large language models while reducing cost and improving performance. TMLR. arXiv:2305.05176
Ding, D., et al. (2024). Hybrid LLM: Cost-efficient and quality-aware query routing. ICLR 2024. arXiv:2404.14618
Ong, I., et al. (2025). RouteLLM: Learning to route LLMs from preference data. ICLR 2025. arXiv:2406.18665
Hu, Q. J., et al. (2024). RouterBench: A benchmark for multi-LLM routing system. arXiv:2403.12031
Feng, T., Shen, Y., & You, J. (2025). GraphRouter: A graph-based router for LLM selections. ICLR 2025. arXiv:2410.03834
OpenAI (2025. 8. 7.). Introducing GPT-5.
Feuerverger, A., He, Y., & Khatri, S. (2012). Statistical significance of the Netflix challenge. Statistical Science, 27(2), 202–231.
van den Berg, R., Kipf, T. N., & Welling, M. (2017). Graph convolutional matrix completion. arXiv:1706.02263
재사용·기억·스킬과 2026년 맥락
Yang, L., et al. (2024). Buffer of Thoughts: Thought-augmented reasoning with large language models. NeurIPS 2024. arXiv:2406.04271
Wang, Z. Z., Mao, J., Fried, D., & Neubig, G. (2025). Agent workflow memory. ICML 2025. arXiv:2409.07429
Zhang, Q., Wornow, M., Wan, G., & Olukotun, K. (2025). Agentic plan caching: Test-time memory for fast and cost-efficient LLM agents. NeurIPS 2025. arXiv:2506.14852
Ouyang, S., et al. (2026). ReasoningBank: Scaling agent self-evolving with reasoning memory. ICLR 2026. arXiv:2509.25140
Anthropic (2025. 10. 16.). Equipping agents for the real world with Agent Skills. 및 agentskills.io 개방 표준(2025. 12.)
Aubakirova, M., et al. (2026). State of AI: An empirical 100 trillion token study with OpenRouter. arXiv:2601.10088
Google (2026. 5. 19.). Sundar Pichai의 Google I/O 2026 기조연설 (월 3.2천조 토큰)