하니스Harness Engineering코딩 에이전트맥락 관리Context Management컴팩션SWE-BenchTerminal-BenchClaude CodeCodexReActMemGPTSWE-agentNemotronMistral에이전트 설계
같은 모델인데 성적이 10배 차이 — 코딩 에이전트 하니스 해부 (Zoom·UMass 176개 실험 완전 정리)
Nemotron-3 550B가 32k 창에서 SWE-Bench Verified 6.4%를 받았다. 모델을 한 글자도 바꾸지 않고 하니스의 맥락 관리만 켜자 58.4%가 됐다. 같은 bash 단독 인터페이스가 550B에게는 +3.6pp에 비용 절반, Mistral에게는 −24pp였다. 2026년 9월 17일 공개된 Zoom·UMass·Emory 연구진의 논문은 코딩 하니스를 계획·행동 공간·맥락 관리 세 부품으로 분해해 4개 모델 × 2개 벤치마크 × 176개 설정에서 부품 하나씩의 효과를 쟀다. 결론은 ‘좋은 하니스’가 아니라 ‘모델·예산·과제에 따라 갈리는 하니스’다. ReAct에서 하니스 엔지니어링까지의 역사, 논문의 네 가지 발견, 그것이 Claude Code·Codex의 오늘과 어떻게 맞물리는지를 인터랙티브 위젯 6종과 삽화로 풀었다.
여기 5,500억 파라미터짜리 모델이 있다. NVIDIA의 Nemotron-3 550B. 이 모델에게 실제 GitHub 이슈 500개를 고치게 했더니(SWE-Bench Verified) 성공률이 6.4%였다. 같은 실험에서 300억짜리 동생 모델(30B)은 9.4%를 받았다. 큰 모델이 작은 모델보다 못한 것이다.
이상한 결과다. 그런데 모델 가중치를 한 바이트도 건드리지 않고, 모델을 둘러싼 소프트웨어 — 논문이 하니스(harness)라고 부르는 층 — 의 설정 하나를 바꾸자 같은 모델이 58.4%를 받았다. 9배가 넘는 차이다.
바뀐 것은 단 하나, 대화 기록이 32k 토큰 창을 넘길 때 하니스가 무엇을 하느냐였다. 아무것도 안 하면(창을 넘기는 순간 오류로 종료) 6.4%. 오래된 기록을 요약해서 접으면 58.4%. 큰 모델은 문제를 오래, 꼼꼼히 파고들기 때문에 기록이 빨리 쌓이고, 그래서 창을 더 자주 넘겼다. 똑똑해서 죽은 셈이다.
6.4%
Nemotron-3 550B · 32k 창 · 맥락 관리 없음 (T0)
58.4%
같은 모델 · 같은 창 · 요약 기반 관리 (T3)
78.7%
32k 창에서 관리 없이 잃은 과제 비율 (4개 모델 평균)
0건
관리를 켠 모든 설정의 창 초과 실패
이 숫자는 2026년 9월 17일 arXiv에 올라온 논문 An Empirical Study of Harness Design for Coding Agents(Fan, Zhang 외, UMass Amherst·Zoom·Emory·UNC Charlotte)의 Table 3에서 가져왔다. 논문은 코딩 하니스를 세 부품 — 계획(planning), 행동 공간(action space), 맥락 관리(context management) — 으로 분해하고, 나머지 실행 루프를 못 박은 채 부품 하나씩만 바꿔 가며 4개 모델 × 2개 벤치마크 × 22개 설정 = 176개 실험을 돌렸다.
결과를 한 줄로 쓰면 이렇다.
🔧
‘좋은 하니스’는 없다. ‘이 모델, 이 예산, 이 과제에 맞는 하니스’가 있을 뿐이다. 맥락 관리는 창이 좁을수록 값지고, 계획은 약한 모델에겐 정확도 비계이지만 강한 모델에겐 비용 절감 장치이며, 미리 만들어 둔 도구 세트는 bash가 서툰 모델을 살리지만 bash에 능한 모델에겐 오히려 짐이 된다. 논문의 표현을 빌리면 하니스 설계는 “조건부 시스템 문제(conditional systems problem)”다.
이 글은 그 논문을 처음부터 끝까지 따라간다. 먼저 하니스라는 개념이 어디서 왔는지(2022년 ReAct에서 2026년 ‘하니스 엔지니어링’까지), 논문이 만든 실험용 하니스가 어떻게 생겼는지, 네 가지 발견이 각각 무엇을 뜻하는지, 그리고 그것이 오늘 우리가 쓰는 Claude Code와 Codex의 설계와 어떻게 맞물리는지를 본다. 표의 수치는 위젯으로 직접 만져 볼 수 있게 옮겼다.
영어 harness는 원래 말에 채우는 마구다. 말의 힘 자체를 키우지는 않지만, 그 힘이 수레를 끄는 방향으로 전달되게 만든다. 소프트웨어에서는 오래전부터 ‘테스트 하니스’라는 말이 있었다. 테스트 대상 코드를 감싸 입력을 넣고 출력을 받아내는 틀이다.
코딩 에이전트에서의 하니스도 같은 뜻이다. 논문은 이렇게 정의한다.
코딩 하니스는 LLM을 에이전트로 바꾸는 소프트웨어 층이다. 제어 루프, 도구 인터페이스, 그리고 코드베이스에 작용하기 위한 맥락 관리로 이루어진다. (§5.2)
모델이 “이 파일을 읽어야겠다”고 생각하면, 실제로 파일을 읽어 그 내용을 다음 입력에 넣어 주는 것은 하니스다. 모델이 테스트를 돌리고 싶어 하면 컨테이너 안에서 명령을 실행하고 결과를 돌려주는 것도 하니스다. 대화가 길어져 창을 넘길 것 같으면 무엇을 지우고 무엇을 남길지 결정하는 것도 하니스다. 모델은 텍스트를 내놓을 뿐이고, 그 텍스트가 세상에 작용하는 모든 경로는 하니스가 쥐고 있다.
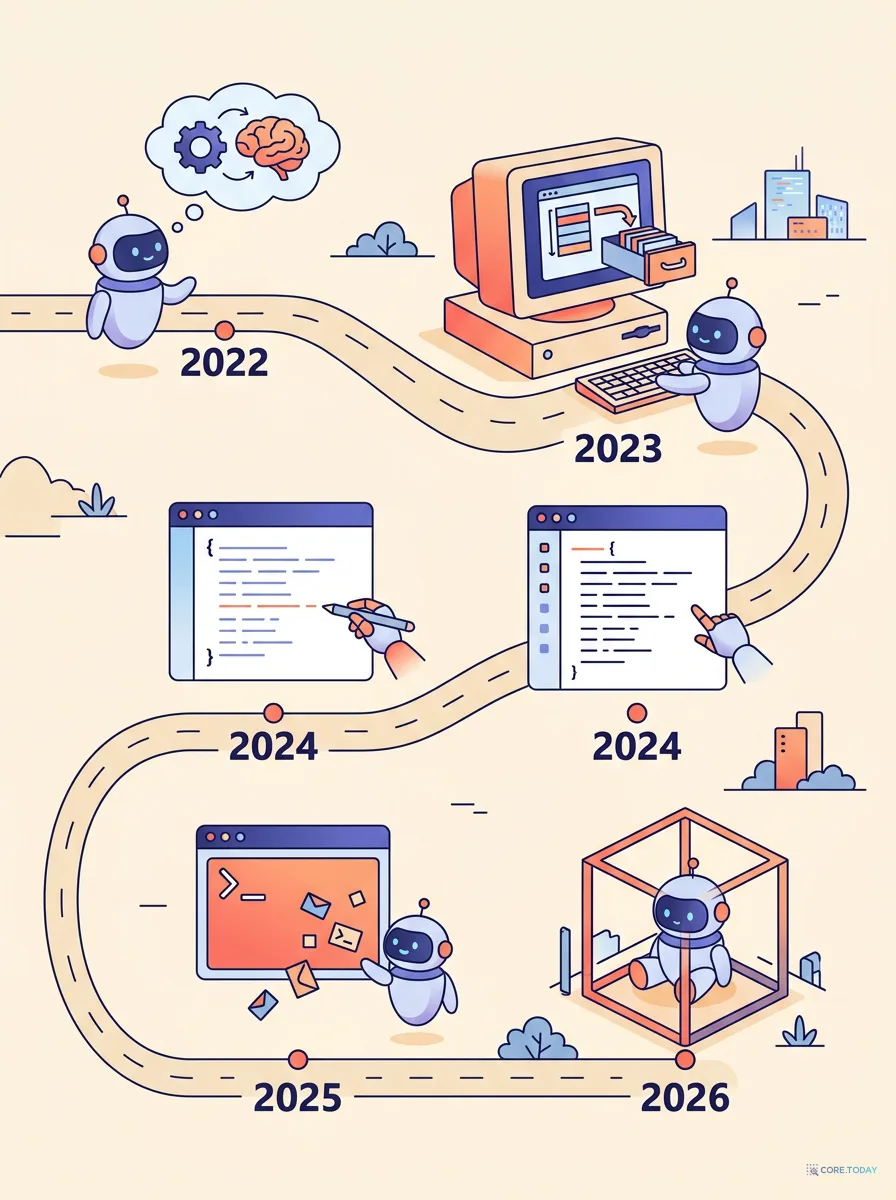
이 층이 어떻게 지금의 모양이 됐는지, 다섯 개의 이정표로 짚어 보자.
2022 — ReAct: 생각하고, 행동하고, 관찰한다
Yao 등이 2022년 10월 제안한 ReAct는 하니스의 골격이 됐다. 모델이 한 턴에 추론(Thought) → 행동(Action) → 관찰(Observation)을 반복한다는 단순한 루프다. 이 논문의 실험용 하니스도 “ReAct 루프를 따르며, 각 턴은 추론 단계·행동·관찰로 구성된다”(§2)고 명시한다. 2026년의 하니스 소스코드 분류 연구(Rombaut, 2026)가 오픈소스 코딩 에이전트 13개를 뜯어 보니, 13개 중 11개가 ReAct·생성-테스트-수리·계획-실행·재시도·트리 탐색 같은 기본 루프를 여러 개 조합하고 있었다. ReAct는 그 기본 루프 중 첫째다.
2023 — MemGPT: 맥락 창을 운영체제의 메모리처럼
문제는 루프를 돌수록 기록이 쌓인다는 것이다. 2023년 10월 버클리의 MemGPT는 이것을 운영체제의 가상 메모리에 빗댔다. 맥락 창은 RAM(주 맥락, main context), 그 밖의 저장소는 디스크(외부 맥락, external context)이고, 모델이 함수 호출로 둘 사이를 오가며 필요한 것만 창에 올린다. 이 논문의 회수(recall, M2) 메커니즘 — 지운 도구 출력을 파일에 저장해 두고 recall_event로 다시 불러오는 것 — 은 MemGPT 계보의 ‘무손실’ 접근이다. 그리고 뒤에서 보겠지만, 모델은 이 기능을 거의 쓰지 않았다.
2024 — SWE-agent: 에이전트에게는 에이전트용 인터페이스가 필요하다
2024년 5월 프린스턴의 SWE-agent는 “LM 에이전트는 새로운 종류의 최종 사용자이며, 사람용 인터페이스가 아니라 에이전트-컴퓨터 인터페이스(ACI)가 필요하다”고 주장했다. 파일을 통째로 보여 주는 대신 100줄씩 창으로 보여 주고, 편집할 때마다 린터를 돌려 문법 오류를 즉시 알려 주고, 검색 결과가 너무 많으면 잘라 주는 식이다. 이 설계만으로 GPT-4의 SWE-bench 성공률이 12.5%까지 올라갔다(당시 최고). “같은 모델, 다른 인터페이스, 다른 성적”이라는 이 글의 주제는 SWE-agent에서 처음 실증됐다.
같은 해 CodeAct와 OpenHands는 반대편 극단을 제안했다. 도구를 하나하나 정의하는 대신 모델이 실행 가능한 코드(파이썬·bash) 자체를 행동으로 내놓게 하자는 것이다. 이 논문의 ‘도구 세트 vs bash 단독’ 비교는 SWE-agent식 구조화 인터페이스와 CodeAct식 코드-행동 사이의 논쟁을 모델 크기별로 다시 재는 실험이다.
2026년 2월 11일 OpenAI는 Harness engineering: leveraging Codex in an agent-first world를 발표했다. 3명으로 시작해 7명이 된 팀이 5개월 동안 사람이 직접 쓴 코드 0줄로 100만 줄 넘는 내부 제품을 만들었고(약 1,500개 PR, 엔지니어 1인당 하루 3.5개), 그 비결은 모델이 아니라 모델을 둘러싼 환경·제약·피드백 루프 — 하니스 — 라는 내용이었다. 이 글 이후 ‘하니스 엔지니어링’은 업계 용어가 됐다. HumanLayer의 3월 글은 Mitchell Hashimoto의 말을 빌려 이렇게 요약한다. “에이전트가 실수하는 것을 볼 때마다, 그 실수를 다시는 하지 않도록 엔지니어링하는 데 시간을 쓴다.”
그리고 학계가 뒤따랐다. 4월에는 소스코드 분류(Rombaut)와 9,374개 궤적의 행동 분석(Mehtiyev & Assunção), 5월에는 “부품을 다 넣으면 오히려 나빠진다”는 요인 실험(Liu), 8월에는 “같은 모델, 다른 하니스, 다른 결과”(Lewis), 9월에는 “하니스냐 모델이냐”(2609.11987). 이 논문은 이 흐름의 9월 결산에 해당한다.
🗺️
이 논문이 서 있는 자리. 앞선 연구들은 대체로 (a) 완성된 하니스끼리 비교하거나, (b) 짧은 추론 과제에서 프롬프트 수준 부품을 비교했다. 이 논문은 구현 수준의 세 부품(계획 스캐폴드·작업 공간 행동 인터페이스·맥락 관리 정책)을, 긴 코딩 과제에서, 맥락 창 예산을 명시적으로 바꿔 가며, 같은 모델 계열의 세 크기에 걸쳐 잰 첫 연구라고 스스로를 자리매김한다.
2. 왜 ‘통째로 비교’는 답이 안 되나
논문의 출발점은 한 가지 답답함이다. 하니스가 중요하다는 것은 다들 안다. 그런데 어느 부품이 중요한지는 아무도 모른다.
논문이 드는 예가 있다. Qwen3-Coder-Next 기술 보고서(Cao 외, 2026)의 교차 하니스 평가에서 Claude Opus 4.5는 OpenHands에서 가장 잘했고, Claude Sonnet 4.5는 SWE-Agent에서 가장 잘했다고 한다. 모델마다 선호하는 하니스가 다르다는 뜻이다. 그런데 OpenHands와 SWE-Agent는 계획 방식도, 도구도, 맥락 처리도 전부 다르다. “A 하니스가 B 하니스보다 3점 높다”는 결과에서 그 3점이 계획 덕인지, 도구 덕인지, 맥락 관리 덕인지, 아니면 그것들과 모델의 상호작용 덕인지 알 길이 없다.
그래서 논문은 질문을 이렇게 바꾼다.
하니스 부품은 어떤 설정에서든 대체로 유용한가, 아니면 각 부품의 효과가 모델 능력·과제 유형·자원 예산에 따라 달라지는가? (§1)
이 질문에 답하려면 부품을 하나씩 바꿔야 한다. 기존 하니스는 부품이 서로 얽혀 있어 하나만 떼어내기 어렵다. 그래서 연구진은 하니스를 처음부터 새로 만들었다.
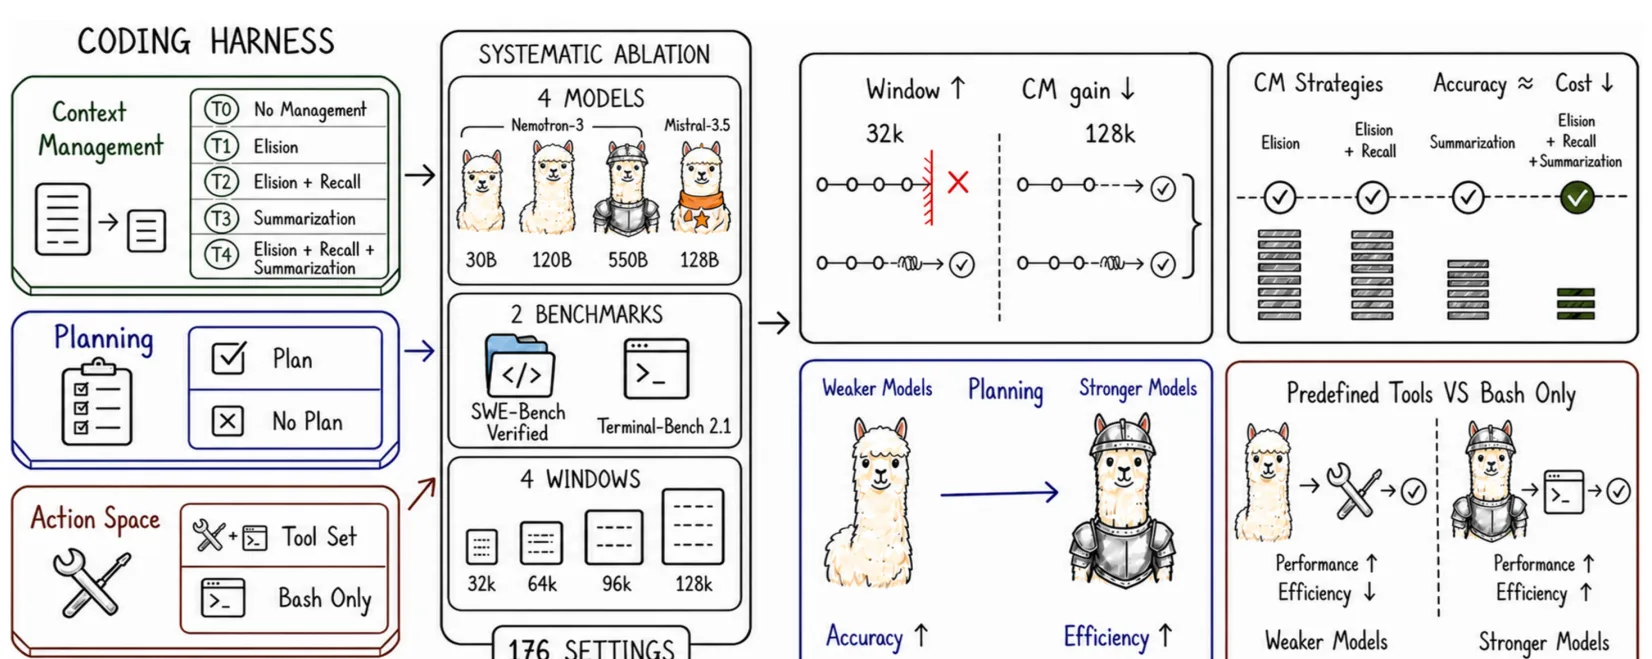
▲ 논문 Figure 1. 왼쪽은 세 부품(맥락 관리 T0~T4, 계획 켬/끔, 도구 세트/bash 단독), 가운데는 4개 모델·2개 벤치마크·4개 창 크기로 만든 176개 설정, 오른쪽은 네 가지 조건부 발견. 알파카 그림은 원 논문의 것이다. (출처: Fan et al., arXiv:2609.20804)
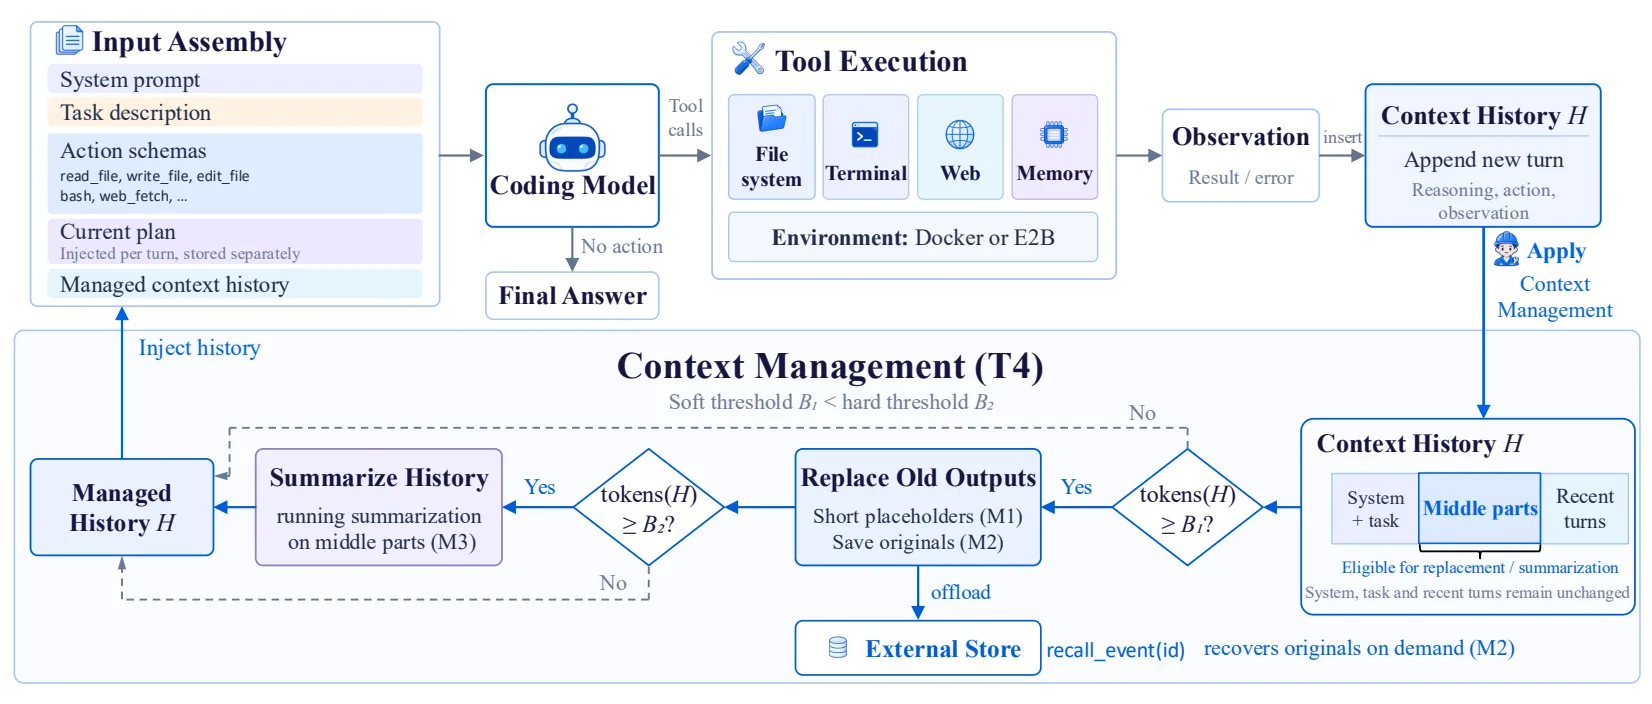
연구진이 만든 하니스는 LangGraph 위에서 도는 ReAct 루프다. 매 턴 (1) 시스템 프롬프트·과제 설명·도구 스키마·현재 계획·관리된 히스토리를 모아 모델 입력을 조립하고, (2) 모델이 내놓은 도구 호출을 컨테이너 안에서 실행하고, (3) 관찰 결과를 히스토리에 붙인다. 이 루프 자체는 모든 실험에서 같다. 바뀌는 것은 세 레버뿐이다.
▲ 논문 Figure 2. 위: ReAct 루프. 계획은 ‘주입된 계획’으로, 행동 공간은 ‘노출된 스키마’로, 맥락 관리는 ‘모델이 보는 히스토리’로 루프에 들어온다. 아래: T4 전략. 소프트 임계 B₁을 넘으면 중간 구간의 큰 도구 출력을 스텁으로 바꾸고 외부 저장소로 내보내며(M1·M2), 하드 임계 B₂를 넘으면 가장 오래된 중간 이벤트를 요약한다(M3). (출처: Fan et al., arXiv:2609.20804)
레버 1 — 계획(planning)
계획을 켜면 세 가지가 추가된다. 계획 프로토콜을 설명하는 시스템 지시, 첫 턴에 “행동하기 전에 계획부터 세우라”는 리마인더, 그리고 update_plan 도구. 모델은 이 도구로 할 일 목록을 만들고 갱신한다. 각 항목에는 내용·상태(pending/in_progress/completed)·진행형 표현이 있고, 정확히 하나만 in_progress여야 한다. 핵심은 저장된 계획이 매 턴 모델 입력에 새로 붙는다는 것이다. 대화 기록에 계획의 과거 사본이 쌓이지 않고, 항상 최신 계획 하나만 보인다.
계획을 끄면 이 셋을 모두 뺀다. 그래서 논문은 “우리 결과는 이 영속적 계획 스캐폴드의 효과이지, 추론 전략으로서의 계획 일반의 효과가 아니다”라고 선을 긋는다. 모델이 머릿속으로 계획하는 것까지 막은 게 아니라, 하니스가 계획을 붙잡아 주는 장치를 뺀 것이다.
Claude Code를 써 본 독자라면 이 도구가 낯익을 것이다. TodoWrite가 정확히 이 모양이다.
레버 2 — 행동 공간(action space)
두 가지 인터페이스를 비교한다.
도구
읽기 전용
주요 인자
하는 일
read_file
✓
path, offset, limit
줄 번호 붙여 파일 읽기
write_file
✗
path, content, overwrite
파일 생성 또는 덮어쓰기
edit_file
✗
path, old_text, new_text, replace_all
정확한 문자열 치환
list_files
✓
path, recursive
디렉터리 목록
glob_files
✓
pattern, path
패턴으로 파일 찾기
grep_text
✓
query, path, include
정규식으로 내용 검색
bash
✗
command, timeout_seconds, cwd
셸 명령 실행
web_fetch
✓
url, format
웹 페이지를 텍스트로
update_plan
✗
plan
계획 생성·갱신 (계획 켬일 때)
recall_event
✓
id
지운 도구 출력 원문 회수 (T2·T4일 때)
도구 세트 조건은 위 여덟 개를 모두 준다. bash 단독 조건은 파일·검색·웹 도구를 빼고 bash만 남긴다(계획과 맥락 관리용 보조 도구는 그대로). 읽기 전용 도구는 한 턴에 최대 8개까지 병렬 실행된다. 웹 검색은 뺐는데, SWE-Bench 과제가 공개 GitHub 이슈라 검색하면 정답 PR이 나올 수 있기 때문이다.
이 목록 역시 Claude Code의 Read·Write·Edit·Glob·Grep·Bash·WebFetch와 거의 일대일이다. 연구진이 업계 표준 인터페이스를 실험대에 올린 셈이다.
한 가지 주의점을 논문이 직접 단다. 도구 세트를 빼면 도구만 빠지는 게 아니다. 사전 정의 파일 도구는 읽기 전 쓰기 금지 검사, 파일 상태 추적, 편집 후 자동 진단까지 함께 가져간다. 그래서 이 비교는 “도구 개수의 효과”가 아니라 “도구 가용성·지시문·상태 추적·검증 지원을 포함한 인터페이스 전체의 효과”로 읽어야 한다.
작업 공간 가드가 프로젝트 루트 밖으로 나가는 경로(심링크 포함)를 거부한다. 읽기 전 쓰기 검사가 이번 세션에서 읽지 않은 파일의 편집·덮어쓰기를 거부하고, 내용 해시로 외부 수정도 잡아낸다. 권한 층이 행동을 허용·질문·거부로 분류한다. 도구 오류는 예외로 던지지 않고 관찰로 돌려줘, 실패한 행동이 루프를 죽이지 않는다.
🩺
편집 후 진단
파이썬 파일을 편집하거나 쓰면 ruff·pyflakes(없으면 문법 검사)를 읽기 전용으로 돌려 결과를 도구 응답에 덧붙인다. 문법 오류·미정의 이름·안 쓰는 import를 즉시 알려 줘, 테스트에 한 턴 쓰기 전에 고칠 수 있다. SWE-agent가 2024년에 보여 준 ‘편집 시 린트’의 직계 후손이다.
🔁
반복 감지(stuck detection)
같은 도구를 같은 인자로 연속 호출하는 ‘줄(streak)’을 센다. 5번 같은 호출(또는 5번 같은 실패)이면 “같은 호출을 {N}번 했다. 반복해도 소용없다. 멈추고 오류를 읽고 다른 명령을 시도하라”는 시스템 리마인더를 한 번 끼워 넣고, 같은 실패가 8번 이어지면 스텝 예산을 다 쓰기 전에 실행을 끝낸다. 권한 거부는 실패로 세지 않는다.
이 셋은 모두 ‘모델이 혼자서는 못 하는 것’을 하니스가 대신하는 장치다. Anthropic의 엔지니어링 블로그가 하니스를 두고 “Claude가 스스로 할 수 없는 것에 대한 가정을 코드로 옮긴 것”이라고 표현한 것과 같은 맥락이다.
에이전트가 한 턴 돌 때마다 히스토리에는 추론·행동·관찰이 붙는다. 그중 관찰(도구 출력)이 가장 무겁다. 파일 하나를 읽으면 수천 토큰, 테스트 한 번이면 수천 토큰이다. 이 논문은 도구 결과를 24,000자에서 자르지만, 그래도 수십 턴이면 32k 창은 금방 찬다.
기존 방법은 두 갈래다. 손실(lossy) 방법은 지우거나 요약해서 줄이는 대신 나중에 필요할지 모를 정보를 잃는다. 무손실(lossless) 방법은 외부에 저장해 두고 되찾을 수 있게 하는 대신 추가 장치가 필요하고, 모델이 알아서 되찾아야 한다. 논문은 두 갈래에서 하나씩과 둘 다를 섞은 것, 총 세 메커니즘을 만들었다.
M1 생략 (elision)
오래된 도구 관찰의 본문을 짧은 스텁으로 바꾼다. [tool output elided: 412 lines / 18,300 chars. Re-read or re-run to get it again.] 규칙 기반이라 싸고 즉각적이지만 세부를 잃는다.
M2 회수 (recall)
지운 관찰을 파일 시스템에 저장하고 recall_event(id) 도구를 노출한다. 스텁에 id가 붙는다. [… Use recall_event(37) for the full output, or re-read/re-run.] 생략을 되돌릴 수 있게 만든다.
M3 요약 (summarization)
오래된 메시지들을 자연어 러닝 서머리로 접는다. 평가 중인 모델과 같은 모델을 도구 없이 별도로 호출해 만든다. 서문 바로 뒤에 <context-summary>로 끼운다. LLM 호출이 드니 비싸다.
요약 프롬프트(논문 Figure 18)는 눈여겨볼 만하다. “## Goal / ## Files touched / ## Done / ## Pending / ## Errors & fixes / ## Current state / ## Next step” 일곱 제목 아래 구조화된 요약을 쓰라고 하고, 이전 요약이 있으면 “아직 참인 사실은 유지하고, 낡은 것은 버리고, 새 이벤트를 합쳐서 갱신하라”고 한다. 그리고 마지막 문장이 이 설계의 철학을 드러낸다. “원본 이벤트는 되찾을 수 있으니, 요약하라 — 옮겨 적지 말고.”
두 개의 임계값과 세 개의 구역
세 메커니즘은 두 임계값으로 묶인다. 소프트 임계 B₁(창의 60%)과 하드 임계 B₂(창의 85%). 히스토리는 세 구역으로 나뉜다.
서문(preamble) — 시스템 프롬프트와 과제 설명. 절대 건드리지 않는다.
최근 창 — 예산의 30% 안에서 최근 턴들, 최소 2턴. 원문 그대로 둔다.
중간 구역 — 나머지. 여기만 압축 대상이다.
히스토리가 B₁을 넘으면 중간 구역의 큰 도구 관찰을 스텁으로 바꾸고 원본을 외부에 저장한다(M1+M2). 그래도 B₂를 넘으면 중간 구역에서 가장 오래된 이벤트들을 요약으로 접는다(M3). recall_event는 매 턴 쓸 수 있다.
다섯 등급(Tier)
각 메커니즘의 기여를 떼어 보려고 다섯 조합을 만들었다.
등급
M1 생략
M2 회수
M3 요약
동작
T0
✗
✗
✗
관리 없음. 창을 넘기면 오류로 종료
T1
✓
✗
✗
하드 임계에서 생략만. 원본 폐기
T2
✓
✓
✗
하드 임계에서 생략, 원본 저장·회수 가능
T3
✗
✗
✓
하드 임계에서 요약만
T4
✓
✓
✓
소프트 임계에서 생략, 하드 임계에서 요약. 기본 설정
T1~T3은 행동이 하나뿐이라 하드 임계에서만 움직인다. T4만 두 단계로 움직인다. 이 ‘단계화(staging)’가 나중에 비용 차이를 만든다.
아래 위젯은 논문의 Algorithm 1을 가상의 18턴 궤적에 적용해 한 턴씩 보여 준다. 32k 창에서 T0로 끝까지 가 보고, T4로 바꿔 다시 가 보라.
5. 실험 설계 — 4개 모델, 2개 벤치마크, 176개 설정
모델. NVIDIA Nemotron-3 계열 세 크기(30B·120B·550B)와, 다른 계열의 Mistral Medium 3.5 128B. 같은 계열 세 크기를 쓴 것은 ‘모델 능력’ 축을 깨끗하게 만들려는 선택이고, Mistral을 넣은 것은 결과가 한 계열에만 맞는 게 아닌지 보려는 것이다. 모두 SGLang으로 로컬 서빙(BF16, temperature 0, top-p 0.95, 턴당 출력 16,384 토큰 상한). 비용은 OpenRouter 가격으로 환산했다(2026년 8월 기준, 입력/출력 100만 토큰당 30B 0.05/0.20달러, 120B 0.08/0.45달러, 550B 0.50/2.20달러, Mistral 1.50/7.50달러).
벤치마크.SWE-Bench Verified(사람이 검증한 실제 GitHub 이슈 500개, 파이썬 전용)와 Terminal-Bench 2.1(명령줄 환경의 종단간 과제 89개 — 소프트웨어 공학·ML·보안·데이터 처리·과학 계산·시스템 관리). Terminal-Bench 2.1은 2.0의 89개 과제 중 28개의 결함(바뀐 외부 의존성, 너무 빡빡한 자원 예산, 지시와 테스트의 불일치)을 고친 판이다. 컨테이너와 검증기는 Harbor가 관리한다. 과제당 최대 300스텝.
설정. 다섯 등급(T0~T4) × 네 창 크기(32k·64k·96k·128k) = 모델·벤치마크 쌍당 20개. 여기에 T4/128k를 기준으로 계획 끔 1개, bash 단독 1개를 더해 22개. 4개 모델 × 2개 벤치마크 × 22개 = 176개 설정. 계획과 행동 공간은 계산 자원 때문에 T4/128k에서만 절제했다 — 이 점은 논문 스스로 한계로 적었다.
통계. 같은 벤치마크 안에서 세 비교군(관리 전략 vs T0, 계획 켬 vs 끔, 도구 세트 vs bash 단독)을 두고, 과제별로 짝지은 결과에 양측 정확 McNemar 검정을 하고 Benjamini–Hochberg로 위발견율 0.05를 통제했다. 표의 별표(*)가 그 결과다.
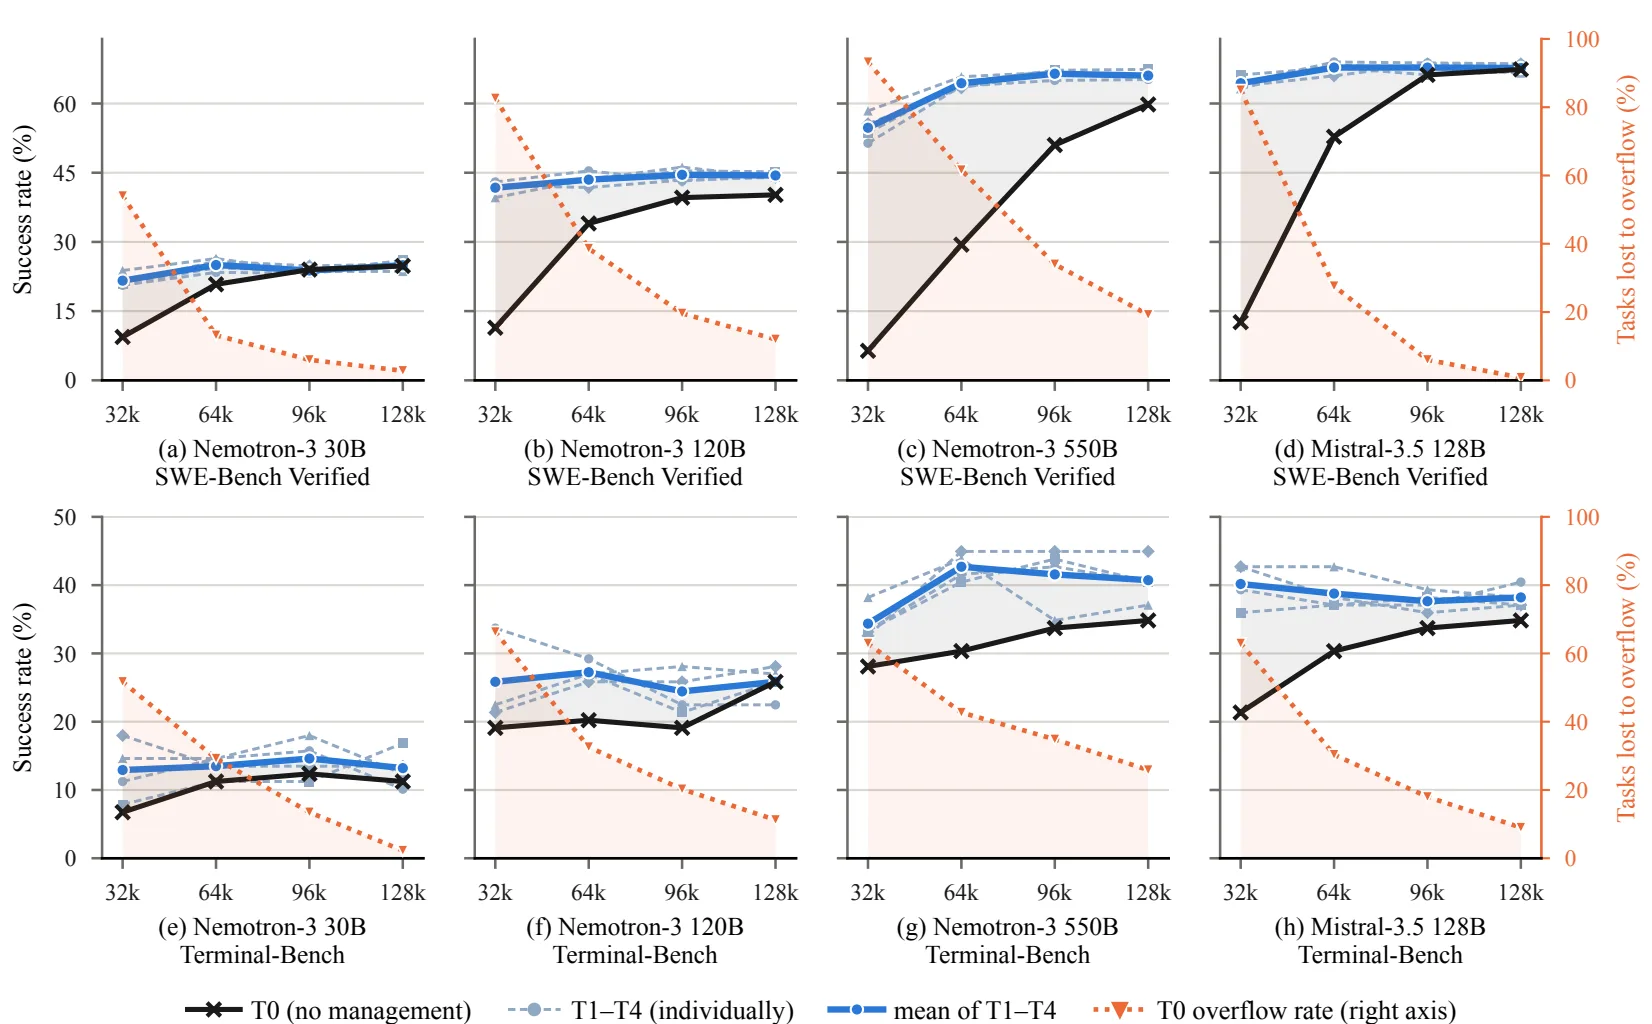
▲ 논문 Figure 3. 검은 선이 T0, 연한 파란 선이 T1~T4 각각, 진한 파란 선이 그 평균, 주황 점선(오른쪽 축)이 T0가 창 초과로 잃은 과제 비율. 창이 넓어질수록 주황 선이 내려가고, 검은 선이 파란 선을 따라잡는다. (출처: Fan et al., arXiv:2609.20804)
격차의 모양이 창 초과 실패율의 모양과 겹친다. 즉 맥락 관리의 가치는 대부분 “조기 종료를 막는 것”에서 나온다. 창이 넓어져 관리 없이도 궤적이 창 안에 들어오면, 관리의 추가 이득은 작아지고 모델에 따라 갈린다. 128k에서는 Nemotron-3 30B의 T3(23.6%)이 T0(24.8%)보다 낮은 셀도 있다.
논문의 요약: 맥락 관리는 과제 성공이 창 크기에 민감하지 않게 만든다. 더 좁은 예산에서도 효과적으로 실행할 수 있게 해 준다.
이 발견은 8월의 Lewis 논문과 정확히 같은 방향이다. Lewis는 20,480 토큰이라는 극단적으로 좁은 창에서 “오래된 도구 결과를 기계적으로 줄이고 반복·정체에 반응하는” 하니스가 SWE-bench Verified 169개 과제의 평균 통과 비율을 28%에서 49%로, 완전 해결 수를 43개에서 72개로 올렸다고 보고했다. 두 논문을 나란히 놓으면 결론이 선명하다. 창이 좁을 때 하니스는 성적의 절반을 좌우한다.
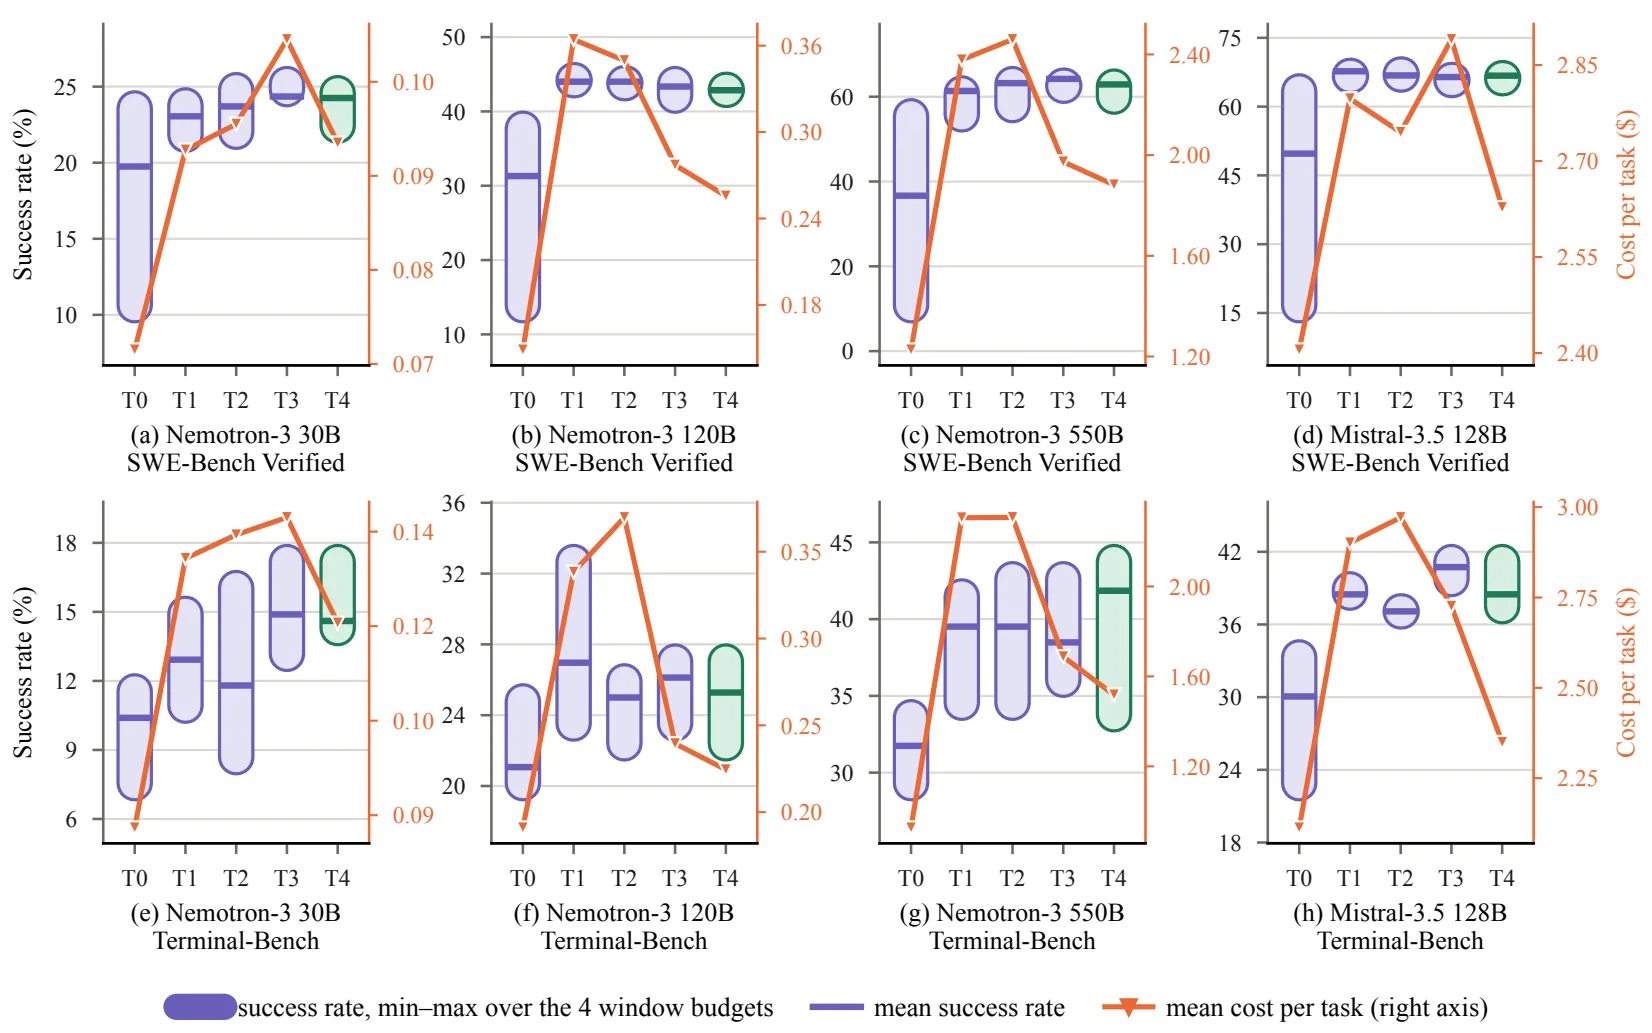
▲ 논문 Figure 4. 각 등급의 캡슐은 네 창 크기에 걸친 성공률의 최소~최대(캡슐이 길수록 창 크기에 민감), 가로선은 평균, 주황 선(오른쪽 축)은 평균 비용. 초록으로 강조된 T4가 8개 패널 중 7개에서 가장 싸다. (출처: Fan et al., arXiv:2609.20804)
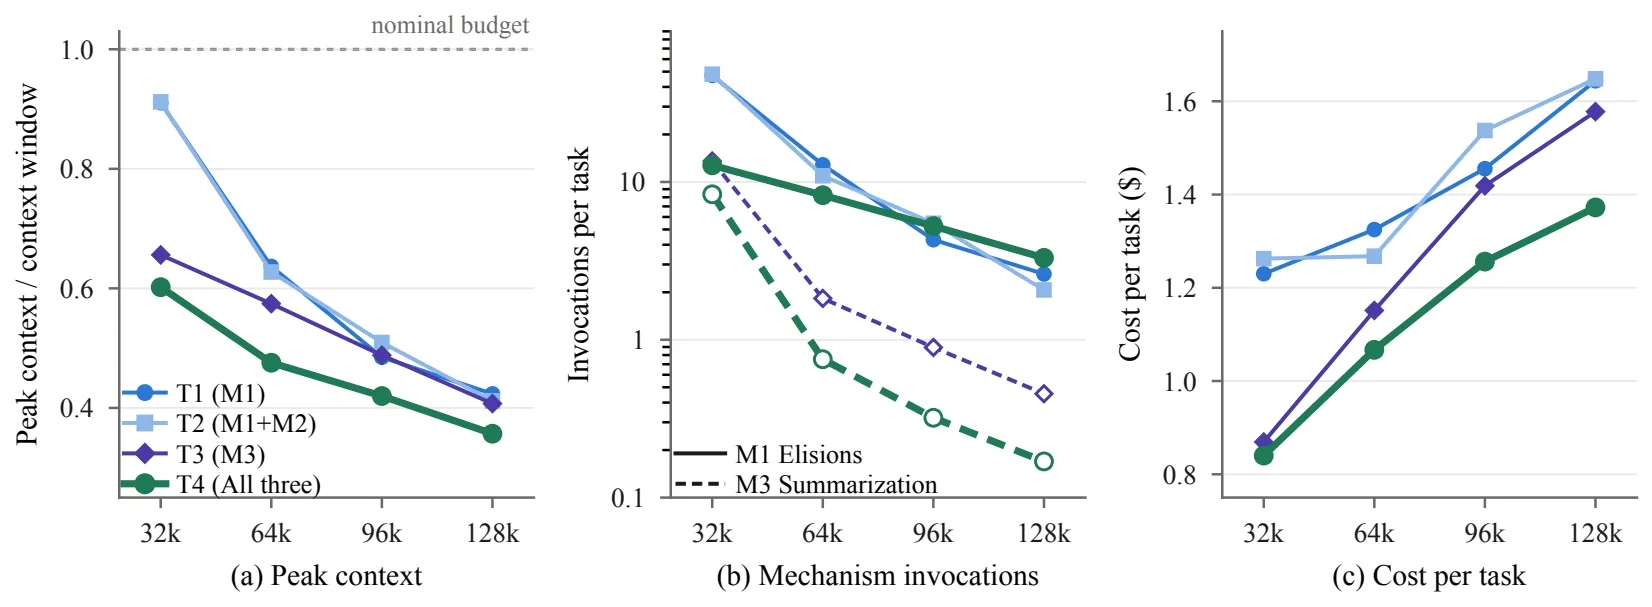
▲ 논문 Figure 5. (a) 최대 맥락 ÷ 창 크기 — 32k에서 T1·T2는 창을 거의 꽉 채우지만 T3·T4는 한참 아래에 머문다. T4가 모든 예산에서 가장 낮다. (b) 과제당 M1 생략(실선)과 M3 요약(점선) 호출 수, 로그 눈금 — T4는 32k·64k에서 T1·T2보다 생략을 덜 하고, 모든 예산에서 T3보다 요약을 덜 한다. (c) 과제당 비용 — T4가 모든 예산에서 최저. (출처: Fan et al., arXiv:2609.20804)
논리는 이렇다. T4는 소프트 임계(60%)에서 싼 규칙 기반 생략을 먼저 한다. 이것만으로 많은 궤적이 하드 임계(85%)에 닿지 않는다. 그래서 비싼 LLM 요약 호출이 T3보다 드물게 일어난다. 반면 T1·T2는 생략만 하니 창 끝까지 차오르고, 매 호출의 입력 토큰이 크다. T3은 요약만 하니 요약 호출이 잦다. 두 단계로 나눈 것이 비용을 아낀다.
💡
실무 번역. 컴팩션을 ‘창이 거의 찼을 때 한 번에 요약’으로만 구현하고 있다면, 그 앞에 ‘오래된 도구 출력을 한 줄 스텁으로 바꾸기’를 한 단계 더 두는 것이 정확도 손실 없이 비용을 줄이는 가장 값싼 개선이다. Anthropic이 2025년 9월 Claude Developer Platform에 넣은 clear_tool_uses_20250919(오래된 도구 결과를 [cleared to save context]로 바꾸되 호출 기록은 남김)가 정확히 이 M1이다.
회수(M2)는 아무도 안 쓴다
이 절의 두 번째 결과는 조금 뜻밖이다. T1과 T2는 recall_event의 유무만 다르다. 32개 모델·벤치마크·창 비교에서 T2가 T1을 이긴 것이 15번, 진 것이 14번, 비긴 것이 3번. 평균 차이는 −0.36pp(SWE +0.40, TB −1.12). 아무 차이가 없다.
이유는 Table 13에 있다. 64개 T2·T4 설정 중 36개(56.3%)에서 recall_event가 한 번도 호출되지 않았다. 호출률 중앙값은 0. 과제당 평균 호출 수는 32k에서 0.540, 64k 0.069, 96k 0.011, 128k 0.007로 급감한다. T4/128k의 계획·행동 공간 절제 16개 설정에서는 단 한 번도 없었다. 그나마 호출하는 것은 거의 전부 가장 작은 Nemotron-3 30B였고, 가장 많이 쓴 설정(30B·Terminal-Bench·32k·T2)조차 과제당 4.3번 호출하면서 T1보다 3.37pp 낮았다.
🗄️
MemGPT식 ‘무손실’의 현실. 되찾을 수 있게 만드는 데는 저장소·도구·프롬프트가 필요하다. 그런데 모델, 특히 강한 모델은 지운 것을 되찾지 않는다. 필요하면 파일을 다시 읽거나 명령을 다시 돌린다 — 스텁이 그러라고 적어 두었으니. 논문의 표현으로 “무손실 저장은 대부분의 모델이 거의 쓰지 않는 장치를 추가하며, 지운 관찰을 되찾는 것이 완료된 과제로 일관되게 이어지지 않는다.” 여러분의 하니스에 ‘기억 되찾기’ 도구가 있다면, 호출 로그부터 세어 보라.
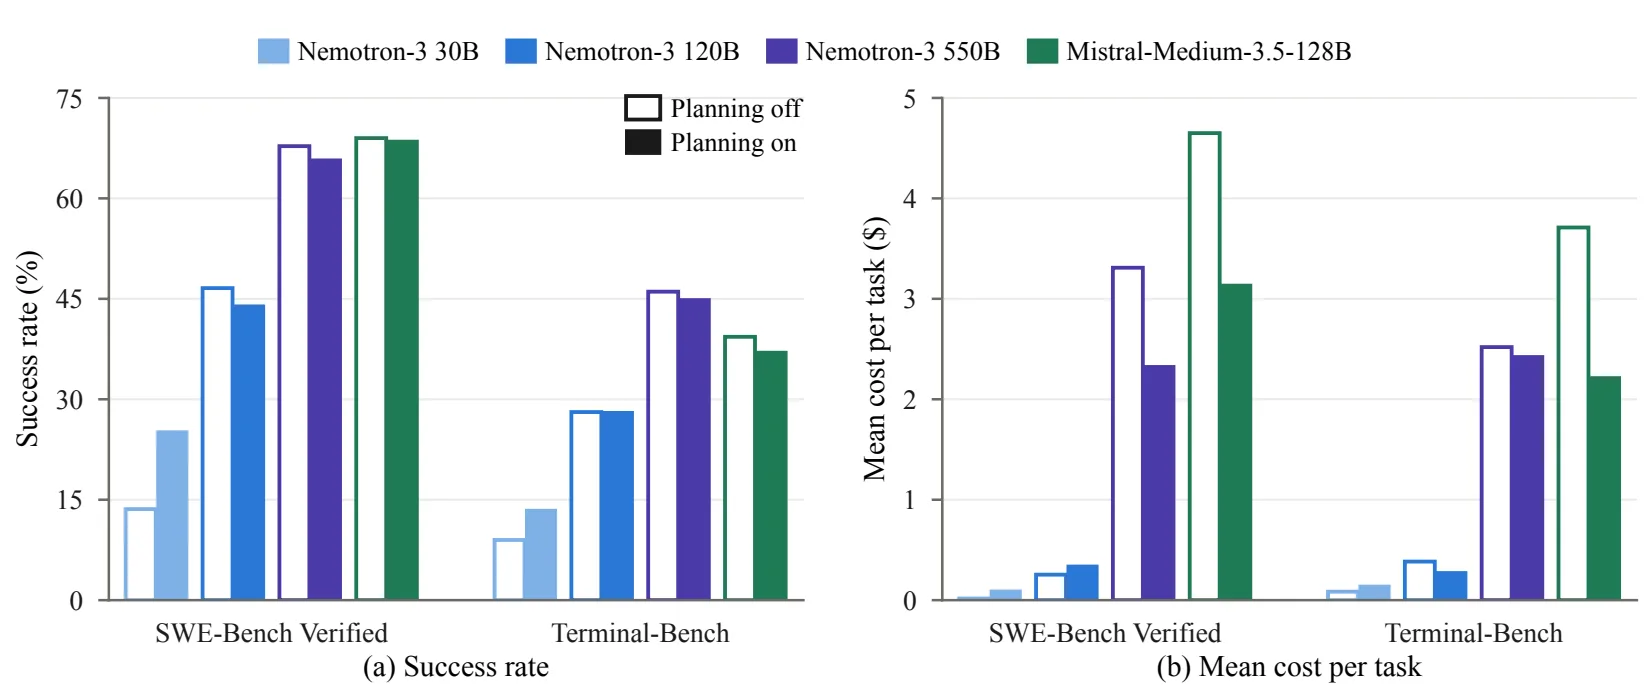
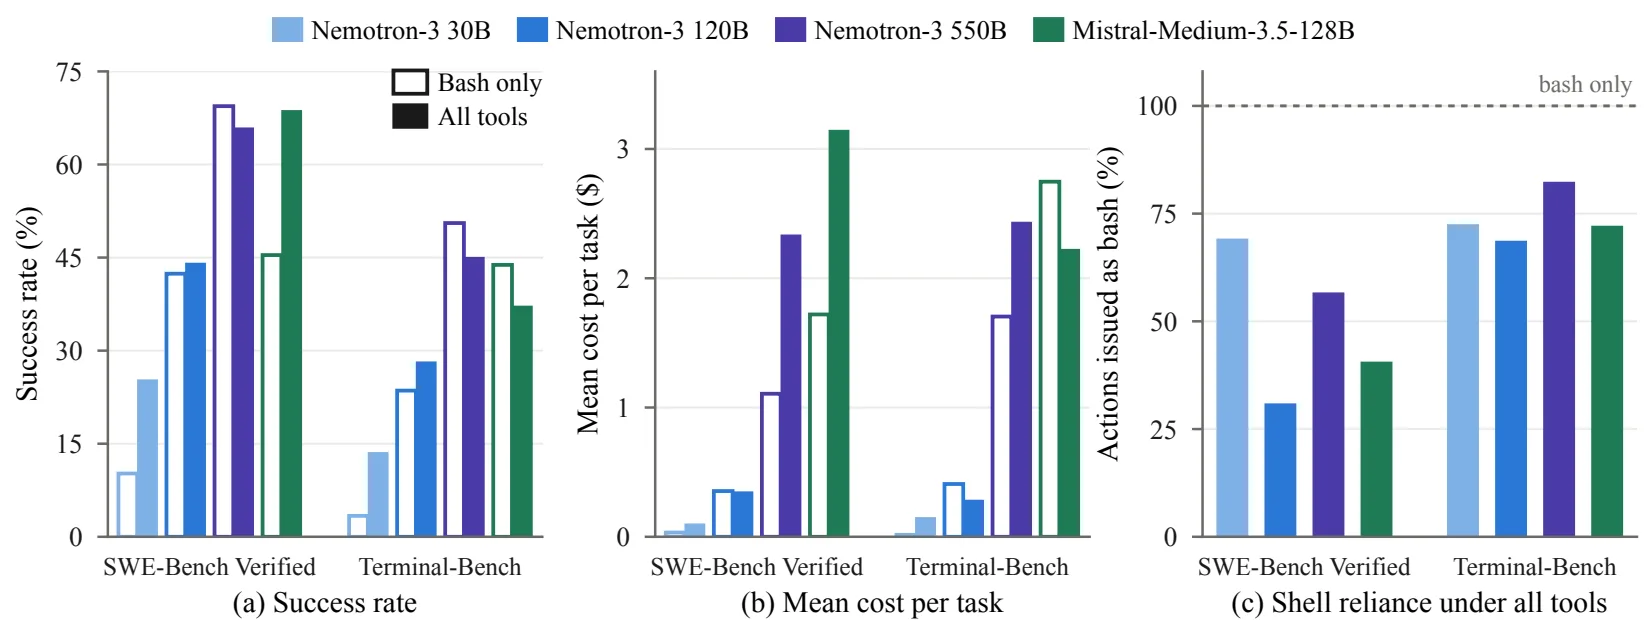
▲ 논문 Figure 6. 각 모델 쌍에서 빈 막대가 계획 끔, 채운 막대가 계획 켬. (a) 성공률, (b) 과제당 비용. 30B는 계획을 켜면 성공률이 오르고 비용도 오른다. 550B·Mistral은 성공률이 거의 그대로인데 비용이 크게 준다. (출처: Fan et al., arXiv:2609.20804)
모델
SWE 성공률 (끔 → 켬)
SWE 비용
TB 성공률 (끔 → 켬)
TB 비용
Nemotron-3 30B
13.6% → 25.2% (+11.6)
$0.02 → $0.09
9.0% → 13.5% (+4.5)
$0.08 → $0.14
Nemotron-3 120B
46.6% → 44.0% (−2.6)
$0.25 → $0.34
28.1% → 28.1% (0)
$0.38 → $0.28
Nemotron-3 550B
67.8% → 65.8% (−2.0)
$3.31 → $2.33 (−30%)
46.1% → 44.9% (−1.1)
$2.52 → $2.43
Mistral 3.5 128B
69.0% → 68.6% (−0.4)
$4.65 → $3.14 (−32%)
39.3% → 37.1% (−2.2)
$3.71 → $2.22 (−40%)
같은 도구, 정반대 효과다. 30B에게 계획은 정확도 비계다. 120B에게는 애매하다. 550B와 Mistral에게 계획은 비용 절감 장치다 — 정확도를 아주 조금 내주고 비용을 30~40% 아낀다.
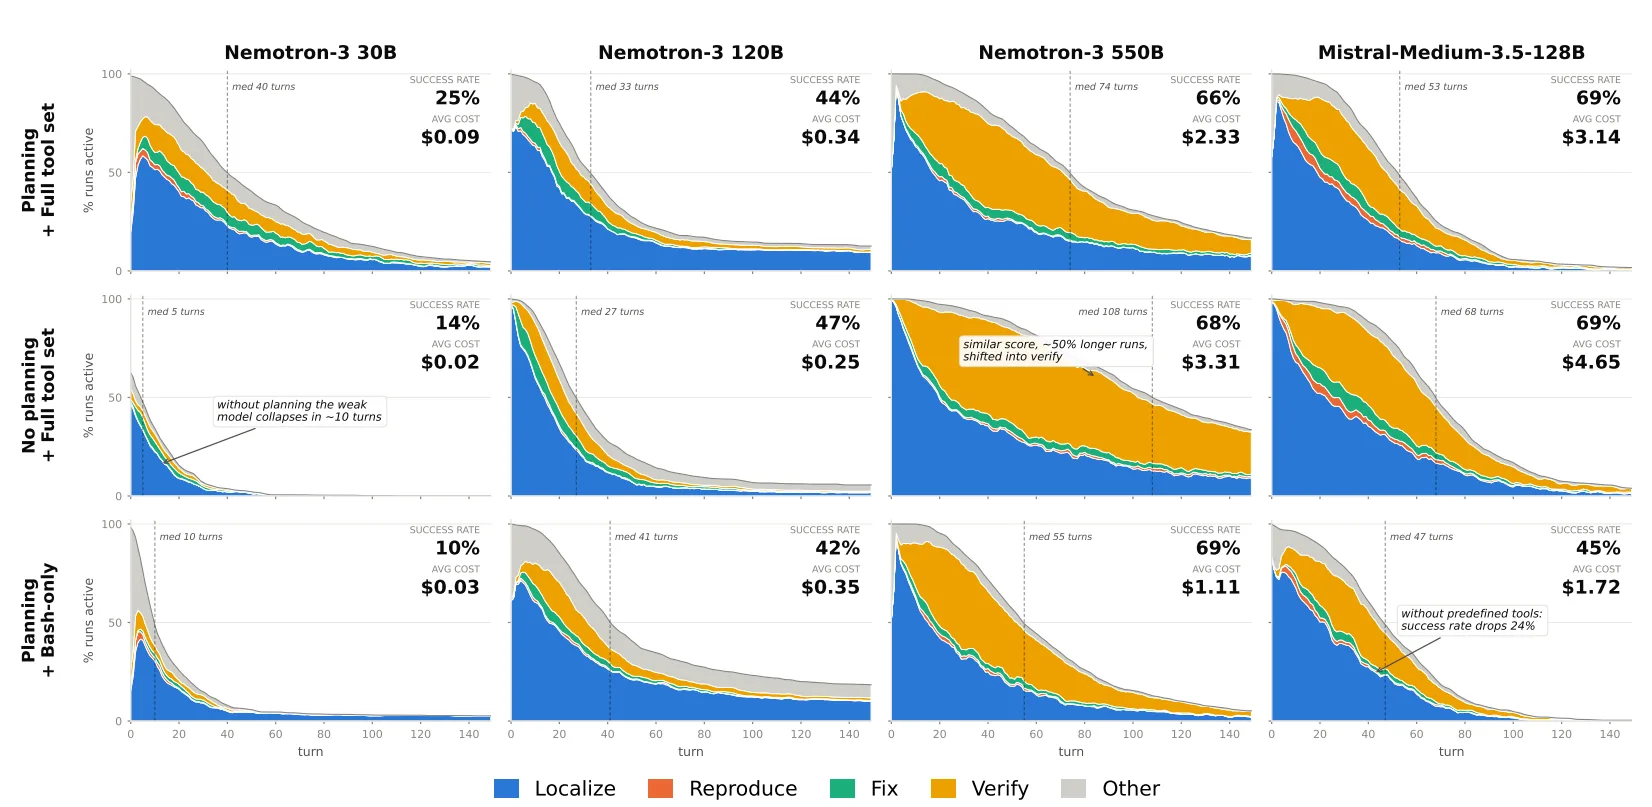
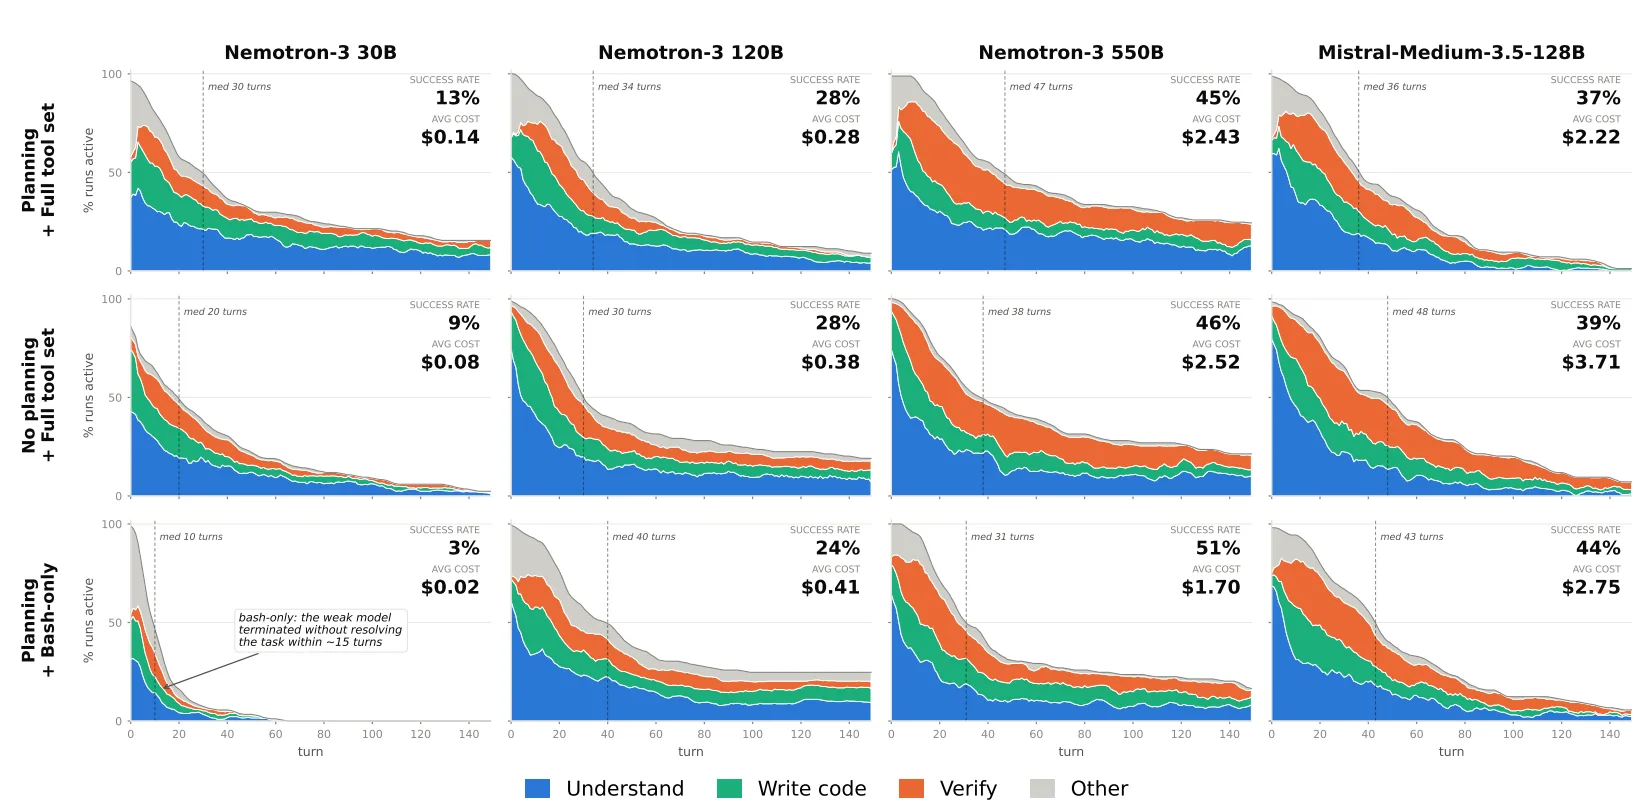
왜 그런가. 논문은 궤적을 열어 본다. 모든 턴을 LLM 판정자(GPT-5.5)가 ‘탐색(Localize)·재현(Reproduce)·수정(Fix)·검증(Verify)·기타’ 다섯 단계로 분류했다(사람 주석자와의 일치도는 부록 C.2에 있다).
▲ 논문 Figure 8. 열은 모델, 행은 하니스 설정(계획+도구 / 계획 없음+도구 / 계획+bash 단독). 가로축은 턴, 세로축은 아직 살아 있는 실행의 비율이며 색은 그 턴의 단계(파랑 탐색, 주황 재현, 초록 수정, 노랑 검증, 회색 기타). 점선은 궤적 길이 중앙값. 30B 두 번째 행의 “계획 없이는 약한 모델이 10턴 안에 무너진다”, 550B 두 번째 행의 “비슷한 점수, 약 50% 긴 실행, 검증으로 쏠림” 주석을 보라. (출처: Fan et al., arXiv:2609.20804)
30B: 계획이 궤적을 살려 둔다. 계획을 끄면 SWE-Bench 궤적 길이 중앙값이 40턴에서 5턴으로 준다. 실행의 68.6%가 편집 한 번 못 하고 끝나고, 58.4%는 파일을 찾는 단계에서 끝난다. 계획을 켜면 각각 27.8%, 10.4%. 계획은 이 모델이 첫 편집을 시도할 때까지 버티게 해 주고, 그 추가 턴이 비용이 된다(SWE에서 턴 +293%, 도구 호출 +474%).
550B·Mistral: 계획이 궤적을 멈춰 준다. 계획을 켜면 궤적 중앙값이 550B는 108턴에서 74턴으로, Mistral은 68턴에서 53턴으로 준다. 줄어든 부분은 대부분 편집 후 검증이다. 파일 못 찾고 끝나는 비율이나 편집 없이 끝나는 비율은 거의 변하지 않는다. 즉 계획은 이 모델들의 탐색이나 수정을 빠르게 하는 게 아니라, “이제 됐다”고 멈추는 행동을 개선한다. 계획 항목이 전부 completed가 되면 검증을 한 번 더 돌리는 대신 끝낸다.
Terminal-Bench에서는 두 효과가 동시에 나타나 모델마다 합이 다르다. 계획은 일찍 죽을 궤적을 늘리고, 지나치게 긴 꼬리를 자른다. 120B는 꼬리가 잘려 비용 −26%, Mistral은 중간·긴 실행이 모두 짧아져 −40%, 550B는 탐색 꼬리가 덜 잘려 −3.6%, 30B는 조기 종료가 사라져 +75%.
📋
TodoWrite의 존재 이유가 바뀐다. 약한 모델에게 할 일 목록은 ‘포기하지 않게 하는 장치’다. 강한 모델에게 할 일 목록은 ‘그만 확인하고 끝내게 하는 장치’다. 같은 기능이 모델 능력에 따라 다른 문제를 푼다. 하니스를 만들 때 “계획 기능이 있느냐”가 아니라 “이 모델에서 계획이 어떤 실패 모드를 막느냐”를 물어야 하는 이유다.
▲ 논문 Figure 7. (a) 성공률, (b) 비용, (c) 전체 도구가 있을 때 bash로 낸 행동의 비율. 빈 막대가 bash 단독, 채운 막대가 도구 세트. (출처: Fan et al., arXiv:2609.20804)
모델
SWE (도구 → bash)
SWE 비용
TB (도구 → bash)
TB 비용
Nemotron-3 30B
25.2% → 10.2% (−15.0*)
$0.09 → $0.03
13.5% → 3.4% (−10.1*)
$0.14 → $0.02
Nemotron-3 120B
44.0% → 42.4% (−1.6)
$0.34 → $0.35
28.1% → 23.6% (−4.5)
$0.28 → $0.41
Nemotron-3 550B
65.8% → 69.4% (+3.6*)
$2.33 → $1.11 (−53%)
44.9% → 50.6% (+5.6)
$2.43 → $1.70 (−30%)
Mistral 3.5 128B
68.6% → 45.4% (−23.2*)
$3.14 → $1.72
37.1% → 43.8% (+6.7)
$2.22 → $2.75
(별표는 짝지은 McNemar 검정에서 BH 보정 q가 0.05 미만인 차이.)
30B는 bash만 주면 무너진다. 이유가 흥미롭다. 도구가 없으면 이 모델은 의도를 bash로 옮기는 대신, 훈련 때 익힌 도구 호출 패턴을 그대로 내뱉는다.read_file을 부르는데 하니스에 그 도구가 없으니 실행이 안 된다. Terminal-Bench에서 bash 단독 궤적의 66%가 이런 ‘인터페이스 밖 호출’로 끝났고, 평균 궤적이 71턴에서 15턴으로 짧아졌다. 사전 정의 도구는 이 모델이 확실히 부를 수 있는 행동 어휘를 쥐여 준 것이다.
550B는 bash만 줘도 더 잘하고 훨씬 싸다. 호출 수가 SWE에서 32%, TB에서 24% 줄었다. 여러 저수준 작업을 한 셸 명령이나 스크립트로 묶기 때문이다. 이 모델에게 도구 세트는 “어느 도구를 고를지” 결정하는 오버헤드와 상호작용 횟수만 늘렸다.
Mistral은 과제 유형에 따라 갈린다. SWE-Bench에서는 도구 세트가 +23.2pp로 압도적인데, Terminal-Bench에서는 bash 단독이 +6.7pp다. Figure 7(c)가 이유를 보여 준다. 도구가 다 있을 때 Mistral은 Terminal-Bench 작업의 71.9%를 이미 bash로 처리하고 있었다(SWE-Bench는 40.4%). 셸 중심 과제에서는 경쟁하는 도구를 치우는 것이 이 모델의 선호와 맞는다. 반면 저장소 이슈 수정에서는 읽기·검색·편집 도구가 여전히 중요하다. bash 단독 SWE-Bench 실행의 32.8%가 파일을 한 번도 편집하지 못하고 끝났다(도구 세트에서는 1.2%).
▲ 논문 Figure 9. Terminal-Bench는 턴이 아니라 도구 호출 단위로 ‘이해·코드 작성·검증·기타’를 분류했다. 550B 세 번째 행(계획+bash 단독)에서 궤적 중앙값이 47에서 31로 짧아지고 초록(코드 작성) 비중이 커진다. (출처: Fan et al., arXiv:2609.20804)
모델
같은 파일 재패치 횟수 (SWE)
최대 편집 줄 수 중앙값 (SWE)
파일 쓰기 중 생성·전체교체 비율 (TB)
Nemotron-3 30B
3.3 → 0.4
26 → 13
28% → 64%
Nemotron-3 120B
2.8 → 2.2
22 → 24
39% → 76%
Nemotron-3 550B
4.6 → 1.5
18 → 54
51% → 76%
Mistral 3.5 128B
3.0 → 1.3
87 → 68
28% → 57%
각 셀은 도구 세트 → bash 단독. 논문 Table 7.
네 모델 모두에서 bash 단독은 이미 고친 파일을 다시 고치는 횟수를 줄이고, Terminal-Bench에서 파일을 조각조각 편집하는 대신 통째로 만들어 쓰는 쪽으로 옮겨 간다. 논문의 결론은 균형 잡혀 있다. “사전 정의 도구는 행동 하나하나의 복잡도를 낮추지만, 그 대가로 같은 작업을 표현하는 데 필요한 상호작용 수와 점진적 수리 사이클을 늘리는 경우가 많다.”
네 발견을 궤적 수준에서 다시 보면 세 부품이 에이전트 행동의 서로 다른 면을 건드린다는 것이 보인다.
맥락 관리 궤적을 연장한다
계획 궤적이 멈추는 곳을 바꾼다
행동 공간 코드를 쓰는 단위를 바꾼다
맥락 관리는 행동을 바꾸지 않고 궤적을 늘린다. 32k에서 T0 궤적은 중앙값 20~30턴에 대부분 탐색 단계에서 죽는다. 관리된 등급은 50~180턴까지 늘어나 검증까지 간다. 그런데 같은 턴에서의 단계 순서와 비율은 거의 같다. 128k에서는 등급 간 차이가 거의 사라진다(재패치 횟수 차이 과제당 2회 미만, 편집 없이 끝나는 비율 차이 4pp 미만). 즉 맥락 관리는 “더 오래 살게” 할 뿐 “다르게 행동하게” 하지는 않는다. 그래서 논문은 이후 분석을 T4/128k에 고정할 수 있었다.
계획은 종료 지점을 옮긴다. 약한 모델은 너무 일찍 포기하고, 강한 모델은 너무 오래 확인한다. 계획은 전자를 늦추고 후자를 앞당긴다.
행동 공간은 굵기를 바꾼다. 구조화 도구는 작은 행동을 여러 번, bash는 큰 행동을 몇 번.
이 그림이 중요한 이유는 각 부품이 어떤 실패 모드를 고치는지가 분명해지기 때문이다. 창을 넘겨 죽는가 → 맥락 관리. 편집도 못 하고 포기하는가, 혹은 끝없이 검증하는가 → 계획. 도구를 못 부르는가, 혹은 도구 고르느라 턴을 낭비하는가 → 행동 공간. 논문의 마지막 문장은 이렇다.
하니스 설계는 조건부 시스템 문제다. 각 부품은 기본값으로 채택할 것이 아니라 대상 모델·과제 유형·자원 예산에 맞춰 선택해야 한다. (§6)
11. 2026년 9월, 현장과의 접점
이 논문의 모델은 Nemotron-3와 Mistral Medium 3.5다. 여러분이 매일 쓰는 Claude나 GPT가 아니다. 그러면 이 결과는 오늘의 도구와 어떻게 맞물리는가. 세 갈래로 보자.
접점 1 — 오늘의 제품은 이미 T4를 닮았다
Claude Code의 맥락 창 문서를 보면, 창의 일정 비율에 이르면 자동 컴팩션이 대화를 구조화된 요약으로 바꾸고, 시스템 프롬프트와 최근 교환은 유지하며, 호출한 스킬 본문은 스킬당 5,000토큰 상한으로 다시 넣는다. 수동 /compact와 autoCompactWindow 설정도 있다. Anthropic의 컨텍스트 엔지니어링 글은 335,279토큰짜리 연구 에이전트 맥락이 약 2,800토큰 요약으로 압축된 사례(도구 출력 기준 약 120:1)를 들고, 그와 별도로 도구 결과 지우기를 “가장 안전하고 가벼운 컴팩션”이라고 부른다.
이 둘을 합치면 정확히 논문의 T4 — 규칙 기반 생략을 먼저, LLM 요약을 나중에 — 다. 논문은 업계가 경험적으로 수렴한 설계에 통제 실험의 근거를 붙인 셈이다. 그리고 한 가지를 덧붙인다. 되찾기 도구(M2)는 굳이 없어도 된다.
접점 2 — 프런티어 모델에서는 하니스 차이가 작아진다
같은 달 나온 Harness or Model?는 오염 통제된 비공개 과제 256개에서 Claude Opus 4.8·GPT-5.5를 벤더 네이티브 하니스(claude-agent-sdk·codex SDK)와 제3자 하니스(deepagents)로 돌려 비교했다. 전체 차이는 −1.25pp, +1.25pp. 무시할 만했다. 4월의 Mehtiyev & Assunção 역시 8개 프레임워크·14개 모델·9,374개 궤적을 분석해 “결과와 행동의 일차 동인은 LLM이며, 모델 능력이 오를수록 프레임워크 간 격차가 줄어든다”고 했다.
모순처럼 보이지만 이 논문과 정확히 맞물린다. 이 논문에서도 창이 128k로 넓고 모델이 강할수록 부품의 효과는 작아졌다(맥락 관리 격차 2.7pp, 계획 −0.4pp). 하니스가 성적을 크게 가르는 것은 모델이 약하거나, 창이 좁거나, 과제가 특정 인터페이스에 치우쳐 있을 때다. 프런티어 모델을 넉넉한 창으로 쓰는 사람에게 하니스는 정확도보다 비용의 문제가 된다(550B에서 계획 −30%, bash 단독 −53%). 오픈 모델을 좁은 창으로, 혹은 온프레미스로 쓰는 사람에게 하니스는 성패의 문제다.
접점 3 — “다 넣으면 좋다”는 틀렸다
5월의 Liu 논문은 계획·도구·기억·자기반성·검색 다섯 부품의 32개 조합 전부를 요인 실험으로 돌려 “전부 넣은(All-In) 시스템은 일관되게 차선”이며, 최적 조합은 과제에 따라 1~4개이고, 부품 간 간섭이 있어 탐욕적 선택이 안 통한다(부분모듈성 위반 56.3%)고 보고했다. 이 논문의 recall_event(안 쓰는 장치), 강한 모델의 도구 세트(오버헤드), 120B의 계획(비용만 증가)이 모두 같은 현상의 사례다. 하니스 엔지니어링의 첫 번째 규칙은 “뺄 것을 찾는 것”일지도 모른다.
🧭
2026년 9월의 하니스 지도. ① 프런티어 모델 + 넓은 창 → 하니스는 비용 최적화 문제. 계획 켜고(검증 반복 절감), bash 능한 모델이면 도구를 줄여 보라. ② 오픈·소형 모델 + 좁은 창 → 하니스는 생존 문제. 단계화된 맥락 관리는 필수, 계획과 사전 정의 도구는 강한 비계. ③ 어느 쪽이든 recall 같은 ‘있으면 좋을’ 장치는 호출 로그로 검증한 뒤 남긴다. ④ 셸 중심 과제인지 저장소 편집 과제인지에 따라 같은 모델의 선호 인터페이스가 뒤집힌다.
12. 한계 — 논문이 스스로 그은 선
좋은 실증 논문답게 한계 절이 솔직하다. 옮겨 둘 가치가 있다.
특정 구현의 효과다. 계획은 프롬프트 하나와 갱신 메커니즘 하나로, 맥락 관리는 임계값 기반 정책 하나(0.6/0.85, 최근 창 0.3)로 구현했다. 다른 계획 방식, 다른 임계값이면 다를 수 있다. 행동 공간 비교는 도구·지시문·상태 추적·진단이 묶인 변화라 “도구 개수”의 효과로 읽으면 안 된다.
설계 공간과 통계력이 제한적이다. 계획과 행동 공간은 T4/128k에서만 절제했다. 다른 창 크기에서 같은지 보려면 완전 요인 설계가 필요하다. 각 설정은 과제당 1회 실행이고, Terminal-Bench는 89개라 많은 비교가 유의하지 않다 — 그쪽 결론은 “모델·예산에 걸친 방향의 일관성”에 기댄다.
외적 타당성. Nemotron-3 세 크기와 Mistral 하나, 두 벤치마크(SWE-Bench는 파이썬 전용). 모델 크기는 능력의 불완전한 대리 변수다 — 훈련 데이터, 도구 인터페이스 노출 경험, 셸 숙련도가 따로 작용한다(Mistral의 벤치마크별 인터페이스 선호가 그 증거). 교차점은 다른 모델 계열·하니스·과제로 옮기기 전에 검증해야 한다.
여기에 이 글의 관찰을 하나 보탠다. 계획 절제에서 120B의 SWE-Bench 성공률은 계획을 끄면 46.6%, 켜면 44.0%로, 이 모델의 전체 최고 성적이 계획 없는 셀에서 나왔다. 논문은 “일관된 이득 없음”으로 처리했지만, 중간 크기 모델에서 계획이 오히려 방해가 되는지는 후속 연구가 필요한 열린 질문이다.
13. 실무 체크리스트 — 내 하니스에 적용하기
논문의 네 발견을 규칙으로 옮긴 도우미다. 여러분의 모델·예산·과제를 넣어 보라.
위젯이 내놓는 권고 뒤에 있는 원칙을 정리하면 이렇다.
📏
먼저 잰다 — 창 초과 실패율과 종료 단계
실패한 궤적이 어디서 죽었는지 세어 보라. 창을 넘겨 죽었으면 맥락 관리, 편집 없이 끝났으면 계획(약한 모델) 또는 행동 어휘(도구 못 부름), 편집 후 검증만 반복하다 예산을 다 썼으면 계획(강한 모델)이 답이다. 논문의 궤적 단계 분류(탐색·재현·수정·검증)를 LLM 판정자로 흉내 내는 데 큰 비용이 들지 않는다.
🪜
맥락 관리는 단계화한다
60%에서 오래된 큰 도구 출력을 한 줄 스텁으로(규칙, 무료). 85%에서 가장 오래된 중간 이벤트를 구조화 요약으로(LLM, 유료). 서문과 최근 2턴 이상은 절대 건드리지 않는다. 스텁에는 “다시 읽거나 다시 실행하라”고 적어 준다. 회수 도구는 호출 로그가 증명하기 전까지 넣지 않는다.
🎚️
계획과 도구는 모델별로 켠다
모델을 바꾸면 하니스 기본값을 다시 잰다. 논문에서 같은 bash 단독 인터페이스가 550B에게는 최고 성적, Mistral에게는 SWE-Bench −23pp였다. 하니스 설정을 모델 이름과 함께 버전 관리하고, 모델 업그레이드 때 절제 실험을 자동으로 돌리는 것이 2026년의 하니스 엔지니어링이다.
마무리 — 말이 아니라 마구를 보라
이 논문에서 가장 오래 남는 장면은 글머리의 그 숫자다. 5,500억 파라미터 모델이 6.4%. 모델은 똑똑했다. 문제를 오래 파고들었고, 그래서 기록이 쌓였고, 하니스가 그 기록을 다룰 줄 몰라서 죽었다. 요약 한 줄을 끼워 넣자 58.4%.
2026년의 AI 논의는 여전히 모델 중심이다. 어느 모델이 벤치마크 몇 점인지, 다음 모델은 언제 나오는지. 그러나 그 벤치마크 점수는 전부 어떤 하니스 안에서 나온 점수다. 같은 모델이 창 크기 하나, 도구 목록 하나, 할 일 목록 하나에 따라 10배 다른 성적을 낸다면, 우리가 비교하고 있는 것은 모델이 아니라 모델과 마구의 조합이다.
논문이 준 도구는 단순하다. 부품을 하나씩 빼 보라. 궤적이 어디서 죽는지 세어 보라. 그리고 “이 부품이 좋은가”가 아니라 “이 모델·이 예산·이 과제에서 이 부품이 어떤 실패를 막는가”를 물으라. 그 질문에 답이 있는 부품만 남기는 것. 그것이 이 논문이 말하는 하니스 설계다.
참고자료
주 논문
Run-Ze Fan, Zihao Zhang, Simin Ma, Yebowen Hu, Shouju Wang, Kaiqiang Song, Fei Liu, Hamed Zamani, Xiaoyang Wang. An Empirical Study of Harness Design for Coding Agents. arXiv:2609.20804, 2026-09-17. arxiv.org/abs/2609.20804 — 본문의 모든 표·그림 수치는 이 논문 v1의 Table 3~7·13, Figure 3~9, §3~4에서 가져왔다. 그림은 인용 목적으로 전재했다.
하니스의 계보
Yao et al. ReAct: Synergizing Reasoning and Acting in Language Models. arXiv:2210.03629, 2022.
Packer et al. MemGPT: Towards LLMs as Operating Systems. arXiv:2310.08560, 2023.
Wang et al. Executable Code Actions Elicit Better LLM Agents (CodeAct). arXiv:2402.01030, 2024.
Yang et al. SWE-agent: Agent-Computer Interfaces Enable Automated Software Engineering. arXiv:2405.15793, NeurIPS 2024.
Wang et al. OpenHands: An Open Platform for AI Software Developers as Generalist Agents. arXiv:2407.16741, ICLR 2025.
Rombaut. Inside the Scaffold: A Source-Code Taxonomy of Coding Agent Architectures. arXiv:2604.03515, 2026-04.
Mehtiyev & Assunção. Beyond Resolution Rates: Behavioral Drivers of Coding Agent Success and Failure. arXiv:2604.02547, 2026-04.
Liu. More Is Not Always Better: Cross-Component Interference in LLM Agent Scaffolding. arXiv:2605.05716, 2026-05.
Lewis. Same Model, Different Harness: Different Coding-Agent Results. arXiv:2608.26218, 2026-08.
Harness or Model? Isolating the Harness Effect in Agentic Coding with a Contamination-Controlled Private Suite. arXiv:2609.11987, 2026-09.
Cao et al. Qwen3-Coder-Next Technical Report. arXiv:2603.00729, 2026 — 본문의 “Opus 4.5는 OpenHands, Sonnet 4.5는 SWE-Agent” 교차 하니스 결과는 주 논문 §1의 인용을 옮긴 것이다.
벤치마크·모델
Jimenez et al. SWE-bench: Can Language Models Resolve Real-World GitHub Issues? ICLR 2024.