ArchonAFlow추론 시점 기법에이전트 워크플로워크플로 최적화신경망 구조 탐색NAS베이즈 최적화MCTS몬테카를로 트리 탐색앙상블Mixture-of-AgentsADAS자기 일관성멀티에이전트복합 AI 시스템특집
[특집] 설계도를 찾는 기계 — Archon과 AFlow, LLM을 '어떻게 엮을지'를 사람 대신 탐색이 정하기 시작했을 때
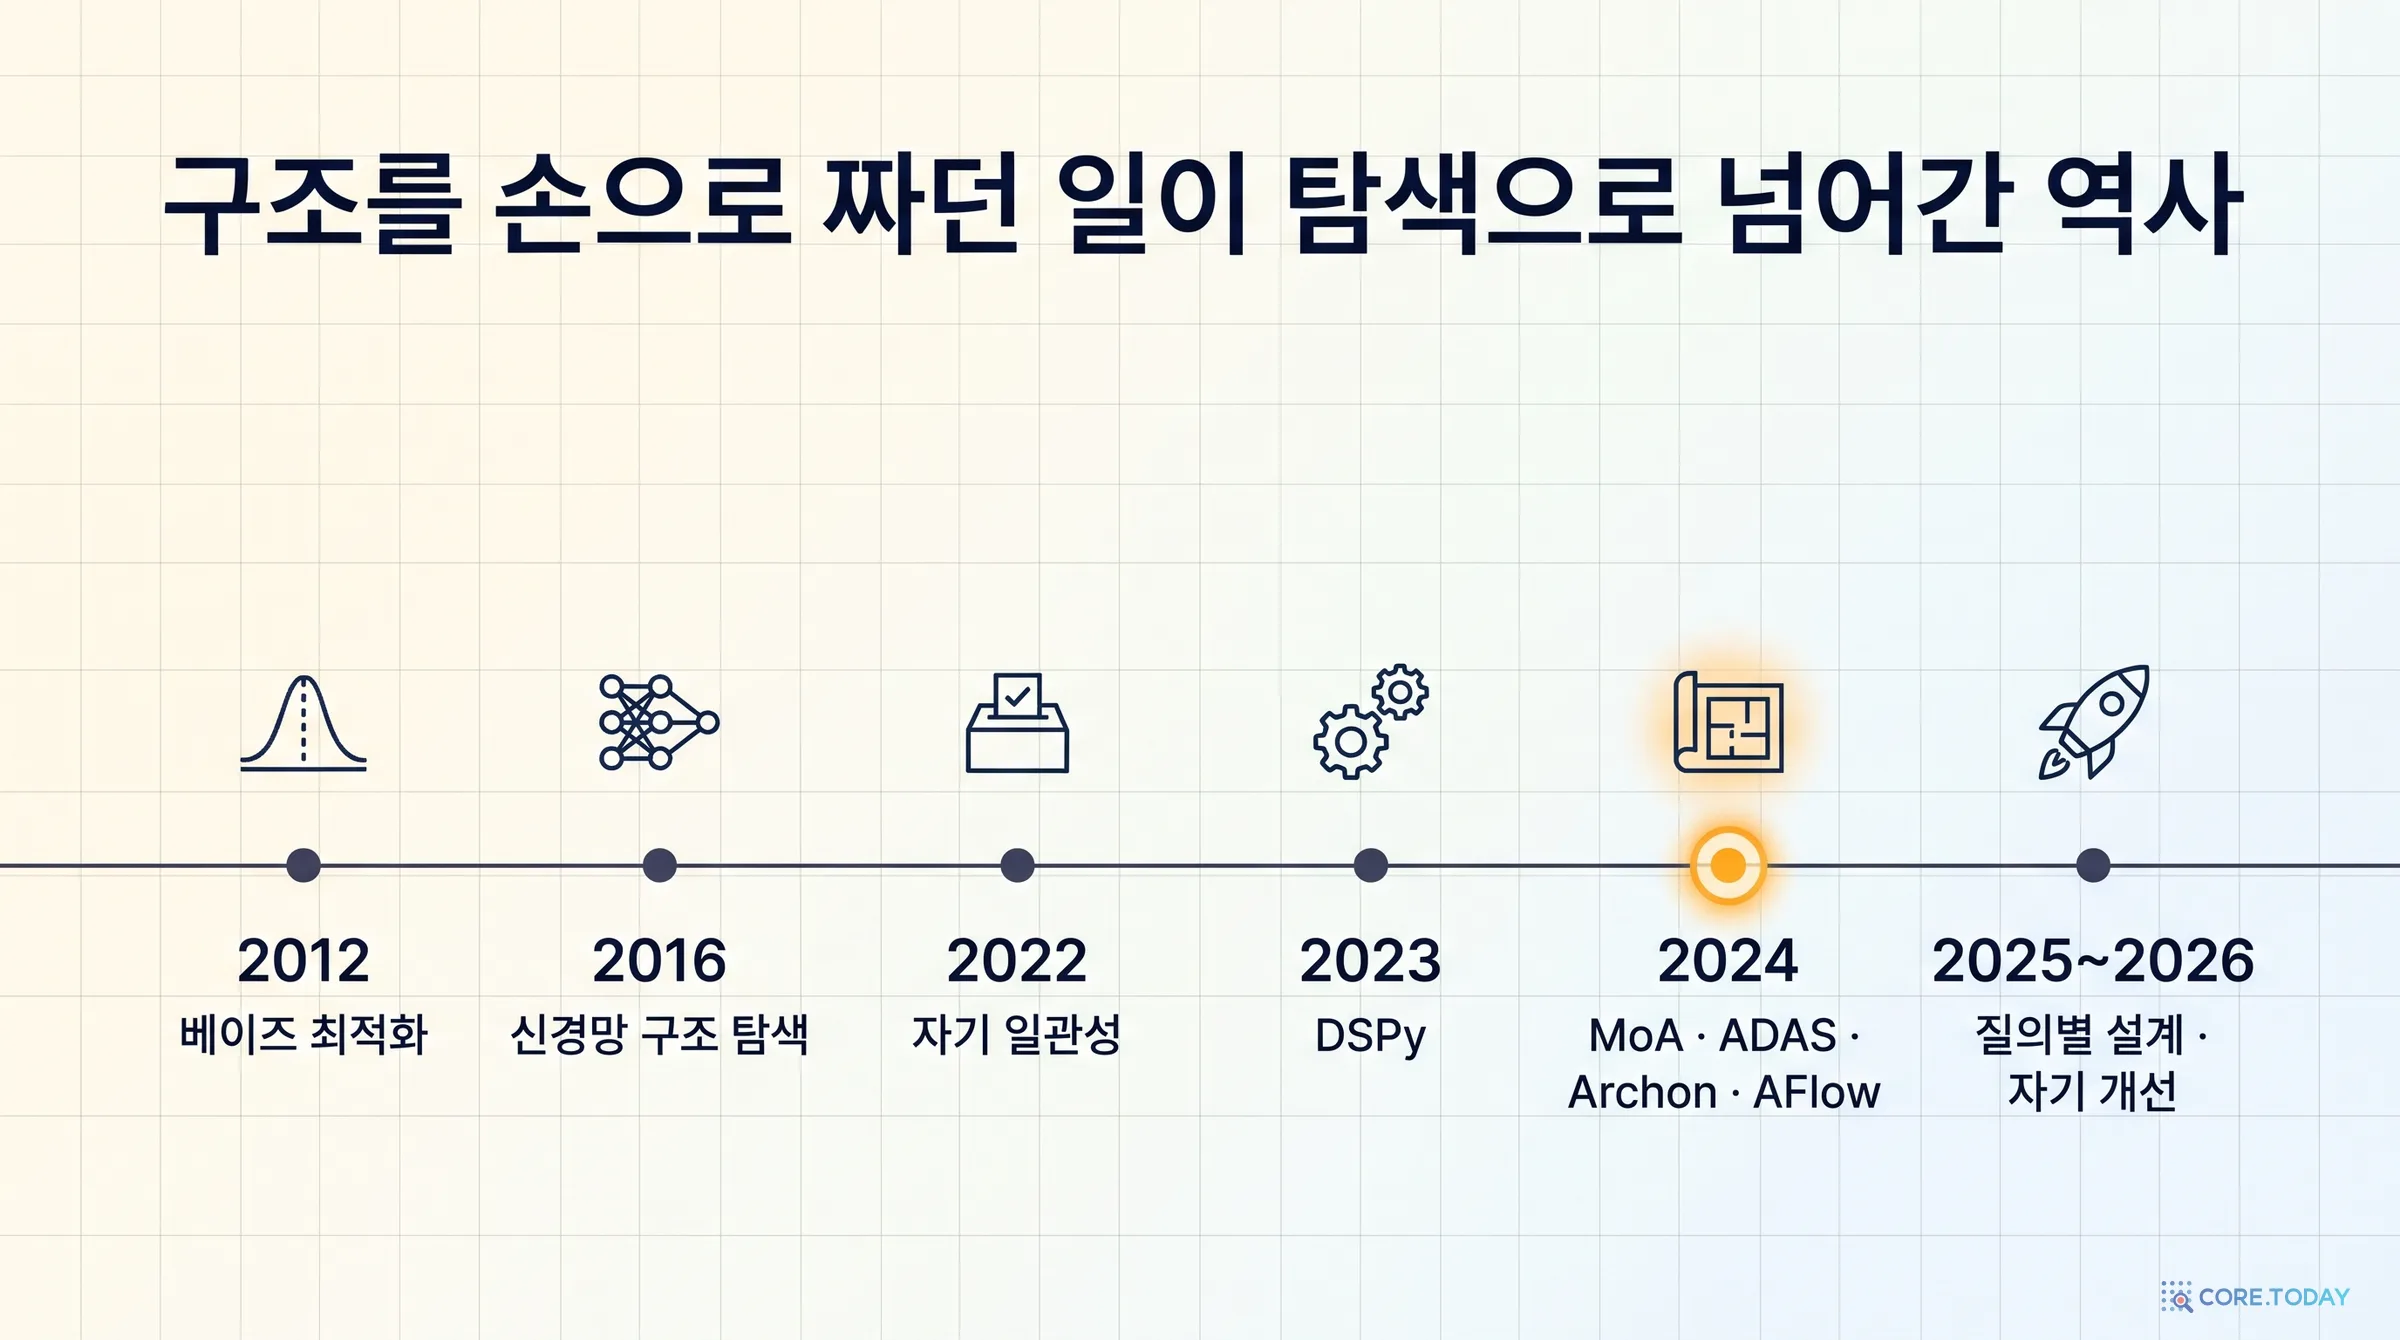
2024년 가을, 3주 간격으로 두 논문이 같은 질문에 서로 다른 답을 냈다. LLM을 여러 번, 여러 개 불러 엮으면 성능이 오른다는 건 다들 안다. 그런데 무엇을 몇 번 부르고 어떤 순서로 엮을지는 누가 정하는가. 스탠퍼드의 Archon(arXiv 2409.15254, ICML 2025)은 구조를 '여섯 개의 다이얼'로 줄이고 신경망 구조 탐색에서 쓰던 베이즈 최적화로 9,576가지 조합을 뒤졌다. DeepWisdom·홍콩과기대(광저우)의 AFlow(arXiv 2410.10762, ICLR 2025 구두 발표)는 구조를 '파이썬 코드'로 두고 LLM이 한 번에 한 군데씩 고치게 하면서 그 시도들을 나무로 기억했다. 이 글은 두 논문을 부록까지 읽고, 왜 한 번만 묻지 않게 됐는지(1785년 콩도르세, 1907년 골턴의 소, 2022년 자기 일관성)에서 시작해 여섯 부품과 깔때기 구조, 9,576가지 공간과 기대 향상, 노드·오퍼레이터·엣지, 선택·확장·평가·역전파 네 단계를 차례로 푼다. 본문과 부록, 공개 코드 사이에 엇갈리는 숫자(비평가 11.5점 대 3.1점, 선택 확률의 α·λ 세 벌)도 짚었다. 그리고 2년이 지난 2026년 11월의 눈으로 다시 본다. 단순 다수결이 자동 설계를 이긴다는 반론, 같은 모델을 여러 번 부르는 편이 섞는 것보다 낫다는 Self-MoA, 모델 안으로 들어간 병렬 추론, 그럼에도 남은 것. 인터랙티브 6개, 일러스트 14장, 논문 그림 15장.
질문을 모델에 한 번 넣어서는 정확도가 모자랍니다. 그래서 다섯 번 묻고 다수결을 붙입니다. 조금 오릅니다. 답을 검토하는 단계를 하나 더 넣습니다. 어떤 문제에서는 오르고 어떤 문제에서는 떨어집니다. 다른 회사 모델을 하나 섞어 봅니다. 검토 단계를 다수결 앞으로 옮겨 봅니다. 화이트보드에는 상자와 화살표가 늘어나고, 파일 이름은 pipeline_v37_final_진짜최종.py가 됩니다.
이 일의 이상한 점은 무엇이 좋은 구조인지 미리 알 방법이 없다는 것입니다. 검토 단계가 도움이 될지는 돌려 봐야 압니다. 돌려 보려면 평가 문제 수백 개를 그 구조로 풀어야 하고, 한 번에 몇 달러에서 몇십 달러가 듭니다. 그런데 선택지는 곱셈으로 늘어납니다. 모델 열 개 가운데 무엇을 쓸지, 몇 번 부를지, 합칠지 고를지, 검증을 넣을지, 몇 겹으로 쌓을지.
2024년 가을, 이 문제에 정면으로 답한 논문 두 편이 3주 간격으로 나왔습니다.
Archon — 「An Architecture Search Framework for Inference-Time Techniques」. 스탠퍼드대학교의 존 사드팰컨(Jon Saad-Falcon), 아잘리아 미르호세이니(Azalia Mirhoseini) 등 11명. arXiv 2409.15254, 첫 버전 2024년 9월 23일, ICML 2025.
AFlow — 「AFlow: Automating Agentic Workflow Generation」. DeepWisdom과 홍콩과학기술대학교(광저우)의 장자이(Jiayi Zhang), 샹진위(Jinyu Xiang) 등 14명. arXiv 2410.10762, 첫 버전 2024년 10월 14일, ICLR 2025 구두 발표(Oral).
두 논문의 주장은 한 문장으로 같습니다. LLM을 어떻게 엮을지는 사람이 감으로 정할 일이 아니라, 기계가 탐색해서 찾을 일이다.
그런데 답은 정반대 방향에서 나왔습니다. Archon은 구조를 다이얼 여섯 개로 줄여 놓고 통계적 최적화로 돌렸습니다. AFlow는 구조를 아예 파이썬 코드로 풀어 놓고 LLM에게 고쳐 쓰게 했습니다. 하나는 신경망 구조 탐색(NAS)에서, 다른 하나는 알파고의 탐색 알고리즘에서 도구를 빌려 왔습니다.
이 글은 두 논문을 나란히 놓고 읽습니다. 순서는 이렇습니다.
왜 LLM에게 한 번만 묻지 않게 됐는가 — 추론 시점 기법의 뿌리
손으로 짜던 설계는 어디서 한계에 닿았고, 그 전에 같은 길을 걸은 분야는 어디인가
Archon의 여섯 부품, 층 구조, 9,576가지 탐색 공간, 베이즈 최적화
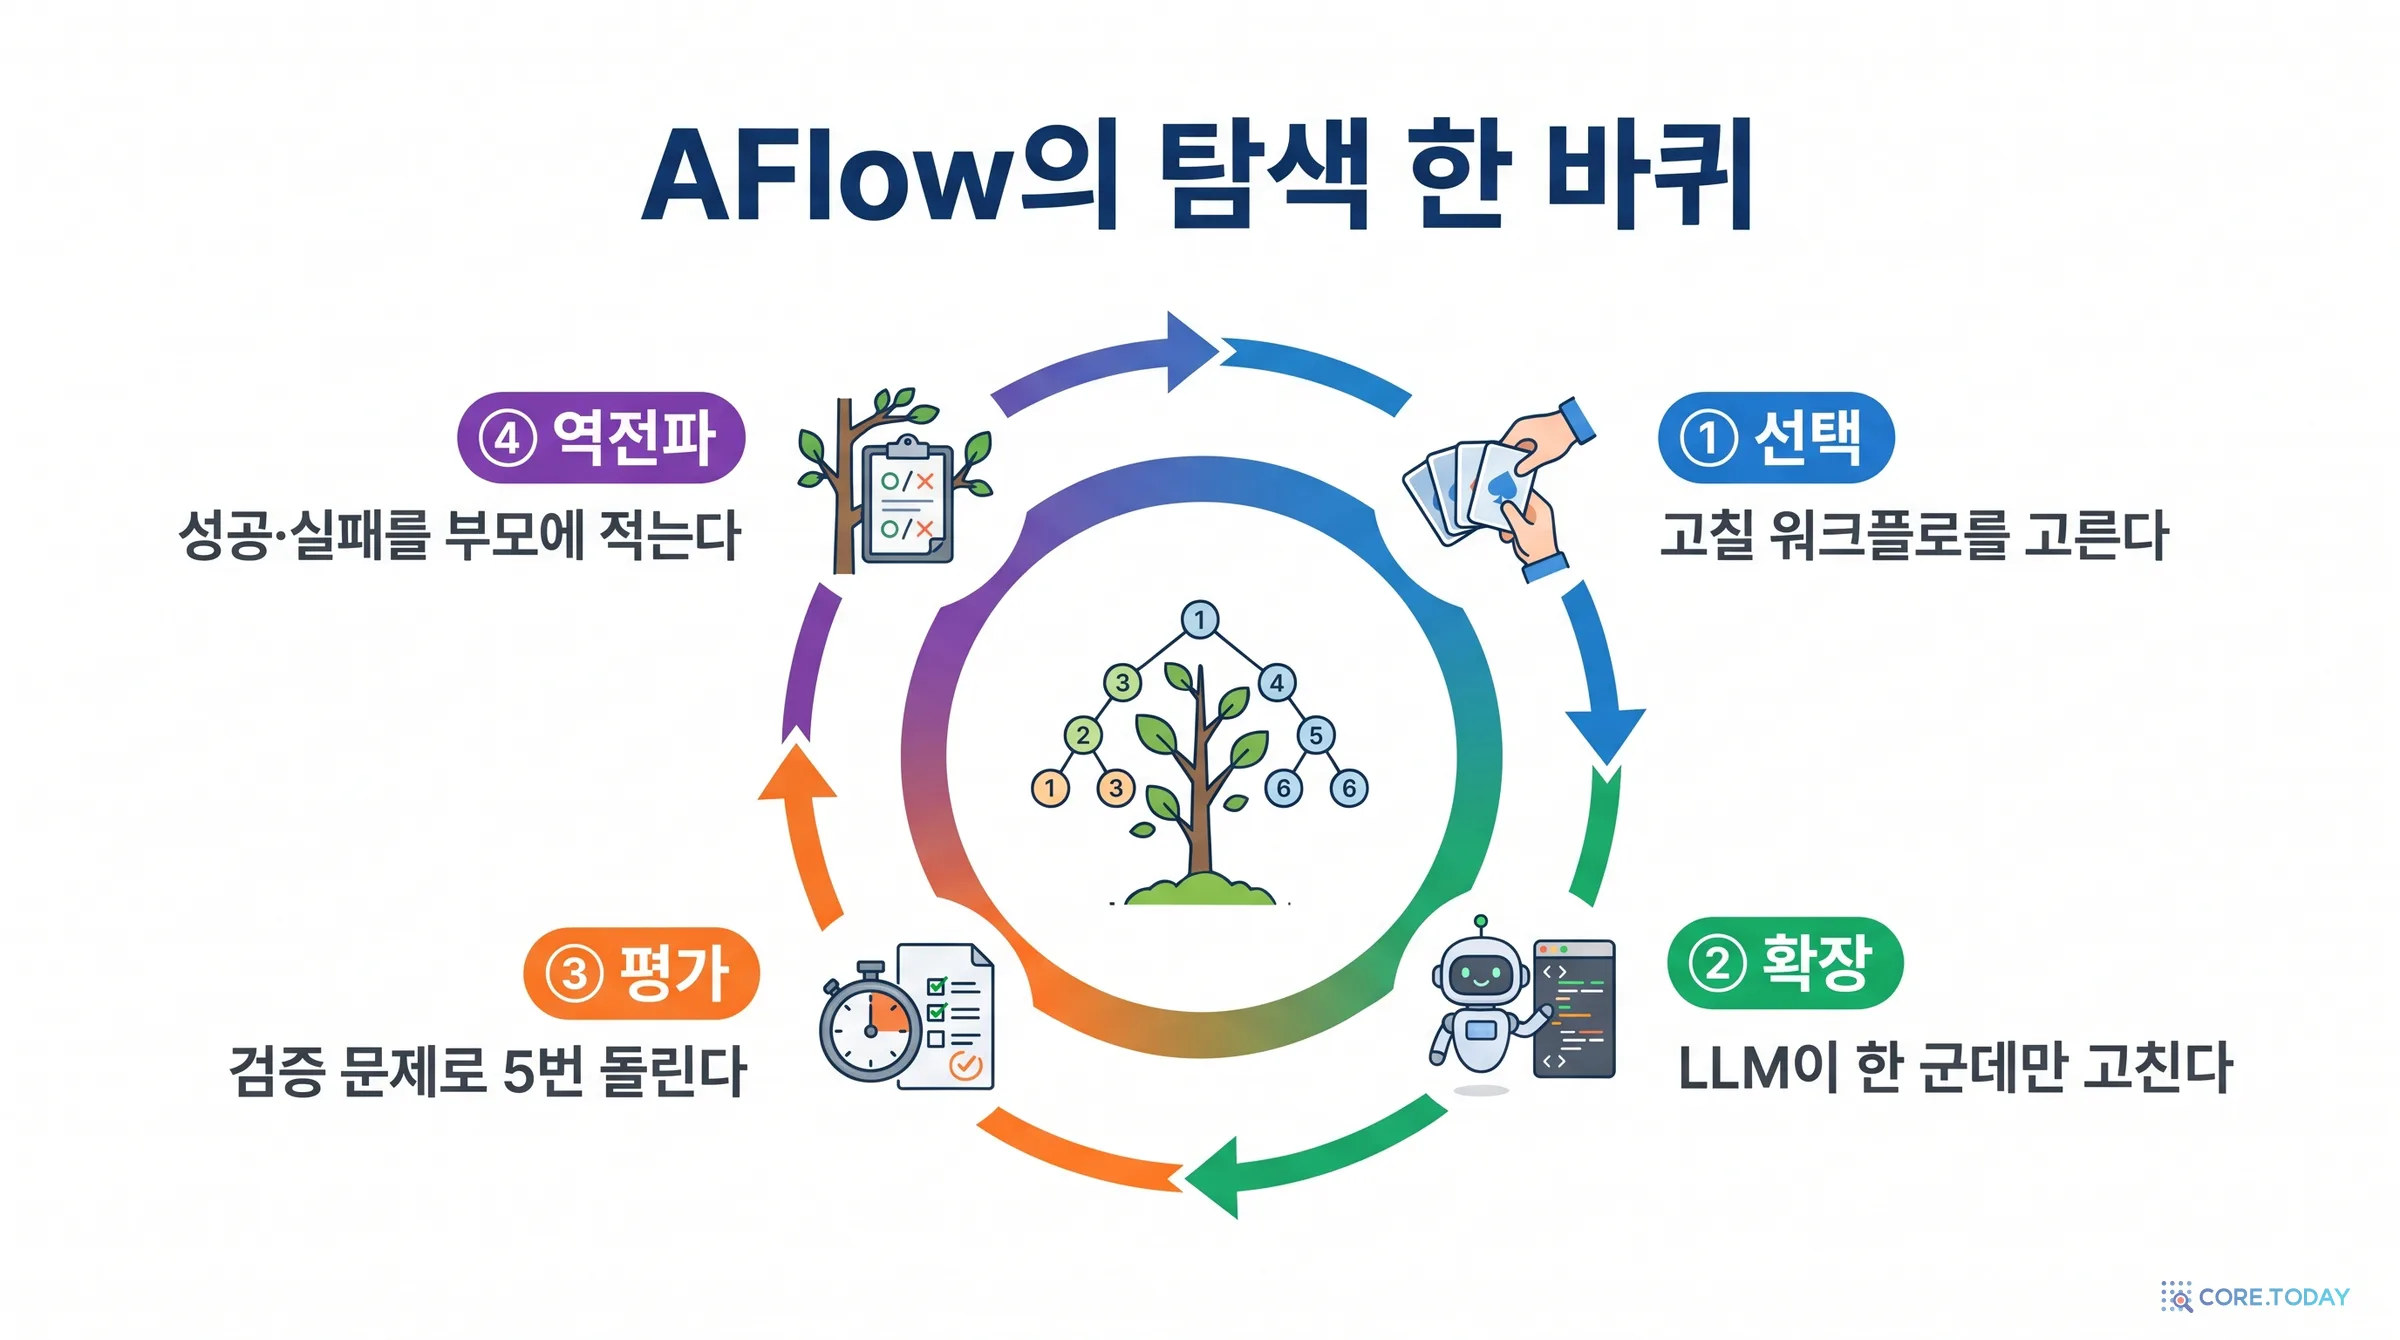
AFlow의 노드·오퍼레이터·엣지, 그리고 선택·확장·평가·역전파 네 단계
두 논문의 결과 표는 무엇을 말하고 무엇을 말하지 않는가
2년 뒤인 2026년 11월, 이 생각은 어디에 남았는가
코어닷투데이는 두 논문의 PDF(Archon 35쪽, AFlow 38쪽)를 부록까지 읽고, AFlow는 공개 저장소의 선택 코드까지 확인했습니다. 아래 위젯의 숫자는 모두 논문의 표와 부록 기록에서 옮긴 것이고, 원리를 보여 주려고 따로 계산한 곳은 그렇게 적었습니다.
1장. 왜 한 번만 묻지 않는가 — 추론 시점 기법의 뿌리
학습이 끝난 뒤에 쓰는 계산
모델의 성능을 올리는 길은 크게 둘입니다. 하나는 학습할 때 계산을 더 쓰는 것입니다. 더 큰 모델, 더 많은 데이터, 더 긴 학습. 다른 하나는 답할 때 계산을 더 쓰는 것입니다. 모델은 그대로 두고, 질문 하나에 호출을 여러 번 쓰거나 여러 모델을 부릅니다.
뒤쪽을 Archon 논문은 추론 시점 기법(inference-time techniques)이라고 부릅니다. 논문의 정의는 짧습니다. “모델 추론 동안 추가 계산을 쓰는 전략.” 다섯 번 묻고 다수결하기, 답을 쓰게 한 뒤 고치게 하기, 여러 모델의 답을 하나로 합치기가 모두 여기에 듭니다.
AFlow 논문은 같은 것을 에이전트 워크플로(agentic workflow)라는 이름으로 부릅니다. “세부 지시가 붙은 LLM 호출들의 구조화된 순서”입니다. 이름은 다르지만 대상은 겹칩니다. 둘 다 LLM 호출 여러 번을 정해진 방식으로 엮은 것을 다룹니다. 이 글에서는 문맥에 따라 두 이름을 모두 쓰겠습니다.
여럿이 한 사람보다 정확하다는 오래된 발견
여러 번 묻는 것이 왜 통하는지는 LLM보다 훨씬 오래된 이야기입니다.
1785년 프랑스의 수학자 콩도르세(Marquis de Condorcet)는 배심원 수를 다룬 글에서 이런 계산을 보였습니다. 배심원 한 사람이 옳은 판단을 할 확률이 절반보다 조금이라도 높고 서로 독립적으로 판단한다면, 배심원이 많아질수록 다수결이 옳을 확률은 1에 가까워진다는 것입니다. 지금은 콩도르세 배심원 정리라고 부릅니다.
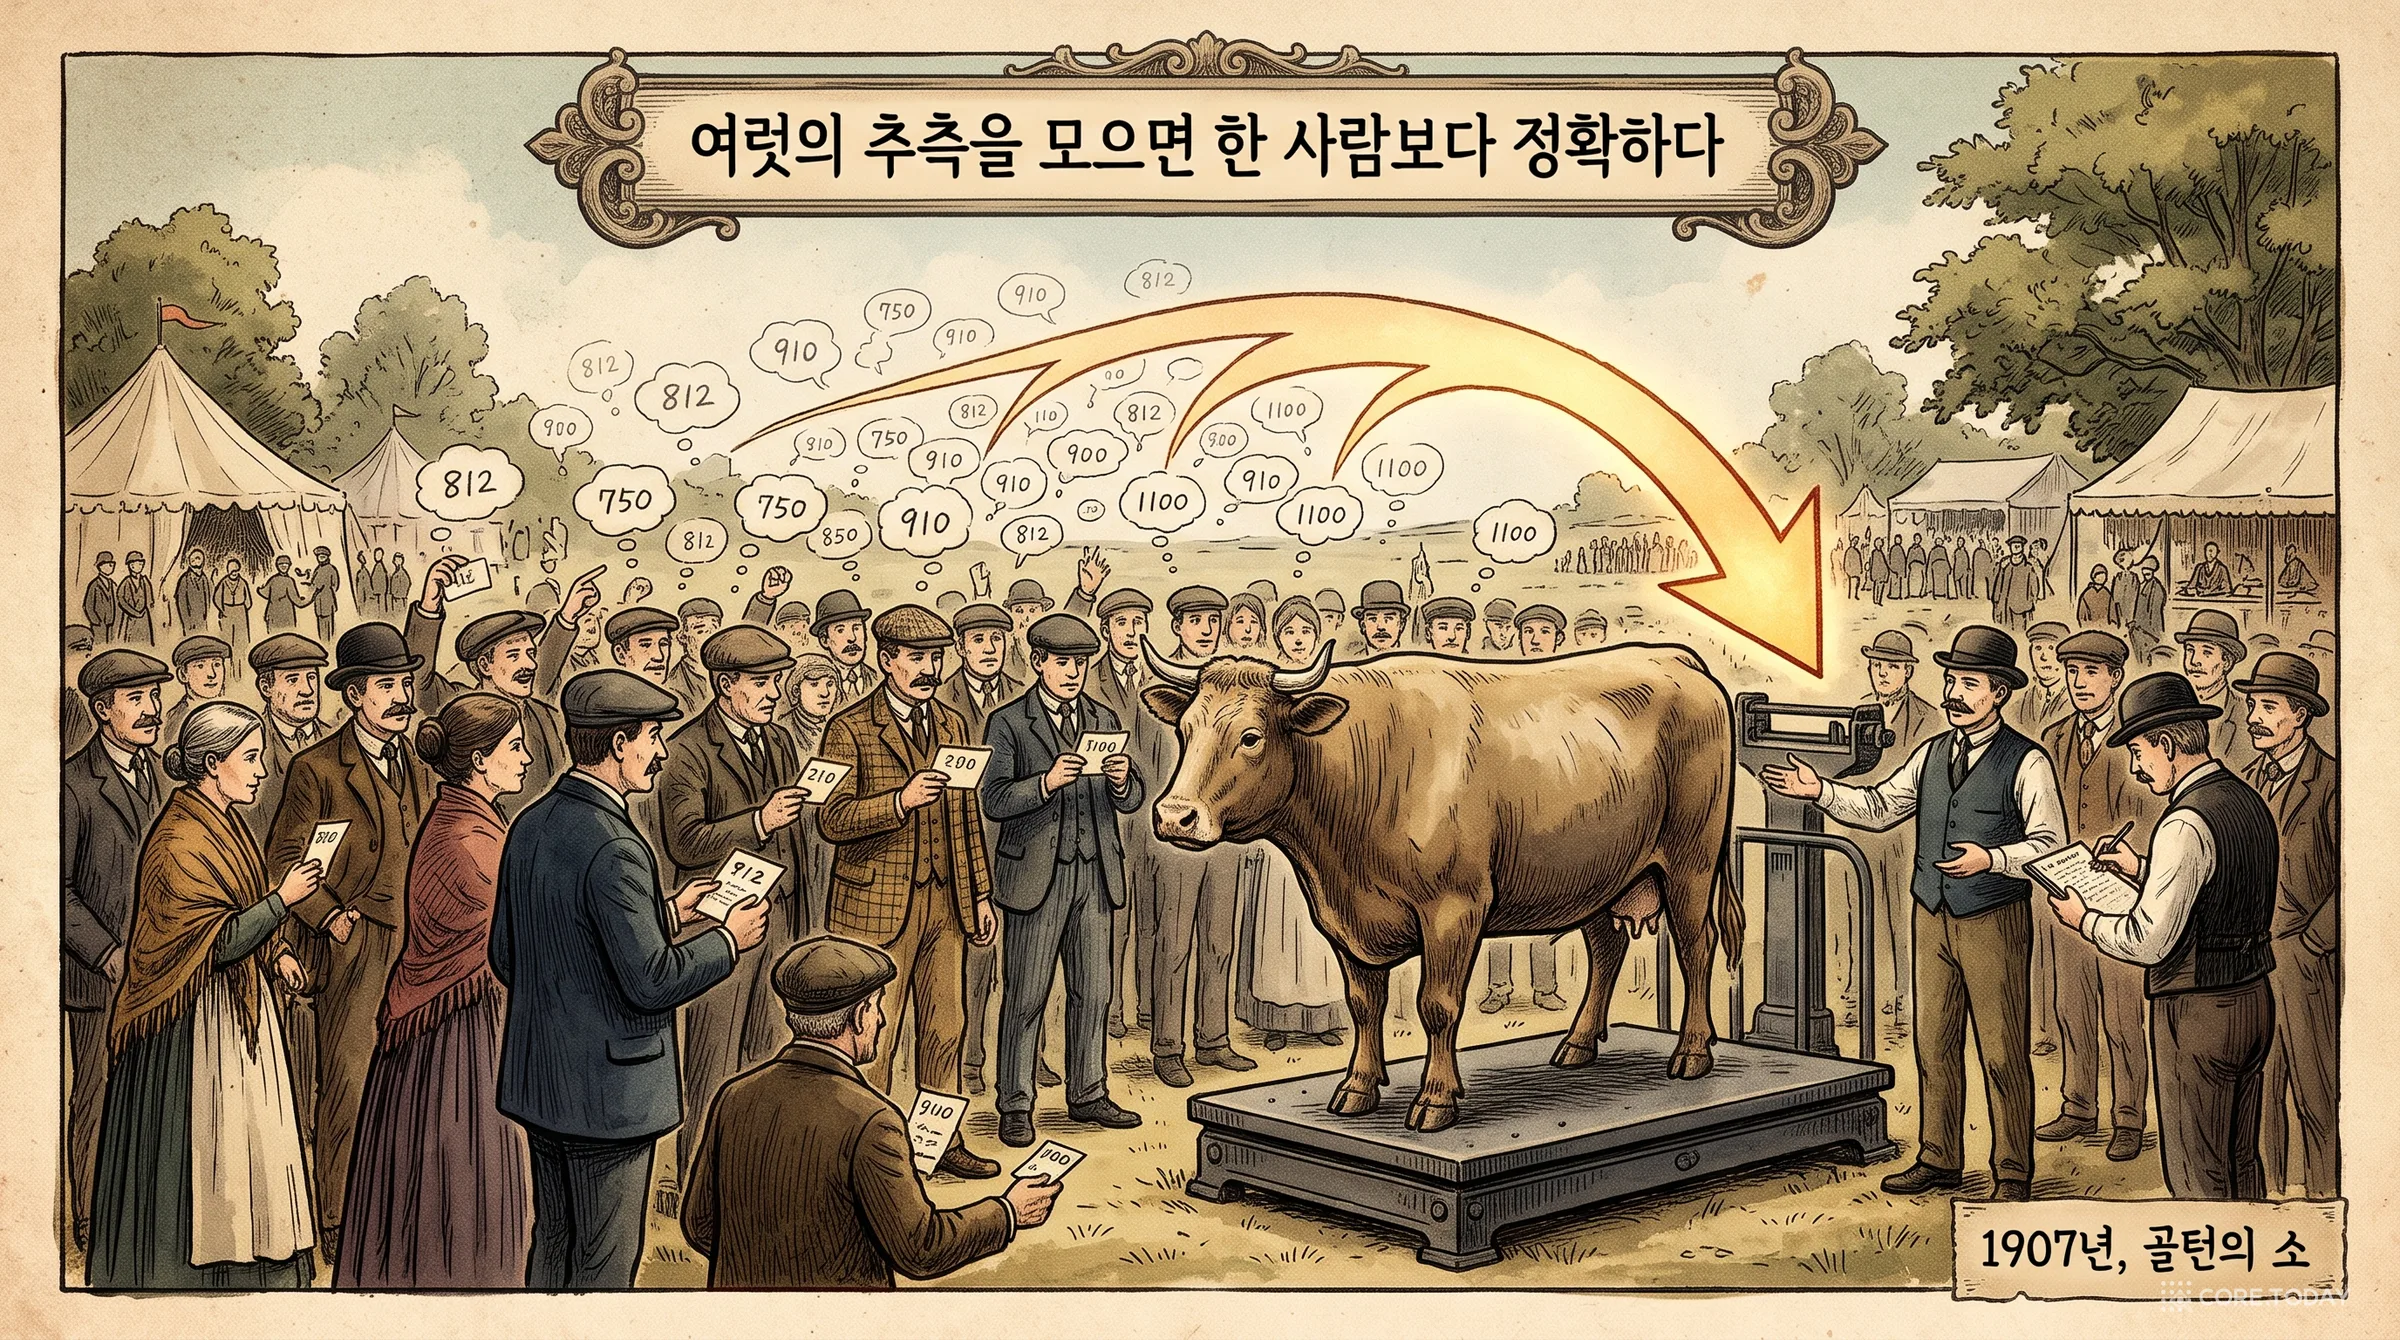
1907년 3월 7일, 영국의 통계학자 프랜시스 골턴(Francis Galton)은 학술지 『네이처』에 「민중의 소리(Vox Populi)」라는 짧은 글을 실었습니다. 가축 박람회에서 소 한 마리의 무게를 맞히는 대회가 열렸고, 사람들은 6펜스를 내고 표를 사서 추측을 적었습니다. 골턴은 읽을 수 없는 13장을 뺀 787장을 정리했습니다. 추측들의 중앙값은 1,207파운드, 도축해 손질한 소의 실제 무게는 1,198파운드였습니다. 오차는 9파운드, 1%가 안 됩니다.
이 일화는 자주 틀리게 인용됩니다. 골턴이 내세운 것은 평균이 아니라 중앙값이었습니다. 평균(1,197파운드)은 독자의 편지를 받고 나서 그해 3월 21일 자에 따로 밝혔습니다. 무게도 살아 있는 소가 아니라 도축 후 무게였습니다. 통계학자 케네스 월리스가 2014년 골턴의 원자료를 다시 확인해 보니 실제 무게는 1,197파운드, 중앙값은 1,208파운드로 한 파운드씩 달랐다는 점도 덧붙여 둡니다.
기계 학습은 이 발견을 앙상블이라는 이름으로 물려받았습니다. 2009년 9월 넷플릭스가 100만 달러를 건 추천 대회의 우승 해법은 여러 팀의 모델을 섞은 거대한 앙상블이었고, 기준 대비 10.06%를 개선했습니다. 여기에도 덜 알려진 뒷이야기가 있습니다. 넷플릭스는 2012년 기술 블로그에서 중간 단계 수상 해법의 두 알고리즘은 실제 서비스에 넣었지만, 최종 우승 앙상블은 “얻는 정확도가 들어갈 엔지니어링 노력을 정당화하지 못해” 쓰지 않았다고 밝혔습니다. 합치면 좋아지지만, 합친 것을 운영하는 비용은 따로 든다. 이 글 끝까지 따라다닐 긴장입니다.
직접 돌려 보기
아래 위젯은 콩도르세의 계산을 그대로 옮긴 것입니다. 한 번 물었을 때 정답률, 묻는 횟수, 그리고 표본들이 같은 실수를 공유하는 정도를 바꿔 보세요.
세 가지를 확인할 수 있습니다.
첫째, 정답률이 50%를 넘으면 많이 물을수록 좋아지지만 이득은 빠르게 줄어듭니다. 정답률 65%인 모델은 5번 물으면 약 76%, 41번 물으면 약 98%가 됩니다. 비용은 8배가 넘습니다.
둘째, 정답률이 50%에 못 미치는 문제에서는 많이 물을수록 나빠집니다. 다수가 틀린 쪽에 서기 때문입니다.
셋째, 표본들이 같은 실수를 공유하면 표를 늘려도 정보가 늘지 않습니다. 같은 모델을 같은 프롬프트로 열 번 부르면 열 명의 배심원이 아니라 한 사람의 판단을 열 번 복사한 것에 가까워집니다.
이 세 가지가 뒤에서 그대로 나옵니다. Archon이 모델 열 개를 섞는 이유, AFlow가 찾아 낸 수학 워크플로가 ‘서로 다른 세 가지 접근’으로 풀게 하는 이유, 그리고 둘 다 ‘어디에 호출을 쓸지’를 탐색해야 하는 이유입니다.
LLM이 이 길을 다시 걷다, 2022~2024
LLM 쪽에서 이 생각이 다시 발견되는 데는 2년이 걸리지 않았습니다.
2022. 3.자기 일관성(Self-Consistency) — 구글의 왕쉐즈(Xuezhi Wang) 등. 같은 질문에 풀이를 여러 번 뽑고 가장 많이 나온 답을 고른다. 초등 수학 벤치마크 GSM8K에서 17.9%포인트 향상.
2023. 6.LLM-Blender — 여러 모델의 답을 둘씩 비교해 순위를 매기고(PairRanker), 상위 답들을 하나로 합친다(GenFuser). Archon의 순위기와 융합기는 이 논문의 직계 후손이다.
2024. 2.복합 AI 시스템 — 버클리 AI 연구소(BAIR) 블로그 「모델에서 복합 AI 시스템으로」. 최고 성능은 점점 모델 하나가 아니라 여러 부품을 엮은 시스템에서 나온다고 선언했다.
2024. 3.「LLM 호출은 많을수록 좋은가?」 — 천링자오(Lingjiao Chen) 등. 호출 수를 늘리면 성능이 올랐다가 다시 내려갈 수 있다는 것을 보였다. 쉬운 문제에는 도움이 되고 어려운 문제에는 해가 되기 때문이다. 위 위젯의 둘째 관찰과 같다.
2024. 6.Mixture-of-Agents(MoA) — 투게더 AI. 공개 모델 여러 개가 답을 내고, 다음 층의 모델들이 그 답을 참고해 다시 쓰는 일을 층층이 반복한다. AlpacaEval 2.0에서 65.1%로 GPT-4o(57.5%)를 넘었다.
2024. 7.Large Language Monkeys — 스탠퍼드. 표본 수를 250개까지 늘리자 SWE-bench Lite에서 ‘하나라도 맞는 표본이 있는’ 비율이 15.9%에서 56%로 올랐다. 미르호세이니가 공저자다.
2024. 9. 12.OpenAI o1-preview — 답하기 전에 길게 ‘생각’하는 모델. 추론 시점 계산을 모델 회사가 상품으로 내놓았다. Archon 첫 버전은 그 11일 뒤에 나왔다.
Large Language Monkeys의 56%에는 주의할 점이 있습니다. 이 숫자는 250개 표본 가운데 정답이 하나라도 있을 비율(커버리지)이지, 시스템이 그 정답을 골라 낼 수 있다는 뜻이 아닙니다. 많이 뽑는 것과 잘 고르는 것은 다른 문제이고, Archon이 순위기·검증기·단위 테스트 같은 ‘고르는 부품’을 따로 두는 이유가 여기에 있습니다.
2024년 여름의 상황을 정리하면 이렇습니다. 기법은 쏟아져 나왔고 하나하나는 효과가 있었습니다. 그러나 어떤 과제에 어떤 기법을, 어떤 순서로, 얼마나 써야 하는지에 대한 답은 없었습니다. Archon 논문은 서론에서 이 공백을 세 가지로 나눠 적었습니다. 기법 하나하나의 쓸모를 모른다, 기법들 사이의 상호작용을 모른다, 그리고 조합의 공간이 너무 커서 손으로 뒤질 수 없다.
2장. 손으로 짜던 설계가 닿은 한계 — 그리고 먼저 같은 길을 간 분야
조합은 곱셈으로 늘어난다
1장의 기법들을 부품이라고 해 봅시다. 생성, 다수결, 순위 매기기, 합치기, 비평, 검증. 부품이 여섯 종류이고 모델이 열 개, 층을 네 겹까지 쌓을 수 있다면 가능한 구조는 금세 수만 가지가 됩니다. 프롬프트 문구까지 바꿀 수 있다면 사실상 무한합니다.
게다가 좋은 구조는 과제마다, 모델마다 다릅니다. 이것은 두 논문이 공통으로 보고한 결과입니다. Archon은 지시 따르기 과제에서는 비평과 융합을 여러 겹 쌓는 구조가, 코딩 과제에서는 한 모델을 많이 뽑아 테스트로 거르는 구조가 좋았다고 적었습니다. AFlow는 DeepSeek 모델로 찾은 워크플로를 GPT-4o-mini에 옮기면 GPT-4o-mini로 직접 찾은 것보다 뚜렷이 약했다며 “모델마다 최적 성능을 내는 워크플로가 다르다”고 썼습니다.
그러면 과제가 바뀔 때마다, 모델이 새로 나올 때마다 화이트보드 앞의 밤을 다시 보내야 합니다. 사람이 이 일을 계속할 수는 없습니다.
신경망 구조 탐색이 먼저 걸은 길
이 상황은 처음이 아닙니다. 2010년대 중반 딥러닝 연구자들도 똑같은 벽 앞에 섰습니다. 그때의 대상은 LLM 호출이 아니라 신경망의 층이었습니다. 합성곱 층을 몇 개 쌓을지, 필터 크기는 얼마로 할지, 건너뛰는 연결은 어디에 둘지. AlexNet, VGG, ResNet은 모두 사람이 손으로 짠 구조였습니다.
2016년 11월 구글 브레인의 배럿 조프(Barret Zoph)와 꾸옥 레(Quoc Le)가 「강화학습을 이용한 신경망 구조 탐색」을 내놓았습니다. 제어기 신경망이 구조를 제안하고, 그 구조를 실제로 학습시켜 얻은 정확도를 보상으로 받아 더 나은 구조를 제안하는 방식입니다. 이것이 신경망 구조 탐색(Neural Architecture Search, NAS)의 출발점입니다.
비용은 엄청났습니다. 후속 논문(NASNet, 2017)의 각주에 따르면 첫 NAS는 GPU 800장을 28일 동안 썼습니다. NASNet은 탐색 대상을 ‘셀’이라는 작은 단위로 줄여 GPU 500장, 4일로 낮췄습니다. 2018년 ENAS는 후보 구조들이 가중치를 공유하게 해서 비용을 “1,000배” 줄였다고 주장했고, 같은 해 DARTS는 구조 선택을 미분 가능한 문제로 바꿨습니다.
Archon 논문은 이 계보를 명시적으로 잇습니다. 본문은 자신들의 방법이 “NAS에서 영감을 받은 베이즈 최적화 기법”이라고 적고 조프와 레의 논문을 인용합니다. 교신 저자 미르호세이니는 그 시기 구글 브레인에 있었고, 강화학습으로 반도체 칩의 배치를 설계한 연구(『네이처』, 2021)의 공동 제1저자입니다. ‘사람이 하던 설계를 탐색에 맡긴다’는 문제 의식이 신경망에서 칩으로, 칩에서 LLM 시스템으로 옮겨 온 셈입니다.
NAS가 남긴 불편한 교훈
그런데 NAS의 역사에는 지금 꼭 기억해야 할 뒷부분이 있습니다.
2019년 리암 리(Liam Li)와 아밋 탈왈카(Ameet Talwalkar)는 「신경망 구조 탐색의 무작위 탐색과 재현성」에서 아주 단순한 실험을 했습니다. 가중치 공유를 쓰되 구조는 그냥 무작위로 뽑은 것입니다. 결과는 당시 최신 NAS 방법들과 비슷했습니다. 언어 모델 벤치마크 PTB에서는 무작위 탐색이 DARTS와 ENAS보다 오히려 나았고, CIFAR-10에서는 근소하게 뒤졌습니다. 조사한 논문 12편 가운데 결과를 정확히 재현할 수 있는 것은 하나도 없었습니다. 이듬해 양(Yang) 등의 「NAS 평가는 답답할 만큼 어렵다」는 여덟 가지 방법 다수가 ‘탐색 공간에서 평균적인 구조’를 뚜렷이 이기지 못한다고 보고했습니다.
정확히 옮기면 이 연구들의 결론은 ‘NAS는 쓸모없다’가 아닙니다. 성능의 대부분은 탐색 알고리즘이 아니라 사람이 정해 둔 탐색 공간에서 나왔다는 것입니다. 좋은 부품만 골라 좁게 만든 공간에서는 아무거나 뽑아도 쓸 만했습니다.
이 교훈을 미리 적어 두는 이유는, 11장에서 2025~2026년의 반론들을 볼 때 똑같은 모양이 다시 나타나기 때문입니다.
두 논문이 빌려 온 두 가지 탐색 도구
탐색 알고리즘 쪽에도 계보가 있습니다. 두 논문은 서로 다른 도구를 집어 들었습니다.
Archon이 고른 것은 베이즈 최적화입니다. 평가 한 번이 비싼 함수의 최댓값을 적은 시도로 찾는 방법으로, 1964년 해럴드 쿠슈너(Harold Kushner)와 1970년대 요나스 모츠쿠스(Jonas Močkus)의 연구에서 시작됐습니다. 기계 학습에 널리 퍼진 계기는 2012년 재스퍼 스누크(Jasper Snoek) 등의 논문 「기계 학습 알고리즘의 실용적 베이즈 최적화」입니다. 학습률이나 층 수 같은 하이퍼파라미터를 사람 대신 맞추는 데 쓰였습니다. Archon은 LLM 시스템의 구조를 하이퍼파라미터 여섯 개로 보고 이 도구를 그대로 가져옵니다.
AFlow가 고른 것은 몬테카를로 트리 탐색(MCTS)입니다. 2006년 레미 쿨롱(Rémi Coulom)이 바둑 프로그램 크레이지 스톤에서 선보였고, 같은 해 코치시(Kocsis)와 세페슈바리(Szepesvári)가 UCT라는 형태로 이론을 붙였습니다. 2016년 알파고가 이세돌 9단을 이기면서 유명해졌습니다. 가능한 수를 나무로 펼치고, 유망한 가지를 더 깊이 파되 가 보지 않은 가지도 가끔 들여다보는 방법입니다. AFlow는 바둑의 한 수를 ‘워크플로 코드의 수정 한 번’으로 바꿔 놓습니다.
그리고 LLM 쪽의 직전 연구들이 있습니다.
연구
시기
무엇을 자동으로 정하는가
두 논문이 본 한계
DSPy
2023. 10.
정해진 파이프라인 안의 프롬프트와 예시
파이프라인 구조는 사람이 먼저 짜야 한다
GPTSwarm
2024. 2.
에이전트 사이의 연결(그래프의 간선)
그래프로는 조건 분기를 표현하기 어렵다(AFlow)
TextGrad
2024. 6.
글로 된 피드백을 ‘기울기’처럼 써서 프롬프트 개선
구조의 다양성을 담지 못한다(AFlow)
MoA
2024. 6.
(자동화 없음) 사람이 정한 층 구조
과제가 바뀌어도 같은 구조다(Archon)
ADAS
2024. 8.
워크플로 전체를 코드로 쓰고 LLM이 새로 발명
과거 시도를 긴 목록으로만 쌓아 탐색이 비효율적이다(AFlow)
마지막 줄의 ADAS(Automated Design of Agentic Systems, 후(Hu)·루(Lu)·클룬(Clune), 2024년 8월)는 AFlow의 직접적인 출발점입니다. 워크플로를 코드로 표현한다는 생각은 ADAS가 먼저 했습니다. AFlow는 그 표현을 물려받되 탐색을 어떻게 기억할 것인가를 바꿨습니다. 8장에서 자세히 봅니다.
이제 두 논문을 하나씩 열어 보겠습니다. 먼저 Archon입니다.
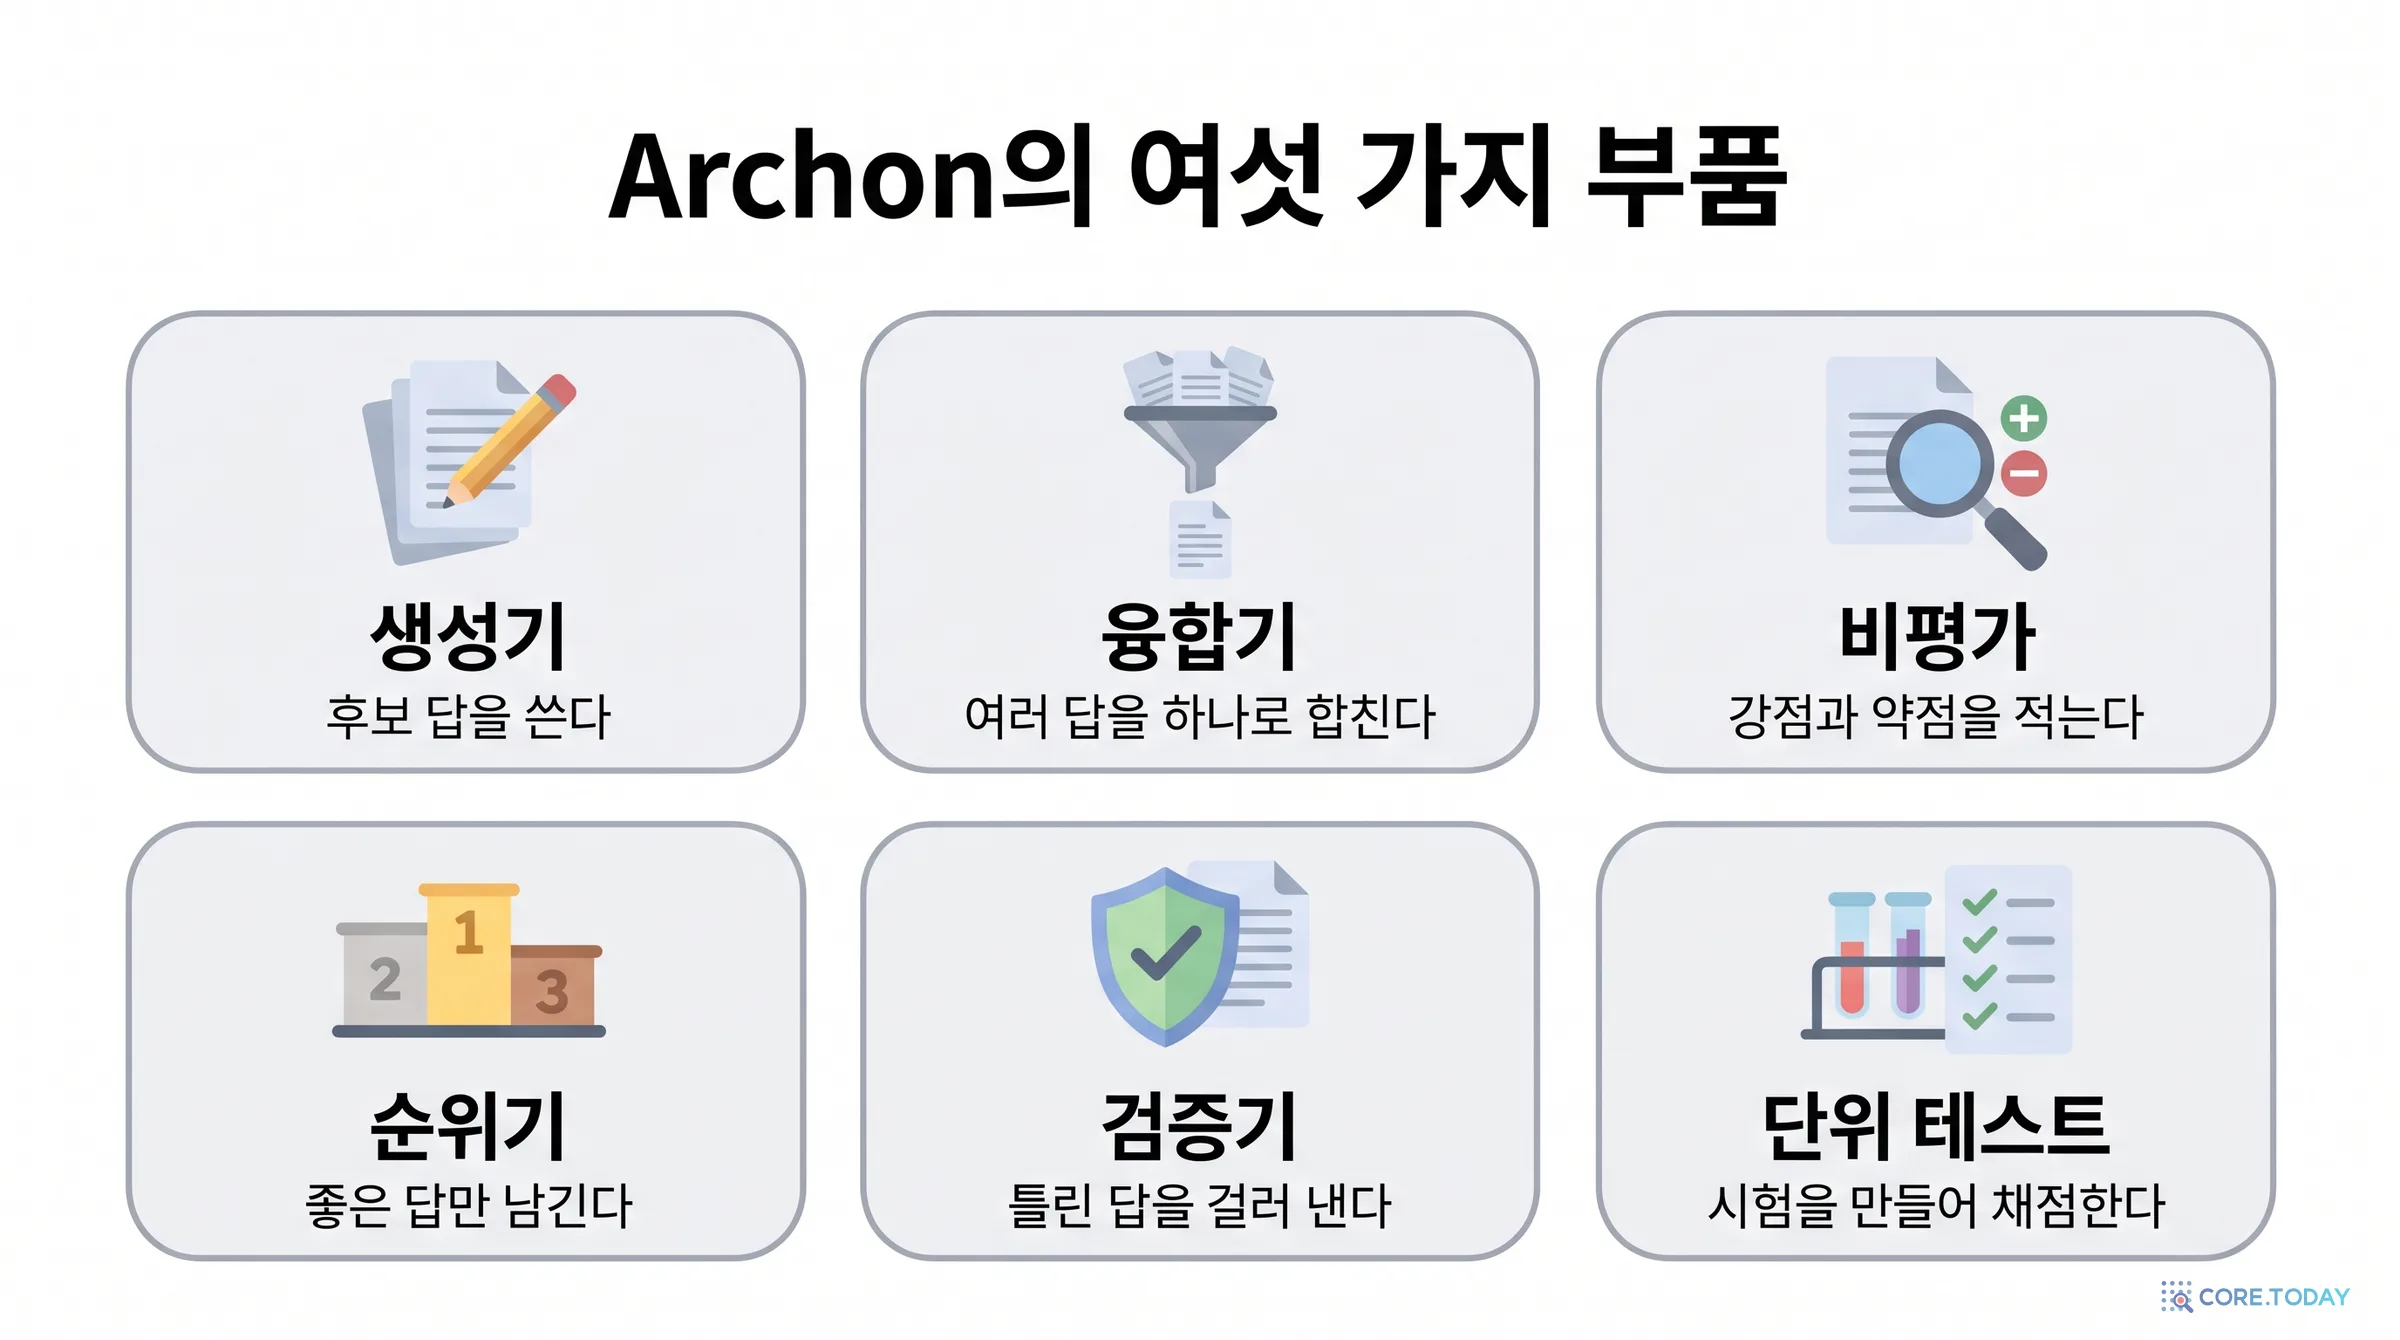
3장. Archon ① 여섯 가지 부품 — 기법들에 이름표를 붙이다
논문의 순서: 재 보고, 쌓고, 찾는다
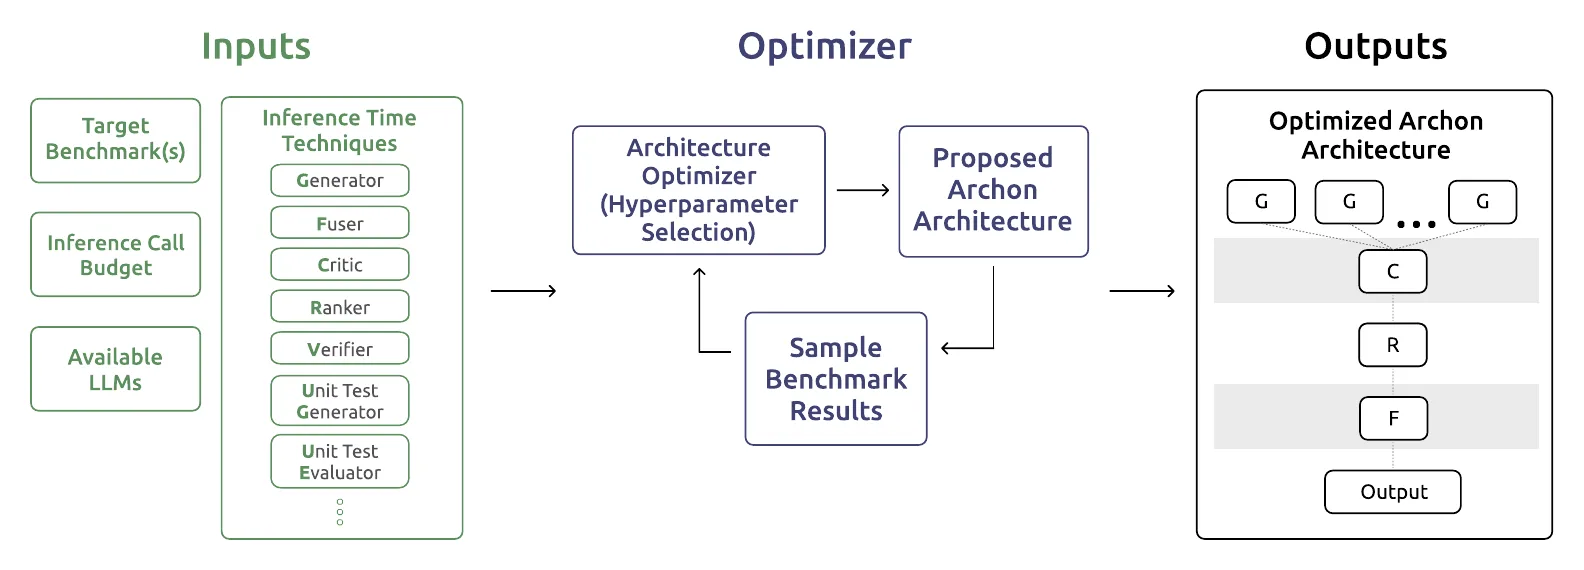
Archon 논문은 세 걸음으로 되어 있습니다. 먼저 흩어져 있던 추론 시점 기법들을 부품 여섯 개로 정리하고 하나씩 효과를 잽니다. 다음으로 그 부품들을 층으로 쌓는 규칙을 정합니다. 마지막으로 그 규칙 안에서 가장 좋은 조합을 자동으로 찾습니다.
질문 + 후보 답 하나 → 근거를 쓴 뒤 [맞음]/[틀림] 판정. 통과한 답만 다음 층으로
MixEval·MixEval-Hard·MATH에서 8.4% 향상
추론·수학
단위 테스트 생성·채점
질문 → 짧은 시험 문장 5~10개 → 후보마다 통과 수로 순위
표본을 늘리며 쓰면 CodeContests 17.9 → 29.3%
코딩, 일부 추론
마지막 부품은 이름 때문에 오해하기 쉽습니다. 여기서 ‘단위 테스트’는 실행되는 코드가 아닙니다. “답이 질문에서 요구한 세 가지 항목을 모두 포함하는가” 같은 자연어 점검 문장을 LLM이 만들고, 다른 LLM 호출이 후보 답마다 그 문장을 통과하는지 판정합니다. 코딩이 아닌 과제에도 쓸 수 있게 넓힌 개념입니다.
본문과 부록의 숫자가 다르다
위 표의 효과 수치는 대부분 부록 A.3에서 가져왔습니다. 본문 3.1절에도 같은 내용이 있는데 숫자가 다릅니다.
같은 주장
본문 3.1절
부록 A.3
비평가를 더했을 때의 평균 향상
11.5%포인트
3.1%포인트
순위기가 무작위 선택보다 나은 정도
10.8%
3.8%
융합 층을 3~4겹 쌓았을 때 MT Bench·AlpacaEval 승률 상승
10~15점
2~5점
어느 쪽이 맞는지 논문만으로는 알 수 없습니다. 부록의 표 5(아래)로 직접 계산해 보면 ‘앙상블 + 융합’에서 ‘앙상블 + 비평 + 융합’으로 갈 때의 차이는 벤치마크에 따라 0.1~14.5점이고, 여덟 칸을 평균하면 약 3.5점입니다. 부록 쪽에 가깝습니다. 이 논문은 여섯 번 개정됐고(v6, 2025년 6월) 초록의 대표 수치도 버전마다 달랐습니다. 방향은 믿되 크기는 표에서 직접 읽는 편이 안전합니다.
부품을 하나씩 더해 본 표
부록의 표 5는 이 논문에서 가장 정직한 표입니다. 70B급 공개 모델 8개의 앙상블에 부품을 하나씩 더하거나 빼면서 잰 결과입니다.
구성
호출 수
MT Bench
Arena-Hard
MixEval-Hard
CodeContests
가장 좋은 모델 하나, 한 번
1
55.0
45.6
58.7
22.5
앙상블 + 순위기
9
52.5
50.5
58.7
24.1
앙상블 + 검증기
24
53.2
52.4
55.9
25.3
앙상블 + 단위 테스트
18
51.5
46.1
55.2
24.6
앙상블 + 융합기
9
58.4
54.3
60.1
23.1
앙상블 + 비평 + 융합
10
60.9
58.8
61.7
24.9
앙상블 + 검증 + 융합
25
60.5
59.2
68.3
26.3
앙상블 + 단위 테스트 + 융합
17
61.4
56.4
63.9
28.0
앙상블 + 비평 + 순위 + 융합
11
64.7
60.9
66.8
25.5
이 표에서 읽을 것은 세 가지입니다.
첫째, 고르기만 하는 부품은 혼자서는 약합니다. 모델 여덟 개의 답 가운데 하나를 순위기로 고르면 MT Bench에서 52.5로, 가장 좋은 모델 하나를 한 번 부른 55.0보다 낮습니다. 여덟 개 중 일곱은 최고 모델보다 못한 모델이고, 순위기가 늘 최고의 답을 집어내지는 못하기 때문입니다. 검증기와 단위 테스트도 마찬가지입니다.
둘째, 융합기가 붙어야 살아납니다. 같은 순위기·검증기·단위 테스트가 뒤에 융합기 하나를 두면 모두 60점대로 올라갑니다. 고르는 부품은 융합기에게 넘길 재료를 다듬는 역할일 때 값을 합니다.
셋째, 1등 구성이 과제마다 다릅니다. MT Bench와 Arena-Hard는 비평 + 순위 + 융합이, MixEval-Hard는 검증 + 융합이, CodeContests는 단위 테스트 + 융합이 가장 좋습니다. 이 한 줄이 탐색이 필요한 이유입니다.
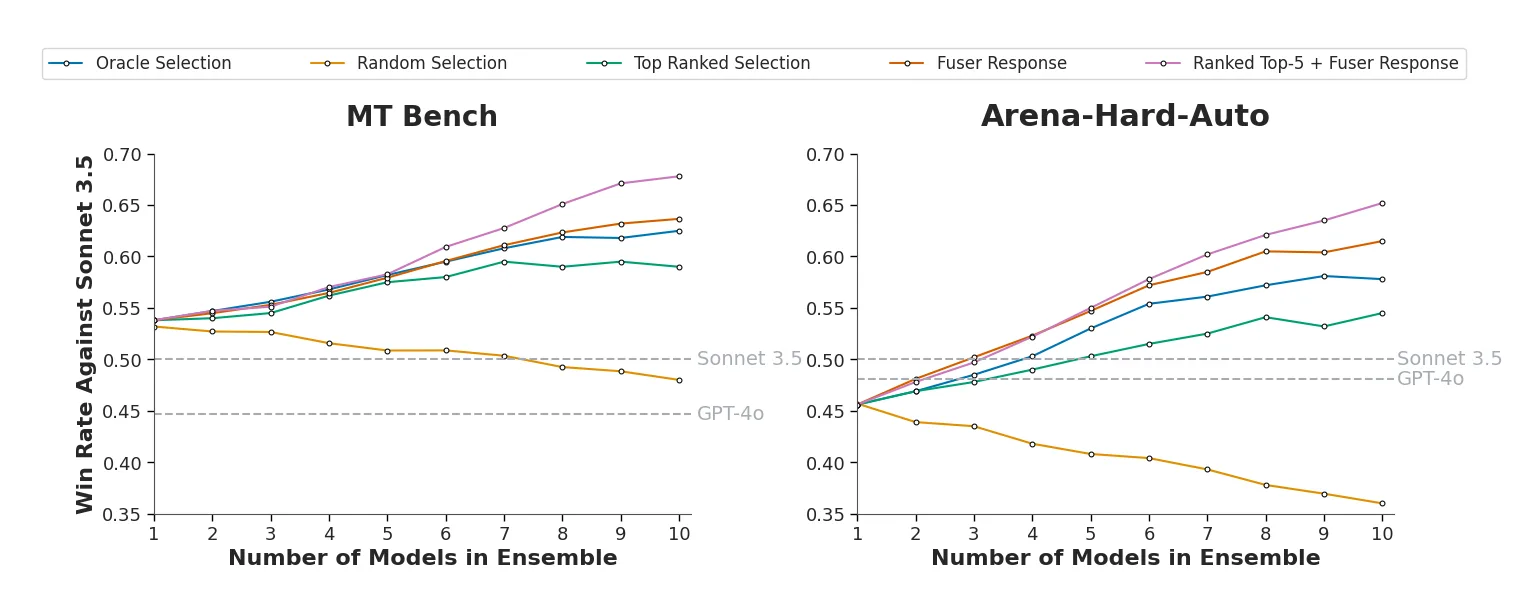
가로축은 앙상블의 모델 수, 세로축은 승률입니다. 신탁 선택(Oracle Selection)은 정답을 아는 가상의 심판이 후보 가운데 가장 좋은 답을 고른 경우로, ‘고르기’만으로 닿을 수 있는 천장입니다.
눈여겨볼 곳은 맨 위의 분홍 선입니다. 상위 5개를 고른 뒤 융합한 답이 신탁이 고른 답보다 위에 있습니다. 논문 수치로는 평균 3.6점 높습니다. 융합기는 후보 가운데 하나를 고르는 것이 아니라 여러 답의 좋은 부분을 엮어 후보 어디에도 없던 답을 새로 씁니다. 그래서 고르기의 천장을 넘을 수 있습니다.
무작위 선택(주황 선)이 모델을 늘릴수록 내려가는 것도 보입니다. 모델을 성능순으로 추가했으니 뒤로 갈수록 약한 모델이 섞이기 때문입니다. 많이 모으는 것만으로는 안 되고, 모은 것을 다루는 부품이 있어야 합니다.
4장. Archon ② 신경망처럼 쌓는다 — 층과 조립 규칙
가중치 없는 신경망
부품을 어떻게 이을까요. Archon은 신경망의 층 구조를 빌립니다.
구조는 여러 층으로 이루어지고, 한 층 안의 부품들은 나란히(병렬로) 실행됩니다.
각 층은 ‘질문 + 지금까지의 후보 답 목록’을 받아 새 후보 답 목록을 다음 층에 넘깁니다. 층 사이를 오가는 것은 언제나 문자열의 목록입니다.
생성기와 융합기는 목록을 다른 목록으로 변환합니다. 순위기와 검증기는 목록을 걸러 냅니다. 논문은 이 걸러 내기를 신경망의 비선형 함수에 빗댑니다.
마지막 층이 목록을 내놓으면 첫 번째 답을 최종 답으로 씁니다.
신경망과 다른 점은 하나입니다. 학습되는 가중치가 없습니다. 층 사이에 흐르는 것은 숫자가 아니라 글이고, 부품은 이미 학습된 LLM을 그대로 씁니다. 그래서 찾아 낸 구조는 추가 학습 없이 바로 배포할 수 있습니다.
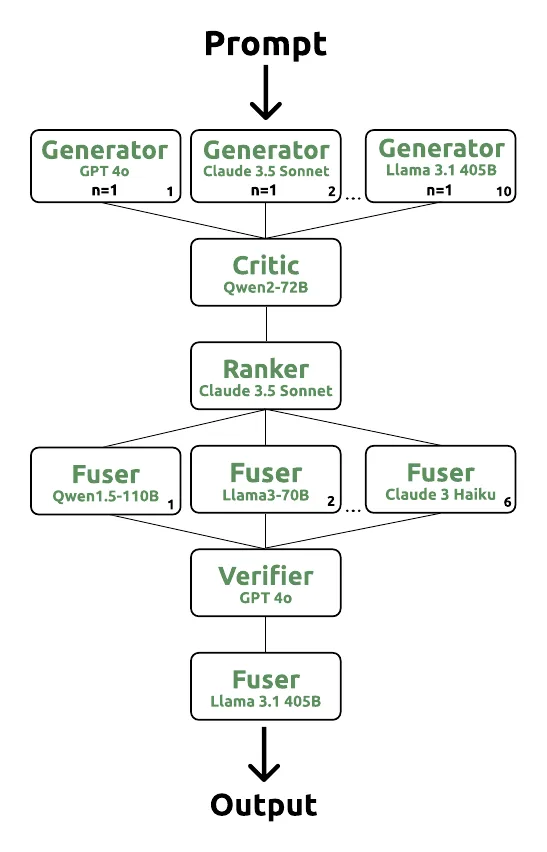
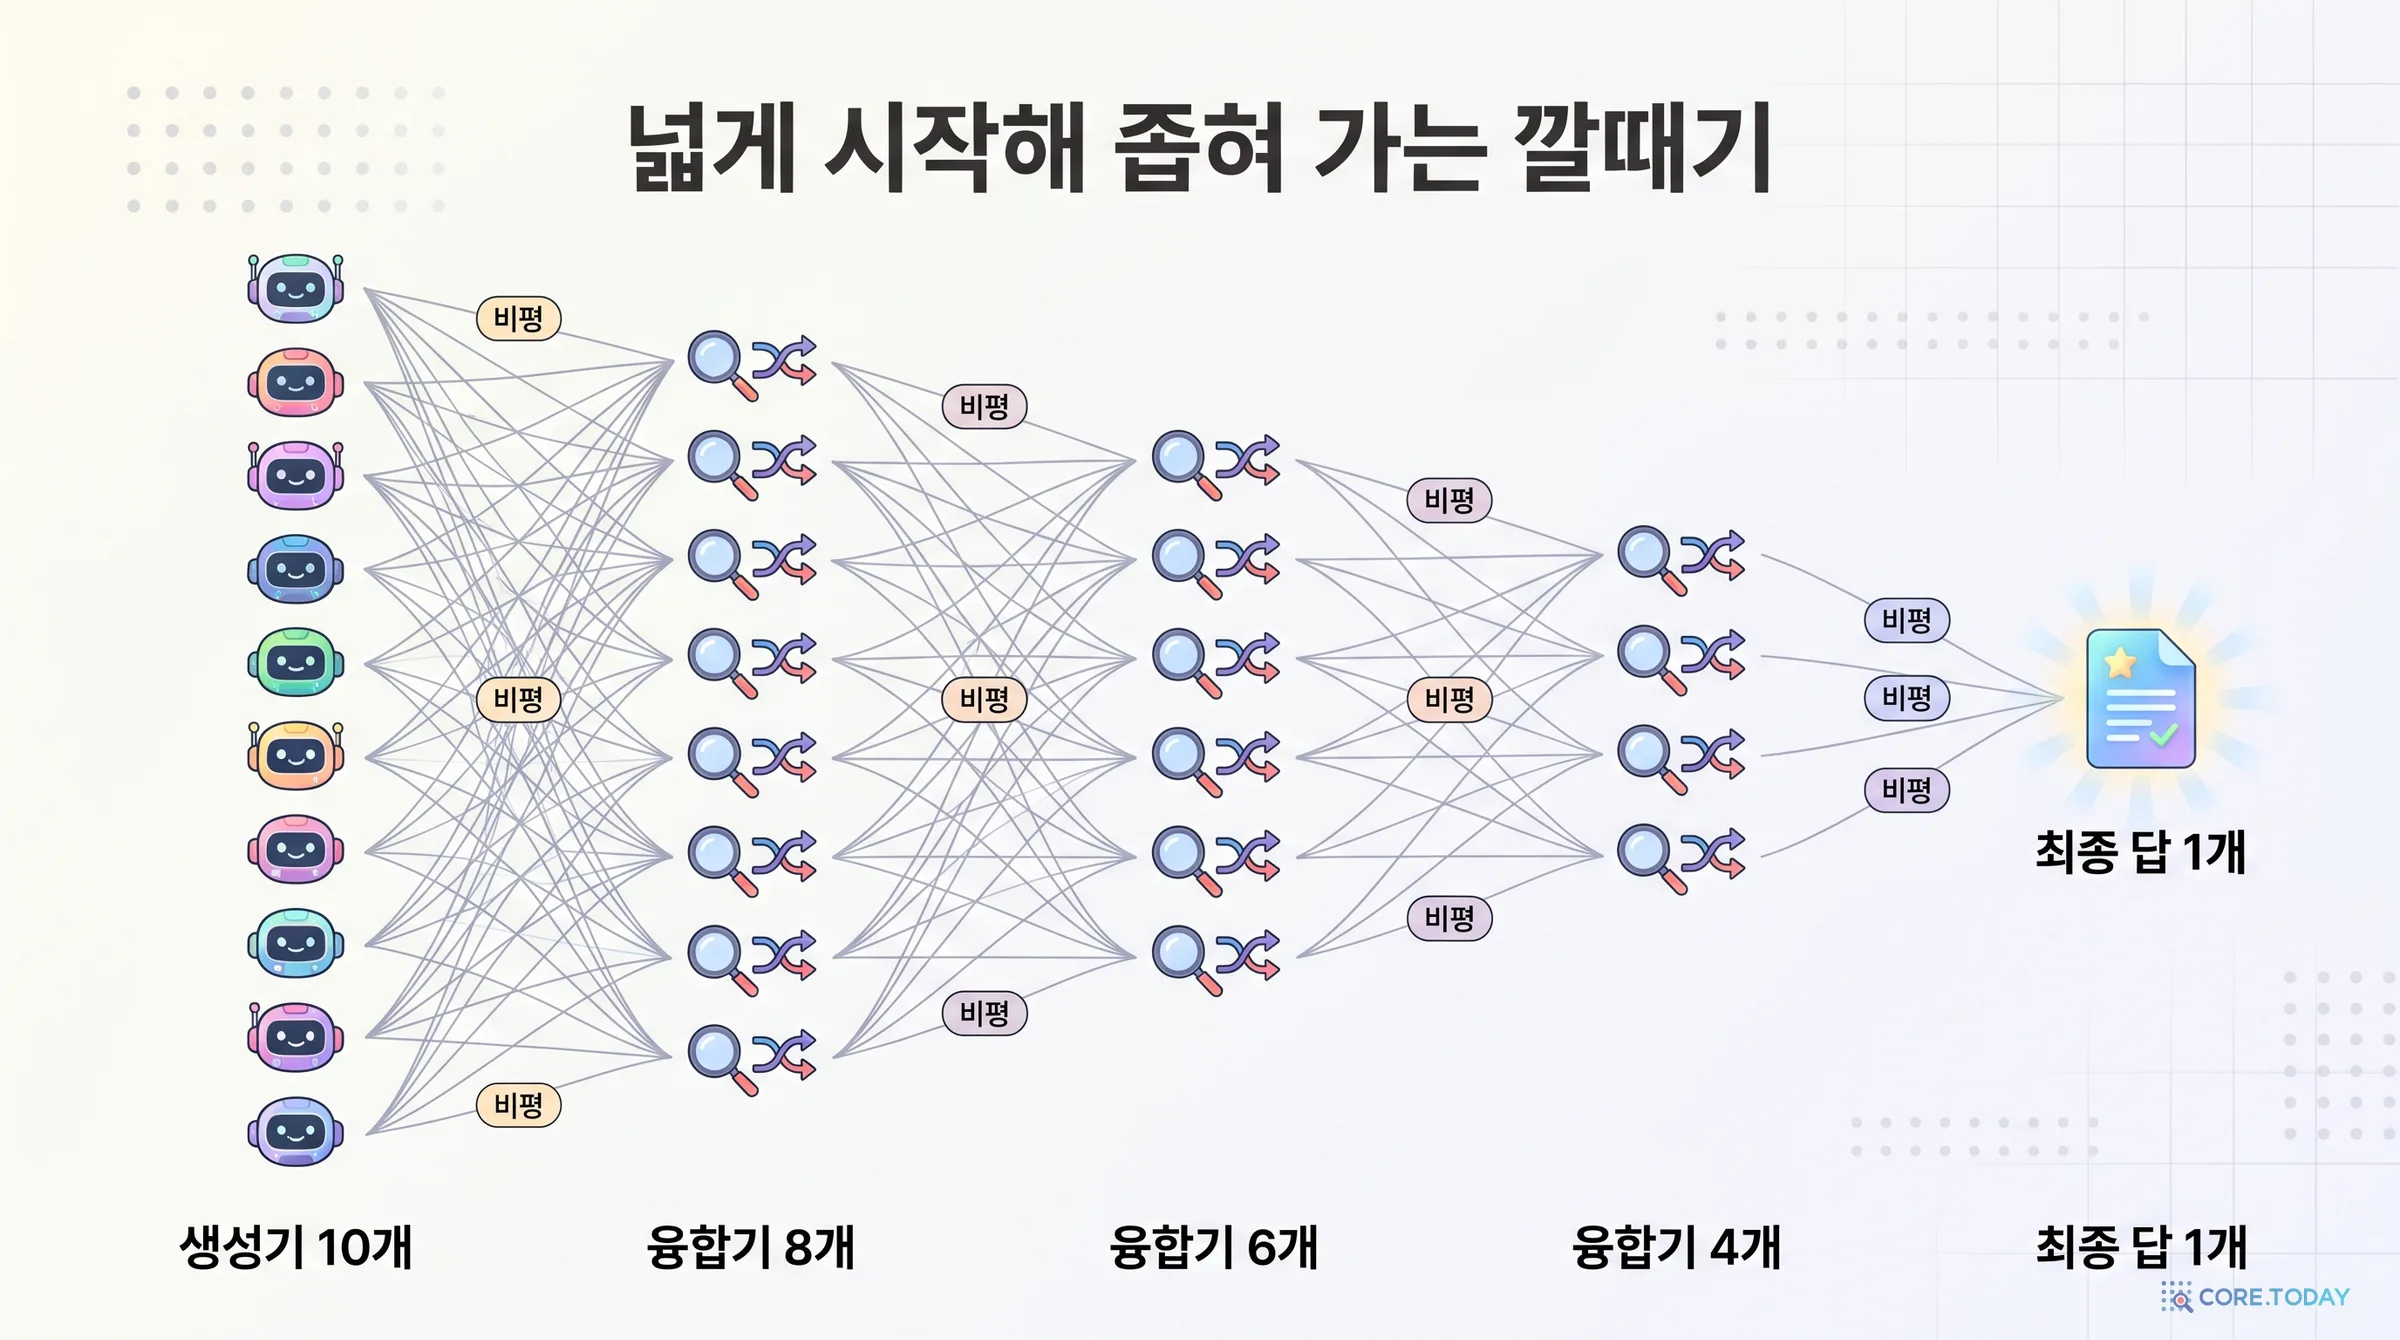
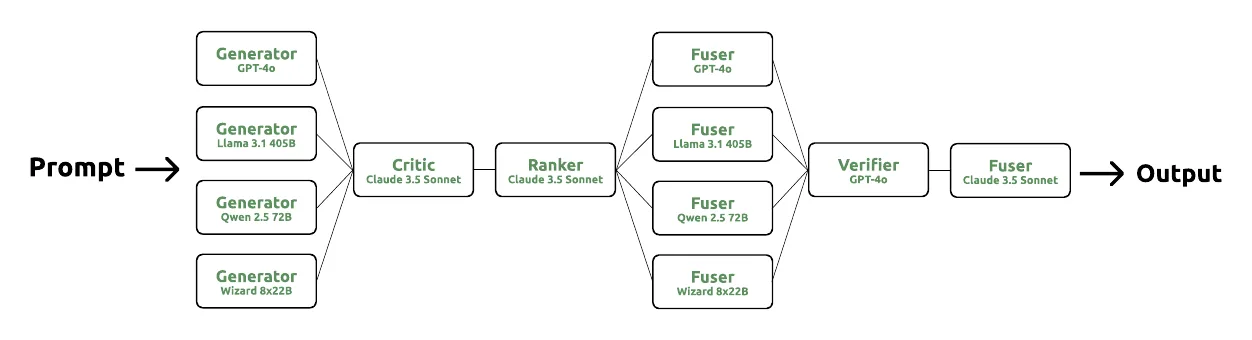
위 그림을 위에서 아래로 따라가 봅시다. 질문이 들어오면 서로 다른 모델 열 개가 각자 답을 씁니다. 비평가가 열 개의 답마다 강점과 약점을 적습니다. 순위기가 그 평가를 참고해 상위 답을 추립니다. 융합기 여섯 개가 각자 그 답들을 합쳐 새 답 여섯 개를 씁니다. 검증기가 그 여섯 개 가운데 추론이 맞는 것만 통과시킵니다. 마지막 융합기가 남은 답을 하나로 합쳐 내놓습니다.
조립 규칙 여섯 줄
아무렇게나 쌓을 수는 없습니다. 논문 표 4의 규칙은 이렇습니다.
규칙 1한 층에는 한 종류의 부품만 둔다.
규칙 2생성기는 첫 층에만 둔다. 하나 이상.
규칙 3비평가는 순위기나 융합기 앞에 둔다. 그래야 적어 둔 강점·약점이 쓰인다.
규칙 4순위기·비평가·검증기·단위 테스트 층은 첫 층만 아니면 어디든 둘 수 있고, 그 층에 혼자 있어야 한다.
규칙 5융합기는 첫 층만 아니면 어디든 둘 수 있고, 한 층에 여러 개를 둘 수 있다.
규칙 6단위 테스트 생성기와 채점기는 연달아 두고, 생성기가 먼저다.
논문은 이 규칙이 일곱 벤치마크와 두 모델 계열에서 부품의 순서를 바꿔 본 실험 끝에 정한 것이라고 설명합니다. 다른 순서도 기술적으로는 가능하지만 이 순서가 가장 좋았다는 것입니다.
여기서 2장의 NAS 교훈을 떠올릴 만합니다. 이 규칙은 사람이 실험으로 얻은 지식을 탐색 공간에 미리 새겨 넣은 것입니다. 탐색기가 ‘비평가는 융합기 앞에 두는 게 좋다’를 스스로 발견하는 것이 아니라, 처음부터 그런 구조만 볼 수 있게 되어 있습니다.
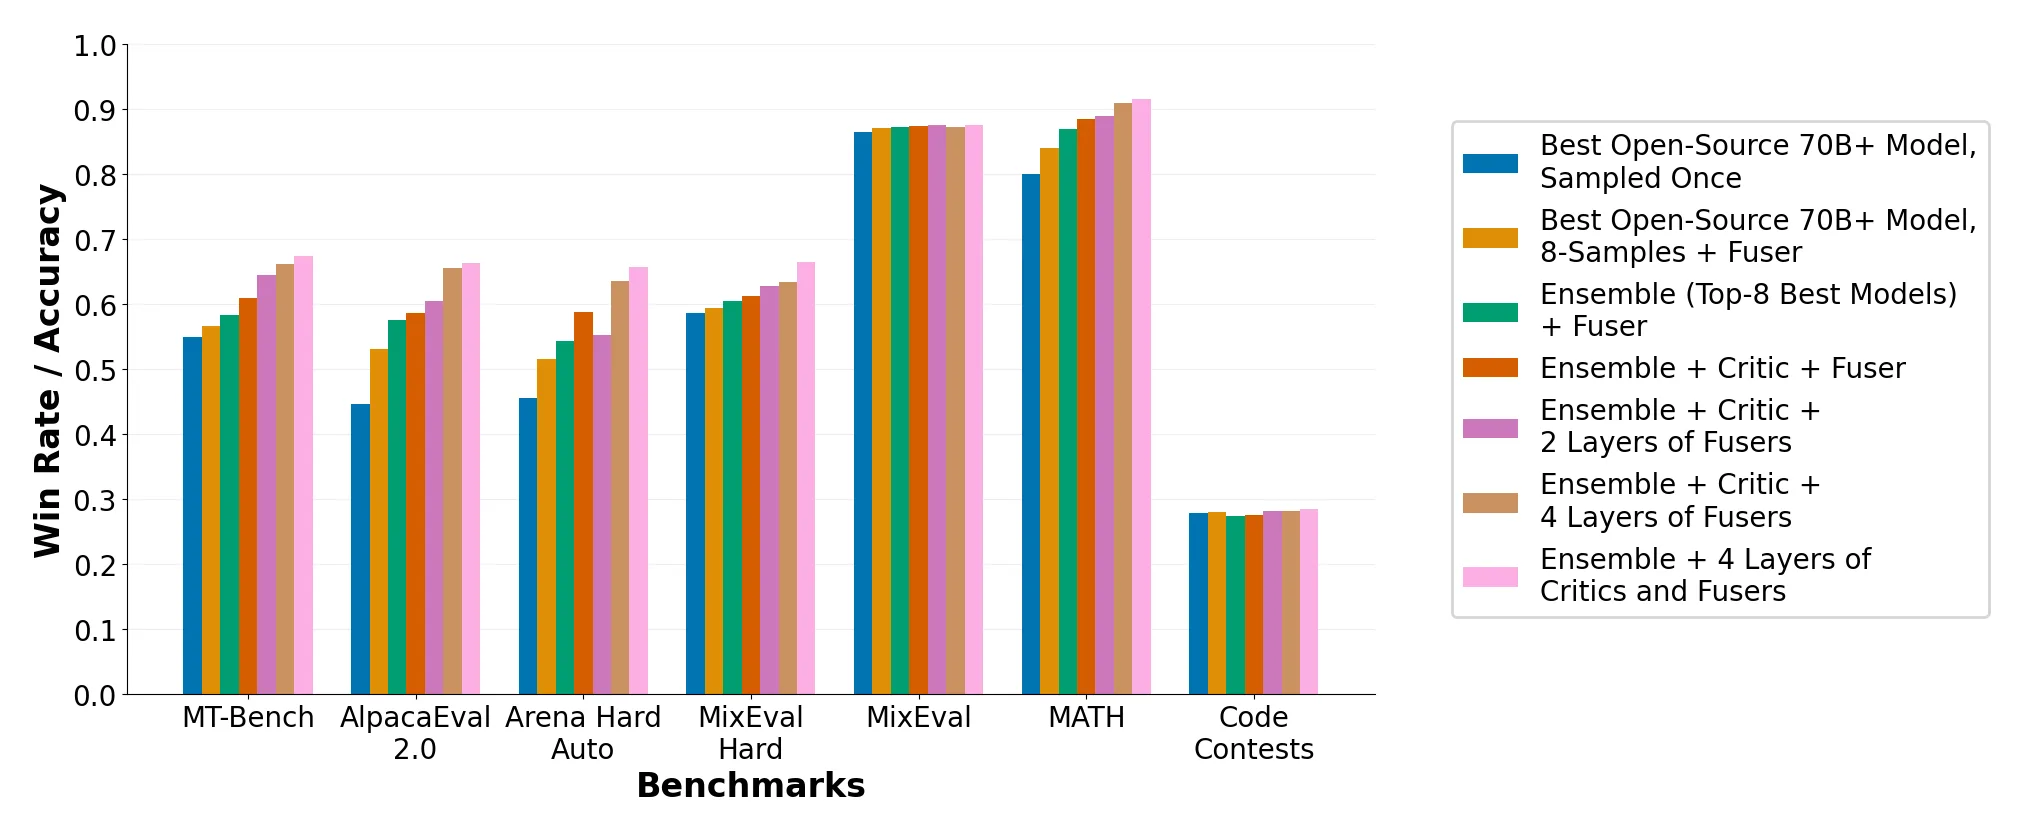
호출 예산을 맞춰 놓고 비교하면 가장 좋은 모델 하나를 여덟 번 부르는 것(주황)보다 서로 다른 모델 여덟 개를 부르는 것(초록)이 대체로 낫습니다. 여기에 비평과 융합 층을 더할수록 막대가 올라가고, 논문은 평균 18.8% 향상이라고 적었습니다. 그런데 오른쪽 두 묶음을 보세요. MixEval은 거의 움직이지 않고, CodeContests는 전혀 움직이지 않습니다. 층을 쌓는 것이 듣는 과제와 안 듣는 과제가 갈립니다.
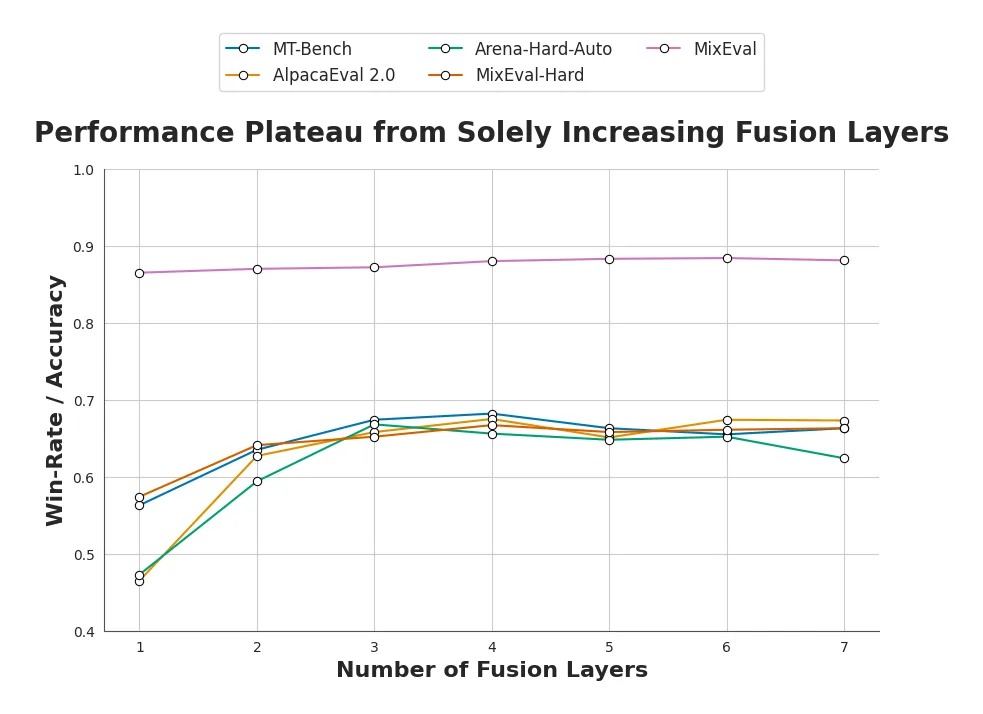
두 번째 그림은 더 분명합니다. 비평이나 순위 없이 융합 층만 늘리면 3~4겹에서 멈추고, 어떤 벤치마크는 7겹에서 오히려 내려갑니다. 그림 제목부터가 ‘융합 층만 늘렸을 때의 성능 정체’입니다. 같은 종류의 부품을 더 쌓는 것은 금방 한계에 닿고, 다른 종류의 부품을 섞어야 계속 오릅니다. 그러면 무엇을 어떤 순서로 몇 겹 섞을지가 다시 문제가 됩니다.
넓게 시작해 좁혀 가는 깔때기
탐색이 실제로 찾아 낸 구조는 어떤 모양일까요. 논문 부록 A.9에 그림으로 실려 있습니다.
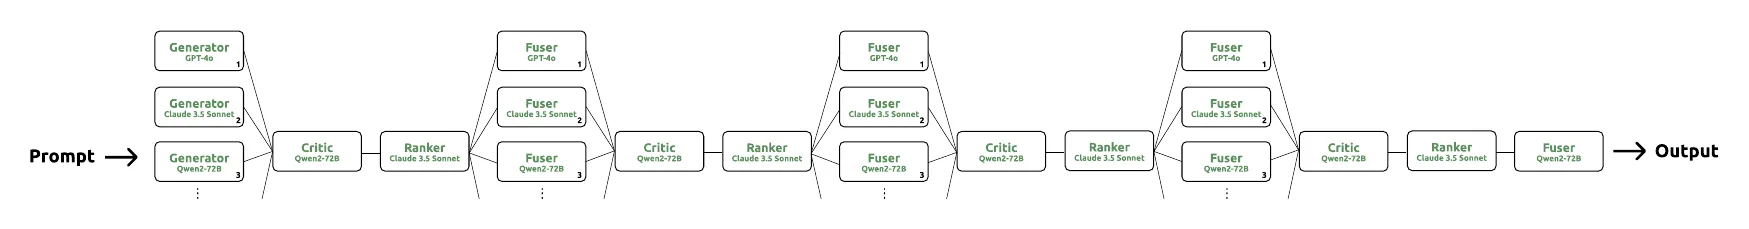
모든 과제를 섞어 놓고 찾은 범용 구조입니다. 가장 좋은 생성기 10개로 넓게 시작한 뒤, Qwen2 72B의 비평과 Claude 3.5 Sonnet 등의 융합을 네 겹으로 거칩니다. 층이 지날수록 융합기 수가 8개, 6개, 4개로 줄어 마지막에 하나가 됩니다. 논문은 이를 깔때기 효과(funneling)라고 부릅니다.
수학 — 넓게 뽑은 뒤 빠르게 하나의 답으로 좁힌다. 정답이 하나뿐인 문제에서 여러 번 고쳐 쓰는 것은 도움이 되지 않는다.
코딩 — 하나의 답을 두고 생성·비평·융합을 여러 번 반복한다. 가장 잘하는 모델 한두 개에 집중한다.
아래 조립기에서 이 구조들을 직접 만들어 볼 수 있습니다. 프리셋을 누른 뒤 다이얼을 돌려 호출 수가 어떻게 변하는지 보세요.
생성기 수와 표본 수를 함께 올리면 빨간 경고가 뜹니다. 첫 층의 후보가 24개를 넘으면 융합기의 문맥 창에 다 들어가지 않는다고 보고 논문이 탐색 공간에서 지운 구성입니다. 이런 제약이 다음 장의 숫자 9,576을 만듭니다.
5장. Archon ③ 9,576가지에서 하나를 찾는 법 — 베이즈 최적화
여섯 개의 다이얼
조립기의 다이얼 여섯 개가 곧 Archon의 탐색 공간입니다. 논문 3.3절은 앞 장의 관찰에서 여섯 축을 뽑아 냅니다.
축
범위
근거가 된 관찰
① 생성기로 쓸 상위 모델 수
1~10 (그 과제의 단독 성적순으로 뽑음)
모델·표본을 늘리면 크게 오른다
② 모델당 표본 수
1~5 (CodeContests는 1, 10, 100, 500, 1000)
같음
③ 융합 층 수
1~4 (마지막 층은 융합기 하나)
층을 쌓으면 오른다
④ 융합 층마다 융합기 수
2, 4, 6, 8, 10
같음
⑤ 융합 층 앞의 비평·순위 층
넣는다 / 안 넣는다
융합 앞의 비평·순위가 특히 효과적이다
⑥ 마지막 융합 앞의 평가 층
검증기 / 단위 테스트 / 없음
추론·코딩에서는 걸러 내기가 듣는다
부록 A.4.1에 따르면 단순히 곱한 조합은 18,750가지이고, 첫 층 후보가 24개를 넘는 구성과 융합 층이 하나인데 융합기가 여럿인 구성을 지우면 9,576가지가 남습니다.
논문은 스스로 한계도 적어 둡니다. 부품마다 온도를 다르게 주거나, 프롬프트를 바꾸거나, 새 부품을 추가하는 것은 공간에 넣지 않았습니다. 온도는 모든 부품에서 0.7로 고정했습니다. “가장 영향이 큰 하이퍼파라미터에 집중하기 위해”서라는 설명입니다.
한 번 평가가 비싼 함수
9,576가지를 전부 돌려 보면 안 될까요. 구조 하나를 평가한다는 것은 검증용 문제 전체를 그 구조로 푸는 것입니다. Archon은 각 벤치마크의 20%를 검증 세트로 씁니다. 가장 작은 MT Bench(80문항)에서도 16문항이고, 구조 하나가 문항마다 LLM을 30~40번 부르니 구조 하나 평가에 호출 수백 번이 듭니다. AlpacaEval 2.0(805문항)이라면 20%가 161문항, 호출 수천 번입니다. 9,576가지 전부는 곤란합니다.
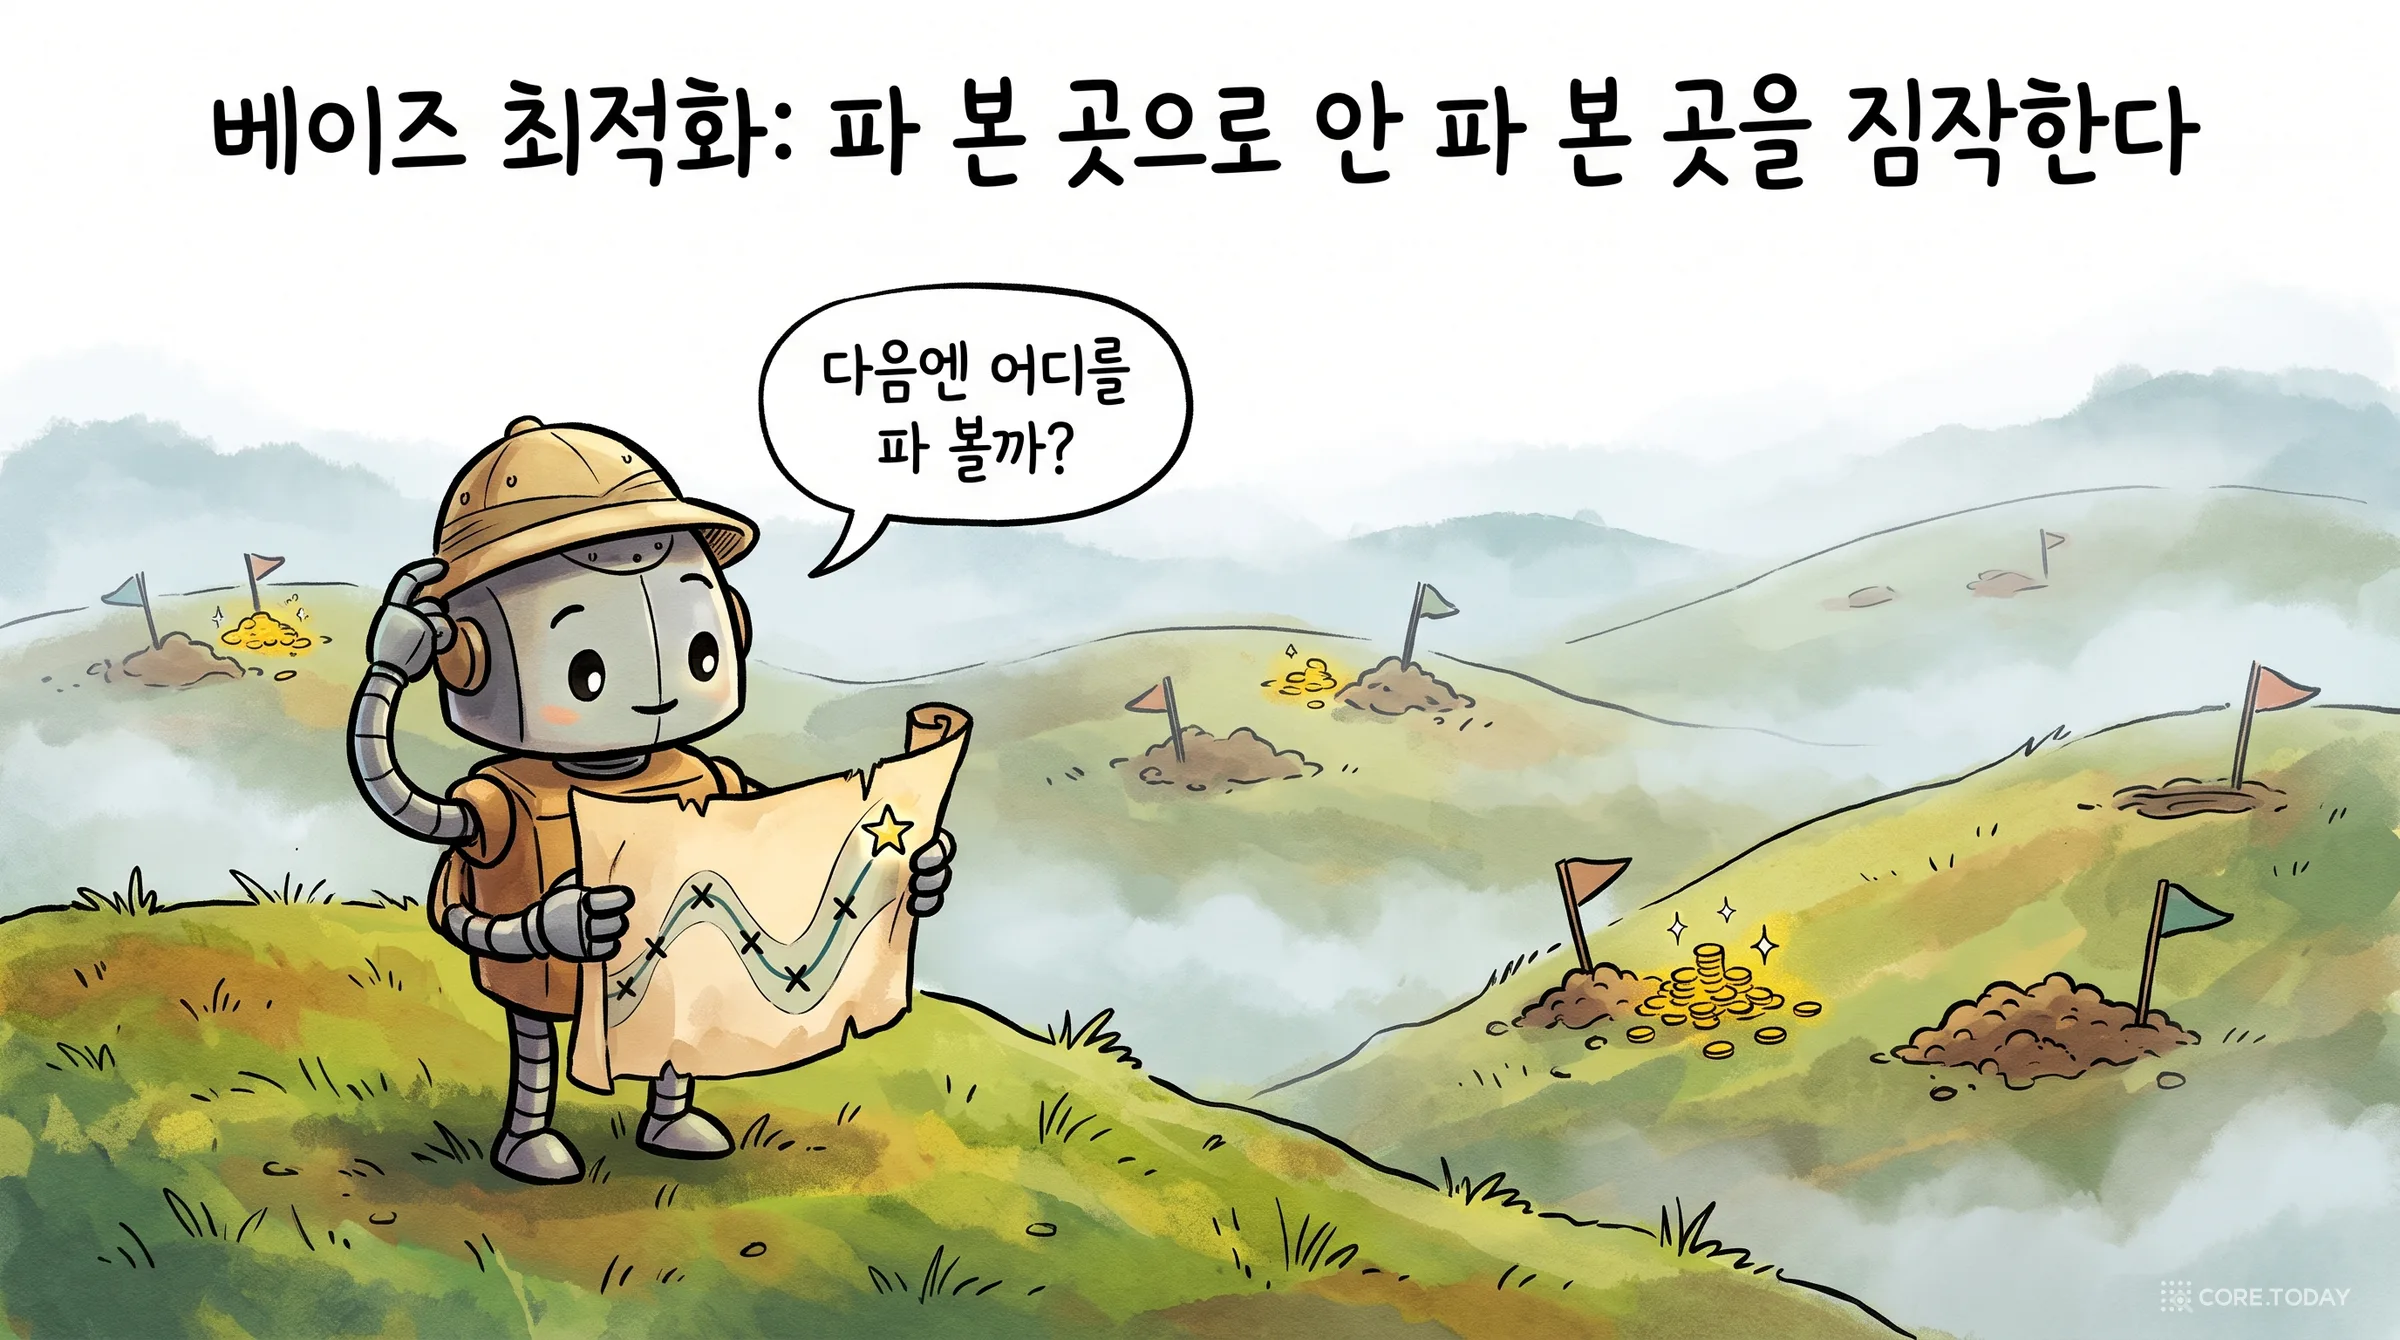
넓은 땅 어딘가에 보물이 묻혀 있고 한 번 파는 데 하루가 걸린다고 합시다. 아무 데나 파는 것(무작위 탐색)도, 방금 판 곳 바로 옆만 파는 것(탐욕 탐색)도 좋은 전략이 아닙니다. 현명한 사람은 지금까지 판 곳의 결과로 땅 전체의 지도를 그립니다. 여기는 많이 나왔으니 근처도 많을 것이고, 저기는 아직 아무도 안 파 봐서 모른다. 그리고 ‘많이 나올 것 같은 곳’과 ‘아직 몰라서 대박일 수도 있는 곳’을 함께 따져 다음 삽질 위치를 정합니다.
이 과정을 논문의 용어로 옮기면 이렇습니다.
대리 모형지금까지 평가한 구조들의 점수로, 아직 평가하지 않은 구조의 점수와 그 불확실성을 예측하는 통계 모형을 만든다. Archon은 가우스 과정(Gaussian Process)을 쓴다. 위 그림의 지도에 해당한다.
획득 함수예측을 보고 다음에 평가할 구조를 고르는 규칙. Archon은 기대 향상(Expected Improvement)을 쓴다. ‘지금까지의 최고 기록을 얼마나 넘을 것으로 기대되는가’가 가장 큰 구조를 고른다.
평가와 갱신고른 구조로 검증 문제를 실제로 풀어 점수를 얻고, 그 결과를 기록에 더해 대리 모형을 다시 맞춘다. 최고 기록이 더 오르지 않거나 예산이 떨어질 때까지 반복한다.
기대 향상을 식으로 쓰면 다음과 같습니다. x는 구조(다이얼 여섯 개의 값), f(x)는 그 구조의 목적 함수 값, x+는 지금까지 본 것 중 최고의 구조, H는 평가 기록입니다.
EI(x;H)=E[max(0,f(x)−f(x+))]
기록을 못 넘으면 0, 넘으면 넘은 만큼을 세어 그 기댓값을 구한 것입니다. 예측 점수가 높은 구조도, 예측은 낮지만 불확실성이 커서 ‘혹시’가 있는 구조도 이 값이 커집니다. 탐색과 활용의 균형이 식 하나에 들어 있습니다.
목적 함수에도 볼 것이 있습니다. 부록은 이를 성능에서 비용을 뺀 형태로 적습니다.
f(x)=Performance(x)−λ⋅Cost(x)
λ를 키우면 싼 구조를 선호하게 됩니다. 정확도만이 아니라 지연 시간이나 달러를 목표에 넣을 수 있다는 논문의 주장은 이 식에 근거합니다.
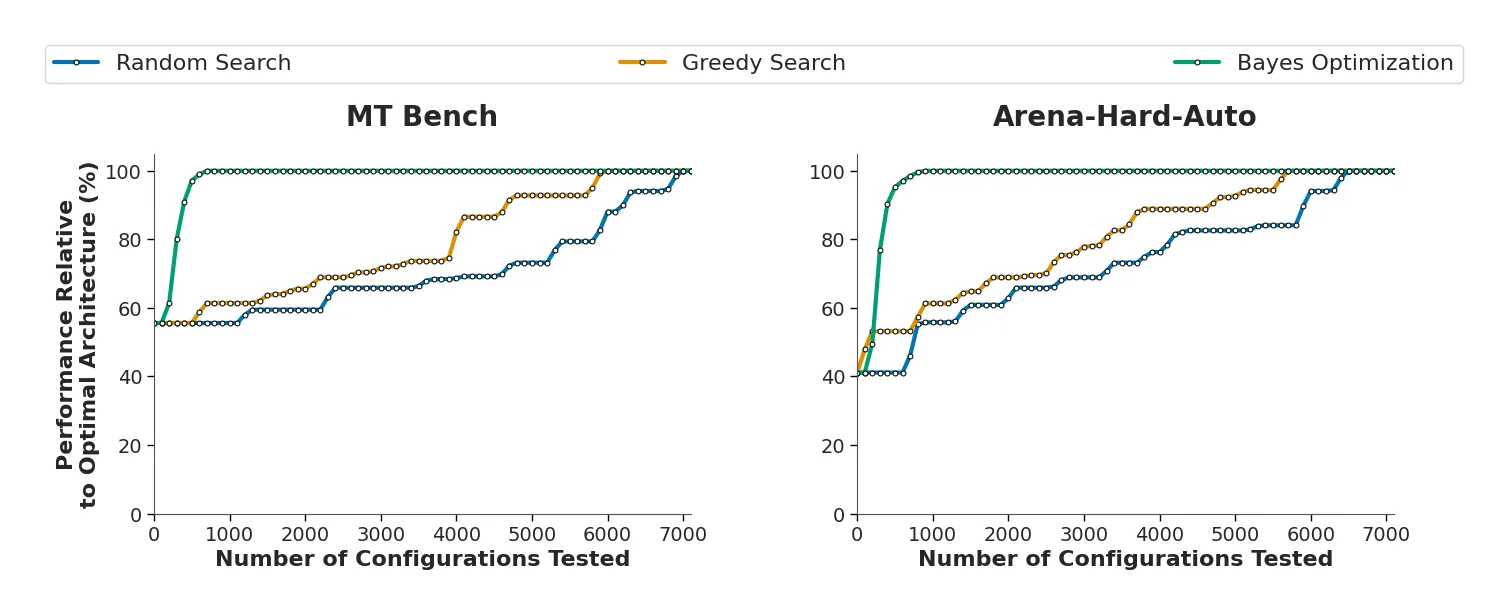
초록 선이 왼쪽에서 거의 수직으로 올라갑니다. 논문의 요약은 이렇습니다. 베이즈 최적화는 탐욕 탐색보다 88.5%, 무작위 탐색보다 90.4% 적은 평가로 최적 구조를 찾았고, 탐색 반복의 96.0%에서 세 방법 가운데 가장 좋은 구조를 쥐고 있었습니다.
아래 위젯에는 부록의 표 26·27을 옮겼습니다. 두 번째 탭도 꼭 눌러 보세요.
두 가지를 짚어 둡니다.
하나, 처음 수백 개는 무작위입니다. 베이즈 최적화는 지도를 그리려면 먼저 몇 군데를 파 봐야 합니다. 논문은 처음 230~240개를 무작위로 평가하는 것이 가장 좋았다고 보고합니다. 전체 9,576가지의 약 2.5%입니다. 그 뒤 250~390개를 더 평가해 최적 구조에 닿았으니, 합쳐서 500~600개의 구조를 실제로 돌려 본 것입니다. ‘90% 적다’는 말은 맞지만, 절대량이 작다는 뜻은 아닙니다.
둘, 공간이 작으면 쓸 이유가 없습니다. 호출 예산이 20번 미만이면 가능한 구조 자체가 몇 안 되므로 탐욕 탐색과 차이가 거의 없습니다. 논문도 이 구간에서는 “전통적인 부품 엔지니어링이 더 나을 수 있다”고 적었습니다. 자동 탐색은 선택지가 사람 손을 벗어날 만큼 많을 때 값을 합니다.
6장. Archon의 성적표 — 무엇을 얻고 얼마를 냈나
표 1 읽기
Archon은 일곱 벤치마크에서 평가했습니다. 지시 따르기·대화(MT Bench, AlpacaEval 2.0, Arena-Hard-Auto), 추론(MixEval, MixEval-Hard, MATH), 코딩(CodeContests)입니다. 탐색은 각 벤치마크의 20%로 하고 성적은 나머지 80%에서 쟀습니다.
비교 대상은 두 부류입니다. 한 번 부르는 단일 모델(GPT-4o, Claude 3.5 Sonnet, Llama 3.1 405B)과 기존 시스템(MoA, ADAS, AFlow, 그리고 OpenAI o1)입니다. Archon은 쓸 수 있는 모델에 따라 세 가지(공개 모델만, 비공개 모델만, 전부)로, 그리고 범용과 과제별 맞춤으로 나눠 여섯 줄이 나옵니다.
논문의 요약 문장은 이렇습니다. 가장 좋은 Archon 구조는 최신 단일 모델을 평균 15.1% 앞섰고, 기존 시스템(MoA·ADAS·AFlow)보다 추론 호출은 20.0%, 입력 토큰은 15.1%, 출력 토큰은 13.5% 덜 썼습니다. 공개 모델만으로도 최신 모델을 평균 11.2% 앞섰습니다.
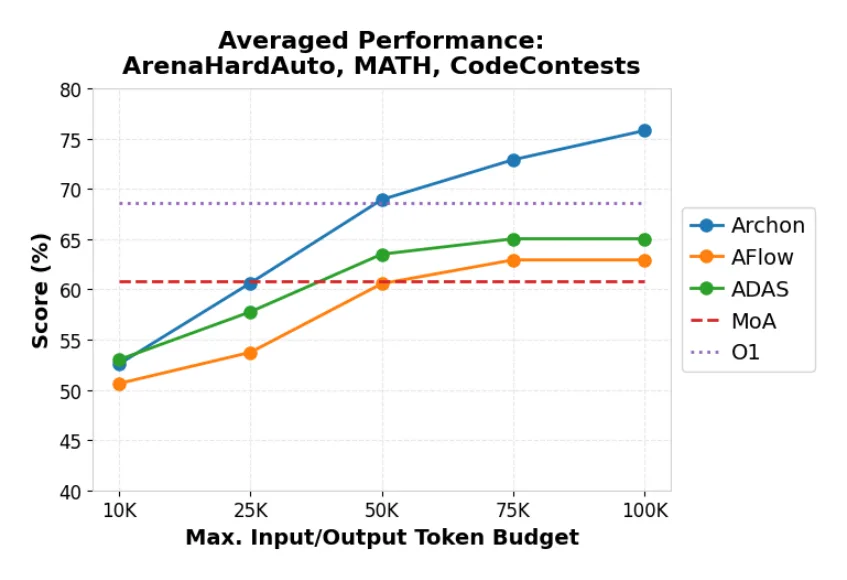
위 그림이 논문의 핵심 주장을 한 장에 담고 있습니다. 예산이 1만 토큰일 때는 Archon도 ADAS·AFlow와 비슷합니다(53점 안팎). 예산을 늘릴수록 Archon의 선이 더 가파르게 올라 5만 토큰 부근에서 o1(보라 점선, 약 68.5점)을 넘고 10만 토큰에서 76점에 닿습니다. MoA와 o1은 구조가 고정이라 예산을 늘려도 수평선입니다.
‘계산을 더 주면 더 잘 쓴다’가 Archon의 주장입니다. 고정된 구조는 예산이 늘어도 쓸 곳이 없지만, 탐색하는 구조는 예산에 맞춰 스스로 커집니다.
얼마를 냈는가
그러나 표 1에는 점수 옆에 다른 열들이 있습니다. 아래 위젯으로 직접 보세요.
첫 번째 탭에서 MT Bench를 고르면 Archon ‘전체·맞춤’이 79.5로 맨 위에 있습니다. 가로축을 보면 질의당 0.37달러입니다. GPT-4o 한 번은 0.01달러로 적혀 있으니 표 1 기준으로 수십 배입니다.
논문 본문은 이 대목을 “단일 LLM 호출보다 시간과 돈이 5배 더 들 수 있다”고 적었습니다. 표의 숫자와 맞지 않는 문장입니다. 부록 표 40의 질의당 비용으로 다시 계산해도 MT Bench에서 범용 Archon(0.364달러)은 GPT-4o(0.0481달러)의 7.6배, Claude 3.5 Sonnet(0.0305달러)의 11.9배입니다. 호출 수로는 32~44배입니다. ‘5배’는 가장 낙관적으로 읽은 값으로 보는 것이 맞습니다.
공정하게 말하면 Archon이 비교 대상으로 삼은 것은 단일 모델만이 아닙니다. o1은 질의당 0.52달러로 적혀 있고, 가장 좋은 Archon(0.37달러)이 더 싸면서 MATH(93.5 대 92.7)와 CodeContests(41.4 대 31.5)에서 앞섭니다. 같은 값을 낼 거라면 탐색한 구조가 낫다는 주장은 이 표 안에서는 성립합니다.
두 번째 탭은 예산을 늘렸을 때 어디서 멈추는지 보여 줍니다. MixEval은 호출 20~30번에서 천장에 닿고 그 뒤로는 돈만 더 듭니다. MT Bench만 50번까지 계속 오릅니다. 그림 1의 가파른 파란 선은 세 벤치마크의 평균이고, 벤치마크 하나하나는 저마다 다른 지점에서 평평해집니다.
세 번째 탭이 가장 중요한 경고입니다. 7B급 작은 모델로 같은 구조를 조립하면 융합이 오히려 성능을 깎습니다. 작은 모델은 열 개의 답 가운데 나은 것을 고를 수는 있지만, 열 개의 답을 읽고 더 나은 답을 새로 쓰지는 못합니다. 논문도 Archon이 70B 이상 모델에서 가장 효과적이라고 인정합니다. 3장에서 본 ‘융합이 고르기를 넘어선다’는 융합기가 충분히 똑똑할 때만 참입니다.
본 적 없는 과제에서도 통하는가
Archon은 범용 구조를 탐색에 쓰지 않은 세 과제(GPQA Diamond, MMLU, MMLU Pro)에 그대로 적용해 봤습니다.
방법
GPQA Diamond 범용 / 맞춤
MMLU 범용 / 맞춤
MMLU Pro 범용 / 맞춤
범용이 맞춤의 몇 %인가
AFlow
37.1 / 52.4
53.0 / 71.8
43.4 / 62.9
67~74%
ADAS
39.8 / 54.4
53.5 / 73.0
44.1 / 66.0
67~73%
Archon
56.1 / 61.2
76.5 / 81.5
71.0 / 75.4
92~94%
범용 Archon 구조는 그 과제에 맞춰 찾은 구조의 92~94%를 유지했고, AFlow와 ADAS의 범용 워크플로는 67~74%에 그쳤습니다.
이 차이는 두 방법의 성격에서 나옵니다. Archon의 구조는 ‘모델 열 개가 답하고 비평하고 합친다’는 과제와 무관한 틀입니다. AFlow의 워크플로는 뒤에서 보겠지만 “최종 답은 숫자 하나로만 써라” 같은 과제에 딱 맞춘 프롬프트를 품고 있습니다. 맞춤이 깊을수록 다른 과제로 옮기면 더 많이 잃습니다. 다만 이 표의 AFlow·ADAS는 Archon 저자들이 자기 환경에서 다시 돌린 것이라는 점은 기억해 둘 필요가 있습니다.
Archon의 그림은 이렇게 정리됩니다. 부품을 정하고, 쌓는 규칙을 정하고, 남은 다이얼 여섯 개를 통계적으로 돌린다. 탐색은 효율적이고 결과는 다른 과제로 잘 옮겨 갑니다. 대신 탐색기가 볼 수 있는 것은 처음부터 사람이 그어 준 9,576칸뿐입니다. 프롬프트를 고칠 수도, 조건문을 넣을 수도, 새 부품을 발명할 수도 없습니다.
3주 뒤에 나온 논문은 바로 그 울타리를 걷어 냅니다.
7장. AFlow ① 워크플로를 코드로 쓴다 — 노드, 오퍼레이터, 엣지
다이얼 대신 백지
AFlow의 출발점은 Archon과 다릅니다. Archon이 ‘좋은 구조는 이런 모양일 것’이라는 틀을 먼저 정했다면, AFlow는 가능한 한 아무것도 정하지 않으려 합니다. 그러려면 구조를 표현하는 언어가 충분히 넓어야 합니다.
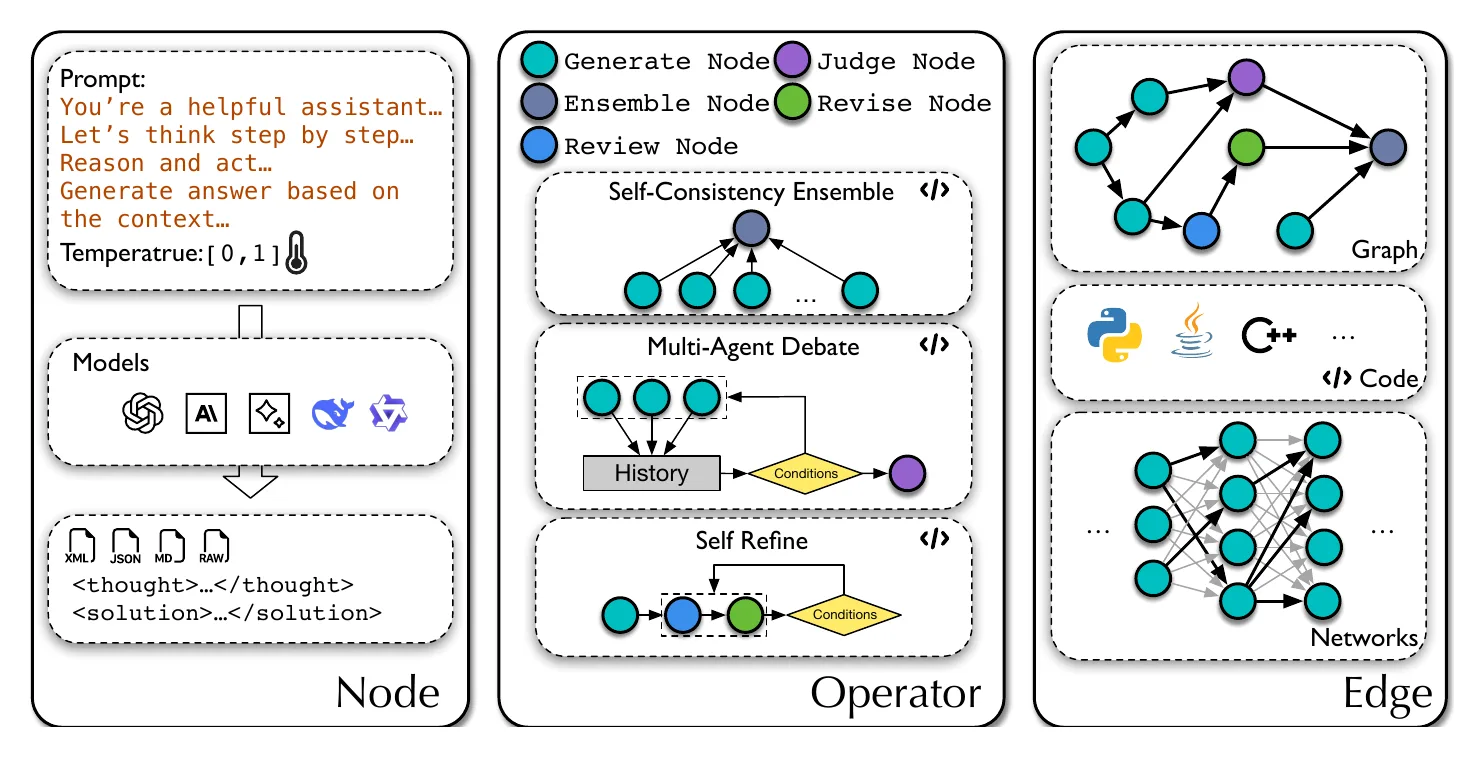
노드(Node)는 LLM 호출 한 번입니다. 네 가지 값으로 정해집니다. 어떤 모델을 부를지(M), 어떤 프롬프트를 줄지(P), 온도를 얼마로 할지(τ), 출력 형식을 무엇으로 할지(F — XML, JSON, 마크다운, 자유 형식).
엣지(Edge)는 노드들을 잇는 방식입니다. 논문은 세 가지 후보를 비교합니다.
엣지를 표현하는 방식
쓴 연구
한계
그래프
GPTSwarm
순서·병렬은 표현하지만, 조건 분기를 자연스럽게 담으려면 페트리 넷이나 BPMN 같은 확장이 필요하다
신경망
DyLAN
입력에 따라 적응하지만 실행 흐름을 정밀하게 통제하기 어렵다
코드
ADAS, AFlow
순차·조건문·반복문을 모두 표현하고 그래프와 신경망 구조도 그 안에 넣을 수 있다
AFlow는 코드를 고릅니다. if와 for가 있는 파이썬 함수 하나가 곧 워크플로입니다. 그래서 “테스트가 실패하면 고쳐 쓰는 단계로 간다” 같은 흐름을 그대로 쓸 수 있습니다. Archon의 층 구조로는 표현할 수 없는 것입니다. Archon에서는 모든 질문이 같은 층들을 같은 순서로 지나갑니다.
오퍼레이터(Operator)는 그 사이에 놓인 타협입니다. 코드는 표현력이 큰 대신 공간이 사실상 무한합니다. 그래서 논문은 문헌에서 검증된 조합을 미리 함수로 묶어 둡니다.
Ensemble여러 답 가운데 가장 일관된 것을 고른다(자기 일관성). 코드에서는 sc_ensemble.
Test공개 테스트 케이스로 코드를 실제로 실행해 본다.
Programmer파이썬 코드를 써서 실행하고 그 결과를 돌려준다. 계산이 필요한 수학 문제에 쓴다.
Custom프롬프트만 주면 되는 기본 노드. 최적화기가 프롬프트를 자유롭게 쓸 수 있는 유일한 곳.
Archon의 여섯 부품과 견줘 보면 겹치는 것이 많습니다. Ensemble은 생성기 여러 개에 순위기를 붙인 것이고, Review & Revise는 비평가와 융합기를 합친 것에 가깝습니다. 차이는 두 가지입니다. AFlow에는 코드를 실제로 실행하는 오퍼레이터(Test, Programmer)가 있고, 오퍼레이터가 없어도 Custom 노드만으로 무엇이든 만들 수 있습니다.
워크플로 한 편 읽기
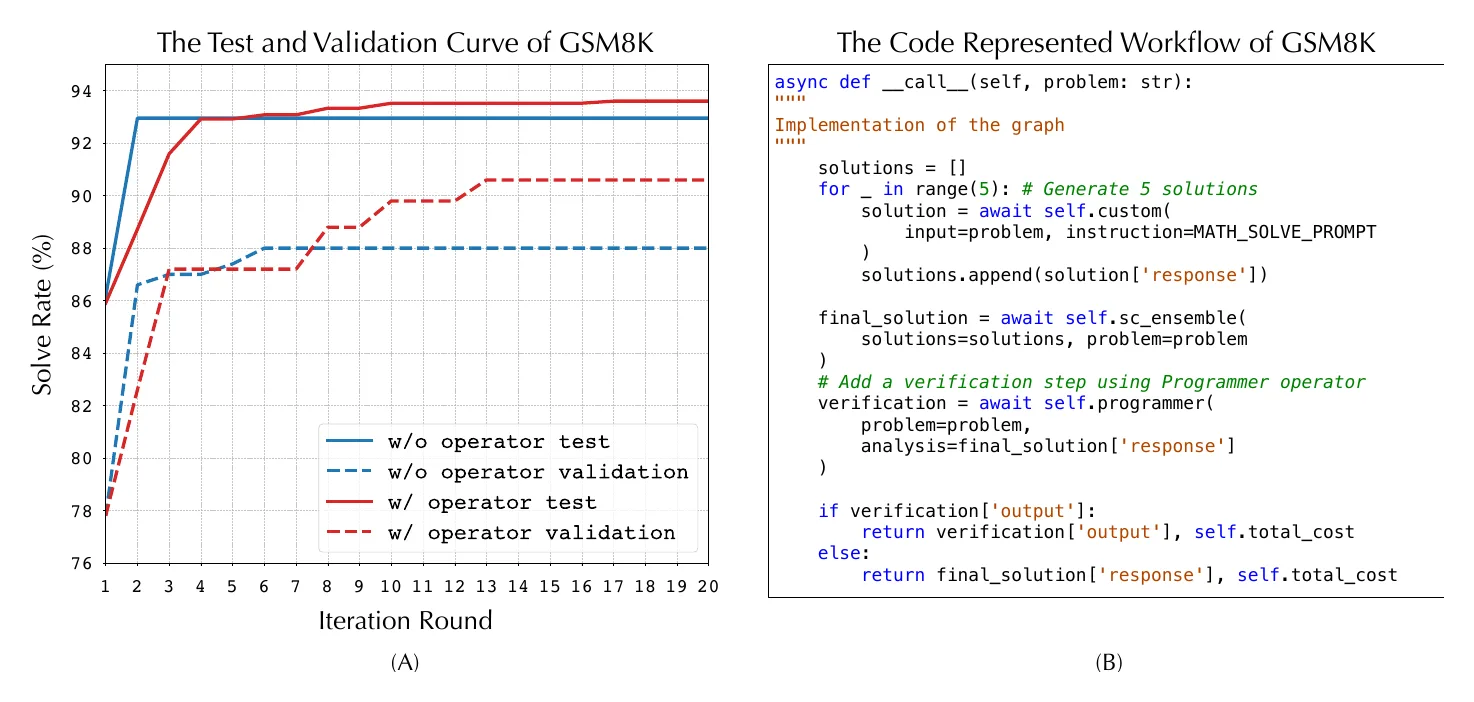
실제 워크플로가 어떻게 생겼는지 보겠습니다. AFlow가 초등 수학 벤치마크 GSM8K에서 찾아 낸 최고 워크플로입니다(논문 그림 5B).
python
asyncdef__call__(self, problem: str):
solutions = []
for _ inrange(5): # 풀이 5개를 만든다
solution = awaitself.custom(
input=problem, instruction=MATH_SOLVE_PROMPT
)
solutions.append(solution['response'])
# 다섯 풀이 가운데 가장 일관된 것을 고른다
final_solution = awaitself.sc_ensemble(
solutions=solutions, problem=problem
)
# Programmer 오퍼레이터로 검산한다
verification = awaitself.programmer(
problem=problem, analysis=final_solution['response']
)
if verification['output']:
return verification['output'], self.total_cost
else:
return final_solution['response'], self.total_cost
열여덟 줄입니다. 같은 프롬프트로 다섯 번 풀고, 다수결로 하나를 고르고, 파이썬 코드를 짜서 검산한 뒤, 검산 결과가 나오면 그것을, 안 나오면 다수결 답을 냅니다.
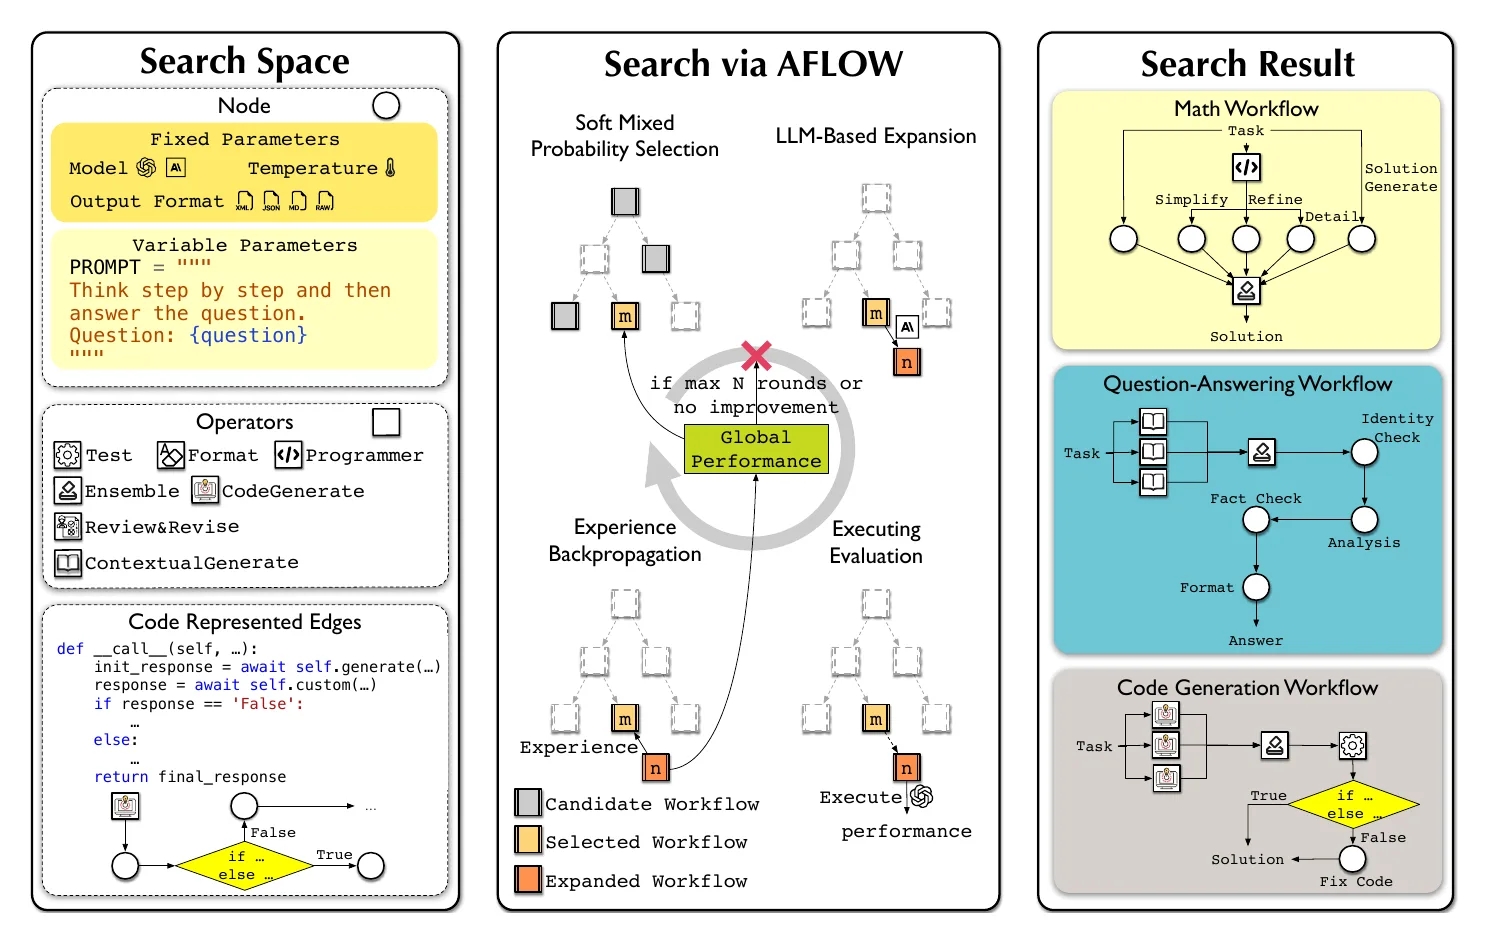
여기서 탐색이 건드릴 수 있는 것은 세 가지입니다. for 문의 5라는 숫자, 오퍼레이터를 부르는 순서와 조건, 그리고 MATH_SOLVE_PROMPT라는 프롬프트의 문장입니다. 모델, 온도, 출력 형식은 탐색을 쉽게 하려고 고정했습니다. 그래서 AFlow의 탐색 공간은 논문 식 (1)처럼 프롬프트들, 오퍼레이터들, 그리고 그것을 잇는 코드의 조합입니다.
최적화기(optimizer) — 워크플로 코드를 읽고 고쳐 쓰는 LLM. 논문은 Claude 3.5 Sonnet을 썼습니다.
실행기(executor) — 그 워크플로 안에서 실제로 문제를 푸는 LLM. GPT-4o-mini나 DeepSeek-V2.5 같은 싼 모델입니다.
비싼 모델이 설계하고 싼 모델이 일합니다. 설계는 한 번이고 실행은 수백만 번일 수 있으니 합리적인 분업입니다.
시작은 빈 템플릿입니다. 프롬프트도 없는 LLM 호출 하나짜리 워크플로입니다. 탐색 전에 데이터를 검증 20%, 시험 80%로 나누고(난수 씨앗 42), 빈 템플릿을 검증 세트에 다섯 번 돌려 점수가 들쭉날쭉한 문제들만 골라 최종 검증 세트로 삼습니다. 늘 맞히거나 늘 틀리는 문제는 워크플로를 바꿔도 차이가 안 나니 빼는 것입니다.
n은 후보 수, si는 후보 i의 점수, smax는 최고 점수입니다. 식은 두 조각의 가중 평균입니다. 앞 조각 1/n은 모두에게 똑같은 확률이고, 뒤 조각은 점수가 높을수록 큰 확률입니다. λ가 둘의 비율을 정하고, α가 점수 차이를 얼마나 예민하게 반영할지 정합니다. 논문은 이를 ‘소프트 혼합 확률 선택’이라고 부릅니다.
빈 템플릿을 후보에 늘 넣어 두는 것이 눈에 띕니다. 지금까지 쌓은 것을 모두 버리고 백지에서 다시 시작하는 길을 열어 둔 것입니다.
주어진 그래프(워크플로 코드)와 프롬프트를 참고해 다시 구성하고 최적화하라. 노드·매개변수·프롬프트를 추가, 수정, 삭제할 수 있다.
제약
수정은 한 가지만 하고 XML 태그로 감싸 밝혀라. 그래프 복잡도는 10을 넘지 않게 하라. 실행 오류가 나지 않도록 완전하고 정확하게 써라.
힌트
검토, 수정, 앙상블(여러 답을 만들어 투표·통합), 자기 질문 같은 방법을 쓸 수 있다. 반복문, 조건문을 고려하라. 복잡한 그래프가 더 좋을 수 있지만 정보 전달이 부족하면 답을 놓친다.
‘수정은 한 가지만’이 핵심입니다. 한 번에 여러 곳을 고치면 점수가 변했을 때 무엇 때문인지 알 수 없습니다. 한 군데만 고치면 ‘이 수정 → 이만큼의 점수 변화’라는 깨끗한 기록이 남습니다. 과학 실험에서 변수를 하나씩만 바꾸는 것과 같은 이치입니다.
최적화기는 코드만 받는 것이 아닙니다. 두 가지 자료가 더 붙습니다.
그 워크플로의 경험 — 이 워크플로를 부모로 삼아 지금까지 시도한 모든 수정과 각각의 성공·실패.
실행 기록 — 이 워크플로가 실제로 틀린 문제 몇 개의 예측과 정답.
③ 평가 — 다섯 번 돌려 평균한다
새 워크플로로 검증 세트를 다섯 번 풀어 평균과 표준편차를 구합니다. LLM의 답은 돌릴 때마다 조금씩 달라지므로 한 번만 재면 운 좋게 오른 것인지 정말 나아진 것인지 구분할 수 없습니다. 논문은 이 때문에 회당 비용이 늘지만 피드백이 정확해져 필요한 반복 수는 오히려 줄어든다고 설명합니다.
④ 역전파 — 실패도 적는다
평가가 끝나면 세 가지를 기록합니다. 새 워크플로의 점수, 최적화기가 한 수정의 내용, 그리고 부모보다 나아졌는지. 이 기록은 부모 워크플로의 경험에 덧붙여집니다.
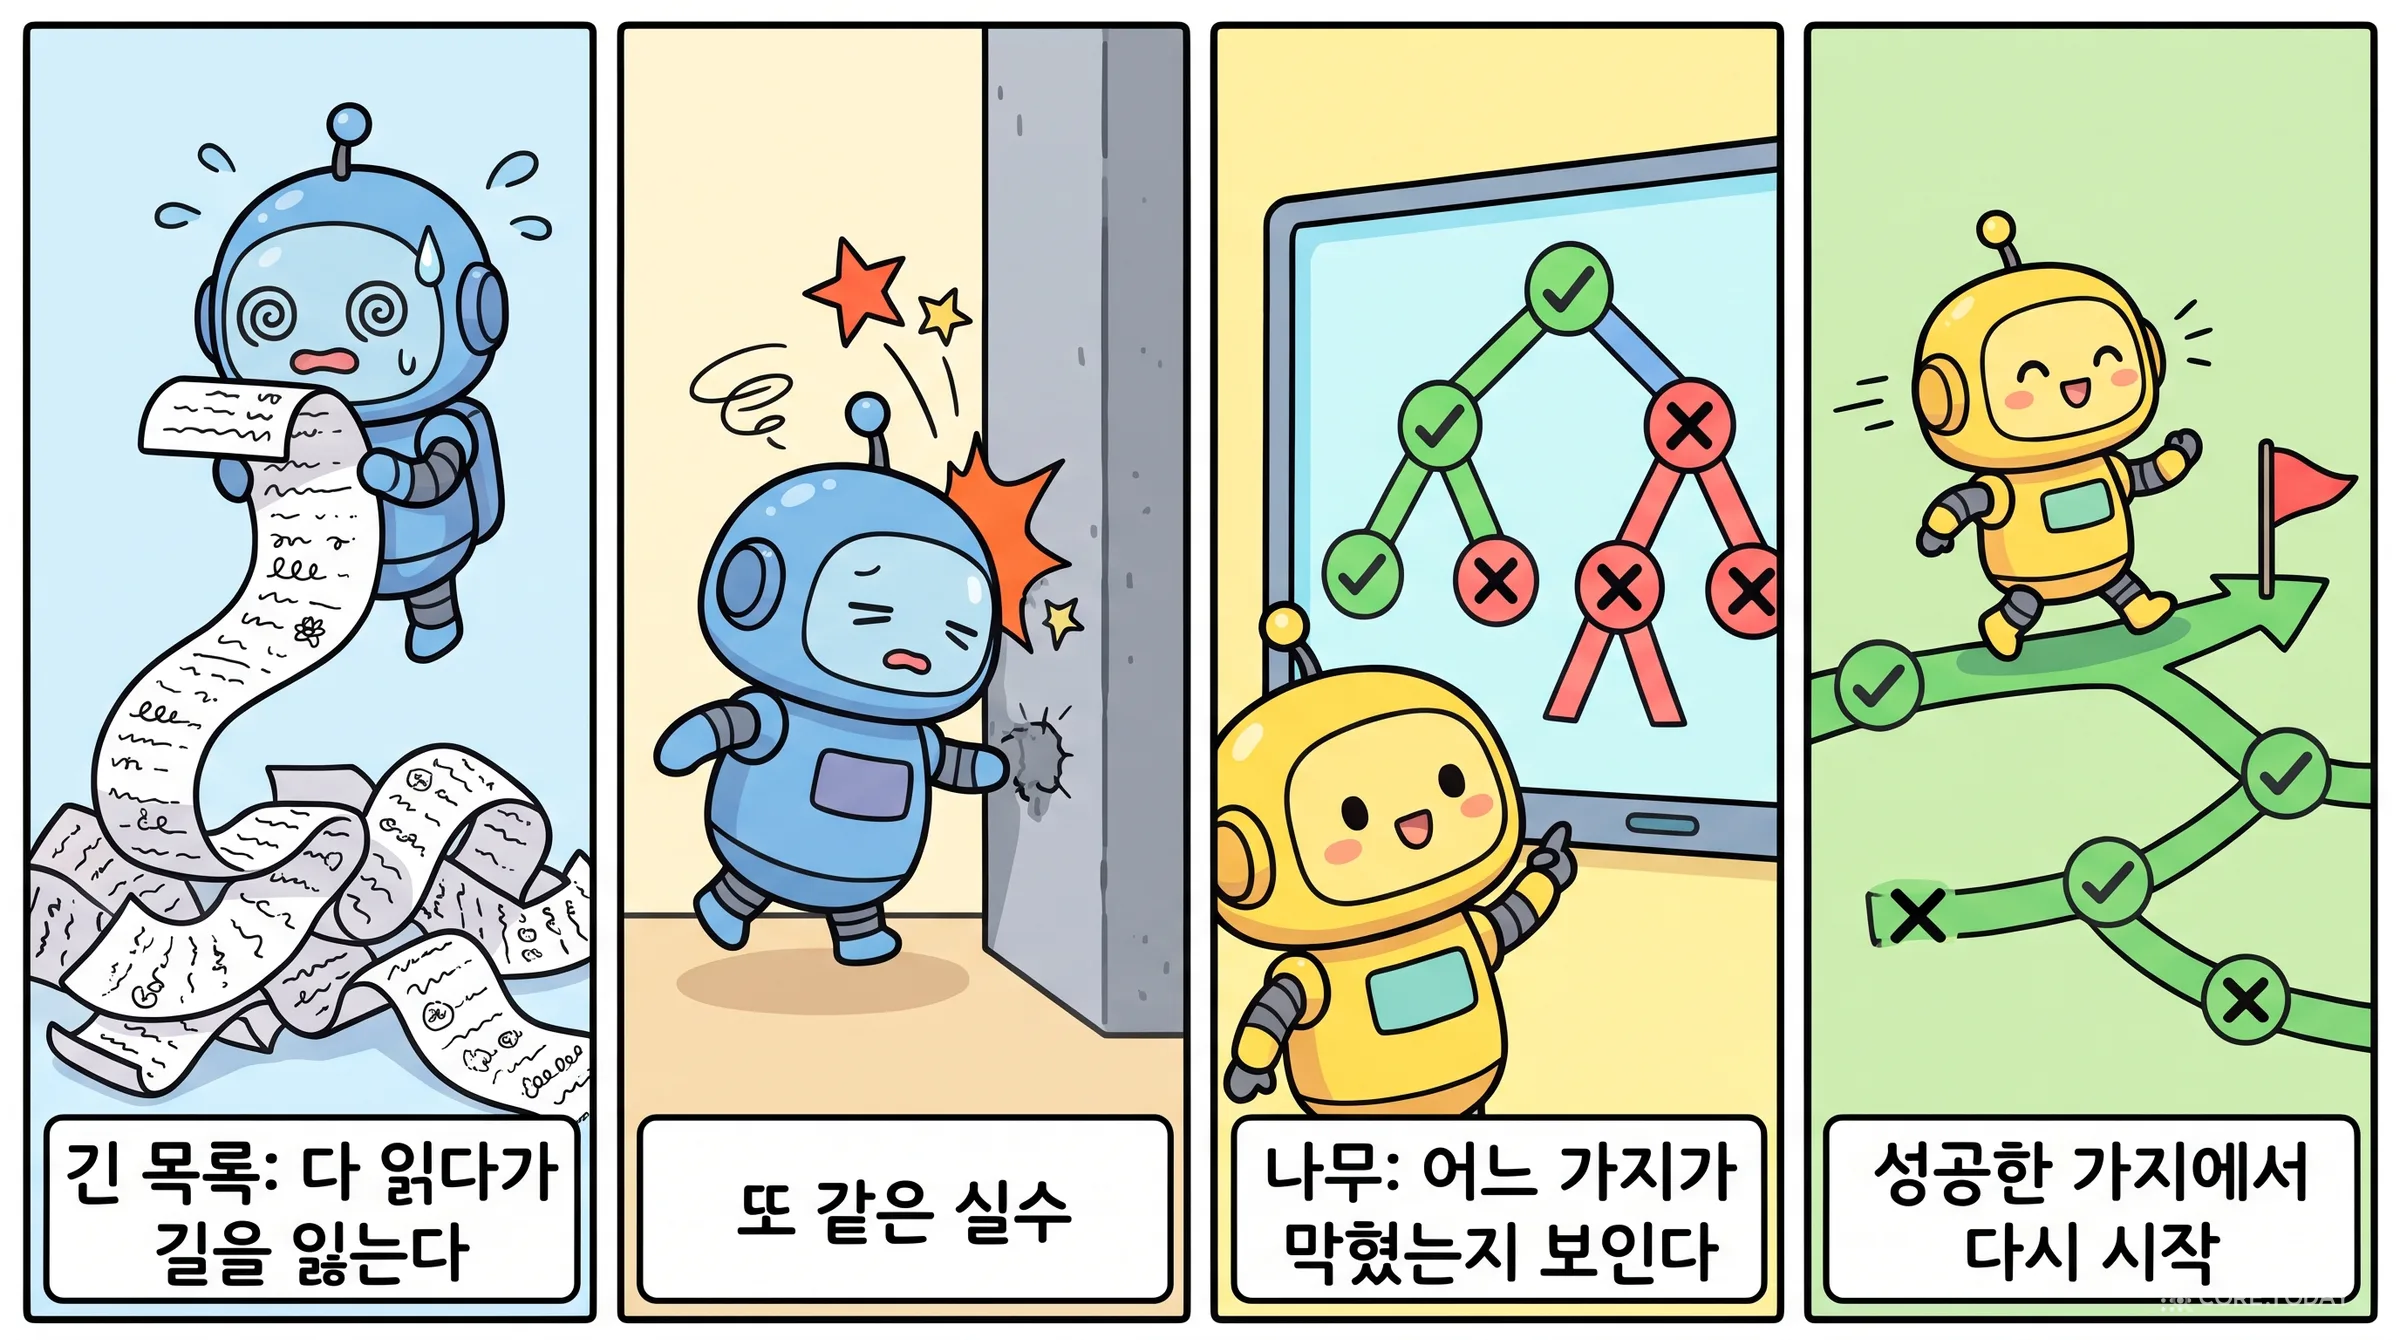
ADAS는 과거에 만든 워크플로를 전부 한 줄로 프롬프트에 넣습니다. 만든 순서와 점수만 붙여서요. 라운드가 쌓일수록 프롬프트는 길어지고, LLM은 그 긴 목록 속에서 ‘무엇을 고쳤더니 어떻게 됐는지’를 스스로 추려 내야 합니다. AFlow 논문은 이를 “가장 거친 단위로 경험을 저장한다”고 비판합니다.
AFlow는 지금 고치려는 워크플로의 자식들에게 일어난 일만 보여 줍니다. “이 워크플로에 앙상블을 더했더니 올랐다. 검토 노드를 더했더니 내렸다.” 최적화기는 같은 실패를 반복하지 않고, 성공한 방향을 더 밀 수 있습니다. 논문이 나무 구조 경험(tree-structured experience)이라고 부르는 것입니다.
실제 탐색 기록 되감기
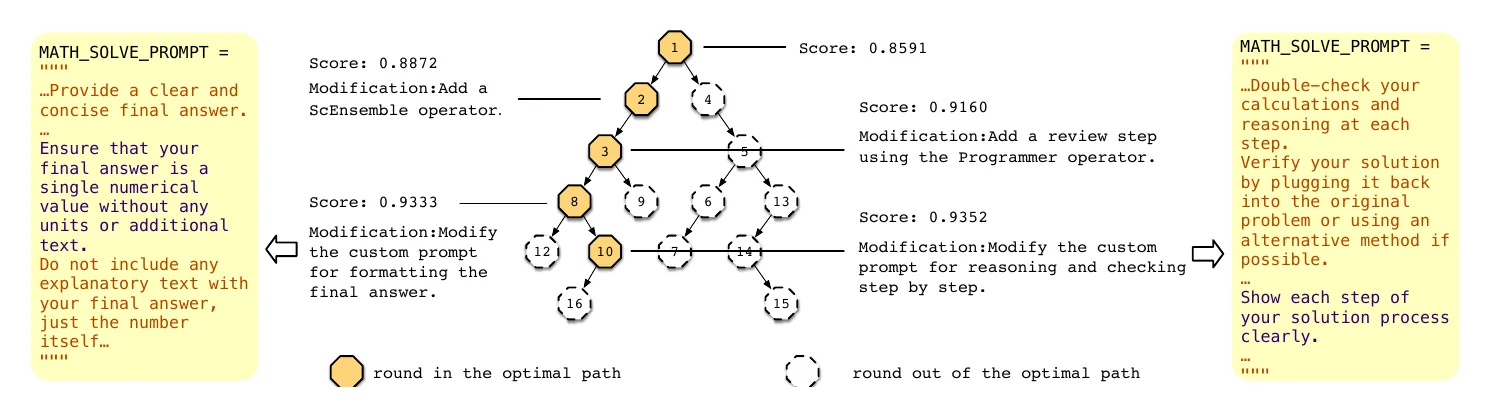
논문 부록 C.1에는 어려운 수학 문제(MATH, 난이도 5) 워크플로를 찾은 실제 기록이 통째로 실려 있습니다. 아래 위젯으로 한 라운드씩 넘겨 보세요.
되감아 보면 몇 가지가 보입니다.
성공은 드뭅니다. 18번의 수정 가운데 부모보다 나아진 것은 5번이고, 최고 워크플로에 이르는 길에 놓인 것은 3번뿐입니다(1 → 2 → 3 → 5). 3번은 실행 자체가 실패해 0점이었습니다.
결정적인 수정은 초반에 나옵니다. 2라운드에서 Programmer 오퍼레이터를 넣어 48.7%가 52.4%로 올랐습니다. 계산을 LLM의 암산에 맡기지 않고 파이썬으로 시킨 것입니다. 반대로 8라운드는 Programmer 없이 앙상블만 넣었다가 43.4%로 떨어졌습니다.
같은 수정도 점수가 다릅니다. 3, 6, 7라운드는 수정 내용이 글자 그대로 같은데(“ScEnsemble 오퍼레이터를 넣는다”) 점수는 52.8%, 47.2%, 52.4%입니다. 5, 9, 10라운드도 그렇습니다. 최적화기 LLM이 같은 생각을 다른 코드로 옮겼거나, 평가의 무작위성이 그만큼 크다는 뜻입니다. 5%포인트쯤은 잡음으로 움직일 수 있는 평가 위에서 3%포인트짜리 개선을 고르고 있는 셈입니다.
탐색은 한 곳에 몰립니다. 18번의 수정 가운데 6번이 3라운드 워크플로를 부모로 삼았습니다. 위젯 아래쪽 막대를 보면 이 워크플로는 대부분의 시점에 상위 3개 안에 들어 있습니다.
여기서는 다른 것이 보입니다. 앞의 두 걸음(앙상블, 검산)은 구조를 바꾼 것이고, 뒤의 두 걸음은 프롬프트의 문장을 바꾼 것입니다. 8라운드에서 더한 문장은 “최종 답은 단위나 다른 글 없이 숫자 하나로만 써라”입니다. 채점기가 숫자만 비교하므로 답 뒤에 ‘달러’를 붙이면 틀린 것으로 처리되던 문제를 고친 것입니다. 부록 C.2에도 같은 종류의 사례가 나옵니다. MATH에서 최적화기는 채점 규칙을 본 적이 없는데도 틀린 문제의 기록을 보고 “최종 답을 \boxed{}로 감싸라”는 문장을 스스로 추가했습니다.
이것은 양면이 있는 발견입니다. 실행 기록을 보고 실패 원인을 찾아 고치는 능력은 인상적입니다. 동시에 올라간 점수의 일부는 문제를 더 잘 풀어서가 아니라 채점기의 형식에 맞춰서 얻은 것입니다.
이것은 정말 MCTS인가
한 가지 짚어 둘 것이 있습니다. 논문은 이 방법을 “MCTS의 변형”이라고 부르지만 교과서의 MCTS와는 꽤 다릅니다.
고전 MCTS (UCT, 알파고)
AFlow
나무의 노드
게임의 한 상태(국면)
완성된 워크플로 하나
선택
뿌리에서 잎까지 내려가며 방문 횟수와 승률로 고른다(UCB)
전체에서 점수 상위 몇 개와 초기 워크플로 가운데 확률로 뽑는다. 방문 횟수는 쓰지 않는다
평가
끝까지 무작위로 두어 보거나(롤아웃) 가치 신경망으로 추정한다
워크플로를 실제로 실행해 점수를 잰다. 추정이 아니다
역전파
결과를 뿌리까지의 모든 조상에 반영한다
바로 위 부모의 경험에 글로 적는다
AFlow는 차라리 나무 모양의 기억을 가진 진화 탐색에 가깝습니다. 좋은 개체 몇을 남기고, 그중 하나를 뽑아 돌연변이를 만들고, 평가해서 다시 넣습니다. 이름이 무엇이든 방법의 값어치가 달라지지는 않지만, ‘알파고의 알고리즘으로 워크플로를 찾는다’는 인상은 실제보다 큽니다.
숫자도 엇갈립니다. 선택 식의 α와 λ가 논문 본문에서는 0.4와 0.2, 부록의 알고리즘에서는 0.2와 0.4, 공개 저장소의 코드에서는 0.2와 0.3입니다. 코드는 점수에 100을 곱해 계산하는데 논문에는 이 설명이 없습니다. 0~1 사이의 점수를 식에 그대로 넣으면 지수 항이 거의 평평해져 사실상 균등 추첨이 됩니다. 재현하려는 사람은 논문이 아니라 코드를 봐야 합니다.
9장. AFlow의 성적표 — 작은 모델에 좋은 설계도를 입히면
표 1 읽기
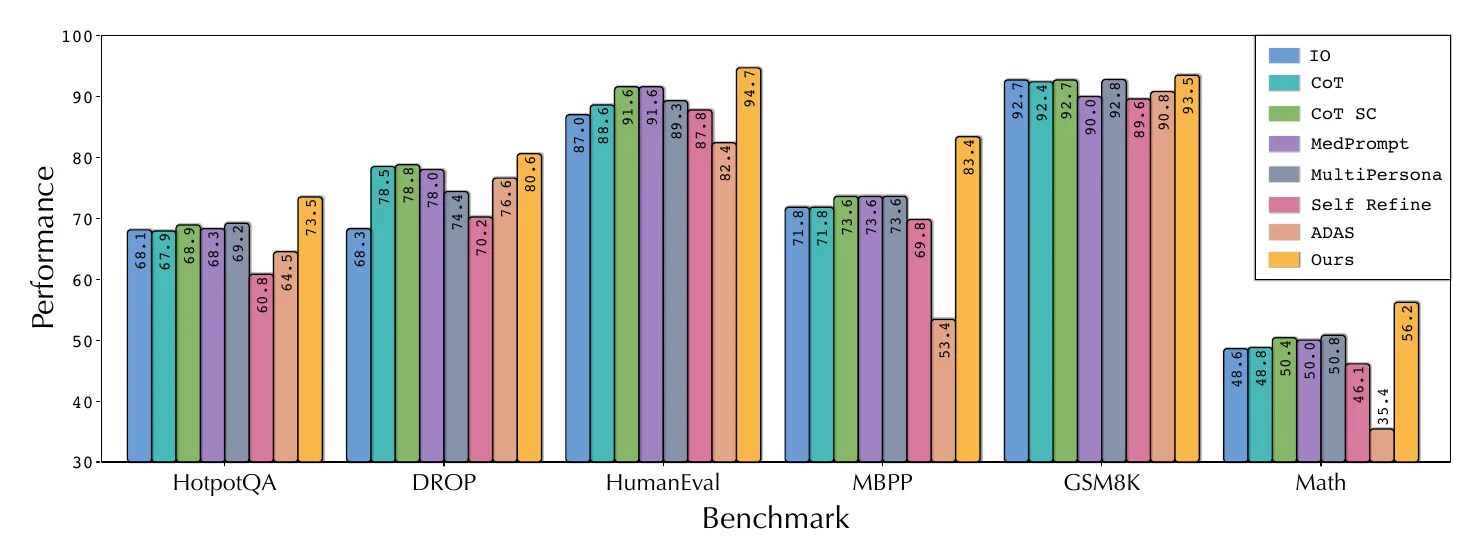
AFlow는 여섯 벤치마크에서 평가했습니다. 질의응답(HotpotQA, DROP), 코드 생성(HumanEval, MBPP), 수학(GSM8K, MATH 난이도 5)입니다. 실행기는 모두 GPT-4o-mini입니다.
초록의 두 숫자가 어디서 나왔는지 풀어 보면 이렇습니다. “사람이 설계한 방법보다 5.7% 향상”은 사람이 설계한 방법 가운데 평균이 가장 높은 CoT + 자기 일관성(76.0)에 대한 비율입니다(80.3 ÷ 76.0 = 1.057). 점수 차로는 4.3점입니다. “기존 자동화 방법보다 19.5% 향상”은 ADAS(67.2)에 대한 비율이고, 점수 차로는 13.1점입니다.
이 표에는 본문이 강조하지 않는 사실이 몇 가지 있습니다.
벤치마크마다 폭이 다릅니다. MBPP는 사람이 설계한 최고(73.6)보다 9.8점, MATH는 5.4점 올랐습니다. GSM8K는 0.7점입니다. GPT-4o-mini가 그냥 풀어도 92.7%를 맞히는 문제집에서는 워크플로가 보탤 것이 별로 없습니다.
사람이 설계한 방법들이 서로 별 차이가 없습니다. CoT, 자기 일관성, MedPrompt, 토론의 평균은 74.7~76.0 사이에 몰려 있습니다. Self Refine은 그냥 한 번 부른 것(72.8)보다 낮은 70.7입니다. ‘스스로 검토하고 고치게 하면 좋아진다’는 직관은 이 표에서 성립하지 않습니다.
ADAS의 숫자가 이상할 만큼 낮습니다. MBPP 53.4, MATH 35.4는 아무 기법 없이 한 번 부른 것(71.8, 48.6)보다 한참 아래입니다. 자동 설계가 기준선보다 18점을 깎았다는 뜻인데, 논문은 이 원인을 ADAS의 탐색이 비효율적이기 때문이라고만 설명합니다. 재현 설정의 문제일 가능성을 이 표만으로는 배제할 수 없습니다.
찾아 낸 워크플로들
탐색이 무엇을 찾았는지가 점수보다 흥미롭습니다.
코드 생성(MBPP) — AFlow가 빈 템플릿에서 출발해 도달한 워크플로는 이렇습니다. 풀이 3개를 만든다 → 앙상블로 하나를 고른다 → 그 풀이를 보고 추가 테스트 케이스를 만든다 → 테스트를 실행한다 → 실패하면 오류 메시지와 함께 고쳐 쓴다. 논문은 이것이 사람이 설계한 AlphaCodium(Ridnik 외, 2024)과 매우 비슷하다고 적습니다. 사람들이 몇 달에 걸쳐 다듬은 흐름을 탐색이 다시 발견한 것입니다.
수학(MATH), 오퍼레이터 없이 — 미리 준비한 오퍼레이터를 모두 빼고 Custom 노드만 주었을 때 AFlow가 찾은 워크플로는 서로 다른 접근 세 가지로 푼 뒤 비교해서 고르는 구조였습니다. 세 번째 접근의 프롬프트는 “어림이나 근사로 먼저 풀고 정확하게 다듬어라”입니다. 앙상블 오퍼레이터를 주지 않았는데도 앙상블을 스스로 만들었고, 게다가 같은 프롬프트를 반복하지 않고 접근을 달리했습니다. 1장 위젯의 셋째 관찰(같은 실수를 공유하면 표가 늘어도 소용없다)을 탐색이 알아서 피해 간 셈입니다.
오퍼레이터 없이도 93.1%에 닿았고(있을 때 93.5%), 사람이 설계한 어떤 방법보다 높습니다. 다만 그림을 보면 파란 선은 2라운드에서 이미 천장에 닿아 20라운드까지 수평입니다. 빨간 선도 7라운드 이후로는 거의 움직이지 않습니다. 20라운드 가운데 뒤쪽 절반 이상은 아무것도 찾지 못했습니다.
4.55%의 비용
AFlow 초록에서 가장 자주 인용되는 문장은 이것입니다. “AFlow는 작은 모델이 특정 과제에서 GPT-4o를 넘게 하며, 그 추론 비용은 4.55%다.”
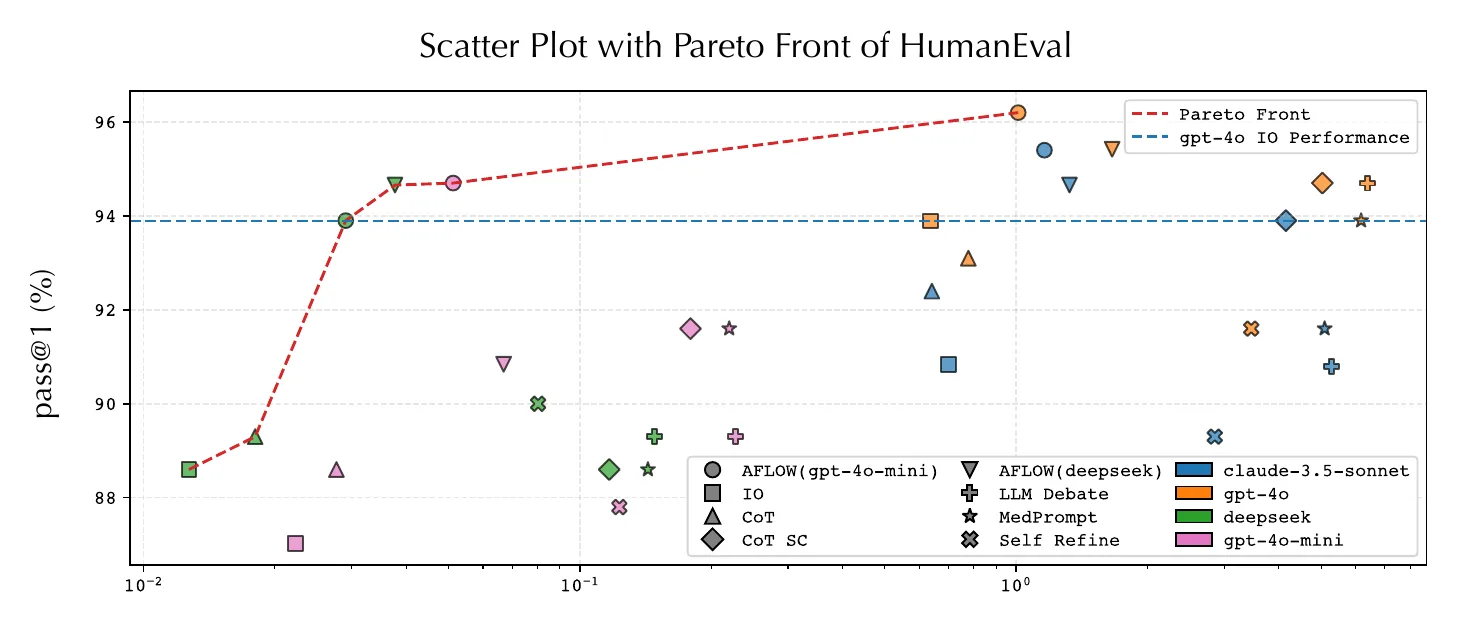
원 그림은 도형과 색이 겹쳐 읽기 어렵습니다. 아래 위젯에 부록 D의 표 전체를 옮겼습니다. 처음 선택된 점이 바로 그 4.55%입니다.
위젯에서 확인할 수 있는 것들입니다.
4.55%는 ‘동률’입니다. DeepSeek-V2.5에 AFlow 워크플로를 입힌 점수는 93.90%, GPT-4o를 그냥 부른 점수는 93.89%입니다. 초록은 ‘넘는다(outperform)’고 썼지만 부록은 ‘같은 수준(parity)’이라고 적었습니다. 실제로 넘는 조합은 비용이 5.92%와 8.05%인 두 점이고, 그 차이는 131문제 가운데 한 문제입니다.
그래도 방향은 분명합니다. 왼쪽 위의 빨간 점선(파레토 경계) 위에 있는 점은 거의 모두 AFlow의 워크플로입니다. 사람이 설계한 앙상블(□)들은 같은 모델에서 비용을 5~10배 쓰고도 AFlow 워크플로보다 아래에 있습니다. GPT-4o-mini에서 자기 일관성은 0.179달러에 91.6%, AFlow 워크플로는 0.051달러에 94.7%입니다.
큰 모델에 무거운 앙상블은 수지가 안 맞습니다. GPT-4o에 MedPrompt를 입히면 비용이 0.64달러에서 6.18달러로 뛰는데 점수는 93.9로 그대로입니다.
탐색 비용은 표에 없습니다. 이 표의 비용은 찾아 낸 워크플로를 실행하는 비용입니다. 워크플로를 찾는 데 든 비용(최적화기 호출 20번 + 검증 세트 실행 100번)은 논문 어디에도 적혀 있지 않습니다. 이 빈칸은 11장에서 후속 연구들이 채웁니다.
다른 모델로 옮기면
논문 표 2는 GPT-4o-mini로 찾은 워크플로와 DeepSeek으로 찾은 워크플로를 네 모델에 입혀 본 결과입니다. 대부분의 칸에서 사람이 설계한 방법보다 높아 옮겨 쓸 수 있음을 보여 줍니다. 그러나 DeepSeek으로 찾은 워크플로를 GPT-4o-mini에 입히면 90.8로, GPT-4o-mini로 직접 찾은 94.7보다 3.9점 낮습니다. 논문의 결론은 솔직합니다. 모델이 다르면 최적 워크플로도 다르다. 뒤집어 말하면, 모델을 바꿀 때마다 탐색을 다시 해야 한다는 뜻입니다.
표의 마지막 줄이 중요합니다. 두 방법 모두 완전한 백지는 아닙니다. Archon은 대놓고 틀을 줬고, AFlow는 오퍼레이터와 프롬프트 힌트(“검토, 수정, 앙상블 같은 방법을 쓸 수 있다”)의 형태로 줬습니다. AFlow가 찾아 낸 워크플로들이 결국 앙상블과 검산의 조합이라는 것은, 최적화기에게 그런 방법을 쓰라고 일러 준 프롬프트와 무관하다고 보기 어렵습니다.
서로를 어떻게 평가했나
AFlow가 3주 늦게 나왔기 때문에 AFlow 논문에는 Archon이 없습니다. 반대로 Archon의 개정판에는 AFlow가 비교 대상으로 들어가 있습니다. 6장의 표 1에서 AFlow는 호출 48번, 질의당 0.59달러로 적혀 있습니다.
같은 AFlow가 자기 논문에서는 HumanEval 131문제를 0.05달러에 풀었습니다. 문제당 0.0004달러입니다. 1,000배가 넘는 차이는 어느 한쪽이 틀려서가 아니라 조건이 달라서 생깁니다. Archon 저자들은 AFlow를 자기들의 큰 모델 풀과 넉넉한 토큰 예산 아래에서 다시 돌렸고, AFlow 저자들은 GPT-4o-mini 하나로 돌렸습니다.
여기서 얻을 교훈은 이것입니다. 이 분야의 숫자는 표 밖으로 들고 나갈 수 없습니다. 같은 방법도 누가, 어떤 모델로, 어떤 예산으로 돌렸느냐에 따라 전혀 다른 값이 나옵니다. 11장에서 볼 후속 연구들에서도 AFlow의 MATH 점수는 표에 따라 51점에서 64점까지 달라집니다.
두 논문 모두에 해당하는 유보
읽으면서 적어 둔 것들을 모으면 이렇습니다.
①
탐색 비용이 빠져 있다
두 논문 모두 찾아 낸 구조의 실행 비용은 적었지만, 찾는 데 든 비용은 달러로 밝히지 않았다. Archon은 구조 500~600개를 검증 세트에 돌렸고, AFlow는 워크플로마다 검증 세트를 다섯 번 돌렸다.
②
검증과 시험이 같은 문제집에서 나왔다
둘 다 같은 벤치마크를 20%와 80%로 나눠 썼다. 같은 분포에서 뽑은 문제에 맞춘 구조가 그 분포의 나머지 문제를 잘 푸는 것은 일반화의 약한 증거다. AFlow는 여기에 더해 검증 세트를 ‘점수가 흔들리는 문제’로 다시 골랐다.
③
본문·부록·코드의 숫자가 엇갈린다
Archon은 부품 효과가 본문과 부록에서 서너 배 다르고, 비용 ‘5배’가 표와 맞지 않는다. AFlow는 선택 확률의 매개변수가 세 군데서 다르고, ‘4.55%에 넘는다’가 부록에서는 ‘동률’이다.
→
그럼에도 남는 것
구조 설계를 평가 함수가 있는 탐색 문제로 적어 냈다는 것, 그리고 성능 옆에 호출 수·토큰·달러를 나란히 적는 표를 표준으로 만들었다는 것. 숫자는 낡아도 이 문제 설정은 남았다.
11장. 그 뒤 2년 — 2026년 11월에 다시 읽기
두 논문이 나온 지 2년이 지났습니다. 그 사이에 일어난 일을 네 갈래로 정리합니다.
갈래 1. 후속 연구 — ‘과제마다 하나’에서 ‘질문마다 하나’로
AFlow는 이 분야의 기준선이 됐습니다. 후속 논문 대부분이 AFlow를 표에 넣고 그 한계를 하나씩 겨냥했습니다.
연구
시기
AFlow의 어떤 한계를 겨냥했나
보고한 수치
ScoreFlow
2025. 2.
벤치마크마다 워크플로 하나. 탐색이 일찍 수렴한다
평균 85.3 대 80.6. 탐색 비용 2.26달러 대 4.61달러
MaAS
2025. 2. (ICML 2025 구두 발표)
“정적이고 모두에게 같은 옷”. 질문마다 구조를 뽑는 ‘에이전트 슈퍼넷’을 제안
탐색 3.38달러·53분 대 22.50달러·184분
MASS
2025. 2. (구글, ICLR 2026)
프롬프트 최적화 단계가 없다
블록 단위 프롬프트 최적화가 약 +6%, 연결 구조 최적화가 약 +3%
FlowBank
2026. 6.
탐색 중 만든 후보를 1등만 남기고 버린다
평균 73.4 대 70.4
LAWA
2026. 10.
지연 시간을 보지 않는다
정확도는 비슷하고 실행 시간은 6.2~11.8초 대 8.6~18.6초
9장에서 빈칸으로 남았던 탐색 비용이 여기서 드러납니다. MaAS가 잰 AFlow의 탐색 비용은 벤치마크 하나에 22.50달러, 3시간입니다. ScoreFlow가 잰 값은 4.61달러입니다. 표마다 다르다는 점까지 포함해 이것이 지금 알 수 있는 전부입니다.
흐름은 뚜렷합니다. AFlow와 Archon은 과제 하나에 구조 하나를 찾았습니다. 2025년의 연구들은 질문 하나에 구조 하나로 옮겨 갔습니다. 쉬운 질문에는 한 번만 부르고 어려운 질문에만 무거운 구조를 쓰자는 것입니다. 코어닷투데이는 그 뒤의 두 갈래를 따로 다뤘습니다. 미리 만든 워크플로 몇 개를 모아 두고 질문마다 골라 쓰는 FlowBank, 정확도가 아니라 대기 시간을 줄이는 쪽으로 구조를 고치는 LAWA입니다.
MASS의 결과는 따로 기억해 둘 만합니다. 구글 연구진이 분해해 보니 연결 구조를 바꿔서 얻는 이득보다 각 단계의 프롬프트를 다듬어서 얻는 이득이 두 배 컸습니다. 8장에서 본 GSM8K 기록(구조 수정 두 번, 프롬프트 수정 두 번)과 통하는 이야기입니다. 프롬프트 쪽의 자동 최적화는 GEPA 같은 연구로 따로 발전했습니다.
Archon 쪽은 조용합니다. 공개 저장소(ScalingIntelligence/Archon)는 별 220개이고 2024년 10월 이후 실질적인 변경이 없습니다. AFlow 저장소는 별 633개이지만 MetaGPT 생태계(별 7만 1천여 개)에 통합되어 쓰입니다. Archon의 제1저자 사드팰컨은 2025년 말 「와트당 지능(Intelligence per Watt)」으로 방향을 틀었습니다. 큰 모델 여럿을 엮어 천장을 올리던 사람이, 로컬의 작은 모델이 질의의 88.7%를 처리할 수 있다는 쪽을 재기 시작한 것입니다.
갈래 2. 반론 — “그냥 다수결이 더 낫다”
2장에서 NAS의 뒷이야기를 미리 적어 둔 이유가 여기에 있습니다. 같은 모양의 반론이 나왔습니다.
Self-MoA(2025년 2월) — 「Mixture-of-Agents 다시 생각하기: 서로 다른 LLM을 섞는 것이 이로운가?」 가장 좋은 모델 하나를 여섯 번 부르고 합친 것이, 서로 다른 모델 여섯을 섞은 것보다 AlpacaEval 2.0에서 6.6점 높았습니다(65.7 대 59.1). 약한 모델을 섞으면 다양성은 늘지만 평균 품질이 내려가고, 융합기는 품질에 더 민감하다는 것입니다. Archon의 표 5에서 본 ‘모델 여덟 개 + 순위기가 최고 모델 한 번보다 낮다’와 같은 현상입니다. Archon이 탐색 축 ①에서 모델을 성적순으로 뽑게 한 것은 이 문제를 알았기 때문이지만, ‘여러 회사 모델을 섞는 것 자체가 이득’이라는 인상은 수정이 필요합니다.
단순한 기준선의 역습 — 2025년 10월 서비스나우 연구진의 논문은 어려운 벤치마크 다섯 개의 평균을 이렇게 보고했습니다.
CoT + 자기 일관성
41.8
CoT
38.0
AFlow (두 설정)
35.2 / 37.2
ADAS (두 설정)
35.3 / 32.0
실행 모델은 GPT-4.1-nano이고 막대 길이는 최고값(41.8) 대비 비율입니다(두 설정이 있는 줄은 높은 쪽 기준). 자동으로 찾은 워크플로가 단계별로 생각하게 하고 다수결하는 2022년의 방법보다 낮습니다. 2026년 6월 세일즈포스 연구진의 「멀티에이전트 우위라는 착각」(NeurIPS 2026)은 더 직설적입니다. 자동 설계된 멀티에이전트 시스템이 “최대 10배 비싸면서도 CoT + 자기 일관성보다 일관되게 낮다”고 썼습니다. 또 다른 연구는 모델이 강해질수록 멀티에이전트의 이점이 줄어든다고 보고했습니다.
2019년의 NAS 반론과 겹쳐 놓으면 이렇습니다.
신경망 구조 탐색
LLM 구조 탐색
출발
2016년 조프·레
2024년 ADAS·Archon·AFlow
초기 주장
탐색한 구조가 사람이 설계한 구조를 이긴다
탐색한 워크플로가 사람이 설계한 워크플로를 이긴다
3년 안의 반론
무작위 탐색이 비슷하다(2019). 평균적 구조도 못 이긴다(2020)
자기 일관성이 더 낫다(2025~2026). 섞지 않는 편이 낫다(2025)
반론의 요지
성능은 탐색 알고리즘이 아니라 사람이 정한 탐색 공간에서 나왔다
성능은 구조가 아니라 실행 모델과 프롬프트, 그리고 다수결에서 나왔다
그 뒤
탐색 비용을 줄이고 하드웨어 제약을 넣는 방향으로 살아남았다
질문별 설계, 비용·지연 제약, 프롬프트 최적화 쪽으로 옮겨 가는 중
이 반론들에도 유보는 붙습니다. 실행 모델, 벤치마크, 탐색 예산이 원 논문과 다릅니다. 10장에서 본 대로 이 분야의 숫자는 표 밖으로 나가지 못합니다. 그러나 여러 연구실이 독립적으로 같은 방향을 가리킨다는 점은 무겁습니다. 코어닷투데이가 찾아본 범위에서 Archon의 수치를 독립적으로 재현한 연구는 없었습니다.
논문 밖에서는 다른 일이 일어났습니다. 추론 시점 기법의 상당 부분을 모델 회사가 상품 안에 넣었습니다.
2024. 12. 5.OpenAI, o1 정식 출시와 함께 월 200달러 요금제. 더 많은 계산을 쓰는 o1 pro 모드 제공.
2024. 12. 19.Anthropic 「효과적인 에이전트 만들기」. 워크플로(미리 정한 코드 경로)와 에이전트(모델이 스스로 과정을 지휘)를 구분하고 다섯 패턴을 이름 붙였다. 프롬프트 체이닝, 라우팅, 병렬화(나눠 하기·투표), 오케스트레이터–워커, 평가자–최적화자. Archon의 부품들과 거의 겹친다.
2025. 5. 14.구글 딥마인드 AlphaEvolve. 빠른 모델(Gemini Flash)이 넓게 후보를 내고 강한 모델(Pro)이 깊게 다듬으며, 자동 평가기가 점수를 매겨 진화시킨다. 4×4 복소 행렬 곱셈을 48번의 곱셈으로 줄였다. ‘LLM이 코드를 고치고 평가로 걸러 낸다’는 AFlow의 틀을 워크플로가 아니라 알고리즘 자체에 적용한 것이다.
2025. 6. 13.Anthropic 「멀티에이전트 연구 시스템을 만든 방법」. 내부 평가에서 단일 에이전트보다 90.2% 나았지만(상대적 향상) 토큰은 일반 대화의 약 15배를 썼다. 대부분의 코딩 작업에는 맞지 않는다고도 적었다.
2025. 6.~8.o3-pro(6월), Grok 4 Heavy(7월, 멀티에이전트), Gemini 2.5 Deep Think(8월, ‘병렬 사고’), GPT-5 Pro(시스템 카드가 ‘병렬 추론 시점 계산’이라고 설명). 여러 번 풀고 고르고 합치는 일이 API 한 번 호출 뒤로 들어갔다.
2026여러 회사 모델의 답을 나란히 받아 합쳐 주는 기능이 소비자 제품에 등장했다(Perplexity의 Model Council, 2월). 모델 중개 서비스가 융합 기능을 내놓았다는 보도도 있다.
2024년에 Archon이 호출 35번으로 하던 일의 일부를 2026년의 ‘Pro’, ‘Deep Think’, ‘Heavy’ 모델은 한 번의 호출 안에서 합니다. 사용자가 구조를 짤 필요도, 탐색할 필요도 없습니다.
그렇다고 바깥의 설계가 사라진 것은 아닙니다. 모델 안으로 들어갈 수 있는 것은 같은 회사의 같은 모델을 여러 번 돌리는 일입니다. 다음은 여전히 바깥에 남습니다.
서로 다른 회사의 모델을 엮는 일 — 어느 모델 회사도 경쟁사의 모델을 자기 추론 안에 넣지 않습니다.
도구를 실제로 실행하는 일 — 테스트를 돌리고, 검색하고, 데이터베이스를 조회하는 단계는 모델 밖에 있습니다. AFlow의 Test와 Programmer 오퍼레이터가 가장 큰 이득을 낸 것도 이 때문입니다.
조직의 평가 기준에 맞추는 일 — ‘우리 업무에서 좋은 답’이 무엇인지는 모델 회사가 모릅니다.
비용을 통제하는 일 — 쉬운 질문에 Pro 모델을 쓰지 않도록 가르는 것은 사용자의 몫입니다.
코어닷투데이가 Squeeze Evolve 글에서 다룬 것처럼, 여러 모델을 싸게 엮는 연구가 2026년에도 계속 나오는 이유가 여기에 있습니다.
갈래 4. 가격 — 앙상블의 산수가 바뀌었다
Archon의 비용 표(표 39)는 GPT-4o를 입력 100만 토큰당 5달러, 출력 15달러로 계산했습니다. 그런데 GPT-4o는 2024년 8월에 이미 2.50달러와 10달러로 내려가 있었습니다. 논문의 표가 발표 시점부터 예전 가격이었던 것입니다. 2025년 6월에는 o3가 한 번에 80% 내렸습니다(10달러·40달러 → 2달러·8달러).
가격 하락은 두 방향으로 작용합니다. 호출 35번짜리 구조의 절대 비용이 내려가니 앙상블을 쓰기 쉬워집니다. 동시에 강한 단일 모델도 싸지므로 작은 모델을 엮어 큰 모델을 흉내 낼 이유가 줄어듭니다. AFlow의 ‘4.55%’가 뜻하던 절약의 절대 크기는 2년 사이 훨씬 작아졌습니다.
그래서 2026년에 남은 질문은 ‘엮으면 더 싼가’가 아니라 ‘엮으면 단일 모델로는 닿지 못하는 곳에 닿는가’입니다. 그리고 그 답은 과제마다 다릅니다. 두 논문이 2년 전에 이미 표로 보여 준 그대로입니다.
1. 평가 세트부터 만든다. 두 논문의 탐색기가 한 일은 결국 ‘점수가 오르는 쪽으로 간다’입니다. 점수가 없으면 탐색도 없고, 사람이 손으로 고칠 때도 마찬가지입니다. 정답이 있는 문제 100~200개와 자동 채점기가 먼저입니다. AFlow가 채점 형식에 맞추는 문장을 스스로 찾아낸 것을 기억하세요. 채점기가 재는 것이 곧 최적화되는 것입니다. 채점기가 형식만 본다면 형식만 좋아집니다.
2. 기준선 세 개를 먼저 잰다. 한 번 부르기, 단계별로 생각하게 하기(CoT), 다섯 번 풀고 다수결(자기 일관성). 2025~2026년의 반론들이 가리키는 것은, 복잡한 구조가 이 셋째 기준선을 못 넘는 경우가 드물지 않다는 사실입니다. 여기서 충분하면 멈춥니다.
3. 같은 구성을 여러 번 돌려 잡음의 크기를 잰다. AFlow의 MATH 기록에서 똑같은 수정이 47.2%와 52.8%를 냈습니다. 내 평가 세트에서 같은 워크플로를 다섯 번 돌렸을 때 점수가 얼마나 흔들리는지 모르면, 2점짜리 개선이 진짜인지 알 수 없습니다.
4. 과제의 성격에 맞는 부품부터 넣는다. 두 논문의 결과는 일관됩니다.
과제
먼저 시도할 것
기대하지 말 것
코드 생성
테스트를 실제로 실행하고 실패하면 오류와 함께 고쳐 쓰기. 가장 잘하는 모델 하나를 여러 번
여러 모델의 답을 글로 합치기
계산이 있는 수학·정량 문제
코드로 계산시키기(Programmer). 서로 다른 접근으로 풀고 비교
같은 프롬프트로 고쳐 쓰기 반복
정답이 하나인 추론
검증 단계로 걸러 낸 뒤 합치기
융합 층을 여러 겹 쌓기
글쓰기·지시 따르기
여러 답 → 비평 → 순위 → 합치기. 층을 쌓으면 더 오른다
단위 테스트식 점검
5. 합치는 일은 강한 모델에게 맡긴다. 작은 모델은 고르기는 하지만 합치기는 못합니다(Archon 표 38). 예산이 빠듯하면 생성은 싼 모델 여럿에게, 마지막 융합 한 번은 가장 강한 모델에게 맡기는 구성이 합리적입니다.
6. 섞기 전에 가장 좋은 모델 하나를 여러 번 불러 본다. Self-MoA의 교훈입니다. 약한 모델을 다양성을 위해 섞으면 평균 품질이 내려갑니다. 섞을 거라면 그 과제에서 비슷하게 잘하는 모델끼리 섞습니다.
7. 성능 옆에 호출 수·토큰·달러·지연 시간을 함께 적는다. 두 논문이 남긴 가장 좋은 습관입니다. ‘79.5점’이 아니라 ‘호출 39번, 0.37달러에 79.5점’이라고 적습니다. 그래야 넷플릭스가 우승 앙상블을 놓고 내린 판단, 얻는 정확도가 운영 비용을 정당화하는가를 내릴 수 있습니다.
8. 자동 탐색은 선택지가 손을 벗어났을 때 쓴다. Archon도 호출 20번 미만에서는 사람이 고르는 편이 낫다고 적었습니다. 쓸 모델이 두세 개이고 단계가 서너 개라면 손으로 다 해 볼 수 있습니다. 탐색을 돌린다면 탐색 자체의 비용(구조 수 × 검증 문제 수 × 구조당 호출 수)을 먼저 계산합니다.
9. 모델을 바꾸면 구조를 다시 본다. AFlow 표 2가 보여 주듯 모델이 다르면 최적 워크플로도 다릅니다. 새 모델로 갈아탈 때 예전 구조를 그대로 두면, 더 이상 필요 없는 단계에 돈을 쓰고 있을 수 있습니다. 추론 모델로 바꿨다면 바깥의 다수결과 검토 단계를 하나씩 빼 보며 점수가 유지되는지 확인합니다.
맺음말 — 구조는 답이 아니라 변수다
2024년 가을의 두 논문을 2026년에 다시 읽으면 숫자는 많이 낡았습니다. 비교한 모델들은 두 세대 전의 것이고, 달러로 적은 비용은 지금 절반 아래로 내려갔고, 자동으로 찾은 구조가 단순한 다수결을 못 넘는다는 반론도 쌓였습니다. 본문과 부록의 숫자가 맞지 않는 곳도 여럿 있었습니다.
그래도 두 논문이 한 일은 남아 있습니다. 그 전까지 LLM을 엮는 방식은 발명품이었습니다. 누군가 좋은 구조를 생각해 내면 이름을 붙여 논문으로 냈습니다. 자기 일관성, Self-Refine, 토론, MoA. Archon과 AFlow는 그것을 변수로 바꿨습니다. 구조는 사람이 떠올리는 것이 아니라 평가 함수 위에서 찾는 것이고, 과제와 모델과 예산이 바뀌면 값이 달라지는 것입니다.
Archon은 그 변수를 다이얼 여섯 개로 적었고, AFlow는 코드 한 편으로 적었습니다. 하나는 잘 옮겨 가지만 울타리가 좁고, 다른 하나는 무엇이든 표현하지만 그 과제에 묶입니다. 2년 동안의 후속 연구는 그 둘 사이 어딘가에서, 질문마다 다른 값을 고르는 쪽으로 움직여 왔습니다.
프롤로그의 화이트보드로 돌아가 보면, 그 밤이 힘들었던 이유는 선택지가 많아서가 아니었습니다. 한 칸을 바꿨을 때 좋아졌는지 나빠졌는지 잴 방법이 없어서였습니다. 두 논문이 공통으로 보여 준 것은 그 반대편입니다. 잴 수 있으면 찾을 수 있고, 찾는 일은 사람이 아니어도 됩니다.
참고문헌
이 글이 다룬 두 논문
Saad-Falcon, J., Lafuente, A. G., Natarajan, S., Maru, N., Todorov, H., Guha, E., Buchanan, E. K., Chen, M., Guha, N., Ré, C., & Mirhoseini, A. (2025). An architecture search framework for inference-time techniques. ICML 2025. arXiv:2409.15254 (v6, 2025. 6. 10.). 코드: github.com/ScalingIntelligence/Archon
Condorcet, M. de (1785). Essai sur l'application de l'analyse à la probabilité des décisions rendues à la pluralité des voix.
Galton, F. (1907). Vox populi. Nature, 75, 450–451.
Wallis, K. F. (2014). Revisiting Francis Galton's forecasting competition. Statistical Science, 29(3). arXiv:1410.3989
Wang, X., et al. (2023). Self-consistency improves chain of thought reasoning in language models. ICLR 2023. arXiv:2203.11171
Madaan, A., et al. (2023). Self-Refine: Iterative refinement with self-feedback. NeurIPS 2023. arXiv:2303.17651
Jiang, D., Ren, X., & Lin, B. Y. (2023). LLM-Blender: Ensembling large language models with pairwise ranking and generative fusion. ACL 2023. arXiv:2306.02561
Li, J., et al. (2024). More agents is all you need. TMLR. arXiv:2402.05120
Zaharia, M., et al. (2024. 2. 18.). The shift from models to compound AI systems. BAIR Blog.
Chen, L., et al. (2024). Are more LLM calls all you need? Towards scaling laws of compound inference systems. arXiv:2403.02419
Wang, J., et al. (2024). Mixture-of-Agents enhances large language model capabilities. arXiv:2406.04692
Brown, B., et al. (2024). Large language monkeys: Scaling inference compute with repeated sampling. arXiv:2407.21787
구조 탐색과 최적화 알고리즘
Zoph, B., & Le, Q. V. (2017). Neural architecture search with reinforcement learning. ICLR 2017. arXiv:1611.01578
Zoph, B., et al. (2018). Learning transferable architectures for scalable image recognition. CVPR 2018. arXiv:1707.07012
Pham, H., et al. (2018). Efficient neural architecture search via parameter sharing. ICML 2018. arXiv:1802.03268
Liu, H., Simonyan, K., & Yang, Y. (2019). DARTS: Differentiable architecture search. ICLR 2019. arXiv:1806.09055
Li, L., & Talwalkar, A. (2019). Random search and reproducibility for neural architecture search. UAI 2019. arXiv:1902.07638
Yang, A., Esperança, P. M., & Carlucci, F. M. (2020). NAS evaluation is frustratingly hard. ICLR 2020. arXiv:1912.12522
Snoek, J., Larochelle, H., & Adams, R. P. (2012). Practical Bayesian optimization of machine learning algorithms. NeurIPS 2012. arXiv:1206.2944
Coulom, R. (2006). Efficient selectivity and backup operators in Monte-Carlo tree search. Computers and Games 2006.
Kocsis, L., & Szepesvári, C. (2006). Bandit based Monte-Carlo planning. ECML 2006.
Mirhoseini, A., Goldie, A., et al. (2021). A graph placement methodology for fast chip design. Nature, 594, 207–212.
워크플로 자동 설계: 선행과 후속
Khattab, O., et al. (2024). DSPy: Compiling declarative language model calls into self-improving pipelines. ICLR 2024. arXiv:2310.03714
Zhuge, M., et al. (2024). GPTSwarm: Language agents as optimizable graphs. ICML 2024. arXiv:2402.16823
Yuksekgonul, M., et al. (2024). TextGrad: Automatic “differentiation” via text. arXiv:2406.07496
Hu, S., Lu, C., & Clune, J. (2025). Automated design of agentic systems. ICLR 2025. arXiv:2408.08435
Ridnik, T., Kredo, D., & Friedman, I. (2024). Code generation with AlphaCodium: From prompt engineering to flow engineering. arXiv:2401.08500
Wang, Y., et al. (2025). ScoreFlow: Mastering LLM agent workflows via score-based preference optimization. arXiv:2502.04306
Zhang, G., et al. (2025). Multi-agent architecture search via agentic supernet (MaAS). ICML 2025 (Oral). arXiv:2502.04180
Zhou, H., et al. (2026). Multi-agent design: Optimizing agents with better prompts and topologies (MASS). ICLR 2026. arXiv:2502.02533
Yuan, L., et al. (2026). FlowBank: Query-adaptive agentic workflows optimization through precompute-and-reuse. arXiv:2606.11290
Zhang, E., Qu, F., Huang, Z., Zhou, D., Chen, E., & Yan, Y. (2026). Optimize once, execute fast: Latency-aware multi-agent workflow learning for recurrent queries (LAWA). NeurIPS 2026. arXiv:2610.14481
Agrawal, L. A., et al. (2026). GEPA: Reflective prompt evolution can outperform reinforcement learning. ICLR 2026 (Oral). arXiv:2507.19457
반론과 재평가
Li, W., Lin, Y., Xia, M., & Jin, C. (2025). Rethinking Mixture-of-Agents: Is mixing different large language models beneficial? arXiv:2502.00674
Cemri, M., et al. (2025). Why do multi-agent LLM systems fail? NeurIPS 2025 Datasets & Benchmarks. arXiv:2503.13657
Gao, M., et al. (2025). Single-agent or multi-agent systems? Why not both? arXiv:2505.18286
Yao, B., Malay, S., & Yadav, V. (2025). ARM: Discovering agentic reasoning modules for generalizable multi-agent systems. ServiceNow. arXiv:2510.05746
Jwalapuram, P., et al. (2026). The illusion of multi-agent advantage. Salesforce AI Research. NeurIPS 2026. arXiv:2606.13003
Saad-Falcon, J., et al. (2025). Intelligence per watt: Measuring intelligence efficiency of local AI. arXiv:2511.07885
산업 동향
Anthropic (2024. 12. 19.). Building effective agents.
Anthropic (2025. 6. 13.). How we built our multi-agent research system.
Google DeepMind (2025. 5. 14.). AlphaEvolve: A Gemini-powered coding agent for designing advanced algorithms.
OpenAI (2025). GPT-5 system card.
Amatriain, X., & Basilico, J. (2012. 4.). Netflix recommendations: Beyond the 5 stars. Netflix Technology Blog.