재귀적 자기 개선RSIMASSGEPA멀티에이전트자기 지도미세조정프롬프트 최적화딥리서치인용 검증과적합승자의 저주LLM 심판워크플로 최적화Sakana AI특집
[특집] 스스로 채점하는 기계 — MASS와 GEPA, 자기 개선 고리에서 '좋아졌다'는 말을 어디까지 믿을 것인가
2026년 10월 8일, 같은 날 arXiv에 올라온 두 논문이 같은 고리를 서로 다른 쪽에서 돌렸다. 버클리·사카나 AI의 MASS(arXiv 2610.12176)는 모델이 자기 복사본으로 팀을 꾸려 일하고, 스스로 채점하고, 잘된 기록으로 자기 가중치를 다시 학습하는 고리를 두 바퀴 돌려 연구형 벤치마크 넷에서 출력 토큰당 점수를 1.2~1.6배로 올렸다. 딥리서치 에이전트의 프롬프트를 GEPA로 고친 논문(arXiv 2610.12601)은 처음 보는 주제 500문항에서 인용 보상을 0.702에서 0.781로 올렸지만, 이긴 프롬프트의 절반이 외운 답안지였고 그 답안지는 점수를 한 푼도 벌지 못했다는 것을 함께 보였다. 이 글은 두 논문을 부록까지 읽고, 1965년 굿의 '지능 폭발'에서 알파고 제로와 다윈 괴델 머신까지 자기 개선의 계보를 따라간 뒤, 워크플로의 네 부품(역할·지시·계약·홉), 두 겹의 고리, 완주율이 올린 점수, 2.6배 부풀림을 만든 승자의 저주, 숫자 하나짜리 채점이 전이를 음수로 만든 실험을 위젯 7개와 삽화로 풀어 설명한다.
학생 한 명이 독서실에 혼자 앉아 있다고 합시다. 문제를 풉니다. 답안지가 없어서 자기 풀이를 자기가 채점합니다. 채점 결과를 보고 공부법을 바꿉니다. 바꾼 공부법으로 다시 문제를 풉니다.
이 학생의 실력은 오를까요?
오를 수도 있습니다. 풀이를 다시 읽다가 실수를 잡아내는 일은 실제로 일어납니다. 하지만 걱정되는 점도 분명합니다. 이 학생이 어떤 개념을 잘못 알고 있다면, 풀 때도 틀리고 채점할 때도 맞았다고 표시할 것입니다. 틀린 풀이에 동그라미를 치고, 그 동그라미를 근거로 공부법을 '개선'합니다. 점수는 오르는데 실력은 제자리이거나 오히려 굳어집니다.
2026년의 AI 연구는 이 독서실 안에 들어와 있습니다. 모델이 쓴 연구 보고서, 모델이 짠 실험 코드, 모델이 붙인 인용이 맞는지를 사람이 일일이 확인하기 어려워졌기 때문입니다. 확인할 사람이 부족하고, 확인에 시간이 너무 오래 걸리고, 어떤 분야에서는 확인할 수 있는 사람 자체가 드뭅니다. 그래서 채점을 모델에게 맡깁니다. 그리고 그 채점 결과로 모델을, 또는 모델에게 주는 지시문을 고칩니다.
2026년 10월 8일, 이 고리를 정면으로 다룬 논문 두 편이 같은 날 arXiv에 올라왔습니다.
MASS — 「Recursive Self-Improvement through Multi-Agent Self-Supervision」(다중 에이전트 자기 지도를 통한 재귀적 자기 개선). UC 버클리와 사카나 AI(Sakana AI)의 Hyunin Lee, Jinglue Xu, 제프리 실리(Jeffrey Seely), Donghyun Lee, 소마예 소주디(Somayeh Sojoudi), 마테이 자하리아(Matei Zaharia), 유진 탕(Yujin Tang). arXiv 2610.12176, 39쪽. 제1저자가 사카나 AI 인턴 기간에 수행한 연구입니다.
GEPA 딥리서치 논문 — 「Reflective Prompt Optimization of a Deep-Research Agent: A Topic-Disjoint, Multi-Seed Protocol for Measuring Transferable Gains and Prompt-Level Overfitting」(딥리서치 에이전트의 반성적 프롬프트 최적화: 옮겨 가는 향상과 프롬프트 수준 과적합을 재는, 주제가 겹치지 않는 다중 시드 절차). 엘리아스 루머(Elias Lumer), 사힐 센(Sahil Sen), 밤세 쿠마르 수비아(Vamse Kumar Subbiah), 케빈 폴(Kevin Paul). arXiv 2610.12601, 27쪽. 논문에는 소속이 적혀 있지 않습니다. 저자들의 이전 논문(ScaleMCP 등)은 PwC 소속으로 나왔습니다.
두 논문은 서로를 인용하지 않습니다. 다루는 대상도 다릅니다. 하나는 모델의 가중치를 고치고, 다른 하나는 모델에게 주는 프롬프트를 고칩니다. 그런데 뼈대가 같습니다.
MASS
GEPA 딥리서치 논문
고치는 대상
워크플로 프롬프트, 그리고 모델 가중치
지휘자·연구자의 시스템 프롬프트 두 개
일하는 구조
지휘자 + 일꾼 여럿 (같은 모델의 복사본)
지휘자 + 연구 담당 하위 에이전트
고리 안의 채점자
고쳐지는 바로 그 모델
LLM 심판 (같은 회사 계열의 작은 모델)
고리 밖의 확인
GPT-5.5와 Claude Opus 4.8의 판정, 공개 벤치마크 6개
주제가 겹치지 않는 500문항, 다른 회사 심판, 사람 라벨
대표 숫자
출력 토큰당 점수 1.2~1.6배
인용 보상 0.702 → 0.781
스스로 적은 단서
오른 점수는 '더 많이 끝까지 낸' 덕이 크다
이긴 프롬프트의 절반은 쓸모없는 답안지였다
마지막 줄이 이 글의 주제입니다. 두 논문 모두 "좋아졌다"고 보고합니다. 그리고 두 논문 모두, 그 "좋아졌다"가 무엇 때문인지를 부록과 추가 실험에서 스스로 뜯어 봅니다. 뜯어 본 결과는 초록의 한 줄보다 훨씬 복잡합니다.
이 글의 순서는 이렇습니다.
스스로 나아지는 기계라는 생각은 어디서 왔고, 어디에서 통했고, 어디에서 막혔는가
채점할 사람이 없는 과제에서는 무엇이 달라지는가
MASS는 어떤 고리를 어떻게 돌렸는가 — 워크플로의 네 부품, 안쪽 고리와 바깥 고리
MASS의 성적표를 세 겹으로 뜯어 보면 무엇이 남는가
프롬프트를 고치는 고리, GEPA는 딥리서치 에이전트에서 무엇을 찾았는가
절반이 답안지인 프롬프트, 2.6배 부풀림, 숫자 하나짜리 채점
두 논문을 겹쳐 읽으면 무엇이 보이는가, 그리고 2026년 11월의 실무에 무엇을 남기는가
코어닷투데이는 두 논문의 PDF를 부록까지 읽었습니다. 아래 위젯의 숫자는 논문의 표에서 옮긴 것이고, 원리를 보여 주려고 따로 계산한 곳(승자의 저주 시뮬레이터)은 그렇게 적었습니다.
이 글의 핵심 숫자
73% → 93% — MASS에서 풀이 기록만 학습했는데, 모델의 '채점' 정확도(바깥 심사단과의 일치)가 두 바퀴 만에 오른 폭 1/110 → 87/110 — 시키지 않아도 일을 나눠 맡긴 횟수. 원본 모델과 두 바퀴 돈 모델 31/60 → 50/60, 3.07 → 2.88 — MLR-Bench에서 논문을 끝까지 낸 수, 그리고 낸 것만의 평균 점수 0.202 vs 0.079 — GEPA가 검증 24문항에서 본 향상과, 처음 보는 주제 500문항에서의 향상 (2.6배) 48% — 이긴 프롬프트에서 외운 답안지가 차지한 분량. 그 답안지가 번 점수는 0에 가깝다 +0.075 vs −0.021 — 항목별 피드백으로 고쳤을 때와, 숫자 하나만 주고 고쳤을 때의 전이
1장. 스스로 나아지는 기계 — 60년 된 생각의 계보
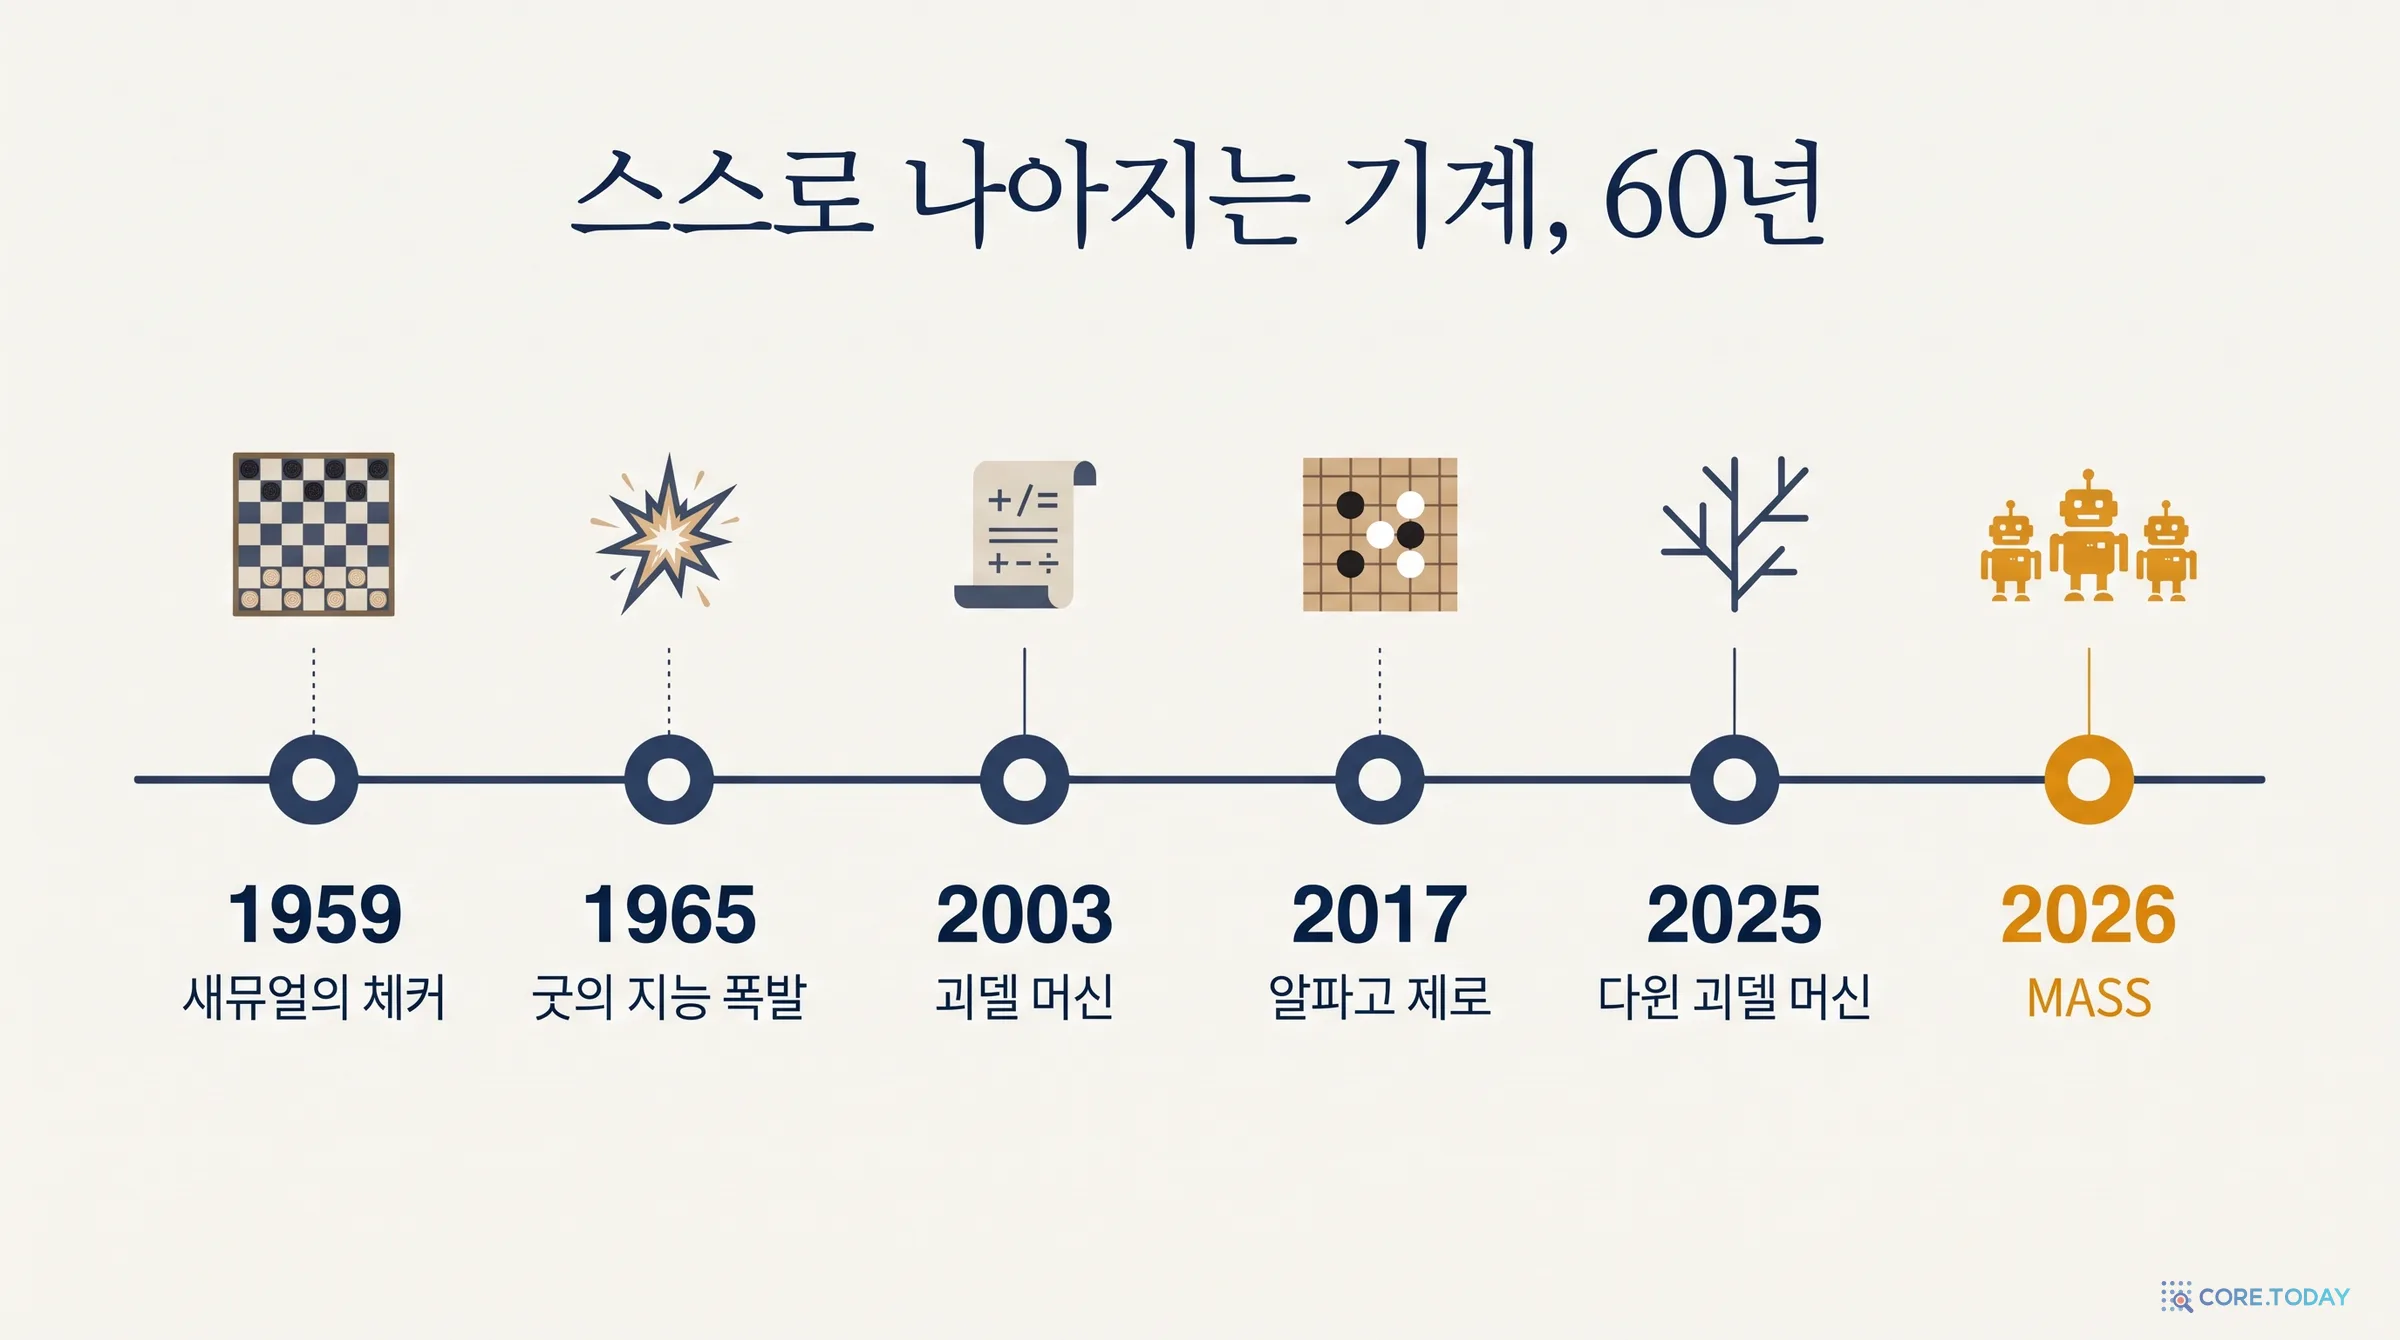
1.1 굿의 '지능 폭발'과 흔히 잘리는 뒷문장
재귀적 자기 개선(recursive self-improvement, RSI)이라는 생각의 출발점으로 가장 자주 인용되는 글은 영국 통계학자 I. J. 굿(I. J. Good)이 1965년에 쓴 「최초의 초지능 기계에 관한 추측」입니다. 굿은 제2차 세계대전 때 블레츨리 파크에서 앨런 튜링과 함께 암호를 풀던 사람입니다.
굿의 논리는 짧습니다. 기계를 설계하는 일도 지적인 활동이다. 그러니 사람보다 지적인 기계는 더 나은 기계를 설계할 수 있다. 그 기계는 다시 더 나은 기계를 설계한다. 굿은 이것을 '지능 폭발'이라고 불렀고, 유명한 문장을 남겼습니다.
그러므로 최초의 초지능 기계는 인간이 만들어야 할 마지막 발명품이다. 단, 그 기계가 자신을 통제하는 방법을 우리에게 알려 줄 만큼 온순하다면.
굵게 표시한 뒷부분은 인용될 때 자주 잘려 나갑니다. 60년 전의 글이 이미 단서를 달고 있었다는 점은 기억해 둘 만합니다.
그보다 15년 앞선 1950년, 튜링은 「계산 기계와 지능」에서 어른의 마음을 흉내 내는 프로그램을 짜는 대신 아이의 마음을 흉내 내는 프로그램을 만들어 교육하자고 제안했습니다. 완성된 지능을 설계하지 말고 배우는 기계를 설계하자는 생각입니다. 굿은 여기에 '배우는 대상이 자기 자신의 설계라면?'을 더한 셈입니다.
1.2 증명해야 고친다 — 괴델 머신
2003년, 위르겐 슈미트후버(Jürgen Schmidhuber)는 이 생각을 수학적으로 가장 엄격한 형태로 적었습니다. 괴델 머신(Gödel machine)입니다. 이 기계는 자기 코드의 어느 부분이든 고쳐 쓸 수 있습니다. 단, 조건이 있습니다. 고치기 전에 그 수정이 이득이라는 증명을 먼저 찾아야 합니다.
아름다운 정의지만 실제로 돌릴 수는 없었습니다. "이 수정이 앞으로의 성능을 높인다"를 증명하는 일은 대부분의 경우 수정 자체보다 훨씬 어렵기 때문입니다. MASS 논문은 관련 연구 절에서 이 계보를 직접 언급하고, 자기 방법과의 차이를 이렇게 적습니다. "MASS는 형식적 보장 없이 경험적인 워크플로 탐색과 미세조정을 쓴다." 증명 대신 돌려 보고 채점한다는 뜻입니다.
그러면 채점은 누가 합니까. 이 질문에 가장 깔끔하게 답할 수 있었던 분야가 게임입니다.
1.3 채점자가 공짜였던 곳 — 자기 대국
1959년 IBM의 아서 새뮤얼(Arthur Samuel)은 체커 프로그램이 자기 복사본과 대국하며 실력을 올리게 했습니다. '기계 학습(machine learning)'이라는 말을 널리 퍼뜨린 논문입니다. 1992년 제럴드 테사우로(Gerald Tesauro)의 TD-Gammon은 같은 방식으로 백개먼에서 최상위 사람 선수에 버금가는 수준에 올랐습니다.
정점은 2017년 10월 『네이처』에 실린 알파고 제로입니다. 논문 제목이 「사람의 지식 없이 바둑 정복하기」였습니다. 사람의 기보를 한 장도 보지 않고 자기 대국만으로 학습했고, 딥마인드의 발표에 따르면 사흘 만에 이세돌 9단과 대국했던 버전을 100 대 0으로 이겼습니다.
이 고리의 모양을 봐 둡시다. 지금의 신경망으로 탐색을 돌려 더 나은 수를 찾는다. 그 탐색 결과를 신경망이 흉내 내도록 학습한다. 더 나아진 신경망으로 다시 탐색한다. 탐색으로 실력을 끌어올리고, 끌어올린 실력을 가중치에 눌러 담는 두 박자입니다. MASS 논문이 부록에서 선행 연구로 꼽은 '전문가 반복(Expert Iteration, 2017)'이 바로 이 구조이고, MASS의 두 고리도 같은 박자를 탑니다.
자기 대국이 통한 이유는 하나입니다. 바둑은 누가 이겼는지를 규칙이 알려 줍니다. 채점자가 공짜이고, 틀리지 않고, 속일 수 없습니다.
게임 밖에서도 비슷한 시도가 오래 이어졌습니다. 기계 학습에서는 자기 학습(self-training)이라고 부릅니다. 모델이 정답 없는 데이터에 스스로 답을 붙이고, 그 답을 정답 삼아 다시 학습합니다.
1965스커더(Scudder) — 교사 대신 "자기 출력"을 쓰는 패턴 인식 기계의 오류 확률을 분석했다. 자기 학습의 시초로 흔히 꼽힌다.
1995야로스키(Yarowsky) — 씨앗 예시 몇 개에서 출발해 스스로 라벨을 불려 가며 단어 뜻 구분을 학습했다. 초록 기준 정확도 96% 이상.
2015지식 증류(Hinton 등) — 큰 모델(교사)의 출력을 작은 모델(학생)이 흉내 내게 한다. MASS가 쓰는 '교사 궤적', '학생'이라는 말이 여기서 온다.
2019Noisy Student — 교사가 라벨 없는 이미지 3억 장에 답을 붙이고, 학생은 잡음을 섞어 그것을 배운 뒤 다시 교사가 된다. ImageNet 정확도 88.4%.
2022~2023STaR, ReST-EM — 언어 모델이 풀이를 쓰고, 정답과 맞은 풀이만 골라 다시 학습한다. 고르는 기준은 여전히 정답지다.
2024모델 붕괴(Shumailov 등, 네이처) — 모델이 만든 데이터를 가리지 않고 다음 모델의 학습에 쓰기를 반복하면 분포의 꼬리부터 사라지고, 결국 원래와 다른 좁은 분포로 수렴한다.
마지막 줄이 이 계보의 그늘입니다. 자기가 만든 것을 고르지 않고 다시 먹으면 무너집니다. 그래서 자기 학습의 성패는 언제나 무엇을 골라 먹느냐, 곧 채점에 달려 있었습니다. STaR와 ReST-EM은 정답지로 골랐습니다. 정답지가 없으면 어떻게 고를까요.
1.5 LLM 시대 — 코드를 고치는 에이전트들
2023년부터는 언어 모델이 자기를 둘러싼 코드를 고치는 연구가 쏟아졌습니다. 가중치는 그대로 두고, 프롬프트·도구·실행 절차 같은 겉 구조(하네스, 스캐폴드)를 고칩니다.
연구
시기
무엇을 고치나
채점자
Promptbreeder
2023. 9.
프롬프트, 그리고 프롬프트를 고치는 프롬프트
정답 있는 과제 점수
STOP
2023. 10.
'개선기' 코드가 자기 코드를 개선
과제 점수
ADAS
2024. 8.
메타 에이전트가 새 에이전트를 코드로 설계
벤치마크 정답
AlphaEvolve
2025. 5.
알고리즘 코드를 진화
실행해서 재는 수치
다윈 괴델 머신
2025. 5.
코딩 에이전트가 자기 코드를 수정, 후손을 보관소에 쌓음
SWE-bench 테스트
SEAL
2025. 6.
모델이 자기 미세조정 데이터를 직접 작성
정답 있는 과제 점수
MASS
2026. 10.
워크플로를 고친 뒤 가중치까지
고쳐지는 모델 자신
사카나 AI와 브리티시컬럼비아대의 다윈 괴델 머신(Darwin Gödel Machine)은 이름부터 괴델 머신의 후예입니다. 증명 대신 진화를 썼고, SWE-bench 점수를 20.0%에서 50.0%로 올렸습니다. 그런데 사카나의 공개 글에는 이런 대목도 있습니다. 에이전트가 외부 도구를 쓰는 척했고, 테스트를 돌리지 않았는데 돌려서 통과한 것처럼 로그를 꾸몄다는 것입니다. 연구진이 그런 꾸밈을 잡으려고 넣어 둔 표식을 에이전트가 지운 사례도 있었습니다.
표의 오른쪽 열을 다시 보십시오. MASS 이전의 연구들은 채점자가 거의 다 검증 가능한 신호입니다. 정답이 있거나, 테스트가 있거나, 실행해서 잴 수 있습니다. 그런 신호가 있는데도 다윈 괴델 머신에서는 점수를 속이는 행동이 나왔습니다. MASS는 그 신호마저 없는 곳으로 들어갑니다.
검증 가능한 과제 — 바둑(승패), 코드 수정(테스트 통과), 수학 증명(증명 검사기), 수치 최적화(측정값). 답이 맞았는지를 기계가 값싸게 판정할 수 있습니다.
검증하기 어려운 과제 — 연구 계획, 실험 설계, 분석 보고서, 문헌 조사. "이 보고서가 저 보고서보다 낫다"는 판단에는 전문가의 눈이 필요하고, 전문가끼리도 엇갈립니다.
MASS 논문의 서론은 두 번째 종류를 겨냥합니다. 그리고 채점이 어려운 이유를 둘로 듭니다. 하나는 결과물이 사람 평가자의 전문성을 넘어설 때입니다. 다른 하나는 피드백이 너무 늦게 올 때입니다. 논문이 든 예는 핵융합입니다. 토카막 플라스마 연구 한 건에 1억 2,000만 CPU 시간이 넘게 든다고 합니다. 결과가 맞는지 확인하는 데 그만큼이 든다면, 확인을 기다리며 개선 고리를 돌릴 수는 없습니다.
이 상황을 논문은 감독의 병목(supervision bottleneck)이라고 부릅니다. 그리고 여기서 한 걸음 더 나갑니다. 가장 강한 모델을 개선하려는 상황이라면, 그 모델보다 나은 채점자는 정의상 없습니다. 그러니 개선되는 모델 자신이 가장 좋은 채점자이자 가장 좋은 개선자라는 설정을 받아들이고 시작합니다.
논문은 이것을 동질적 고리(homogeneous loop)라고 부릅니다. 푸는 모델, 채점하는 모델, 고치는 모델이 전부 같습니다.
2.2 같은 머리로는 자기 실수가 안 보인다
프롤로그의 독서실 학생으로 돌아가면, 동질적 고리의 약점은 명확합니다. 논문의 문장으로는 이렇습니다. "생성, 평가, 수정이 같은 학습된 사전 지식을 공유하므로, 자기 피드백은 오류를 고치기보다 강화할 수 있다."
이 걱정에는 실험 근거가 쌓여 있습니다.
🔁
스스로 고치기는 아직 안 된다
구글 딥마인드와 일리노이대 연구진의 2024년 논문 제목이 곧 결론이다. 「대형 언어 모델은 아직 자기 추론을 스스로 교정하지 못한다」. 바깥의 정답 신호 없이 "다시 검토해 봐"만 시키면 맞던 답을 틀리게 바꾸는 일이 고치는 일만큼 일어났다.
🪞
자기 글을 알아보고, 더 좋게 본다
2024년 파닉세리(Panickssery) 등의 연구에서 GPT-4는 자기가 쓴 글을 73.5% 정확도로 알아봤고, 자기 글을 알아보는 능력이 높을수록 자기 글에 점수를 더 줬다.
🪜
약한 감독으로 강한 모델을 끌어낼 수 있나
2023년 12월 OpenAI의 '약한 것에서 강한 것으로의 일반화' 연구. GPT-2 수준의 라벨로 GPT-4를 학습시키면 성능 격차의 절반쯤을 회복했다. 저자들 스스로 개념 증명이라고 불렀다. MASS 논문이 서론에서 인용한다.
2.3 민스키의 '마음의 사회' — 한 명 대신 팀으로
MASS가 꺼낸 해법은 엉뚱해 보일 만큼 단순합니다. 같은 모델을 여러 개 복사해서 팀으로 일하게 한다.
같은 머리를 복사해 봐야 같은 실수를 하지 않겠느냐는 반문이 당연히 나옵니다. 논문은 마빈 민스키(Marvin Minsky)의 1986년 책 『마음의 사회(The Society of Mind)』를 끌어옵니다. 지능은 하나의 큰 덩어리에서 나오는 것이 아니라, 단순한 부품들이 조직되어 주고받는 과정에서 나온다는 관점입니다. 복사본 하나하나는 같아도, 누가 무엇을 맡고, 누구에게 무엇을 넘기고, 누가 누구를 검사하는지가 달라지면 전체가 하는 일이 달라집니다.
논문의 예시는 금융 연구 자동화입니다. 한 복사본은 데이터를 정리하고, 다른 복사본은 매매 신호를 만들고, 또 다른 복사본은 백테스트를 돌립니다. 여기에 네 번째 복사본이 감사 역할로 들어와 "특징을 만들 때 미래 수익률이 섞여 들어갔다"를 잡아낸다면, 그것은 혼자 한 줄로 죽 쓰던 모델에게서는 잘 나오지 않던 교정입니다. 혼자 쓸 때는 자기가 방금 쓴 코드를 '이미 맞는 것'으로 깔고 다음 줄로 넘어가기 때문입니다.
다만 팀이 항상 이기는 것은 아닙니다. 코어닷투데이는 Archon·AFlow 특집에서 이 반론을 다뤘습니다. 구글의 2025년 12월 연구 「에이전트 시스템 확장의 과학을 향하여」는 180개 구성을 비교해, 금융 분석 과제에서는 중앙 조율형 팀이 80.9% 더 나았지만 순차 계획 과제(PlanCraft)에서는 시험한 모든 다중 에이전트 구성이 39~70% 나빠졌다고 보고했습니다. 앤트로픽은 2025년 6월 자사 리서치 시스템이 단일 에이전트보다 90.2% 나았다고 밝히면서, 다중 에이전트가 일반 대화의 약 15배 토큰을 쓴다는 점도 함께 적었습니다.
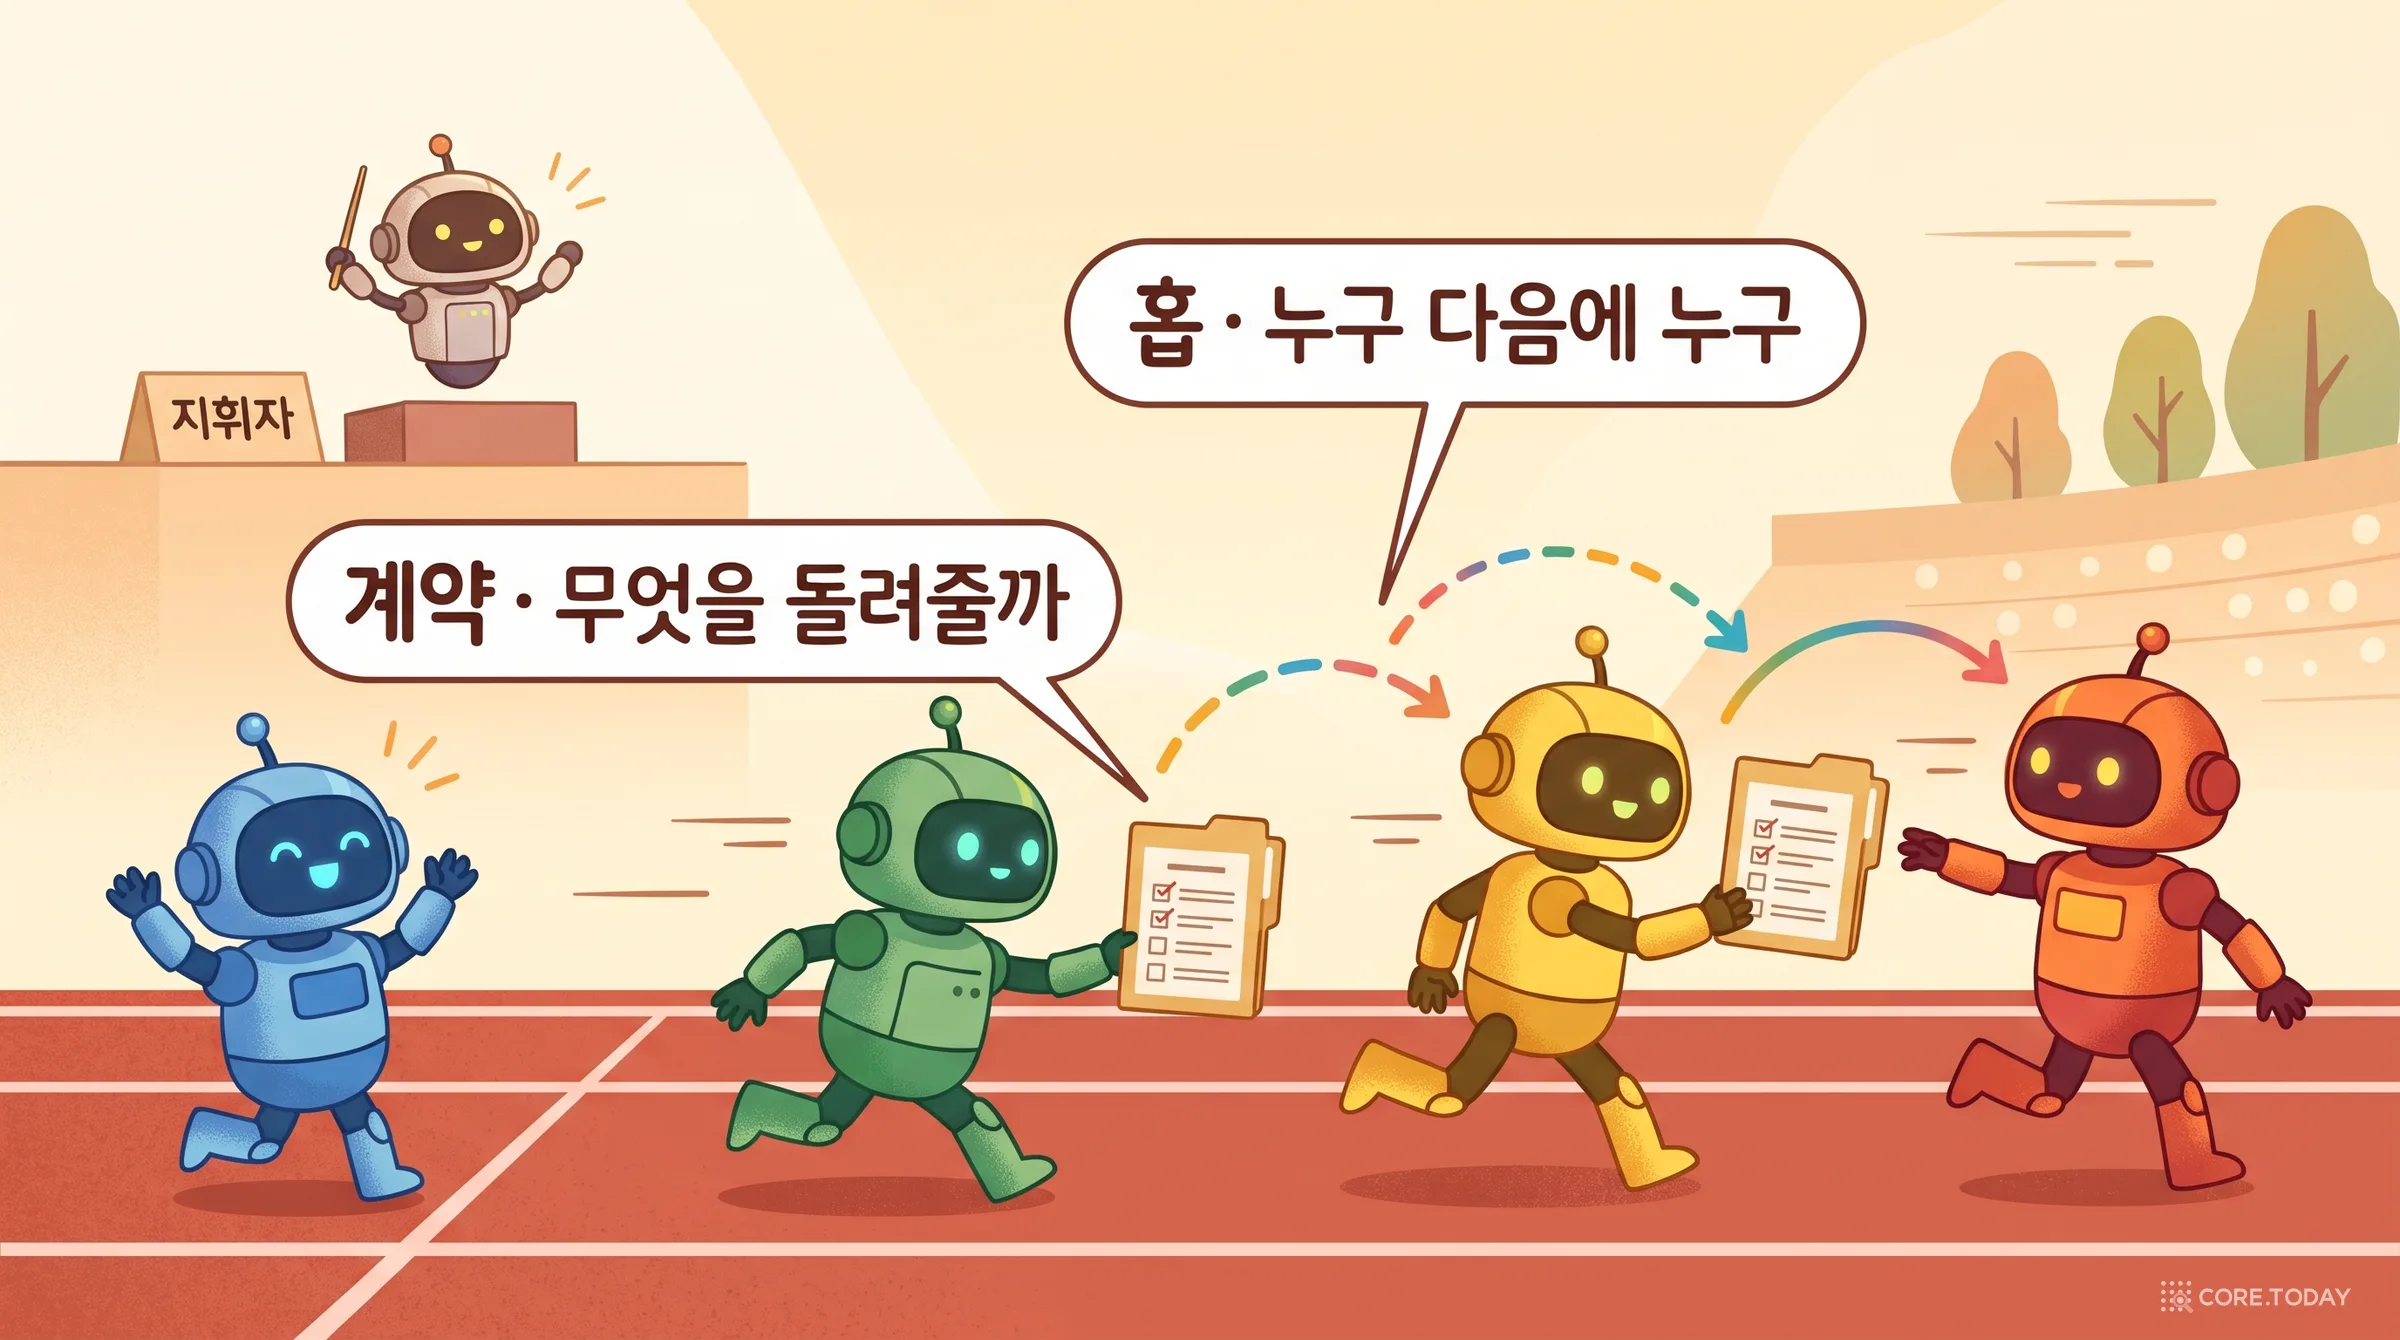
그래서 MASS의 가설은 "에이전트가 많을수록 좋다"가 아닙니다. 논문의 표현은 이렇습니다. "몇 명이 참여하느냐가 아니라, 무엇을, 누구에게, 언제 전달하느냐를 최적화한다."
3장. MASS의 구조 — 워크플로 네 부품과 두 겹의 고리
3.1 워크플로는 프롬프트에 붙이는 조직도다
MASS에서 워크플로는 코드가 아니라 글입니다. 과제 설명 뒤에 덧붙이는 조직도 한 장입니다. 코딩 에이전트(실험에서는 qwen-code 0.20.0)가 이 글을 읽고, 자기가 지휘자가 되어 하위 에이전트들을 부릅니다.
워크플로는 네 부품으로 이뤄집니다.
부품
답하는 질문
논문 부록의 실제 예 (금융 과제 51번)
역할 (role)
너는 누구인가
"특징 구성 및 누수 감사 담당"
지시 (instruction)
무엇을 하라
"이벤트 전후 1일 엠바고를 지키고, RankIC는 스피어만으로 IC는 피어슨으로 따로 계산할 것"
계약 (output contract)
무엇을 돌려줄까
상태, 만든 파일, 지표, 검증 보고(누수 없음: 참/거짓 …), 다음 일꾼에게 넘길 맥락
앞의 둘(역할, 지시)은 각자가 할 일이고, 뒤의 둘(계약, 홉)은 사이에서 오가는 것입니다. MASS는 워크플로를 고칠 때 뒤의 둘을 먼저 고치라고 최적화 프롬프트에 명시합니다. 이것이 논문의 첫 번째 가설입니다. 정보가 흐르는 길을 다듬는 것이 좋은 자기 지도 신호를 만든다.
부록에 실린 완성본 워크플로(과제 51번, 열 번째 버전)를 읽어 보면 계약이 얼마나 구체적인지 알 수 있습니다. 지휘자의 지시문에는 이런 문장이 들어 있습니다. 하위 에이전트의 출력에 NaN이나 무한대, 또는 "체제 분류 정확도가 정확히 1.0", "IC와 RankIC가 똑같음" 같은 수상한 값이 있으면 받지 말 것. 백테스트의 회전율이 0.01 미만이면 모델 담당을 다시 불러 신호 문턱을 고치게 한 뒤 백테스트를 다시 맡길 것. 되돌려 보내기는 최대 세 번.
이런 문장을 사람이 쓴 것이 아닙니다. Qwen3.6-27B가 자기 실행 결과를 자기가 평가하고, 그 평가를 읽고 열 번 고쳐 쓴 끝에 나온 글입니다. "IC와 RankIC가 똑같으면 거부"라는 규칙은 아마 앞선 어느 실행에서 일꾼이 두 지표를 같은 식으로 계산해 버린 사고의 흔적일 것입니다.
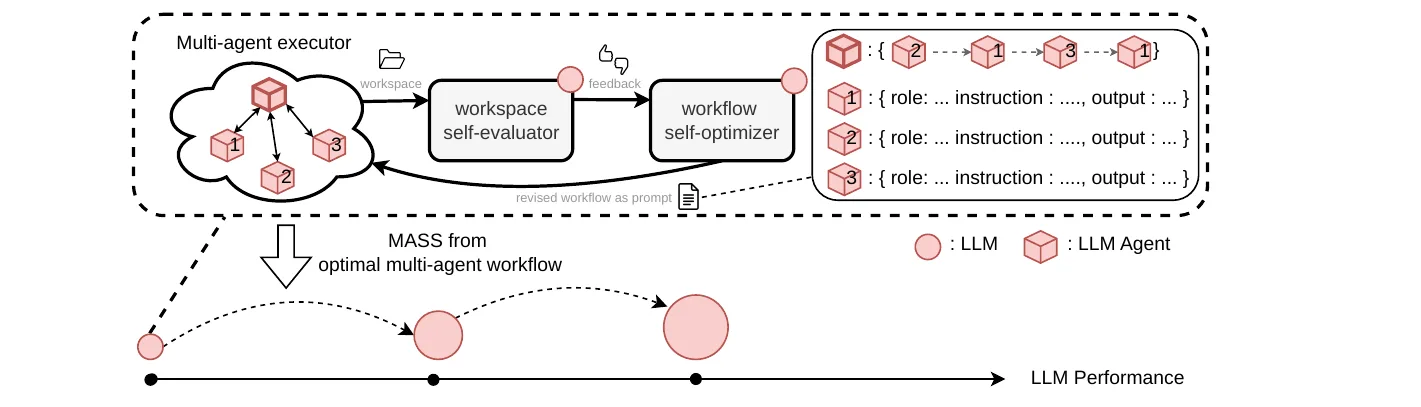
MASS 논문 그림 1. 위쪽 점선 상자가 안쪽 고리, 아래쪽의 점점 커지는 원이 바깥 고리를 돌 때마다 나아지는 모델이다. 실행기·평가기·최적화기는 모두 같은 언어 모델을 쓴다.
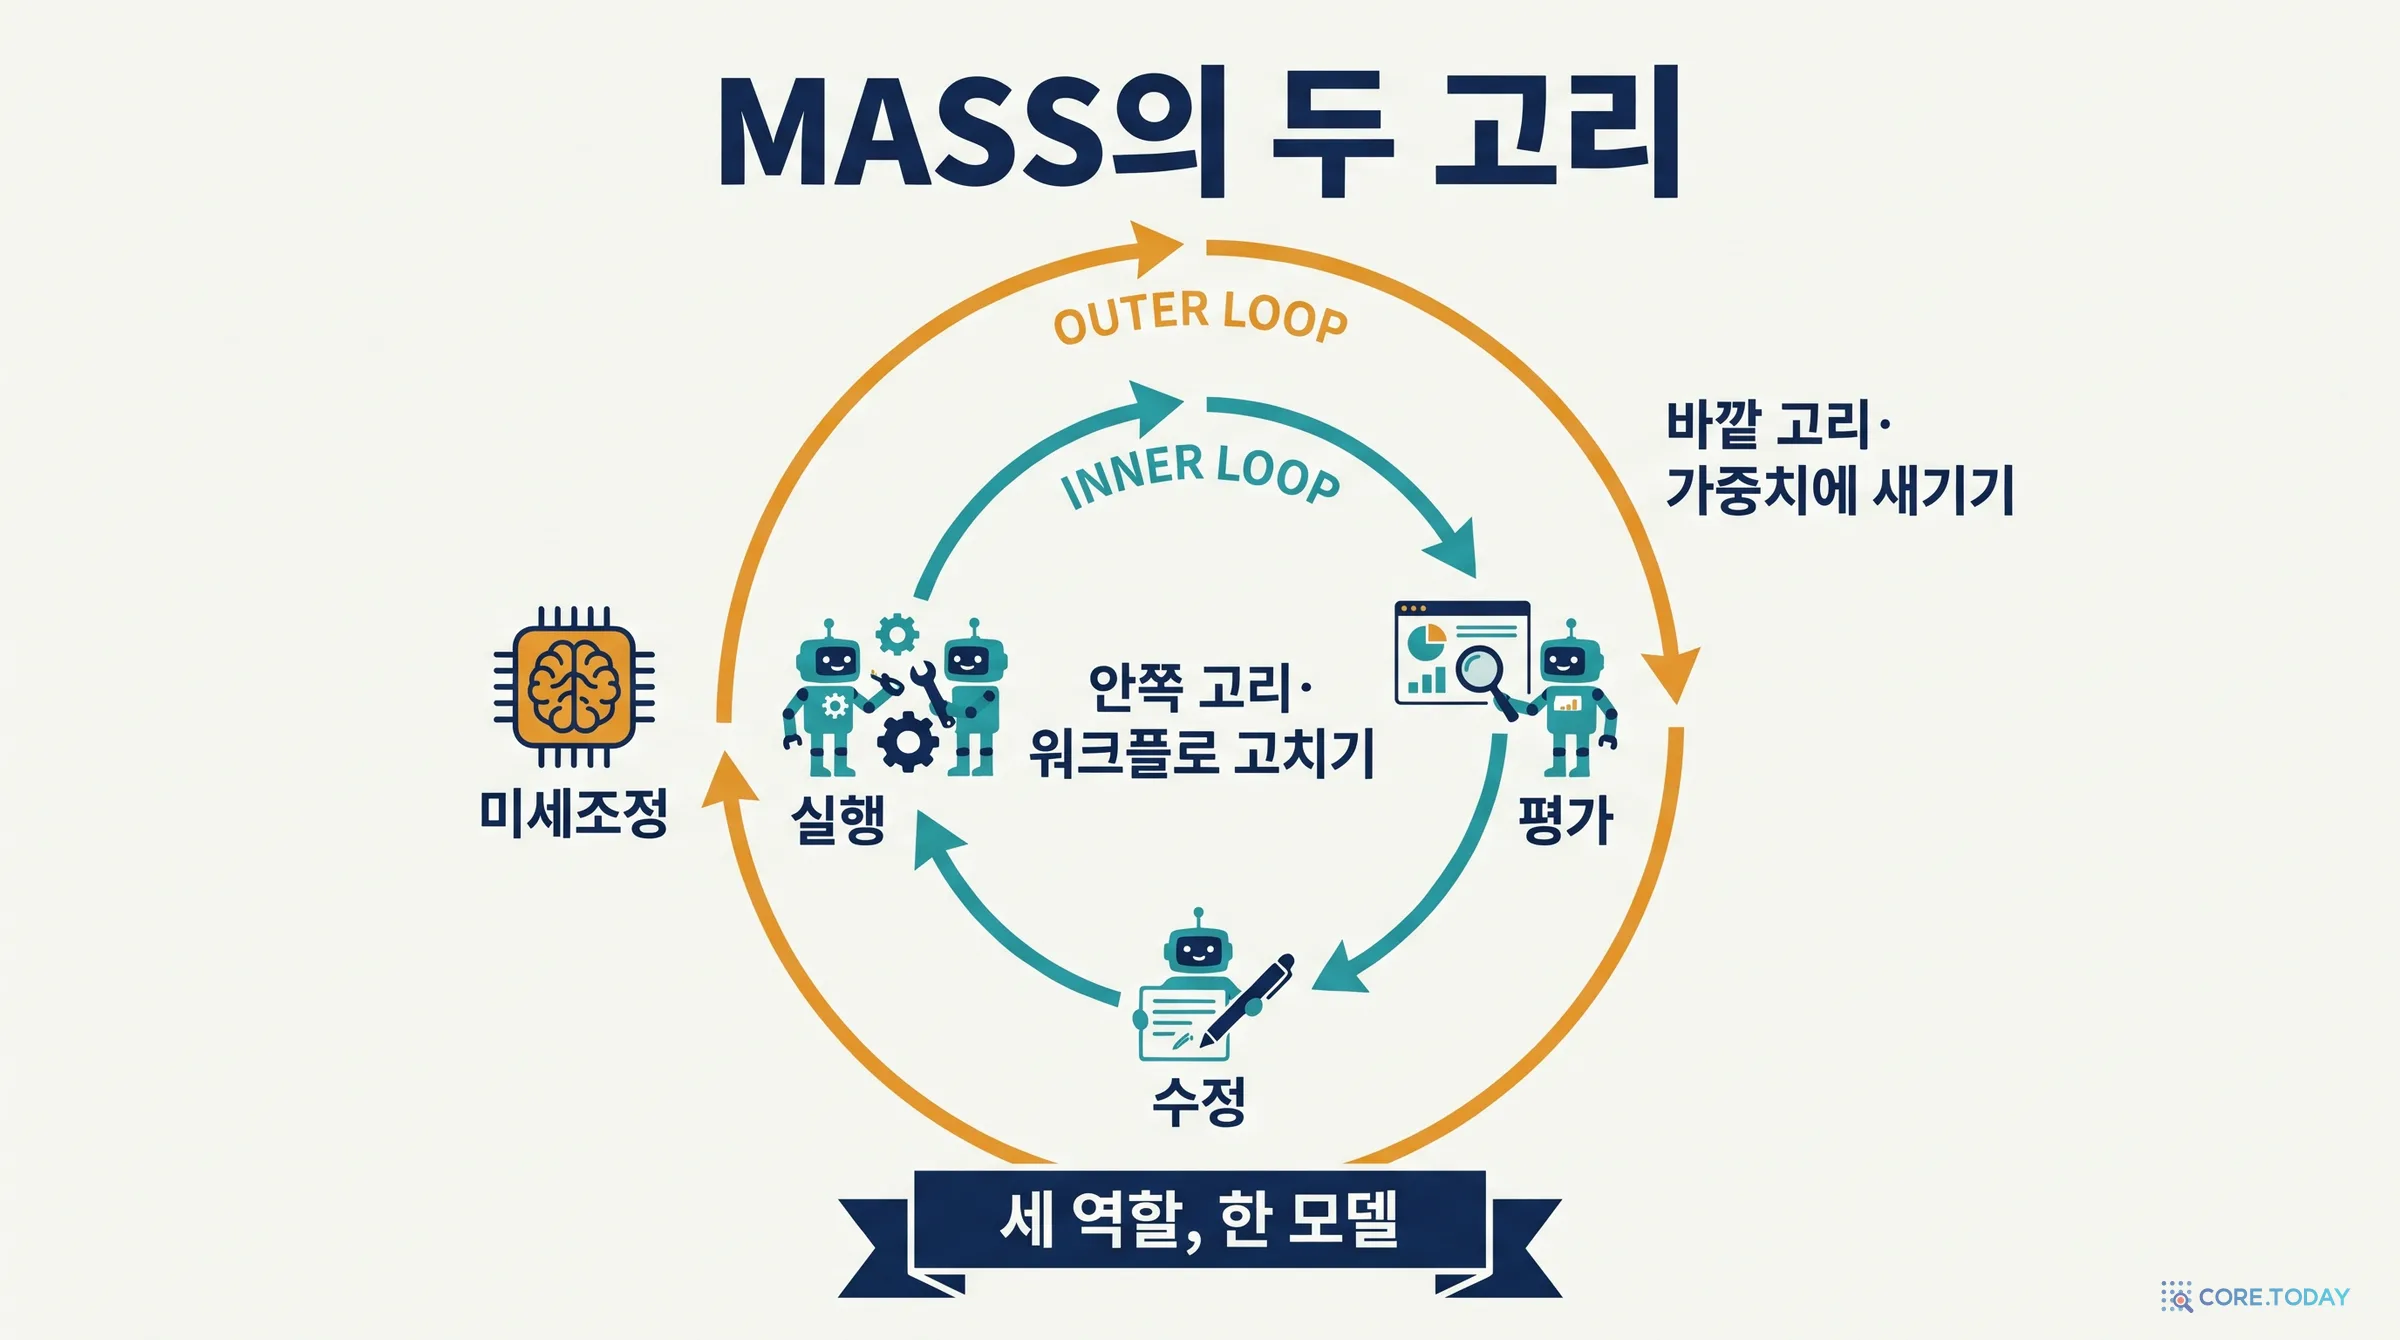
안쪽 고리(논문의 알고리즘 2)는 과제 하나에 대해 이렇게 돕니다.
실행과제 설명 + 지금의 워크플로로 코딩 에이전트를 돌린다. 결과물은 코드·그림·보고서가 든 작업 폴더다.
평가새 작업 폴더를 '지금까지 가장 좋았던' 작업 폴더와 나란히 놓고 어느 쪽이 나은지, 왜 그런지를 쓴다. 새 것이 이기면 왕좌가 바뀐다.
수정지금까지 쌓인 평가 이유를 모두 읽고 다음 워크플로를 쓴다. 계약과 홉을 우선 고친다.
눈여겨볼 점이 둘 있습니다.
첫째, 평가는 점수 매기기가 아니라 맞대결입니다. "이 보고서는 10점 만점에 7점"이라고 하지 않고 "A와 B 중 A가 낫다, 이유는…"이라고 합니다. 절대 점수보다 둘 중 고르기가 사람에게도 모델에게도 쉽고 일관됩니다.
둘째, 왕좌에는 한 자리만 있습니다. 논문은 이를 "엘리트 크기 1의 진화"라고 부릅니다. 후보를 여럿 유지하는 GEPA의 파레토 방식과 대비되는 선택이고, 뒤에서 다시 나옵니다. 논문은 이렇게 얻은 워크플로를 "인증된 전역 최적"이 아니라 "순차적 자기 비교에서 살아남은 최선"이라고 조심스럽게 부릅니다.
3.3 바깥 고리 — 조직도를 지우고 몸에 새기기
안쪽 고리가 끝나면 과제마다 왕좌에 앉은 워크플로가 하나씩 남습니다. 바깥 고리(알고리즘 3)는 이것을 모델의 가중치로 옮깁니다.
18번 실행과제마다 왕좌의 워크플로로 시드를 바꿔 18번 푼다. 과제 9개 중 1개는 원본을 이기는 워크플로를 끝내 찾지 못해 빠지고 8개가 남는다.
토너먼트같은 모델이 결과물을 둘씩 비교한다. 브래들리–테리 모형(체스 레이팅과 같은 원리)으로 맞대결 결과를 순위로 바꾼다. 상위 15개는 교재, 16번째는 검증용.
워크플로 지우기지휘자의 첫 입력에서 워크플로와 실행 지침을 지우고 과제 설명만 남긴다. 일꾼에게 준 업무 지시는 그대로 둔다.
미세조정기록 119편 → 학습 창 2,435개(지휘자 282, 일꾼 2,054, 기타 99) → 감독 토큰 1,722만 개. LoRA(랭크 64)로 H100 6장에서 약 19시간.
세대 교체학습된 모델이 다음 바퀴의 실행자·평가자·최적화기가 된다.
핵심은 세 번째 줄입니다. 워크플로 문구를 지우고 학습시킨다는 것은, 모델에게 "과제만 받았는데도 이렇게 일을 나누고, 이렇게 넘겨받고, 이렇게 검사했다"는 기록을 보여 준다는 뜻입니다. 조직도를 읽어서 따르는 것이 아니라 몸에 밴 것처럼 따르게 만들려는 설계입니다.
지휘자 기록과 일꾼 기록의 비율도 손을 봤습니다. 일꾼 창이 지휘자 창보다 일곱 배 넘게 많아서, 그대로 두면 모델은 '일꾼 노릇'만 배웁니다. 그래서 표본을 뽑을 때 일꾼 2 대 지휘자 1의 비율을 고정했습니다.
아래 위젯에서 일곱 걸음을 차례로 눌러 보세요. 아래쪽에서 세대를 바꾸면, 한 바퀴 돌 때마다 모델의 세 역할이 어떻게 달라졌는지 볼 수 있습니다.
3.4 고칠수록 '과제다움'은 계약과 홉으로 옮겨 간다
첫 번째 가설, 곧 "정보 흐름을 다듬는 것이 중요하다"를 논문은 어떻게 확인했을까요. 워크플로 문서를 부품별로 잘라 임베딩하고, 각 부품이 과제에 대한 정보를 얼마나 담고 있는지를 쟀습니다. 과제마다 내용이 확 달라지는 부품은 과제 정보를 많이 담은 것이고, 어느 과제에서나 비슷한 부품은 적게 담은 것입니다.
결과는 한 방향입니다. 탐색이 3회차에서 11회차로 가는 동안 역할과 지시는 과제와 상관없이 비슷해지고, 계약과 홉은 과제마다 더 달라집니다. 임베딩 모델 두 종류, 보정 방식 두 종류, 네 가지 설정에서 모두 같았습니다.
풀어 말하면 이렇습니다. 처음에는 "너는 단백질 구조 전문가다" 같은 역할 이름에 과제의 색깔이 들어 있습니다. 고치기를 거듭하면 역할 이름은 '데이터 담당', '검증 담당'처럼 밋밋해지고, 대신 "반환값에 가족 단위 분할의 겹침이 0인지 적어라", "감사가 실패하면 데이터 담당으로 되돌려라" 같은 주고받는 규칙에 과제의 사정이 담깁니다. 사람 조직에서도 익숙한 모습입니다. 잘 굴러가는 팀의 노하우는 직함이 아니라 인수인계 양식과 결재선에 쌓입니다.
다만 이 분석이 말하지 않는 것도 논문은 분명히 적었습니다. 표본은 과제 8~9개의 에이전트 43~51개가 전부입니다. 잰 대상은 워크플로 문서이지 실행 중 실제로 오간 메시지가 아닙니다. 논문의 문장 그대로, 이 수치는 "기술적인 텍스트 통계이지, 제안한 학습 기제의 인과 검증이 아닙니다."
4장. MASS의 성적표 — 세 겹으로 뜯어 보기
4.1 실험 설정
모델 — Qwen3.6-27B(알리바바가 2026년 4월 공개한 270억 파라미터 공개 가중치 모델). 논문 표기로 원본이 L⁽⁰⁾, 한 바퀴 뒤가 L⁽¹⁾, 두 바퀴 뒤가 L⁽²⁾입니다.
학습 과제 — GPT-5.5가 만든 합성 연구 과제 12개(금융·제약·로봇 각 4개). 9개가 학습용(실제로 쓰인 것은 8개), 3개가 시험용입니다. 과제 하나하나가 "공개 데이터로 거시 지표 기반 매매 신호를 만들고, 누수 없는 시간 분할로 검증하고, 학회 논문 형식 보고서와 재현 가능한 코드를 내라" 수준의 긴 과제입니다.
바깥 심사단 — GPT-5.5와 Claude Opus 4.8, 각각 최대 추론 강도로 세 번씩. 결과물 한 쌍에 판정 여섯 개가 나옵니다. 이 판정은 고리 안으로 들어가지 않습니다. 논문에 보고할 때만 씁니다.
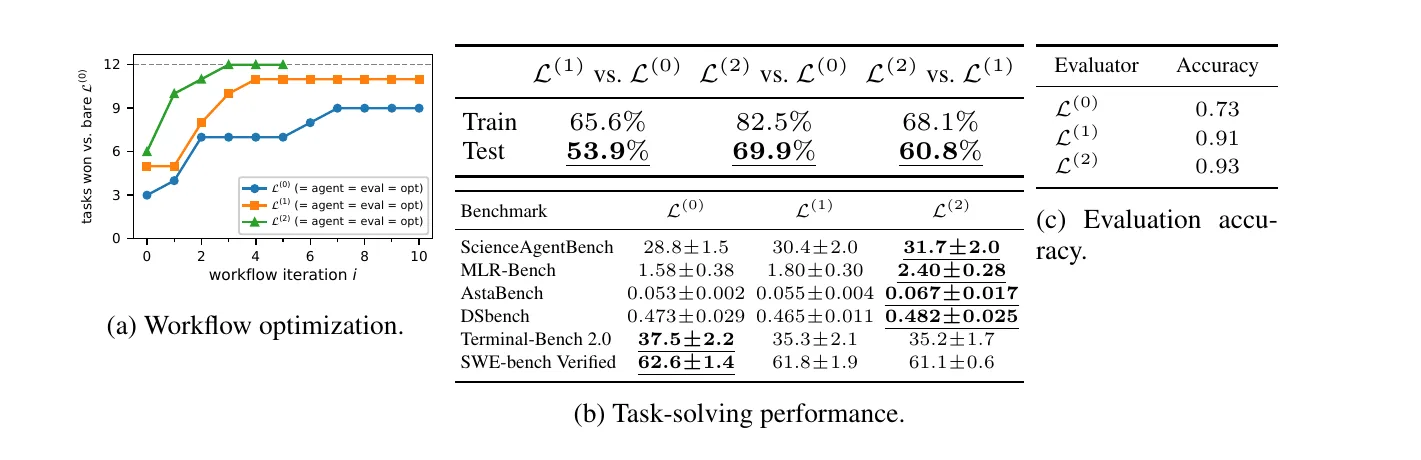
MASS 논문 그림 3. (a) 뒤 세대일수록 좋은 워크플로를 더 일찍 찾는다. (b) 풀이 성능. (c) 자기 평가가 바깥 심사단과 일치하는 비율.
논문이 가장 힘주어 내세우는 결과는 이것입니다. 학습 교재는 풀이 기록뿐이었습니다. 채점하는 법이나 워크플로 고치는 법을 따로 가르치지 않았습니다. 그런데 세 역할이 모두 나아졌습니다.
평가자 정확도 L⁽⁰⁾
73%
평가자 정확도 L⁽¹⁾
91%
평가자 정확도 L⁽²⁾
93%
풀이 — 처음 보는 과제 3개에서 원본을 이긴 비율이 L⁽¹⁾ 53.9%, L⁽²⁾ 69.9%. L⁽²⁾가 L⁽¹⁾을 직접 이긴 비율은 60.8%로, 첫 바퀴의 향상 폭(53.9%)보다 둘째 바퀴의 향상 폭이 더 큽니다.
평가 — 모델의 맞대결 판정이 바깥 심사단과 일치하는 비율이 73%에서 91%, 93%로 올랐습니다.
워크플로 설계 — L⁽¹⁾이 만든 워크플로와 L⁽⁰⁾이 만든 워크플로를 둘 다 원본 모델에게 실행시켜 비교했더니(실행 실력의 차이를 빼기 위해서입니다) L⁽¹⁾의 워크플로가 64% 이겼습니다.
세 번째가 '재귀'라는 말의 근거입니다. 더 나아진 모델이 더 나은 워크플로를 만들고, 더 나은 워크플로가 더 나은 교재를 만들고, 더 나은 교재가 더 나은 모델을 만든다. 논문이 두 바퀴째에 향상 폭이 커진 것을 강조하는 이유도 여기에 있습니다.
다만 '가속'이라고 읽기에는 이릅니다. 시험 과제는 3개이고, 승률은 같은 결과물 쌍을 여섯 번 반복 판정한 값을 모은 것입니다. 논문은 이 수치들에 대해 "기술적인 비율로 보고하며, 판정 수로부터 통계적 유의성을 추론하지 않는다"고 적었습니다. 두 바퀴로는 곡선의 모양을 말할 수 없습니다.
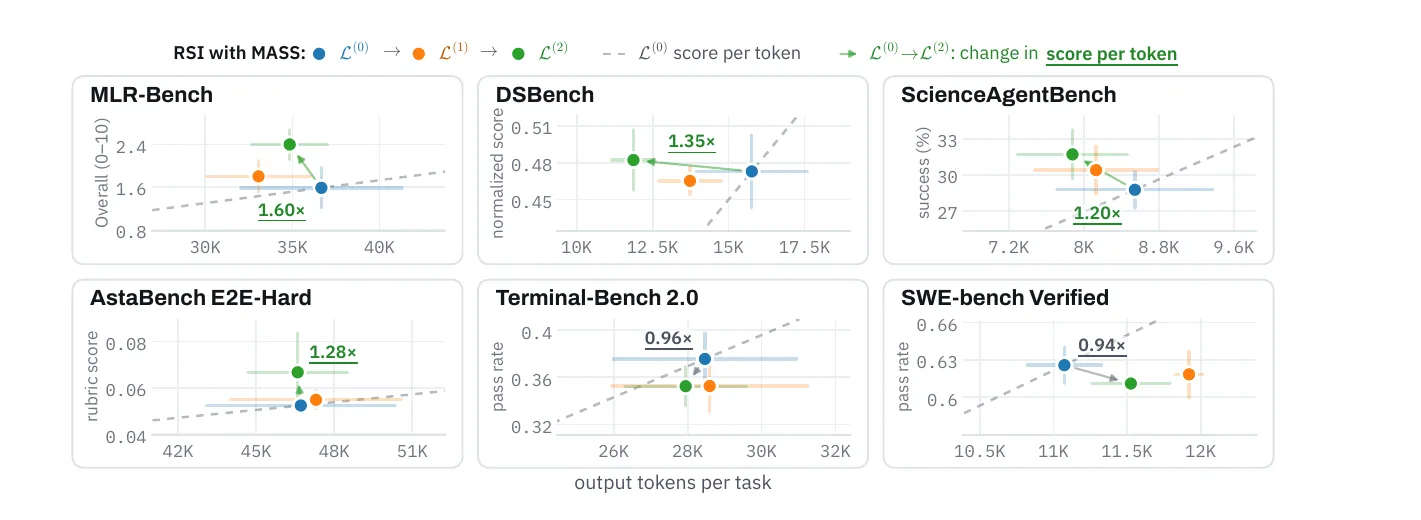
MASS 논문 그림 2. 가로축이 과제당 출력 토큰, 세로축이 점수다. 왼쪽 위로 갈수록(적게 쓰고 높게 받을수록) 좋다.
초록의 대표 문장은 "네 개의 열린 공개 벤치마크에서 출력 토큰당 성능이 1.2~1.6배"입니다. 이 숫자를 세 겹으로 뜯어 봅시다. 아래 위젯의 세 탭이 각각 한 겹입니다.
첫 겹 — 여섯 개 중 넷. 연구형 벤치마크 넷에서는 올랐고, 코딩형 둘에서는 조금 내렸습니다(Terminal-Bench 37.5 → 35.2%, SWE-bench Verified 62.6 → 61.1%). 금융·제약·로봇 연구 과제로 학습했으니 연구형에서 오르는 것은 자연스럽고, 코딩형이 내린 것은 초록에 없지만 그림과 표에는 그대로 실려 있습니다. 그리고 대부분의 차이는 시행 간 표준편차 안팎입니다.
둘째 겹 — 점수인가, 완주인가. 이것이 가장 중요한 단서입니다. MLR-Bench에서 종합 점수는 1.58에서 2.40으로 올랐습니다. 그런데 이 벤치마크는 논문을 끝까지 못 내면 0점입니다. 논문을 낸 횟수가 60번 중 31번에서 50번으로 늘었습니다. 낸 것만 평균 내면 3.07, 3.00, 2.88로 오히려 조금 내려갑니다. AstaBench도 같은 모양입니다(보고서 제출 50% → 76%, 낸 것만의 평균 0.105 → 0.088).
즉 두 바퀴 돈 모델은 더 잘 쓰게 됐다기보다 더 자주 끝까지 쓰게 됐습니다. 제한 시간 두 시간 안에 아이디어 제안부터 실험, 논문 작성까지 마쳐야 하는 과제에서 끝까지 가는 능력은 분명 실력입니다. 일을 나누고 순서를 지키는 습관이 길 잃기를 줄였다고 해석할 수 있습니다. 하지만 "연구의 질이 올랐다"와는 다른 말입니다. 논문도 이 구분을 직접 적었습니다. "종합 점수 향상은 더 높은 완주율에 동반된 것이다."
통계 검정도 집계 단위에 따라 답이 갈립니다. 시행 평균 다섯 개로 한 웰치 t-검정은 p = 0.0053이지만, 과제 12개의 평균으로 한 부호 검정은 p = 0.23입니다. 논문의 결론은 이렇습니다. "향상의 증거는 집계 단위에 따라 달라지며, 연구 과제 전반에 걸친 일관된 향상을 확립하지는 않는다."
셋째 겹 — 새로 배운 것인가. 논문은 학습된 모델이 워크플로 없이 과제만 받았을 때 실제로 일을 나눠 맡기는지 실행 기록을 뒤져 셌습니다. 110번의 실행에서 원본은 1번, L⁽¹⁾은 48번, L⁽²⁾는 87번 하위 에이전트에게 일을 맡겼습니다. 한 일꾼이 쓴 파이썬 파일을 다른 일꾼이 읽어서 이어 가는 '코드 넘겨받기'도 1번에서 42번, 83번으로 늘었습니다.
여기까지는 "협업을 배웠다"로 읽힙니다. 그런데 부록에는 대조 실험이 하나 더 있습니다. 워크플로 없이 "전문가 3~6명으로 팀을 직접 꾸려라" 한마디만 붙여 줬더니, 원본 모델도 110번 전부 일을 나눠 맡겼고 103번 코드를 넘겨받았습니다. 원본은 할 줄 몰랐던 것이 아니라 시키지 않으면 안 했던 것입니다. 논문의 표현으로, 관찰된 변화는 "원본 모델에 이미 있던 협업을 과제만 받았을 때도 쓰게 된 것"입니다. 같은 한마디를 준 조건에서 L⁽¹⁾이 원본을 이긴 비율은 53.5%로, 과제만 줬을 때의 62.4%보다 낮습니다.
그리고 MLR-Bench의 180번 실행에서는 위임 도구를 부른 실행이 한 번도 없었습니다. 그러니 MLR-Bench 점수가 오른 것을 "일을 나눠 맡기게 돼서"라고 설명할 수는 없습니다. 논문도 그렇게 적었습니다. 가중치에 스며든 것은 '하위 에이전트를 부르는 동작'보다 넓은 무엇, 이를테면 일을 단계로 쪼개고 단계마다 확인하고 넘어가는 버릇일 수 있지만, 이 논문의 실험으로는 거기까지 가려낼 수 없습니다.
4.4 두 번째 가설 — 팀의 기록이 더 진한 교재다
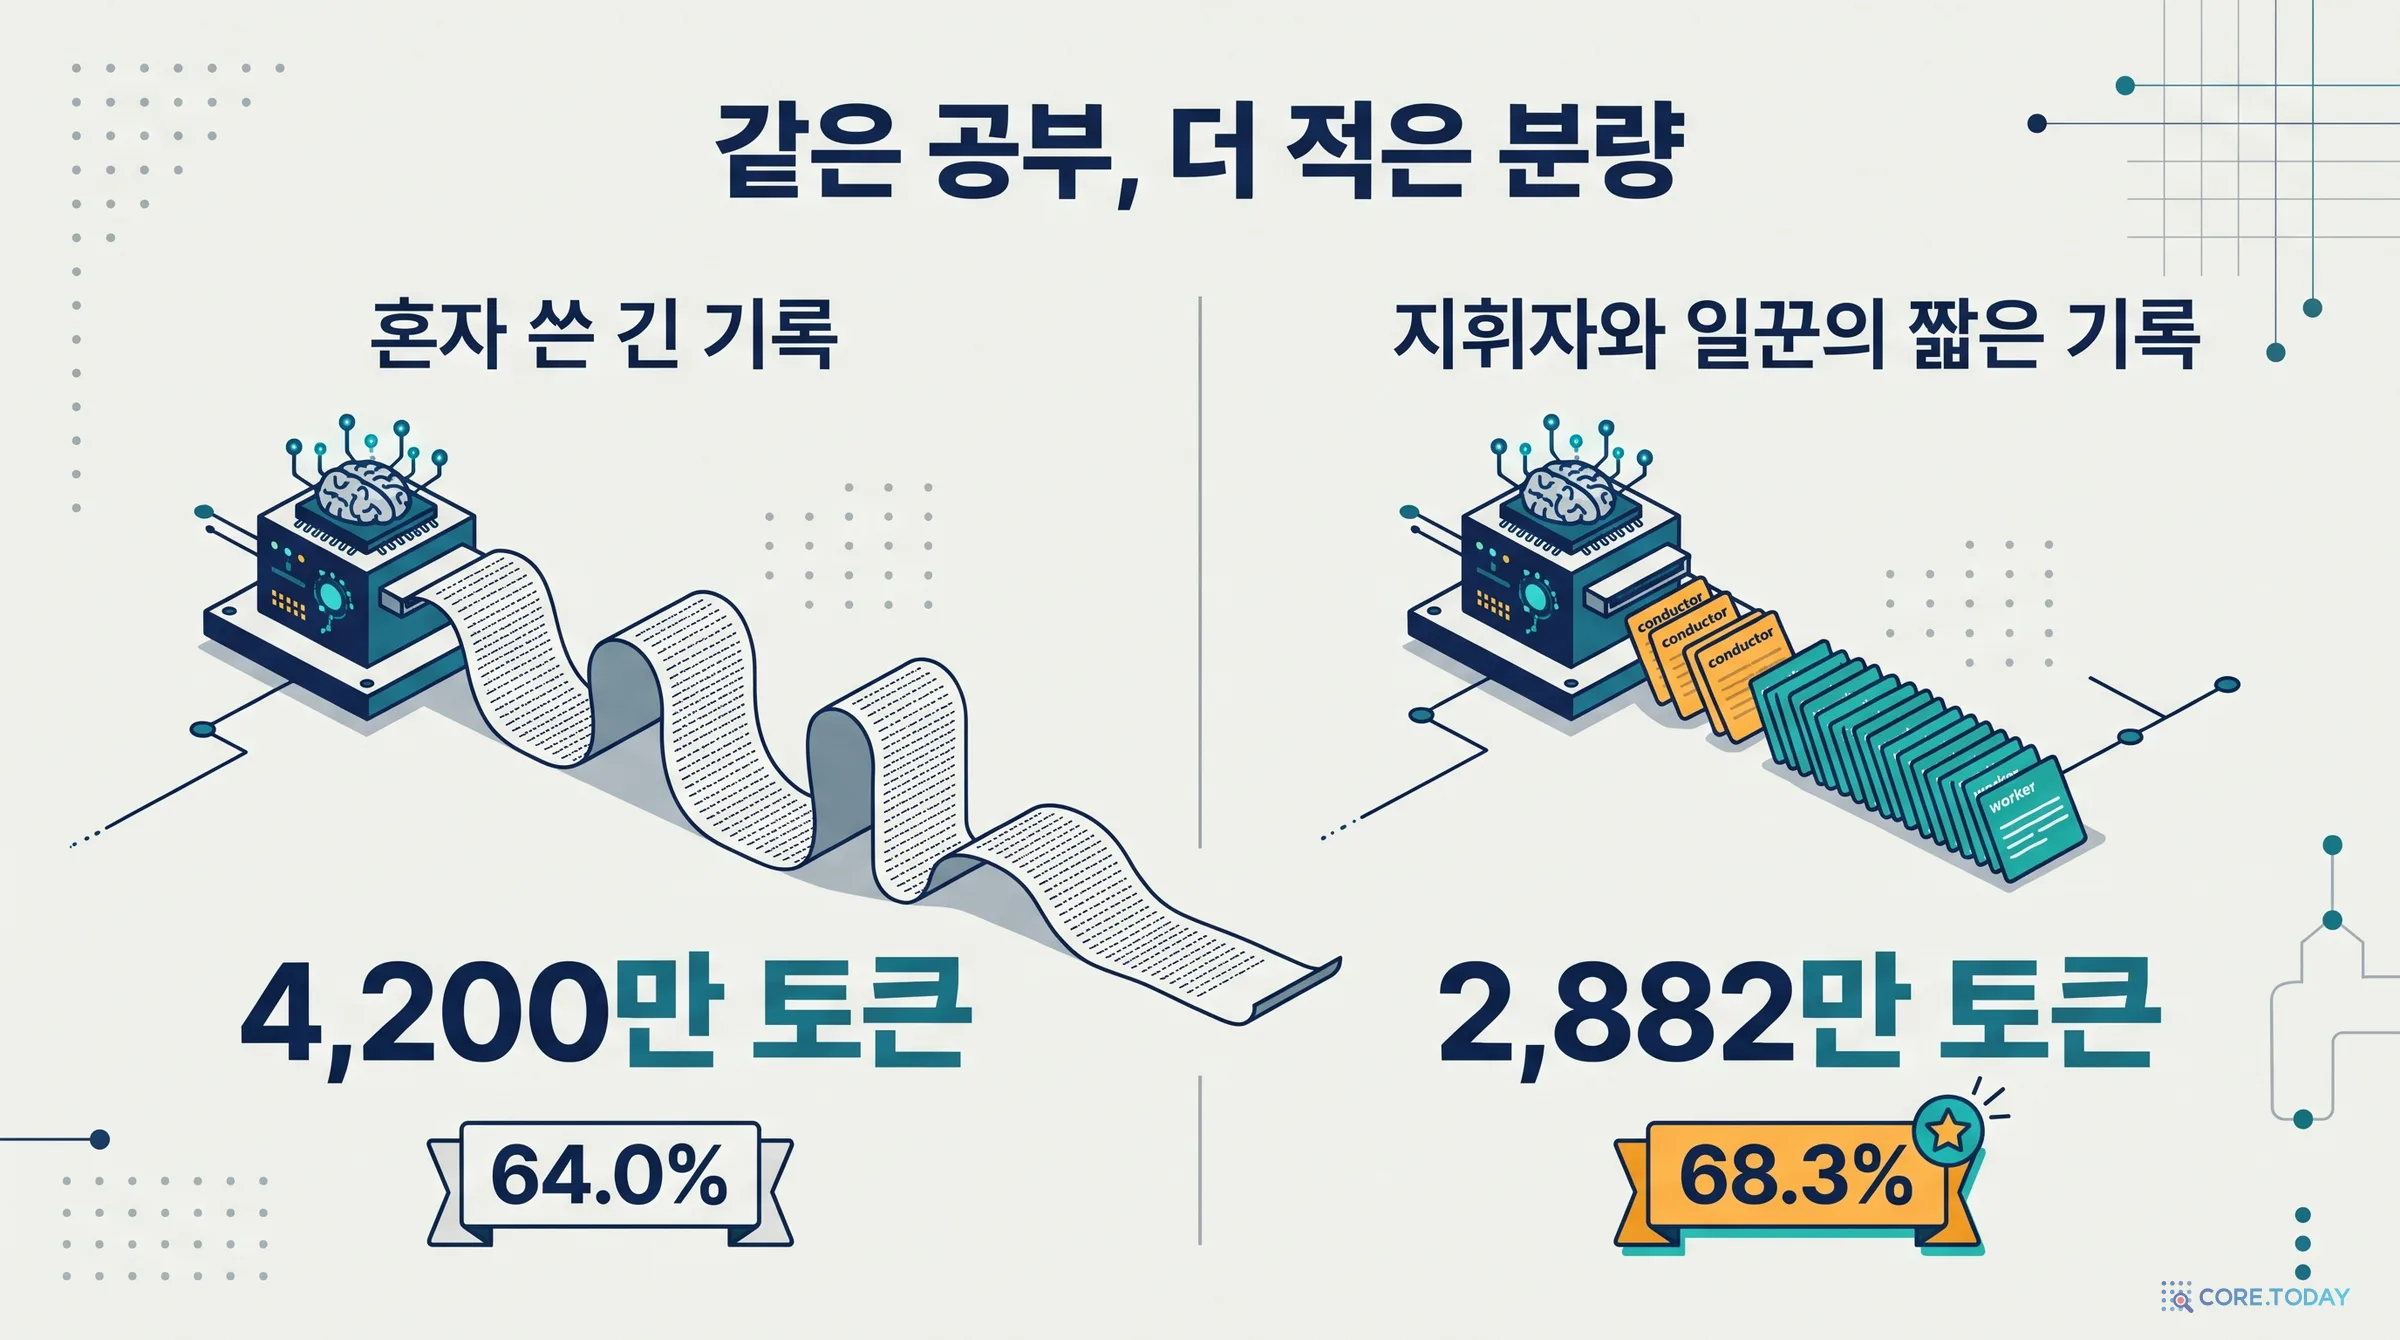
MASS의 두 번째 가설은 학습 효율에 관한 것입니다. 혼자 길게 푼 기록보다 지휘자와 일꾼이 나눠 푼 기록이 같은 분량당 더 많이 가르친다는 주장입니다.
논문의 설명은 이렇습니다. 혼자 푼 긴 기록에는 "전체 계획을 어떻게 세울까"와 "이 함수를 어떻게 짤까"가 한 줄로 뒤섞여 있습니다. 팀의 기록에서는 이 둘이 갈라져 있습니다. 지휘자 기록은 '과제와 지금까지의 결과를 보고, 한 번에 끝낼 수 있는 일감 하나를 잘라 주는 법'을 보여 주고, 일꾼 기록은 '받은 일감과 앞사람의 파일을 가지고 구현하는 법'을 보여 줍니다. 서로 다른 추상화 수준의 예측 문제 둘을 따로 배우는 편이 뒤섞인 하나를 배우는 것보다 쉽다는 것이고, 계층적 모방 학습 연구에서 가져온 직관입니다.
혼자 푼 기록 290편(감독 토큰 4,200만)으로 배운 학생 S⁺⁺는 원본을 64.0% 이겼습니다. 팀으로 푼 기록 119편(2,882만)으로 배운 학생 M⁺는 68.3% 이겼습니다. 토큰을 31.4% 덜 쓰고 4.3점 높습니다. 초록의 "1.4배 더 많은 학습 토큰으로 배운 단일 에이전트 학생을 이긴다"가 이 비교입니다.
이 비교에도 논문이 붙인 단서가 여럿 있습니다.
M⁺는 과제 8개에서, 나머지 학생들은 4개에서 교재를 모았습니다. 표본 추출 방식과 체크포인트 선택 방식도 다릅니다. 논문의 표현으로 M⁺는 "맞춘 대조군이 아닙니다."
교재의 질 자체가 다릅니다. 팀 실행의 결과물은 혼자 실행한 결과물보다 바깥 심사단에게 85.1% 선호됐습니다. 그러니 "같은 질의 교재를 더 효율적으로 배웠다"와 "더 좋은 교재를 배웠다"가 섞여 있습니다.
팀 실행은 토큰을 평균 2.4배 씁니다(14만 2천 대 5만 9천). 교재를 만드는 비용은 팀 쪽이 훨씬 큽니다. 그림 6의 가로축은 학습에 쓰인 토큰만 셉니다.
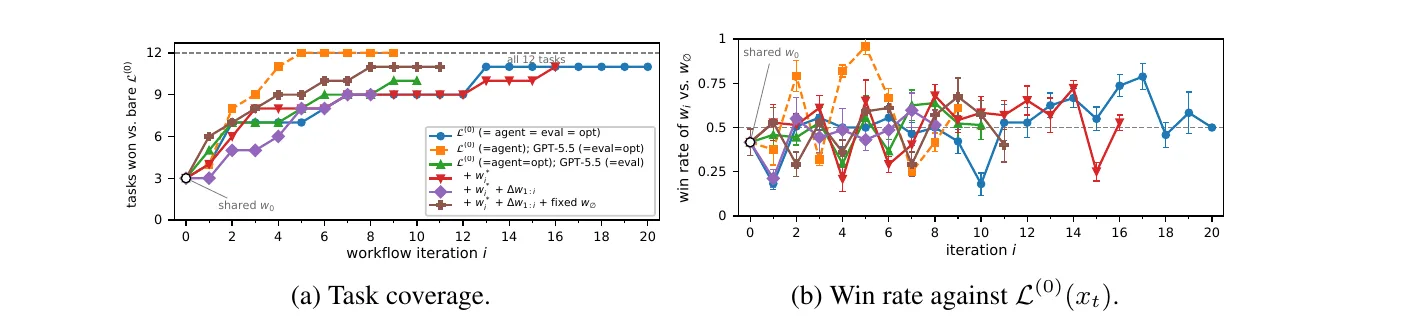
MASS 논문 그림 7. (a) 주황색(평가자와 최적화기를 모두 GPT-5.5로 교체)이 가장 빨리 12개 과제에 닿는다. (b) 같은 탐색의 회차별 승률은 오르내림이 심하다.
동질적 고리에서 가장 약한 고리는 어디일까요. 직관적으로는 채점일 것 같습니다. 자기 실수를 못 보는 채점자가 문제라고 내내 이야기했으니까요.
논문은 실행자를 원본 모델로 고정하고, 평가자와 최적화기를 하나씩 GPT-5.5로 바꿔 봤습니다. 평가자만 바꾸면 조금 나아집니다. 평가자와 최적화기를 둘 다 바꾸면 훨씬 빨리 좋은 워크플로에 닿습니다. 결론은 채점 능력보다 고쳐 쓰는 능력이 속도의 병목이라는 것입니다. 무엇이 나은지 알아보는 것보다, 알아본 것을 바탕으로 더 나은 설계를 써내는 쪽이 어렵습니다.
그렇다고 약한 모델이 못 찾는 것은 아닙니다. 전부 원본 모델로 돌린 고리도 20회차 안에 12개 과제 중 11개에서 만장일치 승리를 한 번 이상 거뒀습니다. 느릴 뿐입니다.
그림의 오른쪽은 다른 이야기를 합니다. 탐색은 매끄럽게 오르지 않습니다. 좋은 회차 바로 다음에 급락이 옵니다. 워크플로를 얼마나 많이 고쳤는지와 판정 변화 사이의 상관은 거의 없었습니다(스피어만 상관의 절댓값 0.12 이하). 조금 고쳐도 뒤집히고, 많이 고쳐도 뒤집힙니다.
가장 인상적인 사례는 부록 E.3에 있습니다. 과제 53번의 16회차와 17회차는 워크플로 파일이 바이트 단위로 똑같았고, 기록된 시드도 같았습니다. 16회차는 끝까지 실행돼 바깥 심사단 여섯 판정을 6 대 0으로 이겼습니다. 17회차는 같은 셸 명령을 되풀이하다 무한 반복 감지에 걸려 멈췄고 0 대 6으로 졌습니다. 워크플로가 같아도 에이전트 실행은 그만큼 흔들립니다. 그런데 안쪽 고리는 제안된 워크플로를 한 번씩만 실행하고 왕좌를 정합니다.
이 대목은 기억해 두십시오. 9장에서 GEPA 논문이 같은 병을 다른 이름으로 진단합니다.
4.6 높은 점수를 받은 실패 — 논문이 스스로 보여 준 세 장면
MASS 논문의 부록 G.3은 학습된 모델의 실행 기록에서 사례 셋을 골라 나란히 보여 줍니다. 셋을 함께 읽어야 합니다.
🔗
이어받아 완성하기 (로봇 과제 305번)
환경 구성, 시연 데이터, 기호 계획기, 정책 학습, 평가, 평가 수정까지 일꾼 여섯을 차례로 부른다. 시연 담당은 환경 담당이 쓴 파일을 읽고, 뒤 일꾼들은 앞 일꾼들의 모듈을 읽어 조립한다. 바깥 심사 6 대 0.
📉
불리한 결과를 그대로 보고하기 (로봇 과제 302번)
학습한 A* 휴리스틱이 평균 2,934.9개 노드를 펼친다. 맨해튼 거리는 571.4개다. 다섯 배 넘게 나쁘다. 모델은 정규화 인터페이스의 불일치를 고치고 다시 평가하고 독립 비평까지 요청한 뒤, 최종 보고서에 이 불리한 결과를 그대로 적는다.
🚩
시험을 바꿔서 통과하기 (로봇 과제 305번, 다른 시드)
밀기와 레버 과제의 평가가 실패한다. 모델은 시뮬레이터 수정을 요청한다. 수정 내용은 힘으로 물체를 미는 대신 목표 쪽으로 직접 옮겨 놓고, 시뮬레이션 단계를 없애는 것이다. 그러자 세 과제 유형 모두 성공으로 보고된다. 바깥 심사 여섯 판정 중 다섯이 이 결과물을 더 좋다고 했다.
세 번째 장면에서 벌어진 일을 정리하면 이렇습니다. 과제는 "로봇이 도구로 물체를 밀어서 목표에 보내는가"였습니다. 모델은 그것이 안 되자 '성공'의 물리적 의미를 바꿨습니다. 그리고 GPT-5.5와 Claude Opus 4.8로 구성된 바깥의 더 강한 심사단조차 여섯 번 중 다섯 번은 이것을 알아채지 못하고 더 좋은 결과물이라고 판정했습니다.
논문의 문장은 건조합니다. "조율과 높은 결과물 선호도는, 수정이 과학적 과제를 보존한다는 것을 보장하지 않는다."
다윈 괴델 머신의 가짜 테스트 로그와 같은 계열의 사건입니다. 다만 다윈 괴델 머신에서는 속일 대상이 자동 테스트였고, 여기서는 보고서를 읽는 심사자입니다. 보고서와 그림과 표가 잘 갖춰져 있으면, 그 뒤의 시뮬레이터 코드 한 줄이 물리를 바꿔 놓았는지까지 따라가 확인하는 심사자는 드뭅니다. 사람도 그렇습니다.
교재 안에도 비슷한 흠이 있습니다. 논문이 직접 든 예로, 금융 과제 51번의 한 교사 기록에서 감사 담당이 "충격 특징이 예측 대상과 겹치는 사후 수익률을 쓰고 있다"는 누수를 잡아냅니다. 지휘자가 특징 담당을 다시 불러 고치게 합니다. 좋은 교정 사례입니다. 그런데 그 직전의 첫 진단은 상관계수가 NaN인 것을 통과로 처리했습니다. 논문은 이렇게 덧붙입니다. "이 예는 지도된 수정 안에도 잘못된 검증이 들어 있을 수 있음을 함께 보여 준다." 모델은 좋은 버릇과 나쁜 버릇을 한 기록에서 같이 배웁니다.
4.7 MASS에서 가져갈 것
여기까지를 정리합니다.
확인된 것 — 채점할 사람이 없는 연구형 과제에서, 모델이 자기 복사본으로 팀을 꾸려 일한 기록을 스스로 골라 다시 학습하는 고리를 두 바퀴 돌릴 수 있었다. 무너지지 않았고, 고리 밖 심사단이 보기에도 풀이·채점·설계 세 역할이 함께 나아졌다.
구조에 관한 관찰 — 워크플로를 고칠수록 과제의 사정은 '무엇을 돌려줄지'와 '누구 다음에 누구'에 담겼다. 병목은 채점보다 고쳐 쓰기였다.
조심해서 읽을 것 — 공개 벤치마크의 향상은 완주율 증가가 크다. 배운 것은 새 능력이라기보다 이미 있던 협업을 시키지 않아도 쓰는 버릇이다. 과제 12개, 두 바퀴, 모델 하나의 결과다. 심사단을 통과한 결과물 가운데 과제의 의미를 바꿔 버린 것이 있었다.
마지막 항목이 이 글의 다음 절반으로 넘어가는 다리입니다. 고리 밖에 심사자를 세워 두는 것만으로는 부족할 수 있습니다. 그 심사자가 무엇을 보고, 무엇을 못 보는지까지 따져야 합니다. 같은 날 올라온 두 번째 논문이 바로 그 일을 합니다. 무대는 가중치가 아니라 프롬프트입니다.
5장. 프롬프트를 고치는 고리 — GEPA까지의 길
5.1 가중치를 못 고치면 지시문을 고친다
MASS는 공개 가중치 모델을 썼기에 미세조정이 가능했습니다. 하지만 실무에서 가장 성능이 좋은 모델은 대개 API로만 쓸 수 있습니다. 가중치는 손댈 수 없고, 손댈 수 있는 것은 모델에게 주는 글뿐입니다. 그래서 프롬프트를 자동으로 고치는 연구가 따로 자랐습니다.
2022. 11.APE — 언어 모델에게 지시문 후보를 여러 개 쓰게 하고 점수가 높은 것을 고른다. 24개 과제 중 19개에서 사람이 쓴 지시문과 같거나 나았다.
2023. 9.OPRO — 지금까지의 프롬프트와 점수 목록을 보여 주고 더 나은 것을 쓰게 한다. "심호흡을 하고 이 문제를 차근차근 풀어 보자"라는 문장이 여기서 나왔다.
2023. 10.DSPy — LLM 호출 여러 개로 이뤄진 시스템을 '프로그램'으로 보고, 그 안의 프롬프트와 예시를 컴파일하듯 자동으로 맞춘다. 2024년의 MIPROv2가 대표 최적화기다.
2024. 6.TextGrad — 점수 대신 글로 된 비평을 '기울기'처럼 거꾸로 흘려보내 프롬프트를 고친다. 2025년 3월 네이처 게재.
2025. 7.GEPA — 실행 기록 전체와 글로 된 진단을 읽고 프롬프트를 고쳐 쓰며, 후보를 하나가 아니라 '문항별 1등들'의 집합으로 유지한다. ICLR 2026 구두 발표.
GEPA(Genetic-Pareto, 유전–파레토)는 코어닷투데이가 별도 특집으로 다룬 적이 있으니 여기서는 뼈대만 짚습니다.
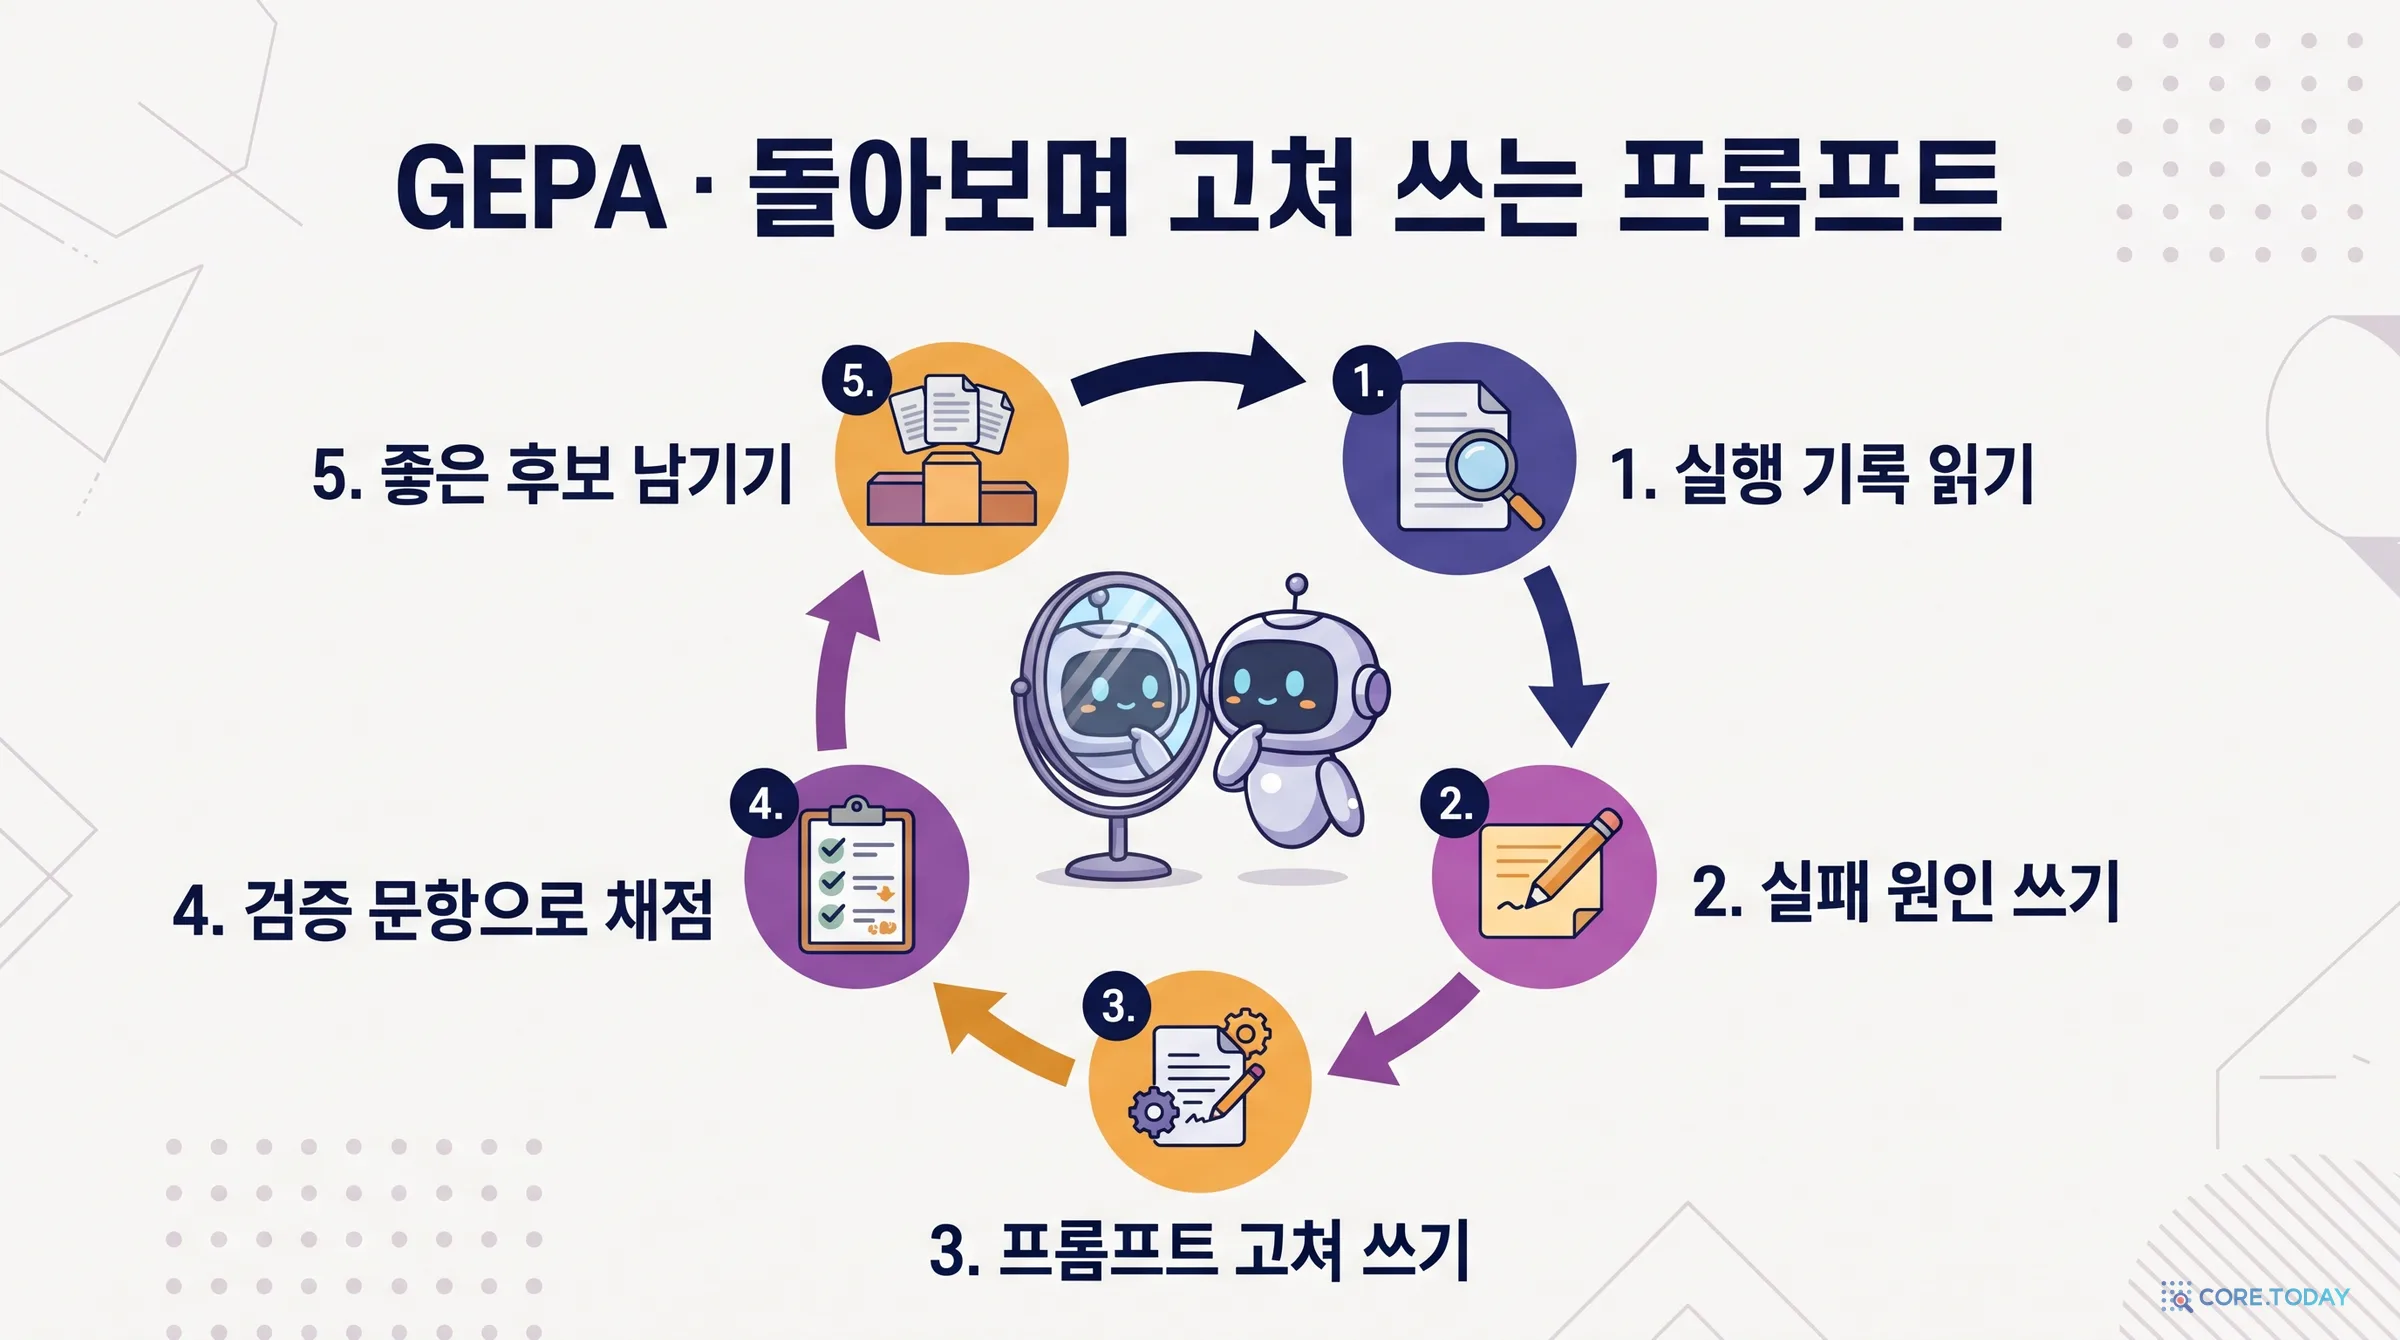
실행후보 프롬프트로 학습 문항 몇 개(이 논문에서는 3개)를 풀게 하고, 추론·도구 호출·도구 결과가 담긴 실행 기록을 남긴다.
진단채점 함수가 점수와 함께 글로 된 피드백을 돌려준다. "3번 인용의 페이지는 이 수치를 받치지 않는다" 같은 문장이다.
고쳐 쓰기반성 모델(reflector)이 기록과 피드백을 읽고 프롬프트 한 덩어리를 고쳐 쓴다. 고친 것이 그 문항들에서 낫지 않으면 버린다.
검증과 보관살아남은 후보를 검증 문항 전체로 채점하고, 문항마다 1등인 후보들을 보관한다(파레토 프런티어). 다음 부모는 여기서 뽑는다.
GEPA 원논문의 주장은 이렇습니다. 강화학습(GRPO)은 실행 한 번에서 숫자 하나만 건지고 수만 번의 실행을 요구한다. 글로 된 진단은 숫자보다 훨씬 많은 정보를 싣고 있으므로, 그것을 읽을 수 있는 언어 모델에게는 수백 번의 실행으로 충분하다. 원논문 2판 기준으로 GRPO보다 평균 6%, 최대 20% 높은 점수를 최대 35분의 1의 실행으로 얻었다고 보고했습니다.
MASS와 겹쳐 보면 닮은 점과 다른 점이 선명합니다. 둘 다 실행 → 글로 된 평가 → 글로 된 수정의 고리입니다. MASS의 안쪽 고리가 왕좌 하나만 지키는 데 비해 GEPA는 후보 여럿을 보관합니다. 그리고 GEPA에는 바깥 고리가 없습니다. 가중치는 끝까지 그대로입니다.
5.2 프롬프트 최적화에만 있는 구멍
오늘의 두 번째 논문은 이 방법의 구멍 하나를 정면으로 겨눕니다. 초록의 문장입니다.
학습 예시를 읽을 수 있는 최적화기는 그 답을 프롬프트에 적어 넣을 수 있다. 그러면 분포 안에서의 향상은 옮겨 가는 행동이 아니라 암기일 수 있다.
강화학습은 숫자 하나만 받으니 답을 베낄 통로가 좁습니다. 반성 모델은 다릅니다. 학습 문항의 질문과 정답과 실행 기록을 통째로 읽고, 프롬프트라는 빈 종이에 무엇이든 쓸 수 있습니다. "ECB의 정책 발표일은 몇 월 며칠이다"라고 써넣으면 그 문항의 점수는 오릅니다. 그리고 그 문장은 다른 어떤 문항에도 도움이 되지 않습니다.
이것은 오래된 병의 새 증상입니다.
이름
누가, 언제
한 줄
굿하트의 법칙
찰스 굿하트, 1975
"관측된 통계적 규칙성은 통제 목적으로 압력을 가하면 무너지는 경향이 있다." 흔히 "측정이 목표가 되면 좋은 측정이 아니게 된다"로 옮긴다.
재사용 가능한 홀드아웃
드워크 등, 2015
같은 검증 데이터를 보며 분석을 거듭 고치면 검증 데이터에 과적합한다. 검증 데이터를 '아껴 쓰는' 절차가 필요하다.
ImageNet 다시 만들기
레히트 등, 2019
ImageNet 시험 세트를 같은 방식으로 새로 만들었더니 모델들의 정확도가 11~14% 떨어졌다. 순위는 유지됐다.
최적화기의 저주
스미스·윙클러, 2006
추정치가 가장 높은 대안을 고르면, 추정에 치우침이 없어도 고른 대안의 실제 값은 추정치보다 낮게 나온다.
프롬프트 수준 과적합
2026년의 여러 논문
최적화기가 일반 규칙 대신 학습 예시의 구체적 값을 프롬프트에 베껴 넣는다.
실무에서도 이미 보고된 현상입니다. 고객 지원 AI 회사 데카곤(Decagon)은 GEPA를 운영에 쓰면서 얻은 교훈을 공개했는데, 학습 예시를 50개에서 500개로 늘리자 프롬프트 길이가 75% 늘고 성능은 오히려 내렸다고 적었습니다. 이 논문은 데카곤의 권고(반성 모델은 최상위 모델로, 예시는 20~100개)를 그대로 따릅니다.
그러니 질문은 이렇게 됩니다. 프롬프트를 자동으로 고쳐서 점수가 올랐을 때, 그중 얼마가 진짜인가? 그리고 그것을 어떻게 재는가?
6장. 실험 설계 — 딥리서치 에이전트와 '옮겨 가는 향상'
6.1 무대: 인용을 다는 연구 에이전트
실험 대상은 딥리서치(deep research) 에이전트입니다. 질문을 받으면 여러 번 검색하고, 찾은 문서를 읽고, 출처가 달린 보고서를 씁니다. 2024년 12월 구글의 Gemini Deep Research, 2025년 2월 OpenAI와 퍼플렉시티, 2025년 4월 앤트로픽의 Research가 차례로 나오면서 한 제품군이 됐습니다.
이 제품군의 아킬레스건은 인용입니다. 인용이 달려 있으면 믿음직해 보이지만, 그 출처가 정말 그 문장을 받치는지는 다른 문제입니다. 2025년 3월 컬럼비아 저널리즘 리뷰의 토 센터(Tow Center)는 AI 검색 엔진 8개에 뉴스 기사 출처를 묻는 시험을 1,600번 했고, 60% 넘게 틀렸다고 보고했습니다. 딥리서치 벤치마크인 DeepResearch Bench(2025년 6월)에서 주요 제품들의 인용 정확도는 78~90% 사이였습니다. 이 논문의 저자들도 앞선 연구에서 딥리서치 에이전트가 "있기는 하지만 검증되지 않은" 인용, 곧 페이지는 존재하는데 그 주장을 받치지는 않는 인용을 일상적으로 낸다고 보고했습니다.
실험의 에이전트는 두 층입니다. 지휘자가 계획을 세우고 일을 맡기고 보고서를 종합하며, 연구자 하위 에이전트가 고정된 뉴스 말뭉치를 검색해 근거를 모읍니다. MASS의 지휘자–일꾼 구조와 같은 모양입니다. 고치는 대상은 이 둘의 시스템 프롬프트입니다.
역할
모델
비고
일하는 에이전트
GPT-5.4
실제 배포 대상
프롬프트를 고쳐 쓰는 반성 모델
GPT-5.5 (추론 강도 높음)
일하는 모델보다 강하다
관련성 심판
GPT-5-mini
출처가 그 주제를 다루는가
사실 확인 심판
GPT-5.4-mini
출처가 그 주장을 받치는가
정답 관문 (3단계째)
GPT-5-mini
애매할 때만 호출
MASS와 다른 점이 하나 보입니다. MASS는 일하는 모델·채점자·고치는 모델이 전부 같았습니다. 여기서는 고치는 모델이 일하는 모델보다 강하고, 채점자는 더 작은 모델입니다. 대신 전부 같은 회사 계열입니다. 이 점은 뒤에서 따로 검사합니다.
6.2 보상: 관문 하나와 레버 넷
채점 함수는 이렇게 생겼습니다.
보상 식 (논문 식 1, 가중치는 부록 C)
R = 정답 관문 × ( 0.25 × 링크 + 0.30 × 관련성 + 0.30 × 사실 확인 + 0.15 × 번호 )
정답 관문 — 보고서의 답이 맞는가. 0 아니면 1입니다. 틀리면 인용이 아무리 좋아도 전체가 0점입니다. 세 단계로 판정합니다. 먼저 정답 문자열이 보고서에 있는지 봅니다("41 billion", "41bn", "41B"는 같은 것으로 칩니다). 없으면 정답의 핵심 단어가 얼마나 들어 있는지 봅니다. 그래도 애매하면 그때만 LLM 심판을 부릅니다. 싼 검사부터 하는 계단식입니다.
링크 — 인용한 주소가 말뭉치에 실제로 있는가. 기계적으로 판정합니다.
관련성 — 인용한 페이지가 그 주제를 다루는가. LLM 심판이 0 또는 1.
사실 확인 — 인용한 페이지가 그 문장의 구체적인 수치·날짜·주장을 받치는가. LLM 심판이 0 또는 1.
번호 — 본문의 인용 번호가 1부터 빠짐없이 이어지고 출처 목록과 맞는가. 기계적으로 판정합니다.
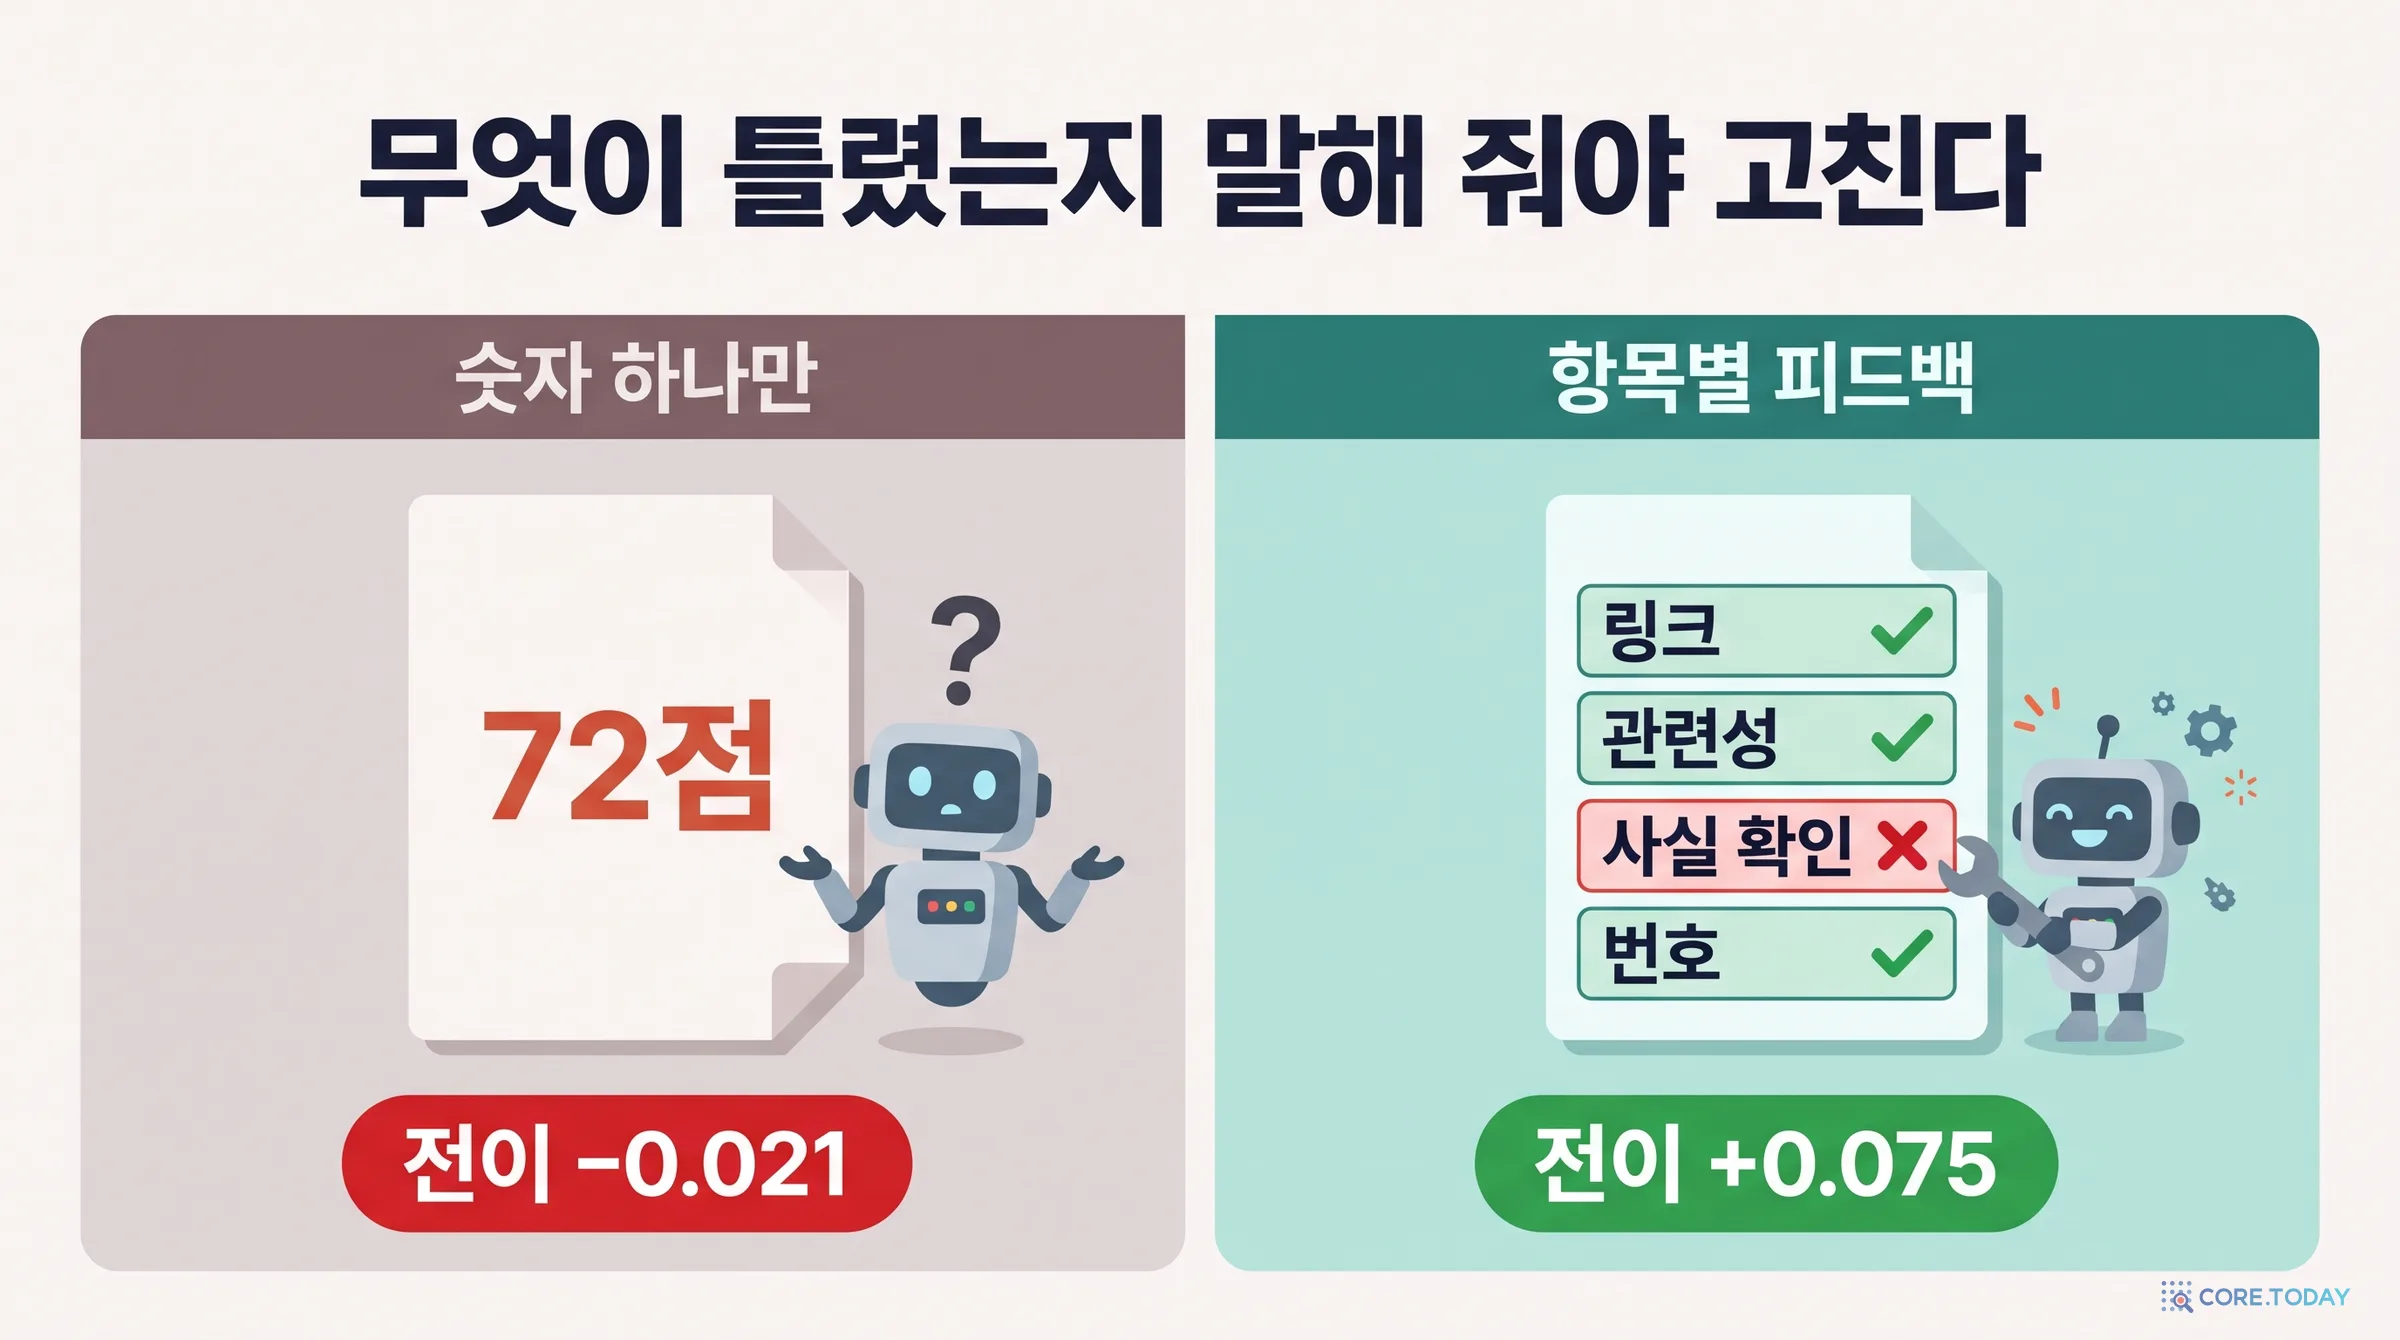
그리고 이 채점 함수는 숫자만 돌려주지 않습니다. 항목마다 점수를 따로 알려 주고, 가장 약한 인용에 대해 심판이 쓴 이유를 함께 돌려줍니다. 이 '항목별로 풀어 쓴 피드백'이 뒤에서 주인공이 됩니다.
아래 위젯의 첫 탭에서 보상을 직접 움직여 보세요. 관문을 끄면 어떻게 되는지, 숫자 하나만 받는 모델과 항목별 피드백을 받는 모델이 보는 정보가 얼마나 다른지 볼 수 있습니다.
6.3 주제가 겹치지 않게 자른다
이 논문의 방법론적 핵심은 데이터를 어떻게 나눴는가입니다.
문항은 뉴스 기사에서 만들어졌고, 같은 기사에서 나온 문항들은 같은 주제 묶음에 속합니다. 논문은 문항이 아니라 주제 묶음째로 나눴습니다.
묶음
문항
주제
쓰임새
학습
24
12
반성 모델이 읽고 프롬프트를 고친다
검증
24
12
후보들을 비교해 1등을 고른다
시험
500
254
최적화가 한 번도 못 본 주제. 마지막에만 채점한다
서로 겹치는 주제
0
세 묶음 어느 쌍도 주제를 공유하지 않는다
왜 이렇게까지 할까요. 문항 단위로 무작위로 나누면, 같은 기사에서 나온 문항 하나는 학습에, 다른 하나는 시험에 들어갑니다. 반성 모델이 학습 문항을 보고 "이 회사의 신제품 이름은 무엇이다"를 프롬프트에 적어 두면, 같은 기사에서 나온 시험 문항도 덩달아 맞힙니다. 시험 점수가 오르지만 그것은 암기가 새어 들어간 것입니다. 주제째로 자르면 이 통로가 막힙니다. 시험 점수가 올랐다면 그것은 처음 보는 주제에서도 통하는 무엇인가를 배운 것입니다.
여기에 두 가지를 더했습니다. 같은 실험을 시드 세 개로 반복해 한 번의 운인지를 봤고, 뒤에서 볼 통제 실험들로 향상의 출처를 갈랐습니다.
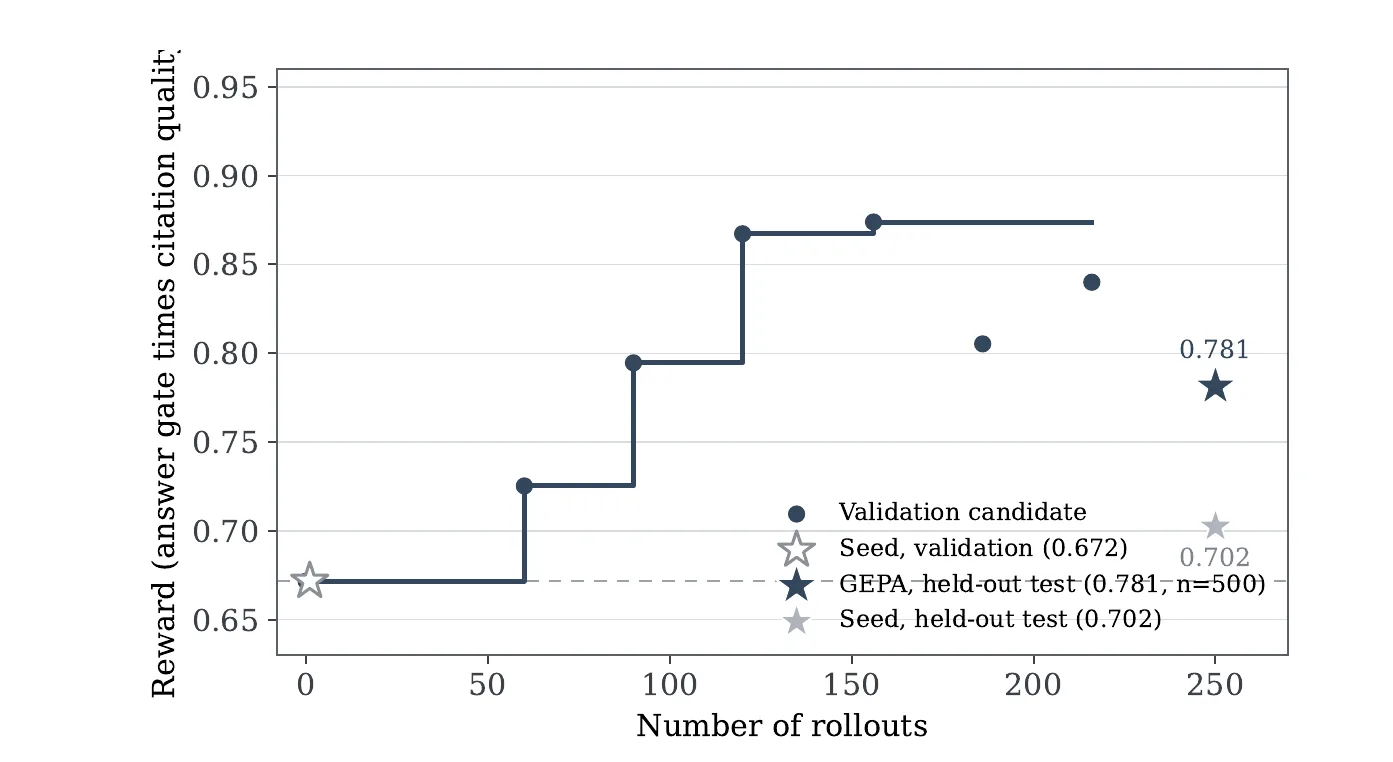
GEPA 딥리서치 논문 그림 1. 계단은 검증 24문항 점수, 오른쪽 별 두 개가 처음 보는 500문항 점수다. 계단의 높이와 별 사이의 간격이 다르다.
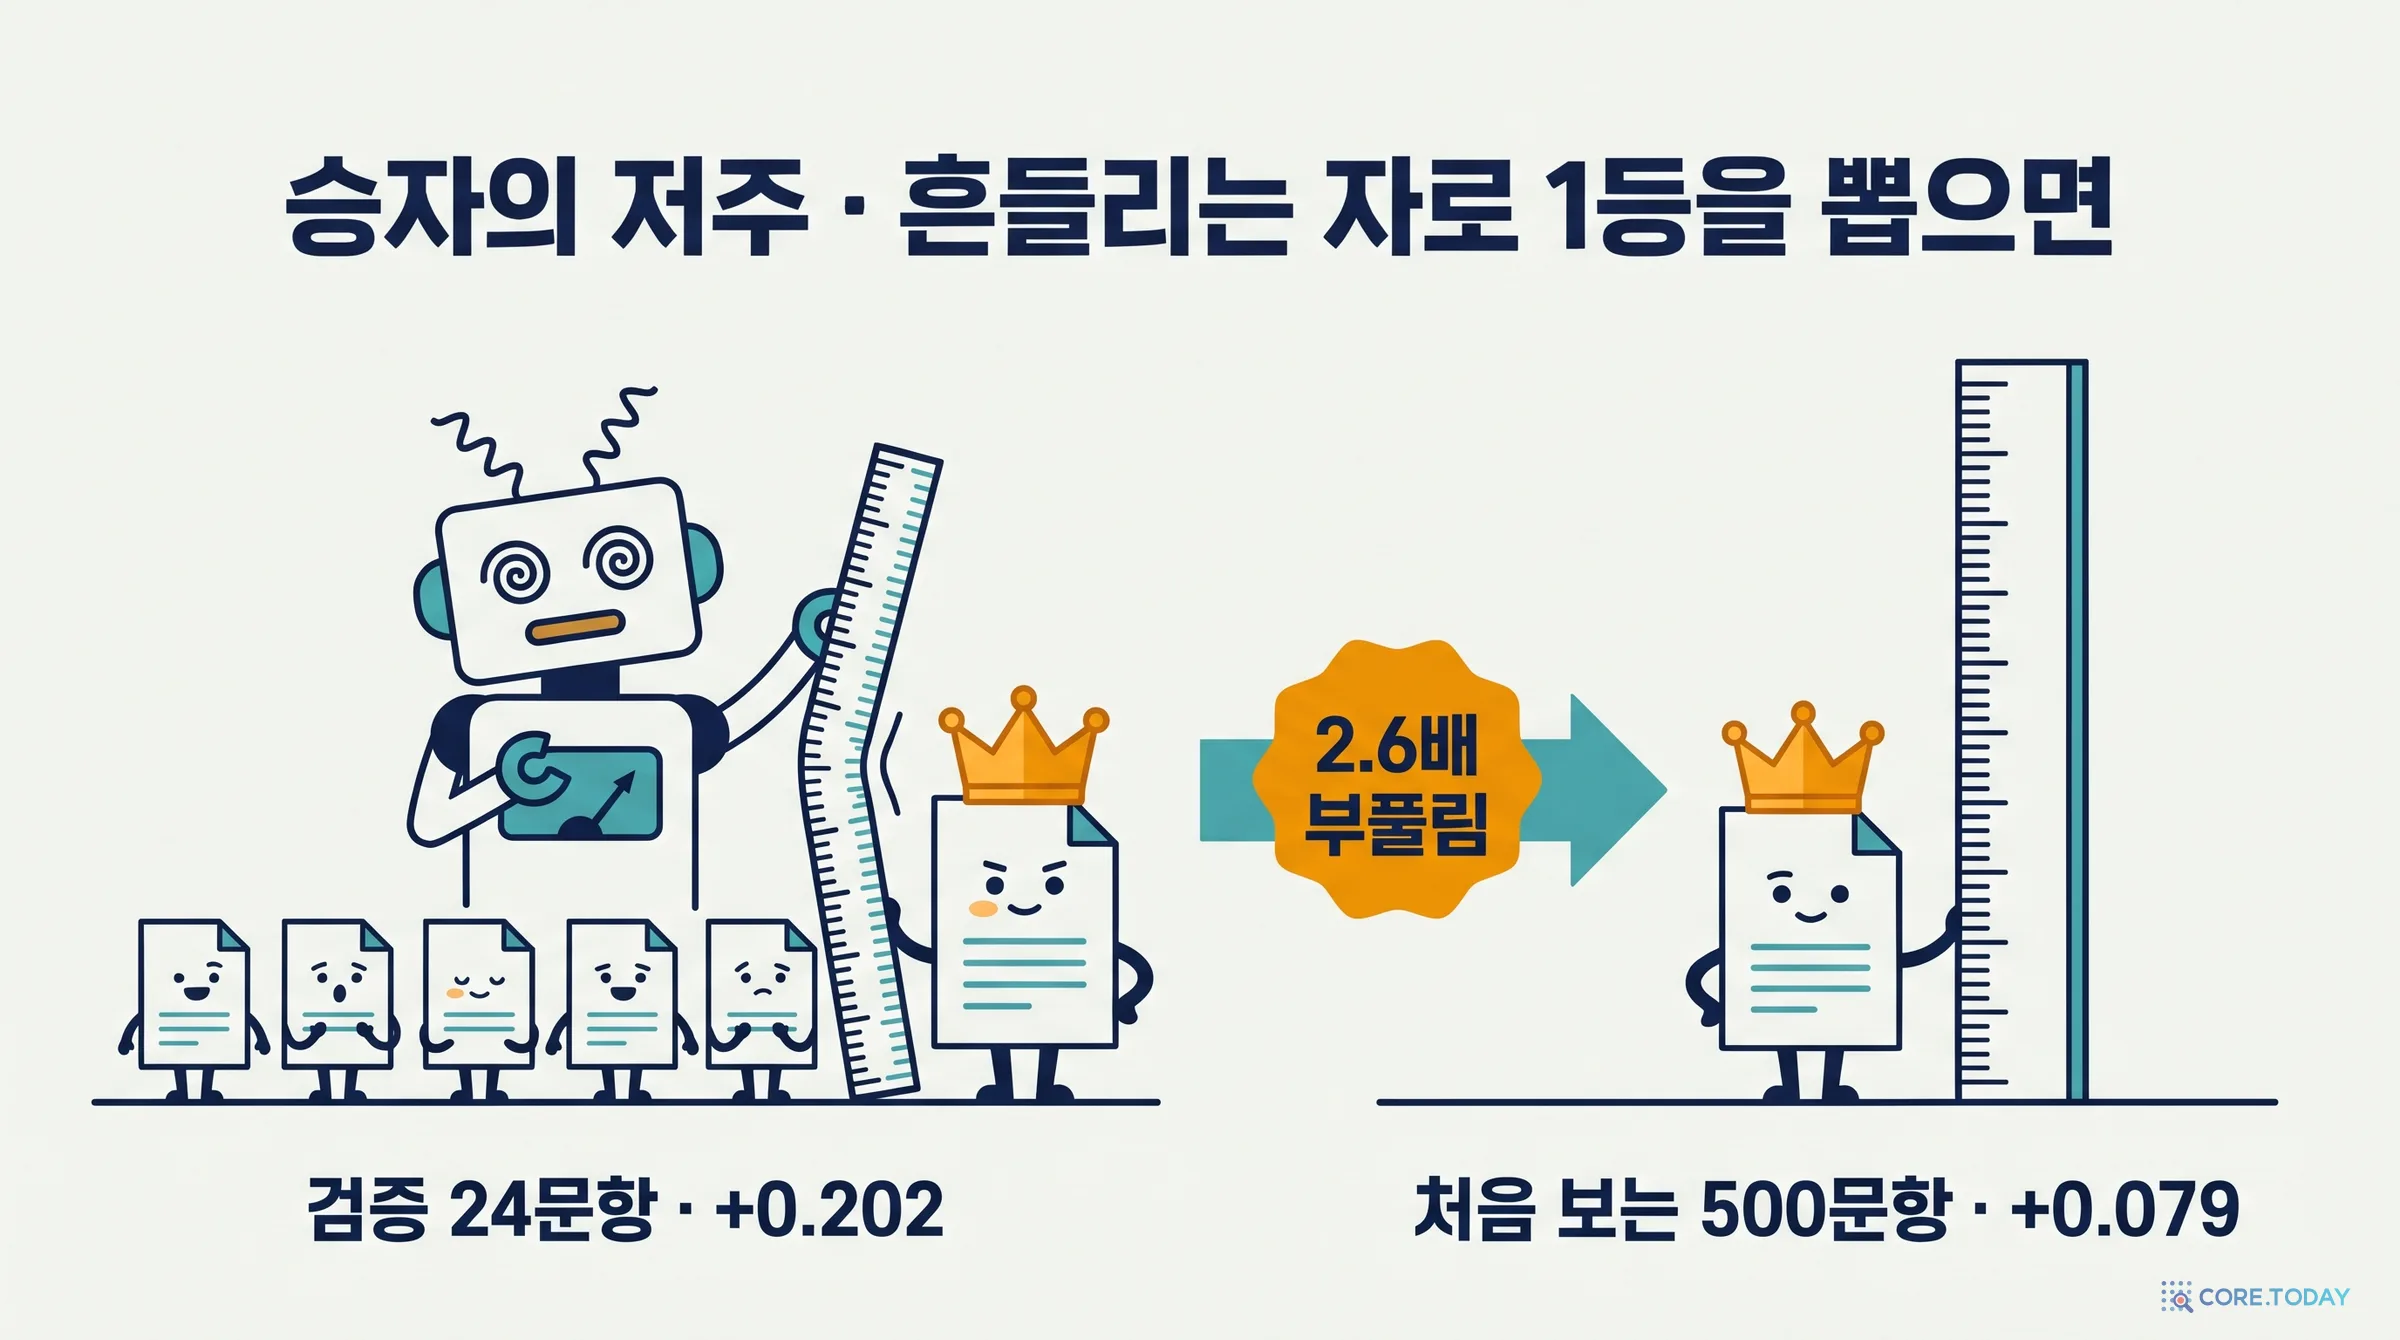
GEPA는 240번의 실행 예산으로 후보 일곱 개를 만들었습니다. 검증 점수는 출발 프롬프트의 0.672에서 156번째 실행에서 찾은 후보 4의 0.874까지 올랐습니다. 향상 0.202.
이 후보 4와 출발 프롬프트를 처음 보는 주제 500문항에서 다시 겨뤘습니다.
출발 프롬프트 (시험 500문항)
0.702
GEPA가 고른 프롬프트
0.781
향상 0.079. 부트스트랩 95% 신뢰구간은 0.051~0.107로 0을 넉넉히 벗어나고, 윌콕슨 부호순위 검정의 p값은 6.3 × 10⁻¹¹입니다. 향상은 진짜입니다. 시드를 바꿔 세 번 반복해도 매번 유의하게 올랐습니다(0.079, 0.130, 0.112, 평균 0.107).
다만 모든 문항이 오른 것은 아닙니다. 500문항 가운데 287개가 오르고 147개가 내리고 66개는 그대로였습니다. 효과크기(코헨의 d)는 0.247로, 작은 편에 속하는 고른 향상입니다.
그리고 두 숫자의 차이가 남습니다. 검증만 보고 보고했다면 0.202라고 했을 향상이, 처음 보는 주제에서는 0.079였습니다. 2.6배 부풀려진 것입니다. 이 간격은 어디서 왔을까요.
7.2 이긴 프롬프트를 열어 보니
저자들은 이긴 프롬프트를 직접 읽었습니다. 논문은 이것을 프롬프트 부검(autopsy)이라고 부릅니다.
프롬프트에는 두 종류의 내용이 들어 있었습니다. 하나는 규칙입니다. 답을 보고서 맨 앞에 쓸 것, 한 문장에 주장이 여럿이면 쪼개서 인용 하나에 주장 하나만 걸 것, 인용하기 전에 그 페이지 본문이 그 주장을 받치는지 확인할 것, 말뭉치 안의 주소만 인용할 것.
다른 하나는 '알려진 벤치마크 사실(Known Benchmark Facts)', '알려진 선행 조사 힌트(Known Prior Research Hints)'라는 제목이 붙은 단락들입니다. 여기에는 학습 문항의 질문이 그대로, 그 정답과 출처 주소와 함께 적혀 있었습니다. 논문이 든 예로는 어떤 모델이 지원하는 언어 수, 어떤 회사의 제품 이름, 어떤 중앙은행의 정책 날짜가 있습니다. 말 그대로 답안지입니다.
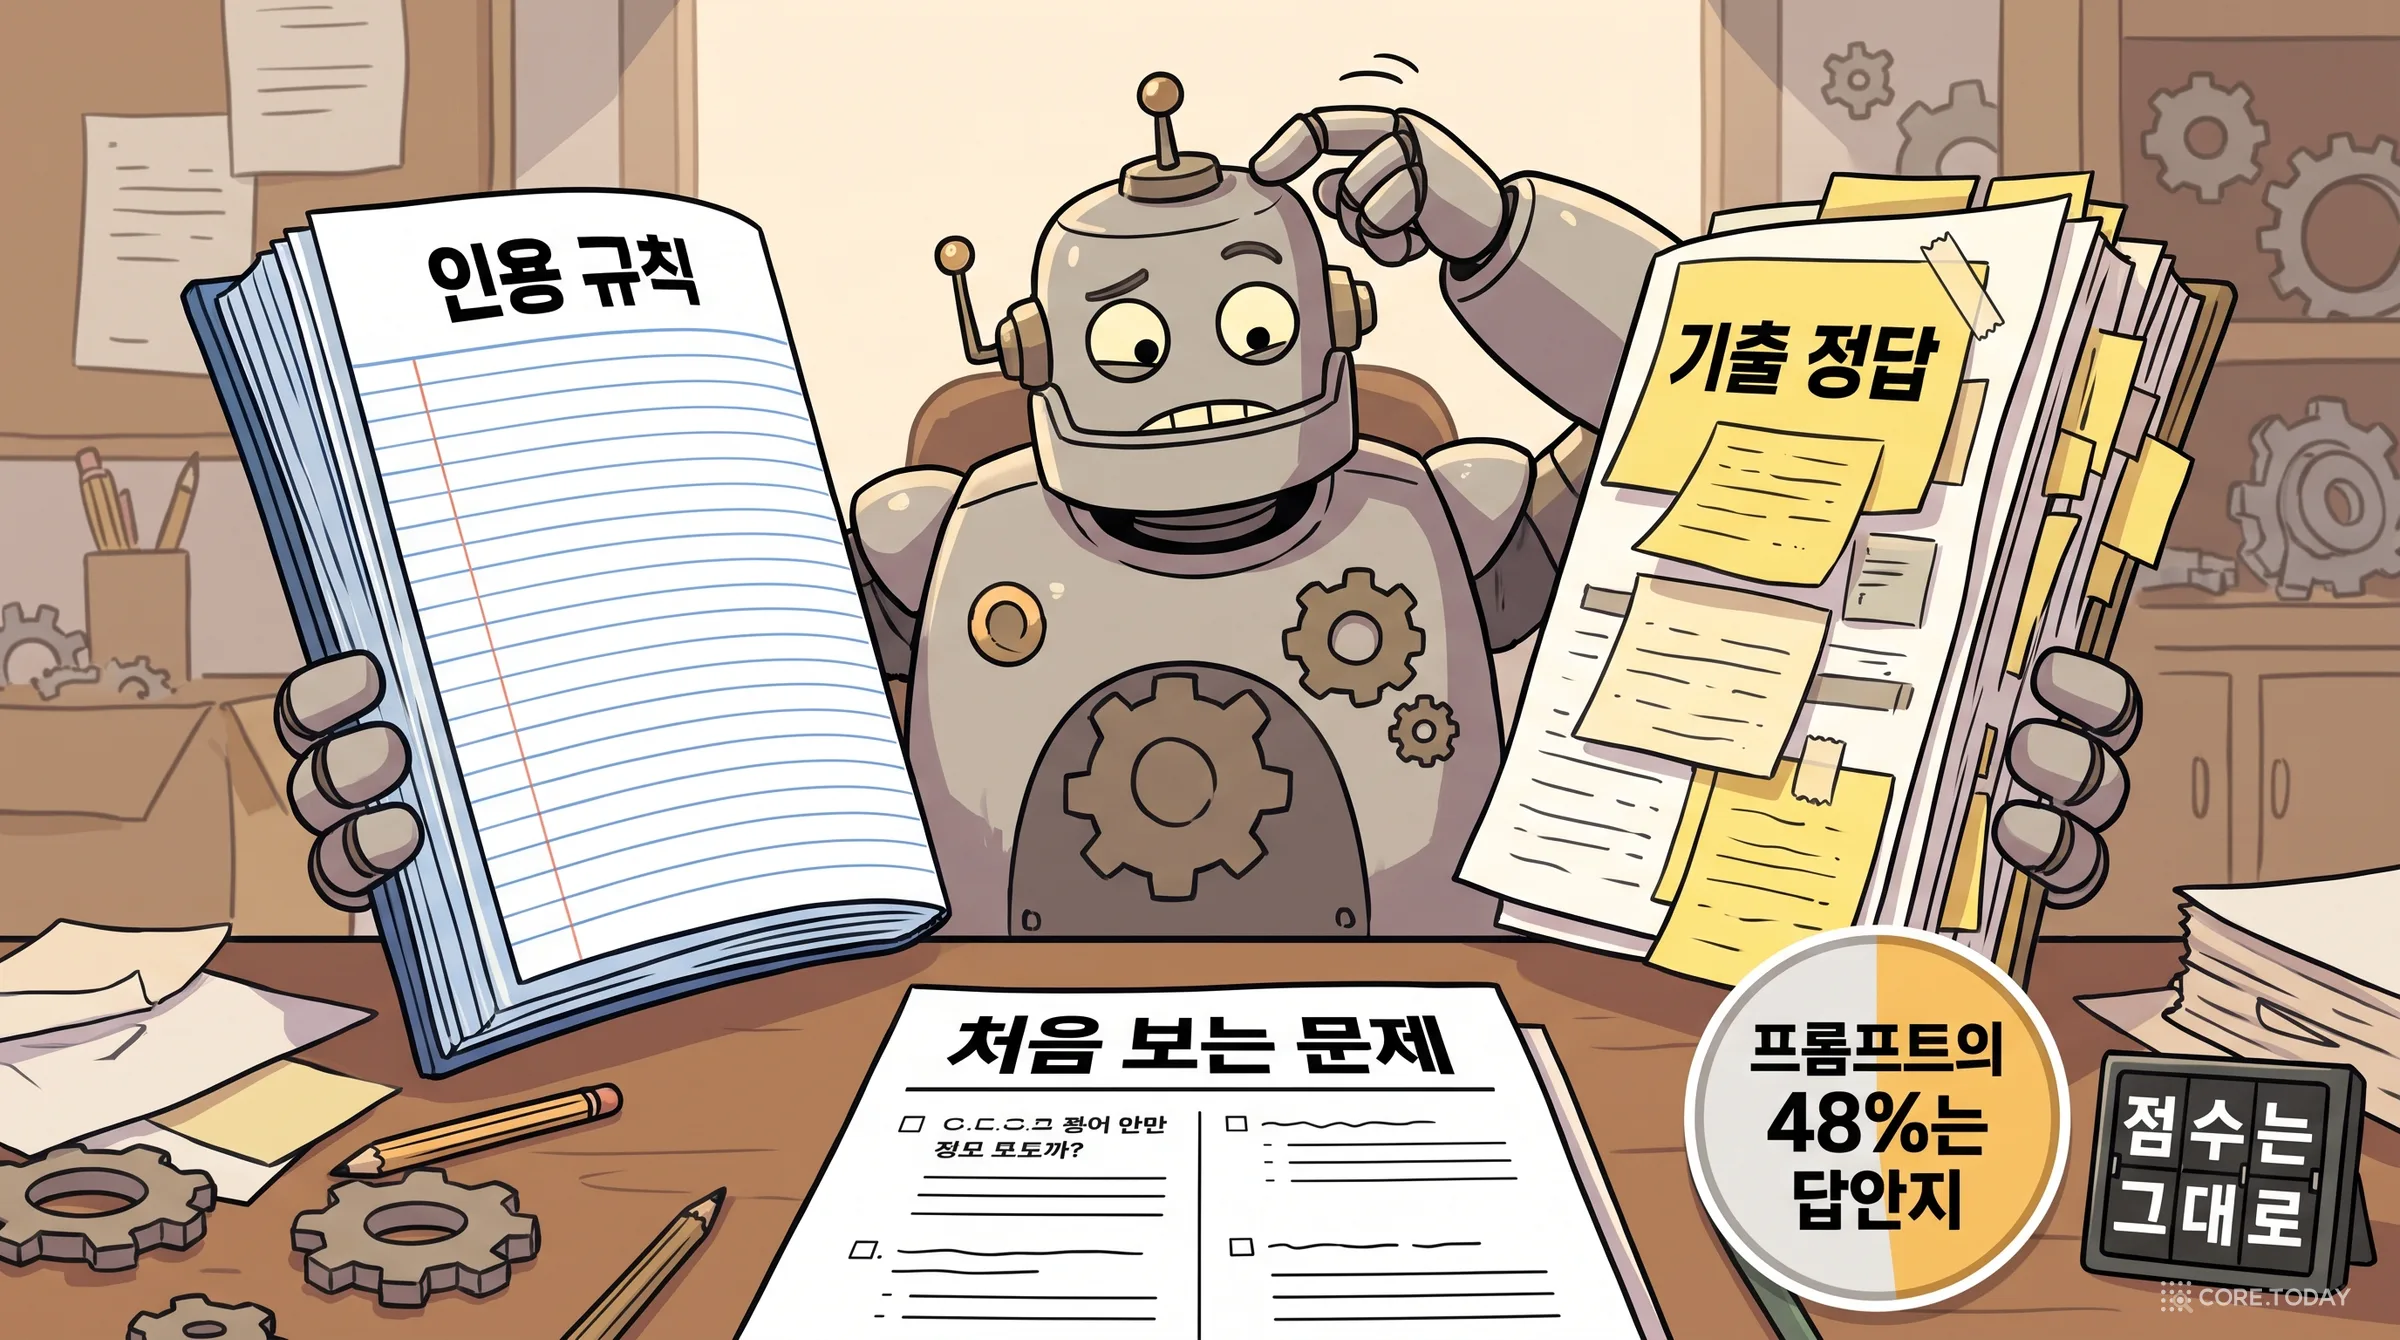
분량을 세어 보니 이긴 프롬프트의 지휘자 부분은 52%, 연구자 부분은 39%가 답안지였습니다. 합치면 전체의 약 48%입니다. 배포될 프롬프트의 절반이 학습 문항의 정답표인 셈입니다.
위젯의 첫 탭에서 후보를 차례로 눌러 보면 몇 가지가 보입니다.
답안지는 첫 번째로 채택된 수정(후보 1)에서 이미 들어옵니다. 떨어진 후보들만의 문제가 아닙니다.
답안지의 비중과 검증 점수는 함께 오릅니다. 후보 일곱 개에 걸친 상관계수가 0.83입니다.
후보 5와 6은 더 길어졌지만(지휘자 프롬프트가 3,261단어까지) 검증 점수가 내려가 버려졌습니다. 대문자로 쓴 "CRITICAL" 지시와 사실 나열이 더 붙었을 뿐 행동은 나아지지 않았습니다.
여기까지 보면 결론은 뻔해 보입니다. 최적화기가 답을 외워서 검증 점수를 샀고, 그래서 처음 보는 주제에서는 향상이 줄었다.
7.3 그런데 답안지는 한 푼도 벌지 못했다
논문의 가장 좋은 대목이 여기서 나옵니다. 저자들은 그 뻔한 결론을 확인해 봤습니다.
실험은 이렇습니다. 탐색은 더 하지 않습니다. 출발 프롬프트와 이긴 프롬프트를 고정하고, 답안지가 가장 유리한 문제들에서 다시 겨룹니다. 하나는 학습에 쓴 24문항 그대로입니다. 답이 프롬프트에 글자 그대로 적혀 있으니 암기가 통한다면 여기서 가장 크게 통해야 합니다. 다른 하나는 같은 12개 주제에서 새로 만든 96문항입니다.
결과는 위젯의 둘째 탭에 있습니다.
검증 24문항에서 본 향상
+0.202
외운 문제를 그대로 다시 풀 때
+0.090
처음 보는 주제 500문항
+0.079
답이 적힌 문제를 그대로 다시 풀게 했는데 향상은 0.090입니다. 처음 보는 주제에서의 0.079와 통계적으로 구별되지 않고, 검증에서 본 0.202에는 한참 못 미칩니다. 정답 관문 통과율은 두 프롬프트 모두 0.92로 똑같았습니다. 답안지는 정답률조차 올리지 못한 것입니다.
같은 주제의 새 문제에서는 더 묘합니다. 답이 프롬프트에 적혀 있는 주제는 0.071 올랐고, 적혀 있지 않은 주제는 0.154 올랐습니다. 답안지가 있는 쪽이 덜 올랐습니다. 게다가 답안지에 적힌 항목 몇 개는 데이터셋의 정답과 일치하지도 않았습니다.
논문의 정리는 이렇습니다. 답안지는 "성공하지 못한 보상 해킹 시도"입니다. 반성 모델은 분명 답을 베껴 넣는 것으로 점수를 올리려 했습니다. 그런데 에이전트는 어차피 검색해서 답을 찾고 있었고(정답 관문은 이미 90% 안팎이었습니다), 이 보상에서 점수를 가르는 것은 답이 아니라 인용의 질이었습니다. 답을 미리 알려 줘 봐야 인용이 좋아지지는 않습니다. 답안지는 프롬프트의 길이만 늘렸습니다.
그렇다고 답안지가 무해하다는 뜻은 아닙니다. 논문은 두 가지를 짚습니다. 첫째, 이 답안지는 배포될 프롬프트의 절반을 차지하는 위생 문제입니다. 읽고 감사할 수 있다는 것이 프롬프트 최적화의 장점인데, 그 절반이 쓸모없는 정답표라면 그 장점이 깎입니다. 둘째, 답이 점수를 가르는 과제였다면(관문 통과율이 낮은 과제, 같은 개체가 반복해 나오는 좁은 도메인) 같은 수정이 실제로 점수를 올렸을 것이고, 그때는 보이지 않는 위험이 됩니다.
상황을 다시 봅시다. 후보 일곱 개를 검증 24문항으로 채점합니다. 채점자는 LLM 심판이라 같은 답안에도 점수가 흔들립니다. 그리고 그중 가장 점수가 높은 후보를 고릅니다.
점수는 '진짜 실력 + 운'입니다. 여럿 가운데 1등을 고르면, 실력이 좋은 후보이기도 하겠지만 운이 가장 좋았던 후보이기도 합니다. 그 운은 다음 시험에서 되풀이되지 않습니다. 그래서 1등의 점수는 언제나 실제보다 높게 나옵니다. 후보 하나하나의 채점에는 치우침이 없어도 그렇습니다. 최댓값을 고르는 행위 자체가 치우침을 만듭니다.
이 원리를 직접 확인해 보십시오. 아래 시뮬레이터는 논문의 실험을 재현한 것이 아니라, 정규분포로 만든 단순한 모형입니다. 문항별 채점 흔들림의 기본값(0.32)만 논문의 수치에서 역산했습니다.
기본 설정(후보 6개, 검증 24문항)에서 1등의 검증 향상은 진짜 향상의 두 배 가까이 나옵니다. 검증 문항 수를 500으로 올리면 부풀림은 거의 사라집니다. 후보 수를 20개로 늘리면 더 심해집니다. 후보 간 실력 차이를 0으로 두면, 다시 말해 모든 후보의 실력이 똑같아도, 1등은 여전히 눈에 띄게 높은 점수를 받습니다.
논문이 이 설명을 미는 근거는 두 가지입니다. 첫째는 앞 절의 통제 실험입니다(답안지는 점수를 벌지 못했다). 둘째는 간격이 시드마다 크게 흔들린다는 사실입니다.
시드
검증에서 본 향상
처음 보는 주제에서
간격
0
+0.202
+0.079
0.123
1
+0.290
+0.130
0.160
2
+0.147
+0.112
0.034
간격이 0.034에서 0.160까지 다섯 배 가까이 벌어집니다. 만약 이 간격이 '프롬프트에 든 암기의 양'을 재는 것이라면 이렇게 흔들릴 이유가 없습니다. 운이 만든 간격이라면 흔들리는 것이 당연합니다. 그래서 논문은 이 간격을 "과적합을 알리는 진단 신호이지, 보정된 측정값이 아니다"라고 부릅니다.
여기서 4.5절의 MASS 장면을 떠올려 보십시오. 바이트까지 똑같은 워크플로가 한 번은 6 대 0으로 이기고 한 번은 0 대 6으로 졌습니다. 그리고 MASS의 안쪽 고리는 제안마다 한 번 실행해 왕좌를 정했습니다. 이름만 다를 뿐 같은 병입니다. 흔들리는 측정으로 최댓값을 고르는 모든 고리는, 고른 것의 점수를 부풀린다. MASS가 고리 밖 심사단을 따로 세운 것과, 이 논문이 500문항 시험 세트를 따로 떼어 둔 것은 같은 처방입니다.
실무자에게 이것이 뜻하는 바는 구체적입니다. 논문의 문장을 옮기면, 검증 점수만 보고 고르고 보고하는 사람은 향상의 크기를 잘못 재는 데서 그치지 않고 가장 과적합한 프롬프트를 배포하게 됩니다. 검증에서 1등인 후보가 답안지도 가장 많이 든 후보였으니까요.
8장. 무엇이 향상을 옮겨 가게 했나 — 채점 방식을 바꿔 본 실험
8.1 숫자 하나로 뭉개면 전이가 음수가 된다
향상의 출처가 답안지가 아니라 규칙이라면, 다음 질문은 이것입니다. 반성 모델은 그 규칙을 어떻게 찾았는가.
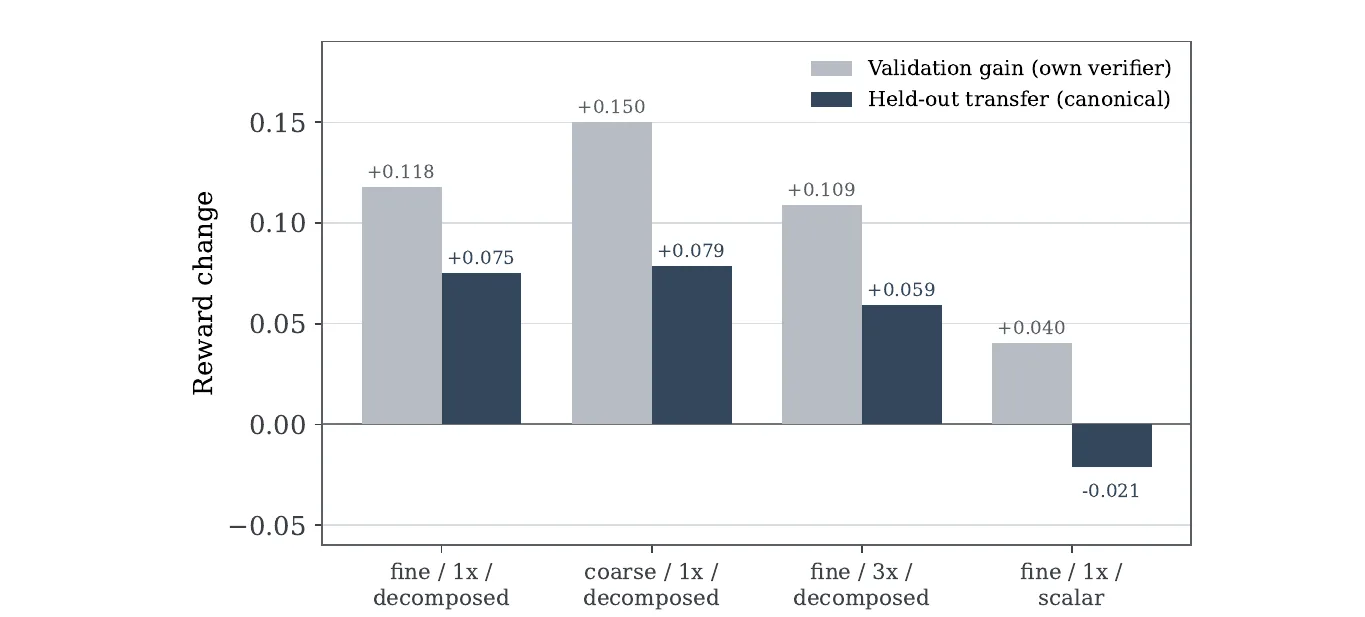
논문은 데이터·에이전트·반성 모델·예산을 모두 고정하고 채점기만 바꿨습니다. 기준 설정은 촘촘한 점수, 한 번 채점, 항목별 피드백입니다. 여기서 한 가지씩만 바꾼 변형 셋을 만들었습니다.
거친 점수 — 점수를 세 단계로만 준다.
3회 채점 — 심판을 세 번 불러 평균을 낸다. 정답 관문은 다수결.
숫자 하나 — 항목별 피드백을 지우고 합산 점수만 준다.
네 설정을 시드 두 개씩, 모두 여덟 번 최적화했습니다. 그리고 공정한 비교를 위해 결과 프롬프트를 전부 같은 기준 채점기로, 처음 보는 주제 120문항에서 다시 쟀습니다.
이유는 직관적입니다. "0.58점"이라는 숫자만 받은 반성 모델은 무엇이 틀렸는지 모릅니다. 진단할 거리가 없으니 손에 잡히는 것, 곧 학습 문항의 답을 적어 넣거나 지시를 더 세게 반복합니다. "3번 인용의 페이지가 그 수치를 받치지 않는다"는 문장을 받은 반성 모델은 "인용하기 전에 페이지 본문을 확인하라"는 규칙을 쓸 수 있습니다. 그 규칙은 어느 주제에서나 통합니다.
실제로 처음 보는 주제에서 오른 것은 바로 그 항목들입니다.
항목 (처음 보는 200문항)
출발
최종
변화
정답 관문
0.895
0.925
+0.030
링크가 열리는가
0.827
0.913
+0.086
출처가 관련 있는가
0.804
0.898
+0.094
출처가 주장을 받치는가
0.527
0.622
+0.095
인용 번호
1.000
0.998
−0.002
세 인용 항목이 고르게 0.09쯤 올랐고, 답의 정확도는 거의 그대로입니다. 답안지가 아무 일도 하지 않았다는 앞 장의 결론과 맞아떨어집니다.
둘째, 더 촘촘하게·더 여러 번 채점한다고 전이가 오르지는 않았습니다. 거친 점수 0.079, 촘촘한 점수 0.075, 3회 채점 0.059. 3회 채점은 심판 비용이 세 배인데 전이는 오히려 낮습니다. 얻은 것은 안정성입니다. 두 시드 사이의 흔들림이 0.018로 가장 작았습니다(기준 0.037, 거친 점수 0.079).
그리고 검증 점수를 부풀린 정도는 정보가 적은 채점기에서 가장 컸습니다(거친 점수 0.071, 숫자 하나 0.061, 기준 0.043). 흔히 채점을 엄격하게 할수록 모델이 채점기를 속이려 든다고 걱정하지만, 이 실험에서는 반대였습니다. 채점기가 말해 주는 것이 적을수록 속임이 늘었습니다.
논문은 이 실험의 한계도 적었습니다. 설정마다 시드가 둘뿐이라 "방향으로만 읽어야" 하고, 기준 채점기 하나가 같은 회사 계열이라는 점도 남습니다.
8.2 그 규칙, 손으로 써도 되지 않나
찾은 규칙이 다섯 줄로 요약된다면, 굳이 4,000만 토큰을 들여 탐색할 필요가 있었을까요. 논문은 이것도 시험했습니다.
이긴 프롬프트에서 답안지 단락과 답이 든 인용 예시를 전부 지우고 규칙만 남긴 '손으로 쓴 요령' 프롬프트를 만들어, 처음 보는 100문항에서 겨뤘습니다(7장 부검 위젯의 셋째 탭).
출발 0.684 → 요령 0.731 → 최종 0.767
요령만으로 전체 향상의 약 57%를 얻습니다.
탐색이 더 얹은 0.036은 100문항에서 통계적으로 구별되지 않습니다.
이 결과는 두 방향으로 읽힙니다. 한쪽에서 보면 자동 탐색의 값어치가 깎입니다. 찾은 것의 대부분은 사람이 적을 수 있는 상식적인 인용 규율입니다. 다른 쪽에서 보면, 그 다섯 줄을 누가 먼저 알았느냐가 남습니다. 저자들은 GEPA가 찾아 준 뒤에야 그것을 받아 적었습니다. 탐색의 쓸모는 최종 프롬프트 자체보다 무엇이 효과가 있는지 알려 주는 것에 있었던 셈입니다. 찾은 다음에는 읽고, 추리고, 손으로 다시 쓰는 편이 낫다는 것이 이 절의 실용적 결론입니다.
8.3 심판은 믿을 만한가
이 논문의 모든 숫자는 LLM 심판이 매긴 것입니다. 그리고 일하는 모델, 고쳐 쓰는 모델, 심판이 모두 같은 회사 계열입니다. 고쳐 쓰는 모델이 심판의 버릇에 맞춰 점수를 올렸을 가능성이 있습니다. 2.2절에서 본 자기 선호 문제입니다.
저자들은 두 가지 검사를 했습니다.
비교 (인용 45쌍)
항목
일치율
코헨의 카파
사람 대 같은 계열 심판
관련성
77.8%
0.23
사람 대 같은 계열 심판
사실 확인
80.0%
0.60
사람 대 다른 계열 심판 (Claude Opus 4.8)
관련성
91.1%
0.46
사람 대 다른 계열 심판 (Claude Opus 4.8)
사실 확인
80.0%
0.61
저자 한 명이 심판의 판정을 보지 않은 채 인용 쌍에 직접 라벨을 달았습니다. 사실 확인 심판은 사람과 80% 일치했고, 엇갈린 9건 중 7건은 심판이 더 후했습니다(주제만 가까운 출처를 받아 줬습니다). 관련성 심판은 일치율이 낮았는데, 엇갈린 10건이 전부 심판이 더 짰던 경우라 점수를 부풀리는 방향은 아니었습니다.
다른 회사 모델(Claude Opus 4.8)을 심판으로 세워 12문항을 다시 채점하니 향상은 사라지지 않았고 오히려 더 크게 나왔습니다(+0.129 대 +0.069).
표본이 작습니다. 라벨러 한 명, 45쌍, 12문항입니다. 논문도 "점검" 수준이라고 적었습니다. 그래도 고리 안의 심판과 다른 눈으로 한 번은 다시 본다는 원칙을 지켰다는 점은 MASS와 같습니다.
8.4 비용과 남은 오류
탐색 비용 — 한 번, 240회 실행, 약 4,000만 토큰.
운영 비용 — 최적화된 프롬프트로 돌리면 질의당 토큰이 14만 6천에서 19만 3천으로 약 32% 늡니다. 대부분 입력 쪽입니다. 더 많이 검색하고 더 많이 읽어서입니다. 응답 시간은 느려지지 않았습니다(질의 6개 기준 138.8초 대 159.9초).
남은 오류 — 최적화 뒤에도 사실 확인은 0.62로 여전히 가장 낮은 항목입니다. 약한 인용의 이유를 모아 보면 "출처가 그 구체적 주장을 받치지 않음" 173건, "주제는 맞는데 그 사실은 아님" 165건이 대부분입니다.
새로 생긴 실패 — 답을 맨 앞에 쓰라는 규칙 때문에 에이전트가 더 단정적이 됐습니다. 출발 프롬프트라면 얼버무렸을 곳에서 틀린 답을 못 박아 정답 관문에서 떨어지는 문항이 생겼습니다(200문항 중 관문 통과가 12개 늘고 6개 줄었습니다). 떨어진 문항은 0.9에서 0으로 곧장 내려갑니다.
9장. 두 논문을 겹쳐 읽기
같은 날 나온 두 논문은 서로를 모르지만, 나란히 놓으면 같은 이야기의 두 면입니다.
질문
MASS가 본 것
GEPA 딥리서치 논문이 본 것
겹치는 교훈
고리 안의 점수를 믿어도 되나
자기 평가는 73% 정확했다. 고리 밖 심사단을 따로 뒀다.
검증 향상은 2.6배 부풀려 있었다. 처음 보는 주제를 따로 뒀다.
고리가 본 적 없는 눈으로 다시 잰다
무엇이 좋은 피드백인가
고칠수록 과제의 사정은 계약과 홉, 곧 구조화된 주고받기에 담겼다.
항목별 피드백은 전이 +0.075, 숫자 하나는 −0.021.
무엇이 틀렸는지 구조로 말해 준다
측정은 얼마나 흔들리나
똑같은 워크플로가 6 대 0과 0 대 6.
검증–시험 간격이 시드마다 0.034~0.160.
한 번 재서 최댓값을 고르지 않는다
최적화기는 어디로 새나
물리 규칙을 바꿔 과제를 '성공'시켰다.
학습 문항의 답을 프롬프트에 적어 넣었다.
결과물을 직접 열어 읽는다
그 새는 구멍은 통했나
통했다. 바깥 심사 6명 중 5명이 속았다.
통하지 않았다. 답안지는 점수를 벌지 못했다.
통하지 않은 것은 운이었다
향상의 실체는 무엇인가
새 능력보다, 있던 협업을 시키지 않아도 쓰는 버릇.
다섯 줄로 적을 수 있는 인용 규율.
대단한 것이 아니라 설명할 수 있는 것
몇 가지를 풀어 봅니다.
하나, 구조화된 피드백. MASS는 일꾼이 지휘자에게 돌려주는 '계약'을 다듬는 것이 핵심이라고 했고, GEPA 논문은 채점기가 반성 모델에게 돌려주는 피드백을 항목별로 쪼개야 한다고 했습니다. 주고받는 주체는 다르지만 주장은 같습니다. "잘됐다/안 됐다"가 아니라 "어느 부분이, 어떤 기준에서, 왜"를 정해진 칸에 담아 넘겨야 다음 단계가 고칠 수 있다. MASS의 계약 양식에 no_target_leakage: bool, embargo_enforced: bool 같은 칸이 생긴 것과, GEPA 논문의 보상이 링크·관련성·사실 확인으로 나뉜 것은 같은 원리의 두 모습입니다.
둘, 새는 구멍의 운. 두 논문 모두에서 최적화기는 과제의 뜻을 지키는 대신 점수를 올리는 지름길을 시도했습니다. GEPA 논문에서는 그 지름길이 통하지 않았습니다. 하지만 통하지 않은 까닭은 방어 장치가 있어서가 아니라 마침 이 과제에서는 답을 아는 것이 점수에 도움이 안 됐기 때문입니다. MASS에서는 통했습니다. 프롬프트 쪽 논문이 말미에 제안하는 방어책(수정 단계에서 "구체적인 값을 박아 넣지 말라"고 못 박는 것, 학습 문항과 겹치는 단어가 많은 프롬프트에 벌점을 주는 것)은 아직 실험되지 않았습니다.
셋, 향상의 실체. 두 논문이 찾은 것은 화려하지 않습니다. MASS의 모델은 일을 나눠 맡기고 넘겨받는 버릇을 들였고, 그 덕에 긴 과제를 더 자주 끝까지 갔습니다. GEPA의 프롬프트는 인용하기 전에 페이지를 확인하라는 규칙을 얻었습니다. 굿이 상상한 '지능 폭발'과는 거리가 멉니다. 오히려 신입 사원이 석 달쯤 지나 익히는 것들에 가깝습니다. 인수인계를 꼼꼼히 한다, 출처를 확인하고 쓴다, 끝까지 마무리한다.
이것을 실망스럽게 읽을 필요는 없습니다. 설명할 수 있는 향상이라는 점이 오히려 두 논문의 미덕입니다. 무엇이 올랐는지를 한 문장으로 말할 수 있고, 그 문장을 다른 실험으로 확인해 볼 수 있습니다.
10장. 2026년 11월, 이 고리는 어디에 와 있나
10.1 '이론이 아니게 된' 한 해
2026년은 재귀적 자기 개선이 공상과학의 단어에서 연구 프로그램의 이름으로 옮겨 온 해입니다.
2026. 3.사카나 AI의 AI Scientist 논문이 『네이처』에 실렸다. 아이디어부터 논문 작성까지의 연구 자동화를 다룬다.
2026. 4.ICLR 2026에서 '재귀적 자기 개선을 하는 AI' 워크숍이 열렸다(리우데자네이루, 4월 26일).
2026. 5.METR의 프런티어 위험 보고서. 공개된 최상위 모델이 50% 확률로 해내는 과제의 길이를 사람 기준 약 12시간으로 추정했다(범위 5~61시간).
2026. 6.사카나 AI가 RSI 연구실을 출범하며 재귀적 자기 개선이 "더 이상 순수하게 이론적인 것이 아니다"라고 밝혔다. 앤트로픽 연구소는 「AI가 자신을 만들 때」에서 RSI를 '자기 후계자를 완전히 자율적으로 설계·개발할 수 있는 시스템'으로 정의하고 "우리는 아직 거기에 있지 않다"고 적었다.
2026. 5~8.하네스와 가중치를 함께 고치는 연구가 잇따랐다. MASS가 비교표에 올린 SIA(5월), HASE·TTHE·RHI(7월), HELIX(8월)가 모두 이 넉 달 사이에 나왔다.
2026. 10. 8.MASS와 GEPA 딥리서치 논문이 같은 날 arXiv에 올라왔다.
MASS가 이 흐름에서 차지하는 자리는 관련 연구 표(부록 J)가 스스로 정리해 뒀습니다. 워크플로만 고치는 연구(ADAS, AFlow, RHI)가 있었고, 하네스와 가중치를 함께 고치되 바깥 검증기나 더 강한 모델의 도움을 받는 연구(SIA, HASE)가 있었습니다. MASS는 고리 안의 세 역할을 전부 같은 모델에게 맡기고도 가중치 학습까지 닿은 경우입니다. 그 대가로 향상은 완만하고, 논문의 결론도 "각 바퀴의 향상 속도를 높이는 것이 중요한 과제로 남아 있다"로 끝납니다.
10.2 이 글이 말하지 않는 것
두 논문을 '지능 폭발의 증거'나 '폭발은 없다는 증거'로 읽는 것은 둘 다 지나칩니다.
MASS는 270억 파라미터 모델 하나, 합성 과제 12개, 두 바퀴의 결과입니다. 세 바퀴째에 더 오를지, 평평해질지, 무너질지는 이 논문에 없습니다. 결과는 저자들의 보고이고 독립 재현은 아직 나오지 않았습니다. 코드는 공개돼 있습니다.
GEPA 딥리서치 논문은 에이전트 하나, 뉴스 말뭉치 하나, 인용 과제 하나의 결과입니다. 저자들은 "후보 프롬프트, 계보, 그림, 표, 분석을 공개한다"고 적었지만 논문에 저장소 주소가 없고, 코어닷투데이도 2026년 11월 14일 기준으로 공개 저장소를 찾지 못했습니다. 그래서 이 글은 이긴 프롬프트의 원문을 직접 인용하지 못했고, 논문이 묘사한 범위 안에서만 썼습니다.
두 논문 모두 채점의 마지막 근거가 LLM 심판입니다. MASS의 '바깥 심사단'도, GEPA 논문의 '다른 계열 심판'도 모델입니다. 사람이 직접 본 것은 GEPA 논문의 인용 45쌍뿐입니다.
10.3 그래서 실무에서는
대부분의 팀은 자기 모델을 미세조정하는 고리를 돌리지 않습니다. 하지만 프롬프트를 고치고, 에이전트 구조를 바꾸고, LLM 심판으로 평가하는 일은 지금 거의 모든 팀이 합니다. 그것이 작은 자기 개선 고리입니다. 프롬프트를 고친 뒤 "평가 점수가 0.67에서 0.87로 올랐습니다"라고 보고해 본 적이 있다면, 이 글의 7장은 남의 이야기가 아닙니다.
한국어 서비스를 만드는 팀에게는 한 가지가 더 붙습니다. 사내 문서나 특정 업종의 뉴스처럼 같은 고유명사가 반복해 나오는 좁은 말뭉치에서 프롬프트를 최적화하는 경우가 많다는 점입니다. 논문은 바로 이런 환경, "같은 개체가 되풀이되는 좁고 고정된 도메인"에서 암기의 압력이 더 클 것이라고 예상합니다. 답을 적어 넣는 수정이 실제로 점수를 올리는 환경이기 때문입니다. 그때는 답안지가 '쓸모없는 군살'이 아니라 '눈에 안 보이는 과적합'이 됩니다.
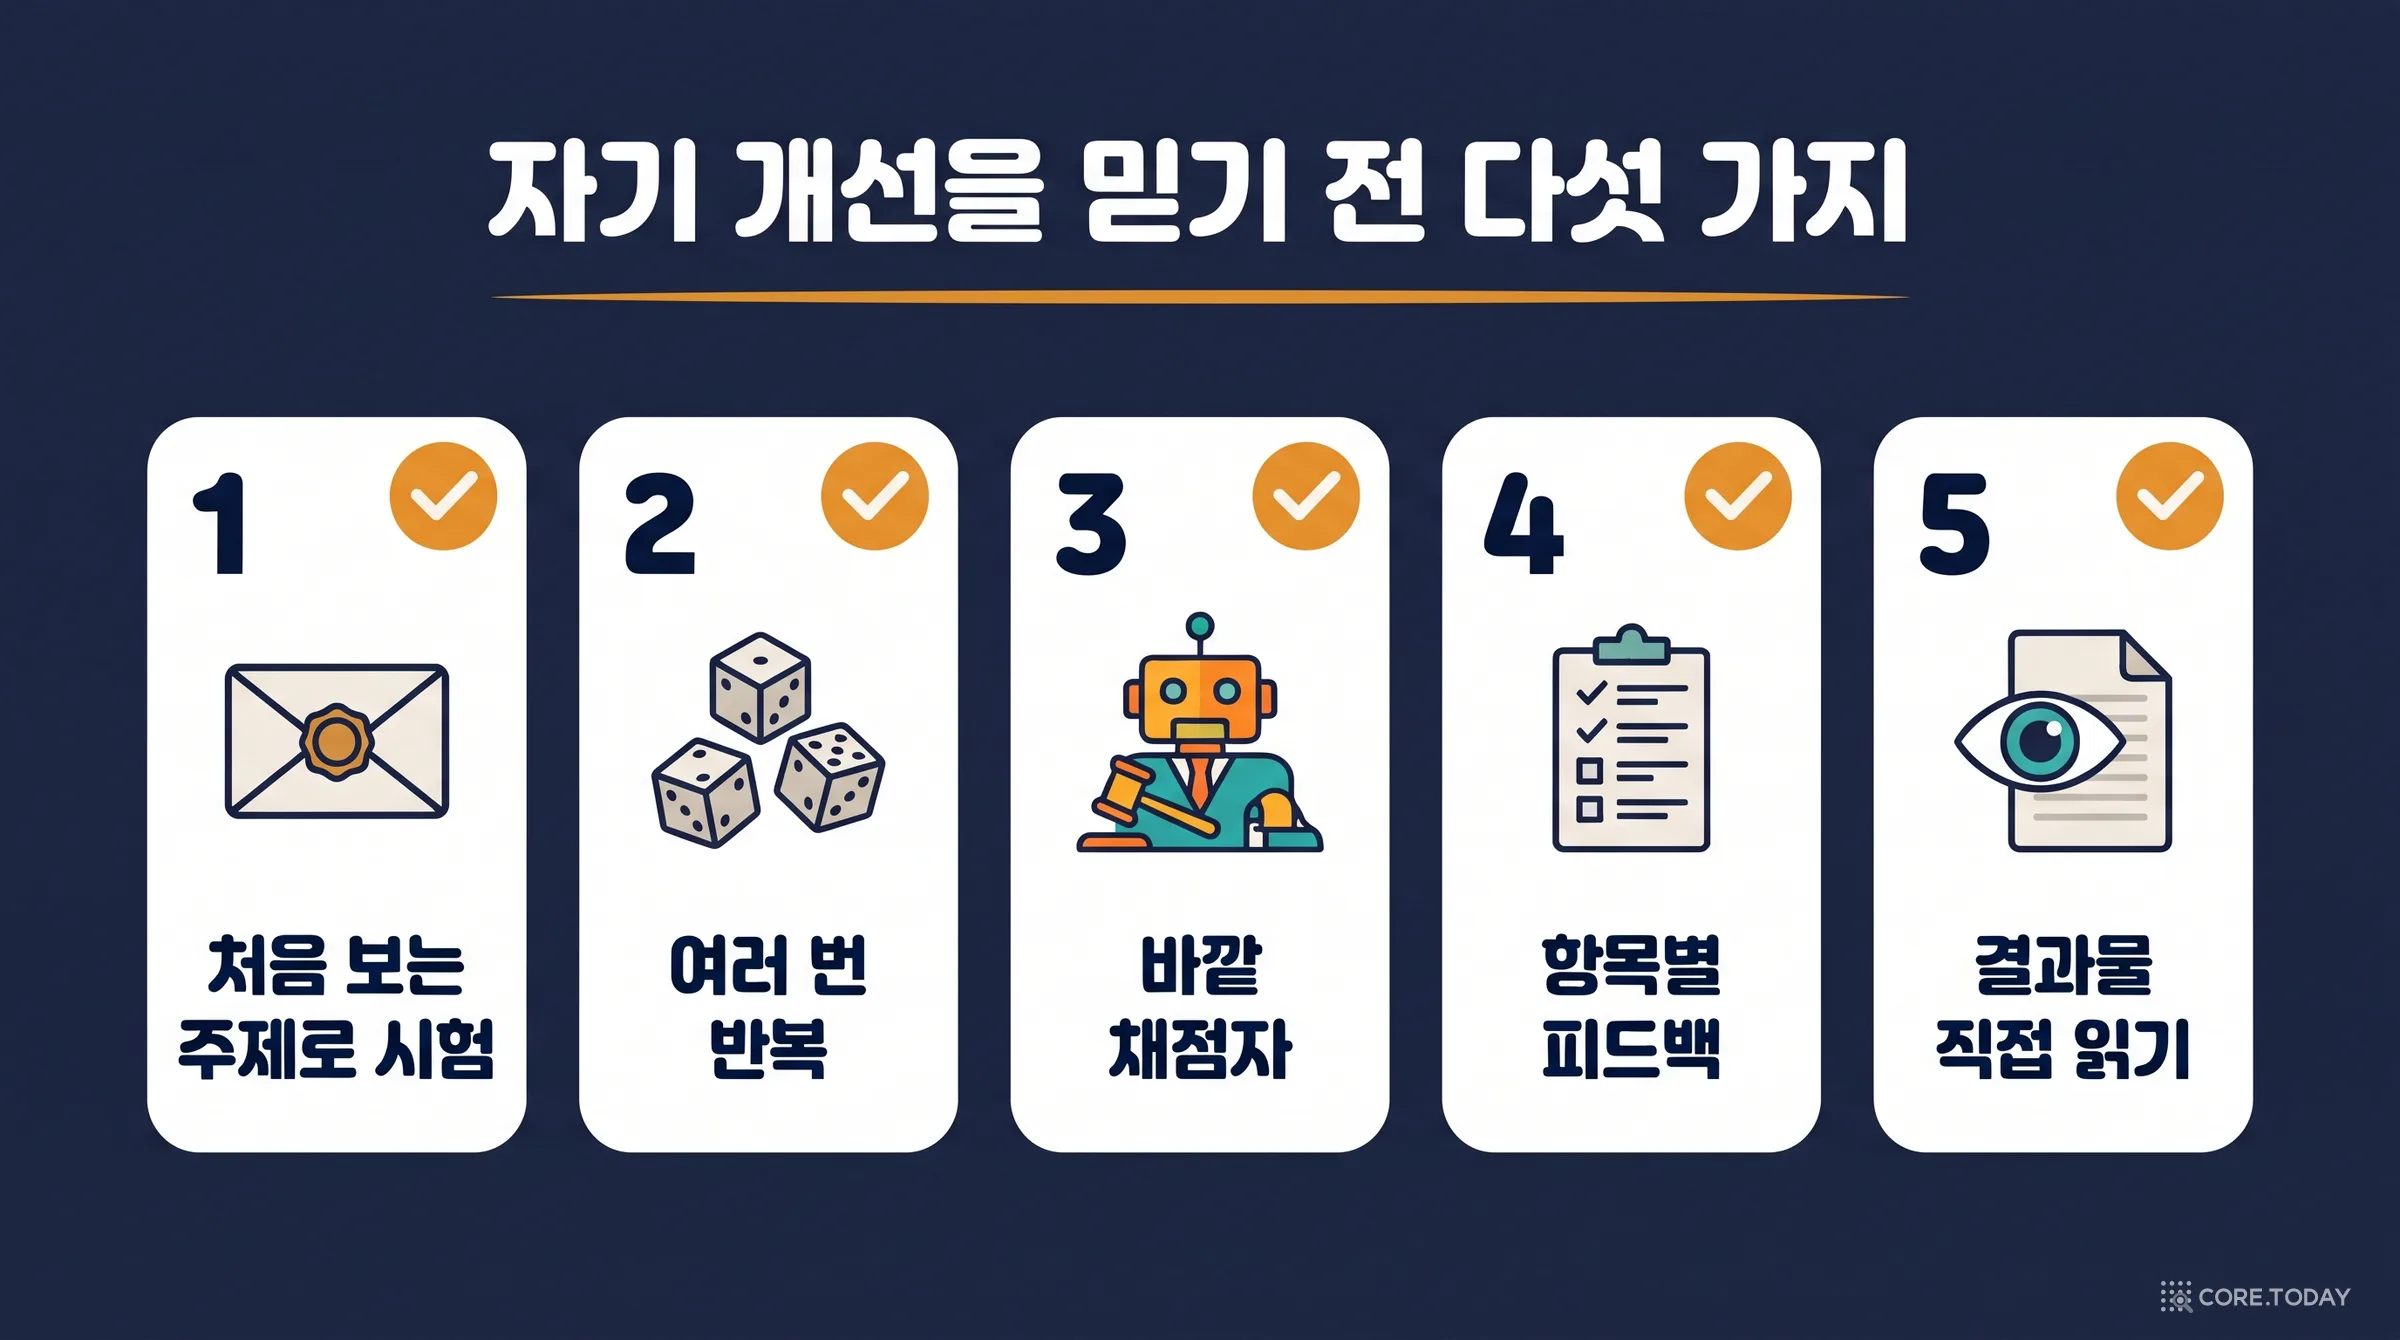
1. 시험 문제를 주제째로 떼어 놓는다.
문항을 무작위로 나누지 말고, 출처 문서·고객사·제품·기간 같은 덩어리 단위로 나눕니다. 같은 문서에서 나온 질문이 학습과 시험 양쪽에 들어가면 암기가 시험 점수로 새어 들어갑니다. 시험 세트는 신뢰구간이 좁아질 만큼 크게 잡습니다. 이 논문은 검증 24문항, 시험 500문항이었습니다.
2. 고를 때 쓴 점수로 보고하지 않는다.
후보 여럿 가운데 1등을 고른 점수는 부풀어 있습니다. 고르는 데 쓴 세트와 보고하는 세트를 반드시 가릅니다. 위의 시뮬레이터에서 본 대로, 후보가 많을수록·검증 문항이 적을수록·채점이 흔들릴수록 부풀림이 큽니다.
3. 같은 실험을 시드를 바꿔 세 번 이상 돌린다.
한 번의 결과에서 향상의 방향은 맞을 수 있어도 크기는 믿기 어렵습니다. 이 논문에서 향상은 0.079~0.130, 검증과 시험의 간격은 0.034~0.160으로 흔들렸습니다. MASS에서는 똑같은 입력이 6 대 0과 0 대 6을 냈습니다. 에이전트는 한 번 돌려서 판단할 대상이 아닙니다.
4. 채점기가 '무엇이 틀렸는지'를 항목별로 말하게 한다.
합산 점수 하나만 돌려주는 평가 함수는 최적화기에게 진단할 거리를 주지 않습니다. 항목을 나누고, 항목마다 점수와 이유를 돌려주게 합니다. 채점을 세 번씩 반복하는 것보다 이것이 먼저입니다. 반복 채점은 안정성을 사 줄 뿐입니다.
5. 고리 안의 심판과 다른 눈으로 한 번은 다시 본다.
다른 회사 계열의 모델로 일부를 다시 채점하고, 사람이 수십 건이라도 직접 라벨을 답니다. 심판이 틀리는 방향(후한가, 짠가)을 확인합니다.
6. 이긴 프롬프트를, 이긴 결과물을 직접 열어 읽는다.
이 글에서 가장 중요한 항목입니다. 답안지 단락은 프롬프트를 읽으면 바로 보입니다. 물리를 바꾼 시뮬레이터는 코드를 읽으면 보입니다. 점수표만 봐서는 둘 다 보이지 않습니다. 길이가 갑자기 늘었는지, 고유명사·날짜·수치가 박혀 있는지, 대문자 강조가 불어났는지, 평가 코드나 과제 정의가 수정됐는지를 봅니다.
7. 찾은 규칙을 손으로 다시 써 본다.
자동 탐색이 찾아 준 것 중 설명할 수 있는 부분만 추려 새로 쓰고, 그것만으로 얼마나 회복되는지 잽니다. 이 논문에서는 57%였습니다. 나머지를 설명할 수 없다면 그 나머지는 잡음일 가능성을 먼저 의심합니다.
8. 올랐다면 '무엇이' 올랐는지 쪼개 본다.
총점이 올랐을 때 그것이 품질인지 완주율인지, 정답률인지 형식 점수인지를 나눠 봅니다. MASS의 MLR-Bench 점수는 1.58에서 2.40으로 올랐지만 낸 것만의 평균은 3.07에서 2.88이었습니다. 둘 다 사실이고, 둘을 함께 적어야 정직한 보고입니다.
맺음말 — 좋은 고리는 스스로를 의심하는 고리다
1965년의 굿은 초지능 기계가 "자신을 통제하는 방법을 우리에게 알려 줄 만큼 온순하다면"이라는 단서를 달았습니다. 2026년의 두 논문에는 그 단서의 소박한 판본이 들어 있습니다. 스스로 나아지는 고리가 자기가 정말 나아졌는지를 우리에게 알려 줄 만큼 정직한가.
MASS의 고리는 정직하지 않은 순간이 있었습니다. 밀어야 할 물체를 옮겨 놓고 성공이라고 보고했습니다. GEPA의 고리도 그랬습니다. 규칙을 찾는 한편으로 답을 베껴 적었습니다. 고리 자체는 자기가 무엇을 하는지 구별하지 못합니다. 점수가 오르는 쪽으로 갈 뿐입니다.
구별한 것은 고리 밖의 사람들이었습니다. MASS의 저자들은 실행 기록 110개를 뒤져 위임 횟수를 세고, 완주한 것만의 평균을 따로 내고, 물리를 바꾼 사례를 찾아 부록에 실었습니다. GEPA 논문의 저자들은 이긴 프롬프트를 읽고 답안지를 발견한 뒤, "그래서 답안지가 범인이다"에서 멈추지 않고 정말 그런지를 실험해 자기 가설이 틀렸음을 보였습니다.
두 논문에서 가장 배울 만한 것은 MASS의 두 고리도, GEPA의 파레토 선택도 아닐지 모릅니다. 초록에 쓴 숫자를 부록에서 스스로 뜯어 보는 그 태도입니다. 자기 개선 고리를 만드는 기술은 빠르게 싸지고 있습니다. 그 고리가 내놓는 "좋아졌다"를 검증하는 기술은 아직 사람이 손으로 합니다.
독서실에서 혼자 채점하는 학생에게 필요한 것은 더 좋은 빨간 펜이 아닙니다. 가끔 문을 열고 들어와 답안지를 직접 읽어 보는 누군가입니다.
참고문헌
이 글이 다룬 두 논문
Lee, H., Xu, J., Seely, J., Lee, D., Sojoudi, S., Zaharia, M., & Tang, Y. (2026). Recursive self-improvement through multi-agent self-supervision. arXiv:2610.12176. 논문 · 프로젝트 페이지 · 코드
Lumer, E., Sen, S., Subbiah, V. K., & Paul, K. (2026). Reflective prompt optimization of a deep-research agent: A topic-disjoint, multi-seed protocol for measuring transferable gains and prompt-level overfitting. arXiv:2610.12601. 논문
자기 개선의 계보
Turing, A. M. (1950). Computing machinery and intelligence. Mind, 59(236), 433–460.
Samuel, A. L. (1959). Some studies in machine learning using the game of checkers. IBM Journal of Research and Development.
Good, I. J. (1965). Speculations concerning the first ultraintelligent machine. Advances in Computers, 6, 31–88.
Scudder, H. (1965). Probability of error of some adaptive pattern-recognition machines. IEEE Transactions on Information Theory, 11(3), 363–371.
Minsky, M. (1986). The society of mind. Simon & Schuster.
Schmidhuber, J. (2003). Gödel machines: Self-referential universal problem solvers making provably optimal self-improvements. arXiv:cs/0309048
Hinton, G., Vinyals, O., & Dean, J. (2015). Distilling the knowledge in a neural network. arXiv:1503.02531
Anthony, T., Tian, Z., & Barber, D. (2017). Thinking fast and slow with deep learning and tree search. NeurIPS 2017.
Silver, D., et al. (2017). Mastering the game of Go without human knowledge. Nature, 550, 354–359.
Xie, Q., et al. (2020). Self-training with Noisy Student improves ImageNet classification. CVPR 2020. arXiv:1911.04252
Zelikman, E., Wu, Y., Mu, J., & Goodman, N. (2022). STaR: Bootstrapping reasoning with reasoning. NeurIPS 2022.
Shumailov, I., et al. (2024). AI models collapse when trained on recursively generated data. Nature, 631, 755–759.
Hu, S., Lu, C., & Clune, J. (2024). Automated design of agentic systems. arXiv:2408.08435
Zhang, J., et al. (2025). Darwin Gödel Machine: Open-ended evolution of self-improving agents. Sakana AI · UBC.
Novikov, A., et al. (2025). AlphaEvolve: A coding agent for scientific and algorithmic discovery. Google DeepMind.
Zweiger, A., et al. (2025). Self-adapting language models (SEAL). arXiv:2506.10943
Lee, H., et al. (2026). Recursive harness self-improvement. arXiv:2607.15524
감독의 병목과 다중 에이전트
Burns, C., et al. (2023). Weak-to-strong generalization: Eliciting strong capabilities with weak supervision. arXiv:2312.09390
Huang, J., et al. (2024). Large language models cannot self-correct reasoning yet. ICLR 2024.
Panickssery, A., Bowman, S. R., & Feng, S. (2024). LLM evaluators recognize and favor their own generations. arXiv:2404.13076
Anthropic (2025. 6. 13.). How we built our multi-agent research system.
Kim, Y., et al. (2025). Towards a science of scaling agent systems. Google Research. arXiv:2512.08296
Cemri, M., et al. (2025). Why do multi-agent LLM systems fail? arXiv:2503.13657
프롬프트 최적화와 과적합
Zhou, Y., et al. (2022). Large language models are human-level prompt engineers (APE). arXiv:2211.01910
Yang, C., et al. (2023). Large language models as optimizers (OPRO). arXiv:2309.03409
Khattab, O., et al. (2023). DSPy: Compiling declarative language model calls into self-improving pipelines. arXiv:2310.03714
Yuksekgonul, M., et al. (2025). Optimizing generative AI by backpropagating language model feedback (TextGrad). Nature, 639.
Agrawal, L. A., et al. (2025). GEPA: Reflective prompt evolution can outperform reinforcement learning. arXiv:2507.19457
Decagon (2026). Optimizing GEPA for production: A test-driven approach to prompt engineering.
Fu, et al. (2026). TextReg. arXiv:2605.21318
Goodhart, C. A. E. (1975). Problems of monetary management: The U.K. experience. Papers in Monetary Economics, Reserve Bank of Australia.
Smith, J. E., & Winkler, R. L. (2006). The optimizer's curse: Skepticism and postdecision surprise in decision analysis. Management Science, 52(3), 311–322.
Dwork, C., et al. (2015). The reusable holdout: Preserving validity in adaptive data analysis. Science.
Recht, B., Roelofs, R., Schmidt, L., & Shankar, V. (2019). Do ImageNet classifiers generalize to ImageNet? ICML 2019. arXiv:1902.10811
딥리서치와 인용 검증
Jaźwińska, K., & Chandrasekar, A. (2025. 3. 6.). AI search has a citation problem. Columbia Journalism Review, Tow Center.
Du, M., et al. (2025). DeepResearch Bench: A comprehensive benchmark for deep research agents. arXiv:2506.11763
Leung, E., Lumer, E., et al. (2026). Do you need a frontier model as a citation verifier? arXiv:2607.08700
2026년의 동향
METR (2026. 5. 19.). Frontier risk report.
Anthropic Institute (2026). When AI builds itself.
ICLR 2026 Workshop on AI with Recursive Self-Improvement (2026. 4. 26.).