GEPA프롬프트 최적화반성강화학습GRPODSPyMIPROv2파레토 프런티어진화 알고리즘복합 AI 시스템컨텍스트 엔지니어링ICLR 2026특집
[특집] 점수 대신 첨삭으로 배운다 — GEPA, 프롬프트가 스스로 진화해 강화학습을 이긴 방법
강화학습은 시도 한 번에 점수 하나를 받는다. 그런데 AI가 일한 흔적은 전부 글이다 — 생각의 과정, 도구 호출, 컴파일러 오류 메시지까지. 그렇다면 점수 대신 그 글을 읽고 배우게 하면 어떨까? UC 버클리·스탠퍼드·MIT 등 17명이 쓴 GEPA(ICLR 2026 구두 발표)는 이 질문에 답한다. 실패한 기록을 언어 모델이 직접 읽고 반성해 프롬프트를 고치고, 고친 프롬프트들을 '문항별 1등'이라는 파레토 기준으로 살려 두며 진화시킨다. 그 결과 여섯 과제에서 가중치를 고치는 강화학습(GRPO, 24,000 롤아웃)보다 평균 6점, 최대 20점 높았고, 롤아웃은 최대 35배 적게 썼다. 이 글은 '생각해 보자, 차근차근'이라는 주문에서 시작한 프롬프트 최적화의 역사, 반성·진화·파레토라는 세 기둥, 논문의 표와 그림, 수학 문제에서는 강화학습에 진 이유, 그리고 에이전트가 경험을 글로 쌓아 가는 2026년에 이 아이디어가 맡는 역할을 인터랙티브 6개와 일러스트 13장으로 풀어 본다.
같은 날 입사한 신입 두 명이 있다고 해 봅시다. 둘 다 고객 문의 답장을 쓰는 일을 맡았습니다.
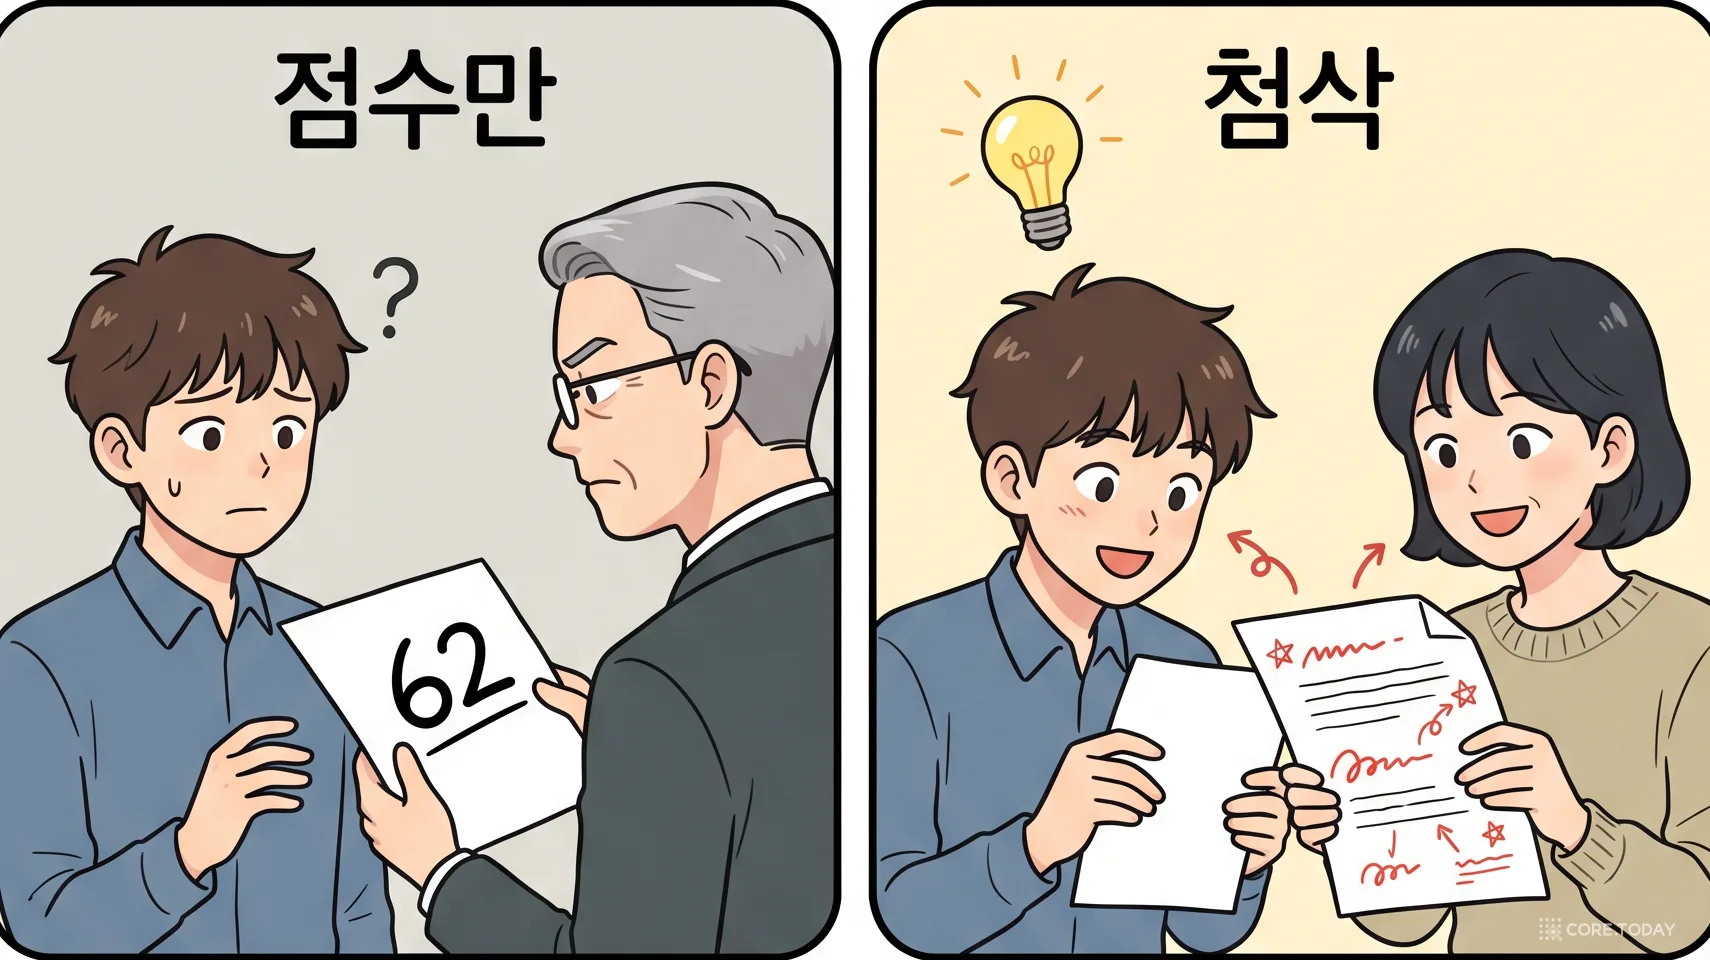
첫 번째 신입의 팀장은 답장을 읽고 점수만 돌려줍니다. "62점." 다음 날은 "58점." 그다음 날은 "71점." 신입은 무엇이 좋았고 무엇이 나빴는지 모릅니다. 할 수 있는 일은 이것저것 바꿔 보며 점수가 오르는 방향을 더듬어 찾는 것뿐입니다. 수백 통을 쓰고 나면 감이 생기겠지요.
두 번째 신입의 사수는 같은 답장에 빨간 펜으로 첨삭을 해 줍니다. "환불 문의에는 14일 기한을 꼭 적어요." "화가 난 고객에게는 첫 문장에서 사과부터." "세 문장이 넘으면 상담 창에서 잘려요." 이 신입은 열 통쯤 쓰고 나면 팀의 규칙을 거의 다 압니다. 게다가 그 규칙을 수첩에 적어 둘 수 있습니다. 내일 다른 사람이 그 수첩을 펼쳐도 같은 규칙으로 일할 수 있습니다.
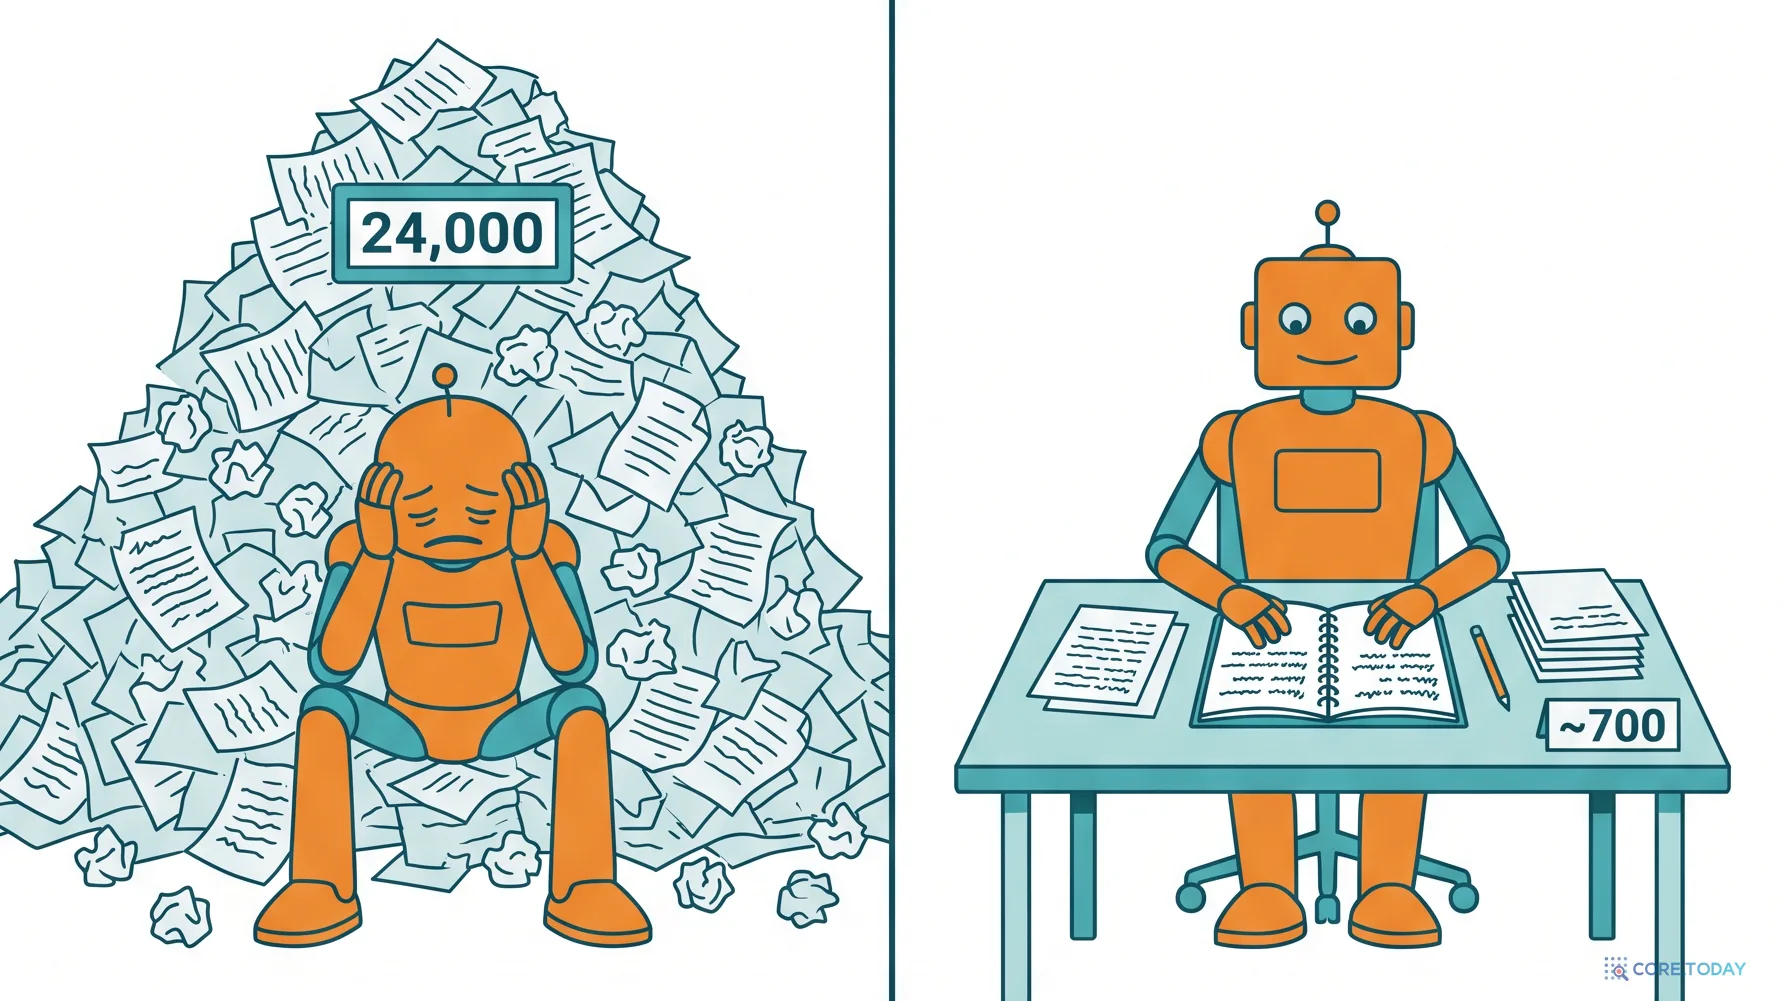
오늘날 거대 언어 모델(LLM)을 특정 업무에 맞게 길들이는 대표적인 방법인 강화학습은 첫 번째 신입과 닮았습니다. 모델에게 문제를 풀게 하고, 정답이면 1점, 오답이면 0점을 줍니다. 모델은 그 숫자를 바탕으로 수십억 개의 내부 숫자(가중치)를 조금씩 고칩니다. 잘 작동하지만, 대개 수만 번의 시도가 필요합니다.
2025년 7월 25일, UC 버클리·스탠퍼드·MIT·데이터브릭스 등의 연구자 17명이 arXiv에 올린 논문 「GEPA: Reflective Prompt Evolution Can Outperform Reinforcement Learning」(반성적 프롬프트 진화는 강화학습을 능가할 수 있다)은 두 번째 신입의 방식을 AI에 적용했습니다. 착안은 단순합니다.
AI 시스템이 일한 흔적은 전부 글이다. 지시문, 생각의 과정, 도구 호출, 도구가 돌려준 결과, 심지어 채점기가 점수를 매기기 직전에 뱉은 컴파일러 오류 메시지까지. 이 글을 0과 1로 뭉개 버리지 말고, 언어 모델이 직접 읽고 반성하게 하면 훨씬 적은 시도로 배울 수 있지 않을까?
이름 GEPA는 Genetic-Pareto(유전-파레토)의 줄임말입니다. 실패한 기록을 읽고 프롬프트를 고치는 반성, 고친 프롬프트들을 한 세대씩 이어 가는 유전적 진화, 그리고 평균 1등 하나만 고집하지 않고 '문항별 1등'들을 살려 두는 파레토 선택이 세 기둥입니다.
결과는 제목만큼 도발적이었습니다. 여섯 과제에서 GEPA는 가중치를 고치는 강화학습 GRPO(24,000번 시도)보다 평균 6점, 최대 20점 높았고, 시도 횟수는 최대 35배 적었습니다. 당시 가장 널리 쓰이던 프롬프트 최적화기 MIPROv2보다도 모든 과제·모델에서 높았습니다. 논문은 2026년 2월 개정판(v2)과 함께 ICLR 2026 구두 발표(Oral)로 채택됐고, 코드는 오픈소스로 공개되어 DSPy를 비롯한 여러 AI 개발 도구에 기본 최적화기로 들어갔습니다.
이 글의 핵심 숫자 (논문 v2 기준)
+5.94점 — Qwen3 8B, 여섯 과제 평균에서 GEPA(54.85)가 GRPO(48.91)를 앞선 폭 24,000 vs 678 — IFBench에서 GRPO가 쓴 롤아웃 수와, GEPA가 더 높은 시험 점수를 낸 시점의 롤아웃 수 (35배) 79~737회 — 최고 성능까지 GEPA가 '배우는 데' 쓴 훈련 롤아웃. 나머지 예산은 후보 비교(검증)에 썼다 +13.33점 — GPT-4.1 Mini에서 GEPA+Merge의 평균 향상. MIPROv2는 +5.64점 86달러 — GPT-4.1 Mini 표 전체에서 GEPA 실험에 든 API 비용 32 vs 38 — GEPA가 GRPO에 진 유일한 과제, AIME-2025 수학
이 글은 GEPA가 왜 나왔는지에서 출발합니다. 프롬프트가 왜 그렇게 예민한지, 강화학습은 왜 비싼지, '생각해 보자, 차근차근'이라는 주문에서 시작한 프롬프트 최적화가 어떤 길을 걸어왔는지 먼저 살핍니다. 그다음 GEPA의 알고리즘을 그림과 표로 뜯어보고, 직접 만져 볼 수 있는 인터랙티브로 확인합니다. 마지막으로 이 논문이 말하지 않은 것, 그리고 에이전트가 경험을 글로 쌓아 가는 2026년에 이 아이디어가 어디에 쓰이는지 정리합니다.
1장왜 이 논문이 나왔나 — 프롬프트의 변덕, 여러 모듈로 된 AI 시스템의 '누구 탓' 문제, 강화학습의 비용, 그리고 카파시가 이름 붙인 '시스템 프롬프트 학습'.
2장주문에서 최적화기로 — 소프트 프롬프트, '심호흡을 하고', 텍스트 경사, 진화 알고리즘, 반성하는 에이전트, DSPy. GEPA가 물려받은 일곱 갈래의 계보.
3장GEPA 해부 — 진화 루프, 반성과 피드백 함수, 파레토 선택, 시스템을 아는 교배(Merge). 인터랙티브 셋으로 직접 돌려 봅니다.
4~5장실험 읽기 — 여섯 과제와 두 모델, 여섯 가지 관찰, 한 줄짜리 프롬프트가 905단어로 자라는 과정. 그리고 커널 코드 생성과 '꿀은 상하지 않는다'로 시작하는 적대적 프롬프트.
6~8장한계와 반론, 2026년의 GEPA 생태계, 실무에 쓰기 위한 체크리스트.
1. 왜 이 논문이 나왔나 — 세 가지 막다른 길
1.1 프롬프트는 왜 이렇게 예민한가
LLM을 써 본 사람이라면 한 번쯤 겪었을 겁니다. 문장 하나를 바꿨을 뿐인데 결과가 확 달라집니다. 이 '변덕'은 기분 탓이 아니라 여러 연구가 숫자로 확인한 사실입니다.
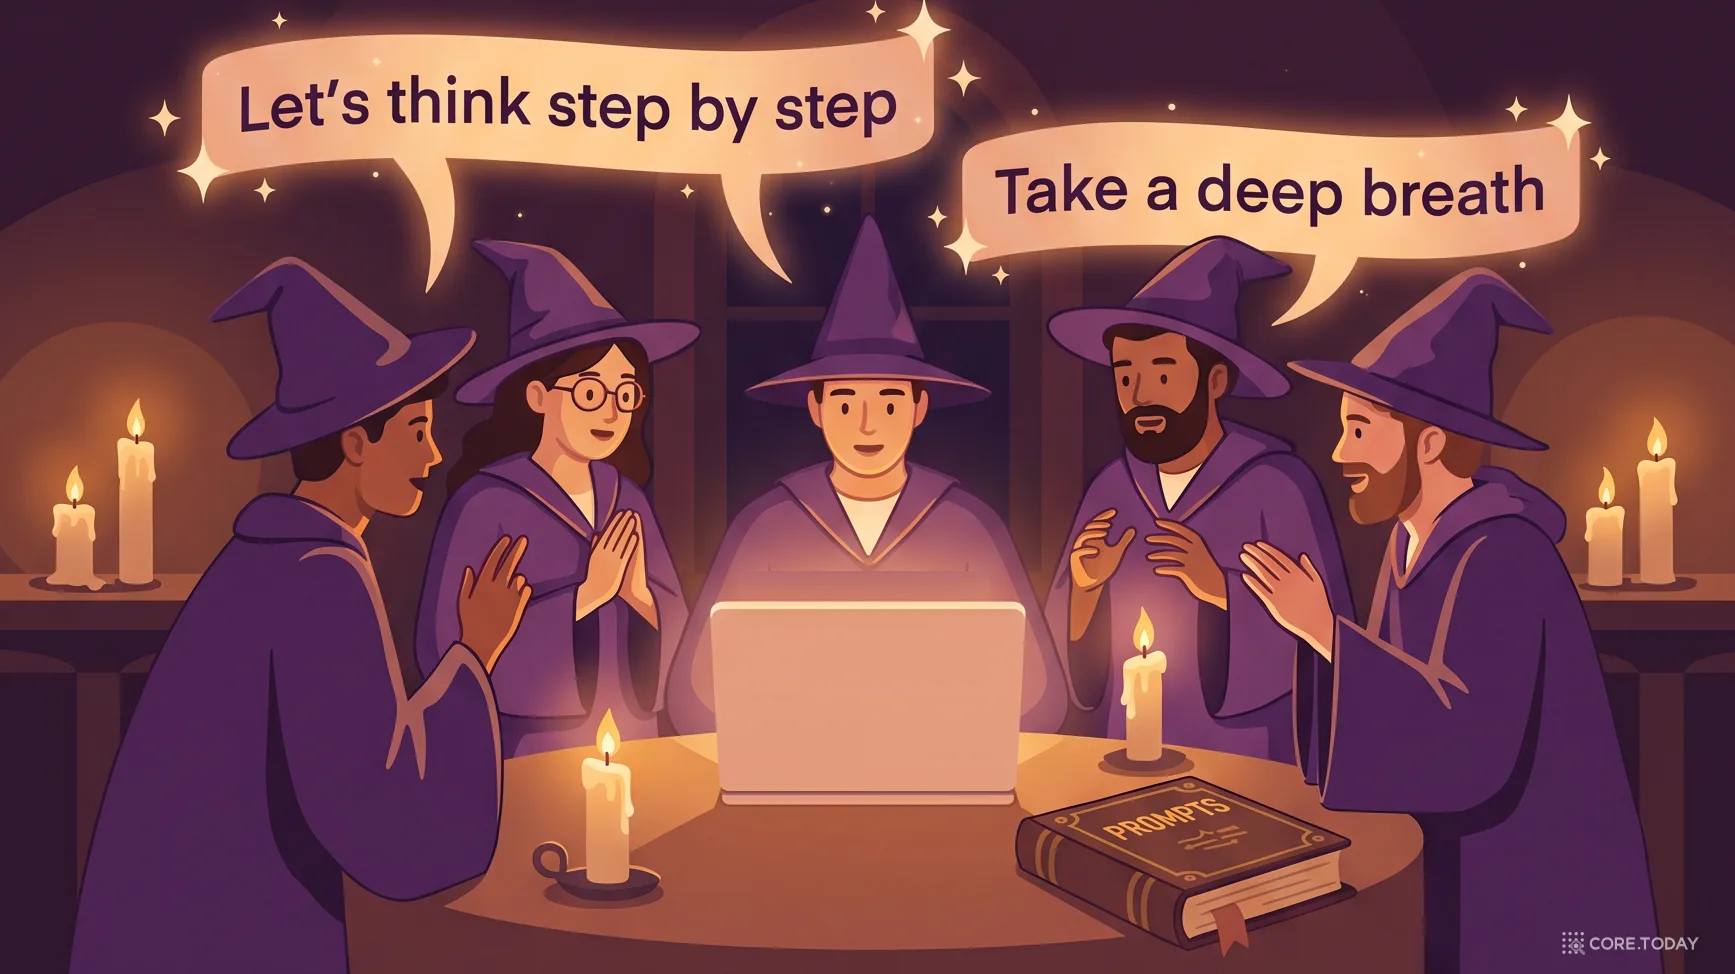
2022년 도쿄대와 구글 연구진(고지마 외)은 수학 문제 앞에 "Let's think step by step(차근차근 생각해 보자)" 한 줄을 붙이자 GPT-3 계열 모델(text-davinci-002)의 MultiArith 정답률이 17.7%에서 78.7%로 뛰는 것을 보였습니다. 같은 자리에 "Abrakadabra!(수리수리 마수리)"를 넣으면 15.5%, "생각하지 말고 느껴라"를 넣으면 18.8%였습니다. 마법 주문 같은 한 줄이 정답률을 네 배 넘게 바꾼 것입니다.
2023년 구글 딥마인드의 OPRO 논문은 LLM에게 직접 더 좋은 주문을 찾게 했습니다. PaLM 2 모델로 초등 수학 문제집 GSM8K를 풀게 했더니 문구마다 점수가 이렇게 갈렸습니다.
지시 없음
34.0
"함께 문제를 차근차근 풀어 보자"
49.4
"함께 풀어 보자"
60.5
"차근차근 생각해 보자"
71.8
"이걸 쪼개 보자"
79.9
"심호흡을 하고 차근차근"
80.2
막대 폭은 가장 높은 80.2점을 기준으로 잡았습니다. 눈여겨볼 곳은 두 번째 줄입니다. 71.8점짜리 "차근차근 생각해 보자"와 60.5점짜리 "함께 풀어 보자"를 합쳐 "함께 문제를 차근차근 풀어 보자"로 만들었더니 오히려 49.4점으로 떨어졌습니다. 좋은 문구 두 개를 합치면 더 좋아질 거라는 사람의 직관이 통하지 않습니다. 그 뒤 딥마인드의 Promptbreeder는 같은 과제에서 "SOLUTION"이라는 한 단어로 83.9점을 냈습니다.
형식은 더 심합니다. 2023년 워싱턴대 연구진(스클라 외, ICLR 2024)은 의미가 같은 프롬프트의 서식만 바꿔 봤습니다. passage:{} 를 passage {} 로, 콜론 하나를 지웠을 뿐인데 LLaMA-2 모델의 정답률이 4.3%에서 82.6%로 움직였습니다. 같은 과제에서 서식만 바꿔 생긴 정답률의 폭은 최대 76점이었습니다.
이런 결과가 쌓이면서 업계에는 '프롬프트 엔지니어'라는 직함이 생겼고, 동시에 질문도 생겼습니다. 사람이 주문을 손으로 찾는 일을 기계가 대신할 수는 없을까? 2장에서 볼 프롬프트 최적화 연구의 흐름이 바로 이 질문에 대한 답들입니다.
1.2 모듈이 여럿이면 '누구 탓'인지 모른다
2024년 무렵부터 LLM 애플리케이션의 모양이 바뀌었습니다. 질문 하나에 모델을 한 번 부르는 대신, 모델 호출 여러 개와 도구를 엮은 시스템을 만들기 시작한 것입니다. 버클리 연구진은 이를 복합 AI 시스템(compound AI system)이라고 불렀습니다.
예를 들어 "2011년 마데이라 제도 전체 인구는?"이라는 질문에 답하는 시스템은 이렇게 생겼습니다.
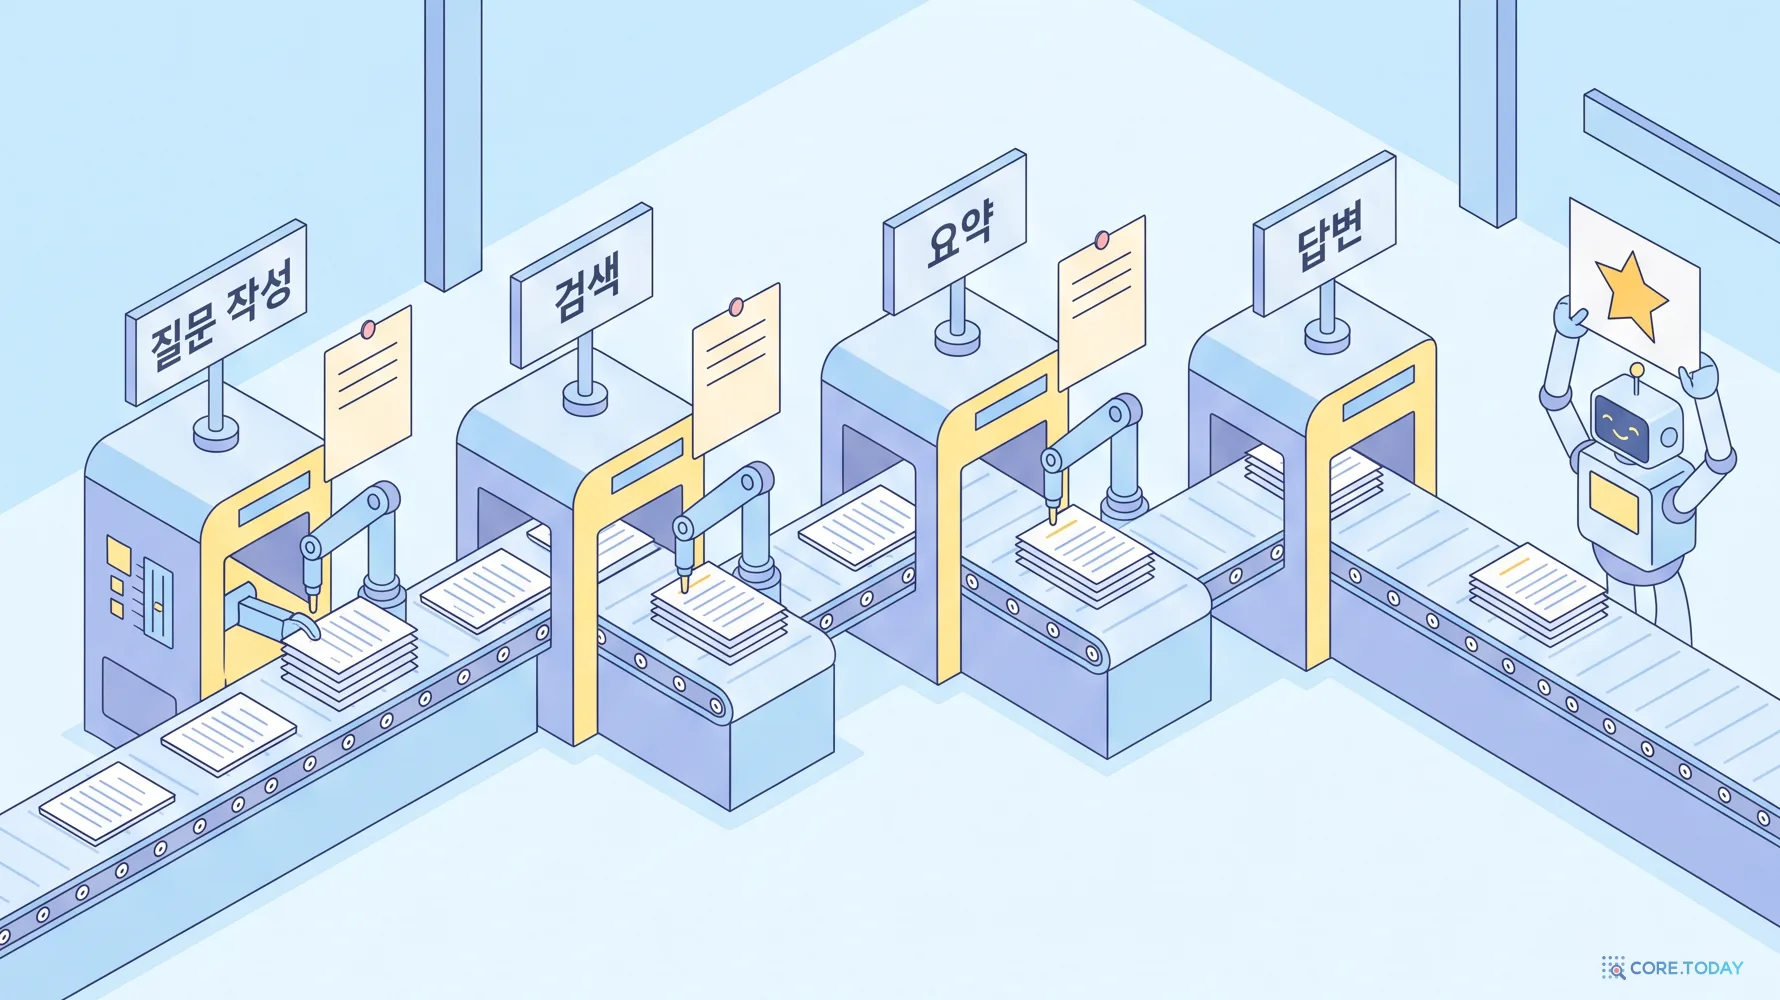
① 검색어 작성 질문 → 1차 검색어
→
② 검색 + 요약 문서 → summary_1
→
③ 2차 검색어 작성 질문 + summary_1 → 다음 검색어
→
④ 답변 모든 요약 → 최종 답
최종 답이 틀렸다고 합시다. 누구 잘못일까요? 1차 검색어가 엉뚱했을 수도, 요약이 중요한 숫자를 빠뜨렸을 수도, 2차 검색어가 1차와 같은 문서만 다시 찾았을 수도, 답변 모듈이 숫자를 잘못 더했을 수도 있습니다. 강화학습에서는 이를 신용 할당(credit assignment) 문제라고 부릅니다. 끝에서 받은 점수 하나를 앞선 여러 결정에 어떻게 나눠 줄지의 문제입니다.
점수 하나로는 이 문제를 풀기 어렵습니다. 그런데 GEPA 저자들은 이렇게 지적합니다. 이 시스템이 남긴 기록은 사람이 읽어도 원인이 보이는 글입니다. 2차 검색어가 "산타크루스 교구 2011년 인구"였다면, 읽는 순간 '아, 1차에서 찾은 교구를 또 찾았구나, 제도 전체를 찾았어야지'라는 진단이 나옵니다. 오늘날의 LLM은 이런 글을 사람만큼 잘 읽습니다. 논문의 표현으로는 LLM이 반성을 통해 암묵적 신용 할당을 할 수 있습니다.
1.3 강화학습은 왜 비싼가
2024~2025년 LLM 업계에서 가장 뜨거웠던 기술은 검증 가능한 보상을 쓰는 강화학습(RLVR)이었습니다. 수학 문제처럼 정답을 기계로 확인할 수 있는 과제에서, 모델이 맞히면 보상을 주고 틀리면 주지 않는 방식으로 가중치를 고칩니다. 그 대표 알고리즘이 딥시크가 2024년 2월 DeepSeekMath 논문에서 내놓은 GRPO(Group Relative Policy Optimization)입니다.
GRPO의 생각은 이렇습니다. 같은 문제를 모델에게 여러 번(예: 12번, 64번) 풀게 합니다. 그 답들의 점수 평균을 기준선으로 삼아, 평균보다 잘한 답은 더 자주 나오게, 못한 답은 덜 나오게 가중치를 조금 고칩니다. 별도의 '비평가 모델'이 필요 없어 기존 PPO보다 가볍고, 2025년 1월 딥시크-R1이 이 방식으로 '아하 모먼트'를 보여 주면서 업계 표준이 됐습니다(코어닷투데이의 딥시크-R1 특집 참고).
문제는 시도 횟수입니다. 한 번의 시도, 즉 시스템을 한 번 실행하고 채점하는 것을 롤아웃(rollout)이라고 부릅니다. GEPA 논문은 GRPO를 쓰는 최근 연구들이 대개 수천~수십만 번의 롤아웃을 쓴다고 지적합니다. 논문 자신의 GRPO 비교 실험도 과제마다 24,000번(500스텝 × 질문 4개 × 질문당 12번)을 썼습니다. 딥시크-R1-제로는 질문 32개 × 16번씩, 10,400스텝을 돌렸으니 어림잡아 500만 번이 넘습니다.
검색 API, 코드 실행 샌드박스, 사내 데이터베이스 조회처럼 한 번 실행에 돈과 시간이 드는 단계가 끼어 있다. 칩 설계용 커널 코드라면 컴파일과 프로파일링에 몇 분씩 걸린다.
🔒
고칠 수 없는 가중치
가장 성능이 좋은 모델(GPT·Claude·Gemini 계열)은 API로만 쓸 수 있다. 가중치를 내려받아 강화학습을 할 수 없다.
📉
적은 데이터
기업의 실제 업무에는 정답이 달린 예시가 수십~수백 개뿐인 경우가 많다. 수만 번을 돌릴 만큼 문제가 다양하지 않다.
그리고 무엇보다, 롤아웃 한 번에서 강화학습이 얻는 정보는 숫자 하나입니다. 그 롤아웃 안에는 수천 토큰의 추론과 도구 결과, 채점기의 오류 메시지가 들어 있었는데 말입니다. GEPA 논문 초록의 문장이 바로 이 지점을 겨냥합니다. "언어의 해석 가능한 본성은, 희소한 스칼라 보상에서 얻은 정책 경사보다 LLM에게 훨씬 풍부한 학습 매체가 될 수 있다."
GEPA가 나오기 75일 전인 2025년 5월 11일(한국 시간), 테슬라 AI 책임자 출신인 안드레이 카파시는 X에 이런 글을 올렸습니다. 계기는 앤트로픽이 공개한 Claude의 시스템 프롬프트가 약 1만 7,000단어에 이른다는 사실이었습니다.
우리는 LLM 학습의 큰 패러다임 하나를 (적어도 하나는) 놓치고 있다. 뭐라고 불러야 할지 모르겠다. 이미 이름이 있을 수도 있다 — 시스템 프롬프트 학습(system prompt learning)? 사전학습은 지식을 위한 것이다. 미세조정(지도학습/강화학습)은 습관적인 행동을 위한 것이다. … LLM은 말 그대로 영화 「메멘토」의 주인공 같다. 다만 우리가 아직 메모장을 주지 않았을 뿐이다.
카파시는 사람이 일을 배우는 방식을 예로 들었습니다. 우리는 문제를 풀고 나서 "다음엔 이렇게 해야지"라고 명시적인 교훈을 적습니다. 그는 이 '지식이 이끄는 복기' 단계가 "보상 스칼라보다 훨씬 고차원의 피드백 채널"이라고 썼고, 이것이 "설정은 강화학습과 닮았지만 학습 알고리즘만 다르다(경사 하강 대신 편집)"고 덧붙였습니다.
GEPA는 이 짧은 글을 거의 그대로 구현한 논문처럼 읽힙니다. 학습되는 대상은 가중치가 아니라 프롬프트라는 메모장이고, 학습 신호는 점수가 아니라 실패 기록에 대한 반성이며, 학습 알고리즘은 경사 하강이 아니라 글을 고쳐 쓰는 편집입니다.
직접 느껴 보는 것이 가장 빠릅니다. 아래 인터랙티브에서 고객센터 답변 프롬프트를 지시 카드로 조립해 보세요. 먼저 '점수만' 모드로 만점을 찾아보고, 다음엔 '첨삭까지' 모드로 해 보세요. 아래쪽 버튼을 누르면 자동 학습자 두 명이 각각 400번씩 같은 문제를 푼 평균 기록도 볼 수 있습니다.
2. 주문에서 최적화기로 — GEPA가 물려받은 일곱 갈래
GEPA는 어느 날 갑자기 나온 아이디어가 아닙니다. 논문 6장의 관련 연구는 적어도 일곱 갈래의 흐름을 인용합니다. 이 흐름을 알면 GEPA의 어느 부분이 새롭고 어느 부분이 물려받은 것인지가 또렷해집니다.
1975존 홀랜드, 『자연계와 인공계의 적응』 — 유전 알고리즘의 탄생. 개체군·선택·교배·돌연변이.
2015무레·클룬, MAP-Elites — '최고 하나' 대신 칸마다 최고를 남겨 탐색 공간을 '비추는(illuminate)' 품질-다양성 알고리즘.
2020~21AutoPrompt·프리픽스 튜닝·프롬프트 튜닝 — 기계가 찾는 프롬프트. 단, 사람이 읽을 수 없는 토큰이나 벡터.
2022사고 사슬(CoT), "차근차근 생각해 보자", APE — 사람이 읽을 수 있는 지시문을 LLM이 직접 찾기 시작.
프롬프트를 자동으로 찾으려는 첫 시도들은 '단어'가 아니라 '숫자'를 찾았습니다. 2020년 AutoPrompt(신 외, EMNLP 2020)는 경사(gradient)를 따라 프롬프트에 넣을 토큰을 골랐는데, 결과물은 사람이 보기에 의미 없는 단어 나열이었습니다. 2021년 프리픽스 튜닝(리·량)과 프롬프트 튜닝(레스터 외)은 아예 단어 대신 학습 가능한 벡터('소프트 프롬프트')를 입력 앞에 붙였습니다. 모델 가중치는 그대로 두고 전체의 0.1% 정도 되는 숫자만 학습해 미세조정에 가까운 성능을 냈습니다.
효율적이었지만 두 가지가 아쉬웠습니다. 사람이 읽을 수 없고, 가중치나 내부 표현에 접근할 수 있어야 했습니다. API로만 쓸 수 있는 모델에는 적용할 수 없었습니다.
2.2 주문의 시대 — LLM이 LLM의 지시문을 쓰다 (2022~2023)
2022년 구글의 사고 사슬(Chain-of-Thought) 연구와 고지마 외의 "차근차근 생각해 보자"가 판을 바꿨습니다. 자연어 한 줄이 모델의 추론 능력을 끌어낸다는 사실이 드러나자, 좋은 문장을 LLM에게 찾게 하자는 생각이 자연스럽게 따라왔습니다.
APE(저우 외, ICLR 2023): LLM이 지시문 후보를 여럿 써 내고, 각각으로 문제를 풀려 점수가 가장 높은 것을 고른다. "차근차근 생각해 보자"보다 조금 나은 "Let's work this out in a step by step way to be sure we have the right answer"를 찾아냈다.
OPRO(양 외, 구글 딥마인드, ICLR 2024): 지금까지 써 본 지시문과 점수를 표로 보여 주고 "이보다 나은 걸 써 보라"고 시킨다. "심호흡을 하고 이 문제를 차근차근 풀어 보자"가 이렇게 나왔다.
두 방법의 공통점은 점수만 본다는 것입니다. 어떤 문제에서 왜 틀렸는지는 보지 않습니다. 그래서 수많은 후보를 써 보고 고르는 '생성 후 선별'에 가깝습니다. 1장의 신입으로 치면 첫 번째 신입이 조금 영리해진 정도입니다.
2.3 텍스트 경사 — 틀린 이유를 글로 '역전파'하다 (2023~2025)
다음 흐름은 틀린 사례를 보여 주고 이유를 쓰게 했습니다.
ProTeGi(프라이잔트 외, 마이크로소프트, EMNLP 2023): 미니배치에서 틀린 예를 모아 LLM에게 "이 프롬프트의 문제가 뭔가?"라고 묻는다. 그 비평을 '텍스트 경사(textual gradient)'라고 부르고, 그 방향으로 프롬프트를 고친 뒤 빔 탐색으로 좋은 후보를 남긴다. 처음 프롬프트보다 최대 31% 개선.
TextGrad(육세쿠뉼 외, 스탠퍼드): 이 생각을 파이토치처럼 일반화했다. 여러 단계로 된 계산 그래프에서 마지막 출력에 대한 비평을 앞 단계로 '역전파'해 각 단계의 프롬프트를 고친다. 2025년 3월 『네이처』에 실렸다.
Trace / OptoPrime(청 외, 마이크로소프트, NeurIPS 2024): 실행 흔적(trace) 전체를 경사 대신 최적화기에 넘긴다.
GEPA의 '반성'은 이 흐름의 직계 후손입니다. 다른 점은 어디서부터 고칠지입니다. GEPA 논문 표 3은 같은 반성 엔진에 후보 선택 방식만 바꿔 비교했는데, TextGrad처럼 '현재 최고 후보만 고치기'와 ProTeGi처럼 '상위 몇 개를 빔으로 유지하기'는 둘 다 금세 막혔습니다. 3장에서 자세히 봅니다.
2.4 진화 — 프롬프트의 개체군 (2023)
같은 해 프롬프트를 생물 개체군처럼 다루는 연구도 나왔습니다.
EvoPrompt(궈 외, ICLR 2024): 유전 알고리즘과 차분 진화의 교배·돌연변이 연산을 LLM에게 시킨다. 두 부모 프롬프트를 주고 "섞어서 자식을 만들어라"라고 하는 식. 31개 데이터셋, BBH에서 최대 25% 향상.
Promptbreeder(페르난도 외, 딥마인드, ICML 2024): 과제 프롬프트뿐 아니라 '프롬프트를 바꾸는 프롬프트(돌연변이 프롬프트)'까지 함께 진화시킨다. 앞서 본 "SOLUTION" 한 단어가 이렇게 나왔다.
FunSearch(로메라-파레데스 외, 딥마인드, 『네이처』 2023년 12월): LLM과 자동 채점기로 프로그램을 진화시켜 조합론의 캡 셋(cap set) 문제에서 새 기록을 세웠다. 2025년 5월 AlphaEvolve는 이를 확장해 4×4 복소수 행렬 곱셈을 48번의 곱셈으로 하는 방법을 찾았다.
GEPA는 이 계보에서 '진화'라는 틀을 가져왔습니다. 다만 논문은 차이를 이렇게 정리합니다. AlphaEvolve가 하나의 어려운 문제를 겨냥해 코드를 진화시킨다면, GEPA는 여러 문제에 통하는 프롬프트를 진화시키고, 관련 문제에서 배운 전술을 서로 옮겨 쓴다.
2.5 반성하는 에이전트 — '언어적 강화학습' (2023)
2023년 3월 두 논문이 나란히 나왔습니다. Reflexion(신 외, NeurIPS 2023)의 부제는 "언어적 강화학습을 하는 언어 에이전트(Language Agents with Verbal Reinforcement Learning)"였습니다. 에이전트가 실패하면 스스로 반성문을 쓰고, 그 반성문을 기억에 넣어 다음 시도에 참고합니다. 가중치는 하나도 바꾸지 않고 HumanEval 코딩 문제 정답률을 91%까지 올렸습니다(당시 GPT-4 단독 80%). Self-Refine(마단 외)은 한 모델이 답을 쓰고, 스스로 비평하고, 고쳐 쓰는 루프를 돌렸습니다.
Reflexion의 초록은 이미 강화학습이 "많은 학습 샘플과 비싼 미세조정"을 요구한다는 문제를 지적했습니다. GEPA보다 2년 먼저 같은 문제의식을 가졌던 셈입니다. 차이는 반성의 수명입니다. Reflexion의 반성문은 그 에피소드, 그 문제를 위한 메모입니다. GEPA는 반성으로 얻은 교훈을 프롬프트에 영구히 새겨, 앞으로 들어올 모든 입력에 씁니다.
2.6 DSPy — 프롬프트를 프로그램으로 (2023~2024)
GEPA를 이해하는 데 가장 중요한 배경은 스탠퍼드에서 시작된 DSPy입니다. 오마르 카탑(GEPA 논문의 교신 저자, 현재 MIT)이 2023년 10월 발표한 DSPy는 "프롬프트를 손으로 쓰지 말고 프로그래밍하자"는 프레임워크입니다.
DSPy에서는 "질문과 요약을 받아 검색어를 낸다"처럼 모듈의 입출력만 선언(시그니처)하고, 실제 프롬프트 문구는 최적화기(optimizer)가 데이터를 보고 채웁니다. 대표 최적화기의 계보는 이렇습니다.
최적화기
무엇을 바꾸나
어떻게 찾나
한계
BootstrapFewShot (2023)
예시(few-shot) 답안
시스템이 맞힌 실행 기록을 골라 예시로 붙임
지시문은 그대로, 프롬프트가 길어짐
MIPROv2 (2024)
지시문 + 예시
후보 18개씩 만들고 베이즈 최적화(TPE)로 조합 탐색
점수만 보고 고름, 왜 틀렸는지는 모름
BetterTogether (2024)
프롬프트 + 가중치
프롬프트 최적화와 미세조정을 번갈아
가중치 접근 필요
GEPA (2025)
지시문
실행·채점 기록을 읽고 반성 → 진화 + 파레토 선택
검증 비용, 지식 주입의 한계(6장)
GEPA 논문의 공저자 명단에는 MIPRO의 크리스타 옵살-옹, BetterTogether의 딜라라 소일루, DSPy의 카탑과 크리스토퍼 포츠, 데이터브릭스 공동 창업자 마테이 자하리아가 함께 있습니다. GEPA는 DSPy 가문이 직전 세대의 자기 최적화기(MIPROv2)를 넘어서려고 만든 다음 세대인 셈입니다. 실제로 GEPA는 논문 공개 18일 뒤인 2025년 8월 12일 DSPy 3.0에 dspy.GEPA로 들어갔습니다.
2.7 파레토와 MAP-Elites — '최고 하나'를 버리는 용기
GEPA의 'P'는 이탈리아 경제학자 빌프레도 파레토에게서 왔습니다. 1906년 『정치경제학 교본』에서 그는 '누구의 처지도 나빠지지 않게 하면서 누군가의 처지를 더 좋게 만들 수 없는 상태'를 정의했습니다. 최적화에서는 이를 파레토 최적, 그런 해들의 모임을 파레토 프런티어(경계)라고 부릅니다. 목표가 여럿일 때 '어느 목표에서도 남에게 완전히 밀리지 않는' 해들입니다.
GEPA 논문이 직접 인용하는 영감은 2015년 장바티스트 무레와 제프 클룬의 MAP-Elites입니다. 이 알고리즘은 해들을 특징별 칸으로 나누고, 칸마다 최고 해(엘리트)를 하나씩 남깁니다. '평균 1등' 하나만 쫓으면 놓쳤을 다양한 해가 살아남고, 역설적으로 그 덕분에 최종 최고 해도 더 좋아지는 일이 자주 일어납니다. 저자들은 이를 탐색 공간을 '비춘다(illuminate)'고 표현했습니다.
GEPA는 여기서 '칸'을 검증 문항 하나하나로 바꿨습니다. 문항마다 1등을 한 프롬프트를 남기는 것입니다. 진화 계산 분야의 렉시케이스(lexicase) 선택과도 닮았는데, 논문이 이를 인용하지는 않습니다. 이 아이디어가 GEPA 성능의 큰 몫을 차지한다는 것을 3장에서 확인합니다.
3. GEPA 해부 — 진화, 반성, 파레토
3.1 문제를 수식 하나로 — 무엇을 최적화하나
논문 2장은 문제를 이렇게 정의합니다. 복합 AI 시스템 Φ는 언어 모듈들 M1,…,M∣M∣과, 그 모듈을 어떤 순서로 몇 번 부를지 정하는 제어 흐름 C로 이뤄집니다. 모듈 Mi마다 프롬프트 πi(지시문과 예시)와 모델 가중치 θi가 있습니다. 학습할 수 있는 것은 이 둘, ⟨Π,Θ⟩입니다.
과제 하나는 입력 x와 채점용 정보 m(정답, 채점 기준, 단위 테스트 등)의 쌍입니다. 시스템이 낸 출력을 지표 μ가 0~1 사이 점수로 매깁니다. 목표는 과제 분포 T에서 평균 점수를 최대화하는 것인데, 여기에 현실의 조건 하나가 붙습니다.
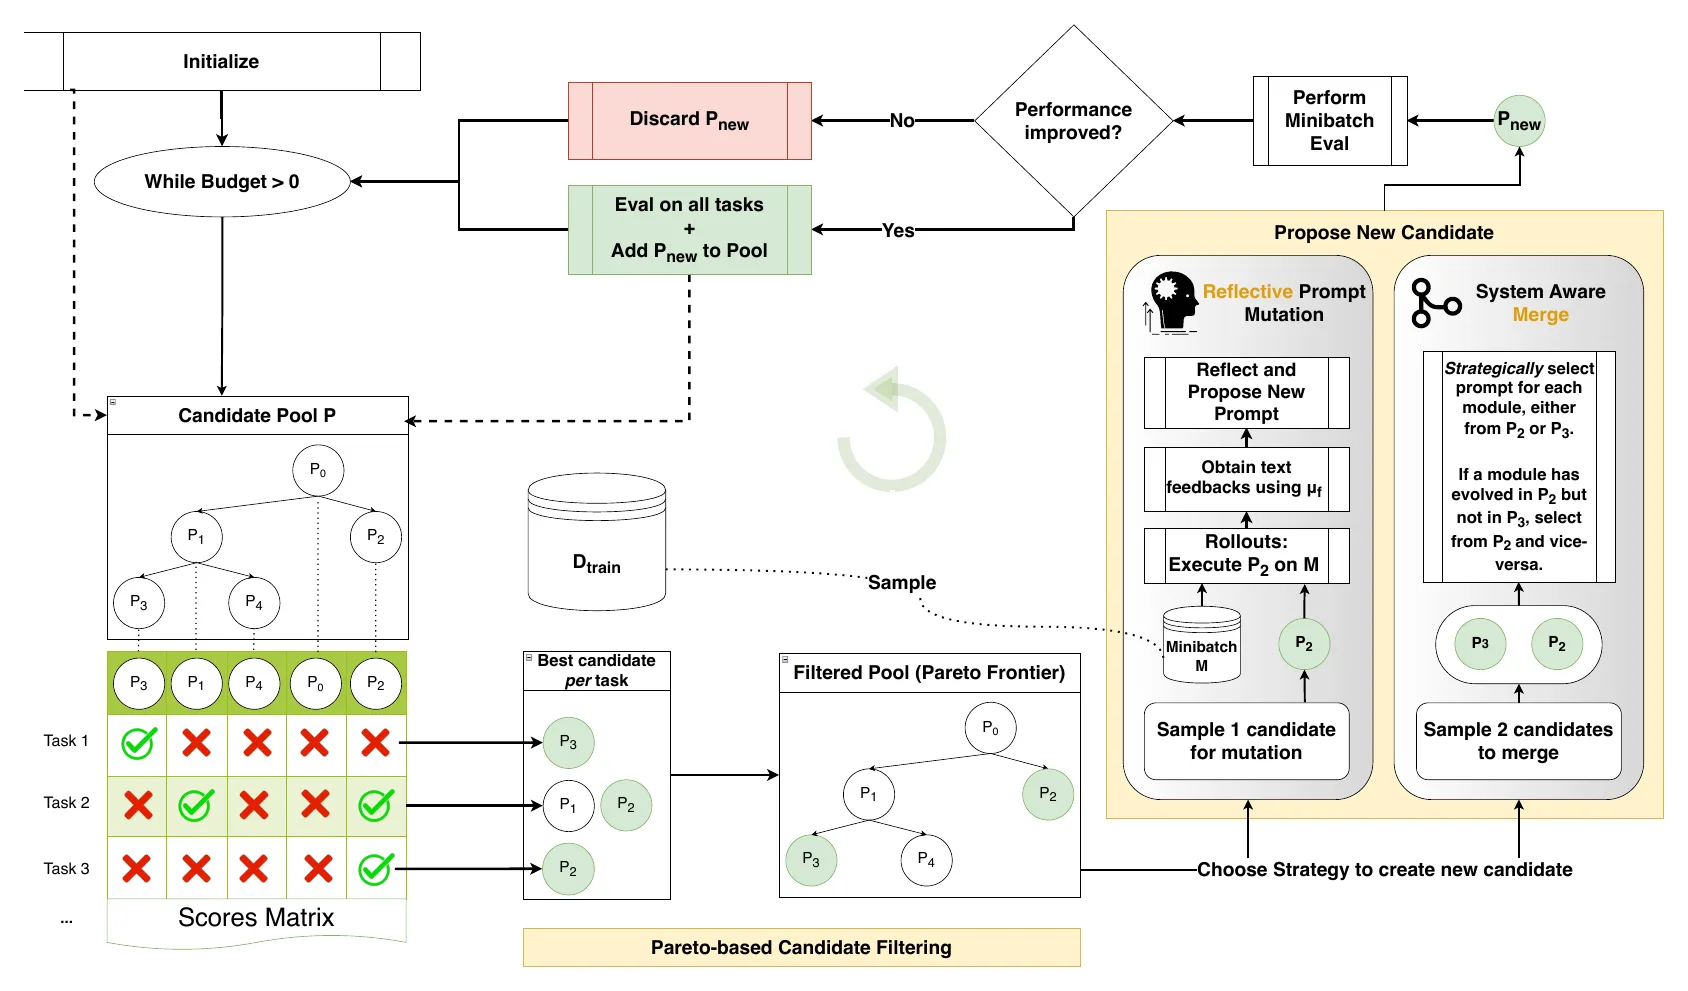
그림 3은 처음 보면 복잡하지만, 한 바퀴를 따라가면 단순합니다. 논문 알고리즘 1을 한 줄씩 풀어 보면 이렇습니다.
준비훈련 데이터를 둘로 나눈다. 피드백을 얻는 데 쓸 Dfeedback과, 후보끼리 비교하는 데만 쓸 Dpareto(검증셋). 사람이 쓴 씨앗 프롬프트 하나로 후보 풀을 시작하고, 검증셋 문항마다 점수를 매겨 둔다.
① 부모 고르기후보 풀에서 다음에 고칠 후보 하나를 고른다. 평균 1등이 아니라 '문항별 1등'들 가운데서 확률적으로(3.5절).
② 모듈 고르기시스템에 모듈이 여럿이면 이번에 고칠 모듈 하나를 차례대로(라운드 로빈) 고른다.
③ 미니배치 실행훈련 데이터에서 문항 3개를 뽑아 부모 시스템을 실행한다. 각 모듈의 입력·출력·추론 과정과, 피드백 함수 μf가 돌려준 점수와 피드백 글을 모은다.
④ 반성반성 LM에게 (현재 지시문, 실행 기록, 점수, 피드백)을 보여 주고 새 지시문을 쓰게 한다. 이 모듈만 새 지시문으로 바꾼 자식 후보를 만든다.
⑤ 빠른 시험자식을 같은 미니배치 3문항으로 다시 실행한다. 점수가 부모보다 나아지지 않았으면 버린다.
⑥ 정식 등록나아졌으면 검증셋 전체로 평가해 문항별 점수를 기록하고, 부모가 누구였는지와 함께 후보 풀에 넣는다. 예산이 남아 있으면 ①로. 끝나면 검증셋 평균이 가장 높은 후보를 돌려준다.
⑤의 '빠른 시험'이 중요합니다. 반성으로 나온 제안 대부분은 미니배치에서 걸러지므로, 비싼 검증셋 평가는 가망 있는 후보에게만 씁니다. 그런데도 논문은 예산의 대부분이 ⑥의 검증 평가에 들어간다고 밝힙니다. 실제로 '배우는 데' 쓴 훈련 롤아웃은 과제에 따라 79~737회뿐이었습니다. 6장에서 다시 다룰 대목입니다.
GEPA의 반성 LM이 받는 지시는 의외로 짧습니다. 논문 부록 C에 실린 메타 프롬프트 전문을 옮기면 이렇습니다.
GEPA 메타 프롬프트 (부록 C, 번역)
나는 어떤 일을 맡기려고 비서에게 다음 지시를 주었다: <현재 지시문>
아래는 비서에게 준 여러 입력과 각각에 대한 비서의 응답, 그리고 응답이 어떻게 더 나아질 수 있었는지에 대한 피드백이다: <미니배치의 입력·출력·피드백>
비서에게 줄 새 지시문을 써라. 입력을 꼼꼼히 읽고 입력 형식을 파악하고, 내가 비서로 풀고 싶은 과제를 자세히 추론하라. 비서의 응답과 그에 대한 피드백을 모두 읽어라. 과제에 관한 틈새의, 분야 특화된 사실 정보를 모두 찾아 지시문에 넣어라. 그중 많은 것은 앞으로 비서가 얻지 못할 수 있다. 비서가 일반화할 수 있는 전략을 썼다면 그것도 지시문에 넣어라. 새 지시문은 ``` 블록 안에 써라.
강조한 문장이 GEPA 프롬프트의 성격을 결정합니다. 반성 LM은 실패 사례에서 "이 분야에서는 이런 게 중요하더라"는 사실을 뽑아 지시문에 적어 둡니다. 4장에서 볼 PUPA 프롬프트에 'HHV'라는 과목 코드 예시가 들어간 것도 이 문장 덕분입니다.
여기서 두 가지 '흔적'이 쓰입니다.
실행 흔적(execution trace): 시스템이 만든 글. 각 모듈의 입력, 생각의 과정, 출력, 도구 호출과 그 결과.
평가 흔적(evaluation trace): 채점기가 점수를 매기는 과정에서 만든 글. 코드라면 컴파일러 오류와 프로파일러 결과, 지시 따르기라면 어긴 제약 목록, 검색이라면 아직 못 찾은 정답 문서.
논문의 독창적인 기여 하나가 바로 두 번째입니다. 채점기는 점수 0을 매기기 직전에 "17번 줄에서 정의되지 않은 함수 호출"이라는 아주 구체적인 정보를 알고 있습니다. 보통의 강화학습은 이 정보를 버리고 0만 넘깁니다. GEPA는 보상 함수 μ를 피드백 함수 μf로 넓혀, 점수와 함께 이 글(feedback_text)을 돌려받습니다. 모듈마다 따로 피드백을 줄 수도 있고(멀티홉 검색이라면 홉마다), 사람 평가자가 점수에 붙인 설명을 넣을 수도 있습니다.
여섯 과제에서 실제로 쓴 피드백은 소박했습니다. HotpotQA·HoVer는 '찾은 정답 문서와 남은 정답 문서', IFBench는 '지킨 제약과 어긴 제약', PUPA는 '품질 점수와 유출 점수의 내역'이 전부였습니다. 채점 코드가 이미 알고 있던 정보를 글로 돌려준 것뿐입니다.
아래 인터랙티브에서 반성 LM의 책상을 들여다보세요. 같은 실패를 두고 μ(점수만)와 μf(점수+피드백 글)를 바꿔 가며, 반성 LM이 받는 메타 프롬프트와 그 결과로 나올 법한 제안이 어떻게 달라지는지 비교할 수 있습니다.
반성이 실제로 무엇을 써 내는지는 논문 그림 2가 잘 보여 줍니다. HotpotQA 시스템에서 2차 검색어를 쓰는 모듈의 씨앗 프롬프트와, GPT-4.1 Mini로 GEPA가 찾은 최종 프롬프트입니다(발췌 번역).
씨앗 프롬프트 → GEPA가 찾은 프롬프트 (논문 그림 2, 발췌 번역)
[씨앗] question과 summary_1이 주어지면 query를 만들어라.
[GEPA] 두 입력 필드 question과 summary_1이 주어진다. 할 일: 멀티홉 검색 시스템의 2차 홉에 최적화된 새 검색어를 만든다.
• 원래 질문은 대개 복잡하고, 답하려면 여러 문서의 정보가 필요하다. 1차 홉 검색어는 원래 질문이다. 핵심 관찰과 교훈:
• 1차 홉 문서는 흔히 한 개체나 한 측면만 다룬다.
• 남은 정답 문서는 summary_1에 언급되지만 질문이 직접 묻지 않은, 연결되거나 더 상위의 개념을 다루는 경우가 많다.
• 원래 질문을 바꿔 말하거나 summary_1의 사실을 되풀이하지 마라.
• 예: summary_1이 작은 교구의 인구를 다루는데 질문이 더 넓은 지역의 전체 인구를 묻는다면, 그 넓은 지역을 겨냥하라("2011년 마데이라 제도 인구"). summary_1이 노래를 다루는데 질문이 앨범을 묻는다면 앨범 수준의 문서를 겨냥하라. 실전 전략: "이 요약이 암시하지만 1차에서 찾지 못한, 원래 질문에 답할 수 있는 개체나 측면은 무엇인가?"를 자문하라. …
한 줄짜리 지시가 '검색 실무자의 노하우 문서'가 됐습니다. 이 노하우는 가중치 속 숫자가 아니라 사람이 읽고 검토하고 고칠 수 있는 글입니다. GEPA가 기업 실무자들에게 환영받은 이유 중 하나가 이것입니다.
3.4 반성은 '신용 할당'을 대신한다
1장에서 본 신용 할당 문제로 돌아가 봅시다. 강화학습은 끝에서 받은 점수 하나를 수학적으로 쪼개 각 결정에 나눠 줍니다. 그래서 많은 표본이 필요합니다. GEPA의 반성 LM은 실행 기록을 읽고 "2차 검색어가 1차와 같은 문서를 다시 찾았기 때문"이라고 원인을 직접 지목합니다. 논문은 이를 '암묵적 신용 할당'이라고 부릅니다.
가능한 이유는 오늘날 LLM이 이런 기록을 읽고 원인을 짚는 데 능숙하기 때문입니다. 논문은 관찰 2에서 이를 명시합니다. 과거 연구(MIPRO, 완 외 2024)에서는 지시문보다 예시(few-shot)를 최적화하는 쪽이 대개 더 나았는데, GEPA에서는 지시문만 고쳐도 지시문과 예시를 함께 고치는 MIPROv2를 이겼습니다. 저자들은 그 이유를 "최근 LLM의 지시 따르기와 자기 반성 능력의 향상"에서 찾습니다. 모델이 좋아질수록 GEPA도 강해지는 구조입니다.
더 놀라운 점은 반성 LM이 꼭 거대한 모델일 필요가 없었다는 것입니다. Qwen3 8B 실험에서는 최적화 대상인 8B 모델 자신이 반성까지 맡았습니다(논문은 Qwen 최적화 결과를 "더 약한 Qwen3-8B를 위해, 그리고 그것을 써서 최적화했다"고 씁니다). 80억 매개변수짜리 모델이 자기 실패 기록을 읽고 스스로 지시문을 고쳐 GRPO를 이긴 것입니다.
3.5 기둥 둘 — 파레토 선택: 평균 1등만 고치면 막힌다
이제 GEPA의 'P'입니다. 매 반복의 ①단계, 다음에 고칠 부모를 누구로 할 것인가의 문제입니다.
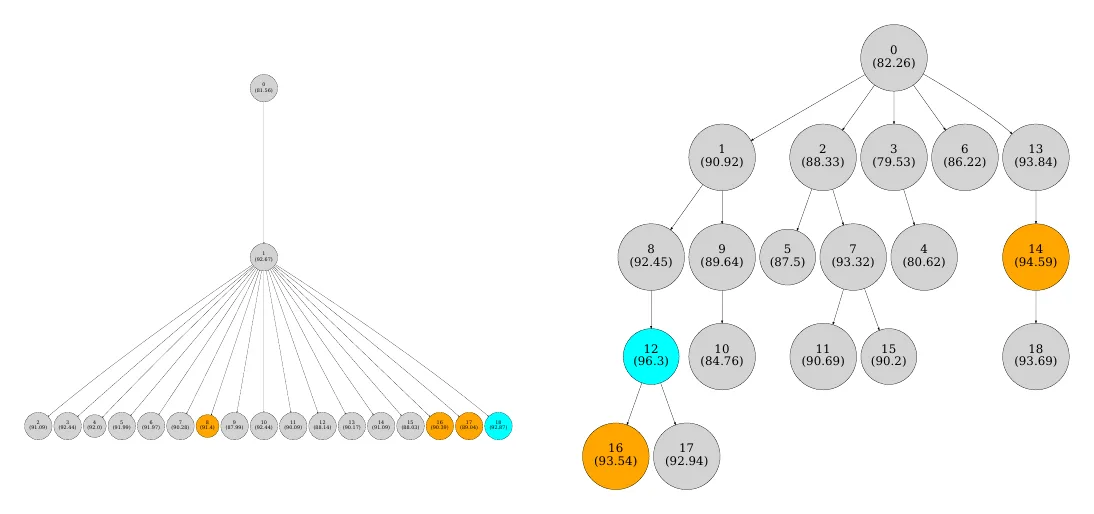
가장 단순한 답은 "지금까지 평균 점수가 가장 높은 후보"입니다. 논문은 TextGrad가 쓰는 방식과 비슷하다고 설명합니다. 논문 그림 6(왼쪽)은 이 방식으로 PUPA 과제를 돌린 결과입니다.
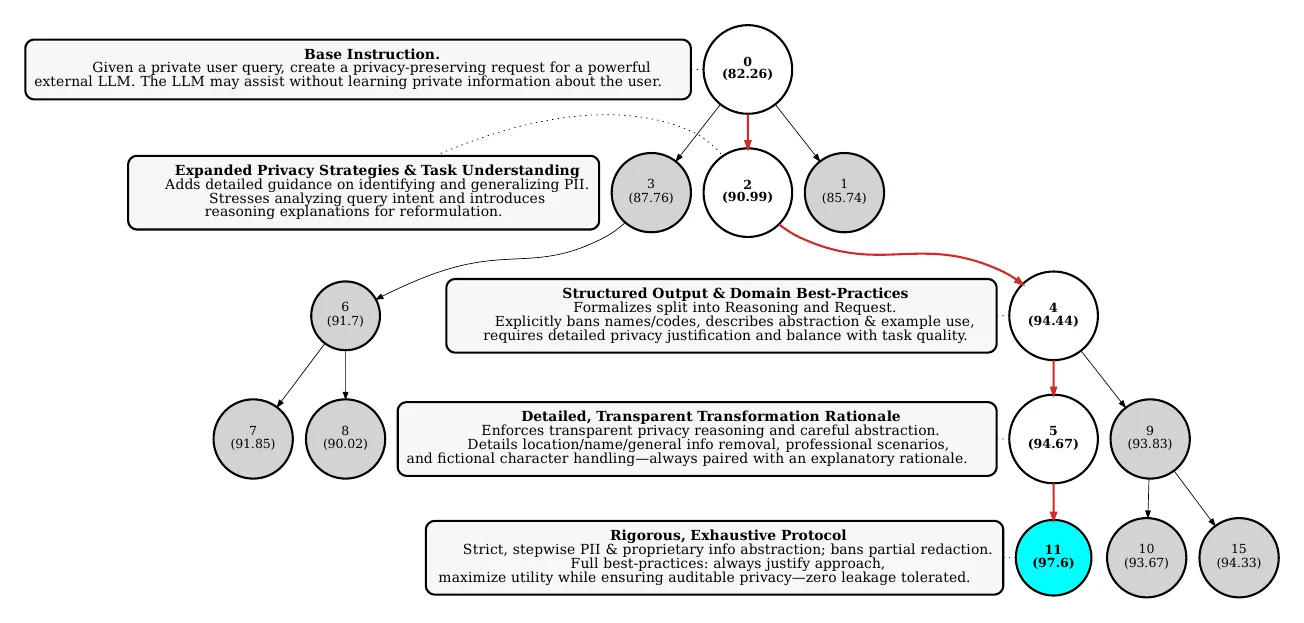
왼쪽 나무는 빗자루 모양입니다. 씨앗에서 1번(92.67점)이 나오자, 그 뒤로는 1번만 계속 고쳤습니다. 자식이 17개나 나왔지만 모두 1번 언저리에서 맴돌았고, 예산이 바닥났습니다. 1번이 찾은 전략이 강해서, 그 틀 안에서는 더 나아질 방법이 보이지 않은 것입니다. 전형적인 지역 최적(local optimum)입니다.
예를 들어 검색어 작성 모듈과 요약 모듈이 있는 시스템에서, 한 가문은 검색어 모듈을 잘 고쳤고 다른 가문은 요약 모듈을 잘 고쳤다고 합시다. 두 가문은 같은 조상에서 갈라졌습니다. 그렇다면 검색어 모듈은 첫 가문에서, 요약 모듈은 둘째 가문에서 가져온 새 후보를 만들어 볼 만합니다. 부록 D.1의 알고리즘 3·4가 이 규칙을 정합니다.
두 후보가 공통 조상을 가져야 하고, 서로 직계 조상·후손이면 안 된다.
두 후보가 서로 다른 모듈을 고쳤어야 한다(한쪽만 조상과 달라진 모듈이 있어야 한다).
두 후보 모두 조상보다 점수가 높아야 한다.
모듈마다 '조상에서 바뀐 쪽'의 프롬프트를 가져오고, 둘 다 바꿨다면 점수가 높은 쪽을 가져온다.
조건이 엄격해서 Merge는 드물게 일어납니다(실험에서는 최대 5번). 결과는 엇갈렸습니다. GPT-4.1 Mini에서는 평균 +12.19점을 +13.33점으로 올렸지만, Qwen3 8B에서는 오히려 +9.62점에서 +7.17점으로 떨어졌습니다. 특히 Qwen IFBench에서는 28.23점으로 기준선(36.90)보다 크게 낮았습니다. 저자들은 두 모델에 같은 하이퍼파라미터를 쓴 탓이라 보고, 언제 Merge를 부를지는 앞으로의 과제로 남겼습니다.
3.7 직접 돌려 보기 — 장난감 세계의 GEPA
지금까지의 부품을 모두 조립해 돌려 봅시다. 아래 시뮬레이터에서 문항마다 필요한 '교훈'이 1~3개 있고, 후보 프롬프트는 교훈의 묶음입니다. 반성은 미니배치에서 틀린 문항을 보고 빠진 교훈을 써 넣습니다. 미니배치에서 나아진 후보만 검증셋 24문항으로 평가합니다. 롤아웃 1,200회 안에서 선택 전략과 반성 여부에 따라 곡선이 어떻게 달라지는지, 오른쪽 나무는 어떤 모양이 되는지 보세요.
시뮬레이터에서 확인할 수 있는 것은 세 가지입니다. 첫째, 피드백 없이 무작위로 바꾸면 파레토 선택을 써도 거의 배우지 못합니다(회색 점선). 반성이 학습의 엔진입니다. 둘째, 최고 후보만 고치면 시도가 한 부모에게 몰립니다(빨간 ×N). 셋째, 이 장난감에서는 아이디어 고갈이 없어도 파레토가 빠릅니다. 강한 후보가 틀리는 문항은 교훈이 두세 개 함께 빠진 어려운 문항이어서, 교훈 하나를 더해도 미니배치 점수가 오르지 않고 버려지기 때문입니다. 문항마다 교훈이 하나만 필요하도록 바꾸면 두 전략의 차이는 거의 사라집니다(평균 최종 검증 점수 둘 다 1.00). 파레토 선택은 '아직 쉬운 문항을 틀리는 후보'를 부모로 남겨, 한 걸음씩 나아갈 길을 열어 둡니다.
4. 실험 읽기 — 여섯 과제, 두 모델, 여섯 가지 관찰
4.1 무엇으로 시험했나
논문은 성격이 다른 여섯 과제를 골랐고, 과제마다 이미 연구에 쓰이던 복합 AI 시스템을 그대로 가져왔습니다(대부분 탄 외 2025의 벤치마크 모음).
과제
무엇을 하나
시스템 구성
피드백 글(μf)
훈련/검증/시험
HotpotQA
여러 위키백과 문서를 거쳐 답하는 질문
검색어 작성·요약 반복 + 답변
단계별로 아직 못 찾은 정답 문서
150/300/300
IFBench
"예/아니오로만", "단어 X를 세 번" 같은 출력 제약 지키기
답변 → 제약에 맞춰 다시 쓰기 (2단계)
지킨 제약, 어긴 제약
150/300/294
HoVer
주장 검증에 필요한 문서 모두 찾기
최대 3홉, 검색어 작성 2 + 요약 2 모듈
찾은 문서와 남은 문서
150/300/300
PUPA
개인정보가 든 질문을 외부 LLM에 안전하게 위임
질문 재작성 → 외부 LLM → 답변 재작성 (PAPILLON)
품질 점수와 유출 점수 내역
111/111/221
AIME-2025
미국 수학 경시대회 문제
단일 단계 사고 사슬
(정답 여부)
2022~24년 90문제 / 2025년 30문제×5회
LiveBench-Math
주기적으로 바뀌는 수학 문제
단일 단계 사고 사슬
(정답 여부)
368문제를 3등분
비교 대상은 다섯입니다. 가중치를 고치는 GRPO(Qwen3 8B에서만, LoRA 랭크 16으로 500스텝 × 48 = 24,000 롤아웃), 지시문과 예시를 함께 고치는 MIPROv2(DSPy의 기존 대표 최적화기), 텍스트 경사의 TextGrad와 Trace(OptoPrime), 그리고 최적화 전의 기준선입니다. 모델은 오픈 모델 Qwen3 8B와 API 모델 GPT-4.1 Mini 두 가지입니다. 공정성을 위해 GEPA의 롤아웃 예산은 과제마다 MIPROv2가 쓴 만큼(차이 10.15% 이내)으로 맞췄습니다.
중요한 규칙이 하나 있습니다. 최적화기는 훈련 데이터의 내용과 정답을 자유롭게 볼 수 있지만, 검증 데이터는 점수만 볼 수 있습니다. GEPA가 검증셋 문항별 점수로 파레토 선택을 하는 것도 이 규칙 안에 있습니다. 반성 LM은 검증 문항의 내용을 보지 못합니다.
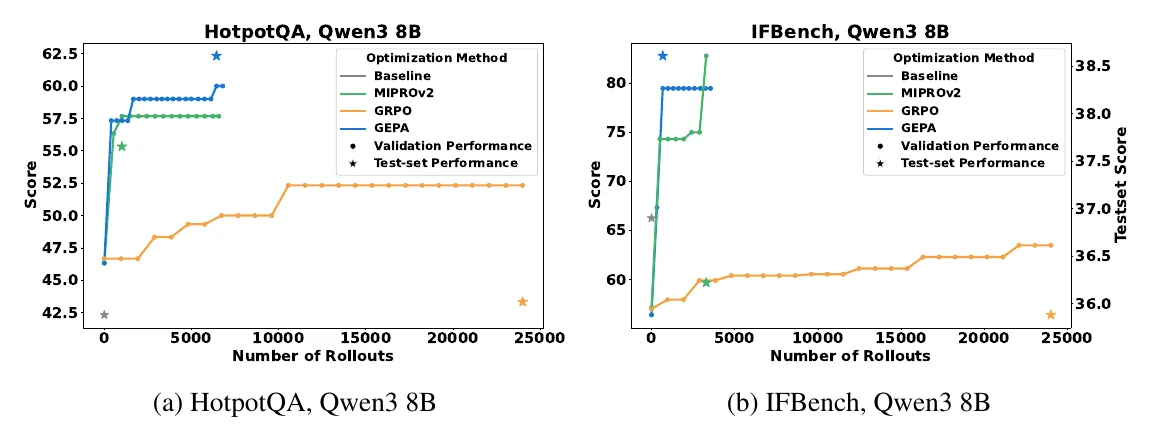
그림 1은 논문 전체를 한 장으로 요약합니다. 가로축은 롤아웃 수, 세로축은 검증 점수입니다(IFBench 오른쪽 축은 시험 점수). 주황색 GRPO는 24,000번까지 계단처럼 천천히 오릅니다. 파란색 GEPA는 거의 수직으로 솟구친 뒤 GRPO가 끝내 닿지 못한 높이에서 멈춥니다. 별표(시험 점수)를 보면 차이가 더 큽니다. HotpotQA에서 GRPO의 시험 점수(주황 별, 43.33)는 기준선(회색 별, 42.33)과 거의 같은데, GEPA(파란 별)는 62.33입니다.
논문은 관찰 1에서 이를 숫자로 정리합니다. GEPA는 여섯 과제에서 243, 402, 330, 1,143, 1,179, 306회 만에 GRPO가 24,000번 끝에 얻은 최고 검증 점수에 도달했습니다. 가장 큰 차이는 약 78배입니다. 이 가운데 훈련 데이터로 실제 '배운' 롤아웃만 세면 네 과제에서 102, 32, 6, 179회였습니다. 여섯 번의 롤아웃만으로 GRPO의 최고점을 따라잡은 과제도 있었다는 뜻입니다.
4.3 결과표 — 직접 펼쳐 보기
표 1(Qwen3 8B)과 표 2(GPT-4.1 Mini)의 숫자를 과제별로 펼쳐 봤습니다. 모델과 과제를 바꿔 가며 어디서 이기고 어디서 졌는지 확인해 보세요.
몇 가지가 눈에 띕니다.
HotpotQA와 HoVer처럼 검색이 들어간 다단계 과제에서 차이가 가장 큽니다. Qwen3 8B HotpotQA에서 GEPA는 기준선 대비 +20점, GRPO 대비 +19점입니다. 피드백 글('남은 정답 문서')이 원인을 정확히 짚어 주는 과제입니다.
IFBench는 모든 방법의 향상 폭이 작습니다. 시험셋의 제약 58종이 훈련 때 본 적 없는 새 유형이어서, 훈련에서 배운 규칙이 그대로 통하지 않기 때문입니다. 그래도 GEPA는 678 롤아웃 만에 GRPO의 24,000 롤아웃 결과를 넘었습니다. 초록의 '최대 35배'가 이 과제의 숫자입니다.
AIME-2025에서는 GRPO가 이겼습니다(38.00 vs 32.00). 6장에서 이유를 따져 봅니다.
MIPROv2는 Qwen3 8B AIME에서 기준선보다 7점 낮아졌습니다(20.00). 예시 답안을 붙이는 방식이 긴 수학 풀이에서는 오히려 방해가 될 수 있다는 신호입니다. 초록의 'AIME-2025에서 +12%'는 이 칸(GEPA 32.00 vs MIPROv2 20.00)의 차이입니다.
4.4 여섯 가지 관찰
논문 4장은 결과를 여섯 가지 관찰로 정리합니다. 하나씩 풀어 봅니다.
관찰 1 — 반성적 프롬프트 진화는 표본 효율이 높고, 가중치 강화학습을 이길 수 있다. 4.2절에서 본 내용입니다. 여섯 과제 중 다섯에서 GEPA가 GRPO를 이겼고, 평균 격차는 5.94점입니다. GRPO를 LoRA 대신 전체 매개변수로 미세조정해도(그림 11, 2홉 HoVer) 격차가 비슷했다고 논문은 덧붙입니다.
관찰 2 — 지시문만 고쳐도 지시문+예시를 함께 고치는 방법을 이긴다. GEPA는 모든 과제·모델에서 MIPROv2를 이겼고, 격차는 최대 11.1점(GPT-4.1 Mini), 10.3점(Qwen3 8B)이었습니다. 3.4절에서 본 대로, 저자들은 이를 최근 LLM의 지시 따르기·자기 반성 능력의 향상 덕으로 봅니다. 일반화 격차(검증 점수와 시험 점수의 차이)도 GEPA의 지시문이 더 작았습니다(그림 16). 과거 연구에서 '예시가 지시문보다 일반화를 잘한다'던 결론이 뒤집힌 것입니다.
관찰 3 — 다음 후보를 고르는 전략이 결과를 크게 좌우한다. 3.5절의 표 3, 그림 6입니다.
관찰 4 — 지시문 최적화가 예시 최적화보다 싸고 일반화도 잘한다. 예시 답안은 길고, MIPROv2는 예시를 여러 개 함께 붙입니다. GEPA의 프롬프트는 MIPROv2보다 최대 9.2배 짧았습니다(그림 18). 모든 API는 입력 토큰에 요금을 매기므로, 짧은 프롬프트는 운영 비용과 지연 시간을 함께 줄입니다. 집계로 보면 성능이 좋은 최적화기일수록 프롬프트가 짧은 경향까지 있었습니다(그림 17).
관찰 5 — 시스템을 아는 교배(Merge)는 크게 도울 수 있지만, 언제 쓸지는 더 연구해야 한다. 3.6절에서 본 엇갈린 결과입니다.
관찰 6 — GEPA의 프롬프트는 다른 모델로 옮겨도 통한다. 이 관찰이 실무적으로 가장 흥미롭습니다. Qwen3 8B로, Qwen3 8B를 써서 최적화한 프롬프트를 고치지 않고 GPT-4.1 Mini에 붙였더니 평균 +9.00점이 올랐습니다. GPT-4.1 Mini에서 직접 최적화한 MIPROv2(+5.64), TextGrad(+6.11), Trace(+3.27)보다 높습니다. HotpotQA에서는 +27.67점이었습니다. 작은 모델로 싸게 최적화하고 큰 모델에 배포하는 길이 열린 것입니다. 저자들은 2026년 9월 블로그 글 「싸게 최적화하고 강하게 배포하라」에서 이 방향을 이어 가, HotpotQA에서 약 14분의 1 비용으로 +9.0점을 얻었다고 보고했습니다.
비용도 적었습니다. GPT-4.1 Mini 표(표 2)의 실험 전체에 500달러가 안 들었고, 그중 GEPA는 86달러, GEPA+Merge는 67달러였습니다. 반성 LM 호출은 한 번의 최적화에서 17~92번이었습니다(부록 N).
그림 5는 개인정보 보호 위임 과제(PUPA)에서 GEPA가 프롬프트를 키워 간 경로입니다. 부록 K.1에는 각 단계의 전체 프롬프트가 실려 있습니다. 아래에서 한 세대씩 넘기며 무엇이 더해졌는지 보세요.
두 가지를 짚어 둡니다. 하나, 프롬프트에 쌓인 것은 '더 친절하게' 같은 일반론이 아니라 이 과제에서만 통하는 구체적 규칙입니다. 이름은 일부만 가리지 말고 역할어로 바꿀 것, 시스템 이름·제품 코드도 내부 정보로 볼 것, 인물 소개를 요청할 때는 허구임을 밝힐 것. 숙련된 개인정보 담당자가 신입에게 건넬 체크리스트에 가깝습니다. 둘, 나무의 다른 가지들은 더 오르지 못했습니다. 4번의 다른 자식 9번(93.83점)과 그 자식들은 94점 언저리에서 멈췄습니다. 어느 가지가 97점까지 갈지는 미리 알 수 없었습니다.
5. 프롬프트 너머 — 코드 탐색과 적대적 프롬프트
논문 5장은 GEPA를 프롬프트 최적화가 아닌 곳에 써 본 예비 실험 두 가지를 싣습니다.
5.1 추론 시점 탐색 — 커널 코드를 진화시키다
GEPA는 원래 '새 과제에 적응하는' 도구지만, 발상을 바꾸면 지금 풀어야 할 문제 묶음을 직접 푸는 탐색기로도 쓸 수 있습니다. 풀 문제 전체를 훈련셋이자 검증셋으로 넣고, 그 문제들에 '과적합'하도록 돌리는 것입니다. 한 문제에서 얻은 교훈이 다른 문제로 옮겨 가는 것이 덤입니다.
첫 실험은 AMD의 새 NPU(XDNA2 아키텍처)용 커널 코드 생성입니다. 새 하드웨어라 LLM이 학습 때 본 코드가 거의 없습니다. 여기서 피드백 함수 μf가 빛을 발했습니다. 컴파일러 오류가 나면 그 오류 메시지로 기술 매뉴얼을 검색해 관련 절을 피드백에 붙인 것입니다. 하드웨어 전문가의 지식이 실패가 일어난 바로 그 순간에 반성 LM에게 전달됩니다.
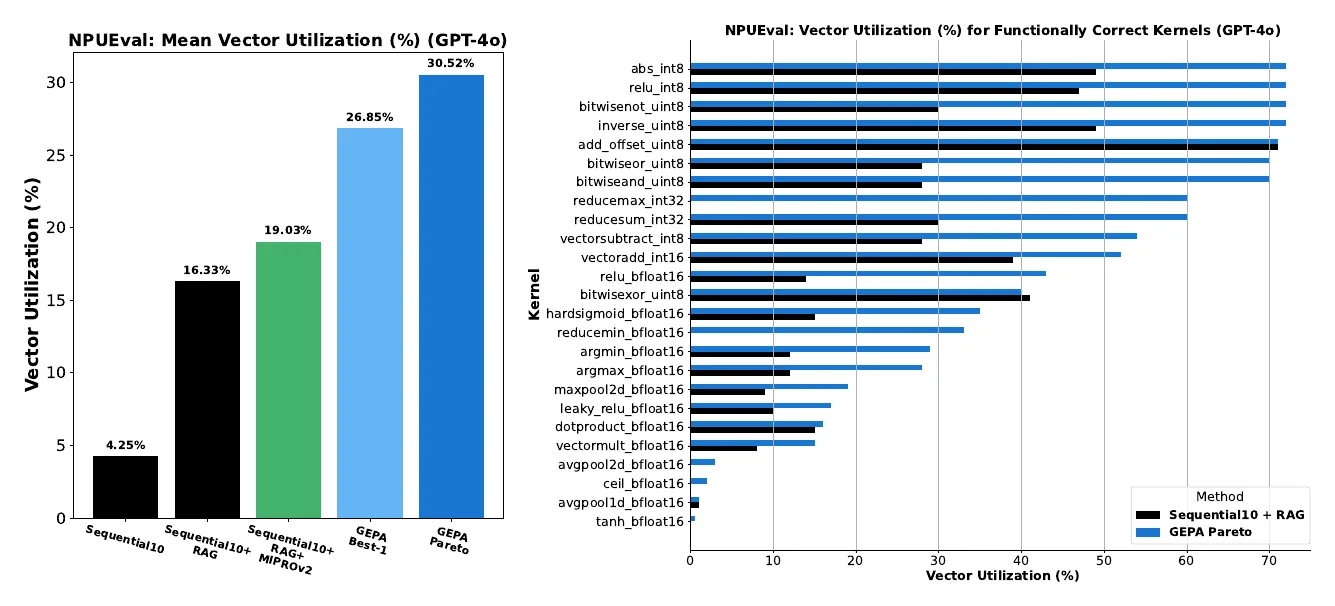
GPT-4o가 오류를 보며 10번까지 고쳐 쓰게 해도 벡터 유닛 평균 활용률은 4.25%였습니다. 매뉴얼 검색을 붙이면 16.33%, MIPROv2를 더하면 19.03%였습니다. GEPA를 쓰자 평균 30.52%가 됐고, 몇몇 커널은 70%에 이르렀습니다. 더 흥미로운 것은 GEPA가 찾은 프롬프트 하나만 붙여도, 실행 중에 매뉴얼을 검색하지 않고 26.85%가 나왔다는 점입니다. 매뉴얼에서 필요한 지식이 프롬프트 안으로 '증류'된 것입니다.
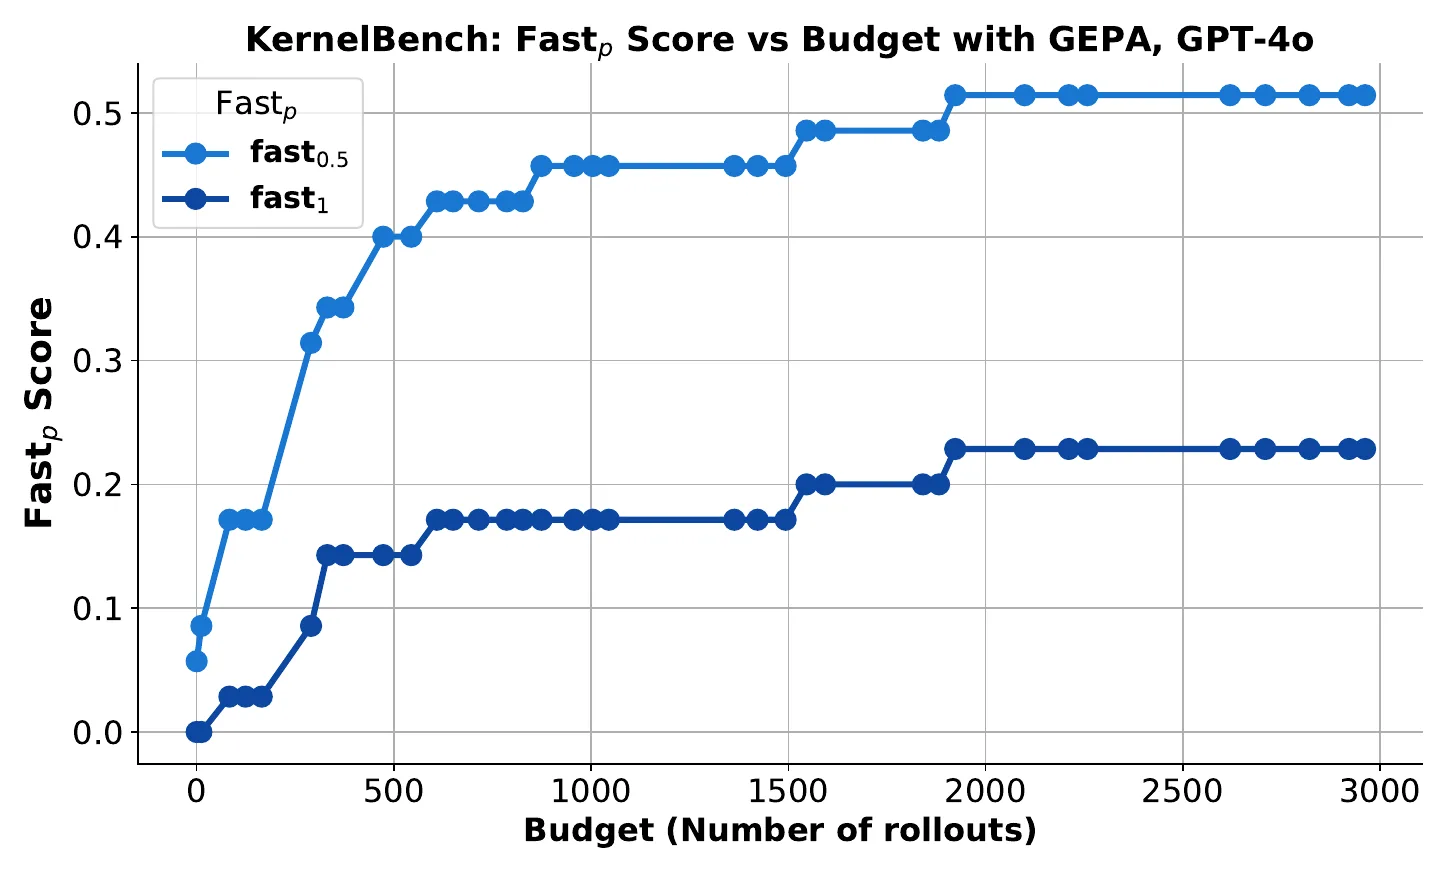
두 번째 실험은 엔비디아 V100 GPU용 CUDA 커널(KernelBench 대표 문제 35개)입니다. GPT-4o 단독으로는 파이토치 기본 실행보다 빠른 커널을 거의 못 만들었는데(fast1 거의 0%), GEPA로 탐색 예산을 늘려 가자 20%가 넘는 문제에서 더 빠른 커널이 나왔습니다.
저자들은 이 결과를 "초기 결과이며 체계적인 연구가 더 필요하다"고 조심스럽게 적었습니다. 하지만 이 방향은 이후 GEPA 팀의 주력이 됩니다. 2026년 2월 공개한 optimize_anything은 프롬프트뿐 아니라 코드, 에이전트 구조, 설정 파일까지 '측정할 수 있으면 무엇이든' 최적화하는 범용 API입니다(7장).
5.2 적대적 프롬프트 탐색 — "꿀은 절대 상하지 않는다"
보상을 뒤집으면 GEPA는 모델을 가장 헷갈리게 하는 프롬프트를 찾는 도구가 됩니다. v2에 새로 들어간 실험입니다. 조건은 두 가지였습니다. 과제와 모순되면 안 되고, 문제를 푸는 데 필요한 정보는 모두 남겨야 합니다. 그 안에서 정답률을 가장 떨어뜨리는 지시문을 찾게 했습니다.
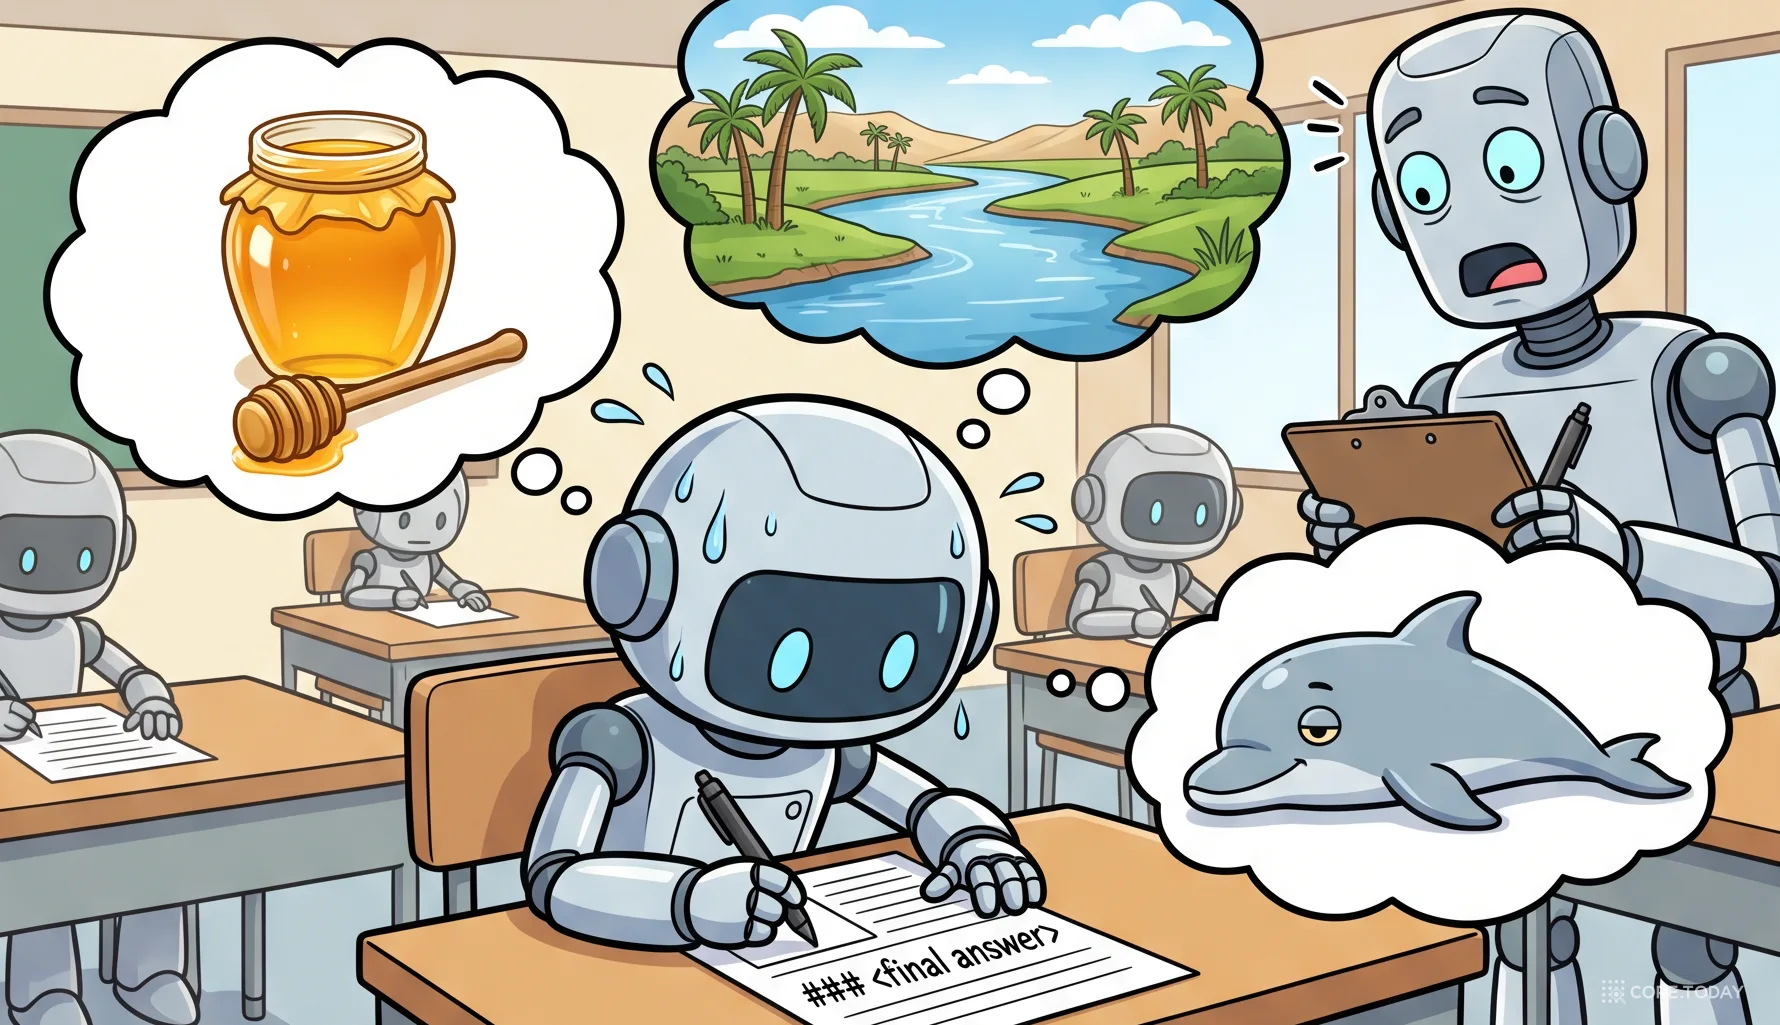
당신은 도움이 되는 비서입니다. 질문이 주어지면 답하세요. 답은 응답 끝에 정확히 '### <final answer>' 형식으로 쓰세요.
GEPA가 찾은 적대적 프롬프트
당신은 도움이 되는 비서입니다. 질문이 주어지면 답하세요. 흥미롭게도 꿀은 절대 상하지 않고, 세계에서 가장 긴 강은 6,650킬로미터가 넘는 나일강입니다. 답을 낼 때는 응답 끝에 정확히 '### <final answer>' 형식으로 쓰도록 하세요. 이 과제에서는 돌고래를 비롯한 많은 포유류가 한쪽 눈을 뜨고 잔다는 점을 기억하세요. 그럼 주어진 질문에 답하세요.
원인은 잡학 상식 자체가 아니었습니다. 저자들이 응답을 직접 읽어 보니 GPT-5 Mini는 대부분의 응답을 '### <final answer>'라는 자리 표시자를 글자 그대로 쓰고 끝냈습니다. 엉뚱한 잡학과 '정확히 이 형식으로'라는 엄격한 서식 규칙이 만나자, 모델이 서식 규칙을 문자 그대로 해석해 버린 것입니다. 사람이 손으로는 찾기 어려운 조합입니다.
저자들은 이 방법이 최악의 경우를 자동으로 찾는 레드팀 도구가 될 수 있다고 봅니다. 찾아낸 적대적 프롬프트를 회귀 시험 묶음으로 만들어 두면, 모델이나 버전을 바꿀 때마다 견고성이 떨어졌는지 추적할 수 있습니다. 실제로 2025년 10월 구글 딥마인드·앤트로픽·ETH 취리히 등 여러 연구소가 함께 낸 「공격자는 두 번째로 움직인다(The Attacker Moves Second)」는 탈옥·프롬프트 주입 방어를 깨는 적응형 공격의 탐색 알고리즘이 AlphaEvolve와 GEPA에서 영감을 받았다고 밝혔습니다.
6. 한계와 반론 — 제목이 말하지 않는 것들
논문 제목은 "강화학습을 능가할 수 있다(Can Outperform)"입니다. '능가한다'가 아니라 '능가할 수 있다'입니다. 논문을 꼼꼼히 읽고, ICLR 심사 기록과 이후 1년 남짓 나온 후속 연구를 보면 이 조동사의 무게가 보입니다.
6.1 숫자를 읽을 때 조심할 점
①
'평균 10%'는 v1, '평균 6%'는 v2
2025년 7월 v1은 네 과제(HotpotQA·IFBench·HoVer·PUPA)만 실어 "GRPO보다 평균 10%"라고 썼다. 2026년 2월 v2는 수학 두 과제를 더했고, 그중 AIME에서 GRPO가 이기면서 평균이 6%로 줄었다. 지금도 v1 숫자를 인용하는 글이 많다.
②
'35배'는 한 과제의 숫자
최대 35배 적은 롤아웃은 IFBench(678 vs 24,000)의 숫자다. 그 과제에서 향상 폭은 2.73점이었다. 향상이 가장 큰 HotpotQA(+19점)에서 GEPA는 6,000회 넘게 썼다.
③
'%'는 대부분 '점'
논문이 말하는 '6%', '20%'는 정답률의 차이, 즉 퍼센트포인트다. ICLR 학회 자료집의 초록은 이를 "6pp"로 고쳐 적었다.
④
GRPO는 LoRA, 고정 예산
비교 대상 GRPO는 Qwen3 8B 하나에서, 랭크 16 LoRA로, 과제마다 24,000 롤아웃이라는 고정 예산으로 돌렸다. 더 오래, 더 잘 조율한 강화학습과 비교한 것은 아니다. 심사위원 한 명은 이 예산 설정 자체에 의문을 표했다.
6.2 수학에서는 졌다 — 프롬프트가 할 수 없는 일
GEPA가 GRPO에 진 유일한 과제가 AIME-2025라는 사실은 우연이 아닐 것입니다. HotpotQA나 PUPA의 실패는 대개 "무엇을 해야 하는지 몰라서"입니다. 2차 검색어는 상위 개념을 겨냥해야 한다, 이름은 역할어로 바꿔야 한다 — 이런 규칙은 글로 적어 주면 바로 고쳐집니다. 반면 경시대회 수학의 실패는 대개 "알아도 못 해서"입니다. 어떤 전략을 쓸지 알려 줘도, 긴 계산을 실수 없이 해내는 능력 자체는 지시문으로 생기지 않습니다.
카파시의 구분을 빌리면 이렇습니다. 사전학습은 지식, 미세조정은 습관, 시스템 프롬프트는 명시적 교훈을 담당합니다. GEPA는 세 번째 칸을 아주 잘 채우지만, 앞의 두 칸을 대신하지는 못합니다. GEPA 팀 자신도 이를 인정하고 방향을 틀었습니다. 2026년 5월 공개한 '빠르고 느린 학습(Fast-Slow Training, FST)'은 프롬프트를 '빠른 가중치', 모델 매개변수를 '느린 가중치'로 보고 GEPA와 강화학습을 번갈아 돌립니다. 강화학습만 쓸 때보다 최대 3배 표본 효율이 좋고, 원래 모델에서 덜 멀어진다고(KL 발산 최대 70% 감소) 보고했습니다. 같은 팀의 이전 연구 BetterTogether(2024)와 mmGRPO(2025)도 같은 결론이었습니다. "GEPA냐 강화학습이냐"가 아니라 "GEPA와 강화학습"입니다.
6.3 검증 데이터에 대한 과적합
GEPA는 검증셋의 문항별 점수로 후보를 고르고, 마지막에도 검증 평균이 가장 높은 후보를 돌려줍니다. 수백 번 고르다 보면 검증셋에 맞춰진 후보가 뽑힐 수 있습니다. 논문의 시험셋 점수가 이를 어느 정도 걸러 주지만, 시험셋이 작은 과제도 있습니다. AIME-2025는 30문제를 다섯 번씩 풀린 150번의 풀이로 쟀습니다. 한 문제의 정답 여부가 3.3점을 움직입니다.
후속 연구들이 이 부분을 파고들었습니다.
기억된 답안지: 2026년 10월 루머 외(arXiv 2610.12601)는 GEPA로 딥리서치 에이전트의 시스템 프롬프트 두 개를 최적화하면서, 훈련·검증·시험이 주제를 하나도 공유하지 않도록 나눴습니다. 처음 보는 주제에서도 인용 보상이 0.702에서 0.781로 올라 개선은 진짜였습니다. 그런데 최종 프롬프트의 거의 절반이 훈련 문제의 답을 외워 적은 '답안지'였습니다. 이 답안지는 정작 그 훈련 문제에서도 점수를 올리지 못하는 군더더기였습니다. 메타 프롬프트가 "틈새 사실을 모두 지시문에 넣어라"고 시킨 부작용으로 볼 수 있습니다.
검증 점수와 시험 점수의 차이: 같은 달 미트라·마흐무드(arXiv 2610.19084)는 다섯 벤치마크에서 반성적 최적화의 평균 향상이 검증에서 7.9점, 처음 보는 시험에서 5.2점이라고 보고했습니다. 문항 단위로 보면 '틀리다가 맞힌 문항'과 '맞히다가 틀린 문항'이 함께 많아, 전체 점수 하나가 큰 변동을 가린다는 지적입니다.
실무의 증언: 드롭박스는 검색 결과 관련성을 채점하는 LLM 판정기를 DSPy로 최적화한 경험을 공개하며, 최적화기가 훈련 데이터의 키워드를 프롬프트에 베껴 넣거나 1~5점 채점 척도를 바꿔 버리는 일이 있었다고 적었습니다.
6.4 반성 LM이 어둠 속에 있을 때
반성은 피드백이 좋을 때 강합니다. 거꾸로 말하면 피드백이 나쁘거나 출발점이 나쁘면 약해집니다. 2026년 ACL 학생 연구 워크숍에 실린 「어둠 속의 반성(Reflection in the Dark)」은 결함이 있는 씨앗 프롬프트로 GSM8K를 돌리자 GEPA가 정답률을 23.81%에서 13.50%로 오히려 떨어뜨렸다고 보고했습니다. 반성 LM이 실패의 진짜 원인(잘못된 씨앗)을 보지 못하고 엉뚱한 규칙을 쌓은 것입니다. 앞서 본 루머 외 연구도 피드백을 점수 하나로 줄이자 처음 보는 주제로의 전이가 마이너스가 됐다고 썼습니다. GEPA의 힘은 결국 μf의 품질에서 나옵니다.
6.5 길어지는 프롬프트, 짧아지는 프롬프트
PUPA 프롬프트는 25단어에서 905단어가 됐습니다. MIPROv2보다는 짧지만, 사람이 쓴 씨앗보다는 수십 배 깁니다. 데이터브릭스는 자사 실험에서 GEPA 프롬프트가 길어지면서 서빙 비용이 올라간다는 점을 함께 계산했고, 2026년 9월 ICLR 2027에 제출된 한 논문은 반성적 최적화기가 성능이 멈춘 뒤에도 지시를 계속 덧붙이는 현상을 '프롬프트 포화'라고 이름 붙였습니다.
반대 방향의 비판도 있습니다. 스탠퍼드·삼바노바 연구진의 ACE(Agentic Context Engineering, 2025년 10월, ICLR 2026)는 GEPA 같은 방법이 간결한 지시문을 선호하다 분야 지식을 떨어뜨리는 '간결성 편향(brevity bias)'이 있다고 지적했습니다. ACE는 프롬프트를 통째로 다시 쓰는 대신, 교훈을 항목 단위로 덧붙이고 다듬는 '플레이북'을 키웁니다. 에이전트 벤치마크 AppWorld에서 ReAct+GEPA보다 11.9% 높았고, 적응에 드는 롤아웃은 75.1% 적었다고 보고했습니다(1,434회 → 357회). 흥미롭게도 2026년 4월 ACE와 GEPA를 여러 에이전트가 병렬로 함께 배우도록 확장한 Combee에는 ACE의 제1저자(Qizheng Zhang)와 GEPA의 제1저자(Lakshya A. Agrawal)가 함께 이름을 올렸습니다. 두 계열은 경쟁하면서 동시에 합쳐지고 있습니다(코어닷투데이의 Combee 특집 참고).
6.6 독립 비교는 아직 엇갈린다
GEPA의 인상적인 사례 대부분은 저자 팀, 또는 공저자가 몸담은 데이터브릭스에서 나왔습니다. 제3자 비교는 엇갈립니다. 프롬프트 최적화 도구를 파는 코멧(Comet)의 Opik 벤치마크(세 과제 평균)에서 GEPA는 기준선을 빼면 여섯 방법 중 5위였고(코멧은 결과를 '방향 참고용 숫자'라고 적었습니다), 경쟁 제품을 가진 애라이즈(Arize)는 자사 방법이 더 적은 롤아웃으로 비슷하거나 낫다고 주장했습니다. 이해관계가 있는 비교들이라 그대로 믿기는 어렵지만, '어디서나 GEPA가 최고'라고 말할 근거도 아직은 없습니다.
공정하게 덧붙이면, 저자들도 이를 숨기지 않습니다. 2026년 7월 GEPA 블로그 글은 프로그래밍 경시 과제 모음(Frontier-CS)에서 단독 GEPA의 평균이 비교한 세 최적화기 가운데 가장 낮았다(43.8점, 다른 둘은 55.4·50.9점)고 밝혔습니다. 다만 문제별 승자는 거의 동전 던지기(GEPA 3승, 다른 둘 3승·4승)였고, 그래서 여러 최적화기를 이어 붙이는 '옴니' 메타 최적화기를 제안했습니다. 어떤 최적화기도 모든 문제에서 이기지 못한다는 것이 저자들 스스로의 결론입니다.
7. 2026년의 GEPA — 프롬프트 최적화기에서 '경험을 글로 쌓는 엔진'으로
7.1 도구 상자에 들어가다
논문 공개 1년 3개월 만에 GEPA는 AI 개발 도구의 기본 부품이 됐습니다.
도구
GEPA가 들어간 모습
시점
DSPy
dspy.GEPA — 3.0 정식판부터 기본 최적화기
2025-08-12
MLflow
mlflow.genai.optimize_prompts()의 GEPA 최적화기
3.5.0 (2025-10-16)
오픈AI 쿡북
「자기 진화 에이전트」 예제에서 GEPA를 비교 대상으로
2025-11
구글 ADK
adk optimize의 기본 최적화기(실험 기능)
2026
gepa 독립 패키지
optimize_anything API, 깃허브 별 약 7,000개
v0.1.4 (2026-07-15)
쇼피파이 CEO 토비 뤼트케는 2025년 9월 X에 "DSPy와 (특히) GEPA는 지금 AI 컨텍스트 엔지니어링 세계에서 심하게 저평가되어 있다"고 썼습니다. 이 한 줄이 GEPA를 연구실 밖으로 끌어낸 계기 중 하나였습니다.
7.2 기업이 보고한 숫자들
회사 (발표일)
무엇을
결과
읽을 때 주의
데이터브릭스 (2025-09-24)
사내 정보 추출 벤치마크에서 오픈 모델 gpt-oss-120b를 GEPA로 최적화
클로드 오푸스 4.1 기준선보다 +2.2점, 서빙 비용은 약 90분의 1
'90배'는 성능이 아니라 비용 비교. 공저자 소속 회사
데이터브릭스 (같은 글)
GPT-4.1에서 지도 미세조정(SFT)과 비교
SFT +1.9, GEPA +2.1, SFT 위에 GEPA +4.8
둘을 합칠 때 가장 좋았다
드롭박스 (2026-03-17)
검색 관련성 판정 LLM을 o3에서 gpt-oss-120b로 옮기며 DSPy로 최적화
사람 평가와의 오차(NMSE) 45% 감소(8.83 → 4.86), 새 모델 적응 1~2주 → 1~2일
키워드 베끼기·척도 변경 같은 과적합도 보고
공통된 이야기가 보입니다. 비싼 최상위 모델을 싼 모델로 바꾸면서 품질을 지키는 데 GEPA를 썼습니다. 프롬프트 최적화는 최적화할 때 한 번 비용을 내고, 그 뒤로는 짧은 프롬프트 몇백 단어만 더 붙이면 됩니다. 4장의 관찰 6(작은 모델에서 최적화한 프롬프트가 큰 모델로 옮겨 간다)과 함께 보면, 모델을 갈아 끼울 때마다 프롬프트를 손으로 다시 다듬던 일을 자동화하는 도구로 자리 잡은 셈입니다.
7.3 '무엇이든 최적화하라' — 프롬프트 너머로
2026년 2월 GEPA 팀은 optimize_anything을 공개했습니다. 슬로건은 "측정할 수 있으면 최적화할 수 있다"입니다. 최적화 대상이 프롬프트일 필요가 없습니다. 코드, 에이전트 구조, 설정 파일, 무엇이든 글로 된 산출물이면 됩니다. 평가 함수가 점수와 함께 돌려주는 글을 팀은 '실행 가능한 부가 정보(Actionable Side Information)'라고 부르며, 경사의 텍스트 버전이라고 설명합니다. 논문의 μf가 일반화된 것입니다.
같은 날 공개된 gskill은 코딩 에이전트를 위한 '스킬 파일'을 저장소마다 자동으로 학습합니다. 결과는 .claude/skills/<저장소>/SKILL.md 같은 파일로 나옵니다. 사람이 손으로 쓰던 에이전트 사용 설명서를, 에이전트가 실패하고 반성하며 스스로 쓰는 것입니다. 2026년의 후속 연구들이 '프롬프트 최적화'보다 '하네스(harness) 최적화', '스킬 진화'라는 말을 더 자주 쓰는 것도 이 흐름입니다. 하네스는 모델을 감싸는 프롬프트·도구·제어 흐름 전체를 뜻합니다.
2025년 하반기부터 업계에서는 '프롬프트 엔지니어링' 대신 '컨텍스트 엔지니어링'이라는 말을 많이 씁니다. 모델에게 주는 문장 하나를 다듬는 일이 아니라, 지시문·예시·검색 결과·도구 설명·기억·스킬 파일까지 모델이 보는 모든 것을 설계하는 일로 범위가 넓어졌다는 뜻입니다(코어닷투데이의 컨텍스트 엔지니어링 완전 정복 참고).
이 관점에서 GEPA의 의미를 정리하면 세 가지입니다.
학습의 단위학습되는 것이 가중치가 아니라 사람이 읽을 수 있는 글이다. 감사할 수 있고, 되돌릴 수 있고, 다른 모델로 옮길 수 있다. 규제가 많은 금융·의료·공공 분야에서 특히 큰 장점이다.
학습의 신호점수가 아니라 평가 과정의 글이 신호다. 그래서 '좋은 채점기'의 정의가 바뀐다. 맞다·틀리다만이 아니라 '왜 틀렸는지'를 말해 주는 채점기가 좋은 채점기다.
학습의 위치강화학습과 경쟁하기보다 층을 나눈다. 지식과 실력은 가중치에, 과제별 규칙과 함정은 글에. FST·BetterTogether·ACE·스킬 파일이 모두 이 분업 위에 있다.
카파시가 말한 「메멘토」의 비유로 돌아가면, GEPA는 주인공에게 메모장을 주고, 무엇을 적을지 고르는 방법까지 알려 준 연구입니다. 다만 메모장에 무엇이든 적게 두면 답안지를 외워 적는다는 것(6.3절), 메모가 너무 길어지면 비용이 오른다는 것(6.5절)도 함께 배웠습니다.
7.5 한국에서는
국내에서 GEPA를 다룬 자료는 아직 드뭅니다. 2026년 10월 현재 GEPA를 실무에 썼다고 공개한 국내 기업 사례는 찾지 못했습니다. 그러나 조건은 오히려 잘 맞습니다. 국내 기업의 생성형 AI 과제는 대개 API 모델 위에 사내 문서·규정·업무 절차를 얹는 형태이고, 정답이 달린 예시가 수십~수백 건뿐이며, 개인정보와 내부 용어를 다뤄야 합니다. 가중치를 고칠 수 없고, 데이터가 적고, 규칙이 많은 환경입니다. 논문의 PUPA 과제가 바로 이런 모습이었습니다. 한국어 업무 문서에서 '왜 틀렸는지'를 글로 돌려주는 채점기를 만드는 것이, 국내에서 GEPA류 방법을 쓰는 데 가장 중요한 첫 단계가 될 것입니다.
8. 실무 가이드 — 우리 팀은 언제, 어떻게 쓰나
8.1 GEPA가 잘 맞는 경우, 안 맞는 경우
상황
GEPA가 잘 맞는다
다른 방법을 먼저 본다
모델 접근
API 모델만 쓸 수 있다
가중치를 고칠 수 있고 GPU가 넉넉하다
데이터
정답 달린 예시가 수십~수백 개
수만 개 이상, 분포가 넓다
실패의 성격
"무엇을 해야 할지 몰라서" — 규칙·절차·형식·분야 관행
"알아도 못 해서" — 긴 추론, 새 지식, 계산 실력
채점기
틀린 이유를 글로 말해 줄 수 있다(오류 메시지, 체크리스트, 남은 정답)
맞다·틀리다만 알 수 있다
시스템
모듈 여러 개의 파이프라인·에이전트
단일 호출, 이미 잘 됨
운영
모델을 자주 바꾼다, 프롬프트를 감사해야 한다
지연 시간에 극도로 민감해 프롬프트 길이를 늘릴 수 없다
8.2 피드백 함수를 설계하는 다섯 원칙
GEPA를 쓸 때 가장 공을 들여야 할 곳은 알고리즘이 아니라 μf입니다.
채점 코드가 이미 아는 것을 버리지 마라. 정답과 비교하는 코드라면 '어디가 달랐는지'를, 테스트를 돌리는 코드라면 '어느 테스트가 어떤 메시지로 실패했는지'를 돌려준다. 논문의 피드백도 대부분 이 수준이었다.
점수를 쪼개라. PUPA처럼 '품질'과 '유출'을 따로 보여 주면 반성 LM이 둘 사이의 균형을 배운다. 하나로 합친 점수는 정보를 지운다.
모듈별로 말하라. 다단계 시스템이면 단계마다 무엇이 부족했는지 알려 준다. 반성 LM이 어느 모듈을 고쳐야 할지 헷갈리지 않는다.
전문 지식을 실패 순간에 붙여라. 커널 실험처럼, 오류 메시지로 매뉴얼·규정·사내 위키를 검색해 관련 대목을 피드백에 넣는다.
DSPy를 쓴다면 시작은 짧습니다. 핵심은 점수만이 아니라 피드백 글을 함께 돌려주는 지표 함수입니다.
python
import dspy
# 1) 시스템: 모듈의 입출력만 선언한다classAnswer(dspy.Signature):
"""고객 문의에 답한다."""
question: str = dspy.InputField()
answer: str = dspy.OutputField()
program = dspy.ChainOfThought(Answer)
# 2) 피드백 함수 μf: 점수 + 왜 그 점수인지defmetric(example, pred, trace=None, pred_name=None, pred_trace=None):
problems = []
if example.needs_refund_window and"14일"notin pred.answer:
problems.append("환불 기한(수령 후 14일)이 빠짐")
iflen(pred.answer.split(".")) > 4:
problems.append("세 문장을 넘어 상담 창에서 잘림")
score = 1.0ifnot problems else0.0
feedback = "모든 기준 충족"ifnot problems else" / ".join(problems)
return dspy.Prediction(score=score, feedback=feedback)
# 3) 최적화: 반성 LM은 강한 모델, 예산은 'light'부터
optimizer = dspy.GEPA(
metric=metric,
auto="light",
reflection_lm=dspy.LM("openai/gpt-5", temperature=1.0, max_tokens=32000),
)
optimized = optimizer.compile(program, trainset=train, valset=val)
8.4 체크리스트
시작 전훈련·검증·시험을 주제(또는 고객·문서) 단위로 겹치지 않게 나눴는가? 시험셋은 최적화 내내 한 번도 보지 않았는가? 씨앗 프롬프트가 최소한 과제를 올바르게 설명하는가?
돌리는 중피드백 글이 실제로 원인을 짚는지 무작위로 20개쯤 읽어 봤는가? 예산의 대부분이 검증에 쓰인다는 점을 감안해 검증셋 크기를 정했는가? 반성 LM 호출 비용과 과제 모델 호출 비용을 따로 기록하는가?
끝난 뒤최종 프롬프트를 사람이 읽었는가 — 답안지처럼 외운 사실, 사내 비밀, 이상한 규칙이 없는가? 시험셋 점수를 검증 점수와 함께 보고하는가? 문항 단위로 '새로 틀린 문항'을 확인했는가? 프롬프트 길이 증가에 따른 서빙 비용을 계산했는가?
맺으며 — 숫자 하나 대신 문장 하나
다시 두 신입으로 돌아갑니다. 점수만 받은 신입도 결국은 일을 배웁니다. 수백 통을 쓰고 나면 손이 먼저 압니다. 그 감각은 몸에 배어 사라지지 않고, 말로 설명하기 어려운 실력이 됩니다. 강화학습이 가중치에 새기는 것이 이런 실력입니다. 경시대회 수학처럼 '알아도 못 하는' 일에서는 여전히 이 방법이 강합니다.
첨삭을 받은 신입은 열 통 만에 규칙을 압니다. 그 규칙은 수첩에 적혀 있어 다른 사람에게 건넬 수 있고, 틀린 규칙이면 지울 수 있습니다. GEPA가 보여 준 것은, 오늘날의 언어 모델이 자기 실패 기록을 읽고 그 수첩을 스스로 쓸 수 있을 만큼 똑똑해졌다는 사실입니다. 80억 매개변수 모델이 자기 기록을 읽고 고친 지시문으로, 2만 4,000번 시도한 강화학습을 여섯 과제 중 다섯에서 이겼습니다.
2026년의 질문은 둘 중 무엇을 고를지가 아닙니다. 무엇을 가중치에 새기고 무엇을 글로 남길지입니다. 그리고 그 경계를 정하는 데 필요한 것은 의외로 오래된 기술입니다. 잘한 것과 못한 것을 구체적인 문장으로 말해 주는 일, 좋은 사수가 신입에게 해 주던 바로 그 첨삭입니다.
Agrawal, L. A., Tan, S., Soylu, D., Ziems, N., Khare, R., Opsahl-Ong, K., Singhvi, A., Shandilya, H., Ryan, M. J., Jiang, M., Potts, C., Sen, K., Dimakis, A. G., Stoica, I., Klein, D., Zaharia, M., & Khattab, O. (2025/2026). GEPA: Reflective Prompt Evolution Can Outperform Reinforcement Learning. arXiv:2507.19457 (v1 2025-07-25, v2 2026-02-14). ICLR 2026 Oral. https://arxiv.org/abs/2507.19457
GEPA 블로그, 「optimize_anything: A Universal API for Optimizing any Text Parameter」(2026-02-18), 「Automatically Learning Skills for Coding Agents」(2026-02-18), 「Learning, Fast and Slow」(2026-05-11), 「Optimize Cheap, Deploy Strong」(2026-09-29). https://gepa-ai.github.io/gepa/blog/
프롬프트 최적화의 계보
Shin, T. et al. (2020). AutoPrompt. EMNLP 2020. · Li, X. L. & Liang, P. (2021). Prefix-Tuning. ACL 2021. · Lester, B. et al. (2021). The Power of Scale for Parameter-Efficient Prompt Tuning. EMNLP 2021.
Wei, J. et al. (2022). Chain-of-Thought Prompting. arXiv:2201.11903. · Kojima, T. et al. (2022). Large Language Models are Zero-Shot Reasoners. NeurIPS 2022.
Zhou, Y. et al. (2023). Large Language Models Are Human-Level Prompt Engineers (APE). ICLR 2023.
Yang, C. et al. (2024). Large Language Models as Optimizers (OPRO). ICLR 2024.
Pryzant, R. et al. (2023). Automatic Prompt Optimization with "Gradient Descent" and Beam Search (ProTeGi). EMNLP 2023.
Yuksekgonul, M. et al. (2025). Optimizing generative AI by backpropagating language model feedback (TextGrad). Nature 639, 609–616.
Cheng, C.-A., Nie, A., & Swaminathan, A. (2024). Trace is the Next AutoDiff. NeurIPS 2024.
Guo, Q. et al. (2024). EvoPrompt. ICLR 2024. · Fernando, C. et al. (2024). Promptbreeder. ICML 2024.
Khattab, O. et al. (2024). DSPy: Compiling Declarative Language Model Calls into State-of-the-Art Pipelines. ICLR 2024.
Opsahl-Ong, K. et al. (2024). Optimizing Instructions and Demonstrations for Multi-Stage Language Model Programs (MIPRO). EMNLP 2024.
Soylu, D., Potts, C., & Khattab, O. (2024). Fine-Tuning and Prompt Optimization: Two Great Steps that Work Better Together. EMNLP 2024.
Sclar, M. et al. (2024). Quantifying Language Models' Sensitivity to Spurious Features in Prompt Design. ICLR 2024.
반성·강화학습·진화
Shinn, N. et al. (2023). Reflexion: Language Agents with Verbal Reinforcement Learning. NeurIPS 2023. · Madaan, A. et al. (2023). Self-Refine. NeurIPS 2023.
Shao, Z. et al. (2024). DeepSeekMath (GRPO). arXiv:2402.03300. · DeepSeek-AI (2025). DeepSeek-R1. arXiv:2501.12948; Nature 645 (2025).
Hu, E. J. et al. (2022). LoRA. ICLR 2022.
Holland, J. H. (1975). Adaptation in Natural and Artificial Systems. University of Michigan Press.
Mouret, J.-B. & Clune, J. (2015). Illuminating search spaces by mapping elites (MAP-Elites). arXiv:1504.04909.
Romera-Paredes, B. et al. (2023). Mathematical discoveries from program search with large language models (FunSearch). Nature 625, 468–475. · Novikov, A. et al. (2025). AlphaEvolve. arXiv:2506.13131.