Combee프롬프트 학습컨텍스트 엔지니어링ACEGEPA플레이북자기 개선 에이전트병렬 스캔MapReduce컨텍스트 과부하멀티 에이전트COLM 2026특집
[특집] 에이전트 마흔 대가 노트 한 권으로 배우는 법 — Combee와 병렬 프롬프트 학습, 그리고 '컨텍스트 과부하'
AI 에이전트가 가중치를 건드리지 않고 '노트'를 고쳐 쓰며 배우는 프롬프트 학습은 2025년 ACE·GEPA로 실력을 인정받았다. 그런데 에이전트 마흔 대를 동시에 돌려 그 경험을 한꺼번에 노트에 반영하려 하자 이상한 일이 벌어졌다. 회고를 많이 넣을수록 노트가 얇아지고, '셋째 자리가 5 이상이면 올린다' 같은 알짜 요령은 사라지고 '꼼꼼히 확인하라'만 남았다. 버클리·스탠퍼드 연구진이 COLM 2026에 낸 Combee는 이 '컨텍스트 과부하'를 병렬 스캔, 복제 셔플, 동적 배치 조절이라는 세 가지 분산 컴퓨팅의 지혜로 푼다. 이 글은 인컨텍스트 학습에서 ACE·GEPA까지의 계보, 과부하가 왜 생기는지, Combee의 설계를 MapReduce와 프리픽스 합의 역사와 함께 풀고, 논문의 표를 전부 다시 읽어 '최대 17배'가 무엇과 비교한 숫자인지 따진 뒤, 수천 대의 에이전트가 일하는 2026년에 이 기술이 맡을 자리를 인터랙티브 6개와 일러스트 14장으로 설명한다.
어느 회사 고객센터에 신입 상담원 한 명이 들어왔다고 해 봅시다. 팀장은 그에게 매일 퇴근 전 '오늘 배운 것' 한 줄을 쓰게 하고, 그 한 줄을 읽어 팀 매뉴얼에 덧붙입니다. "환불 문의에서 '배송 완료' 상태라도 택배사 조회가 안 되면 분실 접수부터 한다." "고객이 '지난번에 말했는데'라고 하면 상담 이력 탭을 먼저 연다." 한 달이 지나면 매뉴얼에는 이런 구체적인 요령이 수십 줄 쌓입니다. 다음 신입은 그 매뉴얼을 읽고 첫날부터 덜 헤맵니다.
이번에는 신입 마흔 명이 한꺼번에 들어왔습니다. 팀장은 똑같이 하려 하지만 하루에 일지가 마흔 장씩 쌓입니다. 하나씩 읽고 반영하면 밤을 새워야 합니다. 그래서 팀장은 마흔 장을 한 번에 펼쳐 놓고 ‘종합’하기로 합니다. 다음 날 아침 매뉴얼에 추가된 문장은 이것입니다.
고객 응대 시 꼼꼼하게 확인하고, 상황에 맞게 신중히 판단한다.
틀린 말은 하나도 없습니다. 그런데 아무 쓸모가 없습니다. 마흔 장 속에 있던 ‘택배사 조회’, ‘이력 탭’ 같은 구체적인 요령은 전부 이 한 문장 속으로 녹아 사라졌습니다.
이 우화는 지어낸 이야기지만, 2026년 4월 arXiv에 올라오고 9월에 고쳐져 언어 모델 학회 COLM 2026에 실린 논문 「Combee: Scaling Parallel Prompt Learning for Self-Improving LLM Agents」가 보고한 현상과 거의 똑같습니다. 다른 점은 상담원 대신 AI 에이전트가, 팀장 대신 집계 역할의 언어 모델이, 매뉴얼 대신 ‘플레이북’이라는 텍스트 파일이 등장한다는 것뿐입니다.
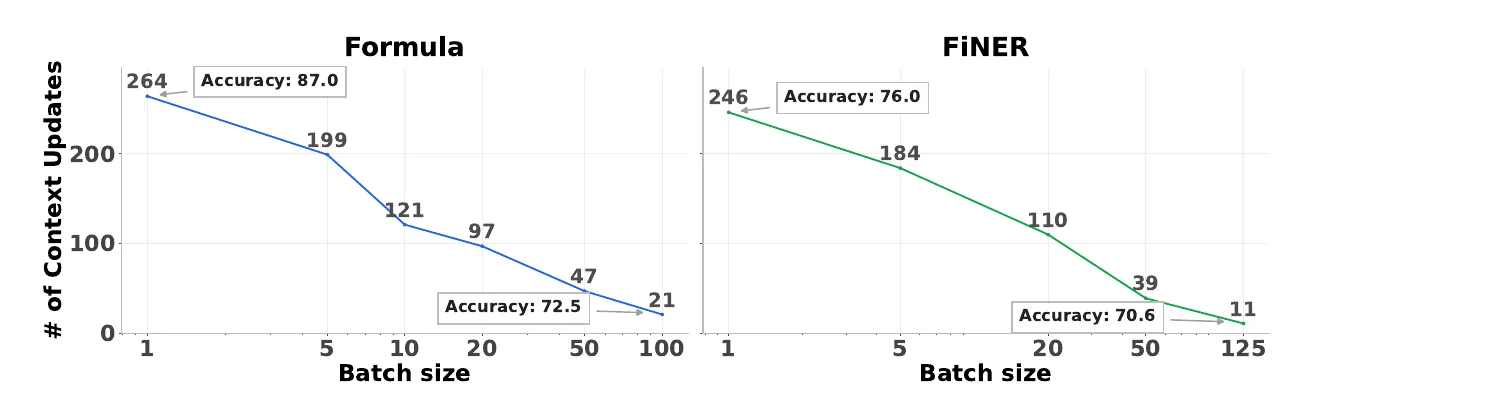
연구진은 재무 계산 문제 250개로 에이전트에게 플레이북을 쓰게 했습니다. 회고를 하나씩 읽으며 고친 플레이북에는 항목이 264개 쌓였고, 이 플레이북을 쓴 에이전트는 시험 문제의 87.0%를 맞혔습니다. 회고 100개를 한 번에 읽고 고친 플레이북에는 항목이 21개뿐이었고 정답률은 72.5%로 떨어졌습니다. 첫 번째 플레이북에서 실제 풀이에 가장 많이 도움이 된 항목(16번)은 이런 것이었습니다.
소수 둘째 자리로 반올림할 때는 셋째 자리를 본다. 5 이상이면 둘째 자리를 올린다(예: 1.335 → 1.34).
두 번째 플레이북에는 이런 항목이 남았습니다.
중간 계산은 높은 정밀도를 유지하고 최종 결과에서만 반올림하라.
반올림이 중요하다는 것까지는 기억했지만, ‘어떻게’는 잊었습니다. 논문은 이 현상에 컨텍스트 과부하(context overload)라는 이름을 붙였습니다. 그리고 그 해법으로 Combee라는 틀을 내놓았습니다. 이름은 벌집(comb)과 벌(bee)을 합친 말로 읽힙니다(논문은 이름의 유래를 따로 밝히지 않습니다). 일벌 여러 마리가 따로 꿀을 모아 와도 벌집 하나가 질서 있게 채워지듯, 에이전트 여러 대의 경험을 플레이북 하나로 잃지 않고 모으겠다는 뜻입니다.
저자 명단도 눈여겨볼 만합니다. UC 버클리와 스탠퍼드의 공동 연구인데, 플레이북 학습법 ACE의 제1저자 치정 장(Qizheng Zhang), 프롬프트 진화법 GEPA의 제1저자 락샤 아그라왈(Lakshya A Agrawal), 그리고 분산 처리 엔진 Spark·Ray와 추론 엔진 vLLM이 나온 버클리 연구실을 이끌어 온 이온 스토이카(Ion Stoica), vLLM·챗봇 아레나 연구에 참여한 조지프 곤잘레스(Joseph E. Gonzalez)가 함께 이름을 올렸습니다. 프롬프트 학습을 만든 사람들과 분산 시스템을 만든 사람들이 한 논문에서 만난 셈입니다. 그래서 이 논문은 ‘프롬프트를 어떻게 잘 쓰나’가 아니라 ‘배움을 어떻게 병렬로 돌리나’라는 시스템의 질문을 던집니다.
이 글은 다음 순서로 갑니다.
1~2장: 가중치 대신 ‘노트’로 배운다는 것이 무슨 뜻인지, 그리고 이 생각이 2020년 GPT-3에서 2025년 ACE·GEPA까지 어떻게 자라 왔는지
3~4장: 왜 2026년에 병렬이 필요해졌는지, 그리고 병렬로 돌리자 무엇이 망가졌는지(컨텍스트 과부하). 논문 부록의 실제 플레이북 두 개를 나란히 놓고 봅니다
5장: Combee의 세 가지 장치. MapReduce, 병렬 프리픽스 합, 임계 배치 크기라는 분산 컴퓨팅의 오래된 지혜가 어떻게 빌려 왔는지
6~7장: 논문의 표와 그림을 전부 다시 읽기. ‘최대 17배’는 무엇과 비교한 숫자인가, 그리고 ‘맥락은 기울기와 같다’는 비유
8~10장: 이 논문의 한계와 반론, 수천 대의 에이전트가 일하는 2026년에 이 기술의 자리, 그리고 우리 팀에 들일 때의 체크리스트
1장. 가중치 대신 노트로 배운다 — 프롬프트 학습이란
두 가지 배우는 법
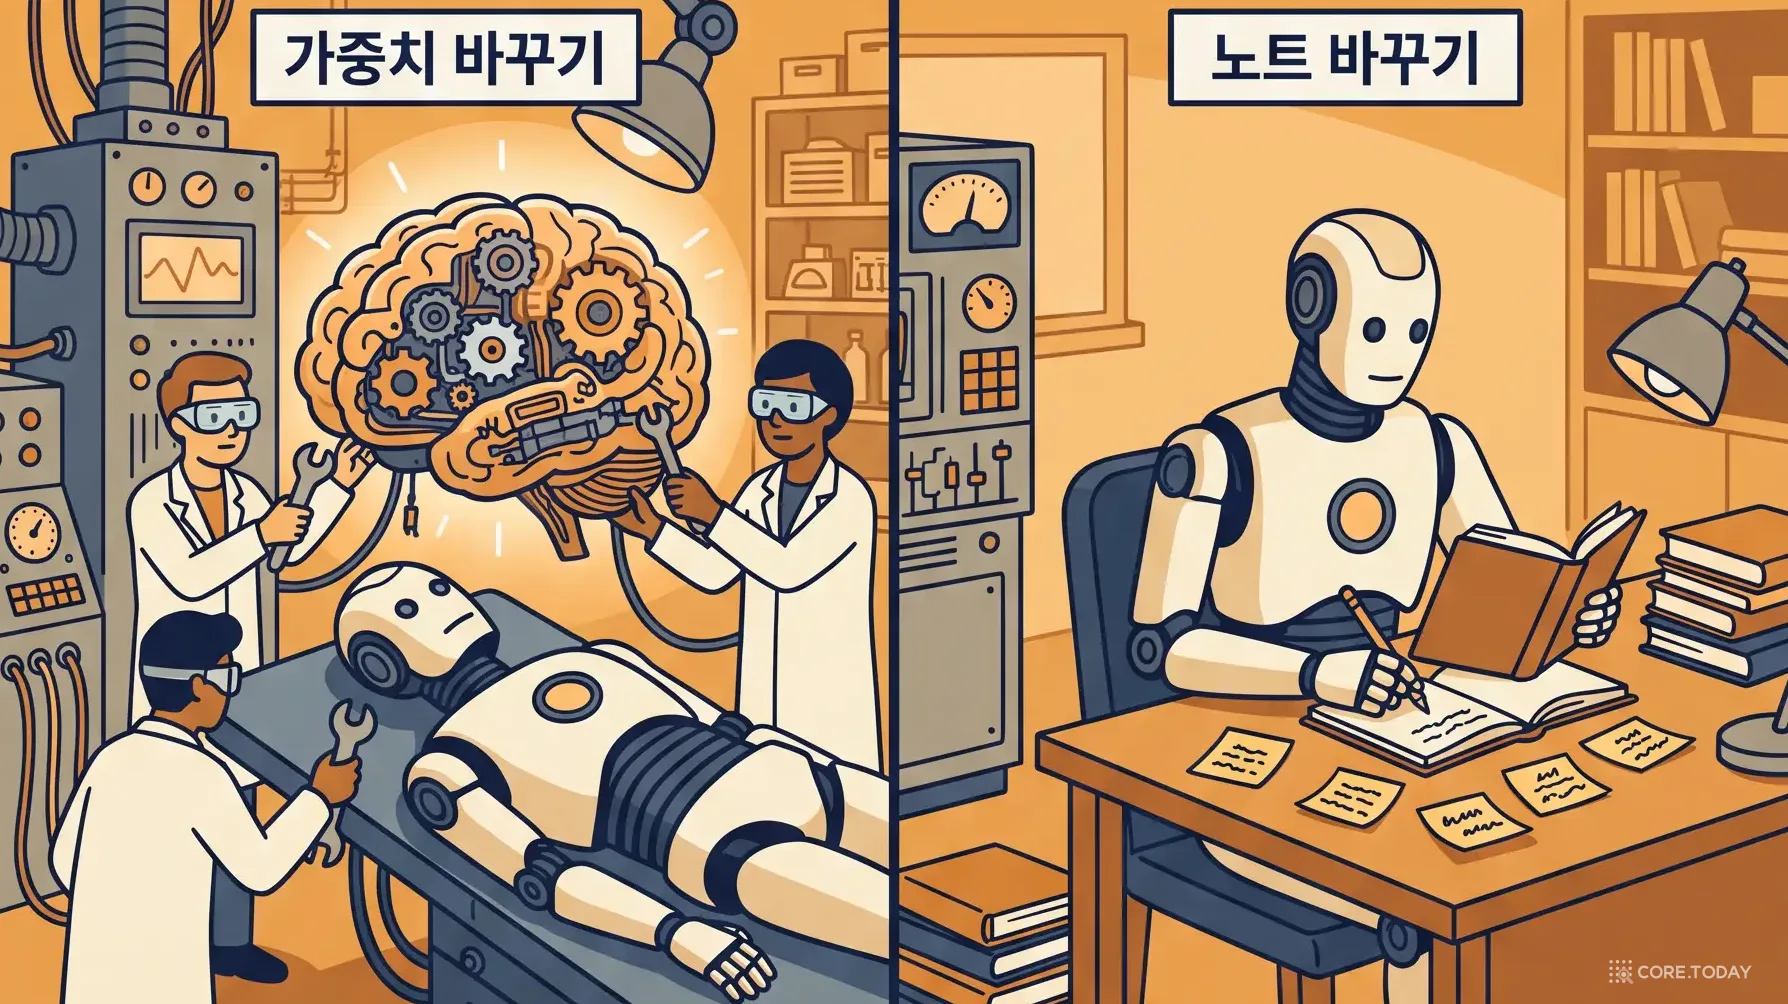
언어 모델이 새 일을 배우는 방법은 크게 둘입니다.
첫째는 가중치를 바꾸는 것입니다. 모델 안의 수천억 개 숫자(파라미터)를 데이터에 맞게 조금씩 고칩니다. 미세조정(fine-tuning)과 강화학습(RL)이 여기에 속합니다. 효과는 확실하지만 비쌉니다. GPU가 필요하고, 학습 데이터를 모아야 하고, 한 번 고친 가중치는 사람이 읽을 수 없습니다. 무엇을 배웠는지 알려면 다시 시험을 봐야 합니다. 무엇보다 오픈AI·앤트로픽·구글의 상용 모델은 사용자가 가중치를 직접 고칠 수 없습니다.
둘째는 모델에게 건네는 글을 바꾸는 것입니다. 모델은 그대로 두고, 시스템 프롬프트나 참고 문서 같은 ‘맥락(context)’을 고쳐 다음 번에 더 잘하게 만듭니다. 사람으로 치면 뇌 수술 대신 업무 노트를 고쳐 주는 것입니다.
두 번째 방식이 처음부터 ‘학습’으로 불린 것은 아닙니다. 오랫동안 이것은 사람이 손으로 하는 프롬프트 엔지니어링이었습니다. 그런데 2023년 무렵부터 모델이 스스로 자기 프롬프트를 고치기 시작했습니다. 일을 해 보고, 결과를 돌아보고, 다음 번을 위해 메모를 남기는 것입니다. 이것을 프롬프트 학습(prompt learning) 또는 컨텍스트 학습이라고 부릅니다. Combee 논문의 정의는 이렇습니다.
프롬프트 학습은 에이전트가 풍부한 입력(실행 궤적, 도구 호출 기록, 문서)에서 과제에 쓸모 있는 지식을 뽑아내, 플레이북·기억·스킬 라이브러리 같은 재사용 가능한 결과물로 굳히는 추론 시점의 학습 패러다임이다. 가중치는 전혀 바꾸지 않는다.
이 방식의 장점은 분명합니다.
싸고 빠릅니다. GPU 학습 없이 API 호출 몇 번으로 끝납니다. 뒤에서 보겠지만 Combee 논문의 한 실험은 학습 전체에 2달러가 들지 않았습니다.
읽을 수 있습니다. 배운 내용이 ‘유동비율은 단위를 맞춘 뒤 나눈다’ 같은 문장으로 남습니다. 사람이 검토하고, 틀린 줄을 지우고, 다른 팀에 복사해 줄 수 있습니다.
모델을 갈아타도 남습니다. 내년에 더 좋은 모델이 나오면 노트만 들고 옮겨 가면 됩니다.
상용 모델에도 됩니다. 가중치를 만질 수 없는 API 모델에서도 맥락은 얼마든지 바꿀 수 있습니다.
실행 → 회고 → 갱신, 한 바퀴
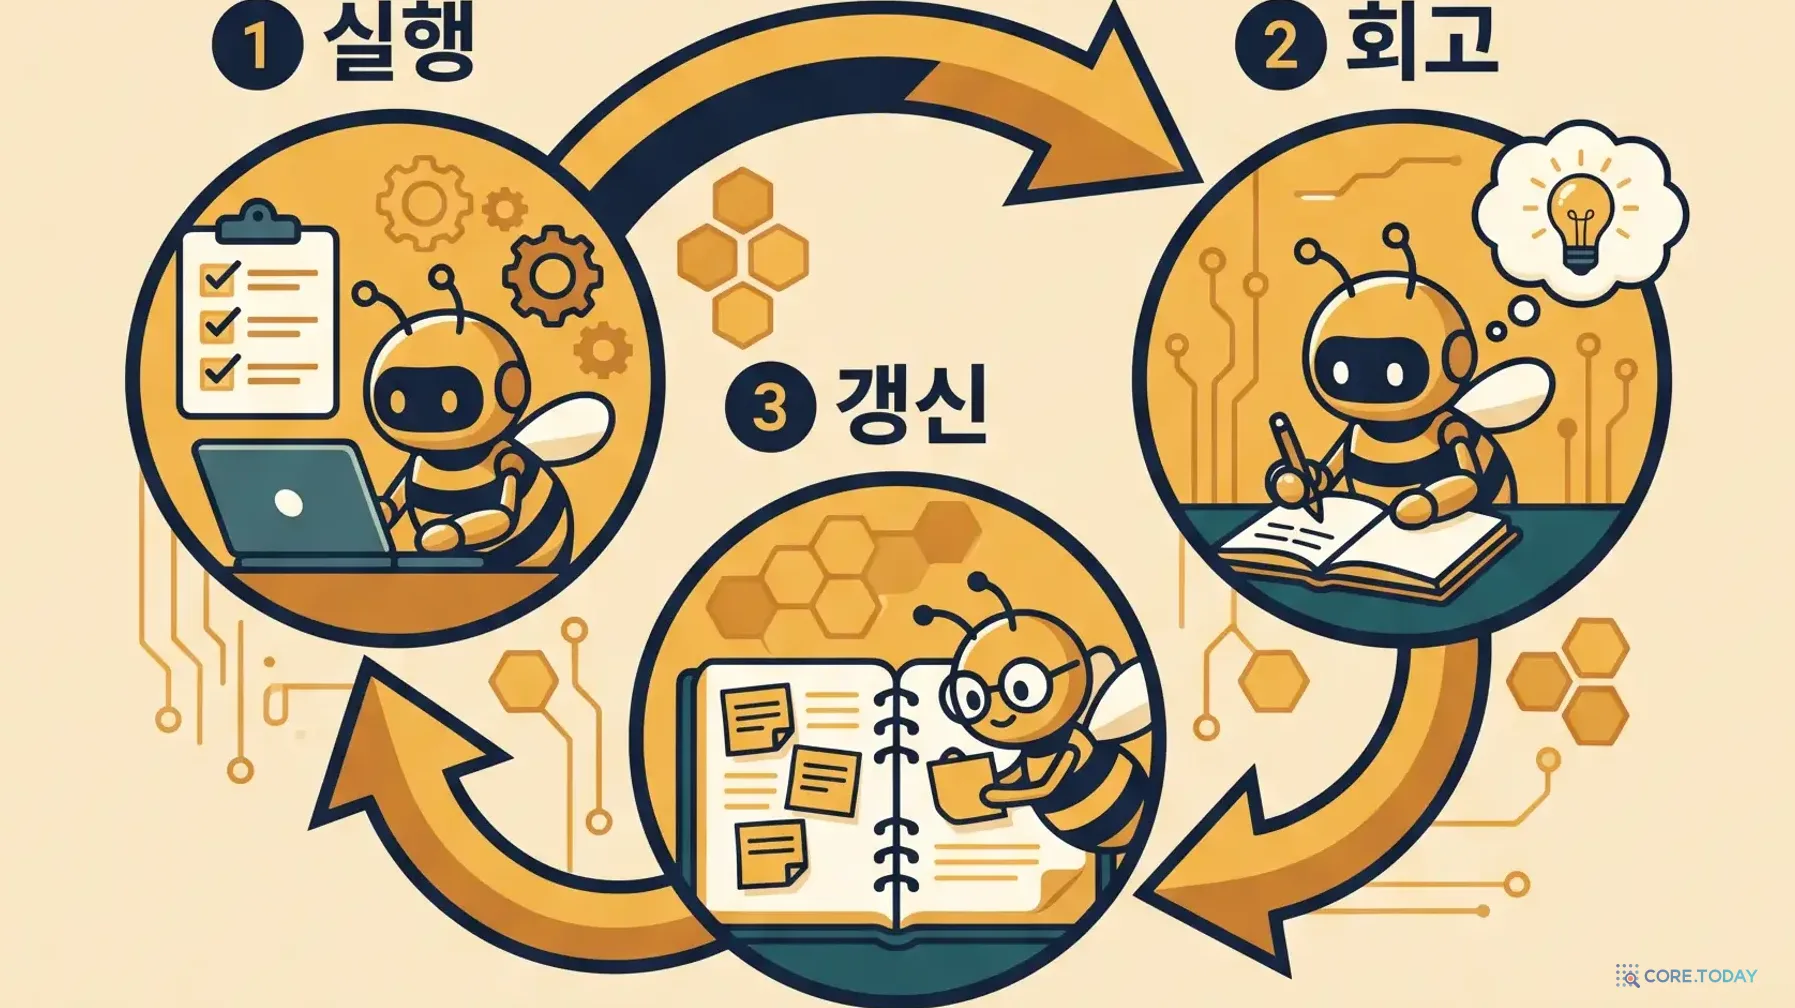
오늘날 대부분의 프롬프트 학습 방법은 같은 고리를 돕니다. 논문은 이것을 생성-회고-갱신(generate-reflect-update) 고리라고 부릅니다.
실행(generate): 에이전트가 현재 플레이북을 들고 과제를 풉니다. 예를 들어 ‘이 회사의 순이익률을 구하라’는 문제를 풀거나, 휴대폰 앱 API를 호출해 ‘지난달 벤모 송금 내역 중 가장 큰 것을 환불하라’는 일을 합니다. 이 과정의 모든 기록이 궤적(trajectory)입니다.
회고(reflect): 언어 모델이 궤적을 돌아보며 무엇이 잘됐고 무엇이 틀렸는지, 다음에는 어떻게 해야 하는지 적습니다. 이 글이 회고(reflection)입니다. 정답이 있는 과제라면 정답과 비교해 원인을 찾습니다.
갱신(update): 또 하나의 언어 모델(논문은 집계자aggregator 또는 큐레이터curator라고 부릅니다)이 회고를 읽고 플레이북에 무엇을 더할지 정합니다.
논문 부록 C는 이 고리를 수식 세 줄로 적습니다. 반복 t에서 맥락(플레이북)을 Ct, 환경을 E라고 하면
입니다. 궤적 τ를 만들고, 회고 F를 뽑고, 맥락 C를 고칩니다. 머신러닝을 아는 분이라면 ‘순전파 → 손실 계산 → 가중치 갱신’의 학습 고리와 꼭 닮았다는 것을 알아챌 겁니다. 다른 점은 고쳐지는 것이 숫자가 아니라 글이라는 것뿐입니다. 이 닮음은 7장에서 다시 중요해집니다.
일상에서 보는 같은 고리
이 고리는 사람에게 새롭지 않습니다.
수험생의 오답 노트. 문제를 풀고(실행), 틀린 문제의 이유를 적고(회고), 노트의 ‘자주 틀리는 유형’ 칸에 옮겨 적습니다(갱신). 좋은 오답 노트는 ‘계산 실수 조심’이 아니라 ‘분모에 루트가 있으면 유리화부터’처럼 구체적입니다.
주방의 레시피 노트. 요리사는 오늘 손님 반응을 보고 ‘소금 2g 줄임, 굽는 시간 40초 늘림’을 적습니다. ‘맛있게 만들 것’이라고 적는 요리사는 없습니다.
군대의 사후 검토(AAR). 훈련이 끝나면 ‘무엇을 하려 했나, 실제로 무엇이 일어났나, 왜 달랐나, 다음엔 무엇을 바꾸나’를 묻습니다.
이 모든 사례의 공통점은 좋은 노트는 구체적이라는 것입니다. 그리고 한 사람이 한 번에 하나씩 쓸 때는 구체성을 지키기 쉽습니다. 문제는 쓰는 사람이 마흔 명이 되고, 그것을 모으는 사람이 한 명일 때 생깁니다.
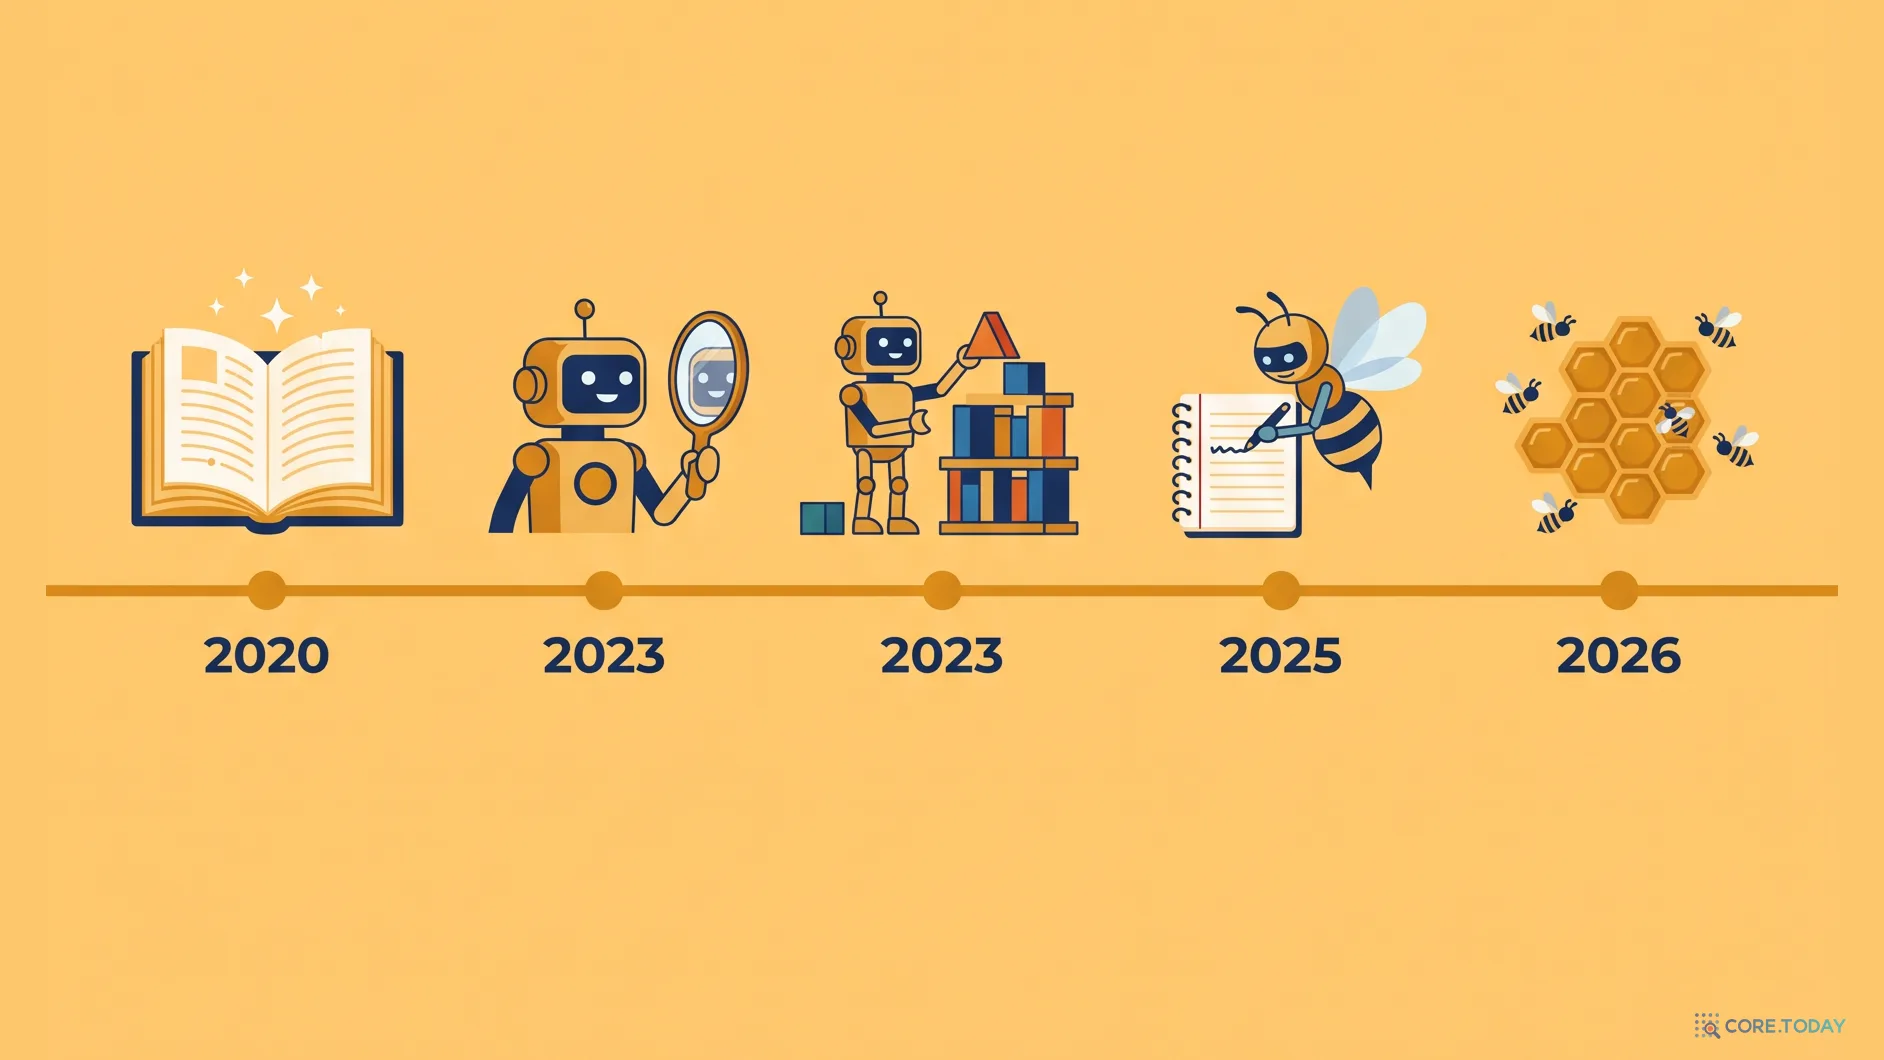
Combee가 무엇을 풀었는지 알려면, 그 앞에 무엇이 쌓여 있었는지부터 봐야 합니다. 프롬프트 학습은 두 갈래의 물줄기가 합쳐진 강입니다. 하나는 ‘프롬프트를 최적화할 변수로 보자’는 갈래, 다른 하나는 ‘에이전트가 경험을 글로 남기게 하자’는 갈래입니다.
출발점: 가중치를 건드리지 않고 배우는 모델 (2020)
2020년 5월 오픈AI는 GPT-3 논문 「Language Models are Few-Shot Learners」를 냈습니다. 1,750억 개 파라미터의 이 모델은 놀라운 일을 했습니다. 프롬프트에 ‘영어 → 프랑스어’ 예시를 몇 개 보여 주기만 하면, 가중치를 한 번도 고치지 않고 번역을 해냈습니다. 논문은 이것을 인컨텍스트 학습(in-context learning)이라고 불렀습니다. 모델이 프롬프트 안에서 배운다는 뜻입니다.
이 발견이 모든 것의 씨앗입니다. 모델이 맥락에서 배울 수 있다면, 맥락을 잘 고르고 고치는 것 자체가 학습이 됩니다. 문제는 ‘누가 고치느냐’였습니다. 처음에는 사람이었습니다. 2021~2022년의 ‘프롬프트 엔지니어’가 그 일을 했습니다.
첫째 갈래: 프롬프트를 기계가 최적화한다 (2022~2025)
APE (2022년 11월): 「Large Language Models Are Human-Level Prompt Engineers」. 언어 모델에게 지시문 후보를 여러 개 지어내게 하고, 점수가 가장 좋은 것을 고릅니다. 24개 과제 중 19개에서 사람이 쓴 지시문과 같거나 나았습니다. 유명한 “Let's think step by step”보다 나은 문구(“Let's work this out in a step by step way to be sure we have the right answer.”)도 이 방법으로 찾았습니다.
OPRO (2023년 9월, 구글 딥마인드): 「Large Language Models as Optimizers」. 지금까지 시도한 프롬프트와 그 점수를 통째로 모델에게 보여 주고 ‘더 나은 걸 제안하라’고 시킵니다. 최적화 알고리즘을 자연어로 돌리는 셈입니다. 여기서 나온 문구 “Take a deep breath and work on this problem step-by-step(심호흡을 하고 단계별로 풀어 보자)”이 한때 화제가 됐습니다.
DSPy (2023년 10월, 스탠퍼드): 프롬프트 문자열을 손으로 쓰지 말고 ‘입력은 질문, 출력은 답’ 같은 선언만 하면, 컴파일러가 예시와 지시문을 알아서 채우게 하자는 틀입니다. 프롬프트를 ‘코드’가 아니라 ‘학습되는 파라미터’로 다루는 관점이 여기서 굳어졌습니다.
TextGrad (2024년 6월, 스탠퍼드 제임스 저우 그룹): 언어 모델의 비평을 ‘텍스트 그래디언트’처럼 거꾸로 전파해 프롬프트를 고칩니다. 2025년 3월 『네이처』에 실렸습니다.
GEPA (2025년 7월, 버클리·스탠퍼드·데이터브릭스 등): 이름은 Genetic-Pareto. 후보 프롬프트들을 유전 알고리즘처럼 ‘진화’시키는데, 변이를 무작위로 하지 않고 반성(reflection)으로 합니다. 언어 모델이 실행 궤적을 읽고 “이 프롬프트는 이런 경우에 이렇게 틀렸으니 이렇게 고치자”고 진단한 뒤 새 프롬프트를 씁니다. 그리고 ‘평균 1등’ 하나만 키우지 않고, 문제마다 가장 잘한 후보들(파레토 전선)을 골고루 살려 둡니다. ICLR 2026 구두 발표로 뽑혔고, 강화학습(GRPO)보다 6개 과제 중 5개에서 나았으며 롤아웃은 최대 35배 적게 썼습니다. 2025년 8월 DSPy 3.0에 dspy.GEPA로 들어갔고, 독립 라이브러리 gepa-ai/gepa는 2026년 10월 현재 깃허브 별 7천 개를 넘겼습니다.
둘째 갈래: 에이전트가 경험을 글로 남긴다 (2023~2025)
Reflexion (2023년 3월): 에이전트가 실패하면 스스로 ‘반성문’을 쓰게 하고, 다음 시도 때 그 반성문을 읽게 합니다. 논문은 이것을 ‘언어적 강화학습’이라고 불렀습니다. 코딩 벤치마크 HumanEval에서 91.0%를 기록해 당시 GPT-4(80.1%)를 넘었습니다. 다만 MBPP에서는 77.1%로 GPT-4보다 낮았으니, ‘반성하면 무조건 좋아진다’는 아닙니다.
Voyager (2023년 5월, 엔비디아 등): 마인크래프트 에이전트가 새로 익힌 기술을 실행 가능한 코드로 저장해 스킬 라이브러리를 쌓습니다. 다음에 비슷한 일이 오면 라이브러리에서 꺼내 씁니다.
ExpeL (2023년 8월, 칭화대): 여러 과제에서 얻은 경험을 ‘인사이트 목록’으로 정리합니다. 인사이트마다 추가(ADD)·수정(EDIT)·찬성(UPVOTE)·반대(DOWNVOTE) 연산이 있고, 반대 표가 쌓여 중요도가 0이 되면 지웁니다. 뒤에 나올 ACE의 ‘도움 됨/해로움’ 카운터의 직계 조상입니다.
Dynamic Cheatsheet (2025년 4월, 스탠퍼드): 정답 라벨 없이 테스트 도중에 스스로 ‘커닝 페이퍼’를 고쳐 쓰는 기억 장치입니다. GPT-4o의 ‘24 만들기’ 퍼즐 정답률을 10%에서 99%로 올렸습니다.
ReasoningBank (2025년 9월, 구글 등): 성공뿐 아니라 실패에서도 일반화할 수 있는 추론 전략을 뽑아 기억으로 만듭니다. 코어닷투데이가 다룬 ReMe의 절차 기억도 이 갈래입니다.
두 갈래가 만나다: ACE (2025년 10월)
2025년 10월 스탠퍼드·삼바노바·버클리 연구진이 낸 ACE(Agentic Context Engineering)는 두 갈래를 하나로 묶었습니다(ICLR 2026). 이름부터 ‘컨텍스트 엔지니어링’입니다. 2025년 6월 쇼피파이의 토비 뤼트케와 안드레이 카파시가 “프롬프트 엔지니어링보다 컨텍스트 엔지니어링이라는 말이 낫다”고 쓰며 유행시킨 바로 그 말입니다.
ACE는 역할을 셋으로 나눕니다.
생성자 Generator현재 플레이북을 들고 과제를 푼다. 풀면서 플레이북의 어느 항목이 도움이 됐고 어느 항목이 오히려 헷갈리게 했는지 표시한다.
반성자 Reflector궤적을 읽고 무엇이 성공·실패의 원인이었는지 교훈을 뽑는다. 필요하면 최대 다섯 번까지 다듬는다.
큐레이터 Curator교훈을 플레이북에 넣을 작은 '변경분(delta)'으로 만든다. 플레이북 전체를 다시 쓰지 않고 항목을 더하거나 고칠 뿐이다.
플레이북은 한 덩어리 글이 아니라 항목(bullet)의 목록입니다. 각 항목은 이렇게 생겼습니다.
text
[calc-00071] helpful=16 harmful=5 :: 소수 둘째 자리로 반올림할 때는 셋째 자리를 본다 ...
맨 앞은 고유 번호, 그다음은 실제 풀이에서 ‘도움 됨(helpful)’과 ‘해로움(harmful)’으로 표시된 횟수입니다. 이 카운터 덕분에 어떤 항목이 실제로 쓸모 있었는지 숫자로 볼 수 있습니다. Combee 논문이 ‘h=16, r=5’처럼 적는 것이 이것입니다.
ACE가 이런 구조를 고집한 데는 이유가 있습니다. 논문은 기존 방법의 두 가지 병을 진단했습니다.
간결성 편향(brevity bias): 최적화를 돌리면 프롬프트가 점점 짧고 일반적인 문장으로 수렴합니다. 짧으면 점수 계산이 싸고 그럴듯해 보이기 때문입니다. ACE는 GEPA를 직접 거론하며 “간결함을 장점으로 내세우지만, 그런 추상화는 도메인 고유의 요령을 빠뜨릴 수 있다”고 비판했습니다.
맥락 붕괴(context collapse): 기억을 매번 통째로 다시 쓰게 하면, 어느 순간 모델이 확 줄여 버립니다. ACE 논문이 보인 사례에서 Dynamic Cheatsheet의 기억은 60번째 단계에서 1만 8,282토큰(정확도 66.7)이었다가 바로 다음 단계에 122토큰(정확도 57.1)으로 쪼그라들었습니다. 학습을 안 한 기준선(63.7)보다도 나빠졌습니다.
그래서 ACE는 ‘다시 쓰지 말고 항목을 더하라’는 원칙을 세웠고, AppWorld 에이전트 벤치마크에서 ReAct 기준 42.4점을 59.4점으로 올렸습니다. 당시 리더보드 1위였던 IBM의 CUGA(GPT-4.1 기반, 60.3)와 비슷한 수준을 더 작은 오픈 모델(딥시크 V3.1)로 냈습니다. 코어닷투데이가 파일 기억과 그래프 기억을 실험한 글에서 ‘통째로 다시 쓰는 기억’을 따로 시험한 것도 이 경고 때문이었습니다.
방법 (발표)
무엇을 고치나
어떻게 배우나
이름난 숫자
GPT-3 (2020.5)
아무것도 (예시만 보여 줌)
인컨텍스트 학습
1,750억 파라미터, 가중치 갱신 0회
APE (2022.11)
지시문 한 줄
후보 생성 → 점수로 선택
24개 중 19개 과제에서 사람과 같거나 나음
Reflexion (2023.3)
다음 시도용 반성문
실패 → 스스로 반성
HumanEval 91.0%
ExpeL (2023.8)
인사이트 목록
추가·수정·찬반 투표
ALFWorld 성공률 59.0% (같은 조건 Reflexion 40.3%)
Dynamic Cheatsheet (2025.4)
커닝 페이퍼 (통째로)
테스트 중 스스로 고쳐 씀
24 만들기 10% → 99%
GEPA (2025.7)
시스템 프롬프트
반성으로 변이 + 파레토 선택
GRPO보다 롤아웃 최대 35배 적게
ACE (2025.10)
항목형 플레이북
생성·반성·큐레이션, 변경분만 추가
AppWorld 42.4 → 59.4
Combee (2026.4)
ACE·GEPA가 고치는 것 그대로
반성 모으기를 병렬화
순차 대비 최대 17배 빠름
한 문장의 복선
ACE 논문에는 Combee의 출발점이 된 문장이 하나 있습니다.
변경이 항목 단위로 국소적이기 때문에, 여러 변경분을 병렬로 합칠 수 있고, 이는 대규모 배치 적응을 가능하게 한다.
이론적으로는 맞는 말입니다. 그런데 ACE의 실험은 전부 배치 크기 1, 즉 회고 하나를 읽을 때마다 플레이북을 고치는 순차 방식이었습니다. 병렬로 합칠 수 있다고만 말했지, 실제로 해 보지는 않았습니다. Combee의 저자들(ACE 저자 두 명이 포함돼 있습니다)이 그것을 실제로 해 보자, 앞에서 본 ‘꼼꼼히 하자’ 사태가 벌어졌습니다.
같은 2025년 하반기, 업계에서는 같은 생각이 다른 이름으로 퍼지고 있었습니다. 앤트로픽은 2025년 9월 ‘컨텍스트 엔지니어링’ 가이드와 기억 도구(memory tool)를, 10월에는 폴더 하나에 지시문·스크립트를 담는 에이전트 스킬(Agent Skills)을 내놓았고 12월에 이를 공개 표준으로 풀었습니다. Claude Code의 CLAUDE.md, 오픈AI 코덱스에서 출발한 AGENTS.md, 커서의 규칙 파일도 모두 ‘에이전트에게 읽힐 노트’입니다. ACE 논문에는 ‘스킬’이라는 단어가 한 번도 나오지 않지만, 둘은 같은 물음에 답하고 있습니다. 배운 것을 가중치가 아니라 사람이 읽을 수 있는 파일에 두자. 이 흐름은 코어닷투데이의 스킬 중심 에이전트 글에서 따로 다뤘습니다.
3장. 왜 2026년에 '병렬'이 필요해졌나
순차 학습은 느리다, 생각보다 훨씬
ACE의 순차 학습이 얼마나 느린지 숫자로 봅시다. Combee 논문 표 1에서 AppWorld 학습 과제 90개를 순차로 배우는 데 86분이 걸렸습니다. 과제 하나에 1분 정도입니다. 부록 표 12의 Terminal-Bench 2.0 실험은 더 자세합니다. 미리 모아 둔 궤적 60개를 순차로 회고하고 반영하는 데 회고 1,466초, 큐레이션 1,580초, 합쳐서 약 51분이 들었습니다. 궤적 하나당 약 51초입니다.
90개, 60개라면 기다릴 만합니다. 하지만 실제 서비스에 붙은 에이전트는 어떨까요? 상담 에이전트 하나가 하루 1만 건을 처리하면, 그날의 경험을 순차로 배우는 데만 1만 × 51초 ≈ 141시간, 거의 6일이 걸립니다. 하루치 경험을 배우는 데 6일이 걸리면 학습은 영원히 따라잡지 못합니다. 이것이 논문이 말하는 첫 번째 동기, 대량의 궤적에서 효율적으로 배우기입니다.
에이전트는 이미 떼로 일한다
두 번째 동기는 에이전트가 일하는 방식 자체가 바뀌었다는 것입니다. 논문은 2026년 초의 업계 사례 두 개를 근거로 듭니다.
커서(Cursor)의 「Scaling long-running autonomous coding」 (2026년 1월): 한 프로젝트에 ‘수백 개’의 에이전트를 동시에 붙여 일주일 가까이 돌렸습니다. 웹 브라우저를 처음부터 만드는 실험에서 파일 1,000개, 약 100만 줄의 코드가 나왔습니다. 흥미로운 것은 실패담입니다. 처음엔 에이전트들이 공유 파일에 잠금(lock)을 걸고 일하게 했더니, 에이전트 20개의 실제 처리량이 2~3개 수준으로 떨어졌습니다. 품질을 관리하는 ‘통합 담당’ 에이전트를 하나 두자 그 에이전트가 병목이 됐습니다. 결국 계획자(Planner)가 일을 나누고 작업자(Worker)는 서로 조율하지 않는 구조로 바꿨습니다.
앤트로픽의 「Building a C compiler with a team of parallel Claudes」 (2026년 2월): Claude 16개가 약 2주 동안 Claude Code 세션 2,000여 회를 돌려 러스트로 된 C 컴파일러 약 10만 줄을 썼습니다. API 비용은 2만 달러가 조금 안 됐습니다. 이 컴파일러로 리눅스 6.9 커널을 x86·ARM·RISC-V용으로 빌드했습니다(일부 단계는 여전히 GCC에 기댔습니다). 여기에는 조율자 에이전트가 아예 없었습니다. 각자 할 일을 잠금 파일로 찜하고, 테스트가 맞고 틀림을 판정했습니다.
두 사례 모두 ‘일을 병렬로 하는 법’에 대한 이야기입니다. 그런데 일을 떼로 하면 경험도 떼로 생깁니다. 에이전트 수백 개가 하루 동안 부딪힌 함정과 찾아낸 요령은 어디로 가야 할까요? 각자의 머릿속(컨텍스트 창)에만 있다가 세션이 끝나면 사라집니다. 논문의 문제의식은 여기서 출발합니다. 논문 관련 연구 절의 표현을 빌리면, 기존 병렬 에이전트 연구는 ‘과제 풀기를 병렬화’했고, Combee는 ‘경험에서 배우기를 병렬화’합니다.
가장 쉬운 방법: 배치를 키운다
병렬로 배우는 가장 쉬운 방법은 이렇습니다. 에이전트 n대를 동시에 돌려 궤적 n개를 얻고, 회고 n개를 동시에 씁니다. 여기까지는 아무 문제 없이 빨라집니다. 그리고 회고 n개를 한꺼번에 큐레이터에게 넘겨 플레이북을 한 번에 고칩니다. 논문은 이 n을 배치 크기(batch size)라고 부릅니다. 딥러닝에서 미니배치를 키워 학습을 빠르게 하는 것과 같은 발상입니다.
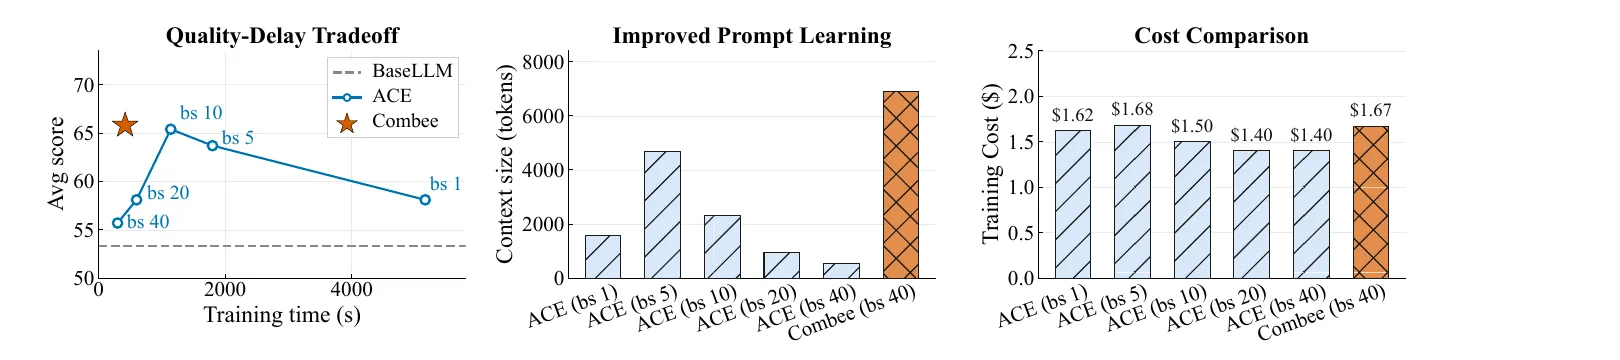
에이전트 과제에서도 같았습니다. AppWorld에서 배치 40으로 올리자 점수가 58.1에서 55.7로, 플레이북 없이 푼 기준선 53.3에 바짝 다가갔습니다. 배치를 키워 얻은 속도를, 배운 것을 버리는 값으로 치른 셈입니다.
아래 위젯에서 직접 배치 크기를 올려 보세요. AppWorld를 고르면 Combee를 얹었을 때의 결과도 함께 볼 수 있습니다.
'창이 넘쳐서'가 아니다
가장 먼저 떠오르는 설명은 ‘회고가 너무 많아 컨텍스트 창에서 잘렸겠지’입니다. 논문은 이 가능성을 처음부터 배제합니다. 실험에 쓴 딥시크 V3.1의 컨텍스트 창은 12만 8천 토큰이고, 모든 회고가 창 안에 충분히 들어간 상태에서도 같은 일이 벌어졌습니다. 잘린 것이 아니라 모델이 스스로 버렸다는 뜻입니다. 논문은 이것을 ‘손실 압축(lossy compression)’이라고 부릅니다.
많은 회고를 한꺼번에 받으면, 집계자는 넓고 일반적인 패턴을 남기고 구체적이고 가치 높은 통찰을 버리는 쪽으로 기운다. 그런데 하류 정확도를 끌어올리는 것은 바로 그 구체적인 통찰이다.
이것은 긴 컨텍스트 연구들이 몇 년째 보고해 온 현상과 같은 줄기입니다.
「Lost in the Middle」(스탠퍼드 등, 2023): 언어 모델은 긴 입력의 처음과 끝은 잘 쓰지만 가운데에 놓인 정보는 잘 못 씁니다. GPT-3.5-Turbo는 정답 문서가 가운데에 있으면 정확도가 20% 넘게 떨어졌고, 최악의 경우 문서를 아예 주지 않았을 때(56.1%)보다 낮았습니다.
NoLiMa(ICML 2025): 질문과 정답 문장이 같은 단어를 공유하지 않게 만들면, 128K를 지원한다는 모델 13개 중 11개가 3만 2천 토큰 길이에서 짧은 입력 때 성능의 절반 아래로 떨어졌습니다. GPT-4o도 99.3%에서 69.7%가 됐습니다. ‘창에 들어간다’와 ‘창을 제대로 쓴다’는 다른 이야기입니다.
크로마의 「Context Rot」 보고서(2025년 7월): 18개 모델 모두, 같은 정보라도 약 11만 3천 토큰짜리 긴 입력으로 줄 때보다 관련 부분만 뽑은 약 300토큰짜리 입력으로 줄 때 더 잘 답했습니다(벡터 데이터베이스 회사의 보고서라 이해관계는 감안해야 합니다).
회고 100개는 서로 다른 말로 같은 교훈을 하거나, 비슷한 말로 다른 교훈을 합니다. 글자를 맞춰 찾는 일이 아니라 의미를 엮어야 하는 일이고, 이것이 긴 입력에서 모델이 가장 약한 일입니다. 결국 모델은 가장 쉬운 길로 갑니다. 모든 회고에 공통으로 들어 있는 ‘최대공약수’를 뽑는 것입니다. 그 최대공약수가 “꼼꼼히 확인하라”입니다.
‘구체적으로 쓰라고 지시하면 되지 않나?’ 싶을 수 있습니다. 논문 부록 I에는 실험에 쓴 큐레이터 프롬프트 전문이 실려 있는데, 이미 이렇게 적혀 있습니다.
양보다 질에 집중하라 — 초점이 분명하고 잘 정리된 플레이북이 망라적인 플레이북보다 낫다. … 간결하고 구체적으로 써라 — 추가하는 항목은 모두 실행할 수 있어야 한다.
그런데도 배치가 크면 일반론만 남았습니다. 논문의 결론은 “프롬프트 수준의 지도만으로는 컨텍스트 과부하를 이기기에 부족하다”입니다. 뒤에서 보겠지만 ‘회고를 먼저 요약해서 넣기’, ‘비슷한 회고끼리 묶어 대표만 넣기’ 같은 방법도 통하지 않았습니다. 문제는 지시의 문구가 아니라 한 번의 호출이 감당해야 하는 양이라는 것이 논문의 진단입니다.
실물 비교: 264줄의 노트와 21줄의 노트
논문 부록 J는 이 차이를 말이 아니라 실물로 보여 줍니다. Formula에서 배치 1로 만든 플레이북(264항목)과 배치 100으로 만든 플레이북(21항목)의 원문이 실려 있습니다. 숫자도 인상적입니다. 배치 1 플레이북은 시험 풀이 중 ‘도움 됨’ 표시를 모두 174번 받았고, 3번 이상 도움 된 항목이 19개, 최고는 16번이었습니다. 배치 100 플레이북은 ‘도움 됨’이 다 합쳐서 5번, 3번 이상 도움 된 항목은 하나도 없었습니다. FiNER도 같았습니다(배치 1: 331번·38개 → 배치 125: 4번·0개).
아래 위젯에서 두 플레이북을 나란히 놓고 필터를 눌러 보세요. 특히 ‘퍼센트냐 소수냐’를 눌러 보면, 배치 100 플레이북이 “비율은 퍼센트(5.0)로 내라”는 항목 네 개와 “소수(0.05)로 내라”는 항목 세 개를 동시에 품고 있다는 것을 알 수 있습니다. 이 플레이북을 받은 에이전트는 매번 동전을 던지는 셈입니다. 배치 1 플레이북도 두 규칙을 다 알지만, ‘ROE·이익률은 퍼센트, 배당성향·배당수익률·실효이자율은 소수’처럼 비율마다 따로 정해 둡니다. 구체성이 모순을 풀어 줍니다.
이 비교에서 하나 더 눈여겨볼 것이 있습니다. 배치 1 플레이북에서 가장 많이 도움 된 항목은 블랙-숄즈 공식도, NPV 계산법도 아닌 반올림 규칙이었습니다(h=16). 두 번째는 ‘딱 떨어지는 비율은 2.0으로 내라’(h=12)였습니다. 시험 채점이 소수점 형식에 민감했기 때문입니다. 사람이 미리 짐작하기 어려운 이런 ‘현장의 요령’이야말로 경험에서 배우는 학습이 잡아내야 하는 것이고, 동시에 일반론으로 뭉개지기 가장 쉬운 것입니다.
일반론의 덫은 사람 조직에도 있다
보고서가 위로 올라갈수록 구체성이 빠지는 현상은 사람 조직의 오래된 병이기도 합니다. 2003년 2월 우주왕복선 컬럼비아호가 재진입 중 공중분해돼 승무원 7명이 숨졌습니다. 발사 때 떨어져 나온 단열재가 왼쪽 날개를 때린 것이 원인이었고, 비행 중에 이미 엔지니어들이 그 위험을 분석하고 있었습니다. 그해 8월 나온 사고조사위원회(CAIB) 보고서는 그 분석이 위로 전달되는 과정을 이렇게 적었습니다.
정보가 분석하는 사람에서 중간 관리자로, 다시 고위 지도부로 조직의 위계를 따라 올라가는 동안 핵심 설명과 뒷받침 정보가 걸러져 나간다.
구체적으로는 이랬습니다. 파편 평가팀은 시나리오 다섯 개와 불확실성을 강조한 정식 브리핑을 했습니다. 그 브리핑의 핵심 슬라이드는 이미 열한 문장짜리 내용을 6단계 글머리표로 재배열한 것이었고, 가장 중요한 사실(충돌한 파편이 계산 모델을 검증한 시험 데이터보다 수백 배 컸다는 것)은 맨 아래 작은 줄에 있었습니다. 그리고 보고서의 표현대로 “위험을 알리던 불확실성과 가정은, 회의 담당 관리자가 그 정식 발표를 경영진 회의용 짧은 구두 보고로 줄이는 순간 정보의 사슬에서 빠져나갔습니다.” 위원회는 이 슬라이드를 NASA의 ‘파워포인트 만연’이 보여 주는 소통 문제의 예로 들었고, 정보 디자인 연구자 에드워드 터프티의 분석을 인용했습니다. (흔히 ‘슬라이드 한 장이 7명을 죽였다’고 말하지만 과장입니다. 위원회가 꼽은 원인은 기술적 결함과 조직 문화이고, 슬라이드는 그 문화의 한 증상이었습니다.)
언어 모델 큐레이터가 회고 100개를 ‘꼼꼼히 하자’ 한 줄로 줄이는 일은 이 이야기와 구조가 같습니다. 정보가 틀려서 사라지는 게 아니라, 한 번에 줄이는 양이 너무 많아서 사라집니다.
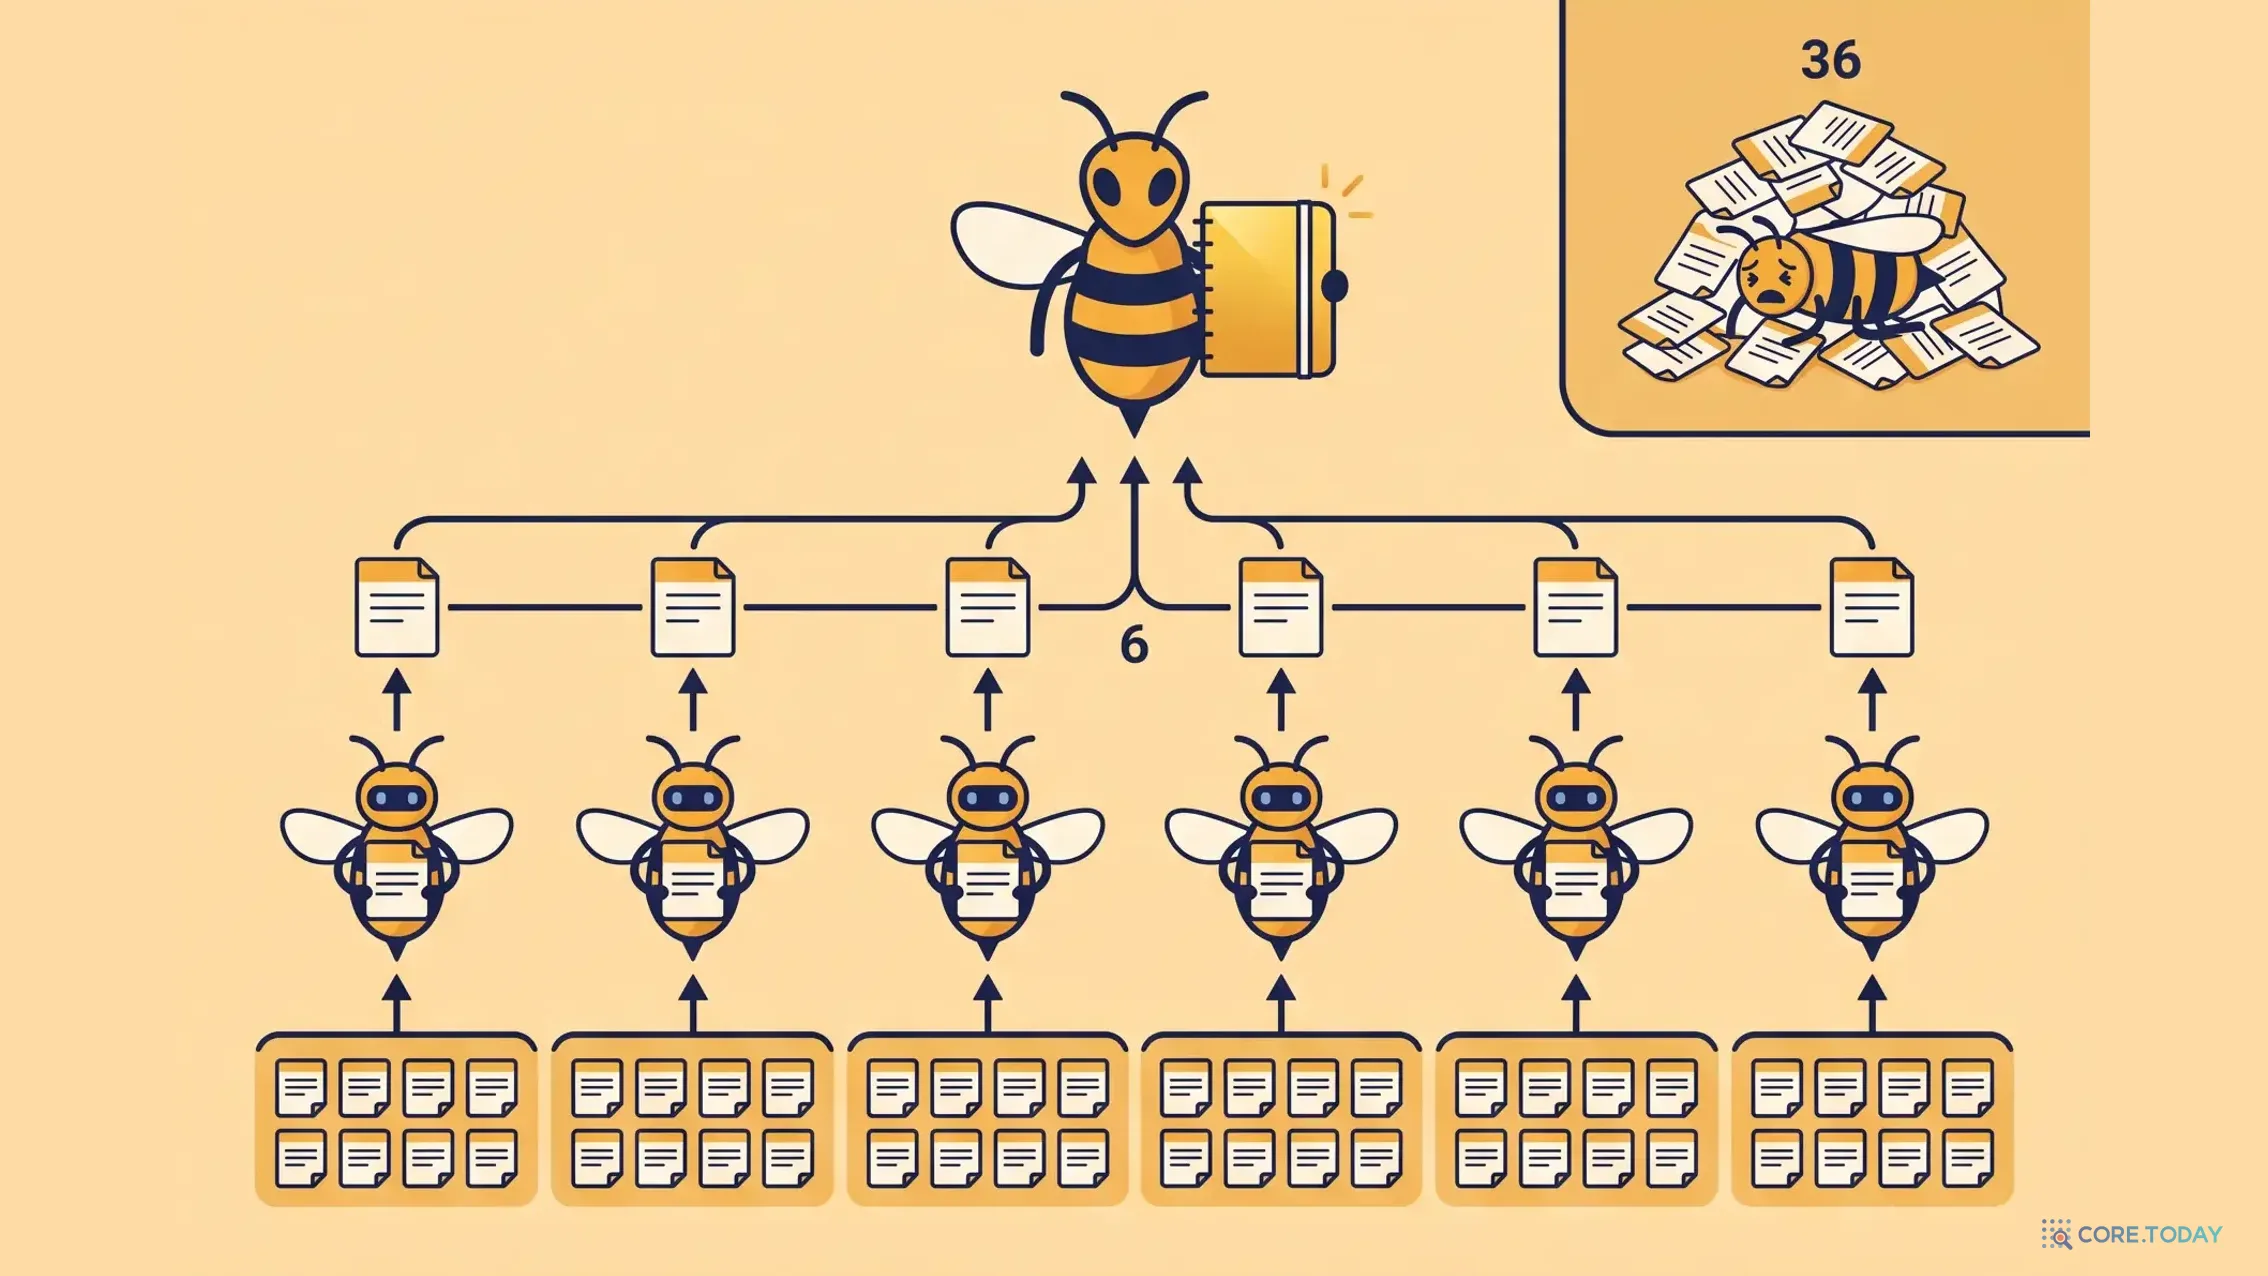
Combee의 해법은 사람 조직이 이 문제를 다루는 방식과도 닮았습니다. 팀장 한 명이 일지 마흔 장을 다 읽게 하지 말고, 조장 여섯 명이 일곱 장씩 나눠 읽고 핵심을 올리게 하는 것입니다. 다만 거기에 두 가지 장치가 더 붙습니다.
5장. Combee의 설계 — 분산 컴퓨팅의 오래된 지혜 세 가지
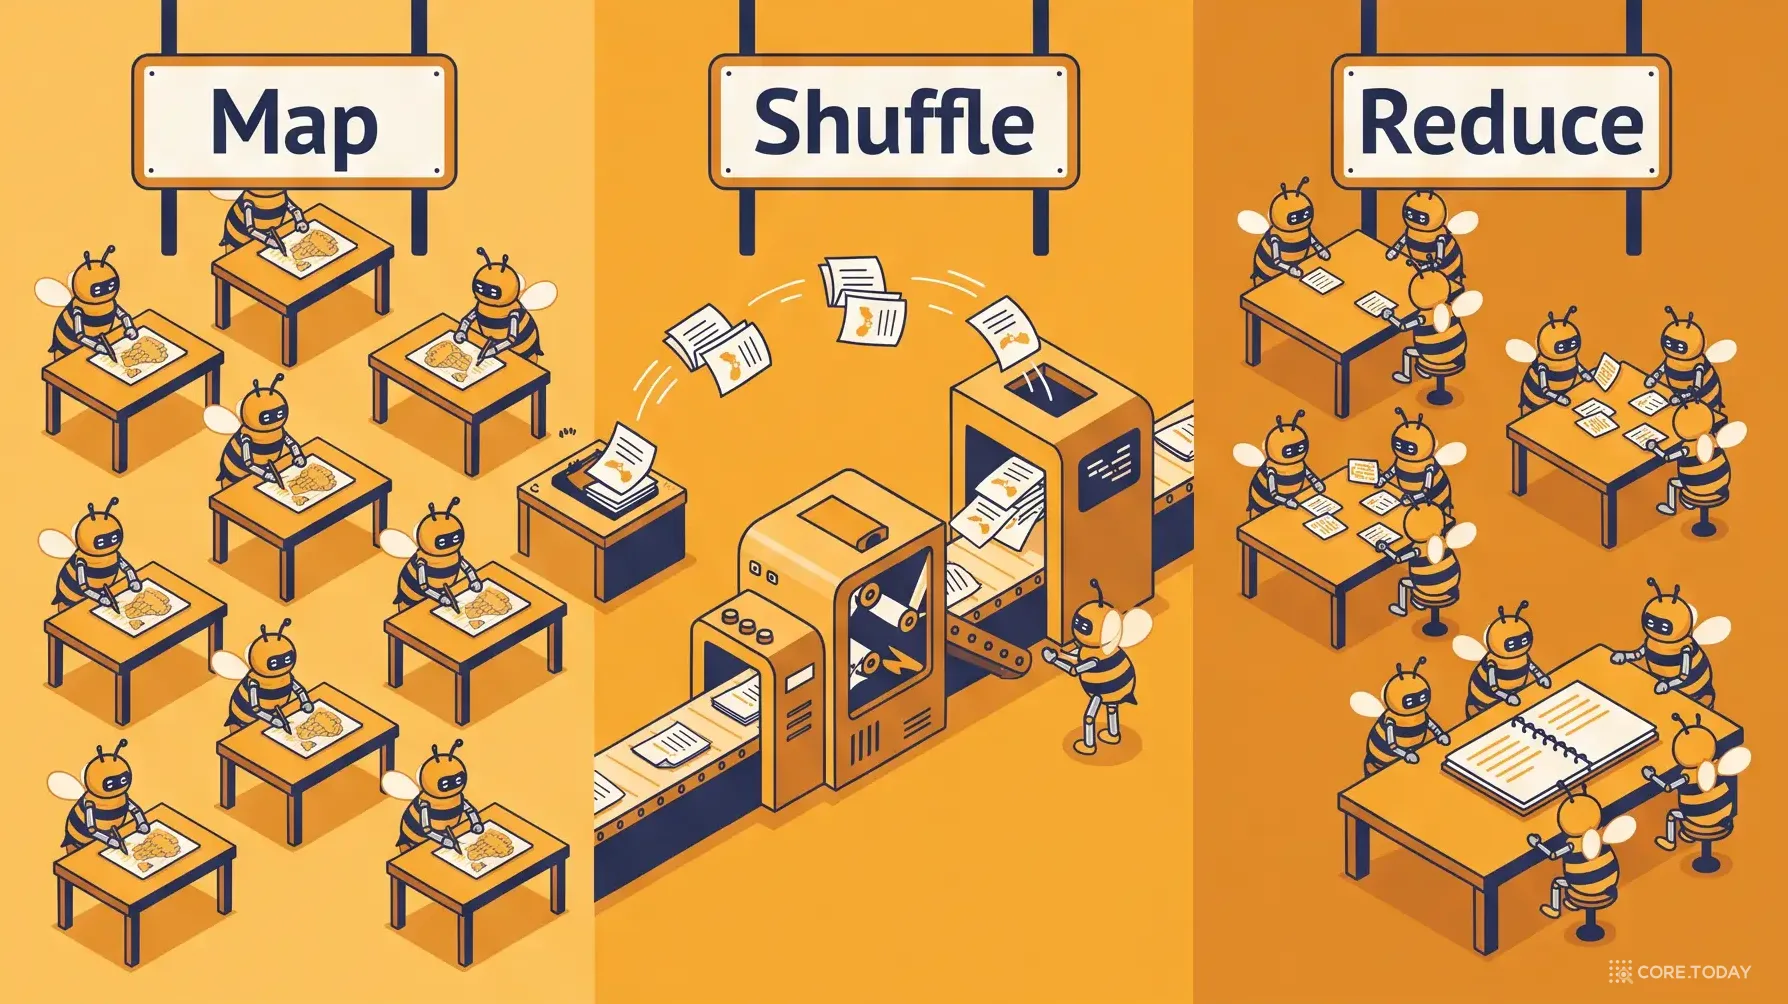
큰 그림: Map → Shuffle → Reduce
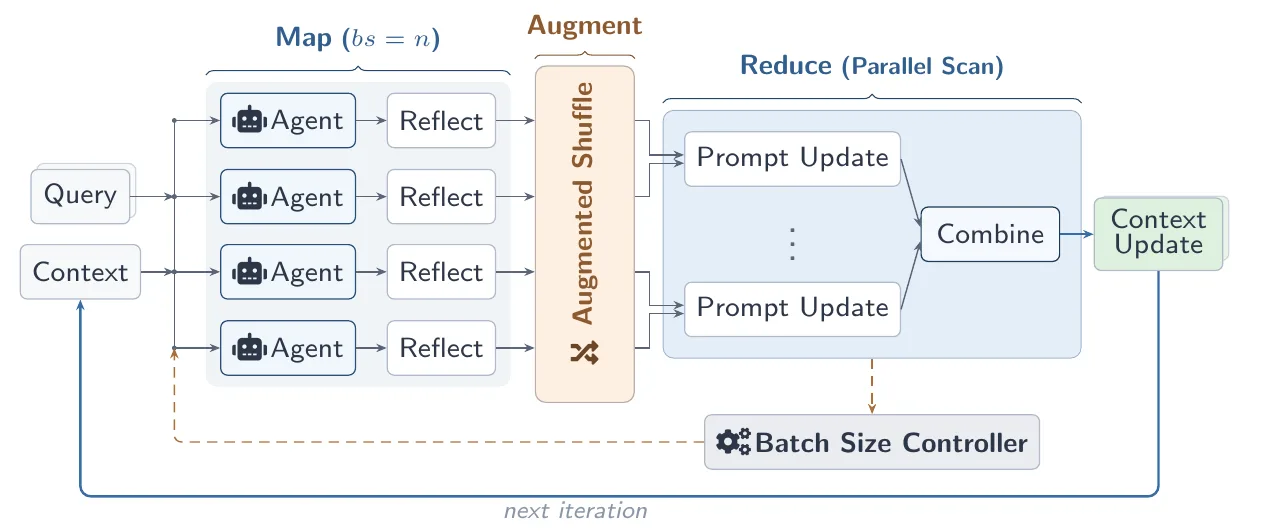
Combee는 새로운 프롬프트 학습법이 아닙니다. 논문이 여러 번 강조하듯, ACE나 GEPA 위에 얹는 확장 층(scaling layer)입니다. 실행(생성)과 플레이북 고치는 방식(갱신)은 밑바탕 방법이 하던 그대로 두고, 회고와 갱신 사이의 ‘모으기’ 단계 하나만 바꿉니다. 기존에는 큐레이터 호출 한 번이 회고를 전부 읽었다면, Combee는 그 한 번의 호출을 ‘섞고 나눠 읽는’ 파이프라인으로 갈아 끼웁니다.
이 구조의 이름은 일부러 Map-Shuffle-Reduce입니다. 2004년 구글의 제프리 딘과 산자이 게마왓이 발표한 MapReduce에서 따왔습니다. MapReduce의 교과서 예제는 ‘단어 세기’입니다. 수천 대의 기계가 문서를 나눠 읽으며 단어마다 ‘1’을 내보내고(map), 같은 단어끼리 모아(shuffle), 더합니다(reduce). 2004년 8월 한 달 동안 구글 안에서 이런 작업이 약 2만 9천 건 돌았고, 처리한 입력은 3,288테라바이트였습니다. 이 논문을 읽은 더그 커팅이 오픈소스로 다시 만든 것이 하둡(Hadoop)이고, 거기서 ‘빅데이터’ 시대가 열렸습니다.
Map: 에이전트 n대가 각자 과제를 풀고 회고를 씁니다. 원래 병렬로 잘 되던 부분입니다.
Shuffle: 회고를 복제하고 섞어서 여러 묶음으로 나눕니다. → 증강 셔플
Reduce: 묶음마다 큐레이터가 따로 갱신을 만들고, 그 갱신들을 다시 하나로 합칩니다. → 병렬 스캔 집계
여기에 반복마다 배치 크기 n을 정하는 동적 배치 크기 컨트롤러가 붙습니다. 하나씩 보겠습니다.
장치 ① 병렬 스캔 집계 — 토너먼트처럼 나눠 읽기
프리픽스 합이라는 오래된 문제. 숫자 여덟 개 [3, 1, 7, 0, 4, 1, 6, 3]이 있습니다. 앞에서부터 누적한 합 [3, 4, 11, 11, 14, 16, 22, 25]를 구하는 것을 프리픽스 합(prefix sum) 또는 스캔(scan)이라고 합니다. 앞의 결과가 있어야 다음을 구할 수 있으니 본질적으로 순차적인 일처럼 보입니다. 카네기멜런대의 가이 블렐록은 1990년 기술 보고서 「Prefix Sums and Their Applications」에서 이 일이 병렬로 효율적으로 풀린다는 것을 체계적으로 정리했습니다. (이 숫자 여덟 개도 블렐록 원문의 예시 그대로입니다.)
핵심 발상은 토너먼트입니다. 숫자 8개를 혼자 더하면 7번을 연달아 해야 합니다. 그런데 네 명이 동시에 두 개씩 더하면 1라운드 뒤 4개, 두 명이 더하면 2라운드 뒤 2개, 한 명이 더하면 3라운드 뒤 1개가 남습니다. 라운드마다 남은 개수가 절반이 되니, 라운드 수는 ‘2를 몇 번 곱해야 n이 되나’, 즉 log₂n입니다. 1,024개면 10라운드, 100만 개면 20라운드입니다. 64강 토너먼트가 6라운드면 끝나는 것과 같습니다. 총 덧셈 횟수는 여전히 n−1번으로 같습니다. 일의 양은 그대로이고 기다리는 시간만 줄어듭니다.
이 생각은 블렐록보다 훨씬 오래됐습니다. 블렐록 원문의 역사 노트에 따르면 스캔을 위한 병렬 회로는 1963년 오프만이 이진수 덧셈용으로 처음 제안했고, 1973년 코기와 스톤의 점화식 알고리즘, 1980년 래드너와 피셔의 범용 프리픽스 회로로 이어졌습니다. 오늘날 CPU 안의 덧셈기 회로(‘코기-스톤 덧셈기’)도, 엔비디아 GPU의 고속 스캔(2007년 『GPU Gems 3』 39장)도, 2023~2024년 트랜스포머의 대안으로 주목받은 맘바(Mamba)의 핵심 연산도 이 계보에 있습니다. 맘바는 입력에 따라 바뀌는 상태 공간 모델을 GPU에서 빠르게 돌리려고 ‘작업 효율적인 병렬 스캔’을 썼습니다.
Combee의 적용. Combee는 ‘회고 합치기’를 덧셈처럼 다룹니다. 회고 n개를 큐레이터 한 번에 다 넣지 않고,
k개의 미니배치로 나눠 미니배치마다 큐레이터가 갱신을 하나씩 만들고(1단),
그 k개의 갱신을 다시 한 번 합칩니다(2단).
기본값은 k = ⌊√n⌋입니다. 회고 100개면 10개씩 10묶음, 마지막에 갱신 10개를 합칩니다. 어떤 큐레이터 호출도 10개 넘게 읽지 않습니다. 왜 하필 √n일까요? 묶음을 크게 하면(k가 작으면) 1단 호출이 과부하에 걸리고, 묶음을 잘게 하면(k가 크면) 2단 합치기 호출이 과부하에 걸립니다. √n은 두 단계가 비슷한 양을 읽게 하는 균형점입니다. 둘씩 짝지어 log₂n단계를 올라가는 진짜 토너먼트로 하면 호출당 부담은 더 작아지지만, 단계가 7개(100개 기준)로 늘어 지연이 길어집니다. 2단 √n은 ‘단계 수’와 ‘호출당 부담’ 사이의 절충입니다.
논문 그림 7과 부록 표 9는 이 선택을 검증합니다. 배치 60에서 미니배치 크기를 6, 8, 10, 15, 20으로 바꿔 보니 최적점이 √60 ≈ 7.7 근처였습니다. 정확히 √n은 아니었지만(GEPA는 10에서 가장 좋았습니다) 늘 그 근처였습니다. 논문은 ‘미니배치 크기까지 탐색하는 비용을 줄이는 원칙 있는 근사’로 √n을 씁니다.
정직한 각주 하나. 엄밀히 말해 Combee가 하는 일은 블렐록 스캔 그대로가 아닙니다. 첫째, 접두합 전부가 아니라 최종 합 하나만 구하는 ‘축약(reduce)’이고 깊이도 2단으로 고정입니다. 둘째, 더 중요한 차이로, 블렐록 원문은 “결과가 옳으려면 연산이 결합법칙을 만족해야 한다”고 못 박습니다. (3+1)+7과 3+(1+7)은 같지만, 언어 모델에게 회고를 ‘(A와 B를 합친 것)과 C를 합쳐라’고 시킨 결과와 ‘A와 (B와 C를 합친 것)을 합쳐라’고 시킨 결과는 같다는 보장이 없습니다. 어떤 회고가 어느 묶음에 들어가느냐에 따라 결과가 달라집니다. Combee는 스캔의 구조는 빌렸지만 스캔의 정확성 보장은 빌릴 수 없었습니다. 그래서 두 번째 장치가 필요합니다. (이 해석은 코어닷투데이의 것이고, 논문은 ‘병렬 스캔에서 착안했다’고만 씁니다.)
MapReduce에도 비슷한 장치가 있었습니다. 2004년 논문 4.3절의 컴바이너(combiner)는 각 기계에서 ‘the’ 같은 흔한 단어의 개수를 미리 더해 두는 1차 합산입니다. 논문은 이 장치를 쓸 조건으로 “리듀스 함수가 교환법칙과 결합법칙을 만족할 것”을 붙였습니다. 단어 세기는 그 조건을 만족하니 어떻게 나눠 더해도 답이 같습니다. LLM 요약은 그렇지 않습니다.
장치 ② 증강 셔플 — 회고를 두 번 보여 주기
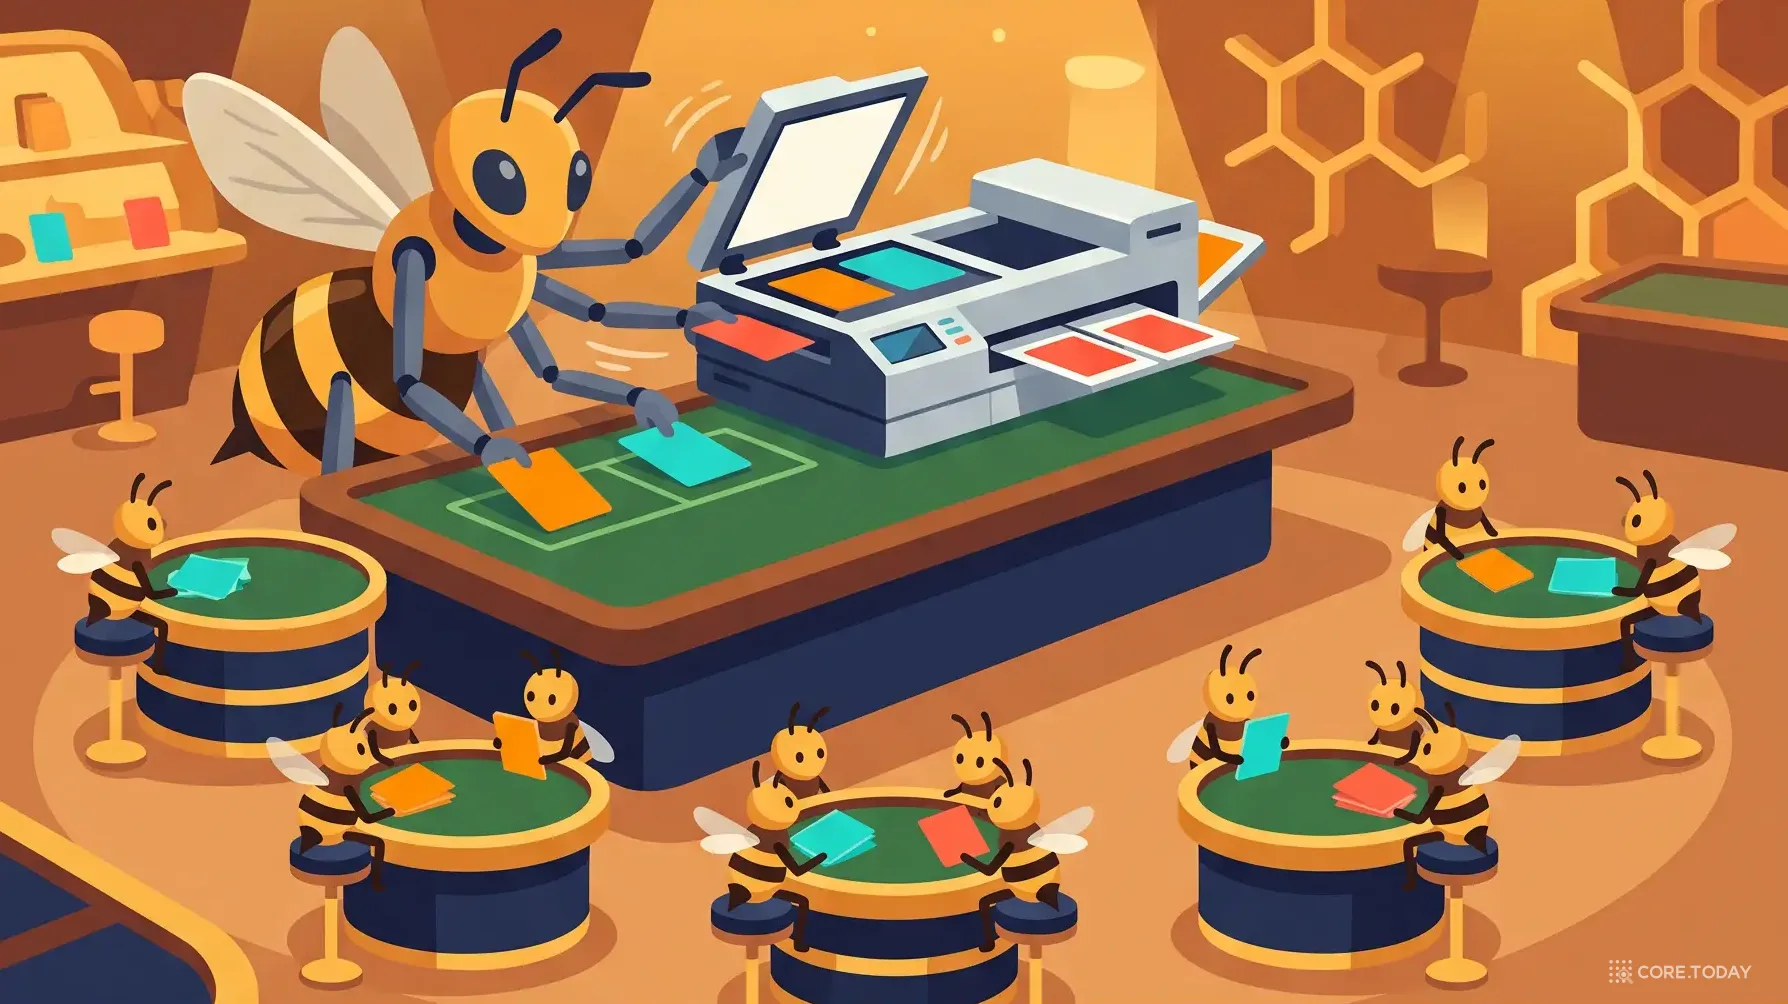
짝이 갈라지는 문제. 회고 중에는 둘이 함께 있어야 뜻이 통하는 것이 있습니다. 예를 들어 회고 A는 “ROE 문제에서 0.15로 답했다가 틀렸다”, 회고 B는 “문제에 ‘plain floating point number’라는 말이 있었다”입니다. 둘이 한 묶음에 있으면 큐레이터는 “ROE는 ‘부동소수’라는 말이 있어도 퍼센트 값으로 낸다”는 정확한 규칙을 뽑을 수 있습니다. 둘이 다른 묶음으로 갈라지면 각 묶음에서는 맥락 없는 반쪽짜리 이야기라 버려지기 쉽습니다. 논문 부록 B는 이것을 ‘순서 의존적이거나 강하게 상호 의존적인 통찰’의 위험이라고 부릅니다.
해법: 복사해서 섞는다. Combee는 회고 x개를 각각 p번(기본 p = 2) 복제한 뒤 섞어서 묶음에 나눕니다. 그러면 각 회고는 서로 다른 이웃과 두 번 묶일 기회를 얻습니다. 한 번의 ‘운 나쁜 분할’로 통찰이 사라질 위험이 줄어듭니다. 묶음 안에서 놓인 위치도 두 번 바뀌니, 앞에서 본 ‘가운데에 놓이면 묻힌다’는 위치 운도 줄어듭니다.
논문은 이 발상을 2022년 구글의 자기 일관성(self-consistency)에 빗댑니다. 어려운 수학 문제를 풀 때 추론 경로를 하나만 뽑지 말고 40개쯤 뽑아 다수결로 답을 고르자는 방법으로, GSM8K 수학 벤치마크 정확도를 17.9%포인트 올렸습니다(PaLM-540B 56.5% → 74.4%). 맞는 답에 이르는 길은 여럿이고 틀린 길은 제각각 다른 곳에 이르니, 여러 번 기회를 주면 신호가 살아남는다는 원리입니다. 통계학에서는 레오 브라이먼이 1996년 제안한 배깅(bagging)이 비슷한 직관을 씁니다. 같은 데이터에서 복원추출로 여러 표본을 만들어 모델을 여러 개 학습하고 평균을 내면, 데이터가 조금만 바뀌어도 결과가 크게 흔들리는 ‘불안정한’ 방법일수록 이득이 큽니다. 묶음이 바뀌면 출력이 달라지는 LLM 큐레이터는 바로 그런 불안정한 방법입니다. (배깅은 논문이 인용하지 않은 코어닷투데이의 비유입니다.)
왜 2배인가. 그렇다면 3배, 4배는 더 좋을까요? 논문 표 3의 답은 ‘아니오’입니다.
복제 횟수 p
Formula · GEPA
Formula · ACE
FiNER · GEPA
FiNER · ACE
1 (복제 없음)
0.803 (407초)
0.825 (3,856초)
0.710 (487초)
0.765 (3,295초)
2 (기본값)
0.857 (470초)
0.855 (3,895초)
0.742 (503초)
0.770 (3,501초)
3
0.848 (445초)
0.830 (4,073초)
0.740 (510초)
0.756 (4,514초)
4
0.834 (483초)
0.820 (4,057초)
0.747 (517초)
0.749 (4,326초)
네 설정 모두 1 → 2에서 크게 오르고, 그 뒤로는 제자리이거나 떨어졌습니다(FiNER·GEPA만 4에서 0.005 더 올랐습니다). 논문의 설명은 두 힘의 줄다리기입니다. 두 번째 사본은 ‘다른 이웃과 묶일 기회’라는 큰 이득을 주지만, 그 이상의 사본은 같은 회고의 복사본이 묶음 자리를 차지해 서로 다른 회고를 밀어냅니다. 묶음 크기는 정해져 있는데 같은 말이 두세 번 들어가니, 그만큼 새로운 말이 빠지는 것입니다.
그림 7(부록 표 9)은 셔플의 효과를 미니배치 크기별로 보여 줍니다. 셔플이 없으면 ACE 정확도가 미니배치 크기에 따라 0.755~0.835로 출렁였고, 셔플을 넣자 0.810~0.850으로 올라가며 덜 출렁였습니다. GEPA 곡선이 ACE보다 매끈한 이유도 논문은 설명합니다. ACE는 매 단계 플레이북 하나를 고쳐서 한 번의 나쁜 갱신이 그대로 남지만, GEPA는 여러 후보 프롬프트의 ‘인구’ 중에서 고르니 잡음이 평균으로 묻힙니다.
아래 실험실에서 회고를 직접 복제하고 섞어 보세요. 금색 A와 파란색 B가 짝 회고입니다. 이 실험실은 정확도를 지어내지 않습니다. 분배 방식 자체에서 정확히 계산되는 양, 즉 가장 바쁜 호출이 읽는 양, 짝이 같은 테이블에 앉을 확률, 같은 회고 사본끼리 자리를 차지한 낭비만 보여 줍니다.
n = 40, k = 6에서 복제 없이(p = 1) 나누면 A와 B가 만날 확률은 약 6분의 1입니다. p = 2로 올리면 셋에 하나꼴 이상으로 오릅니다. p = 4까지 올리면 더 오르지만 테이블당 읽을 양이 네 배가 되고 같은 회고 사본끼리 겹치는 자리도 늘어납니다. 표 3이 말한 줄다리기가 숫자로 보입니다.
장치 ③ 동적 배치 크기 컨트롤러 — 일벌을 몇 마리까지 늘릴까
병렬 스캔과 셔플 덕분에 배치를 키워도 품질이 잘 유지된다면, 남는 질문은 ‘그럼 배치를 얼마나 키우나’입니다. 무작정 키우면 될까요? 두 가지 이유로 아닙니다.
첫째, 속도 이득이 줄어듭니다. 배치를 10에서 20으로 늘리면 에폭(훈련 데이터 한 바퀴) 시간이 거의 절반이 되지만, 80에서 160으로 늘리면 별로 안 줄어듭니다. 반복마다 큐레이터 호출과 동기화 같은 고정 시간이 있고, 가장 느린 에이전트를 기다려야 하기 때문입니다.
둘째, 너무 큰 배치는 여전히 위험합니다. Combee가 과부하를 줄여 주지만 없애 주지는 않습니다.
이 문제는 딥러닝이 2017~2018년에 이미 한 번 겪었습니다. 페이스북의 고얄 등은 2017년 「Accurate, Large Minibatch SGD: Training ImageNet in 1 Hour」에서 미니배치를 8,192장까지 키워 GPU 256개로 이미지넷 학습을 1시간에 끝냈습니다(기존 GPU 8개로는 29시간). ‘배치를 k배 키우면 학습률도 k배’라는 선형 스케일링 규칙과 처음 5에폭 동안 학습률을 서서히 올리는 워밍업이 비결이었습니다. 하지만 8,192를 넘어 1만 6천, 3만 2천으로 가자 오차가 급격히 늘었습니다. 2018년 오픈AI의 매캔들리시 등은 「An Empirical Model of Large-Batch Training」에서 이 한계를 임계 배치 크기(critical batch size)로 설명했습니다. 그 아래에서는 배치를 두 배로 하면 학습 단계가 거의 절반으로 줄지만, 그 위에서는 배치를 키워도 시간은 거의 그대로이고 계산만 낭비됩니다. 임계 배치는 과제마다 달라서, 작은 이미지 오토인코더는 20 정도, 도타 2 강화학습은 1,000만이 넘었습니다. (매캔들리시와 공저자 재러드 캐플런, 다리오 아모데이는 이후 앤트로픽을 공동 창업했습니다.)
Combee의 컨트롤러는 이 ‘수확 체감’을 직접 잽니다.
후보 배치 크기 몇 개(bs₁, bs₂, …)로 반복을 한 번씩 돌려 반복당 지연 d(bs)를 잽니다.
에폭 시간을 Tepoch(bs)=d(bs)⋅Ntrain/bs로 환산하고, 거듭제곱 곡선 Tepoch(bs)=A⋅bs−α를 맞춥니다.
배치를 한 단위 늘릴 때 줄어드는 시간(기울기)이 문턱 τ 아래로 떨어지는 지점을 고릅니다. 미분해서 풀면
bsplateau=(ταA)α+11
입니다. 논문은 τ를 ‘가장 가파른 기울기의 1.6%’로 정했습니다. 한 단위를 늘려 줄어드는 시간이 처음 늘릴 때의 1.6%도 안 되면 그만 늘린다는 뜻입니다. 실제로 컨트롤러는 Formula에서 84, FiNER에서 94를 골랐습니다.
논문은 이 컨트롤러의 목표가 “배치를 최대화하는 것이 아니다”라고 강조합니다. 품질이 떨어지기 전에, 얻을 수 있는 속도 이득의 대부분을 챙기는 지점에서 보수적으로 멈추는 것이 목표입니다. 매캔들리시의 임계 배치는 그래디언트의 통계적 잡음에서 계산되는 값이고, Combee의 것은 벽시계 시간 곡선의 꺾임을 경험적으로 맞춘 값이라 같은 것은 아닙니다. 논문도 ‘비슷하다(analogous)’고만 씁니다.
아래 위젯에서 컨트롤러를 직접 돌려 보세요. 반복마다 드는 고정 지연, 병렬 비효율, 문턱 τ를 바꾸면 곡선과 선택이 바뀝니다.
위젯을 만지다 보면 재미있는 성질이 하나 보입니다. τ를 ‘가장 가파른 기울기의 몇 %’라는 상대값으로 정하면, 곡선의 높이 A가 식에서 약분되어 고른 배치 = (가장 작은 후보) × (1/τ)1/(α+1)이 됩니다. 병렬이 거의 완벽해 α가 1에 가까우면 τ = 1.6%일 때 가장 작은 후보의 약 7.9배입니다. 후보가 10에서 시작했다면 80 안팎이고, 이는 논문이 실제로 고른 64~94와 같은 범위입니다. 반대로 병렬 비효율이 커서 α가 작아지면 이 상대 기준은 오히려 더 큰 배치를 고릅니다. 기울기가 천천히 줄어 1.6% 문턱에 늦게 닿기 때문입니다. 이때 브레이크는 상한뿐입니다. 논문이 부록 B에서 “τ와 후보 목록에 대한 체계적인 민감도 분석은 후속 과제”라고 남긴 것도 이 때문일 겁니다. (이 유도는 논문 식에서 코어닷투데이가 끌어낸 것입니다.)
세 장치가 하지 않는 일
Combee의 경계도 분명히 해 둡시다.
실행 방식과 플레이북 구조는 바꾸지 않습니다. ACE의 항목형 플레이북이든 GEPA의 후보 프롬프트 인구든 그대로 둡니다.
플레이북 크기 관리는 밑바탕 방법의 몫입니다. ACE에는 의미 기반 중복 제거와 가지치기 장치가 있지만, 논문 실험 규모에서는 이 장치가 한 번도 작동하지 않았다고 부록 B가 밝힙니다.
동기식입니다. 한 반복의 모든 에이전트가 끝나야 다음으로 넘어갑니다. 비동기 SGD처럼 기다리지 않는 변형은 후속 과제로 남았습니다.
실제로 쓸 수 있나 — 코드의 현재
논문 v2에는 “코드는 게재 시 공개한다”고 적혀 있지만, Combee는 별도 저장소 대신 두 원조 라이브러리 안에 들어갔습니다. GEPA에는 2026년 8월 1일 ComBEEReflectionLM 클래스(표기가 ComBEE입니다)가 병합됐고, ACE 저장소에는 5월부터 ace_batch.py로 배치 크기·미니배치·증강 셔플이 들어갔습니다. 다만 2026년 10월 현재 GEPA 통합판에는 동적 배치 컨트롤러가 빠져 있고 병렬 스캔과 증강 셔플만 있습니다. 또 GEPA는 기본적으로 회고 미니배치를 3개씩만 처리하므로, 이 값을 그대로 두면 √3 < 2라서 Combee가 사실상 일반 회고로 돌아갑니다. GEPA 문서가 회고 미니배치를 20 이상으로 올리라고 권하는 이유입니다.
6장. 결과를 다시 읽기 — '최대 17배'는 무엇과 비교한 숫자인가
실험 무대
논문은 네 가지 벤치마크에서 Combee를 시험했습니다.
벤치마크
무엇을 시험하나
학습 / 평가
밑바탕 방법
AppWorld
휴대폰 앱 9종(벤모·스포티파이 등) API를 여러 단계 호출해 일을 끝내는 에이전트
학습 90과제 → Test-Normal 평가 (TGC·SGC)
ReAct + ACE
Terminal-Bench 2.0
명령줄에서 소프트웨어 작업을 하는 에이전트 (89과제)
공개된 딥시크 3.2 궤적 60개로 학습 → 29과제, 세 번 평균
Terminus-2 + ACE
Formula
재무 공시 데이터로 수치 계산 (NPV, ROE …)
학습 250개
ACE, GEPA
FiNER
재무 문서의 숫자에 맞는 XBRL 태그 고르기
학습 500개
ACE, GEPA
모델은 대부분 투게더 AI가 제공하는 딥시크 V3.1을 썼고, 부록에서 오픈AI의 오픈 가중치 모델 GPT-OSS 120B로도 확인했습니다. 비교 대상은 네 부류입니다. ① 고정 배치 크기의 단순 병렬, ② 회고를 먼저 요약해서 넣는 요약(Summarization), ③ 회고를 임베딩으로 K개 군집에 나눠 군집마다 대표 하나만 넣는 Top-K, ④ 회고를 하나씩 요약하고 그 요약들을 다시 요약하는 계층 요약(Hierarchical Summarization)입니다.
에이전트 과제: AppWorld와 Terminal-Bench
AppWorld (표 1)
방법
배치
플레이북 (토큰)
학습 시간
학습 비용
TGC
SGC
평균
ReAct (학습 없음)
–
–
0
$0
63.7
42.9
53.3
ReAct + ACE
1
1,578
86분
$1.62
66.1
50.0
58.1
ReAct + ACE
5
4,697
30분
$1.68
70.2
57.1
63.7
ReAct + ACE
10
2,329
19분
$1.50
72.0
58.9
65.4
ReAct + ACE
20
954
10분
$1.40
67.9
48.2
58.1
ReAct + ACE
40
526
5분
$1.40
66.7
44.6
55.7
ReAct + Combee
40
6,887
7분
$1.67
70.8
60.7
65.8
TGC는 개별 과제 완수율, SGC는 같은 시나리오에 속한 과제를 전부 끝냈는지를 봅니다. SGC가 더 엄격합니다. Combee는 배치 40에서 평균 65.8로 표에서 가장 높고, SGC도 60.7로 가장 높습니다. 순차 ACE(86분) 대비 12배 빠릅니다. 같은 배치 40의 단순 병렬과 비교하면 플레이북이 526토큰에서 6,887토큰으로 13배 두꺼워졌고 점수는 10점 올랐습니다. 비용은 $1.40에서 $1.67로 조금 늘었습니다.
그런데 표를 꼼꼼히 보면 두 가지가 눈에 띕니다. 첫째, 순차 학습(배치 1)이 최고가 아닙니다. 58.1점으로 배치 5·10보다 낮습니다. AppWorld처럼 과제가 들쭉날쭉한 환경에서는 한 번의 우연한 성공·실패에 플레이북이 휘둘리는데, 여러 궤적을 함께 보면 그 잡음이 줄기 때문으로 보입니다. 그래서 Combee가 실제로 넘어선 상대는 순차 학습이 아니라 배치 10(65.4점, 19분)이고, 그 차이는 0.4점, 속도는 약 2.7배입니다. 둘째, 이 표의 순차 ACE 점수(TGC 66.1)는 ACE 원 논문이 보고한 AppWorld 점수(TGC 76.2)보다 한참 낮습니다. 에폭 수 같은 설정 차이 때문이니, 두 논문의 숫자를 섞어 비교하면 안 됩니다.
여기서 초록의 ‘최대 17배’가 나옵니다. 42.4분 → 2.4분이니 약 17.7배입니다. 그런데 이 17배는 품질을 2.3%포인트 내준 대가입니다. 순차 ACE가 37.9%, Combee가 35.6%입니다. 단순 병렬은 배치 5에서 이미 학습 없는 기준선(32.2%) 아래로 떨어졌으니, 그에 비하면 Combee가 순차 품질의 대부분을 지킨 것은 분명합니다. 다만 ‘품질 손실 없이 17배’로 읽으면 과장입니다. 실제로 논문의 표현도 판이 바뀌며 달라졌습니다. 2026년 4월 v1 초록은 “품질 저하 없이(without quality degradation), 비슷하거나 더 나은 정확도로”라고 썼고, 9월 학회판 v2는 “순차 학습 품질의 대부분을 보존하며(preserving most of the quality), 최고 정확도에 맞먹거나 근접한다”로 고쳤습니다. 심사를 거치며 더 정확해진 셈입니다.
또 하나, 이 실험은 미리 공개된 궤적 60개로 학습했으므로 에이전트가 실제로 일하는 시간(생성)은 빠져 있습니다. 실제 서비스에서는 생성 시간이 더해지니, 전체 배속은 이보다 작을 수 있습니다.
재무 과제: Formula와 FiNER
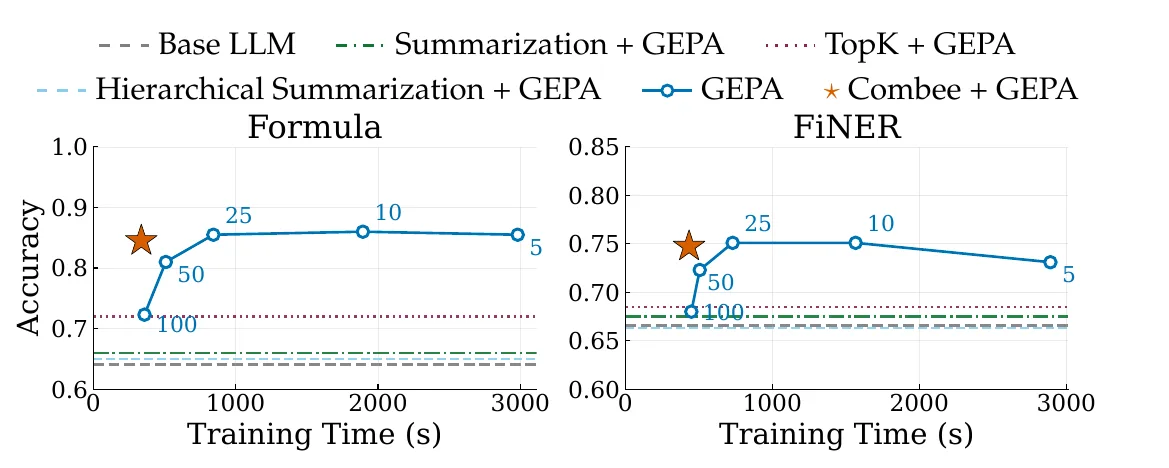
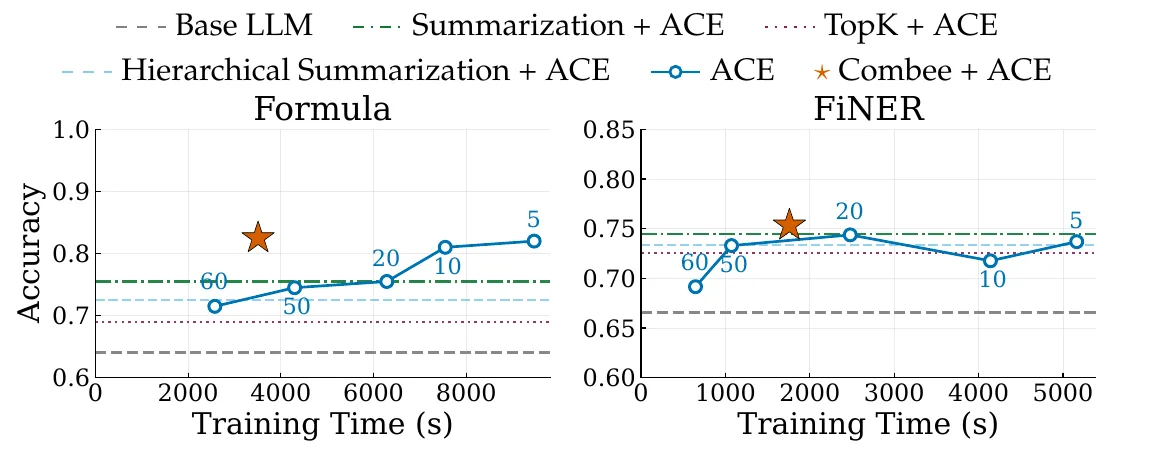
재무 과제에서는 학습 데이터가 많아(250개·500개) 동적 배치 컨트롤러를 켰고, 컨트롤러는 GEPA에서 84·94, ACE에서 80·64를 골랐습니다.
별의 위치. 대부분 파란 선의 왼쪽 위, 즉 ‘같은 시간이면 더 정확하고, 같은 정확도면 더 빠른’ 자리에 있습니다. 논문 표현으로 파레토 전선 위입니다.
GEPA FiNER의 배치 100은 기본 모델(66.6%)보다도 낮은 68.0%로, 사실상 배운 게 없습니다. 지나친 병렬은 학습을 0으로 만들 수 있습니다.
요약·Top-K·계층 요약의 수평선이 거의 다 아래쪽에 깔려 있습니다. 이것이 이 논문에서 가장 중요한 결과일 수 있습니다.
'요약의 요약'은 왜 실패했나
계층 요약은 Combee와 모양이 비슷합니다. 둘 다 2단 트리입니다. 그런데 결과는 크게 갈렸습니다.
Formula · GEPA — Combee
0.857
Formula · GEPA — 계층 요약
0.650
Formula · ACE — Combee
0.855
Formula · ACE — 계층 요약
0.725
FiNER · GEPA — Combee
0.742
FiNER · GEPA — 계층 요약
0.663
FiNER · ACE — Combee
0.770
FiNER · ACE — 계층 요약
0.734
Formula·GEPA에서 계층 요약(0.650)은 기본 모델(0.640)과 거의 같습니다. 배운 게 거의 없다는 뜻입니다. 차이는 1단에서 무엇을 넘기느냐입니다. 계층 요약은 회고를 먼저 요약해서 넘깁니다. 그 순간 ‘1.335 → 1.34’ 같은 구체적인 숫자 예시가 ‘반올림에 주의’로 바뀝니다. Combee의 1단 큐레이터는 회고 원문을 그대로 읽고, 다만 한 번에 읽는 양을 √n개로 제한합니다. 논문의 문장 그대로입니다.
계층 구조만으로는 충분하지 않다. 회고는 정보가 풍부하고, 핵심 난제는 그것을 일반론이 아니라 과제에 특화된 간결한 갱신으로 증류하는 것이다. 큐레이션 전에 회고를 요약하면 첫 단계에서 구체성이 버려진다.
요약을 거듭할수록 내용이 단순하고 뻔해지는 것은 심리학에서도 오래된 관찰입니다. 1932년 영국의 심리학자 프레더릭 바틀릿은 낯선 민담을 한 사람이 읽고 기억해 다음 사람에게 전하는 실험(연쇄 재생)을 했고, 전달될수록 이야기가 짧아지고 전하는 사람들에게 익숙한 틀로 바뀌어 간다는 것을 보였습니다. 요약의 요약은 ‘전화 게임’입니다. Combee는 전화 게임의 줄을 짧게 하는 대신, 원본 쪽지를 조장들이 직접 나눠 읽게 합니다.
플레이북이 두꺼워서 좋은 것뿐 아닌가
Combee의 플레이북은 늘 단순 병렬보다 훨씬 두껍습니다. 그렇다면 ‘그냥 토큰이 많아서 점수가 오른 것 아니냐’는 의심이 듭니다. 논문 부록 G는 이를 따로 확인합니다. 제미나이 3.5 플래시를 심판으로 세워, 완성된 FiNER 플레이북의 포괄성(필요한 요령을 얼마나 덮나)과 구체성(얼마나 실행 가능하게 구체적인가)을 다섯 번씩 채점했습니다.
플레이북
포괄성
구체성
ACE 배치 1 (순차)
90.4 ± 3.6
96.0 ± 1.2
ACE 배치 60
59.6 ± 13.0
90.6 ± 3.1
ACE 배치 125
71.4 ± 2.2
73.8 ± 1.8
Combee + ACE
83.6 ± 5.0
93.8 ± 1.6
Combee는 구체성에서 순차 학습에 거의 붙었고(93.8 vs 96.0), 포괄성은 조금 못 미쳤습니다(83.6 vs 90.4). 배치 125의 단순 병렬은 구체성이 73.8로 무너졌습니다. 점수가 오른 이유가 ‘양’만이 아니라 ‘질’에도 있다는 방증입니다. 물론 LLM 심판 점수는 사람 평가가 아니니 참고 자료로 보는 게 맞습니다.
비용: 거의 같다
‘호출을 쪼개면 비용이 늘지 않나’는 걱정에 대해 부록 표 12가 답합니다. Terminal-Bench에서 단계별 비용을 다시 쟀습니다.
방법
LLM 호출
회고 시간
큐레이션 시간
회고 비용
큐레이션 비용
큐레이션 입력 토큰
ACE 배치 1
120
1,466초
1,580초
$0.1087
$0.1405
366,772
ACE 배치 30
72
65초
88초
$0.1087
$0.0279
61,542
Combee 배치 30
84
66초
96초
$0.1086
$0.0659
158,954
회고 비용은 세 방식이 똑같습니다(회고는 어차피 궤적마다 한 번씩 씁니다). 차이는 큐레이션뿐입니다. Combee는 단순 병렬보다 LLM 호출이 12번 많고 큐레이션 비용이 약 4센트 더 듭니다. 복제 때문에 큐레이터가 읽는 입력이 늘어서입니다. 순차 학습과 비교하면 오히려 쌉니다. 순차는 큐레이터가 매번 전체 플레이북을 다시 읽으니 입력 토큰이 가장 많습니다. 전체로 보면 ‘같은 비용으로 17배 빨리’라는 초록의 주장은 이 실험에서는 맞습니다.
표를 한눈에: 여덟 개의 실험
아래 위젯은 논문의 모든 실험(본문 표 1·2, 부록 표 6·7·10)을 한 그래프에 다시 그립니다. 실험을 바꿔 가며 세 숫자를 비교해 보세요. ‘가장 느린 설정 대비 몇 배’(논문이 내세우는 배속), ‘Combee만큼 정확한 고정 배치 중 가장 빠른 것 대비 몇 배’(실제로 아끼는 시간), 그리고 ‘최고 고정 배치와의 품질 차’입니다.
여덟 실험을 정리하면 이렇습니다.
①
Combee가 최고 고정 배치를 넘은 실험 (3개)
AppWorld, Formula·ACE, FiNER·ACE. 여기서는 '빠르면서 더 정확'이 성립합니다.
②
1포인트 안쪽으로 근접한 실험 (2개)
FiNER·GEPA(−0.4), GPT-OSS Formula·GEPA(−0.6). 같은 품질의 고정 배치보다 1.7~4.2배 빠릅니다.
③
품질을 1.5~3포인트 내준 실험 (3개)
Formula·GEPA(−1.5), Terminal-Bench(−2.3), GPT-OSS Formula·ACE(−3.0). 이 경우 Combee는 '거의 같은 품질을 훨씬 빨리'를 주는 선택지입니다.
그리고 마지막 주의 사항이 하나 있습니다. 같은 설정의 숫자가 표마다 조금씩 다릅니다. 예를 들어 Combee+GEPA의 Formula 정확도는 본문 4.3절에서 0.857, 부록 표 6에서 0.845, 세 번 돌린 평균(표 4)은 0.857 ± 0.005입니다. 대부분의 결과가 한 번 돌린 값이므로 1~2포인트 차이는 잡음으로 읽는 것이 안전합니다. 논문이 세 번씩 돌려 표준편차를 낸 표 4·5에서는 Combee가 느린 GEPA 설정(배치 5·10)과 한 표준편차 안에서 같은 점수를 내면서 3.4~7.4배 빨랐습니다. 이 정도가 이 논문이 단단하게 주장할 수 있는 결론입니다.
논문 부록 D는 짧지만 이 연구의 세계관을 담고 있습니다. 제목은 ‘분산 학습과의 유비’입니다.
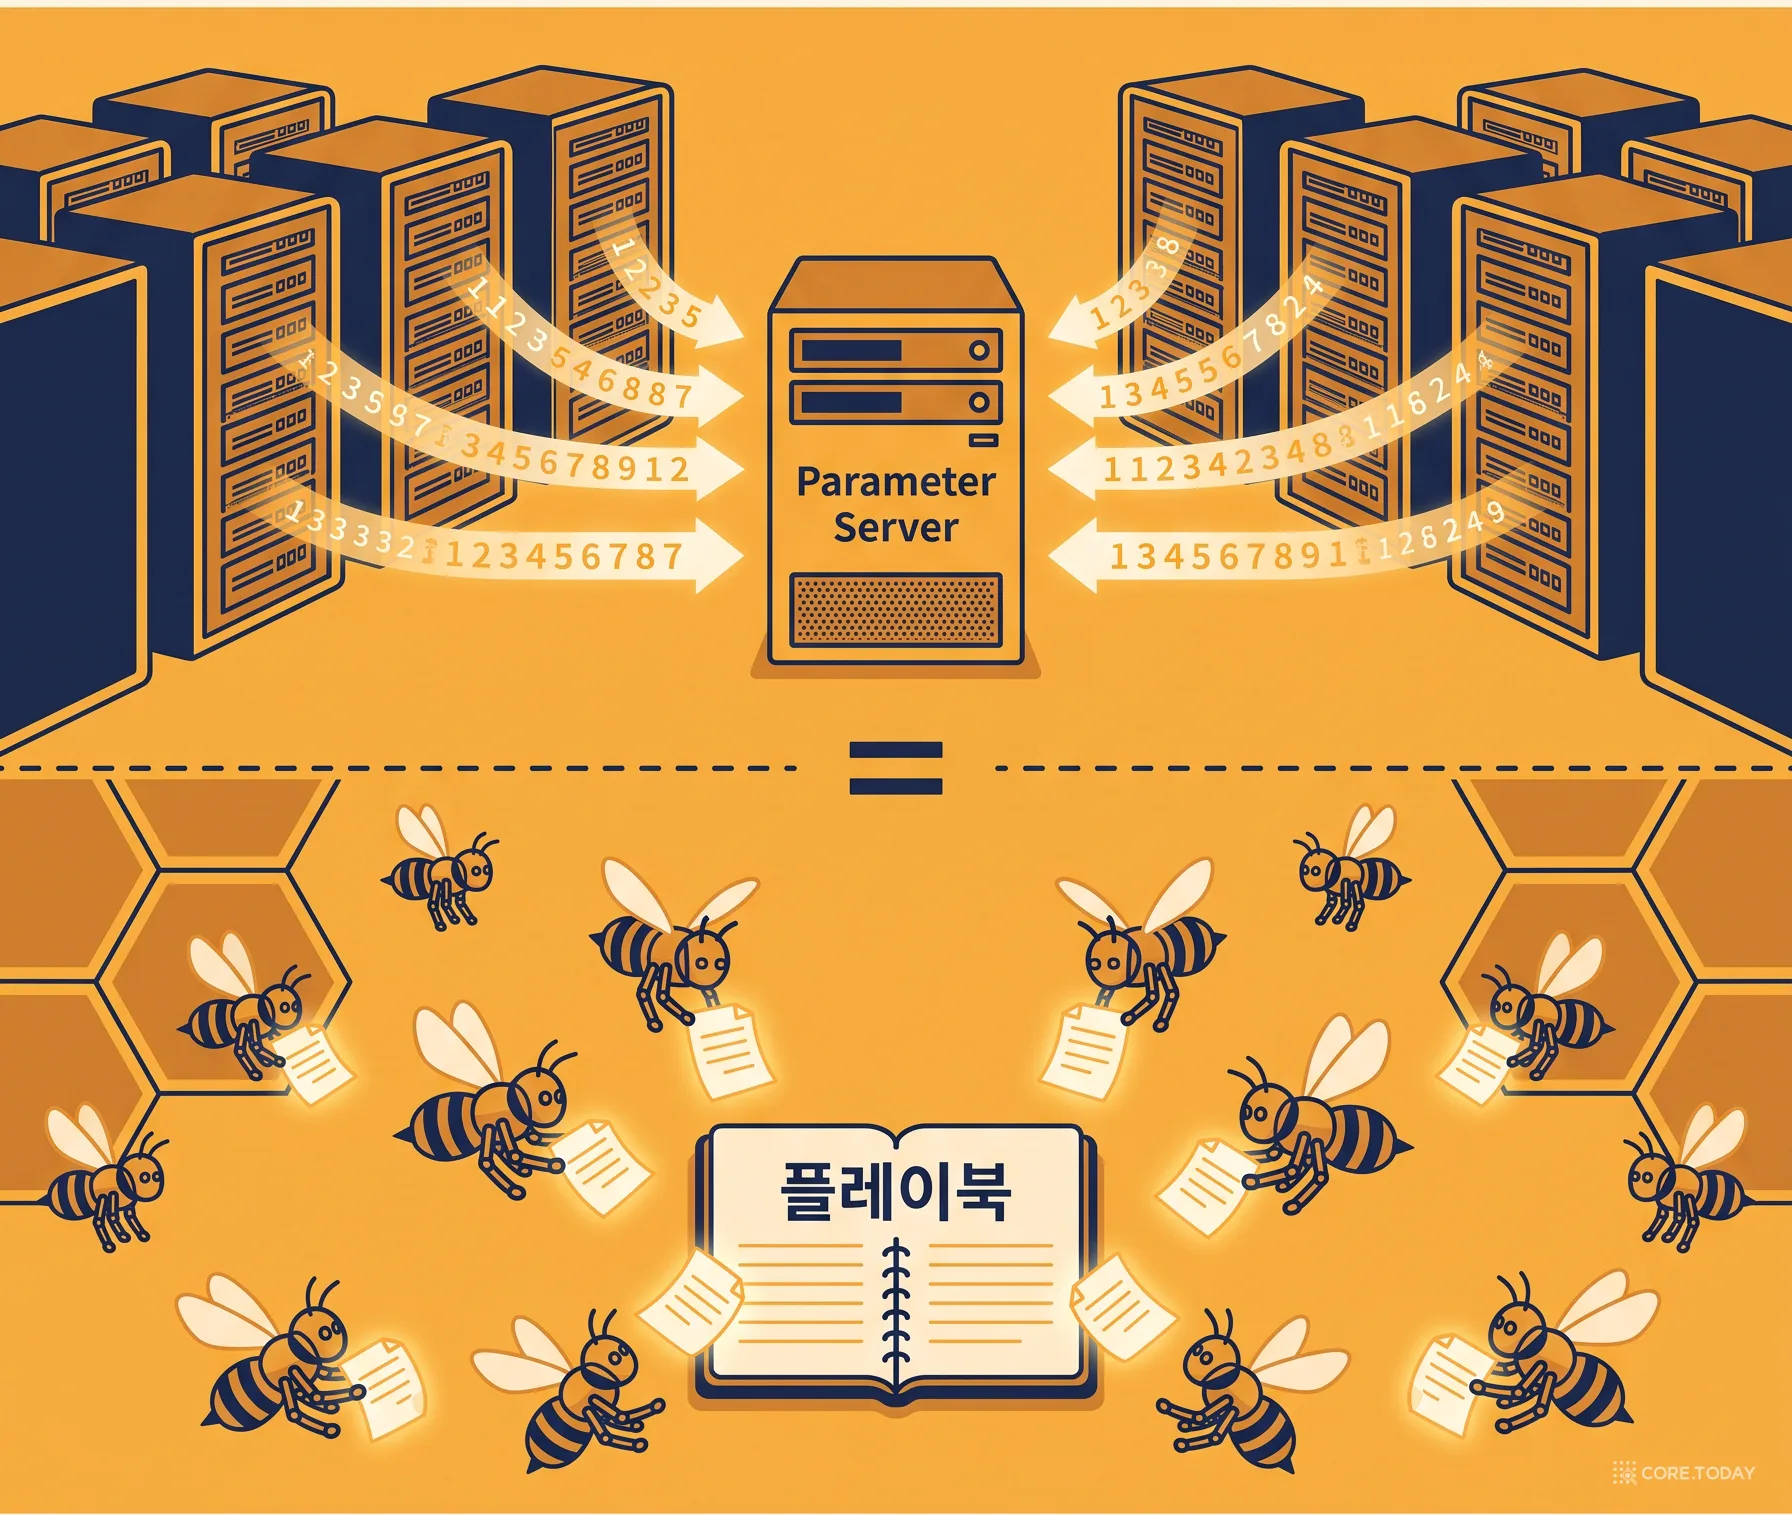
신경망을 여러 기계에서 학습하는 분산 학습에서는 데이터를 여러 일꾼(worker)에게 나눠 주고, 일꾼마다 자기 몫의 데이터로 기울기(gradient), 즉 ‘가중치를 어느 방향으로 얼마나 고치면 좋을지’를 계산합니다. 그 기울기를 중앙의 파라미터 서버가 모아 평균을 내고 가중치를 고칩니다. 어떤 일꾼도 전체 데이터를 다 보지 않지만, 모델은 전체 데이터로 학습한 효과를 얻습니다.
이 구조의 역사도 짧게 보면 이렇습니다.
2011년 Hogwild!(위스콘신대): 한 컴퓨터의 여러 코어가 잠금 없이 같은 파라미터를 마구 고쳐 쓰게 해도, 각 갱신이 파라미터의 작은 부분만 건드리면(희소하면) 거의 최적으로 수렴하고 잠금 방식보다 열 배쯤 빠르다는 것을 보였습니다. 커서가 2026년에 ‘잠금을 걸었더니 에이전트 20개가 2~3개처럼 일했다’고 보고한 것과 같은 교훈입니다.
2012년 디스트빌리프(DistBelief, 구글): 수만 개 CPU 코어로 수십억 파라미터 모델을 학습했습니다. 모델 복제본 여러 개가 조금 낡은 파라미터로 각자 기울기를 계산해 중앙 서버에 비동기로 보내는 ‘다운푸어 SGD’가 핵심이었습니다. (같은 해 1만 6천 개 코어로 유튜브 영상에서 고양이 얼굴을 스스로 찾아낸 유명한 실험은 이 논문이 아니라 같은 팀의 르(Le) 등 ICML 2012 논문입니다.)
2014년 파라미터 서버(Li 외, OSDI): 1,000대 기계로 예시 1,700억 개짜리 광고 클릭 데이터를 학습했습니다. 스스로를 ‘3세대’ 파라미터 서버라고 불렀습니다.
2016년 텐서플로: 이 구조를 데이터 흐름 그래프 안에 일반화했습니다.
Combee는 이 그림에서 가중치 자리에 맥락을, 기울기 자리에 회고를 넣습니다. 부록 D의 핵심 문장입니다.
이 유비에서 맥락은 기울기와 비슷한 역할을 한다. 맥락은 일꾼이 국소적으로 만들어 낸 학습 신호이며, 에이전트가 앞으로의 입력에 어떻게 행동해야 하는지를 담는다. 여러 일꾼의 맥락을 누적하는 것은 기울기 집계와 닮았고, 그것을 큐레이션·압축·증류하는 것은 기울기 평균, 기울기 압축, 지연 동기화 같은 기법에 대응한다.
분산 학습 (2011~)
병렬 프롬프트 학습 (Combee)
일꾼 = GPU·CPU 기계
일꾼 = 에이전트
데이터 조각
과제·궤적 묶음
기울기 (숫자 벡터)
회고 (글)
파라미터 서버의 평균
큐레이터 LLM의 집계
가중치
플레이북
미니배치 크기·임계 배치
회고 배치 크기·동적 컨트롤러
계층적 all-reduce
2단 병렬 스캔
비동기 SGD
(후속 과제로 남음)
이 유비가 멋진 만큼, 어디서 깨지는지도 봐야 합니다. 분산 학습의 기울기는 더해서 합칩니다. 기울기 1만 개를 평균 내면 어떤 기울기의 영향이 희석될 수는 있어도 ‘무시’되지는 않습니다. 덧셈은 모든 입력을 공평하게 반영합니다. 회고는 다릅니다. 큐레이터 LLM은 회고를 읽고 고릅니다. 그리고 많이 받을수록 덜 고르게, 더 일반적으로 고릅니다. 분산 학습에서는 파라미터 서버의 ‘통신 대역폭’이 병목이었다면, 병렬 프롬프트 학습에서는 집계자의 ‘주의력’이 병목입니다. 컨텍스트 과부하는 기울기의 세계에는 없던, 글로 배우는 세계의 새로운 병목입니다. 그래서 Combee의 세 장치는 모두 집계자의 주의력을 아끼는 쪽으로 설계됐습니다. (이 해석은 코어닷투데이의 것입니다.)
그럼에도 이 유비는 쓸모가 큽니다. 분산 학습이 지난 15년 동안 푼 문제 목록이 곧 병렬 프롬프트 학습이 앞으로 풀어야 할 문제 목록이기 때문입니다. 비동기 갱신, 낡은 기울기(stale gradient) 처리, 통신 압축, 고장 난 일꾼 견디기, 가장 느린 일꾼(straggler) 기다리지 않기. 논문의 결론 문장처럼, 이 연구는 “프롬프트 학습이 규모의 시대로 들어서는 첫걸음”입니다.
8장. 비판적으로 읽기 — 이 논문이 아직 보여 주지 못한 것
좋은 논문일수록 한계를 정확히 알아야 쓸 수 있습니다. 논문이 스스로 밝힌 한계(부록 B)와 표를 다시 읽으며 드러나는 한계를 함께 정리합니다.
1. 규모의 역설: 병렬을 말하지만 데이터는 작다
Combee의 동기는 ‘하루 수천 개의 궤적’인데, 실험의 에이전트 과제는 AppWorld 90개, Terminal-Bench 60개입니다. 재무 과제는 250·500개로 더 많지만 에이전트 과제가 아닙니다. 논문도 “Combee를 동기 지운 가장 큰 규모의 병렬 상황, 즉 하루 수천 개의 궤적을 만드는 산업 배치는 아직 시험되지 않았다”고 인정합니다. 배치 40으로 90개를 배우면 반복이 겨우 세 번입니다. 수만 개, 수십만 개의 궤적에서 2단 트리가 충분한지, 3단 이상이 필요한지, 그때 플레이북이 어떻게 자라는지는 열린 질문입니다.
2. 플레이북이 두꺼워지면 추론 비용도 는다
Combee의 플레이북은 AppWorld에서 6,887토큰으로 순차 학습(1,578토큰)의 4배가 넘습니다. 학습 비용은 같아도, 이 플레이북을 매 호출마다 읽는 추론 비용은 늘어납니다. 하루 1만 번 호출하는 에이전트라면 하루 5천만 토큰 남짓을 플레이북 읽기에만 더 씁니다. 프롬프트 캐시가 이 비용을 크게 줄여 주긴 하지만(ACE 논문도 KV 캐시 재사용을 근거로 듭니다), 비교표에 ‘추론 시 비용’ 열이 없다는 점은 기억해 둘 만합니다. 또 플레이북이 계속 자랄 때의 정리 장치(ACE의 중복 제거·가지치기)는 실험 규모에서 한 번도 작동하지 않았습니다.
드문 신호. 쓸모 있는 회고가 드물면, 그것은 두 단계를 모두 살아서 통과해야 합니다. 복제가 기회를 두 번 주지만, 충분히 드문 신호는 마지막 합치기에서 희석될 수 있습니다. 보안 사고, 법적 분쟁처럼 ‘드물지만 치명적인’ 경험이 정확히 이 범주입니다.
모순. 서로 반대되는 회고가 같은 묶음에 들어가면 큐레이터가 그 자리에서 조정합니다. 다른 묶음으로 갈라지면 충돌이 마지막 합치기로 미뤄지는데, 그 단계는 이미 정리된 갱신만 봅니다. 왜 모순이 생겼는지 맥락은 사라진 뒤입니다.
순서 의존. ‘A를 한 다음 B’ 같은 통찰은 같은 묶음에 있어야 잡힙니다. 셔플은 그 확률을 높일 뿐 보장하지 않습니다.
4. '17배'와 '품질 손실 없음'은 같은 실험에서 나오지 않았다
6장에서 본 대로, 가장 큰 배속(17배)은 품질을 2.3포인트 내준 Terminal-Bench에서, 가장 깔끔한 우위는 12배 배속의 AppWorld에서 나왔습니다. AppWorld의 진짜 경쟁자인 배치 10에 비하면 배속은 약 2.7배입니다. 논문 v2 초록이 v1보다 표현을 누그러뜨린 것은 이 점을 반영합니다. 기사나 발표 자료에서 이 논문을 인용할 때는 ‘최고 품질에 근접하면서 순차 대비 최대 17배’가 정확한 표현입니다.
5. 한 번 돌린 결과가 많다
대부분의 표가 한 번 돌린 값이고, 같은 설정의 숫자가 표마다 0.01~0.03씩 다릅니다. 세 번 돌린 표 4·5와 LLM 심판의 다섯 번 채점(표 11)이 있지만, 에이전트 과제는 Terminal-Bench만 3회 평균입니다. 0.4포인트 차이(AppWorld 65.8 vs 65.4)에 큰 의미를 두기는 어렵습니다.
6. 모델과 과제의 폭
주 실험 모델은 딥시크 V3.1, 보조로 GPT-OSS 120B입니다. 2026년의 최상위 상용 모델(Claude·GPT·Gemini 최신판)로 돌린 결과는 없습니다. 긴 컨텍스트를 더 잘 다루는 모델이라면 과부하가 늦게 오고, 그만큼 Combee의 이득이 줄 수도 있습니다. 거꾸로, 최상위 모델도 NoLiMa 같은 시험에서 긴 입력에 약했으니 여전히 유효할 수도 있습니다. 아직 모릅니다.
7. 프롬프트 학습 자체에 대한 의문
마지막으로 더 근본적인 질문이 있습니다. 2026년 7월 RELAI가 낸 기술 보고서 「Do Agent Optimizers Compound?」는 Terminal-Bench 2.0에서 두 단계로 이어서 학습시켰더니, GEPA로 최적화한 에이전트가 새 과제에서 최적화 전보다 낮게 전이됐다고 보고했습니다(자사 방법을 홍보하는 보고서라 감안해서 읽어야 합니다). 배운 것이 쌓이지 않고 특정 과제에 과적합된다면, 그것을 더 빨리 배우는 것의 가치도 줄어듭니다. 코어닷투데이가 다룬 자기 진화 에이전트의 ‘능력 침식’ 문제와 같은 줄기의 우려입니다. Combee는 ‘어떻게 빨리 모으나’를 풀었고, ‘모은 것이 정말 쌓이나’는 여전히 밑바탕 방법과 분야 전체의 숙제입니다.
같은 문제를 다른 축에서 푸는 연구들
Combee 이후 반년 사이에 인용 논문이 아홉 편 나왔습니다(시맨틱 스칼라 기준). 눈에 띄는 것은 2026년 5월의 FlashEvolve입니다. Combee가 ‘한 번의 집계를 어떻게 잘하나’를 다룬다면, FlashEvolve는 실행·회고·갱신 단계를 비동기로 겹쳐 돌려 기다리는 시간을 줄입니다. GEPA 작업에서 제안 처리량을 3.5~4.9배 올렸다고 보고했습니다. Combee 부록 B가 후속 과제로 남긴 ‘비동기 변형’ 방향입니다. 두 축은 겹치지 않으니 함께 쓸 수도 있습니다.
경영학자 피터 센게는 1990년 『제5경영』에서 ‘학습하는 조직’을 말했습니다. 구성원 개개인의 경험이 조직의 지식이 되는 회사입니다. 그 뒤 수십 년 동안 회사들은 위키, 사후 검토, 사례집, 지식 관리 시스템을 만들었지만, 대부분 ‘아무도 안 읽는 문서 더미’로 끝났습니다. 경험을 모으는 비용이 크고, 모은 것을 다시 쓰는 길이 끊겨 있었기 때문입니다.
에이전트 시대에는 이 두 문제가 동시에 풀릴 조건이 생겼습니다. 에이전트는 모든 일을 궤적으로 남기니 모으는 비용이 거의 0이고, 플레이북은 다음 실행 때 바로 읽히니 다시 쓰는 길이 붙어 있습니다. 남은 문제는 ‘수백 대의 경험을 하나의 노트로 잃지 않고 모으는 법’이고, Combee는 그 문제에 처음으로 이름(컨텍스트 과부하)을 붙이고 측정 가능한 해법을 낸 연구입니다. 코어닷투데이가 다룬 메타의 ‘조직 세컨드 브레인’이 ‘무엇을 기억하게 할까’를 다룬다면, Combee는 ‘여럿이 동시에 기억할 때 어떻게 합칠까’를 다룹니다.
사람이 이미 해 온 것: 항공안전보고시스템
대규모 보고에서 배우는 일을 50년째 해 온 사례가 있습니다. 미국 항공 안전 보고 시스템(ASRS)입니다. 1976년 4월 NASA와 연방항공청이 함께 만든 이 제도는 조종사·관제사·정비사가 겪은 아찔한 순간을 익명으로 신고받습니다. 2025년 12월까지 누적 232만 건, 2025년에는 한 주에 약 2,329건이 들어왔습니다.
ASRS의 처리 방식은 Combee와 묘하게 닮았습니다. 경력 조종사·관제사 출신 분석가들이 모든 보고서를 5영업일 안에 1차 분류하고, 같은 사건에 대한 여러 보고는 하나의 기록으로 묶습니다. 모든 보고의 1차 분류는 버리지 않고 남깁니다. 그리고 구체적인 위험을 발견하면 종합 보고서를 기다리지 않고 바로 경보를 보냅니다. 지금까지 8천 건이 넘는 경보가 나갔습니다. 1979년부터는 매달 ‘교훈’ 소식지 「CALLBACK」을 냅니다. 큰 더미를 한 사람이 한 번에 요약하지 않고, 나눠 읽고, 묶을 것은 묶고, 구체적인 것은 일반론에 녹이지 않고 따로 살린다는 점에서 같은 지혜입니다.
한국 현장에서 떠올려 볼 장면들
세무 신고 시즌의 상담 에이전트. 5월 종합소득세 신고 기간에는 상담이 한꺼번에 몰립니다. ‘올해 바뀐 공제 항목’을 묻는 질문 유형은 시즌 초 며칠 사이에 정해집니다. 순차 학습으로는 그 며칠 안에 경험이 플레이북에 반영되지 않습니다. 병렬 학습이라면 첫날 저녁의 플레이북에 ‘이 질문엔 이 서식 번호를 먼저 안내’가 올라갈 수 있습니다.
코드 리뷰 에이전트 군단. 사내 저장소 수백 개에 리뷰 에이전트를 붙이면, 하루치 리뷰 코멘트와 개발자의 수락·거절이 그대로 학습 신호가 됩니다. 저장소마다 다른 관례(‘이 팀은 예외를 로그 대신 슬랙으로’)는 일반론으로 뭉개지기 쉬운 전형적인 구체 지식입니다.
문서 처리 파이프라인. 계약서·공시 자료에서 항목을 뽑는 에이전트는 FiNER와 거의 같은 일을 합니다. 논문의 FiNER 플레이북에 남은 ‘borrowing base는 현재 차입 한도 태그’ 같은 항목이 바로 현장 요령입니다.
아래 플래너에서 하루 궤적 수를 골라 보세요. 논문 부록 표 12가 잰 단가로 순차 학습과 Combee가 하루치를 소화하는 데 드는 시간과 돈을 계산하고, 업무 특성을 고르면 8장의 실패 방식에 맞춘 주의 사항을 붙입니다.
하루 1만 개라면 순차 학습은 약 6일이 걸려 영원히 밀리고, 배치 30의 Combee는 7시간 남짓에 끝납니다. 하루 5만 개가 되면 배치 30으로도 하루를 넘깁니다. 그때 필요한 것이 동적 배치 컨트롤러와 3단 이상의 트리이고, 논문이 아직 시험하지 않은 영역입니다.
가중치 학습과의 관계: 경쟁이 아니라 분업
프롬프트 학습이 미세조정을 대체할까요? 2025~2026년의 흐름은 ‘분업’에 가깝습니다. 데이터브릭스는 2025년 9월 GEPA로 프롬프트를 최적화한 오픈 모델(gpt-oss-120b)이 정보 추출 과제에서 Claude Opus 4.1의 기본 성능을 넘었고, 서빙 비용은 90분의 1이었다고 보고하면서, 프롬프트 최적화와 미세조정을 함께 쓰면 더 좋았다고 덧붙였습니다. 빠르게 바뀌는 현장 요령은 노트(맥락)로, 오래 변하지 않는 능력은 가중치로 배우는 분업입니다. 노트에 오래 머문 항목을 주기적으로 가중치로 ‘증류’하는 파이프라인도 자연스러운 다음 단계입니다. 그 경우 Combee는 ‘노트 쪽의 처리량’을 맡습니다.
거버넌스와 보안: 많은 손이 쓰는 노트는 오염되기도 쉽다
병렬 학습은 더 많은 궤적이 플레이북에 손을 댄다는 뜻이기도 합니다. 악의적인 사용자가 상담 중에 그럴듯한 거짓 정보를 흘리면, 그 궤적의 회고가 플레이북에 들어갈 수 있습니다. 코어닷투데이가 기억 오염 실험과 오염된 스킬 글에서 다룬 위험이 병렬 학습에서는 더 커집니다. 다행히 플레이북은 글이라 검토할 수 있습니다. 항목마다 출처 궤적 ID를 남기고, 사람의 승인 큐를 두고, ‘해로움’ 카운터가 높은 항목을 자동으로 격리하는 장치를 함께 설계해야 합니다. 이것이 가중치 학습에는 없는, 프롬프트 학습만의 장점이기도 합니다.
10장. 우리 팀에 들일 때 — 체크리스트와 최소 구현
언제 쓰나
먼저순차 학습(배치 1~5)으로 플레이북이 실제로 성능을 올리는지부터 확인한다. 순차로도 안 오르면 병렬은 의미가 없다.
그다음궤적이 쌓이는 속도가 학습 속도를 넘는지 잰다. 하루 궤적 수 × 궤적당 회고·갱신 시간이 24시간을 넘으면 병렬이 필요하다.
그리고단순히 배치를 키워 보고, 플레이북 항목 수와 '도움 됨' 카운터가 줄어드는지 본다. 줄어들면 과부하가 시작된 것이다.
GEPA를 쓴다면 ComBEEReflectionLM을, ACE를 쓴다면 ace_batch.py를 쓰면 됩니다. 직접 만든 파이프라인이라면 핵심은 수십 줄입니다. 아래는 개념을 보여 주는 의사 코드입니다(curate는 기존 큐레이터 호출, merge는 갱신 여러 개를 합치는 큐레이터 호출).
python
import math
import random
from concurrent.futures import ThreadPoolExecutor
defcombee_aggregate(reflections, playbook, curate, merge, p=2, seed=None):
"""회고 n개를 √n개 미니배치로 나눠 읽고(1단), 결과를 한 번 더 합친다(2단)."""
n = len(reflections)
k = max(1, math.isqrt(n)) # 미니배치 수 = ⌊√n⌋if k == 1:
return curate(playbook, reflections) # 작으면 그냥 한 번에
pool = [r for r in reflections for _ inrange(p)] # 증강: p번 복제
random.Random(seed).shuffle(pool) # 셔플
groups = [pool[i::k] for i inrange(k)] # k개 묶음with ThreadPoolExecutor(max_workers=k) as ex: # 1단: 묶음별 큐레이션(병렬)
updates = list(ex.map(lambda g: curate(playbook, g), groups))
return merge(playbook, updates) # 2단: k개 갱신 합치기
체크리스트
측정배치를 바꿀 때마다 플레이북 항목 수, '도움 됨' 3회 이상 항목 수, 정확도를 함께 기록한다. 정확도만 보면 과부하를 늦게 알아챈다.
원문 유지1단에서 회고를 요약하지 않는다. 요약 후 집계(계층 요약)는 논문에서 기본 모델 수준까지 떨어졌다.
복제는 2배3배 이상은 이득이 없거나 해롭다. 같은 작업에서 나온 회고는 한 묶음으로 보내 짝이 갈라지지 않게 한다.
모순 처리합치기 프롬프트에 '서로 반대되는 항목은 조건을 나눠 둘 다 남겨라'를 넣는다. 배치 100 플레이북의 퍼센트·소수 사태를 막는 가장 싼 방법이다.
크기 관리토큰 상한과 정기 정리(중복 제거·가지치기)를 따로 둔다. Combee는 플레이북을 두껍게 남기도록 설계됐다.
드문 신호사고·민원·보안처럼 드물고 중요한 궤적은 표시해 작은 배치로 먼저 반영하거나 사람이 직접 올린다.
GEPA 설정GEPA 통합판은 회고 미니배치 기본값이 3이라 Combee가 사실상 꺼진다. 20 이상으로 올린다.
맺으며 — 꿀벌은 혼자 꿀을 만들지 않는다
꿀벌 한 마리가 평생 모으는 꿀은 찻숟가락 하나에 못 미친다고 합니다. 벌집이 꿀로 가득 차는 것은 수만 마리가 각자 모은 것을 잃지 않고 한곳에 모으는 체계가 있기 때문입니다.
AI 에이전트도 이제 혼자 일하지 않습니다. 2026년의 에이전트는 수십, 수백 대가 동시에 일하고, 매일 막대한 경험을 남깁니다. 그 경험을 가중치가 아니라 사람이 읽을 수 있는 노트로 쌓겠다는 것이 프롬프트 학습의 약속이었고, ACE와 GEPA가 그 약속이 통한다는 것을 보였습니다. Combee는 그 약속을 규모로 옮기려 할 때 무엇이 망가지는지를 처음으로 정확히 짚었습니다. 너무 많은 회고를 한 번에 읽힌 집계자는 “꼼꼼히 하자”만 남깁니다. 그리고 해법은 새 모델이 아니라, 1960년대 덧셈 회로와 2004년 구글 데이터센터와 2017년 대형 배치 학습이 이미 알려 준 지혜에 있었습니다. 나눠 읽고, 두 번 보여 주고, 언제 멈출지 재라.
이 논문이 남긴 가장 쓸모 있는 교훈은 어쩌면 기술보다 태도에 있습니다. 경험에서 배우는 시스템을 만들 때 ‘무엇을 기억하나’만큼 ‘어떻게 모으나’가 중요하고, 모으는 과정에서 가장 먼저 사라지는 것은 ‘1.335는 1.34로 올린다’ 같은 작고 구체적인 요령이라는 것. 사람의 조직이든 기계의 조직이든, 배우는 조직은 그 작은 요령을 지키는 조직입니다.
참고문헌
이 글이 다룬 논문
Li, H., He, R., Zhang, Q., et al. (2026). Combee: Scaling Parallel Prompt Learning for Self-Improving LLM Agents. COLM 2026. arXiv:2604.04247 (v1 2026-04-05, v2 2026-09-25. arXiv 등록 제목은 v1의 “Combee: Scaling Prompt Learning for Self-Improving Language Model Agents”) · CC BY 4.0
GEPA 팀 블로그, “Scaling GEPA with Combee: Parallel Prompt Learning for Self-Improving Agents” (2026-04-09), gepa-ai/gepa 문서 docs/guides/combee.md