[특집] 한 번 최적화, 매번 빠르게 — 멀티에이전트 AI의 '가장 긴 줄'을 깎는 LAWA 논문 완전 해설
에이전트 여러 명이 줄지어 일하는 AI 시스템은 똑똑하지만 느리다. 고객센터·장애 대응처럼 같은 종류의 질문이 하루 수만 번 되풀이되는 곳에서는 질의마다 몇 초씩 늘어난 지연이 그대로 쌓인다. 다트머스 연구진의 NeurIPS 2026 논문 「한 번 최적화, 매번 빠르게(LAWA)」는 멀티에이전트 워크플로를 방향 그래프로 보고, 전체 소요 시간을 결정하는 '가장 긴 줄(임계 경로)'을 병렬 재배선과 노드 제거라는 두 가지 안전한 편집으로 깎는다. 정확도는 실행 없이 점수를 예측하는 그래프 신경망이 지킨다. 이 글은 1957년 듀폰의 임계 경로법과 그레이엄의 스케줄링 역설에서 출발해 GPTSwarm·AFlow·DyLAN으로 이어진 에이전트 구조 학습의 계보, 논문의 세 정리와 알고리즘, 7개 벤치마크 결과와 그 한계, 그리고 2026년 AI 상담·장애 대응 현장에서 이 생각이 갖는 의미를 인터랙티브 6개와 일러스트 14장으로 풀어 본다.
택배가 오지 않아 쇼핑몰 앱의 AI 상담 창을 엽니다. "주문한 운동화가 사흘째 배송 중으로만 나와요." 화면에 작은 점 세 개가 깜빡이며 "답변을 준비하고 있어요…"가 뜹니다. 1초, 3초, 7초. 12초쯤 지나서야 그럴듯한 답이 나옵니다. 답은 정확합니다. 주문 번호도 맞고, 물류 센터 지연 공지도 찾아냈고, 말투도 정중합니다. 그런데 그 12초 동안 무슨 일이 있었을까요?
화면 뒤에서는 AI 에이전트 일곱 명이 한 줄로 서서 일했을 가능성이 큽니다. 질문 의도를 분류하는 에이전트가 끝나야 주문을 조회하는 에이전트가 시작하고, 그게 끝나야 배송 정책 문서를 찾는 에이전트가, 그다음 답변 초안을 쓰는 에이전트가, 사실을 검증하는 에이전트가, 말투를 다듬는 에이전트가, 개인정보가 새지 않았는지 검사하는 에이전트가 차례로 일합니다. 한 명이 1~4초씩, 합치면 12초가 넘습니다. 그런데 곰곰이 보면 이상합니다. 주문 조회와 정책 문서 검색은 왜 서로를 기다려야 할까요? 말투 검수와 개인정보 검수는 왜 순서대로 해야 할까요?
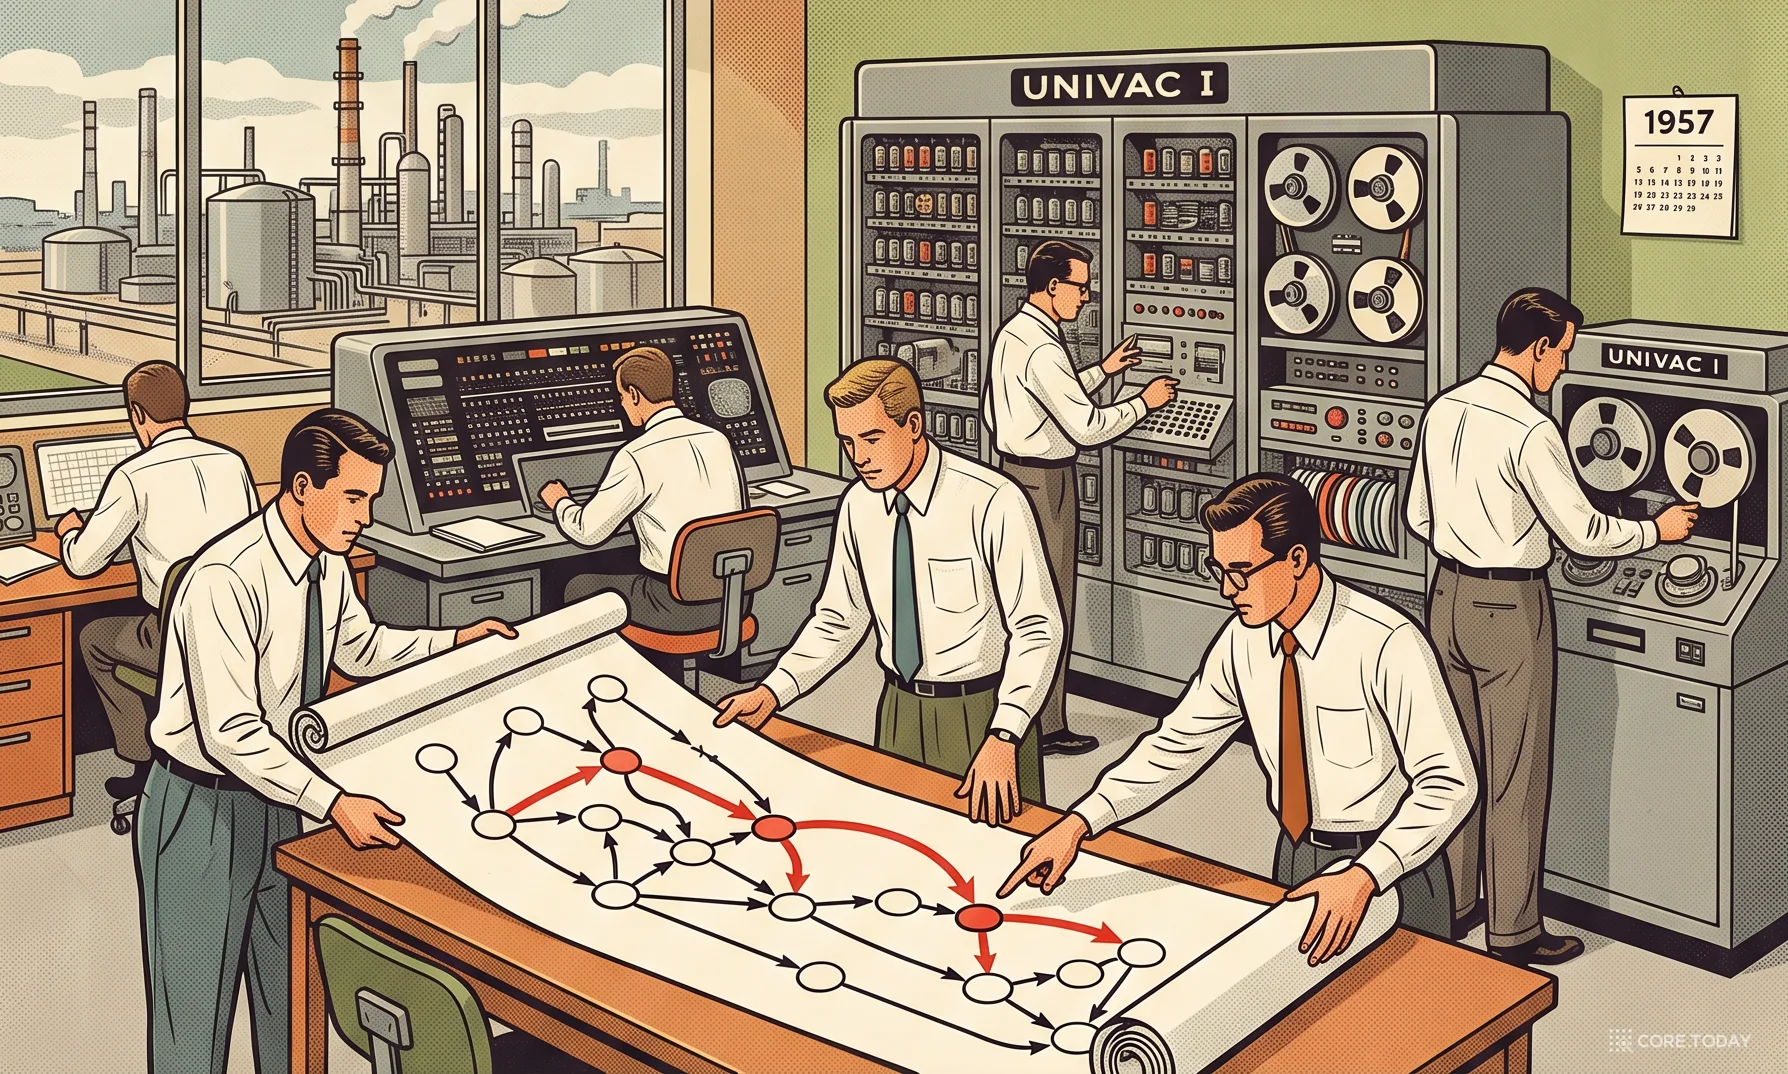
2026년 10월 10일 arXiv에 올라온 다트머스대·버지니아공대·뉴욕대 연구진의 논문 「한 번 최적화, 매번 빠르게: 반복 질의를 위한 지연 인지 멀티에이전트 워크플로 학습(Optimize Once, Execute Fast: Latency-Aware Multi-Agent Workflow Learning for Recurrent Queries)」은 바로 이 질문을 정면으로 다룹니다. NeurIPS 2026에 실린 이 논문이 제안하는 LAWA(Latency-Aware Workflow OptimizAtion)의 아이디어는 놀랄 만큼 오래된 것에 뿌리를 둡니다. 1957년 미국 화학회사 듀폰이 공장 정비 일정을 짤 때 쓰기 시작한 임계 경로(critical path)입니다. 여러 작업이 얽힌 일에서 전체 완료 시간을 결정하는 것은 작업의 총량이 아니라 서로를 기다려야 하는 가장 긴 줄이라는 생각입니다.
논문이 하는 일을 세 문장으로 줄이면 이렇습니다.
문제에이전트 워크플로를 자동으로 설계하는 연구는 많았지만 거의 모두 정확도만 최적화했다. 그런데 고객 상담·클라우드 장애 대응처럼 같은 워크플로가 수없이 반복 실행되는 곳에서는 질의마다 늘어난 몇 초가 누적된다. 그래서 "정확도는 지키면서 전체 소요 시간(makespan)을 최소화하라"는 새 문제를 정의한다.
방법워크플로를 방향 비순환 그래프(DAG)로 보고, 병렬 재배선(두 단계를 나란히 풀기)과 노드 제거(쓸모없는 단계 빼기)라는 두 편집만 쓴다. 이 둘은 수학적으로 시간을 절대 늘리지 않음이 증명된다. 어떤 편집이 정확도를 해치는지는 실제로 돌려 보는 대신 학습된 그래프 신경망 평가기가 예측한다.
결과코딩·수학·상식 7개 벤치마크 중 6개에서 가장 빠르면서 정확도 평균 순위도 1위. 다른 방법이 만든 워크플로에 끼워 넣어도(플러그인) 28개 조합 모두에서 시간을 줄였다. 최적화 자체는 1~2초, 평가기 학습을 더해도 대략 2~7번 쓰면 본전이다.
이 글은 그 세 문장을 하나씩 풀어 갑니다. 먼저 라면 끓이기로 임계 경로라는 개념을 손에 잡히게 만들고(1장), 이 생각이 공장과 컴퓨터에서 어떻게 70년을 살아왔는지 봅니다(2장). 그다음 LLM 에이전트가 어떻게 '팀'이 되었고 왜 2026년에 '속도'가 문제로 떠올랐는지(3·4장), 논문의 수식과 정리, 알고리즘을 차례로 뜯어보고(5~8장), 실험 결과를 비판적으로 읽은 뒤(9~11장), 지금 이 기술이 현장에서 무엇을 뜻하는지 이야기합니다(12장). 중간중간 여섯 개의 인터랙티브 도구로 직접 워크플로를 고쳐 보고, 시간을 계산해 볼 수 있습니다.
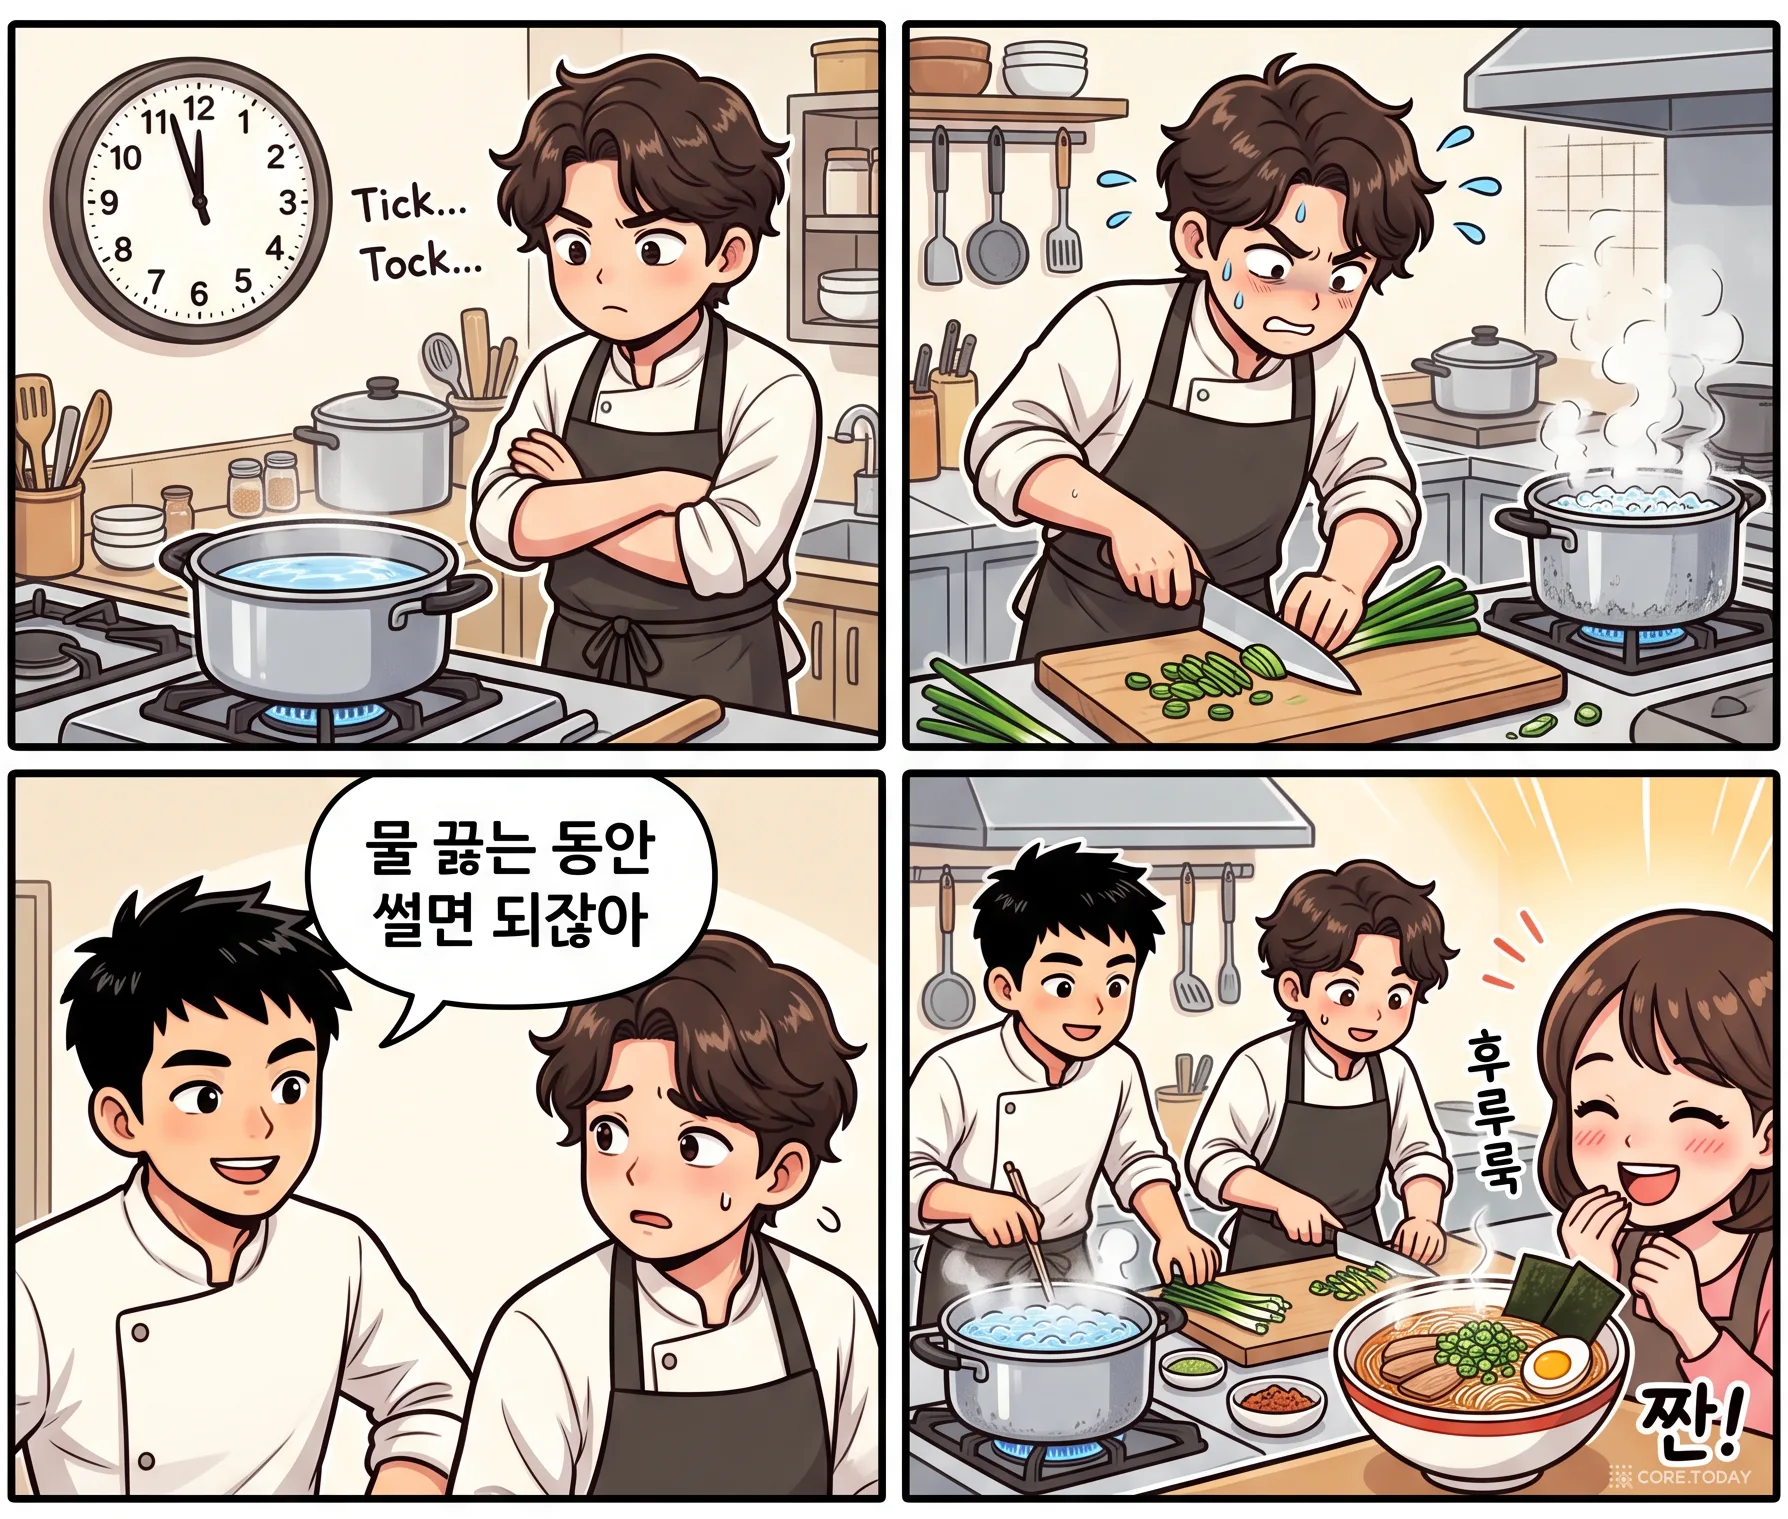
라면을 끓인다고 해 봅시다. 할 일은 네 가지입니다. 물 끓이기(5분), 파 썰기(2분), 계란 풀기(1분), 면과 스프 넣고 끓이기(4분). 하나씩 순서대로 하면 12분이 걸립니다. 그런데 누구도 그렇게 하지 않습니다. 물이 끓는 5분 동안 파를 썰고 계란을 풀면 되니까요. 그러면 5분 + 4분 = 9분이면 됩니다.
여기서 중요한 관찰이 두 가지 있습니다.
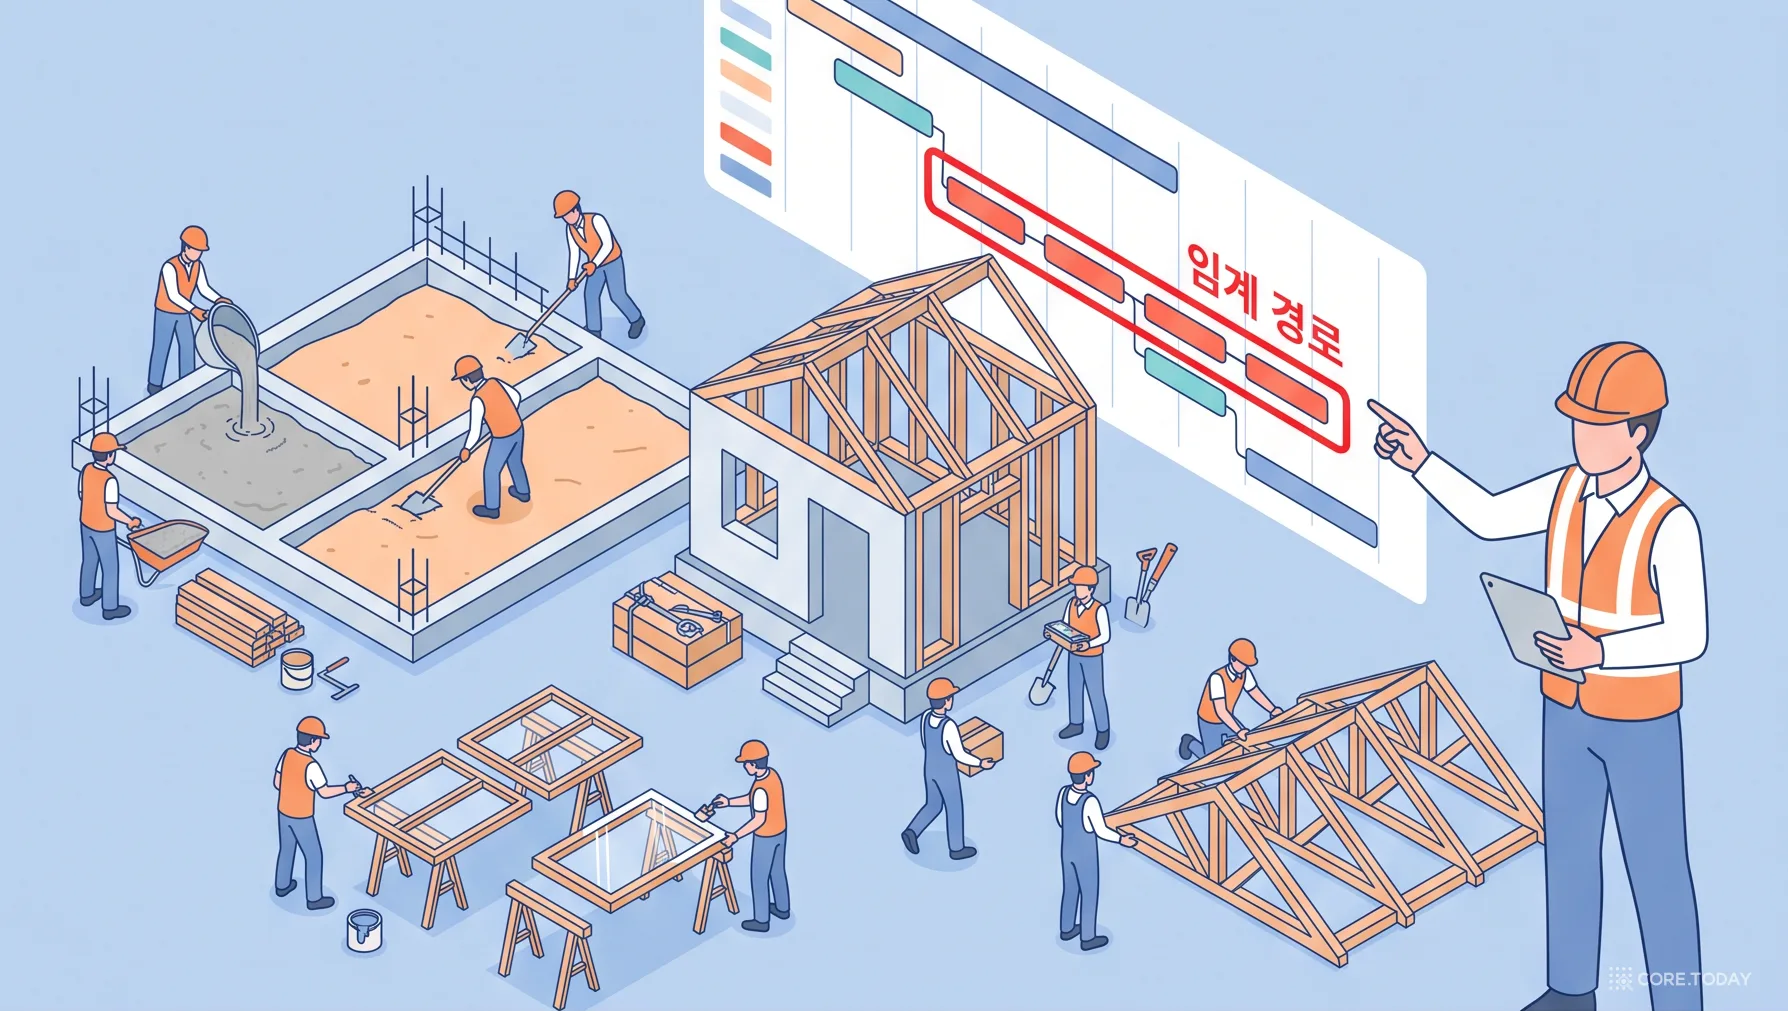
첫째, 9분이라는 시간은 할 일의 총량(12분)이 아니라 '반드시 앞의 일을 기다려야 하는 가장 긴 줄'이 정합니다. 물 끓이기 → 면 넣고 끓이기, 이 줄이 9분이고, 파 썰기나 계란 풀기를 아무리 빨리 해도 9분은 줄지 않습니다. 이 가장 긴 줄을 임계 경로(critical path)라고 부르고, 전체가 끝나는 데 걸리는 시간을 스케줄링 이론에서는 makespan이라고 부릅니다. 우리말로는 '총 소요 시간' 정도이고, 이 글에서는 원어를 그대로 씁니다.
둘째, 시간을 줄이려면 임계 경로 위의 일을 건드려야 합니다. 파를 1분 만에 썰어도 소용없지만, 물을 전기 포트로 3분 만에 끓이면 전체가 7분이 됩니다. 반대로 임계 경로 바깥의 일은 조금 늦어져도 괜찮습니다. 이 '늦어져도 괜찮은 여유'를 프로젝트 관리에서는 여유 시간(float, slack)이라고 합니다. 혼자서 파 썰기와 계란 풀기를 차례로 해도 3분이니, 물이 끓는 5분 안에서 2분의 여유가 남는 셈입니다.
이 관계를 그림으로 그리면 방향 그래프가 됩니다. 각 작업이 동그라미(노드)이고, "A가 끝나야 B를 시작할 수 있다"는 관계가 화살표(간선)입니다. 화살표를 따라가다 같은 자리로 되돌아오는 고리가 없어야 하므로(자기가 끝나야 자기가 시작할 수 있다는 건 말이 안 되니까요) 이런 그래프를 방향 비순환 그래프, 영어 약자로 DAG(Directed Acyclic Graph)라고 부릅니다. 그리고 각 작업을 시간축 위의 막대로 펼친 것이 우리에게 익숙한 간트 차트입니다.
멀티에이전트 AI도 똑같습니다. 에이전트 한 번의 호출이 작업 하나, "이 에이전트의 출력을 저 에이전트에게 넘긴다"가 화살표입니다. LLM 호출 하나는 몇 초씩 걸리므로, 화살표를 어떻게 잇느냐에 따라 같은 에이전트들로도 전체 시간이 크게 달라집니다. 아래 놀이터에서 직접 확인해 보세요. 기본으로 뜨는 것은 이 논문이 부록 D에서 사례로 든 코딩 워크플로입니다.
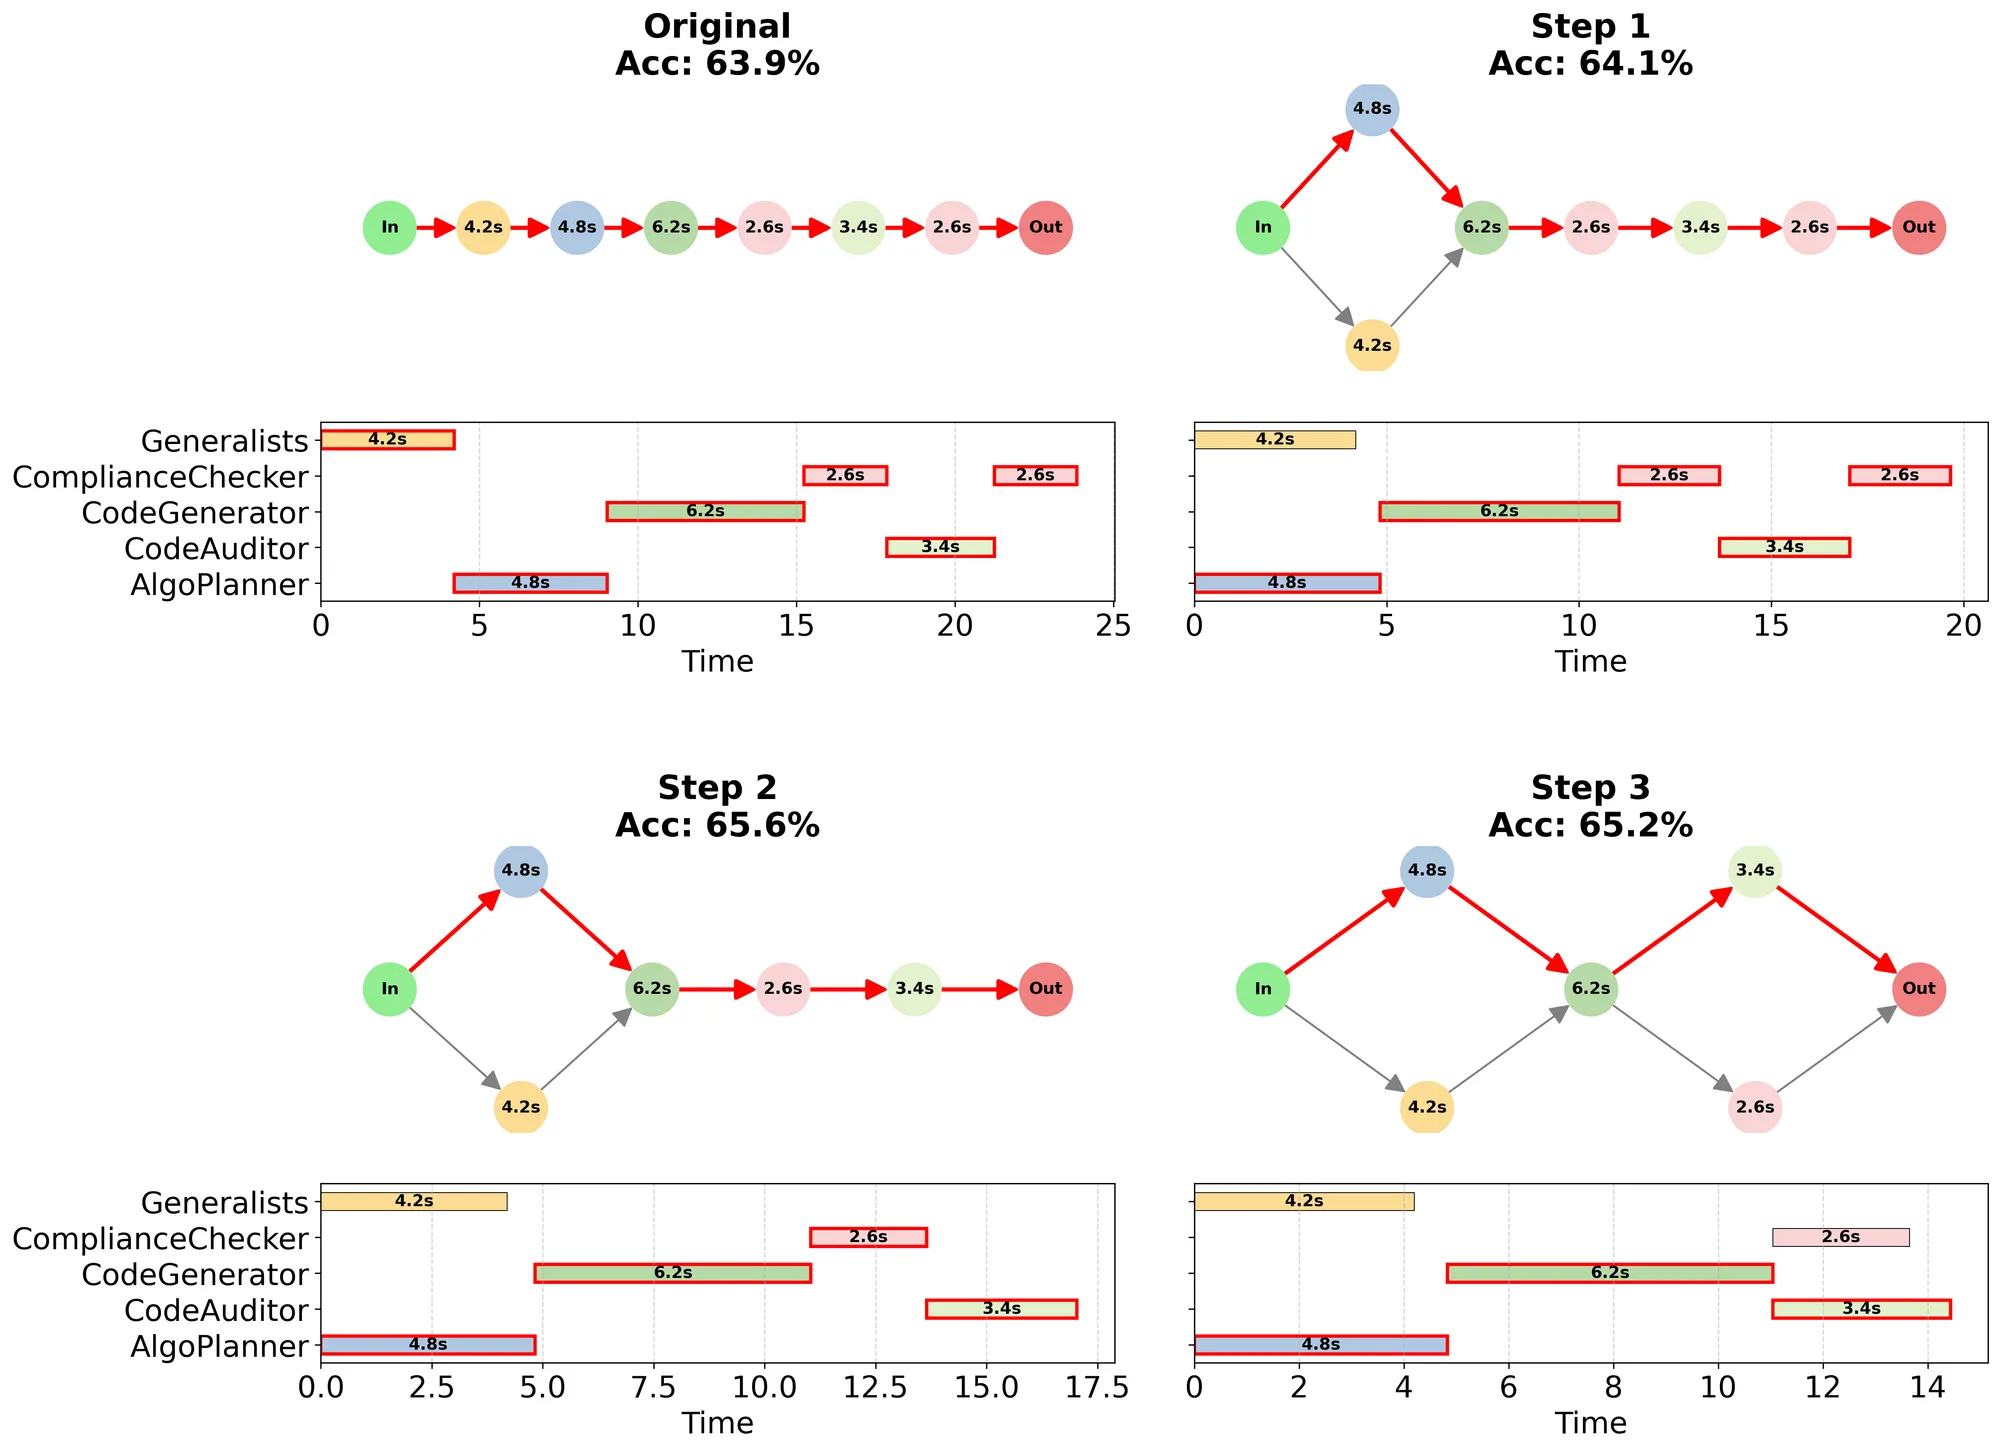
놀이터에서 '논문 궤적 한 단계'를 세 번 누르면 23.8초짜리 한 줄 워크플로가 14.4초로 줄어드는 과정을 볼 수 있습니다. 이 과정은 8장에서 자세히 읽습니다. 지금 기억할 것은 하나입니다. 시간을 결정하는 것은 빨간 줄이고, 빨간 줄을 짧게 하는 방법은 두 가지뿐입니다. 줄에 선 사람을 옆으로 빼서 나란히 세우거나(병렬화), 줄에서 아예 빼거나(제거). LAWA는 이 두 가지를 수학적으로 안전하게, 그리고 정확도를 해치지 않게 하는 방법입니다.
2장. 오래된 문제 — 간트 차트에서 데이터베이스 최적화기까지
LAWA의 핵심 아이디어는 새롭지 않습니다. 논문 스스로도 1962년의 위상 정렬 논문과 1974년의 리스트 스케줄링 논문을 인용합니다. 이 생각이 공장과 컴퓨터에서 어떻게 살아왔는지 알면, 논문이 무엇을 새로 했고 무엇을 물려받았는지가 선명해집니다.
간트의 막대, 1910년대
시간축 위에 작업을 막대로 늘어놓는 간트 차트는 미국의 기계 기술자 헨리 간트가 1910~1915년 무렵 설계했습니다. 원래 목적은 공장 작업자의 일일 생산성을 관리하는 것이었습니다. 1917년 미국이 1차 세계대전에 참전하자 육군 병기감 윌리엄 크로지어 장군이 간트를 생산 자문으로 불렀고, 프랭크퍼드 병기창과 워싱턴의 병기국에서 군수품 생산 일정을 관리하는 데 쓰이면서 널리 퍼졌습니다.
비슷한 도구는 그보다 먼저도 있었습니다. 폴란드의 공학자 카롤 아다미에츠키는 1896년에 '하모노그램'이라는 일정표를 고안했습니다. 다만 폴란드어와 러시아어로만 발표해(널리 읽힌 글은 1931년) 서방에는 거의 알려지지 않았고, 간트가 이를 참고했는지는 확인되지 않습니다. "최초의 유사한 도구" 정도로 기억해 두면 안전합니다.
'임계 경로'라는 말은 1950년대 후반에 태어났습니다. 화학회사 듀폰의 엔지니어 모건 워커와 레밍턴 랜드 UNIVAC 연구 센터의 수학자 제임스 켈리 2세가 1956년 12월부터 1959년 2월까지 함께 개발한 임계 경로법(CPM, Critical Path Method)입니다. 켈리와 워커가 1989년에 남긴 회고에 따르면 첫 시험 네트워크는 작업 61개짜리였고, 1957년 7월 UNIVAC I 컴퓨터로 일정을 계산했습니다. 이후 루이빌 공장의 정기 정비(공장을 멈추고 설비를 점검하는 기간)에 적용해 평균 정지 시간을 약 25% 줄였고, 그 첫해의 생산 증가분만으로 CPM 개발비를 넘게 회수했다고 썼습니다.
흔히 "125시간에서 93시간으로 줄였다"는 구체적 수치가 인용되지만, 이 숫자는 2차 자료에만 나오고 켈리·워커의 회고에는 "약 25%"라고만 적혀 있습니다. 재미있는 것은 회고의 한 문장입니다. "이른 시작 시각과 늦은 시작 시각, 여유 시간의 계산은 수학적으로 사소하다(trivial)." 정말 어려웠던 것은 시간–비용 절충을 푸는 일이었다는 것입니다. 이 말은 2026년의 LAWA에도 그대로 적용됩니다. 그래프가 주어지면 임계 경로를 계산하는 일은 쉽습니다. 어려운 것은 어떤 그래프로 바꿔도 결과물의 품질이 유지되는가를 아는 일입니다. LAWA가 학습된 평가기를 두는 이유가 바로 이것입니다.
같은 시기 미 해군은 폴라리스 잠수함 발사 미사일 계획에서 PERT(Program Evaluation and Review Technique)를 개발했습니다(1958년, 해군 특수계획국·부즈 앨런 해밀턴·록히드). 켈리와 워커는 1959년 초까지 PERT를 들어 본 적이 없다고 했으니 두 방법은 독립적으로 태어난 셈입니다. "PERT 덕분에 폴라리스가 2년 앞당겨졌다"는 이야기도 유명하지만, 이는 당시 해군의 홍보 영화가 퍼뜨린 주장이고, 정치학자 하비 사폴스키는 1972년 저서에서 한 장의 제목을 아예 "PERT와 관리 효율성의 신화"로 달았습니다. PERT가 실제로는 외부 간섭을 막는 방패 역할을 했다는 것입니다. 일정 관리 도구의 효과를 과장하기 쉽다는 교훈은, 뒤에서 LAWA의 실험을 읽을 때도 유용합니다.
작업이 여러 개이고 일꾼(처리기)이 여러 명이면 누구에게 무엇을 먼저 맡길지 정해야 합니다. 가장 간단한 방법은 작업 목록을 우선순위대로 세워 두고, 손이 빈 일꾼이 할 수 있는 첫 작업을 집어 가게 하는 리스트 스케줄링입니다. 벨 연구소의 수학자 로널드 그레이엄은 1966년 논문에서 이 방법이 최적보다 최대 (2 − 1/처리기 수)배까지만 나쁘다는 상한을 증명했습니다. 그리고 같은 논문 초록에서 놀라운 현상을 보고합니다. 처리기를 늘리거나, 작업 시간을 줄이거나, 선후 관계를 완화했는데 오히려 전체 시간이 늘어날 수 있다는 것입니다. 이를 '그레이엄의 이상현상(anomalies)'이라고 부릅니다(1969년 논문은 그 확장이고, 처음 보고된 것은 1966년입니다).
이 역설은 LAWA에 중요한 단서를 줍니다. 직관적으로 "병렬로 풀면 빨라진다"는 말은 처리기가 무한할 때만 무조건 참입니다. 실행기가 제한되면 순서를 잘못 정해 오히려 느려질 수 있습니다. LAWA 논문이 본문에서 '완전 병렬'(모든 노드가 선행자가 끝나는 즉시 시작) 가정을 쓰고, 부록 F.4에서 실행기 수를 1~4개로 제한한 실험을 따로 한 것도 그래서입니다. 그 실험에서 쓴 방법이 바로 1974년 애덤·챈디·딕슨이 비교한 리스트 스케줄 가운데 '가장 높은 레벨 먼저'(HLFET, Highest Level First with Estimated Times) 방식입니다. 출구까지 남은 가장 긴 경로가 긴 작업부터 처리하는, 다시 말해 임계 경로 위의 작업부터 먼저 하는 방식입니다. (HLFET라는 이름은 원논문 초록이 아니라 이후 1999년 콕·아마드의 서베이 같은 문헌에서 굳어졌습니다.)
이론적으로도 이 문제는 어렵습니다. 1975년 제프리 울먼은 선후 관계가 있는 작업을 여러 처리기에 배치해 makespan을 최소화하는 문제가 처리기 수가 입력으로 주어지면 NP-완전임을 보였습니다. 처리기를 정확히 3개로 고정한 경우는 지금도 풀리지 않은 문제로 남아 있습니다. LAWA가 '최적 해'를 약속하지 않고 빔 탐색이라는 휴리스틱을 쓰는 것도 이 어려움 때문입니다.
암달, 브렌트, 그리고 make
컴퓨터 쪽에서도 같은 생각이 반복해서 등장합니다.
암달의 논증(1967): IBM의 진 암달은 병렬 처리로 얻을 수 있는 속도 향상에는 순차적으로만 할 수 있는 부분이 상한을 정한다고 주장했습니다. 흔히 '암달의 법칙'이라는 공식으로 알려져 있지만 원래 3쪽짜리 논문에는 공식이 없고 산문으로 된 논증만 있습니다(공식은 후대의 정리입니다). 순차 비율이 상한을 정하듯, DAG에서는 임계 경로의 길이가 처리기를 아무리 늘려도 넘을 수 없는 하한입니다.
브렌트의 보조정리(1974): 리처드 브렌트는 무한 처리기에서 t단계 걸리는 계산을 p개 처리기로 하면 대략 t + (전체 연산 − t)/p 단계면 된다는 것을 보였습니다. 오늘날 '일(work)과 스팬(span)'이라는 말로 정리되는 생각의 원형입니다. 스팬이 곧 임계 경로입니다.
make(1976): 벨 연구소의 스튜어트 펠드먼이 만든 빌드 도구 make는 파일 사이의 의존 관계를 DAG로 적고, 바뀐 것만 다시 만드는 프로그램입니다. 흔히 make -j로 병렬 빌드를 떠올리지만, 1976년의 원조 make는 순서대로만 실행했습니다. 병렬 빌드는 1980년대 후반 PMake 같은 후속 도구에서 들어왔습니다. 의존성 그래프를 먼저 적어 두면, 병렬화는 나중에 '공짜로' 얻을 수 있다는 교훈입니다.
에어플로(2014~): 에어비앤비의 맥심 보슈망이 시작한 아파치 에어플로는 데이터 파이프라인을 아예 'DAG'라는 이름의 파이썬 객체로 선언하게 만들었습니다. 2026년의 에이전트 프레임워크들(LangGraph 같은)이 워크플로를 '그래프'로 정의하는 것도 이 계보에 있습니다.
1979년, "한 번 컴파일하고, 여러 번 실행한다"
LAWA의 제목 '한 번 최적화, 매번 빠르게'를 보면 떠오르는 고전이 하나 더 있습니다. IBM 산호세 연구소의 퍼트리샤 셀린저 등이 1979년 SIGMOD에 발표한 System R의 질의 최적화 논문입니다. 데이터베이스에 SQL 질의를 보내면 최적화기가 여러 실행 계획(어떤 인덱스를 쓰고 어떤 순서로 테이블을 조인할지)의 비용을 추정해 가장 싼 것을 고릅니다. 셀린저 논문에는 이런 문장이 있습니다.
"두 테이블 조인의 최적화 비용은 데이터베이스 검색 5~20번 정도와 맞먹는다. 이 비용은 System R처럼 응용 프로그램이 한 번 컴파일되고 여러 번 실행되는 환경에서는 더욱 하찮아진다. 최적화 비용이 여러 번의 실행에 걸쳐 분할 상환(amortize)되기 때문이다."
LAWA의 논리가 정확히 이것입니다. 워크플로 구조를 최적화하는 데 드는 일회성 비용(그래프 탐색 1~2초, 평가기 학습 20~95초)은, 같은 워크플로가 고객 상담에서 수천·수만 번 실행되면 금방 회수됩니다. 오늘날 데이터베이스의 '준비된 문장(prepared statement)'과 '실행 계획 캐시'가 이 생각의 후손이고, LAWA는 그것을 에이전트 워크플로에 옮긴 셈입니다. 이 비유는 계속 쓸모가 있습니다. 데이터베이스 최적화기가 질의 결과는 바꾸지 않고 실행 계획만 바꾸는 것처럼, LAWA도 정확도는 지키면서 구조만 바꾸려 합니다. 차이는 하나입니다. 관계 대수의 조인 순서 변경은 결과가 같다는 것이 수학적으로 보장되지만, 에이전트의 화살표를 끊으면 결과가 실제로 달라질 수 있습니다. 이 차이가 LAWA의 가장 어려운 부분이자, 이 논문을 읽을 때 끝까지 붙들고 가야 할 질문입니다.
시대
무엇을 최적화했나
그래프의 노드
LAWA에 물려준 것
1910년대 간트
공장 작업 일정
작업자의 하루 작업
시간축 위의 막대 — 논문의 간트 차트 그림
1957 CPM·1958 PERT
정비·건설·무기 개발 기간
공정
임계 경로와 여유 시간, "계산은 쉽고 판단이 어렵다"
1962 칸, 1972 아호·게리·울먼
그래프 알고리즘
추상 노드
위상 정렬, 이행적 축약(정리 3.6의 조건)
1966 그레이엄, 1974 애덤 외
다중 처리기 스케줄링
계산 작업
리스트 스케줄링, HLFET, '병렬화의 역설'
1979 셀린저(System R)
SQL 실행 계획
조인·스캔 연산
"한 번 최적화, 여러 번 실행" — 분할 상환
2014 에어플로 이후
데이터 파이프라인
태스크
워크플로 = 코드로 적은 DAG
2026 LAWA
에이전트 워크플로의 makespan
LLM 에이전트 호출
— (편집 연산 + 학습된 품질 평가기)
3장. LLM 에이전트는 어떻게 '팀'이 되었나 — 2022~2026 계보
이제 시계를 빠르게 돌려 LLM의 시대로 옵니다. 공장의 작업자가 LLM 에이전트로 바뀌는 데는 4년이 채 걸리지 않았습니다.
1막: 혼자 생각하고 행동하는 에이전트 (2022~2023)
2022년 10월 프린스턴과 구글의 야오 등이 발표한 ReAct는 LLM이 '생각(Reasoning)'과 '행동(Acting)'을 번갈아 하게 만든 프롬프트 기법입니다. 생각을 적고, 검색 같은 도구를 쓰고, 결과를 보고, 다시 생각합니다. 집 안 가상 환경(ALFWorld)과 온라인 쇼핑 환경(WebShop)에서 기존 강화학습·모방학습 방법보다 성공률을 각각 34%p, 10%p 높였습니다. 2023년 3월에는 오픈소스 AutoGPT가 "목표만 주면 알아서 일한다"는 약속으로 깃허브를 휩쓸었습니다.
2막: 역할을 나눈 '팀'의 등장 (2023~2024)
혼자 일하는 에이전트는 긴 일에서 길을 잃기 쉬웠습니다. 그래서 사람 회사처럼 역할을 나누는 시도가 쏟아졌습니다.
CAMEL(2023년 3월, KAUST, NeurIPS 2023): 'AI 사용자'와 'AI 비서' 두 에이전트가 역할극을 하며 협력합니다.
MetaGPT(2023년 8월, ICLR 2024 구두 발표): 제품 관리자·설계자·엔지니어 역할을 둔 소프트웨어 회사를 흉내 냅니다. 사람 회사의 표준 작업 절차(SOP)를 프롬프트 사슬로 옮겨, 마치 조립 라인처럼 일을 넘깁니다. HumanEval 85.9%, MBPP 87.7%를 기록했습니다.
ChatDev(2023년 7월, ACL 2024): 설계 → 코딩 → 테스트 → 문서화의 폭포수 단계를 '채팅 사슬'로 만들었습니다. 첫 판 초록에는 "소프트웨어 개발 전 과정을 7분 안에, 1달러 미만으로"라는 문구가 있었습니다.
AutoGen(2023년 8월, 마이크로소프트, COLM 2024): 에이전트끼리의 대화 패턴 자체를 코드로 프로그래밍할 수 있는 프레임워크입니다.
이 시기의 워크플로는 대부분 사람이 손으로 설계한 한 줄이었습니다. 사람 회사의 조직도를 그대로 본떴으니 자연스러운 일입니다. 그리고 바로 그 점이 LAWA가 겨냥하는 비효율의 출발점입니다. 사람 회사에서 결재 라인이 길면 느려지듯, 에이전트도 줄이 길면 느려집니다.
3막: 워크플로를 '그래프'로 보고 학습하기 (2024~2025)
2024년 2월 위르겐 슈미트후버가 참여한 GPTSwarm(「최적화 가능한 그래프로서의 언어 에이전트」, ICML 2024 구두 발표)이 결정적인 관점 전환을 가져왔습니다. 에이전트 시스템을 계산 그래프로 보자는 것입니다. 노드는 LLM 호출이나 함수, 간선은 정보의 흐름입니다. 그러면 간선을 '있다/없다'가 아니라 확률로 두고, 강화학습(REINFORCE)으로 어떤 연결이 좋은지 학습할 수 있습니다. GPTSwarm은 이렇게 해서 MMLU에서 엉터리 답을 내는 '적대적 에이전트'와의 연결을 스스로 끊어 내는 것을 보였습니다.
이후 그래프 구조를 학습하는 연구가 줄을 이었고, 그 대부분이 LAWA의 비교 대상(베이스라인)으로 실험 표에 등장합니다.
방법
발표
핵심 아이디어
무엇을 줄였나
DyLAN
COLM 2024 (칭화·스탠퍼드)
신경망처럼 층을 이룬 에이전트 네트워크. '에이전트 중요도 점수'로 팀을 고르고, 라운드마다 동적으로 소통
팀 선택으로 MMLU 과목별 정확도 최대 25%↑
AgentPrune
ICLR 2025 「군더더기를 잘라라」
에이전트 간 메시지 그래프를 한 번에 가지치기
토큰 28.1~72.8%↓, 비용 43.7달러 → 5.6달러
G-Designer
ICML 2025 스포트라이트
그래프 신경망(변분 그래프 오토인코더)이 질의마다 통신 구조를 설계
HumanEval 토큰 최대 95.33%↓
AgentDropout
ACL 2025
라운드마다 인접 행렬을 최적화해 쓸모없는 에이전트·간선을 빼는 '드롭아웃'
입력 토큰 21.6%↓, 출력 토큰 18.4%↓
BiRouter
2025년 12월 프리프린트
두 기준을 함께 보는 런타임 라우팅으로 다음 에이전트를 고름
(LAWA 공저자 취페이위가 참여)
AFlow
ICLR 2025 구두 발표
코드로 표현한 워크플로를 몬테카를로 트리 탐색으로 개선
정확도 중심 — 수작업 대비 평균 5.7%↑
표의 오른쪽 열을 보면 경향이 뚜렷합니다. 정확도를 올리거나 토큰(=돈)을 줄였지, 시간을 직접 줄이려 한 방법은 거의 없습니다. 토큰과 시간은 비슷해 보이지만 다릅니다. 같은 1만 토큰도 한 줄로 이어 쓰면 오래 걸리고, 나란히 쓰면 빨리 끝납니다. 토큰은 면적이고 시간은 길이입니다.
AFlow에는 자주 오해되는 숫자가 하나 있어 짚고 넘어갑니다. AFlow 초록의 "4.55%"는 성능 향상폭이 아니라 비용 비율입니다. 작은 모델이 AFlow가 찾은 워크플로를 쓰면 특정 과제에서 GPT-4o 비용의 4.55%로 GPT-4o를 앞선다는 뜻인데, 부록을 보면 4.55% 지점은 HumanEval에서 GPT-4o 단일 호출과 '같은' 수준이고 '앞서는' 것은 비용 5.92%·8.05% 지점입니다. 같은 계열의 ADAS(「에이전트 시스템의 자동 설계」, ICLR 2025)는 메타 에이전트가 새 에이전트를 코드로 직접 짜게 했고, MaAS(ICML 2025 구두 발표)는 '에이전트 슈퍼넷'에서 질의마다 구조를 뽑아 기존 시스템 추론 비용의 6~45%만 썼습니다.
4막: 병렬화와 '지연'이 화두가 되다 (2024~2026)
그사이 다른 줄기에서 병렬화가 무르익었습니다.
스켈레톤 오브 소트(Skeleton-of-Thought, ICLR 2024): 답의 뼈대를 먼저 쓰고 각 항목을 병렬로 채워 12개 모델 중 8개에서 2배 넘게(최대 2.39배) 빨라졌습니다.
LLMCompiler(ICML 2024, UC 버클리): 컴파일러처럼 함수 호출을 DAG로 계획하고 병렬로 실행해, ReAct 대비 지연을 최대 3.7배 줄이고 비용을 최대 6.7배 아꼈습니다. 단일 에이전트 안의 '도구 호출 그래프'에 임계 경로 사고를 적용한 선구자입니다.
M1-Parallel(2025, 마이크로소프트 리서치): Magentic-One 에이전트 팀 여러 개를 동시에 돌리고 먼저 끝난 결과를 쓰는 방식으로 GAIA에서 최대 2.2배 빨라졌습니다. (이 논문의 제1저자 엔하오 장은 LAWA의 제1저자 엔페이 장과 다른 사람입니다.)
산업계에서는 2024년 12월 앤트로픽이 「효과적인 에이전트 만들기」에서 워크플로 패턴을 다섯 가지로 정리했습니다. 프롬프트 사슬(prompt chaining), 라우팅, 병렬화(일을 쪼개 동시에 하는 '분할'과 같은 일을 여러 번 시켜 투표하는 '투표'), 오케스트레이터–워커, 평가자–최적화자. 그리고 이 글은 "에이전트 시스템은 더 나은 성능을 위해 지연과 비용을 대가로 치르는 경우가 많다"고 분명히 적었습니다.
2025년 6월에는 두 글이 하루 차이로 나와 논쟁을 일으켰습니다. 6월 12일 코그니션의 월든 얀은 「멀티에이전트를 만들지 말라」에서 병렬 하위 에이전트들이 서로의 맥락을 모른 채 '암묵적 결정'을 내려 충돌한다고 경고했습니다. 플래피 버드 게임을 두 하위 에이전트에게 나눠 맡겼더니 배경과 새가 전혀 다른 스타일로 나왔다는 예입니다. 6월 13일 앤트로픽은 「멀티에이전트 리서치 시스템을 어떻게 만들었나」에서 반대 경험을 공유했습니다. 오푸스 4가 이끌고 소네트 4 하위 에이전트들이 일하는 구조가 단일 에이전트보다 내부 평가에서 90.2% 나았고, 하위 에이전트 3~5개를 병렬로 띄우고 각자 도구를 3개 이상 동시에 쓰게 하자 복잡한 질의의 조사 시간이 최대 90% 줄었다는 것입니다. 대신 토큰은 일반 채팅의 약 15배를 썼고, 리드 에이전트가 하위 에이전트들을 동기적으로 기다리는 것이 병목이라고 털어놓았습니다.
두 글은 정반대 결론처럼 보이지만 같은 사실을 가리킵니다. 병렬화는 시간을 극적으로 줄이지만, 정보가 끊긴 곳에서 품질이 깨질 수 있다. LAWA의 설계가 정확히 이 긴장 위에 서 있습니다. 병렬 재배선으로 시간을 줄이되, 정보가 끊겨 품질이 깨지는지는 학습된 평가기로 걸러 냅니다.
바로 앞의 선행 연구: LAMaS와 AgentBalance
지연을 직접 겨냥한 위상 학습도 2026년 들어 나오기 시작했습니다. 센트럴플로리다대의 LAMaS(2026년 1월)는 병렬 실행을 전제로 지연을 명시적으로 감독하며 임계 경로를 줄이는 오케스트레이션을 학습합니다. 첫 판은 MaAS 대비 임계 경로를 38~46% 줄였다고 보고했는데, 이때 '임계 경로 길이'는 초 단위가 아니라 경로 위 출력 토큰 수의 합으로 쟀습니다(8월의 둘째 판은 실측 지연을 55.6~75.6% 줄였다고 보고합니다). 홍콩과기대(광저우)의 AgentBalance(2025년 12월)는 토큰 비용과 지연을 '예산 제약'으로 두고 백본 모델과 구조를 함께 고릅니다.
LAWA는 이 둘과 자신을 이렇게 구분합니다. LAMaS는 미리 정해 둔 층(layer) 단위 병렬 구조 안에서 최적화하고, AgentBalance는 지연을 예산으로만 다룰 뿐 구조 편집이 왜 시간을 줄이는지에 대한 이론이 없다. LAWA는 임의의 DAG를 다루고, 편집 연산의 성질(도달 관계 보존, 시간 비증가, 표현력)을 정리로 증명한다는 것입니다. 실험에서 LAWA와 가장 치열하게 붙는 상대가 LAMaS라는 점도 기억해 두세요.
서빙 계층의 노력과의 관계
마지막으로 혼동하기 쉬운 지점 하나. 지연을 줄이는 연구의 대부분은 서빙 계층, 즉 LLM을 돌리는 서버 쪽에서 이뤄졌습니다. vLLM(SOSP 2023)의 PagedAttention, SGLang(NeurIPS 2024)의 RadixAttention 같은 기술은 같은 GPU로 더 많은 요청을 빨리 처리하게 합니다. LAWA가 인용하는 Kairos(멀티에이전트 서빙 지연 17.8~28.4%↓), Aragog, Chimera, Nalar, ThunderAgent 같은 2025~2026년 연구도 '에이전트 워크플로를 아는 서버'를 만듭니다.
LAWA는 이와 다른 층에서 일합니다. 서버를 빠르게 하는 게 아니라, 애초에 서버에 보내는 일의 모양을 바꿉니다. 비유하면 서빙 최적화는 주방 화구를 늘리고 불을 세게 하는 일이고, LAWA는 조리 순서를 다시 짜는 일입니다. 둘은 경쟁 관계가 아니라 곱셈 관계입니다. 실제로 LAWA의 실험은 SGLang 서버 위에서 돌았습니다.
인터페이스 연구에서 응답 시간에 대한 고전적인 기준은 세 개의 숫자입니다. 제이컵 닐슨이 1993년 『사용성 공학』에서 로버트 밀러(1968)와 카드 등(1991)의 연구를 정리한 0.1초(즉각적이라고 느끼는 한계), 1초(생각의 흐름이 끊기지 않는 한계), 10초(주의를 붙잡아 둘 수 있는 한계)입니다. 이 숫자들은 닐슨이 직접 잰 값이 아니라 선행 연구의 요약이라는 점은 알아 두면 좋습니다.
1982년 IBM의 도허티와 타다니는 「빠른 응답 시간의 경제적 가치」에서 시스템 응답이 3초일 때 프로그래머가 시간당 약 180건의 작업을 했지만 0.3초가 되자 371건으로 두 배 넘게 늘었다고 보고했습니다. "컴퓨터와 사용자가 서로를 기다리지 않는 속도로 상호작용하면 생산성이 치솟는다"는 문장이 이 보고서에 있습니다. (UX 업계에서 흔히 말하는 '도허티 임계값 400밀리초'라는 숫자는 정작 이 보고서에 없고, 보고서의 주장은 '1초 미만'입니다.)
웹 시대에는 지연이 돈으로 측정됐습니다. 아마존의 그렉 린든은 2006년 강연 슬라이드에 "+100ms → 매출 −1%"라고 적었고, 구글의 제이크 브루틀랙은 2009년 실험에서 검색 결과를 100~400밀리초 늦추자 사용자당 검색 수가 0.2~0.6% 줄었고, 그 효과가 시간이 갈수록 커지며 지연을 없앤 뒤에도 몇 주간 남았다고 보고했습니다. "100밀리초마다 1%씩 줄어든다"는 식의 선형 법칙은 과장된 일반화이지만, 방향은 분명합니다. 사람은 기다림에 민감하고, 그 비용은 쌓인다.
LLM 에이전트는 '초' 단위로 느리다
웹 페이지의 지연이 밀리초 단위의 싸움이었다면 LLM 에이전트는 차원이 다릅니다. LAWA 저장소에 공개된 에이전트 등록 파일을 보면, 같은 Qwen3-30B 모델로 만든 에이전트들의 한 번 호출 지연(95번째 백분위수, P95)이 문제를 단순화하는 에이전트 2.16초, 수학 추론 에이전트 4.62초, 코드 생성 에이전트 6.21초, 구형 파이썬 코더 에이전트 9.84초입니다. 에이전트 대여섯 명이 한 줄로 서면 20~30초가 금방입니다. 실제로 논문 표 1에서 에이전트를 무작위로 한 줄 세운 'Random Chain'은 질의당 22~37초가 걸렸습니다. 닐슨의 '10초 한계'를 가볍게 넘습니다.
논문은 지연의 원인으로 두 가지를 꼽습니다. 하나는 모델 추론 시간(토큰을 하나씩 생성하는 데 드는 시간), 다른 하나는 서비스 혼잡(같은 서버를 여러 요청이 나눠 쓰며 줄을 서는 시간)입니다. 둘 다 워크플로가 깊어질수록, 즉 줄이 길어질수록 선형 이상으로 쌓입니다.
'반복 질의'가 판을 바꾼다
그런데 왜 하필 '반복 질의(recurrent queries)'일까요? 논문이 예로 드는 무대는 세 곳입니다. AI 고객 상담, 자동화된 소프트웨어 공학, 클라우드 장애 대응. 공통점은 비슷한 요청이 끝없이 되풀이된다는 것입니다. 배송 문의, 환불 문의, 비밀번호 재설정. 메모리 부족 경보, 디스크 가득 참 경보, 배포 직후 오류율 급등.
이런 곳에서는 두 가지가 동시에 성립합니다.
같은 워크플로를 수없이 재사용하므로, 한 번의 최적화 비용이 무시할 만해진다. (셀린저의 "한 번 컴파일, 여러 번 실행")
질의 하나의 몇 초가 곱셈으로 불어난다. 하루 1만 건의 상담에서 질의당 10초를 줄이면 하루 약 28시간, 1년이면 약 1만 시간의 사람 대기 시간이 사라진다.
2026년 현재 이 무대는 실제로 커지고 있습니다. 스웨덴 핀테크 클라르나는 2024년 2월 AI 상담원이 첫 달에 230만 건의 대화(전체 상담 채팅의 3분의 2)를 처리하고 해결 시간을 11분에서 2분 미만으로 줄였다고 발표했습니다. (다만 2025년 5월 CEO는 비용에 치우쳐 품질이 떨어졌다고 인정하고 사람 상담원 채용을 재개했고, 지금은 AI와 사람이 나눠 맡는 혼합형입니다.) 가트너는 2025년 3월 "2029년까지 에이전틱 AI가 흔한 고객 서비스 문제의 80%를 사람 개입 없이 해결할 것"이라고 예측했습니다. 클라우드 쪽에서는 AWS DevOps 에이전트가 2026년 3월 31일 정식 출시됐고, 마이크로소프트의 Azure SRE 에이전트도 같은 달 하순 정식 출시됐습니다. 마이크로소프트가 2025년 1월 공개한 AIOpsLab은 마이크로서비스에 장애를 일부러 주입해 에이전트가 감지·위치 추정·근본 원인 분석·완화의 4단계를 얼마나 잘하는지 재는 평가 틀이고, LAWA는 이를 반복 질의 사례로 인용합니다.
한국도 다르지 않습니다. LG유플러스는 2026년 9월 30일 간담회에서 AI 고객센터(AICC) 도입 후 상담사 연결까지의 평균 대기 시간이 2024년 47초에서 2026년 5초로 줄었고, AI 콜봇·챗봇이 연간 약 800만 건을 처리한다고 밝혔습니다. KT는 2026년 8월 우리은행의 AI 상담 재구축 사업을 맡아 AI가 처리하는 업무 범위를 30%에서 60%로 넓히겠다고 했습니다. 하지만 속도와 만족은 같은 말이 아닙니다. 머니투데이가 2026년 5월 보도한 토스뱅크 내부 자료에 따르면 상담의 70%를 AI 챗봇이 처리하지만, 챗봇 만족도는 36%로 기존 콜센터(72%)의 절반이었습니다. 빠르기만 하고 틀리면 소용없다는 것, 이것이 LAWA가 '정확도를 유지한다'는 제약을 목표와 같은 무게로 두는 이유입니다.
1
문제 — 정확도만 보는 자동 설계
AFlow·G-Designer·AgentPrune 같은 자동 워크플로 설계는 정확도와 토큰을 최적화했다. 하지만 같은 토큰도 줄 세우면 느리다. 반복 질의에서는 이 느림이 매번 되풀이되어 쌓인다.
2
해결 — makespan을 1순위 목표로
"정확도는 처음 워크플로 이상, 그 안에서 makespan 최소"라는 새 문제를 정의하고, 임계 경로를 겨냥한 안전한 그래프 편집과 학습된 품질 평가기로 푼다.
3
결과 — 한 번 최적화의 비용은 금방 회수
탐색은 에이전트를 실행하지 않으므로 워크플로 하나에 1~2초. 평가기 학습까지 더해도 무작위 사슬 대비 대략 2~7번 실행하면 본전이다.
아래 계산기로 '반복'이 얼마나 큰 차이를 만드는지 직접 확인해 보세요. 숫자는 모두 논문의 표에서 가져왔습니다.
5장. 문제를 수식으로 — 그래프, makespan, 그리고 단 하나의 제약
이제 논문 본문으로 들어갑니다. 2절 '문제 정의'는 짧지만 이 논문의 모든 것이 여기서 나옵니다. 수식이 낯설어도 괜찮습니다. 한 줄씩 우리말로 옮기겠습니다.
워크플로 = 그래프
논문은 멀티에이전트 워크플로를 G=(V,A,t)로 적습니다.
V는 노드의 집합입니다. 노드 하나는 '에이전트 호출 한 번'입니다. 같은 에이전트가 두 번 불리면 노드가 두 개입니다. (부록 D의 사례에서 ComplianceChecker가 두 번 등장하는 것처럼요.)
A는 인접 행렬입니다. Aij=1이면 "노드 i의 출력이 노드 j의 입력 맥락으로 들어간다"는 뜻입니다. 0과 1로 된 표라고 생각하면 됩니다.
t는 노드별 지연 시간의 목록입니다. 노드 k가 실행되는 데 tk초가 걸립니다(tk>0).
그리고 특별한 노드 두 개, 입구 vI와 출구 vO가 있습니다. 질문이 입구로 들어오고 최종 답이 출구로 나갑니다. 다른 모든 노드는 입구에서 출구로 가는 어떤 경로 위에 있어야 합니다. 즉 '어디에도 연결되지 않은 외톨이 에이전트'는 없습니다.
makespan = 가장 긴 경로
논문은 완전 병렬을 가정합니다. 모든 노드는 자기 선행자들이 다 끝나는 즉시 시작합니다. 동시에 실행할 수 있는 개수에 제한이 없다는 뜻입니다. 그러면 전체 소요 시간은 입구에서 출구까지의 모든 경로 가운데 노드 시간의 합이 가장 큰 경로, 즉 임계 경로의 길이가 됩니다.
T(G)=P∈PG(vI,vO)maxvk∈P∑tk
식 (1)을 우리말로 읽으면 "입구에서 출구로 가는 모든 길을 하나씩 따라가며 걸리는 시간을 더하고, 그중 가장 큰 값을 고른다"입니다. 라면 예에서 '물 끓이기 → 면 넣기' 길(9분)과 '파 썰기 → 면 넣기' 길(6분) 중 큰 쪽이 9분이었던 것과 같습니다. 이 계산 자체는 위상 정렬 순서로 노드를 한 번씩 훑으면 끝나므로 아주 빠릅니다. 켈리와 워커가 "수학적으로 사소하다"고 한 바로 그 계산입니다.
목표 — "느려지지 말고, 나빠지지도 말 것"
GminT(G)s.t.S(G)≥S(G0)
식 (2)는 이 논문의 문제 정의 전부입니다. S(G)는 워크플로 G의 하류 과제 성능, 예컨대 코딩 문제 정답률입니다. G0는 처음 워크플로입니다. 그러니 "처음 워크플로보다 정확도가 떨어지지 않는 워크플로들 가운데 makespan이 가장 작은 것을 찾아라"입니다.
이 정식화에는 의도적인 선택이 두 가지 있습니다.
첫째, 시간이 목적 함수이고 정확도는 제약입니다. 보통의 자동 설계 연구는 반대입니다(정확도 최대화, 비용은 부차적). 이 뒤집기가 논문의 첫 번째 기여, '지연 인지 워크플로 생성'이라는 새 문제입니다.
둘째, 정확도 기준이 절대값이 아니라 출발점입니다. "정확도 90% 이상"이 아니라 "처음보다 나쁘지 않게"입니다. 그래서 LAWA는 이미 쓰던 워크플로를 받아 고치는 도구로도, 처음부터 만드는 도구로도 쓰일 수 있습니다. 출발점이 사람이 만든 워크플로이면 그것이 기준이 되고, 생성기가 만든 사슬이면 그것이 기준이 됩니다.
노드 시간은 어떻게 아나 — P95 보정
tk는 어디서 올까요? 논문은 탐색 전에 보정 실행(calibration run)을 합니다. 학습용 질의로 각 에이전트를 여러 번 불러 보고, 걸린 시간의 95번째 백분위수(P95)를 그 에이전트의 tk로 씁니다. 평균이 아니라 P95를 쓰는 이유는 간단합니다. LLM 호출 시간은 들쑥날쑥하고, 가끔 서버가 붐비면 몇 배로 늘어납니다. 계획은 운 좋은 날이 아니라 붐비는 날 기준이어야 합니다. 저장소의 update_runtimes.py가 바로 이 일을 하고, README는 "LLM이나 하드웨어가 바뀌면 다시 돌리라"고 안내합니다. 모델이 바뀌면 지연값만 다시 재면 되고, 에이전트 프롬프트가 바뀌지 않았다면 재학습은 필요 없습니다.
여기서 한 가지 짚어 둘 것이 있습니다. 이 정식화에서 tk는 그래프 구조와 무관한 상수입니다. 실제로는 그렇지 않을 수 있습니다. 노드 j가 선행자 셋의 출력을 받으면 입력이 길어지고, 입력이 길어지면 처리 시간도 늘어납니다. 병렬 재배선은 노드의 선행자 집합을 바꾸므로 tk 자체를 바꿀 수 있습니다. 논문은 이를 명시적으로 다루지 않고, 대신 최종 결과를 실측 벽시계 시간으로 보고해 이 근사가 실제로 얼마나 맞는지를 간접적으로 검증합니다. 이 점은 11장에서 다시 다룹니다.
아래 시뮬레이터는 지연이 들쑥날쑥할 때 구조에 따라 무슨 일이 벌어지는지 보여 줍니다. 특히 '모두 끝나야 다음 라운드'로 가는 동기화 장벽이 왜 비싼지 확인해 보세요.
노드 i에서 j로 가는 화살표가 있을 때(Aij=1), 그 의존을 끊고 둘을 나란히 세웁니다. 그냥 끊기만 하면 연결이 엉망이 되므로 이웃을 서로 물려받습니다.
Aij←0;Aik←1∀k:Ajk=1;Akj←1∀k:Aki=1
식 (3)을 풀어 쓰면 세 동작입니다.
i→j 화살표를 지운다. 이제 j는 i의 답을 기다리지 않는다.
i가 j의 후행자들을 물려받는다. j 다음에 오던 노드들이 이제 i의 출력도 직접 받는다.
j가 i의 선행자들을 물려받는다. i 앞에 있던 노드들이 이제 j에게도 직접 출력을 준다.
예를 들어 사슬 A → B → C → D에서 (B, C)를 재배선하면 A → B, A → C, B → D, C → D, 다이아몬드 모양이 됩니다. B와 C가 A의 결과를 동시에 받아 나란히 일하고, D가 둘의 결과를 모두 받습니다. B가 3초, C가 4초라면 B+C=7초 걸리던 구간이 max(B, C)=4초로 줄어듭니다.
잃는 것도 분명합니다. C는 더 이상 B의 답을 보지 못합니다. B가 '알고리즘 계획'이고 C가 '코드 작성'이라면, 계획 없이 코드를 짜게 되는 셈입니다. 이것이 정확도를 해칠지는 그래프만 봐서는 알 수 없습니다.
한 가지 규칙이 더 있습니다. 같은 에이전트를 부르는 두 노드 사이에는 병렬 재배선을 하지 않습니다. 논문은 "그런 노드들은 실제로 병렬로 실행될 수 없다"고 설명합니다. 같은 에이전트(같은 역할·같은 대화 상태)를 동시에 두 번 부를 수 없는 운영 환경을 가정한 것입니다.
입구와 출구가 아닌 노드 k를 통째로 뺍니다. 연결이 끊기지 않도록 k의 선행자들과 후행자들을 모두 직접 이어 줍니다(식 4~6). 사슬 A → B → C에서 B를 빼면 A → C가 됩니다. 사슬이라면 시간은 정확히 tB만큼 줄어듭니다.
잃는 것은 B가 하던 일 전부입니다. 그런데 의외로 이게 손해가 아닐 때가 많습니다. 부록 D의 사례에서 LAWA가 두 번째 ComplianceChecker(규정 준수 검사)를 지웠더니 정확도가 64.1%에서 65.6%로 올랐습니다. 같은 검사를 두 번 하는 것은 시간만 쓰고, 때로는 멀쩡한 답을 괜히 고쳐 망치기도 합니다. 여러 에이전트가 토론하면 오히려 정답에서 멀어질 수 있다는 것은 멀티에이전트 연구에서 반복해서 보고된 현상입니다.
칼 ③ 노드 순열 (Node Permutation)
노드의 순서를 바꿉니다(식 7). 사슬 A → B → C를 B → C → A로 다시 세우는 식입니다. 이 연산은 탐색 중에 직접 쓰이지 않고, 그래프 생성기가 처음 사슬을 만들 때 암묵적으로 수행합니다. 왜 순서가 중요한지는 정리 3.6에서 드러납니다.
세 가지 정리 — 이 칼들은 안전하다
논문은 편집 연산이 만족해야 할 세 가지 요건을 세우고 각각을 정리로 증명합니다.
정리 3.4 도달성 보존노드 제거나 병렬 재배선을 해도, 편집에 직접 관여하지 않은 노드 u, v 사이에서 "u에서 v로 가는 길이 있다"는 관계는 그대로다. 노드 제거는 지름길을 놓아 끊긴 길을 이어 주고, 재배선은 이웃을 물려받아 우회로를 만들어 준다. 그래서 워크플로가 둘로 쪼개지거나 정보가 완전히 사라지는 일은 없다.
정리 3.5 makespan 비증가두 연산 모두 makespan을 절대 늘리지 않는다: T(G′) ≤ T(G). 증명의 요지는 "편집 뒤 그래프의 모든 경로는, 편집 전 그래프의 어떤 경로에서 시간이 양수인 노드를 몇 개 뺀 것"이라는 관찰이다. 새로 생긴 간선 x → j는 원래의 x → i → j에서 i를 건너뛴 것이므로 더 짧을 수밖에 없다.
정리 3.6 완전성아무 사슬에서 출발해도, 노드 순서만 잘 고르면 병렬 재배선과 노드 제거만으로 이행적으로 축약된 어떤 DAG에도 정확히 도달할 수 있다. 즉 이 두 칼은 '안전'할 뿐 아니라 '충분히 강력'하다.
정리 3.5는 사실 직관적으로 당연해 보입니다. 화살표를 지우거나 노드를 빼면 길이 짧아지는 게 당연하니까요. 그런데 병렬 재배선은 화살표를 새로 추가하기도 합니다(이웃을 물려받으면서). 새 화살표가 더 긴 길을 만들지 않는다는 것은 따져 봐야 할 일이고, 증명은 새 화살표가 모두 원래 길의 '지름길'이라는 점을 보여 줍니다. 더 중요한 의미는 따로 있습니다. 이 정리 덕분에 탐색의 모든 한 걸음이 시간을 줄이거나 유지한다는 단조성이 보장됩니다. 탐색 도중에 시간이 늘었다 줄었다 하며 헤맬 필요가 없고, 정확도라는 한 축만 신경 쓰면 됩니다.
정리 3.6의 '이행적 축약(transitive reduction)'은 1972년 아호·게리·울먼이 정의한 개념입니다. A → B → C가 있을 때 A → C 화살표는 중복입니다. A의 정보는 이미 B를 거쳐 C에 닿고, 시간 계산에도 영향을 주지 않으니까요. 이런 중복 간선이 하나도 없는 DAG가 이행적으로 축약된 DAG입니다. 증명은 '역방향 스윕'으로 구성적입니다. 노드를 위상 정렬 순서로 세운 사슬에서 출발해, 끝에서부터 앞으로 오며 "목표에 없는 후행 연결"을 만날 때마다 재배선합니다. 아래 실험실의 세 번째 탭에서 사슬이 다이아몬드·부채꼴·모으기 모양으로 바뀌는 과정을 한 단계씩 볼 수 있습니다.
이 정리는 LAWA 설계의 근거가 됩니다. 생성기가 사슬만 만들면 되는 이유가 여기 있습니다. 사슬의 순서만 잘 뽑으면 나머지 모양은 재배선이 만들어 줍니다. 그리고 탐색 공간이 '안전한 편집'만으로 이뤄지므로, 탐색이 어떤 경로를 택하든 시간은 단조롭게 줄어듭니다. 물론 '도달할 수 있다'는 것이 '찾을 수 있다'는 뜻은 아닙니다. 어떤 순서로 어떤 편집을 할지는 여전히 탐색 문제이고, 7장의 빔 탐색과 평가기가 그 일을 맡습니다.
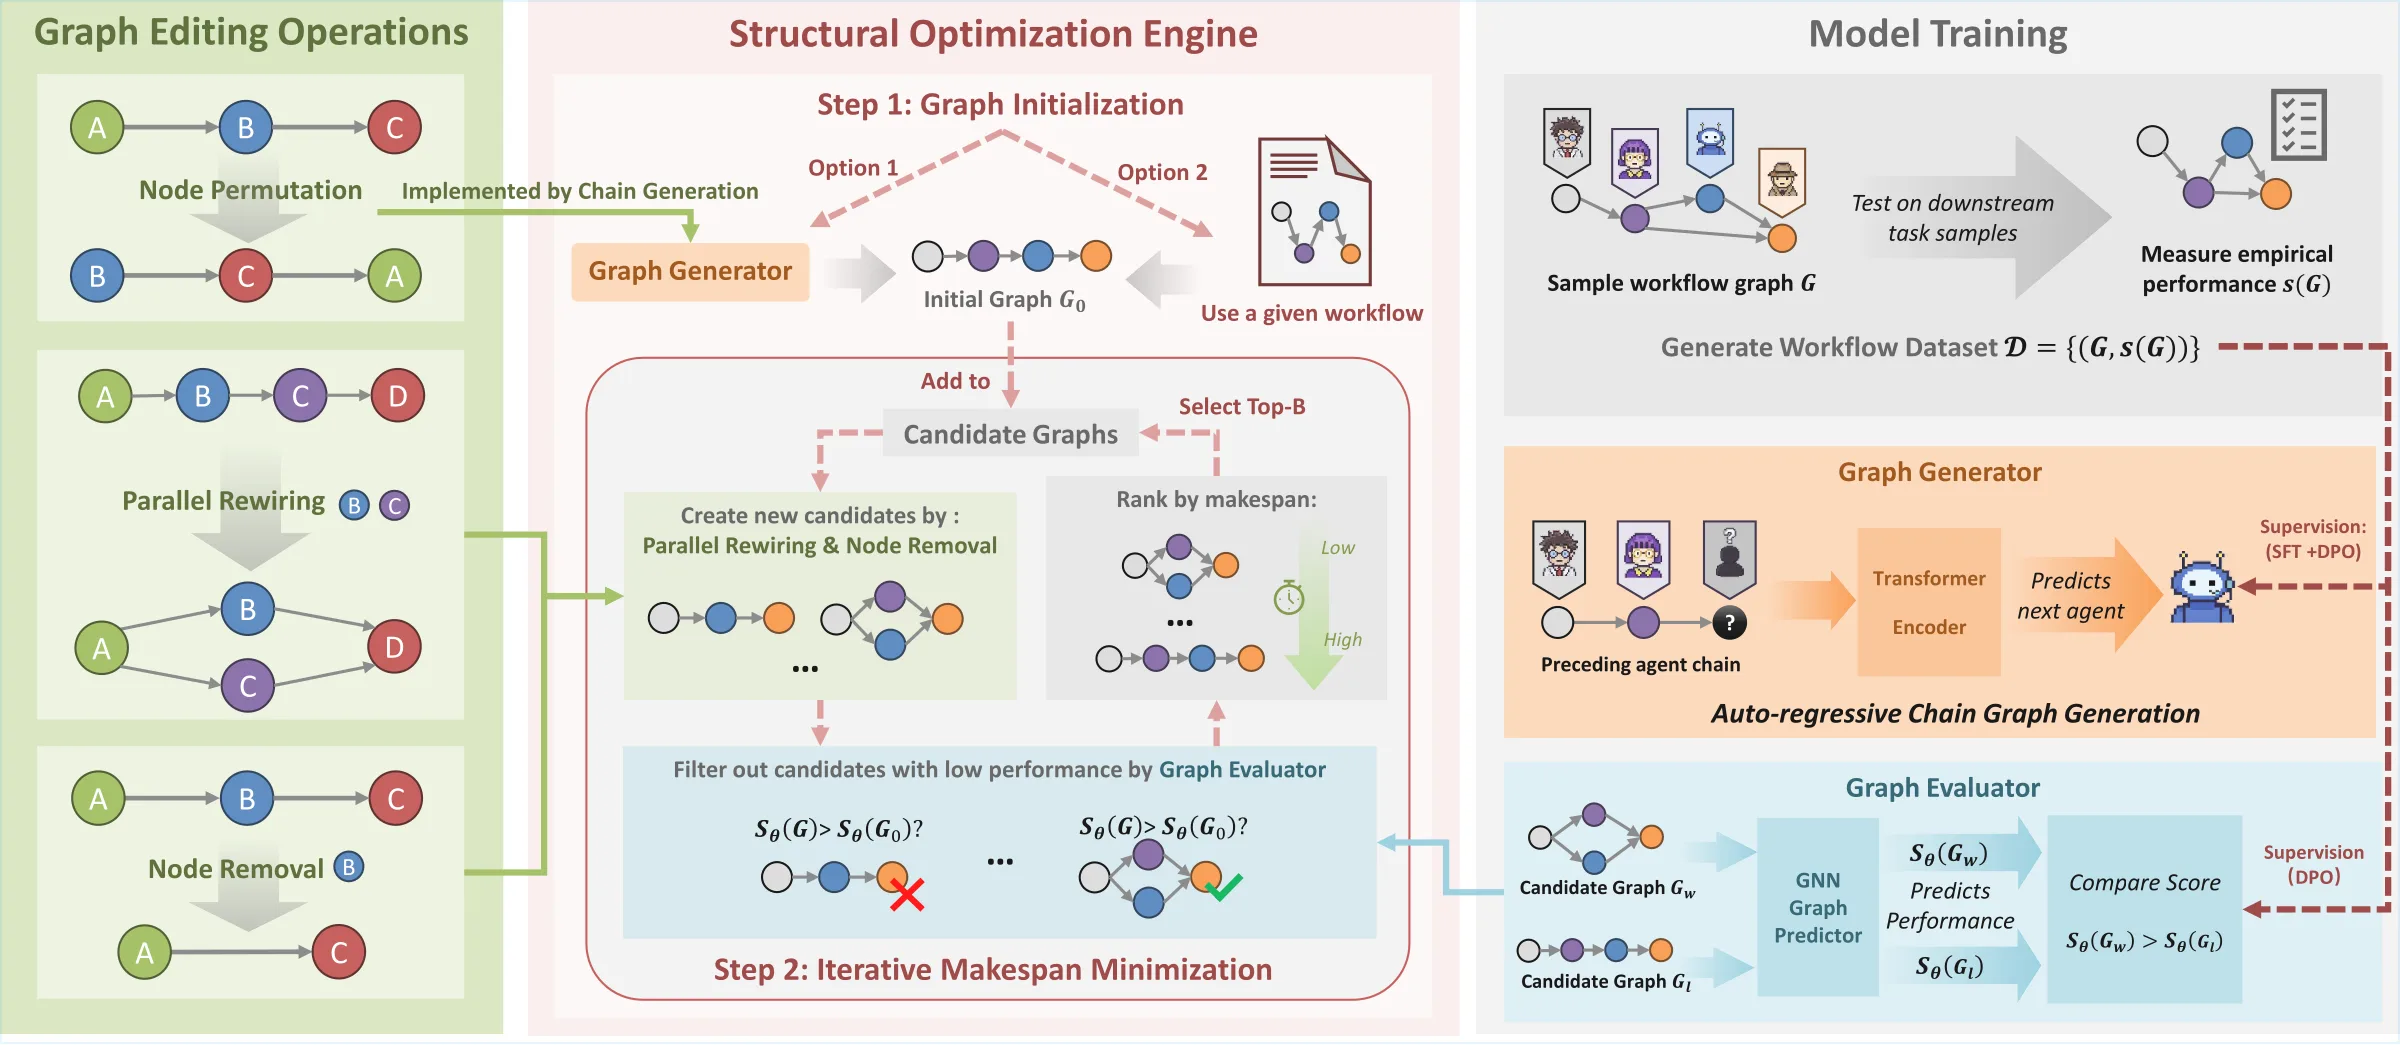
논문 그림 1은 LAWA를 세 칸으로 보여 줍니다. 왼쪽 초록 칸은 6장의 편집 연산들, 가운데 분홍 칸은 그것을 반복 적용하는 구조 최적화 엔진, 오른쪽 회색 칸은 엔진이 쓰는 두 학습 모델(그래프 생성기와 그래프 평가기)을 어떻게 훈련하는지입니다. 가운데 칸부터 읽겠습니다.
1단계: 출발점 정하기
엔진은 두 가지 방식으로 출발합니다(그림의 Option 1·2). 이미 있는 워크플로를 받거나(플러그인 모드), 없으면 그래프 생성기가 사슬을 하나 만듭니다(생성 모드). 플러그인 모드에서는 사람이 설계한 워크플로든, AgentPrune이나 AgentDropout 같은 다른 방법이 만든 워크플로든 그대로 받아 다듬습니다.
알고리즘 1은 빔 탐색(beam search)입니다. 빔 탐색은 갈림길마다 모든 길을 끝까지 가 보는 대신, 매 단계 가장 유망한 몇 개(빔 크기 B)만 남기고 나머지는 버리는 탐색법입니다. 기계 번역에서 다음 단어를 고를 때 쓰던 그 방법입니다. LAWA는 빔 크기 B=32, 반복 횟수 K=11(플러그인 실험은 그래프가 얕아 K=4)을 씁니다. 한 반복은 세 걸음입니다.
① 후보 만들기현재 빔의 각 그래프에 대해, 입구·출구를 뺀 모든 노드에 노드 제거를 한 번씩 적용한 후보를 만든다. 병렬 재배선은 후보가 너무 많아지지 않게, 평가기의 기울기로 추정한 '정확도 변화'가 0 이상인 간선에만 적용한다. 같은 에이전트끼리의 재배선은 금지.
② 정확도 거르기각 후보를 그래프 평가기에 넣어 점수 Sθ(G′)를 받고, 처음 그래프의 점수 Sθ(G0) 이상인 것만 남긴다. 실제 에이전트는 한 번도 실행하지 않는다.
③ 시간순 정렬살아남은 후보를 makespan이 짧은 순으로 세우고 상위 B = 32개만 다음 반복으로 넘긴다. K번 반복한 뒤 남은 것 중 가장 빠른 그래프를 최종 답으로 낸다.
이 구조가 영리한 이유는 두 목표의 역할 분담입니다. 시간은 식 (1)로 정확히, 즉시 계산됩니다. 정확도는 평가기로 예측만 하고, 그것도 '기준 이상이냐 아니냐'라는 거르기에만 씁니다. 순위는 오직 시간으로 매깁니다. 정리 3.5 덕분에 모든 후보는 이미 부모보다 느리지 않으므로, '빠르면서 괜찮은' 그래프를 향해 단조롭게 나아갑니다.
탐색 동안 에이전트를 한 번도 실행하지 않기 때문에, 워크플로 하나를 만드는 데 걸리는 시간은 CPU에서 1.16~2.27초(표 9)입니다. 에이전트를 실제로 돌려 보며 구조를 고치는 AgentDropout 같은 '온-폴리시' 방법과 가장 크게 다른 점입니다.
LAWA의 성패는 사실상 평가기에 달려 있습니다. 평가기 Sθ는 워크플로 그래프를 받아 "이 구조로 돌리면 정확도가 대략 어느 쪽일지"를 하나의 점수로 내는 그래프 신경망(GNN)입니다.
입력: 각 노드(에이전트)를 역할 설명과 시스템 프롬프트로 만든 임베딩 eu로 표현합니다. 논문은 고정된 Sentence-BERT 인코더라고 쓰고, 공개 저장소 README는 bert-base-uncased를 내려받는다고 안내합니다. 같은 에이전트는 어떤 그래프에 있든 같은 벡터에서 출발합니다.
처리: 인접 행렬 A를 따라 이웃끼리 정보를 주고받는 메시지 전달 층을 거친 뒤, 모든 노드를 모아(pooling) 그래프 하나의 표현을 만들고, 작은 신경망(MLP)이 점수 하나로 바꿉니다(식 13). 부록 F.7의 구조 비교(층 수 1~4, 은닉 크기 256/512, GCN·GAT·트랜스포머) 끝에 3층 그래프 트랜스포머, 은닉 크기 512를 기본으로 골랐습니다.
학습 데이터: 벤치마크마다 해당 도메인의 에이전트로 무작위 그래프 2,048개를 만들고, 각각을 학습용 문제(수학 50개, 코딩·상식 30개)로 실제로 돌려 정답률을 잽니다. 이것이 D={(G,s(G))}입니다.
학습 방법: 정답률을 그대로 맞히는 회귀가 아니라, 두 그래프 중 어느 쪽이 나은지를 맞히는 쌍별 선호 학습입니다. 탐색에서 필요한 것은 절대 점수가 아니라 "처음보다 나쁘냐 아니냐"라는 상대 비교이기 때문입니다. 손실 함수(식 14)는 DPO(직접 선호 최적화, 2023)에서 착안한 형태로, 나은 그래프 Gw와 못한 그래프 Gl의 점수 차가 기준 모델의 점수 차보다 크도록 밀어 줍니다.
평가기 학습은 벤치마크당 21~95초(표 10)면 끝납니다. 비싼 것은 학습 데이터, 즉 2,048개 그래프를 실제로 돌려 정답률을 재는 일입니다. MATH500 하나에 GPU 8장으로 38.7분이 걸렸습니다.
기울기로 미리 걸러 내기 — 식 (15)
병렬 재배선 후보는 간선 수만큼 생기므로, 하나하나 평가기에 넣어 보면 비쌉니다. 논문은 평가기의 기울기를 이용해 미리 걸러 냅니다. 평가기 점수를 인접 행렬로 미분한 Γ=∂Sθ/∂A는 "이 칸의 값을 조금 바꾸면 점수가 얼마나 변하나"를 모든 칸에 대해 알려 줍니다. 재배선은 몇 개 칸을 0→1, 1→0으로 바꾸는 일이므로, 점수 변화를 1차 테일러 근사로 ⟨Γ,ΔA⟩, 즉 '바뀌는 칸들의 기울기 합'으로 어림할 수 있습니다. 이를 모든 간선에 대해 행렬 곱 몇 번으로 한꺼번에 계산한 것이 식 (15)이고, 추정 변화가 0 이상인 간선만 실제 후보로 만듭니다.
이 근사가 결과를 해치지 않는지는 부록 F.5가 확인합니다. 근사 없이 정확히 계산한 경우와 비교해 MATH500(67.00 대 67.00), HumanEval(93.29 대 92.89), AQuA(83.86 대 83.46)로 차이가 작았습니다.
그래프 생성기 — 좋은 '줄 세우기' 순서를 배운다
생성 모드에서는 처음 사슬을 생성기가 만듭니다. 정리 3.6이 말하듯 사슬의 순서가 나중에 도달할 수 있는 구조를 정하므로, 생성기의 일은 "어떤 에이전트를 어떤 순서로 세울까"를 고르는 것입니다.
구조: 트랜스포머 인코더가 지금까지 세운 에이전트 열을 보고 다음 에이전트를 예측합니다. 언어 모델이 다음 단어를 고르듯, 지금 상태 벡터와 에이전트 임베딩 행렬의 유사도로 확률을 냅니다(식 10). 입구 토큰에서 시작해 출구 토큰이 나오면 멈춥니다.
1단계 학습(SFT): 데이터셋에서 점수가 가장 높은 그래프들을 골라, 그 그래프의 위상 순서와 맞는 줄 세우기 순서들을 뽑아 따라 하게 합니다(식 11). "잘된 워크플로는 이런 순서로 사람을 세웠다"를 배우는 단계입니다.
2단계 학습(DPO): 점수가 높은 그래프와 낮은 그래프에서 뽑은 순서 쌍으로 선호 학습을 합니다(식 12). "이 순서가 저 순서보다 낫다"를 배웁니다.
이렇게 생성기도 평가기도 결국 같은 데이터셋(무작위 그래프 2,048개와 그 정답률)에서 배웁니다. 데이터를 한 번 크게 만들어 두고 두 모델이 나눠 쓰는 구조입니다.
부록 D는 LAWA가 실제로 무엇을 하는지 한 단계씩 보여 줍니다. 빔 크기를 1로 줄여(매번 가장 좋은 후보 하나만 남겨) 궤적을 따라가기 쉽게 만들었습니다. 무대는 파이썬 코딩 문제 모음인 MBPP입니다. 1장의 놀이터에서 '논문 궤적 한 단계' 버튼을 누르며 함께 따라가 보세요.
출발 (정확도 63.9%, 23.8초). 에이전트 여섯이 한 줄로 서 있습니다. 만능형 Generalists(4.2초) → 알고리즘 설계 AlgoPlanner(4.8초) → 코드 작성 CodeGenerator(6.2초) → 규정 준수 검사 ComplianceChecker(2.6초) → 코드 감사 CodeAuditor(3.4초) → 다시 ComplianceChecker(2.6초). 전부 더해 23.8초이고, 전부가 임계 경로입니다. 간트 차트에서 막대들이 계단처럼 하나씩 이어집니다.
1단계: Generalists ∥ AlgoPlanner (정확도 64.1%, 19.6초). 첫 편집은 맨 앞 두 에이전트를 나란히 세우는 병렬 재배선입니다. 만능형 에이전트의 의견과 알고리즘 설계자의 계획이 서로를 기다릴 이유가 없습니다. 둘 다 문제만 보면 되고, 코드 작성자가 둘의 출력을 함께 받으면 됩니다. 4.2초짜리 Generalists가 4.8초짜리 AlgoPlanner 그늘에 숨으면서 4.2초가 줄었습니다. 정확도는 오히려 약간 올랐습니다.
2단계: 두 번째 ComplianceChecker 제거 (정확도 65.6%, 17.0초). 같은 검사를 두 번 하는 것은 군더더기였습니다. 지웠더니 2.6초가 줄고 정확도는 1.5%p 올랐습니다. 논문은 이 노드가 "임계 경로 위의 중복 계산"이었다고 설명합니다.
3단계: ComplianceChecker ∥ CodeAuditor (정확도 65.2%, 14.4초). 마지막으로 남은 검사와 감사를 나란히 세웁니다. 둘 다 작성된 코드를 보면 되니까요. 2.6초짜리 검사가 3.4초짜리 감사 그늘에 숨어 2.6초가 더 줄었습니다. 이번에는 정확도가 0.4%p 내려갔지만 여전히 출발점(63.9%)보다 높으므로 제약을 만족합니다.
결과적으로 makespan 39% 단축, 정확도 1.3%p 상승입니다. 이 사례에서 눈여겨볼 점이 셋 있습니다.
첫째, 편집은 모두 빨간 줄 위에서 일어났습니다. 임계 경로 바깥의 노드를 건드리는 편집은 시간을 줄이지 못하므로 빔 탐색의 시간순 정렬에서 자연스럽게 밀려납니다.
둘째, 에이전트 구성은 거의 그대로입니다. 다섯 종류의 에이전트가 모두 남았고, 사라진 것은 중복 노드 하나뿐입니다. LAWA는 '누구를 쓸까'보다 '어떻게 세울까'를 바꿉니다. 이 점에서 에이전트를 골라내는 DyLAN이나 AgentDropout과 결이 다릅니다.
셋째, 최종 구조는 사람이 봐도 납득이 갑니다. "계획과 관점 수집은 동시에, 작성은 하나로, 검사와 감사는 동시에." 경험 많은 개발 팀장이 화이트보드에 그렸을 법한 모양입니다. 자동 탐색이 낸 결과가 사람의 직관과 맞아떨어진다는 것은, 그 결과를 운영 환경에 들일 때 꽤 중요한 신뢰의 근거가 됩니다.
9장. 실험 읽기 — 일곱 개 벤치마크, 열한 개 방법
실험 설정
벤치마크 7개, 3개 분야: 코드 생성(MBPP, HumanEval), 수학 추론(GSM8K, MATH500, SVAMP, AQuA), 상식·지식(MMLU).
에이전트: 모든 방법이 같은 에이전트 풀을 씁니다. 백본은 전부 Qwen3-30B-A3B-Instruct-2507이고, 역할만 다릅니다. 코딩 8명, 상식 10명, 수학 11명의 후보 에이전트가 있습니다. 수학 쪽에는 MathReasoner, Calculator, Verifier, ContrarianThinker(반대 의견 내는 사람), ConsensusBuilder(합의 만드는 사람), ExecutiveArbitrator(최종 중재자) 같은 이름이 보입니다.
비교 대상 10개: 앞서 본 DyLAN, G-Designer, AgentDropout, AgentPrune, BiRouter, AFlow, LAMaS에 더해, 기준선으로 세 가지 고정 구조를 둡니다. 모든 에이전트를 무작위 순서로 한 줄 세운 Random Chain, 간선을 확률 0.5로 무작위로 놓은 Random Graph, 모든 에이전트가 세 라운드 동안 동시에 말하고 앞 라운드의 모든 발언을 공유하는 3-Round Discussion(원탁 토론)입니다.
시간 측정: 매 실행마다 새로 띄워 예열한 SGLang 서버 한 대, NVIDIA RTX PRO 6000 Blackwell Max-Q(96GB) GPU 한 장을 독점해 실측 벽시계 시간을 쟀습니다. 질의는 하나씩 순서대로 실행하고, 각 노드는 선행자가 끝나는 즉시 시작합니다. 모든 방법을 3회씩 돌려 평균 ± 표준편차를 냅니다.
표 1·2: 가장 빠르면서, 정확도도 지킨다
표 1(실측 makespan)에서 LAWA는 7개 중 6개 벤치마크에서 가장 빨랐고 평균 순위 1.14입니다. 유일하게 1등을 놓친 MBPP에서는 LAMaS(8.82초)보다 0.02초 느렸는데(8.84초), 두 값의 표준편차(±0.97, ±0.79)를 생각하면 사실상 같은 속도입니다. 가장 큰 차이가 난 곳은 SVAMP(6.18초, 2위 LAMaS 8.12초)와 GSM8K(7.30초, 2위 DyLAN 8.09초)입니다. 반대편 끝에서는 Random Chain이 22~37초, G-Designer가 일부 벤치마크에서 25초 안팎으로 느렸습니다.
표 2(정확도)에서 LAWA의 평균 순위는 1.79로 가장 좋습니다. 다만 모든 칸에서 1등은 아닙니다. HumanEval은 AFlow(93.70)·DyLAN(93.29)이 LAWA(92.89)보다 높고, GSM8K는 AFlow(96.06)가 LAWA(96.03)를 0.03%p 앞서며, MATH500은 AgentPrune(67.33)이 1위입니다. LAWA가 두드러지게 높은 곳은 MMLU(77.77, 2위 AFlow 76.04)와 MBPP(66.28)입니다. 그런데 MMLU에서 LAWA의 표준편차는 ±3.15로 커서, AFlow와의 1.7%p 차이는 잡음 범위와 겹칩니다.
그러니 공정한 요약은 이렇습니다. "LAWA는 정확도에서 최상위권과 비슷하거나 조금 낫고, 속도에서는 거의 모든 경우 가장 빠르다." 논문의 주장도 "정확도 1위"가 아니라 "정확도를 유지하면서(competitive) makespan을 크게 줄인다"이고, 그 주장은 표가 충분히 뒷받침합니다. 특히 정확도 중심 방법인 AFlow와 비교하면 LAWA는 정확도는 비슷하면서 시간은 벤치마크에 따라 1.2~1.6배 빠릅니다. 지연 중심 경쟁자인 LAMaS와 비교하면 속도는 비슷하거나 빠르면서 정확도는 7개 모두에서 높습니다.
아래 탐색기에서 벤치마크별로 속도–정확도 평면을 직접 보세요. 가로축을 토큰으로 바꾸면 비용 관점의 그림도 볼 수 있습니다.
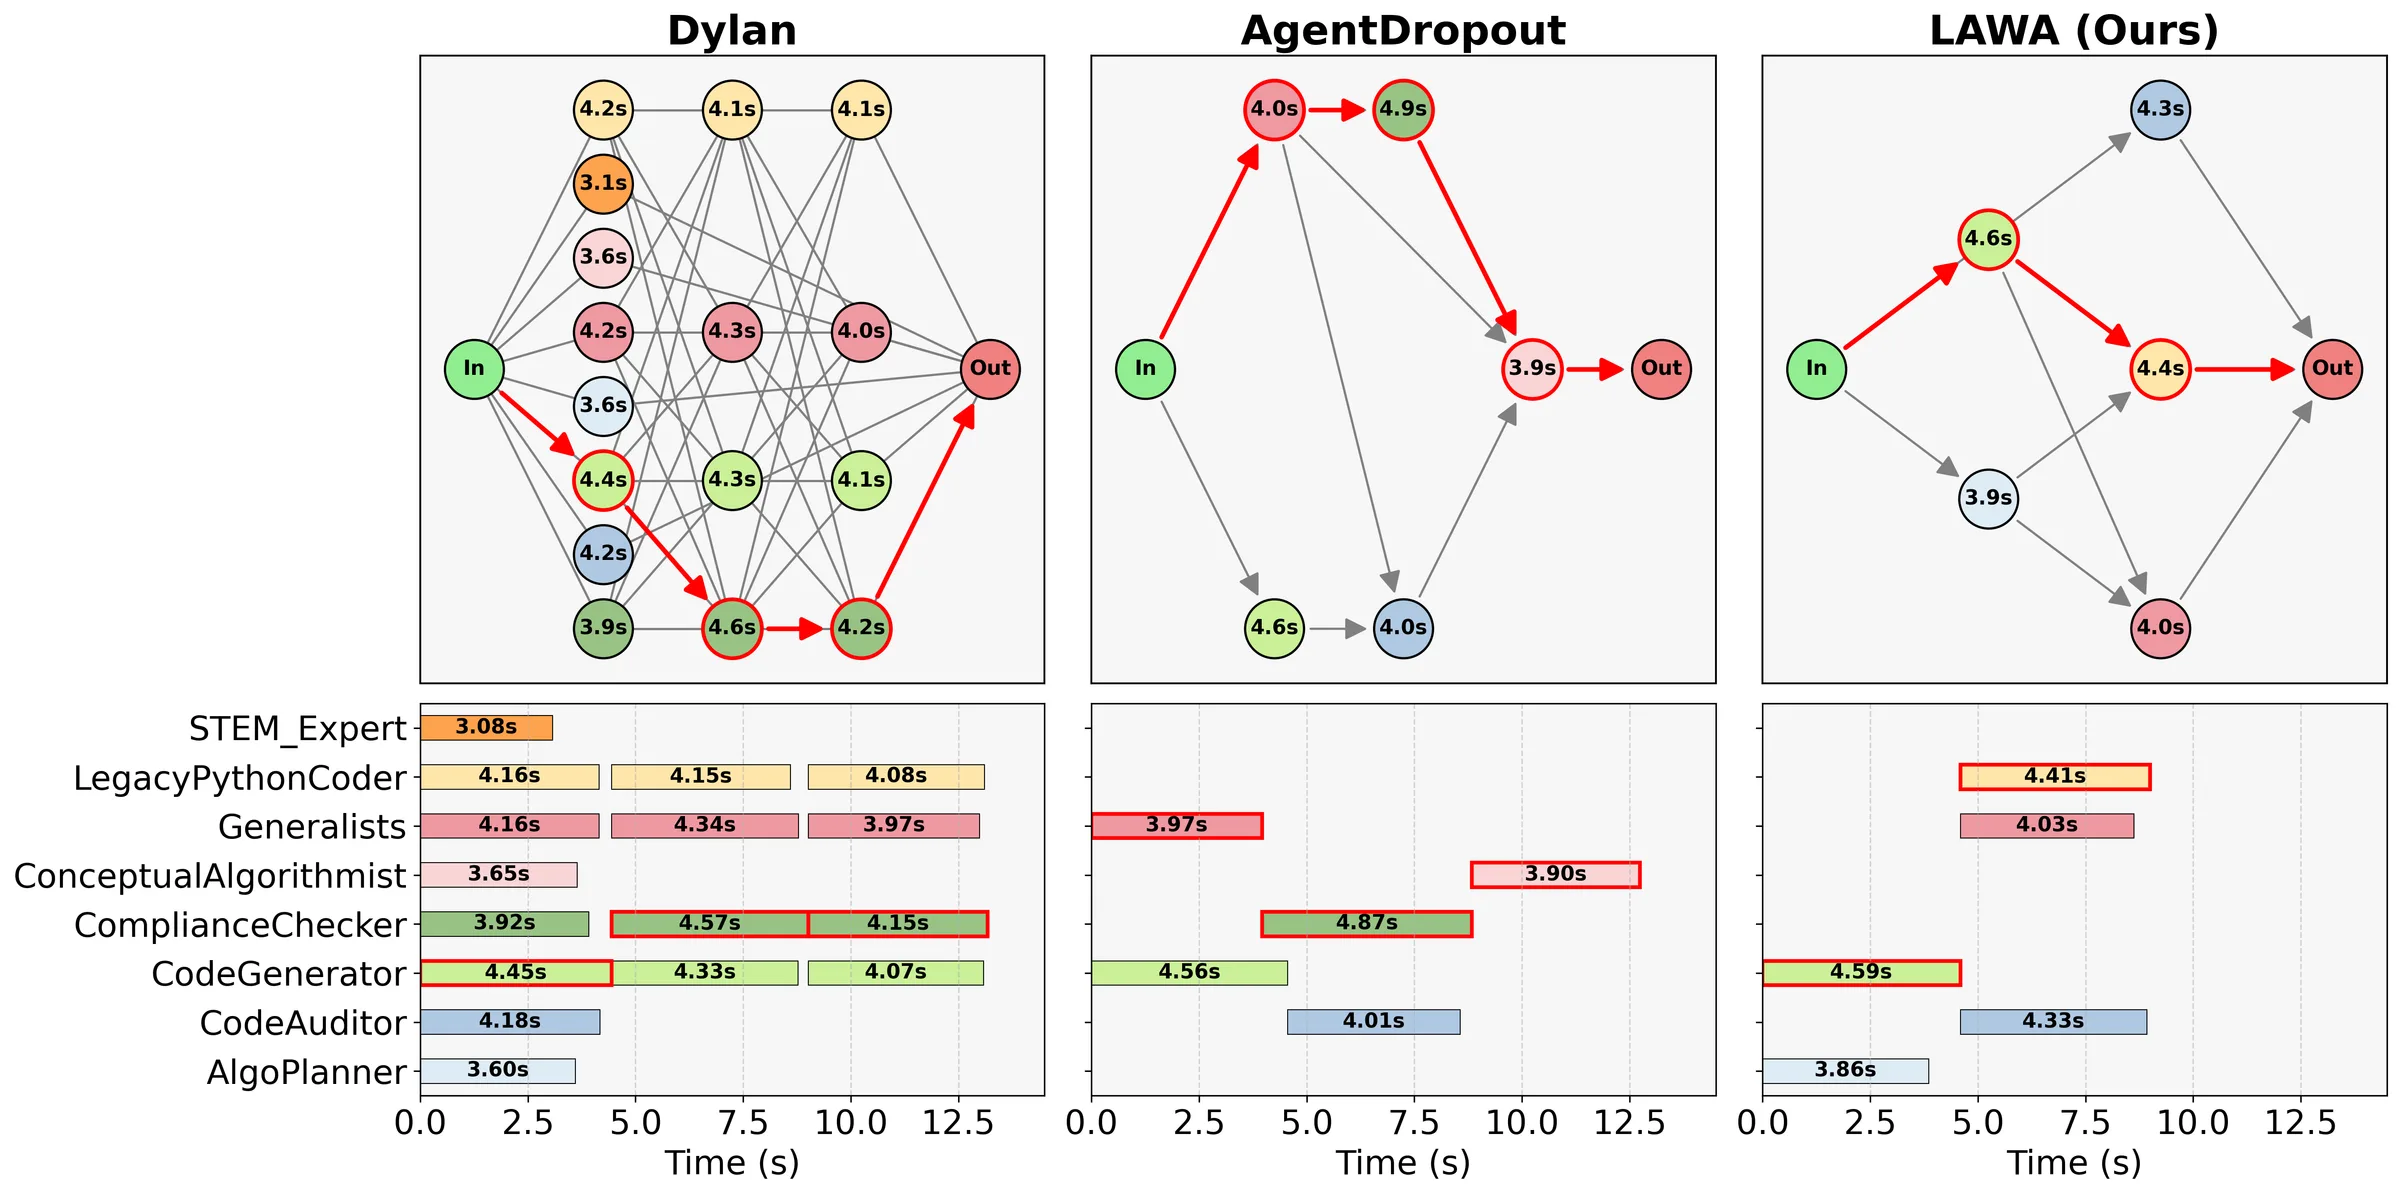
그림 2는 같은 MBPP 문제 하나에서 세 방법이 만든 워크플로와 실제 실행 간트 차트를 나란히 보여 줍니다. 노드 안의 숫자는 그 호출의 실측 시간입니다.
DyLAN(왼쪽)은 신경망처럼 층을 이룹니다. 첫 층에 에이전트 여덟이 동시에 일하고, 두 번째·세 번째 층이 앞 층의 결과를 받아 다시 일합니다. 한 층 안에서는 병렬성이 높습니다. 문제는 층 사이의 동기화입니다. 다음 층은 앞 층에서 가장 느린 에이전트가 끝나야 시작합니다. 간트 차트를 보면 4.1~4.6초짜리 막대들이 세 줄로 정렬되어 있고, 매 라운드가 가장 긴 막대에 맞춰 끝납니다. 전체 약 13초입니다.
AgentDropout(가운데)은 에이전트를 솎아 냈습니다. 노드가 훨씬 적습니다. 그런데 남은 노드들이 긴 줄을 이룹니다. 4.0초 → 4.9초 → 3.9초가 차례로 이어져 약 12.8초입니다. 가지치기가 노드 수는 줄였지만 임계 경로를 겨냥하지 않았기 때문입니다. 논문은 AgentPrune도 같은 이유로 "긴 임계 경로가 남아 전체 시간을 지배한다"고 지적합니다.
LAWA(오른쪽)는 깊이 2의 넓적한 모양입니다. 첫 줄에 두 에이전트(4.6초, 3.9초)가 동시에 시작하고, 둘째 줄의 세 에이전트(4.3초, 4.4초, 4.0초)가 그 결과를 받아 동시에 일합니다. 임계 경로는 4.6 + 4.4 = 약 9초입니다. 노드 수는 AgentDropout과 비슷하지만 줄의 길이가 다릅니다.
이 그림은 "노드 수를 줄이는 것"과 "임계 경로를 줄이는 것"이 다른 일이라는 것을 한눈에 보여 줍니다. 5장의 시뮬레이터에서 본 동기화 장벽의 비용도 DyLAN의 간트 차트에 그대로 드러납니다.
표 3: 남이 만든 워크플로에 끼워 넣어도
LAWA의 두 번째 쓰임새는 플러그인입니다. Random Graph, Random Chain, AgentPrune, AgentDropout이 만든 워크플로를 그대로 받아 LAWA로 다듬었더니, 4개 방법 × 7개 벤치마크 = 28개 조합 모두에서 makespan이 줄었습니다. 줄어든 폭은 무작위 사슬에서 6.9~8.7초, 무작위 그래프에서 4.4~6.6초, 이미 가지치기된 AgentPrune·AgentDropout에서도 2.2~3.7초입니다. 평균 정확도 변화는 28칸 모두 0 이상(+0.02~+3.26%p)이었습니다.
다만 정확도 변화의 표준편차가 평균보다 큰 칸이 많습니다. 예컨대 Random Graph + MMLU는 +1.94 ± 5.88%p입니다. 논문도 이 표를 "평균 정확도의 체계적 저하가 없었다"고 조심스럽게 표현합니다. "시간은 확실히 줄고, 정확도는 평균적으로 잃지 않는다"가 정확한 읽기입니다. 사슬뿐 아니라 일반 DAG에서 출발해도 효과가 있었다는 점은, LAWA가 생성기의 사슬 초기화에 기대지 않는다는 증거이기도 합니다.
표 5: 무엇을 빼면 무너지나 (구성 요소 제거 실험)
빼 본 것
AQuA (정확도 / 시간)
SVAMP
MMLU
노드 제거 없이
−0.65%p / +1.96초
−4.71%p / +8.30초
−3.36%p / +15.92초
병렬 재배선 없이
−0.78%p / +1.64초
−4.45%p / +4.97초
−2.25%p / +18.67초
생성기 SFT 없이
−2.75%p / −1.96초
−0.68%p / +2.37초
−1.66%p / +5.51초
생성기 DPO 없이
−3.41%p / +7.26초
−3.40%p / −0.36초
−6.81%p / +13.08초
편집 연산 둘 중 하나만 남기면 탐색이 일찍 멈추고 시간이 많이 늘어납니다(MMLU에서 16~19초). 흥미로운 것은 정확도도 함께 떨어진다는 점입니다. 시간 최적화 도구를 줄였는데 정확도가 왜 떨어질까요? 논문의 설명은 "쓸 수 있는 구조가 제한되기 때문"입니다. 편집이 한 종류뿐이면 '빠르면서 좋은' 구조에 도달하지 못하고, 평가기를 통과하는 구조 중에서도 덜 좋은 곳에 머문다는 뜻입니다. 생성기 학습에서는 DPO를 뺐을 때 타격이 가장 컸습니다(MMLU −6.81%p). 좋은 사슬 순서를 '흉내 내는' 것(SFT)보다 '좋고 나쁨을 비교해 배우는' 것(DPO)이 더 중요했다는 뜻입니다.
표 8: 토큰도 덜 쓴다
LAWA는 시간을 위해 만든 방법이지만 토큰도 거의 가장 적게 씁니다. 질의당 6,516(MBPP)~15,077(MMLU) 토큰으로, 7개 중 5개 벤치마크(MBPP·HumanEval·AQuA·MATH500·SVAMP)에서 최소입니다. 나머지 둘(GSM8K 9,344, MMLU 14,763)은 라우팅 방식인 BiRouter가 근소하게 적습니다. 3-Round Discussion은 질의당 22만~65만 토큰을 써서 LAWA의 21~58배입니다. 병렬 재배선은 한 노드의 출력을 여러 곳에 뿌리므로 토큰이 늘 것 같지만, 논문의 설명대로 토큰 총량은 주로 에이전트 호출 횟수가 정하고, LAWA는 노드 제거로 호출 자체를 줄이기 때문에 토큰도 줄어듭니다.
표 11: 더 강한 모델로 바꿔도
부록 F.3은 백본을 문샷 AI의 공식 호스팅 Kimi-K2.6으로 바꿔 MBPP·MATH500·MMLU에서 DyLAN·AgentDropout과 비교했습니다. 눈여겨볼 조건이 있습니다. 평가기·생성기를 다시 학습하지 않았고, 지연값 tk도 Qwen3 기준 그대로 썼습니다. 그런데도 LAWA는 세 벤치마크 모두에서 가장 빨랐고(14.19초 대 DyLAN 40.27초 등), 정확도도 MBPP·MMLU에서 1위, MATH500에서 DyLAN과 같은 수준이었습니다. 논문은 "백본이 강할수록 에이전트 하나하나가 유능해져 적은 수로도 충분하므로, 군더더기를 지우는 LAWA에 유리하다"고 해석합니다. 공식 API처럼 남의 서버를 쓰는 환경에서도 구조 최적화의 효과가 유지된다는 점에서 실무적으로 의미가 큰 결과입니다.
표 6: 실행기가 모자라면 — 그레이엄의 역설을 피하는 법
본문은 완전 병렬을 가정했지만, 실제 서비스는 동시 실행 수가 제한될 수 있습니다(GPU 수, API 동시 호출 한도). 부록 F.4는 makespan 계산을 HLFET 리스트 스케줄링으로 바꾸고 실행기 수 m을 1~4로 바꿔 봤습니다.
실행기 1개
43.67% 단축 · 재배선 19 / 제거 64
실행기 2개
65.38% · 83 / 61
실행기 3개
67.74% · 91 / 59
실행기 4개
67.89% · 92 / 59
실행기가 하나뿐이면 병렬화가 의미 없으므로 LAWA는 노드 제거 위주(64회 대 재배선 19회)로 줄을 짧게 만듭니다. 실행기가 둘 이상이면 재배선 위주로 전략을 바꿉니다. 시간 단축 효과는 실행기 2개에서 이미 65%에 이르고, 3~4개에서 거의 포화합니다. 쓸 수 있는 병렬성이 워크플로의 '폭'만큼만 의미가 있다는, 암달과 브렌트가 말한 그 한계입니다. 1장 놀이터에서 실행기 수를 1~3개로 바꿔 보면 같은 그래프의 makespan이 어떻게 달라지는지 볼 수 있습니다.
부록 F.2: 최적화 비용과 본전
워크플로 생성에이전트 실행 없이 그래프만 탐색하므로 1.16~2.27초(표 9, AMD EPYC 9655 CPU).
평가기 학습벤치마크당 21~95초(표 10), 한 번만.
본전무작위 사슬을 LAWA로 바꾸면 위 두 비용이 대략 2~7번의 실행으로 회수된다. 표 값으로 직접 나눠 보면 SVAMP·GSM8K·MATH500 2번, HumanEval 3번, AQuA·MBPP 4번, MMLU 7번.
데이터셋까지 포함하면MATH500 기준 2,048개 그래프 평가에 GPU 8장으로 38.7분, 학습·생성까지 전체 41.2분. 같은 서버, 같은 2,048회 실행 예산에서 AgentDropout은 129.6분. 그래프 평가는 서로 의존이 없어 한꺼번에 던질 수 있으므로, 32개씩 64번 나눠 도는 온-폴리시 방법보다 서버를 꽉 채워 쓴다(64배 많은 그래프를 20배 시간에 평가).
마지막 항목은 재미있는 자기 참조입니다. LAWA의 학습 데이터 구축 자체가 병렬화의 이점을 활용한 덕분에 빠르다는 것입니다. 서로 의존이 없는 2,048개 평가는 '폭이 넓고 깊이가 1인 DAG'이고, 온-폴리시 방법의 64번 반복은 '깊이가 64인 사슬'입니다. 같은 일도 줄 세우면 느립니다.
LAWA의 가장 큰 가정은 평가기를 믿을 수 있다는 것입니다. 평가기가 "괜찮다"고 한 편집이 실제로는 정확도를 떨어뜨린다면, 빠르지만 틀리는 워크플로가 나옵니다. 논문은 이 질문을 세 방향에서 확인합니다.
판정을 일부러 뒤집어 보기(표 4). 거르기 단계에서 후보마다 평가기의 통과/탈락 판정을 확률 α로 무작위로 뒤집었습니다. α=0.1(열 번에 한 번 틀림)에서는 정확도가 거의 그대로였고, α=0.2(다섯 번에 한 번)에서 0.5~1.2%p 떨어졌습니다.
이론적 상한(부록 E). 왜 견고할까요? 최종 답은 "평가기를 통과한 것 중 가장 빠른 것"입니다. 그러니 나쁜 그래프가 최종 답이 되려면 두 일이 동시에 일어나야 합니다. ① 나쁜 후보가 적어도 하나 실수로 통과하고, ② 그 나쁜 후보보다 빠른 좋은 후보들이 전부 실수로 탈락해야 합니다. ①은 후보가 많으면 거의 확실하지만, ②는 α를 좋은 후보 수만큼 곱한 값이라 지수적으로 작아집니다. 식 (19)는 이 곱을 상한으로 적은 것입니다.
평가기를 아예 빼 보기(표 12). 같은 무작위 사슬 8개에서 출발해, 평가기 없이 '가장 빨라지는 편집'만 고르게 했더니 단계가 쌓일수록 정확도가 내려가 5단계에서 HumanEval −2.74%p, MATH500 −1.72%p가 됐습니다. 평가기를 켜면 모든 단계에서 출발점보다 높았습니다. 시간만 보고 고르면 결국 '에이전트를 다 지우는' 방향으로 미끄러진다는 것, 평가기가 그 미끄러짐을 막는 브레이크라는 것을 보여 줍니다.
평가기 자체의 정확도도 부록 F.7에 있습니다. HumanEval에서 구조별로 시험 정확도가 89.9~95.8%였고, 기본으로 고른 3층 그래프 트랜스포머(은닉 512)는 학습 95.97%, 시험 95.11%였습니다. 논문은 이 '정확도'가 정확히 무엇의 정확도인지(아마도 쌍 비교에서 더 나은 쪽을 맞힌 비율) 본문에 명시하지 않았습니다. 그리고 시험 정확도의 표준편차가 ±2~7%p로 커서, 구조 간 차이 대부분은 통계적으로 구분하기 어렵습니다. 평가기 선택의 근거로는 다소 약하지만, '대략 95% 안팎'이라는 수준이 표 4의 α≤0.1 근처와 맞물린다는 정도의 감은 줍니다.
11장. 비판적으로 읽기 — 이 논문이 말하지 않은 것들
좋은 논문일수록 경계를 정확히 아는 것이 중요합니다. LAWA는 문제 정의가 깔끔하고 이론과 실험이 잘 맞물린 논문이지만, 현장에 가져가기 전에 따져 볼 점들이 있습니다. 일부는 논문이 부록 G에서 스스로 인정하고, 일부는 표를 읽으며 드러납니다.
제목과 서론의 무대는 AI 고객 상담과 클라우드 장애 대응이지만, 실험은 코딩·수학·상식 문제 풀이 벤치마크에서 했습니다. 각 벤치마크를 "같은 유형의 질의가 반복되는 과제"로 본 것인데, 실제 상담 로그나 장애 티켓으로 검증한 것은 아닙니다. 실제 상담은 도구 호출(주문 DB 조회, 정책 문서 검색)이 섞이고, 대화가 여러 턴 이어지며, 질의 분포가 계절·이벤트에 따라 바뀝니다. 논문의 결과는 "LLM만으로 이뤄진 단일 턴 워크플로"에서의 증거로 읽는 것이 정확합니다.
② '완전 병렬'의 현실 — GPU 한 장, 질의 하나씩
시간 측정은 GPU 한 장의 SGLang 서버에서 질의를 하나씩 실행하며 했습니다. 이 환경에서 '병렬로 실행되는 두 노드'는 같은 GPU에서 배치로 함께 처리됩니다. 그런데 실제 서비스에서는 수백 명의 질의가 동시에 들어옵니다. 서버가 이미 꽉 찬 상태라면, 한 질의 안의 병렬화가 다른 질의의 대기 시간을 늘릴 수 있습니다. 처리량(초당 처리 질의 수)과 개별 지연은 다른 지표이고, 논문은 후자만 쟀습니다. 부록 F.4의 실행기 제한 실험이 이 방향의 첫걸음이지만, 동시 부하 아래의 실측은 없습니다. 외부 API를 쓰면 분당 호출 한도(rate limit)도 '실행기 수 제한'으로 작동합니다.
③ 노드 시간이 구조와 무관하다는 가정
5장에서 짚었듯, tk는 탐색 내내 상수입니다. 하지만 병렬 재배선은 노드의 입력을 바꿉니다. 선행자 셋의 출력을 한꺼번에 받는 노드는 입력이 길어지고, 그만큼 처리(특히 프리필) 시간이 늘어납니다. 반대로 선행자가 줄면 빨라질 수 있습니다. 출력 길이도 받은 맥락에 따라 달라집니다. 실측 결과가 좋았으니 이 근사가 크게 빗나가지는 않았던 것으로 보이지만, 맥락이 수만 토큰에 이르는 실제 에이전트(긴 문서·긴 대화 기록)에서는 차이가 커질 수 있습니다.
④ 작은 표본에서 나온 라벨
평가기와 생성기의 학습 라벨 s(G)는 그래프마다 30~50문제로 잰 정답률입니다. 30문제면 한 문제 차이가 3.3%p입니다. 즉 그래프 간 정답률 차이의 상당 부분이 잡음일 수 있고, 평가기는 그 잡음 섞인 순위를 배웁니다. 표 4·12가 보여 주듯 결과는 그래도 견고했지만, 정확도 차이가 1~2%p인 미세한 판단(이 검수 단계를 빼도 될까?)을 평가기에 맡기기에는 라벨의 해상도가 거칠다는 점은 기억해 둘 만합니다. 실무에 쓴다면 최종 후보 몇 개는 반드시 큰 검증 세트로 실제로 돌려 보는 것이 안전합니다.
⑤ 표준편차가 말하는 것
본문 표의 많은 차이가 3회 실행의 표준편차 범위 안에 있습니다. MBPP의 0.02초 차이, MMLU의 1.7%p 차이, 표 3의 정확도 변화 대부분이 그렇습니다. 논문은 굵은 글씨와 색으로 1·2위를 표시하지만, 통계적 유의성 검정은 하지 않았습니다. "평균 순위 1위"는 의미 있는 요약이지만, 칸 하나하나의 우열을 강하게 읽지 않는 것이 좋습니다. 반면 Random Chain 대비 2~3배, DyLAN 대비 수십 퍼센트의 속도 차이는 잡음보다 훨씬 커서 의심할 여지가 적습니다.
부록 G가 스스로 인정하는 한계입니다. LAWA는 고정된 에이전트 풀과 고정된 과제 분포를 가정합니다. 새 에이전트를 추가하거나 프롬프트를 고치면, README의 안내대로 그래프 데이터셋을 다시 만들고 평가기·생성기를 다시 학습해야 합니다. 질의 분포가 바뀌면(신제품 출시로 문의 유형이 달라지면) 예전에 최적이던 구조가 더 이상 최적이 아닐 수 있습니다. "한 번 최적화"가 "영원히 최적"은 아닙니다. 데이터베이스 최적화기도 테이블 통계가 바뀌면 실행 계획을 다시 세우듯, 에이전트 워크플로도 주기적인 재최적화가 필요할 것입니다. 논문은 이를 데이터 효율적·점진적으로 하는 방법을 미래 과제로 남겼습니다.
⑦ 끊긴 정보의 '보이지 않는' 비용
평가기는 정답률이라는 하나의 숫자로 구조를 판단합니다. 하지만 정보 흐름이 끊겼을 때의 비용이 정답률에 바로 드러나지 않을 수도 있습니다. 코그니션이 경고한 '암묵적 결정의 충돌'은 코딩 벤치마크의 통과/실패로는 잡히지만, 상담 답변의 일관성이나 말투, 법적 위험 같은 품질은 단순 정답률로 측정하기 어렵습니다. 예컨대 '사실 검증'과 '말투 검수'를 병렬로 돌리면, 말투 검수 에이전트는 검증 전의 초안을 다듬게 되고, 최종 답을 합치는 단계에서 두 결과가 충돌할 수 있습니다. 무엇을 S(G)로 쓸 것인가가 LAWA를 현장에 쓸 때 가장 먼저 정해야 할 질문입니다.
⑧ 그래도, 이 논문이 잘한 것
비판을 늘어놓았지만 이 논문의 기여는 분명합니다. 정확도 경쟁에 몰려 있던 자동 워크플로 설계 분야에 시간을 1급 목표로 올려놓았고, 그 목표를 위한 편집 연산을 증명 가능한 성질로 정리했으며(시간 비증가·도달성 보존·완전성), '정확한 시간 계산 + 근사적 품질 예측'이라는 깔끔한 분업으로 탐색을 1~2초짜리 일로 만들었습니다. 플러그인으로 쓸 수 있다는 점도 실용적입니다. 이미 운영 중인 워크플로를 갈아엎지 않고 다듬는 데서 시작할 수 있으니까요. 코드와 재현 스크립트가 공개되어 있다는 점도 중요합니다.
12장. 2026년, 이 생각의 자리 — 그리고 당장 해 볼 수 있는 것
에이전트 운영의 다음 화두는 '시간'이다
2023~2024년의 질문이 "에이전트가 이 일을 할 수 있는가"였다면, 2025~2026년의 질문은 "얼마에, 얼마나 빨리, 얼마나 안정적으로 하는가"로 옮겨 왔습니다. 가트너는 2025년 6월 "2027년 말까지 에이전틱 AI 프로젝트의 40% 이상이 비용 증가와 불분명한 가치 때문에 취소될 것"이라고 내다봤습니다. 데모에서 운영으로 넘어가는 문턱에서 가장 먼저 부딪히는 것이 바로 비용과 지연입니다.
이 흐름에서 LAWA가 상징하는 변화는 세 가지입니다.
첫째, 워크플로 구조 자체가 최적화 대상이 된다. 지금까지 에이전트의 속도를 높이는 방법은 주로 더 작은 모델로 바꾸거나(증류), 서버를 튜닝하거나(서빙 최적화), 프롬프트를 짧게 하는 것이었습니다. LAWA는 같은 모델·같은 에이전트로도 배치만 바꿔 2~3배 빨라질 수 있음을 보였습니다. 컴파일러가 같은 코드를 더 빠른 기계어로 바꾸듯, 에이전트 워크플로에도 '최적화 컴파일러' 계층이 생기는 셈입니다. LLMCompiler가 단일 에이전트 안의 도구 호출에서 보인 것을, LAWA는 에이전트 팀 수준으로 끌어올렸습니다.
둘째, '학습된 비용 모형'의 시대. 데이터베이스 최적화기는 1979년부터 통계 기반 비용 모형으로 실행 계획을 골랐습니다. 2020년대에는 이 비용 모형을 신경망으로 학습하는 '학습된 질의 최적화' 연구가 활발했습니다. LAWA의 그래프 평가기는 에이전트 워크플로를 위한 학습된 품질 모형입니다. 앞으로 에이전트 플랫폼은 "이 구조로 바꾸면 품질이 어떻게 될까"를 실행 전에 예측하는 모형을 기본 부품으로 갖게 될 가능성이 큽니다.
셋째, 속도와 품질을 함께 재는 문화. 토스뱅크 사례(AI 처리 70%, 만족도 36%)와 클라르나의 방향 수정이 보여 주듯, 빠르기만 하면 소용없습니다. LAWA의 정식화, "정확도는 기준 이상, 그 안에서 시간 최소"는 실무자에게도 좋은 원칙입니다. 속도를 개선할 때는 반드시 품질 회귀를 함께 재고, 품질을 개선할 때는 시간이 얼마나 늘었는지 함께 봅니다.
실무자를 위한 점검표 — LAWA 없이도 오늘 할 수 있는 것
LAWA 코드를 바로 쓰지 않더라도, 이 논문의 사고방식은 지금 운영 중인 에이전트 워크플로에 곧바로 적용할 수 있습니다.
1. 단계별 P95를 잰다각 에이전트·도구 호출의 지연을 평균이 아니라 P95로 기록한다. 로그에 단계 시작·종료 시각만 남겨도 충분하다. 평균은 붐비는 날을 숨긴다.
2. 그래프를 그린다"이 단계는 정확히 어느 단계의 출력을 쓰는가"를 적어 DAG로 그린다. 코드에서 앞 단계의 결과 전체를 다음 단계에 넘기고 있다면, 실제로 그 결과의 어느 부분을 쓰는지 확인한다.
3. 빨간 줄을 찾는다P95 기준으로 임계 경로를 계산한다. 시간 개선은 오직 이 줄 위에서만 의미가 있다. 줄 밖의 단계를 최적화하는 데 시간을 쓰지 않는다.
4. 두 가지 질문을 던진다빨간 줄 위의 화살표마다 "B가 정말 A의 답을 기다려야 하나?"(→ 병렬 재배선 후보), 노드마다 "이 단계가 없으면 품질이 정말 떨어지나?"(→ 제거 후보)를 묻는다. 같은 검사를 두 번 하는 곳, 서로 독립인 조회(주문 DB와 정책 문서)를 순서대로 하는 곳이 흔한 후보다.
5. 품질 회귀 세트를 둔다편집 후보마다 고정된 평가 세트로 실제 품질을 잰다. 30~50문제로는 1~2%p 차이를 가리기 어려우니, 최종 후보는 수백 건 규모로 확인한다. 정답률 외에 말투·일관성·안전 같은 지표도 함께 둔다.
6. 동시 부하와 한도를 확인한다병렬화한 구조를 실제 트래픽 수준의 동시 요청으로 시험한다. API 분당 한도, GPU 수, 같은 에이전트 세션의 동시 호출 가능 여부가 '실행기 수'를 정한다. 실행기가 적으면 병렬화보다 제거가 효과적이다.
7. 모델이 바뀌면 다시 잰다백본 모델·서버·프롬프트가 바뀌면 P95를 다시 재고 임계 경로를 다시 계산한다. 질의 분포가 바뀌면 구조 자체를 다시 검토한다. 한 번 최적화는 영원한 최적화가 아니다.
맺으며 — 가장 긴 줄을 보는 습관
1957년 듀폰의 엔지니어들은 공장 정비 일정표에서 가장 긴 줄을 찾아 정지 시간을 4분의 1 줄였습니다. 그들이 남긴 교훈은 "계산은 쉽고, 판단이 어렵다"였습니다. 70년 뒤 LAWA는 같은 계산을 LLM 에이전트 워크플로에 적용하고, 어려운 판단, 곧 "이 줄을 끊어도 일의 품질이 유지되는가"를 학습된 그래프 신경망에 맡겼습니다.
AI 에이전트가 더 많은 일을 맡을수록, 우리는 에이전트를 어떻게 '조직'할지 결정하게 됩니다. 사람 회사의 조직도를 그대로 옮기면 결재 라인처럼 긴 줄이 생기기 쉽습니다. 이 논문이 주는 가장 실용적인 습관은 단순합니다. 워크플로를 그래프로 그리고, 가장 긴 줄을 찾고, 그 줄 위의 화살표마다 "정말 기다려야 하나?"를 묻는 것. 이 질문은 LAWA 코드 없이도, 오늘 바로 시작할 수 있습니다.
Zhang, E., Qu, F., Huang, Z., Zhou, D., Chen, E., & Yan, Y. (2026). Optimize Once, Execute Fast: Latency-Aware Multi-Agent Workflow Learning for Recurrent Queries. NeurIPS 2026. arXiv:2610.14481. — 그림 1·2·3은 이 논문과 저장소에서 인용했습니다.
GraphmindDartmouth/LAWA. GitHub 저장소(코드, 에이전트 등록 파일 agents/agents_reg.json, 예시 워크플로 results/sample.json).
스케줄링과 최적화의 역사
Kelley, J. E., & Walker, M. R. (1989). The origins of CPM: a personal history. PM Network, 3(2).
Sapolsky, H. M. (1972). The Polaris System Development: Bureaucratic and Programmatic Success in Government. Harvard University Press.
Kahn, A. B. (1962). Topological sorting of large networks. Communications of the ACM, 5(11), 558–562.
Graham, R. L. (1966). Bounds for certain multiprocessing anomalies. Bell System Technical Journal, 45(9), 1563–1581.
Amdahl, G. M. (1967). Validity of the single processor approach to achieving large scale computing capabilities. AFIPS Spring Joint Computer Conference, 30, 483–485.
Aho, A. V., Garey, M. R., & Ullman, J. D. (1972). The transitive reduction of a directed graph. SIAM Journal on Computing, 1(2), 131–137.
Adam, T. L., Chandy, K. M., & Dickson, J. R. (1974). A comparison of list schedules for parallel processing systems. Communications of the ACM, 17(12), 685–690.
Brent, R. P. (1974). The parallel evaluation of general arithmetic expressions. Journal of the ACM, 21(2), 201–206.
Ullman, J. D. (1975). NP-complete scheduling problems. Journal of Computer and System Sciences, 10(3), 384–393.
Selinger, P. G., et al. (1979). Access path selection in a relational database management system. SIGMOD '79.
Kwok, Y.-K., & Ahmad, I. (1999). Static scheduling algorithms for allocating directed task graphs to multiprocessors. ACM Computing Surveys, 31(4).
응답 시간과 사람
Miller, R. B. (1968). Response time in man-computer conversational transactions. AFIPS Fall Joint Computer Conference, 33, 267–277.
Doherty, W. J., & Thadani, A. J. (1982). The Economic Value of Rapid Response Time. IBM (GE20-0752-0).
Nielsen, J. (1993). Usability Engineering, 5장. / Nielsen Norman Group, "Response Times: The 3 Important Limits".
Brutlag, J. (2009). Speed Matters for Google Web Search. Google.
LLM 에이전트와 워크플로
Yao, S., et al. (2023). ReAct: Synergizing Reasoning and Acting in Language Models. ICLR 2023. arXiv:2210.03629.
Li, G., et al. (2023). CAMEL. NeurIPS 2023. arXiv:2303.17760.
Hong, S., et al. (2024). MetaGPT. ICLR 2024. arXiv:2308.00352.
Qian, C., et al. (2024). ChatDev. ACL 2024. arXiv:2307.07924.
Wu, Q., et al. (2024). AutoGen. COLM 2024. arXiv:2308.08155.
Zhuge, M., et al. (2024). GPTSwarm: Language Agents as Optimizable Graphs. ICML 2024. arXiv:2402.16823.
Liu, Z., et al. (2024). A Dynamic LLM-Powered Agent Network for Task-Oriented Agent Collaboration (DyLAN). COLM 2024. arXiv:2310.02170.
Zhang, G., et al. (2025). Cut the Crap: An Economical Communication Pipeline for LLM-based Multi-Agent Systems (AgentPrune). ICLR 2025. arXiv:2410.02506.
Zhang, G., et al. (2025). G-Designer. ICML 2025. arXiv:2410.11782.
Wang, Z., et al. (2025). AgentDropout. ACL 2025. arXiv:2503.18891.
Yang, Q., Qu, F., et al. (2025). Augmented Runtime Collaboration for Self-Organizing Multi-Agent Systems (BiRouter). arXiv:2512.00740.
Klarna (2024.02.27). Klarna AI assistant handles two-thirds of customer service chats in its first month.
Gartner (2025.03.05). Agentic AI will autonomously resolve 80% of common customer service issues by 2029. / (2025.06.25). Over 40% of agentic AI projects will be canceled by end of 2027.
AWS (2026.03.31). AWS DevOps Agent generally available.