블로그로 돌아가기
MoEMixture of Experts전문가 혼합희소 모델조건부 계산라우터게이트top-k부하 균형Switch TransformerGShardMixtralDeepSeekMoEDeepSeek-V3DeepSeek-V4Kimi K3Qwen3gpt-oss전문가 병렬llama.cpp로컬 LLM
파라미터는 크지만 계산은 일부만 — 전문가 혼합(MoE) 35년 (특집)
<!--SUMMARY-->
코어닷투데이2026-11-0851분
<!--SUMMARY-->
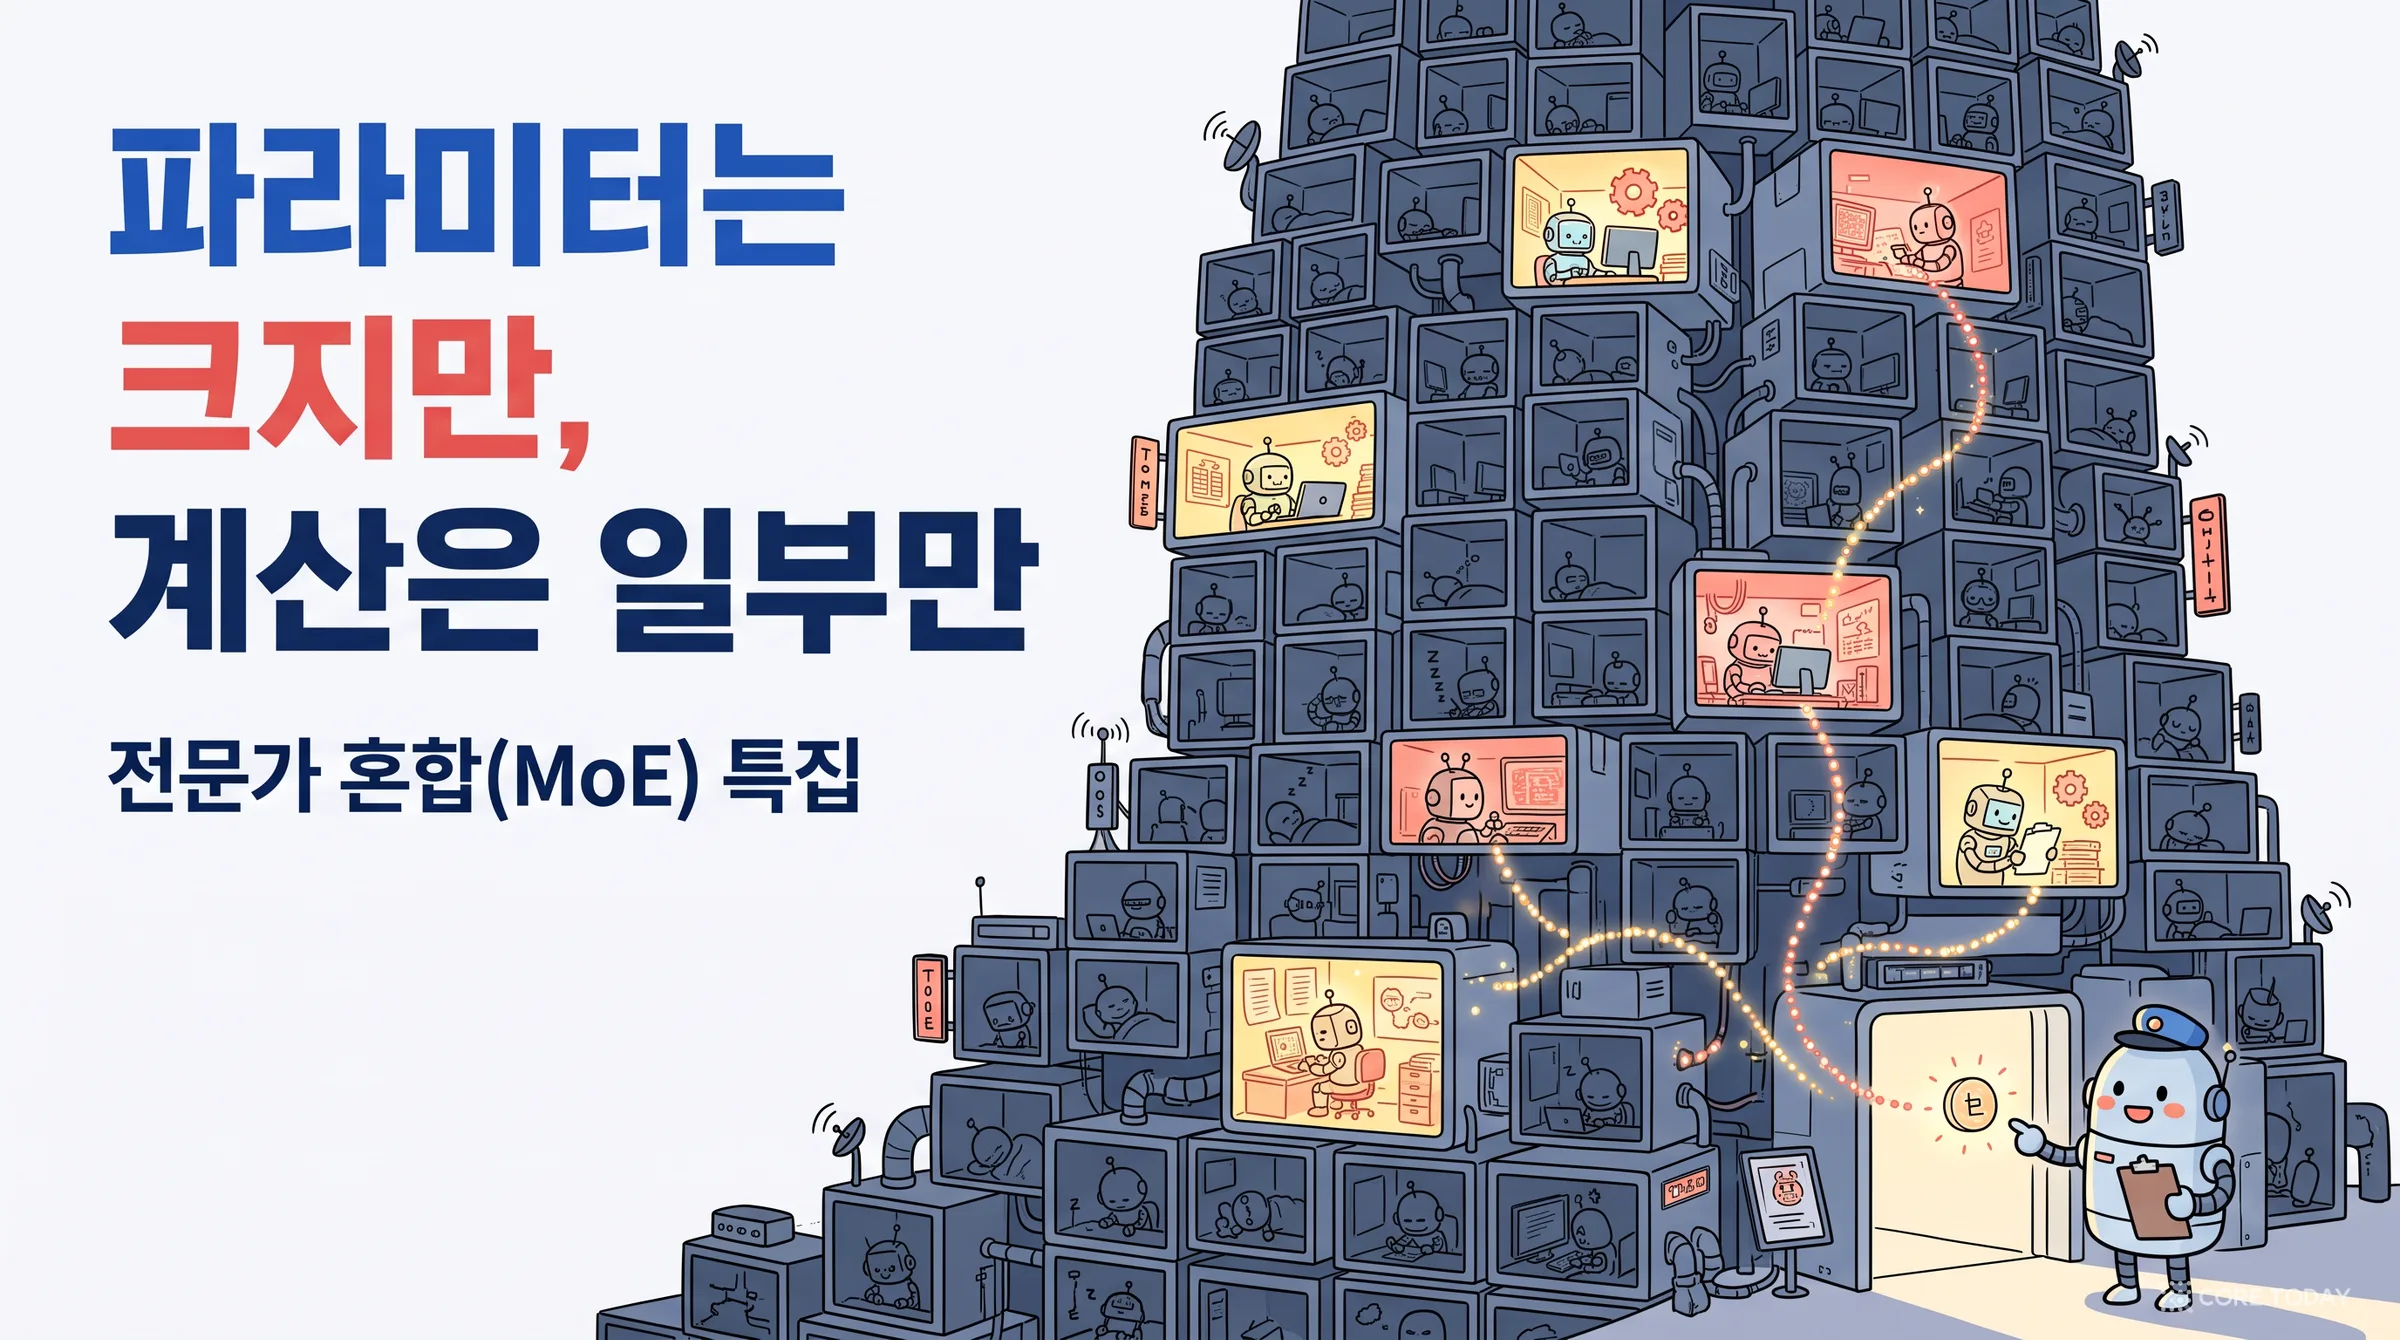
2026년 6월 허깅페이스에 올라온 문샷 AI의 Kimi K3는 파라미터가 2조 8천억 개다. 그런데 이 모델이 단어 하나(정확히는 토큰 하나)를 만들 때 실제로 계산에 쓰는 파라미터는 1,040억 개, 전체의 3.7%뿐이다. 나머지 96%는 메모리에 얌전히 앉아 자기 차례를 기다린다.
어떻게 이런 일이 가능할까. 비결은 모델 안에 전문가(expert) 896명을 두고, 토큰마다 그중 16명만 불러 일을 시키는 것이다. 누구를 부를지는 라우터(router)라는 작은 신경망이 순식간에 정한다. 이 구조를 전문가 혼합(Mixture of Experts, MoE)이라고 부른다.
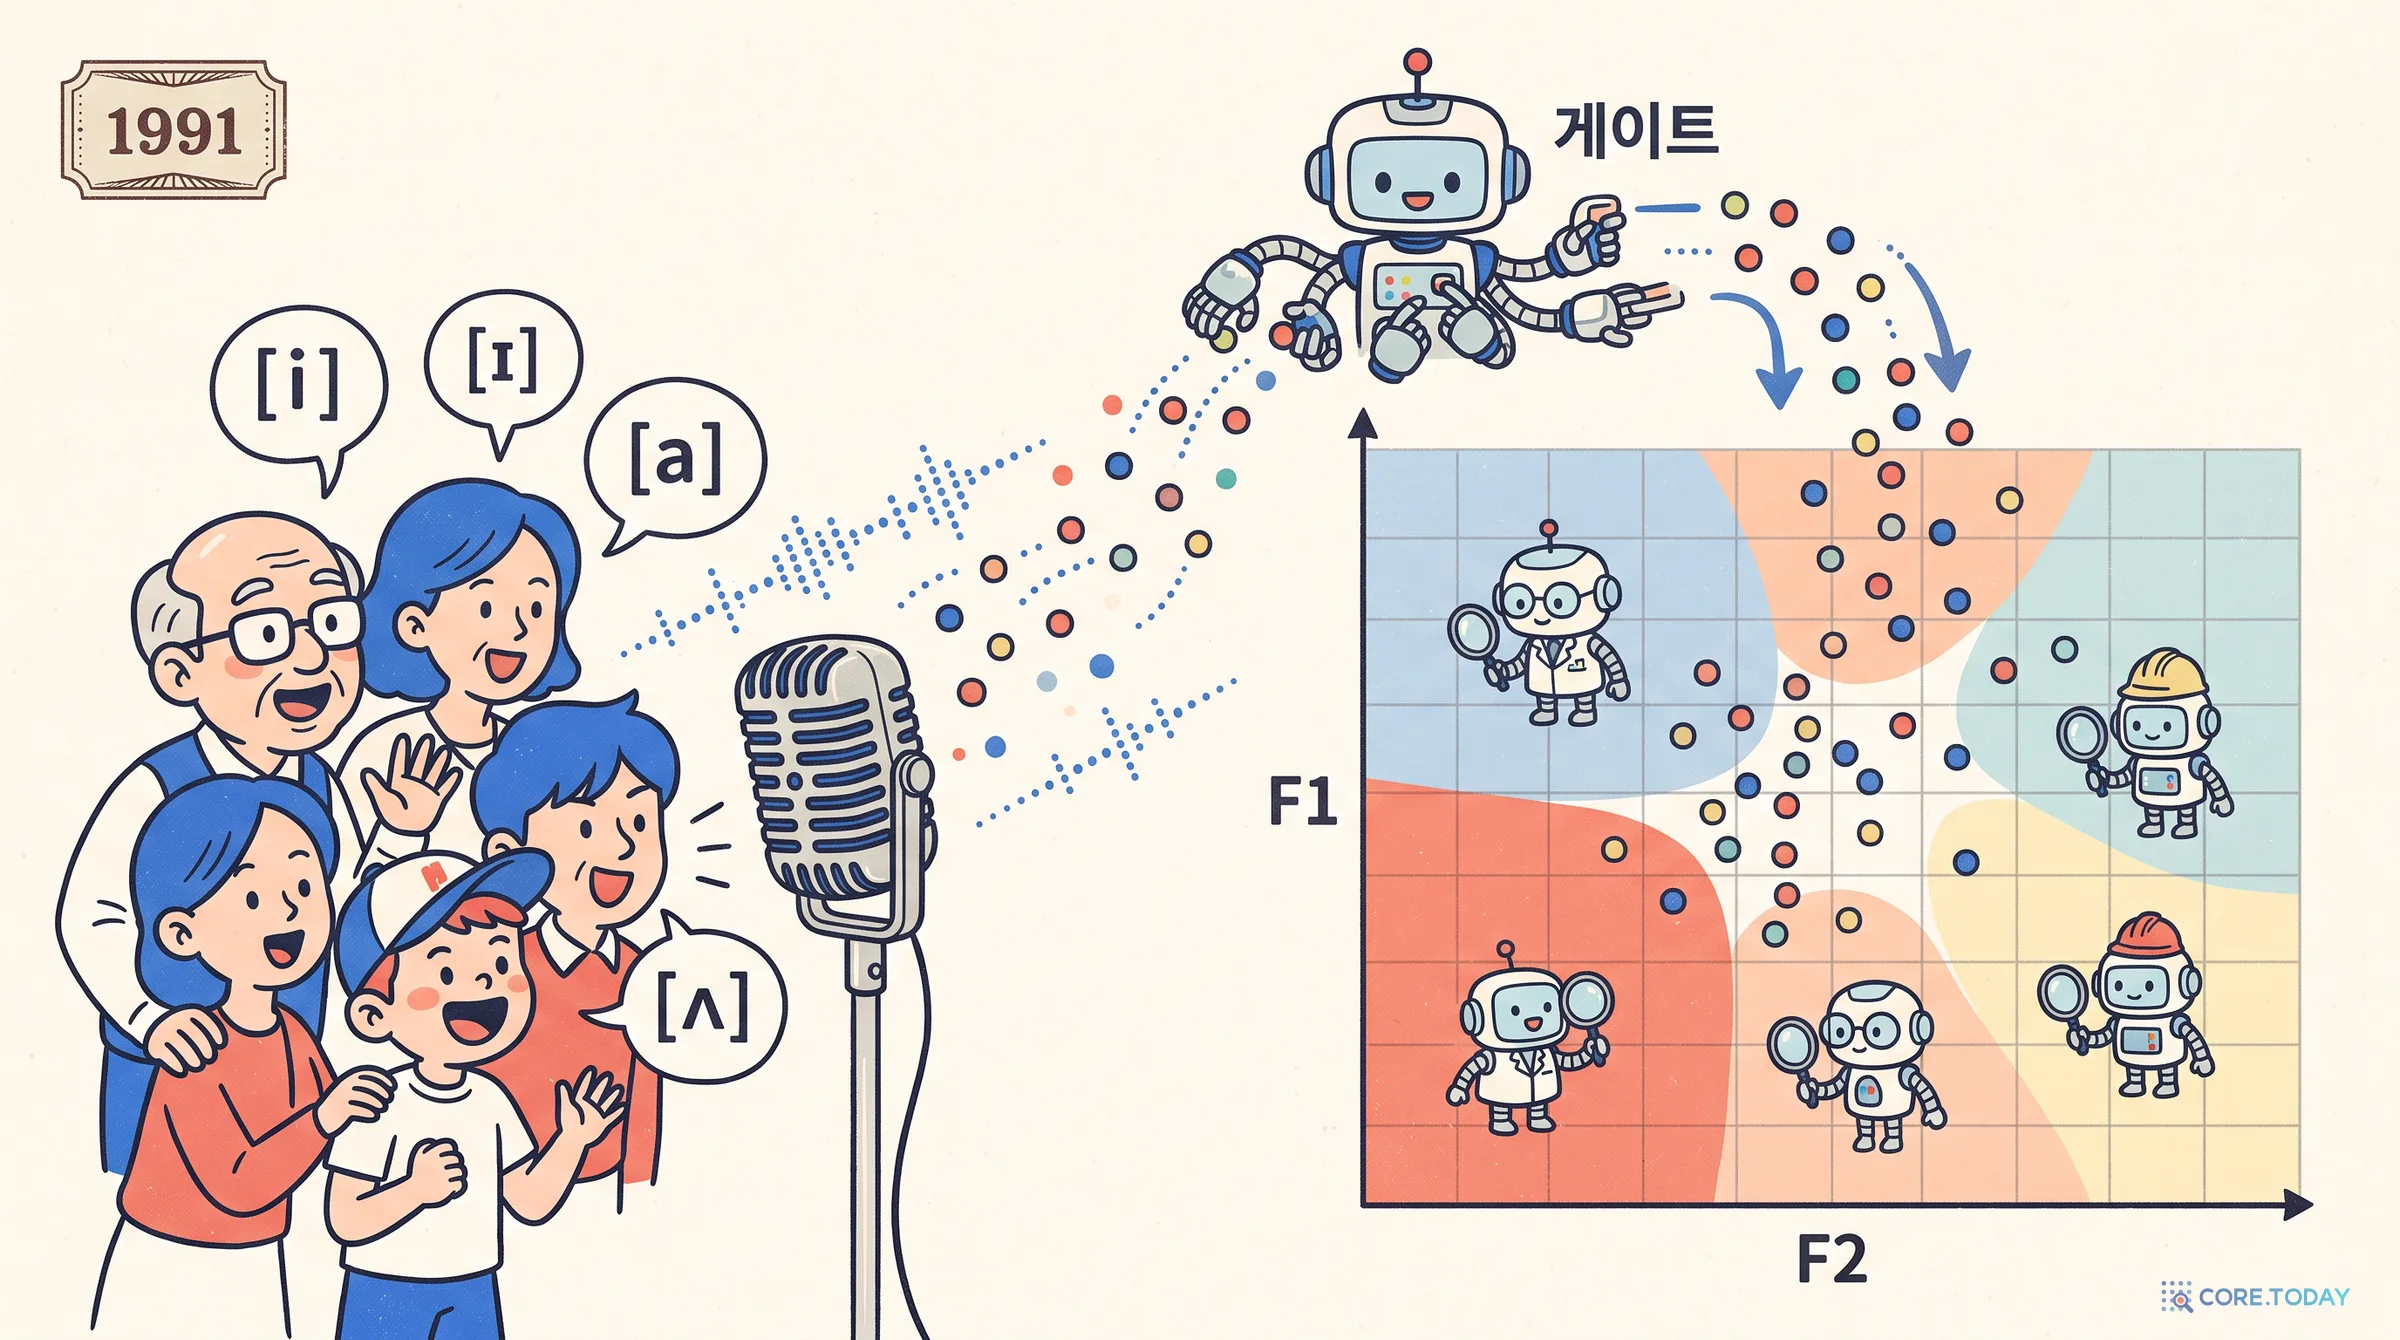
MoE는 2026년의 거의 모든 대형 모델이 쓰는 기본 골격이다. DeepSeek-V4, Qwen3.5와 Qwen3.8, Kimi K3, 미스트랄 Large 4, OpenAI의 gpt-oss, 그리고 LG의 K-EXAONE, SKT의 A.X K1, 업스테이지의 Solar Open까지 모두 MoE다. 그런데 이 아이디어는 새것이 아니다. 시작은 1991년, 제프리 힌턴이 공저자로 참여한 여덟 쪽짜리 논문이었다. 당시 실험 과제는 75명이 발음한 모음 네 개를 구분하는 것이었다.
모음 네 개에서 전문가 896명까지 오는 데 35년이 걸렸다. 이 글은 그 길을 따라간다. 그리고 말로만 설명하지 않으려고 두 가지를 직접 해 봤다. 블로그 글 680여 편으로 작은 MoE 언어 모델을 처음부터 학습시켰고, 이 글을 쓰는 맥북에서 300억 파라미터짜리 MoE를 돌려 80억짜리 덴스 모델과 속도·품질을 비교했다.
이 글의 순서는 다음과 같다.
지난 10년 동안 언어 모델 연구가 확인한 가장 단단한 사실은 크게 만들면 더 똑똑해진다는 것이다. 파라미터를 늘리고, 데이터를 늘리고, 계산을 늘리면 손실이 예측 가능한 곡선을 따라 내려간다. 이른바 스케일링 법칙이다(친칠라 스케일링 법칙 글 참고).
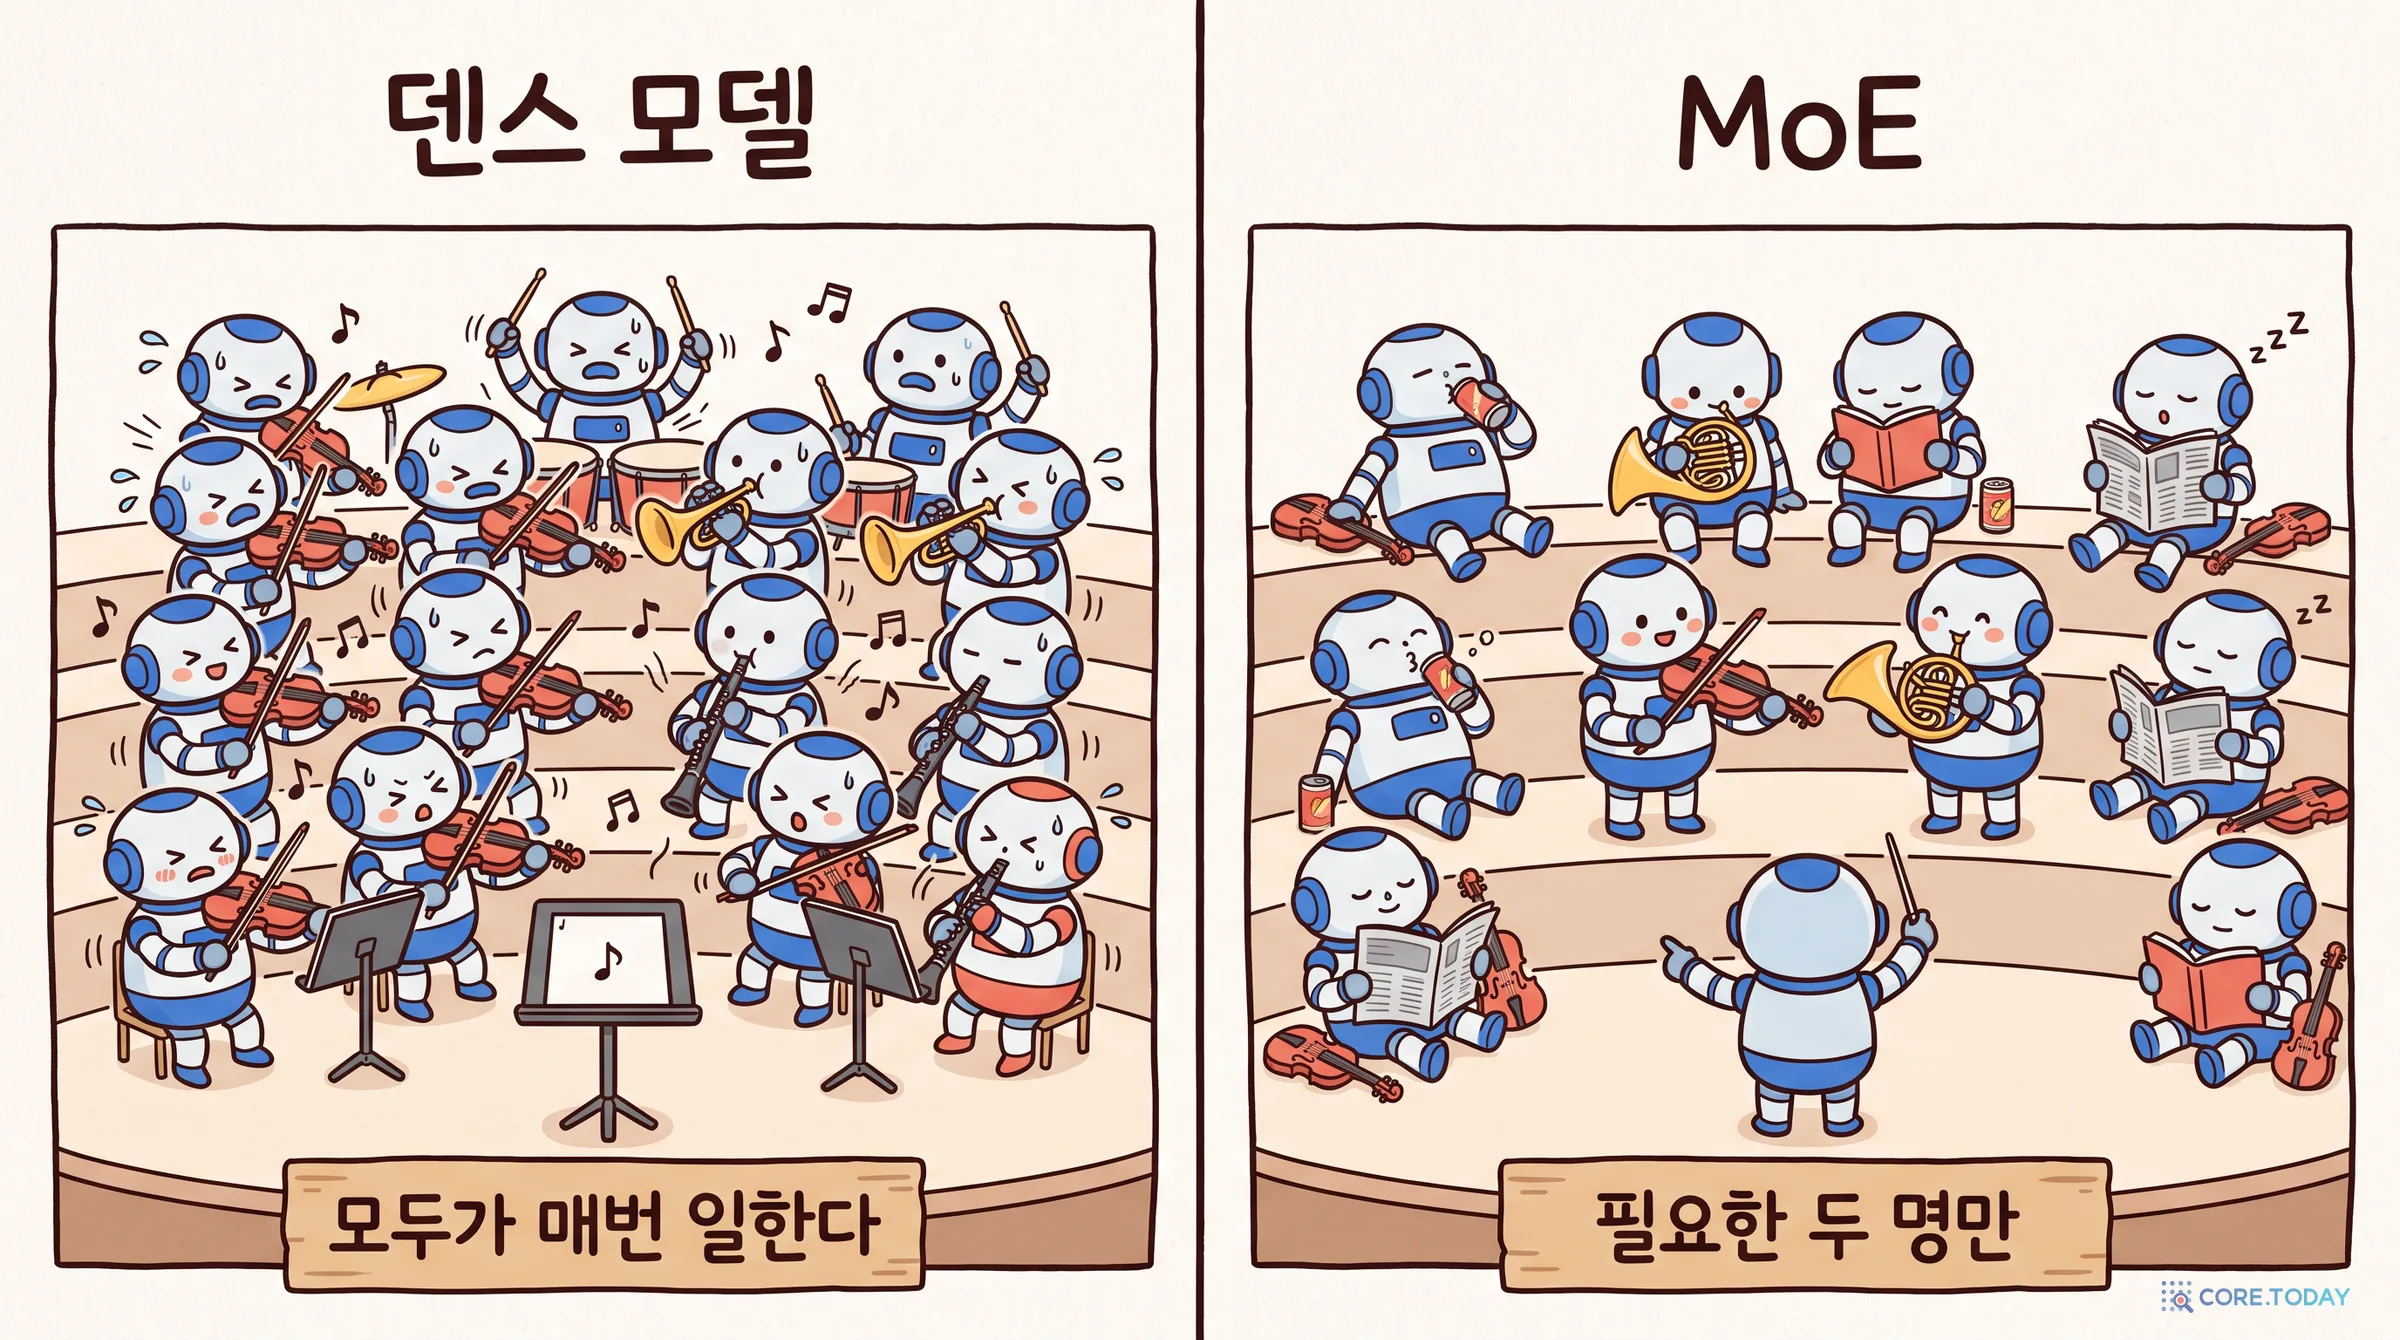
문제는 보통의 신경망, 즉 덴스(dense) 모델에서는 파라미터 수와 계산량이 한 몸이라는 점이다. 파라미터가 4,050억 개인 Llama 3.1 405B는 토큰 하나를 만들 때마다 4,050억 개를 모두 곱하고 더한다. ‘안녕’이라는 인사에 답할 때도, 양자역학 문제를 풀 때도 똑같다. 모델을 두 배로 키우면 토큰 하나를 만드는 비용도 두 배가 된다.
비유하면 이렇다. 오케스트라 단원이 100명인데, 악보에 바이올린 한 음만 적혀 있어도 100명이 모두 연주한다. 단원을 200명으로 늘리면 실력은 늘지만 인건비도 정확히 두 배가 된다.
여기서 자연스러운 질문이 나온다. 모델이 아는 것(파라미터)은 늘리되, 한 번에 쓰는 것(계산)은 그대로 둘 수 없을까?
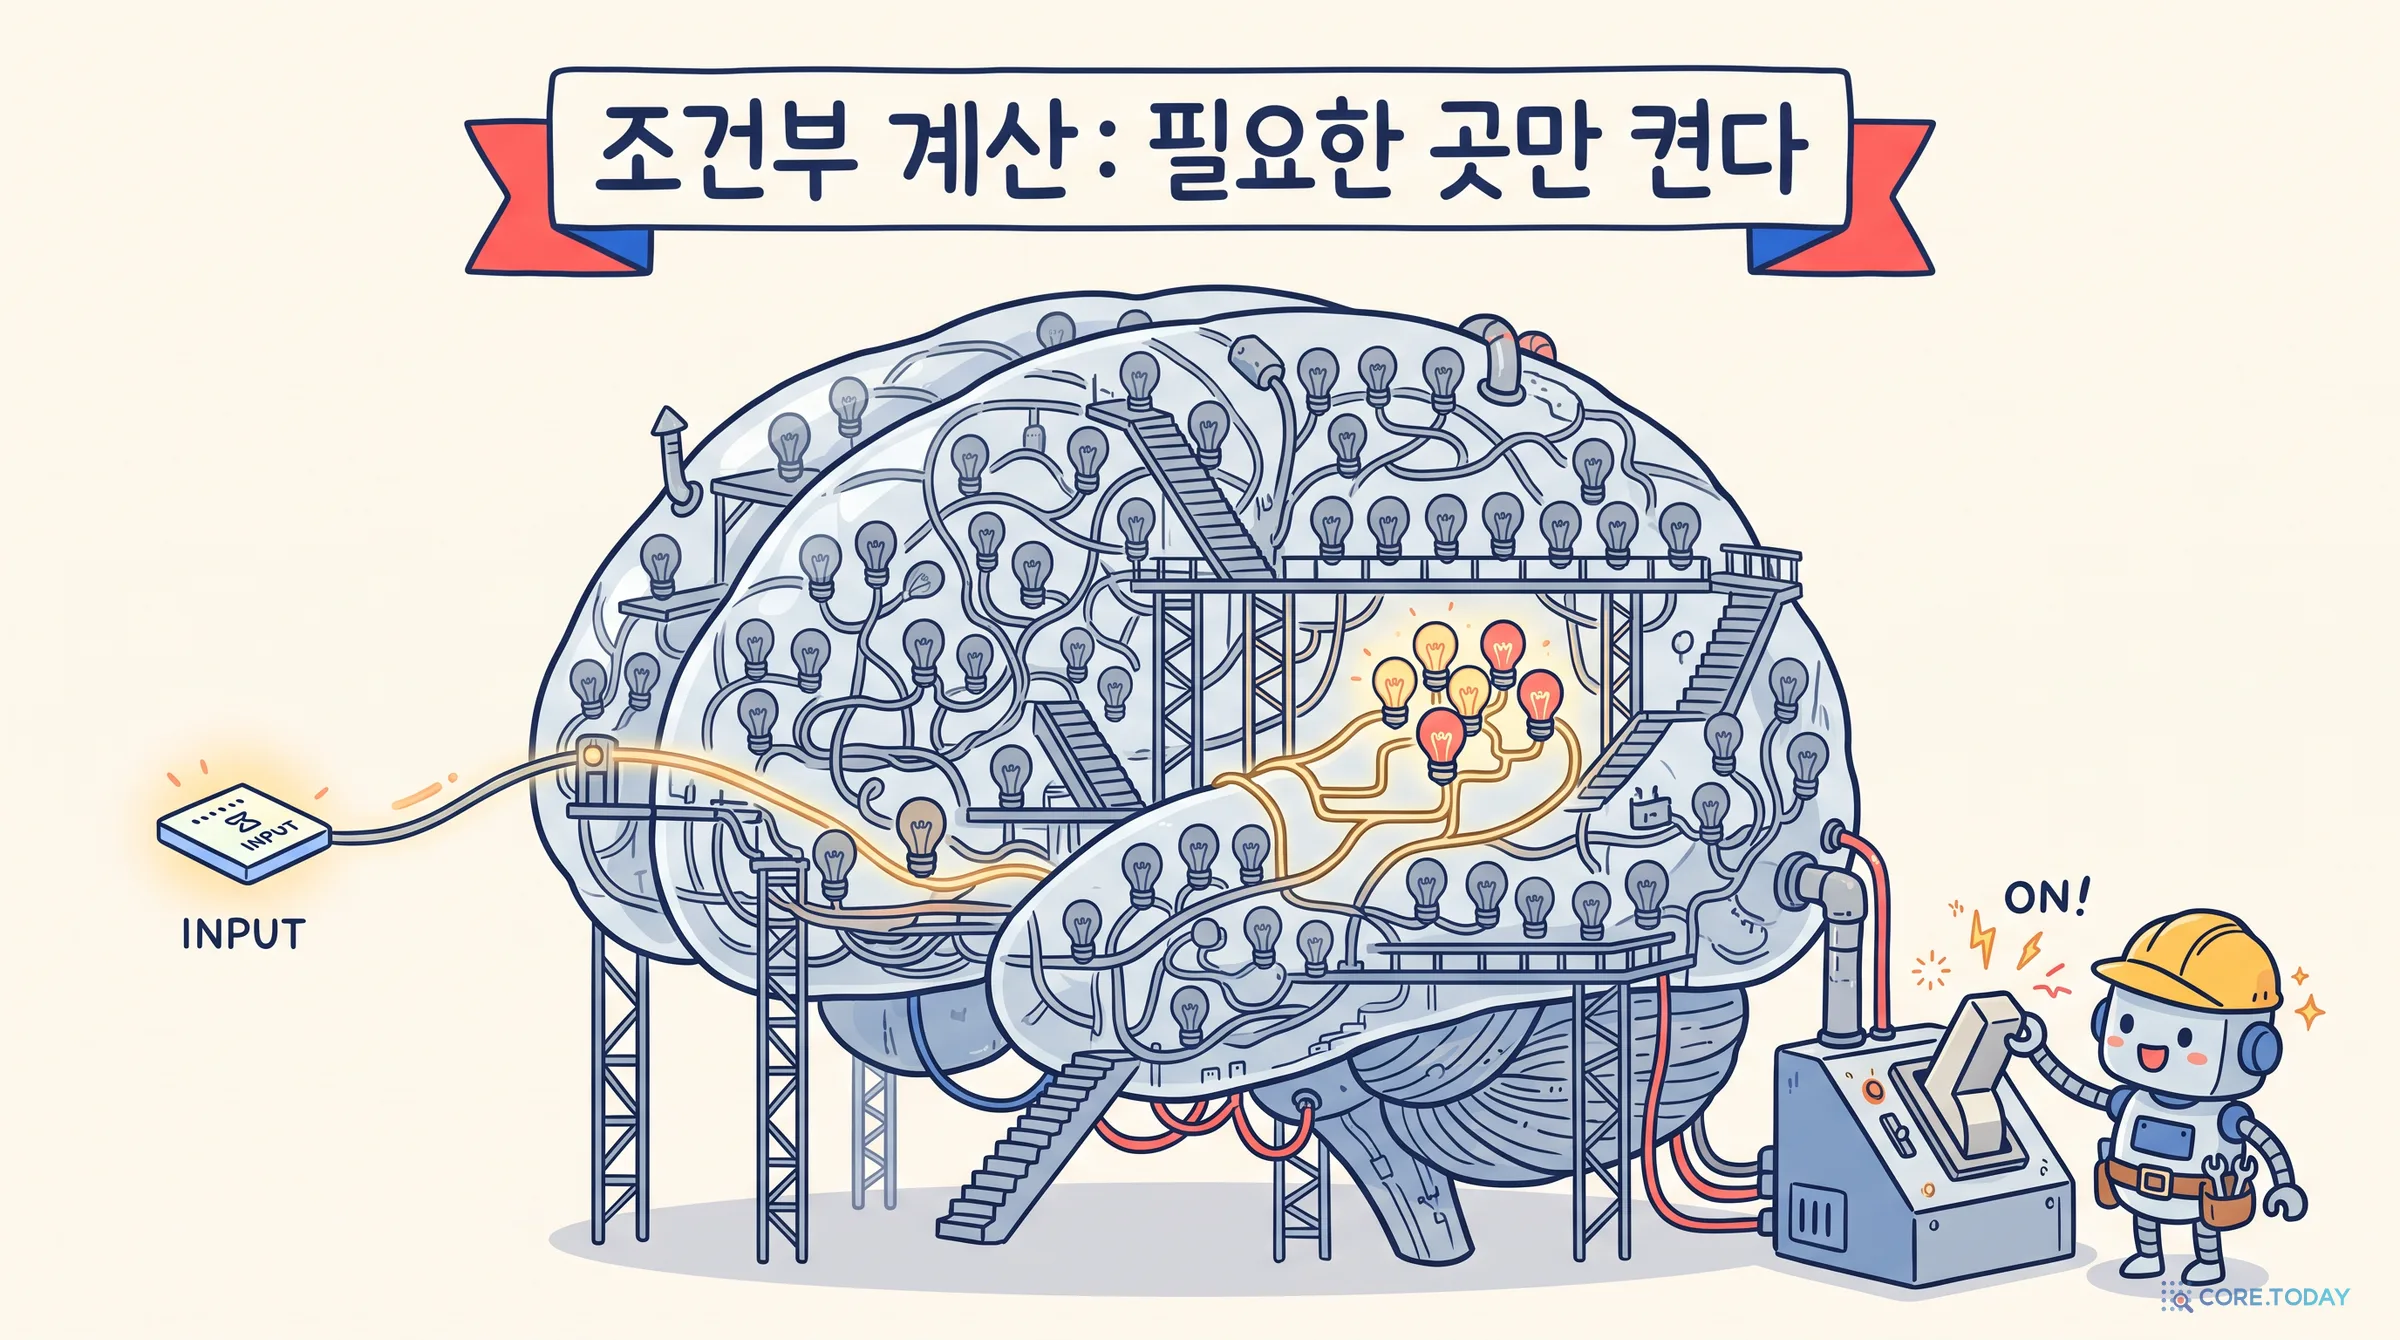
사람의 뇌가 힌트를 준다. 뇌에는 뉴런이 860억 개쯤 있지만 어떤 순간에도 그중 일부만 활발하게 발화한다. 노래를 들을 때와 수학 문제를 풀 때 바쁜 영역이 다르다. 백과사전을 통째로 외운 사람도 질문 하나에 답할 때는 관련된 몇 쪽만 떠올린다.
딥러닝에서는 이 생각을 조건부 계산(conditional computation)이라 부른다. 2013년 요슈아 벤지오 연구진은 「확률적 뉴런을 통한 기울기 추정과 전파」에서 게이트 유닛이 “대부분의 경우 실제로 0을 내놓아” 신경망의 큰 부분을 꺼 둘 수 있어야 한다고 썼다. 2015년에는 에마뉘엘 벤지오 등이 강화학습으로 신경망 블록을 켜고 끄는 방법을 내놓았다. 다만 둘 다 아이디어 수준에 머물렀다. 무엇을 켤지 정하는 장치가 학습하기 어렵고, 당시 GPU는 ‘일부만 계산하기’에 서툴렀기 때문이다.
그런데 그런 장치는 이미 20여 년 전에 나와 있었다. 이름은 전문가 혼합이었다.
1991년 학술지 『뉴럴 컴퓨테이션』 3권 1호에 「적응적 국소 전문가 혼합(Adaptive Mixtures of Local Experts)」이라는 논문이 실렸다. 저자는 로버트 제이콥스, 마이클 조던, 스티븐 노울런, 그리고 제프리 힌턴. 논문 각주에는 이 아이디어가 1988년 피츠버그 커넥셔니스트 여름학교에서 제이콥스와 힌턴이 처음 발표했다고 적혀 있다.
문제의식은 이랬다. 신경망 하나에 여러 종류의 일을 한꺼번에 가르치면, 한 일을 배우면서 다른 일을 망치는 간섭이 생긴다. 차라리 일을 나눠 맡기면 어떨까. 신경망 여러 개(전문가)를 두고, 입력을 보고 누구에게 맡길지 정하는 게이트 신경망을 하나 더 둔다. 게이트는 전문가마다 확률 를 매기고, 최종 답은 전문가들의 출력 를 이 확률로 섞어 만든다.
여기까지는 그 전에도 있던 생각이다. 1991년 논문의 진짜 공헌은 오차를 재는 방식을 바꾼 데 있다.
가장 단순한 방법은 섞은 결과와 정답 의 차이를 줄이는 것이다.
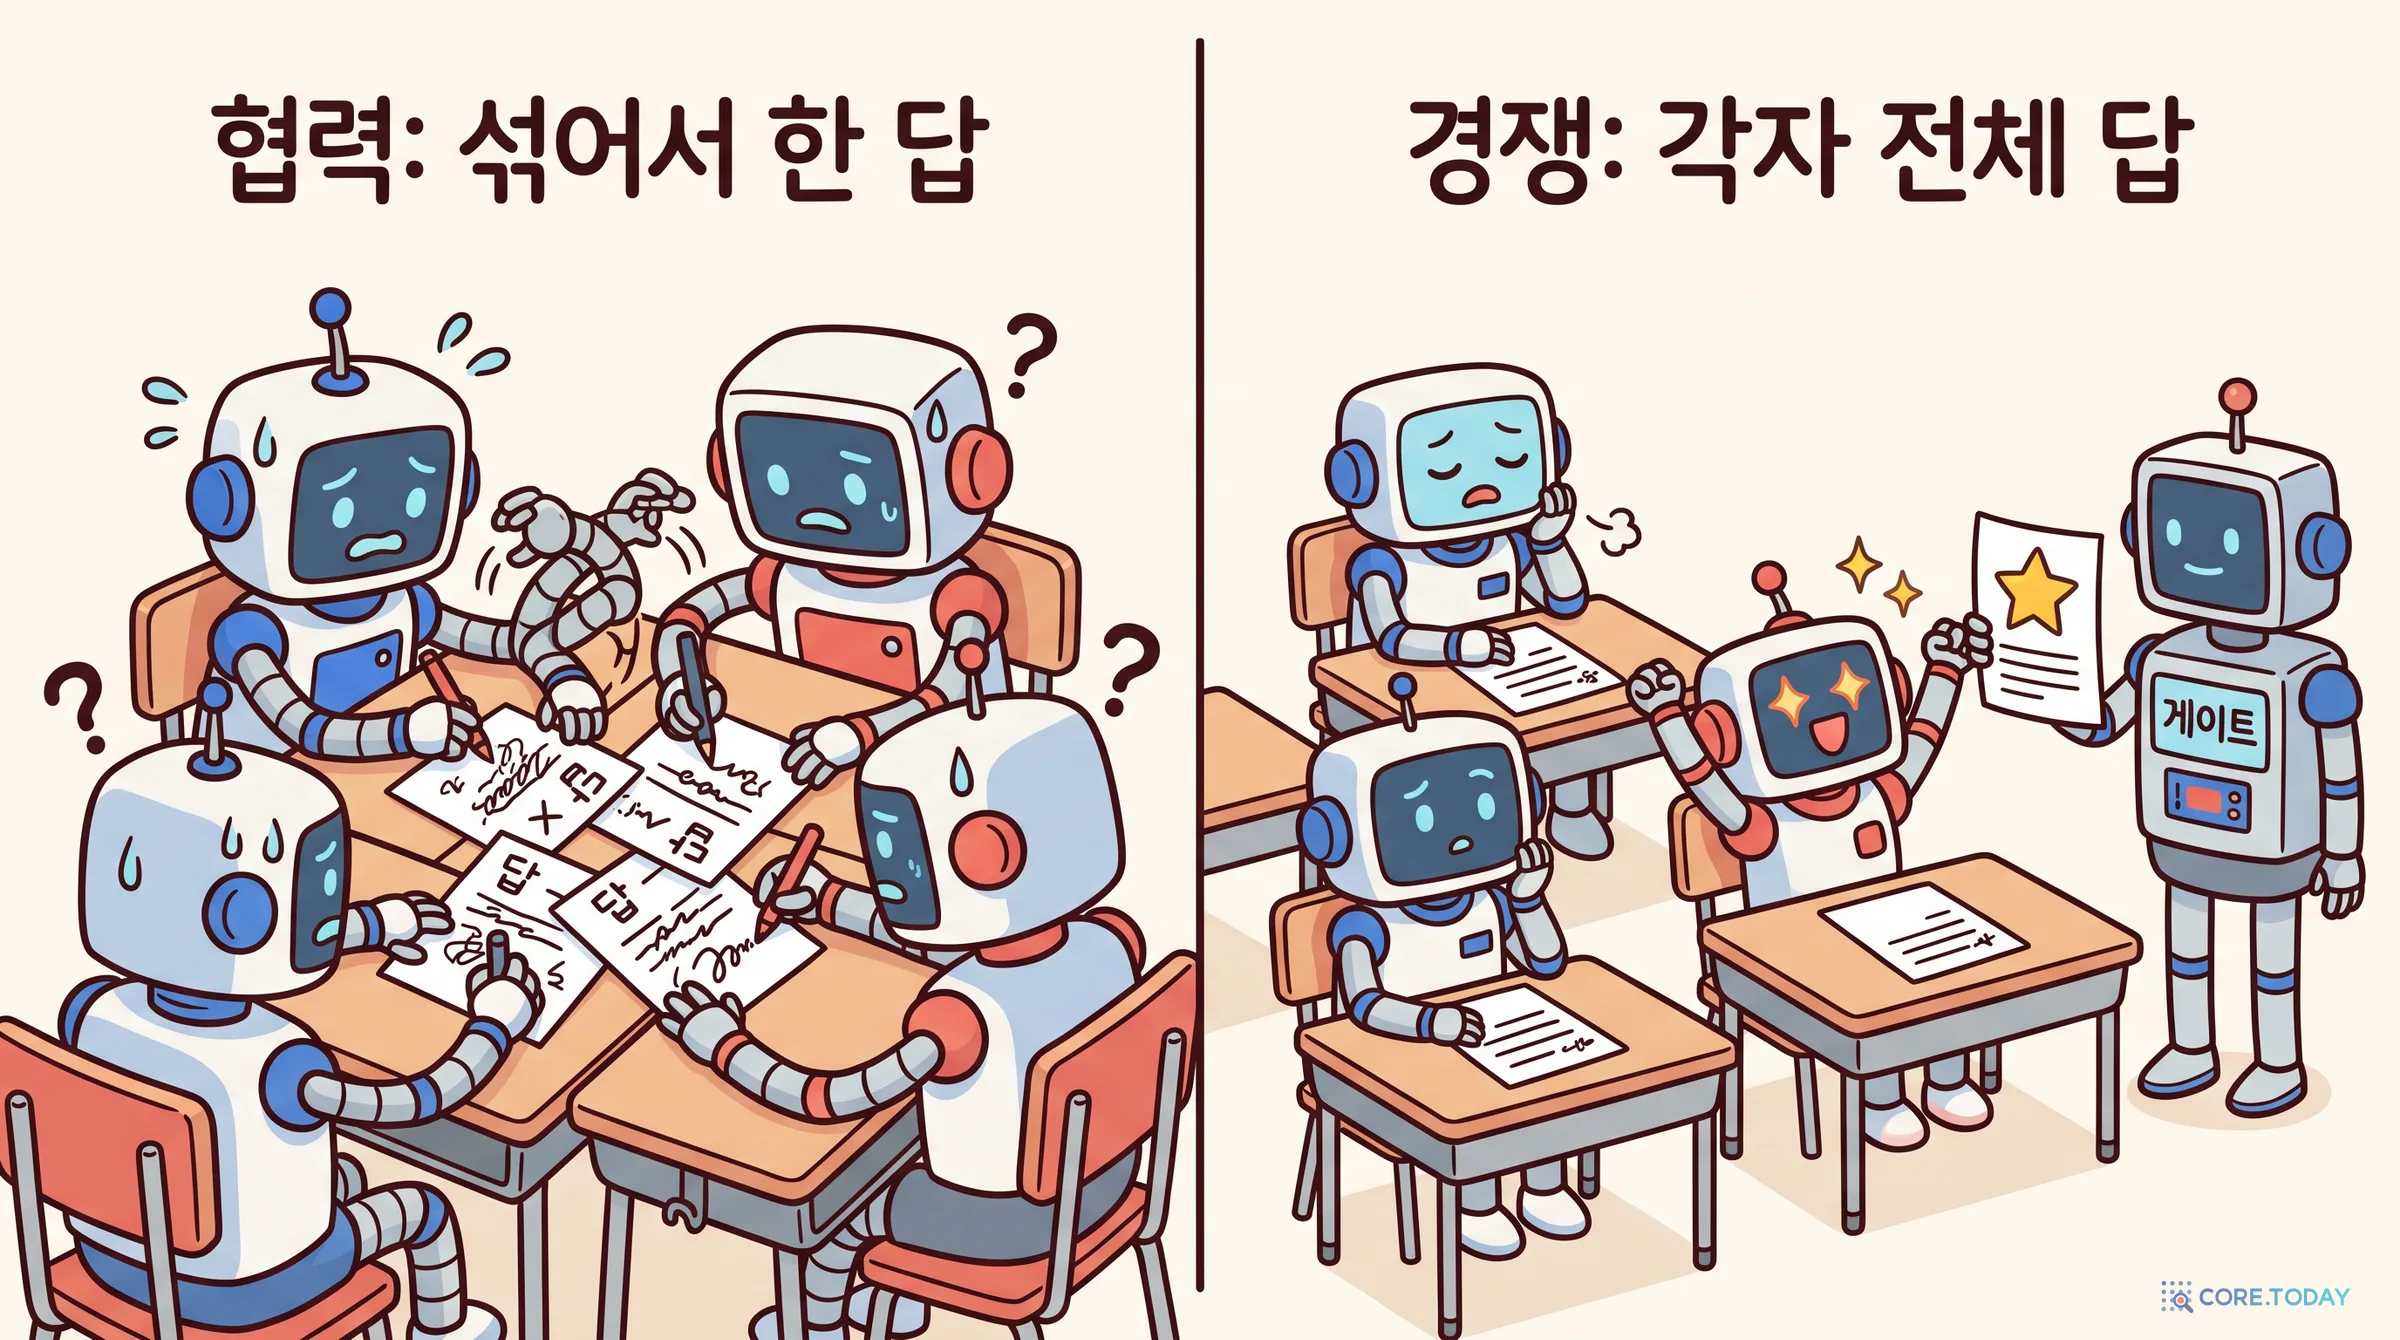
논문은 이 방식을 이렇게 평가한다. 전문가들 사이에 강한 결합이 생겨 “사이좋게 협력”하지만, 그 결과 한 문제에 여러 전문가가 얽힌다. 전문가 하나는 정답을 내는 게 아니라 남들이 남긴 오차를 메우는 조각을 낸다. 조별 과제에서 네 명이 한 문장씩 써서 붙인 보고서와 비슷하다. 누구 한 명을 빼면 보고서가 무너진다.
제이콥스와 동료들은 오차 함수를 “전문가들이 협력하는 대신 경쟁하도록” 다시 정의했다.
이제 각 전문가는 혼자서 완전한 답을 내야 한다. 게이트는 그중 잘한 전문가에게 확률을 몰아주고, 확률을 많이 받은 전문가는 그 입력을 더 열심히 배운다. 실제 실험에서는 이를 조금 다듬어 정규 분포 혼합의 음의 로그 가능도를 썼다.
이 식에서는 정답을 가장 잘 맞힌 전문가가 학습 신호를 거의 다 가져간다. 경쟁에서 이긴 전문가가 그 구역을 맡게 되는 것이다. 이렇게 전문가들은 저절로 입력 공간을 나눠 갖는다. 이름의 ‘국소(local)’가 이 뜻이다.
실험 과제는 화자에 상관없이 모음 네 개([i], [ɪ], [a], [ʌ])를 구분하는 것이었다. 1952년 피터슨과 바니가 남자, 여자, 어린이 75명에게 ‘hVd’ 꼴 단어(heed, hid, hod, hud)를 읽게 해 측정한 두 포먼트(F1, F2) 값을 입력으로 썼다. 50명으로 학습하고 25명으로 시험했다.
선형 전문가 4명 또는 8명을 쓴 혼합 모델은 은닉 유닛 6개나 12개짜리 역전파 신경망보다 약 절반의 에폭만에 목표 오차에 닿았다(평균 1,124·1,083 에폭 대 2,209·2,435 에폭). 흥미롭게도 전문가 4명 실험에서는 한 명의 비중이 사실상 0이 되어, 셋만 일했다.
아래 위젯은 이 실험을 브라우저에서 작게 재현한 것이다. 실제 피터슨·바니 데이터 대신 그 구조를 흉내 낸 합성 데이터를 쓴다. 아이 목소리는 성도가 짧아 포먼트가 높으므로 같은 모음이 다른 자리에 나타난다. 직선밖에 못 긋는 선형 전문가가 한 명이면 이 문제를 풀 수 없다. 전문가를 여러 명 주고 게이트와 함께 학습시키면 어떻게 될까.
전문가 한 명으로는 66% 언저리에서 멈추지만, 둘 이상이면 92%까지 올라간다. 아무도 ‘어른’과 ‘아이’라는 개념을 가르쳐 주지 않았는데, 게이트가 스스로 어른 목소리 구역과 아이 목소리 구역을 서로 다른 전문가에게 맡긴다. 전문가를 8명 줘도 실제로 일하는 건 두 명뿐이라는 점도 눈여겨보자. 1991년 논문에서 한 전문가가 놀았던 것과 같은 현상이고, 30년 뒤 거대 MoE를 괴롭히는 ‘부하 균형’ 문제의 씨앗이다.
1994년 조던과 제이콥스는 게이트를 나무처럼 여러 층으로 쌓은 계층적 전문가 혼합(HME)과, 이를 EM 알고리즘으로 학습하는 방법을 발표했다. 이후 MoE는 통계 학습 교과서에 실리는 우아한 모형이 되었다.
하지만 그 뒤로 20년 가까이 MoE는 주류가 되지 못했다. 이 시기의 MoE는 계산을 아끼는 장치가 아니었다. 게이트가 모든 전문가에게 확률을 주고, 모든 전문가가 계산한 뒤 섞었다. 전문가 수를 늘리면 계산도 늘었다. ‘필요한 전문가만 계산한다’는 발상, 그리고 그걸 감당할 규모의 데이터와 하드웨어가 아직 없었다.
2013년 일리야 수츠케버가 참여한 「깊은 전문가 혼합에서 분해된 표현 학습하기」가 다리를 놓았다. MoE 층을 두 겹으로 쌓자 첫 층 전문가들은 숫자가 ‘어디에’ 있는지를, 둘째 층 전문가들은 ‘무엇인지’를 맡도록 나뉘었다. MoE를 깊은 신경망의 부품으로 쓸 수 있다는 신호였다.
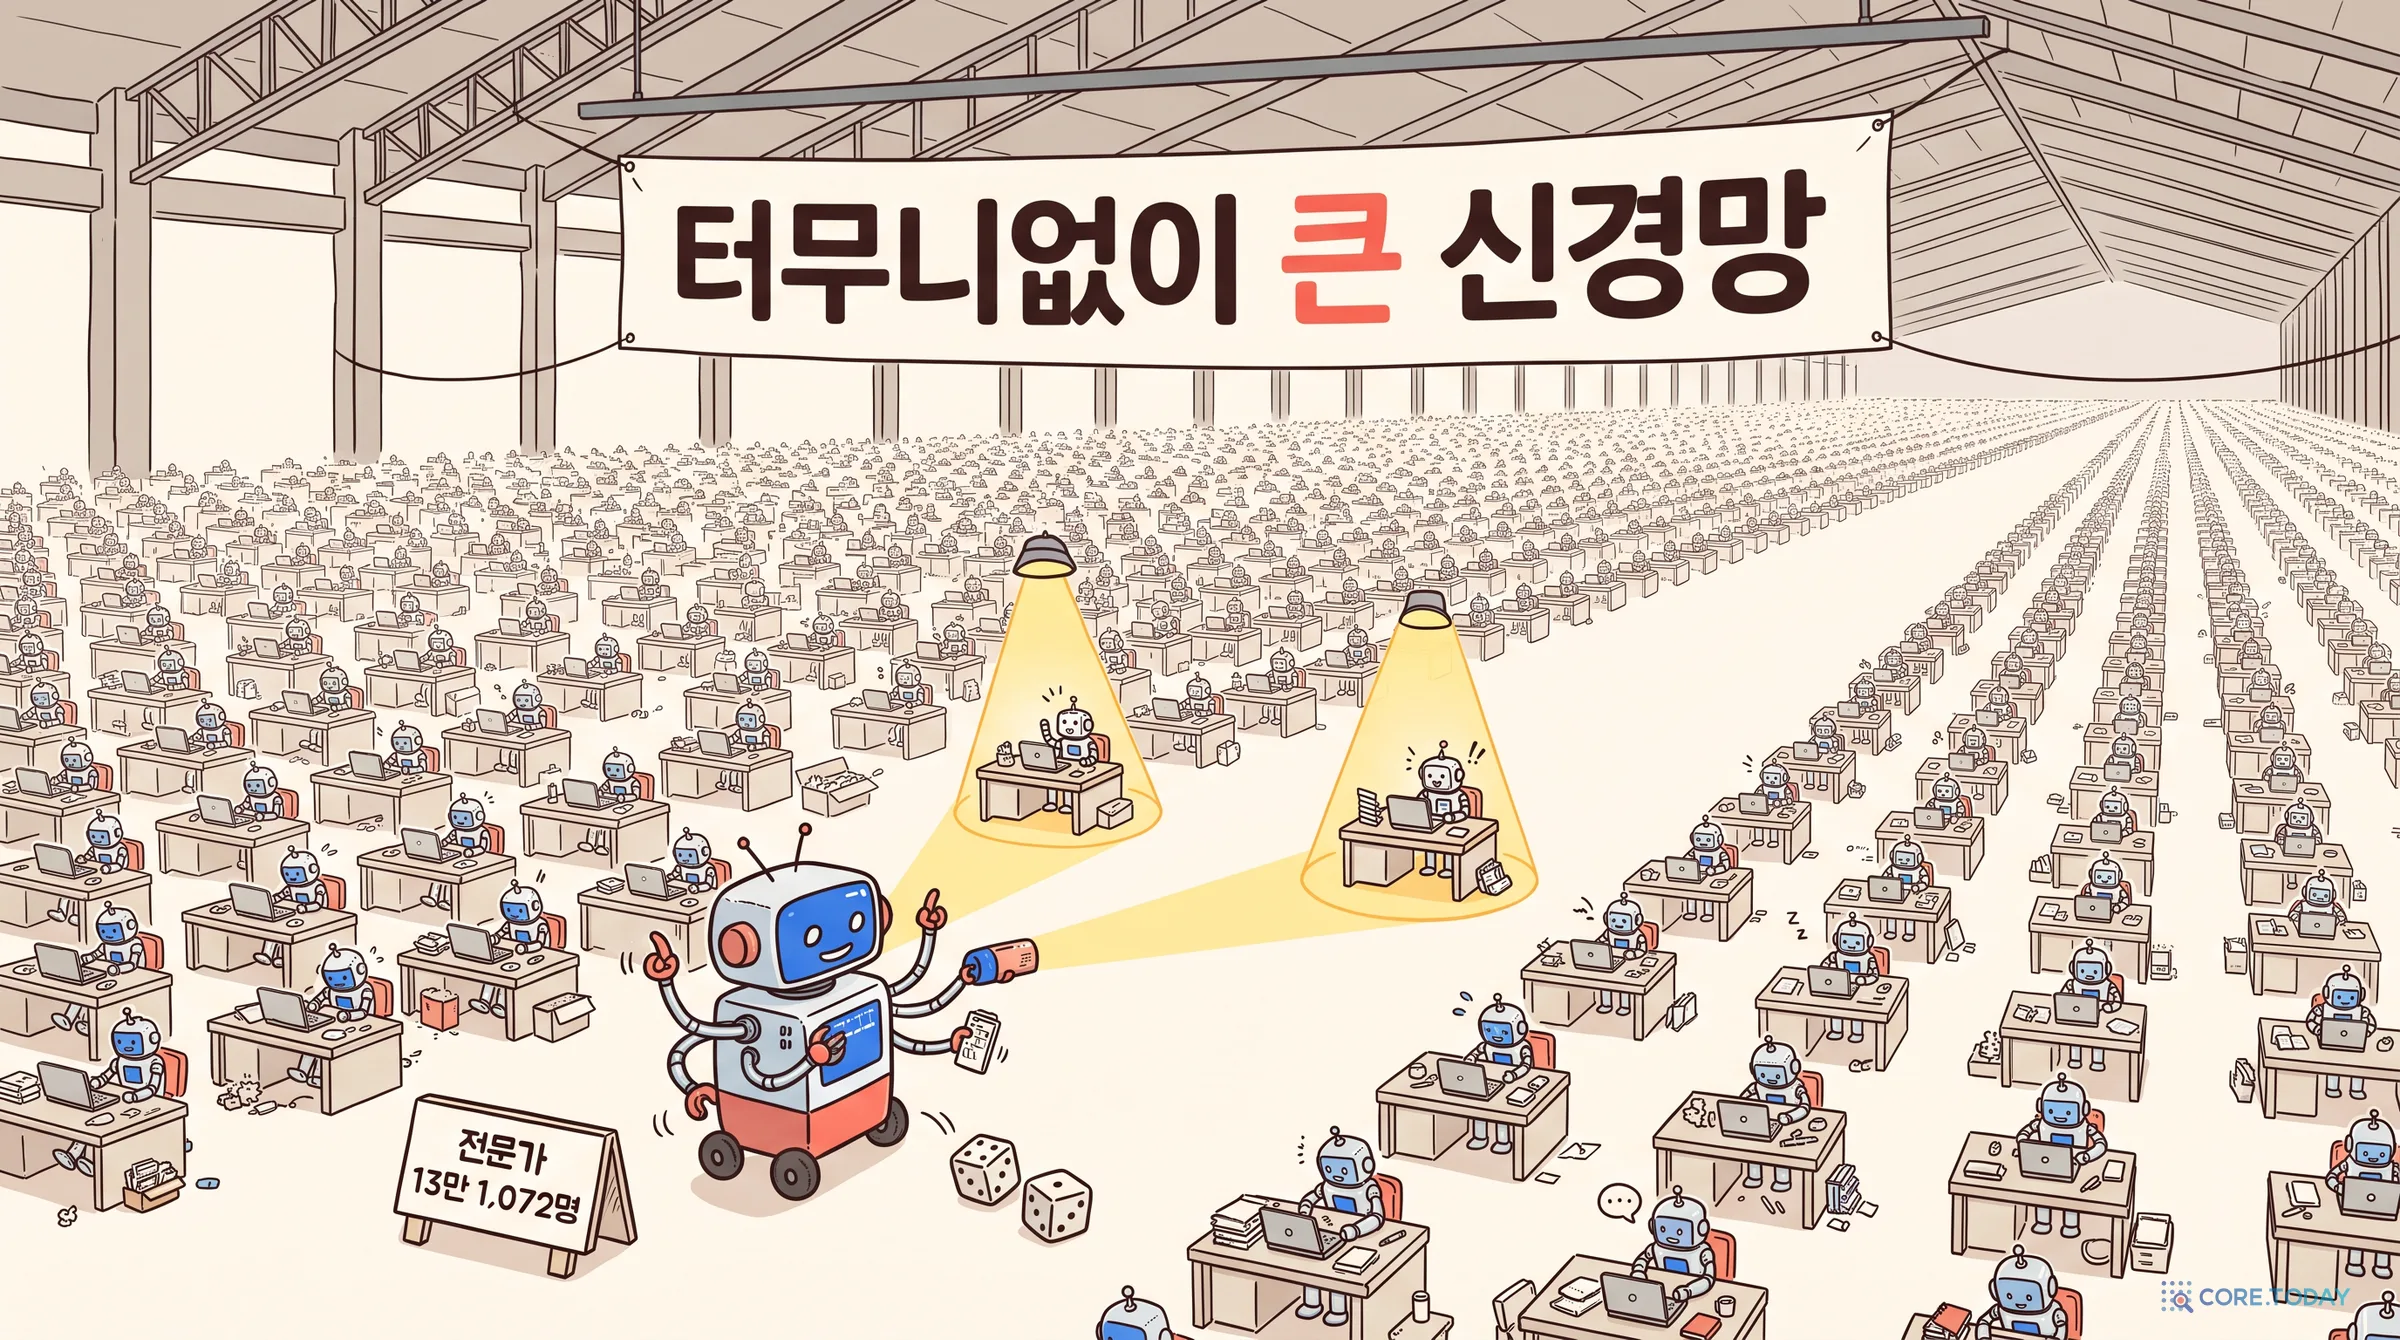
2017년 ICLR에 실린 논문의 제목은 「터무니없이 큰 신경망: 희소 게이트 전문가 혼합 층(Outrageously Large Neural Networks: The Sparsely-Gated Mixture-of-Experts Layer)」이다. 1저자는 구글의 노엄 셰이저, 마지막 저자는 제프 딘. 그리고 저자 목록 가운데 다시 제프리 힌턴이 있다. 1991년 논문과 2017년 논문을 잇는 사람이 같은 셈이다.
셰이저의 아이디어는 간단했다. 게이트가 전문가 몇 명에게만 0이 아닌 값을 주게 하면, 나머지 전문가는 아예 계산하지 않아도 된다. 전문가가 1,000명이든 10만 명이든, 토큰 하나가 계산하는 전문가는 몇 명뿐이다. 1991년의 ‘섞는’ 게이트가 2017년에 ‘고르는’ 게이트가 된 것이다.
MoE 층의 출력은 전문가 출력의 가중합이다.
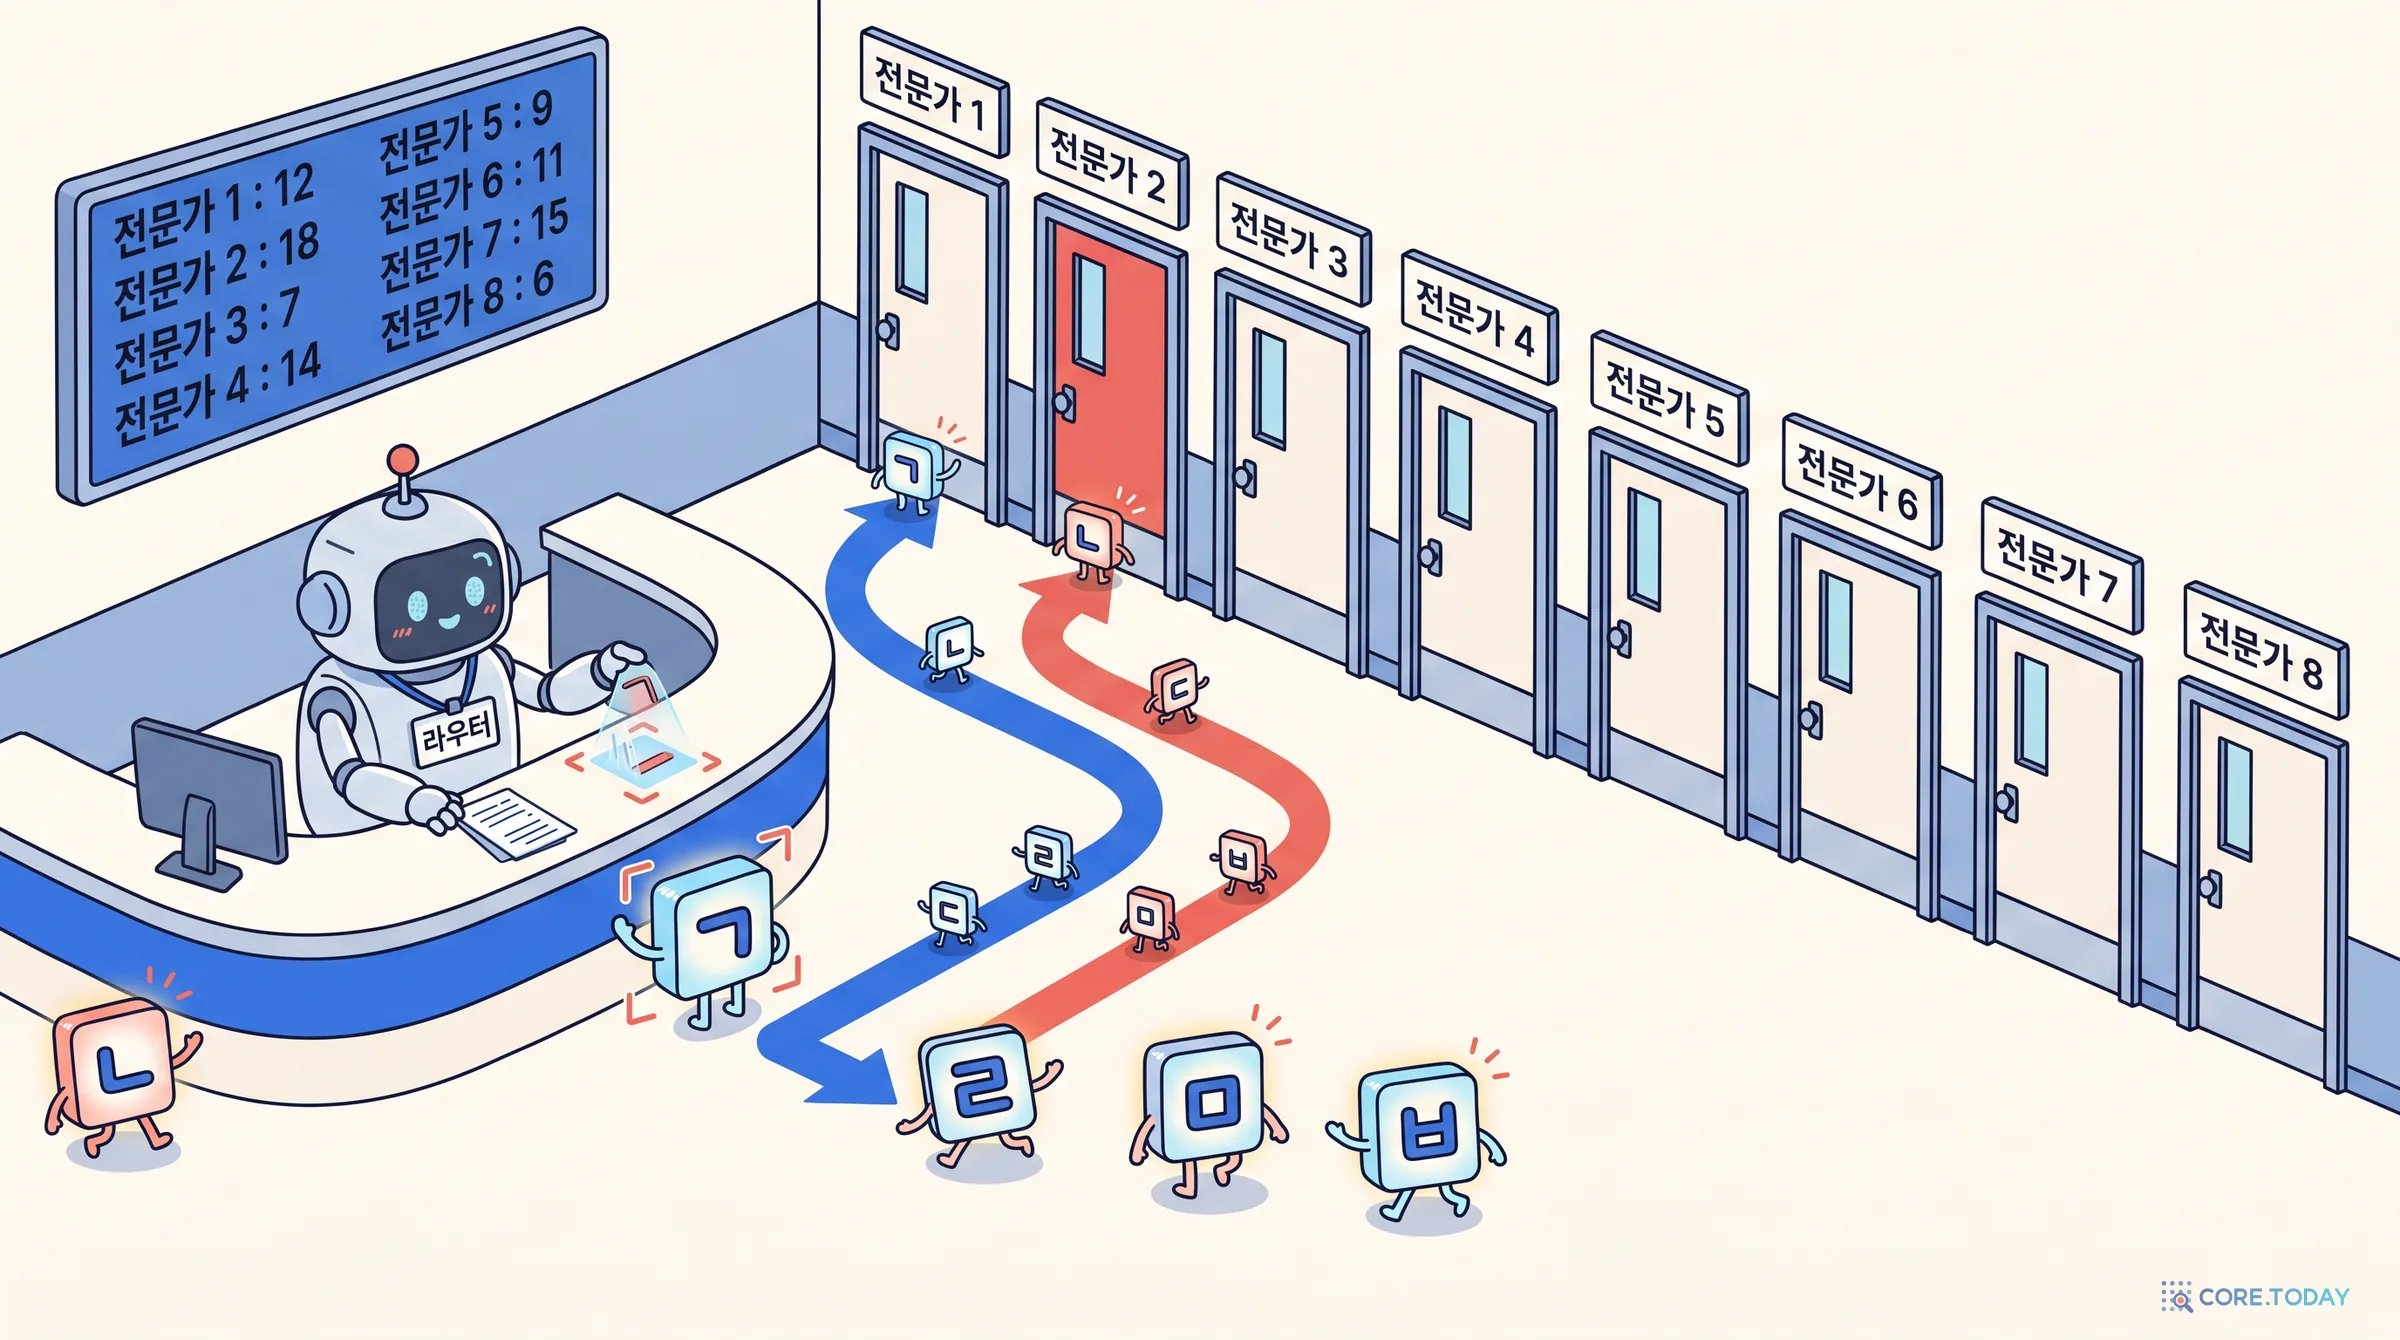
여기서 가 대부분 0이면, 0인 전문가 는 계산할 필요가 없다. 셰이저는 이렇게 만들었다.
풀어 쓰면 이렇다.
그림 속 라우터 로봇이 주사위를 굴리는 이유가 2번이다.
셰이저 연구진은 이 층을 LSTM 층 사이에 끼웠다. 전문가 수는 수천 명까지 늘렸고, 가장 큰 모델은 MoE 층 하나에 전문가 13만 1,072명, 파라미터 약 1,370억 개를 담았다. GPT-2(15억)가 나오기 2년 전의 일이다.
결과도 좋았다. 10억 단어 벤치마크에서 같은 계산량의 기존 최고 모델보다 퍼플렉서티를 24% 낮췄고, 1,000억 단어 구글 뉴스 말뭉치에서는 전문가 6만 5,536명(680억 파라미터) 모델이 39% 낮췄다. 다만 13만 1,072명으로 더 늘리자 오히려 나빠졌다. 무한정 키운다고 좋아지지는 않는다는 신호였다. 번역에서도 당시 최고 수준(WMT’14 영→프 40.56 BLEU)을 기록했다. 초록의 표현대로 “계산 효율을 조금만 잃고 모델 용량을 1,000배 넘게” 늘린 것이다.
논문에는 이후 수많은 MoE가 물려받을 두 가지 숙제도 이미 적혀 있다. 하나는 부하 균형이다. 게이트가 몇몇 전문가만 계속 고르는 경향이 있어서, 전문가별 중요도와 부하가 고르게 되도록 보조 손실 두 개를 더했다. 다른 하나는 배치 축소 문제다. 전문가가 많아질수록 전문가 한 명에게 가는 예시 수가 줄어 GPU가 비효율적으로 돈다. 그래서 여러 GPU에 전문가를 나눠 두는 병렬화를 설계했다. 이 두 숙제는 6부와 11부에서 다시 만난다.
2017년은 「어텐션이 전부다」 논문이 나온 해이기도 하다. 그리고 셰이저는 그 논문의 공저자이기도 했다. MoE가 트랜스포머에 들어가는 건 시간문제였다.
트랜스포머 블록은 크게 어텐션과 FFN(피드포워드 신경망) 두 부분으로 되어 있다. 파라미터 대부분은 FFN에 있다. 그래서 MoE는 거의 언제나 FFN을 전문가 여러 개로 바꾸는 방식으로 들어간다. 어텐션은 모든 토큰이 함께 쓴다.
구글의 GShard는 트랜스포머의 FFN을 한 층 걸러 MoE로 바꾸고, TPU v3 2,048개로 4일 동안 100개 언어를 영어로 옮기는 6,000억 파라미터 번역 모델을 학습시켰다. 여기서 실무 관행 세 가지가 자리 잡았다.
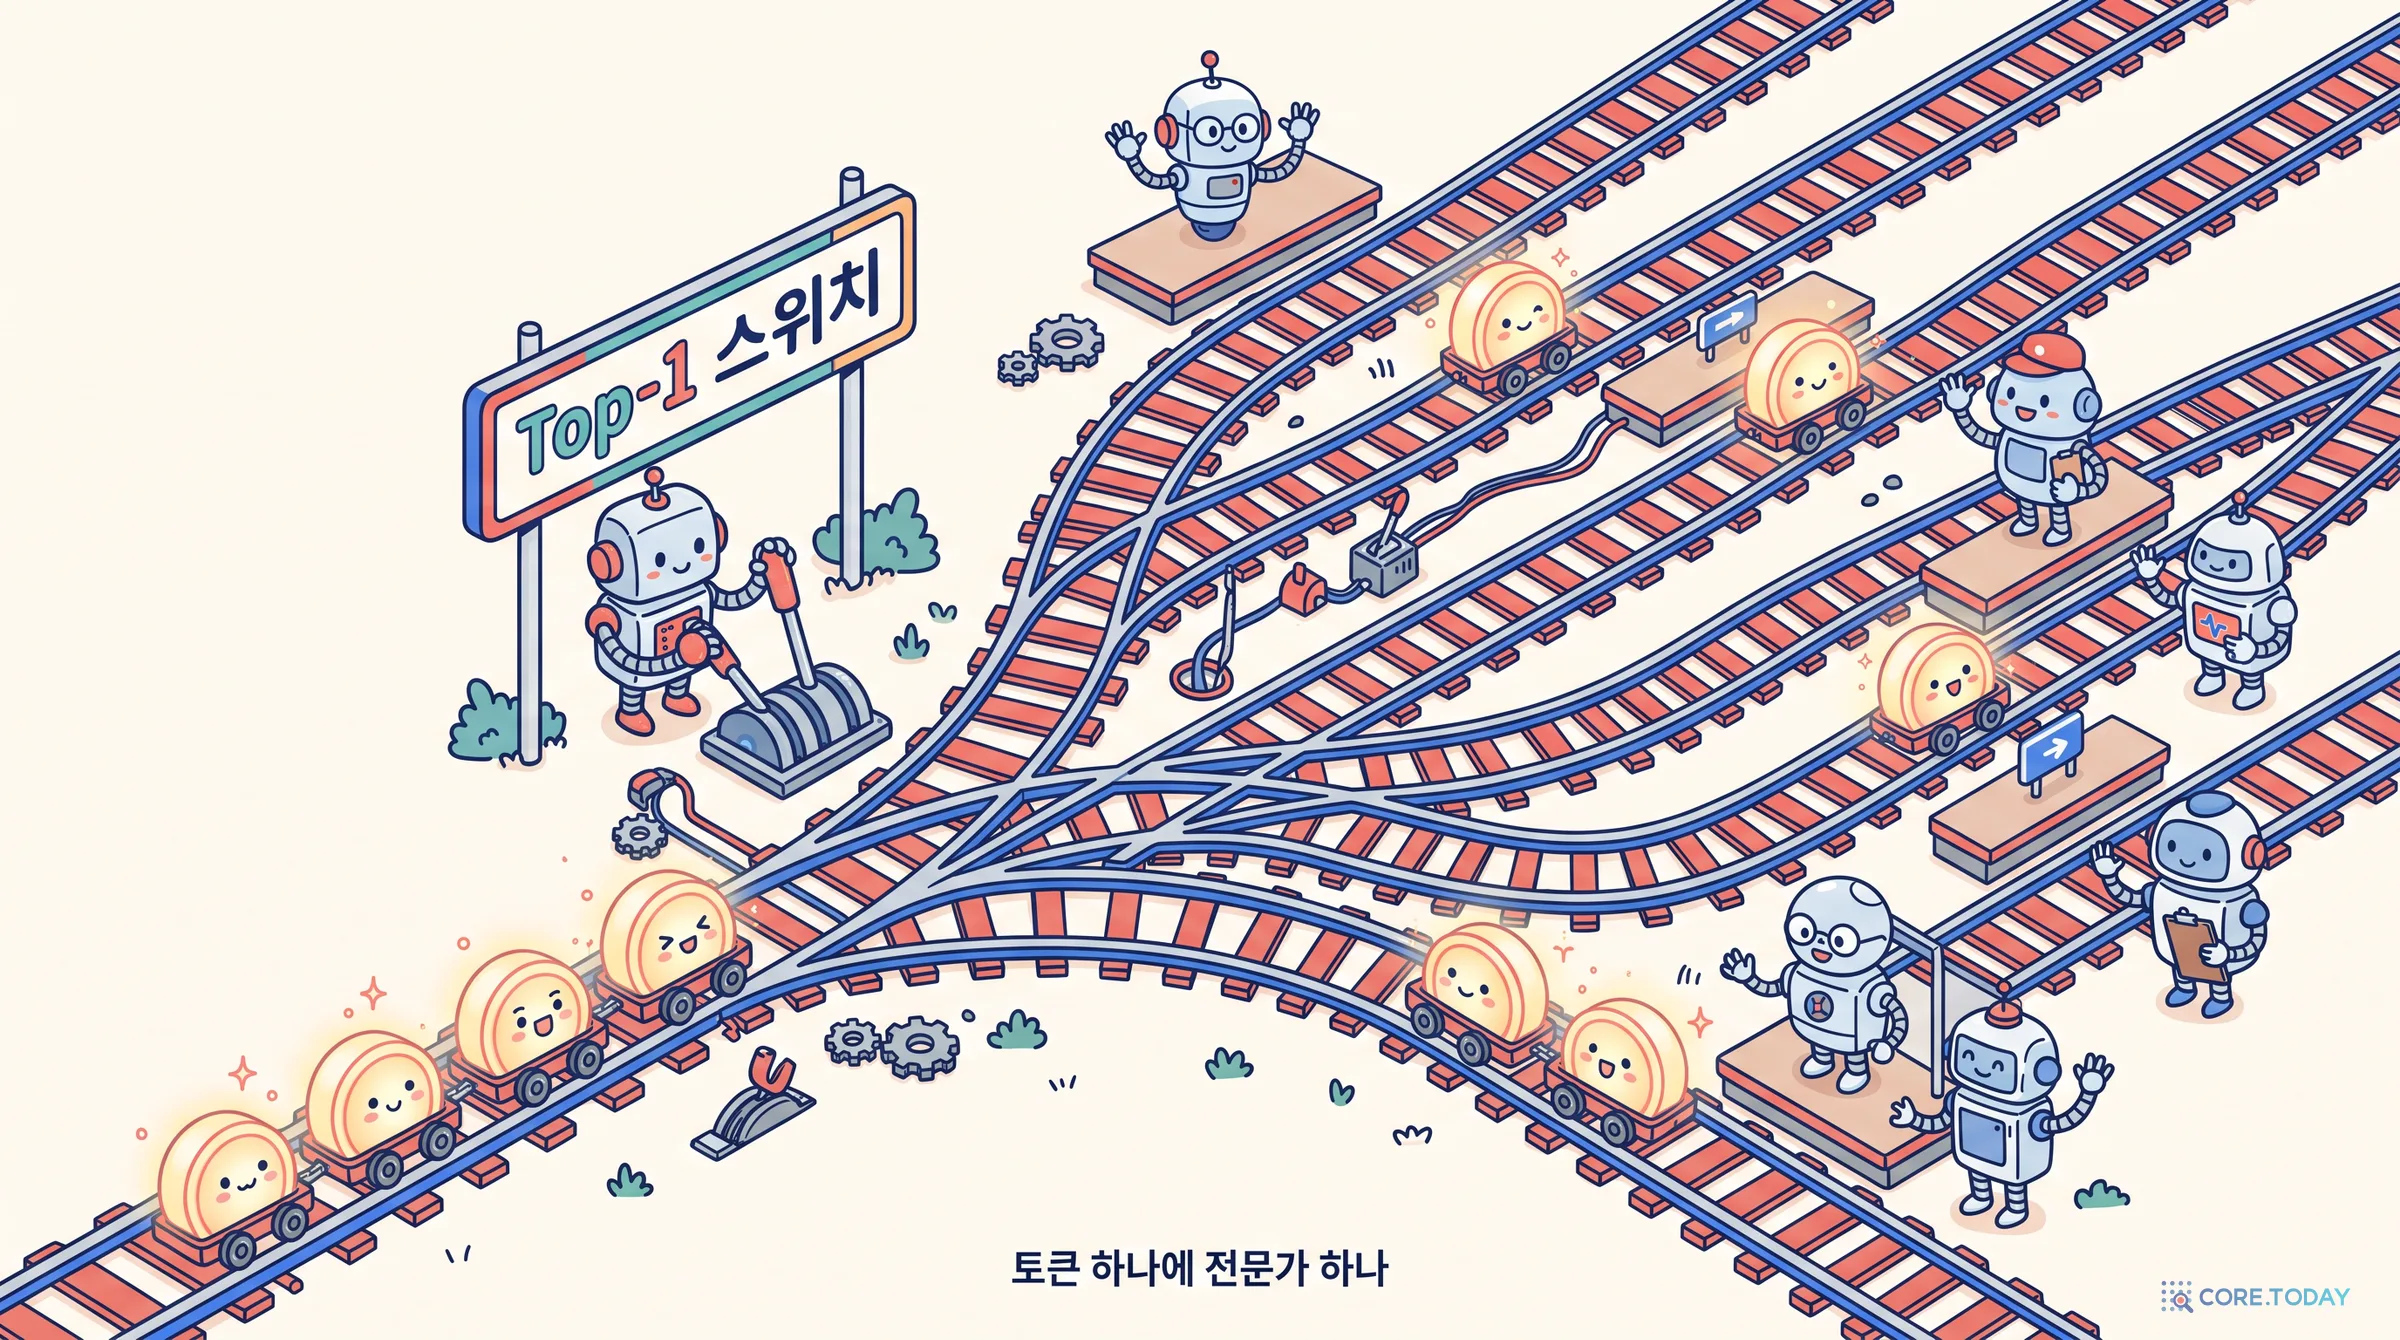
2021년 윌리엄 페더스, 바렛 조프, 셰이저의 Switch Transformer는 과감하게 단순화했다. 토큰마다 전문가 딱 한 명(top-1)만 고른다.
통념은 ‘전문가를 둘 이상 골라야 게이트가 비교하며 배울 수 있다’였다. Switch는 하나만 골라도 잘 된다는 걸 보였고, 덕분에 계산과 통신이 줄었다. 같은 계산량에서 T5보다 사전학습이 최대 7배 빨랐고, 가장 큰 Switch-C는 전문가 2,048명에 1조 6천억 파라미터였다. 학습을 안정시키는 요령도 담겼다. 라우터 계산만 float32로 하고 나머지는 bfloat16으로 하는 ‘선택적 정밀도’, 작게 초기화하기, 그리고 지금도 표준인 보조 손실 식이다(6부).
같은 해 구글의 GLaM은 1조 2천억 파라미터(GPT-3의 약 7배)에 전문가 64명, top-2 구조였다. 토큰당 활성 파라미터는 966억 개로 전체의 8%다. 학습 에너지는 GPT-3의 3분의 1(456 대 1,287MWh), 추론 계산은 절반만 쓰면서 29개 과제 평균에서 GPT-3보다 나았다.
MoE는 학습이 불안정하기로 악명 높았다. 손실이 갑자기 치솟아 학습이 망가진다. 2022년 ST-MoE 논문은 원인 중 하나로 라우터 점수(로짓)가 너무 커지는 현상을 지목하고 라우터 z-손실을 더했다.
라우터 로짓이 커지면 벌점을 주는 식이다. ST-MoE-32B는 2,690억 파라미터로 320억 덴스 모델 수준의 계산을 쓰면서 여러 과제에서 최고 성능을 냈다. 같은 해 나온 Expert Choice 라우팅은 방향을 뒤집었다. 토큰이 전문가를 고르는 대신 전문가가 자기가 처리할 토큰을 고른다. 정원이 처음부터 정해져 있으니 부하 균형이 저절로 맞는다.
역사를 따라오며 나온 개념을 한자리에 모아 보자.
| 개념 | 한 줄 설명 | 비유 |
|---|---|---|
| 전문가 (expert) | 대개 트랜스포머의 FFN 하나. 구조는 서로 같고 가중치만 다르다 | 진료실 |
| 라우터 (게이트) | 토큰마다 전문가 점수를 매기는 작은 선형 층 | 접수처 직원 |
| top-k | 점수 상위 k명만 계산에 참여 | 진료실 k곳만 들른다 |
| 총 파라미터 | 메모리에 올려야 하는 전체 크기 | 병원 전체 의료진 |
| 활성 파라미터 | 토큰 하나를 처리할 때 실제로 쓰는 크기 | 환자 한 명이 만나는 의사 |
| 부하 균형 | 전문가에게 토큰이 고르게 가도록 하는 장치 | 대기 줄 관리 |
| 전문가 용량 | 전문가 한 명이 받을 수 있는 토큰 상한 | 진료실 정원 |
| 공유 전문가 | 라우팅 없이 모든 토큰이 거치는 전문가 | 가정의학과 |
| 전문가 병렬 | 전문가들을 여러 GPU에 나눠 두는 방식 | 병원 분원 |
Mixtral 8x7B라는 이름을 보면 70억짜리 모델 8개, 즉 560억 파라미터를 떠올리기 쉽다. 실제로는 467억이다. 전문가가 되는 건 FFN뿐이고 어텐션과 임베딩은 모두가 같이 쓰기 때문이다. 토큰 하나는 전문가 2명을 거치므로 활성 파라미터는 129억이다. 이 글에 딸린 계산기(moe26-core)에 Mixtral의 층 수와 폭을 넣으면 정확히 467억과 129억이 나온다.
MoE를 볼 때 숫자 두 개를 꼭 따로 봐야 한다.
덴스 모델은 둘이 같다. MoE는 둘을 떼어 놓는다. 아래 위젯에서 지난 6년 동안 나온 모델 20종을 비교해 보자. 2021년 GLaM의 활성 비율은 8%였고, 2026년 Kimi K3는 3.7%다. 정렬을 ‘활성 비율 낮은 순’으로 바꿔 보면 최근 모델일수록 위로 올라온다. ‘직접 설계해 보기’ 탭에서는 전문가 수와 top-k를 바꿔 가며 총·활성 파라미터를 계산할 수 있다.
MoE를 처음 학습시키면 거의 반드시 이런 일이 벌어진다. 학습 초기에 우연히 조금 더 많이 뽑힌 전문가가 있다고 하자. 그 전문가는 토큰을 더 많이 받으니 더 많이 배우고, 더 잘하게 된다. 라우터는 결과가 좋은 쪽으로 점수를 올리니 그 전문가를 또 고른다. 반대로 덜 뽑힌 전문가는 배울 기회가 없어 계속 못하고, 그래서 계속 안 뽑힌다.
이 부익부 빈익빈이 끝까지 가면 전문가 몇 명이 모든 일을 하고 나머지는 파라미터만 차지한 채 논다. 이를 전문가 붕괴(expert collapse)라고 한다. 모델은 이름만 MoE이고 실제로는 작은 덴스 모델이 된다. 여러 GPU에 전문가를 나눠 둔 경우라면 인기 전문가가 있는 GPU만 바쁘고 나머지는 기다리니 시간도 낭비된다.
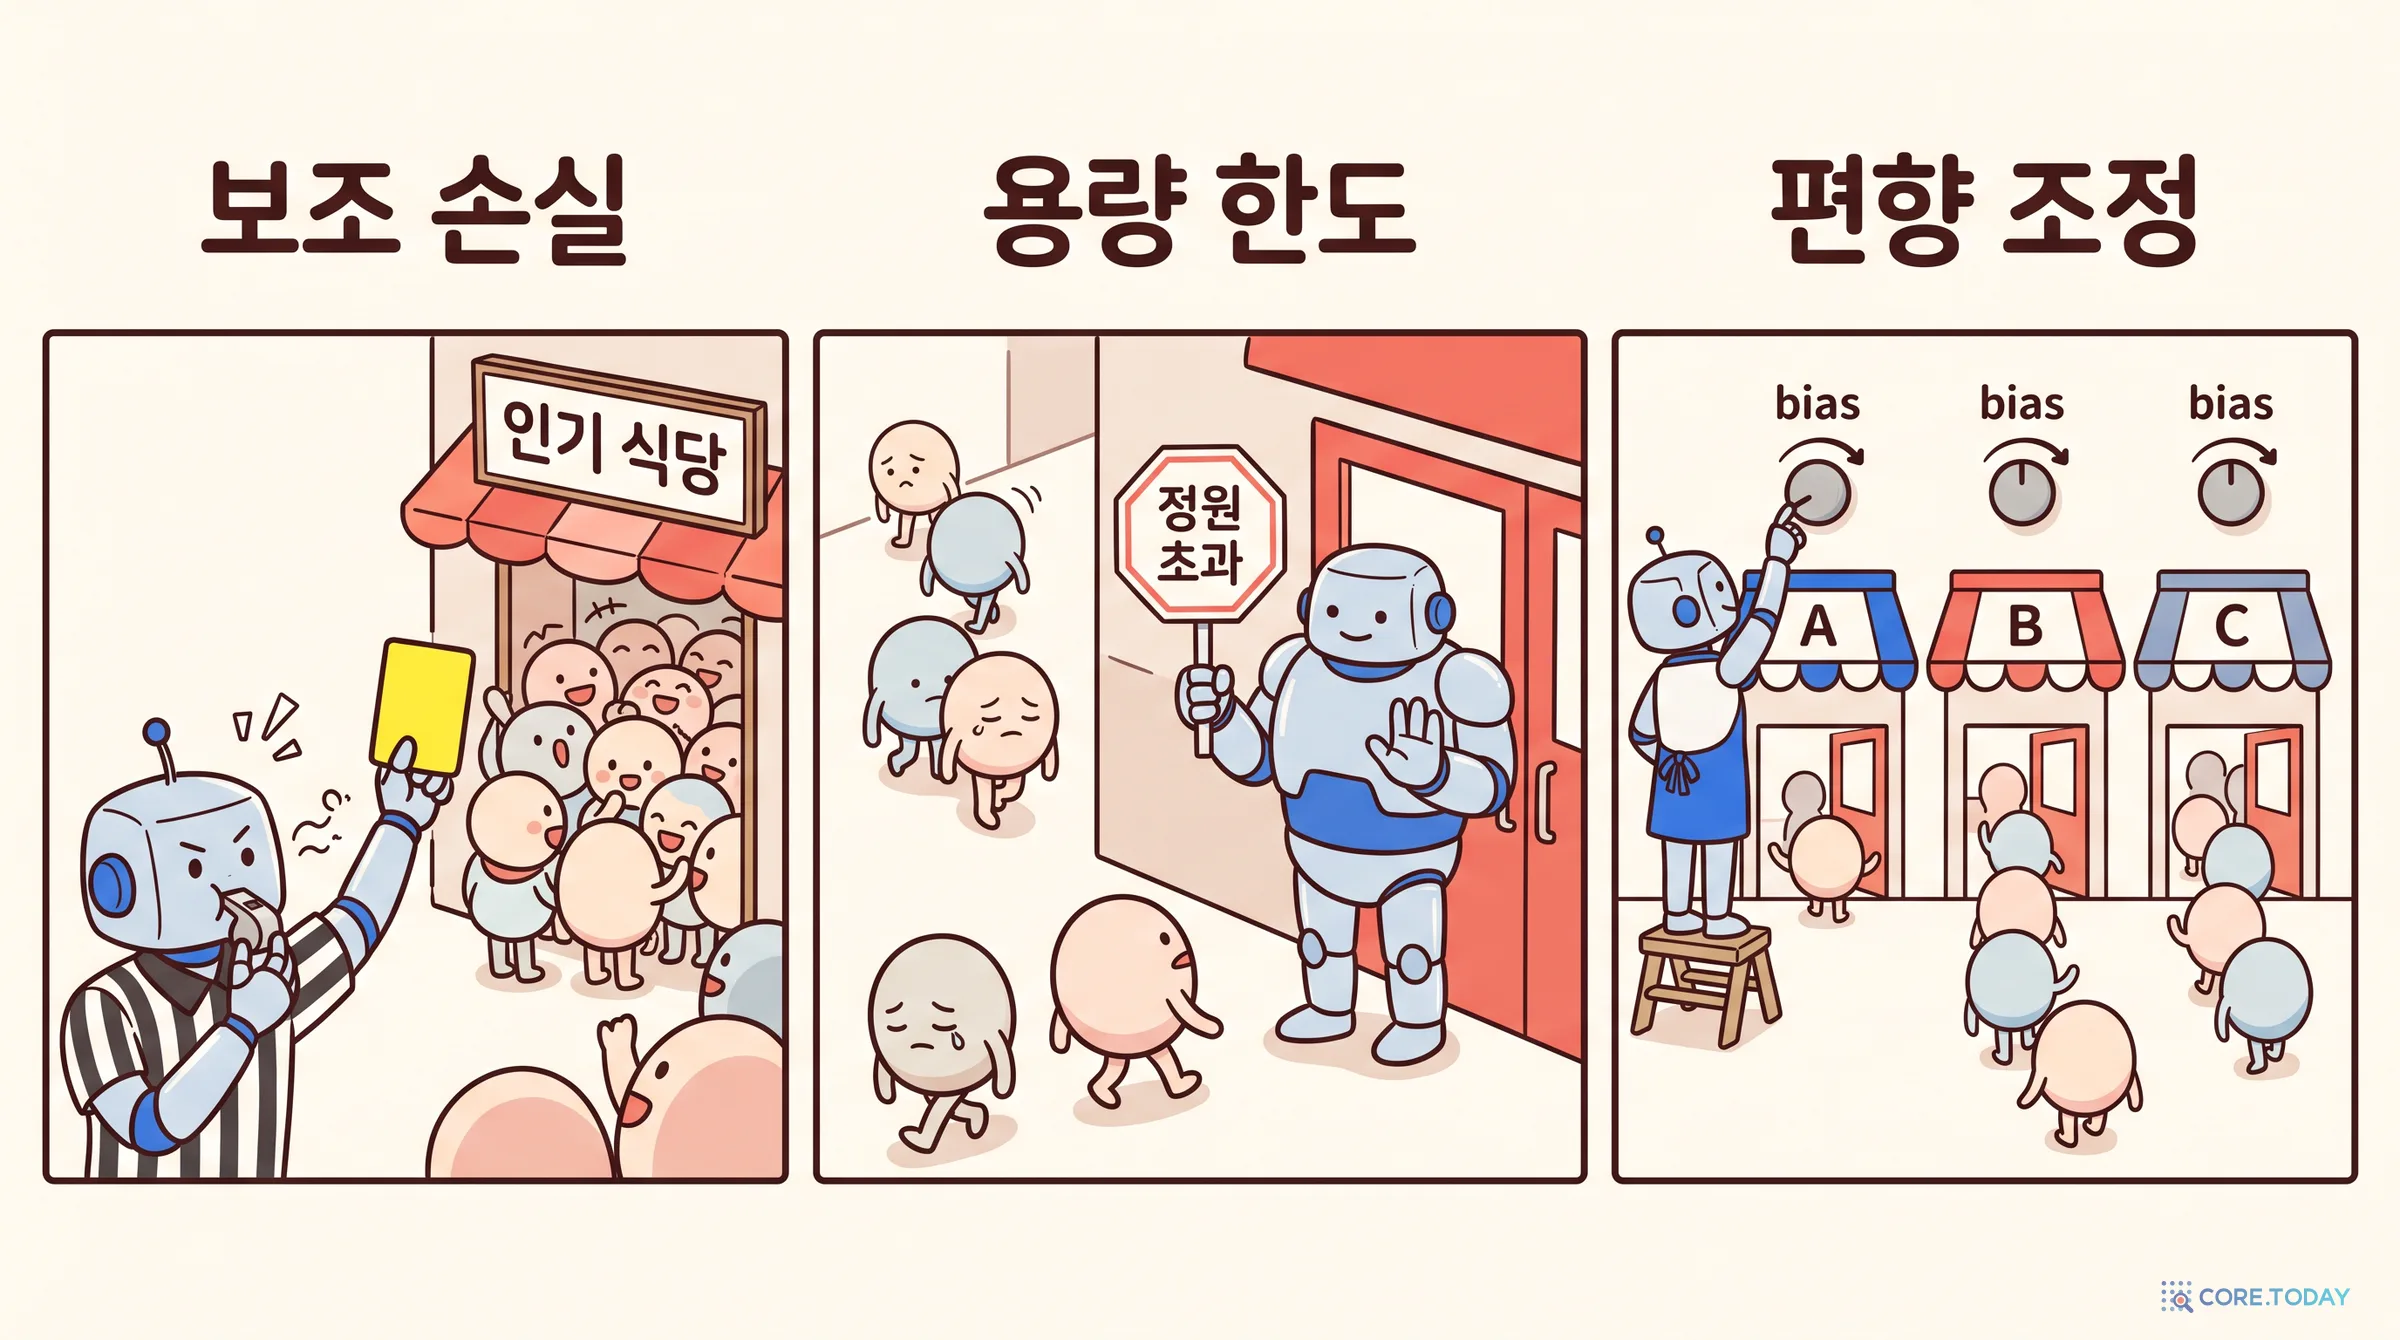
① 보조 손실(auxiliary loss). 셰이저(2017)에서 시작해 Switch Transformer가 다듬은 식이 지금도 표준이다.
는 배치에서 전문가 에게 실제로 간 토큰의 비율, 는 라우터가 전문가 에게 준 확률의 평균, 은 전문가 수다. 부하가 완전히 고르면 이 값이 최소(α)가 된다. Switch는 를 썼다. 문제는 이 벌점이 본래 목표인 언어 모델링 손실과 싸운다는 점이다. 너무 세면 라우터가 ‘잘 맞는 전문가’보다 ‘한가한 전문가’를 고르게 되고 성능이 깎인다.
② 전문가 용량(capacity factor). GShard 방식이다. 전문가 한 명이 받을 수 있는 토큰 수를 ‘(배치 토큰 수 ÷ 전문가 수) × 용량 계수’로 제한한다. ST-MoE는 용량 계수 1.25를 권했다. 과식은 막지만 넘친 토큰은 그 층을 건너뛴다. 사실상 버려지는 셈이다.
③ 편향 조정(auxiliary-loss-free). 2024년 DeepSeek 연구진(Lean Wang 외)이 제안하고 DeepSeek-V3가 쓴 방식이다. 손실 함수는 건드리지 않는다. 대신 전문가마다 편향 를 두고, 전문가를 고를 때만 점수에 더한다.
배치가 끝날 때마다 너무 많이 뽑힌 전문가는 를 γ만큼 내리고, 덜 뽑힌 전문가는 γ만큼 올린다. 섞는 가중치에는 원래 점수 를 쓰므로 모델의 계산 자체는 왜곡되지 않는다. 식당 간판의 작은 다이얼만 몰래 돌리는 셈이다. V3는 γ = 0.001을 썼다(완전히 없애지는 않고, 아주 작은 시퀀스 단위 보조 손실 α = 0.0001을 남겼다).
아래 위젯에서 네 가지 상황을 비교해 보자. 첫 번째 탭은 ‘많이 뽑힐수록 더 배운다’는 피드백만 남긴 단순화 모형이고, 두 번째 탭은 우리가 직접 학습시킨 작은 MoE의 실측 결과다(9부).
2023년 12월 미스트랄의 Mixtral 8x7B는 오픈 모델로는 처음으로 MoE의 위력을 대중에게 보여 줬다. 그런데 같은 시기 중국의 DeepSeek 연구진은 이 구조의 약점을 짚었다. 전문가가 8명뿐이면 전문가 하나가 너무 많은 종류의 지식을 떠안는다. 수학도, 코드도, 한국어 조사도 같은 전문가에게 간다. 이름만 전문가이고 사실상 만물박사가 된다.
2024년 1월 발표된 DeepSeekMoE는 두 가지 처방을 내놓았다.
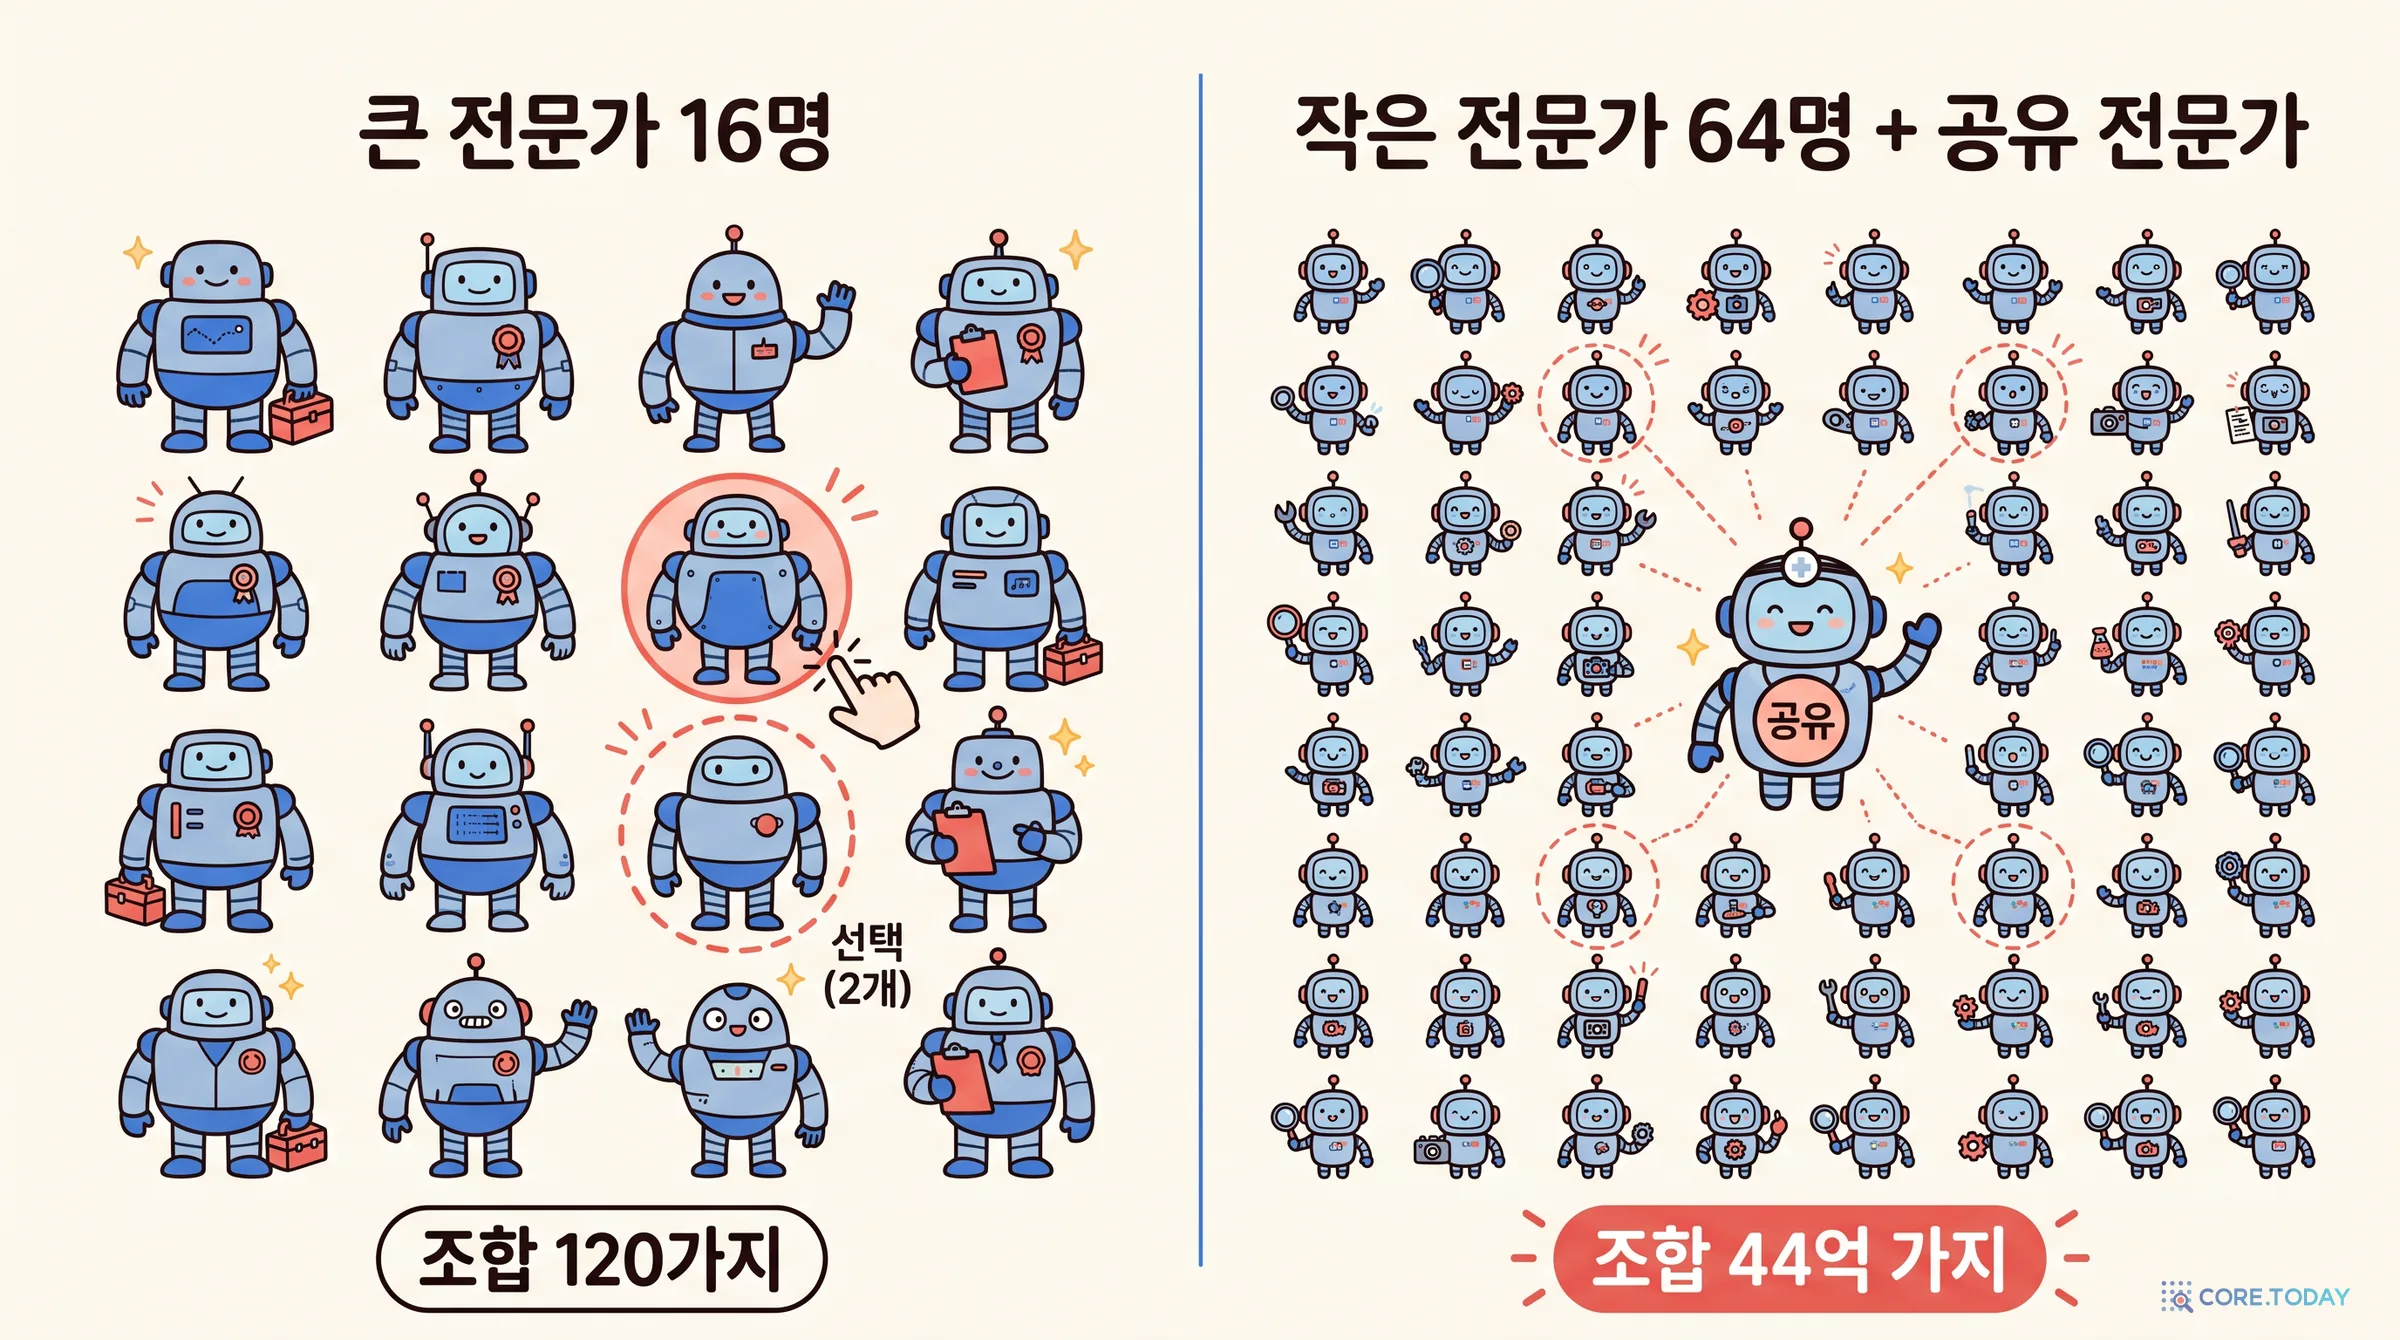
① 미세 분할(fine-grained expert segmentation). 전문가 하나를 4분의 1 크기로 쪼개 4배 많이 두고, 고르는 수도 4배로 늘린다. 계산량은 그대로인데 조합의 수가 폭발한다. 큰 전문가 16명 중 2명을 고르는 방법은 120가지지만, 작은 전문가 64명 중 8명을 고르는 방법은 44억 2,616만 5,368가지다. 토큰마다 훨씬 정교하게 맞춤 조합을 짤 수 있다.
② 공유 전문가 격리(shared expert isolation). 어떤 지식은 모든 토큰에 필요하다. 문법, 흔한 단어, 기본 상식 같은 것이다. 이런 지식을 라우팅되는 전문가들이 각자 중복해서 배우면 낭비다. 그래서 라우터를 거치지 않고 모든 토큰이 항상 거치는 공유 전문가를 따로 둔다. 종합병원으로 치면 모든 환자가 먼저 들르는 가정의학과다.
DeepSeekMoE 16B는 이 구조로 LLaMA2 7B와 비슷한 성능을 계산량의 약 40%만 써서 냈다.
2024년 5월의 DeepSeek-V2는 2,360억 파라미터 중 210억만 활성화했다. 이전 덴스 모델 DeepSeek 67B와 비교해 학습 비용은 42.5% 줄고 생성 처리량은 5.76배가 됐다(KV 캐시를 줄이는 MLA 어텐션의 공도 크다).
2024년 12월의 DeepSeek-V3는 이 노선의 결정판이었다.
마지막 숫자가 2025년 초 엔비디아 주가를 흔든 ‘딥시크 쇼크’의 진원지다. 다만 보고서 스스로 이 비용에는 “공식 학습만 포함되며” 사전 연구와 실험 비용은 빠졌다고 밝혔다. 그래도 프런티어급 모델을 학습시키는 비용이 생각보다 훨씬 낮을 수 있다는 걸 보여 줬고, 그 중심에 MoE가 있었다.
2026년 4월 공개된 DeepSeek-V4-Pro는 1조 6천억 파라미터 중 490억만 활성화한다. 라우팅 전문가 384명 중 6명에 공유 전문가 1명이다. 함께 나온 V4-Flash는 2,840억 중 130억이다. 전문가는 더 많아지고 고르는 비율은 더 작아지는 흐름이 이어진다(자세한 내용은 DeepSeek V4 Pro 특집 참고).
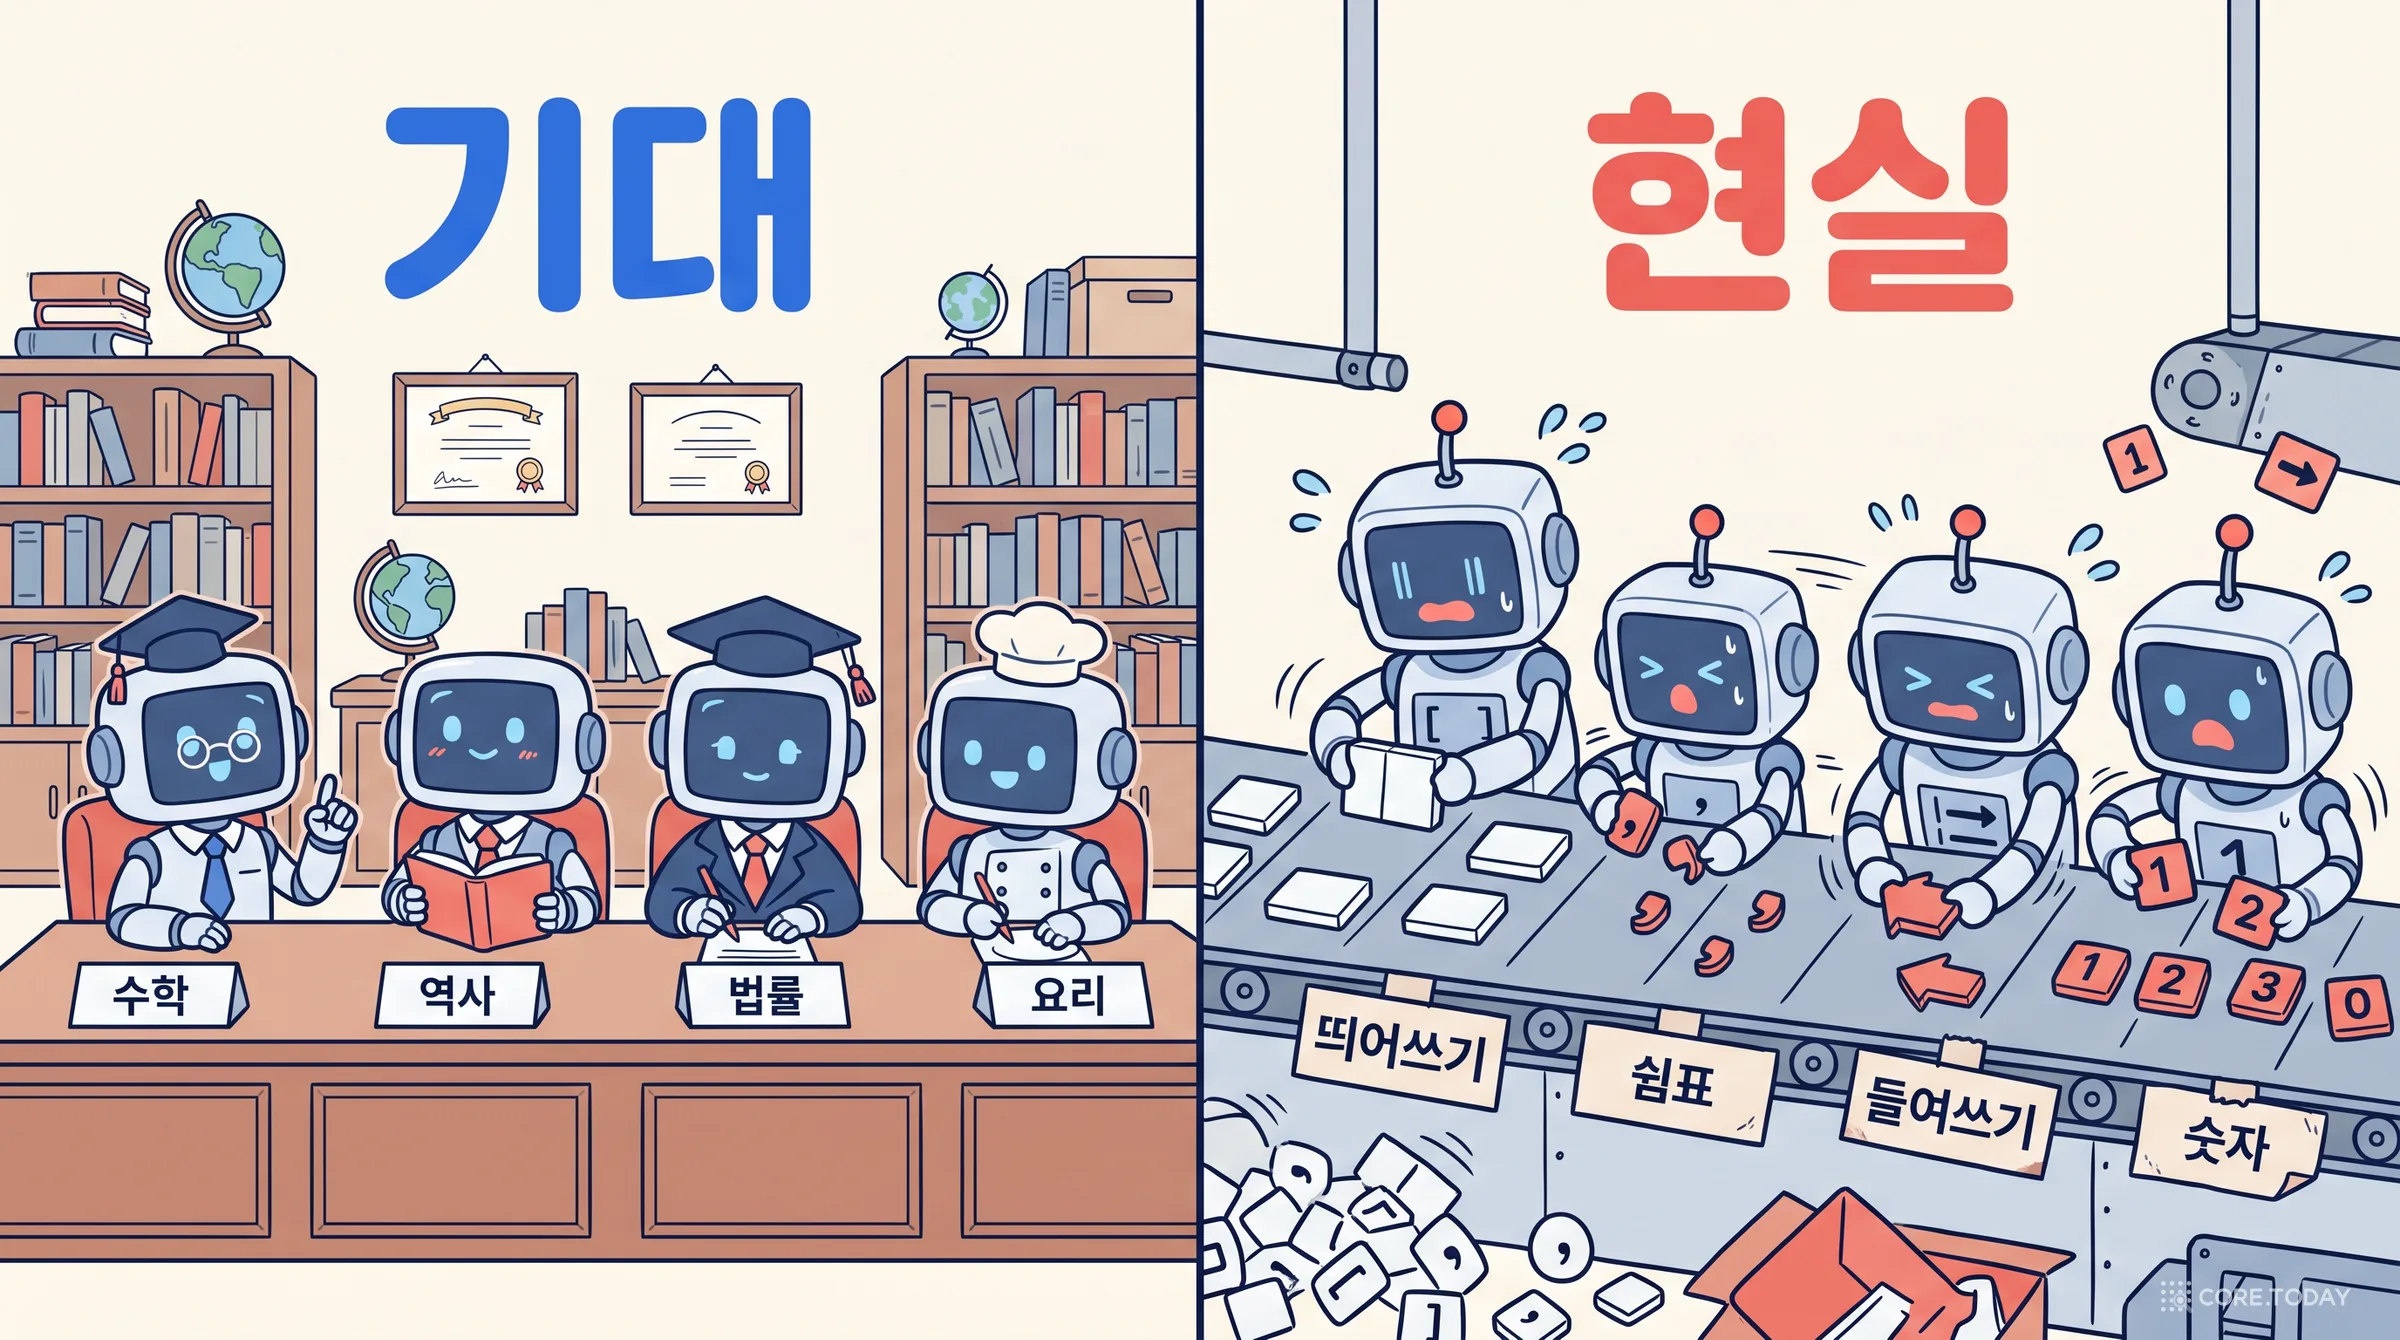
‘전문가’라는 이름을 들으면 수학 전문가, 역사 전문가, 법률 전문가를 상상하게 된다. 정말 그럴까.
Mixtral 논문은 이 질문을 직접 조사했다. 수학, 생물학, 철학, 코드 등 주제가 다른 문서를 넣고 어떤 전문가가 뽑히는지 봤다. 결론은 이랬다.
놀랍게도, 주제에 따라 전문가가 배정되는 뚜렷한 패턴은 보이지 않았다.
수학 문서(DM Mathematics)에서만 조금 차이가 났다. 대신 라우터는 문법적인 규칙을 보였다. 파이썬의 self, 들여쓰기 공백 같은 토큰이 특정 전문가로 몰렸고, 연속한 토큰이 같은 전문가로 가는 경우가 많았다. 15층에서 첫 번째 선택이 직전 토큰과 같은 비율은 24~28%로, 무작위(8명 중 1명이니 12.5%)의 두 배였다.
반면 2024년 앨런 AI 연구소가 학습 데이터까지 모두 공개한 OLMoE(총 69억, 활성 13억, 전문가 64명 중 8명)는 arXiv 논문 전용 전문가처럼 분야에 따른 특화가 뚜렷하다고 보고했다. 전문가가 잘게 쪼개질수록 특화가 더 잘 드러난다는 해석이 있다. OLMoE 연구진은 라우팅이 아주 일찍 굳는다는 사실도 발견했다. 사전학습의 1%만 지나도 최종 라우팅과 최대 60%가 같았다.
정리하면 MoE의 전문가는 사람 기준의 ‘학과’가 아니다. 학습 손실을 가장 잘 줄이는 방향으로 저절로 생긴 분업이고, 그 기준은 주제일 수도 있지만 띄어쓰기나 숫자, 코드 기호 같은 표면적인 패턴일 때가 많다.
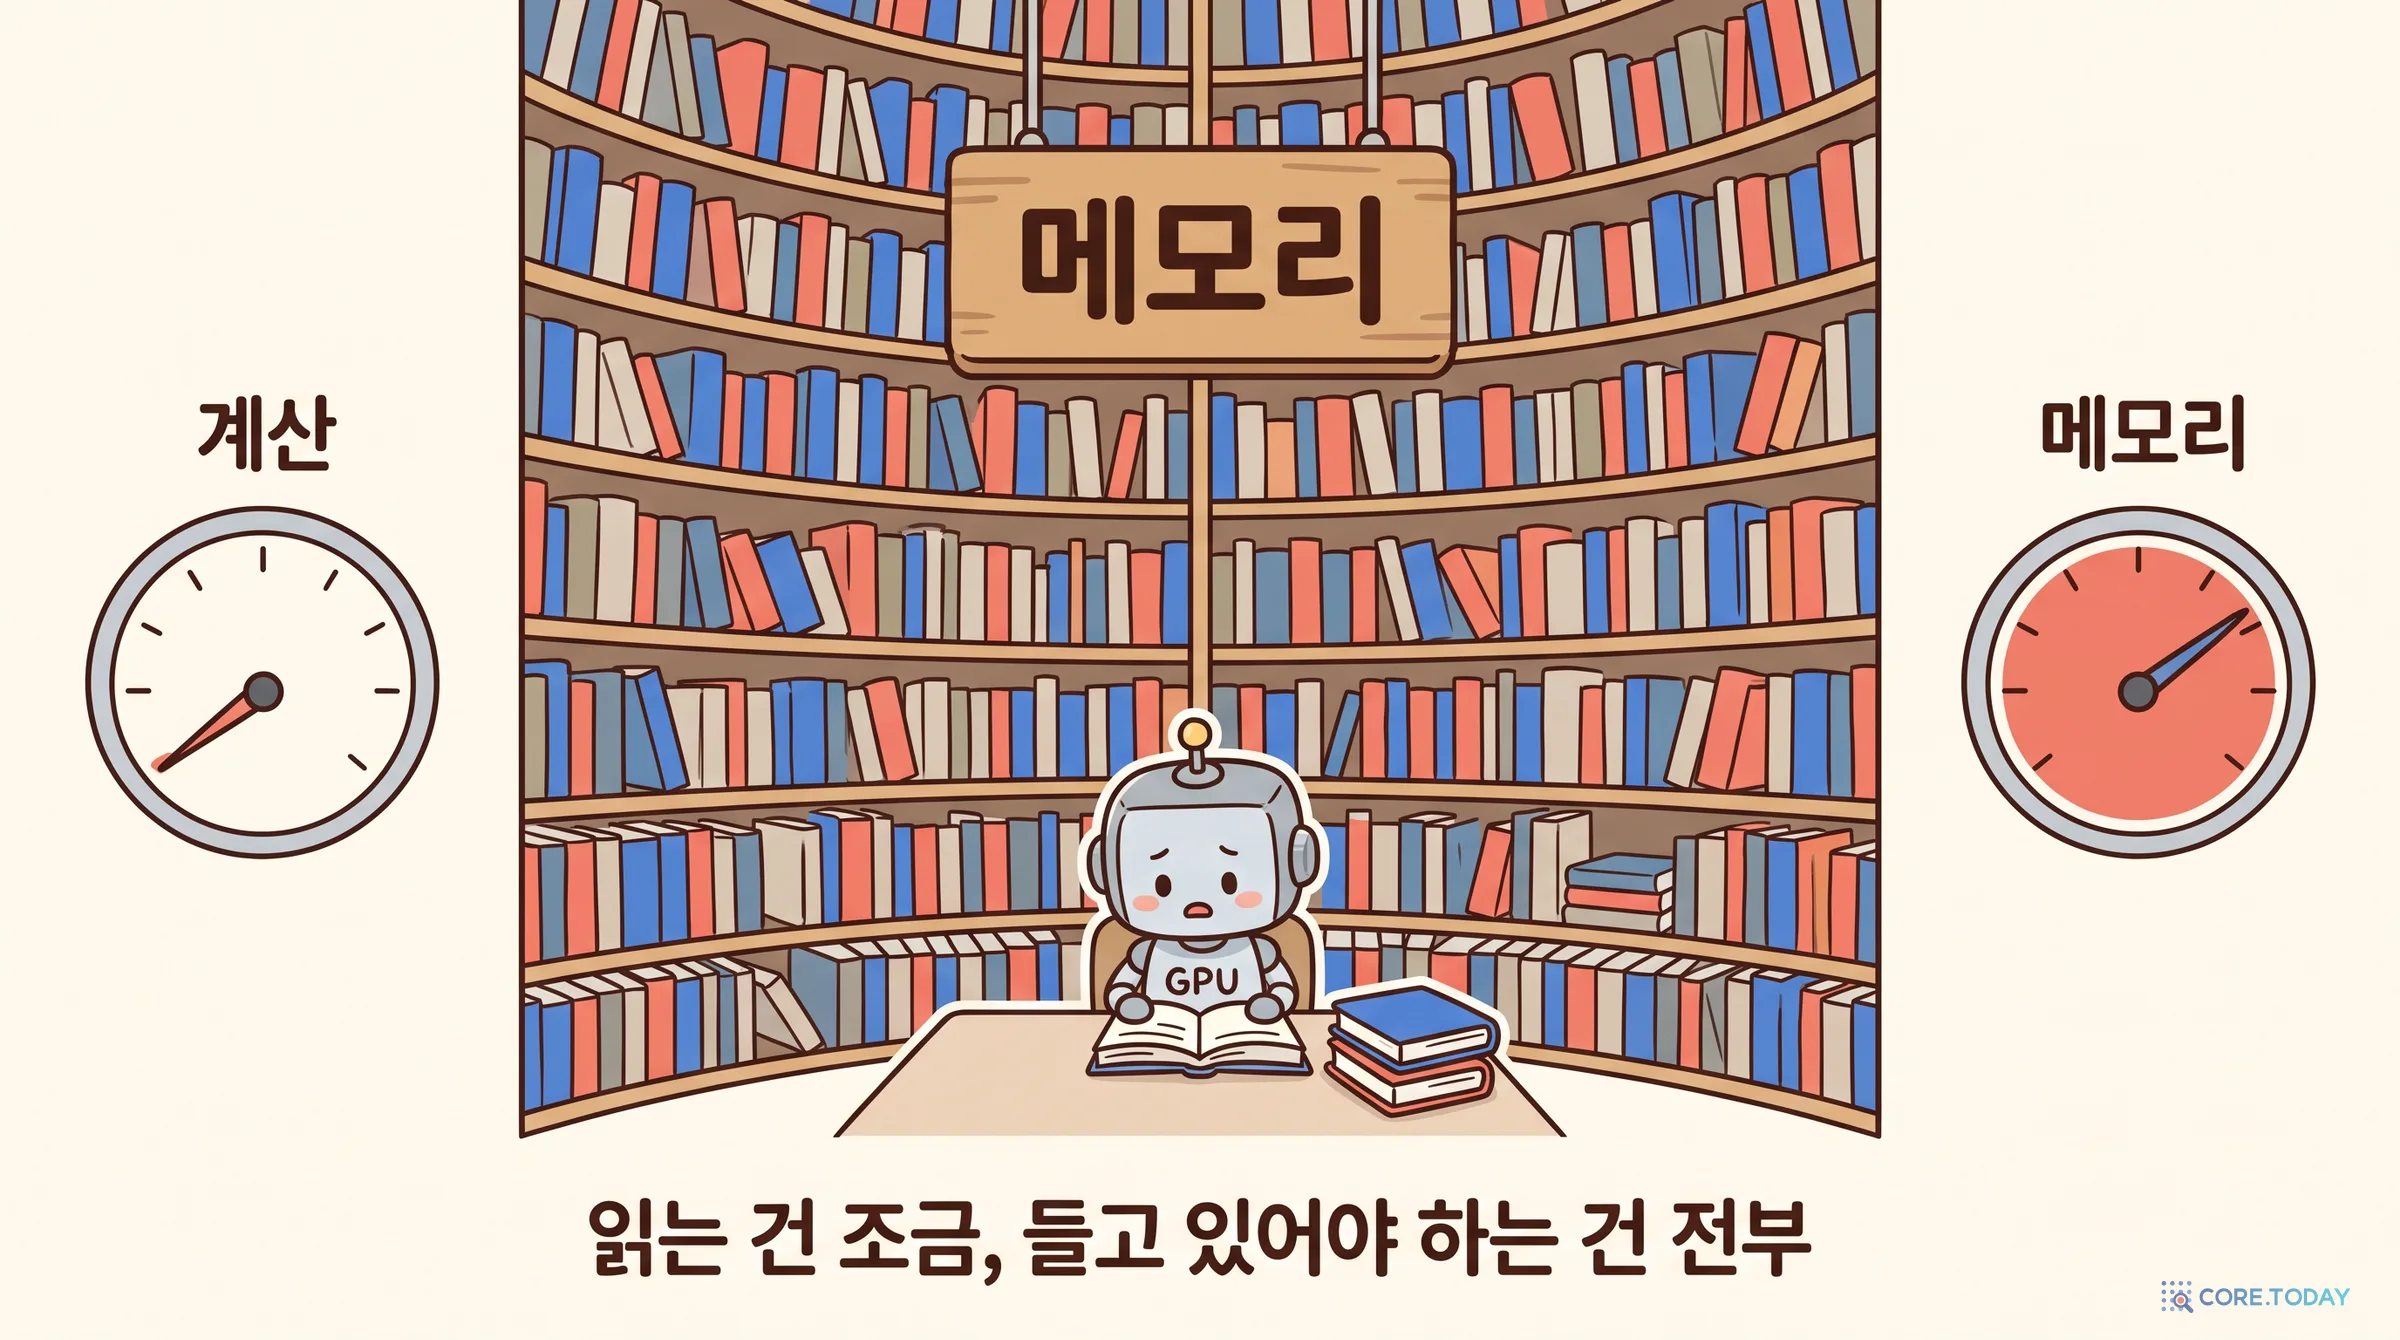
MoE의 계산은 ‘활성 파라미터’만큼이지만 메모리는 ‘총 파라미터’만큼 든다. 어느 전문가가 뽑힐지 미리 알 수 없으니 전부 가까이 둬야 한다.
DeepSeek-V4-Pro를 8비트로 올리려면 가중치만 1.6TB가 필요하다. H100(80GB) 스무 장이 넘는다. 계산만 보면 490억 덴스 모델과 비슷한데, 메모리는 1조 6천억 덴스 모델과 같다. 그래서 MoE는 메모리는 넉넉하고 계산은 아껴야 하는 곳에서 가장 빛난다. 수많은 사용자의 요청을 한데 모아 처리하는 대형 데이터센터가 그렇고, 뒤에서 보듯 메모리를 CPU와 GPU가 함께 쓰는 맥 같은 장비도 그렇다.
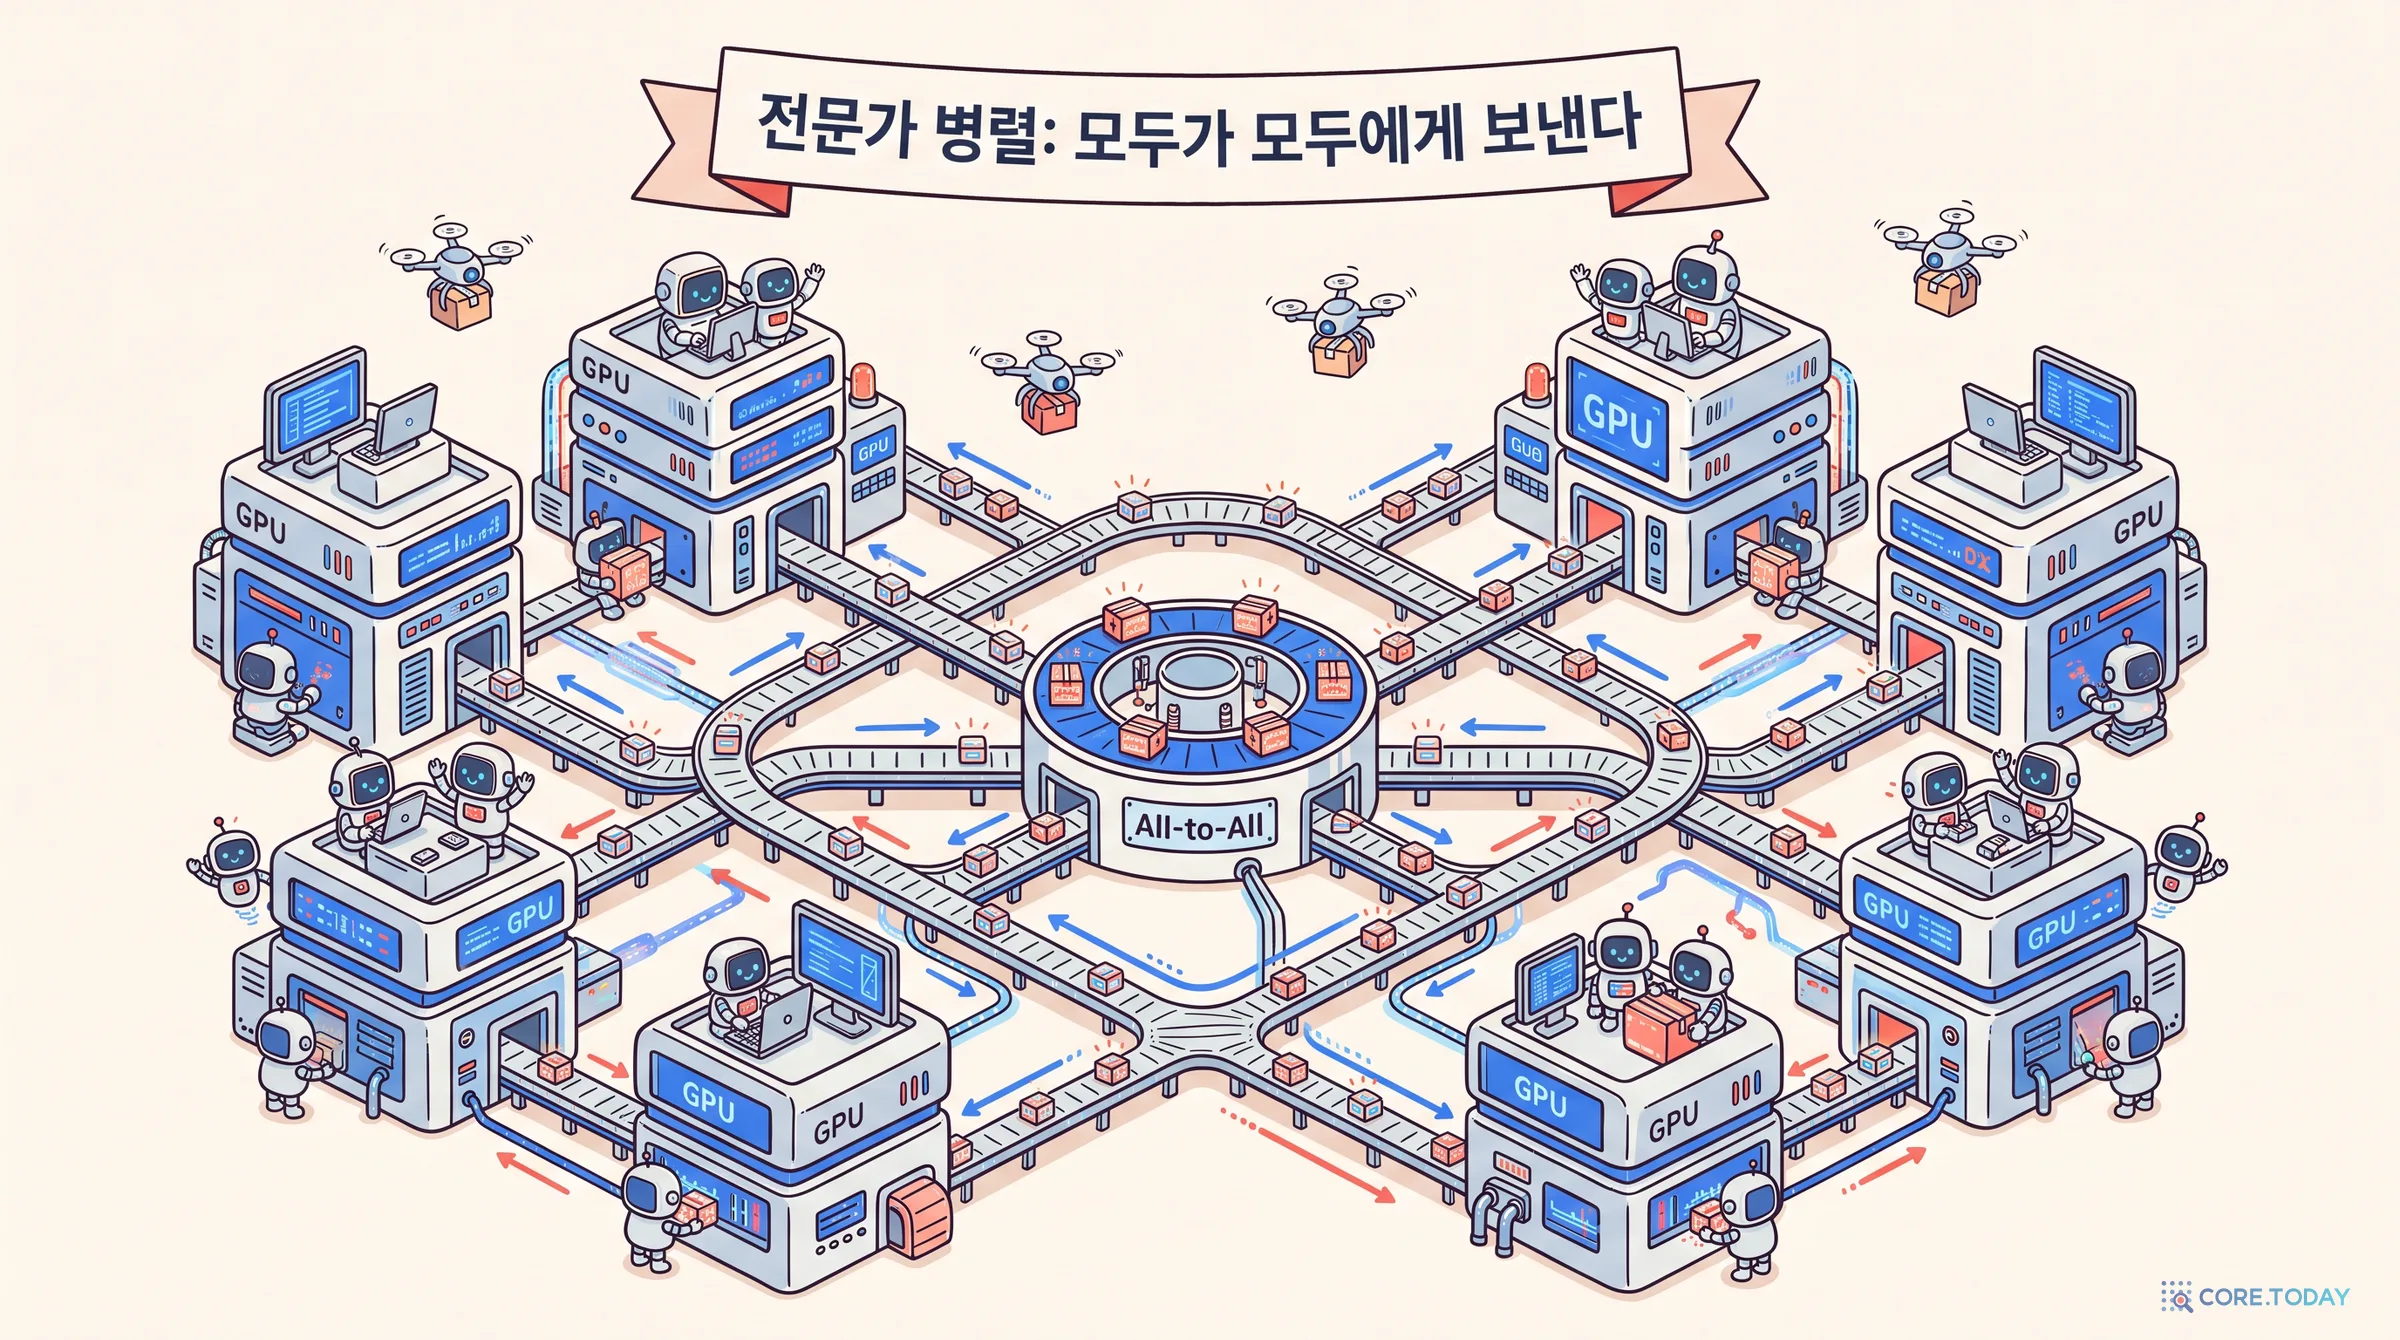
전문가가 수백 명이면 한 GPU에 다 들어가지 않는다. 그래서 GPU마다 전문가 몇 명씩 나눠 두는 전문가 병렬(expert parallelism)을 쓴다. 그러면 매 MoE 층마다 각 GPU에 있는 토큰이 자기를 맡을 전문가가 있는 GPU로 이사 갔다가 돌아와야 한다. 모든 GPU가 모든 GPU에게 데이터를 보내는 all-to-all 통신이다.
이 통신이 MoE 학습과 서빙의 가장 큰 병목이다. DeepSeek이 V3에서 토큰당 노드 수를 4개로 묶은 것도, 2025년 전문가 병렬 통신 라이브러리 DeepEP를 오픈소스로 푼 것도 이 때문이다. 엔비디아가 GPU 72개를 하나의 NVLink로 묶은 GB200 NVL72를 ‘MoE용’으로 홍보하는 이유도 같다. 엔비디아는 2025년 12월 블로그에서 Kimi K2 Thinking이 NVL72에서 H200 대비 10배 빠르다고 주장했다(제조사 자체 측정이다).
MoE의 계산 절약은 토큰이 많을수록 잘 드러난다. 사용자 수백 명의 토큰을 모으면 전문가마다 고르게 일감이 생기지만, 사용자 한 명이 짧은 질문을 던지면 토큰 몇 개가 전문가 수십 명에게 흩어져 GPU가 거의 놀면서 메모리만 읽는다. 셰이저가 2017년에 짚은 ‘배치 축소’ 문제가 그대로 남아 있는 셈이다.
MoE는 덴스 모델보다 학습이 까다롭다. 라우터 로짓 폭주, 손실 급등, 전문가 붕괴를 막기 위해 z-손실, 선택적 정밀도, 편향 조정 같은 장치가 계속 추가됐다. 미세조정에서도 작은 데이터로 학습하면 라우팅이 쉽게 흐트러지고 과적합이 잘 일어난다는 보고가 많다(ST-MoE). 그래서 MoE를 미세조정할 때는 라우터를 얼리거나 학습률을 낮추는 경우가 흔하다.
| 상황 | MoE가 유리 | 덴스가 유리 |
|---|---|---|
| 학습 예산이 정해져 있을 때 | 같은 계산으로 더 낮은 손실 | — |
| 대규모 서빙(사용자 많음) | 토큰당 비용이 낮음 | — |
| GPU 메모리가 빠듯할 때 | — | 같은 메모리에 더 강한 모델 |
| 한 사용자, 짧은 요청, 낮은 지연 | 메모리 읽기가 병목이면 이득이 줄어듦 | 구현이 단순 |
| 작은 데이터 미세조정 | 라우팅 흔들림·과적합 주의 | 안정적 |
| 메모리 대역폭에 비해 용량이 큰 장비(맥, 통합 메모리) | 큰 모델을 빠르게 | — |
2025년 4월 알리바바의 Qwen3와 메타의 Llama 4, 7월 문샷의 Kimi K2, 8월 OpenAI가 6년 만에 공개한 오픈 가중치 모델 gpt-oss가 모두 MoE였다. 엔비디아는 2025년 12월, Artificial Analysis 순위 상위 10개 오픈 모델이 모두 MoE이고 그해 오픈소스 모델 출시의 60% 이상이 MoE를 택했다고 집계했다. 비공개 모델도 마찬가지다. 구글은 Gemini 1.5부터 MoE라고 밝혔고, Gemini 2.5 기술 보고서도 희소 MoE 트랜스포머 위에 만들었다고 적었다. (GPT-4가 1조 8천억 파라미터 MoE라는 2023년의 이야기는 유출 소문일 뿐 OpenAI가 확인한 적은 없다.)
한국도 같은 길을 걸었다. 2025년 말부터 업스테이지 Solar Open 100B(활성 120억), SKT A.X K1(5,190억 중 330억), LG AI연구원 K-EXAONE(2,360억 중 230억), 카카오 kanana-2-30b-a3b(300억 중 30억)가 잇달아 MoE로 공개됐다. 2026년 8월 LG의 K-EXAONE 2.0은 7,500억 파라미터로 커졌다. 국가 단위로 큰 모델을 만들되 운영 비용을 감당하려면 MoE 말고는 답이 없다는 판단이다.
2026년 MoE의 가장 뚜렷한 흐름은 극단적 희소화다.
| 모델 | 총 / 활성 | 전문가 구성 | 활성 비율 |
|---|---|---|---|
| Mixtral 8x7B (2023) | 467억 / 129억 | 8명 중 2명 | 27.6% |
| DeepSeek-V3 (2024) | 6,710억 / 370억 | 256명 중 8명 + 공유 1 | 5.5% |
| DeepSeek-V4-Pro (2026.4) | 1조 6천억 / 490억 | 384명 중 6명 + 공유 1 | 3.1% |
| Kimi K3 (2026.6) | 2조 8천억 / 1,040억 | 896명 중 16명 + 공유 2 | 3.7% |
| Qwen3.8-2.4T-A95B (2026.8) | 2조 4천억 / 950억 | 512명 중 10명 + 공유 1 | 4.0% |
이 흐름에는 이론적 근거도 생겼다. 2024년 크라예프스키 등은 전문가를 FFN 크기 그대로 두는 것이 거의 언제나 최적이 아니며, 더 잘게 쪼갤수록(‘세분도’를 높일수록) 좋다는 스케일링 법칙을 내놓았다. 2025년 애플의 압나르 등은 계산 예산마다 최적의 희소도가 있다고 보였다. 앤트그룹 링 팀은 ICLR 2026 논문에서 ‘효율 레버리지’라는 지표로, 활성 8.5억짜리 MoE가 61억 덴스 모델과 같은 성능을 7배 넘게 적은 계산으로 낸다고 보고했다.
2026년 1월 DeepSeek 연구진(저자 목록 기준)은 「확장 가능한 조회를 통한 조건부 기억: 희소성의 새로운 축」이라는 논문에서 Engram을 발표했다. MoE가 ‘어떤 계산을 할지’를 희소하게 고른다면, Engram은 거대한 n-그램 표에서 ‘어떤 기억을 꺼낼지’를 희소하게 고른다. 270억 규모에서 같은 계산량의 MoE보다 MMLU가 3.4점 높았다. Qwen3.8-Flash-Next는 MoE 옆에 510억 파라미터짜리 n-그램 임베딩을 붙여 나왔다. ‘전부 들고 있되 조금만 쓴다’는 MoE의 철학이 계산에서 기억으로 번지고 있다.
MoE는 데이터센터 기술로 시작했지만 2026년에는 개인 장비로도 내려왔다. OpenAI의 gpt-oss-20b(총 209억, 활성 36억)는 MoE 가중치를 4비트대(MXFP4)로 저장해 16GB 메모리에서 돈다. llama.cpp는 --cpu-moe, --n-cpu-moe 옵션으로 전문가 가중치만 CPU 메모리에 두고 나머지를 GPU에 올리는 방법을 제공한다. 활성 파라미터가 작으니 메모리 대역폭이 넉넉하지 않은 장비에서도 토큰이 빠르게 나온다. 10부의 실측이 이걸 보여 준다.
2026년의 관점에서 MoE의 의미를 세 가지로 정리할 수 있다.
1991년 제이콥스와 힌턴의 전문가들은 직선 하나를 긋는 선형 모델이었고, 맡은 일은 모음 네 개였다. 2026년의 전문가들은 하나하나가 수천만 파라미터의 신경망이고, 수백 명이 모여 2조 개가 넘는 파라미터를 이룬다. 그러나 핵심 아이디어는 그대로다. 일을 나누고, 누가 맡을지 고르는 법을 함께 배운다.
35년 사이에 바뀐 것은 ‘고르기’의 의미다. 1991년에는 모든 전문가가 계산한 뒤 결과를 섞었다. 2017년 셰이저는 고르지 않은 전문가는 아예 계산하지 않게 했고, 그 순간 MoE는 계산을 아끼는 기술이 됐다. 그 뒤의 역사는 고르기를 더 공정하게(부하 균형), 더 정교하게(미세 분할), 더 싸게(통신 최적화) 만드는 과정이었다.
--cpu-moe, --n-cpu-moe).RELATED