
TECH BLOG
기술 블로그
AI 기술 인사이트와 엔지니어링 경험을 공유합니다.
EDITOR'S PICK
에디터 추천
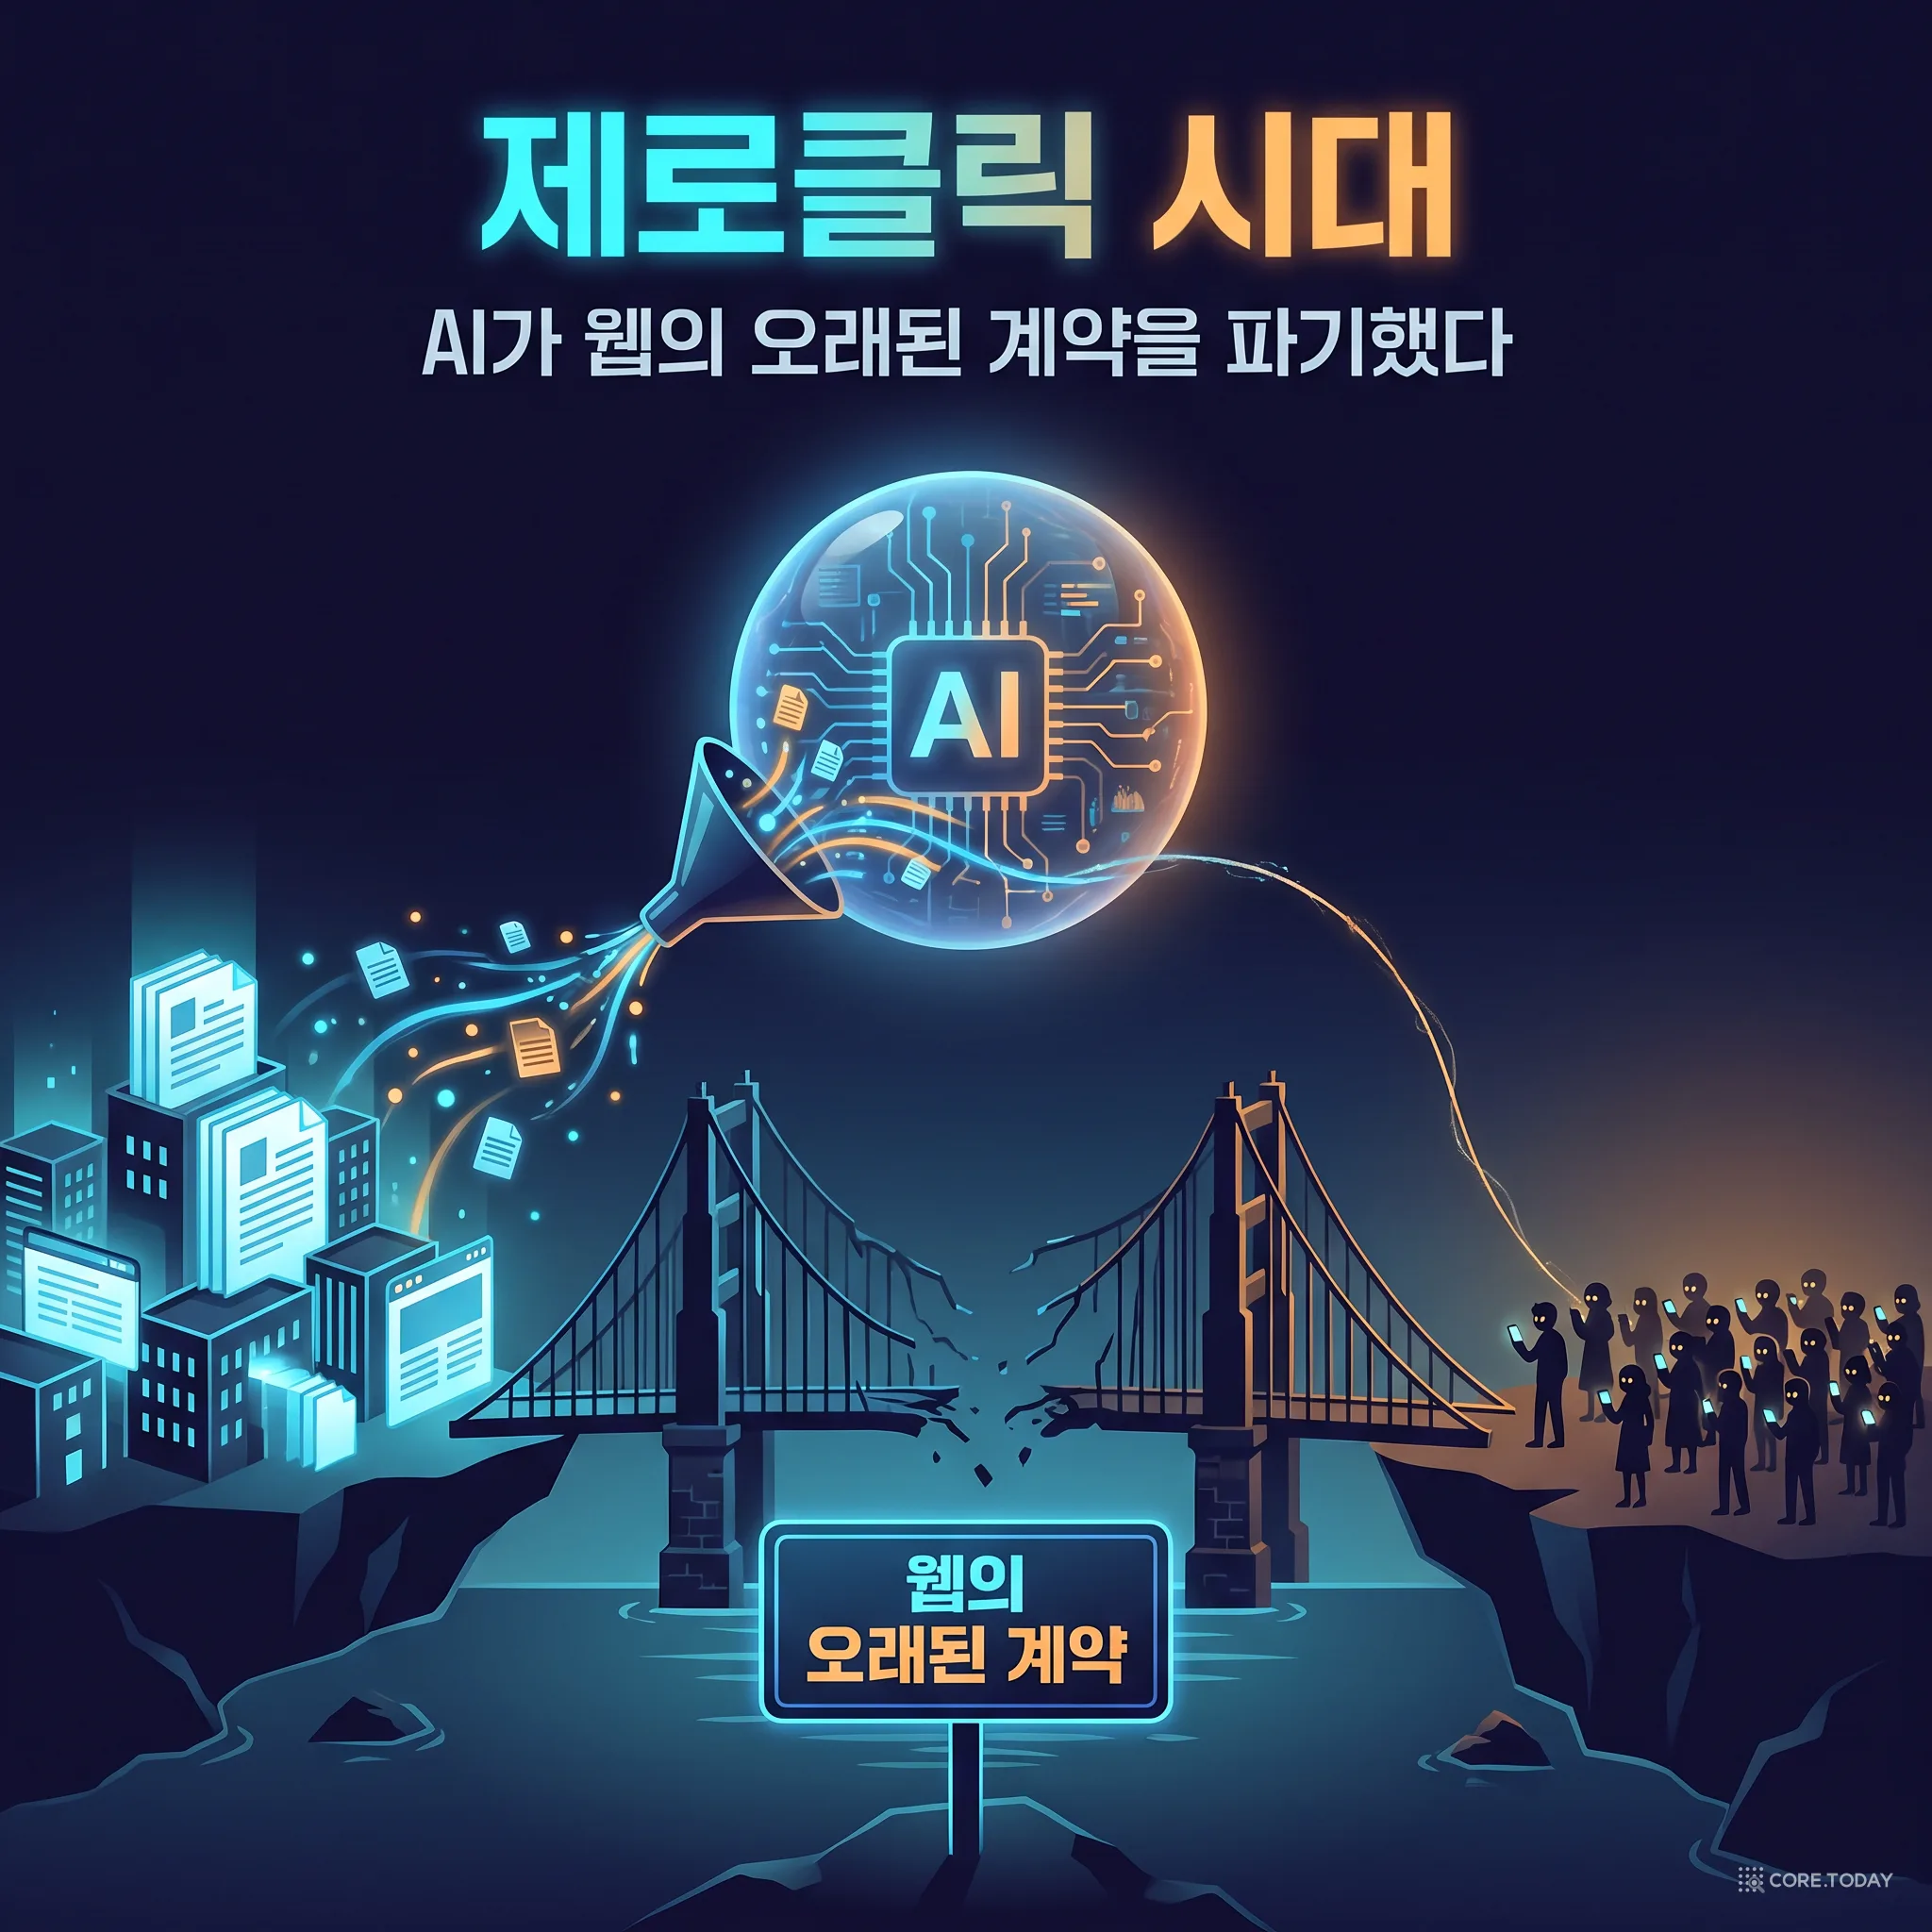
제로클릭 시대 — AI가 웹의 오래된 계약을 파기했다
2026년 8월, 프랑스 신문협회가 구글을 경쟁당국에 제소했다. AI 요약이 언론사 트래픽을 최대 38% 깎아냈다는 규제기관의 추정이 근거였다. 30년간 웹을 지탱해 온 암묵적 계약 — '콘텐츠를 긁어가는 대신 방문자를 돌려보낸다' — 이 깨지고 있다. 구글은 크롤 5번에 방문자 1명을 돌려보내지만, AI 크롤러는 수천, 수만 번을 긁고 1명을 돌려보낸다. Stack Overflow의 질문은 76% 줄었고, 한국의 네이버 블로거들은 수익 급감을 호소한다. 이 글은 이 계약이 어떻게 만들어졌고 왜 깨졌는지, 지금 무슨 일이 벌어지고 있는지, 그리고 콘텐츠를 만드는 조직이 실무적으로 무엇을 해야 하는지를 정리한다.
이단자(Heretic) 특집: '안전 정렬'을 30분 만에 외과수술로 제거하는 도구 — 거부의 단 하나의 방향
Trendshift '오늘의 1위 저장소' 등극, 커뮤니티가 3,000+ 모델을 만들고 있는 화제의 도구 Heretic. 2024년 Arditi 등의 발견 — '대형 언어 모델의 거부 행동은 잔차 흐름의 단 하나의 방향이 매개한다' — 을 출발점으로, 직교화(orthogonalization) · 투영 어블리트레이션 · 노름 보존 양투영(norm-preserving biprojection)을 거쳐 Optuna TPE 자동 튜너까지. 검열을 제거하면서도 KL divergence 0.16(Gemma-3-12B 기준, 경쟁 도구의 1/3~1/6)을 달성한 이 도구의 수학·구현·역사·윤리를 한 번에 정리한다.
Attention의 모든 것: '집중'이 AI의 역사를 바꾸기까지
2014년, 한 박사과정생이 '신경망에게 집중력을 주자'는 아이디어로 번역의 벽을 넘었다. 3년 뒤, 8명의 구글 연구자가 '집중만 있으면 된다'고 선언했다. Attention 메커니즘의 역사, 직관적 이해, 그리고 트랜스포머 혁명의 전 과정을 추적한다.
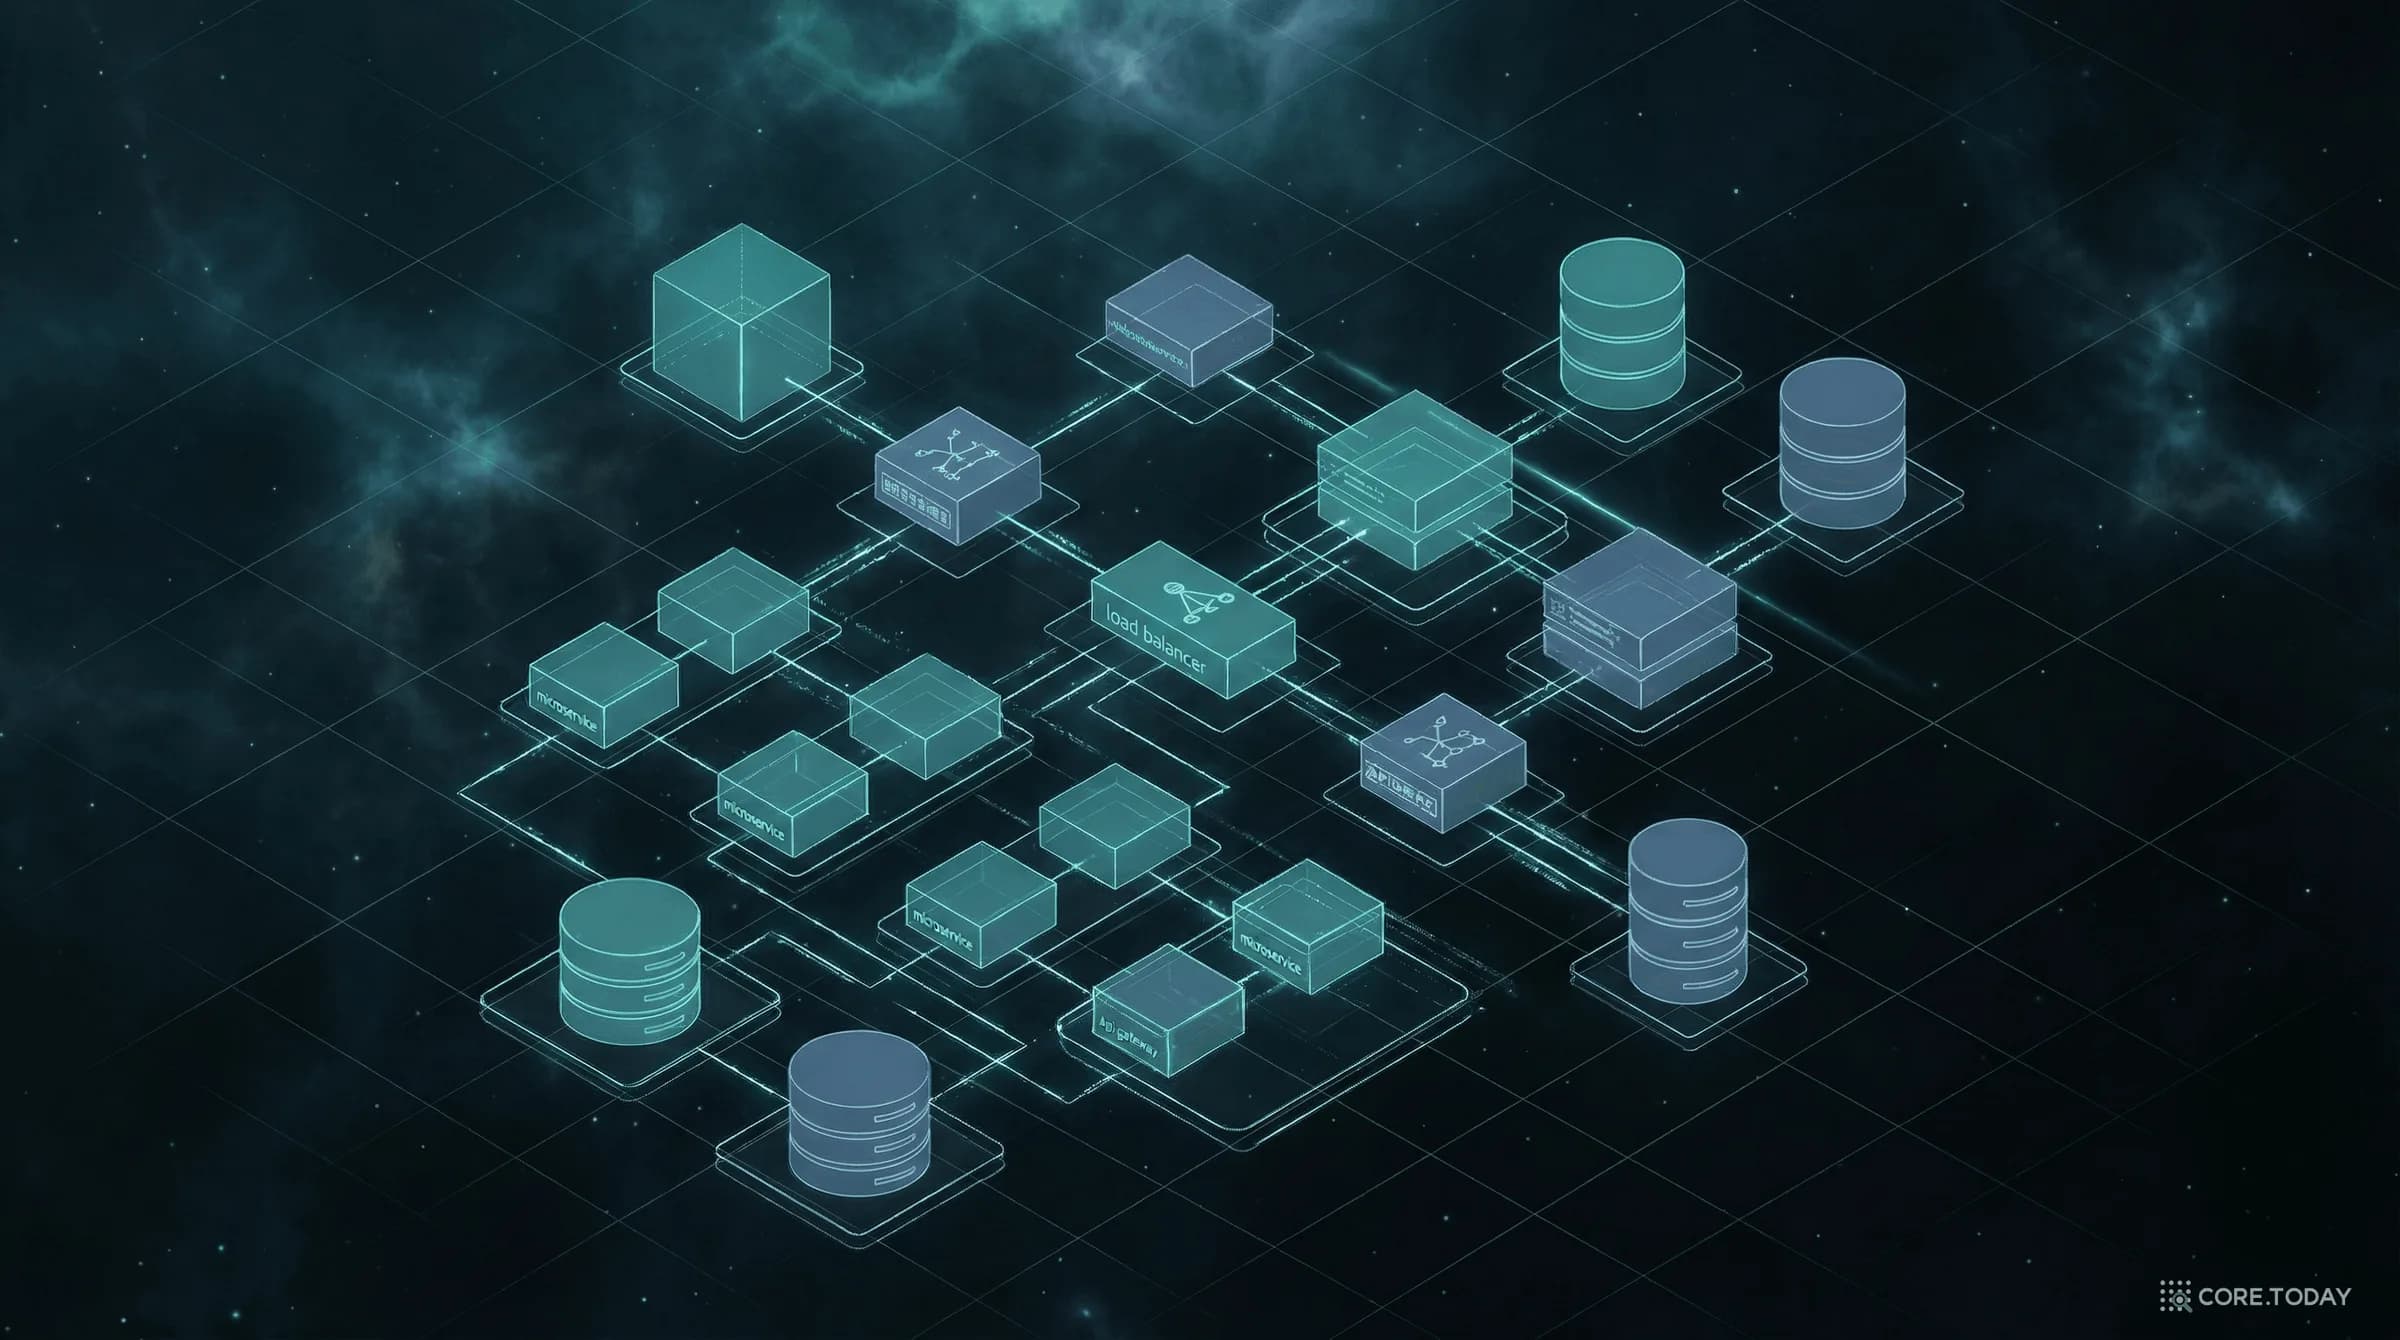
그림으로 설계 못하면 구현 못한다 — DX를 위한 시스템 아키텍처의 기술
DX 전문가 로드맵 5편 — 폰 노이만의 1945년 설계부터 2026년 AI 인프라까지. 카카오 판교 화재 10시간 장애, Facebook BGP 6시간 정전, Netflix Chaos Monkey의 교훈 — 시스템 아키텍처는 '그림을 그리는 능력'에서 시작한다.
ALL POSTS
모든 포스트
‘롯데 홈구장 새로 짓는 거’를 찾아라 — 부산 공적 기록으로 잰 한국어 임베딩 모델 14종
사실탐색기가 질문 속 바꿔 말한 이름을 찾을 때 쓰는 임베딩 모델을 고르려고, 부산 공적 기록 362건에서 만든 네 과제로 임베딩 14종(설정 28가지)을 맥과 A100에서 쟀습니다. 한국어로 다시 학습한 1.1B 모델 KURE-v3가 8B 모델들보다 앞섰고, 300M짜리 EmbeddingGemma 1세대가 그 바로 뒤에 붙었습니다. 그러나 과제마다 1위가 바뀌었고, 권장 접두사를 빼면 1위 모델이 글자 검색보다도 못해졌으며, 열네 모델 가운데 여섯은 ‘7월 1일’과 ‘7월 8일’처럼 숫자 하나 다른 값의 절반 넘게를 같은 값 쪽으로 봤습니다. 무엇을 고를지와 함께, 임베딩에 맡기지 말아야 할 일을 정리했습니다.
‘299억’을 고른 재정렬기 — 재정렬기 15종·로컬 LLM·질의 고쳐 쓰기로 정한 사실탐색기 검색 설계
1편에서 고른 임베딩 KURE-v3 위에 무엇을 더 얹어야 할지 정하려고, 재정렬기 15종과 로컬 LLM 두 개, 질의 고쳐 쓰기, 문단에 제목 붙이기를 같은 부산 시험지로 쟀습니다. 재정렬기는 근거·술어 찾기를 올렸지만 주어 찾기는 대부분 깎았습니다. 작은 재정렬기는 '순천만 박람회 경제적 효과'에 대상 이름 대신 '299억'을 골랐습니다. 지시문 한 줄이 이 어긋남을 고쳤고, 값 가르기까지 거의 완벽하게 만들었습니다. 근거 찾기의 가장 큰 개선은 재정렬이 아니라 제목 붙이기였고, '기록에 없음'은 어떤 점수로도 잘 걸러지지 않았습니다. 프로덕트에 무엇을 넣을지 설치 환경별로 정리했습니다.
‘비슷하다’는 네 가지 질문이다 — 알프스 꽃밭의 자카드에서 2026년 한국어 사실탐색기까지, 유사도 125년
2026년 10월, 코어닷투데이 사실탐색기는 부산 조례 부칙의 '1981년 1월 1일부터 시행'과 '1984년 1월 1일부터 시행'을 같은 값으로 묶었습니다. 두 문장이 71% 비슷하다는 계산 때문이었습니다. 이 글은 '비슷하다'를 재는 기술이 왜 생겨났는지부터 시작합니다. 1901년 알프스 식물 목록을 비교한 자카드, 인구조사 이름을 소리로 묶은 사운덱스, 단어를 벡터로 바꾼 설턴과 IDF의 스파크 존스, 뜻을 좌표로 만든 임베딩까지요. 그리고 같은 기술이 한국어 공적 기록 앞에서 어디서 미끄러지는지, 2026년 임베딩 14종 실측과 최신 논문으로 따라갑니다. 결론은 하나입니다. '비슷하다'는 같은 대상·같은 값·같은 사건·비슷한 사안이라는 네 가지 다른 질문이고, 질문마다 도구가 다릅니다.
약속은 사실이 아니다 — 코어닷투데이 사실탐색기 v2 설계
에이전트 기억 엔진 다섯 개를 해부하고 나서 남은 질문은 하나였다. 공적 기록에서 '지금 참인 것'은 무엇이고, 누가 그것을 바꿀 수 있는가. 최신 문장이 이기는 기억은 개인 비서에게는 맞지만, 국장의 약속·뉴스의 오보·공보의 확정이 섞인 세계에서는 틀린 답을 자신 있게 낸다. 코어닷투데이 사실탐색기 v2는 문장을 클레임과 명제로 가르고, 권위 격자(전언 ≺ 1인칭 ≺ 공식)와 발화행위로 '닫을 자격'을 따지는 AGS(권위 기반 대체)를 중심에 둔다. 닫는 조건 다섯 가지, 도착 순서와 무관한 키별 재생, 허용성 세 축과 인증서로 정하는 기권, 지우지 않고 가리는 봉인, 세상 사실과 사용자 기억의 분리, 그리고 한국어를 1급 시민으로 다루는 결정론 계층까지 — 설계의 뼈대를 위젯 4개로 직접 돌려 본다.
실패는 열쇠에서 났다 — 사실탐색기 v2를 실제 공시 2,851건과 부산 기록 362건에 돌려 보니
합성 코퍼스에서 모든 질문을 맞힌 사실탐색기 v2를 실제 기록에 넣었다. 2026년 DART 배당 공시 2,742건과 뉴스 109건, 부산시의회 회의록·고시공고·조례 공포문·현행 조례 362건이다. 깨진 곳은 권위를 따지는 AGS가 아니라 그 앞의 '열쇠'였다. DART에서 정정이 아닌 대체 305건 가운데 304건이 열쇠 오류였다. 분기배당 네 번이 한 열쇠가 되었고, 지주사가 자회사 배당을 다시 낸 공시가 주체를 바꿨고, 서로 다른 조례의 '이 조례'가 시행일을 서로 덮었다. 원칙 하나 — 기록 밖에서 뜻이 정해지지 않는 주어는 그 기록의 이름으로 좁힌다 — 와 측정으로 고른 회차 간격 45일·연도 오기 문턱 180일, 그리고 '설명되지 않는 대체'라는 건강 신호로 부산의 숨은 버그 94건을 6건까지 줄인 과정을 위젯 4개로 따라간다.
답은 맞았는데 서랍은 엉망 — 에이전트 기억을 '속까지' 채점하는 FEB-30, 그리고 한국어 미니판 실측
에이전트 기억은 지금까지 '질문에 답을 잘하나'로만 채점됐습니다. AWS와 클루지나포카 공대 연구진의 FEB-30(arXiv 2610.22209)은 문서가 하나 들어올 때마다 기억 저장소를 직접 열어 정답 상태와 비교하자고 제안합니다. 30개 궤적에서 서랍 검사(내재)와 질문 채점(외재)은 평균 16.8점 벌어졌고, 두 채점의 통과·실패 일치도는 κ=0.118로 우연을 겨우 넘었습니다. 시스템이 생성·강화·갱신·대체 중 맞는 연산을 고른 비율은 20%였습니다. 이 개념이 어디서 왔는지(1993년 스파크 존스의 내재·외재 구분, 2013년 word2vec 유추, 2016년 '내재 점수는 실전을 예측하지 못한다' 논쟁)부터, 논문의 설계·표 13개·숨은 모순(외재 점수 30개 중 16개가 11번 내내 정확히 50%), 한국어 궤적 12개로 직접 돌린 미니 실측(같은 저장소가 판정 방식만 바꿔 100%와 25%), 2026년 기억 시스템의 변화와 실무 점검표까지 정리했습니다. 인터랙티브 7개.
[특집] 체육관에 지게차를 들이면 — AI가 대신 풀어 주는 세상에서 배운다는 것, 그리고 AI 튜터는 버티는가
테드 창은 숙제를 ChatGPT에 맡기는 것을 '역도장에 지게차를 들이는 것'에 빗댔다. 생성 효과와 인출 연습, 바람직한 어려움 같은 학습 과학, 소크라테스에서 계산기와 GPS까지 이어진 '떠넘기기'의 역사, 그리고 바스타니의 1,000명 실험부터 철회된 메타분석까지 2023~2026년의 증거를 정리한다. 마지막으로 AI 튜터 5종이 '답만 알려 달라'는 학생의 압박을 몇 번째 턴에 무너지는지 직접 쟀다.
[특집] 기계가 해설자가 될 때 — Manim 해설 에이전트의 1년 반, 그리고 정리 10개를 직접 영상으로 만들어 보다
3Blue1Brown의 그랜트 샌더슨은 해설 영상을 만들려고 Manim을 직접 만들었다. 2025년 TheoremExplainAgent 이후 LLM이 Manim 코드를 써서 정리 해설 영상을 만드는 연구가 이어졌다. Manim의 구조와 역사, 애니메이션 학습 연구의 미지근한 숫자, TheoremExplainAgent와 Code2Video·OmniManim·ManimAgent까지 정리했다. 그리고 정리 10개를 Claude 세 모델과 로컬 Qwen에게 맡겨 영상 80편을 직접 만들고 렌더 성공률, 오류 원인, 배치와 수학 오류, 화면을 보고 고치기의 효과를 쟀다.
기억력 시험은 만점, 심부름은 낙제 — MemoryArena가 보여 준 에이전트 기억의 진짜 시험
LoCoMo 같은 기억력 시험에서 90점대를 받는 에이전트가, 어제 산 카메라에 맞는 렌즈를 오늘 사 오는 심부름은 거의 못 합니다. ICML 2026 논문 MemoryArena는 기억을 '회상'이 아니라 '다음 행동'으로 채점합니다. 묶음 쇼핑·단체 여행·점진 검색·수학/물리 증명 사슬 701과제(하위 과제 4,850개)에서 롱컨텍스트·기억 에이전트·RAG 13가지 방식의 과제 성공률은 모두 0.20 이하였고, 단체 여행은 전원 0이었습니다. 기억 장치를 붙였다고 나아지지도 않았습니다. 왜 이런 시험이 필요해졌는지 1990년대 인지과학과 POMDP부터 건초더미 속 바늘, LoCoMo·LongMemEval까지 거슬러 올라가고, 네 경기장의 설계와 표·그림·부록 사례·공개 심사평을 하나씩 읽습니다. 공개 데이터로 '기억해 내기'와 '기억으로 행동하기'를 직접 갈라 재 보니, 같은 모델이 같은 기억으로 앞 여행자의 선택을 97% 떠올렸지만 그 선택을 기준 삼은 행동은 36%만 맞혔고, 필요한 사실을 정답으로 쥐여 줘도 31%였습니다. 모델이 직접 쓴 요약 메모는 취향만 적고 결정을 버려 회상 0%였습니다. 인터랙티브 5개.