4096차원에 HNSW가 필요한 이유 — 전수 비교의 벽, 차원의 저주, 그리고 그래프를 걸어서 찾는 법 (한국어 검색 스택 4편)
1편에서 가장 좋았던 Qwen3-Embedding-8B는 문장 하나를 4,096개 숫자로 바꿉니다. 문서 589건이면 질문 하나에 589번 내적하면 되니 1초도 안 걸립니다. 그런데 문서가 5,000만 건이면? 같은 방식으로는 질문 하나에 2,000억 번 곱셈이고, 서버가 아무리 좋아도 초 단위입니다. 벡터 DB가 HNSW라는 인덱스를 쓰는 이유가 여기 있습니다. 이 글은 왜 고차원에서는 트리 인덱스가 소용없는지(차원의 저주), HNSW가 어떻게 스킵 리스트와 작은 세상 그래프를 합쳐 로그 시간에 근사 최근접을 찾는지, M·ef_construction·ef_search 세 손잡이가 무엇을 바꾸는지를 그림과 장난감 시뮬레이터로 풀고, 4,096차원 벡터 1만·10만·30만 개로 전수 비교와 hnswlib을 직접 재서 비교합니다. 10만 개에서 전수 비교 56ms 대 HNSW 1.3ms(재현율 0.98). 그리고 4,096차원의 진짜 병목은 그래프가 아니라 벡터 자체라는 것, 그래서 3편의 마트료시카 절단과 양자화가 HNSW와 곱해진다는 것을 메모리 계산기로 보입니다. 인터랙티브 4개와 삽화 8장.
이 시리즈의 실험은 문서 589건으로 했습니다. 질문 하나가 오면 589개 벡터와 전부 내적해서 가장 큰 열 개를 고릅니다. 넘파이로 행렬곱 한 번, 1밀리초도 안 걸립니다. 그래서 1~3편에는 인덱스가 없었습니다.
그런데 독자 여러분이 만들 시스템은 589건이 아닐 것입니다. 원문 메모의 예시는 5,000만 청크였습니다. 전수 비교는 문서 수에 정비례하므로, 5,000만 건이면 질문 하나에 4,096 × 5,000만 = 2,000억 번의 곱셈 입니다. 최신 CPU 한 코어가 초당 수백억 번쯤 하니 몇 초, GPU를 써도 메모리 대역폭에 막힙니다. 검색 한 번에 몇 초는 쓸 수 없습니다.
벡터 DB가 하는 일의 핵심이 이것입니다. 전부 비교하지 않고 거의 같은 답 을 훨씬 빨리 찾는 것. 그 대표적인 방법이 HNSW(Hierarchical Navigable Small World)이고, pgvector·OpenSearch·Elasticsearch·Qdrant·Milvus·Weaviate가 모두 기본 또는 주력으로 씁니다. 이 글은 왜 그것이 필요하고 어떻게 작동하며 무엇을 조절해야 하는지를, 4,096차원 벡터로 직접 재면서 설명합니다.
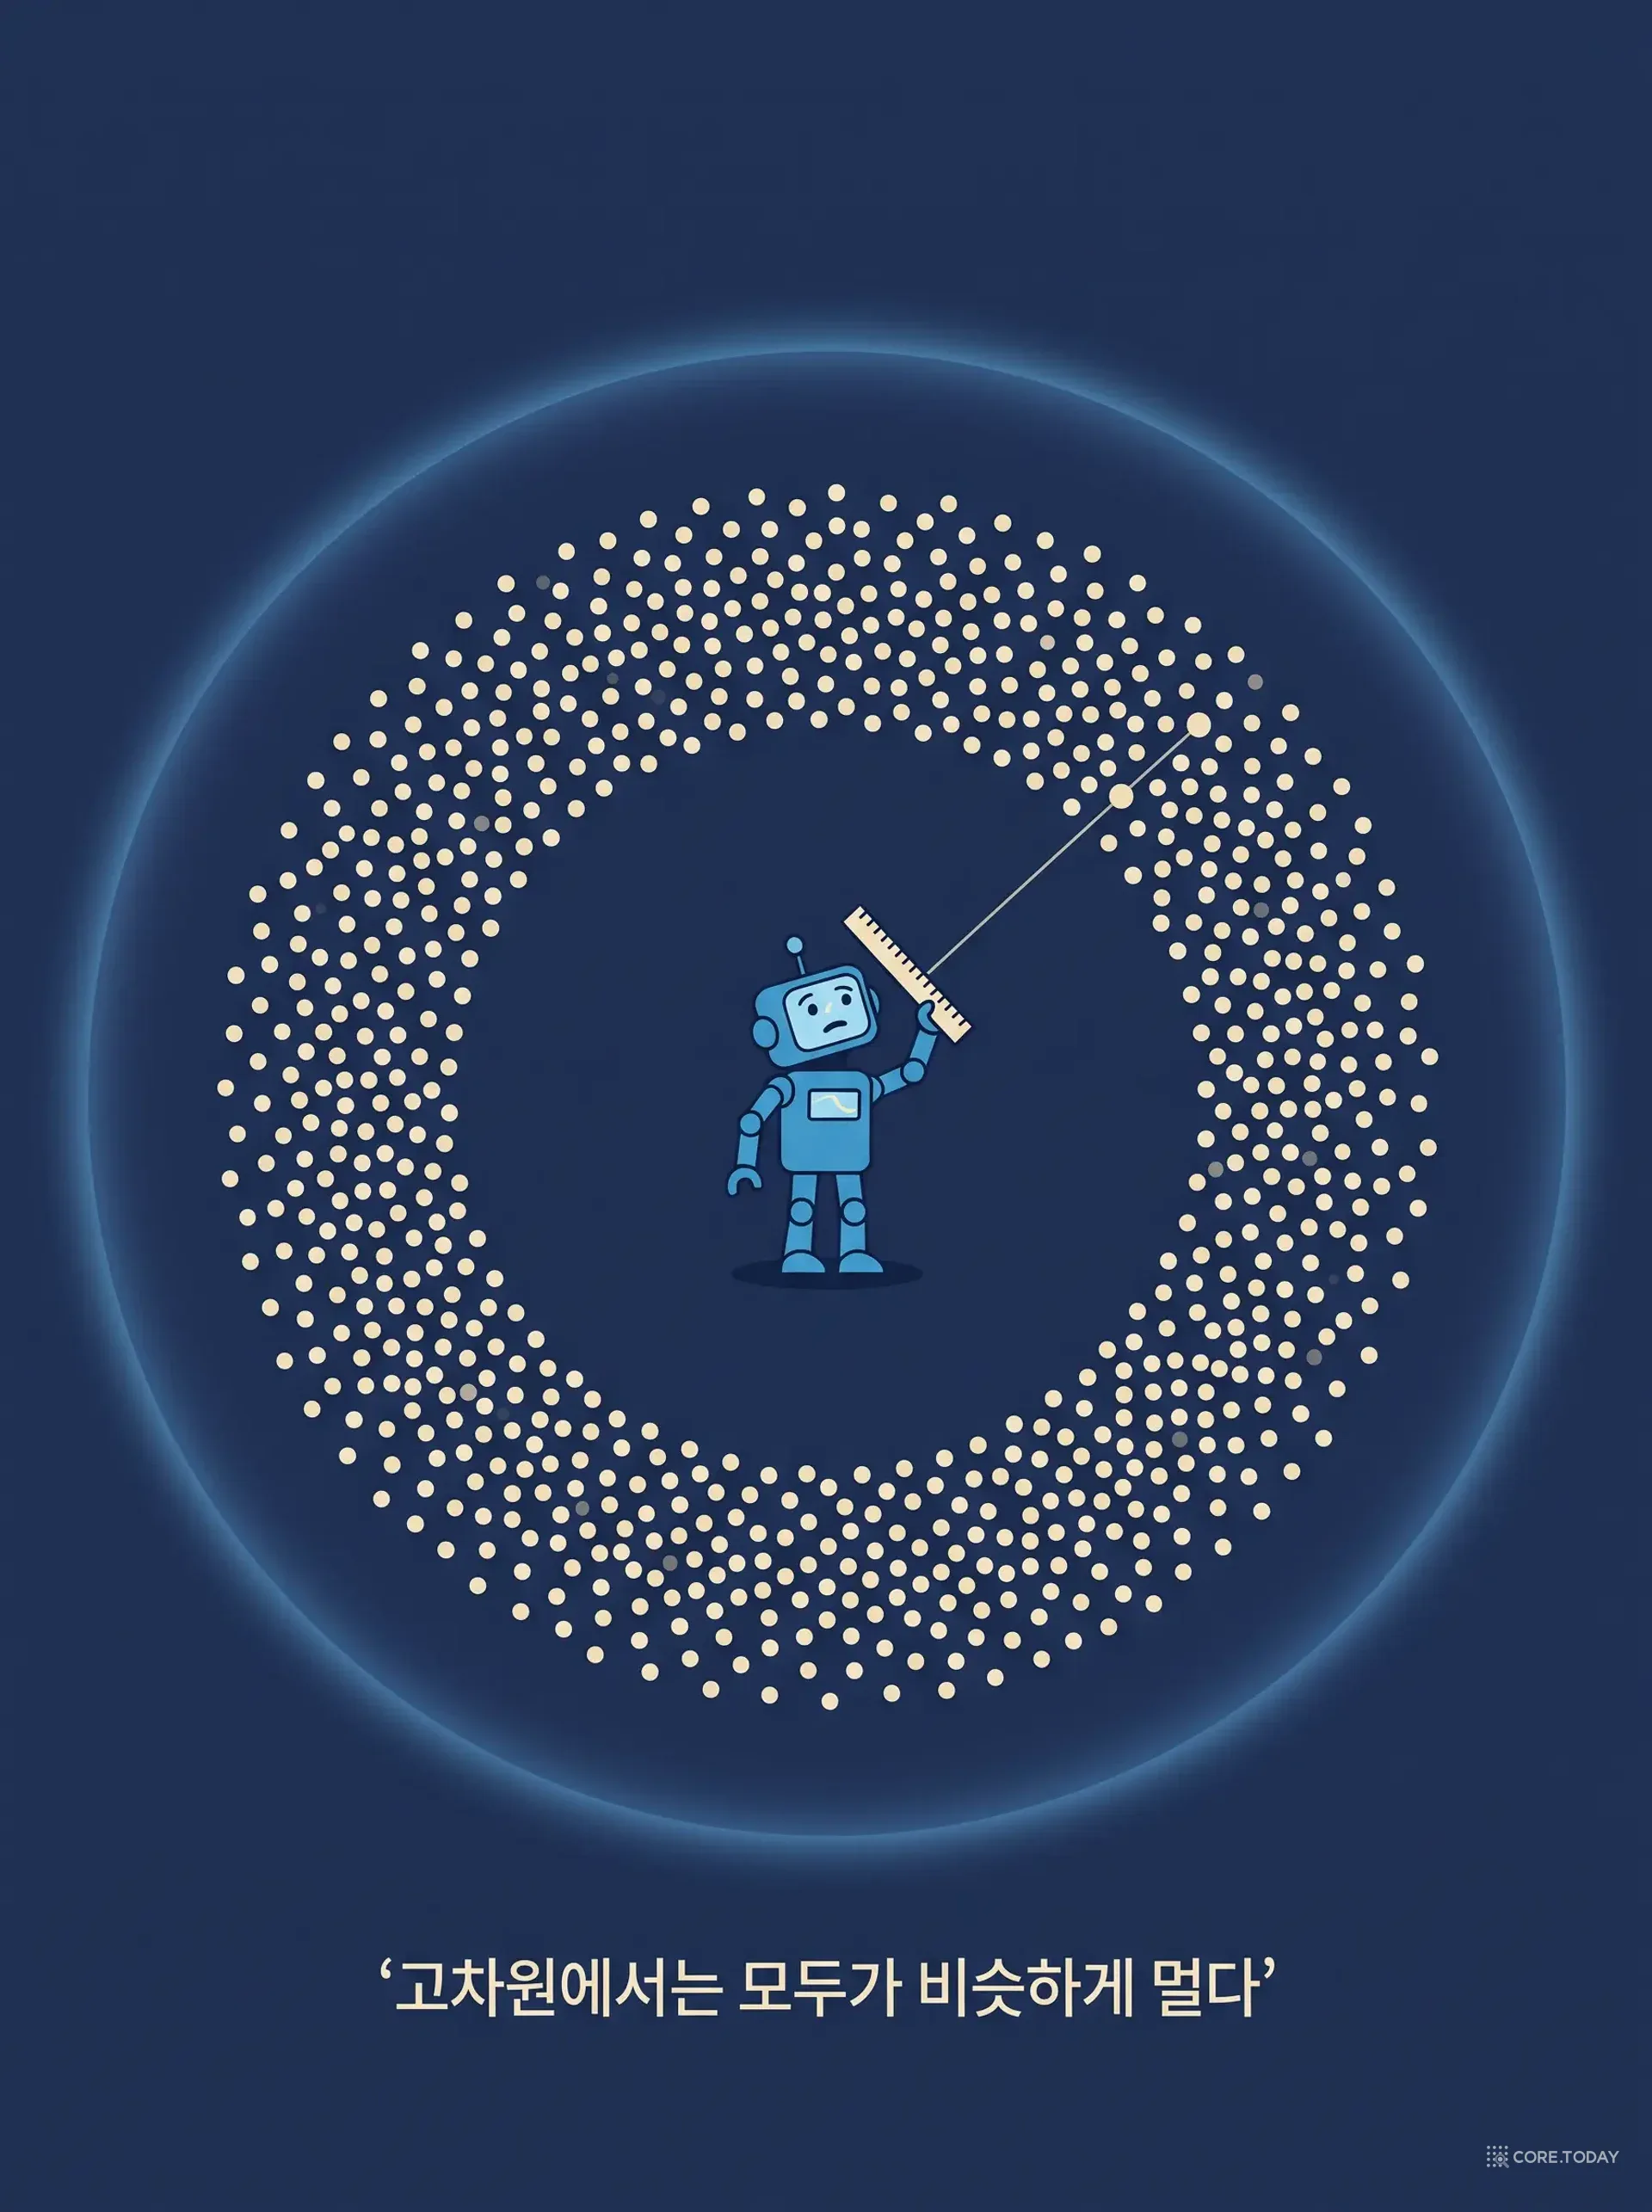
차원의 저주 입니다. 차원이 올라가면 공간의 부피가 지수적으로 커지고, 데이터는 그 안에서 극도로 희박해집니다. 그 결과 이상한 일이 벌어집니다. 임의의 점에서 가장 가까운 점과 가장 먼 점의 거리 차이가 점점 작아져서, 모두가 비슷하게 멀어집니다. 트리 인덱스는 "이 영역은 질의에서 멀다"고 통째로 잘라 내는 방식으로 빨라지는데, 모두가 비슷하게 멀면 잘라 낼 영역이 없습니다. 가지치기가 안 되니 결국 대부분을 다 봐야 하고, 전수 비교보다 느려집니다. 1998년 인디크와 모트와니의 논문 제목이 그래서 「차원의 저주를 없애는 방향으로」였고, 2016년의 대규모 실험 논문은 대략 20차원을 넘으면 정확한 트리 방법이 전수 비교를 이기지 못한다고 정리했습니다.
그래서 고차원에서는 질문을 바꿉니다. 정확한 최근접 대신 근사 최근접(ANN, Approximate Nearest Neighbor)을 찾되, 훨씬 빨리. 열 개 중 아홉 개나 열 개가 진짜 최근접이면 검색 용도로는 충분합니다. 그 정확도를 재현율(recall) 이라 부르고, 이 글의 모든 HNSW 수치는 전수 비교 결과 대비 재현율@10입니다.
3부. HNSW: 급행에서 완행으로
작은 세상 그래프
HNSW는 2016년 말코프와 야슈닌이 제안했고 2018년 최종본이 나왔습니다. 두 가지 오래된 아이디어를 합친 것입니다.
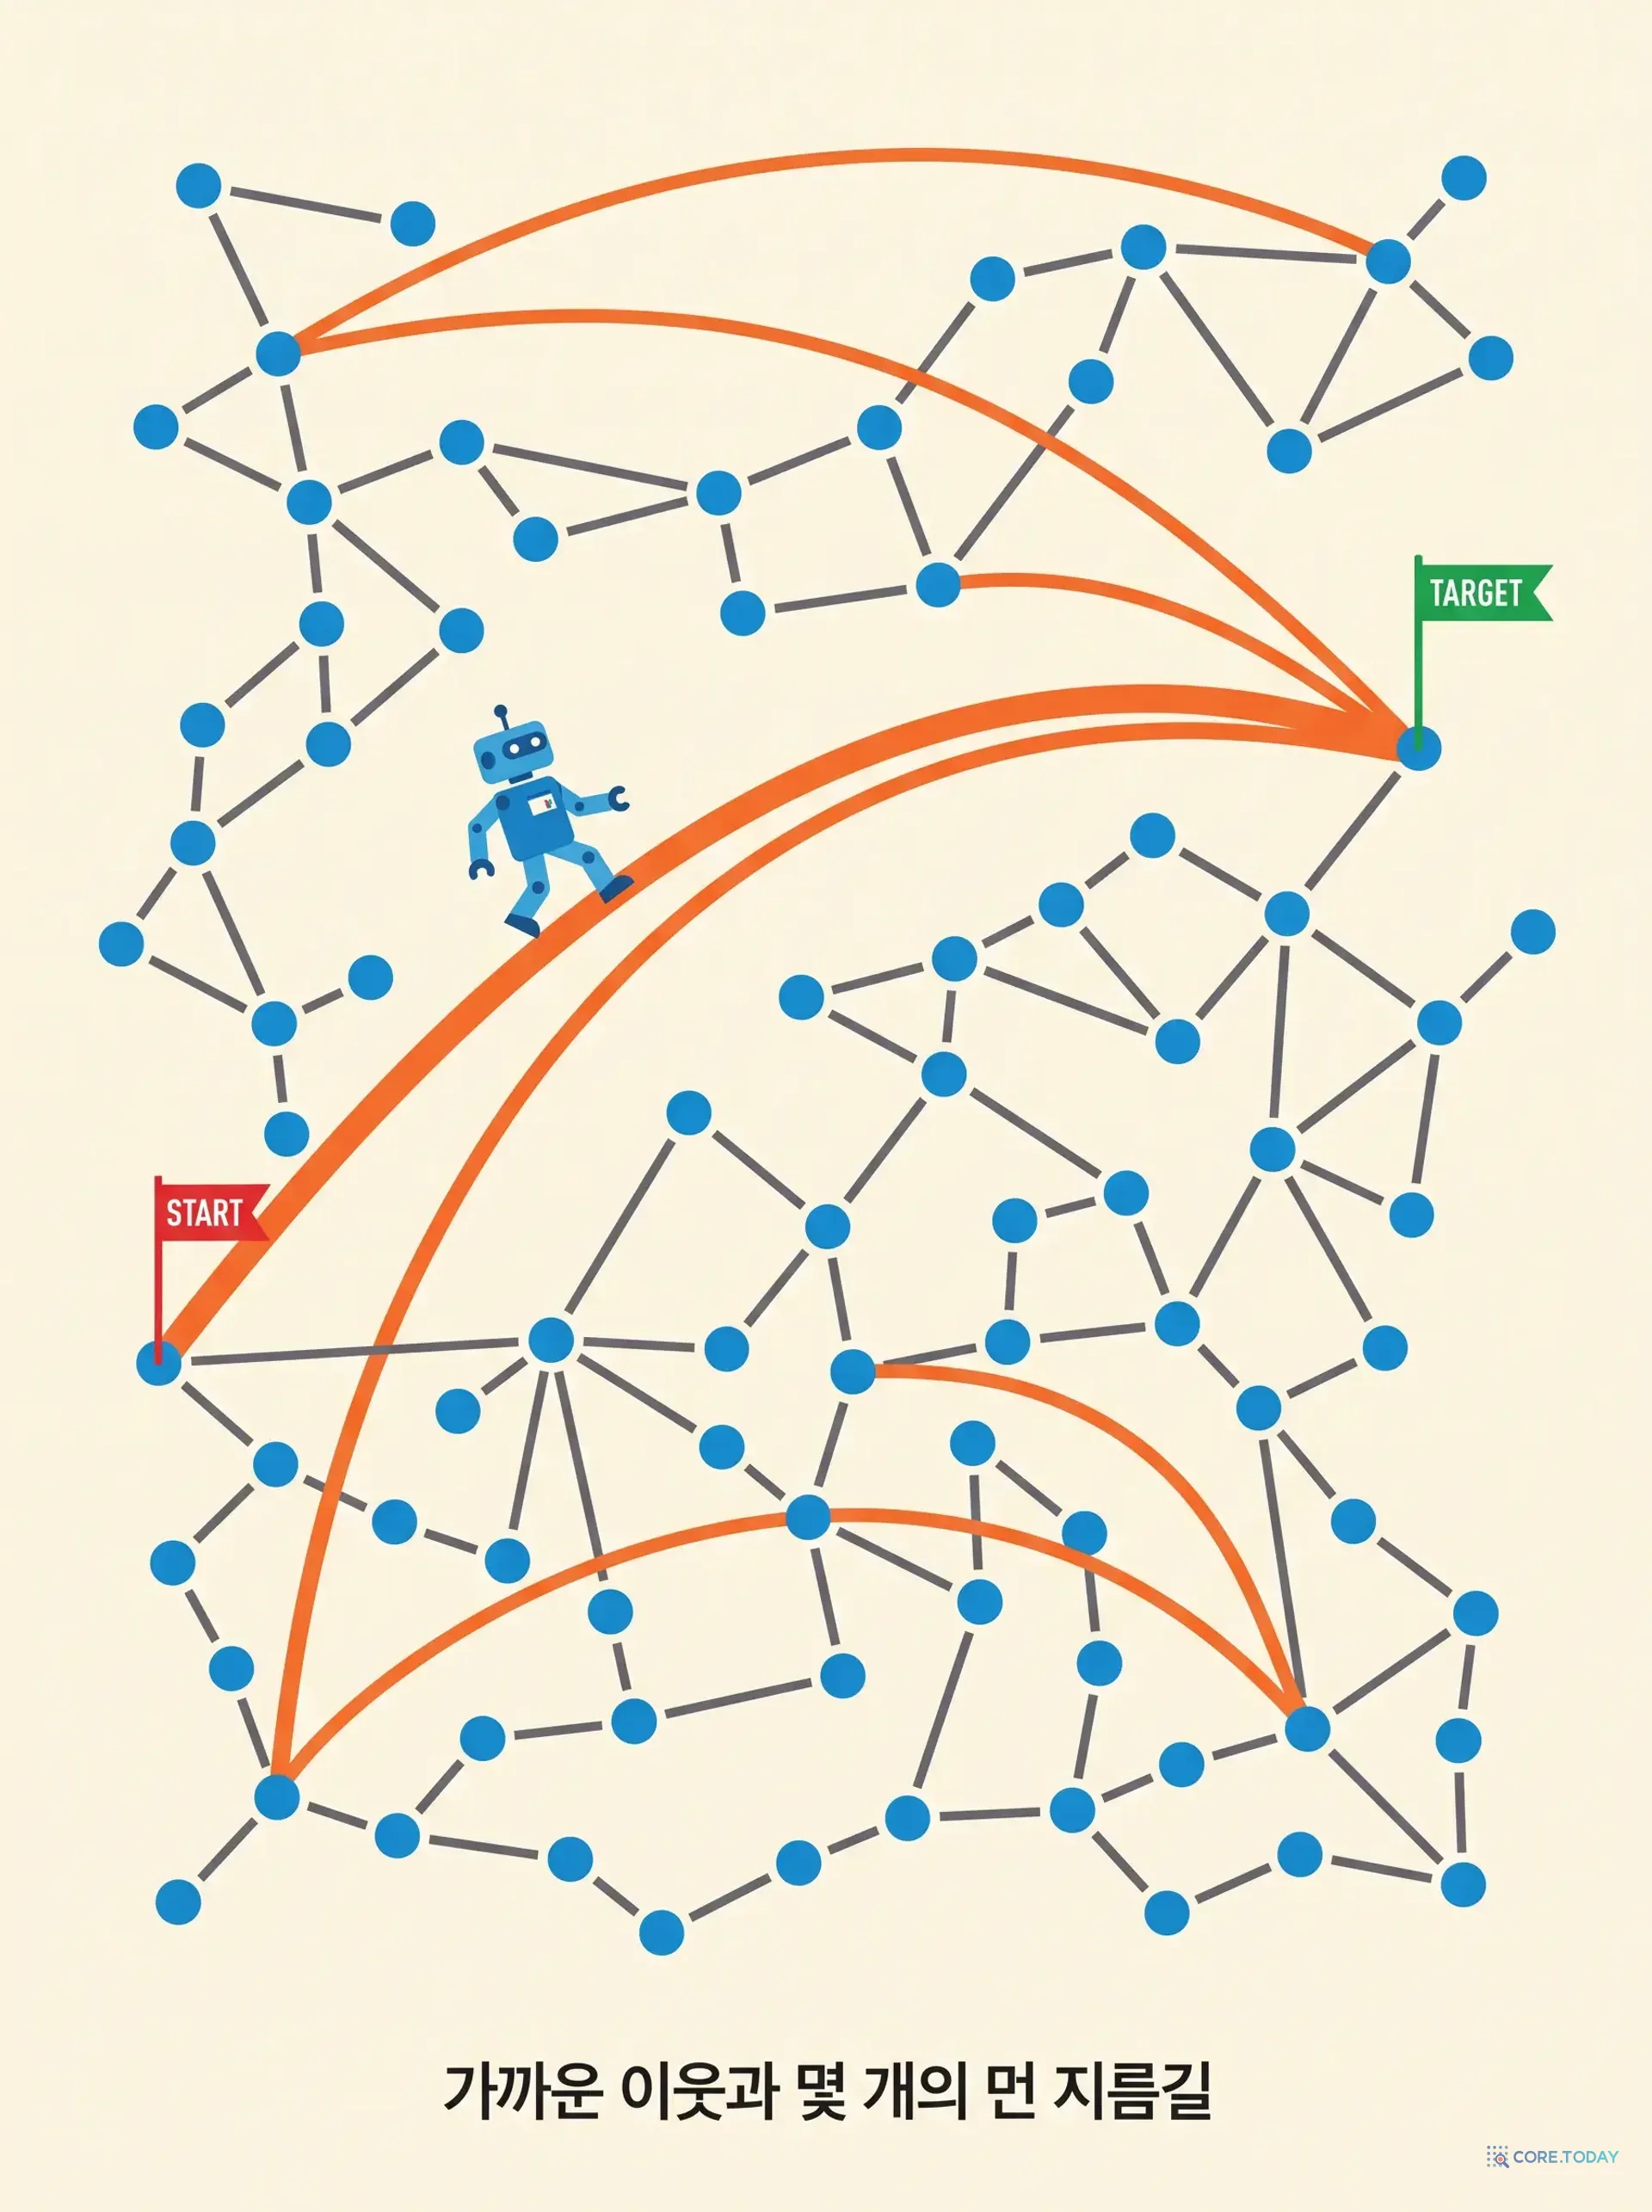
첫째는 작은 세상 그래프(small world graph) 입니다. 모든 벡터를 점으로 놓고, 각 점을 가까운 이웃 몇 개와 연결합니다. 여기에 몇 개의 먼 지름길이 섞이면, 어느 점에서 출발해도 몇 걸음 만에 어디든 갈 수 있습니다. 사회학의 '여섯 다리' 실험과 같은 원리입니다. 검색은 아무 점에서 시작해 "내 이웃 중 질의에 더 가까운 점"으로 계속 옮기는 탐욕 탐색입니다.
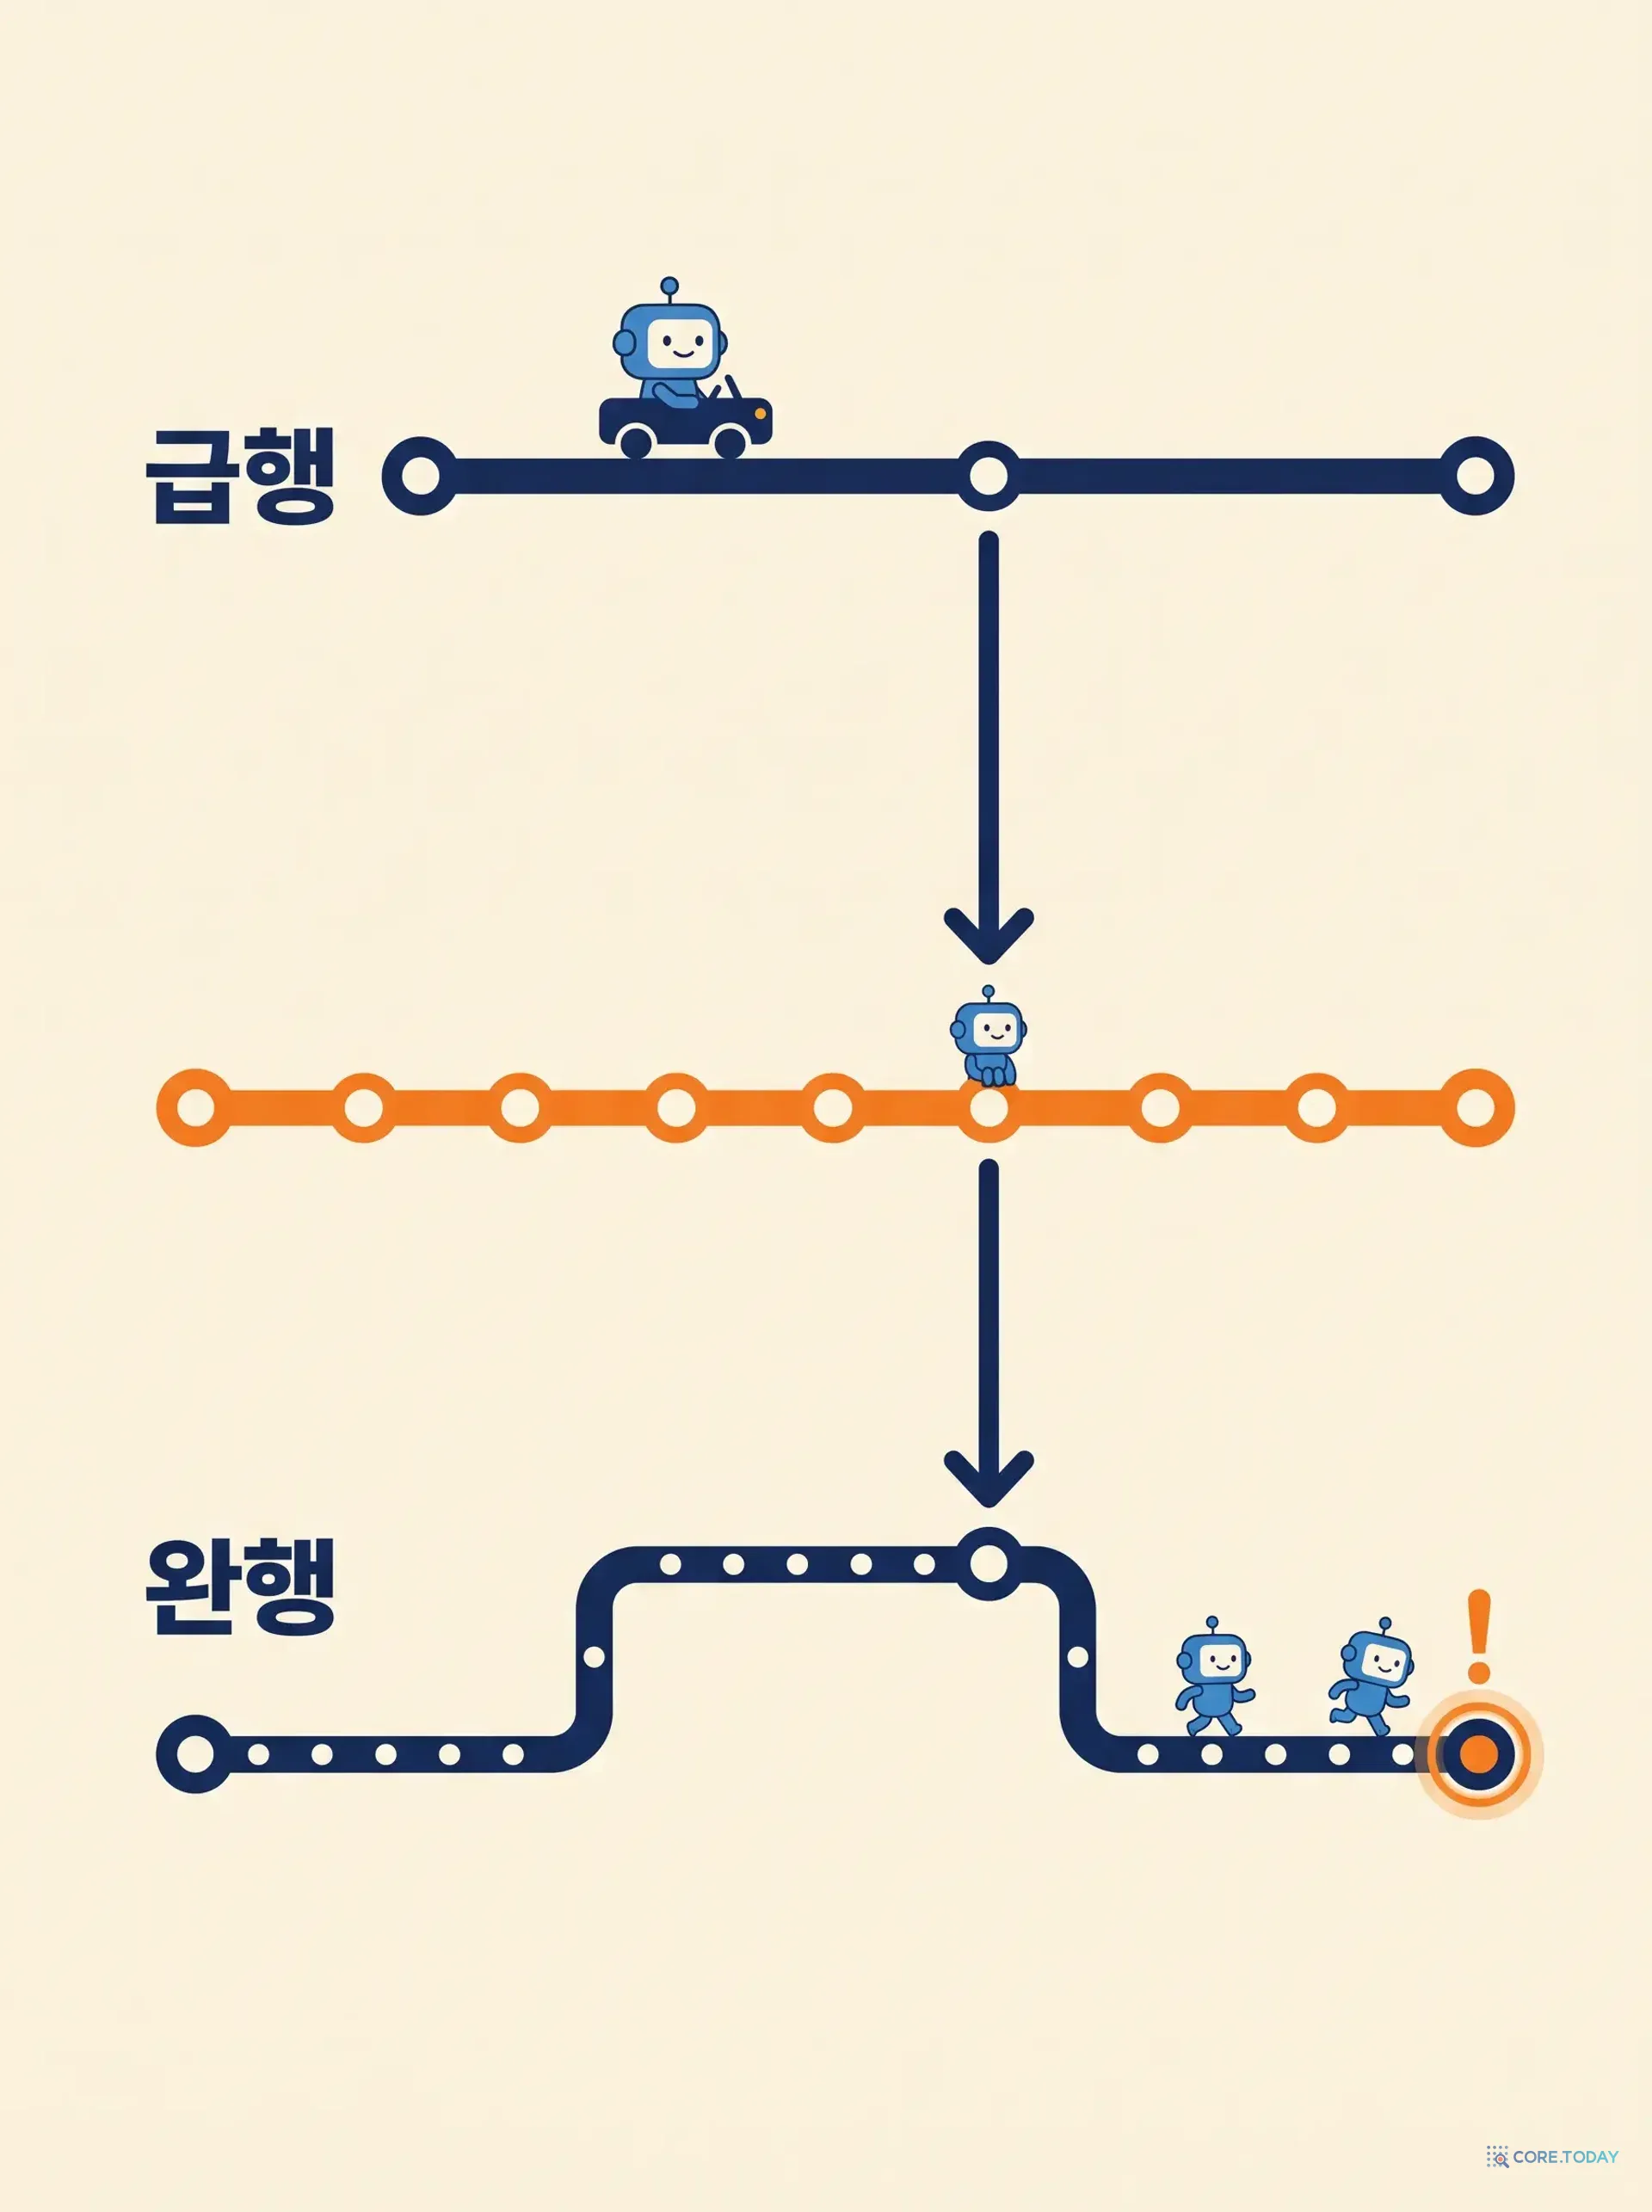
둘째는 스킵 리스트 입니다. 평면 그래프에서 탐욕 탐색을 하면 시작점이 멀 때 걸음 수가 많습니다. HNSW는 그래프를 여러 층으로 쌓습니다. 맨 위층에는 점의 아주 일부만 있고(급행), 내려갈수록 점이 많아지고(완행), 맨 아래층에는 전부 있습니다. 검색은 맨 위층에서 시작해 대략적인 위치를 잡고, 한 층씩 내려오며 좁혀 갑니다. 각 점이 몇 층까지 올라가는지는 지수적으로 감소하는 확률로 정해집니다. 그래서 층 수가 로그로 늘고, 탐색도 로그에 가깝게 늡니다.
hnswlib으로 같은 합성 코퍼스에 인덱스를 만들고(M=16, ef_construction=200), 질문 200개를 단일 스레드로 검색했습니다.
벡터 수
전수 비교
HNSW ef=40
HNSW ef=100
빌드
인덱스 크기
1만
6.2ms
1.39ms · 재현율 1.000
2.86ms · 1.000
5초
165MB (벡터 164MB)
10만
56ms
1.30ms · 0.980
1.64ms · 1.000
54초
1.65GB (벡터 1.64GB)
30만
182ms
1.97ms · 0.929
2.29ms · 0.970
137초
4.96GB (벡터 4.92GB)
세 가지가 보입니다.
첫째, 30배 늘어도 HNSW는 거의 그대로입니다. 전수 비교는 6ms에서 56ms, 182ms로 정비례해 늘었는데, HNSW ef=40은 1.39ms, 1.30ms, 1.97ms입니다. 로그 시간의 약속이 실측에서 그대로 나타납니다. 30만 개에서 93배 차이이고, 5,000만 개로 외삽하면 초 대 밀리초, 차수가 세 개 벌어집니다. 다만 30만 개에서 같은 ef=40의 재현율이 0.929로 내려간 것도 보입니다. 코퍼스가 커지면 같은 재현율을 지키기 위해 ef를 올려야 하고(ef=100에서 0.970), 그 비용은 2.29ms입니다.
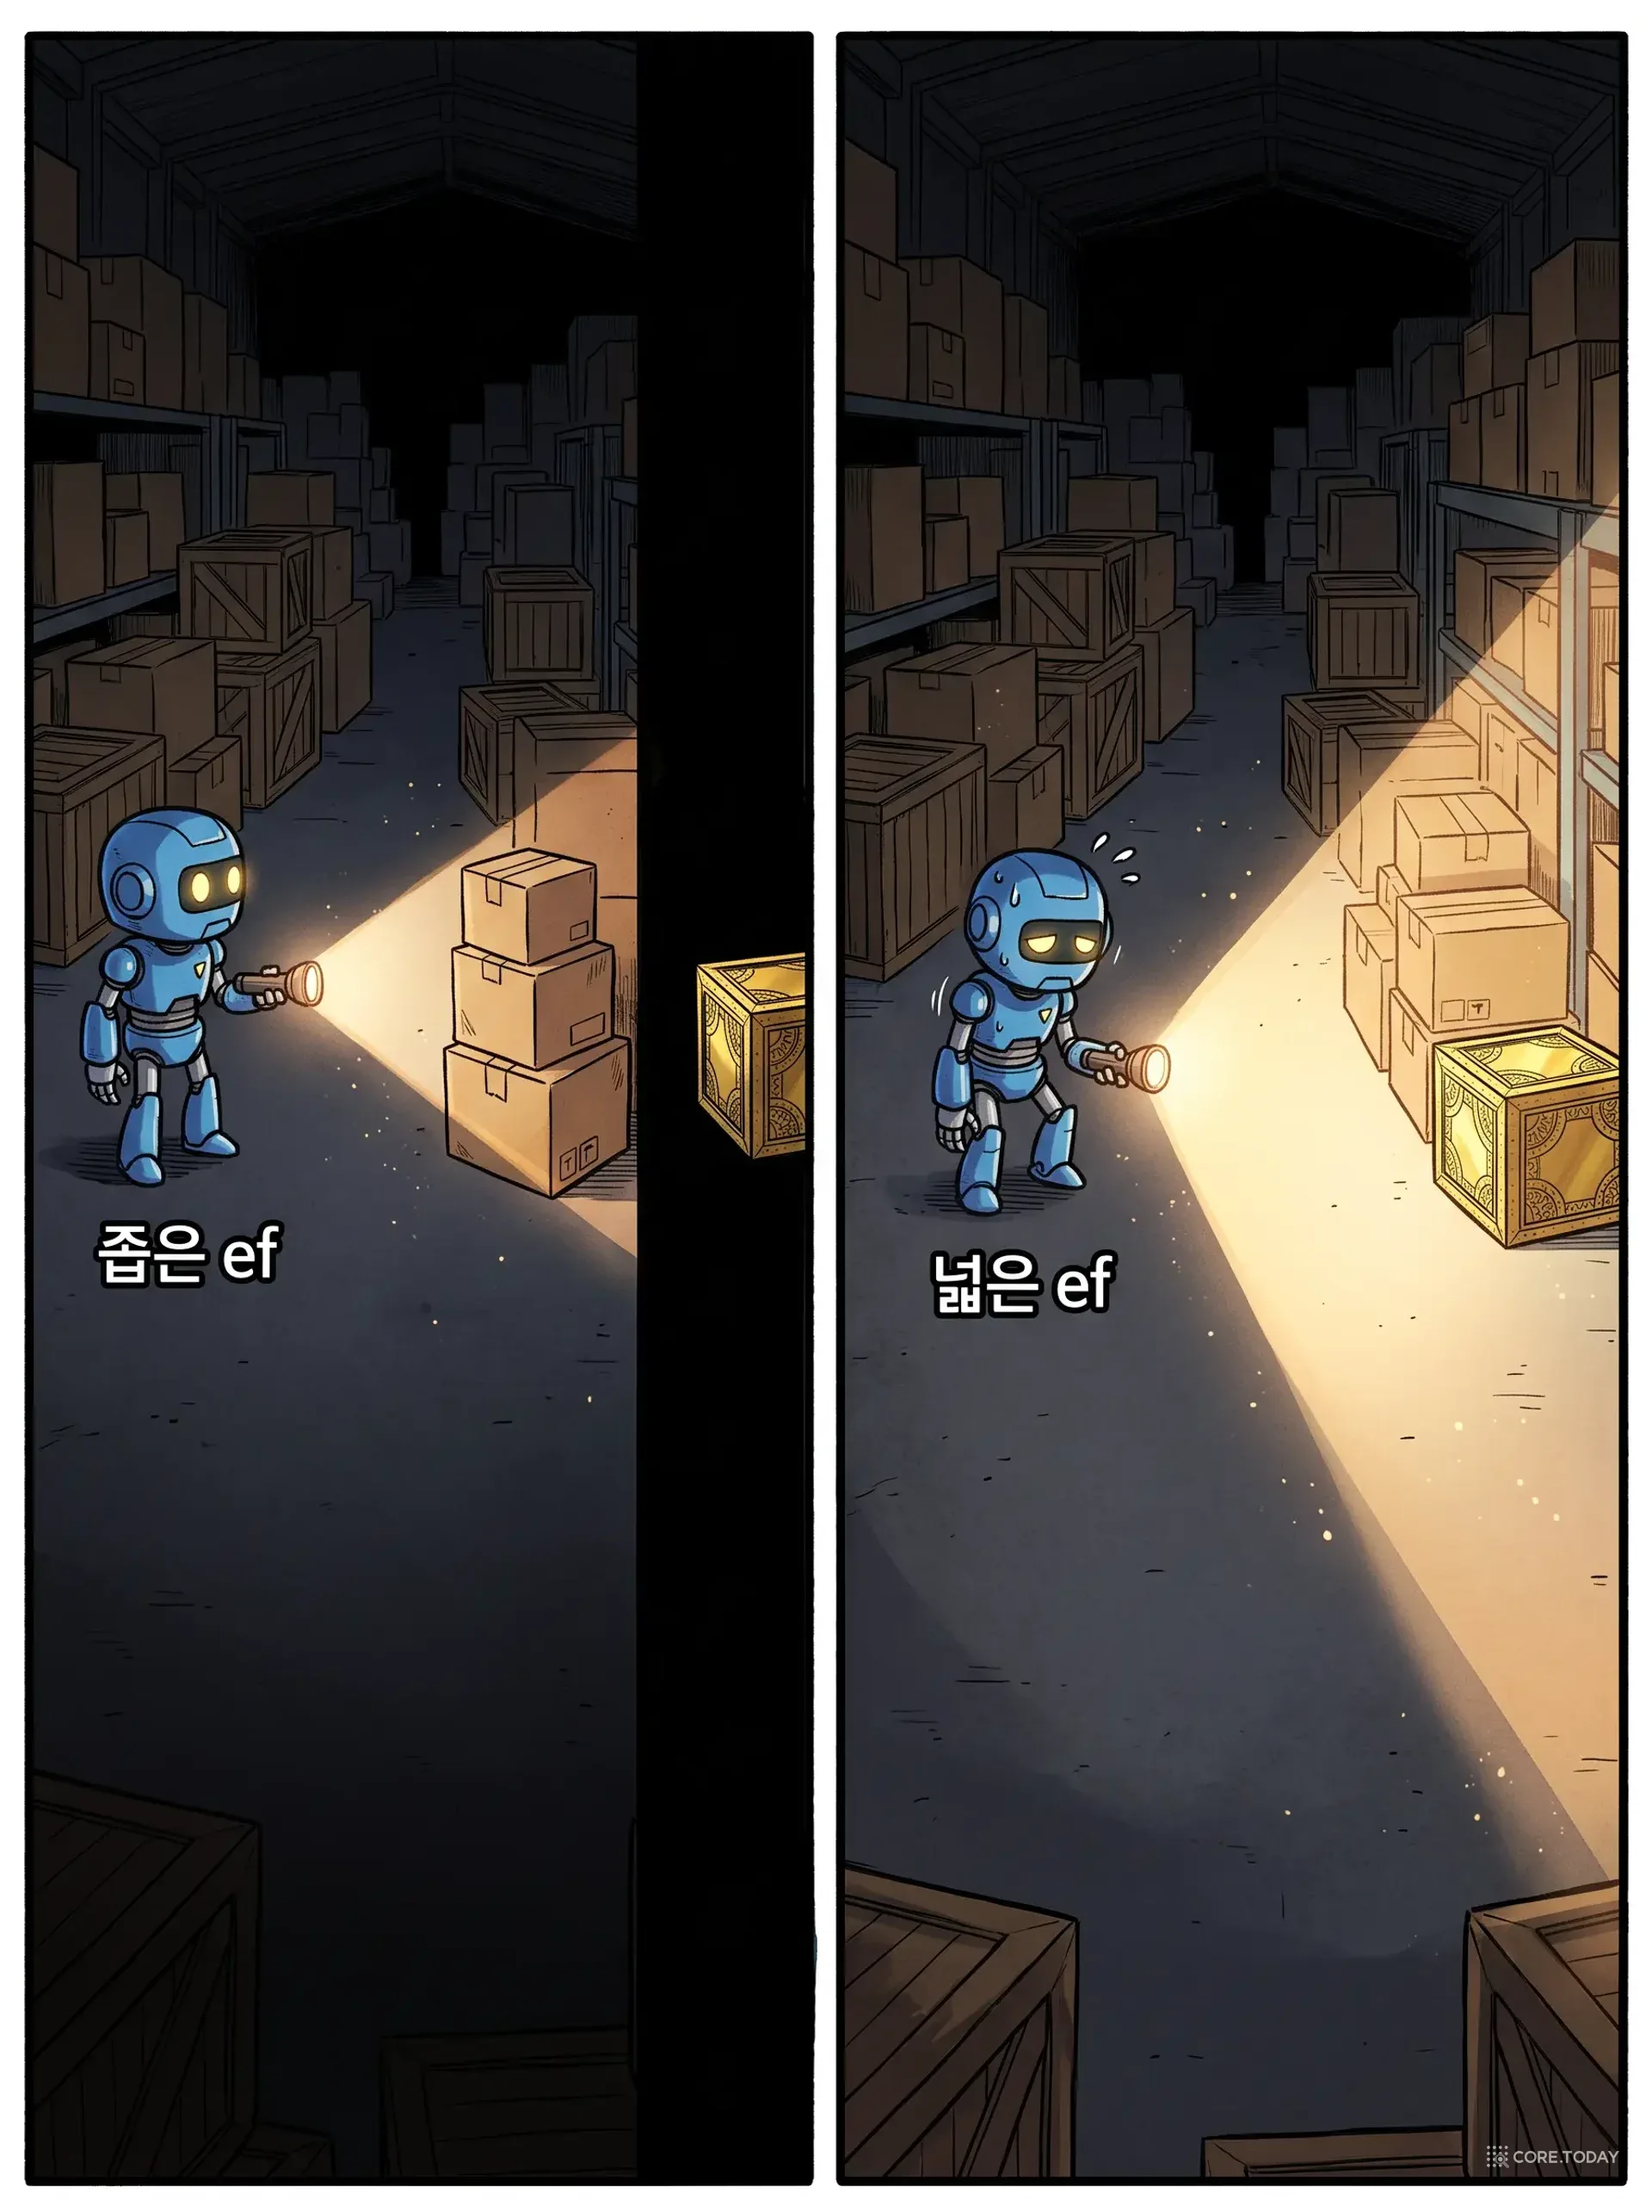
둘째, 재현율은 ef로 삽니다. 10만 개에서 ef=10은 0.878, ef=40은 0.980, ef=100은 1.000입니다. 시간은 1.0ms, 1.3ms, 1.6ms. 재현율 1%를 더 사는 데 0.3ms를 냅니다. 검색 뒤에 리랭커를 둔다면(2편) 상위 20~50개만 정확하면 되므로 ef를 낮춰도 되고, 리랭커 없이 상위 3개를 바로 쓴다면 ef를 올리는 것이 맞습니다.
셋째, 인덱스 크기는 곧 벡터 크기입니다. 10만 개 인덱스 1.65GB 중 벡터가 1.64GB이고 그래프 링크는 15MB, 벡터당 150바이트입니다. 4,096차원에서 HNSW의 메모리 오버헤드는 1%입니다. 이것이 이 글의 가장 실무적인 발견입니다.
M과 차원을 바꾸면
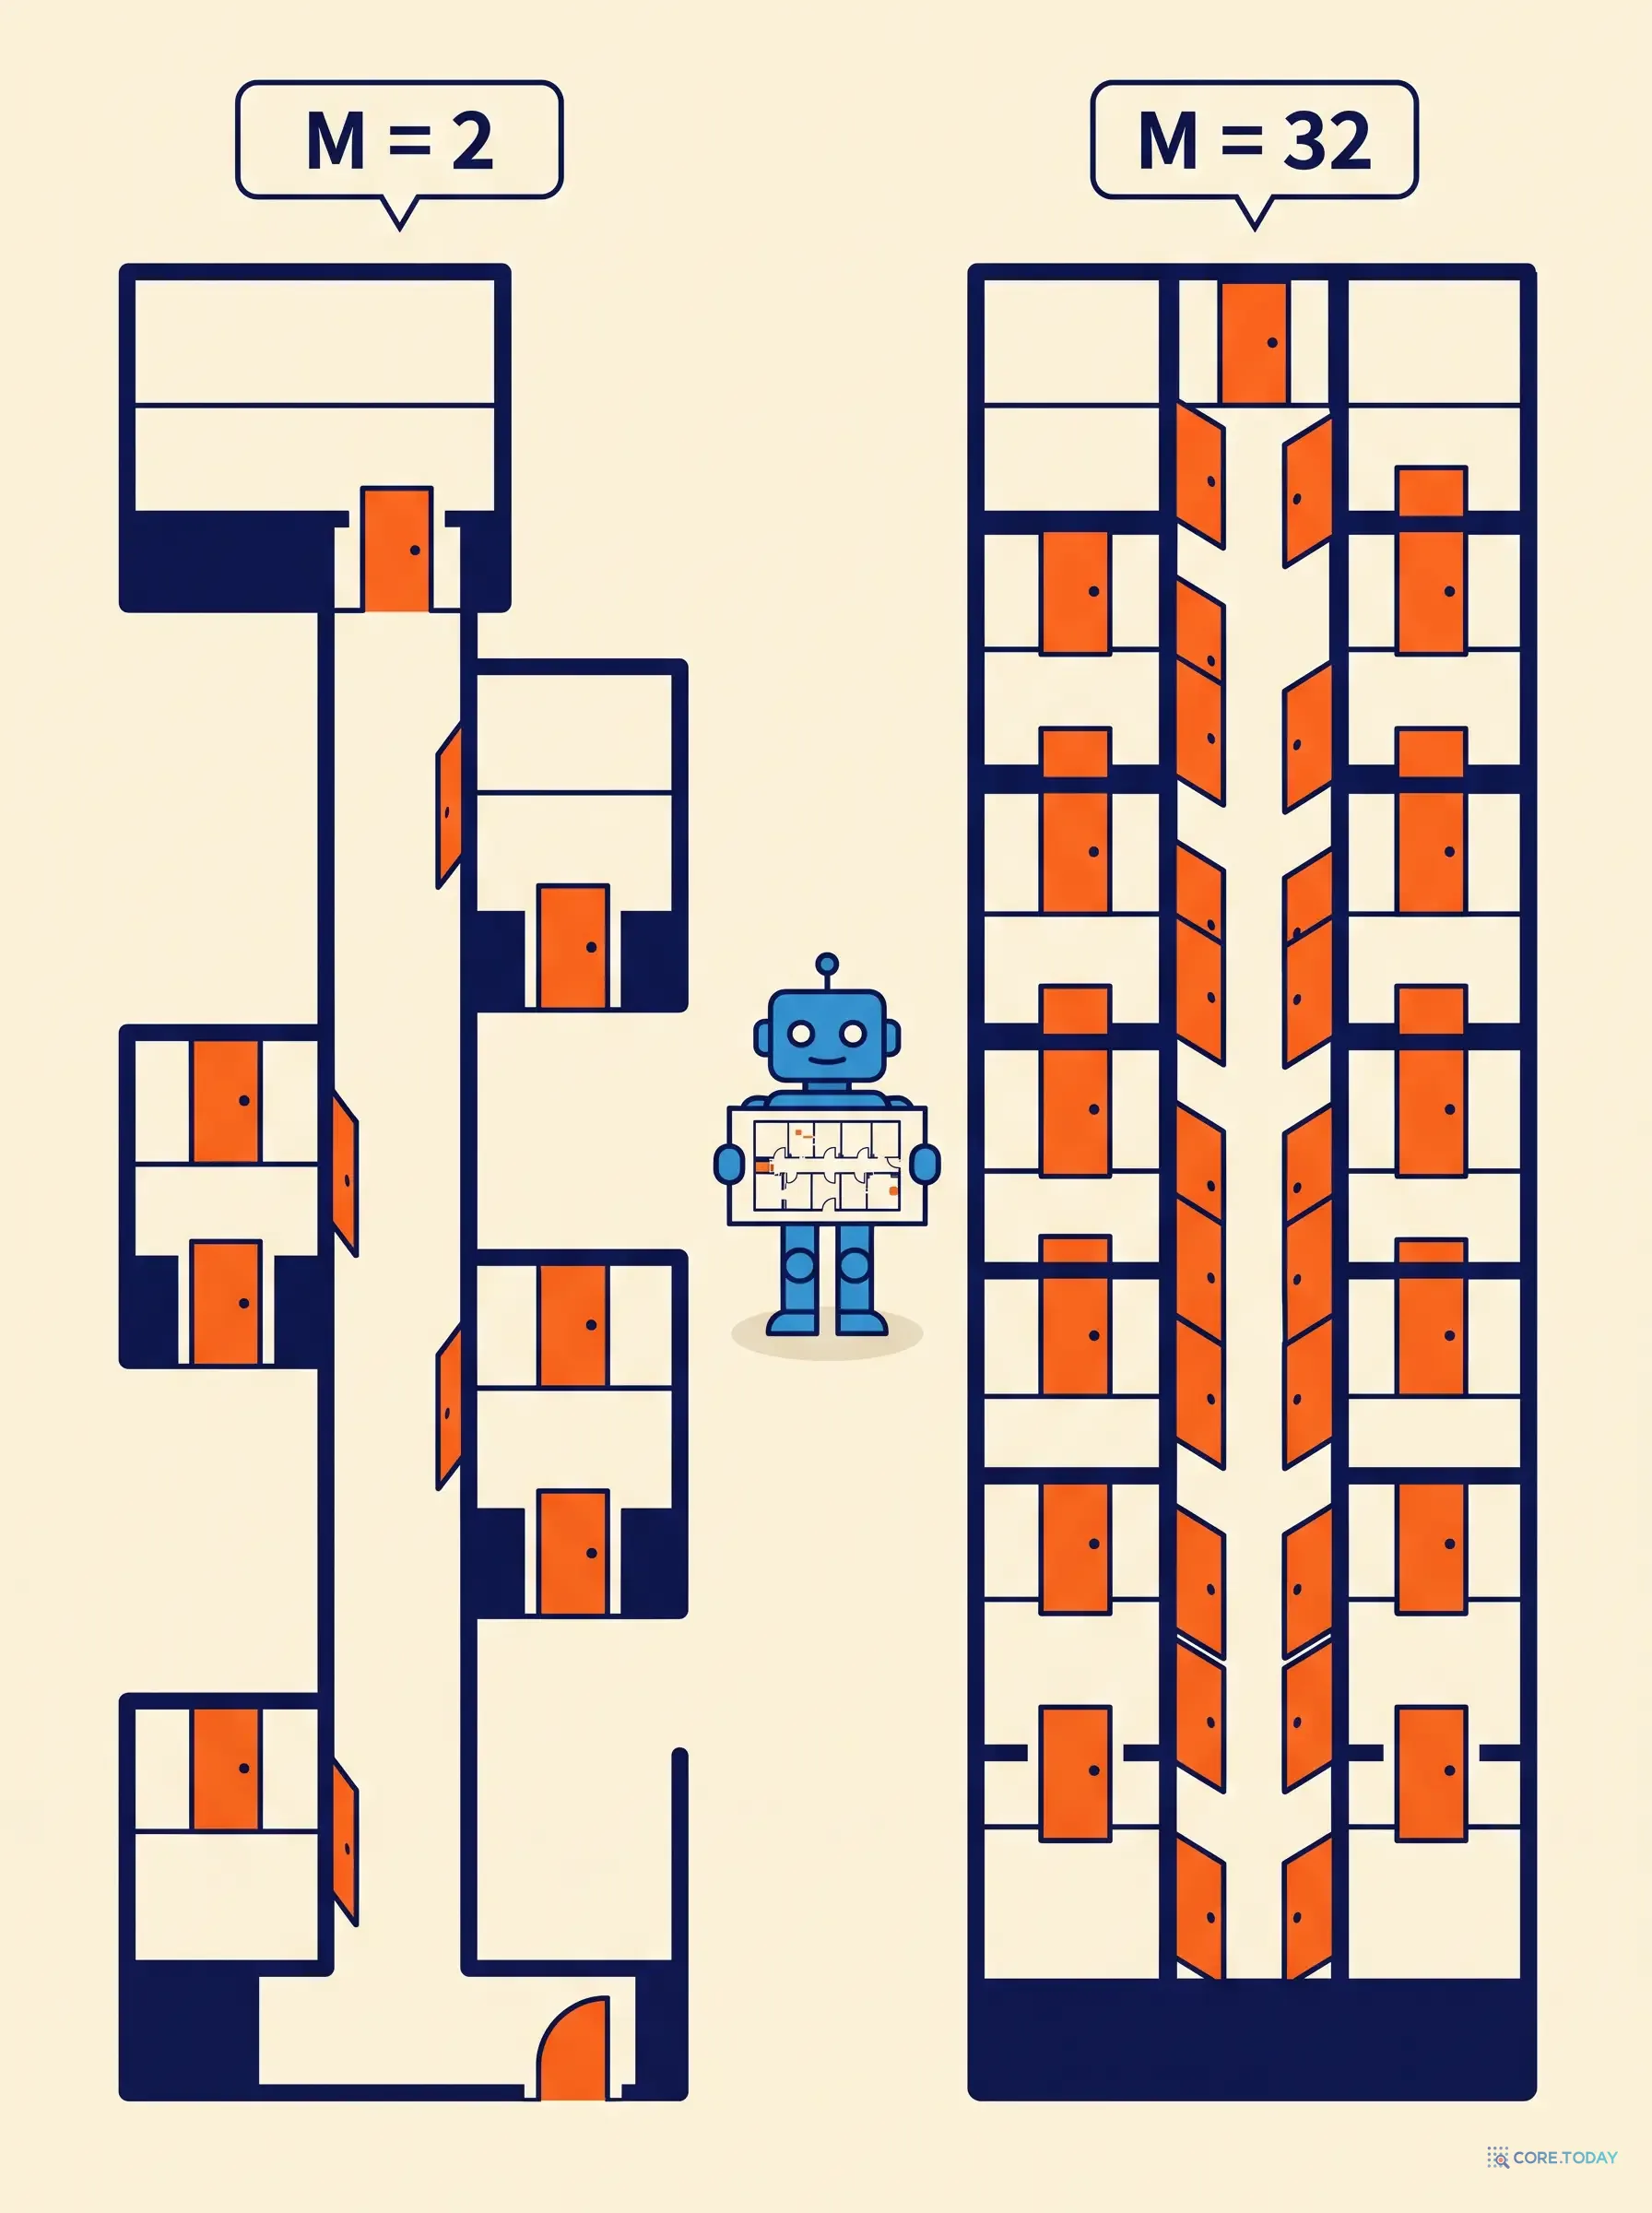
M을 8에서 48로 올리면 같은 ef=10에서 재현율이 0.792에서 0.978로 오르고, 빌드는 45초에서 57초, 링크 메모리는 벡터당 85바이트에서 400바이트로 늡니다. 4,096차원 벡터 16KB 옆에서 400바이트는 여전히 2.5%입니다. hnswlib 문서가 고차원 임베딩에는 M을 높이라고 권하는 이유가 이 계산에 있습니다. 비용이 거의 없습니다.
차원을 줄이면 모든 것이 함께 작아집니다. 1,024차원에서 전수 비교는 17.7ms, HNSW ef=40은 0.43ms, 인덱스 425MB. 256차원에서는 3.4ms, 0.14ms, 117MB. 3편에서 Qwen3-8B를 1,024차원으로 잘라도 품질이 그대로였으니, 4,096차원 인덱스를 만들 이유가 사실 없습니다. HNSW는 시간을 로그로 만들고, 마트료시카는 상수를 4분의 1로 만듭니다. 둘은 곱해집니다.
"HNSW는 메모리를 많이 쓴다"는 말을 자주 듣습니다. 저차원(예: 128차원 이미지 특징)에서는 맞습니다. 벡터 512바이트에 링크 150~400바이트가 붙으면 30~80%가 오버헤드입니다. 그러나 4,096차원에서는 1~2%입니다. OpenSearch 문서의 추정식으로 계산해 보세요.
5,000만 개 × 4,096차원 float32는 링크를 포함해 약 900GB입니다. 이것은 HNSW의 문제가 아니라 벡터의 문제이고, 해법도 벡터 쪽에 있습니다.
float32 → float16(절반) → int8(4분의 1). 대부분의 벡터 DB가 스칼라 양자화를 지원하고 재현율 손실은 1% 안팎. pgvector는 4,096차원을 halfvec(float16)으로만 인덱싱한다.
3. 그래프는 M을 아끼지 않는다
링크는 어차피 작다. M=32~48로 재현율을 사고 ef를 낮춰 지연을 줄인다.
4. 두 단계로 나눈다
짧은 차원·양자화 벡터로 HNSW 후보 100개 → 원본 벡터로 재정렬(3편의 적응형 검색). 원본은 디스크에 있어도 된다.
이 네 가지를 다 적용하면 5,000만 개가 1,024차원 int8로 51GB, 링크 포함 60GB 남짓입니다. 서버 한 대의 RAM에 들어옵니다.
6부. 언제 HNSW가 아닌가
1만 건 이하. 전수 비교가 6ms입니다. 인덱스의 빌드·갱신·튜닝 비용이 이득보다 큽니다. 이 시리즈의 589건이 그랬습니다.
필터가 많을 때. "2025년 이후, 부서 = 재무"처럼 필터를 걸면 HNSW 그래프의 연결이 끊겨 탐색이 막히거나 후보가 비어 버립니다. 벡터 DB마다 사전 필터·사후 필터·필터 인식 그래프(ACORN 등) 전략이 다르고, 성능이 크게 갈립니다. 필터 선택도가 높으면 차라리 필터로 줄인 뒤 전수 비교하는 것이 빠릅니다.
갱신·삭제가 잦을 때. HNSW는 삭제를 표시만 하고 그래프를 유지하며, 오래 운영하면 품질이 떨어져 재구축이 필요합니다. 하루에 수백만 건이 바뀌는 코퍼스는 IVF 계열이나 세그먼트 재구축 전략을 봐야 합니다.
메모리보다 디스크가 싼 규모. 수억 개 이상이면 그래프 전체를 RAM에 두는 HNSW 대신 DiskANN 계열(SSD 상주)이나 IVF+PQ(양자화 압축)가 경제적입니다.
7부. 이 실험의 한계
코퍼스가 합성입니다. 실제 임베딩 589개에 잡음을 더해 만든 것이라 군집 구조가 실제 문서 집합과 다르고, HNSW의 재현율은 데이터 분포에 따라 달라집니다.
단일 스레드 지연입니다. 서버에서는 동시 질의 처리량(QPS)이 더 중요하고, HNSW는 스레드가 늘수록 잘 확장됩니다.
hnswlib 하나로 쟀습니다. pgvector·Lucene·faiss의 HNSW 구현은 메모리 배치와 기본값이 달라 절대 수치가 다릅니다.